Engineering
아파치 플링크와 CDC의 만남. 플링크 CDC 맛보기
louis.sml카카오
2024년 9월 4일
원문에서 보기 ↗안녕하세요, 데이터분석플랫폼 조직의 루이스입니다.
저희 조직의 주요 미션은 서비스 팀들의 데이터를 취합하여 일단위의 지표를 추출하고 제공하는 것입니다. 이를 위해 다양한 소스에서 데이터를 수집하고 있으며, 그 과정에서 서비스 조직의 데이터베이스에 있는 데이터를 활용해야 하는 경우도 있습니다. 그러나 서비스 조직의 데이터베이스는 실제 서비스에 사용되고 있기에, 지표 추출을 목적으로 서비스 조직의 데이터베이스에 접근하여 데이터를 가져오는 방식은 실 서비스의 운영에 부담을 줄 수 있습니다.
따라서, 실 서비스 데이터베이스가 아닌 별도의 데이터베이스에서 지표 추출을 목적으로 데이터를 가져와야 합니다. 이를 위해 서비스 조직의 데이터베이스가 저희 조직 내 데이터베이스에 실시간 연동이 될 필요가 있는데요, 이런 실시간 연동 작업을 CDC(Change Data Capture)라고 칭합니다. 이를 지원하는 여러 라이브러리와 프레임워크가 존재하며 그중 최근 주목받고 있는 아파치 플링크 (Apache flink )와 플링크 CDC(Flink CDC) 라이브러리를 사용하여 MySQL 데이터베이스 간 CDC를 구축 및 운영해 본 경험을 독자분들께 공유하고자 합니다.
본글의 순서는 아래와 같습니다.
- 아파치 플링크에 대한 소개
- CDC와 플링크 CDC에 대한 소개 및 각각의 장점
- 플링크 CDC 라이브러리의 동작 과정
- 조직의 상황에 맞추어 라이브러리를 수정 및 개선한 부분
- 소회 및 마무리
아파치 플링크 (Apache flink)
아파치 플링크는 스트리밍 데이터를 처리하기 위해 만들어진 오픈소스 분산 처리 프레임워크입니다. 사용자가 플링크 잡(Job)을 작성하여 플링크 클러스터에 제출하면 작업이 시작되는데, 대부분의 작업은 아래와 같은 순서로 수행됩니다.
- 플링크 잡에 정의된 외부 시스템에서 메시지를 읽기
- 플링크 잡에 정의된 처리 로직을 읽어온 메시지에 수행
- 플링크 잡에 정의된 다른 외부 시스템으로 처리된 메시지 적재
가장 보편적으로 사용되는 예시를 꼽자면, 아파치 카프카(Apache kafka)에서 메시지를 가져와 실시간으로 메시지를 처리하고 그 결과를 하둡(Hadoop)이나 S3 같은 다른 외부 시스템에 적재하는 과정일 것입니다. 아파치 플링크는 메시지를 단순 가공하는 map() 함수나 필터링하는 filter() 함수부터, window() 같은 함수를 통해 메시지들에 대한 최솟값 또는 최댓값 같은 집계를 수행하는 다양한 처리 함수들을 제공합니다. 혹은 사용자의 필요에 따라 자신만의 처리 로직을 정의하여 사용할 수도 있습니다.
또한, 아파치 플링크는 분산 처리를 지원합니다. 이 기능은 가용할 수 있는 자원이 충분하다면, 사용하는 자원에 비례하여 성능을 향상할 수 있는 이점이 있습니다(예: 실시간으로 처리하는 메시지의 양).
본격적으로 기술적인 내용을 독자분들께 공유드리기 전에, 배경지식으로 알아두면 좋은 아파치 플링크의 주요 모듈들과 단위 및 특징들을 간단히 소개하겠습니다.
플링크의 주요 모듈들과 작업 단위
아파치 플링크(Apache Flink)에는 잡 매니저(JobManager)와 태스크 매니저(TaskManager)가 있습니다. 잡 매니저는 사용자의 플링크 잡(Flink job)을 요청받고 분산 환경에서 실행할 수 있는 실행 그래프(Execution graph)로 변환하며, 생성된 태스크(Task)를 태스크 매니저에게 할당합니다.
이 외에도 잡 매니저는 태스크 매니저들에 대한 관리의 역할도 수행하는데요, 태스크 매니저가 잡 매니저의 태스크 요청을 받으면 해당 태스크를 수행하고 그 결과를 다시 잡 매니저에게 보고합니다.
플링크에는 데이터 소스(Data source)라는 개념도 존재합니다. 데이터 소스는 3개의 주요 모듈인 스플릿(Split), 스플릿 이뉴머레이터(SplitEnumerator) 및 소스 리더(SourceReader)로 구성됩니다. 이를 앞서 설명드린 잡 매니저와 태스크 매니저의 역할을 고려하여 설명하면 아래와 같습니다.
- 스플릿(Split): 잡 매니저가 태스크 매니저에게 전달하는 객체로, 외부 시스템에서 데이터를 읽어와야 할 위치나 기준이 담긴 실 구현된 객체입니다.
- 스플릿 이뉴머레이터(SplitEnumerator): 잡 매니저에 존재하며, 태스크 매니저에게 스플릿을 할당하는 역할을 수행합니다.
- 소스 리더(SourceReader): 태스크 매니저에 존재하며, 잡 매니저에게 스플릿을 요청하고 할당받은 스플릿을 기반으로 외부 시스템에서 데이터를 읽어옵니다.
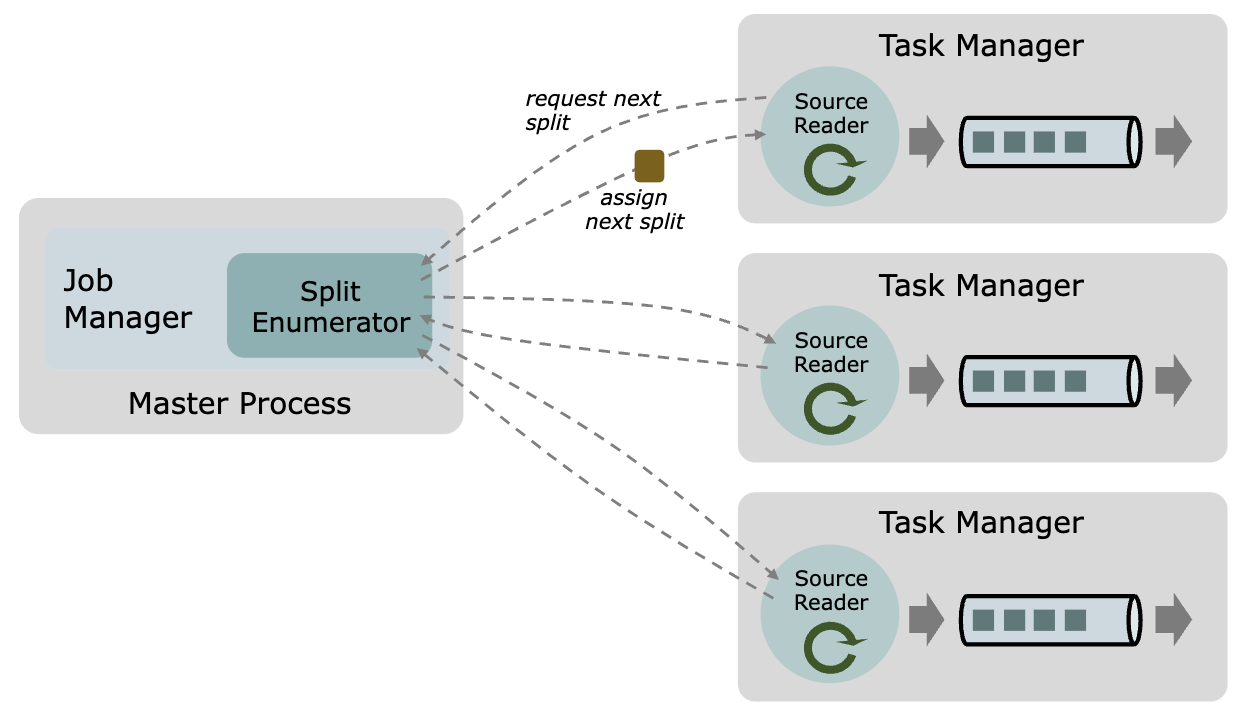
언뜻 생각하기에는 스플릿과 태스크의 관계가 모호할 수 있습니다. 이를 좀 더 명확히 설명드리면, 태스크는 수행해야 할 일이며 스플릿은 외부 시스템에서 데이터를 읽어와야 하는 위치나 기준 및 정책 등이 담긴 객체라는 것입니다. 즉, 스플릿은 태스크에 있는 다양한 연산들 중 외부 시스템에서 데이터를 읽어오는 소스 연산자(Source operator)에 필요한 정보가 담긴 객체로 이해할 수 있습니다.
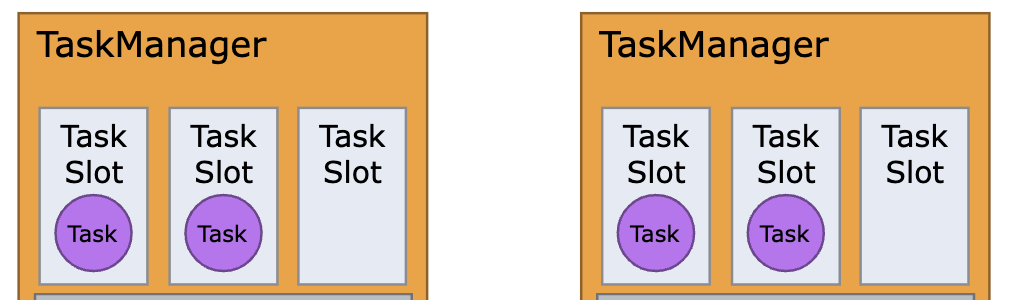
이외에도 태스크 매니저에는 태스크 슬롯(Task slot)이라는 모듈이 존재합니다. 이는 실제로 태스크를 수행하는 주체로, 태스크 매니저는 보유한 태스크 슬롯의 수만큼 여러 태스크를 동시에 수행할 수 있습니다. 공식 문서에서는 태스크 매니저를 시작할 때 CPU의 코어 수와 동일하게 태스크 슬롯을 할당하는 것을 권장합니다. 따라서, 태스크 슬롯을 간단하게 태스크를 수행하는 하나의 프로세스로 이해하여도 독자분들이 본 글에 이어서 소개되는 내용들을 이해하기에는 충분할 것입니다.
플링크의 상태 저장 기능
다음으로 소개드릴 주요 특징은 체크포인트(Checkpoint)입니다. 체크포인트란 플링크 잡의 상태(State)를 사용자가 정의한 저장소에 주기적으로 저장하는 기능입니다. 이때 상태에는 데이터를 읽어오는 외부 시스템과 관련된 정보들이 포함됩니다.
예를 들어, 아파치 카프카에서 데이터를 읽어오는 경우 아래 예시처럼 카프카 토픽(Topic), 카프카 토픽의 파티션(Partition) 및 오프셋(Offset) 정보가 체크포인트에 저장됩니다. 만약 플링크 잡이 모종의 이유로 실패할 경우, 잡 매니저는 실패 직전 마지막으로 성공적으로 생성 및 저장된 체크포인트를 사용하여 자동으로 플링크 잡 복구를 시도합니다. 이 기능은 이후 소개드릴 플링크 CDC에도 적용되어 있는데요, 이 기능은 데이터베이스를 읽은 위치를 체크포인트에 저장하기 때문에 문제가 발생하더라도 다시 안정적으로 플링크를 복구하여 운영하는 것이 가능합니다.
// 실제 상태 정보는 바이너리 형태로 저장되며, flink-state-processor-api 라이브러리를 사용해 아래와 같이 해독할 수 있습니다.
topic=flink-kafka-state-test-topic, partition=0, startingOffset=50393519, stoppingOffset=Optional.empty
topic=flink-kafka-state-test-topic, partition=1, startingOffset=50416351, stoppingOffset=Optional.empty
topic=flink-kafka-state-test-topic, partition=2, startingOffset=50405380, stoppingOffset=Optional.empty
topic=flink-kafka-state-test-topic, partition=3, startingOffset=50419730, stoppingOffset=Optional.empty
< 파티션이 4인 카프카 토픽에서 메시지를 읽어 올 경우 기록되는 체크포인트 예시 >
CDC, 그리고 플링크 CDC
CDC(Change Data Capture)는 데이터의 변화와 변경을 추적하여 이를 실시간으로 반영하는 소프트웨어의 디자인 패턴입니다. 간단히 말해, 소스 시스템(예: 데이터베이스)의 데이터와 발생하는 변동 사항들을 타겟 시스템(예: 데이터베이스, 아이스버그 등)에 실시간으로 반영하는 과정을 의미합니다. 앞서 설명드린 것처럼 저희 조직의 미션은 서비스 조직의 데이터를 가져와 일 단위의 지표를 추출하는 것입니다. 이 과정에서 실 서비스 데이터베이스에 대한 부하를 최소화하기 위해, 실 데이터베이스를 저희 조직 내의 데이터베이스로 CDC 연동하는 작업이 필요합니다. 플링크 CDC는 이러한 CDC 기능을 제공하는 하나의 라이브러리로, 다양한 데이터베이스 종류에 대해 개별적인 소스 커넥터(Source connector)를 지원합니다.
스냅샷, 빈로그 스트림, 그리고 GTIDs
CDC를 이해하기 위해 필요한 몇 가지 용어와 개념을 간단히 소개하겠습니다.
첫 번째는 CDC의 두 단계입니다. 최초 1회 데이터베이스의 테이블을 타겟 시스템에 덤프 또는 복사하는 스냅샷(Snapshot) 단계와, 데이터베이스의 바이너리 로그(Binary log)를 실시간으로 읽어 변화분을 타겟 시스템에 반영하는 빈로그 스트림(Binlog Stream) 단계가 있습니다. 먼저 스냅샷 단계를 통해 전체 데이터를 한 번 가져오고, 이후 바이너리 로그를 실시간으로 읽은 후 타겟 시스템에 반영하는 빈로그 스트림을 수행하여 CDC 연동을 진행합니다.
두 번째는 GTIDs(Global Transaction Identifiers)입니다. GTIDs는 데이터베이스 서버의 유니크한 식별자(UUID)와 데이터베이스 트랜잭션의 아이디(Transaction ID) 또는 구간(Range)로 구성됩니다. 주-복제(Primary-Secondary) 구성처럼 두 대 이상의 서버로 데이터베이스가 구성된 환경에서는 여러 개의 UUID가 GTIDs에 존재할 수 있으며, 이러한 경우 여러 GTIDs가 콤마(,)로 열거됩니다. 이때, GTIDs는 소스 데이터베이스 서버 바이너리 로그의 특정 위치를 가리킵니다. 타겟 시스템 관점에서는 GTIDs를 기준으로 소스 데이터베이스 바이너리 로그를 어디까지 읽었는지, 즉 어느 변화분 까지 반영했는지를 알 수 있어, 전반적인 운영과 복구의 관점에서 중요하게 관리되어야 하는 정보입니다.
// 단일 UUID. UUID:transaction_id_range
b1fida2c9-2710-11ec-affa-b4lefh87156:1-2173497272

// 다중 UUID. UUID-A:transaction_id_range-A,UUID-B:transaction_id_range-B,UUID-C:transaction_id_range-C
3bxf2xbb-2fc8-11eb-855f-fax8f741gxe3:1-128377129,3c3xd21b-c931-11ed-b0db-b4xxab9ddx9e:1-273703345,901d637c-8add-11eb-8e3f-b4xdf10gxa6:1-3577694930,b46xdx51-5254-11ed-a648-d0x705ff8x48:1-1069556331
< GTIDs 예시>
디비지움 기반의 플링크 CDC
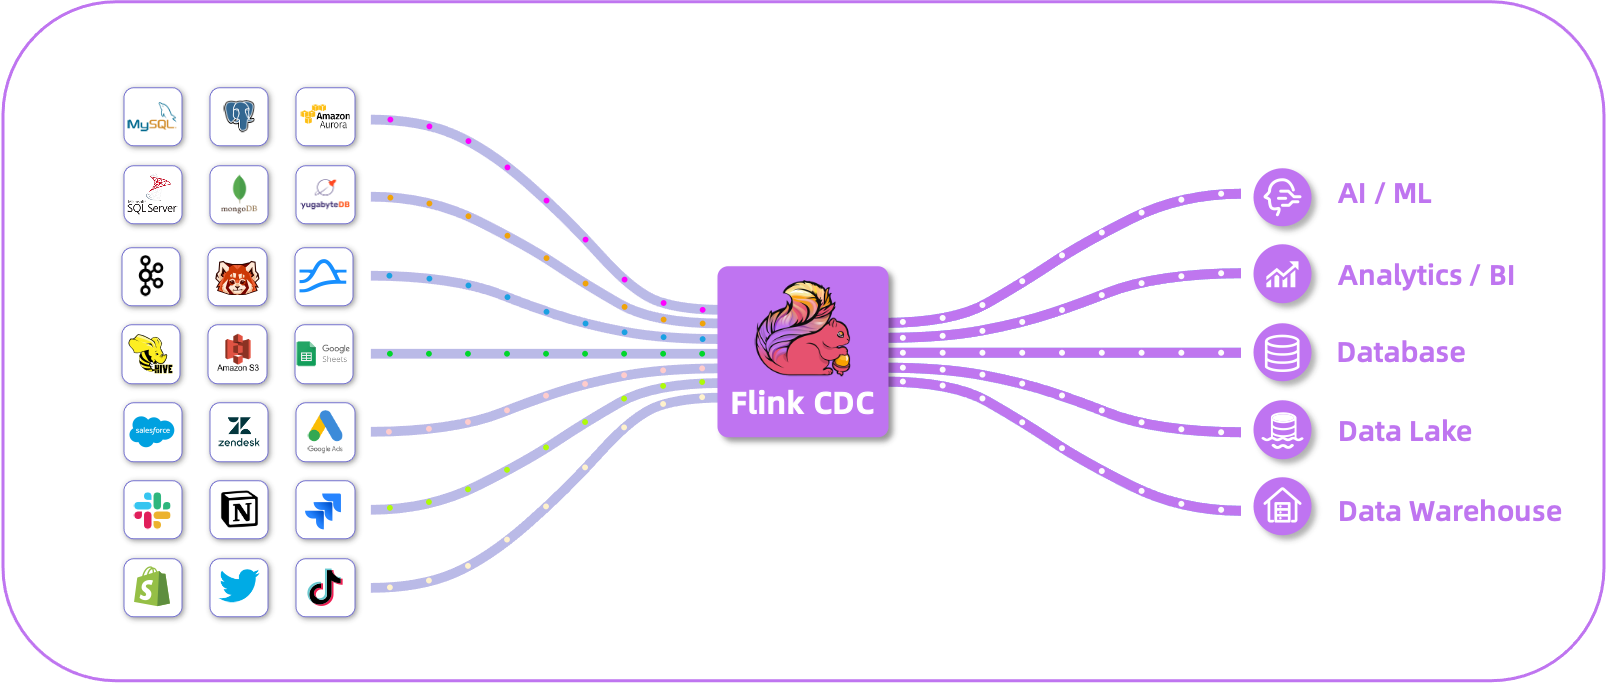
CDC의 근간이 되는 프레임워크로 디비지움(Debezium) 이 있습니다. 대부분의 CDC 라이브러리나 프레임워크들이 디비지움을 기반으로 한다 해도 과언이 아닙니다. 디비지움은 증분 스냅샷(Incremental snapshot) 기능을 제공하며 테이블을 청크(Chunk) 단위로 나누고 가져올 수 있습니다. 이를 통해 스냅샷 단계부터 변경분을 가져와 타겟 시스템에 실시간으로 반영하는 빈로그 스트림 단계를 하나의 시스템에서 수행이 가능하도록 만들었습니다.
디비지움을 통한 CDC 수행 방법 중 가장 널리 사용되는 방식은 디비지움의 소스 및 싱크 커넥터(Sink & Source connector)와 카프카 커넥트(Kafka connect)를 조합하여 사용하는 방법입니다. 예를 들어, MySQL 데이터베이스의 데이터를 가져오는 경우, 디비지움의 JDBC 소스 및 싱크 커넥터와 카프카 커넥트를 사용하면 간단히 MySQL 데이터베이스를 CDC 연동할 수 있습니다. 여기까지만 설명드리면 디비지움과 카프카 커넥트의 조합을 실 프로덕트에 적용해도 문제가 없어 보이며, 플링크 CDC를 굳이 사용해야 될 이유가 없어 보입니다. 하지만 이 방법에는 명백한 단점이 있습니다.
예를 들어, 대규모 MySQL 테이블은 내부 레코드의 수가 수천만에서 수억을 넘는 경우들이 있습니다. 이런 환경에서 디비지움 방식을 사용할 경우, 애플리케이션의 최적화 정도나 테이블 레코드의 크기에 따라 차이가 있지만, 초당 만개 이상의 레코드를 가져오기가 쉽지 않습니다. 일례로 스냅샷 단계에서 테이블 전체 데이터를 가져오는 경우, 짧게는 반나절에서 최대 수일이 넘게 걸리는 작업이 될 수 있습니다. 빈로그 스트림 단계에서 사용되는 바이너리 로그의 기본 유지(Retention) 기간이 3일인 것을 고려하면, 이런 방식은 실제 운영 환경에서 사용하기 어렵습니다.
비록 디비지움이 스냅샷과 빈로그 스트림 단계를 하나의 시스템으로 가능하게 했어도, 말씀드린 성능이나 시간의 문제 때문에 실제 운영 환경에서는 스냅샷 단계에서 mysqldump 명령어를 사용하거나 아파치 스파크(Apache Spark)와 같은 별도의 시스템을 사용하는 것을 선호합니다. 이렇게 별도의 시스템으로 스냅샷 단계를 수행한 후, 반환된 GTIDs를 기준으로 소스 커넥터를 통해 바이너리 로그를 읽은 다음, 카프카 커넥트와 싱크 커넥터를 거쳐 변경된 내용을 타겟 시스템에 실시간으로 반영하는 방식이 대중적으로 사용되는 실제 사례라고 할 수 있습니다. 이러한 방식은 스냅샷 단계의 수행시간을 대폭 단축할 수 있는 장점이 있지만, 수행 단계에 따라 별도의 시스템을 사용해야 한다는 단점 또한 존재합니다.
플링크 CDC는 기존 방식에서 발생하는 성능 문제 및 스냅샷 단계와 빈로그 스트림 단계에서 서로 다른 시스템을 사용해야 하는 단점을 해소할 수 있습니다. 아파치 플링크는 분산 처리 프레임워크로, 디비지움을 기반으로 하기 때문에 증분 스냅샷 기능을 지원합니다. 이 기능을 통해 플링크 CDC는 테이블을 청크 단위로 나누어 여러 프로세스가 병렬적으로 청크를 가져오는 작업을 수행할 수 있습니다. 결과적으로, 소스 데이터베이스에 적절한 부하를 조절하면서 병렬성에 비례해 성능을 극대화할 수 있습니다. 또한, 플링크의 체크포인트 기능 덕분에 스냅샷 작업이 외부 요인으로 인해 실패하더라도 스파크와 달리 처음부터 스냅샷 단계를 다시 수행할 필요가 없습니다. 즉, 체크포인트에 남아 있는 상태를 기준으로 실패한 청크들부터 다시 스냅샷을 수행할 수 있습니다.
하지만 아쉽게도 플링크 CDC는 적재 커넥터를 제공하지 않기 때문에, 데이터 및 변화분을 플링크로 적재한 후, 카프카 커넥트 및 별도의 적재 커넥터를 조합하여 데이터를 타겟 시스템에 적재해야 합니다. 그러나 데이터를 가져오는 시스템을 플링크 CDC로 통일하면 관리할 부분이 줄어들고, 체크포인트의 이점을 활용할 수 있다는 장점이 여전히 있습니다. 예를 들어, 지표 추출을 위해 식별 데이터가 포함된 데이터베이스 테이블의 데이터를 가져와야 할 경우, 식별 데이터는 개인 정보 보호를 위해 해싱 등의 처리가 필요합니다. 만약 각 단계에서 별도의 시스템을 사용한다면, 각 시스템마다 해싱 로직을 개별적으로 추가해야 합니다. 그러나 플링크 CDC에서는 플링크 잡에만 해당 로직을 추가하면 단일한 시스템에서 모든 처리가 가능합니다.
flink-connector-mysql-cdc 살펴보기
플링크 CDC는 Alibaba와 Ververica에서 시작된 오픈 소스 프로젝트입니다. 2.0 버전부터 Apache 라이선스를 사용하기 시작하였으며, 3.1 버전부터는 Apache Flink의 하위 프로젝트로 편입되었습니다. 프로젝트 안에는 MySQL 외에도 Postgres, Oracle, MongoDB 및 TIDB 등 다양한 종류의 데이터베이스에 대한 소스 커넥터를 제공하고 있습니다.
저희 조직의 경우 지표 추출을 위해 연동해야 할 대부분의 데이터베이스가 MySQL 데이터베이스였기 때문에, 플링크 CDC에서도 MySQL 데이터베이스 소스 커넥터 라이브러리인 flink-connector-mysql-cdc 라이브러리를 사용하였습니다. 이제 본격적으로 flink-connector-mysql-cdc 라이브러리를 활용하여 실제 연동이 작업이 수행되는 단계에 따른 코드 구현과 그 동작 과정을 설명드리겠습니다.
MySQL 계정과 설정 확인
연동 작업이 진행되기 전 가장 먼저 필요한 것은 데이터베이스의 계정 및 권한입니다. 필요한 권한들을 아래의 명령어를 실행해 부여할 수 있습니다. 각 권한에 대해 세부적으로 설명드리면 스냅샷 단계에서 쿼리로 데이터를 가져오기에 SELECT 권한, 연동할 데이터베이스와 테이블을 조회해야 하기에 SHOW DATABASES 권한, MySQL의 Replication Protocol을 사용하여 바이너리 로그를 가져오기에 REPLICATION SLAVE 및 REPLICATION CLIENT 권한이 필요합니다.
GRANT SELECT, SHOW DATABASES, REPLICATION SLAVE, REPLICATION CLIENT ON *.* TO 'user' IDENTIFIED BY 'password';
< 필요 권한들을 계정에 부여하는 쿼리 예시 >
계정 생성 및 권한 부여가 완료되면 flink-connector-mysql-cdc 라이브러리의 API를 통해 데이터베이스에 접근할 수 있습니다. 이후, 실제 연동 작업을 진행하기 전에 MySQL의 일부 설정 값을 확인하고 설정하는 절차를 먼저 수행해야 합니다. 이러한 설정 값들이 올바르게 설정되어 있어야 차후 연동 작업을 진행할 수 있기 때문인데요, 사용자가 확인해야 할 세부 설정과 그 자세한 의미는 아래와 같습니다.
- binlog_format : 바이너리 로그의 포맷을 정합니다. 로그가 바이너리 형태로 저장되어야 하기에
ROW로 설정되어있어야 합니다.
private void checkBinlogFormat(JdbcConnection connection) throws SQLException {
   String mode = connection.queryAndMap("SHOW GLOBAL VARIABLES LIKE 'binlog_format'", rs -> rs.next() ? rs.getString(2) : "").toUpperCase();
   if (!BINLOG_FORMAT_ROW.equals(mode)) {...}
}
< binlog_format 설정값 확인 함수 >
- binlog_row_image : 바이너리 로그에 행 이미지(Row image)를 어떠한 설정으로 저장할지 결정합니다. 로그에 모든 칼럼에 대한 정보와 값이 바이너리 형태로 저장되어야 하기에
FULL로 설정되어 있어야 합니다.
private void checkBinlogRowImage(JdbcConnection connection) throws SQLException {
   String rowImage = connection.queryAndMap("SHOW GLOBAL VARIABLES LIKE 'binlog_row_image'", rs -> {
                             if (rs.next()) { return rs.getString(2); }
                             return BINLOG_FORMAT_IMAGE_FULL;
                           }).toUpperCase();
   if (!rowImage.equals(BINLOG_FORMAT_IMAGE_FULL)) {...}
}
< binlog_row_image 설정값 확인 함수 >
- binlog_row_value_options: JSON 관련 칼럼에서 변경된 부분의 값들만 바이너리 로그에 저장할지 정합니다. 모든 값들이 저장되어야 하기에 빈값으로 설정되어 있어야 합니다.
private void checkBinlogRowValueOptions(JdbcConnection connection) throws SQLException {
   String rowValueOptions = connection.queryAndMap("SHOW GLOBAL VARIABLES LIKE 'binlog_row_value_options'", rs -> rs.next() ? rs.getString(2) : DEFAULT_BINLOG_ROW_VALUE_OPTIONS).trim().toUpperCase();
   if (!DEFAULT_BINLOG_ROW_VALUE_OPTIONS.equals(rowValueOptions)) {...}
}
< binlog_row_value_options 설정값 확인 함수 >
연동 테이블 조회
MySQL 데이터베이스의 설정 값에 문제가 없다면, 이제 데이터베이스와 테이블을 조회할 차례입니다. 모든 데이터베이스와 테이블을 조회하면서, 사용자가 지정한 연동 대상 데이터베이스와 테이블의 이름을 기준으로 필터링합니다. 이 작업을 수행하려면, 데이터베이스 계정에 SHOW DATABASES 권한이 필요합니다. 작업 과정에서 로그를 확인하면, 어떤 데이터베이스와 테이블이 조회되었는지, 그리고 연동을 위해 어떤 테이블이 선택되었는지 또한 확인할 수 있습니다.
public static List listTables(...) {
   final List capturedTableIds = new ArrayList<>();
   final List databaseNames = new ArrayList<>();

   ...

   jdbc.query("SHOW DATABASES",  rs -> { // 데이터베이스 조회
               while (rs.next()) {
                   String databaseName = rs.getString(1);
                   if (tableFilters.databaseFilter().test(databaseName)) {
                       databaseNames.add(databaseName);
                   }
               }
           });
    for (String dbName : databaseNames) { // 테이블 조회 및 캡처
       try {
           jdbc.query("SHOW FULL TABLES IN " + StatementUtils.quote(dbName) + " where Table_Type = 'BASE TABLE'",  rs -> {
                       while (rs.next()) {
                           TableId tableId = new TableId(dbName, null, rs.getString(1));
                           if (tableFilters.dataCollectionFilter().isIncluded(tableId)) {
                               capturedTableIds.add(tableId);
                           } else {...}
                       }
                   });
       } catch (SQLException e) {...}
   }
   return capturedTableIds;
}
< 데이터베이스 및 테이블 조회 함수 >
INFO org.apache.flink.cdc.connectors.mysql.source.utils.TableDiscoveryUtils [] - Read list of available databases
INFO org.apache.flink.cdc.connectors.mysql.source.utils.TableDiscoveryUtils [] - list of available databases is: [config_generator_test, database_name, information_schema, mysql, performance_schema, sys, test]
INFO org.apache.flink.cdc.connectors.mysql.source.utils.TableDiscoveryUtils [] - Read list of available tables in each database
INFO org.apache.flink.cdc.connectors.mysql.source.utils.TableDiscoveryUtils [] - 'mysql.columns_priv' is filtered out of capturing
...
INFO org.apache.flink.cdc.connectors.mysql.source.utils.TableDiscoveryUtils [] - 'performance_schema.accounts' is filtered out of capturing
...
INFO org.apache.flink.cdc.connectors.mysql.source.utils.TableDiscoveryUtils [] - including 'database1.table1' for further processing
< 데이터베이스와 테이블 조회 및 테이블이 포함되는 로그 예시 >
스냅샷 수행
연동할 테이블 조회 및 캡처까지 완료되었다면 이제 CDC 연동의 첫 단계인 스냅샷 단계가 시작됩니다. 플링크 CDC는 증분 스냅샷을 기본으로 지원하기에 먼저 데이터를 가져올 청크 크기를 계산해야 합니다. 이 과정에서 distributionFactor를 계산하여, 사용자가 넘겨준 청크 키 칼럼(Chunk key column)의 값 분포 정도를 확인하고 청크 크기를 결정하는 데 사용합니다. 이 값은 distributionFactor = (max(id) - min(id) + 1) / #record의 형태로 계산되며, 사용자가 넘겨준 청크 크기에 계산한 distributionFactor를 곱한 값을 실제 청크 크기로 사용합니다.
예를 들어, distributionFactor가 2로 계산되면, 레코드 개수에 비해 청크 키 칼럼의 범위(최댓값 - 최솟값)가 2배라는 의미입니다. 이 경우 사용자가 청크 크기로 초기값인 8,096을 사용한다면 distributionFactor 2가 곱해져 실제 청크 크기는 16,192가 됩니다.
private int getDynamicChunkSize(
       TableId tableId,
       Column splitColumn,
       Object min,
       Object max,
       int chunkSize,
       long approximateRowCnt) {
   if (!isEvenlySplitColumn(splitColumn)) {
       return -1;
   }
   final double distributionFactorUpper = sourceConfig.getDistributionFactorUpper();
   final double distributionFactorLower = sourceConfig.getDistributionFactorLower();
   double distributionFactor =
           calculateDistributionFactor(tableId, min, max, approximateRowCnt);
   boolean dataIsEvenlyDistributed =
           ObjectUtils.doubleCompare(distributionFactor, distributionFactorLower) >= 0
                   && ObjectUtils.doubleCompare(distributionFactor, distributionFactorUpper)
                           <= 0;
   if (dataIsEvenlyDistributed) {
       // the minimum dynamic chunk size is at least 1
       return Math.max((int) (distributionFactor * chunkSize), 1);
   }
   return -1;
}
< 청크 크기 계산 함수 >
아래 예시는 id라는 청크 키 칼럼 기준으로 16,192 만큼의 청크 크기로 스플릿을 생성 후 발생하는 스냅샷 스플릿(SnapshotSplit) 예시입니다. 외부 시스템에서 데이터를 읽어와야 할 위치나 기준이 담긴 실 구현된 객체가 스플릿이라고 일전에 설명을 드렸었는데요, CDC에서는 스냅샷과 빈로그 스트림 두 단계가 있기에 각 단계에 맞추어 스플릿이 정의되어 있습니다. 스냅샷 스플릿에는 데이터베이스 이름, 테이블 이름, 청크 키 및 청크의 범위 정보가 들어 있고 태스크 매니저는 해당 정보를 취합하여 MySQL에서 데이터를 가져옵니다. 잡 매니저가 스냅샷 스플릿을 계산하는 과정과 태스크 매니저가 스냅샷 스플릿을 참고하여 데이터를 조회하는 작업은 비동기로 수행되기에, 스냅샷 스플릿 계산 및 데이터를 가져오는 작업은 동시에 수행됩니다.
splitId='database1.table1:split_number1', splitKeyType=[`id` INT NOT NULL], splitStart=[0], splitEnd=[16192]
splitId='database1.table1:split_number2', splitKeyType=[`id` INT NOT NULL], splitStart=[16192], splitEnd=[32384]
...
< 스냅샷 스플릿 예시 >
만약 계산한 distributionFactor가 0.05보다 작거나 1,000보다 크면 청크 키 칼럼의 값이 불균등(Unevenly)하게 분포되었다 판단하여, 아래 예시와 같은 쿼리들을 순차 반복적으로 적용해 청크의 범위를 나누는 작업을 수행합니다. 단, 앞서 설명드린 작업처럼 단순히 청크 크기를 기준으로 구간을 나누어 스냅샷 스플릿을 생성하는 것은 아닙니다.
- 청크 크기만큼 쿼리에 조회 개수 제한 (Limit)을 설정합니다.
- 조회 쿼리를 실행합니다.
- 조회 쿼리의 결과를 사용하여 다음 조회 쿼리의 범위를 생성 한 후, 해당 범위에서 1번부터 다시 실행합니다.
이 작업은 이전 쿼리의 결과를 다음 쿼리에 사용하는 동기적인 작업입니다. 따라서, 꽤나 시간을 소모하기에 플링크의 병렬 처리 기능을 완전히 적용할 수도 없고 전체 수행 시간이 늘어나는 부정적인 영향이 있습니다. 공식 문서에서도 해당 과정은 효율적이지 않다고 설명되었기 때문에, 사용자 분들이 비교적 균등하고 적절한 청크 키 칼럼을 고르는 것 또한 중요하다고 말씀드릴 수 있겠습니다(Unevenly-sized chunks which will request many queries and is not efficient).
// 사용자가 전달한 청크 크기를 limit으로 사용
Query SELECT MAX(`id`) FROM (SELECT `id` FROM `database1`.`table1` WHERE `id` >= 0 ORDER BY `id` ASC LIMIT 8096) AS T
// 위 쿼리의 결과로 18710008400가 나온 상황
Query SELECT MAX(`id`) FROM (SELECT `id` FROM `database1`.`table1` WHERE `id` >= 18710008400 ORDER BY `id` ASC LIMIT 8096) AS T
// 위 쿼리의 결과로 38049871000가 나온 상황
Query SELECT MAX(`id`) FROM (SELECT `id` FROM `database1`.`table1` WHERE `id` >= 38049871000 ORDER BY `id` ASC LIMIT 8096) AS T
...
< 수행되는 쿼리 예시 >
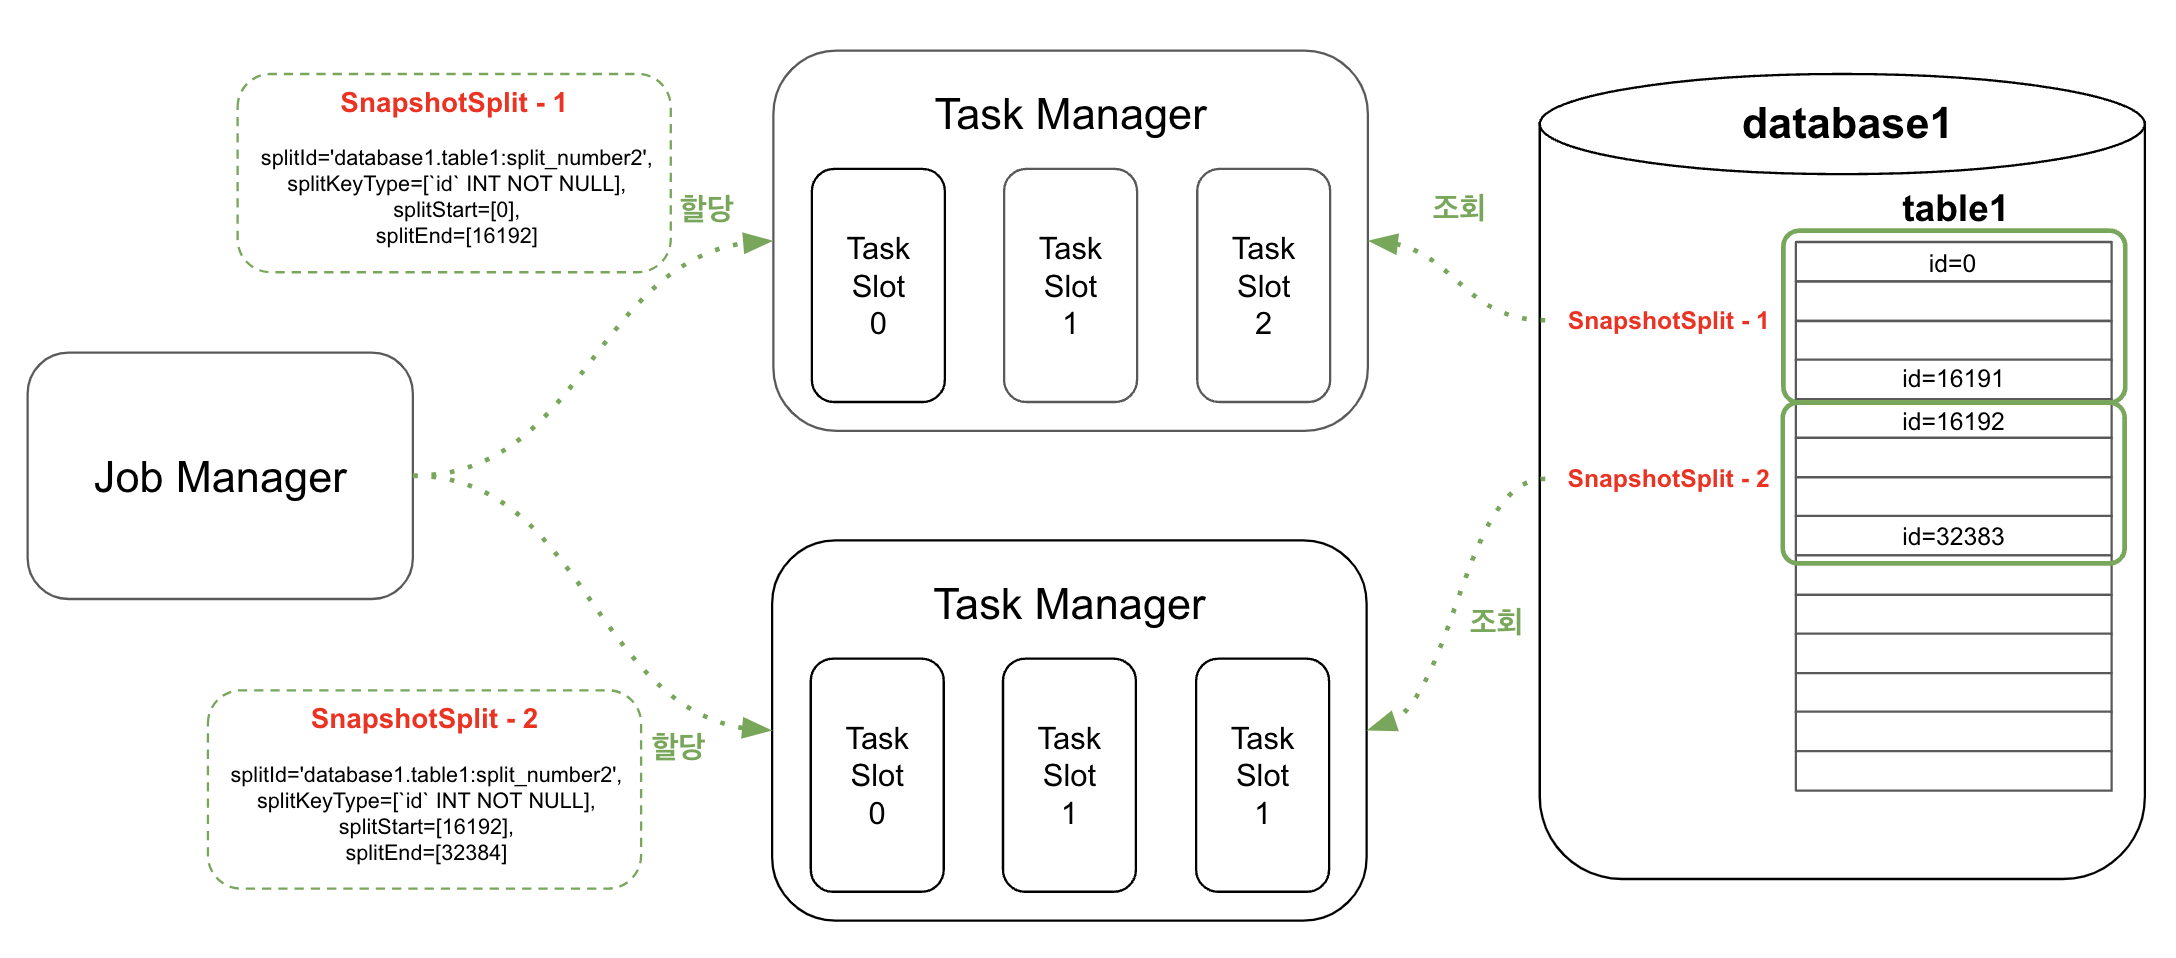
위의 그림에서 묘사된 것처럼 태스크 매니저는 할당받은 스냅샷 스플릿을 기준으로 데이터를 조회하고, 조회 이후 타겟 시스템에 데이터 적재까지 완료되면 잡 매니저에게 해당 스냅샷 스플릿이 성공적으로 완료되었음을 알립니다. 모든 스냅샷 스플릿들이 할당되었으며, 할당된 스냅샷 스플릿들이 모두 성공한 것을 잡 매니저가 확인하면 스냅샷 단계가 종료됩니다. 다만, 해당 과정에서 플링크 잡의 병렬성을 2 이상으로 설정한 경우, 태스크 매니저들 간의 상태 동기화를 위해 한 번의 체크포인트가 더 수행된 이후 스냅샷 단계가 완료됩니다.
private boolean allSnapshotSplitsFinished() {
   return noMoreSnapshotSplits() && assignedSplits.size() == splitFinishedOffsets.size();
}
< 스냅샷 단계가 완료되었는지 확인하는 함수 >
빈로그 스트림 단계
스냅샷 작업이 완료되면 이제 MySQL 데이터베이스의 바이너리 로그를 읽는 과정이 시작됩니다. 바이너리 로그에는 데이터베이스에서 발생한 이벤트들(테이블 생성, 데이터 입력 및 변경 등의 변경분이 있습니다. 이 단계까지 오면 연동 작업은 사실상 완료된 것으로 생각하여도 좋습니다.
스냅샷 단계에서 설명드린 것처럼 flink-connector-mysql-cdc는 스냅샷 단계를 위해 스냅샷 스플릿을 정의하여 사용하였습니다. 마찬가지로 빈로그(Binlog) 스트림 단계에서는 빈로그 스플릿(BinlogSplit)를 정의하여 사용합니다. 스냅샷 단계가 완료되면 빈로그 스트림이 시작되었다는 정보와 함께 빈로그 스트림 단계에 사용되는 빈로그 스플릿이 로깅됩니다. 이 로깅된 빈로그 스플릿에는 읽어와야 하는 바이너리 로그의 시작 위치를 가리키는 GTIDs가 존재합니다. 즉, 스냅샷 단계가 끝나면, 빈로그 스플릿에 존재하는 GTIDs를 기준으로 바이너리 로그를 읽어오며 CDC 연동 작업이 완료됩니다.
The enumerator assigns split MySqlBinlogSplit{splitId='binlog-split',
	offset={ts_sec=0, file=mysql-bin.000001, pos=12345678, kind=SPECIFIC, gtids=b1bda2c9-x12x-11ec-affa-f124x97g14xg0:1-9999, row=0, event=0},
	endOffset={ts_sec=0, file=, pos=-9223372036854775808, kind=NON_STOPPING, row=0, event=0}, isSuspended=false} to subtask 0
< 로깅된 빈로그 스플릿 예시 >
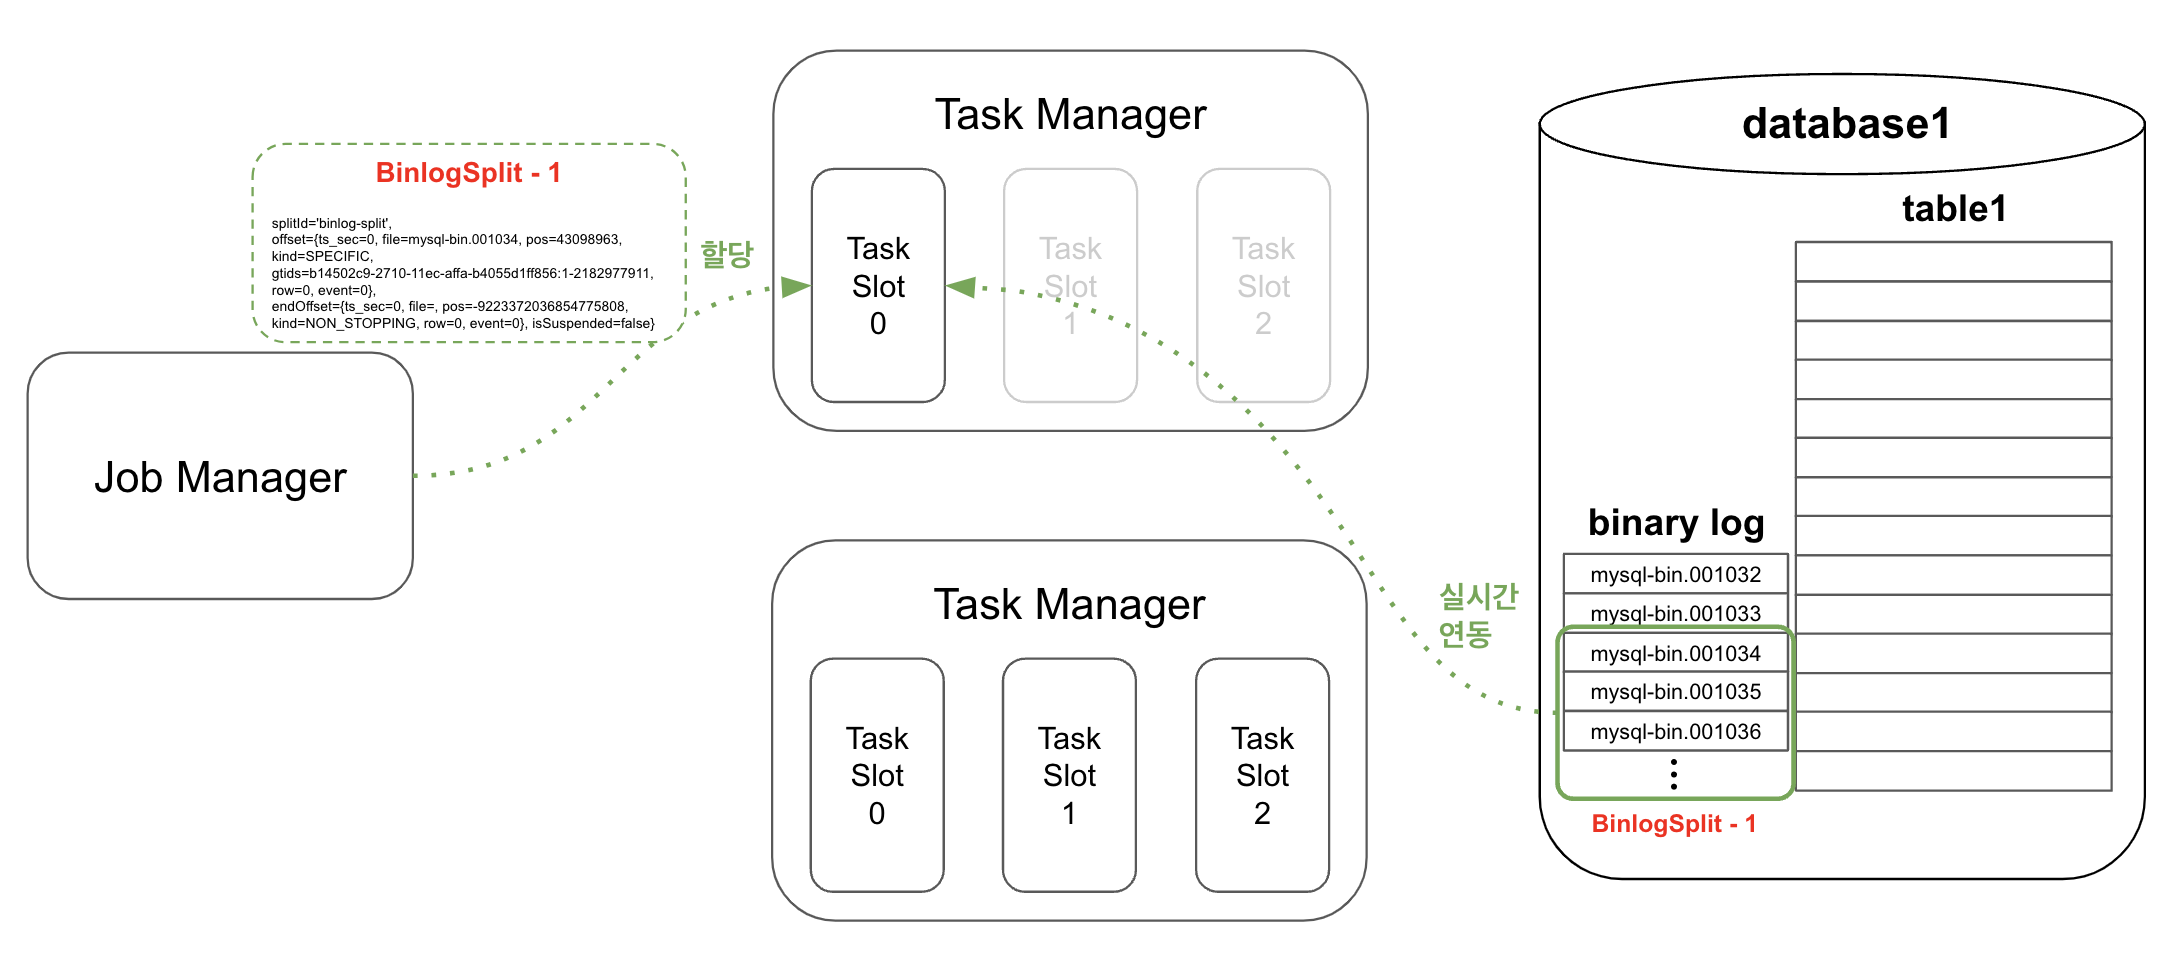
여기서 한 가지 궁금증이 생길 수 있습니다. 앞서 빈로그 스트림 단계에서는 GTIDs가 가리키는 바이너리 로그부터 읽어온다고 설명드렸습니다. 로그에 대해 더 고찰해 본다면, 플링크가 아무리 빠르게 스냅샷 단계를 완료하더라도 스냅샷 과정에서 바이너리 로그가 생성되는 것은 불가피하며, 이 로그들은 스냅샷 도중에도 데이터베이스에서 발생하는 변경 사항을 기록하며 생성될 것입니다. 따라서, 이를 적절히 처리하지 않으면 데이터 손실이나 일관성 문제가 발생할 수 있습니다.
이를 해결하기 위해 flink-connector-mysql-cdc는 처음 조회하여 가져온 청크의 GTIDs를 메모리에 저장합니다. 이 청크는 0번째 청크일 수도 있고, 여러 태스크 슬롯이 동시에 조회하기 때문에 그렇지 않을 수도 있습니다. 잡 매니저는 완료된 스냅샷 스플릿들이 조회한 GTIDs 중 가장 낮은 값을 확인하고, 이를 기준으로 빈로그 스트림을 시작합니다. 따라서, 스냅샷 단계에 1시간이 걸렸다면, 빈로그 스트림 단계는 1시간 전의 바이너리 로그를 가리키는 GTIDs를 기준으로 시작하게 됩니다.
flink-connector-mysql-cdc 라이브러리 200% 활용
위에서 설명드린 대로만 동작하면, 이론적으로는 좋은 성능으로 CDC 작업을 마무리할 수 있는 것처럼 보입니다. 하지만 여기에도 몇 가지 아쉬운 부분들이 있는데, 그중 하나는 아파치 플링크의 리소스에 관한 문제입니다.
먼저, 이미 실행 중인 플링크 잡에 대해서는 병렬성 조정이 불가능합니다. 또한 빈로그 스트림 단계는 발생되는 이벤트의 순서가 반드시 보장되어야 합니다. 예를 들어 소스 테이블의 특정 레코드의 값이 A로 변경된 후 B로 변경되는 이벤트가 발생되었다면, 타겟 시스템에도 동일한 순서로 이벤트가 적용되어야 합니다. 순서가 보장되지 않는다면 타겟 시스템과 소스 데이터베이스는 서로 다른 상태가 됩니다. 이러한 순서가 보장될 수 있도록 flink-connector-mysql-cdc에서는 항상 0번째 태스크 슬롯만이 바이너리 로그를 읽도록 설계되었습니다.
만약 스냅샷 단계에서 높은 성능을 위해 플링크 잡의 병렬성을 20으로 설정했다면, 빈로그 스트림 단계에 진입 시 단 1개(0번째)의 태스크 슬롯만이 바이너리 로그를 읽고 나머지 19개의 태스크 슬롯은 대기하며 플링크 잡을 점유하고 있는 상황이 발생합니다. 이는 결과적으로 플링크 잡이 불필요하게 많은 리소스를 점유하는 상황을 초래합니다. 문제를 어느 정도 대응할 수 있도록, 동적으로 병렬성을 조절하는 기능이 아파치 플링크 1.18 버전부터 제공되었지만, 저희 팀 내에서 사용하는 버전은 1.17 버전이었기 때문에 아쉽게도 도입할 수 없었습니다.
이러한 문제들을 해결하고 운영의 편리성을 높이기 위해 flink-connector-mysql-cdc 라이브러리에 몇 가지 기능을 추가 및 수정하였는데, 이제 그 내용들을 하나씩 소개드려보겠습니다.
단계가 변경됨을, 그리고 필요한 정보를 반환받습니다
플링크 CDC는 스냅샷과 빈로그 스트림 두 단계로 구성됩니다. 저희 팀에서는 플링크 CDC를 사용해 테이블의 데이터와 바이너리 로그를 카프카 토픽으로 전송하는데, 각 두 단계에서 사용하는 토픽이 다릅니다.
먼저 스냅샷 단계는 테이블 전체 데이터를 가져오기 때문에, 카프카 클러스터의 부하를 줄이기 위해 테이블 크기에 비례하여 카프카 토픽의 파티션 수를 설정하고 있습니다. 반면, 빈로그 스트림의 경우 앞서 설명드린 것처럼 이벤트의 순서 보장을 위해 카프카 파티션의 수가 1로 고정되어야 합니다. 즉, 스냅샷 단계와 빈로그 스트림 단계는 각 단계의 목적에 맞는 별도의 카프카 토픽을 사용해야 합니다.
문제가 되는 부분은 이미 실행된 플링크 잡에서는 병렬성에서 발생한 문제와 마찬가지로 카프카 토픽을 동적으로 변경하는 것이 불가하다는 점과, 단계가 변경되는 것은 오직 로그를 통해서만 확인 가능하다는 점입니다. 이를 해결하기 위해 아래의 기능들이 필요했었습니다.
- 스냅샷 단계에서 빈로그 스트림으로 단계가 변경되었음을 쉽게 확인하는 기능
- 빈로그 스플릿에 있는 GTIDs 및 빈로그 스트림용 카프카 토픽을 사용하여 플링크 잡 재시작
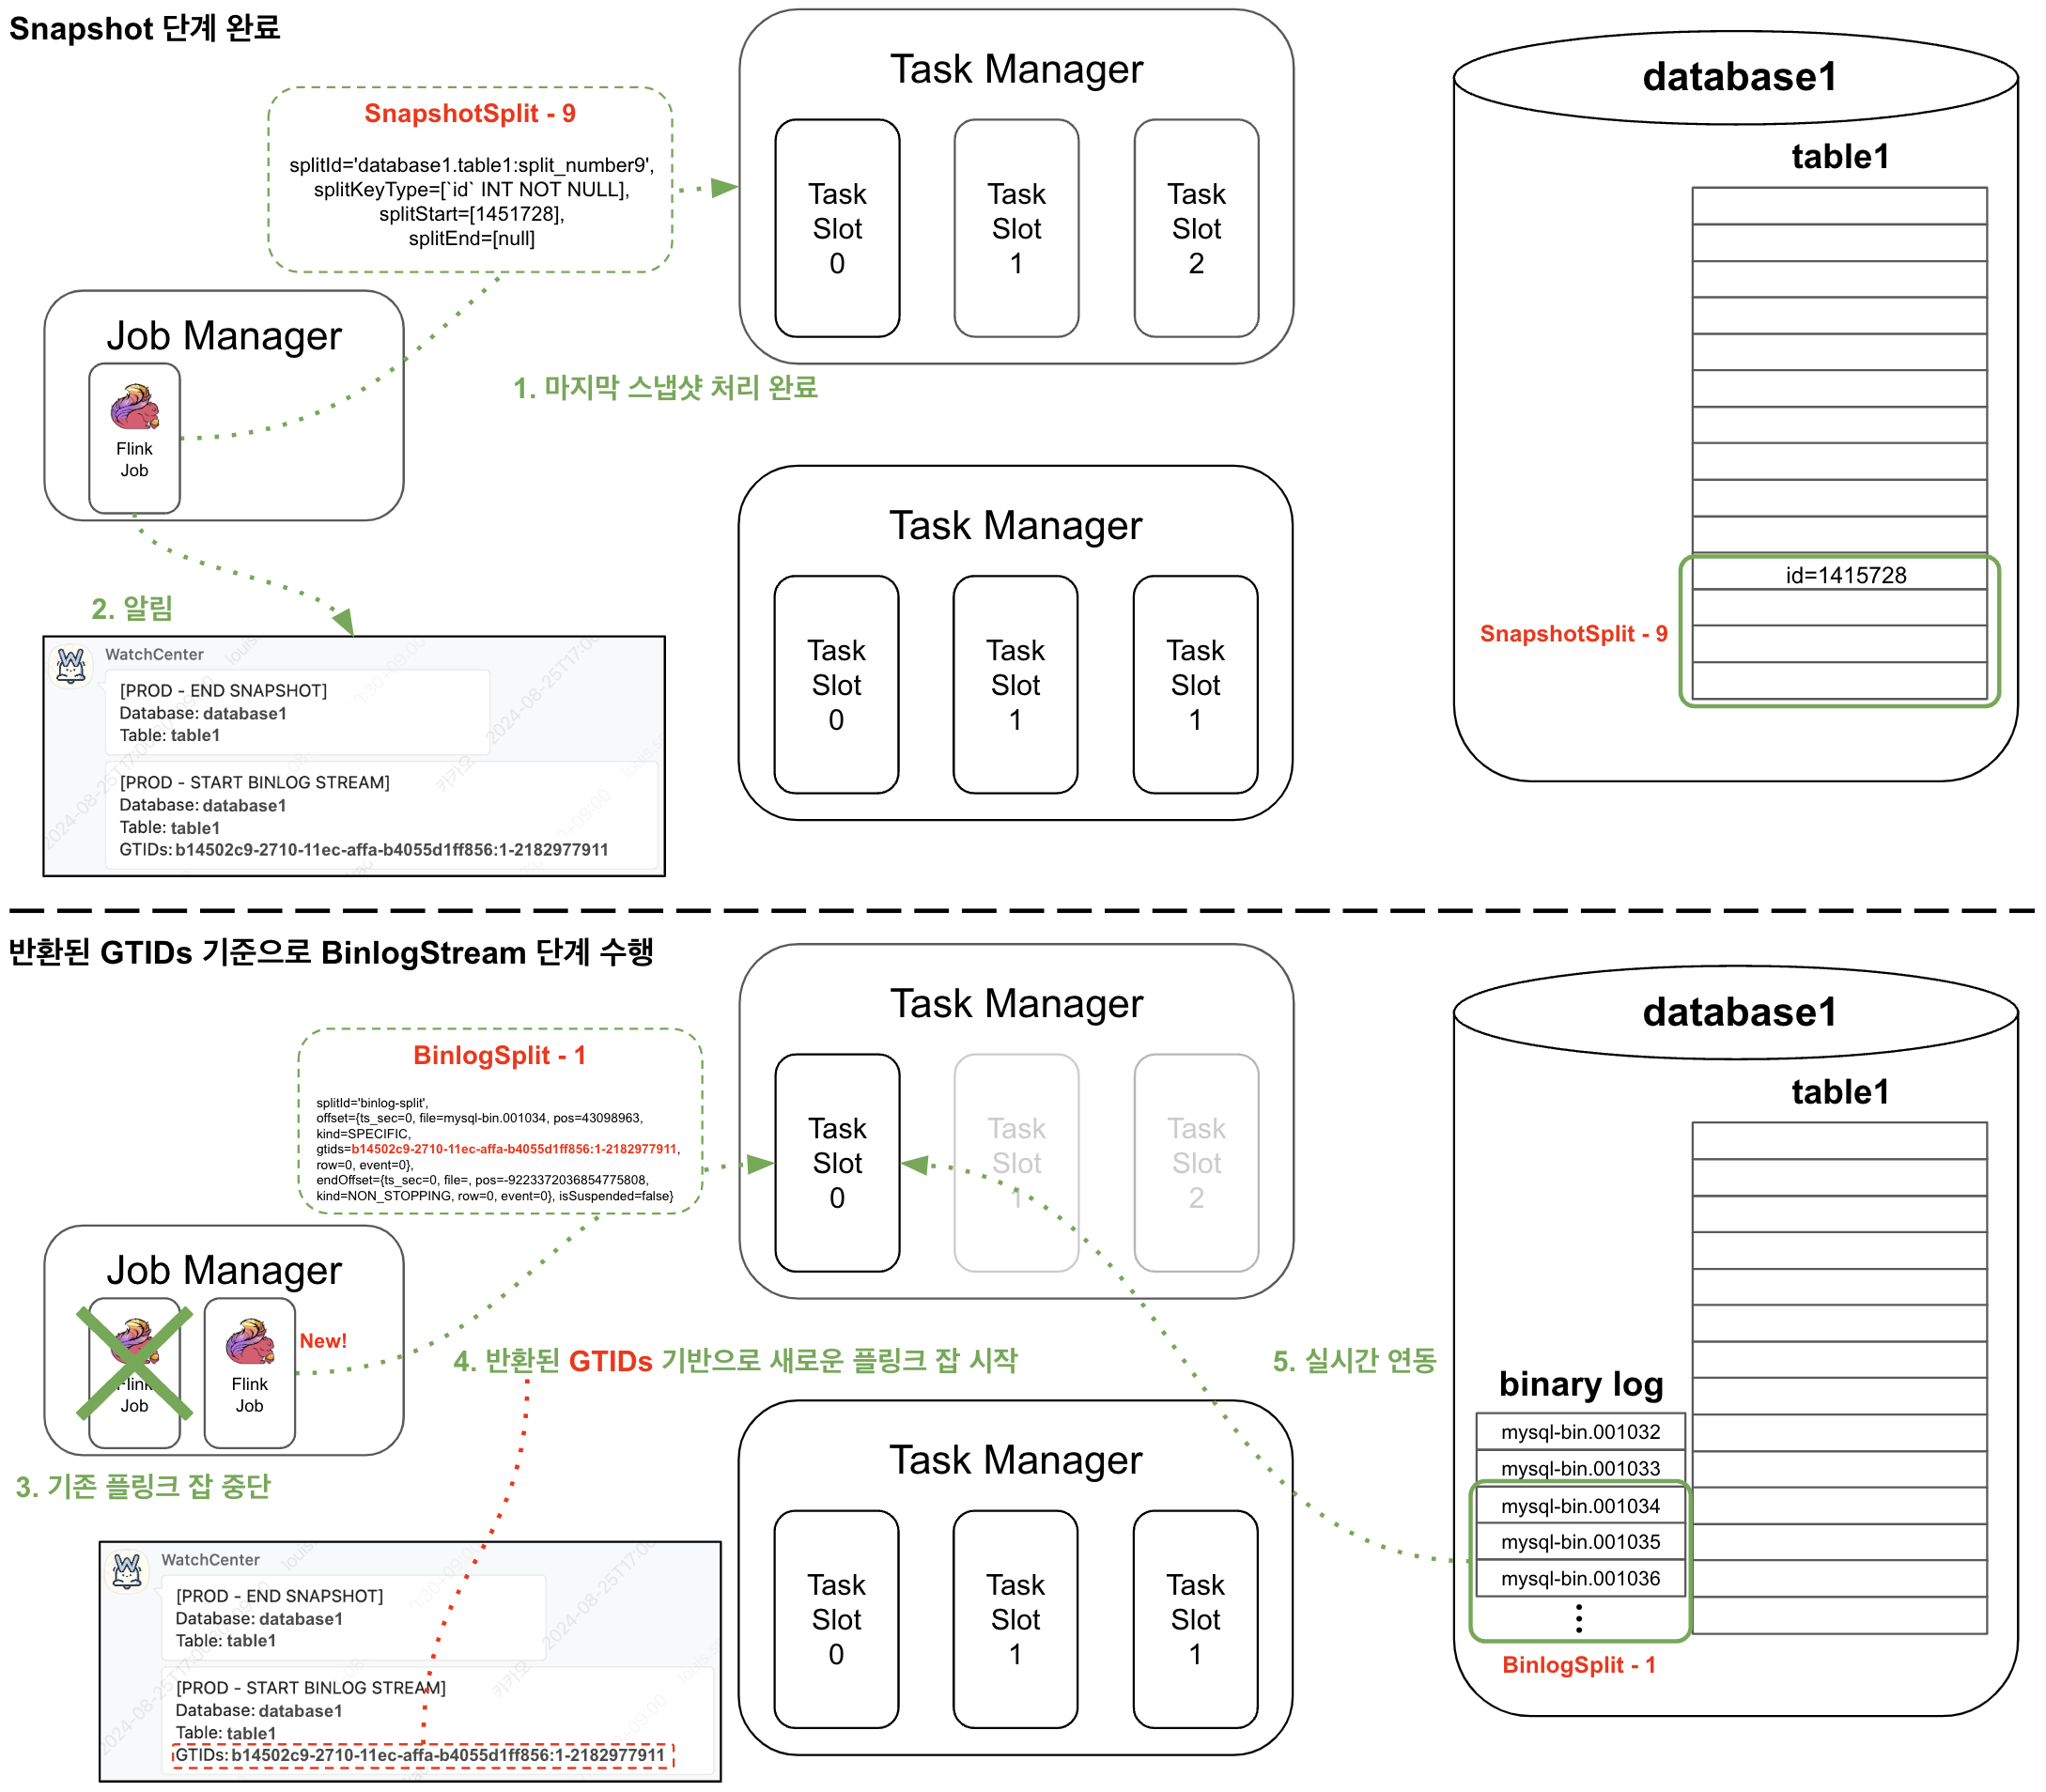
이를 위해 각 단계의 시작 시 알림을 추가하고, 빈로그 스트림 단계 시작 시 빈로그 스플릿에 포함된 GTIDs를 사내 알림 시스템인 Watchtower로 반환하도록 기능을 추가했습니다. 아래는 flink-connector-mysql-cdc에서 스냅샷 단계의 완료 여부를 확인하는 함수들입니다. 함수가 두 개로 분류된 이유는 병렬성이 2 이상일 때 체크포인트가 추가로 수행되기를 기다려, 태스크 매니저들의 상태를 동기화하는 과정을 거치기 때문입니다. 이 함수에 스냅샷 단계가 완료되었음을 알리는 기능을 추가하여, 스냅샷 단계가 끝난 후 빈로그 스트림 단계가 시작된 것을 손쉽게 확인할 수 있게 했습니다. 이를 통해, 스냅샷 단계가 종료된 후 플링크 잡을 중지하고, 빈로그 스트림 목적의 카프카 토픽과 알림을 통해 반환된 GTIDs를 사용해 빈로그 스트림 단계를 시작할 수 있게 되었습니다.
public void onFinishedSplits(Map splitFinishedOffsets) {
   ...
   if (allSnapshotSplitsFinished() && isAssigningSnapshotSplits(assignerStatus)) {
       if (currentParallelism == 1) {
	  ...
           NotificationUtils.notifyPhaseSwitch("END SNAPSHOT", ...);
       }
   ...
   }
}

public void notifyCheckpointComplete(long checkpointId) {
   ...
   if (checkpointIdToFinish != null && isAssigningSnapshotSplits(assignerStatus) && allSnapshotSplitsFinished()) {
       if (checkpointId >= checkpointIdToFinish) {
	 ...
          NotificationUtils.notifyPhaseSwitch("END SNAPSHOT", ...);
       }
       ...
   }
}
< 스냅샷 단계 완료 알림이 추가된 함수 >
private void assignSplits() {
   ...
   while (awaitingReader.hasNext()) {
       ...
       Optional split = splitAssigner.getNext();
       if (split.isPresent()) {
			...
           if (mySqlSplit instanceof MySqlBinlogSplit) {
               ...
				NotificationUtils.notifyPhaseSwitch("START BINLOG STREAM", this.sourceConfig.getTableList().get(0), position);
           }
       }
       ...
   }
< 빈로그 스트림 단계 시작 및 사용되는 GTIDs 정보 알림이 추가된 함수 >
DDL 이벤트와 그 이후 이벤트들을 스킵합니다
저희 조직은 타 서비스 조직들의 데이터베이스를 연동하여 데이터를 가져오고, 이를 통해 다양한 지표들을 생성하고 있습니다. 이때, 연동하는 서비스 조직의 테이블에는 식별 가능 정보가 포함되어 개인 정보 보안 문제가 발생할 가능성이 있습니다. 이러한 민감 데이터들은 저희 조직의 데이터베이스에 적재하기 전, 조회 시점에 해싱 또는 마스킹 작업을 거치게 됩니다. 이때 만약 연동된 서비스 테이블의 스키마가 변경되어(예: ADD COLUMN) 조직 데이터베이스에 민감한 식별 데이터가 해싱이나 마스킹 없이 적재 및 조회된다면 큰 문제가 발생합니다. 이를 사전에 방지하기 위해, 저희 팀에서는 테이블에 DDL 이벤트가 발생하면 이를 감지하고 타겟 시스템에 반영해도 문제가 없음을 확인한 후, 타겟 시스템에 반영하고 재연동하는 절차를 거치고 있습니다.
이제 DDL 이벤트가 발생할 때의 처리 로직을 어떻게 구성할지 고민해야 합니다. DDL 이벤트가 발생했을 때 메시지가 카프카 토픽으로 정확히 한 번만 전송되도록 보장하는 것이 중요한데, 이를 위해 flink-connector-kafka 라이브러리에서 제공하는 exactly once 설정을 사용하고 있습니다. 이 설정은 DDL 이벤트가 발생할 때 메시지의 일관성과 신뢰성을 유지하는 데 중요한 역할을 합니다.
처음에는 DDL 이벤트 발생 시 예외(FlinkRuntimeException)를 발생시켜 플링크 잡을 중단시키는 방법을 고려했습니다. 하지만 이 경우, DDL 이벤트 직전에 발생한 메시지들이 카프카 토픽으로 전송되는 것을 보장할 수 없습니다. exactly once 설정에서는 플링크가 체크포인트를 수행할 때, 카프카에 메시지가 안정적으로 전송되었음을 커밋(Commit)하며, 이 커밋이 성공해야만 메시지가 카프카로 제대로 전송된 것을 보장할 수 있습니다. 만약 플링크 잡이 중단되면 카프카로의 커밋이 이루어지지 않기 때문에, 메시지가 카프카로 전송되었는지 확신할 수 없습니다.
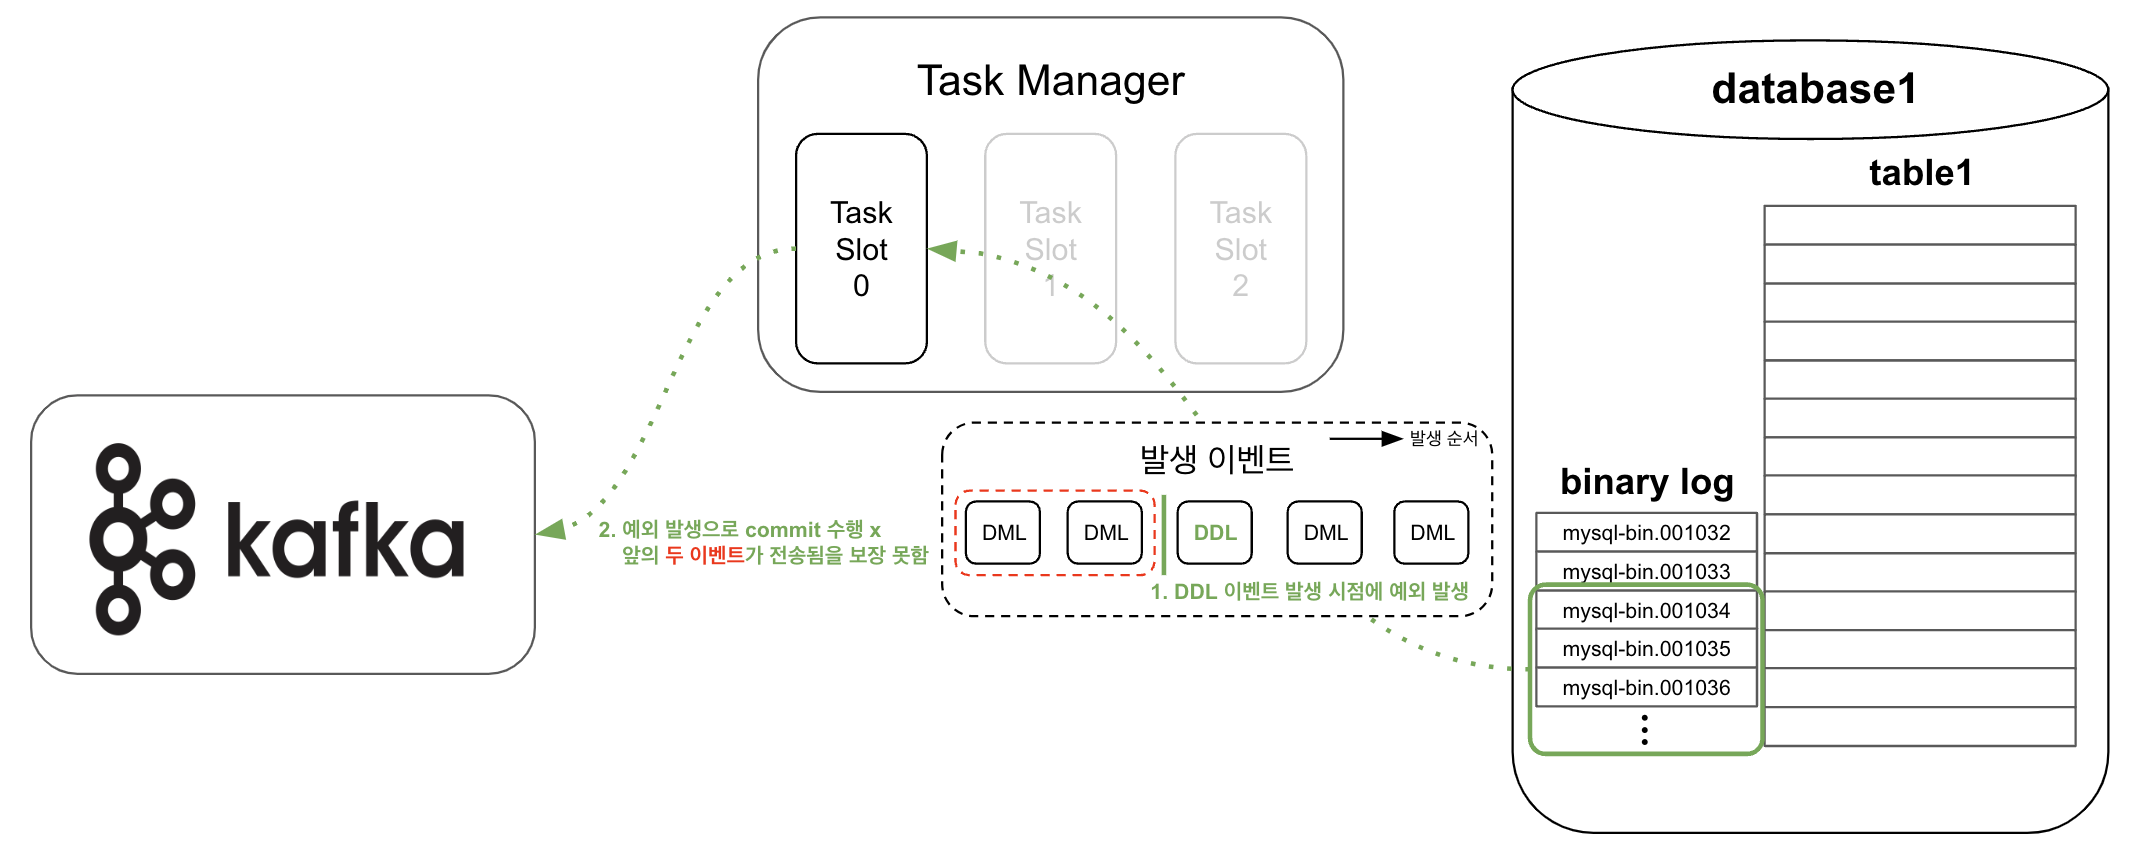
두 번째로 생각한 방법은 DDL 이벤트 발생 시 해당 DDL 이벤트와 이후 발생하는 이벤트들을 스킵하는 것입니다. 플링크 잡이 DDL 이벤트를 감지하면, 해당 이벤트 및 이후 이벤트들에 대해 어떠한 작업도 하지 않도록 로직을 수정하였습니다. 이렇게 구현할 시, DDL 이벤트 직전에 발생한 이벤트들의 메시지들은 카프카로 전송 및 커밋까지 완료되며, DDL 이벤트 및 그 이후 이벤트들에 대해서는 타겟 시스템에 반영이 되지 않도록 할 수 있습니다.
하지만 이 방법을 사용하려면 발생한 DDL 이벤트의 GTIDs 정보를 알고 있어야 합니다. 이 GTIDs 정보를 아는 상태여야만 타겟 시스템에 DDL을 반영한 후 해당 GTIDs 기준으로 빈로그 스트림을 재시작하여 재연동 작업을 마무리할 수 있습니다. 이를 위해 DDL 이벤트가 들어오면, 수행된 DDL 이벤트에 대한 정보 및 GTIDs를 Watchtower로 전송하여 DDL 이벤트를 인지하고, 발생한 이벤트를 확인한 후 재연동이 가능하도록 구현하였습니다.
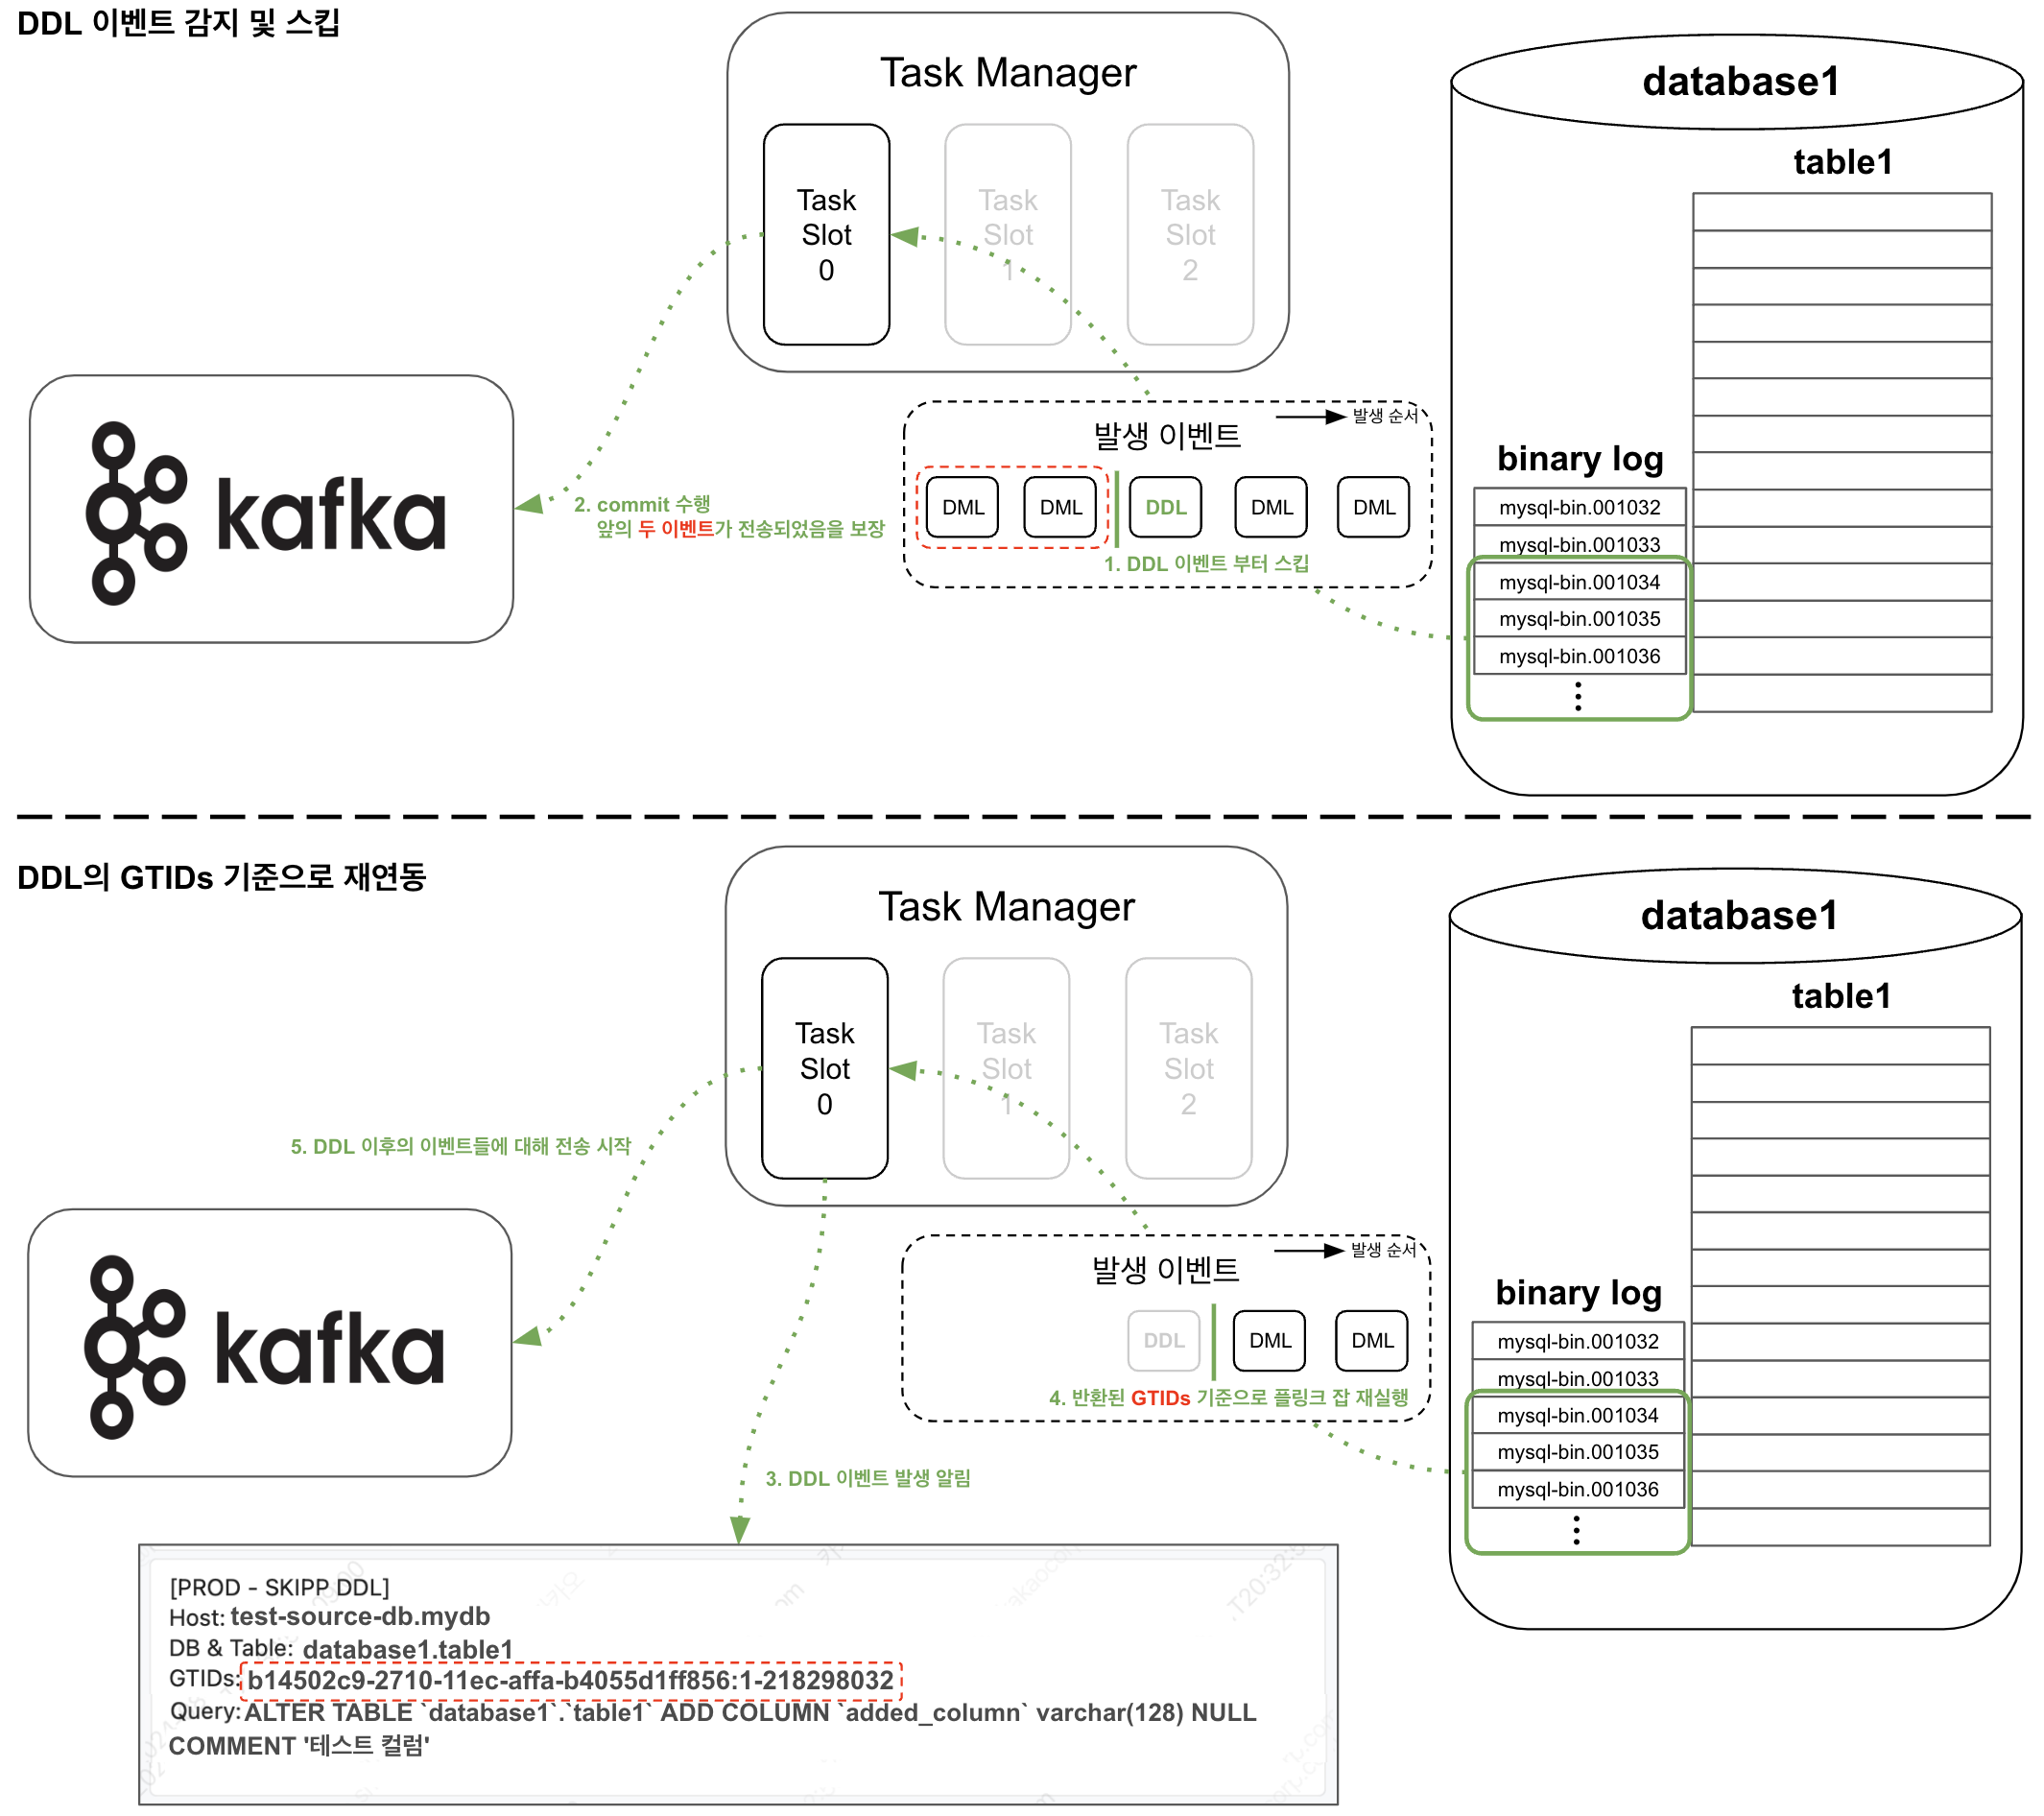
아래 코드는 flink-connector-mysql-cdc의 handleQueryEvent 함수로, 바이너리 로그를 읽어 이벤트 타입을 분류하고, 각 타입에 맞추어 대응하는 함수입니다. 이 로직에서 SchemaChangeEvent, 즉 DDL 쿼리가 감지되면 특정 변수를 변경하여 이후 모든 메시지를 스킵하도록 변경하였습니다.
protected void handleQueryEvent(...) throws InterruptedException {
   QueryEventData command = unwrapData(event);
   String sql = command.getSql().trim();
    if (sql.equalsIgnoreCase("BEGIN")) {
       if (doesDdlPassed) { // DDL 이벤트 발생 이후의 이벤트들을 스킵합니다.
           return;
       }
   ...
   }
   if (sql.equalsIgnoreCase("COMMIT")) {
       if (doesDdlPassed) { // DDL 이벤트 발생 이후의 이벤트들을 스킵합니다.
           return;
       }
   ...
   }
   ...
   final List schemaChangeEvents =  taskContext.getSchema().parseStreamingDdl(...)
   try {
       for (SchemaChangeEvent schemaChangeEvent : schemaChangeEvents) {
           if (taskContext.getSchema().skipSchemaChangeEvent(schemaChangeEvent)) {
               continue;
           }
            final TableId tableId = schemaChangeEvent.getTables().isEmpty() ? null : schemaChangeEvent.getTables().iterator().next().id();
            if (this.handleQueryAndCheckIfSkipNeeded(tableId, offsetContext, event, sql, true)) { // DDL 이벤트에 대해 알림을 보내며, DDL 이벤트와 이후 이벤트들을 스킵합니다.
               return;
           }
            ...
       }
   }
   ...
}
< 발생한 쿼리 타입에 따라 대응하는 함수 >
데이터베이스 스위칭에 대응합니다
연동 작업 수행 시 MySQL의 복제 서버 도메인으로 데이터베이스에 접속합니다. 그러나 스위칭이 발생하면 주 서버와 복제 서버가 변경되어, 실제 서비스가 되는 데이터베이스의 주 서버에 접속하는 상황이 발생합니다. 비록 복제 프로토콜(Replication protocol)이 실제 쿼리를 수행하지는 않아 데이터베이스에 부하가 있지는 않으나, 실 서비스 데이터베이스의 주 서버에 연결하는 건 권장하지 않습니다. 따라서 주기적으로 CDC 연동된 소스 데이터베이스의 서버가 주 서버로 승격되었는지 확인이 필요합니다.
이때, 주 서버에 연결되어 있는지 감지하는 방식은 MySQL 데이터베이스 서버의 구성 방식에 따라 달라집니다. 현재 구성된 감지 로직은 아래와 같은 두 가지 경우를 대상으로 합니다.
- 2대의 서버가 주-복제 형태로 구성된 경우
- 2대 이상의 서버가 InnoDB Cluster로 묶여 있는 경우
이 각각의 상황에 맞게 감지하는 로직을 라이브러리에 추가했습니다. 또한, 별도의 모니터링 잡을 추가하는 대신 데이터베이스와 테이블이 늘어남에 따라 모니터링 잡을 관리하기 어려워지는 점과 스위칭 대응을 고려하여, 플링크 잡을 중단하고 복제 서버 도메인 기준으로 다시 연결하는 작업을 자동화했습니다. 이를 위해 라이브러리에 스레드(Thread)를 하나 추가하여 관련 작업을 수행하도록 했습니다.
먼저 2대의 서버가 주-복제 형태로 구성된 경우는 연동 시 건네준 복제 서버 도메인을 기준으로 DNS 서버를 주기적으로 조회하여 IP 주소를 확인하며, 만약 IP 주소가 변경된 것이 감지되면 DNS 서버의 도메인의 IP가 변경되었다는 메시지와 함께 플링크 잡에 예외를 발생시킵니다. 이후 플링크에 설정된 재시작 정책에 따라 플링크 잡이 재실행되며, 복제 서버 도메인 기준으로 다시 데이터베이스에 연결됩니다. 단, 해당 과정을 위해 플링크 잡에서 DNS 캐시(Cache)를 비활성화해야만 합니다.
public class DNSIpChecker {
	...
   private int checkIntervalMs = 1000;
   private int logInterval = 60 * checkIntervalMs / 1000;
   private ExecutorService executorService;

   private void execute() throws Exception {
       String currentIpInDNS = "";
       Integer checkCnt = 0;
       while (this.currentTaskRunning) {
           ...
           currentIpInDNS = this.getIp(); // (1) DNS 상의 도메인의 IP 주소 조회
           if (!currentIpInDNS.equals(this.initIp)) { // (2) IP 주소가 변경되면 예외를 발생
               ...
               NotificationUtils.notifyIPChanged(...); // (3) DNS 상의 IP가 변경되었다고 Watchtower로 알림 전송
               throw new FlinkRuntimeException("CONNECTED TO PRIMARY (IP address has changed)");
           }
           Thread.sleep(checkIntervalMs);
       }
   }

   private String getIp() {
       String ipInDNS = "";
       try {
           ipInDNS = InetAddress.getByName(this.fqdn).getHostAddress();
       }
       ...
       return ipInDNS;
   }

   public void close() {
      ...
      this.executorService.shutdownNow(); // (4) SourceReader 종료 시 호출되어 스레드 종료
      ...
   }
}
< DNS에서 IP 주소를 조회하는 기능 >
InnoDB Cluster로 구성된 경우에는 앞서 설명한 방식을 사용할 수 없습니다. 복제 서버가 2대 이상이기에, 도메인을 기준으로 IP 조회 시 여러 복제 서버의 IP가 조회될 수 있습니다. 사내 MySQL InnoDB Cluster 구성시 주 서버와 복제 서버의 read_only 설정값은 각각 false와 true로 상이합니다. 이 설정 값을 주기적으로 조회하여 false가 나온다면 주 서버에 연결되었다 판단하여 플링크 잡에서 예외를 발생시킵니다. 이후 작업은 기존 방식과 동일하게 동작하여 복제 서버 도메인을 기준으로 다시 연결이 설정됩니다.
public class ReadOnlyChecker {
   ...
   private static final String GET_READONLY_SQL = "select @@global.read_only";
   private ExecutorService executorService;

   private void execute() throws Exception {
       ...
       while (this.currentTaskRunning) {
           ...
           boolean readOnly = this.getReadOnly(); // (1) read_only 설정값을 확인
           if (!readOnly) { // (2) read_only 설정값이 false로 변경되면 예외를 발생
               NotificationUtils.notifyIPChanged(...) // (3) read_only의 설정값이 변경되었다고 Watchtower로 알림 전송
               throw new FlinkRuntimeException("CONNECTED TO PRIMARY (read_only = true)");
           }
           Thread.sleep(checkIntervalMs);
       }
       ...
   }

   private boolean getReadOnly() throws SQLException {
       boolean res = true;
       try (Statement stmt = this.conn.createStatement()) {
           ResultSet rs = stmt.executeQuery(GET_READONLY_SQL);
           if (rs.next()) {
               res = rs.getBoolean(1);
           }
           ...
       }
       return res;
   }

   public void close() {
      ...
      this.executorService.shutdownNow(); // (4) SourceReader 종료 시 호출되어 스레드 종료
      ...
   }
}
< read_only 설정을 확인하는 기능 >
지금까지 이렇게 추가된 데이터베이스 스위칭 감지 기능들은 아래 코드 주석에 설명된 대로 태스크 매니저의 소스 리더와 라이프 사이클을 공유합니다. 그러나 스냅샷 단계에서 병렬성을 2 이상으로 설정하면 여러 스레드가 동일한 로직을 수행하는 문제가 발생할 수 있습니다. 이를 방지하기 위해 항상 항상 0번 태스크 슬롯에 한해, 위의 감지 로직을 수행하도록 설정합니다.
public class MySqlSourceReader {
   ...
   private DNSIpChecker dnsIpChecker;
   private ReadOnlyChecker readOnlyChecker;
   private List curBinlogSplit;

   @Override
   public void start() {
       ...
       this.prepareBeforeStart();
   }

   public void close() throws Exception {
       ...
       this.cleanupBeforeClose();
   }

   private boolean isFirstSubtask() { // (1) 0번 subtask(task slot) 여부 인지 확인
      return this.subtaskId == 0;
   }

   private void prepareBeforeStart() { // (2) SourceReader 동작시, innoDB Cluster 여부에 따라 스위칭 탐지 방법 선택 및 동작 시작
       if (this.dnsIpCheckerRequired()) {
           this.dnsIpChecker = new DNSIpChecker(this.subtaskId, this.context, sourceConfig);
           this.dnsIpChecker.run();
       } else if (this.readOnlyCheckerRequired()) {
           this.readOnlyChecker = new ReadOnlyChecker(this.subtaskId, this.context, sourceConfig);
           this.readOnlyChecker.run();
       }
   }

   private void cleanupBeforeClose() { // (3) SourceReader 종료 시, 데이터베이스 스위칭 감지 여부 체크하는 스레드 종료
       ...
       if (this.dnsIpCheckerRequired()) {
           this.dnsIpChecker.close();
       }
       if (this.readOnlyCheckerRequired()) {
           this.readOnlyChecker.close();
       }
   }
   ...
}
< MySqlSourceReader 및 스위칭 감지 모듈들의 라이프 사이클 >
Chunk key 칼럼 제약을 완화합니다
지금까지 살펴본 주제들은 팀의 필요나 운영의 관점에서 필요한 기능을 라이브러리에 추가한 것이라면, 이 문단에서는 보다 일반적인 오류 상황을 개선하는 방법을 제안드리고자 합니다. 앞서 플링크 CDC는 증분 스냅샷 기능을 지원하여 청크 단위로 테이블을 나누고 읽어 오는 것이 가능하다 말씀드렸습니다. 여기서 테이블을 청크 단위로 분할하는 기준 칼럼에 대한 제약은 기본 키(Primary key)가 있는 테이블과 없는 테이블이 서로 다릅니다. 기본 키가 있는 테이블은 기본 키에 속한 칼럼만을 청크 키 칼럼으로 사용해야 하며, 기본 키에 속하지 않은 칼럼을 사용하면 에러가 발생합니다. 기본 키가 없는 테이블에 대해서는 플링크 CDC 2.4 버전부터 증분 스냅샷 기능을 지원되며, 별도의 제약이 없습니다.
여러 서비스 조직의 데이터베이스를 연동하다 보면 다양한 스키마의 테이블을 만나게 되는데, 그중에는 기본 키가 Varbinary 타입 칼럼인 테이블도 있습니다. 증분 스냅샷 기능을 위해 Varbinary 타입 칼럼을 청크 키 칼럼으로 설정할 경우, 청크 범위 계산이 제대로 되지 않아 테이블 전체 데이터를 하나의 청크로 가져오는 상황이 발생합니다. 이로 인해 소스 데이터베이스에 부하가 발생하며, 태스크 매니저에 너무 많은 데이터를 한 번에 가져와 OOM(Out of Memory) 에러를 발생시킵니다.
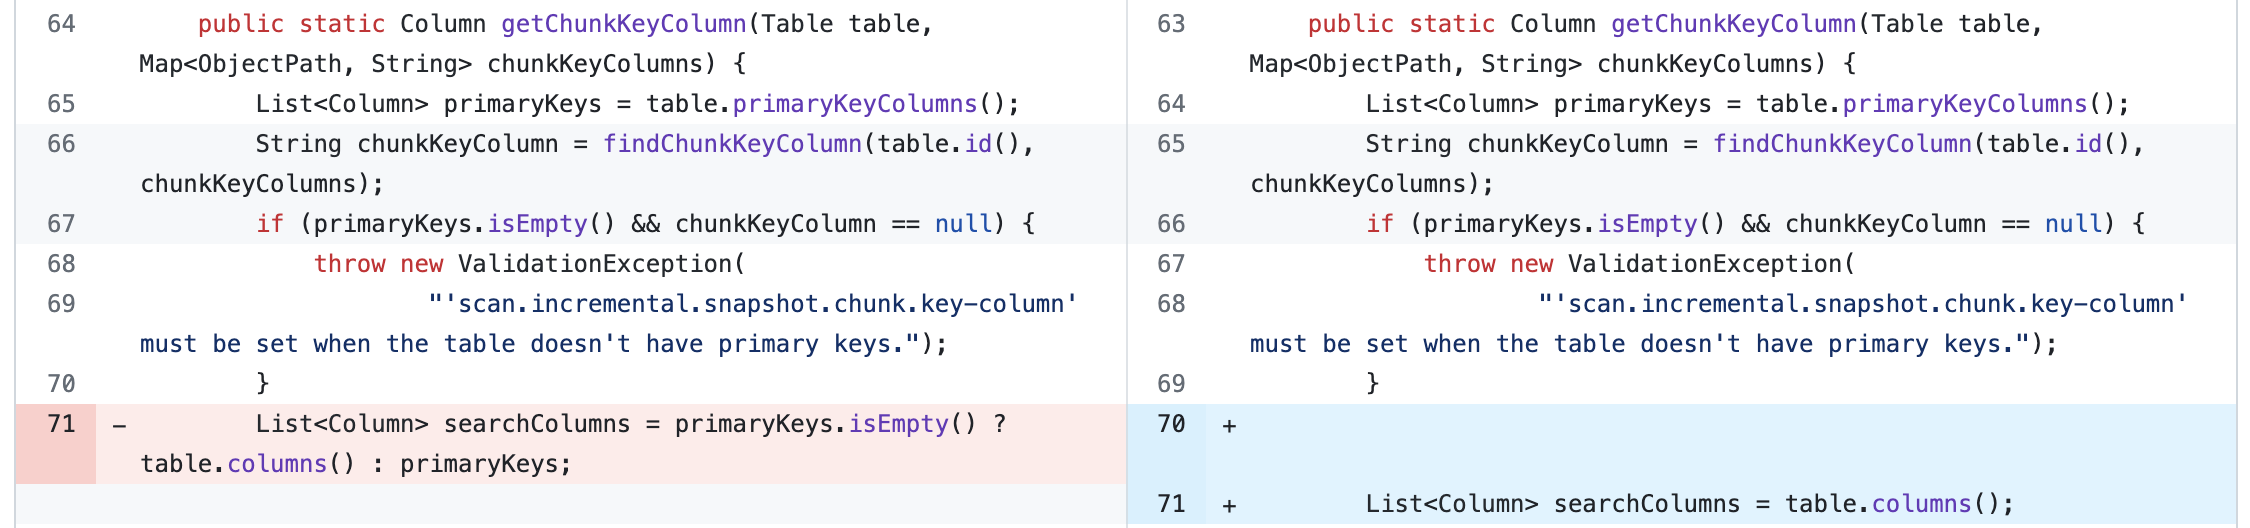
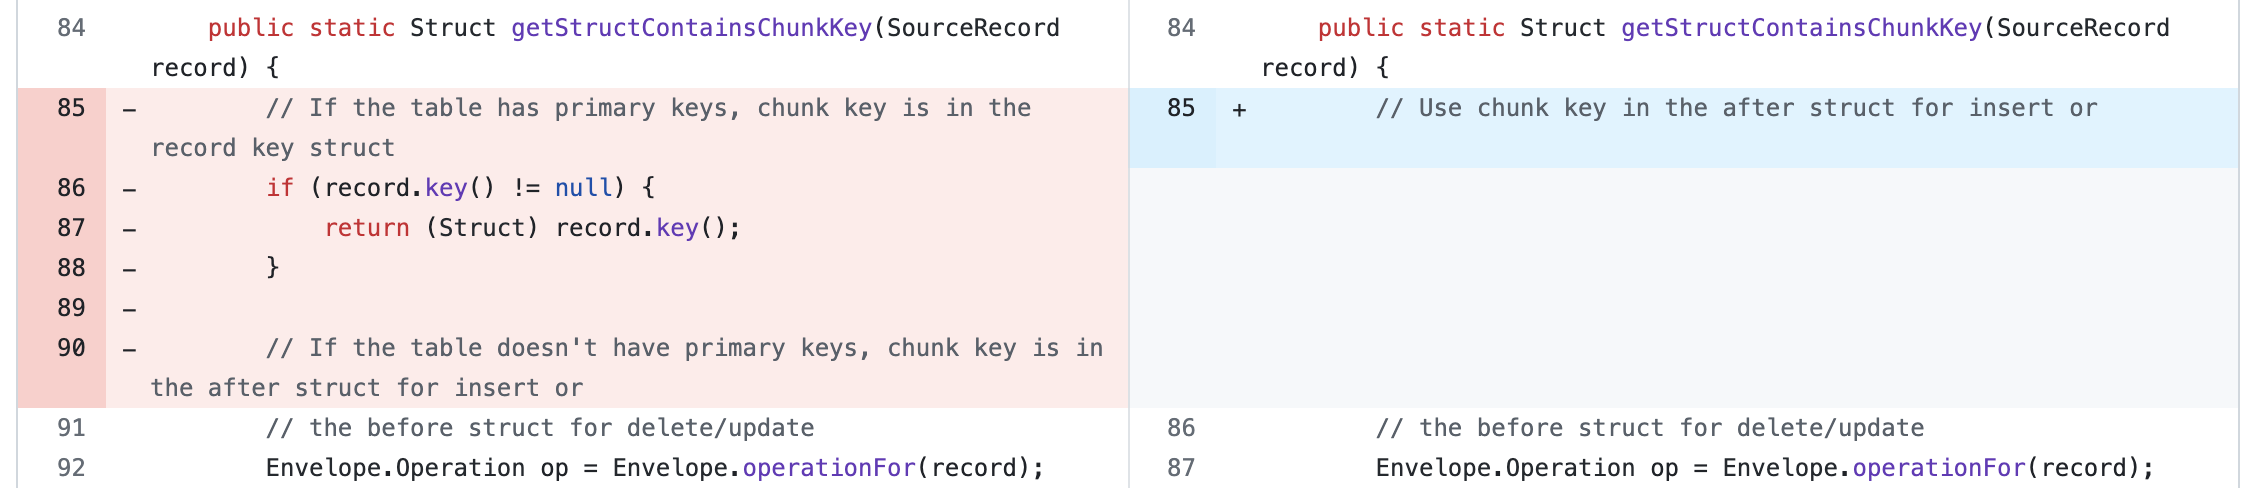
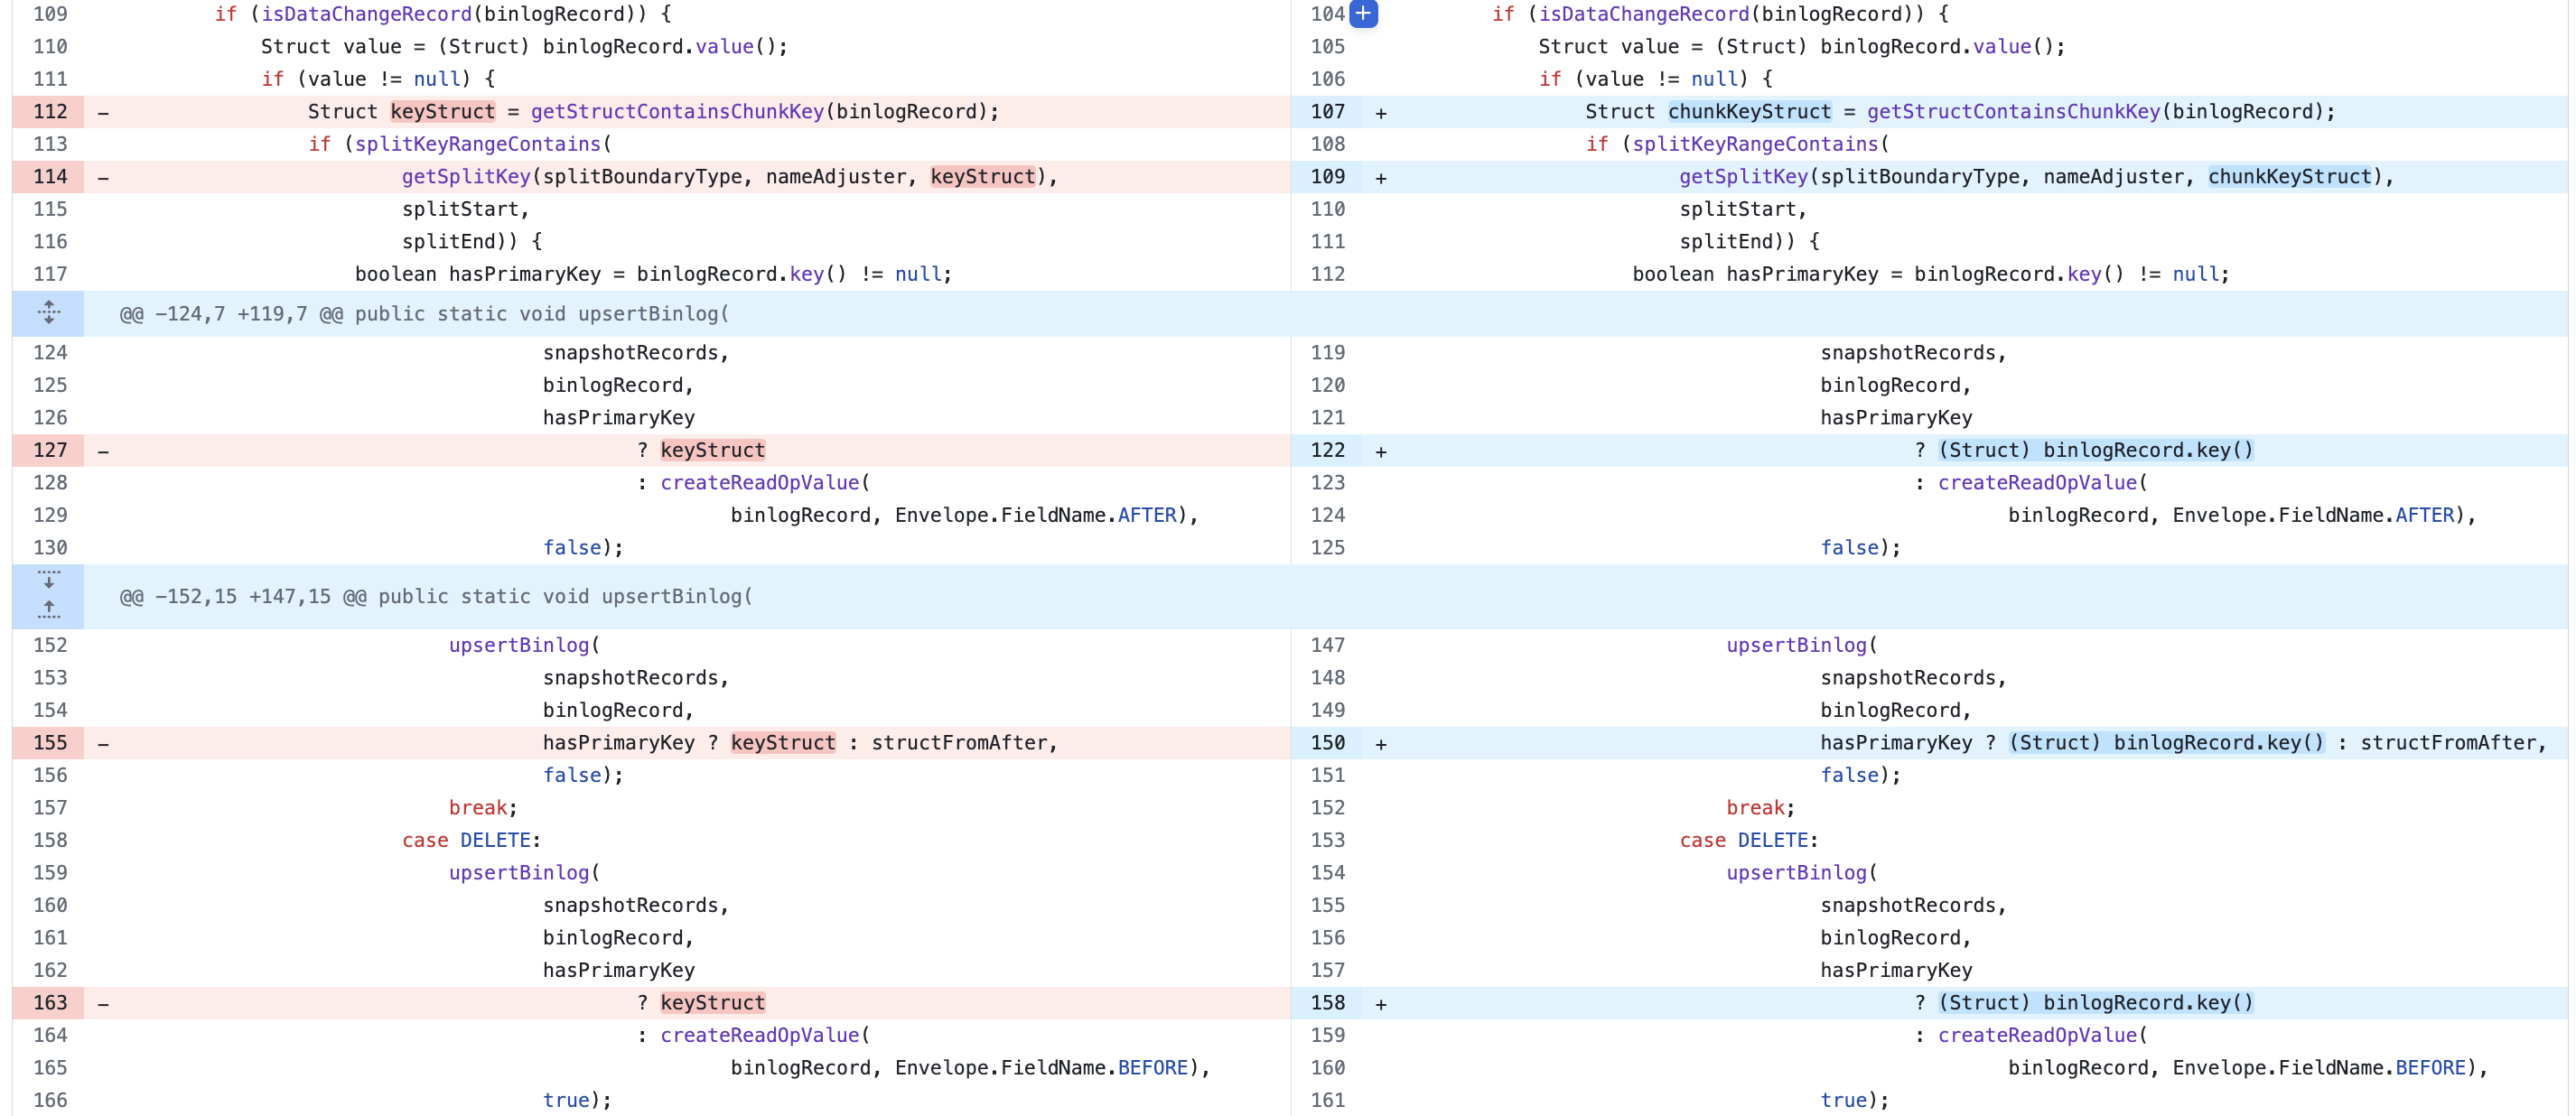
이를 해결하기 위해 기본 키가 있는 테이블에 대해 아래의 로직들을 제안 및 수정하였으며, 전체 변경사항은 [FLINK-35740] apache/flink-cdc GitHub에서 확인할 수 있습니다.
- 청크 키 칼럼이 기본 키에 속하는지 확인하는 로직 제거
- 기본 키가 있는 테이블인 경우, 기본 키 관련 오브젝트를 그대로 청크 키로 사용하지 않고 별도의 청크 키 오브젝트를 생성 및 사용하도록 로직 변경
- 기본 키 관련 오브젝트와 청크 키 관련 오브젝트를 공유하지 않고 상황에 알맞은 오브젝트를 각각 생성 및 사용하도록 변경
마무리하며
긴 글의 끝까지 함께 해주신 독자분들에게 감사 인사를 드리며, 마무리로 개인적인 소회와 함께 플링크 CDC 사용을 고려하시는 분에게 유용한 팁을 공유드리며 글을 끝맺으려 합니다.
개인적으로도 이번처럼 하나의 라이브러리를 이 정도로 깊이 있게 분석한 경험은 처음이었던 것 같습니다. 라이브러리의 동작 과정을 파악하고, 필요한 기능을 확인 및 수정하며, 제안([FLINK-34689] apache/flink-cdc · GitHub, [FLINK-35740] apache/flink-cdc GitHub)한 후 실 적용까지하는 과정은 고되었지만 만족스러운 개발 경험이었습니다. 또한, 플링크 CDC 실 서비스에 적용하기 위해 전통적인 관계형 데이터베이스, 아파치 플링크, 아파치 카프카 및 카프카 커넥트와 같은 분산 프레임 워크 및 분산 스트리밍 플랫폼등 다양한 분야의 지식이 필요했었습니다. 이번 경험을 통해 아직 시스템이나 인프라 및 플랫폼에 대한 이해가 많이 부족함을 느꼈고, 지식적인 부분 외적으로도 다양한 사내 조직들과 협업 과정에서 심도 있는 논의를 진행하며 일하는 방식이나 협업의 관점에서도 좋은 경험이 되었습니다.
플링크 CDC 사용 시 공유드리고 싶은 팁은 버전에 대한 내용을 말씀드리고자 합니다. 본 글 작성 시 사용한 플링크 및 플링크 CDC 버전은 각각 1.17.1과 2.4.1입니다. 플링크 CDC는 2023년 12월 3.0 버전이 배포되었고, 가장 최근에는 2024년 6월 20일 3.1.1 버전이 배포되었습니다. 3점대 버전부터는 스냅샷 단계만 수행하는 기능과 함께, MySQL 설정들을 확인하는 로직 보완 등 다양한 기능들이 개선 및 추가되었습니다. 또한, 더 간편한 사용을 위해 개별적인 소스 커넥터의 제공뿐만 아니라 읽는 작업부터 적재하는 작업까지 전체 파이프라인을 제공하고 있습니다. 특히 MySQL에서 아파치 카프카로의 파이프라인이 공식 기능으로 지원되어, 카프카 커넥트와 조합하여 활용하는 방식이 더욱 용이해졌습니다. 만약 플링크 CDC 사용을 고려하신다면 3점대 이상을, 특히 3.1 버전 이상을 사용하기를 권장드립니다. 단, 플링크 CDC 3점대 버전은 2024년 8월 기준 아파치 플링크 1.18 버전하고만 호환되는 점을 고려하시면 좋을 것 같습니다.
마지막으로 관련 작업을 같이 지원하고 진행해 준 동료분들 archer.kang, dawn.choi, levie.yumtam, stephen.c, max.iam과 wayne.pk에게 감사 인사를 드리며 글을 마치겠습니다. 감사합니다.
참고 문서
- Apache Flink® — Stateful Computations over Data Streams | Apache Flink
- Debezium
- Kafka Connect | Confluent Documentation
- Apache Flink Stream Processing & Analytics | Ververica
Written by Louis.sml
Edited by June.6