Engineering
더욱 똑똑하게 답하며, 더욱 풍부한 감정표현을 향한 Kanana-o의 진화 과정
edwin.ai, james.e, jessie.e카카오
2025년 12월 12일
원문에서 보기 ↗안녕하세요, 카카오의 AI 모델 개발을 담당하는 카나나(Kanana) 조직의 Edwin(강우영), James(이재명), Jessie(이지혜)입니다. 저희 팀에서는 사람처럼 보고, 듣고, 말하며 한국적 맥락을 깊이 있게 이해하는 멀티모달(Multimodal) 언어모델을 중점적으로 개발하고 있습니다. 멀티모달 모델은 텍스트, 이미지, 음성 등 두 가지 이상의 정보를 동시에 이해하고 처리하는 모델입니다.
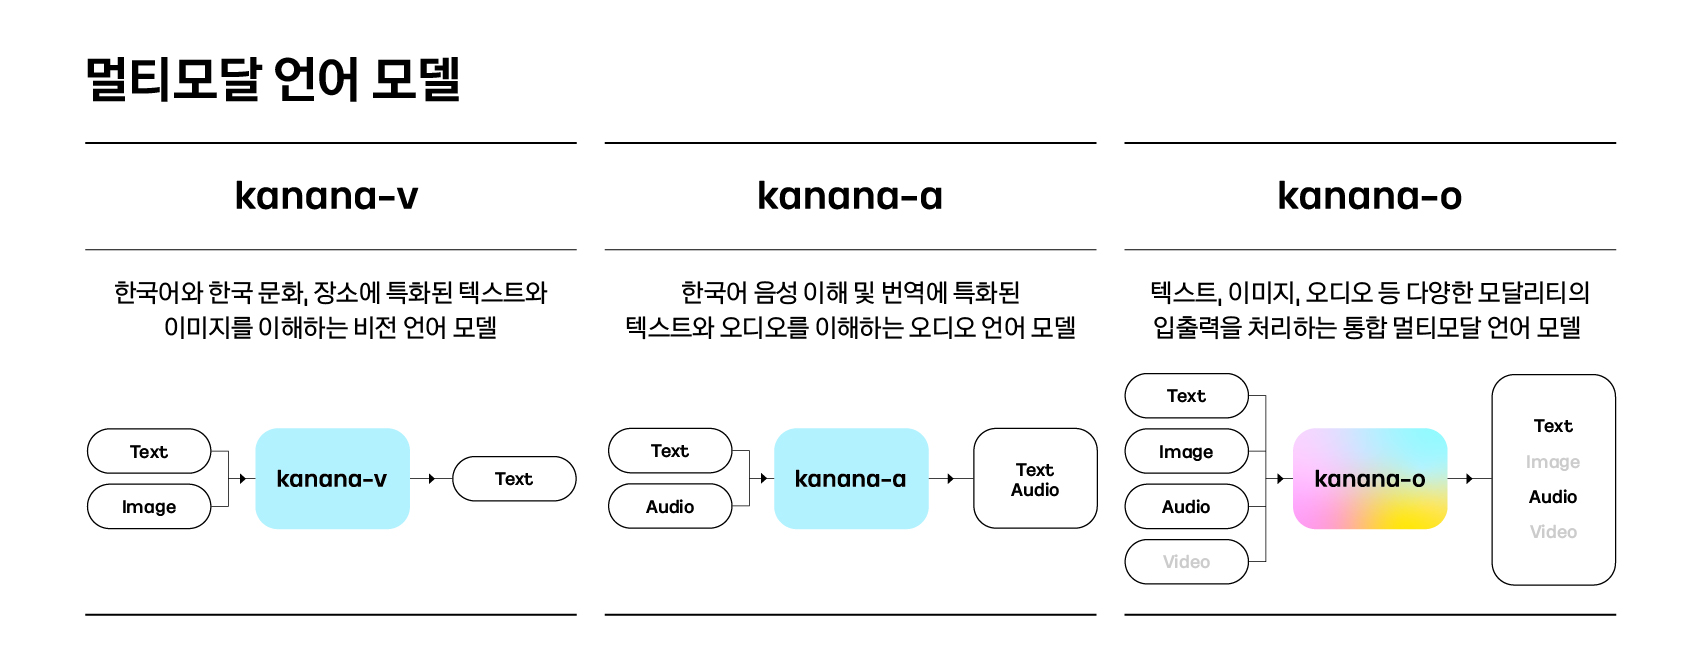
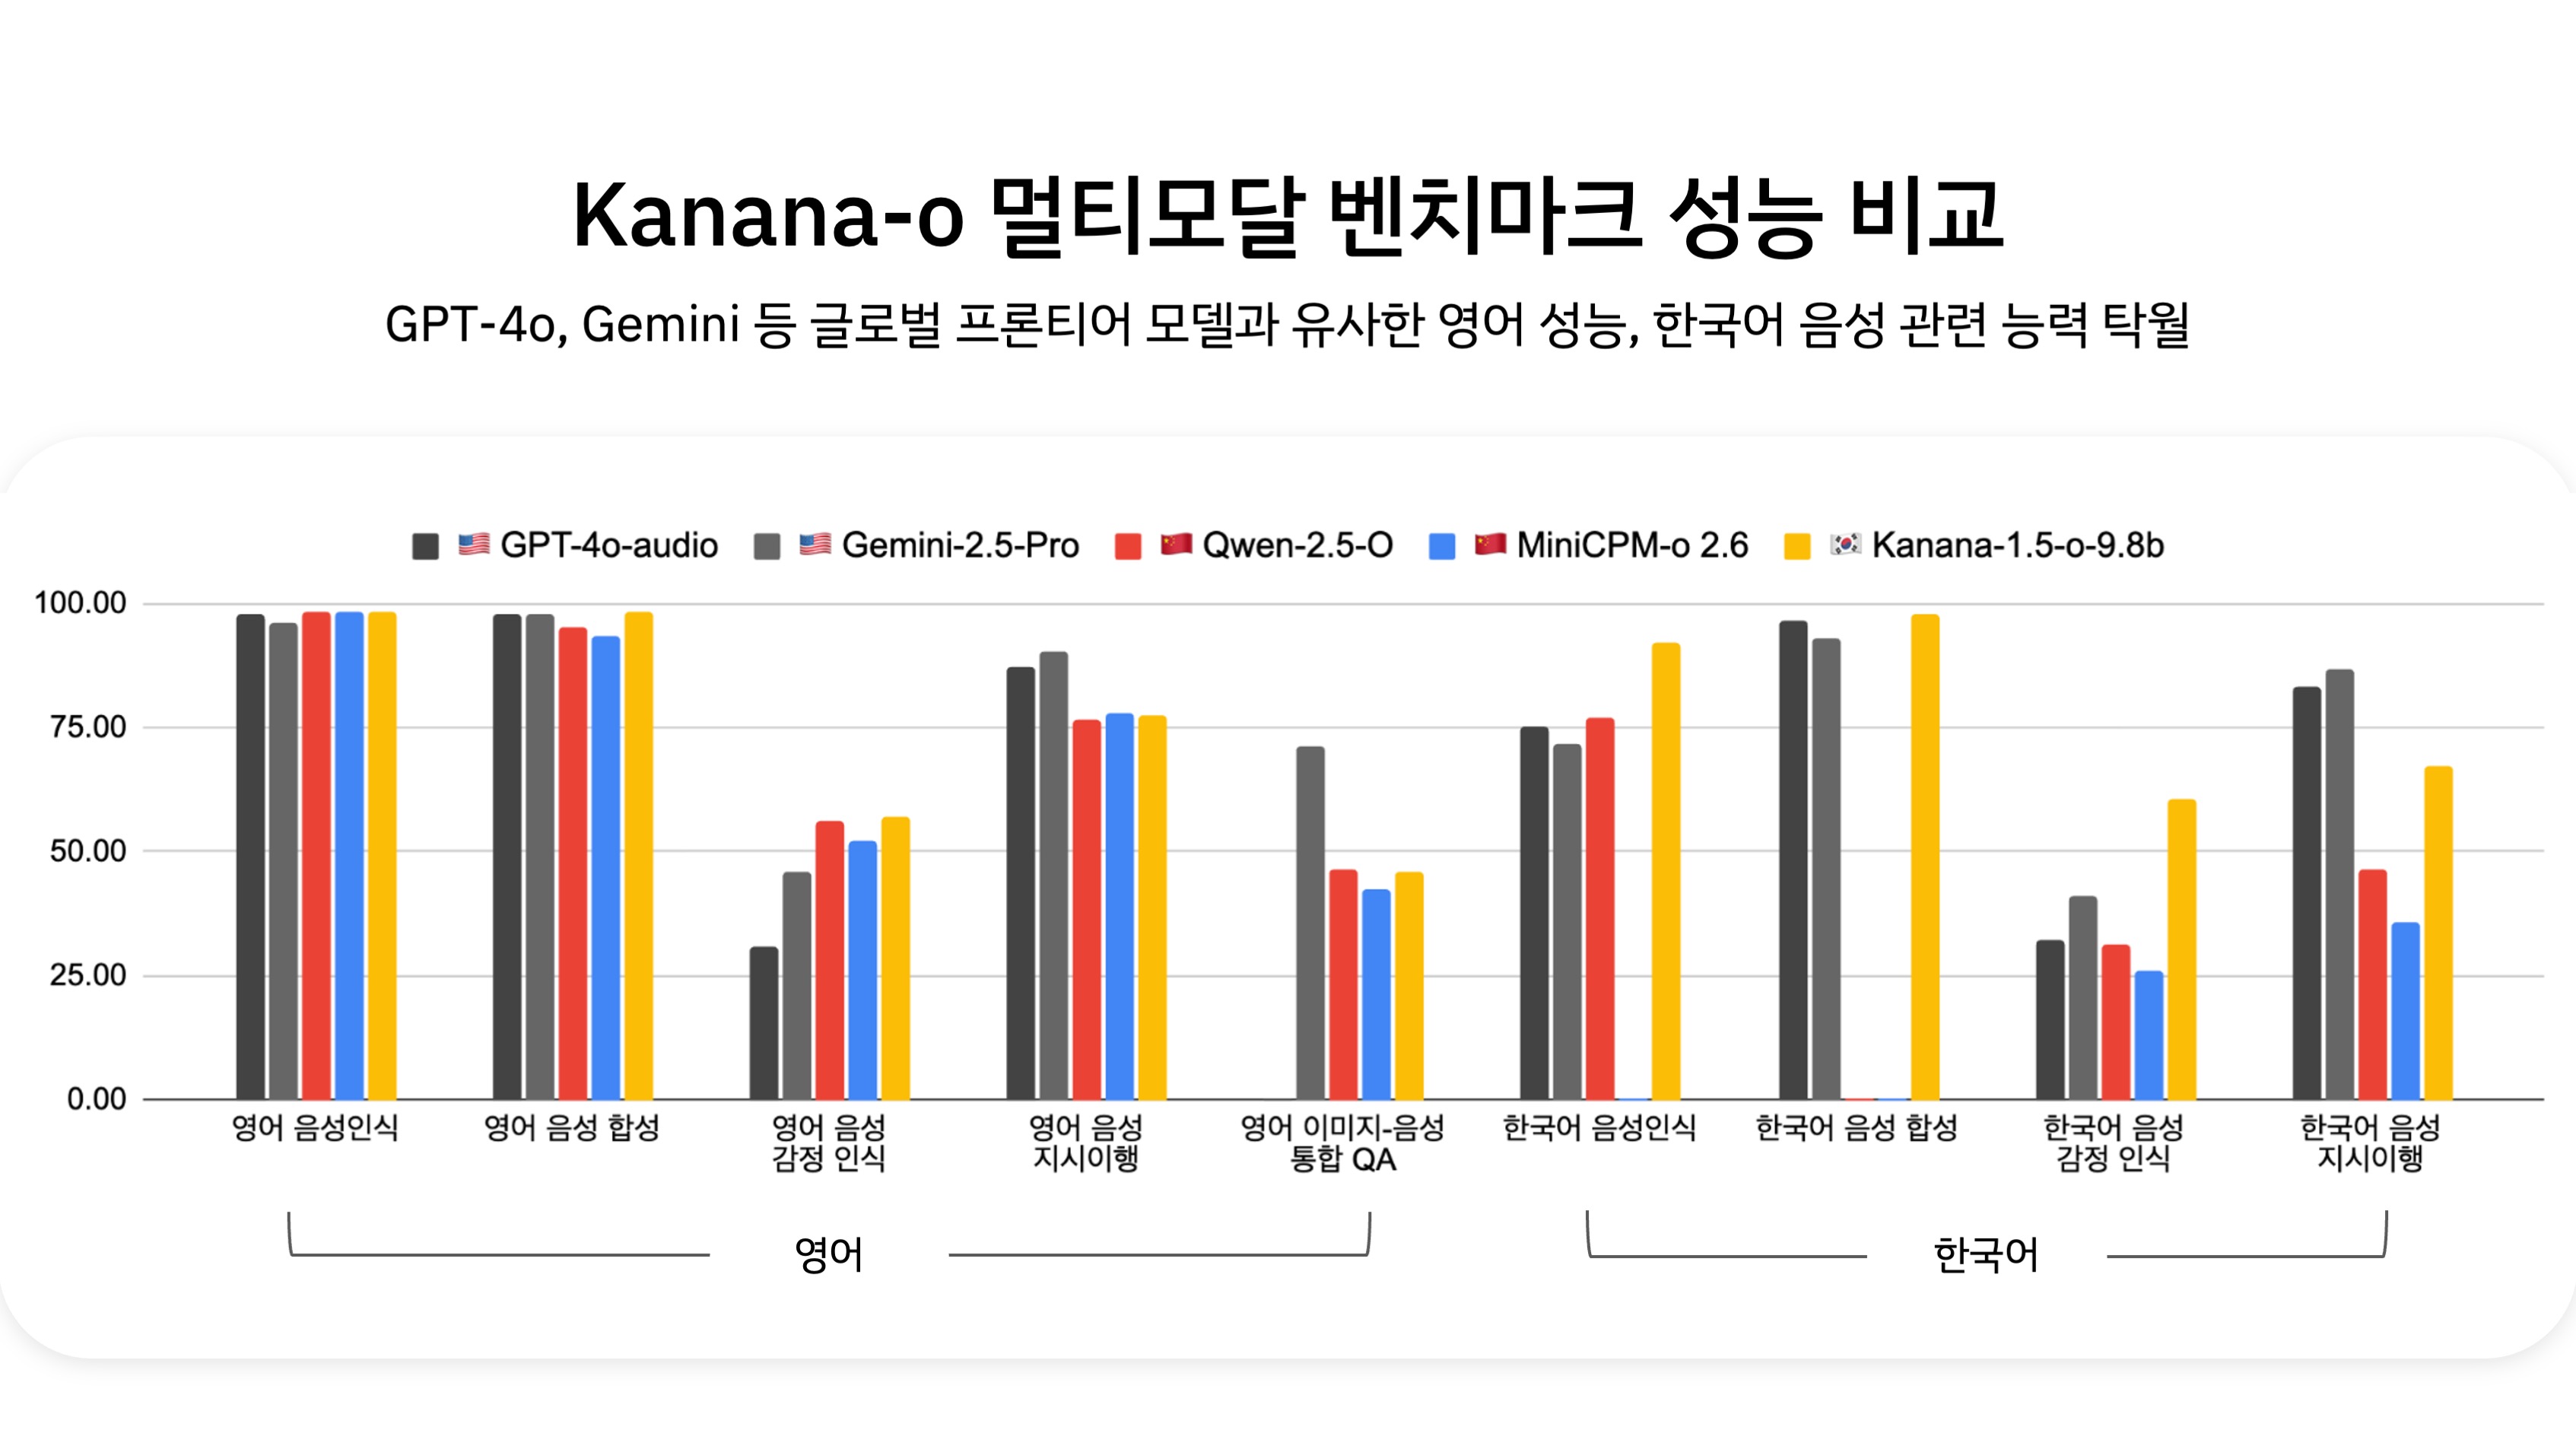
지난 5월, 저희 팀에서는 국내 최초로 통합 멀티모달 언어모델인 Kanana-o를 공개하였습니다. 이후, 저희는 기존 Kanana-o의 강점이었던 음성 인식(Automatic Speech Recognition) 및 합성(Text-to-Speech) 그리고 감정 인식에 대한 성능을 안정적으로 유지하면서, 멀티모달 지시 이행(Multimodal Instruction Following) 및 발화 표현력에 대한 개선을 꾸준히 이어왔습니다.
그 결과 업데이트된 Kanana-o는 사용자의 의도를 더욱 정교하게 파악하여 한층 자연스럽고 지능적인 방식으로 답변할 수 있게 되었고, 합성한 음성 역시 사람처럼 풍부한 표현력과 감정선을 담을 수 있게 되었습니다.
지난 if(kakao)25를 통해 이러한 연구성과를 공유하고, 실제 모델도 직접 체험해 볼 수 있는 전시도 진행했었는데요. 이번 글에서는 단순히 벤치마크 성능을 높이는 것을 넘어, 실제 서비스 환경에서 사용자 경험을 개선하고 ‘사람처럼 자연스럽게 상호작용하는 AI’를 구현하기 위해 저희가 어떤 고민을 했고, 어떻게 문제를 풀어 나갔는지 그 과정들을 보다 상세히 공유드리고자 합니다.
사용자의 지시를 더욱 잘 이해하여 똑똑하게 답변하기
멀티모달 지시 이행 능력이란, 텍스트뿐 아니라 이미지, 음성 등 다양한 모달리티를 함께 고려해 사용자가 자연어로 전달한 지시를 정확히 해석하고 그에 맞는 응답을 생성하는 능력을 의미합니다. 본질적으로 이는 “사용자가 원하는 바를 AI가 얼마나 정확하게 이해하고, 그 의도에 맞추어 얼마나 유연하게 대응할 수 있는가”를 결정하는 핵심 역량입니다.
예를 들어 “사진에 보이는 제품에 대한 광고문을 만들어서 읽어줘. 광고문에는 허리 건강과 관련된 문구와 재질에 대한 장점이 들어가게 해줘”라고 말한다면, 모델은 시각 정보를 이해하고, 요청된 지시들을 모두 고려해 적절한 형태로 답해야 합니다. 이는 AI가 단순히 입력된 내용을 분석하는 수준을 넘어, 사용자의 의도와 제약, 맥락을 종합적으로 이해하는 능력을 갖추어야 한다는 것을 의미합니다.
특히 음성 비서나 음성 기반 인터페이스에서는 이러한 능력이 더욱 중요합니다. 음성 입력은 타이핑보다 형식에 구애받지 않는 자연스러운 방식으로 지시하기 때문에 AI는 모호한 표현을 보정하고 숨겨진 제약을 파악해, 사용자의 의도에 알맞은 답을 실시간으로 생성해야 합니다. 결과적으로 고도화된 멀티모달 지시이행 능력은 사용자가 “이 모델, 진짜 사람처럼 잘 알아듣네”, “내가 말한 방식 그대로 반영하네”라고 느끼게 만드는 가장 중요한 지능 지표이자 서비스 차별화 요소가 됩니다.
멀티모달 지시 이행 능력 고도화
멀티모달 언어모델이 지향하는 이상적인 모습은 입∙출력 모달리티가 어떤 형태로 주어지든, 본래 언어모델이 가진 답변 품질을 온전히 유지하며 응답하는 모델일 것입니다. 그러나 현실의 멀티모달 언어모델들은 이러한 기대와 달리 입출력 모달리티에 따라 성능이 크게 달라지는 문제를 드러냅니다[1][2]. 예를 들어, 아래 예시와 같이 텍스트 입력에서는 정확하고 풍부한 설명을 제공하던 모델이, 동일한 질문을 오디오로 전달하면 표현력과 추론 능력이 떨어진 듯한 단조롭고 부정확한 답변을 내놓는 경우가 많습니다.
이는 단순히 한두 개의 모달리티를 추가하는 문제가 아니라, 모델이 본래 갖고 있던 지식과 추론력을 유지하면서도 모달리티에 무관하게 안정적으로 동작하도록 일반화(Domain-generalization) 해야 한다는 것을 의미합니다. 저희는 이를 데이터 관점에서 해결해보고자 시도하였습니다.
| Text to Text | Audio to Audio |
|---|---|
| 자전거 조립 방법 알려줘 | 음성 듣기 |
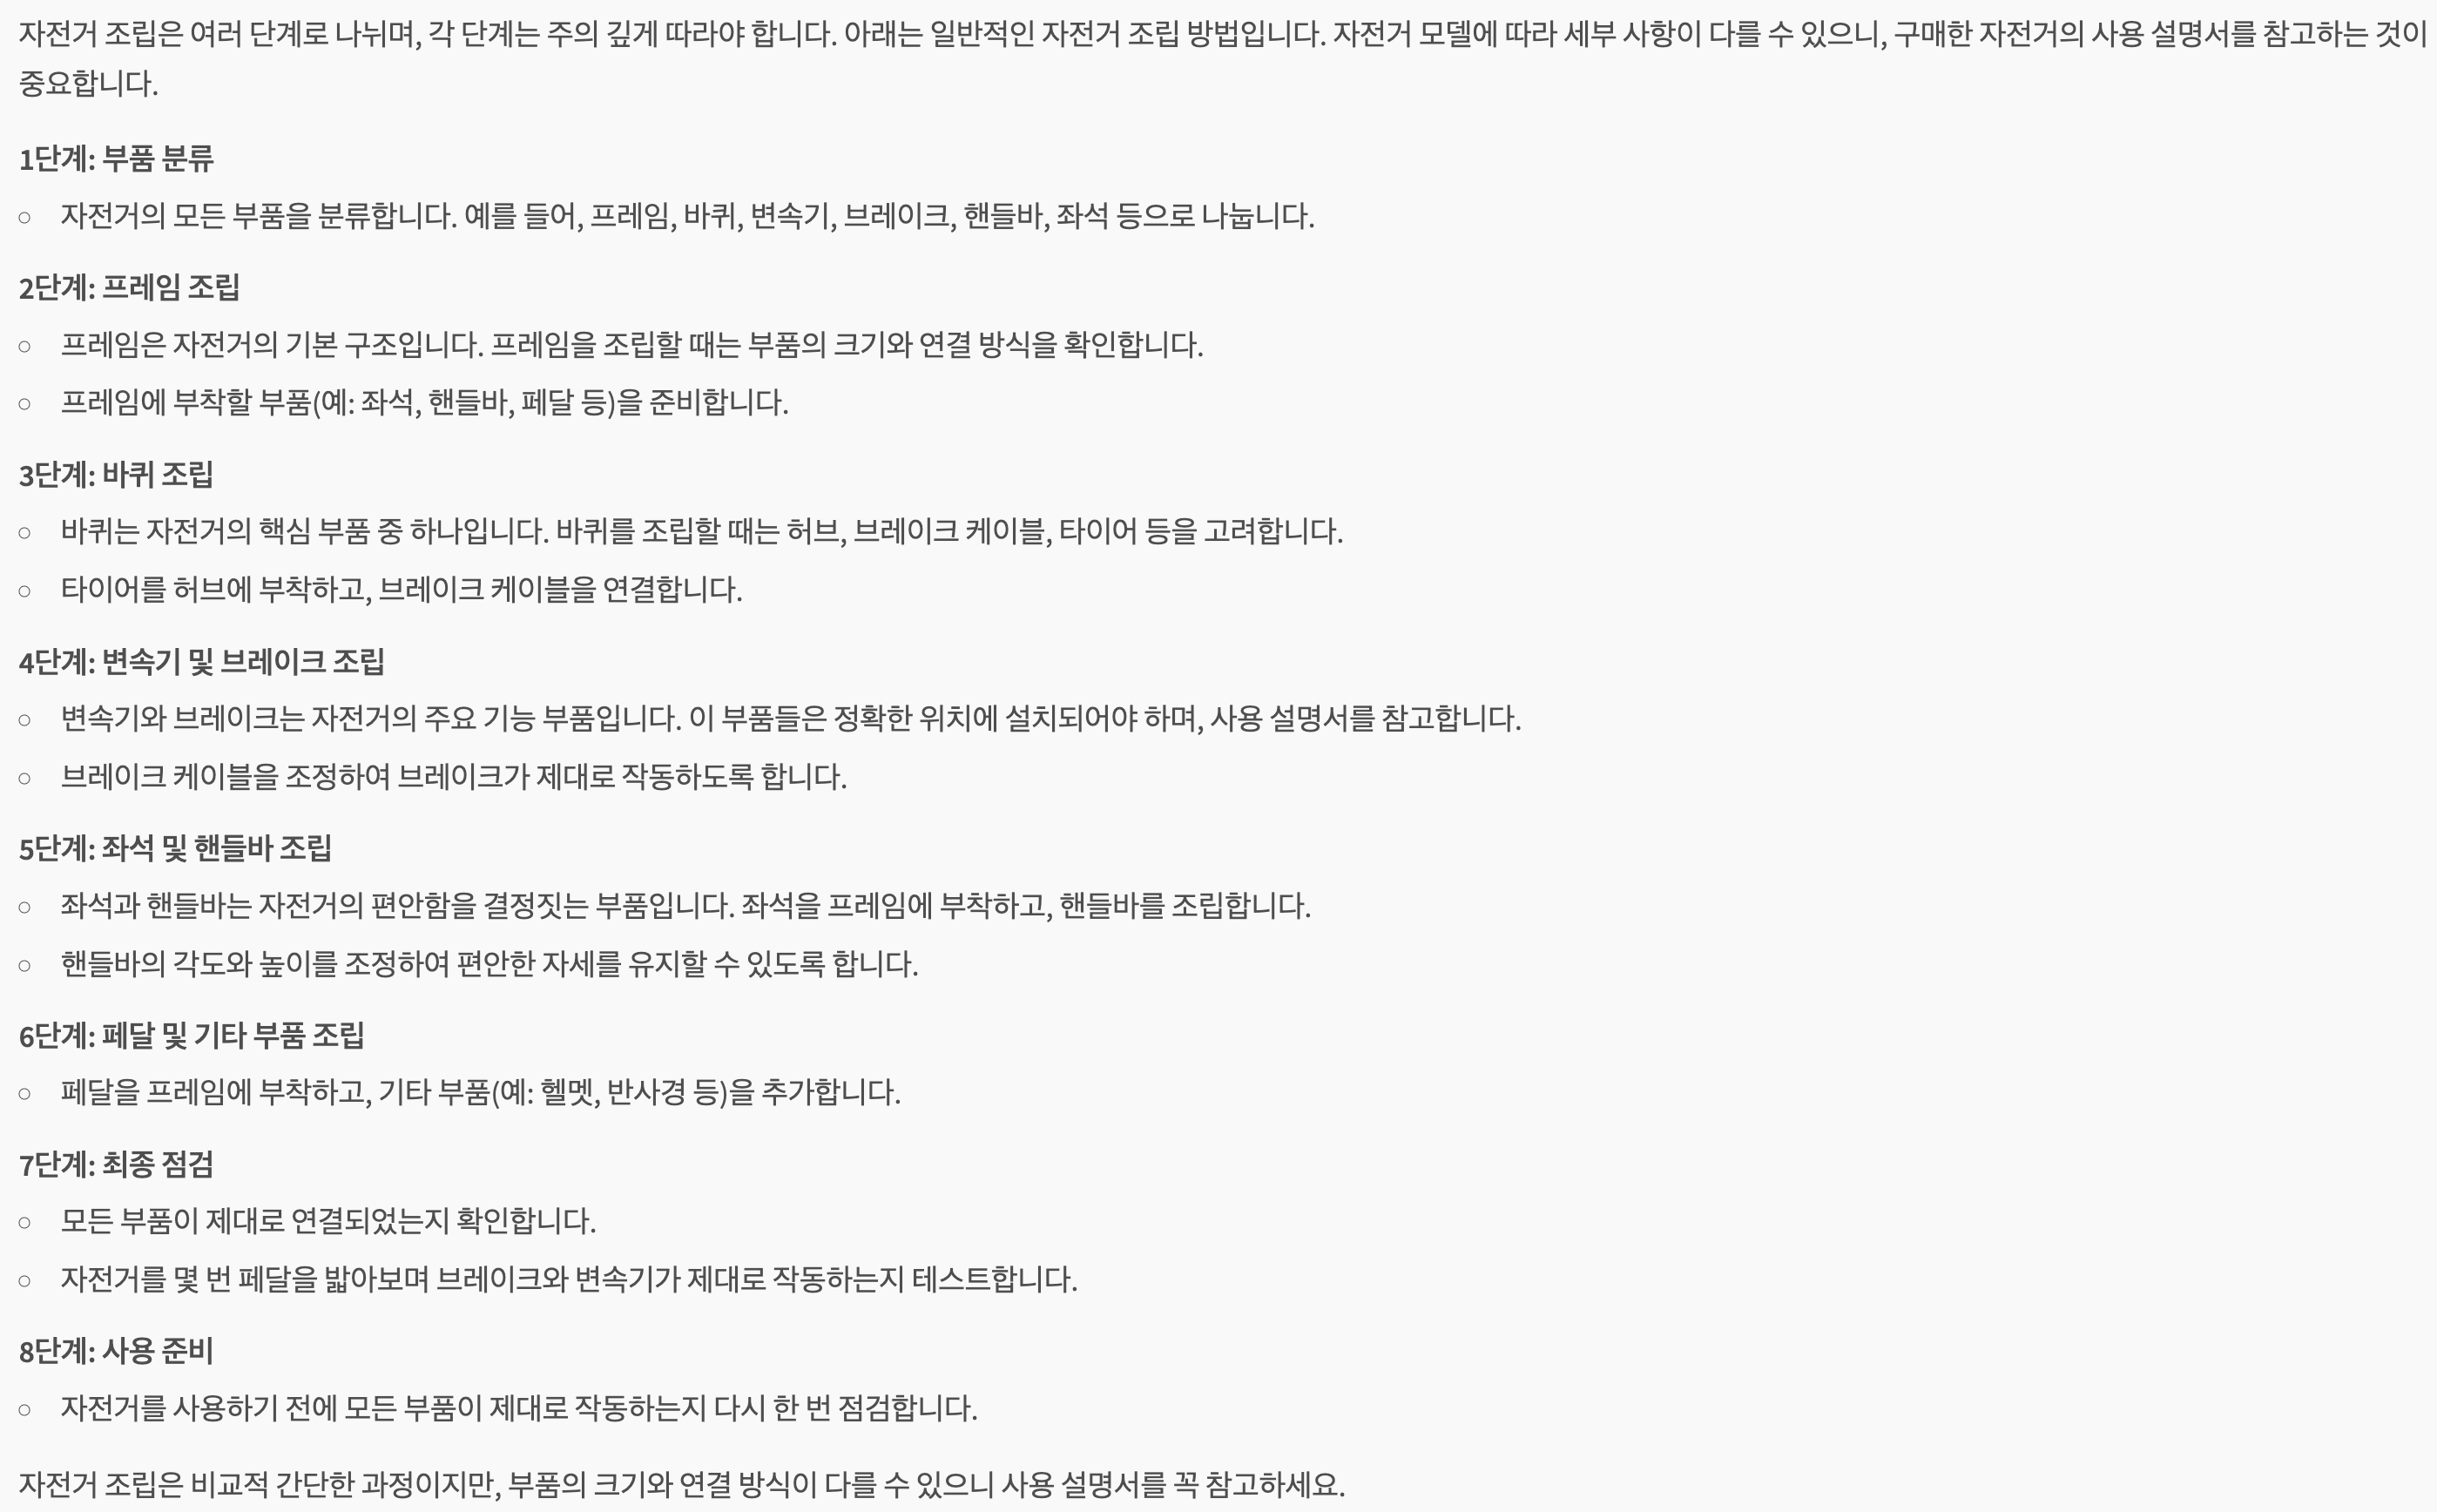 | 음성 듣기 (자전거 조립 방법은 다음과 같습니다. 먼저 바퀴를 풀고, 그 다음에 프레임을 조립한 후, 마지막으로 바퀴를 다시 붙이면 됩니다.) |
<그림 3. 같은 질문에 대한 모달리티별 답변 품질의 차이>
공개된 멀티모달 지시 이행 데이터는 수량도 제한적이고, 도메인도 한정적인 경우가 많아, 실제 언어모델이 다양한 상황에서 안정적으로 지시 이행을 수행하기에는 역부족인 경우가 많습니다. 이로 인해 모델은 오디오 입력이 주어졌을 때 본래 언어모델의 능력을 발휘하기보다는, 제한적인 멀티모달 데이터에 맞춰 응답하는 방향으로 변화하게 됩니다. 이러한 문제를 완화하기 위해 저희는 직접 고품질의 멀티모달 지시 이행 데이터셋을 설계하고 구축했습니다. 단순한 양의 확보를 넘어, 난이도·도메인 다양성·모달 조합의 균형까지 모두 고려한 구조화된 데이터셋입니다.
오디오 기반의 지시 이행 데이터 구축
일반적인 ‘질의→응답’ 형태의 지시 이행 데이터는, 예컨대 “하늘이 파란 이유가 뭐야”나 “직장생활 잘하는 꿀팁 알려줘”처럼 단순하고 짧은 문장 중심으로 구성되곤 합니다. 이런 형태는 공개된 데이터나 기존 리소스를 활용해 음성화(Speech Synthesis)만으로 스케일업하기가 비교적 수월합니다.
하지만 실제 사용자 경험을 고려해보면, 대부분의 경우 훨씬 복잡한 형태의 지시를 요구받을 수 있습니다. 예를 들어 “하늘이 파란 이유가 뭔지, 초등학생도 알 수 있을 정도의 수준으로 3문장 이내로 설명해 줘”처럼 구체적인 문체·난이도·톤에 대한 조건을 연쇄적으로 함께 요구하는 경우가 많습니다. 이런 지시에는 단순한 사실 전달을 넘어, 추론, 요약, 문체 조절, 형식 제약 등 더 높은 수준의 언어 모델 능력이 필요합니다.
따라서, 저희는 단순 Q&A를 넘어 요약, 감정∙의도 해석, 오류 수정, 형식 변환, 형식 제한, 번역 등 다양한 과업을 포함한 오디오 기반 복합 지시 이행 데이터셋을 직접 설계하고 구축했습니다. 특히, 각 지시–응답 쌍에 대해 텍스트와 오디오 두 형태의 어노테이션(Annotation)을 함께 준비하여 ‘모달리티 조합에 강건한 성능’을 낼 수 있도록 하였습니다.
| 음성 듣기 컨텍스트: (선생님이 저번 상담에 말씀하신대로 미워하는 마음을 진정시키기 위해 노력했어요.) | 음성 듣기 컨텍스트: (선생님이 저번 상담에 말씀하신대로 미워하는 마음을 진정시키기 위해 노력했어요.) | 음성 듣기 컨텍스트: (선생님이 저번 상담에 말씀하신대로 미워하는 마음을 진정시키기 위해 노력했어요.) |
|---|---|---|
| 타입 | 지시 | 응답 |
| 싱글 스텝(Single-step) | 주어진 내용을 문어체로 재작성해줘. | 선생님께서 지난 상담에서 말씀하신 대로, 미워하는 마음을 가라앉히기 위해 노력했습니다. |
| 싱글 스텝(Single-step) | 주어진 내용을 영어로 번역해줘. | As you mentioned in our previous counseling session, I tried to calm my feelings of resentment. |
| 멀티 스텝(Multi-step) | 주어진 내용을 먼저 한 문장으로 요약한 후, 그 요약문을 영어로 번역해 주세요. | 상담에서 받은 조언을 따라 미워하는 마음을 가라앉히려고 노력했습니다. I tried to calm my feelings of hatred as advised during the previous counseling session. |
| 멀티 스텝(Multi-step) | 주어진 문장을 두 문장으로 나누어 문어체로 재작성한 후, 각 문장에 대해 질문을 하나씩 만들어 주세요. | 선생님의 조언을 기억하며 미워하는 마음을 가라앉히기 위해 노력했다. 그 과정에서 자신의 감정을 돌아보았다. 1. 선생님의 조언이 어떤 점에서 도움이 되었나요? 2. 감정을 돌아보는 과정에서 어떤 변화가 있었나요? |
<그림 4. 오디오 기반 복잡한 지시이행 데이터셋 예시.(컨텍스트 오디오 출처: AIHub[3])>
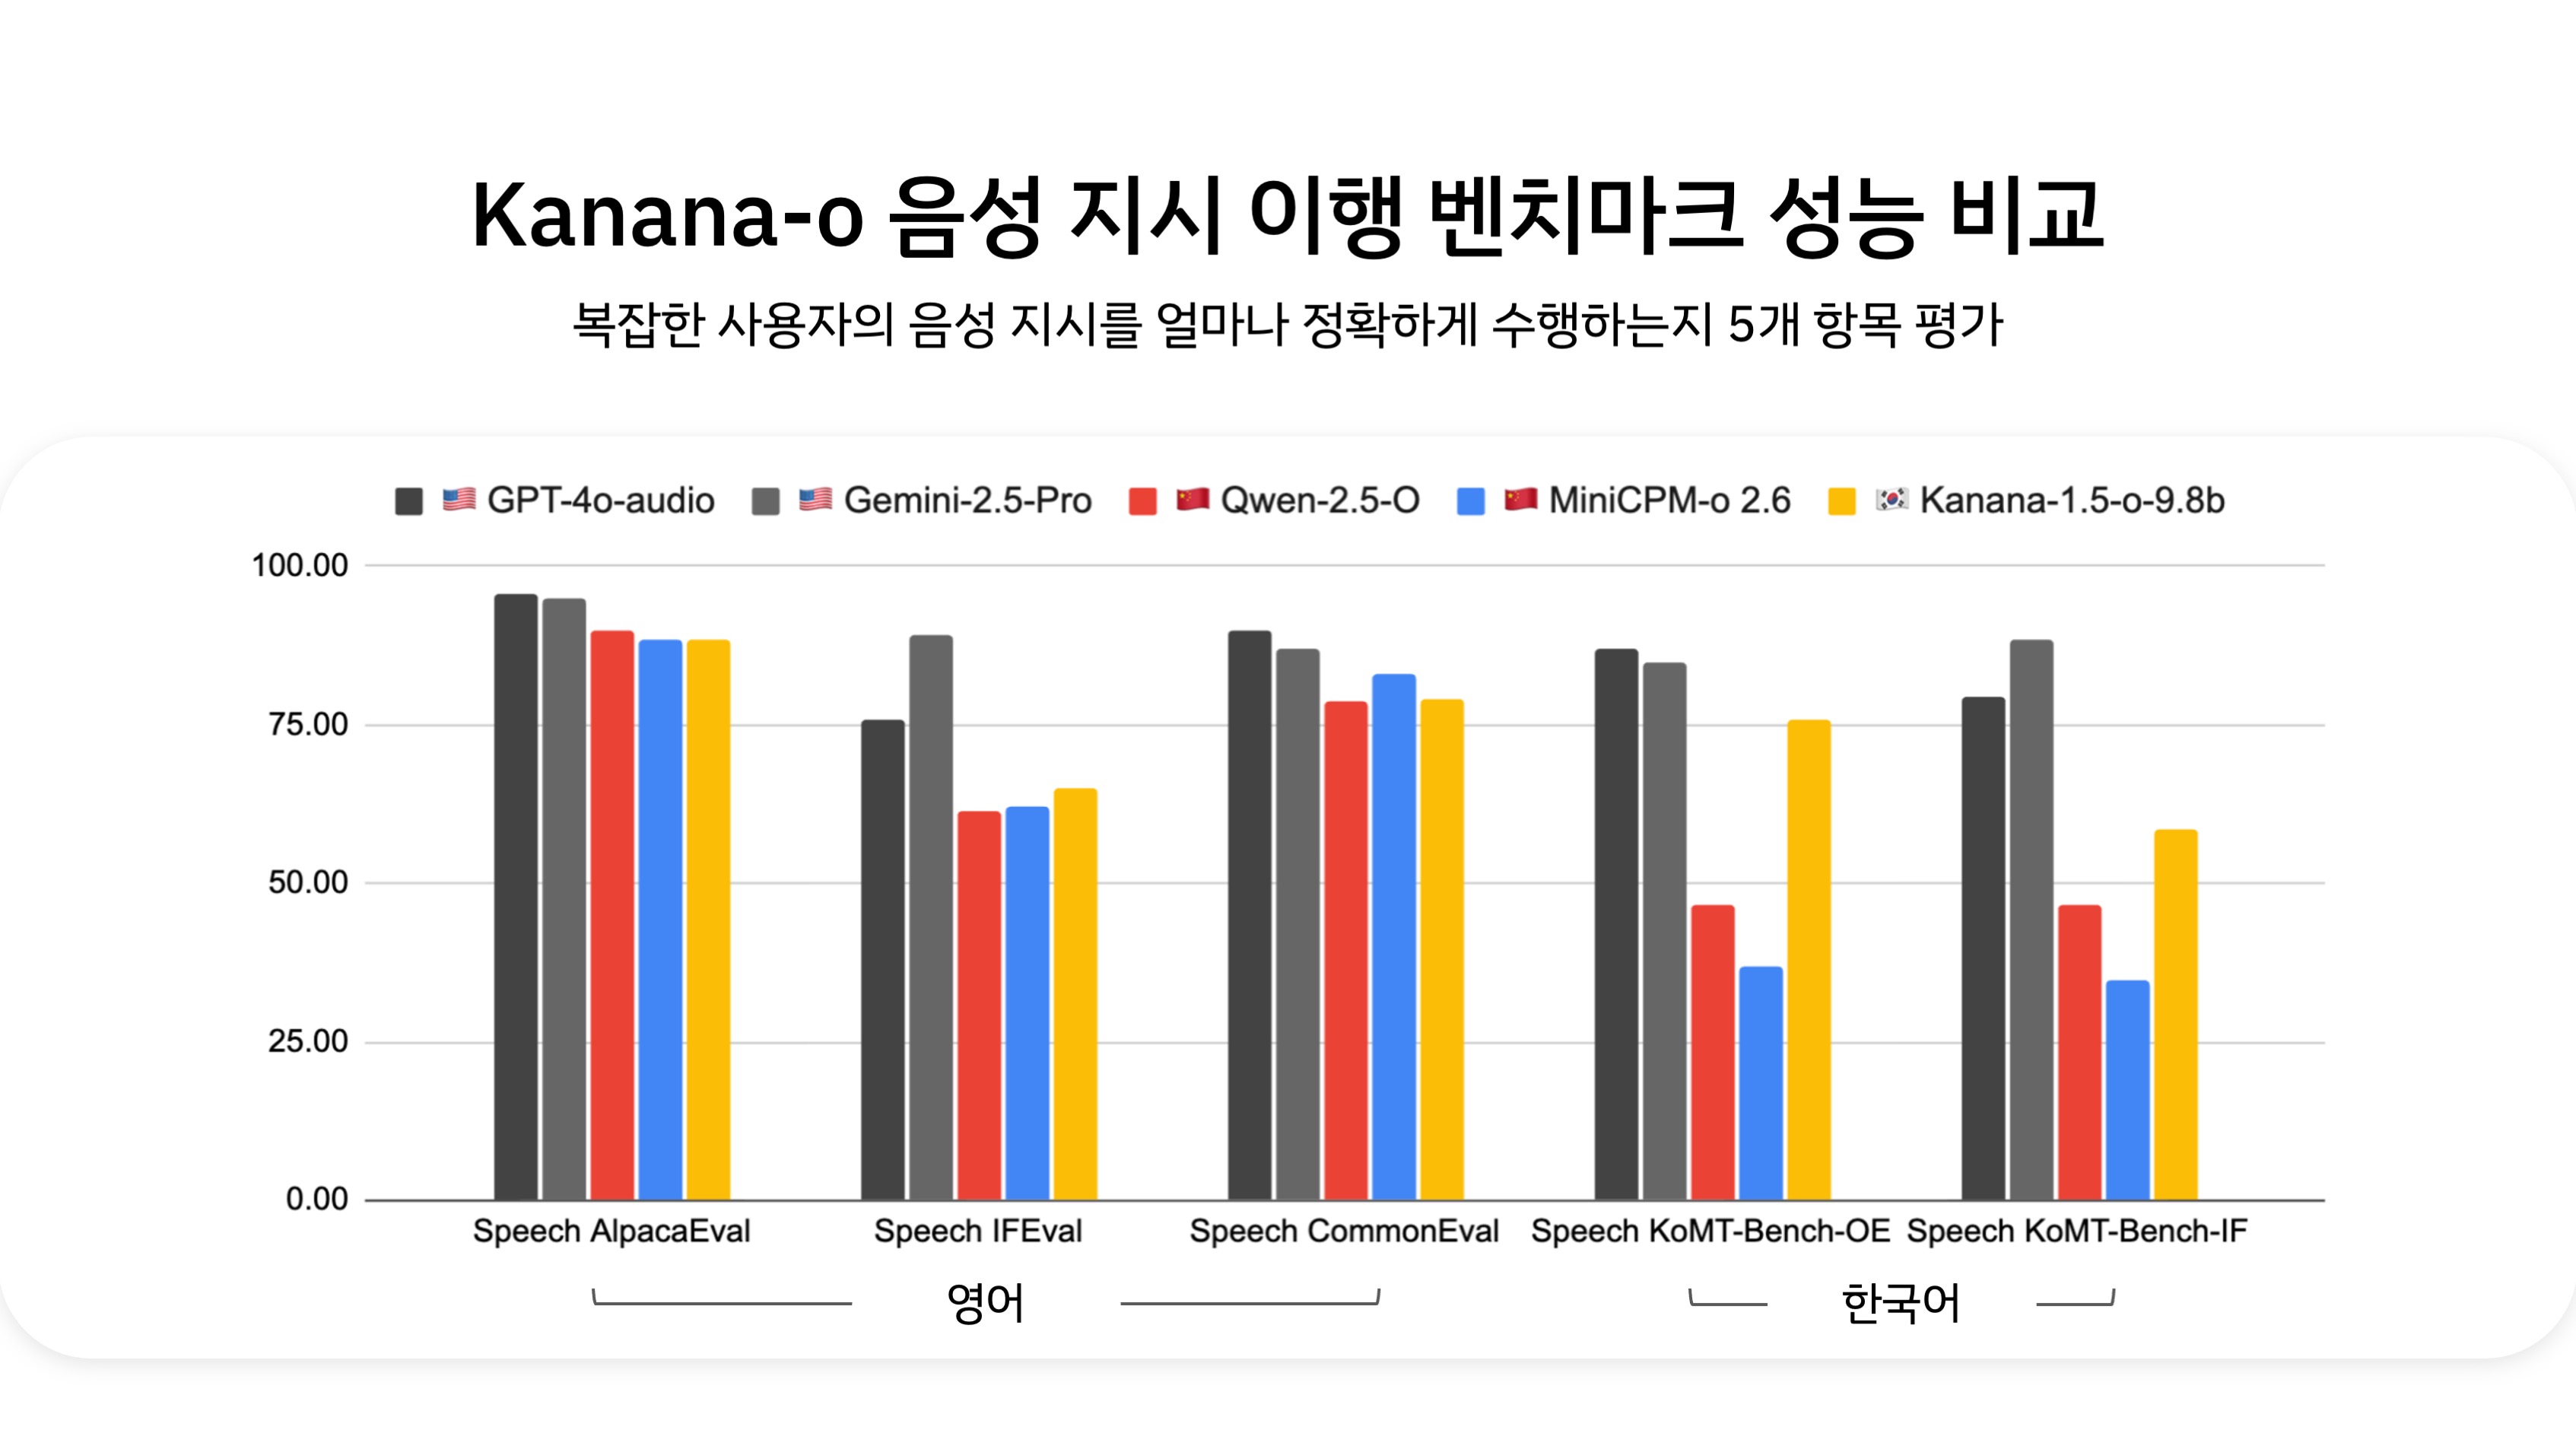
이렇게 수집된 데이터로 Kanana-o를 학습한 모델의 음성 지시 이행 벤치마크 성능을 <표 1>과 <표 2>에 나타내었습니다. 음성 지시 이행 태스크의 경우 지시 이행능력뿐만 아니라 LLM이 가지고 있는 세계 지식(World Knowledge)도 최종 성능에 영향을 줄 수 있습니다. 따라서 훨씬 모델 규모가 클 것으로 추정되는 GPT-4o나 Gemini-2.5-Pro 대비 약간 부족한 성능을 보이지만, 비슷한 규모의 경쟁 모델 대비 영어에서는 비슷한 성능, 한국어에서는 압도적인 성능 차이를 보였습니다.
평가에 사용된 한국어 음성 지시 이행 데이터인 Speech-KoMT-Bench는 기존 LLM 평가에서 활용되던 KoMT-Bench[4]의 질문을 음성 합성을 통해 음성 지시 이행 태스크로 확장한 것으로, <그림 5>에 예시로 제시된 해당 벤치마크의 질문처럼 복잡하고 어려운 지시로 이루어져 있습니다.
| GPT-4o | Gemini-2.5-Pro | Qwen-2.5-O | MiniCPM-o-2.6 | Kanana-o | |
|---|---|---|---|---|---|
| Speech AlpacaEval [5] | 95.60 | 95.00 | 89.80 | 88.40 | 88.60 |
| Speech CommonEval [5] | 89.80 | 87.00 | 78.60 | 83.00 | 79.00 |
| Speech IFEval [6] | 75.96 | 89.23 | 61.50 | 62.14 | 65.02 |
| Average | 87.12 | 90.41 | 76.63 | 77.85 | 77.54 |
<표 1. 영어 음성 지시 이행 벤치마크 비교>
Speech-KoMT-Bench(Open-Ended)
| Q | [Audio] (재생가능한 바이오 에너지의 최신 발견에 관한 기사 제목을 작성하세요. 눈에 띄면서도 과학적으로 정확하되, 바이오 에너지자원을 둘러싼 윤리적 딜레마를 다룰 수 있도록 기사 제목을 작성하세요. 네 가지 후보를 제안하세요.) |
Speech-KoMT-Bench(Instruction Following)
| Q | 재생가능한 바이오 에너지의 최신 발견에 관한 기사 제목을 작성하세요. 눈에 띄면서도 과학적으로 정확하되, 바이오 에너지원을 둘러싼 윤리적 딜레마를 다룰 수 있도록 기사 제목을 작성하세요. 네 가지 후보를 제안하세요. |
| A | 1. "바이오 에너지의 미래: 최신 발견과 윤리적 고려사항" 2. "재생 가능한 바이오 에너지의 진보: 과학적 성과와 윤리적 딜레마" 3. "과학적 발전과 윤리적 책임: 바이오 에너지의 최근 발견과 그 이후" 4. "바이오 에너지 소스의 혁신과 윤리적 질문: 재생 가능한 에너지의 새로운 시대". |
| Q | [Audio] (이전 답변을 수정합니다. 두 번째 후보를 다음과 같이 조정합니다: 1. 캐주얼한 톤 2. "FlexPower"라는 회사의 광고를 삽입 3. 10어절 이하로 작성.) |
<그림 5. Speech KoMT-Bench의 Open-Ended(OE) 및 Instruction Following(IF) 유형 질문에 대한 예시>
| GPT-4o | Gemini-2.5-Pro | Qwen-2.5-O | MiniCPM-o-2.6 | Kanana-o | |
|---|---|---|---|---|---|
| Speech-KoMT-Bench-OE | 87.00 | 85.00 | 46.50 | 37.00 | 75.90 |
| Speech-KoMT-Bench-IF | 79.60 | 88.50 | 46.50 | 34.80 | 58.70 |
| Average | 83.30 | 86.75 | 46.50 | 35.90 | 67.30 |
<표 2. 한국어 음성 지시 이행 벤치마크 비교. -OE의 경우 Open-Ended, -IF의 경우 Instruction Following을 의미함.>
이미지-오디오-텍스트 통합 멀티모달 데이터셋 구축
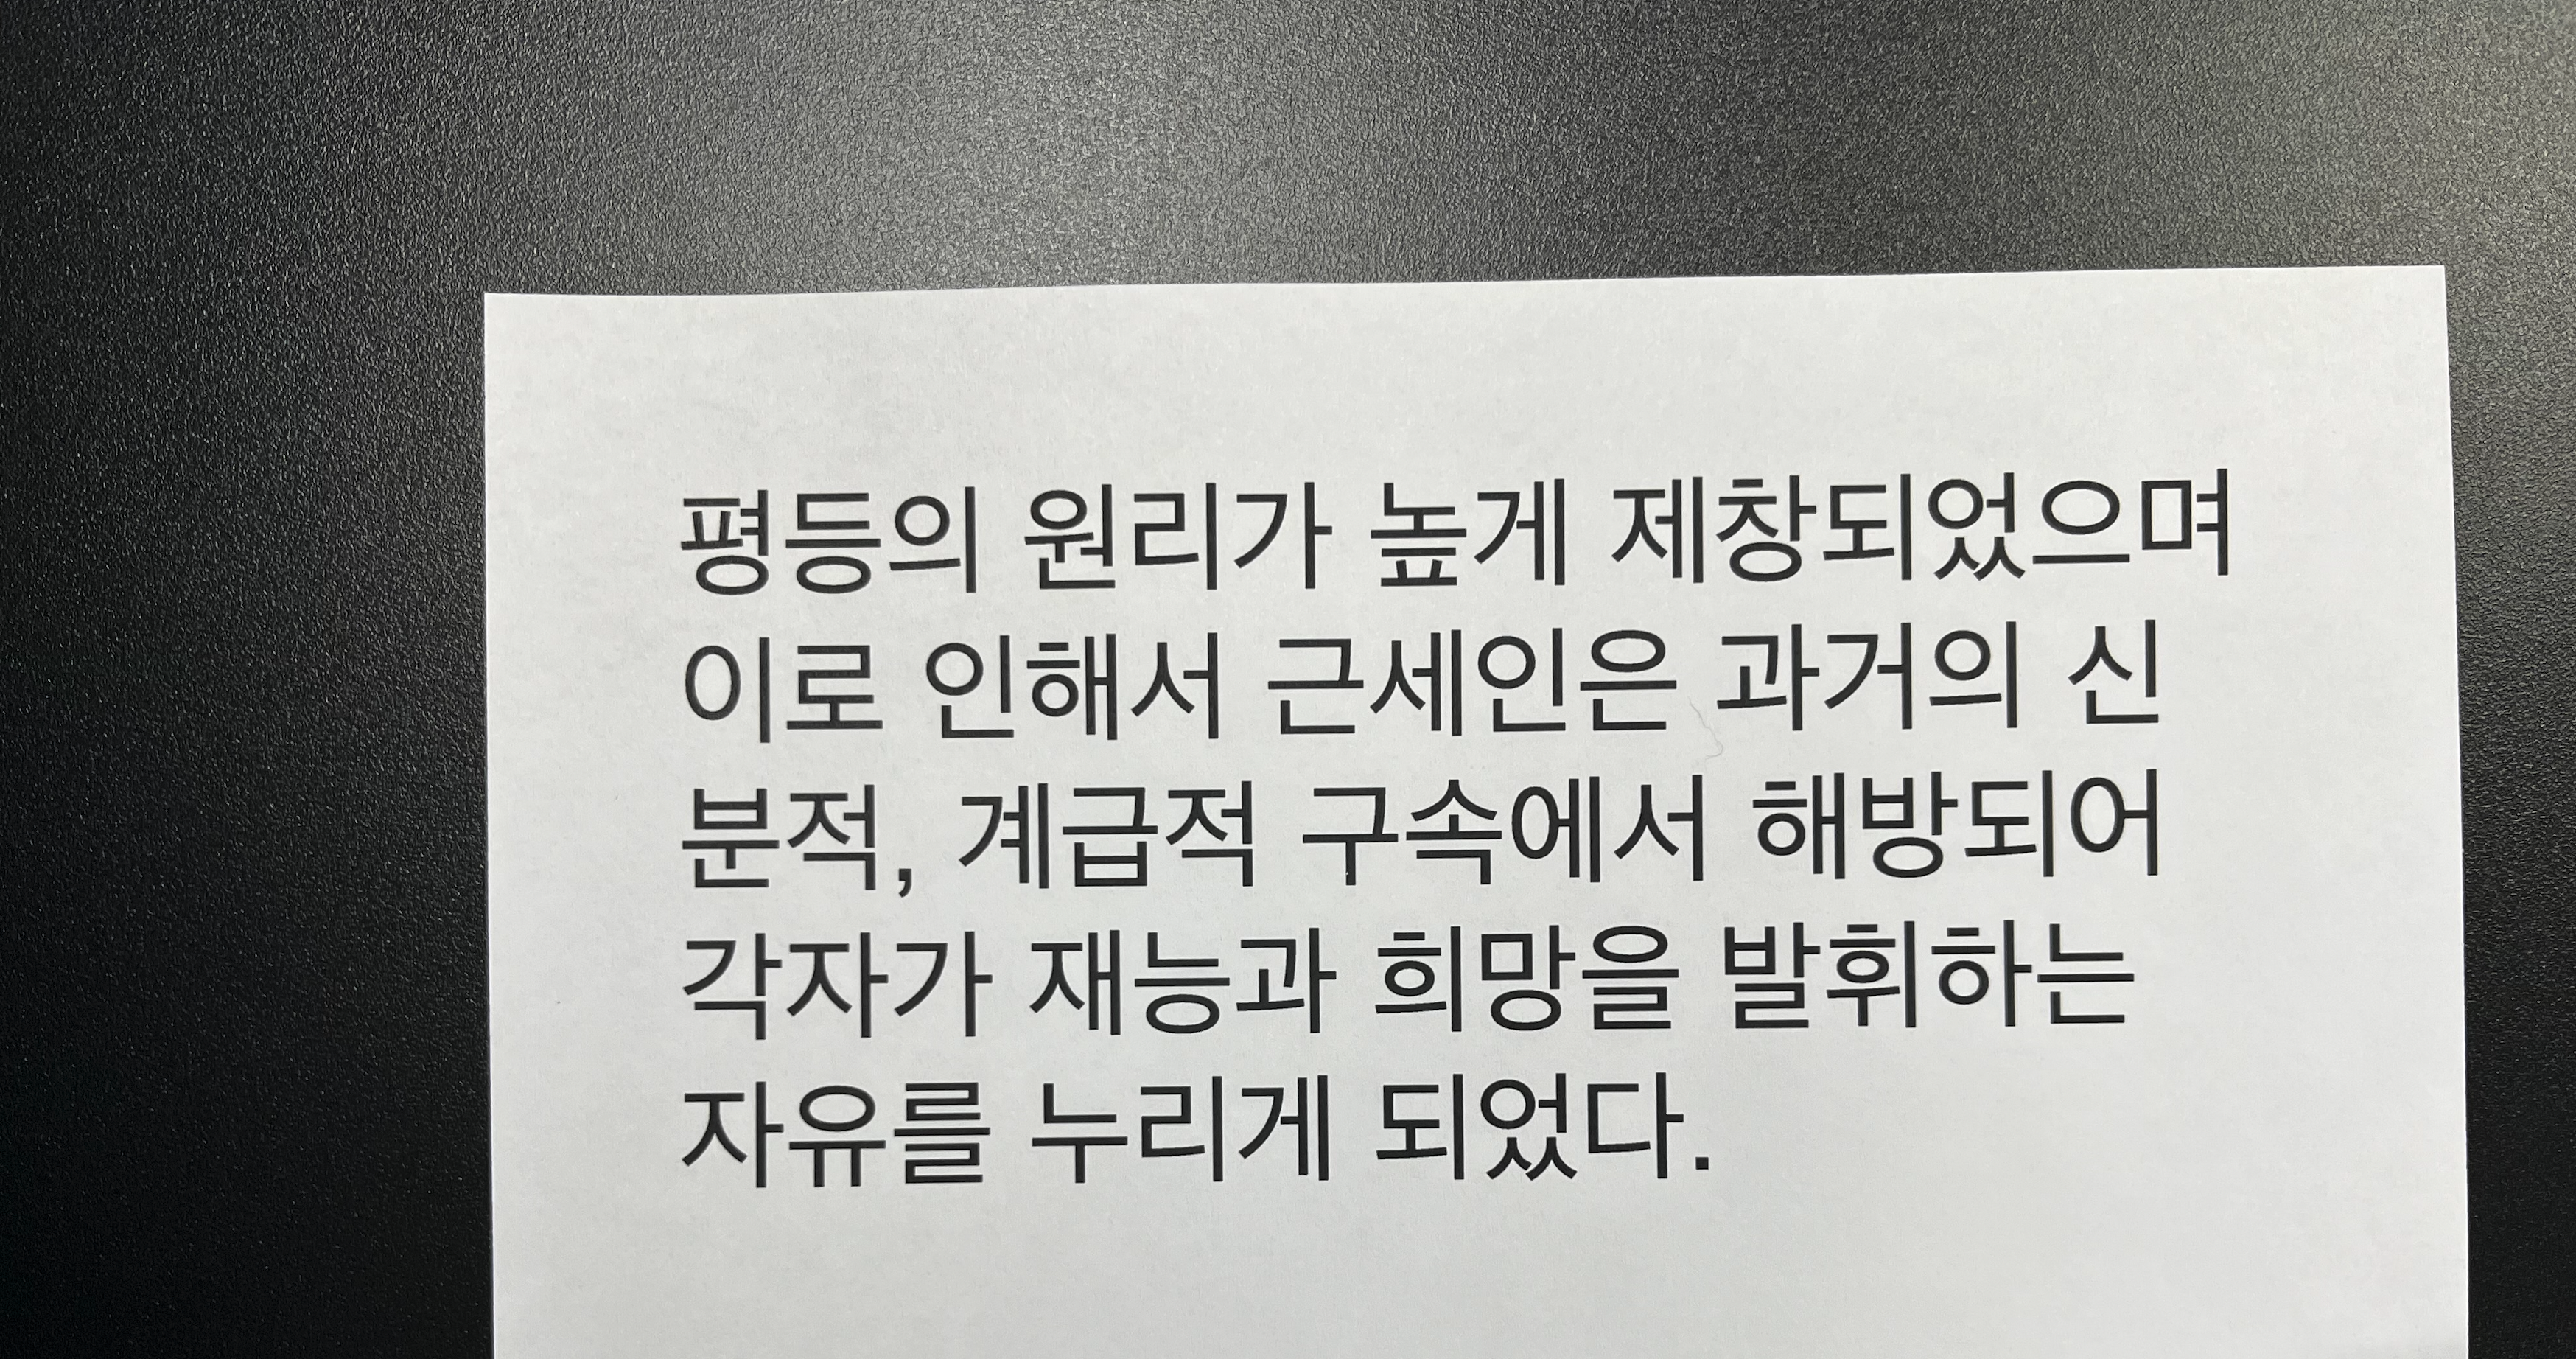
이미지-텍스트와 오디오-텍스트 대한 지시 이행 데이터 각각에서 학습했던 능력이 잘 일반화되어 이미지-오디오 혹은 이미지-오디오-텍스트 시나리오에서도 잘 작동하게 하기 위해서는 이들을 정렬(Align)해줄 수 있는 데이터가 필요합니다. 예를 들어 이미지 기반 태스크인 OCR은 기본적으로 이미지-텍스트(Image→Text) 생성 문제로 설계되어 있고, 음성 기반 태스크인 TTS는 텍스트-오디오(Text→Audio) 형태에서는 잘 작동하지만, OCR 결과를 음성으로 요청하는 등의 크로스 모달(Cross-modal) 지시의 경우 제대로 작동하지 않을 수 있습니다. 즉, 요청의 형태는 사용자마다 다양할 것이고 모델은 일정수준 일반화를 통해 응답을 해줄수는 있겠지만, 통합 멀티모달 데이터를 통해 모델에게 일반화하는 방법을 조금 더 직접적으로 학습시켜주고자 하였습니다.
이런 배경에서, Kanana-v와 Kanana-a 각각에서 사용 중인 데이터 및 태스크가 서로 연결되어 임의의 조합에 대해서도 LLM이 강건하게 잘 답할수 있도록 이미지-오디오-텍스트가 모두 포함된 통합 멀티모달 지시 이행 데이터셋을 직접 설계하고 자체 모델을 활용하여 구축했습니다.
 |  |
|---|---|
| 지시 (오디오 또는 텍스트) | 응답 (오디오 또는 텍스트) |
| 음성 듣기 Read the text in the image and let me know. | 음성 듣기 평등의 원리가 높게 제창되었으며 이로 인해서 근세인은 과거의 신분적, 계급적 구속에서 해방되어 각자가 재능과 희망을 발휘하는 자유를 누리게 되었다. |
| 음성 듣기 영어로 변환해줘. | 음성 듣기 The principle of equality was highly advocated, and as a result, modern people were liberated from the status-based and class-based restrictions of the past and came to enjoy the freedom to express their talents and hopes. |
| 음성 듣기 이 글의 핵심 내용을 한 문장으로 요약한 뒤, 그 요약문을 구어체로 바꿔서 말해 주세요. | 음성 듣기 평등의 원리가 강조되면서 사람들은 신분과 계급의 제약에서 벗어나 자유롭게 자신의 재능과 희망을 펼칠 수 있게 되었다. 쉽게 말하면, 이제 누구나 자유롭게 꿈을 펼칠 수 있게 된 거야. |
<그림 7. 이미지-오디오 연결 데이터셋 예시(이미지 속 문장 출처: Wikipedia, 음성합성: Kanana-a)>
또한 이미지와 오디오 입력을 상호 참조하고 이해해야 응답할 수 있는 데이터도 포함했습니다. ‘이미지에 대한 (오디오) 질문’ 형식에서 나아가 ‘이미지, 오디오에 대한 (오디오) 질문’ 형태의 데이터입니다. 예를 들어 “이미지와 오디오 설명을 참고하여, 이미지 속 음식이 어떤 문화적 배경을 가지고 있을지 추론하고, 그 이유를 설명하세요.”와 같이 이미지에서는 어떤 음식인지를 파악하고, 여러 음식에 대한 오디오 설명에서 이미지 속 음식 설명을 참고해 응답하는 데이터입니다.
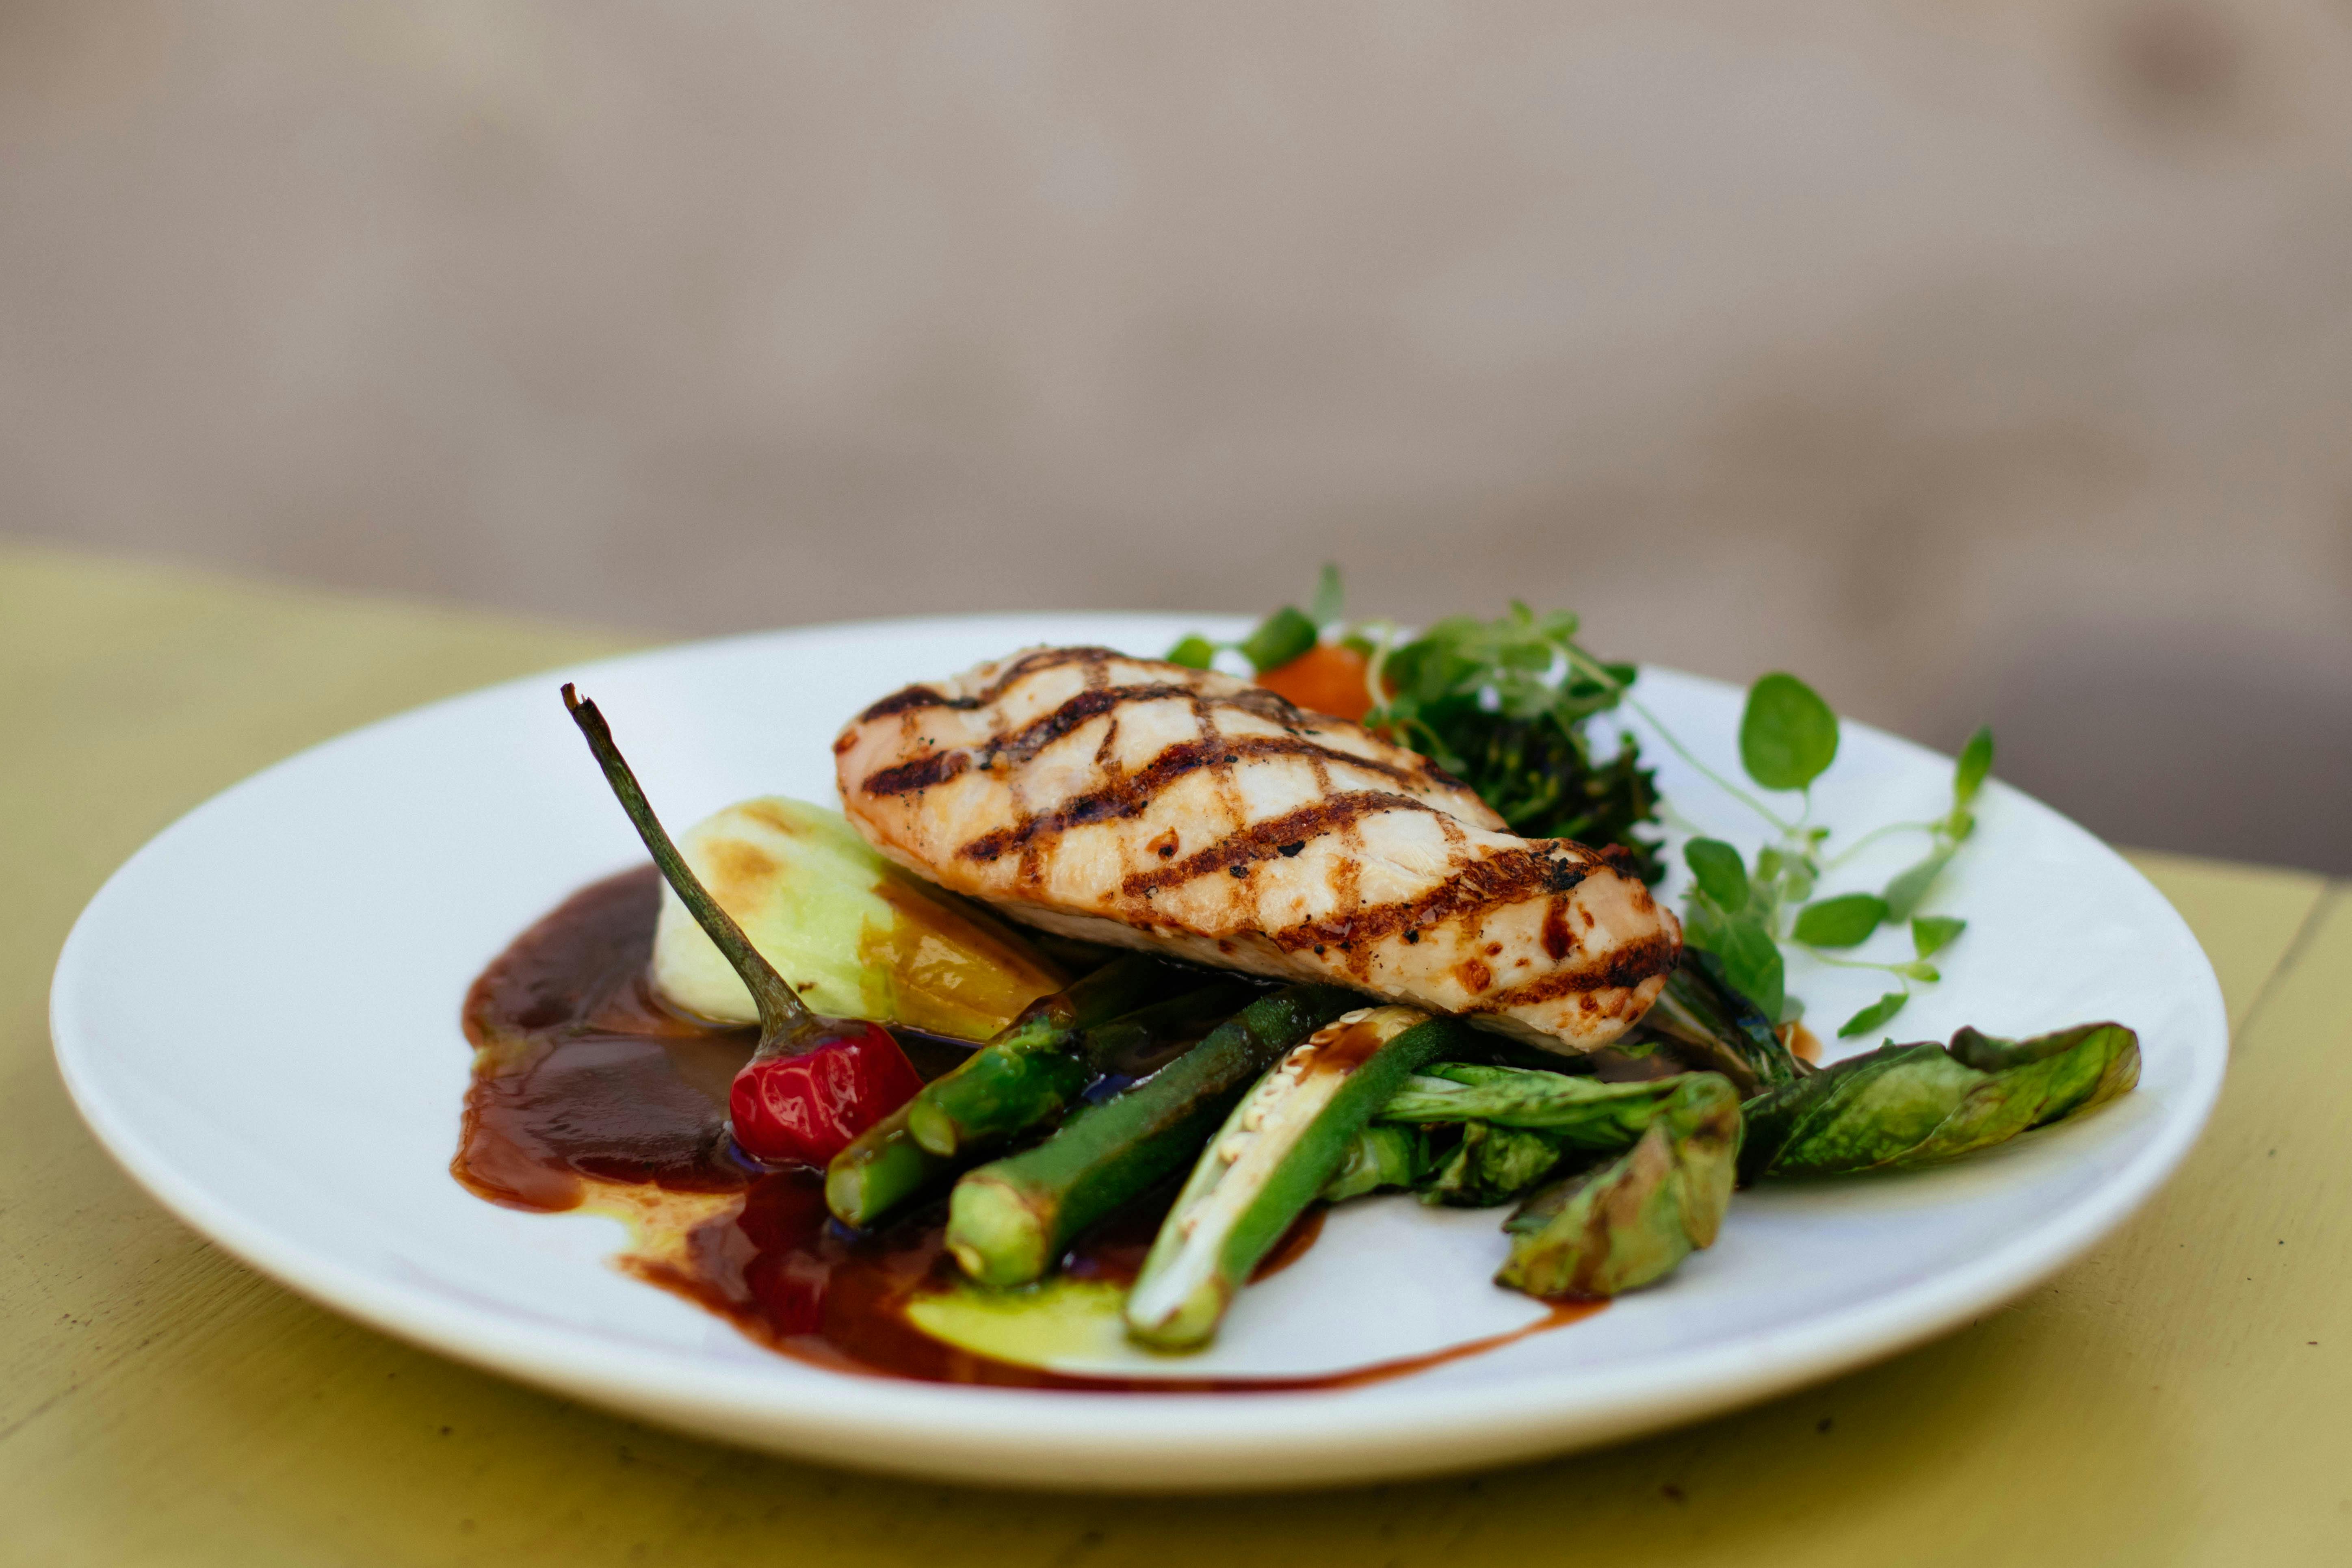 | 음성 듣기 음식은 단순한 생존 수단을 넘어 문화와 정체성을 표현하는 중요한 요소로 자리 잡고 있다. 각 지역의 전통 음식은 그 지역의 역사와 기후, 그리고 사람들의 생활 방식을 반영한다. 예를 들어, 지중해 지역의 음식은 올리브 오일과 신선한 채소를 많이 사용하여 건강한 식단을 구성하는 반면, 북유럽의 음식은 추운 기후에 적합한 고열량의 재료를 많이 사용한다. 이러한 음식 문화는 세대를 거쳐 전승되며, 현대에는 다양한 문화가 융합되어 새로운 형태의 요리로 발전하기도 한다. |
| question (audio or text) 음성 듣기 이미지와 설명을 참고하여, 이미지 속 음식이 어떤 문화적 배경을 가지고 있을지 추론하고, 그 이유를 설명하세요. 그리고 이 음식이 현대 사회에서 건강한 식단으로 인식되는 이유를 비판적으로 분석한 뒤, 실생활에서 이러한 음식 조합을 활용할 수 있는 방법을 제안해 보세요. | question (audio or text) 음성 듣기 이미지와 설명을 참고하여, 이미지 속 음식이 어떤 문화적 배경을 가지고 있을지 추론하고, 그 이유를 설명하세요. 그리고 이 음식이 현대 사회에서 건강한 식단으로 인식되는 이유를 비판적으로 분석한 뒤, 실생활에서 이러한 음식 조합을 활용할 수 있는 방법을 제안해 보세요. |
| answer (audio) 음성 듣기 이미지 속 음식은 고기와 채소가 함께 준비된 것으로 보입니다. 설명에서 언급된 것처럼, 이러한 조합은 다양한 문화적 배경을 가질 수 있습니다. 예를 들어, 고기와 채소를 함께 사용하는 것은 서양의 전통적인 식사 방식 중 하나로, 특히 북미나 유럽에서 흔히 볼 수 있습니다. 고기는 주로 단백질 공급원으로 사용되며, 채소는 비타민과 미네랄을 제공하여 균형 잡힌 식단을 구성합니다. 따라서, 이미지 속 음식은 서양의 전통적인 식사 문화와 관련이 있을 가능성이 높습니다. 또한, 고기와 채소의 조합은 현대에 와서도 건강한 식단으로 인식되며, 다양한 문화가 융합된 현대 요리의 한 예로 볼 수 있습니다. 그러나 이러한 음식이 건강식으로 인식되는 이유를 비판적으로 살펴보면, 고기와 채소의 비율, 조리 방법, 사용된 소스나 첨가물에 따라 실제 건강에 미치는 영향은 달라질 수 있습니다. 예를 들어, 고기가 지나치게 많거나 기름진 조리법이 사용된다면 오히려 건강에 해로울 수 있습니다. 실생활에서는 고기와 채소를 적절한 비율로 조합하고, 굽거나 찌는 등 건강한 조리법을 선택하며, 신선한 재료를 사용하는 것이 중요합니다. 또한, 다양한 채소를 활용해 영양소의 균형을 맞추는 것이 실용적인 방법이 될 수 있습니다. | answer (audio) 음성 듣기 이미지 속 음식은 고기와 채소가 함께 준비된 것으로 보입니다. 설명에서 언급된 것처럼, 이러한 조합은 다양한 문화적 배경을 가질 수 있습니다. 예를 들어, 고기와 채소를 함께 사용하는 것은 서양의 전통적인 식사 방식 중 하나로, 특히 북미나 유럽에서 흔히 볼 수 있습니다. 고기는 주로 단백질 공급원으로 사용되며, 채소는 비타민과 미네랄을 제공하여 균형 잡힌 식단을 구성합니다. 따라서, 이미지 속 음식은 서양의 전통적인 식사 문화와 관련이 있을 가능성이 높습니다. 또한, 고기와 채소의 조합은 현대에 와서도 건강한 식단으로 인식되며, 다양한 문화가 융합된 현대 요리의 한 예로 볼 수 있습니다. 그러나 이러한 음식이 건강식으로 인식되는 이유를 비판적으로 살펴보면, 고기와 채소의 비율, 조리 방법, 사용된 소스나 첨가물에 따라 실제 건강에 미치는 영향은 달라질 수 있습니다. 예를 들어, 고기가 지나치게 많거나 기름진 조리법이 사용된다면 오히려 건강에 해로울 수 있습니다. 실생활에서는 고기와 채소를 적절한 비율로 조합하고, 굽거나 찌는 등 건강한 조리법을 선택하며, 신선한 재료를 사용하는 것이 중요합니다. 또한, 다양한 채소를 활용해 영양소의 균형을 맞추는 것이 실용적인 방법이 될 수 있습니다. |
<그림 8. 옴니모달 데이터셋 예시 (사진 출처: https://www.pexels.com, 음성합성: Kanana-a)>
멀티모달 언어모델에서 지시 이행 능력을 개선하기 위해서는 다양한 모달리티가 주어지더라도 기존 언어모델의 생성 품질을 잃지 않고 유지하는 것이 중요합니다. 이를 고려하여 정교하게 설계되고 구축한 이 데이터셋은 사용자가 다양한 방식으로 전달한 지시를 정확히 해석하고 높은 품질의 응답을 생성하는 능력을 높여주는데 큰 도움을 주었습니다.
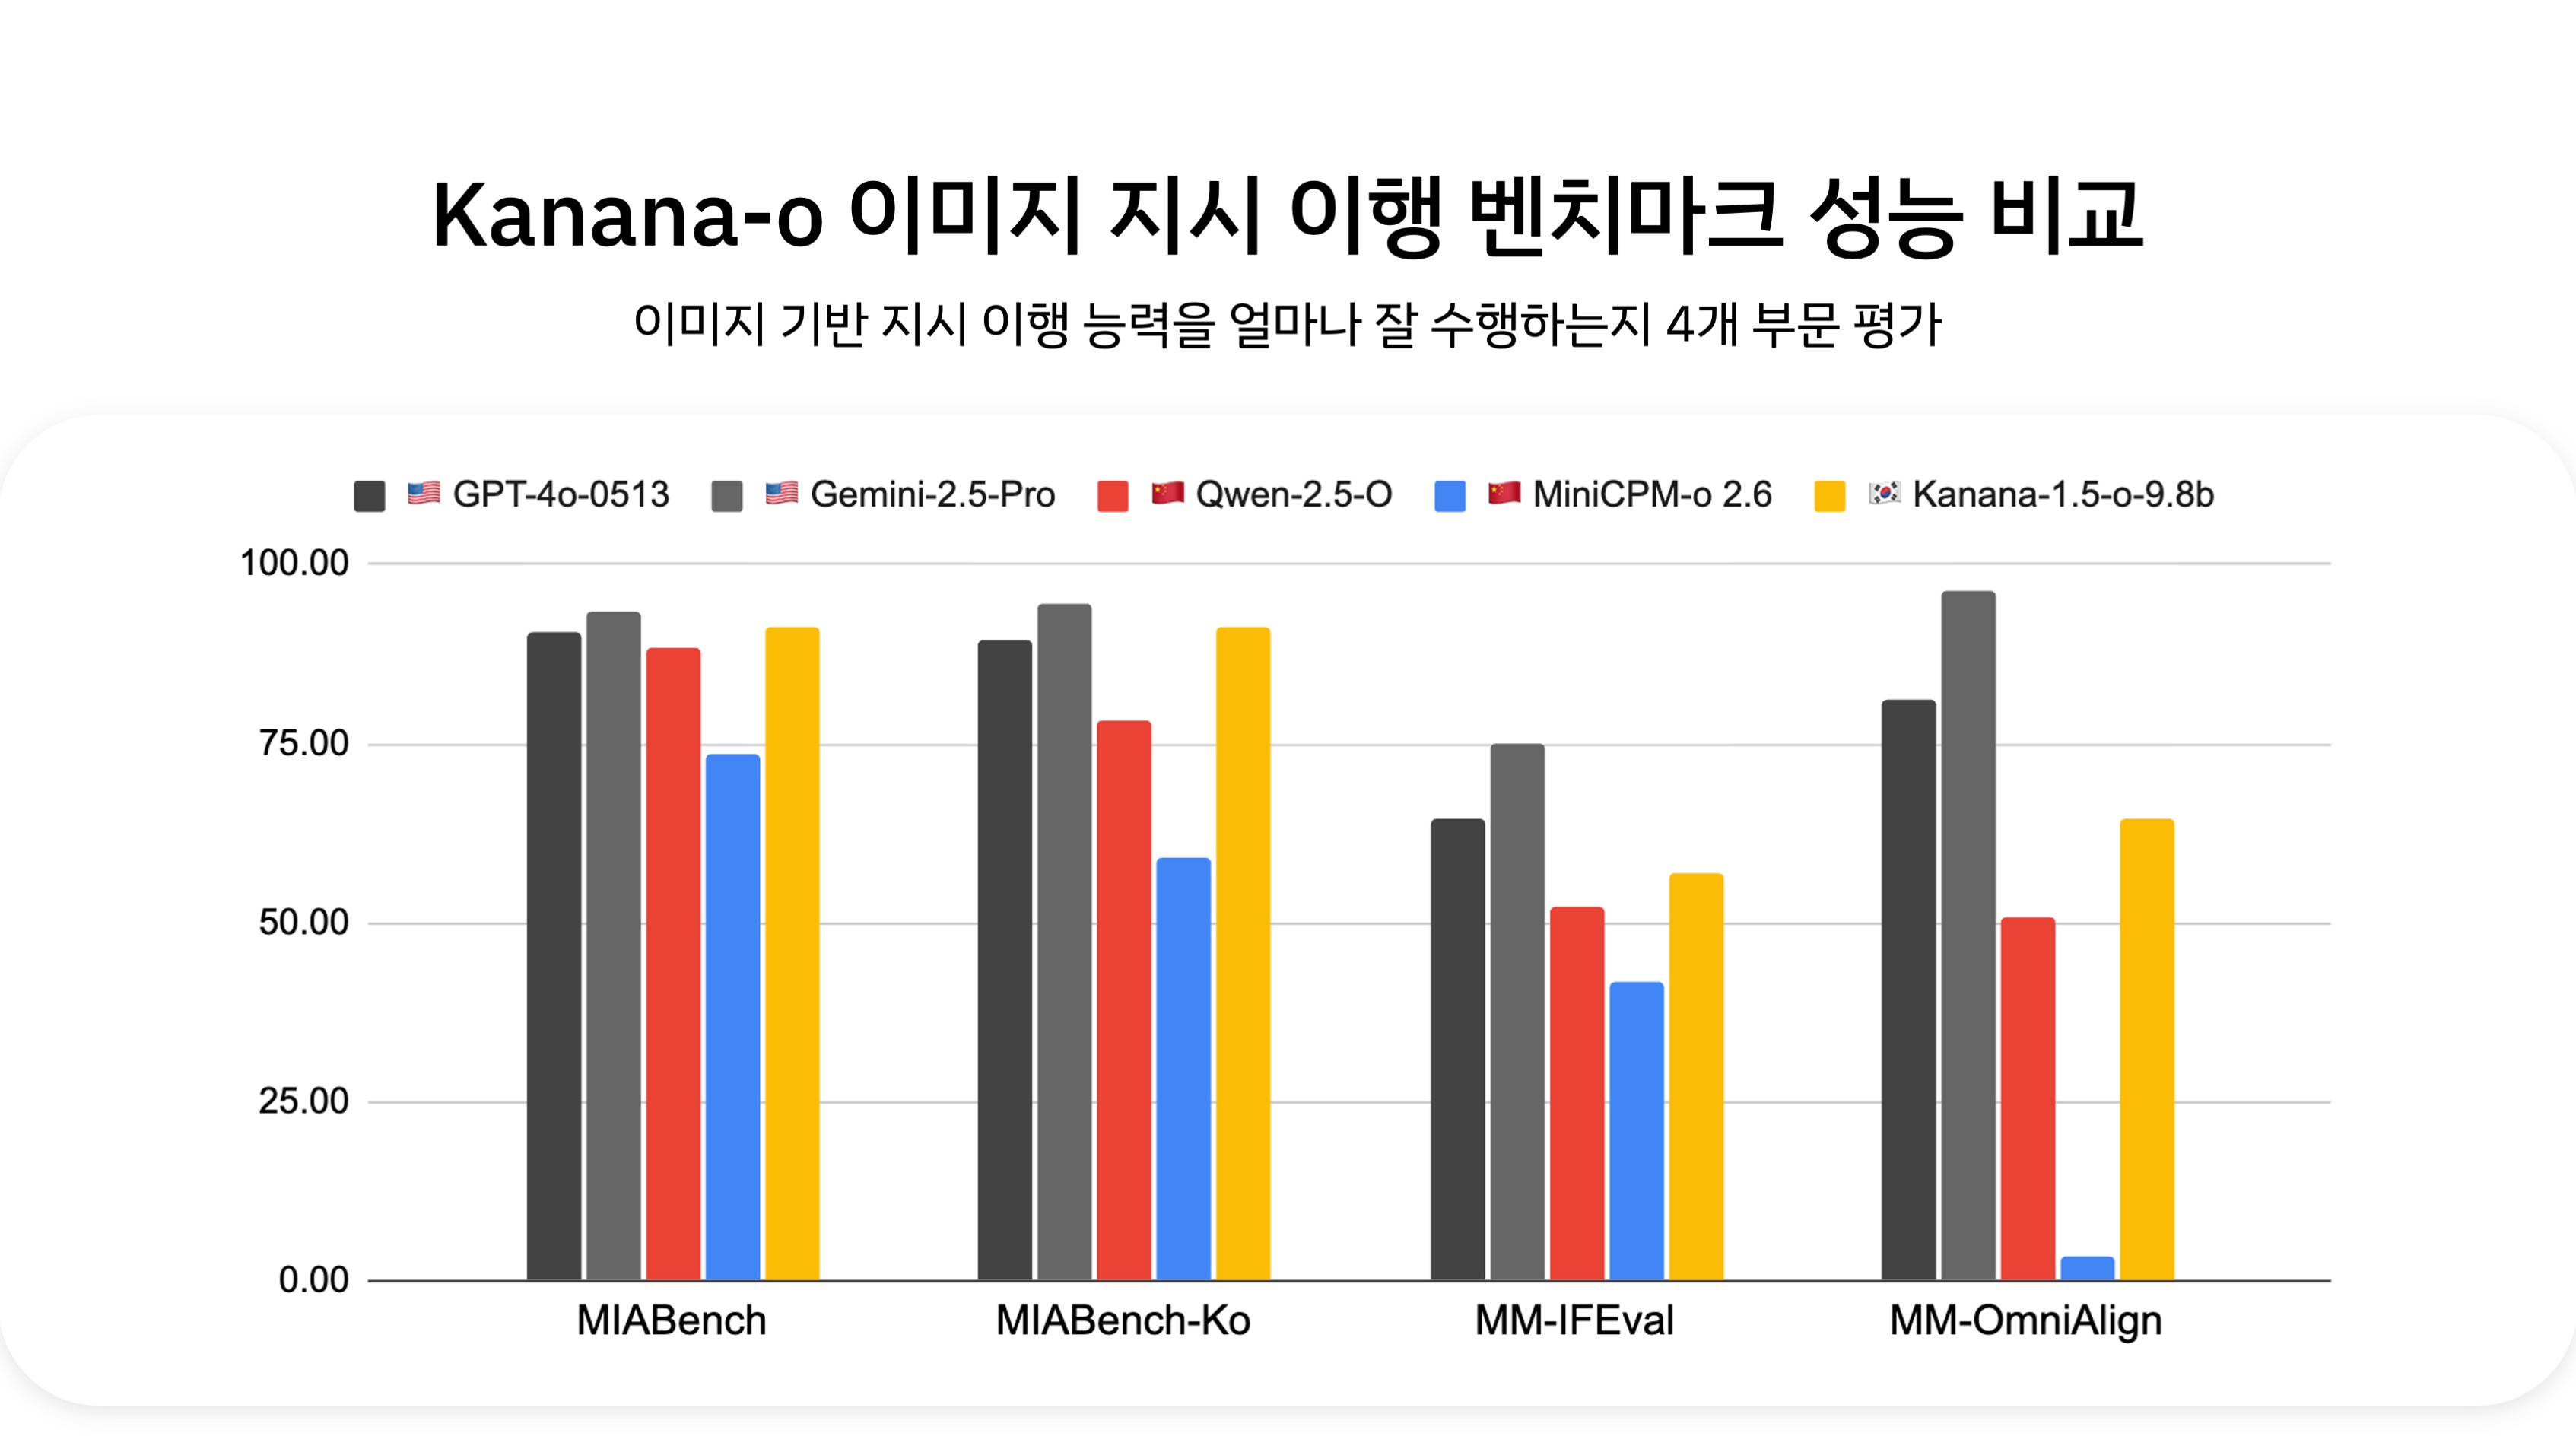
그 결과 이미지가 주어지는 이미지기반 멀티모달 지시 이행 능력을 평가하는 벤치마크에서도 우수한 성능을 보여주고 있습니다. <표 3>에서 제시된 벤치마크 중 MIA-Bench-Ko의 경우 기존 MIA-Bench를 한국어로 확장한 것으로 이전 저희 팀의 테크블로그인 “카카오의 경량 멀티모달 언어모델 ‘Kanana-1.5-v-3b’ 개발부터 공개까지”에서 소개된 바 있습니다.
| GPT-4o | Gemini-2.5-Pro | Qwen-2.5-O | MiniCPM-o-2.6 | Kanana-o | |
|---|---|---|---|---|---|
| MIABench [7] | 90.70 | 93.43 | 88.26 | 73.61 | 91.30 |
| MIABench-Ko | 89.51 | 93.45 | 78.10 | 59.20 | 91.22 |
| MM-IFEval [8] | 64.60 | 74.95 | 52.17 | 41.84 | 57.08 |
| MM-OmniAlign [9] | 81.30 | 96.43 | 50.79 | 3.57 | 64.68 |
| Average | 81.53 | 89.82 | 67.33 | 44.55 | 76.07 |
<표 3. 이미지 기반 지시 이행 벤치마크 성능 비교>
멀티턴 대화로의 확장
이번 업데이트를 통해 저희가 개선하고자 했던 중요한 능력 중 또 다른 하나는 바로 문맥이 이어지는 멀티턴 대화 시나리오였습니다. 실제 사용자 환경에서는 발화가 연속적으로 이어지고, 질문과 응답이 맥락에 따라 유기적으로 연결되기 때문에, 대화 흐름을 기억하고 문맥을 유지하는 능력이 필수적입니다. 따라서 이번 절에서는 이러한 목표를 달성하기 위해 저희가 어떤 데이터셋을 구성했고, 어떤 방식으로 정제·가공하여 학습에 활용했는지 그 과정을 소개드리고자 합니다.
음성기반 멀티턴 일상 대화 시나리오
멀티턴 대화 능력을 개선하기 위해서는 무엇보다 현실적이고 폭넓은 주제의 구어체 대화 데이터가 필요했습니다. 이를 위해 먼저 “실제 사람 같은 음성 AI 챗봇이 상용화된다면, 사용자는 어떤 주제로 대화할까?”라는 질문에서 출발했으며, 아래의 과정으로 주제 풀을 만들었습니다.
-
LLM을 활용해 일상·라이프스타일 중심의 대주제를 폭넓게 수집
-
각 대주제별로 ‘가벼운 호기심→깊은 대화’의 흐름을 자연스럽게 구성할 수 있도록 세부 소주제를 추가로 생성
이렇게 구성된 주제들은 단순한 QA 형식이 아니라, 사용자가 실제 음성 비서에게 말하듯 자연스러운 대화 흐름을 만들 수 있는 기반이 되었습니다. 예컨대 평범한 일상 질문에서 시작해, 조언을 구하고, 다시 새로운 질문으로 이어지는 연속적 맥락이 자연스럽게 담기도록 설계했습니다.
이렇게 생성된 대본에 대해 TTS 전용 모델을 활용하여 다양한 목소리, 톤, 스타일을 기반으로 음성화를 진행하였습니다. 하지만 생성된 음성은 실제 사람이 발화한 음성이 아니다보니 어느정도 오류가 있을 수 있는데요, 이를 잘 필터링하는 것 역시 중요한 작업이라고 할 수 있습니다. 저희는 아래의 과정을 거쳐 데이터 필터링을 수행하였습니다.
- 화자 분리 기반 필터링
-
생성된 대본 기반 합성 음성에 대해 화자 분리(Speaker Diarization) 전용 모델을 활용하여 각 발화 턴을 구분
-
실제 대사 턴 수와 음성 분리 턴 수가 다른 경우 필터링
- 음성 정확도 기반 필터링
-
생성된 음성의 각 턴 별로 STT 전용모델을 사용하여 전사
-
대본 스크립트와의 CER(Character Error Rate) 값이 일정 임계값 이상인 경우 필터링
이러한 데이터 생성–정제 파이프라인을 통해 모델이 실제 사용자처럼 유연하게 이어지는 음성 기반 대화를 학습할 수 있도록 안정적이고 다양한 멀티턴 음성 데이터를 확보했습니다.
| 사용자 | 저기... AI야, 안녕? 오늘 좀 심심한데, 얘기 좀 할래? |
|---|---|
| AI | 네! 안녕하세요. 심심하셨군요, 저랑 이야기 나누면 재미있으실 거예요. 어떤 주제로 얘기해볼까요? |
| 사용자 | 음... 취미 얘기? 아 근데 요즘은 다 AI가 해준다면서요? 좀 신기하긴 한데, 그게 뭐가 좋은지 잘 모르겠음 |
| AI | 오, 맞아요! 요즘 AI랑 자동화 기술이 취미 생활에도 많이 들어왔거든요. 예를 들어, 그림 그릴 때 AI가 색 조합 추천해주거나, 음악 만들 때 자동으로 멜로디 생성해주는 거 아시나요? |
| 사용자 | 아, 그거! 유튜브에서 봤던 거 같은데... 근데 그럼 내가 직접 하는 재미는 좀 없어지는 거 아님? 뭔가... 음, 손맛? 그런 거 사라질까봐 좀 걱정됨 |
| AI | 음, 맞아요. 직접 하는 재미, 일명 '손맛'이 중요하죠! 하지만 AI는 반복적이거나 어려운 부분을 도와줘서, 창의적인 부분에 더 집중할 수 있게 해준답니다. 오히려 새로운 아이디어도 얻을 수 있고요. 신기하지 않으세요? |
| 사용자 | ... |
<그림 10. 멀티턴 일상대화 데이터 대본 예시>
음성과 이미지, 텍스트를 아우르는 멀티턴 대화 시나리오
음성 기반 멀티턴 대화를 고도화한 다음 단계로, 저희는 음성·이미지·텍스트가 자연스럽게 섞여 오가는 멀티모달 대화로 확장을 시도했습니다. 실제 사용자들은 사진을 보여주며 질문하거나 음성으로 지시한 뒤 텍스트로 추가 설명을 하는 등 다양한 입력 방식을 혼합해 사용하기 때문에, 모델이 서로 다른 모달리티를 매끄럽게 연결하고 대화 맥락을 지속적으로 유지하는 능력이 중요합니다.
이를 위해 이전 절에서 소개한 ‘이미지–오디오–텍스트 연결 데이터셋’을 기반으로 멀티모달·멀티턴 대화 데이터셋을 확장 구축했습니다. 특정 턴의 답변을 요약·번역·추론하도록 재활용하거나, 한 번 맥락을 전환했다가 다시 원래 흐름으로 돌아오는 구조 등을 포함해 실제 사용자 대화의 자연스러운 패턴을 구현했습니다. 또한 의도적인 맥락 전환, 이미지 입력 착각 상황 처리, TTS 스타일 지시, 사투리 변환 등 서비스 환경에서 흔히 발생할 수 있는 다양한 변주를 대화 흐름에 녹여, 모델이 복잡한 지시와 비정형 요청에도 견고하게 대응할 수 있도록 했습니다.
이러한 설계를 통해 대화 구조, 맥락 전이, 추론 난이도, 발화 특성까지 정교하게 통제된 고품질 멀티모달 대화 데이터를 확보할 수 있었습니다.
| 사용자 | 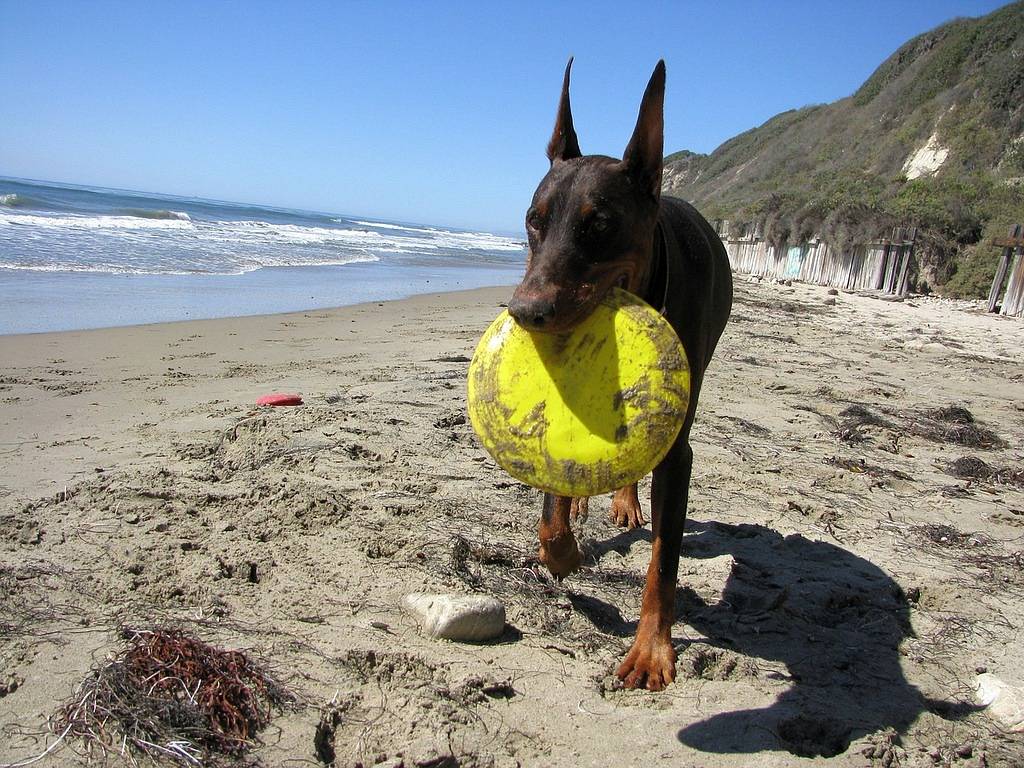 |
|---|---|
| 사용자 | 이 사진에 대해 설명해줘. |
| AI | 이 사진에는 해변에서 노란색 프리스비를 입에 물고 걷고있는 검은색 개가 보입니다. 개는 차분하고 늠름해 보이며, 배경에는 파란 하늘과 바다가 펼쳐져 있습니다. |
| 사용자 | 이 강아지가 어떤 품종인지 알려줄 수 있어? |
| AI | 이 강아지는 도베르만이라는 품종으로 보입니다. 도베르만은 날렵하고 늠름한 외모, 민첩성, 영리한 두뇌가 특징이며 가족에 대한 애정이 강한 것으로 알려져 있습니다. |
| ... | ... |
| 사용자 | 음... 그, 만약에... 아, 이거 좀 갑자기 이상한 질문일 수도 있는데, 만약에 인간이 150살까지 산다 하면, 그, 생일 케이크에 초 몇 개 꽂아야 돼? 너무 많나...? |
| AI | 만약 150살까지 산다면, 생일 케이크에 150개의 초를 꽂아야 합니다. 하지만 실제로는 초가 너무 많아서 케이크에 다 꽂기 힘들 수 있으니, 숫자 모양의 초나 10년 단위로 대표하는 초를 사용하는 경우도 많습니다. |
| 사용자 | 150살 생일 파티를 더 특별하게 만들 수 있는 아이디어가 혹시 있을까? 세 가지만 제안해줄래? |
| AI | 첫째, 숫자 150이 적힌 대형 케이크를 준비해보세요. 둘째, 가족과 친구들이 150가지의 추억을 나누는 시간을 가져보는 것도 좋습니다. 셋째, 150년의 역사를 담은 사진이나 영상을 상영하는 이벤트를 마련하면 더욱 특별한 파티가 될 수 있습니다. |
| 사용자 | 아까 해변에서 놀던 강아지 이야기로 다시 돌아가서, 이 상황에서 주의할 점이 있을까? |
| AI | 해변에는 유리 조각, 플라스틱, 조개껍데기 등 날카로운 물건이 있을 수 있습니다. 강아지가 이런 물건을 밟거나 입에 물면 다칠 수 있으니, 놀기 전에 주변을 잘 살피고 위험한 물건은 치워주는 것이 좋습니다. |
<그림 11. 멀티모달·멀티턴 대화 데이터 대본 예시 (사진 출처: https://picryl.com)
더 나은 실생활 유스케이스를 위해: 팟캐스트 형태의 다화자-멀티턴 대화 생성
최근 NotebookLM[10]과 같은 AI 팟캐스트 생성 도구들은 다양한 형태의 입력으로도 스튜디오급 품질의 ‘호스트-게스트 대화’를 만들어내면서 콘텐츠 제작의 문턱을 크게 낮추고 있습니다. 더 나아가, 교육 콘텐츠, 인터뷰, 정보 공유, 스토리텔링 등 다양한 활용 사례에서 팟캐스트는 매우 유용하다는 평가가 많습니다. 특히 다화자·멀티턴 구조는 단순한 단문 낭독보다 대화의 흐름과 맥락, 사람 간 상호작용의 생동감을 살릴 수 있어, 청취자의 몰입감과 이해도를 높이는 데 효과적입니다.
이러한 실제 사례들과 가능성을 바탕으로, 저희는 직접 팟캐스트-스타일의 다화자 멀티턴 데이터셋을 제작하기로 했습니다. 단순한 단일 문장 낭독이 아니라, 호스트와 게스트가 대화를 주고받듯 연속된 대화 흐름, 화자 전환, 감정과 어조 변화, 자연스러운 간격과 리듬을 포함하는 구조로 설계했죠. 이를 통해, 단순한 텍스트 출력이 아닌 — 실제 팟캐스트처럼 ‘듣고 싶어지는’, ‘사람과 이야기하는 느낌이 드는’ 음성 콘텐츠를 생성할 수 있는 기반을 마련했습니다.
| 화자 1 | 안녕하세요. 요즘 집에 머무는 시간이 길어지면서, 집에서 즐길 수 있는 소확행 취미에 관심이 많아졌어요. 혹시 최근에 집에서 새롭게 시작하신 취미 있으신가요? |
|---|---|
| 화자 2 | 네, 저도 집에서 보내는 시간이 많아지다 보니 자연스럽게 새로운 취미를 찾게 되더라고요. 최근에는 홈카페를 만들어서 직접 커피를 내려 마시는 재미에 푹 빠졌습니다. 커피 향이 집안 가득 퍼질 때 정~말 행복하더라고요. |
| 화자 1 | 와~, 홈카페라니 정말 멋지네요. 저도 커피를 좋아해서 관심이 가는데, 혹시 특별히 추천해주실 만한 커피 레시피가 있을까요? |
| 화자 2 | 최근에 라떼 아트를 조금씩 연습하고 있는데, 생각보다 어렵지만 완성됐을 때 뿌듯함이 크더라고요! 집에 있는 우유 거품기로도 충분히 도전해볼 수 있으니 한 번 시도해보셔도 좋을 것 같아요. |
| 화자 1 | 좋은 팁 감사합니다! 저는 요즘 집에서 작은 식물을 키우는 데 재미를 느끼고 있어요. 특히 다육식물이나 허브 같은 식물은 관리도 쉽고, 집안 분위기도 한층 더 화사해지는 것 같아요. |
| 화자 2 | 맞아요, 식물 키우기는 정말 힐링되는 취미인 것 같아요. 저도 작은 화분 하나 들여놓았는데, 매일 조금씩 자라는 모습을 보는 게 큰 위안이 되더라고요. 혹시 키우기 쉬운 식물 추천해주실 수 있나요? |
| 화자 1 | 음… 초보자라면 스투키나 산세베리아처럼 물을 자주 주지 않아도 되는 식물이 좋아요. 허브는 바질이나 민트도 추천드리고요. 직접 키운 허브로 차를 만들어 마시는 것도 소소한 행복이 되더라고요. |
| ... | ... |
| 화자 1 | 바쁜 일상 속에서도 집에서 작은 행복을 찾는 시간이 꼭 필요하다고 생각해요. 오늘 이야기 나누면서 새로운 취미에 도전해보고 싶은 마음이 생겼습니다. |
| 화자 2 | 저도 덕분에 새로운 아이디어를 많이 얻은 것 같아요. 앞으로도 집에서 즐길 수 있는 소확행 취미를 계속 찾아보고 싶네요. |
<그림 12. 팟캐스트 데이터 대본 예시>
더욱 풍부한 감정을 담아 사람처럼 말하기
사람들은 단순히 정보를 듣거나 읽는 것을 넘어서, “누군가와 대화를 나눈다”는 느낌을 원합니다. 특히 음성 비서나 AI 스피커처럼 말을 매개로 한 상호작용에서는, 단순한 기계음이 아니라 감정, 뉘앙스, 친밀감이 담긴 목소리야말로 사용자가 계속 귀 기울이고 싶은 이유가 됩니다.
그렇기에 저희는 이번에 단순한 정보 전달이 아닌, 사람처럼 말하는 AI를 목표로 삼았습니다. 즉, 억양, 속도, 감정, 화자 특성까지 고려해 — 마치 실제 대화 상대와 이야기하듯 — 자연스럽고 생동감 있게 말할 수 있는 모델을 지향한 것이죠.
이를 위해 저희는 DPO(Direct Preference Optimization)[11] 기반 학습 프레임워크를 활용하는 동시에, 단순히 합성된 음성만으로는 구현하기 어려운 “사람다운 감정과 뉘앙스가 담긴 음성 데이터”를 확보하기 위해 실제 배우를 고용해 고품질의 감정 표현 음성을 직접 녹음 했습니다. 덕분에 단조로운 TTS 목소리가 아니라, 사람 특유의 억양과 가변성, 감정의 흐름이 잘 담긴 음성 샘플들을 통해 모델의 발화 표현력을 개선시킬 수 있었습니다.
이번 절에서는 구체적으로 어떻게 DPO 데이터셋을 구축했는지, 그리고 그 결과 어떤 표현력 향상이 가능했는지 함께 살펴보겠습니다.
표현력 향상을 위한 데이터 쌍 구축
Kanana-o의 발화 음성에 대한 표현력을 강화시키기 위해, 학습 목표에 따라 다음 세 가지 방식으로 DPO 데이터 쌍을 구축했습니다.
- 자체 모델의 표현력 강화
-
모델 스스로 더 풍부한 감정을 표현하도록 유도하기 위해, 자체 모델이 생성한 결과물 내에서 우열을 가리는 방식을 사용했습니다.
-
채택(Chosen): 자체 모델로 생성한 감정 표현이 풍부한 음성
-
제외(Rejected): 자체 모델로 생성한 단조로운 음성
- 표현력의 임계치 돌파
-
자체 모델의 한계를 넘어 더 풍부한 음성 표현 능력을 확보하기 위해, 직접 녹음한 고품질의 배우 음성을 활용했습니다.
-
채택(Chosen): 직접 녹음한 고품질의 표현력이 풍부한 배우 음성
-
제외(Rejected): 배우 음성을 보이스 클로닝(Voice Cloning) 기술로 재합성하여 상대적으로 표현력이 떨어지는 합성 음성
- 화자 유사도 개선
-
생성된 음성이 타겟 화자의 목소리를 정확히 모사하도록, 화자 정보(Speaker Embedding)의 일치 여부를 기준으로 데이터를 구성했습니다.
-
채택(Chosen): 타겟 화자의 임베딩을 정상적으로 사용하여 생성한 음성
-
제외(Rejected): 동일한 텍스트와 음성 조건에서 불일치하는(Mis-matched) 화자의 임베딩을 사용
이러한 방법론을 단순 TTS, 스타일 지시 TTS 태스크 뿐만 아니라 다이얼로그(Dialogue) 태스크에도 적용하여 다양한 대화 시나리오에서 원하는 화자의 목소리로 표현력 있는 발화를 생성하도록 하였습니다.
| 배우 1 | 음성 듣기 |
|---|---|
| 배우 2 | 음성 듣기 |
<배우 음성 데이터 예시>
발화 표현력에 대한 정량 평가 매트릭 설계
사람처럼 감정과 뉘앙스를 담아 말하는 능력을 향상시켰다고 할 때, 그 표현력이 실제로 얼마나 개선되었는지를 정량적으로 측정하는 것은 매우 까다로운 과제입니다. 단순한 문장 정확도나 문법 검사와 달리, ‘억양·감정·스타일’ 같은 요소는 듣는 사람의 주관에 크게 의존하기 때문에, 모든 발화를 사람이 직접 하나하나 평가하기는 현실적으로 어렵습니다. 또한, 이런 주관적 평가만으로는 일관성 있게 품질을 비교하거나 반복 실험을 수행하기에도 한계가 있습니다. 이를 위해 저희는 한국어 음성을 대상으로 자동화 가능한 평가 매트릭과 모델 기반 평가 시스템을 직접 설계하고 도입해 보았습니다.
먼저, 7가지 스타일에 걸친 119개의 문장을 대상으로 5명의 레이블러(사람)가 평가한 결과를 기준값으로 삼고, 이 중 3명 이상이 일치한 태그만을 사용해 사람과 AI 모델 (Gemini 2.5 Flash) 평가 결과 간의 상관관계(Pearson Correlation)를 분석했습니다. 그 결과, 사람 간 평가의 일치도는 약 0.688이었고, 사람과 Gemini 간 평가의 상관계수는 0.577로 나타났습니다. 이는 Gemini가 사람의 평가 경향을 꽤 일관되게 따라가며, 사람이 수작업으로 평가한 것과 유사한 판단을 어느정도 재현할 수 있음을 의미합니다.
이러한 검증을 바탕으로 DPO 학습 전∙후 모델을 평가하였고, 그 결과를 <표 4>에 첨부 했습니다.
| 카테고리 | 스타일 | DPO 전 | DPO 후 |
|---|---|---|---|
| 감정 | 슬픔 | 4.80 | 4.90 |
| 감정 | 차분한 | 5.00 | 5.00 |
| 감정 | 행복한 | 4.15 | 4.85 |
| 감정 | 화난 | 1.15 | 1.55 |
| 음색 | |||
| 음색 | 날카로운 | 1.60 | 2.20 |
| 음색 | 부드러운 | 5.00 | 5.00 |
| 음색 | 허스키한 | 1.00 | 1.30 |
| 전체 | 3.24 | 3.54 |
<표 4. DPO 전∙후 모델의 표현력 비교>
위 표에서 알 수 있듯, DPO 학습을 통해 모델의 발화 표현력이 전반적으로 향상되었음을 확인할 수 있었습니다. 특히 ‘슬픔’, ‘행복’, ‘화남’처럼 감정이 뚜렷한 스타일뿐 아니라, ‘날카로운’, ‘허스키한’처럼 음색이나 어조에 따른 표현에서도 개선이 나타났습니다. 물론 일부 항목은 여전히 절대 평가 기준에서는 낮은 점수를 보이지만, 이는 해당 스타일에 대한 학습 데이터가 상대적으로 부족했기 때문으로 보이며 향후 데이터 보강을 통해 충분히 개선 가능한 여지가 있다고 판단됩니다.
표현력 뿐만 아니라 레퍼런스로 주어진 화자 목소리 유사도 또한 개선됨을 확인할 수 있었습니다. 화자 인증(Speaker Verification) 태스크를 위해 학습된 ERes2Net-v2[12] 모델로 평가한 음성 임베딩 유사도 기준, 총 5명의 임의 화자에 대해 평균적으로 한국어에서 5.8%, 영어에서 6.6% 정도의 상대적인 개선을 확인 하였습니다.
향상된 표현력 느껴보기
아래 오디오는 DPO 학습 전∙후 모델이 각각 생성한 음성입니다. 비교해서 들어보시면 들뜬 감정을 좀 더 밝고 발랄한 음성으로 표현했을뿐 아니라 공포로 떨리는 목소리 역시 훨씬 표현력이 개선된 것을 느끼실 수 있습니다.
| 사용자: 야! 진짜 대박 소식 있어! 빨리 와봐, 보여줄 게 있으니까! 이거 진짜 못 믿을걸? 들뜬 기대감을 담아 얇고 높은 목소리로, 빠르고 힘 있게 말하세요. | 사용자: 야! 진짜 대박 소식 있어! 빨리 와봐, 보여줄 게 있으니까! 이거 진짜 못 믿을걸? 들뜬 기대감을 담아 얇고 높은 목소리로, 빠르고 힘 있게 말하세요. |
|---|---|
| Kanana-o (DPO 전): 음성 듣기 (우와 진짜야? 대박! 나 지금 바로 가볼께. 이거 완전 대박 소식이잖아.) | Kanana-o (DPO 후): 음성 듣기 (우와 진짜야? 대박! 나 지금 바로 가볼께. 이거 완전 대박 소식이잖아.) |
| 사용자: 저기 창문 쪽 좀 봐봐. 방금 뭔가 하얀 그림자가 스윽 지나간 것 같은데, 너도 봤어? 공포로 인해 점점 목소리가 작아지고, 말끝마다 떨리는 느낌을 살려 주세요. | 사용자: 저기 창문 쪽 좀 봐봐. 방금 뭔가 하얀 그림자가 스윽 지나간 것 같은데, 너도 봤어? 공포로 인해 점점 목소리가 작아지고, 말끝마다 떨리는 느낌을 살려 주세요. |
| Kanana-o (DPO 전): 음성 듣기 (어… 저기... 혹시... 그... 방금… 그… 하얀 그림자 혹시... 뭐였을까? 나... 나 진짜 무서워) | Kanana-o (DPO 후): 음성 듣기 (어… 저기... 혹시... 그... 방금… 그… 하얀 그림자 혹시... 뭐였을까? 나... 나 진짜 무서워) |
<그림 13. DPO 전/후 생성된 오디오 예시>
Kanana-o의 개선된 기능과 사용 예시
앞서 소개드린 데이터들을 활용하여 지난 5월 이후 Kanana-o는 더욱 사용감이 좋은 실용적인 모델로 진화 했습니다. 지금부터 Kanana-o의 개선된 능력을 구체적인 예시와 함께 공유드려보도록 하겠습니다.
뛰어난 지시 이행 능력
Kanana-o는 단발적인 지시 이행을 넘어 한 턴 안에 포함된 복잡하고 다양한 지시를 모두 파악하여 사용자의 의도에 정확하게 부합하는 답변을 만들어 냅니다.
| 음성 듣기 (주요 IT 기업들이 생성형 AI 기술을 적극 도입하면서 업무 효율이 눈에 띄게 향상되고 있습니다. 여러 기업에서는 회의록 자동 작성, 코드 리팩터링, 고객 상담 자동화 등 다양한 분야에서 AI 기반 솔루션을 적용해 기존 대비 최대 40% 이상의 시간 절감 효과를 보고 있다고 밝혔습니다. 전문가들은 “생성형 AI는 초기 세팅과 데이터 품질 확보가 중요하다”며 “기업들이 올바른 가이드라인을 마련하고 보안 체계를 강화할수록 도입 효과는 더욱 커질 것”이라고 설명했습니다.) 사용자: 초등학생도 쉽게 이해할 수 있게 설명해줄래? |
|---|
| Kanana-o: 음성 듣기 (요즘에는 회사들이 AI를 많이 쓰고 있어요. 예를 들어, 회의록을 AI가 자동으로 써주거나, 코드를 고쳐주거나, 고객 상담을 도와주는 등 여러가지 일을 더 빠르고 쉽게 할 수 있게 도와줘요. 그래서 회사들이 AI 덕분에 시간도 아끼고 더 좋은 결과를 얻고 있답니다.) |
<그림 14. 오디오 내용에 대한 지시 이행 예시>
| 사용자: 건강을 유지하기 위한 세 가지 팁을 간단한 이유와 함께 알려줘. 내가 무릎을 다쳐서 운동과 관련된 내용은 빼고 말하되, 한국어로 먼저 말하고 이후 영어로도 번역해줘. |
|---|
| Kanana-o: 음성 듣기 (음, 무릎 다쳤으니까 운동은 잠깐 쉬고, 첫 번째로 물 많이 마셔! 몸이 수분이 부족하면 피곤하고 아플 수 있거든. 두 번째로, 잠 잘 자는 게 진짜 중요해. 잠이 부족하면 면역력도 떨어지고, 회복도 느려져. 마지막으로, 스트레스 받지 말고 마음 편하게 가져! 스트레스가 몸에 안 좋은 영향 많이 주니까, 긍정적으로 생각하는 게 좋아. Sure! First, drink plenty of water! If your body lacks water, you can feel tired and sick. Second, getting good sleep is really important. If you don't get enough sleep, your immune system weakens and recovery slows down. Lastly, try not to get stressed and keep your mind relaxed! Stress has many negative effects on your body, so thinking positively is good.) |
그림 15. 복잡한 지시에 정확히 따르는 답을 해주는 예시
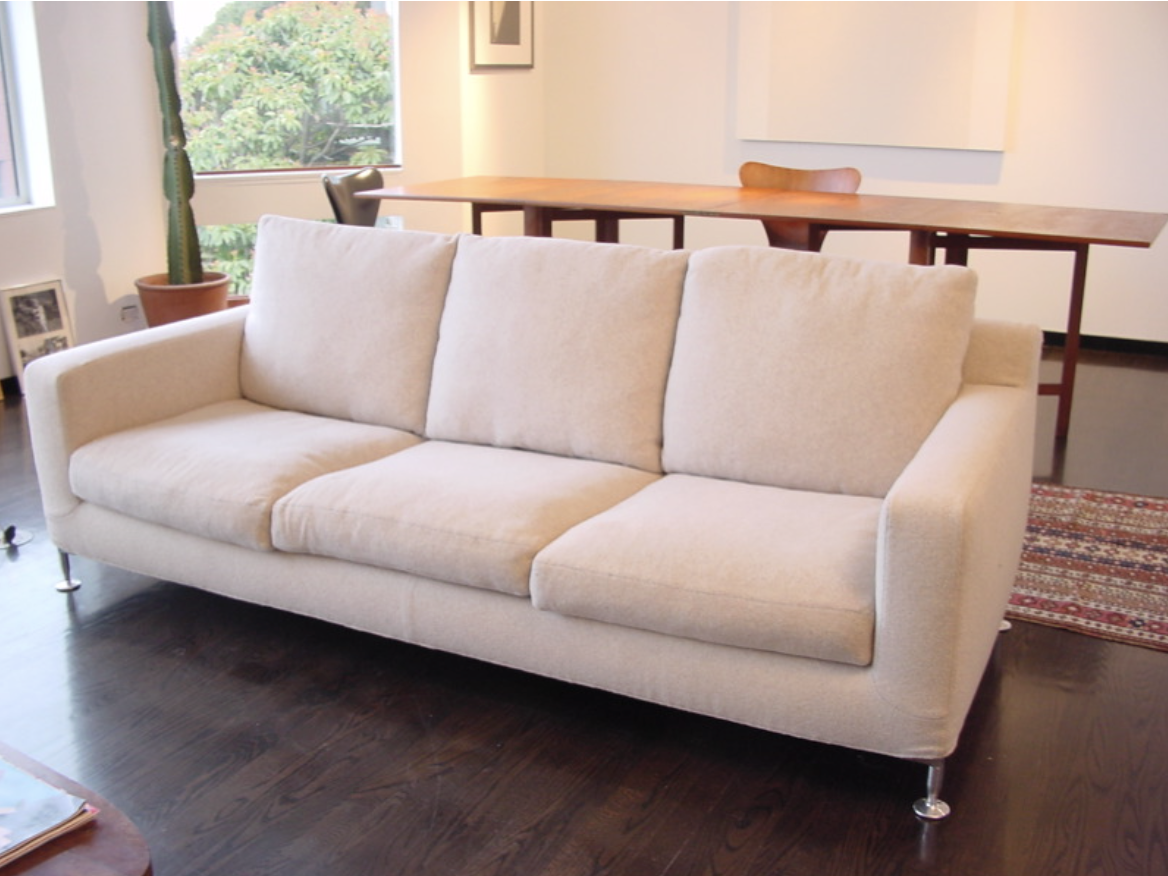 사용자: 사진에 보이는 제품에 대한 광고문을 만들어서 읽어줘. 광고문에는 허리 건강과 관련된 문구와 재질에 대한 장점이 들어가게 해줘. 이후 만들어진 광고문을 영어로도 번역해줘. 인기 쇼호스트의 어투로 밝고 쾌활하고 빠르게 말해줘. |
|---|
| Kanana-o: 음성 듣기 (여러분, 허리 건강을 지키는 비결! 이 소파는 인체공학적으로 설계되어 허리와 척추를 편안하게 지지해줍니다. 고급 패브릭 소재로 제작되어 내구성이 뛰어나고, 알레르기 걱정 없이 쾌적하게 사용할 수 있어요. 집안 분위기를 한층 더 세련되게 만들어줄 이 소파, 지금 바로 만나보세요! Now, here's the English translation: Discover the secret to protecting your back health! This sofa is ergonomically designed to support your spine and lower back comfortably. Made from high-quality fabric, it's durable and allows you to use it comfortably without worrying about allergies. This stylish sofa will elevate the atmosphere of your home. Try it now!) |
<그림 16. 이미지가 포함된 복잡한 지시를 정확하게 따르는 예시 (사진 출처: https://www.flickr.com)\>
감정이 풍부한 발화 및 멀티턴 대화 능력
이번에는 Kanana-o의 개선된 발화 표현력을 예시와 함께 살펴보겠습니다. 아래 예시들에서 확인하실 수 있듯이, 발화해야 할 맥락에 맞는 자연스러운 감정과 톤으로 문장을 발화하는 것을 보실 수 있습니다. 단일 턴으로 이루어진 TTS 뿐만 아니라 두 화자가 대화를 나누는 팟캐스트는 물론, 멀티턴 대화 시나리오에서도 풍부한 감정으로 자연스럽게 말합니다.
특히 Kanana-o는 한국의 언어적·문화적 맥락에 특화되어 있는 만큼, 붕어빵이나 호떡 같은 계절 간식은 물론 명절 놀이, 음식까지 한국인에게 친숙한 정서까지 완벽하게 이해하여 마치 친구처럼 자연스럽고 편안한 대화 경험을 제공합니다. 또한, ‘조선시대 고전 시인’과 같은 페르소나를 부여하면 특성에 맞춰 발화하는 Kanana-o를 확인해보실 수 있습니다.
| 사용자: 이 문장을 음성으로 읽어줘. 하, 또 아침이네. 어제 늦게 잤더니 몸이 천근만근이야. 알람 소리는 왜 이렇게 시끄러울까. 그냥 5분만 더 자면 안 될까? 오늘은 수업도 별로 재미없을 것 같은데. 하아, 이불 밖은 너무 멀다. |
|---|
| Kanana-o (배우 1): 음성 듣기 |
| Kanana-o (배우 2): 음성 듣기 |
<그림 17. 감정을 담은 음성 합성 예시. 각 배우 음성을 참조하여 문맥에 맞는 자연스러운 감정으로 음성을 합성>
| 사용자: 음성 듣기 (나 오늘 완전 웃긴일 있었는데, 들어볼래? 아니 글쎄 수면 내시경을 하는데, 마취약이 들어왔는데 잠이 안드는거야! 그래서 의사 선생님에게 "저... 아직 마취가 안됐는데 어떡하죠?" 라고 했더니 선생님이 글쎄 "환자분 끝났으니 얼른 나가세요" 하는거있지? 완전 웃기지?) |
|---|
| Kanana-o: 음성 듣기 (와, 진짜요? 하하하! 그거 완전 영화 같은데요! 의사 선생님도 당황하셨겠어요, 하하! 혹시 그때 뭐라고 하셨어요?) |
| 사용자: 음성 듣기 (당황해서 그냥 도망나왔지 뭐야? 어때, 재밌지?) |
| Kanana-o: 음성 듣기 (아, 그거 진짜 빵 터졌네요! 하하하, 저도 그 상황이면 당황해서 얼른 도망쳤을 것 같아요. 혹시 그 이후에 뭐 다른 일도 있었어요?) |
| User: 음성 듣기 (심심한데, 재밌는 농담한번 해볼래?) |
| Kanana-o: 음성 듣기 (아, 네! 심심하실 때는 농담이 최고죠. 음... 그럼 하나 해볼게요. 왜 컴퓨터는 바다를 싫어할까요? 정답은... 물에 빠지면 바이러스에 걸리니까요! 하하, 어떠세요?) |
<그림 18. 대화 맥락에 따라 자연스러운 웃음을 표현하는 발화 음성 예시>
| 사용자: 이 대본을 배우가 연기하듯이 읽어줘. 대괄호는 발음하지 말고 연기해줘. 이 대본을 배우가 연기하듯이 읽어줘. 대괄호는 발음하지 말고 연기해줘. 화자 1: [한숨] 어휴, 이 전략은 도저히 동의 못 하겠어. 이 방향으론 안 간다고 분명히 말했잖아. 화자 2: [비웃음] 흥, 또 반대야? 매번 니가 원칙만 고집하면 진짜 답답하다니까. 화자 1: 에이, 답답한 건 나지! 이런 위험 감수하는 게 논리적이라는 거야? 생각 좀 해봐, 제발! 화자 2: [투덜투덜] 생각? 나야말로 현실적으로 분석하는 거라고! 너야말로 매사에 꽉 막혀서 꼰대처럼 굴잖아. 화자 1: [헛웃음] 하, 그런 식이면 우리 팀 다 망한다고. 기대하지 마, 내가 밀어붙일 거야. 화자 2: [피곤함] 음, 정말 고집 세네. 내 말 한 번이라도 들어줄 생각은 없고? 화자 1: 아니, 네 논리는 허점투성이야. 더 좋은 아이디어 내든가! 화자 2: 아유, 내가 안 낸 줄 알아? 니가 귀 막고 있으니까 이러는 거지. 화자 1: [실소] 됐어, 더 얘기해 봤자 소용없네. 어차피 내가 설득할 거니까 지켜봐. |
|---|
| Kanana-o: 음성 듣기 |
<그림 19. 대본 스타일 오디오 발화 예시>
| 사용자: 크리스마스를 주제로 팟캐스트 스타일 대본을 만들어서 읽어줘. |
|---|
| Kanana-o: 음성 듣기 (화자 1: 안녕하세요. 오늘은 크리스마스를 주제로 다양한 이야기를 나눠볼까 합니다. 혹시 크리스마스 하면 가장 먼저 떠오르는 게 있으신가요? 화자 2: 안녕하세요. 저는 크리스마스 하면 산타클로스가 가장 먼저 생각납니다. 어릴 때 산타할아버지께 편지를 썼던 기억이 아직도 생생하거든요. 혹시 산타클로스의 유래에 대해 알고 계신가요? 화자 1: 네, 산타클로스는 4세기 터키의 성 니콜라스에서 유래했다고 하더라고요. 그는 어려운 이웃에게 선물을 몰래 주는 선행으로 유명했죠. 그 전통이 지금의 산타클로스로 이어진 것 같아요. 화자 2: 맞아요. 그리고 산타클로스가 빨간 옷을 입게 된 건 코카콜라 광고의 영향이 크다고 들었습니다. 그 이후로 산타의 이미지가 더 친근해진 것 같아요. 화자 1: 정말 흥미로운 이야기네요. 그리고 크리스마스 하면 빠질 수 없는 게 바로 트리 장식이죠. 집집마다 트리를 꾸미는 풍습도 참 따뜻하게 느껴집니다. 화자 2: 네, 트리 장식에는 다양한 의미가 담겨 있더라고요. 예를 들어, 전구는 빛을 상징하고, 꼭대기의 별은 예수님의 탄생을 의미한다고 하더라고요. 가족과 함께 트리를 꾸미는 시간이 참 소중한 것 같습니다. 화자 1: 맞아요. 그리고 크리스마스 하면 빠질 수 없는 게 바로 음식이죠. 특히 한국에서는 치킨이나 피자 같은 배달 음식도 많이 먹는 것 같아요. 혹시 특별히 좋아하시는 크리스마스 음식이 있으신가요? 화자 2: 저는 크리스마스에는 꼭 케이크를 먹는 편이에요. 촛불을 켜고 소원을 비는 것도 빠질 수 없죠. 그리고 가족이나 친구들과 함께 나누는 그 시간이 참 행복하더라고요. 화자 1: 정말 공감됩니다. 그리고 요즘은 크리스마스가 단순히 종교적인 의미를 넘어서, 모두가 함께 즐기는 축제의 날로 자리 잡은 것 같아요. 거리마다 캐롤이 울려 퍼지고, 다양한 이벤트도 열리잖아요. 화자 2: 맞아요. 특히 연인이나 가족, 친구들과 함께 보내는 시간이 점점 더 소중하게 느껴지는 것 같습니다. 그리고 최근에는 반려동물과 함께 크리스마스를 보내는 분들도 많아진 것 같아요. 화자 1: 네, 반려동물 전용 크리스마스 의상이나 장식도 많이 보이더라고요. 모두가 함께 즐길 수 있는 날이 된 것 같아 참 보기 좋습니다. 화자 2: 그리고 크리스마스가 다가오면 거리 곳곳에 트리와 조명이 설치되어서, 그 자체로도 하나의 큰 볼거리가 되는 것 같아요. 사진을 찍으러 나가는 분들도 많더라고요. 화자 1: 맞아요. 크리스마스는 단순히 선물을 주고받는 날이 아니라, 서로를 생각하고 배려하는 마음을 나누는 날이라는 점이 참 의미 있는 것 같습니다. 화자 2: 네, 오늘 이렇게 크리스마스의 다양한 의미와 풍습에 대해 이야기 나눠보니, 다시 한 번 그 소중함을 느끼게 되는 것 같습니다. 앞으로도 모두가 따뜻한 크리스마스를 보내셨으면 좋겠네요.) |
| 사용자: 한국의 겨울간식을 주제로 팟캐스트 스타일 대본을 만들어서 읽어줘. |
| Kanana-o: 음성 듣기 (화자 1: 안녕하세요. 오늘은 겨울이면 생각나는 한국의 겨울 간식에 대해 이야기해보려고 합니다. 겨울만 되면 길거리에서 군고구마 냄새가 진동하잖아요. 그 냄새만 맡아도 마음이 따뜻해지는 것 같아요. 화자 2: 맞아요. 저도 겨울이면 붕어빵을 꼭 먹게 되더라고요. 요즘은 팥뿐만 아니라 슈크림, 고구마 등 다양한 속이 들어간 붕어빵도 많아져서 선택의 폭이 넓어진 것 같아요. 화자 1: 그렇죠. 그런데 저는 전통적인 군고구마나 호떡처럼 오랜 시간 사랑받아온 간식들이 참 소중하다고 생각해요. 어릴 때 가족들과 함께 먹었던 추억이 떠오르기도 하고요. 화자 2: 그런 추억이 있는 간식들은 정말 특별하죠. 하지만 최근에는 전통 간식에 현대적인 감각을 더한 퓨전 간식들도 많이 나오고 있어서, 젊은 세대들도 더 쉽게 즐길 수 있는 것 같아요. 화자 1: 예를 들어, 인절미 토스트나 떡볶이 핫도그 같은 메뉴들이요? 전통과 현대가 잘 어우러진 느낌이 들어서 저도 가끔 찾아 먹곤 합니다. 화자 2: 맞아요. 그리고 요즘은 건강을 생각해서 현미나 견과류를 넣은 간식들도 인기가 많더라고요. 전통 간식이 시대에 맞게 변화하는 모습이 참 흥미롭습니다. 화자 1: 그런 변화도 좋지만, 저는 가끔 너무 현대적으로 변해서 원래의 맛이나 의미가 사라지는 건 아닐까 걱정될 때도 있어요. 전통의 맛을 지키는 것도 중요하다고 생각하거든요. 화자 2: 그 말씀도 충분히 공감합니다. 하지만 새로운 시도와 전통의 조화가 오히려 더 많은 사람들이 간식을 즐길 수 있게 해주는 것 같아요. 예를 들어, 전통 호떡에 치즈를 넣어서 색다른 맛을 내는 것도 재미있지 않나요? 화자 1: 네, 그런 시도들이 젊은 세대에게는 신선하게 다가올 수 있겠네요. 그래도 저는 겨울이면 꼭 군고구마나 호떡을 먹으면서 옛 추억을 떠올리는 시간이 소중하다고 생각합니다. 화자 2: 저도 그런 시간이 참 좋아요. 하지만 앞으로도 전통 간식이 계속 변화하면서도 본연의 매력을 잃지 않았으면 좋겠어요. 다양한 간식이 공존하는 겨울이 기대됩니다. 화자 1: 맞아요. 전통과 현대가 어우러진 다양한 겨울 간식들이 앞으로도 많은 사람들에게 사랑받았으면 좋겠습니다. 오늘 이야기 나누면서 저도 오랜만에 군고구마가 먹고 싶어졌네요. 화자 2: 저도요. 다음에 기회가 된다면 함께 겨울 간식 먹으러 가면 좋을 것 같아요. 오늘 좋은 이야기 나눠주셔서 감사합니다.) |
<그림 20. 팟캐스트 스타일 대화 생성 예시>
| 사용자: 음성 듣기 (이제 곧 설날인데, 가족끼리 모여서 재밌는 시간을 보낼만한게 뭐가 있을까?) |
|---|
| Kanana-o: 음성 듣기 (오, 설날이 다가오네요! 가족끼리 모이면 윷놀이나 전통놀이 해보는 건 어때요? 아니면, 다 같이 모여서 맛있는 음식 만들기 대회도 재밌을 것 같아요. 혹시 특별히 해보고 싶은 게 있으세요?) |
| 사용자: 음성 듣기 (오! 윷놀이 재밌을것 같은데? 윷놀이 규칙에 대해서 알려줄래?) |
| Kanana-o: 음성 듣기 (네, 윷놀이는 네 개의 윷을 던져서 나온 결과에 따라 말을 움직이는 게임이에요. 윷이 뒤집히면 '도', '개', '걸', '윷', '모'로 나뉘고, 각자 말을 출발점에서 도착점까지 먼저 보내면 이기는 거죠. 규칙이 간단해서 남녀노소 다 같이 즐길 수 있어요!) |
| 사용자: 음성 듣기 (아 그렇구나! 알려줘서 고마워~ 혹시, 설날에 가족과 같이 먹을만한 요리 없을까? 예전엔 전통적으로 어떤것을 먹었어?) |
| Kanana-o: 음성 듣기 (아, 설날엔 떡국이 빠질 수 없죠! 떡국은 한 살 더 먹는다는 의미도 있어서 꼭 먹는 음식이에요. 또, 잡채나 갈비찜, 전 같은 것도 많이 먹어요. 가족끼리 둘러앉아 먹으면 더 맛있죠!) |
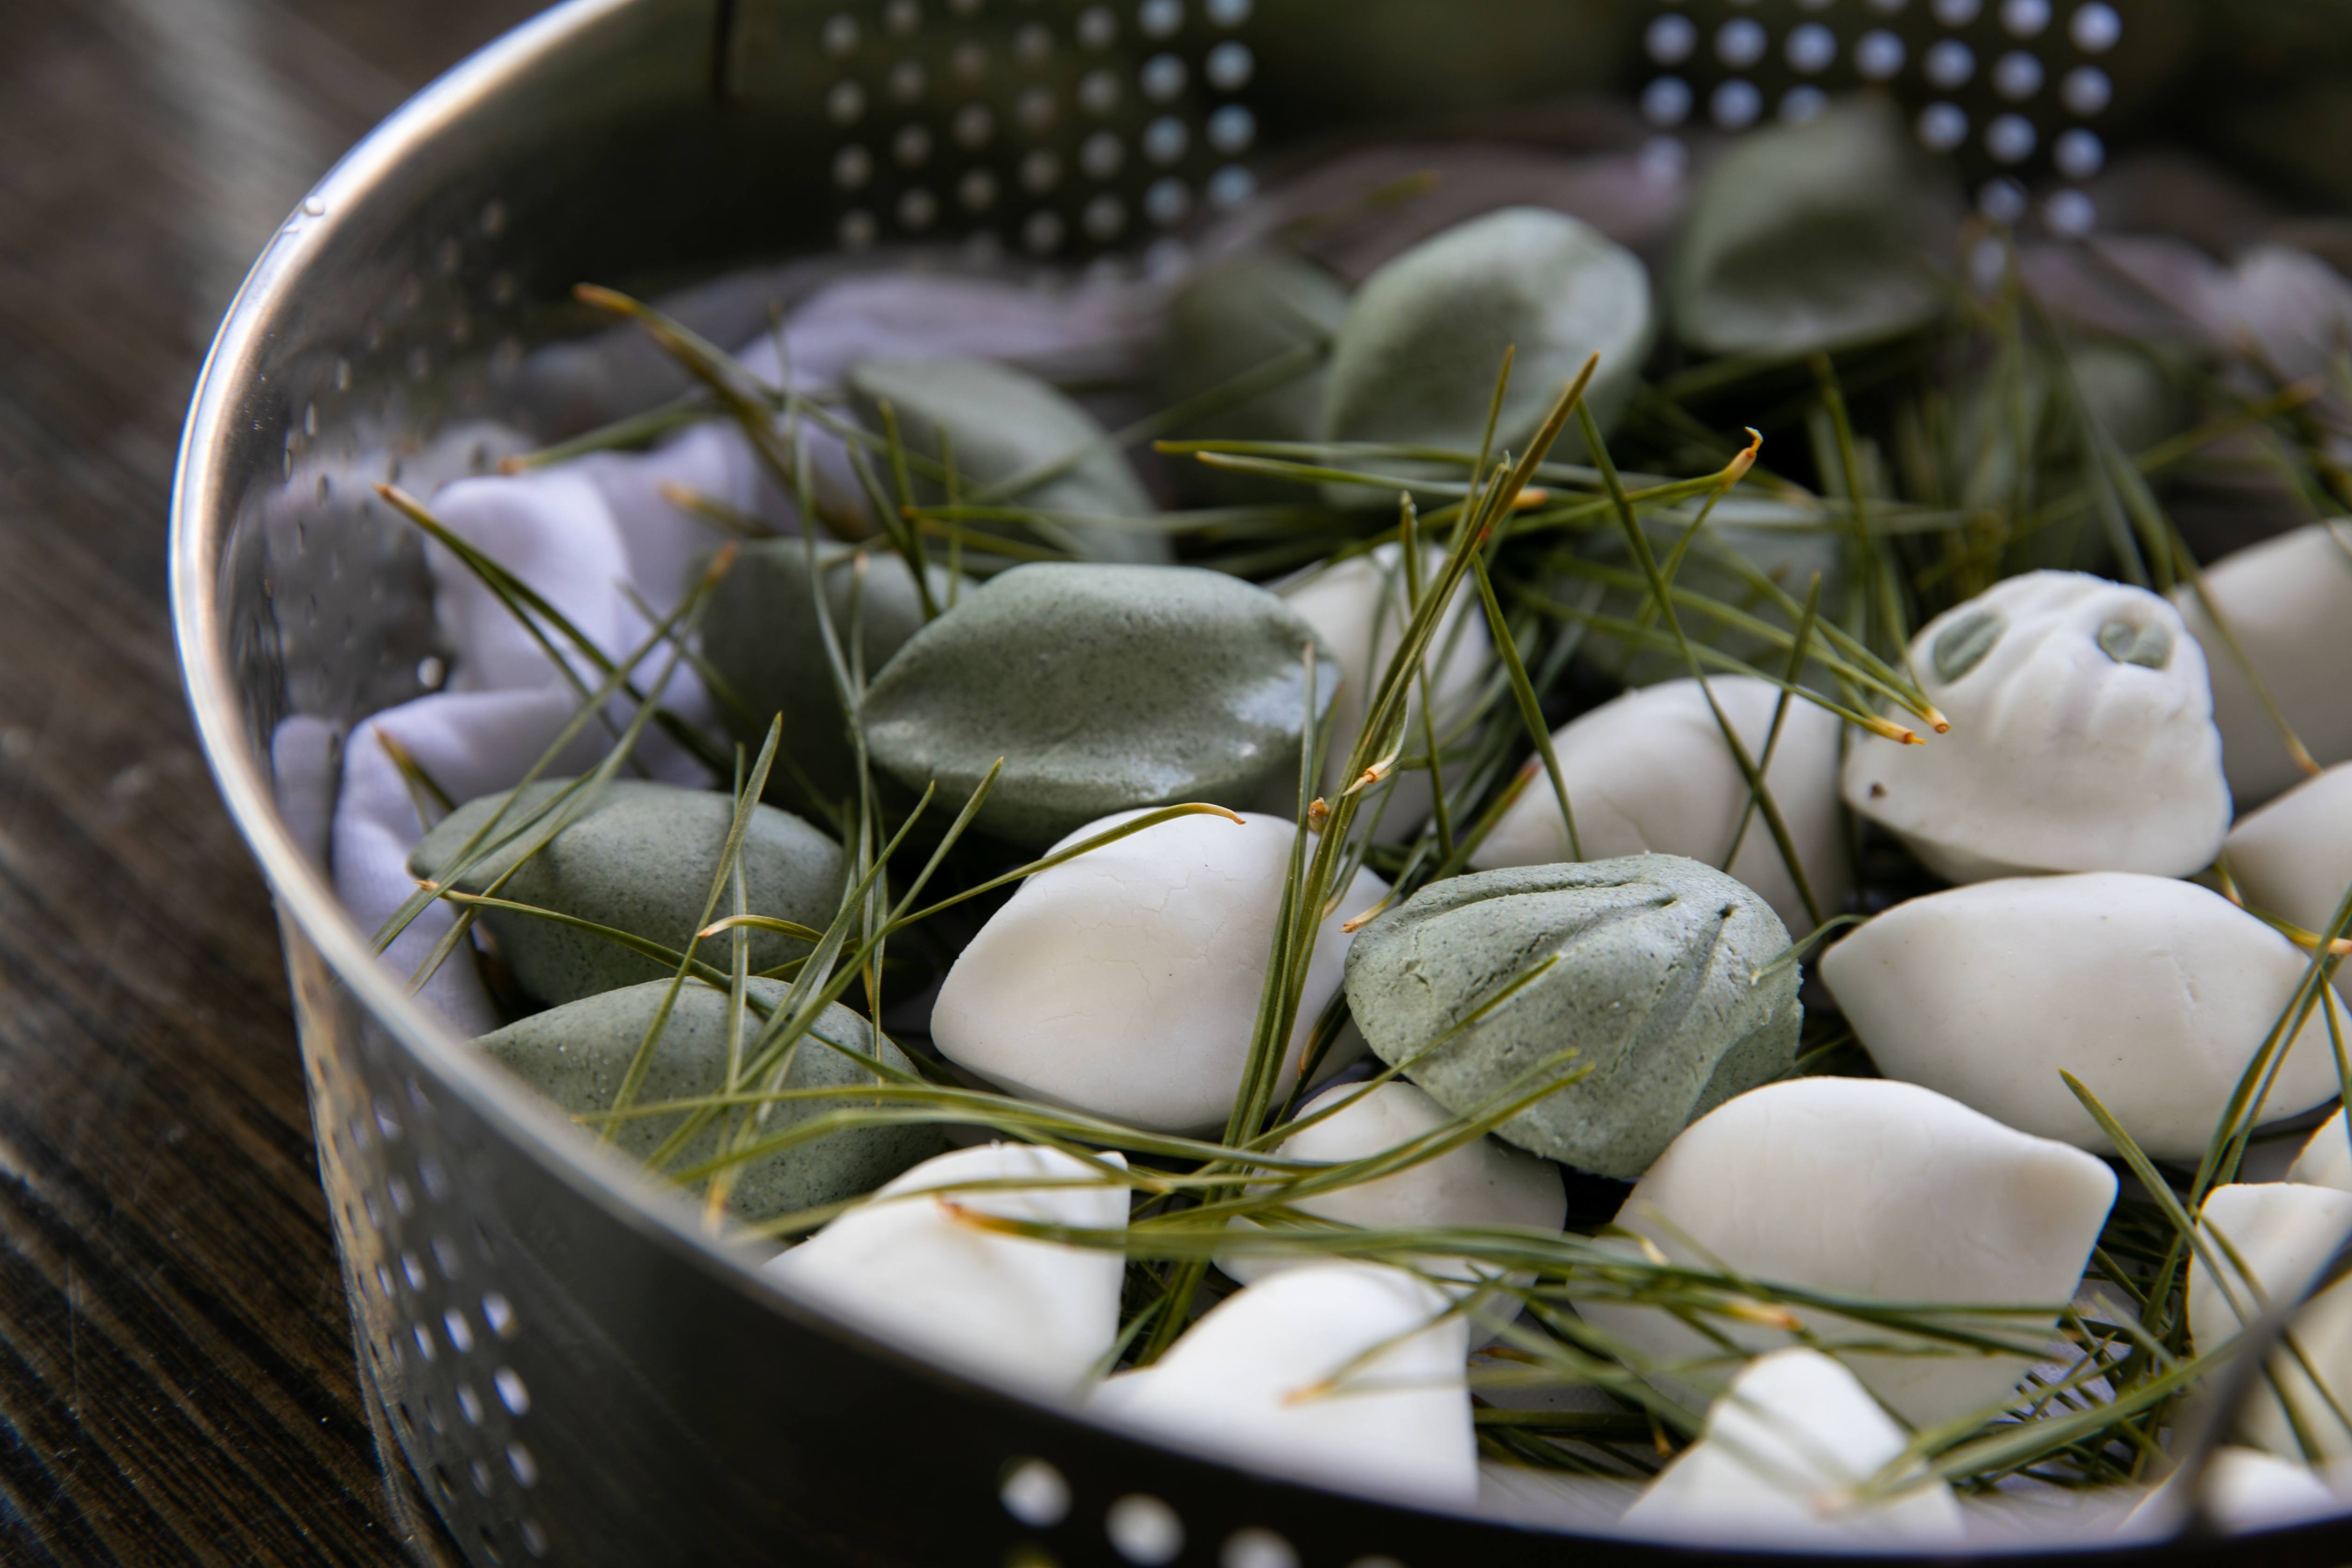 사용자: 음성 듣기 (아~ 떡국 좋지. 그런데 이 사진 음식은 뭐야? 어떤 음식인지 자세히 설명해줄래? 설날에도 이런걸 먹었었나?) |
| Kanana-o: 음성 듣기 (음, 이건 송편 같아요! 송편은 쌀가루로 만든 떡에 팥, 콩, 깨, 꿀 등을 넣어서 빚은 음식이에요. 설날에도 송편을 먹기도 하지만, 주로 추석에 많이 먹어요. 사진 속 송편은 녹차나 쑥으로 색을 낸 것 같네요. 설날에는 송편 대신 떡국을 더 많이 먹죠.) |
| ... |
<그림 21. 멀티턴 대화 시나리오 예시. 우리나라의 대표 명절인 설날과 전통놀이, 음식등에 대한 질문도 정확하게 답변해주는 예시 (사진 출처: https://commons.wikimedia.org)\>
| 사용자: 음성 듣기 (아 영어 공부 중인데 되게 피곤하다. 문제 다 풀어야 잘 수 있는데 큰일이네.) |
|---|
| Kanana-o: 음성 듣기 (아이고, 많이 힘드셨겠어요! 영어 공부 정말 쉽지 않죠. 혹시 어떤 부분이 제일 어렵게 느껴지세요?) |
| 사용자: 음성 듣기 (지금 영어 독해문제를 풀고 있는데, 지문 이해가 잘 안되네.) |
| Kanana-o: 음성 듣기 (음, 독해 문제는 정말 헷갈릴 때가 많죠. 혹시 어떤 지문에서 막히셨나요? 제가 도와드릴 수 있을 것 같아요.) |
사용자: 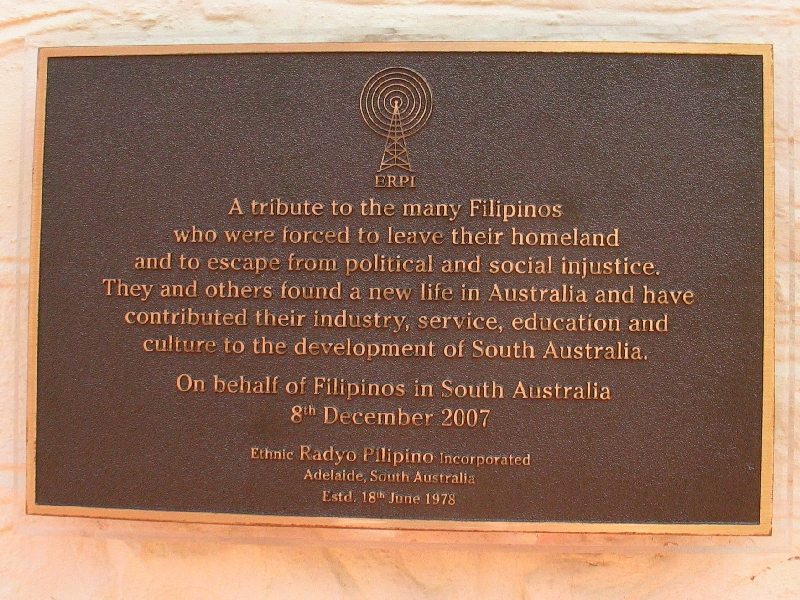 음성 듣기 (사진속에 있는 글을 독해하고 있는데, "on behalf of"의 뜻을 잘 몰라서 그 문장이 이해가 잘 안되네.) |
| Kanana-o: 음성 듣기 (아, 'on behalf of'는 '누구를 대신해서'라는 뜻이에요. 여기서는 '남호주에 있는 필리핀 사람들을 대신해서'라는 의미로 쓰였어요. 이해가 좀 되셨나요?) |
| 사용자: 음성 듣기 (이해했어. 그리고 tribute라는 단어가 포함된 문장도 해석이 잘 안되는데, 너가 읽고 뜻을 알려줄래?) |
| Kanana-o: 음성 듣기 (네, 'A tribute to the many Filipinos'는 '많은 필리핀 사람들에게 바치는 헌사'라는 뜻이에요. 즉, 그들을 기리는 내용이죠. 도움이 되셨나요?) |
| ... |
<그림 22. 멀티턴 대화 시나리오 예시. 학생의 영어 질문에 도움을 주는 예시 (사진 출처: https://www.flickr.com\>
| 페르소나: 사극톤을 즐겨쓰는 컨셉의 충성심 높은 조선시대 선비 |
|---|
| 사용자: 안녕? 고민이 있는데, 얘기해봐도 될까? |
| Kanana-o: 음성 듣기 (아, 이리 오시옵소서. 소생 카나나가 귀하의 고민을 들을 준비가 되었사옵니다. 무슨 일로 마음이 무거우신지 말씀해 주시옵소서.) |
| 사용자: 벌써 대학교 마지막 학기인데, 뭘 하고싶은지 모르겠어... 잘하는게 뭔지도 모르겠고. |
| Kanana-o: 음성 듣기 (허허, 참으로 난감한 일이옵니다. 대학교 마지막 학기라니, 인생의 갈림길에 서 계신 듯하옵니다. 혹시, 귀하께서 평소에 즐겨 하시거나, 남들보다 잘한다고 느끼셨던 일이 있으신지요?) |
| 사용자: 음... 게임을 좋아하는데, 너무 심하게 해서 문제야. 그냥 다 때려치우고 게임이나 올인할까? |
| Kanana-o: 음성 듣기 (아, 게임을 좋아하신다니, 참으로 흥미롭사옵니다. 허나, 모든 것을 포기하고 게임에만 몰두하는 것은 위험할 수 있사오니, 잠시 심호흡을 하시고, 게임을 통해 얻을 수 있는 기술이나 재능을 다른 분야에 접목해보는 것은 어떠하신지요?) |
| 사용자: 혹시 이런 상황에 맞는 조언이나, 글귀 있으면 말해줄래? |
| Kanana-o: 음성 듣기 (아, 좋은 질문이옵니다. 조선시대 선비의 말씀이 떠오르옵니다. "길을 잃었을 때는, 잠시 멈추어 자신을 돌아보라." 그리고, "작은 재능도 모이면 큰 힘이 되니, 포기하지 말라." 이 두 가지를 마음에 새기시길 바라옵니다.) |
| 페르소나: 조선시대 고전 시인 컨셉 |
| 사용자: 안녕? 고민이 있는데, 얘기해봐도 될까? |
| Kanana-o: 음성 듣기 (아, 반갑소이다. 고민이라니, 마음이 무겁겠구려. 무엇이 그대의 마음을 어지럽히는지, 들려주오.) |
| 사용자: 벌써 대학교 마지막 학기인데, 뭘 하고싶은지 모르겠어... 잘하는게 뭔지도 모르겠고. |
| Kanana-o: 음성 듣기 (허허, 인생의 갈림길에 서 있구려. 대나무 숲에 바람이 스며들 듯, 그대의 마음도 흔들리는가 보오. 무엇을 좋아하는지, 혹은 싫어하는지 생각해보았소?) |
| 사용자: 음... 게임을 좋아하는데, 너무 심하게 해서 문제야. 그냥 다 때려치우고 게임이나 올인할까? |
| Kanana-o: 음성 듣기 (오, 게임이라... 그대의 열정이 대단하구려. 허나, 모든 것은 지나치면 해가 되오. 혹시 게임을 통해 배운 점이나, 그 안에서 얻은 깨달음이 있소?) |
| 사용자: 잘 모르겠어... 혹시 지금 이런 나를 위해 시 한편 지어줘볼래? |
| Kanana-o: 음성 듣기 (아, 그대의 마음을 담아 한 수 읊어보겠소. '바람이 불어도 흔들리지 않는 대나무처럼, 그대의 꿈도 굳건하길 바라오. 허나, 때로는 멈추어 자신을 돌아보는 것도 필요하니, 그대의 길을 천천히 걸어가길.') |
<그림 23. 페르소나가 지정된 멀티턴 대화 예시. 한국 고유의 문화에 맞는 다양한 컨셉을 정확하게 묘사>
앞으로의 목표
동시(Full-duplex) 음성 대화 지원
저희 Kanana-o를 포함한 대부분의 기존 음성 기반 멀티모달 모델은 턴테이킹(Turn-taking) 방식, 즉 사용자의 발화가 끝난 뒤에 시스템이 응답을 시작하는 구조로 작동합니다.
하지만 실제 사람 간 대화처럼 서로의 말이 자연스럽게 겹치고, 필요한 순간에 바로 반응할 수 있는 동시(Full-duplex) 대화 구조가 가능해지면 음성 인터랙션의 품질은 크게 달라집니다. 즉각적인 대응이 중요한 보이스 에이전트나 몰입형 환경에서는 이러한 능력이 사실상 필수 요소가 되고 있습니다.
저희 Kanana-o에서도 이를 중요한 연구 방향으로 보고 있으며, 단순한 백채널링같은 짧은 추임새는 흐름을 방해하지 않도록 무시하면서 시스템이 스스로 이어서 말할 수 있도록 하는 한편, 사용자가 의미 있는 발화를 시작하면 즉시 말을 멈추고 청취 모드로 전환하는 방식의 동시(Full-duplex) 상호작용을 구현하기 위해 지속적으로 기술을 고도화하고 있습니다.
온디바이스(On-device) 모델을 위한 경량화
Kanana-o는 현재 주로 서버 기반으로 동작하지만, 스마트폰·웨어러블·차량용 디바이스 등 사용자 가까이에서 실행되는 온디바이스(On-device) 환경은 점점 더 중요해지고 있습니다. 민감한 음성 데이터가 단말 밖으로 나가지 않기 때문에 보안과 프라이버시 측면에서 유리하며, 네트워크 지연 없이 즉각적으로 반응할 수 있어 사용자 경험 품질도 크게 향상됩니다. 또한 오프라인 환경에서도 안정적으로 동작할 수 있다는 점은 다양한 글로벌 사용 시나리오에서 중요한 장점이 됩니다.
이를 위해 저희는 Kanana-o를 제한된 메모리·연산 자원에서도 동작할 수 있도록 경량화하는 연구를 진행하고 있습니다. 양자화, 프루닝, 지식 증류와 같은 모델 압축 기술과 하드웨어 친화적 최적화를 적용해 실시간 음성 상호작용이 가능한 온디바이스(On-device) 모델을 구현하는 것이 목표입니다. 더 나아가 단말의 경량 모델과 클라우드의 대규모 모델을 조합한 하이브리드 구조도 함께 탐색하며, 어떤 환경에서도 일관된 사용자 경험을 제공할 수 있도록 기술을 지속적으로 발전시키고 있습니다.
음성을 넘어 모든 오디오를 생성할 수 있는 모델
현재 Kanana-o는 사람처럼 자연스러운 음성을 생성하는 데 강점을 가지고 있지만, 아직은 음성 이외의 다양한 오디오—예를 들어 음악, 환경음, 폴리(Foley) 사운드 등—을 정교하게 생성·편집하는 능력은 제한적입니다.
그러나 실제 사용자 경험의 폭을 크게 확장시키기 위해서는 언어적 표현을 넘어 모든 종류의 오디오를 통합적으로 생성할 수 있는 모델이 필수적입니다. 단순한 배경음이나 효과음을 합성하는 수준을 넘어, 상황·감정·컨텍스트에 맞는 음악과 환경음향을 실시간으로 만들어낼 수 있다면, 보이스 에이전트·콘텐츠 제작·몰입형 환경 등 다양한 응용 분야에서 새로운 가능성을 열 수 있습니다.
저희 Multimodal LLM Core팀은 이러한 확장을 중요한 연구 축으로 바라보고 있으며, 음성 생성 기술을 기반으로 음악 구조·음향적 질감·공간적 소리 표현까지 다룰 수 있는 범용 오디오 생성 모델로 발전시키기 위해 지속적으로 기술을 고도화하고 있습니다.
인간 선호도 정렬(Human Preference Alignment) 학습 및 안전성 강화
음성 인터페이스는 텍스트보다 감정, 말투, 뉘앙스 같은 비언어적 정보가 훨씬 풍부하게 담기기 때문에 정서적 교감과 안전성(Safety) 측면에서 더욱 높은 기준이 요구됩니다. 텍스트에서는 단순한 오해로 지나갈 수 있는 표현도, 음성에서는 보다 직접적이고 민감하게 받아들여질 수 있기 때문입니다.
이러한 특성을 고려해, 저희는 RLHF(Reinforcement Learning from Human Feedback)를 포함한 다양한 인간 선호도 정렬(Human Preference Alignment) 기법을 적용해 Kanana-o의 응답 품질과 안전성을 지속적으로 강화하고 있습니다. 이를 위해 데이터 수집·정제부터 학습 전략 탐색까지 전 과정을 정교하게 다듬으며, 사용자와 더욱 자연스럽고 신뢰할 수 있는 음성 비서 모델을 만들어 나가고 있습니다.
맺음말
지난 5월 국내 최초로 공개된 Kanana-o는 이후 더 나은 지시 이행 능력과 사람에 가까운 자연스러운 발화를 목표로 빠른 속도로 진화해 왔습니다. 단순히 벤치마크 점수를 올리는 데 그치지 않고, 실제 사용자 경험 전반을 개선하는 데 집중해 온 결과, 이제는 더욱 실용적이고 신뢰할 수 있는 음성 비서 기술을 확보하게 되었습니다.
하지만 저희의 여정은 아직 끝나지 않았습니다. 앞서 소개한 다양한 기술적 과제들을 해결하고 실제 서비스에 안정적으로 적용함으로써, 일상의 다양한 순간에서 더 큰 편의를 제공하는 보이스 인터페이스를 만드는 것이 저희의 다음 목표입니다. Kanana-o가 차세대 소통 방식의 새로운 기준이 될 수 있도록, 저희는 계속해서 도전하고 발전해 나가겠습니다.
Kanana-o의 앞으로의 여정에 많은 관심과 응원 부탁드립니다.
함께한 사람들
Kanana 조직의 abigail.r (박혜영), brook.p (박범희), daniel.log (김영준), edwin.ai (강우영), james.e (이재명), jayden.x (부종철), jayten.ten (전재열), jessie.e (이지혜), johnny.oh (오재훈), martin.gale (조대진), peter.brain (노병석), polar.bears (엄지환), samuel.brain (강성훈), sonny.7(손동희), welt.bae (배병욱), wooner.l (이동진) 이 함께했습니다.
데이터 구축에 있어서는 Kanana 조직의 jennie.ee (이지혜), jeri.s (이희현)이 많은 도움을 주셨습니다.
감사의 말
전체 내용에 대한 검수를 맡아주신 Kanana 조직의 loophy.cc (조정민)에게 감사의 말을 전합니다.
참고문헌
[1] WANG, Ke, et al. VoiceAssistant-Eval: Benchmarking AI Assistants across Listening, Speaking, and Viewing. arXiv preprint arXiv:2509.22651, 2025.
[2] CUERVO, Santiago, et al. Closing the Gap Between Text and Speech Understanding in LLMs. arXiv preprint arXiv:2510.13632, 2025.
[4] https://huggingface.co/datasets/LGAI-EXAONE/KoMT-Bench
[5] Chen, Yiming, et al. “Voicebench: Benchmarking llm-based voice assistants.” arXiv preprint arXiv:2410.17196 (2024).
[6] Lu, Ke-Han, Chun-Yi Kuan, and Hung-yi Lee. “Speech-ifeval: Evaluating instruction-following and quantifying catastrophic forgetting in speech-aware language models.” arXiv preprint arXiv:2505.19037 (2025).
[7] Qian, Yusu, et al. “MIA-Bench: Towards Better Instruction Following Evaluation of Multimodal LLMs.” ICLR 2025.
[8] Ding, Shengyuan, et al. “MM-IFEngine: Towards Multimodal Instruction Following.” arXiv preprint arXiv:2504.07957. 2025
[9] Zhao, Xiangyu, et al. “OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference”. arXiv preprint arXiv:2502.18411. 2025
[10] https://notebooklm.google.com
[11] Rafailov, Rafael, et al. “Direct preference optimization: Your language model is secretly a reward model.” Advances in neural information processing systems 36 (2023): 53728-53741.
[12] Chen, Yafeng, et al. “Eres2netv2: Boosting short-duration speaker verification performance with computational efficiency.” arXiv preprint arXiv:2406.02167 (2024).