Engineering
Big things in JDK 12
2020년 4월 21일
원문에서 보기 ↗Java 12
2019년 3월 19일에 GA 배포된 JDK 12 입니다. 주요 기능들은 아래와 같습니다.
- JEP189: Shenandoah: A Low-Pause-Time Garbage Collector (Experimental)
- JEP230: Microbenchmark Suite
- JEP325: Switch Expressions (Preview)
- JEP334: JVM Constants API
- JEP340: One AArch64 Port, Not Two
- JEP341: Default CDS Archives
- JEP344: Abortable Mixed Collections for G1
- JEP346: Promptly Return Unused Committed Memory from G1
참고: https://openjdk.java.net/projects/jdk/12/
Big Features
(JEP189) Shenandoah: A Low-Pause-Time Garbage Collector (Experimental)
Shenandoah라는 이름의 GC(Garbage Collector) 알고리즘이 새로 추가됩니다. 실행 중인 Java 쓰레드와 동시에 GC를 실행하여 GC 중지 시간을 단축하는 알고리즘으로. 힙 크기와는 무관하게 동일한 중지 시간을 유지합니다.
GC는 각각의 알고리즘별로 추구하는 바가 다른데요. 이 알고리즘은 처리량과 메모리 공간의 효율성보다는 응답성에 초점을 맞추고 있습니다. 따라서, 반응성을 요구하는 애플리케이션에 적합한 알고리즘입니다. 그렇지만 GC 외에 발생하는(e.g. TTSP: Time To Safe Point) 문제에 대해서는 이 JEP의 범위를 벗어난다고 이야기하고 있습니다.
Shenandoah는 아래와 같은 단계를 거쳐 수행됩니다.
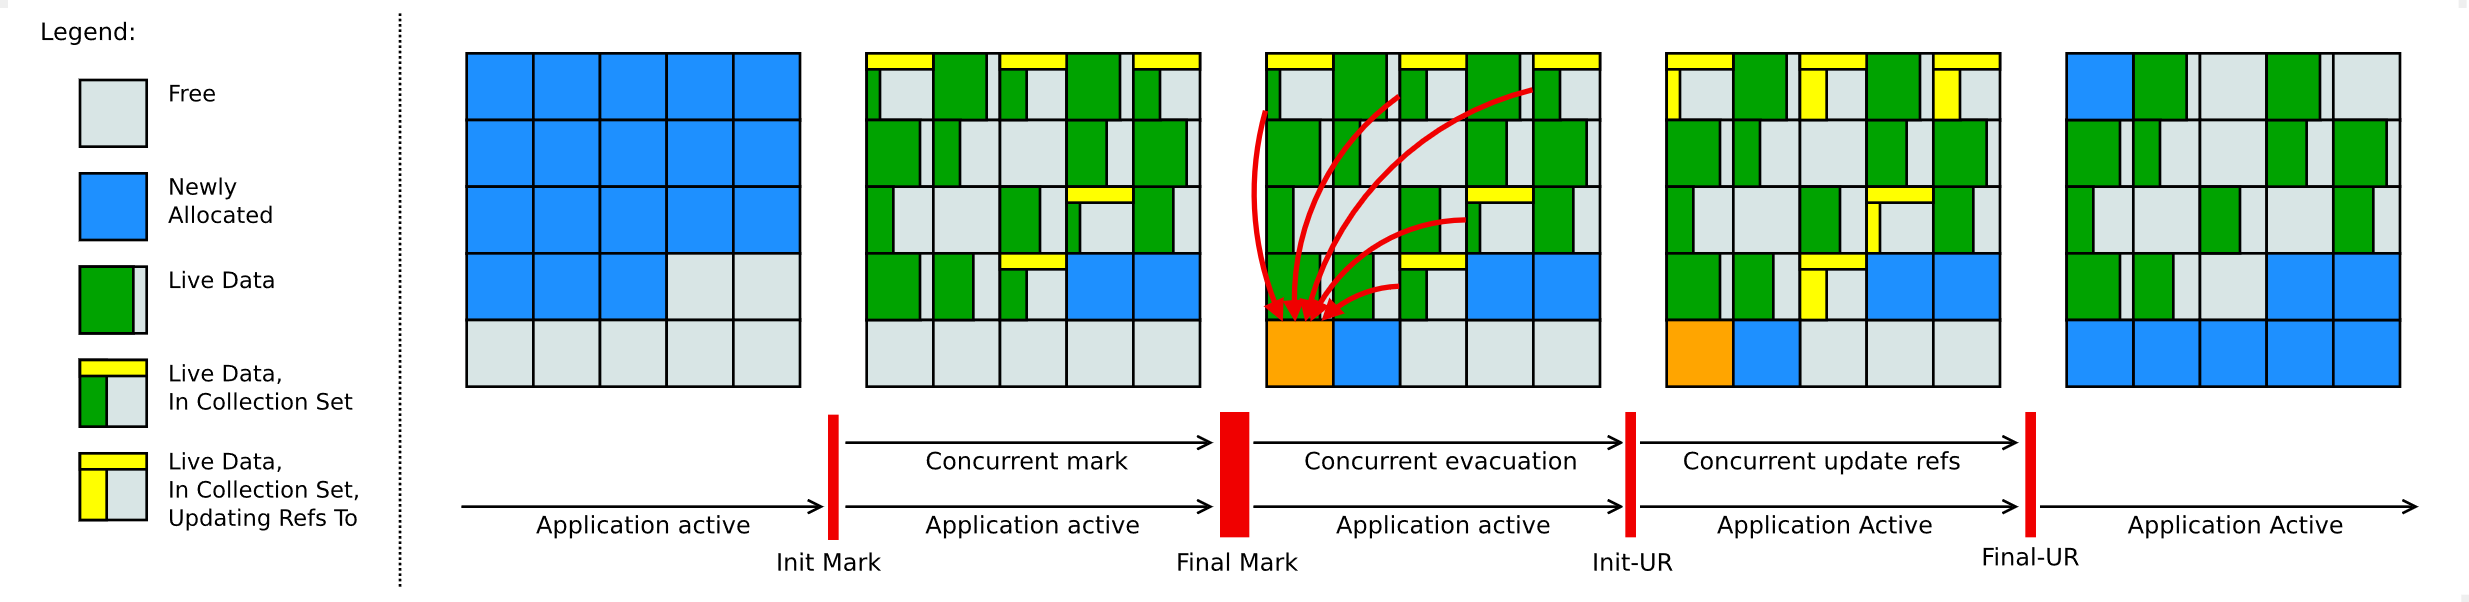 출처: https://wiki.openjdk.java.net/display/shenandoah/Main
- Initial Marking
- Concurrent Marking
- Final Marking
- Concurrent Compaction
Stop The World(STW) 후 Root set을 스캔하고, Java 쓰레드와 동시에 Marking을 수행합니다. 그 이후 한번 더 Stop The World를 수행하여 Final Marking을 수행하고 마지막 압축 단계에서 Marking된 객체들을 제거합니다. 전체적인 흐름은 CMS GC와 비슷하다고 생각하시면 될 것 같습니다.
Safe Point: JIT컴파일러가 실행을 중단하는 코드 내의 이벤트 또는 위치 Stop The World: GC를 수행하기 위해 GC 쓰레드를 제외한 모든 쓰레드가 중지되는 상태 Root set: Object의 참조를 열거된 형태로 가지고있는 묶음
(JEP230) Microbenchmark Suite
JDK에 기본 마이크로 벤치마크 제품이 추가됩니다. 추가되는 마이크로 벤치마크를 사용하여 기존 마이크로 벤치마크를 실행하거나 새로운 마이크로 벤치마크를 쉽게 만들 수 있도록 합니다. 추가되는 마이크로 벤치마크는 JMH(Java Microbenchmark Harness)를 기준으로 합니다.
벤치마크는 성능의 비교를 위해 수치화하는 것을 말합니다. JMH는 그 중에서 JVM에서 돌아가는 프로그램의 성능을 테스트하기 위한 벤치마크입니다. 작성하는 방법은 여기를 참고해주세요.
(JEP325) Switch Expressions (Preview)
기존에 제공하던 switch문을 이후 JDK 14에서 Preview로 제공될 instance of의 패턴매칭(JEP 305)을 사용할 수 있도록 단순화된 표현으로 변경되었습니다. 이 변경 또한 JDK 12에서는 Preview로, 실제 적용은 JDK 13에서 JEP 354로 적용됩니다.
switch문은 기본적으로 위에서 아래로 흐르는(Fall Through) 형태로 동작합니다. 따라서, 중간중간에 break;로 중단문을 걸어서 이후의 조건이 해당되지 않도록 제어문을 추가해주어야 합니다. 이런 방식은 저수준의 언어에서는 유용하게 사용되지만, 고수준의 컨텍스트에서는 오류 발생 가능성이 높아집니다. 실수로 break;를 누락하는 경우 의도치 않은 코드가 동작 할 수 있고, 중간중간에 break;를 넣어줘야하기 때문에 코드가 길어져 디버깅이 힘들어지기 때문이죠.(Intellij에서도 warning으로 표시되고 if-else로 변경하도록 유도됨)
switch (day) {
    case MONDAY:
    case FRIDAY:
    case SUNDAY:
        System.out.println(6);
        break;
    case TUESDAY:
        System.out.println(7);
        break;
    case THURSDAY:
    case SATURDAY:
        System.out.println(8);
        break;
    case WEDNESDAY:
        System.out.println(9);
        break;
}
아래와 같은 형태로 작성된다면 한결 보기 편하고, 불필요한 코드의 양도 줄어들며 의미에도 맞게 작성할 수 있습니다. (점점 코틀린을 닮아가는..)
switch (day) {
    case MONDAY, FRIDAY, SUNDAY -> System.out.println(6);
    case TUESDAY                -> System.out.println(7);
    case THURSDAY, SATURDAY     -> System.out.println(8);
    case WEDNESDAY              -> System.out.println(9);
}
만약 switch문 내부에서 case별로 다른 결과값을 내야한다면 어떻게 할까요? switch문에서 사용하는 블럭도 하나의 범위로 지정되기 때문에 외부에 변수를 두고, 해당 변수에 할당하는 방식으로 작성해야 했습니다.
int numLetters;
switch (day) {
    case MONDAY:
    case FRIDAY:
    case SUNDAY:
        numLetters = 6;
        break;
    case TUESDAY:
        numLetters = 7;
        break;
    case THURSDAY:
    case SATURDAY:
        numLetters = 8;
        break;
    case WEDNESDAY:
        numLetters = 9;
        break;
    default:
        throw new IllegalStateException("Wat: " + day);
}
새로 제안되는 표현식에서는 이런 불필요한 표현을 줄이고 아래와 같이 깔끔하게 작성하는것을 제안하고 있습니다. 물론, case에 해당되는 표현식에서도 블럭을 사용할 수 있습니다.
int numLetters = switch (day) {
    case MONDAY, FRIDAY, SUNDAY -> 6;
    case TUESDAY                -> 7;
    case THURSDAY, SATURDAY     -> 8;
    case WEDNESDAY              -> 9;
    default                     -> {
        // 이렇게도 가능합니다.
        throw new IllegalStateException("Wat: " + day);
    }
};
그리고 굳이 이렇게 해야할까 싶긴하지만, 기존의 switch 문법과도 섞어서 쓸 수 있도록 제안하고 있습니다.
int result = switch (s) {
    case "Foo":
        break 1;
    case "Bar":
        break 2;
    default:
        System.out.println("Neither Foo nor Bar, hmmm...");
        break 0;
};
(JEP334) JVM Constants API
struct Class_File_Format {
   u4 magic_number;
   u2 minor_version;
   u2 major_version;
   u2 constant_pool_count;
   cp_info constant_pool[constant_pool_count - 1];
   u2 access_flags;
   u2 this_class;
   u2 super_class;
   u2 interfaces_count;
   u2 interfaces[interfaces_count];
   u2 fields_count;
   field_info fields[fields_count];
   u2 methods_count;
   method_info methods[methods_count];
   u2 attributes_count;
   attribute_info attributes[attributes_count];
}
Java 클래스는 위와 같은 구조를 가지고 있고, 모든 클래스는 cp_info라고 명시된, 내부의 메서드와 클래스 그리고 String과 Integer 같은 값을 바이트코드 형태로 저장하는 constant pool을 가집니다.
cp_info {
    u1 tag;
    u1 info[];
}
constant pool은 어떤 메서드나 필드를 참조할 때, JVM이 해당 메서드와 필드의 실제 메모리상 주소를 알기위해서 참조하는 테이블 입니다. 그리고 constant pool의 각 entry는 tag라는, 각 Constant Type을 나타내는 1바이트 값을 가지고있습니다 (info 배열의 내용은 tag의 값에 따라 다름).
이 JEP에서는 이런 constant pool에서 사용할 수 있는, 런타임 아티팩트와 키 클래스 파일의 nominal description을 모델링하기 위한 API를 소개하고 있습니다. nominal description은 값이 아니라, 어떤 값을 설명하거나 constant pool에 값을 저장하기 위한, 설명서에 가깝습니다. 이 nominal descriptor를 사용하여 클래스 파일 내부에 어떤 형태의 값이 들어가는지를 기술합니다.
추가된 java.lang.constant 패키지의 대표적인 nominal descriptor로는 ConstantDesc가 있습니다.
(JEP340) One AArch64 Port, Not Two
32비트 ARM 포트와 64비트 AARCH64 포트를 유지하면서 ARM64 포트와 관련된 모든 소스를 제거합니다.
ARM64 비트와 관련된 소스가 JDK 내부에 중복으로 들어있었습니다. 각각 src/hotspot/cpu/arm과 open/src/hotspot/cpu/aarch64 디렉토리 하위에 들어있었는데요. 둘 모두 AARCH64를 구현하지만, ORACLE이 기여한 패키지를 ARM64로 부른다고합니다.
ORACLE과 의존성을 없애기 위한 Proposal로, AARCH64에 대한 자세한 내용은 여기에서 확인해 보실 수 있습니다.
(JEP341) Default CDS Archives
64비트 플랫폼에서의 JDK 빌드 프로세스를 개선하여 CDS(Class Data Sharing) 아카이브를 생성하는것을 목표로하는 제안입니다. 32비트 플랫폼에 대해서는 이후에 추가될 수 있다고 합니다.
CDS는 이전 Big things in Java 10에서도 언급했었는데요. JVM 기동시에 성능을 향상하거나, 여러 대의 JVM이 하나의 물리장비 또는 가상장비에서 돌아가는 경우, 자원에 미치는 영향을 줄이기 위해 개발된 기능입니다.
이 제안에서는 사용자가 직접 실행할 필요 없이, -Xshare:dump 옵션을 통해서 CDS를 사용할 수 있도록 제안하고 있습니다. 또한, JDK 11의 VM에는 -Xshare:auto가 기본적으로 사용되도록 설정되어 있기때문에 CDS의 이점을 사용할 수 있습니다. 이를 사용하지 않기 위해서는 -Xshare:off 명령어를 사용하면 됩니다.
java -Xshare:off HelloWorld.java
(JEP344) Abortable Mixed Collections for G1
GC(Garbage Collection) 중 하나인 G1이, 효율적으로 동작하도록 하기 위해 중단 가능한 Collection을 가지도록 변경하는 것 입니다.
GC가 발생할 경우, STW(Stop The World)라는 이름의 동작으로 불필요한 데이터들을 수집할 수 있는 시간을 가지는데, 이 시간은 일반적으로 애플리케이션 동작 중간에 들어가는 시간입니다. 이 시간이 길어질수록, 애플리케이션은 느려지게 됩니다. 따라서, 정해진 시간 내에 불필요한 객체들을 수집하지 못할 경우, GC를 중단할 수 있도록 하는 제안입니다.
GC 대상을 80%의 필수 대상(Mandatory)과 20%의 선택적 대상(Optional)으로 나눈 뒤, 우선적으로 필수적인 부분에서 수집을 진행합니다. 이후 남은 시간에 선택적 부분에서 수집을 진행하되, 남아있는 정지시간에 선택적 부분을 수집하지 못하리라 판단하면, 이를 다음 GC 시간의 선택적 부분으로 넘기게 됩니다. 따라서 휴리스틱스라는, 필수적 부분과 선택적 부분을 구분하는 예측이 정확할수록 선택적 부분은 줄어들게됩니다.
(JEP346) Promptly Return Unused Committed Memory from G1
마찬가지로 G1의 개선건인데요. GC가 활성화된 상태일때 Java의 힙 메모리를 운영체제에 반환하도록 하는 내용입니다.
현재 G1은 Full GC가 일어나거나 Concurrent cycle이라는 상황에만 Java의 힙 메모리를 운영체제에 반환합니다. 하지만, Full GC는 Java에서 최대한 피해야 할 상황이므로, Concurrent cycle만 해당 반환작업을 일으킬 수 있는데, 외부에서 강제하지 않는 한 대부분의 경우에는 힙 메모리를 반환하지 않습니다.
이러한 동작은 하이퍼바이저의 자원을 공유해서 사용하는 컨테이너 환경에서 특히나 불리합니다. VM이 비활성인 경우, 해당 VM에 할당된 메모리의 일부만 사용하는 단계에서도 G1은 모든 힙 메모리를 유지하게 되고, VM을 사용하는 사용자는 불필요한 메모리를, 자원을 제공하는 클라우드 공급자는 하이퍼바이저의 자원을 모두 활용하지 못하게 됩니다. 따라서, VM의 활동 상태를 감지하여 힙 사용량을 조절할 수 있다면, 둘 모두에게 이점이 있습니다.
위에서 설명한 Shenandoah와 OpenJ9의 GenCon collector에서는 이미 유사한 기능을 제공하고 있다고 합니다.
OpenJDK에서 테스트한 결과, 야간에는 메모리의 약 85%까지 줄일 수 있었다고 합니다.
그 외
Files.mismatch
java.nio.file 패키지에 두 개의 파일을 비교하기 위한 Files.mismatch(Path path, Path path2) 함수가 추가됩니다.
public static long mismatch(Path path, Path path2) throws IOException
인자로 받은 두 개 Path에 위치한 파일을 비교하여, 처음으로 다른 부분의 위치를 반환합니다. 동일한 경우, -1L을 반환합니다.
NumberFormat.getCompactNumberInstance
Locale과 NumberFormat.Style에 따라서 다른 형태로 값을 반환해주는 함수가 추가됩니다.
NumberFormat format = NumberFormat.getCompactNumberInstance(new Locale())
Collectors.teeing
Stream API에 추가되는 Collectors.teeing 함수입니다. 두 개의 Collector와 하나의 BiFunction로 총 세 개의 인자를 받습니다. 처음 받은 두 개의 Collector의 결과를 세 번째 BiFunction에서 받아서 계산할 수 있습니다.
double mean = Stream.of(1, 2, 3, 4, 5)
                .collect(Collectors.teeing(
                        summingDouble(i -> i),
                        counting(),
                        (sum, n) -> sum / n));

System.out.println(mean); // 3.0
String 클래스
- String.indent(int n) : 말 그대로 입력한 n 만큼 들여쓰기 하는 함수입니다. 음수를 넣을경우, 앞으로 당깁니다.
- String.transform(Function f) : Function<T, R>에 들어가는 형태로 변환됩니다.