Engineering
이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기
logan.c카카오
2024년 12월 5일
원문에서 보기 ↗안녕하세요, 카카오의 AI 모델 개발을 담당하는 카나나 알파(Kanana ⍺) 조직에서 멀티모달 언어모델을 개발하고 있는 Logan (차준범)입니다.
최근 언어모델의 놀라운 발전은 AI를 일상의 동반자로 만들며, 혁신적인 변화를 가져왔습니다. 하지만, 우리의 일상적인 소통은 텍스트를 넘어 시각, 청각 및 음성 등 다양한 감각에 걸쳐 이루어지는데요. 다른 사람들의 표정과 목소리 톤에서 그 감정을 느끼고, 때로는 사진이나 영상을 함께 보며 이야기를 나누죠.
바로 이러한 이유에서 텍스트, 이미지와 음성 등 다양한 정보를 처리할 수 있는 멀티모달 언어모델이 크게 주목받고 있습니다. 현재 저희 조직에서는 사람처럼 보고 듣고 말하며 사용자와 자연스럽게 상호작용을 하는 AI 개발을 목표로, 멀티모달 언어모델 연구에 매진하고 있습니다. 이를 통해 AI가 사용자가 보는 것을 함께 보고, 문제를 파악하여 적절한 해결책을 제시하거나, 영상과 음성을 활용하여 더 직관적이고 효과적인 의사소통을 할 수 있을 것으로 기대하고 있습니다.
이번 글에서는 카카오의 멀티모달 언어모델의 시작점인 이미지 이해 모델 Kanana-v의 현재 성능을 시작으로, 개발 과정과 활용 예시, 그리고 앞으로의 발전 방향을 소개하고자 합니다.
멀티모달 언어모델이란?
2023년이 대형 언어모델(Large Language Model)의 해였다면, 올해 가장 큰 화두는 멀티모달 언어모델(Multimodal Large Language Model)이라 할 수 있습니다. 멀티모달 언어모델은 기존 언어모델이 텍스트 입출력만을 지원하는 것과 달리, 텍스트뿐만 아니라 이미지, 음성, 영상 등 다양한 형태의 데이터를 처리할 수 있는 AI 모델입니다.
이러한 멀티모달 모델은 마치 사람이 여러 감각 정보를 바탕으로 세상을 느끼고 경험하는 것처럼 다양한 모달리티(Modality)를 통합적으로 처리하고 이해하는 것을 목표로 합니다. 이를 통해 기존 언어모델이 가진 한계를 극복하는데요. 언어모델이 큰 주목을 받던 2023년에도 주어진 이미지를 보고 텍스트 설명을 생성하거나, 음성을 통해 자유롭게 AI와 상호작용을 할 수 있는 멀티모달 언어모델의 등장은 많은 사람들이 기대하고 상상했던 방향이었습니다. 그리고 올해, 이러한 상상은 더욱 가까운 현실이 되어 우리 곁으로 성큼 다가왔습니다.
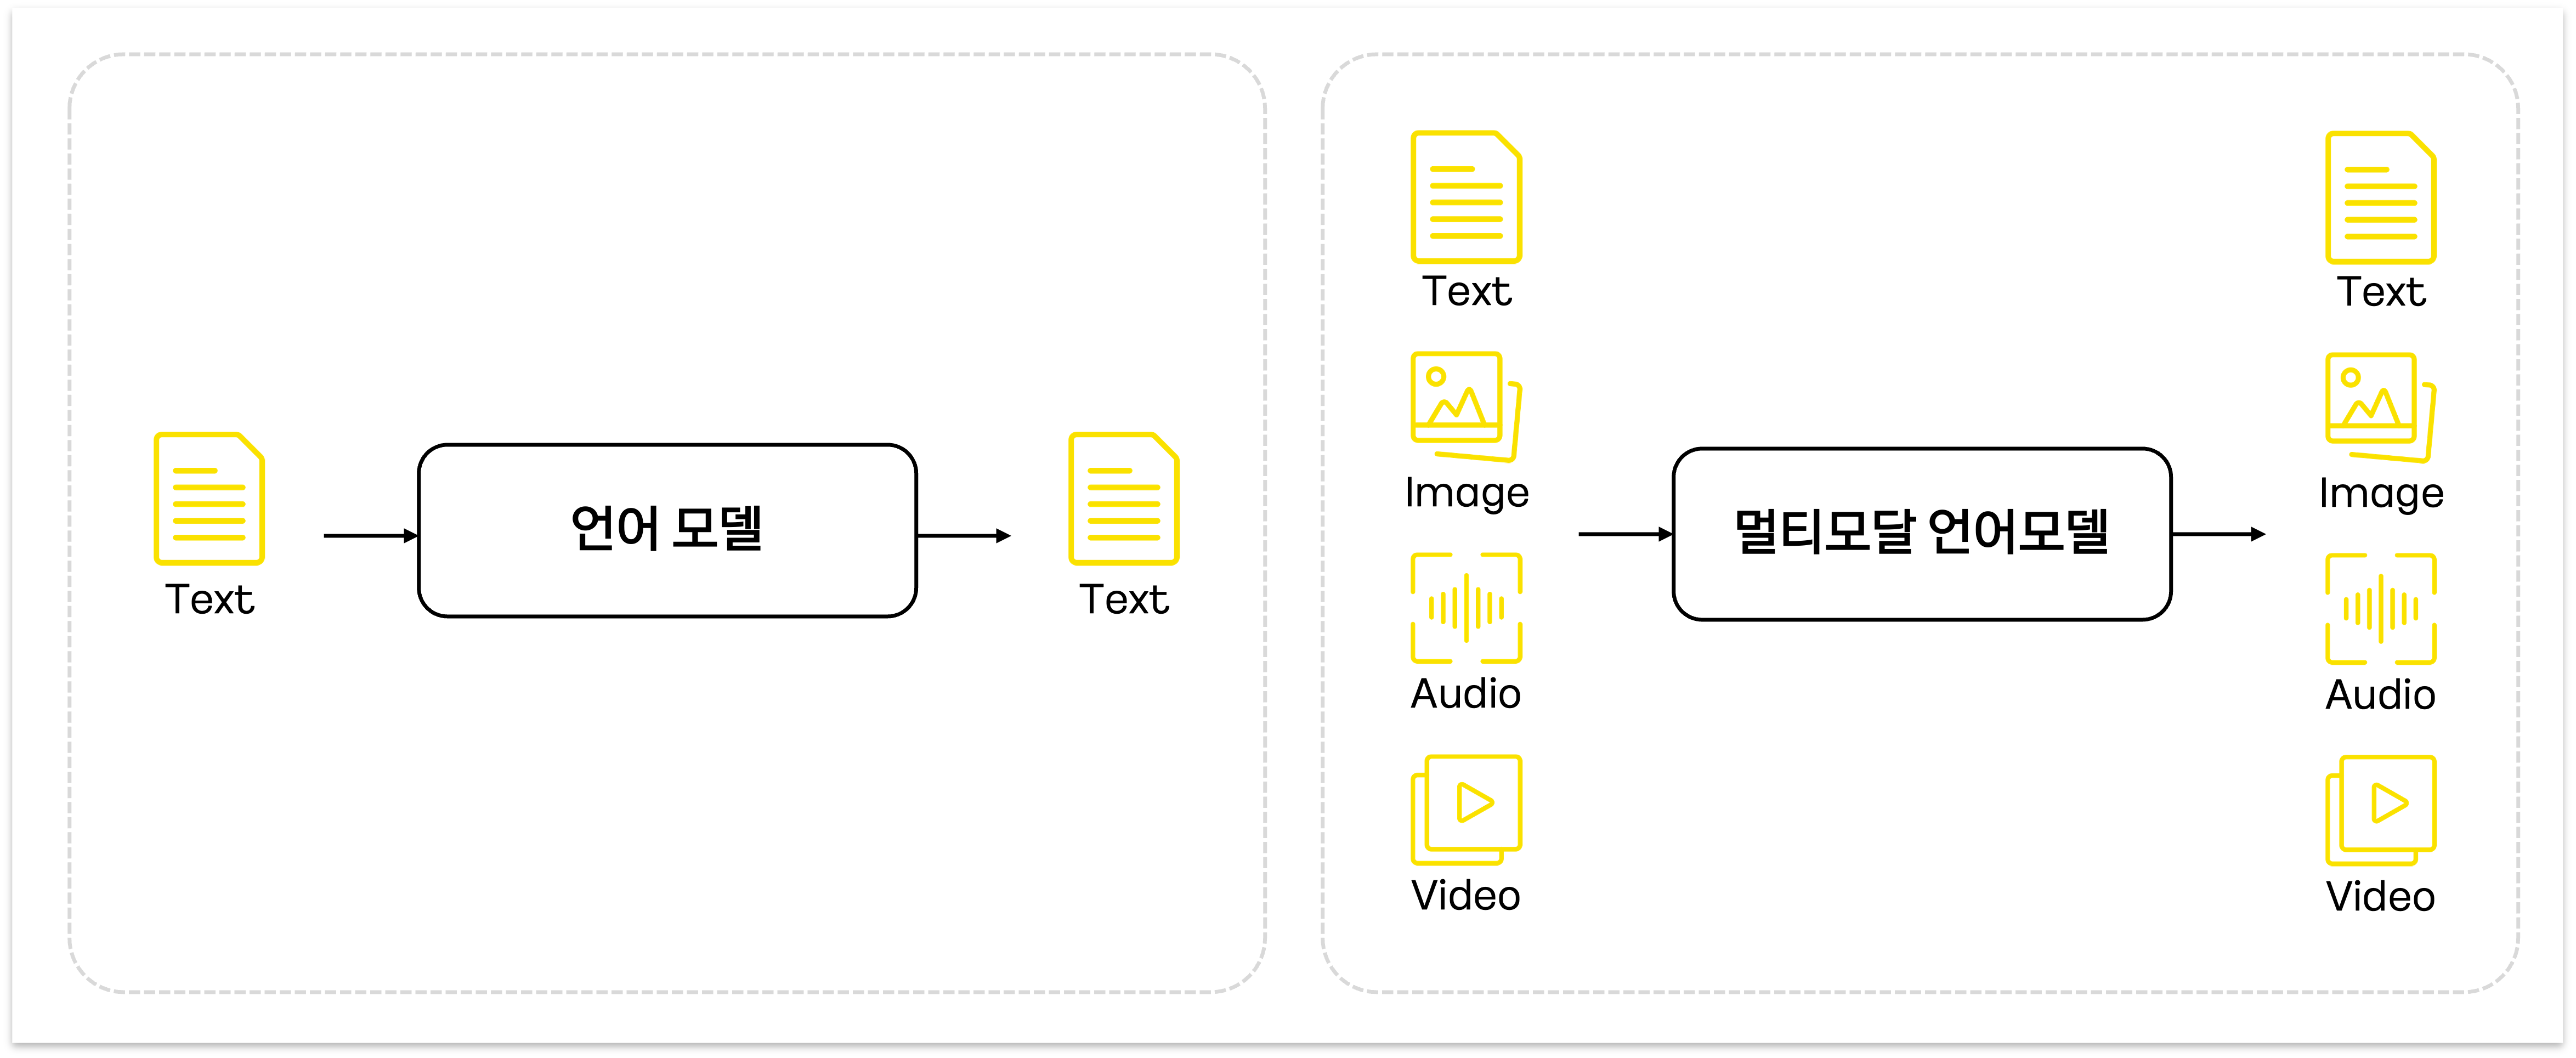
카카오의 멀티모달 언어모델
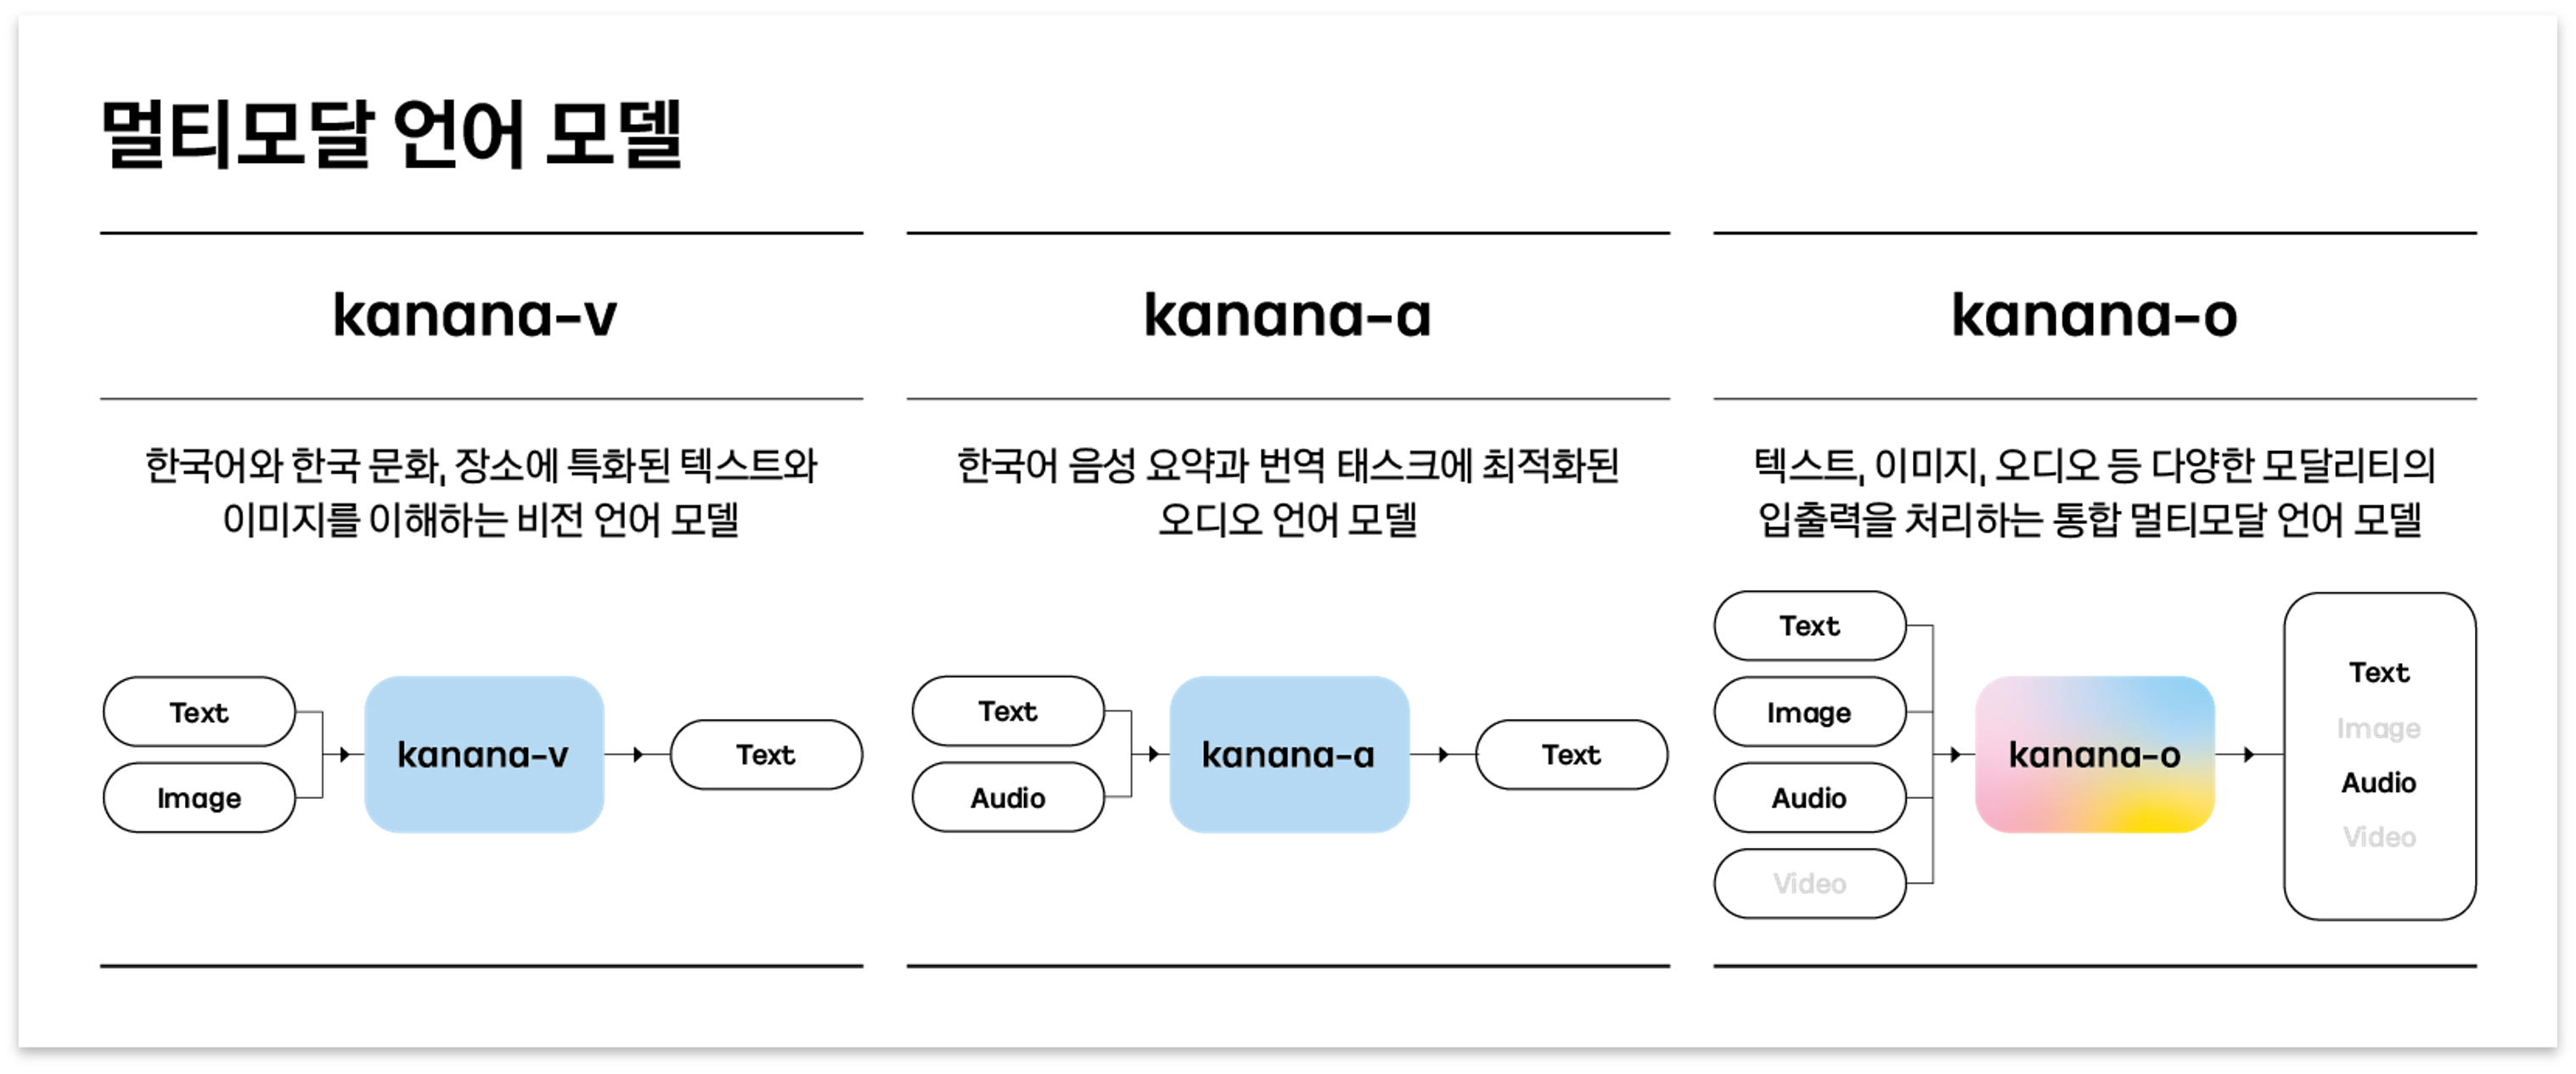
저희 조직에서는 이러한 상상을 카카오 서비스에서 실현할 수 있도록 카카오의 자체 멀티모달 언어모델을 연구하고 있습니다. 현재 이미지와 텍스트를 다루는 Kanana-v 와 오디오를 포함하여 모든 모달리티의 입출력을 목표로 하는 통합 멀티모달 언어모델 Kanana-o를 개발 중입니다.
이번 글에서는 카카오의 멀티모달 언어모델인 Kanana-v를 중점적으로 소개하고자 합니다. Kanana-v는 올해 CVPR 2024에서 하이라이트로 선정된 “Honeybee: Locality-enhanced projector for multimodal LLM”^[1]^ 등의 연구 성과를 기반으로 개발된 모델로, 현재도 성능 고도화 작업 중에 있습니다. 참고로 지난 if(kakaoAI)2024에서 Edwin이 “이미지까지 이해하는 Multimodal LLM의 학습 방법 밝혀내기”라는 내용으로 허니비의 연구 성과를 소개한 바 있습니다. 작년 11월 당시 허니비는 세계 최고 수준의 성능을 달성했었지만, 현재의 Kanana-v와 비교하면 상당한 성능 차이가 있는데요.
Kanana-v는 아직 프리뷰 단계로 볼 수 있지만, 허니비와 비교해 한국어와 영어 성능에서 모두 큰 발전을 이루었습니다. 지금부터 Kanana-v가 그동안 어떻게 성능을 개선할 수 있었는지 그 방법과 결과를 소개하겠습니다. 옛말에 “될성부른 나무는 떡잎부터 알아본다”는 말이 있듯, 현재의 성능을 통해 Kanana-v의 미래 가능성을 함께 살펴보시기 바랍니다.
Kanana-v 한국어 성능 비교: 압도적인 한국어 성능
한국어의 경우, 영어와 달리 세계적으로 널리 사용되는 보편적인 평가 지표들이 존재하지 않기 때문에 한국어 모델의 성능을 정확히 평가하고 발전시킬 수 있는 평가 벤치마크들이 턱없이 부족한 상황입니다. 단순히 영어 벤치마크를 번역해서 사용할 수는 있지만, 그렇게 만든 벤치마크로는 우리말을 제대로 읽을 수 있는지부터, 고유한 특성이나 문화적 맥락에 대한 이해, 한국향 지식 등을 제대로 평가하기 어렵습니다. 이에 모델의 다양한 한국어 능력을 정확하게 평가하고, 한국어 특유의 뉘앙스나 문화적 배경까지 잘 반영할 수 있도록 벤치마크를 직접 제작하였습니다.
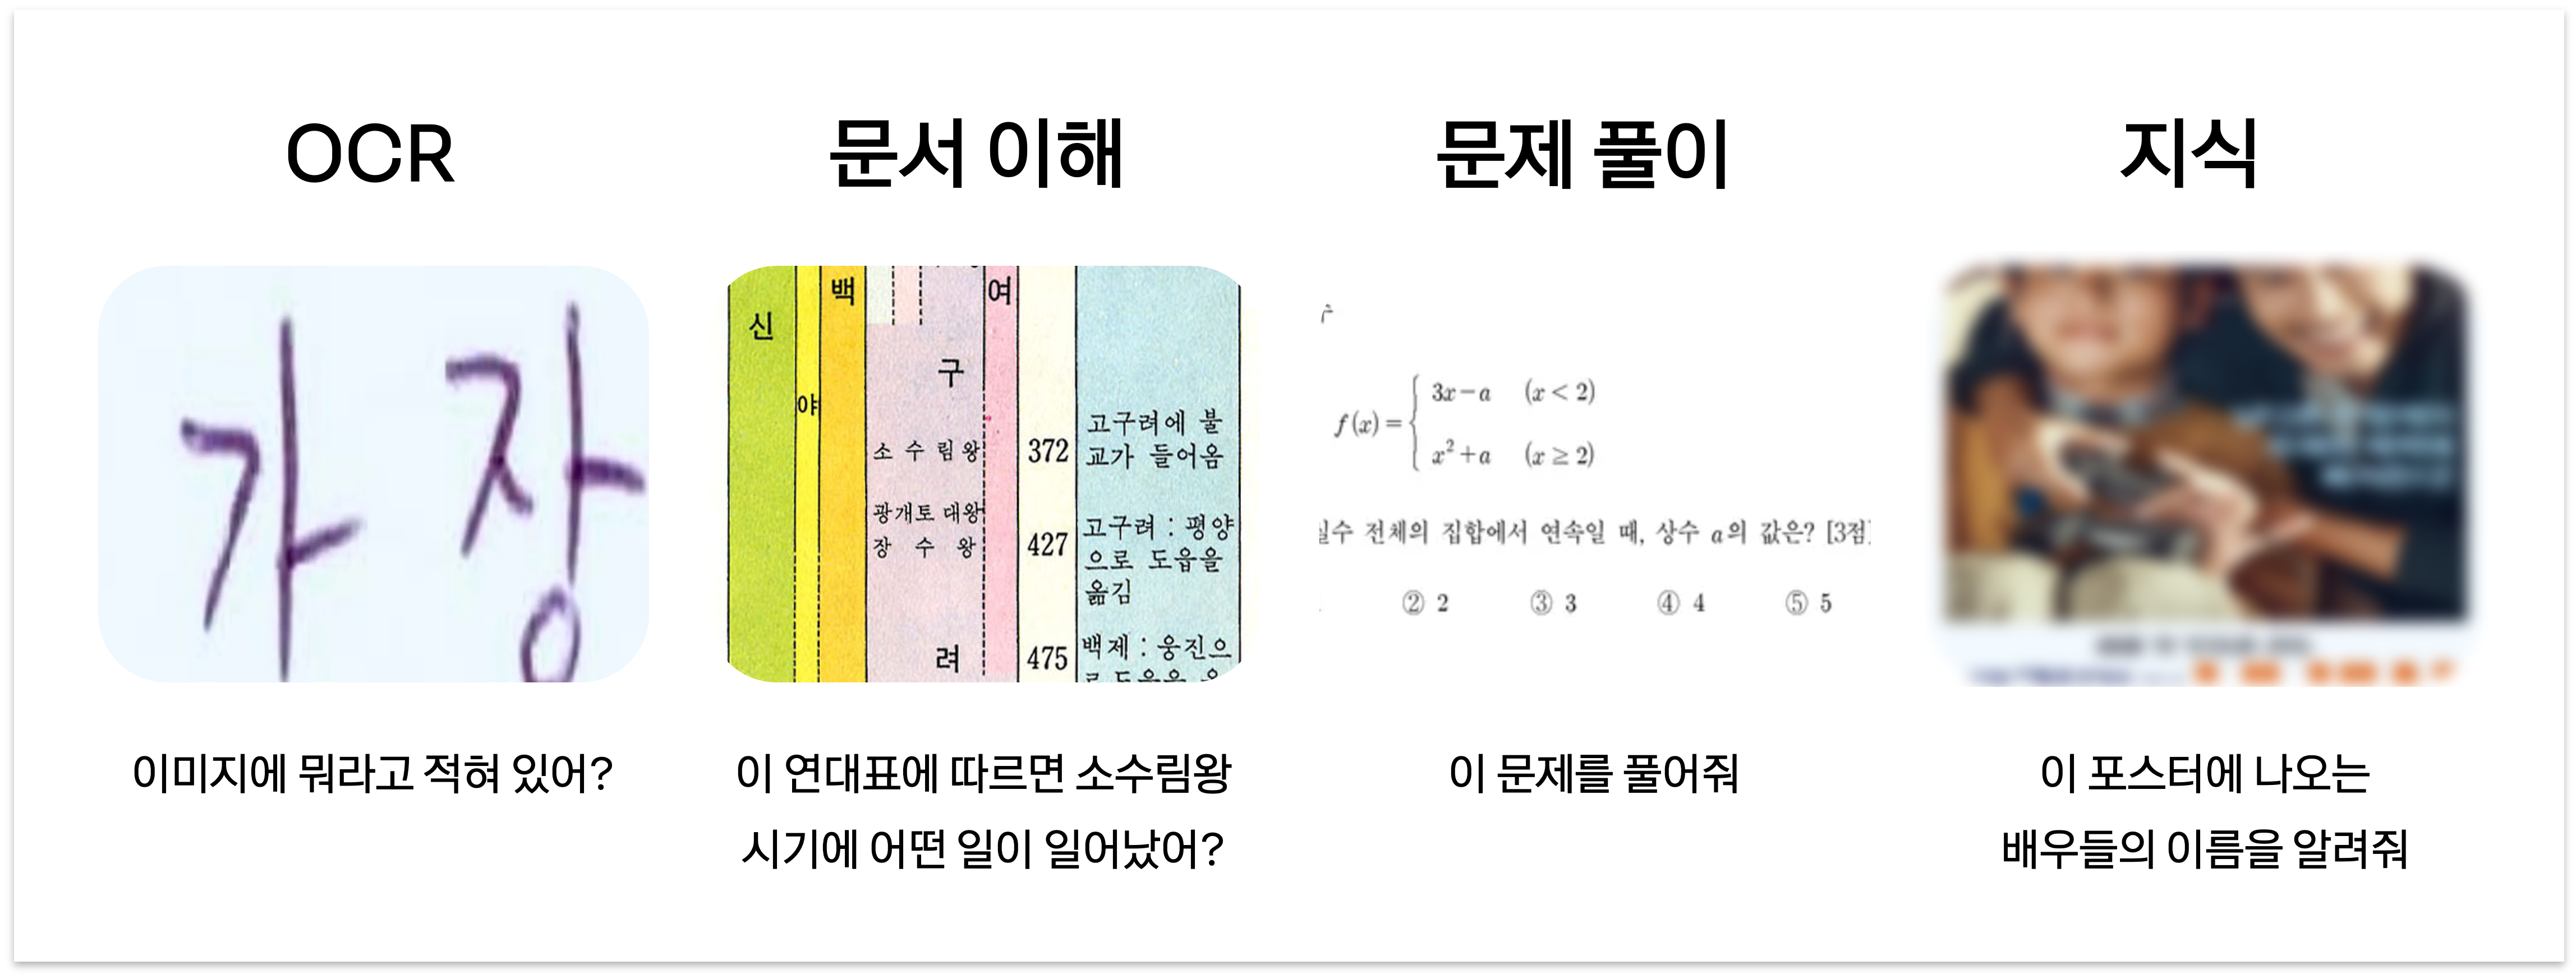
그림 3과 같이, 크게 한국어 OCR, 한국어 문서 이해, 한국어 문제 풀이 및 한국형 지식이라는 4가지 카테고리의 벤치마크를 구축했습니다. 이 벤치마크는 각각 한국어를 정확히 읽어낼 수 있는지, 한국어로 작성된 문서와 도표를 얼마나 이해하는지, 한국어 문제를 잘 이해하고 풀어낼 수 있는지, 그리고 한국 문화와 관련된 지식을 얼마나 알고 있는지를 평가하였습니다.
실제 한국어 성능을 세계적으로 인정받는 모델들과 비교해 본 결과, 아래 표 1과 같이 전반적으로 뛰어난 성능을 보여주고 있음을 확인할 수 있었습니다. 특히, 한국어에 대한 읽기 능력이 요구되는 과제에서는 압도적인 능력을 확인하였습니다.
| 한국어 OCR | 한국어 문서 이해 | 한국어 문제 풀이 | 한국형 지식 | 평균 | |
|---|---|---|---|---|---|
| GPT-4V | 7.0 | 58.1 | 45.1 | 49.0 | 39.8 |
| GPT-4o | ++49.0++ | 75.3 | ++67.3++ | 55.9 | ++61.9++ |
| Kanana-V | 84.4 | 85.9 | 76.9 | ++53.3++ | 75.1 |
| LLaVA-OneVision | 0.3 | 59.3 | 26.4 | 41.0 | 31.7 |
| Qwen2-VL | 44.4 | ++77.5++ | 44.3 | 50.9 | 54.3 |
< 표 1. Kanana-v의 한국어 성능 비교. 굵은 글씨는 최고 성능, 밑줄은 두 번째 성능을 나타냅니다. >
한국형 지식 영역에서는 유사한 모델 크기의 공개 모델들과 비교했을 때 가장 뛰어난 성능을 보였으나, 상용 모델들과 함께 비교할 경우에는 두 번째로 높은 성능을 기록하며, 추가 개선이 필요한 영역임을 확인했습니다. 앞으로 한국형 지식 관련 데이터를 지속적으로 확보하여, 이 영역에서도 압도적인 성능을 달성할 수 있도록 개선을 이어갈 계획입니다.
Kanana-v 영어 성능 비교: 글로벌 경쟁력 확보
한국어를 잘하는 멀티모달 언어모델 개발이 목표라 하더라도 영어 성능을 등한시할 수는 없습니다. 높은 수준의 멀티모달 언어모델을 학습시키기 위해 필수적인 고품질 데이터의 상당 부분이 영어로 되어 있기 때문입니다. 따라서 복잡하면서도 고품질의 영어 데이터를 활용하여 모델의 기본적 역량을 강화함과 동시에, 이를 한국어 도메인으로 확장하는 전략은 모델 학습의 효율성을 높이는 핵심 요소라고 할 수 있습니다. 더불어, 영어에서 뛰어난 성능은 모델의 전반적인 확장성과 글로벌 경쟁력을 확보하는 데 필수적입니다. 따라서 저희는 최고의 한국어 모델을 목표로 하는 동시에, 영어에서도 세계 최고 수준의 성능을 지향하고 있습니다.
이에 따라 현재 가장 널리 사용되는 멀티모달 언어모델들과 영어 성능을 비교한 결과는 표 2와 같습니다. 이를 통해 Kanana-v가 한국어만 잘하는 것이 아니라 영어 성능에서도 세계적으로 경쟁력 있는 수준임을 확인할 수 있습니다.
| MMStar | MMVet | MMB-1.1 | MME | DocVQA | ChartQA | OCRBench | MathVista | 평균 | |
|---|---|---|---|---|---|---|---|---|---|
| GPT-4V | 57.1 | ++67.7++ | 77.0 | 68.8 | 88.4 | 78.5 | 64.5 | 49.9 | 69.0 |
| GPT-4o | 63.9 | 69.1 | 82.2 | 83.2 | ++92.8++ | 85.7 | 73.6 | 63.8 | 76.8 |
| Kanana-V | 59.9 | 60.5 | ++81.6++ | 82.8 | 94.5 | ++83.5++ | ++81.8++ | 63.0 | ++75.9++ |
| LLaVA-OneVision | ++61.7++ | 57.5 | 80.8 | 71.4 | 87.5 | 80.0 | 70.4 | ++63.2++ | 71.6 |
| Qwen2-VL | 60.7 | 62.0 | 80.7 | ++83.1++ | 94.5 | 83.0 | 84.5 | 58.2 | 75.8 |
< 표 2. Kanana-v의 영어 성능 비교. 굵은 글씨는 최고 성능, 밑줄은 두 번째 성능을 나타냅니다. >
Kanana-v 개발 과정
모델 구조
Kanana-v의 전체 구조는 그림 4와 같습니다. 큰 구조는 기반 모델이라고 할 수 있는 허니비 모델과 동일한데요. 많은 멀티모달 언어모델이 따르는 구조이기도 합니다. 언어 입력부는 기존의 언어모델과 동일하게 처리하고, 비전 입력에서는 비전 인코더(Vision encoder)와 프로젝터(Projector)를 통해 인코딩한 후, 모달리티별 토큰들을 모아 언어모델의 입력으로 넣어주게 됩니다.
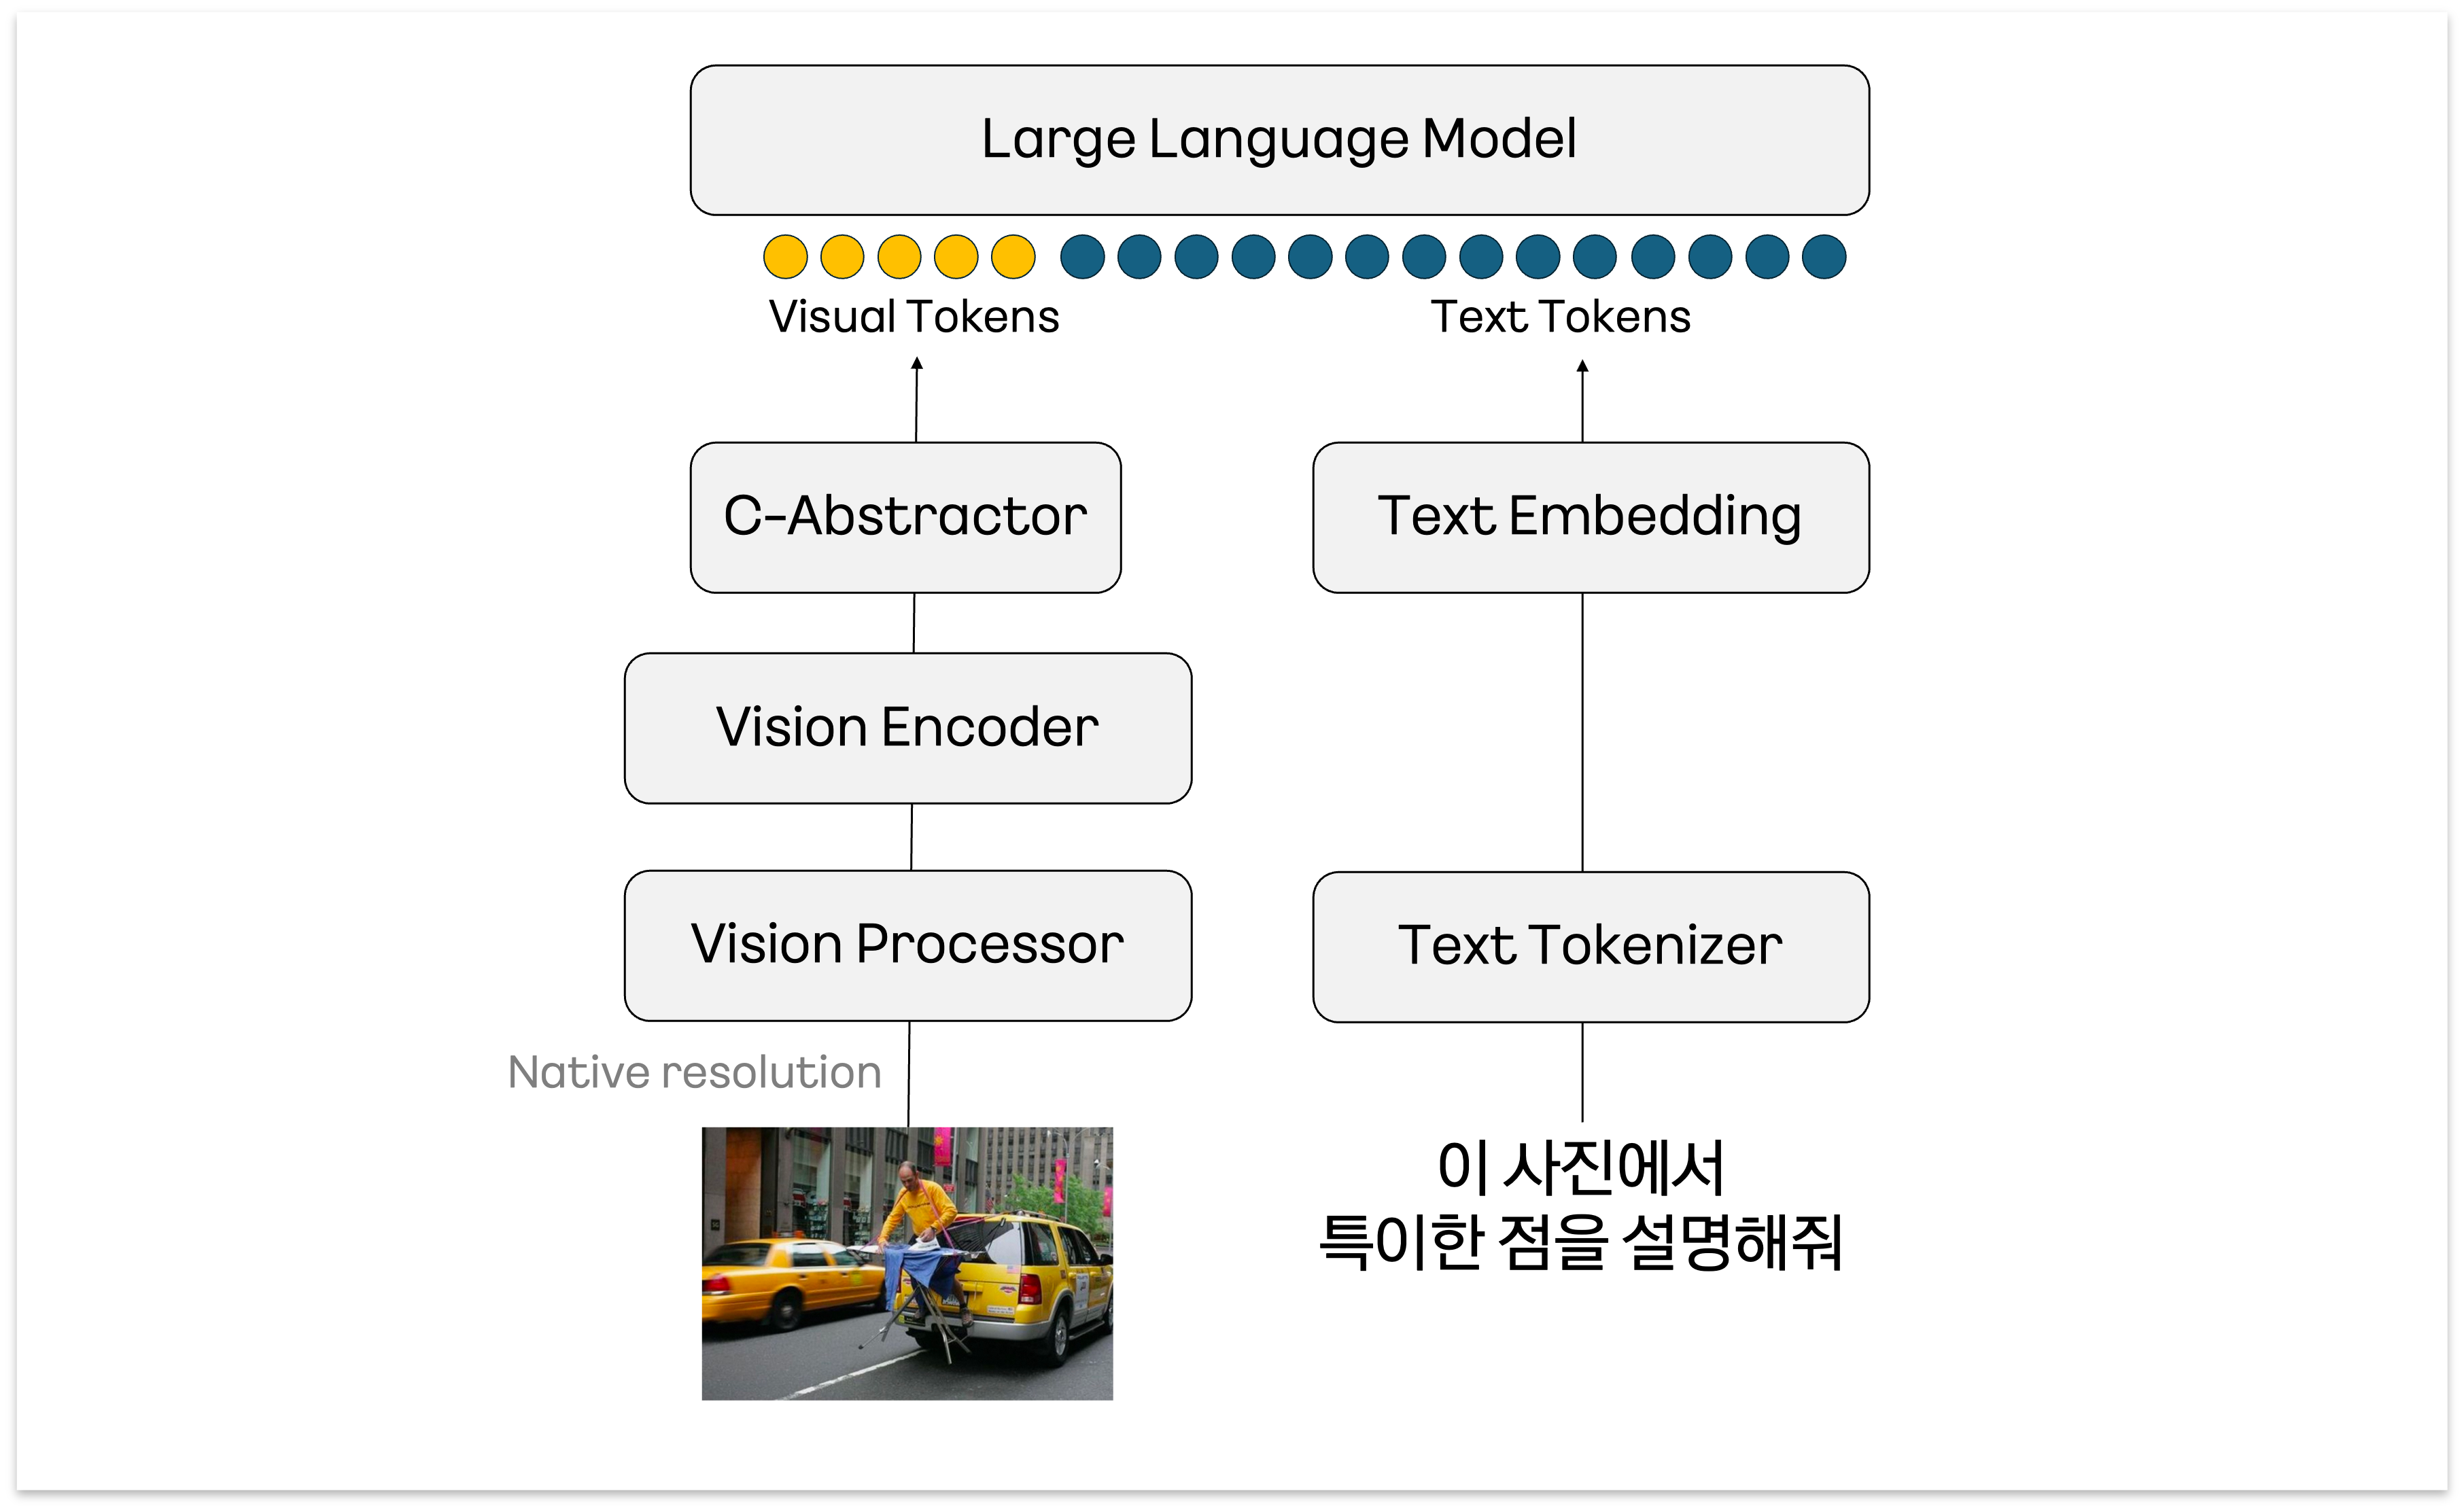
모델의 구조적인 측면에서는 아래 2가지 요소를 집중적으로 고민하였고, 이에 대한 저희의 경험을 공유해 드리겠습니다.
- 어떻게 고해상도(High-resolution) 이미지를 처리할지
- 비전 인코더를 통해 이미지로부터 특성(Feature)을 추출한 후에는 이를 어떻게 언어모델과 연결해 줄 것인지
High-resolution
이미지 처리에 있어 중요한 요소 중 하나는 고해상도 이미지 처리입니다. 특히 글자가 빼곡히 적혀 있는 문서를 다룰 경우, 글자를 명확히 읽을 수 있도록 충분히 높은 해상도가 요구됩니다. 그러나 일반적으로 사전 학습된 비전 인코더(Pre-trained vision encoder)는 고해상도 이미지가 충분히 고려되지 않은 상태로 설계 및 학습되는 경우가 많습니다. 따라서 멀티모달 언어모델에서는 이 한계를 어떻게 극복하여 고해상도 이미지를 처리할 것인지가 주요 챌린지가 됩니다.
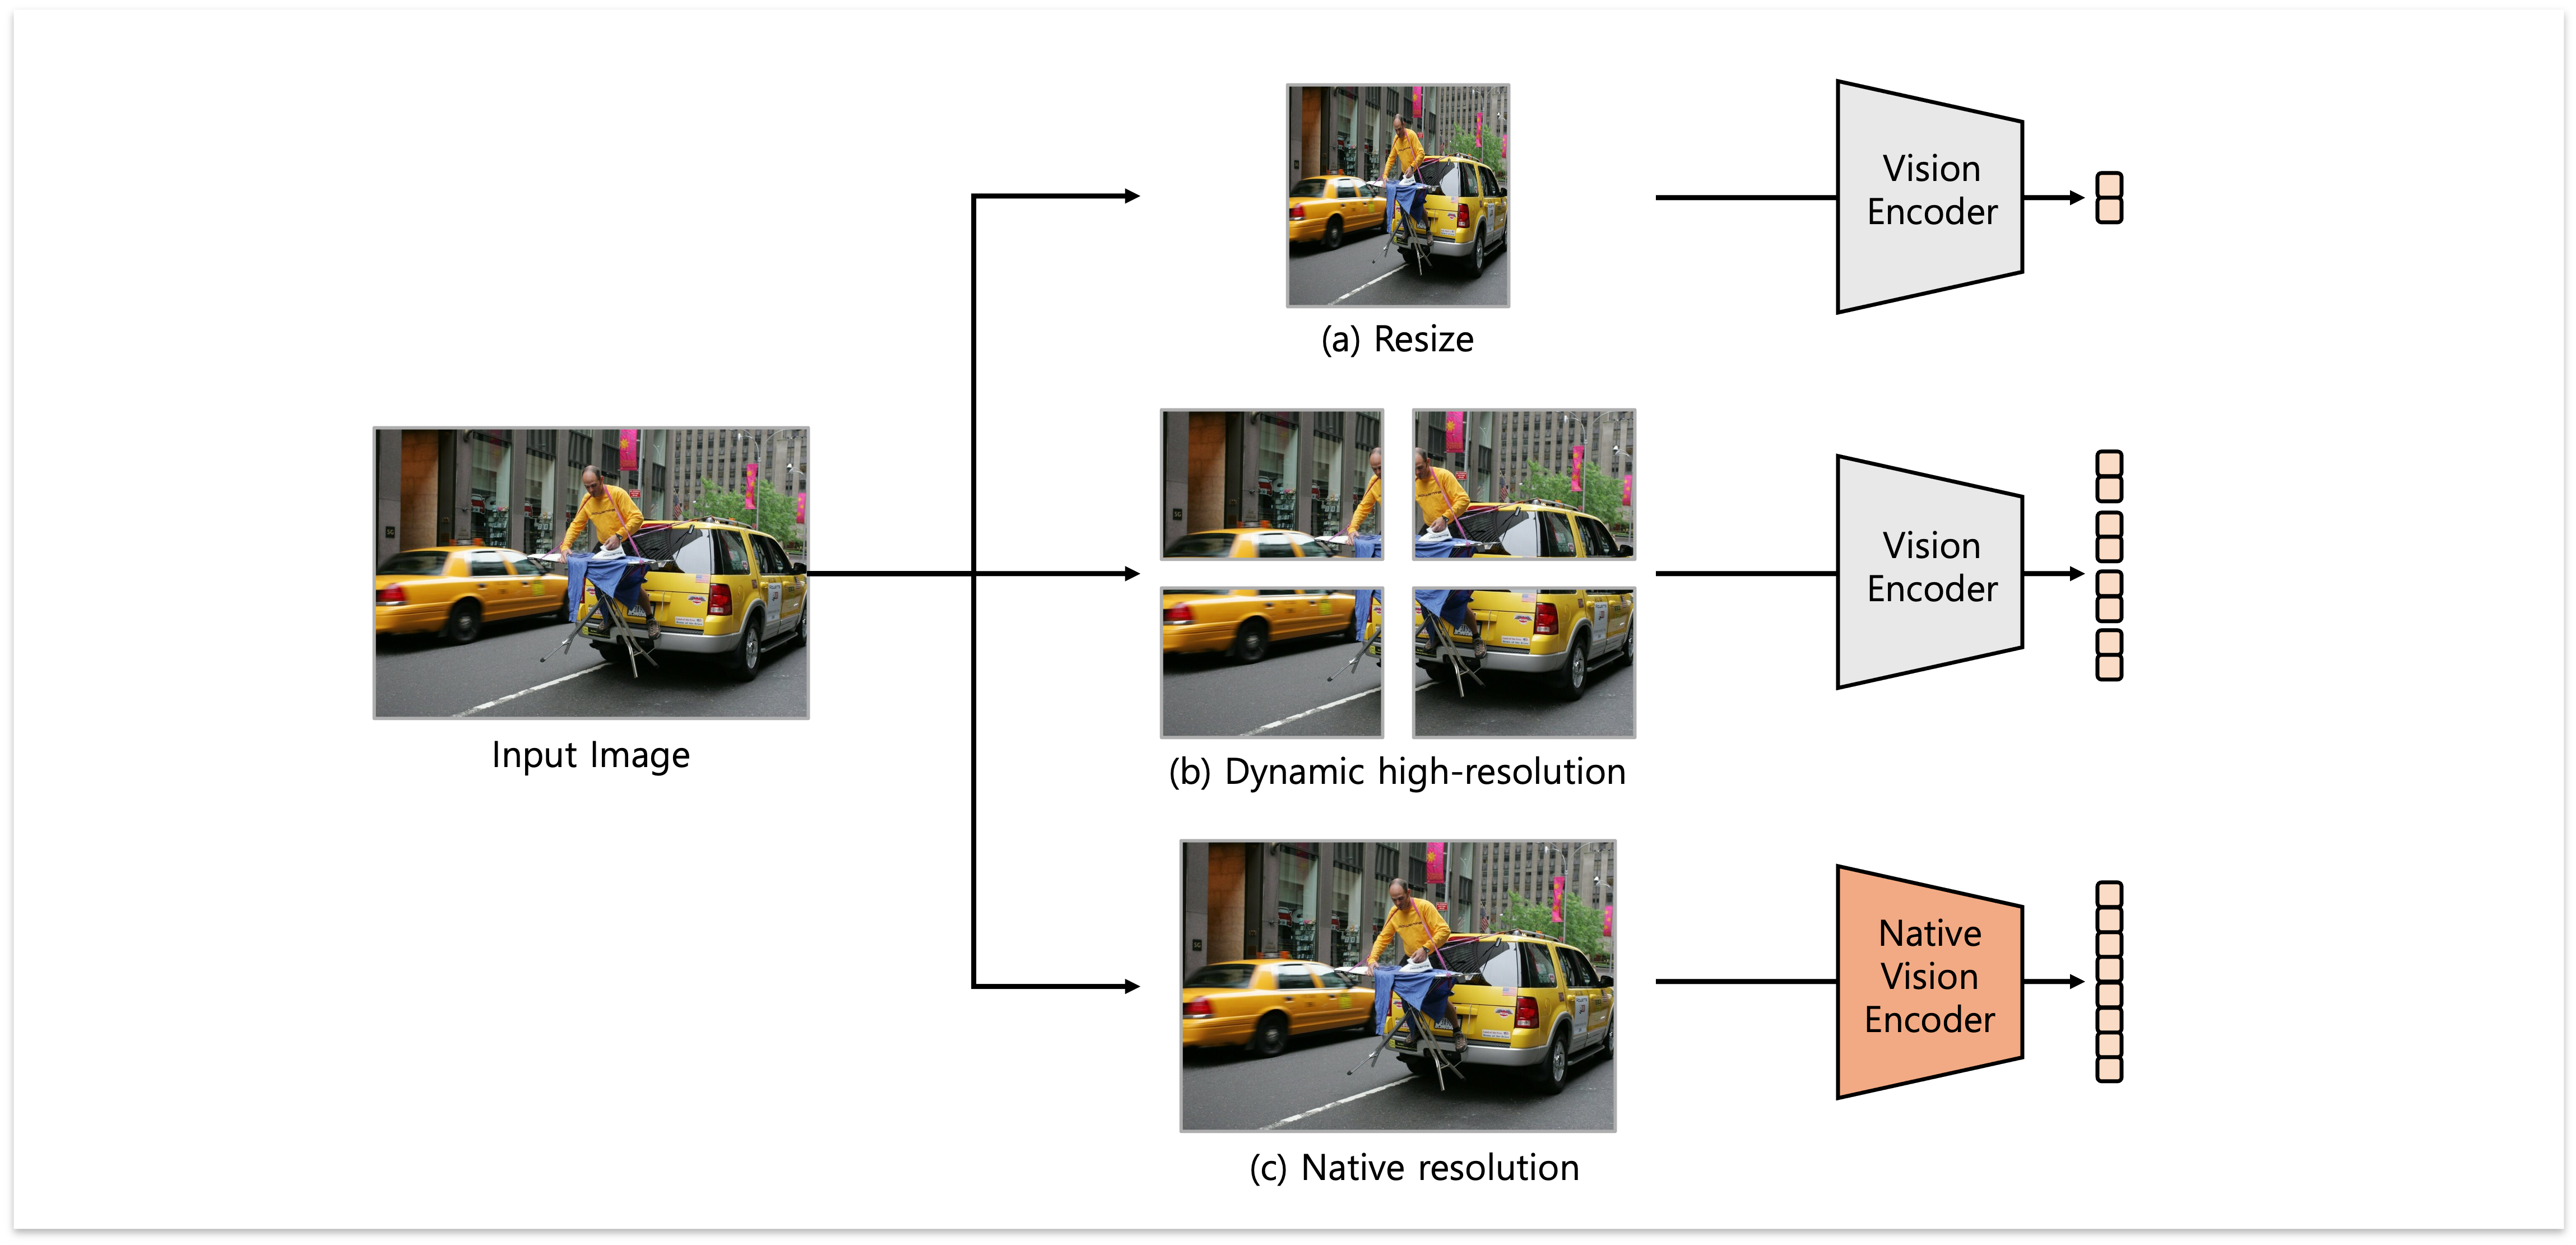
위 그림은 이렇게 고해상도 이미지를 처리하기 위한 여러 이미지 전처리 방법들을 보여줍니다. 가장 기본적인 방법인 리사이즈(Resize)는 고해상도 이미지를 비전 인코더가 처리할 수 있는 고정된 크기로 조정합니다. 그러나 이는 고해상도 이미지를 입력으로 받아도 실제로는 저해상도로 변환하여 이미지를 처리하게 되므로 근본적으로 고해상도 이미지를 처리하는 방법이라 할 수 없습니다.
이 문제를 LLaVA-1.5^[2]^에서는 고해상도 이미지를 조각내어 사용하는 방식으로 대응합니다. 위 그림의 (b)에서 볼 수 있듯이, 비전 인코더가 처리할 수 없는 큰 이미지를 처리 가능한 크기로 나누어 사용하는 아이디어입니다. 이 접근은 단순하지만 꽤 효과적이며, 현재 가장 널리 사용되는 고해상도 이미지 처리 방식입니다. 하지만, 이 방식은 이미지를 조각내어 부분마다 인코딩하기 때문에 전체 이미지 맥락을 고려하지 못한다는 한계가 있습니다. 이를 보완하기 위해 실제로는 조각낸 이미지에 더해 리사이즈한 전체 이미지도 함께 사용하지만, 결국 각 이미지 조각을 인코딩할 때는 여전히 전체 맥락을 반영하지 못한다는 근본적인 한계점은 그대로 남아 있게 됩니다.
반면, 최근 공개된 Qwen2-VL^[3]^에서는 NaViT^[4]^에서 제안한 Native resolution이라는 방법을 채택했습니다. 이미지를 리사이즈하거나 조각내지 않고 있는 그대로 사용하는 방법입니다. 이렇게 들으면 가장 당연하고 기본적인 접근인 것 같지만, 대부분의 사전학습된 비전 인코더가 이를 지원하지 않아 적용이 어렵습니다. 즉, 이 방법을 활용하여 사전학습된 비전 인코더를 사용하려면 추가적인 확장 작업이 필요합니다.
정리하자면, 현재보다 널리 사용되는 Dynamic high-resolution의 경우 별도의 확장 작업 없이 사전학습된 비전 인코더를 그대로 활용할 수 있어 편리하지만, 이미지를 조각내어 처리하기 때문에 전체 맥락을 제한적으로만 고려하게 된다는 한계점이 있습니다. 저희는 장기적으로, 비전 인코더의 확장 작업이 필요하다 하더라도 이러한 한계가 없는 Native resolution이 더 원칙적이고 근본적인 접근(Principled approach) 이라고 판단하여 채택하였습니다.
C-Abstractor
Kanana-v에서는 비전 인코더와 언어모델을 연결하기 위해 C-Abstractor를 사용했습니다. C-Abstractor는 앞서 소개해 드린 저희 연구인 Honeybee에서 제안한 프로젝터(Projector) 구조입니다. 당시에 널리 사용되던 두 종류의 프로젝터인 Resampler와 Linear의 한계점을 지적하며, 이를 해결하기 위해 공간 정보(Spatial information)를 보존하면서도 visual token의 개수를 유동적으로 조절할 수 있는 새로운 프로젝터 구조를 제안하였습니다. 기존의 문제점과 개선 방법에 대한 자세한 내용은 앞서 언급한 허니비 논문^[1]^과 if(kakaoAI)2024 발표에서 다루고 있습니다.
Kanana-v에서도 마찬가지로 C-Abstractor를 프로젝터로 사용하며, Native resolution에 맞게 고정된 개수의 Visual tokens이 아니라 입력 이미지에 따라 유동적으로 Visual tokens의 수를 조정하도록 설계하였습니다.
학습 전략
4-stage 학습
이전 연구였던 허니비에서는 Vision encoder를 freeze 하여 학습하지 않도록 두고, C-Abstractor를 먼저 학습한 뒤 이후 LLM과 같이 학습하는 2-Stage 학습 전략을 사용했었습니다. Kanana-v에서는 이 단계를 보다 세분화해 4-stage 학습 전략을 사용합니다.
| Stage | Training modules | Data domains | |
|---|---|---|---|
| Projector pre-training | 1 | Projector | Image captions, OCR |
| Continued pre-training | 2 | Entire model | Dense image captions, grounding, OCR, document |
| Supervised fine-tuning | 3 | Entire model | Various QA-format datasets on various domains |
| Human preference alignment | 4 | Entire model | Human preference data with preference ranking |
< 표 3. Kanana-v의 4-stage 학습 전략. 4단계의 Human preference alignment는 현재 연구개발이 진행 중인 단계입니다. >
-
Stage-1: Projector pre-training. 첫 스테이지에서는 대규모의 이미지 캡션(Image caption) 데이터셋을 이용하여 비전 인코더와 언어모델을 연결하는 C-Abstractor(Projector)의 사전학습(Pre-training)을 수행합니다. 멀티모달 언어모델은 기본적으로 사전학습된 비전 인코더와 언어모델을 사용하기 때문에, 이를 연결하는 C-Abstractor 역시 적절한 사전학습을 통해 좋은 가중치(Weight) 로 초기화(Initialize)하는 것이 중요합니다. 만약 C-Abstractor를 랜덤 한 값으로 초기화하면, 언어모델의 입력으로 전달되는 시각 정보가 거의 랜덤 노이즈(Random noise)에 가까운 상태가 됩니다. 이는 비전 인코더나 언어모델이 정확히 작동하더라도 잘못된 결과를 출력하게 만들어, 이후 학습 과정 전반이 왜곡될 위험을 야기합니다.
-
Stage-2: Continued pre-training. 이 단계에서는 모델이 다양한 Visual understanding 능력을 학습할 수 있도록 합니다. Stage-1에서 사용하는 이미지 캡션 데이터셋은 대규모이지만, 그만큼 노이즈도 많고 고품질을 담보하지 않습니다. Stage-2에서는 이미지를 자세히 설명하는 고품질의 데이터셋을 활용하며, 이 고품질의 캡션은 이미지에 대한 대략적인 설명을 넘어 주의 깊게 봐야만 보이는 작은 물체들까지 빠짐없이 설명하고 글자를 읽거나 위치관계를 설명하는 등, 이미지의 자세한 부분까지 이해해야만 하도록 데이터셋이 구성됩니다.
-
Stage-3: Supervised fine-tuning. 두 번째 단계에서 모델이 충분한 능력을 학습했다면, 이제 사용자의 선호에 맞는 답변을 내놓을 수 있도록 모델을 정렬(Aligning)하는 과정이 필요합니다. 이를 위해, 단순히 이미지에 대한 캡션을 넘어, 이미지에 대해 할 수 있는 다양한 질문들과 그에 대한 대답으로 이루어진 Visual Question Answering(VQA) 포맷의 데이터셋을 이용한 학습이 바로 세 번째 단계입니다. 이 단계에서 모델은 다양한 질문에 대해 어떻게 답변해야 하는지, 그리고 그러한 답변을 하기 위해 어떤 능력을 적절히 활용해야 하는지 등을 배우게 됩니다.
-
Stage-4: Human preference alignment. 마지막 단계는 현재 활발히 연구개발이 진행 중인 Human preference alignment입니다. 강화학습(Reinforcement learning) 기반의 접근법을 활용하기 때문에 Reinforcement learning with human preference(RLHF)라고 많이 불리는 단계죠. 세 번째 단계에서는 사람이 선호하는 정답 답변만을 학습했다면 이 단계에서는 선호와 비선호 답변 간의 차이를 학습함으로써 보다 사용자가 원하는 답변을 잘할 수 있게 됩니다. 또한, 모델이 거짓말을 하거나 위험한 발언을 하지 않도록 학습하는 단계이기도 합니다.
Learning without forgetting
사전학습된 모델을 사용할 때 주의해야 할 문제로 “망각”(Catastrophic forgetting) 현상이 있습니다. 망각 현상은 AI 모델에서 널리 알려진 문제로, 새로운 지식을 학습할 때 예전에 학습한 지식을 잊어버리는 문제를 가리킵니다. 예를 들어, 학습 과정을 통해 이미지는 잘 이해하게 되었지만 언어 능력을 망각하여 자연스러운 대화를 잘하지 못한다면 우리가 원하는 멀티모달 언어모델이 아니게 됩니다. 이 문제를 방지하기 위해, 모듈과 레이어에 따라 섬세하게 학습률(Learning rate)을 조정하고, 언어모델의 학습 시 사용했던 말뭉치(Text corpus) 데이터를 함께 사용했습니다. 또한, 언어 벤치마크를 통해 모델의 망각 정도를 추적하여 망각 현상이 발생하지 않도록 데이터셋과 학습률을 조정했습니다. 이를 통해 다양한 언어 벤치마크에서 성능을 유지한 채 경쟁력 있는 Kanana-v 모델을 학습시킬 수 있었습니다.
Learning with rationales
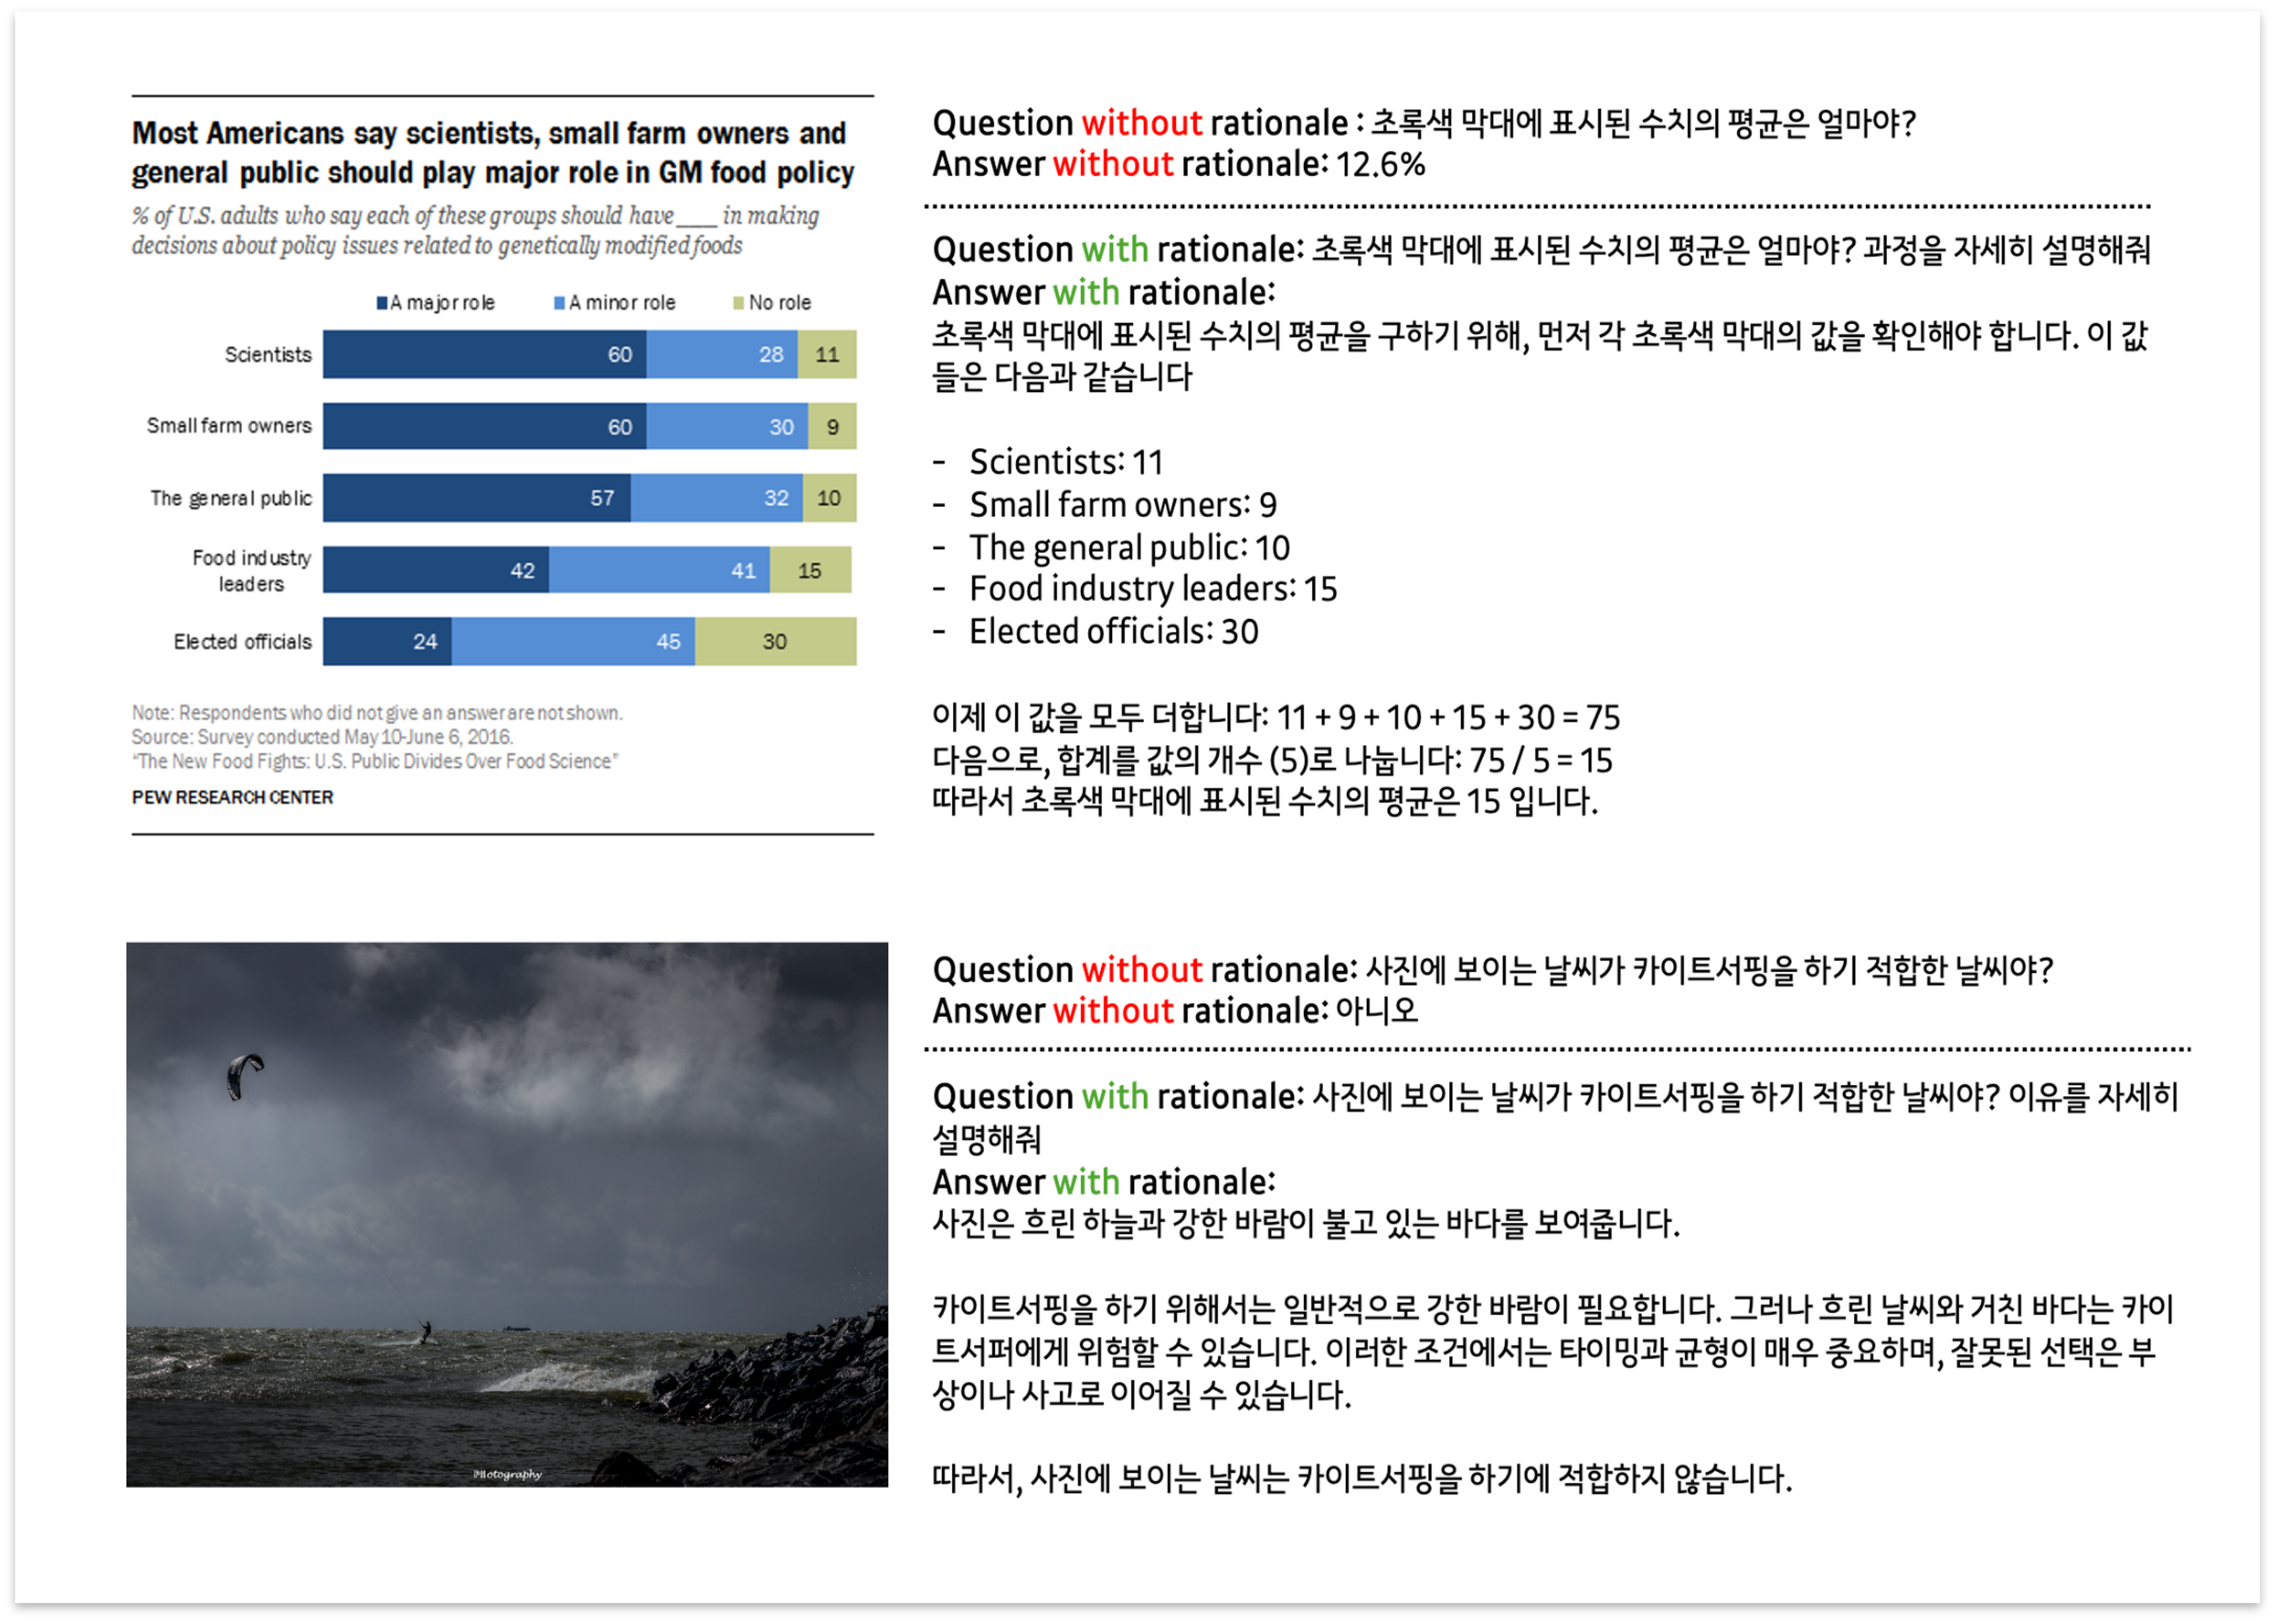
모델이 단순히 질문에 대한 결론만 내뱉는 것이 아니라, 해당 결론에 도달하기까지의 구체적인 이유를 들어 사고 과정을 논리 정연하게 설명하는 것은 여러 측면에서 중요한 요소입니다. 최근 학계에서는 모델에게 정답을 추론할 때 사고 과정을 차근차근 설명하도록 요구함으로써 복잡한 문제를 더욱 쉽게 해결할 수 있음을 보이는 연구들이 활발하게 진행되고 있습니다. 널리 알려진 Chain-of-Thought(CoT) ^[5]^ 방식은 단계적인 사고 과정이 모델의 복잡한 문제를 푸는 능력을 높이는 데 기여할 수 있음을 보여주는 대표적인 사례입니다.
이는 성능적인 측면뿐만 아니라 사용성 측면에서도 중요한 역할을 합니다. 단순히 정답만을 말해주는 것을 넘어 정답을 도출한 논리적 근거를 자세하게 제시하는 것은 정답을 쉽게 판단할 수 없는 어려운 문제에 대해 답변의 신뢰성을 높이고, 사용자가 더 나은 의사결정을 할 수 있도록 도울 수도 있습니다. 또한, 연구개발 과정에서 모델이 제시한 근거를 분석함으로써 오류의 원인을 쉽게 파악할 수 있고, 이를 보완하여 더 강력하고 강건한 모델을 만드는 데 도움이 되기도 합니다.
이러한 이유에서 저희는 모델이 자신의 판단 과정을 구체적으로 설명할 수 있기를 바랐고, 이를 위해 정답에 대한 정확한 근거를 포함하는 고품질의 학습 데이터를 직접 수집하여 자체 학습 데이터셋을 구축하였습니다. 이를 통해 저희 모델의 추론 능력을 한층 강화할 수 있었습니다.
아래 두 가지 예시를 보면, 먼저 첫 번째 예시에서는 사고 과정 없이 정답만을 대답했을 때와 달리 자세한 과정을 설명하면서 보다 정확한 답을 말하는 차이를 확인할 수 있습니다. 이는 성능 측면뿐만 아니라, 위와 같이 정답만을 대답했을 때는 어떤 부분에서 틀렸는지 알 수 없는 것과 달리 아래처럼 풀이 과정을 설명하면 혹시 결과가 틀리더라도 어떤 부분에서 틀렸는지를 알 수 있게 되죠. 아래 예시에서도 마찬가지로, 단답형으로 정답만을 말했을 때와 달리 구체적인 근거를 함께 설명하기 때문에 사용자는 이 대답을 보고 왜 모델이 이렇게 판단했는지를 구체적으로 알 수 있다는 장점이 있습니다.
Data, Data, and Data!
지금까지 Kanana-v의 모델 구조와 학습 전략을 설명드렸지만, 사실 제일 중요한 것은 데이터입니다. 고성능의 멀티모달 언어모델을 학습하기 위해서는 고품질의 대규모 데이터셋은 필수요소입니다. 하지만, 풍부한 양질의 데이터를 확보하기 위해서는 그만큼 많은 비용과 시간이 소요되며, 퍼블릭 데이터를 사용할 때에는 라이선스 또한 신경 써서 사용해야 합니다. 그럼 지금부터 이러한 조건들을 고려하여 저희가 어떻게 데이터를 구축하였는지 간략히 소개드리겠습니다.
영어 데이터
영어는 굉장히 많은 퍼블릭 데이터가 공개되어 있으므로 이를 효과적으로 활용하는 것이 중요합니다. AI 업계에 유명한 말 중 하나로 “Garbage in, garbage out”이라는 말이 있습니다. 이는 모델이 학습하는 데이터의 품질이 좋지 않으면 결과 역시 좋지 않다는 의미입니다. 즉, 다양한 퍼블릭 데이터가 존재하더라도 무작정 모든 데이터를 활용하는 것은 좋은 전략이 아닙니다.
저희는 데이터를 추가할 때마다 직접 데이터를 검토하고, 모델 학습에 적합하도록 전처리한 후, 그렇게 정제한 데이터를 직접 학습에 이용해 보고 나서야 데이터의 가치를 판단하고 어느 정도의 양을 사용할지 등을 결정했습니다. 결국, 크루들이 데이터를 일일이 살펴보며 데이터셋을 구축했다는 이야기입니다. 간단히 설명했지만, 이 작업은 매우 많은 시간과 섬세함을 요구하며, 많은 크루들의 노력이 투입된 과정입니다. 데이터셋의 규모를 고려할 때 사람이 하나하나 챙기는 것은 한계가 분명하기에, 장기적으로는 자동화할 수 있도록 노력하고 있는 영역이기도 합니다.
한국어 데이터
영어와 달리 한국어의 경우 멀티모달 언어모델을 위한 퍼블릭 데이터를 찾기 어렵기 때문에, 거의 모든 데이터를 저희가 직접 제작했습니다. 먼저, 멀티모달 언어모델만을 위한 데이터가 아니더라도 사용가능한 모든 한국어 데이터셋을 모았습니다. 카카오에서 기존에 확보하고 있던 한국어 데이터들과, AI HUB에 공개된 한국어 데이터를 가져왔습니다. 이렇게 모은 데이터셋들을 멀티모달 언어모델이 학습할 수 있도록 이미지에 대한 질문-답변 형태로 변환했습니다. 이때 기존 데이터셋에 따라 변환 과정이 달라지는데, 이미지만 활용하고 적절한 질문-답변을 새로이 만들어야 했던 경우도 있었습니다.
이 작업이 어느 정도 정리되고 나서 살펴보니, 사용 가능한 모든 데이터를 모았음에도 한국어 데이터가 상대적으로 부족했습니다. 위 방식으로 모을 수 있었던 한국어 데이터가 적은 양은 아니었지만, 도메인의 다양성이 부족하다는 한계점이 있었습니다. 데이터가 부족한 도메인을 살펴보고, 필요한 데이터의 품질과 종류에 따라 수집 방법을 추가하였습니다. 고품질의 데이터가 필요한 경우 저희가 직접 이미지를 모으고 어노테이션(Annotation)을 수행하여 데이터셋을 구축했고, 저품질이라도 괜찮은 경우 영어 데이터를 번역하여 사용하기도 했습니다. 이 과정에서 효율을 높이기 위해 사람이 즉각적으로 어노테이션을 하는 것이 아니라 모델을 이용하여 먼저 초벌을 만들고, 이후 사람이 후처리 하는 방식을 사용했습니다.
라이선스
라이선스의 경우 상업적 용도에 따라 제한이 크게 달라지기 때문에, 회사에서 모델을 개발할 때에는 주의깊게 살펴봐야 합니다. 이때 까다로운 점 중 하나는, 많은 퍼블릭 데이터들이 사용 제한이 걸려 있다는 것입니다. 라이선스 문제가 없는 License-free 데이터만 모으는 방법이 있지만, 이렇게 되면 다른 모델들과 사용하는 데이터가 달라져서 비교분석이 어려워진다는 또 다른 문제가 생깁니다. 이 문제에 대응하기 위해 각 데이터의 라이선스를 꼼꼼히 기록하여, 목적에 따라 데이터를 달리 활용할 수 있도록 했습니다.
데이터를 통한 반복적인 개선
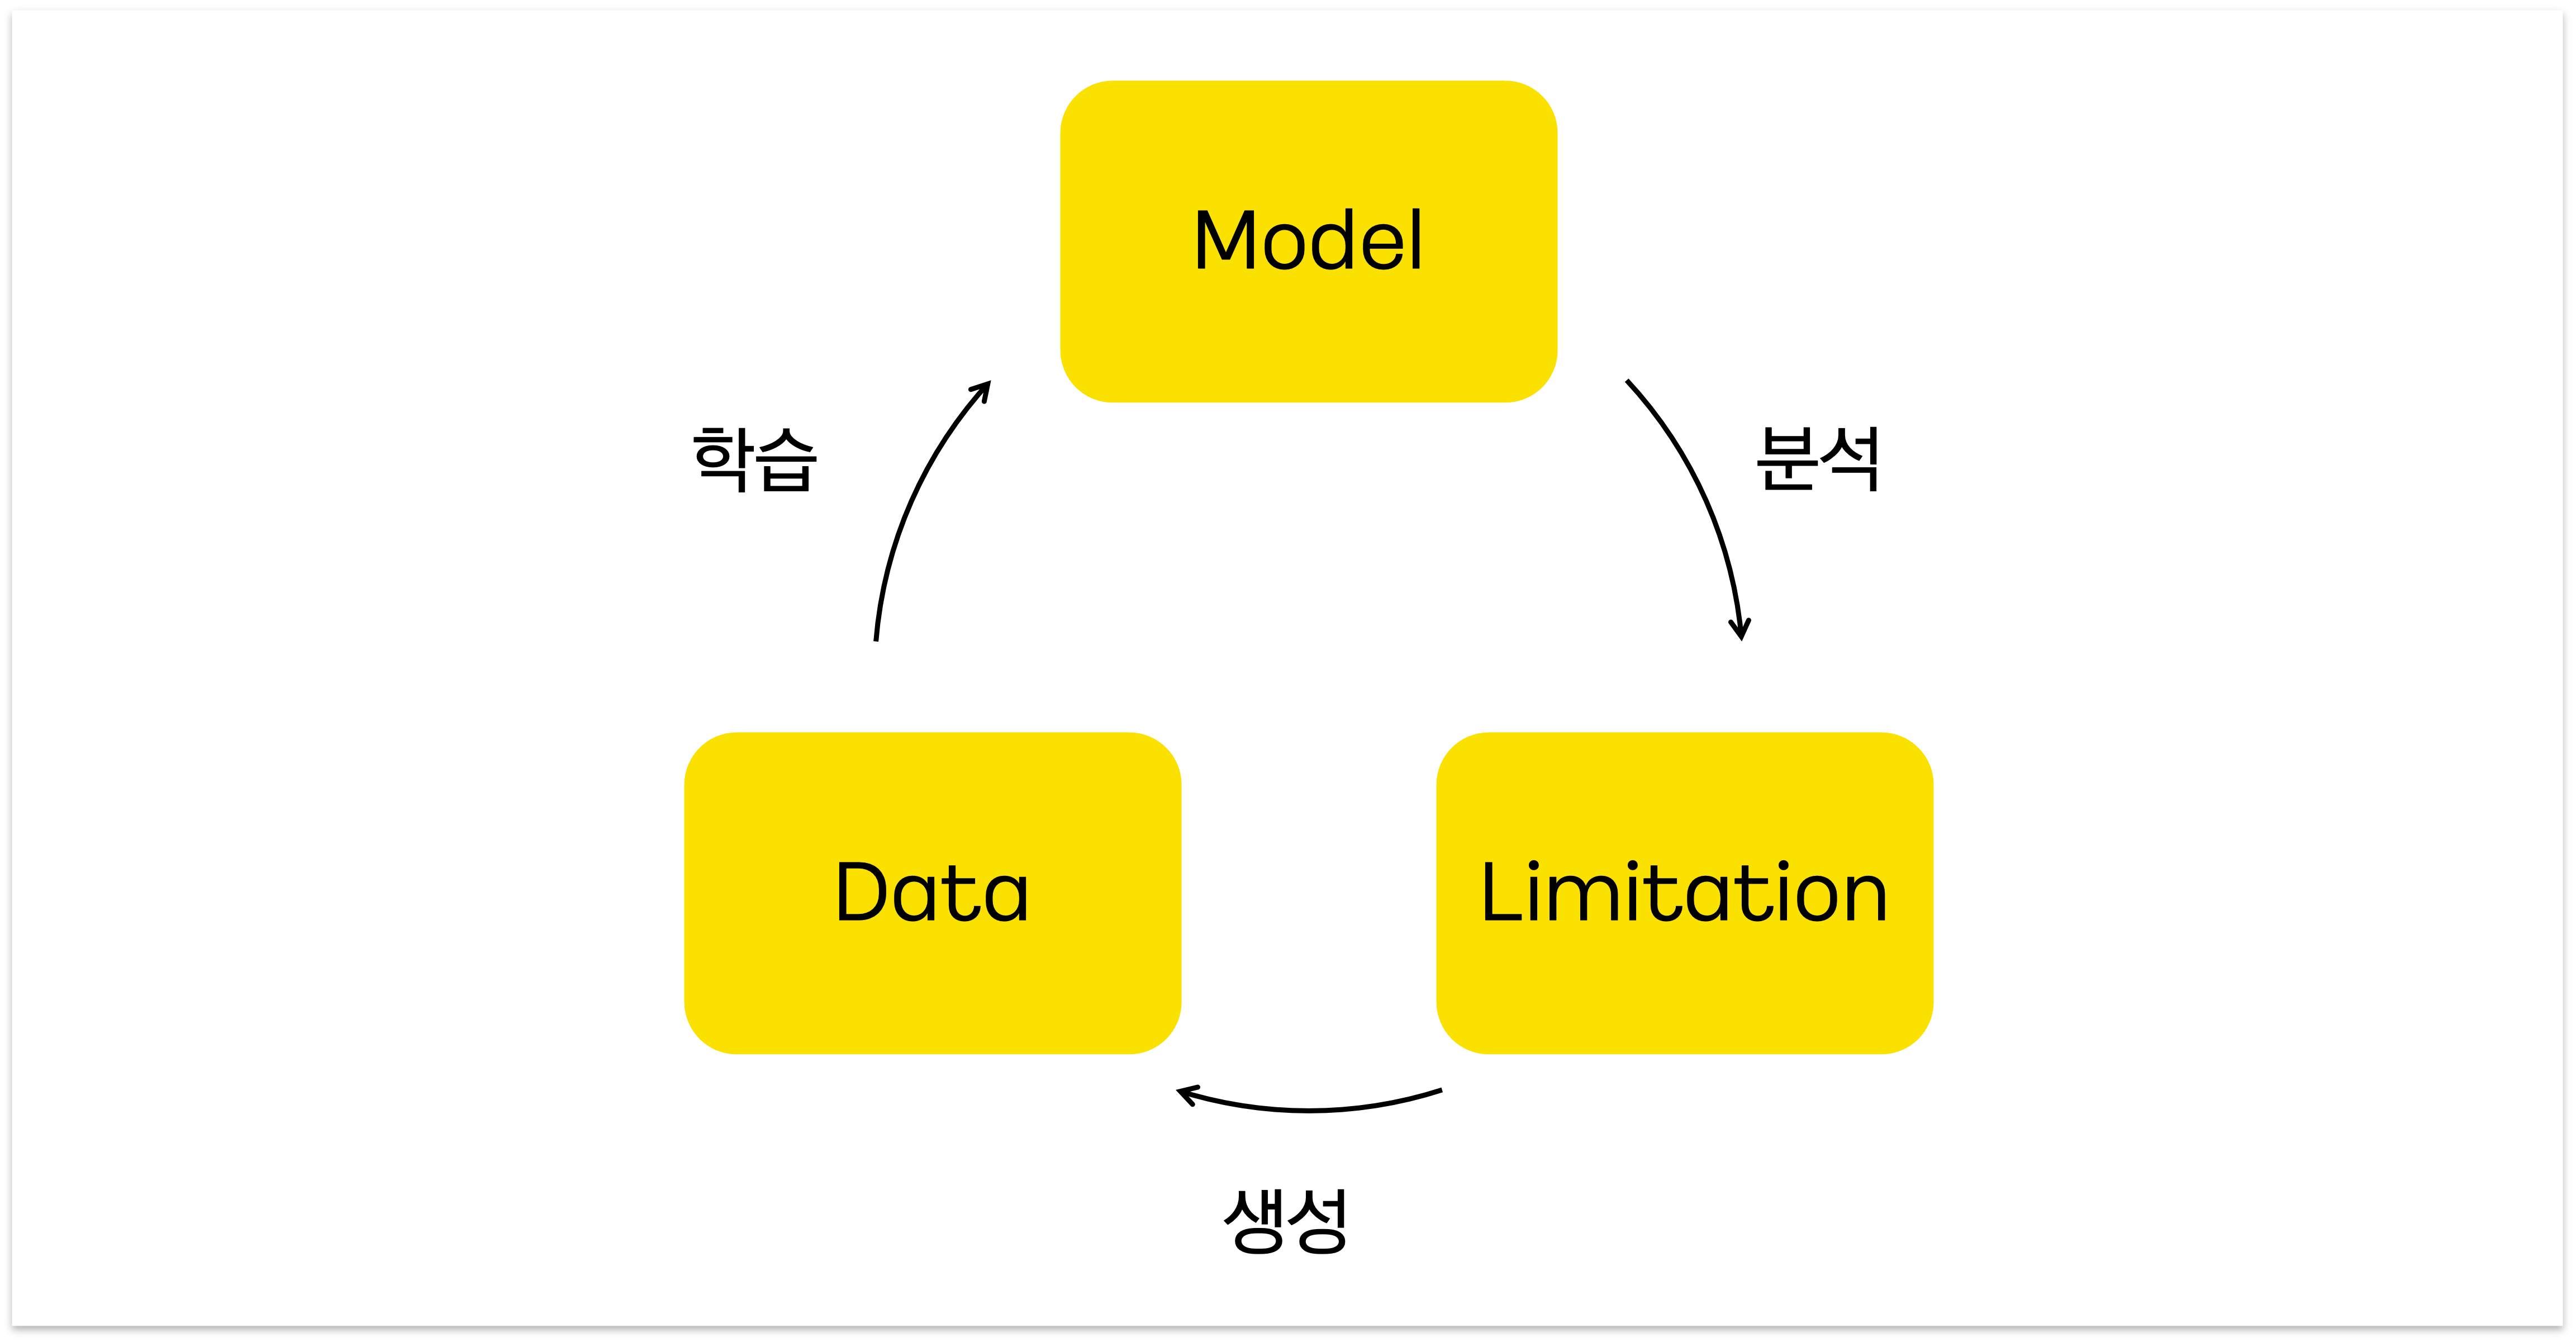
위 과정만으로 충분했을까요? 당연히 그렇지 않습니다. 모든 것이 첫 술에 배부를 수 없듯이, 처음 만들어진 모델이 만족스럽기는 어렵습니다. 위 과정을 통해 만든 모델이 나오면 이 모델을 다시 분석하고 부족한 점을 찾아 개선하는 과정을 반복했습니다.
먼저 모델을 분석하여 영어든 한국어든 부족한 점을 찾고, 이를 개선할 수 있는 데이터를 만들어서, 모델을 다시 학습하는 과정을 반복하여 모델의 부족한 점을 하나씩 채워나갔습니다. 처음에는 영어에 비해 한국어 데이터가 부족하여 한국어 데이터를 수집했고, 이후에는 모델이 문서를 읽을 때 정보를 하나씩 빠뜨리곤 해서 고해상도 문서 데이터를 수집했으며, 정답만이 아니라 그 판단 근거도 같이 설명할 수 있도록 Rationale 데이터도 추가적으로 구축했습니다. 이러한 반복적인 개선 끝에 지금의 모델이 나오게 된 것이죠.
Kanana-v 기능과 활용 예시
그렇다면 이러한 기술로 어떻게 세상을 바꿀 수 있을까요? 그 가능성은 무궁무진하지만, 현재 Kanana-v가 어떤 기능을 가지고, 실제로 무엇을 할 수 있는지 예시를 중심으로 소개드리려고 합니다.
Image understanding and creative writing
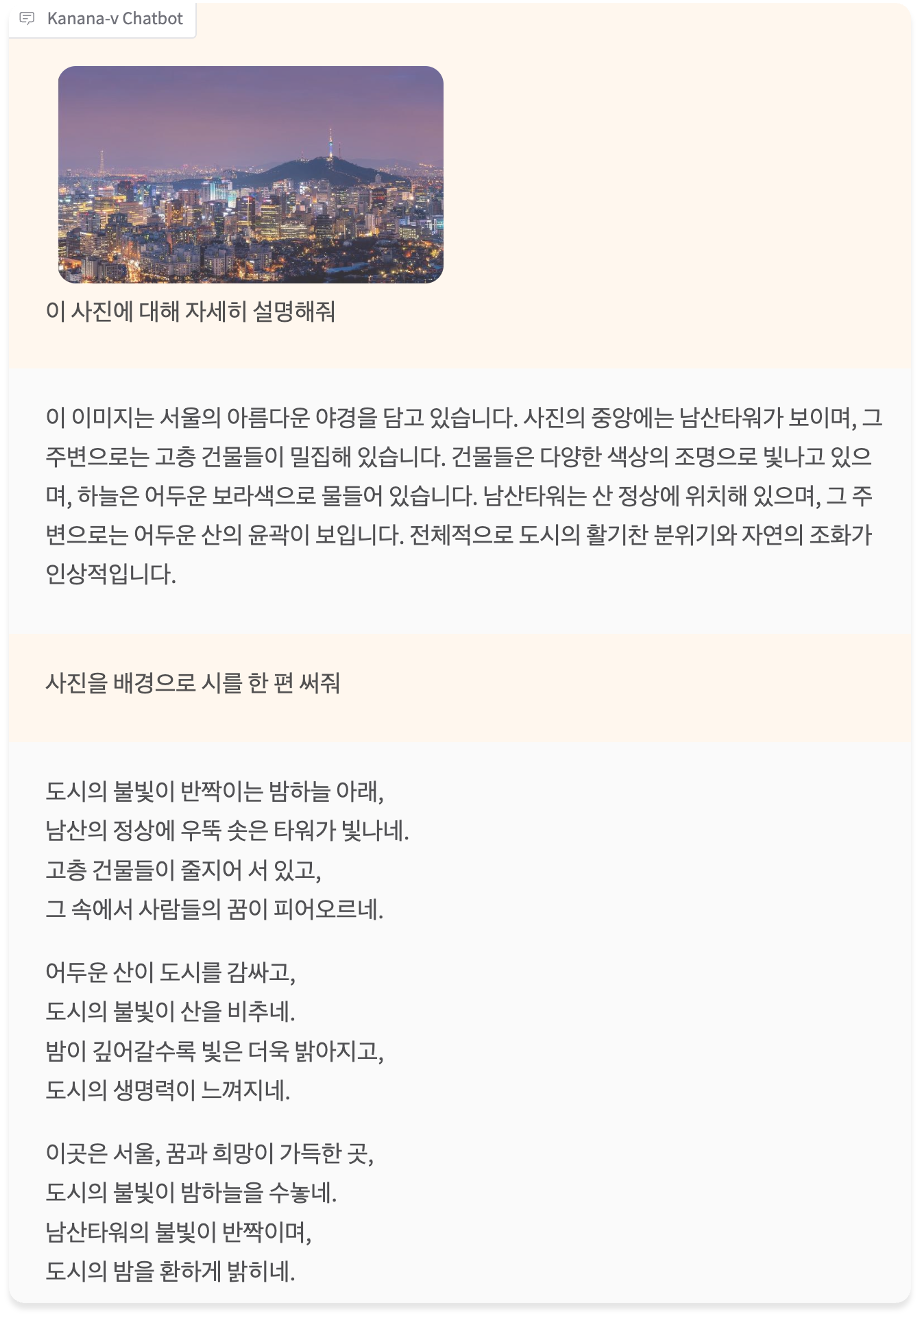
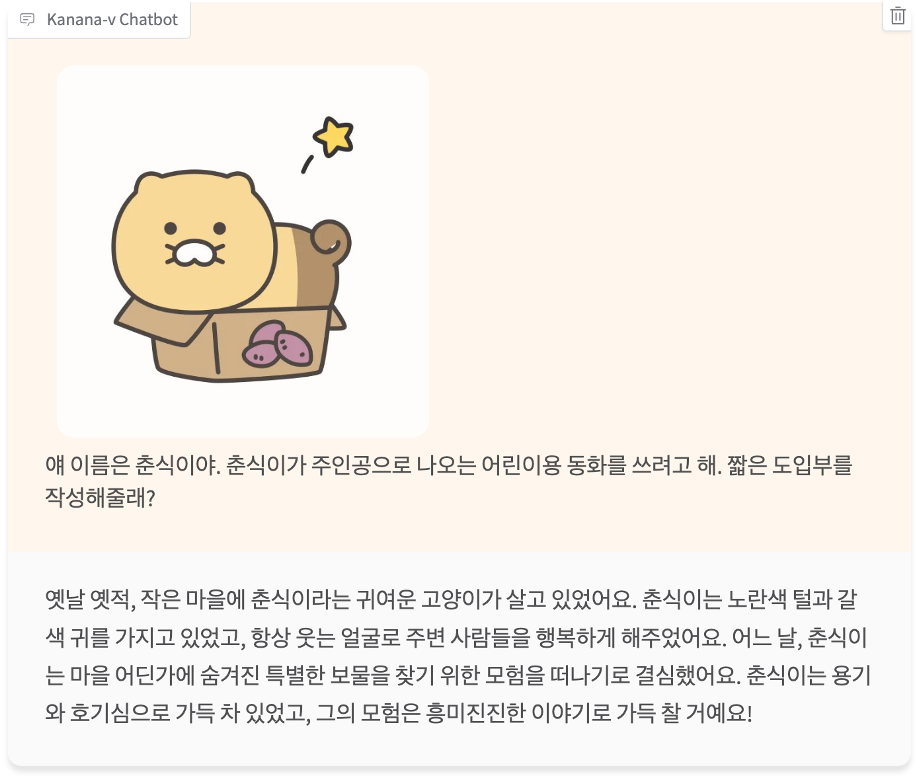
이미지를 보고 이해하여 설명하거나, 이를 소재로 새로운 글을 쓸 수 있는 기능입니다. 아래 예시와 같이 이미지의 디테일한 부분까지도 잘 이해하고, 사용자의 요청에 맞춰 잘 응답하는 것을 확인할 수 있습니다.
Document Understanding
현재 다양한 데이터가 문서 형태로 저장되어 있는 만큼, 문서 이해는 멀티모달 언어모델에서 아주 중요한 역할을 하는 활용도가 높은 기능입니다. 아래 예시를 통해 Kanana-v가 단순히 글을 이해하는 것을 넘어 복합적인 능력을 요구하는 과제 또한 잘 수행하는 것을 확인할 수 있습니다. 긴 글을 잘 읽고 요약할 뿐만 아니라, 요청한 정보를 찾아내거나 JSON 포맷과 같이 사용자가 원하는 형태로 정리할 수도 있습니다.
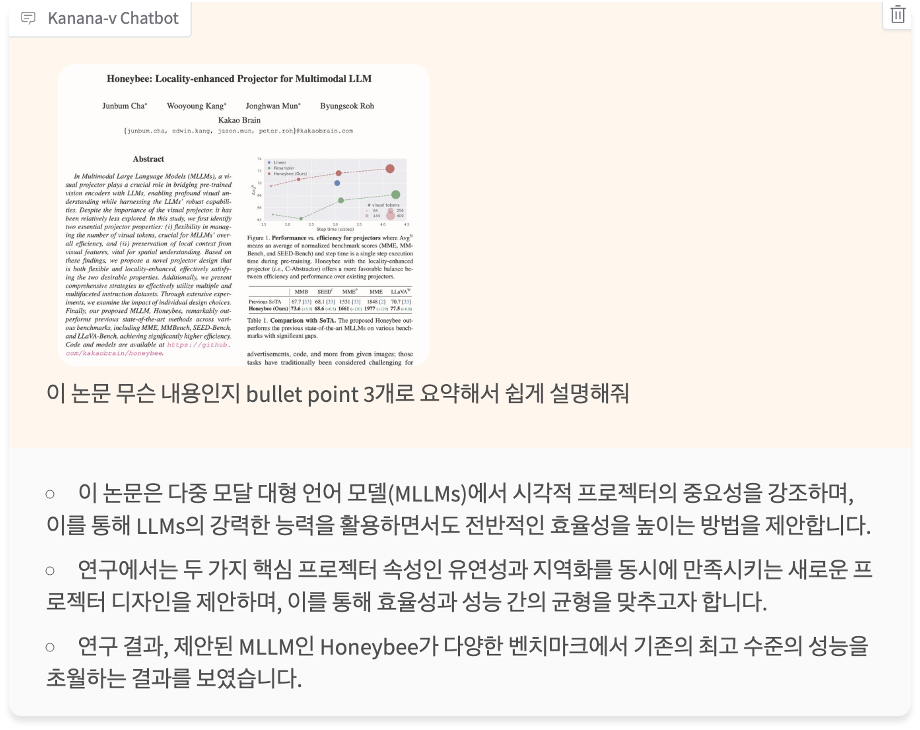
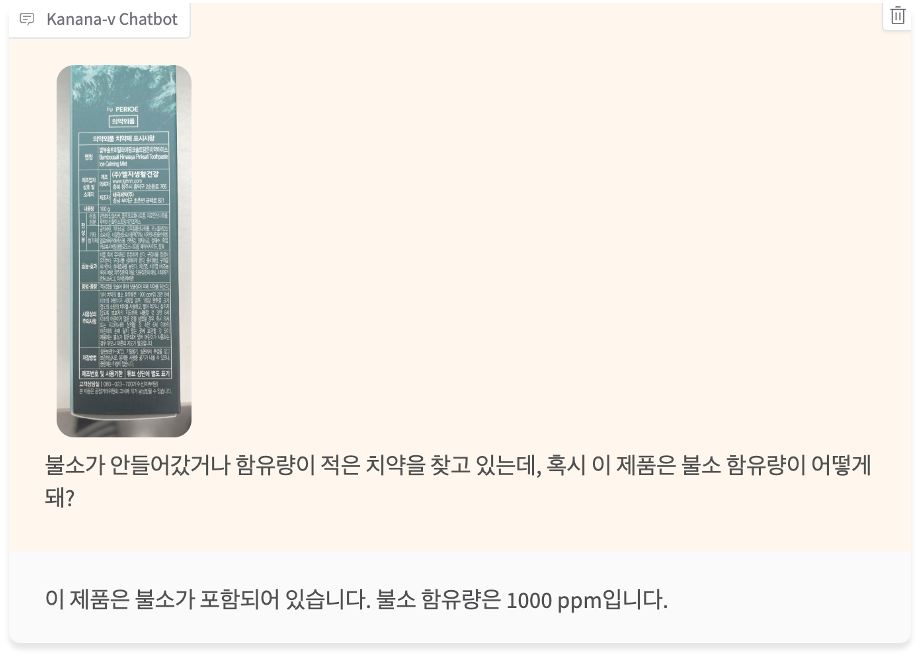
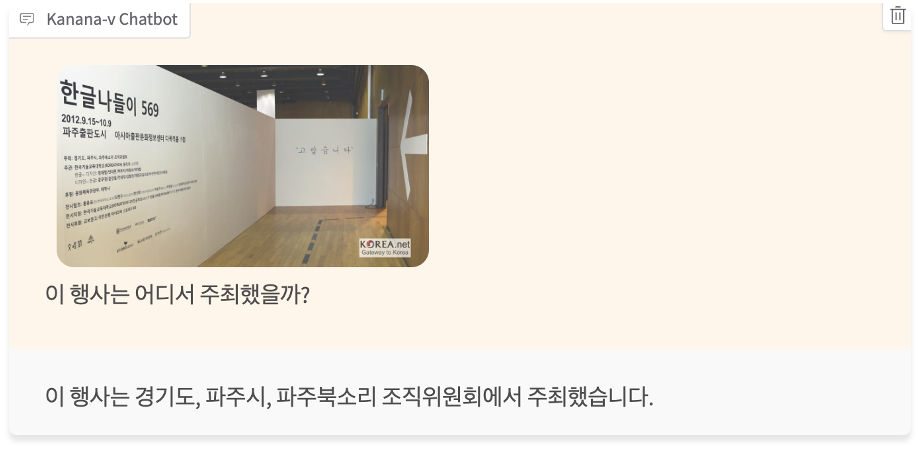
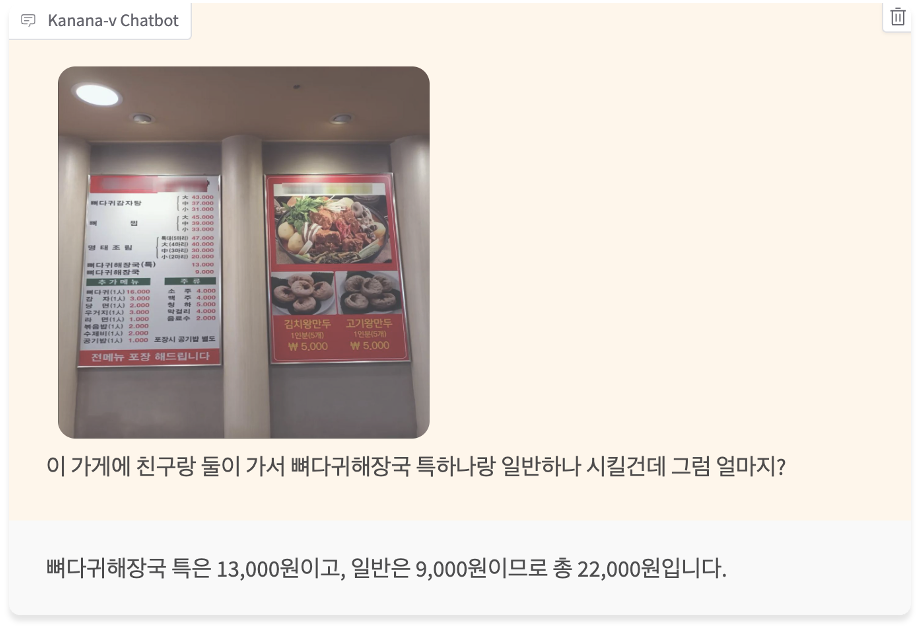
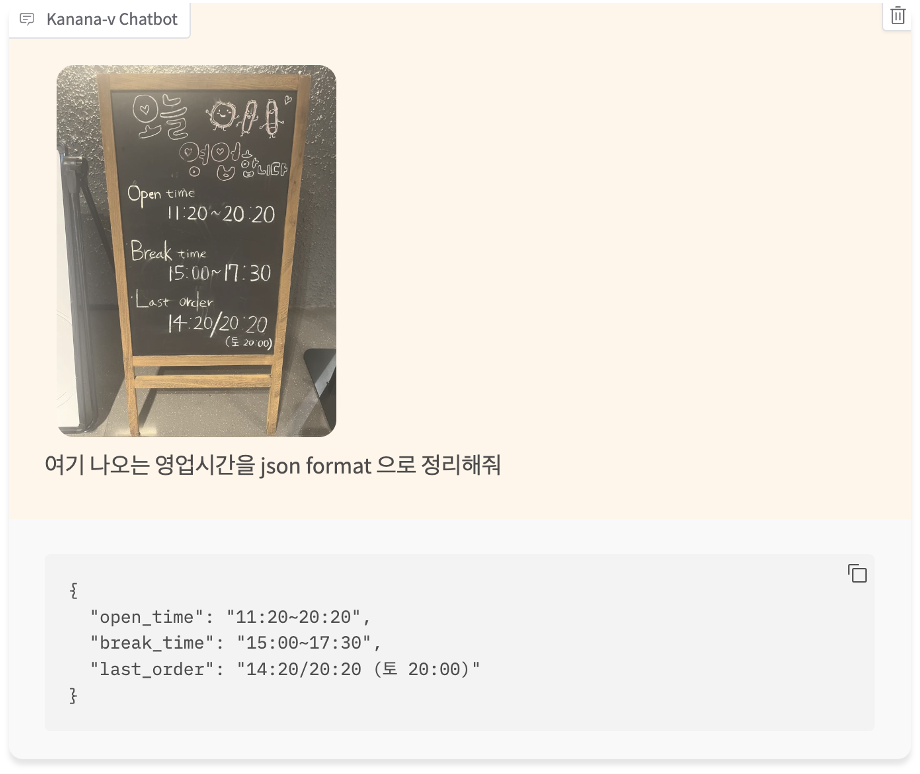
Chart and diagram understanding
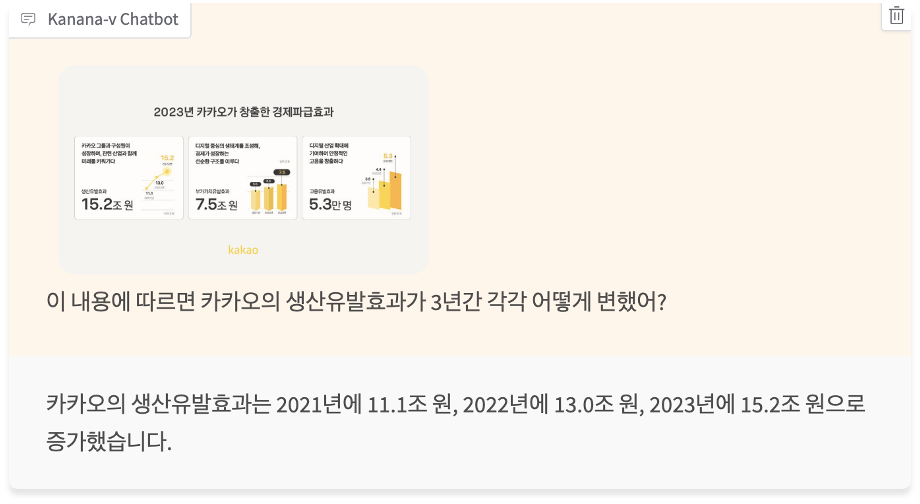
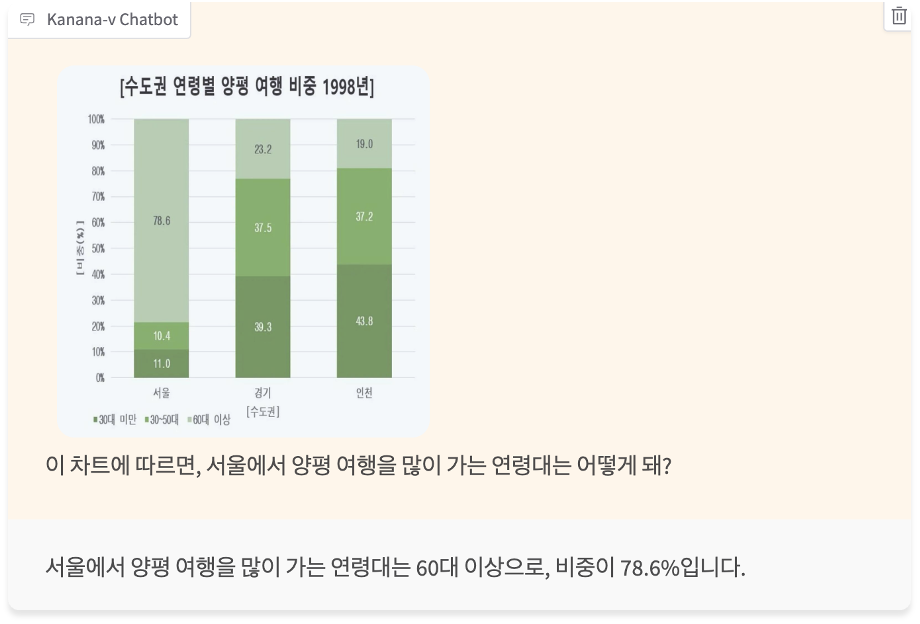
데이터 분석에 있어 빠지지 않는 것이 바로 차트와 도표입니다. 멀티모달 언어모델이 복합 데이터를 처리하기 위해서는 차트와 도표 이해 능력이 필수적인데요. 차트와 도표는 문서 이해의 일종이지만, 더욱 복합적인 이해와 추론 능력을 요구하는 과제입니다. 아래 예시를 통해 Kanana-v가 다양한 구조의 차트와 도표 형태를 잘 이해하고 정확히 응답하는 것을 확인할 수 있습니다.
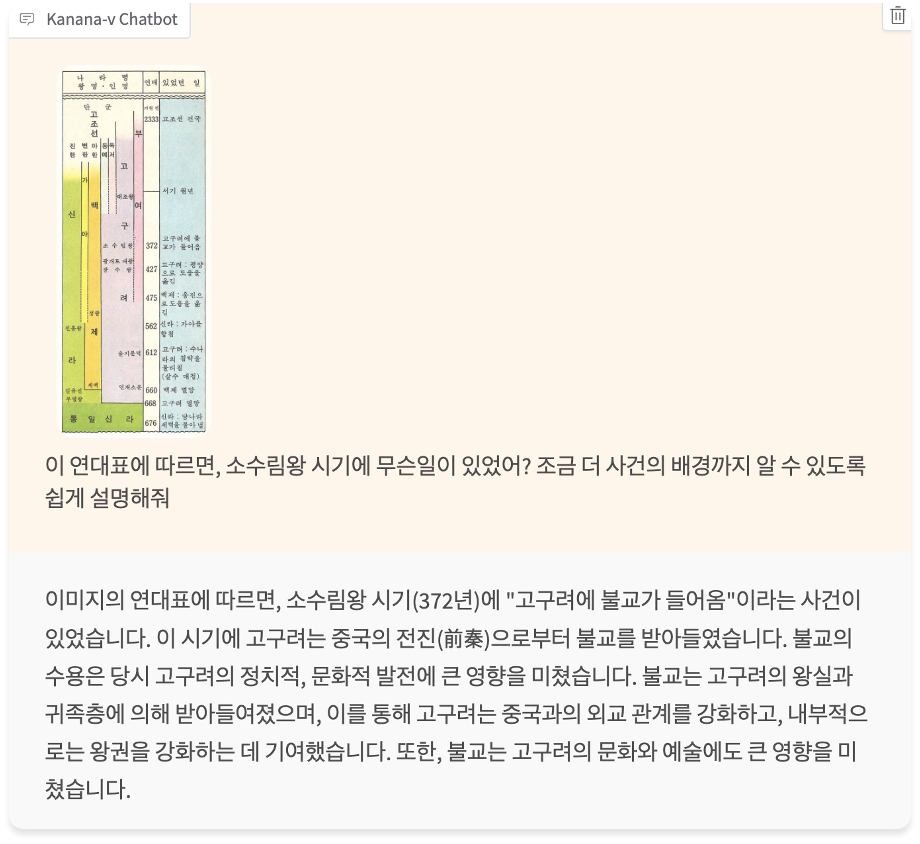
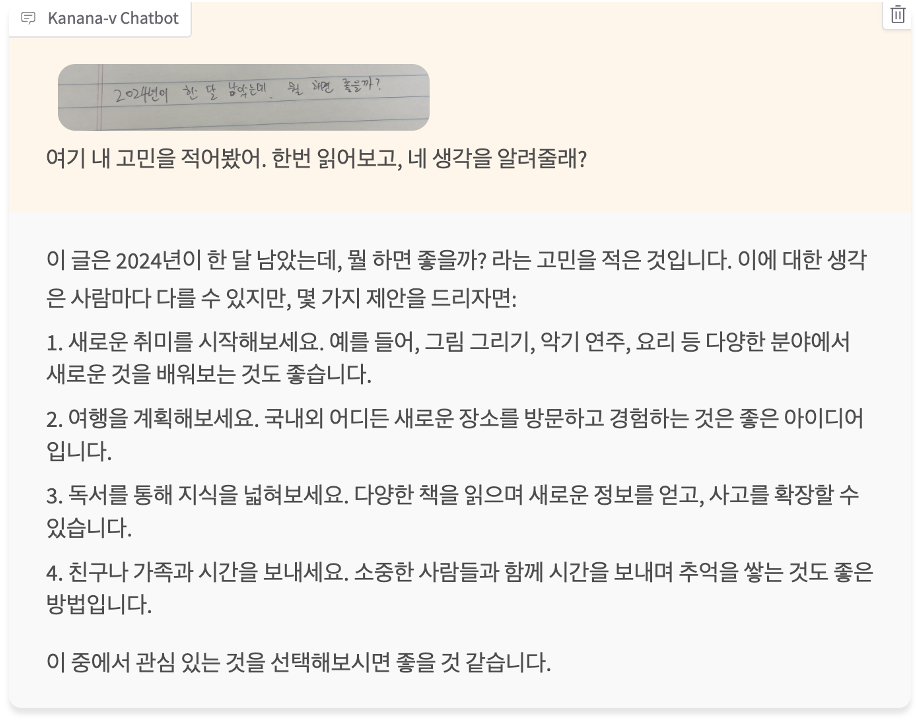
Handwritten text understanding
손글씨는 사람마다 다양한 스타일이 존재해 사람도 서로의 손글씨를 읽을 때 헷갈리기 쉬운데요. 인공지능 모델에게도 각기 다른 손글씨를 잘 읽고 응답하는 것은 어려운 부분입니다. 다음 예시는 제가 직접 쓴 손글씨인데요. 상당한 악필임에도 불구하고 잘 인식하고 답변하는 모습을 보여줍니다.
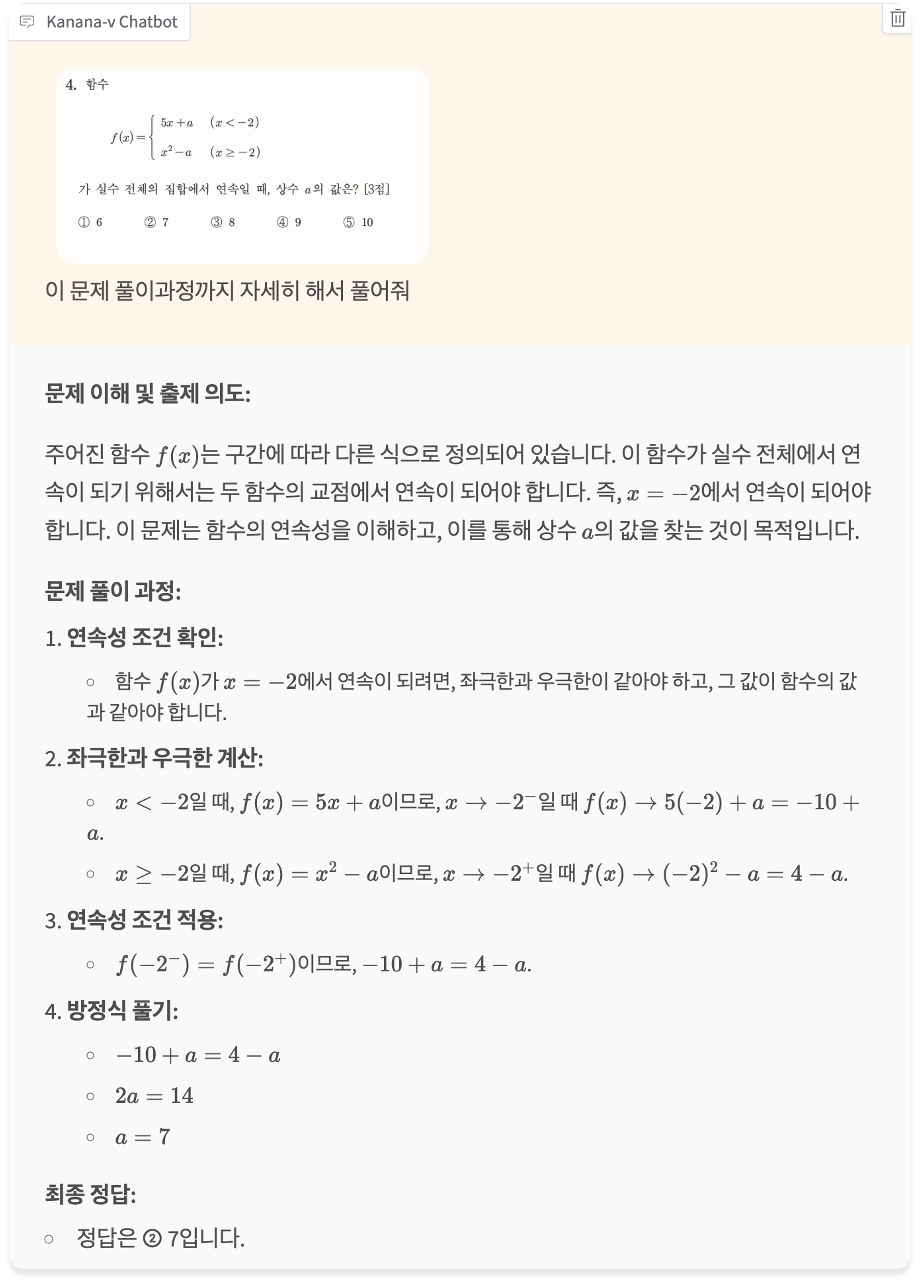
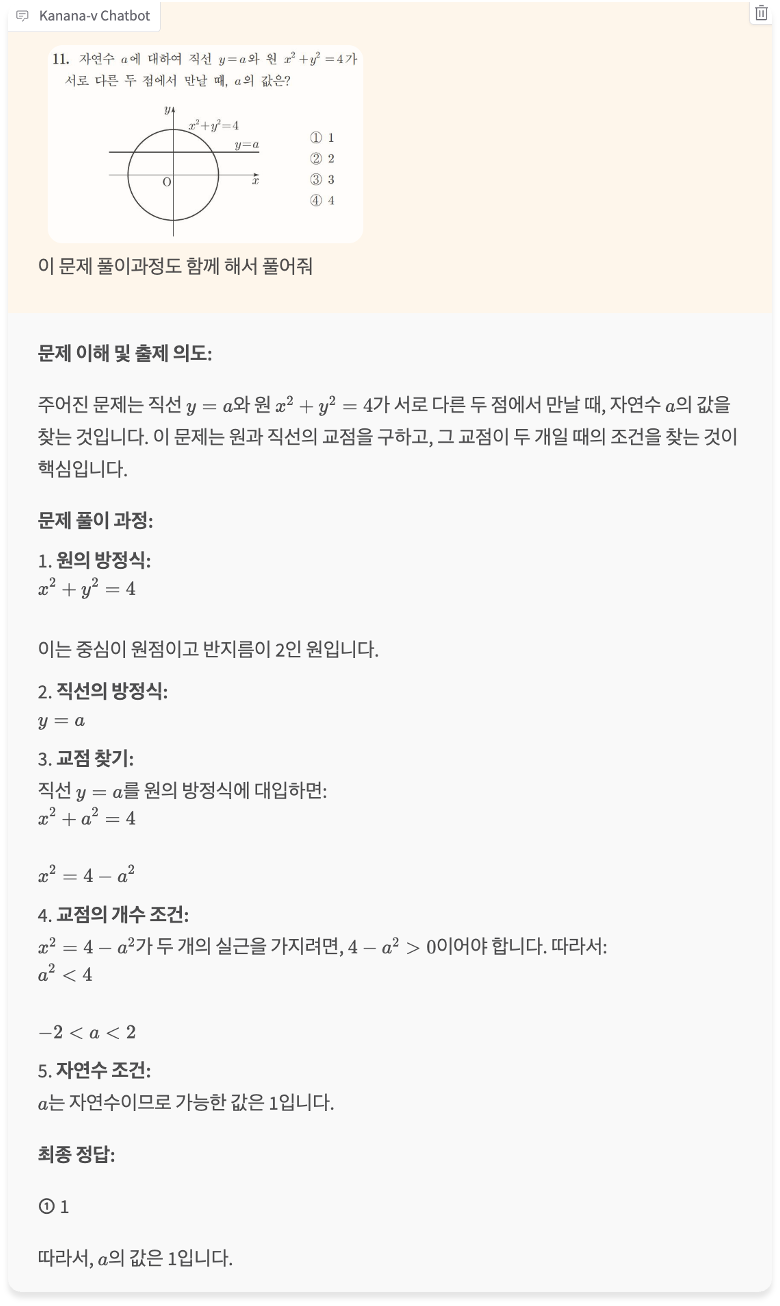
Math
수학은 추론 능력을 요구하는 대표적인 과제입니다. 수학 능력 그 자체 이상으로 모델이 얼마나 여러 단계를 걸친 어려운 추론 과제를 잘 해결하는 능력이 있는지를 보여주죠. 현재 Kanana-v는 복잡하고 어려운 문제는 아직 자주 틀리고는 하지만, 쉬운 수능 문제나 고등 검정고시 문제는 곧잘 풀어냅니다.
Commonsense
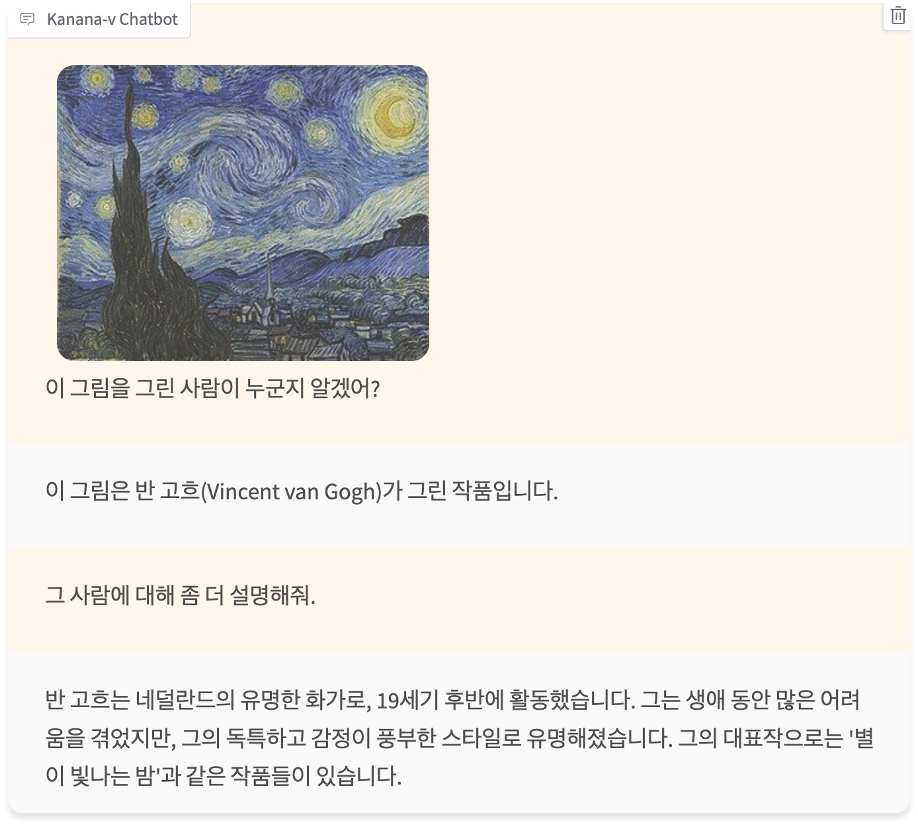
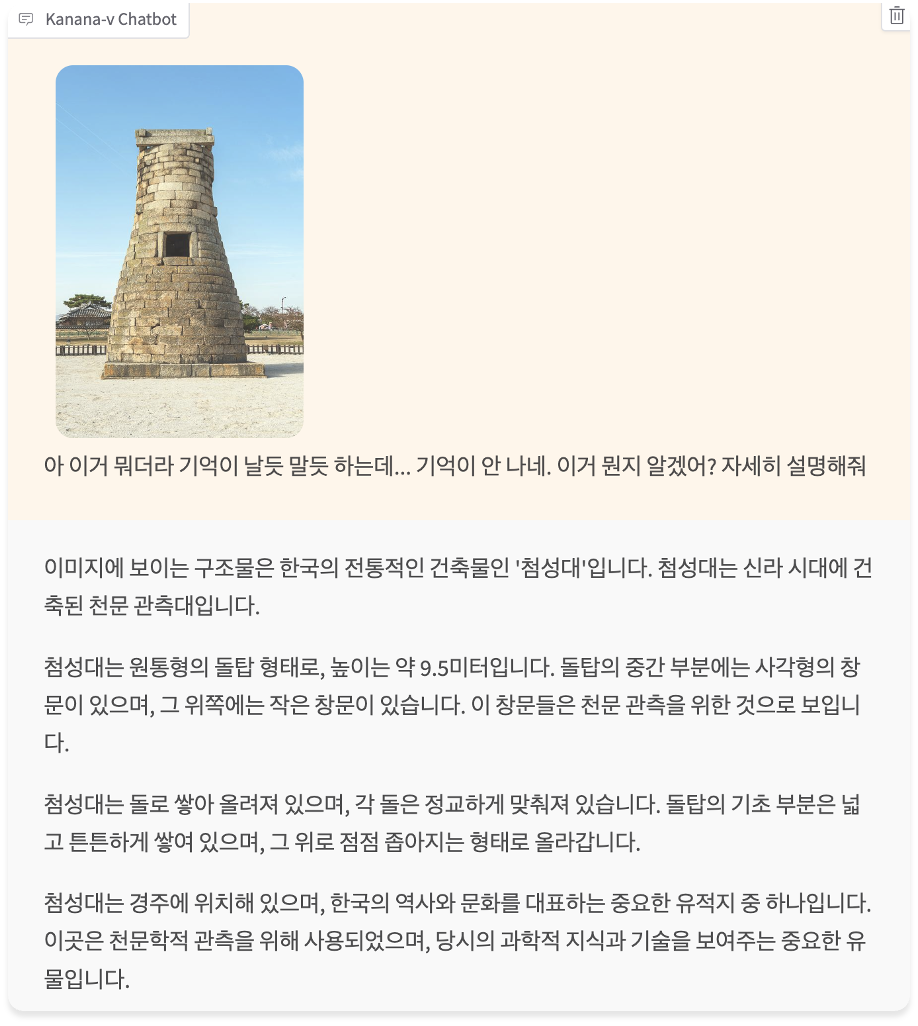
사용자와 자연스러운 의사소통을 하기 위해서는 고차원적인 사고 능력 외에도, 풍부한 상식을 갖추는 것이 중요합니다. 특히 한국어 서비스에 적용되기 위해서는 한국어와 한국문화에 대한 뛰어난 이해 능력을 가져야 하는데요. 아래 예시와 같이 일반 상식뿐만 아니라 한국 문화, 역사에서도 정확한 답변을 하는 것을 볼 수 있습니다.
앞으로의 목표
멀티모달 언어모델 개발을 목표로 올해 6월 저희 조직이 만들어진 이래로, 지금까지 저희가 달려온 약 반년 간의 여정을 소개해드렸습니다. 현재 Kanana-v가 세계적인 모델들과 견주어 충분한 경쟁력이 있다는 것을 보여드렸지만, 아직 개발 진행 중인 모델이기에 여전히 부족한 점도 많고 개선해야 할 부분도 많습니다. 앞으로 Kanana-v의 발전방향과 저희가 주요하게 보고 있는 목표를 소개하겠습니다.
Learning from human preference
저희가 바라는 인공지능 모델은 위험하거나 공격적인 발언을 삼가야 하고, 모르는 것은 아는척하지 않고 모른다고 말할 줄 알아야 합니다. 사용자에게 확실하지 않은 정보를 제공해서는 안 되고, 같은 말을 해도 친절하고 편안하게 전달해야 하죠. 예를 들면 보통은 논리 정연하게 정확한 정보를 전달하는 MBTI가 T같은 모델이어야 하겠지만, 때로는 사용자와 공감하며 소통하는 F같은 면도 갖추기를 바랍니다. 이처럼 사용자가 선호하는 대답을 할 수 있도록 모델을 정렬하는 Human preference learning은 현재에도 일부 적용되었지만, 앞으로는 이에 대해 보다 집중하여 모델을 고도화할 예정입니다. 앞서 소개드린 4단계 학습 스테이지 중 마지막 단계이기도 하지요. 이를 위해서는 높은 다양성(High-diversity)을 갖춘 고품질(High-quality)의 데이터를 확보해야 하기 때문에 데이터 수집 및 정제에 힘을 쏟고 있습니다.
Multi-turn dialogue
멀티턴(Multi-turn) 대화 능력은 평가의 어려움 때문에 벤치마크로는 잘 드러나지 않는 부분입니다. 하지만 직접 모델을 사용하면서 정성 평가를 해 보면, 많은 모델들이 멀티턴으로 대화가 길게 진행될 때 대화의 맥락을 잃어버리지 않고 오래 전의 대화 내용도 잘 기억하며 답변하는 것을 어려워한다는 것을 알 수 있습니다. 특히 현재 가장 널리 사용되는 상용 모델인 GPT와의 격차를 잘 확인할 수 있는 부분이기도 합니다. 멀티모달 언어모델에게 굉장히 중요한 능력인 만큼, 저희도 주요 과제로 삼아 개선을 진행 중입니다.
Person identification
실제로 맞닥뜨리기 전에는 생각하지 못했던 어려운 문제들도 몇 있었는데, 인물 식별이 대표적인 예입니다. 저희는 모델이 학습 과정에 본 인물이라도 새로운 구도의 사진을 보았을 때 동일 인물임을 잘 인지하지 못하는 경향을 관측했는데요. 비전 인코더가 한국 인물들에 대해 충분한 학습이 이루어지지 않아, 서로 다른 인물 간의 차이를 효과적으로 파악하지 못하여 발생하는 문제라고 추정하고 있습니다. 즉, 사람을 구분하기 위한 적절한 특성(Feature)을 추출하지 못하고 있는 것이죠. 앞으로 비전 인코더의 학습 시 보다 다양한 한국 인물들의 이미지를 활용하여 모델의 인물 특성 추출 능력을 강화할 예정입니다.
On-device serving
모델이 서버에서 작동하는 것이 아니라 모바일과 같은 제한된 자원 환경에서 작동하는 온디바이스(On-device) 모델을 만드는 것 또한 중요한 과제입니다. 모델이 크면 클수록 성능이 좋다는 것은 잘 알려진 사실이지만, 이는 그대로 비용으로 이어지고 사용자의 부담으로 연결됩니다. 이러한 부담을 최소화하기 위해서는 작지만 좋은 모델을 개발하는 것이 필수적이죠. 현재 저희는 다방면에 활용할 수 있는 중소형 규모로 모델을 개발했지만, 앞으로 모바일 환경에서도 동작 가능한 수준의 작은 사이즈로 줄이는 것을 목표로 하고 있습니다.
맺음말
지금까지 이미지도 찰떡같이 이해하는 멀티모달 언어모델, Kanana-v에 대해 소개드렸습니다. Kanana-v는 세계적인 모델들과 비교했을 때, 영어에서는 경쟁력 있는 성능을, 한국어에서는 압도적인 성능을 확인할 수 있었는데요. 다양한 예시를 통해 차트와 도표 이해, 손글씨 등 문서 이해 능력을 바탕으로 추론 능력, 상식까지 갖춘 Kanana-v의 기능까지도 함께 살펴보았습니다. 앞으로 Kanana-v는 멀티턴 대화를 위한 메모리 능력과 온디바이스 동작 등의 목표 과제를 수행하며, 고도화할 계획입니다. 특히 Kanana-v는 저희가 공유드리는 첫 멀티모달 언어모델인 만큼, 앞으로 얼마나 더 발전해 나갈지 많은 기대 부탁드리겠습니다.
현재 카카오에서는 Kanana-v 외에도, 통합 멀티모달 언어모델 Kanana-o를 개발 중에 있습니다. 이미 if(kakaoAI)2024에서 데모 영상이 소개된 바 있는데요. 내년에는 비디오 입력까지도 처리할 수 있도록 모델을 확장할 예정입니다. 더 많은 모달리티를 다루며, AI가 우리 일상에 보다 실질적인 도움을 제공하는 진정한 파트너로서 발전하길 기대하고 있습니다. 다음에는 이미지와 텍스트를 넘어 음성을 듣고 말할 수 있는 Kanana-o 모델 이야기로 다시 찾아뵙겠습니다. 감사합니다.
함께한 사람들
Kanana ⍺ 조직의 brook.p (박범희), chad.pp (전해성), coco.upgrade (한건수), edwin.ai (강우영), james.e (이재명), jessie.e (이지혜), kevin.nlp (고현웅), logan.c (차준범), martin.gale (조대진), peter.brain (노병석), samuel.brain (강성훈), welt.bae (배병욱), wooner.l (이동진) 이 함께했습니다.
데이터 구축에 있어서는 Kanana ⍺ 조직의 alan.zero (노영만), el.if (조민범), hulk.5 (오형석), isaac.newton (신종주), jaden.o (박지호), jennie.ee (이지혜), jeri.s (이희현) 이 많은 도움을 주셨습니다.
짧은 기간 동안 경쟁력 있는 기술을 확보하기 위해 함께 노력해 주신 모든 크루분들께 이 자리를 빌려 감사의 인사를 전합니다.
감사의 말
전체 내용에 대한 검수를 맡아주신 Kanana ⍺ 조직의 loophy.cc (조정민) 에게 감사의 말을 전합니다.
관련 글 목록
- 카카오의 AI 모델, 카나나 모델 패밀리를 소개합니다
- 밑바닥부터 Kanana-LLM 개발하기: Pre-training
- 밑바닥부터 Kanana-LLM 개발하기: Post-training
- 나만의 프로필 이미지 생성 모델 개발기
- 이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기
- 작지만 강한 Kanana Nano 효율적으로 개발하기
참고문헌
[1] Cha, Junbum, et al. “Honeybee: Locality-enhanced projector for multimodal llm.” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2024.
[2] Liu, Haotian, et al. “Improved baselines with visual instruction tuning.” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2024.
[3] Wang, Peng, et al. “Qwen2-vl: Enhancing vision-language model’s perception of the world at any resolution.” arXiv preprint arXiv:2409.12191 (2024).
[4] Dehghani, Mostafa, et al. “Patch n’pack: Navit, a vision transformer for any aspect ratio and resolution.” Advances in Neural Information Processing Systems 36 (2024).
[5] Wei, Jason, et al. “Chain-of-thought prompting elicits reasoning in large language models.” Advances in neural information processing systems 35 (2022): 24824-24837.