QA
실시간 코드 리뷰 및 품질 관리: 단위 테스트 자동 생성을 통한 코드 품질 향상
dl.kim카카오
2025년 9월 19일
원문에서 보기 ↗단위 테스트는 코드 품질을 유지하고 회귀 오류를 방지하기 위한 핵심 수단입니다. 하지만 현실적으로 단위 테스트는 작성이 어렵고, 시간이 오래 걸리며, 작성자의 역량과 시간 제약에 따라 누락되기 쉽습니다.
이러한 한계를 극복하기 위해 최근에는 LLM 기반의 테스트 코드 자동 생성 기술이 급속도로 도입되고 있으며, 이는 코드 커버리지를 향상시키고 개발자의 생산성과 품질을 동시에 높이는 새로운 접근으로 주목받고 있습니다.
LLM은 코드의 문맥과 제어 흐름을 이해하고, 적절한 테스트 케이스를 생성할 수 있는 능력을 갖추고 있습니다. 기본적인 동작 흐름은 다음과 같습니다.
- 분석 대상 메소드의 시그니처 및 본문 파싱
- 입력 타입, 조건 분기, 예외 흐름 등을 기반으로 테스트 시나리오 도출
- 테스트 프레임워크(JUnit 등)에 맞는 템플릿에 삽입
- 가상(Mock) 객체, 어서션(Assertion), 경계값 등을 자동 구성
[예제: 대상 코드]
public  class  Calculator  {
    public  int  divide(int  a,  int  b)  {
        if  (b  ==  0)  throw  new  IllegalArgumentException("Division by zero");
        return  a  /  b;
    }
}
[GPT 기반 자동 생성 테스트 예시 (JUnit 5)]
@Test
void  testDivide_ValidInputs()  {
    Calculator  calc  =  new  Calculator();
    assertEquals(2,  calc.divide(4,  2));
}

@Test
void  testDivide_DivideByZero()  {
    Calculator  calc  =  new  Calculator();
    assertThrows(IllegalArgumentException.class,  ()  ->  calc.divide(4,  0));
}
이처럼 LLM은 코드의 의미를 파악해 정상 케이스와 예외 케이스에 대한 테스트를 자동으로 생성할 수 있습니다.
자동 테스트 생성을 위해 AI는 다음과 같은 코드 요소를 분석합니다.
| 요소 | 역할 | 예시 |
|---|---|---|
| 파라미터 타입 | 입력 값의 유효 범위 추정 | int, String, List |
| 조건문 (if, switch) | 경계 조건별 테스트 분기 생성 | if (x > 100) → x=99, x=100, x=101 |
| 예외 처리 | 실패 케이스 유도 | throw new IllegalArgumentException(…) |
| 의존성 주입 | 가상(Mock) 객체 생성 여부 판단 | UserService userService = … |
이러한 정보를 종합해 GPT등의 모델들은 단순 단일 테스트 시나리오가 아닌 여러 테스트 시나리오를 자동 구성할 수 있습니다.
단위 테스트 품질 향상을 위한 AI 전략
AI는 단위 테스트 코드를 자동 생성할 수 있지만, 기계적으로 생성된 테스트 코드가 실무에서 곧바로 실행 가능하고 의미 있는 품질을 보장하지는 않습니다.
따라서 다음과 같은 전략적 요소를 활용하면 생성된 테스트 코드의 실용성과 신뢰성을 대폭 높일 수 있습니다.
1. 의존성 분석을 통한 의존 클래스 코드 활용
AI가 테스트 대상을 분석할 때, 해당 클래스가 내부적으로 호출하거나 사용하는 의존 클래스를 자동으로 식별하고, 이를 함께 테스트에 포함시키는 능력은 생성된 테스트 코드의 품질을 높이는데 큰 역할을 합니다.
예를 들어 다음과 같은 코드가 있습니다.
public class UserService {
    private final UserRepository repository;
    public UserService(UserRepository repository) {
        this.repository = repository;
    }
    public User findUser(long id) {
        return repository.findById(id).orElseThrow(() -> new NotFoundException());
    }
}
AI는 단순히 UserService만 테스트하는 것이 아니라, 아래와 같이 UserRepository를 분석하여 적절한 가상(Mock) 동작을 구성해야 합니다.
@Test
void testFindUser_Found() {
    UserRepository repo = mock(UserRepository.class);
    User user = new User(1L, "test");
    when(repo.findById(1L)).thenReturn(Optional.of(user));

    UserService service = new UserService(repo);
    User result = service.findUser(1L);

    assertEquals("test", result.getName());
}
이처럼 의존성 분석은 정확한 컨텍스트 모킹(Context Mocking)¹을 가능하게 하며, 불필요한 NPE 회피 코드 생성을 줄이고, 진짜 의미 있는 테스트 흐름을 만들 수 있게 함에 필수적입니다.
2. Java 컴파일러를 통한 단위 테스트 유효성 자동 체크
AI가 생성한 테스트는 문법적으로는 그럴듯해 보여도, 컴파일 시 오류가 나는 경우가 빈번히 발생합니다. 예를 들어:
- 테스트 클래스 내부에 import 누락
- private 메소드 호출
- 없는 필드나 메소드 호출
이러한 문제를 사전에 방지하기 위해, 생성된 테스트 코드는 Java Compiler API 또는 javac로 사전 컴파일 시도 후, 실패 시 AI에게 오류 내용을 재피드백하는 구조가 반드시 필요합니다.
3. JUnit Runner를 통한 단위 테스트 실행 검증
테스트는 코드만으로는 그 가치에 큰 의미가 없습니다. 실제로 성공/실패를 구분하고 의미 있는 결과를 내야 그 가치가 스스로 입증되고 제품의 품질을 증진시킬 수 있다고 할 수 있습니다.
이를 위해 AI를 통해 생성된 테스트는 자동으로 JUnit Runner를 통해 실행되어야 하며, 다음과 같은 방식으로 결과를 도출하고 실패 시 AI를 통하여 분석하고 그 결과를 반영하여 다시 테스트 코드를 생성할 수 있는 자동화된 피드백 루프 형태를 구성해야 합니다.
[예시: 카카오 테스트 생성 Agent가 수행한 생성된 테스트 코드의 JUnit Runner를 통한 실행 결과]
{
    "status": "FAILED",
    "summary": "5 tests found.\n4 tests successful.\n1 tests failed.\n",
    "errorLog": "\nFailures (1):\n  testAverageWithSingleElementArray()\n    MethodSource [className = 'com.kakao.quality.sample.AverageCalculatorTest', methodName = 'testAverageWithSingleElementArray', methodParameterTypes = '']\n    => org.opentest4j.AssertionFailedError: expected: <-3.3> but was: <-3.0> [...]\n",
    "failedTestMethodList": [
        {
            "className": "com.kakao.quality.sample.AverageCalculatorTest",
            "methodName": "testAverageWithSingleElementArray",
            "failedMessage": "expected: <-3.3> but was: <-3.0>"
        }
    ],
    "passedTestMethodList": [
        {
            "className": "com.kakao.quality.sample.AverageCalculatorTest",
            "methodName": "testAverageWithMixedNumbers"
        },
        [...]
    ]
}
실패 로그와 함께 실패 및 성공 메소드를 정확하게 분리 관리하고, 실패 로그를 재분석하여 AI를 통하여 생성된 테스트 코드가 정상적으로 수행될 수 있도록 수정할 수 있어야 합니다.
{
    "AiMessage": {
        "text": "(1) `testAverageWithSingleElementArray`\n*

Cause: The failure log likely indicates a mismatch between the expected and actual output for the test case `assertEquals(-3.3, calculator.average(new int[]{-3, -3, -3}), 0.001);`. The test is incorrectly written because it is trying to test the average of an array with identical elements, and the expected value set in the test is incorrect. The expected average of the array `{-3, -3, -3}` should be `-3.0`, as all elements are `-3`, and the average would also be `-3.0`, not `-3.3`.\n\n*

How to fix: Correct the expected value in the `testAverageWithSingleElementArray` method for the test case involving an array with the elements `{-3, -3, -3}`. Change the expected value from `-3.3` to `-3.0`.\n\nHere's the corrected test method:\n\n```java\n@Test\npublic void testAverageWithSingleElementArray() {\n    [...]"

    }
}
4. JaCoCo 모듈을 이용한 커버리지 측정 및 증분 평가
AI가 테스트 코드를 생성했을 때, 가장 신뢰할 수 있는 품질 지표 중 하나는 바로 코드 커버리지 증가량입니다.
이를 위해 JaCoCo²와 같은 커버리지 측정 도구를 테스트 실행 후 연동하여 실제 커버리지를 수치화합니다.
[예시: 카카오 테스트 생성 Agent가 수행한 커버리지 변동 결과]
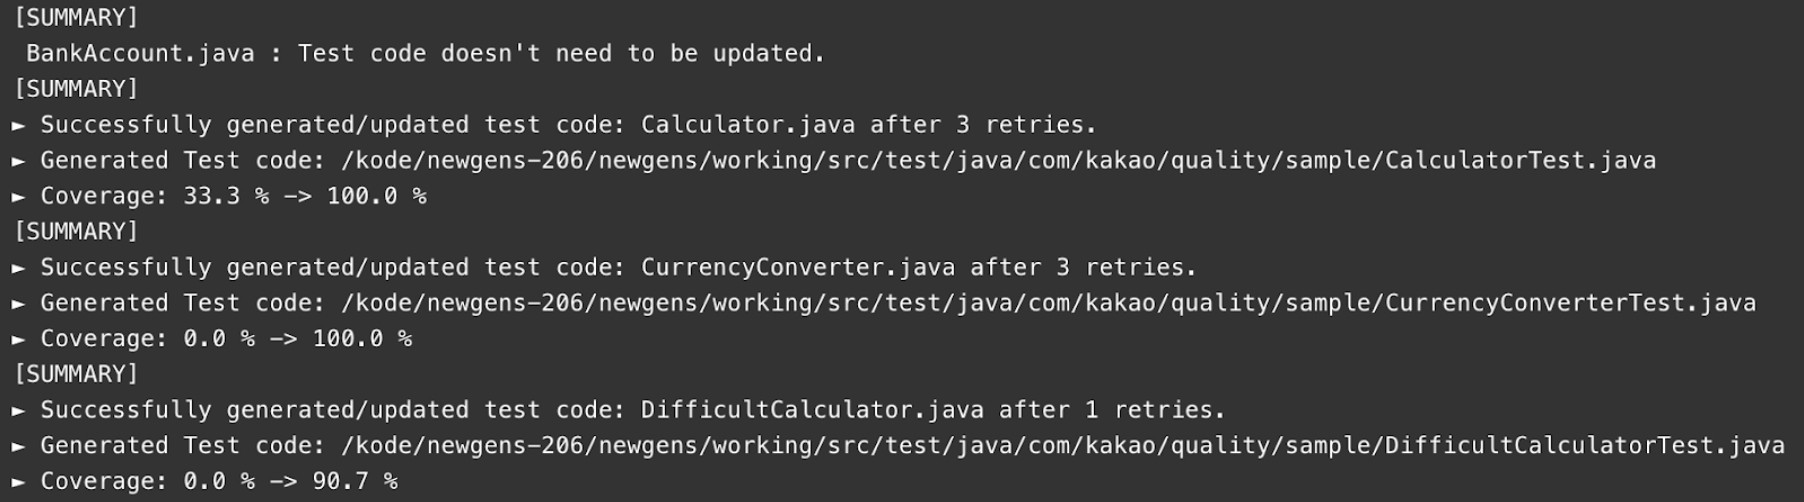
커버리지 증가는 단순히 테스트가 “존재한다”라는 사실을 넘어서, 기존 커버리지 맹점(blind spot)을 메웠는가에 대한 실질적 근거가 됩니다. 또한 이 결과는 코드 리뷰 시 자동 배지로 PR에 등록되어 품질 가시성을 높일 수 있습니다.
5. Jaro-Winkler / Levenshtein 기반 유사 코드 활용
AI가 이전에 생성한 테스트 코드나 프로젝트 내 유사한 테스트 클래스를 분석하여, 기존 테스트 흐름과 유사한 구조/경로/패턴을 재사용하면 생성되는 테스트 코드의 품질을 높일 수 있습니다.
이를 위해 Jaro-Winkler, Levenshtein 등 문자열 거리 알고리즘을 사용해 다음을 자동 분석할 수 있습니다.
| 기준 | 활용 |
|---|---|
| 클래스명 유사도 | OrderService, OrderHandler, OrderManager → 공통 유닛 검출 |
| 클래스명 역순 유사도 | OrderService, MemberService, AccountService → 유사 패턴 로직 검출 |
| 기존 테스트와의 유사도 | OrderServiceTest.testCalculateTotal() 구조 복제 가능성 판단 |
[예시 코드 (Levenshtein Distance)]
LevenshteinDistance levenshtein = new LevenshteinDistance(threshold)

int distance = levenshtein.apply(aClass.getCode(), bClass.getCode());
이 방식은 테스트 생성의 일관성 유지, 중복 피드백 방지, 패턴 기반 최적화에 기여하며 프로젝트 내의 기존 테스트 자산을 기반으로 일관된 코드 컨벤션을 지키며 품질 높은 테스트 생성을 가능하게 만듭니다.
실시간 코드 리뷰와 테스트 자동 생성 연계
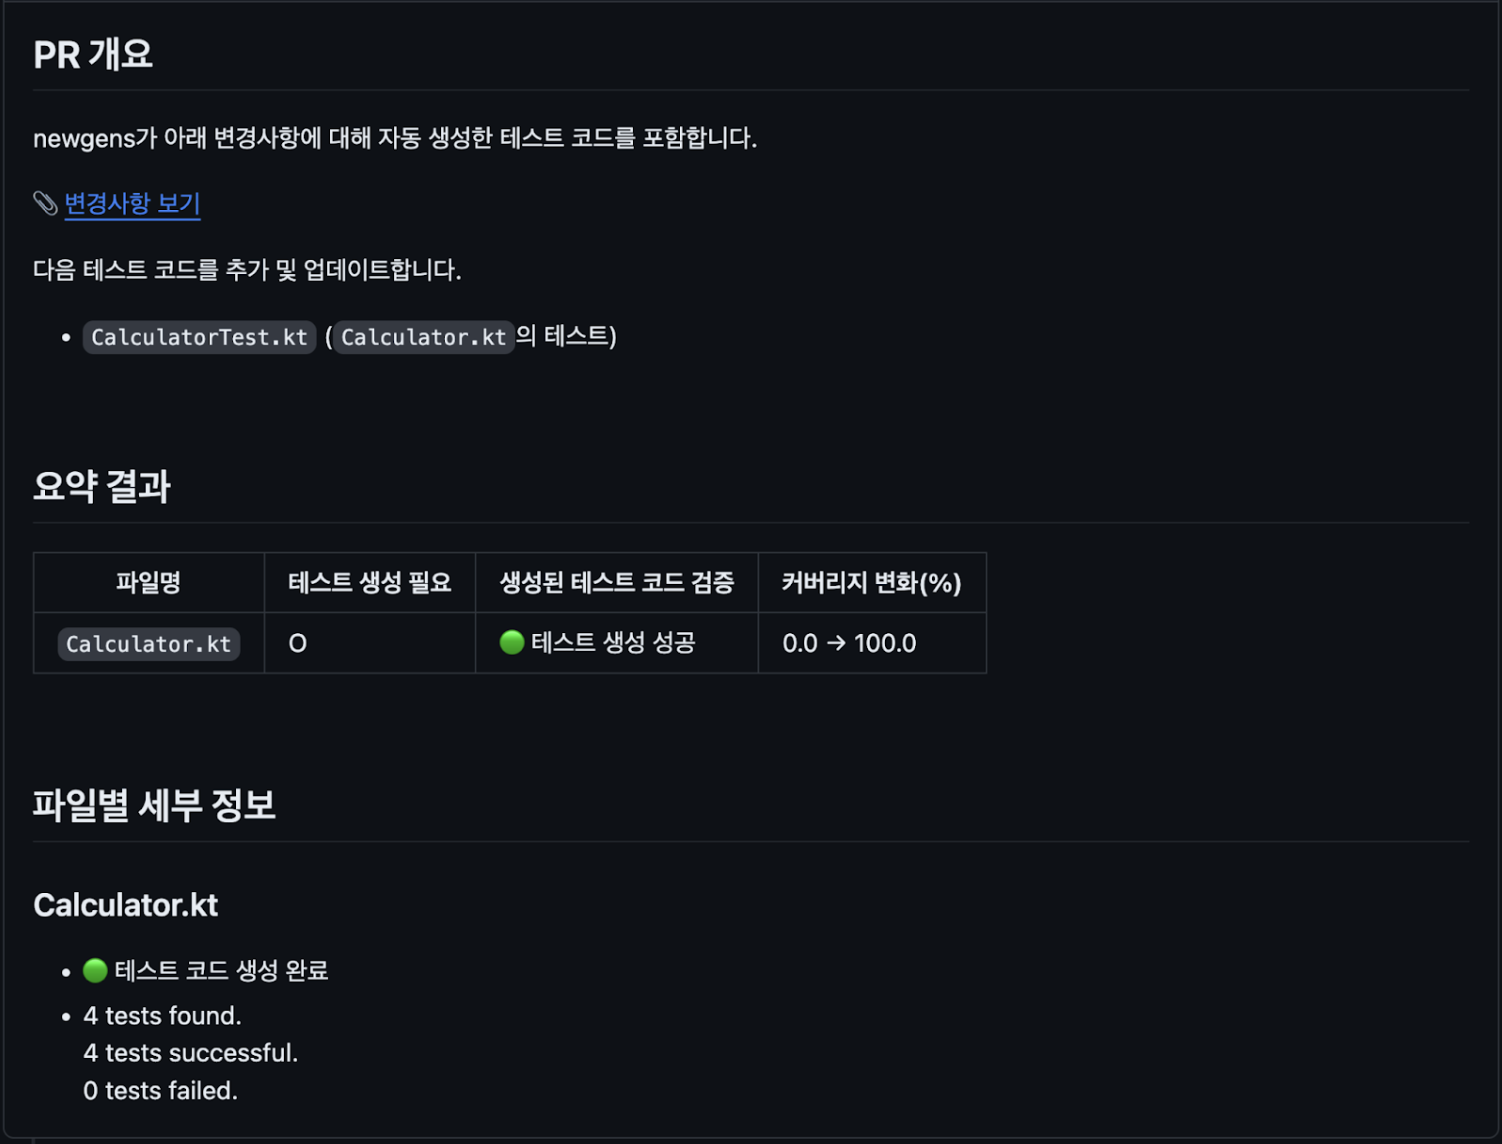
단위 테스트 자동 생성은 단순 IDE 내 도구로 끝나지 않고, 코드 리뷰 또는 PR 시점과 실시간으로 연동될 때 큰 효과를 발휘합니다.
다음은 실시간 코드 리뷰와 연계된 테스트 자동 생성에 대한 추천 워크플로입니다.
- PR 생성 → 변경된 클래스 감지
- 자동으로 테스트 생성 요청
- 생성된 테스트 코드는 PR에 자동 커밋 또는 주석 코멘트로 제안
- 테스트 커버리지 배지 갱신 (JaCoCo 연동)
[예시: 카카오 테스트 생성 Agent가 수행한 PR 리뷰 코멘트]
위 설명처럼 AI가 생성한 테스트 코드를 품질 있는 자산으로 만들기 위해서는 다음 전략이 중요합니다.
- 의존성 분석을 통한 정확한 가상(Mock) 클래스코드 구성
- 컴파일러 기반 유효성 확인으로 실패 방지
- JUnit 실행 기반 테스트 실효성 확보
- JaCoCo 커버리지 측정을 통한 성과 수치화
- 유사도 기반 재사용 전략으로 테스트 품질·일관성 확보
이 모든 요소가 결합되면, AI 기반 테스트 생성은 단순 자동화를 넘어, 신뢰 가능한 QA 프로세스의 일부로 통합될 수 있습니다.
자동화 파이프라인을 통한 품질 관리
앞서 다룬 AI 리뷰, 정적 분석, 테스트 자동 생성 기술은 실시간 코드 품질 관리를 가능하게 만들었지만, 이는 시작에 불과합니다.
이제는 각 기술 요소를 단절된 기능이 아닌 유기적인 흐름으로 엮어내는 자동화 파이프라인이 필요합니다.
에이전틱 워크플로 기반의 리뷰 및 품질 관리
에이전틱 워크플로(Agentic Workflow)는 각 품질 관리 단계에 맞는 전문 에이전트들이 자율적으로 판단하고 협력하면서 전체 리뷰 프로세스를 수행하는 아키텍처입니다.
다음은 카카오의 코드 퀄리티 통합 에이전트에 대한 에이전틱 워크플로 구성 예시입니다.
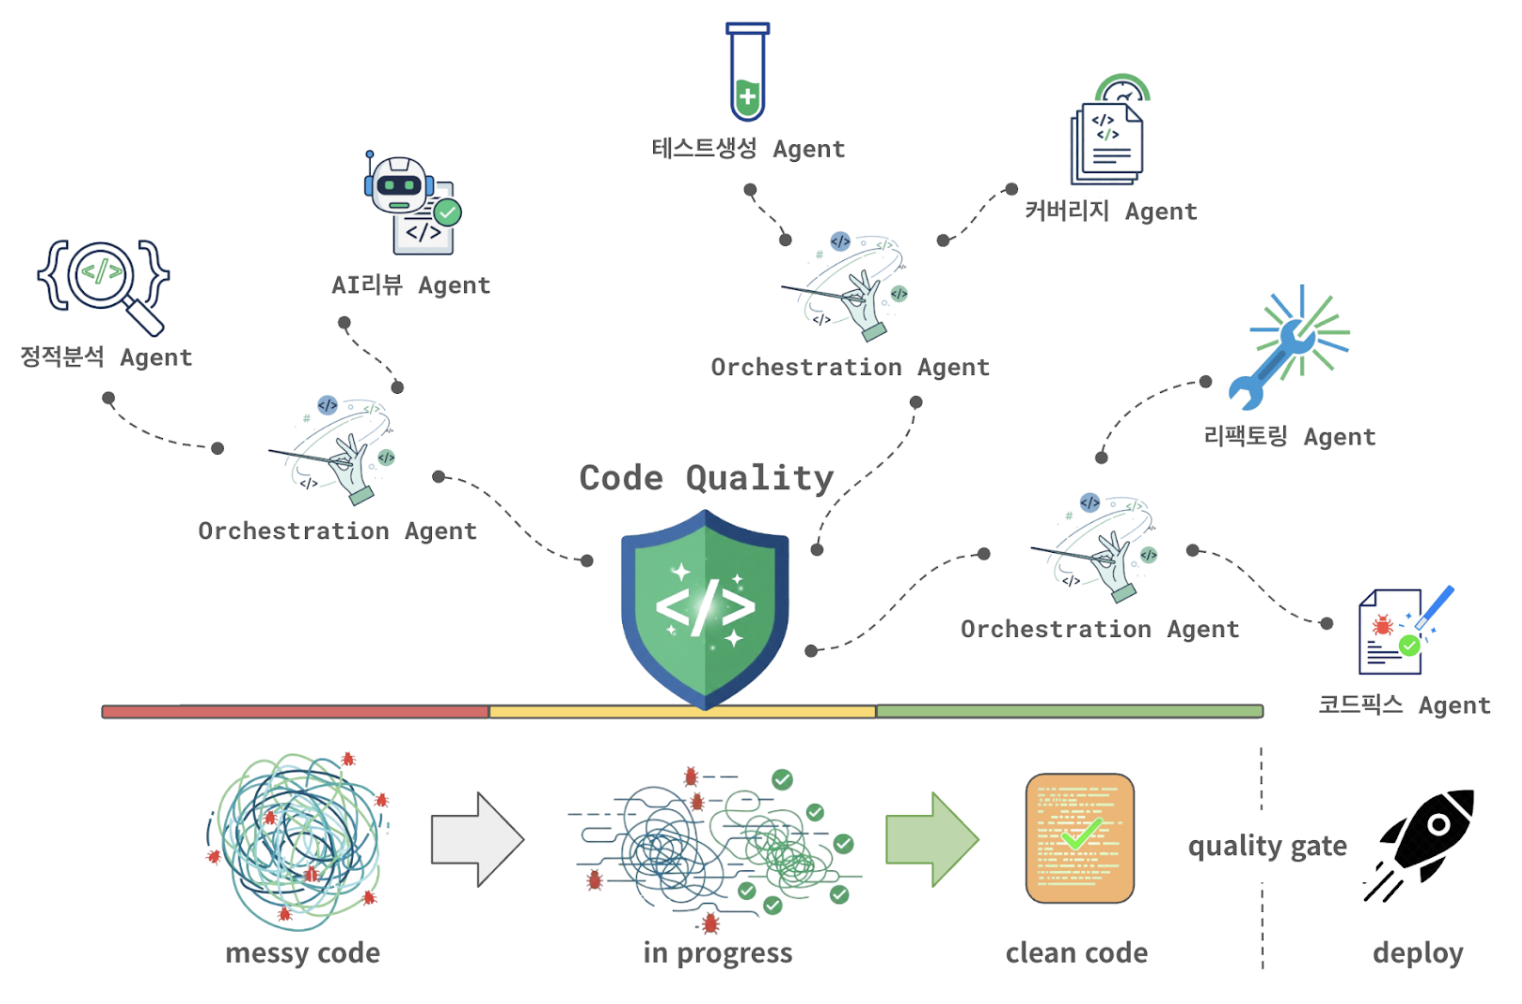
코드 변경의 감지를 시작으로 코드 퀄리티 통합 에이전트는 여러 지능형 에이전트와 연계하여 안전한 배포가 이루어 질 수 있도록 동적으로 판단하며 코드를 수정해 나갑니다. 이러한 복잡한 품질 보증 과정을 에이전틱 워크플로로 구성하여 유연하게 자동화할 수 있습니다.
개발 생산성 향상 도구와의 연계 시나리오
에이전틱 워크프로는 코드 품질 자동화에 그치지 않고, Jira, 카카오워크, GitHub 같은 협업 도구와 카카오릴리즈등 배포 관리 도구와 연동해 실제 개발자의 행동을 유도하고 지원할 수 있어야 합니다.
다음은 연계 시나리오 예시입니다.
- PR(Pull Request) 생성 시, 관련 지라 태스크(Jira Task)를 자동 추적
- 카카오워크 에서 AI 리뷰 결과 요약 알림 (위험도 80% 이상인 경우)
- GitHub PR에 테스트 누락 여부 또는 배포 차단 기준 표시
- 테스트 커버리지 낮은 모듈을 Confluence Wiki 문서로 자동 정리
- 카카오릴리즈에 코드품질 점수를 제공하여 배포 관리
각주
- 컨텍스트 모킹(Context Mocking)은 소프트웨어 테스트 시, 특정 코드나 구성 요소가 의존하는 '컨텍스트(환경 또는 상태 정보)'를 실제가 아닌 가상(모의)의 객체로 대체하여 테스트하는 기법입니다.
- JaCoCo (Java Code Coverage)는 Java 애플리케이션의 코드 커버리지(Code Coverage)를 측정하는 데 사용되는 오픈소스 도구이자 라이브러리를 말합니다.
