AI/ML
이미지 분류 모델 개발, 아직도 데이터만 기다려?
zayden.lee카카오
2024년 7월 3일
원문에서 보기 ↗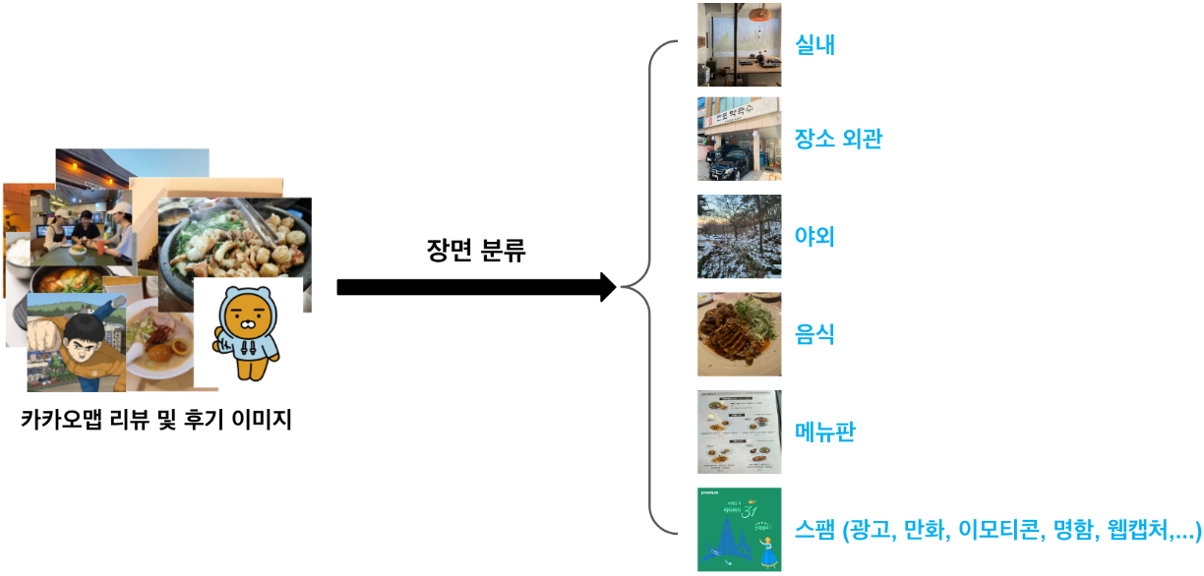
안녕하세요. 맵비전플랫폼개발의 Zayden(이동진)입니다.
제가 속한 조직은 카카오맵의 지도 데이터를 고도화하거나 카카오맵에서 활용할 수 있는 비전 시스템을 개발하고 있는데요. 오늘은 이러한 업무를 수행하는 저희 조직에서 진행했던 프로젝트인, 카카오맵의 리뷰 이미지를 분류하는 이미지 분류 모델의 개발 과정을 독자분들께 공유하고자 합니다.
현재 이미지 분류 기술은 딥러닝 분야에서 비교적 간단한 작업으로 간주되며, 다양한 구현 예제를 쉽게 찾아볼 수 있습니다. 이번 글에서는 다양한 예제들 중, Zero-shot 분류를 사용하여 가공한 선분류 데이터셋을 통해 모델 개발 기간을 단축하고, OOD(Out-of-Distribution) 필터링을 이용하여 정의되지 않은 카테고리를 분류해 내는 방법을 중점으로 소개하겠습니다.
이미지 분류 모델 선정
딥러닝 모델을 개발하려면 먼저 수많은 모델 중에서 어떤 모델을 선택할지 결정하는 과정이 필요합니다. 딥러닝 기술이 급속히 발전하던 시기에는 해마다 공개되는 모델 간의 성능 차이가 컸기 때문에, 더 나은 모델을 찾기 위해 수많은 실험을 해야 했습니다. 그러나 현재는 딥러닝 기술이 상당히 성숙한 상황이며, 모델의 종류보다는 개발자가 학습에 사용할 데이터에 초점을 맞추는 것이 더 현명합니다. 이는 모델의 종류보다는 학습 데이터의 양과 품질이 모델의 성능에 더 큰 영향을 끼치기 때문입니다.
당시 진행 중이었던 리뷰 이미지 분류 프로젝트의 요구사항은 ‘실내’, ‘장소 외관’, ‘야외’, ‘음식’, ‘메뉴판’ 및 ‘스팸’의 총 6개의 카테고리를 분류해야 하는 비교적 간단한 작업이었습니다. 따라서, 가볍고 단순하면서도 성능이 좋은 모델을 선택해야 했습니다.
이 조건들을 고려하여, 많은 모델들 중에서도 CVPR 2022에서 공개된 ConvNext[1]라는 순수 컨볼루션 신경망(Convnet) 모델을 선정했습니다. ConvNext 논문의 저자는 컨볼루션 신경망도 최적화 과정을 통해 최신 트랜스포머 모델의 성능을 능가할 수 있다고 주장하기도 했었습니다. 이후, 논문의 실제 결과가 이 주장을 뒷받침하며 ConvNext 모델은 좋은 성능뿐만 아니라 단순한 구조로 경량화되어 효율성 또한 높다는 것이 확인되었습니다.
이러한 이유들로 프로젝트의 주 모델을 ConvNext로 선택하게 되었습니다.
학습 및 평가 데이터 구축
학습 및 평가 데이터를 구축하기 위해서는 먼저 퍼블릭 데이터셋을 찾아보는 것이 좋습니다. 학습 데이터를 구축하는 데 걸리는 시간을 단축할 수 있기 때문입니다. 이번 프로젝트에서 필요한 ‘실내’, ‘장소 외관’, ‘야외’ 등의 데이터는 평범한 이미지기 때문에 공개된 퍼블릭 데이터가 많을 것이라 기대했지만, 원하는 조건의 데이터를 찾는 것은 쉽지 않았습니다. 예를 들어, ‘실내’ 이미지는 음식점, 카페, 전시장 등에서 분위기와 공간감이 충분히 나타나는 이미지여야 했고, ‘장소 외관’의 경우 특정 장소의 간판 등을 포함한 외관의 특징을 갖추어야 하는 조건이 있었습니다.
이처럼 좋은 모델을 만들기 위한 기반이 되는 고품질의 데이터셋은 분류 기준을 충족해야 하며, 최대한 최종 사용자의 데이터와 유사한 분포를 가져야 합니다. 예를 들어, 서양 가정집의 ‘실내’ 이미지로만 학습 데이터를 구축하면, 해당 모델은 한국 카페의 ‘실내’를 제대로 분류하기 어려울 수 있습니다.
이러한 이유로, 저희 조직에서는 카카오에서 수집한 이미지 데이터를 분류하여 학습 및 평가 데이터를 구축하기로 했습니다.
그렇게 약 20만 장의 이미지 데이터를 수집하였으며, 이 이미지들을 분류 기준에 따라 분류해야 했습니다. 물론 요청 시 사내 레이블링 작업자분들이 작업을 진행해 주실 수도 있었겠지만, 20만 장의 이미지를 분류하는 데는 상당한 시간이 소요됩니다. 그 시간 동안 저희 조직에서는 다음 작업을 진행할 수 없는 상황이 되는 것이죠.
학습 데이터 선분류
그래서 저희는 이미 잘 학습된 AI 모델을 활용해 수집한 학습 데이터의 일부를 선분류하기로 했습니다. CLIP[2]과 같은 멀티 모달 모델에 이미지와 텍스트 쿼리를 입력하여, 이미지와 각 텍스트 간의 상관관계를 추출하는 Zero-shot 분류가 가능합니다. 예를 들어, 강아지 이미지와 ‘강아지’, ‘고양이’ 및 ‘자동차’와 같은 텍스트 쿼리를 입력하면 ‘강아지’ 텍스트에 가장 높은 스코어를 출력해 주는 형식입니다.
이와 같은 방식으로, 20만 장의 이미지와 [‘실내’, ‘장소 외관’, ‘야외’, ‘음식’, ‘메뉴판’, ‘스팸’]이라는 텍스트 쿼리를 CLIP 모델에 입력하여 모든 이미지의 의사 라벨(Pseudo label)을 얻을 수 있습니다. 물론 이렇게 단순하게 처리하면 레이블에 상당히 노이즈가 섞이게 되어 데이터셋의 품질이 떨어질 수 있습니다. 따라서 텍스트 쿼리를 구체화하고 일부 샘플 데이터를 테스트하여 텍스트별 정확도를 측정한 후, 정확도가 높은 텍스트만 신뢰하는 방식을 사용했습니다. 또한, 모델의 출력에는 이미지와 텍스트 간의 유사도가 포함되기 때문에, 특정 Threshold 이상의 유사도를 가진 이미지들만 선분류 데이터로 사용했습니다.
결과적으로 음식, 음료, 야외, 자동차 및 동물에 대한 구체적인 텍스트 쿼리에서는 높은 정확도를 얻을 수 있었습니다. 그러나 실내, 건물 외관, 광고 및 웹캡처와 같은 추상적인 개념을 가진 텍스트에서는 정확도가 높지 않았습니다. 그래서 조금 더 구체적인 텍스트 쿼리를 사용했습니다. 예를 들어, 실내의 경우 대부분 의자와 테이블이 포함된 경우가 많기 때문에 ‘의자와 테이블’이라는 쿼리를 추가하는 방식입니다.
결국, CLIP 모델도 이미지와 텍스트 쌍을 활용하여 학습된 모델이기 때문에, 학습에 사용된 이미지와 텍스트와 유사한 경우에만 높은 신뢰도를 가지는 결과를 보여주게 됩니다.
이렇게 선분류한 이미지들도 정확한 데이터는 아니기 때문에, 카테고리별로 폴더에 정리한 후 대략적인 검수 작업을 진행했습니다. 오분류가 많은 일부 클래스는 선분류 데이터로 사용하지 않았으며, 이러한 과정을 거쳐 최종적으로 전체 학습 데이터셋의 약 40%에 해당하는 선분류 데이터를 얻을 수 있었습니다.
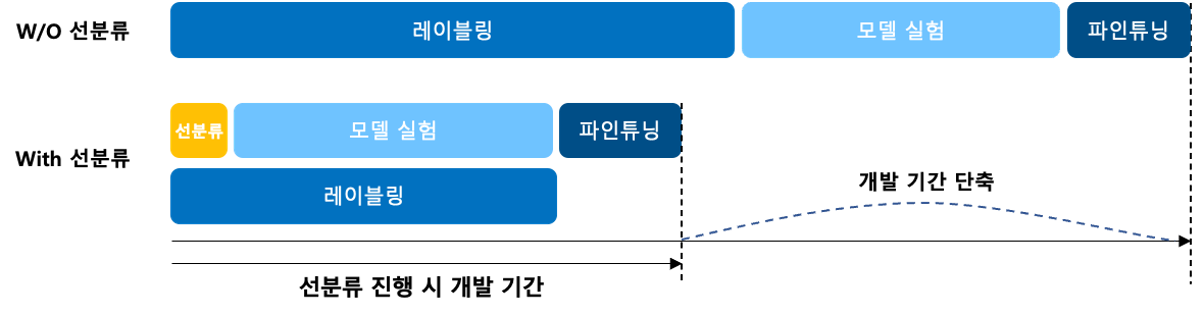
이러한 과정을 통해 짧은 시간 안에 상당한 양의 학습 및 평가 데이터를 확보할 수 있었습니다. 이후 레이블링 작업자들이 작업을 하는 동안 선분류 데이터를 활용하여 모델 실험을 진행했고, 레이블링이 완료된 후 전체 학습 데이터로 파인튜닝만을 진행하여 모델 개발을 완료할 수 있었습니다. 결론적으로 선분류 데이터를 활용한 덕분에 개발 기간을 크게 단축할 수 있었습니다.
테스트 데이터셋 구축
테스트 데이터셋을 만드는 과정도 매우 중요합니다. 단순히 전체 데이터의 일부를 테스트 데이터로 분리하는 것만으로는 부족하며, 테스트 데이터를 통해 모델의 성능을 면밀하게 평가하는 것이 최종 목표인 것을 기억해야 합니다. 이를 위해 테스트 데이터셋에는 각 카테고리별로 다양한 형태의 이미지가 포함되어야 합니다. 예를 들어, ‘실내’ 카테고리에는 다양한 음식점, 카페, 전시장, 호텔 및 운동 시설 등의 실내 이미지가 포함되어야 하고, ‘음식’ 카테고리에는 한식, 중식, 일식, 분식, 음료 및 베이커리 등 다양한 종류의 음식이 포함되어야 합니다. 이처럼 테스트 데이터셋을 잘 구성해야만 학습된 모델을 평가할 때 성능을 신뢰할 수 있습니다.
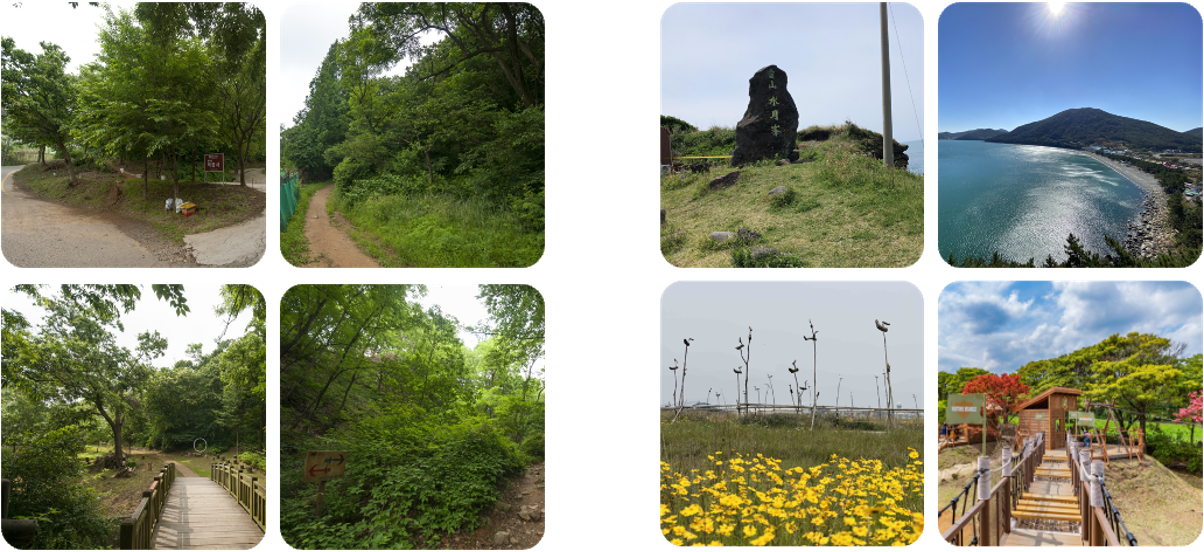
간혹 학습 데이터의 퀄리티에만 집중하다 보면 편향된 테스트 데이터셋이 만들어질 수 있습니다. 이 경우 일부 카테고리의 성능이 과도하게 높거나 낮게 나올 수 있는데요. 이렇게 되면 모델의 개발 과정에서 어느 부분을 어떻게 보완해야 할지 판단하기 어려워질 수 있습니다. 따라서, 테스트 데이터셋을 구성할 때는 다양한 사례를 고려하여 포괄적으로 데이터를 포함시켜야 합니다.
모델 학습 및 평가
작업자 분들이 레이블링 데이터를 작업하는 동안, 앞서 확보한 선분류 데이터로 이미지 분류 모델로 선정한 ConvNext 모델을 학습하였습니다. 최종적으로 Zero-shot 분류로 구축한 선분류 데이터셋 만으로 학습한 모델의 Mean accuracy가 90%를 넘어 나쁘지 않은 수치를 기록했으나, 사실 이는 6개의 카테고리로 진행한 이미지 분류 작업에서는 그다지 높은 성능은 아닙니다.
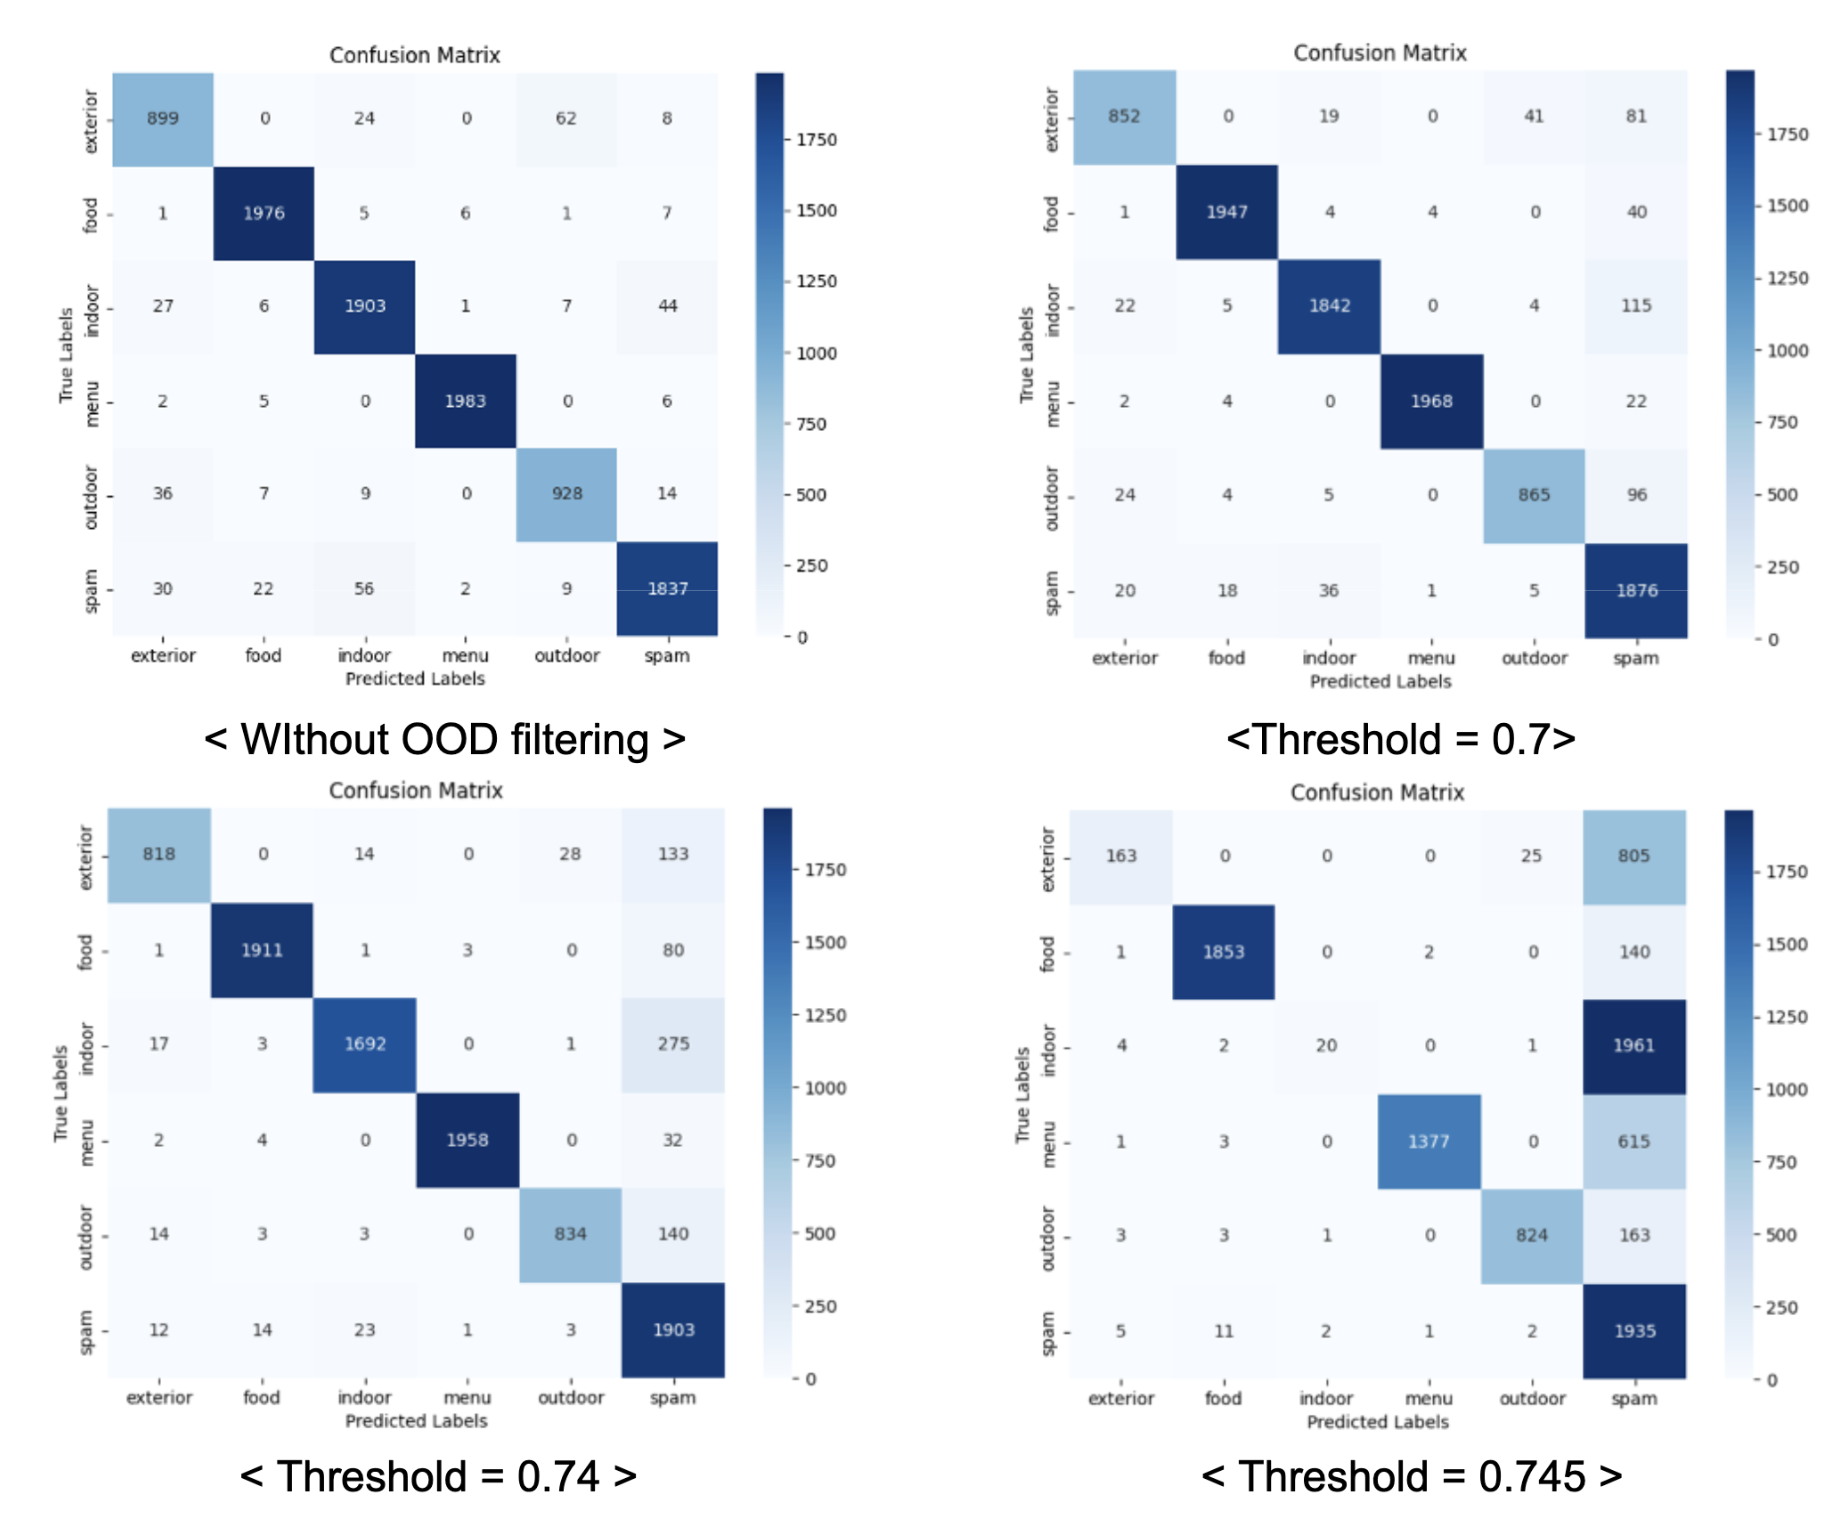
원인을 분석하기 위해 모델의 Confusion matrix를 추출했습니다. 이미지 분류 시 Mean accuracy만으로는 모델이 어떤 카테고리를 잘못 분류하는지 알기 어렵지만, Confusion matrix를 사용하면, 실제 데이터의 카테고리별로 정답에 대비해 어떤 카테고리로 잘못 분류되었는지 상세히 분석할 수 있기 때문입니다. 결과를 확인하니, 아래와 같이 ‘스팸’ 카테고리가 정답 ‘스팸’이 아닌 다른 카테고리로 분류된 경우가 종종 있었습니다.
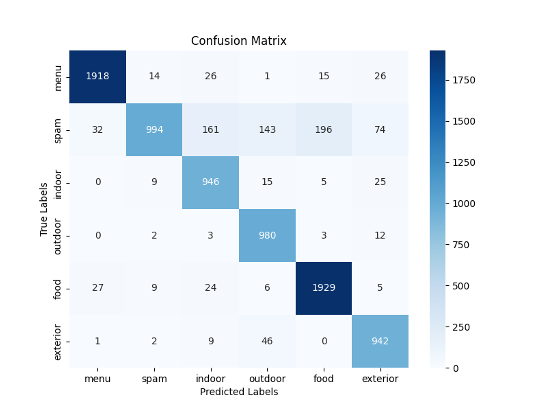
‘스팸’ 카테고리는 카카오맵 장소의 후기 및 리뷰 이미지로 사용되지 않길 원하는 스팸성 이미지로 정의했으며, 광고, 포스트, 캡처 이미지, 이모티콘, 만화, 문자 및 카톡 대화내용 및 명함 등의 이미지가 포함됩니다.
더 깊이 들여다보면 실내나 장소 외관 이미지에 광고가 붙어 스팸 카테고리가 되거나 예상치 못한 형태의 스팸성 이미지가 발견되었습니다. 이는 다른 다섯 가지 카테고리에 비해 ‘스팸’ 카테고리의 데이터 분포가 상당히 넓다는 것을 의미합니다. 때문에 저희는 더욱 다양한 스팸성 이미지를 수집하였고, 레이블링 작업 시에도 스팸성 이미지를 철저하게 분류했습니다.
이러한 과정을 통해 전체 데이터로 모델을 학습하면서 최적의 하이퍼파라미터 세팅 값을 찾고, 최종적으로 Mean accuracy를 3% 이상 향상할 수 있었습니다. 이제, 정답을 맞히지 못한 케이스들은 두 가지 이상의 카테고리 특성을 동시에 지닌 이미지들에서만 발생했습니다.
그럼에도 불구하고, 실제 서비스에서 유입되는 사용자 데이터는 데이터 분포가 더욱 다양할 수 있기 때문에, 스팸성 데이터가 ‘스팸’으로 분류되지 않는 경우가 발생할 수 있습니다. 이를 보완하기 위해, ‘스팸’을 보다 보수적으로 분류할 수 있도록 Out-of-Distribution 데이터를 추가로 필터링하는 후처리 기능을 추가했습니다.
모델 비교
모델 개발 과정에서 적절한 모델을 선정하기 위해, 주 모델로 선정한 ConvNext 모델과 ResNet[3] 모델을 모두 학습시킨 후 그 결과를 비교해 보았습니다. 아래 이미지와 같이 두 모델 간 최종 성능의 차이는 크지 않은 것처럼 보이지만, 모델 학습 과정을 살펴보면 상당한 차이가 있다는 것을 확인할 수 있었습니다. 먼저 Training Loss를 비교해 보면, ConvNext 모델이 빠르게 더 낮은 Loss 값으로 수렴했으며, Test accuracy 또한 ConvNext 모델이 훨씬 더 빠르게 상승하는 것을 확인할 수 있었습니다.
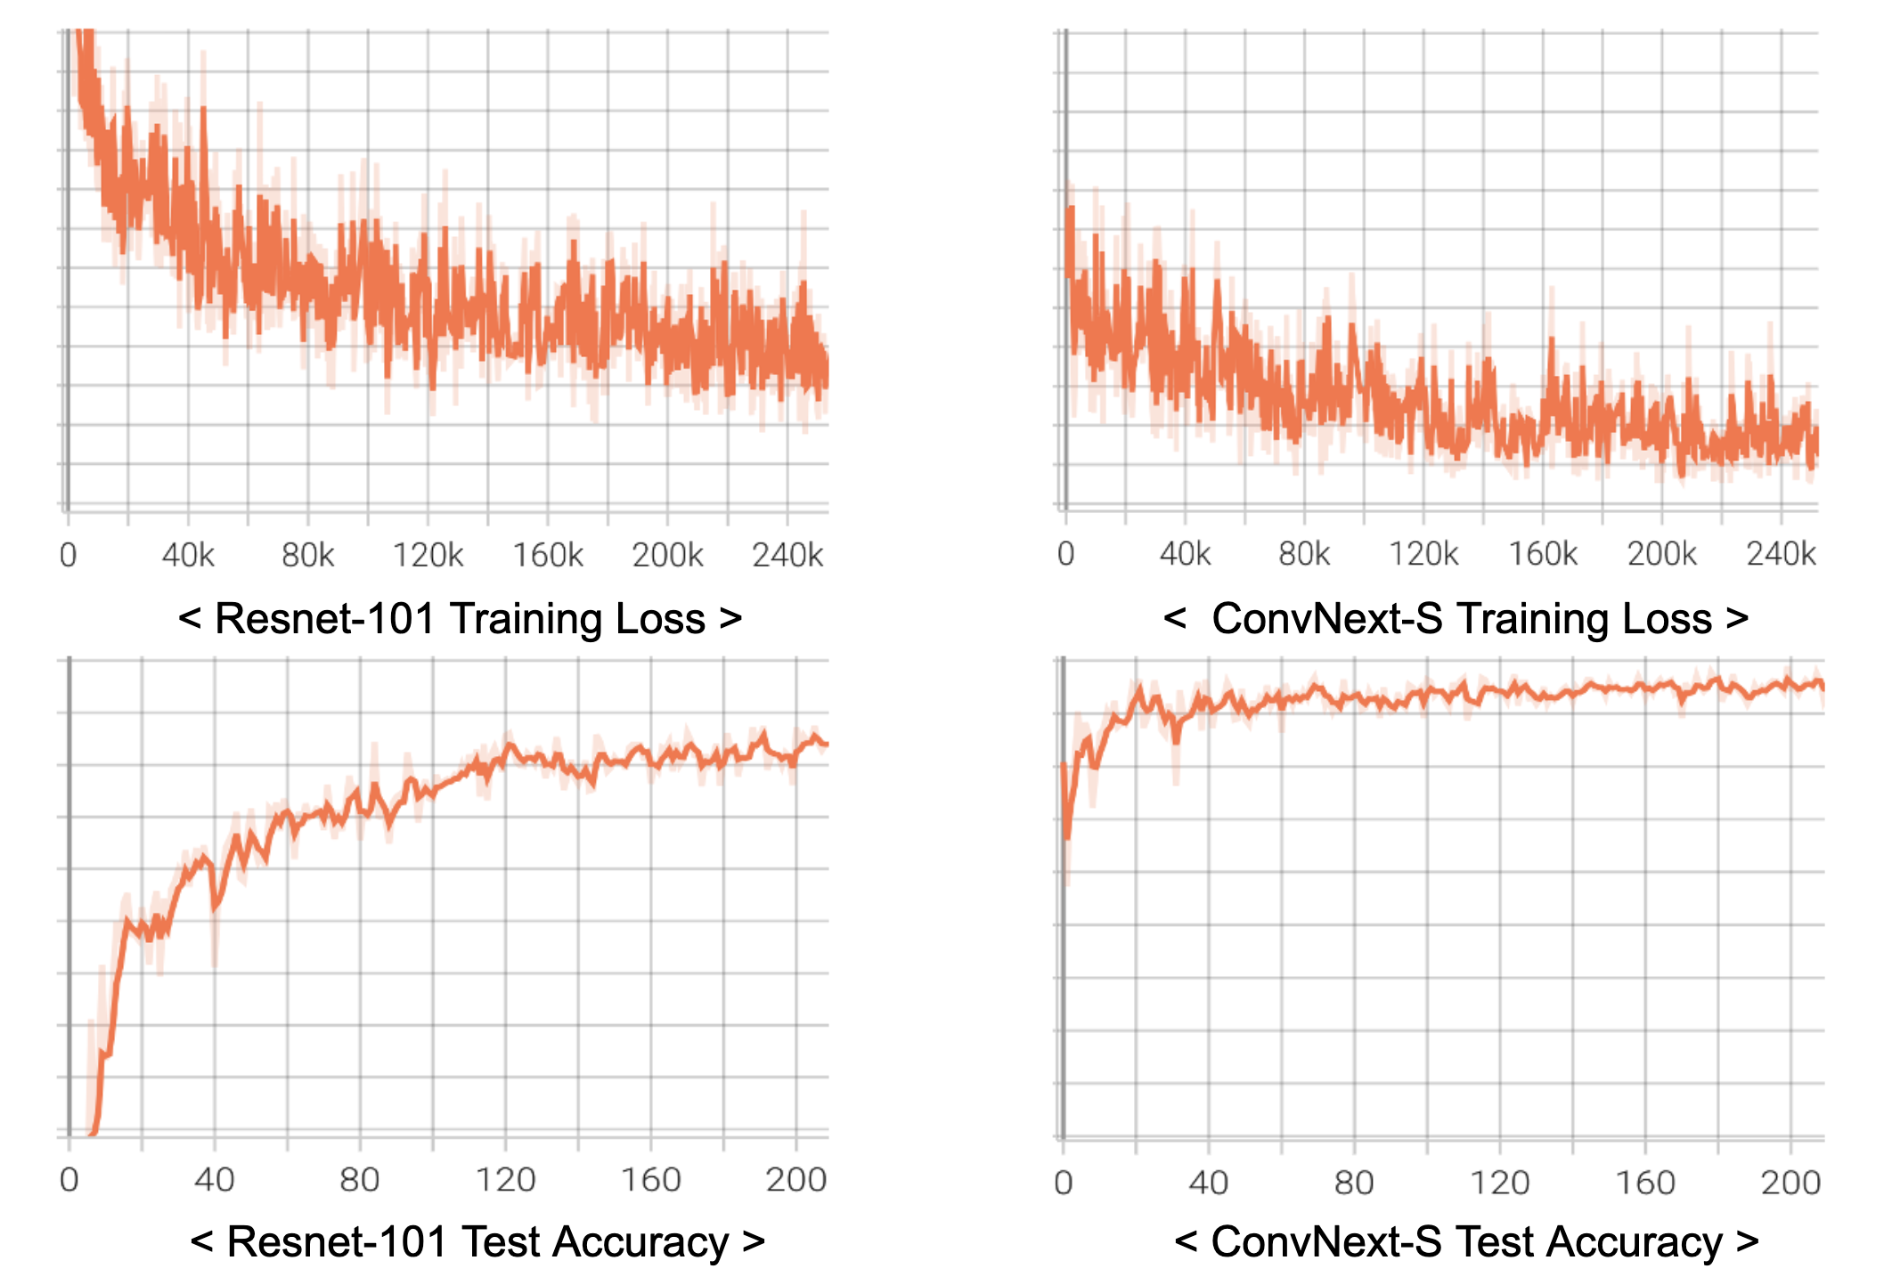
이처럼 정량적 지표를 그래프로 시각화하여 비교하면, 어떤 모델이 더 효율적인지 선택하기가 훨씬 수월해집니다. ConvNext 모델은 구조적으로 최신 기술이 반영되어 있어, ResNet 모델에 비해 학습 속도와 수렴 속도에서 뛰어난 성능을 보였습니다. 이러한 점들을 고려하면, 비슷한 최종 성능을 달성하더라도 더 빠르게 학습하고 최적의 결과에 도달할 수 있는 모델을 선택하는 것이 유리합니다.
이러한 비교 분석을 통해, 우리는 ConvNext 모델이 학습 효율성에서 더 우수하다는 결론을 내릴 수 있었습니다. 아직 최종 모델을 선택하기 전이라면 이러한 학습 과정에서의 중간 산출물을 토대로 적합한 모델을 선택하는 데 도움을 받을 수 있습니다.
모델 파라미터 업데이트 시, EMA(Exponential Moving Average) 적용
모델 파라미터 업데이트 시 EMA(Exponential moving average)를 적용하는 실험도 진행했는데요, EMA는 모델 학습 시 파라미터를 스무딩 하여 모델의 안정성과 일반화 성능을 향상하는 기술입니다. 좀 더 구체적으로 설명하자면, EMA는 모델의 파라미터를 업데이트할 때, 과거의 파라미터를 일정 비율로 반영하여 현재 파라미터에 반영하는 방식입니다. 이로 인해 모델 파라미터의 변화를 완화시켜 급격한 변화를 줄이고, 모델의 안정성을 높여 예측이 일관되게 나올 수 있게 합니다.
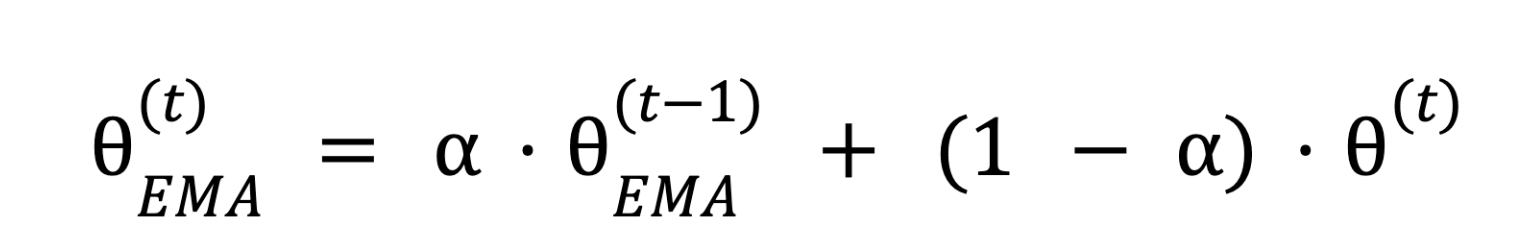
아래의 그래프를 참고하면, 실제 실험에서도 EMA를 적용했을 때 모델의 성능이 훨씬 안정적이며, 학습이 더 빠르게 수렴하는 것을 확인할 수 있습니다. 이처럼 EMA는 모델이 새로운 데이터에 대해 더 견고하게 반응할 수 있도록 도와주며, 특히 변동성이 큰 데이터에 대해 더 안정적인 학습을 가능하게 합니다. 이러한 이유로, 이미지 분류 모델 개발 시 EMA를 도입하는 것이 매우 효과적이라는 결론을 내릴 수 있었습니다.
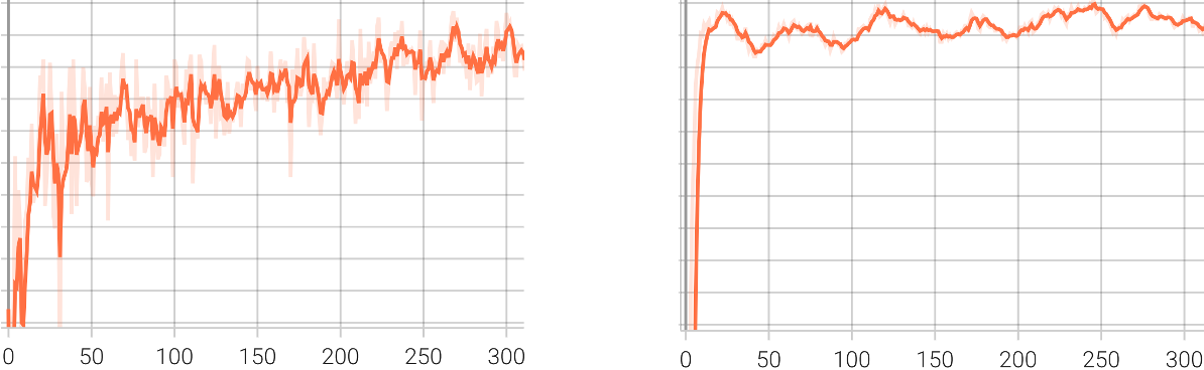
EMA 적용 여부에 따른 Test accuracy
OOD (Out-of-Distribution) Filtering
OOD(Out-of-Distribution) 필터링은 모델이 학습하지 않은 데이터 또는 학습 데이터와 매우 다른 데이터를 식별하고 분류하는 과정으로, 앞서 설명한 스팸 분류를 더욱 강력하게 수행하기 위해 적용한 기술입니다. 모델을 학습 후 적용할 수 있는 가장 간단한 방법인 Confidence score 기반 필터링[4]을 적용했으며, 이는 모델의 Softmax 출력 중 가장 높은 값의 크기를 기준으로 특정 Threshold를 설정하여 이를 초과하는 경우 OOD로 판단하는 방법입니다.
이때, 딥러닝 모델의 특성상 Softmax 출력이 모델의 불확실성(Uncertainty)을 정확하게 반영하지 못할 수 있습니다. 이를 보완하기 위해 Confidence score를 Temperature scaling[5]하여 조정합니다. 이렇게 스케일링된 Softmax 스코어 값 중 최댓값이 특정 Threshold 보다 작으면 해당 이미지를 OOD로 판단합니다. 이는 모델이 특정 클래스에 대해 충분히 높은 확신을 가지지 않으면 해당 입력을 OOD로 판단한다는 뜻입니다.
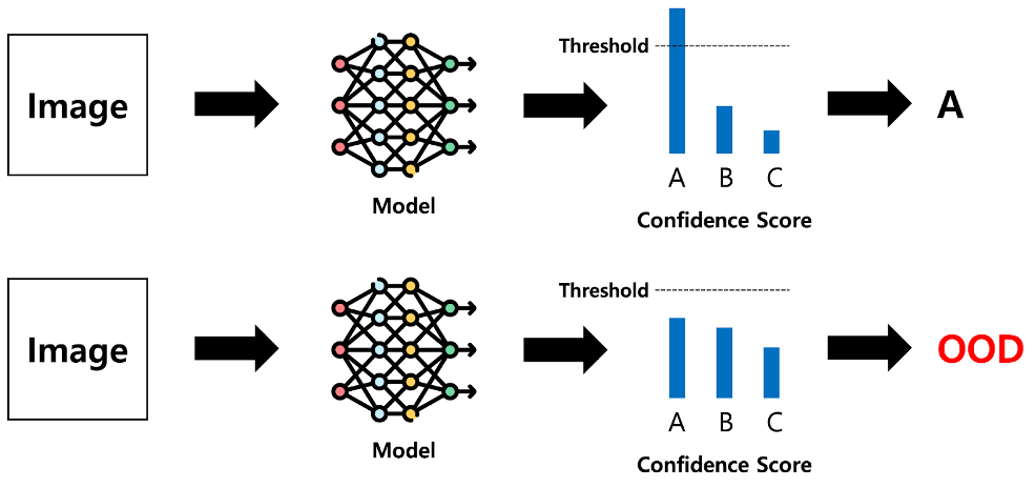
이번 프로젝트에서는 Temperature scaling은 T=1.5로 설정하고, Threshold는 0.5에서 0.8까지 높여 가며 실험했습니다. Threshold를 높일수록 이미지를 OOD로 분류할 확률이 커져 Spam-class의 정확도(Accuracy)는 증가하지만, Mean accuracy는 점차 감소하는 것을 확인할 수 있습니다. 때문에, 실험적으로 적정 Threshold를 구하여 사용하는 것이 좋습니다.
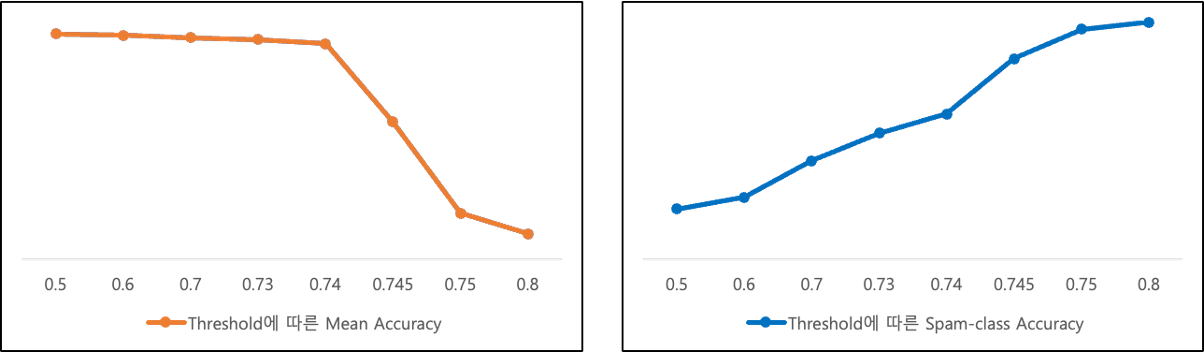
이러한 간단한 OOD 필터링 알고리즘을 적용하면, 모델을 재학습하거나 수정하는 작업 없이 효율적으로 OOD를 필터링할 수 있습니다.
모델 결과 예시
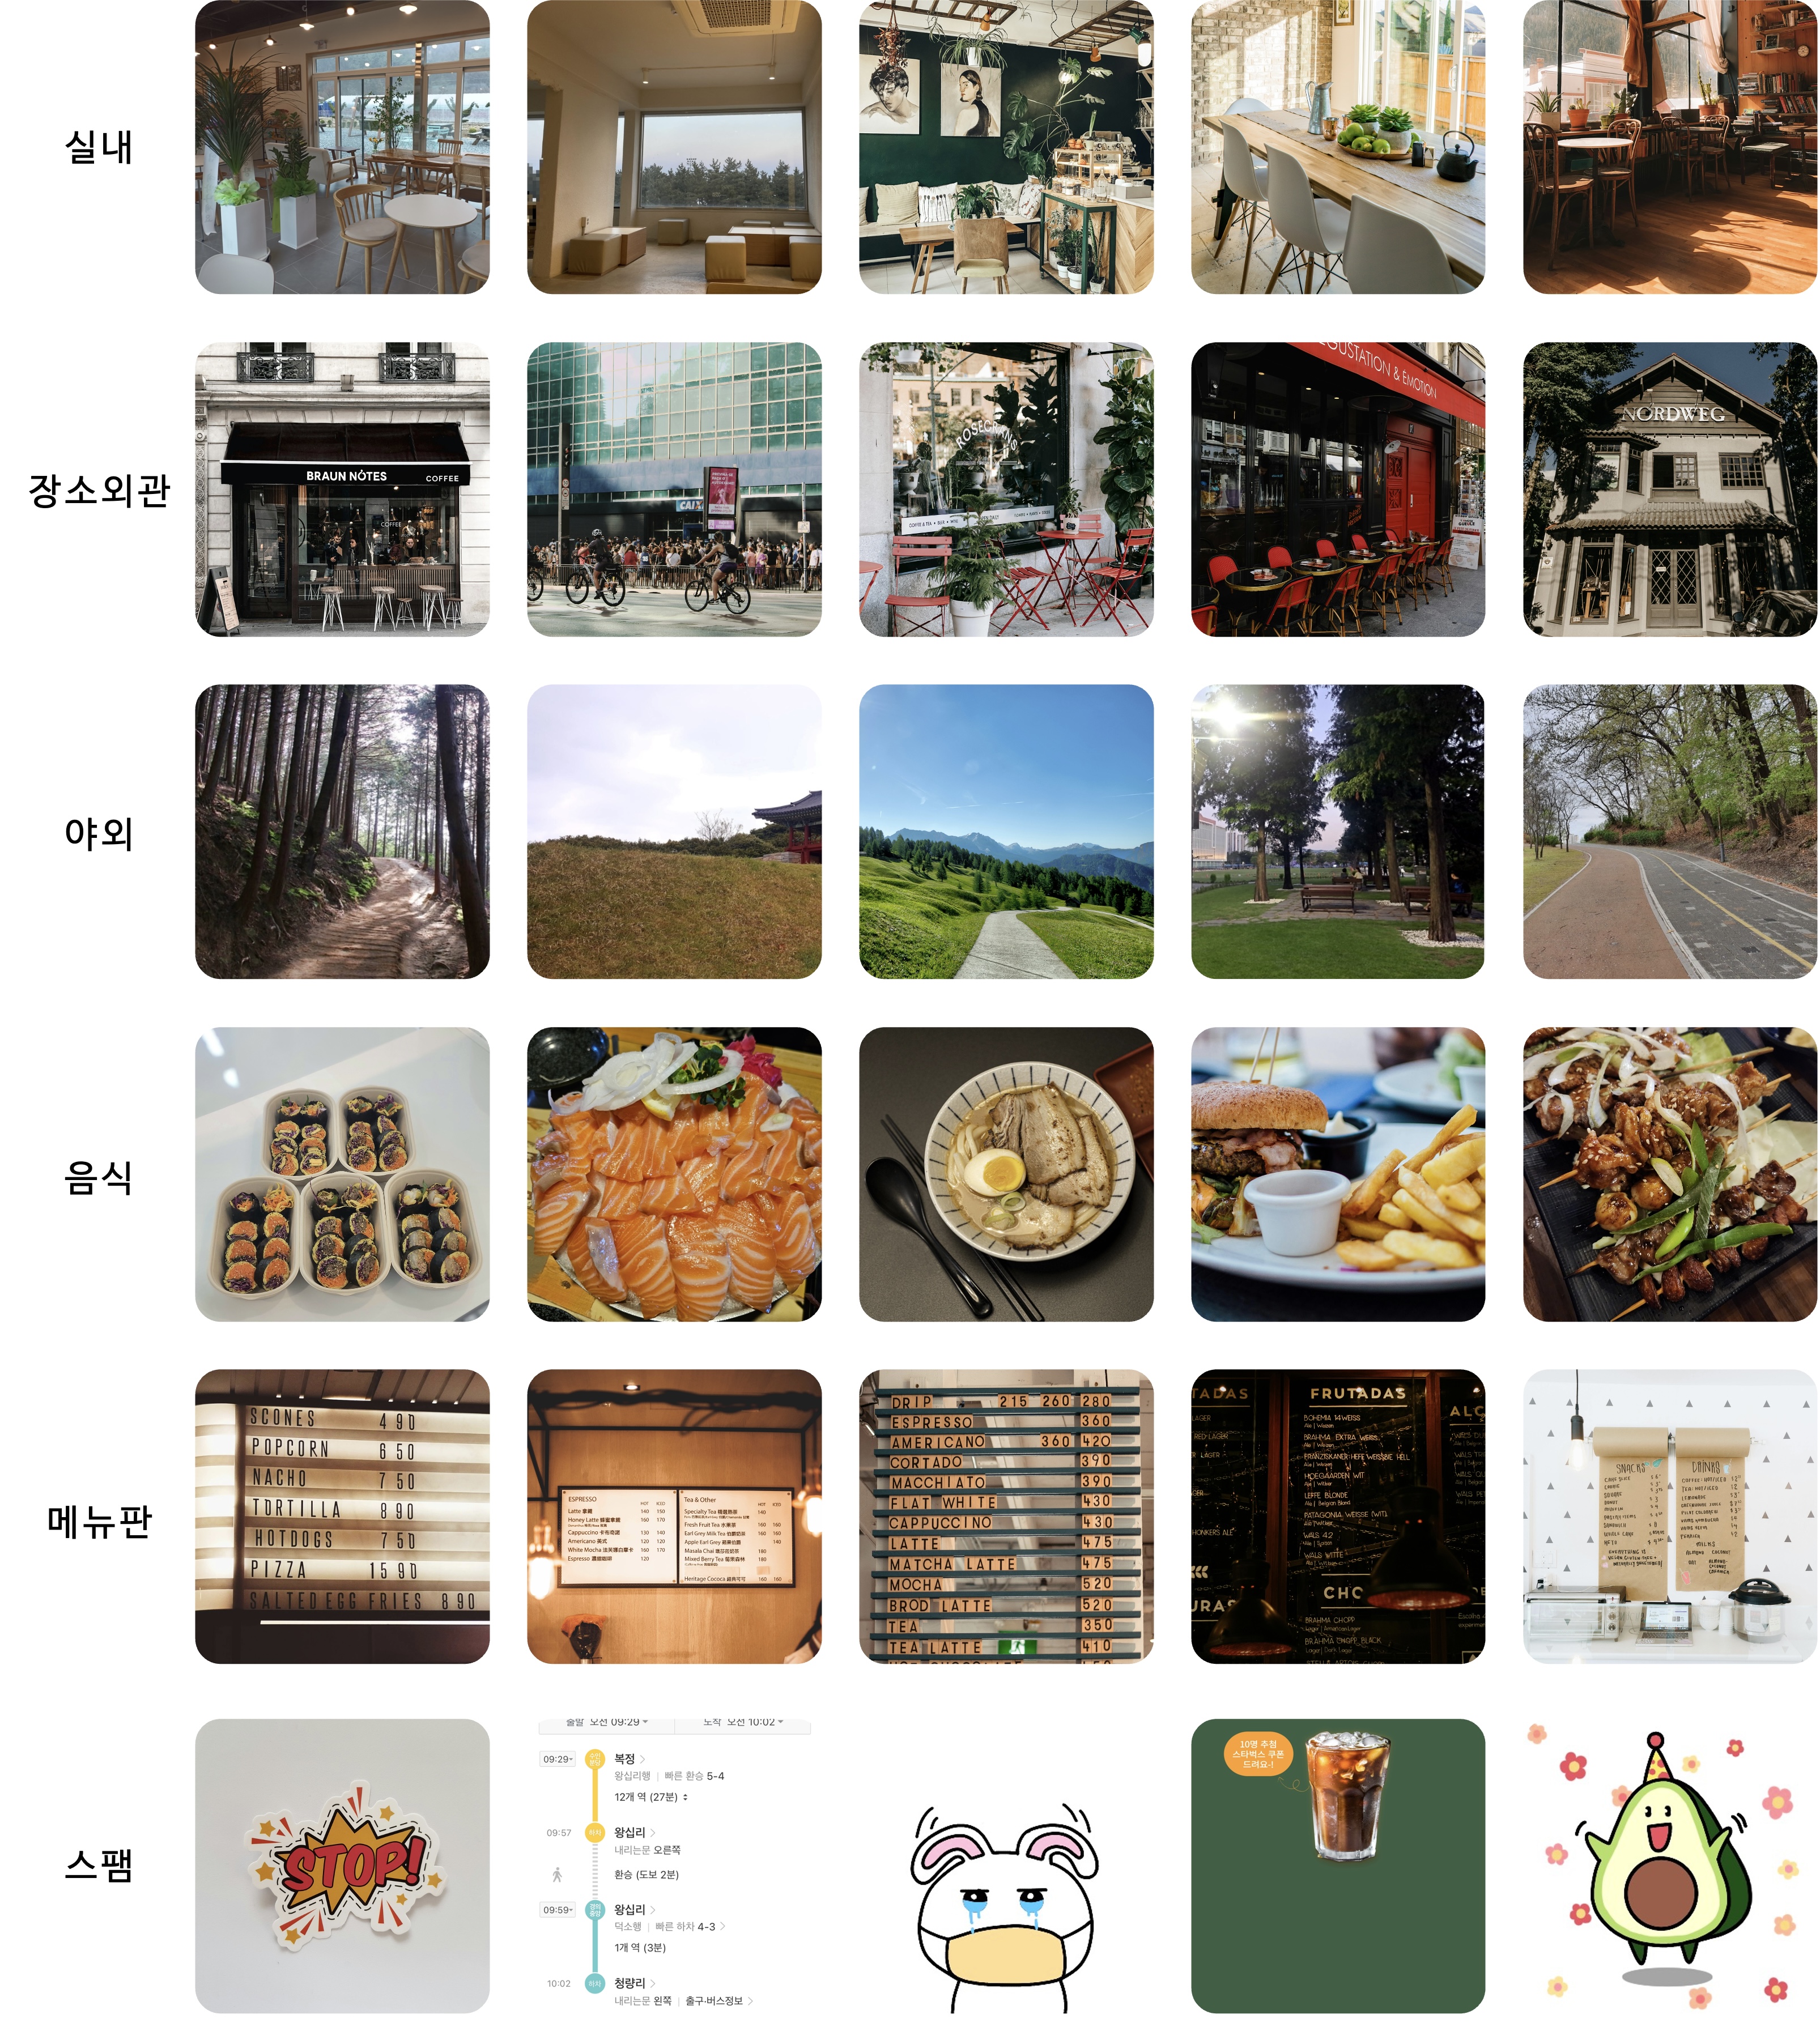
아래의 예시는 학습을 완료한 실제 모델의 예측 결과입니다.
맺음말
지금까지 카카오맵 리뷰 이미지 분류 모델을 개발한 과정을 소개해 드렸습니다. 그간의 딥러닝 모델과 프레임워크의 발전, 그리고 다양한 오픈소스 모델의 공개 덕분에, 불과 몇 년 전과 비교하여도 훨씬 더 효율적으로 딥러닝 모델을 개발할 수 있는 여러 전략이 생겼다는 것을 알 수 있었습니다.
이 글이 딥러닝 모델을 도입하고자 하는 독자분들에게 조금이나마 도움이 되셨기를 바라며, 긴 글 읽어주셔서 감사합니다.
Reference
[1] Liu, Zhuang, et al. “A convnet for the 2020s.” Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2022.
[2] Radford, Alec, et al. “Learning transferable visual models from natural language supervision.” International conference on machine learning. PMLR, 2021.
[3] He, Kaiming, et al. “Deep residual learning for image recognition.” Proceedings of the IEEE conference on computer vision and pattern recognition. 2016.
[4] Hendrycks, Dan, and Kevin Gimpel. “A baseline for detecting misclassified and out-of-distribution examples in neural networks.” arXiv preprint arXiv:1610.02136 (2016).
[5] Guo, Chuan, et al. “On calibration of modern neural networks.” International conference on machine learning. PMLR, 2017.
written by Zayden.lee
edited by June.6