Engineering
Ingress Nginx Controller의 Prometheus Metric 병목 현상: 원인 분석과 해결 (1부)
pooh.duck카카오
2025년 1월 17일
원문에서 보기 ↗개요
안녕하세요. 카카오 광고 추천팀에서 광고 추천 개발 업무를 담당하는 pooh.duck입니다.
이 글에서는 Ingress Nginx Controller에서 발생한 Prometheus metric 병목 현상에 대한 원인 분석과 해결 방법을 소개합니다.
본 글은 1부와 2부로 구성되어 있으며, 실무에서 Trouble Shooting을 어떻게 하는지, Ingress Nginx Controller, Go 프로파일링에 관한 내용을 담고 있습니다.
1부에서는 문제 발생의 배경과 원인 분석 과정을 상세히 설명하고, 2부에서는 이를 바탕으로 한 해결 방법을 소개합니다. 단계별로 우리 팀이 겪었던 실제 사례와 적용했던 방법들을 공유하며, 비슷한 문제를 겪고 있는 다른 분들께 도움이 되기를 기대합니다.
카카오의 광고 API 서버들
우리는 웹사이트를 방문할 때마다 다양한 광고를 접하게 됩니다. 이러한 광고가 사용자에게 노출되기까지 여러 카카오 광고 API 서버들이 상호작용을 하게 되고, 이에 따라 대부분의 광고 API 서버들은 평균적으로 매우 높은 트래픽을 받게 됩니다. 제가 담당하는 API 서버 중 하나는 피크 시간대에 최대 약 16만 req/sec의 요청을 처리하고 있습니다.
Ingress Nginx Controller
대용량 트래픽을 처리하기 위해서, 저희 API 서버는 Kubernetes 위에서 다수 Pod를 실행 중입니다. 이 서버들에 HTTP(S) 트래픽을 라우팅하기 위해 Ingress를 사용하고 있으며, 구현체로는 가장 범용적으로 사용되는 Ingress Nginx Controller를 채택하고 있습니다.
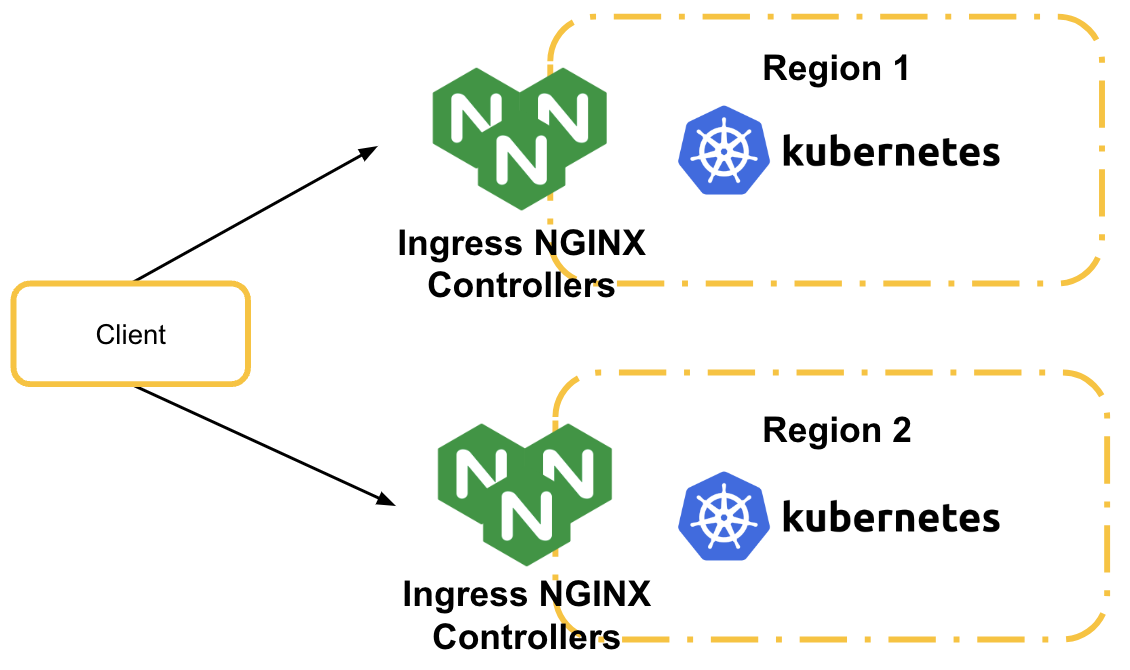
현재 저희는 재해 복구(Disaster Recovery)와 부하 분산을 위해 두 개의 Region에 걸쳐 다수의 Ingress Nginx Controller를 구성해 운영하고 있습니다.
문제 정의
Metric 유실
저희는 서비스 모니터링을 위해 서버에서 발생하는 Metric들을 Prometheus로 수집하고, Grafana를 통해 모니터링하고 있습니다. 그러던 어느 날 모든 Nginx 'request volume’이 No Data라는 알람이 발생했습니다. 또한, 간헐적으로 기록되는 Metric도 정상치에 비해 매우 낮게 기록되는 것을 확인할 수 있었습니다.
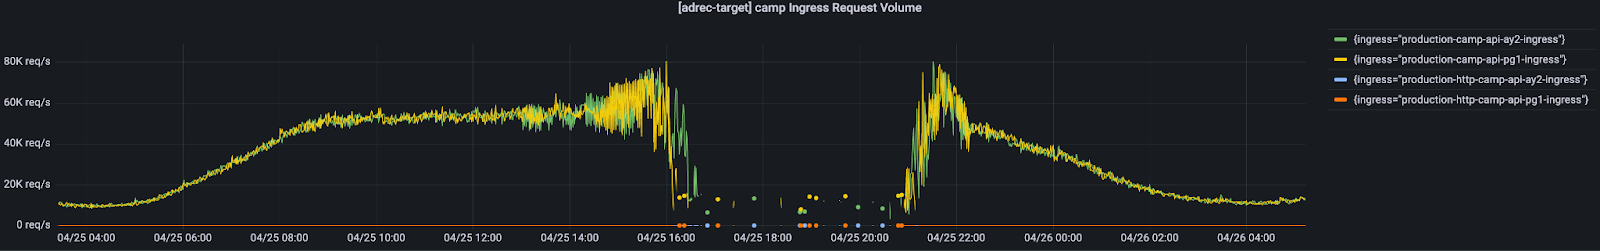
Request Volume은 Nginx의 Prometheus Metric 중 하나로, 현재 Nginx가 처리하는 Request Count를 뜻합니다. 이 값이 Null이라는 것은 현재 Nginx 자체에 문제가 발생해 트래픽을 제대로 처리하지 못하고 있거나, Nginx가 처리하는 요청에 대한 metric이 정상적으로 수집되지 않는 상태임을 뜻합니다.
이에, 서비스를 점검해 보니 서버는 요청을 정상적으로 처리하고 있었습니다. 만약 Nginx에 문제가 생겼다면 이는 불가능한 일입니다.
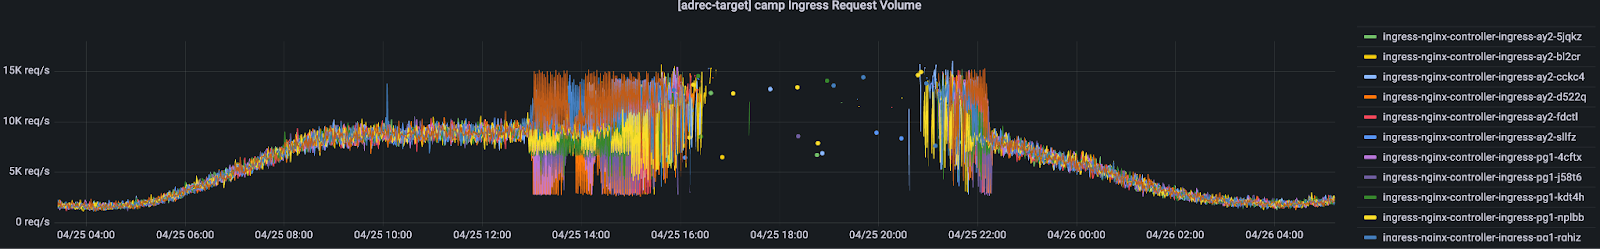
이러한 현상은 트래픽이 일정 기준치를 상회하면 재현된다는 것을 확인할 수 있었습니다. 아래와 그래프와 같이 Metric이 요동치다, Metric이 유실되고 이후 트래픽이 감소하면 Metric이 복구되는 것을 관찰할 수 있었습니다. 아래 그래프는 Ingress Nginx Controller Pod 별 Request Volume 그래프로, 시간에 따른 서버 요청량 변화를 나타낸 것입니다.
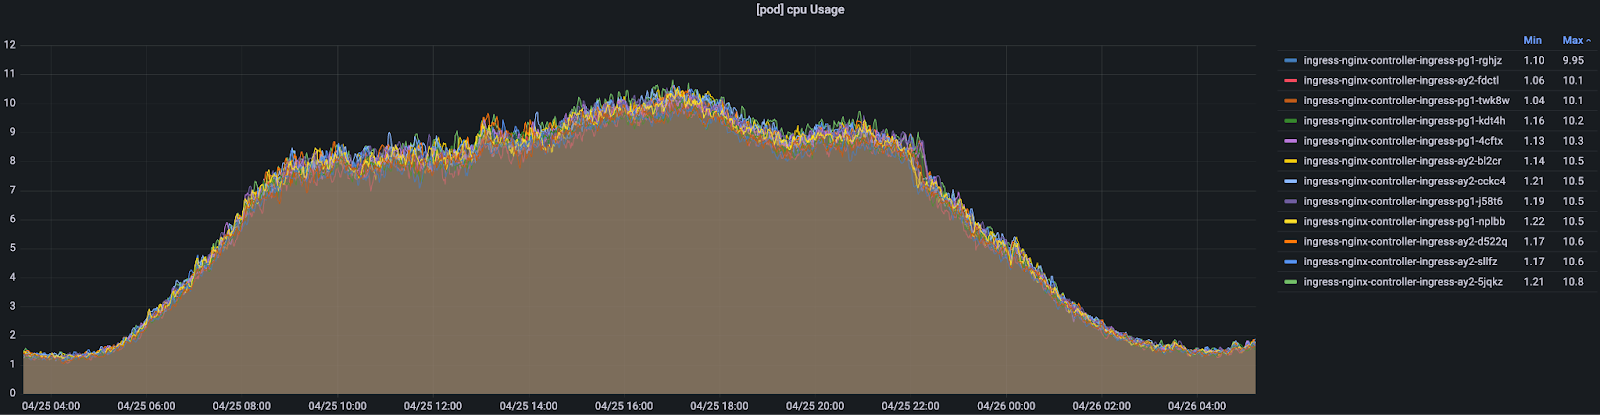
그럼에도 해당 시점에 Nginx의 CPU Load는 특이점이 관찰되지 않았습니다. CPU는 Resource Limit에 비해 매우 여유가 있었고 Spike 또한 관찰할 수 없었습니다. 아래 그래프는 Ingress Nginx Controller Pod CPU 사용량 그래프로, y축은 CPU 사용량을 나타냅니다.
저희는
- 서버가 정상적으로 Request를 처리하고 있는 점
- Metric이 0이 아닌 No-Data인 점
- Nginx CPU Load가 높지 않은 점
을 근거로 이는 Nginx 이슈가 아닌, Metric을 처리하는 부분에 문제가 생겼다고 판단하게 되었습니다.
문제 원인 분석
Ingress Nginx Controller Pod 구조
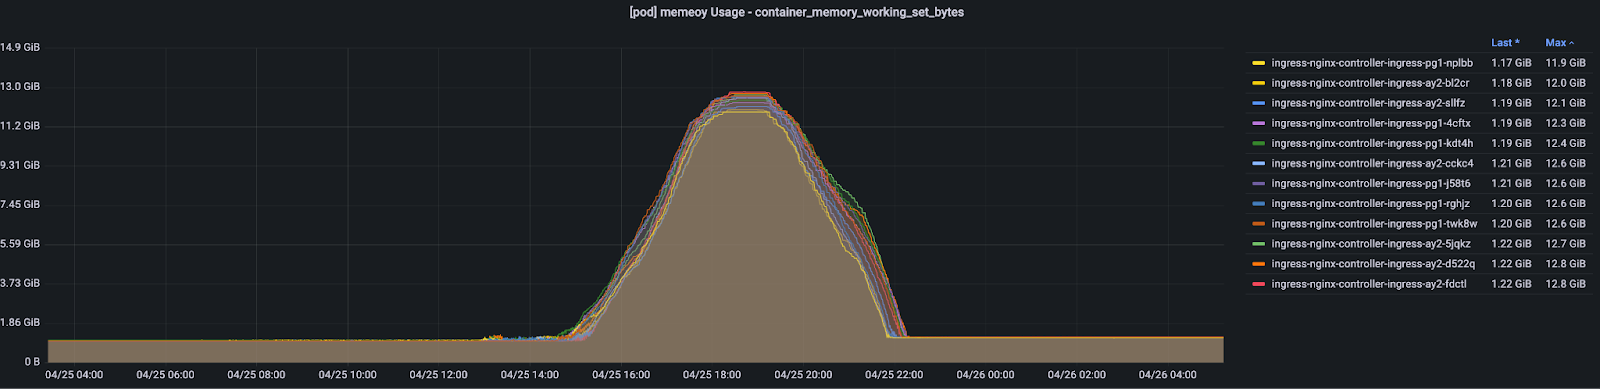
그렇다면 무엇이 Metric을 정상적으로 수집하지 못하게 하는 걸까요? 이를 확인 위해 Ingress Nginx Pod의 여러 리소스를 모니터링 했는데, CPU와 다르게 Memory는 비정상적으로 치솟는 것을 확인할 수 있었습니다. 아래 그래프는 Ingress Nginx Controller Pod Memory 사용량 그래프로, y축은 Memory 사용량을 나타냅니다.
문제의 원인을 파악하기 위해 Ingress Nginx Controller Pod의 구조를 살펴보았고, 간략하게 요약하면 아래와 같습니다
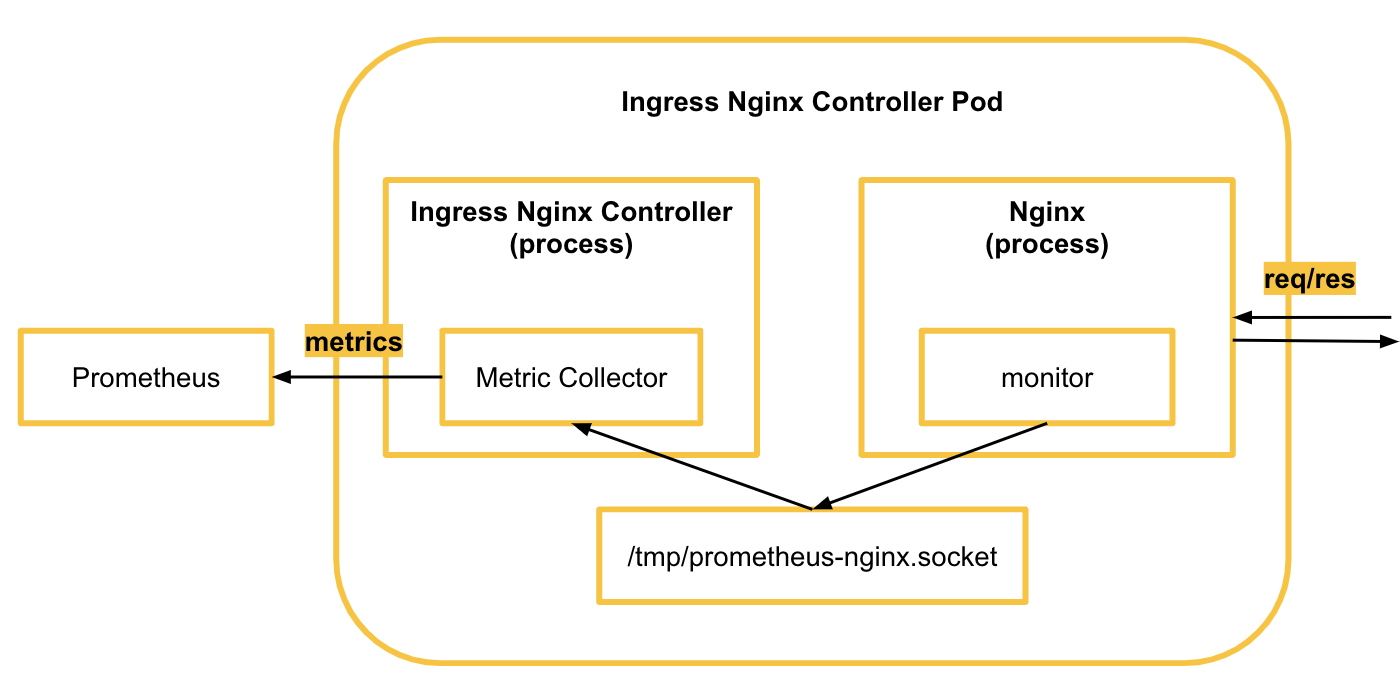
Ingress Nginx Controller Pod는 실제로 트래픽을 처리하는 Nginx와 Metric 수집과 같은 부가적인 기능을 위한 Ingress Nginx Controller로, 크게 2개의 Process로 구성되어 있습니다.
Nginx는 Lua script를 통해 Ingress Nginx Controller에 Metric을 전송하는데, 이때 /tmp/prometheus-nginx.socket을 사용합니다.
리눅스 시스템에서는 모든 것이 File입니다. 그래서 모든 객체와 행동은 파일로 관리되는데, 리눅스에서는 이러한 File들에 접근할때 File descriptor를 이용합니다. File descriptor는 커널이 다양한 리소스를 관리하고 접근하는 데 사용하는 추상적인 핸들러로, Socket도 포함됩니다.
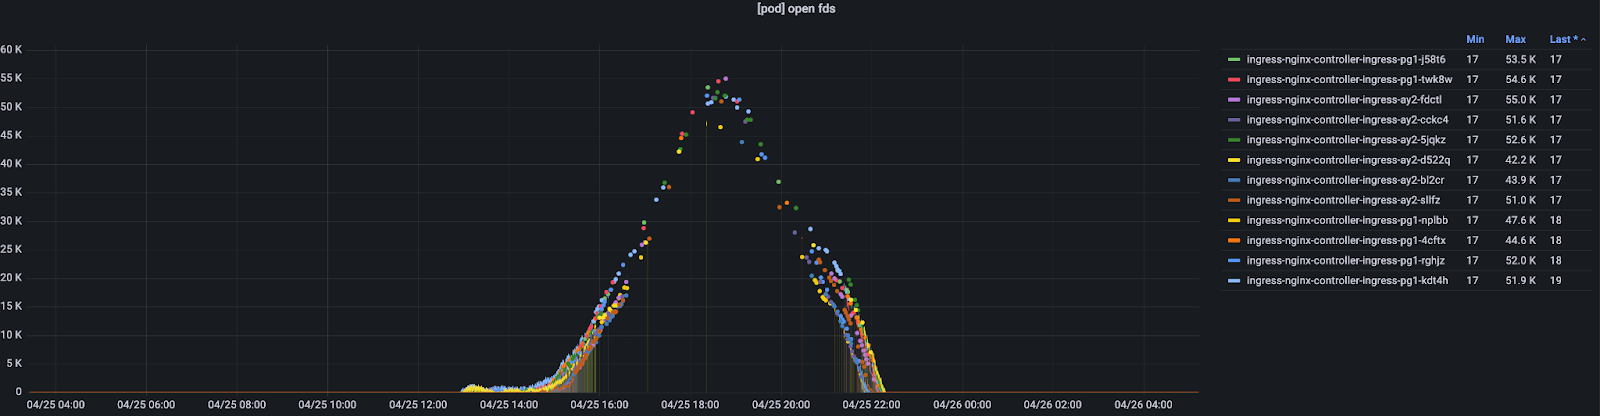
저희는 문제 시점에 Open된 File Descriptor가 어느 정도인지 확인했고, 아래와 같이 open\_fds 수가 Memory Usage와 같이 비정상적으로 치솟는 것을 확인할 수 있었습니다.
Kubernetes Node에서 실제 Open된 Socket을 다시 한 번 확인했고,
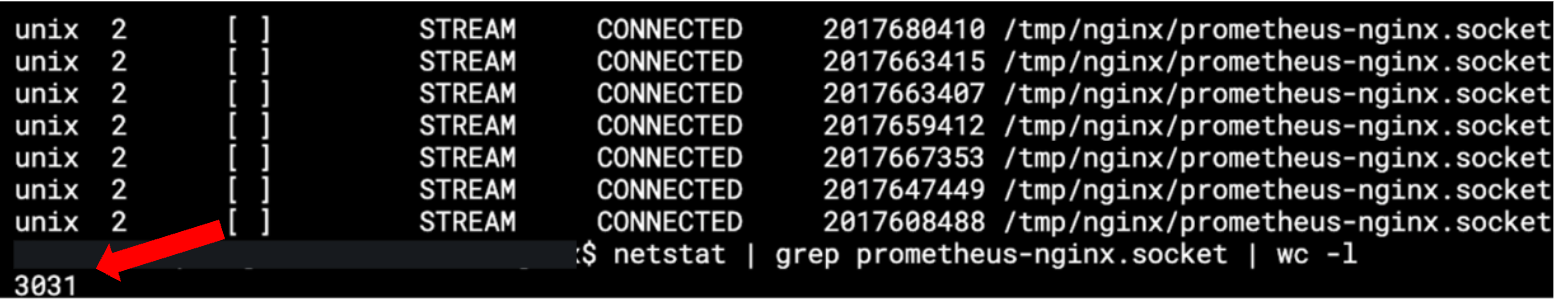
위와 같이 Nginx가 Metric을 Controller로 전송할 때 사용되는 /tmp/nginx/prometheus-nginx.socket이 3,000개가 넘게 쌓여 있는 것을 확인할 수 있었습니다.
병목 지점을 찾아서
해당 Socket을 어디서 사용하는 지, Ingress Nginx Controller(이하 Controller) 소스코드 레벨에서 분석을 진행했습니다. 먼저 Nginx에서 Controller로 Metric을 전송하는 부분입니다. 이 부분은 Lua Script로 작성되어 있습니다. 간단한 코드이기에 Lua Script를 모르시는 분들도 이해하는 데 큰 어려움은 없습니다.
-- if an Nginx worker processes more than (MAX_BATCH_SIZE/FLUSH_INTERVAL) RPS
-- then it will start dropping metrics

local MAX_BATCH_SIZE = 10000
local FLUSH_INTERVAL = 1 -- second
[code #1 monitor.lua - local variable ]
Nginx는 FLUSH\_INTERVAL 값에 설정된 일정한 주기로, MAX_BATCH_SIZE만큼의 Metric을 처리하도록 설정되어 있습니다. 기본값은 MAX_BATCH_SIZE/FLUSH_INTERVAL = 10000 /1 = 10000으로 초당 1만입니다.
위 변수들이 사용되는 부분은 아래와 같습니다. 만약 metrics 수가 MAX_BATCH_SIZE를 넘으면 Metric을 전송하지 않고, Drop 후 Warn Level Log를 남기는 것을 확인 할 수 있습니다.
function _M.call()
 // 일정 수준을 넘으면 log만 남기고 drop
 if metrics_count >= MAX_BATCH_SIZE then
   ngx.log(ngx.WARN, "omitting metrics for the request, current batch is full")
   return
 end

 // 정상 case code
 // 생략 ....
end
[code #2 monitor.lua - function _M.call() ]
Nginx에서 Controller로 Metric을 전송하는 부분은 현재 트래픽 규모와 관계없이 사전에 지정된 값에 따라 최대 처리량(Throughput)까지만 지원하는 구조로 설계되어 있음을 확인할 수 있습니다. 때문에 이 부분에서는 병목이 발생할 확률이 매우 낮습니다.
반면에 Socket에서 Metric을 수신하는 부분은 그렇지 않습니다. Go로 작성된 Controller는 NewScoketCollector라는 함수를 통해 SocketCollector를 생성하고 내부적으로 /tmp/nginx/prometheus-nginx.socket을 Listen합니다.
// NewSocketCollector creates a new SocketCollector instance using
// the ingress watch namespace and class used by the controller
func NewSocketCollector(pod, namespace, class string, metricsPerHost, reportStatusClasses bool, buckets HistogramBuckets, excludeMetrics []string) (*SocketCollector, error) {
	socket := "/tmp/nginx/prometheus-nginx.socket"
	// unix sockets must be unlink()ed before being used
	//nolint:errcheck // Ignore unlink error
	_ = syscall.Unlink(socket)

	listener, err := net.Listen("unix", socket)
	if err != nil {
		return nil, err
	}

	err = os.Chmod(socket, 0o777) // #nosec
	if err != nil {
		return nil, err
	}

// 이후 생략
}
[code #3 socket.go - func NewSocketCollector() ]
SocketColellector는 Start() 리시버 함수에 의해 실행되는데, /tmp/nginx/prometheus-nginx.socket 으로부터 연결 요청이 들어올 경우, 요청별로 Socket을 Open하고 Goroutine(Go의 경량 스레드)을 생성, handleMessages() 함수를 실행해 병렬적으로 Metric을 처리하게됩니다.
// Start listen for connections in the unix socket and spawns a goroutine to process the content
func (sc *SocketCollector) Start() {
	for {
		conn, err := sc.listener.Accept()
		if err != nil {
			continue
		}

		go handleMessages(conn, sc.handleMessage)
	}
}
[code #4 socket.go - func Start() ]
이를 바탕으로, 메모리가 계속 치솟는 원인은 Goroutine으로 처리하는 handleMessages() 함수가 트래픽이 높아짐에 따라 실행 속도가 느려지고, Goroutine이 계속 누적되기 때문이라 추측할 수 있습니다.
실제로 Grafana에서 Memory Usage Graph와 동일한 양상으로 Goroutine이 계속 누적되는 것을 확인할 수 있었습니다.
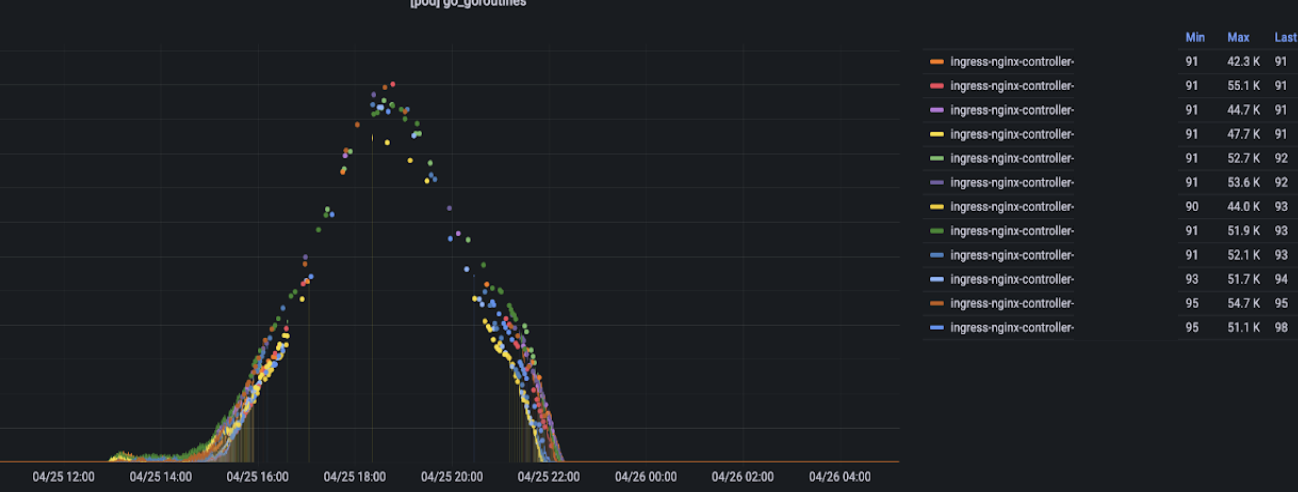
이 단계에선 handleMessages() 함수가 느려지는 원인이 무엇인지 확신할 수는 없습니다. 그러나 일반적으로 병렬적으로 Metric을 처리하는 과정에는 Critical Section이 존재할 가능성이 높습니다. 때문에 Critical Section을 보호하기 위한 Mutex 관련된 로직이 병목의 원인일 수 있다고 추측해 볼 수 있습니다.
1부를 마치며
1부에서는 저희 광고 추천팀에서 서버를 운영하면서 발생한 현상을 공유하고, 여러 근거를 바탕으로 문제의 원인을 좁혀나가는 과정에 관해 이야기했습니다.
이어서 2부에서 Go 프로파일링을 통해 문제의 함수, handleMessages()가 왜 트래픽이 높아짐에 따라 느려져 병목을 유발하는지 보다 명확히 확인해 보겠습니다. 긴 글 함께 해주셔서 감사합니다.