Engineering
지속 가능한 소프트웨어를 위한 코딩 방법 - 마지막 맺음말.
2020년 1월 28일
원문에서 보기 ↗멱등성 (Idempotent)
전산학이나 수학에서 사용하는 용어입니다. 연산을 여러 번 적용하더라도 결과가 달라지지 않는 성질을 의미합니다. 함수 f(x)를 예를 들면 다음과 같은 등식이 성립됩니다. 즉 메서드가 여러 번 실행되어도, 결과는 같으므로 안전하게 사용할 수 있는 성질이기도 합니다.
f(f(x)) ≡ f(x)
예를 들면 다음과 같은 메서드가 멱등성을 갖고 있습니다. 다음 메서드는 메일 주소에 브래킷을 제거하는 일을 합니다. 여러 번 적용해도 브래킷이 제거된 메일 주소는 항상 같은 값을 가지고 있습니다. 사용하는 입장에서 여러 번 사용해도 안전하게 사용할 수 있습니다. 그리고 조금만 주의를 기울이면 쉽게 코딩할 수 있습니다.
pubic class MailAddressUtils {
    public static String removeBrackets(String bracketMailAddress) {

        if (StringUtils.isEmpty(bracketMailAddress))
            return bracketMailAddress;

        if (bracketMailAddress.startsWith("<"))
            bracketMailAddress = bracketMailAddress.substring(1);

        if (!StringUtils.isEmpty(bracketMailAddress) && bracketMailAddress.endsWith(">") )
            bracketMailAddress = bracketMailAddress.substring(0, bracketMailAddress.length() - 1);

        return bracketMailAddress;
    }
}

@Test
public void testRemoveBrackets() {
    String mailAddress = "<byungboo.kim@nhn.com";

    String expected = MailAddressUtils.removeBrackets(mailAddress);

    //3번 적용
    String actual = MailAddressUtils.removeBrackets(
            MailAddressUtils.removeBrackets(
                    MailAddressUtils.removeBrackets(
                        mailAddress
                    )
            )
    );

    // removeBrackets 함수를 3번 실행한 값과 1번 실행한 값이 같음
    Assertions.assertEquals(expected, actual);
}
위의 testRemoveBrackets() 테스트 케이스를 보면, removeBrackets 함수를 3번 실행한 값과 1번 실행한 값이 같음을 알 수 있습니다. 결과만 놓고 보면 함수가 멱등성을 갖도록 코딩하는 것이 여럽지 않은 것을 알 수 있어요.
REST API 멱등성
REST API도 이 멱등성이 중요합니다. REST-API에서 가장 많이 사용하는 HTTP Method는 GET, PUT, DELETE 그리고 POST입니다. 이중 POST를 제외한 나머지 HTTP Method를 사용하는 API 들(GET, PUT 그리고 DELETE)은 이 멱등성이 유지되어야 합니다. 다음과 같은 상황에서 멱등성이 왜 중요한지 확인해봅시다.
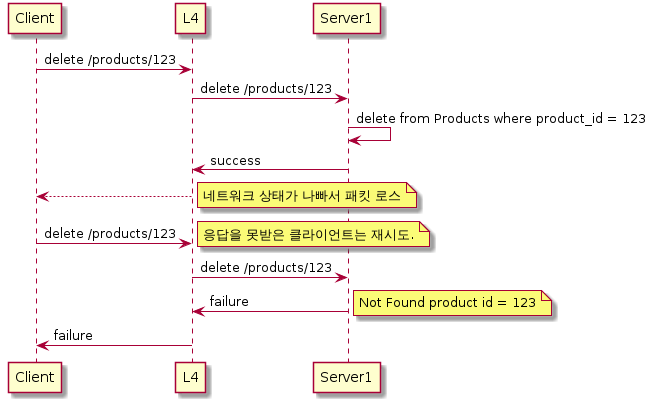
위의 상황은 productId 가 123 인 상품을 삭제하는 과정에서 충분히 발생할 수 있는 상황입니다. 기본적으로 네트워크는 100% 신뢰해서는 안 되는 매체라서 그렇습니다. 첫 번째 요청에 대해서 Server1은 정상 처리했지만, 응답이 네트워크에서 유실되었습니다. 그래서 클라이언트는 두 번째 요청을 하고 멱등성이 보장 안된 삭제 rest api는 실패를 응답합니다. 결과적으로 Client는 productId 가 123 인 상품을 삭제하는 것을 실패했다고 생각할 수 있습니다. 서버에서는 이미 해당 제품은 삭제되었는데 말이죠. 이로 인하여 클라이언트와 서버 간에 데이터가 맞지 않는 상황이 발생할 수 있습니다.
Spring-Data-Jpa에서 흔히 하는 실수
많은 개발자들이 Spring-Data-Jpa를 사용하는데요. 이 멱등성과 관련된 실수가 알게 모르게 발생합니다. 다음 코드를 보시죠. 그리고 다음 코드가 멱등성과 어떻게 연관되는지 확인해봅시다.
@RestController
public class ProductController {

    @Autowired
    private ProductRepository productRepository;

    @DeleteMapping("/products/{productId}")
    public ResponseEntity deleteProduct(@RequestParam Long productId){

        // deleteById 를 기억해주세요.
        productRepository.deleteById(productId);
        return ResponseEntity.ok();
    }
}

@Repository
// JpaRepository 인터페이스를 상속받고 있습니다.
public interface ProductRepository extends JpaRepository<ProductEntity, Long> {

}
유의하실 점은 ProductRepository는 org.springframework.data.jpa.repository.JpaRepository 인터페이스를 상속받고 있습니다. 그래서 사용자는 쉽게 부모가 제공하는 deleteById() 메서드를 사용할 수 있습니다. JpaRepository의 계층 구조는 아래 그림과 같습니다.
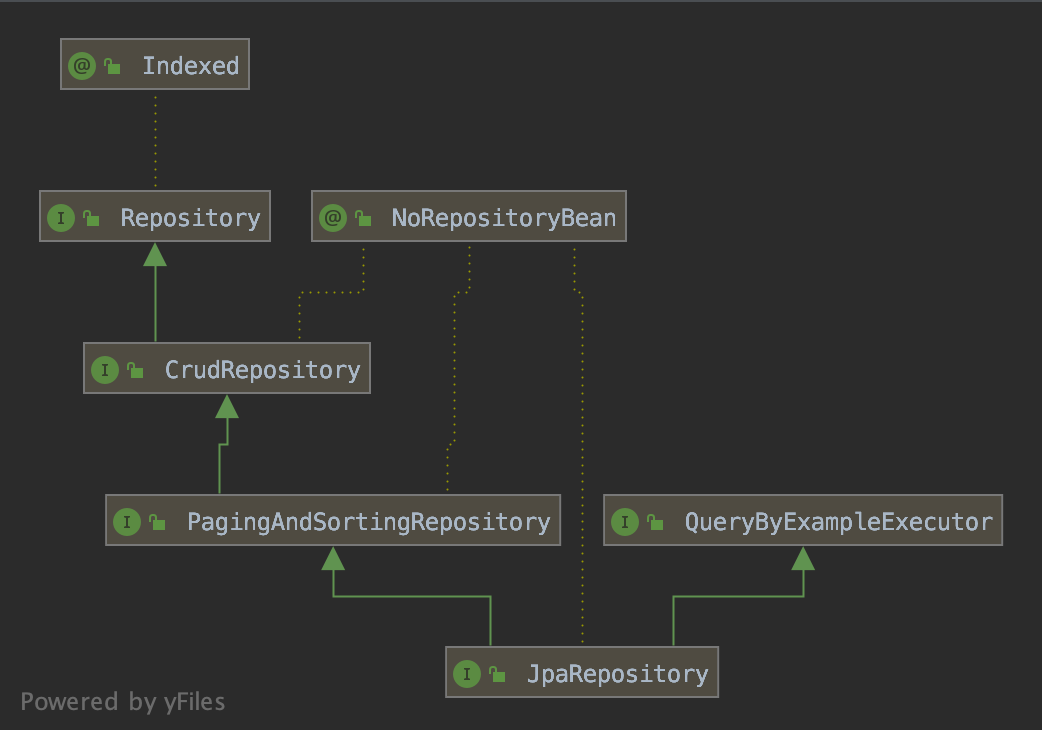
스프링에서 CrudRepository의 기본 구현 클래스는 SimpleJpaRepository이고 deleteById()의 구현은 다음과 같습니다.
@Transactional
public void deleteById(ID id) {

    Assert.notNull(id, ID_MUST_NOT_BE_NULL);

    // 이부분을 주목해주세요.
    delete(findById(id).orElseThrow(() -> new EmptyResultDataAccessException(
        String.format("No %s entity with id %s exists!", entityInformation.getJavaType(), id), 1)));
}
delete 메서드 내부에 findById(id). orElseThrow(()...) 가 보이시나요? 첫 번째 호출되면 findById 가 정상적으로 데이터를 찾아오지만. 2번 호출되면 데이터를 찾을 수 없으므로 Exception 이 발생합니다. 그러므로 위의 Sequence Diagram과 같은 현상이 발생할 수 있습니다. 이런 경우를 방지하기 위해서는 다음과 같은 방법으로 회피해야 합니다.
- QueryDSL을 이용하여 deleteByProductId() 메서드를 직접 구현하는 방법.
- deleteById() 메서드를 호출하기 전에, findById()와 같은 메서드로 데이터가 있는지 없는지 확인하는 방법
테스트 케이스.
이제까지의 내용은 지속 가능한 소프트웨어를 위한 개발이라고 했지만 객체 지향에 대한 이야기만 계속한 것 같습니다. 지속 가능한 소프트웨어는 기능 확장과 에러 관리 가 반드시 요구됩니다. 기능이 늘어나고 복잡해지면, 그만큼 코드 간에 복잡도는 증가합니다. 앞서 이야기한 여러 가지 원리들을 이용해서 리펙토링을 하면 됩니다. 하지만 에러를 관리하는 것은 다른 이야기입니다. 테스트 케이스야 말로 우리가 기댈 수 있는 마지막 장치입니다. 그래서 이보다 더 중요한 것은 없다고 생각합니다.
테스트라고 하면 보통 단위 테스트(unit test), 통합 테스트(integration test), 인수 테스트(acceptance test), 회귀 테스트(regression test)등이 있습니다. 지속 가능한 소프트웨어를 위해서는 인수 테스트 외의 3가지 테스트 모두 중요하다고 생각합니다. 먼저 단위 테스트와 통합 테스트를 구분하는 방법은 논란의 여지가 있지만 제가 생각하는 차이점은 다음과 같습니다.
- 개발한 클래스들로 구성된 유즈 케이스를 테스트하는 것을 유닛 테스트
- 클래스뿐만 아니라 데이터 베이스나 Redis 같이 다른 컴포넌트들과 같이 테스트 하는 것을 통합 테스트
유닛 테스트는 목업을 사용해서 테스트 환경을 구성하고, 통합 테스트는 스프링 부트의 기능을 이용해서 H2 디비나 혹은 embbeded redis를 이용합니다. 이 두 테스트에 회귀 테스트가 있으면 에러 관리가 가능해집니다. 즉 에러가 발생한 상황을 구성하고, 결괏값이 올바른지 검사합니다. 이런 회귀 테스트가 쌓이면 같은 에러가 발생할 확률이 줄어듭니다. 이 외에도 회귀 테스트들은 다음과 같은 상황에 도움이 됩니다.
* 단정적 프로그래밍을 하는데 매우 도움됨.
- assert 구문이 정상 동작하는지 확인
- 불변 클래스의 상태를 유지하는지 확인
* 계약의 의한 설계 선입 조건 등등등..
* 완벽하지 않는 소프트웨어를 적절히 유지하는데 도움됨
* 리 렉토링을 하는데 도움됨
테스트 케이스들을 작성하기 시작하면, 젠킨스 같은 CI/CD 툴에서 항상 테스트해주세요. 물론 패키징 단계나 혹은 배포 단계에서 테스트는 꼭 해야 합니다. 저에게 테스트 케이스 작성에 도움을 준 분들의 말을 적어봅니다.
TC 가 깨졌는데 잠이 오냐? by Dongmyo TC는 작성했나요? by Yoda
마지막으로 테스트 케이스에 대한 제안 한 가지만 더 하겠습니다. 주요 라이브러리에 대한 테스트 케이스도 작성해두시는 것이 좋습니다. 버전마다 변화가 심한 Jackson 라이브러리나 여러분들이 만든 유틸성 클래스들을 말합니다. 특히 유틸성 클래스는 반드시 테스트 케이스가 있어야 합니다. 여러 개발자가 광범위하게 사용할 것이므로, 나중에 리펙토링이나 새로운 기능을 개발할 때 신뢰성 있는 코드를 작성할 수 있습니다.
완벽한 소프트웨어는 없다.
제목은 지속 가능한 소프트웨어를 위한 개발이라고 했지만, 실제 내용은 객체 지향 설계 방법에 대한 이야기를 한 것 같습니다. 아마도 제가 노동자의 언어인 Java 개발자라서 그런가 봅니다. 우리들이 OOP 개발을 하면서 가장 힘든 것은 스스로 완벽함을 추구하는 것입니다.
- 이 메서드를 어느 정도 추상화해야지?
- 이 클래스가 DRY 원칙으로 개발되었나?
- 이 Value 객체는 Class Invariant, Immutable Class 인가?
- 샤이 코딩, 디미터의 법칙으로 개발되었나?
실용주의 프로그래머에서 가장 감명 깊었던 내용은 적당히 괜찮은 소프트웨어입니다. 물론 적. 당. 히라는 것이 매우 어렵고 측정하기 어려운 단어입니다. 예술을 하듯 지나칠 정도로 방법론에 집착하는 것은 프로젝트를 망치는 일이 될 수 있습니다. 프로그램이 아무리 예쁘게 코딩되어있고 유기적으로 동작해 보이면 뭐합니까. 실행하면 버그만 내뱉고 엉망진창인데요. 그래서 PM 이 여러분의 예술혼을 적당히 제어해줄 것입니다.
항상 리펙토링을 통해서 좀 더 나은 소프트웨어로 발전하는 게 좋겠습니다. 메서드를 쪼개거나 합치면서 적절한 추상화의 정도를 찾아봅시다. 혹은 변수 이름에 메타포를 넣어봅시다. 우리에게는 이미 수많은 테스트 케이스가 있으니까 걱정하지 말자고요. 테스트 케이스 숫자가 작다고 리펙토링을 못하신다고요? 그럼 작은 부분부터 테스트 케이스를 만들면서 리펙토링을 하자고요 =)
사실 완벽하게 객체지향을 쫓기란 힘듭니다. 코드의 내용이 매우 장황해질 수 있습니다. 어느 순간 calculateFinalPriceByVendorClassAndOrderQuantity(...) 같이 장황한 메서드를 쓰고 있는 자신을 발견합니다. 혹은 코드의 내용에는 온갖 단정문(assert)들이 난무하고요. 그리고 메서드를 호출하기 전에 인수값을 검증해야 하나, 메서드 내부에서 검증해야 하나 온갖 생각에 사로 잡힙니다. 스스로 괴로워하지 마십시오. 적절한 수준에서 타협하시는 게 좋습니다. 나중에 리펙토링 하면 되니까요.
적. 당. 히. 괜찮은 소프트웨어.
아! 저 같으면 저렇게 장황한 메서드는 중요한 일을 하고 있음을 의미하므로 그냥 다음과 같이 코딩하렵니다. 어떤 분은 클래스 이름에 Service라고 붙이는 것을 지양한다고 하시는데, 적당히 괜찮은 이름이지 않습니까? 유즈 케이스를 담고 있는데 말이죠 =). 아니면 나중에 클래스 이름을 리펙토링 하죠~
@Service
pubic class FinalPriceService {

    public FinalPrice calculate(Vendor vendor, Order order){
        assertNotNull(vendor);
        assertNotNull(order);
        ///....
    }
}
결론
객체 지향 관련된 글이나 책을 읽으면서 공통된 것이 하나 있습니다. 비즈니스에 관련된 (혹은 도메인이라고도 표현하는) 해결에 대해서 공통된 용어를 만드는 것입니다. DDD에서 공용 언어(유비쿼터스 언어)를 만드는 것과도 일맥상통합니다. 이 공통 용어가 있으면 개발자는 쉽게 유즈 케이스를 만들어낼 수 있고, 유즈 케이스를 분해하면서 적절한 수준의 추상화된 클래스를 설계할 수 있습니다. 그리고 이 클래스들을 유기적으로 조합하면서 하나의 기능 즉 유즈 케이스가 만들어집니다. 기획자 혹은 PO와 수많은 이야기를 나누세요. 추상화도 거기서 출발하는 것 같습니다.
마지막으로 코드 리뷰를 하시길 바랍니다. 이 문서도 새로운 프로젝트를 하면서 새로운 동료와 코드 리뷰를 하기 위해서 작성했습니다. 3편으로 마무리하려고 했는데, 말이 길어지면서 5편까지 왔네요. 동료와 코드 리뷰를 하면서 왜 메서드를 더 합쳐야 하는지, 왜 더 쪼개야 하는지 적절한 논리를 만들기 위해서 작성했습니다. 코드 리뷰야 말로 서로가 비즈니스 로직을 이해하고, 서로의 코드를 가져다 쓰고(DRY를 위해서), 내가 작성한 코드가 잘못되어있는지 (샤이 코딩, 디미터의 법칙) 확인할 수 있습니다.
즐거운 코딩 하시길 바랍니다.