Engineering
한국 문화 이해부터 화면 조작까지: Kanana-V 기능 확장의 모든 것
daniel.log, jayten.ten, wooner.l카카오
2026년 3월 11일
원문에서 보기 ↗한국문화, 문서, 다중 이미지, 그리고 GUI까지
안녕하세요. 카카오의 AI 모델 개발을 담당하는 Daniel(김영준), Jayten(전재열), Wooner(이동진)입니다. 저희 팀은 텍스트와 이미지뿐만 아니라 음성까지 포함한 다양한 모달리티를 이해하고 답변하는 멀티모달 언어모델을 개발하고 있습니다.
Vision Language Model(VLM)은 이미지와 텍스트를 함께 이해하는 멀티모달 AI의 핵심 기술로 자리잡고 있습니다. 하지만 실제 서비스 환경에서 VLM에 요구되는 역량은 단일 이미지에 대한 질의응답 수준을 훨씬 넘어섭니다. 수십 페이지의 PDF 문서를 읽고 이해해야 하고, 여러 장의 이미지를 동시에 비교·분석해야 하며, 나아가 GUI(Graphical User Interface) 화면을 인식해 직접 조작하는 수준까지 그 역할이 빠르게 확장되고 있습니다.
이 글에서는 VLM의 능력을 다양한 방향으로 확장하기 위해 저희 팀이 수행한 연구와 개발 과정을 공유합니다. 테라바이트 규모의 Interleaved(교차 배치) 데이터셋을 정제하여 모델의 한국적 문맥 이해 능력을 강화한 과정, 한국어 PDF 벤치마크(KoPDFBench)를 자체 구축하고 PDF 이해 능력을 체계적으로 끌어올린 과정, 그리고 다중 이미지와 Long-Context 학습 최적화 과정을 다룹니다. 덧붙여 화면을 직접 인식하고 조작하는 Computer Use Agent(CUA)의 핵심인 GUI Grounding 기술에 이르기까지, VLM이 실질적인 서비스에 필요한 기능들을 갖추기 위해 거쳐온 여정을 상세히 소개합니다.
각 장에서는 단순한 결과 보고를 넘어 실제로 직면했던 문제와 그 해결 과정에서 얻은 실질적인 인사이트를 중심으로 서술합니다. 데이터 정제 파이프라인의 설계 원칙, 학습 데이터의 양과 질 사이의 트레이드오프, 시퀀스 병렬 처리에서의 경계 처리 문제, 데이터 증강을 통한 할루시네이션 완화 전략 등 실무에서 바로 참고할 수 있는 경험을 담았습니다.
아래 표는 문서 이해(Document), GUI Grounding(CUA), 다중 이미지(Multi-Image), 한국어 이해(Korean benchmark) 등 주요 카테고리별 벤치마크에서 동일 파라미터 규모의 Qwen3-VL 4B 모델과 비교한 성능입니다. 비슷한 크기의 글로벌 오픈소스 모델과 비교해 전반적으로 대등한 성능을 보이며 특히 한국어 특화 태스크에서 뚜렷한 경쟁력을 확인했습니다. 아래표에서 자체 제작한 벤치마크의 이름은 한글로 표기하였습니다. 이제 각 수치의 배경이 된 기술적 고민과 실험 과정을 이어지는 장에서 하나씩 풀어보겠습니다.
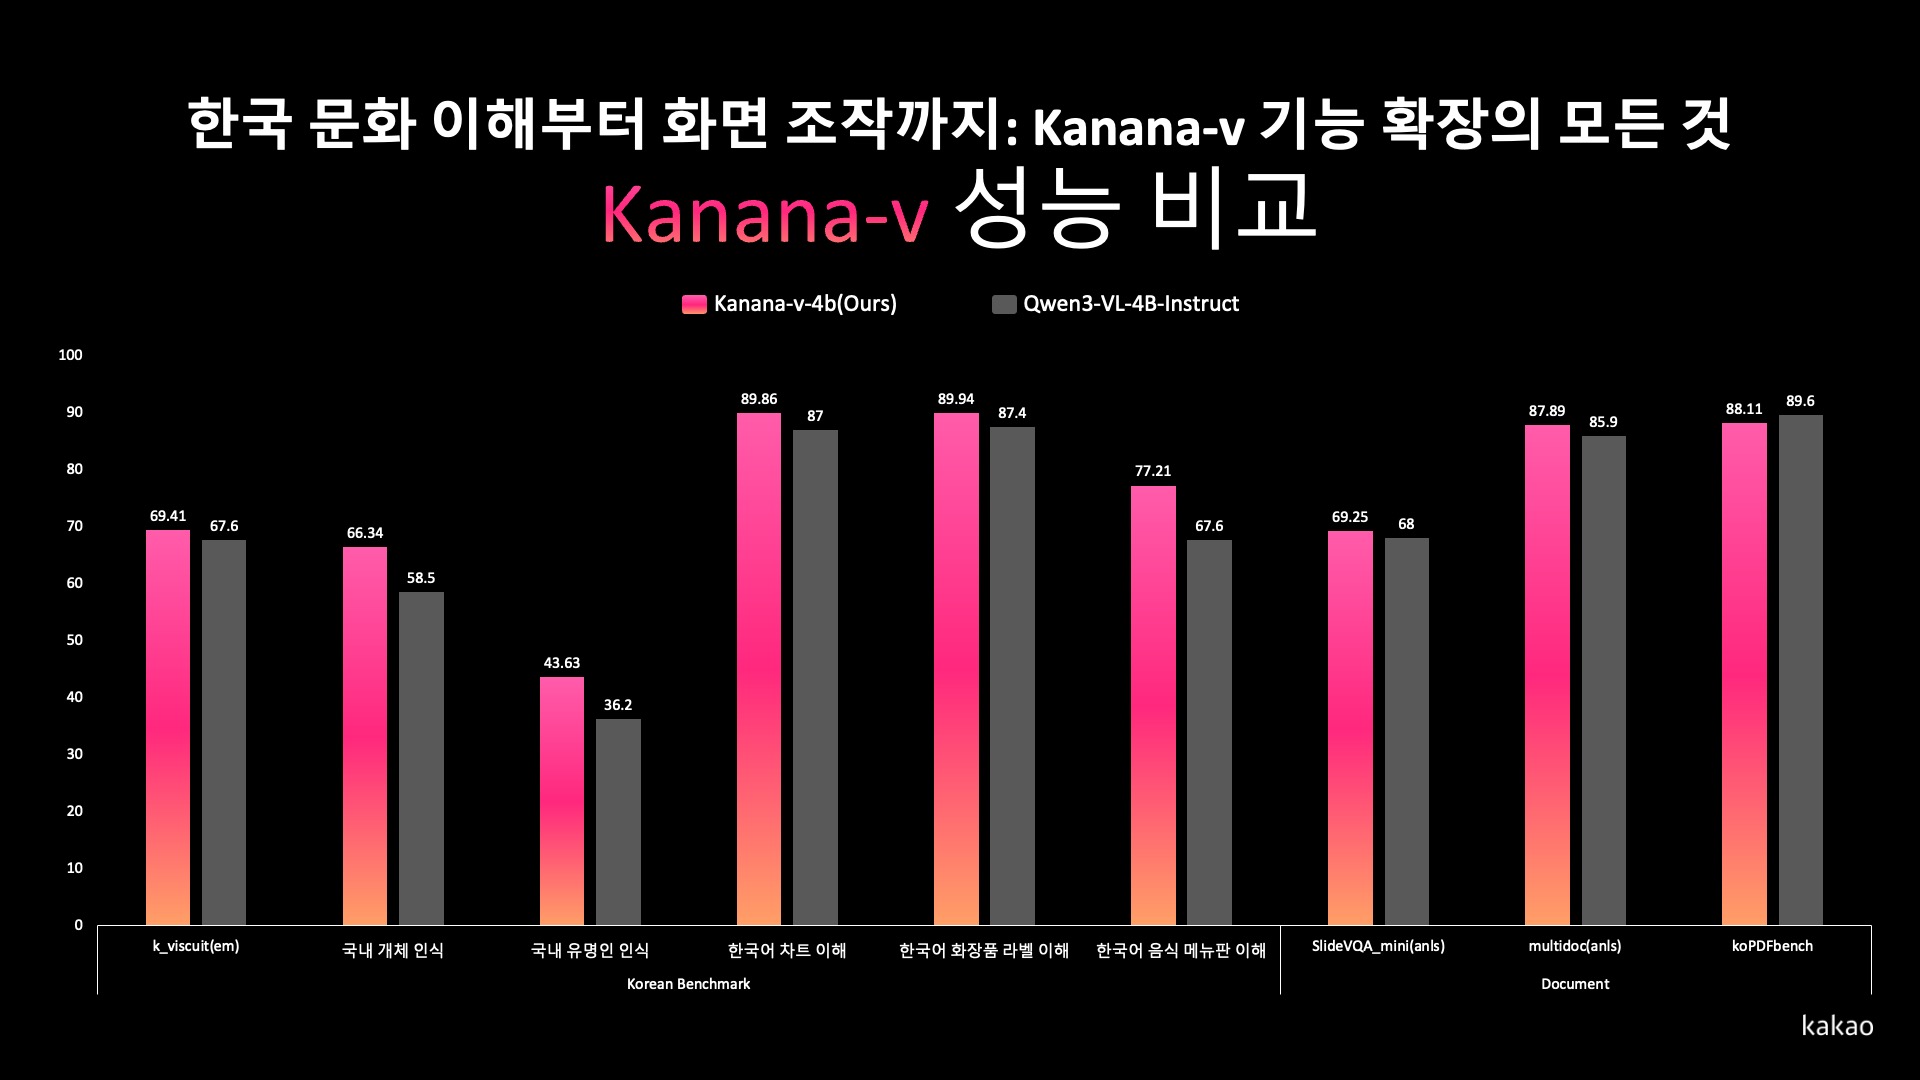
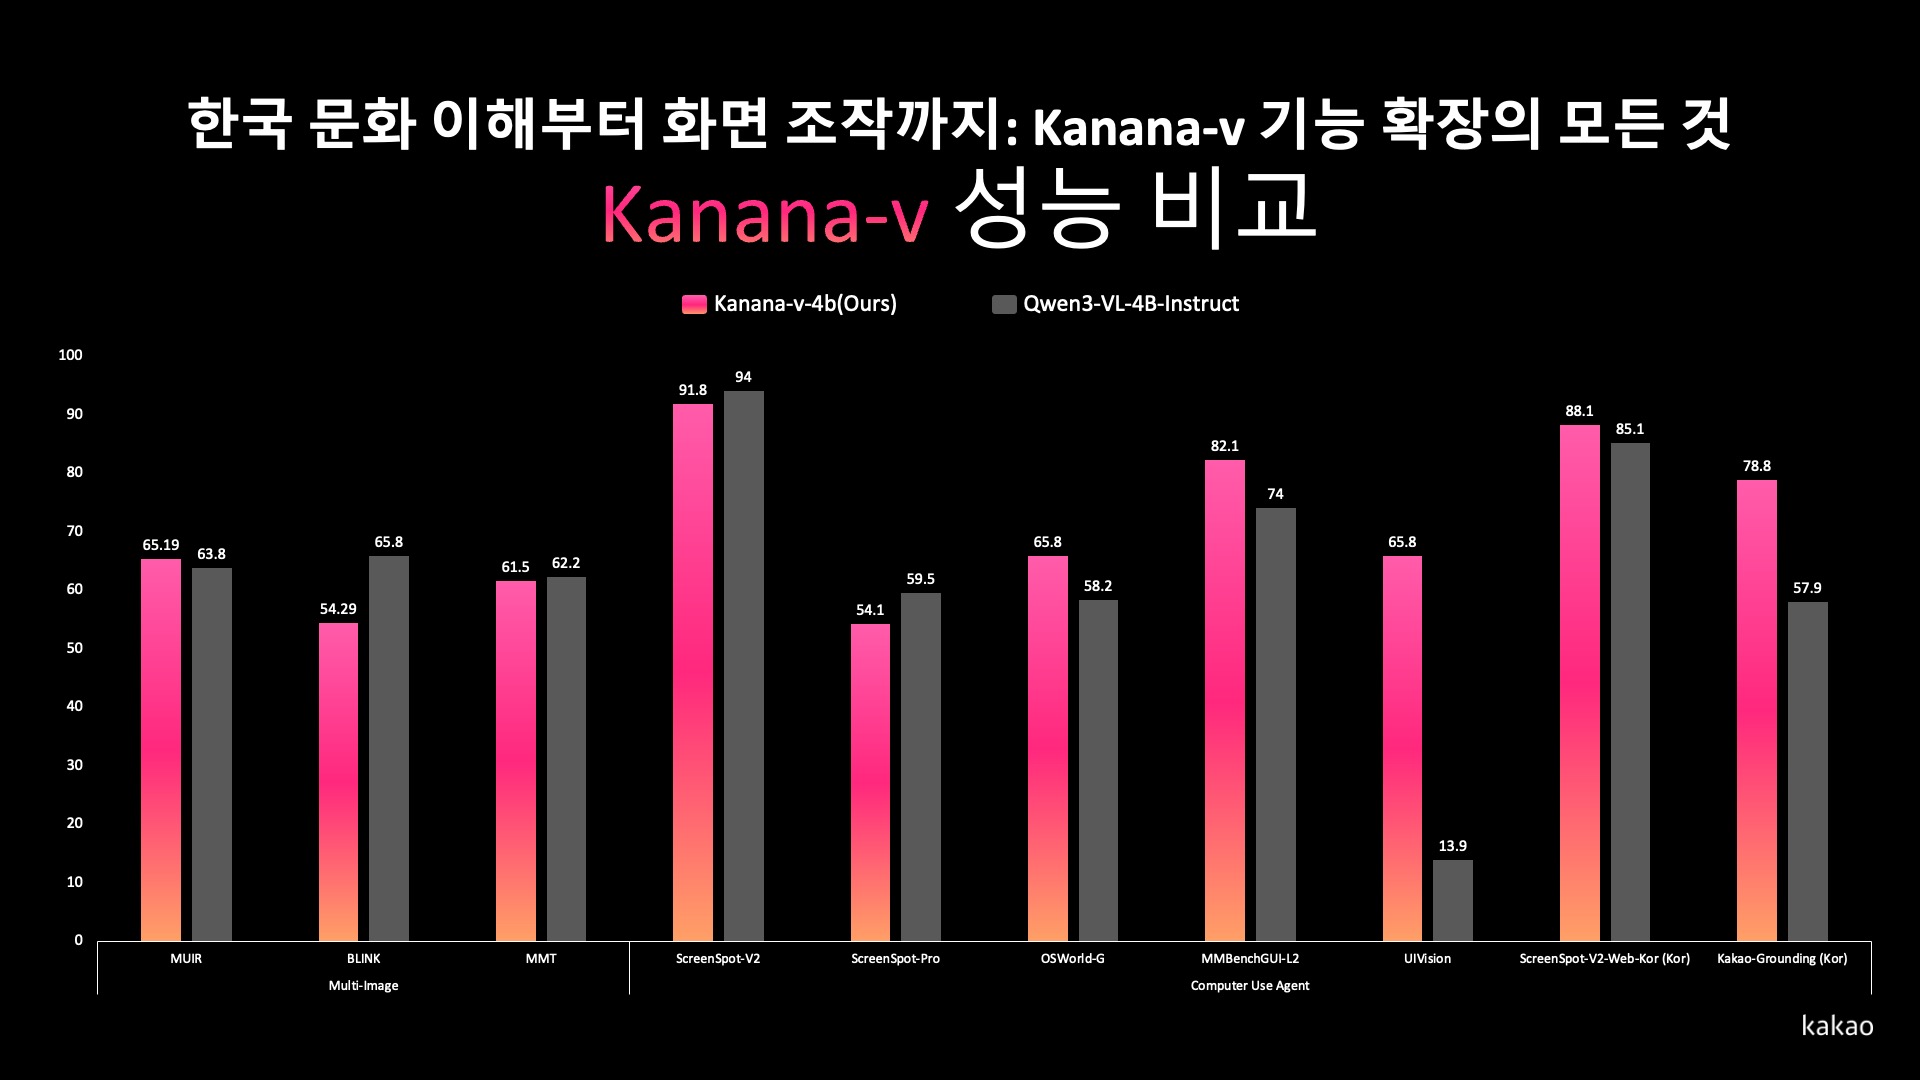
<그림 1. 벤치마크 결과>
Interleaved 한국어 데이터셋 적용 및 실험기
이번 장에서는 Vision Language Model(VLM)이 한국 문화를 더 깊이 이해할 수 있도록 Interleaved 한국어 데이터셋을 적용한 실험 과정과 그 과정에서 얻은 인사이트를 공유합니다. 단순히 이미지를 학습시키는 것을 넘어 한국적 맥락(Context)을 이해하는 모델을 만들기 위해 어떤 고민들이 있었는지 소개합니다.
Interleaved 데이터셋이란
Interleaved 데이터셋은 이미지와 텍스트가 교차하며 등장하는 형태의 데이터셋입니다. 블로그가 대표적인 예시입니다. 이러한 데이터셋을 활용하면 다양한 지식을 학습할 수 있고, 모델의 in-context learning 효과[1]를 강화할 수 있는 것으로 알려져 있습니다.
직면한 문제
가장 먼저 마주한 문제는 품질과 데이터 규모였습니다. 무작위로 수집된 데이터인 만큼 광고성 저품질 콘텐츠가 상당수 포함되어 있었습니다. 게다가 데이터 규모가 수백 테라바이트 단위여서 간단한 전처리 작업에도 오랜 시간이 소요되었습니다.
이 문제를 해결하기 위해 Hugging Face 팀에서 공개한 Datatrove 프레임워크[7]를 도입했습니다. Datatrove는 방대한 데이터를 샤딩(Sharding)하여 병렬 처리할 수 있게 해주며, 복잡한 필터링 과정을 파이프라인 형태로 손쉽게 관리할 수 있다는 장점이 있습니다. 정제 파이프라인은 아래와 같이 구성하였습니다.
8단계 정제 파이프라인
1) Image-based Document Filtering (이미지 기반 문서 필터)
가장 먼저 이미지의 품질을 검증합니다. 데이터에는 깨진 이미지, 저해상도 이모티콘, 극단적인 종횡비를 가진 광고 이미지 등이 상당수 포함되어 있었습니다. 이러한 이미지들은 모델 학습에 노이즈로 작용할 수 있어 초기 단계에서 제거해야 했습니다. OBELICS[1]에서 제안한 기준을 참고하여 종횡비 3.0 이상인 이미지, 28픽셀 미만의 극소 이미지 등을 제거했습니다. 또한 문서 내에 유효한 이미지가 최소 1개 이상 존재하는지 확인하여, 이미지가 모두 제거된 문서는 제외했습니다.
2) Language ID (언어 식별)
다음으로 한국어 콘텐츠만을 선별합니다. 한국어 판별 정확도를 높이기 위해 FastText 기반의 언어 식별 모델을 사용했습니다. 한국어 콘텐츠일 확률이 90% 이상인 문서만 통과시켰으며, 이 임계값은 실제 데이터를 샘플링한 정성평가를 통해 결정되었습니다. 이 기준에서 기계 번역으로 생성된 저품질 다국어 혼합 문서는 효과적으로 걸러지면서도, 영문 인용이나 코드 스니펫이 포함된 기술 콘텐츠는 전체적인 맥락이 한국어이기 때문에 충분히 통과할 수 있었습니다.
3) Gopher Repetition Filter (반복 패턴 제거)
세 번째 단계에서는 반복적인 패턴을 가진 문서를 제거합니다. DeepMind의 Gopher 논문[2]에서 제안된 휴리스틱을 한국어 특성에 맞게 조정하여 적용했습니다. 이 필터는 두 가지 관점에서 반복을 탐지합니다. 동일한 라인이나 단락이 과도하게 반복되는지 확인하고, 2-gram부터 10-gram까지의 n-gram 패턴을 분석하여, 특정 구문이 비정상적으로 자주 등장하는 문서를 걸러냅니다. 이를 통해 스팸성 콘텐츠나 템플릿 기반으로 자동 생성된 광고성 게시물을 효과적으로 제거할 수 있었습니다.
4) Gopher Quality Filter (기본 품질 필터)
네 번째 단계에서는 기본적인 언어 품질을 검증합니다. 평균 단어 길이, 비알파벳 문자 비율, 불용어 출현 빈도 등을 확인합니다. 이때 영어 기준의 파라미터를 그대로 적용하면 한국어 문서가 과도하게 필터링되는 문제가 있었습니다. 영어는 평균 단어 길이가 4자 이상이지만, 한국어는 조사와 어미가 분리되면 1~2글자 토큰이 많아져 평균이 낮아지기 때문입니다. 따라서 최소 평균 단어 길이를 1자로 완화했습니다. 불용어 체크도 마찬가지입니다. 불용어(은, 는, 이, 가 등)는 그 자체로는 의미가 없지만, 자연스러운 문장이라면 일정 비율 이상 등장해야 합니다. 키워드만 나열된 스팸성 글에는 불용어가 거의 없다는 점을 활용한 것입니다. 기본 설정은 영어 불용어 기준이라 한국어 조사와 어미로 구성된 리스트를 별도로 적용했습니다.
5) C4 Quality Filter (문장 구조 검증)
다섯 번째 단계에서는 C4 데이터셋 구축 방법론[3]을 차용하여 문장 구조를 검증합니다. 핵심은 최소 문장 수 기준인데, 저희는 4문장 이상을 요구했습니다. 이 기준은 한 줄짜리 메모 등 짧은 콘텐츠를 제거하면서도 짧지만 완결된 설명문은 보존할 수 있는 균형점이었습니다. 다만 한국어 문서는 문장 끝에 마침표를 생략하는 경우가 많아, 종결 부호 필터는 적용하지 않았습니다.
6) FineWeb Quality Filter (종합 품질 평가)
여섯 번째는 Hugging Face의 FineWeb 프로젝트에서 개발된 종합 품질 필터입니다. 이 필터는 라인(줄) 단위의 문서 구조를 검사합니다. 구체적으로는 짧은 라인 비율, 글머리 기호로 시작하는 라인 비율, 줄임표(…)로 끝나는 라인 비율 등을 확인합니다. 이를 통해 상품 목록 나열, 메뉴판 형식의 콘텐츠 등을 걸러냅니다. 이 단계까지 통과한 문서는 학습에 적합한 품질을 갖춘 것으로 판단하여, 이후로는 모델 학습 효율성과 모델 안정성을 향상시키기 위한 단계를 추가로 구성했습니다.
7) MinHash Deduplication (유사 문서 중복 제거)
일곱 번째는 중복 문서를 제거하는 단계입니다. 데이터 특성상 동일하거나 유사한 콘텐츠가 여러 번 수집되는 경우가 많았습니다. 펌글, 복사-붙여넣기 콘텐츠, 템플릿만 살짝 바꾼 유사 게시물들이 대표적인 예입니다. 수백만 개의 문서에서 중복을 찾는 것은 계산적으로 매우 비용이 큰 작업입니다. 모든 문서 쌍을 비교하면 O(n²)의 복잡도가 발생하기 때문입니다. 이 문제를 해결하기 위해 MinHash 알고리즘을 적용했습니다. MinHash는 문서를 고정 길이의 시그니처로 압축한 뒤, Locality-Sensitive Hashing(LSH)을 통해 유사한 문서끼리 같은 버킷에 배치합니다. 이렇게 하면 전체 문서가 아닌 같은 버킷 내 문서들만 비교하면 되므로, 비교 대상이 대폭 줄어들어 효율적으로 중복 제거를 수행할 수 있습니다.
8) PII Processing (개인정보 처리)
마지막 단계는 개인정보 보호를 위한 마스킹 처리입니다. 간혹 데이터에 전화번호, 이메일 주소 등이 포함되어 있는 경우가 있었습니다. 이러한 민감 정보는 학습 데이터에서 반드시 제거해야 합니다. 카나나 LLM 조직에서 개발한 한국어에 특화된 PII(Personally Identifiable Information) 탐지 로직을 적용하여 개인정보를 마스킹 토큰으로 대체했습니다. 동시에 이미지 제거로 인해 발생한 빈 텍스트 노드를 정리하고, 연속된 텍스트 블록을 병합하는 등의 콘텐츠 정제 작업도 함께 수행했습니다.
이 파이프라인을 전체 데이터셋에 적용한 결과, 원본 대비 약 77%의 데이터가 필터링되어 최종적으로 약 23%만 남았습니다. 많은 양이 필터링되었지만, 고품질 데이터만 학습에 사용하겠다는 원칙을 지키기 위한 선택이었습니다. 정제의 실질적인 효과를 검증하기 위해 Ablation 실험을 진행했습니다. 동일한 모델 구조와 학습 설정에서 정제 전 데이터와 정제 후 데이터로 각각 학습시킨 뒤 성능을 비교한 결과, 정제된 데이터로 학습한 모델이 한국 문화 이해 및 VQA 벤치마크에서 더 높은 점수를 기록했습니다. 데이터의 품질 향상이 성능 개선으로 이어진 것입니다. 다음은 1B 크기의 모델로 필터링 적용 전/후 비교 실험 결과입니다.
| Category | Benchmark | 필터링 적용 전 | 필터링 적용 후 |
|---|---|---|---|
| Instruction Following | IFEval | 34.75 | 35.30 |
| VQA | MMStar | 39.87 | 40.60 |
| MMVet | 33.76 | 36.79 | |
| LLaVA-Wild | 75.10 | 78.00 | |
| Korean Benchmark | 국내 개체 인식 | 50.05 | 53.66 |
| 한국어 음식 메뉴판 이해 | 44.56 | 47.02 | |
| 한국어 차트 이해 | 58.33 | 57.43 | |
| 한국어 화장품 라벨 이해 | 67.02 | 68.09 |
<표 1. Interleaved 필터링 적용 전/후 비교 결과>
파이프라인을 구축하며 배운점은 다음과 같습니다. 첫째, 필터 순서가 중요합니다. 계산 비용이 낮은 필터를 앞에 배치하고 비용이 높은 필터는 뒤에 배치하면, 초기 단계에서 명확한 저품질 문서를 빠르게 제거하여 후속 단계의 처리량을 줄일 수 있습니다. 둘째, 중간 결과물을 저장해두면 유용합니다. 각 필터에서 제외된 문서들을 단계별로 따로 저장하면 필터가 의도대로 동작하는지 검증하고 필요시 임계값을 조정할 수 있습니다. 또한 중복 제거까지 완료된 데이터도 별도로 저장해두면, PII 처리 방식이나 출력 포맷을 변경할 때 전체 파이프라인을 처음부터 다시 돌리지 않아도 됩니다. 셋째, 영어 기준의 파라미터를 한국어에 그대로 적용하면 안 됩니다. 언어별 특성을 고려한 튜닝이 필수적입니다. 마지막으로 멀티모달 데이터는 이미지 제거 후 텍스트도 함께 정리해야 합니다. Interleaved 데이터는 “이미지 → 텍스트 → 이미지 → 텍스트” 형태로 교차 배치되어 있는데, 중간의 이미지가 제거되면 그 앞뒤 텍스트가 분리된 채로 남게 됩니다. 이렇게 연속으로 이어지게 된 텍스트 블록을 하나로 병합하는 후처리가 필요합니다.
Interleaved 학습 상세
InternVL[5]의 학습 전략을 참고하여, VLM 학습 초기 SFT(Supervised Fine-Tuning) 단계에 정제된 Interleaved 데이터셋을 함께 투입하는 방식을 채택했습니다. 다만 일반적인 SFT 데이터와 달리, Interleaved 데이터에는 chat template을 적용하지 않았습니다. 일반적인 SFT 학습에서는 사용자와 어시스턴트 간의 대화 구조를 명시하는 chat template을 적용하여 모델이 역할을 구분하고 적절한 응답을 생성하도록 학습합니다. 반면 Interleaved 데이터는 자연스러운 텍스트-이미지 흐름을 그대로 유지한 채 Next Token Prediction 방식으로 학습했습니다. 이를 통해 모델이 장문의 문맥에서 이미지와 텍스트 간의 자연스러운 상호작용을 학습할 수 있도록 했습니다.
Interleaved 데이터는 일반적인 VQA 데이터셋과 구조적으로도 다릅니다. VQA 데이터셋은 보통 하나의 이미지에 대해 하나의 질문-답변 쌍으로 구성되지만, Interleaved 데이터는 하나의 문서 내에 여러 이미지가 텍스트와 번갈아 등장합니다. 이러한 구조 덕분에 모델이 긴 문맥 속에서 여러 이미지를 참조하며 텍스트를 이해하는 능력을 학습할 수 있었습니다.
필터링을 거쳤음에도 Interleaved 데이터셋의 규모는 기존 SFT 데이터셋보다 상당히 컸습니다. 효율적인 대용량 데이터 처리를 위해 lazy loading 방식을 도입했습니다. 이미지를 미리 메모리에 로드하지 않고 경로만 저장해두었다가 실제 학습 시점에 필요한 이미지만 로드하는 방식으로, 메모리 사용량을 최소화하면서 수백만 건의 데이터를 처리할 수 있었습니다.
두 데이터셋 간의 최적 샘플링 비율을 찾기 위한 실험도 진행했습니다. 실험 주기를 단축하기 위해 1B 규모의 소형 모델에 시퀀스 패킹을 적용하여 다양한 비율로 학습했습니다. 그 결과, Interleaved 데이터의 샘플링 비율을 높이면 한국어 벤치마크 점수가 전반적으로 향상되는 것을 확인했습니다. 이는 Interleaved 데이터셋이 모델의 한국어 이해 능력을 강화시킨 것으로 해석됩니다. 그러나 동시에 일반 VQA 성능은 감소하는 trade-off가 관찰되었습니다. Interleaved 데이터의 특성상 명시적인 질문-답변 형식보다 서술형 텍스트가 많아, 직접적인 VQA 태스크에 대한 학습 신호가 희석되었기 때문으로 분석됩니다. 최종적으로는 한국어 성능 향상과 VQA 성능 유지 사이의 균형점을 찾아 샘플링 비율을 결정했습니다.
PDF 이해 능력 향상 과정
본 장에서는 Vision Language Model(VLM)의 PDF 문서 이해 능력을 개선하기 위해 수행한 연구 및 개발 과정을 소개합니다.
PDF 한국어 벤치마크 구축
PDF 이해 능력 향상을 위한 첫 번째 과제는 평가 체계의 부재였습니다. 한국어로 작성된 PDF 문서에 대한 모델의 이해도를 정량적으로 측정할 수 있는 벤치마크가 존재하지 않았기 때문입니다. 이에 한국어 PDF 벤치마크를 자체 구축하기로 결정했습니다. PDF 문서는 AI-HUB에서 수집하였으며, 기존 영어권 문서 이해 벤치마크를 참고하여 질문 유형을 체계화했습니다. 질문 유형은 크게 기본형과 추론형으로 구분하고, 각각 4가지 세부 타입으로 구성했습니다. 기본형은 문서 내 특정 위치를 탐색하고 텍스트를 정확히 인식하는 능력을 평가하며, 추론형은 문서의 종합적 이해와 복합적인 추론 능력을 측정하도록 설계했습니다.
| 분류 | 유형 | 평가 목표 및 예시 |
|---|---|---|
| 기본형 | 문서 메타데이터 및 구조 정보 추출 | 평가 목표 : 문서의 기본 정보와 전체 구조를 파악하는 능력 평가 예시: - 첫 페이지 상단에 표시된 논문 제목을 그대로 작성하세요. - ‘3. 연구 방법’ 섹션의 페이지 번호는 무엇인가요? |
| 특정 텍스트 추출 | 평가 목표 : 문서 내 특정 위치에 있는 텍스트를 정확히 찾고 추출하는 능력 평가 예시: - 7페이지 하단 각주 1번의 내용을 그대로 작성하세요. - 3페이지 두 번째 단락에서 첫 번째로 등장하는 볼드체 용어는 무엇인가요? | |
| 표 및 그림 정보 추출 | 평가 목표 : 표와 그림에서 메타정보 및 기본 데이터를 추출하는 능력 평가 예시: - <표 1> 상단에 표시된 캡션 텍스트를 그대로 작성하세요. - [그림 1] 하단 캡션에서 그래프 유형으로 명시된 용어는 무엇인가요? | |
| 목록 및 항목 열거/계산 | 평가 목표 : 문서 내 목록 항목을 정확히 세거나 나열하는 능력 평가 예시 - ‘참고문헌’ 섹션에 나열된 문헌의 총 개수는 몇 개인가요? - 5페이지 ‘핵심 키워드’ 항목에 나열된 모든 키워드를 순서대로 쉼표로 구분하여 작성하세요. | |
| 추론형 | 정보 통합 및 추론 | 평가 목표: 문서 내 여러 곳의 정보를 종합해야 하는 질문예시: - '2. 방법론’에서 제안한 3가지 기법 중, '4. 결과’에서 가장 높은 성능을 보인 기법은 무엇인가요? - <표 1>의 '데이터셋 크기’와 <표 2>의 '정확도’를 비교할 때, 가장 작은 데이터셋으로 가장 높은 정확도를 달성한 모델은 무엇인가요? |
| 비교 및 대조 | 평가 목표: 두 요소를 비교하여 관계를 파악하는 능력 평가 예시: - [그림 2]에서 2023년 막대와 2024년 막대 중 더 높은 값을 나타낸 연도는 언제인가요? - <표 3>의 ‘모델 A’ 처리 시간에서 ‘모델 B’ 처리 시간을 뺀 값은 몇 ms인가요? | |
| 인과관계 추론 | 평가 목표: 요소 간 인과관계나 변화 추세를 추론하는 능력 평가예시: - [그림 1]에서 2020년부터 2024년까지의 추세는 “증가”, “감소”, “유지” 중 무엇인가요? - 본문 4.2절에서 "오류율 증가를 초래한"이라고 서술된 실험 조건은 무엇인가요? | |
| 수치 계산 및 추론 | 평가 목표: 수치 데이터를 계산하여 정확한 값을 도출하는 능력 평가 예시: - <표 4> 두 번째 열의 모든 수치를 합산한 후 행의 개수로 나눈 평균값은 얼마인가요? (소수점 둘째 자리까지) - [그림 3]에서 2024년 값에서 2023년 값을 뺀 차이는 얼마인가요? |
<표 2. 한국어 PDF 벤치마크 질문 유형>
벤치마크 초안을 빠르게 구축하였으나, 텍스트 오인식, 부정확한 답변 생성 등의 오류가 확인되었습니다. 이를 해결하기 위해 2인 검수 체계를 도입하였으며, 검수자 중 1인이라도 오류로 판단한 문항은 데이터셋에서 제외하는 엄격한 기준을 적용했습니다. 사람 검수 결과, 초기 8,031건의 문항 중 최종적으로 5,677건의 데이터셋이 구축되었습니다. 약 29%의 문항이 검수 과정에서 제외된 것으로, 2인 검수 체계의 엄격한 기준이 반영된 결과입니다.
PDF 학습 데이터 구축 파이프라인
PDF 이해 능력을 높이기 위해서는 학습 데이터를 구축해야 했습니다. PDF는 텍스트, 표, 수식, 차트, 이미지가 혼재된 복합 문서입니다. 한국어 PDF는 AI-HUB에서 수집했고, 영어 PDF는 HuggingFace 팀에서 공개한 FinePDF[8] 데이터셋을 활용했습니다. PDF-to-Markdown 데이터는 VLM을 이용해 페이지별 PNG 이미지를 Markdown으로 변환하는 방식으로 확보할 수 있었지만, PDF VQA 데이터는 그렇지 않았습니다. 자연스러운 질문을 생성하려면 여러 기술적 결정이 필요했습니다. 이 글에서는 PDF VQA 학습 데이터를 생성하기 위해 설계한 파이프라인을 공유합니다.
전체 파이프라인은 HuggingFace의 오픈소스 데이터 처리 라이브러리 DataTrove 위에 구축했습니다. 한국어와 영어 파이프라인은 동일한 설계 철학을 공유하지만, 데이터 소스의 특성에 맞게 세부 구현이 다릅니다. 여기서는 한국어 파이프라인을 중심으로 설명합니다. 파이프라인은 크게 1) Markdown 추출 2) 중복제거 3) 문서 청크 분할 4) 품질 평가 5) QA 생성 및 검증의 다섯 단계로 구성됩니다.
파이프라인의 출발점은 VLM을 이용한 Markdown 추출입니다. AI-HUB에서 제공된 페이지별 PNG 이미지를 Markdown으로 변환합니다. 이 단계는 PDF-to-Markdown 학습 데이터를 확보하는 목적도 겸하기 때문에 모든 페이지에 대해 수행됩니다. 여기에 한 가지를 더했습니다. 첫 페이지를 처리할 때, Markdown 변환과 함께 문서 메타데이터를 추가로 추출하도록 한 것입니다. “이 문서의 예상 독자는 누구인가”, “어떤 도메인의 문서인가”, "작성자의 전문 분야는 무엇인가"를 분석하는 프롬프트를 사용합니다. 예를 들어 세무 관련 문서라면 “예상 독자: 세금 신고가 필요한 자영업자”, "작성자: 세무사"가 추출되는 식입니다. 첫 페이지만으로도 문서의 성격을 충분히 파악할 수 있기 때문에, 나머지 페이지에서는 Markdown 변환만 수행하여 불필요한 비용을 줄였습니다.
이 메타데이터를 추출한 이유는 QA의 자연스러움 때문입니다. 처음에는 Markdown만으로 곧바로 QA를 생성했는데, “이 표에 적힌 숫자는 무엇인가요?”, "이 문서의 제목은 무엇입니까?"처럼 누가 읽어도 어색한 시험 문제 같은 질문들이 나왔습니다. 실제 사람이 문서를 읽을 때 던지는 질문은 그렇지 않습니다. 세무 서류를 보는 자영업자는 "이 소득 구간이면 세금을 얼마나 내야 하나요?"라고 묻고, 건강검진 결과지를 받은 환자는 "이 수치가 정상 범위인가요?"라고 묻습니다. 질문의 자연스러움은 "누가 이 문서를 읽는지"를 아느냐 모르느냐에 달려 있었습니다. 확보된 메타데이터를 QA 생성 프롬프트에 주입하자, "이 문서의 예상 독자인 자영업자의 관점에서 자연스러운 질문을 생성하라"는 맥락이 부여되어 질문의 품질이 크게 개선되었습니다.
다음으로 추출된 Markdown를 기반으로 MinHash 중복제거를 수행합니다. 수집된 PDF에는 유사한 양식의 문서가 포함되어 있어 이 단계가 필수적이었습니다. 이 단계에서 양식은 같고 내용만 약간 다른 유사 문서를 효과적으로 걸러냈습니다.
중복이 제거된 문서는 청크 분할 단계로 진입합니다. PDF 수십 페이지를 입력하고 QA를 생성하면 특정 페이지에 집중하지 못하고 피상적인 질문만 생성하는 문제가 있었습니다. 그래서 최대 4페이지 단위로 분할하되, 단순히 앞에서 4장씩 자르는 것이 아니라 균등 분배 알고리즘을 적용했습니다. 7페이지 문서는 4+3으로, 9페이지는 3+3+3으로, 13페이지는 4+3+3+3으로 분할합니다. 이렇게 하면 마지막 청크만 페이지가 극단적으로 적어지는 상황을 방지할 수 있어, 모든 청크에서 의미 있는 QA를 생성할 확률이 높아집니다. QA 생성 전에는 FastText 기반 edu score를 추출하여 학습할 가치가 있는 문서만 걸러냅니다.
QA 생성 단계에서는 각 청크에 대해 추론형 QA를 먼저 생성한 뒤, 별도의 모델이 원본 이미지를 보고 정답의 정확성, 근거 페이지, 신뢰도, 난이도를 추출합니다. 추론형 QA는 여러 페이지의 정보를 종합하거나 인과관계를 파악하는 질문으로, 문서 내용이 풍부하지 않으면 억지스러운 질문이 만들어질 수 있습니다. 검증을 통과하면 그대로 채택하지만, 통과하지 못하면 기본형 QA를 새로 생성하여 다시 검증합니다. 기본형 QA는 특정 값을 읽거나 항목을 찾는 질문으로, 추론형보다 문서 내용에 대한 요구가 낮아 안전한 대안이 됩니다. 기본형마저 검증에 실패하면 해당 청크를 건너뜁니다. 이처럼 생성과 검증 단계를 분리함으로써 데이터 품질 저하를 방지했습니다.
파이프라인의 최종 산출물은 4페이지 단위의 청크별 QA 데이터입니다. 그런데 실제 학습은 이 데이터를 두 단계에 걸쳐 활용합니다. 먼저 청크 단위 QA로 학습하여, 모델이 소수의 페이지를 정밀하게 읽는 기본적인 문서 이해 능력을 확보하도록 합니다. 표의 특정 셀 값을 읽거나, 인접한 페이지에 걸친 수치를 비교하는 것이 이 단계에서 키우는 능력입니다. 이어지는 long-context 학습 단계에서는, 한 PDF의 모든 페이지 이미지를 이어붙여 통째로 입력하는 방식을 on-the-fly로 적용합니다.
학습을 두 단계로 나눈 데는 이유가 있습니다. 청크 QA로 먼저 학습하면 모델은 소수의 페이지를 정밀하게 읽는 능력을 확보합니다. 이 기초 없이 곧바로 수십 페이지를 입력하면, 모델은 긴 컨텍스트에 압도되어 개별 페이지의 세부 정보를 놓치기 쉽습니다. 짧은 컨텍스트에서 페이지 단위의 이해력을 먼저 다진 뒤 긴 컨텍스트로 확장하면, 문서 전체의 흐름을 파악하면서도 페이지 단위의 정밀함을 유지할 수 있습니다. 다음은 PDF 데이터를 추가했을때 성능향상 여부를 확인한 실험결과 입니다.
| Category | Benchmark | w/o PDF 데이터셋 | w PDF 데이터셋 |
|---|---|---|---|
| Document | 한국어 PDF 벤치마크 | 79.42 | 82.45 |
| charXiv(Desc) | 71.82 | 71.41 | |
| charXiv(Reasoning) | 24.8 | 30.45 | |
| OCRBench | 722 | 758 | |
| VQA | MMMU(val) | 49.33 | 53.22 |
| AI2D | 76.06 | 77.52 | |
| MMVet | 49.86 | 52.93 | |
| Multi-Image | MUIR | 36.07 | 42.65 |
| BLINK | 45.6 | 44.87 | |
| Instruction Following | MIA-Bench | 86.08 | 84.97 |
| Long-Context | MM-NIAH(val) | 31.31 | 36.28 |
| MMLongBench(f1) | 13.91 | 15.97 | |
| SlideVQA_mini(anls) | 47.72 | 49.65 |
<표 3. PDF 데이터셋 추가에 따른 성능 변화>
Long-Context 학습을 위한 Ulysses 개발
VLM 학습에서 시퀀스 길이는 주요 병목 중 하나입니다. 고해상도 이미지 하나가 수백~수천 개의 토큰으로 변환되기 때문에 이미지 수가 늘어나면 모델의 입력 길이도 급격히 길어집니다. 이 문제를 해결하기 위해 DeepSpeed Ulysses 기반의 시퀀스 병렬(Sequence Parallelism, 이하 SP)을 도입했습니다.
Ulysses SP의 핵심 아이디어는 데이터 분할의 기준을 전환하는 것입니다. 평소에는 길이 L의 시퀀스를 N개 GPU에 L/N씩 균등 분할해 갖고 있다가, 어텐션 연산 직전에 All-to-All 통신을 통해 '시퀀스 기준 분할’을 '어텐션 헤드 기준 분할’로 변경합니다. 이렇게 하면 각 GPU는 특정 헤드에 대한 전체 시퀀스 정보를 모두 갖게 되어 정확한 어텐션 연산이 가능해집니다. 예를 들어 64K 토큰의 시퀀스를 4개 GPU로 처리한다면, 각 GPU는 16K 토큰씩 담당하게 됩니다. 이번 장에서는 각 GPU가 담당하는 이 연속된 시퀀스 범위를 "구간"이라 부르겠습니다.
SP를 분산 학습의 Data Parallelism(DP)과 결합하면, 같은 SP 그룹 내 GPU들은 동일한 샘플을 나눠 처리하고, DP 그룹 간에는 서로 다른 샘플을 처리하는 이중 구조가 필요합니다. 이를 위해 global rank에서 DP rank와 SP rank를 분리하여, 동일 SP 그룹 내 GPU들이 같은 DataLoader 시드를 공유하도록 설계했습니다. 본 섹션에서는 이러한 기본 동기화를 넘어, VLM 특유의 멀티모달 구조에서 마주한 문제들과 그 해결 과정을 다룹니다.
비전 입력의 분배와 최적화
텍스트 전용 모델에서는 시퀀스를 GPU별 구간으로 나누기만 하면 되지만, VLM에서는 추가적인 문제가 있습니다. VLM의 시퀀스에는 텍스트 토큰 사이사이에 이미지 플레이스홀더 토큰이 섞여 있고, 모델은 이 위치에 비전 인코더가 생성한 임베딩을 삽입해야 합니다. 시퀀스를 GPU별로 나누면 하나의 이미지에 대한 플레이스홀더가 서로 다른 GPU의 구간에 걸쳐 나뉠 수 있습니다. 예를 들어 이미지 A의 플레이스홀더 50개 중 앞쪽 30개는 GPU 0의 구간에, 나머지 20개는 GPU 1의 구간에 속하는 식입니다. 이때 각 GPU는 비전 인코더가 출력한 이미지 A의 임베딩 중에서 자기 구간에 해당하는 부분만 정확히 골라 삽입해야 합니다. 이를 위해 DataLoader 어댑터 단계에서 "각 GPU의 구간에 있는 플레이스홀더가 전체 비전 임베딩의 몇 번째에 대응하는지"를 미리 계산해 둡니다.
여기서 한 걸음 더 나아가, 비전 인코더의 연산량도 줄였습니다. 위의 인덱스 매핑만으로도 학습은 정확하게 동작하지만, 기본 구현에서는 모든 GPU가 시퀀스에 포함된 전체 이미지를 비전 인코더에 통과시킨 뒤 자기에게 필요한 임베딩만 골라 쓰게 됩니다. 예를 들어 시퀀스에 이미지가 10장 있고 4-way SP를 사용하면, GPU 0의 구간에는 이미지 1~3만 관련되어 있더라도 나머지 7장까지 모두 인코딩하는 셈입니다. 이 비효율을 해결하기 위해, 각 GPU가 자신의 구간에서 실제로 참조하는 이미지만 골라 비전 인코더에 넘기도록 최적화했습니다.
Packed 시퀀스의 경계 처리와 Labels Shift
Sequence packing은 짧은 샘플들을 하나의 긴 시퀀스로 연결하여 패딩 낭비를 줄이는 기법입니다. Ulysses SP와 결합하면 이 packed 시퀀스가 다시 GPU별 구간으로 나뉘게 되는데, 이 과정에서 "현재 토큰이 다음 토큰을 예측한다"는 autoregressive 학습의 기본 전제가 두 종류의 경계에서 깨질 수 있습니다.
첫 번째는 샘플 간 경계입니다. 예를 들어 길이 4, 3, 5인 A, B, C 세 샘플을 연결한 packed 시퀀스를 생각해보겠습니다. 일반적인 next-token prediction에서는 Sample A의 마지막 토큰이 Sample B의 첫 번째 토큰을 예측하도록 loss가 계산됩니다. 그러나 이 두 토큰은 완전히 다른 문서에 속하므로, 이러한 예측은 무의미한 학습 신호에 불과합니다. 이를 방지하기 위해, 각 샘플의 첫 번째 토큰 위치의 labels을 마스킹하여, 이전 샘플의 마지막 토큰이 해당 토큰을 예측하는 loss가 계산되지 않도록 마스킹했습니다.
두 번째는 GPU 간 구간 경계입니다. Autoregressive 학습에서는 보통 모델 출력 후 logits와 labels를 한 칸씩 밀어(shift) next-token prediction loss를 계산합니다. 그런데 Ulysses SP에서는 시퀀스가 이미 GPU별 구간으로 나뉘어 있어서, 각 GPU 구간의 마지막 토큰에 대한 정답 label은 다음 GPU의 첫 토큰인데 접근할 수가 없습니다. 구간 단위로 나눈 뒤에 shift를 수행하면 구간 경계에서 label이 누락되는 것입니다.
이 두 문제를 함께 해결하기 위해, 시퀀스를 구간으로 나누기 전에 모든 경계 처리를 완료하는 방식으로 구현했습니다. 어댑터가 전체 packed 시퀀스를 들고 있는 시점에 먼저 샘플 경계를 마스킹하고, 이어서 전역 기준으로 labels shift를 수행한 뒤, 이렇게 만들어진 shift_labels를 각 GPU의 구간으로 슬라이싱합니다. 이렇게 하면 각 GPU가 자신의 구간에 대한 정확한 정답 label을 이미 들고 있게 됩니다.
분산 Loss 집계
Ulysses SP에서는 하나의 packed 시퀀스가 여러 GPU의 구간으로 나뉘어 있으므로, 각 구간에서 계산된 partial loss를 올바르게 집계하는 것이 정확한 학습의 핵심입니다. 단순한 token-level cross-entropy 평균이라면 비교적 간단하겠지만, 샘플 간 loss 균형을 위해 squared average loss weighting[5] 방식을 사용했습니다. 이 방식은 각 샘플의 유효 토큰 수에 제곱근을 취한 값을 분모로 사용하여, 긴 샘플이 loss를 지배하는 것을 완화합니다. 또한, 정확한 loss 계산을 위해 SP 그룹 내에서 가중 loss와 가중치 합을 합산 집계한 뒤 가중치 합으로 나누어 최종 loss를 산출합니다. 데이터 병렬 그룹 간에는 모든 랭크가 동일한 분모를 사용하도록 가중치 합을 평균하여, 전체 배치에 대한 올바른 가중 평균 loss가 산출되도록 했습니다.
최적 학습을 위한 레시피 탐색
Ulysses SP 개발 후, 이를 활용해 실제 long-context 학습의 최적 셋팅을 찾는 실험을 진행했습니다. 이 과정에서 두 가지 주요한 난관을 마주했습니다. 하나는 시퀀스 길이를 급격하게 늘리는 것이 학습에 악영향을 준다는 점이었고, 다른 하나는 학습 데이터 내 Long 데이터 비율을 높이면 long-context 성능은 오르지만 기존 short 벤치마크 성능이 떨어지는 트레이드오프 현상이었습니다.
새로운 능력을 확보하면서도 기존의 강점을 잃지 않는 균형점이 필요했습니다. 이를 해결하기 위해 우선 시퀀스 길이를 무리하게 늘리는 대신 학습이 안정적으로 이루어지는 최적의 길이를 설정했습니다. 또한, 실험을 거쳐 두 능력을 모두 만족하는 최적의 데이터 혼합 비율을 도출해냈습니다. 여기에 이전 학습 단계에서 사용했던 데이터를 다운샘플링하여 데이터셋에 추가하는 방식을 적용함으로써, short 벤치마크 성능 저하를 방어할 수 있었습니다.
현재까지의 long-context 학습은 PDF 데이터셋 중심으로 진행되었습니다. 다수의 페이지가 입력되는 PDF는 long-context 학습의 첫 검증 대상으로 적합했지만, 이것만으로는 모델의 long-context 이해 능력을 충분히 끌어올렸다고 보기 어렵습니다. 향후에는 비디오 등 다양한 데이터셋을 확보하여 long-context 능력을 강화해나갈 계획입니다.
| Initial Ckpt | Exp.1 | Exp.2 | Exp.3 | Exp.4 | ||
|---|---|---|---|---|---|---|
| Settings | max_len | 9k | 64k | 32k | 64k | 32k |
| Long : Short | - | 5:5 | 5:5 | 3:7 | 3:7 | |
| Document | 한국어 PDF 벤치마크 | 82.45 | 85.45 | 86.31 | 84.46 | 86.38 |
| OmniDocBench(eng) ↓ | 55.9 | 49.8 | 48.6 | 47.5 | 45.1 | |
| OCRBench | 758 | 749 | 759 | 758 | 759 | |
| Long-Context | MM-NIAH(val) | 36.28 | 31.79 | 28.48 | 36.06 | 39.85 |
| SlideVQA_mini(anls) | 49.65 | 59.76 | 59.1 | 59.18 | 59.96 | |
| multidoc(anls) | 74.37 | 80.93 | 81.88 | 80.92 | 81.27 | |
| VQA | MMMU(val) | 53.22 | 53.44 | 51 | 53.77 | 54 |
| AI2D | 77.52 | 77.23 | 76.68 | 76.42 | 77.55 | |
| MMVet | 52.93 | 50.5 | 50.55 | 51.42 | 50.77 | |
| llava_in_the_wild(all) | 73.6 | 75 | 71.8 | 69.6 | 69.1 | |
| Multi-Image | MUIR | 42.65 | 41.15 | 41.34 | 43.03 | 46.8 |
| BLINK | 44.87 | 42.76 | 44.71 | 43.87 | 46.55 | |
| Instruction Following | MIA-Bench | 84.97 | 83.35 | 83.13 | 83.96 | 82.95 |
| ifeval(inst_level_loose) | 84.17 | 83.57 | 82.73 | 84.65 | 82.95 | |
| Korean Benchmark | k_viscuit(em) | 68.49 | 71.38 | 70.16 | 70.31 | 70.92 |
| 국내 유명인 인식 | 44.65 | 41.82 | 43.88 | 41.69 | 42.85 | |
| 한국어 차트 이해 | 81.15 | 80.25 | 83.69 | 79.34 | 84.23 | |
| 한국어 화장품 라벨 이해 | 82.01 | 82.44 | 83.94 | 86.29 | 86.5 | |
| 국내 개체 인식 | 71.85 | 71.9 | 71.52 | 69.95 | 71.52 | |
| 한국어 수학 문제 풀이 | 41.87 | 41 | 44.5 | 39.5 | 45.37 | |
| 한국어 음식 메뉴판 이해 | 70.43 | 69.19 | 70.84 | 68.37 | 70.43 | |
| avg | 89.54 | 88.82 | 89.55 | 89.24 | 89.81 |
<표 4. Long-Context 최적 학습 셋팅을 찾기 위한 실험>
이미지 한 장을 넘어서: 다중 이미지(Multi Image) 이해 능력 확장
다중 이미지 이해의 필요성
앞선 “Interleaved 한국어 데이터셋 적용 및 실험기” 에서는 텍스트와 이미지가 번갈아 나오는 형태의 입력에 대해 소개했고, ”PDF 이해 능력 향상 과정” 에서는 연속적인 문서 이미지 입력을 다뤘습니다. 이 두가지 형태의 입력을 모두 잘 처리하기위해서는 여러 장의 이미지를 동시에 이해할 수 있어야 합니다. 즉, 모델이 여러장의 이미지를 입력으로 받고, 이미지들 사이의 관계를 종합적 분석할 수 있어야 합니다.
이는 Interleaved 또는 PDF 데이터셋에 국한되지 않습니다. 사용자들의 실제 사용 시나리오에서는 “두 제품 사진을 보고 비교해줘”, “영수증 두 장의 총 합계를 알려줘”, “인테리어 전 후 사진을 보고 달라진 점을 알려줘” 와 같이 여러장의 이미지가 주어지고 각 이미지에 대한 비교 및 분석 등 이미지 간의 관계 파악을 해야만 답변할 수 있는 상황이 존재합니다.
다중 이미지 이해의 핵심 요소
단일 이미지 이해에서는 보통 이미지 한 장과 해당 이미지에 대한 질문을 입력으로 받게 됩니다. 하지만 다중 이미지 이해에서는 여러장의 이미지와 질문을 동시에 받게 되고, 이에 따라 추가적으로 고려해야할 사항들이 발생합니다.
1) 이미지 간의 관계 인식
다중 이미지가 입력으로 주어지는 상황에서는, 이미지간의 관계성을 파악할 수 있어야 합니다. 이미지들이 공통점이나 차이점을 갖는 비교 대상인지, 시간의 순서에 따라 변화하는 이미지인지, 하나의 사물을 여러 각도에서 촬영한 것인지, 혹은 아예 관계성이 없는 무작위 이미지들의 연속인지 등 단일 이미지에서는 존재하지 않았던 상황이 생깁니다.
2) 질의와 관련 있는 이미지 선별
단일 이미지 인식에서는 주어진 이미지에 대한 문맥만 고려하면 충분히 좋은 답변을 할 수 있지만, 다중 이미지 인식에서는 질문에 답변을 하기위해 필요한 이미지를 선별하는 능력도 요구됩니다. 함께 주어지는 모든 이미지가 질문에 관련이 있을 수도 있고, 특정 이미지만 관련이 있을 수도 있습니다. 모델이 관련된 이미지에 대한 선별을 제대로 하지 못한다면 질의와 상관없는 엉뚱한 답변을 생성하게 될 수 있습니다.
3) 주어진 이미지로 답변할 수 없는 요구사항 파악
질의와 관련있는 이미지 선별 능력과 대조적으로, 주어진 이미지만으로는 질문에 대해 답변할 수 없는 상황에도 마주칠 수 있습니다. 가령 주어진 이미지와 관련 없는 질문을 하거나 객관식 질문에서 보기에 정답이 없는 경우가 이와 같은 경우입니다.
이러한 문제는 단일 이미지에서도 동일하게 존재하지만, 다중 이미지 이해에서는 주어지는 이미지가 여러 장으로 늘어남에 따라 주어진 문맥의 복잡도가 높아지고, 이에 따라 할루시네이션 현상도 더욱 빈번해질 수 있습니다.
다중 이미지 이해 학습 데이터
위와 같이 다중 이미지 상황에서 발생하는 새로운 문제들을 고려하여, 이를 완화하고 모델의 다중 이미지 이해 능력 향상을 위한 학습 데이터 확보에 집중했습니다.기존의 학습 파이프라인은 단일 이미지 중심으로 설계되어 있었고, 여러 이미지를 함께 보고 추론하는 형태의 학습 데이터는 상대적으로 부족한 상황이었습니다.
앞서 소개한 Interleaved 한국어 데이터셋과 PDF 데이터셋 또한 다중 이미지 데이터셋의 부분집합으로 정의할 수 있지만, 이 두 데이터셋은 다중 이미지 이해를 위한 기초능력보다는 특정한 목적성을 가진 데이터입니다. 따라서 다중 이미지 이해의 기초능력 확보를 위한 학습 데이터 확보에 노력을 기울였습니다.
저희는 공개된 다중 이미지 데이터셋들을 폭넓게 조사하고 이 중 저희 모델의 학습 목적에 부합하는 데이터셋들을 선별하여 활용했습니다. 이 데이터는 여러 장의 이미지가 하나의 세트로 구성되어 있고 그에 대한 질문과 답변 쌍으로 이루어져 있습니다. 예를 들어 여러 장면을 보고 시간 순서를 맞추거나, 유사한 이미지들 사이에서 특정 속성의 차이를 식별하거나, 여러 각도의 사진을 종합하여 판단을 내리는 등 다양한 태스크가 포함되어 있습니다.
새롭게 추가된 Interleaved 한국어 데이터셋과 PDF 데이터셋을 학습 파이프라인에 추가함에 따라 다중 이미지 이해를 위한 초석을 마련할 수 있었고, 수집한 다중 이미지 데이터셋도 학습 파이프라인에 추가하면서 기본적인 다중 이미지 이해 능력을 향상시켰습니다.
하지만 앞서 서술한 다중 이미지 이해의 핵심 요소 중 마지막 요소인 “주어진 이미지로 답변할 수 없는 요구사항 파악” 능력은 개선되지 않았습니다.
이는 수집한 공개된 데이터셋이 모두 주어진 보기 중, 항상 정답이 존재하는 객관식 문제이기 때문이었습니다. 이러한 데이터로만 학습을 하게 될 경우, 주어진 보기중 정답이 없는 경우에는 정답이 없다고 답변하는 능력은 학습하지 못하게 됩니다. 이러한 문제를 해결하기 위해 저희는 수집한 데이터셋에 대해 데이터 증강(Data Augmentation) 기법을 도입했습니다.
데이터 증강 기법
앞선 다중 이미지 이해의 핵심 요소에서 설명한 것과 같이, 다중 이미지 이해 상황에서의 완성도 높은 답변을 위해서는 “주어진 이미지로 답변 할 수 없는 요구사항 파악” 능력도 매우 중요합니다. 실제 서비스 환경에서 사용자가 보내는 여러장의 이미지는 모두 온전한 상태가 아닐 수도 있고, 몇 장은 누락되었지만 질의는 누락된 이미지에 대한 것일 가능성도 있습니다. 이러한 상황에서 모델이 주어진 이미지들을 종합하여 억지로 답변을 생성한다면 할루시네이션이 발생할 확률이 매우 높습니다.
이러한 문제를 극복하기 위해, 확보한 데이터셋에 증강 기법을 적용하여 의도적으로 주어진 이미지로는 답변할 수 없는 상황을 구성하였습니다.
1) 이미지 교체: 필요한 정보를 의도적으로 누락시키기
첫번째로 적용한 방법은 이미지 교체입니다. 기존 다중 이미지 세트에서 질문에 답변하기 위해 반드시 필요한 특정 이미지를 의도적으로 전혀 관련 없는 다른 이미지로 대체하는 것 입니다.
예를 들어 “두 음식의 차이점에 대해 설명해줘” 라는 질문과 함께 음식 사진 A, B 가 주어져야하는 상황에서 음식 사진 B 를 음식이 아닌 사진으로 바꿔버리거나 아예 이미지 세트에서 제외시킵니다.
원래 데이터에서는 정답이 존재하지만 이미지를 다른 이미지로 교체하거나 제외시키는 순간 이 질문은 답변할 수 없는 문제가 됩니다. 모델은 이러한 데이터를 통해 기존에는 학습하지 못했던 “주어진 이미지들이 질문에 답하기 충분한지”를 먼저 판단하는 법을 학습하게 됩니다.
2) 선택지 변경: 보기 중 정답이 없을 때 고르지 않는 법 배우기
두번째 방법은 “선택지 변경” 입니다. 객관식 형태의 문제에서 정답에 해당하는 선택지를 “정답 없음” 선택지로 교체하거나 제외시키는 방법입니다. 이러한 데이터 증강기법의 목적은 모델의 “답을 반드시 골라야만 한다” 라는 편향을 없애는 것입니다. 기존에 수집한 공개 데이터셋의 객관식 문제는 모두 보기 중 답이 있는 형태로 구성되어있고 이러한 데이터로만 모델을 학습하게 될 경우 모델은 “주어진 선택지 중 정답이 반드시 하나 있다” 는 전제 하에 훈련됩니다. 그래서 실제로 정답이 없는 상황에서도 모델은 가장 그럴듯한 선택지를 골라버리는 경향이 생기게 됩니다. 이러한 문제를 해결하기 위해 “정답 없음” 선택지를 만들어 모델이 정답이 없는 상황에서도 그럴듯한 다른 선택지를 고르는 것이 아닌 “선택지 중 적절한 답이 없다” 라는 판단을 내릴 수 있도록 합니다.
이 두가지 데이터 증강 방법의 공통 목표는 결국 “모델이 답변할 수 있는 상황과 그렇지 않은 상황”을 구분할 수 있는 능력을 갖추도록 하는 것입니다. 이를 통해 모델은 주어진 이미지로만으로 충분히 답변을 할 수 없는 상황에서 그럴듯한 답변을 만들어내는 할루시네이션 현상을 완화하게 됩니다.
벤치마크 성능 결과
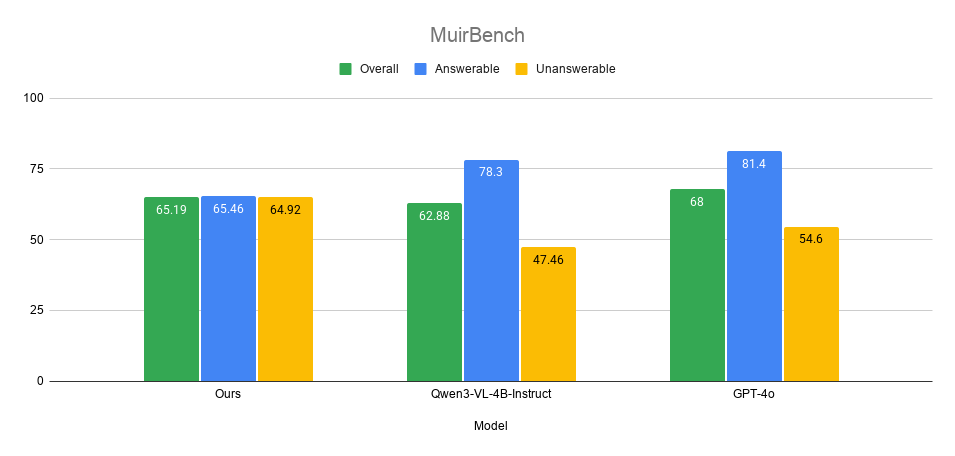
MuirBench 는 11,264 장의 이미지와 2,600개의 객관식 문제로 구성된 다중 이미지 이해 벤치마크로 장면 이해, 시간 순서 파악 등 12가지 다양한 다중 이미지 태스크를 포함하고 있습니다.
2,600개의 객관식 문제는 평균 4.3개의 다중 이미지로 구성되어 있으며 1,300개의 정답이 있는 (answerable) 문제와 모든 answerable 문제에 대응되는 정답이 없는 (unanswerable) 문제 1,300개로 이루어져있습니다. 기존 연구에 따르면 GPT-4o 조차 answerable 문제와 unanswerable 문제 사이에 26.8%p의 정확도 차이를 보입니다. 이처럼 unanswerable 문제는 다중 이미지 이해에 있어서 할루시네이션을 일으킬수 있는 해결해야할 도전 과제 중 하나입니다.
앞서 저희는 이러한 할루시네이션 문제를 해결하기위해 이미지를 교체하거나 선택지를 변경하는 데이터 증강 기법을 적용했고, 이를 통해 answerable 문제와 unanswerable 문제 간 정확도 차이가 0.54%p에 불과했습니다. 비슷한 모델 사이즈의 Qwen3-VL-4B-Instruct 역시 GPT-4o 와 유사하게 30.84%p 의 정확도 차이가 발생합니다. 이는 기존 모델들은 answerable 문제에 대해서는 높은 정확도를 보이지만 unanswerable 문제에 대해서는 오답을 정답으로 인식하는 할루시네이션 현상이 발생한 반면 저희 모델은 두 상황에서 할루시네이션 현상 없이 동일한 성능을 유지함을 보여줍니다.
다중 이미지 이해를 넘어서: 동영상으로의 확장
동영상은 다중 이미지의 연장선에 있습니다. 동영상을 프레임 단위로 분해하면 결국 여러 장의 이미지가 시간 순서대로 나열된 것입니다. 따라서 이번 장에서 다뤘던 여러장의 이미지를 종합하고, 이미지간의 관계를 파악하고, 정보가 부족한 상황을 인식하는 것은 동영상 이해의 기반이 되는 능력이기도 합니다. 또한 이는 Long Context 학습과도 밀접하게 연결됩니다. 1분 짜리 동영상을 1초 당 1프레임으로 샘플링하면 60장의 이미지가 되기에 긴 문맥 안에서 핵심 정보를 놓치지 않는 것이 동영상 이해에서는 필수적입니다.
또한 다중 이미지 이해와는 달리 동영상 이해에서는 추가적인 시간 축을 고려해야 합니다.다중 이미지 이해 데이터셋도 시간의 흐름에 따라 변화하는 집합으로 종종 구성되기도 하지만, 동영상에 비하면 입력 이미지 개수도 훨씬 적을 뿐 아니라, 입력 이미지 각각의 정보량이 크게 차이납니다.
저희는 다중 이미지 이해를 넘어 동영상으로의 확장을 위한 실험도 진행하고 있습니다. 다중 이미지 이해를 위해 확보한 학습 데이터와 데이터 증강 기법들을 바탕으로 동영상 데이터에 적용하는 방법을 탐색하고 있고, 동영상 데이터에서 요구되는 시간적 추론 능력을 어떠한 학습 데이터와 학습 방식으로 향상 시킬 수 있을지 검토하고 있습니다. 이번 다중 이미지 이해로의 확장이 동영상 이해 연구의 출발점이 될 것이라 기대합니다.
디지털 세상을 누비는 AI의 탄생
CUA(Computer Use Agent)란 무엇인가?
최근 AI 분야에서 가장 뜨거운 키워드 중 하나는 바로 에이전트(Agent) 입니다. 기존의 LLM이 “질문에 답변하는” 수동적인 역할에 머물렀다면, 에이전트는 한 발 더 나아가 “목표를 달성하기 위해 스스로 계획을 세우고 외부 도구를 활용해 실제 작업을 수행”하는 능동적인 시스템입니다.
예를 들어, “다음 주 부산 출장 일정 잡아줘”라고 했을 때, 기존 LLM은 예시 일정표나 항공권 예매 방법을 텍스트로 보여주는 게 전부였습니다. 반면 에이전트는 실제로 캘린더를 열어 일정을 등록하고, 항공권 사이트에서 가격을 비교하고, 호텔을 예약합니다. 이처럼 사용자의 요청을 듣고 실제 환경(웹사이트, 앱 등)에서 직접 작업을 수행하는 능동적인 시스템을 에이전트라고 부릅니다.
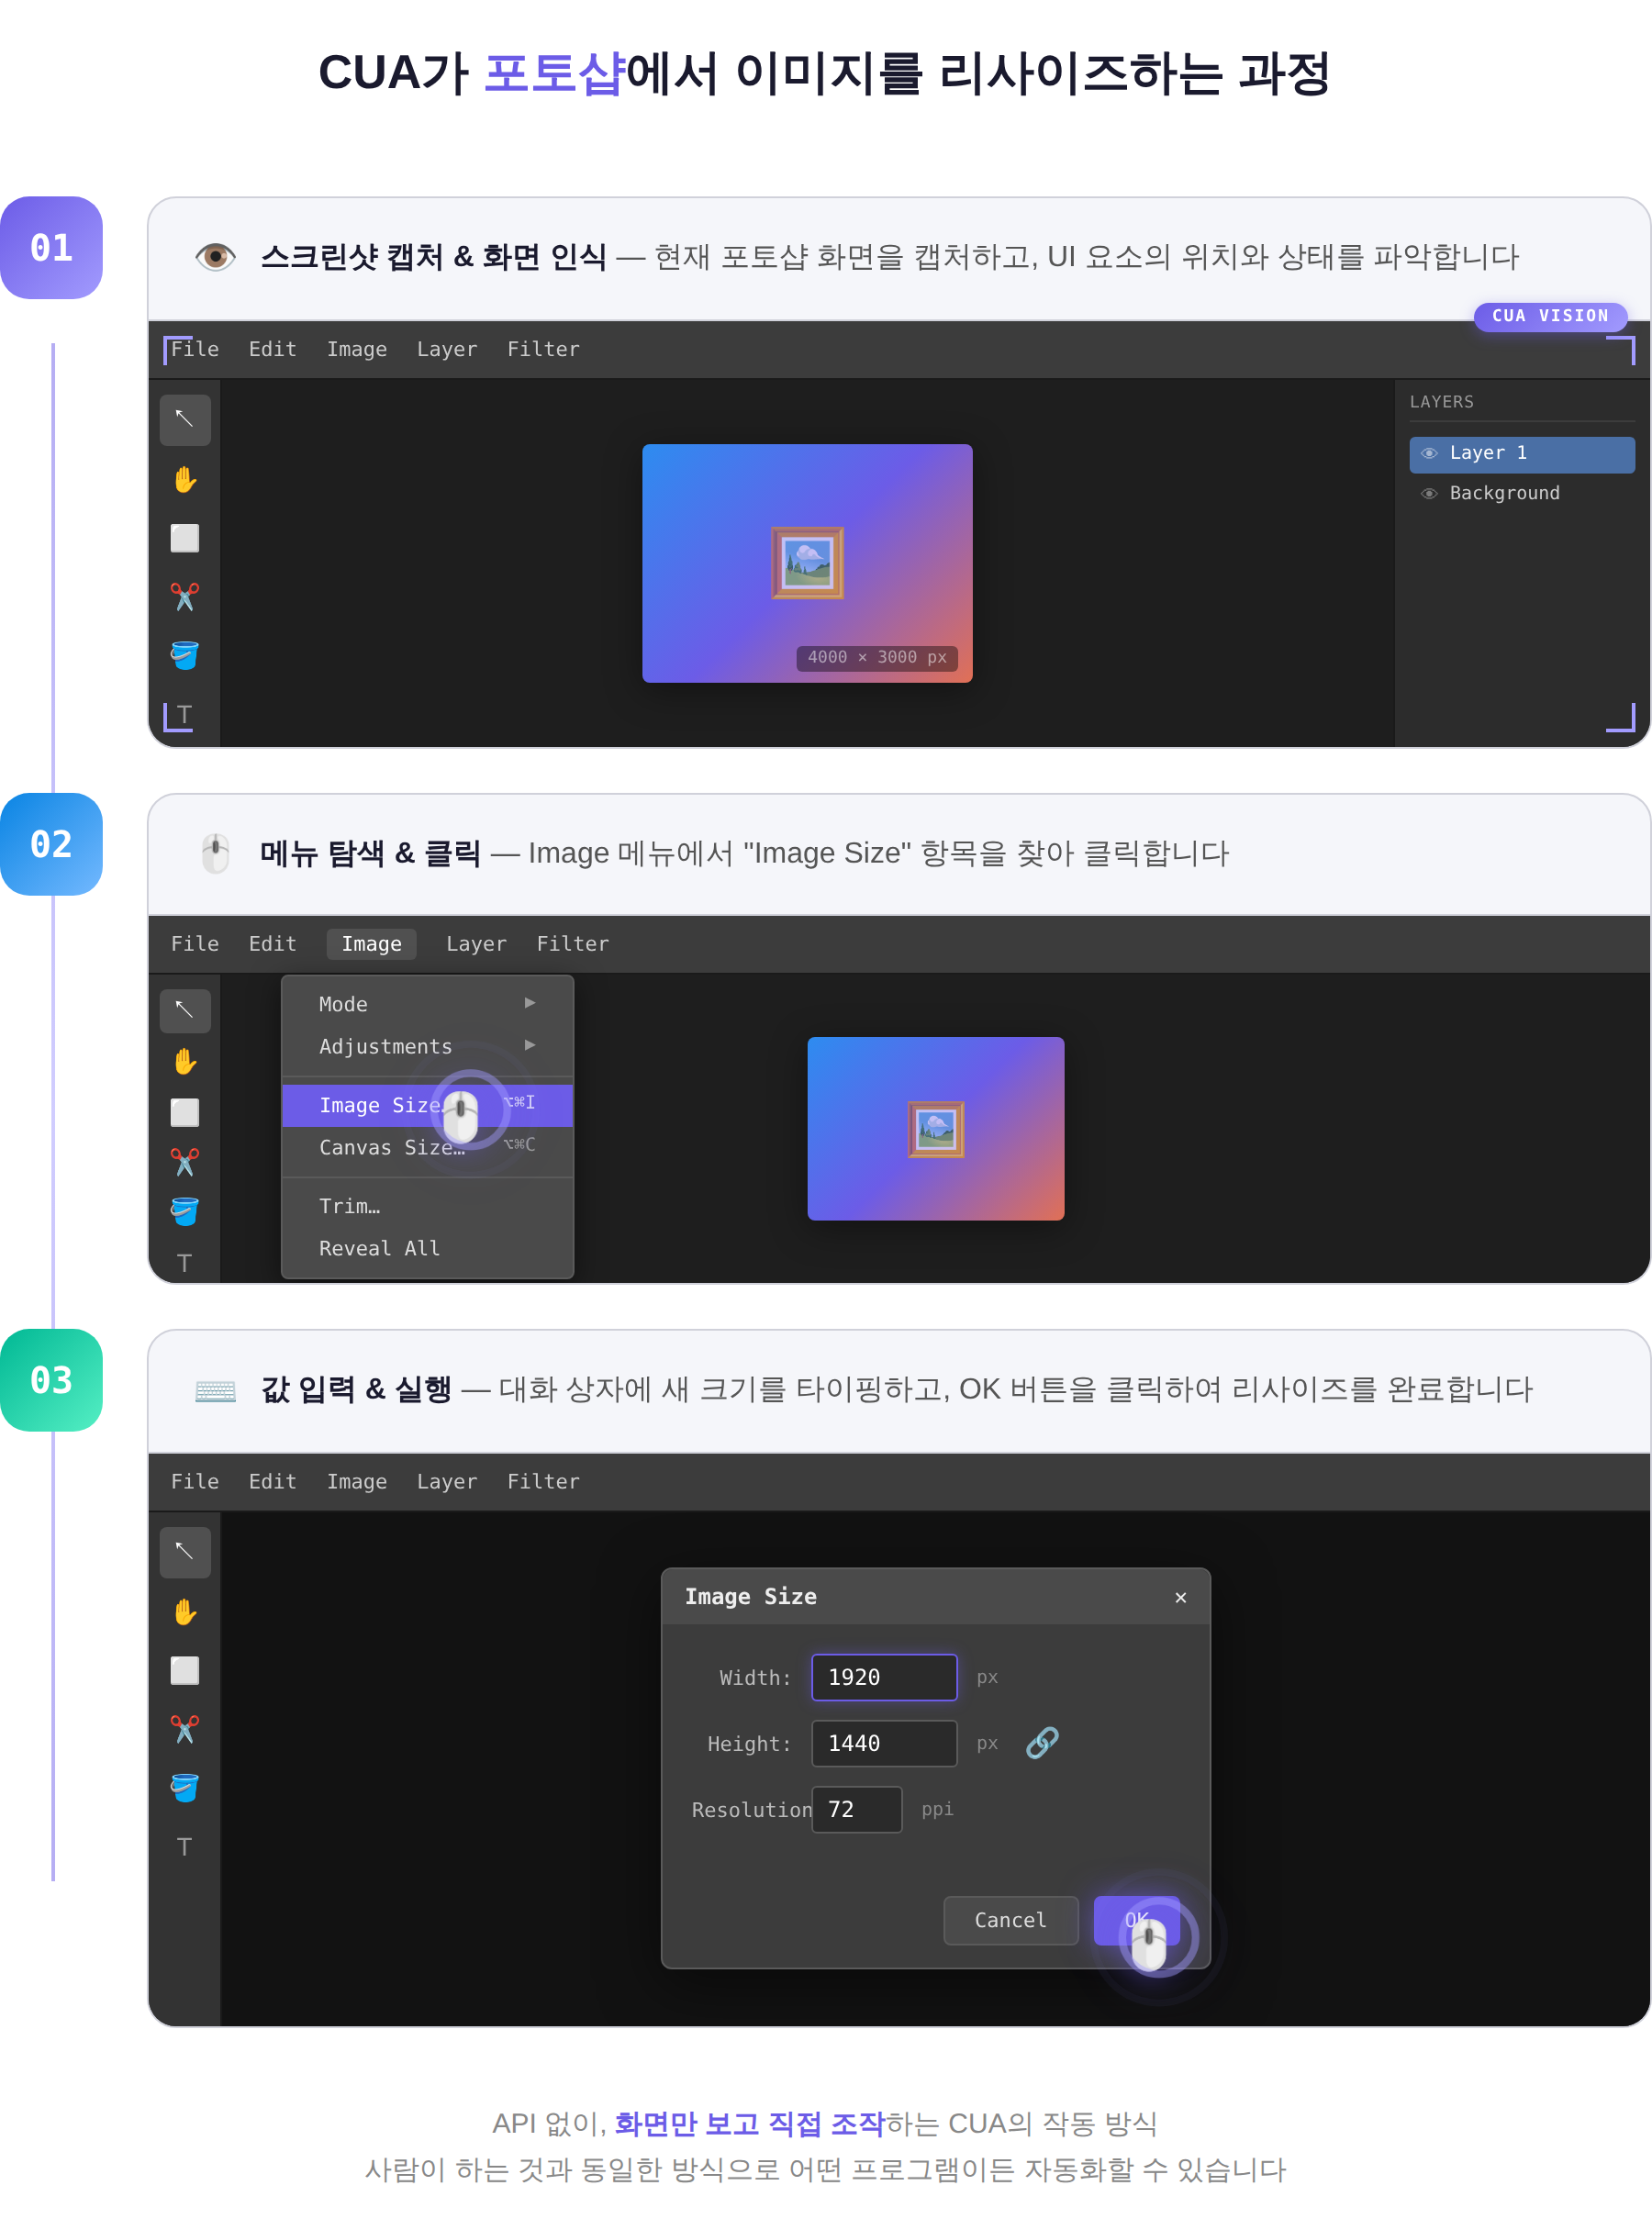
에이전트 중에서도 최근 가장 주목받는 분야 중 하나가 바로 “Computer Use Agent (CUA)”입니다. 이름 그대로 컴퓨터를 직접 조작하는 에이전트입니다. 사람이 컴퓨터 앞에 앉아 GUI(Graphical User Interface), 즉 화면을 보고 마우스를 움직이고 키보드를 두드리듯, CUA도 GUI를 보고 직접 클릭하고 타이핑합니다. 스크린샷은 CUA의 “눈”이 되고, 마우스와 키보드는 “손”이 되는 셈입니다.
| [사용자 지시] → [화면 캡처] → [계획 수립] → [클릭/입력] → [결과 확인] → [반복] |
|---|
CUA가 주목받는 이유: “API가 없는 세계”를 자동화하다
현재 대부분의 에이전트는 ‘함수 호출(Function calling)’ 방식을 통해 외부 서비스와 상호작용합니다. 즉, 에이전트와 서비스 사이에 미리 정의된 API(Application Programming Interface)라는 전용 통로가 있을 때만 원활한 작업 수행이 가능합니다.
다시 예를 들어 보겠습니다. 에이전트에게 "내일 서울-부산 항공권 검색해줘"라고 요청하면, 에이전트는 항공사가 제공하는 API를 호출해서 결과를 가져옵니다. 캘린더에 일정을 추가하거나, 이메일을 보내는 것도 마찬가지입니다. Google Calendar API, Gmail API처럼 잘 정비된 통로가 있기 때문에 가능한 일입니다.
하지만 실제 기업 환경과 비즈니스 현장, 그리고 일반적인 컴퓨터 사용에 있어서 이러한 표준화된 API가 존재하지 않는 경우가 상당수 존재합니다.
- 아주 오래된 사내 프로그램
- 보안이 까다로운 은행, 공공기관, 혹은 국가 보안 시설의 프로그램
- 복잡한 디자인 도구(포토샵, 3D 설계 툴 등)
이러한 환경에서 기존의 API기반의 에이전트는 성능을 발휘하기 어렵습니다.
CUA는 이 문제를 완전히 다른 방식으로 접근합니다. API라는 전용 통로가 없다면, 사람처럼 화면을 직접 보고 조작하면 됩니다. 스크린샷으로 현재 상태를 파악하고, 버튼이 어디 있는지 찾아서 클릭하고, 필요한 내용을 타이핑합니다. API가 있든 없든, 화면만 있으면 작동하는 것이죠.
GUI Grounding: CUA의 핵심 역량
CUA가 제대로 동작하려면 크게 세 가지 능력이 필요합니다.
- Planning (계획 수립)
- 개념: 사용자의 목표를 컴퓨터가 실행할 수 있는 구체적인 단계들로 쪼개는 능력입니다.
- 예시: "내일 오후 2시 회의 일정을 등록해줘"라는 명령을 받으면, [캘린더 앱 실행 → 내일 날짜 선택 → 오후 2시 클릭 → 일정 내용 입력 → 저장]과 같이 실행 순서를 구성합니다.
- Grounding (실행 위치 파악)
- 개념: 계획된 동작을 실행하기 위해, 목표 대상(버튼, 입력창 등)의 정확한 화면 좌표를 찾아내는 능력입니다.
- 예시: 위 계획 중 '저장 버튼 클릭’을 수행할 때, 화면의 수많은 요소들 사이에서 ‘저장’ 버튼의 좌표를 찾아냅니다. 계획이 아무리 완벽해도 좌표가 틀리면 클릭은 엉뚱한 곳으로 향합니다.
- Reflection (자기 점검 및 오류 복구)
- 개념: 행동의 결과를 확인하고, 예상치 못한 상황(팝업, 로딩 지연 등)이 발생하면 계획을 수정하거나 재시도하는 능력입니다.
- 예시: '결제 버튼’을 눌렀는데 “보안 프로그램 설치”팝업이 뜨면 팝업을 먼저 처리하고 이어서 한다거나, 실수로 잘못된 메뉴를 클릭했다면 뒤로 가기를 눌러 원래 작업으로 복귀합니다.
이 세 가지 능력 중 저희가 가장 먼저 주목한 것은 바로 Grounding입니다. Grounding은 에이전트의 계획과 판단이 실제 결과로 이어지기 위한 가장 기본적인 실행 단위이며, 에이전트 전체 성능을 결정하는 요소이기 때문입니다. 아무리 완벽한 계획을 세우고 오류를 정확히 찾아도 이를 실행할 ‘좌표’를 모르면 목표를 달성할 수 없습니다.
- 예시 1: “결제 버튼을 누르자”는 계획을 세웠어도, 해당 버튼의 정확한 좌표(x, y)를 모르면 실행이 불가능합니다. 엉뚱한 곳을 클릭하는 순간 전체 작업은 실패로 돌아갑니다.
- 예시 2: “팝업창을 닫고 다시 시작하자”는 판단을 내려도, ‘닫기’ 버튼이나 ‘뒤로 가기’ 아이콘의 위치를 찾지 못하면 복구 프로세스가 시작될 수 없습니다.
이처럼 Planning과 Reflection은 정확한 Grounding이 뒷받침될 때만 유효합니다. 반대로 Grounding만 정확하다면, 계획이 다소 비효율적이더라도 결국 목표에 도달할 수 있습니다.
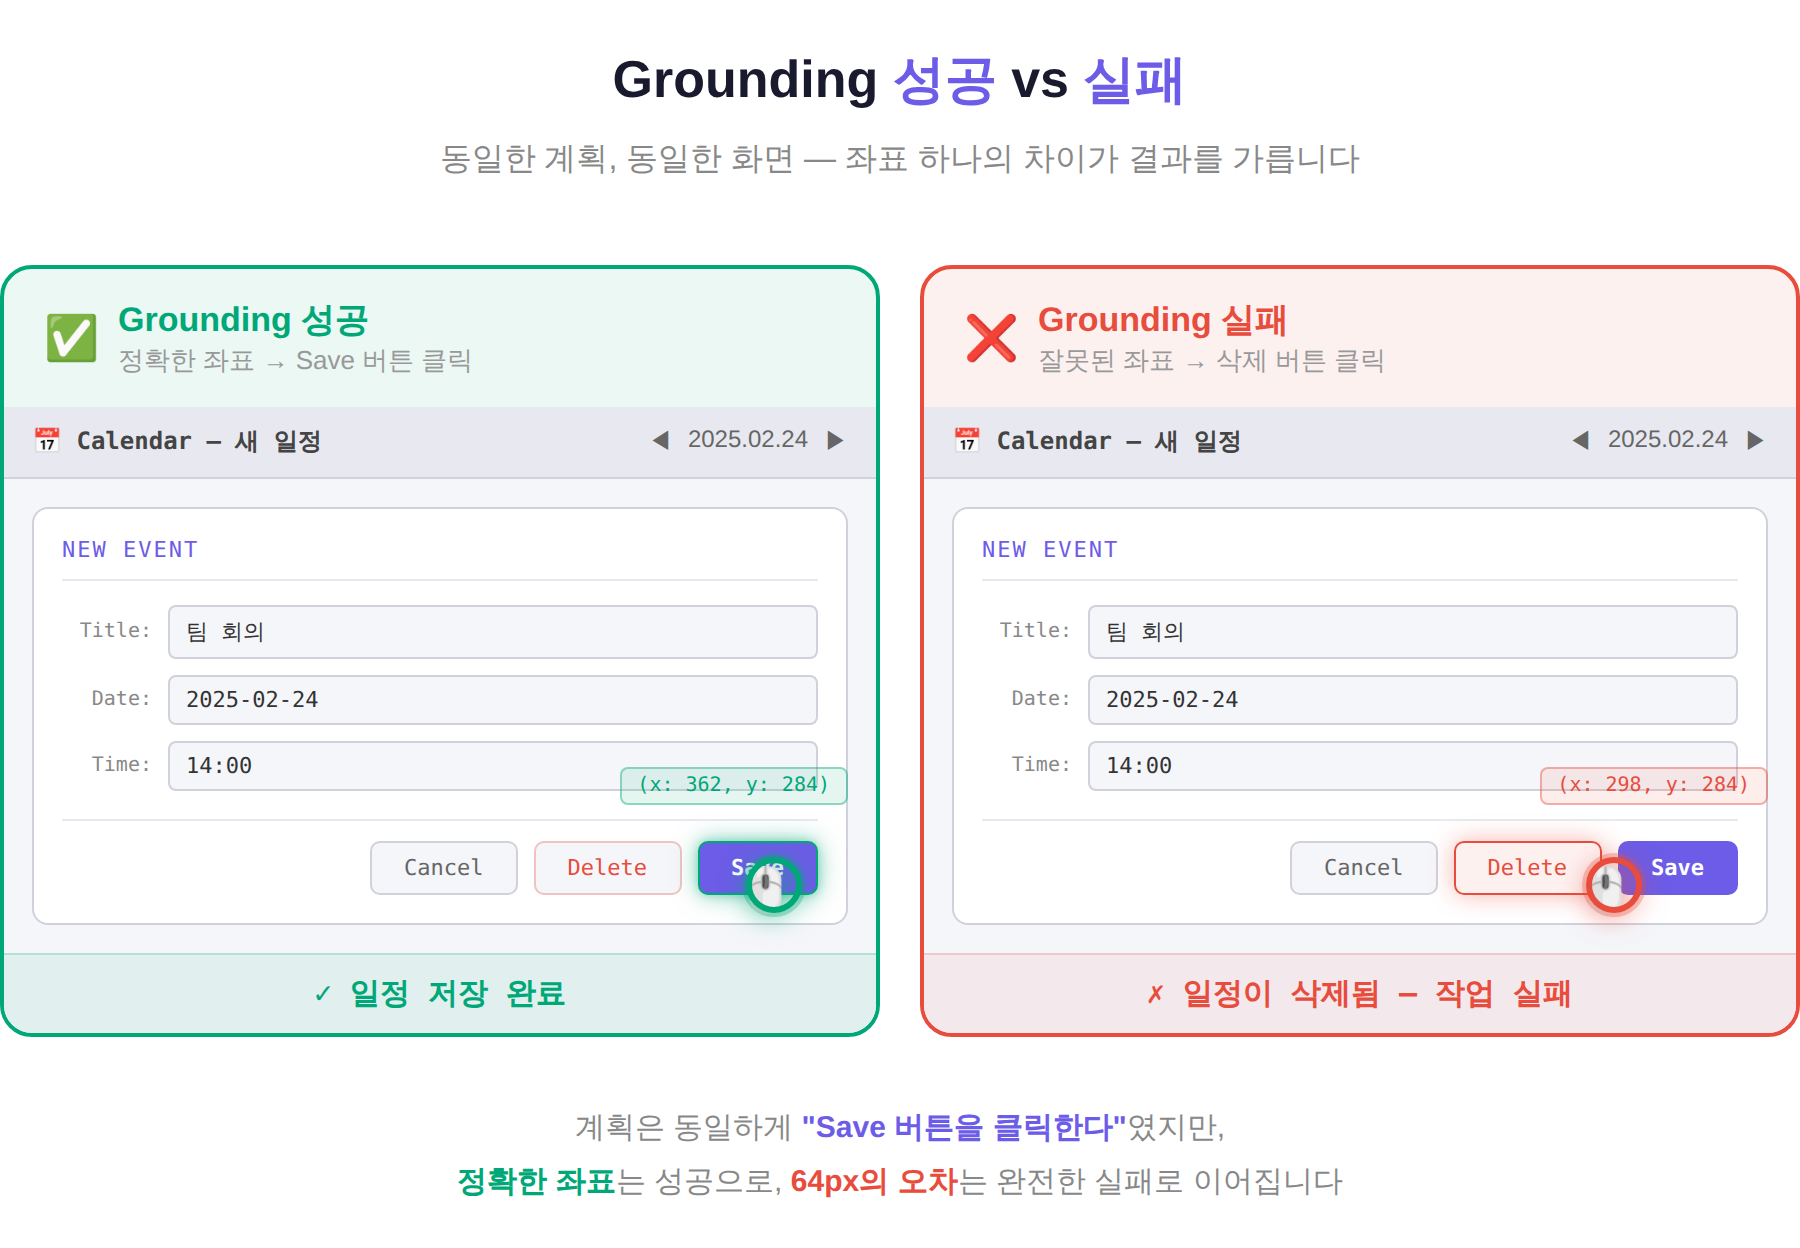
저희는 CUA 개발을 위한 첫걸음으로 GUI 화면에서 목표 좌표를 정확히 찾아내는 능력, 즉 GUI Grounding 모델 개발에 집중했습니다.
다양한 GUI Grounding 데이터셋 수집
GUI Grounding 모델을 학습시키기 위해서는, 스크린샷과 그 안의 UI 요소 좌표가 쌍으로 구성된 대규모 데이터셋이 필요합니다. 저희는 공개된 다양한 오픈소스 데이터셋을 수집하여 하나의 통합 학습 데이터를 구축했습니다.
1. 과제(Task) 유형별 분류
수집한 데이터셋은 모델이 학습해야 할 성격에 따라 크게 세 가지 과제 유형으로 나뉩니다.
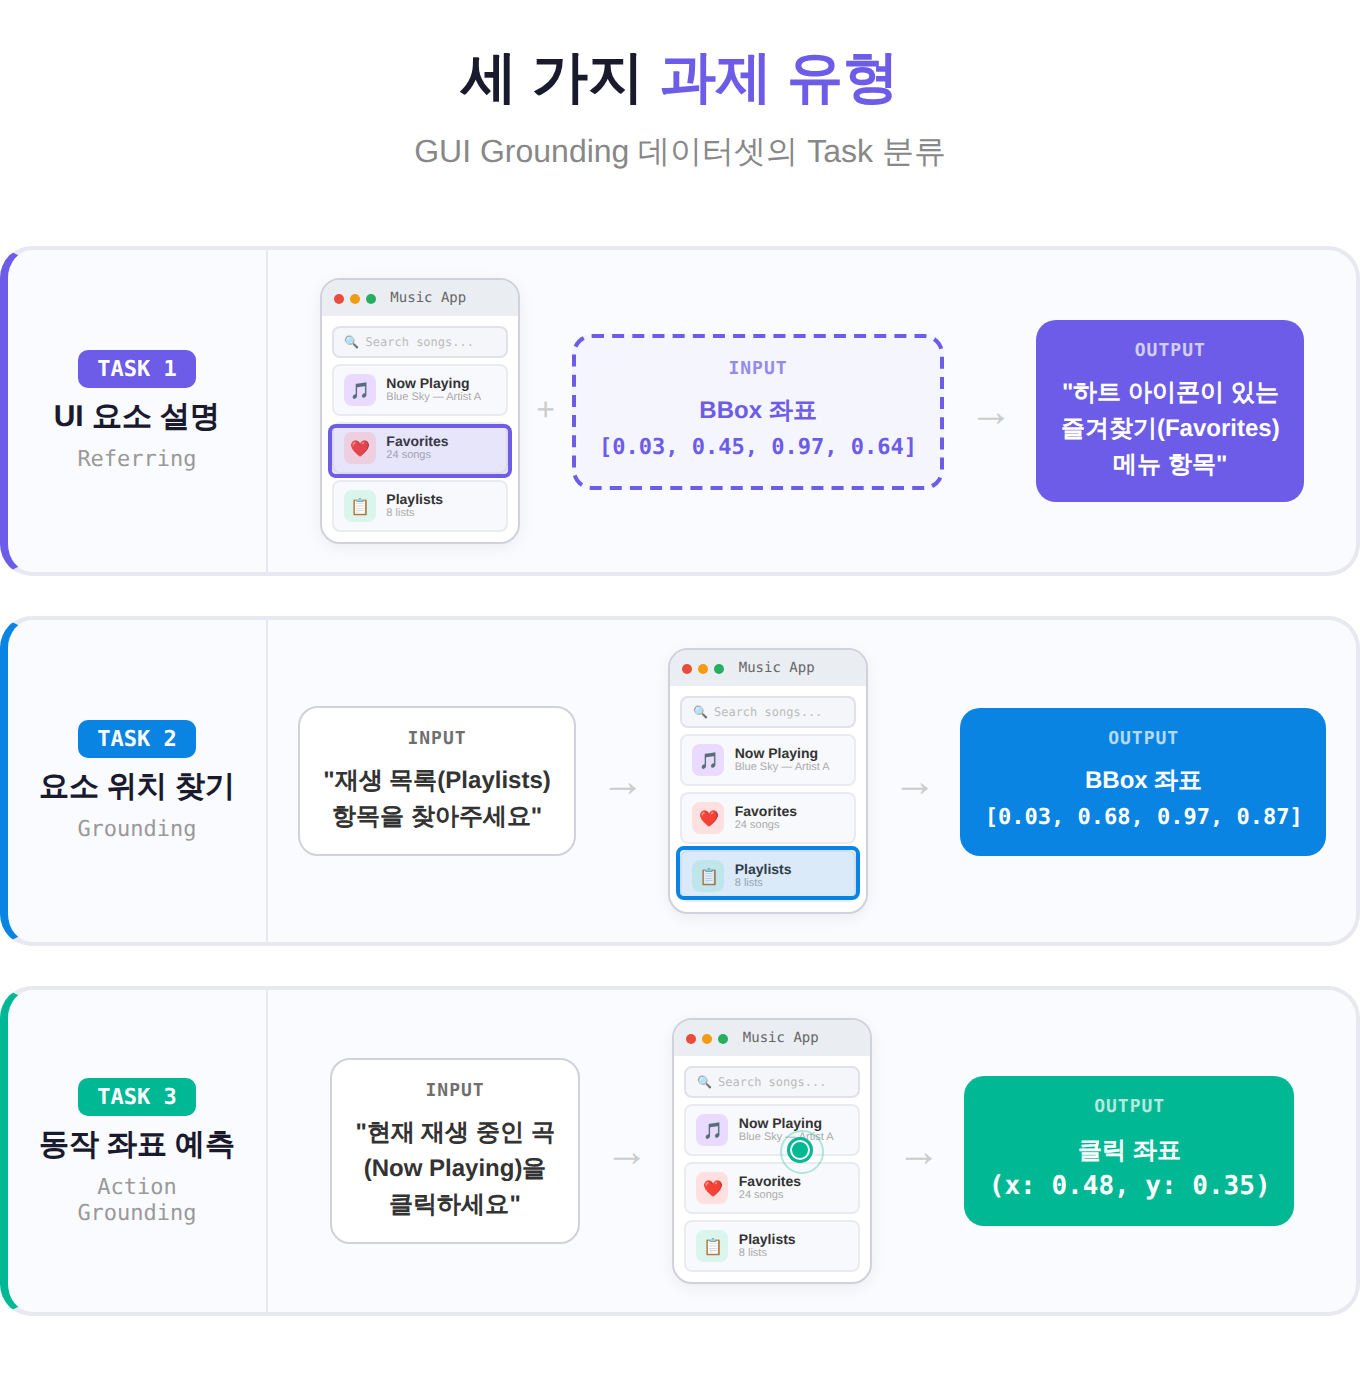
- UI 요소 설명(Referring): 스크린샷의 특정 영역(Bounding box)이 주어지면, 해당 요소가 무엇인지 자연어로 기술하는 과정입니다. 모델이 UI의 의미를 이해하는 기초가 됩니다.
- 요소 위치 찾기(Grounding): 텍스트 설명이 주어지면 그에 해당하는 UI 요소의 위치를 바운딩 박스로 예측합니다.
- 동작 좌표 예측(Action Grounding): “검색 버튼을 클릭하세요”와 같은 행동 지시(Instruction)가 주어졌을 때, 실제 클릭해야 할 정확한 좌표 (x, y)를 예측합니다. CUA가 실제 환경에서 동작하기 위해 가장 핵심적인 능력입니다.
2. 데이터셋 구성 및 규모
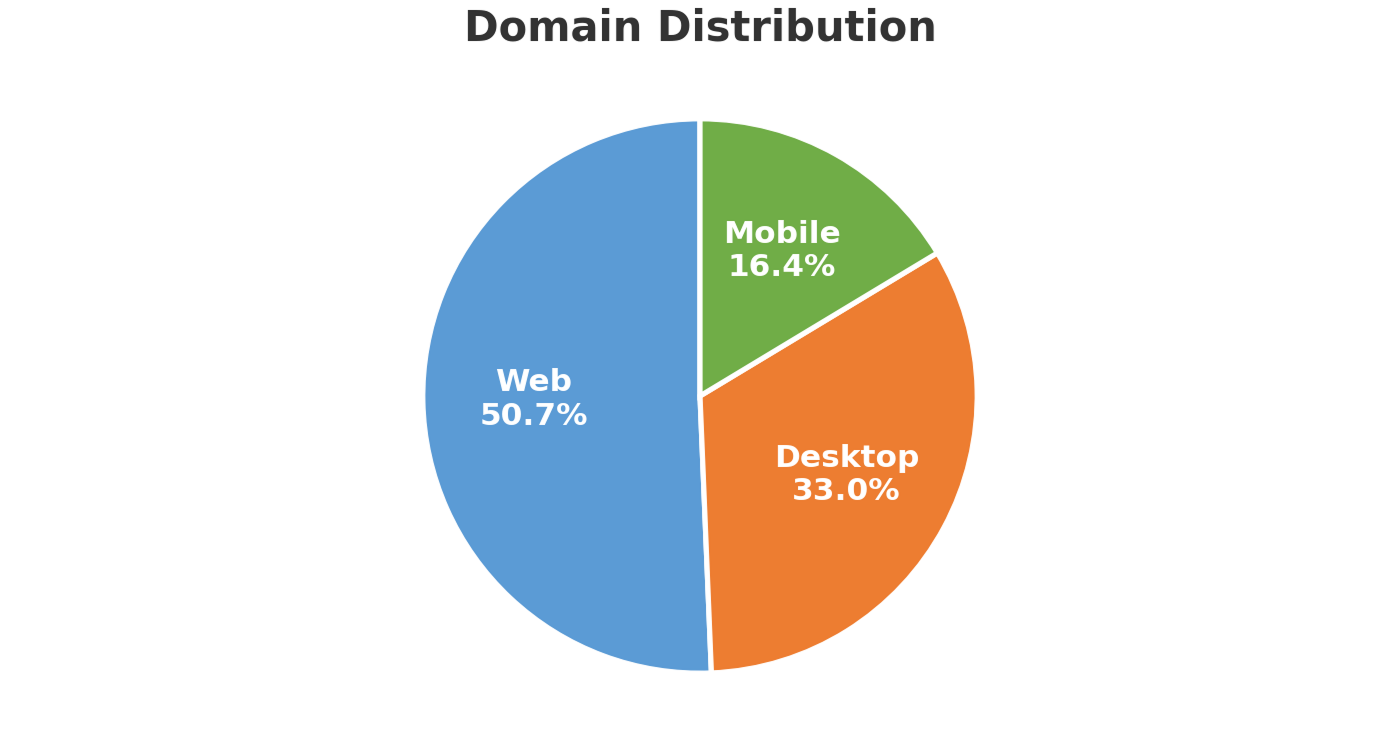
저희가 수집한 데이터셋의 구체적인 통계는 표 6와 그림 6에서 살펴보실 수 있습니다. 단순히 양을 늘리는 것에 그치지 않고, 모델의 범용성을 위해 다양한 출처의 데이터를 확보하는 데 주력했습니다. 또한 데이터셋의 출처를 모바일 , 데스크탑 , 웹의 세 가지 도메인으로 분류하여 관리했습니다. 각 환경은 UI 레이아웃, 해상도, 디자인 패턴이 상이하기 때문에, 다양한 도메인의 데이터를 균형있게 확보하는 것이 범용 Grounding 능력을 갖추는 데 필수적입니다.
| Dataset | Task | Domain | #Images | #QAs | Avg QA/Image |
|---|---|---|---|---|---|
| Aguvis | Action Grounding | M + D + W | 459K | 3.8M | 8.36 |
| Jedi | Action Grounding | D | 262K | 1.4M | 5.29 |
| Jedi-Ref | Referring | D | 275K | 1.0M | 3.74 |
| Jedi-Grounding | Grounding | D | 8K | 1.7M | 210.91 |
| GTA1 | Action Grounding | M + D + W | 517K | 1.6M | 3.01 |
| ScaleCUA | Action Grounding | M + D + W | 330K | 892K | 2.70 |
| ScaleCUA-Ref | Referring | M + D + W | 313K | 860K | 2.74 |
| GroundCUA | Action Grounding | D | 51K | 699K | 13.74 |
M: Mobile, D: Desktop, W: Web
<표 5: 수집한 데이터셋 통계>
2단계 데이터셋 정제 파이프라인
다양한 출처에서 수집한 만큼, 데이터의 품질이 균일하지는 않았습니다. 수집된 데이터를 살펴보니, 상당수의 샘플에서 품질 문제가 발견되었습니다. 렌더링이 완료되지 않은 빈 화면이 스크린샷으로 캡처된 경우, 좌표 레이블(Ground Truth)이 실제 요소 위치와 전혀 다른 곳을 가리키는 경우, 그리고 아무런 의미 있는 정보를 담고 있지 않은 단색 화면 등이 섞여 있었습니다.
이러한 저품질 데이터가 섞여 있으면 모델이 잘못된 패턴을 함께 학습하게 되어 성능 저하를 초래합니다. 특히 좌표 레이블이 틀린 샘플은 모델이 엉뚱한 위치를 정답으로 기억하게 만들기 때문에, 단순히 정확도가 떨어지는 것을 넘어 특정 방향으로 일관되게 틀리는 편향이 생길 수 있습니다.
저희는 이 문제를 해결하기 위해 2단계 데이터셋 필터링 파이프라인을 설계했습니다. 특히, 데이터 품질이 낮다고 판단된 Aguvis 데이터셋과 GTA1 데이터셋을 중점적으로 필터링했습니다.
1. 1단계: 비정상 스크린샷 제거 (Rule-based Filtering)
첫 번째 필터링에서는 스크린샷 자체에 문제가 있는 샘플들을 제거했습니다. 오픈소스 데이터셋들은 대부분 자동화된 크롤링으로 수집되기 때문에, 페이지 로딩이 완료되기 전에 캡처된 빈 화면, 단색 배경만 찍힌 이미지, 혹은 블러 처리된 스크린샷 등이 섞여 있었습니다. 이런 샘플들은 모델에게 유익한 학습 신호를 제공하지 못합니다.
저희는 이미지 통계량(Image statistics) 기반의 필터링을 적용했습니다. 구체적인 방법은 다음과 같습니다.
각 스크린샷을 그레이스케일로 변환한 뒤, 픽셀 밝기값(0-255)에 대해 두 가지 지표를 계산합니다. 표준편차 (Standard Deviation )는 이미지 내 밝기 변화의 정도를 나타내며, 값이 낮을수록 화면 전체가 비슷한 밝기, 즉 단조로운 화면임을 의미합니다. 엔트로피 (Entropy)는 픽셀 밝기 분포의 정보량을 측정하며, 값이 낮을수록 특정 밝기값에 픽셀이 극도로 집중되어 있다는 뜻입니다. 빈 화면이나 단색 배경이 대표적인 사례입니다.
저희는 표준편차 값이 4보다 작거나 엔트로피 값이 0.01보다 작은 이미지를 모두 제거했습니다. 정상적인 UI 스크린샷이 잘못 걸러지지 않도록 기준을 보수적으로 설정했기 때문에, 이 단계에서 제거되는 이미지는 사실상 빈 화면이나 단색 배경에 가까운 수준입니다. 이렇게 "시각적으로 무의미한 이미지(Visually Trivial Images)"를 걸러낸 뒤, 더 정교한 두 번째 필터링을 적용합니다.
2. 2단계: 잘못된 레이블 제거 (Model-based Filtering)
첫 번째 필터링으로 비정상 스크린샷은 제거했지만, 스크린샷 자체는 정상이면서 좌표 레이블(Ground Truth; GT)이 틀린 경우는 여전히 남아있습니다. 수십만 건의 샘플을 사람이 일일이 검증할 수는 없으므로, 저희는 공개된 SOTA급 모델 두 개를 검증기(Verifier)로 활용하는 크로스 체크 전략을 도입했습니다.
기본 아이디어는 단순합니다. GUI Grounding을 잘 수행하는 두 개의 독립적인 모델이 같은 질문에 대해 비슷한 답을 내놓는다면, 그 답이 맞을 확률이 높다는 것입니다.
검증기로는 GUI Grounding 성능이 검증된 UI-Venus 7B [9] 와 GTA1 7B [10] 를 선정했습니다. 각 샘플에 대해 두 모델의 예측 좌표를 구한 뒤, GT ↔ UI-Venus , GT ↔ GTA1 , UI-Venus ↔ GTA1 세 쌍의 거리를 계산합니다. 세 점 중 어떤 것끼리 가깝고, 어떤 것끼리 먼가에 따라, 각 샘플을 네 가지 유형으로 분류할 수 있습니다.
(참고: 가깝고 먼 것을 분류하는 임계값(threshold)은 상대좌표 기준 0.05로 설정했습니다.)
- Type A - 세 점이 모두 가까운 경우 (High Confidence), 두 모델의 예측이 모두 GT에 근접합니다. 세 점이 좁은 영역에 모여 있으므로, GT가 정답일 확률이 매우 높습니다.
- Type B - 두 모델은 일치하지만 GT와는 다른 경우 (Suspected GT Error), 두 모델이 서로 비슷한 위치를 예측하지만, 둘 다 GT에서 멀리 떨어져 있습니다. 이는 GT자체에 오류가 있을 가능성이 높은 샘플입니다. 물론 GT가 맞고 두 모델이 동시에 틀린 경우도 존재하지만, 확률적으로 GT 오류를 의심할 충분한 근거가 됩니다.
- Type C - 한 모델만 GT에 근접한 경우 (Partial Agreement), 두 모델 중 하나의 예측만 GT에 가까운 경우입니다. 모델 간 불일치가 있지만 하나는 GT와 일치하므로, GT가 정답일 확률이 높습니다. 동시에 이런 샘플은 난이도가 높은 케이스일 가능성이 있어, 학습에 포함하면 모델의 일반화 능력 향상에 도움이 됩니다.
- Type D - 세 점이 모두 떨어져 있는 경우 (High Noise), 세 점이 모두 서로 멀리 떨어져 있습니다. 두 모델이 각기 다른 곳을 예측하고 GT와도 일치하지 않으므로, 문제 자체에 오류가 있거나 GT가 틀렸을 확률이 매우 높은 샘플입니다.
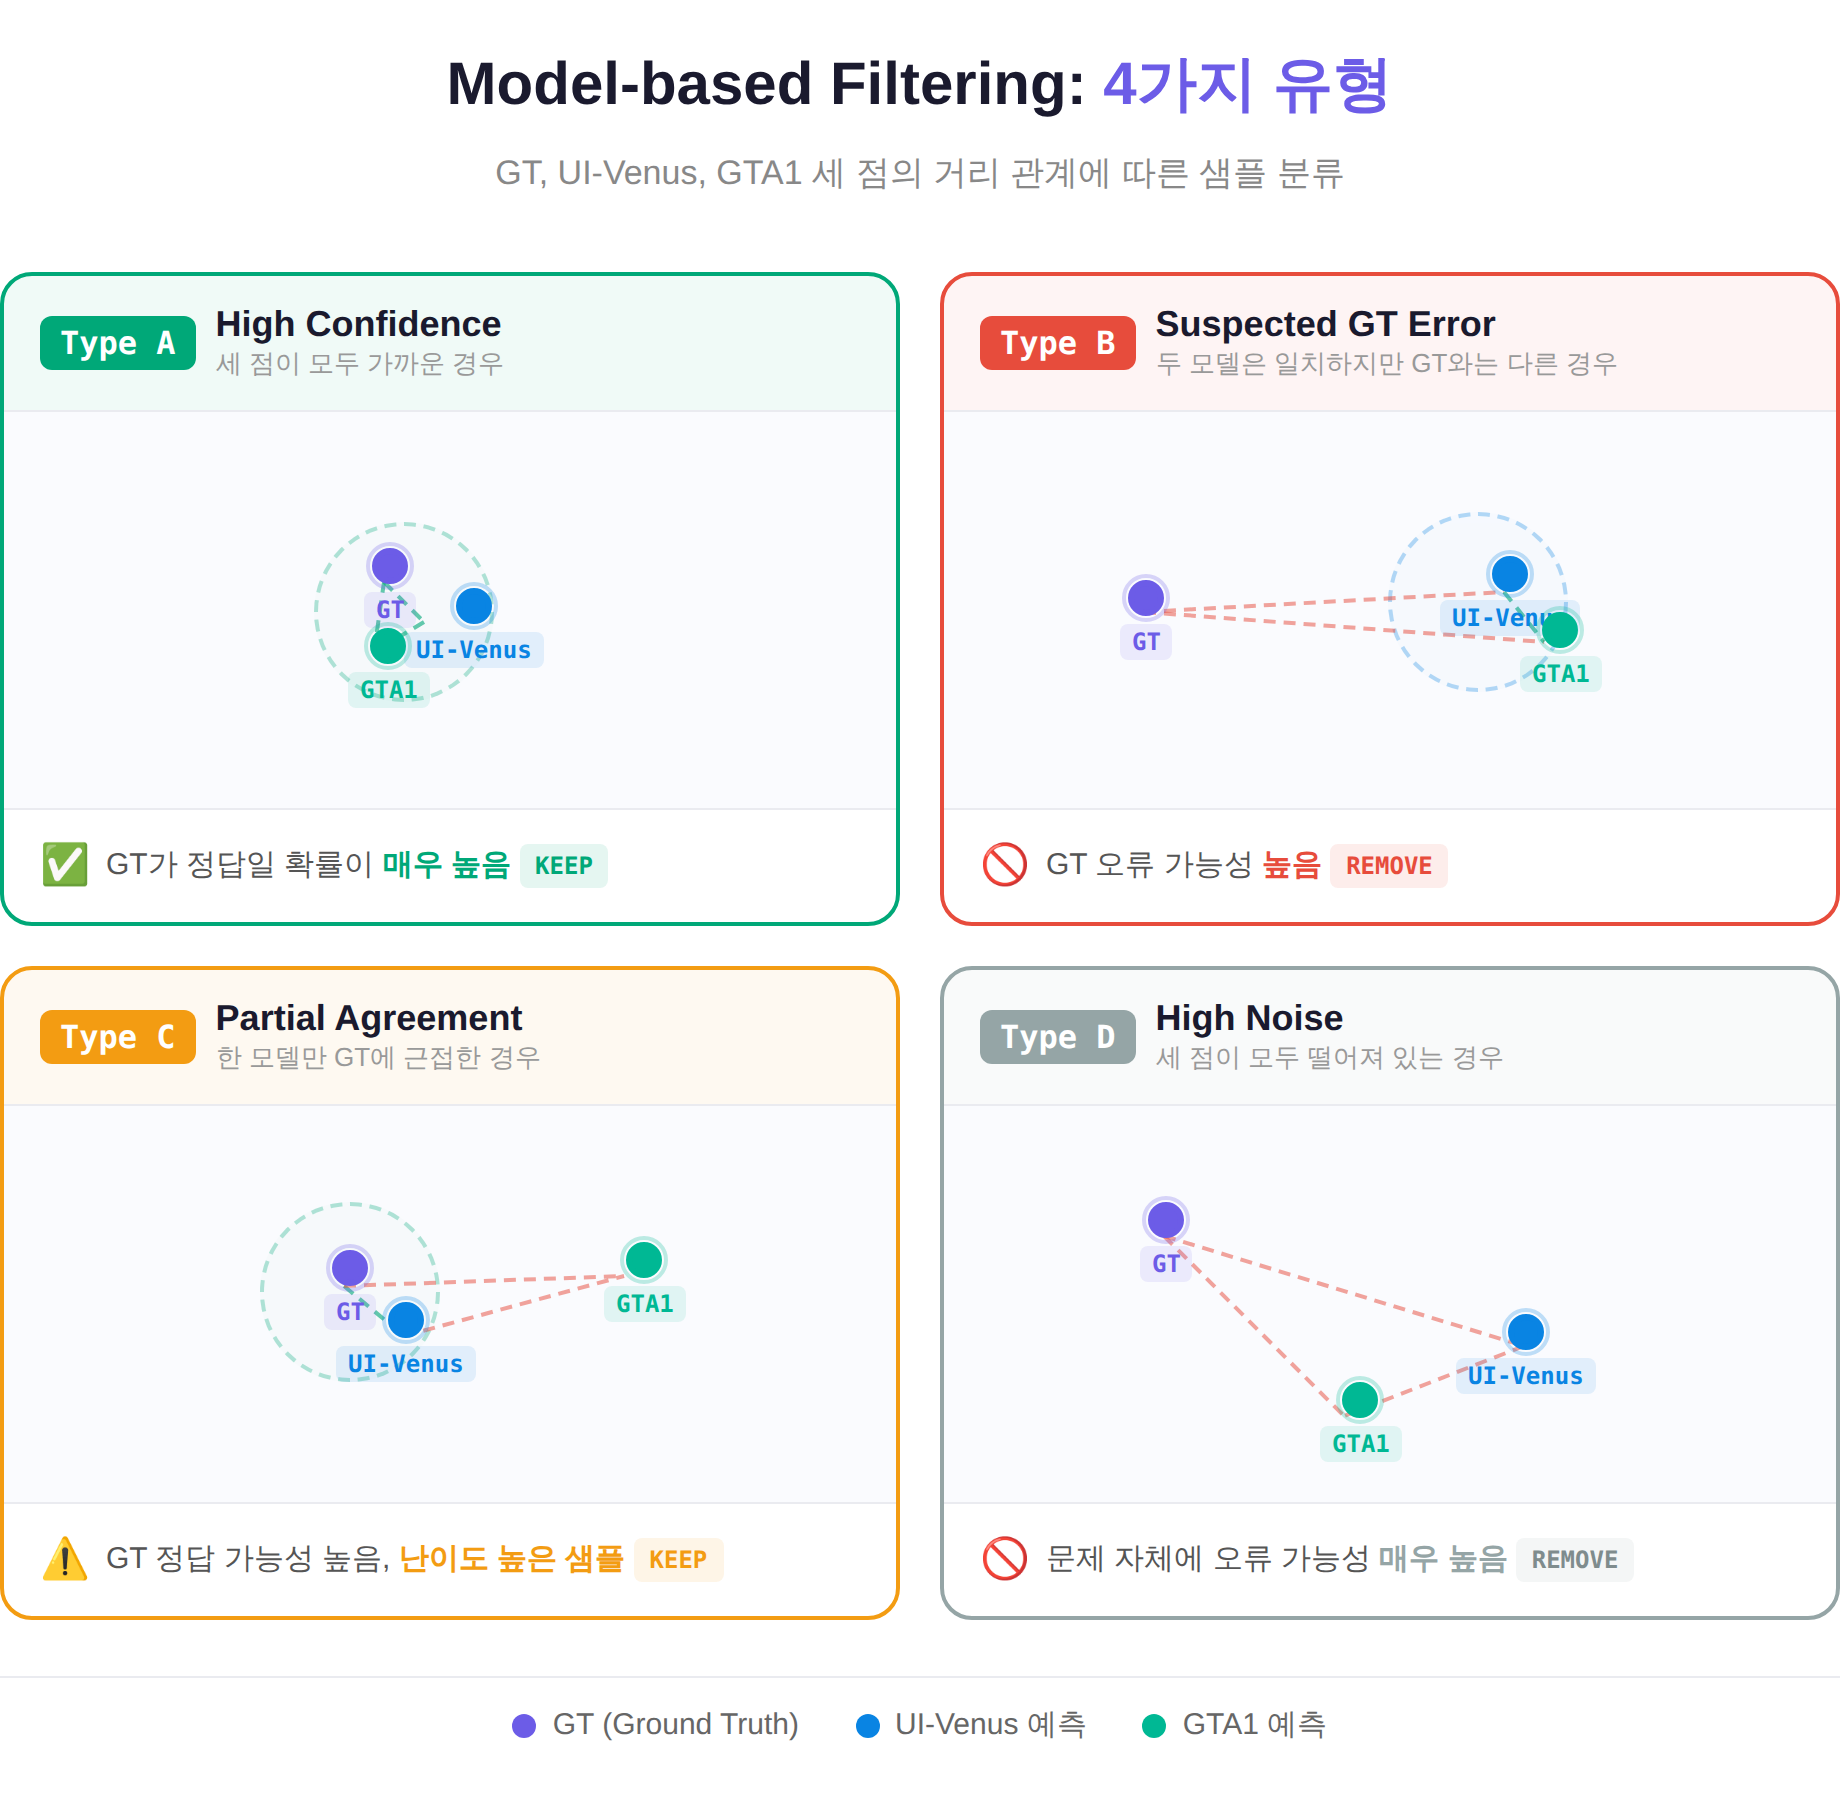
분류 결과를 바탕으로, 저희는 Type A와 Type C만을 학습 데이터로 사용했습니다. Type A는 세 점이 모두 일치하는 가장 신뢰도 높은 데이터이고, Type C는 GT가 정답일 확률이 높으면서도 난이도 있는 샘플을 포함하고 있어 모델 학습에 유의미합니다.
반면, Type D는 명백한 노이즈이므로 제거했습니다. Type B는 판단이 필요한 영역이었는데, 실험 결과 Type B를 포함했을 때 모델 성능이 오히려 하락했습니다. GT 오류가 섞인 샘플들이 “그럴듯하게 틀리는” 패턴을 학습시킨 것으로, 단순 노이즈(Type D)보다 오히려 모델에 더 큰 악영향을 미쳤습니다. 이에 따라 Type B도 학습 데이터에서 제외했습니다.
결과적으로, 전체 데이터에서 상당량을 제거했음에도 불구하고 GUI Grounding 성능은 오히려 눈에 띄게 향상되었습니다. 데이터의 양보다 질이 중요하다는 것을 명확히 확인할 수 있었습니다.
실험 결과
정제된 데이터셋을 최종 학습 레시피에 포함하여 모델을 학습한 뒤, 총 7개의 벤치마크에서 GUI Grounding 성능을 평가했습니다.
벤치마크 구성
이 중 5개는 GUI Grounding 분야에서 널리 사용되는 공개 벤치마크이고, 나머지 2개는 저희가 자체적으로 구축한 한국어 벤치마크입니다.
- ScreenSpot-v2-Web-KOR: ScreenSpot-v2 벤치마크의 Web 카테고리 샘플들의 Instruction을 한국어로 번역한 태스크입니다.
- Kakao-Grounding: 카카오 사내 시스템 및 카카오 서비스 페이지에서의 Grounding 태스크입니다.
기존 공개 벤치마크는 대부분 영어 기반이기 때문에, 한국어 UI 환경에서의 Grounding 능력을 별도로 검증할 필요가 있었습니다.
성능 비교
저희는 유사한 규모의 Qwen3-VL모델들과 GUI Grounding 성능을 비교했습니다.
| SS-V2 | SS-Pro | OSWorld-G | MMB-GUI-L2 | UI-Vision | SS-V2-Web-Kor | Kakao-G | Avg | |
|---|---|---|---|---|---|---|---|---|
| Qwen3-VL-4B-Instruct | 94.0 | 59.5 | 58.2 | 74.0 | 13.9 | 85.1 | 57.9 | 63.2 |
| Ours (4B) | 91.8 | 54.1 | 65.8 | 82.1 | 65.8 | 88.1 | 78.8 | 75.2 |
<표 6. GUI 성능 비교>
가장 강력한 베이스라인인 Qwen3-VL-4B-Instruct와 비교했을 때, ScreenSpot-v2와 ScreenSpot-Pro에서는 소폭 미달하였으나, 나머지 벤치마크에서는 저희 모델이 유의미한 차이로 더 높은 성능을 달성했습니다.
특히 한국어 벤치마크에서의 성능 격차가 두드러졌습니다. 저희 모델은 한국어 UI와 한국형 서비스 환경의 데이터를 학습에 적극적으로 포함했기 때문에, 한국어 Grounding 태스크에서 기존 모델들 대비 큰 폭의 성능 향상을 달성할 수 있었습니다.
앞으로의 연구 방향
이번 연구는 CUA 개발의 첫 단계로, GUI 화면에서 목표 좌표를 정확히 찾아내는 Grounding 능력에 집중했습니다. 앞으로는 크게 두 가지 방향으로 연구를 확장할 계획입니다.
첫째, Grounding 성능 자체를 더 끌어올리는 것입니다. 좌표 예측은 정답 여부를 명확히 판별할 수 있는 태스크인 만큼, RLVR(Reinforcement Learning with Verifiable Rewards) 기반의 강화학습이 효과적일 것으로 기대하고 있습니다.
둘째, 에이전트 태스크 수행이 가능하도록 기능을 확장하는 것입니다. 글 서두에서 언급했듯이, CUA가 실제로 동작하려면 Grounding뿐 아니라 Planning과 Reflection 능력까지 갖춰야 합니다. Planning 데이터셋을 함께 학습하여, Grounding이라는 기반 위에 계획 수립과 오류 복구 능력을 쌓아 올리는 것이 다음 목표입니다.
의미 있는 진전이 있을 때마다 그 과정을 공유하겠습니다.
마무리
이 글에서는 VLM의 능력을 문서 이해, Long-Context, 다중 이미지, GUI Grounding까지 확장하기 위한 과정을 공유했습니다. 각 영역에서 공통적으로 얻은 교훈은 결국 데이터 품질이 모델 성능을 결정한다는 점이었습니다. Interleaved 데이터의 정제 파이프라인, PDF VQA의 데이터 생성-검증 분리 구조, GUI Grounding의 2단계 필터링 모두 방대한 데이터에서 노이즈를 걸러내면서 성능이 향상되었습니다.
동시에 하나의 능력을 키우면 다른 능력이 희석되는 트레이드오프도 반복적으로 확인했습니다. Interleaved 데이터 비율을 높이면 한국어 성능은 올라가지만 VQA 성능이 떨어지고, Long-Context 데이터를 늘리면 기존 Short 벤치마크가 하락했습니다. VLM의 기능확장은 결국 이러한 균형점을 찾아가는 과정이기도 했습니다.
아직 갈 길이 남아 있습니다. 동영상 이해로의 확장, CUA의 Planning과 Reflection 능력 강화, 그리고 더 긴 컨텍스트에서의 다양한 데이터셋 확보 등 풀어야 할 과제가 많습니다. 이 글에서 공유한 경험이 비슷한 도전을 하고 계신 분들에게 실질적인 참고가 되기를 바랍니다.
함께한 사람들
Kanana 조직의 abigail.r (박혜영), brook.p (박범희), daniel.log (김영준), edwin.ai (강우영), james.e (이재명), jayden.x (부종철), jayten.ten (전재열), jessie.e (이지혜), johnny.oh (오재훈), martin.gale (조대진), polar.bears (엄지환), peter.brain (노병석), samuel.brain (강성훈), sonny.7 (손동희), welt.bae (배병욱), wooner.l (이동진)이 함께 했습니다.
데이터 구축에 있어서는 Kanana 조직의 jennie.ee (이지혜), jeri.s (이희현) 이 많은 도움을 주셨습니다.
한국형 GUI Grounding 벤치마크는 Kanana 조직의 dion.g (기대환), erin.hh (홍은빈), michael.l22 (이주영) 이 많은 도움을 주셨습니다.
참고문헌
- [1] LAURENÇON, Hugo, et al. Obelics: An open web-scale filtered dataset of interleaved image-text documents. Advances in Neural Information Processing Systems, 2023, 36: 71683-71702.
- [2] RAE, Jack W., et al. Scaling language models: Methods, analysis & insights from training gopher. arXiv preprint arXiv:2112.11446, 2021.
- [3] ZHU, Wanrong, et al. Multimodal c4: An open, billion-scale corpus of images interleaved with text. Advances in Neural Information Processing Systems, 2023, 36: 8958-8974.
- [4] WANG, Weiyun, et al. Internvl3. 5: Advancing open-source multimodal models in versatility, reasoning, and efficiency. arXiv preprint arXiv:2508.18265, 2025.
- [5] ZHU, Jinguo, et al. Internvl3: Exploring advanced training and test-time recipes for open-source multimodal models. arXiv preprint arXiv:2504.10479, 2025.
- [6] BAI, Shuai; CAI, Yuxuan; CHEN, Ruizhe, et al. Qwen3-VL Technical Report. arXiv preprint arXiv:2511.21631, 2025.
- [7] PENEDO, Guilherme, et al. DataTrove: large scale data processing. GitHub repository, 2024. https://github.com/huggingface/datatrove
- [8] KYDLÍČEK, Hynek, et al. FinePDFs: Liberating 3T of the finest tokens from PDFs. Hugging Face Blog, 2025. https://huggingface.co/spaces/HuggingFaceFW/FinePDFsBlog
- [9] GU, Zhangxuan, et al. Ui-venus technical report: Building high-performance ui agents with rft. arXiv preprint arXiv:2508.10833, 2025.
- [10] YANG, Yan, et al. Gta1: Gui test-time scaling agent. arXiv preprint arXiv:2507.05791, 2025.
관련 글 목록
- Kanana-o 신규 모델 및 API 베타 서비스를 공개합니다.
- Kanana-2 개발기 (2): 개선된 post-training recipe를 중심으로
- Kanana-2 개발기 (1): Pre-training에서의 의사결정들을 중심으로
- “생각하고 답변하는” 카카오의 하이브리드 멀티모달 언어모델, Kanana-v-4b-hybrid 개발기
- 카카오의 경량 멀티모달 언어모델 ‘Kanana-1.5-v-3b’ 개발부터 공개까지
- 이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기
- 더욱 똑똑하게 답하며, 더욱 풍부한 감정표현을 향한 Kanana-o의 진화 과정
- 눈으로 보고, 귀로 듣고, 입으로 말하는 AI – 통합 멀티모달 언어모델 Kanana-o 개발기
- 이미지와 음성을 아우르는 카카오의 멀티모달 언어모델 Kanana-o 알아보기
- Agentic AI를 향한 카나나 모델의 진화
- 더 똑똑하고 효율적인 Kanana-2 오픈소스 공개
- 한국어와 이미지를 한 번에, 카카오의 멀티모달 임베딩 모델 개발기
- Kanana 언어모델에 추론 기능 붙여보기 (feat. Kanana-1.5)
- 국내 최초 MoE 모델 ‘Kanana-MoE’ 개발기
- 더 똑똑해진 카카오의 언어모델 ‘Kanana 1.5’ 상업적 활용 가능한 오픈소스 공개
- 카카오의 언어모델, Kanana 테크니컬 리포트 공개