Engineering
개인화 추천을 위한 랭킹 모델 개발기
2026년 9월 23일
원문에서 보기 ↗안녕하세요! 카카오에서 유저 편의성을 높이는 데 관심이 많은 토리입니다.
카카오에는 정말 다양한 서비스와 그 안에 쌓이는 방대한 데이터가 있습니다. 이 많은 콘텐츠와 유저를 잘 이어주는 역할을 하는 것이 바로 추천이고, 그중에서도 "얼마나 이 유저에게 맞는 콘텐츠를 보여주는가"는 서비스 체류시간과 만족도에 직결되는 핵심 문제입니다. 그래서 세그먼트 단위로 동작하던 추천 로직을, 유저 개인의 히스토리를 반영하는 개인화 랭킹 모델로 교체하는 프로젝트를 진행했습니다.
이 글에서는 그 과정에서 구축한 랭킹 아키텍처와 모델 설계 , 그리고 실제 배포 후 데이터로 확인한 도입 효과까지 순서대로 공유해보려고 합니다.
참고) 본 프로젝트의 모델 학습과 분석에 사용된 데이터는 식별정보를 제외한 행동 로그 집계값이며, 데이터 수집·보관·활용 전 과정은 사내 개인정보 보호 정책과 절차에 따라 진행됐습니다.
1. 기존 추천의 한계
프로젝트를 시작하기 전 저희 서비스의 추천 로직은 성별·연령 등 세그먼트 단위로 묶여 동일한 결과를 내려주는 방식이었습니다. 세그먼트는 유저를 거칠게 나눈 대표값일 뿐이라, 개인이 방금 무엇을 보고 좋아요를 눌렀는지·어떤 크리에이터를 구독하는지 같은 개인화 시그널은 전혀 반영하지 못했습니다.
그래서 유저 개인의 시청 히스토리와 실시간 상호작용을 반영하는 개인화 추천이 필요하다고 판단했고, 그 결과물이 이번에 소개할 딥러닝 기반 개인화 랭킹 모델입니다.
2. 랭킹 아키텍처
2-1. 시스템 구조
랭킹 시스템은 크게 4개의 컴포넌트로 나뉩니다.
| 컴포넌트 | 역할 |
|---|---|
| 피처 파이프라인 | 모델 학습/예측용 피처 생성 |
| 학습 파이프라인 | 모델 학습 |
| GPU 추론 서버 | 모델 추론 |
| 서빙 API 서버 | 모델 비즈니스 로직 (후보 생성·리랭킹 등) |
전체 흐름은 크게 네 갈래입니다. ① 실시간 스트리밍 이 방금 일어난 유저 행동을 즉시 반영하고, ② 배치 처리 가 하루·시간 단위로 피처와 모델을 만들어냅니다. 이 결과물이 ③ 저장소 에 쌓이면, ④ 서빙 파이프라인이 요청 시점에 이를 조합해 최종 추천을 만들어냅니다.
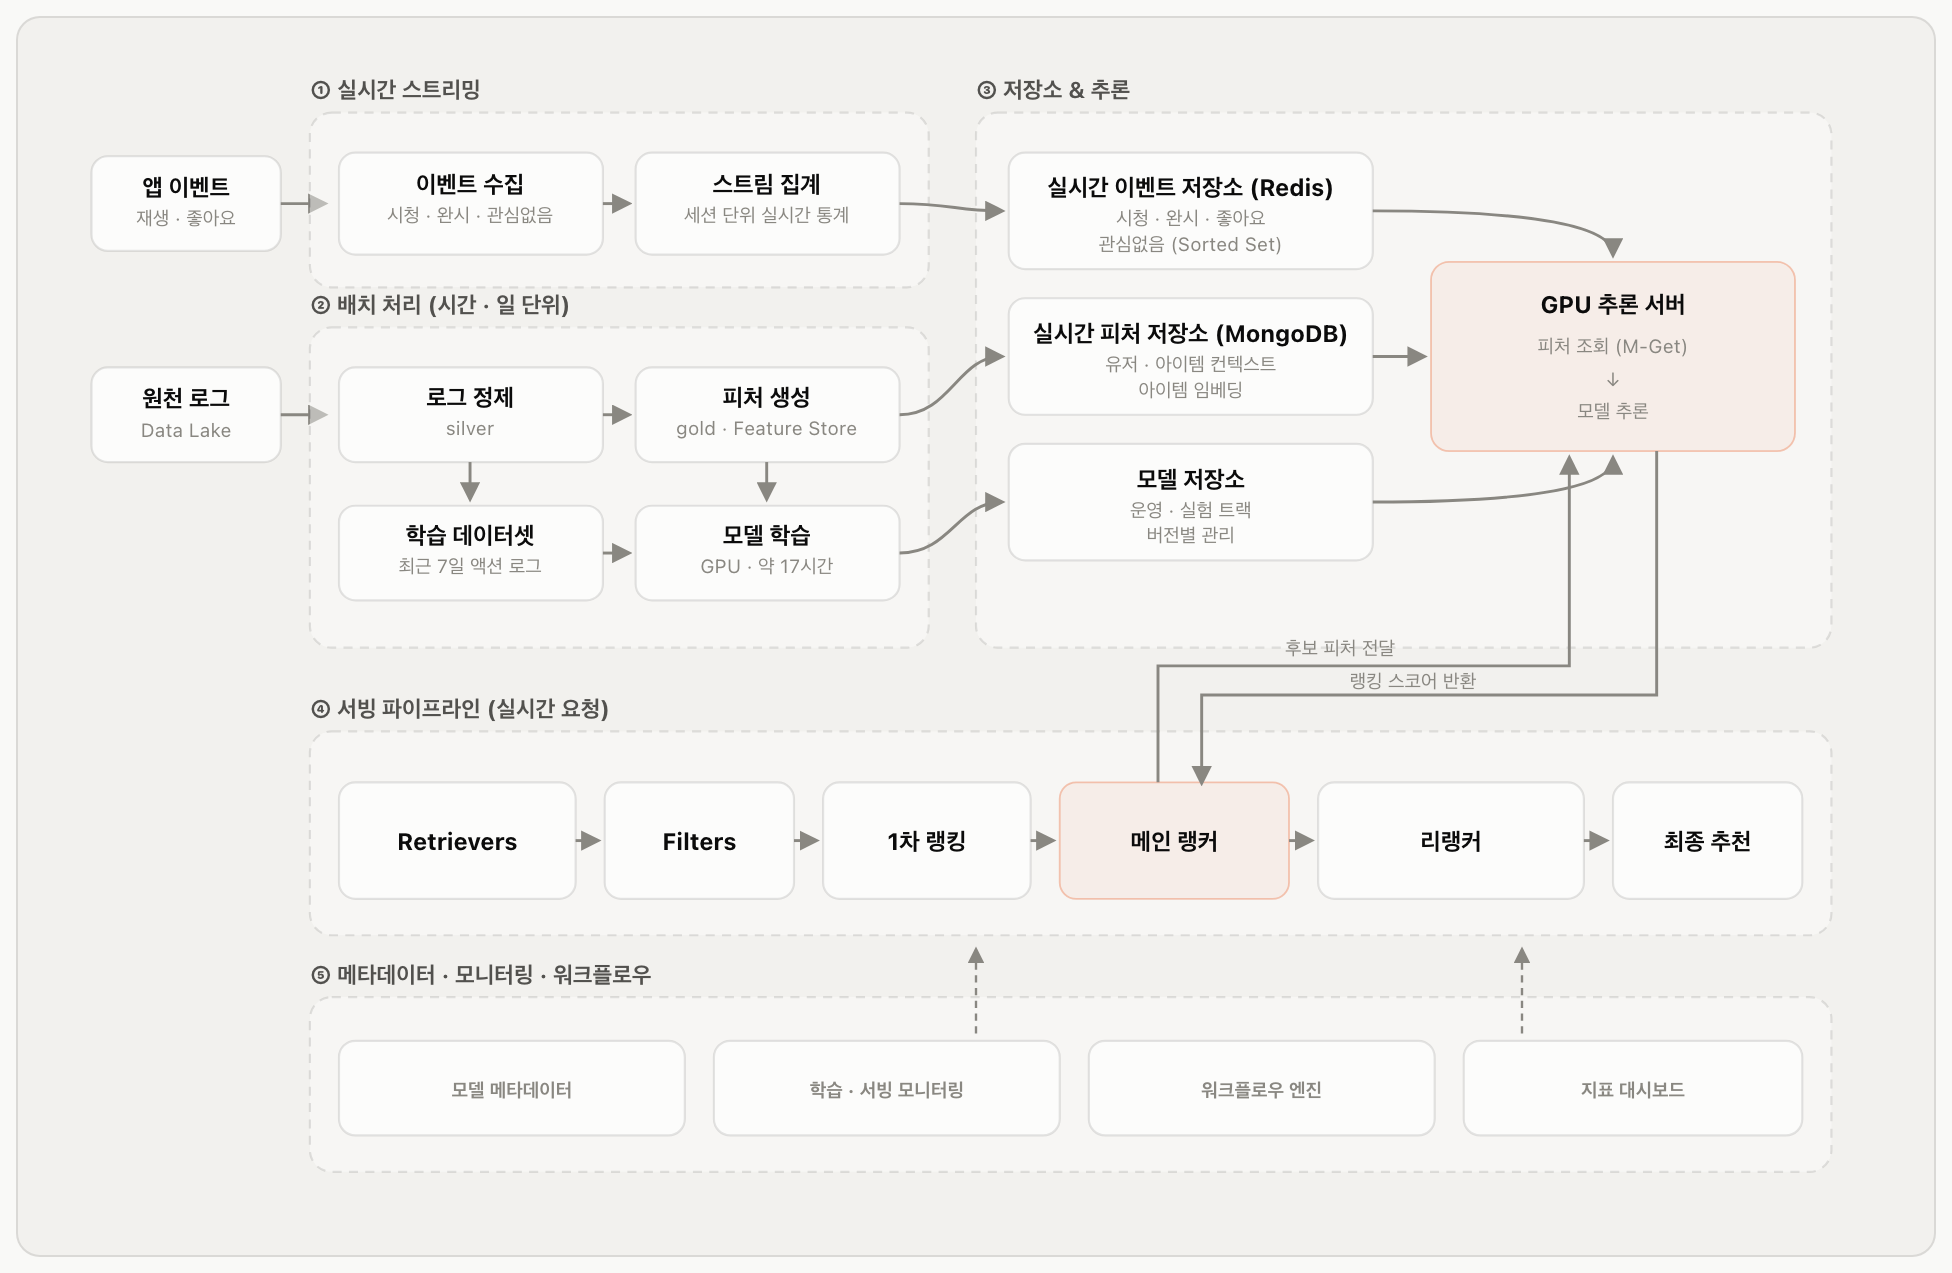
배치 파이프라인은 Hadoop에 쌓인 로그를 정제해 Feature Store와 학습 데이터셋 을 만들고, 이걸로 학습한 모델을 올립니다. 배치에서 생성된 유저·아이템 피처와 Two-Tower 임베딩은 실시간 조회가 가능하도록 MongoDB 및 Redis에 적재됩니다.
서빙 시점에는 서빙 API 서버가 여러 Retriever → Filter를 거쳐 Candidates를 추리고, 랭킹 모델에서 inference 합니다. 여기서 나온 정렬 결과에 최신성·크리에이터 다양성을 보정하는 리랭커를 한 번 더 거쳐 최종 추천 리스트가 완성됩니다.
2-2. 학습과 추론 파이프라인
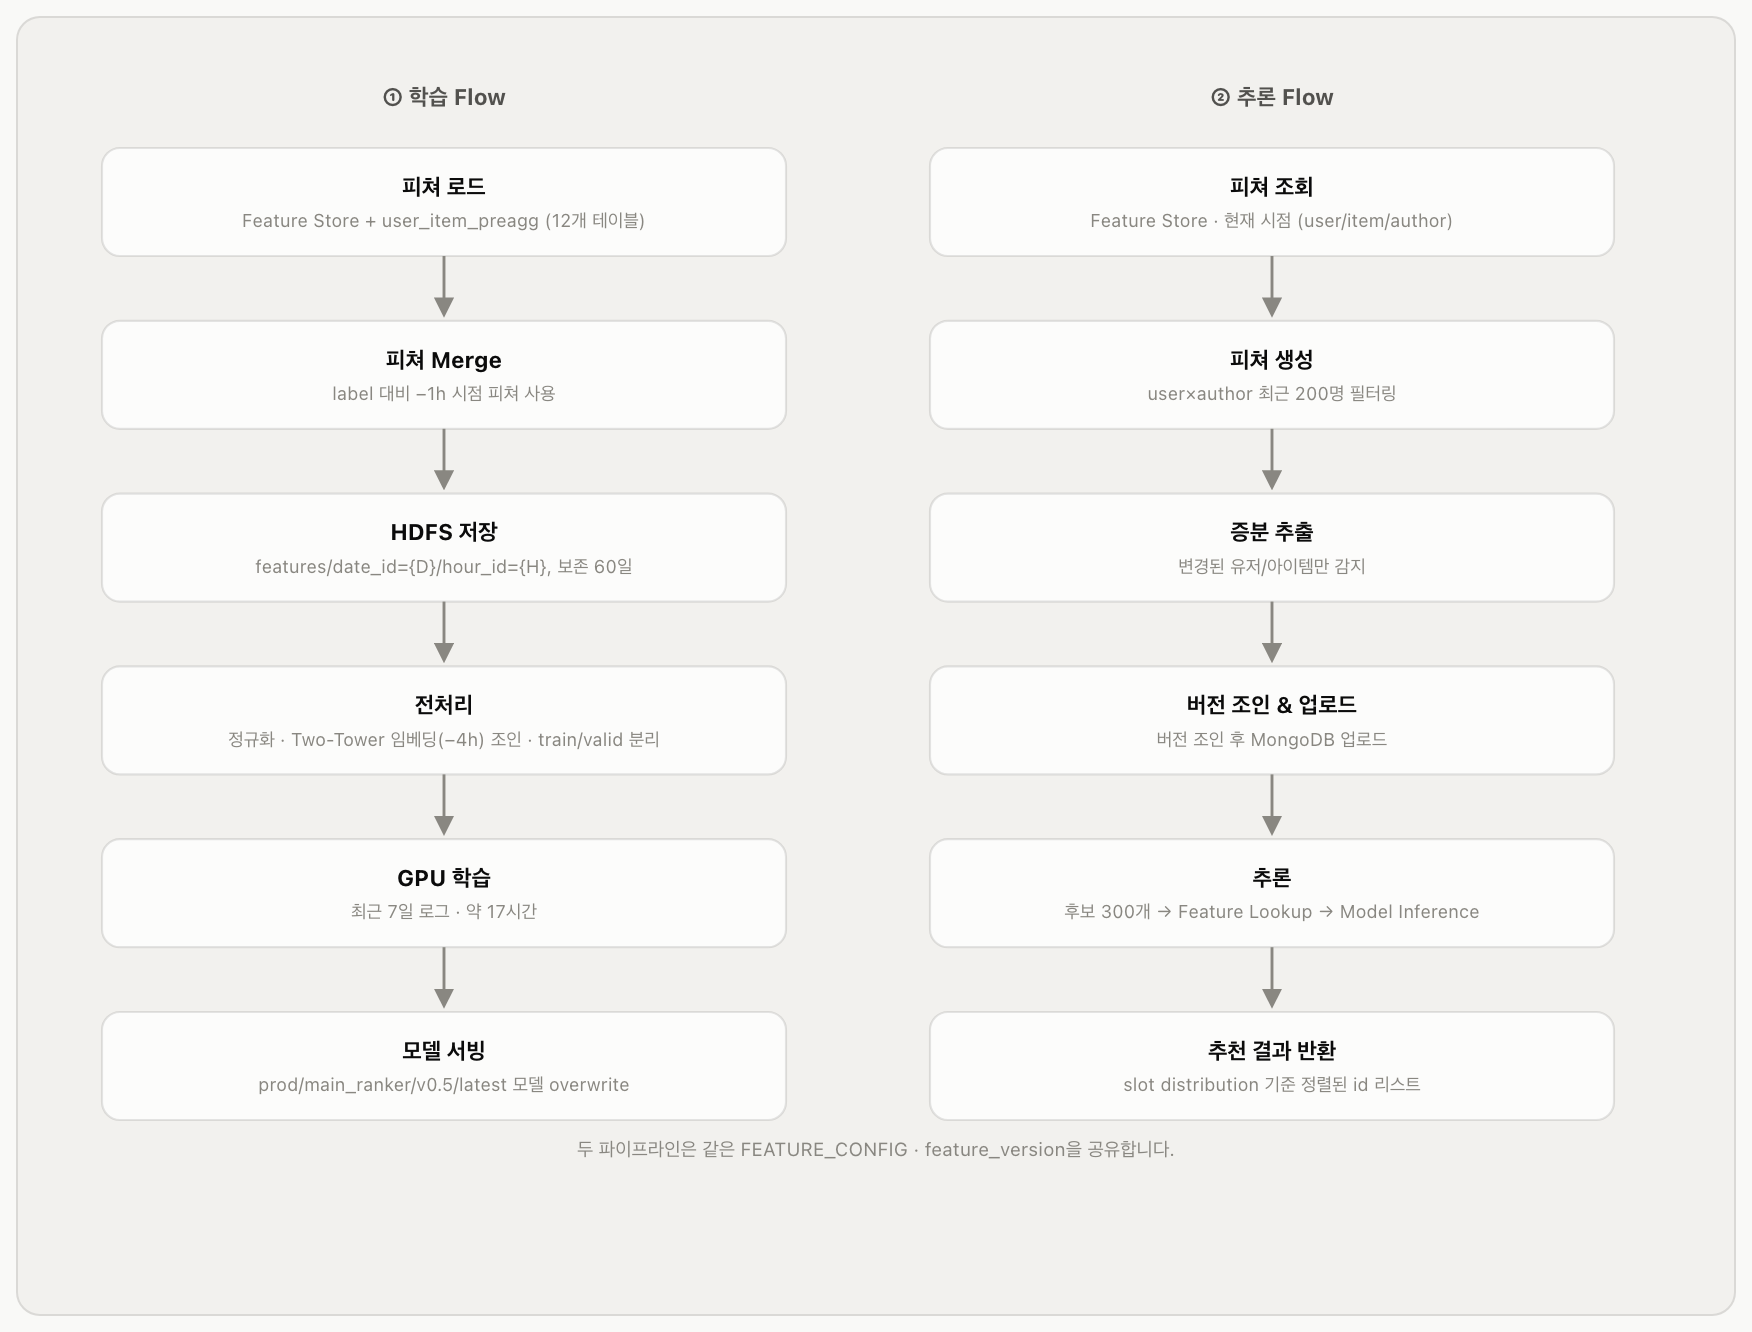
배치로 학습된 모델이 실제로 서비스에 나가기까지의 흐름을 조금 더 자세히 보면 아래와 같습니다.
학습에는 4개의 base_type(user/item/author/user_author) × 3개 윈도우(1d/7d/30d) 조합의 피처가 사용됩니다. 모델은 일 배치로 학습했고, 실험 결과 학습을 더 최신화하여도 성능에 큰 영향을 주지 않아 배치주기를 더 줄이진 않았습니다.
추론 쪽에서는 모든 유저·아이템 피처를 매번 갱신하면 쓰기 부하가 크기 때문에, 변경이 감지된 유저/아이템만 증분만 온라인DB에 서빙하는 구조로 설계했습니다. 실제 추론 시점에는 300개로 좁혀진 후보의 피처를 읽어 벡터화한 뒤 모델에 넣어 점수를 매깁니다.
3. 모델 설계
3-1. Label 설계
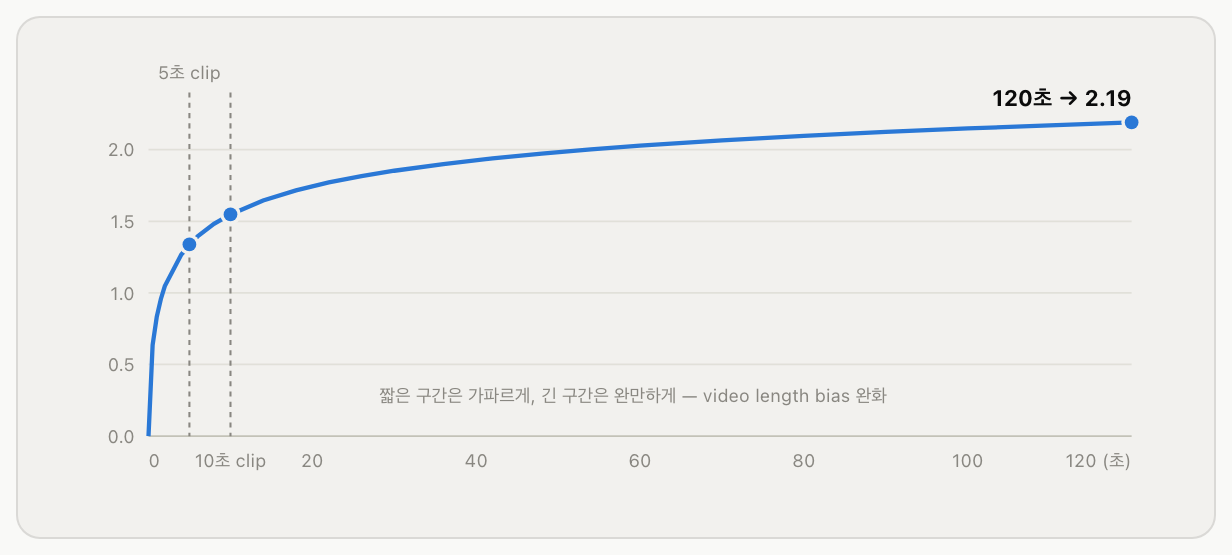
랭킹 모델의 label로는 시청 시간(watch length)을 사용했는데, 영상 길이가 길수록 시청 시간도 자연히 길어지는 video length bias 가 존재합니다. 이를 줄이기 위해 watch length에 Root + Log 변환 (RLTW, Root-Log Transformed Watch time)을 적용했습니다. 변환식은 RLTW = √(ln(1 + watch_length))로, 로그로 큰 값의 스케일을 눌러준 뒤 제곱근으로 한 번 더 완만하게 만드는 형태입니다.
3-2. 모델 구조: 세 번의 실험을 거쳐 GDCN + MoE로
지금의 구조로 처음부터 시작한 건 아니었습니다. 다양한 오프라인 실험을 거치며 아키텍처를 다듬었고, 매 실험마다 "모델이 재정렬했을 때 기존 노출 순서(imp_ordnum) 대비 평균 시청시간·시청 비율이 얼마나 개선되는가"를 기준으로 다음 실험 방향을 정했습니다.
| 실험 | 아키텍처 | 평균 시청 시간 | 평균 시청 비율 |
|---|---|---|---|
| 1차 | DCNv2 | +28.6% | +3.5% |
| 2차 | DCNv2 + MoE | +32.9% | +5.5% |
| 3차 | GDCN + MoE | +35.0% | +6.5% |
1차 — DCNv2로 베이스라인 잡기
1차 실험의 목표는 정확도보다 인사이트 확보 였습니다. 우선순위를 ① 피처 importance ② 모델 아키텍처 ③ 학습 속도 ④ 추론 속도 ⑤ 학습 주기 순으로 두고, 모델 경량화를 위해 weight를 low-rank로 분리한 DCNv2를 사용했습니다. 이 실험에서 세 가지를 확인했습니다.
-
장기 피처가 잘 통했습니다. 라이트 유저가 많은 도메인이라 짧은 윈도우만으로는 취향이 잘 안 잡혔는데(User×Author 상호작용이 존재하는 쌍의 비율이 7일 윈도우 기준 10% 미만), 장기 피처를 추가하니 실제로 추론 성능이 올라갔습니다.
-
경량화 여지가 넉넉했습니다. weight를 rank 32로 분리해도 모델 성능 저하는 거의 없었습니다. 이 rank 32는 이후 3차 실험의 GDCN까지 그대로 이어졌습니다.
-
학습 최신성은 어느 정도 여유가 있었습니다. 모델 학습이 하루이틀 늦어지는 정도는 성능에 큰 영향이 없었지만, 3일 이상 지나면 성능이 눈에 띄게 떨어졌습니다.
2차 — MoE로 Light/Heavy 편차 보완
1차 실험에서 드러난 문제는 Light 유저의 예측력이 Heavy 유저보다 눈에 띄게 낮다 는 점이었습니다. 유저마다 활동 패턴이 크게 다른데 하나의 네트워크가 모든 유저를 동일하게 학습하다 보니 생긴 문제로 보고, Single-gate 3-Experts 구성의 MoE를 추가했습니다.
3차 — DCNv2 → GDCN, 그리고 경량화
Two-Tower 임베딩 버전 변경 후 DCNv2 성능이 눈에 띄게 흔들리는 문제가 나타났습니다. 원인을 파고들어보니 DCNv2는 모든 피처를 동일한 비중으로 교차시키는 구조라, 피처 분포가 바뀌면 그만큼 민감하게 반응한다는 게 문제였습니다.
그래서 어떤 피처를 얼마나 반영할지 Gate로 선별할 수 있는 GDCN(Gated DCN)으로 교체했습니다. 여기에 지연시간(latency) 목표를 맞추기 위해 레이어 수와 임베딩 차원을 줄이는 경량화도 함께 진행했습니다.
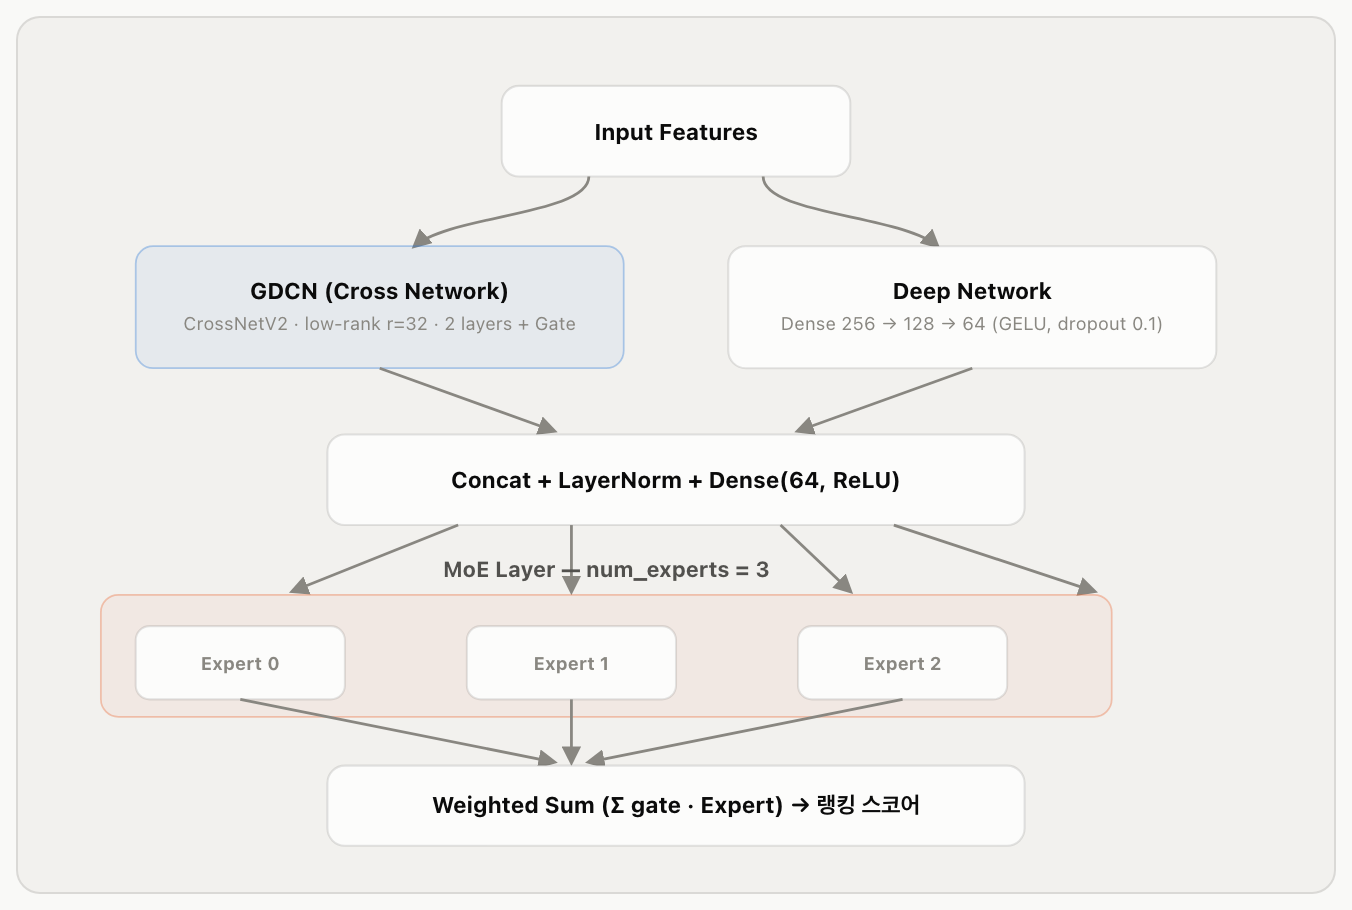
이렇게 GDCN + MoE 조합으로 구조를 확정했습니다. 정리하면 아래와 같습니다.
-
GDCN: 어떤 피처를 얼마나 반영할지 information gate로 조절하며, Cross Layer마다 교차 피처의 중요도를 식별하도록 설계된 구조입니다.
-
MoE: 라이트 유저와 헤비 유저 간 활동성 차이가 커서, 여러 Expert가 서로 다른 유저 패턴을 학습하고 Gate가 이를 유저별로 다르게 조합하도록 했습니다.
# GDCN CrossNet 핵심 로직 (의사코드)
# [Step 1] Low-rank 교차 상호작용 (DCN-V2)
vtx  = xi · V_i            # (batch, D) → (batch, low_rank)
uvtx = vtx · U_i^T         # (batch, low_rank) → (batch, D)
dot  = uvtx + bias_i       # 피처 간 교차 신호

# [Step 2] Gating Mechanism (GDCN 핵심)
gate = sigmoid(xi · W_gate + b_gate)   # 정보 통과율 제어

# [Step 3] Gate 적용 + Residual
xi_next = x0 · (dot * gate) + xi      # x0: 초기 입력 (Residual)
# Cross Layer (GDCN, layer l = 0, 1 반복)
x_(l+1) = x_0 ⊙ ( C_l(x_l) ⊙ g_l ) + x_l

  C_l(x_l) = V_l · (U_l^T · x_l) + b_l    # low-rank 교차항 (rank = 32)
  g_l      = σ(W_g,l · x_l + b_g,l)       # information gate ∈ (0, 1)

# MoE 최종 출력 (num_experts = 3, single gate)
y = Σ[i=1..3] G(x)_i · E_i(x)

  G(x)   = softmax(W_gate · x)            # expert별 혼합 비중 (라이트/헤비 분기)
  E_i(x) = ReLU(W_i · x + b_i)            # expert i (Dense 128)
후보(candidates) 개수 튜닝
모델 구조를 확정한 뒤에는 최종 랭킹에 태우는 후보 개수도 함께 튜닝했습니다. 유저 2만 명을 대상으로 후보 개수를 늘려가며 최종 6개를 추출하는 오프라인 테스트를 해봤는데, 늘릴수록 유효재생 비율(일정 시청시간 기준을 넘긴 시청, VTR)이 개선되긴 했지만 개선폭은 빠르게 줄어드는 형태였습니다.
| 후보 개수 | VTR | 300개 대비 |
|---|---|---|
| 300 | 78.86% | - |
| 600 | 79.60% | +0.73%p |
| 900 | 79.77% | +0.90%p |
900개까지 늘려도 +0.9%p 수준에 그쳐, 후보를 더 늘리는 이득보다 지연시간 비용이 크다고 판단했습니다. 그래서 앞서 아키텍처에서 소개한 대로 후보 300개로 서비스를 운영하며, 이후 실서비스 모니터링을 통해 조정하기로 했습니다.
3-3. 입력 피처
모델이 실제로 보는 입력은 크게 몇 가지 카테고리로 나뉩니다. 온라인/컨텍스트는 요청이 들어온 순간 실시간으로 채워지고, 나머지는 배치로 미리 집계해 Feature Store에 쌓아둔 값을 그대로 읽어옵니다.
| 카테고리 | 소스 | 예시 |
|---|---|---|
| 온라인 / 컨텍스트 | 실시간 요청 | 요일·시간대, 노출 위치, 세션 내 조회수, 후보를 뽑아온 retriever 종류 |
| Two-Tower 임베딩 | 별도 학습된 임베딩 | 아이템 임베딩 — 신규·저노출 아이템은 평균으로 대체 |
| 유저 | Feature Store | 시청시간·시청비율·유효재생율 등 (단기·장기 윈도우) |
| 아이템 | Feature Store | 조회수·좋아요율·완시율 등 (단기·장기 윈도우) |
| 작가(크리에이터) | Feature Store | 아이템과 동일한 구조를 작가 단위로 집계 |
| 유저×작가 상호작용 | Feature Store | 상호작용 지표 + 마지막 시청 후 경과시간(친밀도 신호). 최근 상호작용한 작가 위주로만 유지 |
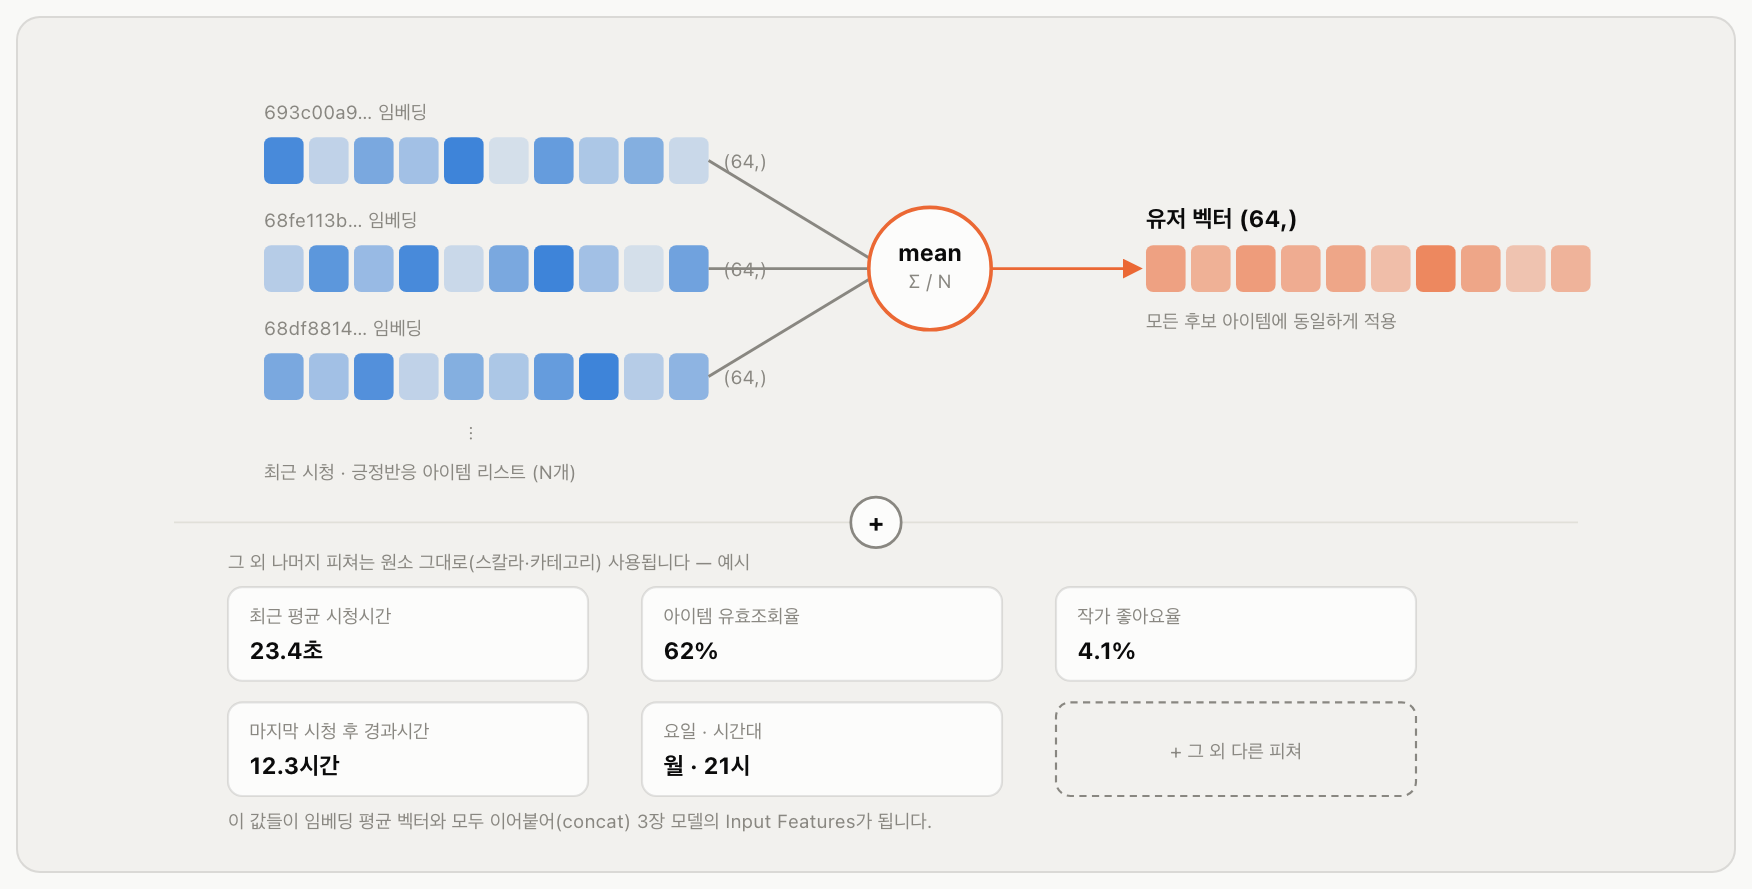
유저의 최근 선호도를 좀 더 세밀하게 파악하기 위해, 임베딩 기반 피처도 두 개 추가했습니다. 아이템 id 리스트를 그대로 넣는 대신, 최근 시청한 아이템들의 Two-Tower 임베딩을 평균 내어 하나의 벡터로 압축해서 넣는 방식입니다.
-
최근 긍정 시청 아이템 임베딩 평균 — 최근 며칠 내 이 유저가 명시적으로 긍정 반응을 남긴 아이템 리스트가 요청과 함께 들어오면, 각 아이템의 Two-Tower 임베딩을 가져와 평균 낸 뒤 이 유저가 평가 중인 모든 후보에 동일하게 적용합니다. 유저 단위 피처라 후보마다 값은 같고, 요청 시점 값을 그대로 씁니다.
-
최근 유효재생 아이템 임베딩 평균 — 최근 일정 기간 내 유효재생(일정 시청시간 기준을 넘긴 시청) 처리된 아이템 중 최근 순으로 추려서, 마찬가지로 임베딩을 평균 냅니다. 이쪽은 배치로 미리 계산돼 Feature Store에 올라가 있는 값을 그대로 읽어옵니다.
3-4. Feature Importance
피처는 크게 4가지 유형(유저 / 아이템 / 유저×크리에이터 상호작용 / 크리에이터 정보)으로 나뉘고, 각각 1일·7일·30일 윈도우로 단기·장기 특성을 함께 사용합니다. 여기에 추출 retriever 정보, 요일·시간대 같은 컨텍스트 피처가 더해집니다.
실제 학습된 모델의 feature importance를 뜯어보면, 유저×크리에이터 상호작용 피처의 중요도가 가장 높게 나타났습니다. 이는 "개인화"라는 프로젝트의 목적과도 정확히 맞아떨어지는 결과였습니다. 결국 이 유저가 이 크리에이터와 얼마나 자주, 얼마나 깊게 상호작용했는지가 다음 추천을 결정짓는 가장 강력한 신호였던 셈입니다.
4. 도입 효과
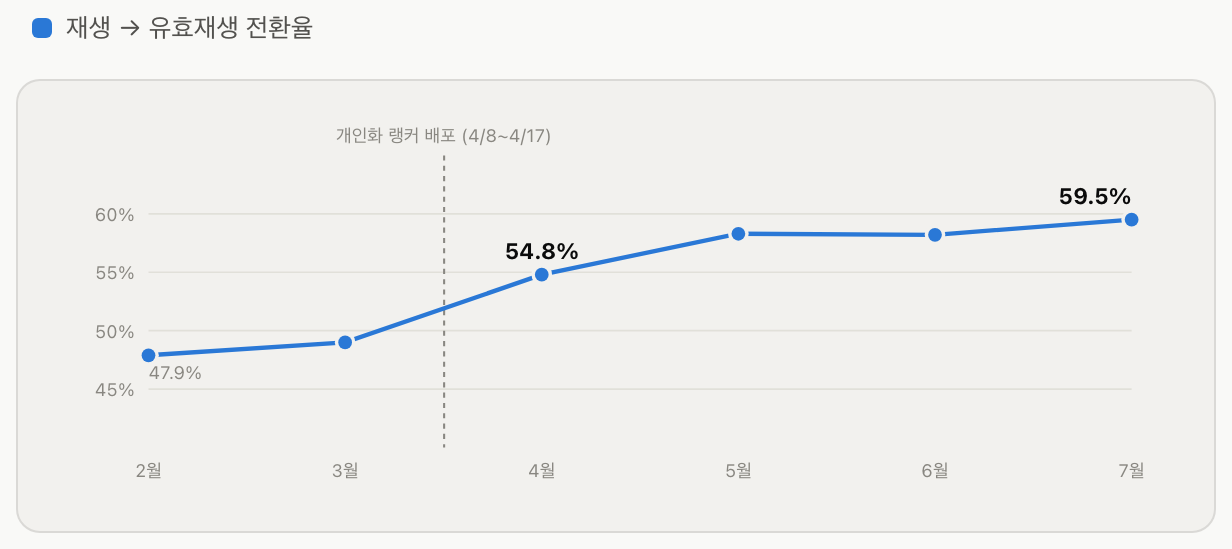
아래는 배포 전후 유효재생 UV 지표를 뜯어본 결과입니다.
4-1. 유효재생 비율(VTR) +10%p (+20%) 상승
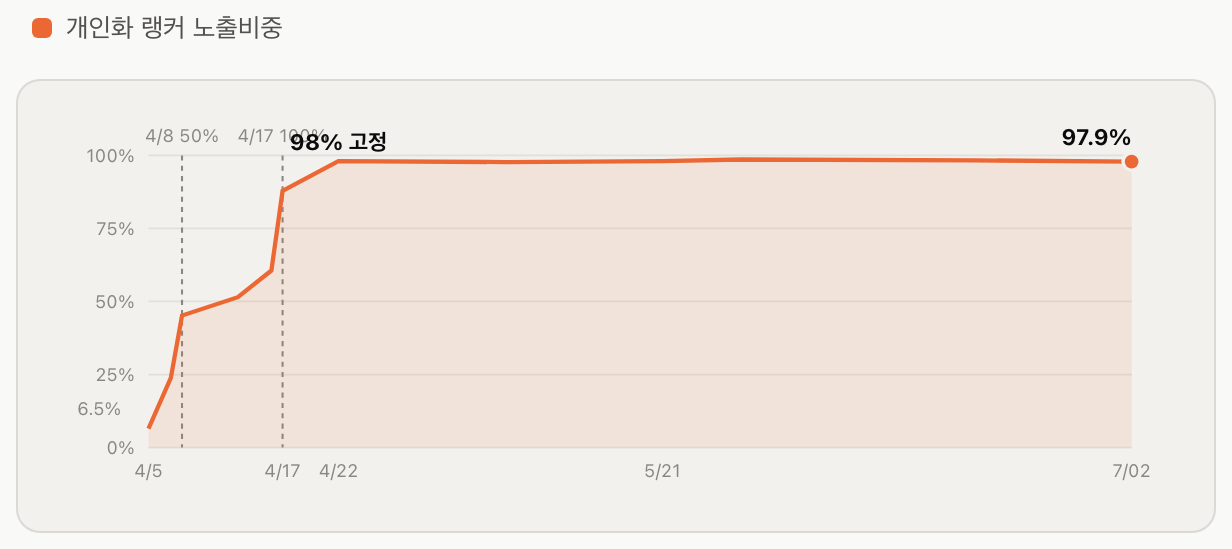
개인화 랭커 배포에 따라 재생→유효재생 비율(VTR)이 계단식으로 상승 후 현재까지 효과가 유지되고 있습니다. 이 전환율 상승은 개인화 랭커 노출비중 추이와 정확히 일치합니다. 배포 일정과 동일한 타이밍에 전환율이 함께 뛰어올랐습니다.
4-2. 콜드/라이트 유저군에서도 효과를 보임
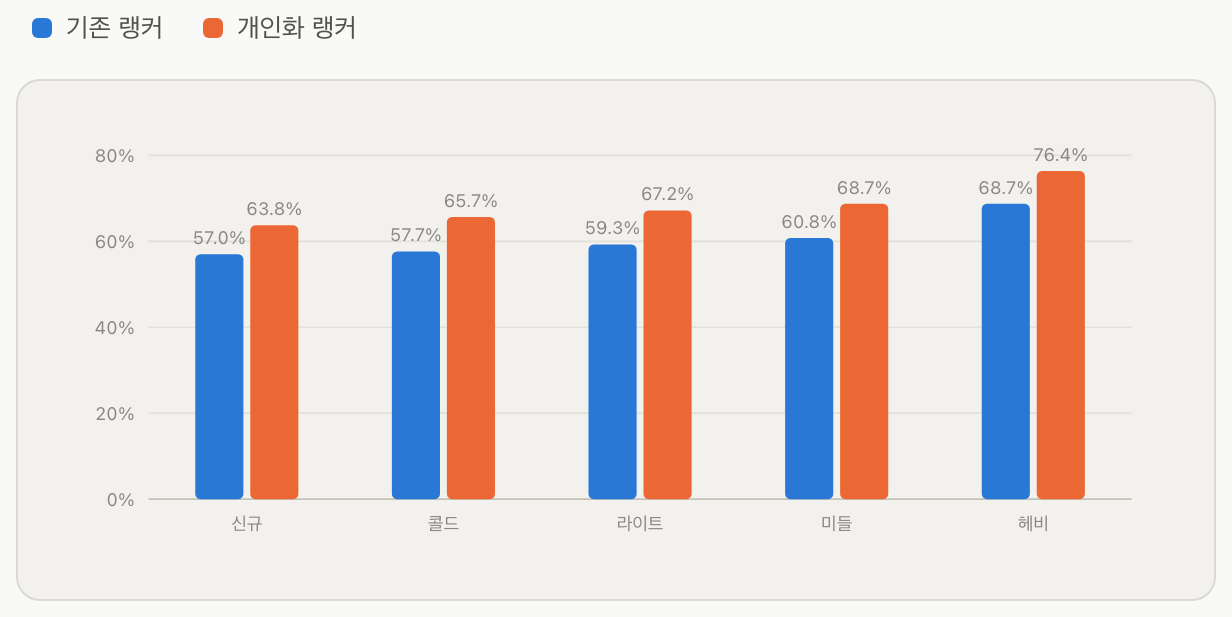
또 한 가지 인상적이었던 건 유저 활동성 구간(신규 · 콜드 · 라이트 · 미들 · 헤비)에 관계없이 유효재생비율이 고르게 +7~8%p씩 개선됐다는 점입니다. 활동 히스토리가 거의 없는 콜드 유저에서도 효과가 있었다는 건, 개인화가 헤비 유저의 풍부한 히스토리에만 기대는 게 아니라 GDCN의 피처 선별 + MoE의 활동성 분기 구조 자체가 의도대로 작동한 것으로 해석됩니다.
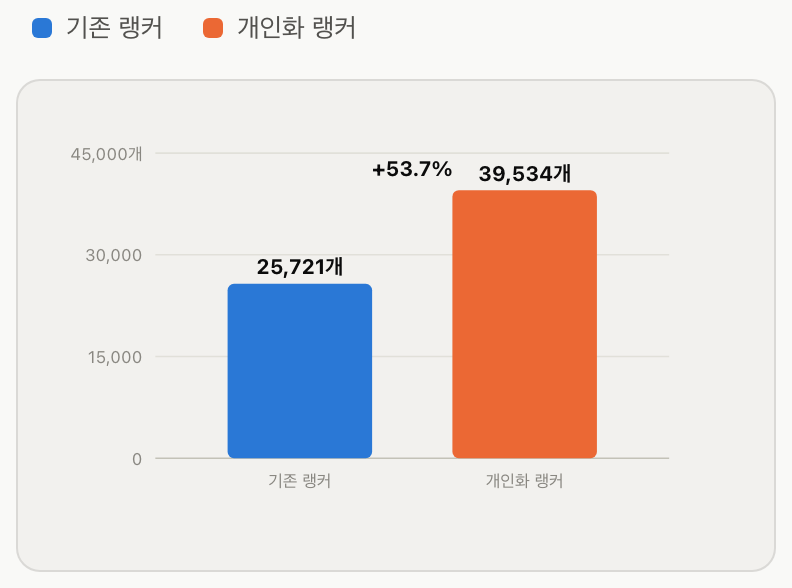
4-3. 추천 다양성 +50% 증가
개인화 랭커를 배포하면서 추천 콘텐츠 자체도 눈에 띄게 다양해졌습니다. 하루 평균 추천에 쓰인 서로 다른 아이템 개수가 +53.7% 늘었습니다. 유저 개인의 취향을 세밀하게 반영하다 보니, 더 다양한 콘텐츠가 추천되는 셈입니다.
5. 마치며
개인화는 추천에서 이제 선택이 아니라 필수라는 걸, 이번 프로젝트로 다시 한번 확인했습니다. 세그먼트 단위로 동일한 추천을 내려주던 시스템을 개인의 히스토리를 반영하는 딥러닝 랭커로 바꾸는 과정을 아키텍처 설계부터 모델 구조, 실제 효과 검증까지 공유해봤습니다. 특히 라이트·헤비 유저의 활동성 차이가 커서 하나의 네트워크로는 두 그룹을 동시에 잘 맞추기 어려웠는데, MoE로 유저 세그먼트별 피처를 고르게 학습시키고 나니 라이트 유저에서까지 뚜렷한 성능 개선으로 이어졌습니다.
이 글이 추천 랭킹 모델을 고민하시는 분들께 조금이나마 도움이 되길 바라며, 긴 글 끝까지 읽어주셔서 감사합니다.