AI/ML
이상 탐지 4부-딥 러닝으로 이상 탐지하기
2023년 11월 6일
원문에서 보기 ↗
들어가며
안녕하세요. 클라우드AI팀 박현목입니다.
지난 글에서는 이상 탐지가 무엇인지와 통계적 기법, 머신 러닝 기법을 활용해 어떻게 이상 탐지를 하는지 알려드렸습니다. 이번 글은 이상 탐지 시리즈 중 마지막인 4부-딥 러닝으로 이상 탐지하기입니다.
1부-정상과 비정상, 그리고 이상 탐지 2부-통계적 기법으로 이상 탐지하기 3부-머신 러닝으로 이상 탐지하기 4부-딥 러닝으로 이상 탐지하기
최신 이상 탐지 기법들을 소개하며 시계열 데이터를 다룰 때 어떤 점을 주의해야 하는지 제가 겪었던 이야기와 함께 알려드리겠습니다.
1. 배경지식
지난 글에서 시계열 딥 러닝 이상 탐지는 크게 2가지 분류로 나눌 수 있다고 했습니다.
- Prediction-based: 주어진 시계열을 분석하여 다음에 올 값을 예측하고 실제 값과의 차이를 시계열 이상 탐지에 사용하는 방법입니다.
- Reconstruction-based: 예측과 달리 주어진 시계열 그 자체를 그대로 복원하여 그 차이를 시계열 이상 탐지에 사용하는 방법입니다.
두 접근법은 분명히 차이가 있지만 큰 의미에서는 모두 같은 분석이 가능합니다.
- 어떤 네트워크(MLP, RNN, Transformer 등)를 사용해 시계열에서 특성(feature)을 추출할 것인가
- 어떤 아이디어를 결합하여 성능을 높일 것인가
- 추출한 특성(feature)으로 어떤 결과를 만들어낼 것인가 → 다음값 = prediction, 본래값 = reconstruction
마지막 단계에서 갈림길이 나뉘고 이전 단계에서는 대부분 유사한 과정을 거칩니다. 그래서 저는 두 번째까지의 과정만 소개해 드리고자 합니다. 시계열 이상 탐지에 이런 아이디어를 적용할 수 있구나! 라는 생각으로 읽어 주시면 감사하겠습니다.
우선 최신 딥 러닝 모델들에는 어떤 것들이 있는지 조사해 볼까요? 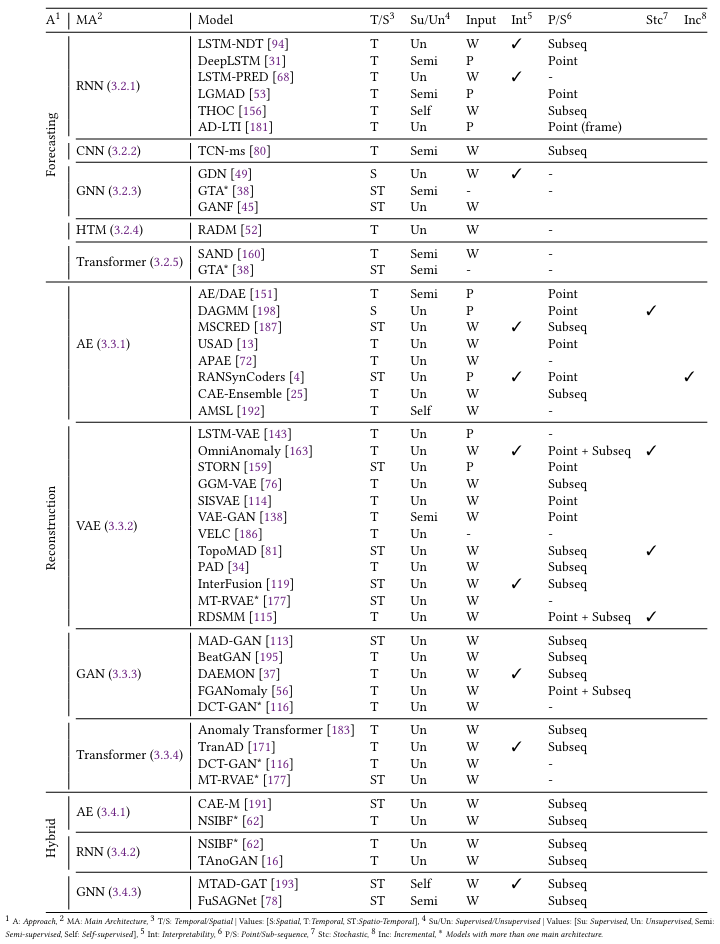
모든 모델을 다 살펴볼 수는 없으니 영향력이 컸던 모델 3개만 살펴보면서 원리와 아이디어를 알아보겠습니다. 구체적인 모델의 구조와 수식까지 접근하면 내용이 정말 깊어지기 때문에 핵심만 알려드리겠습니다. 제가 선택한 3개의 모델은 다음과 같습니다.
| 방법 | 사용 네트워크 | 모델명 |
|---|---|---|
| Prediction | RNN | THOC |
| Reconstruction | VAE | SISVAE |
| Reconstruction | Transformer | Anomaly Transformer |
본격적으로 모델들을 살펴보기 전에 미리 알아 두면 도움이 되는 딥 러닝 네트워크들을 살펴보겠습니다.
Recurrent Neural Network(RNN)
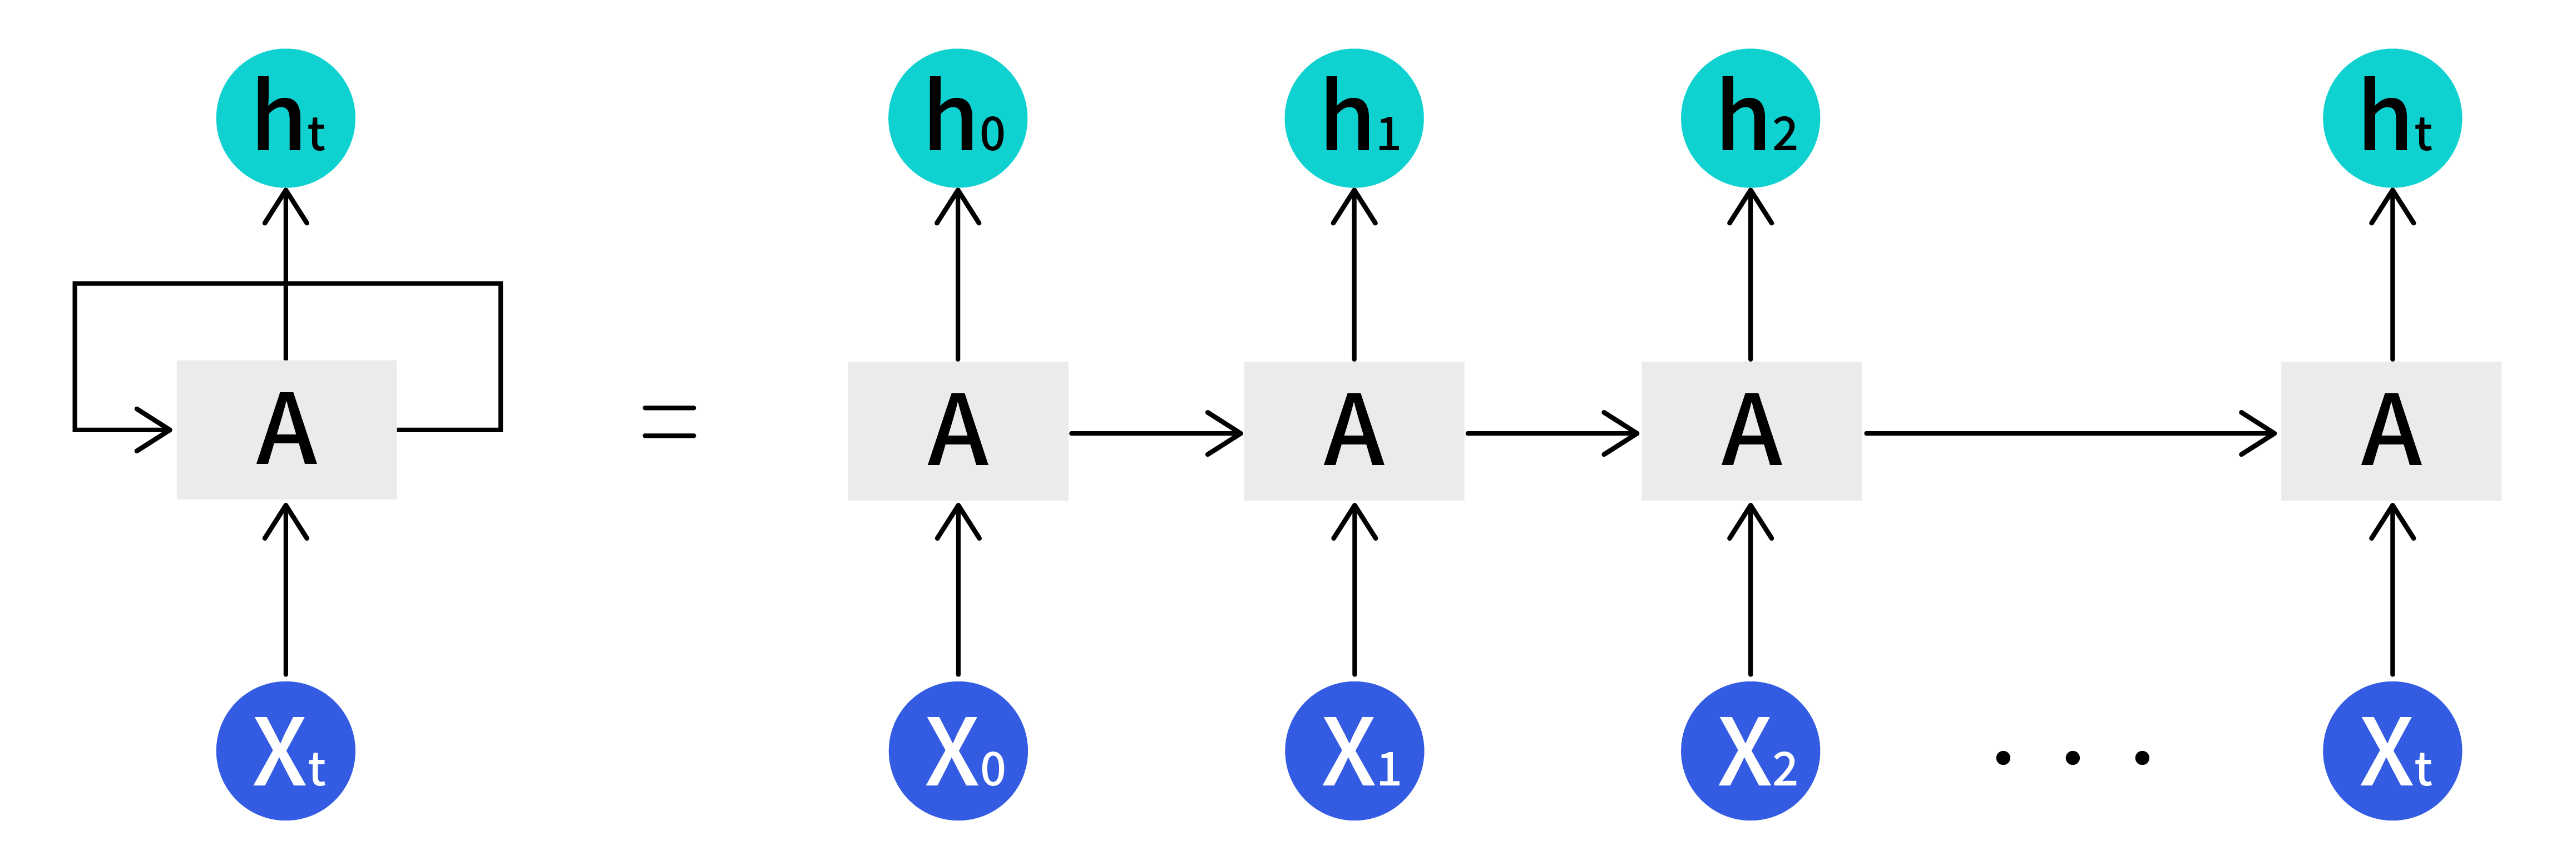
순환 신경망이라고 불리는 _RNN_은 시퀀스 데이터에 특화된 모델입니다. 데이터를 순차적으로 네트워크에 입력하여 _hidden state_라고 하는 결과값을 얻어냅니다. 해당 결과값은 다음 입력 데이터와 함께 다시 네트워크에 입력되어 다음 결과값을 얻어냅니다. 이렇게 순환되며 동작하기 때문에 순환 신경망이라고 불리고 있습니다.
Variational Auto Encoder(VAE)
VAE는 오토 인코더와 변분추론(variational inference)을 결합한 모델입니다. 오토 인코더는 입력 데이터를 압축하여 다시 입력을 복원하는 기법이고 변분추론은 모델링하기 어려운 사후 확률을 이미 알고 있는 확률 분포에 근사하여 추론하는 기법입니다. VAE는 오토 인코더에 의해 압축된 잠재 변수(latent variable)가 특정한 확률 분포를 따를 것이라고 가정하며 최적화하는 기법입니다.
예를 들어 사과를 입력했다면 인코더에 의해 사과들의 특성(feature)들이 추출될 것입니다. 저희는 어떤 특성이 추출될지는 잘 모르지만 각 특성이 이미 우리가 알고 있는 확률 분포(일반적으로 가우시안 분포)를 따를 것이라고 가정합니다. 그 다음에 추출한 특성을 바탕으로 디코더는 본래의 입력을 복원합니다. 오토 인코더와 구조적으로 유사하지만 확률적 가정이 추가되면서 데이터의 분포를 모델링할 수 있다는 차별점을 가지고 있습니다.
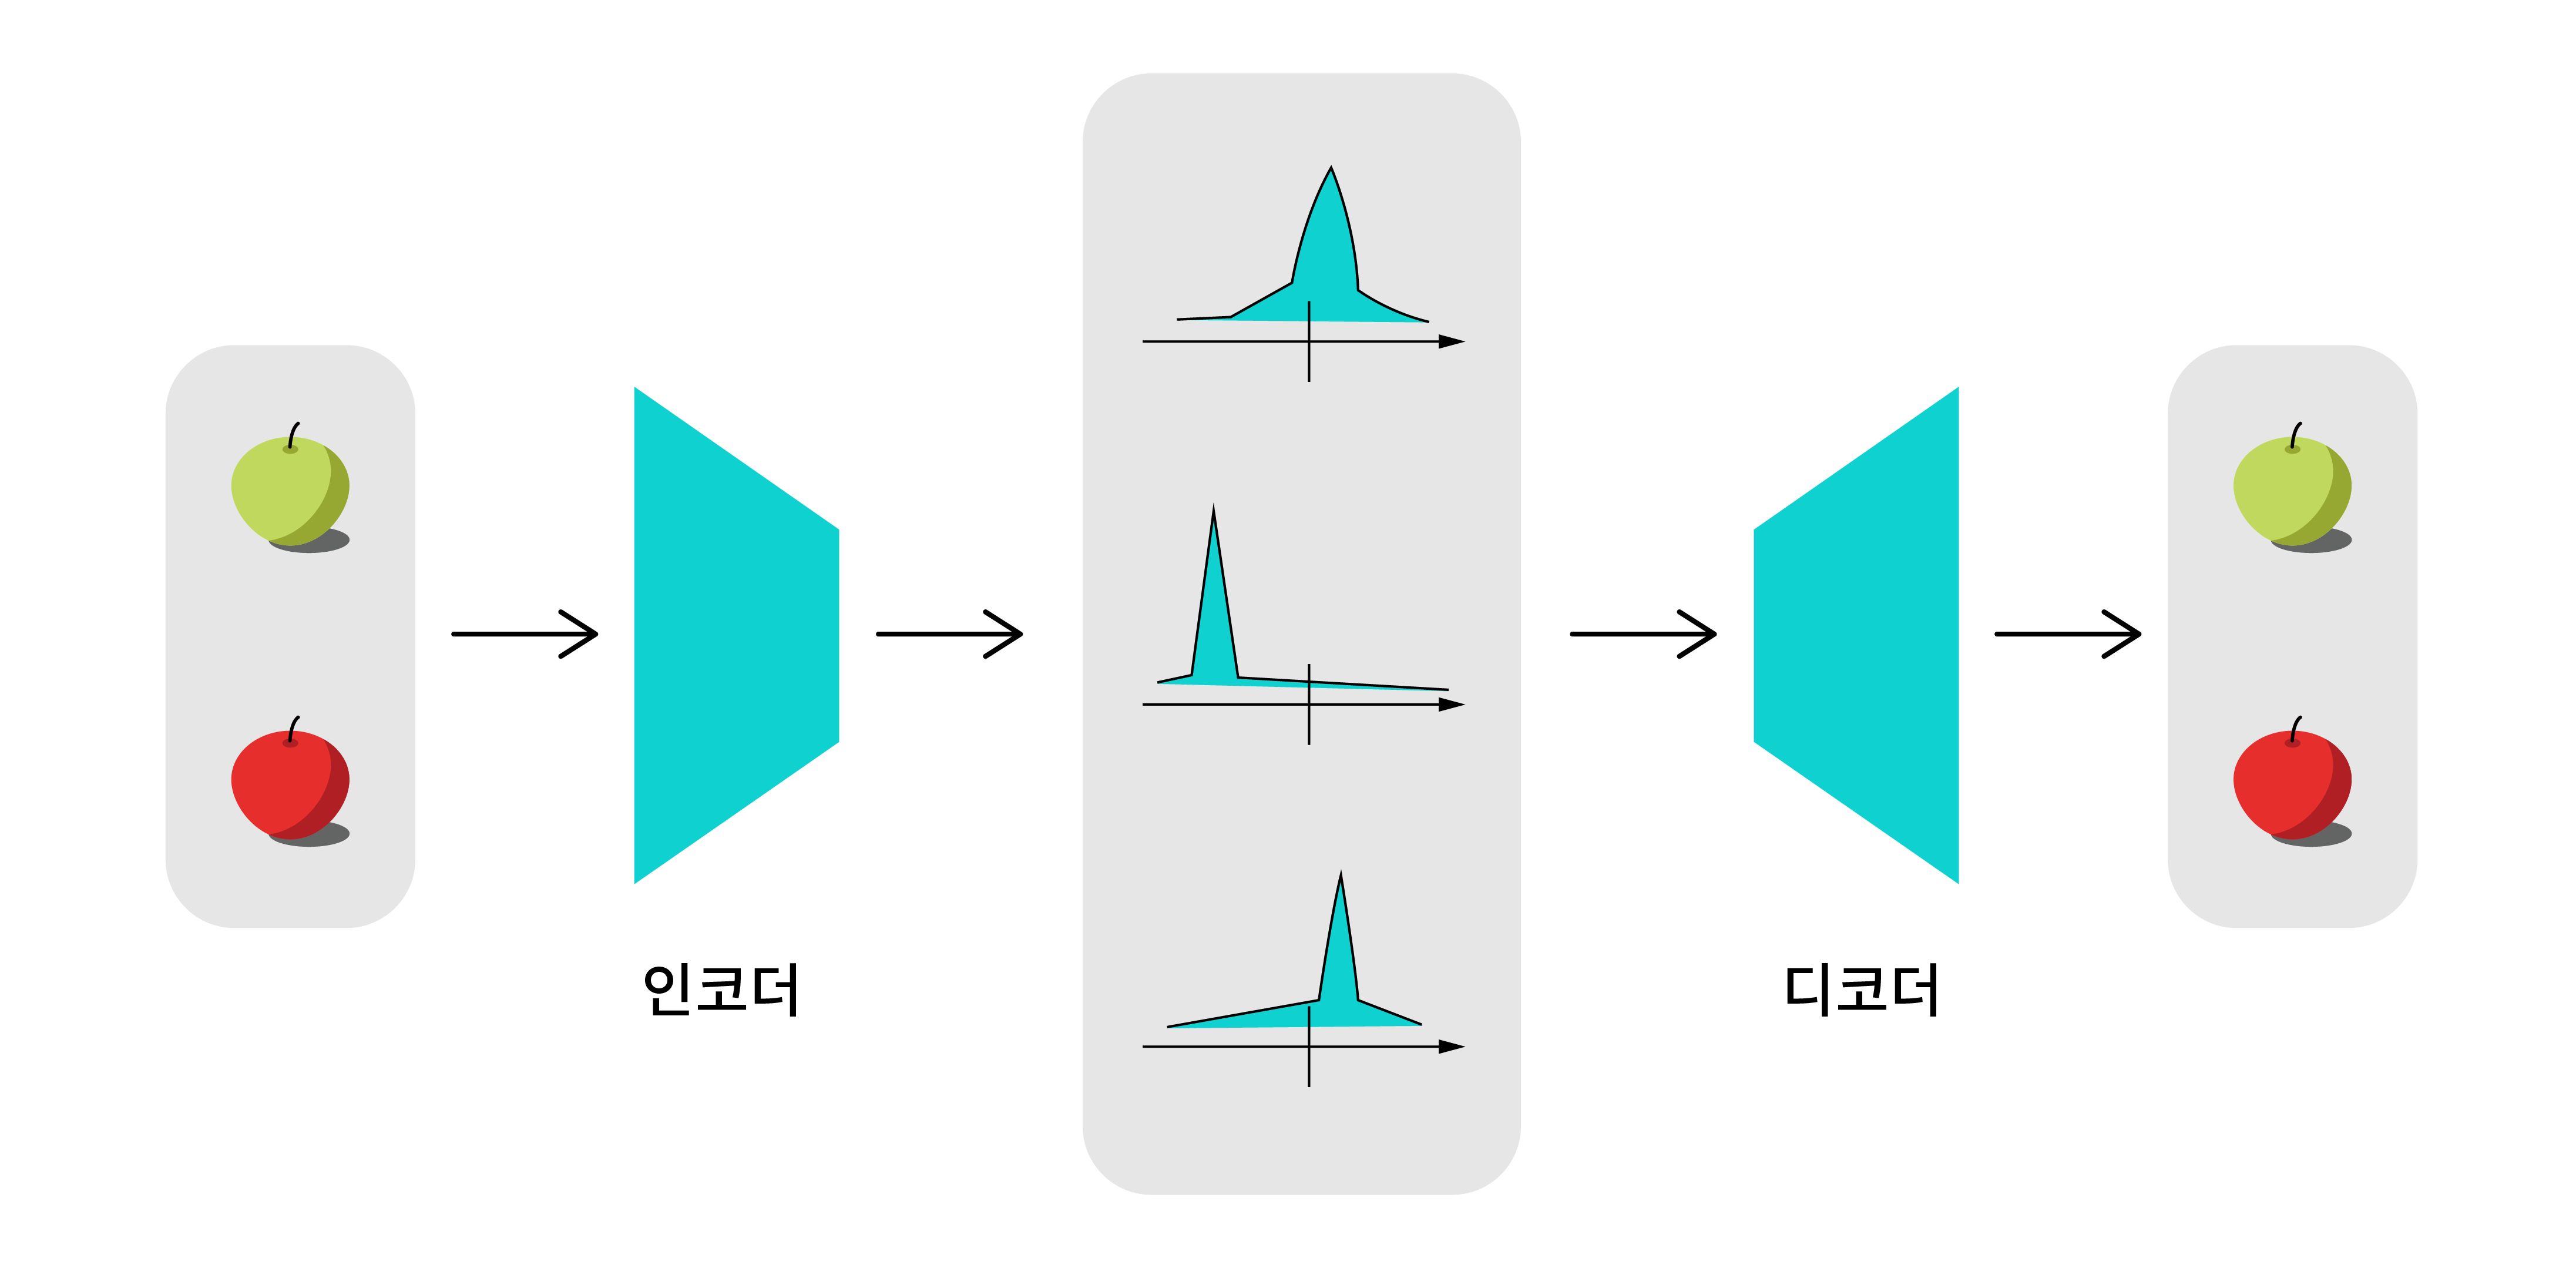
주의하실 점은 오토 인코더와 구조가 유사할 뿐 두 개의 모델은 엄밀히 다른 모델입니다. 해당 내용은 여기서 자세하게 다루기는 어렵기 때문에 간략하게 설명 드리면 오토 인코더는 주어진 데이터를 특정한 공간으로 잘 투영하는 법을 배웁니다. 반면에 VAE는 데이터의 특성을 확률적으로 분석하여 추출합니다. 이런 이유로 오토 인코더는 manifold learning, VAE는 _generative model_이라고 부릅니다.
Transformer
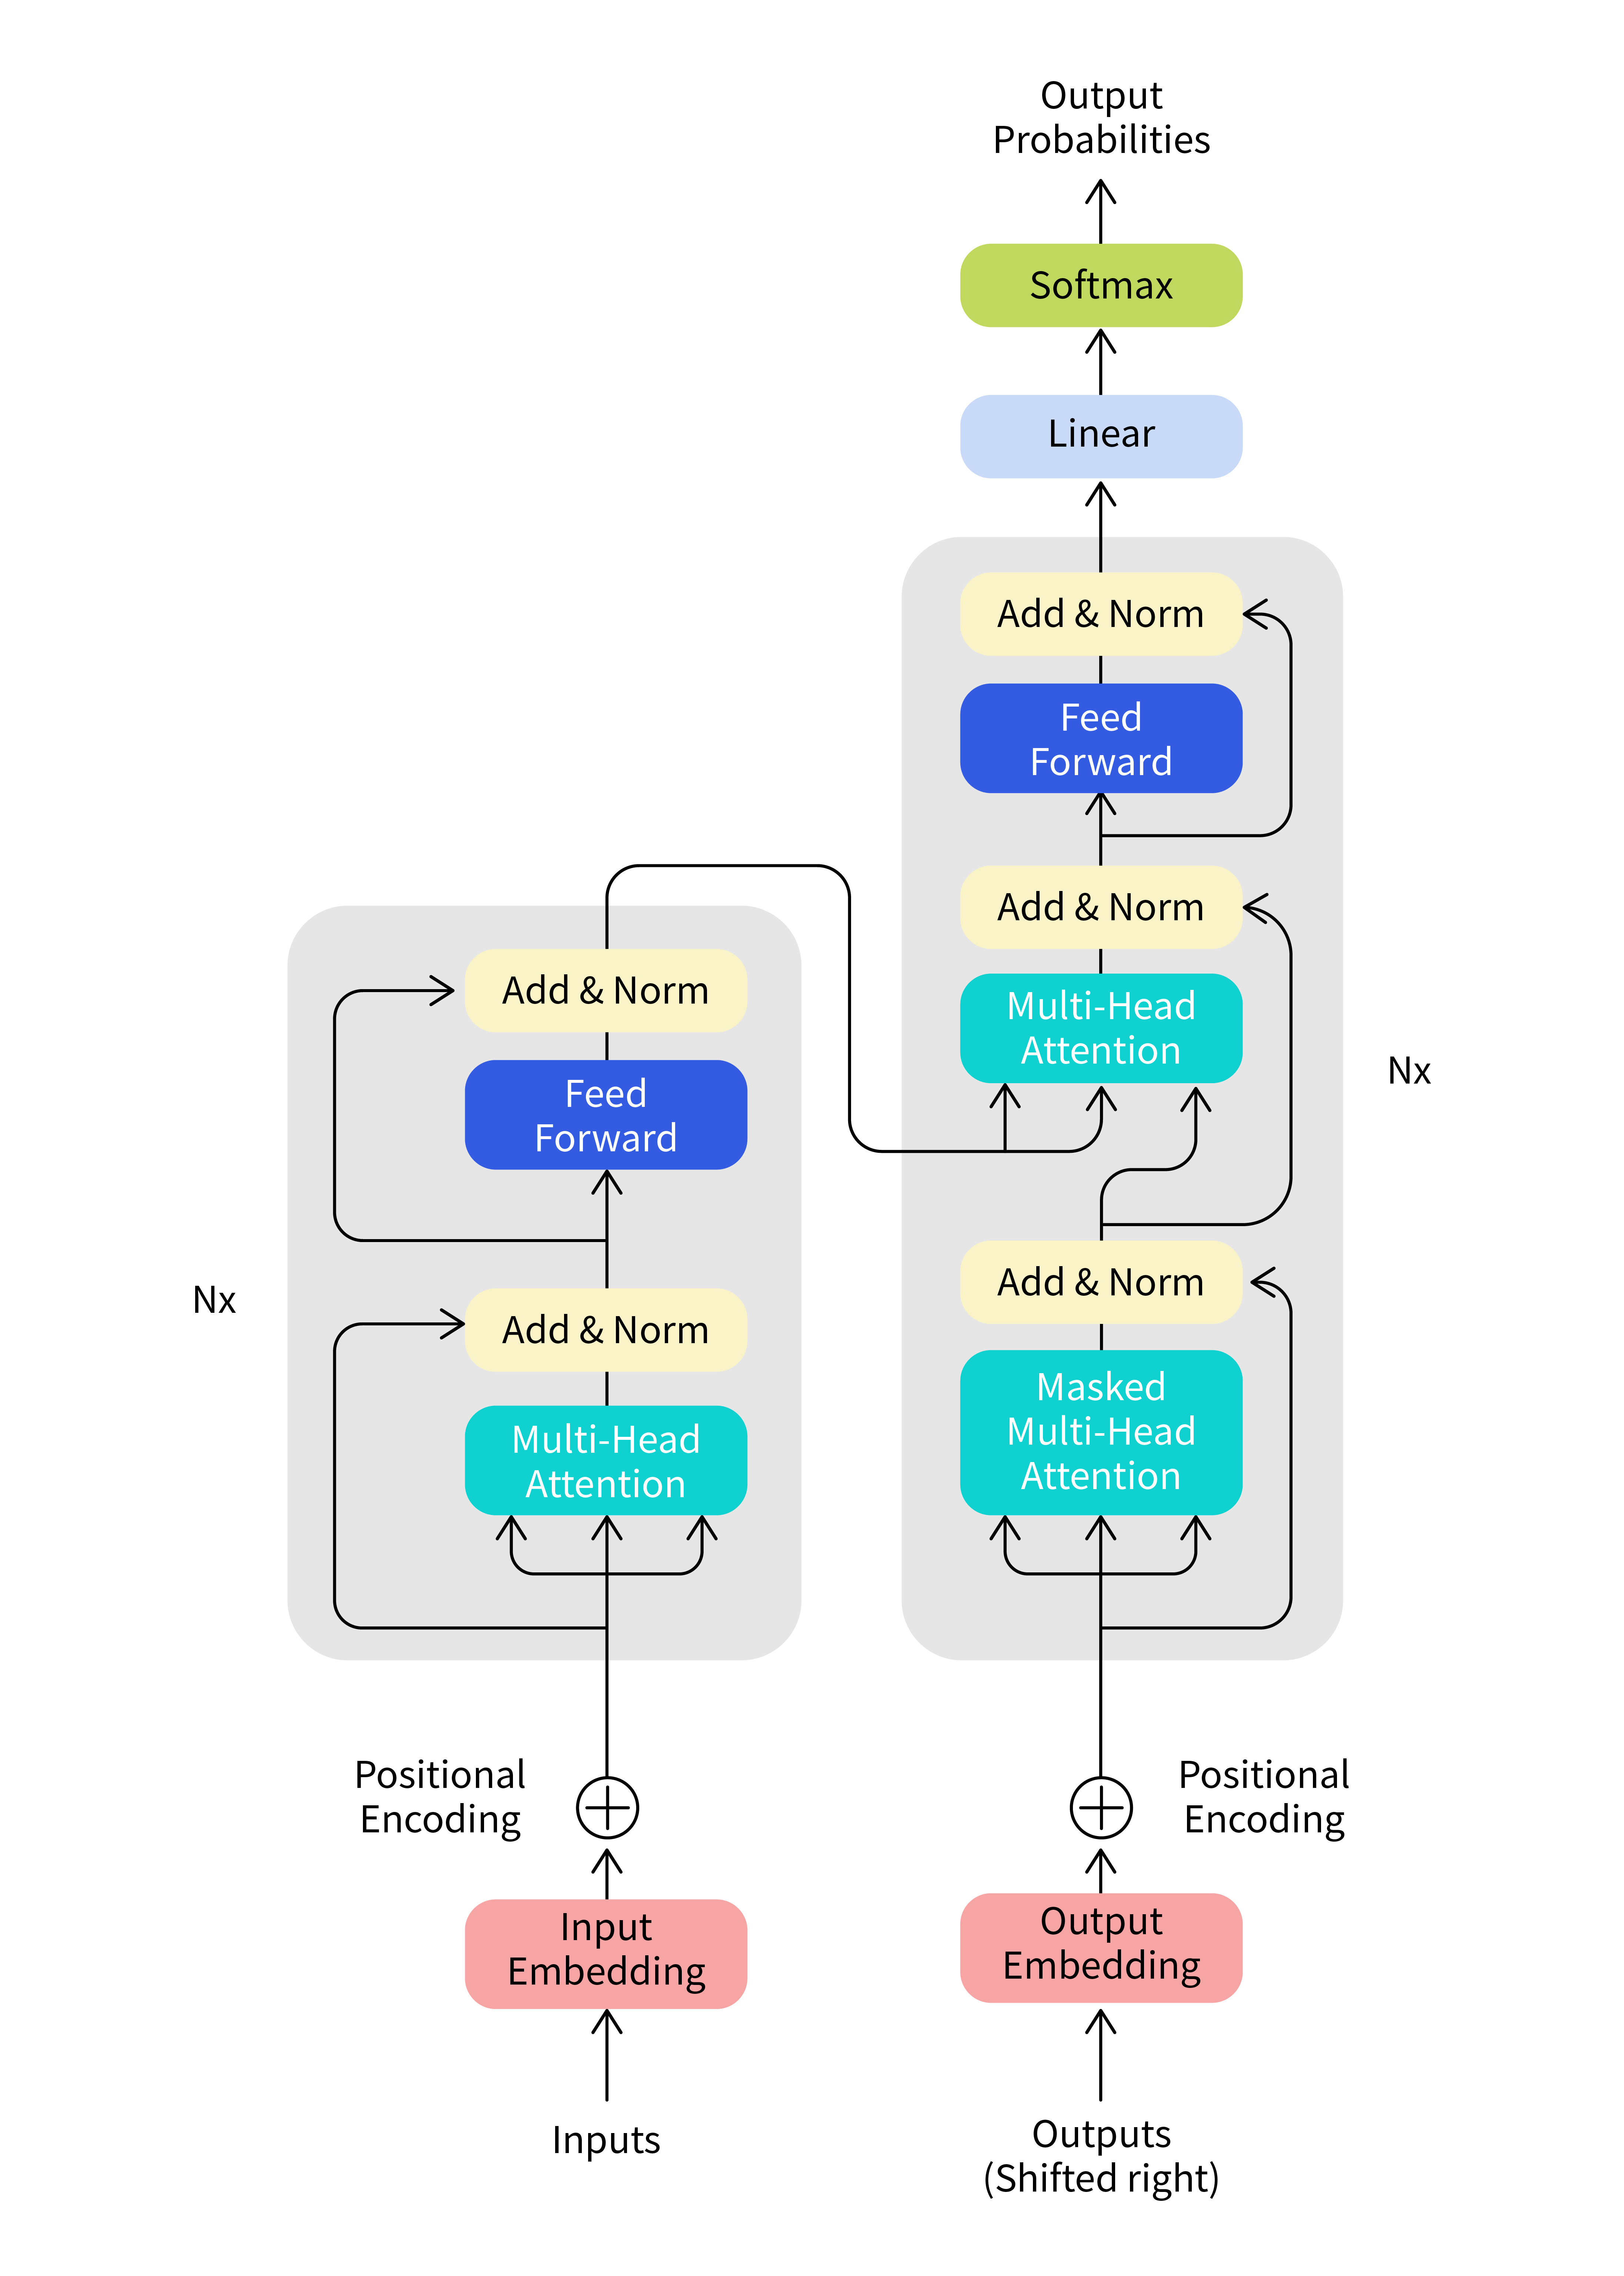
트랜스포머는 발표 이후 현재까지도 엄청난 영향력을 보여주고 있는 네트워크로 _RNN_의 역할을 하면서 _RNN_의 단점은 해결한 네트워크입니다. _RNN_은 분명히 시퀀스 데이터에 특화된 네트워크였지만, 다소 아쉬운 점이 있었습니다.
- 순차적으로 진행되기 때문에 시간이 너무 많이 걸린다는 점
- 순환 구조로 인해서 기존에 추출된 정보가 서서히 사라진다는 점
그런데 _Transformer_는 self-attention이라는 메커니즘으로 시퀀스 데이터 내에 존재하는 연관성 정보를 한 번에 추출할 수 있었고 나아가 뛰어난 성능까지 보여주었습니다.
2. 딥 러닝 시계열 이상 탐지
그럼 이제 본격적으로 실제 딥 러닝 모델들을 살펴보겠습니다.
2.1 THOC
THOC 는 Temporal Hierarchical One-Class Network의 줄임말입니다. 시간...계층...단일 클래스...네트워크..? 이게 무슨 말인가 싶지만 수식과 모델이 복잡할 뿐 아이디어는 간단합니다.
Q) 어떤 네트워크로 특성을 추출했는가! A) _RNN_으로 시계열에서 뽑아내겠다! = Temporal
Q) 어떤 아이디어를 결합했는가! A) 특성을 다단계로 뽑겠다! = Hierarchical A) 뽑아낸 특성들은 서로 유사성을 가질 것이다! = SVDD(one-class)
딥 러닝을 설명할 때 _feature extraction, representation learning_이라는 용어를 자주 사용합니다. 딥 러닝이 좋은 성능을 내는 이유에 꼭 언급되는 용어인데 네트워크가 학습되면서 입력 데이터를 기반으로 유용한 특성(feature), 표현(representation)을 학습한다는 것입니다. _Hierarchical_이라는 용어는 여기서 적용됩니다. 네트워크를 사용해서 좋은 특성, 표현을 찾아낸 후에 그 정보를 바탕으로 다시 특성, 표현을 뽑아내기를 반복한다면 더 깊고 의미 있는 정보를 얻을 수 있지 않을까요?
THOC에서는 시계열 데이터를 _RNN_에 입력하여 특성(feature)을 추출합니다. 그리고 그 특성들로 또 하나의 시계열 데이터를 만들어 다시 _RNN_에 입력하기를 반복하며 계층적으로 특성을 추출하기 때문에 _Temporal Hierarchical_이라는 단어를 사용했습니다. _One-class_는 지난 글에서 설명한 SVDD를 사용하기 때문입니다. _RNN_으로 추출한 특성(feature)들이 feature space 내에서 밀집해 있을 것이라 가정하고 특성들에 SVDD를 적용합니다.
2.2 SISVAE
SIS-VAE는 Smoothness-Inducing Sequential Variational Auto-Encoder의 줄임말입니다. 이번에는 정말 무슨 뜻인지 감도 안 오는 단어들입니다. 하지만 가장 중요한 단어는 단 하나, _Smoothness_입니다.
Q) 어떤 네트워크로 특성을 추출했는가! A) RNN, _VAE_로 시계열에서 뽑아내겠다!
Q) 어떤 아이디어를 결합했는가! A) 우린 _VAE_로 입력 데이터의 분포(평균, 분산)를 복원하겠다! 그런데 정상 데이터라면 이 분포가 부드럽게 이어지지 않을까! = Smoothness
_Reconstruction-method_인 SIS-VAE 는 _RNN, VAE_를 사용하여 입력 데이터를 복원합니다. 다만 다른 모델들과 조금 다르게 값 자체를 복원하는 것이 아니라 값의 확률 분포를 복원합니다. 그리고 이때 인접한 데이터들의 확률 분포가 부드럽게 이어질 것이라는 게 바로 _Smoothness_라는 아이디어입니다. 굉장히 간단하면서도 직관적인 아이디어입니다. 단순하게 생각하면 정상적인 시계열 데이터는 급격하게 변하지 않을 것이라는 걸 확률을 사용해서 수학적으로 표현한 것입니다.
아래의 그림에서 검은색 선이 SIS-VAE에 의해 예측된 데이터의 평균, 파란색 영역이 신뢰 구간이라고 가정하겠습니다. 매 데이터 포인트마다 가우시안 분포가 옆으로 누워 있고 3 표준 편차의 범위를 색칠했다고 생각하시면 편합니다. 이때 왼쪽에 두 점은 확률 분포가 유사해서 서로 부드럽게 이어지지만, 오른쪽의 두 점은 데이터의 중심(평균)이 크게 변하면서 확률 분포가 부드럽게 이어지지 않는 것을 알 수 있습니다. 이렇게 부드럽지 않은 데이터가 있다면 이것이 바로 이상 데이터(anomaly)라는 것입니다. 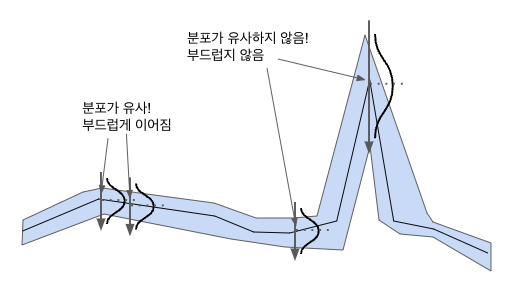
2.3 Anomaly Transformer
Anomaly Transformer는 _RNN_이 아닌 _Transformer_를 사용해서 시계열 데이터에서 특성(feature)을 추출합니다. 그리고 이때 한 가지 아이디어가 추가됩니다.
Q) 어떤 네트워크로 특성을 추출했는가! A) _Transformer_로 시계열에서 뽑아내겠다!
Q) 어떤 아이디어를 결합했는가! A) _Transformer_로 추출한 특성에서 입력 시계열을 복원하겠다. 그리고 이때 함께 추출한 시계열 축 데이터 연관성 분포를 우리가 알고 있는 확률 분포에 근사하겠다!
모델 이름에서도 알 수 있듯이 Anomaly Transformer는 시계열 데이터에 트랜스포머를 접목시킨 모델입니다. 여기에 추가로 트랜스포머로 얻은 시퀀스 데이터 내의 연관율 분포를 이미 알고 있는 확률 분포에 근사합니다. 이때 다양한 확률 분포를 적용할 수 있지만, 논문의 저자는 가우시안 분포를 사용하는 것이 가장 좋은 결과를 보여주었다고 합니다.
이 부분에 대해서는 조금 더 자세하게 설명하자면 _Transformer_를 사용했을 때 모델은 시퀀스 데이터 내의 연관성을 확률 분포로 추출할 수 있습니다. 아래의 그림처럼 "I am a cute cat"이라는 문장을 학습한다면 모델은 I와 cat이 서로 높은 연관성을 가졌다고 말할 것입니다. 그리고 이때 I와 각 단어의 연관성을 오른쪽의 확률 분포로 나타낼 수가 있습니다.
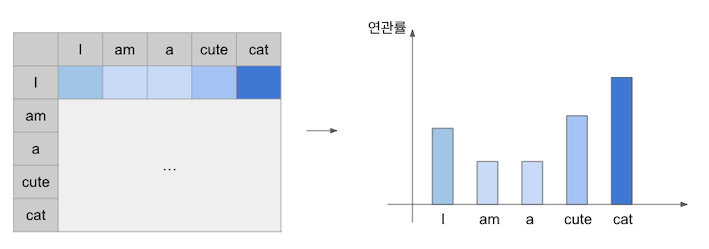 여기서 Anomaly Transformer의 아이디어가 추가됩니다. 정상적인 흐름을 가진 시계열 데이터라면 연관성 분포가 고르게 나타나지 않을까? 반대로 이상 데이터라면 오직 인접한 데이터들과 높은 연관성을 지니고 있지 않을까? 간단한 예를 들어보겠습니다. 아래의 그림처럼 별다른 이상(anomaly)이 없는 시계열 데이터가 있습니다. 이 데이터에서 빨간 지점을 기준으로 연관성을 추출한다면 아래처럼 균등한 모양이 나오지 않을까요?
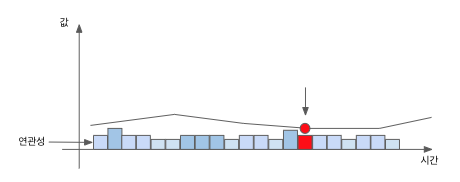 이번엔 이상 데이터가 포함된 시계열을 보겠습니다. 기존과는 다르게 빨간 지점의 데이터는 인접한 데이터와 높은 연관성을 보이고 있습니다. 이상 데이터가 발생할 때 전후로 전조증상과 흔적이 남을 것이라고 해석할 수도 있을 것 같습니다. 이렇게 인접한 데이터와 높은 연관성을 가진 데이터를 이상 데이터(anomaly)라고 판단합니다.
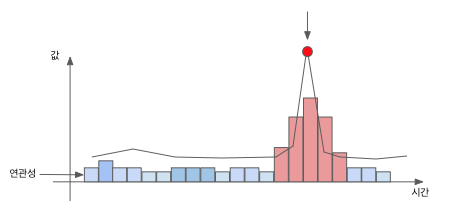 이것이 Anomaly Transformer가 제안한 아이디어입니다. 위에서 SIS-VAE가 시간축에서 데이터 변화의 부드러움을 추구했다면 Anomaly Transformer는 데이터 연관성의 균일함을 추구했습니다.
위에서 소개해 드린 3개의 모델을 제외하고도 정말 다양한 아이디어들이 시계열 이상 탐지에 적용되었습니다. 어떤 아이디어가 뛰어나다거나 정답이라고 단언할 수는 없으며 사용 환경에 맞추어 적절한 모델을 사용할 수 있어야 합니다. 실제로 저희 팀에서도 위의 모델을 그대로 적용했을 때 오히려 탐지 성능이 급격히 낮아지는 경우가 많았습니다. 어떤 데이터를 사용하며 무엇을 탐지할 지에 따라 독창적인 아이디어가 얼마든지 나올 수 있습니다.
3. 실제 적용까지...
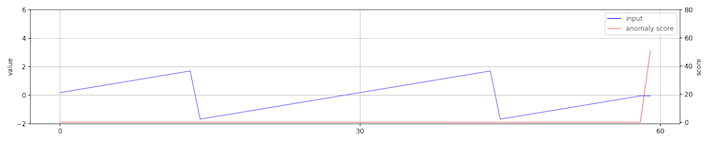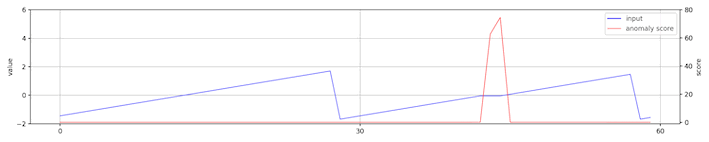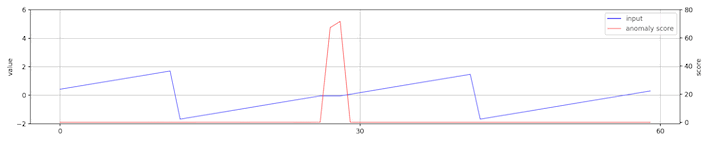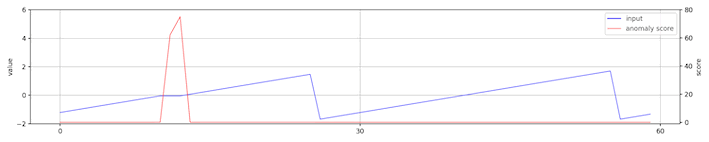
지금부터는 실제로 저희 팀에서 학습한 모델의 탐지 결과를 보여드리면서 어떤 시행착오를 겪었는지 공유드리겠습니다. 만약 시계열 데이터를 분석할 계획이 있으시다면 이 글을 통해 제가 겪었던 고난을 피해가시길 바랍니다. 지금 보여 드리는 모델은 일정한 주기로 상승/감소를 반복하는 가상 데이터를 학습시킨 Transformer 기반 딥 러닝 모델입니다.
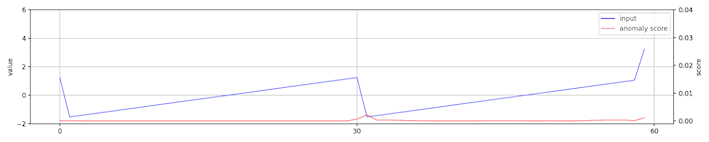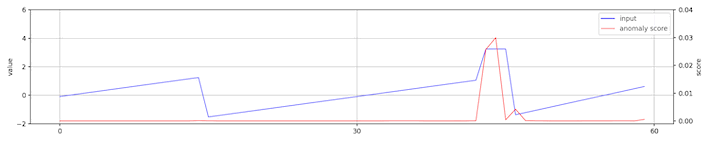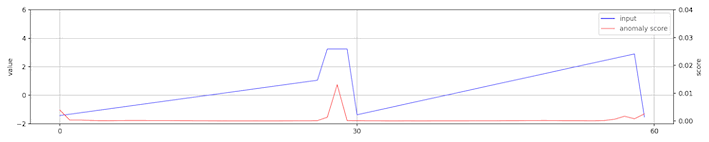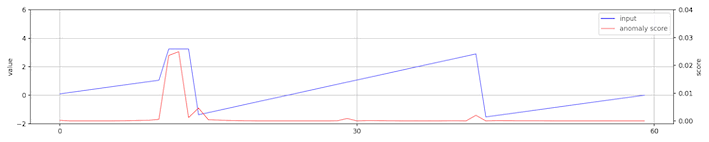
예시 파란 선은 입력 시계열 데이터, 빨간 선은 어노말리 스코어를 나타냅니다. 어노말리 스코어가 임계값을 넘어간다면 이상 데이터로 판단하여 알림을 보내게 됩니다.
해당 데이터는 일정하게 상승하던 값이 갑자기 급증하는 이상 데이터가 발생하였고 딥 러닝 모델이 이것을 잘 탐지하는 것을 확인할 수 있습니다. 단순하게 최댓값을 기준으로 탐지했다면 바로 다음에 오는 주기에서 비슷한 수준까지 값이 상승했을 때도 이상 신호가 탐지되었겠지만 모델은 이를 잘 구분해냈습니다.
 아래의 데이터에서는 상승 구간 중간에 약간의 이상 데이터가 발생했습니다. 사람의 눈으로도 놓치기 쉬운 작은 데이터인데 이번에도 딥 러닝 모델은 이상 신호를 잘 구분하였고 이것이 딥 러닝 모델의 강점을 보여주는 사례입니다.
 사실 위의 예시는 매우 간단한 단변량 데이터이기 때문에 rule-based 이상 탐지만으로도 충분하겠지만, 실제 데이터는 이렇게 간단하지 않습니다. 만약 _rule-based method_를 적용한다면 감당하지 못할 정도로 많은 조건만 쌓이게 될 가능성이 높습니다. 이렇게 복잡한 규칙을 세우지 않아도 이상 탐지가 가능하다는 것이 딥 러닝 모델의 강점이라고 할 수 있습니다.
그럼 모델만 잘 만들면 데이터는 그냥 입력만 하면 될까? 당연하지만 절대 아닙니다. 원본 데이터를 그대로 모델에 사용했다가는 성능이 바닥을 칠 가능성이 높습니다. 반드시 데이터 전처리 과정을 거쳐야 하는데 시계열 데이터에서 크게 고려해야 할 사항은 다음과 같습니다.
- 데이터 누락, 측정 오류 수정
- 시계열 정상성(stationary) 확인
첫 번째 고려 사항이 무엇을 의미하는지는 금방 아실 것 같습니다. 가장 기본적이고 가장 중요한 작업입니다. 이때 제대로 수정을 하지 않고 넘어간다면 이 문제는 나중에 눈사태가 되어 돌아올 수 있습니다... 보통 누락된 데이터는 0이나 평균값으로 대체해 사용합니다. 하지만 도메인에 따라 0, 평균값이 가지는 의미를 확인하시고 주의해서 적용해야 합니다. 전후 데이터로 누락 데이터를 예상 가능하다면 regression으로 보강할 수 있습니다. 또 다른 방법으로는 누락 데이터 자체를 이상(anomaly)이라고 판단할 수도 있습니다. 측정 오류가 발생한 데이터에 대해서도 유사한 방법으로 처리 가능합니다. 이런 결정을 적절히 내리기 위해서 반드시 도메인에 대한 충분한 이해와 지식이 필요합니다.
두 번째 고려 사항에서 말하는 시계열 정상성의 사전적 정의는 _"시간이 변해도 특성이 일정한 시계열"_입니다. 여기서 특성은 평균, 분산, 트렌드 등 시계열의 특성을 나타낼 수 있는 여러 지표들을 말합니다. 시계열 분석에서는 비정상성 시계열을 정상성 시계열로 변환하는 게 매우 중요합니다. 비정상성 시계열을 그대로 분석한다는 것은 마치 어른과 아이에게 같은 시험을 보게 하는 것과도 같습니다. 그래서 사전에 차분(differencing), detrending, deseasonalizing 등의 여러 전처리 과정을 통해 시계열 데이터의 비정상성을 제거해야 합니다. 다만 이러한 방법이 효과적이긴 해도 데이터를 변환하는 과정 자체가 비용이 많이 소모되고, 그 과정에서 데이터가 가진 고유의 특성이 유실될 가능성이 있습니다. 그래서 원본 시계열 데이터는 그대로 보존하고 정규화(normalization)만 적용하기도 합니다. 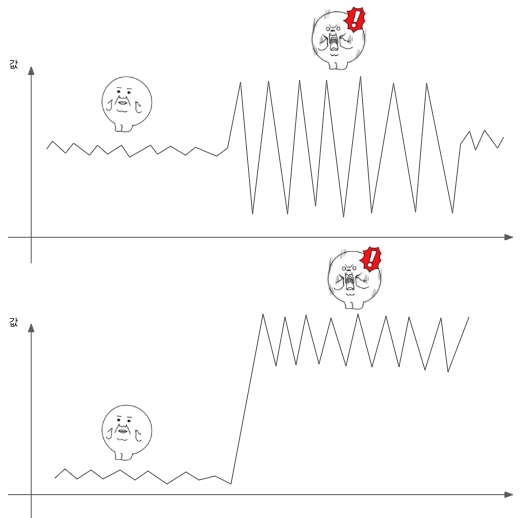
보통은 이 정도의 처리만 해 주어도 큰 문제없이 다음 단계로 넘어갈 수 있지만... 시계열 데이터에서는 일반적인 정규화로는 부족하다는 의견이 많습니다. 그 이유는 일반적인 정규화는 시계열 데이터가 'stationary'하다고 가정하기 때문입니다. 그래서 'non-stationary'한 시계열에 동일한 정규화를 적용한다면 실제 환경에서 문제가 발생할 가능성이 있습니다.
예시를 보면서 더 자세히 확인해 보겠습니다. 아래와 같은 데이터가 있습니다. 점선을 기준으로 추세가 크게 변화했고 빨간점으로 표시된 변동성이 발생했습니다. 점선을 기준으로 왼쪽에서는 빨간 점의 변동성이 매우 크게 느껴질 것 입니다. 하지만 오른쪽에서는 이 정도의 변동성은 크게 신경 쓰일 정도는 아닙니다. 그런데 여기에 동일한 정규화를 적용한다면 이 강도의 차이를 반영할 수 없습니다. 왼쪽/오른쪽 모두 같은 크기의 변동성으로 표현되며 이게 만약 이상 탐지였다면 아마 왼쪽의 빨간 점은 찾아내지 못할 가능성이 높습니다.
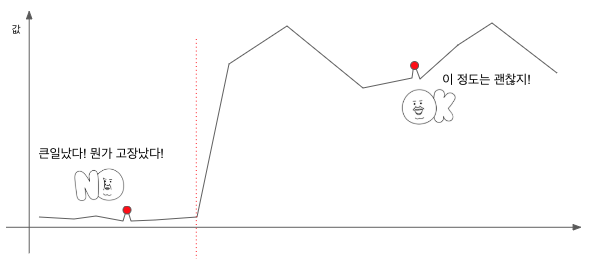
그럼 어떻게 해야 할까요? 직관적인 방법은 점선을 기준으로 왼쪽, 오른쪽을 따로 정규화하는 것입니다. 그런 아이디어에서 나온 정규화 기법을 _sliding-window normalization_이라고 합니다. 하지만 완벽한 알고리즘은 없듯이 기존 알고리즘의 단점을 보완하는 더욱 더 좋은 새로운 정규화 기법들이 활발하게 연구되고 있습니다.
4. 좋은 이상 탐지를 위한 도전 과제
정확한 이상 탐지를 위해서는 기본적으로 좋은 모델을 만들어야 합니다. 하지만 완벽한 모델을 만드는 것은 현실적으로 불가능합니다. 도메인에 대한 충분한 이해를 바탕으로 적절한 기법과 아이디어를 추가해야만 좋은 모델을 만들 수 있습니다. 저희도 다양한 모델을 바탕으로 독창적인 아이디어를 추가해가며 정확도를 조금이라도 높이기 위해 꾸준히 연구를 진행 중입니다. 또한 단순히 데이터를 넣어 줌으로써 좋은 결과를 얻을 수 없으며 특히 변동성이 높은 시계열 데이터는 섬세하게 다뤄야 합니다. 이렇게 모든 요소가 적절히 조화를 이룰 때 비로소 좋은 모델을 완성할 수 있습니다.
이상 탐지는 단순 분류로 해결하기 어려운 문제이기 때문에 측정된 어노말리 스코어를 보고 적절한 임계값을 정해 주어야 합니다. 이 과정에서 아무리 좋은 모델이라도 오류가 발생할 수밖에 없습니다. 실제로 제가 경험했던 사례를 들어 보겠습니다. 이상 탐지를 하다 보면 아래와 같은 상황이 정말 많이 나옵니다. 모든 이상 신호를 찾아내면 오탐지가 발생하고, 오탐지를 방지하면 미탐지가 발생합니다. 이럴 경우 어쩔 수 없이 오탐지과 미탐지 중 한 가지는 포기해야만 합니다. 애초에 모델이 정확하게 탐지해 준다면 좋겠지만 완벽한 모델 만들기는 정말 어려운 일입니다...
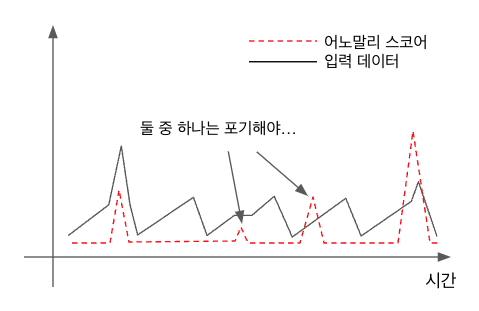 데이터마다 적절한 임계값이 모두 다를 가능성도 높습니다. 이렇게 임계값을 정하는 것은 따로 연구가 진행될 정도로 어려운 문제입니다. 가장 단순한 방법으로는 규칙을 정해서 고정값(ex. 어노말리 스코어 상위 0.5 %)을 임계치로 설정하는 것입니다. 이 방법은 일반적으로 잘 동작하지만 많은 데이터를 필요로 하고 다소 유연하지 못하다는 단점이 있습니다. 그 외에도 적절한 임계치를 찾아내기 위한 극한치 분포(extreme value theory), Gap Statistic method 등 다양한 이론이 연구되었습니다.
5. 비용 이상 탐지
현재 NHN Cloud의 클라우드AI팀에서는 NHN Cloud 비용 이상 탐지 서비스를 준비 중입니다. 혹시라도 발생할 수 있는 어뷰징으로 인한 오과금 이슈를 사전에 인지하여 그 원인을 해결하고자 함이 목적입니다. 더 나아가 비용 이상 탐지 서비스를 시작으로 점차 다양한 도메인으로 넓혀가기 위한 계획을 세우고 있습니다. 비록 많은 부분이 미흡하지만 더 정확한 이상 탐지를 위해 계속해서 노력하고 있으며 함께 다양한 도메인의 문제를 풀 수 있는 기회가 왔으면 좋겠습니다.
나가며
여기까지 총 4부로 이상 탐지에 대한 소개부터 딥 러닝 실제 적용까지 소개해 드렸습니다. 비록 저도 부족하지만 지난 몇 개월간 직접 경험하면서 얻은 지식을 조금이나마 공유해 드릴 수 있었던 좋은 기회였습니다. 이상 탐지라는 게 무엇인지 이해하시는 데 도움이 되었길 바라며 바쁘신 와중에 긴 글 읽어 주셔서 감사합니다!