Engineering
카카오의 언어모델, Kanana 테크니컬 리포트 공개
Kanana카카오
2025년 2월 27일
원문에서 보기 ↗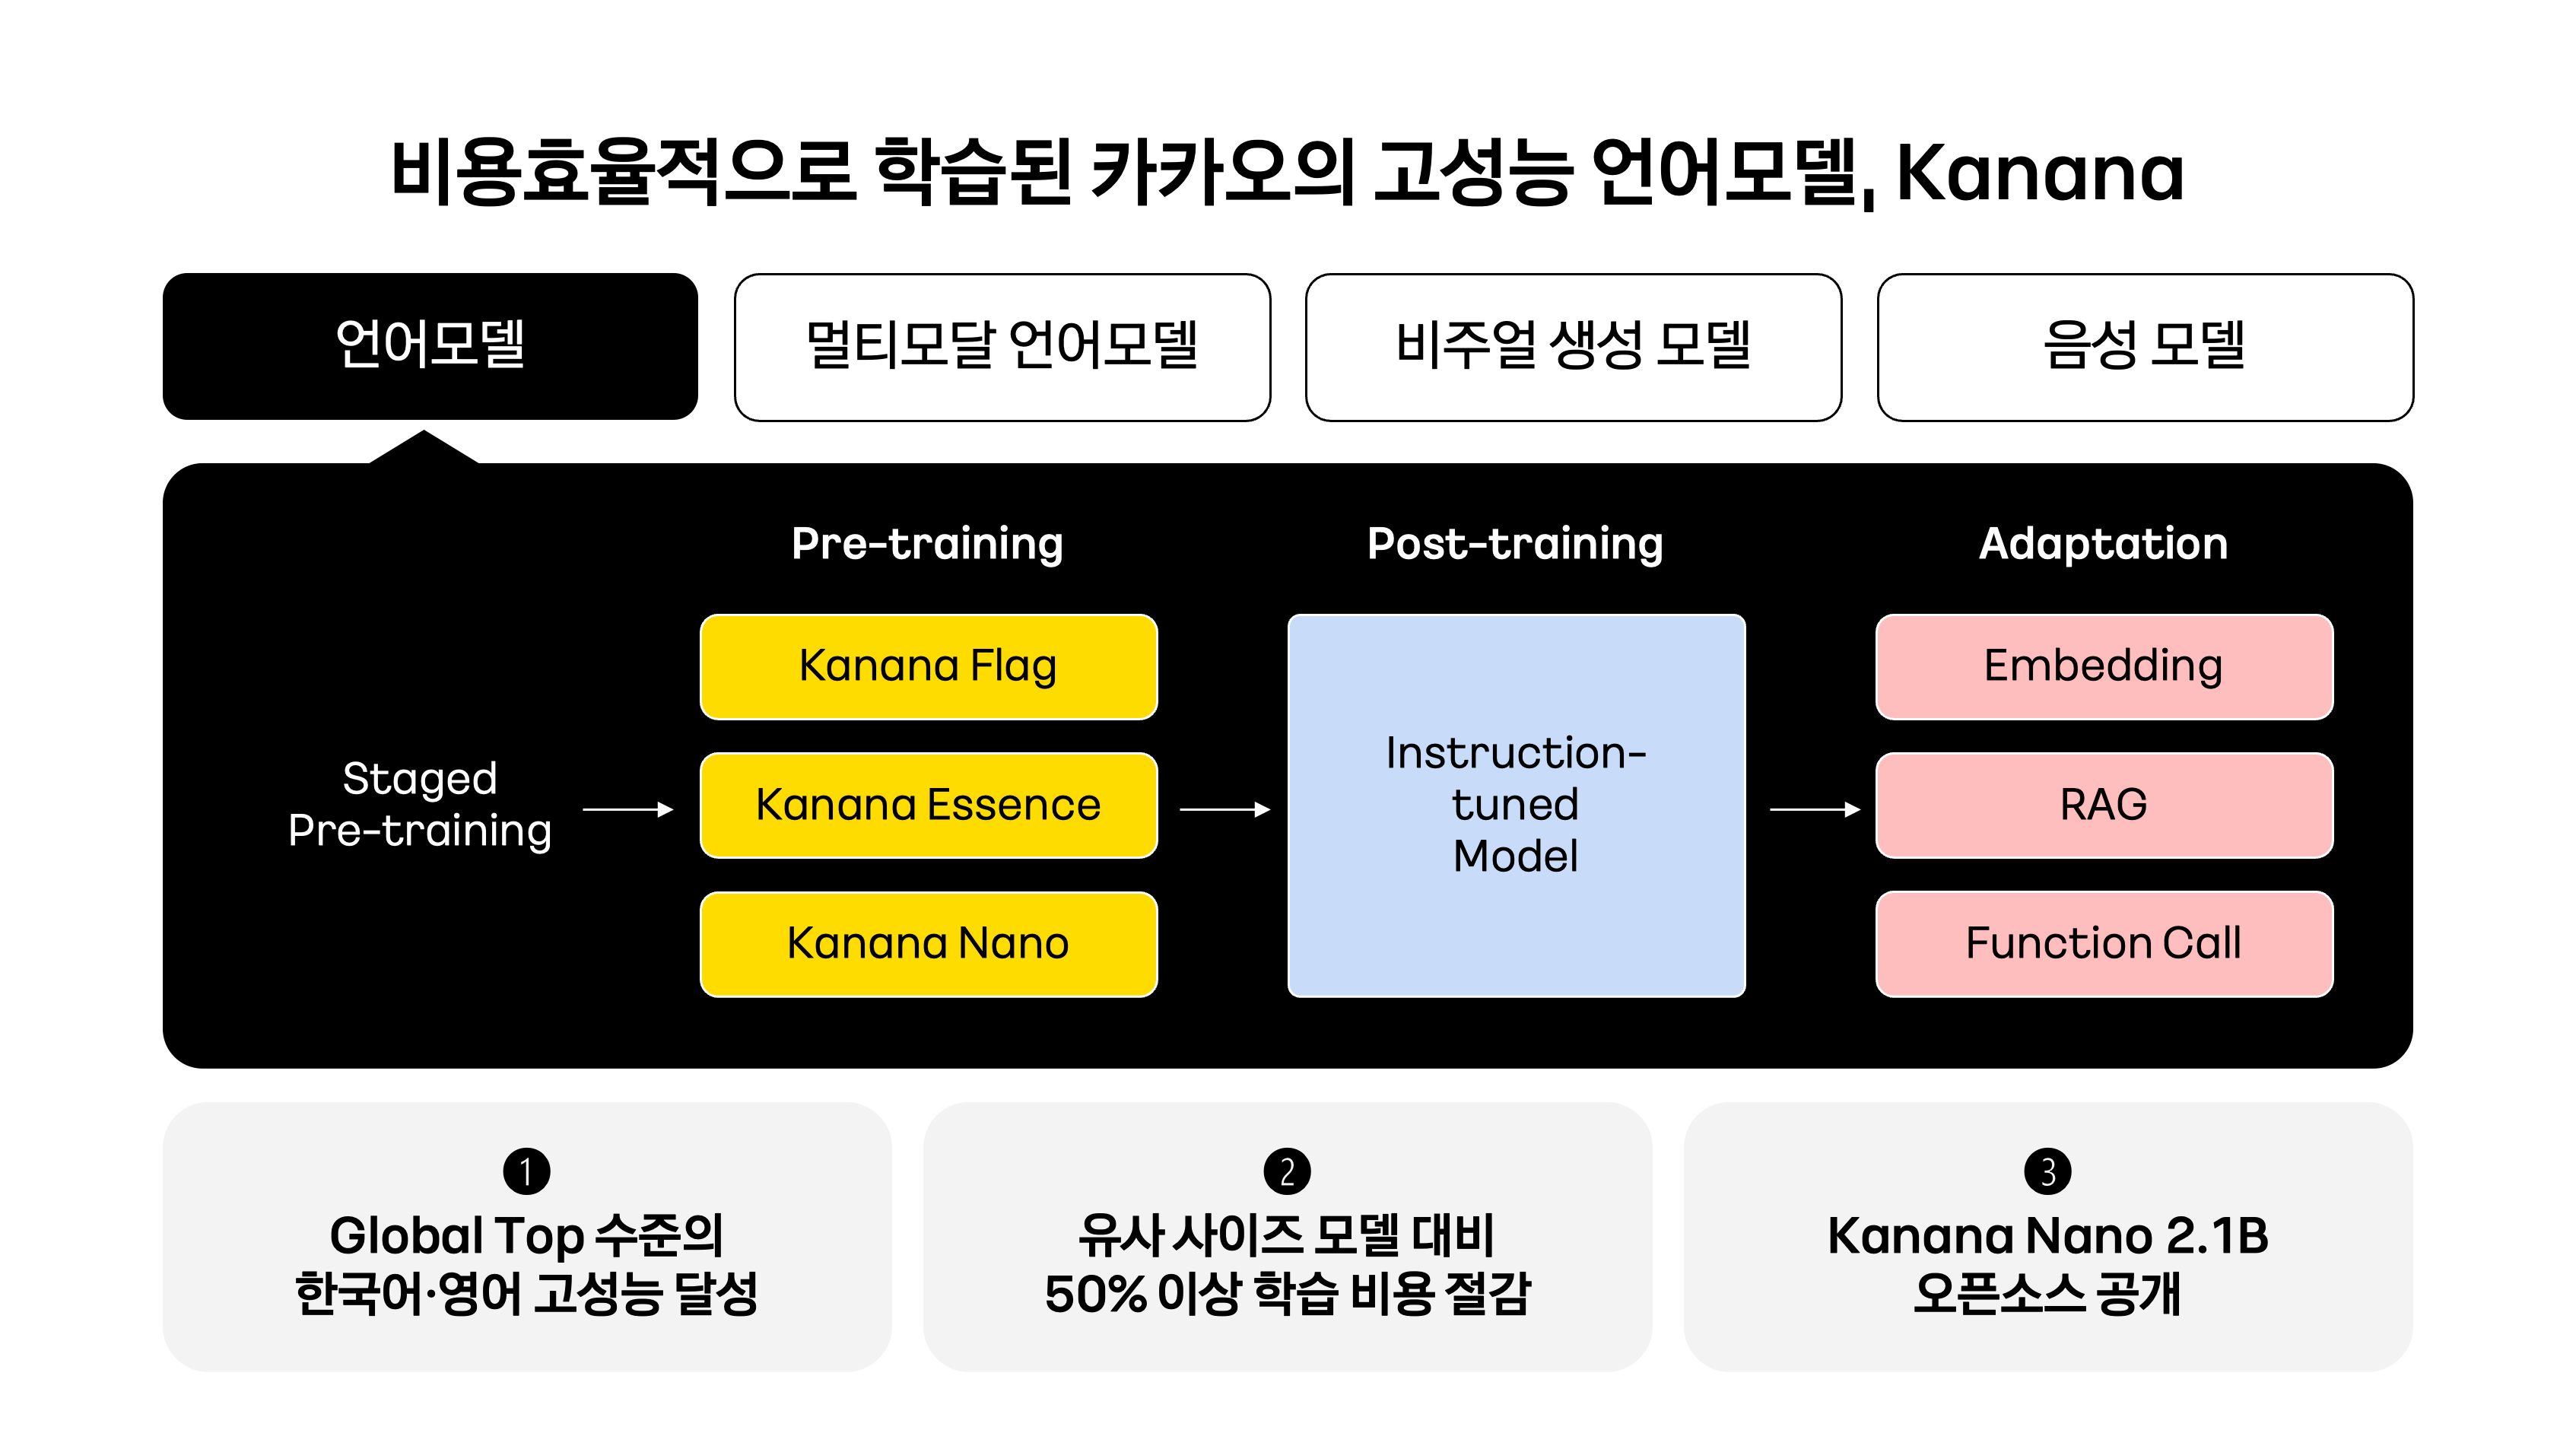
카카오는 서비스 적용에 최적화된 실용적이면서도 안전한 AI 모델을 목표로, 높은 성능과 비용 효율성을 동시에 고려한 자체 AI 모델 ‘카나나 모델 패밀리(Kanana Model Family)’를 개발하고 있습니다.
지난해말 카카오는 초거대 언어모델 'Kanana Flag’의 학습을 완료하며, pre-training부터 post-training까지 전 과정을 거쳐 카나나 언어모델 라인업 (Kanana Flag, Essence, Nano )을 완성했습니다. 이에 따라 전체 언어모델의 구조와 학습과정, 성능을 상세히 다룬 테크니컬 리포트를 공개하였습니다.
또한, 국내 AI 연구 생태계에 기여하고 글로벌 AI 커뮤니티와 협업을 확대하고자 연구자 및 개발자가 활용할 수 있도록 ‘Kanana Nano 2.1B’ 3개의 모델(base, instruct, embedding)을 오픈소스로 공개합니다.
1. Global Top 수준의 한국어·영어 고성능 달성
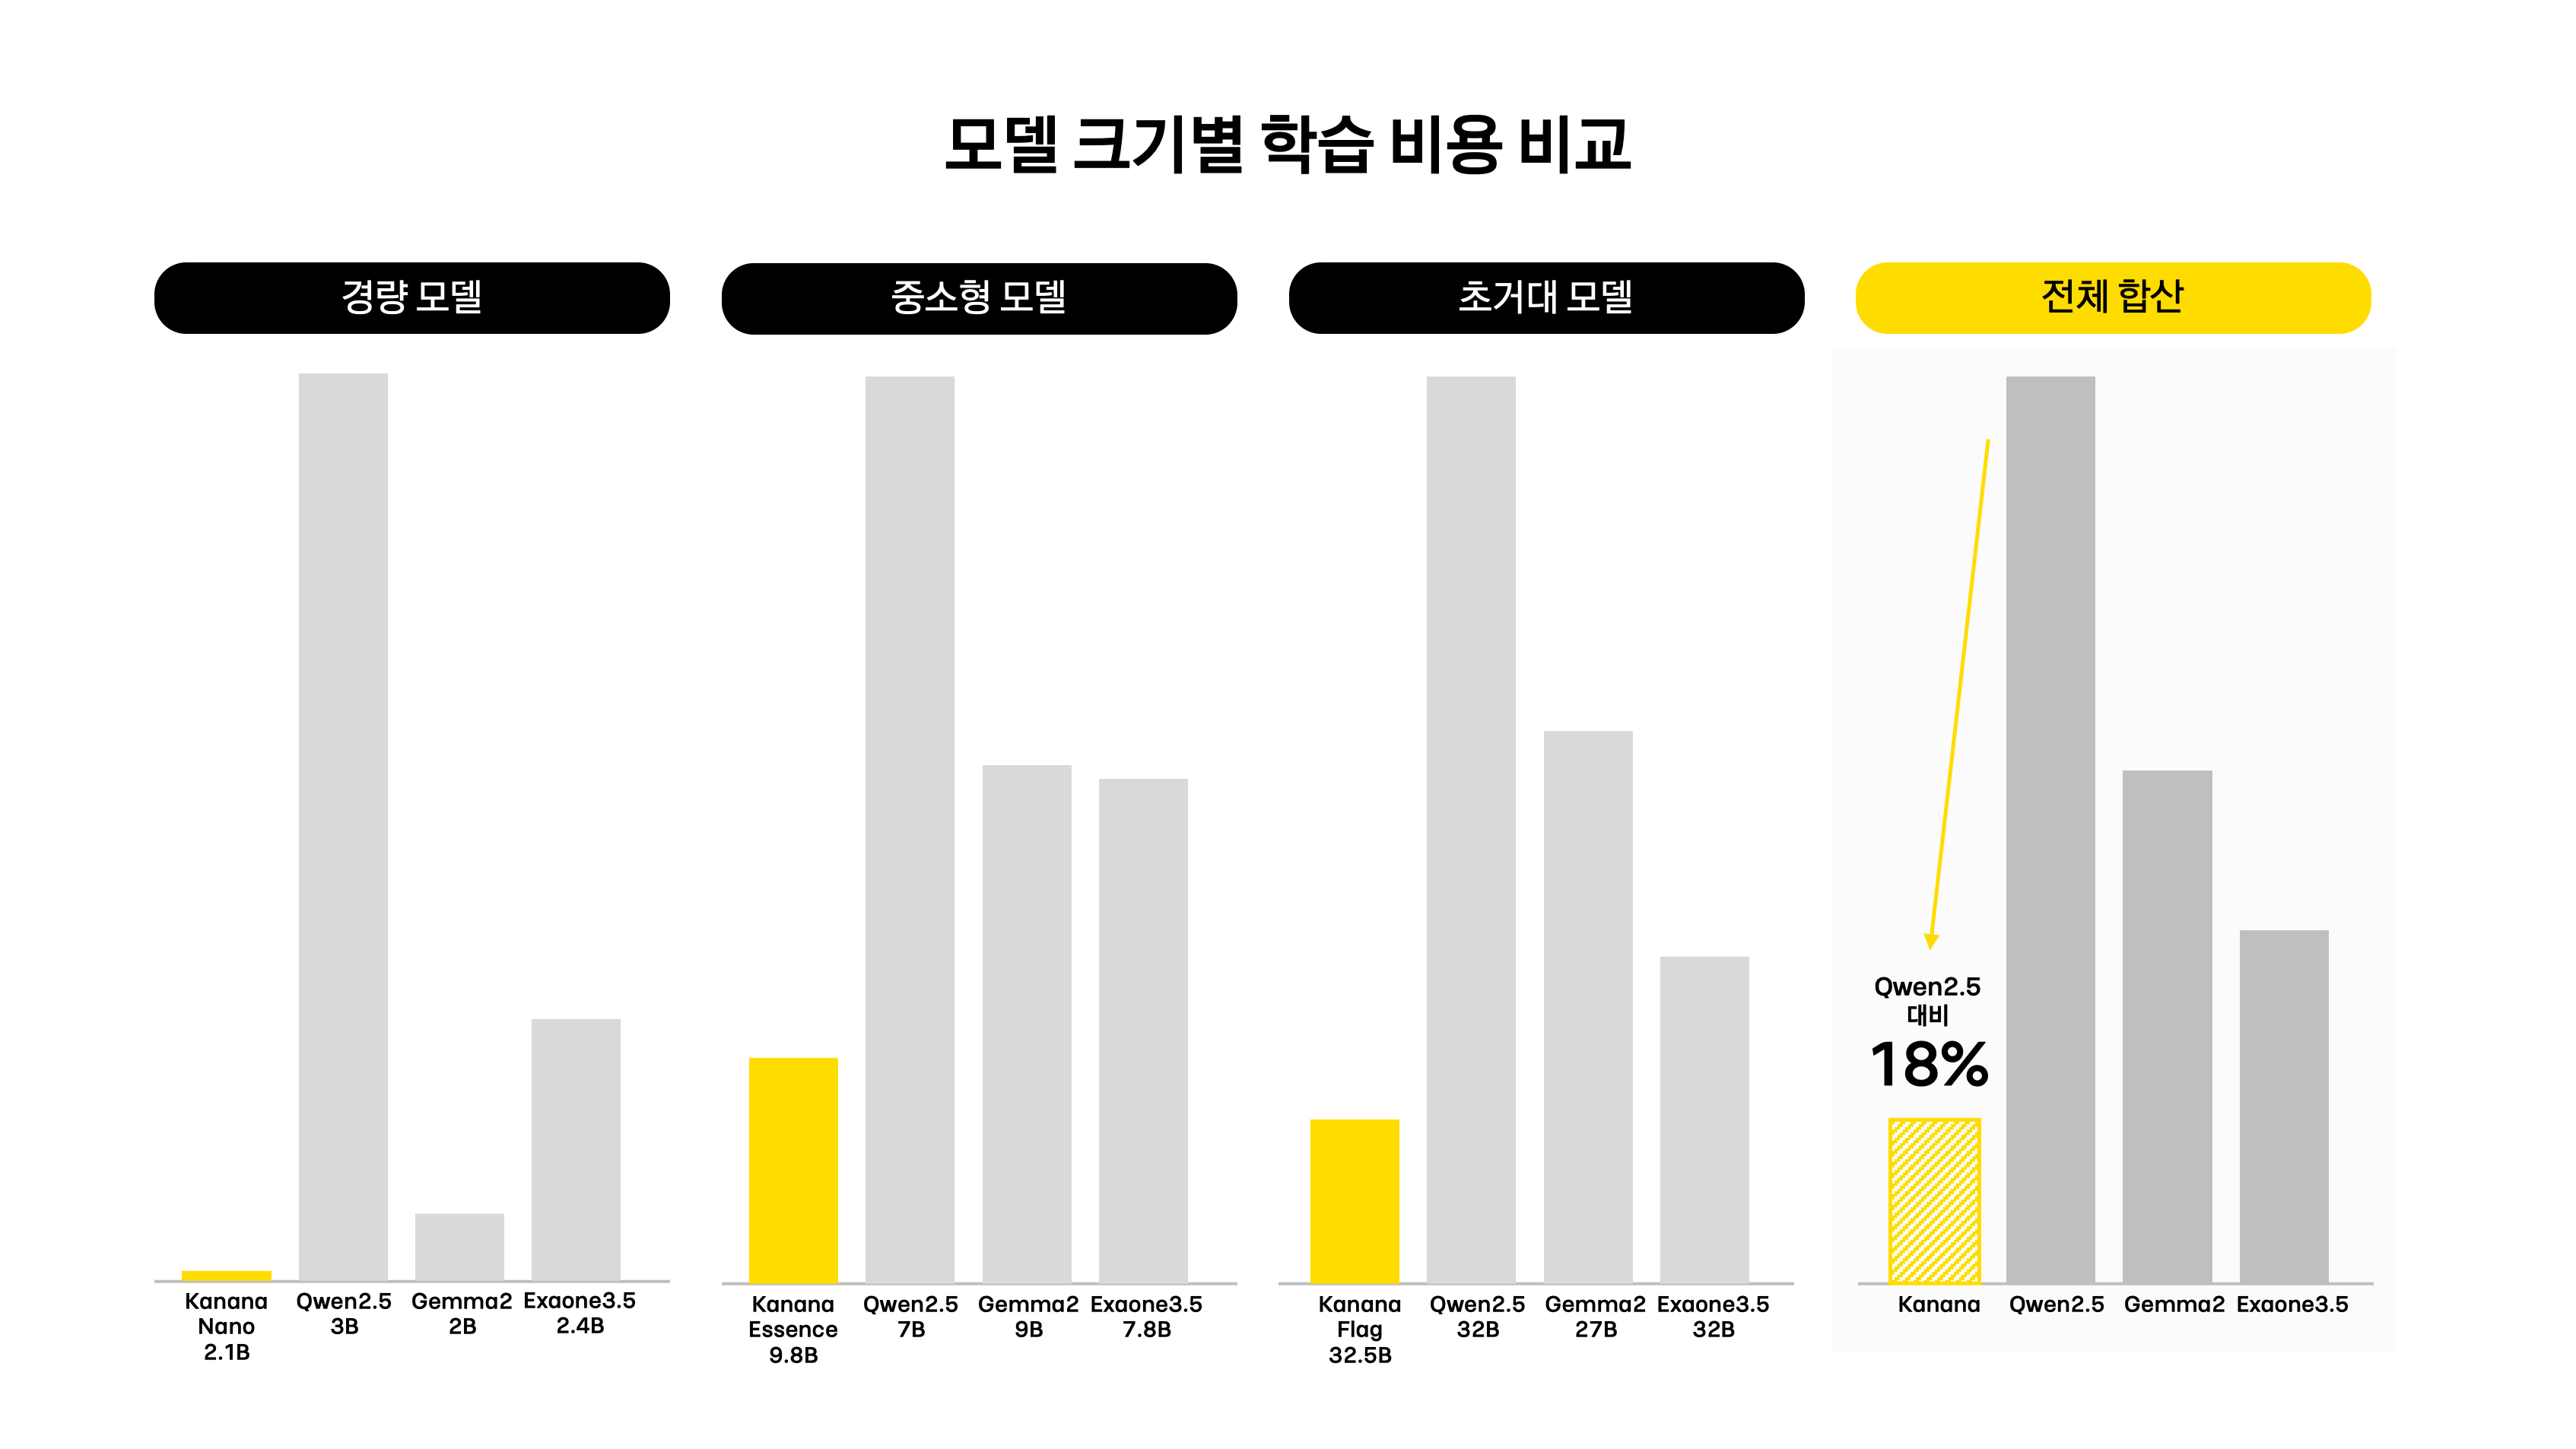
카카오는 글로벌 경쟁력을 확보한 모델을 개발하고자 한정된 자원 내에서 최고의 성능을 달성하기 위해 다양한 학습 기법을 실험하였습니다. 그 결과 Kanana Flag는 학습자원 최적화를 통해 타사 모델 대비 50% 이상 학습 비용을 절감하며, SOTA (State-of-the-Art ) 수준의 성능을 기록할 수 있었습니다.
영어 벤치마크인 MMLU, MT-Bench 등에서 글로벌 모델과 유사한 성능을 보이며, 특히 한국어의 벤치마크인 KMMLU, KoMT-Bench 등에서는 경쟁 모델 대비 압도적인 한국어 처리 성능을 입증했습니다.
| Models | Chat | Chat | Chat | Chat | Instruction Following |
|---|---|---|---|---|---|
| Models | MT-Bench 지식기반영어대화 | WildBench 일반영어대화 | LogicKor 지식기반한국어대화 | KoMT-Bench 지식기반한국어대화 | IFEval 사용자요청수행 |
| Kanana Flag 32.5B | 8.356 | 54.14 | 9.524 | 8.058 | 0.856 |
| Qwen2.5 32B | 8.331 | 51.13 | 8.988 | 7.847 | 0.822 |
| Gemma 2 27B | 8.088 | 46.46 | 8.869 | 7.373 | 0.817 |
| EXAONE-3.5-32B | 8.375 | 54.30 | 9.202 | 7.907 | 0.845 |
| Models | General Knowledge | General Knowledge | Coding | Coding | Mathematics | Mathematics |
|---|---|---|---|---|---|---|
| Models | MMLU (0-Shot Cot) 영어지식 | KMMLU (0-Shot Cot) 한국어지식 | HumanEval+ (0-Shot Cot) 코드완성 | MBPP+ (0-Shot Cot) 코드솔루션 | GSM8K (0-Shot Cot) 기초수학 | MATH (0-Shot Cot) 수학 |
| Kanana Flag 32.5B | 81.08 | 64.19 | 77.44 | 69.84 | 90.83 | 57.82 |
| Qwen2.5 32B | 84.40 | 59.37 | 82.32 | 71.96 | 95.30 | 81.90 |
| Gemma 2 27B | 78.01 | 49.98 | 70.12 | 70.90 | 91.05 | 53.80 |
| EXAONE-3.5-32B | 78.30 | 55.44 | 78.66 | 70.90 | 93.56 | 76.80 |
2. 학습 효율화로 유사 사이즈 모델 대비 절반 이하의 학습 비용
대규모 언어 모델의 학습에는 막대한 컴퓨팅 자원이 소요됩니다. 카카오는 초경량(2.1B)부터 초거대 언어모델(32.5B)에 이르기까지 카나나 언어모델의 학습 효율성을 극대화하기 위해 다음과 같은 Pre-training 전략을 적용하였습니다.
먼저 Staged pre-training 방식을 활용하여 8B와 26.8B 크기의 모델을 각각 학습했습니다. 8B 모델을 바탕으로 모델 최적화를 위한 가지치기(Pruning)^[1]^와 지식증류(Distillation)^[2]^ 과정을 거쳐 경량 모델 Kanana Nano 2.1B 를 구축하였습니다. 또한, 8B, 26.8B 두 모델에 깊이 업스케일링(DUS, Depth Up-Scaling)^[3]^ 기법을 적용하여, Kanana Essence 9.8B 와 Kanana Flag 32.5B를 개발하였습니다.
이렇게 이미 학습된 모델을 활용하여 다양한 사이즈의 고성능 모델을 개발함으로써 유사 사이즈의 글로벌 모델 대비 절반보다도 적은 수준의 학습 비용으로 학습자원을 최적화할 수 있었습니다. 실제로 카나나 언어모델과 사이즈 별로 비슷한 모델의 학습비용(모델 크기*학습에 사용한 데이터의 양 기준)을 비교한 결과는 다음과 같습니다.
3. 온디바이스에서도 활용 가능한 고성능 경량 모델, Kanana Nano 2.1B 오픈소스 공개
카나나 언어모델 중, 연구자 및 개발자의 활용도를 고려해 연구 목적으로 활용할 수 있도록 'Kanana Nano 2.1B ’의 base, instruct 버전과 함께 문서 임베딩을 위해 adaptation을 적용한 embedding 버전을 오픈소스로 공개합니다. 이를 통해 국내 AI 연구 생태계에 기여하고, 글로벌 AI 커뮤니티와의 협업을 확대하는 계기를 마련하고자 합니다.
Kanana Nano 2.1B는 연구자와 개발자가 활용하기 적절한 크기의 모델로, 온디바이스 환경에서도 원활히 운영될 수 있도록 설계되었습니다. 대형 모델은 학습 및 운영 비용이 높고, 지나치게 작은 모델은 정확도가 낮아질 수 있는 문제를 고려하여, 가장 활용도가 높은 사이즈로 공개를 결정했습니다.
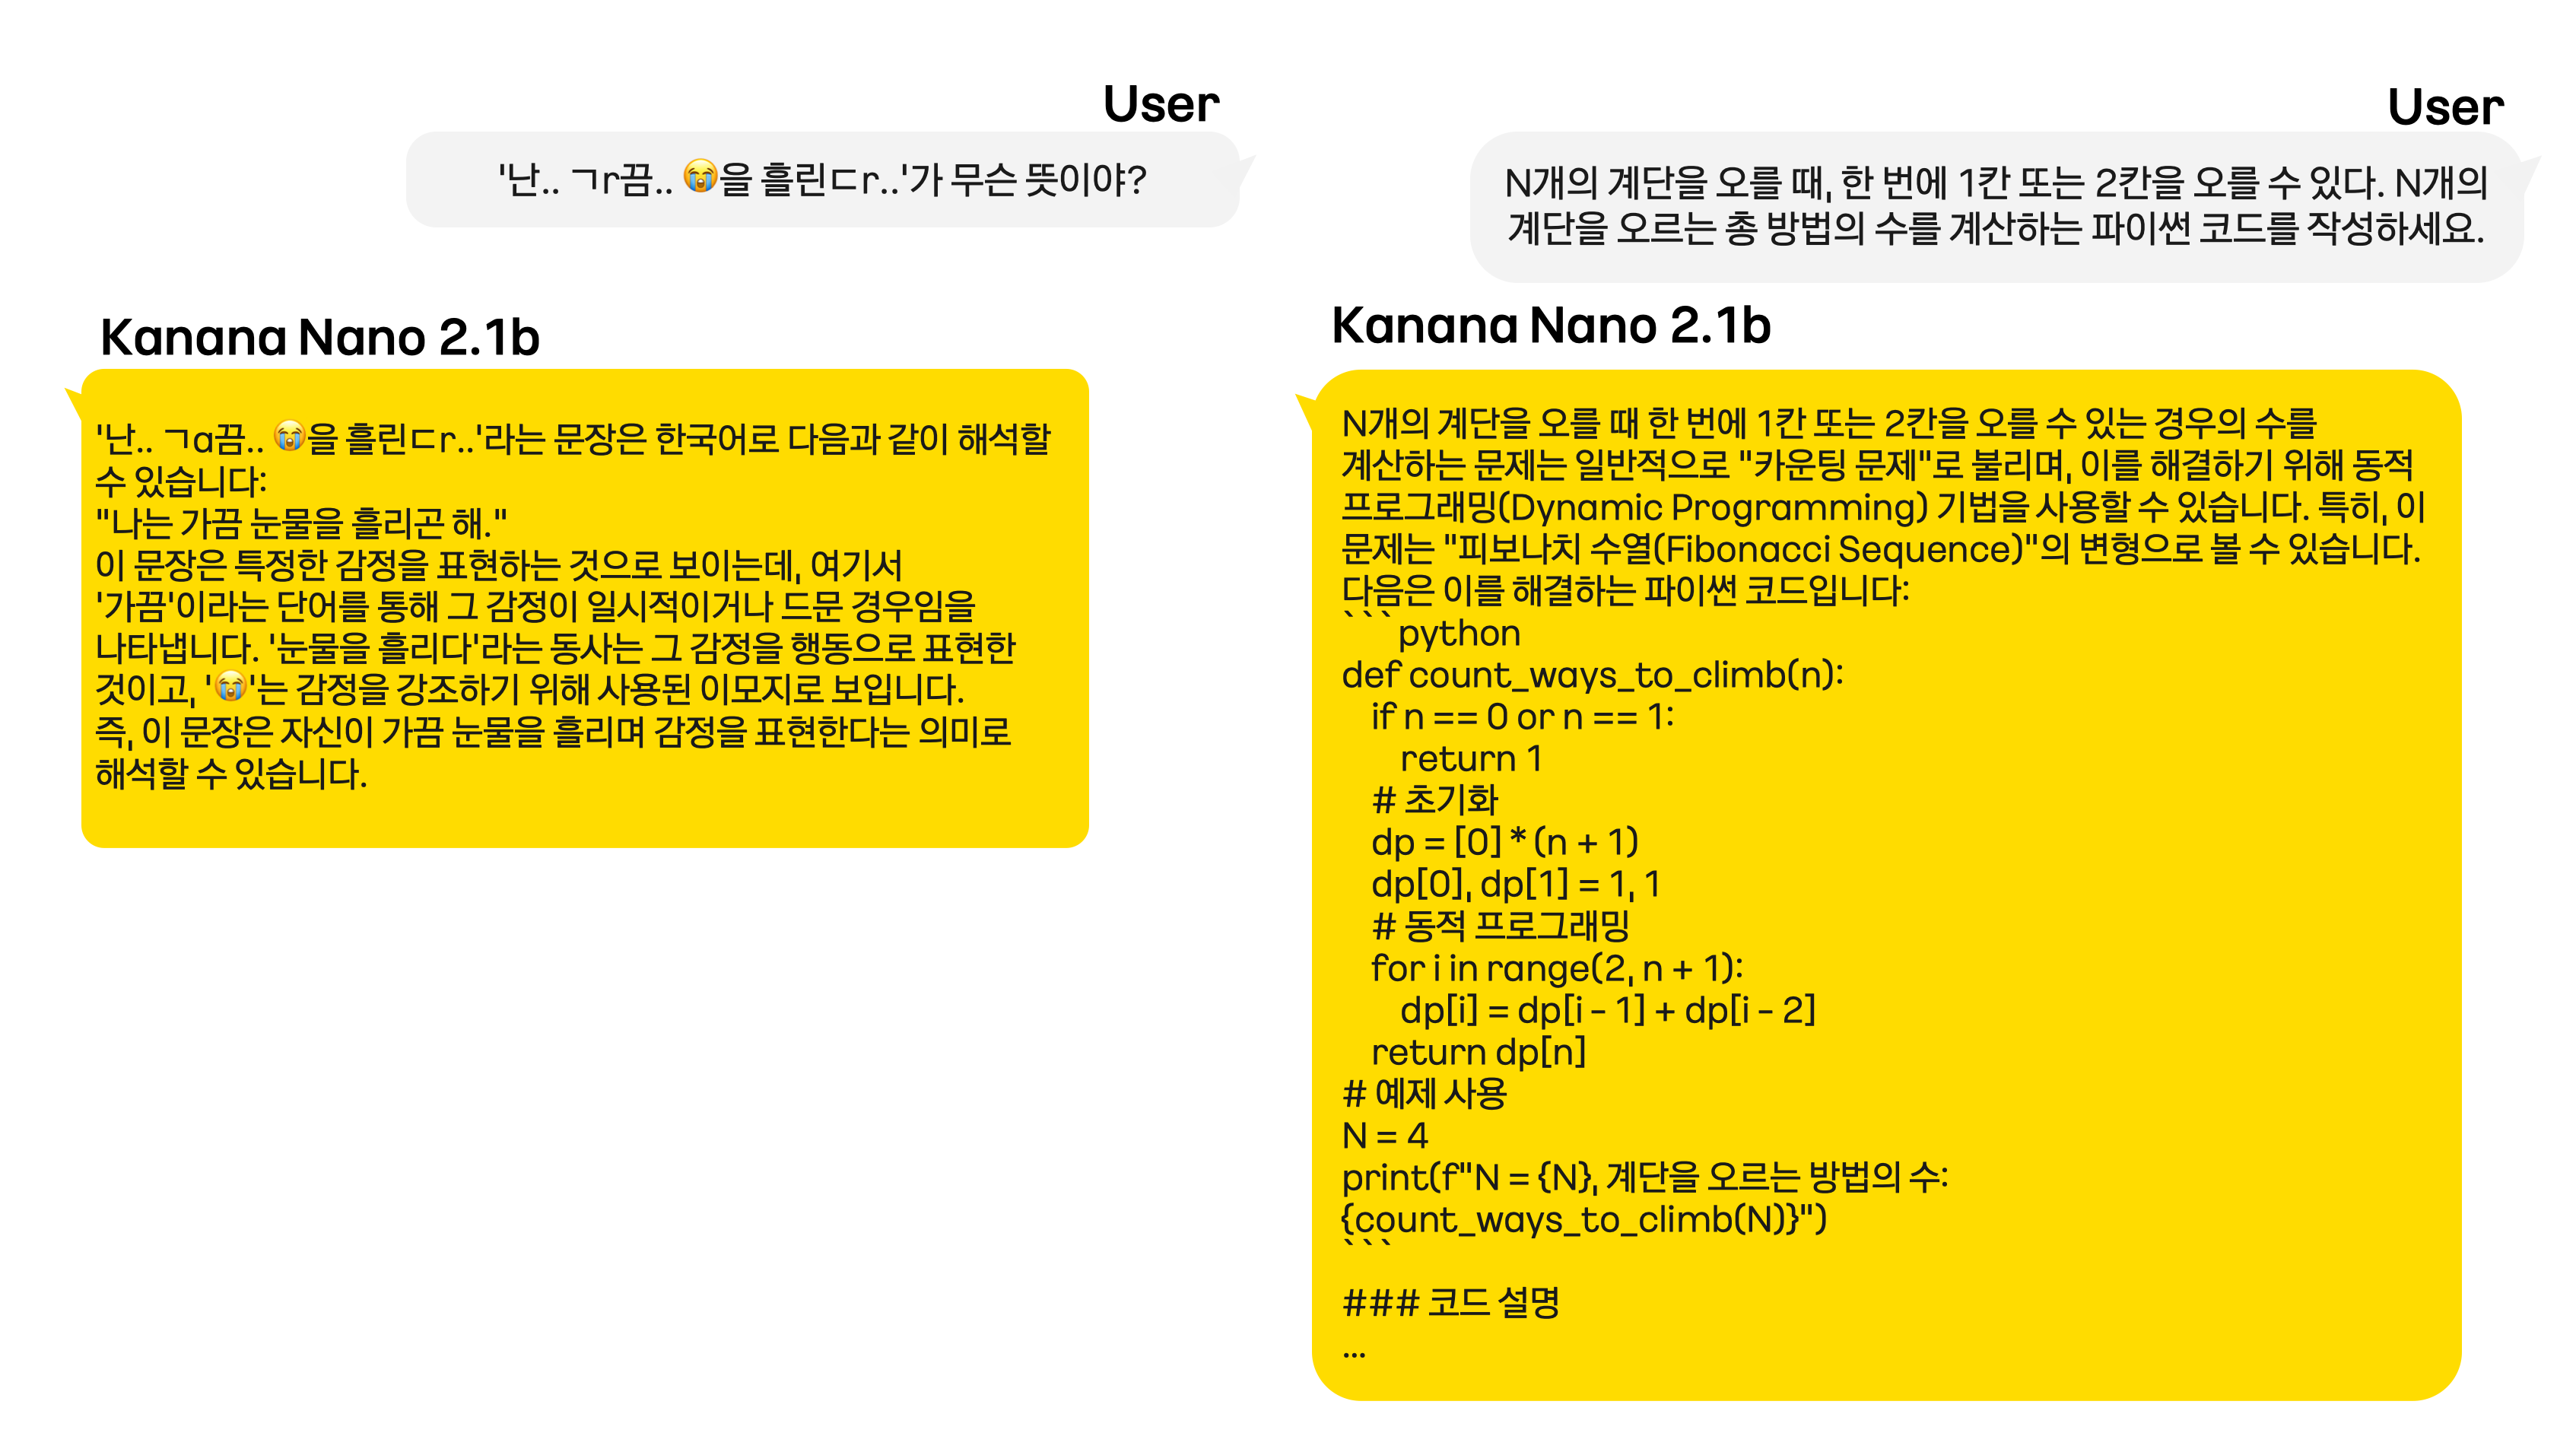
Kanana Nano 2.1B는 비교적 작은 모델임에도 불구하고 유사한 크기의 글로벌 모델과 견줄 수 있는 성능을 보이며, 다양한 응용 가능성을 제공합니다. 다만, 경량 모델 특성상 복잡한 추론이나 수학 문제 해결 등의 고난도 태스크에서는 한계가 있을 수 있지만, 이를 기반으로 연구자 및 개발자들이 다양한 응용을 시도할 수 있도록 지원할 예정입니다.
마무리
이번 카나나 테크니컬 리포트에서는 카나나 언어모델 전체 라인업과 오픈소스로 공개하는 Kanana Nano 2.1B에 대해 소개했습니다. 아래 링크에서 자세한 모델 학습과정과 평가 내용을 확인할 수 있으며, 2.1B 모델도 다운로드할 수 있습니다.
향후 카나나 언어모델은 강화학습(RL) 기반의 최신 기술을 접목해 추론(reasoning) 능력과 수학, 코드 성능을 강화하는 한편, 연속 학습(Continual learning)을 통해 모델이 새로운 데이터를 지속 학습하면서 기존 학습 내용을 잊지 않고 유지할 수 있도록 발전시켜 나갈 것입니다. 또한, AI 모델이 사용자의 요청이나 지시사항을 더욱 정확하게 이해하고 수행할 수 있도록 얼라인먼트(alignment) 기술을 고도화하여 사용자 경험을 개선할 예정입니다.
이를 바탕으로 카나나 모델은 사람처럼 보고, 듣고, 말하며, 직관적으로 소통할 수 있는 멀티모달 모델로 진화할 것입니다. 카카오는 이번 수치상의 성과를 넘어, 실제 우리 일상에 가치를 더하는 AI를 만들기 위해 끊임없이 도전하겠습니다. AI가 사용자와 자연스럽게 대화하고, 음성, 이미지, 영상 등 다양한 형태로 소통할 수 있도록 지속적인 모델 고도화를 통해 기술 경쟁력을 더욱 강화해 나가겠습니다.
🔗 Kanana Technical Report link
관련 글 목록
^[1]^ 가지치기 (Pruning): AI 모델의 구성 요소를 가지치기해 중요 요소만 남기는 기법
^[2]^ 지식증류 (Distillation): 큰 모델의 지식을 더 작은 모델로 전달하는 기법
^[3]^ 깊이 업스케일링(Depth Up-Scaling): 기존 모델의 레이어를 더 많이 쌓아 올려 모델 규모를 효과적으로 키우는 방식