Engineering
Python의 멀티프로세싱과 Airflow, 그리고 관련된 문제 해결기 1편
2026년 9월 1일
원문에서 보기 ↗저희 팀은 데이터 입수 플랫폼의 배치 워크플로를 Airflow 2.10.2로 운영하고 있습니다. 2025년 4월 Airflow 3.0이 릴리스되었고, UI 개선과 다양한 신규 기능이 포함되었습니다. 이 변화가 저희 운영 환경에 필요하다고 판단했고 도입을 위한 PoC(Proof of Concept)를 진행했습니다.
이 글은 그 PoC 과정에서 Python의 멀티프로세싱 방식 중 하나인 fork로 인해 발생한 문제를 발견해 해결하고 기여한 과정을 다루는 시리즈의 1편입니다. 1편에서는 이 문제를 이해하는 데 필요한 배경지식을 다룹니다. Airflow가 task를 실행할 때 요구되는 조건을 살펴보고, 이를 만족하는 Python 멀티프로세싱 방식을 비교한 뒤, Airflow가 실제로 채택한 방식과 그 한계를 설명합니다.
2편에서는 이 한계가 Airflow에 실제로 어떤 문제를 일으켰는지, 원인과 해결 과정을 다룹니다.
Airflow의 task 실행 요구 사항
Apache Airflow는 Python으로 작성된 워크플로 오케스트레이션 도구입니다. 사용자는 task들 사이의 의존 관계를 Dag로 정의하고, Airflow는 정해진 스케줄에 따라 그 task들을 실행합니다. Dag는 task 집합과 그 사이의 의존 관계, 실행 순서를 정의하는 Airflow의 기본 단위입니다.
task 실행에는 병렬성과 격리성이라는 두 가지 핵심적인 요구 사항이 있으며, Airflow는 이를 모두 만족해야 합니다.
병렬성
병렬성은 여러 task를 동시에 수행할 수 있는 능력입니다. Airflow는 정해진 스케줄에 따라 다수의 task를 실행해야 하므로 병렬성이 필요합니다.
그런데 Airflow는 Python으로 작성된 도구입니다. Python의 표준 구현체인 CPython에는 GIL(Global Interpreter Lock)이 있습니다. 이 때문에 하나의 인터프리터 안에서는 스레드가 아무리 많아도 Python 바이트코드는 한 순간에 하나만 실행됩니다. 즉, 멀티코어 CPU에서도 Python 코드는 동시에 코어 하나에서만 실행됩니다. CPU 집약적인(CPU-bound) 작업에서 멀티코어의 병렬 처리 이점을 얻지 못합니다. Airflow는 이 제약을 극복해야 합니다.
격리성
각 task의 수행이 부모 프로세스와 다른 task에 영향을 주지 않아야 합니다. 여기서 부모 프로세스는 task를 실행하는 프로세스를 생성한 상위 프로세스를 뜻합니다.
Airflow는 사용자가 작성한 코드가 task로 실행되는 구조입니다. 심한 경우 해당 task가 부모 프로세스 전체를 종료시킬 수도 있으며, 이는 전체 task의 장애로 이어질 수 있습니다.
Airflow가 격리성을 필요로 하는 이유는 하나 더 있습니다. Python은 모듈을 전역(sys.modules)으로 관리하며, 한 번 등록된 모듈을 전역에서 삭제하거나 갱신하기가 어렵습니다. 런타임에 import된 모듈은 코드가 바뀌어도 이를 다시 등록하기가 매우 어렵다는 뜻입니다.
가령 사용자는 task에서 import mypackage.plugins와 같이 본인이 작성한 모듈을 불러옵니다. 격리성이 보장되지 않는다면, 해당 모듈은 Git-Sync를 통해 변경이 일어나도 반영되지 않음을 의미합니다. task가 등록한 모듈은 task 완료와 함께 폐기되어야 합니다.
Airflow의 멀티프로세싱 도입
Airflow는 앞서 살펴본 두 요구 사항을 만족하기 위해 멀티프로세싱을 사용했습니다. 즉, task 하나당 프로세스를 하나씩 생성해 그 안에서 실행하고, 종료 시 폐기하는 것입니다.
이를 통해 진정한 CPU 병렬성을 얻을 수 있습니다. 또한 task의 비정상 종료가 부모 프로세스에 영향을 주지 않게 하고, 부모 프로세스의 전역 모듈이 오염되는 것을 막습니다. task 종료 시 프로세스를 폐기함으로써 격리성을 보장할 수 있습니다.
Python의 멀티프로세싱 방식
Airflow가 멀티프로세싱을 택했다면, 다음 질문은 프로세스를 어떻게 만드느냐입니다. Python에서 멀티프로세싱을 지원하는 방식은 fork와 spawn 두 가지입니다(forkserver 방식도 있지만 이 글에서는 다루지 않습니다). 두 방식이 각각 어떻게 동작하는지 살펴본 뒤, 같은 조건에서 실행해 생성 시간과 메모리 사용량을 비교하겠습니다.
fork와 spawn
fork는 Unix의 fork(2) 시스템 콜을 그대로 사용합니다. 호출 순간 커널이 프로세스의 복제본을 만들고, 자식은 부모의 모든 것(로드된 모듈, 생성된 객체, 열린 파일 디스크립터)을 승계한 채 fork 지점부터 실행을 이어갑니다.
하지만 커널은 메모리를 실제로 복사하지 않습니다. 부모의 페이지 테이블만 복사하고, 물리 메모리 페이지는 부모와 자식이 공유합니다. 어느 한쪽이 페이지에 쓰기를 시도하는 순간에야 해당 페이지가 복사되는데, 이러한 방식을 Copy-on-Write(COW)라고 합니다.
spawn은 새 Python 인터프리터를 처음부터 실행하고(fresh interpreter), 자식에게는 실행에 필요한 최소한의 인자만 pickle로 직렬화해 넘깁니다. 자식은 부모의 메모리를 전혀 공유하지 않고, 필요한 모듈을 스스로 다시 import합니다.
실행 결과 비교
앞의 설명만으로는 차이를 직관적으로 이해하기 쉽지 않기 때문에, 장단점을 비교하기 위해 스크립트를 실행해 보았습니다.
측정에 사용한 코드는 다음과 같습니다.
from __future__ import annotations

import multiprocessing as mp
import sys
import time

K = 10  # 자식 프로세스 수

def import_heavy_modules():
    import airflow

def read_mem_mb(pid: int | str) -> tuple[float, float, float]:
    """해당 pid의 (RSS, PSS, USS) MB — Linux 전용."""
    d = {}
    with open(f"/proc/{pid}/smaps_rollup") as f:
        for line in f:
            key = line.split(":")[0]
            if key in ("Rss", "Pss", "Private_Clean", "Private_Dirty"):
                d[key] = int(line.split()[1])
    return d["Rss"] / 1024, d["Pss"] / 1024, (d["Private_Clean"] + d["Private_Dirty"]) / 1024

def child(q: mp.SimpleQueue, ev, t_start: float) -> None:
    t_ready = time.monotonic() - t_start
    t0 = time.monotonic()
    import_heavy_modules()

    q.put((t_ready, time.monotonic() - t0))
    ev.wait()  # 부모가 측정을 마칠 때까지 생존 (측정 창)

def bench(method: str) -> None:
    ctx = mp.get_context(method)
    ev, q = ctx.Event(), ctx.SimpleQueue()
    ps = []
    for _ in range(K):
        p = ctx.Process(target=child, args=(q, ev, time.monotonic()))
        ps.append(p)
        p.start()
    times = [q.get() for _ in range(K)]  # K개 전원 준비 대기 -> 공유자 수를 K+1로 고정
    t_ready, t_import = sum(t[0] for t in times) / K, sum(t[1] for t in times) / K
    time.sleep(1.0)

    mems = [read_mem_mb(p.pid) for p in ps]
    rss, pss, uss = sum(m[0] for m in mems) / K, sum(m[1] for m in mems) / K, sum(m[2] for m in mems) / K
    total = sum(m[1] for m in mems) + read_mem_mb("self")[1]  # PSS 합 = 실제 물리 사용량

    ev.set()
    for p in ps:
        p.join()
    print(
        f"{method:5s} | ready {t_ready * 1000:7.1f} ms | import {t_import * 1000:7.1f} ms"
        f" | child avg: RSS {rss:6.1f} | PSS {pss:6.1f} | USS {uss:6.1f} MB"
        f" | sum(PSS, +parent) {total:7.1f} MB"
    )

if __name__ == "__main__":
    if sys.platform != "linux":
        sys.exit("smaps_rollup 기반 측정은 Linux에서 실행하세요.")
    t0 = time.monotonic()
    import_heavy_modules()

    r, p_, u = read_mem_mb("self")
    print(f"parent | import {(time.monotonic() - t0) * 1000:.1f} ms | RSS {r:.1f} | PSS {p_:.1f} | USS {u:.1f} MB")
    print(f"--- K={K} children (동시 기동: 시간은 순차 측정보다 다소 부풀 수 있음) ---")
    for method in ("fork", "spawn"):
        bench(method)
측정은 다음 환경에서 진행했습니다.
- Kubernetes Pod(Airflow 2.10.2 공식 이미지 기반)
- Python 3.11, Debian GNU/Linux 12
- CPU: requests 500m, limits 4 / Memory: requests 1Gi, limits 4Gi
부모 프로세스에서 airflow 모듈을 import한 뒤, fork 방식과 spawn 방식으로 서브 프로세스 10개를 생성합니다. 각 프로세스에서 airflow 모듈을 다시 import하고 그 소요 시간과 메모리 사용량을 측정합니다.
아래 실행 결과의 첫 행은 부모 프로세스 자체의 측정값이고, 다음 두 행이 fork와 spawn의 결과입니다. ready는 프로세스 생성까지 걸린 시간, child avg는 자식 10개의 평균, sum(PSS, +parent)는 부모를 포함한 전체 물리 메모리 사용량입니다.
parent | import 1057.7 ms | RSS 102.1 | PSS 100.9 | USS 100.2 MB
--- K=10 children (동시 기동: 시간은 순차 측정보다 다소 부풀 수 있음) ---
fork  | ready     4.3 ms | import     0.0 ms | child avg: RSS   84.7 | PSS    9.4 | USS    1.9 MB | sum(PSS, +parent)   120.8 MB
spawn | ready   206.6 ms | import  2694.8 ms | child avg: RSS  102.3 | PSS   83.5 | USS   81.4 MB | sum(PSS, +parent)   918.2 MB
각 수치가 왜 이렇게 나왔는지 항목별로 살펴보겠습니다.
생성 시간
fork는 최초 프로세스 생성까지의 시간이 spawn 방식에 비해 50배 가까이 빠른 것으로 확인됩니다. 이는 spawn이 새로운 인터프리터 환경을 구성하는 반면, fork는 페이지 테이블 복사가 전부인 가벼운 작업이기 때문입니다.
import 수행 시간
fork의 airflow를 import하는 시간이 0에 가깝습니다. 앞서 fork와 spawn에서 설명한 바와 같이 fork는 COW 방식으로 부모의 실행 환경과 같은 환경으로 시작합니다. 따라서 새로운 프로세스가 시작되더라도 이미 전역 모듈에 등록되어 있는 모듈이기 때문에 모듈을 다시 등록할 필요가 없어집니다.
그에 반해 spawn 방식은 프로세스마다 새롭게 import를 해야 합니다. 단건으로는 약 1초인 작업인데, 10개를 병렬로 수행했음에도 프로세스당 평균 2.7초가 걸렸습니다. import 작업이 CPU 집약적이라 CPU 경합이 일어났기 때문입니다. 그만큼 실효 3.9코어 정도로 나눠 처리했다는 뜻이며, Pod에 설정한 CPU limit 4와 거의 일치합니다.
메모리 사용량
메모리는 다음 세 지표로 측정했습니다.
- RSS: 물리 메모리에 올라와 있는 페이지 총량. 공유 페이지도 각 프로세스가 전부 자기 몫으로 계산
- PSS: 공유 페이지를 공유하는 프로세스 수로 나눠 안분한 값
- USS: 그 프로세스만 쓰는 페이지
fork는 부모 프로세스의 메모리 공간을 그대로 사용하기 때문에(쓰기 작업이 일어나지 않는다면) airflow의 import로 인한 독립적인 메모리 공간을 사용하지 않습니다. 자식 프로세스의 PSS 9.4MB는 다음과 같이 분해됩니다.
자기만 쓰는 USS 1.9MB + 부모와 공유하는 82.8MB(84.7 - 1.9)를 11개 프로세스로 나눈 7.5MB ≈ 9.4MB
반면 spawn 방식의 자식 프로세스는 PSS 83.5MB, USS 81.4MB로 둘이 거의 같습니다. 부모와 공유하는 페이지가 없다는 뜻입니다. 그 결과 전체 물리 사용량은 fork 120.8MB 대 spawn 918.2MB로 7.6배 가까이 벌어집니다. spawn에서는 프로세스 수에 정비례해 메모리가 늘어납니다.
정리
지금까지 살펴본 내용을 정리하면 다음과 같습니다.
| 구분 | fork | spawn | 비고 |
|---|---|---|---|
| 프로세스 생성 시간 | 4.3ms | 206.6ms | fork는 부모의 페이지 테이블만 복사하면 끝나지만, spawn은 새 인터프리터를 처음부터 기동 |
airflow import 수행 시간 | ≈0ms | 2,694.8ms | fork는 부모의 sys.modules를 그대로 승계해 재import가 불필요. spawn은 프로세스마다 airflow를 새로 import해야 함(단건 약 1초) |
| 자식 1개당 메모리(PSS) | 9.4MB | 83.5MB | fork는 부모와 메모리를 공유하여 나눠서 측정됨. spawn은 공유 페이지가 없기 때문에 부모와 비슷한 수준의 PSS로 측정 |
| 총 물리 메모리(부모 + 자식 10개) | 120.8MB | 918.2MB | fork는 COW로 대부분의 페이지를 공유하므로 프로세스가 늘어도 물리 사용량이 거의 증가하지 않음. spawn은 정비례하여 증가 |
Airflow의 task 수행 모델
이제 멀티프로세싱 기반 task 수행 모델을 Airflow에서 어떻게 구현했는지 살펴보겠습니다. 이후 설명하는 구조는 Airflow 3 기준입니다.
supervisor가 감싸는 프로세스 구조
앞서 Airflow의 멀티프로세싱 도입에서 설명한 바와 같이 Airflow는 task를 수행하기 위해 별도의 프로세스를 생성하고 task 종료 시 해당 프로세스를 폐기합니다. 하지만 생성되는 프로세스는 단순히 사용자가 Dag에 정의한 Python 함수를 실행하는 것이기 때문에 이를 감독하는 supervisor로 감싸서 실행합니다. supervisor는 task 프로세스와 소켓으로 통신하며 프로세스가 끝날 때까지 대기합니다.
supervisor의 역할은 다음과 같습니다.
- 프로세스 생애 주기 관리: 프로세스 생성, task 타임아웃 시 kill, 주기적 좀비 검사, 종료 상태 보고와 시그널 처리
- 로그 관리: 자식의 stdout/stderr/구조화 로그를 소켓에서 읽어 파일에 저장하고, task 종료 후 원격 스토리지에 업로드
- API 게이트웨이: Airflow 3부터 task는 metaDB에 직접 접근할 수 없음. task의 DB 접근 요청을 소켓으로 받아 Execution API 호출로 대신 수행(AIP-72: Task Execution Interface 참고)
위와 같은 역할은 supervise 함수가 수행합니다. supervise는 task 전용 프로세스를 생성하고 프로세스의 종료까지 대기하는 동기 함수입니다. Airflow 메인 프로세스(scheduler 또는 Celery worker의 최상위 프로세스)에서 직접 호출하면 메인 루프가 task 하나에 블로킹되어 병렬성을 보장할 수 없습니다. 따라서 Airflow는 supervise 함수의 실행 또한 메인 프로세스가 아닌 별도의 프로세스에서 수행하도록 했습니다.
다음은 LocalExecutor에서 task 실행 시의 프로세스 상태입니다. 병렬도 32 기준이면 worker 프로세스가 32개 존재해야 하지만, 여기서는 일부만 표기했습니다. PID와 PPID의 관계를 보면, 7 → 27 → 1379로 서브 프로세스가 생성되는 방식을 확인할 수 있습니다.
UID          PID    PPID  C STIME TTY          TIME CMD
airflow        1       0  0 07:10 ?        00:00:00 /usr/bin/dumb-init -- /entrypoint scheduler
airflow        7       1 11 07:10 ?        00:00:09 /usr/python/bin/python3.12 /home/airflow/.local/bin/airflow scheduler
airflow       27       7  0 07:10 ?        00:00:00 airflow worker -- LocalExecutor: 019fdb0f-e517-744c-ad4b-9dd637809c45
airflow     1379      27  1 07:11 ?        00:00:00 [airflow worker ] <defunct>
LocalExecutor는 별도의 worker 컴포넌트가 없기 때문에 scheduler 내부에서 worker 프로세스를 병렬도만큼 생성합니다. 다음 다이어그램은 그 구조를 보여줍니다.
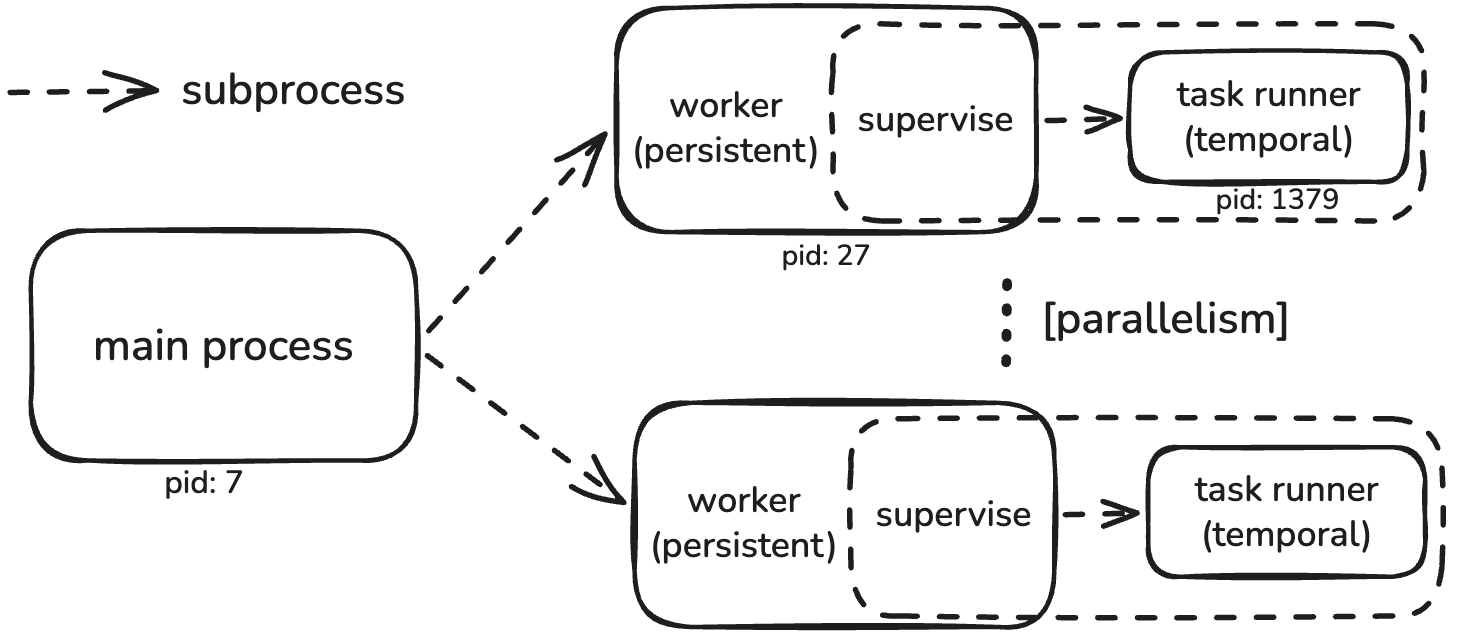
LocalExecutor와 CeleryExecutor에서는 worker 프로세스가 task의 종료와 함께 폐기되지 않습니다. 병렬도만큼 만들어져 메인 프로세스의 서브 프로세스로 유지됩니다. 추후 worker 프로세스가 task 실행 명령을 받으면 그 안에서 supervise 함수를 실행하고, task용 서브 프로세스를 만들었다가 task가 끝나면 폐기합니다.
각 프로세스는 fork인가 spawn인가
Airflow는 위와 같은 구조로 병렬성과 격리성을 모두 만족합니다. 그럼 각 프로세스는 fork와 spawn 중 어떤 방식을 사용했을까요?
task 실행 프로세스(단기 프로세스)
task 실행 프로세스는 주로 성능 때문에 fork 방식을 고정해서 사용하고 있습니다.
앞서 실행 결과 비교에서 본 바와 같이 fork 방식은 spawn 방식에 비해 프로세스 생성의 시간 소요가 매우 적습니다. 물론 spawn 방식도 1초가 걸리지 않기 때문에 큰 효용이 없지 않은가 하는 의문이 들 수 있습니다. 하지만 task를 잘게 나눠 0.1초가 걸리는 task를 1,000개 수행해야 하는 경우는 어떨까요? 무거운 프로세스 생성이 병목이 되어 전체적인 처리량이 떨어집니다.
부모 프로세스의 모듈을 재사용하는 것도 fork의 큰 강점입니다. 실행 결과 비교에서 airflow를 로드하는 것만으로도 1초가 걸리는 무거운 작업임을 확인했습니다. spawn 방식은 매번 프로세스를 폐기하기 때문에 task를 수행할 때마다 airflow를 다시 로드해야 합니다. 이 또한 성능 저하로 이어집니다.
실제로 이러한 fork의 성질 때문에, CeleryExecutor의 worker에서는 NumPy나 Kubernetes 같은 무거운 모듈을 자체적으로 사용하지 않음에도 import해 두고 있습니다. 이는 다음 코드에서 확인할 수 있습니다(Airflow 3.3.0의 celery_executor_utils.py에서 일부를 줄여 옮긴 코드입니다).
@celery_import_modules.connect
def on_celery_import_modules(*args, **kwargs):
    """
    Preload some "expensive" airflow modules once, so other task processes won't have to import it again.

    Loading these for each task adds 0.3-0.5s *per task* before the task can run. For long-running tasks this
    doesn't matter, but for short tasks this starts to be a noticeable impact.
    """
    try:
        import airflow.providers.standard.operators.bash
        import airflow.providers.standard.operators.python
    except ImportError:
        import airflow.operators.bash
        import airflow.operators.python  # noqa: F401

    with contextlib.suppress(ImportError):
        import numpy  # noqa: F401

    with contextlib.suppress(ImportError):
        import kubernetes.client  # noqa: F401
supervise 실행 프로세스(장기 프로세스)
supervise 실행 프로세스는 spawn 방식으로도 만들 수 있지만 기본값은 fork이며, Airflow 역시 fork를 권장합니다.
생성된 프로세스를 재사용하는 방식이라 task 실행 프로세스만큼 생성 속도가 중요하지는 않지만, 메모리 효율 측면에서는 큰 이득을 얻을 수 있습니다. supervise 함수를 실행하려면 airflow 모듈을 반드시 로드해야 하는데, 앞의 실행 결과 비교에서 확인한 바와 같이 이것만으로 RSS 기준 약 100MB를 차지합니다. 여기에 무거운 모듈이 추가로 로드됩니다.
이는 앞서 실행 결과 비교에서 확인한 바와 같이 spawn 방식이 '각 모듈의 메모리 x 프로세스 수(병렬도)'만큼의 메모리를 소요해야 한다는 뜻입니다. LocalExecutor의 기본 병렬도가 32인 만큼([core] parallelism 설정 기준) 점유량이 상당해집니다. 그에 반해 fork는 추가적인 메모리 점유가 없고 병렬도가 늘어도 메모리 사용량이 늘지 않습니다.
fork의 한계와 그로 인한 문제
지금까지 살펴본 내용에서 fork는 spawn 방식에 비해 성능 면에서 훨씬 우수했고, Airflow는 이 이점을 적극 활용했습니다. 하지만 fork에도 명백한 단점이 있습니다. 부모의 자원을 그대로 승계한다는 점과, COW가 기대만큼 동작하지 않는다는 점입니다.
부모의 모든 것을 그대로 사용한다
부모의 자원을 그대로 승계하는 것은 fork의 좋은 성능에 가장 크게 기여하는 특징입니다. 하지만 현대 소프트웨어에서는 이것이 위험 요소가 되기도 합니다. fork 방식에서는 부모 프로세스가 생성한 DB 커넥션 객체, 파일 디스크립터, 뮤텍스 등이 모두 승계됩니다. 만일 이에 따른 별다른 조치를 하지 않고 이용한다면, 부모 프로세스에 디버깅이 매우 힘든 문제를 야기할 수 있습니다.
Python + fork는 완전하지 않다
LocalExecutor에서는 worker 프로세스가 최초 fork로 생성되며, COW에 의해 부모 프로세스의 메모리를 공유한 상태로 시작합니다. 각 worker 프로세스의 생성 직후 메모리를 보면 PSS가 잘 나눠서 측정되는 것을 확인할 수 있습니다. worker 프로세스의 RSS는 159MB 안팎이지만 PSS는 35MB 안팎으로, 대부분의 페이지를 부모와 공유하고 있습니다.
  PID User     Command                         Swap      USS      PSS      RSS
    7 airflow  /usr/python/bin/python3.12         0   106716   116419   196144
   38 airflow  airflow worker -- LocalExec        0    23280    35810   162572
   39 airflow  airflow worker -- LocalExec        0    23640    36138   162640
   53 airflow  airflow worker -- LocalExec        0    23756    36545   163928
   50 airflow  airflow worker -- LocalExec        0    23844    36625   163992
COW 방식을 통해 fork는 매우 좋은 메모리 효율을 얻을 수 있었습니다. 하지만 task 수행이 어느 정도 이뤄진 뒤 다시 메모리를 측정해 보면, worker 프로세스의 USS와 PSS가 증가함을 확인할 수 있습니다.
  PID User     Command                         Swap      USS      PSS      RSS
    7 airflow  /usr/python/bin/python3.12         0   287896   297592   375492
   39 airflow  airflow worker -- LocalExec        0    98724   102342   169024
   38 airflow  airflow worker -- LocalExec        0    98988   102606   169284
   50 airflow  airflow worker -- LocalExec        0    99820   103441   170120
   53 airflow  airflow worker -- LocalExec        0    99840   103460   170136
프로세스가 건드리는 페이지의 총량은 거의 그대로인데, 그중 부모와 공유하던 페이지가 자기만의 복사본으로 바뀐 것입니다. 그만큼 COW의 이점이 사라졌다는 뜻입니다. fork는 Linux 커널에서 제공하는 시스템 콜이며 안정적이지만, Python과는 궁합이 좋지 않습니다. 원래는 쓰기가 발생한 페이지만 물리적으로 복사되어야 하지만, Python 자체의 동작 때문에 쓰기가 없는데도 복사가 일어납니다.
마치며
이번 글에서는 Airflow가 task를 실행할 때 요구되는 병렬성과 격리성을 살펴보고, 이를 만족하는 Python 멀티프로세싱의 두 방식을 비교했습니다. fork는 프로세스 생성과 모듈 로드, 메모리 사용 모두에서 spawn을 크게 앞섰습니다. Airflow는 두 종류의 프로세스를 모두 fork로 만듭니다. task를 실행하는 단기 프로세스는 생성 속도 때문이고, supervise를 실행하는 장기 프로세스는 메모리 때문입니다.
다만 fork에는 부모의 자원을 그대로 승계한다는 위험과, Python에서 COW가 온전히 동작하지 않는다는 한계가 따라옵니다. 2편에서는 이 두 한계의 원리를 자세히 살펴보고, 그것이 Airflow에서 어떤 문제로 이어졌는지, 어떻게 해결해 기여했는지를 다룹니다.