AI/ML
Kanana LLM 1.5 개발기
ryan.u, json.bourne, daniel.rl, mat.mul, wavy.jung카카오
2025년 5월 23일
원문에서 보기 ↗Kanana 1.5: Agentic AI를 위한 LLM 성능 강화
안녕하세요, Kanana LLM팀입니다. 저희는 언어모델의 성능을 꾸준히 개선하기 위해 지속적인 연구 개발에 매진하고 있으며, 최근 AI 분야의 주요 화두인 Agentic AI의 무한한 가능성에 주목하고 있습니다.
Agentic AI는 스스로 목표를 설정하고 주변 환경과 상호작용하며 복잡한 과제를 자율적으로 계획하고 실행하는 지능형 시스템입니다. 이러한 Agentic AI가 제 기능을 제대로 발휘하려면 단순 정보 검색이나 텍스트 생성을 넘어, 사용자의 복잡한 의도를 파악하고 여러 단계의 추론을 통해 문제를 해결해야 합니다. 이때, 문제 해결을 위한 구체적인 실행 계획을 코드로 변환하고, 외부 도구 및 API와 효과적으로 연동하며, 사용자와의 긴 대화나 방대한 문서로부터 맥락을 정확히 파악하여 일관성을 유지하는 능력이 필수적입니다. 기존 LLM들이 특정 질의에 대한 응답 생성에는 능숙했지만, 이처럼 능동적이고 복잡한 작업을 자율적으로 수행하기에는 핵심 역량을 한층 더 발전시켜야 할 필요가 있었습니다.
Kanana 1.5는 Agentic AI로서 역할을 할 수 있도록 코딩 및 수학 능력 고도화 , Long context 처리 능력 확대 , 그리고 Post-training 방법 개선을 통하여 사용성 강화를 주요 목표로 삼았습니다. 본 글에서는 기존 1.0 버전 대비 Kanana 1.5의 다각적인 개선을 위해 저희 팀이 기울인 노력과 그 구체적인 성과를 공유해 드리고자 합니다.
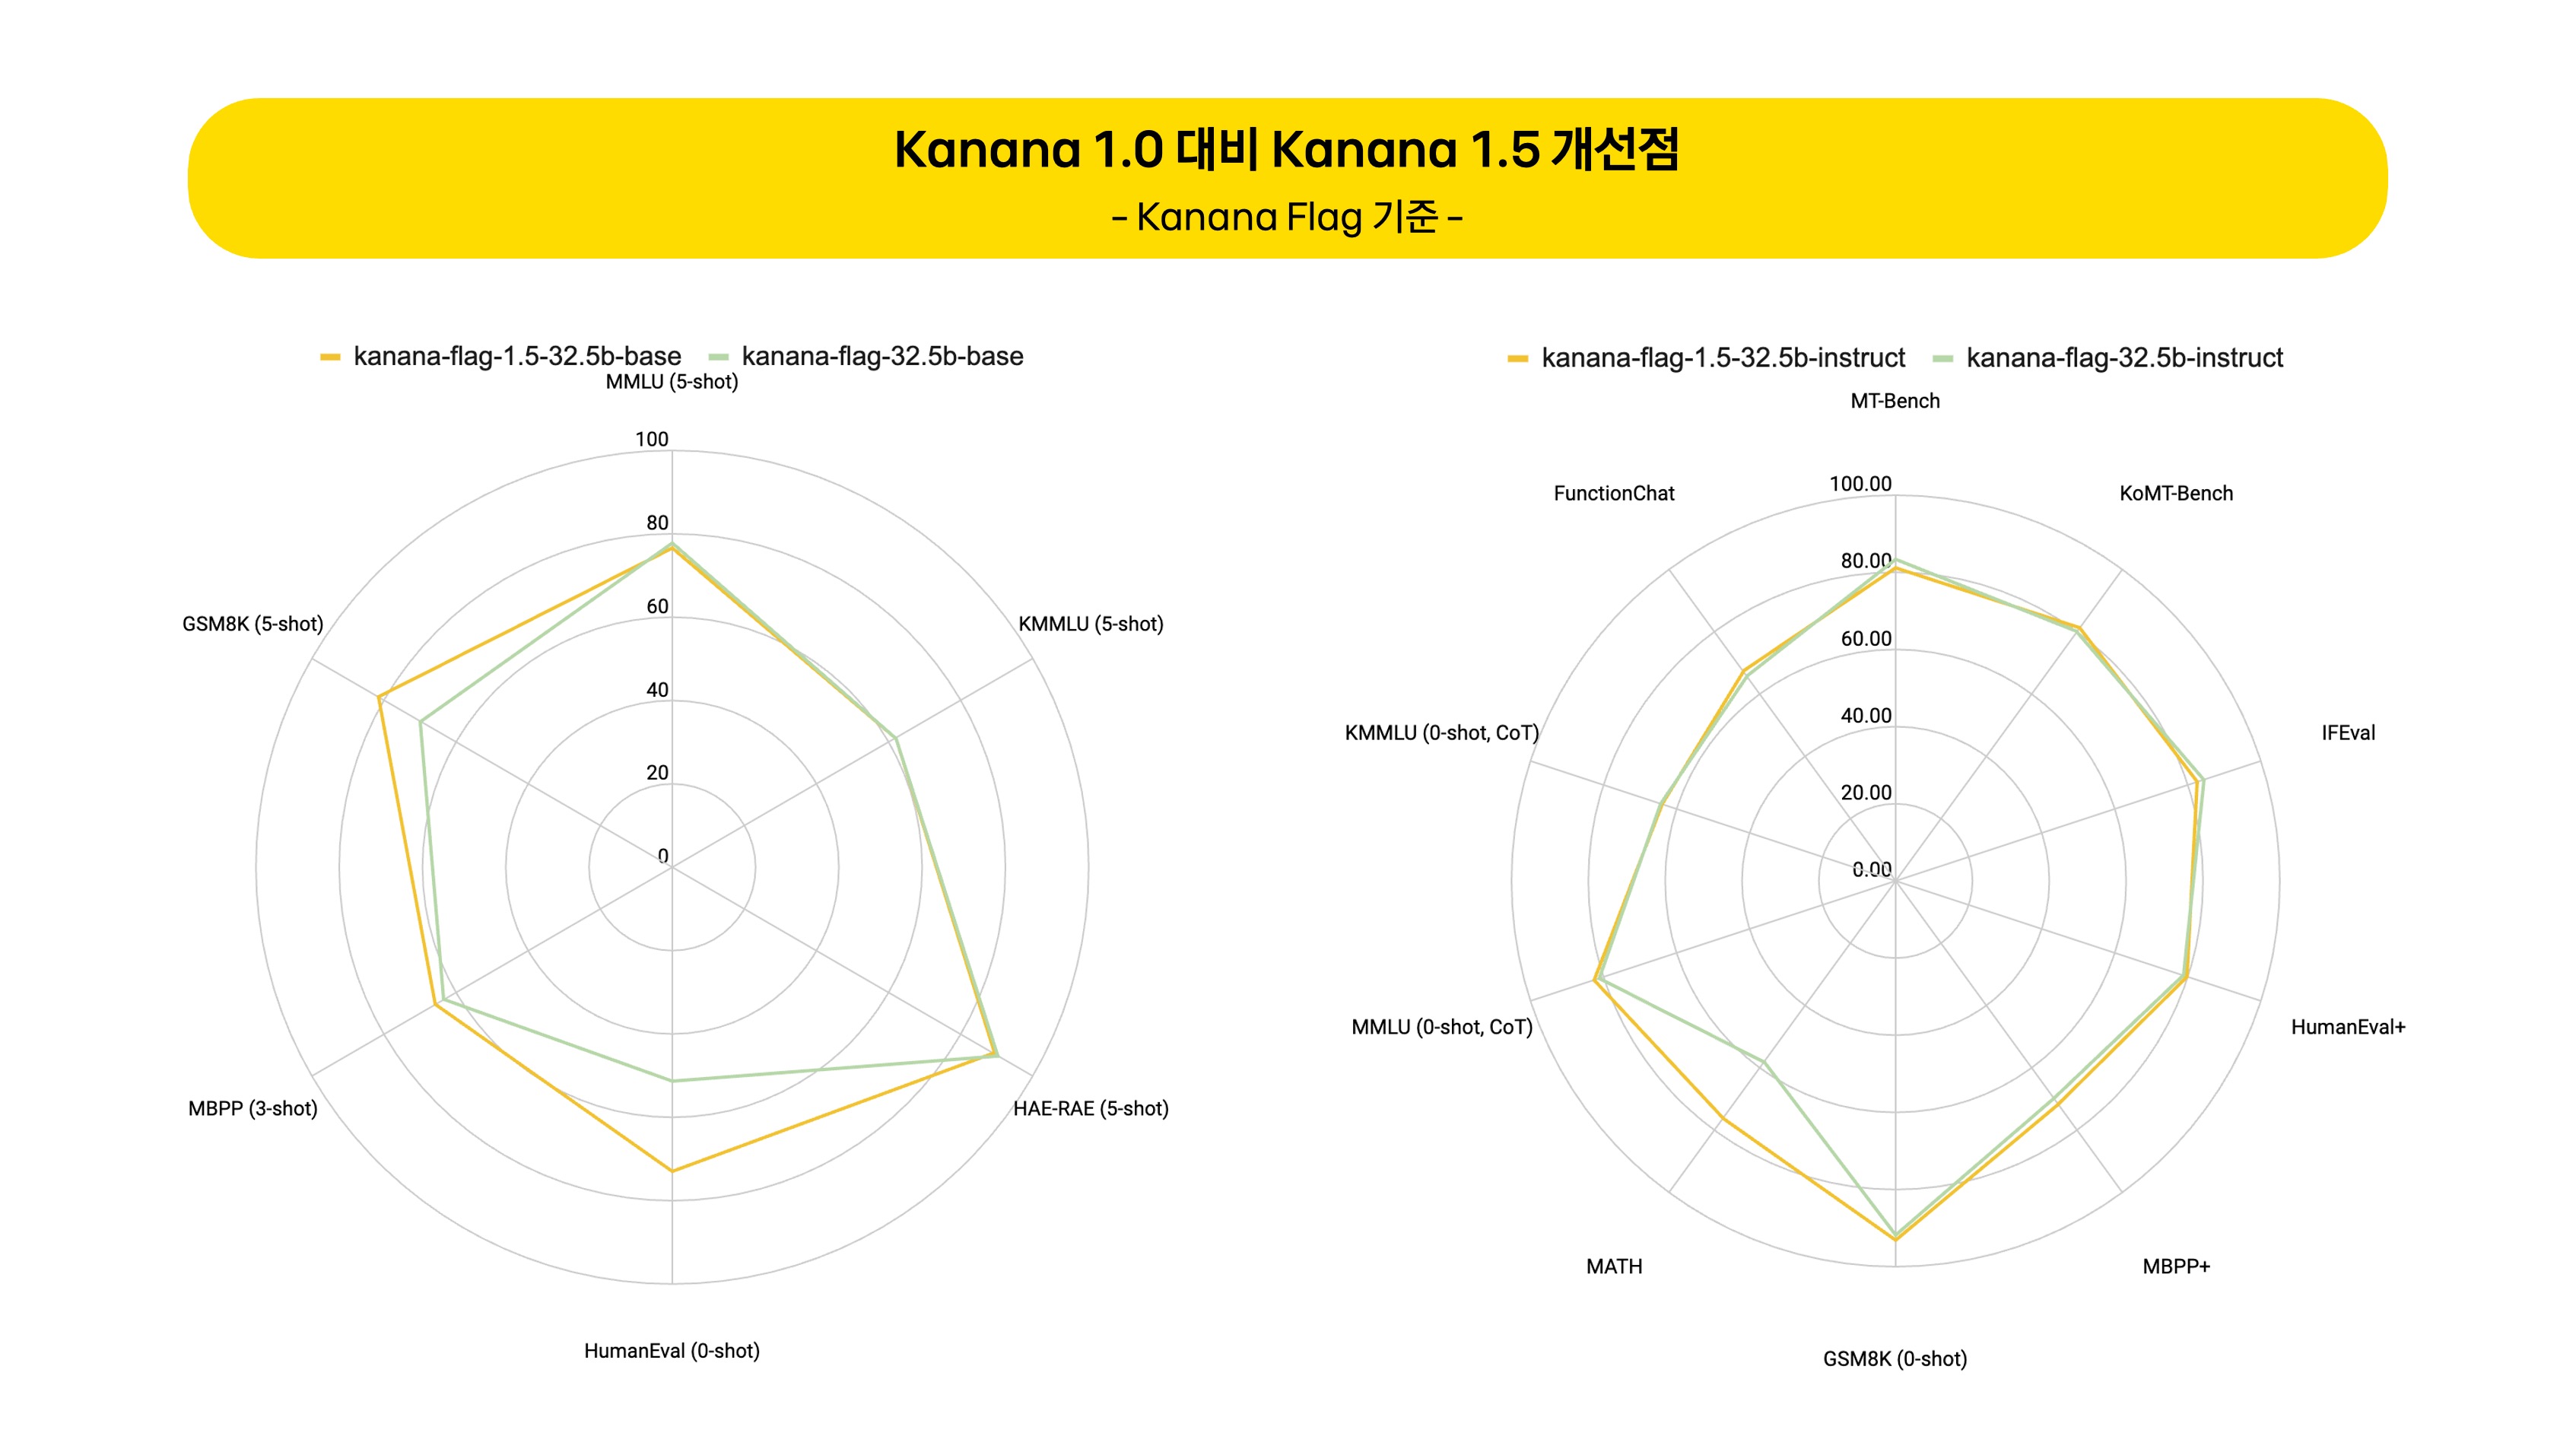
1. Base 성능 개선: 수학, 코드 중심
Kanana LLM의 첫 번째 버전의 모델도 출시 당시에는 준수한 성능을 보였으나, 코딩과 수학 성능에서 상대적으로 아쉬운 측면이 있었습니다. 기존 학습 데이터는 주로 일반적인 웹 코퍼스에서 수집된 내용이 많아, 전문적이거나 고품질의 코드, 수학 데이터가 상대적으로 부족했습니다. 이러한 데이터로 학습된 모델은 때때로 피상적인 패턴만을 학습하여 복잡한 문제 해결에 실패하거나, 논리적 오류가 있거나 비효율적인 코드를 생성할 가능성이 있었습니다. 특히, 다단계 추론이 필수적인 수학 문제나, 실제 환경에서의 실행 정확성과 안정성이 중요한 코드 생성에 있어서는 이러한 한계가 더욱 두드러졌습니다. 예를 들어, 수학 문제에서는 풀이 과정의 논리적 비약이 발생하거나, 코드 생성에서는 특정 엣지 케이스를 고려하지 못하는 경우가 있었습니다.
이러한 한계를 극복하기 위해 Kanana 1.5 개발 초기 단계에서는 다양한 공개 코드 및 수학 데이터셋을 면밀히 검토 했습니다. 몇몇 데이터셋이 특정 영역에서는 가능성을 보였지만, 저희가 목표로 하는 포괄적인 품질, 충분한 데이터 양, 그리고 학습에 이슈가 없는 라이센스 조건을 만족시키는 경우는 찾기 어려웠습니다. 단순히 많은 데이터를 투입하는 것만으로는 해결되지 않는, 데이터의 '질’에 대한 근본적인 고민이 필요했습니다. 결국 Agentic AI로 가기위한 관련된 역량을 제대로 강화하기 위해서는 목표 성능에 부합하는 고품질 데이터를 직접 확보해야 한다는 결론에 도달했습니다. 여러 데이터 확보 방안 중, 특히 의도에 맞는 데이터를 수집해야한다는 점에서 우수한 성능의 LLM을 활용하여 통제된 환경에서 목적에 맞는 양질의 데이터를 직접 생성하는 것이 가장 효과적이고 효율적인 전략이라고 판단했습니다.
고품질 수학, 코드 데이터 구축
LLM의 성능은 학습 데이터의 품질에 의해 결정된다고 해도 과언이 아닙니다. 특히 특정 도메인의 전문성을 높이기 위해서는 무작정 양을 늘리기보다는 데이터의 질을 높이는 것이 중요하며, 때로는 목적에 맞게 정교하게 설계하고 생성한 합성 데이터(Synthetic data)가 기대 이상의 효과를 가져오기도 합니다. 저희는 이러한 원칙에 따라 수학 및 코드 코퍼스 구축에 많은 노력을 기울였습니다.
- 수학 코퍼스 생성 과정: 수학 문제를 잘 풀려면 논리적인 사고력과 단계별 추론 과정의 정확성이 뒷받침 되어야 합니다. 따라서 학습 데이터를 어떻게 구성하느냐가 매우 중요합니다. 저희는 Apache 라이선스로 공개된 NuminaMath 데이터의 일부를 초기 시드(Seed) 코퍼스로 활용하여 데이터 생성의 일관된 스타일과 구조를 확보하고, 기본적인 품질 기준선을 설정했습니다. 이 데이터를 기반으로, 강력한 외부 고성능 모델 및 저희가 내부적으로 개발한 수학 문제 특화 모델들을 동원하여 문제에 대한 풀이 과정과 정답을 생성했습니다. 이 과정에서는 단순히 많은 문제를 생성하는 데 그치지 않고, 하나의 문제에 대해서도 여러 모델이 각기 다른 접근 방식이나 설명 스타일로 답변을 만들도록 유도했습니다. 이렇게 답변의 다양성을 확보하는 것이 모델이 다양한 문제 해결 전략을 학습하고, 특정 표현 방식에 과적합되지 않으며, 결과적으로 일반화 성능을 높이는 데 매우 효과적이라는 사실을 실험을 통해 확인할 수 있었습니다. 생성된 데이터는 최종 평가에 사용될 주요 벤치마크와의 데이터 중복 및 유사성을 제거하는 오염 제거(Decontamination) 과정을 거쳤습니다. 최종적으로 데이터 형식은 주로 문제와 상세한 풀이 과정 및 최종 정답의 쌍으로 구성하여, 모델이 정답뿐만 아니라 문제 해결 과정 자체를 학습하도록 유도했습니다.
- 코드 코퍼스 생성 과정: 코드 데이터 역시 수학 데이터와 유사한 정제 및 생성 과정을 거쳤으며, 실용성과 다양성 확보 에 중점을 두었습니다. 우선, 라이선스 문제가 없는 대규모 오픈소스 코드 저장소 그리고 알고리즘 학습 자료 등에서 다양한 난이도와 프로그래밍 언어, 그리고 다양한 문제 유형을 포괄하는 문제들을 시드(Seed) 데이터로 확보했습니다. 이후, 코드 생성에 특화된 최신 고성능 LLM들을 활용하여 확보된 문제에 대한 솔루션 코드를 생성했습니다. 수학 데이터 생성에서와 마찬가지로, 하나의 문제에 대해 여러 가지 유효하거나 스타일이 다른 코드 솔루션을 생성하여 모델이 다양한 코딩 패턴과 문제 해결 접근법을 학습하도록 했습니다. 이는 실제 개발 환경에서 다양한 스타일의 코드를 접하게 되는 상황에 대한 대비이기도 합니다. 최종적으로 HumanEval, MBPP 등 주요 코드 생성 벤치마크와의 오염 제거(Decontamination) 과정도 수행하였습니다.
안정적 성능 향상을 위한 2단계 학습
다른 벤치마크 성능을 유지하면서 수학 및 코딩 능력을 향상시키기 위하여 두 단계로 데이터 조합을 나누어 학습을 진행하였습니다.
- Stage 1: 이 첫 번째 단계에서는 총 100B 토큰의 비교적 대규모 추가 학습을 진행했습니다. 주요 목표는 새롭게 구축한 고품질 코드 및 수학 데이터가 포함된 데이터 혼합(Data Mixture)에 모델이 효과적으로 적응하게끔 하는 것이었습니다. 이때 사용된 데이터 구성 비율은 영어 35%, 한국어 35%로 일반 언어 데이터의 비중을 높게 유지하고, 코드 15%, 수학 15%로 전문 분야 데이터를 점진적으로 도입했습니다. 일반 언어 데이터의 높은 비율은 모델이 MMLU, KMMLU와 같은 일반 지식 관련 벤치마크에서의 성능을 최대한 보존하면서, 동시에 새로운 코드 및 수학 지식을 점진적으로 학습하도록 돕는 역할을 합니다.
- Stage 2: Stage 2에서는 최대 10B 토큰의 추가 학습을 진행했습니다. 이 단계에서는 모델의 코딩 및 수학 전문성을 더욱 집중적으로 강화하기 위해 데이터 비율을 영어 30%, 한국어 30%로 일반 언어 데이터의 비중을 다소 낮추고, 코드 20%, 수학 20%로 전문 분야 데이터의 상대적인 비율을 높였습니다. 또한, 단순히 비율만 조정한 것이 아니라, 해당 코퍼스 내에서도 더욱 정제되고 문제 해결에 핵심적인, 난이도 있는 고품질 데이터를 선별하여 학습에 사용했습니다.
| MMLU (5-shot) | KMMLU (5-shot) | HAE-RAE (5-shot) | HumanEval (0-shot) | MBPP (3-shot) | GSM8K (5-shot) | |
|---|---|---|---|---|---|---|
| Kanana-Flag-32.5B-Base | 77.68 | 62.10 | 90.47 | 51.22 | 63.4 | 70.05 |
| 수학, 코딩 성능이 개선된 Kanana-Flag-32.5B-Base | 77.28 | 63.06 | 89.73 | 73.78 | 66.4 | 80.67 |
표1. Kanana-Flag-32.5B-Base 성능 변화
2단계 학습 전략을 Kanana-Flag-32.5B-Base 모델에 적용한 결과, 위 표에서 보시는 것처럼 다른 주요 벤치마크에서의 성능을 안정적으로 유지하면서도 코드 및 수학 관련 주요 벤치마크에서 큰 폭의 성능 향상을 확인할 수 있었습니다. HumanEval 점수는 51.22점에서 73.78점 으로, GSM8K 점수는 70.05점에서 80.67점 으로, MBPP 점수도 63.4점에서 66.4점으로 상승했습니다. 이는 정교하게 설계된 2단계 학습 전략이 모델의 전문 역량 강화에 매우 효과적임을 보여줍니다.
경량 모델 Kanana Nano 개선
저희는 이전 Kanana Nano 모델 개발 과정에서 얻은 경험과 교훈을 Kanana 1.5의 초기 설계 단계부터 적극적으로 적용했습니다. 그중 가장 핵심적인 발견은 모델 경량화 시 전체적인 성능, 특히 복잡한 추론 능력 저하에 가장 큰 영향을 미치는 요소 중 하나가 어텐션 헤드(Attention head) 수의 감소라는 점이었습니다. 어텐션 헤드(Attention head)는 입력 데이터 내 다양한 토큰 간의 관계 및 패턴을 여러 관점에서 포착하고 학습하는 데 결정적인 역할을 합니다. 따라서 어텐션 헤드(Attention head)의 수를 유지하는 것은 모델이 복잡한 특징을 추출하고 다양한 문맥적 정보를 처리하는 능력을 보존하는 데 매우 중요합니다. 반면, 은닉층 크기(Hidden size)나 중간층 크기(Intermediate size)는 상대적으로 전체적인 추론 능력에 미치는 영향이 어텐션 헤드(Attention head) 수보다는 적으면서도 모델의 파라미터 수와 연산량에 직접적인 영향을 줍니다. 이러한 통찰을 바탕으로, 저희는 기존 8B 파라미터 모델을 기반으로 어텐션 헤드(Attention head)의 개수는 그대로 유지하면서 은닉층 크기(Hidden size)와 중간층 크기(Intermediate size)만을 효율적으로 줄여 새로운 3B 파라미터 모델 구조를 설계했습니다. 해당 모델을 기준으로 코드 및 수학 성능 향상을 위한 2단계 학습을 적용했을 때 결과는 아래와 같습니다.
| MMLU (5-shot) | KMMLU (5-shot) | HAE-RAE (5-shot) | HumanEval (0-shot) | MBPP (3-shot) | GSM8K (5-shot) | |
|---|---|---|---|---|---|---|
| Kanana-Nano-3B-Base | 56.27 | 45.60 | 78.19 | 32.93 | 48.0 | 50.72 |
| 수학, 코딩 성능이 개선된 Kanana-Nano-3B-Base | 60.23 | 47.69 | 81.21 | 53.66 | 54.4 | 64.52 |
표2. Kanana-Nano-3B-Base 성능 변화
표에서 확인할 수 있듯이, 32.5B 결과와 마찬가지로 코드 및 수학 관련 벤치마크에서 눈에 띄는 성능 향상이 있었습니다. HumanEval 점수는 기본 모델의 32.93점에서 53.66점 으로, GSM8K 점수는 50.72점에서 64.52점 으로, MBPP 점수는 48.0점에서 54.4점으로 크게 향상되었습니다. 뿐만 아니라, Kanana-Nano-3B-Base 모델에 2단계 학습을 적용했을 때 MMLU 점수가 +3.96점, KMMLU 점수가 +2.09점, HAE-RAE 점수가 +3.02점 상승하는 등 일반 지식 관련 벤치마크에서도 의미 있는 성능 개선을 확인할 수 있었습니다.
2. Context Length 확장
언어 모델 자체의 성능을 높이는 것도 중요하지만, 모델이 실제 사용자 환경에서 긴 문서를 잘 이해하여 작업을 원활히 수행하기 위해서는 긴 문맥을 이해하기 위한 능력이 필수적입니다. 저희는 모델의 핵심 능력을 유지하면서도 언어 모델의 Context length를 8K에서 최대 128K까지 확장시켰습니다.
Long Context 이해 능력 측정을 위한 벤치마크
먼저 현재 모델의 Long Context 이해 능력을 측정하기 위해 다양한 벤치마크를 검토하였습니다. 가장 많이 활용되는 벤치마크는 NIAH, RULER, HELMET이 있습니다.
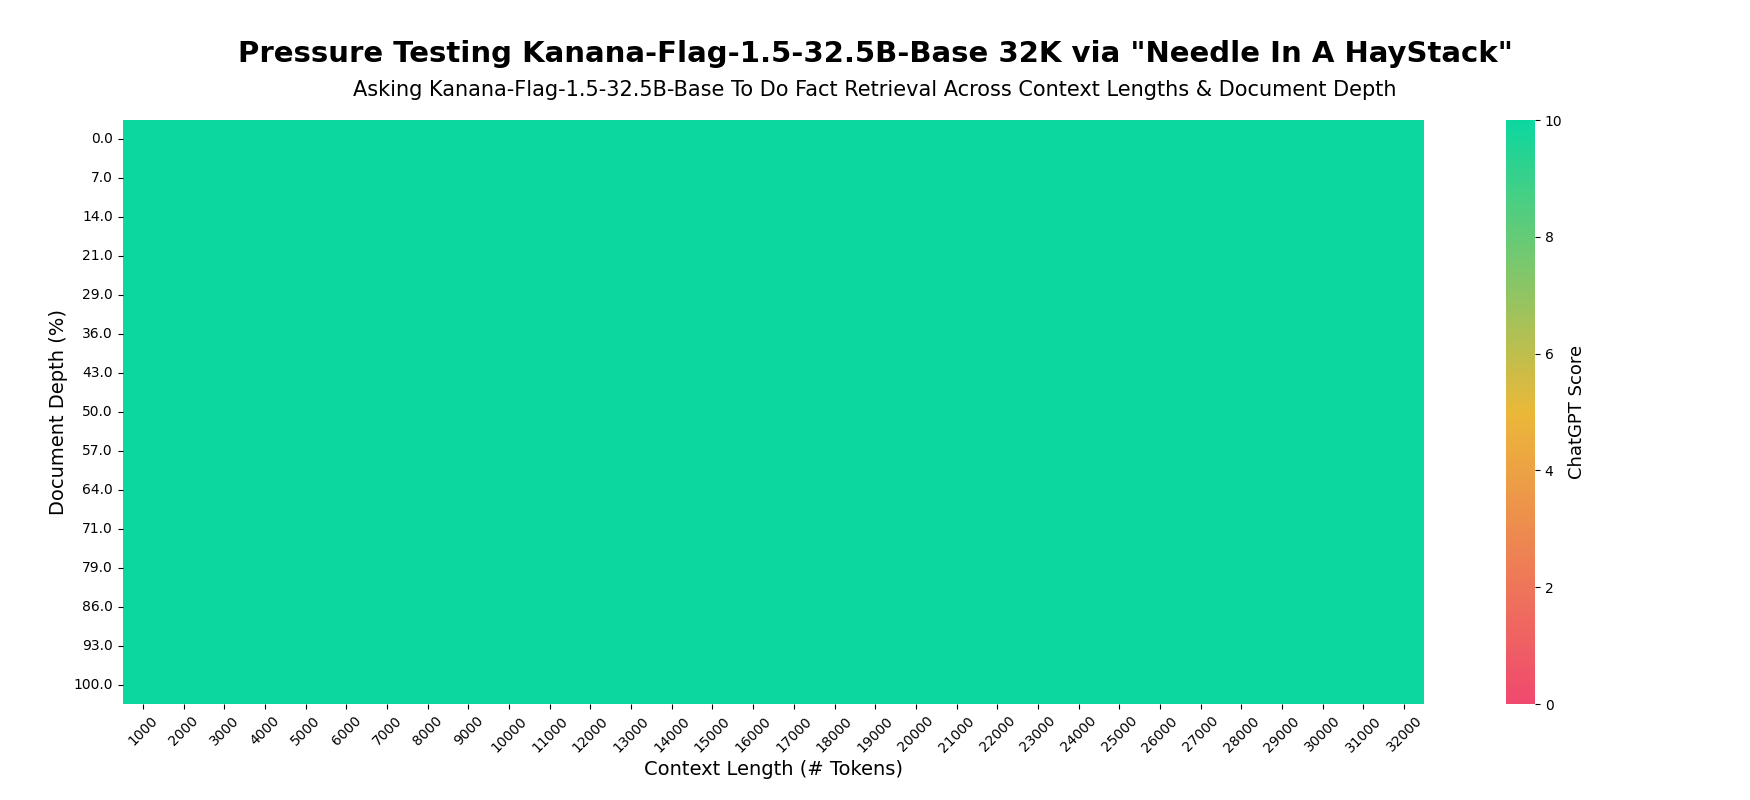
먼저 NIAH (Needle-in-a-Haystack) 는 주어진 토큰 길이를 채우는 서로 관련 없는 여러 문장들(Haystack)과 함께 마지막에 질문이 주어질 때, 질문에 대한 정답(Needle)을 여러 문장들 속에서 찾는 벤치마크입니다. 평가 방식이 매우 직관적이고 다양한 토큰 길이에 대해 Haystack 속 정답 문장의 위치(Depth)를 다르게 하여 평가하기 때문에 모델이 어느 길이에 대응을 못하는지 혹은 주어진 길이에 대해 어느 깊이에서 대응을 못하는지를 한눈에 파악할 수 있다는 장점이 있습니다. 또한, Needle과 Haystack에 해당하는 문장들을 커스터마이징 할 수 있고 프롬프트 변경이 용이합니다.
다음으로 RULER는 Retrieval, Multi-hop Tracing, Aggregation, QA 등의 네 가지 카테고리에서 총 13개의 항목을 종합적으로 평가하는 벤치마크입니다. SOTA 오픈소스 모델들도 낮은 점수를 기록할만큼 복잡도가 높은 평가도 포함하고 있어 다각적인 Long Context 성능 평가가 가능합니다.
마지막으로 HELMET은 RAG, Citation, Re-rank, In-context learning, Long QA, Summarization, Recall 등의 7개 항목에서 보다 다양하고 복잡한 Long Context 과제를 수행하는 벤치마크입니다. 마찬가지로 다양한 각도에서 성능 평가가 가능하며, 아래 그림2와 같이 RULER 등의 벤치마크에서 지적되었던 평가 일관성 문제와 평가 지표를 개선했습니다.
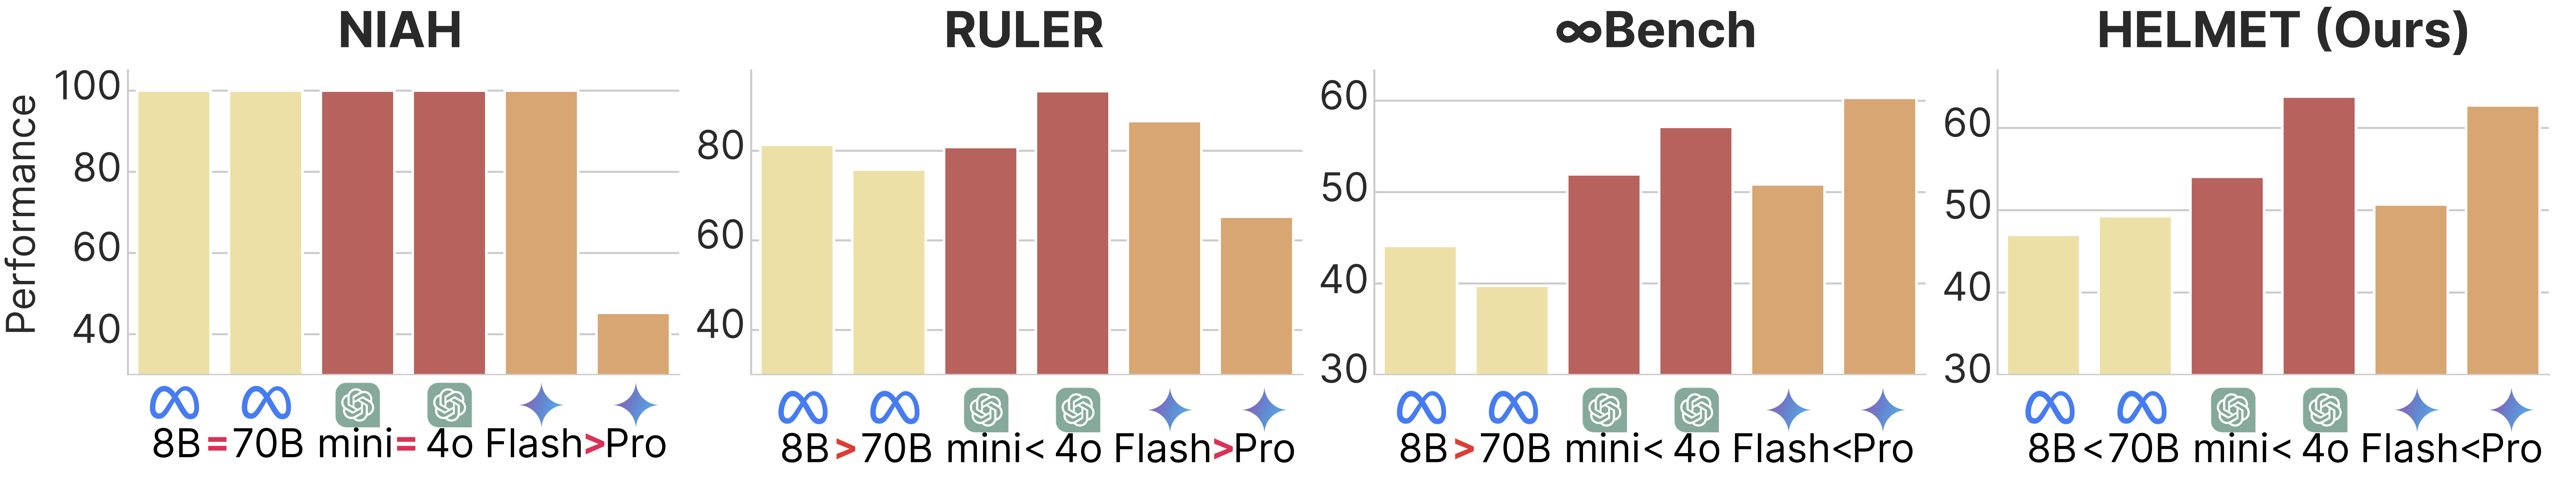
앞서 수학과 코딩 성능을 개선한 모델에 Long Context 이해 능력을 추가 개선해야 했기 때문에, 다양한 길이 시나리오에 대한 결과를 한눈에 볼 수 있는 NIAH와, 평가의 직관성이 높고 RULER의 일부 태스크를 포함하는 HELMET의 Recall을 사용하여 평가를 진행하였습니다.
Base 모델의 Long Context 이해 성능을 측정하는 방법
LLM 평가의 난점 중 하나는 모델이 입력 프롬프트의 방식에 매우 민감하다는 점입니다. 이러한 특성은 특히 지시(Instruction) 수행 능력이 별도로 주입되지 않은 Base 모델에서 더 두드러집니다. 예를 들어, MMLU와 같은 대중적인 벤치마크에서는 Few-shot 혹은 Cloze-style(빈칸 채우기) 프롬프트를 활용하여 평가의 안정성과 일관성을 확보합니다. 하지만 Long Context가 요구되는 시나리오에서는 상황이 다릅니다. 긴 문서 전체를 이해하거나 문맥 내 특정 정보를 찾아 추출해야 하므로, 여러 Shot 프롬프트를 입력하기 어렵고, 그만큼 프롬프트 구성의 영향을 크게 받게 됩니다.
특히 Base 모델은 명시적인 지시어에 덜 익숙하기 때문에, 정보 추출이나 질문 응답 등의 태스크에서 의도한 대로 동작하도록 프롬프트를 설계하는 것이 쉽지 않습니다. 또, 길어진 입력 때문에 토큰 위치, 정보의 분산, Attention의 한계 등 다양한 영향이 평가 결과에 혼재되어 나타납니다. 반면 Instruct 모델은 이러한 태스크에 부합하도록 Fine-tune되어 있기 때문에, 비교적 직관적인 프롬프트만으로도 안정적인 평가가 가능합니다.
결국 Long Context 학습에서 Base 모델을 제대로 평가하려면, 평가 프롬프트를 신중하게 설계하고, 다양한 프롬프트 형태에 대한 반응성을 확인하는 등 추가적인 노력이 필요합니다. 이로 인해 Instruct 모델에 비해 Base 모델의 Long Context 처리 능력을 객관적으로 비교·평가하는 데 더 큰 어려움이 따르게 됩니다.
예를 들어, Base 모델을 대상으로 Needle in a haystack 과제를 평가할 때, 예시 QA pair를 제공하지 않고 단순히 Question과 Answer만 제시하는 경우, "Answer를 반드시 주어진 문서 내에서 찾아야 한다"는 의도를 모델이 제대로 파악하지 못할 수 있습니다. 이는 Base 모델이 명시적인 지시문에 익숙하지 않기 때문입니다. 결과적으로 모델이 문서와 무관한 일반적 답변을 생성하거나, 아예 의도와 동떨어진 출력을 내놓는 경우가 빈번하게 발생합니다.
좀 더 일관적이고 안정적인 평가를 위해서는, 프롬프트 내에서 Question을 넘어선 설명이나 추가 정보 없이, 다음과 같이 모델의 순수한 Retrieval 능력만을 측정할 수 있도록 프롬프트를 설계해야 합니다. 아래 그림3에서 기존과 변경 후 프롬프트를 각각 QA form과 Retrieval form으로 정의하여 Instruct 모델과 Base 모델을 평가하는 프롬프트로 사용하였습니다.
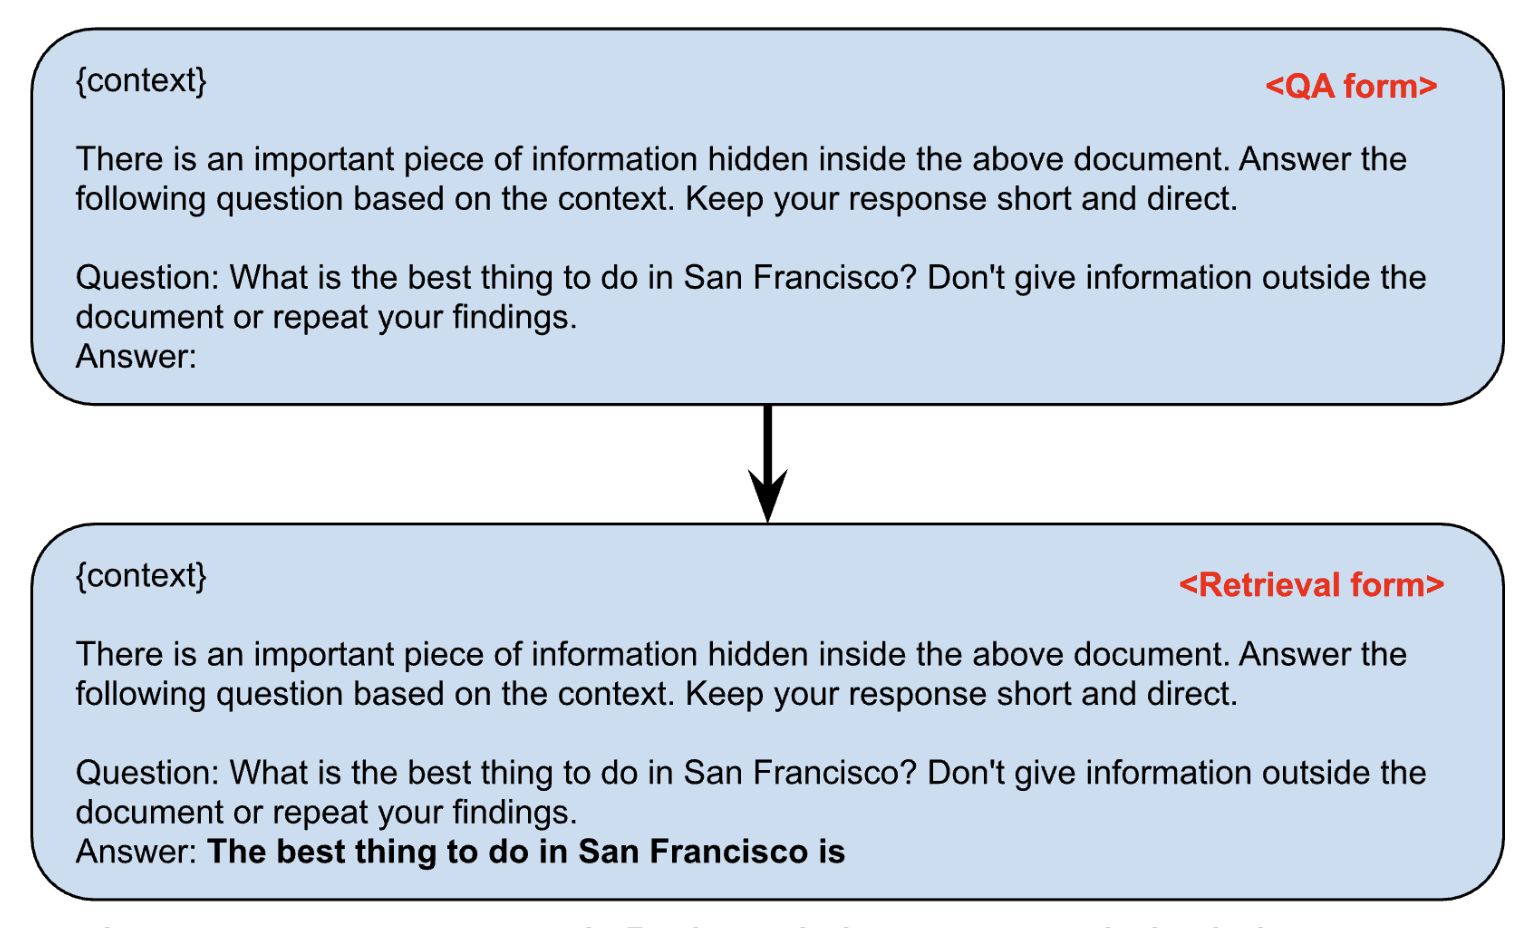
반면, HELMET은 이러한 문제를 해소하고자 Base 모델 평가를 위한 프롬프트를 제공합니다. HELMET의 프롬프트는 명시적인 지시문 없이도 Base 모델이 문서 내에서 답을 추출해야 한다는 과제를 보다 명확하게 인식할 수 있도록 설계되어 있습니다.
Context Length 확장 방법
Long Context 이해 능력을 개선하기위해서, 모델의 Context length를 확장하는 학습을 효과적으로 수행하기 위해서는 두 가지 접근이 중요하게 고려됩니다. 우선, Position embedding을 조정하여 모델이 긴 시퀀스에서도 위치 정보를 안정적으로 인식할 수 있도록 모델 구조를 개선할 수 있습니다. 또한 모델에 Context length를 확장하면서 기존의 성능도 유지해야하기 때문에 1) 긴 데이터 비중과 2) 이전 학습 단계에 사용되었던 데이터의 재사용(Data replay)이 동시에 고려되어야 합니다. 기존에 8K까지의 길이에만 노출되었던 모델이 32K 이상의 길이에도 대응이 가능하도록 32K 이상의 길이를 갖는 새로운 데이터를 학습에 사용 하는 동시에, 이전 학습 단계를 거치며 주입된 언어 모델 자체의 능력을 잃지 않도록 이전 학습 데이터를 재사용해야하며, 이 둘의 비율을 적절히 설정하는 것이 데이터 선정의 핵심입니다.
Position Embedding
모델 관점에서 context length 확장하는 방법으로는 Position embedding을 적절하게 변형하여 사용하는 방법들이 있습니다. 이러한 방법으로는 학습과 동반되어야 하는 방법과 학습 없이(Training-free) 확장하는 기법으로 나눌 수 있습니다. Kanana 1.5 언어모델 시리즈에서는 먼저 학습 기반 접근법으로 8K에서 32K까지의 컨텍스트 길이 확장을 수행한 뒤, 이후 단계에서는 Training-free 방법을 적용하여 최대 128K까지의 입력 지원을 계획하였습니다.
우선, 학습 기반의 context length 확장 방법 중 가장 단순하고 널리 사용되는 접근은 RoPE(Rotary Position Embedding)에서 Base frequency 값을 조정하여 성능을 향상시키는 것입니다. 기존의 Kanana 언어모델 시리즈는 Base frequency값을 500K로 설정하여 학습이 된 상태로, context window를 8k보다 확장하기위해서는 Base frequency 값을 어느정도까지 조정해야하느냐는 문제가 있었습니다. 따라서 학습에 적합한 Base 값을 찾기 위해, Replay 데이터와 High quality long 데이터를 사용하여 다양한 RoPE base 값을 적용하여,기존의 Kanana-8B-Base의 가중치를 이용하여 Ablation을 위한 모델 학습을 진행하였습니다.
| base freq | 1M | 2M | 4M | 8M | 16M |
|---|---|---|---|---|---|
| Long Context | 89.63 | 93.30 | 94.38 | 95.61 | 93.61 |
표3. Base frequency별 Long Context 성능 비교
각 실험에서는 Long Context 벤치마크의 평균 성능을 기준으로 결과를 비교하였으며, 최적의 RoPE base로 8M을 채택하였습니다. Llama-3 8B 모델 기반의 ProLong 연구의 유사한 실험과 일관된 결과를 확인할 수 있었습니다.
데이터 비율 탐색
첫 번째로 길이가 긴 데이터를 수집하기 위해 기존 Pre-training 단계에서 사용했던 데이터 및 별도의 웹 코퍼스 소스에서 다양한 도메인에 걸쳐 64K길이의 고품질 Long data를 선별하였습니다. 실제 목표 길이는 32K이지만, ProLong 등의 연구에서 평가 목표 길이보다 긴 데이터로 학습하는 것이 효과적인 것으로 나타나 32K보다 더 긴 64K 길이로 학습을 진행했습니다.
다음으로 이전 학습에 사용되었던 데이터의 재사용입니다. Long Context 능력을 부여함과 동시에 Short context 성능을 유지하기 위해서는 고품질 Short data가 필요하다고 알려져있습니다. 이를 위해 Kanana의 첫 번째 버전의 고품질 데이터와 이번 Base 성능 개선에 사용된 고품질 수학, 코드 데이터를 Replay 데이터로 선정하였고, 새롭게 구성한 고품질 Long data와의 적절한 비율을 탐색하는 실험을 진행하였습니다. 실험은 수학, 코딩 성능이 개선된 Kanana-Essence-9.8B 모델로 40B token을 학습하여 진행하였습니다.
| 비율 (Replay: long) | Long Context perf(avg) | Short context perf(avg) |
|---|---|---|
| 4:4 | 93.68 | 66.79 |
| 5:3 | 94.33 | 65.22 |
| 6:2 | 93.51 | 67.40 |
| 7:1 | 93.30 | 67.29 |
표4. Base frequency별 Long/Short Context 성능 비교
* Long Context는 NIAH, HELMET-recall task, short context는 MMLU, KMMLU, HAERAE, MBPP, HumanEval, GSM8K로 이루어져 있습니다.
위 표는 다양한 데이터 비율로 모델을 학습하고 기존에 주요 지표로 삼았던 벤치마크(Short context)들의 평균 점수와 이번 1.5에서 Long Context 성능을 측정에 주요 지표로 삼은 벤치마크(Long Context)들의 평균 점수를 분석한 결과입니다. 이를 통해 긴 데이터의 소량 학습만으로 모델의 Long Context 성능을 개선할 수 있었으며, 보다 좋은 성능을 위해 위 실험들 중 양쪽의 벤치마크에서 고르게 좋은 성능을 보인 4:4, 6:2의 모델을 병합하여 최종 모델을 선정하였습니다.
한편, 3B 이하의 작은 모델은 위와 동일한 학습 레시피로 Long context 이해 능력이 충분히 향상되지 않았습니다. 따라서 이렇게 작은 사이즈의 모델은 Long context 학습에 적합한 데이터(예: Long QA, Long summarization)를 추가적으로 수집하여 약 25B token을 추가로 학습하였습니다.
결과
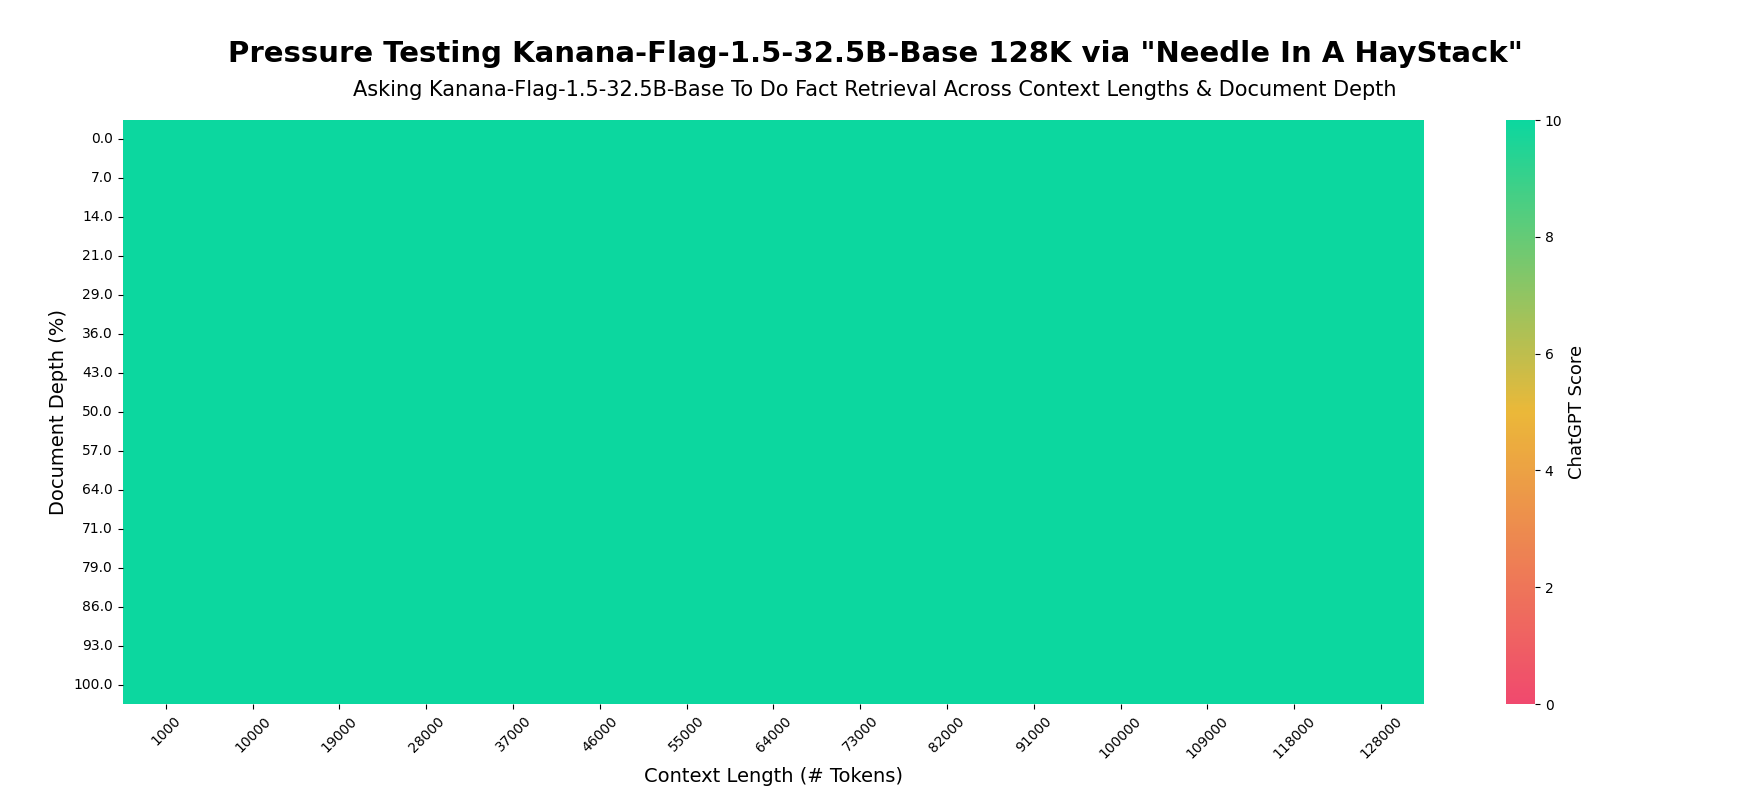
위에서 소개한 Position embedding 조정과 데이터 비율을 적용하여 Kanana의 모든 사이즈에 적용하여 1.5를 학습하였습니다. 그림4는 Kanana-Flag-1.5-32.5B-Base 모델의 context length ~32K NIAH 시각화로, 대부분의 길이와 깊이에서 높은 점수를 보이고 있습니다. 그림5는 학습 없이 YaRN을 통해 Kanana-Flag-1.5-32.5B-Base의 Context length를 128K까지 확장하여 평가한 결과로, 대부분의 칸이 높은 점수를 기록하여 Context length가 효과적으로 확장된 것을 확인할 수 있습니다.
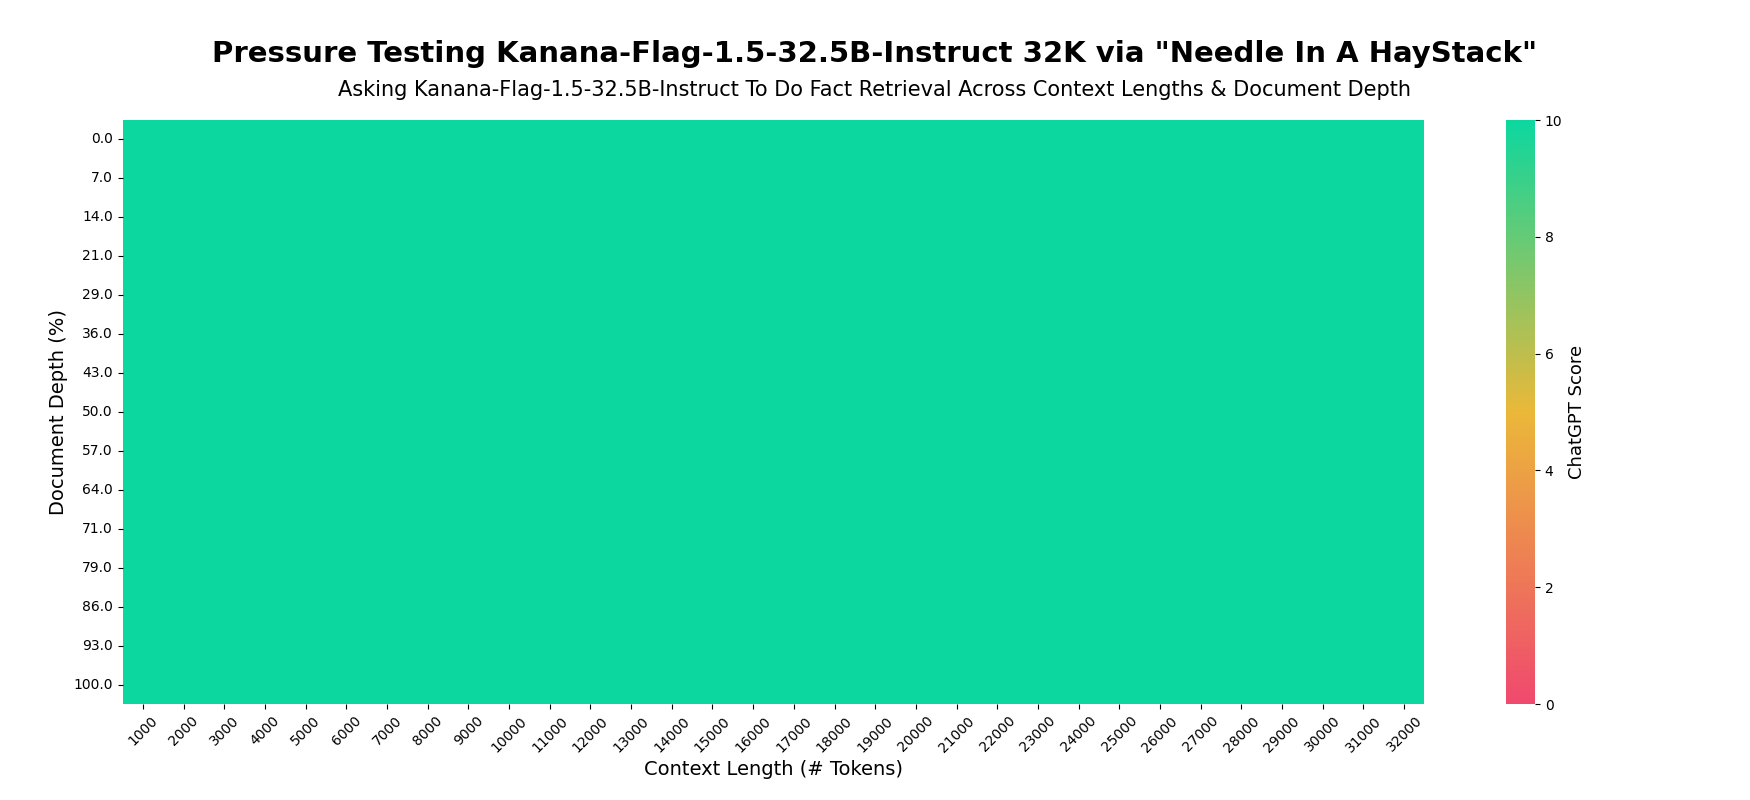
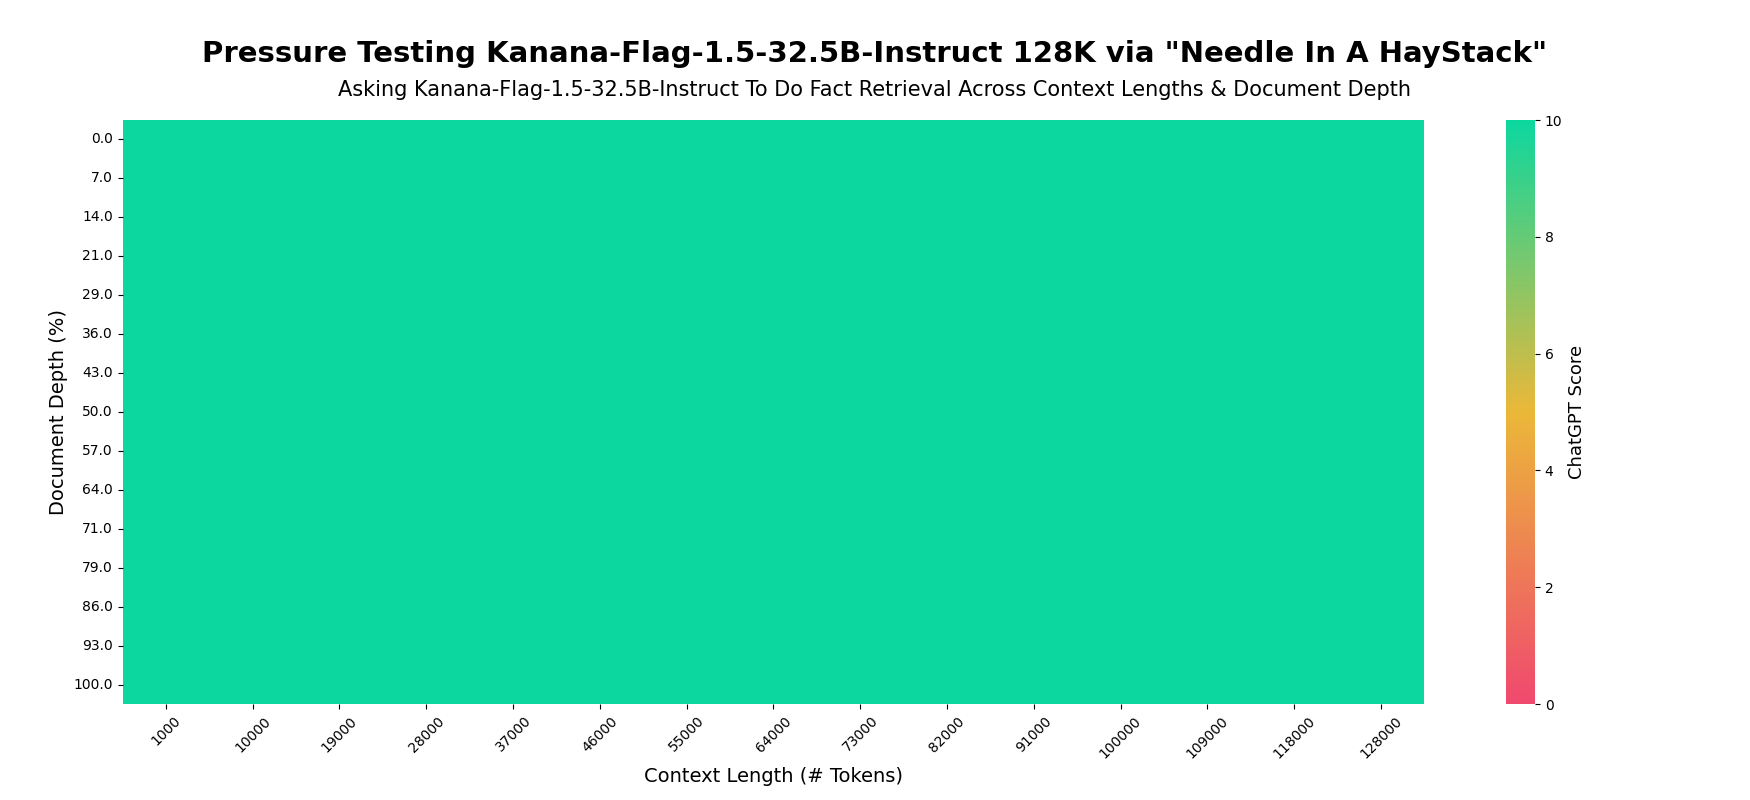
또한 base 단계에서 개선된 성능은 후술할 Post-training 단계에서 Long context를 위한 특별한 학습 없이도 NIAH에서 향상된 결과를 확인할 수 있었습니다. 그림6, 7은 각각 Kanana-Flag-1.5-32.5B-Instruct의 ~32K, YaRN으로 확장하여 평가한 ~128K NIAH 결과입니다. 이 평가는 Retrieval form의 프롬프트로 평가한 Base 모델과 달리 QA form을 사용하여 난이도가 높은 형태로 평가했음에도 불구하고 향상된 결과를 보였습니다.
3. Post-training: 사용성 개선
수학 및 코딩 성능 개선과 Context length 확장 이후, 사용성을 강화하기위한 Post-training을 수행했습니다. 이번에 Kanana 1.5로 업데이트 하면서 특정 기능의 발현보다는 실제 모델의 사용성 증진과 강건한 방법론의 개발을 목표로 하였습니다. 이 과정에서 결과적으로 변경된 지점들은 아래의 3가지 항목으로 요약할 수 있습니다.
- On-policy 강화학습법의 도입
- Scalar reward model 에서 Generative reward model 로의 변경
- Verifiable reward function 과의 결합
On-policy 강화학습법의 도입
지난 3월에 발표된 Kanana 테크리포트의 내용을 보면 기존에는 SFT 이후 Offline Direct Preference Optimization(DPO) 와 Online DPO 이렇게 두번의 Preference alignment 과정을 적용한것을 확인하실 수 있습니다. Reasoning 모델들이 보편화되기 직전까지만 해도 Proximal Policy Optimization(PPO) 등의 강화학습 기반 알고리즘 대비 리소스 효율적이면서 Offline으로 학습함으로 방법론과 구현 측면에서도 훨씬 간단간 DPO와 같은 Direct Alignment Algorithm(DAA)가 주류를 이루었습니다. 하지만 SFT 이후 이루어질 과정(Post-SFT)의 목적을 단순화해 생각했을때 DAA는 다소 부족한 부분이 있습니다.
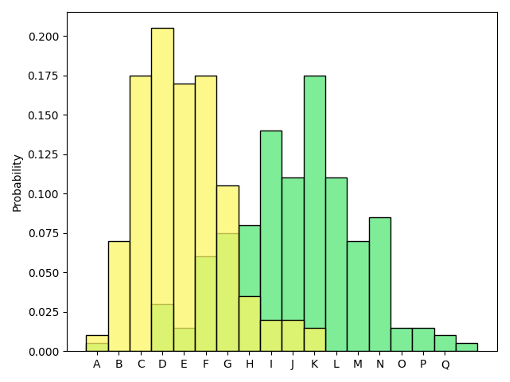
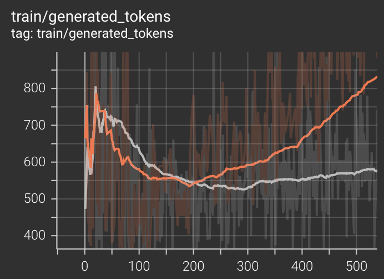
Post-SFT의 목적을 간결하게 표현하면 **“특정 지표에 기준하여 지속적으로 모델의 성능을 향상시키는 것”**으로 표현할 수 있습니다. 여기서 특정지표는 일반적으로 이야기하는 reward model의 점수와 동일하게 볼 수 있습니다. 이때 PPO 등의 online learning 학습법들은 직접적으로 reward maximization이라는 목적을 가지고 있을 뿐만 아니라 conservative policy iteration 등에 기반하여 지속적으로 policy가 업데이트 될 때마다 최소 이전 버전보다는 같거나 더 좋다 라는 이론적 근거 또한 고려하고 있습니다. 하지만 반대로 DPO의 경우 optimal policy와 implicit reward 사이의 closed-form solution을 이용한 관계성을 이용하고 있지만, 근본적으로는 reward model 학습법을 목적함수로 사용하고 있기 때문에 이로 인해 얻어지는 policy 모델이 이전 버전보다 더 좋다 라는 보장 혹은 목적성을 직접적으로 내포하고 있지 않습니다. 더 나아가 offline DPO와 같이 학습 시작 전 데이터를 미리 만드는 경우 이후 policy의 실제 output distribution에서 많이 벗어난 데이터들에 대해서만 reward model 학습을 진행하는 형태가 될 수 있어 알고리즘적으로 예측력이 많이 떨어집니다 (see 그림8).
추가적으로, DAA 계열을 사용할만한 장점은 연산적으로 효율적이라는데 있었습니다. RL(Reinforcement Learning)에서처럼 value function 을 따로 메모리에 올려야 한다거나 inference와 training을 번갈아 가면서 진행함으로 쉬고 있는 메모리가 발생한다던가 하는 문제로부터 자유롭기 때문입니다. 하지만 최근에 많은 오픈소스 프레임워크(e.g., verl)들이 관련 문제들을 훌륭한 엔지니어링으로 해결하고 있습니다. 따라서 기존보다 훨씬 더 효율적으로 강화학습 계열의 알고리즘들을 적용할 수 있게 되었고, 이와 관련된 DAA의 장점이 많이 퇴색되었습니다.
이에 맞추어 Kanana 1.5에서는 저희도 기존의 DAA에서 벗어나 강화학습 기반의 PPO를 적용하게 되었습니다. PPO를 적용함으로 개발 과정에서 얻는 중간결과들에 대해 더 명확한 해석들이 가능해졌고, 나아가 뒤에서 설명할 답변의 간결성까지 챙길 수 있게 되었습니다.
Generative reward model 의 도입
앞에서 설명했던것처럼 reward maximization을 직접적으로 타겟팅하는 강화학습을 도입함으로 학습자의 의도를 잘 반영할 수 있는 알고리즘을 설정해두었으니 이제 “의도” 자체를 명확하게 할 때입니다. 이를 다르게 이야기하면 reward model 자체를 더 강력하게 만들면서 동시에 우리의 의도를 명확하게 반영하는 과정을 거치는것으로 풀어낼 수 있습니다. 이전에 online DPO를 적용할 때 사용했던 reward function은 질문과 답변 쌍이 주어졌을 때 하나의 점수를 내뱉는 scalar reward model이었습니다. DPO 에서 흔히 사용하는 preference dataset들을 이용해서 학습할 수 있다는 점과 한 번에 한 숫자만 생성하면 된다는 점에서 이점이 있는 형태의 reward model입니다. 반대로 scalar reward model이 지닌 단점으로는 어려운 해석과 일반화 입니다. 오직 하나의 숫자만 내뱉기때문에 특정 질문 답변 쌍에 대해서 학습으로 얻어진 reward model이 왜 특정 점수를 부여하는지에 대해서는 해석하기가 매우 어려워집니다. 이는 모델을 개선해야하는 입장에서 상당히 큰 장애물이 될 수 있습니다.
Scalar rewar model은 일반화에서도 큰 문제가 생기게 됩니다. 인공신경망은 흔히 학습한 데이터와 유사할 수록 좋은 예측력을 가지는 반면 그렇지 않을 경우 상당히 불안정한 예측값을 생성하기도 합니다. 따라서 학습이 진행되고 policy 모델이 업데이트되어 질문/답변 쌍에서 답변의 부분이 한번 학습이 완료된 reward model의 데이터 범주에서 벗어나기 시작하면 예측된 reward 값의 신뢰도가 하락하게 됩니다. 이를 방지하기 위해서는 주기적으로 reward model을 새롭게 학습해주어야하는 상황이 발생합니다. 이와 비슷한 결로 앞서 이야기한 학습자가 reward model에 담고 싶은 “의도”가 변화했을때도 새롭게 reward model을 학습시켜야 한다는 단점이 존재합니다.
이런 문제들을 해결하는 방법으로 Kanana 1.5에서는 generative reward model을 도입하게 되었습니다. Generative reward model은 주어진 질문/답변 쌍에 대해 점수를 부여하기전 논리적 근거를 우선 생성함으로 부여된 점수에 대한 해석력이 올라가게 됩니다. 또 논리적 근거에 기반한다는 면에서 기존에 학습해둔 범용적 지식을 활용하여 일반화의 능력또한 상승하게 됩니다. 그리고 학습자가 원하는 의도를 반영하기 위해서는 재학습이 아닌 평가를 위한 prompt에 학습자의 기준을 잘 명시해주기만 하면 바로 적용이 가능하게 됩니다(see 그림9). 마지막으로 generative reward model이 가진 단점이었던 생성시간은 최근 vLLM, SGLang 등의 여러 inference engine의 발전으로 매우 현실성있는 범주로 들어오게 되었습니다.
하지만 이런 논리적 근거나 범용적 지식을 동반하더라도 LLM이 실수를 할 수 있다는 것은 이미 LLM에 대한 경험을 해보신 분이라면 일반적으로 예측할 수 있는 부분입니다. 이런 실수들은 답변의 정확도를 요구하는 질문들에 대해서는 매우 치명적일 수 있습니다. 따라서 이런 부분들을 보완하기 위해 저희는 verifiable function을 함께 도입하였습니다.
Verifiable reward function 과의 결합
보편적 지식에 대한 질문이나 평범한 대화 혹은 창의성을 요구하는 질문등 명확한 답변이 정해지지 않거나 답변을 포장하는 방식에 더 중요도가 있는 경우 LLM을 이용한 generative reward model이 충분한 가이드만 주어졌다면 어느정도 만족스러운 판단을 내릴 수 있게 됩니다. 하지만 수학이나 코딩, 특정 지시를 따라야하는 질문들에 대해서는 명확한 답이 존재하고 답만 주어져있다면 그걸 검증하는 과정또한 비교적 직관적이게 됩니다. 이런 영역들에 대해서는 generative reward model의 예측이 부족하다고 판단하여 Kanana 1.5에서는 추가적으로 verifiable function을 도입하였습니다. Verifiable function은 주어진 문제에 대해 정답이 같이 주어졌을때 예를 들어 모델의 답변에도 해당 정답이 포함여부에 따른 점수 부여방식을 의미합니다. 따라서 수학의 경우 정답이 있는지, 코딩의 경우 테스트 케이스들에 대해 통과 하는지 등등이 verifiable function의 단순화된 예시라고 할 수 있습니다.
결과
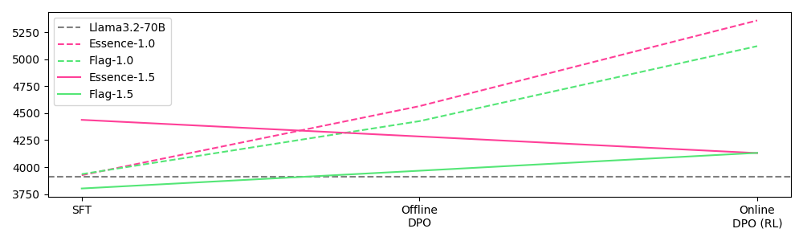
앞서 설명드린 세가지의 변경점과 함께 추가적인 데이터의 업그레이드를 거쳐 Kanana 1.5가 탄생하였습니다. Kanana 1.5는 기존 대비 수학과 function calling 등에서는 더 우수한 성능을 보이는 동시에 생성토큰을 유의미하게 줄여 간결하면서 정확한 모델이라고 할 수 있습니다.
그림10에서 확인할 수 있듯 간결성에 있어서 기존에는 Post-SFT 과정을 거칠 수록 평균 답변의 길이가 유의미하게 증가했었습니다. 하지만 Kanana 1.5에서는 Post-SFT 과정에서 답변길이가 모델 크기에 따라 오히려 감소하는 경우도 있음을 확인할 수 있습니다. 그렇게 얻어진 최종모델의 길이 또한 기존에 잘 알려져있던 Llama 시리즈의 대표 모델중 하나와 크게 벗어나지 않음을 알 수 있습니다.
조금 더 직관적인 예시로 표5에서 실제 각 모델들의 비교 답변을 확인하실 수 있습니다. 기존에는 부가설명과 예시, 마무리문장까지 사용자가 요청하지 않은 불필요하게 복잡한 답변의 형태를 하고 있었다면 새로운 버전에서는 딱 필요한 정보를 전달하는것으로 마무리하는것을 확인하실 수 있습니다. 지속적으로 과한 정보의 제공은 사용자로 하여금 쉽게 피로감을 느끼게 할 수 있기에 이러한 간결성은 사용성으로 직결되게 됩니다.
| 질문 | 화무십일홍이 무슨 뜻이야? |
|---|---|
| 기존 모델 답변 | “화무십일홍”(花無十日紅)은 중국 송나라 때의 문인 조본방(趙本方)이 지은 시구에서 유래한 성어로, "10일 동안 붉은 꽃은 없다"는 뜻입니다. 이는 어떤 권력이나 명성, 아름다움도 오래 지속되지 못하고 반드시 쇠락하게 된다는 의미를 내포하고 있습니다. 더 구체적으로는, 꽃이 10일 동안 붉게 피어 있을 수 없다는 자연 현상에 비유하여, 사람의 권력이나 명예, 아름다움 등도 그와 같이 오래 지속되지 못하고 반드시 쇠퇴하게 된다는 인생의 무상함을 표현합니다. 이 성어는 주로 권력이나 명성의 일시적 성격을 강조할 때 사용됩니다. 예시 문장: - “권력의 자리에 오른 사람들도 화무십일홍의 법칙을 피할 수 없다.” - “어떤 유명 연예인도 화무십일홍의 운명을 맞이하게 된다.” 이처럼, 이 성어는 모든 것이 영원하지 않다는 교훈을 담고 있습니다. |
| Kanana 1.5 모델 답변 | "화무십일홍(花無十日紅)"은 한자로 "꽃은 열흘 동안 붉게 피어 있을 수 없다"는 뜻입니다. 이 고사성어는 시간이 흐르면 영원히 지속되지 않는다는 자연의 이치를 비유적으로 표현한 말입니다. 즉, 아무리 강렬하고 화려하게 피어있는 꽃도 결국 시들게 되듯이, 세상 모든 것은 영원히 지속되지 않고 변화하고 사라진다는 의미를 담고 있습니다. 이러한 표현은 보통 인간의 권력, 명성, 성공 등이 아무리 강력하게 보일지라도, 시간이 지나면 쇠퇴하고 사라질 수 있다는 의미로 사용됩니다. |
표5. 기존 모델과 Kanana 1.5 모델의 동일한 질문에 대한 답변 예시. 기존에는 더 구체적인 설명이나 예시문장, 결론을 다시 정리하는 등 부수적인 내용들로 구조화 되어 있는 답변인 반면 Kanana 1.5 모델에서는 자연스럽고 비교적 간결한 형태의 답변을 생성하고 있다.
Kanana LLM 시리즈의 전체 성능 테이블
Kanana LLM의 첫 번째 버전과 1.5 버전의 base, instruct 모델의 전체 성능은 아래의 표와 같습니다. 특히 1.5 버전의 Kanana Flag, Essence, Nano를 개발하는 과정에서 축적한 레시피를 좀 더 정교하게 다듬어, 이 레시피를 Kanana-1.5-8B의 base, instruct, Kanana-1.5-2.1B의 base, instruct 학습에 적용하였습니다. 또한 LLM 기반의 여러 연구에 기여하고자, 이 모델들을 Apache 2.0 라이센스로 공개합니다.
Base Models
| Base Models | MMLU (5-shot) | KMMLU (5-shot) | HAE-RAE (5-shot) | HumanEval (0-shot) | MBPP (3-shot) | GSM8K (5-shot) |
|---|---|---|---|---|---|---|
| Kanana-Flag-1.5-32.5B | 76.76 | 61.90 | 89.18 | 73.17 | 65.60 | 81.50 |
| Kanana-Flag-32.5B | 77.68 | 62.10 | 90.47 | 51.22 | 63.40 | 70.05 |
| Kanana-Essence-1.5-9.8B | 68.27 | 52.78 | 86.34 | 64.63 | 61.60 | 71.57 |
| Kanana-Essence-9.8B | 67.61 | 50.57 | 84.97 | 40.24 | 53.60 | 63.61 |
| Kanana-1.5-8B | 64.24 | 48.94 | 82.77 | 61.59 | 57.80 | 63.53 |
| Kanana-8B | 64.22 | 48.30 | 83.41 | 40.24 | 51.40 | 57.09 |
| Kanana-Nano-1.5-3B | 59.23 | 47.30 | 78.00 | 46.34 | 46.80 | 61.79 |
| Kanana-1.5-2.1B | 56.30 | 45.10 | 77.46 | 52.44 | 47.00 | 55.95 |
| Kanana-Nano-2.1B | 54.83 | 44.80 | 77.09 | 31.10 | 46.20 | 46.32 |
표6. Kanana LLM 라인업 전체 Base 모델 성능
Instruct Models
| Instruct Models | MT-Bench | KoMT-Bench | IFEval | HumanEval+ | MBPP+ | GSM8K (0-shot) | MATH | MMLU (0-shot, CoT) | KMMLU (0-shot, CoT) | FunctionChat Bench |
|---|---|---|---|---|---|---|---|---|---|---|
| Kanana-Flag-1.5-32.5B | 8.13 | 8.12 | 82.70 | 79.88 | 71.96 | 93.03 | 75.96 | 82.76 | 64.10 | 67.17 |
| Kanana-Flag-32.5B | 8.33 | 8.03 | 84.59 | 78.66 | 69.84 | 91.66 | 58.08 | 81.08 | 64.19 | 65.67 |
| Kanana-Essence-1.5-9.8B | 7.88 | 7.35 | 76.34 | 72.56 | 66.93 | 90.07 | 62.02 | 72.85 | 52.00 | 51.43 |
| Kanana-Essence-9.8B | 7.81 | 7.65 | 80.20 | 72.56 | 68.52 | 84.91 | 42.24 | 70.64 | 50.76 | 26.77 |
| Kanana-1.5-8B* | 7.76 | 7.63 | 80.11 | 76.83 | 67.99 | 87.64 | 67.54 | 68.82 | 48.28 | 58.00 |
| Kanana-8B | 7.13 | 6.92 | 76.91 | 62.20 | 43.92 | 79.23 | 37.68 | 66.50 | 47.43 | 17.37 |
| Kanana-Nano-1.5-3B | 7.01 | 6.52 | 70.08 | 70.73 | 64.29 | 80.36 | 56.70 | 59.69 | 37.60 | 55.37 |
| Kanana-1.5-2.1B* | 7.01 | 6.54 | 68.61 | 68.90 | 65.08 | 81.43 | 60.62 | 53.87 | 32.93 | 53.70 |
| Kanana-Nano-2.1B | 6.40 | 5.90 | 71.97 | 63.41 | 62.43 | 72.32 | 29.26 | 52.48 | 38.51 | 26.10 |
표7. Kanana LLM 라인업 전체 Instruct 모델 성능
* Apache 2.0으로 공개되는 모델들은 타 모델 대비 최신 버전으로 학습되었습니다. 추후에 다른 모델들도 업데이트 할 예정입니다.
마무리하며
Kanana 1.5는 Kanana 2 개발을 위한 실험적 도약이었습니다. 기존 모델을 개선하며 향후 Kanana 2가 지향하는 방향을 구체화할 수 있었고, 이를 통해 국내 AI 생태계 활성화를 위한 8B 및 1.5B 모델의 오픈소스 공개도 추진할 수 있었습니다. 앞으로도 지속적인 모델 업데이트를 통해 Kanana 모델의 활용성을 높여가겠습니다.
현재 저희는 AI 에이전트를 지향하는 더욱 고도화된 모델, Kanana 2를 개발 중입니다.
- 데이터 측면에서는 생성 데이터뿐 아니라 수학·코딩 관련 데이터를 수집하기 위한 자체 파이프라인을 구축해 활용하고 있습니다.
- 모델 측면에서는 Context Length 확장을 위한 Long SFT 데이터셋을 직접 제작해 적용 중입니다. 특히 파라미터 규모가 작은 모델에서 Long SFT 데이터의 중요성을 확인했기에, 향후 경량 모델 고도화를 위해 해당 데이터셋을 더욱 확장해나갈 계획입니다.
- 또한, Post-training 단계에서는 글로벌 모델과의 경쟁력 확보를 목표로, reasoning에 특화된 모델과 reasoning/non-reasoning이 결합된 하이브리드 모델도 함께 개발하고 있습니다.
앞으로도 지속적인 기술 고도화를 통해 글로벌 수준의 모델을 만들고, 활발한 기술 공유를 통해 국내 AI 생태계 발전에 기여하도록 나아가겠습니다. 많은 관심과 응원 부탁드립니다. 감사합니다.
🔗 Kanana 1.5 download (8B, 2.1B)
Acknowledgements
- Language Model Training
juliet.bak,lana.ny,lambda.xprime
- Language Model Alignment
chloe.py,kevin.nlp,khel.2h,louie.m,sean.ai
- AI Engineering
harry.win,jacob.crux
- Multimodal Model
loophy.cc
관련 글 목록
- 더 똑똑해진 카카오의 언어모델 ‘Kanana 1.5’ 상업적 활용 가능한 오픈소스 공개
- 이미지와 음성을 아우르는 카카오의 멀티모달 언어모델 Kanana-o 알아보기
- 카카오의 언어모델, Kanana 테크니컬 리포트 공개
- 작지만 강한 Kanana Nano 효율적으로 개발하기
- 이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기
- 나만의 프로필 이미지 생성 모델 개발기
- 밑바닥부터 Kanana-LLM 개발하기: Post-training
- 밑바닥부터 Kanana-LLM 개발하기: Pre-training
- 카카오의 AI 모델, 카나나 모델 패밀리를 소개합니다