Backend
전시 API 서비스 전환기: Part-2
Jude여기어때
2022년 12월 20일
원문에서 보기 ↗안녕하세요. 여기어때 서비스개발팀에서 백엔드 개발을 담당하고 있는 주드입니다. 저는 여기어때 전시를 위한 상품데이터와 메인데이터를 동기화하는 서비스 개발을 담당하고 있습니다.
지난 번 ”전시 API 서비스 전환기: Part-1"에서는 전시 API 서비스의 간략한 소개와 개선의 이유, 목적 그리고 개발 과정을 소개해 드렸습니다. 지금 Part-2에서는 API 컨버팅 과정에서 API 응답 검증과 테스트코드에 대한 이야기를 해보겠습니다.
API검증을 위한 섀도잉
저희는 레거시 API와 신규 API의 응답을 비교하기 위한 방법으로 섀도잉(Shadowing)을 도입하였습니다.
섀도잉(Shadowing) 이란?
- 레거시 서비스와 신규 서비스에 동일한 요청을 했을 때 동일한 응답이 오는지 비교 하는 과정입니다. 만약 두 응답이 일치하지 않는다면 신규 서비스에 잘못된 비즈니스 로직이 적용되었다고 판단할 수 있습니다.
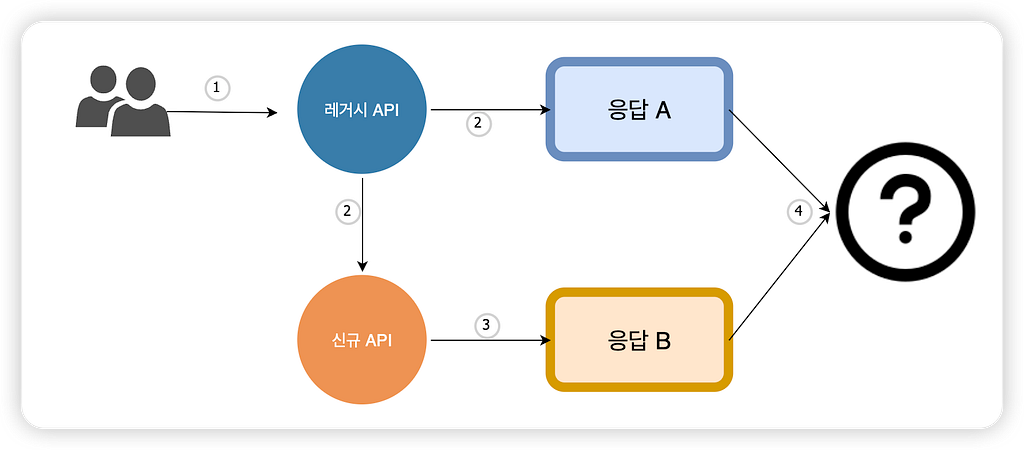
섀도잉을 통한 API Response 비교
결론부터 말씀드리면 섀도잉을 통한 비교 과정은 이번 프로젝트를 성공적으로 완수할 수 있었던 가장 중요한 열쇠였습니다. 저희는 응답 객체에 하나의 단순 Value가 불일치되었을 때 이를 해결하기 위해 많은 비즈니스 로직을 분석했고, 응답일치를 이뤄내는 과정에서 레거시 서비스에 숨겨진 버그도 찾아낼 수 있었습니다.
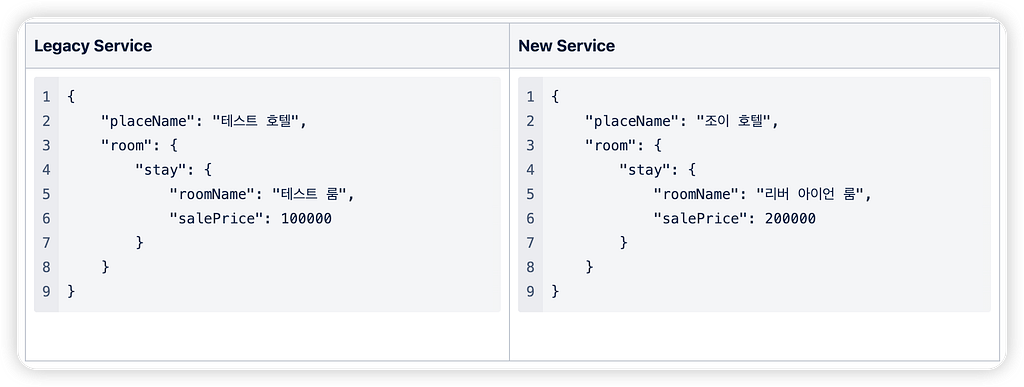
API Response 단순 비교
예를 들어 위 그림과 같이 레거시API의 요청에 대한 응답과 신규 API의 응답이 서로 다르게 반환된다면 이 두 서비스의 응답은 일치하지 않는다고 판단할 수 있습니다. 이런 불일치는 신규 서비스로 전환되었을 때 장애로 이어질 수 있어 Production(상용)환경에서 실제 사용자들의 요청에 의한 응답을 비교해 응답불일치가 제로에 수렴될 수 있도록 만들고자 하였습니다.
섀도잉 도입과정
저희는 주어진 환경에서 최고의 효율을 내는 섀도잉 도입 방안을 찾아보기로 했습니다.
STEP 1. 고민 단계
-
미들웨어를 사용할 수 있는 비용과 시간이 부족했음
-
섀도잉으로 인한 트래픽이 감당할 수 있는 수준인지 가늠할 수 없음
-
Production(상용) 환경에서 기존 서비스에 영향을 주지 않아야 함(중요)
-
Error Response까지 동일한지 확인하여 정합성을 높여야 함
섀도잉 도입 방법 제안!
“Spring 내부에서 처리하자”
“섀도잉 On/Off 기능을 통해 Peek time은 피해서 비교해 보자”
STEP 2. 실행 단계
Spring 내부에서 처리하고, 레거시 API 호출 시 별도의 스레드로 HttpServelet을 통해 신규 서비스로 요청을 하고 전달받은 응답값을 비교하기로 합니다.
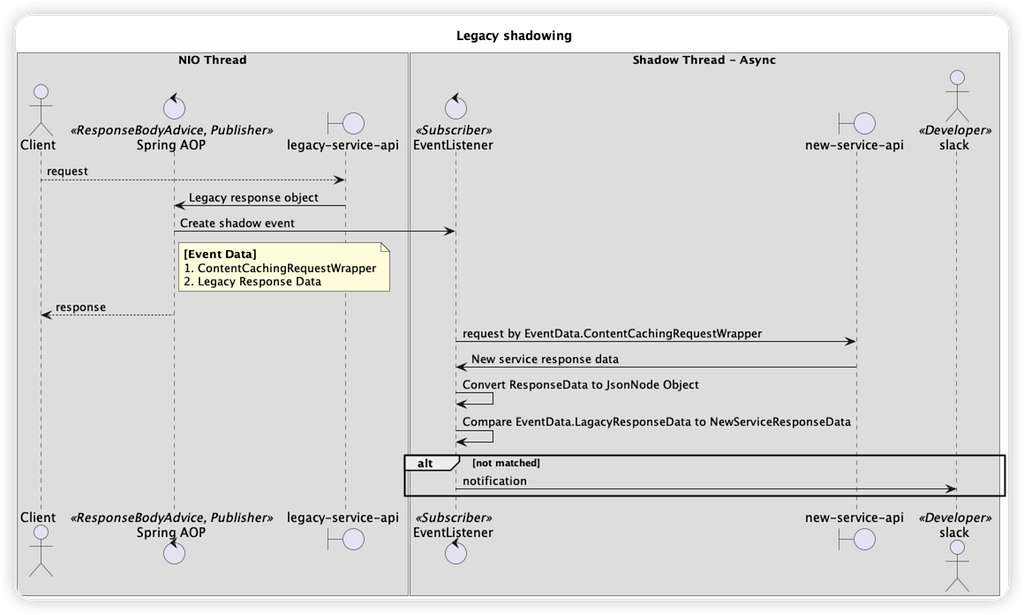
섀도잉 프로세스 다이어그램
섀도잉 Process
 1. ResponseBodyAdvice에서 Request, Response Object를 담아 Event 발행
 2. Listener는 별도 ThreadPool에서 관리, 사용자 요청의 Thread와는 분리
 3. Listener는 전달받은 HttpServlet을 기준으로 신규 서비스에 요청
 4. 레거시 서비스와 신규 서비스의 응답 객체를 비교
 5. 비교 후 알림 발생을 통해 응답값 확인
과정3. Trouble Shooting
섀도잉 진행 중 응답 불일치가 발견되면 비즈니스 로직과 정책 확인을 하면서 지속적인 수정과 리팩토링을 진행했습니다. 그 결과 내부 로직 이슈나 서비스에 문제는 없으나 섀도잉을 위한 응답 객체의 동일성 보장 등 여러 현상들이 발견되었습니다. 그중 내부 로직 이외에 경험했던 이슈 몇가지를 공유하겠습니다.
- Timezone Offset (with Colon)
- 신규 서비스의 framework version이 전체적으로 향상되면서 jackson-databind version에 따른 timezone 방식이 변경되며 API 응답이 불일치 되는 경우가 생겼고 ObjectMapper의 defaultDateFormat의 withColonInTimeZone 설정변경을 통해 응답을 일치시킬 수 있었습니다.
Timezone 응답 불일치
 - Lagacy Service (jackson-2.9.x) : 2022-01-01T18:00:00.000+0000
 - New Service (jackson-2.13.x) : 2022-01-01T18:00:00.000+00:00
- HashMap Load Factor
- n개의 상품 중 1개의 상품만 노출하는 정책이 있습니다. 정렬 조건에 의해 1개의 상품을 노출해야 하지만 여러 개의 상품이 모두 같은 정렬 정책 을 갖고 있는 상품들이 존재했습니다. 레거시 서비스는 HashMap.values()에 의한 첫 번째 상품, 신규 서비스는 ArrayList에서 첫 번째 상품을 응답하도록 하였으나 서로 다른 결과값이 노출되는 현상이 발생되었습니다. 응답일치를 위한 섀도잉이었기 때문에 신규 서비스에 임시로 상품 리스트를 HashMap으로 동일하게 맞춘 뒤 응답을 일치시킬 수 있었습니다. 늘 너무 당연하게 순서가 없이 저장될거라 생각하며 쓴 Map이었지만 그 안에서 키값 정렬을 위해 HashCode를 사용하고 있고 Map의 크기에 따라 달라질 수 있다는 배움을 얻었습니다. HashMap Load Factor와 관련된 내용은 하단 테스트코드 부분에서 다시 한번 설명 드리겠습니다.
HashMap Load Factor 관련 내용은 Java Docs에서 확인해 보시기 바랍니다.
- 재고의 변화
- 잠깐의 섀도잉 요청 동안에도 상품과 쿠폰의 재고는 실시간으로 변경되었습니다. 찰나에 발생한 데이터 변경은 섀도잉이 불가능한 케이스였지만 변경Diff를 확인하며 수기로 확인할 수 있는 수준이었기에 섀도잉을 통한 불일치는 Skip하였습니다. 이 글을 읽고 있는 분들께서 섀도잉 도입을 고민 중이며 실시간 데이터에 대한 변경점을 고려해야 하는 상황이라면 충분한 검토를 통해 도입하시기 바랍니다.
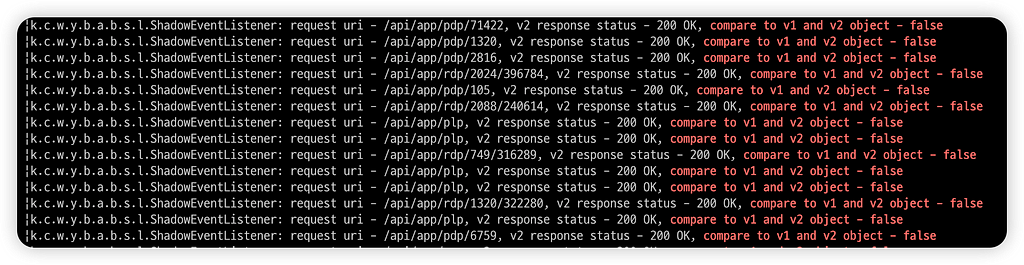
섀도잉 실패 로그
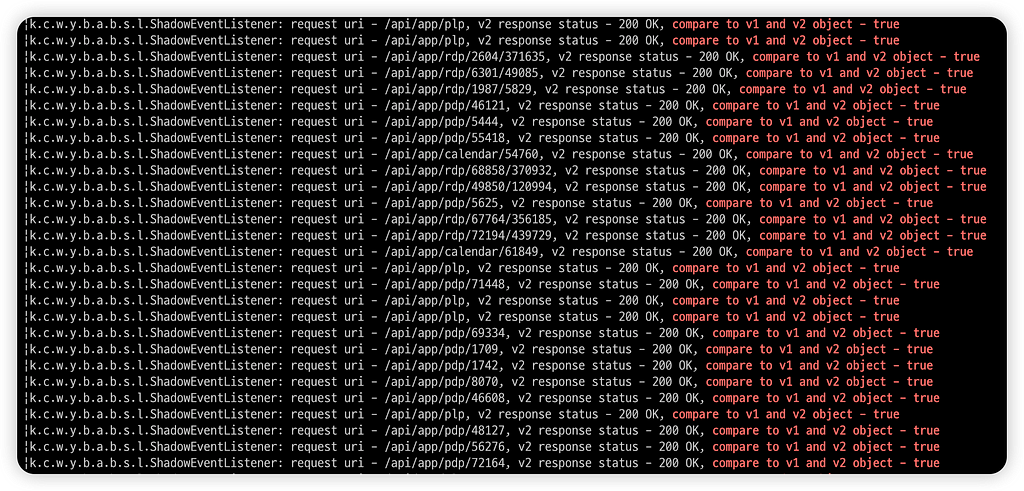
섀도잉 성공 로그
개발검증을 위한 테스트코드
이전 포스팅(Part-1)에서 기술한 대로 ‘기존 코드의 복잡성과 테스트코드의 부재’는 서비스 유지보수에 있어서 매우 어렵고 힘든 과정입니다. 물론 소스코드를 읽고 기획서를 확인하면 비즈니스에 대해 어느 정도 파악할 수 있겠지만 항상 외우고 있을 수는 없기에 저희는 비즈니스 정책을 먼저 정리했습니다.
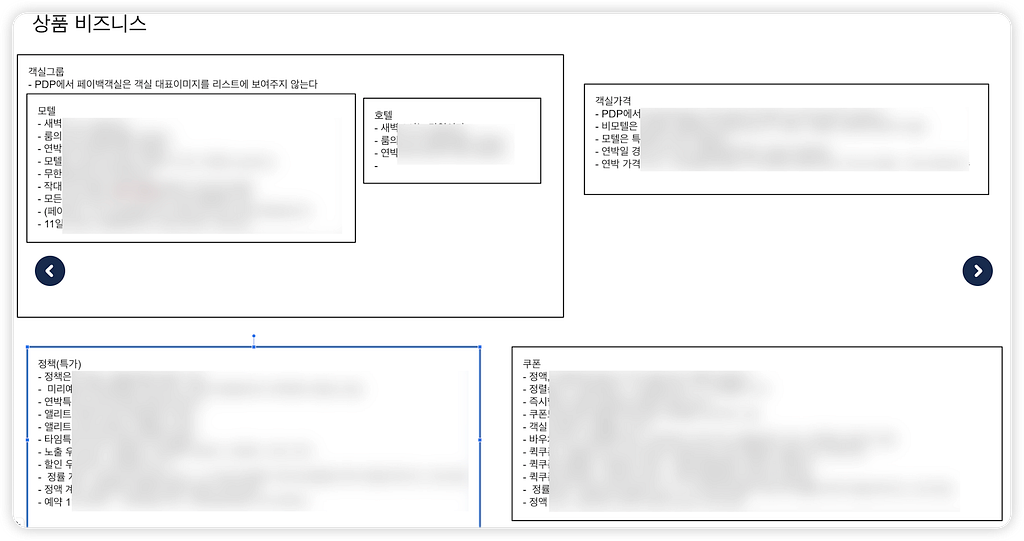
주요 비즈니스 정책 정리 카드
위와 같이 비즈니스를 리스트업 한 후 우리가 개발한 특정 도메인에 맞게 테스트 케이스를 상세하게 쪼개면서 아래와 같이 테스트 코드를 작성했습니다. 단, 여기어때에서는 객실 가격과 객실에 대한 정렬이 매우 중요하므로 그것들 위주로 테스트케이스를 작성해 나갔습니다.
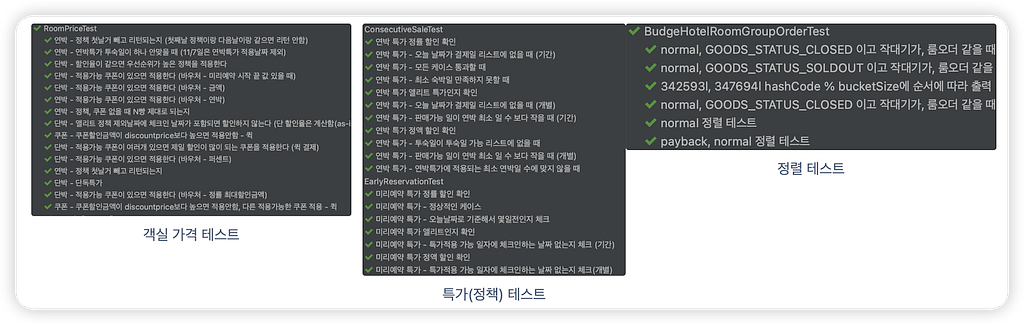
특가(정책) 테스트 케이스
테스트 케이스를 꼼꼼히 작성했던 덕분에 신규 서비스를 개발 하는 도중에 변경 되었던 신규 정책들로 인해 가장 중요한 객실 가격과 정렬이 흐트러지는 일은 발생하지 않도록 사전에 예방할 수 있었습니다. 특가(정책)은 할인할 때 정액, 정률 할인을 할 수 있기 때문에 아래와 같이 몇 개의 데이터를 만들어 상수화 해두고 필요할 때 지정해서 사용할 수 있는 방안으로 사용하였습니다.
하나의 사례를 공유드리는 차원에서 여기어때의 가장 간단한 정책인 엘리트 정책으로 예를 들어 보겠습니다. 테스트에 필요한 데이터를 미리 셋팅해 두는 방법에는 여러가지가 있지만 저희는 특가(정책)을 몽고DB에 저장해두고 사용하기 때문에 Mocking데이터를 만들 때 몽고의 데이터 형식인 json을 생성하여 document 클래스로 역직렬화 하였고, 테스트 시 달라지는 할인율, 할인 금액 부분을 파라미터화 하여 쉽게 테스트할 수 있도록 하였습니다.
public class Constants {
   public static Discount PERCENT_10 = createPer10();
   public static Discount AMOUNT_10000 = createAmount10000();
   // 중략
   public static Discount createPer10() {
      Discount Discount = new Discount();
      Discount.setCode(UnitTypeValue.PERCENT.getCode());
      Discount.setType(UnitTypeValue.PERCENT.getType());
      Discount.setValue(10);
      return Discount;
   }

   public static Discount createAmount10000() {
      Discount Discount = new Discount();
      Discount.setCode(UnitTypeValue.KRW.getCode());
      Discount.setType(UnitTypeValue.KRW.getType());
      Discount.setValue(10000);
      return Discount;
   }
   // 중략
   public static Policy createDefaultElite() {
      // 중략
      policy = objectMapper.readValue(new File("/resources/policy/elite.json"), Policy.class);
      policy.setAttributeList(List.of(createAttribute("", "", PERCENT_10)));
      // 중략
      return policy;
   }

   public static Policy createSandboxExceptDateElite(String... exceptDates) {
      // 중략
      policy = objectMapper.readValue(new File("/resources/policy/elite.json"), Policy.class);
      policy.setAttributeList(List.of(createAttribute("", "", PERCENT_10)));
      policy.setApplyDate(eliteExceptDates(exceptDates));
      // 중략
      return policy;
   }
}
@Test
@DisplayName("엘리트 특가 10프로 할인")
void discount_10_percent() throws IOException {
  // given
  var elite = getDiscountPolicy(createDefaultElite());

  // when
  var discountAmount = elite.getDiscountAmount(10000);

  // then
  assertThat(discountAmount).isEqualTo(1000);
}

@Test
@DisplayName("엘리트 특가 제외 날짜에 포함되면 할인하지 않는다")
void noDiscount_exceptDate() throws IOException {
  // given
  var checkIn = LocalDate.of(2022, 12, 1);
  var checkOut = LocalDate.of(2022, 12, 3);
  var request = new RequestParameter(checkIn, checkOut);

  // when
  var elite = getDiscountPolicy(createSandboxExceptDateElite(checkIn.toString()));

  // then
  assertThat(elite.validation(request, checkIn)).isFalse();
}
테스트 코드를 작성하는 일은 코드 품질을 높이는 중요한 개발 요소지만 반복적인 부분이 많기 때문에 위와 같이 유틸리티 메소드로 작성 해 둔다면 테스트 하고자 하는 비즈니스에 집중 할 수 있습니다.
또 하나의 사례는 위에서 언급했던 HashMap Load Factor관련 테스트 코드 입니다. HashMap/HashSet은 Map인터페이스를 구현한 컬랙션으로 Key Object를 기반으로 데이터를 저장하고 접근하며 저장 순서와 출력 순서를 보장하지 않는 데이터 구조라고 알고 있었습니다. 하지만, 섀도잉을 통해 결과값을 비교하는 과정에서 흥미로운 사실을 하나 발견했습니다. 바로 키값 정렬을 위해 HashCode를 사용하며 크기에 따라 버킷이 다르게 생성된다는 건데 여기서 버킷 수는 배열의 크기라고 생각하면 됩니다.
이해를 돕기 위해 테스트 코드 먼저 보도록 하겠습니다.
@Test
void mapHashCodeAndBucketSizeDefault() {
   var strings = new HashSet<String>();
   strings.add("1");
   strings.add("2");
   strings.add("3");
   strings.add("11");

   // hashCode % 버킷수 를 index로 배열에 저장
   for (var integer : strings) {
      System.out.println(integer + ": " + integer.hashCode() + ", " + (integer.hashCode() % 16));
   }
}
위 테스트 코드의 결과값은 다음과 같습니다.
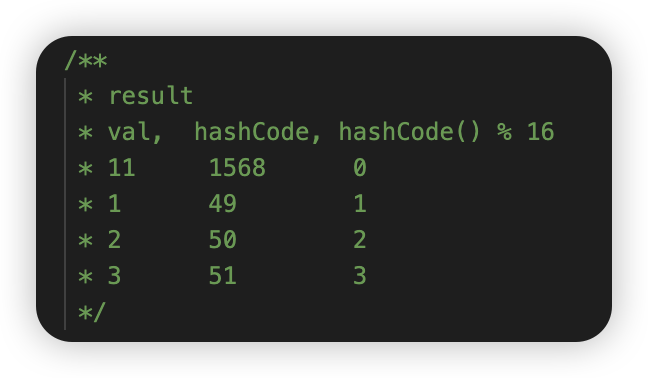
HashMap을 기본적으로 선언하게 되면, 디폴트 버킷 사이즈는 16입니다. 16개의 인덱스를 가진 HashMap은 HashCode를 버킷 수로 나눈 나머지를 배열의 index로 사용 하게 됩니다. 따라서, 11의 해시 코드 1568을 16으로 나누면 나머지가 0이기 때문에 배열의 가장 앞에 저장 되었던 겁니다.
그렇다면, 16개 보다 더 많은 데이터가 들어오면 어떻게 동작 할까요? 여기서 Load Factor의 개념이 나오며 “HashMap에 얼마만큼의 데이터가 들어오면 저장 공간을 늘릴것이냐"가 Load Factor 입니다.
HashMap의 디폴트 로드팩터는 0.75로 75%의 데이터가 차게되면 용량이 2배로 늘어나게 됩니다. 즉, HashCode 값에 32로 나눈 나머지로 인덱스를 구한 다음 저장 되는 구조 입니다.
@Test
void mapHashCodeAndBucketSize32() {
 var integers = new HashSet<Integer>();
 integers.add(17);
 integers.add(2);
 integers.add(3);
 integers.add(4);
 integers.add(5);
 integers.add(6);
 integers.add(7);
 integers.add(8);
 integers.add(9);
 integers.add(10);
 integers.add(11);
 integers.add(12);
 for (var integer : integers) {
  System.out.println(integer + ": " + integer.hashCode() + ": " + (integer.hashCode() % 16));
 }
}
12개의 값을 가진 HashMap은 디폴트 16의 버킷을 갖고 있기 때문에 아래와 같은 결과를 반환하게 됩니다.
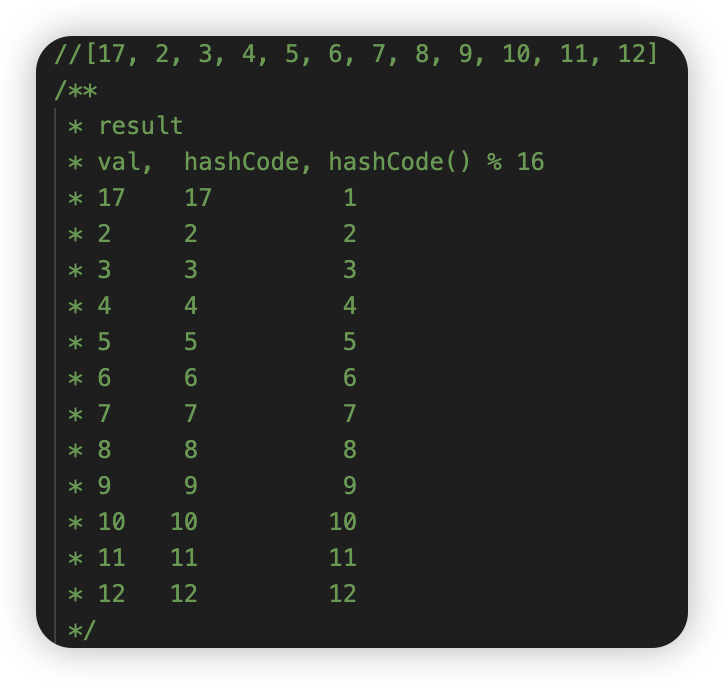
여기에 1개의 값을 더 추가하여 13개의 값을 가진 HashMap을 만든다면 HashMap의 디폴트 로드팩터 0.75를 초과하기 때문에 32개의 버킷을 가진 HashMap이 됩니다.
@Test
void mapHashCodeAndBucketSize32() {
 var integers = new HashSet<Integer>();
 integers.add(17);
 integers.add(2);
 integers.add(3);
 integers.add(4);
 integers.add(5);
 integers.add(6);
 integers.add(7);
 integers.add(8);
 integers.add(9);
 integers.add(10);
 integers.add(11);
 integers.add(12);
 for (var integer : integers) {
  System.out.println(integer + ": " + integer.hashCode() + ": " + (integer.hashCode() % 16));
 }
 System.out.println("bucket size diff -------------------");
 // 원소 한개 더 추가 하여 버킷 사이즈 늘림
 integers.add(13);
 // hashCode % 버킷수 를 index로 배열에 저장
 for (var integer : integers) {
  System.out.println(integer + ": " + integer.hashCode() + ": " + (integer.hashCode() % 32));
 }
}
따라서, 13개의 값을 가진 HashMap은 32의 버킷을 갖고 있기 때문에 아래와 같은 결과를 반환하게 됩니다.
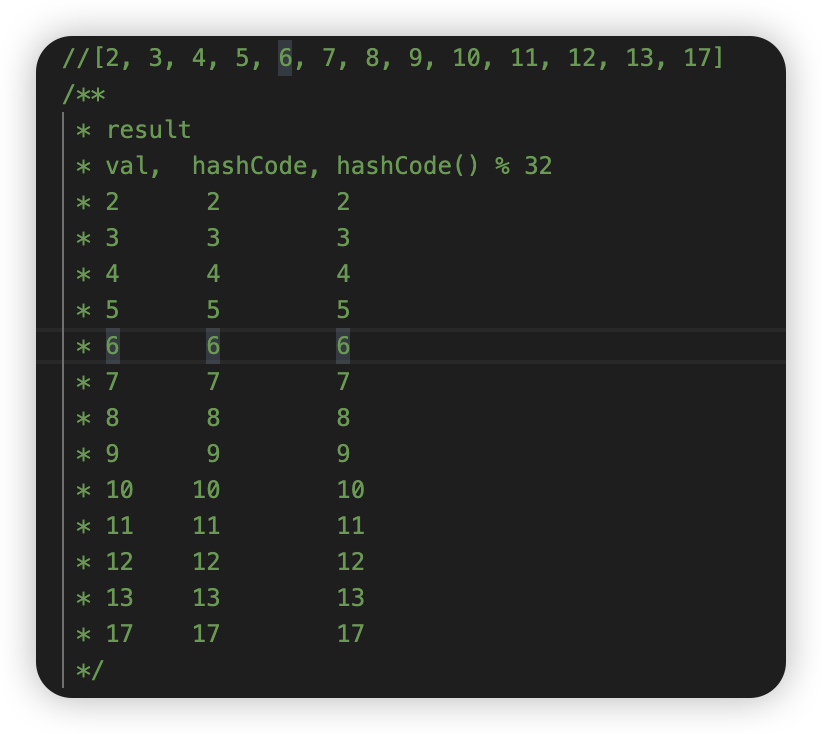
이와 같은 원리로 인해 HashMap/HashSet은 데이터의 순서를 보장하지 않고 저장된다고 하는 것 이었습니다.
마치며
2022년 12월! 3개월의 개발 기간을 거쳐 드디어 신규 Builder-API가 세상에 모습을 드러냈습니다.
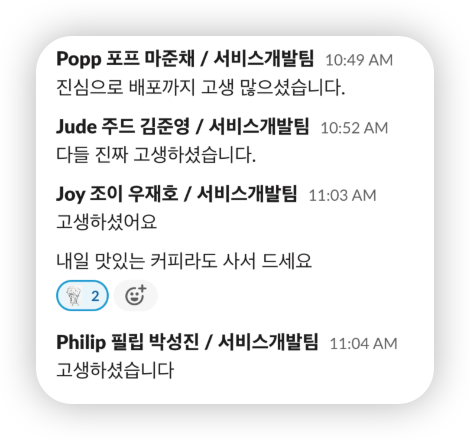
오픈 후 팀장님(포프)의 따뜻한 한마디
레거시 서비스를 개선 한다는 건 쉽지 않은 일이었습니다. 이미 운영 중인 상용 서비스를 장애없이 새로운 시스템으로 교체한다는 건 매우 큰 리스크를 안고 있다는 걸 모두가 알고 있었기 때문입니다. 이러한 우려는 섀도잉 기능을 통해 두 서버간 동작의 동일 함을 검증 하며 진행했기 때문에 레거시 코드의 숨겨진 비즈니스까지 파악하고 개선 할 수 있었고 개발자들 모두 전환이 완료 되기까지 안정감속에 일할 수 있었다고 생각합니다.
이와 같은 전략도 중요했지만 결국 좋은 동료들과 함께 했기에 저희팀의 전시 서비스는 사용자들에게 여기어때 국내 숙박 정보를 안정적으로 서비스 할 수 있는 원동력이 되었다고 생각 합니다.
저희의 경험담이 이 글을 읽으신 모든 분들께 작은 도움이 되었으면 합니다.
마지막 마무리는 저희 신규 레거시 프로젝트 첫 삽 뜨던 날 슬랙으로 마무리 하겠습니다.
신규 전시 API 개선 프로젝트 첫 삽 뜨던 날
긴 글 읽어주셔서 감사합니다.