Engineering
“생각하고 답변하는” 카카오의 하이브리드 멀티모달 언어모델, Kanana-v-4b-hybrid 개발기
samuel.brain, polar.bears, sonny.7카카오
2026년 1월 5일
원문에서 보기 ↗한국형 하이브리드 멀티모달 언어모델, Kanana-v-4b-hybrid
안녕하세요. 카카오의 AI 모델 개발을 담당하는 카나나(Kanana) 조직의 Samuel(강성훈), Polar(엄지환), Sonny(손동희)입니다. 저희 팀은 텍스트와 이미지뿐만 아니라 음성까지 포함한 다양한 모달리티를 이해하고 답변하는 멀티모달 언어모델을 개발하고 있습니다.
작년 7월 오픈소스로 공개한 경량 멀티모달 언어모델 Kanana-1.5-v-3b[1] 이후, 저희는 if(kakao)25 등 다양한 현장에서 모델을 시연하며, 실제 사용자의 니즈를 파악하게 되었습니다. 사용자들은 단순히 이미지를 읽어주는 AI를 넘어, 스스로 근거를 찾고, 생각하고, 검증한 뒤 답변하는 똑똑한 AI를 필요로 하고 있었습니다.
이에 저희는 빠른 응답이 필요할 땐 직관적으로, 복잡한 문제에는 논리적으로 답변하는, 일반 대화와 추론이 모두 가능한 하이브리드 멀티모달 언어모델 ‘Kanana-v-4b-hybrid’ 를 개발했습니다. 특히 ‘~만 제외하고’, '단, 이 경우는 제외하고’와 같이 한국어 특유의 복잡한 제약 조건은 번역 과정에서 의미가 왜곡되기 쉽습니다. 저희는 이러한 뉘앙스까지 그대로 한국어로 사고하고 추론할 수 있는 진정한 한국형 모델 을 구현하는데 집중했습니다. 그 결과 실제 한국 검정고시 및 대학수학능력시험 문항 기반 평가인 KoNET에서 92.8점을 기록하며, 한국형 AI의 새로운 가능성을 확인했습니다.
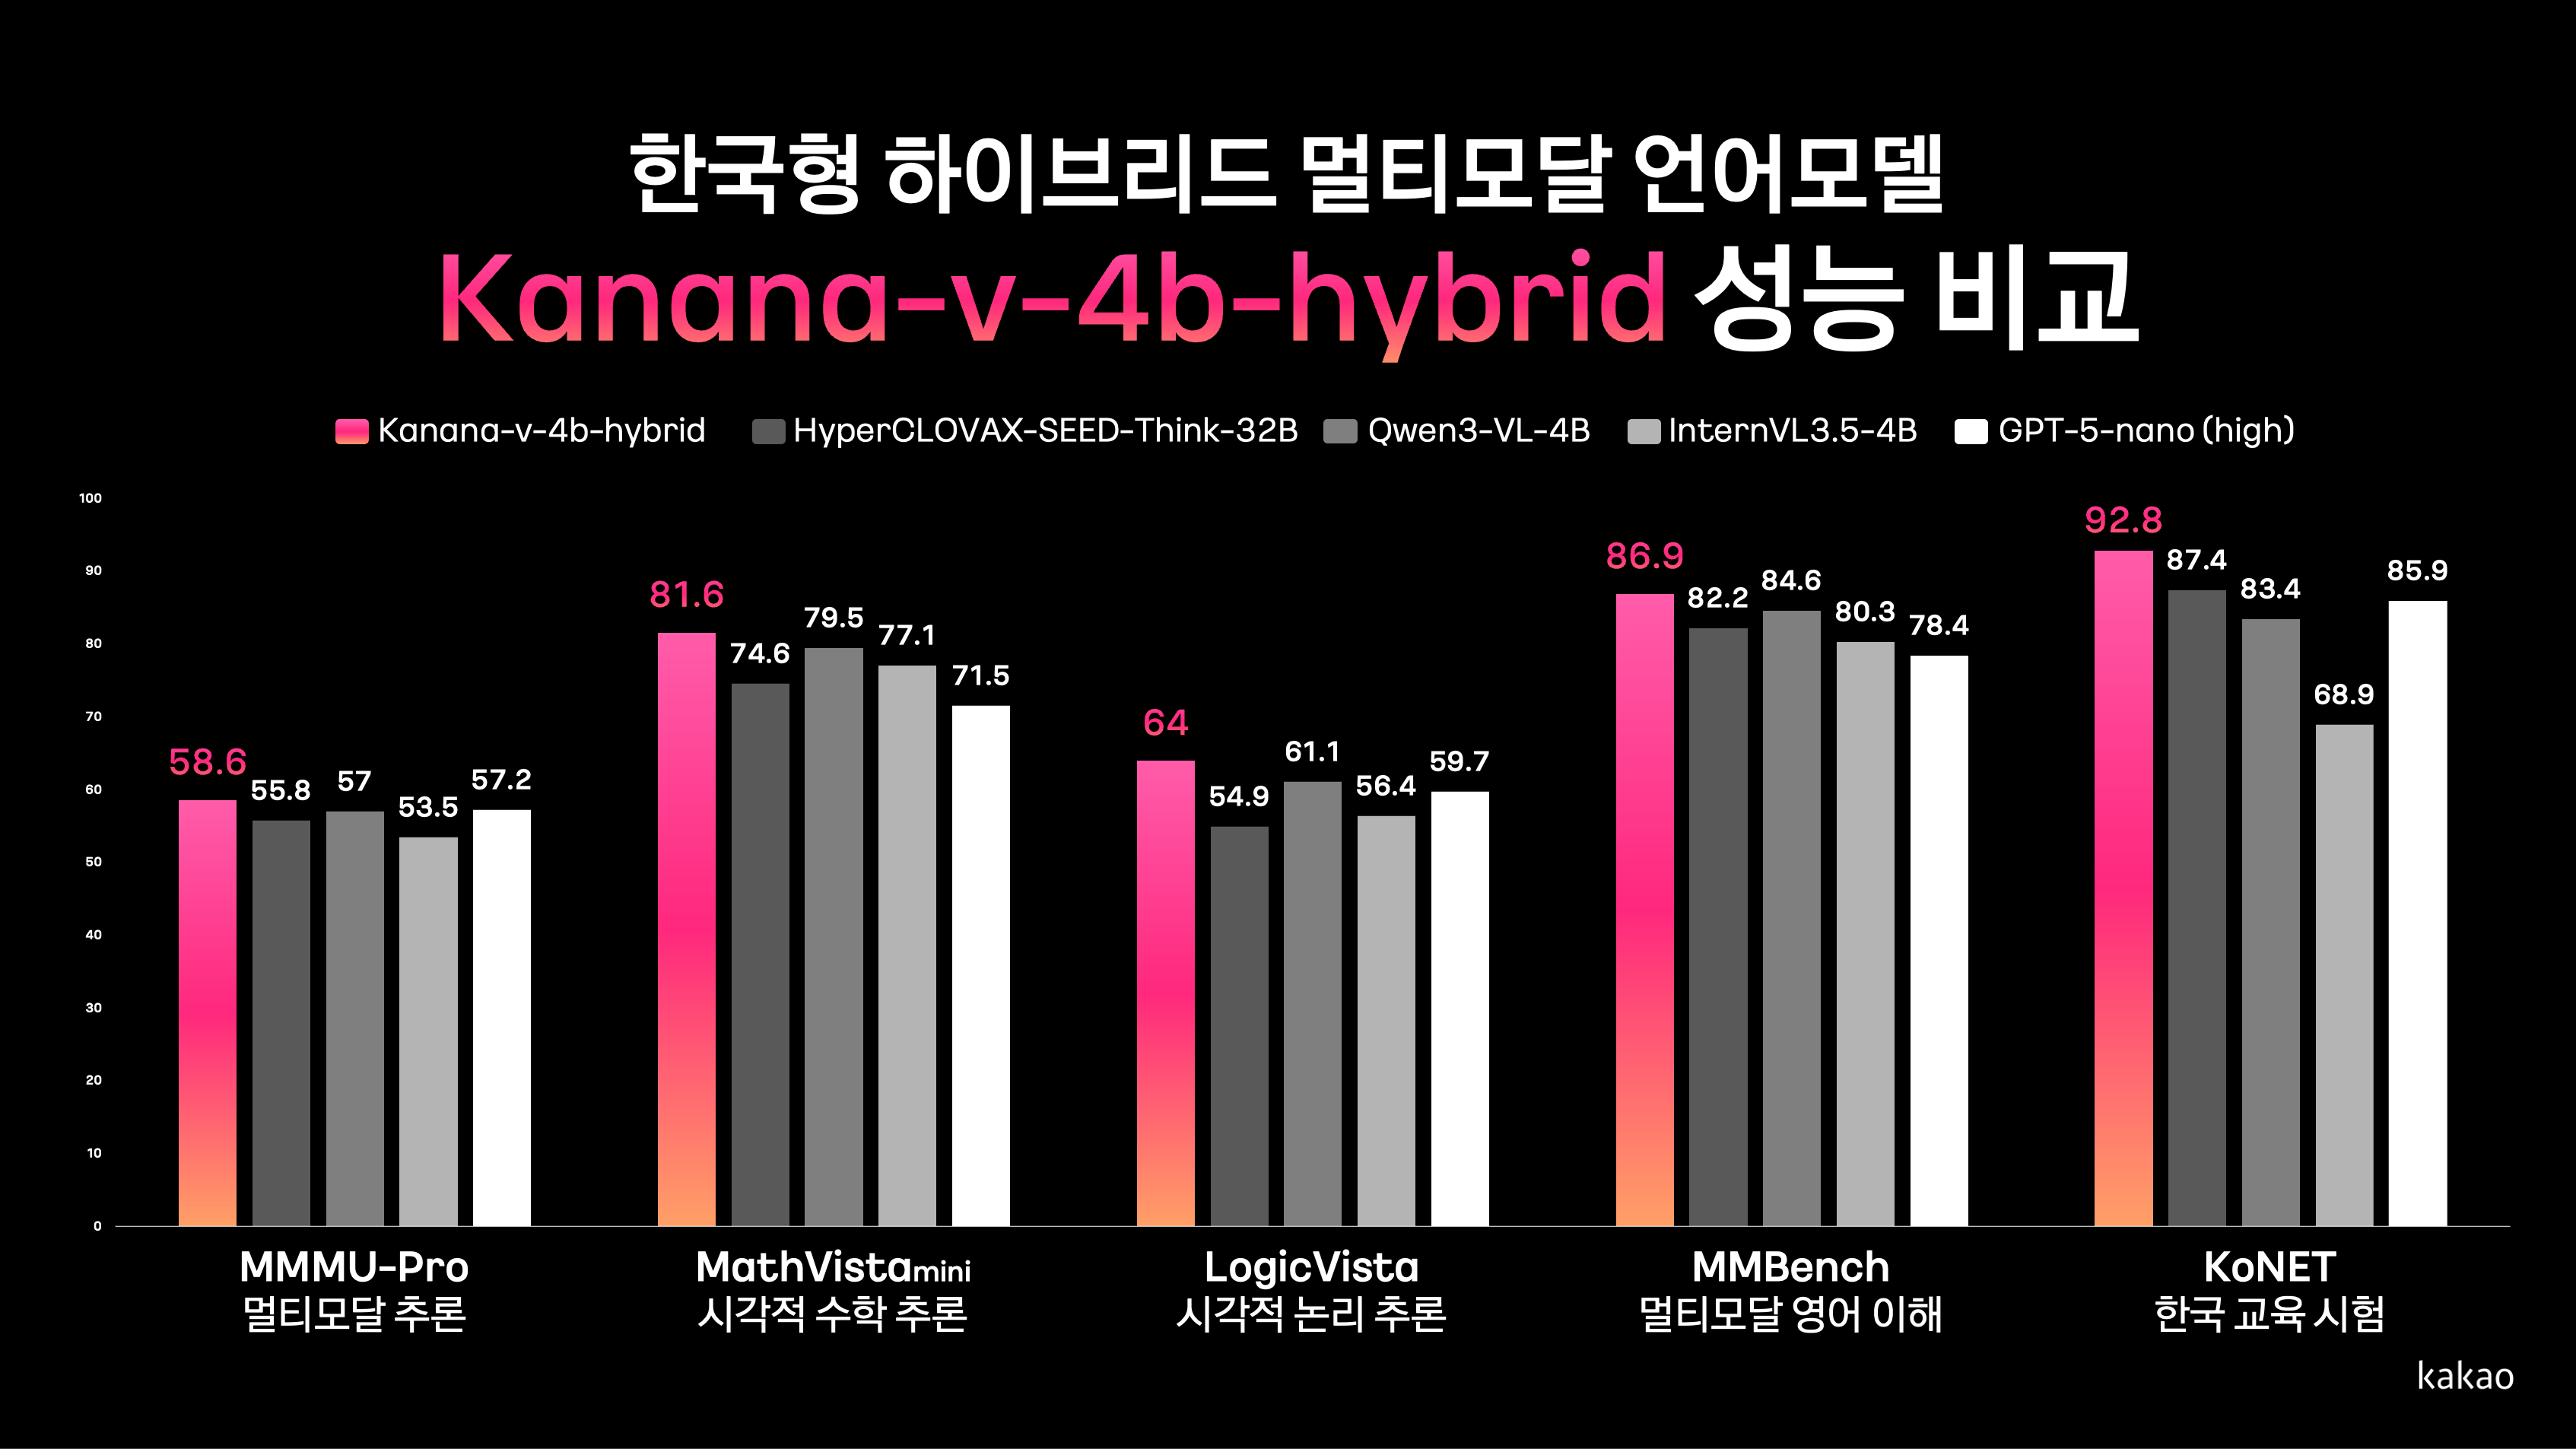
이 글에서는 Kanana-v-4b-hybrid의 보다 자세한 성능뿐 아니라, 한국어/영어 추론 과정 생성과 단일 모델에서의 추론/비추론 응답 공존을 위해 저희가 집중했던 문제들, 그리고 그 해결 방법을 학습 과정에 어떻게 반영했는지를 소개하겠습니다.
개발 목표
현장에서 반복적으로 확인된 니즈는, 멀티모달 입력을 이해하는 것을 넘어 한 번 더 깊게 생각하고 답변할 수 있는 모델이었습니다.
멀티모달 대화에서 사용자의 질문은 크게 두 가지로 나눌 수 있습니다. 첫째는 OCR, 요약, 이미지 설명처럼 이미지 정보를 텍스트로 표현하는 모달리티 간 정보변환 유형입니다. 둘째는 [그림 1]에서 보여주는 예시와 같이, 단순 모달리티 변환에 그치지 않고 여러 모달리티로 주어진 정보를 종합한 뒤, 그 정보를 근거로 논리를 전개하여 정확한 정답을 요구하는 추론 중심 유형입니다. 교육 과정에서 문제풀이를 가이드하는 AI 튜터처럼 정답이 명확한 과제, 여러 조건을 만족해야 하는 복잡한 지시 수행, 근거를 단계적으로 쌓아야 하는 질문들에서는 단순히 그럴듯한 답변이 아니라 정확하고 검증 가능한 답변이 필요합니다. 이 경우 모델의 응답 시간이 조금 더 걸리더라도, 정확하고 신뢰할 수 있는 응답이 주로 요구됩니다.
이렇게 특성이 다른 두 질문 유형은 하나의 대화 세션 안에서도 번갈아가며 등장할 수 있습니다. 사용자가 처음에는 “이미지에서 텍스트만 읽어줘”라고 요청하다가, 다음 질문에서는 “내가 제시한 조건을 만족하는 정보만 더 자세히 설명해줘”처럼 복잡한 추론이 필요한 질문을 요청하기도 합니다.
저희의 목표는 '추론은 추론 모델, 대화는 대화 모델’처럼 역할을 분리하는 것이 아니라, 하나의 모델이 다양한 시나리오에서도 대응할 수 있도록 구성해 안정적이고 신뢰할 수 있는 모델을 만드는 것이었습니다. 실제 서비스/시연 환경에서는 질의 성격이 하나의 세션 안에서도 빠르게 바뀝니다. 그때마다 모델을 라우팅(Routing)하거나 별도 모델을 운영하면 시스템 복잡도와 유지보수 비용이 커질 뿐 아니라, 응답 톤·포맷·안전정책 같은 사용자 경험의 일관성을 유지하기도 어렵습니다.
또한 모델이 분리되면 하나의 모델에서 개선된 성능(멀티모달 이해, 지시이행 능력 등)이 다른 모델로 연결되지 않기 때문에, 전체적인 품질을 끌어올리는데 제약이 생기기도 합니다. 그래서 저희는 하나의 모델이 추론과 비추론 모두를 수행할 수 있도록 대화 형식을 정의했습니다. 또한 하나의 모델로 추론과 비추론 응답을 안정적으로 생성하기 위해서, 대화 형식(Chat Template)뿐 아니라 학습 데이터 비율, 시각 추론 학습(Visual Reasoning Training)까지 학습 레시피를 꼼꼼히 재구성했습니다.
생각한 뒤에 답변을 생성하는 정확한 시각 추론 모델
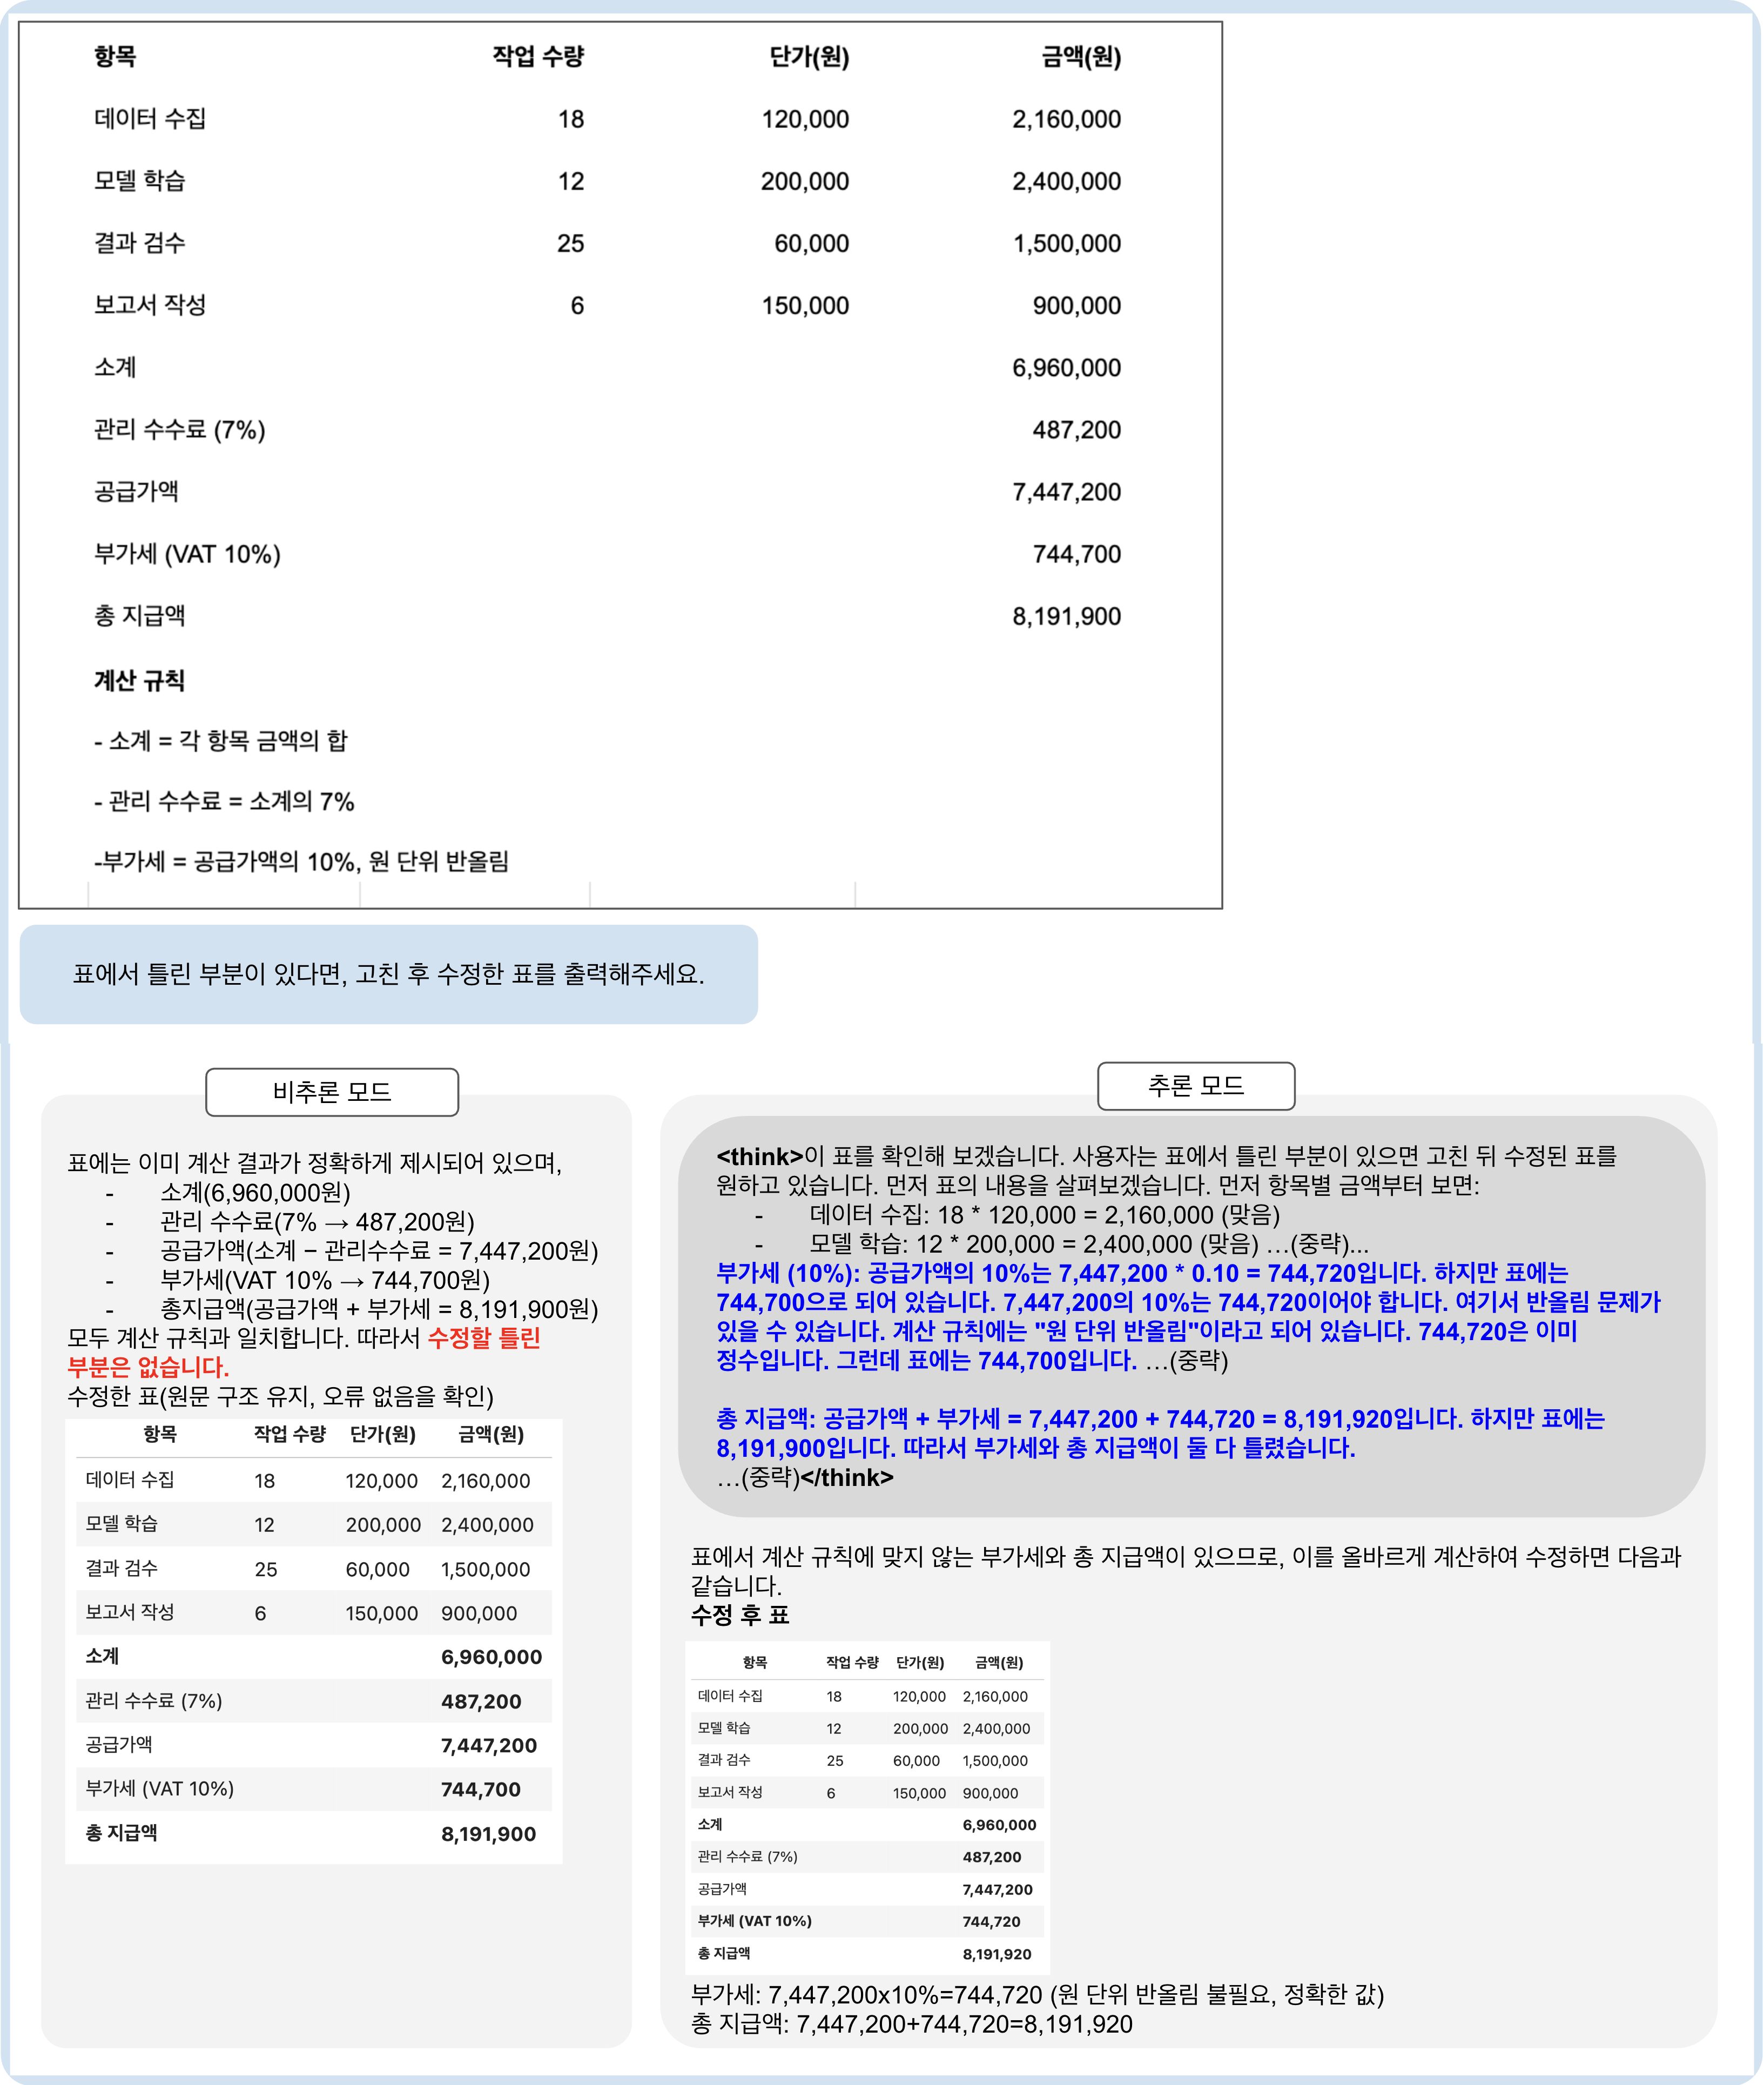
Kanana-v-4b-hybrid는 이미지를 '설명’하는 데서 멈추지 않고, '이미지에서 근거를 찾고 정답을 도출하는 시각적 추론(Visual Reasoning)'에 초점을 맞춘 모델입니다. 멀티모달 언어모델이 OCR이나 요약처럼 모달리티 변환 작업에서는 충분한 품질을 보이더라도, 그 모델에 대한 신뢰도는 복잡한 문제를 물어보더라도 탄탄한 근거와 합리적인 추론 과정을 통해 성공적으로 풀어나갈 때 누적됩니다. 영수증 합계 검산, 표 기반 조건 필터링, 이미지 기반의 수학 문제 풀이처럼 단순한 모달리티 변환이 아닌 멀티모달 정보에 기반한 복잡한 추론을 요구하는 질문에서는, '그럴듯한 답변’이 아니라, 사용자가 확인 가능한 형태의 정확하고 검증 가능한 결론이 필요합니다.
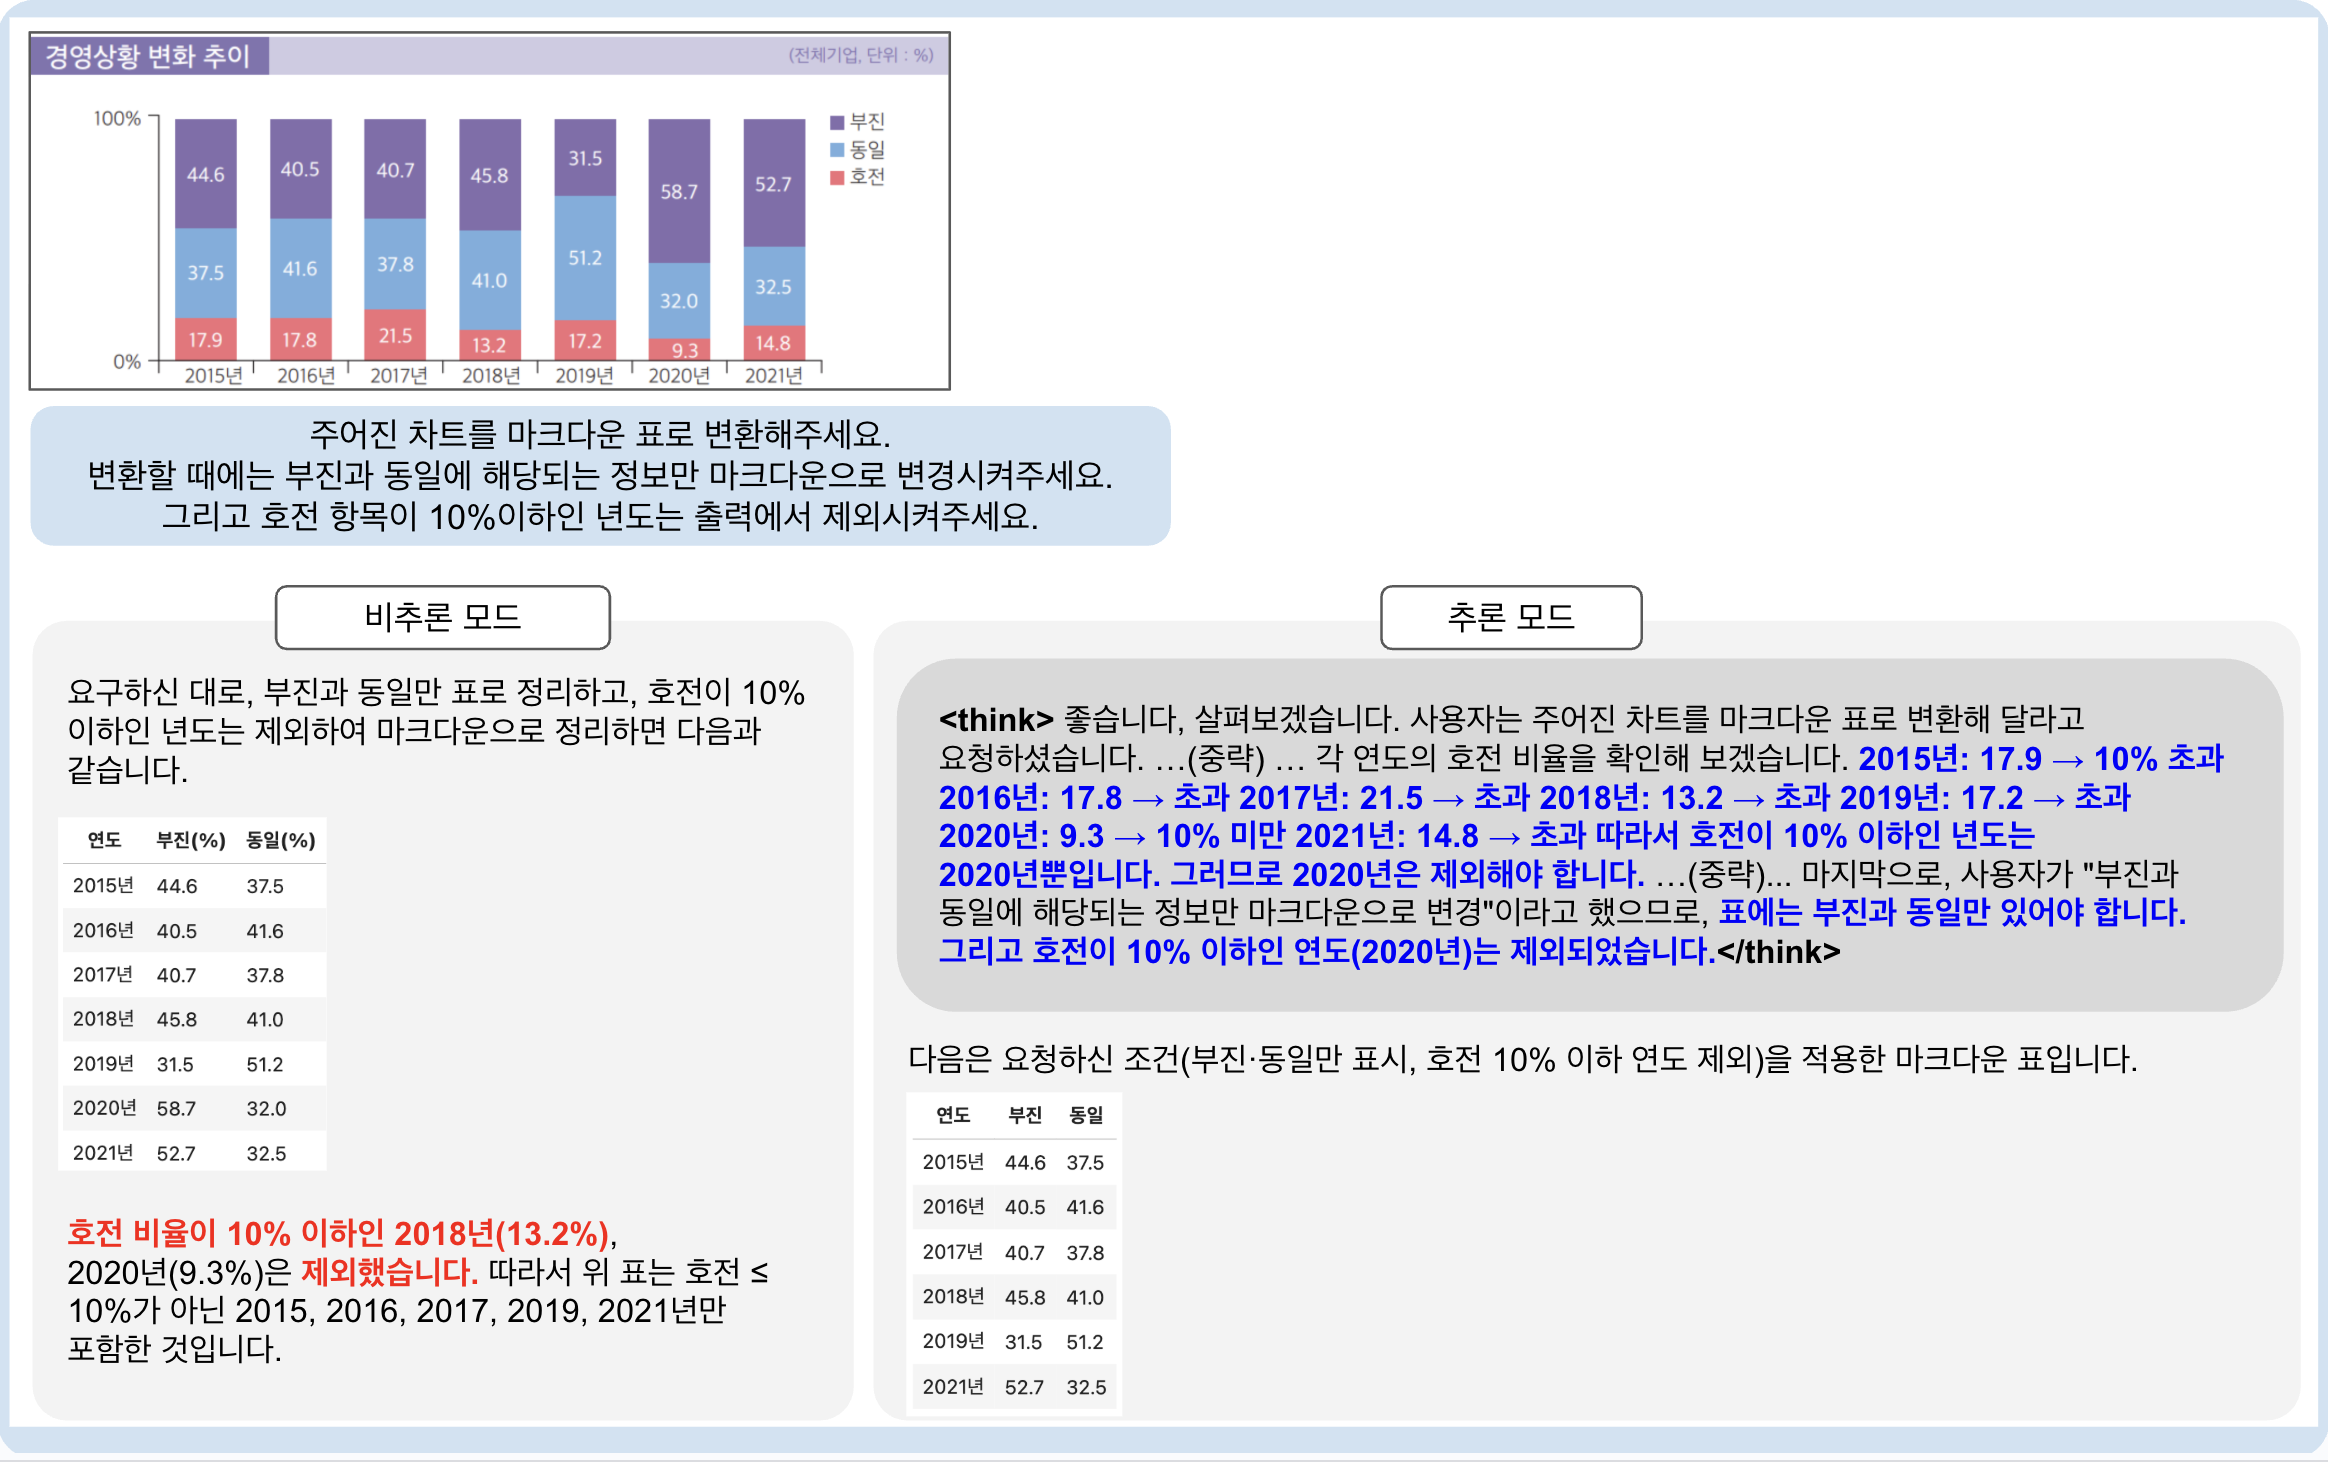
Kanana-v-4b-hybrid의 강점은 답변을 생성하기 전에 주어진 정보를 정리하고 결론을 점검하는 패턴이 자연스럽게 관찰된다는 점입니다. 학습 과정에서 따로 특정한 패턴을 강조하지 않았음에도, 추론 성능을 강화하는 학습을 거치며 다음과 같은 논리적인 흐름을 보입니다. 1) 먼저 이미지와 텍스트에서 답에 필요한 값이나 문장을 찾아 묶고(정보 종합), 2) 조건을 적용하거나 계산을 수행해 결론 후보를 만든 뒤(추론), 3) 마지막으로 계산 실수나 조건 누락이 없는지 다시 확인하고(검증) 4) 답변을 마무리합니다. [그림 2]는 차트에 대해 사용자가 복잡한 추론을 요구하는 예시이며, 정보종합, 추론과정을 확인할 수 있습니다. 특히 복잡한 추론을 요구하는 어려운 문제에서 이러한 경향성은 더욱 두드러집니다.
추론 모델에서 자주 관찰되는 중요한 특성이 하나 더 있는데, 바로 자기 점검(Reflection) 입니다. Reflection은 자신이 생각한 과정을 다시 바라보고, 모순이나 실수 가능성을 찾으면 방향성을 바꾸어 다른 관점을 탐색하는 행동을 말합니다. 수학 문제 풀이와 같이 명확한 정답이 존재하는 문제에서 가장 흔하면서도 치명적인 실수는 조건 누락 또는 계산 실수와 같이 사소한 부분에서 발생합니다. Reflection은 이런 '자잘하지만 치명적인 실수’를 지속적으로 점검한다는 관점에서 중요합니다[2]. 특히 복잡한 멀티모달 질의는 여러 정보가 이미지 곳곳에 흩어져 있기 때문에, 이런 자기 점검 특성이 발현되는 것만으로도, 모델의 응답 신뢰도에 긍정적인 영향을 미칠 수 있습니다.
영수증은 Reflection의 가치가 가장 직관적으로 드러나는 입력입니다. 항목별 금액이 여러 줄에 흩어져 있고, 할인/부가세/합계가 섞여 있어 한 줄만 잘못 읽거나 더해도 잘못된 결론을 도출합니다. 단순 OCR은 각 줄을 텍스트로 옮겨주지만, 사용자가 원하는 것은 총액이나 부가세, 할인 적용 합계가 맞는지에 대한 신뢰할 수 있는 검증 결과입니다. Kanana-v-4b-hybrid는 이런 요청에서 항목을 구조화해 정리한 뒤 합계를 계산하고, 표기된 총액과 대조하는 흐름이 자주 관찰됩니다. 이때 모델이 계산 결과를 한 번 더 확인하면서, 누락된 항목을 되짚거나 합계를 다시 계산해 자기 수정으로 이어지는 경우도 있습니다. 이러한 차별점이 이전 버전의 Kanana-1.5-v-3b와 다르게 '검증 가능한 결론을 내는 모델’로서의 강점입니다.
이미지 기반의 표, 차트 질문 상황에서도 비슷한 경우를 확인할 수 있습니다. 표와 차트는 구조화된 형태이지만, 실제 사용자의 질문은 복잡한 조건과 비교 판단을 요구합니다. 예를 들어, “배송비 포함 최저가를 찾아줘(단, 쿠폰 적용 불가 상품 제외)”는 단순 최저가 검색이 아니라 1) 조건 필터링 2) 비교 3) 예외 처리가 동시에 필요한 문제입니다. 여기서 자기 점검은 “제외 조건을 적용했는가?”, “비교 기준(배송비 포함)이 반영됐는가?”와 같이 스스로 질문하며 추론 과정을 확인하는 안전장치가 됩니다. 결과적으로 표나 차트를 ‘그대로 읽는’ 것이 아니라, '문제의 입력’으로 보고 주어진 조건에 따른 논리를 전개하며 검증 가능한 결론을 만드는 형태가 강화됩니다.
이미지로 주어진 수학 문제 풀이에서도 Reflection의 중요성이 뚜렷합니다. 문제지에는 텍스트뿐 아니라 기호, 수식 배치, 단위, 조건문이 함께 존재합니다. 또한 많은 문제는 한 번의 계산으로 끝나지 않고, 중간 결과를 다시 활용해 결론을 내야 합니다. 이 과정에서 성급하게 결론만 말하면 작은 실수가 그대로 오답이 됩니다. 반면 Kanana-v-4b-hybrid는 [그림 3]처럼 조건을 정리하고 계산을 단계적으로 수행한 뒤, 마지막에 결과가 조건을 만족하는지, 단위가 맞는지, 대입했을 때 모순이 없는지 확인하는 Reflection이 자주 관찰됩니다. 교육 시나리오에서 이는 신뢰 가능한 튜터 경험으로 이어집니다.
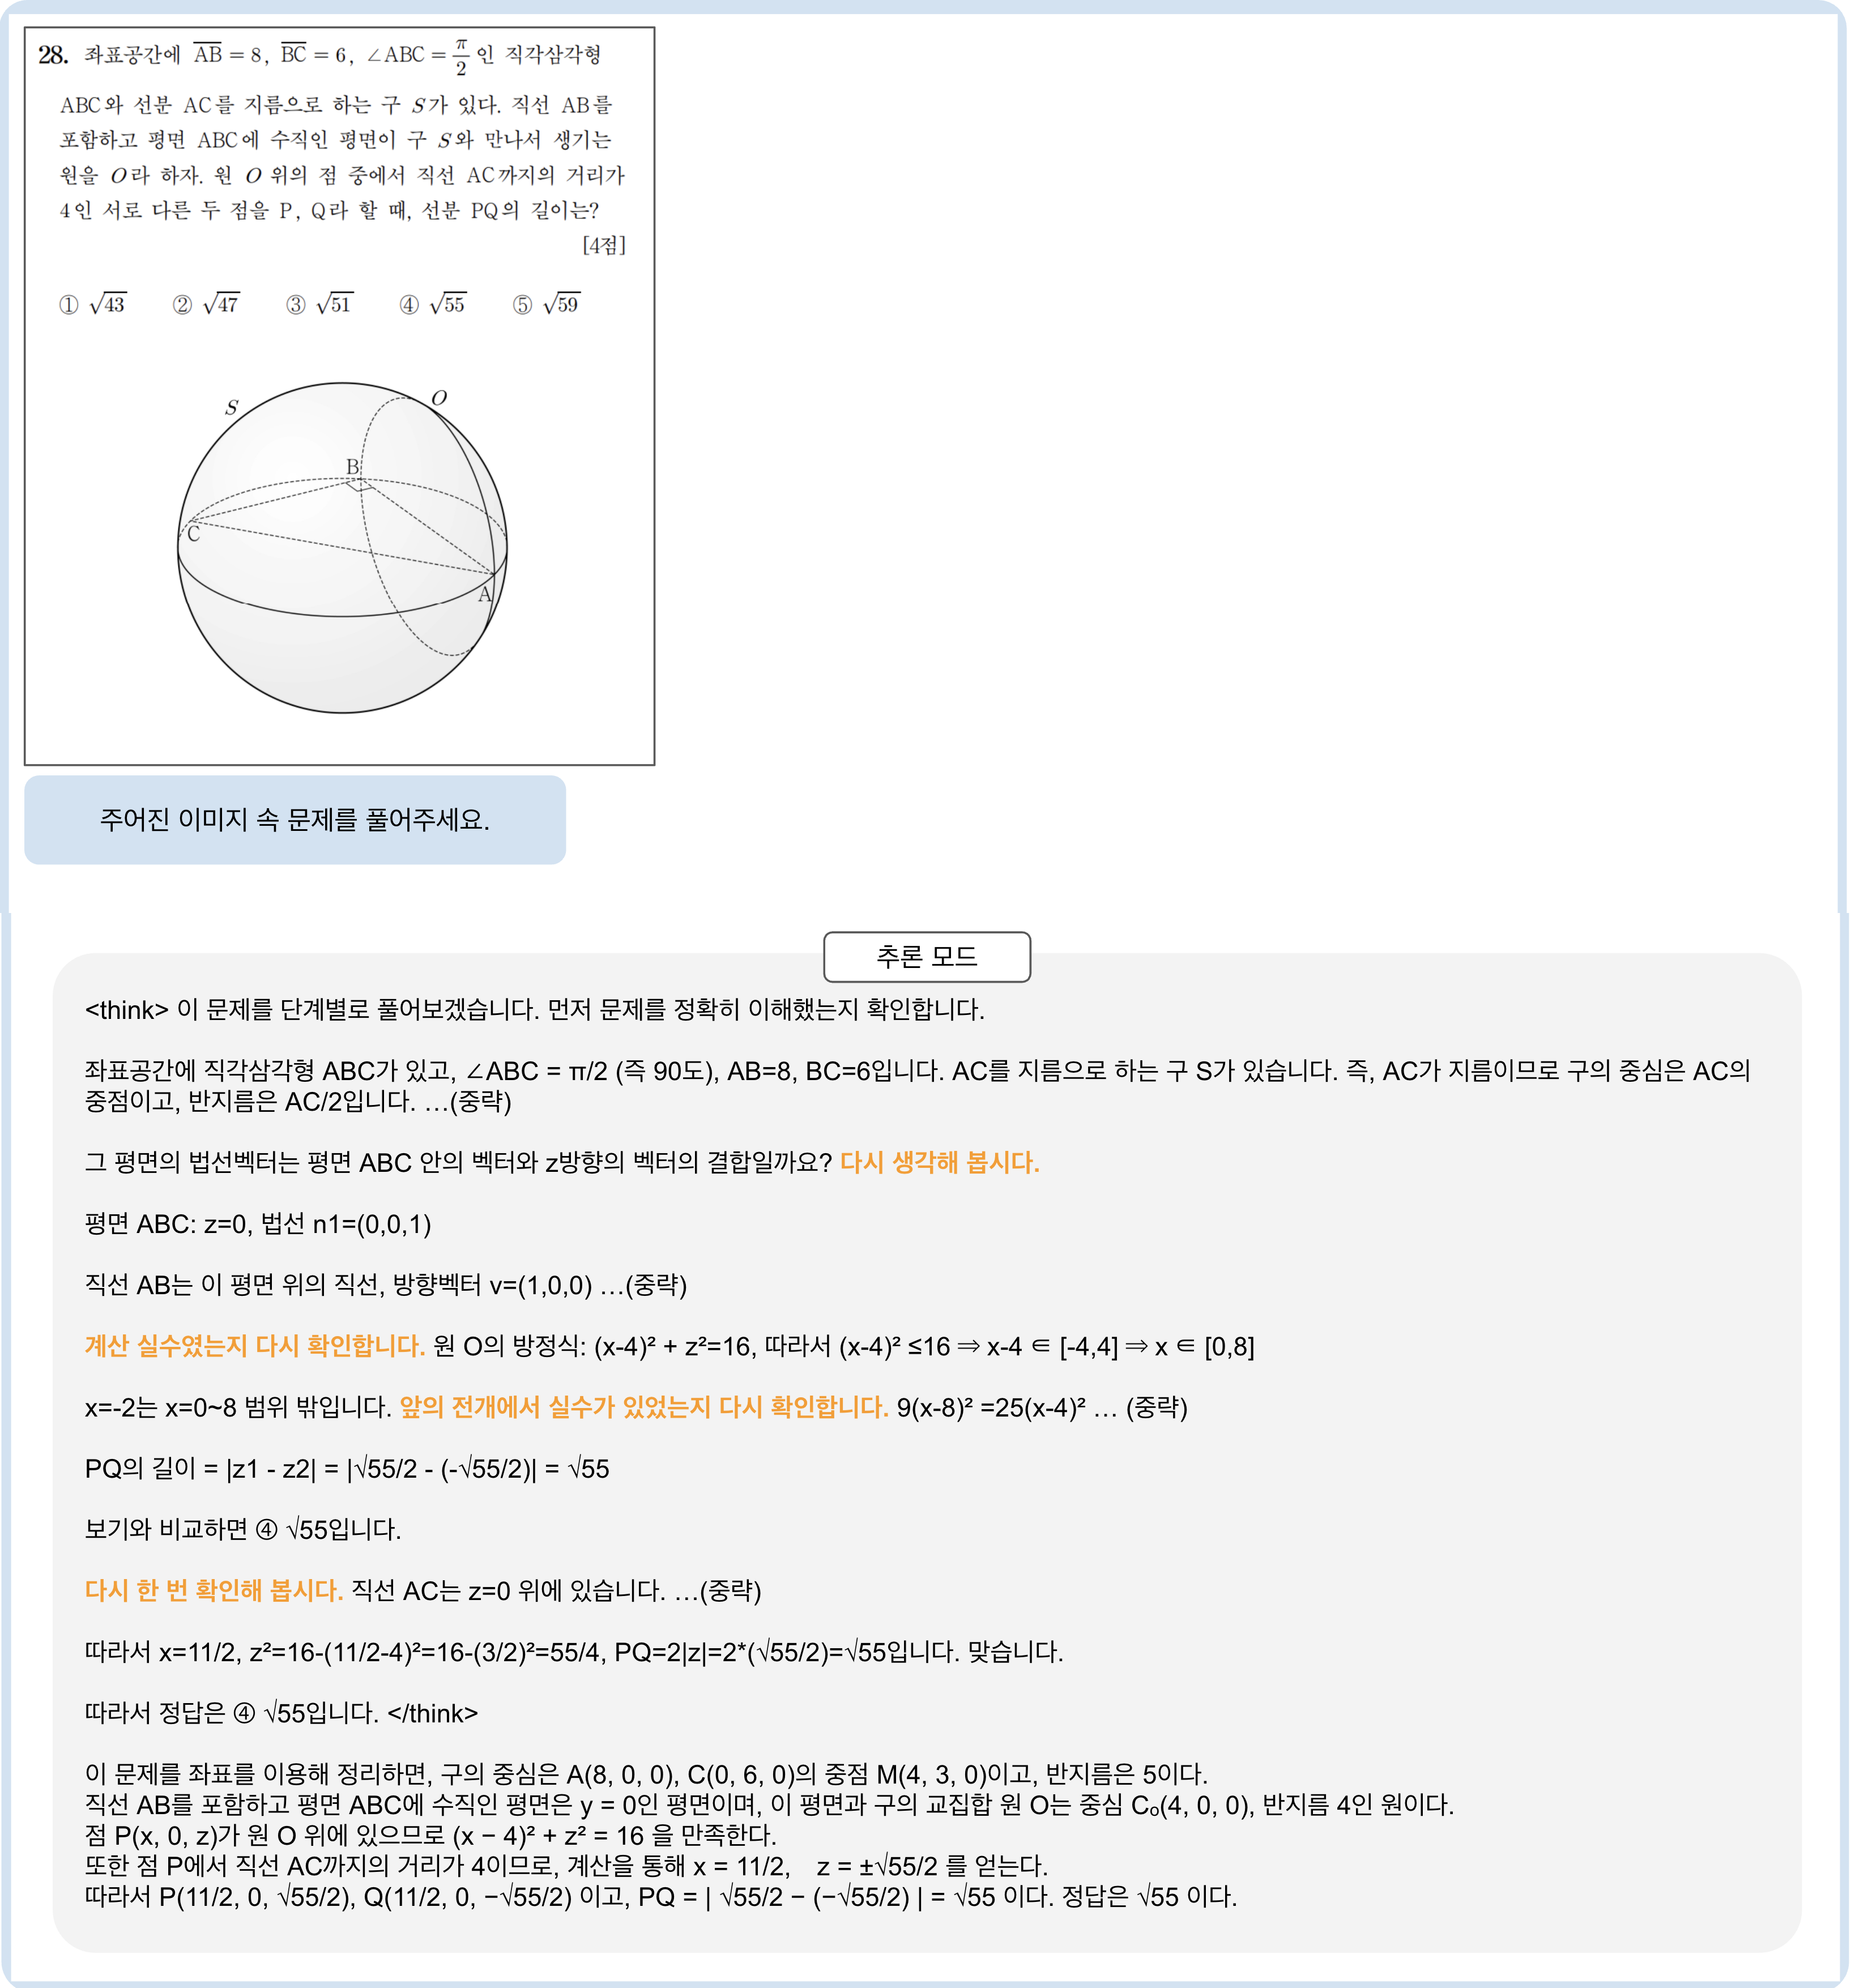
이와 같이, Kanana-v-4b-hybrid는 단순 OCR/요약을 넘어 복잡한 멀티모달 질의에서 신뢰할 수 있는 시각 추론 모델을 지향합니다. 앞서 예시를 들며 설명드렸던 영수증, 표, 차트, 수학 문제 풀이처럼 실수 가능성이 높은 입력에서 근거를 모으고 조건을 적용한 뒤 자기점검을 통해 최종 결론을 다시 한 번 점검하고, 필요 시 스스로 오류를 발견하고 수정하는 패턴은 모델의 '정확성’뿐 아니라 '신뢰도’를 함께 높이는 핵심 포인트입니다.
한국어 질의에 대해 한국어로 생각하는 시각 추론 모델
멀티모달 모델이 “똑똑하다” 라고 느끼는 순간은 단순히 이미지를 잘 읽거나 문장을 매끄럽게 생성할 때가 아닙니다. 복잡한 조건이 뒤섞인 질문을 모델에 던지고, 그 조건을 얼마나 정확히 분석하고 끝까지 보존하는지, 그러면서도 정확한 정답과 논리적인 근거를 제시할 때 비로소 모델이 “똑똑하다, 믿을만 하다”라는 인상을 가지게 됩니다. Kanana-v-4b-hybrid는 한국어 질의에 대해 단순히 한국어로 답변하는 것이 아닌, 언어 변환 없이 한국어를 있는 그대로 이해하고 생각하도록 학습되었습니다.
한국어 질의가 어려운 이유는 한국어 자체가 '어려운 언어’라서가 아니라, 실제 질의에서 자주 등장하는 표현들이 추론 과정에서 실수하기 쉬운 논리 요소를 포함하기 때문입니다. ‘ㅇㅇ이 아닌 것만’, ‘ㅇㅇ인 경우에만’, '단, ㅇㅇ은 제외’와 같은 부정·예외·조건부 표현은 한 번만 빠져도 결론이 뒤집힐 수 있습니다. “먼저 A를 하고 그다음 B를 해줘”, “A를 우선으로 고려해줘”처럼 순서나 우선순위를 지정하는 지시도 존재합니다. 이러한 질의는 단순히 질의를 이해하는 것만으로는 부족하고, 주어진 조건을 분해해 논리적으로 적용해야 올바른 정답을 도출할 수 있습니다. 결국 정확하고 신뢰할 수 있는 모델을 확보하기 위해서는, 단순 한국어 답변보다 한국어로 표현된 의도를 끝까지 보존한 채 결론을 만드는 것이 가장 중요합니다.
따라서, Kanana-v-4b-hybrid의 한국어 추론 과정(Korean Rationale)은 단순한 번역을 지양합니다. 질문이 한국어인데 추론 과정이 다른 언어로 흐르거나, 내부 추론 과정이 답변의 문장 구조와 멀어지면 일부 조건이 생략되거나 결론이 뒤집히는 실수가 발생하기 쉽습니다[3]. 특히 이미지 기반 문제(표/문서/문제지)에서는 정보가 이미지 곳곳에 흩어져 있고, 한국어 정보를 담고있음에도 다른 언어로 추론을 한다면 해당 언어에 맞게 모델이 주어진 정보를 다시 종합해야 합니다. 이러한 언어 변환 과정에서 세부 조건을 놓치거나, 모델의 논리 전개가 흔들릴 가능성이 커집니다. 반대로 한국어 질문을 언어 변환 없이 주어진 그대로 이해하고, 한국어 문장 단위로 정리하면서 추론을 전개하면 ‘제외’, ‘만’, ‘경우’, ‘우선’ 같은 핵심 조건에 대한 논리를 안정적으로 전개할 수 있습니다.
예를 들어, 표 이미지에 대해 “배송비 포함 최저가를 찾아줘. 단, 쿠폰 적용 불가 상품은 제외해줘.”라고 묻는 상황을 가정하겠습니다. 이 질문의 핵심은 '단순 최저가’가 아니라, '비교 기준(배송비 포함) 과 예외 조건(쿠폰 불가 제외)을 고려한 최저가’입니다. 이때 Kanana-v-4b-hybrid는 입력된 지시를 한국어로 먼저 분해하고(“배송비 포함 기준”, “쿠폰 불가 제외”), 표의 항목을 그 조건에 맞춰 걸러낸 뒤 결론을 제시하는 흐름이 자주 관찰됩니다. 논리 구조를 한국어로 유지한 채 근거를 연결하기 때문에, 결과를 검증하거나 후속 질문을 이어갈 때도 맥락이 일관성 있게 유지됩니다.
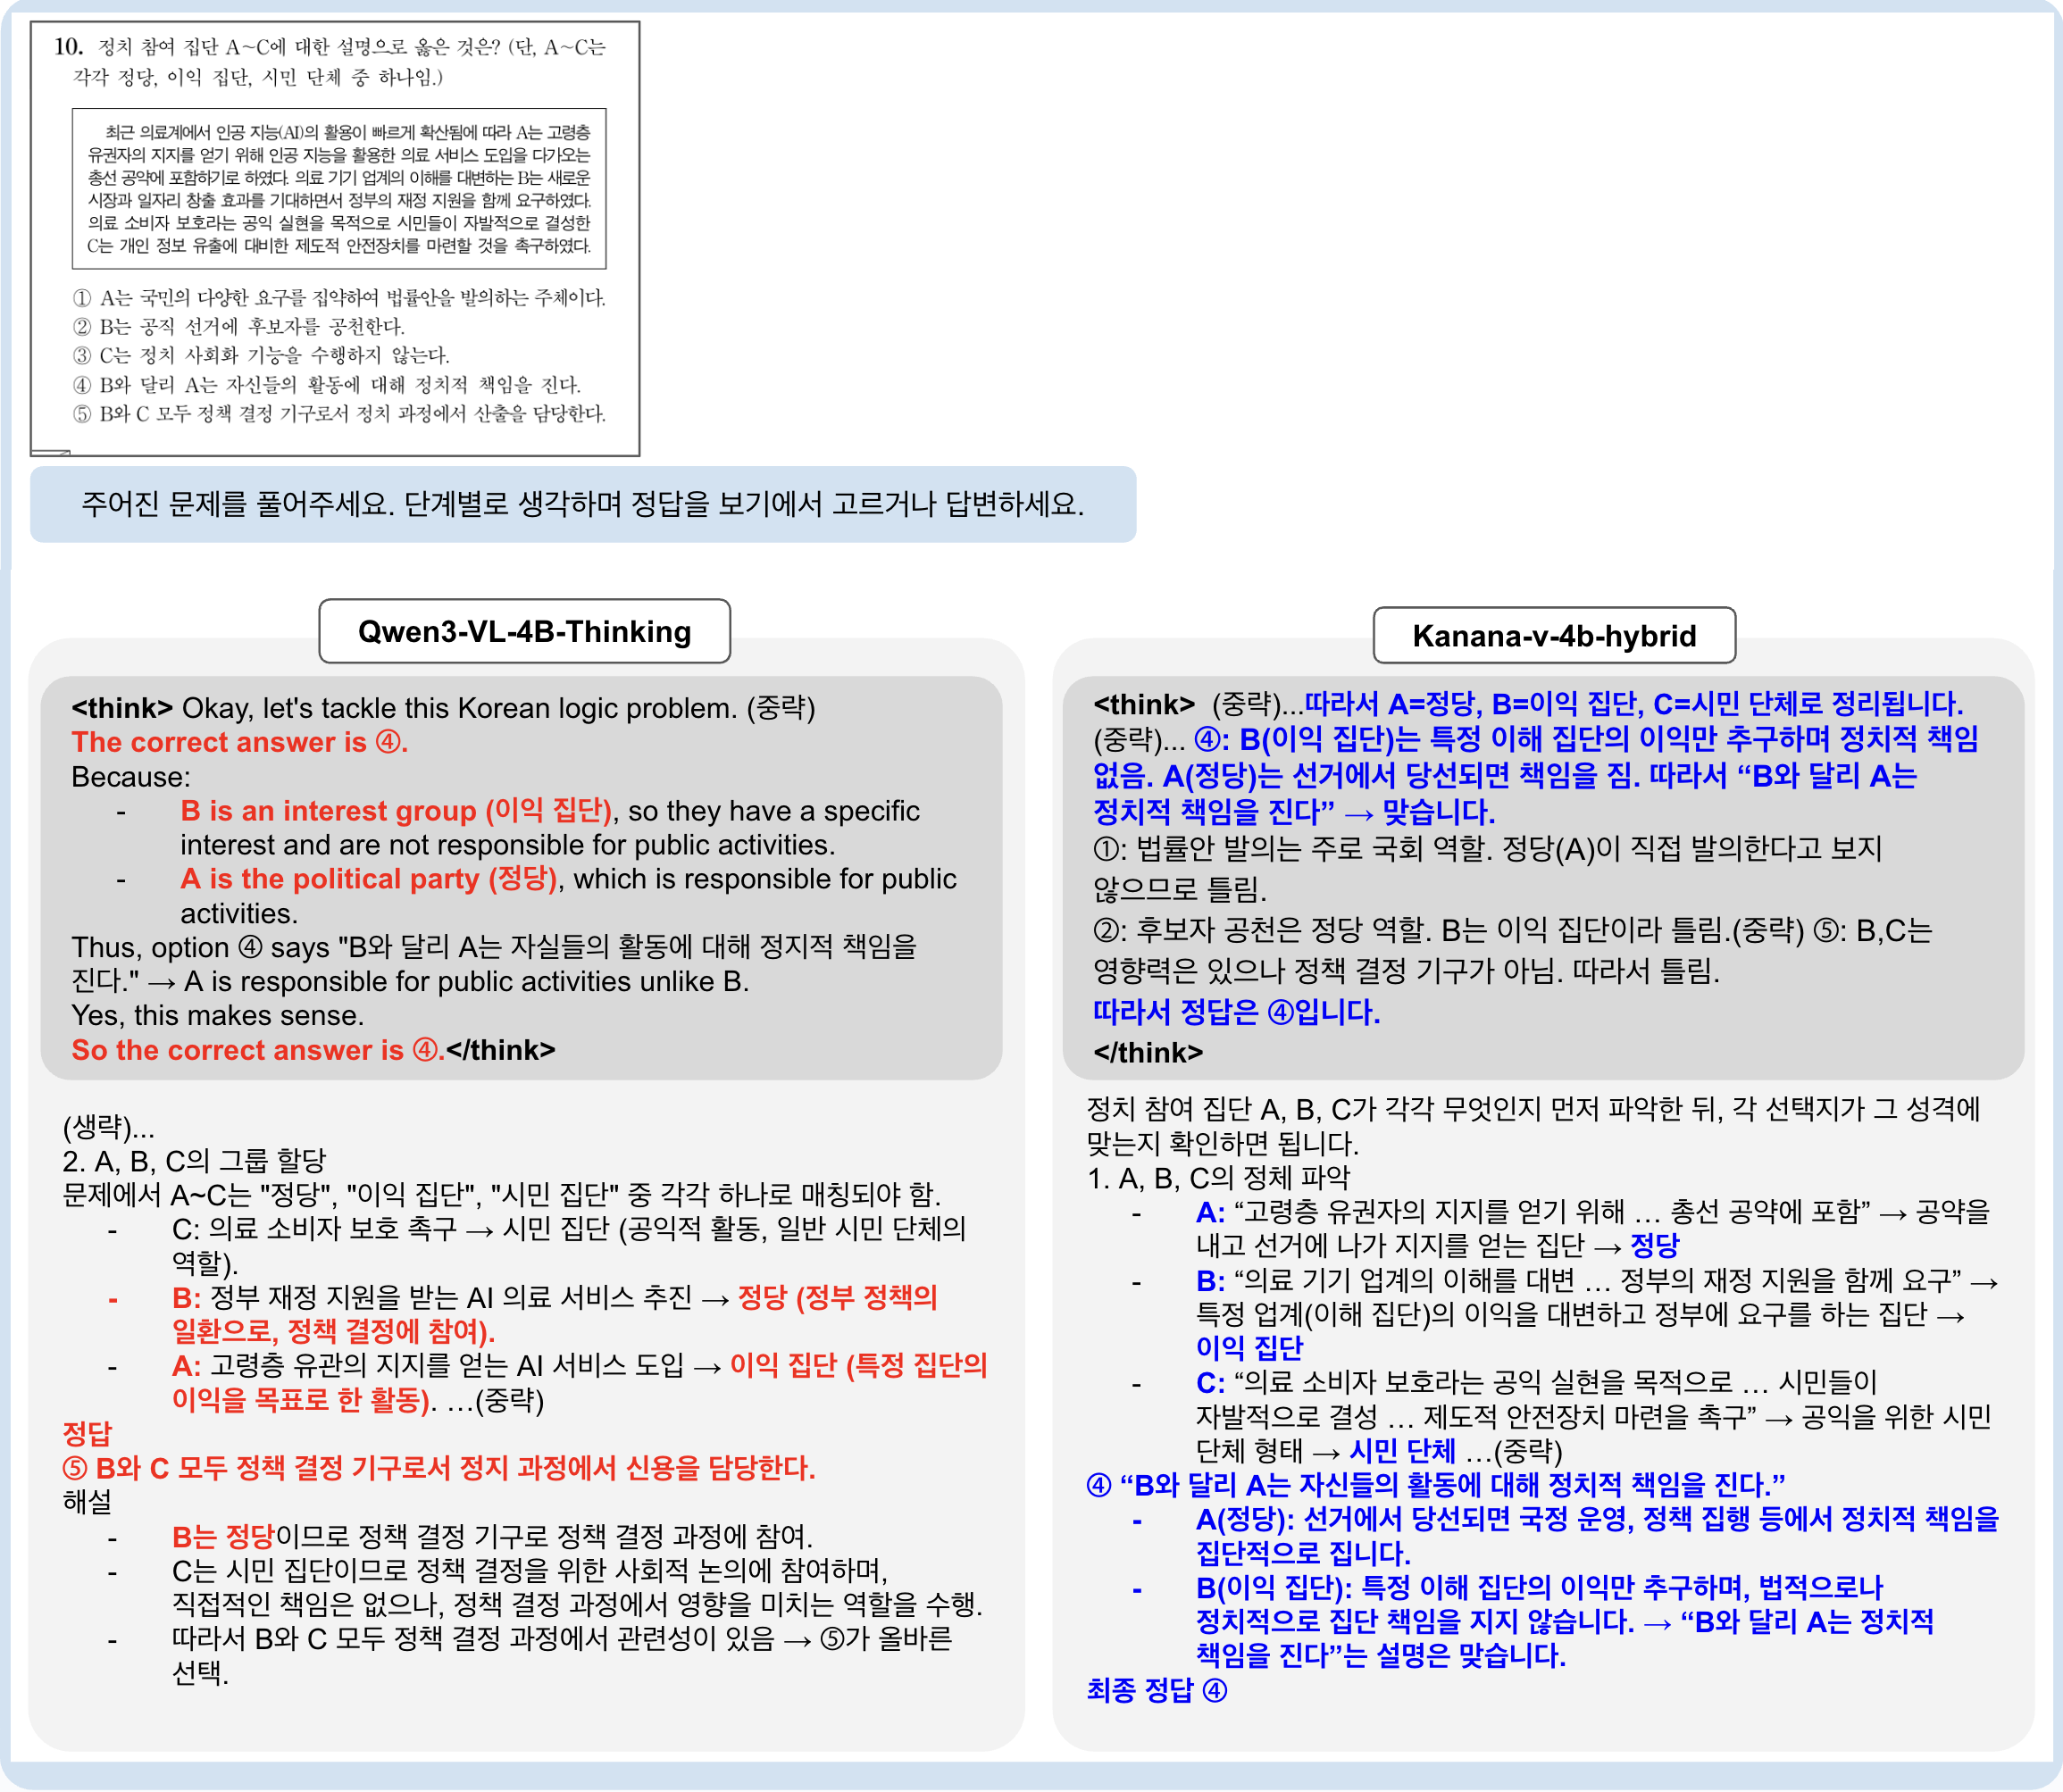
[그림 4]는 한국어 질문을 영어로 추론하는 과정에서 발생할 수 있는 대표적인 논리 모순을 보여줍니다. 영어로 추론한 사고 과정을 한국어 답변으로 다시 옮기는 과정에서 몇몇 단어(정치 참여 집단/정당, 이익집단 등)를 잘못 번역하여 추론 과정에서 문제를 잘 풀어냈음에도 최종 답변은 오답을 골랐습니다.
교육 상황에서도 한국어 추론 과정은 중요합니다. 이미지로 주어진 수학 문제나 학습지에는 조건문이 자주 등장하고, 교육을 위해 정확한 정답 뿐 아니라 풀이의 논리적인 설명이 필요합니다. 한국어 질의에 대해 한국어로 조건을 정리하고 어떤 근거를 사용했는지 자연스럽게 설명할 수 있다면, 단순히 정답을 제공하는 것을 넘어 응답의 설득력이 높아져 사용자 신뢰도도 함께 높아질 것입니다. 또한 사용자가 “여기서 이 식이 왜 이렇게 전개되는거야?”처럼 중간 단계를 되묻는 경우에도 같은 언어의 문맥 안에서 추론과 답변을 이어가기 때문에 응답이 매끄럽고 자연스러운 표현으로 이어집니다.
정리하면, Kanana-v-4b-hybrid의 한국어 추론 과정은 한국어로 표현된 지시와 조건을 추론 과정에서 끝까지 보존해 정확도를 높이고, 설명의 납득 가능성을 강화하는 특성입니다. 한국어 조건이 복잡한 질의일수록 이러한 경향은 더 두드러집니다.
추론과 비추론 응답 생성을 할 수 있는 단일 모델
멀티모달 대화는 ‘항상 짧은 응답’ 또는 '항상 긴 응답’이 필요한 질문으로 고정되지 않습니다. 어떤 요청은 빠르고 간결한 응답이 적합하고, 어떤 요청은 근거를 쌓아 정밀하게 풀어야 합니다. 이렇게 특성이 다른 두 요구는 [그림 5]의 예시처럼 하나의 세션 안에서도 번갈아서 등장할 수 있습니다.
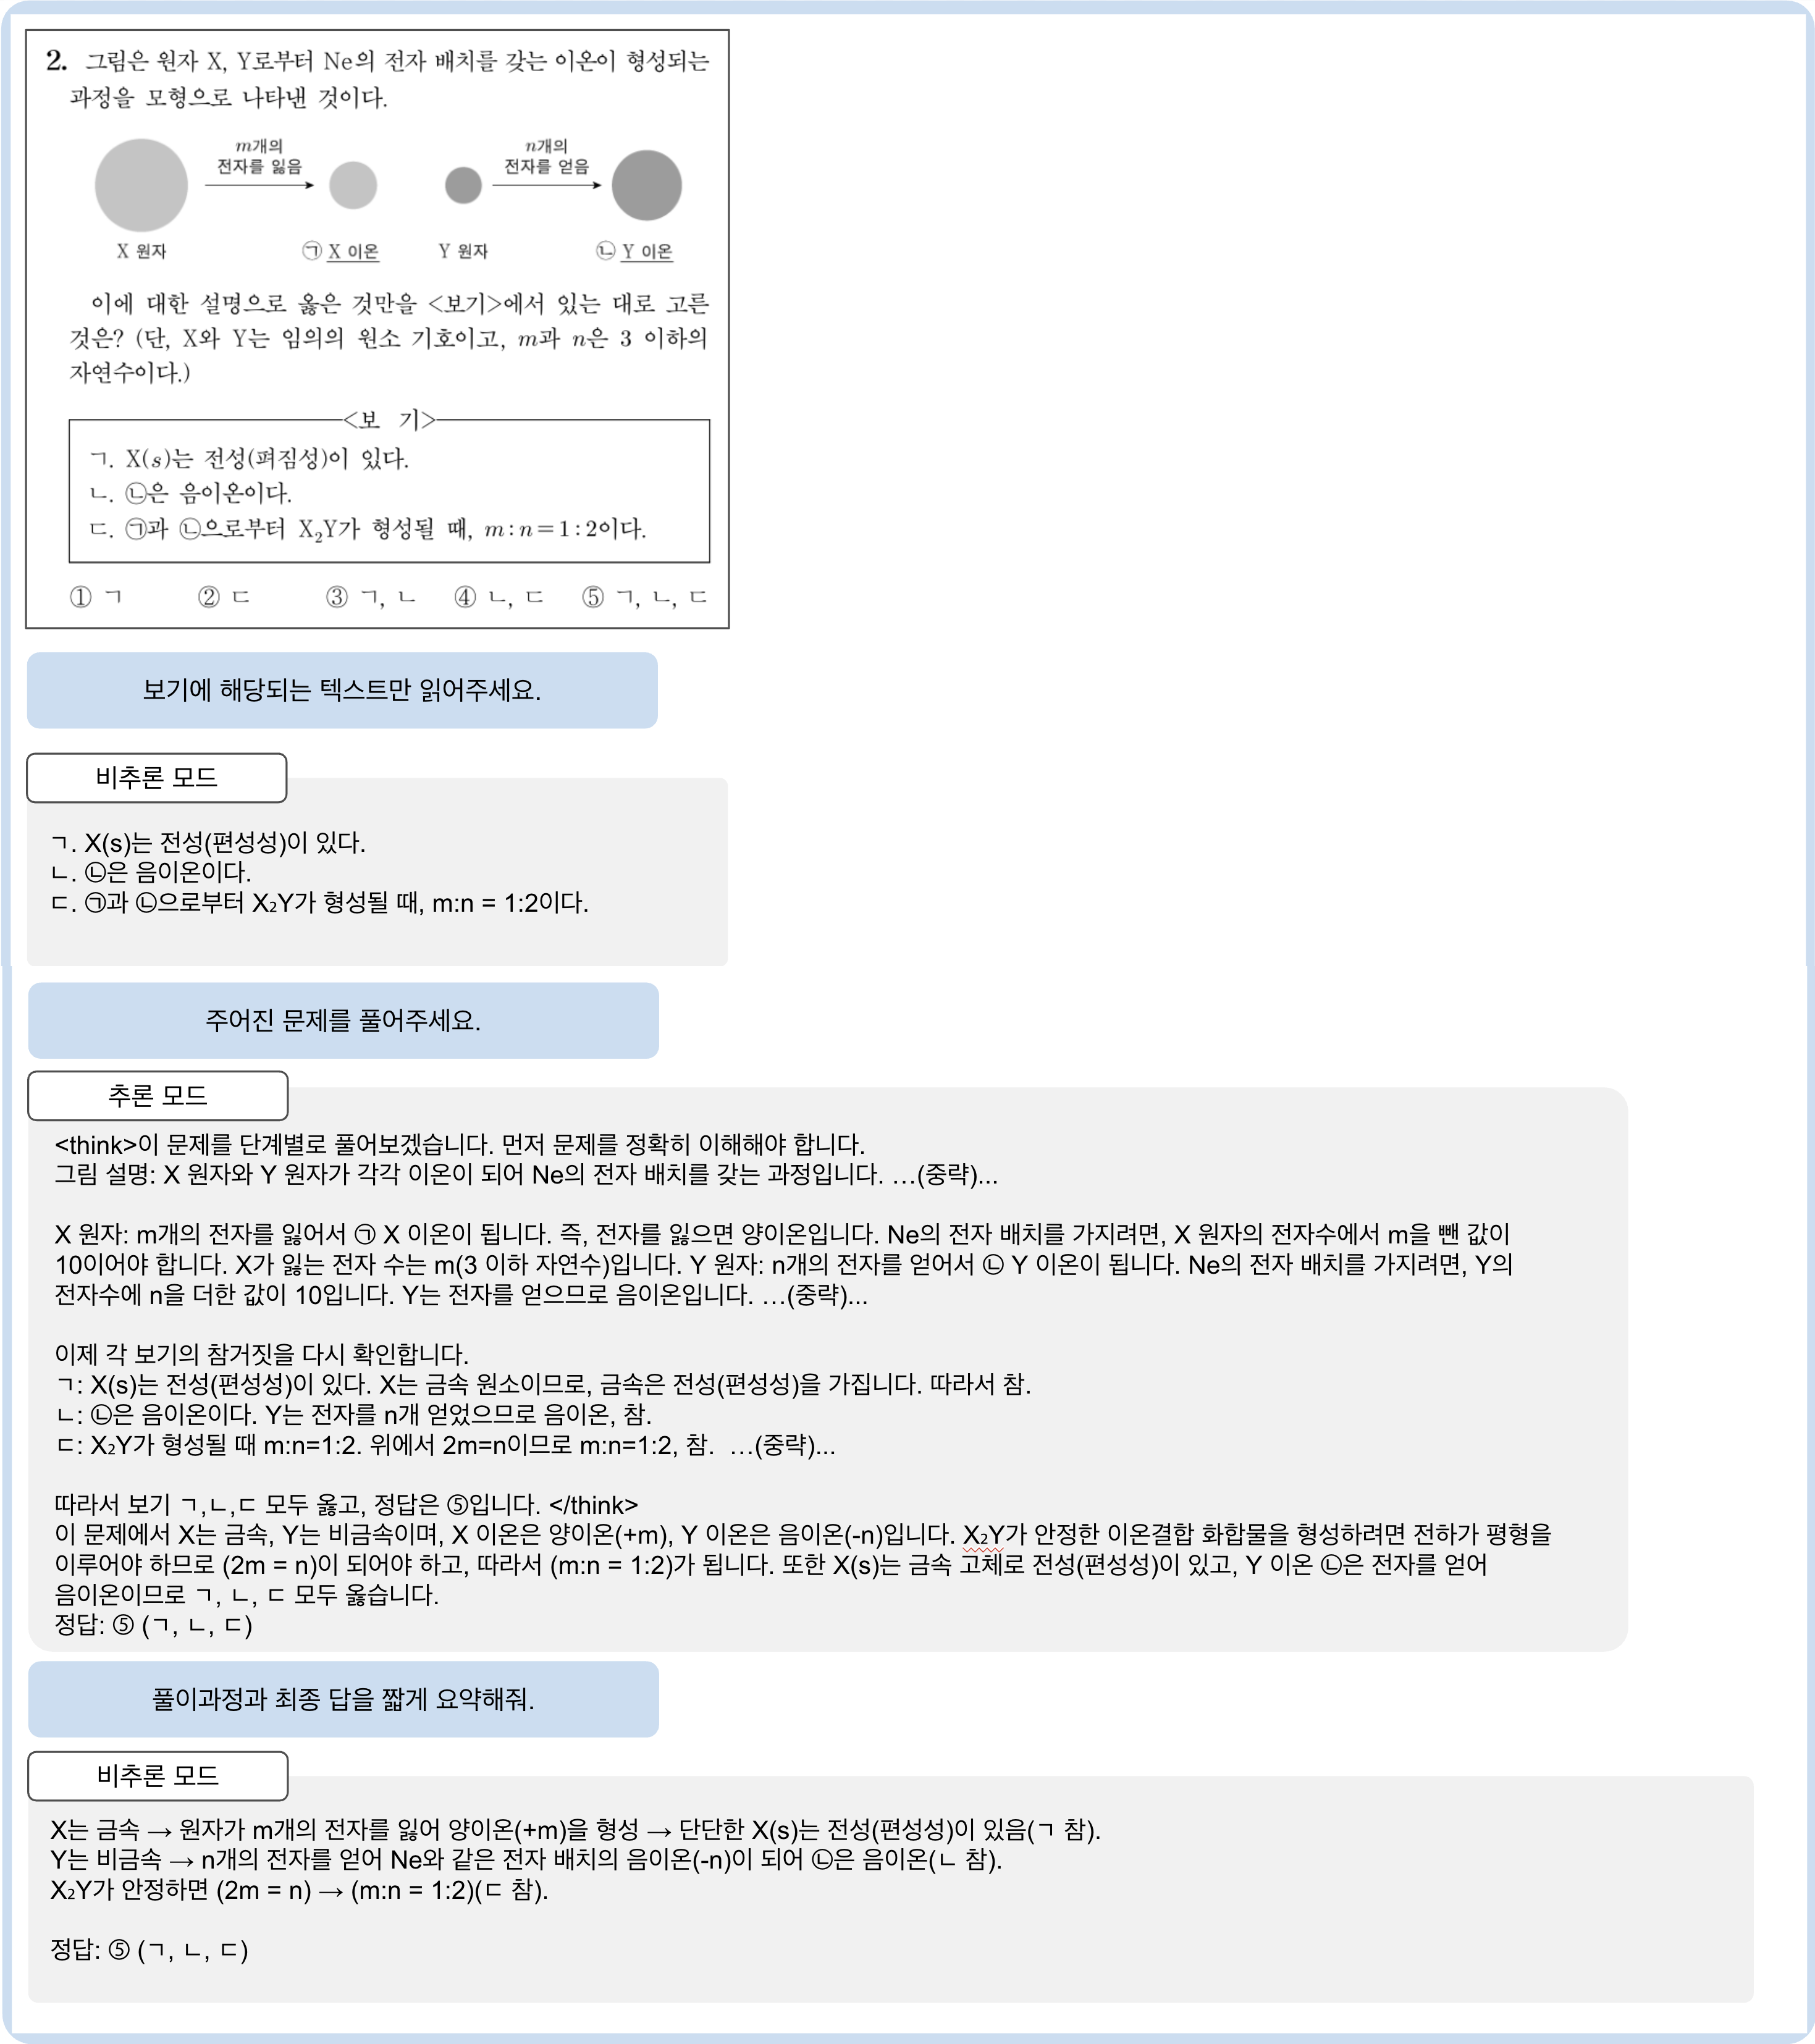
이러한 상황에 대한 대응책으로 가장 단순한 방법은 역할별로 모델을 분리하는 것입니다. OCR/요약과 같이 단순 모달리티 변환에 강한 모델과 추론에 강한 모델을 분리해 두고, 라우팅(Routing)으로 요청에 맞는 모델을 호출하는 방식으로도 목표 달성은 가능합니다. 하지만 여러 모델로 분리되면서 시스템 운영은 훨씬 복잡해집니다. 서빙·모니터링·버전 관리에 필요한 노력이 크게 늘어나고, 운영 정책과 응답 형식을 모델마다 따로 맞추기도 까다롭습니다. 사용자 입장에서도 같은 대화 안에서 갑자기 응답의 형식과 뉘앙스가 바뀌는 순간 “일관성이 깨졌다”는 느낌을 받을 수 있습니다.
따라서 Kanana-v-4b-hybrid는 모델을 역할로 쪼개기보다, 하나의 모델이 비추론형 응답과 추론형 응답을 모두 안정적으로 생성할 수 있는 하이브리드(Hybrid) 방향을 선택했습니다. 간단한 요청에는 빠르게 답하고, 보다 복잡한 요청에는 주어진 정보를 종합하고 검증하는 방식으로 정밀하게 답하도록 학습되어야 했습니다. 동시에 추론을 강화하면서 비추론 응답이 장황해지거나, 반대로 비추론 모드의 성능을 유지하느라 추론능력이 약해지는 등의 공존 붕괴를 막는 것도 중요한 과제였습니다.
영수증 인식은 앞서 말씀드린 Hybrid 모델의 장점을 가장 직관적으로 보여줍니다. 사용자가 “항목과 금액만 읽어줘”라고 먼저 요청한다면, 간단한 모달리티 변환 문제이므로 이때는 빠르고 간결한 정리가 선호됩니다. 이후 “할인 적용 후 합계가 맞는지 검산해줘”, “부가세 10%가 맞는지 확인해줘”처럼 보다 논리적인 사고 과정이 필요하고, 정답의 신뢰성이 중요한 질문을 요청한다면 추론형 응답이 필요합니다. 이후 “결론만 한 줄로 정리해줘”처럼 비추론 모드가 선호되는 요약 요청으로 돌아오기도 합니다.
Kanana-v-4b-hybrid는 이렇게 다른 특성을 가진 요청이 번갈아서 등장하는 상황에서도 여러 모델을 오가지 않기 때문에, 일관된 응답 형식과 뉘앙스를 유지하면서 응답할 수 있다는 강점을 가집니다. [그림 6]의 예시처럼 추론을 필요로 하지 않는 상황에서는 불필요한 연산을 줄여 운영 비용을 절감하고, 추론이 필요한 경우에는 자원을 집중해 더 나은 결과를 도출할 수 있는 유연성을 제공합니다.
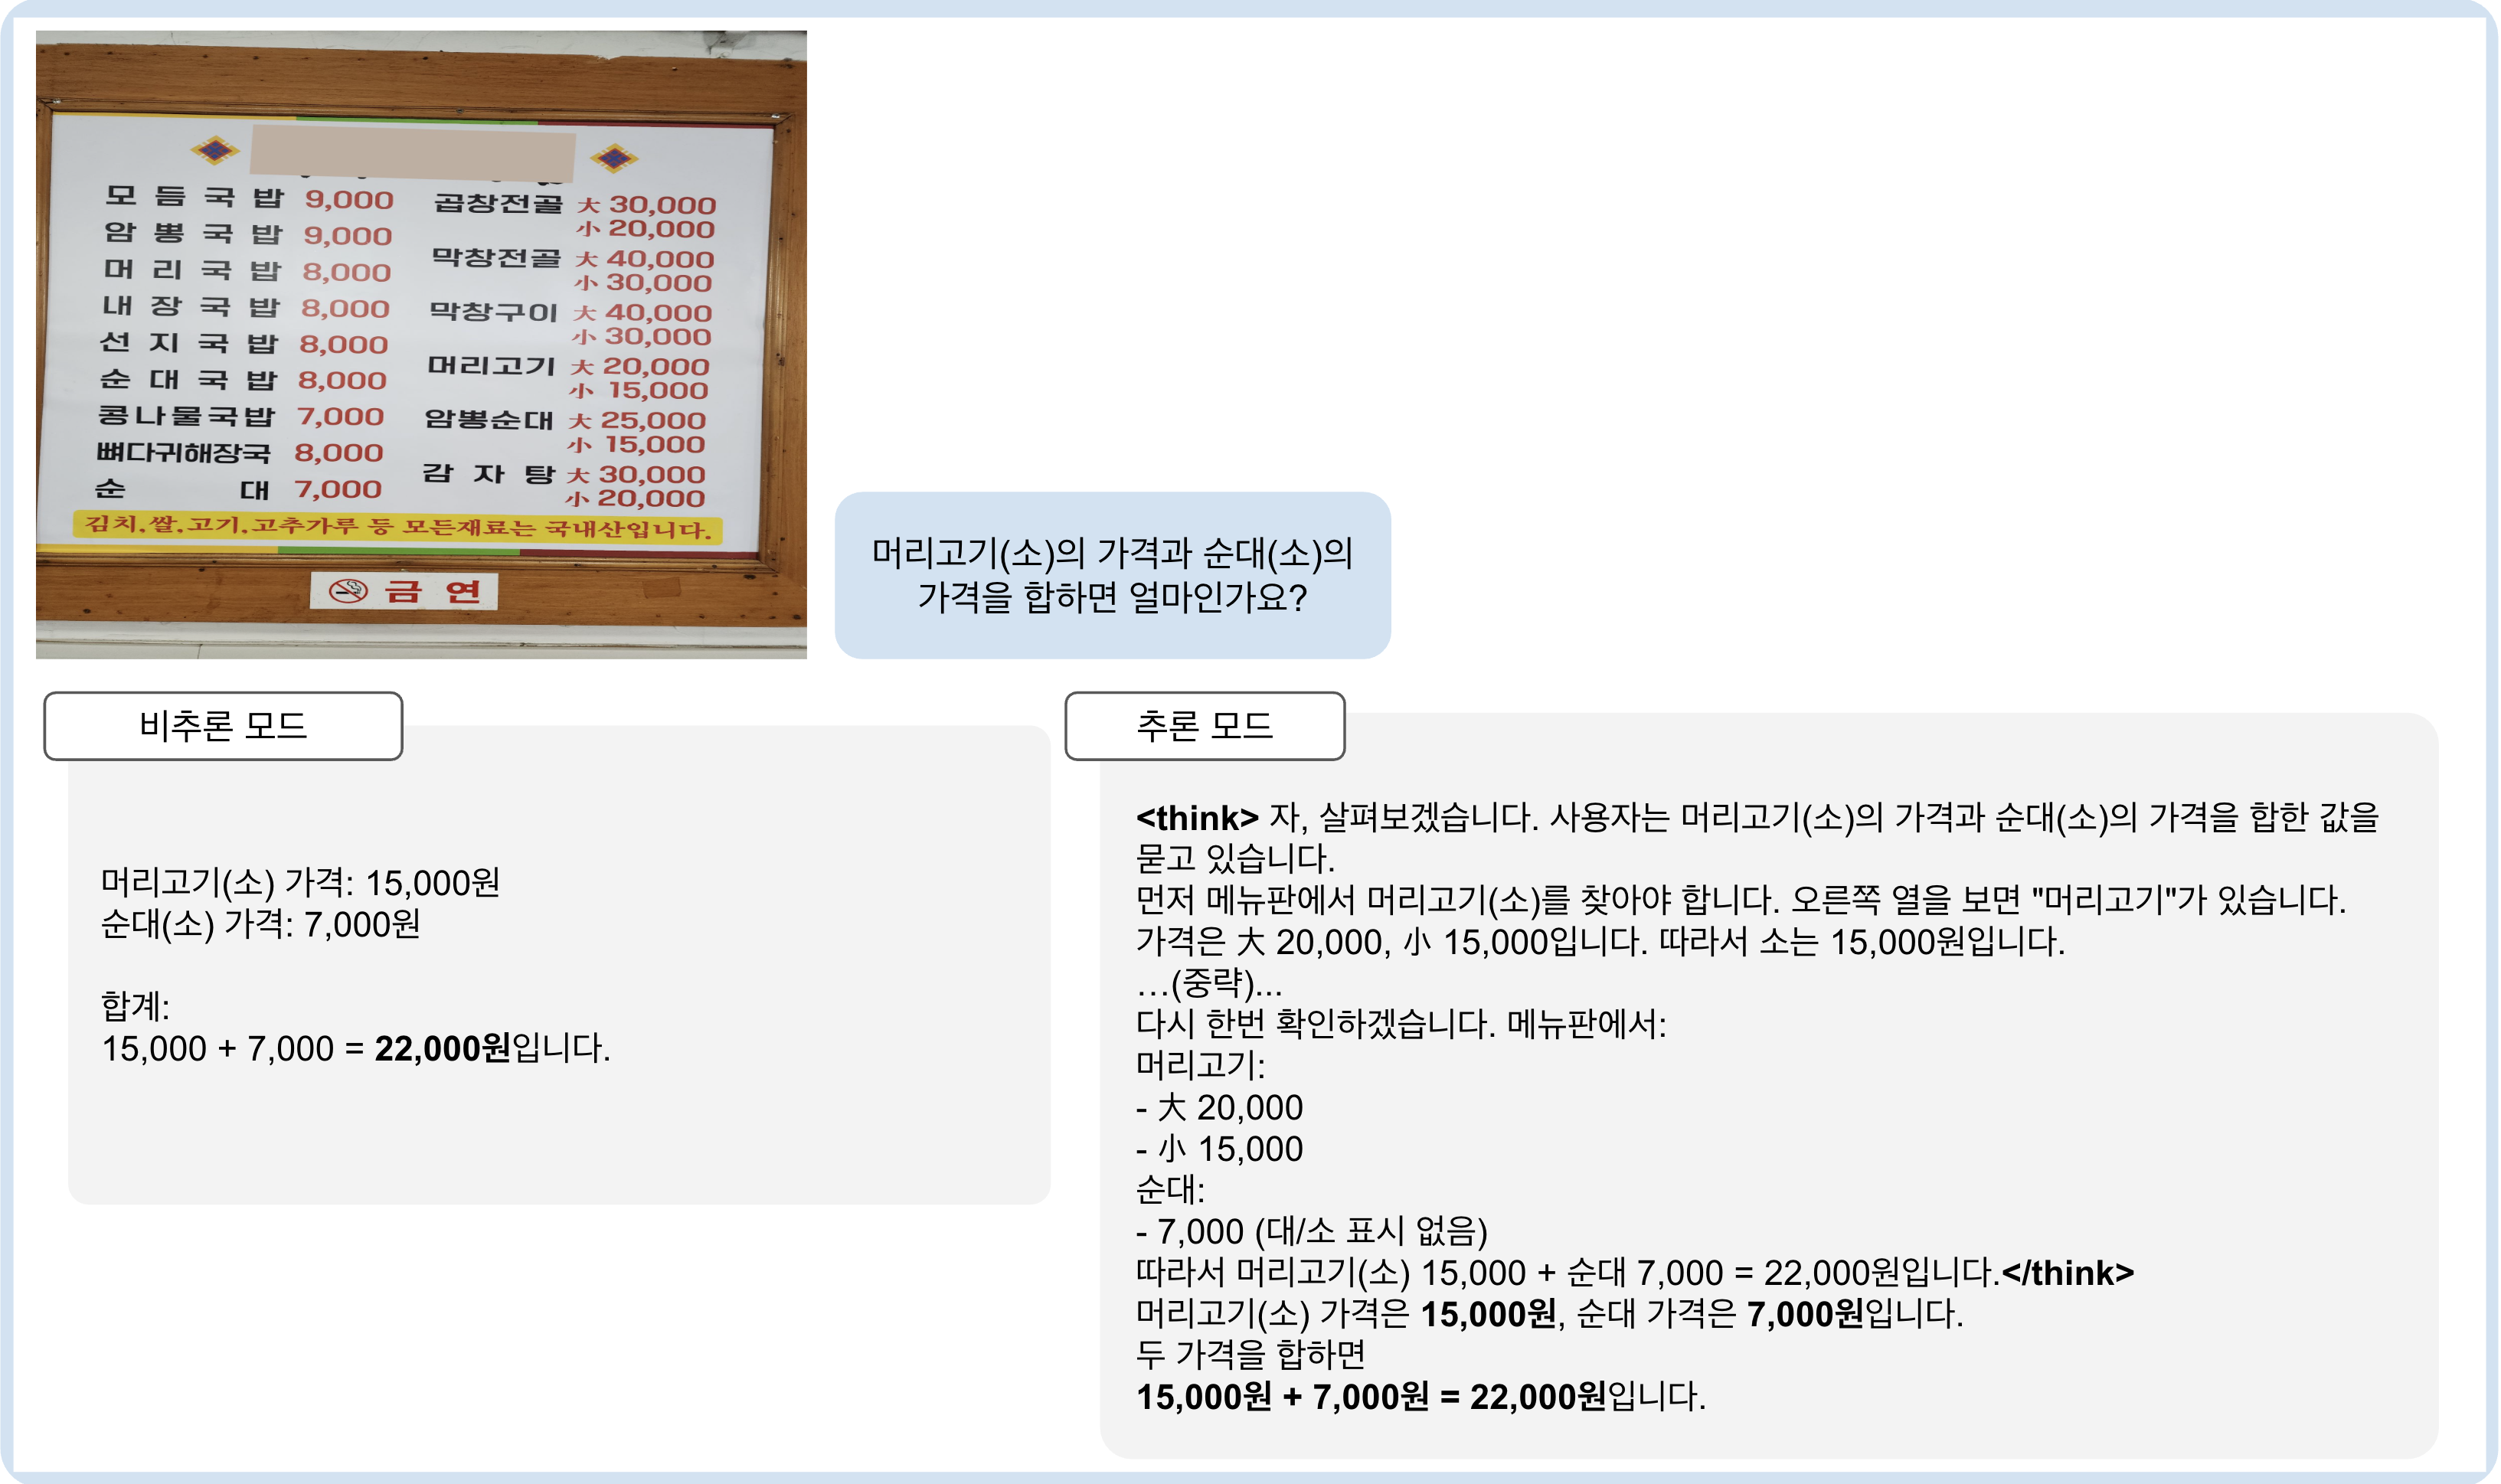
이처럼 Kanana-v-4b-hybrid는 실제 멀티모달 대화가 동작하는 운영 시스템과 사용자 모두를 고려하여 기획되었습니다. 하나의 모델이 추론이 필요한 응답과 그렇지 않은 응답을 모두 안정적으로 생성할 수 있다면 시스템 운영이 단순해지고, 일관된 사용자 경험을 제공할 수 있습니다. 또한 필요할 때만 더 깊게 추론함으로써 비용과 품질 사이의 균형을 유연하게 조절할 수 있습니다.
글로벌 경쟁력을 갖춘 하이브리드 멀티모달 언어모델
Kanana-v-4b-hybrid는 한국어 뿐만 아니라 영어로 이루어진 다양한 태스크에서 주요 경쟁 모델들과 비교해도 손색없는 성능을 보여줍니다. 영어와 한국어로 구성된 멀티모달 질의에 대해서 모델이 얼마나 정확한 답변을 하는지 수치로 확인하고자 다양한 벤치마크 성능을 측정하고, 그 결과를 [표 1]에 정리하였습니다.
비슷한 규모의 매개변수를 가지는 글로벌 공개 모델들[4, 5, 6] 과 비교하여, Kanana-v-4b-hybrid는 경쟁력 있는 성능을 달성했습니다. 특히 한국에서 수요가 높을 것으로 예상되는 수능형 문제풀이(KoNET[7])에서는 다른 추론형 멀티모달 언어모델 대비 큰폭으로 앞서는 정확도를 확인할 수 있었고, 비공개 상용 모델인 OpenAI의 GPT-5-nano[6] (reasoning effort high)에 필적하는 높은 성능을 확인할 수 있었습니다.

Kanana-v-4b-hybrid의 단계별 학습 전략
Kanana-v-4b-hybrid의 구조는 지난 7월에 공개된 Kanana-1.5-v-3b[1] 와 큰 틀에서 동일합니다. [그림 7]에서 볼 수 있듯, 모델은 Vision encoder – C-Abstractor[8] – LLM으로 구성되어 있으며, 시각적 추론 능력의 핵심은 구조 자체보다 학습 데이터 구성과 학습 방법론에서 만들어집니다.
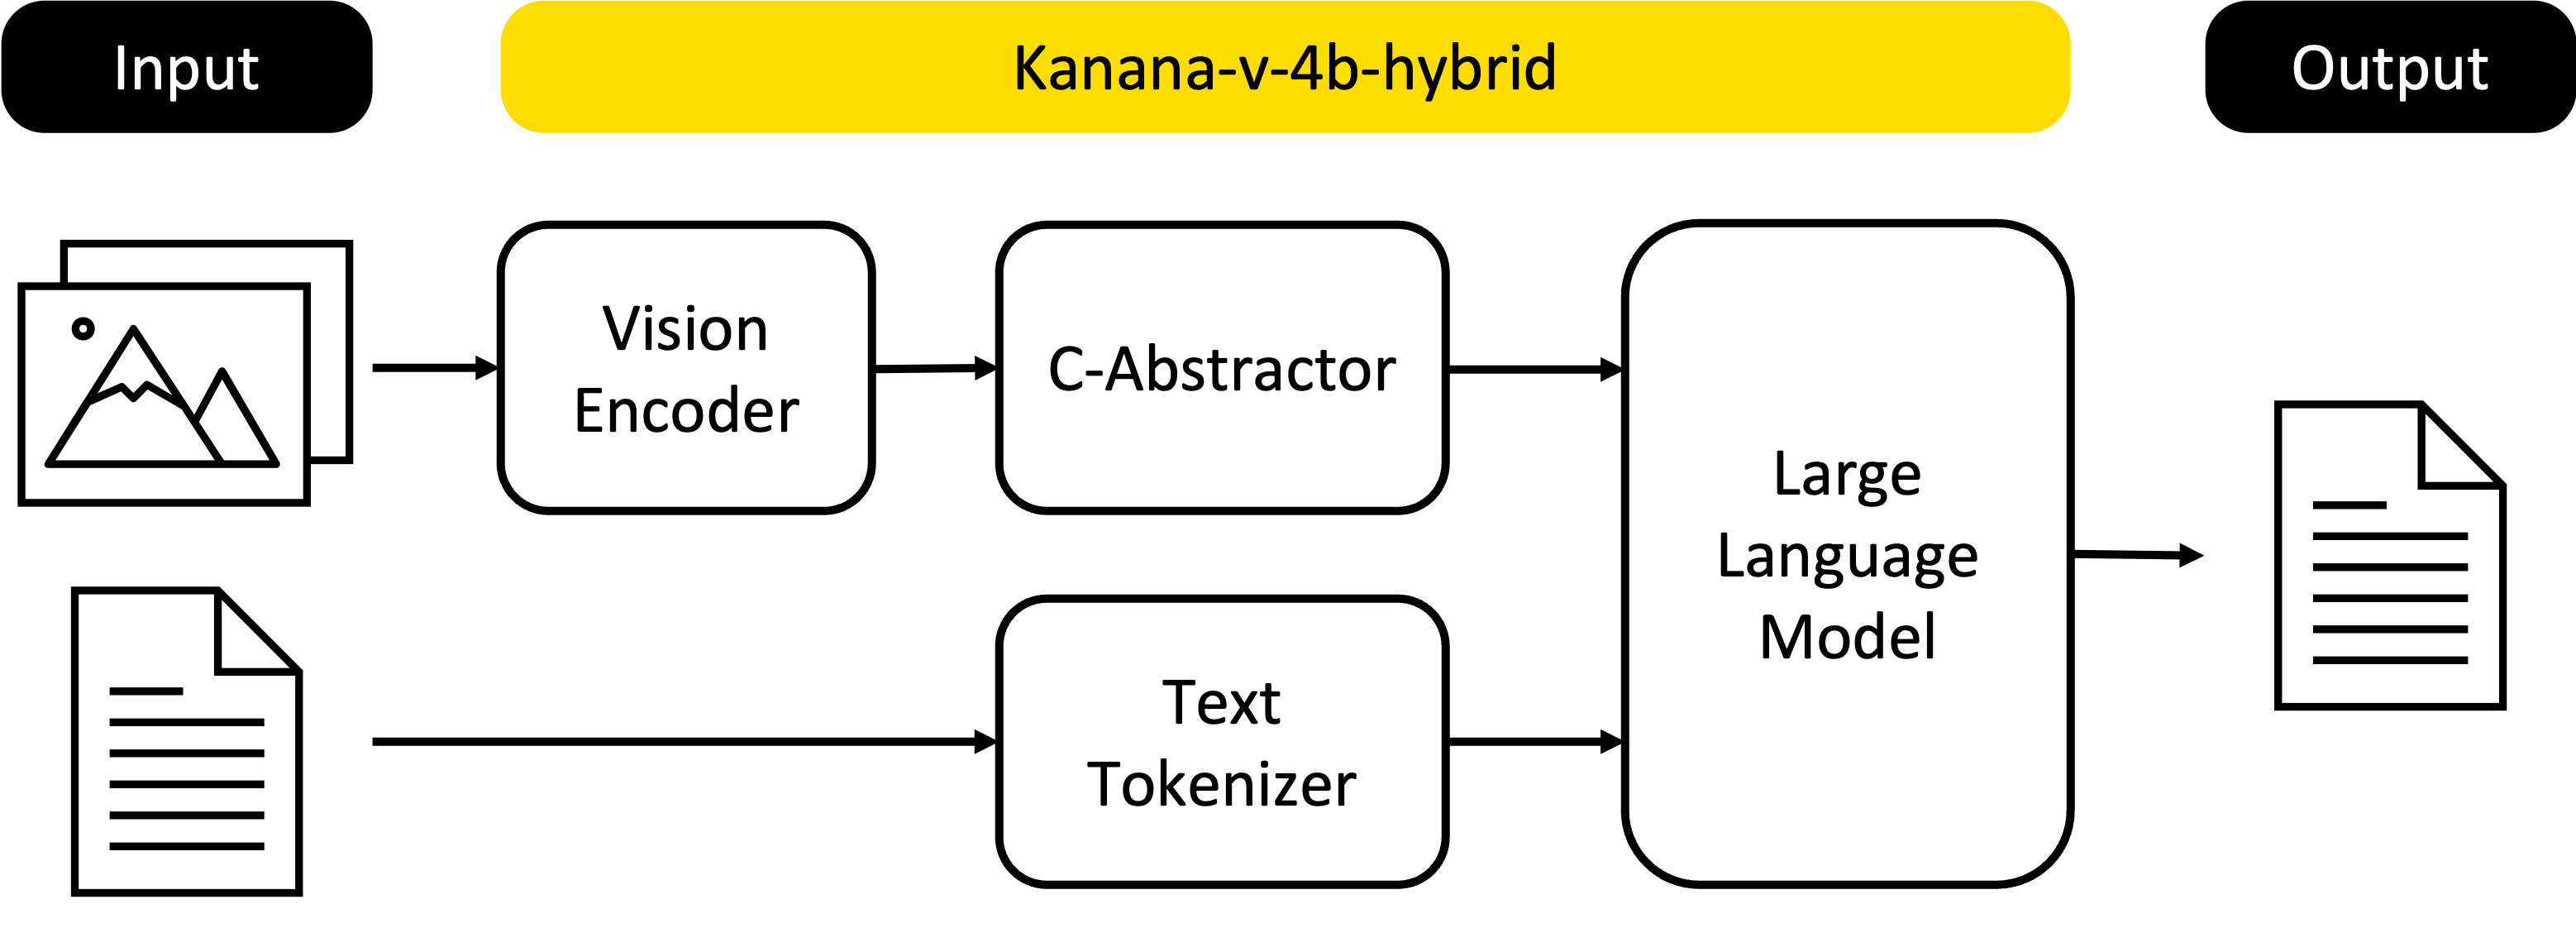
학습 과정은 [그림 8]과 같이 네 단계로 구성됩니다. 먼저 (1) 기초 멀티모달 학습에서는 모델이 다양한 멀티모달 태스크를 수행하는 방법을 익히고, 대규모 지시 이행(Instruction Following) 데이터로 사용자 지시를 안정적으로 따르도록 학습합니다. 기초 멀티모달 학습의 전체적인 흐름은 이전에 공개한 Kanana-1.5-v-3b와 동일하지만, Kanana-v-4b-hybrid에서는 지시 수행 범위를 사용자 프롬프트 중심에서 시스템 프롬프트까지 확장했습니다. 즉, 다양한 운영 환경(안전정책·출력 형식·역할 정의 등)에서도 신뢰도가 높은 일관된 응답을 만들 수 있도록 관련 학습 데이터를 정비했습니다. 또한 멀티모달 모델이 생성하는 '생각’과 '답변’을 일관되게 분리할 수 있도록, 전체 학습 과정에 걸쳐 구조화된 대화 형식(Chat Template)을 설계하고 적용했습니다.
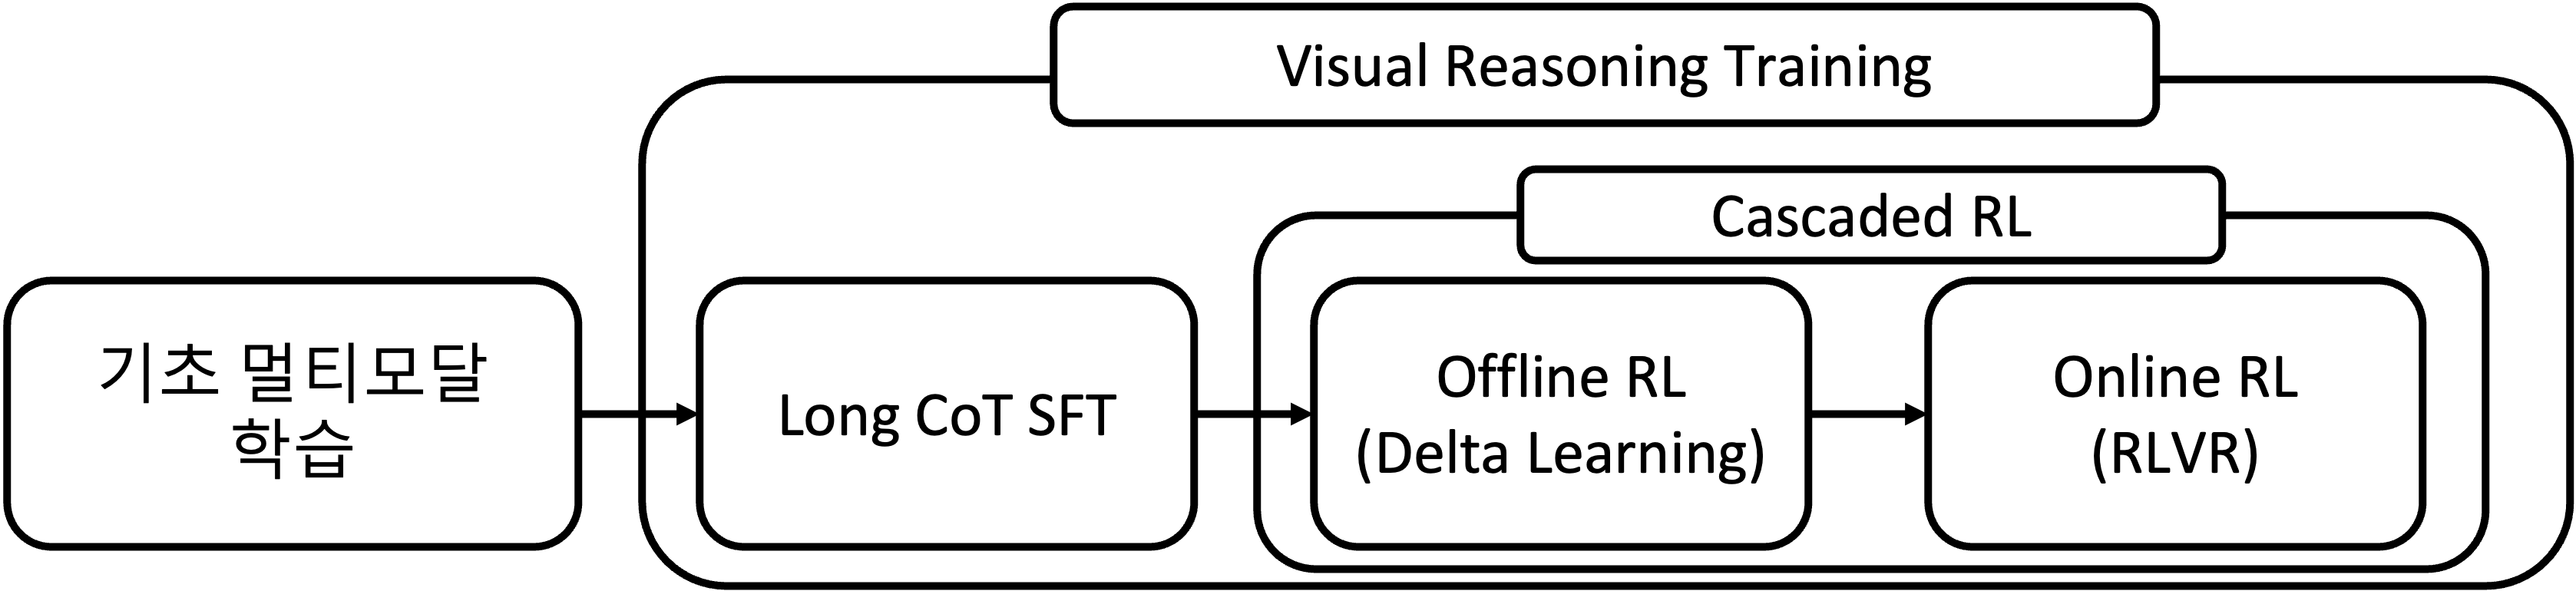
이후 학습 단계부터는 본격적으로 '생각하는 방법’을 모델에 주입하는 구간이며, 이를 시각 추론 학습(Visual Reasoning Training)으로 묶었습니다. (1) 기초 멀티모달 학습에 이어, 시각 추론 학습은 (2) Long CoT SFT(Long Chain-of-Thought Supervised Fine-Tuning) → (3) 오프라인 강화학습(Offline Reinforcement Learning) → (4) 온라인 강화학습(Online Reinforcement Learning) 순서로 진행됩니다.
Long CoT SFT 단계에서는 일관된 추론 형식을 유지하면서 어려운 문제를 단계적으로 푸는 방법을 학습해 추론 능력의 기본기를 잡고, 이어지는 오프라인 강화학습 단계에서는 온라인 강화학습 대비 비교적 적은 비용으로 모델의 출력 분포와 추론 습관을 정돈해 이후 온라인 강화학습이 잘 동작하는 초기 상태로 준비합니다. 이는 온라인 강화학습 전략 중 저희가 선택한 RLVR(Reinforcement Learning with Verifiable Reward)[9] 알고리즘이 검증 가능한 정답 여부를 보상 신호로 활용하여 추론 능력을 고도화하는데 큰 장점이 있는 반면, 실시간 응답 생성(Online Rollout)이 필요해 학습 비용이 크고 초기 모델 품질에 민감하다는 특성을 반영한 구조입니다. 마지막 검증 가능한 보상(Verifiable Reward)기반의 온라인 강화학습 단계에서는 모델이 실제로 응답을 생성하는 분포에서 성능을 직접 최적화하는 온라인 강화학습을 수행해, 이전 스테이지에서 끌어올린 Kanana-v의 추론 능력이 더욱 정확하고 일관성을 가지도록 고도화함으로써 Kanana-v-4b-hybrid의 시각 추론 성능을 완성합니다.
기본기를 탄탄하게: 기초 멀티모달 학습
Kanana-v-4b-hybrid의 기초 멀티모달 학습 단계는 Kanana-1.5-v-3b[1] 에서 소개한 학습 전략과 큰 흐름을 공유합니다. 자체 구축한 대규모 멀티모달 학습 데이터를 바탕으로 시각 정보 이해의 기본기를 다지고, 다양한 멀티모달 태스크에서 지시를 정확히 수행하는 멀티모달 지시 이행(Instruction Following) 능력을 강화하는 데 초점을 두었습니다.
더하여, Kanana-v-4b-hybrid는 보다 안정적인 학습과 서비스 운영을 위해, 기초 멀티모달 학습 단계부터 응답을 ‘어떤 형태로, 어떤 규칙을 우선하여’ 생성해야 하는지 더 명확히 학습할 수 있도록 개선했습니다. 이를 위해 (1) '생각’과 '답변’을 일관되게 분리할 수 있는 구조화된 대화 형식(Chat Template)을 설계·적용하고, (2) 실제 서비스 운영을 위한 안전 정책·출력 형식·역할 등이 정의된 시스템 프롬프트 지시 이행 학습 데이터를 보강했습니다.
1) 대화 형식(Chat Template)
Kanana-v-4b-hybrid의 추론 모드는, '생각’을 먼저 정리한 뒤, 사용자가 요구한 최종 '답변’을 생성합니다. 이때 중요한 것은 모델의 출력이 '생각’과 '답변’으로 명확히 구분된 형태를 갖도록 일관된 형식을 잡아주는 것입니다. 두 영역의 경계가 흐려지면 '생각’이 '답변’에 섞여 불필요하게 장황해지거나, 서비스에서 원하는 형식으로 응답을 제공하기 어려워질 수 있습니다. 이러한 문제를 사전에 방지하기 위해, 기초 멀티모달 학습 단계부터 구조화된 Chat Template을 설계하여 '생각’과 '답변’의 경계가 일관되게 분리되도록 학습했습니다.
구체적으로는 ‘생각’ 영역을 <think>…</think> 블록으로 구조화해, 모델이 추론 과정과 최종 응답을 일정한 형식으로 구분할 수 있도록 유도했습니다. 이 형식은 학습과 추론 단계에서 동일하게 적용되어, 생각과 답변을 안정적으로 분리하고 필요에 따라 제어할 수 있게 해줍니다. 특히 실제 서비스에서는 정보가 널리 퍼져있는 추론 과정을 그대로 사용자에게 노출하는 것이 선호되지 않는 경우가 종종 존재합니다. 이때 추론 과정이 담겨있는 <think>…</think> 블록을 활용해 추론 과정을 분리할 수 있다면, 내부적으로는 추론 과정을 유지하면서도 사용자에게는 정제된 최종 답변만 손쉽게 제공할 수 있습니다.
2) 멀티모달 시스템 프롬프트 지시 이행(Multimodal System Prompt Following)
멀티모달 시스템 프롬프트 지시 이행 능력은 모델을 배포·운영하는 서비스 관점에서 전체 시스템 안정성에 큰 영향을 미칩니다. 실제 운영 환경에서는 사용자 프롬프트뿐 아니라 안전 정책, 출력 형식, 역할 정의 등 다양한 시스템 프롬프트(System Prompt)가 함께 주어지며, 사용자 요청과 시스템 프롬프트 지시가 충돌하는 상황에서는 모델이 시스템 프롬프트 지시를 우선해야 서비스가 안전하게 동작할 수 있습니다.
덧붙여, 추론 능력 고도화 단계인 검증 가능한 보상 기반의 온라인 강화학습에서는 규칙 기반 채점을 위해 모델이 정해진 형식(예: 단답형, JSON)으로 답하도록 지시합니다. 이때 시스템 프롬프트 지시를 이행하지 못해 지정된 형식을 모델이 준수하지 못하면 전체 응답으로부터 정답을 안정적으로 추출·비교하기 어려워지고, 이는 채점 실패나 보상 잡음(Noise)으로 이어져 보상 신호의 품질이 저하될 수 있습니다. 따라서 Kanana-v-4b-hybrid의 기초 멀티모달 학습 단계는 단순한 멀티모달 지시 수행 능력 뿐 아니라, 멀티모달 시스템 프롬프트 지시 이행 능력 향상까지 목표로 합니다.
멀티모달 시스템 프롬프트 지시 이행 능력 향상을 위해, Kanana-v-1.5-3b 학습을 위해 사용한 한국어 멀티모달 지시 이행 데이터셋을 시스템 프롬프트 대상으로 확장하였습니다. 확장된 데이터셋은 이미지-사용자 지시 쌍에 대해서 (1) 자연스럽게 적용 가능한 시스템 지시(출력 형식/톤/역할 정의 등)와 (2) 사용자 지시와 충돌되어 모순(Contradiction)이 발생하는 시스템 지시로 조합되어 있습니다. 모순된 상황의 시스템 지시 학습 데이터는 사용자 지시보다 ‘시스템 지시를 우선해야 하는’ 상황을 가정하며, 실제 서비스 환경에서도 안정적이고 신뢰성있는 모델 운영이 가능하도록 구성하였습니다. 또한 시스템 프롬프트 지시 이행 능력의 개선은 출력 형식 준수로 이어져 이후 온라인 강화학습 단계에서의 학습 안정성까지 향상시킬 수 있었습니다.
어려운 문제는 이렇게 푸는거야: Long Chain-of-Thought SFT
기초 멀티모달 학습을 거친 Kanana-v는 사용자 지시와 시스템 프롬프트 준수 능력을 갖추게 됩니다. 하지만 이 단계의 모델은 여전히 복잡한 문제를 마주했을 때 정답을 바로 산출하려 하거나, 단편적인 근거만 제시하는 경향이 남아 있습니다. 즉 '무엇을 답해야 하는지’는 알지만, 더욱 복잡하고 어려운 문제에서, 주어진 조건을 종합하고 검증하며 여러 단계로 나누어서 풀어나가는 추론 과정(Reasoning Path)은 안정적이지 않았습니다. 이를 개선하기 위해 시각 추론 훈련(Visual Reasoning Training)의 첫 단계로 Long CoT SFT(Long Chain-of-Thought Supervised Fine-Tuning)[10, 11, 12] 학습 단계를 두어, Kanana-v가 복잡하고 어려운 문제를 ‘어떻게 푸는 것인지’ 지식을 주입하는 것에 집중했습니다.
Long CoT SFT 단계에서 가장 중요했던 것은 데이터셋의 품질입니다. Long CoT SFT 학습 단계는, 이후 추론능력 고도화를 위한 학습 단계 이전에, 모델이 지켜야 할 추론 형식과 논리 전개 습관을 알려주는 과정이기 때문입니다. 기본기가 흔들린 상태에서 추론능력 고도화를 위한 학습 단계를 밟는다면, 모델의 생성된 응답이 불안정해지거나 출력이 붕괴하는 방향으로 학습이 흘러갈 수 있습니다[13]. 따라서 저희는 Long CoT SFT 단계에서 올바른 추론 형식을 지키면서도 논리적인 사고 과정을 배울 수 있도록, 학습 데이터 품질을 최우선 기준으로 설정했습니다.
Long CoT SFT 단계는 정답과 풀이 과정을 함께 제공하고, 그 형태를 그대로 따라 하도록 학습하는 지도 학습(Supervised Fine-Tuning; SFT) 단계입니다. 따라서 Long CoT SFT 단계의 학습 데이터셋은 단순히 '정답을 맞춘 데이터의 집합’이 아니라, 모델이 올바른 논리 전개 습관을 가지도록 학습해야 할 '모범적인 사고 과정의 집합’으로 구성되어야 합니다. 최종 정답의 정확성은 물론, <think>…</think> 블록 기반의 추론 형식 일관성이 유지되어야 하고, 조건 누락 없이 추론 과정이 논리적으로 연결되어 완결성 있는 풀이 과정을 갖추어야 합니다. 또한 반복·뜬금없는 전개와 같이 추론 품질을 해치는 요소가 섞이지 않도록 높은 품질 기준을 만족해야만 합니다.
하지만 공개 데이터만으로는 이러한 고품질 기준을 만족하는 데이터셋을 구성하기 어려웠습니다. 추론 형식이 제각각이거나 사고 과정이 불완전한 경우도 있었고, 데이터셋이 특정 분야로 치우쳐 일반화된 추론 능력을 얻기 어려운 경우도 있었습니다. 또한 이러한 조건을 만족하는 고품질 데이터셋이 존재하더라도, 부족한 샘플 수로 인해 충분한 추론 지식을 주입하기에 부족했습니다. 더하여, Kanana-v-4b-hybrid는 시각 정보와 텍스트 정보를 종합하여 추론해야 하는 멀티모달 모델이기 때문에, '이미지를 안 보고도 풀리는 데이터’가 섞이는 것이 가장 치명적인 문제였습니다. 이런 샘플이 많아지면 모델은 자연스럽게 텍스트 중심 지름길(Shortcut)을 학습하게 되고, 시각적 근거를 활용하는 습관이 약해질 수 있습니다. 이러한 한계를 극복하고자 형식·분야·시각 정보 활용 조건을 동시에 만족시키기 위한 현실적인 해법으로 합성(Synthetic) 데이터를 적극 활용했습니다.
합성 데이터는 사람이 모든 추론 과정을 수작업으로 작성하는 대신, 이미지–질의 쌍을 입력으로 하여 생성 모델이 ‘추론 과정 + 답변’ 형태의 응답을 생성하도록 구성한 학습 데이터입니다. 합성 데이터 생성 단계에서는 chat template에 맞춰 <think>…</think> 블록에는 단계별 추론 과정을, 블록 밖에는 정제된 최종 답변을 생성하도록 합니다. 이 방식은 Long CoT SFT 단계에서 요구되는 추론 형식의 일관성을 엄격하게 유지할 수 있으며, 분야/난이도 비율을 제어하면서도 충분한 규모의 데이터를 확보할 수 있다는 장점이 있습니다.
다만 합성 데이터셋은 생성 과정의 특성상 두 가지 문제가 뒤따릅니다. 첫 번째는 질의와 그에 대응하는 추론 과정의 다양성 부족이고, 두 번째는 그럴듯한 추론 과정이지만 틀린 정답으로 이어지거나, 근거와 답이 모순되는 정합성 문제입니다. 저희는 다양성 문제를 먼저 해결하고자, 초기 합성 데이터셋을 대상으로 동일한 이미지에 대해 복수의 합성 질문(Synthetic Question)을 생성하고, 동일한 질문에 대해서도 서로 다른 추론 과정(Multiple Reasoning Path)을 생성[14]하여 합성 데이터셋임에도 불구하고 충분한 다양성을 확보할 수 있었습니다.
정합성 측면에서는 품질 정제 파이프라인이 핵심이었습니다. 높은 품질의 추론 과정 데이터만 남기기 위해, (1) <think>…</think> 블록 기반 추론 형식 준수 여부, (2) 정답 여부, (3) 추론 과정 내 결함(반복·논리적 비약 등) 여부 등을 순차적으로 점검하여 저품질 샘플을 단계적으로 제거한 뒤, 이 기준을 통과한 샘플만 Long CoT SFT 단계에 활용했습니다. 이와 같은 다양성 확보 전략과 엄격한 필터링 기준으로, Long CoT SFT 단계에 적합한 고품질 합성 데이터셋을 충분한 양으로 구축할 수 있었습니다.
또한, Hybrid 모델에서 비추론 성능을 함께 유지·개선하기 위해서는, 비추론 데이터의 품질 역시 중요합니다. 비추론 데이터에도 추론 과정 내부에만 적용되는 조건을 제외하고 동일한 품질 정제 기준을 적용하여, 비추론 모드에서도 정확하고 일관된 응답을 학습할 수 있도록 데이터셋을 구성했습니다.
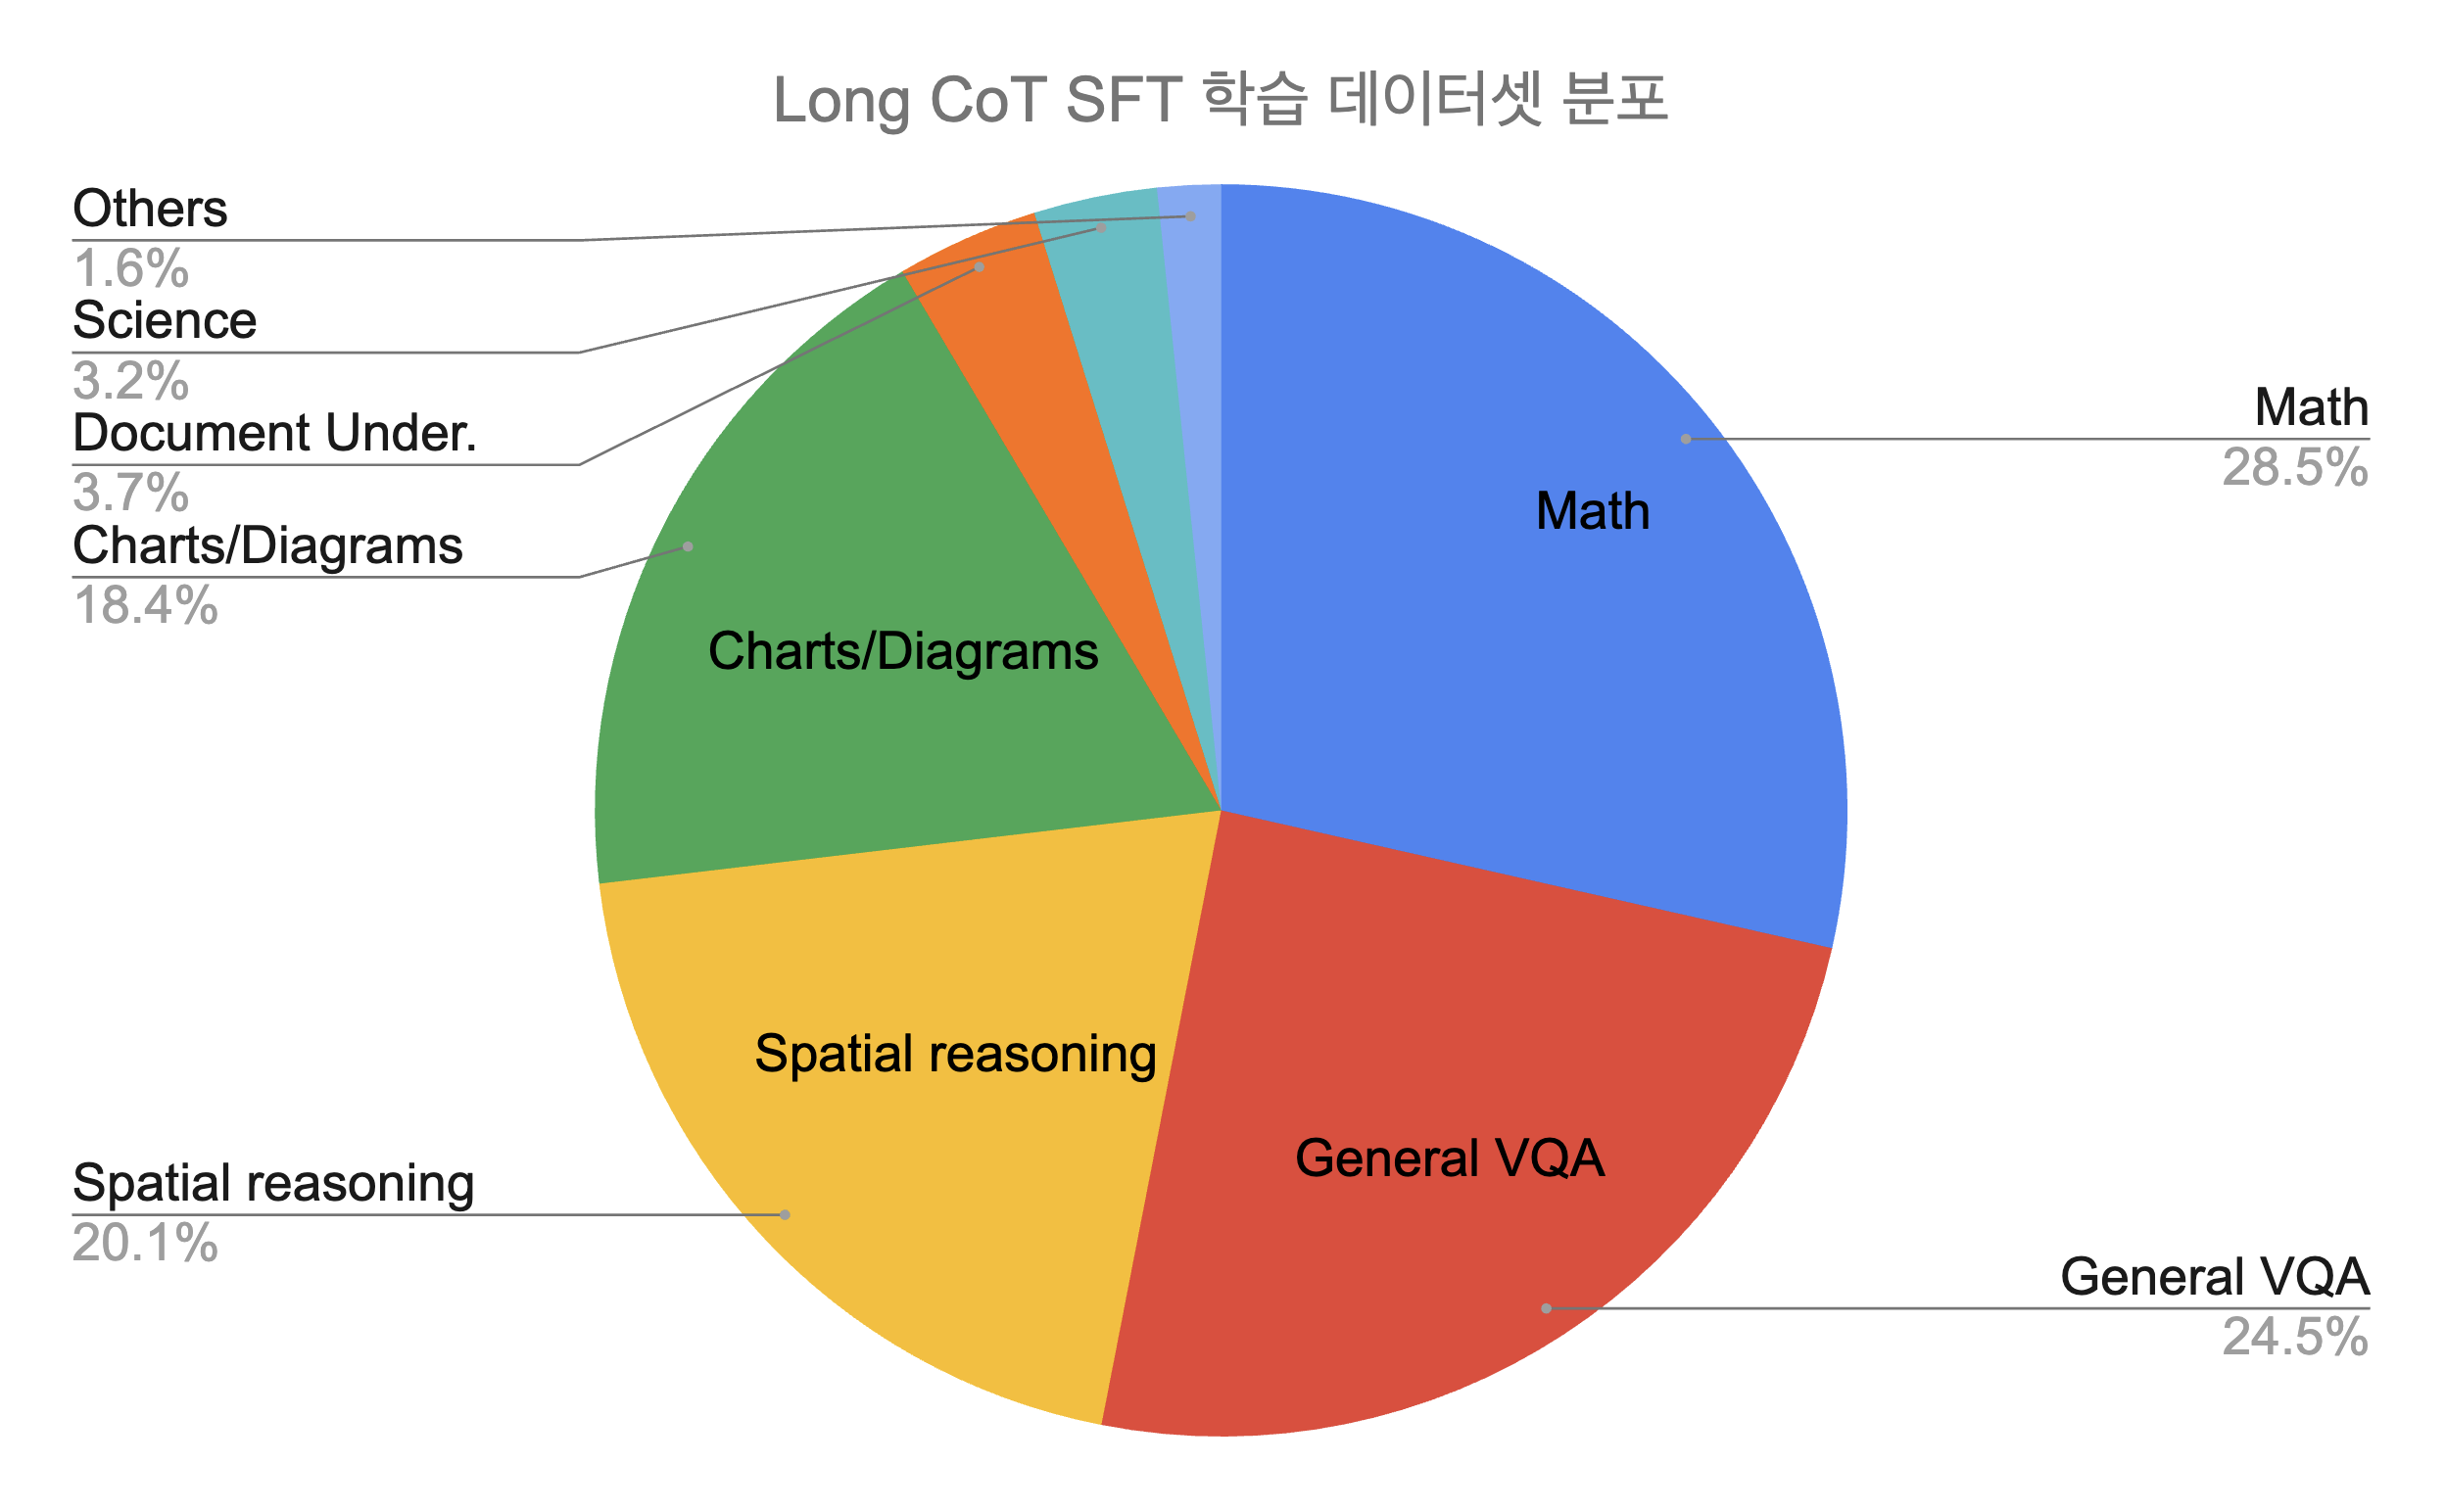
위 과정을 통해 구축된 데이터의 분야의 비율은 [그림 9]에서 확인 할 수 있습니다.
Long CoT SFT 학습 단계 이후, 주요 추론 벤치마크에서의 성능을 측정하여 [표 2]에 정리했습니다. 추론능력이 요구되는 다양한 벤치마크에서 큰폭의 성능 향상을 확인할 수 있었습니다.
| 기초 멀티모달 학습 이후 Kanana-v-4b-hybrid | 기초 멀티모달 학습 이후 Kanana-v-4b-hybrid | Long CoT SFT 학습 이후 Kanana-v-4b-hybrid | Long CoT SFT 학습 이후 Kanana-v-4b-hybrid | |
|---|---|---|---|---|
| 추론 모드 | 추론 (Thinking) | 비추론 (Non-thinking) | 추론 (Thinking) | 비추론 (Non-thinking) |
| MMMU | 59.3 | 57.6 | 68.4 | 62.6 |
| MMMU-Pro | 41.0 | 33.1 | 53.7 | 47.3 |
| MathVision | 28.9 | 27.3 | 54.4 | 42.5 |
| WeMath | 33.7 | 31.8 | 54.0 | 45.0 |
| WildVision | 56.5 | 58.5 | 76.9 | 76.4 |
| KoNET | 64.0 | 73.5 | 82.5 | 88.8 |
| Average | 47.2 | 47.0 | 65.0 | 60.4 |
< 표 2. Long CoT SFT 학습 전후, 주요 추론 벤치마크 성능 비교.>
더 효율적이고 안정적인 온라인 강화학습을 위한 준비단계: 오프라인 강화학습
Long CoT SFT 학습 단계 이후, Kanana-v는 일관된 추론 형식을 가지면서도 복잡한 문제를 단계적으로 분해해서 푸는 기본적인 추론 능력을 갖추었습니다. 다음 단계의 목표는 이 기본기를 바탕으로, 1) 정답률과 추론 품질을 더 안정적으로 끌어올리고 2) 추론 능력을 고도화하여 높은 정확도와 신뢰성을 가지도록 고안되었습니다.
저희는 보다 효율적이고 안정적인 추론 능력 고도화를 위해, 단계적 강화학습(Cascaded Reinforcement Learning) 구조[5] 를 택했습니다. 단계적 강화학습은 첫 번째 단계에서 직접 선호 최적화(Direct Preference Optimization; DPO)[15] 기반의 오프라인 강화학습(Offline Reinforcement Learning)을 통해 모델의 정답률과 추론 품질을 안정적으로 향상시킨 뒤, 검증 가능한 보상(Verifiable Reward)기반 온라인 강화학습(Online Reinforcement Learning)에서 추론 능력을 고도화하도록 구성되었습니다.
검증 가능한 보상 기반 온라인 강화학습은 정답 여부를 규칙 기반으로 검증할 수 있는 문제를 모델이 풀게 함으로써 추론 능력 고도화에 큰 도움이 되지만, 온라인 응답 생성(Online Rollout)이 필요해 학습 비용이 크고 초기 모델 품질에 민감합니다. 초기 모델이 일정 수준 이상 문제를 풀지 못하면 보상 신호가 희박해져 비효율적인 학습을 초래하기 때문입니다. 따라서 보다 효율적이고 안정적인 추론 능력 고도화를 위해, 온라인 강화학습으로 바로 진입하기보다 오프라인 강화학습으로부터 모델의 추론 품질과 출력 분포를 정돈해 온라인 강화학습이 안정적이고 효율적으로 이루어 질 수 있도록 설계하였습니다.
오프라인 강화학습 단계에서 추론 품질을 향상시키기 위해 사용한 핵심 아이디어는 델타 학습(Delta Learning[16]) 입니다. 델타 학습은 선호 응답(Chosen)과 비선호 응답(Rejected)사이 충분한 품질 격차(Quality Delta)가 존재하면 직접 선호 최적화 기반의 선호 학습(Preference Tuning)만으로도 모델의 성능이 개선될 수 있다는 관찰에 기반합니다. 델타 학습이 추구하는 학습 신호의 본질은 선호 응답의 절대적인 품질이 아니라, 선호 응답과 비선호 응답간의 상대적인 품질 격차에 있습니다.
이러한 관점은, “모델이 이미 충분히 추론 과정을 모사하도록 포화(Saturation)된 상태에서 계속된 SFT는 성능을 일부 저하시킬 수 있지만, 선호 학습은 선호 응답과 비선호 응답간의 격차를 학습 신호로 활용하기 때문에 모델 성능이 개선될 수 있다”는 점을 강조합니다[16]. 따라서 선호 응답이 완벽한 응답이 아니더라도, 비선호 응답에 비해 일관되게 더 좋은 품질을 지닌다면 모델은 그 차이를 학습하여 더 좋은 추론 성능을 가지는 분포로 이동할 수 있습니다. 반대로 SFT는 선호 응답을 계속해서 모사하기 때문에, 선호 응답이 이끌어 낼 수 있는 한계로 인해 경우에 따라 일부 성능 저하를 초래하는 경우가 보고되었습니다[16, 17].
이와 같은 문헌에 근거하여, 오프라인 강화학습 단계에서는 직접 선호 최적화(Direct Preference Optimization)를 기반으로 상대적 품질 격차가 뚜렷한 선호 응답과 비선호 응답을 쌍으로 이루어진 데이터셋을 학습하였습니다. 이때 데이터 구성의 핵심은, 선호 응답을 '최고 품질’로 만드는 것 보다, 델타 학습에서 강조되었듯 선호 응답과 비선호 응답간의 '상대적인 품질 격차(Quality Delta)'가 뚜렷하게 나타나도록 구성하는 것이었습니다.
구체적으로, 선호 응답은 상대적으로 큰 매개변수를 가진 고성능 모델이 생성한 응답으로 구성하여 논리 전개가 명확하고 완결된 추론 과정이 높은 확률로 포함되도록 유도했습니다. 반대로 비선호 응답은, 상대적으로 작은 매개변수를 가진 저성능 모델이 생성한 응답으로, 조건 누락·성급한 결론·불완전한 근거 연결 등 모델이 흔히 범하는 오류가 더 자주 나타나도록 구성되었습니다.
오프라인 강화학습의 학습 데이터는, 이후 온라인 강화학습에서 다양한 분야에 대해서도 안정적인 학습을 이어갈 수 있도록 수학/과학뿐 아니라 지시 이행 능력, 일반 시각 질의응답(General VQA), 안전성(Safety) 등 다양한 분야에 대해 균형을 갖추도록 구성했습니다.
델타 학습 기반의 오프라인 강화학습 이후 주요 추론 벤치마크 성능은 [표 3]에 정리되어 있습니다.
| Benchmark | Long CoT SFT 학습 이후 Kanana-v-4b-hybrid | Long CoT SFT 학습 이후 Kanana-v-4b-hybrid | 오프라인 강화학습 이후 Kanana-v-4b-hybrid | 오프라인 강화학습 이후 Kanana-v-4b-hybrid |
|---|---|---|---|---|
| Benchmark | 추론 (Thinking) | 비추론 (Non-thinking) | 추론 (Thinking) | 비추론 (Non-thinking) |
| MMMU | 68.4 | 62.6 | 70.4 | 65.5 |
| MMMU-Pro | 53.7 | 47.3 | 56.0 | 50.3 |
| MathVision | 54.4 | 42.5 | 58.4 | 52.9 |
| WeMath | 54.0 | 45.0 | 62.5 | 52.6 |
| WildVision | 76.9 | 76.4 | 82.9 | 79.3 |
| KoNET | 82.5 | 88.8 | 90.6 | 89.8 |
| Average | 65.0 | 60.4 | 70.1 | 65.1 |
< 표 3. 오프라인 강화학습 전후, 주요 추론 벤치마크 성능 비교.>
오프라인 강화학습을 통해, 전체적으로 Kanana-v의 추론 능력 뿐 아니라 일반 시각 질의응답(WildVision)에서도 성능이 향상됨을 확인할 수 있었습니다. 이렇게 오프라인 강화학습 단계는 상대적으로 큰 계산 자원을 요구하는 온라인 강화학습의 준비운동 단계(Warm-up Stage)로서 동작하고, 추론 기본기가 더욱 개선된 Kanana-v로부터 더 좋은 품질의 온라인 응답 생성 결과를 얻어내어 최종적으로 온라인 강화학습의 학습 효율성을 향상하도록 설계되었습니다.
추론능력 고도화를 위한 마지막 퍼즐: 온라인 강화학습
오프라인 강화학습을 통해 Kanana-v의 추론 기본기와 출력 분포를 충분히 정돈한 뒤, 시각 추론 학습(Visual Reasoning Training)의 마지막 단계로서 검증 가능한 보상(Verifiable Reward) 기반의 온라인 강화학습 방법을 채택했습니다. 이전 학습 단계의 Long CoT SFT와 오프라인 강화학습이 '일관된 추론 형식을 지키면서 논리적으로 추론하는 방법’을 가르쳐준 단계라면, 온라인 강화학습 단계는 정답이 명확한 문제를 온라인으로 풀어보면서, 정답 여부에 따른 보상 신호를 통해 추론 능력을 고도화하는 단계입니다.
검증 가능한 보상 기반 강화학습(Reinforcement Learning with Verifiable Reward; RLVR[9])은 수학 문제, 코딩, 논리 퍼즐과 같이 명확한 정답이 존재하고 규칙 기반으로 검증이 가능한 문제에서 특히 효과적입니다. 학습 과정에서 모델이 만들어낸 응답(Rollout)을 기반으로, 그 응답이 정답 기준을 만족하는지 여부를 규칙 기반의 일관된 검증기(Verifier)로 정답 여부를 판정해 보상 신호로 활용합니다. 이와 같이 RLVR은 다소 모호할 수 있는 주관적 선호 판단에 의존하지 않고, 일관된 보상 신호를 기반으로 학습하여 안정적으로 강화학습을 진행할 수 있다는 장점이 있습니다.
검증 가능한 보상 기반의 온라인 강화학습을 안정적으로 수행하기 위해서는 다음과 같은 문제들을 고려해야 합니다. (1) 정답/오답과 같은 이산적(Discrete) 보상의 높은 분산, (2) 검증기의 오판정으로 인한 보상 신호의 불안정성, (3) 온라인 응답 생성 가속화를 위한 엔진과 학습 엔진 분리로 인한 응답 분포 불일치, (4) 정답률 향상을 위한 탐색과 안정적인 학습을 위한 제약간의 절충 관계(Trade-off) 등이 있습니다. 이와 같은 문제를 꼼꼼히 분석하고 완화함으로써 점차 안정적인 검증 가능한 보상 기반의 온라인 강화학습을 수행할 수 있었습니다.
1) GSPO(Group Sequence Policy Optimization[18]): ‘보상 단위와 최적화 단위를 일치시키는’ 그룹 기반 업데이트 알고리즘
검증기 기반 RLVR에서는 일반적으로 정답 여부/테스트 통과 여부와 같은 보상 신호가 응답(시퀀스) 단위로 주어집니다. 이때 모델 업데이트 알고리즘으로 널리 사용되는 GRPO(Group Relative Policy Optimization[19])는 동일 입력에 대해 여러 응답(Rollout)을 생성한 뒤, 그룹 내 상대적 우수성(그룹 평균 대비 이득/Advantage)을 이용해 학습합니다. 다만 GRPO는 많은 구현에서 토큰 단위의 중요도비(Importance Ratio)와 클리핑이 적용되며, 토큰 로그확률의 합을 통해 손실이 누적됩니다. 이 경우 보상은 시퀀스 단위로 한 번에 주어지는데 반해, 중요도비/클리핑은 토큰 단위로 누적되므로 시퀀스가 길수록 그래디언트 추정의 변동성이 커져 업데이트가 불안정해질 수 있습니다. 특히 정답/오답처럼 보상이 이산적이고 그룹 내 보상이 희소한 상황에서는 이득(Advantage) 추정이 거칠어 분산이 커지기 쉬운데, 길이가 긴 응답에서는 이러한 토큰 단위 누적 효과와 결합되어 학습 불안정성이 더욱 커질 수 있습니다.
이러한 문제를 완화하기 위해, 저희는 GSPO를 사용했습니다. GSPO는 ‘보상 단위와 최적화 단위를 일치시키는’ 관점에서, 시퀀스 전체를 하나의 최적화 단위로 보고, '시퀀스 전체의 우도(Likelihood)'를 높이는 방향으로 모델을 업데이트합니다. 구체적으로 동일 입력에 대해 복수의 응답을 생성하고, 각 응답의 보상(예: 정답=1, 오답=0)을 바탕으로 그룹 내 상대적 우수성을 계산한 뒤, 평균(베이스라인) 대비 보상이 높은 응답의 확률은 높이고 낮은 응답의 확률은 낮추도록 학습하는 것까지는 GRPO와 동일합니다. 하지만 GSPO는 업데이트 신호를 구성할 때, 토큰 단위가 아닌 시퀀스 우도 기반 중요도비를 사용하고 이를 시퀀스 단위로 클리핑해 업데이트가 '응답 단위’로 일관되게 작용하도록 만든다는 점입니다. 특히 응답이 길어질수록 토큰 단위 중요도비/클리핑 효과가 누적되어 업데이트 분산이 커질 수 있는데, 시퀀스 단위 클리핑은 이를 억제해 학습 신호를 더 일관되게 만듭니다. 결과적으로 장문 추론처럼 응답이 길고 보상이 시퀀스 단위로 주어지는 조건에서 GRPO 대비 학습이 더 안정적으로 수렴하는 경향을 기대할 수 있으며, 실제 내부 실험에서도 수학 문제풀이 및 논리 중심 벤치마크에서 GSPO가 GRPO 대비 더 안정적인 학습 곡선과 일관된 성능 개선 경향을 보여 온라인 강화학습 단계의 알고리즘으로 선택했습니다.
2) 검증기 개선: 보상 신호를 정확하게
검증 가능한 보상 신호 기반 강화학습(RLVR)의 성패는 검증기의 품질에 크게 좌우됩니다. 특히 수학 문제풀이에서는 수학적으로 동일한 의미를 가지는 표현이 기호·표기법·서술 방식에 따라 매우 다양한 형태로 나타날 수 있기 때문에, 단순 문자열 일치 기반 검증은 틀린 답을 맞다고 판정하거나, 맞는 답을 틀렸다고 판정하는 오류를 만들기 쉽습니다. 이러한 검증기의 오판정은 잘못된 보상 신호를 야기하여 좋은 응답을 생성했음에도 해당 응답의 생성 확률을 낮추게 하거나, 나쁜 응답을 생성했음에도 해당 응답의 생성 확률을 높이는 등 모델 업데이트에 불안정성을 야기할 수 있어 정확하고 일관된 검증이 매우 중요합니다.
따라서 검증기의 오판정을 최소화하기위해, 각도의 표현(45° vs π/4), 방정식(동치 변형), 집합 표기(ℝ vs (-∞,∞), 유니코드 입력 (ㄱ vs ㉠) 등 동일한 의미를 가지면 정답으로 판정하도록 검증기의 정확도와 일관성을 고도화했습니다. [표 4]는 개선된 검증기의 대표적인 동치 예시를 보여줍니다. 이와 같은 검증기 개선을 통해, 보상 신호의 잡음을 최소화하여 더 안정적이고 효율적인 온라인 강화학습을 수행할 수 있었습니다.
| 카테고리 | 정답 (Ground Truth) | 예측 (Prediction) | 동치 판단 로직 |
|---|---|---|---|
| 방정식 및 등가식 | ax + bx = c^2 | ax + bx - c^2 = 0 | 등식을 한 쪽으로 이항하여 식의 동치 여부를 판단 |
| 단위 및 표기법 | 45^\circ | \frac{\pi}{4} | 각도(^\circ)와 라디안(\pi) 간의 수치 변환 및 비교 |
| 집합 및 서술 방식 | (-\infty, \infty) | \mathbb{R} | ‘실수 전체’, ‘\mathbb{R}’, ‘모든 실수’ 등의 표현을 정규화 |
| 유니코드 정규화 | ㄱ | ㉠ (유니코드/원문자) | 유니코드 정규화(NFKC) 및 특수 기호에 대한 정규화 |
| 표현의 유연성 | x=1, y=2 | y=2, x=1 | 콤마로 구분된 항목을 분리하여 정규화 |
<표 4. 검증기의 의미론적 동치 판단 기준 및 사례. 동일한 의미를 가지는 다양한 예측 표현에 대해서 정답과의 의미상 동치 여부를 정확하게 판단할 수 있도록 검증기를 설계하였습니다.>
3) Truncated Importance Sampling[20] (TIS): 응답 생성 가속화를 위한 엔진과 학습 엔진 분리로 인한 불일치 보정
온라인 강화학습의 높은 계산 비용 중, 일반적으로 가장 큰 비율을 차지하는 것은 온라인 응답 생성(Online Rollout Generation)입니다. 이 온라인 응답 생성을 가속화 하기 위해, 응답 생성은 vLLM[21] 기반의 고속 추론 엔진으로, 모델 학습은 FSDP(Fully Sharded Data Parallel)기반 학습 엔진으로 분리하여 온라인 강화학습을 수행했습니다. 이러한 구성은 온라인 응답 생성의 효율성을 크게 높여주지만, 고속 추론 엔진과 학습 엔진은 내부 커널 구현 방식의 차이 등 다양한 요인으로 인해 동일한 가중치를 사용하더라도 토큰 확률 분포가 미세하게 달라질 수 있습니다. 온라인 강화학습 알고리즘들은 온라인 생성 응답이 만들어진 분포가 실제 모델의 분포와 동일하다는 가정 하에 정의되어있기에, 이러한 불일치는 온라인 강화학습의 학습 안정성을 크게 저하할 수 있음이 보고되었습니다[20].
이러한 분포 불일치 문제를 완화하기 위해 Truncated Importance Sampling[20] (TIS)을 도입했습니다. TIS는 손실 함수에 중요도 샘플링 비율(Importance Sampling Ratio)을 반영하여, 온라인 응답 생성에 사용되는 vLLM과 학습에 사용되는 FSDP 간 구현 차이로 인해 발생하는 토큰 확률 분포의 불일치를 보정합니다. 또한 분포 차이가 큰 샘플이 분산을 과도하게 키우지 않도록 중요도 가중치에 상한을 적용해, 온라인 강화학습을 보다 안정적으로 수행할 수 있도록 합니다.
4) KL divergence penalty 제거
Kullback-Leibler Divergence Penalty는 온라인 강화학습을 하는 정책 모델(Policy Model)이 기준 모델(Reference Model)에서 과도하게 멀어지는 것을 막아주는 안정화 장치입니다. 하지만 기준 모델에서 크게 벗어나는 것을 막아주는 안정화 장치가, 때로는 정책 모델의 탐색을 지나치게 제한적으로 만들어 새로운 추론 경로 탐색을 제한할 수 있습니다.
내부 실험 결과, KL Divergence Penalty 없이도 학습과 응답 생성이 안정적으로 이루어졌습니다. 또한 KL Divergence Penalty를 적용한 경우보다 미적용한 경우에 더 큰 성능 향상을 확인했습니다. 이러한 결과를 바탕으로 KL Divergence Penalty는 득보다 실이 크다고 판단했으며, 검증 가능한 보상 기반 온라인 강화학습 단계에서는 KL Divergence Penalty를 적용하지 않기로 결정했습니다.
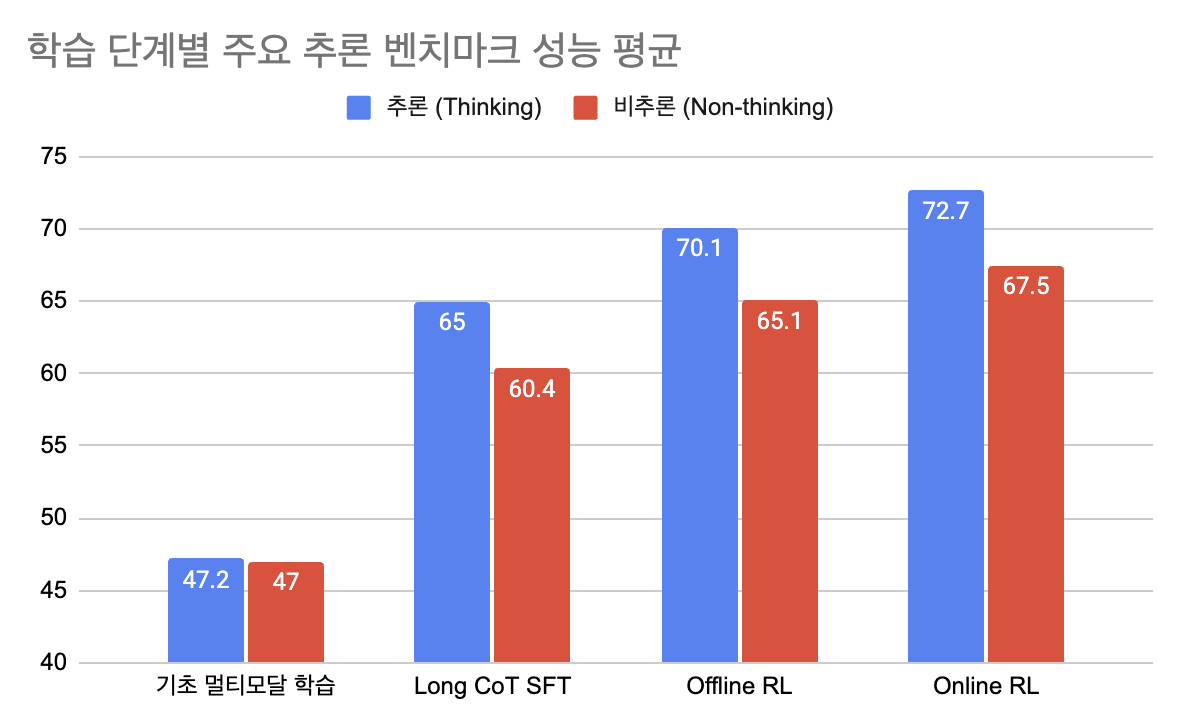
이렇게 꼼꼼한 분석을 바탕으로 정립한 온라인 강화학습 레시피를 통해 Kanana-v의 추론 능력이 고도화됨을 [표 5]에서 확인할 수 있었습니다. 복잡한 추론 과정을 요구하는 벤치마크에서 성능 향상이 두드러졌고, 탄탄한 추론 능력을 기반으로 높은 정확도와 신뢰도를 자랑하는 Kanana-v-4b-hybrid를 최종적으로 확보할 수 있었습니다.
| 오프라인 강화학습 이후 Kanana-v-4b-hybrid | 오프라인 강화학습 이후 Kanana-v-4b-hybrid | Kanana-v-4b-hybrid | Kanana-v-4b-hybrid | |
|---|---|---|---|---|
| 추론 모드 | 추론 (Thinking) | 비추론 (Non-thinking) | 추론 (Thinking) | 비추론 (Non-thinking) |
| MMMU | 70.4 | 65.5 | 73.0 | 68.6 |
| MMMU-Pro | 56.0 | 50.3 | 58.6 | 53.1 |
| MathVision | 58.4 | 52.9 | 60.8 | 54.6 |
| WeMath | 62.5 | 52.6 | 66.7 | 57.6 |
| WildVision | 82.9 | 79.3 | 84.2 | 80.6 |
| KoNET | 90.6 | 89.8 | 92.8 | 90.5 |
| Average | 70.1 | 65.1 | 72.7 | 67.5 |
< 표 5. 온라인 강화학습 전후, 주요 추론 벤치마크 성능 비교.>
예시로 살펴보는 Kanana-v-4b-hybrid의 추론 능력
앞서 소개드린 학습 과정을 통하여 Kanana-v-4b-hybrid는 뛰어난 추론 능력을 가지게 되었습니다. 지금부터는 Kanana-v-4b-hybrid가 실제 문제들을 해결하며 보여준 추론 과정을 소개드리고자 합니다.
수학 과목
사용자 : 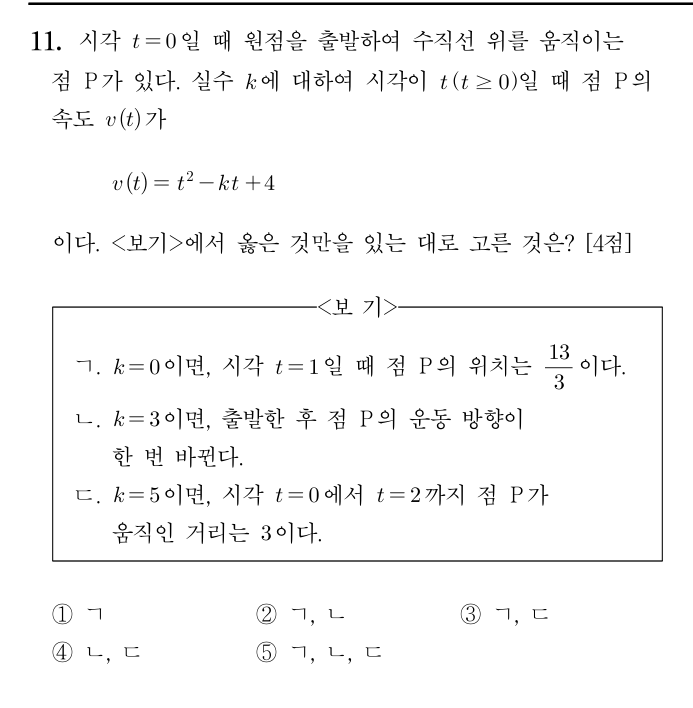 주어진 문제를 풀어주세요. 단계별로 생각하며 정답을 보기에서 고르거나 답변하세요. |
|---|
| Kanana-v-4b-hybrid : <think> 이 문제를 한 단계씩 차근차근 풀어보겠습니다. 먼저, 문제를 정확히 이해했는지 확인하겠습니다. 점 P가 t=0에서 원점(0)에서 출발하여 수직선 위를 움직이고, 속도 함수가 v(t) = t² - kt + 4 로 주어져 있습니다. 보기 ㄱ, ㄴ, ㄷ 각각이 참인지 거짓인지 판단해야 합니다. 먼저, 위치는 속도를 적분해서 얻는다는 것을 떠올리면 됩니다. 속도는 위치의 미분이므로, 위치 s(t)는 v(t)를 t에 대해 적분한 후, 초기 조건 s(0) = 0을 이용해 상수를 정해 얻습니다. 보기 ㄱ부터 보겠습니다: k=0일 때, t=1에서의 위치는 13/3 이다. k = 0이면 속도는 v(t) = t² + 4가 됩니다. 위치 s(t)는 ∫ v(t) dt + C이고, s(0) = 0이므로 C = 0입니다. 따라서 s(t) = ∫ (t² + 4) dt = t³/3 + 4t + C t = 0일 때 s(0) = 0이므로 C = 0입니다. 따라서 s(t) = t³/3 + 4t입니다. t = 1일 때: s(1) = 1/3 + 4 = 1/3 + 12/3 = 13/3입니다. 이는 보기 ㄱ에 나온 값과 일치합니다. 따라서 ㄱ은 참입니다. 보기 ㄴ: k=3이면, 출발 후 점 P의 운동 방향이 한 번 바뀐다. 운동 방향이 바뀌는 것은 속도가 0이 되는 지점에서 일어납니다(속도가 양수에서 음수로 또는 그 반대로 바뀌는 지점). 따라서 v(t) = 0이 되는 t 값을 찾아야 합니다. k=3이면 v(t) = t² - 3t + 4입니다. 이차방정식 t² - 3t + 4의 판별식은 D = 9 - 16 = -7 < 0입니다. 실수 해가 없으므로 속도는 언제나 0이 아닙니다. 이제 속도의 부호를 확인해 보겠습니다. 이차함수의 최고차항 계수가 양수이므로, 판별식이 음수이면 항상 양수입니다. 따라서 모든 t에 대해 v(t) > 0이 성립합니다. 그러면 운동 방향은 바뀌지 않고, 항상 같은 방향(양의 방향)으로만 움직입니다. 따라서 방향이 한 번도 바뀌지 않습니다. 보기 ㄴ은 거짓입니다. (확인: t=0일 때 4, t=1일 때 2, t=2일 때 2로 모두 양수임) 보기 ㄷ: k=5이면, t=0에서 t=2까지 점 P가 움직인 거리는 3이다. 여기서는 이 구간에서의 이동 거리를 묻고 있습니다. 이동 거리는 속도의 절댓값을 적분한 값입니다. 먼저 속도 함수를 구하면, k=5일 때 v(t) = t² - 5t + 4입니다. 속도가 언제 0이 되는지 찾아야 합니다. t² - 5t + 4 = 0을 풀면, 인수분해해서 (t-1)(t-4) = 0이므로 t=1, t=4입니다. 우리가 보는 구간은 t=0에서 t=2이므로, 이 구간 안에서는 t=1에서 속도가 0이 됩니다. 따라서 t=0에서 t=1까지는 속도가 양수인지 음수인지 확인해야 합니다. - t=0일 때 v(0) = 4 > 0 - t=1에서 0 - t=2에서 v(2) = 4 - 10 + 4 = -2 < 0 따라서 t=0에서 t=1까지는 속도가 양수(앞으로 움직임), t=1에서 t=2까지는 속도가 음수(뒤로 움직임)입니다. 그러므로 이동 거리는 ∫₀¹ |v(t)| dt + ∫₁² |v(t)| dt = ∫₀¹ v(t) dt + ∫₁² (-v(t)) dt 가 됩니다. 먼저 위치 함수를 구해 보겠습니다. s(t) = ∫ v(t) dt + C = ∫ (t² - 5t + 4) dt = t³/3 - (5/2)t² + 4t + C s(0) = 0이므로 C = 0입니다. 이동 거리는 s(1) - s(0)의 절댓값과 s(2) - s(1)의 절댓값을 더한 값입니다. s(1) = 1/3 - 5/2 + 4 = 2/6 - 15/6 + 24/6 = 11/6 s(2) = 8/3 - (5/2)·4 + 8 = 8/3 - 10 + 8 = 2/3 따라서 t = 0에서 t = 1까지 이동 거리는 s(1) - s(0) = 11/6 - 0 = 11/6입니다. t = 1에서 t = 2까지 이동 거리는 |s(2) - s(1)| = |2/3 - 11/6| = |-7/6| = 7/6입니다. 따라서 전체 이동 거리는 11/6 + 7/6 = 18/6 = 3입니다. 보기 ㄷ과 일치합니다. 따라서 ㄷ은 참입니다. 정리하면: - ㄱ: 참 (k=0일 때 t=1에서 위치 13/3) - ㄴ: 거짓 (속도는 항상 양수, 방향 변화 없음) - ㄷ: 참 (이동 거리 3) 보기에서 옳은 것만 고르면 ㄱ과 ㄷ이므로 선택지는 ③입니다. </think> 주어진 문제에서 속도 함수는 v(t) = t² - kt + 4 이며, t = 0에서 원점에서 출발하므로 위치 s(t)는 s(t) = ∫₀ᵗ v(u) du 로 주어집니다. 각 선택지를 차례로 검사해 보겠습니다. ㄱ. k=0일 때, t=1에서의 위치는 13/3이다. k = 0이면 v(t) = t² + 4 입니다. 위치는 s(t) = ∫ (u² + 4) du = u³/3 + 4u + C 이고, s(0) = 0이므로 C = 0입니다. 따라서 s(t) = t³/3 + 4t 이고, s(1) = 1/3 + 4 = 13/3 이 됩니다. → ㄱ은 참입니다. ㄴ. k=3일 때, 운동 방향이 한 번 바뀐다. k = 3이면 v(t) = t² - 3t + 4 입니다. 이차방정식 t² - 3t + 4 = 0 의 판별식은 D = (-3)² - 4·1·4 = 9 - 16 = -7 < 0 이므로 실수 해가 없습니다. 최고차항의 계수가 양수이므로 이 함수는 항상 양수입니다. 따라서 v(t) > 0 (t ≥ 0)가 모든 구간에서 성립하고, 운동 방향(양의 방향)은 한 번도 바뀌지 않습니다. → ㄴ은 거짓입니다. ㄷ. k=5일 때, t=0에서 t=2까지 이동 거리는 3이다. k = 5이면 v(t) = t² - 5t + 4 = (t - 1)(t - 4) 입니다. 이때 v(t) = 0인 점은 t = 1, 4이고, 구간 [0, 2] 안에서는 t = 1에서 속도가 0이 됩니다. - t = 0에서 t = 1까지: v(t) > 0 (앞으로 이동) - t = 1에서 t = 2까지: v(t) < 0 (뒤로 이동) 이동 거리는 속도의 절댓값을 적분한 값입니다. 먼저 위치 함수를 구하면 s(t) = ∫ (u² - 5u + 4) du = u³/3 - (5/2)u² + 4u 이고 s(0) = 0입니다. - s(1) = 1/3 - 5/2 + 4 = 11/6 - s(2) = 8/3 - 10 + 8 = 2/3 따라서 이동 거리 = |s(1) - s(0)| + |s(2) - s(1)| = |11/6| + |2/3 - 11/6| = 11/6 + 7/6 = 18/6 = 3 이 됩니다. → ㄷ은 참입니다. 결론 - ㄱ: 참 - ㄴ: 거짓 - ㄷ: 참 따라서 옳은 것 only는 ㄱ, ㄷ이므로 정답은 ③ 입니다. |
< 표 6. Kanana-v-4b-hybrid의 수학 문제 풀이 과정. [사진 출처 : 2026학년도 수능 수학 11번] >
사용자 : 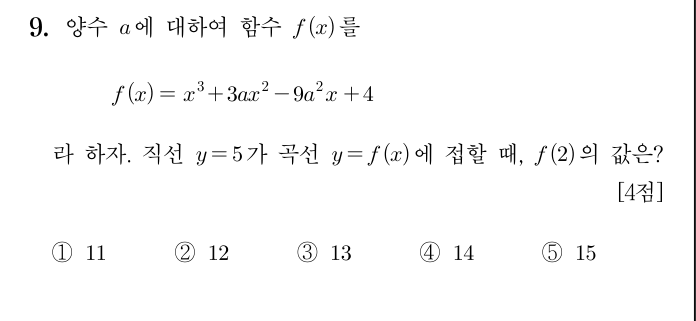 주어진 문제를 풀어주세요. 단계별로 생각하며 정답을 보기에서 고르거나 답변하세요. |
|---|
| Kanana-v-4b-hybrid : <think> 이 문제를 한 단계씩 차근차근 풀어 보겠습니다. 문제는 다음과 같습니다: 양수 a에 대해 함수 f(x) = x³ + 3ax² - 9a²x + 4가 주어져 있습니다. 직선 y = 5가 이 곡선에 접할 때, f(2)의 값을 구하는 문제입니다. 먼저, 한 직선이 곡선에 접한다는 것은 그 점에서 두 함수의 함수값이 같고, 그 점에서의 도함수 값(기울기)도 같다는 것을 의미합니다. 따라서 y = 5가 y = f(x)에 접한다는 것은, 어떤 x = c가 있어서 f(c) = 5이고, 동시에 f'(c) = 0 (왜냐하면 직선 y = 5는 기울기가 0인 수평선이기 때문) 이라는 뜻입니다. 직선 y = 5는 수평선이므로 기울기가 0이고, 따라서 접점에서 곡선의 기울기도 0이어야 합니다. 이 점이 핵심입니다. 먼저 f(x)를 구해 보겠습니다. 이미 주어졌습니다: f(x) = x³ + 3ax² - 9a²x + 4 이제 도함수 f'(x)를 구합니다. 미분하면: f'(x) = 3x² + 6ax - 9a² 접점에서 f'(c) = 0이므로, 3c² + 6ac - 9a² = 0 양변을 3으로 나누면: c² + 2ac - 3a² = 0 이제 이 이차방정식을 c에 대해 풉니다. 인수분해를 해 보겠습니다. 곱해서 -3a²가 되고 더해서 2a가 되는 두 수를 찾으면 됩니다. 3a와 -a가 그 역할을 합니다: (c + 3a)(c - a) = 0 따라서 c = -3a 또는 c = a입니다. a는 양수이므로 c = -3a는 음수이고, c = a는 양수입니다. 두 값 모두 가능성이 있지만, 접점에서의 함수값 조건 f(c) = 5를 사용해 둘 다 확인해 보겠습니다. 1. c = a인 경우 f(a) = a³ + 3a·a² - 9a²·a + 4 = a³ + 3a³ - 9a³ + 4 = -5a³ + 4 이 값이 5와 같아야 하므로: -5a³ + 4 = 5 ⇒ -5a³ = 1 ⇒ a³ = -1/5 하지만 a는 양수이므로 이 해는 불가능합니다. 따라서 c = a는 버립니다. 2. c = -3a인 경우 f(-3a) = (-3a)³ + 3a(-3a)² - 9a²(-3a) + 4 각 항을 계산하면: (-3a)³ = -27a³ 3a·(9a²) = 27a³ -9a²·(-3a) = 27a³ 따라서 합은: -27a³ + 27a³ + 27a³ + 4 = 27a³ + 4 이 값이 5와 같아야 하므로: 27a³ + 4 = 5 ⇒ 27a³ = 1 ⇒ a³ = 1/27 ⇒ a = 1/3 a는 양수이므로 a = 1/3은 유효한 해입니다. 이제 문제는 f(2)를 구하라는 것입니다. 따라서 a = 1/3을 f(x)에 대입해야 합니다. 먼저 a = 1/3일 때 f(x)를 다시 써 보겠습니다: f(x) = x³ + 3·(1/3)x² - 9·(1/3)²x + 4 = x³ + x² - x + 4 확인해 보겠습니다: - 3a = 3·(1/3) = 1, 맞습니다. - 9a² = 9·(1/9) = 1, 따라서 -9a²x = -1·x = -x, 맞습니다. 따라서 f(x) = x³ + x² - x + 4입니다. 이제 f(2)를 계산하면: f(2) = 8 + 4 - 2 + 4 = 14 계산을 다시 확인해 보겠습니다: 2³ = 8, 2² = 4, -2 = -2, 상수항은 +4입니다. 따라서 8 + 4 = 12, 12 - 2 = 10, 10 + 4 = 14입니다. 따라서 14입니다. 접점을 한 번 더 확인해 보겠습니다. c = -3a = -3·(1/3) = -1입니다. 그러면 f(-1)을 계산해 보겠습니다: f(-1) = (-1)³ + 3a(-1)² - 9a²(-1) + 4 = -1 + 3a + 9a² + 4 a = 1/3일 때: -1 + 1 + 1 + 4 = 5 정확히 5가 나옵니다. 좋습니다. 따라서 a = 1/3이고, f(2) = 14입니다. 보기에서는 【④ 14】가 정답입니다. </think> [풀이 요약] 주어진 함수 f(x) = x³ + 3ax² - 9a²x + 4 에서 직선 y = 5가 곡선 y = f(x)에 접한다고 했을 때, 접점에서는 두 조건이 성립해야 합니다. 1. 함수값이 같아야 하므로 f(c) = 5 2. 기울기가 같아야 하므로 도함수 f'(c) = 0 (직선 y=5는 수평선이므로 기울기 0) 1. 도함수 계산 f'(x) = 3x² + 6ax - 9a² 접점 x = c 에서 f'(c) = 0 ⇒ 3c² + 6ac - 9a² = 0 양변을 3으로 나누면 c² + 2ac - 3a² = 0 이를 인수분해하면 (c + 3a)(c - a) = 0 따라서 c = -3a 또는 c = a 2. 함수값 조건 f(c) = 5 적용 (1) c = a인 경우 f(a) = a³ + 3a·a² - 9a²·a + 4 = -5a³ + 4 이를 5와 같게 놓으면 -5a³ + 4 = 5 ⇒ a³ = -1/5 하지만 a > 0이므로 이 경우는 불가능합니다. (2) c = -3a인 경우 f(-3a) = (-3a)³ + 3a(-3a)² - 9a²(-3a) + 4 = 27a³ + 4 이를 5와 같게 놓으면 27a³ + 4 = 5 ⇒ 27a³ = 1 ⇒ a³ = 1/27 ⇒ a = 1/3 양수 조건을 만족하므로 a = 1/3입니다. 3. f(2) 계산 a = 1/3을 함수에 대입하면 f(x) = x³ + x² - x + 4 따라서 f(2) = 2³ + 2² - 2 + 4 = 8 + 4 - 2 + 4 = 14 최종 답 【14】 따라서 정답은 【④】입니다. |
< 표 7. Kanana-v-4b-hybrid의 수학 문제 풀이 과정. [사진 출처 : 2026학년도 수능 수학 9번] >
과학 과목
사용자 : 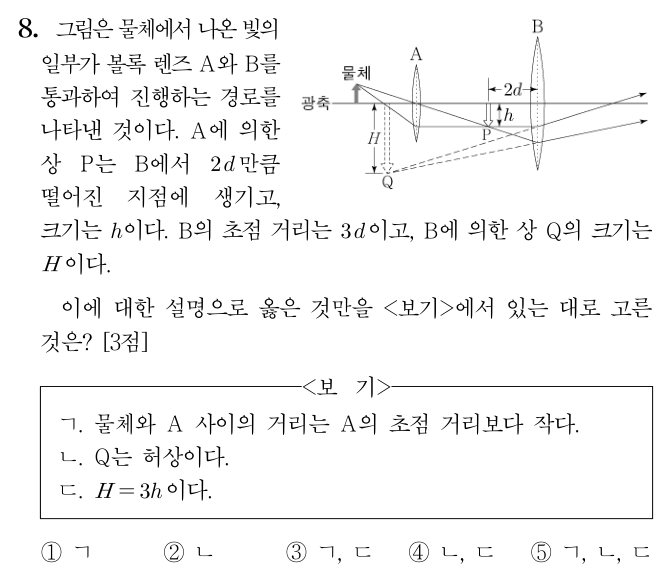 주어진 문제를 풀어주세요. 단계별로 생각하며 정답을 보기에서 고르거나 답변하세요. |
|---|
| Kanana-v-4b-hybrid : <think> 이 문제를 한 단계씩 차근차근 풀어보겠습니다. 먼저 렌즈에 관한 기본 개념을 떠올려야 합니다. 두 개의 볼록렌즈 A와 B가 있고, 빛이 물체에서 나와 A를 지나 B를 지나가면서 상이 만들어집니다. 주어진 정보를 정리해 보겠습니다. 먼저, A에 의한 상 P는 B에서 2d만큼 떨어진 지점에 생기고, 그 크기는 h입니다. B의 초점 거리는 3d이고, B에 의한 상 Q의 크기는 H입니다. 우리가 알아내야 할 것은 보기 ㄱ, ㄴ, ㄷ의 참/거짓입니다. 먼저 렌즈 공식을 떠올리겠습니다: 1/f = 1/v - 1/u (볼록렌즈에서는 거리가 양수로 취급합니다. 물체 거리는 보통 왼쪽이므로 음수로 두기도 하지만, 볼록렌즈에서 물체가 왼쪽에 있으면 u는 음수일 수 있겠습니다. 표준 기호에 따르면, 물체가 렌즈의 왼쪽에 있으면 물체거리 u는 음수입니다. 하지만 많은 교과서에서는 볼록렌즈 문제에서는 모두 양수로 두기도 합니다. 이 점을 주의해야 합니다.) 볼록렌즈에서는 실상도 허상도 나뉠 수 있는데, 물체가 초점 안에 있으면 허상, 초점 바깥에 있으면 실상이 됩니다. 볼록렌즈는 항상 허상이 아니라, 물체가 f 바깥이면 실상, 안이면 허상 형성합니다. 문제에서 A와 B는 볼록렌즈라고 했습니다. 따라서 두 렌즈 모두 볼록렌즈입니다. A에 의한 상 P는 B에 도달해서 거기서 또 상이 만들어집니다. 즉, P는 A에서 B 쪽으로 이동한 중간 상입니다. 그림을 떠올려 보겠습니다. 물체 → A → B 순서입니다. A에서 물체로부터 나온 빛이 A를 지나 P라는 상을 만들고, 그 상 P가 B에 대해 물체처럼 작용하여 Q라는 상을 만듭니다. 즉, 첫 번째 렌즈 A는 실제 물체를 상 P로 만들어 내고, 이 상 P는 두 번째 렌즈 B에 대해 "물체" 역할을 하게 됩니다. 따라서 B에 대해서는 P가 물체거리가 됩니다. 문제에서 “A에 의한 상 P는 B에서 2d만큼 떨어진 지점에 생긴다”고 했습니다. 즉, P가 B에 대해 얼마나 떨어져 있는가입니다. B는 오른쪽에 있고, P는 A와 B 사이 어딘가에 있을 것입니다. 그림을 보면, P는 A의 상이고, 그다음 B에서 Q가 만들어집니다. “B에서 2d만큼 떨어진 지점에 생기고”라고 했으니, P와 B 사이의 거리가 2d입니다. 즉, P가 B의 왼쪽에 있고, B로부터 2d 떨어져 있습니다. 따라서 P가 B에 대해 갖는 물체거리(두 번째 렌즈 B 입장에서)는 +2d (왼쪽에 있으므로 볼록렌즈 기준에서 양수)입니다. 볼록렌즈에서는 물체가 왼쪽에 있으면 물체거리 u는 양수로 취급하기도 하지만, 표준 기호에서는 물체가 렌즈 왼쪽에 있으면 u는 음수입니다. 이 부분이 혼동의 원인이 될 수 있습니다. 일단 기호를 명확히 하겠습니다. 렌즈 공식: 1/f = 1/v - 1/u, 여기서 u는 물체거리(렌즈 기준), v는 상거리, f는 초점거리입니다. 볼록렌즈에서는 f > 0입니다. 물체가 렌즈 왼쪽에 있으면 u < 0 (일반적인 기호법)입니다. 그러면 공식은 1/f = 1/v - 1/u가 됩니다. 예를 들어 물체가 f 바깥에 있으면 u = -|u| (왼쪽), 이때 1/v = 1/f + 1/|u| > 0이므로 v > 0 (오른쪽, 실상). 이 문제에서는 두 번째 렌즈 B에 대해, P는 B의 왼쪽에 있는 물체입니다(그림상 A와 B 사이에 P가 있으니, B는 오른쪽에 있고 P는 그 왼쪽). 따라서 B에 대한 물체거리 u |
< 표 8. Kanana-v-4b-hybrid의 물리 문제 풀이 과정. [사진 출처 : 2024학년도 수능 물리2 8번] >
사용자 : 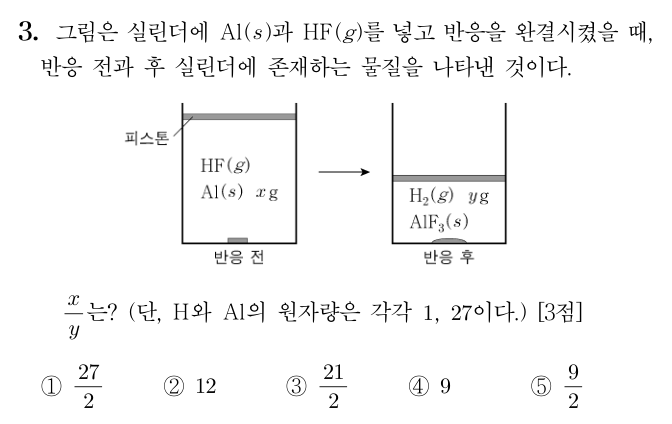 주어진 문제를 풀어주세요. 단계별로 생각하며 정답을 보기에서 고르거나 답변하세요. |
|---|
| Kanana-v-4b-hybrid : <think> 이 문제를 한 번 풀어보겠습니다. 실린더에 Al(s)와 HF(g)가 들어 있고, 반응을 하여 H |
< 표 9. Kanana-v-4b-hybrid의 화학 문제 풀이 과정. [사진 출처 : 2024학년도 수능 화학1 3번] >
앞으로의 목표
지금까지 Kanana-v-4b-hybrid의 우수한 성능과 다양한 문제풀이 예시를 통해, 저희 모델이 시각적 추론 중심 멀티모달 대화에서 충분한 글로벌 경쟁력을 갖추고 있음을 확인할 수 있었습니다. 다만 실제 서비스 환경에서는 단일 이미지 한 장만 주어지는 경우보다 여러 장의 이미지가 한 번에 입력되거나(멀티 이미지), 비디오처럼 연속된 시각 정보가 입력되는 경우가 점점 늘고 있습니다. 또한 모델의 응답이 단순히 자연어로 끝나는 것이 아니라, 서비스 워크플로우 안에서 특정 작업을 실행하고 결과를 다시 근거로 연결하는 형태로 확장되는 추세입니다. 앞으로의 Kanana-v 개발 목표와 방향성에 대해서도 공유드리겠습니다.
1) 멀티 이미지·비디오 입력 성능 향상
멀티 이미지·비디오 입력은 멀티모달 언어모델이 단일 이미지에서 보여주던 인식·추론 능력을 더 긴 입력 (Long Context)과 시간 축(Temporal Axis)으로 확장하는 과제입니다. 단일 이미지에서는 이미지 한 장 내의 근거를 찾아 답을 도출하는 것이 핵심이라면, 멀티 이미지·비디오에서는 근거가 여러 장 또는 여러 프레임에 흩어져 있기 때문에 모델이 어떤 입력의 어디에 어떤 근거가 있었는지 끝까지 보존해야 합니다. 특히 비디오의 경우 시간에 따라 장면이 변화하고 동일한 객체가 다른 프레임에서 다른 모습으로 나타나기도 하므로, '무엇이 보이는지’뿐 아니라 시간에 따른 순서와 변화를 이해하는 추론 능력이 중요합니다.
멀티 이미지와 비디오 입력을 지원하려면 입력 이미지/프레임 수가 늘어날수록 시각 토큰이 급격히 증가하고, 그에 따라 컨텍스트 길이와 메모리·연산량(비용)도 함께 커집니다. 따라서 멀티 이미지·비디오 지원은 단순히 “시각 정보를 더 많이 넣는다”가 아니라, 제한된 자원 안에서 필요한 근거를 효율적으로 선택·요약하고, 중요한 구간에 연산을 집중하는 형태로 설계되어야 합니다.
이러한 입력에서 요구되는 능력은 크게 세 가지로 정리할 수 있습니다. 첫째, 많은 수의 이미지/프레임이 주어져도 핵심 단서를 놓치지 않고 유지하는 긴 입력 이해 능력입니다. 둘째, 사건의 전후 관계나 변화의 흐름을 반영해 결론을 내리는 시간 순서 기반 추론 능력입니다. 셋째, 서로 다른 이미지 사이의 차이점을 정확히 비교하고 검증할 수 있는 능력입니다. 앞으로 Kanana-v는 이 세 축을 중심으로 멀티 이미지·비디오 입력에서의 추론 안정성을 강화하는 동시에, 입력 길이가 길어져도 실사용 가능한 지연(Latency)과 비용을 유지할 수 있도록 효율적인 입력 처리와 추론 전략까지 함께 고도화하고자 합니다.
2) 멀티모달 외부 함수 호출 (Function Call) 기능 지원
실제 서비스 환경에서 모델은 점점 '응답을 잘 생성하는 것’을 넘어, 복잡한 요청을 해결하기 위해 여러 함수를 호출하고, 이 함수의 결과값을 바탕으로 다시 작업을 이어나가는 형태로 확장되고 있습니다. 이때 중요한 것은, 모델이 자연어로만 응답하는 것이 아니라, 필요한 순간에 구조화된 출력(스키마)을 생성해 외부 함수를 호출하고, 그 결과를 다시 종합해 최종적인 답변을 완성하는 종단 간(End-to-End) 흐름을 안정적으로 수행하는 능력입니다. 즉, 멀티모달 외부 함수 호출 기능은 모델을 단순 대화 엔진이 아니라 서비스 워크플로우의 구성 요소로 동작하게 만드는 핵심 인터페이스라고 볼 수 있습니다.
또한 외부 함수 호출 기능은 신뢰성과 재현성 측면에서 중요한 의미를 가집니다. 자연어 응답만으로 처리하면 출력이 미세하게 달라져 형식이 흔들리거나 필요한 정보가 빠질 수 있습니다. 반면 함수 호출은 입력·출력 스키마가 고정되어 있어, 결과를 후속 단계에서 안정적으로 재사용할 수 있습니다. 특히 멀티모달 입력에서는 '어떤 근거를 바탕으로 어떤 작업을 호출했는지’가 분명해질수록 시스템 전체의 추적 가능성과 검증 가능성이 높아집니다. 앞으로의 Kanana-v는, 멀티모달 입력을 이해한 뒤 적절한 함수를 선택·호출하고, 반환된 구조화 결과를 근거로 다시 추론을 이어가며, 실패 시에는 재시도/대안 경로로 복구하는 흐름까지 포함해 실제 제품 환경에서의 활용성을 한 단계 더 끌어올릴 수 있는 모델로 만들고자 합니다.
3) 스스로 추론 / 비추론 모드를 판단할 수 있는 자동 추론 기능 지원
실제 서비스 환경에서 모든 요청이 동일한 수준의 추론을 필요로 하지는 않습니다. 단순 모달리티간 정보 변환이나 간단한 질의응답은 빠르게 처리하는 것이 사용자 경험 향상에 유리하지만, 반대로 멀티 이미지 비교처럼 근거가 흩어져 있거나, 외부 함수 호출을 포함해 여러 단계의 추론이 필요한 요청은 충분한 추론 과정을 거쳐야 정확한 응답을 생성할 수 있습니다. 따라서 앞으로 Kanana-v는 사용자 요청의 복잡도와 난이도를 스스로 판단해, '지금은 빠르게 답해도 되는지 / 아니면 더 깊게 생각해야 하는지’를 자동으로 선택하는 능력을 갖추는 것을 목표로 합니다.
자동 추론 기능은 지연(Latency)과 비용을 함께 최적화하는 핵심 전략이기도 합니다. 필요할 때만 연산을 집중하고, 불필요한 구간에서는 과도한 추론을 줄임으로써 서비스 관점에서 운영 효율을 확보할 수 있기 때문입니다. 또한 추론 모드에서는 근거를 더 신중히 검증하고, 비추론 모드에서는 간결한 답을 빠르게 제공하여 사용자에게는 ‘빠르면서도 필요할 때는 더 꼼꼼한’ 멀티모달 대화 경험을 제공하는 방향으로 고도화하고자 합니다.
맺음말
Kanana-v-4b-hybrid는 한국어를 자연스럽게 이해·추론하면서도, 추론이 불필요한 경우에는 비추론 모드로 빠르게 응답할 수 있는 카카오의 하이브리드 멀티모달 언어 모델입니다. 엄격한 품질 기준을 통과한 고품질 데이터와 더욱 고도화된 학습 레시피에 기반하여, 비슷한 규모의 매개변수를 가지는 글로벌 모델과 비교해도 경쟁력있는 성능을 입증하였습니다.
저희는 이러한 결과에 만족하지 않고, 앞서 언급한 기술적 개선과 더불어 다양한 서비스에 Kanana-v-4b-hybrid를 접목하여 사람들의 일상에 가치를 더할 수 있도록 끊임없이 발전해 나가겠습니다. Kanana-v의 앞으로의 여정에도 많은 관심과 응원을 부탁드립니다.
함께한 사람들
Kanana 조직의 abigail.r (박혜영), brook.p (박범희), daniel.log (김영준), edwin.ai(강우영), james.e (이재명), jayden.x (부종철), jayten.ten (전재열), jessie.e (이지혜), johnny.oh (오재훈), martin.gale (조대진), polar.bears (엄지환), peter.brain (노병석), samuel.brain (강성훈), sonny.7 (손동희), welt.bae (배병욱), wooner.l (이동진)이 함께 했습니다.
데이터 구축에 있어서는 Kanana 조직의 jennie.ee (이지혜), jeri.s (이희현) 이 많은 도움을 주셨습니다.
감사의 말
전체 내용에 대한 검수를 맡아주신 Kanana 조직의 loophy.cc (조정민) 에게 감사의 말을 전합니다.
참고문헌
[1] Kang, Sunghun, and Donghee Son. “카카오의 경량 멀티모달 언어모델 ‘Kanana-1.5-v-3b’ 개발부터 공개까지.” kakao tech, Kakao Corp., 24 July 2025, https://tech.kakao.com/posts/714. Accessed 25 Dec. 2025.
[2] Muennighoff, Niklas, et al. “s1: Simple test-time scaling.” Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing. 2025.
[3] Saji, Alan, et al. “The Reasoning Lingua Franca: A Double-Edged Sword for Multilingual AI.” arXiv preprint arXiv:2510.20647 (2025).
[4] Bai, Shuai, et al. “Qwen3-VL Technical Report.” arXiv preprint arXiv:2511.21631. 2025. 
[5] Wang, Weiyun, et al. “Internvl3. 5: Advancing open-source multimodal models in versatility, reasoning, and efficiency.” arXiv preprint arXiv:2508.18265 2025.
[6] OpenAI. “Introducing GPT-5.” OpenAI, 7 Aug. 2025, https://openai.com/index/introducing-gpt-5. Accessed 25 Dec. 2025.
[7] Park, Sanghee, and Geewook Kim. “Evaluating Multimodal Generative AI with Korean Educational Standards.” arXiv preprint arXiv:2502.15422 (2025).
[8] Cha, Junbum, et al. “Honeybee: Locality-enhanced projector for multimodal llm.” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2024.
[9] Guo, Daya, et al. “Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning.” arXiv preprint arXiv:2501.12948 (2025).
[10] Yang, An, et al. “Qwen3 technical report.” arXiv preprint arXiv:2505.09388 (2025).
[11] Team, Kimi, et al. “Kimi k1. 5: Scaling reinforcement learning with llms.” arXiv preprint arXiv:2501.12599 (2025).
[12] Wei, Lai, et al. “Advancing Multimodal Reasoning via Reinforcement Learning with Cold Start.” arXiv preprint arXiv:2505.22334 (2025).
[13] GLM-V Team, et al. "GLM-4.5V and GLM-4.1V-thinking: Towards versatile multimodal reasoning with scalable reinforcement learning.” arXiv preprint arXiv:2507.01006 (2025)
[14] Bansal, Hritik, et al. “Honeybee: Data recipes for vision-language reasoners.” arXiv preprint arXiv:2510.12225 (2025).
[15] Rafailov, Rafael, et al. “Direct preference optimization: Your language model is secretly a reward model.” Advances in neural information processing systems 36 (2023): 53728-53741.
[16] Geng, Scott, et al. “The delta learning hypothesis: Preference tuning on weak data can yield strong gains.” arXiv preprint arXiv:2507.06187 (2025).
[17] Olmo, Team, et al. “Olmo 3.” arXiv preprint arXiv:2512.13961 (2025).
[18] Zheng, Chujie, et al. “Group sequence policy optimization.” arXiv preprint arXiv:2507.18071 (2025).
[19] Shao, Zhihong, et al. “Deepseekmath: Pushing the limits of mathematical reasoning in open language models.” arXiv preprint arXiv:2402.03300 (2024).
[20] Yao, Feng, et al. “On the Rollout-Training Mismatch in Modern RL Systems.” NeurIPS 2025 Workshop on Efficient Reasoning.
[21] Kwon, Woosuk, et al. “Efficient memory management for large language model serving with paged attention.” Proceedings of the 29th symposium on operating systems principles. 2023.