Engineering
Ingress Nginx Controller의 Prometheus Metric 병목 현상: 원인 분석과 해결 (2부)
aiden.song카카오
2025년 1월 17일
원문에서 보기 ↗개요
안녕하세요. 카카오 광고추천팀에서 광고 추천 개발 업무를 담당하고 있는 aiden.song입니다.
이번 글은 ingress nginx controller의 대용량 트래픽 환경에서의 병목 현상 분석의 두 번째 글로 1부에서 문제 발생의 배경과 ingress-nginx-controller의 구조적인 측면에서 발생했던 원인에 대해 파악 했다면, 2부에서는 controller에서 병목이 발생한 근본적인 원인을 찾는 과정과 이를 해결하는 방법에 대해 정리해보겠습니다.
배경 지식
본론에 들어가기에 앞서 본 글은 golang과 kubernetes 그리고 prometheus에 대한 기본적인 이해가 필요합니다. golang은 자체적인 문법이 간단해서 초보자가 코드를 봐도 이해하기 어렵지 않으나 kubernetes와 prometheus에 대해서는 사용해본 경험이 있는 수준의 배경 지식이 있어야 본론을 이해하기 수월합니다. 각 기술셋에 대한 자세한 내용을 모두 설명하기는 어려우나 설명 중간중간에 최대한 이해를 도울 수 있게 설명을 해보도록 해보겠습니다.
Ingress Nginx Controller 내부 구성
1부에서 간단하게 설명했던 Ingress Nginx Controller(이하 IC)에 대해 조금 더 설명을 해보겠습니다.
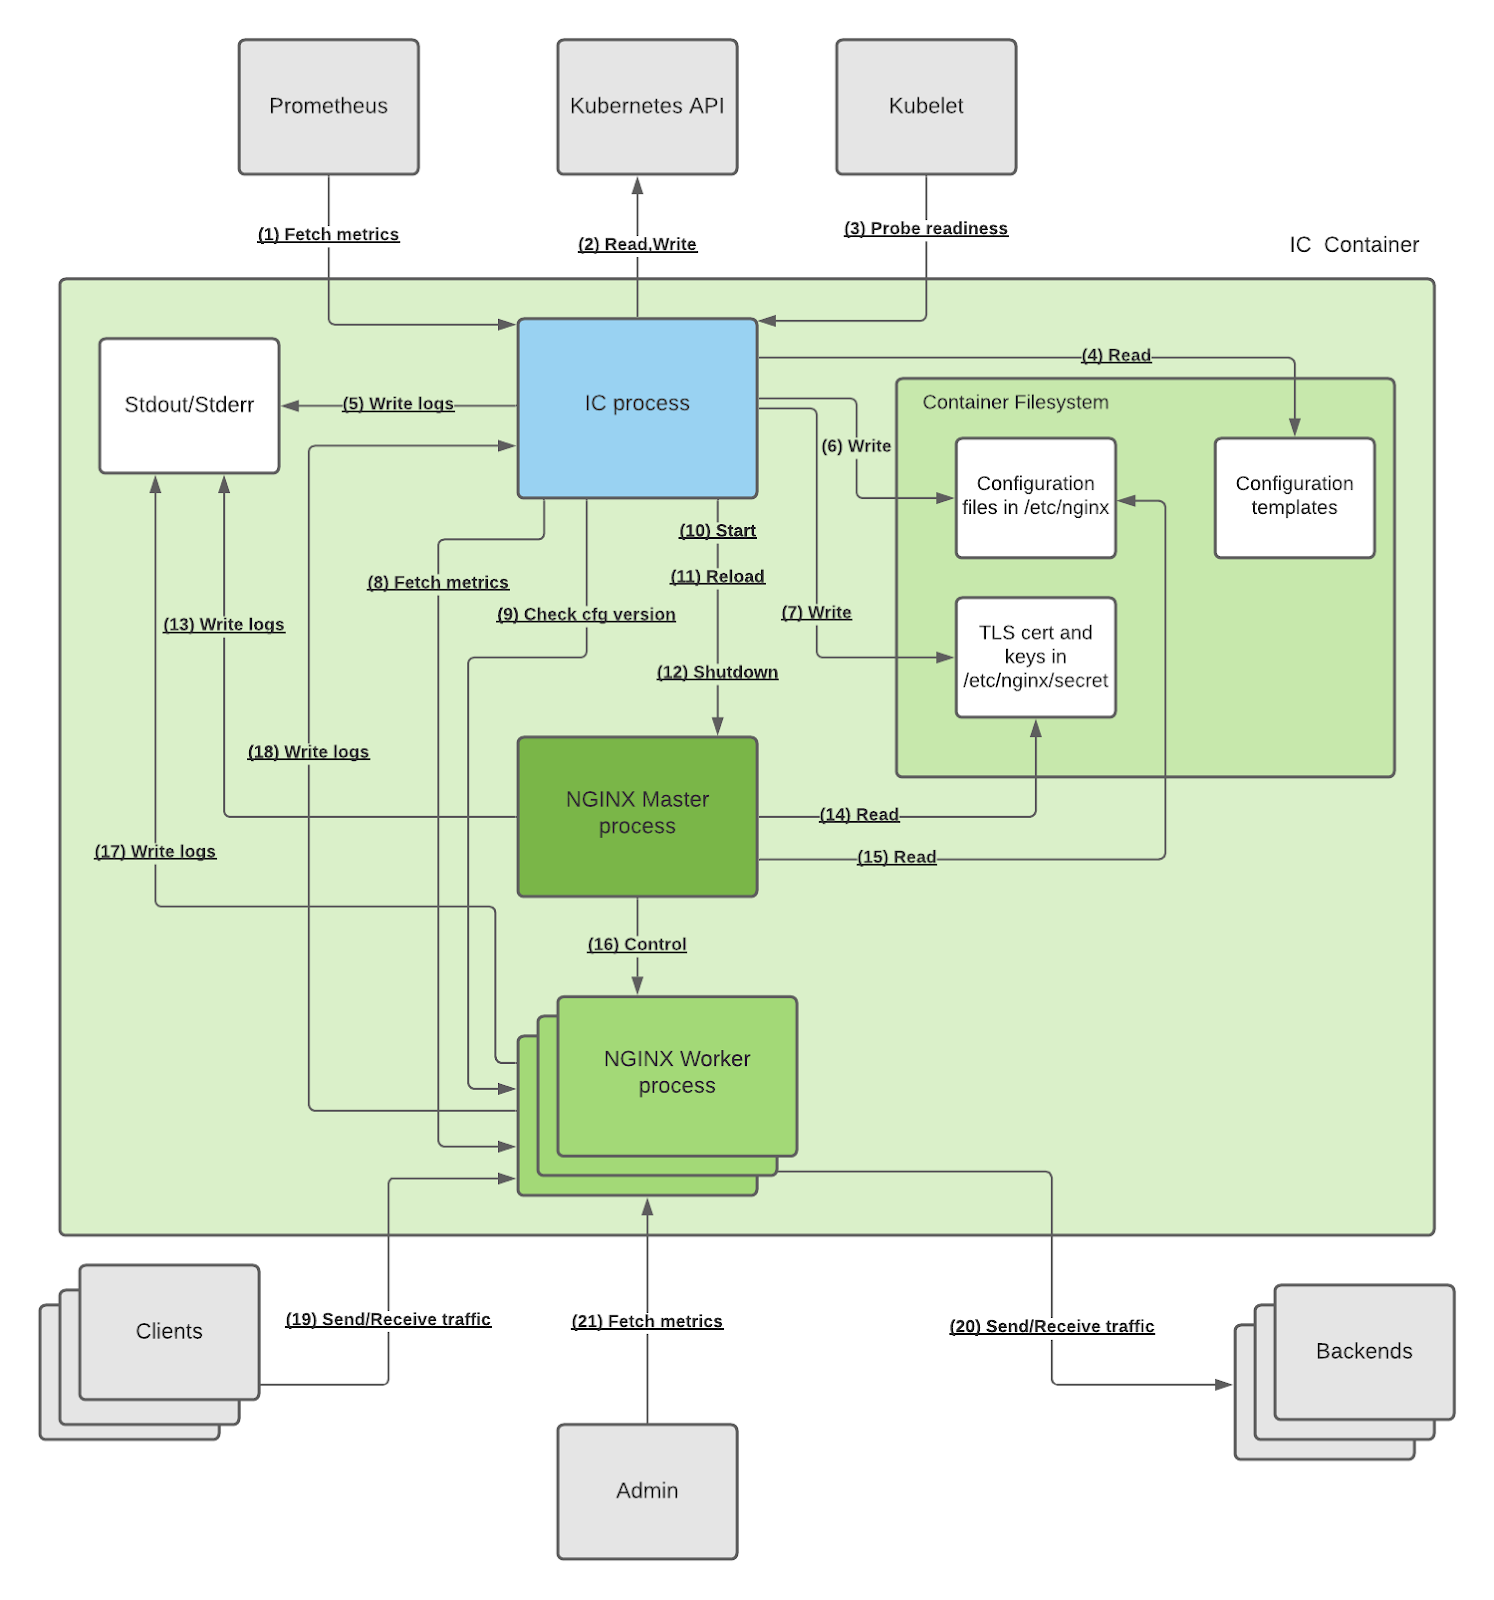
IC는 kubernetes에서 Pod 형태로 실행됩니다. IC Pod 내부에는 크게 세 종류의 프로세스가 실행되며 IC, Nginx master, Nginx worker가 이에 해당합니다. 이 세 종류의 프로세스는 Pod의 리소스를 공유합니다. 이런 구조 때문에 Nginx Master나 Worker 프로세스 뿐만 아니라 IC 프로세스 메모리 사용량이 늘어나게 되면 IC Pod의 메모리 사용량이 증가하게됩니다.
마지막으로 IC 프로세스의 주요 역할은 아래와 같습니다
- Nginx의 master, worker 프로세스를 실행하고 관리
- kubernetes 리소스로 관리되는 Nginx 관련 설정들을 Nginx 프로세스와 동기화
- Nginx의 설정(/etc/nginx, TLS cert 등등) 제어 및 메트릭 수집
이번 트러블 슈팅 과정에서 중심적으로 살펴볼 IC 프로세스의 동작은 마지막 항목인 메트릭 수집 부분입니다.
메트릭 수집 병목 원인 확인
1부에서 nginx worker가 생성하는 메트릭들을 소켓 통신을 통해 IC 프로세스로 전달되고, 이 메트릭들을 처리하는 과정에서 병목이 발생할것으로 추정하며 마무리 했었습니다. 이번에는 해당 추정이 맞았는지 확인하는 과정, 그리고 병목 현상을 해결하는 방법을 찾는 과정을 자세히 정리해보겠습니다.
goroutine 프로파일을 통한 병목 지점 확인
go는 자체적으로 프로세스를 진단할 수 있는 프로파일 기능을 풍부하게 지원하고 있고 간단한 설정 및 CLI을 활용해 모니터링이 가능합니다. 관련해서 프로파일 설정 및 자세한 활용 방법에 대해서는 카카오 테크 블로그의 “Golang GC 튜닝 가이드 포스트”(https://tech.kakao.com/posts/618)를 참고하시면 좋습니다.
앞서 handleMessages() 안에 고루틴 영역을 병목지점으로 추정했으니, 실제로 해당 지점에 병목이 있는지를 goroutin 프로파일을 통해서 확인해 봤습니다.
goroutine profile: total 4309
4213 @ 0x43b916 0x44cc8f 0x44cc66 0x46b246 0x48acc5 0x86afae 0x86af8c 0x16edae2 0x16ef437 0x46f381
#  0x46b245  sync.runtime_SemacquireMutex+0x25  runtime/sema.go:77
#  0x48acc4  sync.(*Mutex).lockSlow+0x164       sync/mutex.go:171
#  0x86afad  sync.(*Mutex).Lock+0x6d            sync/mutex.go:90
#  0x86af8b  github.com/prometheus/client_golang/prometheus.(*summary).Observe+0x4b  github.com/prometheus/client_golang@v1.14.0/prometheus/summary.go:285
#  0x16edae1  k8s.io/ingress-nginx/internal/ingress/metric/collectors.(*SocketCollector).handleMessage+0xe21  k8s.io/ingress-nginx/internal/ingress/metric/collectors/socket.go:327
#  0x16ef436  k8s.io/ingress-nginx/internal/ingress/metric/collectors.handleMessages+0xb6  k8s.io/ingress-nginx/internal/ingress/metric/collectors/socket.go:520
[ goroutine dump 일부 ]
goroutine 프로파일에서 가장 많은(4309개) goroutine이 위와 같은 stack 상태임을 확인 할 수 있었습니다. call stack을 살펴보면 SockerCollector 구조체의 handleMessage() 함수를 수행하는 과정에서 Mutex의 Lock을 걸기위해 block된 상태입니다. 따라서 1부에서 가정했던 병목 지점이 실제와 일치하는것을 확인 했습니다. 그렇다면 왜 해당 부분에서 왜 병목이 발생하는지 더 근본적인 이유를 확인하기 위해 코드를 자세히 살펴보겠습니다. 참고로 해당 시점에 서비스에서 사용중이던 Ingress Controller 버전은 v1.5.1(https://github.com/kubernetes/ingress-nginx/tree/controller-v1.5.1) 입니다.
SocketController struct의 handleMessage() 함수 분석
SocketController의 handleMessage() 함수는 Nginx로부터 소켓으로 전달된 요청과 관련된 메트릭들을 prometheus를 사용해 수집하는 동작을 수행합니다.
func (sc *SocketCollector) handleMessage(msg []byte) {
	// Unmarshal bytes
	var statsBatch []socketData
	err := jsoniter.ConfigCompatibleWithStandardLibrary.Unmarshal(msg, &statsBatch)
	if err != nil {
	    klog.ErrorS(err, "Unexpected error deserializing JSON", "payload", string(msg))
	    return
	}

	for i := range statsBatch {
		...
		if stats.Latency != -1 {
		    ...
		    if sc.upstreamLatency != nil {
		       latencyMetric, err := sc.upstreamLatency.GetMetricWith(latencyLabels)
		       if err != nil {
		          klog.ErrorS(err, "Error fetching latency metric")
		       } else {
		          latencyMetric.Observe(stats.Latency)
		       }
		    }
		}

		...
	}

}
[ code #1 k8s.io/ingress-nginx/internal/ingress/metric/collectors/socket.go ]
handleMessage() 함수 동작을 간단하게 정리하면 아래와 같습니다.
- 인자로 전달된
[]byte타입의 JSON 메트릭 데이터를socketData타입의 array로 변경 socketData array요소들 중 유효한 항목들에 대해 prometheus 메트릭을 수집
그리고 goroutine 덤프를 통해 수집한 데이터 바탕으로 메트릭 수집 과정 중 Blocking 되는 부분은 latencyMetric.Observe(stats.Latency) 코드 부분으로 확인했습니다. summary는 prometheus에서 제공하는 메트릭 타입(https://prometheus.io/docs/concepts/metric_types/)중에 하나로 주로 분위(quantile)값을 수집하는 용도로 사용합니다.
summary Observe() 함수 분석
func (s *summary) Observe(v float64) {
   s.bufMtx.Lock()  // *
   defer s.bufMtx.Unlock()

   now := time.Now()
   if now.After(s.hotBufExpTime) {
      s.asyncFlush(now)
   }
   s.hotBuf = append(s.hotBuf, v)
   if len(s.hotBuf) == cap(s.hotBuf) {
      s.asyncFlush(now)
   }
}
[ code #2 github.com/prometheus/client_golang@v1.14.0/prometheus/summary.go ]
Observe() 함수는 인자로 전달된 float64 값을 프로메테우스 메트릭에 저장하는 역할을 합니다. 데이터를 기록하는 과정에서 Mutex의 락(s.bufMtx.Lock())을 획득하려는 고루틴들이 많아져, 다수의 고루틴이 Blocking 상태에 놓인 것을 확인할 수 있습니다. 여기서 Lock을 시도하는 이유는 prometheus 메트릭을 저장하는 과정에서 I/O 비용감소를 위해 buffer를 사용하는데 buffer에 쓰는 부분(s.hotBuf = append(s.hotBuf, v))이 임계 영역이기 때문에 buffer를 경합으로부터 보호하기 위함입니다. golang에서 append 함수는 thread safe하지 않기 때문에 반드시 Mutex와 같은 기능을 사용해 동시성 처리를 해줘야합니다.
summary 타입이 느린 이유
Observe() 함수에서 Unlock() 호출이 지연되는걸 확인했으니 Observe() 함수가 왜 느린지, summary 타입 메트릭 수집이 왜 느린지 확인이 필요하고 이를 위해 Prometheus의 summary 타입에 대한 이해가 필요합니다.
Prometheus에서는 분위값 표현을 위한 메트릭 종류로 histogram과 summary를 제공하는데 두 메트릭 타입은 내부 자료구조 및 데이터 저장 방식이 많이 다릅니다. 때문에 주요 특징에서 차이가 있는데 대표적으로 summary는 저장은 느린대신 분위 조회가 빠르고 histogram은 저장이 빠른대신 분위 조회가 느립니다. histogram이 데이터를 저장하는 동작에 대해서는 https://grafana.com/blog/2022/03/01/how-summary-metrics-work-in-prometheus 자료를 참고하시면 자세히 이해할 수 있습니다.
다시 IC 메트릭 수집 과정으로 돌아와서 Nginx가 보낸 다양한 종류의 메트릭들은 summary 뿐만 아니라 histogram, counter 같이 다양 종류의 메트릭으로 수집되고 있으나, summary 타입에 해당하는 upstreaLatency 수집에 더 많은 연산이 필요해 병목이 발생했고 그 영향으로 경합이 심해졌습니다
메트릭 수집 병목 현상 정리
메트릭 수집 병목 원인이 확인 됐고 전반적인 상황을 정리하면 아래와 같습니다.
- nginx에서 요청들을 처리할 때 마다 로그가 생성되고, 이 데이터를 모아서 1초마다 IC로 보냄
- IC에서는 수집 메트릭중 하나인
upstreamLatency를 summary 타입으로 저장하는 과정에서 지연이 발생했고Unlock()호출이 늦어져 Lock 경합이 심해짐 - 위의 이유로 인해 IC에서 1초안에 메트릭 처리를 완료하지 못하고 goroutine과 처리되지 않은 메트릭 객체들(
socketDataarray)이 계속 쌓여 메모리 점유율이 지속적으로 늘어남
Grafana 집계 오류 원인 확인
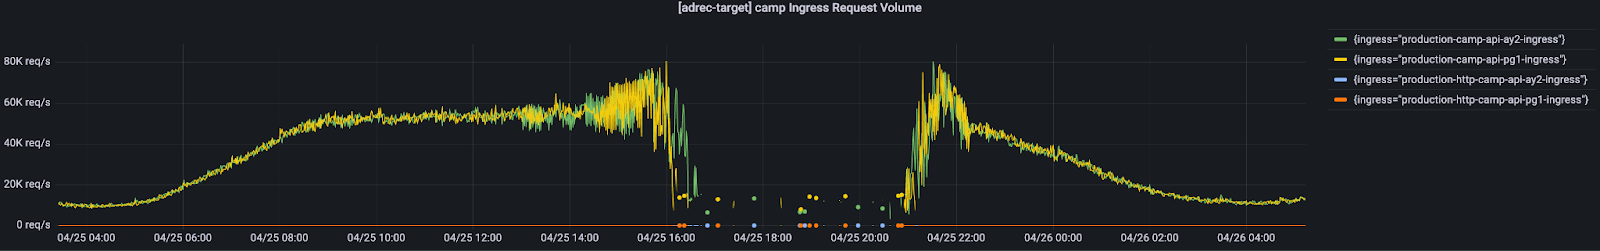
여기까지 IC에서 Nginx 메트릭들이 수집 지연이 발생한 원인을 찾았고 이를통해 메모리 leak 증상에 대한 궁금증은 풀렸습니다. 하지만 1부에서 발견했던 증상중 하나인 메트릭 유실(No Data) 현상과 연관짓기는 어렵습니다. 그 이유에 대해 먼저 설명하고 No Data 발생 원인을 확인하는 과정을 보여드리겠습니다.
Prometheus의 메트릭 수집 방법
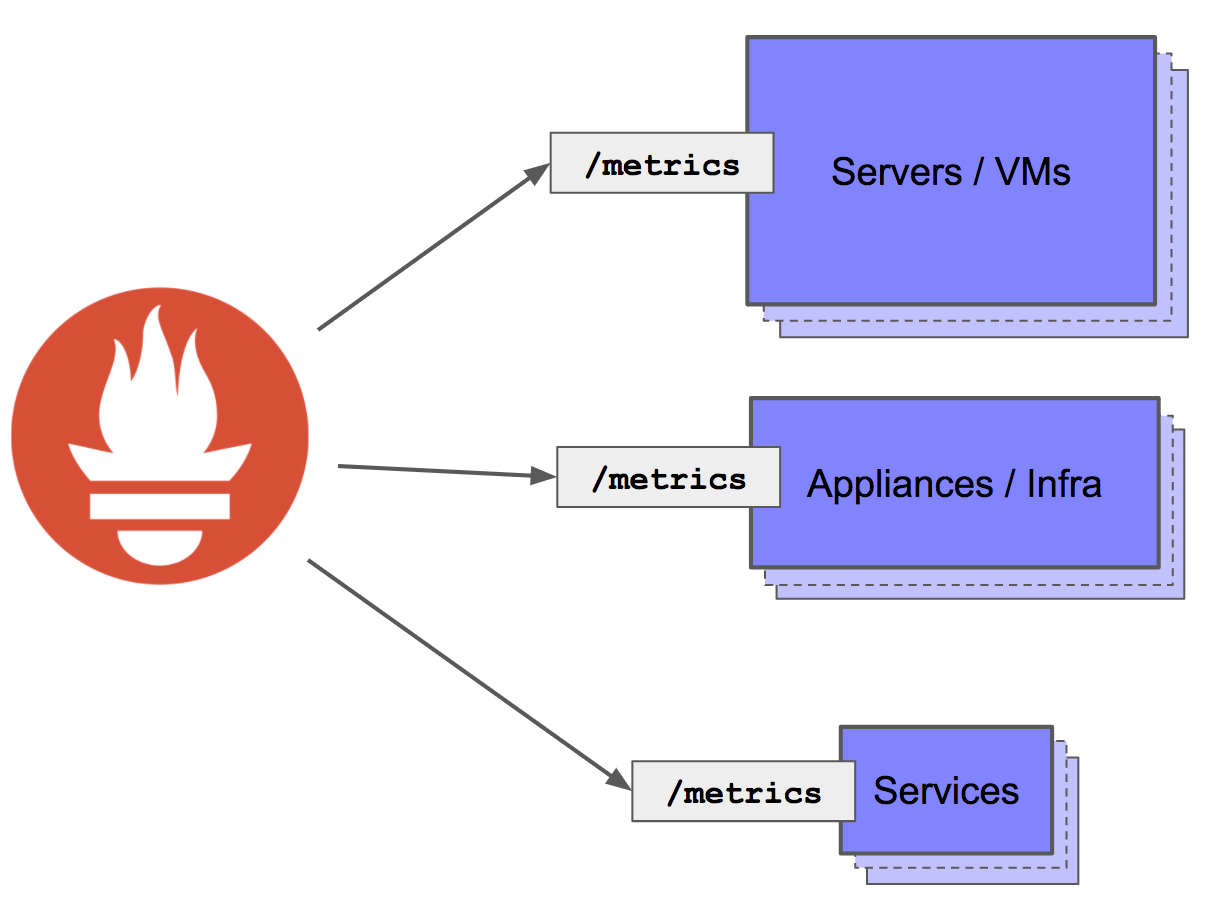
No Data 현상을 이해하기 전에 먼저 Prometheus의 메트릭 수집 구조에 알아보겠습니다
Prometheus는 Pull 방식으로 수집 대상으로부터 메트릭을 집계합니다. 즉 TSDB(Time Series Database) 역할을하는 Prometheus 서버는 수집 대상 서버들을 순회하며 대상으로부터 수집된 메트릭을 서버에 저장하게됩니다. 여기서 Prometheus 서버와 수집 대상 서버의 메트릭 구조에는 큰 차이가 있는데 이는 시간축 유무입니다. Prometheus 서버는 TSDB이며 시간축이 중요합니다. 때문에 메트릭을 집계 할때 시간별로 메트릭을 저장합니다. 즉, Prometheus 서버에서 설정한 인터벌마다 수집 대상 서버들의 메트릭을 수집된 시간과 함께 Prometheus 서버에 저장합니다. 하지만 수집 대상인 어플리케이션은 다릅니다. 어플리케이션 서버(IC)는 시간별 데이터를 모두 저장하지 않고 항상 최신 데이터만 갖고 있고 Prometheus 서버에 전달합니다.
No Data 발생 원인
이와 같은 수집 방식으로인해 수집 대상 어플리케이션인 IC가 Nginx로부터 전달받은 메트릭을 처리하지 못했더라도 그 전까지 성공적으로 수집한 Prometheus 서버에 전달할 수 있고, Prometheus 서버가 메트릭 수집하는 시점에 가장 최근에 수집한 데이터를 전달하여 No Data가 발생하지 않습니다. No Data가 발생하는 주요 원인은 어플리케이션(IC)이 메트릭 수집을 실패한게 아닌 Prometheus 서버가 Timeout과 같은 에러로 인해 IC로부터 메트릭 가져오는것을 실패해 해당 시점의 데이터를 null로 저장했기 때문입니다.
Ingress Controller의 메트릭 export 과정 분석
그렇다면 Prometheus 서버가 IC로부터 메트릭 수집을 실패한 원인을 찾아보겠습니다.
Prometheus 서버는 일반적으로 수집 대상 서버들의 http endpoint(/metrics)를 호출하고 응답으로 전달되는 텍스트를 파싱해 Prometheus 서버에 저장합니다. 그리고 수집 대상 서버들은 endpoint가 호출되면 메모리에 저장돼 있던 메트릭들을 모두 집계해 http response로 전달하는 과정을 거치며 그 과정에서 summary 타입의 데이터는 아래 함수를 호출하게 됩니다
func (s *summary) Write(out *dto.Metric) error {
   sum := &dto.Summary{
      CreatedTimestamp: s.createdTs,
   }
   qs := make([]*dto.Quantile, 0, len(s.objectives))

   s.bufMtx.Lock()
   s.mtx.Lock()
   // Swap bufs even if hotBuf is empty to set new hotBufExpTime.
   s.swapBufs(time.Now())
   s.bufMtx.Unlock()

   s.flushColdBuf()

  ...
}
[ code #3 github.com/prometheus/client_golang@v1.14.0/prometheus/summary.go ]
위에서 설명한 메트릭 수집 과정과 동일하게 s.bufMtx.Lock()을 호출하는 과정이 있는데, 그 이유는 Prometheus 서버에 전달할 메트릭 응답을 생성하기 전에 buffer에 임시 저장된 데이터를 flush하여 최대한 최신 데이터를 반영하기 위함입니다. 하지만 buffer를 flush 하는 과정에서 buffer Mutex의 Lock을 시도하고, 위에서 설명한 메트릭들을 수집하는 과정에서 호출되는 Observe() 에서 이미 많은 goroutine들이 Lock을 시도한 상황이라 오랜시간 Blocking 됩니다. 그 결과 IC에서 응답을 제시간에 전달하지 못해 Timeout이 발생하고 에러를 반환해 Pulling이 실패하게 됩니다.
문제 상황 및 원인 정리
| 문제 상황 | 원인 |
|---|---|
| File descriptor, 메모리 증가 | IC가 Nginx로부터 전달된 메트릭을 수집하는 과정에서 지연이 발생하여 Socket, goroutine, 메트릭 객체가 쌓임. 수집 지연 이유는 summary 데이터를 쌓는 과정에서 Lock 획득에서 경합 발생 |
| Prometheus Metric 유실 | Prometheus 서버가 IC로부터 메트릭을 수집하는 과정에서 Timeout이 발생. Timeout이 발생하는 이유는 IC가 metric 응답을 생성하는 과정에서 summary 데이터에 대한 Lock 획득에서 경합 발생 |
해결방법
문제 원인 찾았으니 이제 해결 방법을 찾아보겠습니다. 결론적으로 2가지 옵션이 있었습니다.
방법1 - ingress-nginx 리소스 증설
1부에서의 설명처럼 upstream latency를 포함하여 nginx의 지표들은 기본적으로 1초마다 최대 1만개 로그가 전달될 수 있으며 그 이상 데이터는 Nginx에서 버립니다. 서비스 운영 히스토리를 봤을 때 Nginx 한대당 7~8K 수준의 트래픽을 받았을때는 문제가 없었으나 10K 이상의 가까운 수준의 트래픽을 받는 시점부터 지표 누락 및 메모리 증가 현상이 발생하기 시작했습니다. 따라서 IC Process 하나가 처리해야하는 지표양을 줄이면 병목이 해결되기 때문에 가장 간단하지만 비싼 방법으로는 nginx를 늘리는(Scale out) 옵션이 있습니다.
방법2 - 근본적인 병목 지점 제거
근본적인 해결 방법으로는 병목 지점인 upstreaLatency 메트릭을 수집하지 않는 방법입니다.
for i := range statsBatch {
		...

		if stats.Latency != -1 {
		    ...

		    if sc.upstreamLatency != nil {
		       latencyMetric, err := sc.upstreamLatency.GetMetricWith(latencyLabels)
		       if err != nil {
		          klog.ErrorS(err, "Error fetching latency metric")
		       } else {
		          latencyMetric.Observe(stats.Latency)
		       }
		    }
		}

		...
	}
[ code #4 k8s.io/ingress-nginx/internal/ingress/metric/collectors/socket.go ]
메트릭 수집하는 코드를 다시 살펴보면 upstreamLatency를 집계하는 과정에서 sc.upstreamLatency != nil 체크하는 로직이 있습니다. 따라서 upstreamLatency를 null로 선언하면 수집을 해당 메트릭을 수집하지 않고 넘어갑니다.
upstreamLatency 생성하는 부분을 찾다보면 아래 코드를 발견할 수 있습니다
func summaryMetric(opts *prometheus.SummaryOpts, requestTags []string, excludeMetrics map[string]struct{}, metricMapping metricMapping) *prometheus.SummaryVec {
   if containsMetric(excludeMetrics, opts.Name) {
      return nil
   }
   m := prometheus.NewSummaryVec(
      *opts,
      requestTags,
   )
   metricMapping[prometheus.BuildFQName(PrometheusNamespace, "", opts.Name)] = m
   return m
}
[ code #5 k8s.io/ingress-nginx/internal/ingress/metric/collectors/socket.go ]
upstreamLatency를 초기화하는 summaryMetric() 함수를 보면 excludedMetrics 파라미터중에 자신에 해당하는 문자열ingress_upstream_latency_seconds이 포함 돼 있는 경우 nil을 리턴합니다.
func ParseFlags() (bool, *controller.Configuration, error) {
	...

	excludeSocketMetrics = flags.StringSlice("exclude-socket-metrics", []string{}, // 생략)

	...
}
[ code #6 k8s.io/ingress-nginx/pkg/flags/flags.go ]
그리고 Ingress Controller 실행 인자를 파싱하는 코드를 보면 exclude-socket-metrics 에 upstreamLatency 메트릭명에 해당하는 ingress_upstream_latency_seconds을 추가하면 됩니다.
결론
리서치한 두가지 해결방법 중, 어떤 방식을 선택할지 의사결정만 남은 상태였습니다. 담당자들과 모여 회의한 결과 Ingress 노드 증설로 결정했고 이유는 아래와 같습니다.
- Nginx의 기본 설정상으로 초당 1만개 이상의 메트릭은 버리고 있어서 IC에서 upstream latency 수집을 제외하여 병목을 제거하더라도 메트릭 누락은 여전히 발생함
- upstream latency 수집을 비활성화하려면 IC 실행 인자를 변경해야 하며, 이를 위해 Ingress-Nginx의 Helm Chart를 수정해 배포해야 하는 상황. 그러나 전사적으로 공통 사용 중인 Chart를 수정할 경우, upstream latency 메트릭을 모니터링 중인 다른 서비스에 영향을 미칠 우려가 있으며. 동시에 광고 추천 조직만 별도의 Helm Chart로 Ingress-Nginx를 운영하는 것도 장기적인 운영 리스크가 우려됨
upstreamLatency 근황 {#upstreamlatency-근황}
upstreamLatency는 과거부터 deprecated된 지표였으나 하위 호환성을 위해 기본 설정으로 수집되고 있는 상태였습니다. 그러나 2024년 12월 말에 릴리즈된 v1.12.0(https://github.com/kubernetes/ingress-nginx/releases/tag/controller-v1.12.0) 드디어 기본 집계 대상에서 제외됐습니다.
2부를 마치며
Ingress-Nginx-Controller를 대규모 트래픽 환경에서 운영하며 겪은 성능 이슈의 원인 확인과 해결 과정을 정리했습니다. 트러블슈팅 과정을 공유하며 관련 자료를 리서치하는 동안 Ingress와 Prometheus에 대해 깊이 이해할 수 있는 계기가 되었고, 개인적으로도 많은 것을 배울 수 있었습니다. 이러한 경험을 바탕으로 앞으로도 카카오 서비스를 이용하는 사용자들에게 도움이 되는 광고를 안정적으로 제공하기 위해 최선을 다하겠습니다.