Engineering
잘 말하는 AI를 넘어, 원하는 대로 말하는 AI로: Kanana-o 음성 생성 고도화 과정
2026년 8월 4일
원문에서 보기 ↗Intro
안녕하세요, 카카오의 AI 모델 개발을 담당하는 카나나(Kanana) 조직의 Martin(조대진), Abigail(박혜영), Edwin(강우영)입니다. 저희 팀에서는 사람처럼 보고, 듣고, 말하는 통합 멀티모달(Multimodal) 언어모델을 중점적으로 개발하고 있습니다.
지난 5월, 국내 최초로 공개한 통합 멀티모달 언어모델 공개 이후, 저희는 실제 서비스 환경에서 더 나은 사용자 경험을 제공하기 위해 계속해서 모델을 고도화하고 있습니다 .
이번 고도화 과정에서 저희는 Kanana-o의 음성 생성 능력을 두 가지 방향으로 발전시키고자 했습니다.
-
더욱 효율적으로 음성을 생성하기
실제 서비스에서 자연스러운 음성 대화를 제공하려면 음질뿐만 아니라 생성 속도와 연산 효율도 중요합니다. 이를 위해서는 음성을 더 짧고 효율적인 토큰 시퀀스로 표현하고, 생성된 토큰을 실제 음성으로 변환하는 디코딩 과정도 간결하게 구성해야 합니다.
-
‘사람처럼 자연스럽게 말하기’를 넘어 ‘사용자가 원하는 방식으로 말하기’
사용자는 각자 선호하는 말하기 속도와 스타일, 음량이 다르며, 주변 환경이나 사용 목적에 따라 이러한 음성 특성을 쉽게 조절하기를 기대합니다. 따라서 모델이 자연스러운 음질을 유지하면서도 사용자가 요구한 발화지시를 정확하게 따를 수 있어야 합니다.
이 두 가지 목표를 달성하려면, 두 가지 핵심 기술이 결합해야 합니다.
- 음성 표현 기술: 음성의 의미와 음향적 특성을 언어모델이 효과적으로 학습·생성할 수 있는 형태로 표현하는 기술
- 지시 이행 학습 기술: 다양한 발화 지시를 충실히 따르도록 모델을 정교하게 학습시키는 기술
저희는 이를 위해 언어모델 친화적 음성 토크나이저인 LM-SPT [1]를 독자적으로 개발하고 Kanana-o에 적용했습니다. LM-SPT는 기존 Kanana-o에서 사용한 음성 토크나이저 대비 낮은 frame rate(오디오 1초당 프레임 수)로 음성을 표현합니다. 덕분에 Voice Token LM이 생성해야 하는 시퀀스의 길이가 줄었고, 보다 간결한 디코딩 구조를 통해 음성 복원 과정의 효율을 높였습니다. 또한 의미 정보와 함께 다양한 음향적 특성을 토큰으로 표현함으로써, 언어모델이 음성의 세부적인 특성을 직접 생성하고 제어할 수 있는 기반을 마련했습니다.
이와 함께 모델이 사용자의 다양한 발화지시를 정확하게 반영하면서 동시에 음질의 자연스러움을 유지할 수 있도록 온라인 강화학습(Online Reinforcement Learning)을 적용해 Kanana-o의 음성 생성 모듈을 고도화했습니다.
이번 글에서는 Kanana-o가 더 효율적으로 음성을 생성하고, 동시에 사용자가 원하는 방식으로 말할 수 있도록 어떤 문제를 고민했는지 살펴봅니다. 이어 새로운 음성 토크나이저와 온라인 강화학습을 통해 이러한 문제를 어떻게 해결했는지 소개하겠습니다.
더욱 효율적이고 지시를 잘 따르는 음성 생성을 향해
음성을 토큰으로 생성하는 Kanana-o
기존에 공개한 Kanana-o는 음성을 초당 25개의 이산형 토큰(discrete token)으로 표현하는 음성 토크나이저를 사용했습니다. Kanana-o의 Voice Token LM은 텍스트 언어모델이 생성한 답변과 대화 문맥정보를 바탕으로 다음에 이어질 음성 토큰을 순차적으로 예측합니다.
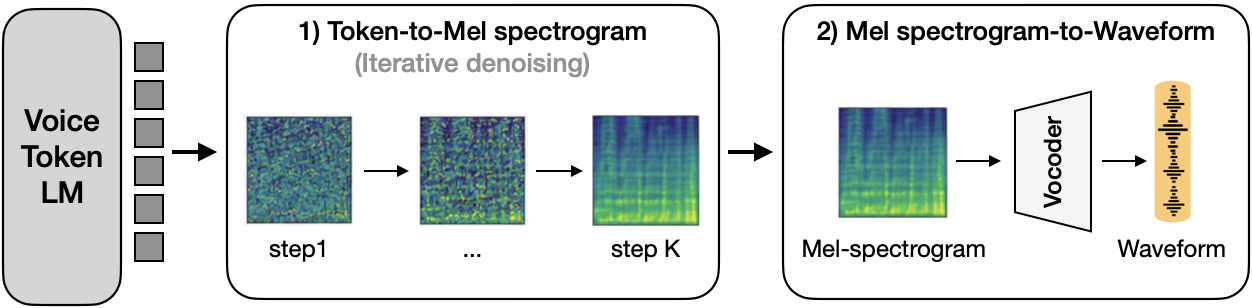
이렇게 생성된 음성 토큰은 그림 1처럼 2단계 디코딩(2-stage decoding) 과정을 거쳐 실제 음성으로 변환됩니다.
- Token-to-Mel: 음성 토큰을 mel-spectrogram으로 변환
- Mel-to-Waveform: mel-spectrogram을 최종 waveform으로 복원
기존 음성 토크나이저의 한계
기존 Kanana-o의 음성 토크나이저는 음성을 비교적 적은 수의 토큰으로 압축하면서도 발화 내용을 안정적으로 표현할 수 있었습니다. 하지만 음성 생성 능력을 더욱 정교하게 제어하고 실제 서비스에서의 생성 효율을 높이기 위해서는 두 가지 측면에서 개선이 필요했습니다.
1. 음향적 특성을 직접 제어하기 어려운 표현 구조
사람의 음성에는 말의 내용뿐만 아니라 음색, 높낮이, 억양, 발화 속도, 감정과 같은 다양한 음향 정보가 포함되어 있습니다. 기존 토크나이저는 발화의 언어적·의미적 정보를 표현하는 데에는 효과적이었지만, 이러한 세부적인 음향 정보를 충분히 담는 데에는 한계가 있었습니다. 이로 인해 멀티모달 언어모델이 음성 토큰을 생성하더라도 “더 빠르게”, “낮은 목소리로”, “속삭이듯이”와 같은 음향적 특성을 토큰 수준에서 직접 제어하기 어려웠습니다. 보다 풍부하고 세밀한 음성 생성을 위해서는 발화 내용과 함께 음성의 다양한 음향적 특징을 구조적으로 표현할 수 있는 토크나이저가 필요합니다.
2. 긴 토큰 시퀀스와 복잡한 디코딩 과정
기존 토크나이저는 음성을 초당 25 프레임 길이의 토큰으로 표현했습니다. 음성의 길이가 길어질수록 Voice Token LM이 순차적으로 생성해야 하는 토큰 수도 함께 증가하기 때문에, 이는 음성 생성 속도와 연산량에 직접적인 영향을 줍니다.
한편, 발화의 의미적인 정보를 중점적으로 인코딩하는 기존 토크나이저의 특성으로 인해 Token-to-Mel 변환모델은 일반적으로 Diffusion 또는 Flow-matching 같은 iterative denoising 기반의 multi-step inference 모델을 요구합니다. 뿐만 아니라, 생성된 음성 토큰을 실제 음성으로 복원하기 위해서는 Token-to-Mel 모델과 Mel-to-Waveform 모델을 차례로 거치는 2-stage decoding 과정이 필요했습니다. 이러한 구조는 디코딩 파이프라인을 복잡하게 만들어 실시간 서비스에서 요구되는 빠른 응답 속도를 장담하기 어렵습니다.
LM-SPT
이러한 한계를 해결하고자 저희는 언어모델과의 결합을 고려해 설계한 음성 토크나이저 LM-SPT(LM-aligned SPeech Tokenizer)를 자체 개발했습니다. LM-SPT는 음성을 기존의 절반인 초당 12.5 프레임 길이로 압축하면서도, 발화의 내용과 세부적인 음향 특성을 함께 표현하는 것을 목표로 합니다.
구조
사용자가 원하는 형태로 발화하기 위해서는 음성 언어모델이 발화의 내용뿐만 아니라 음향적 특성도 함께 생성해야 합니다. 다만 이 두 종류의 정보가 하나의 토큰에 구분 없이 뒤섞이면, 동일한 발화 내용도 화자나 억양에 따라 서로 다른 토큰으로 표현될 수 있습니다.
이 경우 언어모델이 대화 문맥에 따라 발화 내용을 안정적으로 예측하기 어려워지고, 특정 음향 특성만 선택적으로 조절하는 것도 쉽지 않습니다. 따라서 언어모델과 효과적으로 결합하기 위해서는 의미 정보와 음향 정보를 모두 보존하되, 각각의 역할이 구분된 토큰으로 표현할 필요가 있습니다.
- 의미 토큰(Semantic Speech Token): 텍스트 및 대화 문맥에 대응하는 발화 내용을 담당
- 음향 토큰(Acoustic Speech Token): 화자의 음색, 억양, 높낮이, 발화 속도 등 실제 목소리를 구성하는 세부 특성을 보완
이러한 구조를 통해 언어모델은 발화 내용과 음향 특성을 함께 학습하면서도, 두 요소를 보다 안정적이고 세밀하게 생성할 수 있게됩니다.
이처럼 음성의 의미 정보와 음향 정보를 구분해 표현하는 방식은 최근 음성 언어모델을 위한 토크나이저에서 널리 활용되고 있습니다. SpeechTokenizer [2]나 Moshi [3]의 음성 토크나이저인 Mimi 역시 의미 표현을 담당하는 토큰과 음향 정보를 담당하는 토큰을 분리한 구조를 채택했습니다. 두 모델 모두 사전 학습된 음성 모델의 의미 표현을 증류하여, 언어모델이 다루기 적합한 토큰을 학습한다는 공통점이 있습니다.
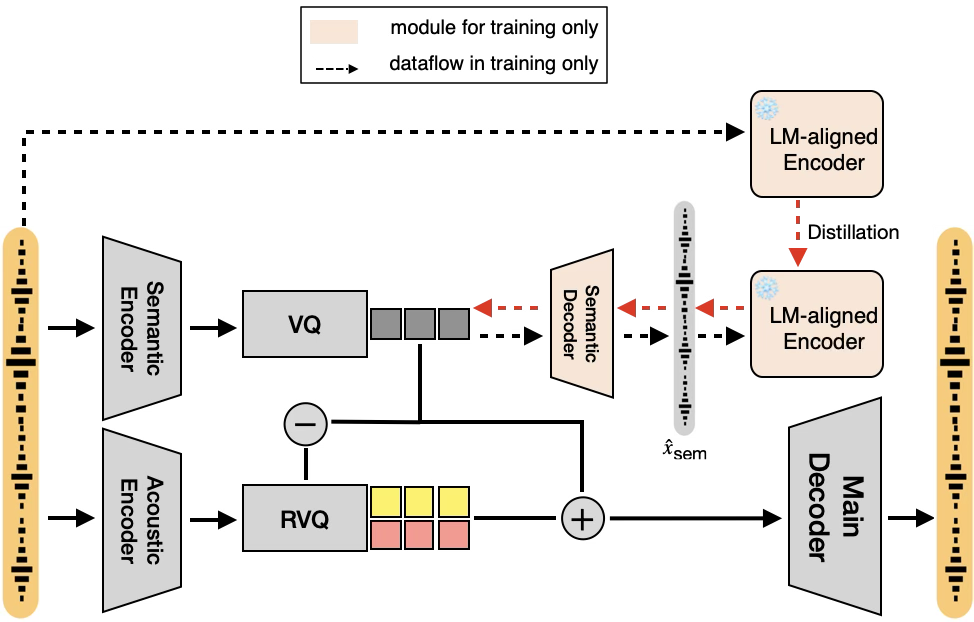
LM-SPT 역시 음성에 포함된 정보를 의미 토큰(semantic speech token)과 음향 토큰(acoustic speech token) 으로 나누어 표현합니다. 이를 위해 의미 정보와 음향 정보를 각각 담당하는 두 개의 인코더와, 하나의 의미 코드북(codebook) 및 여러 개의 음향 코드북으로 구성된 Split RVQ (Residual Vector Quantization) 구조를 사용합니다. 여기서 각 코드북은 음성 특징을 표현하는 이산적인 벡터들의 집합으로, 입력된 음성 특징과 가장 가까운 표현을 선택해 토큰으로 변환합니다.
학습 방법
먼저 의미 코드북(그림 2. VQ)이 발화의 핵심적인 의미 정보를 토큰으로 표현하고, 이후 여러 단계의 음향 코드북(그림 2. RVQ)이 앞선 단계에서 충분히 표현되지 않은 음향 정보를 순차적으로 보완합니다. 이처럼 두 종류의 토큰을 함께 활용해 음성을 복원하도록 음성 토크나이저를 학습하게 됩니다.
하지만 음성 복원만을 목표로 학습하면 의미 코드북과 음향 코드북이 각각 의미와 음향 정보를 명확하게 나누어 담는다고 보장하기 어렵습니다. 음성을 더 잘 복원하는 과정에서 의미 토큰에도 화자의 음색이나 억양과 같은 음향 정보가 섞이거나, 반대로 발화 내용이 여러 음향 토큰에 분산될 수 있기 때문입니다.
의미와 음향 정보를 구분하기 위해 SpeechTokenizer 나 Mimi같은 기존 음성 토크나이저에서는 HuBERT [6]나 WavLM [7]과 같은 자기지도학습(self-supervised learning) 기반 teacher 모델에서 추출한 표현을 의미 토큰의 표현과 시간 단위로 직접 맞추도록 하는 증류 방식을 주로 사용했습니다.
이러한 방식은 의미적으로 풍부한 토큰을 유도하는 데 효과적이지만 몇 가지 한계가 있습니다.
- 고수준 의미의 불일치: 증류 teacher로 쓰인 자기지도학습 모델은 주로 음소나 발음 패턴을 표현하므로, 언어모델이 다루는 고수준 의미 표현과 완벽히 정렬되지 않을 수 있습니다.
- 시간 해상도 맞춤에 따른 정보 희석: 시간 단위로 특징을 비교하려면 teacher 모델과 토크나이저 간 시간 해상도를 맞춰야 합니다. 보통 teacher 모델의 frame rate가 더 높기 때문에 teacher 표현을 평균하거나 축약하게 되며, 이 과정에서 중요 의미 정보가 희석될 수 있습니다. 토크나이저의 frame rate가 낮아질수록 이 문제는 심화됩니다.
LM-SPT는 의미 토큰을 언어모델 수준의 의미 표현과 더 잘 정렬하기 위해 Whisper [8]와 같이 언어모델과의 연계에 적합한 사전 학습 음성 인코더를 활용합니다. 또한 기존 방식처럼 teacher와 의미 토큰의 특징을 각 시간 구간에서 직접 비교하지 않고, 의미 음성-재합성 기반의 증류(Semantic Speech-Resynthesis Distillation)기법을 개발하여 적용하였습니다.
구체적으로, LM-SPT의 의미 토큰만으로 음성을 다시 합성하고 원본 음성과 재합성된 음성을 언어모델과 잘 정렬된 음성 인코더에 입력하고, 두 음성에서 추출된 의미 표현이 유사해지도록 학습합니다. 즉, 각 토큰에 해당하는 teacher 모델의 표현을 정확히 따라 하도록 요구하는 대신, 강하게 압축된 의미 토큰만으로도 원본과 동일한 발화 내용을 보존하도록 학습하는 방식입니다. 이를 통해 서로 다른 frame rate 사이의 인위적인 정렬 없이도 언어모델이 다루기 좋은 의미 정보를 토큰에 담을 수 있습니다.
실제 음성을 토큰으로 변환하거나 복원할 때는 무거운 별도의 사전 학습 음성인코더는 필요하지 않고, 임의로 초기화되어 학습된 가벼운 음성인코더만을 사용하게 됩니다. 최종 decoding에서는 의미 토큰과 음향 토큰을 함께 사용해 mel-spectrogram과 같은 중간 표현을 거치지 않고 waveform을 직접 복원합니다.
결과적으로 LM-SPT는 발화의 의미와 음향 정보를 구조적으로 나누어 표현함으로써 Voice Token LM이 음성의 세부적인 특성을 토큰 수준에서 학습하고 생성할 수 있는 기반을 마련했습니다. 또한 12.5Hz의 낮은 frame rate를 통해 Voice Token LM이 순차적으로 생성해야 하는 시간 스텝을 기존 대비 절반으로 줄이고, 가벼운 단일 디코더로 waveform을 직접 복원하여 전체 음성 생성 과정을 더욱 간결하게 구성할 수 있었습니다.
성능 평가
음성 토크나이저 성능 평가는 통상 두 가지 축으로 이루어집니다.
- 코덱 성능: 입력 음성을 이산화한 후 복원된 음성의 품질 측정
- 다운스트림 활용성: 음성-언어 모델과 결합했을 때의 이해 및 생성 능력 측정
LM-SPT는 기존의 의미표현이 강화된 다른 음성토크나이저들과 비교했을 때 코덱으로서도 비교 우위의 성능을 기록하였습니다. (자세한 내용은 [1] 참조.)
LM-SPT와 같은 음성 토크나이저를 활용하여 음성-언어 모델을 구축하려면, 음성 토큰에 담긴 발화 내용을 언어모델이 정확하게 이해할 수 있어야 하고, 반대로 언어모델이 생성한 음성 토큰으로 정확한 음성을 합성할 수도 있어야 합니다. 이를 확인하기 위해 각 음성 토크나이저를 언어모델과 결합 한 뒤 음성 이해를 평가하는 자동음성인식(ASR)과 음성생성 능력을 평가하는 음성합성(TTS) 두 가지 과제를 실험했습니다. 음성 토크나이저에 따른 차이를 비교할 수 있도록, 다양한 최신 음성 토크나이저들을 모두 동일한 환경과 동일한 방식으로 음성-언어모델에 적용했습니다.
-
ASR 실험에서는 입력 음성을 각 토크나이저의 이산 토큰으로 변환해 언어모델에 입력하고, 해당 음성의 텍스트를 생성하도록 학습했습니다. 평가는 한국어 KSponSpeech와 영어 LibriSpeech의 clean 및 noisy 환경에서 수행했으며, 한국어는 문자 오류율(CER), 영어는 단어 오류율(WER)로 측정했습니다. 두 지표 모두 낮을수록 언어모델이 음성 토큰에 담긴 내용을 정확하게 이해했음을 의미합니다.
-
TTS 실험에서는 텍스트와 화자 정보를 입력받아 각 토크나이저의 음성 토큰을 생성하도록 학습했으며, 화자 임베딩을 조건으로 사용하는 zero-shot TTS 환경으로 구성했습니다. 여러 코드북으로 구성된 토크나이저에는 코드북별 출력 모듈과 1-step delay pattern을 동일하게 적용했습니다. 공정한 평가를 위해 음성 합성시 화자 정보는 토크나이저별 모델간에 모두 동일한 화자레퍼런스를 부여하였습니다.
| Encoder Params. ↓ | Korean-ASR | Korean-ASR | English-ASR | English-ASR | Zero-shot TTS | Zero-shot TTS | |
|---|---|---|---|---|---|---|---|
| Encoder Params. ↓ | clean (CER↓) | noisy (CER↓) | clean (WER↓) | noisy (WER↓) | Korean (CER↓) | English (WER↓) | |
| CosyVoice2 | 124M | 39.82 | 42.18 | 35.27 | 45.61 | 9.98 | 3.08 |
| Mimi | 38M | 13.65 | 15.2 | 3.82 | 13.65 | 11.03 | 3.29 |
| DualCodec | 622M | 12.92 | 12.93 | 3.95 | 12.13 | 10.37 | 4.62 |
| LM-SPT | 32M | 11.91 | 11.37 | 3.39 | 11.21 | 6.64 | 1.48 |
<표 1. 음성-언어모델의 음성 이해 및 생성 능력 비교.>
표 1은 다양한 최신 음성 토크나이저들을 사용하여 각각의 음성-언어모델을 구축했을 때, 한국어·영어 ASR 및 TTS 성능을 비교한 결과입니다. LM-SPT는 한국어와 영어, clean과 noisy 환경을 포함한 모든 ASR 평가 항목에서 가장 낮은 오류율을 기록했습니다. 음성 생성에서도 LM-SPT는 가장 낮은 오류율을 기록했습니다. 뿐만아니라 첨부한 표의 인코더 파라미터 기준으로 LM-SPT는 비교 모델 중 가장 작은 32M 규모로 구성되었습니다. DualCodec [4] 처럼 대규모 사전 학습 음성 인코더에 의존하지 않는 비교적 가벼운 구조를 사용하면서도 음성 이해와 생성에서 가장 우수한 결과를 얻었습니다.
Zero-shot TTS 사람 평가
앞서 사용한 CER과 WER 같은 오류율은 생성된 음성이 원래 문장을 얼마나 정확하게 전달하는지는 평가할 수 있지만, 음성이 사람처럼 자연스럽게 들리는지 또는 주어진 화자의 목소리를 얼마나 잘 재현하는지까지 보여주지는 못합니다. 따라서 음성 합성 모델은 자동 평가와 함께 사람이 직접 음성을 듣고 평가하는 주관적 평가를 수행하는 것이 일반적입니다. 저희는 학습에서 보지 못한 화자의 조건을 바탕으로 음성을 생성하는 zero-shot TTS 환경에서, 한국어와 영어 합성 결과를 다음 두 가지 기준으로 평가했습니다.
- NMOS(Naturalness Mean Opinion Score): 생성된 음성이 얼마나 자연스럽고 사람의 실제 발화처럼 들리는지를 평가합니다.
- SMOS(Similarity Mean Opinion Score): 생성된 음성이 목표 화자의 목소리와 얼마나 유사하게 들리는지를 평가합니다.
두 지표 모두 1점부터 5점까지 평가하며, 점수가 높을수록 자연스러움과 화자 유사도가 높다는 것을 의미합니다. 각 평가는 무작위로 선정한 15개의 동일한 발화문장에 대해 각 모델이 생성한 합성 음성을 대상으로 진행했으며, 15명의 전문 평가자가 이를 청취한 후 점수를 부여했습니다.
| Korean NMOS ↑ | Korean SMOS ↑ | English NMOS ↑ | English SMOS ↑ | |
|---|---|---|---|---|
| CosyVoice2 | 3.22 | 2.73 | 2.84 | 2.95 |
| Mimi | 3.10 | 3.38 | 2,96 | 3.73 |
| DualCodec | 3.62 | 3.80 | 3.54 | 3.67 |
| LM-SPT | 3.87 | 3.79 | 3.89 | 3.91 |
<표 2. Zero-shot 사람평가 결과.>
표 2에서 나타난 바와 같이 LM-SPT를 적용한 음성-언어모델은 한국어와 영어 모두에서 가장 높은 NMOS를 기록하여 비교한 음성 토크나이저들 가운데 가장 자연스러운 음성을 생성하는 것으로 평가되었습니다. 화자 유사도를 나타내는 SMOS에서도 영어에서는 가장 높은 결과를, 한국어에서는 가장 높은 DualCodec과 유사한 수준을 기록했습니다.
디코딩 속도 비교
음성 토크나이저의 효율성을 확인하기 위해, 생성된 음성 토큰을 실제 파형으로 복원하는 디코더의 크기와 속도를 비교했습니다. 디코딩 속도는 RTF(Real-Time Factor)로 측정했습니다. RTF는 음성을 처리하는 데 걸린 시간을 생성된 음성의 길이로 나눈 값으로, 수치가 낮을수록 빠르게 음성을 복원한다는 의미입니다. 예를 들어 10초 길이의 음성을 생성할 때 RTF가 0.1이라면 디코딩에 약 1초가 소요됩니다.
| Decoder Params. ↓ | RTF ↓ | |
|---|---|---|
| CosyVoice2 | 133M | 0.131 |
| Mimi | 40M | 0.004 |
| DualCodec | 53M | 0.006 |
| LM-SPT | 40M | 0.005 |
<표 3. 디코딩 속도 비교>
CosyVoice2 [5]의 경우 mel-spectrogram으로 변환한 뒤, 다시 waveform으로 복원하는 2-stage
decoding 구조를 사용합니다. 이로 인해 133M 규모의 디코딩 모듈과 0.131의 RTF가 필요합니다. 반면 LM-SPT는 별도의 mel-spectrogram 변환 과정 없이, 의미 토큰과 음향 토큰으로부터 waveform을 직접 복원하는 단일 단계 디코더를 사용합니다. LM-SPT 디코더는 40M 규모로 CosyVoice2 대비 약 69% 작으며, RTF는 0.005를 기록했습니다. 동일한 실험 환경 기준, CosyVoice2 대비 약 26배 빠른 디코딩 속도에 해당합니다. 또한 LM-SPT는 단일 디코더를 사용하는 Mimi의 RTF와 유사한 속도를 보였습니다.
LM-SPT 기반 Kanana-o
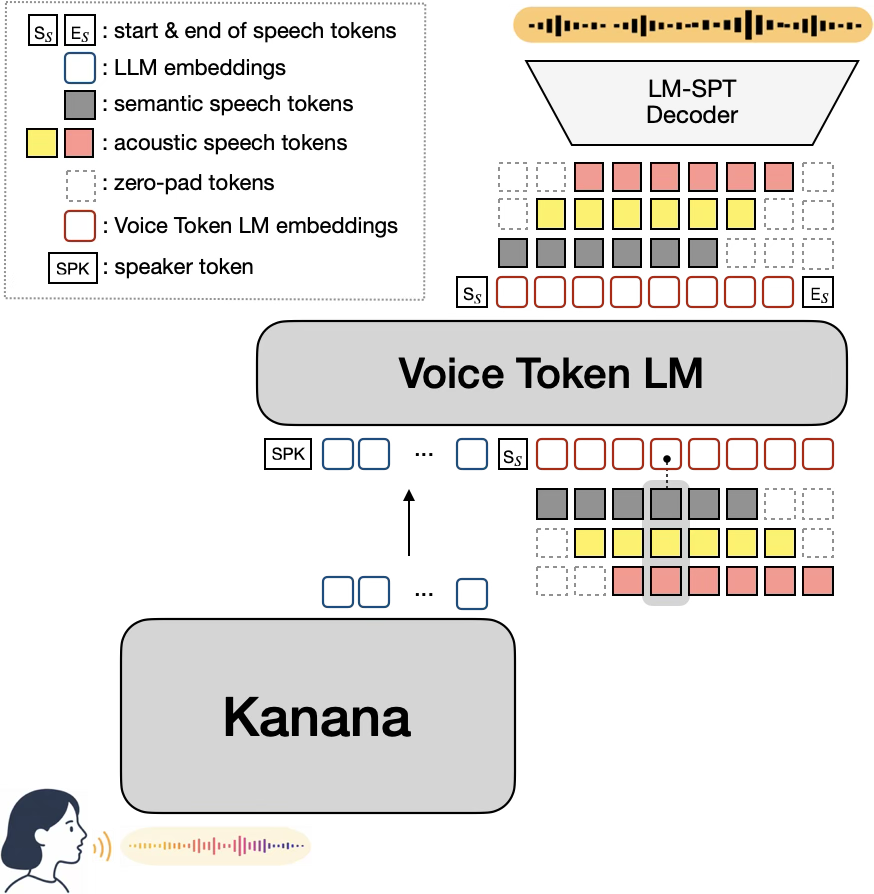
그림 3는 LM-SPT를 적용한 Kanana-o의 음성 생성 구조를 보여줍니다.
- 문맥 처리: Kanana가 사용자 입력과 대화 문맥을 처리해 LLM 임베딩(LLM embeddings)을 만듭니다.
- 토큰 생성: Voice Token LM이 LLM 임베딩과 화자 정보를 바탕으로 의미 토큰과 음향 토큰을 생성 합니다.
- 음성 복원: 생성된 토큰이 LM-SPT 디코더를 통해 최종 음성 파형으로 직접 복원됩니다.
LM-SPT는 음성을 초당 12.5개의 frame으로 표현하지만, 하나의 frame은 단일 토큰이 아니라 하나의 의미 토큰과 여러 개의 음향 토큰으로 구성됩니다. 따라서 Voice Token LM이 최종 음성을 생성하려면 각 frame마다 여러 코드북에 해당하는 토큰을 모두 예측해야 합니다.
가장 단순한 방법은 의미 토큰과 음향 토큰을 하나의 긴 시퀀스로 직렬화하여 차례대로 생성하는 것입니다. 하지만 이 방식에서는 frame을 구성하는 토큰 시퀀스의 길이가 코드북의 수 만큼 배로 늘어나게 되며, 이는 LM-SPT를 통해 중인 시퀀스 길이의 이점을 충분히 활용하기 어렵게 만듭니다. 저희는 이러한 문제를 해결하기 위해 Multi-codebook Voice Token LM을 구축했습니다. 각 코드북의 토큰을 하나의 시퀀스로 길게 펼치는 대신, 코드북별 출력 헤드를 별도로 두어 한 번의 decoding step에서 의미 토큰 스트림과 여러 음향 토큰 스트림을 병렬로 예측합니다. 그림 3의 회색, 노란색, 분홍색 토큰 행은 각각 의미 토큰과 여러 음향 토큰의 출력 시퀀스를 나타냅니다. 이를 통해 여러 코드북을 활용해 음성을 세밀하게 표현하면서도, 전체 autoregressive generation은 12.5Hz의 시간축을 기준으로 효율적으로 진행할 수 있습니다.
다만 LM-SPT의 음향 코드북은 RVQ 구조로 구성되어 있어, 뒤쪽 코드북의 토큰은 앞선 코드북이 표현하고 남긴 정보를 순차적으로 보완합니다. 즉, 각 음향 토큰은 서로 완전히 독립적이지 않으며 앞 단계의 토큰에 의존합니다. 모든 토큰을 같은 시점에 아무런 순서 없이 예측하면 이러한 코드북 간 의존관계를 충분히 반영하기 어려워져 예측 정확도가 낮아질 수 있습니다.
저희는 여러 코드북의 토큰을 한 번의 decoding step에서 병렬로 예측하되, 코드북 간 의존관계를 반영하기 위해 각 토큰 시퀀스에는 1-step delay pattern을 적용했습니다. 즉 의미 토큰을 먼저 생성하고, 각 음향 토큰을 담당하는 시퀀스를 앞선 코드북보다 한 step씩 지연시킴으로써 뒤쪽 코드북의 토큰이 같은 frame에 해당하는 앞쪽 코드북의 정보를 참고할 수 있도록 했습니다.
이 방식은 RVQ의 순차적인 정보 보완 구조를 유지하면서도, 여러 코드북의 토큰을 병렬적으로 생성할 수 있게 해줍니다. 마지막으로 생성된 의미·음향 토큰 시퀀스는 delay를 제거해 같은 frame 단위로 다시 정렬한 뒤 LM-SPT 디코더에 전달됩니다. LM-SPT 디코더는 모든 코드북의 토큰을 함께 활용해 mel-spectrogram과 같은 별도의 중간 표현을 거치지 않고 최종 음성 파형을 복원합니다.
결과적으로 Multi-codebook Voice Token LM은 LM-SPT가 제공하는 풍부한 의미·음향 표현을 활용하면서도, 모든 토큰을 직렬로 생성할 때 발생하는 과도한 시퀀스 증가를 방지합니다. 이를 통해 Kanana-o는 보다 세밀한 음성 정보를 직접 생성하는 동시에, 음성 생성 과정의 효율성도 함께 높일 수 있었습니다.
발화지시 잘 따르도록 학습하기
LM-SPT를 적용하면서 Kanana-o는 발화 내용뿐만 아니라 음색과 억양, 속도와 같은 세부적인 음향 특성까지 토큰으로 표현하고 생성할 수 있게 되었습니다. 하지만 이러한 표현 능력이 곧바로 사용자의 지시를 정확하게 따르는 능력으로 이어지는 것은 아닙니다. 예를 들어 사용자가 “아주 빠르게 읽어줘”라고 요청했을 때, 모델이 단순히 평소보다 조금 빠르게 말하는 것에 그치지 않고 ‘아주 빠르게’라는 강도의 차이까지 구분해 표현해야 합니다. 또한 발화 속도나 음량을 조절하는 과정에서도 발음의 정확성, 화자의 음색, 자연스러운 음질이 함께 유지되어야 합니다.
저희는 이러한 능력을 학습시키기 위해 자체적으로 개발한 Counterfactual Preference Alignment 방법론을 적용하였습니다. 핵심은 다른 조건은 동일하게 유지한 채 발화지시를 따르는 정도가 다른 음성 쌍을 구성하고, 모델이 두 음성 중 사용자의 요구에 더 잘 부합하는 쪽을 구별하도록 학습하는 것입니다.
이는 언어모델 alignment에 널리 활용되는 RLHF (Reinforcement Learning from Human Feedback)의 학습 방식을 Kanana-o 같은 음성 생성 모델에 적용한 것입니다. 일반적인 RLHF에서는 동일한 입력에 대해 생성된 두 응답 중 어느 결과의 품질이 더 높은지 선호 관계가 정의된 preference 데이터셋을 구축하고, 이를 바탕으로 선호된 생성 결과에 더 높은 점수를 부여하도록 보상모델 (Reward Model)을 학습합니다. 이후 모델이 생성한 결과를 보상모델로 평가하고, 더 높은 보상을 얻도록 강화학습을 수행합니다.
발화지시 이행 여부를 평가하는 보상모델을 학습하려면 preference dataset을 세밀하게 설계하는 것이 중요합니다. 두 음성 사이에 발화 스타일뿐만 아니라 화자, 문장 내용, 음질과 같은 여러 차이가 함께 존재하면, 보상모델은 사용자의 지시를 얼마나 잘 따랐는지가 아니라 더 자연스럽거나 표현력이 풍부한 음성을 선택하는 방식으로 학습될 수 있습니다. 만약 보상 모델이 화자 특성이나 문장 분위기 같은 잘못된 단서를 학습하면, 이러한 편향이 강화학습 과정에서 더욱 확대될 수 있습니다.
예를 들어 한쪽 음성이 더 표현력이 좋은 화자의 목소리로 생성되었다면, 보상모델은 발화지시와 관계없이 해당 화자의 음성에 높은 점수를 부여할 수 있습니다. 또한 “이건 비밀이야”와 같은 문장은 그 내용 자체가 작은 목소리나 속삭이는 말투를 연상시키기 때문에, 모델이 사용자의 명시적인 지시보다 문장에 내재된 분위기를 기준으로 음성을 평가할 가능성도 있습니다.
발화지시의 강도를 세밀하게 구분하는 것도 중요한 과제입니다. “빠르게 말해줘”와 “아주 빠르게 말해줘”처럼 유사한 지시를 동일한 범주로만 학습하면, 보상모델이 속도의 미묘한 차이를 구분하지 못하고 두 음성에 비슷한 점수를 부여할 수 있습니다. 이 경우 강화학습을 수행하더라도 모델은 사용자가 요구한 표현의 강도를 정교하게 조절하기 어렵습니다.
Counterfactual Preference 데이터셋 구축하기
일반적인 preference dataset은 하나의 지시에 대해 생성된 두 개의 음성 후보를 비교하고, 그중 전반적으로 더 좋은 음성에 선호 관계를 부여하는 방식으로 구성됩니다. 예를 들어 동일한 발화지시 및 발화문장으로 생성한 두 음성을 듣고 자연스러움, 음질, 발음 정확도 등을 종합적으로 판단하여 pair를 만듭니다.
이러한 방식은 전반적인 음성 품질을 높이는데는 효과적이지만, 어떤 요인 때문에 한 음성이 선호되었는지 명확하게 구분하기 어렵다는 한계가 있습니다. 특히 발화지시 이행능력을 학습하려는 경우에도 보상모델이 실제로 지시를 잘 따른 음성보다, 단순히 표현력이 더 좋은 화자의 음성을 선호할 수 있습니다.
저희가 구축한 Counterfactual Preference 데이터셋은 이러한 일반적인 선호 데이터와 달리, 비교하려는 발화의 속성에만 의도적으로 변화를 주고 화자 및 발화 문장 등 나머지 조건은 동일하게 유지합니다. 즉, 현재 주어진 발화지시를 기준으로 어느 음성이 더 적합한지를 비교하여, 기준이 되는 지시에 따라 선호관계를 정의한다는 점이 핵심입니다.
예를 들어 다음과 같은 세가지 조건으로 음성이 있다고 가정해 보겠습니다.
- A: “다음 문장을 아주 빠르게 읽어줘”라는 조건으로 생성한 음성
- B: “다음 문장을 빠르게 읽어줘”라는 조건으로 생성한 음성
- C: “다음 문장을 읽어줘”라는 조건으로 생성한 음성
이 세 음성을 “다음 문장을 아주 빠르게 읽어줘”라는 지시 기준으로 비교하면, 해당 조건을 가장 잘 반영한 A가 B와 C보다 선호되므로 A > B, A > C의 선호 쌍을 구성할 수 있습니다. 반대로 “빠르게 읽어줘”라는 지시에서는 지나치게 빠른 A나 일반적인 속도의 C보다 B가 적절하므로 B > A, B > C의 관계를 정의할 수 있습니다. 마찬가지로 별도의 속도 조절이 없는 지시를 기준으로는 C > A, C > B와 같은 선호 쌍을 만들 수 있습니다.
이처럼 하나의 음성 후보 집합을 서로 다른 발화지시와 조합하면, 음성을 추가로 수집하지 않고도 여러 개의 pairwise preference data로 확장할 수 있습니다. 특히 같은 두 음성이라도 어떤 지시를 기준으로 평가하느냐에 따라 선호 관계가 달라질 수 있기 때문에, 보상모델은 특정 음성의 절대적인 특성이나 발화의 내용에 편향되지 않고 발화지시와 음성 사이의 적합성을 학습하게 됩니다.
발화지시 이행을 평가하는 보상모델
자체 구축한 한국어 counterfactual preference 데이터셋으로, 두 음성 중 어떤 음성이 사용자의 지시를 더 잘 따르는지를 평가하는 보상모델을 학습했습니다. 보상모델은 사전 학습된 음성-언어 모델인 Kanana-a를 기반으로 구축했으며, 발화지시, 발화문장과 생성된 음성을 함께 입력받아 해당 음성이 지시를 얼마나 충실하게 반영했는지를 점수로 출력합니다.
절대적인 정답 점수를 직접 지정하는 대신, 선호되는 음성이 그렇지 않은 음성보다 상대적으로 더 높은 점수를 갖도록 학습하는 Bradley–Terry 방식의 pairwise preference modeling을 사용했습니다. 이를 통해 감정, 말투, 속도, 음량 등 다양한 발화지시 조건에 대한 지시 이행 정도를 하나의 평가 신호로 활용할 수 있게 됩니다.
저희는 preference dataset의 효과를 평가하기 위해 자체적으로 보상모델의 벤치마크 데이터를 구축하였습니다. 학습 데이터에 포함되지 않은 발화문장, 발화지시 및 다양한 화자로부터 수집된 음성들에 대해 3명 이상의 사람의 검수를 통해 1,000 개의 평가용 선호 쌍을 구성하였습니다.
표 4에서 볼 수 있듯이, counterfactual preference 데이터셋을 기반으로 학습된 보상모델은 일반적인 형태의 preference 데이터셋을 기반으로 학습된 보상모델 대비 일반화 성능을 유의미하게 개선하였습니다.
| Dataset | 보상모델의 분류 정확도 ↑ |
|---|---|
| 일반 preference 데이터셋 | 79.1% |
| Counterfactual preference 데이터셋 | 86.0% |
<표 4. Preference 데이터셋별 보상모델의 분류 성능>
여러 품질 기준을 함께 고려하는 Multi-objective 온라인 강화학습
앞서 구축한 preference dataset을 활용하는 가장 간단한 방법은 DPO(Direct Preference Optimization) [12]와 같이, 미리 정의된 선호 관계를 바탕으로 모델을 직접 학습하는 것입니다. 이렇게 미리 정의된 preference dataset을 기반으로 선호되는 음성의 생성 확률은 높이고, 선호되지 않는 음성의 생성 확률은 낮추는 방식으로 학습할 수 있어 비교적 안정적이고 효율적이라는 장점이 있습니다.
그러나 이러한 offline preference 학습 방식은 일반적으로 학습 전에 구축된 고정된 데이터만을 사용하기 때문에 학습이 진행되며 현재 모델이 새롭게 생성하는 음성의 장단점을 확인하고, 이를 다시 학습신호에 반영하기는 어렵습니다. 특히 학습 중 모델이 변화하면서 나타나는 실패 유형은 정의 된 preference dataset에 충분히 포함되어 있지 않을 수 있습니다. 따라서 저희는 현재 모델이 직접 음성을 생성하고, 생성 결과를 평가한 뒤, 그 결과를 다시 모델 업데이트에 반영하는 온라인 강화학습(Online RL)[9,10]을 음성발화 모델에 적용하였습니다.
한편, 보상모델의 점수만 높이도록 모델을 최적화하면 새로운 문제가 발생할 수 있습니다. 모델이 발화지시를 과도하게 강조하는 과정에서 일부 단어를 부정확하게 발음하거나, 주어진 화자의 음색을 변화 시키거나, 전체적인 음질이 낮아질 수 있기 때문입니다.
예를 들어, 빠르게 말하라는 지시 점수만 최적화하면 모델이 지나치게 속도를 높이는 과정에서 음절을 누락할 수 있습니다. 보상모델은 단순히 선호관계만을 학습했기 때문에 이러한 품질 저하까지 포착하기는 어렵습니다. 이에 저희는 보상모델이 예측하는 하나의 점수만 사용하는 대신, 다음 네 가지 목표를 함께 고려하는 Multi-objective 강화학습을 적용했습니다.
- 보상 모델 점수: 발화 지시를 얼마나 정확히 이행했는가
- 발화 오류율: 주어진 문장을 빼먹거나 틀리지 않고 정확히 읽었는가
- 화자 유사도: 지정된 화자의 고유 음색이 유지되는가
- 음질 점수: 생성 음성이 자연스럽고 노이즈 없이 깨끗한가
이로써 Kanana-o는 특정 평가 점수 하나만 높이는 방향으로 치우치지 않고, 높은 음질과 정확한 발음, 화자의 특성을 유지하면서도 사용자가 요청한 발화 방식에 충실하게 음성을 생성하도록 학습할 수 있었습니다.
성능평가
사용자의 발화 지시를 얼마나 충실하게 따랐는지 평가하기 위해, 저희는 InstructTTSEval [11]의 평가 시스템을 참고해 자연어 형태의 한국어 발화 지시 TTS 벤치마크를 구축했습니다. 평가 단계에서는 생성된 음성과 해당 음성에 주어진 발화지시를 음성이해 능력을 갖춘 멀티모달 언어모델에 함께 입력하고, 두 정보의 일치 여부를 판정하는 LLM(Gemini)-as-a-Judge 방식을 사용합니다.
평가 모델은 생성된 음성의 주요 발화 특성을 분석한 뒤, 속도와 음량, 음높이, 감정 등이 지시와 전반적으로 부합하면 True, 하나 이상의 핵심 특성이 명확하게 충돌하거나 전체적인 발화 스타일이 지시에서 벗어나면 False로 평가합니다. 최종 점수는 전체 평가 데이터 중 지시를 올바르게 따른 것으로 판정된 비율로 계산합니다. 이를 통해 개별 음향 지표만으로는 측정하기 어려운 복합적인 자연어 발화지시의 이행 능력을 자동으로 평가할 수 있습니다.
표 5.에서 보듯이, 한국어 InstructTTSEval 벤치마크에서 multi-objective 온라인 강화학습을 적용했을 때 DPO 와 비교해서 더 큰 성능 개선을 확인할 수 있었습니다. 또한 Kanana-o 모델이 최신 타사 tts 전용 모델들과 비교할만한 발화지시 이행 능력을 갖추었음을 확인하였습니다.
| 모델 | 한국어 InstructTTSEval 스코어 |
|---|---|
| GPT-4o-mini-tts | 91.10 |
| Gemini-2.5-flash-preview-tts | 95.38 |
| Kanana-o (초기 체크포인트) | 73.90 |
| Kanana-o (DPO 이후) | 81.30 |
| Kanana-o (multi-objective 온라인 강화학습 이후) | 94.50 |
<표 5. 한국어 InstructTTSEval 성능 비교>
발화지시 기반 음성 합성 예시
앞서 소개드린 방법이 적용된 Kanana-o의 개선된 발화지시 이행력을 예시와 함께 살펴보겠습니다. 아래 예시들에서, 자연어 형태의 단순한 발화지시 부터 복합적인 발화지시를 따라 음성의 다양한 음향적 요소를 제어하여 발화된 음성을 확인할 수 있습니다.
발화문장:
“카카오는 단순한 텍스트 생성을 넘어 AI가 스스로 단계별 실행 계획을 수립하고, 필요한 기능을 호출해 과업을 완수하는 ‘종합 실행 역량’ 검증에 집중하고 있습니다.”
지시어 타입: "지시어 없음"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 지시어 없음 | 음성 듣기 | 음성 듣기 |
지시어 타입: "음량"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 작은 소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 큰 소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 아주 작은 소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 아주 작은 소리로 속삭이듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "속도"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 빠른속도로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 엄청 빠른속도로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 정신없이 엄청 빠른속도로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 조금 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
| 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
| 아주 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "톤"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 목소리를 높여서 읽어줘 | 음성 듣기 | 음성 듣기 |
| 힘껏 목소리를 높여서 읽어줘 | 음성 듣기 | 음성 듣기 |
| 낮은 목소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 아주 낮은 목소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "억양"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 전라도 사투리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 경상도 사투리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 랩 하듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "감정"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 밝고 명랑하게 읽어줘 | 음성 듣기 | 음성 듣기 |
| 어린아이처럼 밝고 명랑하게 읽어줘 | 음성 듣기 | 음성 듣기 |
| 슬픈 목소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 힘이 없는 낮은 목소리와 슬픔이 담긴 어조로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 화난 사람처럼 읽어줘 | 음성 듣기 | 음성 듣기 |
| 졸려서 만사가 귀찮은 사람처럼 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "역할"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 스포츠 중계하듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
| 아나운서 처럼 읽어줘 | 음성 듣기 | 음성 듣기 |
| 동화책을 읽어주는 것처럼 크고 실감 나게 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "복합"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 빠르고 속삭이듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
| 톤을 높여서 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
| 톤을 높여서 어린아이처럼 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
| 톤을 낮춰서 어린아이처럼 빠르게 읽어줘 | 음성 듣기 | 음성 듣기 |
| 톤을 높여서 어린아이처럼 빠르게 읽어줘 | 음성 듣기 | 음성 듣기 |
| 톤을 낮춰서 빠르게, 슬픈 목소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 톤을 낮춰서 빠르게, 슬픈 어린아이 목소리로 읽어줘. | 음성 듣기 | 음성 듣기 |
흥미로운 점은 preference 데이터셋과 온라인 강화학습을 모두 한국어 음성으로만 구성했음에도, 학습된 발화 제어 능력이 영어 음성 발화에서도 동작했다는 것입니다. 이는 속도, 음량, 음높이, 감정과 같은 음향적 특성이 특정 언어의 발화 내용과 완전히 결합된 정보라기보다, 여러 언어에서 공통적으로 활용할 수 있는 제어 요소이기 때문으로 볼 수 있습니다.
특히 LM-SPT는 발화 내용을 담당하는 의미 토큰과 세부적인 음성 특성을 담당하는 음향 토큰을 구조적으로 분리해 표현합니다. 이에 따라 모델은 한국어 데이터로 발화 지시와 음향적 변화 사이의 관계를 학습하더라도, 해당 제어 능력을 특정 한국어 표현에만 종속시키지 않고 영어를 비롯한 다른 언어의 음성 생성에서도 발현이 가능하게 됩니다.
이러한 결과는 의미와 음향 정보가 잘 분리된 음성 표현이 한 언어에서 학습한 발화 제어 능력을 다른 언어로 전이하는 데에도 효과적일 수 있음을 보여줍니다. 아래 예시들에서, 영어 발화문장 또한 발화지시를 따라 음성을 발화하는 것을 확인할 수 있습니다.
발화문장:
“With the rapid progress of speech language models, discrete speech tokens have emerged as a core interface between speech and text, enabling unified modeling across modalities.”
지시어 타입: "지시어 없음"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 지시어 없음 | 음성 듣기 | 음성 듣기 |
지시어 타입: "음량"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 아주 작은 소리로 속삭이듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
| 엄청 큰 소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "속도"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 빠른속도로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 정신없이 엄청 빠른속도로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 조금 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
| 아주 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "톤"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 목소리를 높여서 읽어줘 | 음성 듣기 | 음성 듣기 |
| 낮은 목소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "억양"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 한국인 사투리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 랩 하듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "감정"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 어린아이처럼 밝고 명랑하게 읽어줘 | 음성 듣기 | 음성 듣기 |
| 슬픈 목소리로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 힘이 없는 낮은 목소리와 슬픔이 담긴 어조로 읽어줘 | 음성 듣기 | 음성 듣기 |
| 화난 사람처럼 읽어줘 | 음성 듣기 | 음성 듣기 |
| 졸려서 만사가 귀찮은 사람처럼 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "역할"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 스포츠 중계하듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
| 동화책을 읽어주는 것처럼 크고 실감 나게 읽어줘 | 음성 듣기 | 음성 듣기 |
지시어 타입: "복합"
| 발화지시어 | 화자 1 | 화자 2 |
|---|---|---|
| 빠르고 속삭이듯이 읽어줘 | 음성 듣기 | 음성 듣기 |
| 톤을 높여서 천천히 읽어줘 | 음성 듣기 | 음성 듣기 |
| 엄청 낮은 저음으로 아주 빠르게 읽어줘 | 음성 듣기 | 음성 듣기 |
| 스포츠 중계하듯이, 엄청 낮은 저음으로 아주 빠르게 읽어줘 | 음성 듣기 | 음성 듣기 |
앞으로의 목표
1. 더 발전된 음성 토크나이저
최근 음성 토크나이저에 대한 연구에서는 음성-언어 모델과 효과적으로 결합되고 음성 이해 및 생성에 공통으로 활용할 수 있는 통합된 음성 토큰 표현을 학습하는 것을 중요한 과제중 하나로 여기고 있습니다. 기존 음성-언어 모델은 음성을 이해할 때 사용하는 인코더 표현과 음성을 생성할 때 사용하는 토큰 표현이 서로 다른 경우가 많지만, 하나의 음성 토크나이저가 두 역할을 모두 담당할 수 있다면 모델은 동일한 표현 공간에서 음성을 이해하고 생성할 수 있습니다.
이 통합 구조는 다음과 같은 명확한 이점을 가집니다.
- 표현 공유 및 상호 학습 시너지: 음성 이해와 생성 과정에서 학습한 의미·음향 표현을 두 과제에서 공유하고 재활용합니다. 이를 통해 음성 이해와 생성이 서로의 성능 향상에 기여하는 시너지를 만들 수 있습니다.
- 모델 구조 단순화: 음성 이해와 생성을 서로 다른 표현 체계와 별도의 처리 파이프라인으로 구성하는 대신, 하나의 통합된 음성 표현을 중심으로 모델을 설계할 수 있습니다. 이를 통해 중복되는 모듈과 표현 변환 과정을 줄여 전체 아키텍처를 단순화하고, 모델의 구현과 운영 효율도 높일 수 있습니다.
- 실시간 처리 및 온디바이스 최적화: 통합된 표현을 사용하면 음성 이해와 생성 사이에서 발생하는 중복 연산과 메모리 사용, 표현 변환 과정을 줄일 수 있습니다. 이로인해 실시간 대화에서 낮은 지연 시간을 확보하는 데 유리하며, 연산 자원과 메모리가 제한된 온디바이스 환경에서도 더 효율적으로 동작할 수 있습니다.
이번 글에서 소개한 LM-SPT는 기존 음성 토크나이저보다 낮은 frame rate와 언어모델 친화적인 토큰 표현을 통해 음성 이해와 생성 모두에서 우수한 성능을 확인했습니다. 그러나 음성 이해 성능만 놓고 보면 Whisper [8]와 같이 음성 인식만을 위해 대규모 데이터로 학습된 전용 음성 인코더와 비교해서 아직 개선의 여지가 있습니다.
앞으로는 음성 토크나이저의 의미 표현 능력을 더욱 강화하여, 하나의 토크나이저가 음성 이해와 생성 모두 전용 모델에 가까운 성능을 제공할 수 있도록 연구를 이어갈 계획입니다. 또한 현재 LM-SPT는 초당 12.5개의 frame으로 음성을 표현하지만, 앞으로는 복원 음질을 유지하면서도 더 높은 압축률을 통해, 생성해야 하는 토큰 수를 더욱 줄여 나갈 계획입니다.
2. 실시간 음성 어플리케이션 지원
LM-SPT의 낮은 frame rate와 높은 연산 효율을 바탕으로, 음성을 실시간으로 이해하고 생성하는 다양한 음성-언어모델 어플리케이션으로의 확장을 진행하고 있습니다. 특히 Full-duplex 음성 비서, 실시간 음성 인식, 실시간 통역과 같이 낮은 지연 시간(latency)이 중요한 서비스에서도 자연스럽고 끊김 없는 음성 상호작용을 제공하는 것을 목표로 하고 있습니다.
3. 비언어적인 발화 및 지역적인 발화지시 능력 강화
현재의 음성 언어모델은 텍스트를 자연스럽게 읽는 수준을 넘어, 사람처럼 다양한 비언어적 표현을 함께 전달하는 방향으로 발전하고 있습니다.
이를 위해 웃음, 한숨, 감탄과 같은 비언어적 발화를 자연스럽게 생성할 수 있도록 모델을 고도화할 예정입니다. 예를 들어 발화 문장에 [웃음]과 같은 태그를 입력하면, VoiceToken LM이 해당 태그의 위치와 문맥을 함께 고려하여 자연스럽게 웃음소리를 생성하는 것을 목표로 합니다.
더 나아가, 비언어적 표현 뿐만아니라 [공감하듯이], [속삭이듯이], [강조하며]와 같은 제어태그를 원하는 위치에 삽입함으로써 기존의 자연어 기반 발화지시보다 더 세밀하게 발화의 감정 및 표현 방식을 제어할 수 있도록 확장해 나갈 계획입니다.
맺음말
이번 글에서는 Kanana-o가 사람처럼 자연스럽게 말하고, 사용자의 의도에 맞춰 다양한 방식으로 표현할 수 있도록 발전해 온 과정을 소개해 드렸습니다. 음성 토크나이저부터 Voice Token LM, 온라인 강화학습까지, 각각의 기술은 단순히 모델의 성능을 높이기 위한 것이 아니라 실제 사용자와의 대화를 더욱 자연스럽고 편안하게 만들기 위한 고민에서 출발했습니다.
앞으로도 카카오는 음성을 더 효율적으로 이해하고 생성할 수 있는 핵심 기술을 지속적으로 발전시키는 한편, 실시간 음성 인터페이스와 더욱 정교한 음성 제어 기능까지 지원하는 차세대 음성 언어모델을 만들어 나가고자 합니다. 이를 통해 사용자가 AI와 대화한다는 사실을 의식하지 않을 만큼 자연스럽고 편리한 음성 경험을 제공하는 것이 저희의 목표입니다.
계속 진화해 나갈 Kanana-o의 여정에 많은 관심과 응원 부탁드립니다.
함께한 사람들
Kanana 조직의 abigail.r (박혜영), brook.p (박범희), charlie.robust(최중원), daniel.log (김영준), edwin.ai (강우영), james.e (이재명), jayden.x (부종철), jayten.ten (전재열), jessie.e (이지혜), johnny.oh (오재훈), martin.gale (조대진), peter.brain (노병석), polar.bears (엄지환), sam.shkim (김세훈), samuel.brain (강성훈), welt.bae (배병욱) 이 함께했습니다.
데이터 구축에 있어서는 Kanana 조직의 jennie.ee (이지혜), jeri.s (이희현)이 많은 도움을 주셨습니다.
감사의 말
전체 내용에 대한 검수를 맡아주신 Kanana 조직의 peter.brain (노병석), hunter.jo (조훈) 에게 감사의 말을 전합니다.
참고문헌
- [1] D. Jo, J. Yun, B. Roh, and S. Kim, “LM-SPT: LM-Aligned Semantic Distillation for Speech Tokenization”, IEEE Transactions on Audio, Speech and Language Processing, 2026.
- [2] X. Zhang, D. Zhang, S. Li, Y. Zhou, and X. Qiu, “SpeechTokenizer: Unified speech tokenizer for speech language models,” International Conference on Learning Representations, 2024.
- [3] A. Défossez, L. Mazaré, M. Orsini, A. Royer, P. Pérez, H. Jégou, E. Grave et al., “Moshi: a speech-text foundation model for real-time dialogue,” arXiv preprint arXiv:2410.00037, 2024.
- [4] J. Li, X. Lin, Z. Li, S. Huang, Y. Wang, C. Wang, Z. Zhan, and Z. Wu, “DualCodec: A low-frame-rate, semantically-enhanced neural audio codec for speech generation,” Interspeech, 2025.
- [5] Z. Du, Y. Wang, Q. Chen, X. Shi, X. Lv, T. Zhao, Z. Gao, Y. Yang, C. Gao, H. Wang et al., “CosyVoice 2: Scalable streaming speech synthesis with large language models,” arXiv preprint arXiv:2412.10117, 2024.
- [6] W.-N. Hsu, B. Bolte, Y.-H. H. Tsai, K. Lakhotia, R. Salakhutdinov, and A. Mohamed, “HuBERT: Self-supervised speech representation learning by masked prediction of hidden units,” IEEE Transactions on Audio, Speech and Language Processing, 2021.
- [7] S. Chen, C. Wang, Z. Chen, Y. Wu, S. Liu, Z. Chen, J. Li, N. Kanda, T. Yoshioka, X. Xiao et al., “WavLM: Large-scale self-supervised pre-training for full stack speech processing,” IEEE Journal of Selected Topics in Signal Processing, 2022.
- [8] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust speech recognition via large-scale weak supervision,” International Conference on Machine Learning, 2023.
- [9] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. L. Wainwright, P. Mishkin, C. Zhang et al., “Training language models to follow instructions with human feedback,” in Advances in Neural Information Processing Systems, 2022.
- [10] D. Khatri, L. Madaan, R. Tiwari, R. Bansal, S. S. Duvvuri, M. Zaheer, I. S. Dhillon et al., “The art of scaling reinforcement learning compute for LLMs,” International Conference on Learning Representations, 2026.
- [11] K. Huang, Q. Tu, L. Fan, C. Yang, D. Zhang, S. Li, Z. Fei, Q. Cheng, and X. Qiu, “InstructTTSEval: Benchmarking complex natural-language instruction following in text-to-speech systems,” arXiv preprint arXiv:2506.16381, 2025.
- [12] R. Rafailov, A. Sharma, E. Mitchell, C. D. Manning, S. Ermon, and C. Finn, “Direct preference optimization: Your language model is secretly a reward model.” Advances in Neural Information Processing Systems, 2023