Data
Spark Cluster 구축기
Amber Bae여기어때
2024년 3월 18일
원문에서 보기 ↗안녕하세요. 여기어때컴퍼니 공통플랫폼개발팀 데이터 엔지니어 앰버입니다.
Copyright 2024. 여기어때컴퍼니 All Right Reserved. Graphic by 김제린(Riny).
EC2로 Spark Cluster를 구성 해보았던 경험을 공유하면서 Spark를 처음 접하는 분들도 Spark Cluster의 전반적인 개념을 이해할 수 있도록 글을 작성해보았습니다.
제가 속한 공통플랫폼개발팀은 더 많은 데이터(대용량)를, 빠르게 처리하도록 개선하고자 하는 니즈가 있었습니다. 데이터 엔지니어로서 주요 업무 중 하나는 데이터를 가공하는 것인데요. 이 중 데이터 웨어하우스에 적재하기 전, 원시 데이터(Raw Data)에서 원하는 형식으로 선택 및 가공하여 처리하는 작업이 있는데, 이를 ‘데이터 전처리’라고 말합니다. 이러한 데이터 전처리 및 이관 작업을 위해 오픈 소스 고속 분산 처리 엔진인 Spark를 사용하고 있습니다.
필요에 따라 AWS의 EMR(Elastic MapReduce, AWS가 제공하는 빅데이터 플랫폼 서비스)를 사용하기도 하지만, 대부분의 경우 프로젝트에 속한 데이터를 단일 서버에 Spark를 설치하여 처리합니다. 그러나 단일 서버에서 작업하는 방식은 서버 메모리가 부족하면 처리할 수 있는 데이터의 양이나 처리 속도에 제한이 생기는 문제가 있습니다. 이와 같은 상황에서 시간 당 처리할 수 있는 데이터양을 늘리기 위해 Spark Cluster의 구축 필요성을 느끼게 되었습니다.
Spark와 Hadoop은 어떤 관계인가? Spark Cluster 구성
빅데이터 처리를 위한 도구로 주로 사용되는 Hadoop과 Spark를 비교하고, Spark Cluster를 구성할 때의 선택지에 대해 알아보겠습니다.
Spark는 빅데이터 처리를 위한 오픈 소스 고속 분산처리 엔진이라고 간단히 소개를 드렸는데, Hadoop과 어떤 차이를 가지고 있을까요? Hadoop은 HDFS(Hadoop Distributed File System)라는 파일시스템과, Yarn이라는 리소스 관리 매니저, MapReduce를 활용하여 연산처리하는 데이터 분산 처리 시스템입니다. Spark와 Hadoop 모두 대용량의 데이터를 처리하는 데 사용되지만, 둘은 연산 방식에서 차이점을 가지고 있습니다. Hadoop은 Disk I/O를 기반으로 동작하기 때문에 연산 처리 속도의 한계를 갖는 반면, Spark는 인메모리로 데이터를 처리하기 때문에 실시간 스트리밍이 가능할 만큼 속도가 빨라서 Hadoop의 느린 연산속도를 보완합니다.
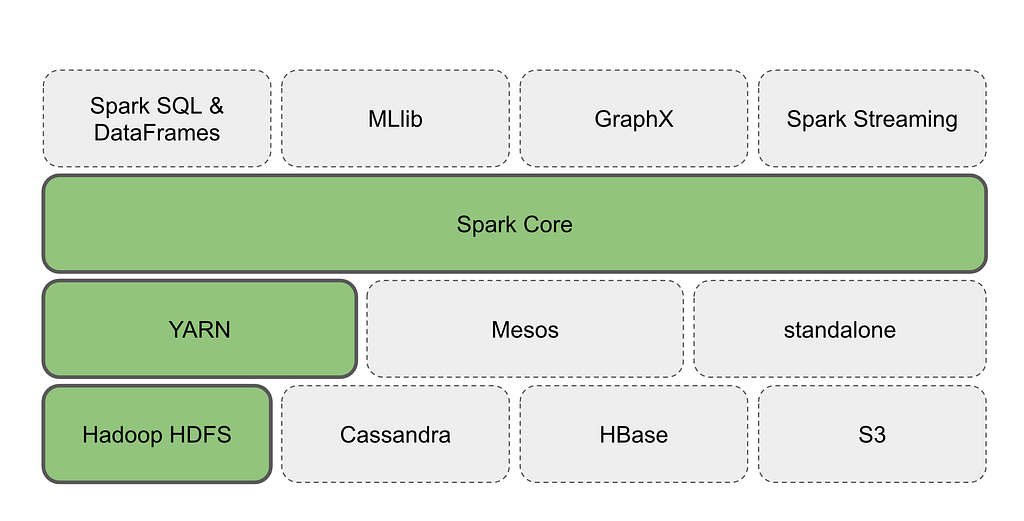
Spark Cluster를 구성할 때는 파일 저장 및 처리 시스템과 리소스 매니저를 선택해야 합니다. 다양한 선택지들 중에서 가장 일반적으로 선택되는 구성은 “Hadoop의 HDFS 파일 처리 시스템과 Yarn 리소스 매니저”입니다.
- HDFS 파일 처리 시스템: Hadoop의 HDFS를 선택하는 경우, 동일한 시스템 내에서 데이터를 저장하고 처리하기 때문에 액세스 및 처리 속도가 우수합니다. 데이터가 클러스터 내에 머무르고 대량의 데이터를 빠르게 처리해야 하는 경우에 적합합니다.
- 기타 선택지: AWS의 S3와 같은 클라우드 기반 스토리지를 사용하는 것도 다른 선택지가 될 수 있습니다. HDFS는 데이터를 블록(Block)으로 나누어 저장하는 반면, S3는 객체 스토리지 서비스로 데이터를 객체(Object) 단위로 저장합니다. S3를 사용할 경우 스토리지의 확장성과 유연성을 높일 수 있지만, 데이터 액세스 및 처리 속도는 HDFS에 비해 느릴 수 있습니다. S3를 선택하는 경우는 클라우드에서 데이터를 저장하고 클러스터 간에 데이터를 공유하거나 다른 클라우드 서비스와 통합해야 하는 경우에 유용하다고 판단됩니다.
구축시 겪은 시행착오와 해결방법
Spark Cluster를 설치형으로 구축하면서 겪은 시행착오는 다양했는데요. 대표적으로 노드간 유기적으로 연결되어 동작하도록 만들 때 가장 큰 시행착오를 겪었습니다.
문제 상황 1 (설정의 오류): org.apache.hadoop.yarn.exceptions.InvalidAuxServiceException 발생
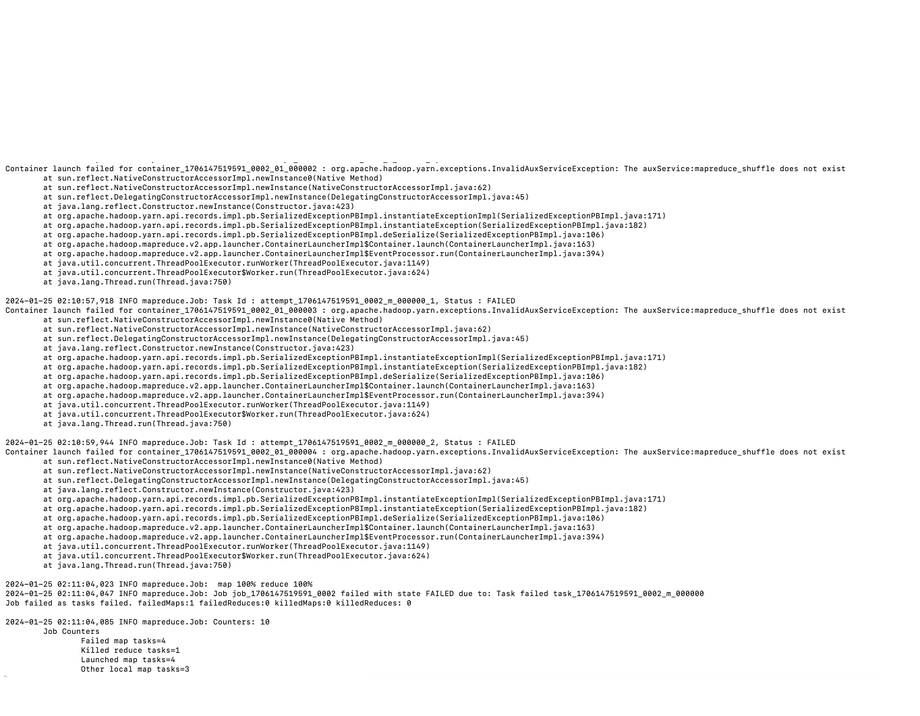
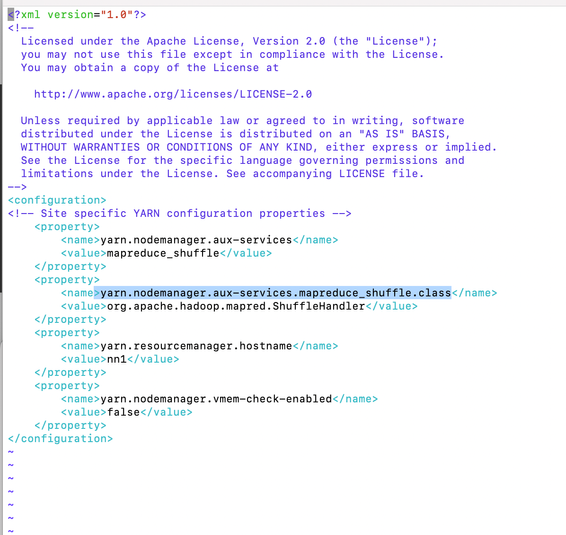
(좌) 에러메시지 (우) yarn-site.xml 이미지
현상:
Hadoop Cluster 설치를 끝낸 후 어플리케이션 실행 시 org.apache.hadoop.yarn.exceptions.InvalidAuxServiceException 오류가 발생했습니다. 에러 메시지는 “auxService:mapreduce_shuffle가 존재하지 않는다”는 것이었습니다.
원인 및 해결책:
해당 오류는 yarn-site.xml 설정 파일에서 yarn.nodemanager.aux-services.mapreduce_shuffle.class 속성에 잘못된 값을 기입했었기 때문에 발생했습니다. Cluster 구축을 위해 core-site.xml, hdfs-site.xml, mapred-site.xml, yarn-site.xml의 속성 값을 실행 환경에 맞춰 커스텀하게 되는데, 위와 같은 exceptions 관련 오류는 주로 설정 시 오류를 범했을 때 발생할 확률이 높습니다.
문제 상황 1과 같이, Cluster에 필요 요소들을 설치하고 환경 설정이 잘못되면 수정된 설정값을 반영하기 위해 재시작하는 일이 빈번해졌고, 필요에 따라 초기화를 수행하게 되었습니다. 이러한 설정 변경 작업을 반복하다보니, 특정시점에서는 Name Node와 Data Node가 외부적으로는 연결되어 동작하는 것 같아 보여도 내부적으로 자원 리소스나 스케줄링이 정상적으로 분배되지 않는 증상을 발견했습니다. 올바르게 환경설정이 마무리되면 이러한 증상이 발생하지 않습니다.
문제 상황2. /usr/local/hadoop/bin/hdfs dfsadmin -report
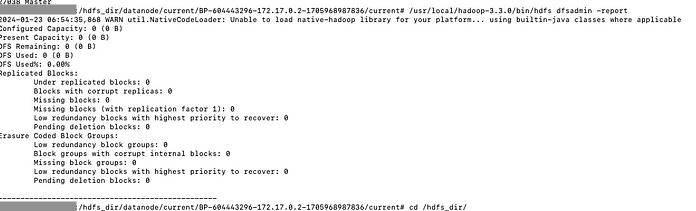
hdfs dfsadmin -report 명령을 실행하여 클러스터의 전체 리소스를 조회해보았는데, 전체 리소스가 0으로 표시되는 것이 확인되었습니다.
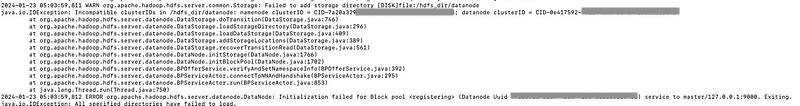
Name Node를 초기화한 후 Data Node를 초기화하면 동일한 Cluster ID의 값으로 인증이 진행됩니다. 그런데 저의 잦은(?) 수정으로 Name Node 초기화 → Data Node 초기화를 최초 1회 수행한 이후에도 수정이 필요하여 클러스터 재시작하는 경우가 많았습니다. 클러스터 재시작 후 Name Node만 환경변수 수정 후 다시 초기화하거나 Data Node만 환경변수 수정 후 다시 초기화와 같은 상황이 생기다보니 Name Node와 Data Node의 ID값이 상이해지는 경우가 생겨 벌어진 현상이었습니다.
이러한 시행착오를 겪으면서 Hadoop Cluster를 구축하는 과정에서는 올바른 설정 값으로 각 노드 간의 초기화를 정확하게 하는 것이 중요하다는 것을 느꼈습니다.
Spark Job은 어떻게 실행되나?
다음으로 Spark Job이 실행될 때 Job의 작업단위로 실행되는 과정에 대해 설명해 드리겠습니다. Spark Cluster에 제출되는 Job이 완료되는 과정은 다음과 같습니다.
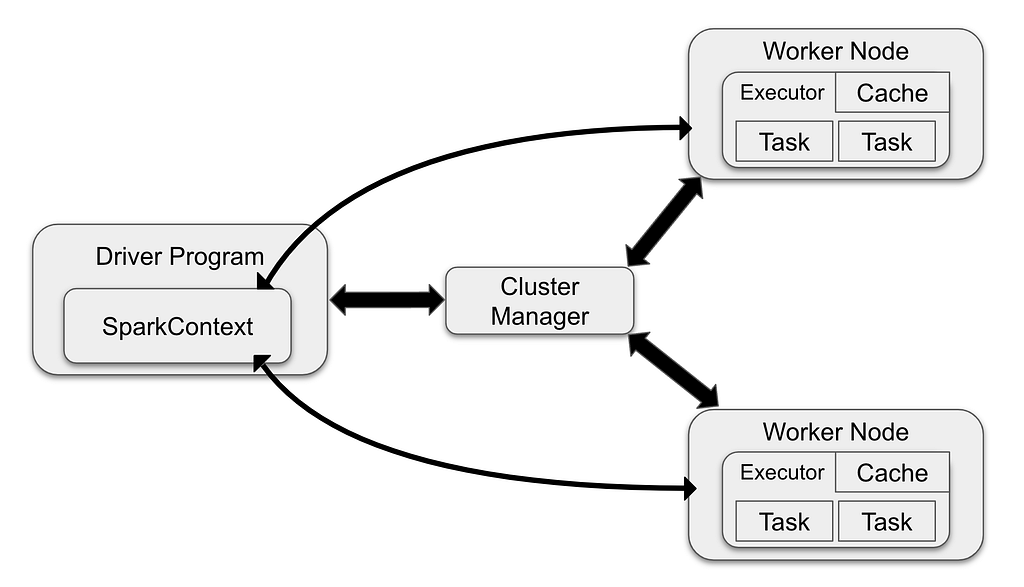
1 ) 작업 제출: 사용자는 스파크 애플리케이션을 마스터 노드에 제출
2 ) 자원 할당: 클러스터 매니저가 애플리케이션 실행에 필요한 자원(메모리, CPU 시간 등)을 Worker Node에 할당하고 Task를 수행하는 Executor 프로세스를 시작. Executor의 위치와 정보를 드라이버 프로세스에 전송함.
3 ) 작업 실행: Worker Node는 할당된 자원을 사용하여 실제 데이터 처리 작업 수행. Task를 할당 받은 Worker는 Task의 상태와 성공/실패 여부를 드라이버에 전송
4 ) 결과 반환: Spark애플리케이션 실행이 완료되면 드라이버 프로세스가 성공/실패 중 하나의 상태로 종료. 그런 다음 클러스터 매니저는 클러스터의 모든Executor를 종료시킴.
Cluster의 가용성을 높이자 (고가용성 구성)
드라이버 프로그램을 띄우는 Name Node를 두 개 준비합니다. 그 중 하나는 평상시에 Active 상태로 사용할 것이고, 나머지는 예비용(Standby)으로 사용할 것입니다.
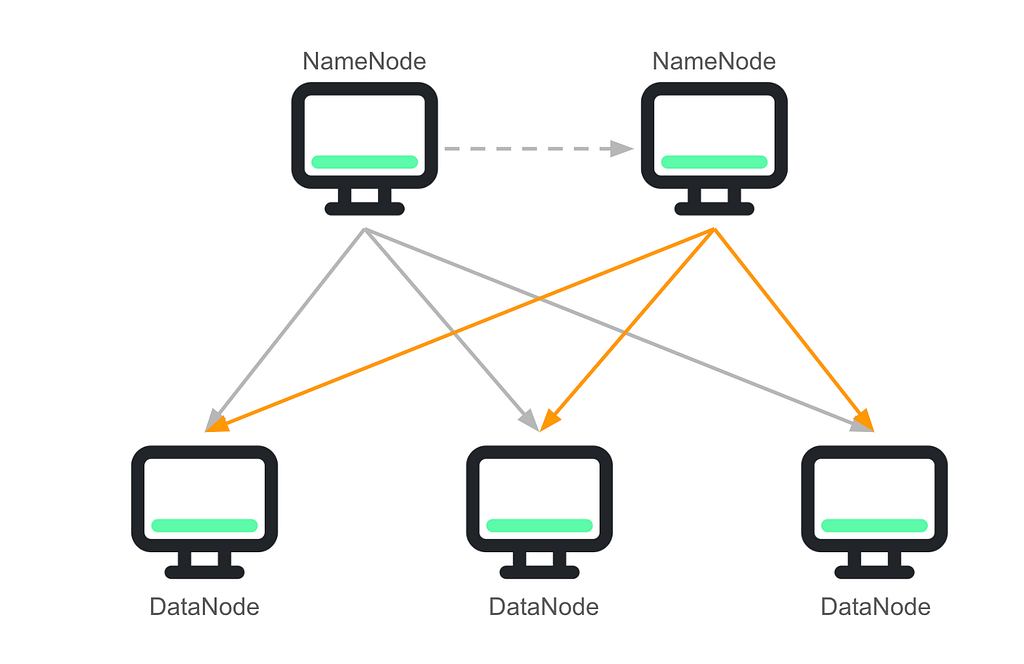
Spark Job이 실행되는 과정을 보면 Master를 사용해 스케줄링 결정을 내리고 실패 시 전체 시스템이 중단됩니다. 이를 방지하기 위해 하나의 Name Node가 고장나더라도 다른 Name Node가 활성화되어 서비스의 지속적인 가용성을 제공할 수 있도록 Name Node를 이중화하는 방식으로 고가용성(HA) 설정을 구성하였습니다.
hdfs haadmin -getServiceState namenode1 --> active
hdfs haadmin -getServiceState namenode2 --> standby


(좌) Main Name Node의 상태, (우) Standby Name Node의 상태
평소에 두 개의 Name Node는 실행중이지만 Main Name Node(NameNode1)은 Active, 예비 Name Node(NameNode2)는 Standby인 상태를 띠게 되고


Active 상태였던 NameNode1을 Kill하면 Standby 상태였던 NameNode2가 Active 되고, NameNode1는 연결이 거부됩니다. NameNode2는 NameNode1을 대체하여 Data Node의 작업을 스케줄링하는 역할을 이어받아 수행합니다.
NameNode2가 NameNode1를 바로 대체 할 수 있는 이유는, Hadoop의 저널노드 매니저와 Zookeeper가 Name Node끼리의 상태를 동기화하고, Active Name Node의 장애가 감지되면 Standby Name Node를 리더노드로 선출하여 작업을 이어 수행하기 때문입니다.
Name Node 장애시 타임라인
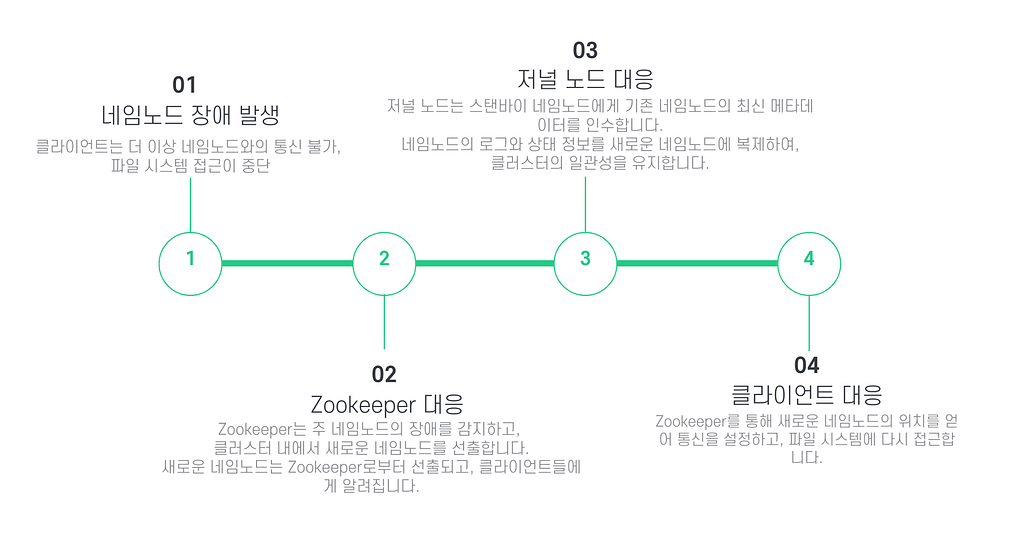
위와 같이 Spark 자체는 Zookeeper나 저널 노드에 의존하지 않지만, Spark Cluster가 Hadoop 생태계와 통합되어 운영될 때 이러한 컴포넌트들과 상호 작용하는데 필요합니다. 이로써 Spark Job 실행 중 Main Name Node에 문제가 생겨도 Standby Name Node가 대체하여 Cluster의 가용성을 높이게 됩니다.
추가로,
**Spark의 Driver, Executor는 JVM(Java Virtual Machine)상에서 실행되기 때문에 비효율적으로 메모리를 사용할 경우 가비지컬렉션에 영향을 받아 성능이 저하될 수 있습니다. 그리고 Spark 애플리케이션 실행 시 데이터의 처리목적과 특성에 맞게 다양한 설정 옵션을 조정한다면 클러스터의 자원을 최적화하여 처리 속도를 더욱 향상시킬 수 있습니다.
Spark의 성능을 더욱 향상시키고 싶다면 JVM과 Spark 설정 튜닝을 수행하면 좋습니다. 그러나 튜닝에 대한 내용은 더 기술적으로 깊이 들어가고, 이 글의 주제는 Spark Cluster 구축에 대한 내용이므로 다루지 않겠습니다.
Spark Cluster 구축이 완료되었으니 데이터 처리 성능이 어떻게 향상되고, 시간이 얼마나 단축되었는지 확인해보았습니다.
성능 테스트 1) 속도
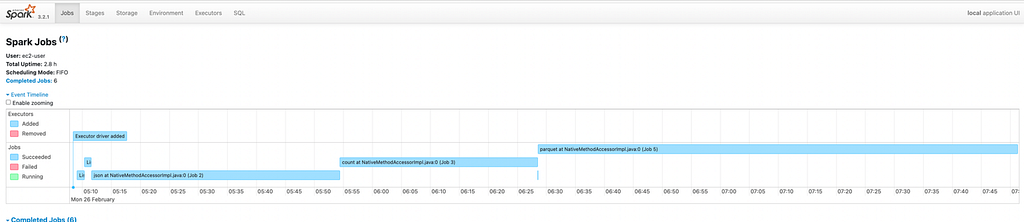
동일한 데이터인 마케팅 Appsflyer의 한달치 데이터를 돌렸을 때의 속도를 비교해보았습니다
단일 서버로 돌렸을 경우) 2.8시간 소요
Spark Cluster로 실행할 경우) 36분 소요
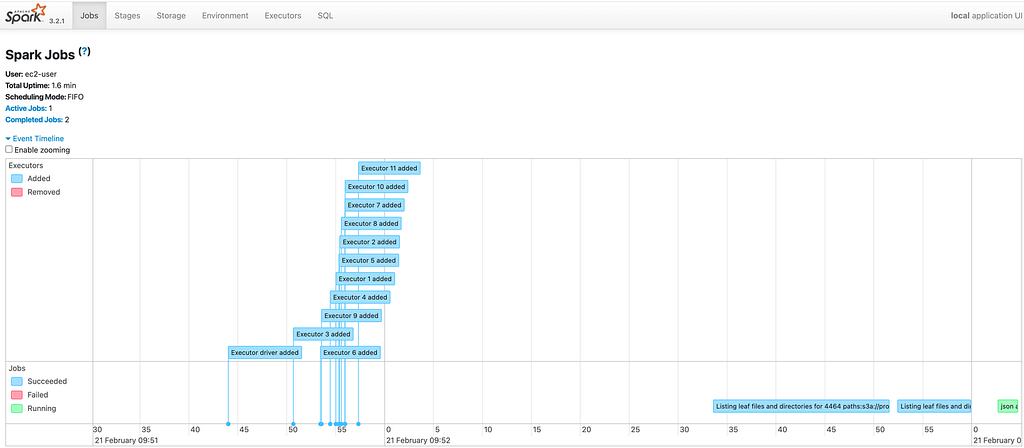
2.8시간 → 36분으로 처리 속도가 감소하였습니다.
성능 테스트2) 데이터 용량
사용자 로그 데이터, 약 500GB 테스트
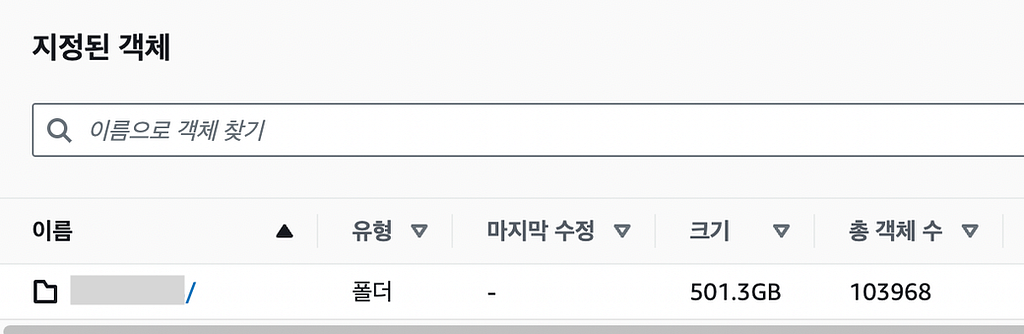
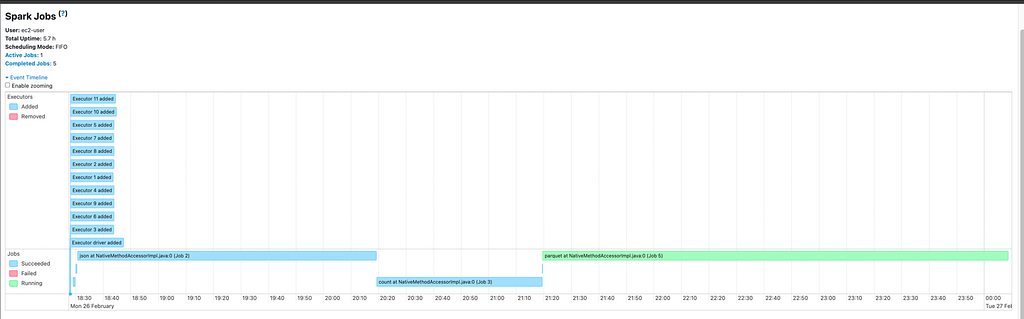
Spark Cluster로 500GB의 데이터를 처리하는데 9.8시간이 소요되었습니다.
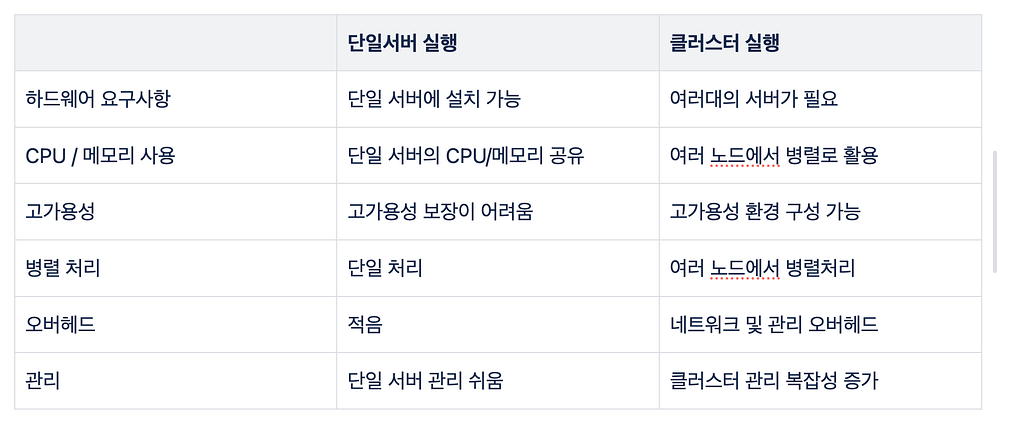
위와 같이 Spark Cluster를 구축함으로써 긍정적인 결과를 얻을 수 있었습니다. 그러나 Spark Cluster의 구축이 항상 정답인 것은 아닙니다. 단일 서버 환경은 성능 및 확장성에 제한이 있지만 초기 투자 및 유지보수 비용이 낮고 관리가 간편하다는 장점이 있습니다. 반면에 클러스터 환경에서는 높은 성능과 확장성을 제공하지만 초기 구축과 유지보수가 어렵고 관리가 복잡할 수 있습니다. 따라서 조직의 요구 사항과 자원 가용성을 고려하여 상황에 맞게 선택하는 것을 권장드립니다.
이상으로 Spark Cluster 구축에 대한 설명을 마치며, 다음에는 이를 운영하며 습득한 Spark Cluster 운영 노하우에 관한 글로 찾아뵐 수 있도록 하겠습니다.
감사합니다.