AI/ML
이상 탐지 3부-머신 러닝으로 이상 탐지하기
2023년 8월 14일
원문에서 보기 ↗
들어가며
안녕하세요. 클라우드 AI팀 박현목입니다.
지난 글에서는 통계적 기법을 활용한 이상 탐지에 대해 소개해 드렸습니다. 1부와 2부는 아래 경로에서 다시 읽어 보실 수 있습니다.
1부-정상과 비정상, 그리고 이상 탐지 2부-통계적 기법으로 이상 탐지하기 3부-머신 러닝으로 이상 탐지하기 4부-딥 러닝으로 이상 탐지하기
이번 글은 위와 같이 4부로 나눈 글 중 3부-머신 러닝으로 이상 탐지하기에 대한 이야기입니다.
1. Machine learning
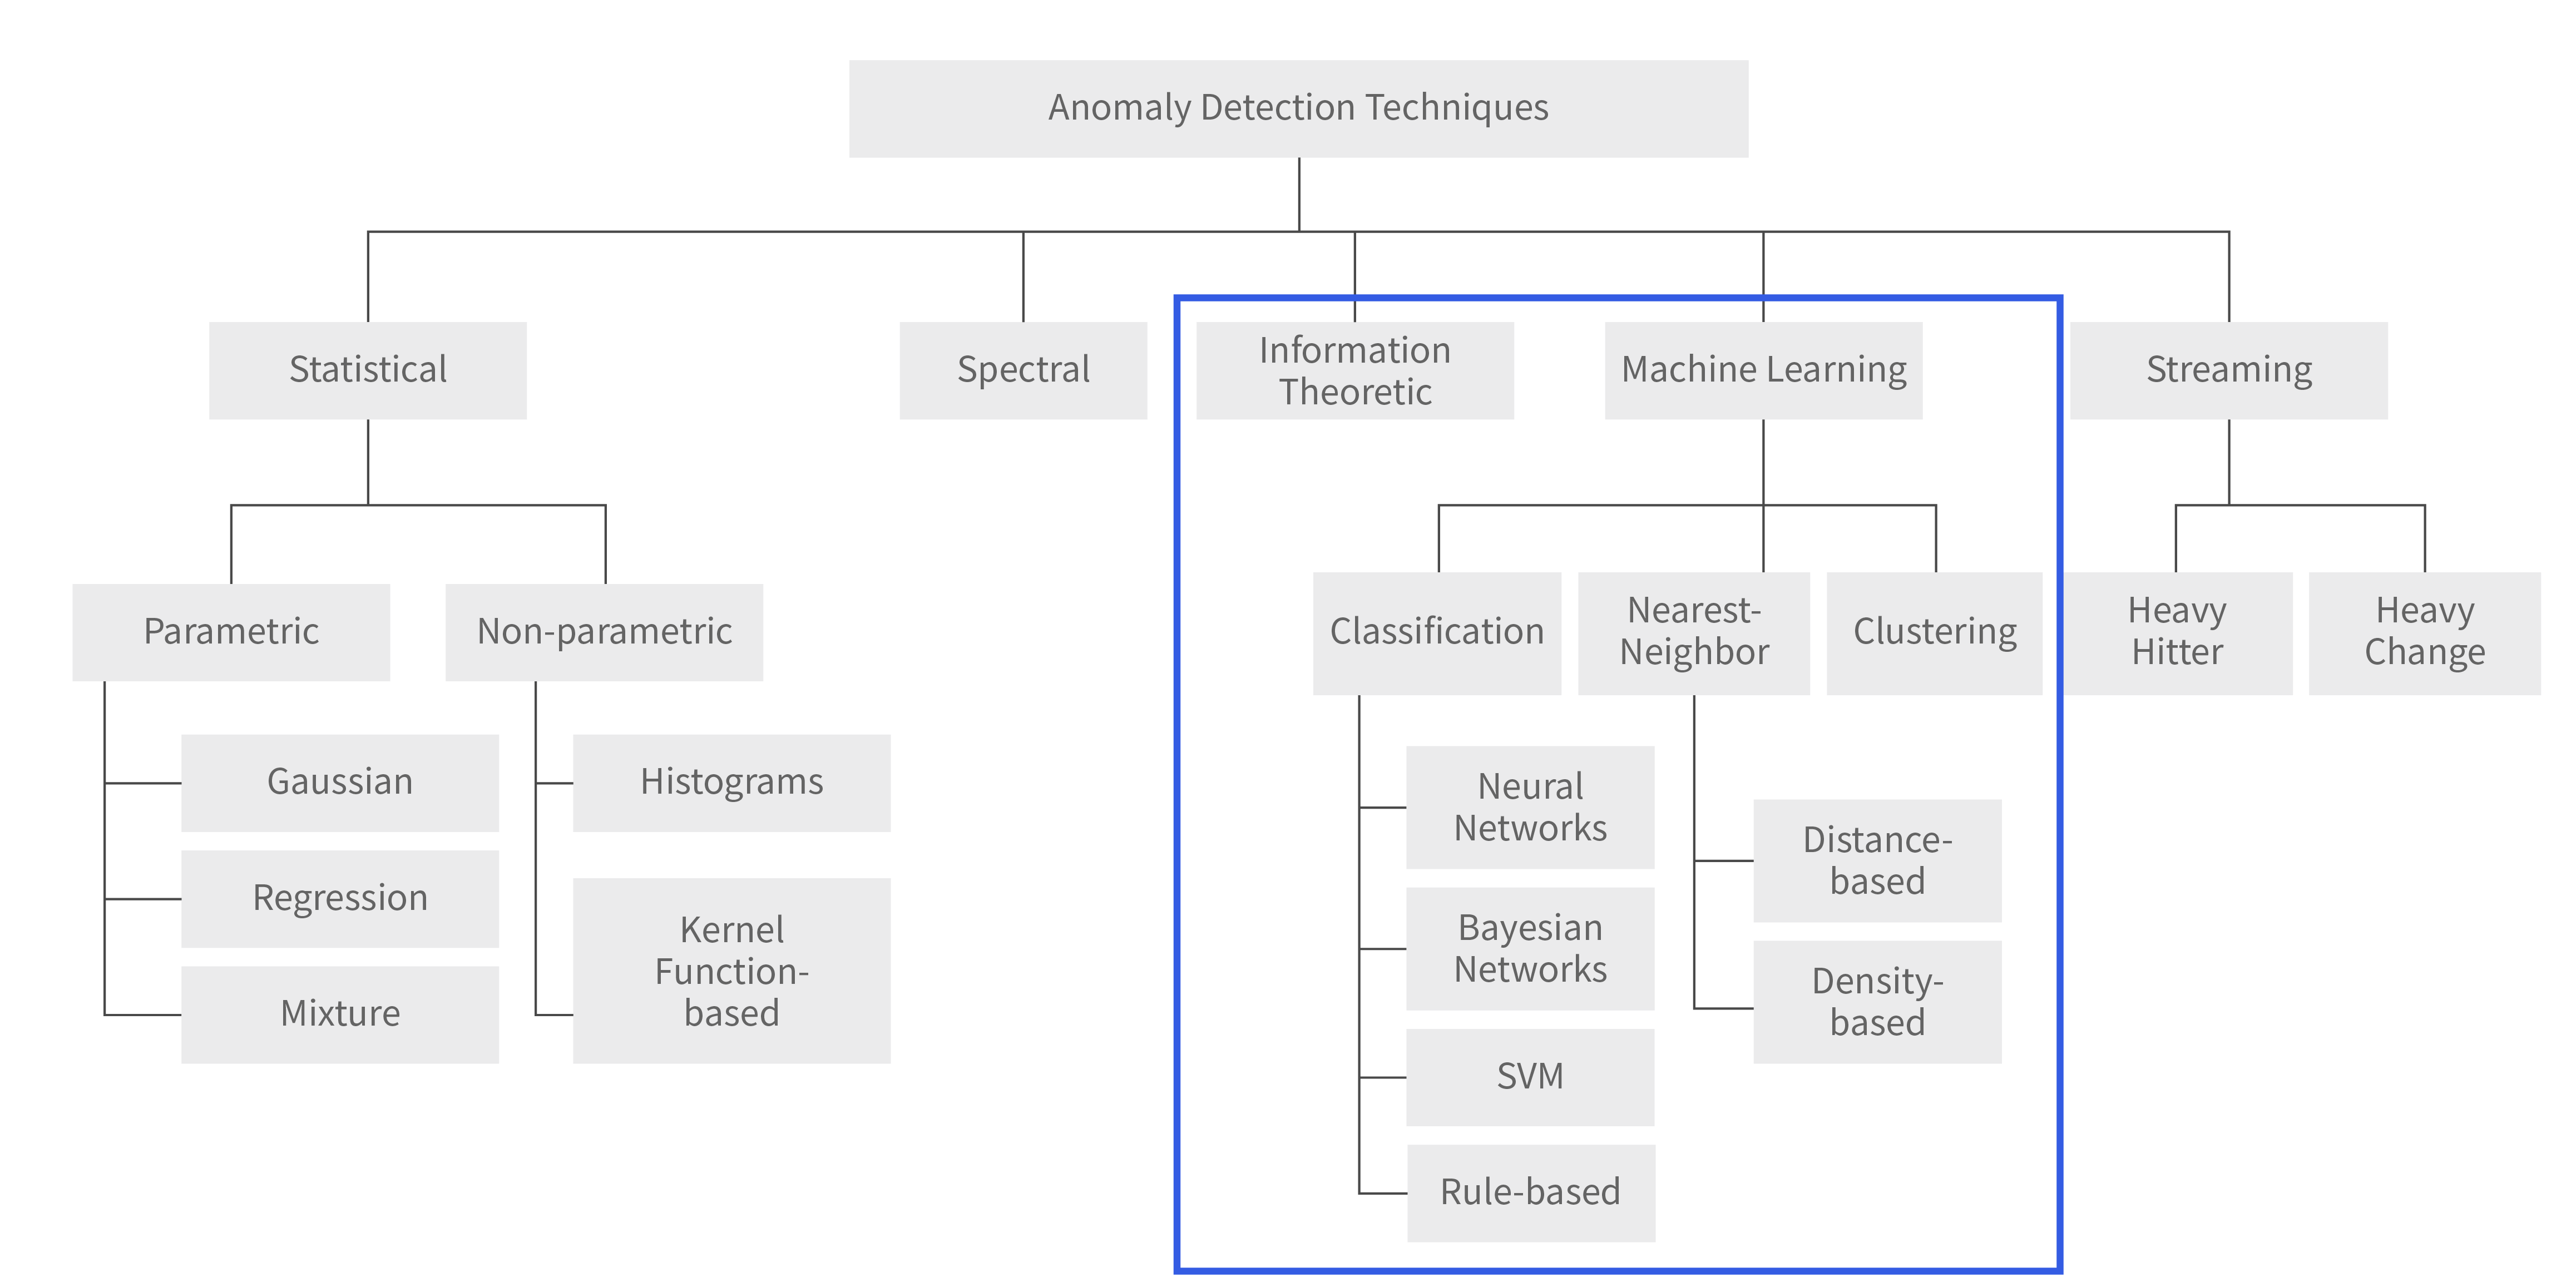
사실상 현재 개발되고 있는 최신 이상 탐지 모델들은 대부분 머신 러닝에 기반을 두고 있습니다. 뉴럴 네트워크 기반의 딥 러닝 기법들은 4부에서 더 자세하게 설명해 드릴 예정이기에 지금은 고전 머신 러닝 위주로 소개 드리겠습니다. 대표적인 머신 러닝 기반 이상 탐지에는 분류(classification), nearest-neighbor, clustering 등이 있습니다. 그리고 추가로 reconstruction-based라는 기법이 있는데 현재 가장 대중적으로 쓰이는 방법 중 하나입니다.
1.1 Classification
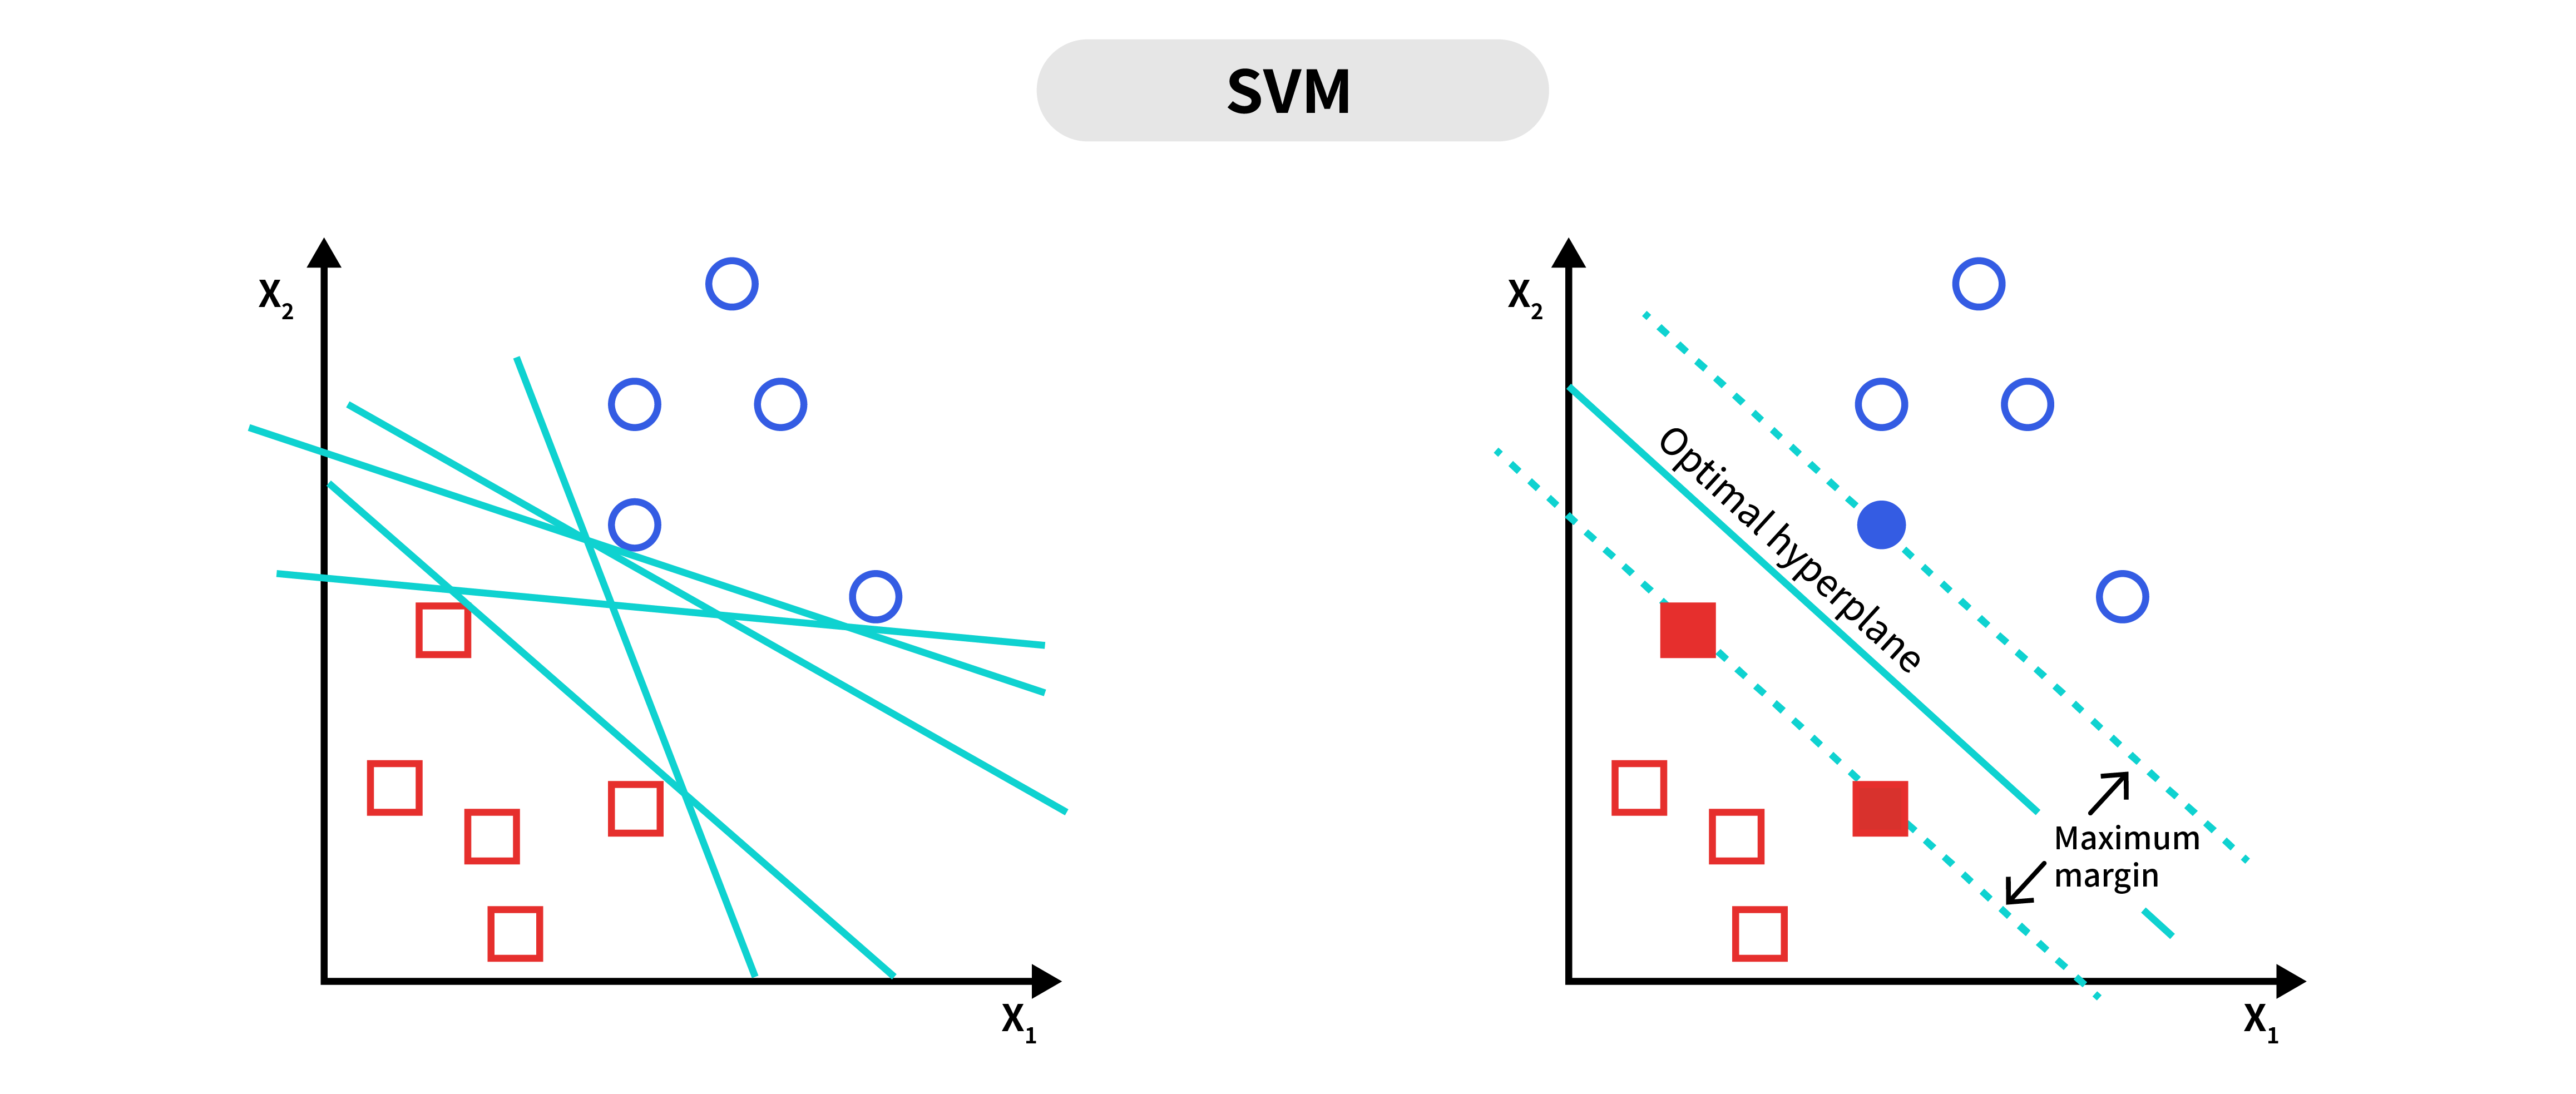
분류(classification)를 간략하게 한 문장으로 요약하면 '경계를 긋는 일'이라고 할 수 있습니다. 이상 탐지는 정상/이상 데이터를 구분하는 경계를 찾는 이진 분류 문제라고 볼 수 있습니다. 다만 이상 탐지에서 분류를 적용하기에는 큰 제약 사항이 하나 있습니다. 지난 글에서도 말했지만, 이상 탐지는 데이터의 불균형이 매우 심한 분야입니다. 그런데 분류는 데이터가 균등할 때 잘 동작하는 알고리즘입니다. 그런 이유로 데이터 불균형을 해결하기 위해 하나의 클래스만 학습시키는 방법들이 연구되었지만 그럼에도 분류는 이상 탐지에서 활발하게 쓰이지는 않습니다. 대표적인 분류 이상 탐지 모델로는 support vector machine(이하 SVM)이 있습니다. SVM의 과정은 간략하게 설명한다면
- 데이터 공간에 클래스별로 라벨링된 데이터가 있습니다. 여기서는 간단하게 2차원 공간과 +1/-1 라벨링만 고려하겠습니다.
- 우리는 클래스들을 가장 잘 나눌 수 있는 경계면(hyperplane)을 찾는 것이 목적입니다.
- 이때 고려해야 할 사항은 얼마나 클래스를 잘 나누었는가, 그리고 경계면과 데이터들이 충분히 떨어져 있는가(margin)입니다.
아래 오른쪽의 그림을 보시면 SVM에 대해 쉽게 이해하실 수 있습니다. 초록색 실선으로 표현된 hyperplane이 파란색 원, 빨간색 사각형을 나눌 수 있는 경계면이 되어 주고 있으며 이때 색칠된 데이터들과 hyperplane 사이의 거리를 margin이라고 부릅니다. 그리고 색칠된 데이터들을 support vector라고 부르며 hyperplane 형성에 가장 큰 영향을 주는 데이터들입니다.
그럼 이상 탐지는 어떻게?
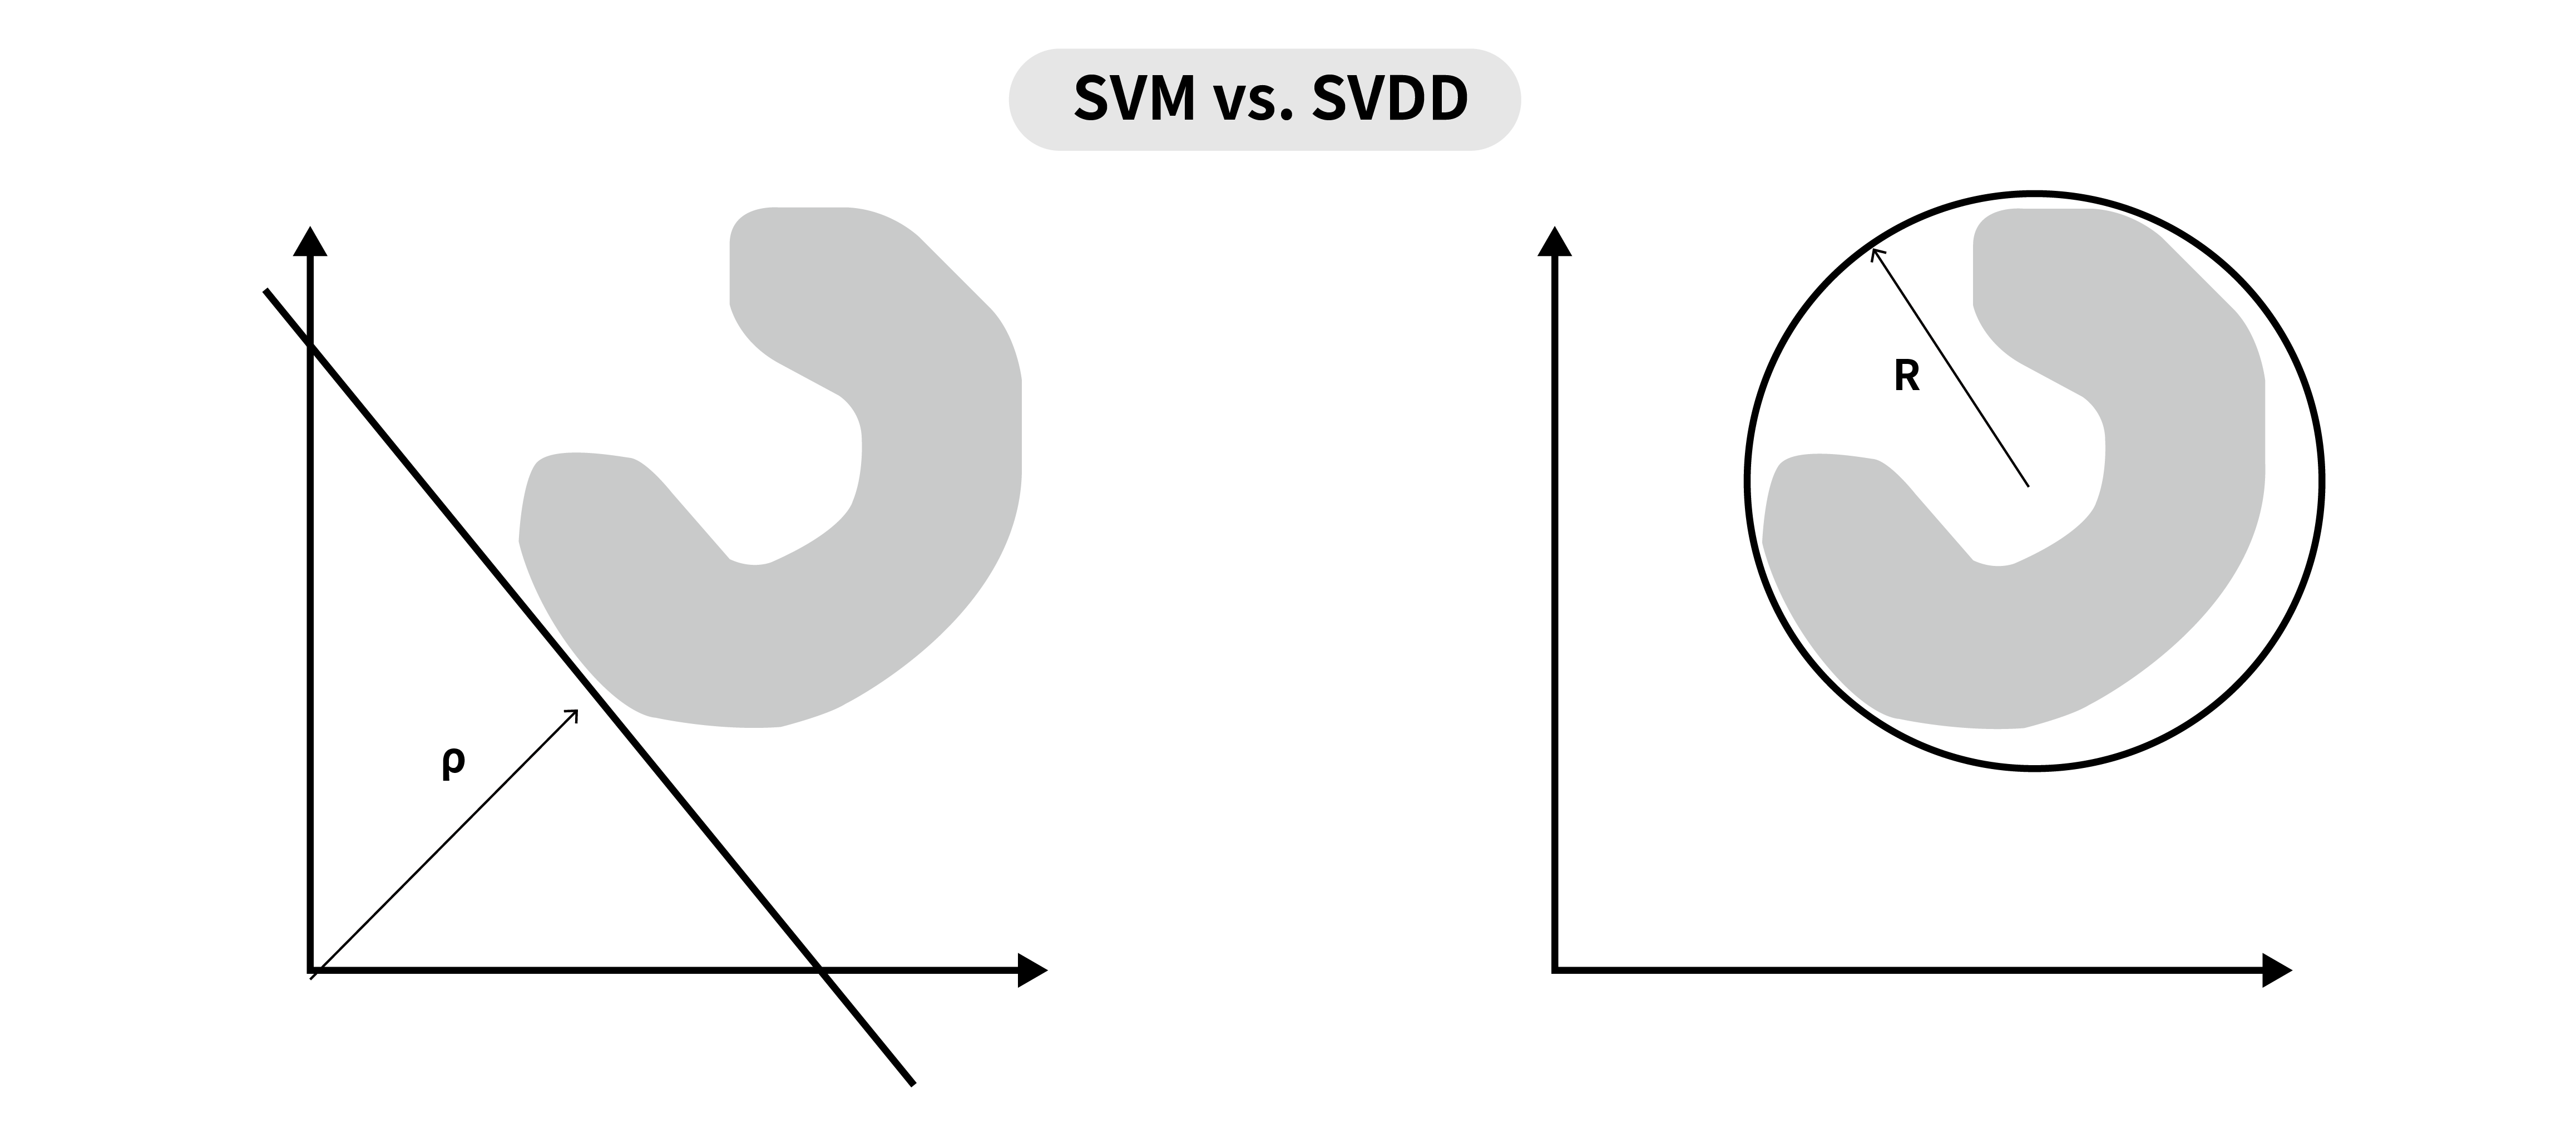
SVM으로 novelty detection을 하기 위해 나온 것이 one class support vector machine(이하 OCSVM)입니다. OCSVM의 기본적인 동작 원리는 SVM과 동일합니다. 하지만 이름에서 알 수 있듯이 OCSVM은 하나의 클래스만을 학습합니다. 대신에 hyperplane을 형성하는 기준에 원점이 추가되었습니다. 학습 데이터와 원점을 가장 잘 나눠 주는 hyperplane을 찾는 것이 OCSVM의 목적입니다.
비슷한 모델로 support vector data description(이하 SVDD)이라고 하는 분류 모델도 있습니다. SVDD는 OCSVM과 성격이 매우 유사한데 이번에는 hyperplane이 아닌 hypersphere를 찾는 게 목적입니다. 아래의 그림을 보시면 OCSVM, SVDD의 동작 과정을 쉽게 알 수 있습니다. 주의 사항으로 이상 탐지에서는 두 방법 모두 정상 데이터만을 학습해야 합니다. 둘 중에 무엇이 더 좋다고 단언하기는 어렵고 데이터를 바라보는 관점이 다르다 정도로 이해하시면 될 것 같습니다.
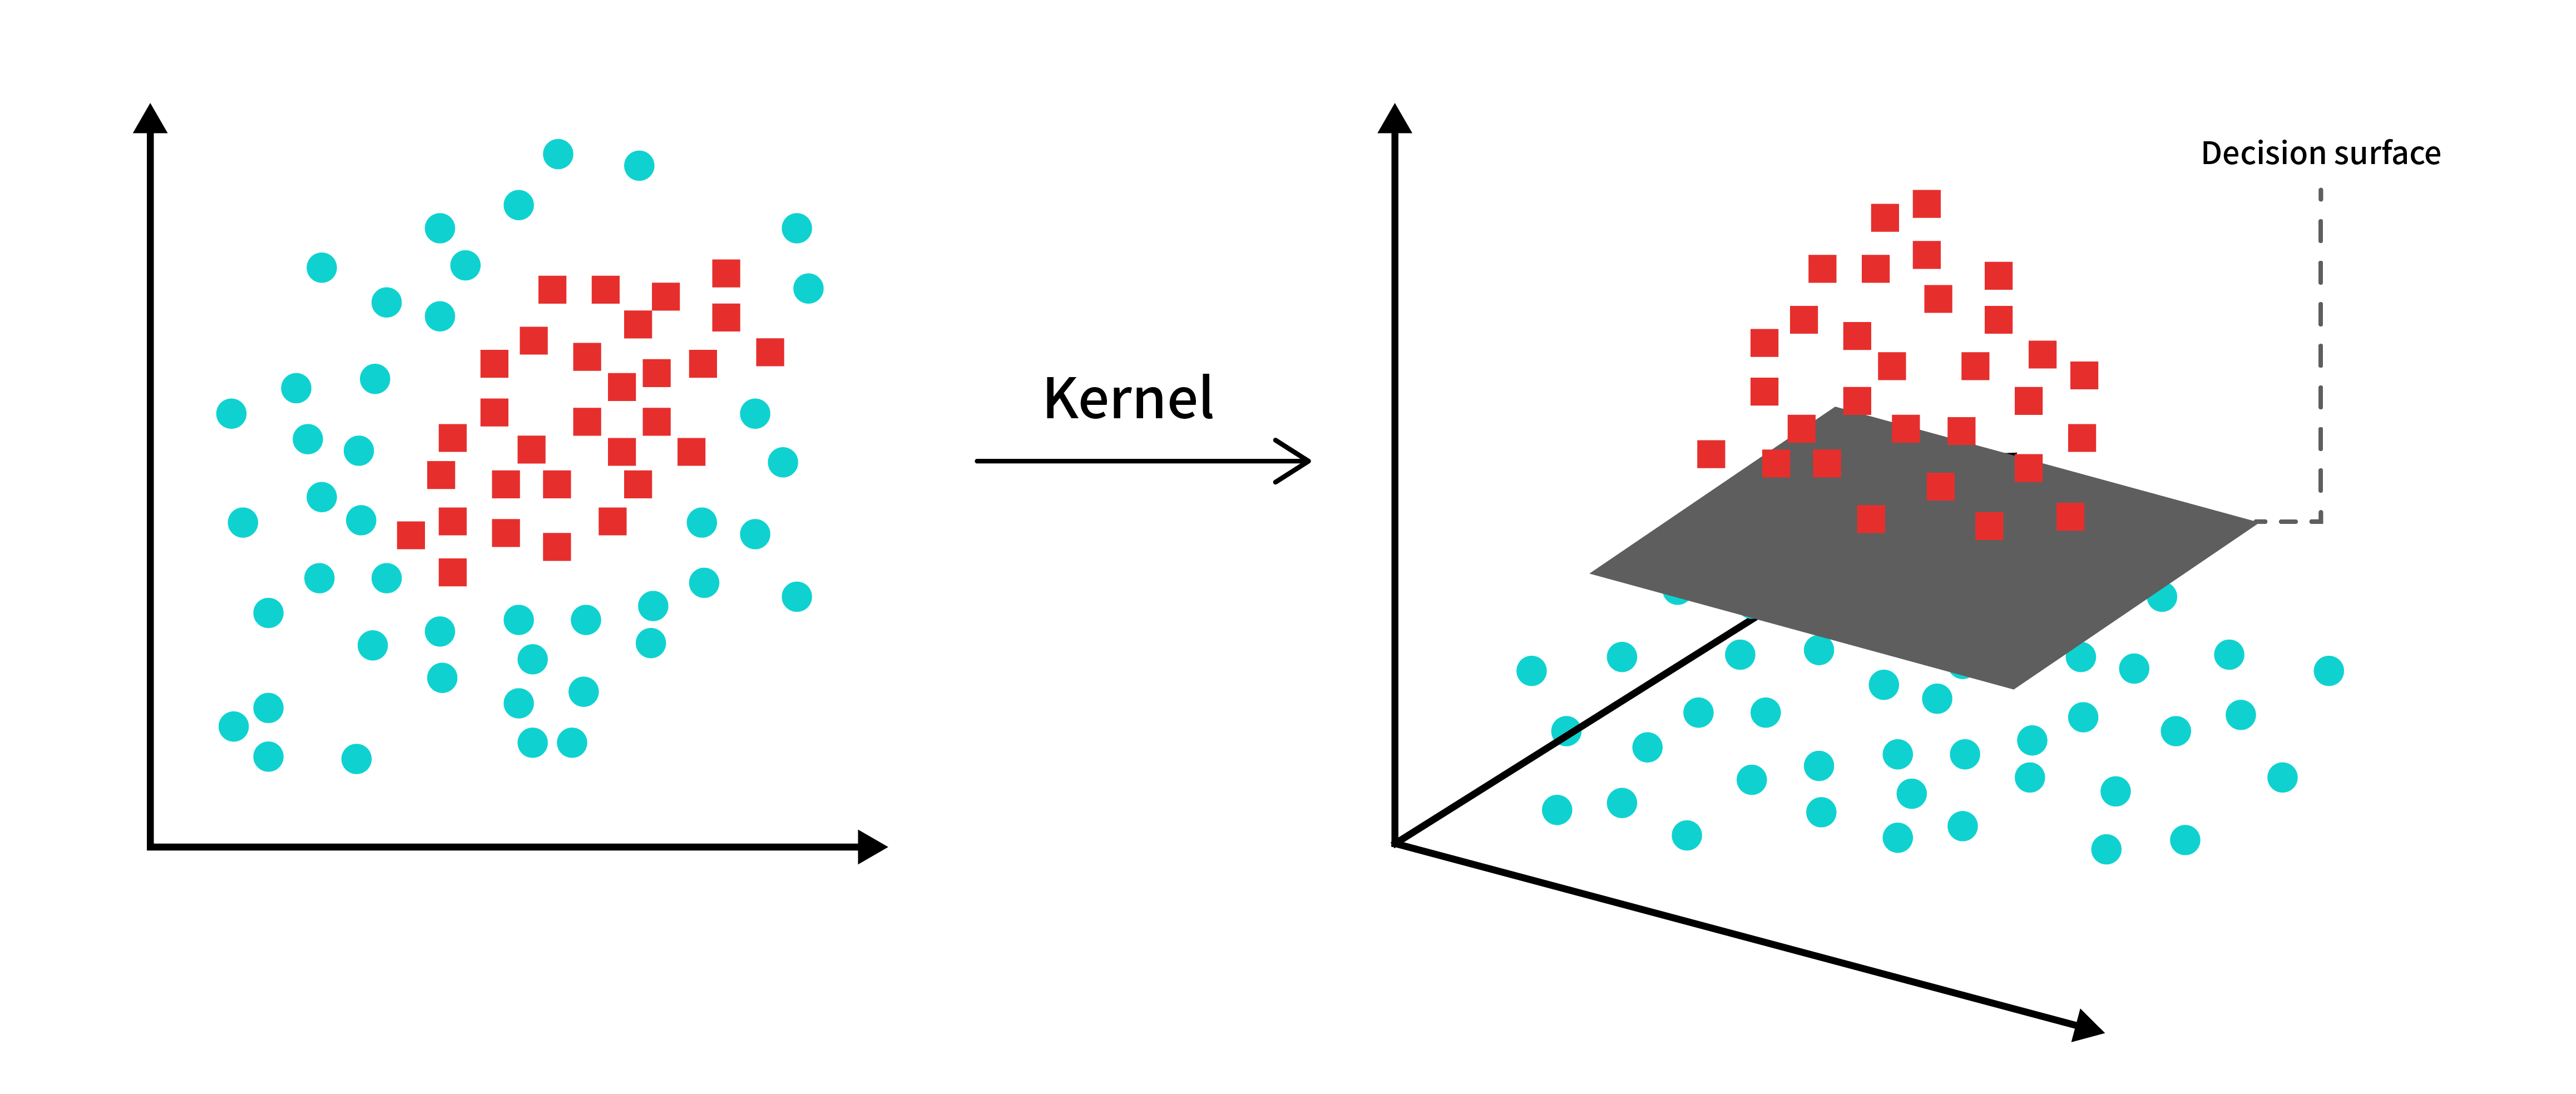
위의 3가지 기법들은 모두 kernel trick이라는 데이터 확장 기법과 함께 사용하는 일이 많습니다. Kernel trick은 데이터의 차원을 확장하여 비선형 분류 문제를 선형 문제로 바꿔 주는 기법입니다. 아래의 그림처럼 2차원 공간에서는 경계면을 찾기 어려운 문제를 kernel trick을 통해 3차원으로 데이터를 확장하면 쉽게 경계면을 찾을 수 있습니다.
단점
분류 이상 탐지 모델들은 준수한 성능을 보여 주었고 특히 SVDD와 딥 러닝을 결합한 DeepSVDD는 2018년에 발표되어 현재까지도 많은 연구의 베이스라인으로 활용되고 있습니다. 하지만 분류 모델은 아래와 같은 단점 때문에 실제 활용이 어렵다는 의견이 많습니다.
- 라벨링된 데이터를 필요로 한다.
- 비선형 분류 문제를 다루지 못한다.
OCSVM, SVDD는 라벨링 데이터를 요구하지 않지만, 좋은 이상탐지 모델을 만들기 위해서는 모두 정상 데이터만 학습해야 한다는 추가 제약 사항이 있습니다. 두 번째는 비선형 분류 문제를 다루기 어렵다는 것입니다. Kernel trick을 쓴다면 선형 문제로 변환할 수는 있지만 언제나 만능은 아닙니다.
1.2 Nearest-Neighbor
Nearest-Neighbor 방법은 하나의 가정에서 출발합니다. 정상적인 데이터들이라면 데이터 차원상에서 서로 밀집되어 있을 것이라는 가정입니다. 쉽게 말한다면 '끼리끼리 논다(?)' 정도로 표현할 수 있을 것 같습니다. 데이터의 분포에 대한 어떠한 가정도 하지 않으며 순수하게 데이터 자체만을 보기 때문에 모델의 효율성에 따라 이상 탐지 성능이 크게 달라질 수 있습니다. 이웃 데이터들의 거리 정보(distance)와 밀도 정보(density)를 활용하여 데이터마다 점수를 부여하고 임곗값을 넘으면 이상 데이터로 간주하는 방식입니다.
- Distance-based: 이웃한 데이터들과의 거리정보를 고려하여 점수 부여. ex) K-Nearest Neighbor(KNN)
- Density-based: 이웃한 데이터들의 밀도를 고려하여 점수 부여. ex) Local Outlier Factor
거리 기반 이상 탐지의 대표적인 예시인 KNN은 인접한 K개의 데이터까지의 거리의 평균, 합, 최댓값, 최솟값 등을 고려해서 데이터에 점수를 부여합니다. 이 점수가 임곗값을 넘으면 이상 데이터로 간주합니다. 굉장히 직관적이면서도 간단한 원리로 동작하는 방법입니다.
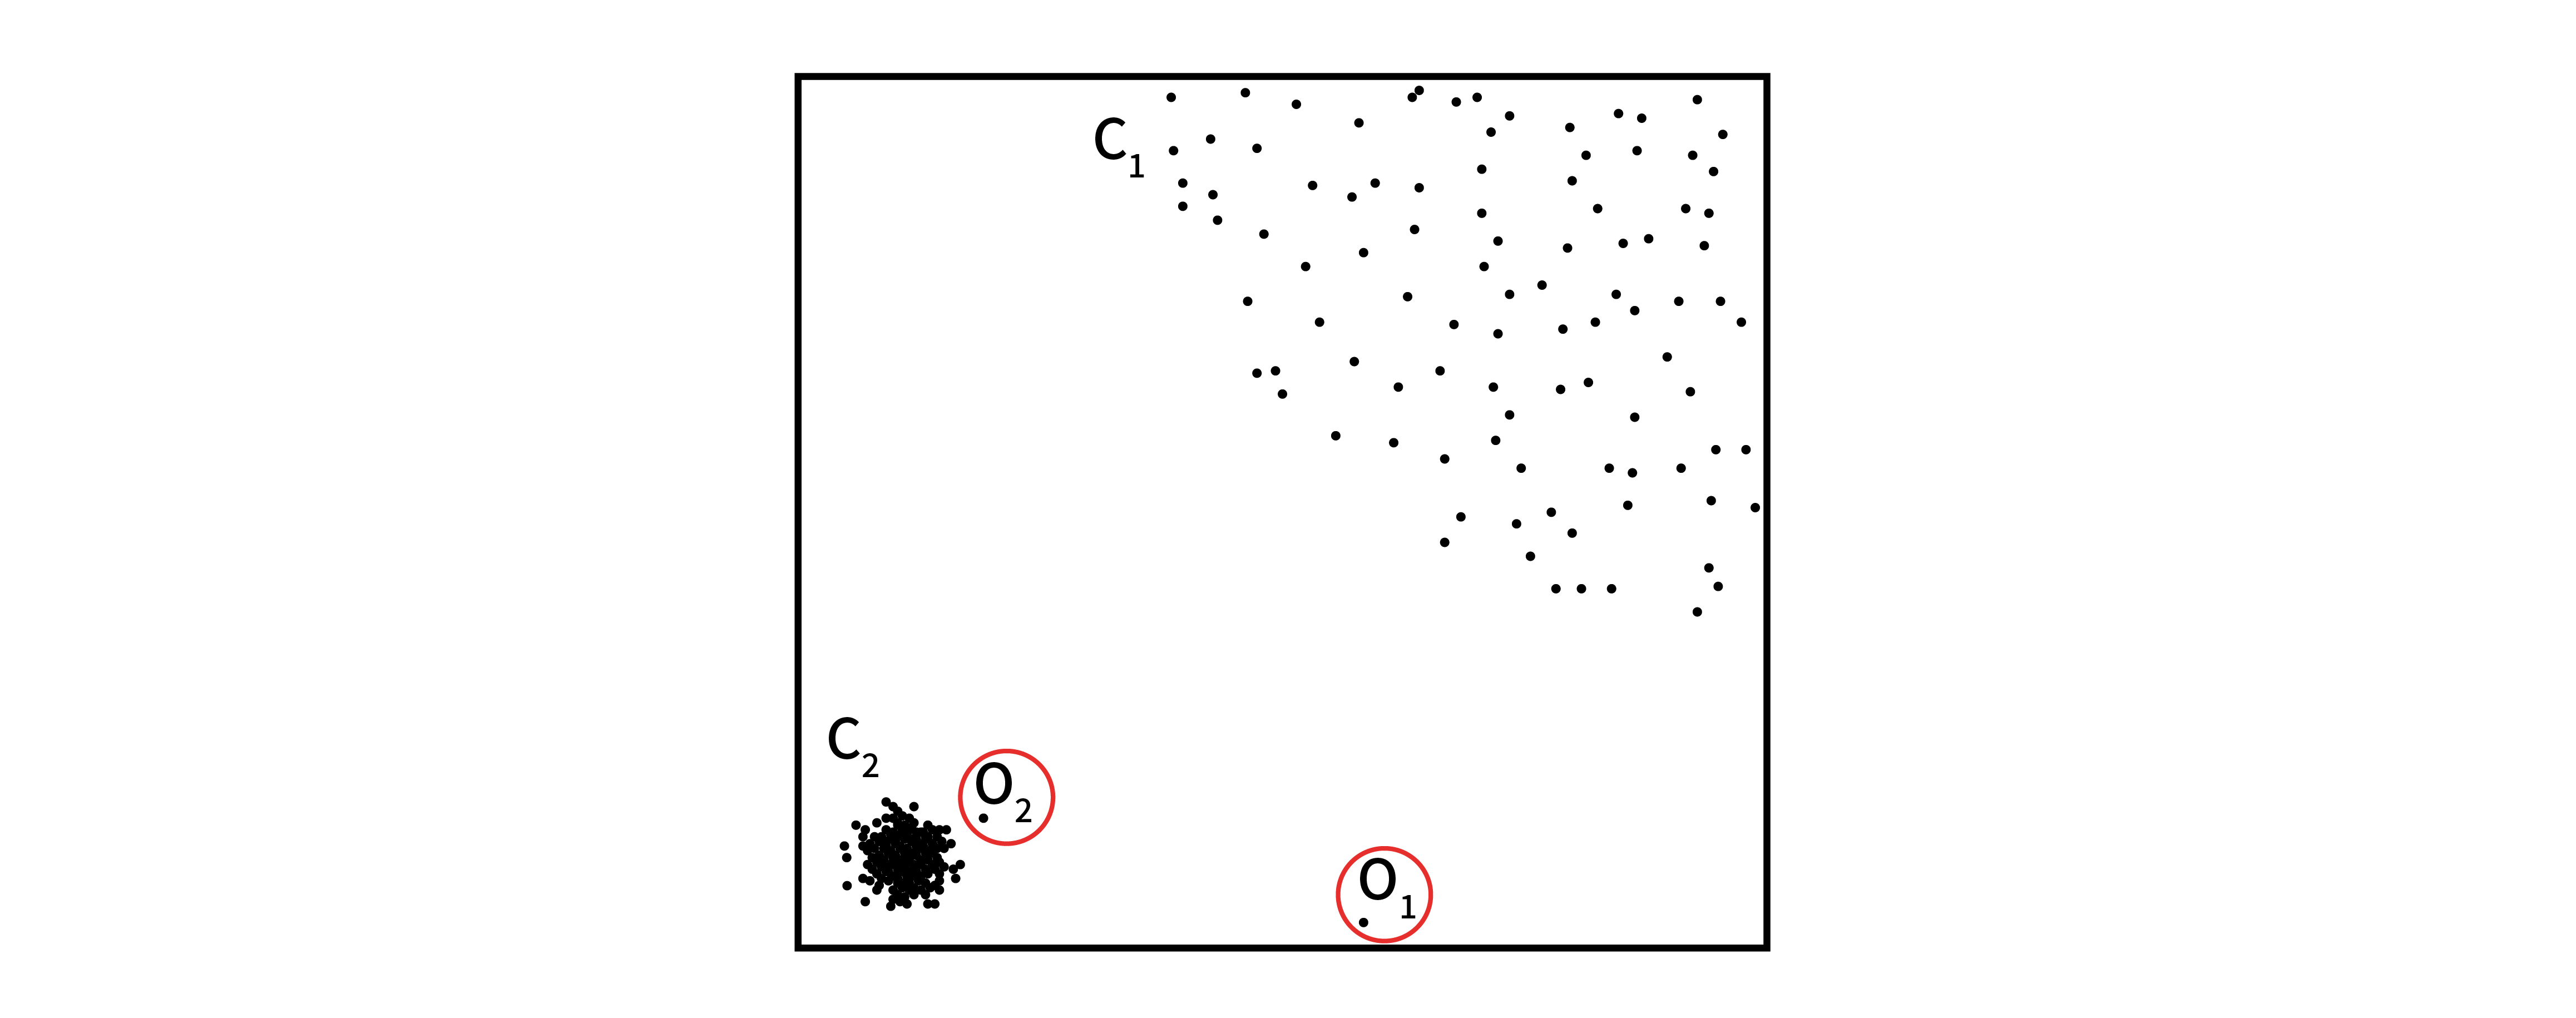
하지만 거리 기반 이상 탐지에는 한 가지 단점이 존재합니다. 아래의 오른쪽 그림을 보시면 쉽게 이해하실 수 있습니다. 빨간색 원으로 표시된 O1, O2 데이터는 둘 다 outlier입니다. 사람의 눈으로 관찰한다면 두 데이터 모두 outlier라는 걸 쉽게 알 수 있지만 거리 기반 이상 탐지를 한다면 모델은 O2 데이터를 정상으로 판단할 가능성이 높습니다. 왜냐하면 C1으로 표현된 군집으로 인해서 O2와 C2 군집까지의 거리가 충분히 가깝다고 판단하기 때문입니다. 그래서 제안된 방법이 인접한 데이터들의 밀도까지 고려하는 Local Outlier Factor(LOF) 입니다. LOF를 자세히 다루면 글을 따로 하나 더 작성해야 할 정도로 내용이 많기 때문에 밀도를 고려한다는 것 정도만 알고 계시면 좋을 것 같습니다.
1.3 Clustering
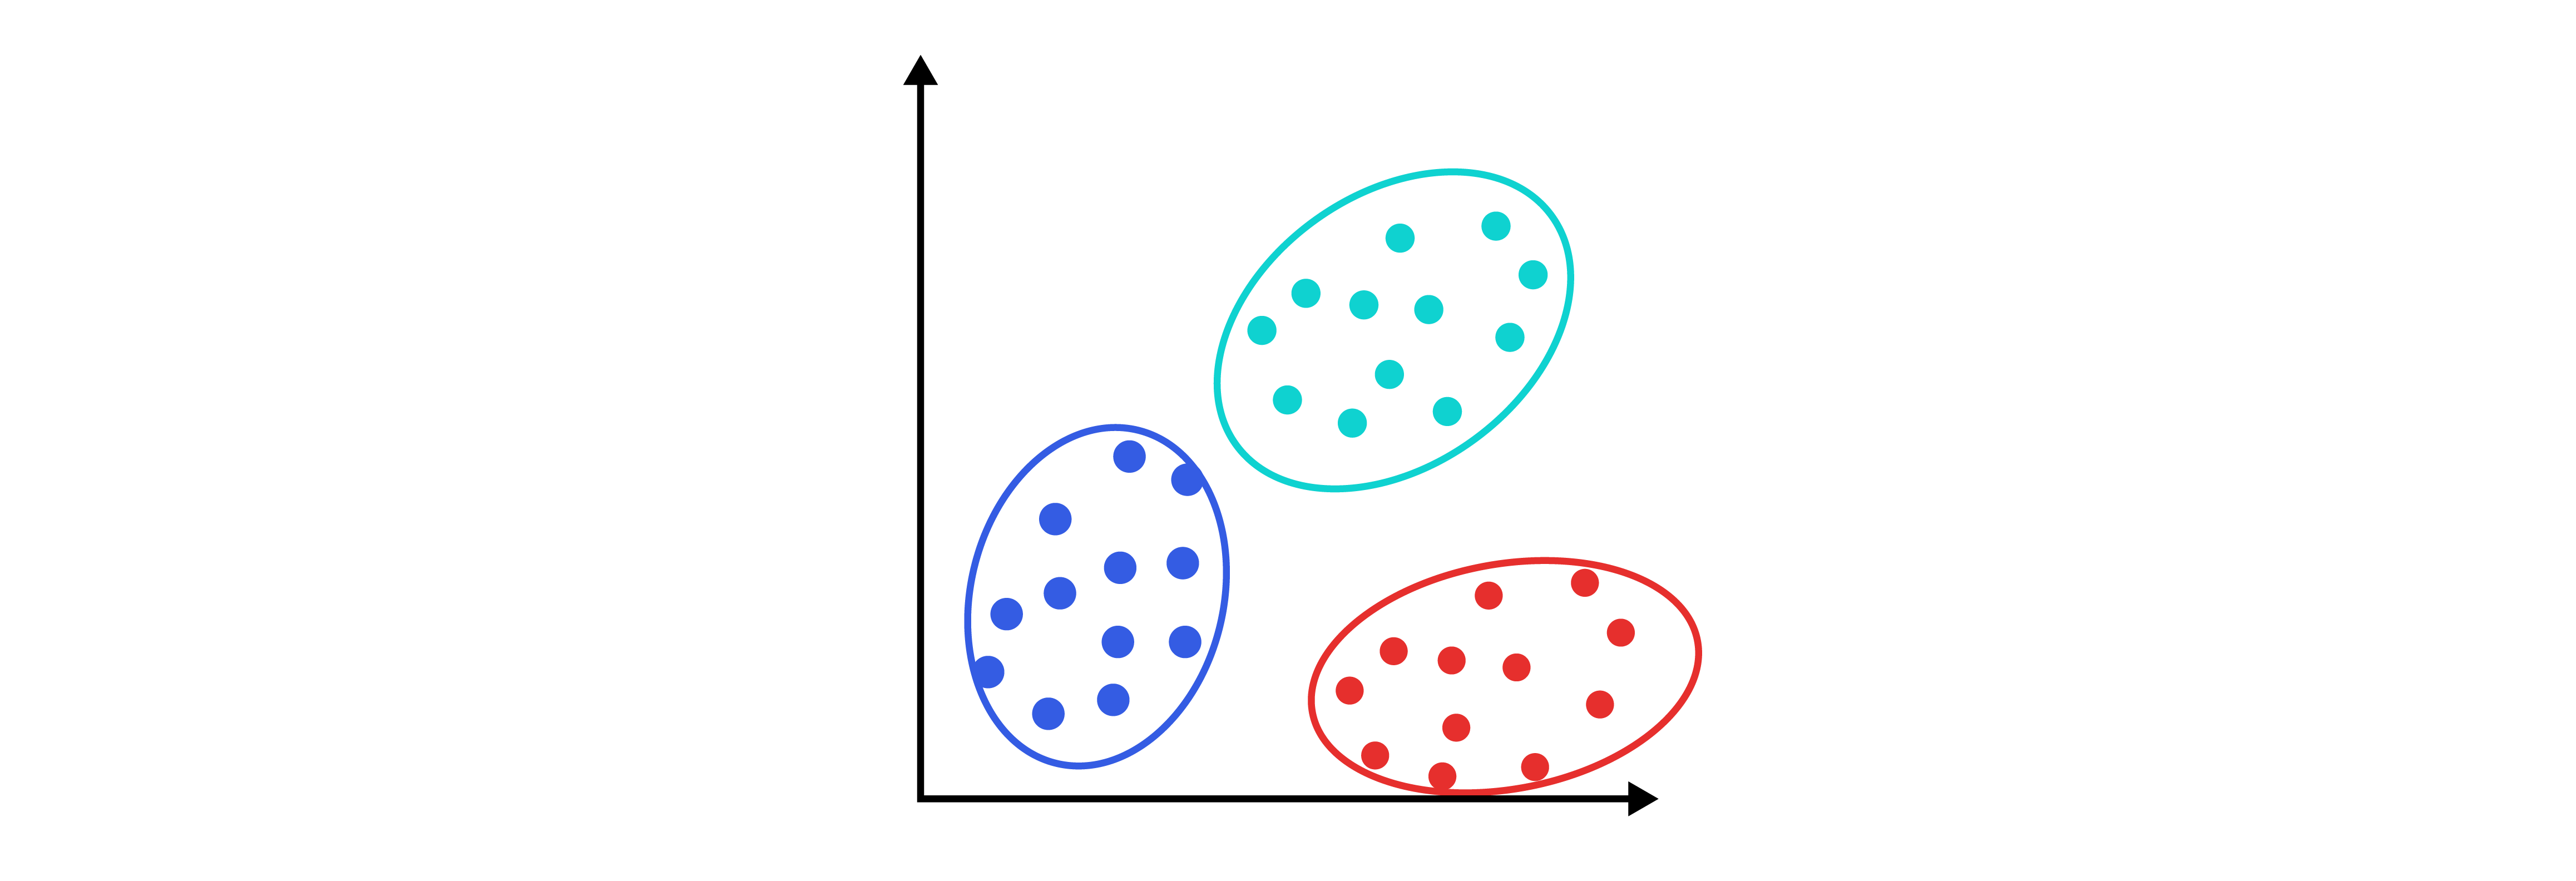
Clustering 방법은 Nearest-Neighbor와 유사한 느낌이 있지만 최종 목표가 군집을 찾는 것이라는 차이점이 있습니다. 그리고 이상 데이터라면 어느 군집에도 속하지 않을 것이라고 가정합니다. 대표적인 예시로 K-Means가 있습니다. Nearest-Neighbor와 동일하게 라벨링된 데이터를 필요로 하지 않는다는 장점이 있지만 군집의 개수를 미리 지정해야 한다는 점, 알고리즘의 효율성에 따라 성능이 크게 차이가 난다는 점 등의 단점이 있습니다. Clustering 방법 자체가 이상 탐지에 적절하지 않다는 의견도 있습니다. 왜냐하면 대부분의 군집화 알고리즘들은 모든 데이터가 어느 군집이든 무조건 포함되도록 하는 경우가 많은데 이것이 이상 탐지의 취지와 맞지 않다는 것입니다.
1.4 Reconstruction-based
Reconstruction-based 방법은 현재 이상 탐지의 대세 중 하나입니다. Reconstruction-based 방법은 주어진 데이터에 숨어 있는 유효한 특성(feature)을 추출한 후에 다시 데이터를 복원했을 때 정상 데이터라면 본래대로 복원되지만, 비정상 데이터라면 제대로 복원되지 않을 것이라고 가정합니다.
대표적으로 방법으로 principal component analysis(이하 PCA)가 있습니다. PCA는 본래 고차원 데이터를 다루기 위한 차원 축소법으로 주어진 데이터를 분산이 가장 커지는 축으로 환원하는 기법입니다. 이때 데이터를 축소하는 변환 정보를 기억해 둔다면 본래의 데이터를 어느 정도 다시 복원할 수 있습니다. 이 개념을 응용해서 비정상 데이터라면 제대로 복원되지 않을 것이라는 게 이론적 배경입니다. 주의 사항으로는 데이터를 축소할 때 정상 데이터만을 사용해야 한다는 점입니다.
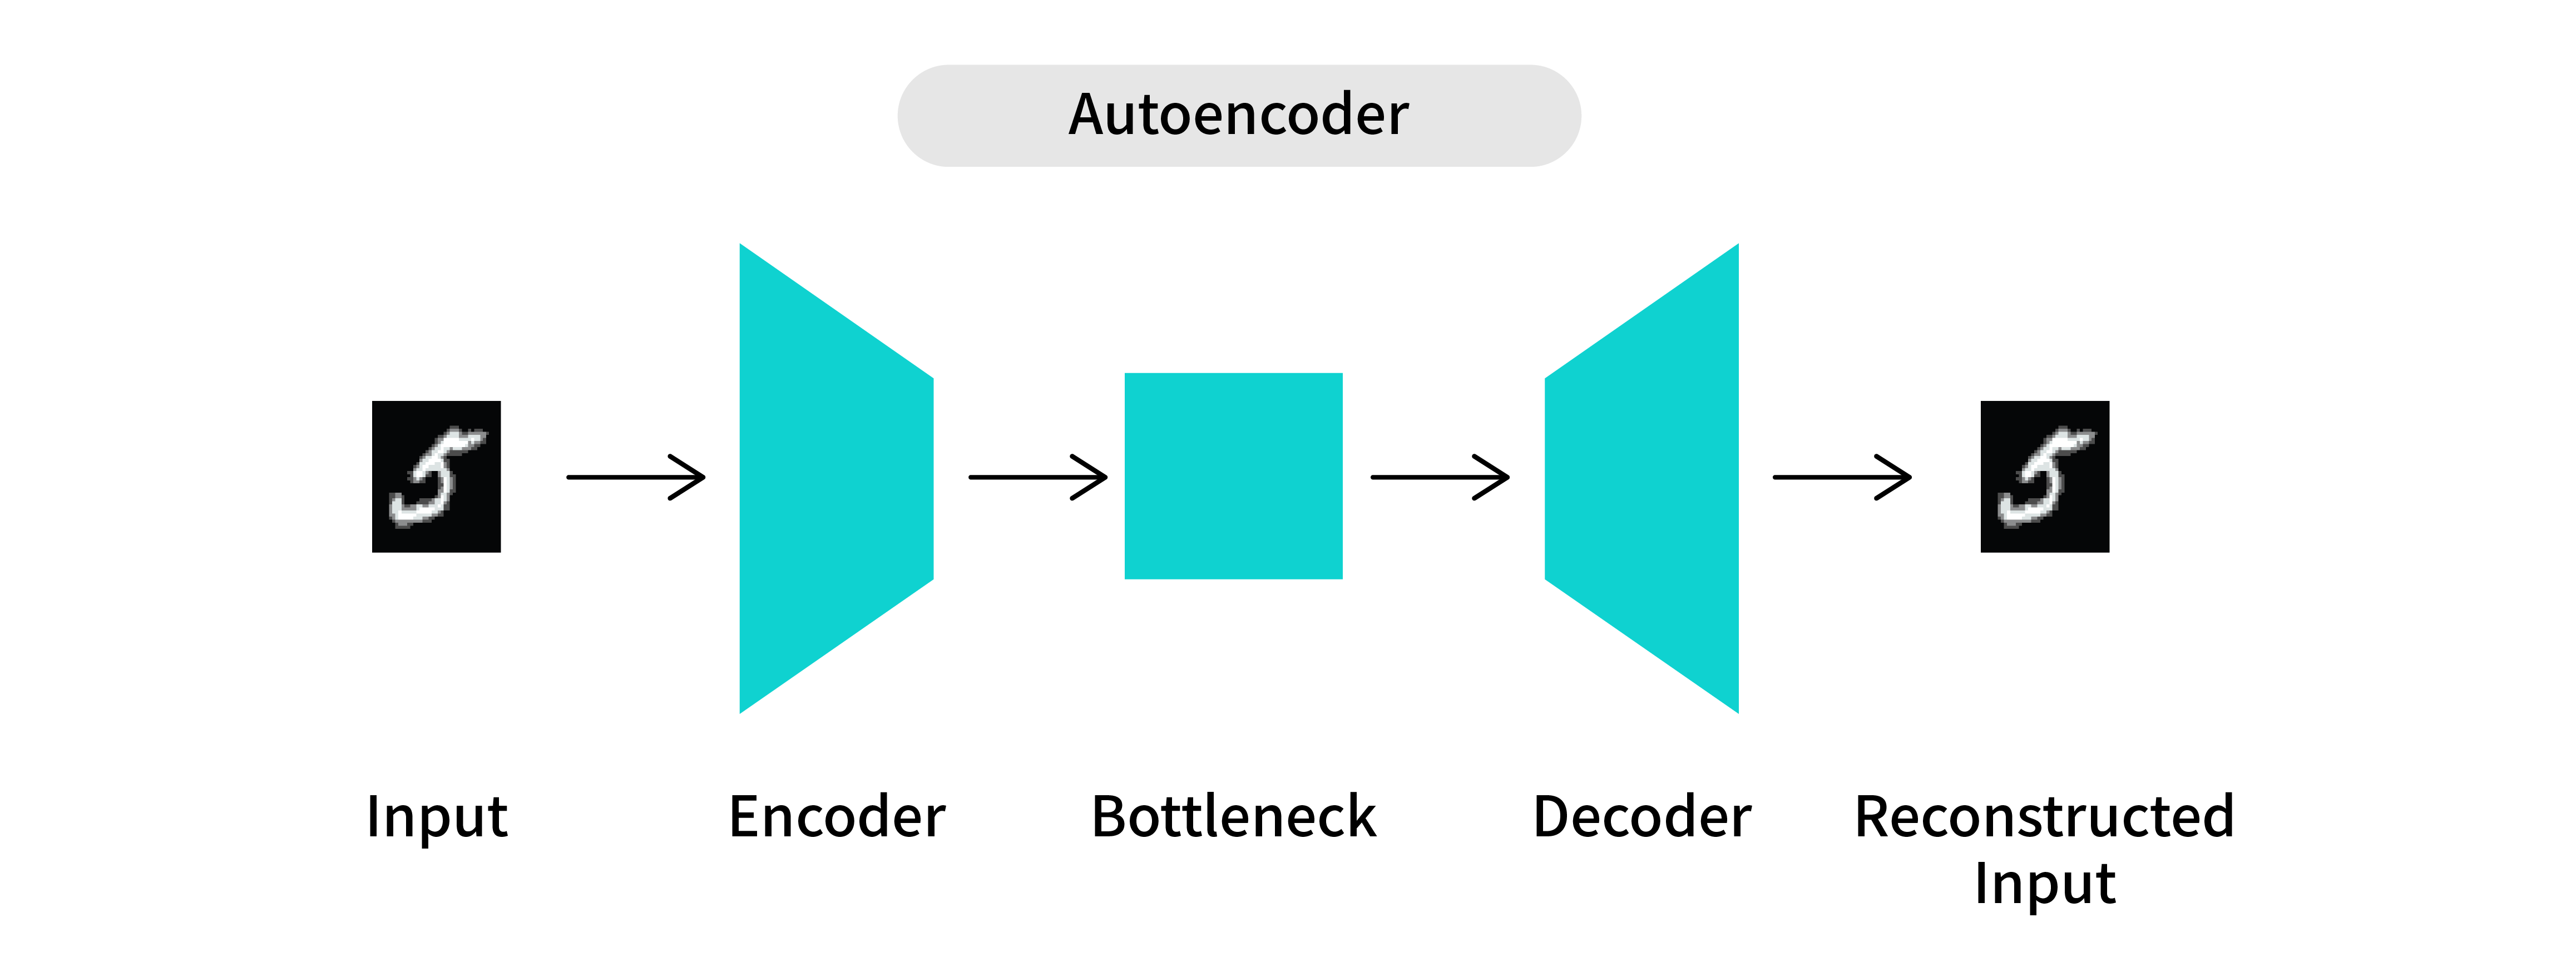
하지만 PCA는 선형 변환이라는 한계점이 존재했고 다차원 데이터 간의 연관성을 다루기에는 부족함이 있었습니다. 그래서 사용된 것이 바로 뉴럴 네트워크 기반의 오토인코더입니다. 오토인코더도 데이터를 압축한 후에 복원한다는 점에서 PCA와 동일하지만 비선형 변환이 가능하다는 차별점이 있습니다. 오토인코더는 지금까지도 최신 모델에 많이 적용되고 있을 정도로 성능이 입증된 모델이기 때문에 기억해 두시는 걸 추천합니다.
2. 고전 머신 러닝 vs 딥 러닝
2.1 왜 딥 러닝을 써야 할까?
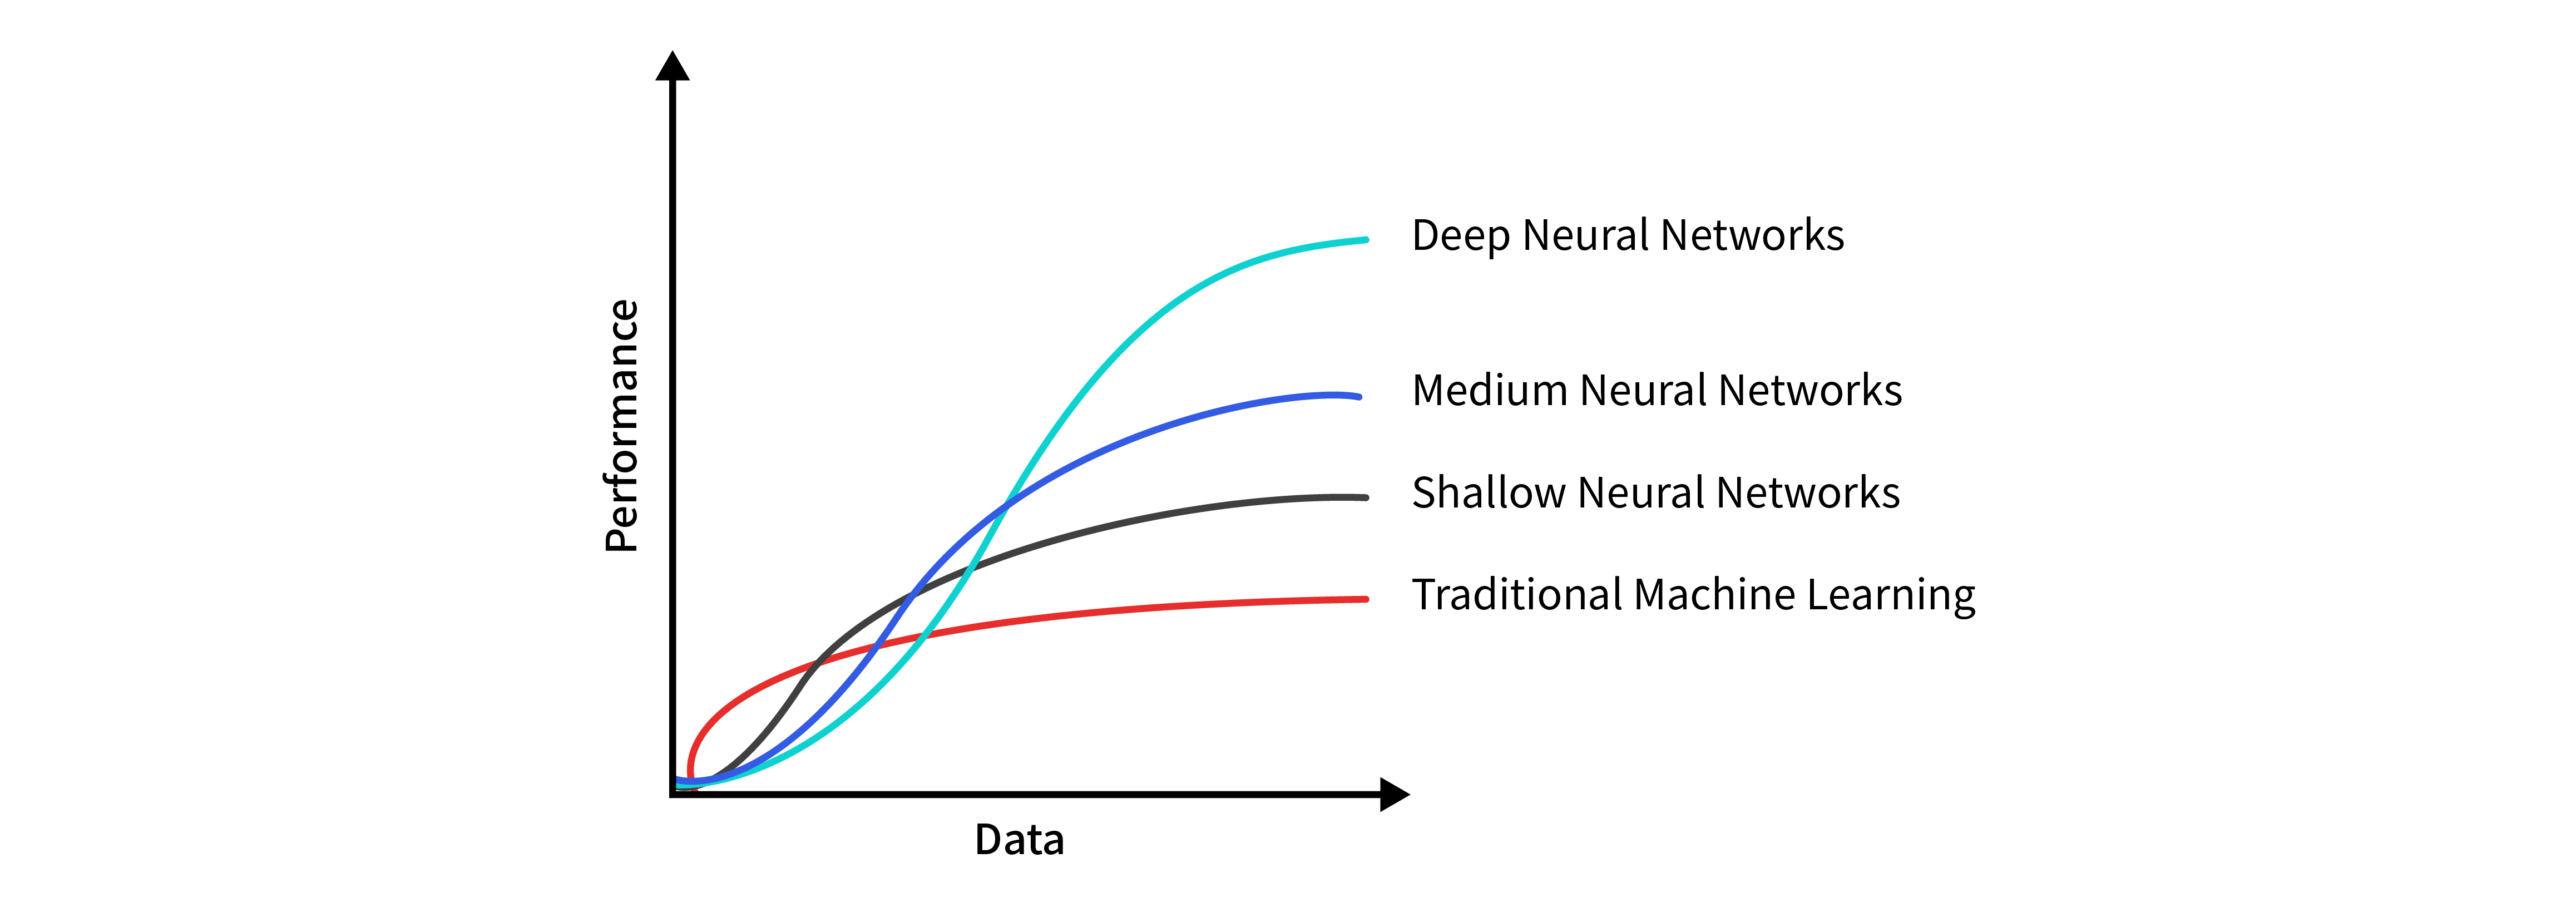
위에서 소개한 모델들은 일부를 제외하고 대부분 고전 머신 러닝 모델들입니다. 고전 모델들도 좋은 성능을 보여 주었지만, 현재는 딥 러닝 기반 모델들이 많이 사용되고 있습니다. 다양한 이유가 있지만 근본적인 이유는 데이터의 양이 점차 많아지고 있기 때문입니다. 데이터의 양도 문제지만 데이터의 차원이 높아지고 차원 간의 연관성도 높아지면서 고전 머신 러닝 모델들은 충분한 성능을 보여 주지 못하는 상황입니다. 하지만 고전적인 접근법이 전혀 사용되지 않는 것은 아닙니다. 고전 머신 러닝의 개념과 딥 러닝을 결합한 모델들이 많이 연구되고 있으며 그 중에서는 뛰어난 성능을 보여주는 모델도 많습니다.
2.2 시계열 이상 탐지에서의 딥 러닝
시계열 이상 탐지도 위에서 소개해 드린 방법들을 적용할 수 있습니다. 하지만 아쉽게도 성능이 그다지 좋지 않습니다. 시계열 데이터에 이상 탐지를 적용하려면 추가적인 고려 사항이 있습니다.
- 데이터 차원 간의 연관성
- 데이터 시간 축에서의 연관성
첫 번째 고려 사항은 사실 모든 이상 탐지 데이터에서 고려해야 할 사항입니다. 하지만 두 번째 고려 사항은 확실히 시계열 데이터에서 나타나는 특성입니다. 위에서 소개해 드린 기법들은 별도의 연산을 추가하지 않는다면 시계열 축에서의 연관성을 찾아내지 못합니다. 딥 러닝에서는 시간 축의 연관성을 찾아내기 위해서 TemporalCNN, RNN, Transformer 등 시퀀스 데이터에 특화된 모델을 많이 사용합니다.
현재 시계열 이상 탐지는 데이터의 불균형, 라벨링 데이터 부족 등의 문제로 정상 데이터만을 학습시키는 비지도 학습법이 대세를 이룹니다. 그 안에서도 다양한 범주가 존재하지만 가장 큰 틀에서 모델들은 나눈다면 prediction, reconstruction-based로 나눌 수 있습니다. 각 방법론에 대한 자세한 설명과 예시는 다음 글에서 소개하도록 하겠습니다.
- Prediction-based: 주어진 시계열을 분석하여 다음에 올 값을 예측하고 실제 값과의 차이를 시계열 이상 탐지에 사용하는 방법입니다.
- Reconstruction-based: 예측과 달리 주어진 시계열 그 자체를 그대로 복원하여 그 차이를 시계열 이상 탐지에 사용하는 방법입니다.
둘 중에서 어느 것이 더 성능이 뛰어나다고 말하기는 어렵지만, prediction-based는 예측을 시작한 시점에서 시간이 지날수록 오차가 점차 누적될 가능성이 있습니다. 그런 이유로 일반적으로 reconstruction-based 방법이 더 안정적인 성능을 보여 줍니다.
나가며
2, 3부에 걸쳐 전통적인 이상 탐지 기법들에 대해 소개해 드렸습니다. 다음 글은 시리즈의 마지막 이야기인 4부-딥 러닝으로 이상 탐지하기로 최신 딥 러닝 이상 탐지 모델들과 제가 직접 경험했던 시계열 데이터를 다룰때 주의해야 할 점들에 대해 소개해 드리겠습니다.
이미지 출처 및 참고 자료
- Sherenaz W. Al-Haj Baddar 외, Anomaly Detection in Computer Networks: A State-of-the-Art Review, ResearchGate, December 2014
- Pier Paolo Ippolito, Support Vector Machines, June 2019
- Grace Zhang, What is the kernel trick? Why is it important?, November 2018
- Markus M. Breunig 외, LOF: Identifying Density-Based Local Outliers
- Erik Bernhardsson, Nearest neighbor methods and vector models – part 1, September 2015
- javaTpoint, K-Means Clustering Algorithm, javatpoint.com
- Victor Dibia 외, Deep Learning for Anomaly Detection, January 2020
- Safaa Laqtib 외, A deep learning methods for intrusion detection systems based machine learning in MANET, ResearchGate, October 2019