Engineering
멀티 테넌트 데이터를 격리하고 더 안전하게 만드는 방법
2024년 10월 21일
원문에서 보기 ↗
들어가며
이번 글에서는 멀티 테넌트 서비스에서 테넌트 데이터 격리 방법과 격리 수준을 높일 수 있는 몇 가지 방법에 대해 알아봅니다.
1. 테넌트 데이터 격리
테넌트(tenant)는 하나의 플랫폼을 사용하는 사용자나 조직, 프로젝트를 의미합니다. 일반적인 클라우드 서비스나 플랫폼 서비스는 각 테넌트에게 독립적인 데이터 접근과 관리 기능을 제공하면서도, 서버나 데이터베이스 같은 인프라 자원은 서비스에 요구되는 보안 수준, 성능, 비용에 따라 구성합니다.
이번 글에서는 테넌트 데이터를 저장하는 데이터베이스의 테넌트 데이터 격리 수준에 대해 알아봅니다. 테넌트 데이터 격리 수준은 크게 3가지로 나눌 수 있습니다.
테넌트 데이터 격리 수준
| 레벨 1 - 행 단위 | 레벨 2 - 테이블 단위 | 레벨 3 - 데이터베이스 단위 | | - | - | - | | 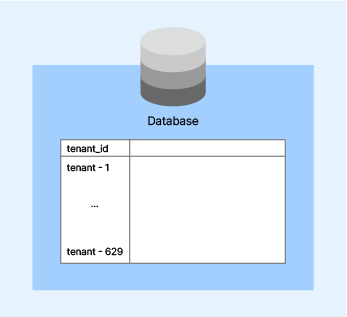
-
각 테넌트 데이터를 하나의 데이터베이스, 하나의 테이블에 테넌트 아이디를 다르게 부여해 저장합니다.
-
여러 테넌트의 데이터는 하나의 데이터베이스 테이블에 행 단위로 격리됩니다. |
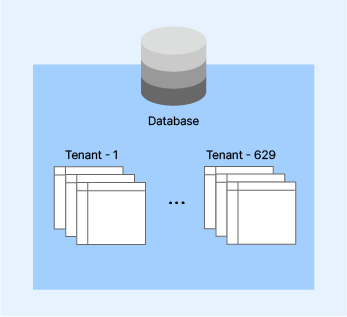
-각 테넌트 데이터를 하나의 데이터베이스에서 테넌트 단위로 분리된 테이블에 저장합니다. |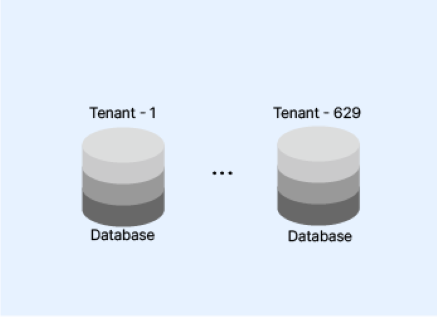
- 각 테넌트 데이터를 분리된 데이터베이스에 저장합니다. |
레벨 3, 데이터베이스 단위 격리가 격리 수준이 가장 높습니다. 하지만, 테넌트마다 데이터베이스가 할당되어 데이터베이스 운영 및 관리 비용이 크고, 테넌트 수에 따라 비용이 선형적으로 증가할 수 있습니다. 반대로 레벨 1은 테넌트 데이터 격리 수준이 가장 낮습니다. 하지만, 하나의 데이터베이스만 존재하기 때문에 운영 및 관리 비용이 저렴해 경제적입니다. 그에 따라 고객에게 저렴한 가격에 서비스를 제공할 수 있습니다.
각 방법은 고유한 장점과 단점을 가지는데요. 아래에서 레벨 1인 행 단위 격리 수준의 장점과 단점에 대해 더 자세히 알아보고 단점을 극복할 수 있는 방법을 살펴보겠습니다.
이 글에서도 어느 정도 다루겠지만 멀티 테넌트 데이터 관리 방법에 대해 더 많은 지식을 원하시는 분은 Microsoft Azure 글을 읽어보시는 것을 추천합니다. 제가 멀티 테넌트 데이터를 효과적으로 관리하기 위해 고민했던 부분에 대해서 잘 정리되어 있습니다.
레벨 1, 행 단위 격리 수준의 장점과 단점
서비스에 요구되는 성능과 보안 관련 요구 사항에서 이슈가 없다면 테넌트 데이터 격리 수준을 레벨 1로 하는 것이 가장 경제적이고 서비스 구조를 단순하게 가져갈 수 있습니다. 테넌트 데이터 격리 수준 레벨 1의 장점과 단점에 대해 더 알아보겠습니다.
레벨 1, 행 단위 격리 수준 테이블 예시
| tenant_id | sender | recipient | title | body |
|---|---|---|---|---|
| 629 | no-reply@nhn.com | recipient1@example.com | Title | Body |
| 39 | ... | ... | ... | ... |
| 1234 | ... | ... | ... | ... |
| 927 | ... | ... | ... | ... |
하나의 데이터베이스 안에 하나의 테이블에 여러 테넌트들의 데이터를 저장하기 때문에 각 테이블마다 테넌트를 식별할 수 있는 테넌트 ID 칼럼이 필요합니다.
장점 - 비용 절감
하나의 데이터베이스와 테이블에 많은 수의 테넌트의 데이터를 저장할 수 있습니다. 이는 적은 자원으로 많은 수의 테넌트를 수용할 수 있어 경제적입니다. 개발 및 운영에 들어가는 자원도 낮게 유지할 수 있습니다.
단점 - 보안 위험 증가, 성능 저하
여러 테넌트가 동일한 데이터베이스와 테이블을 공유하고 있기 때문에, 예기치 않은 버그나 취약점 공격으로 인해 다른 테넌트의 데이터에 접근할 위험이 있습니다. 이러한 리스크를 방지하기 위해 보안 측면에서 고려해야 할 사항들이 많아지며, 그중 하나가 멀티 테넌트 데이터 격리 방법입니다.
일부 고객은 낮은 격리 수준을 꺼려 할 수도 있습니다. 특히 금융이나 공공과 같이 높은 보안 수준을 요구하는 산업에서 다른 테넌트 데이터에 접근할 리스크 때문에 테넌트 데이터 격리 수준이 레벨 1인 클라우드 서비스 도입에 주저할 가능성이 있습니다. 또한 여러 테넌트가 같은 데이터베이스를 공유하기 때문에 시끄러운 이웃 효과로 특정 테넌트가 전체적인 성능을 저하시킬 수 있습니다.
시끄러운 이웃 효과: 하나의 테넌트가 클라우드 자원을 과도하게 점유해 다른 테넌트가 정상적으로 자신의 자원을 이용하지 못하는 것을 뜻합니다.
2. 레벨 1, 행 단위 격리 수준의 단점 개선 방법
위에서 설명했지만 레벨 1에서 다른 테넌트의 데이터에 접근하는 것을 방지하기 위한 방법 중 가장 간단하고 강력한 방법 중 하나는 애플리케이션 개발 시 항상 테넌트를 식별하는 테넌트 아이디를 필수로 사용하도록 강제화하는 것입니다. 테넌트 데이터는 다양한 곳에 다양한 형태로 저장될 수 있습니다. 이번 글에서는 데이터베이스에 저장하는 사례에서 멀티 테넌트 데이터 격리를 강화하는 방법에 대해 알아보겠습니다.
멀티 테넌트 데이터 격리 실패 사례
설계 및 코드 리뷰 시 데이터 격리를 중요하게 생각하고, 항상 고려해 개발을 해도 시스템적으로 강제화하지 못한다면 테넌트 데이터 격리가 실패할 가능성이 있습니다.
다음은 테넌트 데이터 격리가 실패한 예시입니다.
아래는 메시지 단건 조회 API입니다. 테넌트 아이디와 메시지 아이디를 전달받아 데이터베이스에서 메시지를 조회합니다.
GET /notification/v1.0/tenants/{tenantId}/messages/{messageId}
메시지를 저장하는 테이블은 다음과 같이 정의되어 있었습니다.
| tenant_id | message_id | title | body |
|---|---|---|---|
| 629 | 1234 | 제목 | 내용 |
| 123 | 4567 | 다른 테넌트 데이터 | 다른 테넌트 데이터 |
| ... | ... | ... | ... |
하지만, 테넌트 데이터 격리에서 문제가 되는 부분은 메시지를 조회하는 쿼리입니다.
테넌트 데이터 격리에 실패한 쿼리
SELECT * FROM message WHERE message_id = #{messageId};
위 쿼리에서 테넌트 데이터 격리가 실패한 원인은 테넌트 아이디가 메시지를 조회하는 쿼리에서 사용되지 않았다는 것입니다. API 요청을 받을 때, 테넌트 아이디 인증을 수행한다 하더라도 문제가 됩니다. 공격자는 자신의 테넌트 식별자를 사용하고 다른 테넌트의 메시지 아이디를 입력해 자신의 테넌트가 아닌 테넌트 메시지를 조회할 수 있습니다.
애플리케이션 로직에서 테넌트의 아이디와 메시지 아이디와 관계를 검증하는 로직을 추가해 보완할 수 있겠지만, 제일 단순하며 근본적으로 이런 보안 위협을 제거하는 방법은 쿼리에 항상 테넌트 아이디가 들어가는 지 검증해 테넌트 아이디 사용을 강제화하는 것입니다.
테넌트 데이터 격리에 성공한 쿼리
SELECT * FROM message WHERE tenant_id = #{tenantId} AND message_id = #{messageId};
테넌트 아이디 검증을 통한 테넌트 아이디 강제화 방법
멀티 테넌트 데이터를 다루기 때문에 코드 리뷰에서도 항상 테넌트 데이터 격리를 달성하기 위한 시큐어 코딩에 대해 생각하는 것은 매우 중요합니다. 앞서 말씀드린 것처럼 시스템적으로 강제화하지 못한다면 테넌트 데이터 격리가 실패할 보안 리스크가 항상 존재합니다. 멀티 테넌트 기반 클라우드 서비스에서 테넌트 데이터 격리가 실패하면 서비스의 안정성과 신뢰 하락에 큰 영향을 미칩니다.
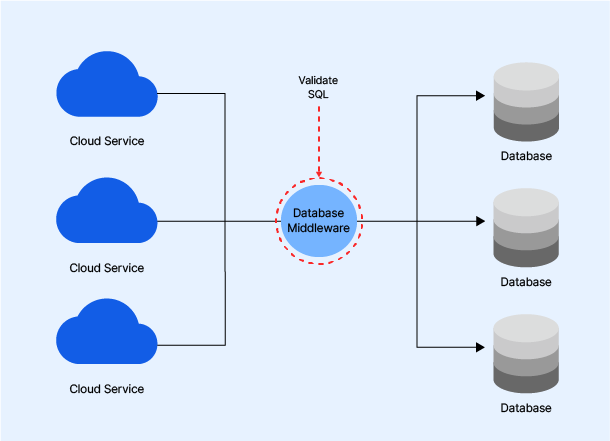
쿼리에 테넌트 아이디가 사용되도록 강제화하는 방법으로 애플리케이션 레벨에서는 JDBC DataSource를 확장하는 방법, Spring AOP나 AspectJ를 이용한 방법도 고려해 볼 수 있습니다. 그리고 시스템 아키텍처 레벨에서는 데이터베이스 미들웨어인 Apache ShardingSphere도 고려해 볼 수 있습니다. 개인적으로 이런 테넌트 데이터 격리를 클라우드 서비스 전체의 거버넌스로 가져가 중앙에서 관리를 한다면 Apache ShardingSphere와 같은 데이터베이스 미들웨어를 사용하는 것이 더 적절하다고 생각합니다.
| 애플레케이션 레벨 | 시스템 아키텍쳐 레벨 | | - | - | | 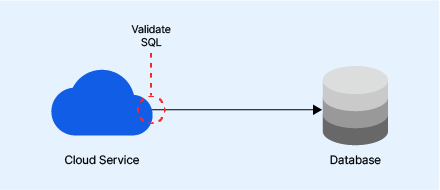 |
 |
상대적으로 단순하고 적용하기 쉬운 JDBC DataSource를 확장해 Spring 애플리케이션에서 테넌트 아이디를 강제화하는 방법에 대해 아래에서 알아봅니다.
JDBC DataSource Wrapper 클래스 구현과 Spring BeanPostProcessor 이용해 테넌트 아이디 강제화
Spring에서 쿼리 실행 시 쿼리를 검증하는 방법에는 여러 가지가 있습니다. 여기에서는 쿼리에서 테넌트 아이디 칼럼을 검증하는 JDBC DataSource Wrapper 클래스를 구현하고 Spring의 BeanPostProcessor를 이용해 원래 Bean으로 등록된 DataSource를 Wraper 클래스로 감싸서 다시 Bean으로 등록해 쿼리의 테넌트 아이디 강제화를 달성하는 방법에 대해 알아보겠습니다.
아래 코드는 설명을 위한 예시이므로 실제 구현에서는 추가적인 작업이 필요할 수 있습니다.
1. PreparedStatement Wrapper 클래스 구현
제일 먼저 PreparedStatement Wrapper 클래스인 TenantIsolationPreparedStatementWrapper를 구현합니다. 생성자에서 PreparedSatement와 쿼리를 파라미터로 받아 쿼리를 검증하는 역할을 합니다.
아래 코드에서 쿼리를 검사하는 로직은 예시를 위해 단순하게 구현된 코드입니다. 실제 구현에서는 복잡한 쿼리도 검사해야 하기 때문에 SQL Parser를 이용해 쿼리를 검사하는 방법이 더 좋을 수 있습니다.
public static class TenantIsolationPreparedStatementWrapper implements PreparedStatement {
	private static final String WHERE_CLAUSE = " tenant_id = ? ";

	private final PreparedStatement preparedStatement;

	public TenantIsolationPreparedStatementWrapper(PreparedStatement preparedStatement, String sql) {
		this.preparedStatement = preparedStatement;

		if (notContainsTenantIdIn(sql)) {
			throw new IllegalArgumentException("SQL statement must contain tenant_id column in where clause. SQL: " + sql);
		}
	}

	protected boolean notContainsTenantIdIn(String sql) {
		sql = sql.toLowerCase();

		if (sql.startsWith("show ") || sql.startsWith("insert ")) {
			return false;
		}

		int indexOfWhereClause = sql.indexOf("where");
		if (indexOfWhereClause == -1) {
			return true;
		}

		return !sql.substring(indexOfWhereClause).contains(WHERE_CLAUSE);

	}

	...

}
2. Connection Wrapper 클래스 구현
두 번째로 PreparedStatement를 생성하는 Connection에 대한 Wrapper 클래스 TenantIsolationConnectionWrapper를 구현합니다. 쿼리를 파라미터로 받아 PreparedStatement를 리턴하는 메서드를 오버라이딩해 TenantIsolationPreparedStatementWrapper로 감싸서 리턴합니다.
public static class TenantIsolationConnectionWrapper implements Connection {

	private final Connection connection;

	public TenantIsolationConnectionWrapper(Connection connection) {
		this.connection = connection;
	}

	@Override
	public Statement createStatement() throws SQLException {
		throw new UnsupportedOperationException("Statement is unsafe. Use PreparedStatement.");
	}

	@Override
	public PreparedStatement prepareStatement(String sql) throws SQLException {
		return new TenantIsolationPreparedStatementWrapper(connection.prepareStatement(sql), sql);  // Connection의 PreparedStatement를 감쌉니다.
	}

	... // 이하 생략

}
3. TenantIsolationDataSourceWrapper
세 번째로 DataSource를 감싸 TenantIsolationConnectionWrapper를 사용하도록 하는 TenantIsolationDataSourceWrapper 클래스를 구현합니다.
public class TenantIsolationDataSourceWrapper implements DataSource {
    private final DataSource dataSource;

    public TenantIsolationDataSourceWrapper(DataSource dataSource) {
        this.dataSource = dataSource;
    }

    @Override
    public Connection getConnection() throws SQLException {
        return new TenantIsolationConnectionWrapper(dataSource.getConnection());
    }

    @Override
    public Connection getConnection(String username, String password) throws SQLException {
        return new TenantIsolationConnectionWrapper(dataSource.getConnection(username, password));
    }

	... // 이하 생략
}
4. TenantIsolationBeanPostProcessor
먼저 등록된 DataSource Bean을 받아 TenantIsolationDataSourceWrapper로 감싸서 리턴합니다. 이렇게 하면 DataSource Bean으로 TenantIsolationDataSourceWrapper가 사용되어 실행되는 쿼리를 검증해 테넌트 데이터 격리를 강제화할 수 있습니다.
@Component
public class TenantIsolationBeanPostProcessor implements BeanPostProcessor {
    @Override
    public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException {
        if (bean instanceof DataSource && !(bean instanceof TenantIsolationDataSourceWrapper)) { // TenantIsolationDataSourceWrapper가 아닌 DataSource를 감쌉니다.
            return new TenantIsolationDataSourceWrapper((DataSource) bean);
        }
        return bean;
    }
}
위에서 언급한 '테넌트 데이터 격리에 실패한 쿼리'처럼 WHERE에 tenant_id 칼럼이 없다면 아래와 같이 예외를 발생시킵니다.
Caused by: java.lang.IllegalArgumentException: SQL statement must contain tenant_id column in where clause. SQL: SELECT * FROM message WHERE message_id = #{messageId};
	at com.nhncloud.tenant.isolation.datasource.TenantIsolationDataSourceWrapper$TenantIsolationPreparedStatementWrapper.<init>(TenantIsolationDataSourceWrapper.java:391)
	at com.nhncloud.tenant.isolation.datasource.TenantIsolationDataSourceWrapper$TenantIsolationConnectionWrapper.prepareStatement(TenantIsolationDataSourceWrapper.java:110)
	at java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
	at java.base/jdk.internal.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62)
	at java.base/jdk.internal.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
	at java.base/java.lang.reflect.Method.invoke(Method.java:566)
3. 테넌트 데이터 보호
멀티 테넌트 데이터 격리를 위해 테넌트 아이디 강제화도 중요하지만, 멀티 테넌트 데이터 격리가 실패했을 때 리스크를 최소화하기 위한 방법도 중요합니다. 제일 일반적인 방법은 테넌트 데이터를 테넌트별 고유 키로 암호화하여 저장하는 것입니다. 이렇게 하면 테넌트 데이터 격리에 실패하더라도 다른 테넌트는 해당 데이터를 해석할 수 없게 되어 테넌트 데이터를 보호할 수 있습니다. 아래에서 이러한 방법에 대해 더 구체적으로 알아보겠습니다.
테넌트별 키를 통한 암복호화
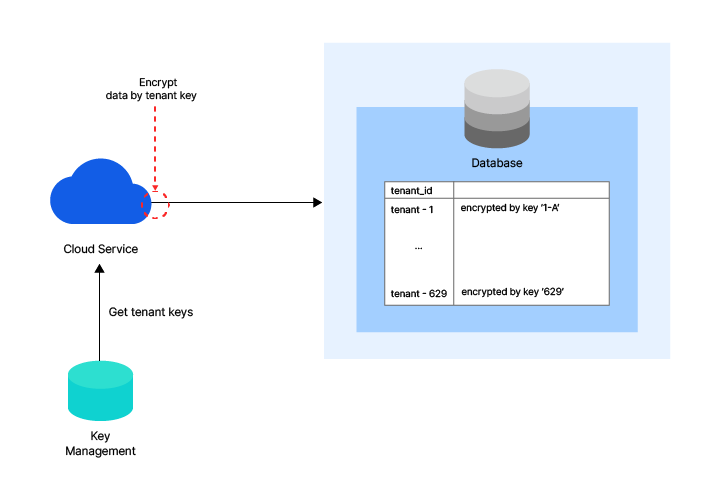
멀티 테넌트 환경에서 데이터 격리가 실패한 경우, 다른 테넌트의 데이터가 노출되는 리스크를 최소화하기 위한 한 가지 방법 중 하나는 테넌트 별로 고유 키를 부여하고 이 키를 이용해 암호화하는 것입니다. 이 방법은 같은 데이터베이스 및 테이블을 공유하는 상황에서도 각 테넌트의 데이터는 각 테넌트의 암호화 키로 암호화되어 저장되기 때문에 다른 테넌트의 데이터가 노출되어도 해석할 수 없습니다.
| 테넌트 아이디를 이용한 암호화 | 외부 키 관리 서비스를 이용한 암호화 | | - | - | |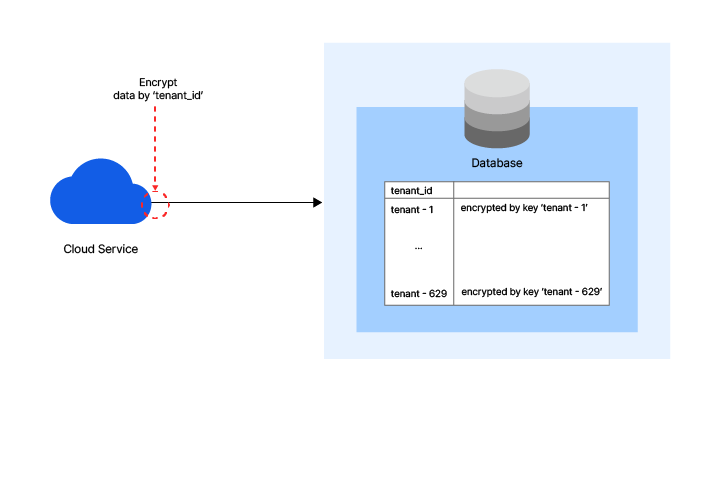
-
제일 단순한 방법입니다.
-
보안 측면에서는 다소 취약할 수 있지만, 구조가 단순하여 성능 면에서 이점이 있을 수 있습니다. |
-
NHN Cloud SKM(Secure Key Manager), Vault, AWS KMS, 같은 기밀 데이터나 키를 관리하는 서비스에 테넌트의 암호화 키를 관리하면 보안을 더 강화할 수 있습니다.
-
키 저장소가 외부에 있기 때문에 장애 상황 시 결함 허용성(fault tolerance) 등 고려해야 될 부분이 많아 집니다.
-
만약, 키 관리 서비스에서 테넌트 데이터의 암/복호화를 진행한다면 성능적인 부분도 고려해야 합니다. |
결론
멀티 테넌트 환경에서 테넌트 데이터 격리는 보안을 보장하기 위한 필수 요소입니다. 특히 여러 테넌트가 동일한 데이터베이스와 테이블을 공유하는 상황에서 테넌트 간의 데이터 접근을 방지하고 격리 수준을 강화하는 것은 클라우드 서비스의 신뢰성을 높이는 중요한 과제입니다.
행 단위, 테이블 단위, 데이터베이스 단위의 격리 방법은 각각 장단점이 있으며, 각 서비스의 요구 사항에 따라 적합한 방식을 선택해야 합니다. 더 높은 수준의 데이터 격리를 제공하는 방법은 보안성과 안정성을 높일 수 있지만, 운영 비용의 증가도 고려해야 합니다.
시큐어 코딩 원칙을 적용하여 쿼리 내에서 테넌트 아이디를 강제하는 것과 같은 기술적 조치는 데이터 격리 실패로 인한 보안 위험을 크게 줄일 수 있습니다. 그리고 이러한 기술적 접근과 더불어 테넌트별 암호화 키를 사용하여 데이터를 보호하는 방법은 데이터 노출 리스크를 최소화하는 추가적인 보안 장치로 작용합니다.
결론적으로, 멀티 테넌트 환경에서 성공적인 데이터 격리는 보안성, 비용 효율성, 성능의 균형을 고려하는 전략적인 접근을 요구하며, 이를 통해 안정적이고 신뢰할 수 있는 서비스를 제공할 수 있습니다.