Engineering
Java에서의 Emoji처리에 대해
2022년 3월 17일
원문에서 보기 ↗프롤로그
NHN Cloud의 메세징 플랫폼인 Notification의 SMS 서비스는 4byte 이모지에 대해 제한 정책이 존재합니다. 벤더사와 SMS 표준 정책 상 인코딩 문제로 인하여 4byte 이모지는 허용되지 않는 문자로 처리합니다. 애플리케이션 레벨에서 4byte 이모지를 쉽게 판별하고 처리하기 위해서 시작된 기초적인 인코딩에 관련된 학습과 이슈 해결 과정 내용을 공유합니다.
문자 집합과 인코딩
먼저 몇 가지 용어에 대해 정리가 필요합니다. 언어 별로 다양한 문자 체계, 숫자, 특수문자 등을 표현하기 위해 각 문자 별로 고유한 코드나 값을 할당하고, 체계를 만들어 표현합니다. 문자 집합은 특정 언어권에서 사용하는 모든 문자의 집합입니다. 문자 집합에 정해진 문자들을 일대일로 특정 코드(값)에 할당하여 표현하는 논리적인 문자 집합을 코드화 된 문자 집합(CCS, Coded Character Set)이라 합니다. 특정 문자에 지정된 특정 코드를 코드 포인트(Code Point) 혹은 코드 유닛(Code Unit)이라 합니다. 그리고 정해진 문자 집합을 컴퓨터에 저장하기 위해 Octet 단위로 표현하는 방식을 인코딩 방식(CES, Character Encoding Scheme)이라 합니다. 대표적으로 한글을 표현하는 인코딩 방식인 euc-kr은 자세하게 정의하면 KS X 1001(KS-C-5601), KS X 1003(KS-C-5636)의 합집합을 문자 집합으로 가지고, 2Byte로 완성형 한글을 표현하는 인코딩 방식입니다.
문자체계의 역사와 한글 문자 집합
최근의 인코딩 체계에 대한 설명에 앞서 문자 체계의 역사에 대해 알아볼 필요가 있습니다. 먼저 1963년에 정의된 ASCII(American Standard Code for Information Interchange)입니다. 7bit(0x00~0x7F) 범위의 128개의 부호를 이용하여 영문 키보드에서 사용하는 모든 기호를 할당한 기본적인 문자 체계입니다. 나머지 1bit는 parity bit로 사용하거나 0x80~0xFF 에 새로운 문자를 할당하여 확장된 아스키코드를 구성하기도 합니다.^[1]^ HTML의 기본 인코딩으로 우리가 자주 듣게 되는 ISO-8859-1도 확장된 아스키코드 문자 집합을 사용합니다. Latin-1이라고도 불립니다.^[2]^서유럽 언어권의 문자 집합이기 때문에 한글을 지원하지 않습니다.
서구권의 언어체계는 알파벳과 강세 알파벳을 이용해 거의 모든 문자가 표현되지만 동양권의 문자들, 특히 CJK(Chinese, Japanese, Korean) 문자 집합에 포함되는 언어의 문자들은 많은 코드가 필요했습니다. 한글의 경우 현대 한글의 문자는 11,172개의 완성 문자가 존재한다고 합니다. 이를 위해 1987년 국가기술표준원에서 한글자당 2byte의 고정 크기를 가지는 KS X 1001(KS-C-5601) 완성형 한글 문자 집합을 만들었습니다. 자주 사용하는 완성형 한글 문자 2350자, 한자 4888자, 특수문자 등이 포함된 문자 집합을 만들고, euc-kr 인코딩이 만들어졌습니다. 하지만 빈약한 한글 문자 집합의 문제로 표준어가 입력되지 않는 문제가 있었습니다. 샾, 똠, 믜와 같이 사용되는 표준어가 문자 집합에 포함이 되어 있지 않다 보니 많은 문제가 발생하였습니다.
Microsoft사의 한글 Windows에서는 이런 문제 때문에 CP949라는 새로운 문자 집합을 만들고 사용하였습니다. 기존의 euc-kr에서 표현하지 못하는 문자들을 더하여 만든 문자 집합으로 확장 완성형 문자 집합이라고도 합니다. Windows-949, MS949 등으로도 불립니다.
유니코드, 기본 평면, 보조 평면
유니코드(Unicode)는 전 세계의 모든 문자를 표현하기 위해 만들어진 문자 집합입니다. 유니코드는 한 글자당 2~3byte의 가변크기를 가지는 문자 집합입니다. 여기서 기본 평면(BMP, Basic Multilingual Plane)이라는 용어가 등장하는데, 유니코드의 핵심인 0~2byte 영역에 해당되는 영역으로, 대부분의 문자들이 이 영역에 정의되어 있습니다. 유니코드임을 의미하는 U+ (또는 \u 기호를 사용) 기호와 4개의 16진수로 표현 가능한 범위로, U+0000~U+FFFF 안에 속하는 문자들이 기본 다국어 평면에 정의된 문자로 이해할 수 있습니다.
- 유니코드 평면^[3]^
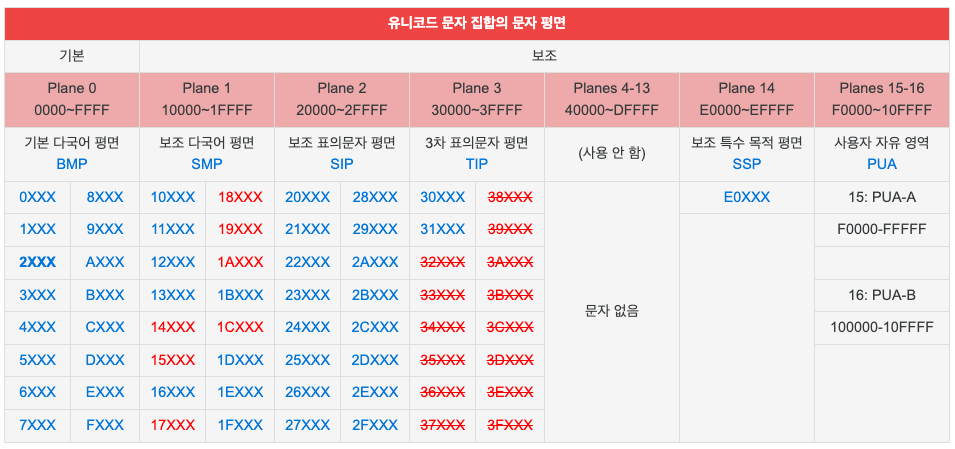 유니코드 평면은 다음과 같이 구성되어 있습니다. 앞에서 말한 것처럼 U+0000~U+FFFF 사이의 유니코드는 기본 다국어 평면에 속하는 유니코드입니다. U+10000~U+10FFFF 영역은 보조 평면에 속한 유니코드들로 보조 다국어 평면, 보조 표의문자 평면 등으로 구성되고, 비슷한 문자들끼리 묶여 평면을 구성하게 됩니다.
- 기본 다국어 평면 (BMP, Basic Multilingual Plane)^[4]^
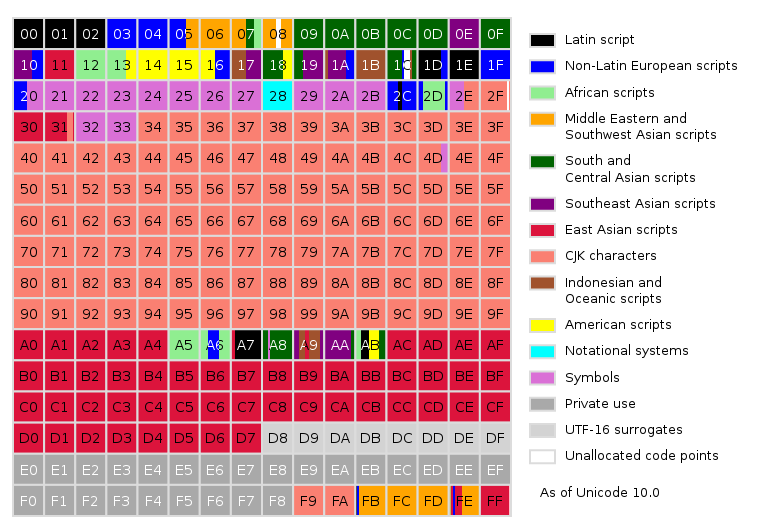 기본 다국어 평면은 U+0000~U+FFFF 범위의 유니코드들을 포함한 평면입니다. 이 평면에는 많은 기호들과 거의 모든 현대 문자들이 포함됩니다. BMP를 구성하는 문자들 중 가장 많은 범위를 차지하는 것은 역시 한자와 한글입니다. U+3400~U+9FFF의 CJK character가 한자 영역과, U+AC00~U+D7FF의 완성형 한글 영역을 위의 그림에서 확인할 수 있습니다.
- 보조 다국어 평면(SMP, Supplementray Multilingual Plane)^[5]^
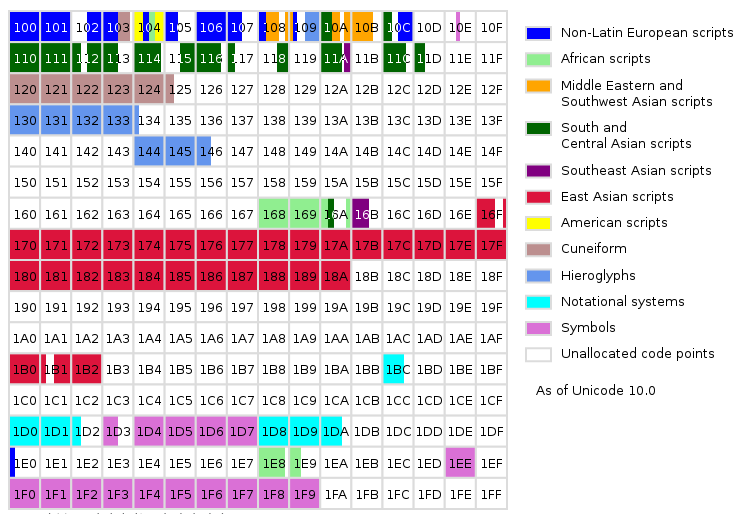 보조 다국어 평면은 U+10000~U+1FFFF 범위의 유니코드들을 포함한 평면입니다. BMP 이후에 이어진 유니코드들이 포함되어 있으며, 옛 문자나 음악, 수학 기호 등이 포함되어 있습니다. U+1F000~U+1F9FF의 Symbols가 이모지가 포함된 영역입니다.
2022년 2월 기준으로 유니코드의 버전은 14.0으로 2021년 9월 23일에 릴리스 되었습니다. 아직 포함되지 않은 문자들이 꾸준히 제안되고 구조화되어 정의되고 있습니다. 유니코드 14.0의 자세한 내용은 http://www.unicode.org/versions/Unicode14.0.0/ 다음 페이지에서 확인 가능합니다. 여담으로 유니코드 14.0부터 매년 3분기에 메이저 버전 릴리스를 목표로 하여 15.0 릴리스는 2022년 9월이 예상된다고 합니다.
UTF-8, UTF-16
이런 유니코드를 표현하고 코드로 매핑하기 위한 CES가 여러 방식으로 존재합니다. 이번 단락에서 설명할 UTF-8이나 UTF-16이 대표적인 유니코드의 인코딩 방식입니다.
- UTF-8(Unicode Transformation Format - 8bit) UTF-8은 1~4byte 가변 길이 인코딩입니다. 문자를 표현하기 위해 필요한 최소 bit는 8bit입니다. ASCII 범위의 유니코드는 1바이트 인코딩이 가능하지만, 한글의 포함범위인 3바이트 구간이 4byte로 표현된다는 단점이 있습니다. 하지만 기존 아스키코드와의 호환성이 좋고, endian을 신경 쓰지 않아도 된다는 아주 큰 장점이 있어 대세로 자리 잡고 있습니다. 가변 길이에 따라 시작 bit 가 달라지므로 몇 바이트인지 바로 구분이 가능합니다.
| 유니코드 범위 | 2진수 | UTF-8 인코딩 |
|---|---|---|
| U+0000 ~ U+007F | 0000 0000 0xxx xxxx | 0xxx xxxx |
| U+0080 ~ U+07FF | 0000 0yyy xxxx xxxx | 110y yyxx 10xx xxxx |
| U+0800 ~ U+FFFF | yyyy yyyy xxxx xxxx | 1110 yyyy 10yy yyyy 10xx xxxx |
| U+010000 ~ U+10FFFF | 000z zzzz yyyy yyyy xxxx xxxx | 1111 0zzz 10zz yyyy 10yy yyxx 10xx xxxx |
2진수로 변환된 bit를 x, y, z로 표현하였습니다. 인코딩 된 값의 x, y, z는 원래의 bit를 순서대로 대입하면 됩니다.
- UTF-16(Unicode Transformation Format - 16bit) UTF-16은 16bit 단위로 문자를 인코딩하므로 2 또는 4바이트 가변 길이 인코딩입니다. 기존 2바이트 유니코드까지는 그대로 인코딩 됩니다. 21bit를 넘어간 표준 평면에 속하지 않는 유니코드의 경우 써로게이트(Surrogate) 쌍으로 인코딩합니다. Java는 기본적으로 UTF-16 BE(Big Endian) 인코딩을 사용합니다.
| 유니코드 범위 | 2진수 | UTF-16 BE |
|---|---|---|
| U+0000 ~ U+FFFF | yyyy yyyy xxxx xxxx | yyyy yyyy xxxx xxxx |
| U+010000 ~ U+10FFFF | 000z zzzz yyyy yyyy xxxx xxxx | 1101 10zz zzyy yyyy 1101 11yy xxxx xxxx |
위의 UTF-8의 예와 같이 x, y, z bit를 그대로 인코딩 된 bit에 순서대로 대입하면 됩니다. z의 사라진 1bit는 최상위 bit로 0x10000을 뺀 20bit 영역을 인코딩하는 방식입니다.
- 써로게이트 U+10000보다 큰 값에 할당된 유니코드의 경우 써로게이트 쌍(1101 10zz zzyy yyyy의 high 써로게이트와 1101 11yy xxxx xxxx의 low 써로게이트)으로 인코딩 됩니다. high 써로게이트의 최솟값은 1101 1000 0000 0000 (0xD800)이고, 최댓값은 1101 1011 1111 1111 (0xDBFF)입니다. low 써로게이트의 최솟값은 1101 1100 0000 0000 (0xDC00)이고, 최댓값은 1101 1111 1111 1111 (0xDFFF)입니다. 유니코드는 이 범위의 코드 포인트에 UTF 16 인코딩을 위한 영역을 지정하였습니다.
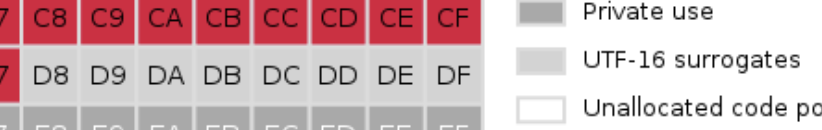 위의 기본 평면 그림에서도 보았듯이 0xD800~0xDFFF는 UTF-16 써로게이트를 위해 사용되지 않는 영역입니다. 따라서 상위 5bit를 체크하면 해당 인코딩 문자열이 써로게이트 쌍인지, 기본 평면에 속하는 문자인지 판별 가능합니다.
Java의 인코딩 처리
Java의 기본 인코딩은 UTF-16
위에서 Java는 기본적으로 UTF-16 BE 인코딩을 사용한다고 언급하였습니다. 초기 Java는 유니코드 인코딩을 UCS-2를 사용하였는데, 이는 2바이트 고정 인코딩 방식입니다. 하지만 유니코드 2.0부터 추가된 기본 평면 이외의 보조 평면에 속한 2바이트 이상의 유니코드를 표현할 수 없다는 치명적인 단점이 있었습니다. 이에 JSR-204(Java Spectification Requests) 제안을 통해 Java 2.0부터 UTF-16 인코딩으로 바뀌게 되었습니다.^[6]^
- JSR-204 : https://jcp.org/en/jsr/detail?id=204
- Oracle 기술문서 : https://www.oracle.com/technical-resources/articles/javase/supplementary.html
다음은 java.lang.Character에 선언된 Character의 SIZE의 BYTES 상수입니다. 이를 통해 Java가 primitive char를 표현하기 위해 기본적으로 2byte 인코딩을 사용함을 알 수 있습니다.
public final class Character implements ... {
    public static final int SIZE = 16;
    public static final int BYTES = SIZE / Byte.SIZE;
}
이런 인코딩과 관련된 메소드들이 Character나 String 클래스에 여러 가지로 존재합니다. 다음은 써로게이트와 관련된 Character의 메소드들입니다. 이는 내부적으로 인코딩에 관련된 클래스들에서 범용적으로 사용됩니다.
public final class Character implements ... {
    public static final char MIN_HIGH_SURROGATE = '\uD800';
    public static final char MAX_HIGH_SURROGATE = '\uDBFF';
    public static final char MIN_LOW_SURROGATE  = '\uDC00';
    public static final char MAX_LOW_SURROGATE  = '\uDFFF';
    public static final char MIN_SURROGATE = MIN_HIGH_SURROGATE;
    public static final char MAX_SURROGATE = MAX_LOW_SURROGATE;

    public static boolean isSurrogate(char ch) {
        return ch >= MIN_SURROGATE && ch < (MAX_SURROGATE + 1);
    }
    public static boolean isSurrogatePair(char high, char low) {
        return isHighSurrogate(high) && isLowSurrogate(low);
    }
    public static boolean isHighSurrogate(char ch) {
        // Help VM constant-fold; MAX_HIGH_SURROGATE + 1 == MIN_LOW_SURROGATE
        return ch >= MIN_HIGH_SURROGATE && ch < (MAX_HIGH_SURROGATE + 1);
    }
    public static boolean isLowSurrogate(char ch) {
        return ch >= MIN_LOW_SURROGATE && ch < (MAX_LOW_SURROGATE + 1);
    }
}
두 개의 써로게이트 쌍으로 표현되는 보조 문자는 1 character에 2 code point를 가지므로 우리가 인식하는 문자의 개수와 character의 length는 달라집니다. 이를 위해 character 배열의 해당 index가 표현하는 문자를 숫자로 변환한 값을 리턴하는 메소드가 존재합니다.
public final class Character implements ... {
    public static int codePointAt(char[] a, int index, int limit) {
        if (index >= limit || limit < 0 || limit > a.length) {
            throw new IndexOutOfBoundsException();
        }
        return codePointAtImpl(a, index, limit);
    }

    // throws ArrayIndexOutOfBoundsException if index out of bounds
    static int codePointAtImpl(char[] a, int index, int limit) {
        char c1 = a[index];
        if (isHighSurrogate(c1) && ++index < limit) {
            char c2 = a[index];
            if (isLowSurrogate(c2)) {
                return toCodePoint(c1, c2);
            }
        }
        return c1;
    }
}
Character 내부엔 UnicodeBlock이라는 이너 클래스가 존재합니다. UnicodeBlock은 유니코드 표준에 따라 특정 유니코드들의 범위를 정의해놓았습니다. 다음은 UnicodeBlock에 정의된 한글 자, 모음과 관련된 코드입니다.
public final class Character implements ... {
    public static final class UnicodeBlock extends Subset {
        public static final UnicodeBlock HANGUL_JAMO =
            new UnicodeBlock("HANGUL_JAMO",
                             "HANGUL JAMO",
                             "HANGULJAMO");

        private static final int[] blockStarts = {
            ....
            0x1100,   // 1100..11FF; Hangul Jamo
            ....
        }

        private static final UnicodeBlock[] blocks = {
            ....
            HANGUL_JAMO,
            ....
        }
    }
}
Java 9의 Compact String
UTF-8이면 1byte로 인코딩 되는 U+0000~U+007F의 문자들도 UTF-16에선 2바이트가 사용되기 때문에 힙 사용에서 손해를 보게 됩니다. 이를 위해 Java 9부터는 -XX:-CompactStrings option을 통해 ISO-8859-1(Latin-1) 문자 집합으로 표현 가능한 문자는 1byte로 저장합니다. 해당 문자열이 LATIN1로 인코딩 되었는지, UTF-16으로 인코딩 되었는지 Coder라는 flag로 내부적으로 저장하고, value를 기존 char에서 byte 배열로 저장하게 됩니다.^[7]^
// java 8
public final class String implements ... {
    private final char value[];
    ....
}

// java 11
public final class String implements ... {
    @Stable
    private final byte[] value;
    private final byte coder;

    @Native static final byte LATIN1 = 0;
    @Native static final byte UTF16  = 1;
    ...
}
이렇게 내부적으로 Latin1 인코딩을 사용하게 되어 String 클래스에도 많은 변화가 생겼습니다. String 클래스 내부의 대부분의 메소드에서 인코딩 타입에 따라 분기를 하여 구현되어 있습니다.
// java 8
public final class String implements ... {
    public char charAt(int index) {
        if ((index < 0) || (index >= value.length)) {
            throw new StringIndexOutOfBoundsException(index);
        }
        return value[index];
    }
}

// java 11
public final class String implements ... {
    private boolean isLatin1() {
        return COMPACT_STRINGS && coder == LATIN1;
    }
    public char charAt(int index) {
        if (isLatin1()) {
            return StringLatin1.charAt(value, index);
        } else {
            return StringUTF16.charAt(value, index);
        }
    }
}
- Java 8
- Java 11
문제해결
Java에서 문자가 어떻게 처리되는지 다음과 같이 확인하였습니다.^[8]^
// Code Point를 통해 유니코드 확인
for (int i = 0; i < text.length(); i++) {
    System.out.print("U+%04X ", text.codePointAt(i));
}

// UTF-8로 인코딩 된 값
byte[] bytes = text.getBytes(StandardCharsets.UTF_8);
for (byte b : bytes) {
    System.out.print("0x%02X ", b);
}

// UTF-16으로 인코딩된 값
byte[] bytes2 = text.getBytes(StandardCharsets.UTF_16);
for (byte b : bytes2) {
    System.out.print(String.format("0x%02X ", b));
}
다음은 몇가지 이모지들의 문자열 처리 결과입니다.
| Emoji | Code point | UTF-8 | UTF-16BE |
|---|---|---|---|
| ✅ | U+2705 | 0xE2 0x9C 0x85 | 0xFE 0xFF 0x27 0x05 |
| 😁 | U+1F601 | 0xF0 0x9F 0x98 0x81 | 0xFE 0xFF 0xD8 0x3D 0xDE 0x01 |
| ❣️ | U+2763 U+FE0F | 0xE2 0x9D 0xA3 0xEF 0xB8 0x8F | 0xFE 0xFF 0x27 0x63 0xFE 0x0F |
| #️⃣ | U+0023 U+FE0F U+20E3 | 0x23 0xEF 0xB8 0x8F 0xE2 0x83 0xA3 | 0xFE 0xFF 0x00 0x23 0xFE 0x0F 0x20 0xE3 |
| 🇰🇷 | U+1F1F0 U+1F1F7 | 0xF0 0x9F 0x87 0xB0 0xF0 0x9F 0x87 0xB7 | 0xFE 0xFF 0xD8 0x3C 0xDD 0xF0 0xD8 0x3C 0xDD 0xF7 |
이모지 처리 결과를 통해 알 수 있는 점들이 몇 가지 있습니다.
- UTF-16 BE로 인코딩 된 값은 모두 0xFE 0xFF로 시작합니다. 이는 Big Endian을 나타내는 BOM(Byte-Order Marker)입니다. 이를 통해 이 Hex 코드가 UTF-16 BE로 인코딩 된 문자임을 알 수 있습니다.
- 다음 문자열들 중 4byte 이모지로 판별해야 할 이모지는 😁, 🇰🇷입니다. 기본 평면에 해당하지 않는 이모지로 U+10000 보다 큰 값으로 정의되어 있습니다.
- 세 번째 이모지인 ❣️는 U+2763(❣) 이모지에 U+FE0F (Variation Selector-16)가 붙어 스타일이 변경되었습니다. Variation selector는 유니코드의 뒤나 중간에 붙어 이모티콘의 스타일 지정에 사용합니다. U+FE0E (Variation Selector-15), U+FE0F (Variation Selector-16)가 존재합니다.
- 네 번째와 다섯 번째 이모지는 결합 문자라 합니다. 네 번째 이모지인 #️⃣는 U+0023 인 # 해시 기호와 U+20E3 키 캡 기호, U+FE0F를 통해 결합된 결합 문자입니다. 다섯 번째 이모지인 🇰🇷는 U+1F1F0 🇰와 U+1F1F7 🇷이 합쳐져서 국기 모양 이모지를 나타냅니다. 다른 나라의 국기도 역시 Regional indicator에 속하는 알파벳 두 개를 붙여서 나타냅니다.
그 외에도 여러 가지 결합 문자와, 변형 이모지들이 존재합니다^[9]^.
글의 서두에서 말했듯이 해결해야 할 이슈는 4byte 이모지를 필터링하는 것이었습니다. 이모지를 판별할 수 있는 정규식을 사용하거나, 문자의 유니코드가 이모지 유니코드의 범위 안에 속하였는지를 확인하거나, 이모지 파싱 라이브러리를 사용하는 등의 여러 가지 방법이 있을 것입니다. 하지만 모든 이모지를 판별하지 않고 4byte 이모지를 판별해야 함에 더하여, 기본 다국어 평면(BMP)에 속하지 않는 문자들 역시 판별해야 하였습니다. 따라서 기본 다국어 평면에 포함되지 않는 U+10000 이상의 유니코드가 포함되어 있는지를 판별하는 것으로 이슈 해결 방법을 선택하였습니다. Java에서는 해당 문자열을 Character 단위로 쪼개서 Character의 값이 써로게이트인지 확인하는 것으로 간단하게 U+10000 이상의 유니코드가 포함되었는지 판별할 수 있습니다. Java의 UTF-16 BE 인코딩에 따라 기본 다국어 평면에 포함된 16비트로 나타내는 문자는 그대로 16비트로 인코딩 되고, 이후의 확장된 범위에 속하는 21비트로 표현된 문자는 써로게이트 쌍으로 인코딩 되기 때문입니다.
public static boolean isContains4ByteUnicode(String text) {
    for (int i = 0; i < text.length(); i++) {
        if (Character.isSurrogate(text.charAt(i))) {
            return true;
        }
    }
}
참고문서
[1] : 확장된 아스키코드의 예 CP 437의 코드 페이지 : https://www.ascii-codes.com/ [2] : Latin-1 ISO Spec : https://www.iso.org/standard/28245.html [3] : 유니코드 문자 집합의 문자 평면 : https://namu.wiki/w/유니코드#s-4.1 [4] : 기본 평면 이미지 : https://namu.wiki/w/BMP#s-3 [5] : 보조 다국어 평면 이미지 : https://namu.wiki/w/SMP [6] : https://stackoverflow.com/questions/36236364/why-java-char-uses-utf-16 [7] : JEP 254: Compact Strings : http://openjdk.java.net/jeps/254 [8] : https://d2.naver.com/helloworld/76650 [9] : http://pluu.github.io/blog/android/2020/01/11/unicode-emoji/