Engineering
Trino로 타임아웃 개선하기
2025년 3월 4일
원문에서 보기 ↗
들어가며
안녕하세요. NHN Cloud의 클라우드AI팀 이태형입니다. 로그 데이터가 쌓일수록 조회 속도가 느려지는 문제, 한 번쯤 겪어 보셨을 텐데요. 이 글에서는 이러한 문제를 해결하기 위해 저희 팀에서 Trino를 도입하여 성능을 개선한 과정을 공유해 보려 합니다. 재미있게 읽어 주세요! 😊
개요: NHN AppGuard
NHN AppGuard 서비스에 Trino를 적용한 이야기를 드릴 예정이라서 먼저 해당 서비스를 소개하겠습니다.
NHN AppGuard는 모바일 애플리케이션을 보호하기 위해 사용자의 이상 행위를 탐지하거나 차단하는 모바일 앱 보안 솔루션입니다. NHN AppGuard의 서버는 탐지/차단 로그를 안전하게 저장하고, 각종 조건 검색과 대시보드를 제공합니다.
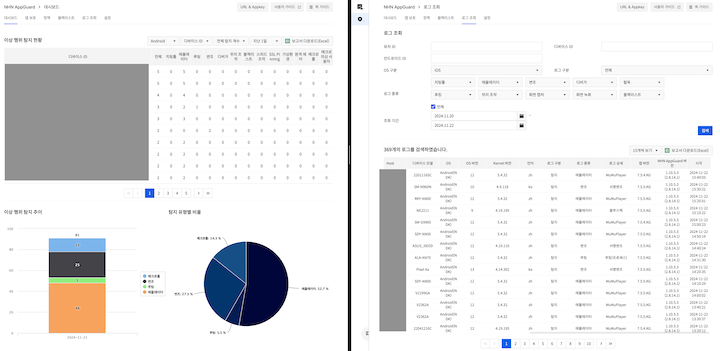
NHN AppGuard 로그
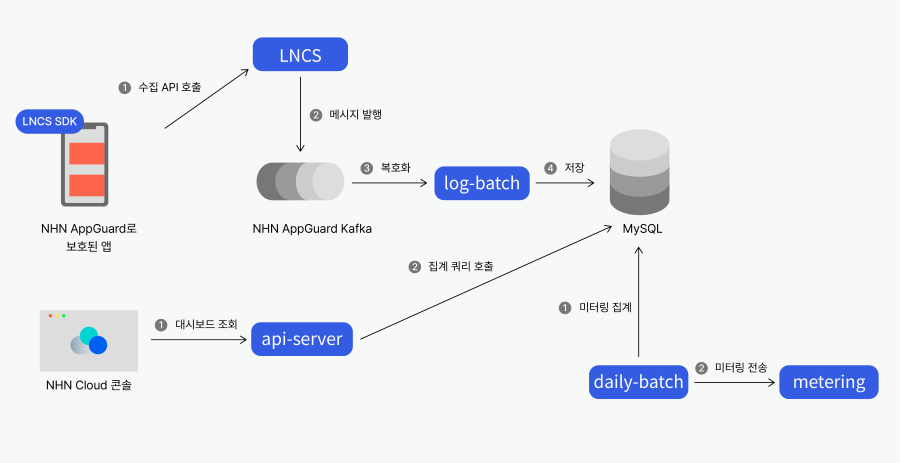
NHN AppGuard는 평균 600만개/일 가량의 로그를 수집하고 있습니다. 이러한 로그는 NHN AppGuard 로그 워크플로에 따라 DB에 적재됩니다.
이슈 발생
대부분의 쿼리가 월 단위 집계 성격을 띠는 이유로 질의 대상 row 가 1억 건이 넘는 경우가 많아 이슈가 발생했습니다. 발생한 이슈는 아래와 같습니다.
- 검색 조건 변경 시 대시보드 화면에서 타임아웃 발생
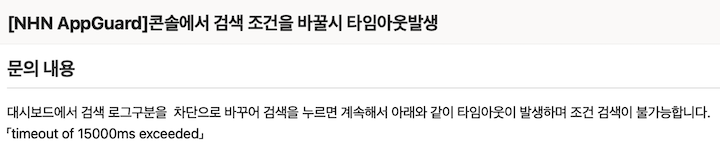
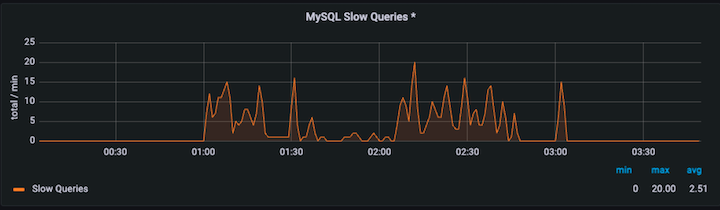
- 집계 쿼리가 수행되는 새벽 시간대에 slow query 발생
일반적인 해결 방안
위 이슈들은 결국 쿼리의 성능이 원인이기 때문에 먼저 쿼리 최적화를 수행했습니다.
- index 문제
- 쿼리 검수를 통해 index의 순서를 변경하고
- 의도한 index가 적용되도록 쿼리에 index hint를 추가했습니다.
- 쿼리의 문제
- 한 달 기간 전체 데이터를 스캔하는 쿼리를 당일 증가분만 조회하도록 수정하고
- 대시보드를 매번 조회하지 않고 일 배치 작업으로 미리 계산해 둔 데이터를 조회하고
- 조회 가능한 기간을 제한했습니다.
이러한 최적화를 통해 일시적으로 이슈가 해소되었습니다. 하지만 NHN AppGuard의 로그는 점차 늘어나고, 집계할 데이터의 종류도 증가했으며, 조회 기간 감소에 대한 불만이 발생하여 다른 접근이 필요했습니다.
로그 저장소 검토
MySQL을 대신해 로그를 저장하기에 적절한 로그 저장소를 검토했습니다.
- Elasticsearch (LNCS)
- 검색에 좋은 성능
- 상품 스펙상 최대 120일 저장 제한
- Trino (DataQuery)
- 복잡한 집계 쿼리에 좋은 성능
- 여러 데이터 소스 간 federation 지원
- 저장 기간 제한 없음
NHN AppGuard는 로그의 저장 기간을 기존 90일에서 늘리는 것을 계획하고 있었고, 무엇보다 대부분의 쿼리가 집계 성격을 많이 띠어 Trino가 적절하다고 판단했습니다.
Trino와 DataQuery
Trino란
Trino 공식 홈페이지를 보면 아래와 같은 문구를 찾을 수 있습니다.
Trino, a query engine that runs at ludicrous speed Fast distributed SQL query engine for big data analytics that helps you explore your data universe.
키워드를 뽑아 보면 아래와 같습니다.
- Fast - 빠르다
- Distributed - 분산 처리한다
- analytics - 분석에 적절하다
Trino 특징
마찬가지로 Trino 공식 홈페이지에서는 아래와 같은 특징을 소개합니다. 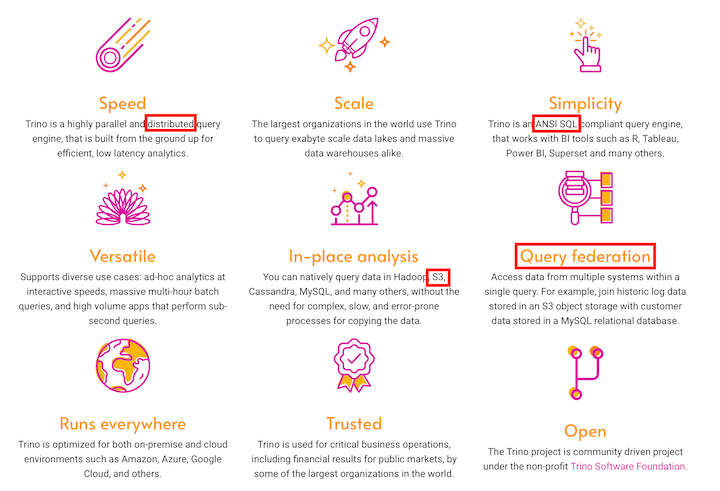
여기서도 키워드를 뽑아보면 아래와 같습니다.
- distributed: 분산 처리로 빠르고
- ANSI SQL: 표준 SQL 을 호환하여 현재 쿼리문을 수정할 필요가 없고
- S3: OBS에 저장하여 스토리지 비용을 줄일 수 있고
- Query Federation: OBS의 데이터와 MySQL 데이터를 하나의 쿼리로 join할 수 있다.
Trino 동작 원리
Trino의 동작 원리는 Presto: SQL on Everything라는 논문에 자세히 소개하고 있습니다. 해당 논문의 일부를 가볍게 살펴보겠습니다.
구조도
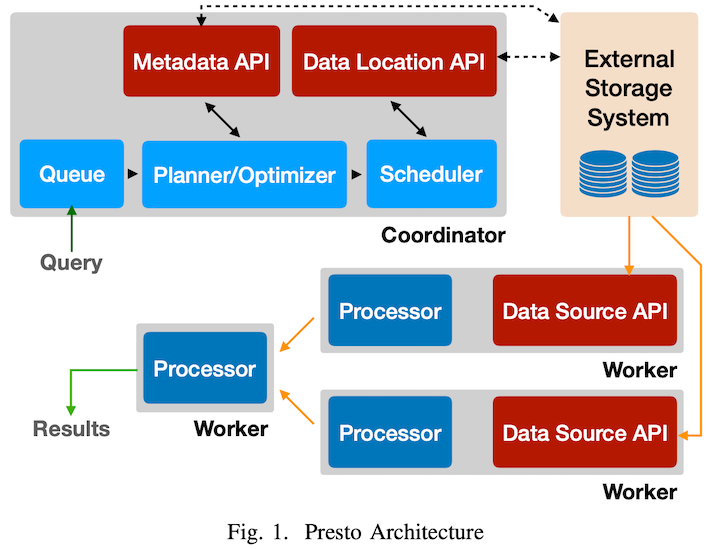
Trino는 하나의 Coordinator 노드와 여러 개의 Worker 노드로 구성됩니다. Coordinator 노드는 쿼리의 인입 지점으로 admit, parsing, planning, optimizing, orchestration 등을 수행하고, worker node는 query processing을 담당합니다.
요청 처리 순서
Coordinator 노드가 분산 처리를 계획하면 worker node가 병렬로 처리해서 복잡한 쿼리가 더 빠르게 실행되는 원리입니다.
- client → coordinator: http request (SQL stmt)
- coordinator: evaluate request(parsing, analyzing, optimizing distributed execution plan)
- coordinator: plan to worker
- task 생성
- splits 생성(addressable chunk in external storage)
- splits을 task에 할당
- worker: run task
- fetching splits
- 다른 worker에서 생성한 intermediate data 처리
- worker 간에는 intermediate data를 memory에 저장하여 공유
- shuffle이 발생할 수 있음 *shuffle = node 간 데이터 재분배
- query의 shape에 따라 모든 데이터를 처리하지 않고 반환
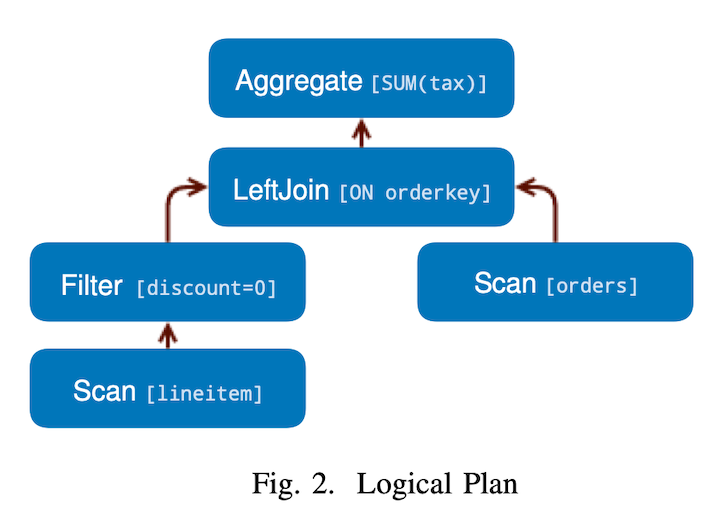
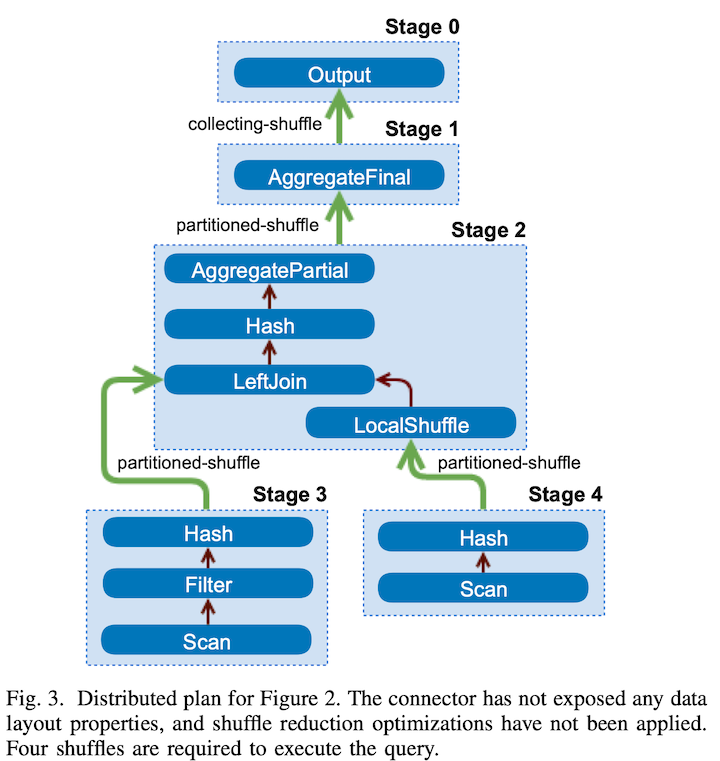
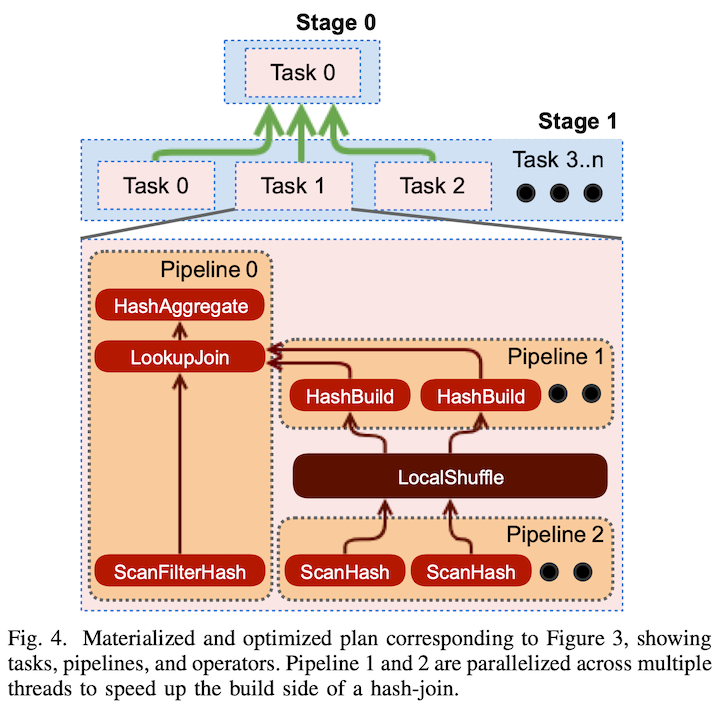
Trino 쿼리 실행 예시
그림으로 살펴보기
-
쿼리문
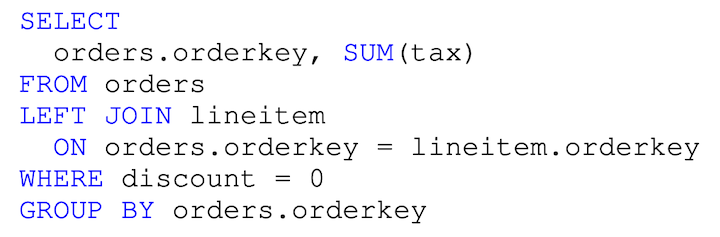
-
logical plan
-
distributed plan (stage)
-
optimized plan (pipeline, parallelism)
실행 순서
- Planner: SQL → SQL syntax tree → Logical Planning (IR 생성)
- IR = Intermediate Representation
- Optimizer: Logical Plan → evaluate transformation rules → optimize → Physical Structure
- transformation rules = sub-tree query plan + transformation
- 사용되는 optimizing 기법 = predicate and limit pushdown, column pruning, decorrelation, table and column statistics 기반 cost-based 최적화
- Data Layouts = Connector Data Layout API로 얻어내는 위치, 파티션, 정렬, 그룹화, 인덱스
- Predicate Pushdown = connector에 따른 filtering 최적화
- *pushdown : 읽어야 하는 데이터를 줄이는 것
- *Predicate Pushdown : 조회 조건에 맞는 데이터만 읽는 것
- Inter-node Parallelism = stage 단위의 병렬 실행
- Intra-node Parallelism = stage 내에서 single node의 thread에 걸친 병렬 실행
- Scheduler: Stage Scheduling → Task Scheduling → Split Scheduling
- Task Scheduling = Leaf Stage / Intermediate Stage 분리하여 배치
- Query Execution = Local Data Flow → Shuffles → Writes
DataQuery
NHN Cloud의 DataQuery 서비스는 위에서 소개한 Trino를 기반으로 대규모 데이터에 대해 쿼리를 실행할 수 있는 서비스입니다. 이를 통해 원하는 클러스터 스펙을 지정하고 연결할 데이터 소스만 작성하면 Trino의 복잡한 설치와 설정 과정 없이 사용이 가능합니다.
Trino 적용 - 개념
Trino를 적용하기 위해 알아야 할 개념을 소개합니다.
데이터 소스 선정
Trino는 여러 종류의 데이터 소스를 지원합니다.
NHN AppGuard는 로그 저장 기간 증가를 계획하고 있어 저장 비용을 절약하기 위해 OBS를 데이터 소스로 선정하였습니다. OBS 데이터 소스를 사용하는 경우 데이터의 타입도 Parquet, JSON, ORC, CSV, Text 중에 선택해 주어야 해서, 위와 동일한 이유로 Parquet 파일 포맷을 선택하였습니다.
Apache Parquet
Apache Parquet 홈페이지에는 Parquet를 아래와 같이 설명합니다.
Apache Parquet is an open source, column-oriented data file format designed for efficient data storage and retrieval. It provides efficient data compression and encoding schemes with enhanced performance to handle complex data in bulk. Parquet is available in multiple languages including Java, C++, Python, etc...
여기서도 키워드를 뽑아보면 아래와 같습니다.
- column-oriented data
- efficient data storage and retrieval
- efficient data compression
- encoding schema
- handle complex data in bulk
column-oriented data의 설명은 아래의 그림을 보시면 이해가 쉽습니다. 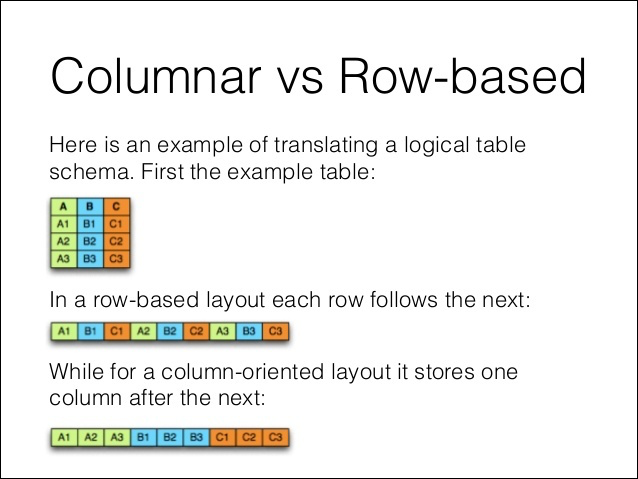 (Source: https://devidea.tistory.com/92)
동일한 타입의 데이터가 나열되기 때문에 압축 효율이 높아지는 효과가 있습니다. 또한 footer에 데이터에 대한 메타데이터를 저장해 두어 reader에게 데이터에 대한 힌트를 주어 조회 성능을 높입니다.
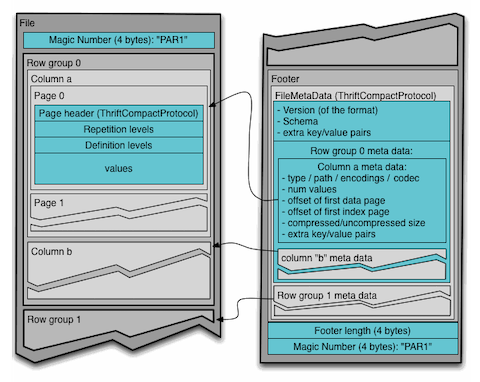 (source: https://parquet.apache.org/docs/file-format/)
구상안
parquet는 columnar한 형식이기 때문에 row 단위로 데이터를 append하는 것은 비효율적입니다. 그러므로 데이터를 모아서 parquet 형식으로 파일을 생성하는 것이 효율적입니다. 이를 위해 NHN AppGuard에서는 3가지 구성 방법을 고려했고 3번째 안을 선택했습니다.
- micro batch
- kafka → log-batch → create parquet / 1 minute → save obs → obs
- trino는 OBS를 사용하는 경우 파일 기반으로 동작하기 때문에 파일의 개수가 많아지면 비효율적입니다.
- 1분 단위로 파일을 쓸 경우 작은 파일이 많아져 조회 성능이 현저히 떨어지기 때문에 선택하지 않았습니다.
- hourly batch
- kafka → log-batch → create parquet / 1 hour (save data in memory or redis) → save obs → obs
- 메모리에 저장하는 경우 데이터 유실의 리스크가 걱정되었고
- NHN AppGuard는 redis를 사용하고 있지 않아 trino와 redis 두 컴포넌트의 추가로 인한 운영 복잡도 증가가 부담되어 선택하지 않았습니다.
- 중간 DB 사용 - MySQL
- kafka → log-batch → save to mysql → mysql → tier down in daily-batch → save obs → obs
- 기존에 사용하던 MySQL 구성을 변경하지 않아 수정 소요가 적었고
- MySQL을 통해 실시간 데이터 또한 조회할 수 있어 실시간 데이터 조회가 쉬워 선택하였습니다.
구성도
-
AS-IS
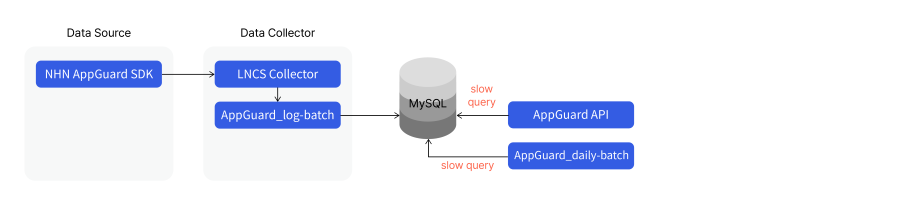
-
TO-BE
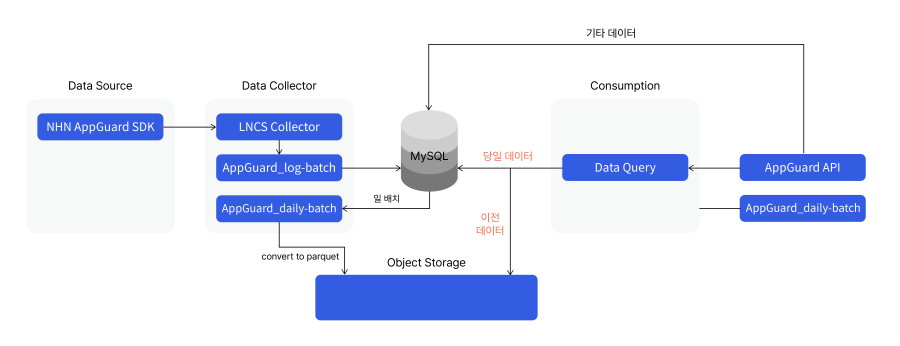
tier down 개념
ElasticSearch는 데이터의 역할 또는 접근 빈도에 따라 노드를 분배하는 기법으로 Data Tiering 을 사용합니다.
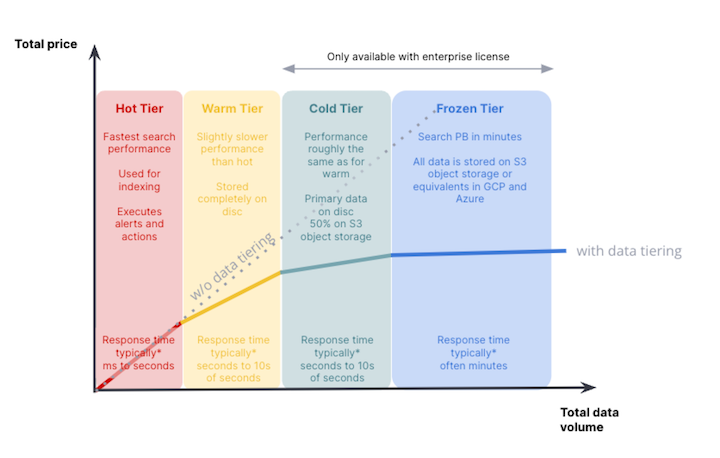 (source:
이렇게 tier를 적용한 데이터를 높은 티어에서 낮은 티어로 낮추는 것을 tier down이라고 부릅니다. hot tier는 일반적으로 성능이 좋고 반응이 빠르지만 비용이 비싸고, cold tier는 반응은 조금 느리지만 비용이 저렴한 저장소를 사용합니다.
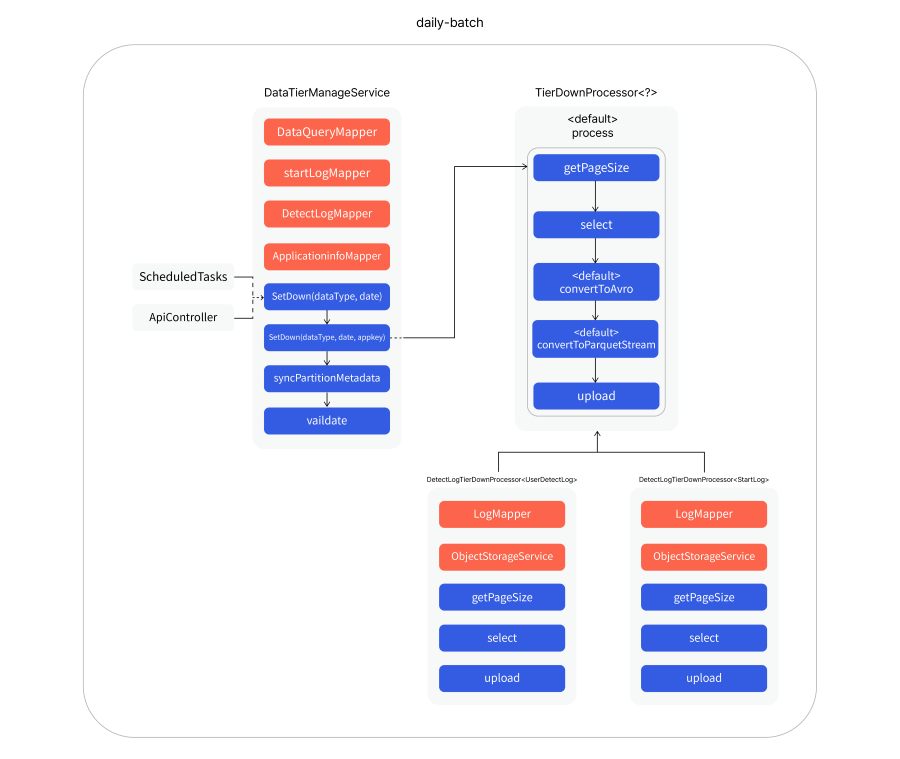
NHN AppGuard에서는 MySQL을 hot tier, Trino를 cold tier로 정의하고 daily-batch에서 MySQL 데이터를 Parquet로 변환해 Trino에 삽입시키는 작업을 tier down으로 정의했습니다.
Parquet 파일 생성 방법
Parquet는 원래 HDFS에 쓰는 용도로 고안되어서 Parquet 파일을 직접 쓰려면 org.apache.hadoop:hadoop-common:3.3.6과 같은 hdfs writer에 세그먼트 관리, 열 압축 등의 기능을 구현해야 합니다. 이러한 작업을 피하기 위해 일반적으로 Spark 등의 외부 컴포넌트를 쓰거나 avro 포맷의 파일을 거쳤다가 parquet로 변환하는 방법을 사용합니다.
Apache Avro는 data를 serialize하기에 좋은 포맷으로 스키마를 갖습니다. ParquetFileWriter를 지원하기 때문에 손쉽게 변환이 가능합니다.
Apache Avro™ is the leading serialization format for record data, and first choice for streaming data pipelines. It offers excellent schema evolution, and has implementations for the JVM (Java, Kotlin, Scala, …), Python, C/C++/C#, PHP, Ruby, Rust, JavaScript, and even Perl.
Trino 적용 - 구현
tier down 구현
논리 구조
Trino 테이블 생성
Trino 데이터 소스로 OBS를 사용하는 경우 Hive를 사용하기 때문에 HQL을 사용해야 합니다. HQL 또한 SQL 표준을 따르기 때문에 거의 유사하지만 묵시적 형 변환과 같은 편의 기능을 지원하지 않고, with 문의 external location, partitioned_by 등의 옵션이 추가됩니다.
CREATE TABLE log
 (
    seq              bigint,
    log_time         timestamp,
    // 생략
    log_date         date,
    appkey           varchar(64),
 )
 WITH (
    format = 'Parquet',
    external_location = 's3a://data-query/log',
    partitioned_by = ARRAY['appkey','date']
);
avro schema 작성
{
  "type" : "record",
  "name" : "log",
  "namespace" : "avro",
  "fields" : [
    { "name" : "seq", "type" : "long" },
    { "name" : "log_time", "type" : [ "null", "string" ], "default" : null },
    // 생략
  ]
}
tier down process
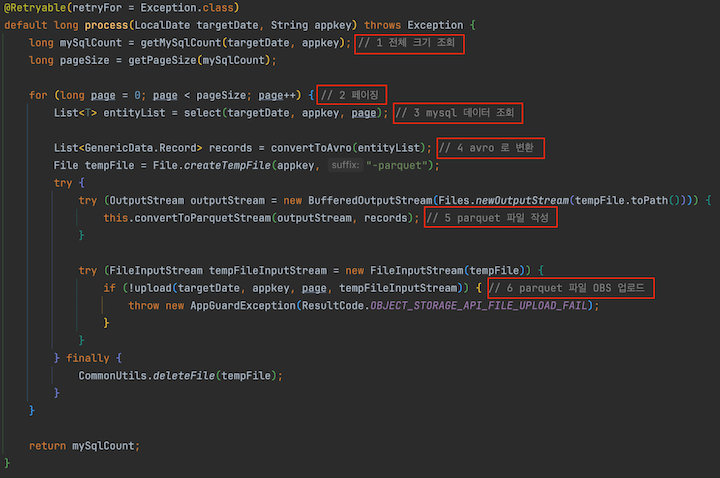 데이터를 메모리에 올려서 변환하기 때문에 장비와 데이터에 따라 적절한 페이징을 적용해야 합니다.
convert to parquet
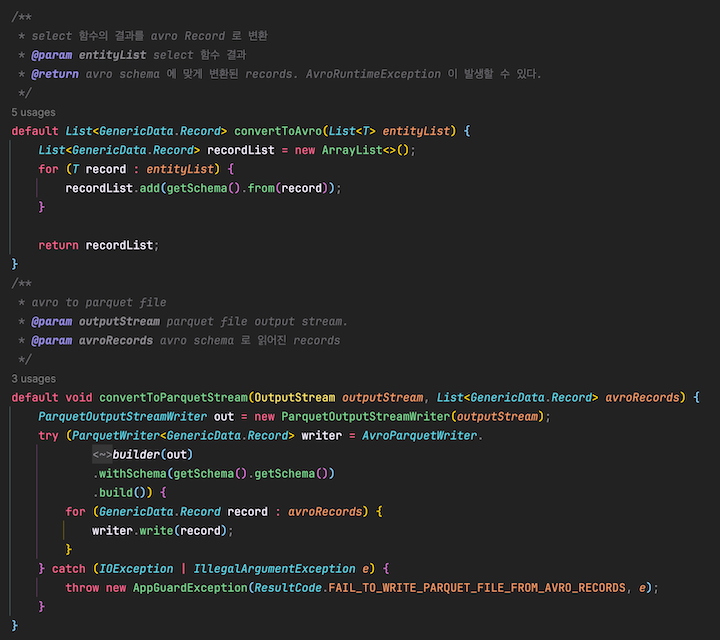 avro 변환은 apache avro 모듈의 schema.from 함수로 쉽게 변환이 가능합니다. parquet는 apache parquet 모듈의 PositionOutputStream 객체의 writer를 구현하여 변환할 수 있습니다.
다른 방법은 없을까?
CTAS(Create Table As Select)가 가장 쉬운 방법입니다. 수행 시간은 위 방법과 비슷하게 소요되지만 용량이 30% 정도 더 효율적인 것으로 확인하였습니다. 하지만 DataQuery에서 사내 DB를 아직 데이터 소스로 지원하지 않아 현재는 사용이 어렵습니다. 여기에서는 방법만 소개하겠습니다.
CREATE TABLE obs.test.log_ctas
    WITH (
        format = 'Parquet',
        external_location = 's3a://ctas-test/log-ctas',
        partitioned_by = ARRAY['log_date', 'appkey']
        )
AS
select seq,
// 생략
       cast(log_time as date) as log_date,
       appkey
from "mysql".log
where log_time >= date '2024-11-01'
  and log_time < date '2024-11-02';
실시간 데이터 union 구현
논리 구성도
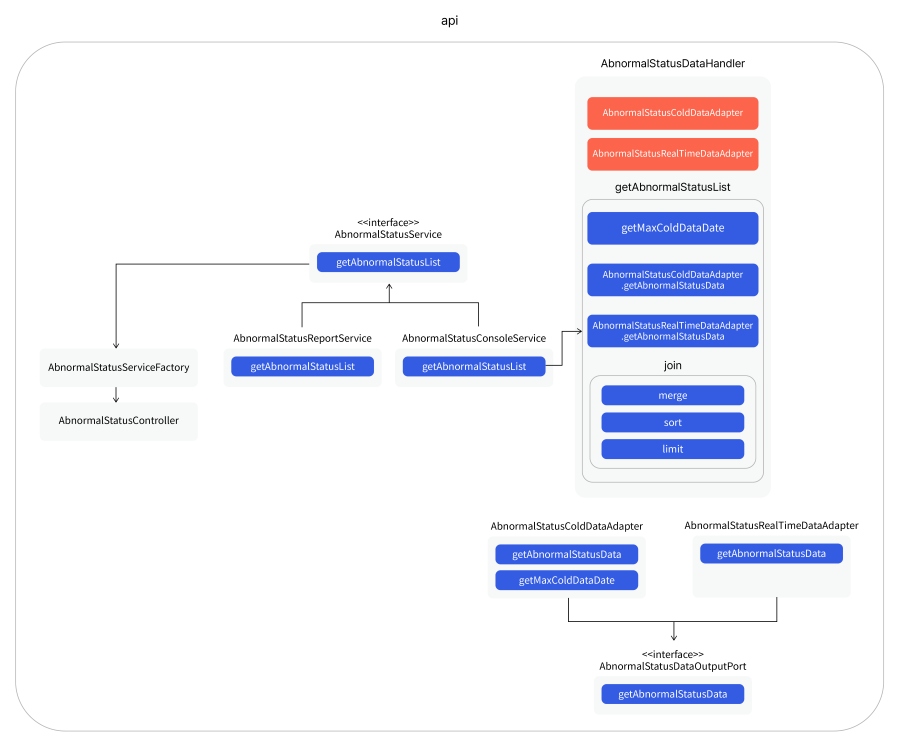
- cold data에 마지막으로 저장된 시간을 조회하고
- cold data와 hot data를 조회해
- join / union 하여 응답합니다.
Data 조회
Cold - max cold data 기준 왼쪽을 조회합니다. 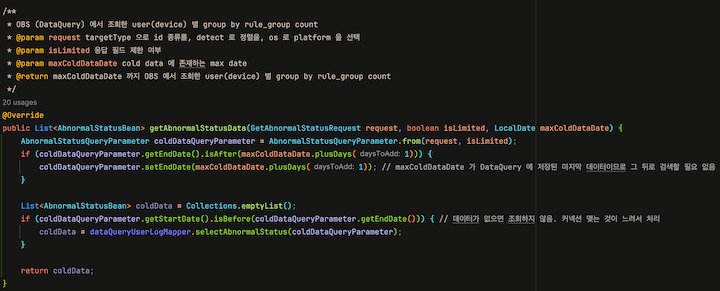
Hot - max cold data 기준 오른쪽을 조회합니다. 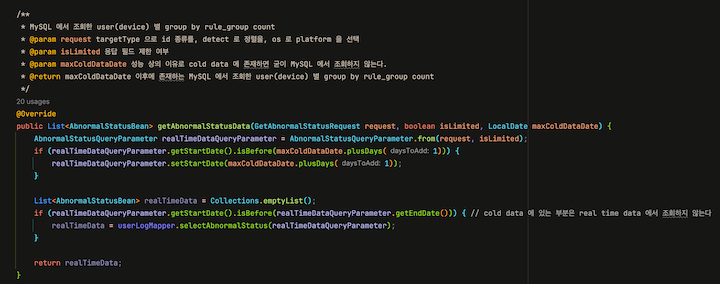
Data Join / Union
집계의 경우 toMap과 id 값을 이용해 Join 합니다. 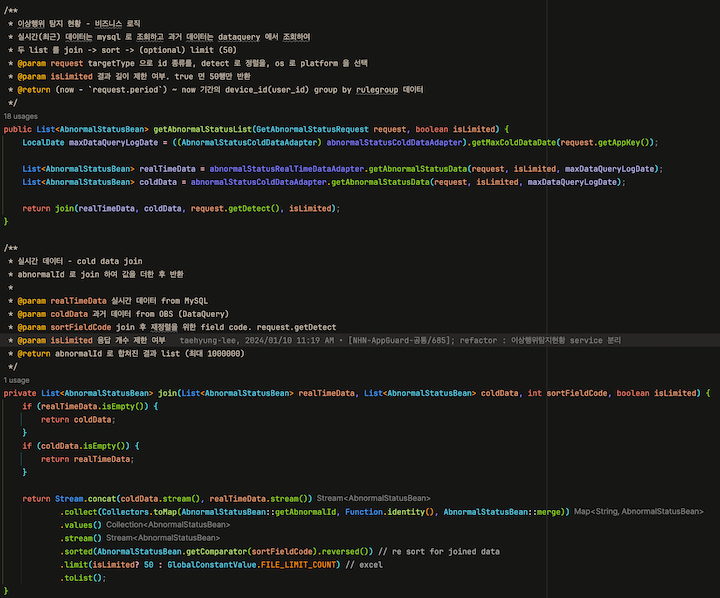
단순 조회의 경우 stream.concat으로 Union 합니다. 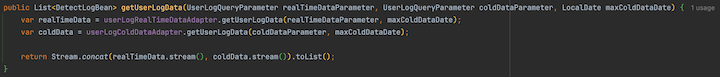
성능 테스트
환경
- DataQuery 스펙: c2m8 * 3
- DataQuery 데이터는(log_date, appKey) 파티셔닝 되어 있고
- 참고 *partition = RDBMS의 index 와 유사. parquet 가 저장된 경로를 의미
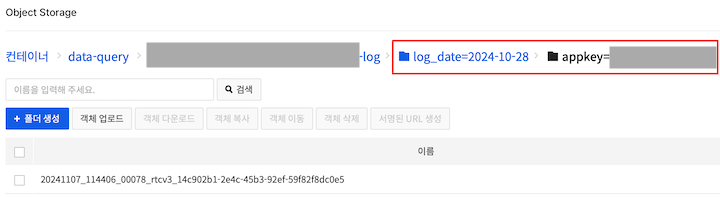
- 참고 *partition = RDBMS의 index 와 유사. parquet 가 저장된 경로를 의미
- MySQL 데이터는 일 단위로 파티셔닝되어 있습니다.
- MySQL 데이터는 log_time, appkey 각각의 인덱스와 (log_time, appkey) 복합 index 가 적용되어 있습니다.
데이터 조회
이슈 대응 등의 이유로 개발자가 쿼리 엔진에 자주 질의하는 일반 쿼리 와 서비스에서 사용하는 서비스 쿼리로 구분하여 테스트했습니다.
일반 쿼리
단순한 select * 조회는 mysql이 7배가량 빠르고, count 등의 집계 함수가 포함된 쿼리는 DataQuery가 적게는 4배에서 6배가량 빠른 양상을 보였습니다. Trino + Parquet 조합은 열 기반 데이터 포맷으로 인한 행 조회의 비효율성, Trino의 쿼리 플래닝과 file fetch에서의 오버헤드로 인해 단순한 행 조회가 느리기 때문입니다.
| 쿼리 | dataquery | mysql |
|---|---|---|
| 단순 조회 (select * limit 500) | 1 s 151 ms | 148 ms |
| count 조회 (select count(*) 한 달 | 8 s 957 ms | 30.987 s |
| filter - appkey & log_time 행 조회 | 1 s 323 ms | 393 ms |
| filter - appkey & log_time count | 349 ms | 14.662 s |
| group by - appkey 하루 | 814 ms | 2.385 s |
| group by - appkey 한 달 | 18 s 530 ms | 2m 15s 538ms |
NHN AppGuard 서비스 쿼리
DataQuery가 전반적으로 10배 정도 빨랐습니다. 이상 행위 탐지 현황의 한 달치 데이터는 MySQL에서 30분 이상 소요되어 조회할 수 없었지만 DataQuery는 36초만에 조회하였습니다.
| 쿼리 | dataquery | mysql |
|---|---|---|
| 이상행위 탐지현황 - limit 50 하루 | 1 s 696 ms | 9.676s |
| 이상행위 탐지현황 - limit 50 한 달 | 6 s 468 ms | 6m 19s 459ms |
| 이상행위 탐지현황 report - 하루 | 7.06s | 21s 890ms |
| 이상행위 탐지현황 report - 한 달 | 36.81s | 조회 불가(30분 이상) |
| 로그 조회 - 하루 | 1 s 531 ms | 7s 264ms |
| 로그 조회 - 한 달 | 5 s 728 ms | 5m 58s 381ms |
Parquet 크기별 비교
appkey로 파티션 되기 때문에 appkey별 로그 양이 달라 로그 개수에 따른 성능 차이를 비교해 보았습니다. 로그 수 기준 중위의 appkey까지도 MySQL이 더 빠른 양상을 보였습니다. 2-300ms가량의 차이를 보이는 만큼 로그가 적은 사용자 입장에서는 데이터가 없는데 굼뜨다는 느낌을 받을 수 있습니다. 이에 반해 로그 수가 평균을 넘어가면 MySQL은 30초가 넘어가는 응답을 보여 콘솔에서 서비스하기에 어려운 반응 속도를 보입니다.
| 대시보드 조회 쿼리 | DataQuery | MySQL |
|---|---|---|
| 데이터 없음 | 267 ms | 102 ms |
| 최소 | 365 ms | 100 ms |
| 중위 | 610 ms | 168 ms |
| 평균 | 505 ms | 34 s 24 ms |
| 최대 | 15s 85 ms | 10 m 23 s 982 ms |
성능 테스트 결론
- 행 전체 조회, 데이터가 적은 경우는 MySQL이 빠르다.
- 100ms VS 500ms의 차이 → 참을만하다.
- 집계 조회, 데이터가 많은 경우에는 DataQuery가 빠르다.
- 수십 초 VS 수 분 차이 → 참을 수 없다.
결과
좋아졌나요?
- 이상 행위 탐지 현황의 30일치 데이터를 조회하지 못하던 고객이 이제 조회할 수 있게 되었습니다.
- 2024년 초 공개한 NHN AppGuard public api는 MySQL로는 30분 이상 소요되어 개발이 어려웠는데, DataQuery를 통해 7초 이내로 조회하여 개발할 수 있었습니다.
- 내부 집계 시간이 38m36s → 22m16s로 약 43% 개선했습니다.
- mysql에서의 집계로 인한 slow query가 제거되어 일 배치로 인한 서비스의 영향성이 없어졌습니다.
- 집계 연산이 빨라져서 집계 데이터의 종류를 늘리는 것에 부담이 없어졌습니다.
- 스토리지 비용 감소로 데이터 저장 기간을 60일에서 1년으로 늘렸습니다.
나쁜 점은 없나요?
- 대시보드의 기본 응답 속도가 300ms 정도 느려졌습니다.
- tier down 실패 시 집계, 미터링 등에 영향을 주기 때문에 모니터링 요소가 늘어났습니다.
- DataQuery와 OBS 비용이 추가되었습니다. (대략 100만 원/월)
앞으로 해야 할 것이 있을까요?
- 일 단위 tier down을 시간 단위로 변경하는 것을 고민하고 있습니다.
- 고객 로그 수에 따라 적절한 쿼리 엔진을 사용하도록 최적화하는 부분에 대해 고민하고 있습니다.
이상 NHN AppGuard에 Trino를 적용해 본 과정과 결과에 대해 정리하였습니다. 도움이 되셨길 바라며, 긴 글을 읽어 주셔서 감사합니다. 😊
