Engineering
로그 유형별 Iceberg 테이블 적재 및 운영 전략
louis.sml카카오
2025년 4월 18일
원문에서 보기 ↗안녕하세요, 데이터분석플랫폼 조직의 루이스입니다.
시리즈의 마지막 글을 쓰게 되었습니다. 첫 번째 글에서는 아파치 플링크로 CDC(Change Data Capture)를 수행하여 MySQL 테이블을 다른 MySQL 테이블로 연동하는 내용을, 두 번째 글에서는 MySQL 테이블을 아파치 아이스버그(Apache Iceberg)로 CDC를 수행하고 운영하면서 얻은 경험을 공유했는데요. 이번 글에서는 수집하는 로그 형태에 따라 아이스버그 테이블의 파티션 및 최적화 방식을 어떻게 수행하면하면 좋을지, 현재 운영 방식과 테스트해본 내용을 공유하고자 합니다.
먼저 저희 팀의 미션을 간략하게 말씀드리면, 서비스 팀들의 데이터를 취합하여 일단위의 지표를 추출하고 제공하는 것이라고 할 수 있습니다. 아파치 카프카(Apache Kafka)와 데이터베이스(Database) 등 다양한 소스에서 데이터를 수집하고 있으며, 그 과정에서 서비스 팀의 데이터베이스를 활용해야 하는 경우도 있습니다. 그러나 서비스 팀의 데이터베이스에 접근하여 데이터를 가져오는 방식은 서비스 운영에 부담을 줄 수 있기에, 앞서 첫 번째 글에서 보여드린 것처럼 CDC를 통해 데이터 레이크하우스 기술 중 하나인 아이스버그로 연동하여 지표 추출 파이프라인을 개선했습니다.
본 글은 두 유형의 로그를 아이스버그 테이블로 적재 시 필요한 설정 및 최적의 운영 방법을 공유하는 것을 목표로 합니다. 먼저 지표 추출을 위해 수집하는 로그를 유형과 특성에 따라 아이스버그 테이블에 적재하는 방식을 소개합니다. 그리고 적재된 데이터 및 조회 패턴을 고려한 아이스버그 테이블의 파티션 전략과 최적화 방식에 대한 경험을 공유합니다. 마지막으로, 아이스버그 관련 지표 모니터링을 어떻게 하면 좋을지 정리하면서 글을 마무리합니다.
만약 아파치 플링크(Apache Flink)와 아이스버그 관련 배경 지식이 없으신 경우 본 글을 이해하기 어려울 수 있으니, 아이스버그 관련 기본적인 내용을 다루는 두 번째 블로그 글을 먼저 읽으시는 것을 권장드립니다.
로그 유형과 수집 방식
저희 팀은 지표 계산을 위해 다음과 같은 유형의 로그를 활용합니다:
- 클라이언트 로그
- 서버 로그
- 데이터베이스 변경 로그(이하 DB 로그)
이 중 서버 로그와 DB 로그는 팀에서 직접 수집하여 지표를 계산하는데 활용됩니다. 이번 파트에서는 DB 로그에 대해서는 현 운영 방식에 대한 소개를, 그리고 서버 로그에 대해서는 현 수집 상황과 어떻게 개선해 나갈 예정인지 테스트한 내용을 공유하겠습니다.
다만, DB 로그는 현재 실제 운영 환경에서 적용 중인 방식이고, 서버 로그는 테스트 중인 방향성임을 미리 밝히며 , 이 글에서 다루는 설정이나 방식은 사용 목적과 환경에 따라 더 최적의 설정이나 방식이 있음을 참고해주시기 바랍니다.
DB 로그
DB 로그는 앞선 블로그에서 설명한 것처럼, 각 서비스 조직들의 MySQL 테이블들을 아파치 플링크를 활용하여 팀 내 하둡 파일 시스템의 아이스버그 테이블로 CDC 연동하고 있습니다. 현재 운영 중인 아이스버그 테이블의 적재 모드, 파티션 전략, 그리고 커밋(commit) 주기에 대해 간략히 공유드리겠습니다.
MySQL 테이블의 Primary Key 기준으로 UPSERT 모드로 아이스버그 테이블에 적재하고 있습니다. 이는 MySQL 테이블의 데이터가 지속적으로 변경되기에, 아이스버그 테이블에도 변경사항이 반영된 최신 데이터를 조회할 수 있도록 하기 위함입니다. 또한 쿼리나 컴팩션의 성능 최적화를 위해 Primary Key 기준으로 bucket transform 파티션을 적용하여, 불필요한 데이터를 읽지 않고 적절한 프루닝이 수행되도록 합니다.
커밋 주기는 플링크 job의 체크포인트 주기와 동일하게 설정되며, 작은 파일(small file) 문제를 최소화하면서 적절한 데이터 신선도(data freshness)를 유지하기 위해 10분으로 설정했습니다. 이를 통해, 이전처럼 매일 MySQL 테이블 전체 데이터를 소싱하거나, MySQL 서버 부하를 고려해 스파크 애플리케이션의 성능을 임의로 제한할 필요도 없어졌습니다. 결과적으로, 필요한 만큼 스파크 애플리케이션에 자원을 할당하여 소싱 시간을 단축할 수 있게 되었습니다.
서버 로그
서버 로그는 각 서비스 조직의 서버에서 발생하는 로그를 의미합니다. 서비스 별로 다양한 서버에서 발생하는 로그이기에 로그의 형식이나 구조는 서비스 조직별로 다양하게 나타납니다. 저희는 팀에서 정의한 아래 Figure 1 의 예시와 같은 Json 스펙에 맞추어, 서비스 조직에 아파치 카프카를 통해 로그를 전송해줄 것을 요청합니다. 이후 플링크를 통해 카프카에 있는 로그들을 컨슘(Consume)하여 팀 내 하둡 클러스터에 ORC 포맷으로 적재하고 있습니다.
{
	"cluster_name": "...",
	"host": "...",
	"meta": {..},
	"log": "{..}",
	"log_format": "json"
}
Figure 1. Json 스펙 예시
로그 적재 시 플링크 job에서 처리 시간(process time) 값을 추가하여 일 단위 및 시간 단위 파티션을 적용해 저장합니다. 이벤트 타임(event time)과 워터마크(watermark)를 사용하지 않는 이유는 데이터 재처리 시에도 최종 지표 값이 변하지 않도록 멱득성을 보장하기 위해서입니다. 다만, 이 방식에서는 일부 지연 데이터가 실제 발생 일자보다 이후의 파티션에 적재될 수 있지만, 이러한 예외 케이스는 이후 스파크를 이용한 소싱 단계에서 보정합니다.
ORC 포맷 및 기존 수집 방식은 팀내 오래 사용된 방식으로, 현재까지는 큰 문제 없이 운영되고 있습니다. 그러나, DB 로그는 이미 아이스버그로 CDC 연동되어 운영 중이므로, 서버 로그 또한 아이스버그에 APPEND 모드로 적재하는 방향을 고민해보았습니다. 이를 통해 스파크에서 소싱하는 데이터 포맷을 아이스버그로 통일하고, DB 로그와 서버 로그에 대한 일관된 모니터링 체계를 구축할 수 있습니다.
APPEND 모드를 선택한 이유는 서버 로그에도 고유한 ID가 존재하기에 UPSERT 모드로 적재하면 중복을 제거할 수 있지만, 데이터 양이 너무 방대하여 이점에 비해 최적화 수행 비용이 너무 크기 때문입니다. 또한 중복 제거는 스파크를 통한 지표 계산 과정에서 수행되기에, 적재될 데이터 양에 따른 데이터 파일 및 삭제 파일 수와 이에 따른 최적화 비용을 고려해 APPEND 모드를 선택했습니다.
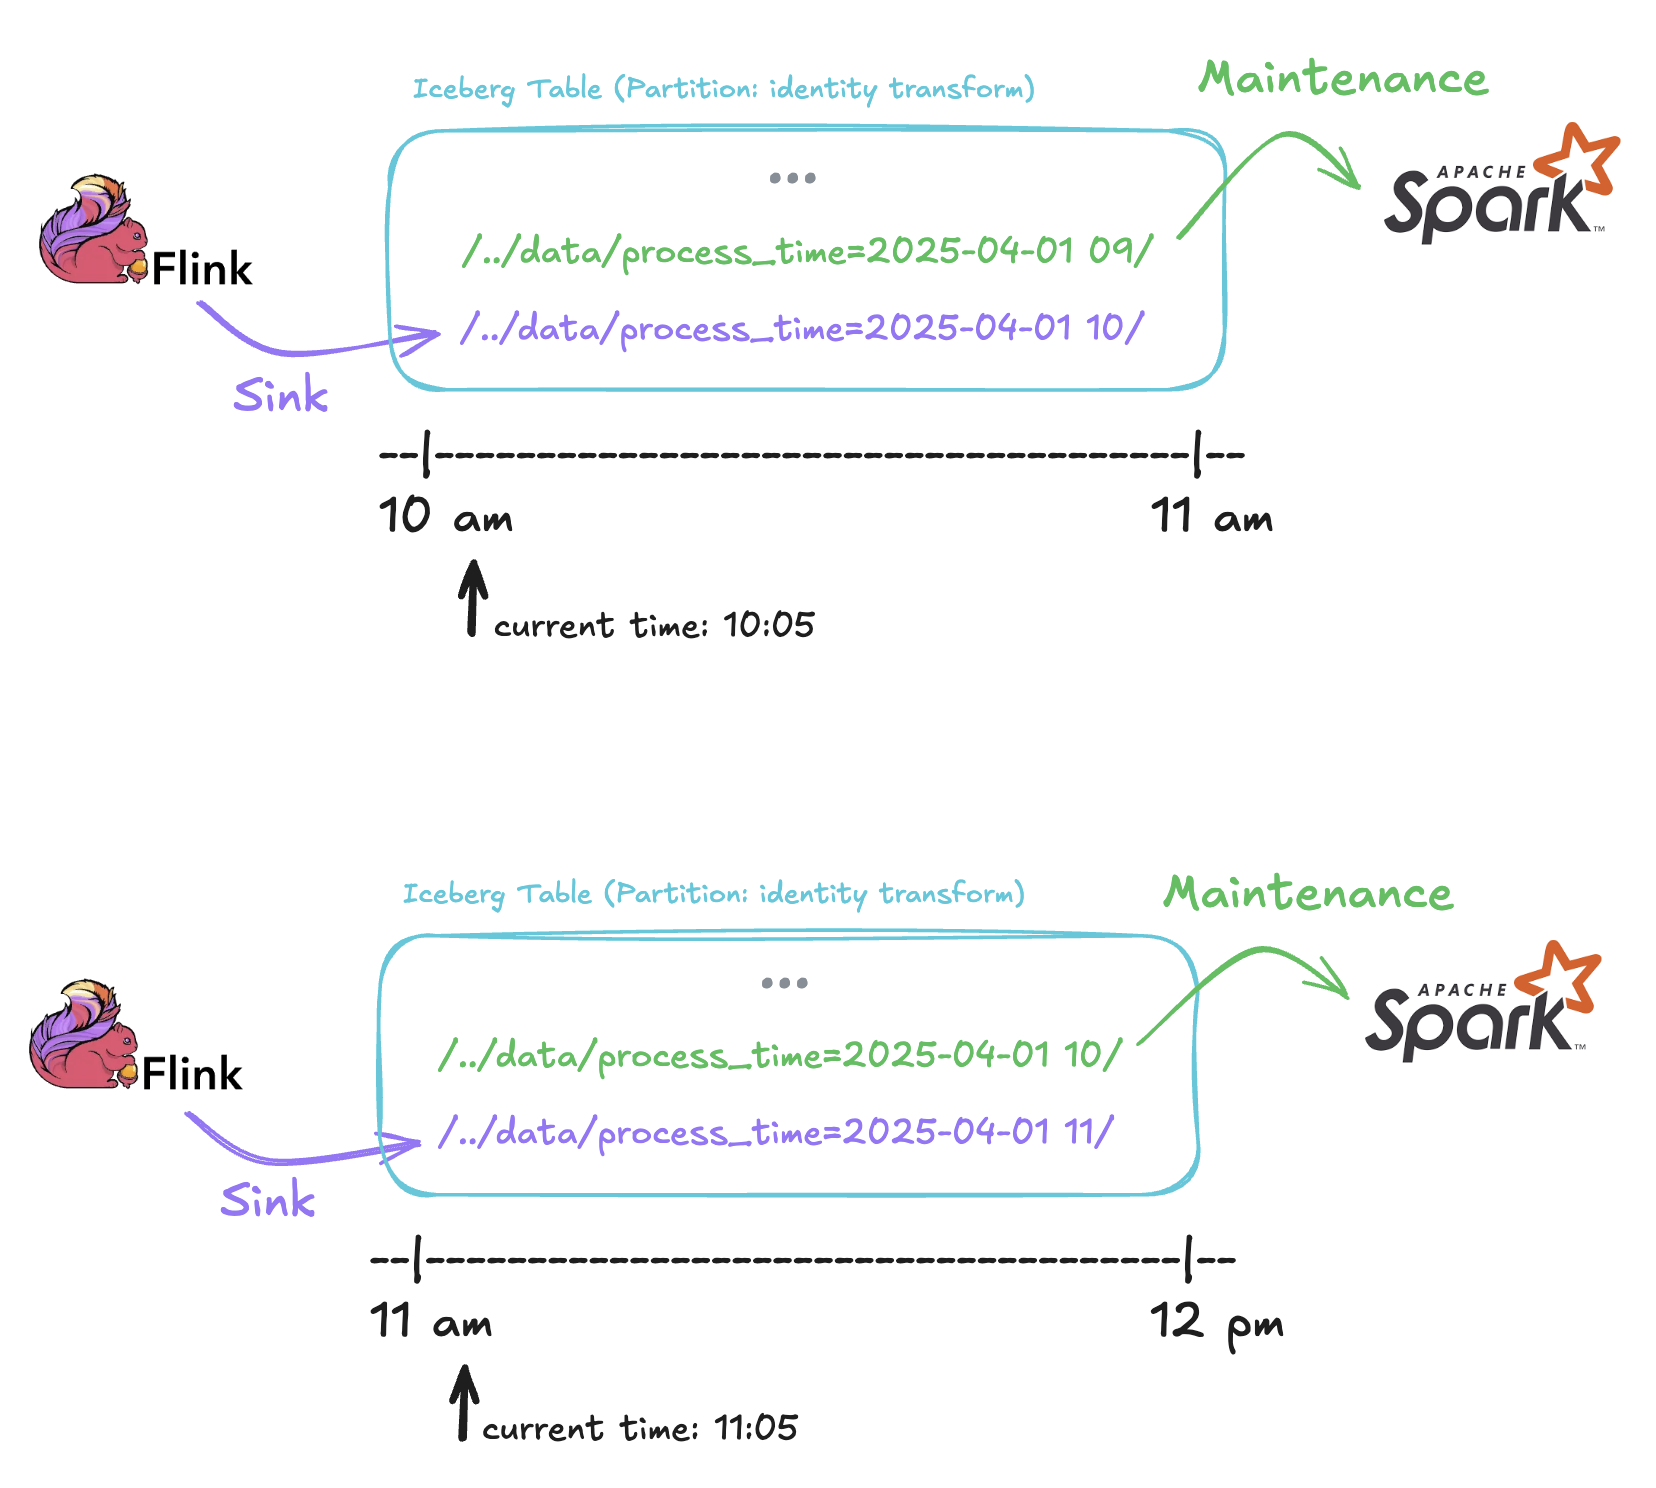
또한, 카프카 Lag Count를 줄이기 위해 플링크 job의 체크 포인트 주기를 기존 3분에서 더 짧게 조정하는 방향을 검토 중입니다. 그러나 체크포인트가 자주 수행되면 적재되는 파일들의 크기가 작아져 작은 파일 문제가 발생하고, 이는 하둡 파일 시스템과 스파크 소싱 성능에 부정적인 영향을 줄 수 있습니다. 이를 해결하기 시간 단위까지의 시간 값에 대해 identity transform 파티셔닝을 적용하고, 아래 Figure 2에 묘사된 것 처럼 매 시간마다 이전 시간대 파티션에 대해 아이스버그의 최적화 기능을 수행하는 방안을 적용해보았습니다.
즉, 컴팩션을 통해 작은 파일을 합쳐 큰 파일로 만들고 스냅샷 만료 및 고아 파일 제거 기능을 활용하여 불필요해진 작은 파일은 삭제하는 방식입니다. 이를 통해 체크포인트 주기를 단축하여 카프카 Lag Count를 줄이는 동시에, 아이스버그의 최적화 기능을 활용해 파일 크기와 개수를 최적 수준으로 관리하여 스토리지 사용률과 분석 성능을 동시에 개선할 수 있습니다. 더 세부적인 내용은 후속 파트에서 공유드리겠습니다.
압축, 파티션 및 최적화 전략
아이스버그를 활용할때 고려해야할 3가지 요소가 있으며 다음과 같습니다:
- 파일 포맷 및 압축 (Format & Compression)
- 파티션 (Partition)
- 최적화 전략 (Compaction, Expire Snapshots, Delete Orphan Files)
이번 파트에서는 DB 로그에 대해 위 세가지를 어떻게 활용 및 운영 중인지, 그리고 서버 로그에 대해서는 어떻게 개선해 볼 예정인지 테스트한 내용을 공유드리겠습니다.
압축
아이스버그의 기본 파일 포맷은 Parquet이며, 기본 압축 코덱은 아이스버그 1.4.0 버전부터 zstd를 사용하는데 [압축에서의 더 나은 성능과 gclocker 관련 잠재적 이슈](Core: use ZSTD compressed parquet by default by dbtsai · Pull Request #8158 · apache/iceberg · GitHub)를 위해 gzip에서 변경했다고 합니다. 저희는 스파크를 통해 데이터를 소싱하기에, 파일 포맷의 경우 수집하는 로그 유형과 관계 없이 스파크와 호환이 좋은 Parquet를 그대로 사용했습니다. 압축의 경우 DB 로그를 아이스버그로 CDC 연동할 당시, 그 크기나 양이 서버 로그에 비하면 매우 작은 편이기에 별다른 고민없이 기본값들인 zstd 및 압축 레벨 3을 사용했습니다.
하지만 서버 로그는 DB 로그 대비 최소 수십 배 더 많은 로그가 수집되기에 압축 설정까지 고려할 필요가 있습니다. 압축 코덱은 기본 값인 zstd를 사용하되, 압축 레벨에 대해서는 일 평균 30억 개, 초당 5만 개 정도의 서버 로그가 인입되는 카프카 토픽을 기준으로 테스트 해보았습니다. 테스트를 위해 확인한 사항은 아래와 같습니다:
- 압축 레벨 변화에 따라 CPU 사용 비율이 변화 여부
- 지연 발생 여부
CPU 사용 비율이 높아지고 결과적으로 지연까지 발생할 경우, 높은 압축 레벨 사용을 신중히 고려해야 합니다. 이를 검증하기 위해 zstd의 압축 레벨에 따른 CPU 사용 비율을 확인했습니다. 측정 방식은 플링크에서 FlameGraph를 활성화 한 후, 압축 관련 메소드가 차지하는 CPU 사용 비율을 확인했습니다. 그 결과, 아래 Table 1 처럼 압축 레벨이 증가할수록 CPU 사용 비율도 유의미하게 증가하는 경향을 보였지만, 플링크의 개별 Task Manager들의 CPU 사용률에는 큰 차이가 없었습니다.
| 압축 레벨 1 | 압축 레벨 3 | 압축 레벨 6 | 압축 레벨 9 | 압축 레벨 12 | 압축 레벨 15 | |
|---|---|---|---|---|---|---|
| CPU 사용 비율 | 10% 이하 | 9 ~ 14% | 18 ~ 27% | 29 ~ 38% | 41 ~ 53% | 75 ~ 84% |
Table 1. zstd 압축 레벨에 따른 CPU 사용률
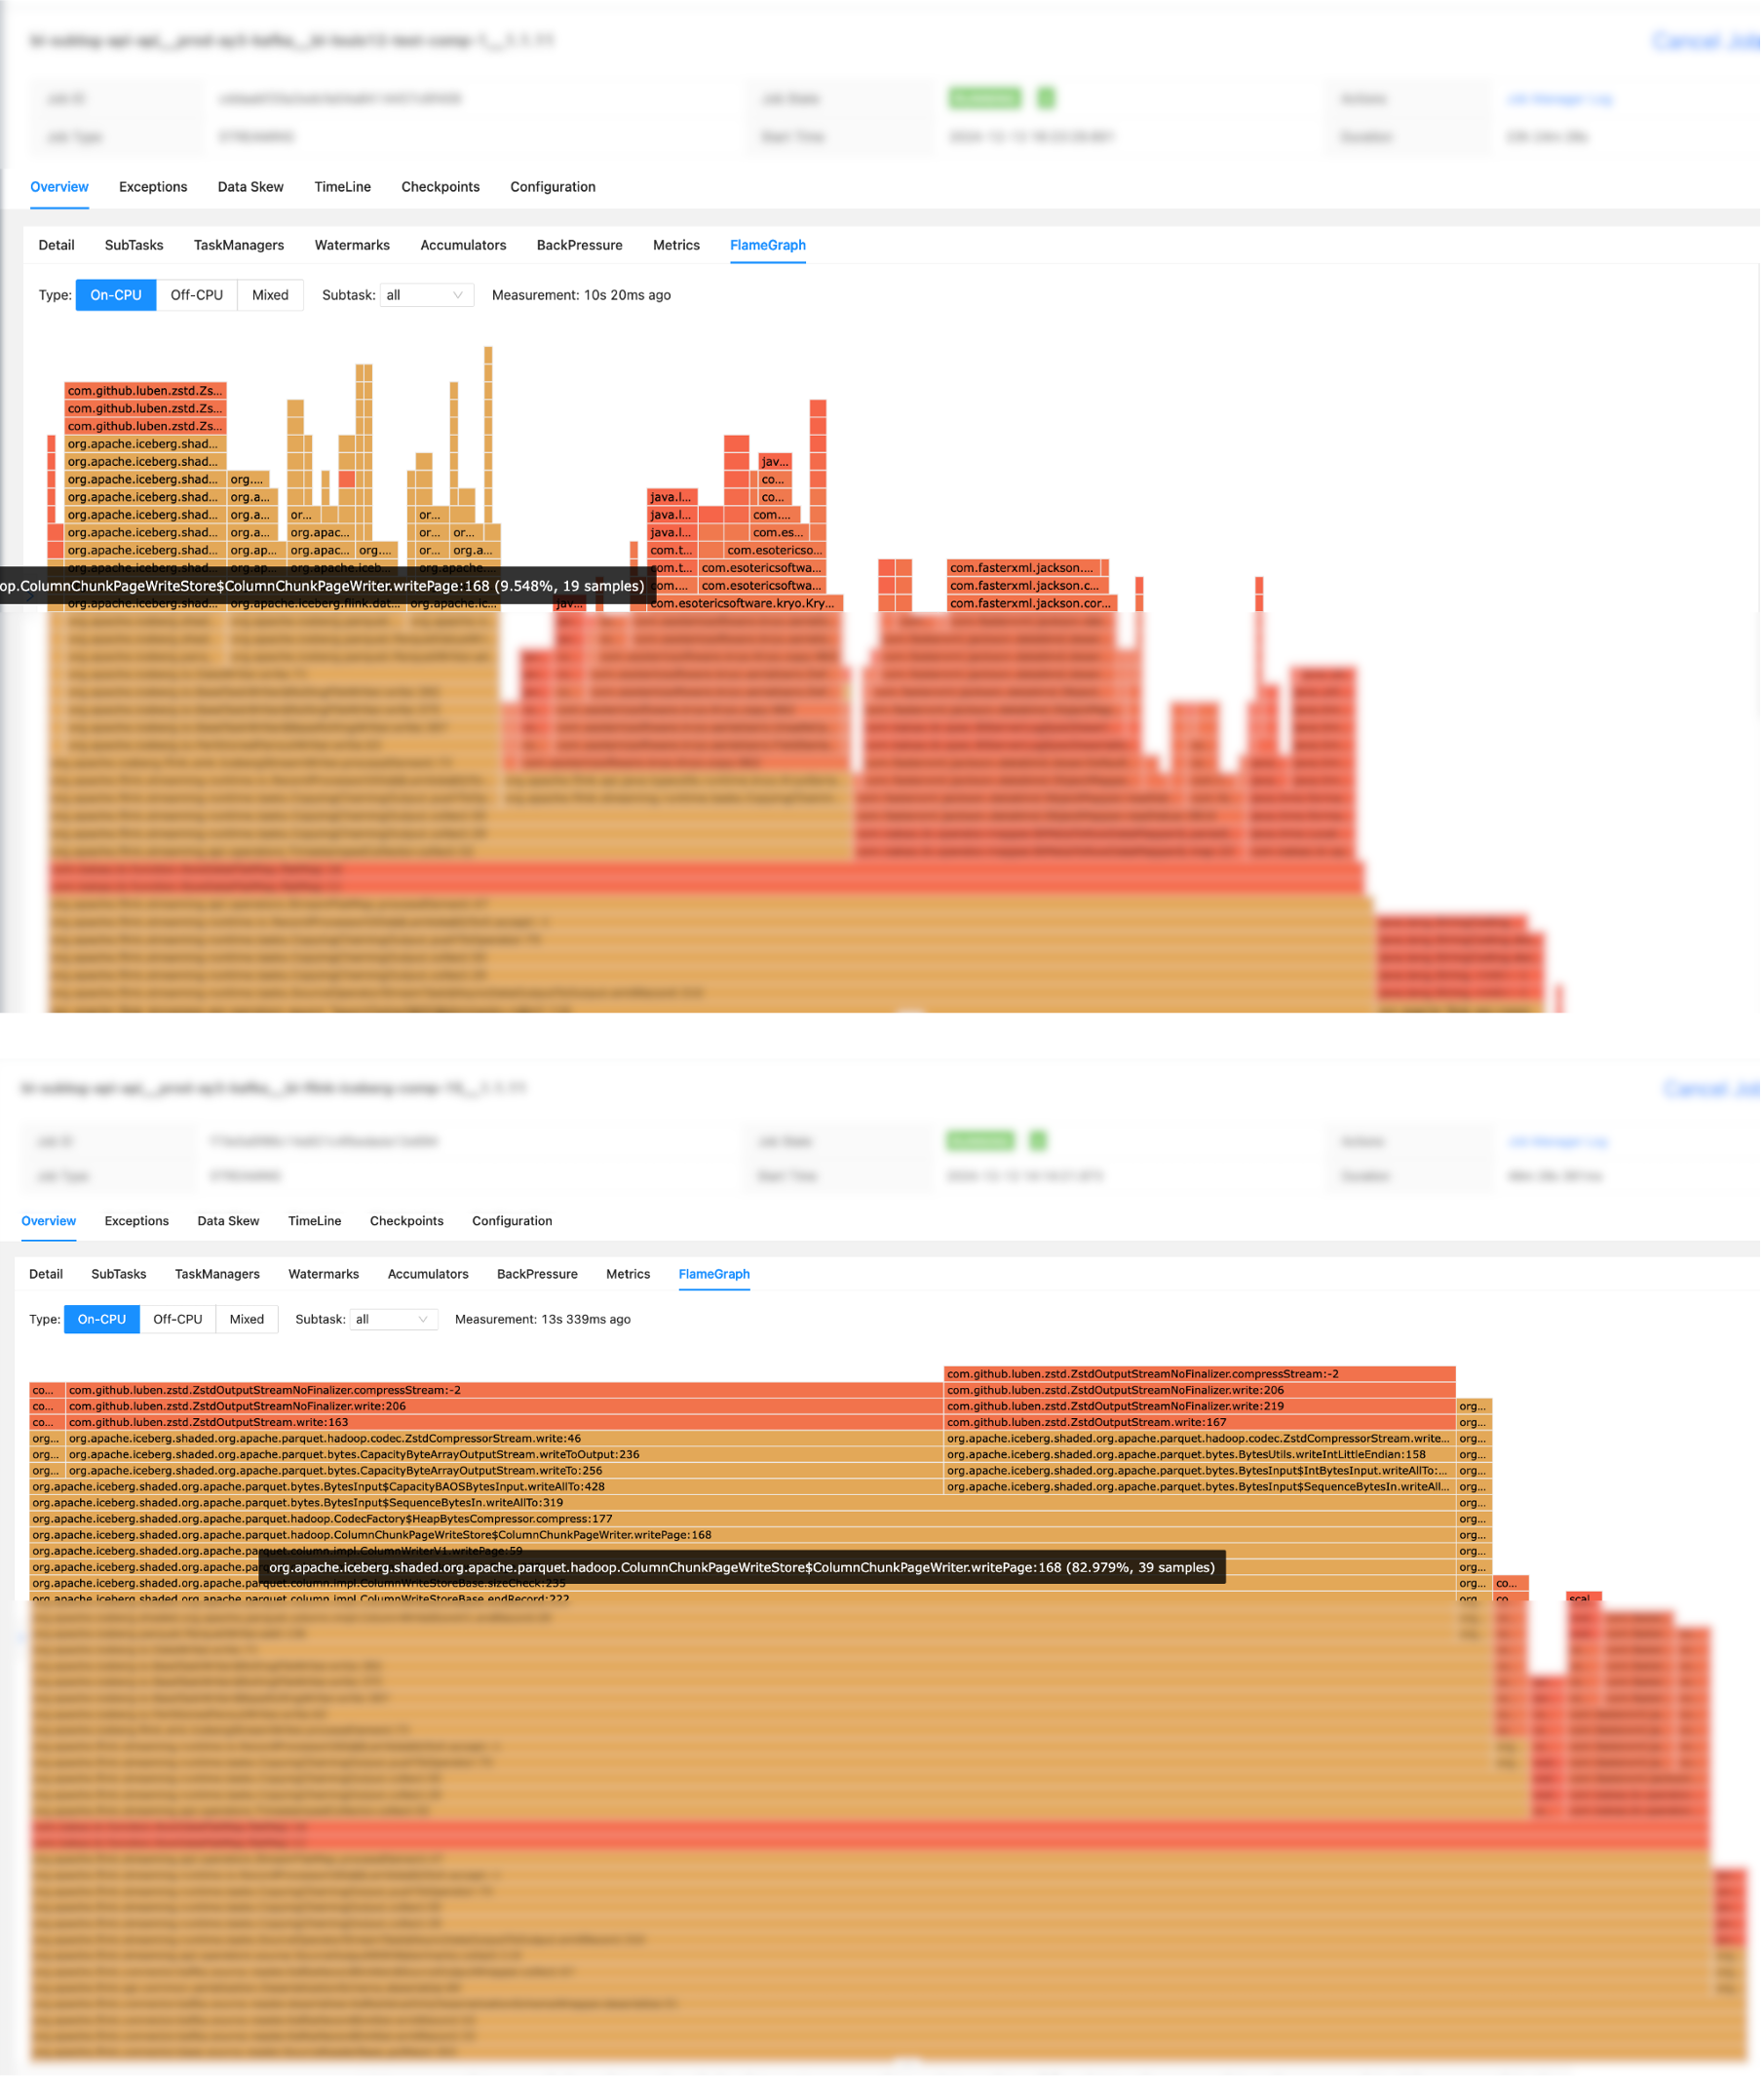
CPU 사용 비율이 증가했음에도 개별 Task Manager의 CPU 사용률에는 큰 차이가 없음을 확인했지만, 실제 데이터 적재 과정에서 지연이 발생하는지 또한 확인이 필요한 부분입니다. 아이스버그 테이블 적재에 지연이 존재한다 판단될 경우 실제 운영 환경에 적용이 가능한지 다시 고려해야합니다. 이에 따라, 앞선 테스트에 활용한 동일한 카프카 토픽을 기준으로 카프카와 플링크 관점에서 아래의 지표를 분석했습니다:
- 카프카 관점: 4시간 동안 카프카에서 컨슘(consume) 및 커밋된 레코드 개수 차이
- 카프카 관점: 1시간 동안 카프카의 감소한 Lag Count 개수 차이
- 플링크 관점: 연산자별 메시지 처리율
먼저 카프카 관점에서 4시간 동안 컨슘 및 커밋된 레코드 개수의 차이와 1시간 동안 감소한 Lag Count를 확인했습니다. 테스트 결과는 아래 Table 2와 같으며, 압축 레벨에 가장 큰 차이가 발생한 경우를 정리해보면 다음과 같습니다.
- 커밋된 레코드 개수: 압축 레벨 9와 6에서 약
0.6%의 차이 - 감소된 Lag Count: 압축 레벨 6과 15에서 약
0.3%의 차이
카프카 커밋은 플링크 job의 체크포인트 주기에 따라 수행되며, 수행 주기는 동일하더라도 커밋 시점에서 차이가 발생할 수 있습니다. 이를 감안했을 때, 저희의 경우 압축 레벨이 증가에 따라 CPU 사용 비율이 Table 1과 같이 최대 84% 증가하지만, 지연은 사실상 발생하지 않는다고 판단했습니다.
| 압축 레벨 3 | 압축 레벨 6 | 압축 레벨 9 | 압축 레벨 12 | 압축 레벨 15 | |
|---|---|---|---|---|---|
| 4시간 동안 commit된 레코드 개수 | 555.677M | 553.437M | 556.599M | 554.476M | 555.494M |
| 1시간 동안 감소한 lag count | 128.5M | 128.319M | 128.672M | 128.422M | 128.726M |
Table 2. 압축 레벨에 따른 카프카에 커밋된 레코드 개수 및 감소한 Lag Count
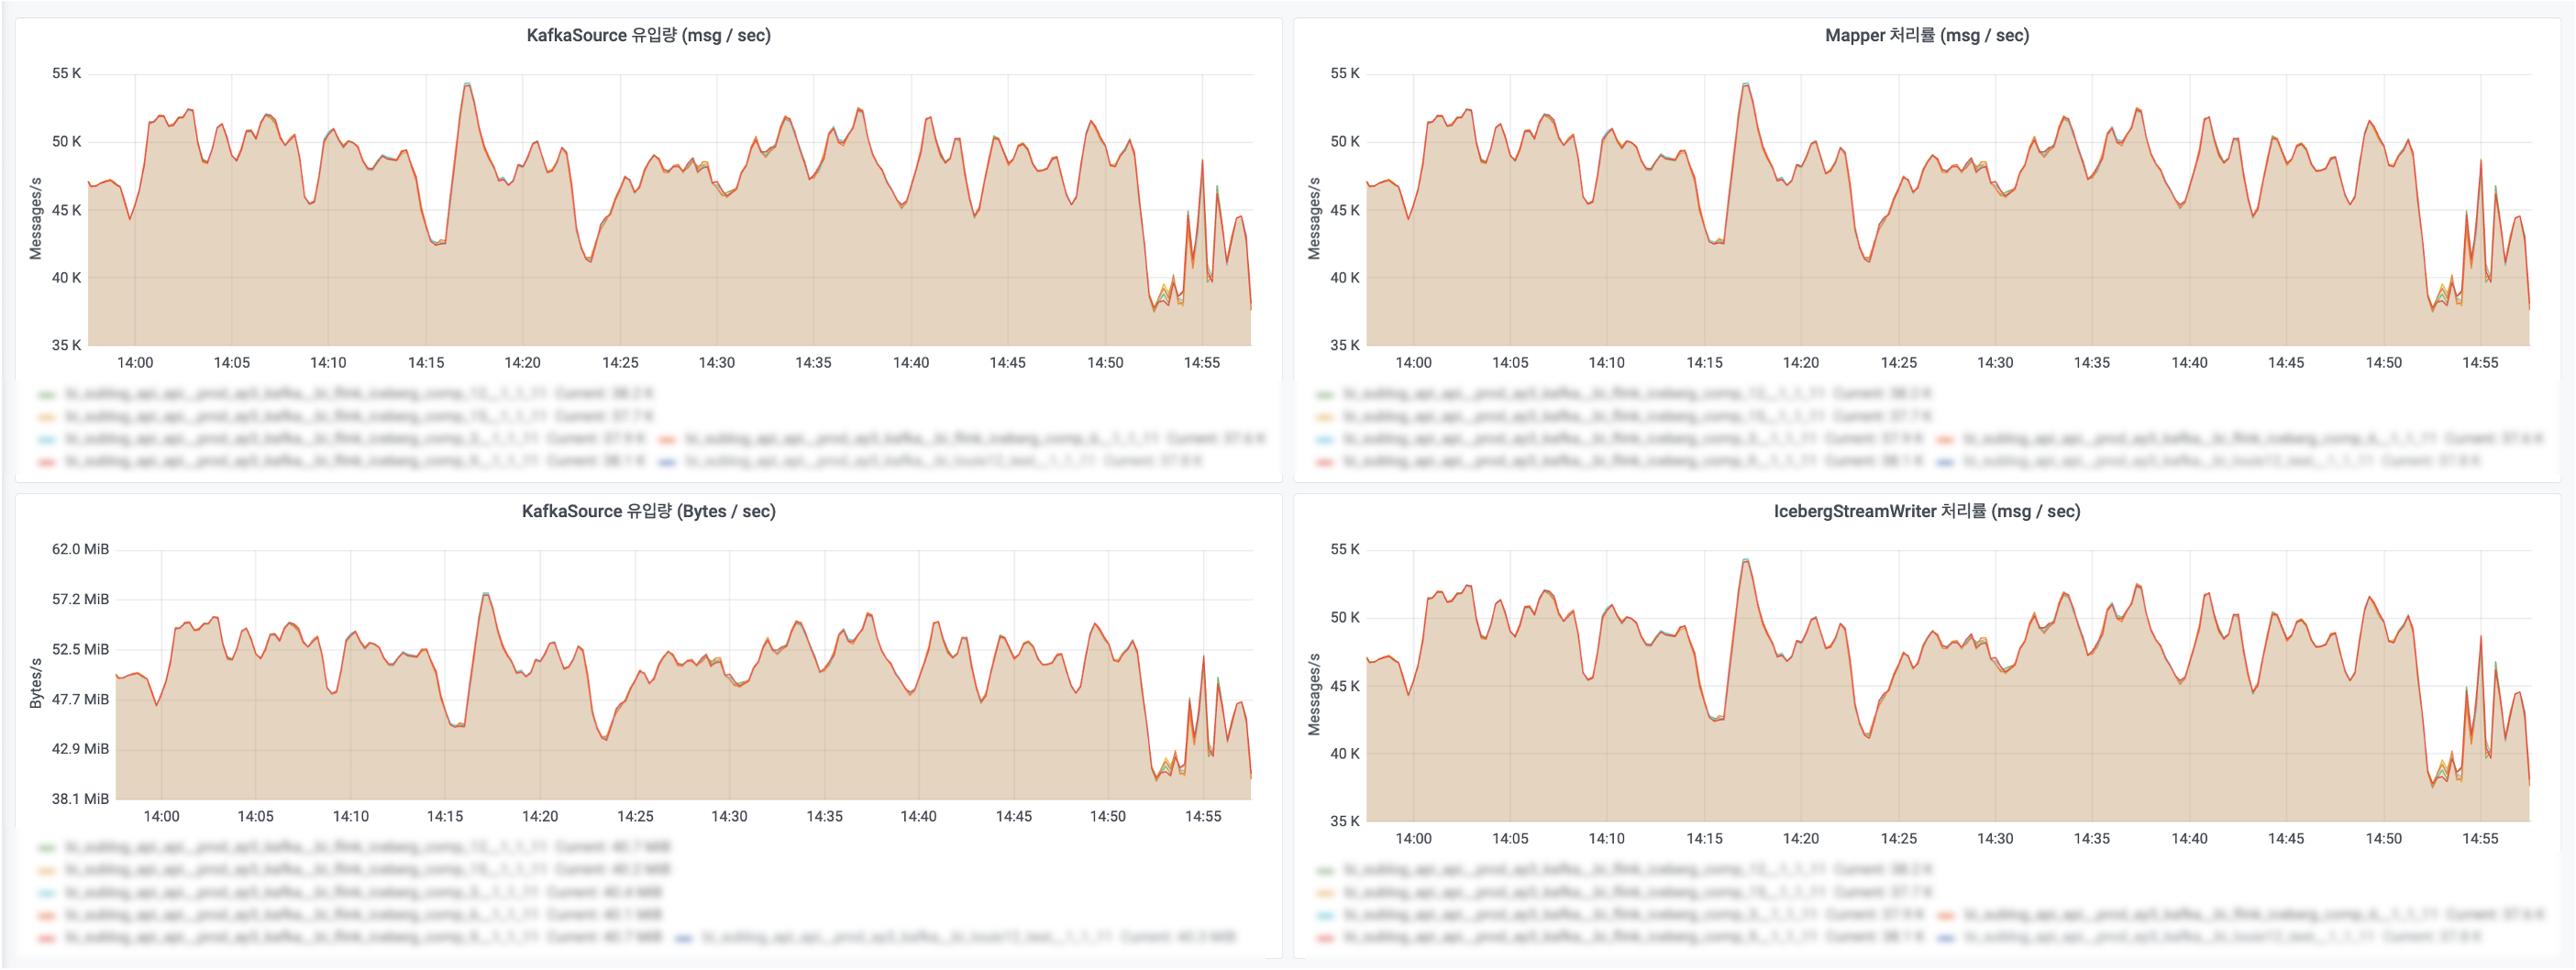
다음으로 플링크 관점에서 지연 여부를 확인하기 위해 플링크 job의 연산자 별 메시지 처리율을 측정했습니다. 참고로, 테스트에 사용한 플링크 job은 팀 내부 정책상 재처리에 유용하도록 원천 데이터의 변환을 최소화해야 하므로, 복잡한 연산 없이 카프카에서 로그를 컨슘하고, Jackson 라이브러리를 통해 파싱(Parsing)한 후, 아이스버그 테이블 적재에 사용되는 RowData 포맷으로 변환 및 적재하는 방식으로 동작하도록 구성했습니다.
테스트 결과는 아래 Table 3 과 같으며, 동일 압축 레벨내에서는 플링크 job들의 처리율이 거의 동일했고 압축 레벨 변경에 따른 처리율 변화 또한 미미하며 최대 차이도 약 0.3% 수준이었습니다. 이러한 결과를 종합적으로 고려했을 때, 압축 레벨 증가로 CPU 사용 비율은 상승했지만, 개별 Task Manager의 CPU 사용률에는 큰 차이가 없었으며, 카프카 및 플링크 관점에서도 지연이 발생하지 않았습니다 . 따라서, 전반적인 성능에 미치는 영향은 크지 않으며, 압축 레벨 증가로 인해 실질적인 지연이 발생할 가능성은 낮다고 판단했습니다.
| 압축 레벨 3 | 압축 레벨 6 | 압축 레벨 9 | 압축 레벨 12 | 압축 레벨 15 | |
|---|---|---|---|---|---|
| 초당 메시지 처리율 | 46,456 | 46,437 | 46,426 | 46,339 | 46,602 |
Table 3. 압축 레벨에 따른 플링크 Job 및 연산자별 처리율 차이
이제, 지연이 발생할 가능성은 거의 없다는 점을 확인한 후, 서버 로그를 아이스버그 테이블에 압축하여 적재할 경우 얻을 수 있는 이점을 살펴보았습니다. 그중 하나는 압축 레벨 증가가 파일 크기 감소에 미치는 영향으로, 이를 테스트하고 비교해보았습니다. 다만, 결과를 해석할 때 고려해야 할 점은 현재 ORC 포맷으로 적재중인 플링크 job의 체크 포인트 주기는 3분이며, 아이스버그 테이블 적재를 위한 테스트 목적의 플링크 job의 체크포인트 주기는 1분 이라는 차이가 있다는 점입니다. 체크포인트 주기를 1분으로 줄인 이유는 앞서 설명드린 것 처럼 더 빈번한 체크포인트를 통해 카프카의 Lag Count를 줄이기 위함입니다.
또한, 아이스버그 테이블의 동작 방식을 고려했을때 작은 파일로 남겨두는 건 쿼리나 최적화 기능의 성능에 좋지 않습니다. 이에 작은 파일을 합쳐 큰 파일을 만들고, 작은 파일을 삭제하는 과정이 중요합니다. 이러한 최적화 방식은 후속 파트인 파티션 및 최적화 전략에서 자세히 설명드리겠습니다.
아래 Table 4 는 지연 테스트시 사용한 일 평균 30억개의 서버 로그가 들어오는 카프카 토픽을 컨슘하여 아이스버그 테이블로 적재할 때 압축 레벨별 주중 하루치 파일 크기를 계산한 결과입니다. 또한, 기존 방식인 ORC 파일 포맷으로 적재한 서버 로그의 하루치 파일 크기(750.3GB)와 압축 레벨 1 및 3(기본 압축 레벨) 대비 얼마나 줄어드는지도 함께 정리했습니다.
| 압축 레벨 1 | 압축 레벨 3 | 압축 레벨 6 | 압축 레벨 9 | 압축 레벨 12 | 압축 레벨 15 | |
|---|---|---|---|---|---|---|
| 주중 하루치 파일 크기 합 | 473.4 GB | 453.5 GB | 402.9 GB | 364.4 GB | 358.1 GB | 347.1 GB |
| ORC 포맷 (750.3 GB) 대비 크기 감소율 | 36.9% | 39.6% | 46.3% | 51.4% | 52.3% | 53.7% |
| 압축 레벨 1 (473.4 GB) 대비 크기 감소율 | - | 4.2% | 14.9% | 23.0% | 24.4% | 26.7% |
| 압축 레벨 3 (453.5 GB) 대비 크기 감소율 | - | - | 11.2% | 19.6% | 21.0% | 23.5% |
Table 4. 압축 레벨에 따른 파일 크기 합 및 비율
그러나 이러한 압축 효과가 모든 경우에 동일하게 나타나는 것은 아닙니다. 발생하는 서버 로그 개수에 따라 압축률이 달라질 수 있으며, 위 결과는 상대적으로 많은 서버 로그가 생성되는 경우에 해당합니다. 이를 추가로 확인하기 위해, 서버 로그 발생량이 상대적으로 더 적은 카프카 토픽들을 대상으로 압축 레벨을 9에서 테스트를 수행했습니다. 그 결과는 아래 Table 5와 같으며, 예상대로 일 평균 30억 개의 그의 경우 약 51.4%의 가장 높은 크기 감소율을 보였고, 그보다 적은 경우에는 평균 23.9%에서 31.8% 수준의 크기 감소율을 보였습니다.
| 서버 로그 규모 (일 평균) | 압축 레벨 9에서 ORC 포맷 파일 크기 대비 크기 감소율 |
|---|---|
| 30억 개 | 51.4% |
| 9,000만 개 | 27.7% |
| 2,000만 개 | 23.9% |
| 200만 개 | 31.8% |
Table 5. 메시지수에 따른 파일 크기 감소율
하지만 이러한 테스트 결과들을 해석할때 중요한 점은 이러한 파일 크기 감소 효과가 아이스버그 테이블 자체에서 기인한 것인지, 아니면 단순히 Parquet 파일 포맷 및 zstd 압축 코덱을 사용했기 때문인지를 명확히 구분해하는 것입니다. 즉, Parquet 파일 포맷 및 zstd 압축 코덱을 사용하여 서버 로그를 바로 적재했을 경우, 위의 결과와 차이가 있는지 확인할 필요가 있습니다.
테스트 결과, 아이스버그 테이블에 Parquet 파일 포맷 및 zstd 압축 코덱으로 적재하는 경우와 Parquet 파일 포맷 및 zstd 압축 코덱으로 직접 적재하는 경우에 파일 크기 차이는 없었습니다. 아래 Table 6 는 일 평균 30억 개의 로그가 발생하는 서버 로그를 기준으로 수행한 테스트 결과로, Parquet 파일 포맷 및 zstd 압축을 사용한 파일 크기(469.1 GB)는 동일한 파일 포맷 및 압축 코덱에 압축 레벨 3을 사용하여 아이스버그 테이블로 적재한 파일 크기(469.6 GB)와 거의 동일했습니다. 다만, 앞선 Table 4 와는 테스트 수행 일자가 달라 미세한 차이가 있음을 참고 부탁드립니다. 따라서 앞서 언급된 파일 크기 감소는 아이스버그 테이블로 적재해서가 아닌 Parquet 파일 포맷 및 zstd 압축 코덱을 사용하기에 발생하는 이점으로 해석할 수 있습니다.
| ORC | Parquet & zstd | Parquet & gzip | 아이스버그 (압축 레벨 3) | 아이스버그 (압축 레벨 6) | 아이스버그 (압축 레벨 9) | |
|---|---|---|---|---|---|---|
| 파일 크기 합 | 799.4 GB | 469.1 GB | 590.9 GB | 469.6 GB | 418.5 GB | 379.6 GB |
| orc 대비 파일 크기 감소율 | - | 41.3% | 26.1% | 41.3% | 47.6% | 52.5% |
Table 6. 아이스버그 테이블과 직접 Parquet & zstd로 적재한 파일 크기 차이
마지막으로, 압축 레벨에 따라 스파크에서 아이스버그 테이블을 하루치 소싱하는 시간에 차이가 발생하는지를 확인했습니다. 이번 테스트도 일 평균 30억개의 로그가 발생하는 서버 로그를 기준으로 수행했으며, 스파크 익스큐터의 개수는 32개로 익스큐터의 메모리는 4GB로 고정했습니다. 또한, 별도의 컴팩션과 같은 최적화 작업은 수행하지 않았음을 참고해주시기 바랍니다.
테스트 결과 압축 레벨이 증가함에 따라 소싱시간에 약간의 차이가 있었고, 압축레벨 3과 9에서 약 4분, 비율로는 10% 정도의 시간 차이가 있었습니다. 그러나, 이번 테스트에서는 컴팩션을 수행하지 않았고, 실제 운영 환경에서는 더 많은 리소스를 할당할 수 있으며, 실제로는 하루치 데이터를 한번에 소싱하는 것이 아니라 시간 단위로 소싱이 이루어지는 점을 고려해야 합니다. 결과적으로, 실제 운영 환경에서는 압축 레벨이 증가해도 그 차이가 훨씬 줄어들 것으로 예상되어 스파크 소싱에는 문제 없을 것으로 판단했습니다.
| 압축 레벨 1 | 압축 레벨 3 | 압축 레벨 6 | 압축 레벨 9 | 압축 레벨 12 | 압축 레벨 15 | |
|---|---|---|---|---|---|---|
| 5회 소싱 수행 후 평균 시간 | 37.8분 | 37.2분 | 38.4분 | 41.6분 | 40.8분 | 40.6분 |
Table 7. 압축 레벨에 따른 평균 스파크 소싱 시간
파티션
아이스버그의 파티션과 최적화 전략은 쿼리 성능에 직접적인 영향을 미치는 핵심 요소입니다. 이번 파트에서는 DB 로그와 서버 로그의 특성을 고려한 아이스버그 테이블의 적재 방식과 최적화 전략을 공유드립니다. 들어가기에 앞서 각 로그 유형 별 적재 방식, 파티션, 그리고 최적화 수행 주기를 다시 정리해보면 아래 Table 8 과 같습니다.
| DB 로그 (실제 운영 환경) | 서버 로그 (테스트 환경) | |
|---|---|---|
| 적재 방식 | UPSERT | APPEND |
| 파티션 | Primary Key 칼럼 기준 Bucket transform (bucket size = 5) | 처리 시간(process time) 칼럼 기준 Identity transform |
| 최적화 수행 주기 | 오전 / 오후 한번 (일 2회) | 한시간에 한번 |
Table 8. 로그 유형에 따른 아이스버그 테이블 상황
DB 로그는 데이터의 갱신과 삭제가 빈번하게 발생하는 특성상 Primary Key 칼럼 기준으로 UPSERT 모드로 적재하며, bucket transform 파티션을 적용하여 효율적으로 데이터 조회가 가능하도록 했습니다. 또한, 하루 두번 최적화 기능을 수행하여 성능을 유지합니다.
반면, 서버 로그는 새로운 로그가 발생하고 쌓이기 때문에 APPEND 모드로 적재 테스트를 진행했습니다. 또한, 서버 로그는 플링크 job에서 처리 시간 칼럼과 값을 추가하는데, 이는 기존 ORC 포맷으로 적재하는 플링크 job과 동일합니다. 다만 처리 시간에서 분 이하의 단위를 생략하고 문자열 타입으로 저장합니다.
Timestamp와 같은 시간 관련 타입의 칼럼으로 적재하고 hour transform 파티션을 적용하면 시 단위 파티션이 가능하나, 이 경우 타임존 차이를 고려해야 하는 문제가 발생합니다. 아이스버그는 저장된 시간 관련 칼럼의 값을 항상 UTC로 간주하며, 아이스버그 커뮤니티에서는 아이스버그는 저장된 값을 어디서 조회하든 항상 일관된 값을 제공하는 것을 목표로 하고 있습니다. 따라서 아이스버그는 항상 시간 관련 칼럼 값을 UTC로 가정하여 저장하며, 타임존 처리는 스파크나 트리노 같은 처리 엔진에서 수행해야 합니다.
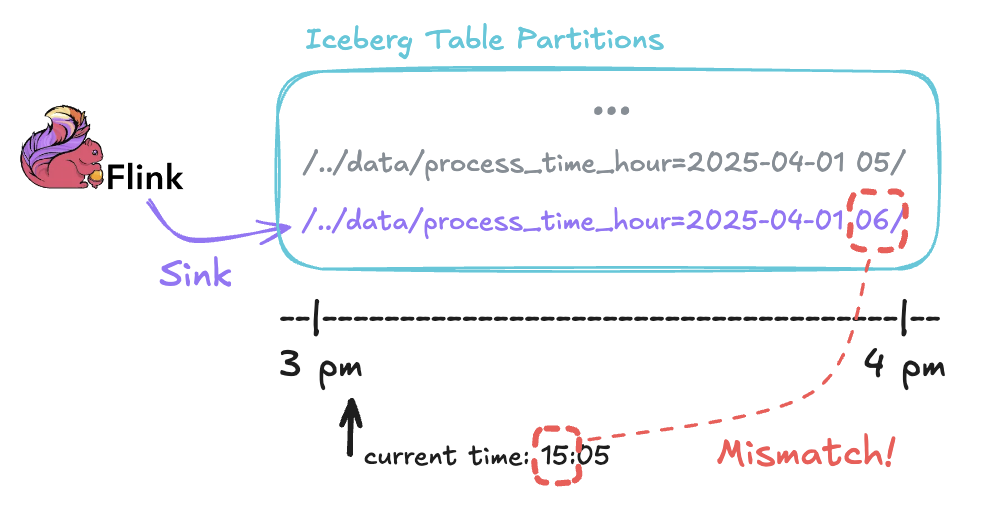
플링크 job에서 처리 시간을 생성하면 KST 기준으로 생성되지만, 이 값을 아이스버그에 저장하면 값 자체는 변경되지 않으나 UTC 타임존의 값으로 인식됩니다. 이로 인해, 팀내 스파크 세션은 KST로 설정되어 있어 UTC로 저장된 값을 KST로 읽을 때 +9 시간이 반영되어 잘못된 시간이 반환되는 문제가 발생합니다.
이를 해결하기 위해 처리 시간 생성시 -9시간을 반영할 수 있지만, 이 경우 스파크 소싱에는 문제가 없더라도 처리 시간 칼럼에 hour transform으로 파티션을 적용하면 실세 처리된 시간보다 9시간이 이전의 파티션에 적재 되기에 사용할 수 없습니다. 예를 들어, 아래 Figure 5 와 같이 2025년 4월 1일 15시에 들어온 로그가 9시간 전인 2025년 4월 1일 06시 파티션(../data/process_time_hour=2025-04-01 6)에 적재됩니다.
테스트 과정에서 저희는 타임존을 고려하지 않는 방향을 선택해, 처리 시간을 앞서 설명드린대로 문자열 타입 칼럼에 저장했습니다. 또한 day, hour와 같은 시간 관련 transform은 시간 관련 타입의 칼럼에만 적용 가능하므로, 처리 시간을 저장한 문자열 타입 칼럼에 identity transform을 적용하여 시 단위 파티션과 동일하게 동작하도록 했습니다.
최적화 전략
두주요 최적화 기능에는 컴팩션(Compaction) , 스냅샷 만료(Expire Snapshots) , 그리고 고아 파일 제거(Delete Orphan Files) 기능이 존재합니다. 이번 파트에서는 DB 로그는 현재 운영 환경에서 적용중인 최적화 전략을, 서버 로그는 테스트를 통해 최적화 방안을 검토한 내용을 공유드리겠습니다.
먼저 컴팩션 설정의 전략은 두 유형의 로그에 대해 동일하게 기본 전략인 binpack 전략을 사용합니다. 이는 DB 로그는 전체 테이블 조회를, 서버 로그는 전날 하루치 조회가 주로 이루어지는 팀내 아이스버그 테이블의 사용 패턴을 고려한 선택입니다. 따라서 sort나 z-order 전략 같은 특정 칼럼 기준으로 조회시 더 유리한 전략을 고려하지 않습니다.
그리고 컴팩션 수행 시 모든 파일이 컴팩션 후보에 포함되도록 rewrite-all 설정을 true로 설정합니다. 해당 설정을 하지 않을 경우 min-file-size-bytes, max-file-size-bytes 설정의 기본 값인 0.75와 1.8이 적용되어, 데이터 파일이나 삭제 파일의 크기가 target-file-size-byte의 0.75~ 1.8배 사이일 경우 컴팩션 후보에서 제외되기 때문입니다. 일부 파일이 컴팩션에서 제외되면 이후 생성되는 일부 삭제 파일은 참조 상태가 유지되어, 결과적으로 유저가 정의한 리텐션 기간이 지나도 삭제되지 않는 문제를 야기할 수 있습니다.
또한, 컴팩션의 partial-progress.enabled설정은 true로 설정하여 컴팩션 과정에서도 커밋이 수행되도록 했습니다. 다만, 해당 기능은 컴팩션 과정에서 수행되는 쿼리에대해, 컴팩션의 일부 결과를 활용하여 쿼리 성능을 개선킬때 유용하기에 컴팩션 중간에 쿼리 수행을 하지 않는 환경이라면 false로 설정하는 것을 권장합니다. max-concurrent-file-group-rewrites 설정은 DB 로그의 경우 bucket의 크기와 동일하게 5를 사용합니다. 서버 로그의 경우 이전 시간대 파티션에 대해 하나씩 컴팩션을 수행하면 되기에 1로 설정합니다. 컴팩션 주기는 DB 로그는 하루에 두번, 서버 로그는 매 시간마다 수행됩니다. 이러한 설정들을 정리하면 아래 Table 9와 같으니 참고하시기 바랍니다.
| 설정 | DB 로그 (실제 운영 환경) | 서버 로그 (테스트 환경) |
|---|---|---|
| rewrite-all | true | true |
| target-file-size-byte | 256 MB (하둡 파일 시스템 블록 사이즈와 동일) | 256 MB |
| partial-progress.enabled | true | true |
| max-concurrent-file-group-rewrites | 5 (bucket size와 동일) | 1 |
| 주기 | 일 2회 수행 | 매 시간 수행 |
| 타겟 | 모든 파티션 | 수행 시점 기준 이전 시간 파티션 |
Table 9. 로그 유형에 따른 아이스버그 테이블 특성 및 컴팩션
스냅샷 만료와 고아 파일 제거는 컴팩션과 달리 추가적인 설정 조율이 필요하지 않습니다. 그러나 partial-progress.enabled을 설정으로 인해 컴팩션 과정에서 많은 매니페스트 리스트와 파일들이 생성됩니다. 이러한 파일들도 동일한 최적화 수행 시점에서 스냅샷 만료와 고아 파일 제거를 통해 삭제될 수 있도록, 컴팩션과 이후 스냅샷 만료 및 고아 파일 제거 기능 사이에 약간의 딜레이를 설정했습니다.
딜레이 및 스냅샷 만료와 고아 파일 제거의 리텐션 설정은 아이스버그 테이블의 커밋 주기인 플링크의 체크포인트 주기를 고려하여 설정했습니다. 딜레이에는 DB 로그의 경우 30분, 서버 로그는 3분으로 설정했으며, 각각 주기의 3배수를 적용했습니다. 스냅샷 만료와 고아 파일 제거의 리텐션은 DB 로그의 경우 20분, 서버 로그는 2분으로 주기의 2배수를 적용했으며 이러한 수치 값들은 경험적으로 조율했습니다.
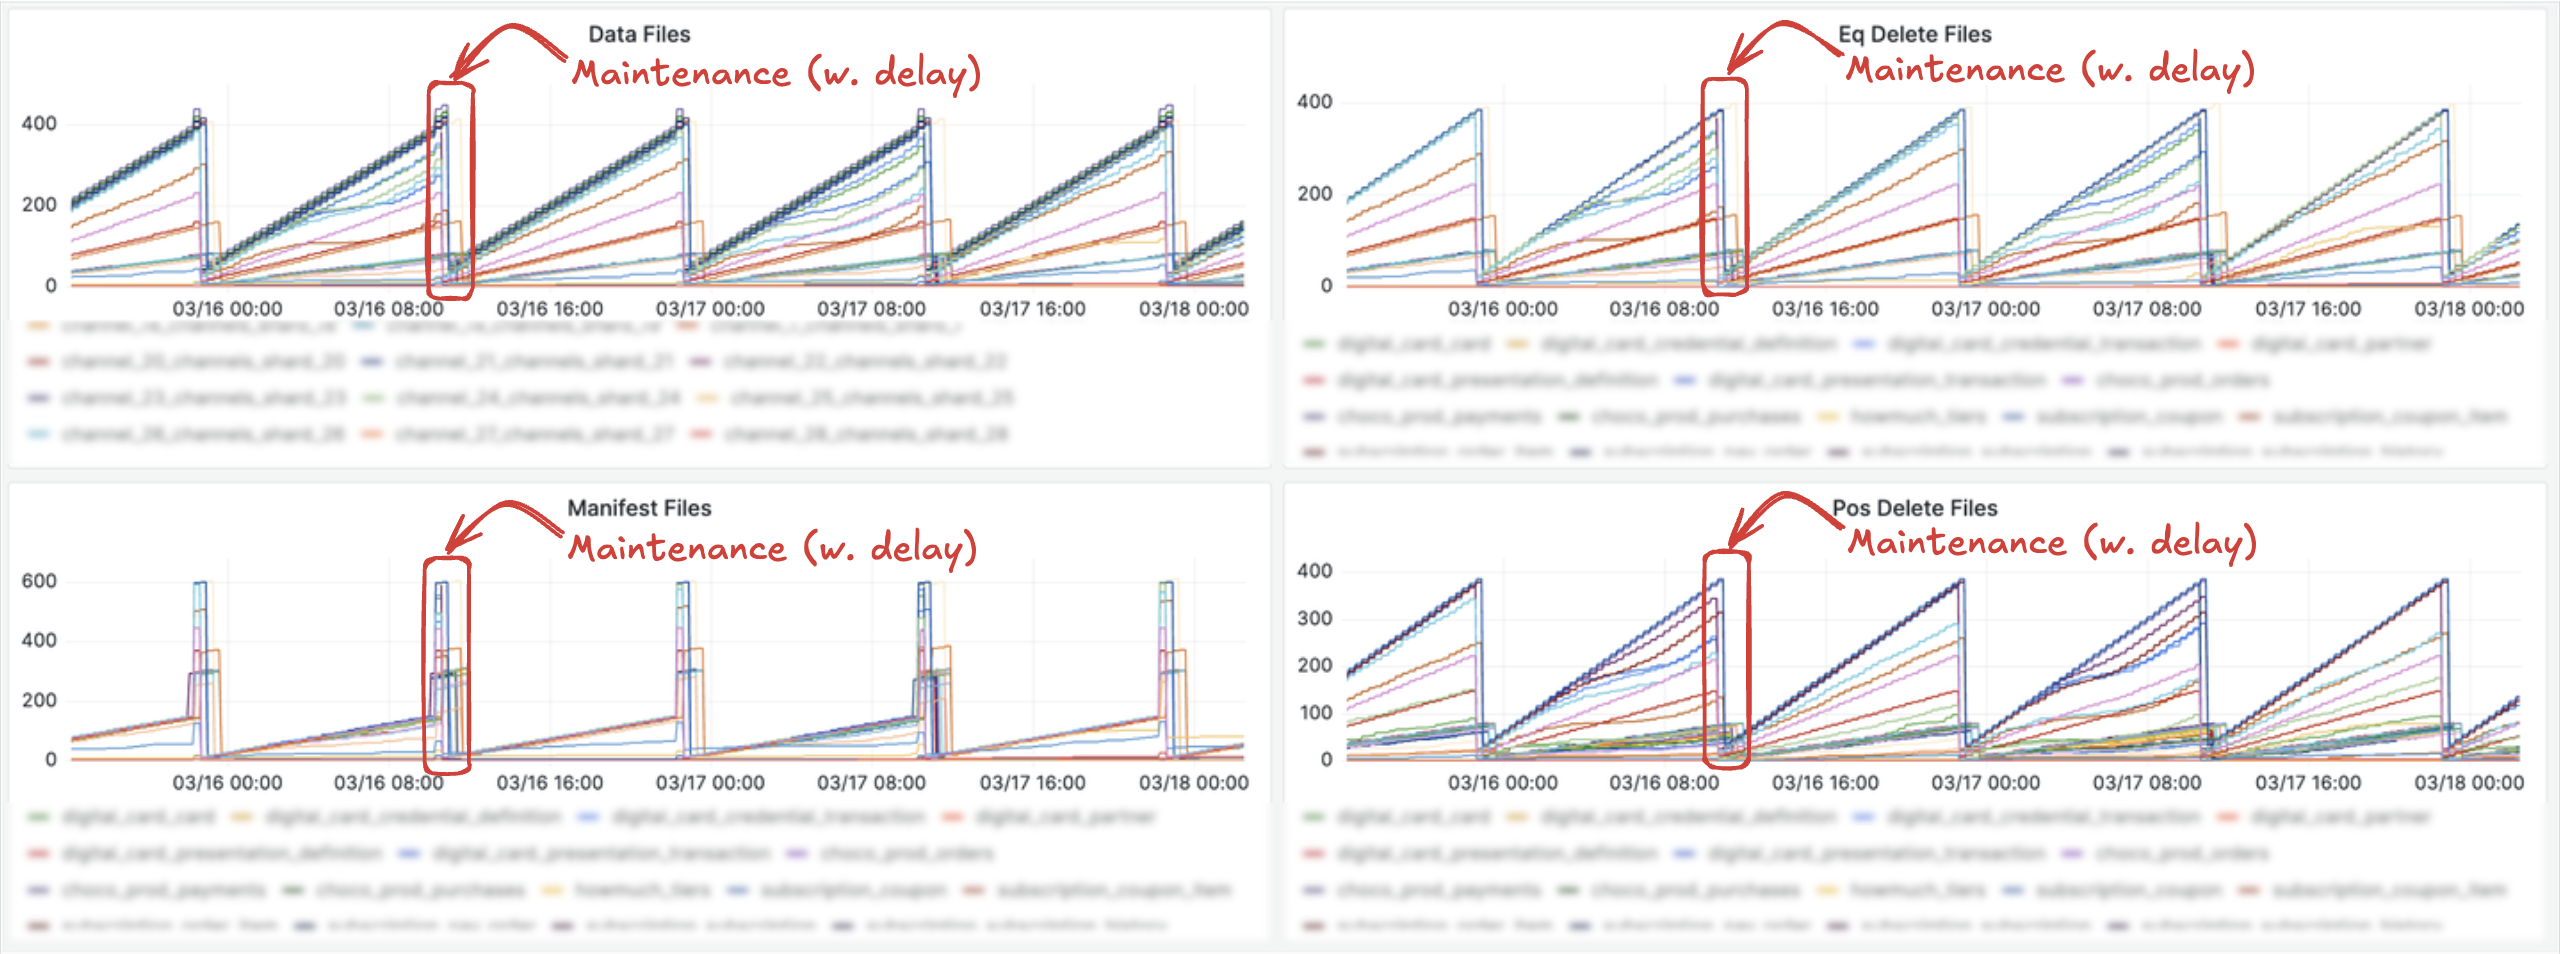
아래 Figure 6 은 실제로 DB 로그를 적재 중인 아이스버그 테이블에 대해 하루에 두 번 최적화 작업이 수행되는 과정과, partial-progress.enabled가 true로 설정되어 매니페스트 파일의 개수 증가하는 현상을 보여줍니다. 이후, 스냅샷 만료와 고아 파일 제거를 통해 파일이 삭제되는 과정도 함께 확인할 수 있습니다.
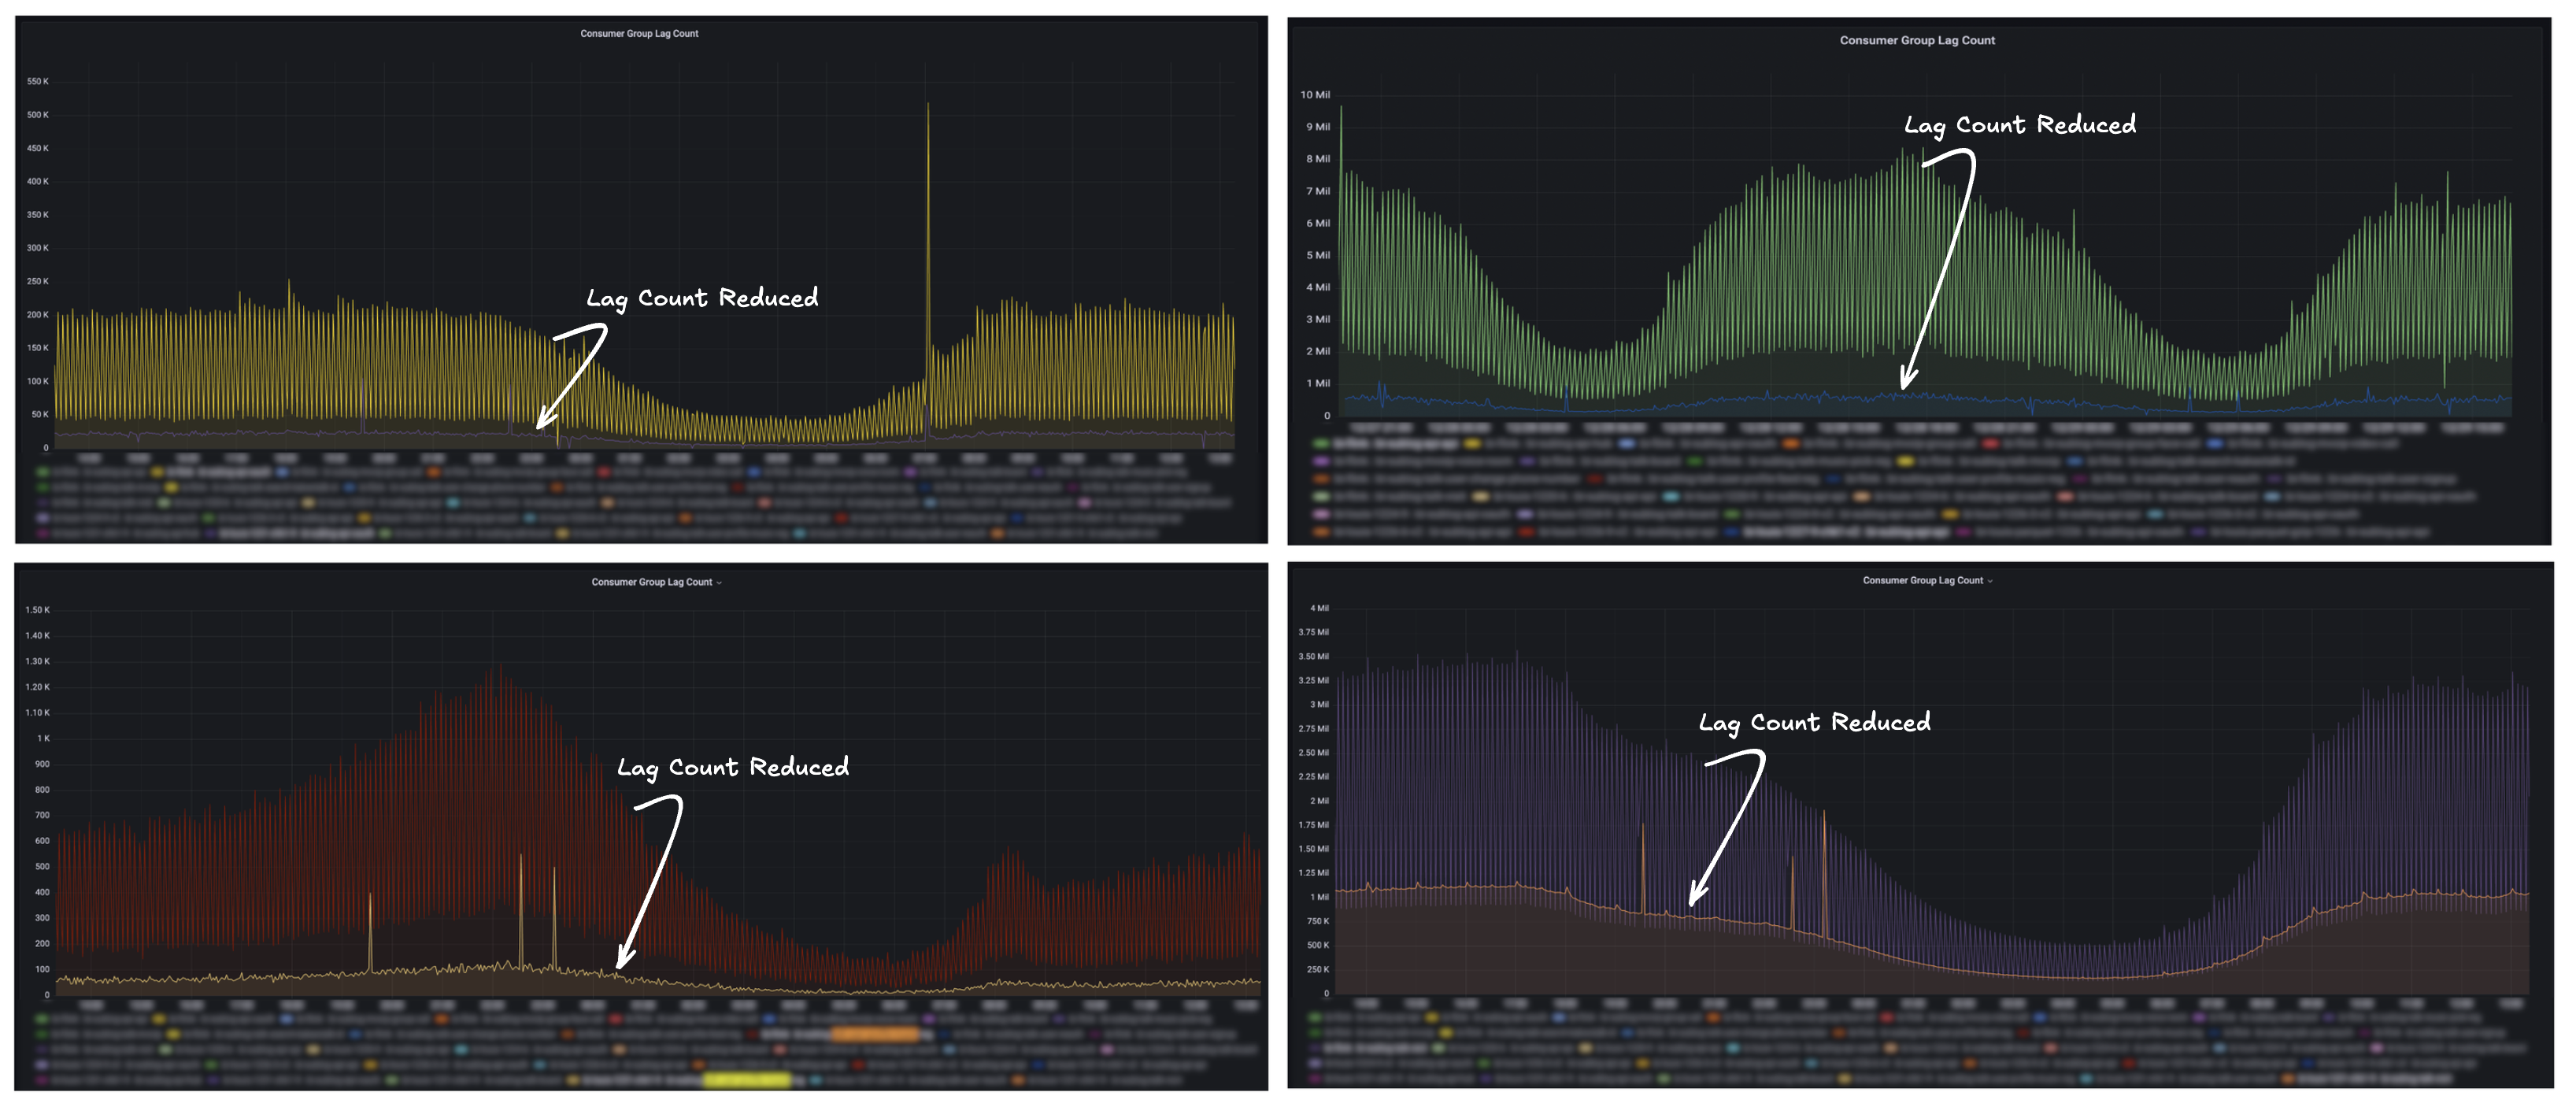
서버 로그의 경우, 카프카의 Lag Count를 낮추기 위해 기존 ORC 포맷으로의 적재하는 방식보다 체크포인트 시간을 3분에서 1분으로 더 짧게 설정하여 데이터를 적재합니다. 이를 통해 Figure 7과 같이 기존보다 최소 3분의 1수준의 더 낮은 토픽별 Lag Count를 유지할 수 있습니다. 하지만 짧아진 체크포인트 주기로 인해 파일 크기가 작아지는데, 이러한 작은 파일들은 하둡 파일 시스템이나 스파크 소싱 작업시 비효율적입니다. 이를 개선하기 위해 매 시간마다 이전 시간대 파티션에 대해 컴팩션, 스냅샷 만료, 그리고 고아 파일 제거를 수행하도록 설정하고 테스트했습니다.
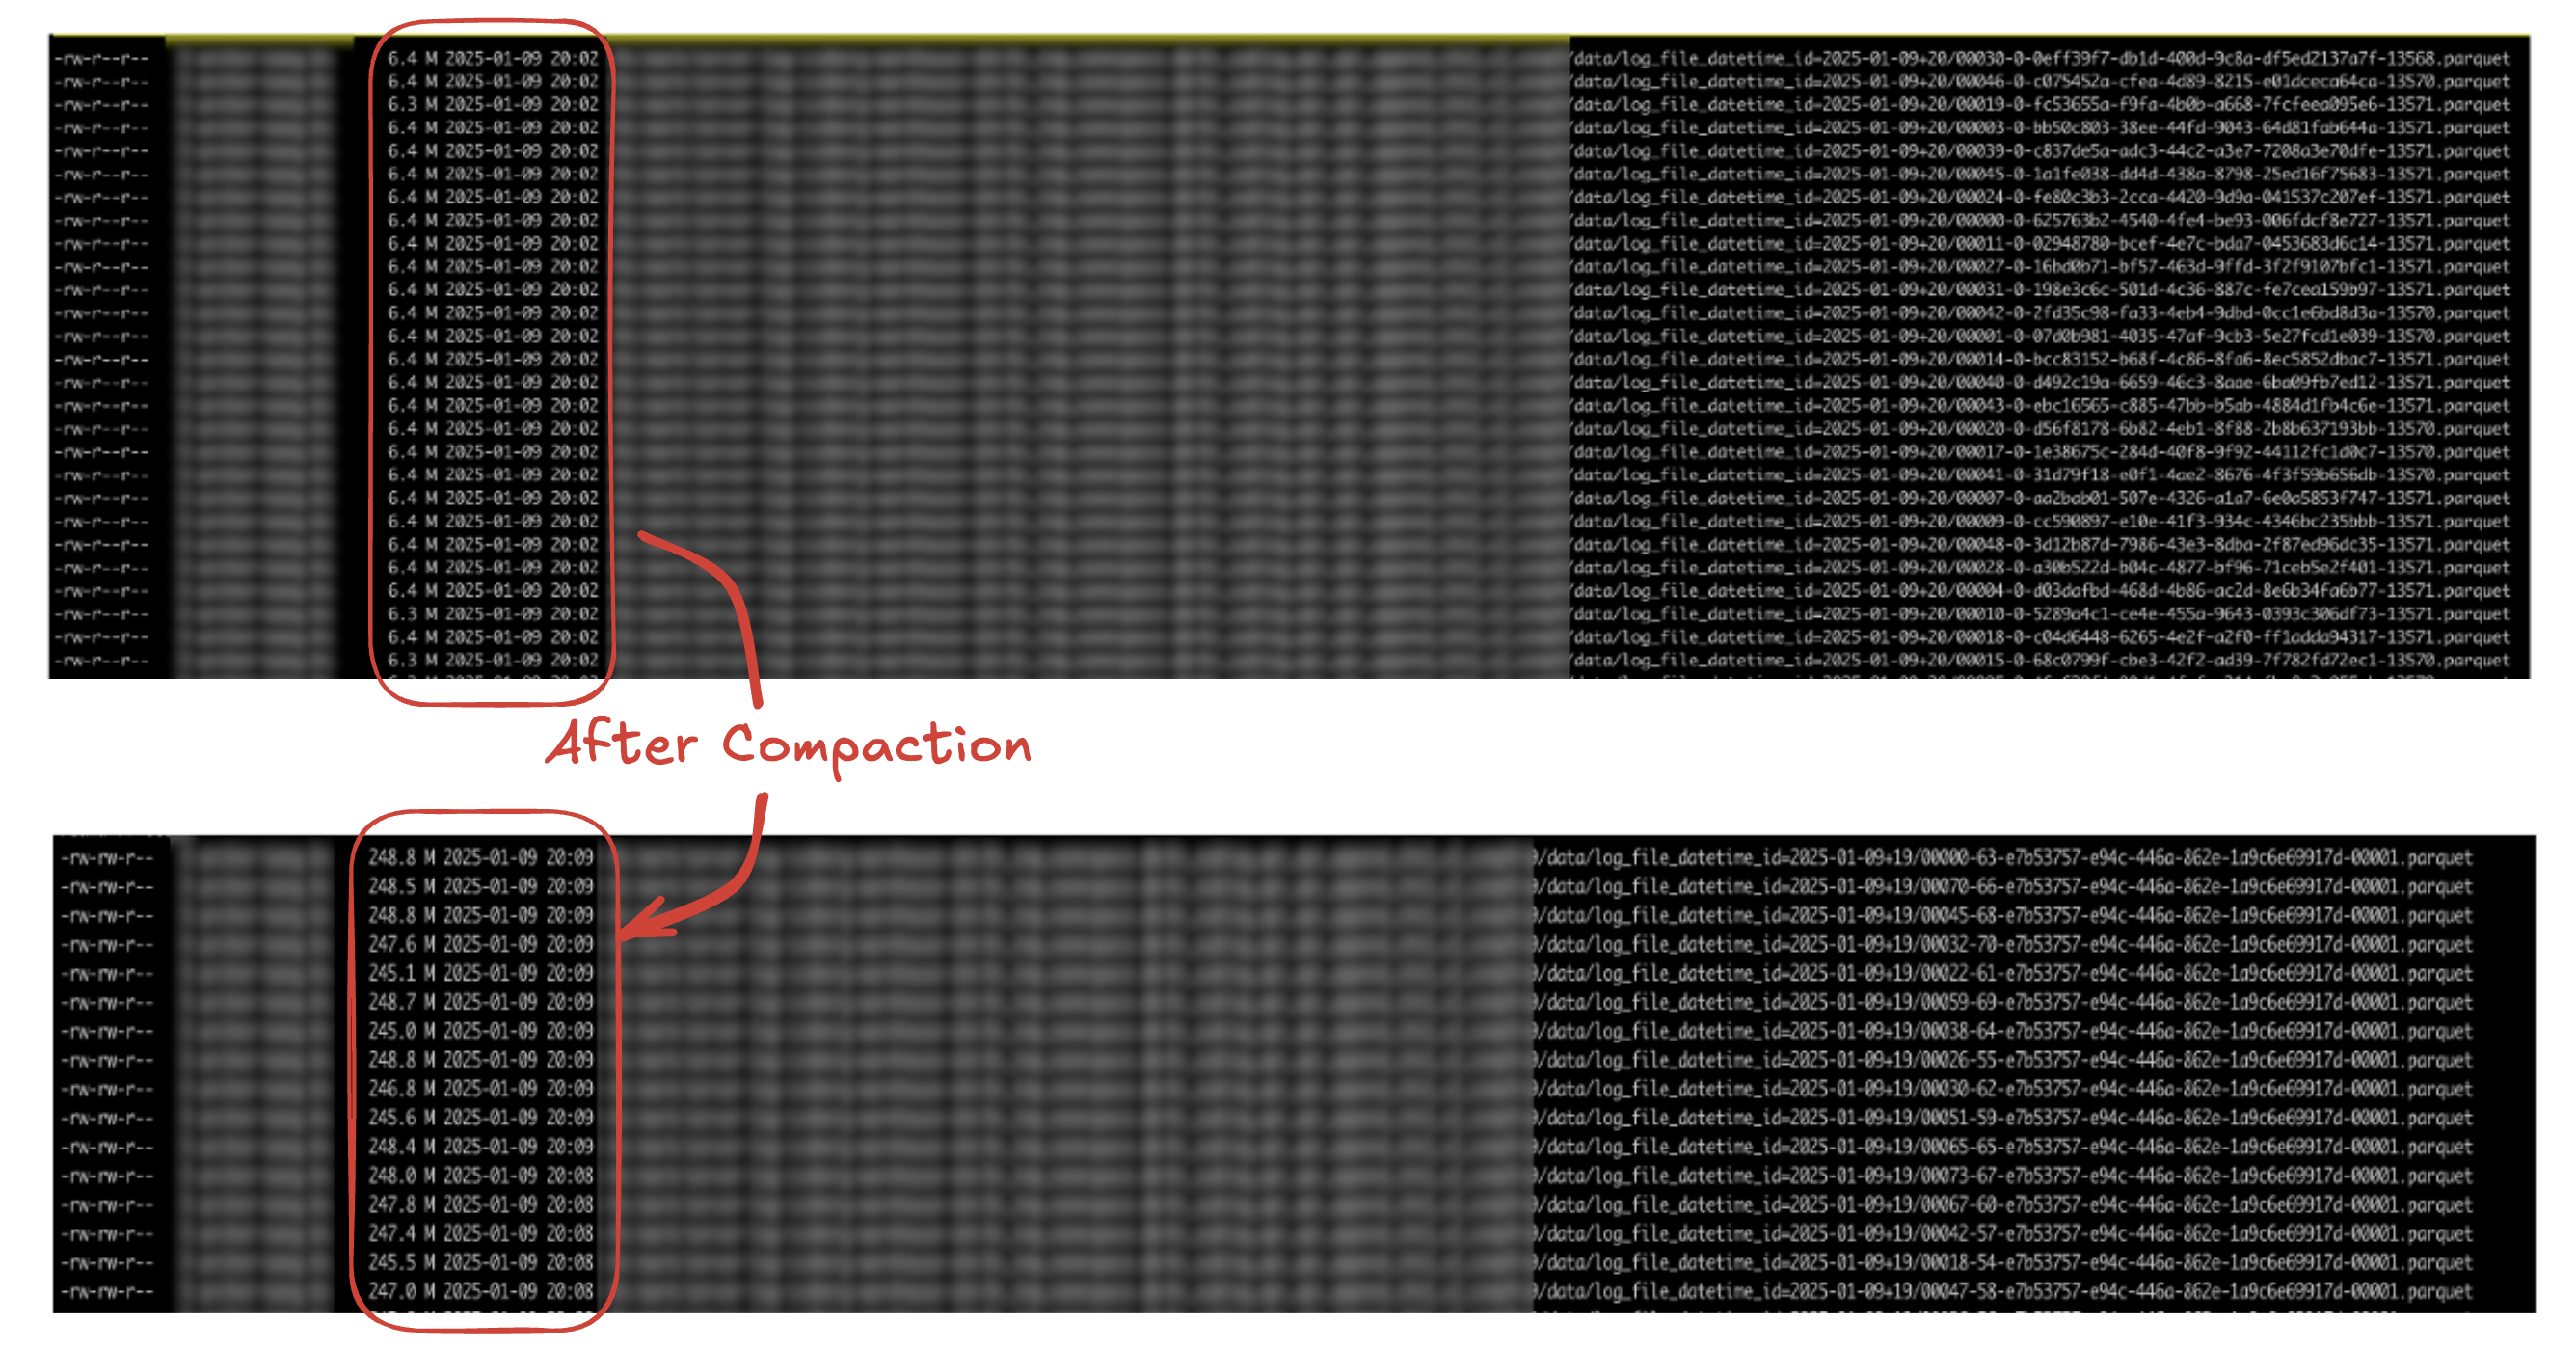
아래 Figure 8 은 일 평균 30억개의 로그가 발생하는 서버 로그를 기준으로 테스트 한 결과를 보여줍니다. 약 6MB 정도의 크기로 적재된 작은 파일들이 최적화 작업 이후 약 256 MB 정도의 파일 크기로 합쳐지며 작은 파일들은 삭제 된것을 확인할 수 있습니다. 이를 통해 체크포인트 주기를 단축하여 Lag Count는 낮추면서 동시에 작은 파일 문제를 효과적으로 다룰 수 있다 판단했습니다.
이처럼 DB 로그와 서버 로그는 데이터의 특성과 적재 방식(UPSERT vs APPEND), 그리고 운영 목표(최신성 유지 vs 대용량 처리 및 Lag 최소화)가 다르기에 최적화 전략 역시 다르게 가져가야 합니다. DB 로그는 UPSERT 특성상 별도의 삭제 작업 없이 일 2회 전체 파티션 컴팩션과 상대적으로 긴 리텐션(20분)으로 관리하는 반면, 서버 로그는 짧은 커밋 주기(1분)에 맞춰 매시간 이전 파티션 컴팩션과 짧은 리텐션(2분)을 적용하여 작은 파일 문제를 적극적으로 해결합니다.
특히 서버 로그는 APPEND 모드의 한계로 인해 스냅샷 만료 기능만으로는 오래된 데이터를 삭제할 수 없어 별도의 DELETE 쿼리를 주기적으로 수행하여 실제 데이터의 리텐션을 관리해야 하는 중요한 차이가 있습니다. 이러한 로그 유형별 아이스버그 테이블 운영 방식과 최적화 전략의 주요 차이점은 아래 Table 10에 종합적으로 정리되어 있습니다.
| DB 로그 (실제 운영 환경) | 서버 로그 (테스트 환경) | |
|---|---|---|
| 적재 방식 | UPSERT | APPEND |
| 컴팩션 | 모든 파티션에 수행 | 이전 시간대 파티션에 수행 |
| 스냅샷 만료 리텐션 | 20분 | 2분 |
| 고아 파일 제거 리텐션 | 20분 | 2분 |
| 커밋 주기 | 10분 | 1분 |
| DELETE 쿼리 수행 필요 여부 | UPSERT 모드로 적재되어 필요 X | APPEND 모드로 적재되어 DELETE 쿼리 수행 필요 O |
Table 10. 로그 유형에 따른 아이스버그 테이블 특성 및 최적화 전략 차이
모니터링
아이스버그 테이블을 안정적으로 운영하고 최적의 성능을 유지하기 위해서는 테이블의 상태를 지속적으로 모니터링하는 것이 중요합니다. 특히 아이스버그 운영 시 쿼리 성능에 직결되는 작은 파일들이 잘 관리되는지, 파티션 설정은 적절한지, 그리고 관련 최적화 작업이 잘 수행되는지 확인하는 것이 핵심입니다. 이번 파트에서는 이러한 목표를 달성하기 위해 어떤 지표들을 수집하고, 어떻게 시각화하여 운영하려 하는지 테스트 내용을 공유드리겠습니다.
지표 수집
아이스버그 테이블의 상태를 파악하기 위한 지표 수집은 크게 두 가지 관점에서 접근할 수 있습니다. 하나는 쿼리 성능에 직접적으로 영향을 미치는 참조 상태의 파일들의 상태를 파악하는 것이고, 다른 하나는 **스토리지에 물리적으로 존재하는 모든 파일(아직 삭제되지 않은 고아 파일 포함)**의 상태를 추적하는 것입니다.
참조 상태 파일 모니터링은 아이스버그 테이블 운영에서 가장 중요하게 보는 부분입니다. 최신 스냅샷이 참조하고 있는 데이터 파일들의 개수, 평균 크기, 파티션별 분포 등을 주기적으로 확인하여 다음의 사항들을 점검합니다:
- 작은 파일이 계속 늘어나는지
- 최적화 작업이 잘 수행되고 있는지
- 파티션 적절성 (e.g. 특정 파티션에 데이터가 몰리는 현상) 확인
이 지표들은 최신 스냅샷의 메타데이터 조회만으로도 충분하며, Trino의 $files 테이블이나 Spark SQL의 테이블명.files 메타데이터 테이블을 활용할 수 있습니다.
특히 저희는 파티션 설정의 적절성을 판단하기 위해 Trino의 $partitions 테이블 을 사용하고 있습니다. 이 테이블을 통해 각 파티션별 레코드 수, 데이터 파일 수, 총 파일 크기 등의 정보를 빠르게 조회할 수 있습니다. 수집된 파티션별 레코드 수나 파일 크기의 평균과 상대 표준 편차(Relative Standard Deviation, RSD)를 계산하여 파티션이 적절한지 확인합니다. 실제 운영 환경에 적용중인 DB 로그에 한하여, PK 기반 bucket transform이 적용된 테이블을 기준으로 테스트해보았을 때 모든 테이블들에 대해 고르게 데이터가 분포되어있으며 대부분 1% 미만의 상대 표준 편차를 보였습니다.
또한 테이블의 전체 파일 크기를 기준으로 적정 bucket 크기인지도 가늠해보려하는데, 파티션당 평균 파일 크기가 너무 작으면(예: 수 MB 수준) 오히려 파일 관리 오버헤드(Overhead)가 발생할 수 있으므로 파티션 재조정을 고려합니다. 저희는 최초 파티션 설정 시에는 원본 데이터의 레코드 수를 기준으로 삼으며, 운영 중에는 아이스버그 테이블의 총 파일 크기를 기준으로 파티션 수를 조정하는 방식을 사용해보려 합니다. 다만, bucket크기를 과도하게 늘리는 것은 오히려 작은 파일을 발생할 수 있기에 지양하고 있습니다.
반면, 전체 파일 모니터링은 스토리지에 남아있는 모든 파일들에 대해 파일 개수나 스토리지 사용량을 추적하고 싶을 때, 또는 고아 파일 제거 작업으로 몇 개의 파일이 제거되었는지 확인할 때 사용합니다. 이 경우에는 스냅샷 만료로 참조는 끊겼지만, 삭제되지 않은 스냅샷들이 참조하는 파일 정보까지 모두 포함하는 메타데이터 조회가 필요하며, 트리노에서는 all_files을 아직 지원하지 않기에 현재로서는 Spark SQL의 테이블명.all_files 메타데이터 테이블을 사용해야 합니다.
저희 운영 환경에서는 스냅샷 만료 및 고아 파일 제거 작업이 비교적 안정적으로 관리되고 있어, 일상적인 모니터링은 주로 활성 파일 상태를 중심으로 트리노나 스파크를 이용해 최신 스냅샷 기준의 지표($files, $partitions)를 수집하는 데 집중 하고 있습니다. 하지만 전체 파일 수를 정확히 파악해야 하거나 유지보수 작업의 상세 검증이 필요한 경우에는 Spark SQL의 all_files 기능의 활용 가능성을 항상 염두에 두고 있습니다.
지표 수집 주기는 테이블의 변경 빈도나 중요도에 따라 조절할 수 있습니다. 저희는 CDC 연동 테이블의 경우 초기에 15분 간격으로 수집 테스트를 했으나, 현재는 30분 또는 1 시간당 1회 정도의 수집 주기를 조정하여 테스트 해보려합니다. 파티션별 상세 지표는 전체 파일 개수 지표보다는 더 낮은 빈도인 하루에 한번 수집으로도 충분할 것으로 현재 판단중입니다.
지표 시각화
수집된 지표의 시간 흐름에 따른 변화 추이를 한눈에 파악하는데 시각화는 매우 효과적인 방법입니다. 저희는 프로메테우스(Prometheus) , 그라파나(Grafana), 그리고 지표 보관을 위한 사내에서 제공되는 타임시리즈 디비인 TSCoke를 조합하여 시각화를 하고 있습니다. 프로메테우스는 시계열 데이터 저장 및 조회에, 그라파나는 이를 바탕으로 대시보드와 다양한 차트를 구성하는데 사용됩니다.
다만, 프로메테우스는 Pull 방식으로 일정 주기마다 지표를 가져가는 형상이기에, 배치 job을 통해 지표를 전송하는 방식과는 부적합할 수 있습니다. 이를 위해 프로메테우스 푸시게이트웨이(Prometheus Pushgateway) 를 추가했습니다. 푸시게이트웨이는 배치 job이 수집한 지표를 HTTP 요청으로 전송할 수 있는 중간 게이트웨이 역할을 합니다. 배치 job에서 지표를 수집 및 계산하여 REST API를 통해 푸시게이트웨이로 전송하면, 프로메테우스는 설정된 주기에 따라 푸시게이트웨이에 있는 지표를 스크래핑하여 지표를 가져갑니다.
푸시게이트웨이를 사용할 때는 다음 설정 및 주의 사항에 유의해야 합니다. 첫째, 배치 작업에서 생성한 고유 레이블(예: 지표이름{레이블1="값1", 레이블2="값2"})을 프로메테우스가 레이블 충돌을 방지하기위해 임의로 변경하지 않도록 프로메테우스 설정(scrape_config)에 honor_labels: true 옵션을 설정해야 합니다.
둘째, URL 경로에 레이블을 포함하여 지표 그룹을 명시적으로 구분하는 것을 권장합니다. 지표 전송 포맷에만 레이블을 넣고 URL 경로로 그룹을 구분하지 않으면, 서로 다른 테이블에 대한 동일 지표가 하나의 그룹으로 취급되어 마지막 전송 값으로 덮어쓰일 수 있습니다. 이 문제를 해결하기 위해 REST API의 URL 경로에 $PUSHGATEWAY_URL/metrics/job/$namespace/table/$table과 같이 그룹핑 정보를 명시해야 합니다.
마지막으로 지표 전송 시 HTTP 메소드는 POST를 권장합니다. PUT 방식은 해당 URL 경로 그룹의 모든 기존 지표를 새로 전송된 지표로 완전히 교체하므로, 의도치 않게 지표가 사라질 수 있습니다. 반면 POST를 사용하면 동일 지표 이름 및 동일 레이블을 가진 지표의 값만 갱신하므로 안전하게 기존 지표를 유지 및 업데이트할 수 있습니다.
이렇게 수집되고 저장된 지표들이 위에 보여드렸던 Figure 6과 같은 그라파나 대시보드를 통해 시각화됩니다. 이러한 대시보드를 통해 시간에 따른 총 데이터 파일, 삭제 파일, 매니페스트 파일 수의 변화 추이를 확인하고 최적화 작업을 통해 몰작은 파일들이 늘어나지 않고 일정 수준 이하로 유지되는지 확인합니다.
마치며
글을 읽어주신 모든 독자 분들께 진심으로 감사 인사를 드립니다.
본 글에서는 서로 다른 특성을 가진 DB 로그와 서버 로그에 대해 아이스버그 테이블로 효율적으로 관리하기 위한 여정을 공유했습니다. DB 로그 측면에서는 CDC와 UPSERT모드, bucket transform 파티셔닝을 통한 안정적인 운영 경험을, 서버 로그 측면에서는 APPEND 모드, 처리 시간 기반 identity transform 파티셔닝, 그리고 zstd 압축 레벨 테스트를 통한 최적화 과정을 다루었습니다. 더불어 안정적인 운영을 위한 컴팩션, 스냅샷 관리 등의 최적화 전략과 모니터링 방안까지 살펴보았습니다. 다만 서버 로그의 경우, 테스트 결과외에 실제 운영 환경에 적용한 경험을 공유드리지 못해 아쉬움이 남습니다.
이 과정에서 아이스버그 테이블 사용 목적과 데이터가 소비되는 패턴에 따라 파이프라인의 구조나 세부 설정이 매우 다양하게 달라진다는 점을 느꼈습니다. 비슷한 작업을 계획하시는 독자분들이 있으시다면, 먼저 아이스버그 테이블로의 적재 목적과 데이터가 소비되는 패턴을 잘 정의한 후, 그에 맞게 파이프라인 구조와 세부 설정을 설계해보시길 권해드립니다.
더불어 글의 흐름상 본문에는 포함하지 않았지만, 운영 과정에서 간혹 메타데이터 파일의 삭제 등의 이슈로 아이스버그 테이블 연동이 깨지는 경우가 있습니다. 이런 경우에는 보통 Spark SQL을 활용해 DROP TABLE을 통해 테이블 등록만 제거하고, 물리적인 파일들은 보존한 채 register_table(table => ‘’, metadata_file => ‘’) 프로시저를 이용해 과거 메타데이터 파일 기준으로 테이블을 재등록합니다. 이후 일정 수준의 중복을 감수하고 과거 시점부터 데이터를 재처리하면 복구가 가능하니 참고하시기 바랍니다. 또한, 이러한 복구를 위해 플링크의 체크포인트 주기와 최대 메타데이터 보존 개수(기본값: 100)를 잘 조율 하시기 바랍니다. 이는 복구 가능한 최대 과거 시점을 결정하기 때문입니다.
마지막으로 관련 작업에 대해 함께 검토해준 동료분들 archer.kang, huan.15, wayne.pk에게 감사 인사를 드리며 글을 마치겠습니다.