Backend
실시간 메시징 시스템 개발기 - “성능 개선 레슨런“
george.5카카오
2024년 12월 12일
원문에서 보기 ↗실시간 메시징 시스템 개발 시리즈
-
Part 1. 실시간 메시징 시스템 개발 - “삽질 과정”
- 실시간 메시징 시스템 구축 과정에서 직면한 기술적 과제들과 해결 과정을 공유합니다.
-
Part 2. 실시간 메시징 시스템 개발 - “성능 테스트 설계와 분석”
- 대규모 트래픽 처리를 위한 실시간 메시징 시스템 성능 테스트 방법론과 테스트 설계 및 분석 과정을 소개합니다.
-
👉 Part 3. 실시간 메시징 시스템 개발 - “성능 개선 레슨런”
- 실시간 메시징 시스템의 병목 지점 발견, 개선 방안 도출과 실제 적용 사례까지 전체 과정을 공유합니다.
들어가며
안녕하세요, 인터랙션플랫폼에서 알렉스 플랫폼 개발을 담당하고 있는 george입니다.
앞의 글에서 pprof를 통해 카리브에서는 I/O 연산이 많이 발생하고 있고, 이것이 CPU에 부하를 주고 있다는 것을 인지하였습니다. 해당 글에서는 카리브가 어디에서 성능 개선 포인트를 발견했고, 어떤 식으로 해결하려 했는지, 결과는 어땠는지, 그 과정에서 알게 된 것은 무엇인지 등을 중점으로 이야기해 보겠습니다.
네트워크 I/O 연산 줄이기
우선 네트워크 I/O 연산에 대한 내용부터 시작해 보겠습니다.
코르크?
실시간 메시징 서비스에서 I/O 연산은 지속적으로 많이 발생할 수밖에 없습니다. 그러면 어떻게 해야 해당 연산을 조금이라도 더 줄일 수 있을까요? 실시간성을 해치지 않는 선에서 메시지를 모아서 한 번에 뿌려주는 것은 어떨까요? 저희는 우선 관련된 자료들을 리서치하기 시작했습니다. 그 과정에서 다양한 오픈소스 코드들을 살펴보았고, 그중에서도 socketify와 µWebSockets 코드를 살펴보던 중, 코드에서 "코르크"라는 개념을 발견하게 되었습니다. 우선 이러한 코르크 개념이 적용된 옵션인 TCP_CORK 를 소개하기 전, Nagle 과 TCP_NODELAY에 대해 가볍게 살펴보겠습니다.
Nagle
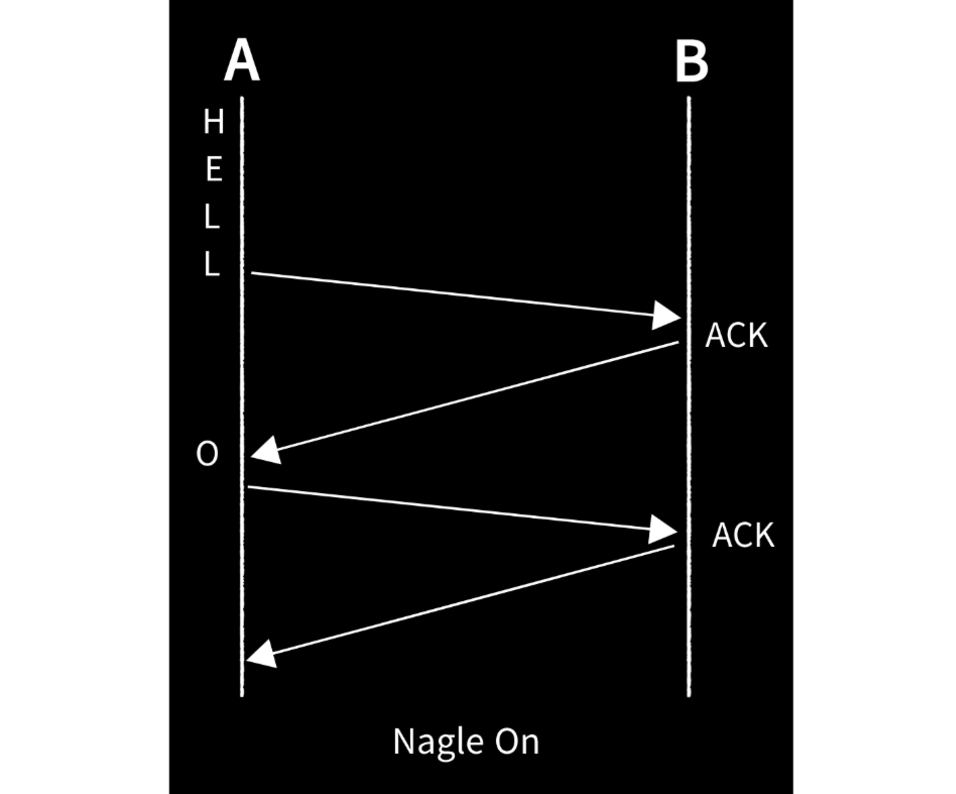
TCP는 데이터의 신뢰성과 순서를 보장하며, 인터넷상에서 데이터를 전송하기 위해 가장 널리 사용되는 프로토콜입니다. 그리고 TCP 소켓에는 데이터 전송의 효율성을 높이기 위해 Nagle 알고리즘 이 적용되어 있습니다. 네트워크에서 데이터는 여러 계층의 헤더로 캡슐화되어 전송됩니다. 이러한 헤더 의 크기는 상대적으로 크기 때문에, 데이터를 자주 소량으로 전송하면 네트워크에 오버헤드가 많이 발생합니다. 이런 문제를 해결하기 위해 도입된 것이 바로 Nagle 알고리즘입니다.
Nagle 알고리즘은 아래와 같이 동작합니다.
1. 데이터가 MSS(Maximum Segment Size) 만큼 쌓이면, 바로 전송합니다.
2. 보낼 데이터가 더 이상 없다면, 남은 데이터를 즉시 전송합니다.
3. 둘 다 아닌 경우에는, 이전에 전송한 데이터에 대한 **ACK(응답)**을 받을 때까지 기다립니다. ACK가 오면, 그동안 모아둔 데이터를 한꺼번에 전송합니다.
이를 통해 패킷 전송 횟수를 줄이고, 네트워크 오버헤드를 감소시킬 수 있습니다. 즉, Nagle 알고리즘은 패킷을 바로바로 보내지 않고 데이터를 모아두었다가, 이전에 보낸 데이터에 대한 ACK를 받은 후에 한 번에 전송하는 방식으로 동작합니다.
TCP_NODELAY
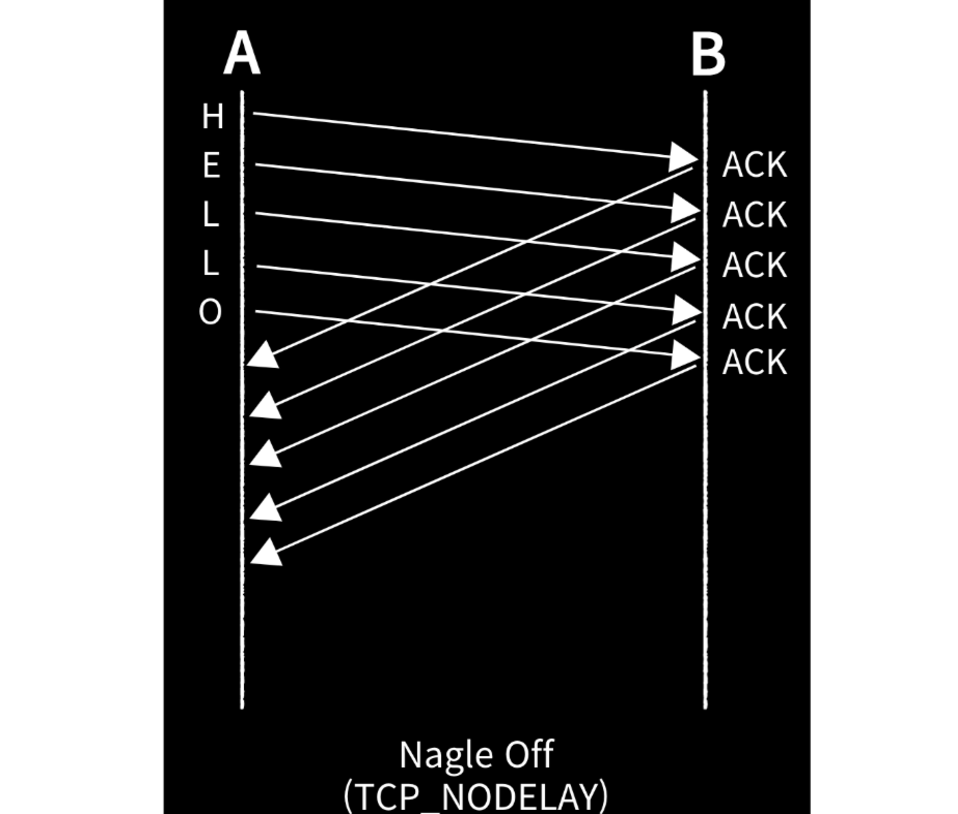
Nagle 알고리즘과 반대되는 옵션이 존재하는데, 이것은 TCP_NODELAY 라고 합니다. TCP_NODELAY는 간단하게 Nagle 알고리즘을 사용하지 않고 바로바로 데이터를 전송한다고 보시면 됩니다. 실시간성이 매우 중요한 스트리밍 서비스 같은데에 사용될 수 있겠지만, 당연히 오버헤드가 큽니다.
TCP_CORK
그렇다면 위에서 잠깐 언급한 TCP_CORK는 어떤 것이며, 어떤 문제를 해결하고 있을까요? 어찌 보면 앞에 소개한 둘 사이의 절충안이라고도 볼 수 있는 것이 바로 TCP_CORK 입니다. TCP_CORK 옵션은 Nagle 알고리즘과 비슷하게 데이터를 모아서 전송 하는 역할을 하지만, ACK(응답)에 의존하지 않고 사용자가 직접 제어할 수 있다는 점에서 차이가 있습니다.
TCP_CORK는 아래와 같이 동작합니다:
1. TCP_CORK 옵션을 켜면(on), MSS(Maximum Segment Size)보다 작은 데이터는 계속 버퍼링됩니다. 단, 이때 운영 체제는 내부적으로 데이터를 강제로 전송하는 타이밍을 제어할 수 있습니다. 이 타이밍은 TCP_CORK의 기능이 아니라 네트워크 스택의 구현 방식에 따라 달라질 수 있습니다.(ex) 200ms)

2. TCP_CORK 옵션을 끄면(off), 그동안 버퍼링된 데이터가 전송됩니다.
이 옵션은 마치 코르크처럼 작동합니다. 데이터를 전송하지 않도록 “코르크로 막아두었다가,” 사용자가 원하는 시점에 “코르크를 따서” 데이터를 내보낼 수 있는 것입니다.
아래 그림을 참고하면, TCP_CORK의 동작 방식을 더 쉽게 이해할 수 있습니다.
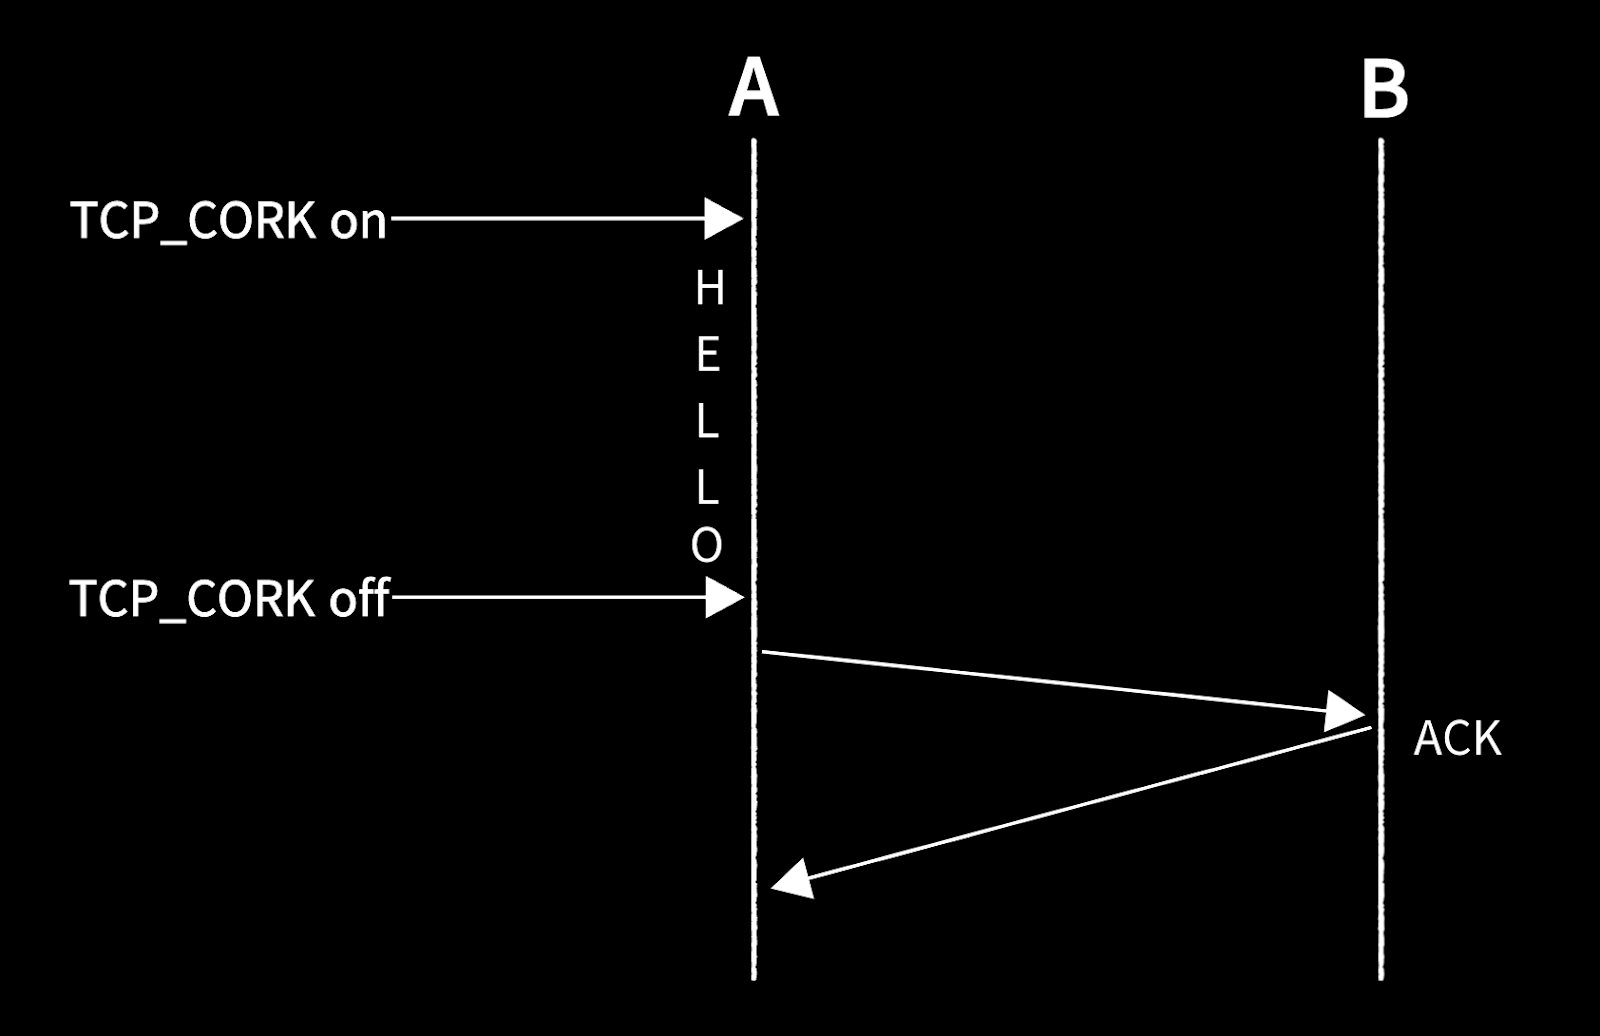
카리브의 경우에는 이를 통해 I/O 연산을 줄일 수 있을 것으로 예상되었습니다. 그래서 저희는 이 TCP_CORK를 카리브에서 사용해 보고 테스트를 진행해 보았습니다. 저희 같은 경우, 50ms 주기로 코르크를 열어주었습니다. 테스트 결과 정말로 성능 향상이 가능했습니다. 메시지 유실률, CPU 점유율 모두 더 좋은 지표를 나타냈습니다. 하지만 아쉬운 부분이 있었습니다.
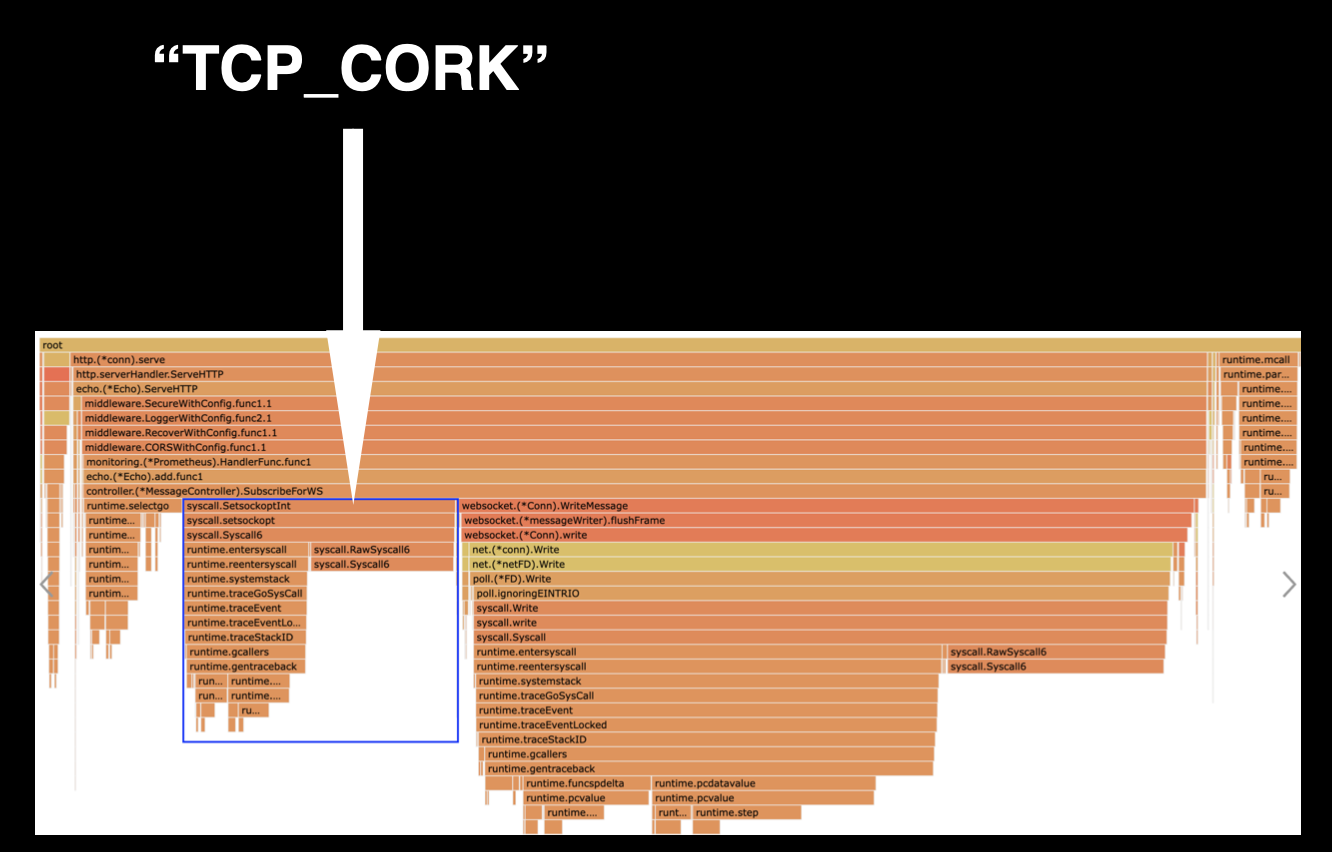
위 그림은 테스트 결과 pprof 지표입니다. 파란색 네모 부분이, TCP_CORK를 사용하며 CPU를 점유한 부분입니다. Go 언어에서 TCP_CORK를 사용하는 과정에서 계속해서 system call이 발생하였고 이는 CPU를 생각보다 많이 잡아먹고 있었습니다. TCP_CORK를 활성화하고 비활성화하는 과정에서 빈번히 setsockopt와 같은 시스템 호출이 발생하였고, TCP_CORK로 작은 데이터를 묶어 효율적으로 전송하여 네트워크 I/O는 줄였지만, 반대로 소켓 상태를 관리하기 위한 system call 오버헤드가 증가한 것으로 보였습니다. 컨텍스트 스위칭과 커널 모드에서의 작업이 예상보다 많은 CPU 리소스를 소모하게 되어, 결과적으로 성능 최적화를 위한 선택이 다른 부분의 비용을 올린 셈이 되었습니다.
그래서 저희는 더 좋은 방법은 없을지 고민하였습니다. 우선 모아서 보내어 I/O 연산을 줄인다는 아이디어 자체는 좋아 보였습니다. 이것을 애플리케이션 레벨에서 지원해 주는 라이브러리는 없을까 생각하게 되었고, Go 언어의 websocket 라이브러리인 gobwas가 버퍼 기반으로 웹소켓 프레임을 버퍼링 할 수 있는 기능을 제공한다는 것을 알게 되었습니다. 그리고 저희는 이를 이용해서, TCP_CORK를 적용했을 때와 동일하게, 50ms 주기로 버퍼에 담아 두었다가, flush 하도록 로직을 수정하였습니다.
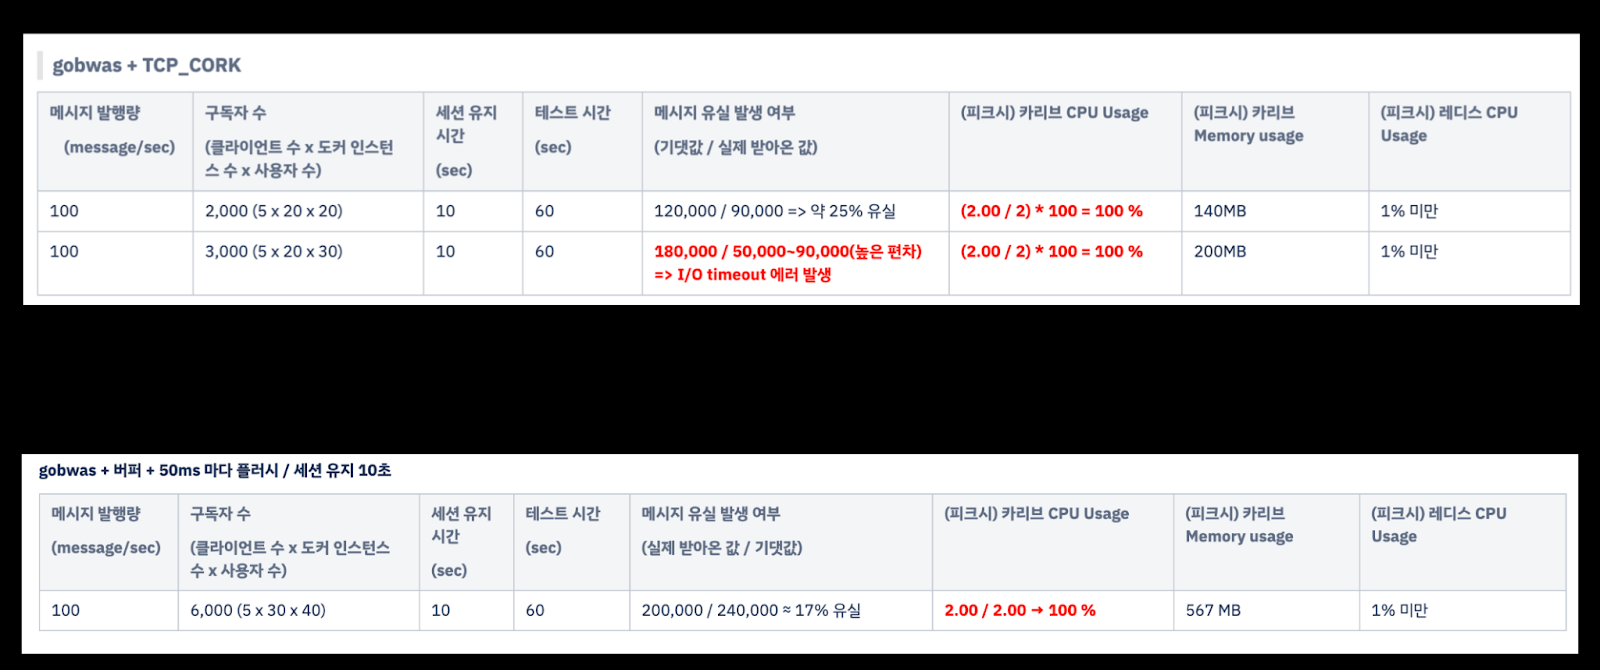
위 이미지는 TCP_CORK를 적용했을 때와, gobwas의 버퍼 기반으로 웹소켓 프레임을 버퍼링하는 기능을 활용했을 때 각각 성능 테스트의 유실이 커지는 limit 지점을 비교해 본 것입니다. 60초 동안 테스트가 진행되었고, 10초마다 세션이 끊기고 다시 연결되어 메시지를 받는 것을 반복합니다. 해당 테스트 환경을 기준으로 TCP_CORK 만 적용하였을 경우, 구독자 수가 2K 만 되어도 25%의 유실이 발생하고 있는 것을 확인할 수 있습니다. 여기서 구독자수를 3K로 더 늘릴 경우, I/O timeout이 발생하며 더 높은 유실률로 이어지죠. 이에 비해서 gobwas의 웹소켓 프레임 버퍼링 기능을 활용하였을 때는 구독자 수가 6K가 되어도 17%의 유실만 발생하고 있는 것을 확인할 수 있었습니다.
결과적으로 gobwas의 웹소켓 프레임 버퍼링 기능을 활용하는 것이 TCP_CORK를 사용하는 방식보다 더 높은 퍼포먼스를 기대할 수 있었고 저희는 해당 방식을 적용하였습니다.
io_uring 검토
I/O 연산은 여전히 시스템에서 가장 큰 부하 포인트였습니다. 이를 더 줄일 방법을 고민하던 중, 저희는 io_uring 이라는 기술에 대해 알게 되었습니다. io_uring은 리눅스에서 제공하는 최신 비동기 I/O API 입니다. 기존의 select, poll, epoll과 같은 이벤트 기반 I/O API는 대량의 I/O 작업을 처리하는 데 한계가 있었습니다. 이러한 한계는 주로 시스템 콜 오버헤드, 컨텍스트 스위칭 의 빈번한 발생, 그리고 동기적인 I/O 처리 방식에서 기인합니다. 이러한 문제를 해결하기 위해 등장한 것이 바로 io_uring입니다.
io_uring은 대량의 비동기 I/O 작업을 효율적으로 처리 할 수 있는 API로, 커널과 사용자 공간 사이에서 링 버퍼를 활용합니다. 링 버퍼는 I/O 요청과 결과를 저장하는 두 가지 주요 큐로 구성됩니다. 두 큐를 공유 메모리 형태로 사용하기 때문에, 메모리 복사 없이 데이터 전달 이 가능하며, 이를 통해 시스템 콜의 빈도를 최소화 하고 컨텍스트 스위칭 비용을 줄일 수 있습니다.
이는 아래 그림처럼 동작합니다.
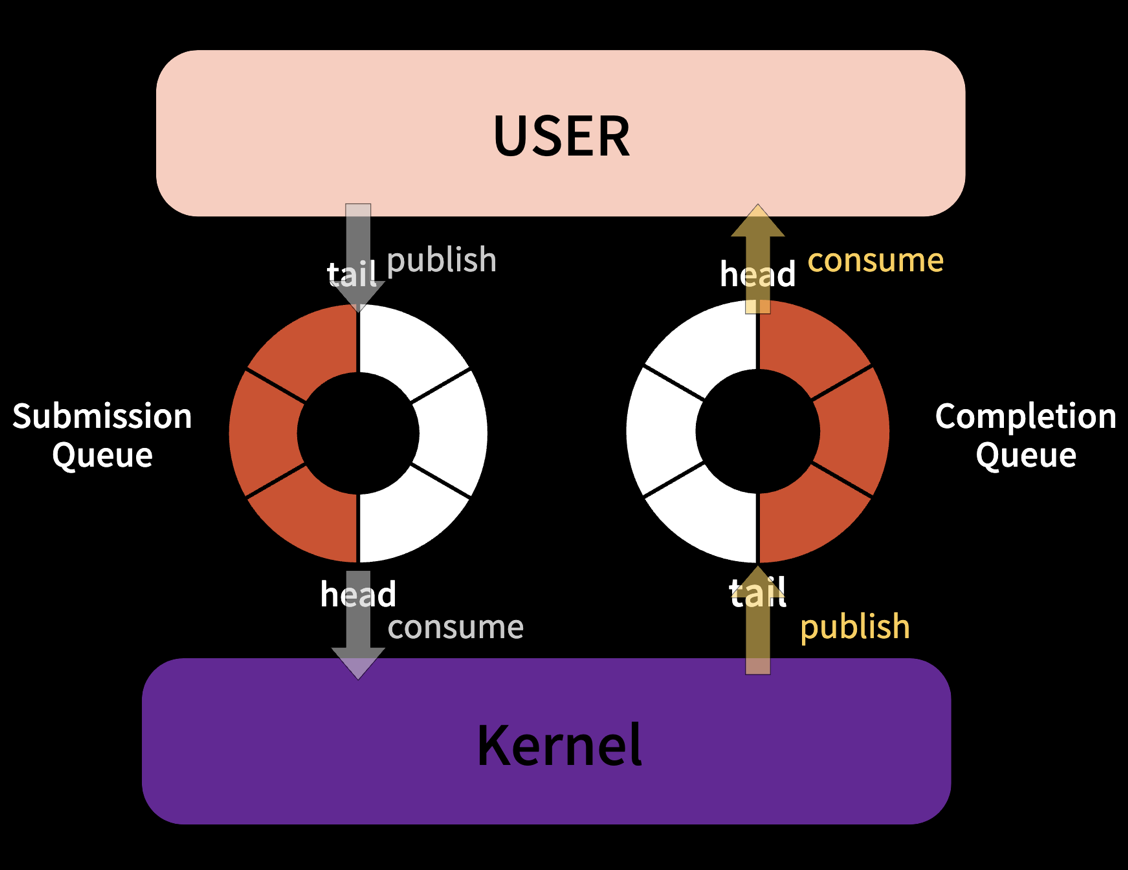
io_uring에서 I/O 요청은 2가지 주요 큐인 Submission Queue (SQ )와 Completion Queue (CQ)를 통해 처리됩니다.
1. Submission Queue(SQ)
어플리케이션은 I/O 요청을 SQ의 tail에 추가하며, 커널은 SQ의 head부터 순차적으로 요청을 처리합니다. 이 과정은 생산자-소비자 모델로 동작하며, SQ의 동기화는 커널과 어플리케이션이 공유하는 메모리 상에서 이루어집니다.
2. Completion Queue(CQ)
커널이 처리 완료된 요청은 CQ의 tail에 추가되며, 어플리케이션은 CQ의 head부터 순차적으로 결과를 소비합니다. 이를 통해 커널과 어플리케이션 간의 데이터 전달이 효율적으로 이루어집니다.
또한 io_uring의 주요 성능 최적화 중 하나로 Submission Queue Polling 기능이 있는데요. 이 기능을 활성화하면 커널은 SQ를 모니터링하는 특수 커널 스레드 를 생성합니다. 그리고 어플리케이션이 SQ의 tail에 요청을 추가하면, 커널 스레드는 이를 시스템 콜 없이 직접 감지 하고 처리합니다. 즉, 추가적인 시스템 콜 없이 요청이 처리 되므로, 성능 향상과 지연 시간 감소를 기대할 수 있습니다. 다만, 이 방식은 CPU 자원을 더 많이 소모 하기 때문에, I/O 작업의 빈도가 높은 워크로드에 적합합니다.
이는 카리브에서 충분히 검토해 보고 테스트해 볼 수 있는 스펙으로 보였습니다. 저희는 카리브에서도 적용할 수 있을지 검토를 시작하였습니다.
확인해 보니 실제로 Go 언어 내부적으로도 io_uring 적용 여부를 검토 중이었습니다. 하지만 아직 논의 단계였습니다. 이슈를 좀 확인해 보니 “고루틴들 사이에서 Ring 버퍼에 대한 접근을 조정하는 것이 걱정된다 .”, “Go 언어에서 투명하고 효율적으로 적용하여 수행하기에는 내부 구조상 어려움이 있다.” 등 바로 도입하기에는 Go 언어의 구조와 일정 부분 맞지 않는 부분, 고민이 좀 더 필요한 부분이 존재해 보였습니다. 아쉽게도 이 부분은 관련하여 자료들을 검토한 것과 iio_uring이라는 개념에 대해 알게 된 것으로 우선 만족하고, 그에 대한 적용은 보류하기로 결정하였습니다.
카리브 내부의 메시지 전달 프로세스 개선
이번 목차에서는 카리브 내 메시지 전달 과정을 다시 한번 살펴보며 성능 개선 포인트들을 발견하고 개선한 경험을 중심으로 이야기해 보겠습니다.
카리브 내부의 메시지 수신 구조체 Delivery
본격적인 내용을 시작하기 전에, 카리브 내부에서 사용하는 Delivery에 대해 간단히 소개드리겠습니다.
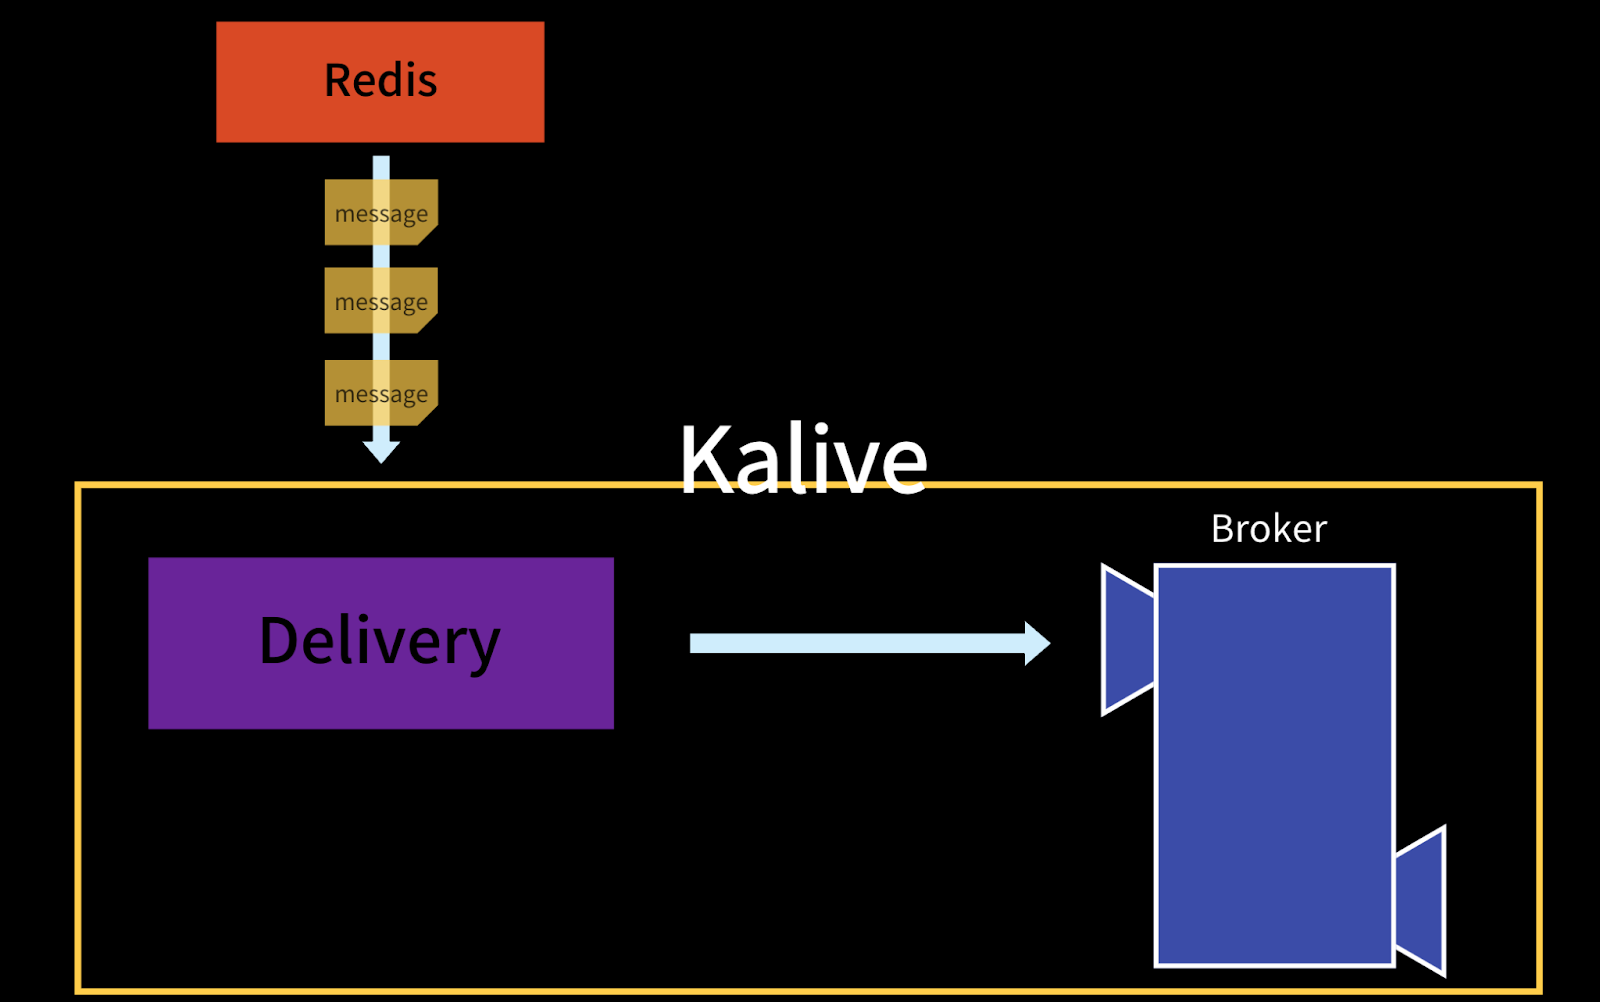
Delivery는 redis로 부터 발생한 메시지를 받아옵니다. 이것은 그저 메시지를 받아오는 역할을 하는 작은 구조체입니다. 그리고 Broker는 이 Delivery 에게 메시지를 전달 받게 됩니다. Broker는 내부적으로 각 메시지를 운송 되어야하는 채널로 보내게 됩니다. 그러면 Delivery에 대해서도 간단한 이해를 갖추었으니, 이제 본격적인 이야기를 시작해보겠습니다.
불필요한 중복된 메시지 마샬링 감소: CPU 감소량 25% 감소
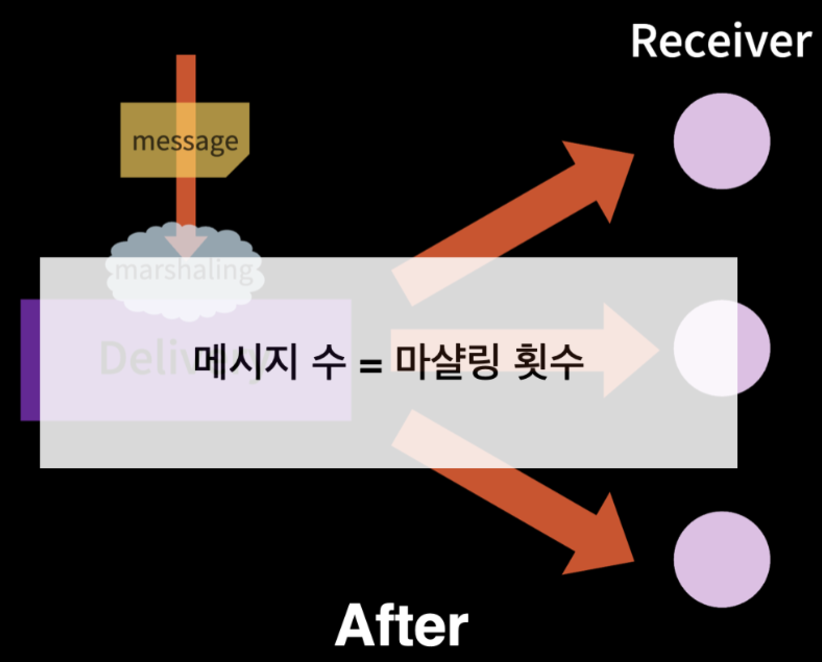
카리브는 메시지를 JSON 포맷으로 관리하는데요. 이러한 데이터의 네트워크 전송을 위해서는 마샬링 작업이 필요합니다. 이번에는 카리브에서 메시지 마샬링 횟수 를 개선한 작업에 대해 소개하겠습니다. 카리브는 기존에 각 커넥션에서 메시지를 받을 때마다 마샬링을 수행하고 있었습니다. 메시지를 받아오고 해당 메시지를 목적지에 보내기 위해 각 커넥션으로 전달하고 응답할 때 마샬링을 수행되게 됩니다. 이러한 방식은 동일 메시지에 대해서 각 커넥션 마다 마샬링을 별도로 수행하게 했습니다. 즉 아래 그림처럼 메시지수 X 수신자수 만큼의 마샬링이 발생했습니다. 이는 불필요한 중복된 마샬링이었습니다.
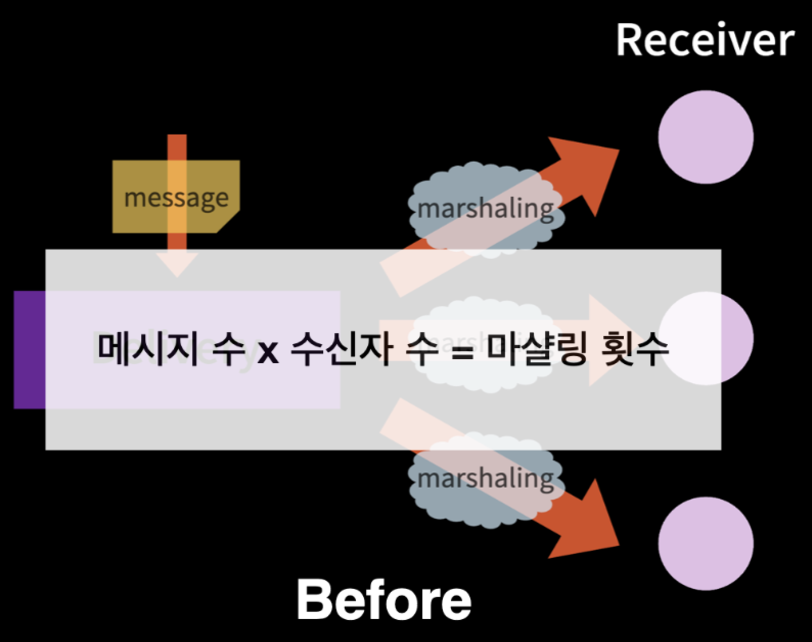
그래서 이를 개선하기 위해서 redis에서 메시지를 받아와서 전달하는 역할을 하는 delivery 쪽에서 같은 메시지에 대해서는 한 번만 마샬링 할 수 있도록 수정하였습니다.
즉 해당 메시지가 여러 곳으로 갈 수 있다고 해도, 동일 메시지에 대해서는 delivery에서 목적지로 가기 전에 미리 마샬링 될 것이고 , 해당 마샬링된 결과가 포함되어 전달 되도록 하였습니다. 이를 통해 불필요한 마샬링 횟수를 줄여 아래 그림처럼 메시지수만큼만 마샬링 하도록 수정하였습니다. 이러한 개선으로 기존 CPU 사용량의 약 25%를 감소시키는 성능 향상 효과를 확인할 수 있었습니다.
Json 라이브러리 교체: 메시지 유실률 2.5% 개선
이번엔 메시지 전달 과정 중, 사용했던 JSON 라이브러리를 개선포인트로 잡은 경험에 대해 이야기드리겠습니다. 카리브는 내부적으로 메시지 포맷을 JSON 포맷으로 관리합니다. 기존에는 Go 언어에서 이미 제공하는 표준 encoding/json도 사용함에 불편함이 없었기에 이를 이용하여 마샬링을 진행하였습니다.
하지만 더 성능을 올리고자 이 JSON 라이브러리에 따른 성능 편차도 확인이 필요하였습니다. 여러 라이브러리들을 살펴보고 더 좋은 지표를 가진 라이브러리를 리서치하기 시작하였습니다. 그렇게 go-json을 알게 되었습니다.
go-json은 README에 보인 벤치마킹 결과가 우수하여 채택하게 되었는데요. 아래 이미지는 그 결과를 캡쳐해 온 것입니다. 그리고 캡쳐 이미지에서 위는 기존 라이브러리의 결과, 아래는 go-json의 결과입니다.
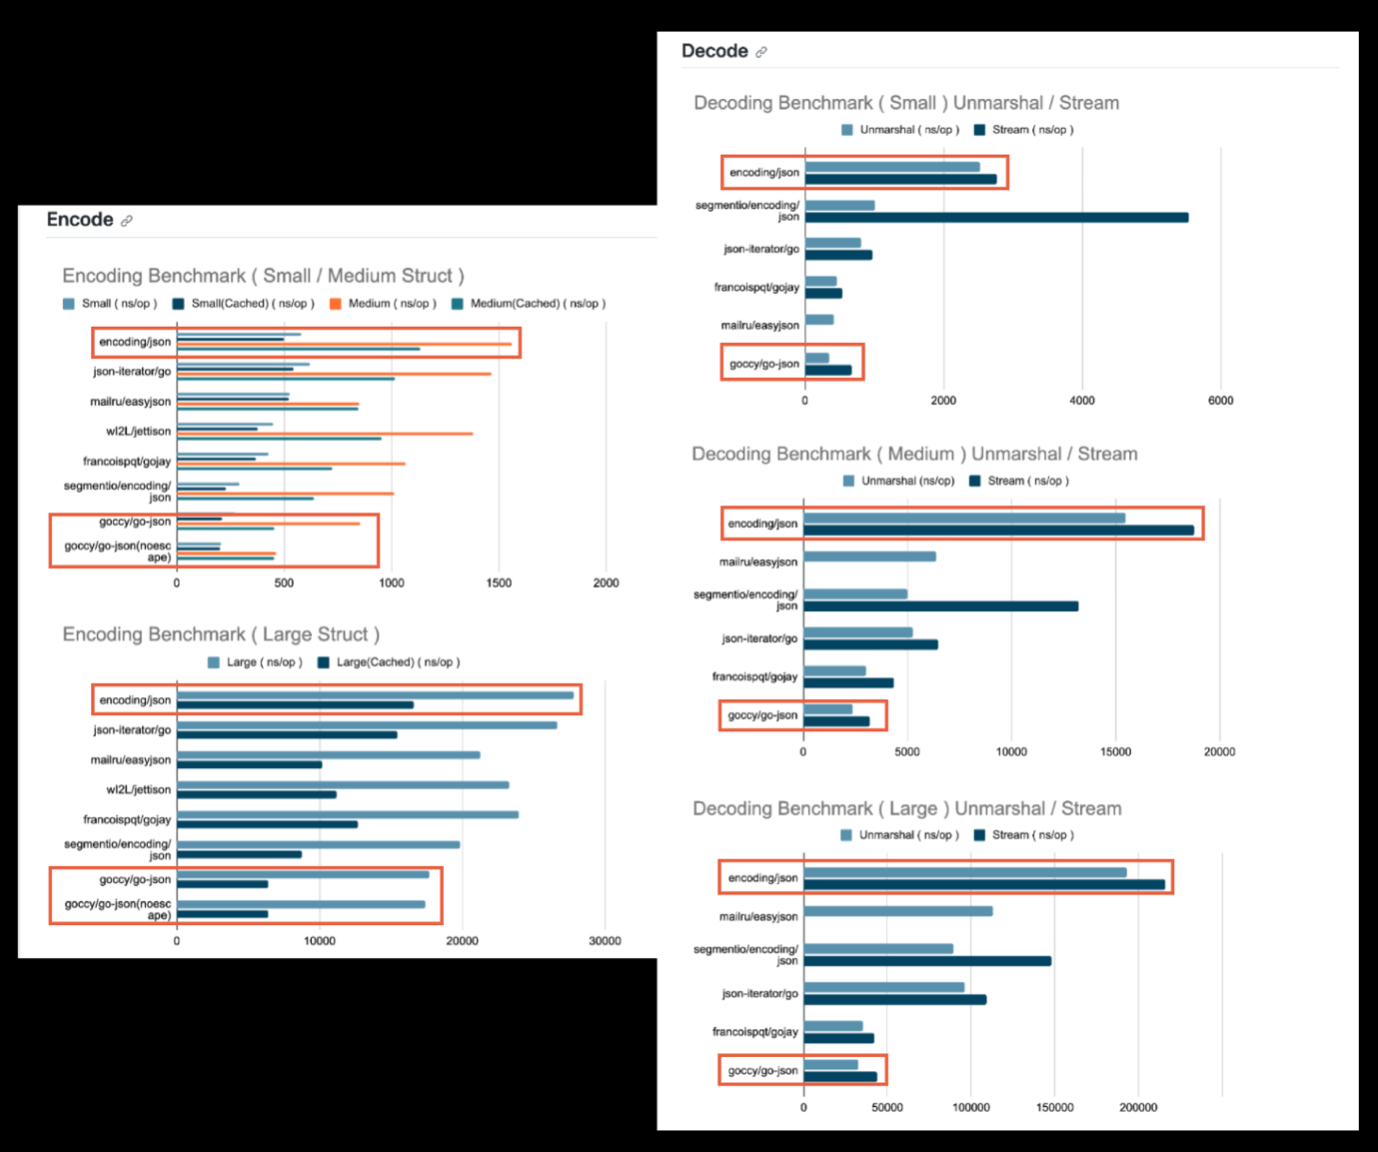
저희는 바로 go-json을 적용하고 성능 비교를 시작하였습니다. 테스트 결과 메시지 유실률에 대해서 미세한 차이가 발생하였습니다. 기존보다 약 메시지 유실률이 2.5% 정도 개선된 결과를 확인할 수 있었고, 이러한 부분들도 작지만 성능 향상이 가능한 부분이라는 것을 알 수 있었습니다.
스케줄링 확률 증가: 메시지 유실률 60% 감소
이후, 메시지 전달 과정에서 더 이상 성능 향상 포인트를 찾아낼 수는 없을까 고민하던 저희는 pprof를 통해, 레디스에서 메시지를 가져와서 내부 채널들에 전달해 주는 delivery에 병목이 있음을 발견할 수 있었습니다.
우선 왜 병목이 발생하였는지를 파악하는 게 중요했었는데요. 저희는 고민 끝에 “delivery를 실행하는 고루틴이 예상보다 적게 스케줄링되어 병목이 생긴 것은 아닐까?” 하는 가정을 세우게 되었습니다.
기존 코드를 살펴보면, delivery가 레디스(redis)에서 메시지를 가져올 때마다 채널로 보내고, 콜백함수를 실행하는 flow로 수행되게 됩니다.
for _, msg := range stream.Messages {
	m.messageChan <- message.NewMessage(
	// ...
	)
}

// ...

select {
case m:= <- messageChan:
	messageHandler(m)
// ...
}
저희는 이러한 flow를 아래 코드와 같이 수정해 보았습니다. delivery에서 메시지를 모아서 채널로 보내고, 콜백 함수를 고루틴으로 띄워서 실행 하도록 하였습니다. 이러한 로직 개선으로 메시지 유실률을 기존 대비 약 60% 정도 개선 할 수 있었습니다. 기존 방식은 하나의 고루틴을 사용하게 되면서 고스케줄러에 의해 스케줄링되어 실행되는 시간이 적었지만, 이후 방식으로 메시지의 묶음들에 콜백함수 처리를 각각의 고루틴들이 맡도록 하면서, 좀 더 메시지 전달에 대한 로직이 스케줄링되어 실행되는 시간이 늘어나서 성능이 향상된 것으로 추측하고 있습니다.
for _, msg := range stream.Messages {
	messages = append(messages, message.NewMessage(
	// ...
	))
}

m.messageChan <- messages

// ...
select {
case m:= <- messageChan:
	go messageHandler(m)
// ...
}
저희는 이러한 경험을 하며, 고 스케줄러는 매우 훌륭하지만 특정 고루틴에 스케줄링이 우선되었으면 하거나, 항상 상주했으면 하는 고루틴이 존재할 경우에는 아쉬운 상황이 발생하기도 한다는 것을 느꼈습니다. 그리고 고성능을 추구하면 추구할수록 이 부분에 대해서는 더 많은 이해가 필요하다는 것을 느꼈습니다.
Go Story
이제 마지막으로 Go 언어와 관련되어 발견한 성능 개선 포인트와 알게 된 부분 대해서 말씀드리겠습니다.
Heap Escape
Heap Escape부터 설명드려보겠습니다. Go 언어는 동적 할당을 위해 전역 힙과 각 고루틴의 스택 메모리에 메모리를 할당 합니다. 일반적으로, CPU 명령인 push, pop만 사용하면 되는 스택 할당은 비용이 훨씬 적습니다. 스택 할당은 단순히 포인터를 증가시키거나 감소시키는 방식으로 이루어져 빠르고 오버헤드가 적습니다. 반면, 힙 할당은 적절한 크기의 빈 공간을 찾아야 하고, 할당된 메모리에 대한 메타데이터를 관리하는 추가적인 작업이 필요하여 비용이 더 높습니다. 스택 할당을 위해서는 컴파일러가 변수의 수명과 메모리 사용량을 컴파일 시점에 분석할 수 있어야 합니다.
이때 컴파일러는 스택/힙 어디에 할당할지 결정하기 위해 escape analysis라는 기술을 사용하게 됩니다. 이를 통해 변수의 스코프를 추적하고, 런타임에서의 수명을 알 수 있는지 확인합니다. 그리고 수명(라이프사이클)을 알 수 없는 경우 힙에 할당합니다.
이 Heap Escape는 아래의 경우에서 자주 발생합니다.
1. Go 채널에 포인터 혹은 포인터를 포함한 값을 전송하는 경우
2. 슬라이스에 포인터 혹은 포인터를 포함한 값을 저장하는 경우
3. 인터페이스 메서드를 호출하는 경우
4. Slice에 지정한 capacity를 초과하는 경우
여기서 포인터는 힙에 할당된 데이터를 가리키는 데 사용됩니다. 값을 복사하는 cost를 고려하여 포인터를 사용하려 하는 경우가 있는데, 이 Heap Esacpe의 발생으로 인해, 포인터를 사용하는 것이 더 많은 비용이 들 수 있습니다.
카리브에서도 Heap Escape가 많이 발생할만한 포인트가 존재했습니다. 카리브는 각 커넥션에 메시지를 전달할 때, 내부적으로 Go 언어의 채널을 사용했습니다. 그리고 채널에 메시지의 포인터를 넘겨주어 전달하였습니다. 그러나 채널에 포인터를 전달할 경우, 힙이스케이프가 발생할 것이고, 이는 성능 저하를 초래할 수 있었습니다.
그래서 저희는 메시지를 포인터가 아닌 값으로써 전달하도록 수정했습니다. 그리고 테스트를 진행하였습니다. 이외로 카리브의 경우에는, 테스트 결과 오히려 채널에 포인터로 보내는 것이 더 좋은 지표를 보였습니다. 엄청난 양의 메시지가 매번 전달될 때마다 복사되는 것보다 Heap Escape로 인한 코스트가 저렴한 것이었습니다.
결과적으로 성능 테스트 후, 힙이스케이프라는 개념을 알게 되었지만 cost 비교 결과, 현재 방식을 유지하는 것이 더 최선이라 판단되어 이 부분은 기존처럼 메시지의 포인터를 채널을 통해 전달하는 방식을 유지하였습니다. 이를 통해 저희는 Heap Escape를 피하는 것이 무조건 성능 향상을 야기하지는 않는다는 것을 알게 되었고, 오히려 특정 케이스에 따라서는 불필요한 복사를 없애는 것이 더 성능 향상에 도움을 주기도 한다는 것을 알게 되었습니다.
Zero Allocation
이번엔 Zero Allocation에 대해 말씀드리겠습니다. Zero Allocation은 Go 언어에서 메모리 할당을 최소화하고 성능을 향상하는 방법 중 하나입니다. 앞에 Heap Escape 에서 설명했듯이 Go 언어는 메모리를 할당할 때, 스택영역과 힙영역을 결정하게 됩니다. Go 언어 escape analysis 기술을 사용해 이를 결정합니다.
여기서 Zero Allocation은 Go 언어의 벤치마크 테스트에서 ‘allocs/op’ 지표가 0임을 의미 합니다. Go 언어는 언어 차원에서 벤치마크 테스트를 지원하며, 그중 ‘allocs/op’ 지표는 특정 연산을 수행할 때 발생하는 평균 메모리 할당 횟수 를 나타냅니다. 이 수치를 줄이는 것이 중요한 이유는 힙 할당이 많아질수록 GC(Garbage Collection) 오버헤드가 증가하여 프로그램의 성능에 부정적인 영향을 미칠 수 있기 때문입니다. 따라서 힙 영역에 메모리 할당을 줄이는 것이 성능 최적화에 도움이 될 수 있습니다.
Zero allocation을 실현하기 위해서는 런타임에 메모리를 할당하는 대신, 미리 할당된 메모리를 재사용하거나 스택 메모리처럼 빠르게 할당되고 해제될 수 있는 메모리를 사용하는 방식을 적용해야 합니다. 이러한 접근법은 GC의 개입을 최소화하여 성능을 향상할 수 있습니다.
func BenchmarkHighAllocation(b *testing.B) {
	for i := 0; i < b.N; i++ {
		var s []int
		for j:= 0; j < 100; j++ {
			s.append(s,j)
		}
	}
}

func BenchmarkZeroAllocation(b *testing.B) {
	var arr [100]int
	for i := 0; i < b.N; i++ {
		for j := 0; j < 100; j++ {
			arr[j] = j
		}
	}
}
위 이미지는 제가 간단히 작성한 Zero Allocation에 대한 예시 코드입니다. 0~ 99까지의 숫자를 저장하는 단순한 코드입니다. 더 명시적인 비교를 위해 위에는 메모리 할당이 자주 일어나도록 작성한 코드이고, 아래는 동일한 동작을 하는 코드를 Zero Allocation이 일어나도록 수정한 코드입니다. 참고로 Go 언어 벤치마크 테스트는 기본적으로 함수를 여러 번 반복 실행하며 그 결과를 측정하는데, 위의 N은 그 반복 횟수를 나타냅니다. 해당 코드에서는 크게 신경 쓰지 않아도 괜찮을 것 같습니다.
각 코드의 가장 큰 차이점은 아래 코드는 이미 컴파일 타임 때 arr의 크기가 결정된다는 것입니다. 그리고 그 메모리를 모든 벤치마크 테스트에서 재사용하면서 Zero Allocation이 일어나도록 하고 있습니다. 이에 대한 결과 지표는 아래와 같습니다.
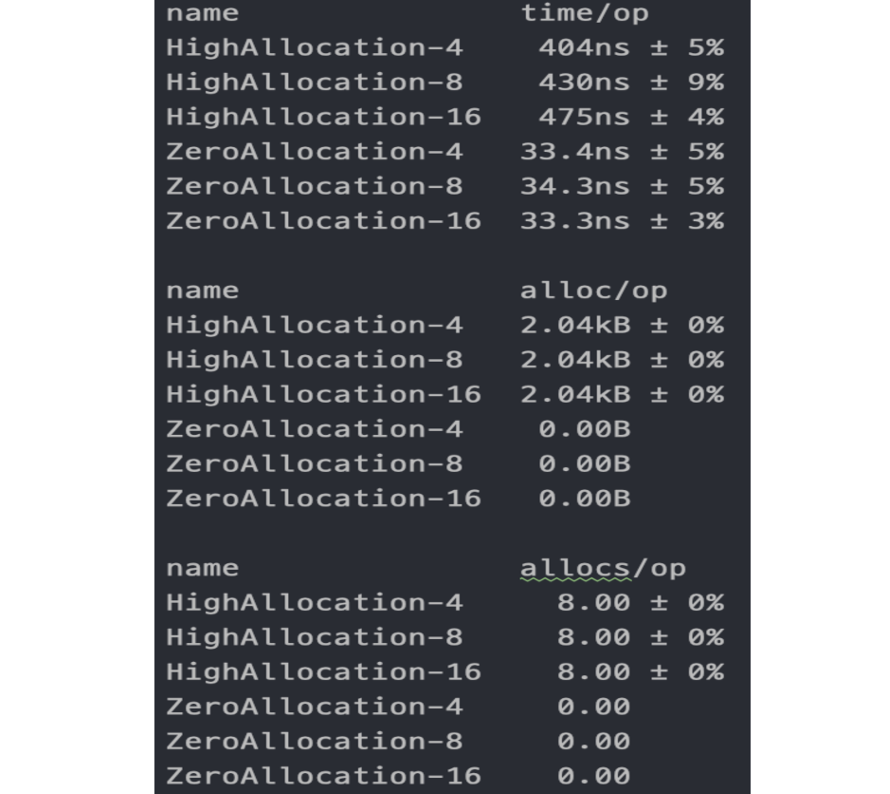
지표 각각의 의미는 아래와 같습니다.
- time/op: 평균 단위 작업 시간. 각 반복에서 수행된 작업의 평균 시간을 나노초로 표시한 것. 낮을수록 더 빠른 성능을 의미.
- alloc/op: 각 반복에서의 할당된 바이트 수. 작업을 수행하면서 발생하는 메모리 할당 양을 바이트 단위로 표시.
- allocs/op: 각 반복에서의 할당 횟수. 작업을 수행하면서 메모리 할당이 얼마나 발생하는지를 의미.
이번 글에서 가장 핵심이 되는 "allocs/op"인, 메모리 할당수를 확인해 보면 위의 코드에 비해 아래의 코드는 0, 즉 Zero Allocation이 실제로 일어난 것을 확인할 수 있습니다.
여기서 추가적으로 알면 도움이 되는 부분이 존재하는데요. slice의 Zero Allocation에 대해 설명을 드리겠습니다.
Go 언어의 slice가 heap에 저장될 것이냐 stack에 저장될 것이냐는 특정 조건에 따라서 결정되는데요.
1. 슬라이스의 크기가 결정되고, 슬라이스의 크기가 64kb 이하일 때, stack에 저장
2. 함수에 의해 반환될 경우, heap에 저장
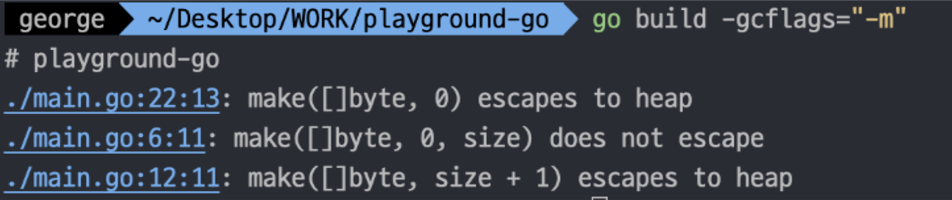
각각 정말로 그러한지 heap escape 유무와 벤치마크 테스트 결과를 확인해 보겠습니다.
const size = 64 * 1024 // 64kb

func main() {
	u := make([]byte, 0, size) // Does not escape to heap
	_ = u

	test := returnSlice()
	_ = test

	v := make([]byte, size + 1) // Escape to heap = 64kb
	_ = v
}

// 작은 함수는 inline 이 발생
// 강제로 inline 을 막음
// inline 될 경우 escape 되지 않음
//
//go:noinline
func returnSlice() []byte {
	return make([]byte, 0)
}
const size = 64 * 1024 // 64KB

func Benchmark_Slice_EqualOrLess64KB(b *testing.B) {
	for i := 0; i < b.N; i++ {
		dataLarge := make([]byte, size)
		_ = dataLarge
	}
}

func Benchmark_Slice_EqualOrLess64KB_len0(b *testing.B) {
	for i := 0; i < b.N; i++ {
		dataLarge := make([]byte, 0, size)
		_ = dataLarge
	}
}

func Benchmark_Return_Slice_EqualOrLess64KB_len0(b *testing.B) {
	for i := 0; i < b.N; i++ {
		dataLarge := dataLargeSlice()
		_ = dataLarge
	}
}

//go:noinline
func dataLargeSlice() []byte {
	return make([]byte, 0, size)
}

func Benchmark_Slice_LargerThan64KB(b *testing.B) {
	for i := 0; i < b.N; i++ {
		dataLarge := make([]byte, size + 1)
		_ = dataLarge
	}
}

func Benchmark_Slice_LargerThan64KB_len0(b *testing.B) {
	for i := 0; i < b.N; i++ {
		dataLarge := make([]byte, 0, size + 1)
		_ = dataLarge
	}
}
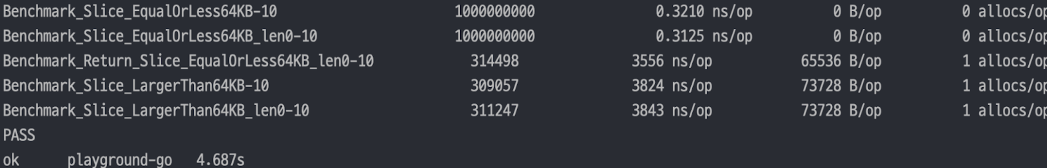
각각의 결과를 확인해 보면 1,2번이 검증됨을 알 수 있습니다.
이러한 특징과 더불어서 slice의 append를 사용할 때, 인지하고 있으면 좋은 부분이 있는데요. 바로 slice는 append 할 때, capacity 가 부족할 경우, 2배씩 늘리면서 append 한다는 것입니다. 아래 벤치마크 테스트 결과를 확인해 보겠습니다.
const size = 8192 // int 자료형을 사용하기에 8192 로 설정

func Benchmark_Zero_Cap_Append(b *testing.B) {
	for i := 0; i < b.N; i++ {
		data := make([]int, 0)
		for j := 0; j < size; j++ {
			data = append(data, j)
		}
	}
}

func Benchmark_Return_Append(b *testing.B) {
	for i := 0; i < b.N; i++ {
		data := Append()
		_ = data
	}
}

//go:noinline
func Append() []int {
	data := make([]int, 0, size)
	for j := 0; j < size; j++ {
		data = append(data, j)
	}
	return data
}

func Benchmark_Size_Len_Append_EqualOrLess8192(b *testing.B) {
	for i := 0; i < b.N; i++ {
		data := make([]int, size)
		data = data[:0]
		for j := 0; j < size; j++ {
			data = append(data, j)
		}
	}
}

func Benchmark_Size_Cap_Append_EqualOrLess8192(b *testing.B) {
	for i := 0; i < b.N; i++ {
		data := make([]int, 0, size)
		for j := 0; j < size; j++ {
			data = append(data, j)
		}
	}
}

func Benchmark_Size_Cap_Append_LargerThan8192(b *testing.B) {
	for i := 0; i < b.N; i++ {
		data := make([]int, 0, size+1)
		for j := 0; j < size; j++ {
			data = append(data, j)
		}
	}
}

각각의 결과를 보면 1,2번의 검증뿐만 아니라 추가적으로 capacity를 0 으로 할 경우, capacity를 2배씩 늘리는 slice 이기에 allocation이 많이 발생할 확률이 높아짐 을 알 수 있습니다. 그렇기에 가능하다면 capacity를 미리 설정하는 것이 좋겠죠. 또한 지표를 보면 heap allocation 보다 stack에서 사용하는 것(Zero Allocation)이 더 성능상 좋은 지표를 보이는 것을 알 수 있습니다. 마지막으로 heap escape에 대한 기준이 64KB가 된 것은 golang 1.17 버전부터 이니 참고 부탁드리겠습니다. (이 개념과 test code는 sam.photo 크루의 도움을 받았습니다. 너무 감사합니다 🙇🏻♂️)
이러한 개념을 학습하고 테스트해 보았지만, 현 카리브 코드 내에서는 아쉽게도 크게 관련하여 개선점을 찾지 못하여, 이 부분도 개념을 아는 것에 만족하고 추후 적용할 포인트가 생길 경우 적용해 보기로 하였습니다.
Go 언어를 사용하며…
마지막으로 저희가 Go 언어를 사용하여 실시간 메시지 서비스를 개발하고 개선하며 느낀 점에 대해 말씀드리겠습니다.
아래 2가지 문장은 git 이슈에서 사람들이 토론하다가 나온 내용 중, 공감되어 가져온 부분입니다.
1. “나는 우리가 현재 go언어를 사용함으로써 높은 성능과 대량의 동접을 모두 얻을 수는 없다고 생각합니다.”
2. “간단하고 사용하기 쉬우며 성능도 나쁘지 않습니다.”
저희도 Go 언어를 사용하며 내린 결론은 발표 자료에 나온 대로 “Go언어는 쉬운 사용성을 가지고 좋은 성능의 어플리케이션을 만들 수 있는 언어 ”라는 것이었습니다. 보통 비동기 방식의 콜백 함수를 기반으로 하는 프로그래밍 방식은 사람들의 선형 사고와는 일치하지 않습니다. 하지만 Go 언어는 이를 고루틴과 채널을 이용해 최대한 단순하게 풀어냈다고 생각 합니다. 또한 그로 인해 사용성도 높아졌습니다. Go 언어는 단순성과 사용 용이성을 고려할 뿐만 아니라 쓰레드 전환의 손실을 최대한 방지하도록 설계된 좋은 언어라고 느꼈습니다.
다만, 저희처럼 성능이 중요한 실시간 메시징 서비스를 개발하거나 대량의 커넥션이 발생할 수밖에 없는 시스템의 경우, 고루틴에 의해 메모리 비용이 급격히 증가하게 되는데 이를 해결하기 위해서는 GO 언어에 대한 더 높은 이해도가 필요해 보였습니다.
Go 언어의 표준라이브러리인 net.Conn을 사용하는 std 기반 프레임워크의 경우, 모두 연결당 하나 이상의 고루틴을 사용하게 됩니다. 즉, 연결 수가 증가함에 따라 하드웨어 비용이 빠르게 증가한다는 단점이 존재하였습니다. 또 스케줄링에 대한 비용을 줄이거나, 특정 고루틴이 스케줄링이 우선되도록 하는 등 좀 더 스케줄링 관련하여 미세하게 컨트롤하기에는 쉽지 않다는 단점도 있었습니다.
물론 Go 언어는 좋은 언어이고, 쉬운 언어지만 더 높은 성능, 효율성을 추구하기에는 Go 언어 자체, 고루틴의 스케쥴링 등에 대한 더 높은 이해도가 선행되어야 한다고 느꼈습니다.
마치며
많은 시행착오를 겪으며 실시간 메시징 시스템인 “카리브 v2”의 개발과 성능 개선을 마무리하였습니다. 입사 후 처음 접한 Go 언어를 이용하여 실시간 메시징 시스템을 개발하는 것은 도전적이였지만, 지금 돌이켜보면 그래서 더욱 많이 부딪히고, 많은 것을 배울 수 있었던 것 같습니다. 다양한 기술을 리서치하고 적용하는 과정에서 개발자로서 값진 경험을 할 수 있었습니다.
현재는 v2 프로젝트가 종료된 후, v3를 배포하며 여러 기능들을 추가하고 있습니다. 앞으로도 더 나은 성능과 안정성, 사용성을 위해 꾸준히 노력하겠습니다. 이 시리즈가 실시간 메시징 시스템 개발에 관심이 있는 분들께 조금이나마 도움이 되는 글이 되었으면 좋겠습니다. 감사합니다.
참고문서
[1] https://baus.net/on-tcp_cork/
[2] https://kernel.dk/io_uring.pdf
[3] https://developers.redhat.com/articles/2023/04/12/why-you-should-use-iouring-network-io
[4] https://unixism.net/loti/tutorial/sq_poll.html
[5] https://github.com/goccy/go-json
[6] https://segment.com/blog/allocation-efficiency-in-high-performance-go-services/
관련 글 목록
Written by George.5
Edited by Marron.b