Backend
공통 Kafka 전환기 [Part 1. 공통 Kafka 전환 배경 및 전략]
Sofie여기어때
2024년 11월 5일
원문에서 보기 ↗안녕하세요. 여기어때컴퍼니 공통플랫폼개발팀 데이터 엔지니어 소피입니다.
이번에 다룰 주제는 분산된 시스템 간에 필요한 데이터를 효과적으로 관리하는 Kafka 입니다. 기존 여기어때 서비스에서는 각 도메인 개발팀이 여기어때 서비스에서 생산되는 데이터의 정의와 흐름을 체계적으로 관리하기 위해 자체적으로 Kafka Cluster를 관리하고 운영하고 있었습니다. 공통플랫폼개발팀에서는 인프라 자원 및 운영의 효율성까지 고려하여 모든 도메인 개발팀이 사용할 수 있는 하나의 공통 Kafka Cluster로 전환하는 계획을 세우게 되었습니다. 공통 Kafka로 전환함으로써 인프라 비용을 절감하고 운영 효율성을 극대화하여 모든 도메인 팀이 표준화된 환경에서 개발할 수 있도록 하는 것을 목표로 하고 있습니다.
본 글에서는 공통 Kafka로의 전환 배경과 이를 통해 기대할 수 있는 효과, 그리고 운영 방향성에 대해 공유드리고자 합니다.
1장. 공통 Kafka 전환 배경: AS-IS Kafka Cluster 운영 방식
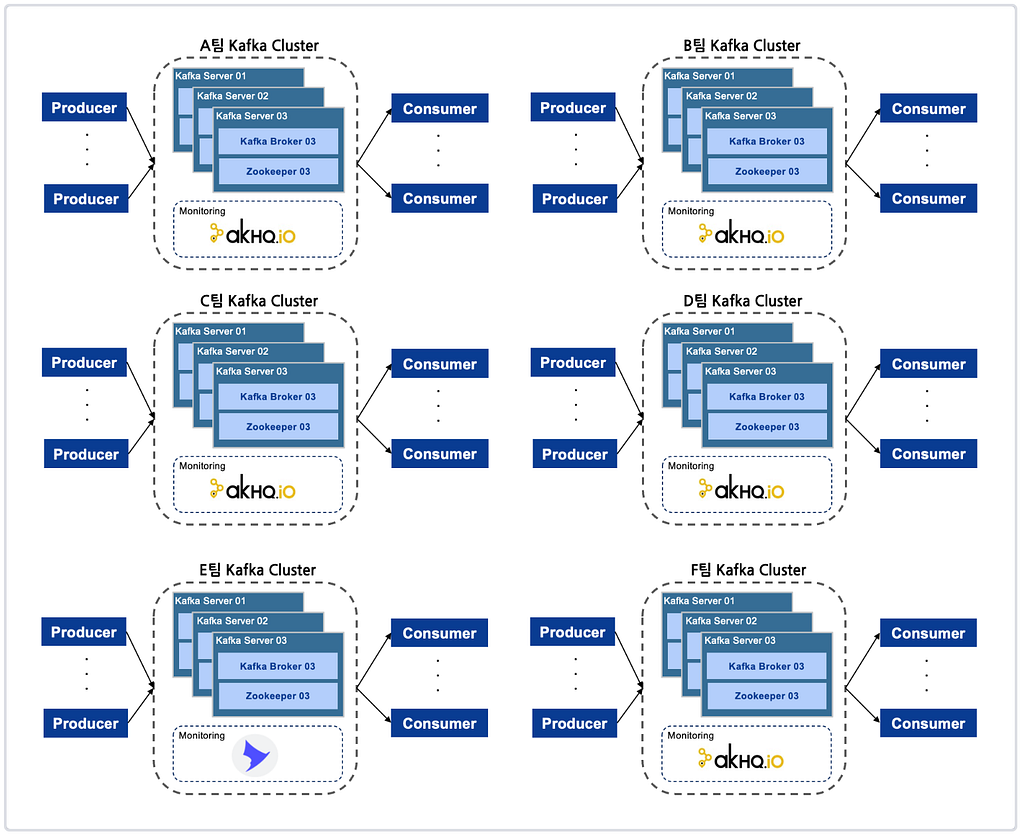
AS-IS Kafka Cluster
기존에 운영되던 AS-IS Kafka Cluster 운영 방식에 대해 살펴보겠습니다.
- 기존 각 도메인 개발팀에서 필요에 따라 자체적으로 Kafka Cluster를 생성 및 운영하고 있습니다.
- 각 도메인 개발팀의 Kafka Cluster 운영자는 개발팀의 요청에 따라 Kafka 계정/토픽 생성 및 권한 부여 작업을 진행합니다.
- 개발자들은 구독하고자 하는 토픽이 있을 시 해당 도메인 개발팀에게 요청하고 Cluster 별 토픽을 Consume 합니다. (하나의 개발팀에서 A팀 Kafka Cluster의 토픽과 B팀의 Kafka Cluster의 토픽을 Consume 하는 경우 다수 존재)
- 각 도메인 개발팀의 Kafka Cluster 운영자는 별도의 모니터링 서버를 구축하여 해당 팀의 토픽과 브로커를 모니터링합니다.
도메인 개발팀별로 Kafka Cluster를 개별적으로 운영하던 방식은 각 팀의 특정 요구 사항에 맞춰 유연하게 Kafka Cluster를 구성할 수 있고 자체적으로 Kafka Cluster를 운영함으로써 다른 팀과의 의존성 없이 독립적으로 관리할 수 있습니다.
이처럼 도메인 개발팀에서 Kafka Cluster를 개별적으로 운영하는 방식에는 여러 장점이 있을 수 있지만 시간이 지남에 따라 다음과 같은 문제점이 발생할 수 있습니다.
- 불필요한 인프라 비용 증가
- 도메인 개발팀이 개별적으로 Cluster를 관리하면서 미사용 리소스가 발생하거나 사용 빈도가 낮은 토픽을 위해서도 각 환경(개발/스테이징/상용)마다 별도의 Cluster를 유지해야 하기 때문에 비효율적인 자원 사용이 발생할 수 있습니다.
- 운영 비효율성
- 도메인 개발팀이 자체적으로 Cluster를 관리하다 보니 각 Cluster에 대해 별도로 유지 보수 및 모니터링 등을 수행해야 했으며, 이 과정에서 각 팀 별 운영 인력이 필요하게 됩니다.
- 일관성 및 표준화 부족
- 도메인 별 Cluster 운영 시, 전사적으로 표준화된 구성(e.g. Kafka 버전, 메타데이터 관리 모드, 인증 방식 등)을 적용하는 것이 어렵고 모니터링 방식 또한 팀 별 상이하게 구성됩니다.
이러한 이유로 리소스 비용과 운영 효율성을 고려하여 모든 도메인 팀이 사용할 수 있는 하나의 공통 Kafka Cluster로 전환이 필요하게 되었습니다.
2장. TO-BE 공통 Kafka Cluster 구성
공통 Kafka에서는 두 개의 Kafka Cluster로 통합하여 관리합니다.
- Kafka Cluster 1 : 기존에 각 도메인 개발팀에서 개별적으로 운영되던 Kafka Cluster를 한 개의 공통 Kafka로 통합하여 운영됩니다. 주로 도메인의 주요 애플리케이션 데이터 스트리밍에 사용됩니다.
- Kafka Cluster 2 : 데이터, 로그 표준과 공통 개발 환경을 제공하는 Cluster입니다. 주로 로그성 데이터와 Queue 데이터 스트리밍에 사용됩니다.
이 글에서는 공통 Kafka 전환 대상 Cluster인 Kafka Cluster 1에 대해 다루겠습니다. 아래는 TO-BE 공통 Kafka 아키텍처 플로우입니다.
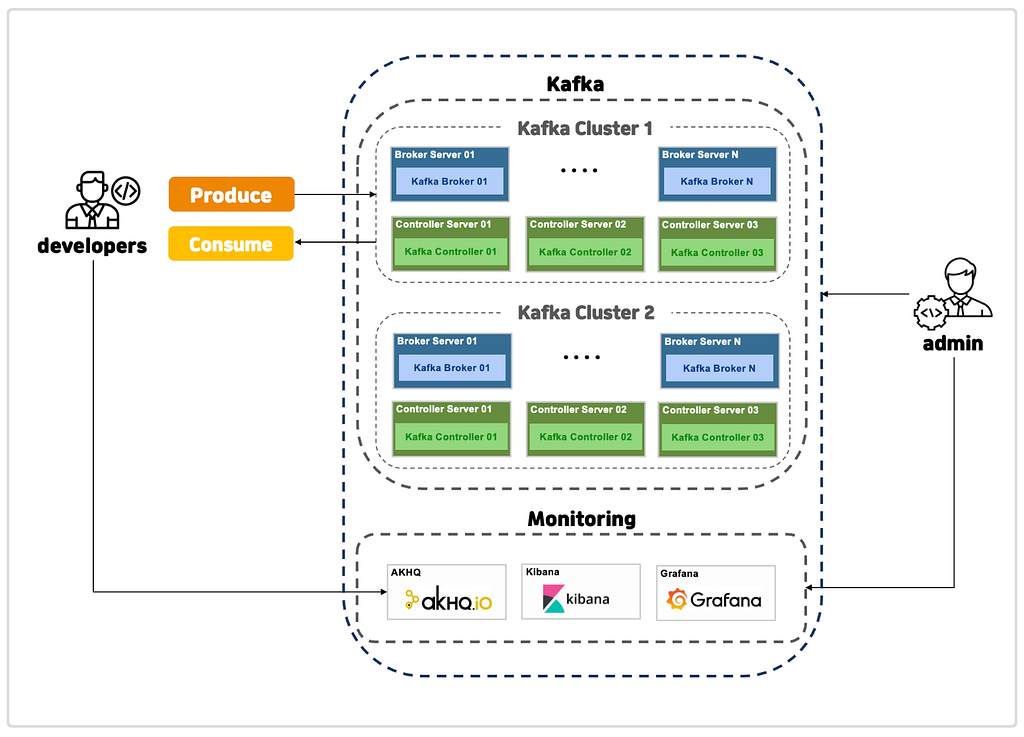
TO-BE 공통 Kafka Architecture
- 관리자(운영자)는 Kafka Cluster를 관리하고 개발자의 요청에 따라 계정 및 토픽 생성과 권한 부여 작업을 진행합니다.
- 개발팀에서 공통 Kafka Cluster에 접근하여 권한이 부여된 토픽에 데이터(메시지)를 Produce 및 Consume 합니다.
- 개발팀은 AKHQ를 통해 Kafka 토픽의 상태를 실시간으로 모니터링할 수 있습니다.
- 관리자(운영자)는 공통 Kafka Cluster의 운영을 위해 모니터링 툴 (AKHQ, Grafana)를 통해 모니터링하고 브로커 혹은 컨트롤러 서버에 이상이 있을 경우 Slack Alert를 통해 즉각 조치하게 됩니다.
공통 Kafka 전환을 통해 얻을 수 있는 기대효과는 다음과 같습니다.
- 리소스 최적화 및 비용 절감
- 각 도메인 팀에서 관리하던 리소스들을 하나의 Cluster에 통합하여 관리함으로써 인프라 비용을 절감할 수 있습니다.
- 운영 효율성 향상
- 공통 Kafka Cluster를 통해 운영 관리가 중앙 집중화되어 Kafka 설정, 인증 구성 그리고 모니터링 구성 등이 표준화되어 관리자(운영자)는 일관된 방식으로 운영하게 됩니다.
3) 개발자 생산성 향상
- 기존 각 팀 별 필요했던 운영 인력을 하나의 팀에서 관리함으로써 서비스 팀에서는 운영 리소스를 줄이고 개발자 팀은 메시지 Produce, Consume 부분에만 집중하여 업무 생산성이 개선됩니다.
3장. 공통 Kafka 전환 전략 및 운영 방안
3장에서는 도메인 팀이 개별적으로 운영하던 Kafka Cluster를 하나의 공통 Kafka Cluster로 전환하기 위해 고려했던 전략과 운영 방안을 다루겠습니다.
1️⃣ 최신 Kafka 버전 및 KRaft 모드 도입
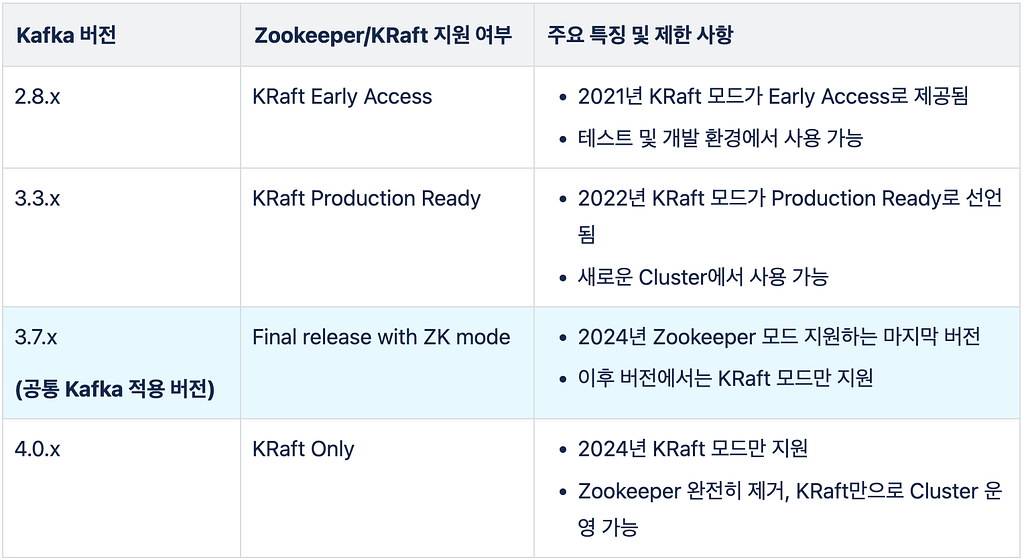
기존 도메인 별 Kafka Cluster는 다양한 버전으로 운영되고 있었습니다. 이로 인해 호환성 문제와 신규 기능 사용 제한이 발생할 수 있기에 공통 Kafka Cluster는 Kafka 3.7.0 버전으로 통합 구축하였습니다.
Kafka 3.7.0 버전은 최신 기능 제공뿐 아니라 안정성 측면에서도 이전 버전에 비해 크게 개선되었습니다. 특히, KRaft 모드를 완전하게 지원하며 Zookeeper와의 의존성을 제거함으로써 Cluster 관리의 복잡성을 줄이는 데 중요한 역할을 합니다.
위의 표에서 확인하실 수 있듯이 Kafka 3.3.x부터 KRaft 모드는 프로덕션 환경에서 사용 가능해졌으며 Kafka 4.0.x부터는 Zookeeper의 사용이 완전히 제한되어 KRaft 모드만 지원됩니다.
공통 Kafka 운영 시 버전 업그레이드 정책을 수립하여 최신 메이저 버전에 대한 주기적인 테스트와 업그레이드를 통해 안정성과 성능을 균형 있게 관리할 것입니다.
2️⃣ 용도별 Kafka Cluster 분리 운영
공통 Kafka는 용도에 따라 두 개의 Cluster로 구분하여 운영하는 전략을 채택했습니다. 첫 번째 Cluster는 모든 도메인 팀이 공통으로 사용하는 Cluster로 도메인의 주요 애플리케이션 데이터 스트리밍에 사용됩니다. 두 번째 Cluster는 데이터, 로그 표준과 공통 개발 환경을 제공하는 Cluster로 주로 로그성 데이터와 Queue 데이터 스트리밍에 사용됩니다. 공통 Kafka Cluster로의 전환은 도메인 별 분산되어 운영되던 Kafka 토픽을 하나의 Cluster에서 통합 운영하는 것을 의미합니다. 이에 따라 데이터가 중앙 집중화되며 대용량 처리에 대한 대비가 필요했기에, 이러한 구분은 각 Cluster의 특성에 맞는 리소스를 배분하고 각자의 역할에 최적화된 환경을 제공합니다.
3️⃣ SASL/SCRAM 인증 방식 적용
도메인 별 Kafka Cluster는 각기 다른 인증 방식과 보안 설정을 사용했기 때문에 통합된 공통 Kafka Cluster에서는 일관되면서도 강화된 보안 체계를 구축이 필요했습니다. 이를 위해 공통 Kafka Cluster에서는 SASL/SCRAM SHA-512 인증 방식을 적용하여 개발팀 별 별도의 계정을 생성하고 ACL을 통해 각 계정이 접근할 수 있는 토픽을 제한했습니다. 이와 같은 중앙 관리되는 보안 정책을 통해 공통 Kafka Cluster의 데이터와 통신을 안전하게 보호하며, 안정적이고 신뢰할 수 있는 데이터 스트리밍 환경을 제공합니다.
4️⃣ 실시간 모니터링으로 안정성 확보
Kafka Cluster의 안정성을 유지하고 잠재적인 문제를 사전에 감지하기 위해서는 철저한 모니터링이 필수적이며 특히, 공통 Kafka Cluster로 전환하면서 여러 도메인 팀이 공유하는 환경에서는 모니터링이 더욱 중요해졌습니다.
공통 Kafka Cluster에서는 AKHQ 와 Grafana 를 활용한 모니터링 전략을 채택했습니다. (AKHQ Link : https://akhq.io/ ) AKHQ는 Kafka 토픽을 모니터링하고 관리하는 데 최적화된 도구로 토픽 상태, 컨슈머 그룹, 오프셋 등을 실시간으로 확인할 수 있습니다. Grafana는 Cluster 전반의 성능과 리소스 사용 상태를 시각화하는 도구로 브로커의 CPU 사용량, 메모리, 네트워크 트래픽 등 중요한 메트릭을 실시간으로 모니터링하고 문제 발생 시 운영자에게 즉각 Slack Alert이 오도록 구성하였습니다. 아래는 AKHQ를 통한 토픽 모니터링과 Grafana를 통한 Cluster 모니터링 예시 화면입니다.
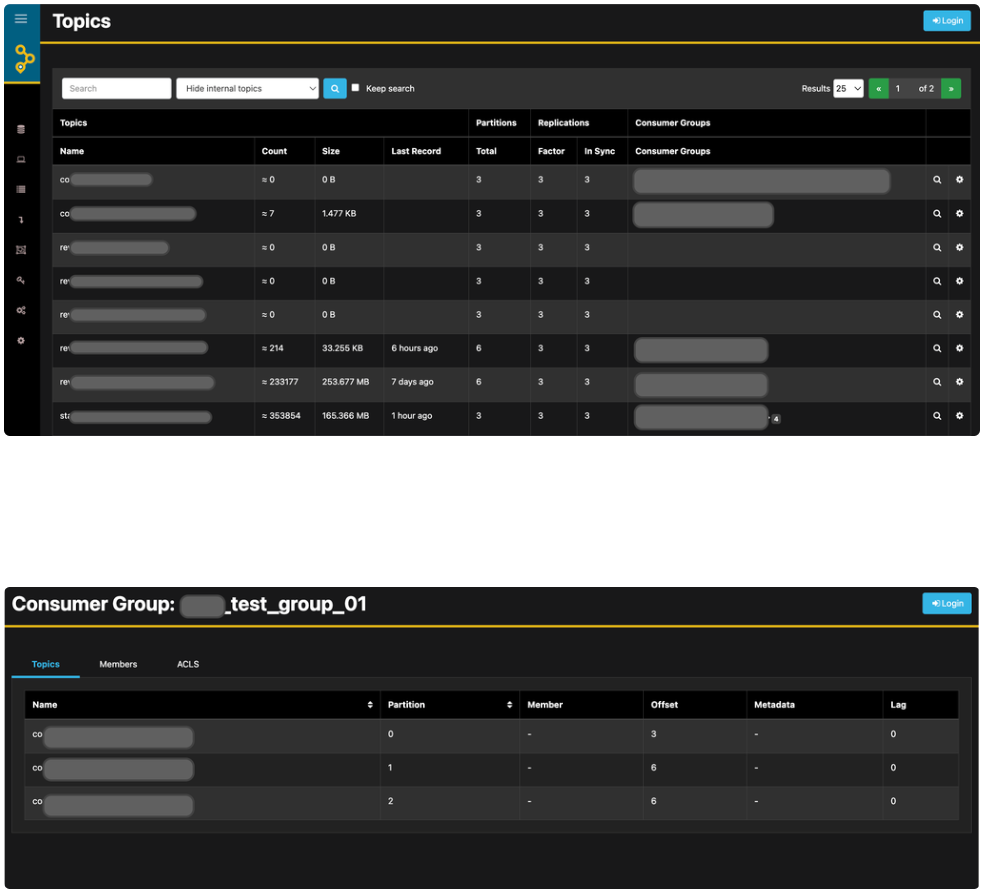
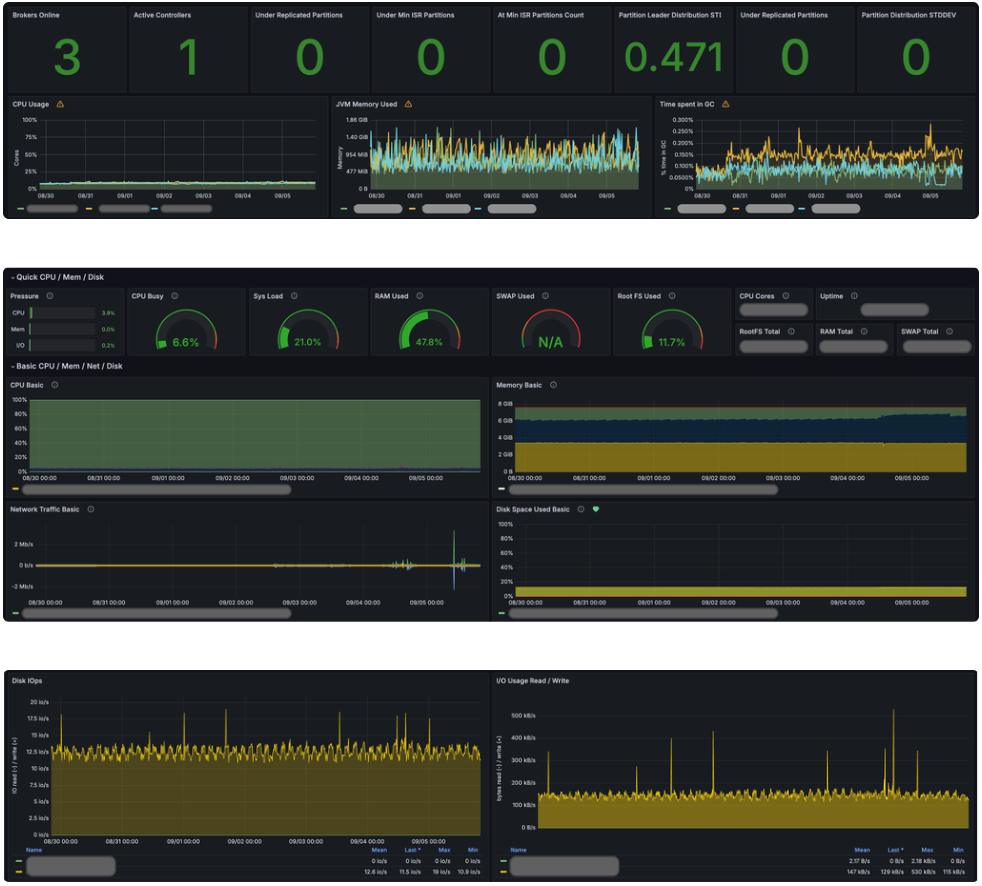
(왼) AKHQ — 토픽 모니터링 / (오) Grafana — Cluster 모니터링
4장. KRaft 모드 기반 공통 Kafka Cluster 구축
앞에서 공통 Kafka 전환 전략으로 KRaft 모드를 도입하였다고 언급하였는데 KRaft 모드가 무엇인고 Zookeeper와의 차이점은 무엇인지 간략하게 알아보겠습니다.
먼저 KRaft Mode는 무엇일까요?
KRaft(Kafka Raft)는 Zookeeper 의존성을 제거하기 위해 KIP-500에 도입된 합의 프로토콜입니다. KRaft Mode의 주요 목적은 Kafka Cluster의 구조를 단순화하고 확장성, 안정성, 관리 용이성을 개선하기 위한 아키텍처로 별도의 Zookeeper를 관리할 필요가 없어 복잡성이 줄어들고 간소화된 메타데이터 관리 덕분에 대규모 Cluster를 보다 효율적으로 처리할 수 있는 관리 기법입니다. Zookeeper 모드와 비교하여 알아보겠습니다.
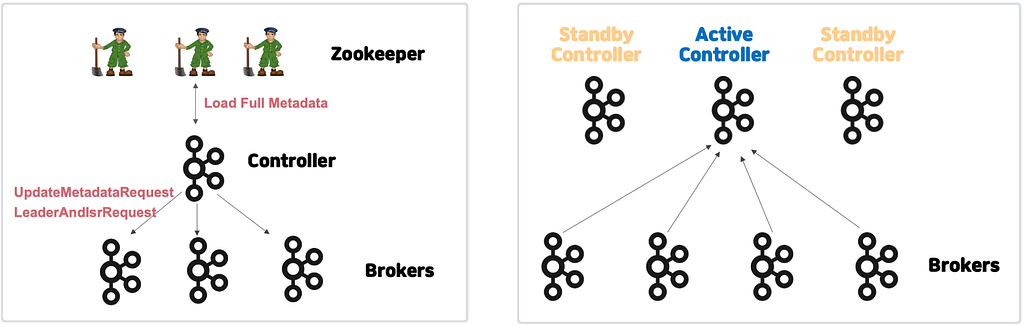
Zookeeper Mode VS KRaft Mode
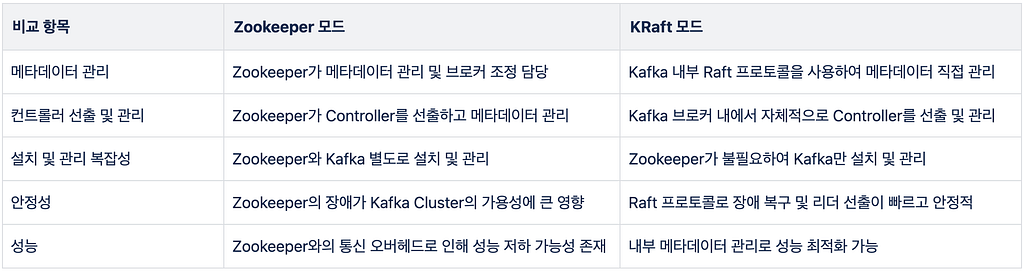
이처럼 KRaft 모드는 Kafka의 운영을 단순화하고, 성능과 확장성을 개선하는 데 큰 장점을 제공합니다. 공통 Kafka Cluster에서도 KRaft 모드를 채택함으로써 더 효율적이고 안정적인 Kafka 운영을 기대할 수 있습니다.
5장. 초기 운영 및 전환 준비 현황
현재 공통 Kafka Cluster는 올해 6월에 구축되어 약 3개월간 안정적으로 운영되고 있으며, 기존 도메인 개발팀이 운영하던 Kafka Cluster 대상으로 개발팀의 업무 일정을 고려하여 순차적으로 공통 Kafka로 전환을 준비하고 있습니다.
1차 전환: 6개의 설치형 Kafka Cluster
2차 전환: 2개의 관리형 AWS MSK Kafka Cluster
전환 후에도 여기어때 개발팀에서 더 편리하게 공통 Kafka를 사용할 수 있도록 지속적으로 고도화 예정입니다.
마무리
지금까지 여기어때에서 도메인 별 Kafka Cluster를 공통 Kafka로 전환하게 된 배경과 운영 방향성에 대한 포스팅이었습니다. 다음 글에서는 실제 팀 별 Kafka Cluster를 공통 Kafka로 전환하며 생긴 에피소드와 운영에 대한 내용으로 찾아 뵙겠습니다.
감사합니다.