Backend
MySQL Ver. 8.0 New Feature: Instant DDL Algorithm에 대한 이해
joom.out카카오
2025년 9월 2일
원문에서 보기 ↗1. 개요
MySQL은 2000년대부터 웹서비스를 많이 사용하는 개발자들에 의해 많이 사용되었습니다. 오픈 소스로서 사용이 쉬웠을 뿐 아니라 개발자들이 다루기 쉽고 이해하기 쉬운 관계형 데이터베이스이기 때문입니다. 하지만, MySQL은 서비스가 잘되고 사용자가 늘어날수록 운영하기 쉽지 않았습니다. 서비스가 운영 중인 상황에서 Online DDL을 수행하기 어려웠기 때문입니다.
하지만, MySQL Ver. 8.0 부터 ALTER DDL에 대한 사용성이 높아지게 되었습니다. DDL 수행 시간을 획기적으로 줄여주는 Instant 알고리즘 기반 DDL 처리 기능이 추가되었기 때문입니다. 이는 MySQL 엔지니어로 기대하던 기능입니다. 그래서, 해당 기능을 MySQL Ver. 8.0.19부터 사용해왔습니다.
해당 기능을 도입 초기 부터 사용하면서 여러 문제들을 겪었고, 이후에 어떻게 로직을 변경해서 조치되었는지 엔지니어로서 궁금했습니다. Instant 알고리즘이 어떤 로직으로 구현되었기에 이와 같은 문제점들이 나타났는지, 현재는 어떻게 변경되어 문제를 해결하였는지 분석하는 것이 필요하다고 생각했고, 그래서 해당 내용을 분석하여 정리했습니다.
참고
이 문서의 내용은 2023년 11월에 분석한 내용으로 MySQL Ver.8.0.12에 등장한 초기 Instant 알고리즘이 아닌 MySQL Ver. 8.0.29에 개선된 Instant 알고리즘을 중심으로 설명합니다. 또한, 이 문서에서 내부 구조 및 동작방식을 설명하기 위한 그림은 참고자료로 포함한 링크에 표현된 그림을 가져오거나 참고하였고, 테스트 케이스 또한 참고한 문서의 내용을 기반으로 진행하였음을 미리 공유합니다.
2. Instant 알고리즘의 소개
MySQL은 초기에 DDL을 수행할 때, Copy 방식의 알고리즘으로 DDL을 수행했습니다.
Copy 방식의 알고리즘은 가장 처음에 MySQL에서 소개된 알고리즘으로, DDL 수행 전반에 걸쳐 Read Lock을 확보한 상태에서, 변경된 구조의 임시 테이블(Table)을 만들고 데이터를 이동하는 방식입니다. 작업 수행 전반에 걸쳐 Read Lock을 먼저 확보해야 하므로 24시간 트래픽을 받아야 하는 서비스를 지원하는 MySQL에서는 서비스를 중지해야 하는 상황을 유발했습니다.
이 문제를 해결하고자, MySQL은 In-Place 알고리즘을 개발해 장시간에 걸친 Lock 획득 상황을 제거했습니다. 하지만, 변경하려는 구조로 새 테이블을 만들고 데이터를 복사하여 처리하는 방식 자체는 변경된 것이 없었습니다. 그래서, 테이블의 데이터 사이즈가 커지면 커질수록 ALTER 수행 시 더 많은 공간을 확보해야 하고, 더 오랜 시간이 소요된다는 문제를 계속 가지고 있었습니다.
이와 같은 MySQL이 가진 문제점을 해결하기 위해 새로운 Instant 알고리즘이 MySQL Ver. 8.0에 도입됐습니다.
2.1 초기 버전 (Instant v1)
MySQL이 DDL 수행 시 사용하던 Copy/In-Place 알고리즘 방식의 문제점을 해결하고자 MySQL Ver. 8.0.12부터 Instant 알고리즘이 추가되어 컬럼(Column) 추가가 빠르게 수행될 수 있도록 기능 개선이 이루어졌습니다. 이 기능을 통해 물리적 구조를 변경하지 않고 오직 테이블의 메타 정보만 수정함으로써 테이블 크기에 관계없이 새로운 컬럼을 즉각 추가할 수 있게 되었습니다.
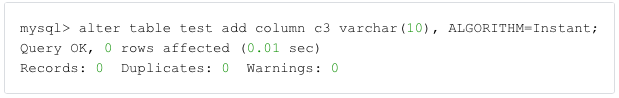
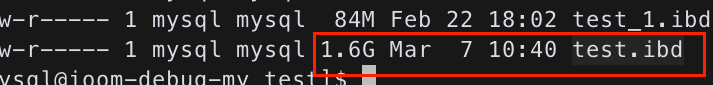
다음은 MySQL Ver. 8.0.12에서 Instant 알고리즘을 사용해 컬럼을 추가한 결과입니다. 테이블 사이즈가 1.6GB임에도 0.01초 만에 컬럼이 추가된 것을 확인할 수 있습니다.
[Instant 알고리즘 실행 결과]
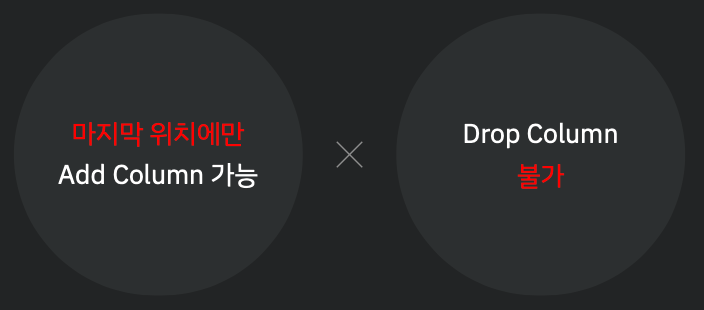
하지만, 초기의 Instant 알고리즘은 다음과 같은 한계를 가지고 있었습니다.
- 새로운 컬럼을 테이블의 마지막 컬럼으로만 추가할 수 있다.
- DROP COLUMN은 지원되지 않는다.
2.2 개선된 Instant 알고리즘 (Instant v2)
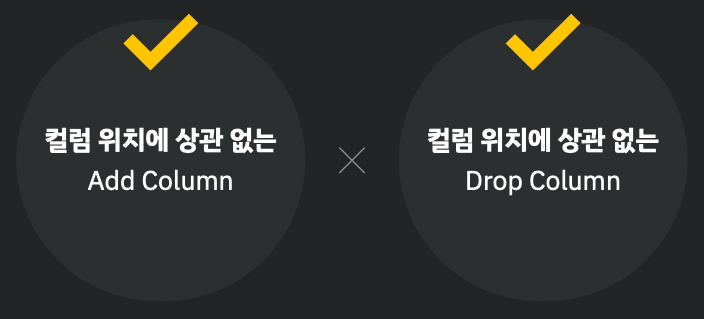
Instant 초기 버전에서 보여준 한계를 벗어나기 위해 MySQL Ver. 8.0.29부터 내부 설계가 변경되었고, 이를 통해 위치에 상관없이 컬럼을 추가/삭제할 수 있게 되었습니다.
물론 Instant v2에서도 데이터영역의 물리적인 변경 없이 메타데이터(Metadata)만 수정하여 DDL을 수행합니다. 따라서, ADD 및 DROP COLUMN 작업에 소요되는 시간이 테이블 크기와 상관없이 거의 동일합니다.
사용하는 구문은 다음과 같습니다.
ALTER TABLE ADD COLUMN [DEFAULT default_value] [FIRST]/[AFTER column_name], ALGORITHM=Instant;
ALTER TABLE DROP COLUMN , ALGORITHM=Instant;
이런 기능 개선을 위해 어떤 과정을 거쳤는지 좀 더 자세히 알아보도록 하겠습니다.
2.2.1 ROW_VERSION 개념의 등장
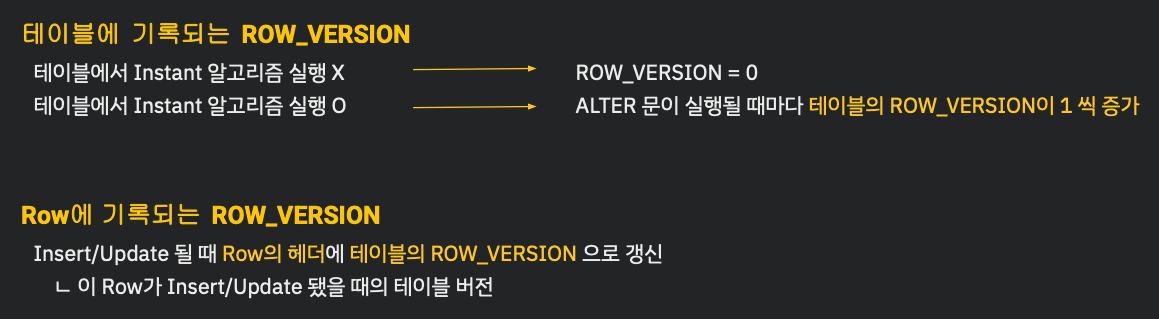
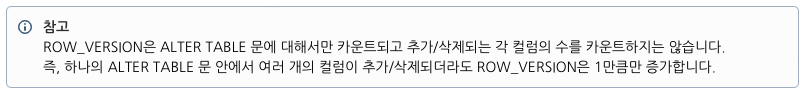
MySQL Ver. 8.0.29부터 ROW_VERSION이라는 개념이 등장했습니다. ROW_VERSION은 테이블마다 독립적으로 기록되는 값으로, Instant 알고리즘을 통해 ALTER문이 수행된 횟수를 뜻합니다. 이 값은 테이블의 메타데이터를 저장하는 영역과 Row의 메타데이터를 저장하는 영역에 각각 저장됩니다.
ROW_VERSION이 기록되는 방식을 좀 더 자세히 정리해 보면 다음과 같습니다.
2.2.1.1 Version Limit
MySQL Ver. 8.0.29에서 ROW_VERSION은 64까지만 증가할 수 있다는 한계가 있습니다. 그래서 해당 제한값에 도달할 때까지만 Instant 알고리즘으로 DDL 수행이 가능하며, 그 이후부터는 다음과 같은 오류가 발생합니다.
/*
    Maximum row versions에 도달해 test/t1 테이블에 Instant 알고리즘으로 컬럼 추가 및 삭제를 시도할 수 없다는 오류
*/

ERROR 4080 (HY000): Maximum row versions reached for table test/t1. No more columns can be added or dropped Instantly. Please use COPY/INPLACE.
NOTE : Above error is thrown only if ALGORITHM=Instant is used explicitly in ALTER TABLE statement. Otherwise, till version=64, Instant algorithm is used implicitly and after that it falls back to ALGORITHM=INPLACE implicitly.
또한 ROW_VERSION이 64까지 증가된 후에 algorithm=instant를 명시하지 않고 DDL을 수행하면 In-place 알고리즘으로 동작합니다. 이 경우 의도치 않은 동작이 될 수 있기 때문에 주의가 필요합니다.
2.2.2 ROW_VERSION 확인 방법
테이블의 현재 ROW_VERSION 값은 INFORMATION_SCHEMA.INNODB_TABLES에서 확인 가능합니다. INNODB_TABLES 테이블에 TOTAL_ROW_VERSIONS라는 컬럼이 해당 테이블의 ROW_VERSION 값을 보여줍니다.
/*
    1. 테이블을 추가했을 때는 TOTAL_ROW_VERSIONS가 0 입니다.
*/
mysql> create table t1 (c1 char(10));
mysql> SELECT NAME,TOTAL_ROW_VERSIONS FROM INFORMATION_SCHEMA.INNODB_TABLES WHERE NAME LIKE "%t1%";
+---------+--------------------+
| NAME	| TOTAL_ROW_VERSIONS |
+---------+--------------------+
| test/t1 |                  0 |
+---------+--------------------+

/*
    2. Instant 알고리즘을 사용해 컬럼을 추가하고, TOTAL_ROW_VERSIONS를 조회하면 1로 변한 것을 확인할 수 있습니다.
*/
mysql> alter table t1 add column c0 char(10) first, algorithm=Instant;
mysql> SELECT NAME,TOTAL_ROW_VERSIONS FROM INFORMATION_SCHEMA.INNODB_TABLES WHERE NAME LIKE "%t1%";
+---------+--------------------+
| NAME	| TOTAL_ROW_VERSIONS |
+---------+--------------------+
| test/t1 |                  1 |
+---------+--------------------+

/*
    3. 다시 Instant 알고리즘을 사용해 컬럼을 드랍하면 TOTAL_ROW_VERSIONS가 2로 변한 것을 확인할 수 있습니다.
*/
mysql> alter table t1 drop column c1, algorithm=Instant;
mysql> SELECT NAME,TOTAL_ROW_VERSIONS FROM INFORMATION_SCHEMA.INNODB_TABLES WHERE NAME LIKE "%t1%";
+---------+--------------------+
| NAME	| TOTAL_ROW_VERSIONS |
+---------+--------------------+
| test/t1 |                  2 |
+---------+--------------------+
1 row in set (0.01 sec)
2.2.3 ROW_VERSION 값 초기화 방법
테이블의 ROW_VERSION값이 64에 도달했더라도 더 이상 Instant 알고리즘을 사용하지 못하는 것은 아닙니다. ROW_VERSION값을 초기화하면 다시 Instant 알고리즘을 사용할 수 있습니다. ROW_VERSION 값을 초기화하기 위해서는 테이블 재구축을 진행하면 됩니다. 이때 사용할 수 있는 구문들은 다음과 같습니다.
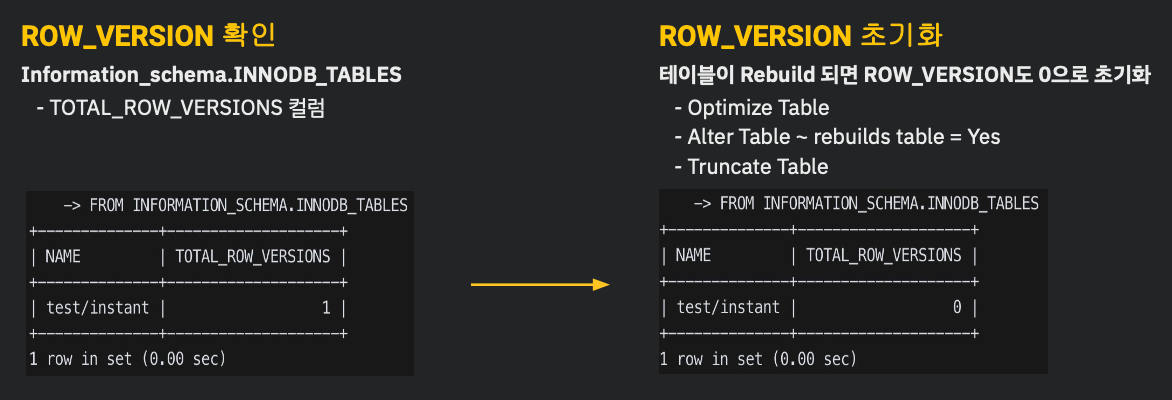
참고로 TRUNCATE TABLE 구문도 ROW_VERSION값을 초기화할 수 있습니다. 하지만, TRUNCATE TABLE 구문은 데이터를 모두 제거하는 구문이기 때문에 의미가 있을 것 같지는 않습니다.
2.2.4 MySQL Ver. 8.0.29 Instant v2 알고리즘의 한계점
위의 설명과 같이 Instant v2 알고리즘은 Instant v1 알고리즘의 문제점을 해결했지만, 그래도 다음과 같은 한계점이 존재합니다.
- FTS(Full-Text-Search) Index 존재 시 테이블에 사용이 불가능하다.
- ROW_FORMAT=COMPRESSED 인 테이블에서는 사용이 불가능하다.
- 임시 테이블에서는 사용이 불가능하다.
3. Instant 알고리즘 수행 후 Row Fetch 동작 방식
앞서 설명한 대로 Instant 알고리즘을 통한 컬럼 추가 및 삭제 작업은 메타데이터만 수정하는 방식으로 동작합니다. 즉, 컬럼을 추가했어도 데이터 파일에 존재하는 로우(Row)에 해당 컬럼이 물리적으로 존재하지 않을 수 있다는 뜻입니다. 반대로 컬럼을 삭제했다는 것이 물리적인 데이터 파일에 존재하는 모든 로우에서 해당 컬럼을 삭제했다는 뜻도 아닙니다.
즉, 다음과 같이 정리할 수 있습니다.
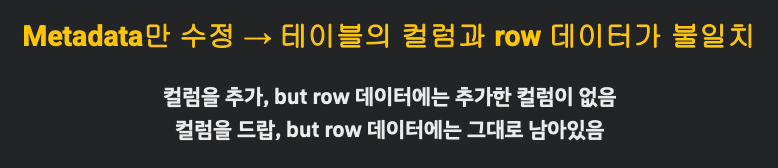
메타데이터와 물리적인 구조의 불일치가 발생하는 상황에서 어떻게 MySQL은 정확한 데이터를 추출하여 처리하는지 그 동작 방식을 알아보도록 하겠습니다.
3.1 Instant 알고리즘을 위한 Metadata
테이블 구조의 메타 정보와 물리적인 구조의 불일치를 인지하여 정확한 동작을 하기 위해 MySQL은 데이터 해석에 필요한 메타 정보를 내부적으로 저장합니다. 필요한 정보들을 테이블 메타 정보 영역/로우 메타 정보 영역에 각각 저장하여 관리합니다.
이제 각 영역에 어떤 메타 정보들이 추가되고 관리되는지 알아보도록 하겠습니다.
3.1.1 Row Metadata
로우 메타데이터는 각 로우에 저장되어 관리되고, 로우 데이터를 해석하는 데 사용됩니다. 기본적인 구조는 다음과 같습니다.
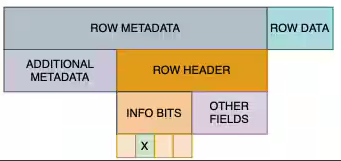
<이미지 출처 [2] https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2\>
여기에서 중요한 정보가 INFO BITS 부분입니다. INFO BITS는 로우의 상태를 나타내는 4 비트(bit) 사이즈의 메타데이터입니다. 이 부분 중 x로 표시된 두 번째 비트가 ROW_VERSION의 유무를 표시합니다. 이 비트가 1이라는 값으로 설정된다면 ROW HEADER 영역에 1 Byte의 ROW_VERSION 영역이 존재한다는 것을 의미합니다.
즉, 다음과 같이 메타데이터가 사용되고 있다고 판단합니다.
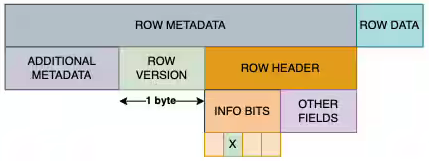
<이미지 출처 [2] https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2 >
INFO BITS의 값이 어떤 상태를 뜻하는지 좀 더 자세히 정리해 보겠습니다.
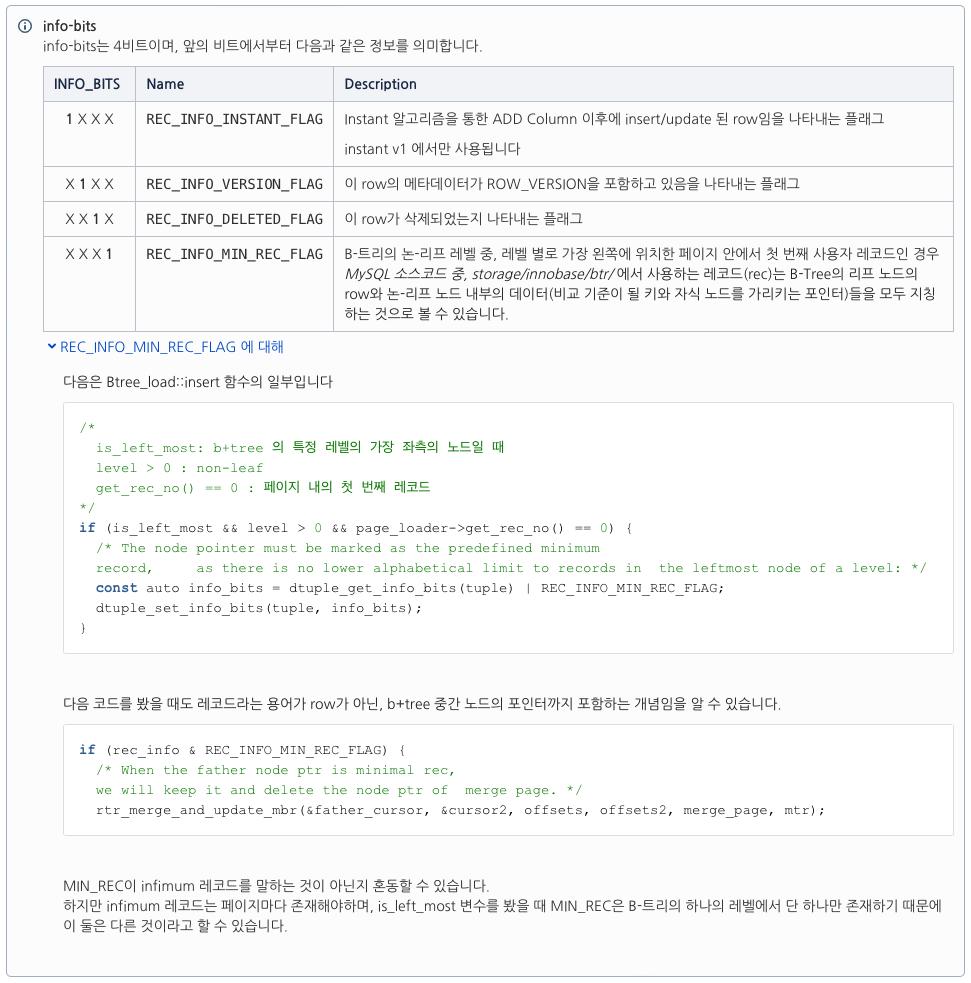
3.1.2 ROW VERSION 메타 정보
INFO BIT의 두 번째 비트가 1 인 경우 ROW_VERSION 메타데이터가 존재한다고 판단합니다. ROW_VERSION 은 로우가 입력되거나 수정될 때 테이블에 저장되는 TOTAL_ROW_VERSION 값을 읽어서 입력합니다. 로우의 메타 정보 영역에 저장되는 ROW VERSION 값은 사용자가 해당 로우를 읽을 때 현시점의 정확한 로우 데이터를 만들기 위해 필요한 정보입니다.
3.1.3 Table Metadata
로우나 테이블 단위로 관리되는 메타데이터인 ROW VERSION 말고도, Fetch 작업을 제대로 처리하기 위한 정보로 컬럼 단위 작업에 대한 메타데이터인 VERSION_ADDED와 VERSION_DROPPED가 있습니다. 두 항목은 다음과 같은 정보를 뜻합니다.
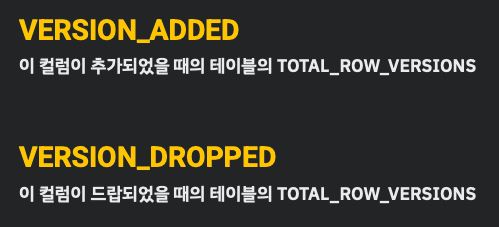
위 메타데이터가 어떻게 동작하는지 예제를 통해 간단히 알아보도록 하겠습니다.
먼저, ROW VERSION 값이 0일 때 Instant 알고리즘을 사용하여 C1 컬럼을 삭제하고, C2 컬럼을 추가해 보겠습니다.
첫 번째로 ALTER 구문을 사용하여 C1 컬럼을 삭제하면 ROW VERSION 값이 1로 변경되면서 VERSION_DROPPED 값이 1로 설정됩니다. 이어서 다시 ALTER 구문을 수행하여 컬럼을 추가하면 해당 테이블의 ROW_VERSION 값에 1이 추가돼 2로 바뀌고, VERSION_ADDED 값이 현재 ROW_VERSION인 2로 설정됩니다.
결과적으로, 두 DDL 작업을 완료하면 테이블 메타데이터 인 VERSION_ADDED와 VERSION_DROPPED는 다음과 같이 변경됩니다.
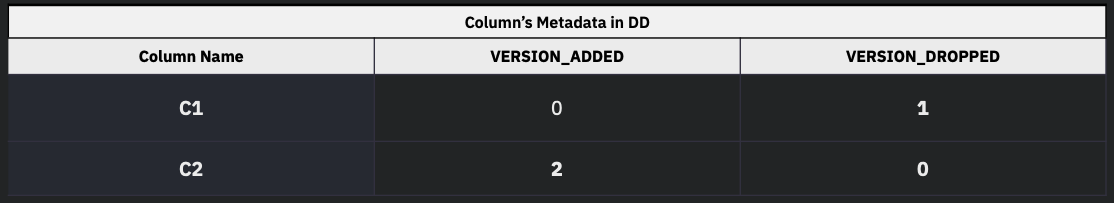
<이미지 출처 [2] https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2\>
VERSION_ADDED와 VERSION_DROPPED는 관련 문서를 찾아보면 테이블 메타 정보를 저장하는 Data Dictionary에 저장되는 정보라고 나와있습니다. 해당 정보들이 물리적으로 어느 영역에 저장되어 관리되는지는 파악되지 않아, 여기서는 Fetch 수행 시 사용하는 정보임을 논리적으로만 이해하고 마무리하려 합니다.
3.2 INSTANT 알고리즘 수행 후 ROW 처리 프로세스에 대한 이해
Instant 알고리즘은 로우 데이터를 수정하지 않고 테이블의 메타데이터만 수정하여 DDL을 수행하는 알고리즘입니다. 그래서, Instant 알고리즘을 사용하면, 테이블의 메타데이터와 실제 데이터 파일에 존재하는 로우 데이터에 불일치가 발생하기 때문에, 로우를 Fetch 할 때 사용자가 구조의 불일치로 인해 발생하는 문제를 인지하지 못하도록 기존과 다른 방법으로 처리해야 합니다.
이때 MySQL은 앞서 설명한 메타 정보를 사용하여 다음의 규칙으로 로우를 추출합니다.
3.2.1 규칙을 이해하기 위한 시나리오
간단한 시나리오를 통해 위 규칙을 알아보도록 하겠습니다.
다음과 같이 특정 테이블에 데이터를 입력하고 Instant 알고리즘으로 ALTER를 수행했다고 가정하겠습니다.
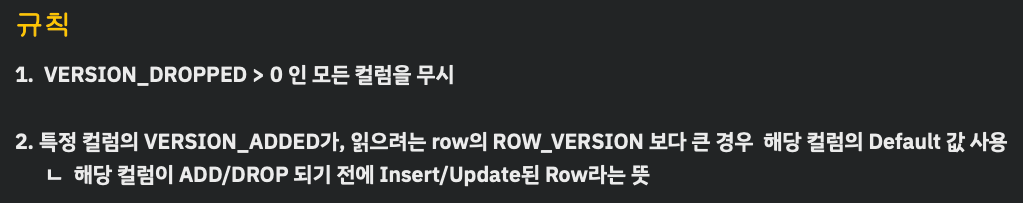
1. 컬럼이  [c1, c2, c3, c4] 총 4개 있는 테이블 생성
CREATE TABLE t1 (
    C1 CHAR(10),
    C2 CHAR(10),
    C3 CHAR(10),
    C4 CHAR(10)
);

2. row를 추가 (이때, ROW VERSION = 0)
-- Insert a row R1
INSERT INTO t1 VALUES ("rA", "rB", "rC", "rD");

3. c5 컬럼 추가
ALTER TABLE t1 ADD COLUMN C5 CHAR(10) DEFAULT "rE", ALGORITHM=Instant;

4. c3 컬럼 드랍
ALTER TABLE t1 DROP COLUMN C3, ALGORITHM=Instant;

-- FETCH Row R1
SELECT * from t1;
<테스트 시나리오 출처 [2] https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2\>
위 작업 내용은 다음과 같이 정리해 볼 수 있습니다.
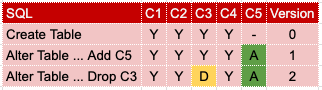
<이미지 출처 [1] https://www.slideshare.net/slideshow/mysql-innodb-storage-engine-deep-dive-mydbops/269817324#25\>
그러면 정말 우리가 예측한 대로 실제 로우 메타데이터가 저장되었는지 확인해 보겠습니다.
3.2.2 DDL 수행 후 Row Data 정보 변경 확인
다음과 같이 실제 DDL/DML을 수행하면서 로우를 저장하는 영역이 어떻게 저장되는지 확인해 보겠습니다. 위 시나리오대로 수행 후 xxd 명령어를 사용하여 데이터 파일의 바이너리 값을 확인하면 다음과 같은 정보를 확인할 수 있습니다.
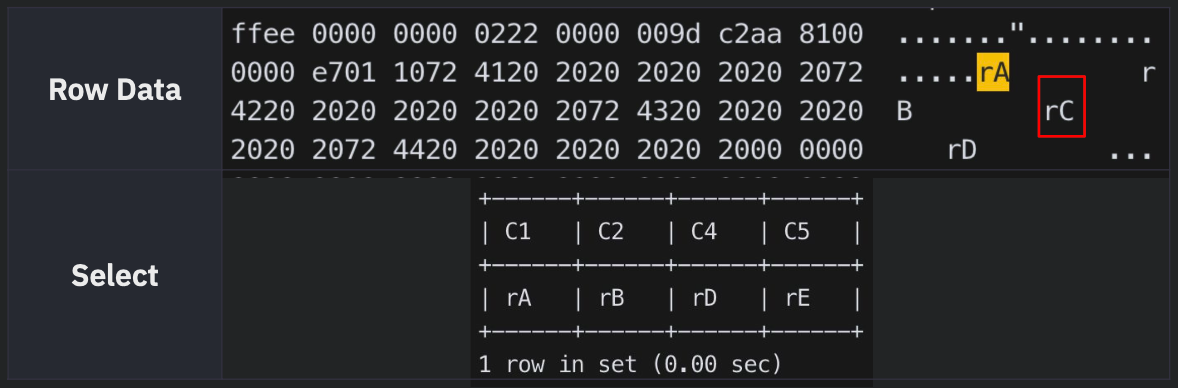
C5 컬럼을 추가한 후, Select 구문을 수행하면 C5 컬럼의 default 값인 'rE’가 조회결과에 나타남을 확인할 수 있었습니다. 하지만, 데이터 파일의 바이너리 내용을 확인하면 해당 값을 확인할 수 없습니다.
C3 컬럼을 드랍한 후, Select 구문을 수행하면 C3 컬럼의 값이 조회 결과에 없음을 확인할 수 있습니다. 하지만, 데이터 파일의 바이너리 내용을 확인하면 여전히 C3 컬럼의 값 인 rC가 남아 있는 것을 확인할 수 있습니다.
즉, Instant 알고리즘을 통해 컬럼을 추가/삭제했다고 해서, 로우를 저장하는 영역에 물리적인 변경이 일어나는 것은 아님을 확인할 수 있습니다.
3.2.3 단계별 테스트를 통한 Row Metadata 변경 확인
이제 Instant 알고리즘 수행 후 각 로우의 메타데이터가 어떻게 변화하는지를 확인해 보겠습니다. 위 3.3 구문과 동일한 시나리오로 진행하면서 자세히 알아보겠습니다.
3.2.3.1 테이블 생성 후
테이블을 생성하고 로우를 하나 입력하면 다음과 같이 특별한 변화가 없을 것임을 예상할 수 있습니다.
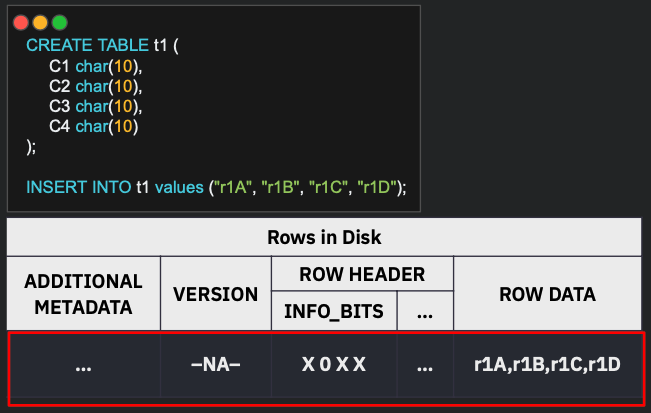
<이미지 출처 [2] https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2\>
xxd를 사용하여 실제 데이터 파일의 binary 값을 확인해 보면 예상과 같습니다.
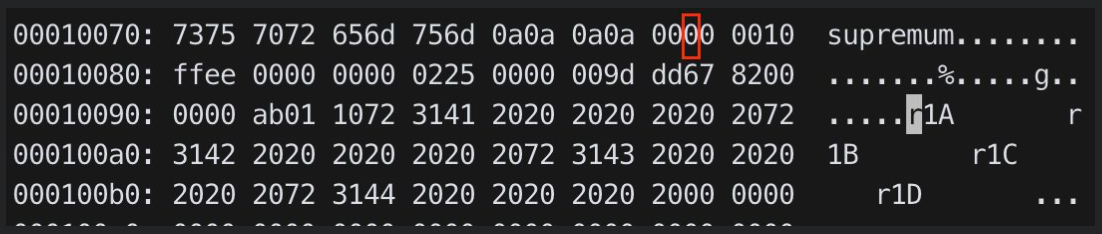
즉, INFO BITS에서 Row Version을 사용하는지 아닌지 확인하는 두 번째 비트 값이 0이고, 아직은 해당 테이블에 ROW_VERSION값이 없음을 확인할 수 있습니다.
3.2.3.2 컬럼 추가 후 Row 입력 시
위에서 생성한 테이블에 Instant 알고리즘으로 컬럼을 하나 추가하고 로우를 하나 더 입력해 보도록 하겠습니다.
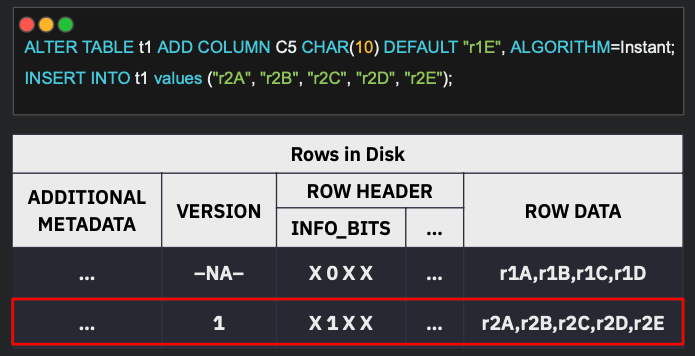
<이미지 출처 [2] https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2\>
그러면, 위에서 보시는 것과 같이 ROW_VERSION 값이 1로 변경되고, INFO_BITS의 두 번째 비트 값이 1로 변경될 것이라고 예측할 수 있습니다.
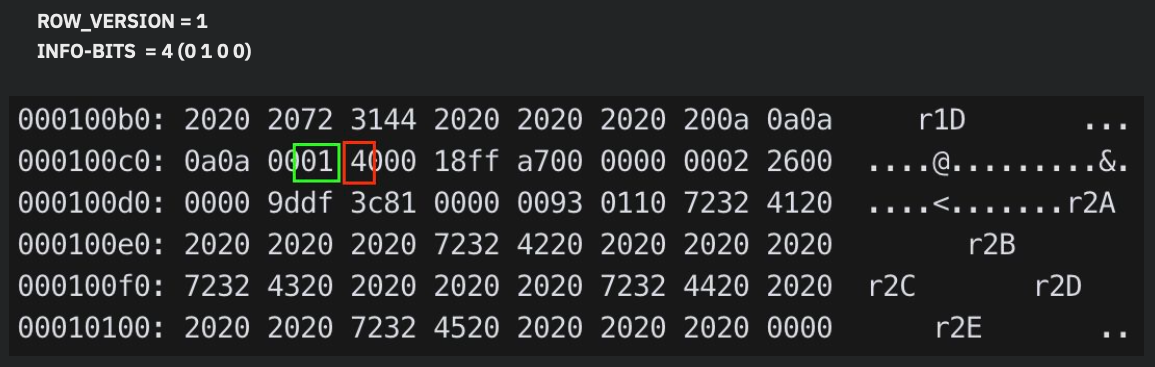
실제 데이터 파일에 변경된 정보를 xxd를 통해 확인하면 초록색 박스로 표시한 것처럼 ROW_VERSION 값이 1로 설정되어 사용되었음을 확인할 수 있습니다. 그리고 총 4 비트 중 두 번째 비트값이 1로 변경되며 INFO_BITS값이 4로 보이는 것을 확인할 수 있습니다.
3.2.3.3 컬럼 삭제 후 Row 입력 시
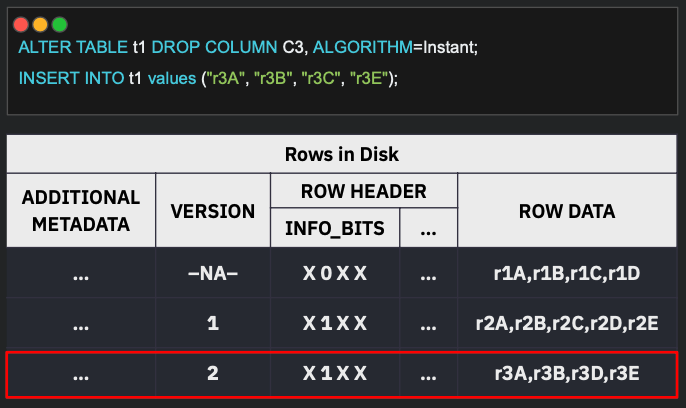
위에서 생성한 테이블에 Instant 알고리즘으로 컬럼을 하나 삭제하고 로우를 하나 더 입력해 보겠습니다.
<이미지 참고 url .2 https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2\>
두 번째 Instant 알고리즘을 사용한 DDL 수행으로, 우리는 ROW VERSION 값이 2로 변경될 것이라 예측할 수 있습니다. 실제 데이터 파일의 Binary 값을 확인하면 다음과 같습니다.
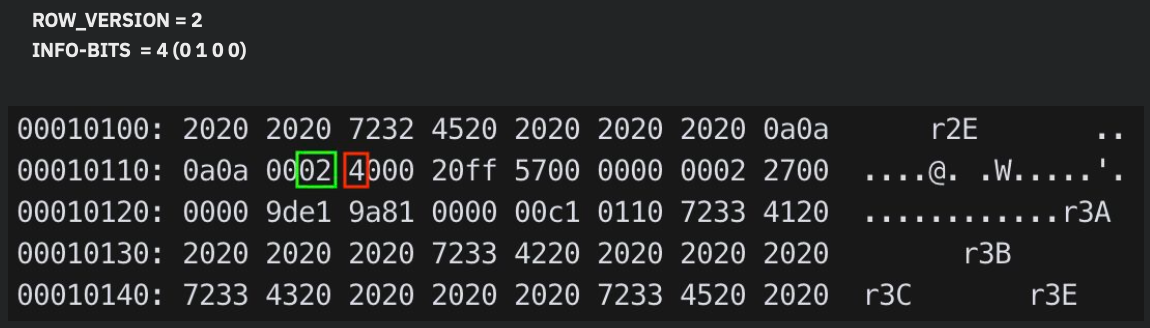
예측한 것과 같이 ROW_VERSION 값이 2로 변경되었음을 확인할 수 있습니다.
3.2.4 Instant 알고리즘 수행 후 Fetch 동작 방식
이제 위에서 정리한 내용을 기반으로 MySQL이 데이터를 어떻게 파악하여 사용자에게 정확한 데이터를 전달하는지 그 로직을 확인해 보도록 하겠습니다.
3.2.3까지 작업을 수행한 내용을 다시 정리하면 다음과 같습니다.
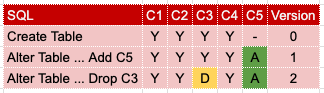
<이미지 출처 [1] https://www.slideshare.net/slideshow/mysql-innodb-storage-engine-deep-dive-mydbops/269817324#25\>
위 작업에 대한 내용은 해당 테이블의 Data Dictionary에 다음과 같이 저장됩니다.
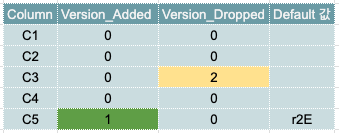
<이미지 출처 [1] https://www.slideshare.net/slideshow/mysql-innodb-storage-engine-deep-dive-mydbops/269817324#25\>
위와 같이 저장된 Version_Added, Version_Dropped 값을 다음과 같이 처리하여 데이터를 추출합니다.
- Version_Added, Version_Dropped 값이 0인 컬럼은 데이터파일에 저장된 그대로의 값을 그대로 가져갑니다.
- Version_Dropped 값이 0이 아닌 컬럼은 조회 대상에서 제외합니다.
- Version_Added 값이 0이 아닌 컬럼의 경우 로우 메타데이터에 있는 ROW_VERSION과 비교합니다.
- 컬럼의 Version_Added 가 Row의 ROW_VERSION 보다 크다면 컬럼의 기본값을 읽습니다.
- 반대로 컬럼의 Version_Added가 로우의 ROW_VERSION 보다 작다면 컬럼의 기본값은 무시하고 데이터파일에 저장된 그대로의 값을 읽습니다.
즉, 위의 예제에서는 다음과 같이 동작하게 됩니다.
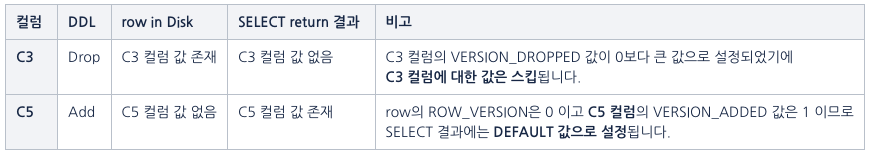
Fetch 흐름은 다음과 같이 도식화하여 표현해 볼 수 있습니다.
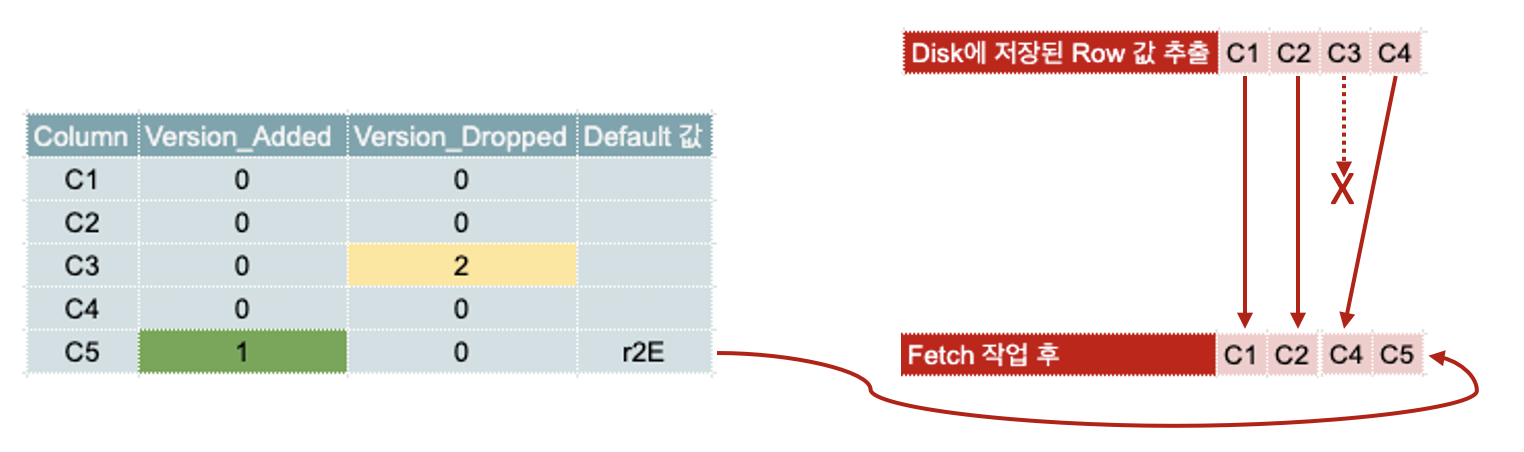
<이미지 출처 [1] https://www.slideshare.net/slideshow/mysql-innodb-storage-engine-deep-dive-mydbops/269817324#25\>
위 내용을 통해 Instant 알고리즘을 사용한 DDL을 수행한 후의 Fetch 방식은 그렇지 않은 경우에 비해 좀 더 복잡한 Fetch 로직을 가지고 있음을 확인할 수 있습니다. 즉, Instant 알고리즘 수행 후의 SELECT 쿼리는 해당 Fetch 작업의 복잡도로 인해 성능이 떨어질 수도 있음을 확인할 수 있었습니다.
참고
위 내용을 확인하고 카카오에서도 해당 기능의 사용이 SELECT 쿼리의 성능 저하를 불러올 수 있음을 인지하였습니다. 그래서, Sysbench를 사용하여 성능 테스트를 진행했습니다. Instant 알고리즘으로 DDL을 수행한 후 bulk_insert, oltp_read_write 시나리오로 성능 테스트를 진행했습니다만, 결론적으로 카카오 표준 DB 구성 하에서는 크게 의미 있게 성능이 저하되지 않는다고 판단하였습니다. 여기에 성능 테스트 내용을 다 작성하면 내용이 너무 길어질 것 같아서 간단히 결론만 공유합니다.
4 Update 수행 시 Row Metadata 및 Row 값 수정 방식
지금까지의 내용을 통해, 테이블의 컬럼 정보와 실제 Disk에 저장된 로우는 그 형태가 다를 수 있음을 알 수 있음을 확인할 수 있었습니다. 이제는 마지막 분석으로 Instant 알고리즘 수행 후 Update가 수행될 때 테이블 컬럼과 불일치 상태인 로우들이 어떻게 처리되는지 간단히 알아보고자 합니다.
4.1 Update 처리에 대한 테스트 테이블 조건
다음과 같은 테이블에 미리 Instant 알고리즘으로 DDL을 수행한 후 Update 테스트를 진행합니다.
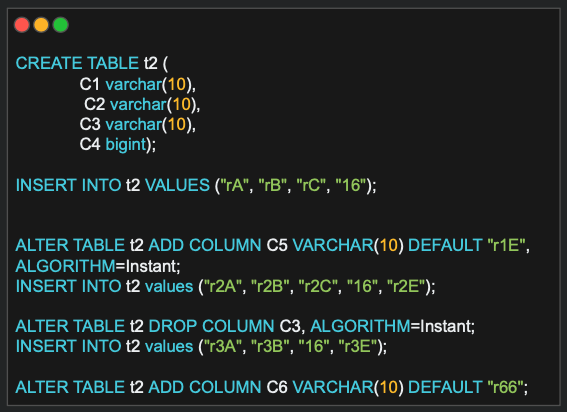
위와 같이 수행하고 나면 해당 테이블의 TOTAL_ROW_VERSIONS 정보는 3이 될 것입니다. Instant 알고리즘을 사용한 DDL이 3번 수행되었기 때문입니다.
그리고 두 번째 입력한 (‘r2A’, ‘r2B’, ‘r2C’, ‘16’, ‘r2E’ )는 ROW_VERSION=1 값을 가지게 될 것입니다. 세 번째로 입력한 (‘r3A’, ‘r3B’, ‘16’, ‘r3E’)는 ROW_VERSION=2 값을 가질 것이라는 것도 알 수 있습니다.
4.2 Update 테스트 수행
다음과 같은 2가지로 Update 수행 시 어떻게 로우가 변경되는지 테스트해 봅니다.
- 기존보다 작은 Row Header + Data로 Update 수행
- 기존보다 큰 Row Header + Data로 Update 수행
4.2.1 기존보다 작은 값(Row Header + data)으로 Update 구문을 수행
4.1과 같은 조건에서 2번째 입력한 레코드를 기존 데이터보다 작은 사이즈로 업데이트했다고 가정합니다. 즉, 두 번째 로우의 c2 컬럼의 값을 'r2B’에서 'rU’로 수정하고 난 뒤에 파일 내용이 어떻게 변경되는지 확인해 봅니다.
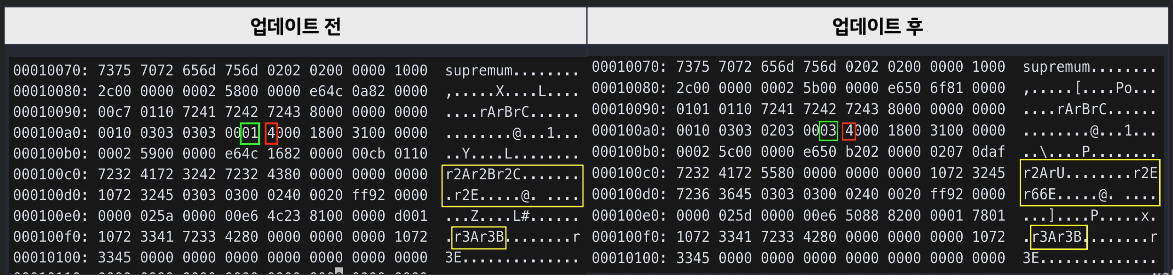
xxd를 통해 데이터 파일의 Binary 정보를 확인하면 변경된 로우의 사이즈가 기존 로우보다 작기 때문에 그 자리에서 데이터가 변경된 것을 확인할 수 있습니다. 그리고 ROW_VERSION값이 1에서 3으로 update 되었음을 확인할 수 있습니다.
4.2.2 기존보다 큰 값(Row Header + data)으로 Update 구문을 수행
4.1인 테이블 조건에서 2번째 입력한 레코드를 기존 데이터보다 큰 사이즈로 업데이트했다고 가정합니다. 즉, 두 번째 로우의 c2 컬럼 값을 'r2B’보다 더 큰 값인 'rBRBRBR…'로 수정하고 난 뒤에 파일 내용이 어떻게 변경되는지 확인해 봅니다.
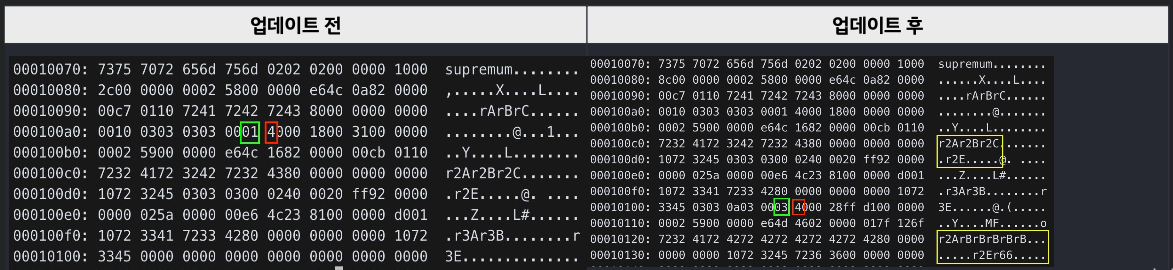
xxd를 통해 데이터 파일의 Binary 정보를 확인하면 변경된 로우의 사이즈가 기존 로우보다 크기 때문에 그 자리에서 변경되지 못하고 가장 뒷부분에 새로 입력된 것을 확인할 수 있습니다. 또한, 새롭게 추가된 로우의 ROW_VERSION의 값은 3으로 입력되어 있습니다. 이때 기존 Row의 값은 변경되지 않습니다.
5. 마무리
Instant 알고리즘을 사용한 DDL 기능은 앞서 설명한 대로 Online 상에 테이블의 컬럼을 빠르게 Add, Drop 할 수 있게 하기 위해 도입되었습니다. 해당 기능을 수행하기 위해, 관리를 위한 메타데이터도 추가되었으며 Fetch 동작 방식도 변경되어 복잡도가 높아졌음을 확인할 수 있었습니다.
이 기능의 도입으로 DDL 작업 시 서비스의 영향도가 낮아져서 좋아진 측면도 있지만, SELECT 쿼리의 성능 저하가 예측되기 때문에 해당 기능을 사용하는 것이 맞는지 고민해 봐야 합니다. 하지만, 이러한 기능적 특징 및 제한 사항을 잘 파악하고 필요한 곳에 적절하게 사용한다면 MySQL의 사용성을 높이면서 운영할 수 있지 않을까 합니다.
Link: https://tech.kakao.com/posts/703
참고 자료
-
https://www.slideshare.net/slideshow/mysql-innodb-storage-engine-deep-dive-mydbops/269817324#15
-
Mayank Prasad, ‘MySQL 8.0 INSTANT ADD and DROP Column(s)’, https://dev.mysql.com/blog-archive/mysql-8-0-instant-add-and-drop-columns/, https://blogs.oracle.com/mysql/post/mysql-80-instant-add-and-drop-columns-2, 2023년 9월 27일.
-
MySQL Server Team, ‘Online DDL Operations’, https://dev.mysql.com/doc/refman/8.0/en/innodb-online-ddl-operations.html