Engineering
작지만 강한 Kanana Nano 효율적으로 개발하기
juliet.bak카카오
2025년 1월 10일
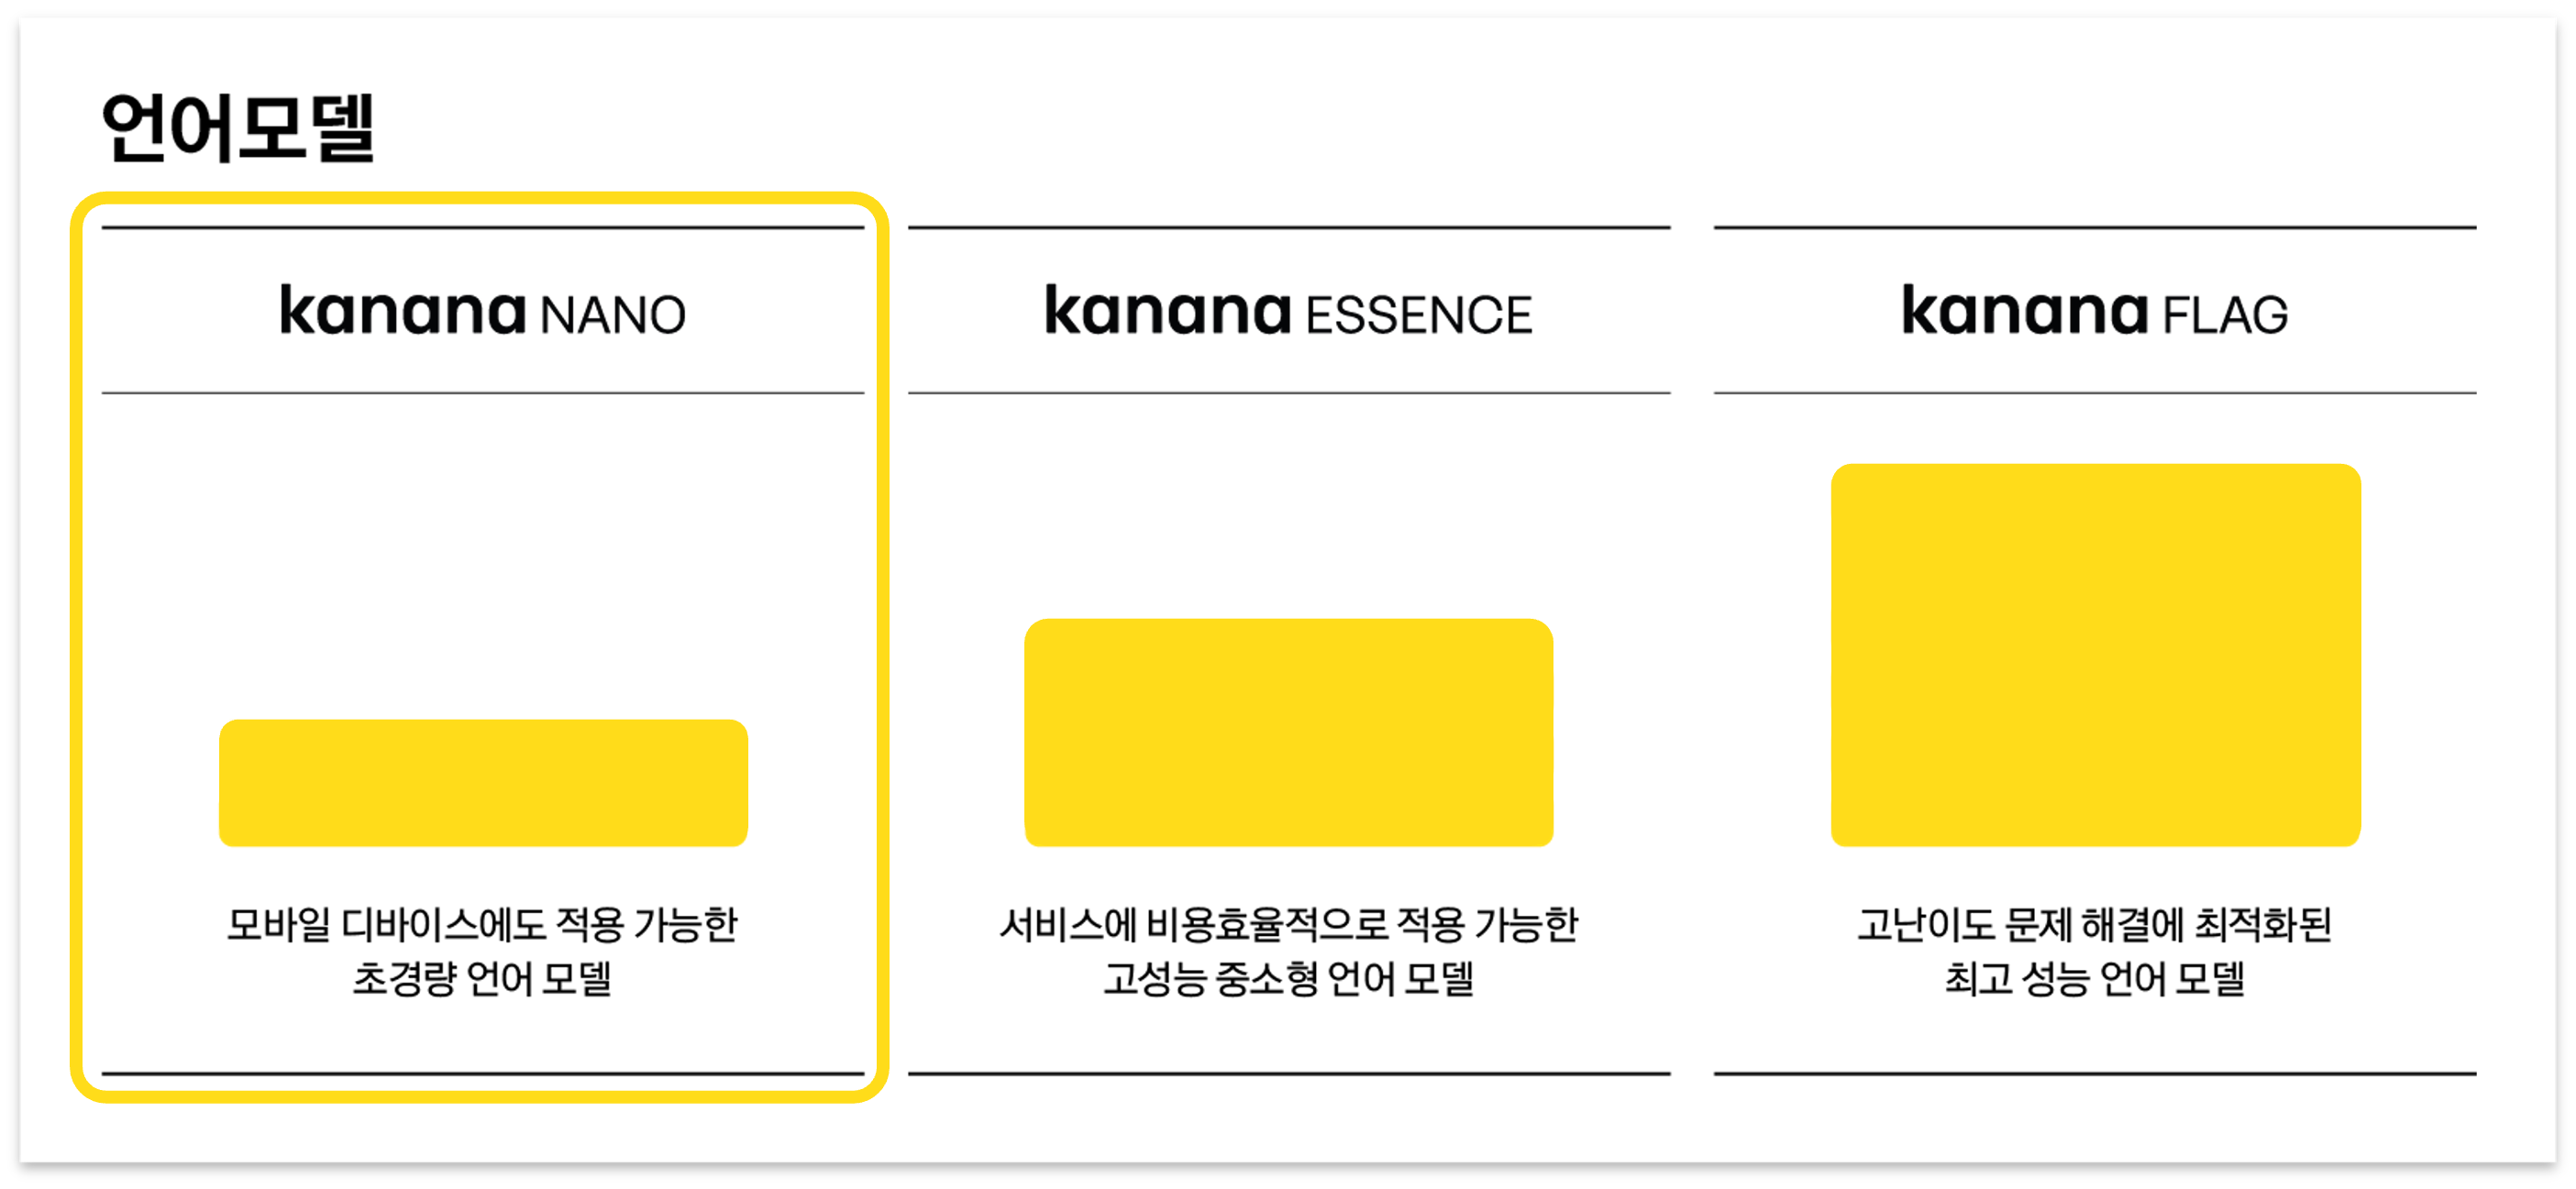
원문에서 보기 ↗안녕하세요, 카카오의 AI 모델을 개발하는 카나나 알파(Kanana ⍺) 조직에서 자체 언어모델을 개발하고 있는 Juliet입니다. 저희 조직에서는 카나나 언어모델(Kanana LLM: Kanana Nano, Essence, Flag)의 Pre-training을 담당하고 있습니다.
이번 글에서는 글로벌 경쟁력을 갖춘 작은 언어모델(SLM) 시리즈를 비용 효율적으로 개발 하기 위한 실험 과정과 결과를 소개하고자 합니다. 이전 “밑바닥부터 Kanana LLM 개발하기: Pre-training”에서 소개해 드린 Kanana Essence와 이를 Kanana Nano로 압축하는 과정을 넘어, 그보다 훨씬 더 작은 언어모델까지 개발하며 얻은 노하우를 상세히 공유하겠습니다.
참고로, 여기서 소개하는 Kanana Nano-2.1B와 이를 기반으로 한 Instruct 및 Embedding 모델은 직접 사용해 보실 수 있도록 추후 오픈소스로 공개할 예정입니다. 이때 카나나 언어모델 전체를 소개하는 Tech report도 함께 공개할 예정이니 많은 관심 부탁드립니다.
SLM이 정말 필요할까?
이미 많은 분들이 아시는 것처럼 모든 작업에 대규모 언어모델(LLM)이 꼭 필요한 것은 아닙니다. 작은 언어모델(SLM)도 서비스의 로그 데이터를 직접 학습시킬 경우, 특정 작업에서 LLM에 근접하거나 더 나은 성능을 보일 수 있습니다.
또한, 언어모델이 많이 활용되는 챗봇 쿼리의 대부분은 LLM 수준의 고도화된 추론 능력을 필요로 하지 않습니다. 이 경우 일반적인 작업은 SLM으로 처리하고 복잡한 작업만 LLM을 활용하여 속도를 단축하면서도 성능을 유지할 수 있습니다. 이를 실현하는 대표적인 기술 중 하나는 Speculative decoding입니다. “Accelerating Large Language Model Decoding with Speculative Sampling” [1] 에 따르면, 70B 모델을 4B 모델과 결합해 Speculative decoding을 수행하면 70B 모델과 동일한 수준의 성능을 유지하면서 속도를 약 2배 이상 높일 수 있습니다.
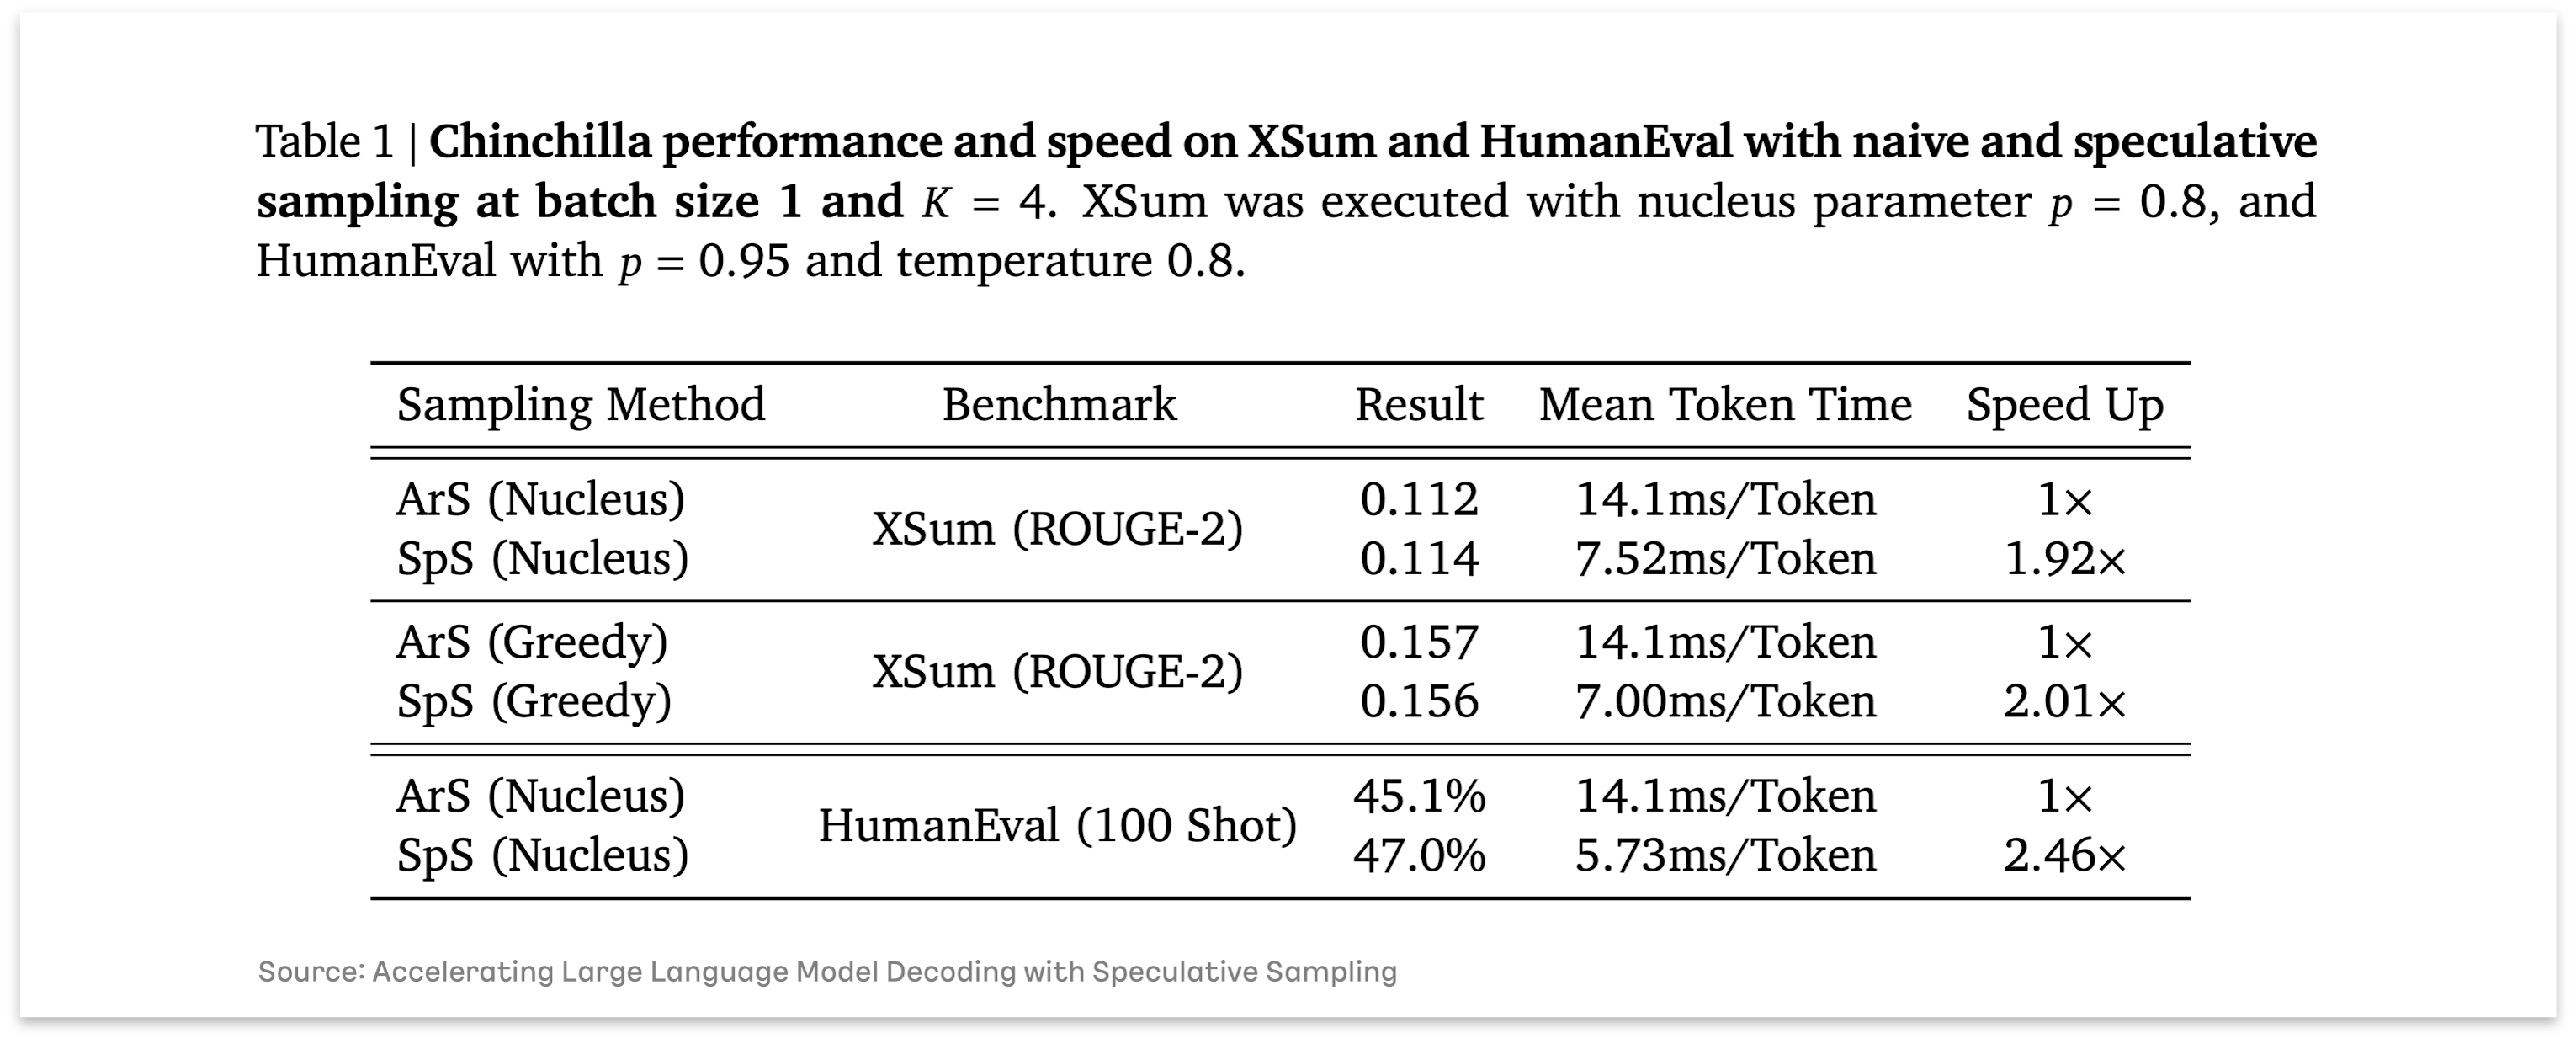
이처럼 SLM은 LLM 대비 적은 비용과 빠른 처리 속도로 특정 작업에 최적화된 결과를 제공하며, 비용과 성능을 동시에 고려했을 때 서비스에서 핵심적인 역할을 할 수 있습니다.
비용 효율적인 고성능 SLM 학습의 핵심: Pruning & Distillation
그렇다면 경쟁력 있는 SLM을 비용 효율적으로 학습시키는 방법은 무엇일까요? 그 핵심은 Pruning과 Distillation 기술에 있습니다. 먼저 Pruning은 AI 모델 내 중요도가 낮은 요소를 제거하여 크기를 줄이면서도 성능을 유지하려는 기법이고, Distillation은 큰 모델(Teacher)이 가진 지식을 더 작은 모델(Student)로 전달하는 기법입니다.
저희는 SLM을 처음부터 훈련하기보다, 이미 확보한 중소형 언어모델인 Kanana Essence로부터 Pruning & Distillation하여 훨씬 적은 데이터로 성능을 극대화했습니다. 특히 언어모델 압축에 효과적이고 실용적인 Minitron [2, 3] 의 방법론을 채택하고 발전시켰습니다.
이를 바탕으로 개발된 Kanana Nano 시리즈는 유사한 크기의 Llama 3.2 [4], Gemma 2 [5] 등과 비교해 비슷하거나 우위인 영어 성능과 압도적인 한국어 성능 을 달성했습니다. 특히 Kanana Nano-2.1B는 크기를 26%로 줄였음에도, Kanana Essence의 93%에 달하는 한국어 성능을 유지할 수 있었습니다. 나아가, 한두 단계의 압축만을 실험한 Minitron 연구와 달리, 저희는 대여섯 단계를 거쳐 모바일 환경에서도 쉽게 사용 가능한 크기의 모델까지 유의미한 성능을 유지하는 데 성공했습니다.
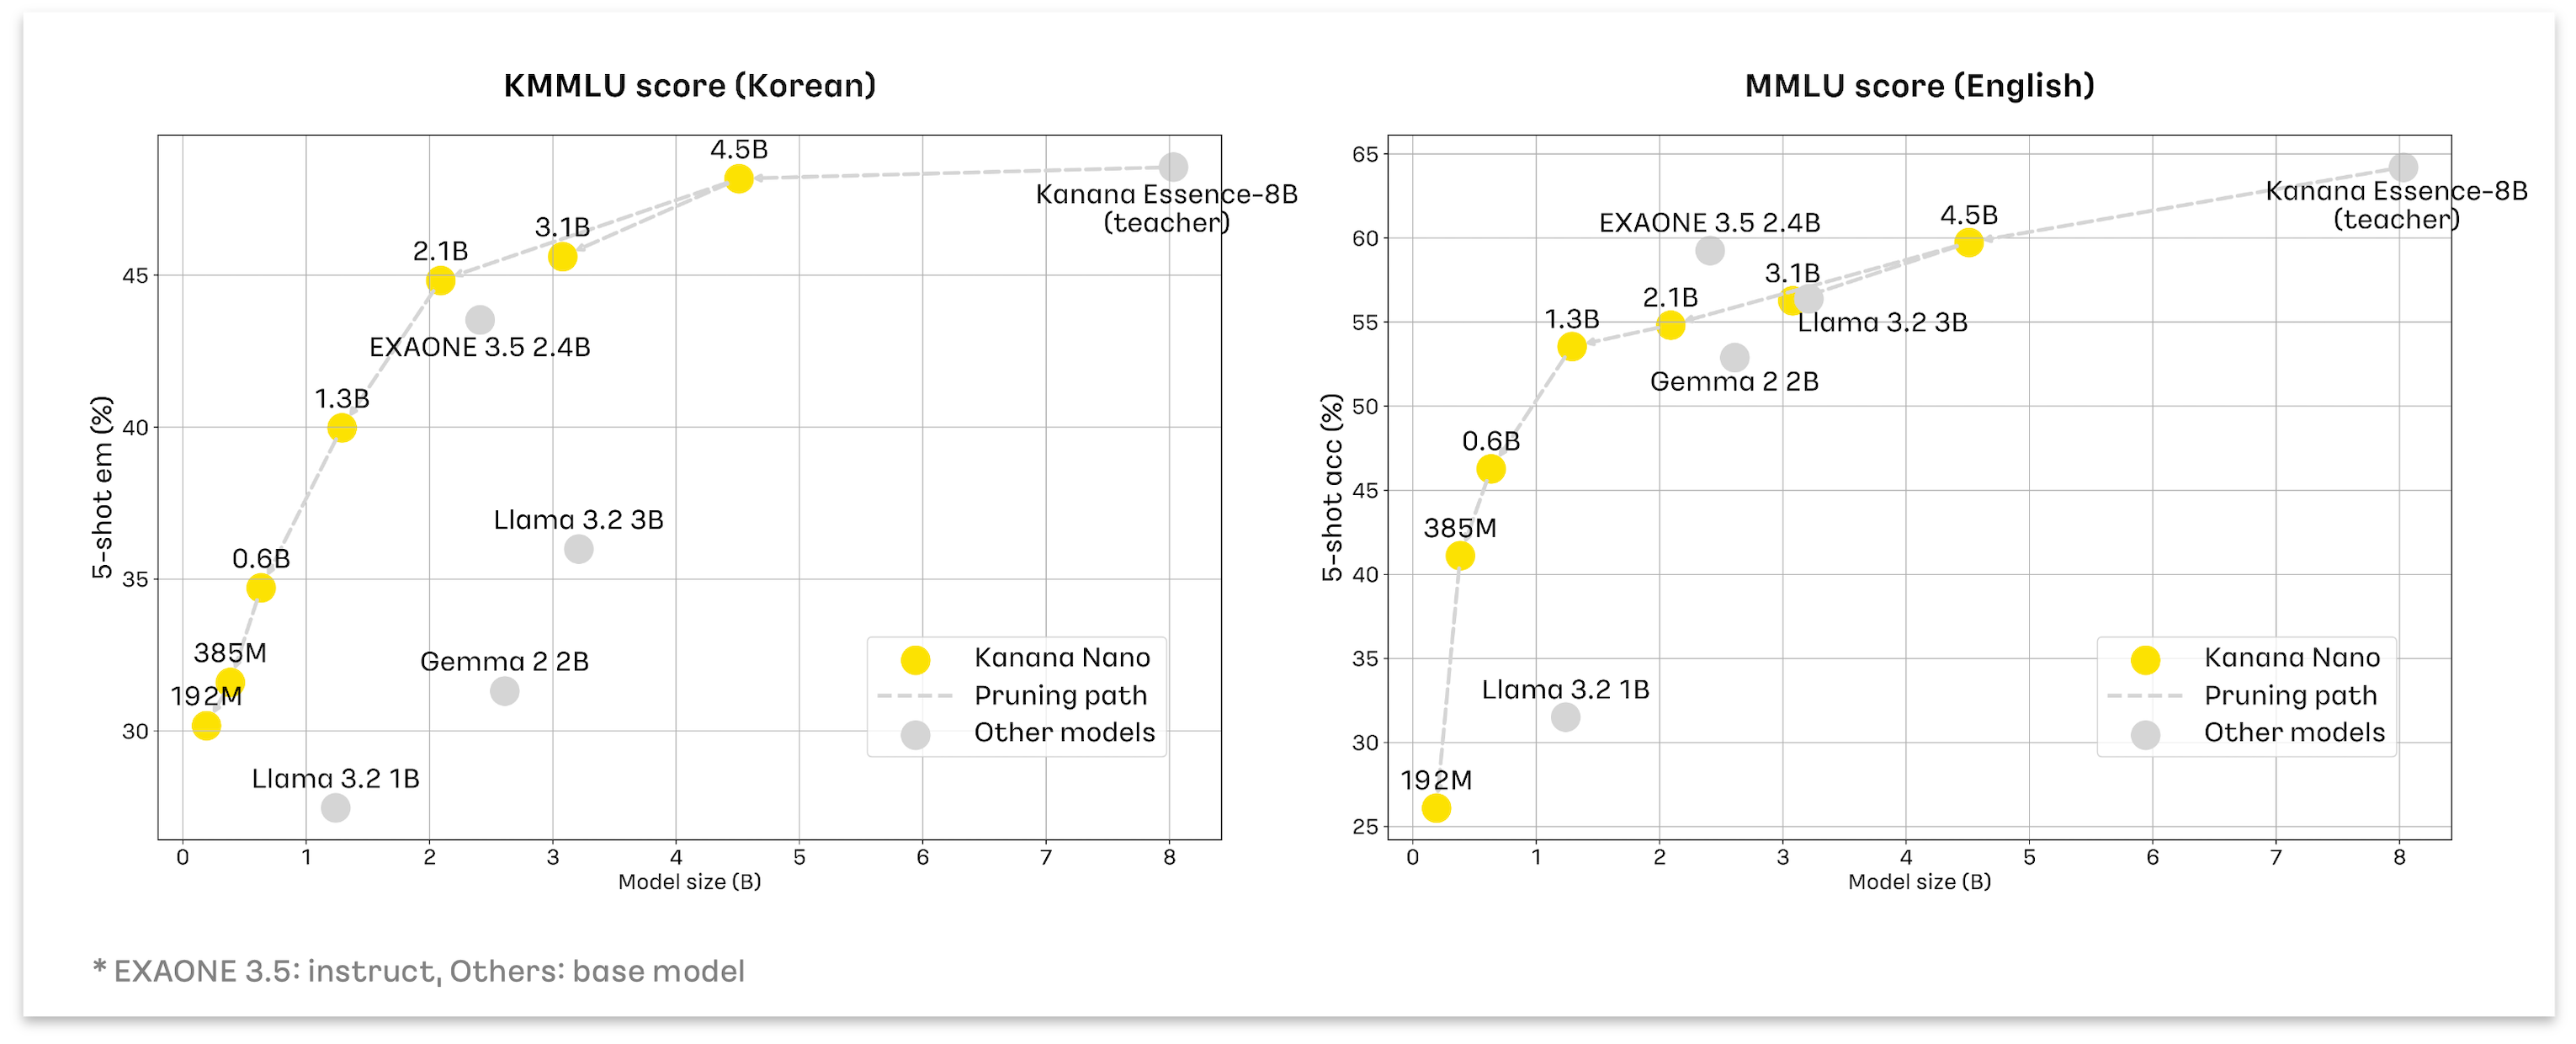
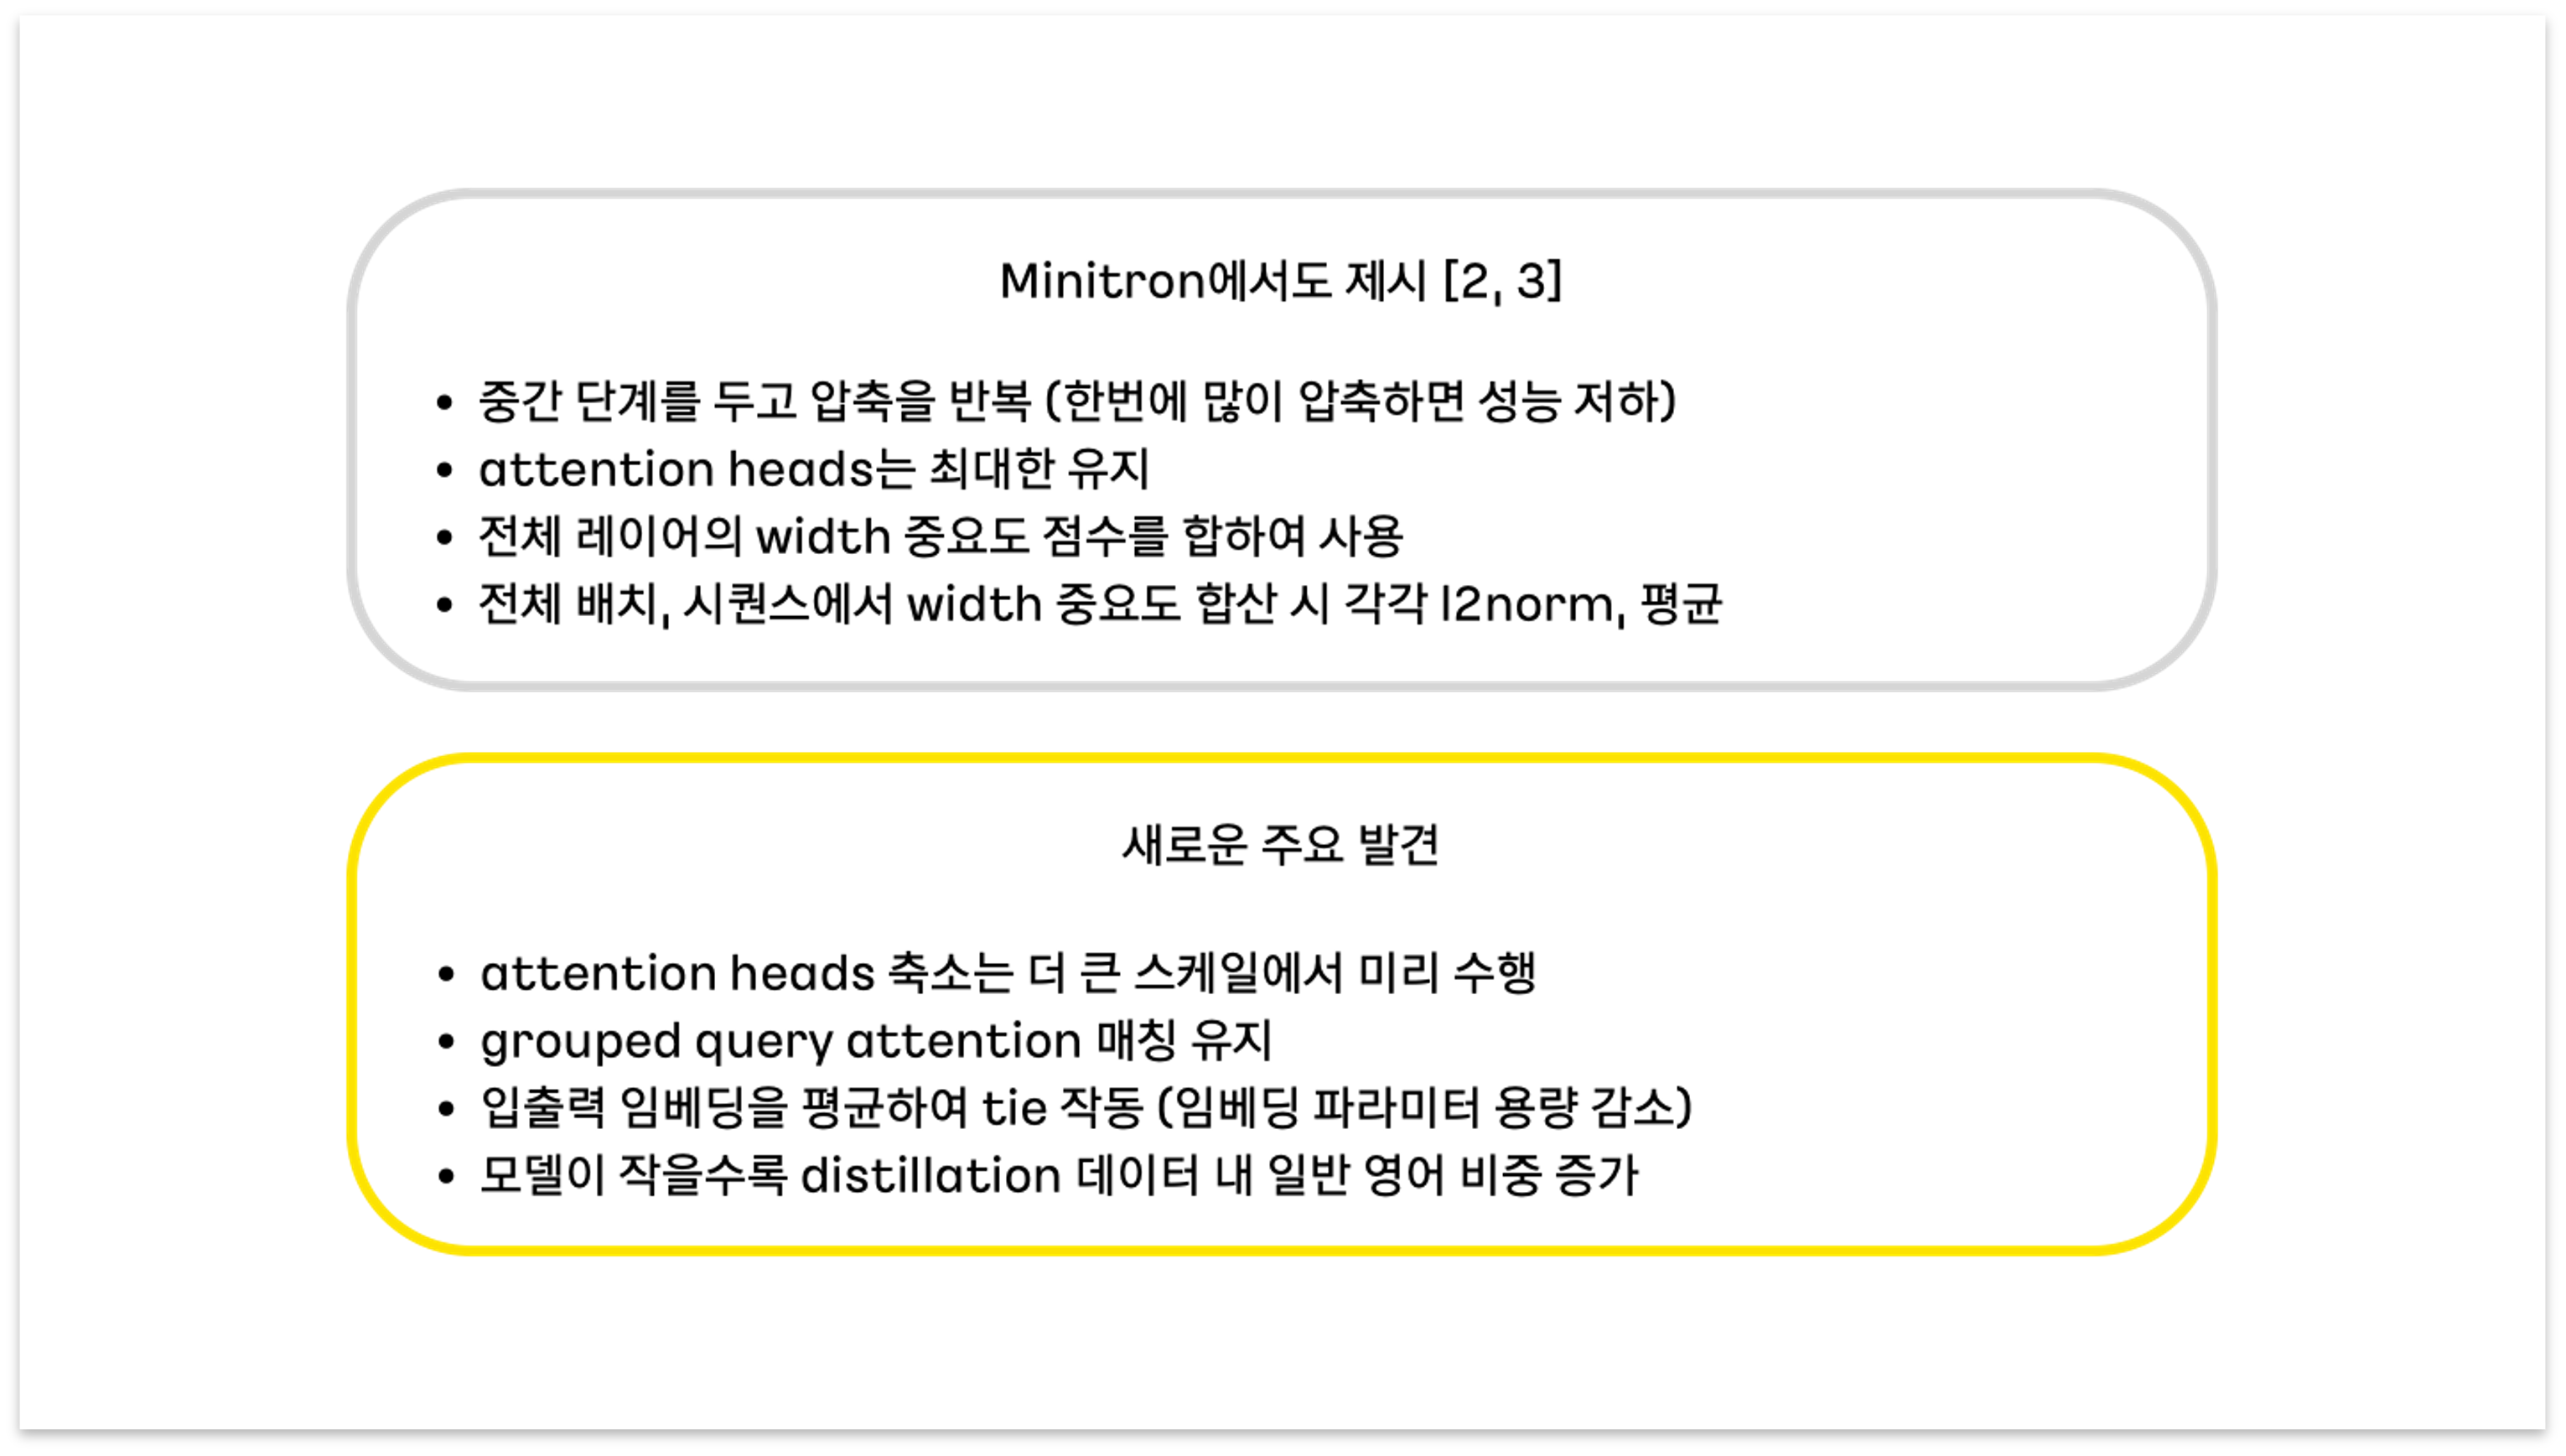
이 과정에서 저희가 재확인하거나 새로이 발견한 Best practice를 먼저 요약하면 아래 그림과 같습니다. 상세한 개발 과정은 이어 소개하겠습니다.
Minitron의 Pruning & Distillation 연구
Minitron [2, 3] 에서는 Structured pruning과 Knowledge distillation을 결합하였습니다. Structured pruning에서는 모델의 특정 구조적 단위를 통째로 제거하여, 기존의 행렬 연산 방식을 그대로 사용하면서 실질적인 추론 속도를 개선할 수 있습니다. 예를 들어, 중요도가 낮은 Attention head, Neuron, Embedding channel을 제거하여 Width 축을 따라 Pruning하거나 트랜스포머 레이어를 통째로 제거하여 Depth 축을 따라 Pruning할 수 있습니다. 참고로, Depth pruning은 Width pruning에 비해 성능이 낮으므로 이 글에서는 다루지 않겠습니다.
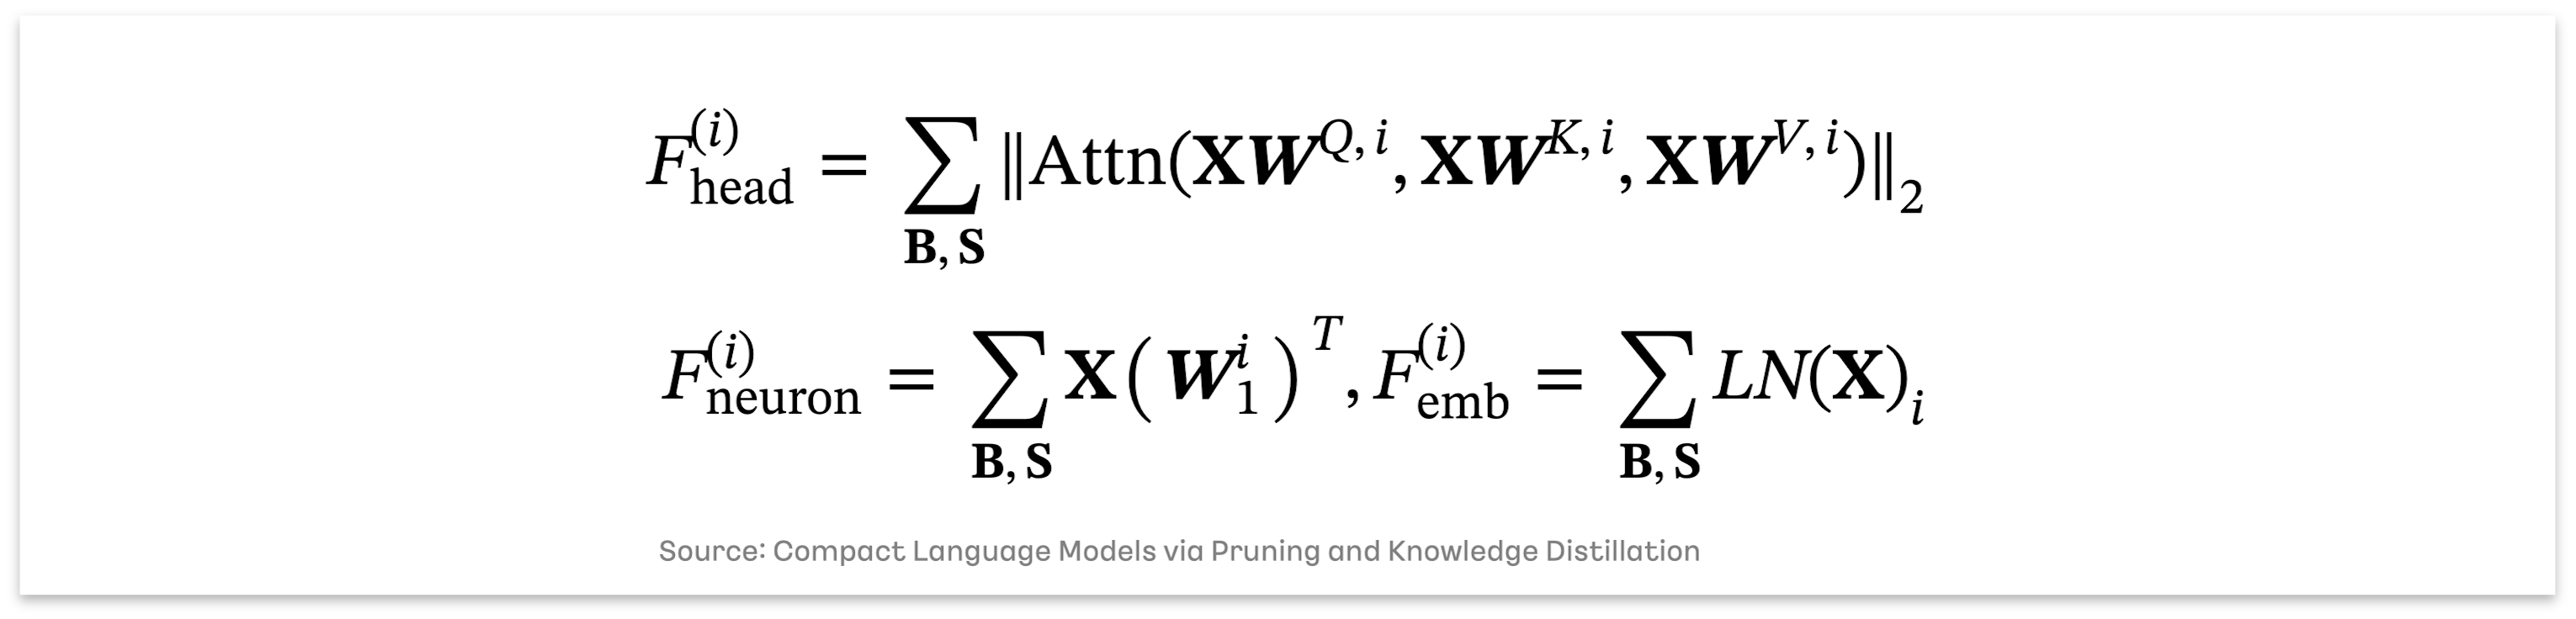
Minitron에서는 Width 중요도를 LLM에 효과적이면서 실용적으로 추정하는 방법을 제안했습니다. Calibration 데이터로 단 1024개의 샘플만을 사용하여, Backward 과정 없이 Forward 단계에서 생성된 활성값을 기반으로 중요도를 계산합니다. 구체적으로, 각 Head, Neuron, Embedding channel에 대한 중요도 점수는 전체 배치 B와 시퀀스 S에서 합산하여 아래 수식 [2] 과 같이 정의됩니다.
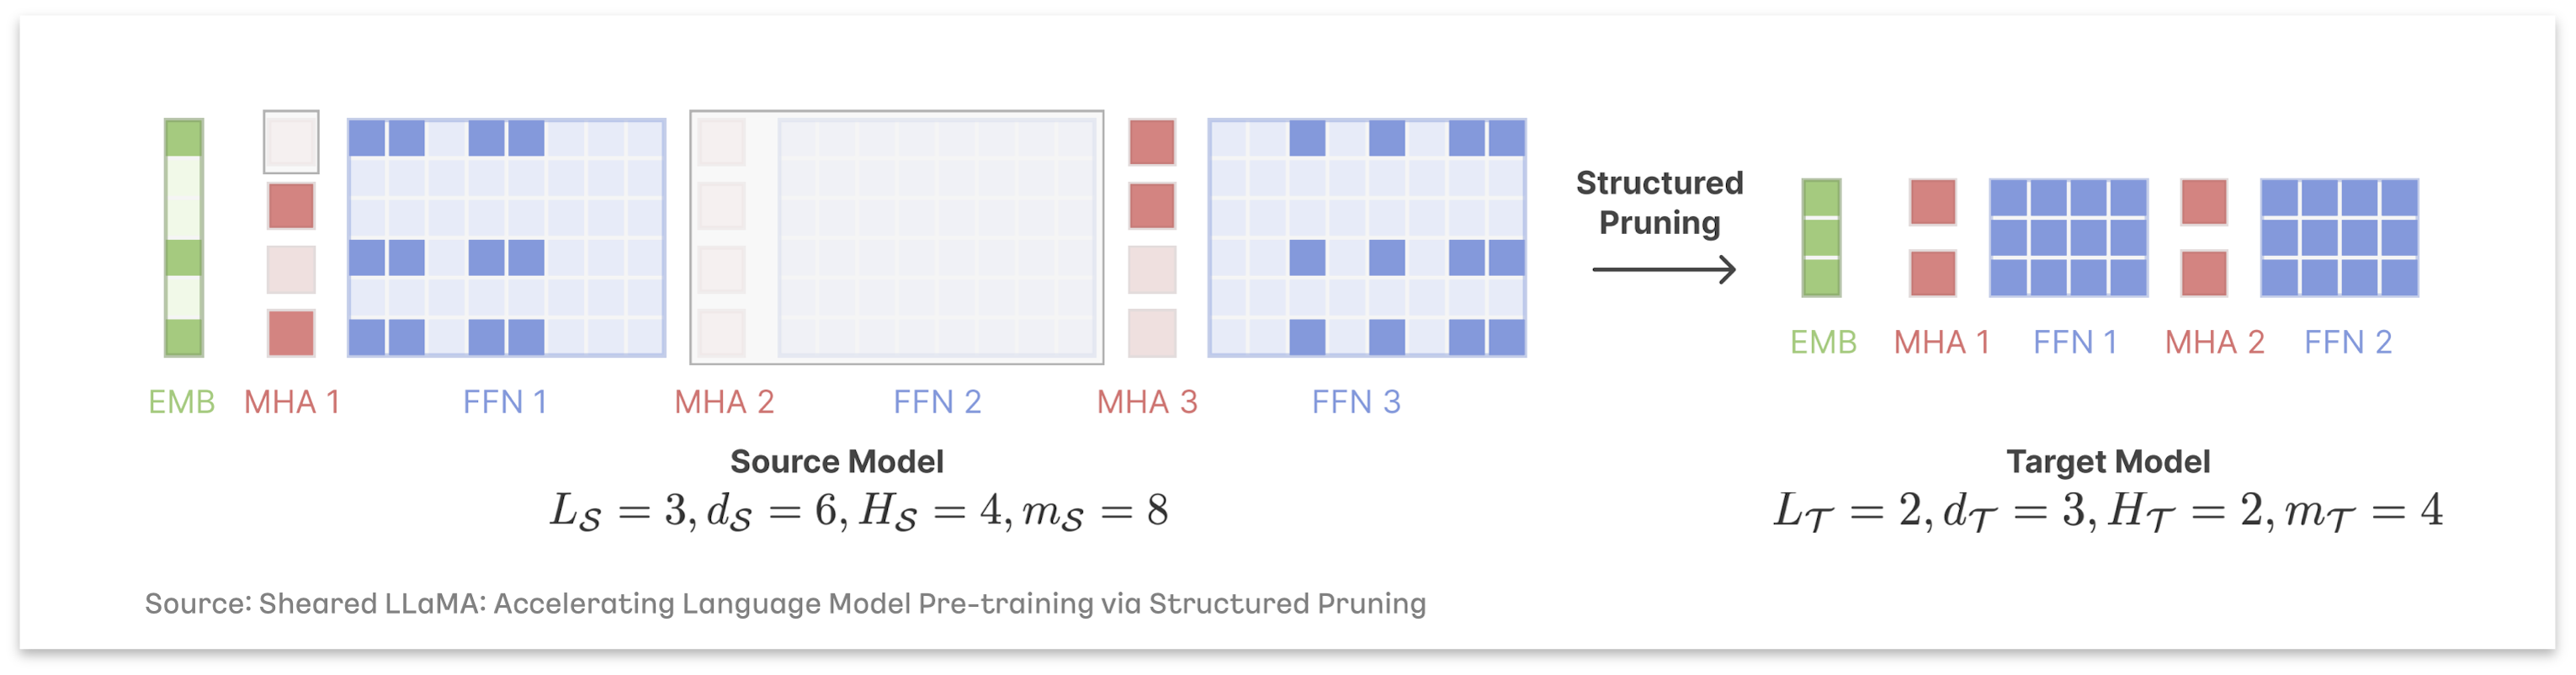
이렇게 계산된 중요도를 기반으로, 아래 그림 [7] 과 같이 가중치 행렬들을 목표하는 만큼 잘라서 Pruning을 수행합니다. Neuron을 Pruning할 때는 Feedforward 레이어의 가중치 행렬을, Attention head를 Pruning할 때는 Attention 레이어의 가중치 행렬을 대상으로 적용합니다. Embedding channel의 경우에는 Feedforward, Attention, LayerNorm의 가중치 행렬을 모두 자릅니다.
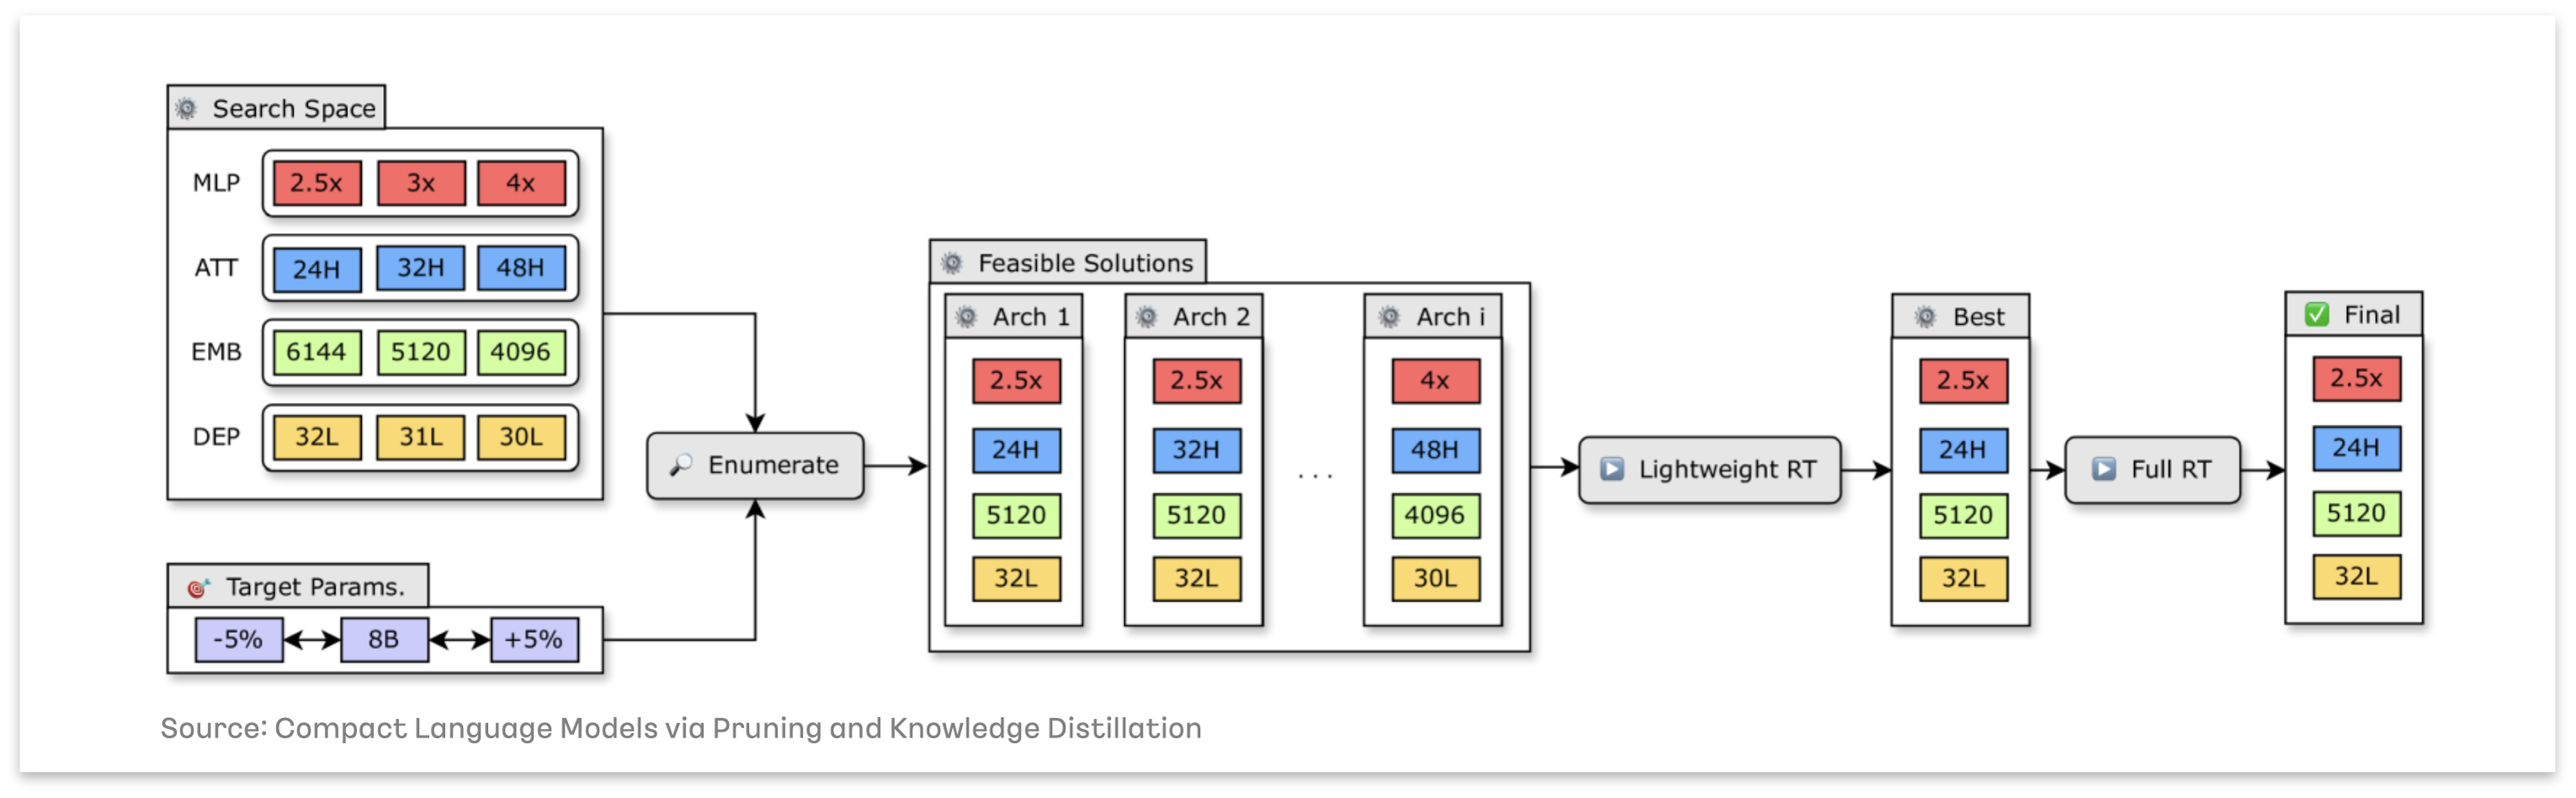
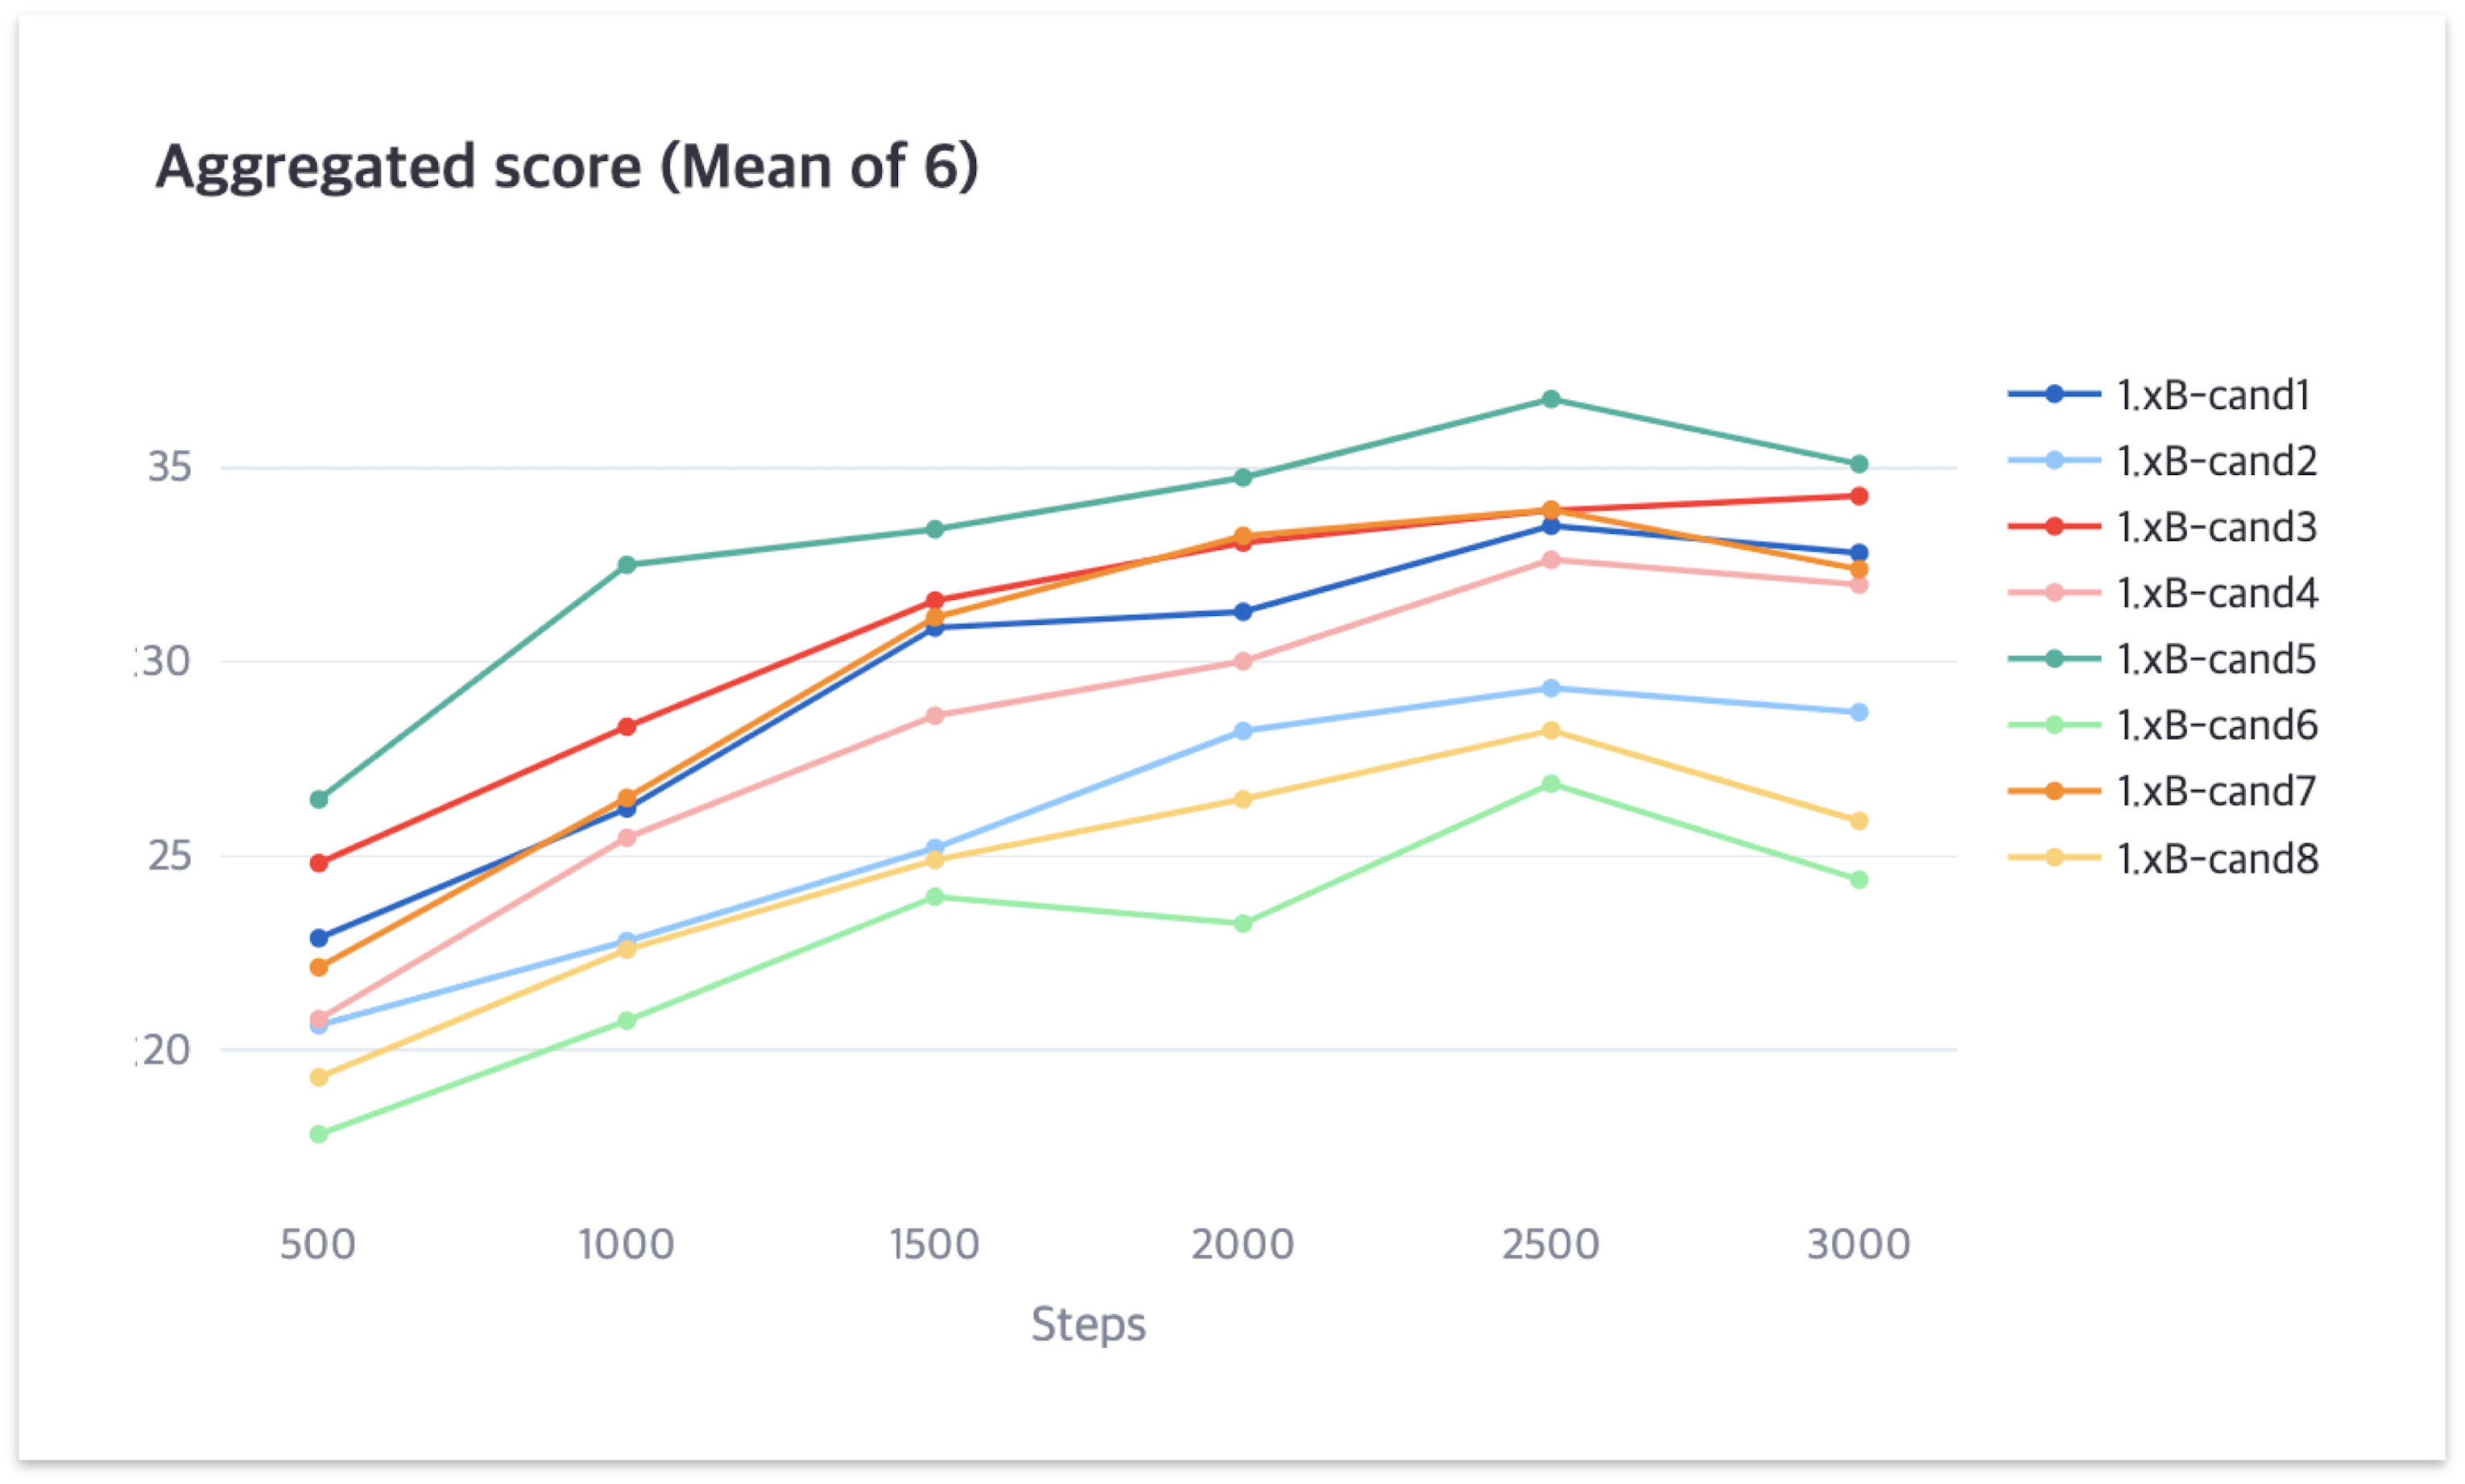
Pruning된 모델은 From-scratch 훈련보다 상대적으로 짧은 “Retraining”을 통해 성능을 회복할 수 있습니다. Minitron은 이 과정에서 가벼운 Neural architecture search (NAS)를 수행할 것을 제안하였습니다. 먼저, 아래 그림 [2] 과 같이 모델의 각 축에서 널리 사용되는 수치를 조합하여, 목표로 하는 파라미터 크기 범위 내에서 여러 후보 구조를 미리 설정합니다. 이러한 후보 구조들 간의 순위는 전체 훈련량의 2% 미만으로도 안정화되어, 빠르게 수렴 정도를 비교해 가장 적합한 구조를 찾을 수 있습니다.
Retraining에서 Knowledge Distillation (KD)을 Objective로 활용하면 성능 회복이 더욱 효율적으로 이루어집니다. KD는 Teacher 모델의 출력을, 혹은 중간 결과까지도 Student 모델이 모사하도록 훈련하는 기법입니다. 여기서는 원래의 모델을 Teacher로, Pruning된 모델을 Student로 사용합니다.
Importance Scoring 세부 개선 및 탐색
아래는 Minitron [2] 의 Importance scoring에서 설명되지 않은 세부 사항은 추가로 발전시키며 탐색한 결과입니다.
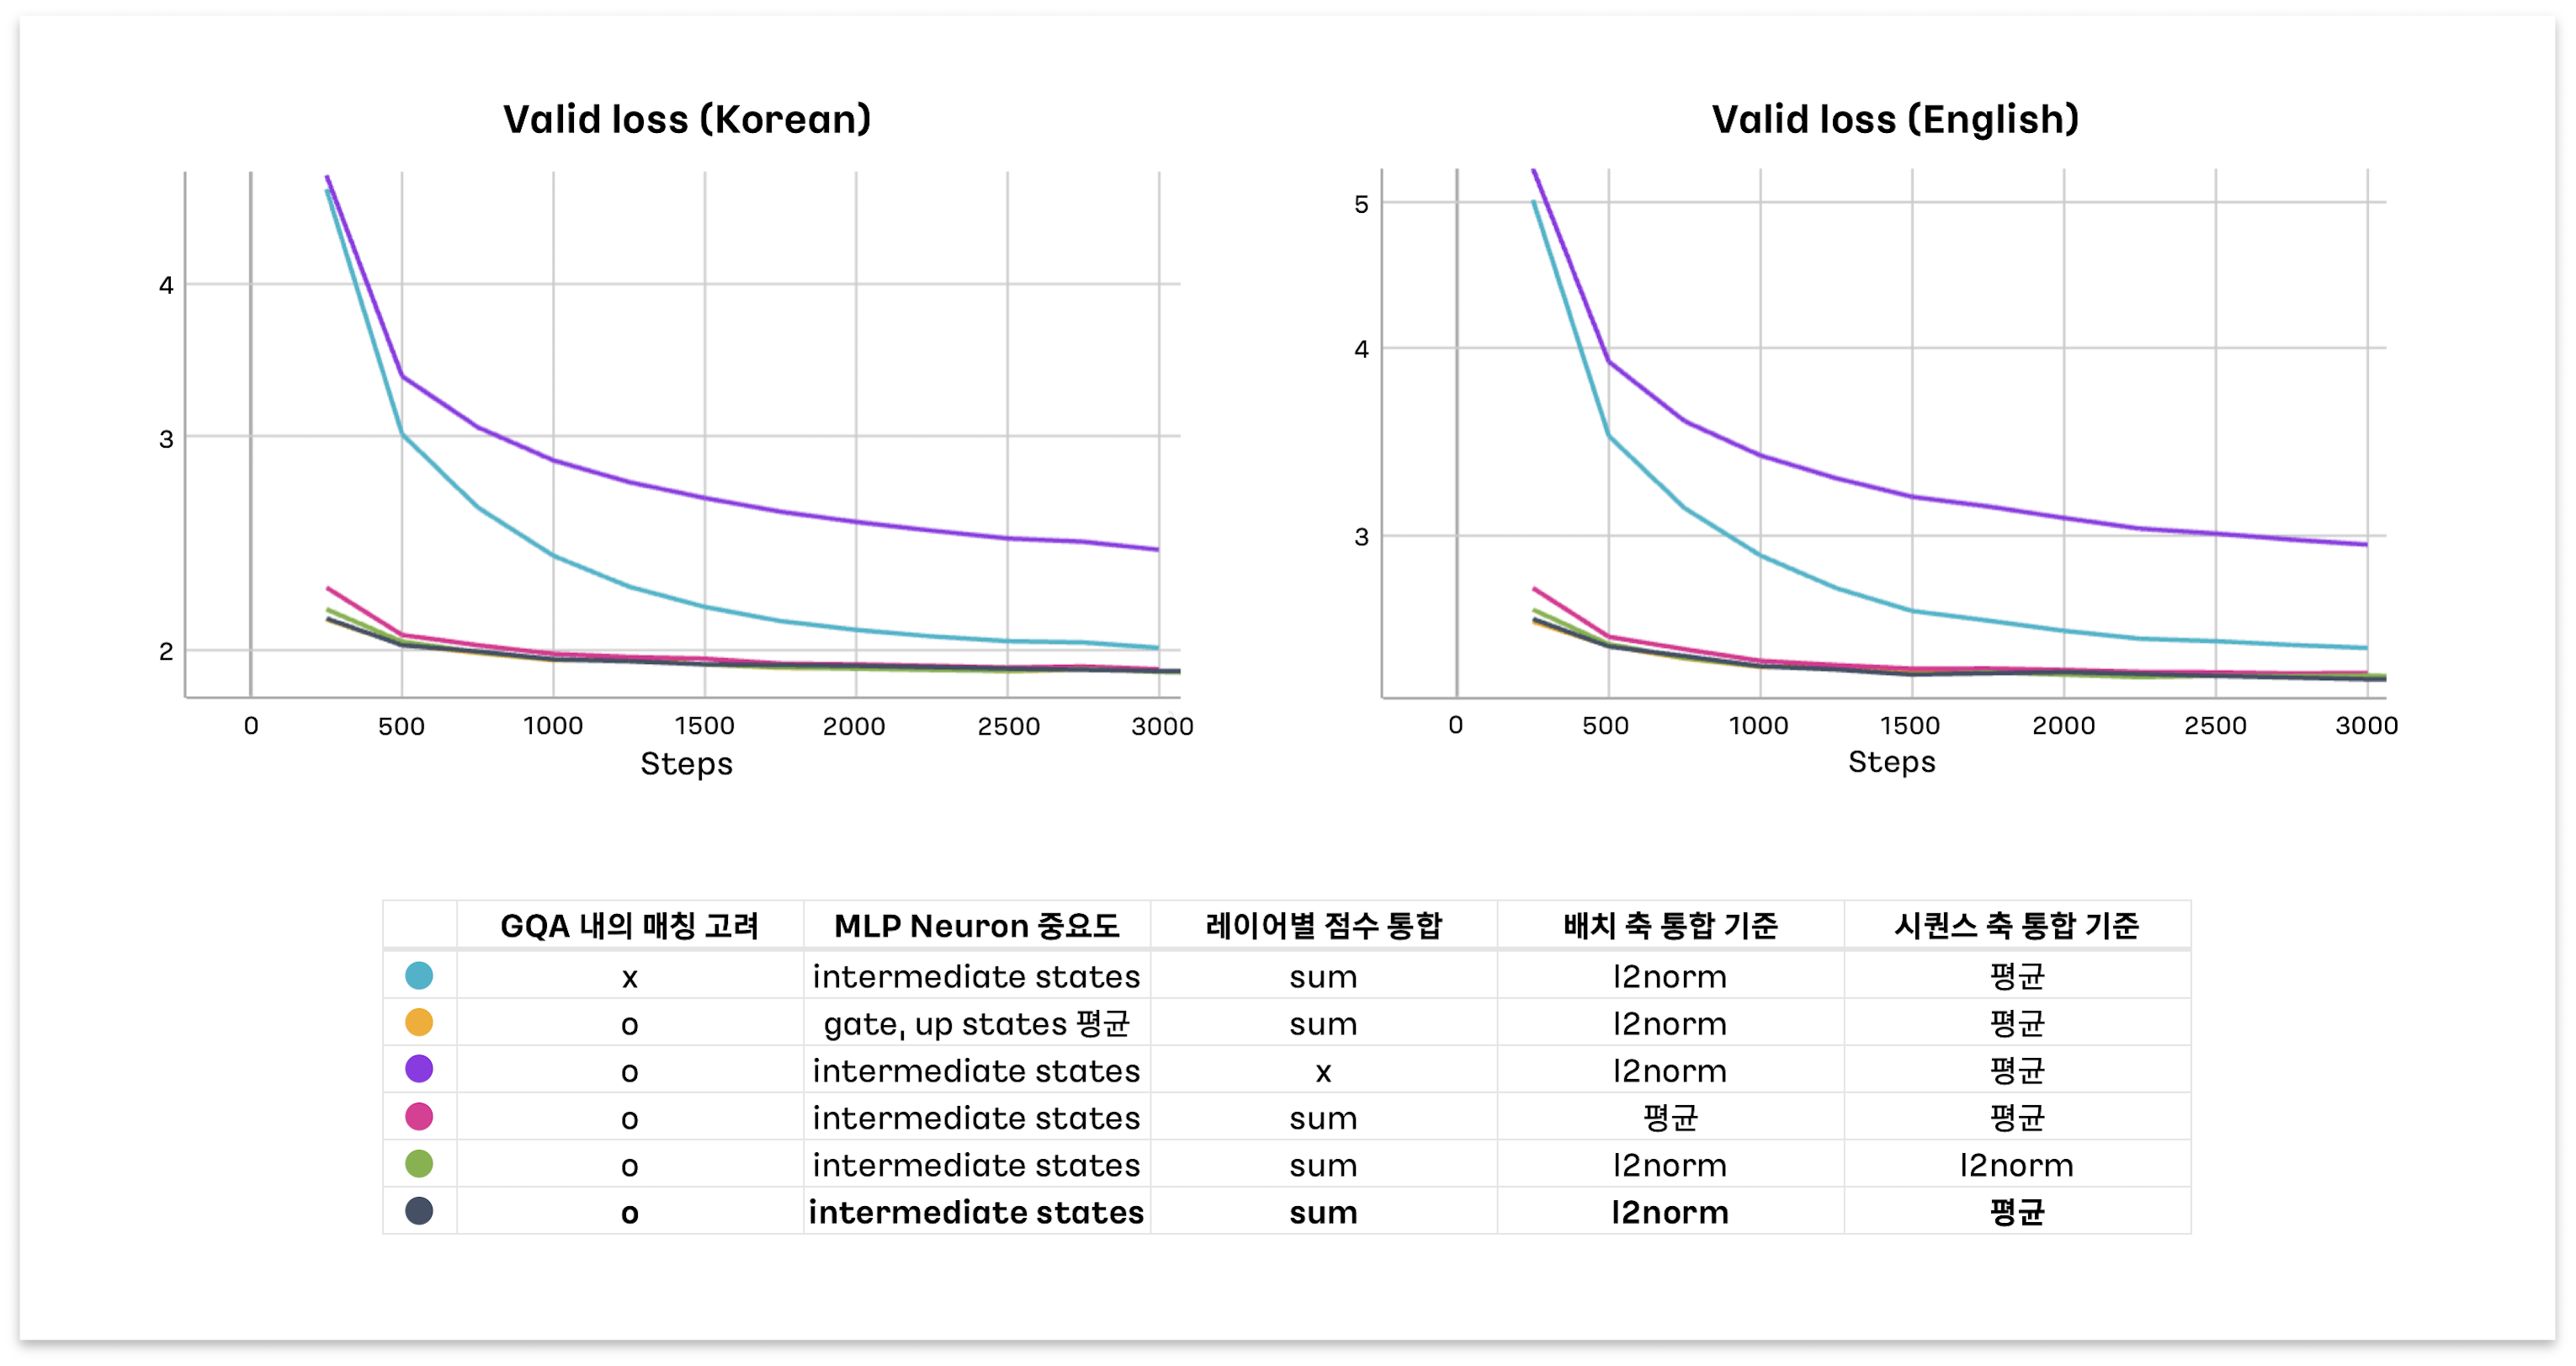
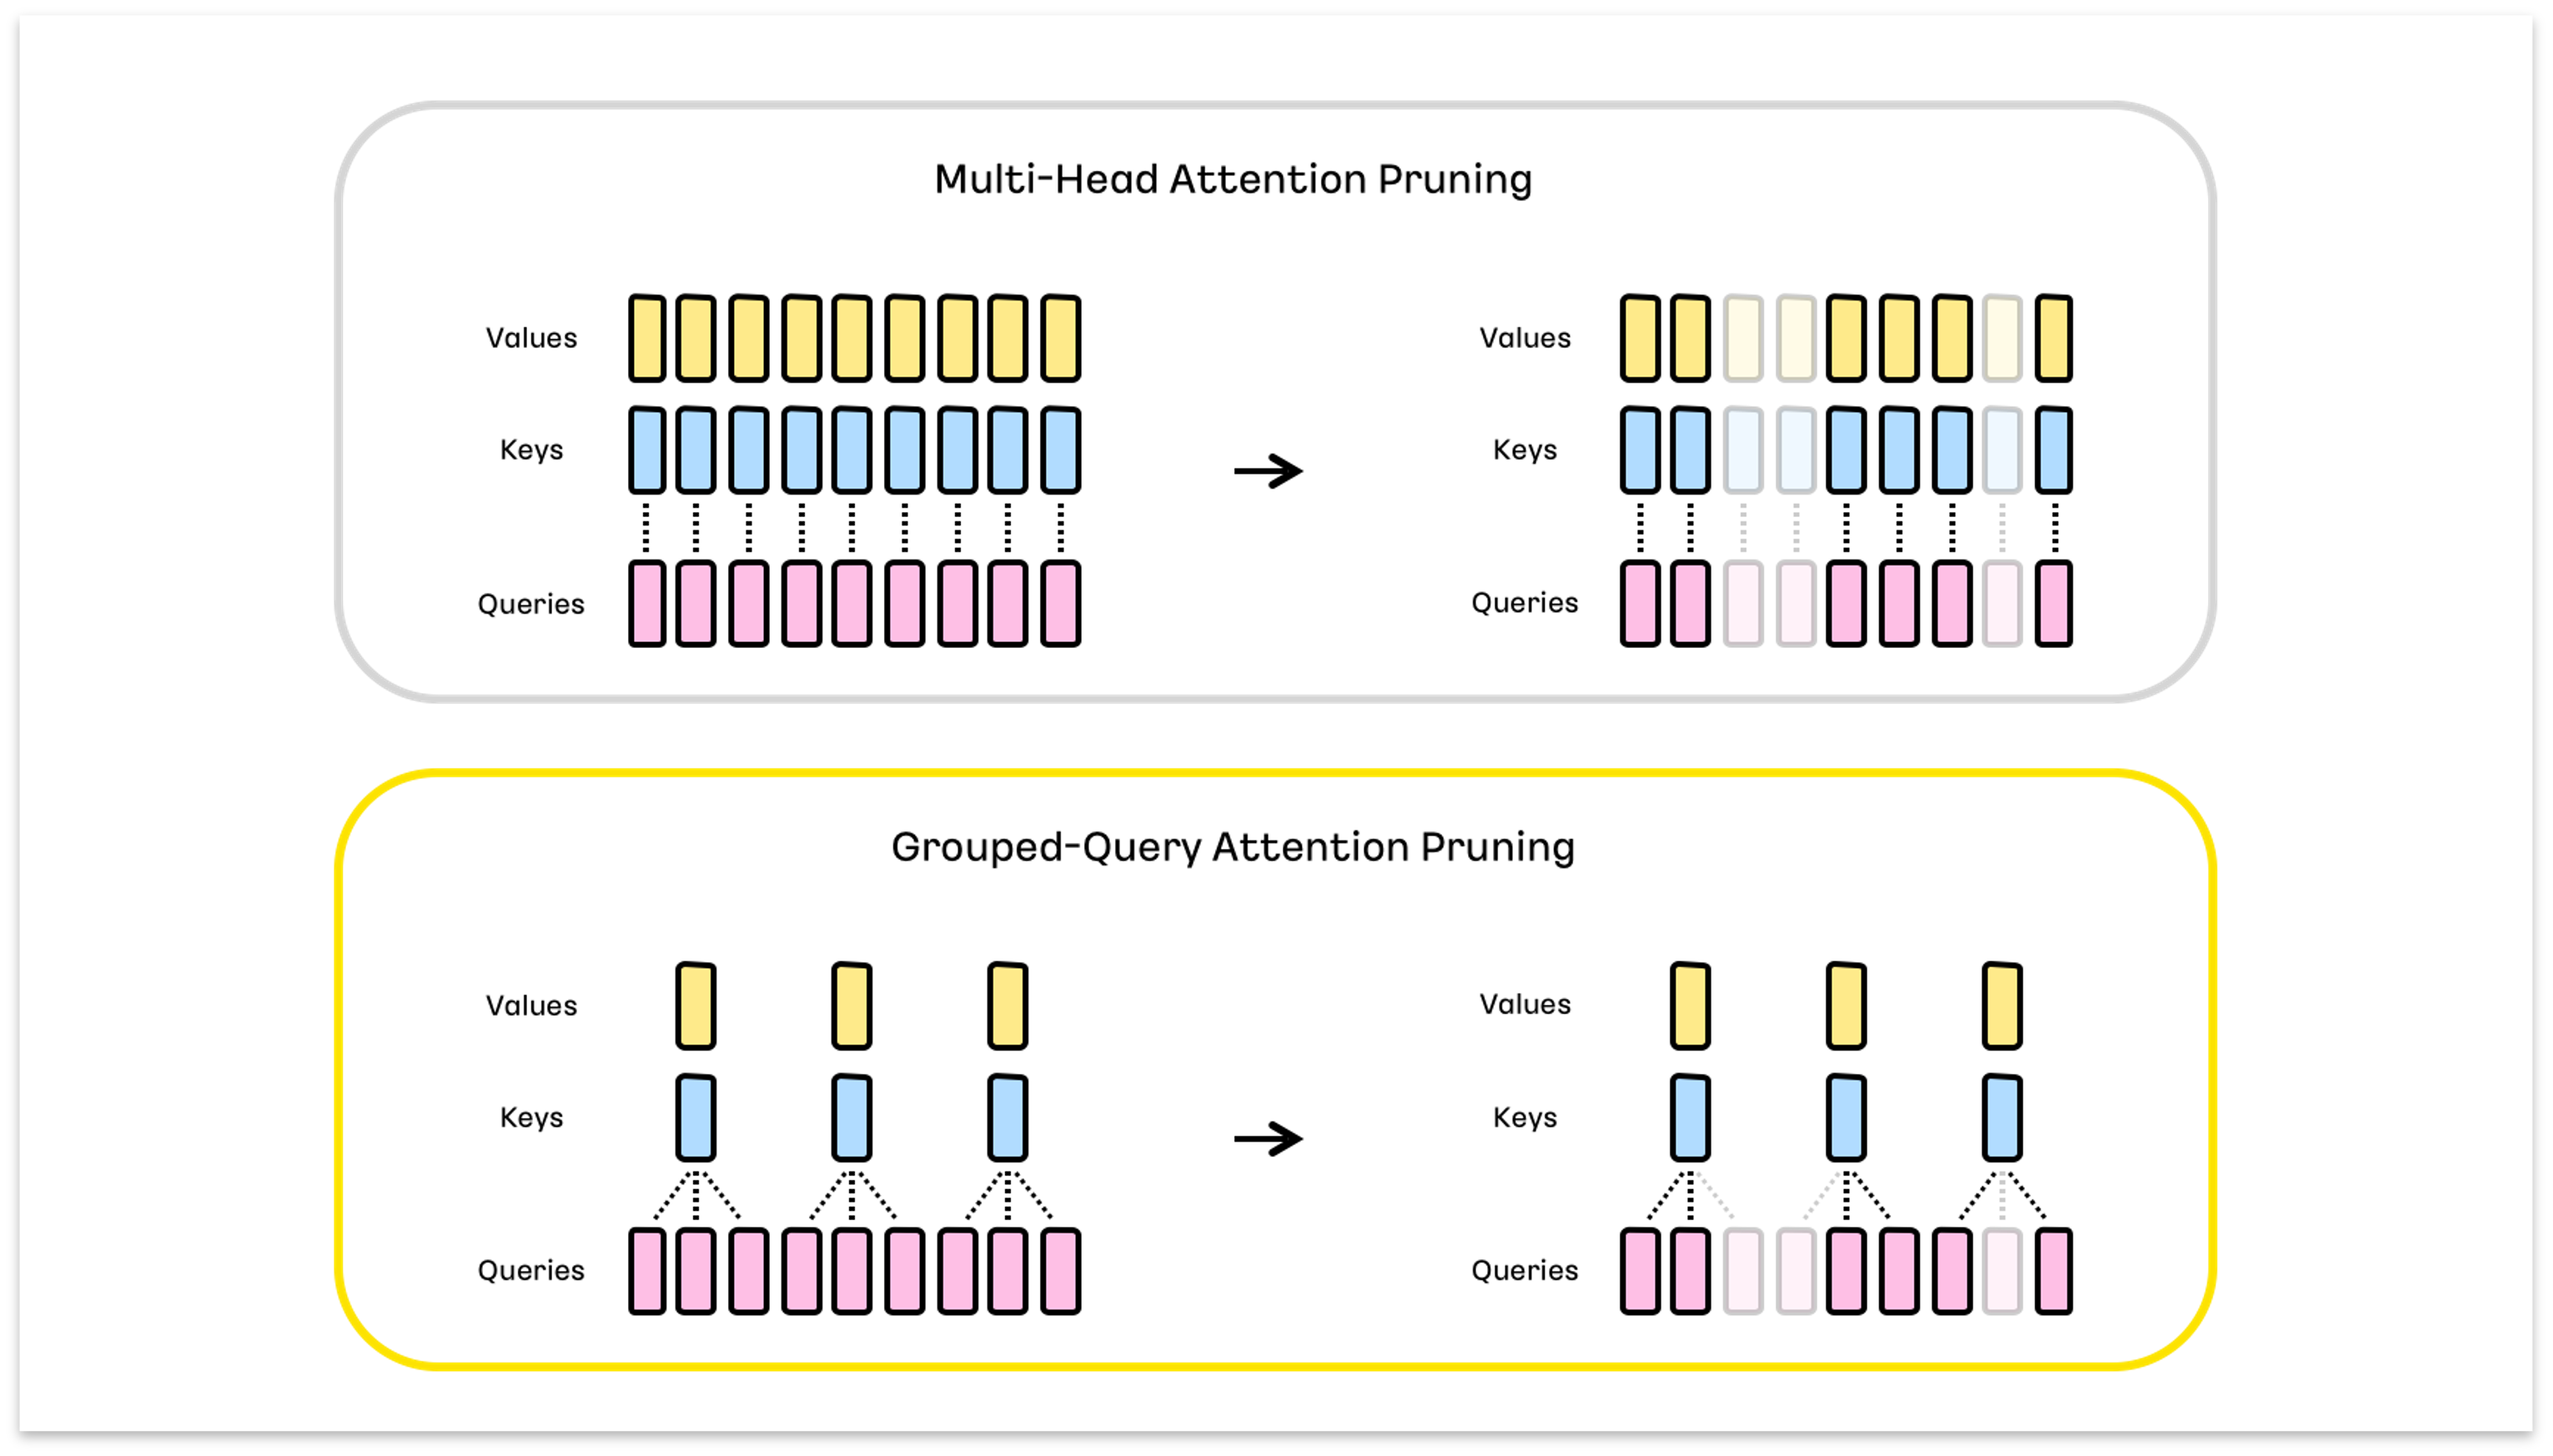
Grouped-Query Attention(GQA)에서 전체 Query head 중 하위를 제거하는 대신, Key/Value를 공유하는 Query head끼리 묶어 동일 개수씩 하위를 제거하는 방식이 효과적임을 발견하였습니다. 이 방식을 통해서 기존에 매칭된 Query와 Key/Value를 유지하면서 제거할 수 있기 때문입니다. 기존 Multi-Head Attention(MHA)에서는 Query head뿐만 아니라 Key/Value head를 같이 제거한다면, GQA 방식에서는 Query만 제거하였습니다. 이 방식은 제거할 Query head의 개수가 Key/Value head의 총 개수로 나누어떨어질 때 적용할 수 있습니다. 아래 그림을 통해 이를 시각화해 보았습니다.
Minitron의 수식에서는 Neuron의 중요도를 활성화 함수를 적용하기 직전의 값을 사용하여 계산합니다. Swiglu 기반인 저희 모델에서는 Gate states와 Up states를 평균하거나, Intermediate states를 사용하는 두 방식을 비교해 보았을 때 큰 차이는 없었습니다.
또한, 레이어별 점수를 독립적으로 사용해 보았으나, Minitron과 동일하게 모든 레이어의 점수를 더해 통합하는 방식이 훨씬 효과적이었습니다. 그리고 배치 축을 따라 합산하는 데에는 L2 normalization을, 시퀀스 축을 따라 합산하는 데에는 평균을 사용하였습니다.
참고로, Scoring과 Pruning의 구현은 PyTorch [8] 와 HuggingFace [9] 라이브러리 기반으로 진행하였습니다. Calibration 샘플들은 Kanana Essence의 Stage2를 위해 구축한 고품질 데이터이며, 모두 LLM 학습에 사용해도 문제가 없는 라이선스에 해당합니다.
Pruning 구조 탐색
Minitron [2] 에서는 한꺼번에 Pruning을 많이 진행할 경우 회복하기 어려운 수준의 성능 저하를 발견했다고 합니다. 이러한 경향은 저희 실험에서도 여러 스케일에 걸쳐 확인되었으며, 일반적으로 약 50%씩 줄일 때마다 Pruning과 Distillation을 반복하며 중간 단계를 두는 것이 필요했습니다.
특히, 어떤 구조의 중간 단계를 거치느냐에 따라 최종 구조가 동일하더라도 모델의 성능이 크게 달라지기도 했습니다. 먼저, Minitron과 동일하게 저희 NAS 결과에서도 어텐션 헤드가 특히 중요한 요소임을 아래와 같이 확인하였습니다.
| Hidden | Intermediate | Query heads | Params (non embed) | |
|---|---|---|---|---|
| 범위 | 1280, 1536, 1792 | x3,3.5,4,4.5 | 24, 16, 8 | 930M~1130M |
| cand1 | 1280 | 5120 | 24 | 0.96B |
| cand2 | 1280 | 5760 | 16 | 0.96B |
| cand3 | 1280 | 5760 | 24 | 1.04B |
| cand4 | 1536 | 4608 | 16 | 0.98B |
| cand5 | 1536 | 4608 | 24 | 1.08B |
| cand6 | 1536 | 5376 | 8 | 0.99B |
| cand7 | 1536 | 5376 | 16 | 1.09B |
| cand8 | 1536 | 6144 | 8 | 1.11B |
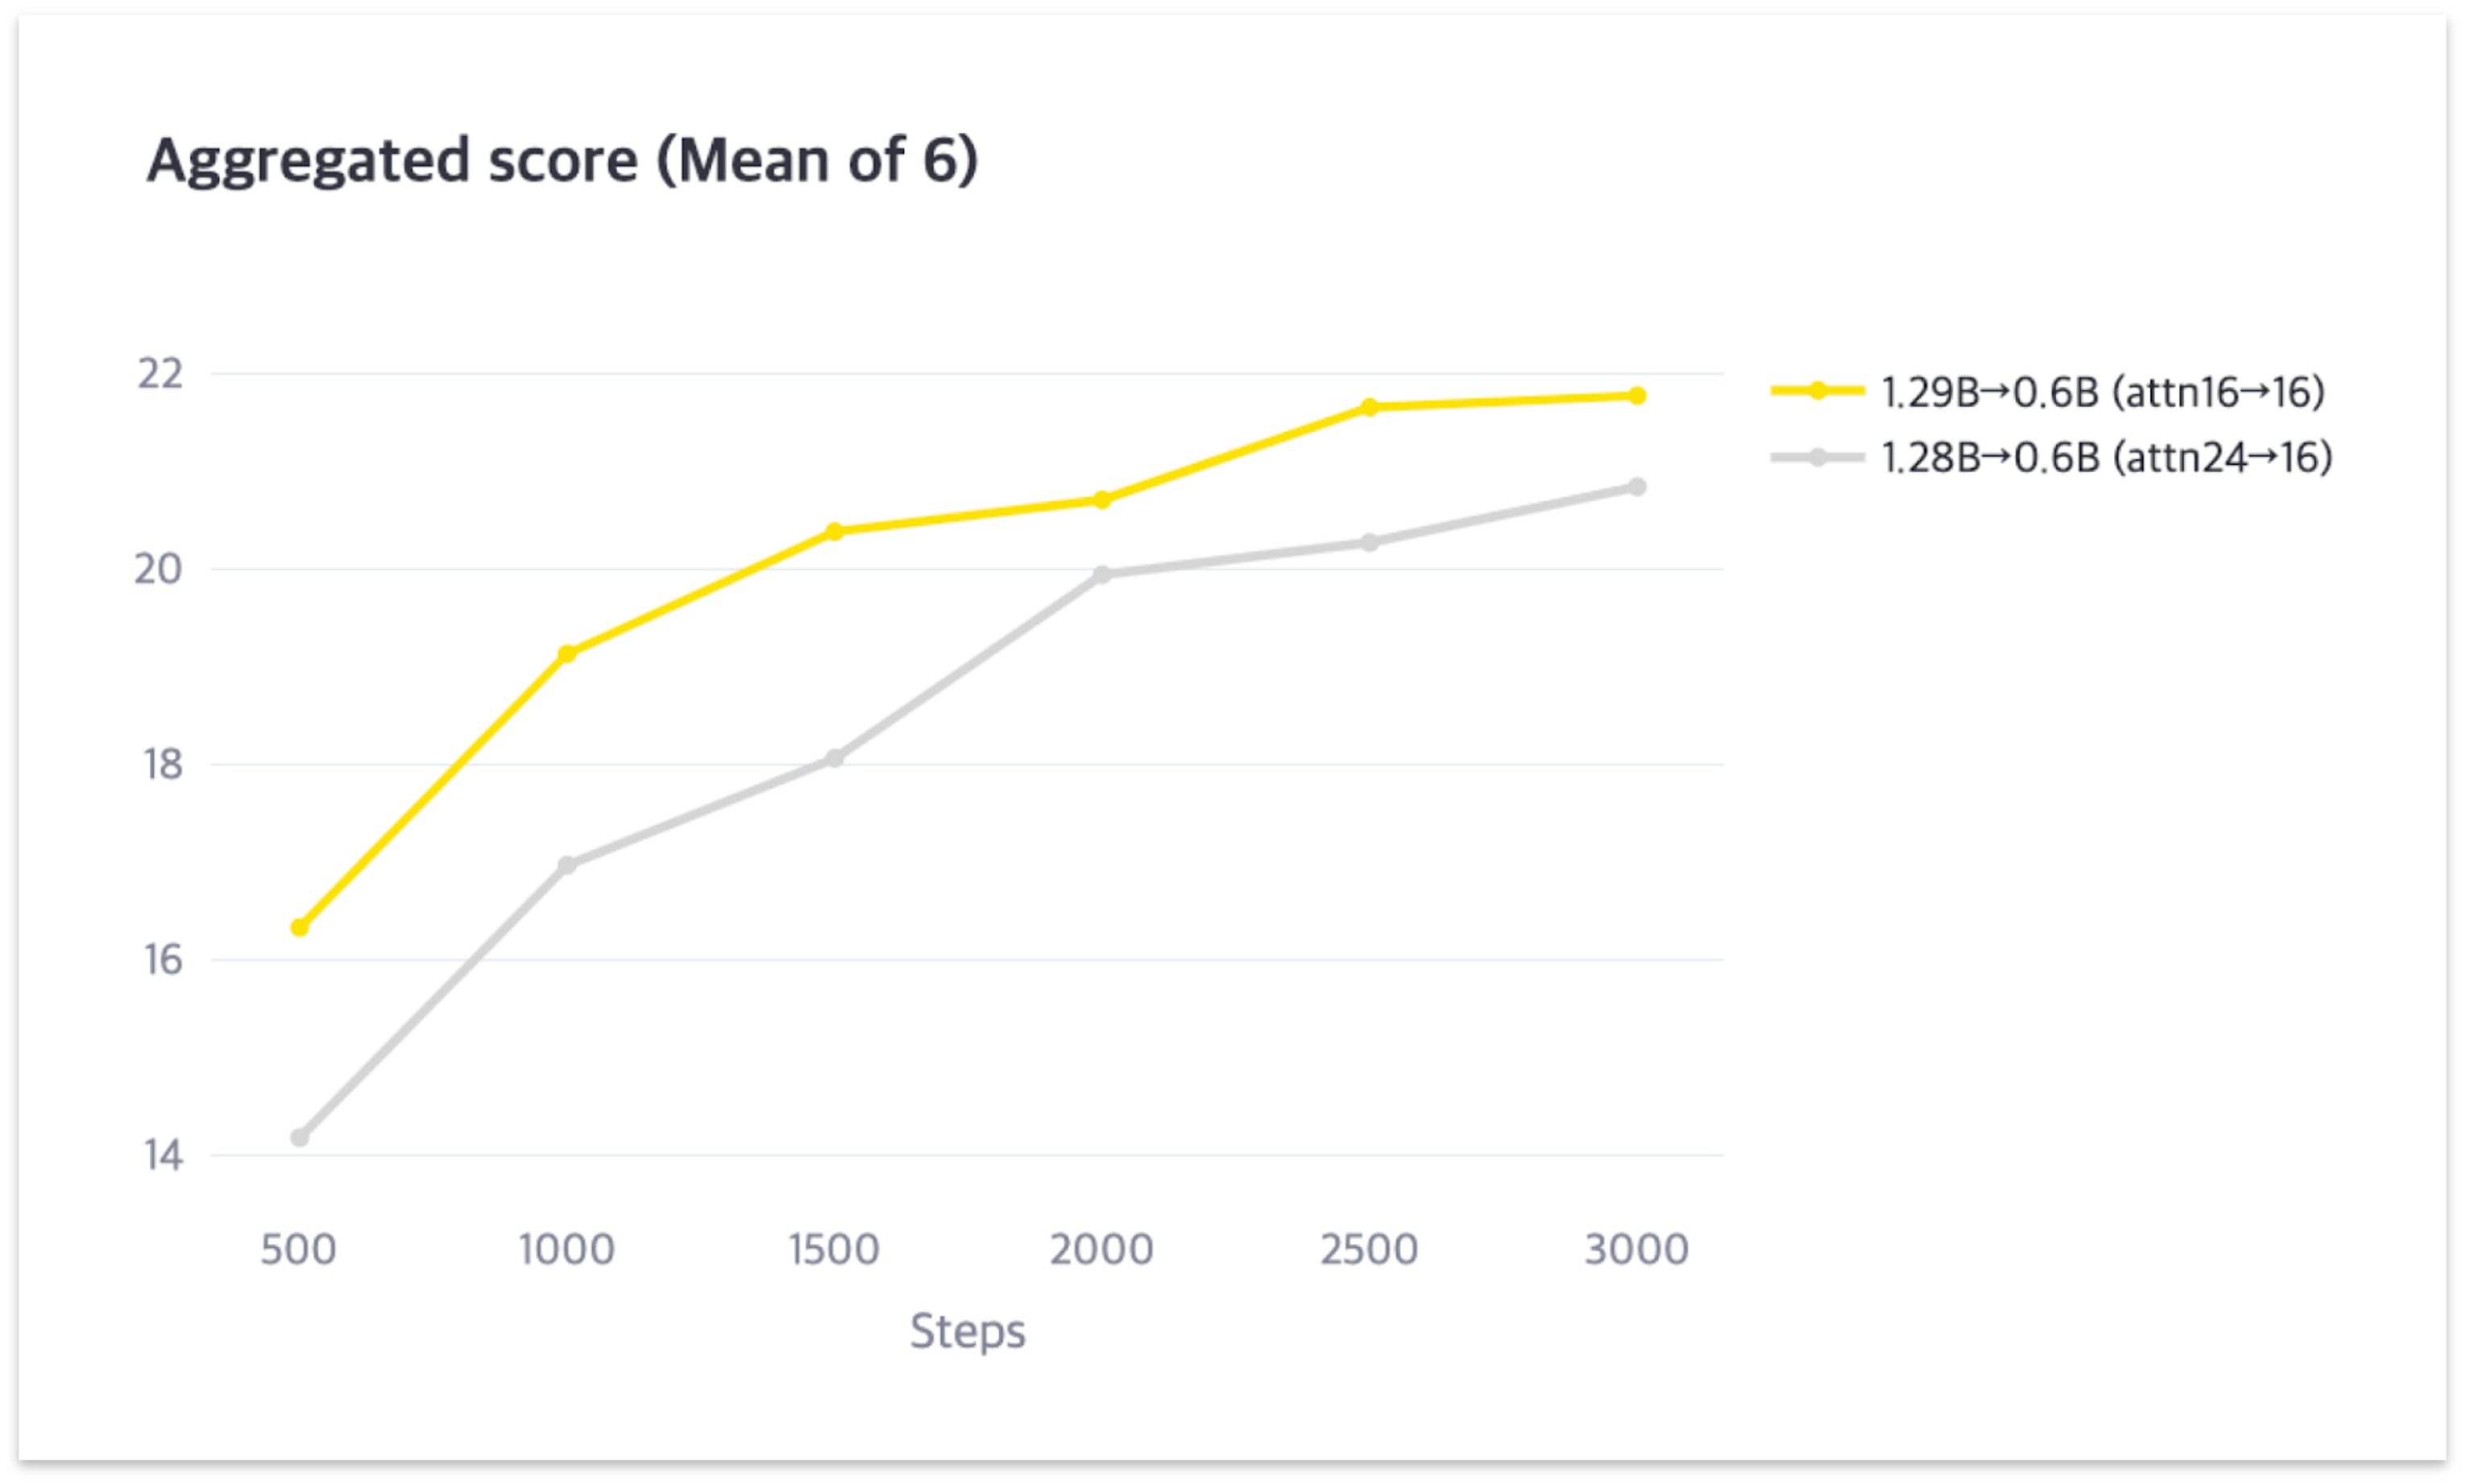
다만, 소형 모델을 설계하면서 Attention head 차원을 줄이고자 할 경우, 더 큰 스케일에서 미리 줄이는 것이 유리할 수 있습니다. 예를 들어, Attention head를 더 유지한 1.28B가 미리 줄인 1.29B보다 성능이 약간 좋았는데, 동일한 구조의 0.6B로 줄일 때는 아래 그래프와 같이 확연히 반대되는 결과를 확인했습니다.
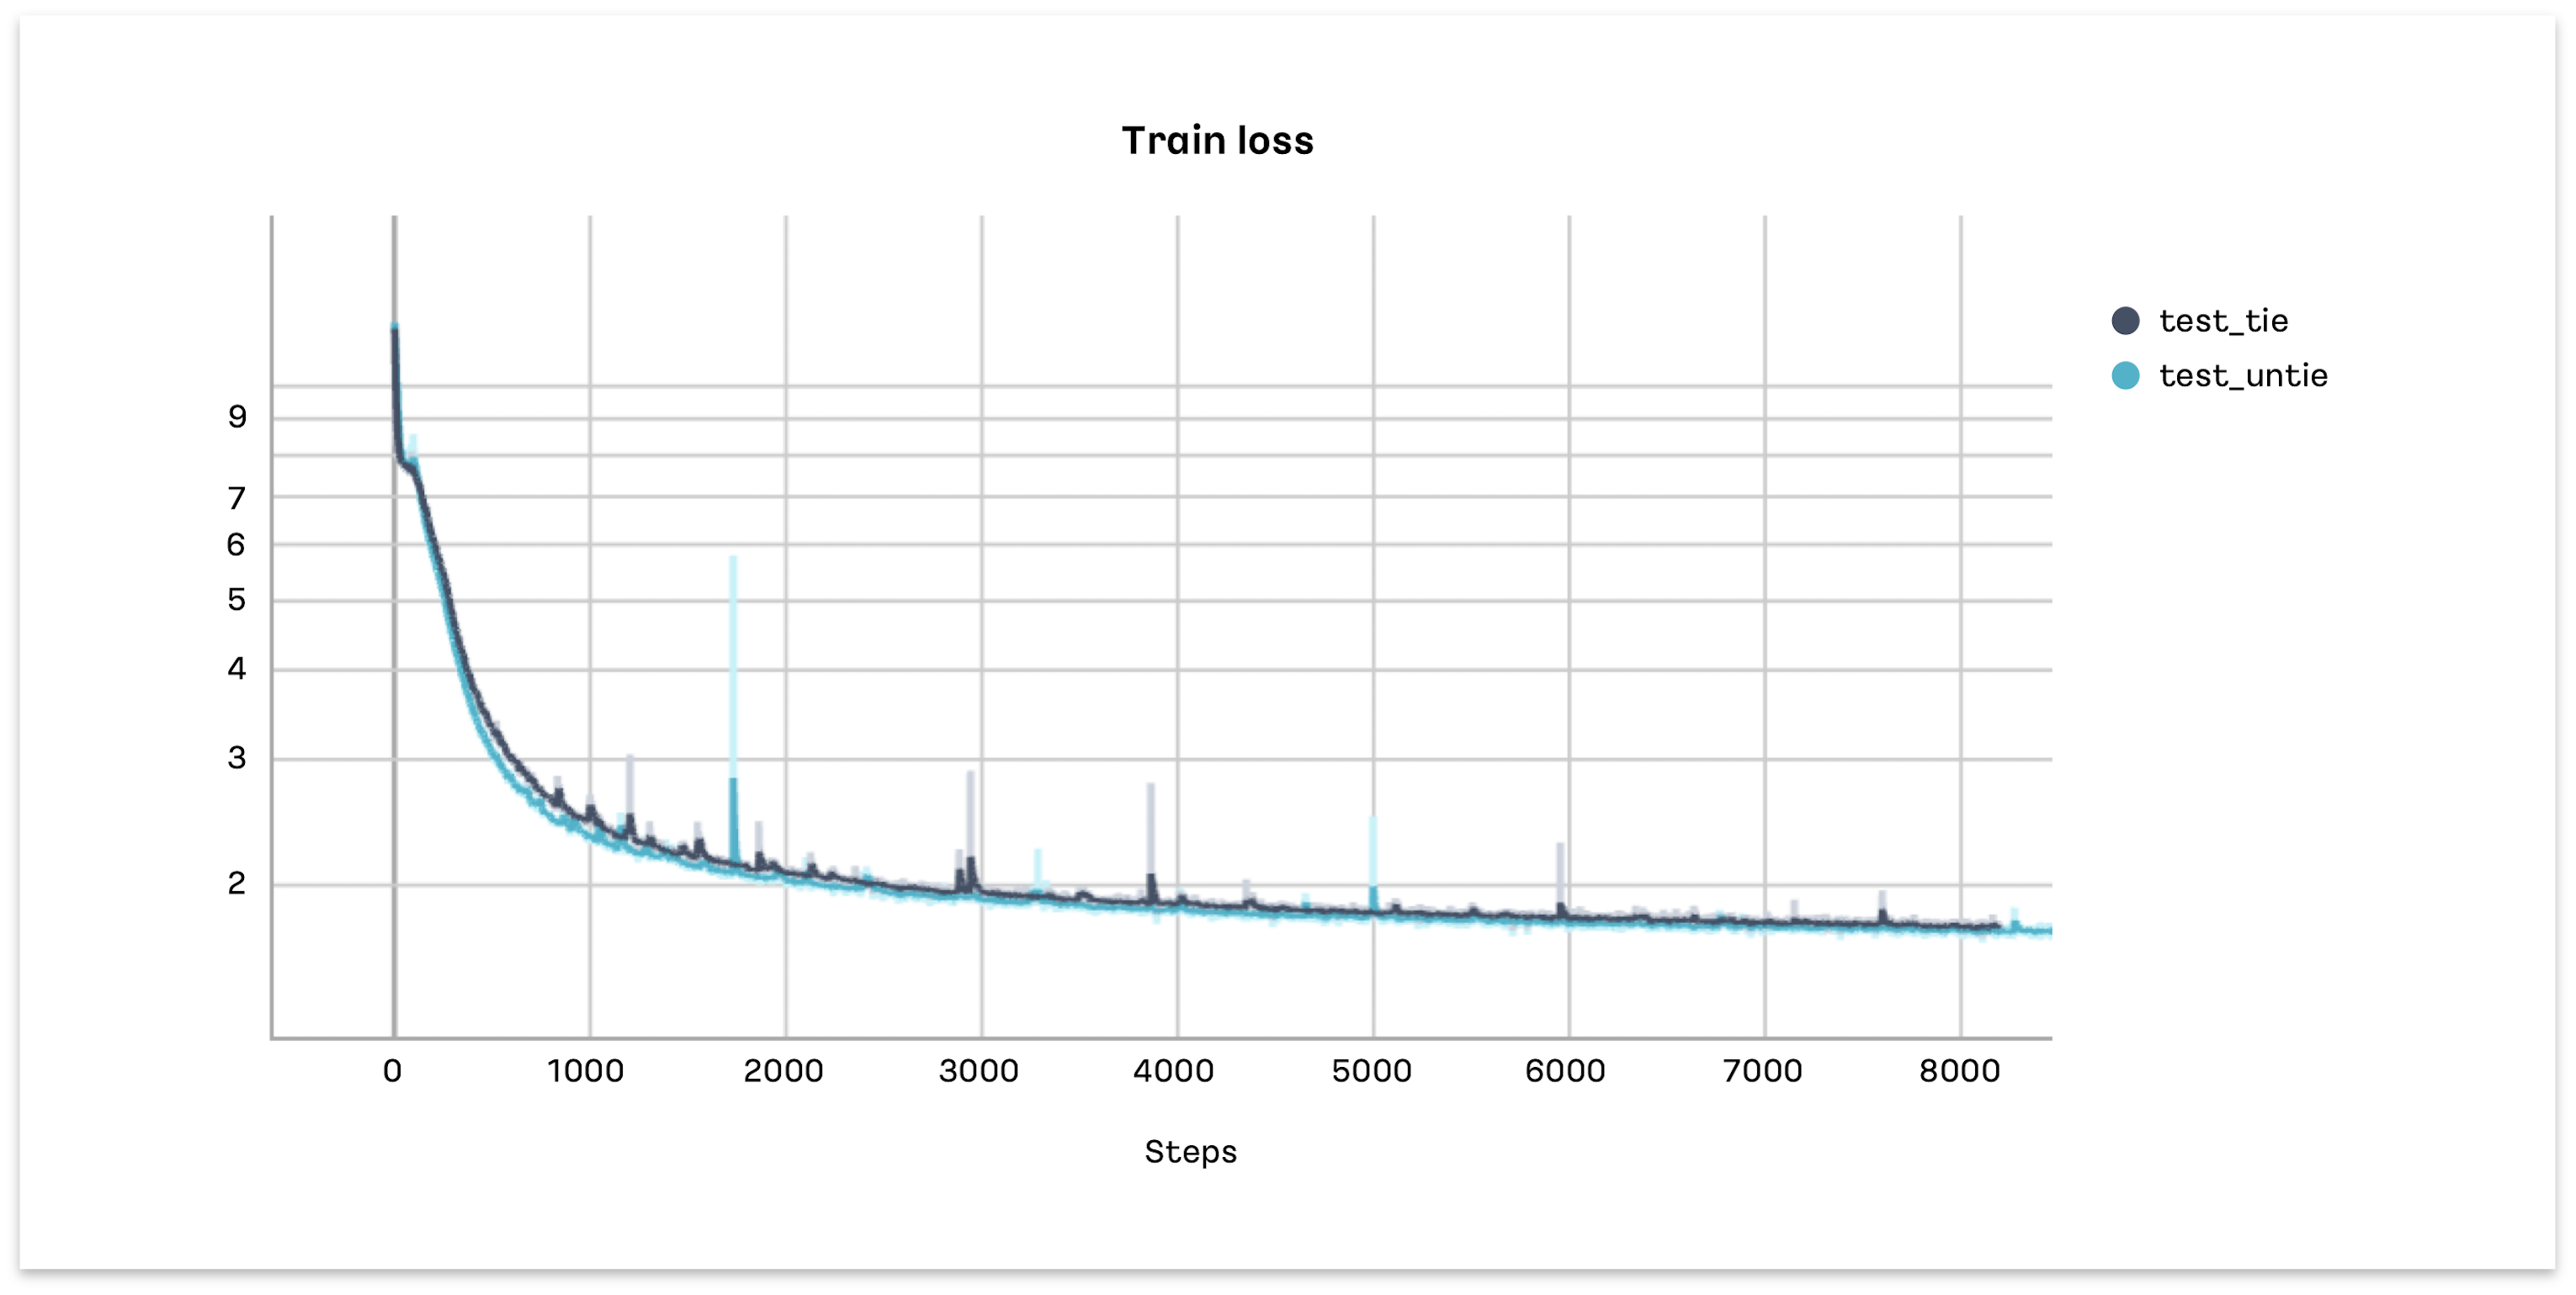
한편, Kanana Essence는 기본적으로 임베딩이 Untie이고 Vocab size가 큰 만큼, 소형 모델로 줄일수록 임베딩 파라미터가 차지하는 비중이 커집니다. 저희는 Pruning 과정에서 입출력 임베딩을 평균하여 초기화함으로써 임베딩을 성공적으로 Tie할 수 있음을 발견했습니다.
Distillation 탐색
Distillation 과정에서 사용하는 데이터는 벤치마크 성능에 직접적인 영향을 미쳤습니다. 특히, 모델 크기에 따라 효과적인 데이터 분포가 달라지는 양상을 보였습니다. 참고로, 여기서 사용한 데이터는 모두 LLM 학습에 사용해도 문제가 없는 라이선스에 해당합니다.
2B 이상의 모델에서는 Kanana Essence stage2의 최종 0.3T 데이터를 그대로 사용해도 우수한 결과를 얻을 수 있었습니다. 반면, 더 작은 모델에서는 같은 훈련량에서 일반적인 영어 데이터의 비중을 높이는 것이 필수적이었습니다. 이는 모델 용량이 작아짐에 따라 모든 벤치마크에서 고른 성능을 유지하기 어렵기 때문으로 추측됩니다. 아래 그래프에서 일반적인 영어 비중이 불충분할 경우 MMLU 성능이 훨씬 낮은 것을 확인할 수 있습니다.
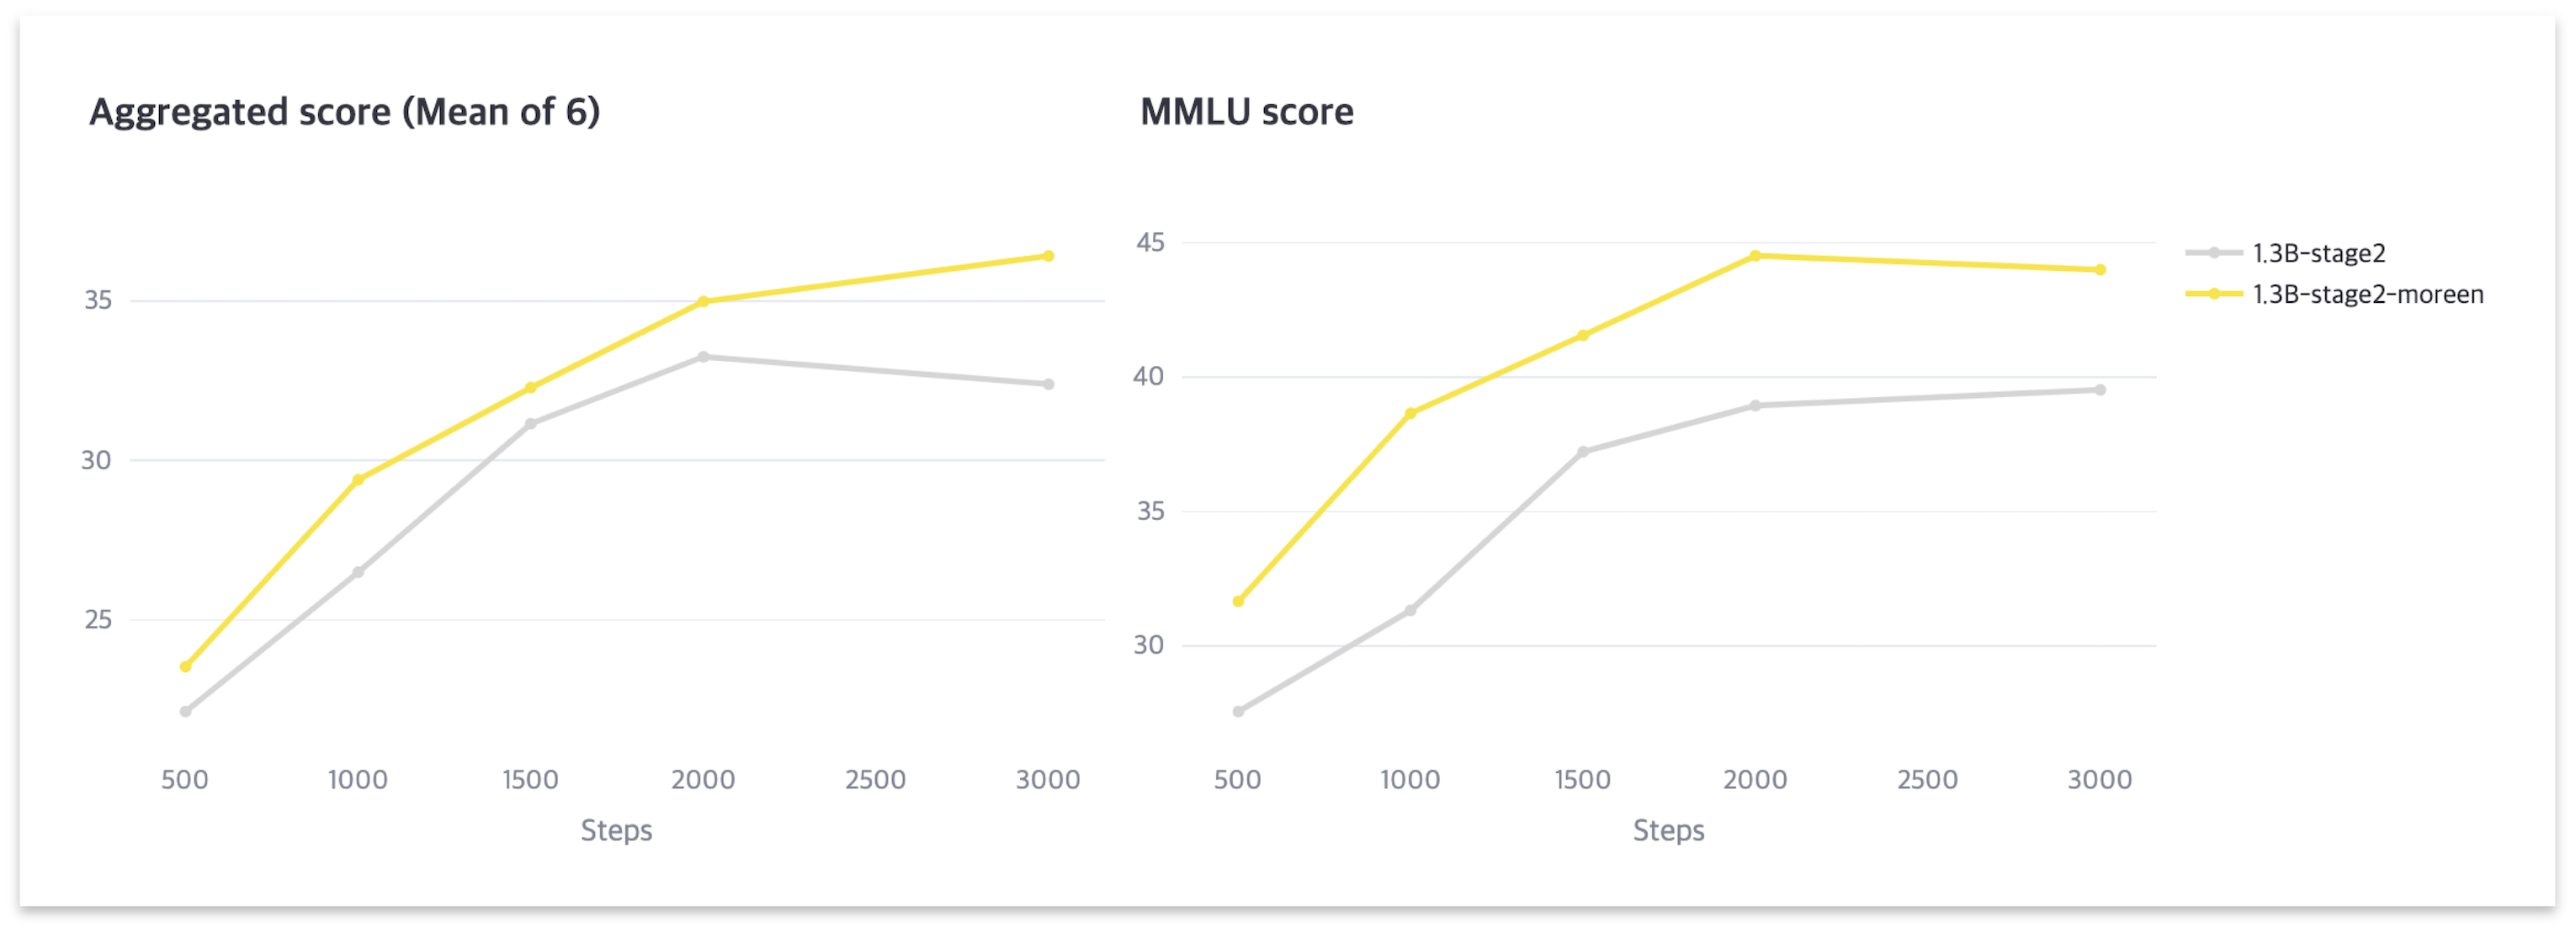
더불어, 일반적인 From-scratch pre-training과는 유효한 하이퍼파라미터가 달랐습니다. 공유해 드린 모든 실험에서 Learning rate는 1.2e-4 cosine, 배치 크기는 512, 시퀀스 길이는 8192, 그리고 Warmup은 100steps를 사용하였습니다. Learning rate annealing과 Checkpoint averaging도 큰 효과를 보지 못했습니다.
참고로, Distillation 구현을 위해서는 Megatron-LM [10] 에 Teacher forward hook과 Tensor parallelism 로스를 추가하였습니다. 로스로는 Minitron [2] 에서 추천한 대로 최종 Logit에 대한 KL divergence만을 사용하였습니다.
최종 성능 결과
탐색을 통해 최적화된 조합으로 다양한 크기의 Kanana Nano를 개발한 최종 결과는 아래 표와 같습니다. 한국어 점수에서는 유사한 크기의 모델 대비 압도적인 성능을 보이며 1위를 기록했습니다. 영어, 수학, 코드에서도 Llama 3.2 [4], Gemma 2 [5] 보다 우수한 성능을 나타내며, 평균적으로 뛰어난 성능을 보였습니다.
| Model | MMLU [12] | KMMLU [13] | HAE-RAE [14] | GSM8K [15] | HumanEval [16] | MBPP [17] | Mean of 6 |
|---|---|---|---|---|---|---|---|
| Domain | 영어 일반 | 한국어 일반 | 한국어 일반 | 수학 | 코드 | 코드 | |
| Metric | 5-shot acc | 5-shot em | 5-shot acc_norm | 5-shot em_strict | 0-shot pass@1 | 3-shot pass@1 | |
| Kanana Essence-8B | 64.22 | 48.56 | 83.59 | 57.08 | 40.24 | 51.40 | 57.52 |
| Kanana Nano-4.5B | 59.74 | 48.18 | 82.58 | 57.01 | 34.76 | 48.60 | 55.15 |
| Kanana Nano-3.1B | 56.27 | 45.62 | 78.19 | 50.80 | 32.93 | 48.60 | 52.07 |
| Kanana Nano-2.1B | 54.83 | 44.83 | 76.90 | 46.55 | 31.10 | 46.20 | 50.07 |
| Kanana Nano-1.3B | 53.55 | 39.98 | 72.59 | 36.01 | 28.05 | 39.60 | 44.96 |
| Kanana Nano-0.6B | 46.28 | 34.71 | 62.69 | 19.26 | 23.17 | 31.40 | 36.25 |
| Kanana Nano-0.4B | 41.11 | 31.60 | 46.93 | 10.61 | 18.90 | 24.60 | 28.96 |
| Llama 3.2 3.2B | 56.40 | 35.99 | 47.67 | 27.37 | 25.61 | 39.00 | 38.67 |
| Llama 3.2 1.2B | 31.51 | 27.47 | 23.65 | 6.29 | 18.90 | 27.60 | 22.57 |
| Gemma 2 2.6B | 52.89 | 31.32 | 45.55 | 24.72 | 20.12 | 28.20 | 33.80 |
| EXAONE 3.5 2.4B Instruct* | 59.27 | 43.53 | 68.65 | 53.07 | 63.41 | 58.40 | 57.72 |
| Qwen 2.5 3.1B | 65.57 | 45.70 | 60.95 | 68.92 | 37.80 | 55.80 | 55.79 |
| Qwen 2.5 1.5B | 60.86 | 37.41 | 49.68 | 62.09 | 37.20 | 44.00 | 48.54 |
| Qwen 2.5 0.5B | 47.58 | 32.54 | 31.26 | 33.06 | 29.27 | 30.80 | 34.09 |
*EXAONE 3.5의 경우 Instruct 모델만 공개됨, 나머지는 모두 Base 모델로 비교 진행함
**B로 표시한 모델 크기는 소수점 첫째 자리까지 반올림
| Model | MMLU (cloze) | KMMLU |
|---|---|---|
| Domain | 영어 일반 | 한국어 일반 |
| Metric | 0-shot acc_norm | 5-shot em |
| Kanana Nano-192M | 30.37 | 30.18 |
| SmolLM2 125M [18] | 31.50 | 25.65 |
One more thing: Decoder to Embedding
그리고 마지막으로 하나 더, 다양한 서비스에서 빛을 발할 한국어 임베딩 모델을 소개해 드리겠습니다. 임베딩 모델을 통해 텍스트를 벡터로 표현하여, 벡터 간 유사도를 기반으로 검색이나 추천 등 여러 작업의 정밀도를 올릴 수 있습니다.
저희는 Kanana Nano와 Kanana Essence에 LLM2Vec [19] 방법론을 적용하여, 경쟁력 있는 한국어 임베딩 모델을 효율적으로 개발하였습니다. LLM2Vec은 Decoder-only 모델을 강력한 텍스트 Encoder로 변환하는 가볍고 직관적인 방법론으로, LoRA를 사용하며 다음 세 가지의 단계로 구성됩니다.
-
양방향 Attention 활성화: 기존 Decoder 모델의 Causal attention mask를 모두 해제하여, 모델이 모든 입력 토큰 간 상호작용을 배울 수 있도록 합니다.
-
Masked Next Token Prediction (MNTP): 모델이 양방향 Attention을 효과적으로 활용하도록 적응시키기 위한 과정입니다. 입력 시퀀스에서 일부 토큰을 마스킹한 후, 모델이 그 직전 위치의 표현을 사용해 이를 복원하도록 훈련합니다.
-
Contrastive learning: 동일한 문장의 임베딩 간 유사도를 최대화하고, 다른 문장들과의 임베딩 유사도를 최소화하는 방식으로 훈련합니다.
MNTP 후, 공개된 데이터셋으로 Supervised contrastive learning만 수행해도 효과적인 성능을 달성할 수 있다고 합니다. 저희도 공개된 코드베이스를 통해 같은 방식을 공개된 모델과 자체 모델들에 적용하였습니다.
MTEB [20] 은 임베딩 모델을 평가하는 데에 가장 많이 사용되는 벤치마크입니다. 저희는 MTEB에서 영어, 한국어, 일본어에 해당하는 Retrieval 벤치마크셋을 선정하여, LLM2Vec을 적용한 모델을 평가하였습니다. 참고로, Llama3 8B (instruct) [4] 는 공개된 결과와는 다소 차이를 보였으며, 이는 학습 및 평가 환경의 차이에서 기인했을 가능성이 있습니다.
아래 표에서 볼 수 있듯이 Kanana 모델이 한국어 벤치마크에서는 비슷한 크기의 Qwen 2.5 [11], Llama 3.2 [4] 대비 압도적으로 우수한 성능을 보여주었으며, 영어 및 일본어에서도 경쟁력 있는 성능을 확보하였습니다. 특히, 2.1B, 0.6B와 같이 Pruning & Distillation 기법을 통해 학습된 모델의 경우 전반적으로 더 우수한 성능을 보여주는 것을 확인할 수 있었습니다.
| Embedding model | ArguAna | NFCorpus | SciFact | AutoRAGRetrieval | Ko-StrategyQA | XPQARetrieval-Ko | JaGovFaqsRetrieval | JaQuADRetrieval | XPQARetrieval-Ja |
|---|---|---|---|---|---|---|---|---|---|
| Language | en | en | en | ko | ko | ko | ja | ja | ja |
| Kanana Essence-8B Embedding | 56.82 | 37.46 | 75.92 | 81.45 | 81.63 | 39.43 | 68.79 | 61.98 | 72.54 |
| Kanana Nano-2.1B Embedding * | 58.82 | 36.20 | 76.64 | 79.57 | 79.70 | 38.58 | 63.46 | 55.17 | 70.07 |
| Kanana Nano-0.6B Embedding | 52.76 | 31.06 | 68.40 | 75.89 | 72.97 | 36.79 | 56.99 | 50.59 | 67.37 |
| Llama 3 8B | 59.88 | 38.16 | 77.23 | 75.82 | 75.29 | 35.91 | 67.06 | 58.88 | 73.34 |
| Llama 3.2 3B | 54.36 | 39.25 | 75.87 | 70.87 | 73.92 | 35.28 | 63.11 | 56.00 | 70.54 |
| Llama 3.2 1B | 51.80 | 36.29 | 74.22 | 71.47 | 63.46 | 33.27 | 60.52 | 52.52 | 66.93 |
| Qwen2.5 7B | 62.52 | 38.38 | 77.91 | 77.65 | 75.70 | 36.89 | 69.77 | 59.84 | 74.00 |
| Qwen2.5 3B | 56.27 | 38.32 | 75.94 | 75.64 | 76.38 | 37.04 | 68.22 | 55.27 | 73.08 |
| Qwen2.5 0.5B | 49.72 | 32.82 | 64.30 | 67.36 | 61.41 | 31.70 | 56.73 | 46.71 | 67.78 |
* Base 모델을 변환해 측정한 점수, 나머지는 Instruct 모델을 변환함
Further work
지금까지 Pruning & Distillation, Decoder to embedding을 바탕으로, 온디바이스 활용이 가능한 다양한 사이즈의 Kanana Nano 개발 과정을 공유해 드렸습니다. 이중, 크기 대비 우수한 성능을 갖춘 2.1B 모델은 추후 공개할 계획이니 많은 관심 부탁드립니다. 앞으로도 카나나 알파에서는 글로벌 경쟁력을 갖춘 SLM을 효율적으로 확보하고, 다양한 카카오 서비스의 지원뿐만 아니라 AI 생태계 발전에 기여할 수 있길 기대하고 있습니다.
저희는 앞으로, 더욱 범용적으로 뛰어난 SLM을 개발하기 위해 아래와 같은 부분을 고도화할 계획입니다.
1. 코드, 수학 등 부족한 도메인의 데이터 보강
그간 저희는 SLM의 서비스 활용도를 고려하여 모델이 작아질수록 코드, 수학 관련 벤치마크 성능을 올리는 대신 일반적인 성능을 확보하는 데에 집중했습니다. 현재 코드, 수학 등 부족한 도메인의 고품질 데이터를 보강하기 위해 다방면으로 노력하고 있고, 이를 기반으로 Distillation 훈련량을 늘리는 등의 시도를 해볼 예정입니다.
2. 모델 압축으로 인한 정보 손실을 방지하는 Pruning 기술 연구
또한, 모델의 크기가 작아질수록 Pruning으로 인한 정보 손실을 복구하기가 어려워지기 때문에, 이를 완화하기 위한 연구도 지속해 나갈 계획입니다. 예를 들어, Sheared LLaMA [7] 는 파라미터 축에 따라 Mask 변수 z를 두고 이를 직접 학습하여 최적화합니다. 이러한 기법은 다소 무겁고 복잡하지만, 초소형 모델에서의 성능 저하를 완화하기 위한 가능성을 탐색할 수 있습니다.
앞으로도 비용 효율성을 고려한 실용적인 모델 연구를 통해 주어진 자원 안에서 모델의 잠재력을 최대한 발휘하는 방향으로 개발을 이어가고자 합니다.
Contributions
카나나 알파 조직의 juliet.bak(박윤주), ryan.u(류민호)가 기여해 주셨습니다.
Acknowledgements
이 글의 방향성 설정과 검수를 함께 해주신 mat.mul(김보섭), ryan.u(류민호), 전체 내용의 검수를 맡아주신 loophy.cc(조정민) 님께 감사의 말을 전합니다.
관련 글 목록
- 카카오의 AI 모델, 카나나 모델 패밀리를 소개합니다
- 밑바닥부터 Kanana-LLM 개발하기: Pre-training
- 밑바닥부터 Kanana-LLM 개발하기: Post-training
- 나만의 프로필 이미지 생성 모델 개발기
- 이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기
참고 문헌
[1] “Accelerating Large Language Model Decoding with Speculative Sampling”
[2] “Compact Language Models via Pruning and Knowledge Distillation”
[3] “LLM Pruning and Distillation in Practice: The Minitron Approach”
[4] “The Llama 3 Herd of Models”
[5] “Gemma 2: Improving Open Language Models at a Practical Size”
[6] “EXAONE 3.5: Series of Large Language Models for Real-world Use Cases”
[7] “Sheared LLaMA: Accelerating Language Model Pre-training via Structured Pruning”
[8] “Automatic differentiation in PyTorch”
[9] “HuggingFace’s Transformers: State-of-the-art Natural Language Processing”
[10] “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism”
[11] “Qwen2.5 Technical Report”
[12] “Measuring Massive Multitask Language Understanding”
[13] “KMMLU: Measuring Massive Multitask Language Understanding in Korean”
[14] “HAE-RAE Bench: Evaluation of Korean Knowledge in Language Models”
[15] “Training Verifiers to Solve Math Word Problems”
[16] “Evaluating Large Language Models Trained on Code”
[17] “Program Synthesis with Large Language Models”
[18] “SmolLM2 - with great data, comes great performance”
[19] “LLM2Vec: Large Language Models Are Secretly Powerful Text Encoders”
[20] “MTEB: Massive Text Embedding Benchmark”