Engineering
한국어와 이미지를 한 번에, 카카오의 멀티모달 임베딩 모델 개발기
shawn.hyo, hash.ai카카오
2025년 12월 12일
원문에서 보기 ↗"해변에서 노는 강아지 사진 찾아줘"라고 말하면 앨범에서 해당 사진만 찾아주고, 마음에 드는 제품을 보여주면 비슷한 상품을 추천해주는 서비스. 이런 기능은 어떻게 만들 수 있을까요?
안녕하세요, 카카오의 AI 모델 연구, 개발을 담당하는 카나나 (Kanana ) 조직에서 멀티모달 임베딩 모델을 맡고 있는 Shawn (정성효 ), Hash (박상하 )입니다. 저희 팀은 오디오, 이미지, 비디오 등 다양한 멀티모달 데이터를 이해하고, 특정 목적에 맞춰 높은 성능을 내는 전용 모델(Task Specialized Models)을 연구하고 있습니다.
최근 RAG(Retrieval-Augmented Generation)나 딥리서치(Deep Research)처럼 외부 정보를 적극적으로 활용하는 LLM 기반 서비스가 늘어나면서, 관련 문서나 이미지를 빠르고 정확하게 찾아주는 임베딩 모델의 중요성이 더욱 커지고 있습니다. 특히 텍스트뿐 아니라 이미지까지 함께 다루는 멀티모달 임베딩은, 사용자 질문에 더 풍부하고 정확한 답변을 제공하는 핵심 기술로 자리잡고 있습니다.
이 글에서는 멀티모달 임베딩 기능에 특화된 ‘Kanana-v-embedding’ 모델을 소개합니다. 이 모델은 한국어 환경과 카카오 서비스 시나리오에 최적화되어 텍스트-텍스트(Text-Text), 텍스트-이미지(Text-Image), 이미지-이미지(Image-Image) 등 다양한 조합의 검색을 지원하는 모델로, 검색, 추천, RAG 등 여러 서비스에 활용될 수 있습니다.
1. 멀티모달 임베딩 모델이란?
1-1. 하나의 임베딩 공간에 텍스트와 이미지를 올려놓기
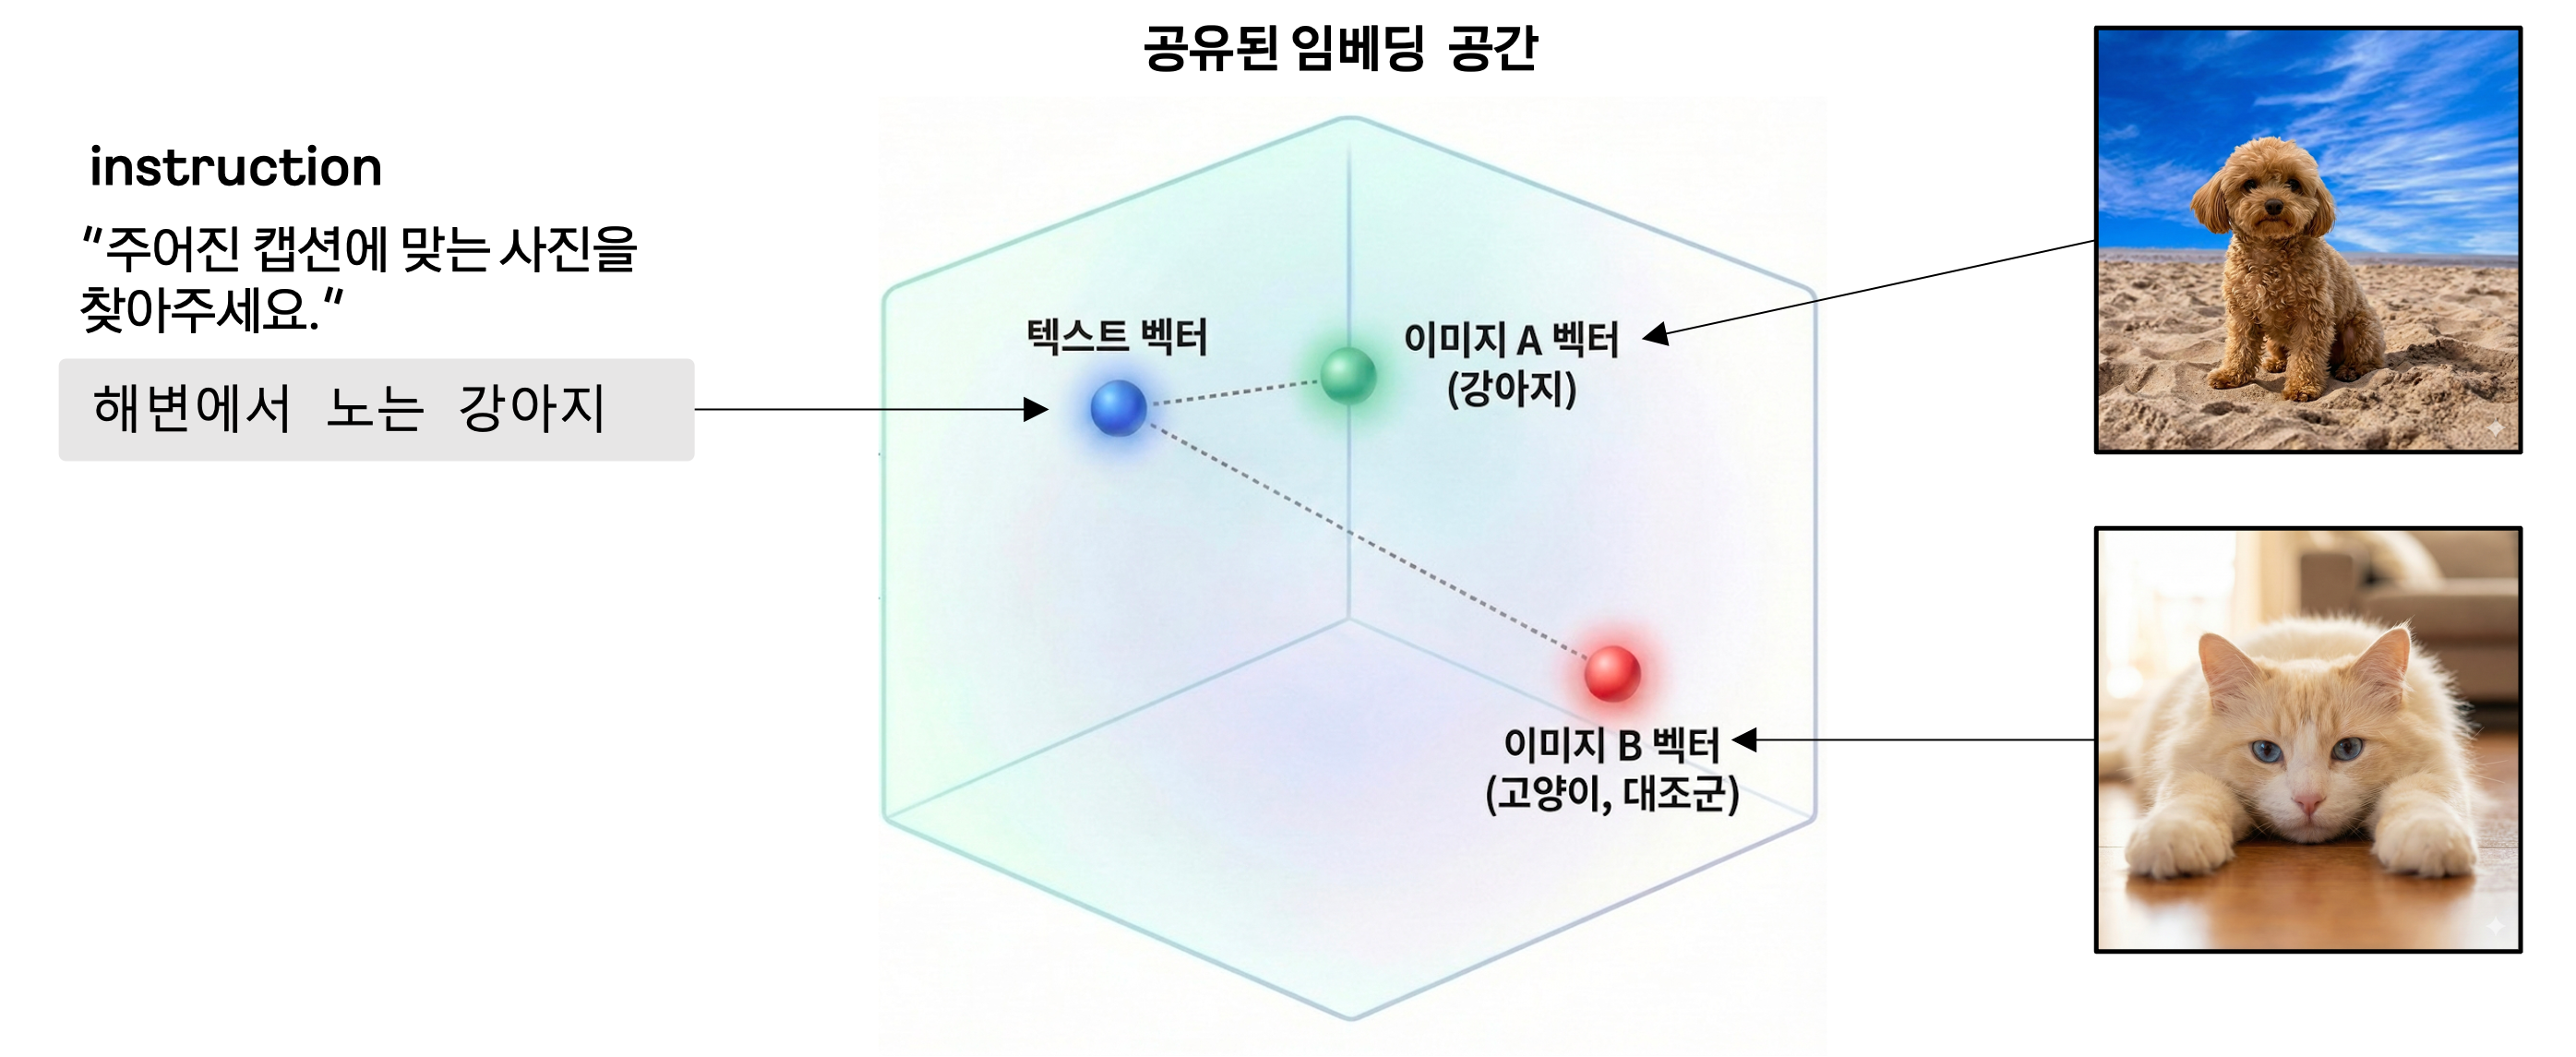
사용자가 "해변에서 노는 강아지"라는 한국어 문장으로 이미지를 검색하거나, 특정 광고 이미지와 비슷한 느낌의 다른 이미지를 찾고 싶을 때가 있습니다. 이런 기능을 구현하려면 텍스트와 이미지를 같은 기준으로 비교할 수 있어야 합니다.
임베딩은 이를 가능하게 하는 핵심 기술입니다. 텍스트나 이미지를 고정 길이의 벡터로 변환해, 서로 다른 형태의 데이터도 '거리’나 '유사도’로 비교할 수 있게 만듭니다. 그림 1처럼 "해변에서 노는 강아지"라는 텍스트를 벡터로 변환하고, 실제 강아지 사진도 벡터로 변환했을 때, 두 벡터 사이의 코사인 유사도가 높다면 모델은 이 둘을 의미적으로 비슷하다고 이해하고 있다는 뜻입니다. 반면 고양이 사진처럼 의미적으로 다른 이미지는 텍스트 벡터와 낮은 유사도를 갖게 됩니다.
멀티모달 임베딩 모델 은 서로 다른 형태(텍스트, 이미지, 나아가 비디오 등)의 데이터를 하나의 공유된 의미 공간에 올려놓는 모델입니다. 텍스트만 처리하는 임베딩 모델과 달리, 텍스트와 이미지가 섞여 있는 실제 서비스 환경의 다양한 문제를 자연스럽게 해결할 수 있습니다.
멀티모달 임베딩을 활용하면 다음과 같은 기능을 구현할 수 있습니다.
-
텍스트 → 이미지 검색: “해변에서 노는 강아지” 같은 한국어 문장으로 이미지 검색
-
이미지 추천: 사용자가 선택한 이미지와 관련된 정보를 검색하는 시스템
-
멀티모달 RAG: 텍스트 질문으로 이미지가 포함된 문서까지 함께 검색하는 시스템
1-2. 기존 멀티모달 임베딩 접근: CLIP에서 VLM2Vec까지
멀티모달 임베딩 분야는 최근 몇 년 사이 빠르게 발전해 왔습니다. 먼저 각 연구가 이전의 한계를 어떻게 극복해왔는지 살펴보겠습니다.
CLIP: 대규모 이미지-텍스트 대조 학습(Contrastive Learning)의 시작
OpenAI의 CLIP은 대규모 이미지-텍스트 쌍(Pair) 데이터를 활용한 대조 학습(Contrastive Learning)의 대표 모델입니다.[1] 이미지 인코더와 텍스트 인코더를 독립적으로 두고, "어떤 이미지에 어떤 문장이 더 잘 맞는지"를 학습하는 방식입니다. 정답 캡션과 이미지의 코사인 유사도는 높이고, 그렇지 않은 조합의 유사도는 낮추도록 학습합니다. CLIP은 제로샷(Zero-shot) 이미지 분류와 텍스트-이미지(Text-Image) 검색에서 획기적인 성능을 보였지만, 몇 가지 한계가 있었습니다. 첫째, 텍스트와 이미지를 개별적으로만 처리할 수 있어 “텍스트+이미지” 조합을 하나의 입력으로 다루기 어렵습니다. 둘째, 영어 중심 데이터로 학습되어 한국어나 다양한 도메인에 적용하기 어렵다는 점입니다.
LLM2Vec: LLM의 지식을 텍스트 임베딩으로
한편 LLM2Vec 계열 연구는 다른 방향에서 접근합니다.[2] 디코더 기반 LLM을 양방향(Bidirectional) 인코더처럼 사용할 수 있도록 재학습하여, LLM이 학습한 방대한 언어 지식을 임베딩에 활용하는 방법입니다. 텍스트 임베딩 성능은 크게 향상되었지만, 텍스트 모달리티에 제한되어 이미지나 다른 모달리티로의 확장이 어렵다는 한계가 있습니다.
VLM2Vec: 멀티모달 임베딩으로 확장
VLM2Vec에서는 멀티모달 처리 능력과 LLM의 강력한 언어 이해력을 결합합니다.[3] 텍스트와 이미지를 동시에 다루는 비전-언어 모델(VLM)을 범용 멀티모달 임베딩 프레임워크로 확장한 것입니다. 핵심 특징은 여러 모달리티 조합 지원 입니다. VLM의 마지막 토큰 표현을 임베딩으로 사용하는 구조 덕분에, 텍스트와 이미지를 하나의 시퀀스로 묶어 입력하고 통합된 의미 표현을 얻을 수 있습니다. 이를 통해 1) 텍스트만, 2) 이미지만, 또는 3) 텍스트+이미지 조합을 모두 하나의 임베딩 공간에 표현합니다.
| 모델 | 입력 모달리티 | 특징 | 주요 한계 |
|---|---|---|---|
| CLIP | 텍스트 또는 이미지 (독립) | 대조 학습(Contrastive Learning) | 모달리티 조합 불가, 영어 중심 |
| LLM2Vec | 텍스트만 | LLM → 임베딩 모델 | 멀티모달 확장 불가 |
| VLM2Vec | 텍스트 + 이미지 (조합 가능) | VLM → 멀티모달 임베딩 모델 | 영어 중심, 텍스트, 도메인 특화 성능 부족 |
<표 1. 멀티모달 임베딩 모델 비교.>
Kanana-v-embedding 은 VLM2Vec의 프레임워크를 기반으로 하면서도, VLM2Vec의 주요 한계였던 한국어 지원 부족과 도메인 특화 성능 문제 를 극복하고, 카카오 서비스 환경에 최적화된 멀티모달 임베딩 모델입니다. 다음 섹션에서는 Kanana-v-embedding이 이러한 한계를 구체적으로 어떻게 극복했는지, 모델 구조와 학습 방법을 살펴봅니다.
2. Kanana-v-embedding: 설계와 구조
Kanana-v-embedding은 VLM을 기반으로 한 임베딩 전용 모델입니다. 이 모델은 한국어와 실 서비스 환경에 최적화된 두 가지 목표를 중심에 두고 설계했습니다.
첫째, 실용적인 멀티모달 처리: 하나의 모델로 텍스트-텍스트(Text-Text), 텍스트-이미지(Text-Image), 이미지-이미지(Image-Image), (텍스트+이미지)-(텍스트+이미지)((Text+Image)-(Text+Image)) 등 실제 서비스에서 발생하는 모든 조합을 지원합니다. LLM의 뛰어난 사전 지식과 추론 능력을 임베딩에 활용할 수 있어, 단순 키워드 매칭을 넘어 의미적 이해가 필요한 복잡한 검색, 추천 시나리오에 대응할 수 있습니다.
둘째, 한국어 및 서비스 시나리오 특화: 한국어 표현, 문화와 카카오 서비스의 실제 니즈(카카오 앨범 검색, 관련 이미지 검색, 콘텐츠 추천 등)를 반영하도록 설계했습니다. 이를 위해 KoEmbed 데이터셋을 구축하여 학습에 활용했습니다.
2-1. VLM 기반 멀티모달 아키텍처
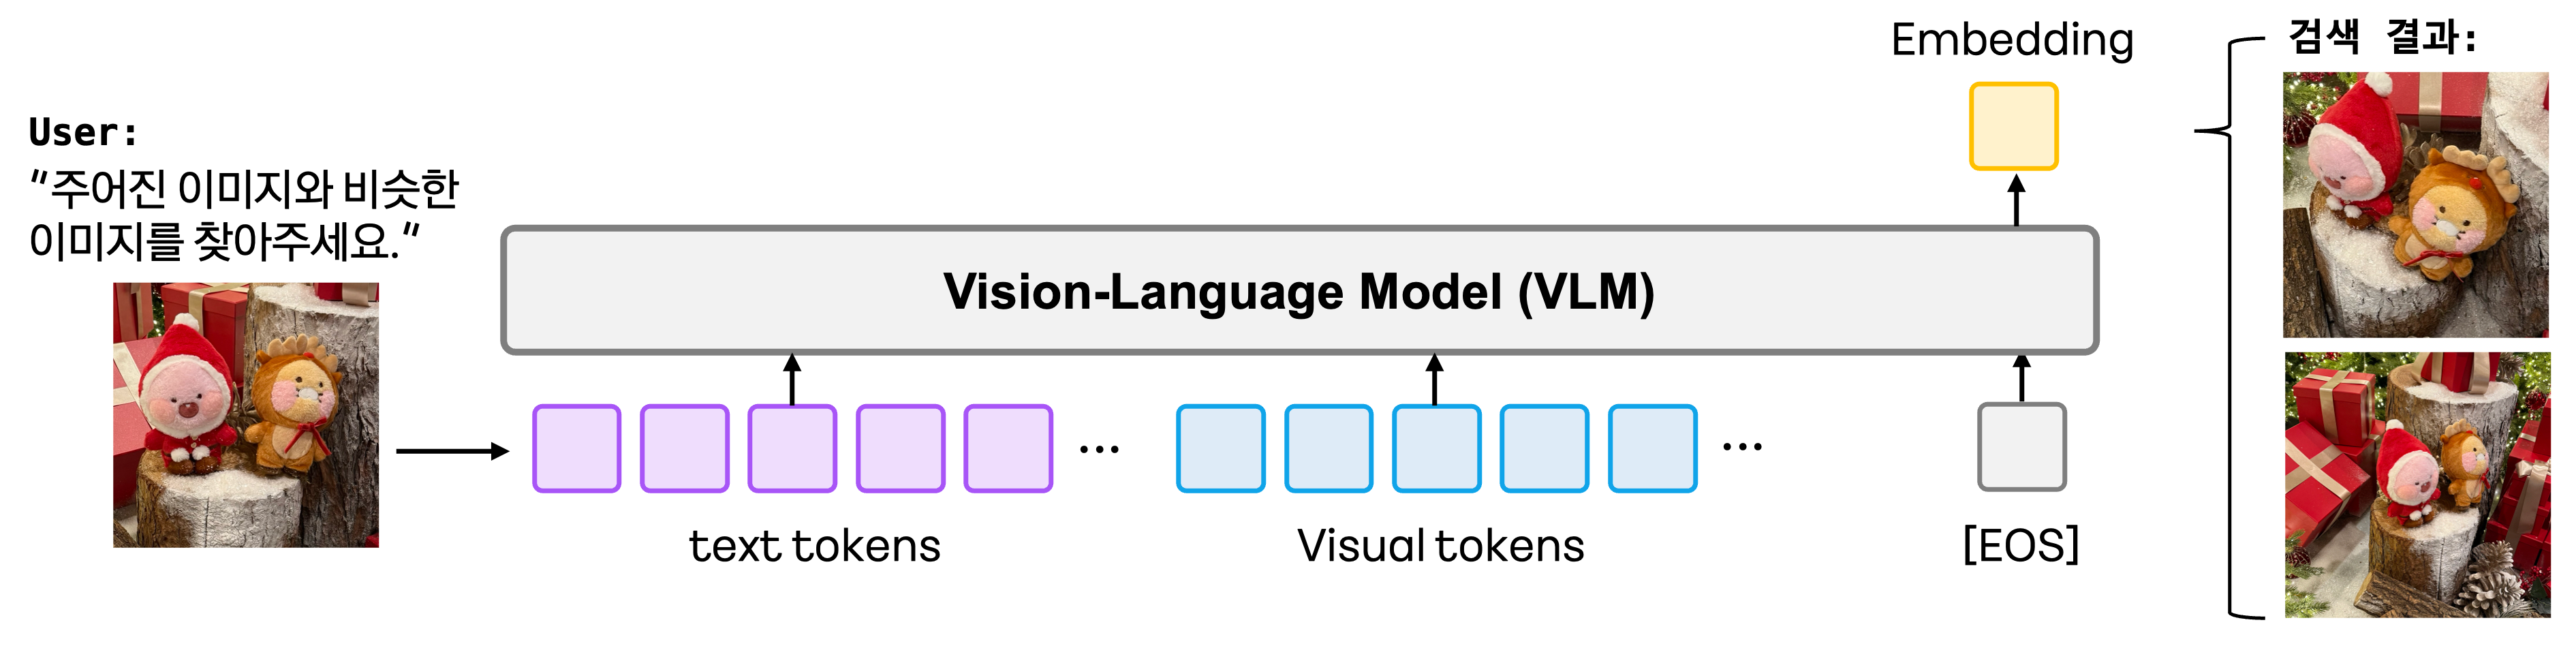
Kanana-v-embedding의 전체 구조는 그림 2와 같습니다. 임베딩 모델은 LLM과 이미지 인코더로 구성된 VLM을 사용해 개발되었습니다. 텍스트와 이미지 표현은 토큰(Token) 형태로 트랜스포머(Transformer) 레이어에 들어가게 되며 히든 스테이트(Hidden State)의 형태로 변환됩니다. 임베딩은 마지막 히든 스테이트(Hidden State)로부터 크게 두 가지 방식으로 추출할 수 있습니다. 하나는 시퀀스의 모든 토큰 표현을 평균/가중 평균하여 만드는 풀링(Pooling) 기반 임베딩(Mean Pooling 등) 이고, 다른 하나는 마지막 [EOS] 혹은 추가한 [EMB] 토큰 하나만 사용하는 방법입니다. 저희 모델에서는 마지막 [EOS] 토큰의 표현을 가져와 임베딩으로 사용하였습니다. 최종적으로 해당 표현을 정규화(Normalization)하여, 코사인 유사도 계산에 바로 사용할 수 있는 임베딩을 얻습니다.
2-2. 지시(Instruction) 기반 쿼리 임베딩
ChatGPT와 같은 생성 모델에서 프롬프트가 결과물에 큰 영향을 주듯이, 임베딩 모델 역시 지시(Instruction)를 통해 성능을 크게 개선할 수 있습니다. 같은 입력이라도 "어떤 태스크에 사용될지"를 명시적으로 알려주면, 해당 목적에 더 적합한 임베딩 표현을 생성할 수 있습니다. Kanana-v-embedding은 검색, 추천, 분류 등 다양한 지시(Instruction) 기반으로 학습하여 여러 태스크에 유연하게 대응합니다.
예를 들어, RAG 검색용 텍스트 쿼리 임베딩을 만들 때는 다음과 같은 지시(Instruction)을 함께 넣습니다
“다음 질문에 관련된 글을 찾아주세요.”
이미지 검색용 텍스트 쿼리를 만들 때는 다음과 같이 지시(Instruction)를 구성합니다
“주어진 캡션과 일치하는 이미지를 찾아주세요.”
추가로 "같은 상품을 다른 스타일로 표현한 이미지를 찾고 싶다"와 같이 목적에 맞는 지시(Instruction)를 구성해, 검색, 추천 목적에 특화된 임베딩을 만들 수 있습니다.
2-3. 지원 모달리티 및 임베딩 사이즈
Kanana-v-embedding이 직접 지원하는 대표 태스크는 다음과 같습니다.
-
텍스트-텍스트(Text-Text): 문서 검색, FAQ 매칭, 문장/문단 유사도, 추천
-
텍스트-이미지(Text-Image): 이미지 검색, 썸네일/배너 추천, 쇼핑/광고 검색
-
이미지-이미지(Image-Image): 유사 광고/썸네일/상품 이미지 검색
-
(텍스트+이미지)-(텍스트+이미지)((Text+Image)-(Text+Image)): 카드, 피드, 상품 게시물과 같이 텍스트와 이미지가 함께 있는 멀티모달 객체 간 유사도 비교
Matryoshka Representation Learning 기법을 활용하여 64~2,048 차원까지 다양한 임베딩 사이즈를 지원합니다. 서비스 특성에 따라 지연(Latency)과 비용이 중요한 환경에서는 64/128 차원처럼 가벼운 설정을, 품질이 더 중요한 서비스에서는 1,024/2,048 차원을 선택하는 식으로 유연하게 운영할 수 있습니다.
3. Kanana-v-embedding 학습 과정과 테크닉
Kanana-v-embedding의 학습은 크게 두 단계로 진행했습니다.
먼저 스테이지 1: 사전 학습(Pretraining) 단계에서는 대규모 텍스트-텍스트(Text-Text) 쌍(Pair) 데이터를 활용한 대조 학습(Contrastive Learning)으로 기본적인 임베딩 능력을 학습합니다. 이 단계에서는 텍스트 간의 의미적 유사도를 파악하는 기초 능력을 쌓습니다. 이후 스테이지 2: 파인튜닝(Fine-tuning) 단계에서는 KoEmbed 내부 데이터셋과 M-BEIR 등 공개 데이터셋을 참고하여, 실제 서비스 환경에 필요한 성능을 집중적으로 향상시킵니다. 모델을 학습 할 때 다음 세 가지 핵심 기술을 적용했습니다: 1) 그래디언트 캐싱(Gradient Caching), 2) 마트료시카 표현 학습(Matryoshka Representation Learning), 3) 하드 네거티브 마이닝(Hard Negative Mining). 아래에서는 해당 방법에 대해 자세히 소개합니다.
3-1. 배치 사이즈의 한계를 넘다: 그래디언트 캐싱(Gradient Caching)
Kanana-v-embedding 모델의 성능을 극대화하기 위해서는 Contrastive Learning의 학습 목표인 InfoNCE Loss의 특성을 적극 활용해야 했습니다.
L_{NCE} = - \log \frac{\exp(\text{sim}(q, k^+) / \tau)}{\sum_{i=0}^{K} \exp(\text{sim}(q, k_i) / \tau)}
위 식에서 알 수 있듯이, 대조 학습 (Contrastive Learning )은 본질적으로 K개의 샘플 중 정답(k^+)을 찾아내는 (K+1)\text{-way Classification} 문제와 같습니다. 즉, 분모의 네거티브 샘플(Negative Sample)(K) 수가 많아질수록 모델은 더 많은 오답 속에서 정답을 구별해야 하므로 학습 난이도가 상승하고, 이에 따라 모델의 판별력(Discriminative Power) 이 강화됩니다. 하지만 거대 모델의 특성상 GPU 메모리(VRAM) 한계로 물리적 배치 사이즈를 늘리는 데 제약이 있었으며, 기존의 큐(Queue) 기반 MoCo [4] 방식은 과거 인코더가 생성한 스테일 임베딩(Stale Embedding) 문제로 인해 학습의 정밀도를 보장하기 어려웠습니다. 이에 우리는 메모리 제약을 극복하면서도 수학적으로 동일한 대형 배치 학습 효과를 내는 그래디언트 캐싱(Gradient Caching) [5] 기법을 도입했습니다.
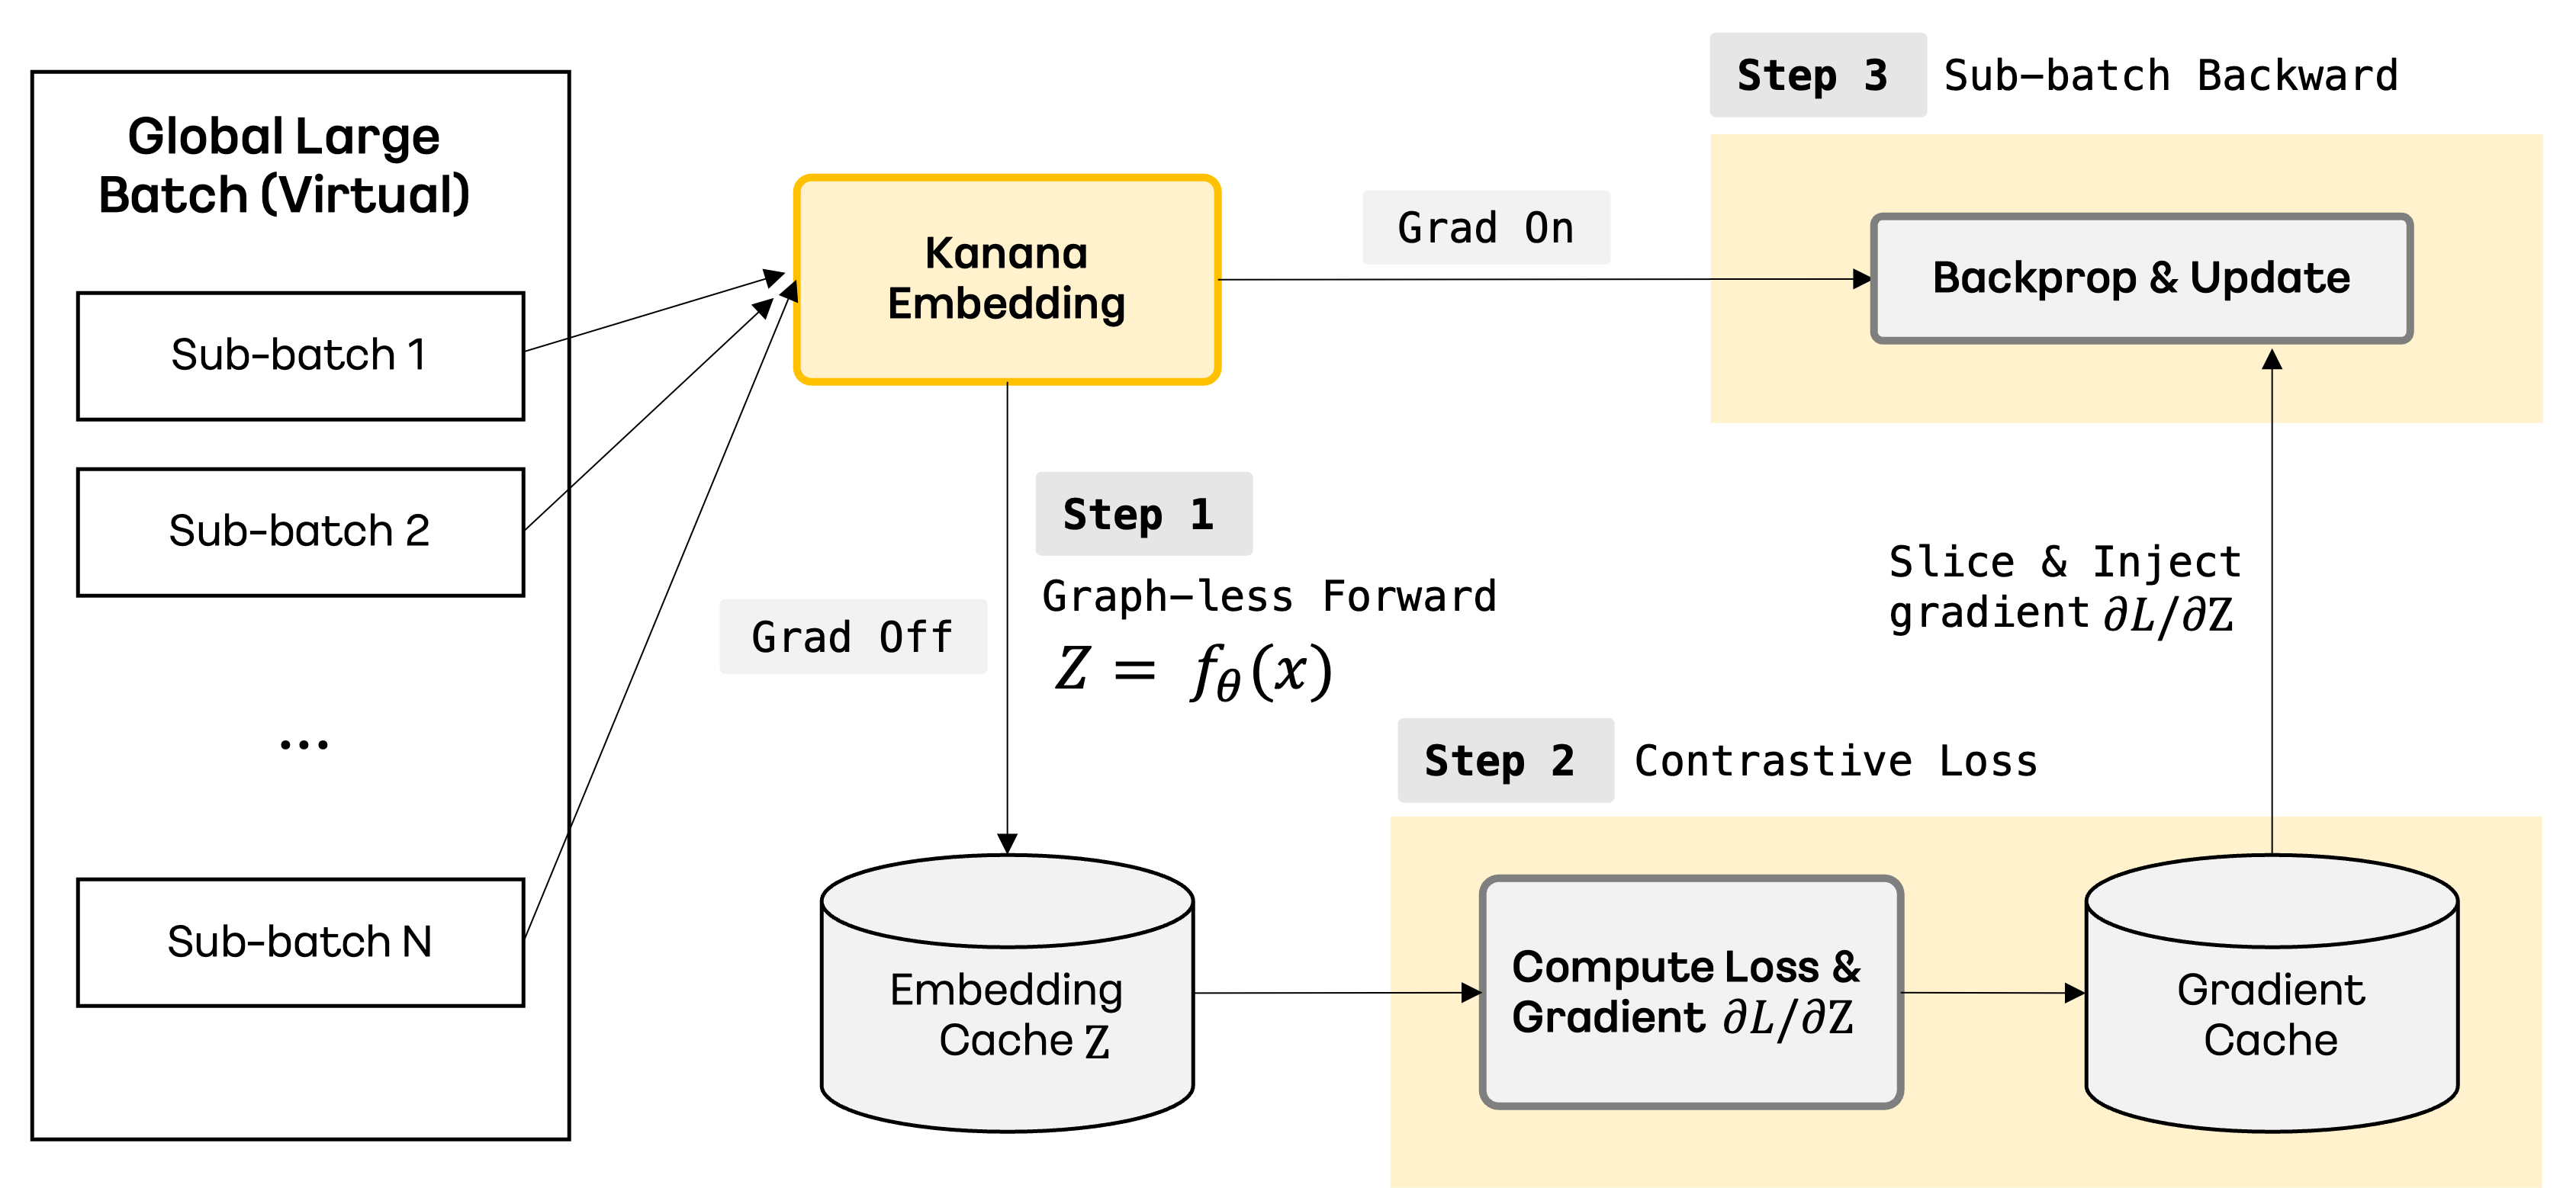
그래디언트 캐싱 (Gradient Caching )은 가벼운 연산(Loss 계산)과 무거운 연산(역전파)을 분리하는 것이 핵심이며, 그림 3과 같이 크게 세 단계로 진행됩니다. 먼저 스텝 1 에서는 미분 그래프 없이 모든 서브 배치에 대해 임베딩 Z = f_{\theta}(x)만 빠르게 계산하여 캐싱합니다. 스텝 2 에서는 캐싱된 전체 임베딩을 모아 풀 배치 콘스트라티브 손실(Full Batch Contrastive Loss) L을 계산하고, 임베딩에 대한 그래디언트(Gradient) \partial L / \partial Z를 미리 구해둡니다. 마지막으로 스텝 3 에서는 서브 배치별로 수행하되, 앞서 계산해 둔 \partial L / \partial Z를 주입하여 연쇄 법칙(Chain Rule)에 따라 모델 파라미터에 대한 그래디언트(Gradient) \partial L / \partial \theta를 계산하고 역전파를 수행합니다. 이를 통해 전체 배치를 한 번에 학습한 것과 이론적으로 동일한 그래디언트(Gradient)를 얻을 수 있으며, 대부분의 설정에서 전체 배치를 한 번에 학습한 것과 거의 동일한 업데이트를 수행합니다.
이 방식은 메모리를 많이 차지하는 중간 연산 값(Activations) 대신 최종 임베딩 벡터만 저장하므로 메모리 소모를 획기적으로 줄여줍니다. 비록 순전파(Forward Pass)가 추가되어 학습 시간은 약 20% 증가하지만, 그래디언트 캐싱 (Gradient Caching )은 물리적 한계를 넘어 스테일 임베딩(Stale Embedding) 문제없는 온전한 대형 배치 대조 학습 (Contrastive Learning)을 Kanana-v-embedding에서 구현할 수 있는 최적의 방법론이었습니다.
3-2. 하나의 모델, 다양한 임베딩 차원 선택: Matryoshka Representation Learning
현업 서비스에서 임베딩 차원 수는 곧 서비스 비용과 지연 시간으로 이어집니다. 차원이 커지면 검색 품질이 좋아질 수 있지만 인덱스 메모리와 쿼리당 연산량이 증가하고, 차원이 너무 작으면 품질이 충분히 나오지 않을 수 있습니다.
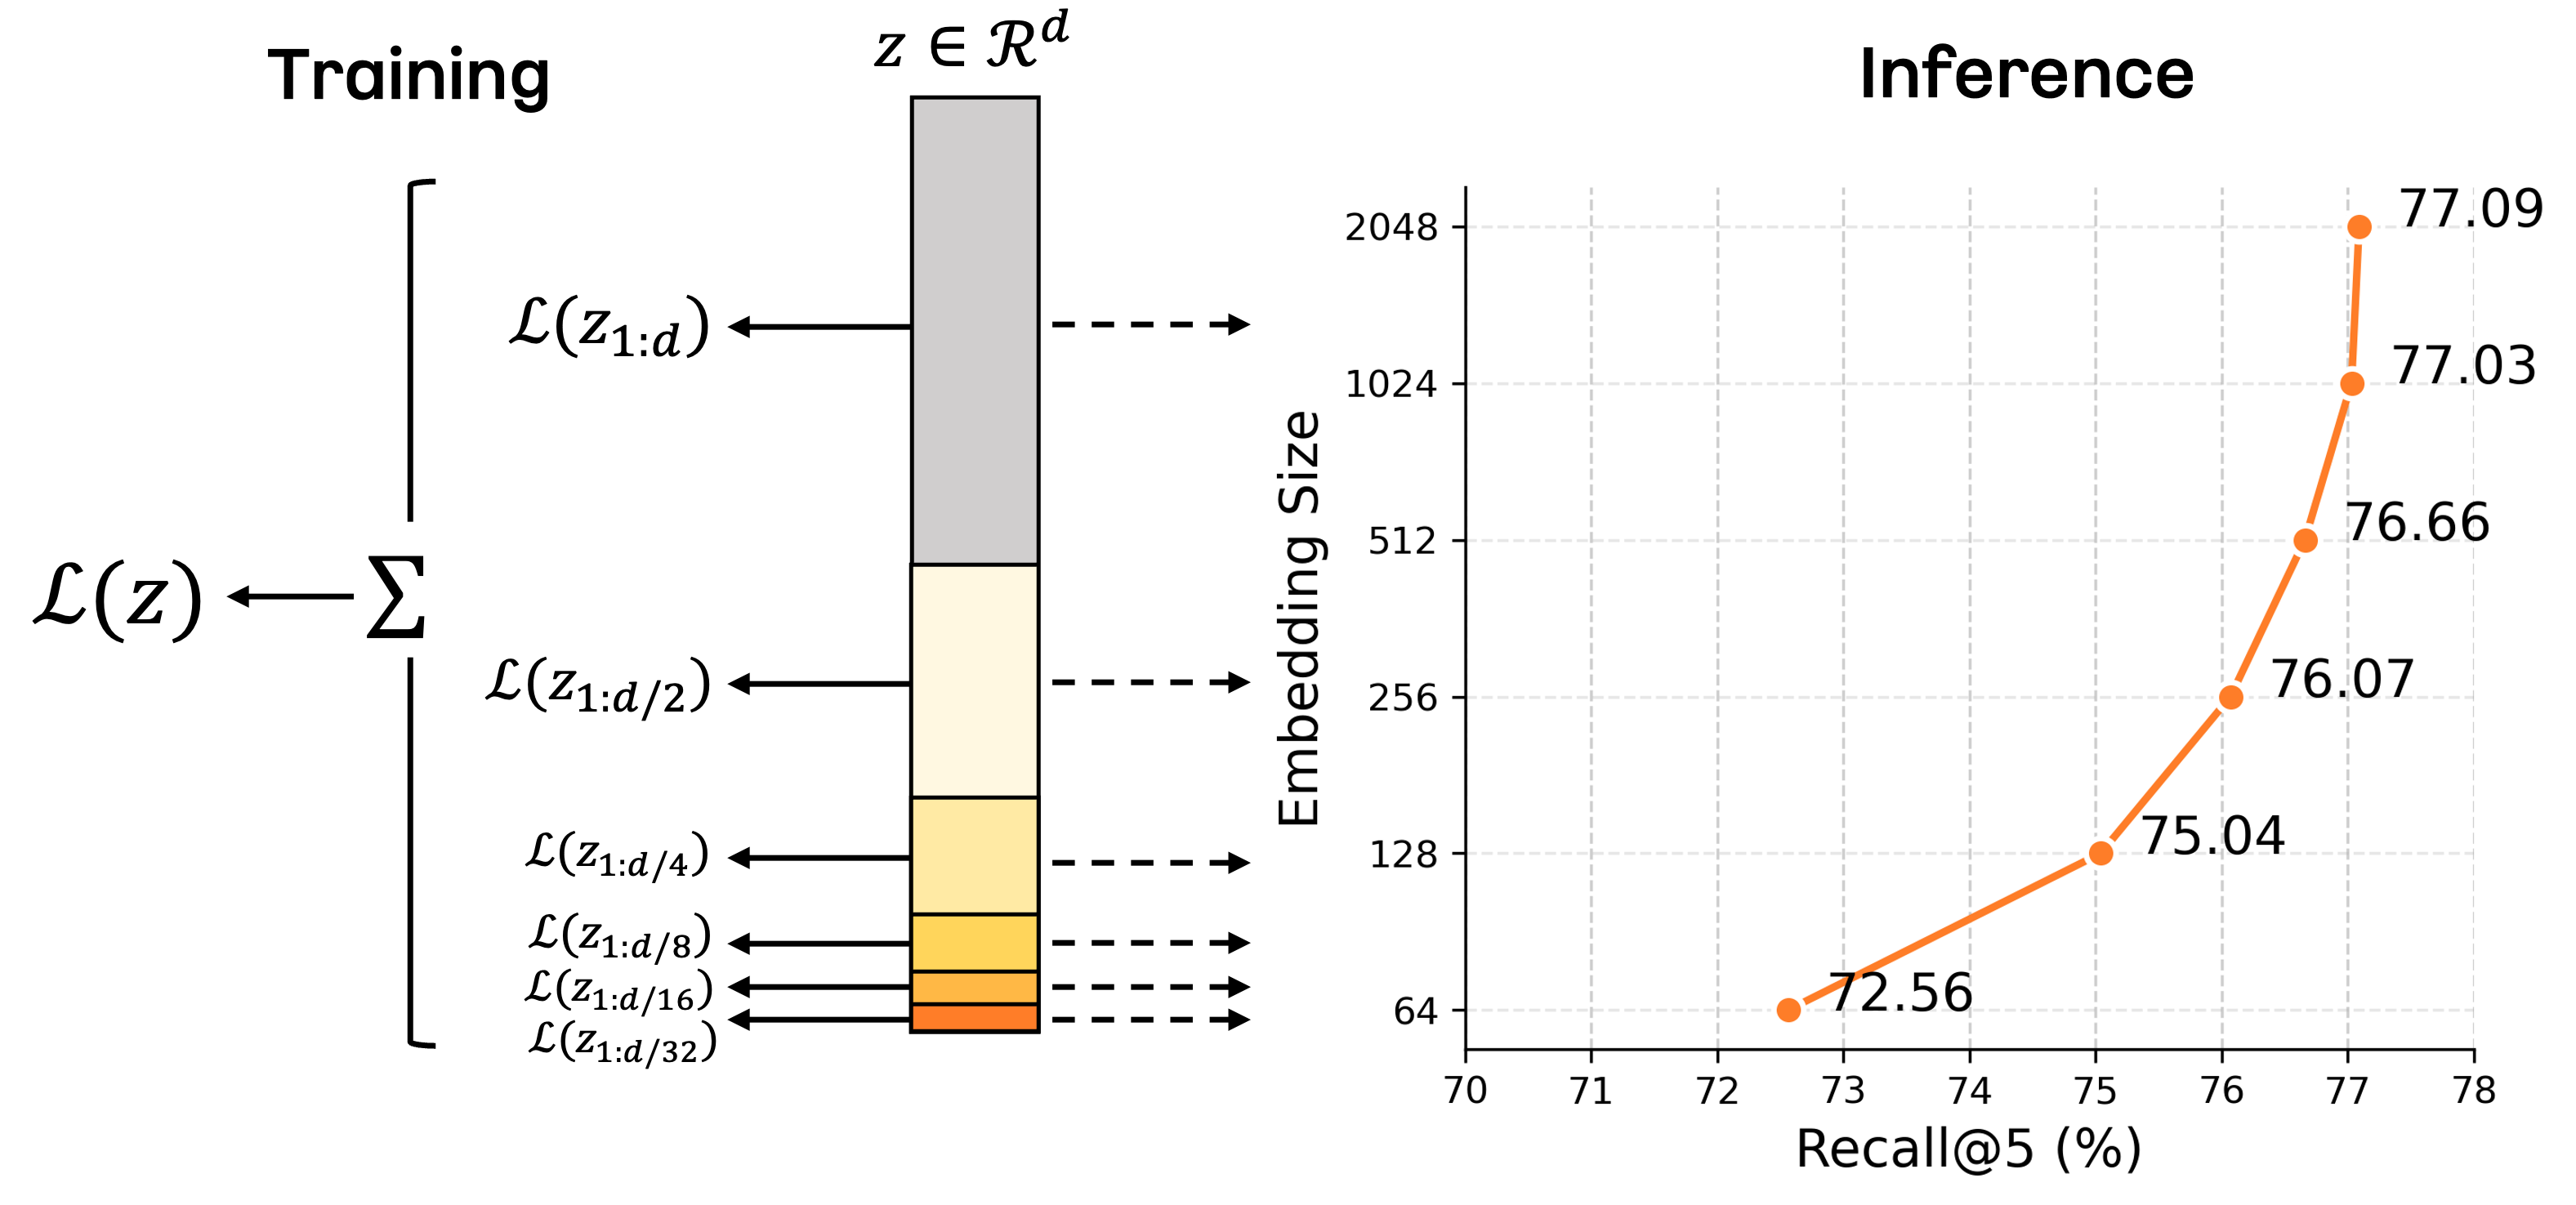
<그림 4. MRL의 학습과 추론. (좌측) 학습 시에는 전체 임베딩 벡터 z \in \mathcal{R}^d에서 다양한 차원 구간의 서브 임베딩에 대해 각각 Loss를 계산하고, 이를 합산하여 전체 Loss \mathcal{L}(z)를 구성합니다. (우측) 추론 시에는 서비스 환경에 따라 64~2,048 차원 중 원하는 크기를 선택할 수 있으며, 차원이 작아져도 Recall@5 성능이 완만하게 감소합니다.>
마트료시카 표현 학습(Matryoshka Representation Learning, MRL) 은 [6] 하나의 고차원 임베딩을 학습하면서, 임베딩 일부분(예: 64, 128, 256, …)만 잘라 사용해도 성능이 크게 떨어지지 않도록 만드는 기법입니다. 그림 4의 좌측과 같이, Kanana-v-embedding에서는 기본 임베딩 차원을 최대 2,048로 두고, 학습 과정에서 64, 128, 256, 512, 1,024, 2,048 차원 등 여러 구간으로 잘라낸 서브 임베딩에도 동일한 손실(Loss)를 계산하였습니다. 전체 MRL 손실(Loss)는 다음과 같이 각 차원 구간의 손실(Loss)를 합산하여 계산됩니다.
\mathcal{L}_{\text{MRL}}(z) = \sum_{m \in M} \mathcal{L}(z_{1:m})
여기서 z_{1:m}은 전체 임베딩 z \in \mathcal{R}^d의 처음 m개 차원만 잘라낸 서브 임베딩이고, M = {64, 128, 256, 512, 1024, 2048}은 학습에 사용하는 차원 집합입니다.
덕분에 추론 단계에서는 리소스에 여유가 있는 환경에서는 1,024~2,048의 큰 차원을 활용해 성능을 극대화할 수도 있고, 모바일,경량 서비스에서는 128/256 차원만 사용해 비용과 지연 시간을 줄일 수 있습니다. 또한 이미 벡터 DB를 사용하고 있고, DB의 임베딩 사이즈에 제약이 있는 경우에도 유연하게 대응 가능합니다.
3-3. 어려운 샘플로 더 정교하게: 하드 네거티브 마이닝(Hard Negative Mining)
앞서 설명드렸듯이 대조 학습(Contrastive Learning)에서 네거티브(Negative) 샘플을 어떻게 선택하느냐 는 최종 성능에 큰 영향을 줍니다. 너무 쉬운 네거티브(Negative)는 학습 효과가 적고, 반대로 포지티브(Positive)에 너무 가까운 샘플을 네거티브(Negative)로 쓰면 학습이 불안정해집니다. 최근 엔비디아의 NV-Retriever [7] 연구에서는 포지티브 인식 하드 네거티브 마이닝(Positive-aware Hard Negative Mining) 개념을 도입해, "타깃과 유사하지만 정답이 아닌 어려운 네거티브(Negative) "를 고르는 방법을 제안합니다. Kanana-v-embedding에서도 이를 참고하여 TopK-PercPos라는 전략을 적용했습니다.
쿼리 q, 정답 문서/이미지 p, 후보 네거티브(Negative) d에 대해, 다음 조건을 만족하는 샘플만 하드 네거티브(Hard Negative)로 사용합니다.
\text{sim}(q, d) < \alpha \cdot \text{sim}(q, p)
구체적인 예시로 살펴보겠습니다. 사용자의 쿼리가 “해변에서 노는 강아지” 라고 가정해봅시다. 이 정답과 쿼리의 유사도가 0.90이고, α = 0.95라면, 임계값은 0.855 (= 0.95 × 0.90)가 됩니다.
| 정답 (Positive) | 학습 후보1 | 학습 후보2 | 학습 후보3 | |
|---|---|---|---|---|
| 이미지 | 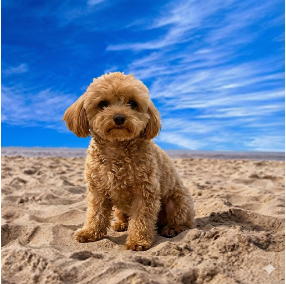 | 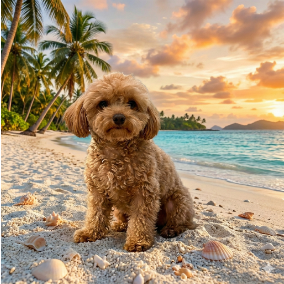 | 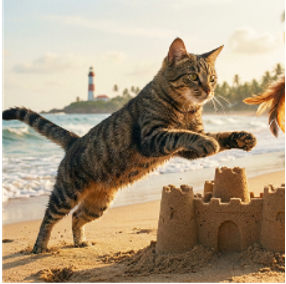 |  |
| 유사도 | 0.90 | 0.88 > 임계값 | 0.72 < 임계값 | 0.2 < 임계값 |
| 학습 조건 만족 | - | No | Yes | TopK 포함 X → No |
| 판정 | - | 정답과 너무 유사, 제외 | 적절한 난이도, 선택 | 너무 쉬움, 학습 효과 낮음 |
<표2. Positive-aware Hard Negative Mining 예시.>
이제 다른 후보 이미지들을 하나씩 살펴보겠습니다. 먼저 후보1은 쿼리와의 유사도가 0.88로 임계값 0.855보다 높습니다. 정답과 너무 비슷해서 모델이 "이게 왜 틀린 거지?"라고 혼란스러워할 수 있으므로 네거티브(Negative)에서 제외합니다. 반면 후보2 "고양이"는 유사도가 0.72로 임계값보다 낮습니다. 쿼리와 어느 정도 관련은 있지만(해변이라는 공통점) 명확히 다른 대상(고양이)이라 모델이 "아, 강아지와 고양이를 구분해야 하는구나"라고 배울 수 있어 좋은 하드 네거티브(Hard Negative)가 됩니다. 마지막으로 후보3 "프로드"는 유사도가 0.2로 조건은 만족하지만, 쿼리와 너무 달라서 모델이 쉽게 구분할 수 있어 학습 효과가 거의 없습니다. 논문의 실험 결과 α = 0.95 근처에서 성능이 가장 좋았고, 내부 실험에서도 일치하는 결과를 얻었습니다. 이 기준을 적용하면 모델이 헷갈릴 만한 “좋은” 네거티브 (Negative)를 자동으로 골라낼 수 있고, 결과적으로 검색, 분류 성능이 눈에 띄게 향상되었습니다.
4. KoEmbed: 한국어 멀티모달 임베딩 데이터셋
기존 공개 데이터셋들(MSCOCO, Flickr30k 등)은 대부분 영어 중심이고, 한국어 혹은 실제 서비스 환경(카카오 앨범, 광고 크리에이티브 검색)을 충분히 반영하지 못했습니다. 이러한 한계를 극복하기 위해 Kanana-v-embedding의 학습과 평가를 위한 한국어 멀티모달 데이터셋, KoEmbed를 구축했습니다. KoEmbed는 다양한 도메인을 포괄하며, 특히 실제 카카오 서비스 시나리오를 고려하여 다음 5가지 세부 데이터셋으로 구성되어 있습니다.
| KoEmbed-Sent | KoEmbed-Word | KoEmbed-Count | KoEmbed-Place | KoEmbed-SimImg | |
|---|---|---|---|---|---|
| 사용자 쿼리 | 세 가지 이상의 나무 옷걸이에 옷이 걸려 있다. | 붕어빵 | 스키장, 사람 2명 | 롯데월드타워 |  |
| 검색 결과 | 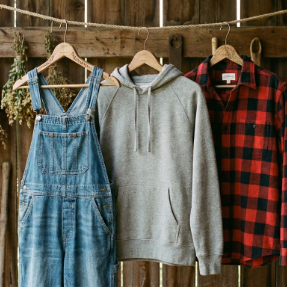 | 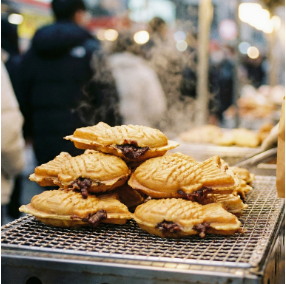 | 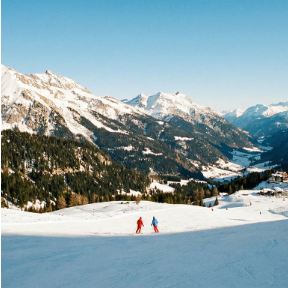 | 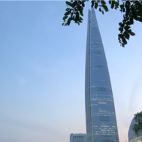 | 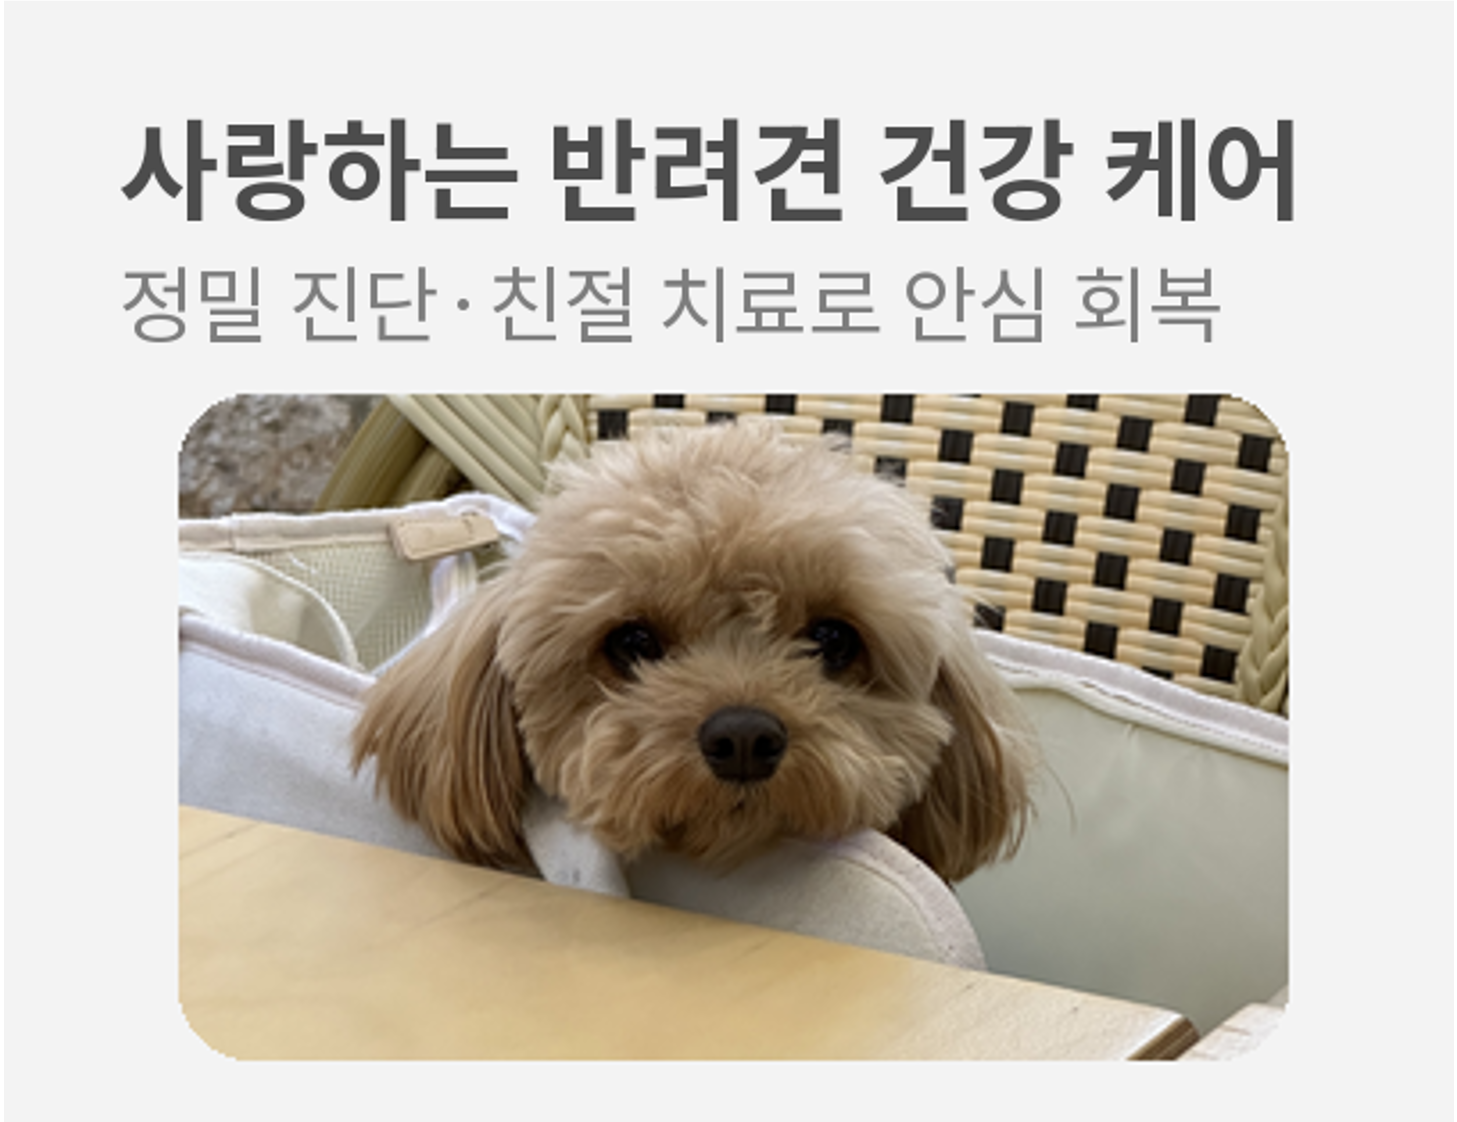 |
<표3. KoEmbed 데이터셋 예시.>
KoEmbed-Sent: 한국어 문장 검색 (Sentence Retrieval)
KoEmbed-Sent는 다양한 도메인(문서, 상품, 블로그, 음식, 장소, 광고, 동물 등)에 걸쳐 수집한 이미지-한국어 문장 쌍(Pair) 데이터입니다. 각 이미지마다 상세한 설명형 캡션(예: “공원에서 산책하는 귀여운 강아지의 모습”, “한강 야경을 배경으로 자전거를 타는 커플”)을 제공합니다. 이를 통해 사용자가 자연스러운 문장으로 이미지를 검색하는 시나리오를 고려하여 설계했습니다.
KoEmbed-Word: 한국어 단일어 검색 (Single-word Lookup)
멀티모달 임베딩이 단순 문장 수준뿐 아니라 단일 개념/객체 중심 표현도 잘 학습할 수 있도록, “한강”, “강아지”, "치즈"처럼 한 단어로만 표현한 캡션과 이미지로 구성한 데이터셋입니다. 짧은 키워드 한 단어로 정확한 이미지를 검색하는 시나리오를 고려하였습니다.
KoEmbed-Count: 인물 수 기반 검색 (Entity Numeracy-People)
이미지 속 사람의 수를 정확히 인식하고 검색할 수 있도록, “한 사람”, “두 사람”, “단체 사진” 등 인물 수에 집중한 캡션과 이미지로 구성한 데이터셋입니다. 이를 통해 앨범에 있는 개인 사진과 단체 사진을 명확히 구분하고, 사용자가 원하는 인물 수 조건에 맞는 이미지를 정확히 찾을 수 있습니다.
KoEmbed-Place: 한국어 장소 검색 (Place/Location Retrieval)
한국 고유의 장소명과 지역 정보를 반영한 데이터셋입니다. “남산타워”, “경복궁”, “광화문”, “롯데월드” 같은 한국 특정 장소명과 해당 장소 이미지를 연결하여, 국내 서비스 환경에서 장소 기반 이미지 검색과 추천이 가능하도록 설계했습니다.
KoEmbed-SimImg: 유사 이미지 검색 (Similar Image Retrieval)
이미지 검색과 추천 시나리오에서 "이 이미지와 유사하지만 다른 대상"을 찾는 일이 매우 중요합니다. KoEmbed-SimImg는 일반적인 유사 이미지 검색 데이터와 함께, 광고 이미지와 그에 대응하는 카피 문구, 타깃 속성(예: 30대, 여행, 패션), 배경/구도 정보 등을 결합한 광고 도메인 데이터도 포함하고 있습니다. 이 데이터를 통해 이미지 검색, 광고 추천 등 다양한 검색 시나리오에 활용될 수 있습니다.
5. 성능 평가 결과
5-1. 멀티모달 임베딩 성능
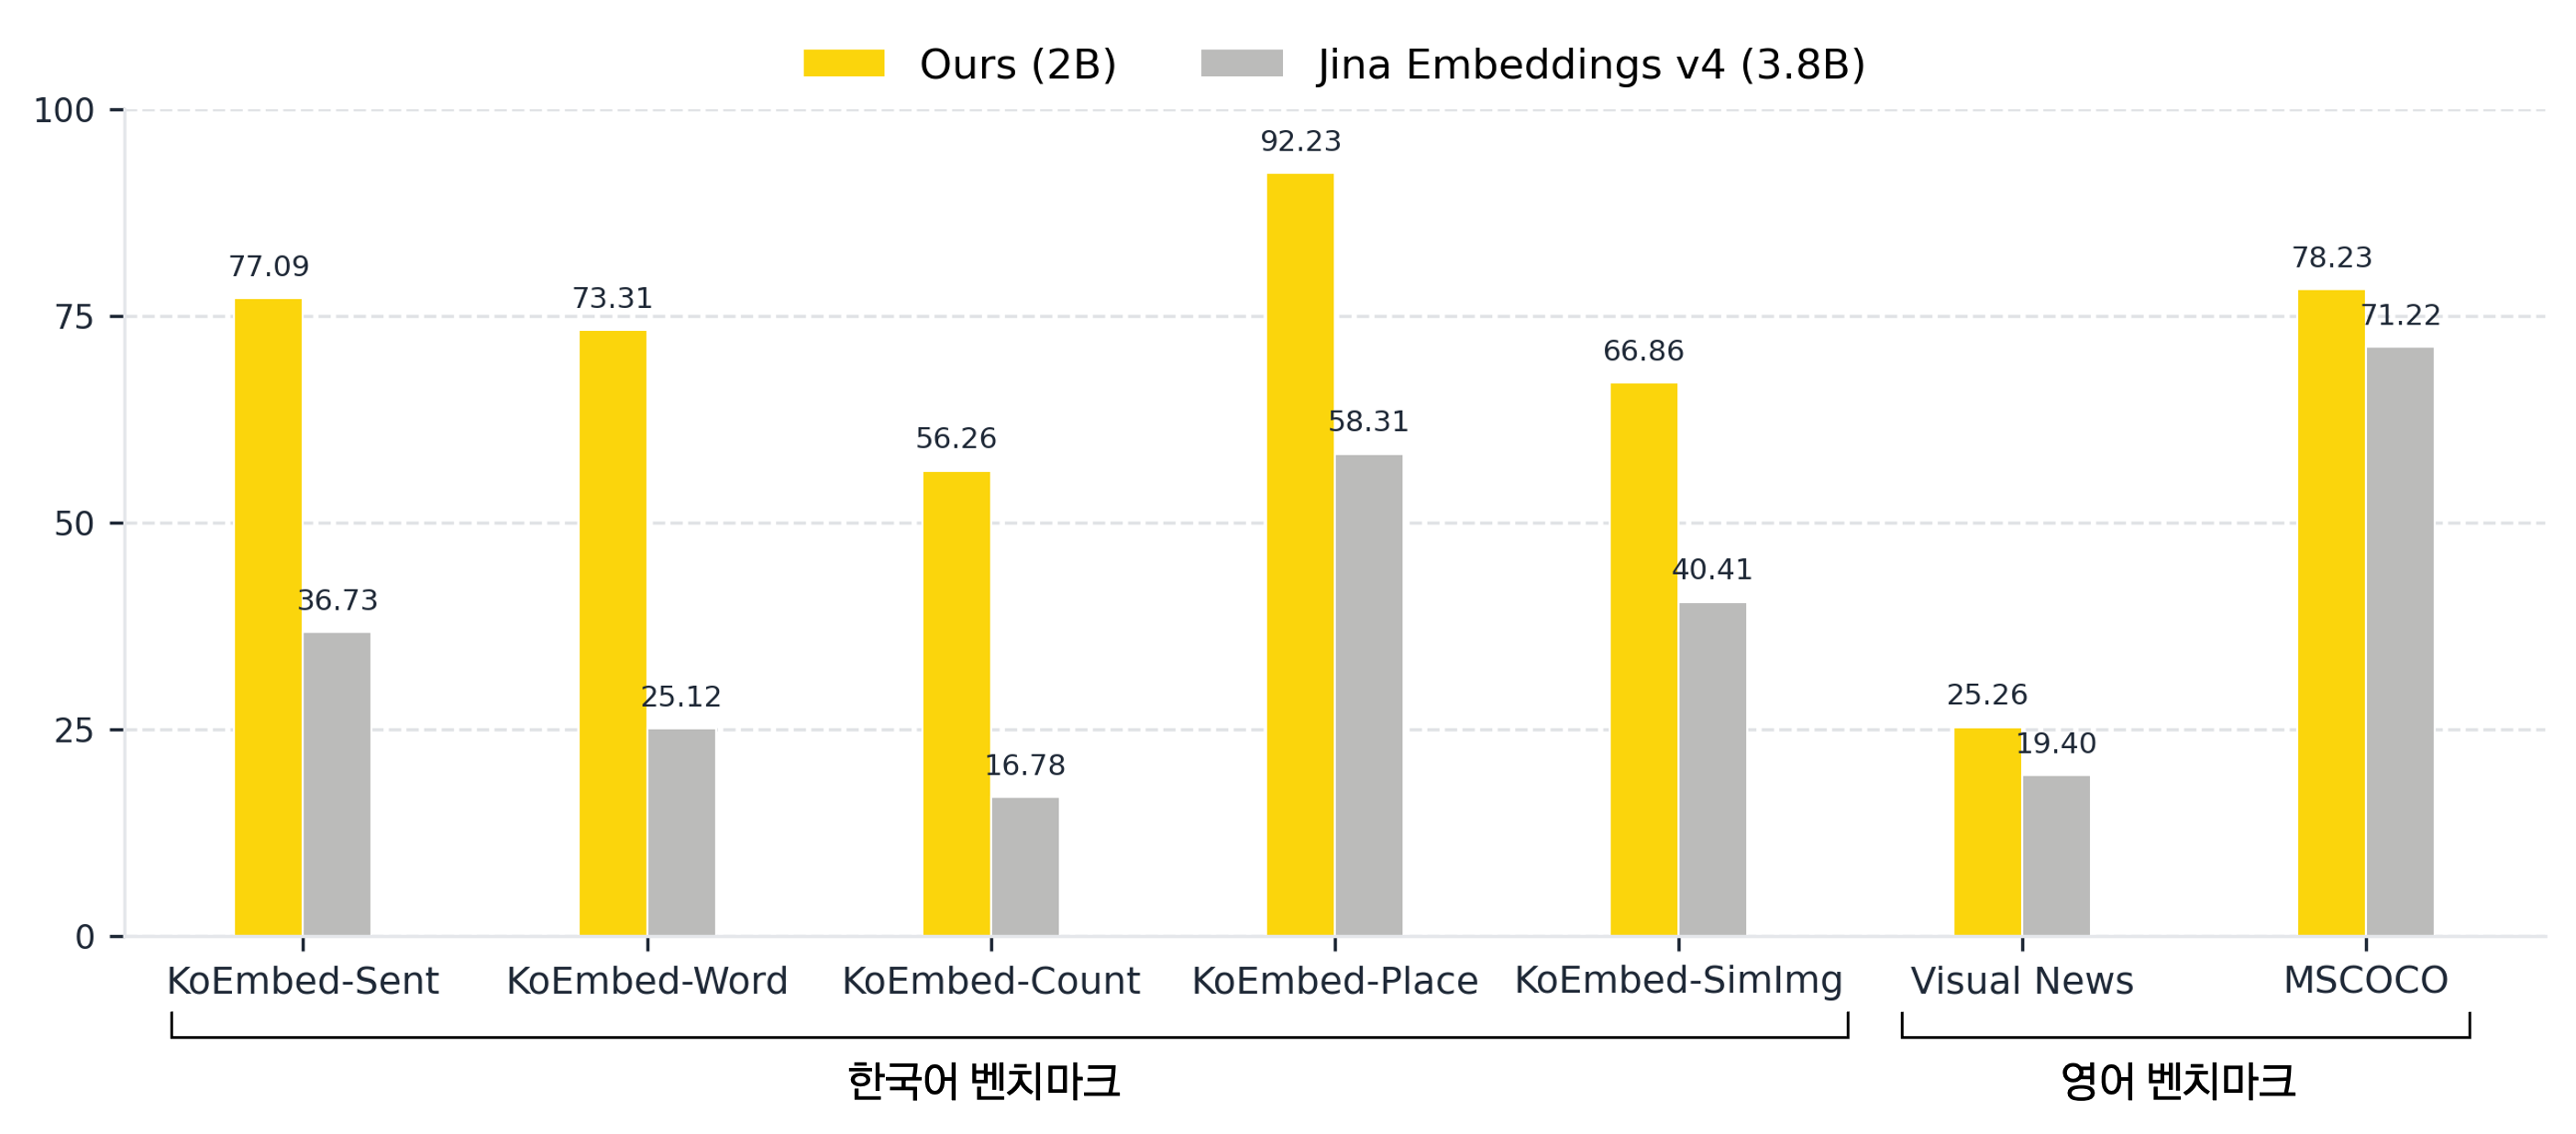
멀티모달 성능 평가를 위해 앞서 소개한 KoEmbed 와 공개되어 있는 Text-Image 평가 데이터셋을 사용했습니다.[9] 멀티모달 공개 모델 중 한국어를 지원하는 다국어 멀티모달 임베딩 모델인 Jina Embeddings v4 (3.8B)를 비교 모델로 선택했습니다.[8]
평가 결과, 한국어 중심 태스크 (KoEmbed)에서 Kanana-v-embedding이 모든 항목에서 큰 폭의 성능 우위를 보였습니다. 특히 한국어 문장 검색 능력을 평가하는 KoEmbed-Sent에서 77.09 vs 36.73으로 큰 차이를 기록했습니다. 영어 중심 태스크 (Visual News, MSCOCO)에서도 Jina Embeddings v4 대비 높은 성능을 보여주었습니다. 이는 Kanana-v-embedding이 절반 수준의 파라미터 (2B vs 3.8B)로도 한국어와 영어 멀티모달 검색 모두에서 경쟁력 있는 성능을 달성했음을 보입니다.
5-2. 텍스트 임베딩 성능
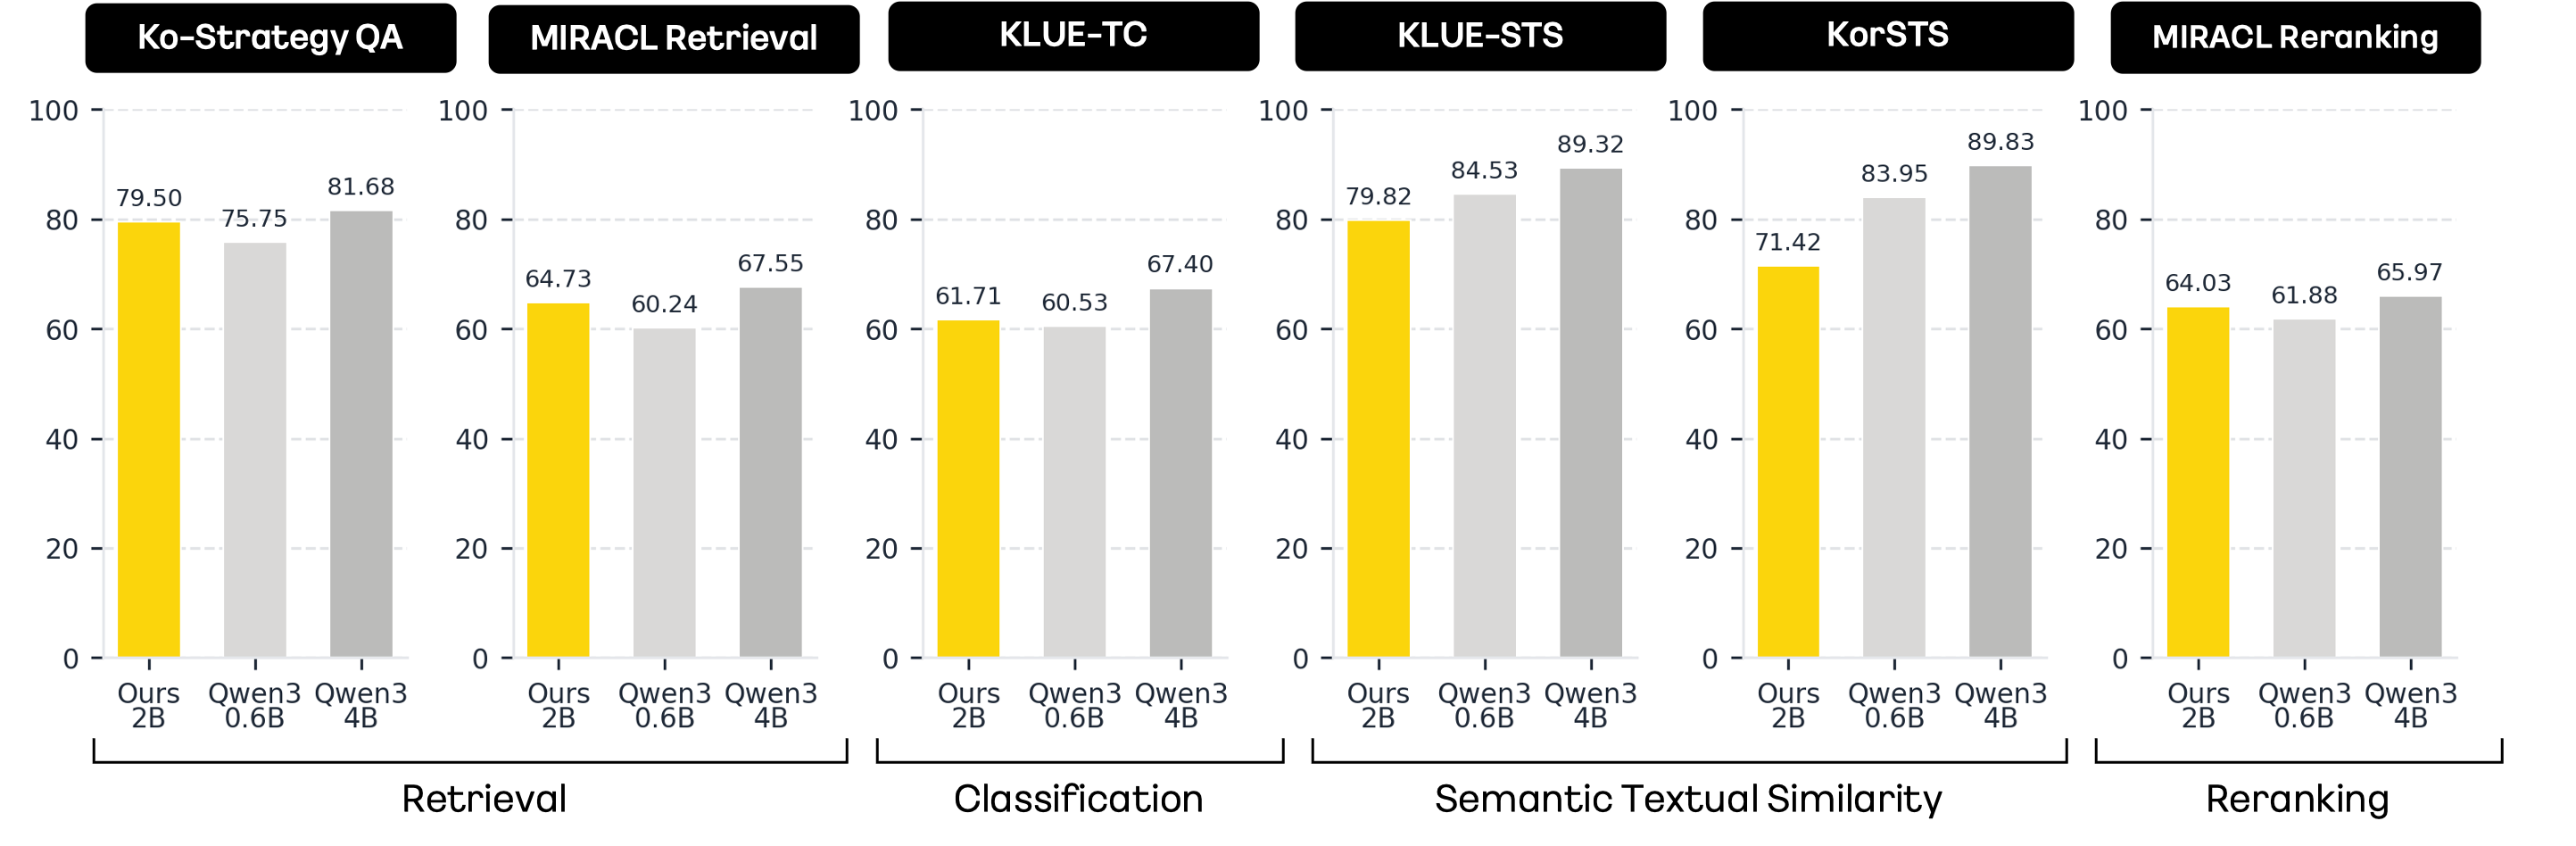
텍스트 임베딩 성능 평가를 위해 MTEB 한국어 태스크 를 사용했습니다.[10] 비교 모델로는 최근 높은 성능을 보여주고 있는 Qwen3 Embedding (0.6B, 4B)을 선택했습니다. Kanana-v-embedding은 Retrieval과 Reranking 태스크에서 Qwen3 0.6B 임베딩 모델보다 우수한 성능을 보였습니다. 반면 STS(Semantic Textual Similarity) 태스크에서는 상대적으로 낮은 성능을 기록했는데, 이는 멀티모달 학습 과정에서 텍스트 간 유사도보다 검색 성능에 더 집중했기 때문으로 분석됩니다. Kanana-v-embedding의 파라미터 수는 약 2B로, 순수 텍스트 임베딩만을 목표로 하는 대형 모델 대비 파라미터가 낮으면서, 동시에 멀티모달까지 지원한다는 점에서 실제 서비스 관점에서 경쟁력이 있습니다.
6. Kanana-v-embedding 활용 예시
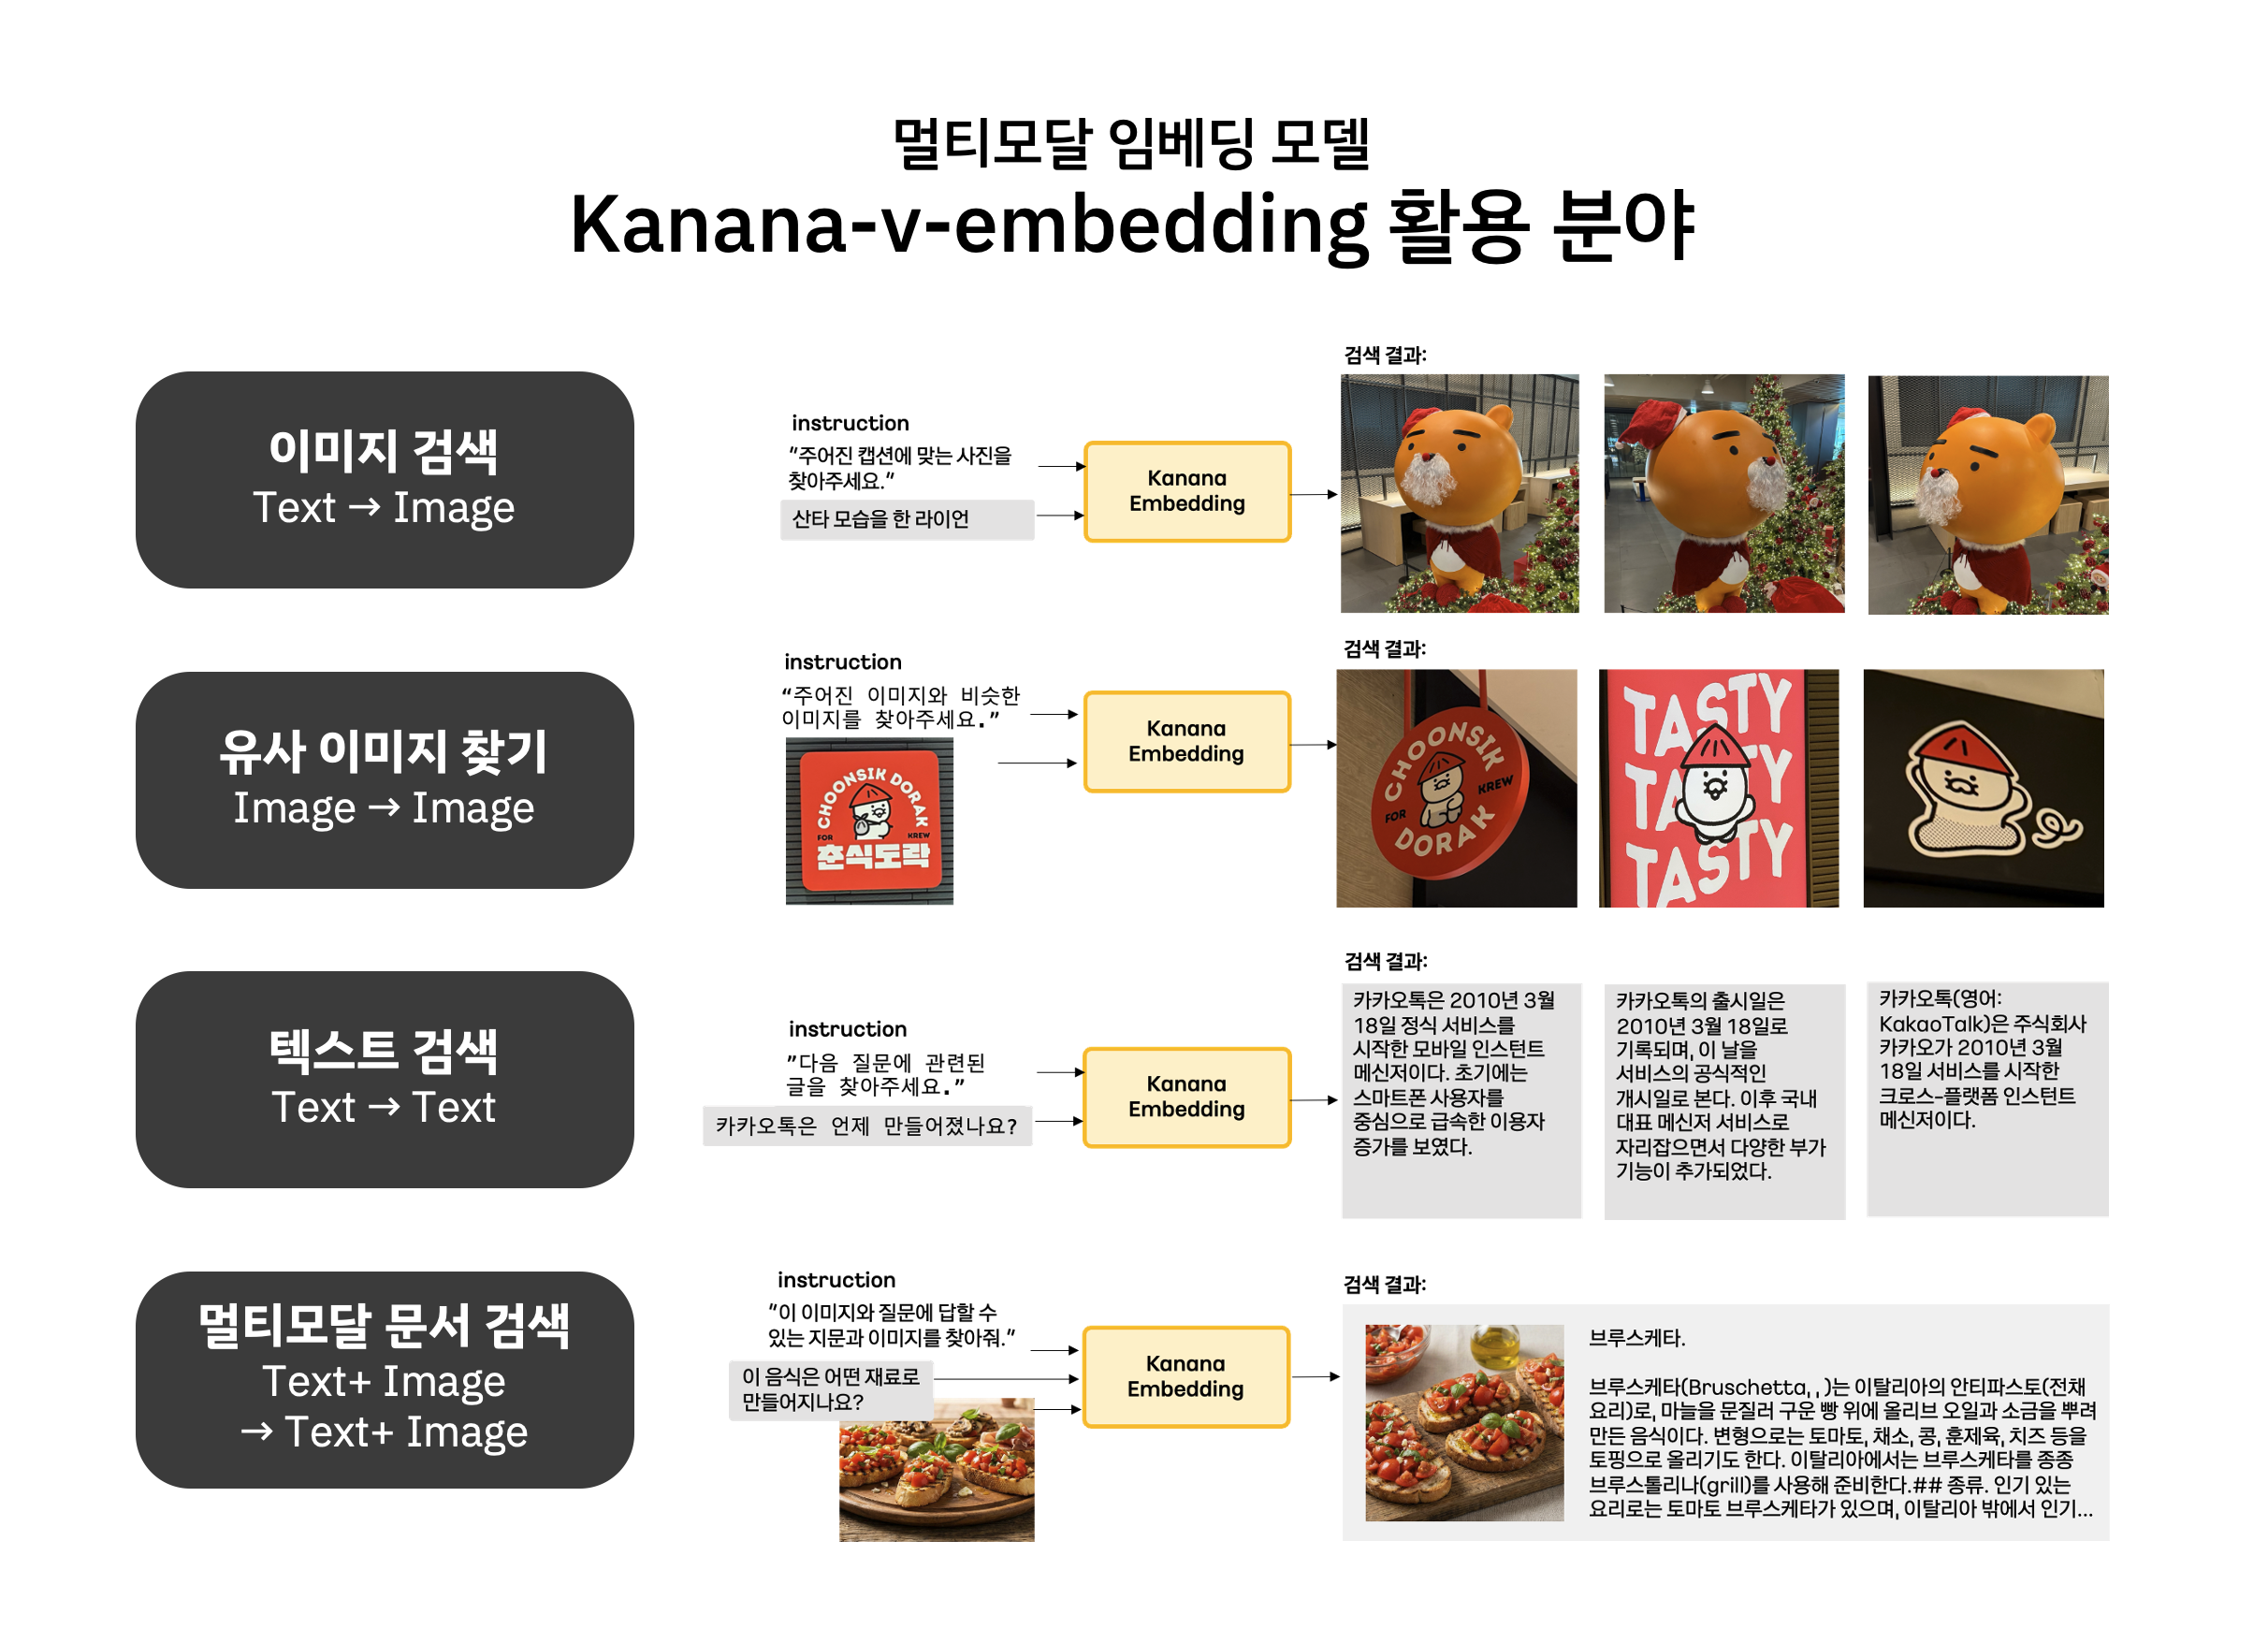
Kanana-v-embedding 모델은 텍스트와 이미지를 동시에 아우르며, 다양한 시나리오에서 활용될 수 있습니다. 현재 실제 사내 광고 심사 플랫폼에 적용되어 광고에 사용하는 이미지(소재)를 분석하고, 유사한 소재가 활용된 광고가 있는지 검색하는 기능을 수행하고 있습니다. 이밖에도, 모델의 서비스 적용 가능성을 엿볼 수 있는 다양한 활용 사례를 소개해보겠습니다.
이미지 검색 (Text→Image)
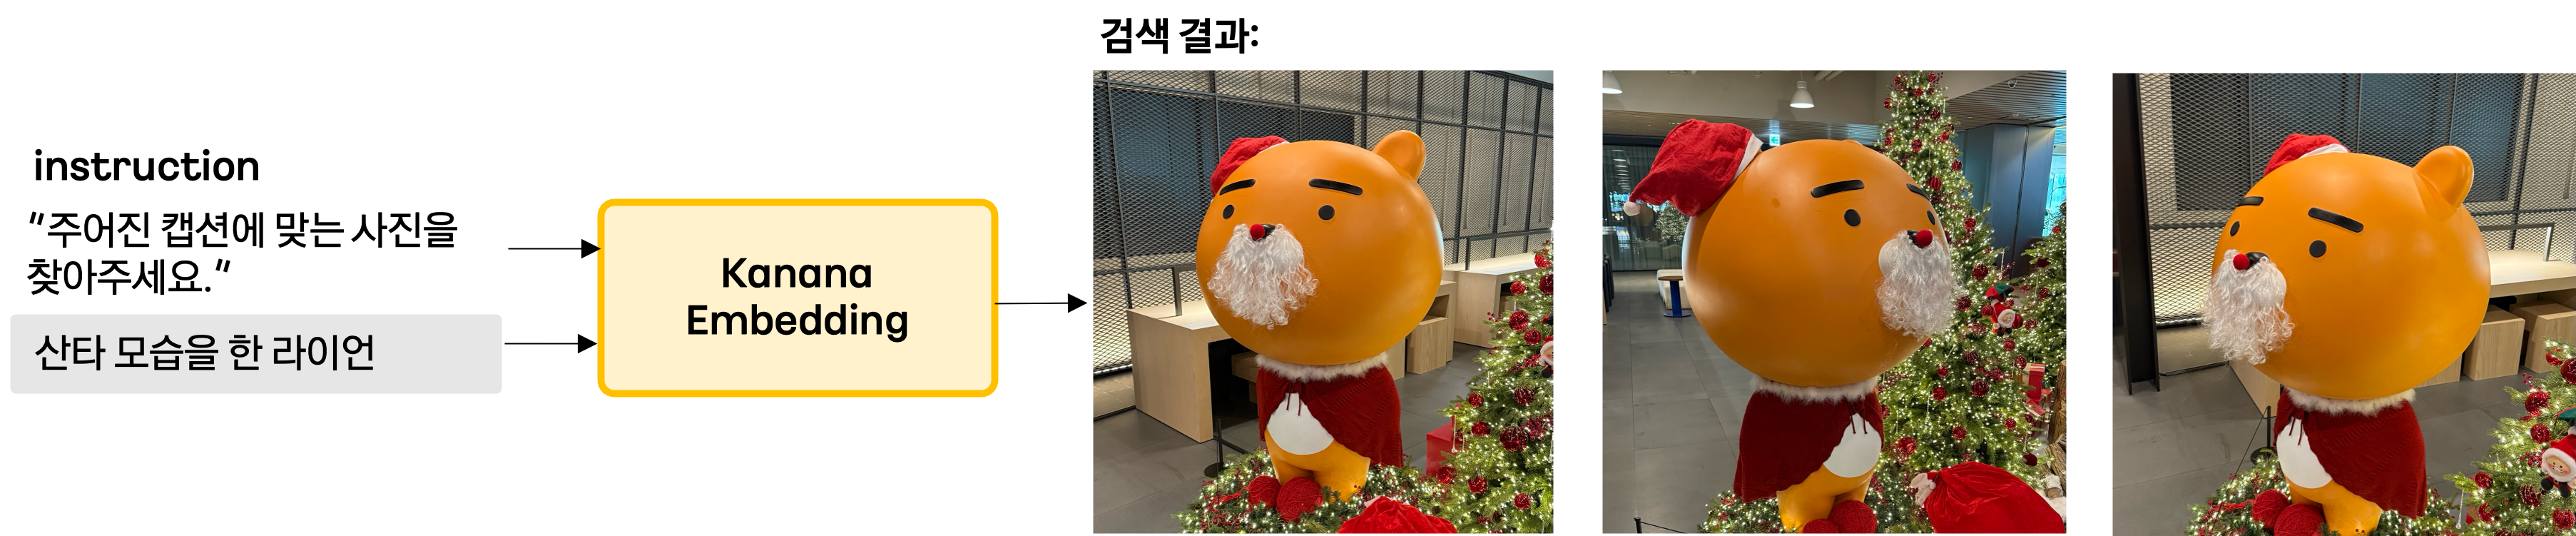
그림 5는 사진 앨범에서 사용자가 "산타 모습을 한 라이언"처럼 자연스러운 문장으로 원하는 사진을 검색하는 시나리오입니다. 사용자의 검색 쿼리를 임베딩으로 변환하고, 미리 인덱싱해 둔 이미지 임베딩과의 코사인 유사도를 계산해 상위 결과를 반환합니다. Kanana-v-embedding은 한국어 표현과 문화적 맥락을 반영하여 학습되었기 때문에, “한복 입고 찍은 사진”, “눈 내린 배경 셀카” 같은 한국적 상황을 묘사하는 쿼리도 정확하게 이해합니다. 또한 “경복궁”, “남산타워” 같은 한국 고유의 장소명까지 의미적으로 파악해 사용자가 원하는 사진을 높은 정확도로 찾아냅니다. 앨범 검색, 웹 검색 등 다양한 시나리오에 적용될 수 있습니다.
| 사용자 쿼리 | 계란찜 | 2022 아반떼 N 후면 | 신라 시대 금관과 금속 장신구 전시품 | 홍길동 명함 | 전통 사찰 등불, 벽화, 나무문 | 겨울 등산 3명 |
|---|---|---|---|---|---|---|
| Ours (2B) |  |  | 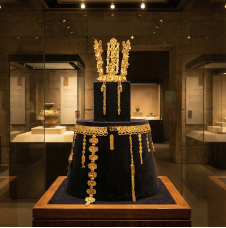 |  | 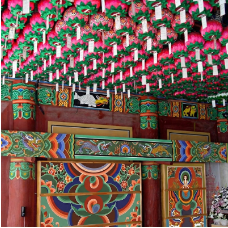 | 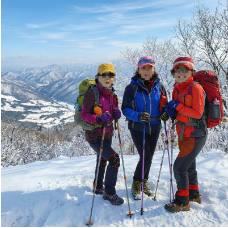 |
| Jina (3.8 B) | 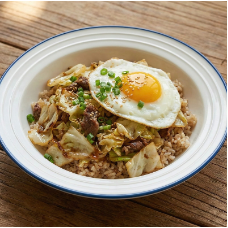 |  | 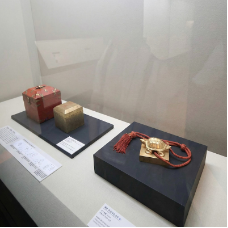 |  | 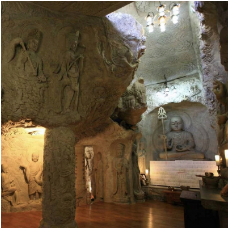 | 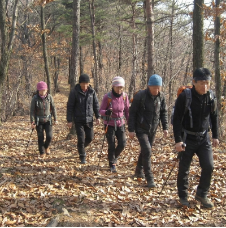 |
<표6. 한국어 쿼리 기반 이미지 검색 결과 비교. 동일한 한국어 쿼리에 대해 Kanana-v-embedding(2B)과 Jina Embeddings v4(3.8B)가 검색한 이미지를 비교합니다.>
표 6은 동일한 한국어 쿼리에 대해 Kanana-v-embedding(2B)과 Jina Embeddings v4(3.8B)의 검색 결과를 비교한 예시입니다. 한국 음식명이나 문화재처럼 한국어 고유의 표현과 문화적 맥락이 필요한 쿼리에서 두 모델의 차이가 두드러집니다. Kanana-v-embedding은 쿼리의 의미를 정확히 이해하여 관련 이미지를 검색하는 반면, Jina Embeddings v4는 키워드 일부만 매칭되거나 관련 없는 이미지를 반환하는 경우도 많았습니다.
유사 이미지 찾기 (Image→Image)
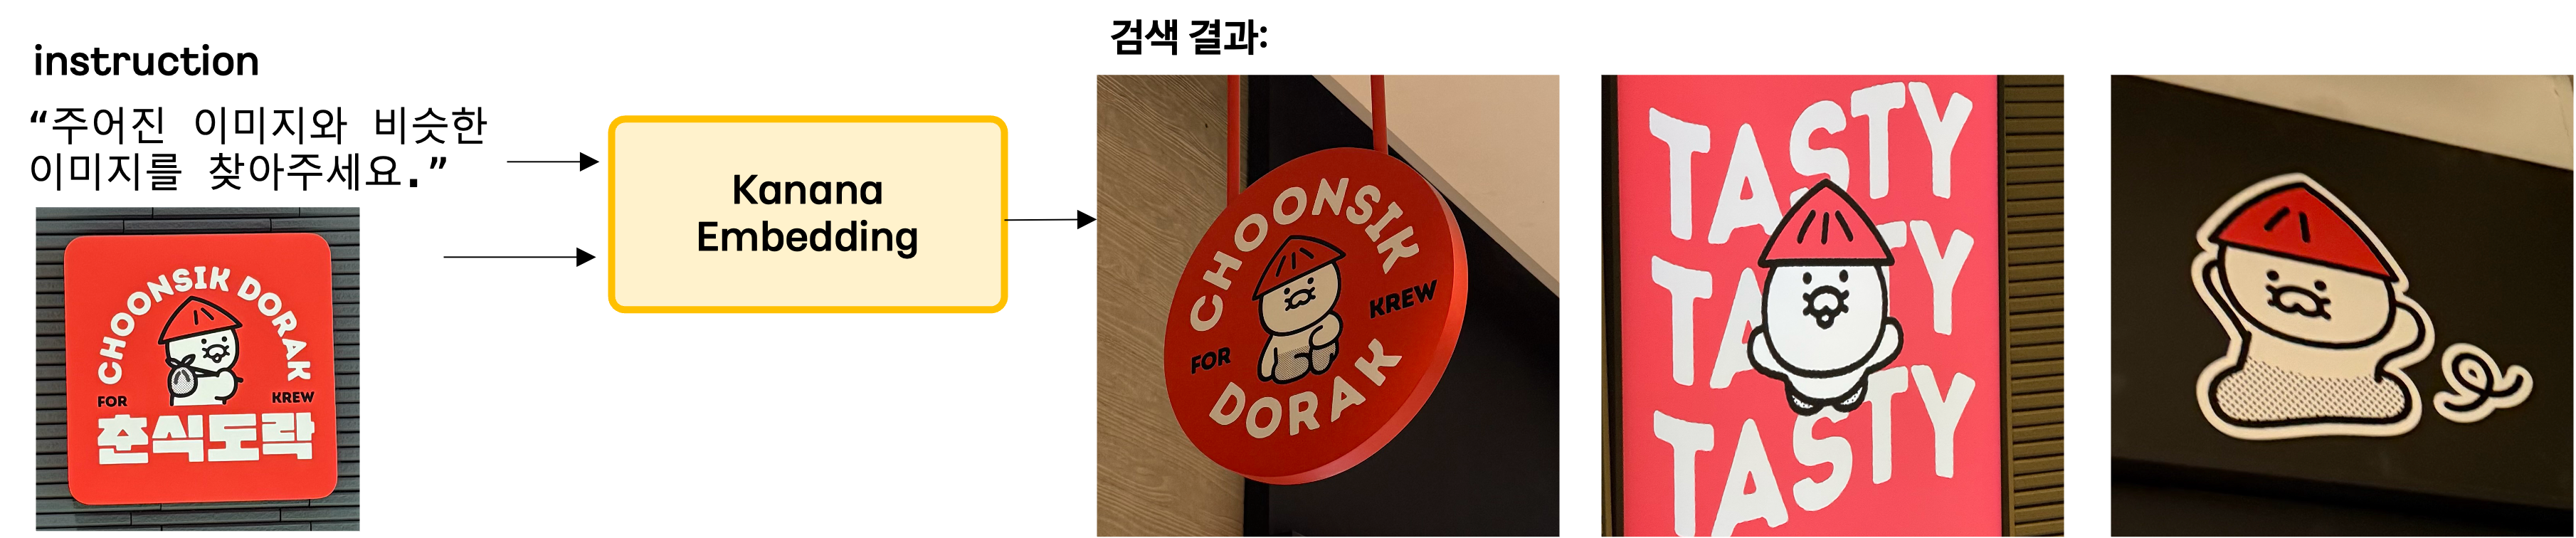
그림 6은 특정 이미지를 기준으로 비슷한 이미지를 찾는 시나리오입니다. "주어진 이미지와 비슷한 이미지를 찾아주세요"라는 지시(Instruction)와 함께 쿼리 이미지를 입력하면, Kanana-v-embedding이 해당 이미지를 임베딩으로 변환하고, 이미지 풀의 임베딩과 유사도를 계산해 상위 N개 후보를 반환합니다. 그림의 예시처럼 춘식도락 간판 이미지를 입력하면, 동일한 캐릭터가 등장하는 이미지나 비슷한 브랜딩 요소를 가진 이미지들이 검색됩니다. 단순히 색상 분포나 레이아웃만 비교하는 것이 아니라, 캐릭터의 형태, 브랜드 아이덴티티, 시각적 스타일 같은 의미적 특성까지 임베딩 공간에 반영되어 있어, 사람이 느끼는 "비슷함"에 가까운 검색 결과를 제공합니다. 이 기능은 앨범에서 비슷한 사진 묶기, 쇼핑몰에서 유사 상품 추천, 브랜드 자산 관리에서 유사 이미지 찾기 등 다양한 서비스에 적용할 수 있습니다.
텍스트 검색 (Text→Text)
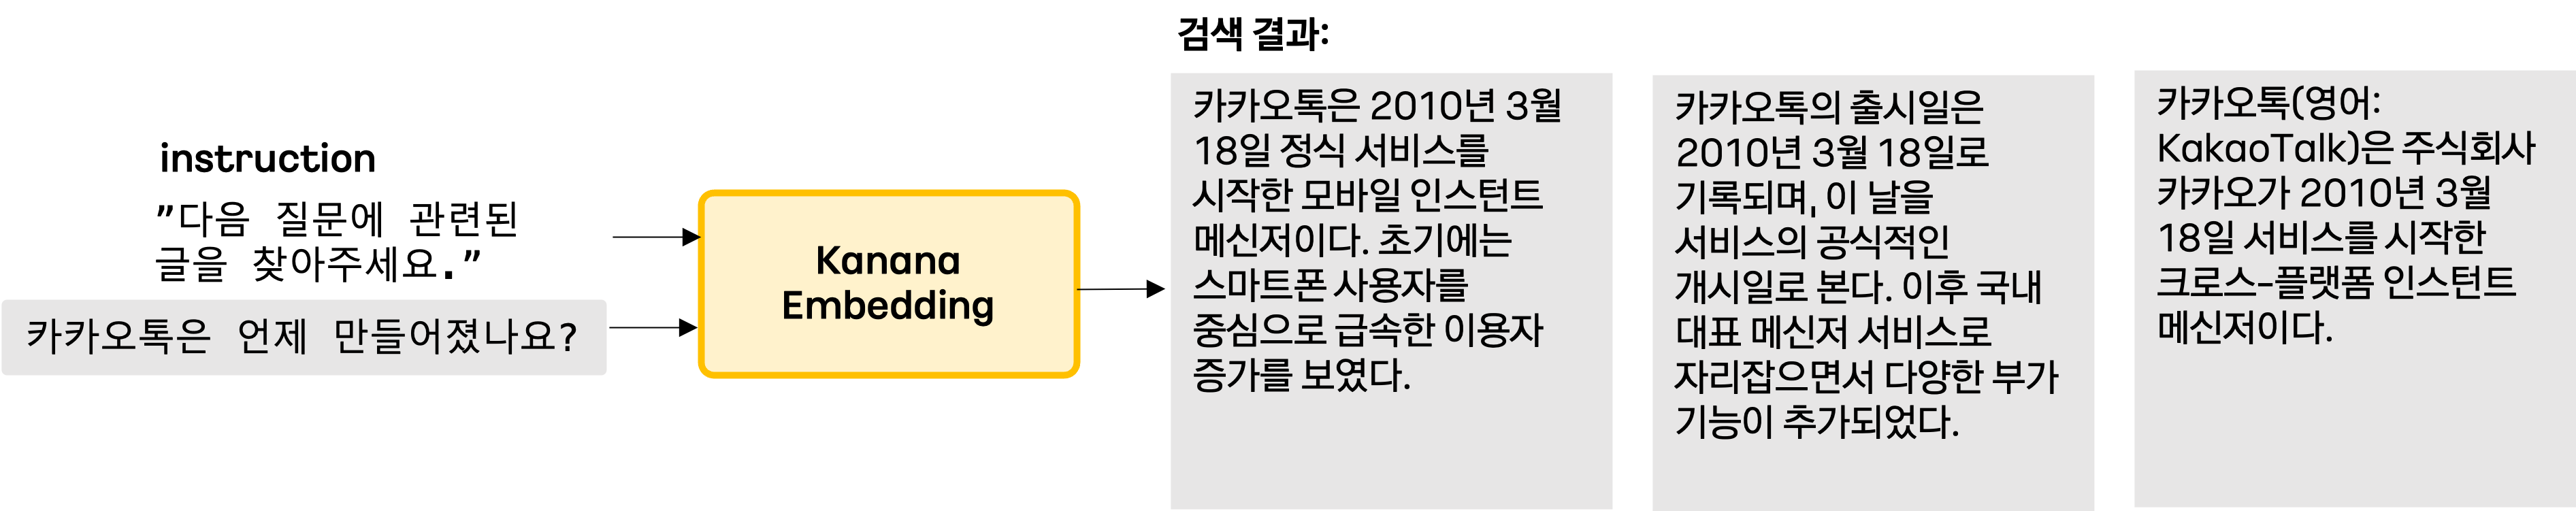
그림 7은 사용자가 "카카오톡은 언제 만들어졌나요?"라고 질문하면, 관련 문서를 검색해 답변을 제공하는 시나리오입니다. 그림의 예시처럼 카카오톡 출시일에 대한 질문을 입력하면, "2010년 3월 18일"이라는 핵심 정보를 담고 있는 여러 문서를 찾을 수 있습니다. Kanana-v-embedding은 MTEB 한국어 태스크에서 검증된 텍스트 임베딩 성능을 갖추고 있어, 순수 텍스트 검색만 놓고 보더라도 기존 텍스트 임베딩 모델과 경쟁력 있는 성능을 보입니다. 특히 한국어 특유의 문화와 표현을 의미적으로 이해하여, 키워드가 정확히 일치하지 않더라도 관련 문서를 정확하게 찾아냅니다. FAQ 검색, 문서 검색, 채팅 상담 자동 응답, RAG 등 다양한 텍스트 검색 시나리오에 적용할 수 있습니다.
멀티모달 문서 검색 (Text+Image→Text+Image)
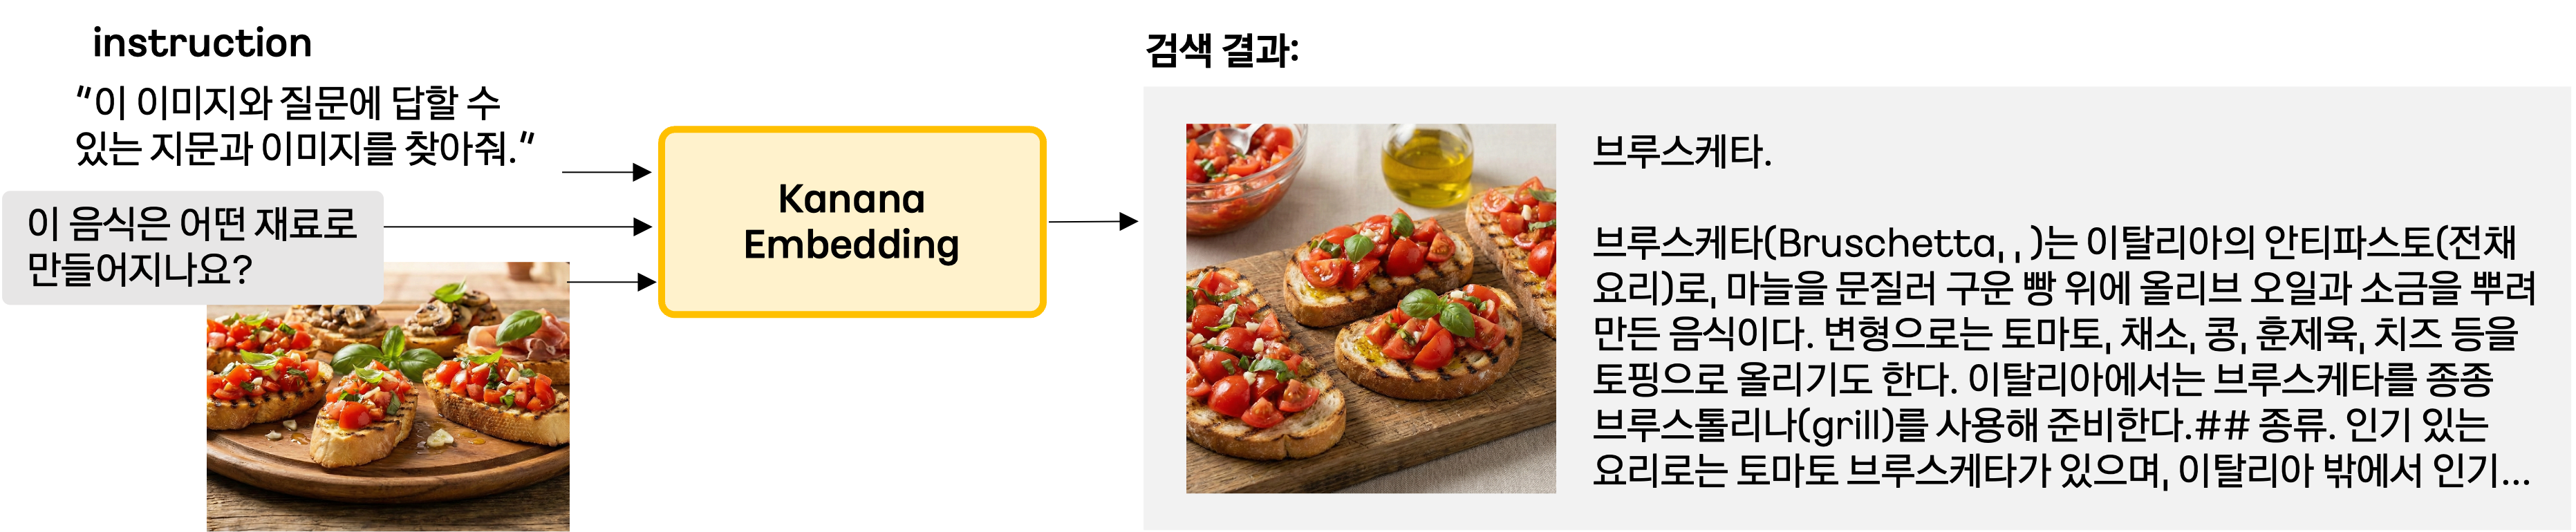
그림 8은 사용자가 음식 사진과 함께 "이 음식은 어떤 재료로 만들어지나요?"라고 질문하면, 해당 음식에 대한 텍스트 설명과 이미지가 포함된 위키피디아 문서를 검색하는 시나리오입니다. 사용자의 질문과 이미지를 질문 전용 지시(Instruction)와 함께 멀티모달 임베딩하고, 위키피디아 문서는 본문 텍스트와 대표 이미지를 함께 입력해 멀티모달 임베딩을 구성합니다. 그림의 예시처럼 브루스케타 사진을 입력하면, "마늘을 문질러 구운 빵 위에 올리브 오일과 소금을 뿌려 만든 음식"이라는 설명과 함께 관련 이미지가 포함된 문서를 찾아줍니다.
기존 텍스트 전용 검색 시스템에서는 사진만으로 음식 종류를 파악하거나, 시각적 정보가 풍부한 문서를 제대로 검색하기 어려웠습니다. Kanana-v-embedding은 텍스트와 이미지를 하나의 의미 공간에서 함께 이해하므로, 이미지 속 음식의 외관, 재료, 조리법 등 시각적 정보까지 검색 품질에 자연스럽게 반영됩니다. 결과적으로 텍스트 문서뿐 아니라 이미지 중심 백과사전 문서 혹은 웹페이지에도 활용될 수 있습니다.
7. 앞으로의 방향
Kanana-v-embedding은 현재 텍스트, 이미지 중심의 멀티모달 임베딩 모델이지만, 향후 다음과 같은 방향으로 확장을 준비하고 있습니다.
모달리티 확대: 비디오, 음성까지
현재 Kanana-v-embedding은 텍스트와 이미지를 지원하지만, 카카오톡 채널, 카카오 숏폼 등 카카오 서비스에는 비디오 콘텐츠와 음성 메시지도 넘쳐납니다. VLM2Vec-V2와 같은 최근 연구에서는 이미지뿐 아니라 비디오, 음성까지 통합하는 멀티모달 임베딩을 제안합니다.[11] Kanana-v 계열 모델에서도 비디오를 임베딩 형태로 요약하거나, 팟캐스트, 음성 메시지 등을 텍스트와 함께 임베딩하는 방향을 검토하고 있습니다. 이를 통해 카카오 숏폼에서 "축구 경기 하이라이트 장면"을 텍스트로 검색하거나, 보이스톡 메시지에서 "여행 계획 관련 대화"를 찾는 등 새로운 검색 시나리오가 가능해집니다.
Search Agent로의 확장
단순히 "쿼리-문서 유사도 점수"를 계산하는 수준을 넘어, 사용자의 의도에 맞게 쿼리를 생성, 수정하고 다양한 모달리티를 조합해 최종 결과를 구성하는 Search Agent 구조와의 결합도 고려하고 있습니다. 예를 들어 "최근 인기 생일 선물 리스트"를 요청하면, 인기 선물을 검색, 트렌드 문서 검색, 사용자 정보 매칭을 순차적으로 수행할 수 있습니다. 이때 Kanana-v-embedding은 에이전트가 생성하는 중간 쿼리, 요약, 계획(Step)마다 최적화된 임베딩을 제공해, 각 단계의 검색 정확도를 높이는데 사용될 수 있습니다.
Reasoning-enhanced Embedding
최근에는 LLM의 추론 과정을 활용해 임베딩을 더 풍부하게 만드는 연구도 활발합니다. 기존 임베딩 모델은 표면적인 단어 매칭이나 시각적 유사도에 의존하는 한계가 있습니다. Kanana-v-embedding은 LLM이 내부적으로 수행하는 추론 단계의 정보를 임베딩에 반영하는 방향을 실험하고 있습니다. LLM이 거치는 추론 단계들(예: “이 상품의 핵심 특징은?”, “어떤 상황에 적합한가?”)의 히든 스테이트(Hidden State)를 임베딩 공간에서 표현하는 방법을 연구 중입니다. 이를 통해 "겨울철 건조한 피부 관리"를 검색할 때 단순히 “겨울” 또는 "피부"가 언급된 상품이 아니라 “보습 크림”, “하이드레이션 세럼” 같은 원인-해결책 관계로 연결된 상품을 더 높은 순위로 제시할 수 있습니다. 카카오 쇼핑 상품 검색, 여행지 추천, 헬스케어 정보 검색처럼 사용자의 니즈와 솔루션을 정확히 매칭해야 하는 도메인에서 성능이 크게 향상될 것으로 기대됩니다.
온디바이스(On-device) AI와 초개인화
사용자의 프라이버시를 지키면서도 정교한 개인화 경험을 제공하기 위한 기술로, 온디바이스(On-device) 환경에서 동작하는 경량화 임베딩 모델에 대한 수요 역시 점점 높아지고 있습니다. 개인 앨범처럼 민감한 정보를 서버로 보내지 않고 기기 내에서 처리하는 방식은 보안성과 응답 속도 면에서 많은 장점을 갖고 있어, 관련 기술의 발전 가능성이 주목받고 있습니다.
이러한 흐름 속에서 모바일 환경에서 Kanana-v-embedding 모델을 활용할 수 있는 방안을 연구하고 있습니다. 온디바이스 환경에서 “우리 가족이 웃고 있는 사진 찾아줘", "뽀삐 작년에 해변가에서 뛰어다니는 사진 찾아줘”와 같은 개인 맥락을 세밀하게 반영하는 초개인화 검색, 추천 기능을 구현하는 것이 목표입니다.
8. 맺음말
Kanana-v-embedding 모델 연구는 ‘어떻게 하면 사용자가 텍스트와 이미지의 제약 없이, 머릿속에 떠오른 생각을 자유롭게 검색해 답을 얻을 수 있을까?’라는 고민에서 출발했습니다.
이를 실현 하기 위해 VLM 기반 아키텍처 위에 그래디언트 캐싱(Gradient Caching), 마트료시카 표현 학습(Matryoshka Representation Learning), 하드 네거티브 마이닝(Hard Negative Mining) 등의 최신 기법과 KoEmbed 데이터셋을 접목했습니다. 그 결과, 파라미터 효율성과 실용성을 모두 갖춘 멀티모달 임베딩 모델을 확보할 수 있었고, 실제 사내 광고 심사 플랫폼에도 적용되어 서비스 적용 가능성을 직접 확인하기도 했습니다.
앞으로 저희는 더욱 다양한 사용자들을 대상으로 유용한 서비스를 제공할 수 있는 기반 기술을 확보할 수 있도록, 비디오, 음성 등의 모달리티를 확장하고, Search Agent 연계까지 지원할 수 있도록 모델을 고도화하겠습니다. 이를 바탕으로 카카오 서비스 곳곳에서 “사용자가 원하는 것을 가장 자연스럽게 찾아주는” 경험을 확대해 나가겠습니다.
함께한 사람
본 프로젝트는 Kanana 조직의 jin.bottle(나병진), milo.h(김정훈), dion.g(기대환), erin.hh(홍은빈), michael.l22(이주영)이 함께하였습니다.
감사의 말
글의 전반적인 피드백을 제공해 주신 Kanana 조직의 loophy.cc(조정민)에게 감사의 말을 전합니다.
참고문헌
-
[1] Radford, Alec, et al. “Learning transferable visual models from natural language supervision.” International conference on machine learning. PmLR, 2021.
-
[2] BehnamGhader, Parishad, et al. “Llm2vec: Large language models are secretly powerful text encoders.” arXiv preprint arXiv:2404.05961 (2024).
-
[3] Jiang, Ziyan, et al. “Vlm2vec: Training vision-language models for massive multimodal embedding tasks.” arXiv preprint arXiv:2410.05160 (2024).
-
[4] He, Kaiming, et al. “Momentum contrast for unsupervised visual representation learning.” Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2020.
-
[5] Gao, Luyu, et al. “Scaling deep contrastive learning batch size under memory limited setup.” Proceedings of the 6th Workshop on Representation Learning for NLP (RepL4NLP-2021). 2021.
-
[6] Kusupati, Aditya, et al. “Matryoshka representation learning.” Advances in Neural Information Processing Systems 35 (2022): 30233-30249.
-
[7] Moreira, Gabriel de Souza P., et al. “NV-Retriever: Improving text embedding models with effective hard-negative mining.” arXiv preprint arXiv:2407.15831 (2024).
-
[8] Günther, Michael, et al. “jina-embeddings-v4: Universal embeddings for multimodal multilingual retrieval.” Proceedings of the 5th Workshop on Multilingual Representation Learning (MRL 2025). 2025.
-
[9] Wei, Cong, et al. “Uniir: Training and benchmarking universal multimodal information retrievers.” European Conference on Computer Vision, 2024.
-
[10] Muennighoff, Niklas, et al. “Mteb: Massive text embedding benchmark.” Proceedings of the 17th Conference of the European Chapter of the Association for Computational Linguistics. 2023.
-
[11] Meng, Rui, et al. “Vlm2vec-v2: Advancing multimodal embedding for videos, images, and visual documents.” arXiv preprint arXiv:2507.04590 (2025).