Culture
KCC2024 후기(2) 무대의 주역, 발표 세션!
sue.cream카카오
2024년 10월 10일
원문에서 보기 ↗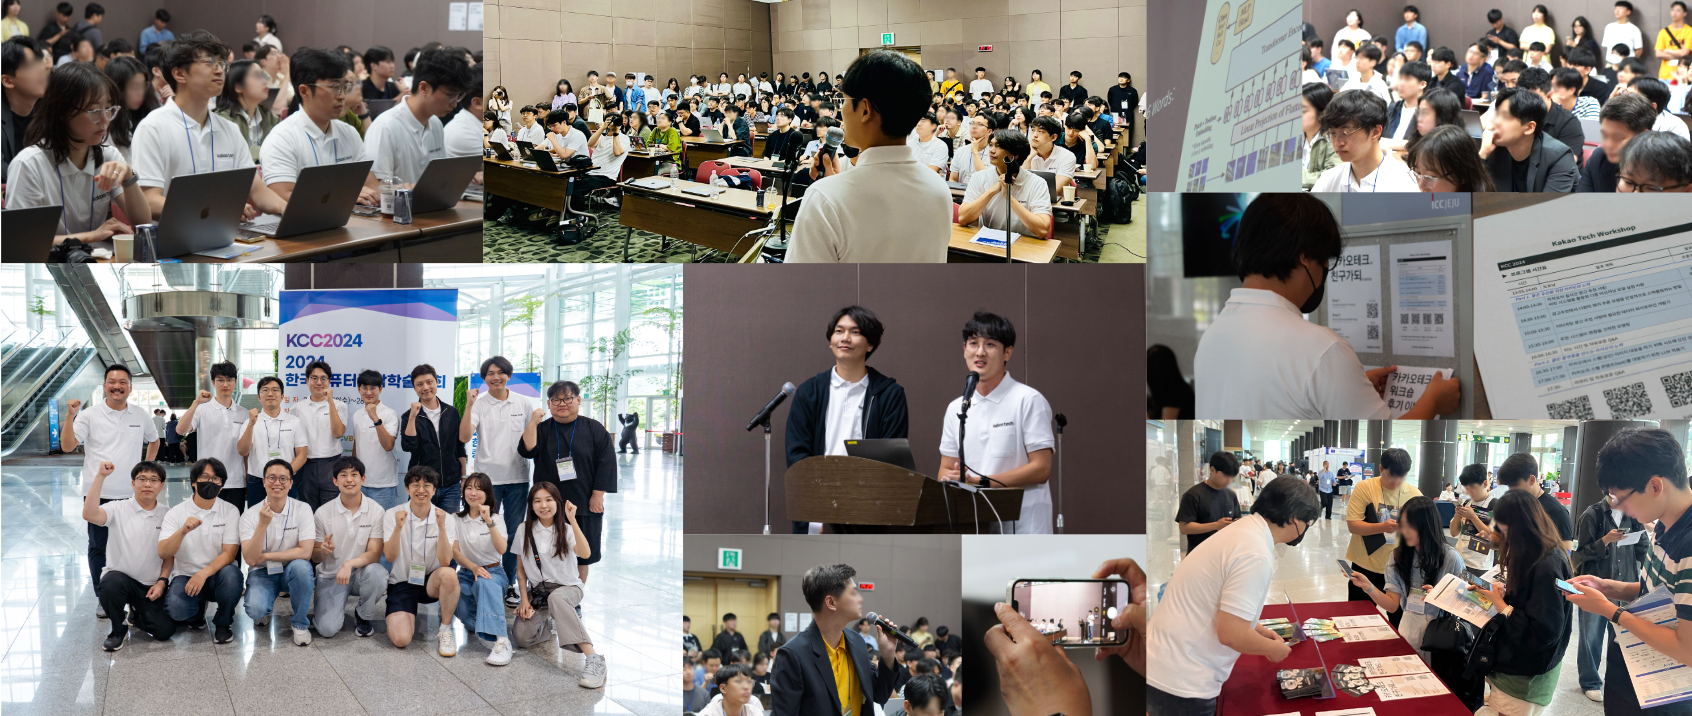
안녕하세요, 기술 생태계를 후원하는 DevRel 담당자 Sue입니다. 🙋♀️
1편에서 Sam이 소개해 주신 것과 같이, 올해도 카카오가 한국컴퓨터종합학술대회(KCC)에 후원사로 참여했어요. 그래서 지난 6/26(수), 제주에서 많은 크루들이 다 같이 Kakao Tech Workshop을 개최하고 왔습니다. (벌써 시간이 많이 흘렀네요!)
행사가 시작되고 마무리하는 과정에서는 자연스레 참가자분들에게 초점을 맞추게 됩니다. 그러다 보면 한 편으로는 발표자들에게 충분한 스포트라이트를 드리고 있는지 생각하게 돼요. 그러므로 작년의 KCC 후기(2편)에서는 참가자분들과 행사 전반에 집중해서 이야기를 들려드렸다면, 이번에는 발표자 크루들에게 좀 더 집중해보려 합니다.
Part 1. 좋은 추천을 위한 카카오의 노력
첫 번째 파트에서는 광고추천개발과 ML플랫폼 소속의 크루들이 강연을 준비했어요. 카카오는 좋은 광고와 콘텐츠의 추천을 위해 데이터 사이언스 기술을 적극 활용하여 모델 연구, 개발, 운영을 하면서 또 안정적으로 실시간 서비스를 제공하기 위해 거대한 서빙 시스템을 개발 및 운영합니다. 이 외에도 데이터 파이프라인 시스템, 모델 학습과 실험 시스템, 지표 모니터링 시스템 등 기반 기술을 바탕으로 MLOps 구조를 가지고 있습니다. 하고 싶은 얘기가 많지만 핵심을 정성스레 담은 네 가지 강연을 소개합니다.
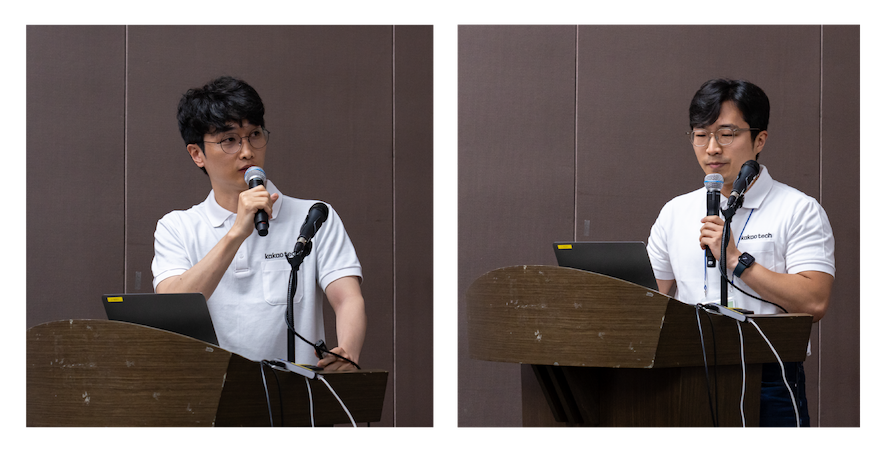
➊ 카카오의 실시간 광고 추천 서빙:버킷 시스템을 활용한 다중 머신러닝 모델 실험 지원 (by Faust, JB)
파우스트와 제이비는 카카오에서 실시간 광고 추천 서빙을 할 때 다양한 모델이 시스템에서 어떻게 사용되는지 소개하고 그중 어떤 모델을 사용할지 선택하는 버킷시스템에 대해 이야기했습니다. 버킷시스템은 모델 동기화 방식과 동적 모델 결정방식 등을 결합한 것으로, 광고추천모델의 선택, 변경, 갱신 등을 서빙 코드의 변경이나 배포 없이 관리하고자 고안한 것인데요, 이 시스템의 구조와 이를 활용한 모델 실험, 실제 운영 적용 등의 사례를 공유했습니다.
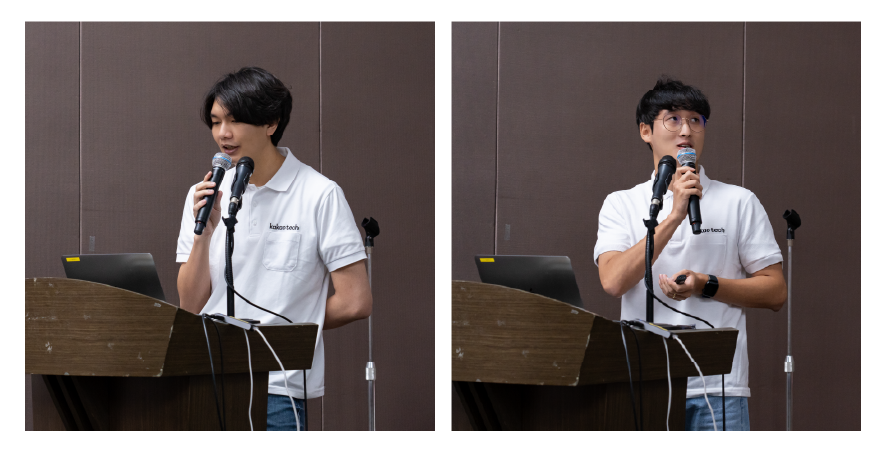
➋ 광고추천에서 다량의 배치 추론 모델을 안정적으로 스케줄링하는 방법 (by Sam, Daniel)
샘과 다니엘은 실시간이 아닌 배치 예측 시스템을 다루었는데요, 다양한 광고주・광고목적・전환의 사례별로 각각 최적화된 모델을 적용하기 위해서 방대한 양의 데이터・피처・모델을 빠르고 안정적으로 관리하는 시스템을 구성한 것입니다. 광고 추천은 무엇이고 다량의 모델과 스케줄러가 왜 필요한지에 대한 배경과 함께, 그 솔루션으로 만든 스케줄러의 구성과 각 작업의 단계들, 나아갈 방향 등을 소개했습니다. 현업에서 모델을 만드는 것뿐 아니라 서비스에 배포하고 관리하는 부분, 특히 다량의 모델이 필요한 경우에 관리에 대해 고민이 필요한 지점들에 대한 화두를 던진 발표였습니다.
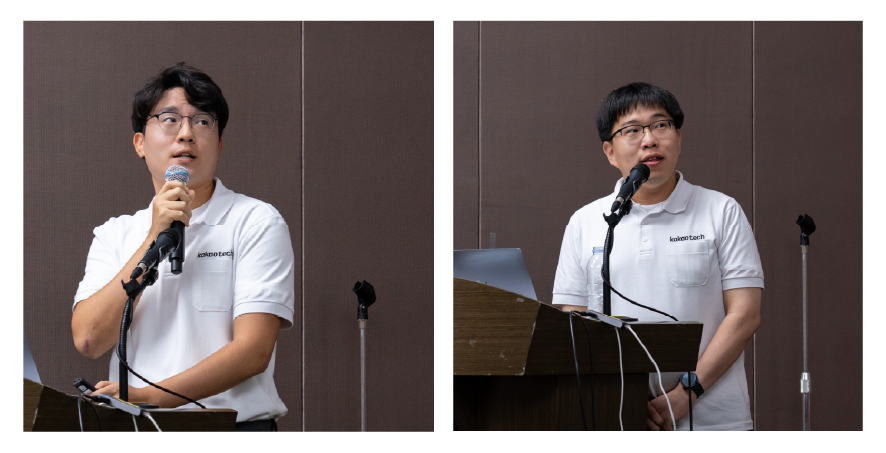
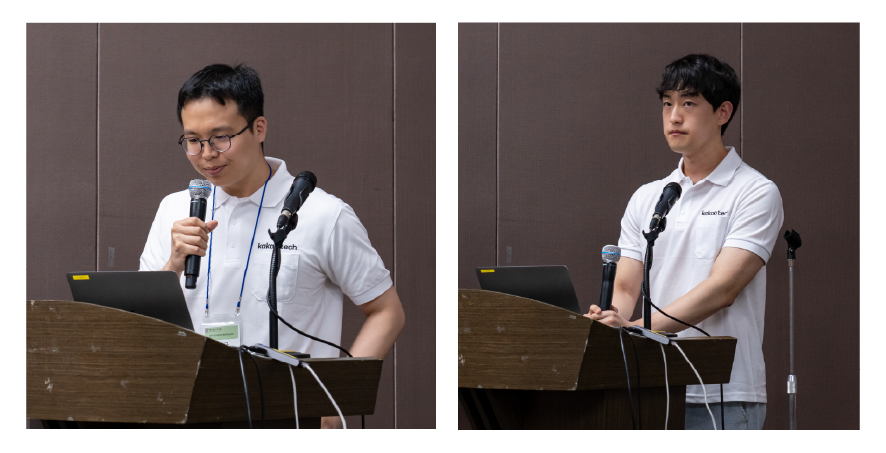
➌ 리타게팅 광고 추천 서빙에 필요한 데이터 파이프라인 개발기 (by Pooh, Moses)
푸와 모세는 광고 도메인의 마지막 세션으로, 리타게팅 광고, 즉 유저 활동을 기반으로 관심 상품과 연관 상품을 추천하는 광고를 집행하기 위한 서빙에 대해 이야기했습니다. 리타게팅 광고에서 좋은 추천을 하기 위해서는 좋은 데이터를 온전히, 적시에 전달하는 것이 중요한데요, 이를 위해 대용량의 데이터를 빠르고 잘 처리하기 위한 고민을 담아 설계한 데이터 중심 추천 시스템을 소개했습니다. 특히 이 시스템을 설계할 때 고려한 기준인 신뢰성, 응답성, 확장성 세 가지 관점에서 다루며, 경험으로 얻은 교훈들도 공유했습니다.
➍ 추천 시스템의 편향을 고려한 모델링 (by Francis, Rick)
프랜시스와 릭은 최근 학계에서 많이 주목받기 시작한 추천 시스템의 편향을 다루었습니다. 모델이 학습한 데이터가 실제 데이터 환경과 차이가 있을 때, 오히려 과도한 데이터 학습으로 추천 시스템의 성능이 감소할 수 있다고 합니다. 여러 편향 중 노출 편향과 귀납 편향을 중점적으로 다루며, 각각을 개선하기 위해 진행했던 노출 편향 완화 실험(eALS 실험)과 귀납 편향 주입 실험(MAB reward 변경 실험)에 대해 소개했습니다. 노출 편향을 완화하기 위한 가중 팩터를 도입했을 때 기존의 방식 대비 실제 서비스에서 모델의 성능이 향상되었던 경험을 공유했습니다. 또 서비스 도메인의 특징에 따라 현재의 모델이 무엇을 최적화하고 있는지 파악하고 이에 따른 적절한 귀납 편향을 모델에 주입했을 때 추천의 성능이 향상되었던 경험도 공유했습니다.
Part 2. 클린 플랫폼을 만드는 카카오의 노력
두 번째 파트에서는 클린플랫폼 소속의 크루들이 ML, LLM 등을 적용하여 스팸을 필터링하고 안전한 플랫폼을 만들기 위한, 보이지 않는 고민들을 다루어 주었습니다. 오후 다소 늦은 시간까지 진행된 세션이었음에도 많은 분들이 자리를 지켜 주시고, 질문도 열심히 해주셔서 인상적이었습니다.
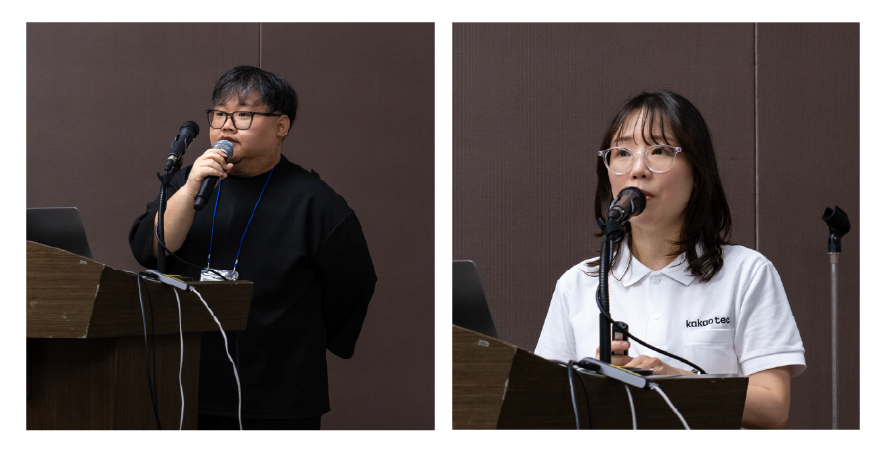
➎ 카카오에서 스팸(성인) 이미지 대응을 하기 위해 시도해 오던 것들 (by Herschel)
허셜은 스팸 이미지를 필터링하기 위해 AI, ML 기술을 사용하는 실무 사례를 공유하면서 라벨링, 오버피팅, 모델의 적합성, 모델 사이즈, CPU 머신, 스케일 아웃, 정책적 이슈 등 다양한 방면에서 어려웠던 점들과 각각 어떻게 해결해 나갔는지를 자세히 설명했습니다. 병목을 해결하고, 트랜스포머를 도입하고, 모델 배포 프로세스를 개선하고, 라벨링 프로세스의 효율과 정확도를 개선하는 등의 다양한 노력을 이야기했어요. 그리고 문제 해결뿐 아니라 성능을 더욱 개선하기 위한 새로운 시도들도 공유했는데요, image to text, image to image, full fine tuning, 주기적인 학습과 배포 등과 앞으로도 계속 고민할 점들을 다루었습니다.
➏ 카카오의 스팸 콘텐츠(text)를 대응하기 위한 LLM 적용기 (by Zoey)
조이는 텍스트로 된 스팸 콘텐츠에 대응하기 위해 대규모 언어모델을 도입했던 경험을 이야기했습니다. 카카오는 사용자를 보호하기 위해 스팸 콘텐츠를 모니터링하고 대응하고 있는데요, 이러한 필터링 방법 중 ML 기반의 필터링도 사용됩니다. 이때 모델이 스팸을 분류한 사유까지 함께 운영자에게 전달하여 운영자의 최종판단을 돕고자 했는데요, 이를 위해 LLM을 도입하게 되었다고 합니다. LLM의 개념도 잠시 설명해 주고, 카카오의 규제 정책을 잘 아는 카카오만의 스팸 LLM을 직접 만들게 된 이야기도 다루었습니다. 학습 데이터를 수집할 때 데이터를 직접 생성하기 위한 고민과 해결의 과정, 라벨러를 통한 데이터 수집 과정, 그리고 오버피팅과 환각을 방지하기 위한 데이터 최적화와 같은 데이터 가공 노하우도 공유했습니다.
마치며
특별히 올해 KCC는 “초거대 AI와 SW 혁신이 이끄는 미래 사회”라는 학회 주제에 맞추어 AI를 주제로 많은 세션들이 진행된 것 같은데요, 카카오의 AI, ML 이야기도 들려드리고, 활발하게 현장에서 나누어주신 질문과 답변들을 들을 수 있어서 즐거웠습니다. 시간 내어 카카오테크워크숍을 찾아주신 참가자분들께 감사인사를 전합니다.
여담이지만 저는 ChatGPT와 좋은 표현에 대해 종종 대화를 나누는데요, 어느 날 “여러분 덕분에 빛났습니다"라는 멋진 표현을 줍줍해 두었습니다. 바로 이곳에 쓰고 싶은 문장입니다.
발표자로서 떨리는 마음으로 마이크를 잡은 크루들 뿐 아니라, 그 뒤에서 함께 발표를 준비하고 행사를 운영한 크루들이 있습니다(알파벳 순으로 적습니다): aaron.seo, coco.bol, cory.doras, hunter.jo, robin.hwang, 감사합니다!
여러분 한 분 한 분 덕분에, 카카오테크워크숍이 빛났습니다. 사실은, 여러분이 가장 빛났습니다! ✨
내년 KCC에서도 Kakao Tech Workshop으로 또 만나요~! 🙋♀️