Engineering
MongoDB WiredTiger의 B+Tree
andy.hj카카오
2025년 2월 20일
원문에서 보기 ↗들어가며
안녕하세요, 카카오 분산데이터베이스 조직에서 MongoDB를 운영하고 있는 앤디입니다.
MongoDB의 메인 스토리지 엔진인 WiredTiger에 관한 시리즈의 첫 글 "MongoDB WiredTiger의 파일 구조"에서는 WiredTiger의 구성요소와 아키텍처를 전반적으로 살펴보았습니다.
이번 글에서는 조금 더 세부적으로 들어가서, MongoDB WiredTiger에서 B+Tree를 활용한 데이터 관리 방법을 심층적으로 다루어 보겠습니다. 앞선 “MongoDB WiredTiger의 파일 구조” 내용과 더불어 MongoDB에 대한 기반 지식이 필요한 내용이 포함될 수 있으니 참고해 주시길 바라며, MongoDB의 데이터 저장 방식에 관심 있는 분들께 유용한 자료가 되기를 기대합니다.
이번 글 작성에 사용된 MongoDB 버전과 주요 도구는 아래와 같습니다.
-
MongoDB Community Edition : v6.0.15
-
gdb (GNU Debugger) : 프로그램 실행을 제어하고 메모리 상태를 분석하는 데 유용한 도구입니다. (구체적인 빌드 방법 및 사용법은 부록을 참조해 주시기 바랍니다.)
B+Tree
B+Tree는 1970년대에 등장해 지금까지도 Oracle, MySQL, PostgreSQL과 같은 주요 DBMS에서 사용되고 있는 자료구조입니다. B+Tree는 데이터 삽입과 삭제 시에도 트리의 높이를 균형 있게 유지하는 동적인 트리 구조로, 여기에서 'B’는 보통 Balanced를 의미합니다. "+"는 실제 레코드가 가장 하위 레벨인 리프 노드(leaf node)에만 저장된다는 것을 의미하며 레코드들은 항상 정렬된 상태를 유지합니다. 아래 그림은 가장 일반적으로 접할 수 있는 B+Tree의 형태를 나타냅니다.
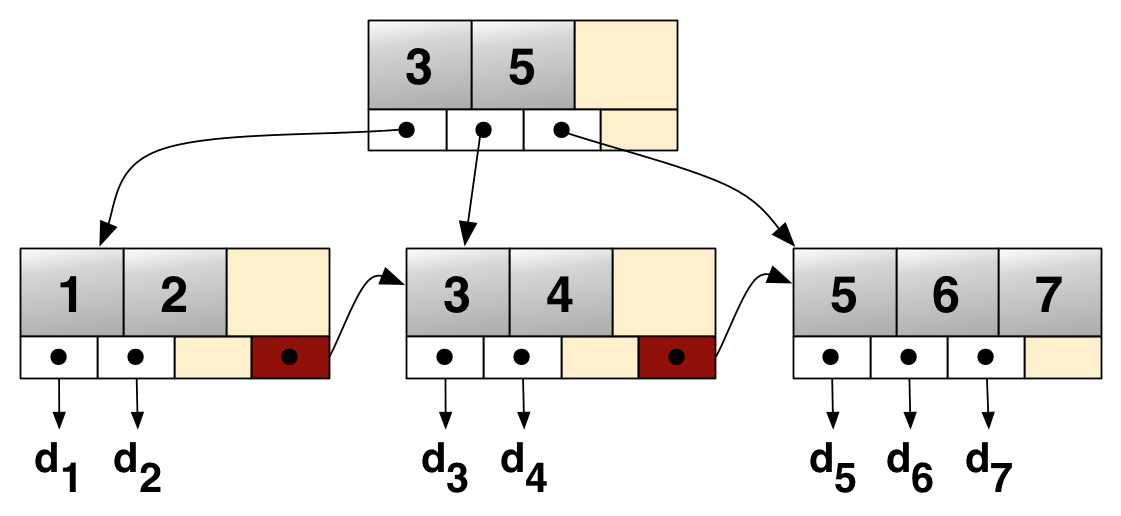
(이미지 출처: 위키백과)
앞서 언급한 DBMS보다는 한참 어린 2007년생 MongoDB도 B+Tree를 사용하고 있는데요. 이렇게 오랜 기간 동안 발전하면서 범용적으로 쓰이다 보니, B+Tree의 세부 구현은 각 DBMS의 특성에 따라 다를 수 있습니다.
이번 문서에서는 제가 주목하는 MongoDB WiredTiger의 B+tree에 대해 몇가지 특징을 살펴보려고 합니다. 특히 페이지 간의 연결구조와 리프 페이지에서의 데이터 추가, 삭제, 변경 처리를 상세히 다루고, 마지막으로 이해를 돕기 위해 MySQL의 InnoDB에서 사용되는 B+Tree와도 가볍게 비교해 보도록 하겠습니다.
페이지 간 연결 구조
페이지는 B+Tree에서 노드라고도 불리며, 데이터를 저장하거나 검색하는 기본 단위로 사용됩니다. 그리고 여러 페이지를 스캔해야하는 범위 쿼리(range query) 혹은 순차 접근(sequential access)이 필요한 작업에서의 효율성을 위해 <그림 1>과 같이 동일한 레벨의 페이지끼리의 연결을 유지하는 방식을 보편적으로 사용합니다.
하지만 WiredTiger에서는 동일한 레벨의 페이지끼리 연결을 유지하지 않습니다. 이를 확인하기 위해 WiredTiger의 B+Tree 구조를 살펴보겠습니다.
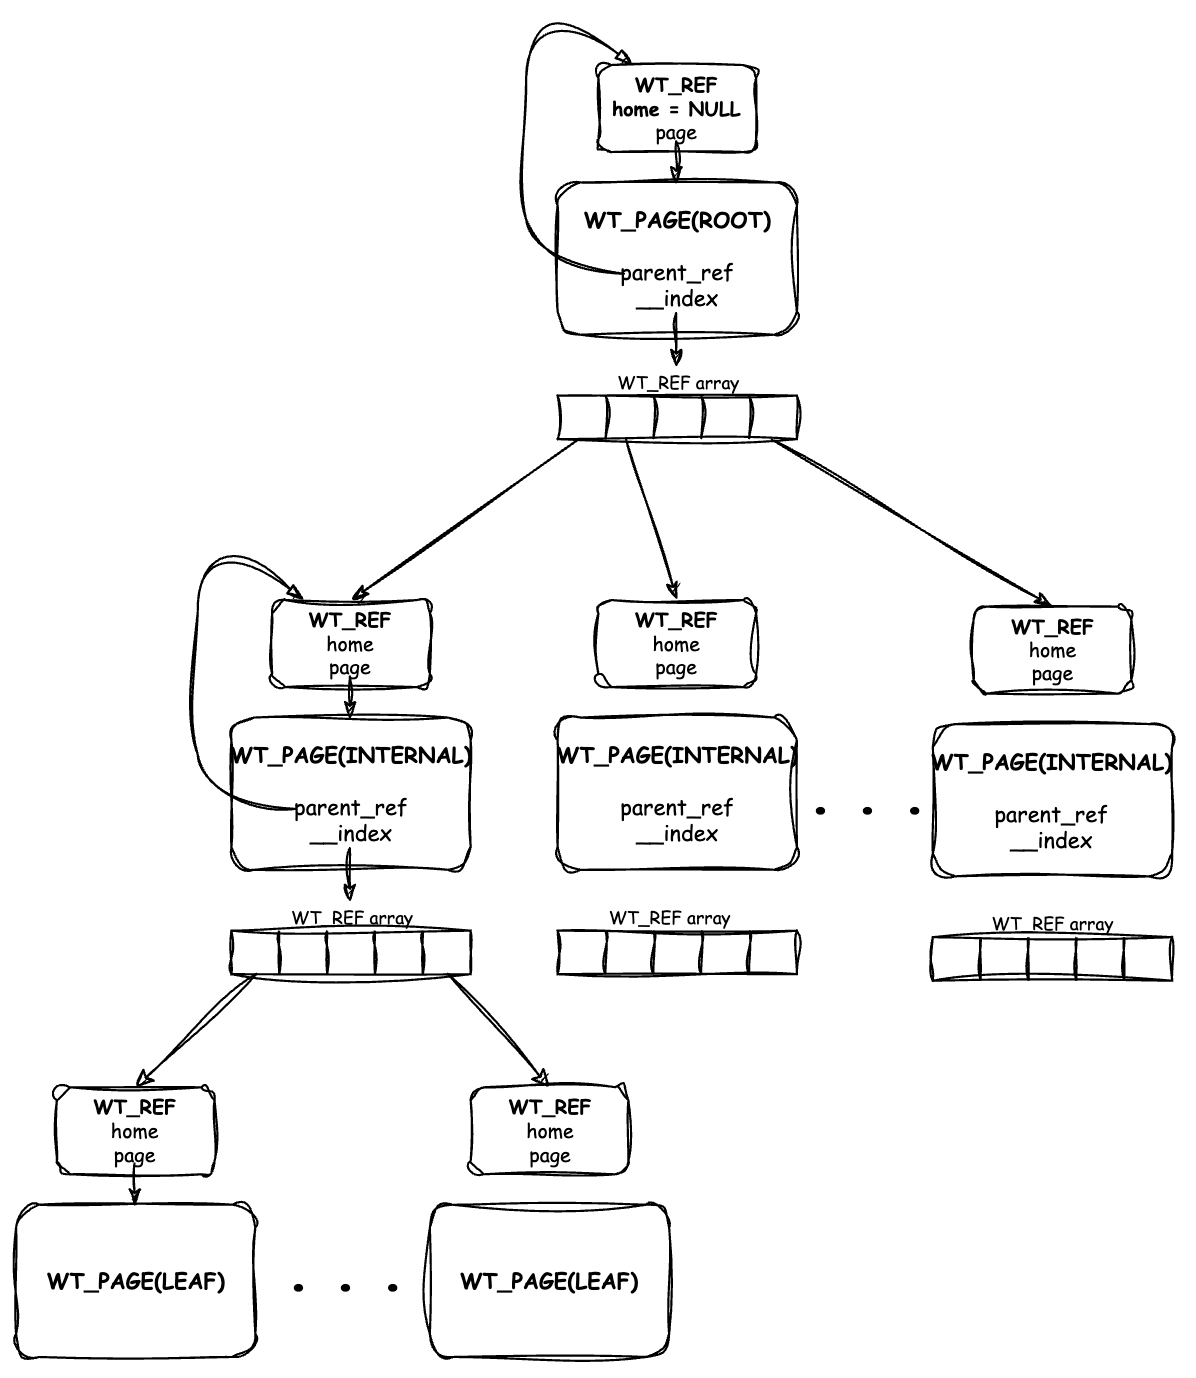
먼저 그림에서 확인할 수 있는 내용을 정리하고, gdb를 통해 상세 구조를 하나씩 확인해 보겠습니다.
위 그림에서와 같이 WiredTiger에서 사용하는 페이지에서는 동일한 레벨의 페이지 간의 연결을 별도로 관리하지 않습니다. WiredTiger에서 사용하는 페이지 구조체는 아래와 같습니다.
struct __wt_page {
    union {
        struct {
            WT_REF *parent_ref; /* Parent reference */
            uint64_t split_gen; /* Generation of last split */

            WT_PAGE_INDEX *volatile __index; /* Collated children */
        } intl;
...
<예시 1. WiredTiger 페이지 구조체>
그리고 메모리 상에서 페이지 관리는 직접 접근하는 방식보다 페이지를 참조하는 WT_REF 구조체를 통해 이루어지고 있습니다. 두 페이지의 역할상 차이가 있기 때문에 이후부터 WT_PAGE는 페이지(page), WT_REF는 레퍼런스 페이지(reference page)라고 칭하겠습니다.
struct __wt_ref {
    WT_PAGE *page;
    WT_PAGE *volatile home;        /* Reference page */
    volatile uint32_t pindex_hint; /* Reference page index hint */
...
<예시 2. WiredTiger 레퍼런스 페이지 구조체>
루트 페이지와 인터널 페이지는 실제 레코드를 저장하지 않고, 자식 페이지의 레퍼런스 페이지를 참조하기 위한 배열("__index")을 유지합니다. 그리고 각 페이지는 “parent_ref” 포인터로 자신을 참조하는 레퍼런스 페이지에 접근할 수 있으며, 레퍼런스 페이지는 "home"을 통해 상위 부모 페이지에 접근할 수 있는 구조로 되어 있습니다.
하지만, 페이지 간 연결을 관리하는 포인터에 대한 정보는 확인되지 않습니다. WiredTiger에서 이러한 구조를 사용하는 주된 이유는 동일한 레벨의 페이지가 서로 연결되어 있을 경우 특정 페이지를 참조하는 다수의 포인터가 생성될 수 있기 때문입니다. 이는 페이지 분할(page split) 과 같은 작업에서 추가적인 동기화 비용을 발생시키고 동시성 제어를 복잡하게 만들 가능성이 있습니다.
예를 들어 페이지 간 연결을 관리하는 경우, 리프 페이지가 분할될 때 부모 페이지의 인덱스("__index") 정보와 분할된 페이지에 인접한 포인터들을 모두 수정해야 합니다. 이러한 작업은 데이터 무결성을 보장하기 위해 잠금을 필요로 하며, 변경사항이 많아질수록 잠금 경합과 성능 저하를 초래할 수 있습니다.
WiredTiger 관점에서 보자면, 페이지 분할 과정에서 부모 페이지의 인덱스("__index") 항목들을 갱신할 때 CAS(Compare-and-Swap)를 활용하여 원자적 업데이트(atomic update)를 수행하는데요. 변경된 페이지를 쓸 때 항상 파일의 새로운 위치에 작성(no-overwrite)하는 WiredTiger의 특성상, 단일 변수가 아닌 여러 포인터를 동시에 갱신하는 것은 복잡하며 CAS 활용이 제한적이라 생각됩니다.
CAS는 특정 메모리 위치의 값을 비교(Compare)하고 조건이 맞으면 값을 교체(Swap)하는 원자적 연산으로, 멀티쓰레드 환경에서 동시성 제어에 유용한 CPU 수준의 명령어입니다. WiredTiger에서는 __wt_atomic_cas_ptr 함수를 통해 CAS 기능을 사용할 수 있으며, 데이터 변경 및 쓰기 작업에도 이를 활용하여 시스템 전반적으로 잠금을 최소화하는 설계를 지향하는 것으로 보입니다.
그렇다면, WiredTiger에서는 여러 페이지를 걸쳐 수행하는 범위 쿼리가 어떻게 수행되는지 궁금하실 수 있는데요. gdb를 활용하여 메모리 상에서의 B+Tree 구조와 함께 동작구조까지 상세히 살펴보겠습니다.
예제
아래는 테스트를 위해 설정된 초기 데이터와 인덱스 생성 과정입니다. 그리고 이후 과정은 { num : 1 } 인덱스에 해당하는 트리에 대한 탐색을 다룹니다.
kakao> for (let i = 1; i <= 10000; i++) { db.test.insert({ "num": i }); }

kakao> db.test.count()
10000

// 'num' 필드에 대한 B+Tree 인덱스 생성
kakao> db.test.createIndex({"num":1}
<예시 3-1. 예제 데이터 생성>
이제 __wt_btcur_next_prefix(v7.0 이후 __wt_btcur_next)와 __tree_walk_internal 두 가지 함수에 브레이크 포인트를 설정하여 동작을 분석하겠습니다. 이 함수들은 각각 페이지에서 다음 로우로 이동하거나, 다음/이전 페이지로 이동하는 역할을 합니다.
(gdb) break __wt_btcur_next_prefix
(gdb) break __tree_walk_internal
<예시 3-2. 트리 탐색 함수 브레이크 포인트 설정>
이어서 범위 쿼리를 실행하면, __wt_btcur_next_prefix 함수가 수행되며 브레이크 포인트에 도달합니다.
kakao> db.kakao.find({"num":{$gt:0}})

(gdb) Thread 292 "conn192" hit Breakpoint 63, __wt_btcur_next_prefix
(cbt=0xaaab0653d800, prefix=0x0, truncating=false)
at src/third_party/wiredtiger/src/btree/bt_curnext.c:732
<예시 3-3. 범위 쿼리 수행>
해당 함수의 파라미터인 cbt(cursor btree)를 통해 현재 커서가 가리키는 페이지 정보와 전반적인 B+Tree 구조를 파악할 수 있습니다. 먼저 현재 커서가 참조하고 있는 리프 페이지의 정보를 확인합니다.
(gdb) print *cbt->ref
$289 = {page = 0xaaab06d97000, home = 0xaaab069f15c0, ...}

(gdb) print *cbt->ref->page
$268 = {u = {intl = {parent_ref = 0xaaab06d97060, __index = 0x0}}, entries = 1981, ...}
<예시 3-4. 커서가 가리키는 리프 페이지 정보 확인>
다음으로, 레퍼런스 페이지는 참조하고 있는 페이지의 주소(page)와 부모 페이지의 주소(home)를 포함하므로 해당 정보를 통해 상위 부모 페이지의 정보를 조회할 수 있습니다.
// 부모 페이지의 레퍼런스 페이지 정보
(gdb) print *cbt->ref->home->u->intl->parent_ref
$262 = {page = 0xaaab069f15c0, home = 0x0, ...}

// 부모 페이지 WT_REF 배열 정보
(gdb) print *cbt->ref->home->u->intl->__index
$263 = {entries = 14, deleted_entries = 0, index = 0xaaab0694d810}
<예시 3-5. 부모 페이지 정보 확인>
위 정보에서 부모 레퍼런스 페이지의 home 값은 비어 있으며(0x0), 이는 상위 부모 페이지가 없는 루트 페이지라는 것을 의미합니다. 또한, 루트 페이지의 WT_REF 배열은 총 14개의 항목(entries)을 가지고 있으며, 삭제된 항목(deleted_entries)이 없으므로 모든 항목은 유효함을 알 수 있습니다.
여기까지 확인된 내용을 그림으로 표현하면 아래와 같습니다.
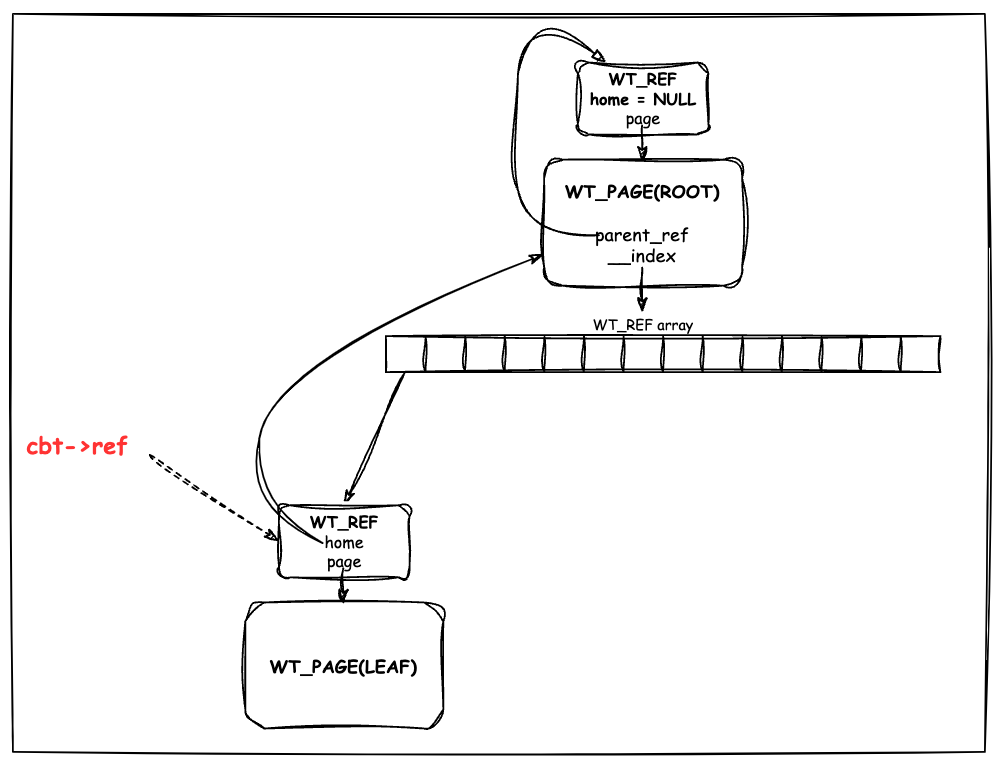
위 그림과 같이 루트 페이지의 WT_REF 배열은 각 항목마다 리프 페이지를 가리키는 포인터를 포함하고 있습니다. 배열의 각 항목에 접근하여 해당 페이지의 정보를 확인함으로써, 리프 페이지에 저장된 로우 수와 같은 세부 정보를 파악할 수 있습니다.
//index[0]에 해당하는 리프페이지 정보
(gdb) print *cbt->ref->home->u->intl->__index->index[0]->page
$268 = {u = {intl = {parent_ref = 0xaaab06d97060, __index = 0x0}}, entries = 1981, ...}

//index[1]에 해당하는 리프페이지 정보
(gdb) print *cbt->ref->home->u->intl->__index->index[1]->page
$268 = {u = {intl = {parent_ref = 0xaaab06e38060, __index = 0x0}}, entries = 651, ...}
...

//index[13]에 해당하는 리프페이지 정보
(gdb) print *cbt->ref->home->u->intl->__index->index[13]->page
$268 = {u = {intl = {parent_ref = 0xaaab07261760, __index = 0x0}}, entries = 400, ...}
<예시 3-6. 리프 페이지 정보 확인>
테스트 데이터로 총 10,000건의 데이터를 삽입한 상태로, 데이터 수가 많지 않기 때문에 루트 페이지와 리프 페이지 두 계층만을 포함하는 간단한 B+Tree 구조로 구성되어 있음을 확인했습니다. 또한, 현재 구조에서 존재하는 리프 페이지의 모든 로우 수를 합산하면 (1981 + 651 + … + 400), 실제 삽입된 10,000건의 데이터와 일치함을 확인할 수 있습니다.
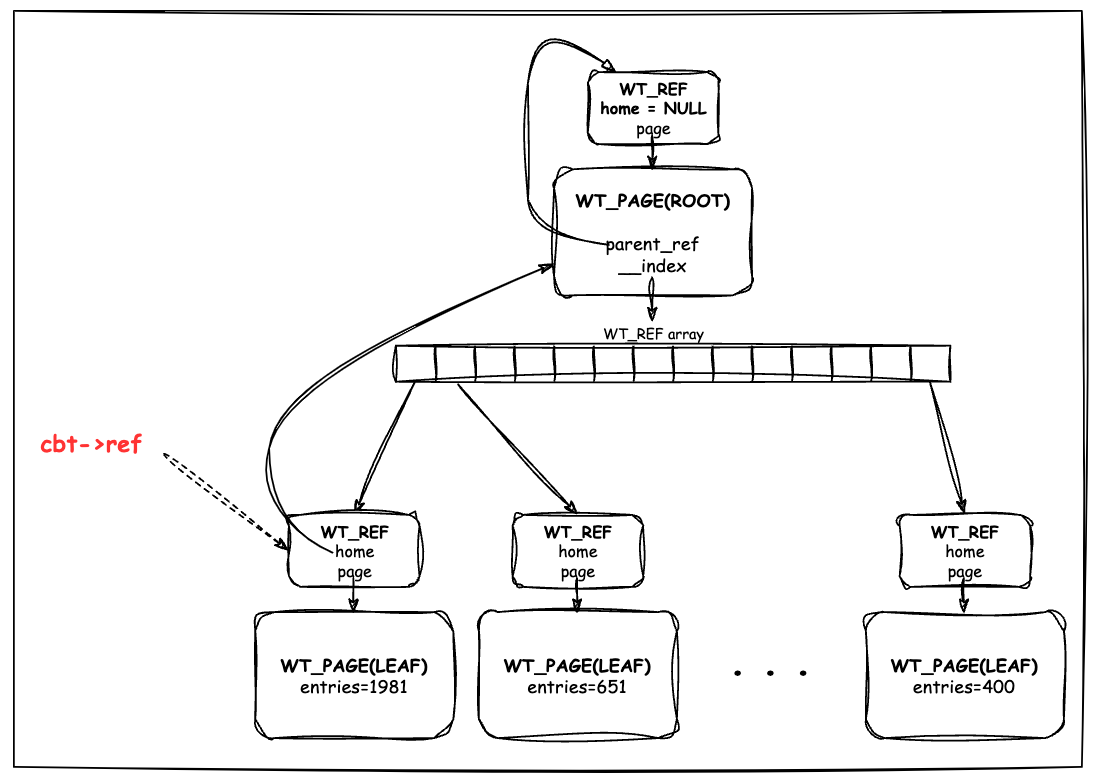
다음으로 num >= 1981 조건의 범위 쿼리를 수행하고, 이 과정에서 다음 페이지로의 이동을 확인해 보겠습니다. 테스트 환경에서는 num=1부터 10,000까지의 데이터를 순차적으로 삽입했고, 인덱스는 오름차순으로 생성했습니다. 따라서 가장 왼쪽 리프 페이지에는 { num : 1981 } 값까지 포함되어 있고, 그보다 높은 값을 조회하려면 페이지 이동이 필요함을 유추할 수 있습니다.
kakao> db.kakao.find({"num":{$gte:1981}})

Thread 933 "conn597" hit Breakpoint 80, __wt_btcur_next_prefix (cbt=0xaaab0742f000, prefix=0x0,truncating=false)
at src/third_party/wiredtiger/src/btree/bt_curnext.c:732

(gdb) print *cbt->ref
$289 = {page = 0xaaab06d97000, home = 0xaaab069f15c0, ...}

(gdb) print *cbt->ref->page
$268 = {u = {intl = {parent_ref = 0xaaab06d97060, __index = 0x0}}, entries = 1981, ...}
<예시 4-1. 범위 쿼리 수행>
초기 호출에서는 예상대로 배열의 첫 번째 항목에 해당하는 page = 0xaaab06d97000에서 조회가 발생합니다. 이어서 진행하면, 현재 페이지의 끝에 도달한 상태이므로 다음 리프 페이지로 이동을 위해 __tree_walk_internal 함수가 호출됩니다.
Thread 933 "conn597" hit Breakpoint 79, __tree_walk_internal (refp=0xaaab0742f178, ...)
at src/third_party/wiredtiger/src/btree/bt_walk.c:243

(gdb) print **refp
$291 = {page = 0xaaab06d97000, home = 0xaaab069f15c0, ...}
<예시 4-2. 페이지 이동 함수 호출>
__tree_walk_internal 함수의 주요 역할은 부모 페이지의 WT_REF 배열에서 현재 페이지에 해당하는 슬롯을 찾아 다음 또는 이전 슬롯으로 이동하는 것입니다. 이 과정에서 커서는 다음 페이지를 가리키게 되며, 조회를 계속 이어나갈 수 있습니다.
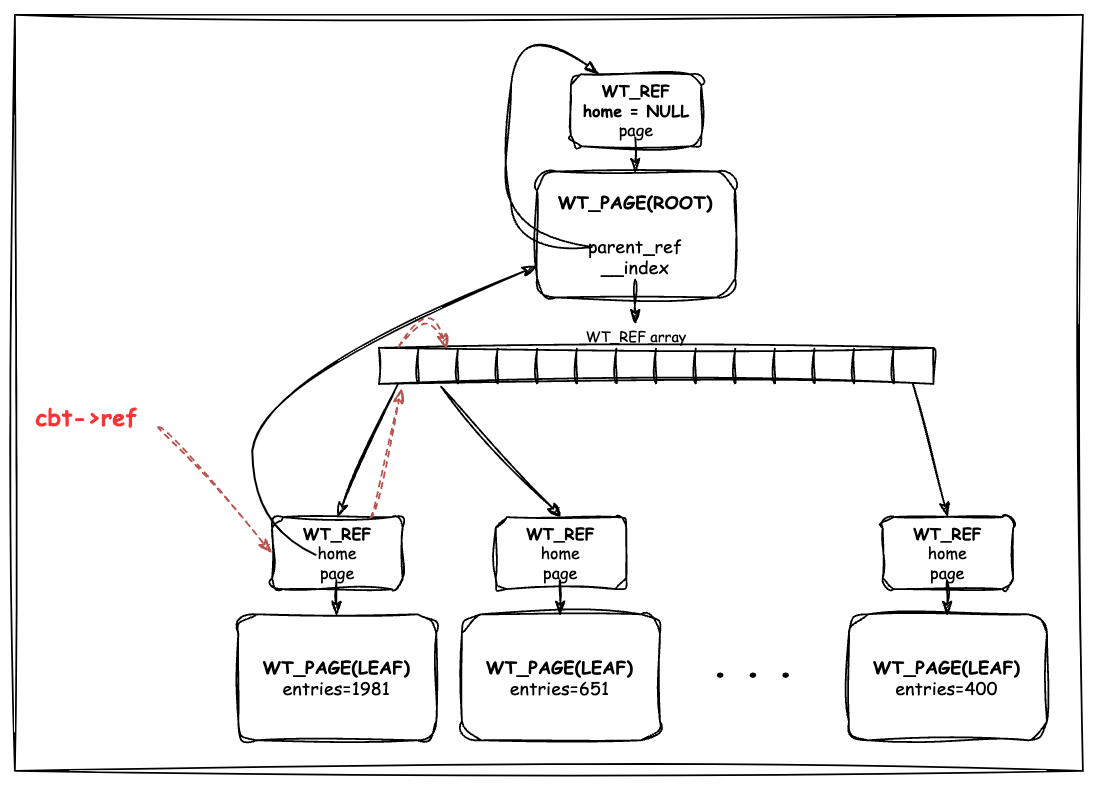
이어서 수행되는 __wt_btcur_next_prefix 함수에서, 커서가 가리키는 페이지를 확인하면 슬롯을 한 칸 이동하여 다음 페이지를 조회하는 것을 알 수 있습니다.
Thread 933 "conn597" hit Breakpoint 80, __wt_btcur_next_prefix
(cbt=0xaaab0742f000, prefix=0x0, truncating=false)
at src/third_party/wiredtiger/src/btree/bt_curnext.c:732

(gdb) print *cbt->ref
$292 = {page = 0xaaab06e38000, home = 0xaaab069f15c0, ...}

(gdb) print *cbt->ref->page
$293 = {u = {intl = {parent_ref = 0xaaab06e38060, __index = 0x0}}, entries = 651, ...}
<예시 4-3. 다음 페이지로 이동한 후의 정보 확인>
위 정보에서 확인할 수 있듯이, 커서는 슬롯을 한 칸 이동하여 page = 0xaaab06e38000 에 해당하는 새로운 리프 페이지를 가리키고 있으며 해당 페이지에는 651개의 항목이 존재합니다. 이처럼 커서의 이동을 확인하고, 동일한 방식으로 범위 쿼리를 이어나갈 수 있습니다.
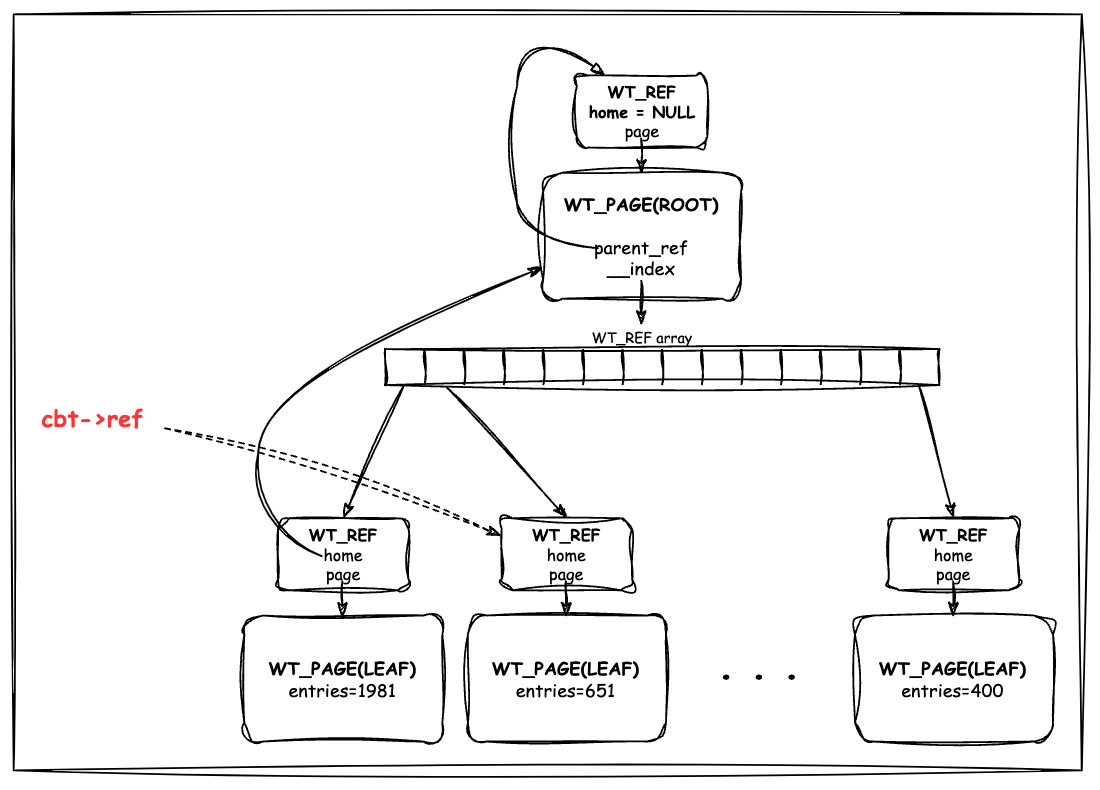
정리하면, WiredTiger의 B+Tree 구조에서는 동일한 레벨의 페이지들 간에 직접적인 연결을 유지하지 않기 때문에 범위 쿼리 수행 시 부모 페이지를 거쳐 추가적인 작업이 필요할 수 있습니다. 이로 인해 다수의 페이지를 검색해야 하는 범위 쿼리 성능은 상대적으로 비효율적일 수 있습니다.
그러나 이러한 설계는 페이지 간의 연결 관리를 단순화하고 원자적 연산을 보다 쉽게 만듭니다. 따라서 실제 운영 환경에서 단일 페이지를 대상으로 하는 쿼리가 주로 사용된다면, 이 접근법이 더 효과적일 수 있다고 생각합니다. 이처럼 두 설계 방식 간에는 트레이드오프가 존재하므로 특정 방식이 더 우수하다고 평가하기보다는 어플리케이션 요구사항에 따라 적합한 방식이 있다고 보는 게 좋을 것 같습니다.
리프 페이지
다음으로, B+Tree 구조의 가장 하위에 위치하며 실제 레코드를 저장하고 있는 리프 페이지를 자세히 살펴보겠습니다. 페이지의 데이터를 효율적으로 관리하기 위해 다양한 자료구조가 사용되며, 일반적으로 배열(Array) 혹은 연결 리스트(Linked List)를 사용합니다. 두 자료구조는 데이터 삽입, 삭제, 조회 작업에서 트레이드 오프 관계에 있어 어느 구조가 더 적합한지는 요구사항에 따라 다를 수 있습니다.
배열은 이진 탐색(Binary Search)을 통해 특정 요소에 빠르게 접근할 수 있는 장점이 있지만, 요소를 삽입하거나 삭제할 경우 다른 요소들까지 조정해야 하므로 비용이 크다는 단점이 있습니다.
반면, 연결 리스트는 요소의 삽입과 삭제를 가리키는 포인터의 변경만으로 쉽고 빠르게 처리할 수 있으며 각 요소의 크기를 동적으로 조절할 수 있는 유연함이 있지만, 특정 요소에 접근하기 위해서는 처음부터 순차적으로 탐색해야 하므로 임의 접근이 비효율적이라는 단점이 있습니다.
이 중 WiredTiger에서는 리프 페이지 내의 로우를 배열 형태로 관리하고 있습니다. 이러한 배열 구조 덕분에 리프 페이지 내에서 이진 탐색을 통해 빠르게 특정 로우를 찾을 수 있습니다.
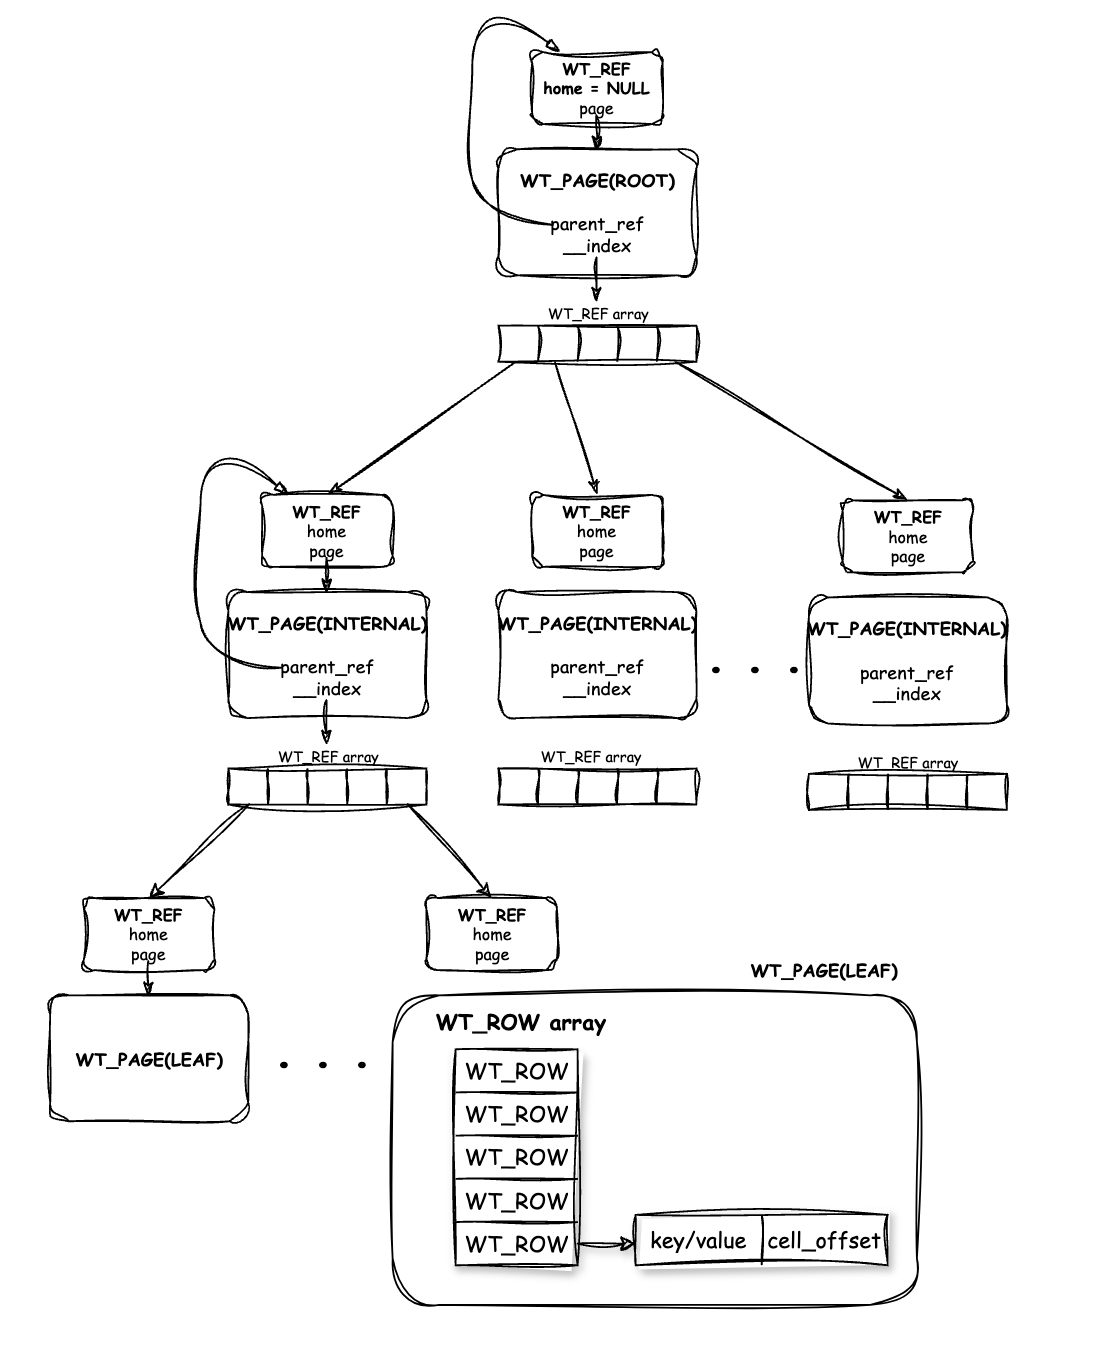
위 그림에서 WT_ROW는 메모리 내 리프 페이지가 각각의 키/값 쌍에 대해 가지는 구조체로, 디스크 파일에서 페이지를 메모리로 읽어올 때 생성됩니다. 그리고 생성된 WT_ROW 배열에서 특정 로우를 찾기 위해 WiredTiger에서 사용하는 함수는 "__wt_row_search"입니다. 이 함수는 아래와 같이 페이지 내에서 특정 로우를 찾기 위해 이진 탐색을 수행합니다.
WT_ROW *rip;
...
base = 0;
limit = page->entries;

for (; limit != 0; limit >>= 1) {
    indx = base + (limit >> 1);
    rip = page->pg_row + indx;
    WT_ERR(__wt_row_leaf_key(session, page, rip, item, true));

    cmp = __wt_lex_compare_short(srch_key, item);
    if (cmp > 0) {
        base = indx + 1;
        --limit;
    } else if (cmp == 0)
        goto leaf_match;
}
<예시 5. WT_ROW 배열 이진 탐색(Binary Search)>
하지만 배열 구조에서는 중간에 로우를 삽입하거나 삭제할 때 나머지 로우들에 대한 재조정이 필요하여 비효율적일 수 있습니다. 이러한 비효율성을 극복하기 위해, WiredTiger는 메모리 상에서 WT_ROW 배열을 직접 수정하지 않는 대신 유연한 삽입과 삭제를 가능하게 하는 별도의 연결 리스트를 관리합니다.
이처럼 배열을 사용하는 데이터베이스의 경우 단점을 보완하기 위해 연결 리스트를 추가적으로 사용하기도 하며, 반대로 연결 리스트를 사용하는 경우에는 배열을 보조 수단으로 활용하는 경우가 많습니다.
그럼 WiredTiger에서 연결 리스트를 사용하여 어떻게 데이터의 추가, 삭제, 변경을 처리하고 있는지 살펴보도록 하겠습니다.
리프 페이지의 데이터 추가, 삭제, 변경 처리
WiredTiger에서 페이지의 변경사항을 관리하기 위해 주로 두 가지 구조체를 활용합니다. 기존 키의 변경 및 삭제는 WT_UPDATE 구조체를 통해 관리되며, 신규 키의 삽입은 WT_INSERT 구조체를 사용합니다.
/*
 * WT_PAGE_MODIFY --
 *	When a page is modified, there's additional information to maintain.
 */
struct __wt_page_modify {
   ...
	struct {
	    /* Inserted items for row-store. */
	    WT_INSERT_HEAD **insert;

	    /* Updated items for row-stores. */
	    WT_UPDATE **update;
	} row_leaf
   ...
}
<예시 6. 페이지 변경사항을 관리하기 위한 구조체>
이러한 구조를 전체적인 그림으로 표현하면 다음과 같습니다.
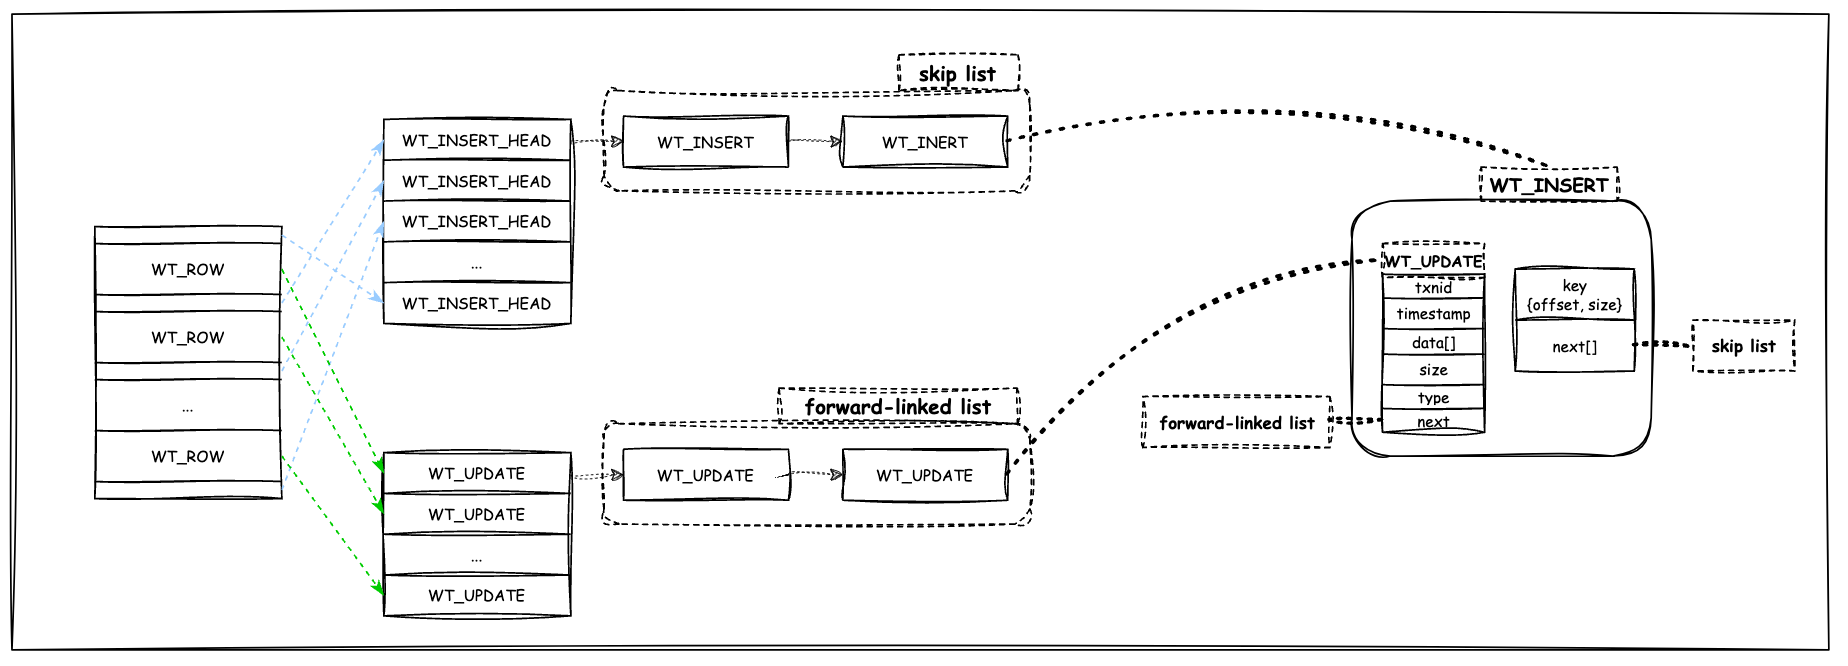
두 개의 구조체 중 기존에 존재하는 키에 대한 변경을 다루는 WT_UPDATE부터 자세히 살펴보겠습니다.
WT_UPDATE
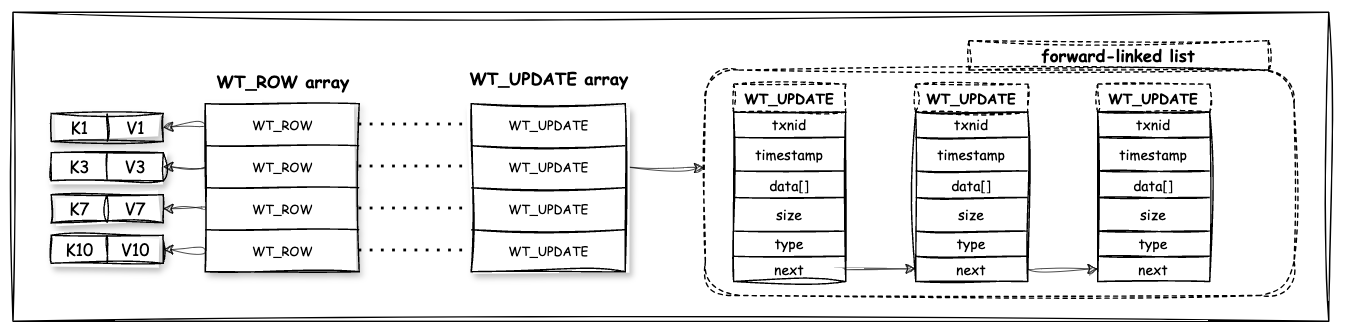
리프 페이지에서 기존에 존재하는 키에 대한 수정이 필요할 때, WT_ROW를 통해 값을 직접 수정하는 대신 WT_UPDATE 구조체를 활용합니다. 존재하는 키에 대한 수정을 담당하므로 각 리프 페이지에서 WT_UPDATE 배열의 크기는 WT_ROW와 동일하게 설정됩니다. 예를 들어 그림과 같이 페이지 내에 WT_ROW 배열이 4개의 항목을 가진다면, WT_UPDATE 배열도 동일하게 4개의 항목을 가지게 됩니다.
그리고 특정 키에 대한 변경사항은 WT_UPDATE 배열에서 관리되며, 업데이트 체인(update chain)을 형성하여 동일 키에 대한 여러 버전의 데이터를 관리합니다.
이러한 방식은 DBMS에서 흔히 사용되는 동시성 제어 방식으로 MVCC(Multi-version Concurrency Control)라고 칭하고 있습니다. MVCC는 용어대로 동일한 데이터에 대해 여러 버전을 유지함으로써, 읽기 연산이 쓰기 연산에 영향을 주지 않고, 반대로 쓰기 연산이 읽기 연산을 방해하지 않는 것을 가능하게 합니다. 이러한 특성으로 MVCC를 통해 스냅샷 격리(snapshot isolation)를 지원할 수 있습니다.
참고로 WiredTiger는 스냅샷 격리 이외에도 REPEATABLE_READ, READ_COMMITTED 도 지원하고 있는데, MongoDB에서는 스냅샷 격리만을 사용합니다.
위와 같은 구조는 gdb를 사용하여, 특정 로우의 업데이트를 담당하는 __wt_update_serial 함수에 브레이크포인트를 설정하여 확인할 수 있습니다.
(gdb) break __wt_update_serial
Breakpoint 84 at 0xaaaac1c73b58: __wt_update_serial. (2 locations)
<예시 7-1. 업데이트 함수 브레이크 포인트 설정>
메모리 상의 업데이트 체인을 확인하기 위해 특정 키에 업데이트를 여러 번 수행한 후 상태를 확인해 보겠습니다. 업데이트 수행을 할 때마다 __wt_update_serial 함수가 실행되며 브레이크 포인트에 도달하게 됩니다.
kakao> db.test.find({"num":7},{"_id":0}).showRecordId()
[ { num: 7, '$recordId': Long('7') } ]

kakao> db.test.update({"num":7},{"$set":{"cnt":1}})
kakao> db.test.update({"num":7},{"$set":{"cnt":2}})
kakao> db.test.update({"num":7},{"$set":{"cnt":3}})

Thread 1457 "conn1204" hit Breakpoint 86, __wt_update_serial
(updp=0xffff7e756da8, page=0xaaab06dab000, ...)
at src/third_party/wiredtiger/src/include/serial_inline.h:247
<예시 7-2. 업데이트 반복 작업 수행>
함수의 파라미터 중 새로 변경된 업데이트를 포함하는 변수(updp)의 메모리 주소를 통해 업데이트 체인의 구성을 확인할 수 있습니다.
(gdb) print **updp
$317 = {txnid = 2416, durable_ts = 0, start_ts = 0,
  prev_durable_ts = 7455550763243143169, next = 0xaaab0697ee40, ...}

(gdb) print *(**updp)->next
$318 = {txnid = 2414, durable_ts = 7455550763243143169,
  start_ts = 7455550763243143169, prev_durable_ts = 7455550741768306689,
  next = 0xaaab0697f9e0, ...}

(gdb) print *(*(**updp)->next)->next
$319 = {txnid = 2412, durable_ts = 7455550741768306689,
  start_ts = 7455550741768306689, prev_durable_ts = 0, next = 0x0, ...}

kakao> db.test.find({"num":7},{"_id":0}).showRecordId()
[ { num: 7, cnt: 3, '$recordId': Long('7') } ]
<예시 7-3. 메모리 상의 업데이트 체인 구성>
위와 같이, 업데이트 체인은 연결 리스트 구조이며 리스트의 헤드에는 가장 최근 업데이트(최신 txnid)가 위치합니다. 위 예시는 컬렉션 파일에 해당하는 트리이며, 컬렉션 파일에서는 키 값으로 recordId를 사용하기 때문에 아래 그림과 같이 표현할 수 있습니다.
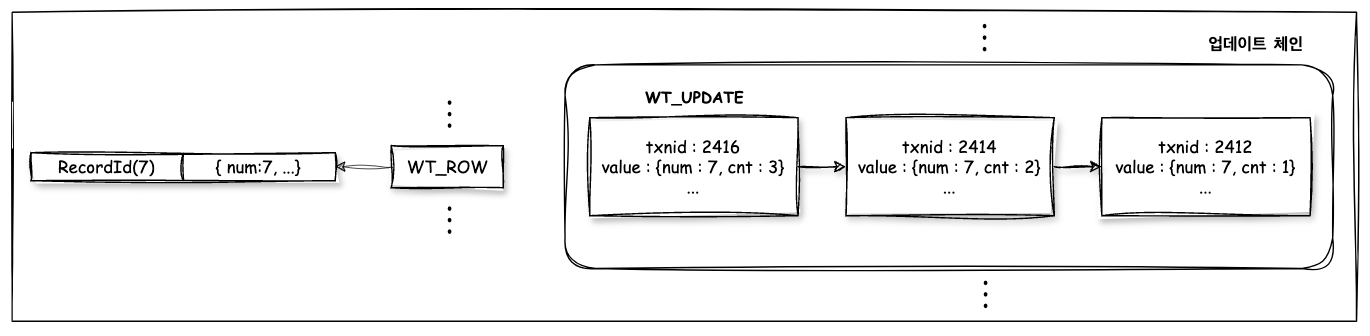
이렇듯 WT_UPDATE는 기존에 존재하는 키의 값을 변경하는 작업을 관리합니다. 해당 변경사항은 연결 리스트 구조의 업데이트 체인을 통해 관리되며, 최신 변경사항이 리스트의 헤드 부분에 추가되기 때문에 빈번한 업데이트가 일어나는 환경에서도 데이터 처리를 효율적으로 수행할 수 있습니다. 또한, 각각의 WT_UPDATE에는 txnid와 같은 정보가 포함되어 있어 스냅샷 격리를 쉽게 구현할 수 있으며, 최신 변경사항에 빠르게 접근할 수 있습니다.
WT_INSERT
WT_INSERT는 기존 키가 아닌 새로운 키의 삽입을 관리하는 구조체입니다.
예를 들어, 페이지 내에 키 값이 1과 10000만 존재한다고 가정하면, 그 사이에는 수많은 새로운 키가 삽입될 수 있습니다. 이러한 새로운 키를 WT_UPDATE 구조체처럼 단순한 연결 리스트로 관리한다면, 새로 추가된 키 값을 조회할 때마다 많은 비용이 발생할 것입니다.
그래서 WT_INSERT의 경우, 삽입과 조회를 모두 효율적으로 처리하기 위해 스킵 리스트(skip list) 구조를 사용합니다.
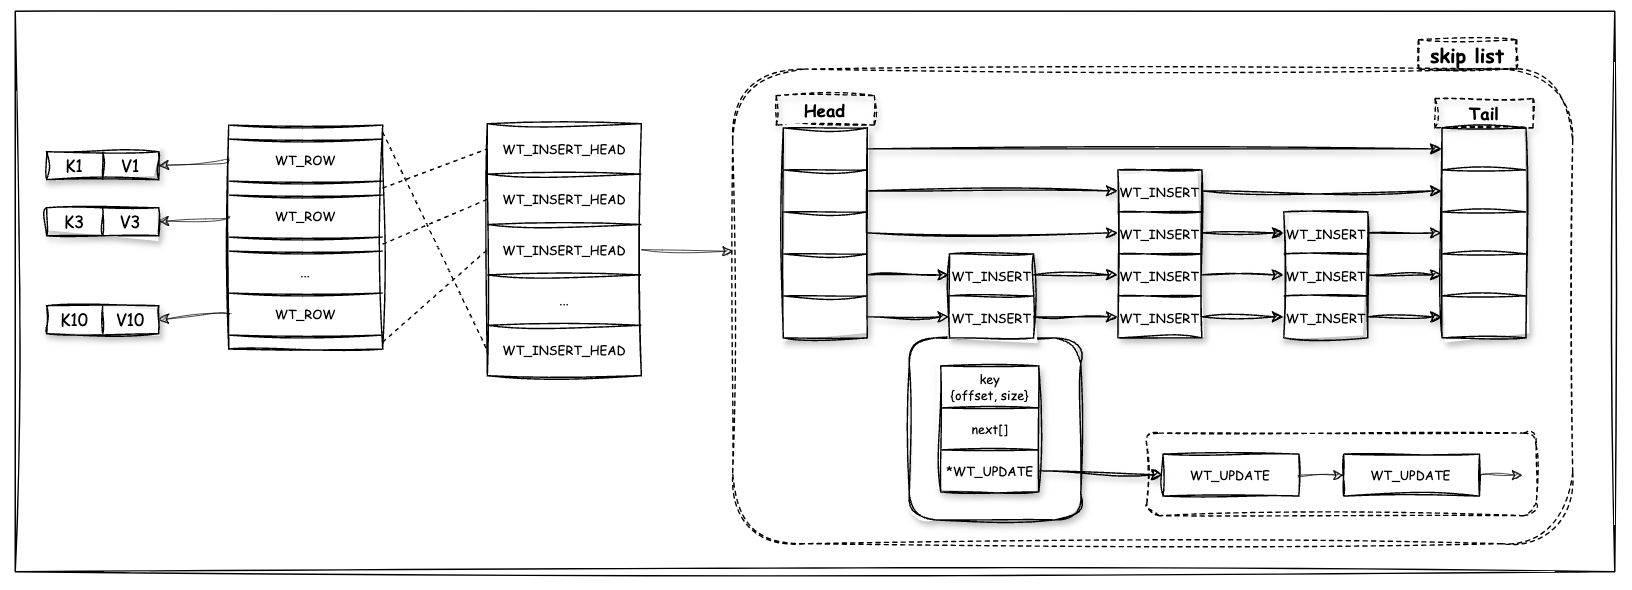
위 그림과 같이, 이미 K1, K3, …, K10 키가 존재하는 경우 새로운 키가 들어갈 수 있는 공간은 min~K1, K1~K3, K3~K10, K10~max와 같이 구간으로 표현될 수 있습니다. 이러한 각 구간을 관리하는 스킵 리스트는 WT_INSERT_HEAD에 정의되어 있으며, 모든 구간을 표현하기 위해서는 WT_ROW 배열의 항목 수보다 하나 더 많은 항목이 필요합니다.
또한, 새로운 키가 삽입된 후에 해당 키에 대한 수정이 필요할 수 있기 때문에, WT_INSERT 구조체는 WT_UPDATE 구조체를 포함합니다.
이와 같은 WT_INSERT의 스킵 리스트 구조도 gdb를 이용하여 자세히 확인이 가능합니다. 가장 기본적인 동작을 살펴보기 위해 새로 생성한 컬렉션에 데이터를 삽입하는 예시를 사용하겠습니다.
kakao> db.kakao.createCollection("kakao")
kakao> db.kakao.createIndex({"num":1})
<예시 8-1. 신규 컬렉션 및 인덱스 생성>
여기에서는 특정 로우의 최종 삽입을 담당하는 “__wt_insert_serial” 함수에 브레이크 포인트를 지정합니다.
(gdb) break __wt_insert_serial
Breakpoint 100 at 0xaaaabd784134: __wt_insert_serial. (2 locations)
<예시 8-2. 삽입 함수에 브레이크 포인트 설정>
메모리 상의 스킵 리스트를 확인하기 위해 새로운 컬렉션에 삽입을 여러 번 수행하며 상태를 확인해 보겠습니다.
새로운 키가 삽입될 때마다 __wt_insert_serial 함수가 실행되며 브레이크 포인트에 도달하게 됩니다.
kakao> db.kakao.insert({"num":1})

(gdb) s
__wt_insert_serial (skipdepth=2, ins_head=0xaaab07d5e820, page=0xaaab07d324a0, ...)
    at src/third_party/wiredtiger/src/include/serial_inline.h:196

(gdb) print *ins_head
$426 = {head = {0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0},
  tail = {0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0}}
<예시 8-3. 스킵리스트 확인 과정(1)>
참고 사항으로 MongoDB에서 데이터 삽입 연산을 수행하게 되면, WiredTiger 내부에서는 여러 번의 삽입이 발생합니다.
위와 같은 경우를 보더라도 컬렉션 데이터, { _id : 1 } 인덱스, { num : 1} 인덱스, oplog 등의 일련의 삽입 동작들이 WiredTiger 트랜잭션으로 수행되기 때문에 쓰기 작업의 일부만 반영되는 일은 발생하지 않습니다.
이 중 지금 다루는 예시는 { num : 1 } 인덱스에 대한 삽입 과정을 다룹니다.
처음에는 아직 삽입된 데이터가 없으므로 ins_head의 head, tail 모두 비어있는 상태입니다.
다음 연산을 이어서 진행합니다.
kakao> db.kakao.insert({"num":2})

(gdb) s
__wt_insert_serial (skipdepth=1, ins_head=0xaaab07d5e820, page=0xaaab07d324a0, ...)
    at src/third_party/wiredtiger/src/include/serial_inline.h:196

(gdb) print *ins_head
$427 = {head = {0xaaab07218860, 0xaaab07218860, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0},
tail = {0xaaab07218860, 0xaaab07218860, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0}}

(gdb) print *ins_head->head[0]->upd
$428 = {txnid = 6275, durable_ts = 7456977985170571265,
  start_ts = 7456977985170571265, prev_durable_ts = 0, next = 0x0, ...}

(gdb) print *ins_head->head[0]->next
$429 = (WT_INSERT *) 0x0
<예시 8-4. 스킵리스트 확인 과정(2)>
새로운 키를 삽입하기 전의 상태를 확인해 보면, 처음에 skipdepth=2 로 삽입된 데이터가 존재하는 상태입니다.
현재 상태를 그림으로 표현하면 아래와 같습니다.
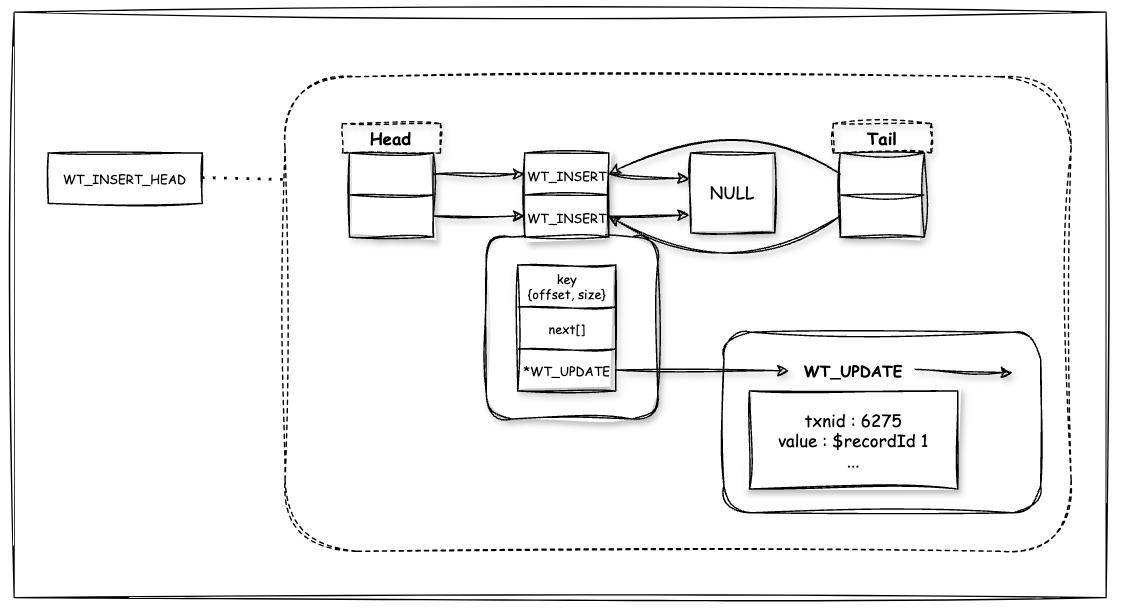
WiredTiger의 스킵리스트 최대 깊이는 10으로 설정되어 있으며, WT_INSERT에는 키 값과 함께 WT_UPDATE 연결 리스트가 포함되어 있습니다. 또한, MongoDB에서 인덱스는 실제 도큐먼트를 저장하는 것이 아니라, 도큐먼트를 찾기 위한 식별자인 recordId를 value 값으로 저장합니다.
추가적인 구조 확인을 위해 연산을 이어서 수행해 보겠습니다.
kakao> db.kakao.insert({"num":3})

(gdb) s
__wt_insert_serial (skipdepth=1, ins_head=0xaaab07d5e820, page=0xaaab07d324a0, ...)
    at src/third_party/wiredtiger/src/include/serial_inline.h:196

(gdb) print *ins_head
$431 = {head = {0xaaab07218860, 0xaaab07218860, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0},
tail = {0xaaab079cd240, 0xaaab07218860, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0}}

(gdb) print *ins_head->head[0]->next
$432 = (WT_INSERT *) 0xaaab079cd240

(gdb) print *ins_head->head[0]->next->upd
$433 = {txnid = 6280, durable_ts = 7456978131199459329,
  start_ts = 7456978131199459329, prev_durable_ts = 0, next = 0x0, ...}
<예시 8-5. 스킵리스트 확인 과정(3)>
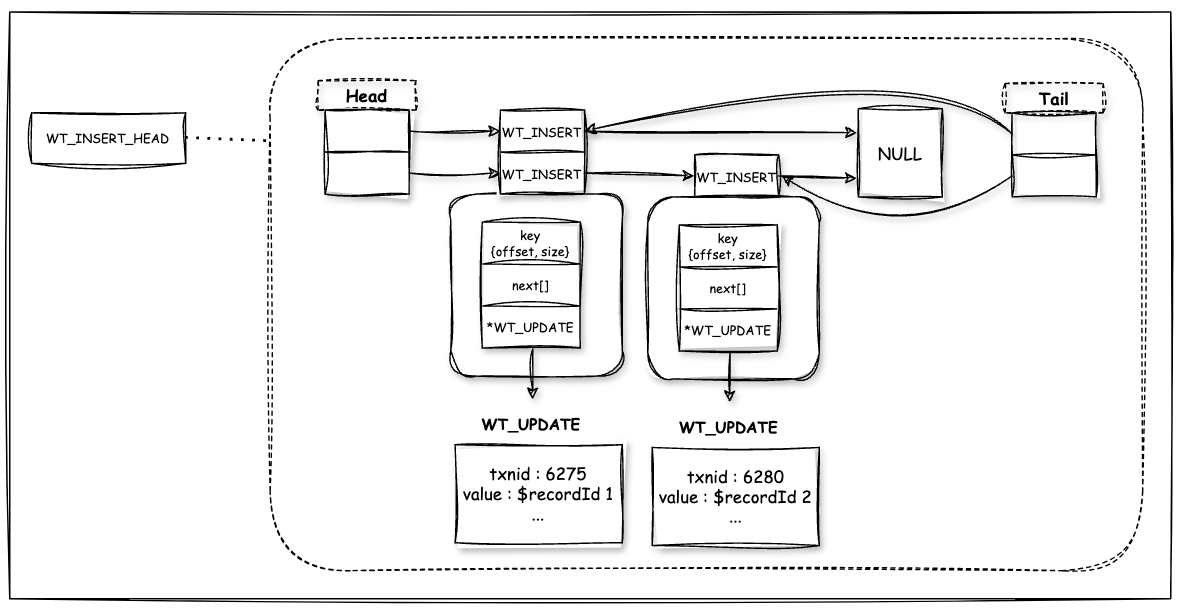
세 번째 도큐먼트가 삽입되기 전 상태를 확인하면, 위 그림과 같이 메모리 상에서 key 값으로 정렬된 상태의 스킵리스트를 그려볼 수 있습니다. 마지막으로 총 5개의 도큐먼트를 삽입한 이후 최종 스킵 리스트의 형태를 확인해 보겠습니다.
kakao> db.kakao.insert({"num":4})
kakao> db.kakao.insert({"num":5})
...

(gdb) s
__wt_insert_serial (skipdepth=1, ins_head=0xaaab07d5e820, page=0xaaab07d324a0, ...)
    at src/third_party/wiredtiger/src/include/serial_inline.h:196

(gdb) print *ins_head->head[0]->upd
$456 = {txnid = 6275, durable_ts = 7456977985170571265,
  start_ts = 7456977985170571265, prev_durable_ts = 0, next = 0x0, ...}
(gdb) print *ins_head->head[0]->next->upd
$457 = {txnid = 6280, durable_ts = 7456978131199459329,
  start_ts = 7456978131199459329, prev_durable_ts = 0, next = 0x0, ...}
(gdb) print *ins_head->head[0]->next->next->upd
$458 = {txnid = 6287, durable_ts = 7456978328767954946,
  start_ts = 7456978328767954946, prev_durable_ts = 0, next = 0x0, ...}
(gdb) print *ins_head->head[0]->next->next->next->upd
$459 = {txnid = 6292, durable_ts = 7456978668070371329,
  start_ts = 7456978668070371329, prev_durable_ts = 0, next = 0x0, ...}
(gdb) print *ins_head->head[0]->next->next->next->next->upd
$460 = {txnid = 6299, durable_ts = 7456978968718082049,
  start_ts = 7456978968718082049, prev_durable_ts = 0, next = 0x0, ...}
<예시 8-6. 스킵리스트 확인 과정(4)>
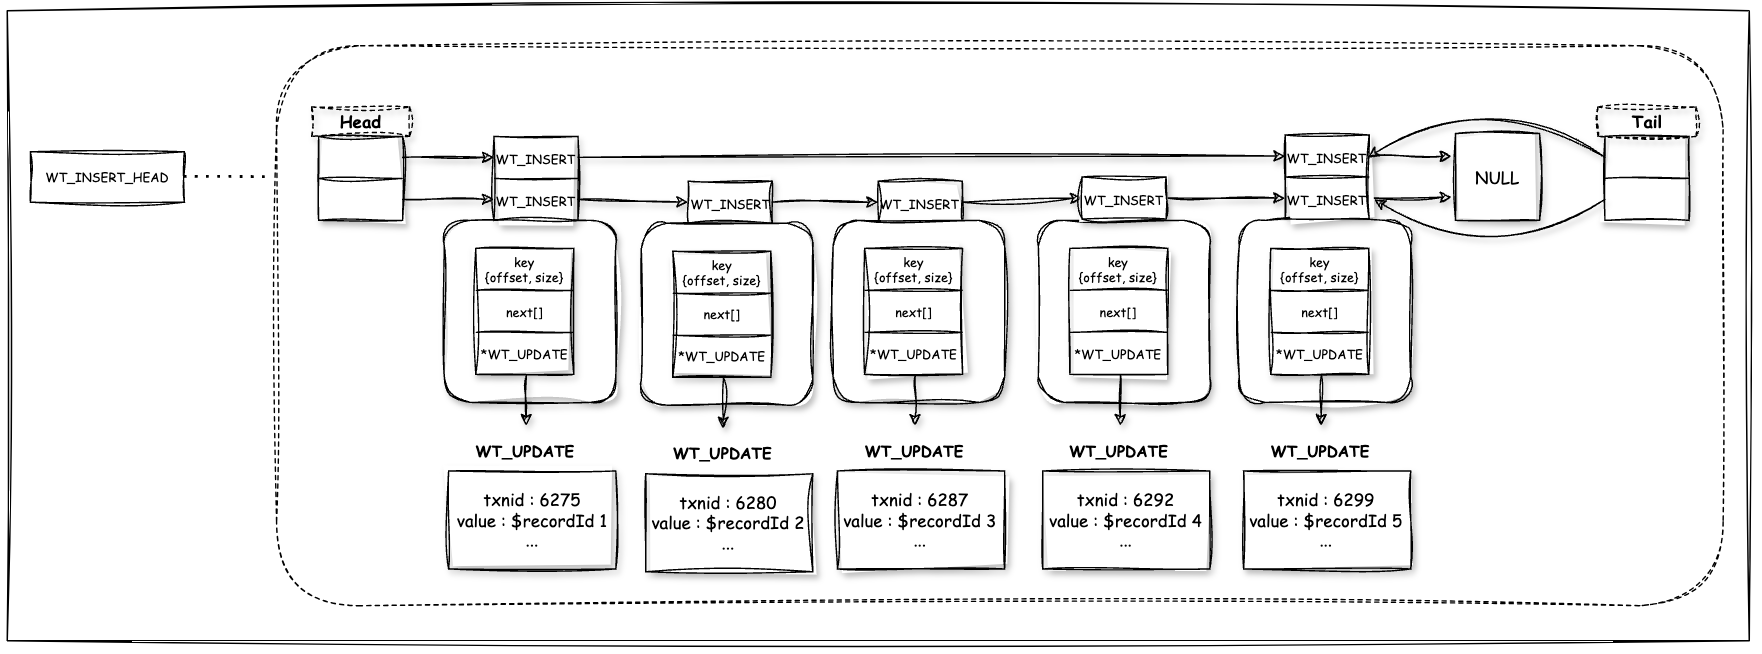
정리하면, WiredTiger에서 새로운 key 값의 삽입은 WT_ROW 배열을 직접 수정하지 않고 별도로 관리하는 스킵리스트에 반영됩니다. 이는 배열 구조의 단점을 보완하여 빠른 삽입을 지원하며, 스킵 리스트 구조 덕분에 새로운 key 값이 많이 추가되어도 연결 리스트에 비해 빠른 조회가 가능합니다.
위 예시에서 그린 것은 인덱스 파일에 해당하는 트리의 리프 페이지입니다. MongoDB 인덱스는 값이 변경될 때마다 삭제와 삽입을 통해 처리하므로 업데이트 체인이 길게 형성되지 않고 예시처럼 새로운 WT_INSERT가 생성되는 구조입니다.
반면 컬렉션 파일에 해당하는 트리의 경우, recordId라는 순차적으로 증가하는 고유 값을 key로 하며 메모리 상에서 value 값의 변경을 허용합니다. 따라서 값의 변경에 따라 업데이트 체인이 길게 형성될 수 있습니다. 하지만 삽입의 경우, 사용자가 중간 값을 임의로 삽입할 수 없기 때문에 WT_ROW 배열의 마지막 슬롯에 해당하는 스킵리스트 이외에는 사용되지 않습니다.
이처럼 기능의 일부만 사용된다는 느낌을 받을 수 있지만, 이는 WiredTiger가 MongoDB에서 2014년에 인수한 오픈소스 스토리지 엔진으로 MongoDB만을 목적으로 개발된 스토리지 엔진은 아니기 때문입니다. 따라서 MongoDB는 WiredTiger의 모든 기능을 사용하는 것이 아니라, 가능한 기능들을 최대한 활용하는 방식으로 사용되고 있다고 보시면 좋을 것 같습니다.
정렬 방향에 따른 성능 차이
예제에서 사용한 것 처럼 MongoDB에서 인덱스는 오름차순 혹은 내림차순으로 지정하여 생성합니다.
// 오름차순 인덱스 생성
> db.kakao.createIndex({"num":1})

// 내림차순 인덱스 생성
> db.kakao.createIndex({"num":-1})
이는 쿼리를 수행할 때 생성된 인덱스 키 패턴과 일치하는 정렬만 지원한다는 것을 의미하지는 않습니다. MongoDB는 단일 필드 혹은 여러 필드에 대해서도 순서만 맞추면 양방향 정렬을 모두 지원하고 있습니다. 예를 들어, 인덱스 키 패턴이 { a : 1 , b : 1 } 일 경우, { a : 1, b : 1 } 정렬 뿐만 아니라 역순인 { a : -1, b : -1 } 정렬도 지원이 가능합니다. 하지만 트리의 내부 데이터는 정렬 방향에 맞춰 단방향으로 생성되어 있기 때문에, 정렬 방향에 따른 동작 방식의 차이는 발생할 수 있습니다.
먼저, WiredTiger는 조회 시 리프 페이지의 WT_ROW 배열을 기본적으로 사용하며 배열 구조에서는 정렬 방향에 따라 배열의 인덱스를 증가시키거나 감소시키는 것으로 조회가 가능하기 때문에 정렬 방향에 따른 성능 차이가 거의 없습니다. 그러나 조회 시 항상 WT_ROW 배열만을 사용하는 것은 아닙니다. WT_ROW 배열의 구간 사이에 새롭게 삽입된 데이터는 스킵 리스트로 관리되며, 스킵 리스트는 단방향 구조로 되어 있어 정렬과 스캔 방향에 따른 차이가 발생할 수 있습니다.
WiredTiger는 이러한 성능 차이를 극복하기 위해 스킵리스트를 역순으로 조회하는 매크로를 사용하여 최적화하고 있습니다.
/*
 * Walking backwards through skip lists.
 ...
*/
#undef PREV_ITEM
#define PREV_ITEM(ins_head, insp, i)                      \
    (((insp) == &(ins_head)->head[i] || (insp) == NULL) ? \
        NULL :                                            \
        (WT_INSERT *)((char *)((insp) - (i)) - offsetof(WT_INSERT, next)))

#undef PREV_INS
#define PREV_INS(cbt, i) PREV_ITEM((cbt)->ins_head, (cbt)->ins_stack[(i)], (i))
<예시 9. 스킵리스트 역방향 탐색 매크로>
최적화를 하더라도 정렬 방향에 따른 성능 차이가 발생할 수 있기 때문에, 이를 알아보기 위한 간단한 테스트를 진행해보겠습니다.
테스트 목적은 정렬 방향에 따른 성능 차이와 WT_ROW 배열과 스킵 리스트를 통한 조회를 비교해 보는 것입니다.
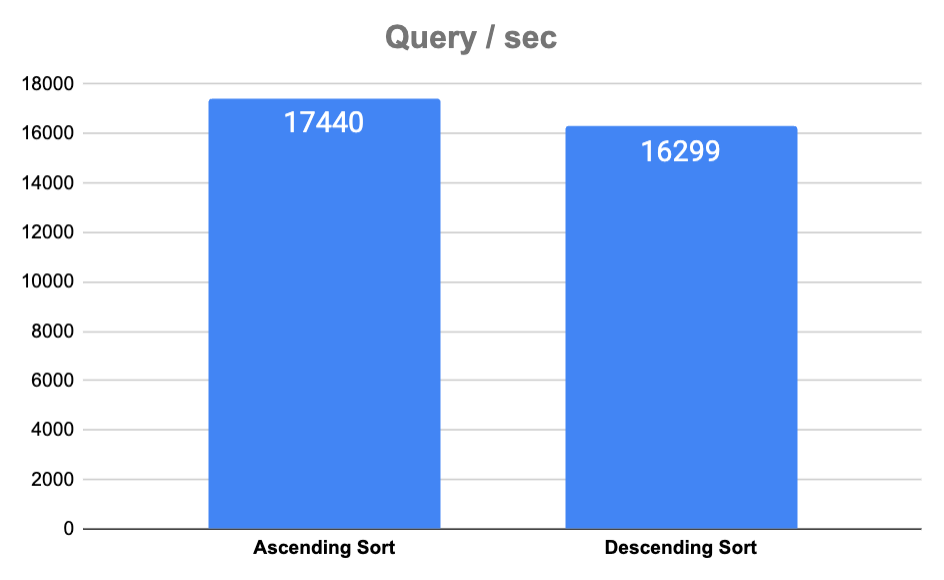
첫 번째 시나리오는 소량의 데이터를 삽입한 후 모든 데이터가 메모리 상의 스킵리스트에 존재하는 상황에서의 조회를 가정합니다. 인덱스는 오름차순으로 생성해 둔 상태입니다.
kakao> db.test.createIndex({"num":1}

kakao> for (let i = 1; i <= 10000; i++) { db.test.insert({ "num": i }); }
<예시 10. 테스트 데이터 생성>
Ascending Sort
- collection.find({}).sort(‘num’, ASCENDING).limit(100)
Descending Sort
- collection.find({}).sort(‘num’, DESCENDING).limit(100)
이어서 두 번째 시나리오는 메모리를 비우기 위해 서버를 재시작한 후 비교를 다시 진행합니다.
서버를 재시작했기 때문에 메모리 상의 스킵리스트는 비어 있으며, 모든 데이터는 WT_ROW 배열형태로 구성되어 있습니다.
Ascending Sort
- collection.find({}).sort(‘num’, ASCENDING).limit(100)
Descending Sort
- collection.find({}).sort(‘num’, DESCENDING).limit(100)
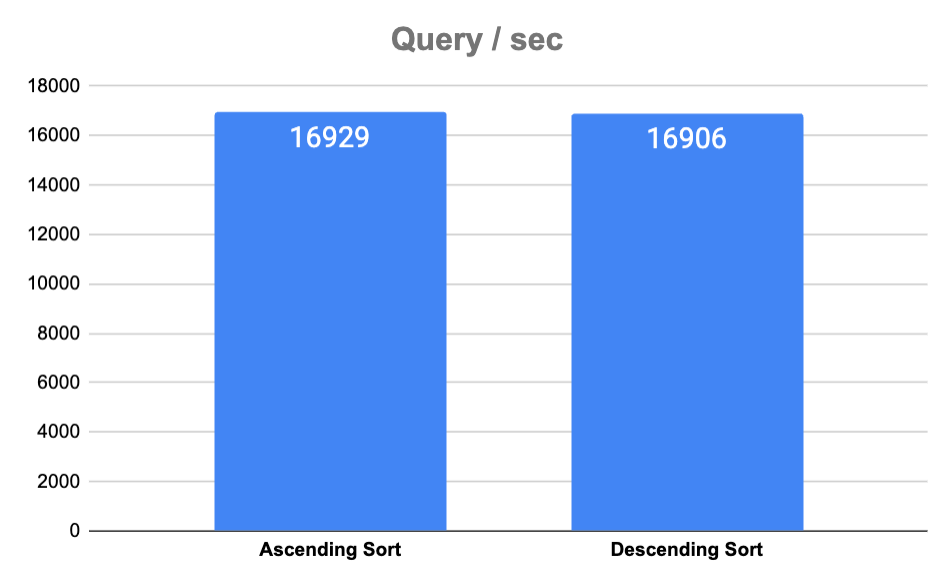
결과적으로 스킵 리스트를 통한 조회 시 정렬 방향에 따라 약 7% 정도의 성능 차이가 있었으며, WT_ROW 배열에서의 조회는 정렬 방향에 따른 차이가 거의 없었습니다.
결과를 분석하기 위해, WT_ROW 배열에서 다음 아이템으로 커서를 이동하는 __cursor_row_next와 __cursor_row_prev 함수, 그리고 스킵리스트의 역순 조회를 위한 __cursor_skip_prev 함수를 중점적으로 확인했습니다. 스킵 리스트를 정방향으로 조회하는 경우에는 구조상 자연스러운 탐색이기 때문에, 별도의 함수 없이 단순한 매크로로 처리가 가능합니다.
첫 번째 시나리오에서는 모든 데이터가 메모리 상의 스킵리스트에 존재하여, 내림차순 조회 시 __cursor_skip_prev 함수가 조회 건수만큼 추가적으로 호출되었습니다. 이로 인해 오름차순 정렬로 수행된 쿼리에 비해 약간의 성능 저하가 있었던 것으로 보입니다.
// Ascending Sort
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
...

vs

// Descending Sort
Thread 141 "conn50" hit Breakpoint 4, __cursor_row_prev
Thread 141 "conn50" hit Breakpoint 3, __cursor_skip_prev
Thread 141 "conn50" hit Breakpoint 4, __cursor_row_prev
Thread 141 "conn50" hit Breakpoint 3, __cursor_skip_prev
...
<예시 11. 첫 번째 시나리오 함수 호출 예시>
반면, 두 번째 시나리오에서는 서버가 재시작되어 모든 데이터가 WT_ROW 배열로 구성되어 있었기 때문에 스킵리스트는 비어 있는 상태였습니다. 따라서, __cursor_skip_prev 함수 호출 없이 정렬 방향에 따라 __cursor_row_next 혹은 __cursor_row_prev 함수만으로 조회가 이루어졌습니다. 배열에서 항목을 다음 또는 이전으로 이동하는 것의 차이가 거의 없기에, 성능 차이도 거의 없음을 확인할 수 있습니다.
// Ascending Sort
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
Thread 183 "conn91" hit Breakpoint 5, __cursor_row_next
...

// Descending Sort
Thread 141 "conn50" hit Breakpoint 4, __cursor_row_prev
Thread 141 "conn50" hit Breakpoint 4, __cursor_row_prev
Thread 141 "conn50" hit Breakpoint 4, __cursor_row_prev
Thread 141 "conn50" hit Breakpoint 4, __cursor_row_prev
...
<예시 12. 두 번째 시나리오 함수 호출 예시>
이렇듯 위 결과에서는 성능 차이를 확인하기 위한 테스트를 진행하여 일부 성능 차이를 확인할 수 있었지만, 사실 일반적인 서비스 환경에서는 체감하기 어려운 경우가 많을 것이라 생각됩니다.
따라서, 양방향 정렬을 모두 활용해야 하는 요구사항이 있다면 크게 걱정하지 않고 사용하셔도 좋을 것 같습니다. 그러나 단일 방향의 정렬만 사용하신다면, 가능한 정렬 방향을 맞춰 사용하는 것이 더 최적화된 접근법이라 생각됩니다.
InnoDB와 WiredTiger의 B+Tree 비교
InnoDB는 MySQL에서 사용하는 스토리지 엔진 중 하나로 B+Tree의 일반적인 특징을 잘 반영하고 있습니다. 그리고 WiredTiger와는 일부 상반된 특징을 가지고 있어, 이해를 돕기 위한 비교 대상으로 적절하다고 생각했습니다. WiredTiger의 B+Tree, InnoDB의 B+Tree의 차이점을 보다 명확히 설명하기 위해 "Jeremy Cole이 그린 InnoDB의 B+Tree 구조"를 참고하여 WiredTiger와 비교해 보겠습니다.
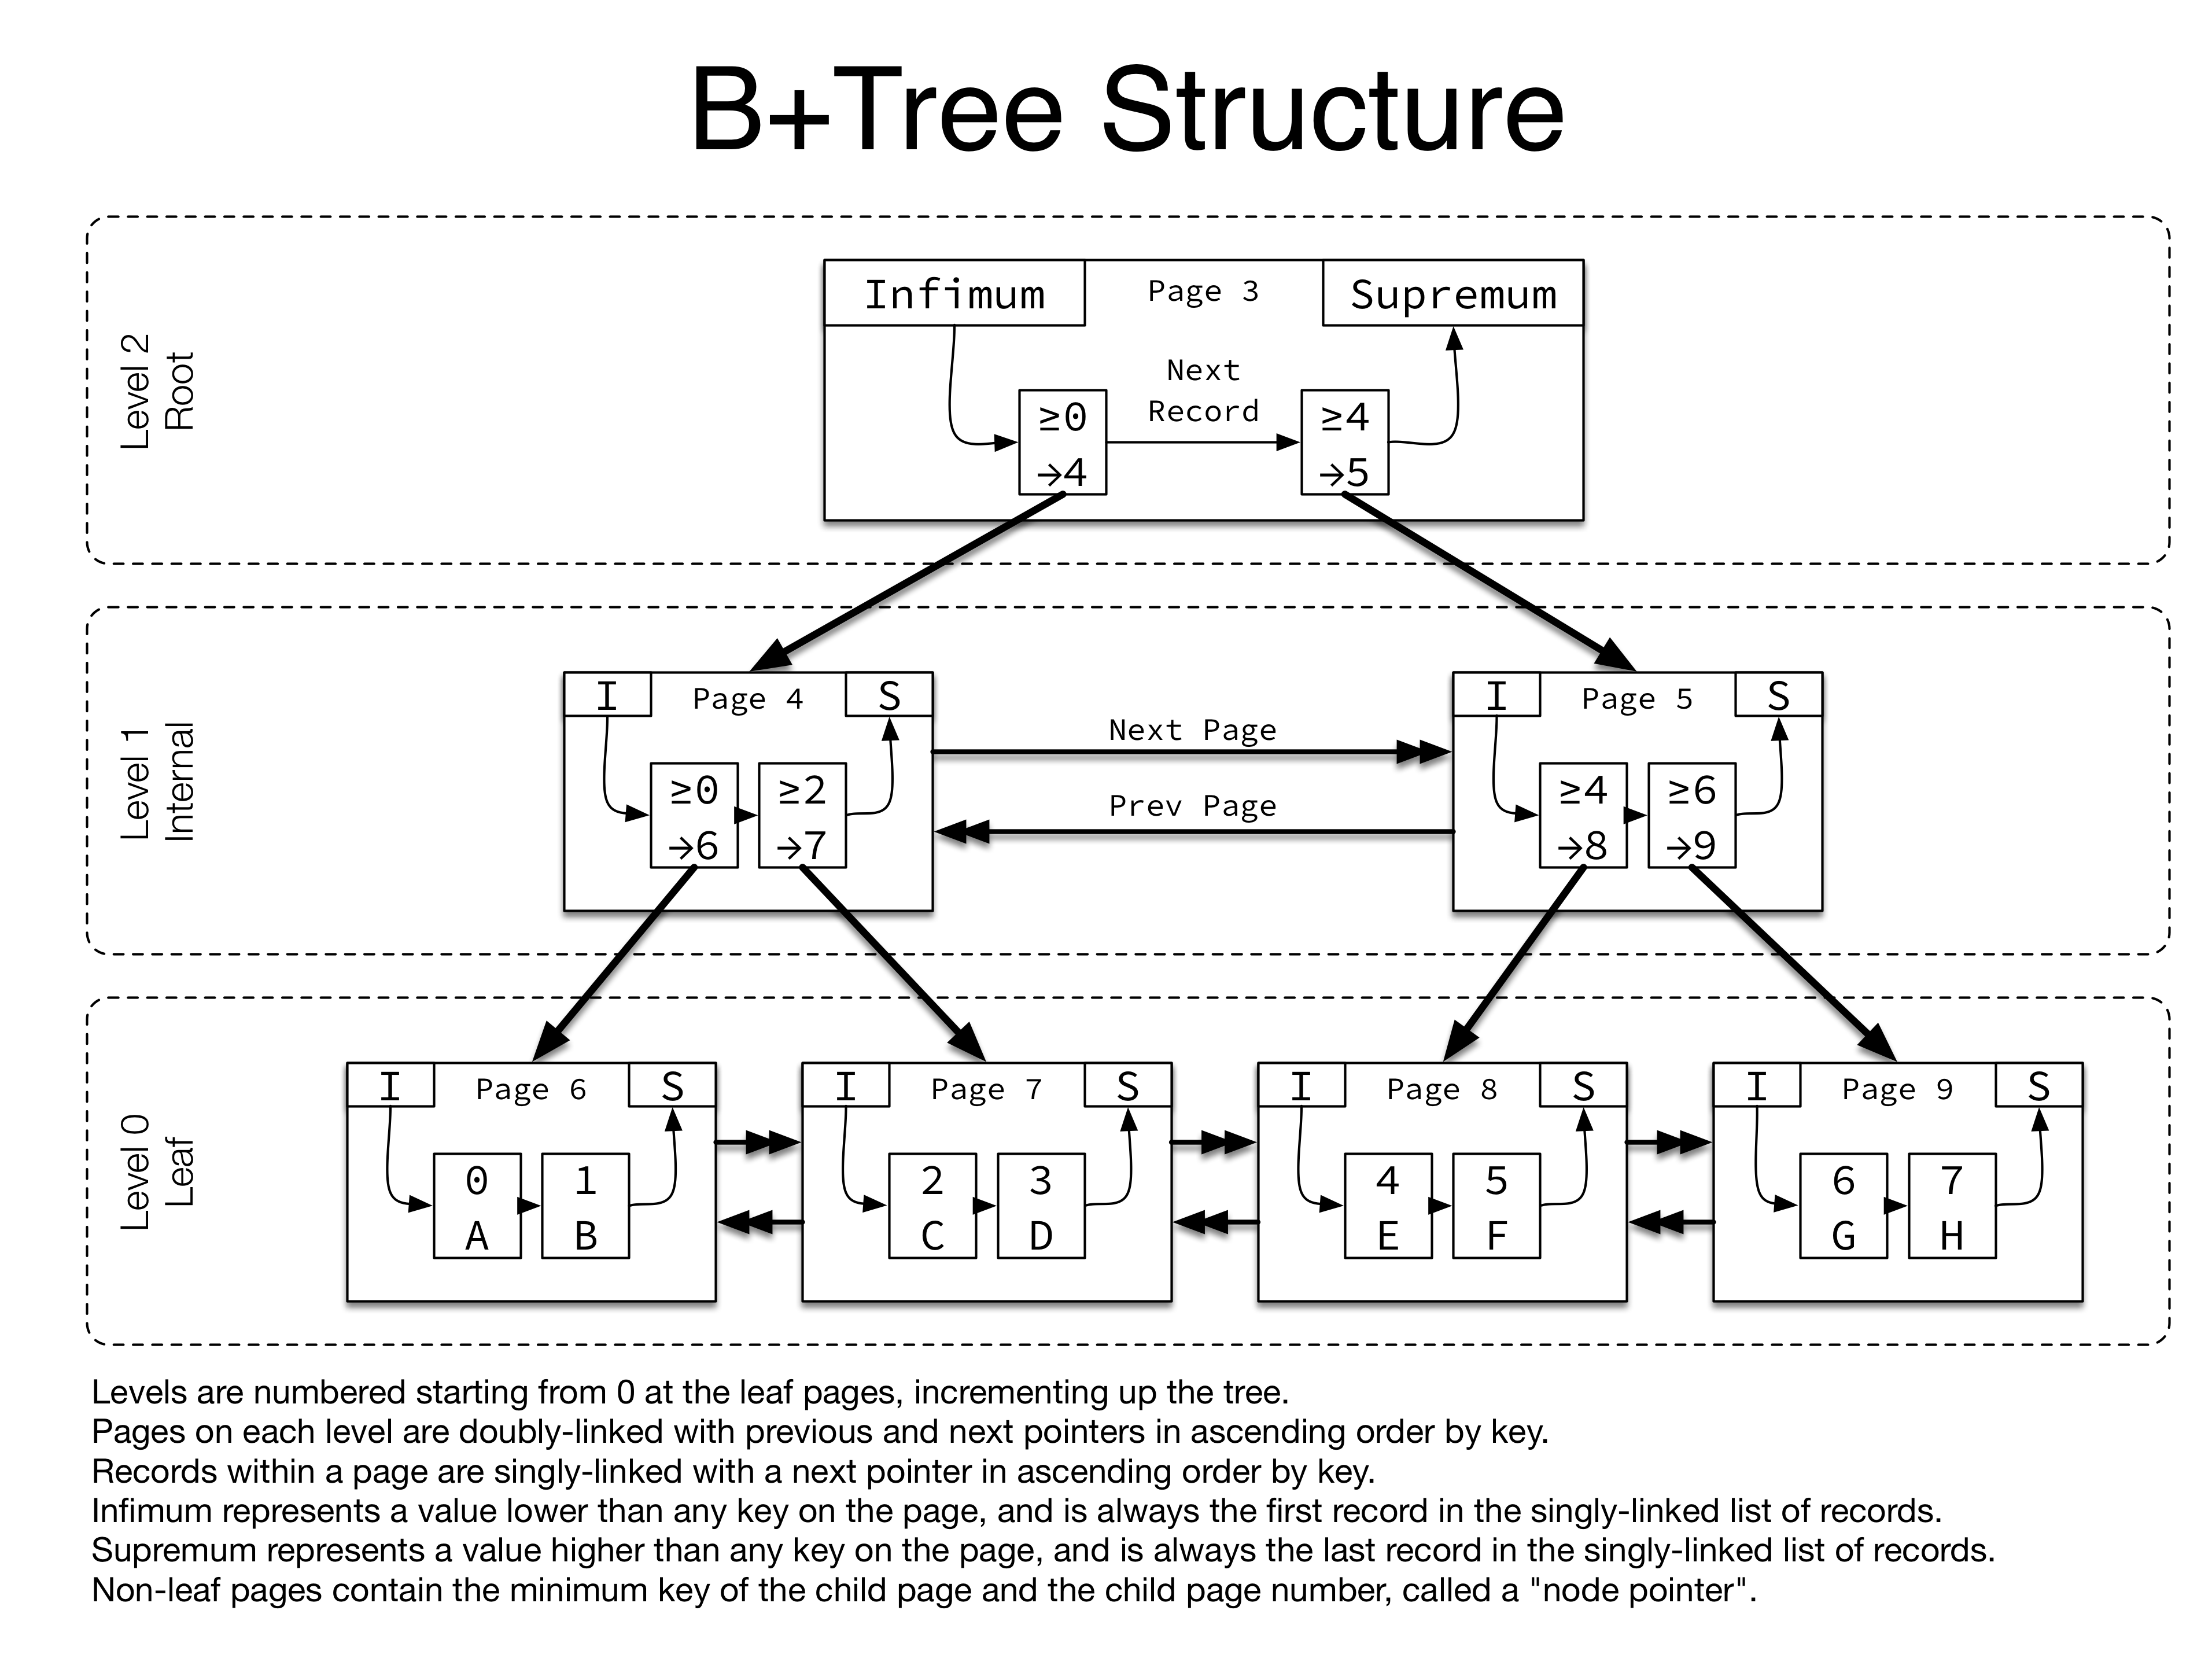
InnoDB의 페이지 간 연결 구조
InnoDB의 경우 동일한 레벨의 페이지끼리 양방향 연결 리스트(Doubly Linked List)로 연결되어 있습니다.
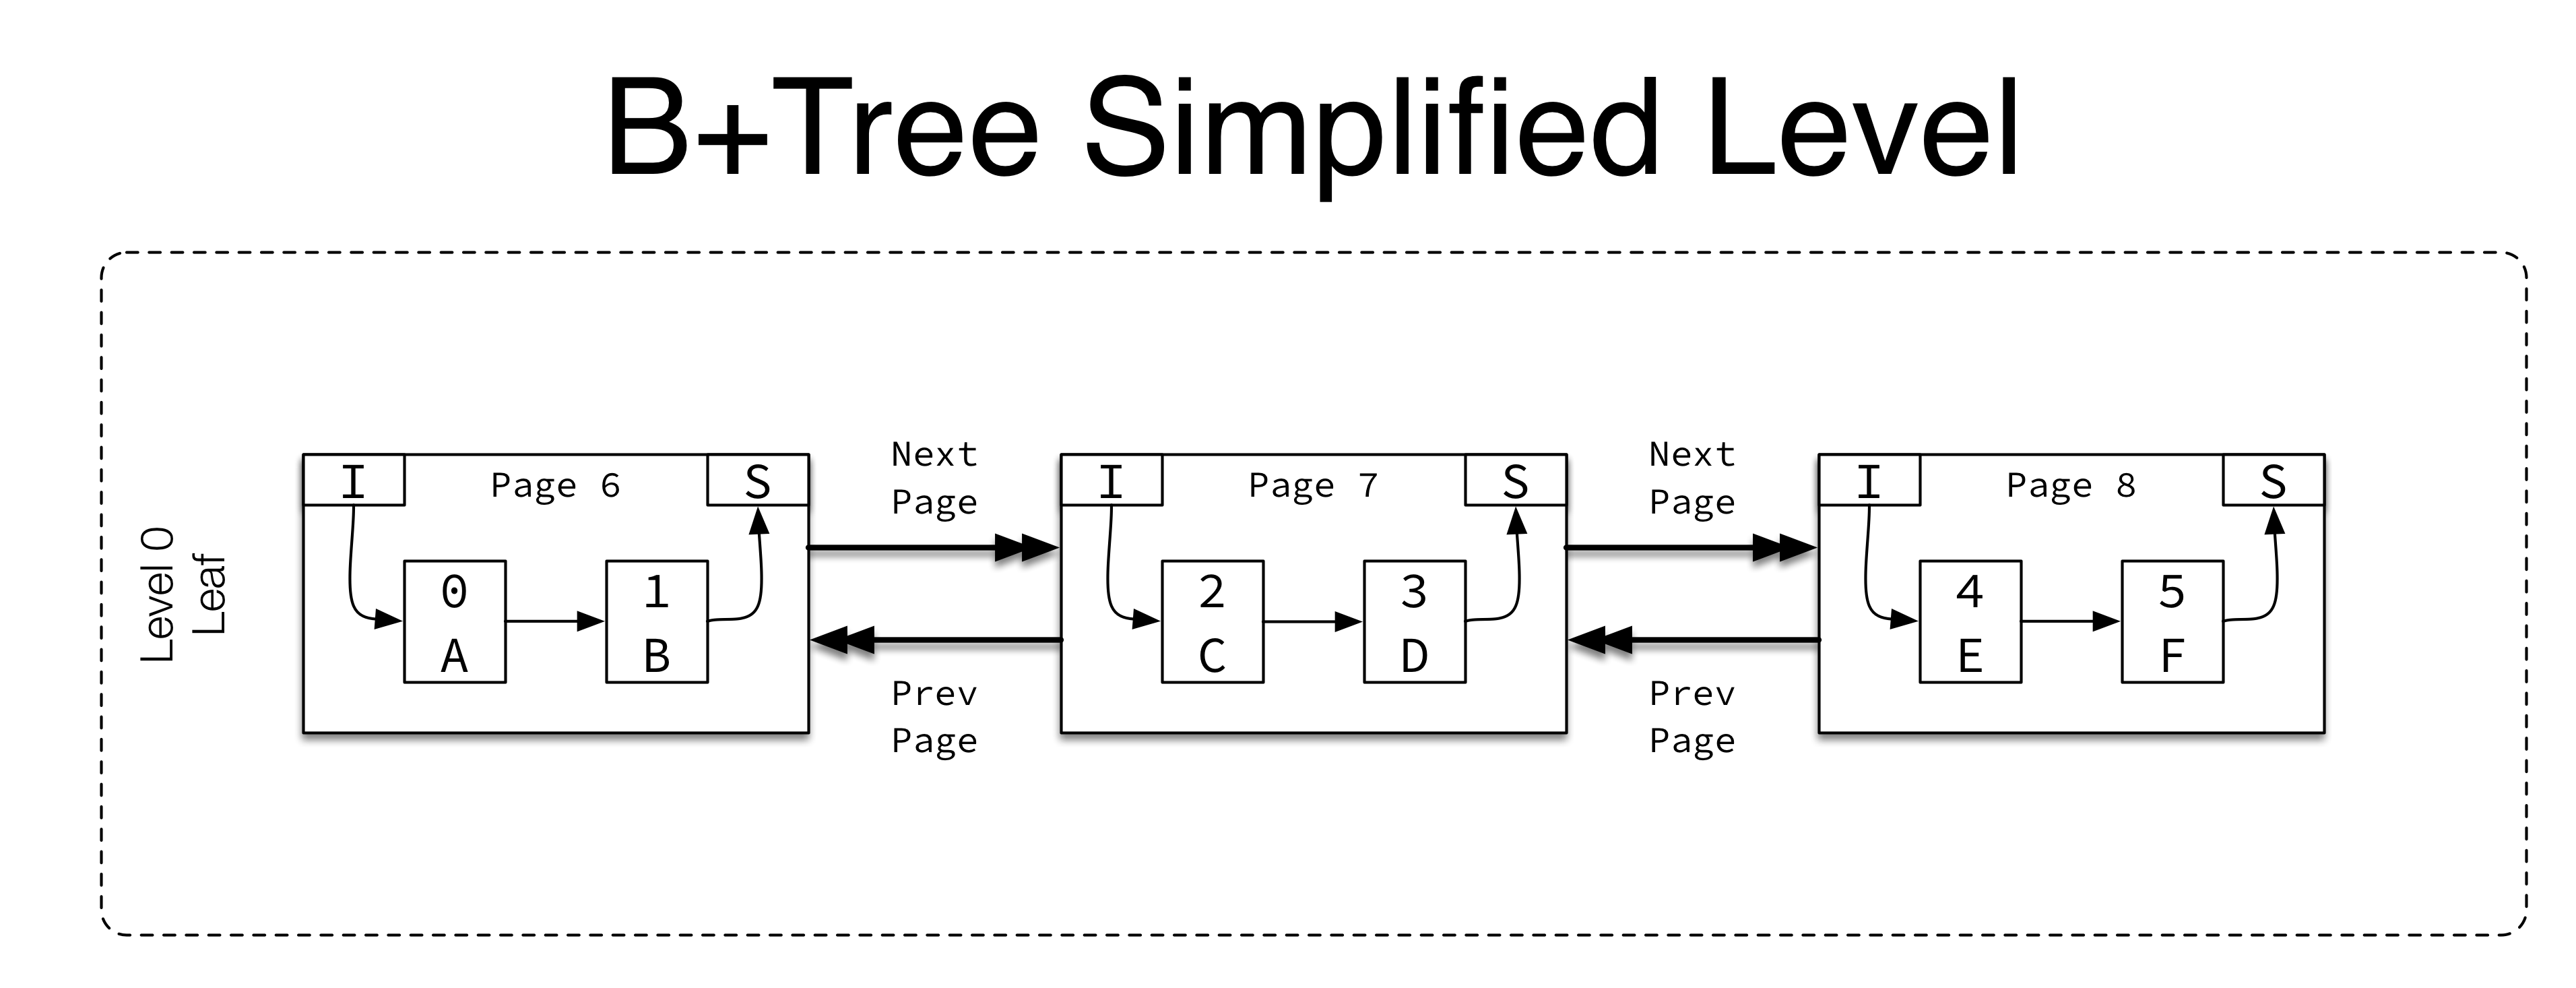
동일한 레벨의 페이지끼리 연결을 유지할 때 장점은 무엇일까요? WiredTiger와 비교해보면, WiredTiger에서는 페이지 간 연결이 없어서 인접한 페이지로 이동하기 위해 부모 페이지의 참조에 의존해야 합니다.
반면, InnoDB의 경우 페이지들이 서로 연결되어 있어 여러 페이지를 스캔해야 하는 범위 쿼리에서도 상위 부모 페이지에 접근할 필요 없이 순차적으로 효율적인 처리가 가능합니다. 그러나 각 페이지의 연결 리스트를 추가 관리하는 비용과 함께 페이지 분할과 같은 작업 시 인접한 페이지의 연결도 함께 조정해야하므로 관리 복잡성이 증가할 수 있습니다.
InnoDB의 리프 페이지
InnoDB의 리프 페이지는 WiredTiger의 B+Tree와 상반된 접근을 보여줍니다. 실제 레코드를 저장하고 있는 InnoDB의 리프 페이지를 자세히 살펴보겠습니다.
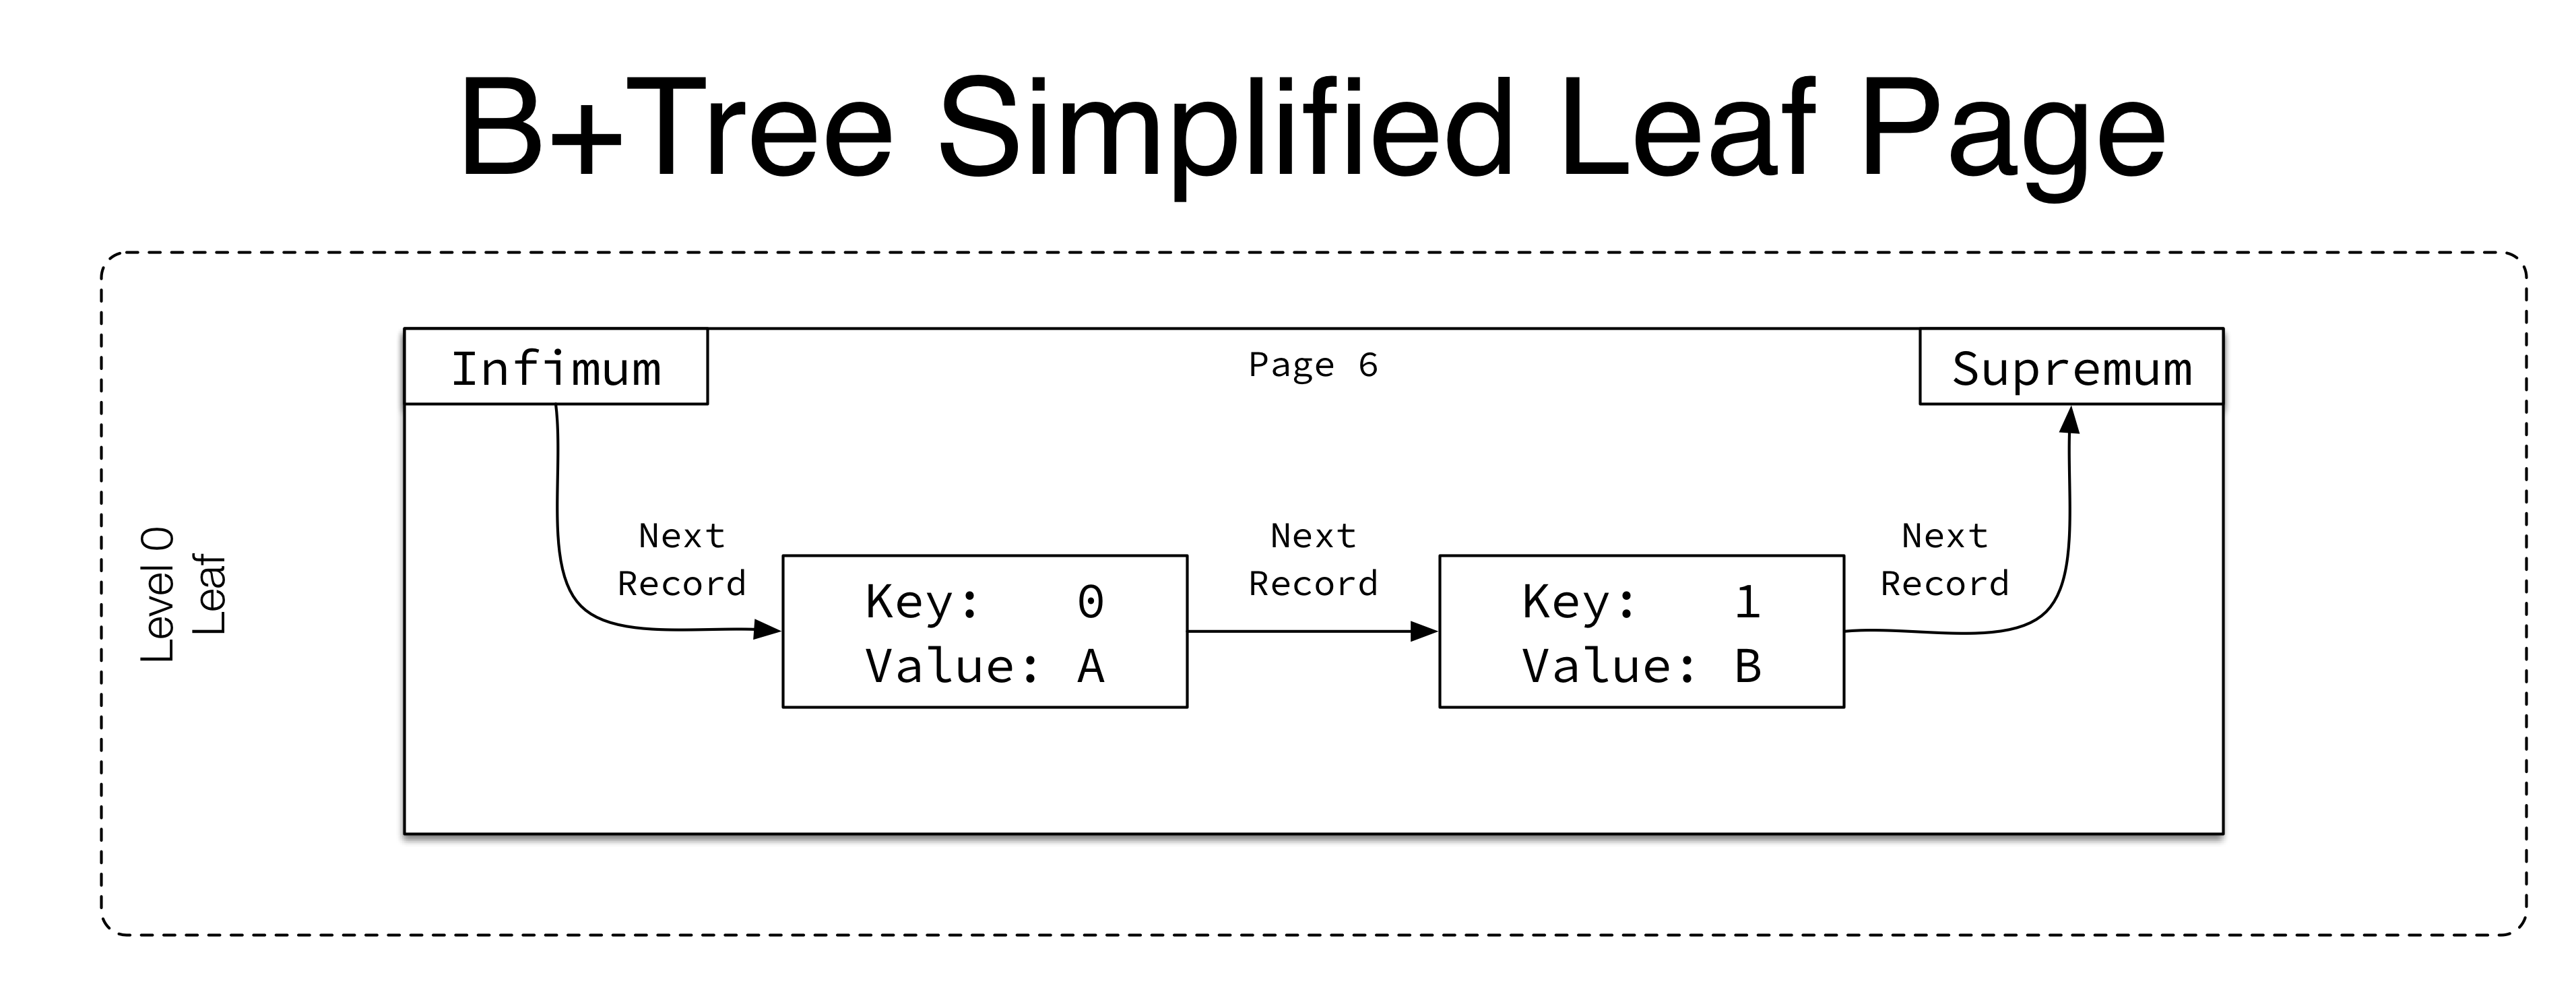
그림과 같이 InnoDB의 리프 페이지 내에서 레코드는 단방향 연결 리스트(Singly Linked List) 구조로 연결되어 있습니다. 연결 리스트는 요소의 삽입과 삭제를 가리키는 포인터의 변경만으로 쉽고 빠르게 처리할 수 있고, 각 요소의 크기를 동적으로 조절할 수 있다는 장점이 있습니다. 반면, 특정 요소에 접근하려면 처음부터 순차적으로 탐색해야 하므로 임의 접근이 비효율적이라는 단점이 있죠.
InnoDB는 연결 리스트를 사용함으로써 레코드의 삽입과 삭제를 빠르게 처리할 수 있습니다. 그리고 갭 락(Gap Lock)과 같이 다양한 잠금 기법을 사용하는 InnoDB 특성상, 배열보다는 레코드를 처음부터 순차적으로 탐색을 수행하는 연결 리스트가 더 유리할 것입니다.
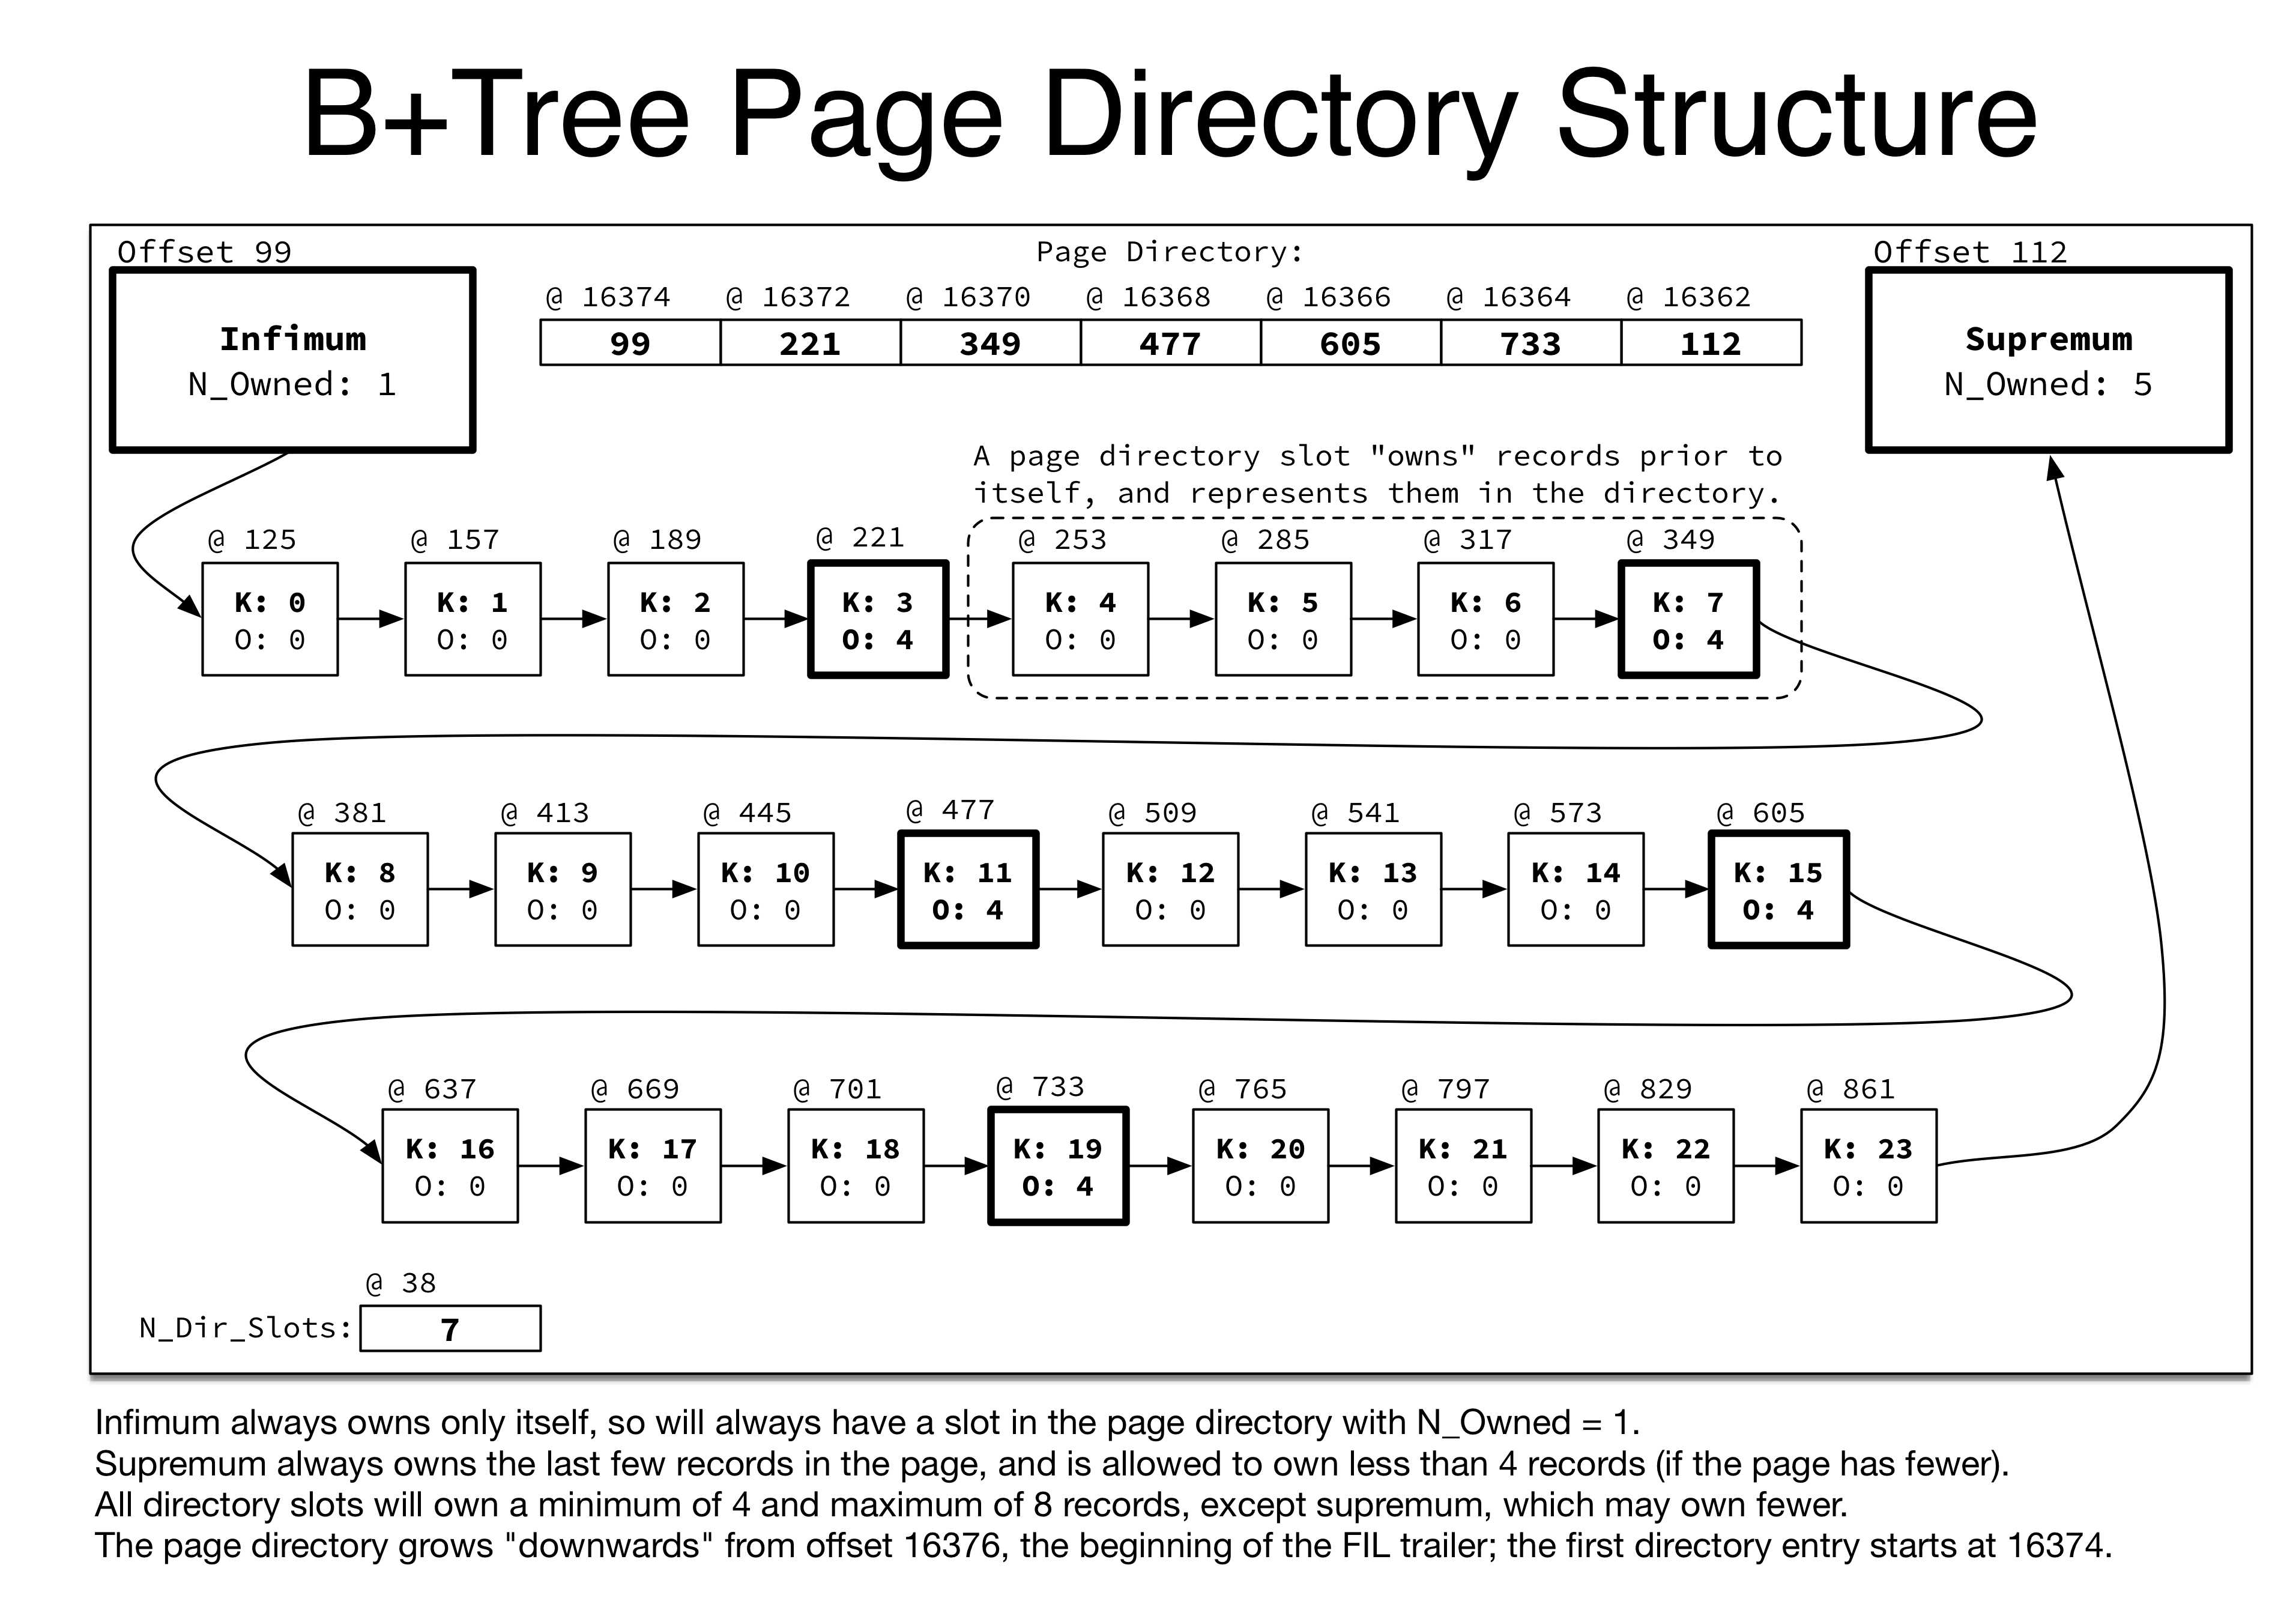
하지만 하나의 페이지에는 크기에 따라 수천 개의 레코드가 저장될 수 있으며, 페이지의 마지막 레코드를 조회할 경우 연결 리스트 구조로 인해 성능 저하가 발생할 수 있습니다.
이런 단점을 극복하기 위해서 InnoDB는 배열 구조인 페이지 디렉터리(Page Directory)를 사용합니다. 페이지 디렉터리는 순차적으로 정렬된 4개에서 8개 간격으로 레코드의 포인터를 배열로 따로 관리합니다. 이를 통해 페이지 내의 모든 레코드를 탐색하지 않고 페이지 디렉터리에서 이진 탐색을 수행하여 해당 값의 근처까지 이동한 후, 최종 값은 연결 리스트를 이용해 검색하는 방식을 사용할 수 있습니다.
비교 정리
이처럼 B+Tree는 여러 DBMS에서 범용적으로 사용되지만, 각 시스템의 목적에 따라 세부 구현이 다를 수 있습니다.
WiredTiger는 시스템 전반적으로 잠금을 최소화하는 전략을 채택하고 있습니다. 동일 레벨의 페이지 간 연결을 제거하고, WT_UPDATE 연결 리스트에서 CAS를 활용하여 잠금 없이 데이터 변경을 수행하며, WT_INSERT 스킵 리스트 역시 잠금을 최소화하도록 설계되었습니다. 잠금을 최소화한다는 것은 그만큼 충돌(conflict)에 취약할 수 있지만, WiredTiger는 연산 수행시 충돌이 발생하지 않을 것이라고 가정하며 작업을 수행합니다.
이렇게 낙관적으로 연산을 수행하고, 충돌이 발생할 경우 연산을 재시도하는 접근 방식을 낙관적 동시성 제어(Optimistic Concurrency Control)라고 합니다.
반면, InnoDB는 충돌이 발생할 것을 가정하여 연산을 수행하기 전에 잠금을 먼저 획득하여 동시성을 제어합니다. 이 접근 방식에서는 각 레코드와 페이지가 연결 리스트 형태로 구성되는 것이 갭 락(Gap Lock)과 같이 다양한 잠금을 수행하는데 용이할 것이라 생각됩니다.
이렇게 연산을 수행하기 전에 잠금을 취득하고 연산을 수행하는 동시성 제어 방식은 비관적 동시성 제어(Pessimistic Concurrency Control)라고 합니다.
만약 충돌이 거의 발생하지 않는 환경이라면 낙관적 동시성 제어가 최선의 선택이 될 수 있지만, 현실은 항상 그렇지는 않습니다. 낙관적 동시성 제어를 사용할 때 충돌이 자주 발생한다면, 연산이 성공할 때 까지 재시도를 해야 하며 때로는 예측할 수 없는 쿼리 성능을 보일 수 있습니다. 반면 비관적 동시성 제어는 잠금을 획득한 후 안전하게 연산을 수행하므로 비교적 균일한 성능을 보일 수 있다고 생각합니다.
결론적으로, 어느 방식이 적합한지는 서비스 특성에 따라 다르기 때문에 요구사항에 맞게 고려하는 것이 중요합니다. 그리고 각 설계 방식은 복합적인 이유로 인해 사용되므로, 이 내용은 하나의 관점으로 봐주시면 좋을 것 같습니다.
| WiredTiger | InnoDB | |
|---|---|---|
| 동일 레벨 페이지 간 연결 | X | O |
| 리프 페이지의 레코드 저장 | Array | Linked List |
| 성능 보완을 위한 추가 구조 | Linked List, Skip List | Array |
| 동시성 제어 방식 | Optimistic | Pessimistic |
<표 1. WiredTiger vs InnoDB>
마무리하며
이번 글에서는 "MongoDB WiredTiger의 파일 구조"에 이어 WiredTiger에서 사용하는 B+Tree 구조를 살펴보았습니다. 기본적인 구조를 소개하는 것이 주요 목적이었던 만큼 생략된 부분도 많습니다. 그래서 이미 구조에 익숙한 분들께는 아쉬움이 남을 수도 있겠지만, 이번에 다루지 못한 MongoDB의 타임스탬프, 잠금, 이빅션 등의 조금 더 세부적인 주제들도 앞으로 기회가 된다면 다뤄보도록 하겠습니다.
그리고 개인적으로 MongoDB를 처음 운영할 때, MongoDB의 B+Tree도 InnoDB의 B+Tree와 유사한 구조일 것이라 생각했었습니다. 그로 인해 몇 가지 동작 과정에서 의문이 들었던 적이 있는데요. WiredTiger와 InnoDB의 내부 동작을 비교하면서 해소된 부분들이 많아, 저와 비슷한 고민을 가지신 분들께 도움이 되었으면 하는 마음에 비교 내용도 추가해보았습니다.
긴 글 읽어주셔서 감사합니다. 또한, 이 글의 최종 검토와 리뷰를 도와주신 dj.seo, david.stdio, vivaan.jang께 감사드립니다.
부록 : gdb를 활용한 메모리 상태 분석
이번 글에서는 메모리 상의 데이터 상태를 분석하기 위해 GNU Debugger(gdb)를 사용했습니다. 이 도구는 프로그램 실행을 제어하고, 변수 상태를 검사하거나 문제를 진단하는 데 유용하게 사용할 수 있습니다.
메모리 상태를 분석하기 위한 상세 정보를 얻기 위해서는 mongod 바이너리를 컴파일할 때 --gdbserver (혹은 --dbg=on) 옵션을 추가하여 빌드해야 하며, 방법은 아래와 같습니다. 빌드 방식은 사용하시는 환경에 따라 다를 수 있으므로, 상세한 빌드 방식은 공식 문서를 참고해 주시기 바랍니다.
> git clone https://github.com/mongodb/mongo.git
> git checkout v6.0
> python3 buildscripts/scons.py install-mongod MONGO_VERSION={$version} --gdbserver
<예시 13. mongod 바이너리 빌드 방법>
빌드된 바이너리는 아래 명령어를 사용하여 gdb를 통해 실행하고 디버깅할 수 있습니다.
> gdb ./mongod

(gdb) run -f /etc/mongod.conf

// 주요 사용 명령어
(gdb) break {$function}
Breakpoint 설정

(gdb) info b
설정된 Breakpoint에 대한 정보

(gdb) delete 1
Breakpoint 제거, delete만 입력하면 전체 제거

(gdb) next
(gdb) step
Breakpoint에서 함수를 통과하거나 다음 실행을 보기 위한 명령어

(gdb) print args
특정 함수, 변수에 대한 상세 정보 확인
<예시 14. gdb 대표적인 명령어>
참고 문서
-
https://github.com/mongodb/mongo/blob/master/docs/building.md
-
Lock-free linked lists using compare-and-swap (https://dl.acm.org/doi/10.1145/224964.224988)