Engineering
if(kakao)2026 첫째 날, 기술 세션 소개
2026년 9월 8일
원문에서 보기 ↗if(kakao)26 첫째 날은 AI 방향성, 신뢰와 안전, Model & Agent, 상생과 성장에 대해 이야기합니다.
키노트를 제외한 총 23개의 기술 세션들이 아래와 같이 진행됩니다.
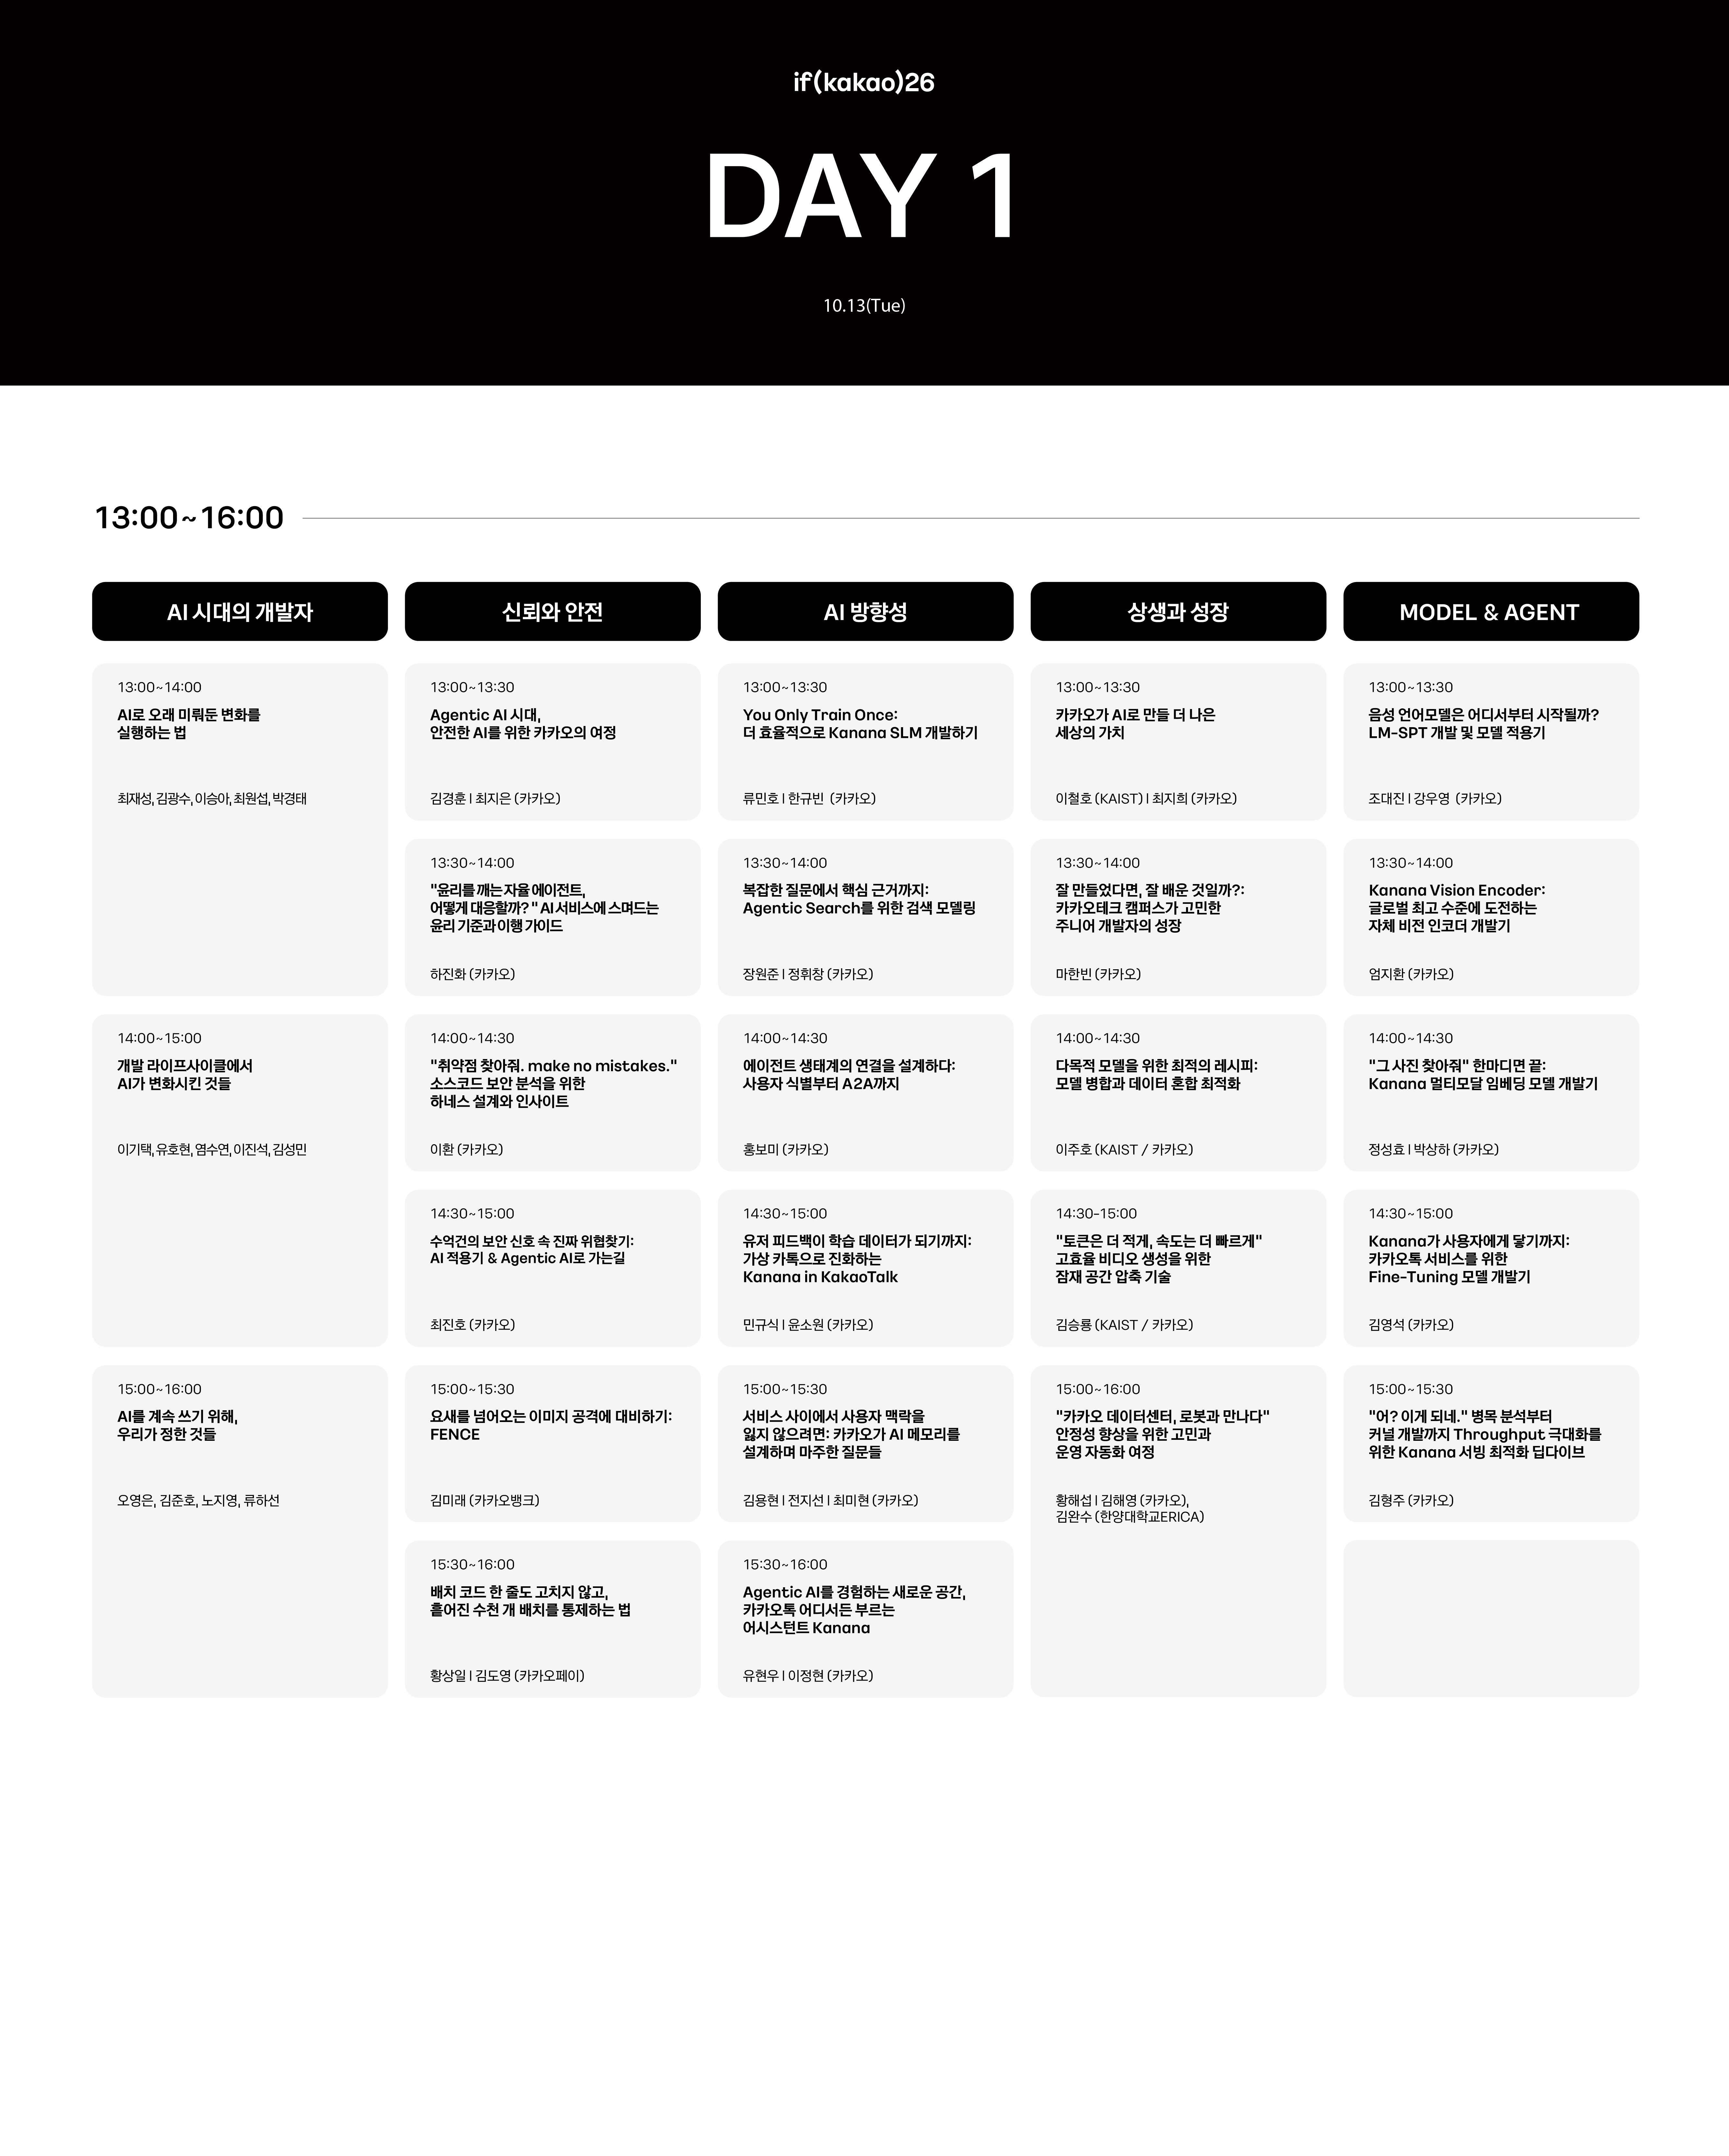
[AI 방향성]
1. You Only Train Once: 더 효율적으로 Kanana SLM 개발하기 (류민호, 한규빈)
단 한 번의 학습으로, 4개의 Small Dense Model Family를 개발한 노하우를 공유합니다!
최근 공개한 Kanana-2 SLM 개발 과정에 대해서 소개하고, 더 나아가 Elastic Training을 적용하여 여러 크기의 Dense Model Family를 한 번에 확보하기 위한 개발 노하우를 공유합니다.
- 시간: 13:00 ~ 13:30
- 장소: B1F Team room 3 4 5
2. 복잡한 질문에서 핵심 근거까지: Agentic Search를 위한 검색 모델링 (장원준, 정휘창)
생성형 AI와 에이전트의 확산으로 검색은 단순히 사용자가 입력한 키워드와 관련된 문서를 찾는 단계를 넘어, 복잡한 의도를 해석하고 답변 생성에 필요한 근거를 정확하게 선별하는 방향으로 변화하고 있습니다.
특히 Agentic Search 환경에서는 여러 조건과 목적이 결합된 복합 질의(Complex Query)를 처리해야 하며, 검색 결과의 관련성뿐 아니라 문서 내부에서 실제로 유용한 정보를 식별하고 제한된 컨텍스트 안에 효과적으로 전달하는 능력이 중요합니다.
본 발표에서는 이러한 변화에 대응하기 위해 카카오가 검색 모델을 연구하며 마주한 문제와 해결 방향을 소개합니다.
- 시간: 13:30 ~ 14:00
- 장소: B1F Team room 3 4 5
3. 에이전트 생태계의 연결을 설계하다: 사용자 식별부터 A2A까지 (홍보미)
“잠시만요, 이건 더 잘하는 에이전트에게 물어볼게요.” 다양한 파트너와 AI 에이전트가 연결되는 환경에서는 단순히 기능을 호출하는 것만으로 충분하지 않습니다.
이 세션에서는 서로 다른 사용자 식별 체계를 연결하는 방법과 데이터·실행 맥락이 섞이지 않도록 연결의 경계와 책임을 설계한 과정, 그리고 여러 에이전트가 하나의 요청을 주고받으며 협력해 자연스러운 하나의 사용자 경험으로 완성되는 흐름을 공유합니다.
- 시간: 14:00 ~ 14:30
- 장소: B1F Team room 3 4 5
4. 유저 피드백이 학습 데이터가 되기까지: 가상 카톡으로 진화하는 Kanana in KakaoTalk (민규식, 윤소원)
Kanana in KakaoTalk은 카카오톡 대화 속 필요한 순간을 이해하고 먼저 도움을 제안하는 AI입니다. 하지만 개발 과정에서는 사용자 발화의 의도와 맥락을 정교하게 해석해야 하고, 선톡의 정확도를 높이기 위해 다양한 실패 케이스를 발견하고 개선해 나가는 과정이 필요합니다.
이번 세션에서는 사용자 피드백에서 발견한 엣지 케이스를 실제 카톡과 유사한 가상 대화로 재현하고, 이를 학습과 평가 데이터로 연결한 개선 파이프라인을 소개합니다.
나아가 개인의 선호와 메모리를 반영해 모두에게는 더 정확하게, 각자에게는 더 알맞은 선톡으로 진화하는 서비스의 방향을 공유합니다.
- 시간: 14:30 ~ 15:00
- 장소: B1F Team room 3 4 5
5. 서비스 사이에서 사용자 맥락을 잃지 않으려면: 카카오가 AI 메모리를 설계하며 마주한 질문들 (김용현, 전지선, 최미현)
AI가 사용자의 맥락을 이어받기 시작하면서, 기억을 잘 저장하는 것보다 언제 지워야 하는지가 더 어려운 문제가 되고 있습니다.
이 세션에서는 어떤 경험을 만들려 하는지와 무엇을 기억하지 않기로 했는지, 이어서 사용자가 확인하고 고치고 지울 수 있으려면 동의와 통제를 어떻게 설계해야 하는지, 마지막으로 그 선택이 실제 시스템 동작이 되도록 플랫폼을 어떻게 설계했는지 다룹니다.
각 서비스가 사용자의 맥락을 매번 처음부터 다시 파악하지 않아도 되면서, 목적에 필요한 만큼만 전달받도록 하는 것이 목표입니다. 그동안 내린 결정과 아직 남은 질문을 함께 나누려 합니다.
- 시간: 15:00 ~ 15:30
- 장소: B1F Team room 3 4 5
6. Agentic AI를 경험하는 새로운 공간, 카카오톡 어디서든 부르는 어시스턴트 Kanana (유현우, 이정현)
"라이언, 해줘” 한마디로 카카오톡의 다양한 기능을 직접 실행하고, 요청 결과에 맞는 화면까지 자연스럽게 보여주는 AI는 어떻게 만들어질까요?
서비스를 구현하기까지의 고민과 개발 과정을 생생한 사례와 함께 소개합니다. 카카오톡의 놀라운 AI 경험을 위해 달려온 여정을 함께 만나보세요.
- 시간: 15:30 ~ 16:00
- 장소: B1F Team room 3 4 5
[신뢰와 안전]
1. Agentic AI 시대, 안전한 AI를 위한 카카오의 여정 (김경훈, 최지은)
"라이언, 해줘” 한마디로 카카오톡의 다양한 기능을 직접 실행하고, 요청 결과에 맞는 화면까지 자연스럽게 보여주는 AI는 어떻게 만들어질까요?
서비스를 구현하기까지의 고민과 개발 과정을 생생한 사례와 함께 소개합니다. 카카오톡의 놀라운 AI 경험을 위해 달려온 여정을 함께 만나보세요.
- 시간: 13:00 ~ 13:30
- 장소: B1F Team room 1 2
2. “윤리를 깨는 자율 에이전트, 어떻게 대응할까?” AI 서비스에 스며드는 윤리 기준과 이행 가이드 (하진화)
자율 에이전트에서는 개별 기능이 정상 작동하더라도 그 조합에서 위험이 창발할 수 있어, 사후 점검만으로는 대응에 한계가 있습니다.
카카오는 3대 가치 아래 7가지 AI 윤리 원칙과, 기획부터 운영까지 AI 전 주기에 대응하는 통제 항목으로 이루어진 이행 체크리스트를 정립해 윤리를 전 주기에 스며드는 설계 원칙(Safety by Design)으로 만들었습니다.
본 발표에서는 이 원칙과 체크리스트의 구조, 그리고 자율 에이전트 위험과 개발 현장에 적용하는 방식을 공유합니다.
- 시간: 13:30 ~ 14:00
- 장소: B1F Team room 1 2
3. “취약점 찾아줘. make no mistakes." 소스코드 보안 분석을 위한 하네스 설계와 인사이트 (이환)
/goal Find critical vulnerabilities in this code. make no mistakes
AI 에이전트는 코드를 빠르게 읽고 패턴을 찾아내는 데 능숙하지만, 취약점 분석이나 보안 검토에 그대로 투입하기에는 결과를 신뢰하기 어렵습니다.
카카오 보안팀은 이 한계를 프롬프트가 아닌 구조와 오케스트레이션으로 해결하기 위해 Auriga라는 하네스를 설계하고 운영해 왔습니다.
이 발표에서는 멀티 에이전트 세션을 구성할 때 내린 설계 결정들, 연결된 도구와 데이터 생태계, 그리고 실제 운영 과정에서 마주친 문제와 대응을 함께 이야기합니다.
- 시간: 14:00 ~ 14:30
- 장소: B1F Team room 1 2
4. 수억건의 보안 신호 속 진짜 위협찾기: AI 적용기 & Agentic AI로 가는길 (최진호)
공격은 매일 수만건 수억건씩 발생하고 있습니다. 이런 공격들은 실제 위협을 잘 선별해서 효율적으로 분석할 수 있는 체계를 갖추어야 합니다.
본 발표에서는 카카오 CERT가 AI를 어떻게 적용하고 발전해 나가고 있는지, 보안에서 AI Agent 적용 하면서 발견한 문제와 해결과정을 소개합니다.
- 시간: 14:30 ~ 15:00
- 장소: B1F Team room 1 2
5. 요새를 넘어오는 이미지 공격에 대비하기: FENCE (김미래)
요새 앞에 이미지로 위장한 트로이 목마가 나타났어요!
금융 서비스가 LLM을 넘어 VLM으로 확장되면, 이미지라는 새로운 입력 경로가 기존 가드레일을 무너뜨릴 수 있습니다. 이에 실제 금융 FAQ를 바탕으로 한국어·영어 텍스트-이미지 쌍 1만 건의 프롬프트 어택 벤치마크 FENCE를 구축하고 VLM 15종을 평가했습니다.
본 발표에서는 FENCE로 확인한 VLM의 주요 취약점과 실험 결과를 공유하고, 멀티모달 환경에서 앞으로의 안전성 평가 방향을 함께 짚어봅니다.
- 시간: 15:00 ~ 15:30
- 장소: B1F Team room 1 2
6. 배치 코드 한 줄도 고치지 않고, 흩어진 수천 개 배치를 통제하는 법 (황상일, 김도영)
“그 배치, 도대체 누가 왜 돌렸죠?”
수천 개 배치가 흩어진 환경에서 이 질문에 명확한 답을 남기기란 쉽지 않습니다. 카카오페이는 배치 코드를 단 한 줄도 고치지 않아도, 배치가 시작되고 끝나는 순간을 가로채 승인 없는 실행을 사전 차단했습니다.
나아가 요청과 승인, 실시간 모니터링, 추적 이력까지 '단 하나의 사내 플랫폼’으로 일원화했습니다. 코드 변경 없이 파편화된 배치들을 하나의 통제권 아래로 묶어낸 아키텍처와 플랫폼화 노하우를 공개합니다.
- 시간: 15:30 ~ 16:00
- 장소: B1F Team room 1 2
[Model & Agent]
1. 음성 언어모델은 어디서부터 시작될까? LM-SPT 개발 및 모델 적용기 (조대진, 강우영)
“우리 음성 언어모델이 달라졌어요!”
최신 음성 언어모델의 성능과 효율은 음성을 어떤 토큰으로 표현하느냐에서 시작됩니다.
본 발표에서는 음성 언어모델 시대에 음성 코덱이 어떤 역할을 하는지 살펴보고, 기존 방식의 한계와 이를 해결하기 위해 개발한 음성 코덱 LM-SPT의 설계 배경, 그리고 이를 카카오의 자체 옴니모달 언어모델 Kanana-o에 실제로 적용한 과정과 결과를 공유합니다.
- 시간: 13:00 ~ 13:30
- 장소: 1F Conference room 2
2. Kanana Vision Encoder: 글로벌 최고 수준에 도전하는 자체 비전 인코더 개발기 (엄지환)
카나나 비전 인코더는 카나나의 눈입니다. 이미지와 영상에서 시각 정보를 읽어내 카나나 LLM이 세상을 이해할 수 있도록 돕습니다.
카나나 비전 인코더는 외부 인코더에 의존하지 않고, 오직 카카오의 기술력으로 프롬 스크래치(from scratch)로 학습되었습니다.
Next Token Prediction 손실 하나만으로 Google SigLIP2를 뛰어넘은 학습 방법부터, 카나나 LLM의 발전이 다시 비전 인코더의 성능 향상으로 이어지는 선순환 파이프라인까지. 글로벌 최고 수준의 비전 인코더에 도전한 여정을 공개합니다.
- 시간: 13:30 ~ 14:00
- 장소: 1F Conference room 2
3. “그 사진 찾아줘” 한마디면 끝: Kanana 멀티모달 임베딩 모델 개발기 (정성효, 박상하)
“그 사진 찾아줘” 한 마디면 사진은 물론 상품, 문서까지 검색 끝!
텍스트, 이미지, 비디오를 하나의 임베딩 공간에서 다루는 멀티모달 임베딩 모델 Kanana-v-embedding의 개발 과정을 소개합니다.
GPU 메모리 제약 속에서 대규모 배치 학습 효과를 확보한 방법, Hard Negative Mining을 적용하며 얻은 경험과 시행착오, 그리고 사진과 비디오 탐색부터 RAG, 상품 검색, 추천까지 멀티모달 임베딩을 서비스에 연결하는 과정과 활용 가능성을 살펴봅니다.
- 시간: 14:00 ~ 14:30
- 장소: 1F Conference room 2
4. Kanana가 사용자에게 닿기까지: 카카오톡 서비스를 위한 Fine-Tuning 모델 개발기 (김영석)
카나나의 카카오톡 실전 적응기!
카카오톡에서 외부 API로 AI 서비스를 제공하려면 보안, 비용, 제약 조건이라는 어려움이 있습니다. 이를 극복하기 위해 자체 언어모델 카나나에 기반한 서비스 특화 모델을 개발해 서비스하고 있습니다.
본 발표에서는 카카오톡에 서비스 중인 특화 모델들의 성능과 강점, 외부 API 대비 비용 절감 성과를 공유하고, 대표 사례로 번역 특화 모델의 데이터 구축부터 GRPO를 활용한 성능 개선까지의 개발 과정을 소개합니다.
- 시간: 14:30 ~ 15:00
- 장소: 1F Conference room 2
5. “어? 이게 되네.” 병목 분석부터 커널 개발까지 Throughput 극대화를 위한 Kanana 서빙 최적화 딥다이브 (김형주)
Kanana MoE 모델을 실제 서빙 환경에 배포하면 GPU 메모리의 상당 부분을 모델 가중치가 차지해 KV 캐시에 할당할 수 있는 공간이 제한됩니다. 그 결과 동시에 처리할 수 있는 요청 수가 줄어들고, 서비스에 필요한 처리량을 확보하기 어려워집니다.
이 발표에서는 이러한 문제에서 출발해 프로덕션 환경에서 마주친 성능 문제를 측정해 병목을 찾고, 모델·서빙 엔진·커널 각 단계에서 이를 하나씩 풀어간 실제 경험을 담았습니다.
- 시간: 15:00 ~ 15:30
- 장소: 1F Conference room 2
[상생과 성장]
1. 카카오가 AI로 만들 더 나은 세상의 가치 (이철호, 최지희)
"카카오에 AI가 더해져 사회를 얼마나, 어떻게 더 낫게 만들까요?”
카이스트 디지털경제연구센터와 카카오 정책 연구진이 함께 추산해 본 '카카오 AI의 사회경제적 가치’를 공유합니다.
- 시간: 13:00 ~ 13:30
- 장소: 1F Conference room 1
2. 잘 만들었다면, 잘 배운 것일까?: 카카오테크 캠퍼스가 고민한 주니어 개발자의 성장 (마한빈)
AI와 함께 개발하는 시대, 개발자에게 필요한 역량을 두고 다양한 질문이 오갑니다. 그 속에서 “개발자가 되겠다”는 꿈을 키우는 이들에게 우리는 어떤 배움과 경험을 건넬 수 있을까요?
카카오의 지역인재양성 프로그램 ‘카카오테크 캠퍼스’가 이 고민을 담은 커리큘럼 개편기를 나눕니다. 그 과정에서 겪은 경험과 시행착오를 바탕으로, 예비 개발자와 그들의 성장을 돕는 사람들이 앞으로 어떤 가치를 함께 키워가야 할지 이야기하고자 합니다.
- 시간: 13:30 ~ 14:00
- 장소: 1F Conference room 1
3. 다목적 모델을 위한 레시피: 모델 병합과 데이터 혼합 최적화 하기 (이주호)
수학, 코딩, 사용자 요청 대응 등 다양한 문제를 하나의 언어모델로 잘 풀려면 데이터 학습 비율, 학습 순서, 특화 모델의 결합 비율 등 수많은 선택이 필요합니다. 기존에는 연구자의 경험이나 반복 실험에 의존해 시간·자원 소모, 휴먼 에러, 인수인계의 어려움이 있었습니다.
본 발표에서는 모델 개발 과정을 하나의 통합된 최적화 문제로 바라보는 Mixture-Trained Merging(MTM)을 소개합니다. MTM은 데이터 혼합 비율과 전문가 모델의 학습 및 병합 비율을 실제 성능 기반으로 자동 탐색·개선합니다.
- 시간: 14:00 ~ 14:30
- 장소: 1F Conference room 1
4. “토큰은 더 적게, 속도는 더 빠르게” 고효율 비디오 생성을 위한 잠재 공간 압축 기술 (김승룡)
내가 원하는 비디오를 기다림 없이 만들어보세요!
잠재 비디오 확산 모델의 비용은 각 단계에서 처리하는 토큰 수에 따라 결정됩니다.
본 발표에서는 사전 학습된 파이프라인을 점진적으로 압축하는 프레임워크를 소개합니다. 사전 학습된 잠재 분포를 보존하면서 높은 압축률로 손실된 정보를 복구하는 오토인코더 설계로, 잠재 토큰 수를 8배 줄이고 추론 지연 시간을 5.7배 단축하면서도 생성 품질을 유지한 고효율 비디오 생성 모델 제작 과정을 소개합니다.
- 시간: 14:30 ~ 15:00
- 장소: 1F Conference room 1
5. “카카오 데이터센터, 로봇과 만나다” 안정성 향상을 위한 고민과 운영 자동화 여정 (황해섭, 김혜영, 김완수)
데이터센터 자산실사 자동화에 대한 고민에서 출발한 카카오 × 한양대학교 ERICA 산학협력 프로젝트입니다.
데이터센터 운영 현장에는 자산실사, 상면 순찰, 위험 구역 점검 등 다양한 반복 수행 업무가 남아 있습니다. 카카오는 이 업무를 로봇으로 개선하고자 했고, 이를 검증하기 위해 현장 문제를 한양대학교 로봇공학과와 캡스톤 디자인 과제로 함께 풀어보기로 했습니다.
2025년 7월부터 2026년 7월까지 12개월간 학생 30명이 8개 팀으로 참여해 8개 팀 전원이 실물 로봇 개발을 완료했습니다. 이 세션에서는 어떤 업무를 과제로 선정했고 어떤 검증 환경을 준비했는지, 협력은 어떻게 설계하고 운영했는지를 카카오와 한양대학교가 함께 공유합니다.
- 시간: 15:00 ~ 16:00
- 장소: 1F Conference room 1
이상 if(kakao AI)2026 첫째 날 기술 세션 소개였습니다. AI 방향성과 신롸와 안전, Model & Agnet, 상생과 성장까지 폭넓은 기술적 고민과 실무 경험을 만나보실 수 있습니다. 둘째 날에는 안정성과 인프라, 거버넌스, AI-DLC, Model & Agent 세션이 이어집니다.
관련 글 목록
- 곧, if(kakao)26의 이야기가 시작됩니다.
- 카카오, if(kakao)26 컨퍼런스 개최… 모든 연결에 지능을
- if(kakao)26 첫째 날, 기술 세션 소개(현재 글)
- if(kakao)26 둘째 날, 기술 세션 소개
- if(kakao)26에서 네트워킹하는 법