DevOps
EKS 환경에서의 EFK 도입기
안다혜Ru(루) /인프라개발팀여기어때
2022년 4월 29일
원문에서 보기 ↗안녕하세요, 인프라개발팀의 데이터 엔지니어 루 입니다.
이번 글은 EKS 환경 위의 애플리케이션과 API에서 보다 효율적인 로그 수집을 위해 EFK 스택을 도입한 이야기에 관해 다룹니다.
다음과 같은 분들이 읽으시면 도움이 되리라고 생각합니다.
- 로그 수집 프로세스에 관심이 있는 개발자·엔지니어
- EFK / Kinesis 도입에 관심이 있는 분
- 여기어때컴퍼니의 로그 수집 파이프라인이 궁금하신 분
기존의 여기어때컴퍼니는 ELK 스택(elastic stack) 을 사용하여 애플리케이션과 API, 서버에서 발생하는 로그 데이터를 검색·수집·모니터링 해 왔습니다. ELK 스택은 검색 및 분석 엔진인 Elasticsearch , 여러 소스에서 동시에 데이터를 수집해 변환한 후 목적지로 전송하는 데이터 처리 파이프라인인 Logstash , 차트와 그래프를 이용해 데이터를 시각화하는 Kibana를 말합니다.
로그를 조회하려면 서버에 접속해 직접 로그를 보는 방법도 있지만, 서버 수가 점점 늘어나거나, 서버와 연결이 원활하지 않을 경우 로그 확인이 어려울 수 있습니다.
만약 서비스에서 수집된 대량 로그를 실시간으로 조회하고, 특정 서버의 로그 검색을 쉽게 할 수 있다면 서비스 운영과 장애 대처 등 여러 상황에 많은 도움이 될 것입니다.
로그를 수집하고 모니터링하는 툴에는 많은 제품이 있고 각 프로젝트에서도 여러 제품을 사용하고 있지만, 여기어때컴퍼니에서는
- 사용자가 의도한 로그를 목적에 맞게
- 실시간, 대량으로 수집하고
- 통일된 인터페이스로 사용하기 위해
ELK, EFK 스택을 이용하여 로그 수집, 모니터링 환경을 구축하였습니다.
Logstash
Logstash는 다양한 소스로부터 쉽게 로그를 수집할 수 있고, 필터를 사용하여 데이터들을 분석하기 쉬운 일관된 형태로 가공해 여러 플랫폼으로 정제된 데이터를 내보내는 로그 수집 프로그램입니다. 다음과 같은 장단점이 있습니다.
장점
- 별도의 코딩 없이 간단한 설정만으로 로그를 가공
- 엘라스틱서치의 인덱싱 성능을 최적화하기 위한 배치 처리, 병렬 처리가 가능
- 현재 처리 중인 이벤트의 최소 1회 전송을 보장
- 유동적인 데이터 처리 방식으로 수집 중인 데이터량이 급증하는 부하 상황에서도 안정성 보장
- 사용자가 많아 Logstash를 사용하다 문제가 발생해도 Elastic Discuss 포럼이나 Stackoverflow에서 같은 상황을 해결한 사람들의 사례를 찾기 쉬움
- 지속적인 버전 업그레이드
단점
- 조건문에 따른 데이터 라우팅이나 grok 패턴이 복잡할 수 있음
- JVM 힙 사이즈가 고정되어 있어 기본 메모리 사용량이 정해져 있음
Logstash의 경우, 애플리케이션 당 메모리를 1GB 정도 사용해 EKS 환경 위에서 사용하기엔 무거운 편이어서 메모리를 더 적게 사용하는 EFK 스택 도입 을 고려하게 되었습니다. EFK에서 F는 보통 Fluentd를 지칭하나, 이 글에서는 더 가벼운 Fluent Bit을 의미합니다.
Fluent Bit은 CNCF의 Graduated Project인 Fluentd의 에코시스템 중 하나입니다. CNCF의 다른 Graduated Project로는 Kubernetes, containerd, etcd, helm, Prometheus 등이 있습니다.
따라서 Fluent Bit은 Kubernetes, Prometheus와 같은 다른 CNCF 프로젝트와 함께 사용하기 용이하며 Elastic.co의 시스템과도 통합을 지원합니다.
Logstash와 같은 기능을 하면서도 메모리는 애플리케이션당 35MB 정도만 사용해, 가볍다는 것이 장점이며 하루에 1PB 가량의 데이터를 처리할 수 있습니다. Logstash와 달리 공식 플러그인 외에도 많은 오픈소스 플러그인이 존재합니다.
Logstash는 장점이 많고 안정적이나, Docker 및 Kubernetes에서 호스팅 되는 마이크로서비스의 경우에는 EFK 스택을 사용하는 것도 좋은 선택일 수 있습니다. 이어서 Logstash와 Fluent Bit을 더 비교해보겠습니다.
데이터 라우팅
https://gist.github.com/efec2b0e5d619e709bbbe8084aef7612.git
Logstash는 if 조건문을 기준으로 데이터마다 다르게 필터를 적용하고, 조건에 따라 다른 목적지로 보낼 수 있습니다.
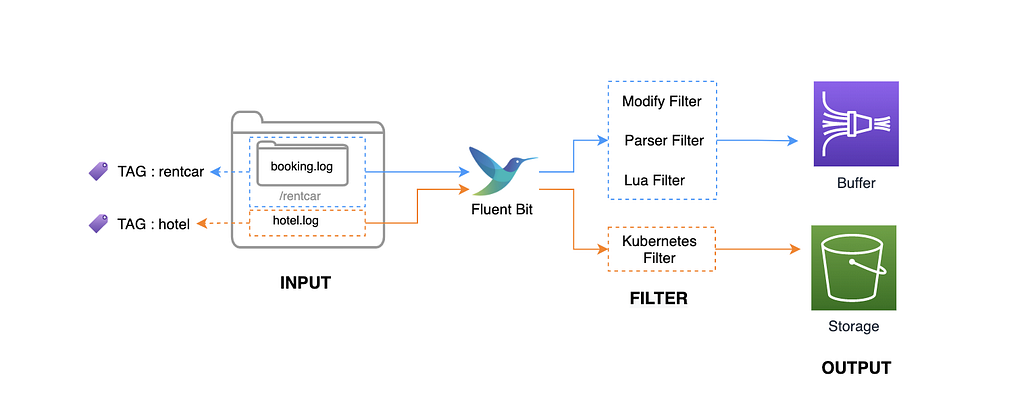
Fluent Bit은 Tag를 기반으로 데이터를 라우팅합니다. 데이터를 수집할 때 특정 위치나 이름을 기준으로 Tag를 붙일 수 있는데, 이 Tag마다 다른 Filter를 추가하고 다른 목적지로 데이터를 전송할 수 있습니다.
로그 파싱
Logstash와 Fluent Bit 둘 다 정규식 기반으로 로그를 파싱합니다.
Logstash는 grok 필터로 데이터 패턴을 만들어 파싱할 수 있습니다. 시스템 로그, 아파치나 다른 웹서버 로그, MySQL 등의 로그에 잘 작동하며, 120개의 패턴을 기본적으로 제공합니다.
Fluent Bit은 Apache, NGINX, JSON, Docker, Syslog 등의 파서를 기본 설정에서 지원하고, Parser 필터를 사용해 정규식 기반으로 원하는 파서를 만들 수 있습니다.
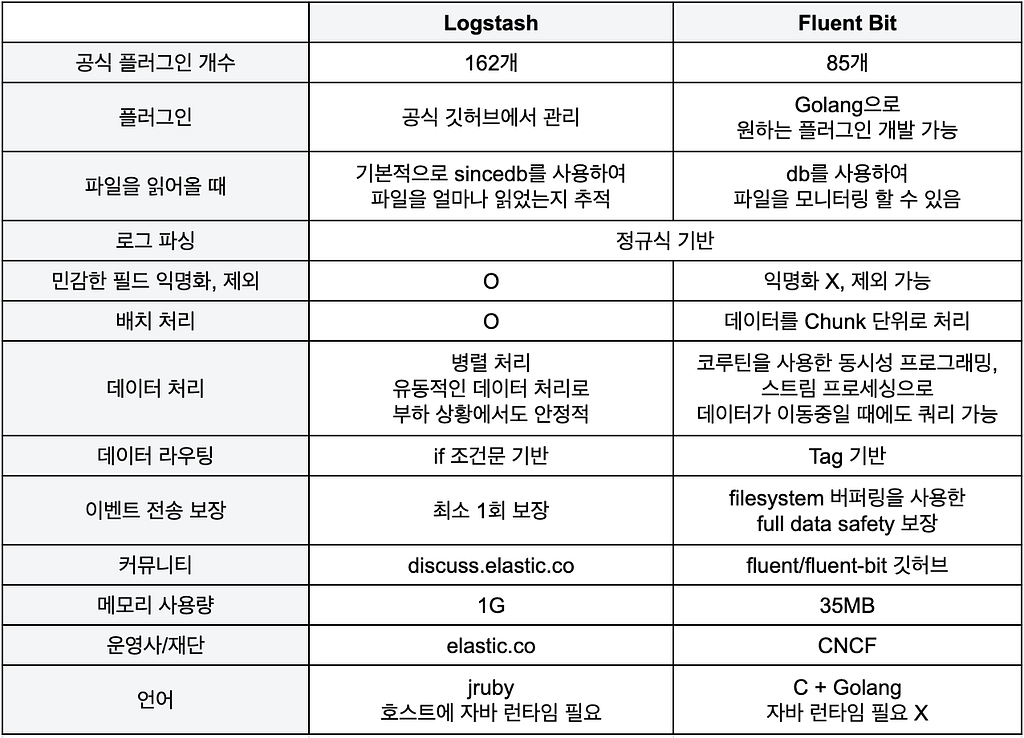
Logstash와 Fluent Bit의 차이점을 정리해보자면 다음과 같습니다.
버퍼
1. 버퍼의 장점
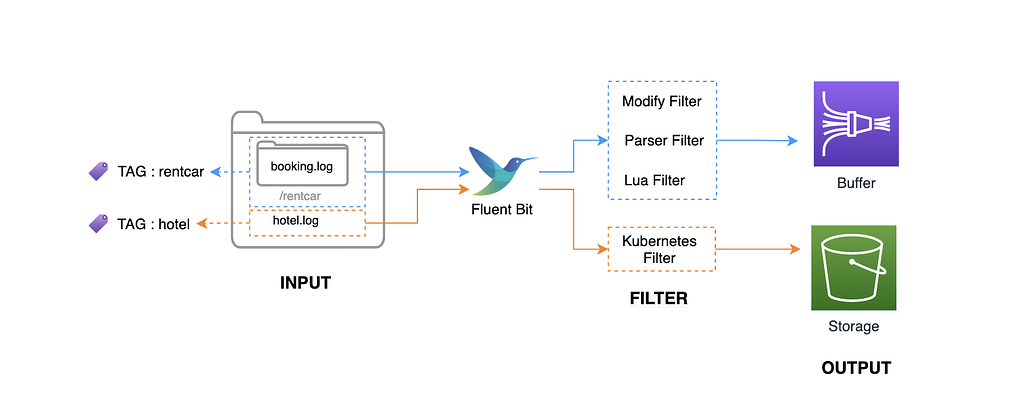
위 아키텍처에서 데이터의 목적지는 버퍼, S3와 같은 저장소입니다. 버퍼는 데이터를 한 곳에서 다른 한 곳으로 전송하는 동안 일시적으로 그 데이터를 보관하는 메모리의 영역을 의미합니다. 데이터의 최종 목적지는 따로 있습니다. 그렇다면 왜 버퍼를 사용할까요? 바로 최종 목적지에 보내지 않고 말입니다.
바로 다음과 같은 장점이 있기 때문입니다.
- 병목 현상이 일어나도 유연한 대처 가능
- 목적지 저장소에 문제가 발생해도 대처가 가능하고, 로그의 손실을 최소화
- 데이터 수집과 파이프라인, 최종 저장소까지의 의존성 완화
2. 버퍼 선택
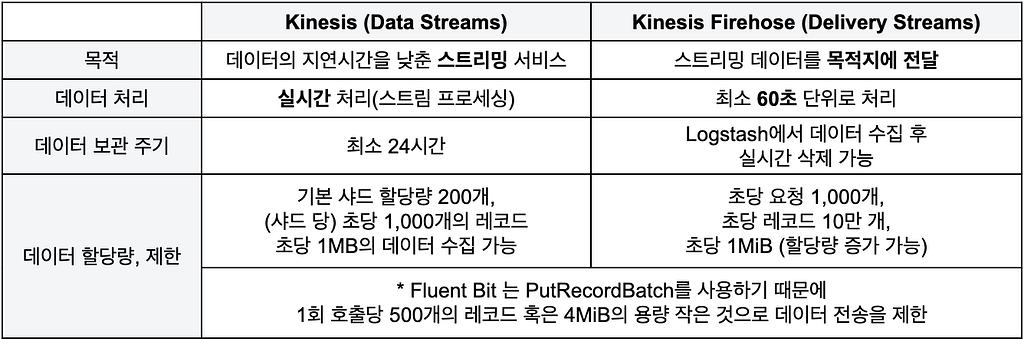
버퍼, 큐 역할을 하는 서비스로 SQS, Kinesis Data Streams, Kinesis Firehose 중 하나를 선택해야 했습니다.
- 기존 로그 수집 시스템에서 사용하는 메시지 큐인 SQS는 Fluent Bit에서 공식적으로 지원되지 않고,
- Kinesis Firehose는 최소 60초 단위의 배치로 데이터를 처리하기 때문에 개발자들이 실시간으로 로그를 확인하기 어렵다는 단점이 있었습니다.
따라서 Kinesis Firehose보다는 비용이 들지만, 데이터를 실시간으로 처리하는 Kinesis Data Streams를 사용하기로 팀에서 결정했습니다.
Kinesis Data Streams와 Kinesis Firehose의 비교는 다음과 같습니다.
3. 테스트
버퍼를 택했으니, Fluent Bit이 기존의 Logstash처럼 로그를 잘 처리할 수 있는지 다음과 같은 테스트를 진행하였습니다.
- 로그 손실/중복 없이 로그를 처리하는지
- 실시간으로 로그를 받아오고 목적지로 전송할 수 있는지
- 초당 20~30MB의 로그도 잘 처리할 수 있는지
Kinesis Data Streams와 Kinesis Firehose를 테스트할 당시, 어떤 Fluent Bit 도커 이미지를 사용하는지에 따라(fluent/fluent-bit, aws/aws-for-fluent-bit), 도커 이미지가 어떤 버전이냐에 따라 Kinesis로 데이터를 전송하는 성능에 차이가 났던 점이 흥미로웠습니다.
- aws/aws-for-fluent-bit 도커 이미지 2.19.1 버전 이하는 배치당 로그를 2,300~2,400개 이상 보낼 수 있지만, 그 이상의 버전에서는 배치당 최대 500개의 로그를 전송합니다.
- Fluent Bit에서 만든 Kinesis 플러그인을 사용할 때 로그가 손실되는 문제가 발생한 경우, AWS에서 만든 Kinesis 플러그인을 사용할 경우 로그 손실이 없어지기도 했습니다.
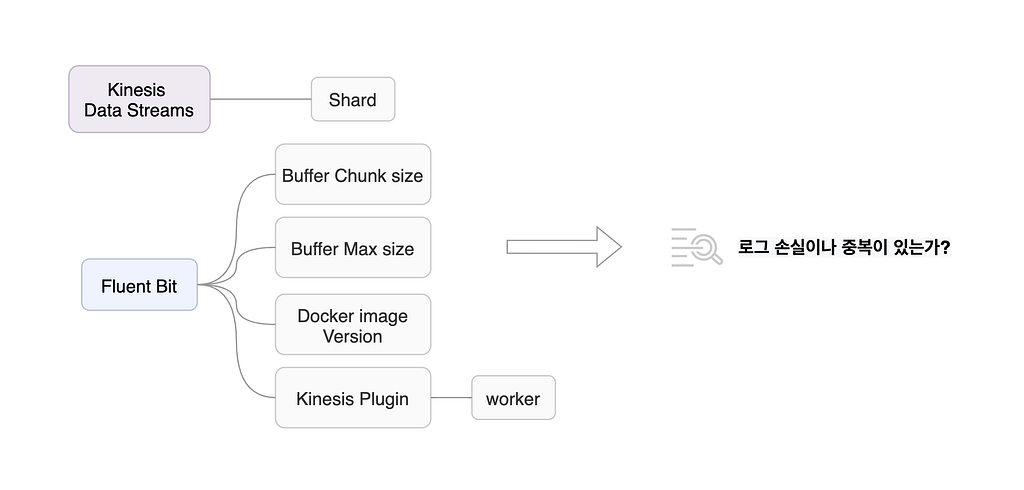
Kinesis Data Streams를 테스트할 경우 위와 같은 변수에 따라서 로그 손실/중복이 있는지를 테스트해보았습니다.
- 레코드(개별 로그)의 크기가 평균 1KB이고, 레코드 수가 초당 1,000개일 경우 필요한 샤드의 개수는 1개입니다. 레코드 수와 평균 크기에 비례하여 필요한 샤드 수는 늘어납니다.
- 평균 로그의 크기가 1KB인 로그를 초당 20000, 25000개 전송한다면 Kinesis 샤드는 각각 20, 25개로 설정하는 것이 안정적이었습니다.
- 현재 설정한 샤드가 감당하기에 너무 많은 로그가 들어오면 로그의 손실이 일어납니다.
- Fluent Bit의 Kinesis Plugin에서 worker를 1 이상 설정할 경우 로그의 중복이 발생했습니다.
Kinesis Data Streams를 사용하실 때 적절한 샤드의 개수가 궁금하시다면 AWS Pricing Caculator 나 KinesisShardCalculator 에서 계산해보실 수 있습니다.
4. 이슈 사항
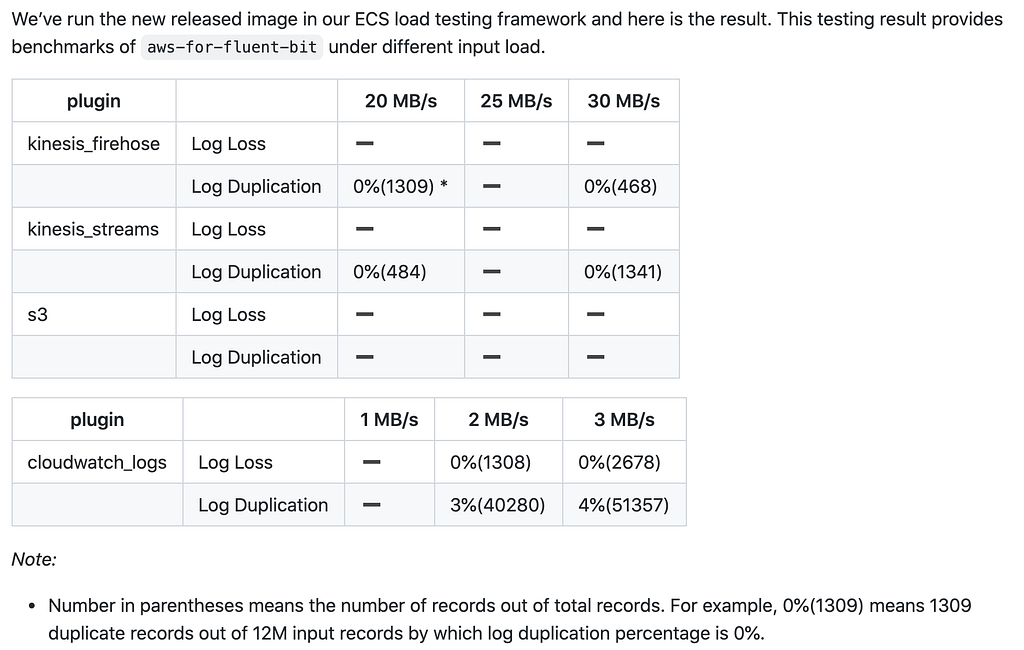
현재 AWS에서 제공하는 Fluent Bit 도커 이미지 버전에 따라 Kinesis, S3으로 데이터를 보내는 데 로그가 중복되는 이슈가 있습니다. (로그 12만 개당 1,341개 꼴로 중복됩니다.)
Fluent Bit에서 Kinesis로 데이터 전송을 고려하신다면 이 점은 유의해야 할 부분입니다.
로그 수집 아키텍처
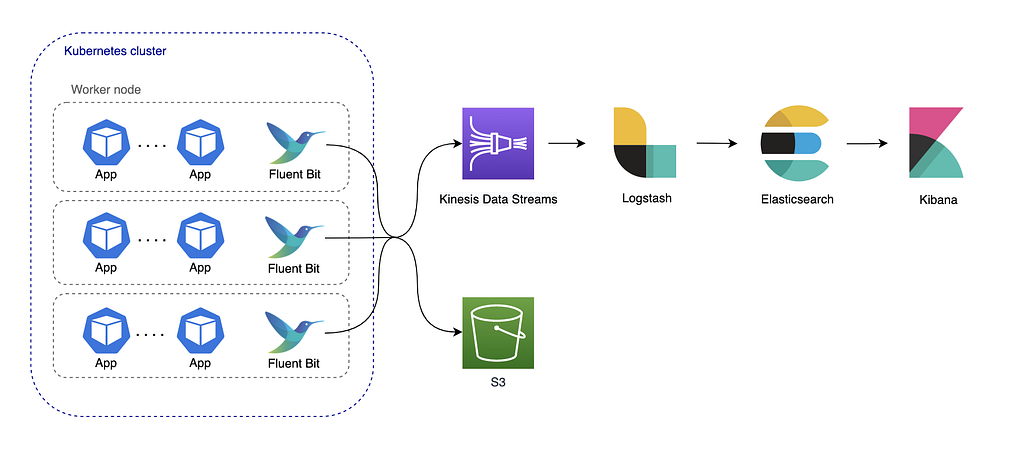
결과적으로, EKS 환경에서의 로그 수집 아키텍처는 위와 같습니다.
Fluent Bit은 /var/log/containers 폴더 하위에 기본적으로 생성되는 애플리케이션 파드의 시스템 콘솔 로그를 수집합니다. 이 로그들이 모두 Kinesis Data Streams를 통해 Elasticsearch로 간다면, 비용 문제 뿐만이 아니라 Elasticsearch에 적재되는 로그 양이 너무 많아져 인덱스*가 무거워지는 문제 가 있습니다. 따라서 애플리케이션들의 app, exception 로그 같은 사용자 로그와 시스템 로그를 분리해주었습니다.
*인덱스 : 엘라스틱서치에서 도큐먼트를 저장하는 논리적 단위로, 관계형 데이터베이스의 테이블과 유사한 개념입니다.
Fluent Bit에서의 로그 수집
1. 사용자 로그와 시스템 로그 분리
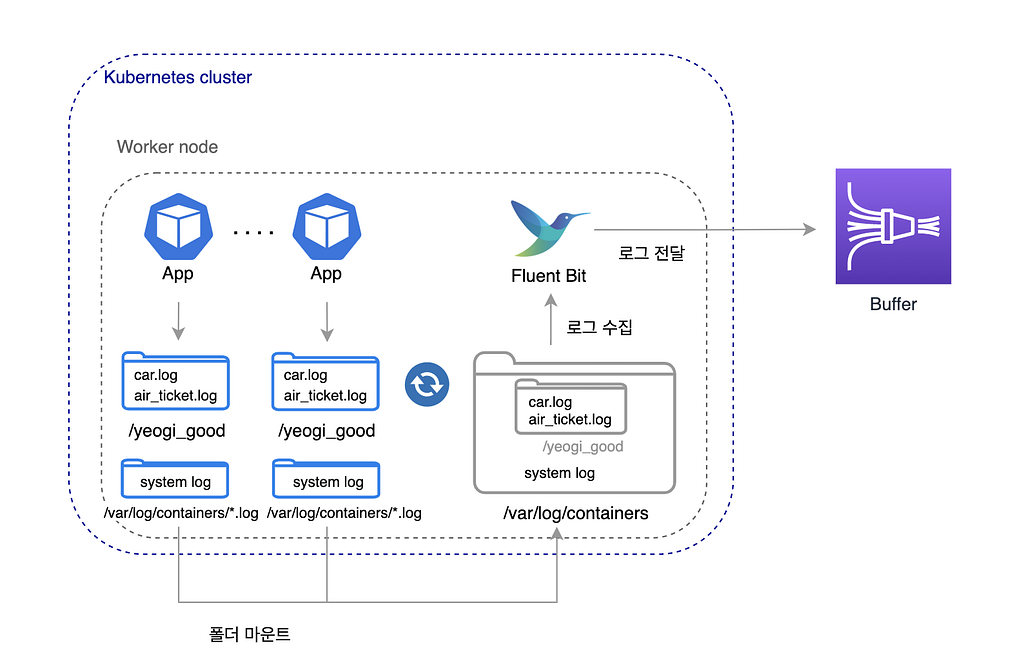
애플리케이션에서 car.log, air_ticket.log 등의 사용자 로그를 특정 폴더(/yeogi_good)에 쌓이게 합니다. 그리고 애플리케이션 파드를 생성할 때 /yeogi_good 폴더가 워커노드의 /var/log/containers/yeogi_good 폴더와 마운트되게 합니다.
그러면 Fluent Bit에서 각 애플리케이션이 남기는 car.log, air_ticket.log를 받아와 버퍼로 보내고, 시스템 로그는 따로 수집하여 처리할 수 있습니다.
2. 쿠버네티스 메타 데이터
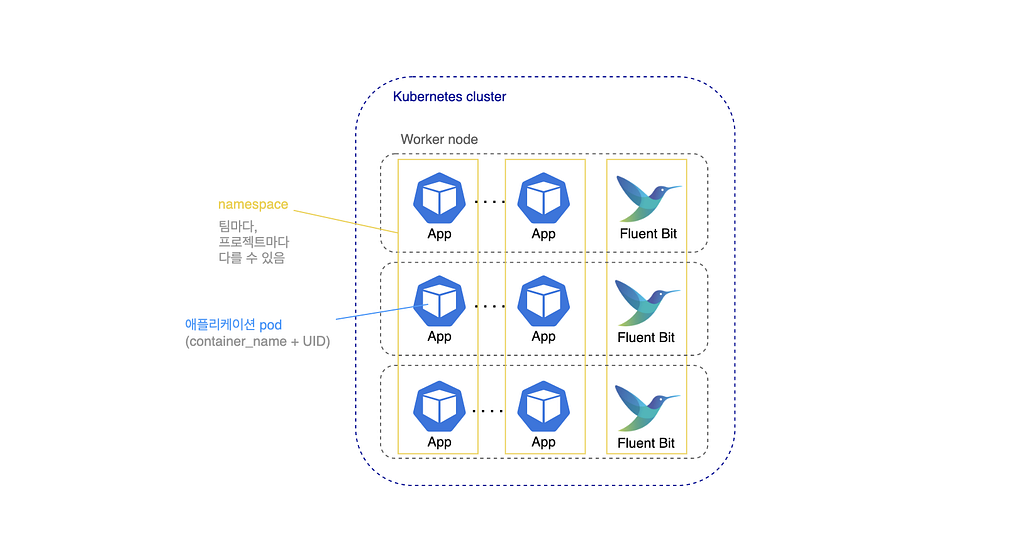
Fluent Bit에서 Kubernetes 필터를 사용하면 로그에 Kubernetes 메타 데이터 를 편하게 더할 수 있습니다. 하지만 워커 노드에 기본적으로 애플리케이션이 생성될 때 남기는 로그가 아닌, 별도의 경로에 저장한 로그를 읽어올 경우 Kubernetes 메타 데이터는 더해지지 않는 문제가 있습니다. (2022.04 기준)
이를 해결하기 위해 Kibana에서 개발자들이 팀별로, API별로 로그를 조회하실 수 있도록 로그를 수집할 때 팀별로 다르게 사용하는 namespace, 애플리케이션마다 다른 container 정보를 로그 파일의 이름에 넣은 후, Fluent Bit에서 정규식을 이용해 해당 정보를 파싱 후 로그에 넣어주었습니다.
3. 여러 개로 나뉜 로그 합치기
Fluent Bit로 로그 수집을 테스트한 초기에는 하나의 로그가 줄마다 분리되어 여러 개의 로그로 인식되는 문제가 있었습니다.
https://gist.github.com/6640eb61dc18b7901d92c1474df12b58.git
Input에 Multiline, Parser_Firstline 설정을 이용하여 정규식으로 로그의 시작 단위를 구분하여 줄 바꿈이 있어도, 특정 패턴이 나오기 전까지 하나의 로그로 인식하도록 했습니다.
4. 이슈 사항
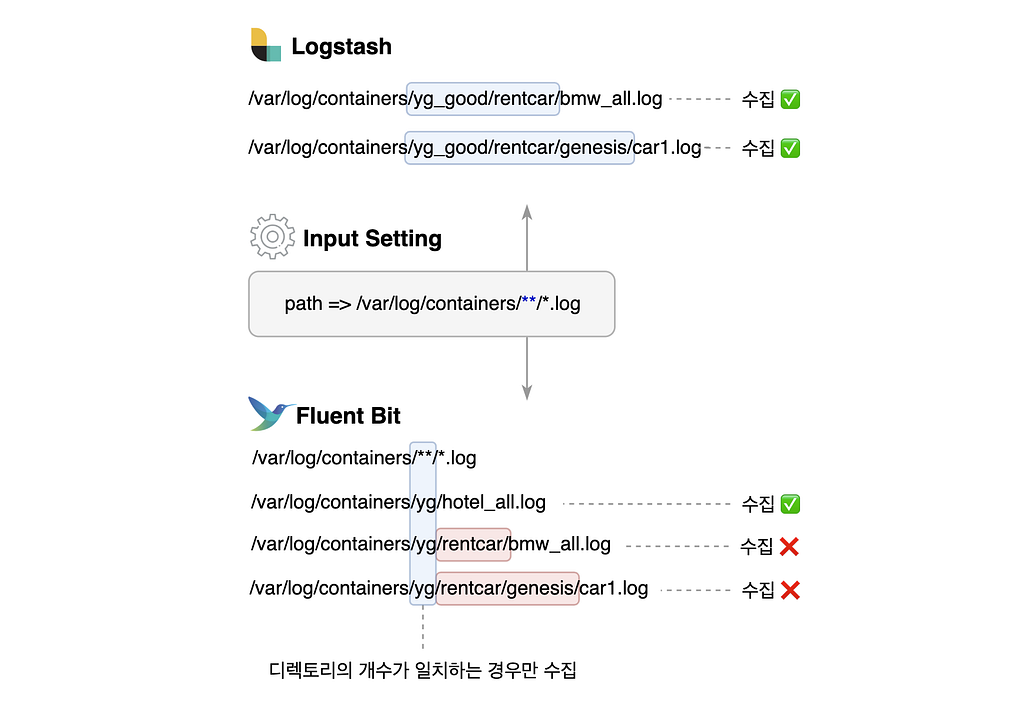
Logstash에서는 Input 설정 시, 파일을 수집하는 경로에 wildcard(/**/)를 넣어 명시한 경로 이후의 하위 디렉터리까지 로그 수집이 가능합니다.
반면 Fluent Bit는 같은 설정에도 디렉터리의 개수가 일치할 때만 로그를 수집합니다. 위 그림에서 보시듯, 경로에 /**/을 넣어도 모든 하위 디렉터리를 순환하며 로그를 수집하지 않습니다.
이번 EKS 환경에서 로그를 수집할 때는 볼륨 마운트를 활용하여 이 문제에 영향을 받지 않았지만, 모든 하위 디렉터리의 로그 수집이 중요하실 경우에는 해당 기능을 지원하는 Fluentd를 고려해보시는 것도 좋을 것 같습니다.
5. 배포
Kubernetes 위에서 Fluent Bit 같은 로그 수집 프로그램을 배포 할 때에는, Kubernetes 클러스터의 모든 노드에 파드를 하나씩 배치하는Daemonset 리소스를 사용합니다. 파드의 수를 지정하지 않아도, 자동으로 노드의 개수에 맞춰서 애플리케이션 파드를 관리할 수 있는 장점이 있습니다.
이상으로
- Logstash와 Fluent Bit의 차이
- Fluent Bit에서 Kinesis로 데이터를 전송할 때의 이슈
- Fluent Bit에서 로그 수집을 하며 해 주었던 작업과 이슈
- 여기어때컴퍼니의 기존 로그 수집 프로세스와, EKS를 도입한 이후의 로그 수집 아키텍처
를 알아보았습니다.
읽어주셔서 감사합니다.