Engineering
効率的な VMWare インフラ運用のための最適な VM 密度テスト
sky.q카카오
2024년 10월 7일
원문에서 보기 ↗이 글은 < 효율적인 VMWare 인프라 운영을 위한 최적의 VM 집적도 테스트 >를 일본어로 작성한 문서입니다.
다른 번역본 보기:
🇰🇷 한국어: https://tech.kakao.com/posts/634
🇯🇵 日本語: https://tech.kakao.com/posts/637
🇺🇸🇬🇧 English: https://tech.kakao.com/posts/638
1. はじめに
仮想化技術の発展により、1 台の PM(Physical Machine ・ 物理サーバー) に複数の VM(Virtual Machine ・ 仮想サーバー)を運用することは、今ではよく見られるようになりました。「 VMWare 」はこのような仮想化技術を提供する代表的なソリューションで、Kakao でも相当規模の VMWare インフラを運用しています。
このような VM インフラを運用していると、1 台の PM で何台の VM を実行させるか、つまり「 VM 密度 」についての壁にぶつかります。PM 1 台で実行している VM 数が増えれば増えるほど、限られた PM リソースに対する競争が激しくなり、VM のパフォーマンスが低下するという事実は明らかです。しかし、具体的にどの程度のパフォーマンス低下が発生するのか、また急激なパフォーマンス低下が発生する VM 数は何台かなどの内容については、明確な答えを出すことは容易ではありません。
実際には、これらの内容は PM のスペックや VM のリソース使用率など、運用環境によって異なるため、一般的な形で定義できないことは言うまでもありません。しかし、現在の運用環境に対応する条件で範囲を限定してテストを進めれば(少なくとも現在の運用環境については)参考基準となる最適な VM 密度を導き出すことができるのではないか、また VM 密度に対する全体的な理解を確保しておけば、今後運用環境が変わっても活用できるのではないかと考えました。
そこで、今回は効率的な VMWare インフラ運用のために、CPU の観点から最適な VM 密度を導き出すテストを行いました。
2. テスト紹介
今回のテストの目的は、CPU の観点からの最適な VM 密度、つまり「 VM の CPU パフォーマンスを低下させることなく 1 台の PM で収容可能な最大 VM 数 」を導き出すことです。最適な VM 密度を決定づける要素には、CPU 以外にもメモリやディスクなどがありますが、今回は CPU に焦点を当てました。
1) コンセプト
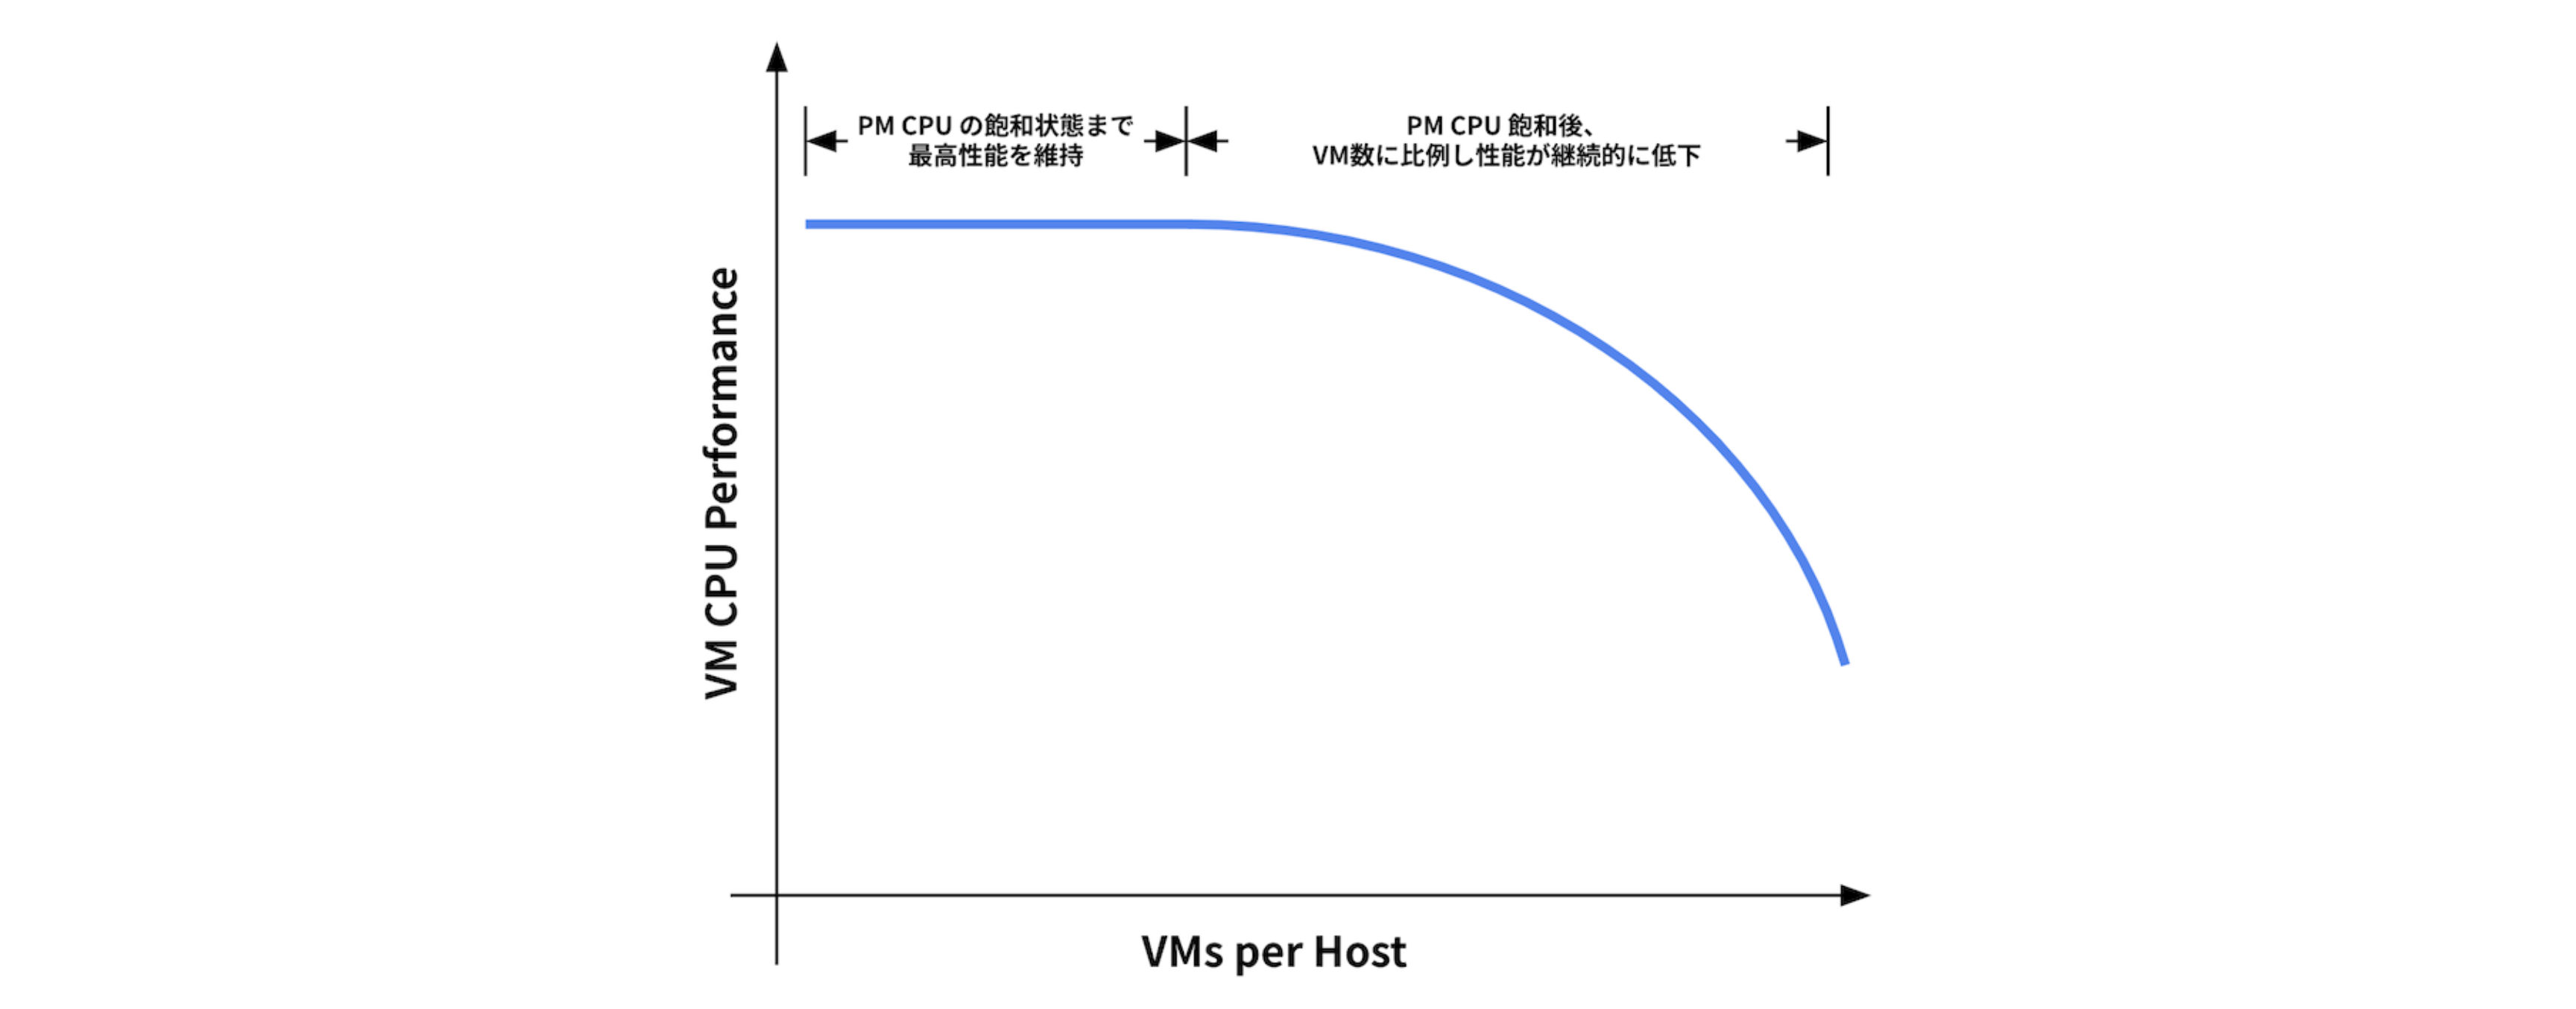
テストのコンセプトは、1 台の PM 上で VM 数を増やしながら VM の CPU パフォーマンスを測定し、VM の CPU パフォーマンスが基準値以下に低下し始める VM 数を見つけることです。
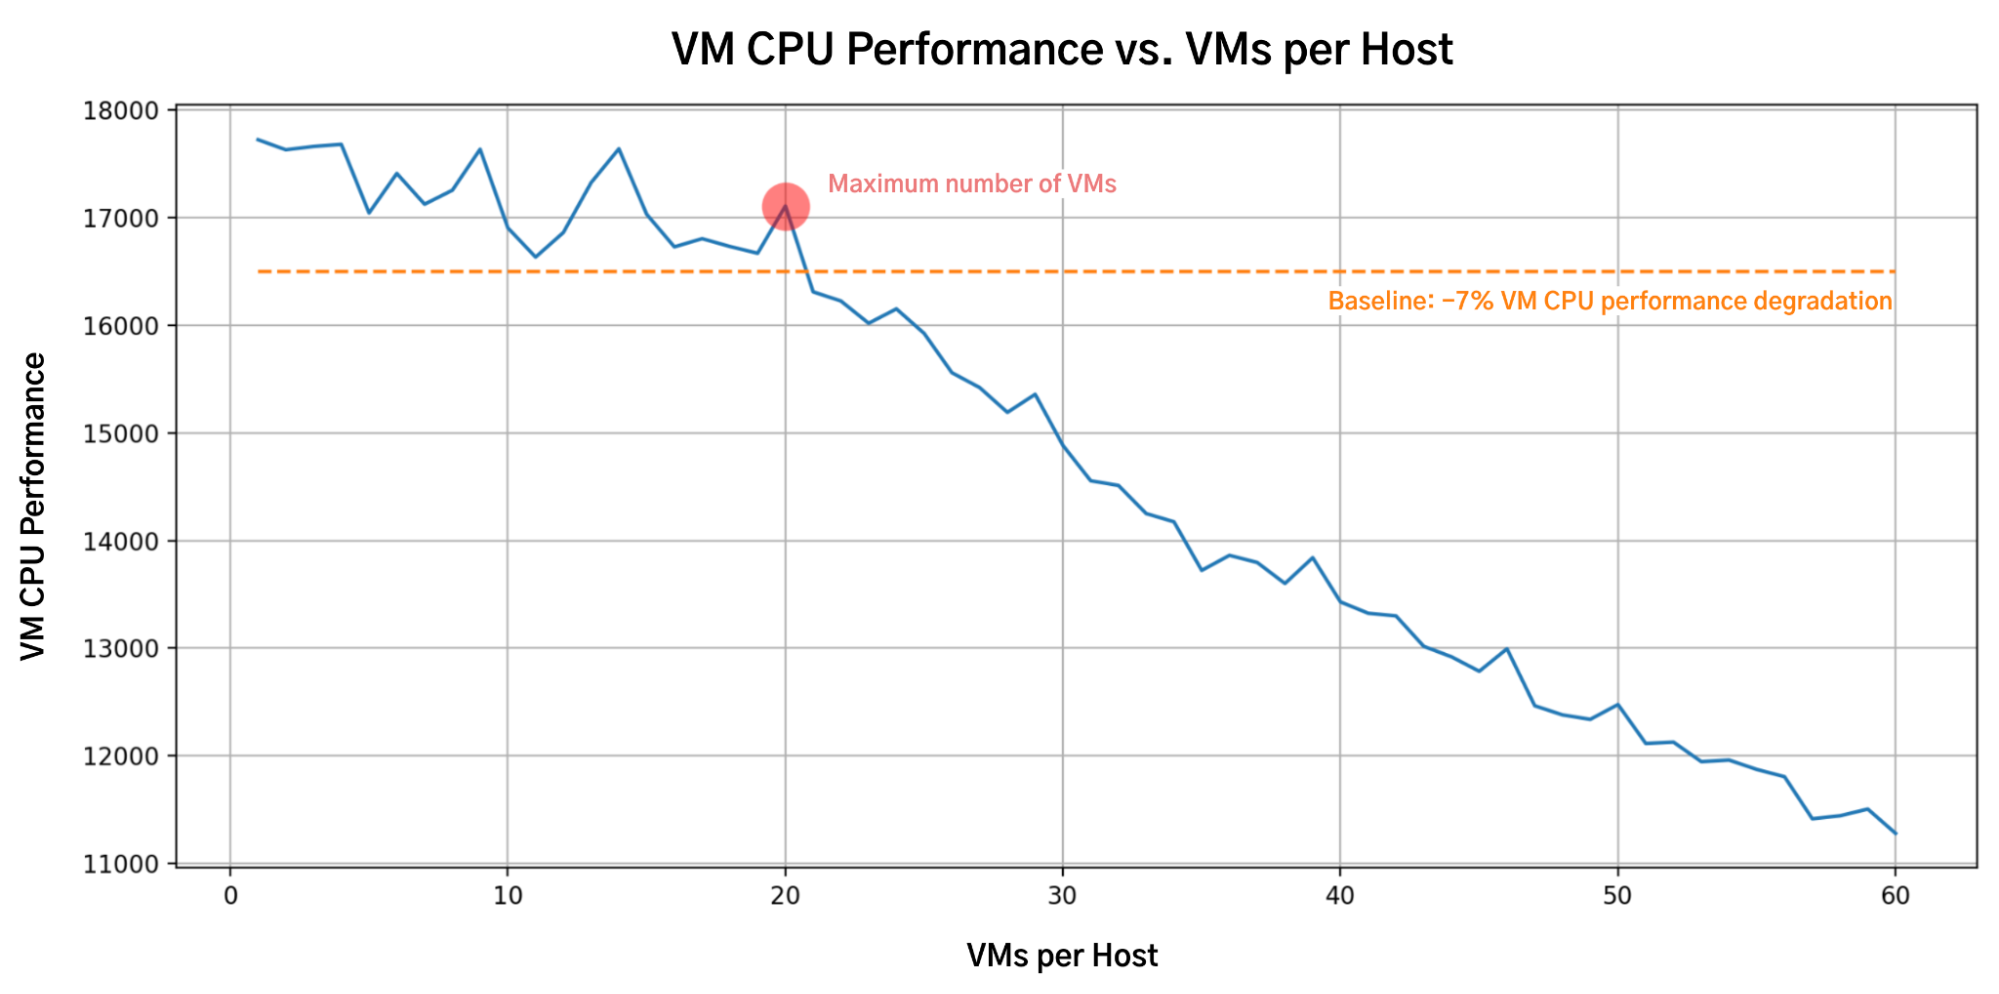
例えば、安定的なサービス運用のための VM の CPU パフォーマンス低下基準値を 7% とした場合、上の図のように、1 台の PM で同時実行中の VM が 20 台を超えた瞬間から基準値以上の VM パフォーマンス低下が発生し始めると、その PM で収容できる最大 VM 数は 20 台となります。
また、他の VM とのリソース競争によって影響を受けた VM の CPU パフォーマンスをどのように測定するかが重要ですが、今回は、PM 上で稼働されている全ての VM で同時にベンチマークプログラムを実行し、その結果の平均を計算する方式を使用しました。ベンチマークプログラムは、VM 自身の CPU パフォーマンスを測定するだけでなく、他の VM に対するリソース競争を発生させる負荷の役割も果たします。
2) VM の CPU 使用率
VM の CPU 使用率によって 1 台の PM で収容できる最大 VM 数が異なるため、VM の CPU 負荷をどの程度割り当てるかも重要です。
実際に VM の平均 CPU 使用率が高くない環境では、PM のリソースを効率的に使用するために、PM のコア数に比べて多くの VM を実行(a.k.a. CPU Overcommit)することが一般的です。そこで、実際の運用時に参考となる結果を得るために、VM の CPU 使用率を 10% から 100% まで 10% 単位で増やしながらテストを行いました。
PM 上のすべての VM が CPU を特定の % だけ使用している状況を再現するために、VM の最大 CPU 使用率を制限した状態でベンチマークプログラムを実行しました。テストに使用したベンチマークプログラムは、使用可能な CPU リソースを最大限使用するため、VM に CPU 使用率を制限した状態でベンチマークプログラムを実行すると、VM の CPU 使用率を希望するレベルに合わせることができます。
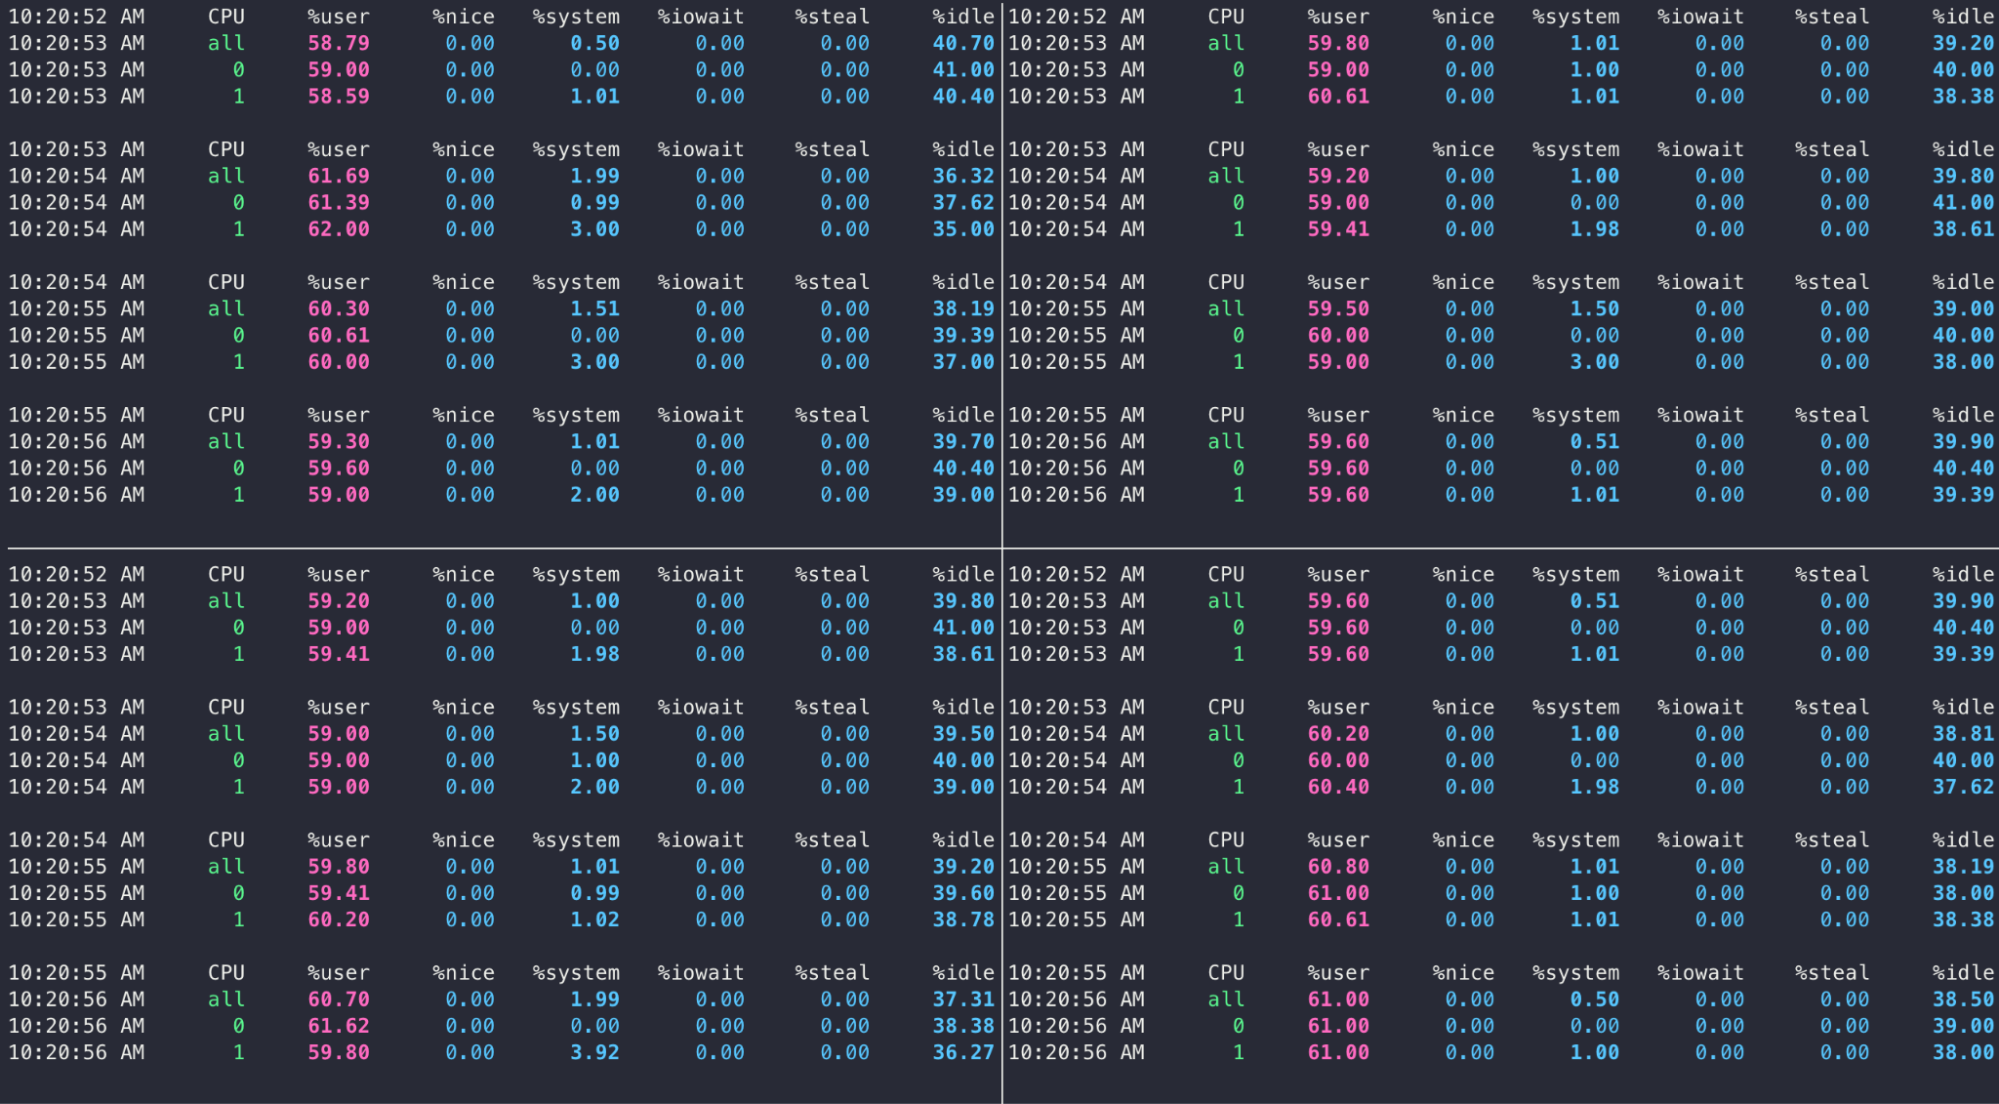
このように、VM の CPU 使用率を制限した状態でベンチマークプログラムを実行すると、CPU 使用率が 100% である場合と比較してスコアが低くなることは言うまでもありません。しかし、比較する対象は VM の CPU 使用率が異なる場合のパフォーマンスではなく、VM 数が異なる場合のパフォーマンス(VM の CPU 使用率は同じ)であるため、ベンチマークスコアが VM の CPU 使用率に比例して低く測定されることは問題ありません。
3) VMのフレーバー
最適な VM 密度は VM のフレーバー、つまり VM の CPU(vCPU)数によって異なります。PM の CPU リソースは限られているため、VM 1 台あたりの CPU リソースをどの程度割り当てるかによって、収容可能な VM 数が変わります。
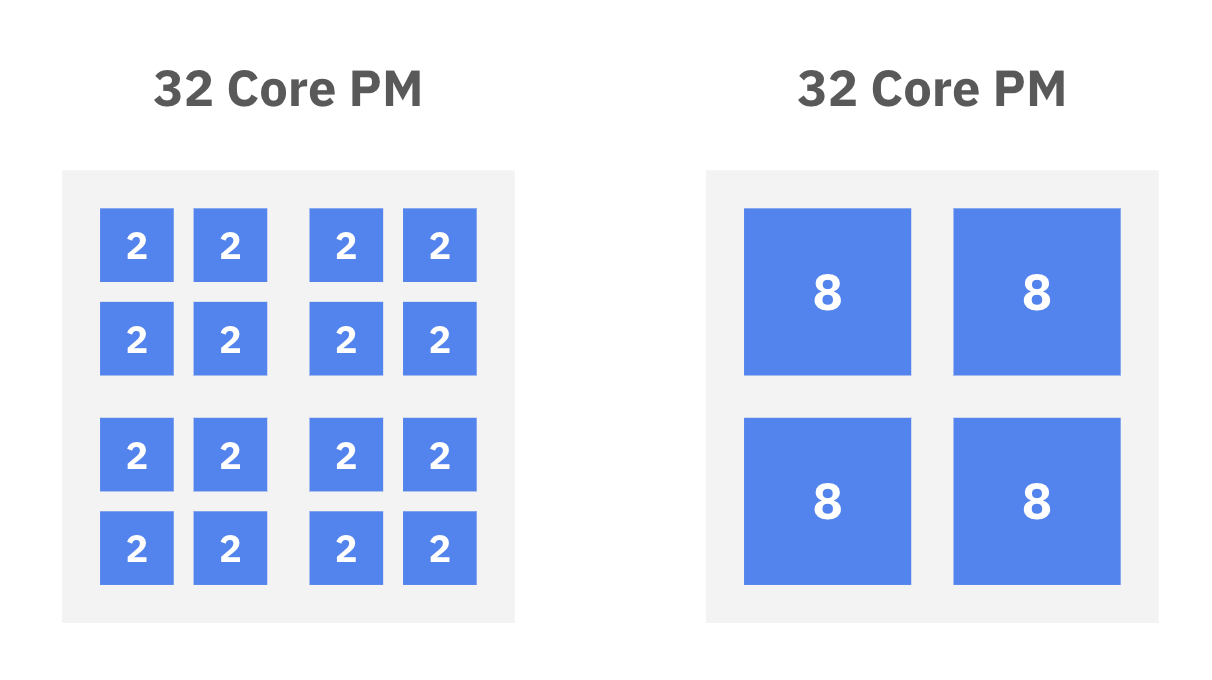
簡単な例として、上記の図のように 32 個のコア(pCPU)を持つ PM がある場合、VM の vCPU 数の合計が PM のコア数と同じ数だけ VM を展開すると、2 vCPU VM は 16 台、8 vCPU VM は 4 台展開することができます。
VM のフレーバーごとに最適な VM 密度を確認するため、2 vCPU / 4 vCPU / 8 vCPU の 3 つのフレーバーを対象に、1 台の PM に各フレーバーの VM が何台まで入るかをテストしました。1 台の PM に様々なフレーバーの VM を混在させることも可能ですが、今回は PM 上のすべての VM が同様のフレーバーで統一されている状況を想定しています。
4) PM の CPU スペック
PM の CPU スペックも最適な VM 密度に影響を与える重要な要素です。コア数、キャッシュメモリの容量など様々な条件によって最適な VM 密度が変わります。
この時、コア数は最大収容可能な VM 数に直接影響します。
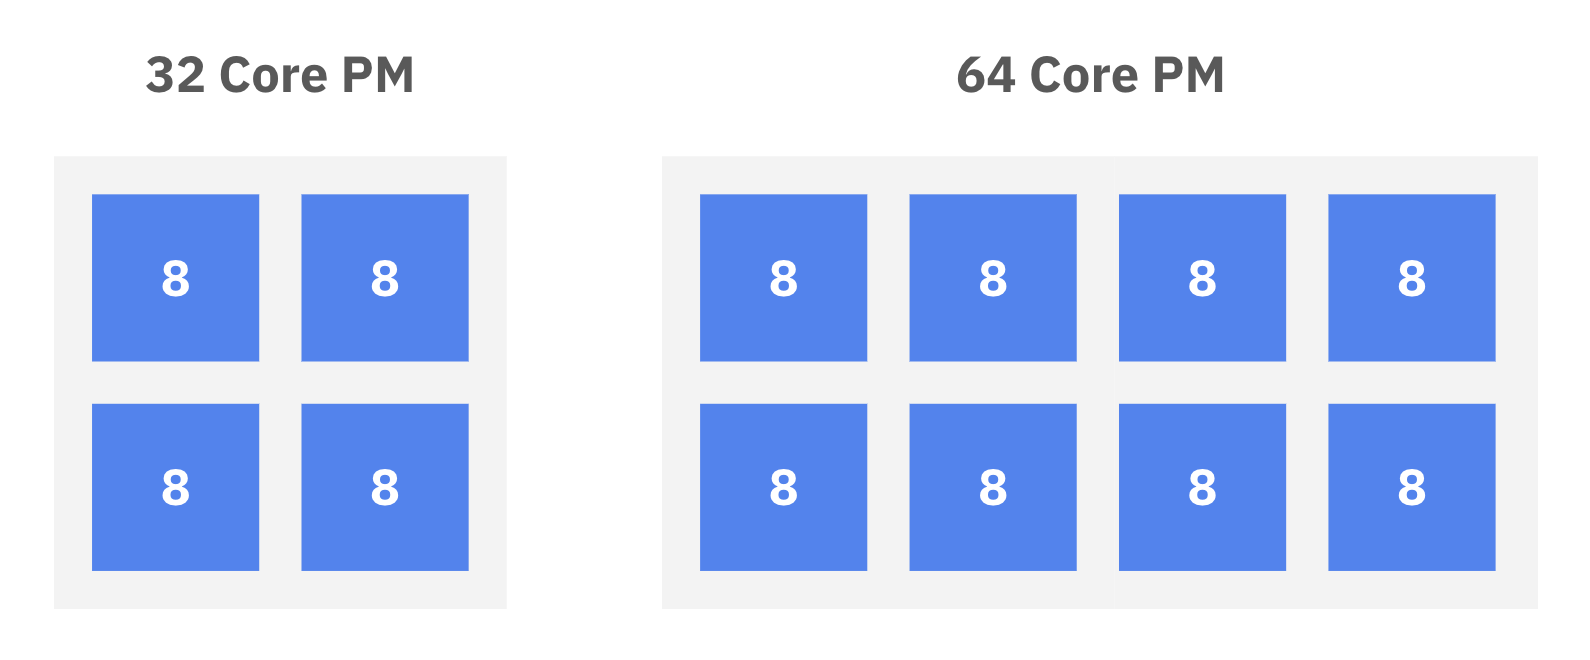
簡単な例として、上記の図のように、PM のコア数が2 倍多ければ、2 倍多くのVMを収容できることが期待されます。
今回使用した PM の CPU は、Intel Xeon Silver 4410Y と Intel Xeon Silver 4214 の 2 種類です。2 つの CPU の コア数は同じですが、CPU の世代の違いによる VM の密度にも違いがある可能性があります。これらを確認するため、PM の CPU スペックについてもケースを分けてテストを行いました。
5) テスト実施
上記の内容を基に、各条件別に最適な VM 密度を導き出すテストを行います。
テスト環境
PM (CPU スペックとハイパーバイザーのバージョン)
| Processor | Sockets | Cores per Socket | Threads per Socket | Total Threads | Hyper-Threading | Base Frequency | Turbo Frequency | Cache Size | Hypervisor Version | |
|---|---|---|---|---|---|---|---|---|---|---|
| Sapphire Rapids CPU PM(Vendor A) | Intel Xeon Silver 4410Y | 2 | 12 | 24 | 48 | Enabled | 2.00GHz | 3.90GHz | 30MB | VMWare ESXi 8.0.2 |
| Sapphire Rapids CPU PM(Vendor B) | Intel Xeon Silver 4410Y | 2 | 12 | 24 | 48 | Enabled | 2.00GHz | 3.90GHz | 30MB | VMWare ESXi 8.0.2 |
| Cascade Lake CPU PM | Intel Xeon Silver 4214 | 2 | 12 | 24 | 48 | Enabled | 2.20GHz | 3.20GHz | 16.5MB | VMWare ESXi 7.0.2 |
Sapphire Rapids CPU PM の場合、ベンダー間比較のため、同様のスペックで 2 つのベンダーの PM で同様のテストを実施
VM のフレーバー
- 2 vCPU 4GB MEM
- 4 vCPU 8GB MEM
- 8 vCPU 16GB MEM
VM の CPU 使用率
- 10% から 100% まで 10% ずつ増加
VM 数
- 1 個から 60 個まで 1 ずつ増加
ベンチマークプログラム
テスト方法
特定の PM ・ VM フレイバーの組み合わせに対して、VM 数と VM の CPU 使用率を変更し、VM の CPU パフォーマンスを測定します。
テストの進行順序は以下の通りです。
-
特定の PM に特定のフレイバーの VM を 1 台から 60 台まで 1 台ずつ増やしながら N 台展開
-
VM N 台に対して CPU 使用率の制限を 10% から 100% まで 10% ずつ増やしながら設定
-
VM N 台で同時にベンチマークプログラムを実行
-
N 台の VM の各 CPU 使用率別のベンチマーク実行結果を集計し平均を計算
つまり、一つの PM ・ VM フレイバーの組み合わせに対して下記のような二重の for 文を実行し、それぞれの VM 数 ・ VM の CPU 使用率別に合計 600 個のケースに対する VM の CPU パフォーマンスを測定するということです。
for N in range(1, 60, 1):  # 1から60までVM数を1ずつ増加
    # PMにVMをN台展開
    for M in range(10, 100, 10):    # 10%から100%までVMCPU使用率の制限10%ずつ増加
        # N台のVMでM%のCPU使用率の制限を設定した状態で同時にベンチマークを実行
        # VM別ベンチマーク実行結果集計
6) テスト結果
テスト後、各PM ・ VM フレイバーの組み合わせごとに、VM 数 ・ VM の CPU 使用率別による VM の CPU パフォーマンスの結果を得られます。
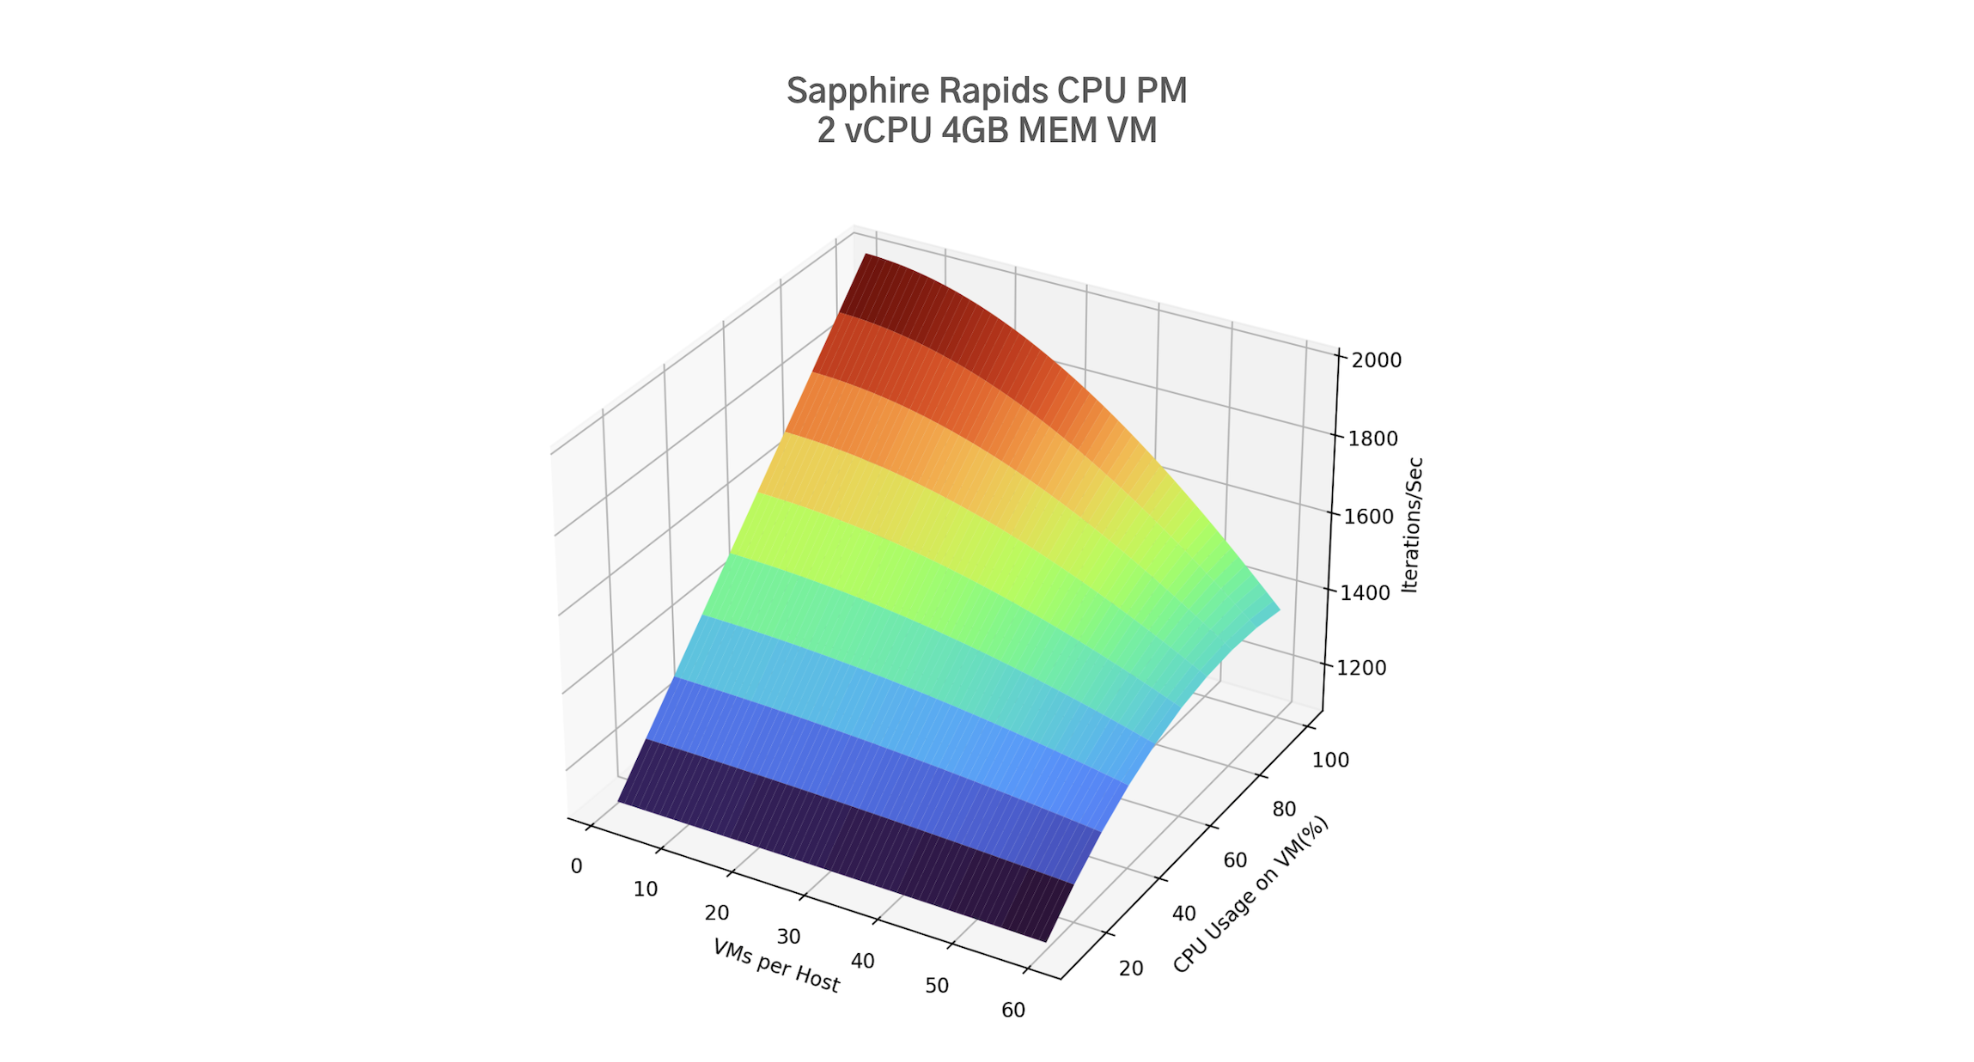
例えば、すべての要素が最もよく表れる形で結果を示すなら、上記のようなグラフを作成することができます。各PM、VM フレイバーの組み合わせごとに、VM の数を X 軸、VM の CPU 使用率を Y 軸、そしてベンチマークスコアの平均を Z 軸としています。
このグラフは、テストを進める前に全体的な結果がどうなるかを予想して作成したものです。より多くの VM がより多くの CPU を使用するほど、限られた CPU リソースに対する競争が増加するため、VM の CPU パフォーマンスが低下することを予想しました。
確認したい値によってテストの結果を視覚化する方法は異なりますが、これらのテスト結果により、各条件ごとに VM の CPU パフォーマンスが基準値以下に低下し始める点、つまり最適な VM 密度を導き出すことができます。
3. VM 数の増加に伴う VM の CPU パフォーマンスの変化
| SPR Silver 4410Y @ 2.00GHz (Vendor A) | SPR Silver 4410Y @ 2.00GHz (Vendor B) | Cascade Silver 4214 @ 2.20GHz | |
|---|---|---|---|
| 2 vCPU 4GB MEM | 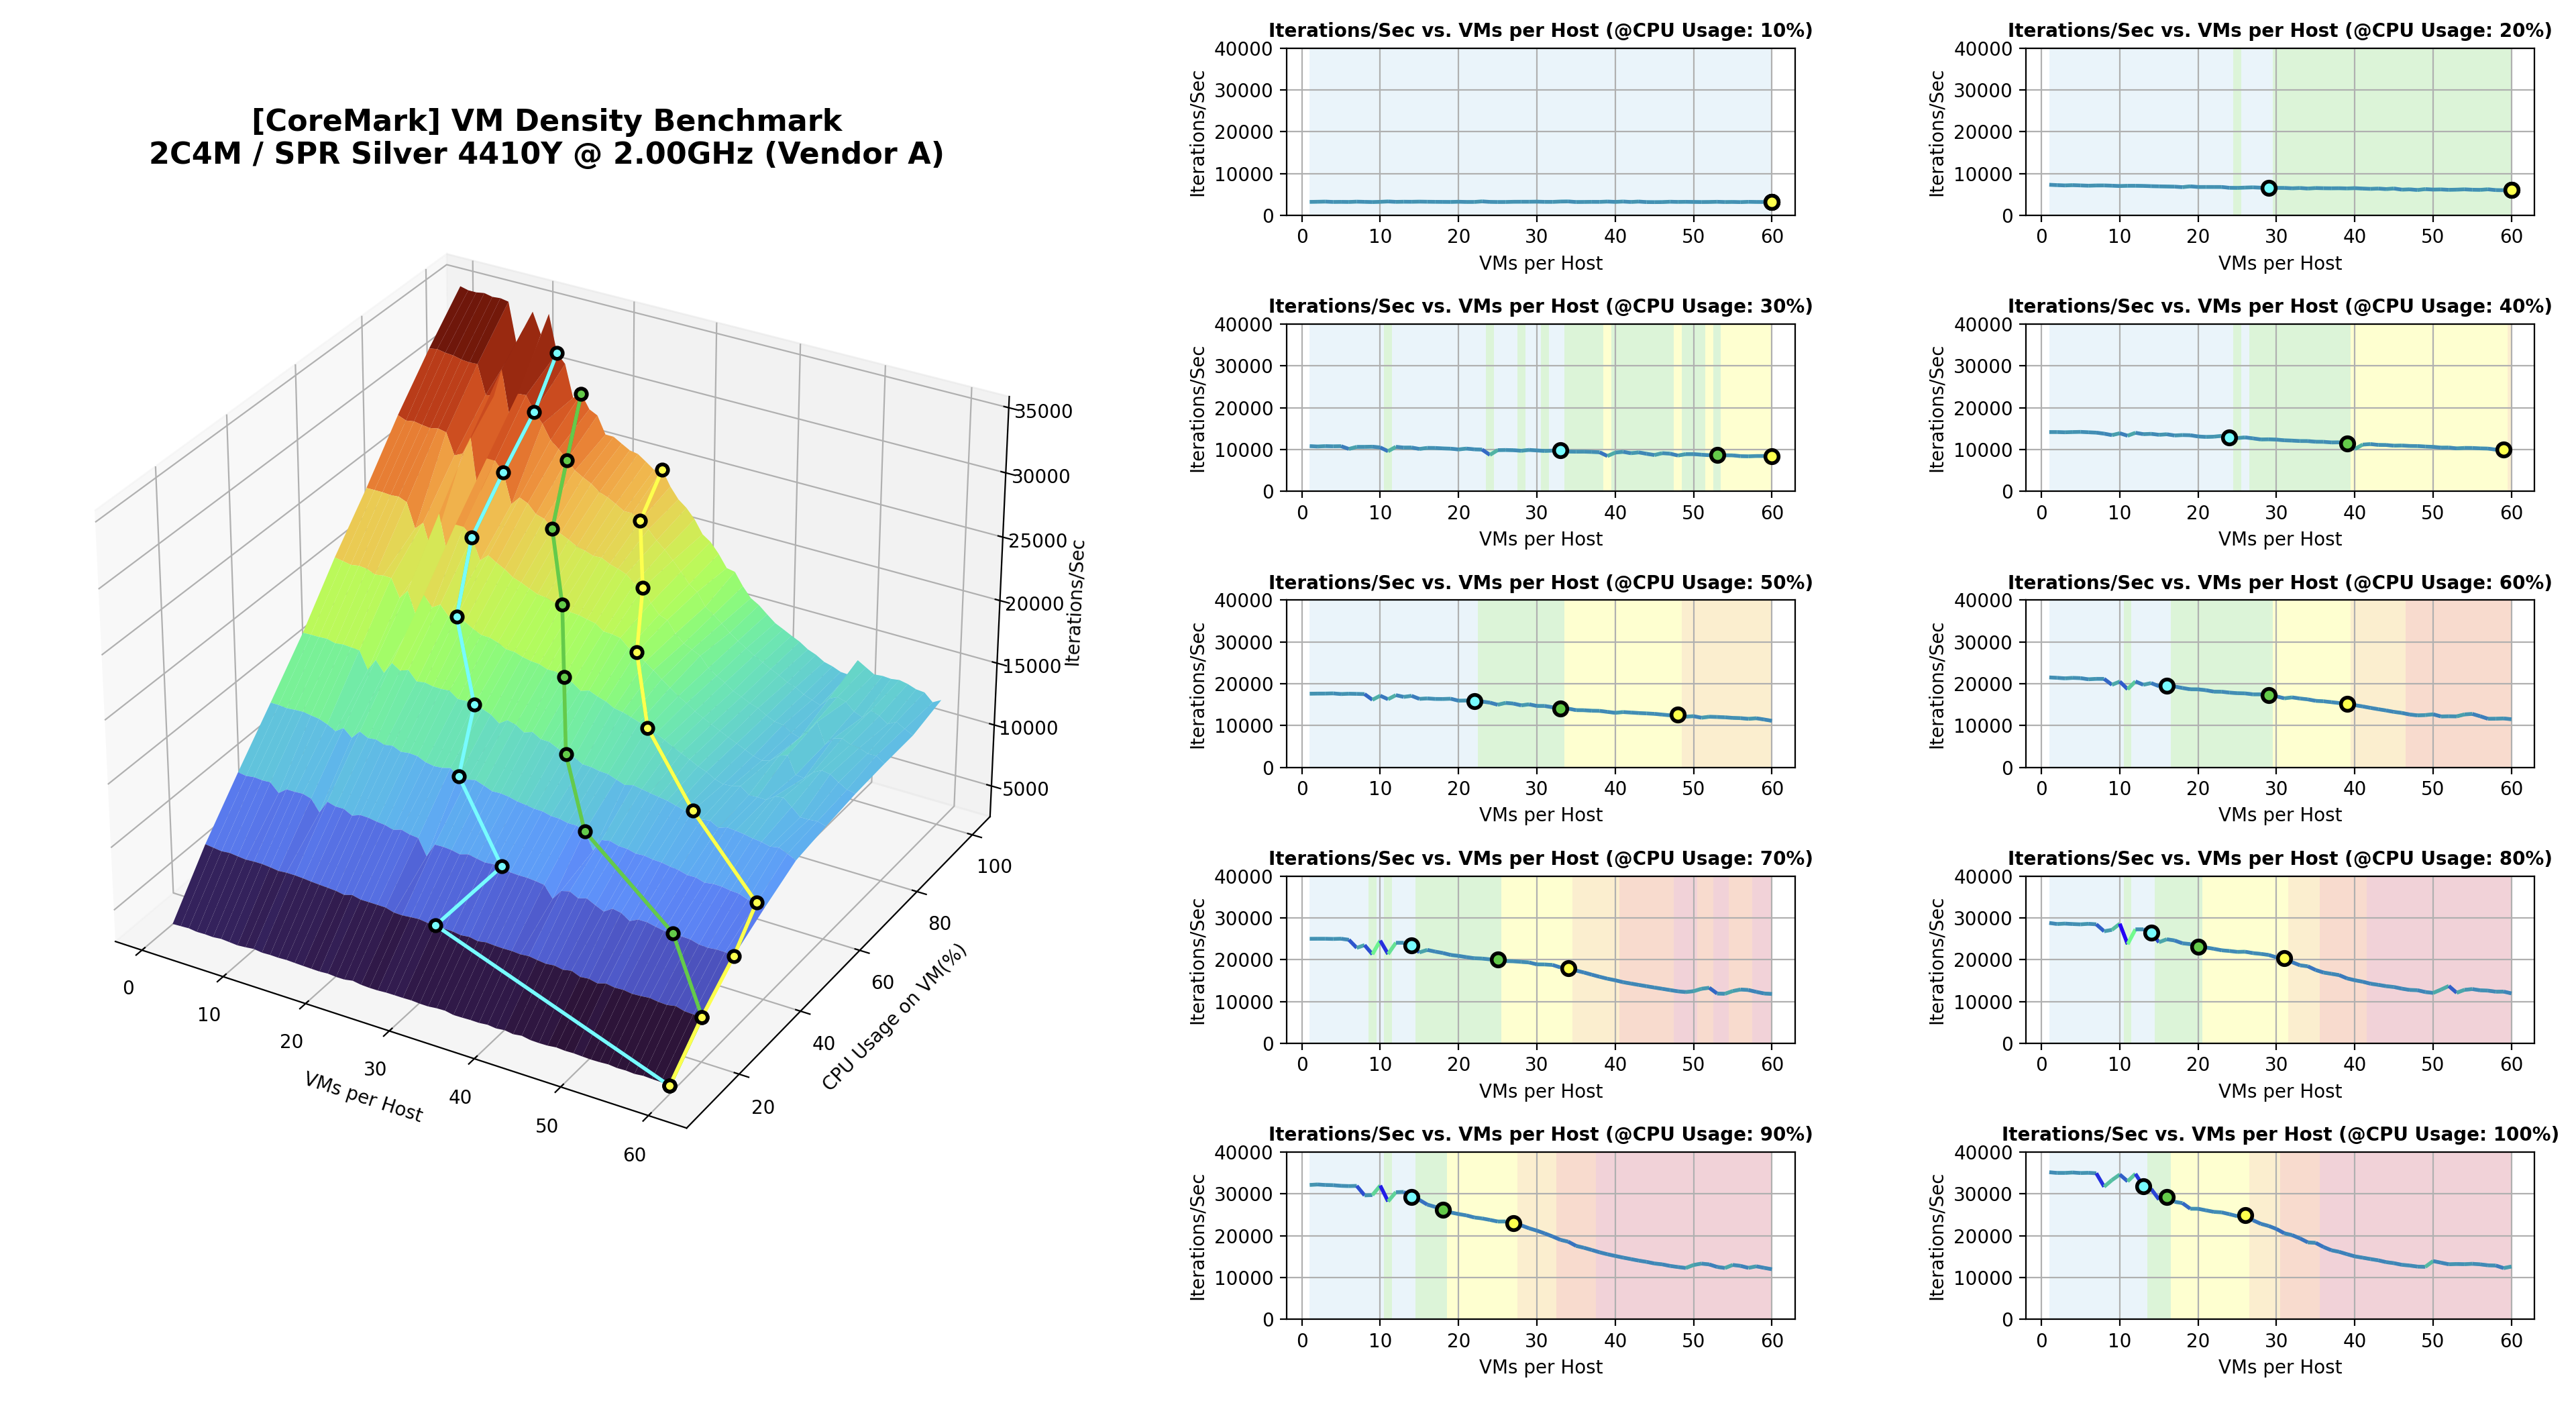 | 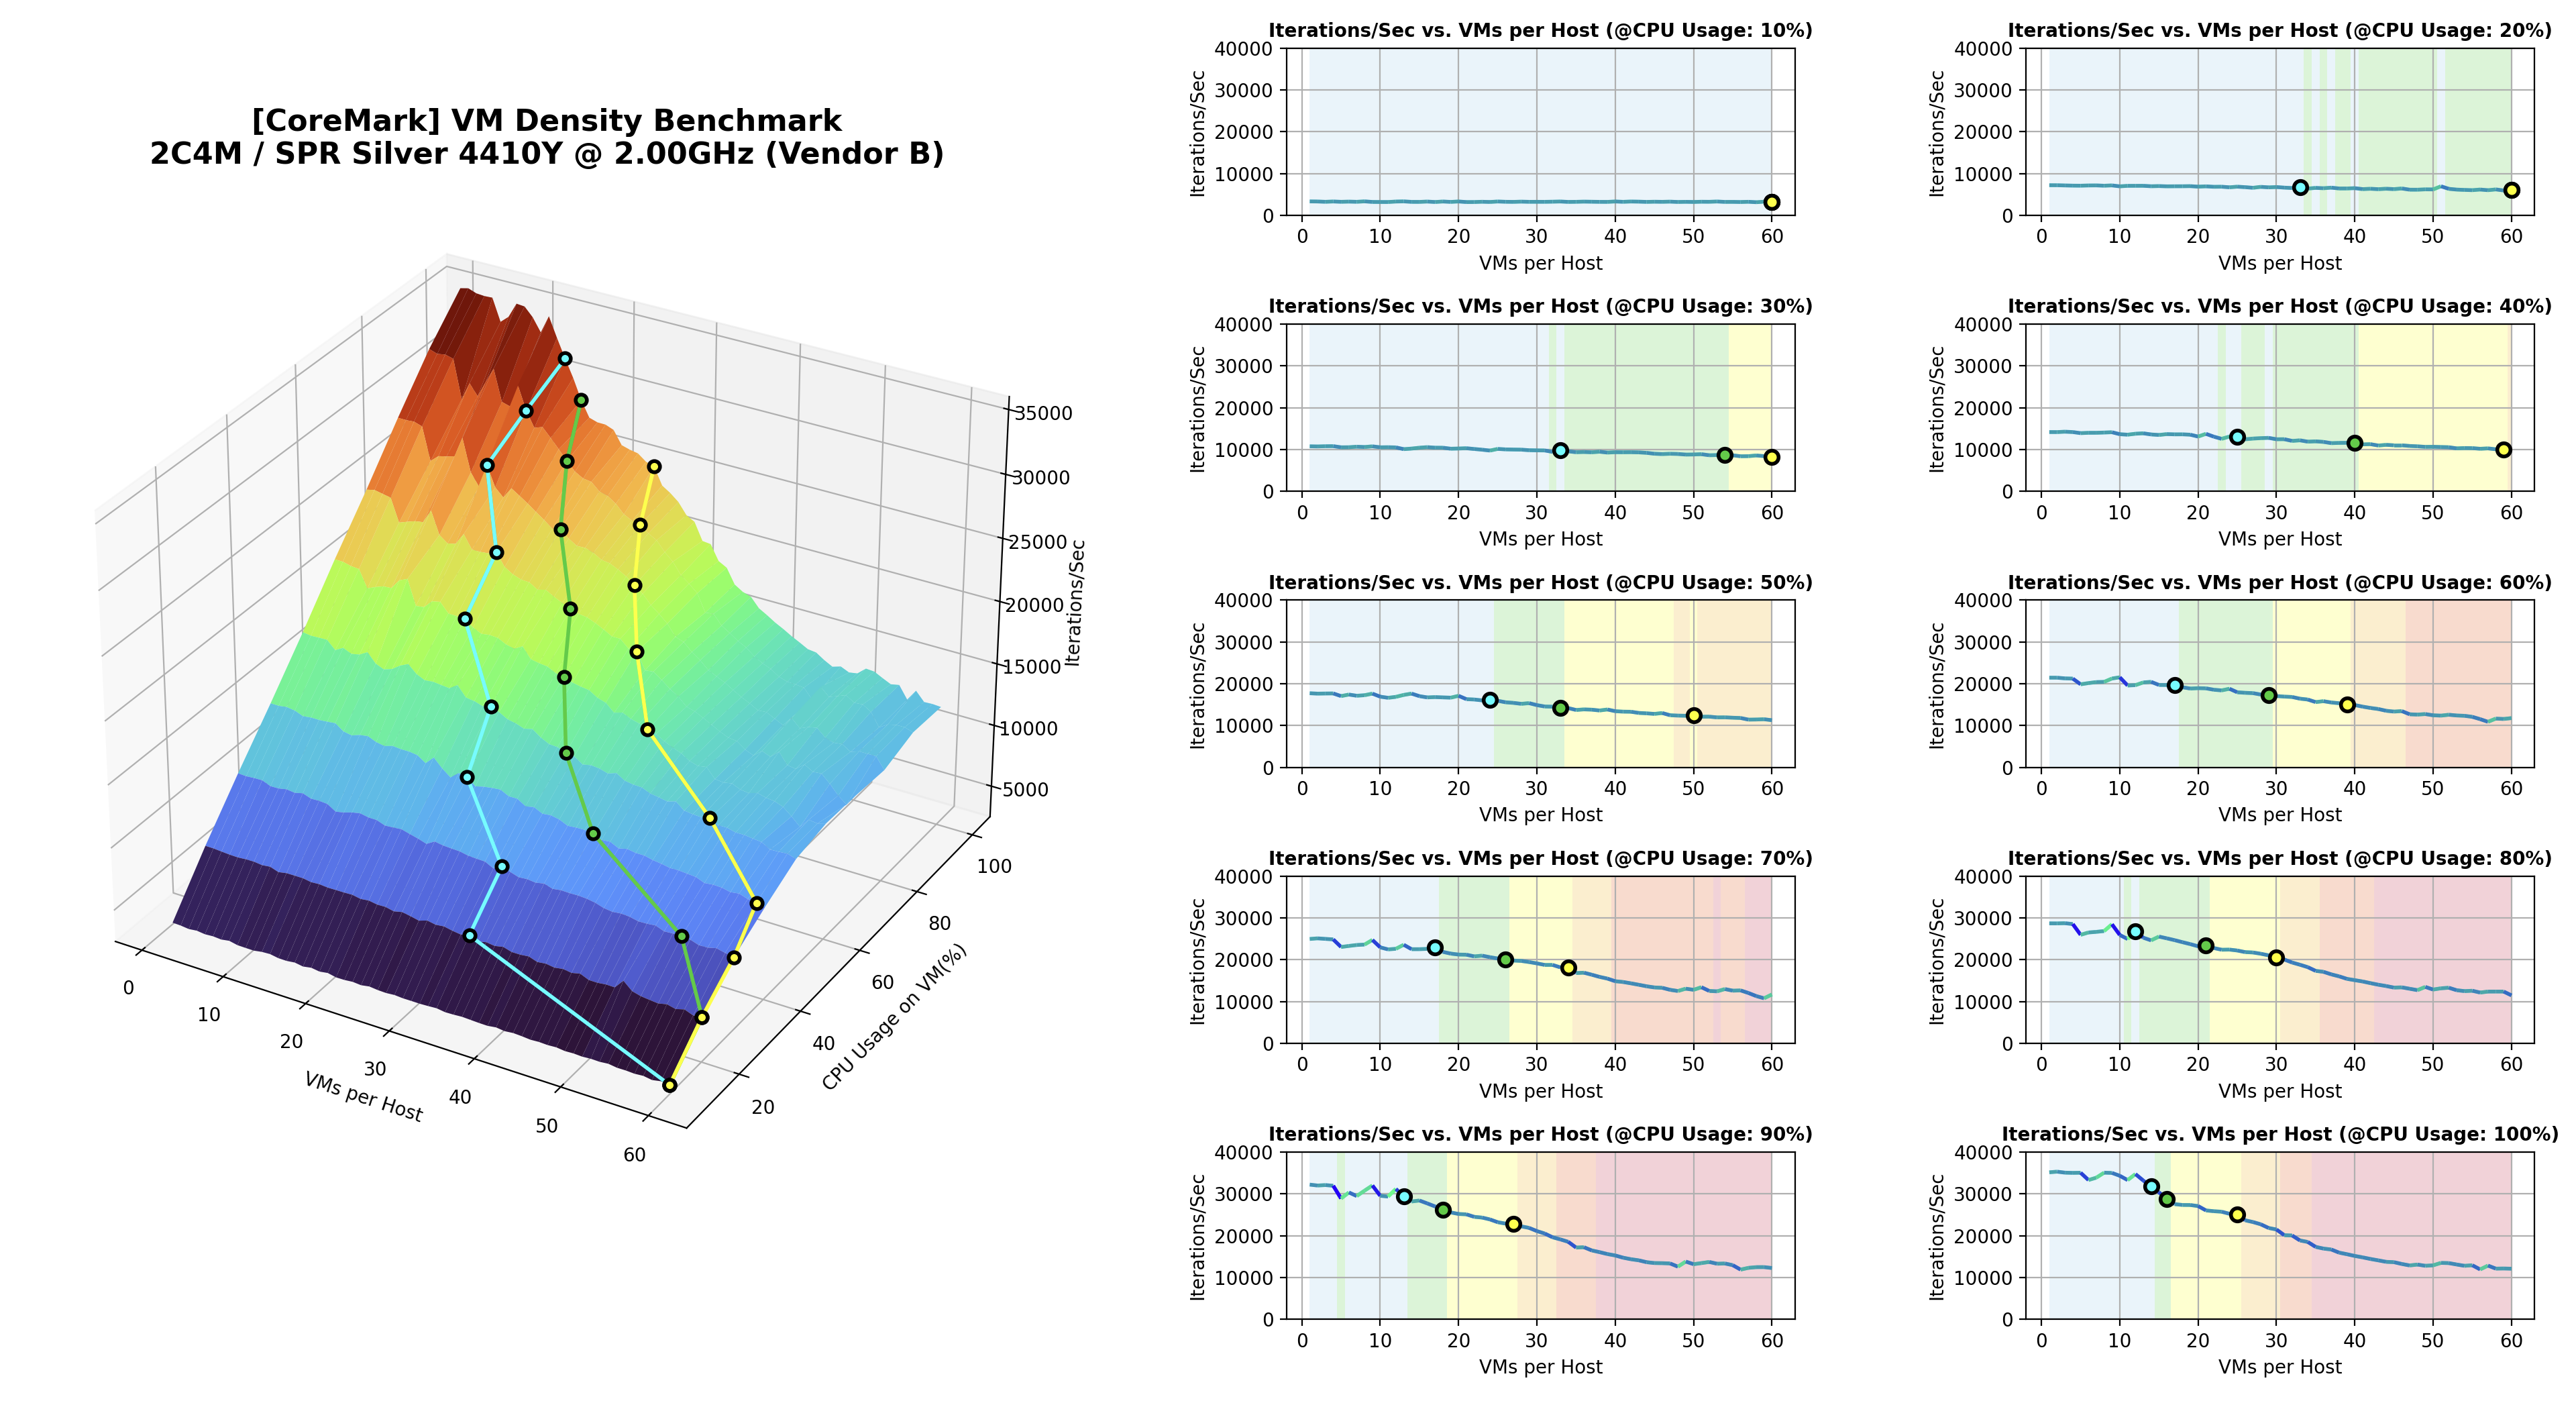 | 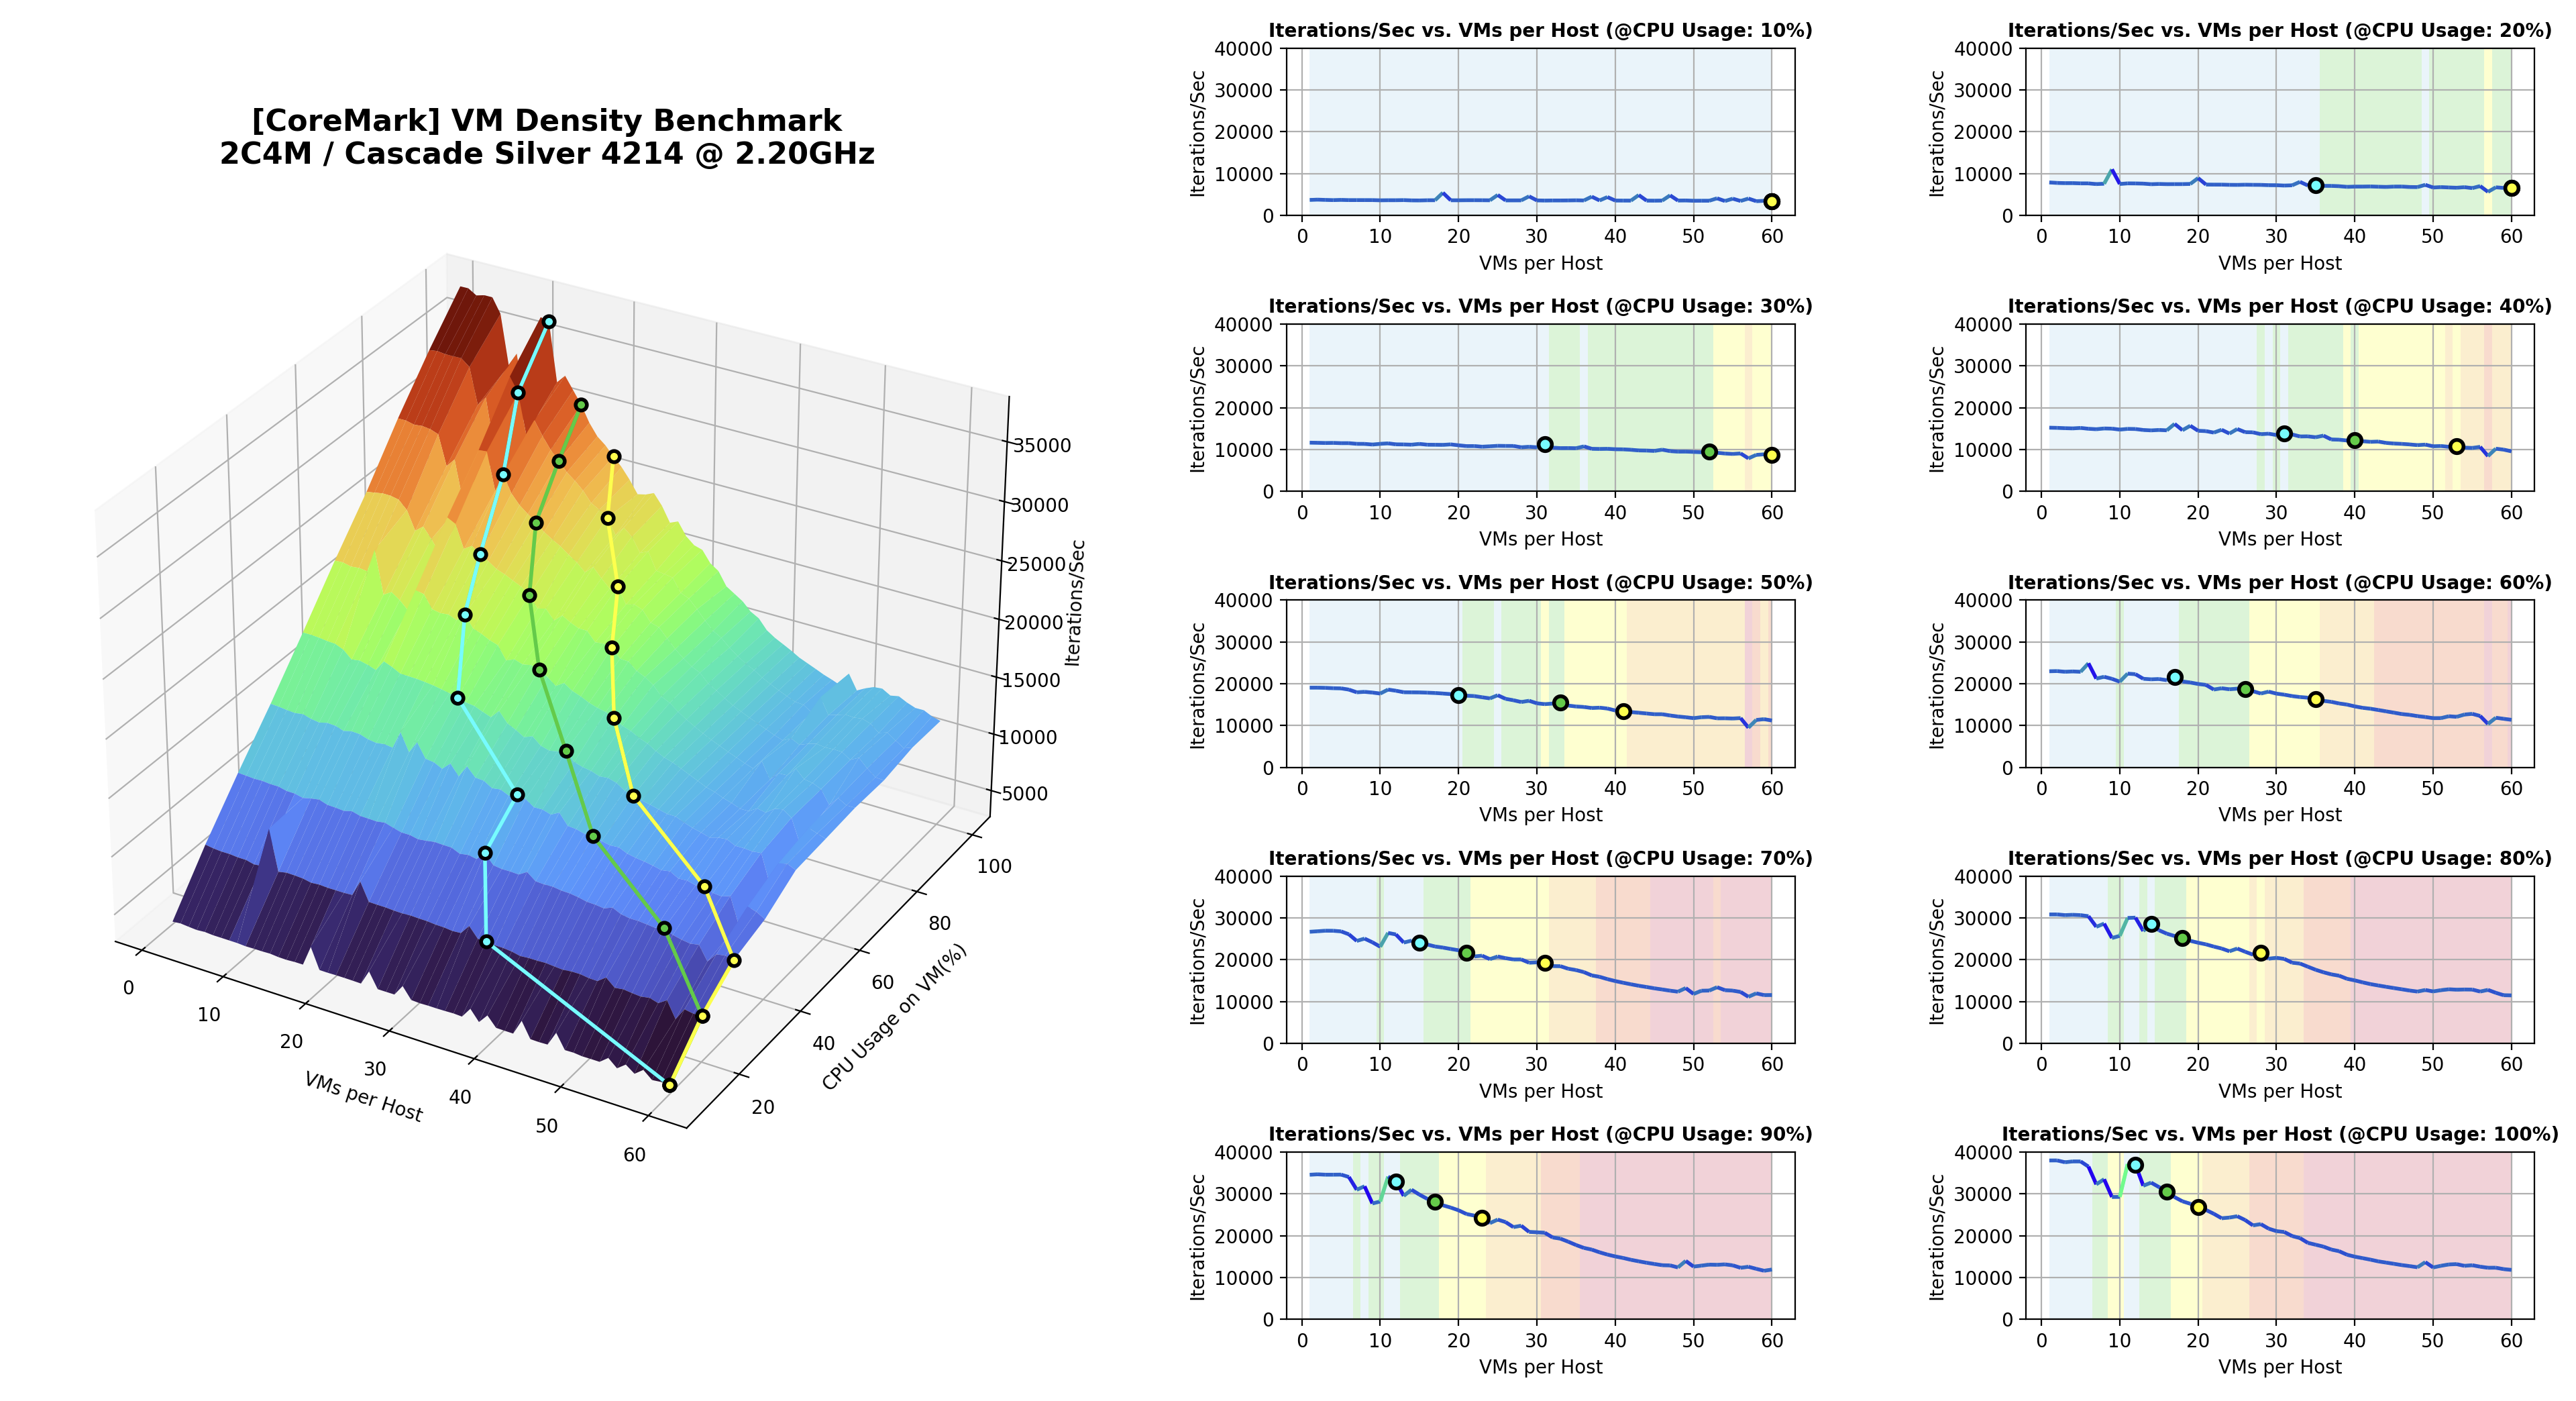 |
| 4 vCPU 8GB MEM | 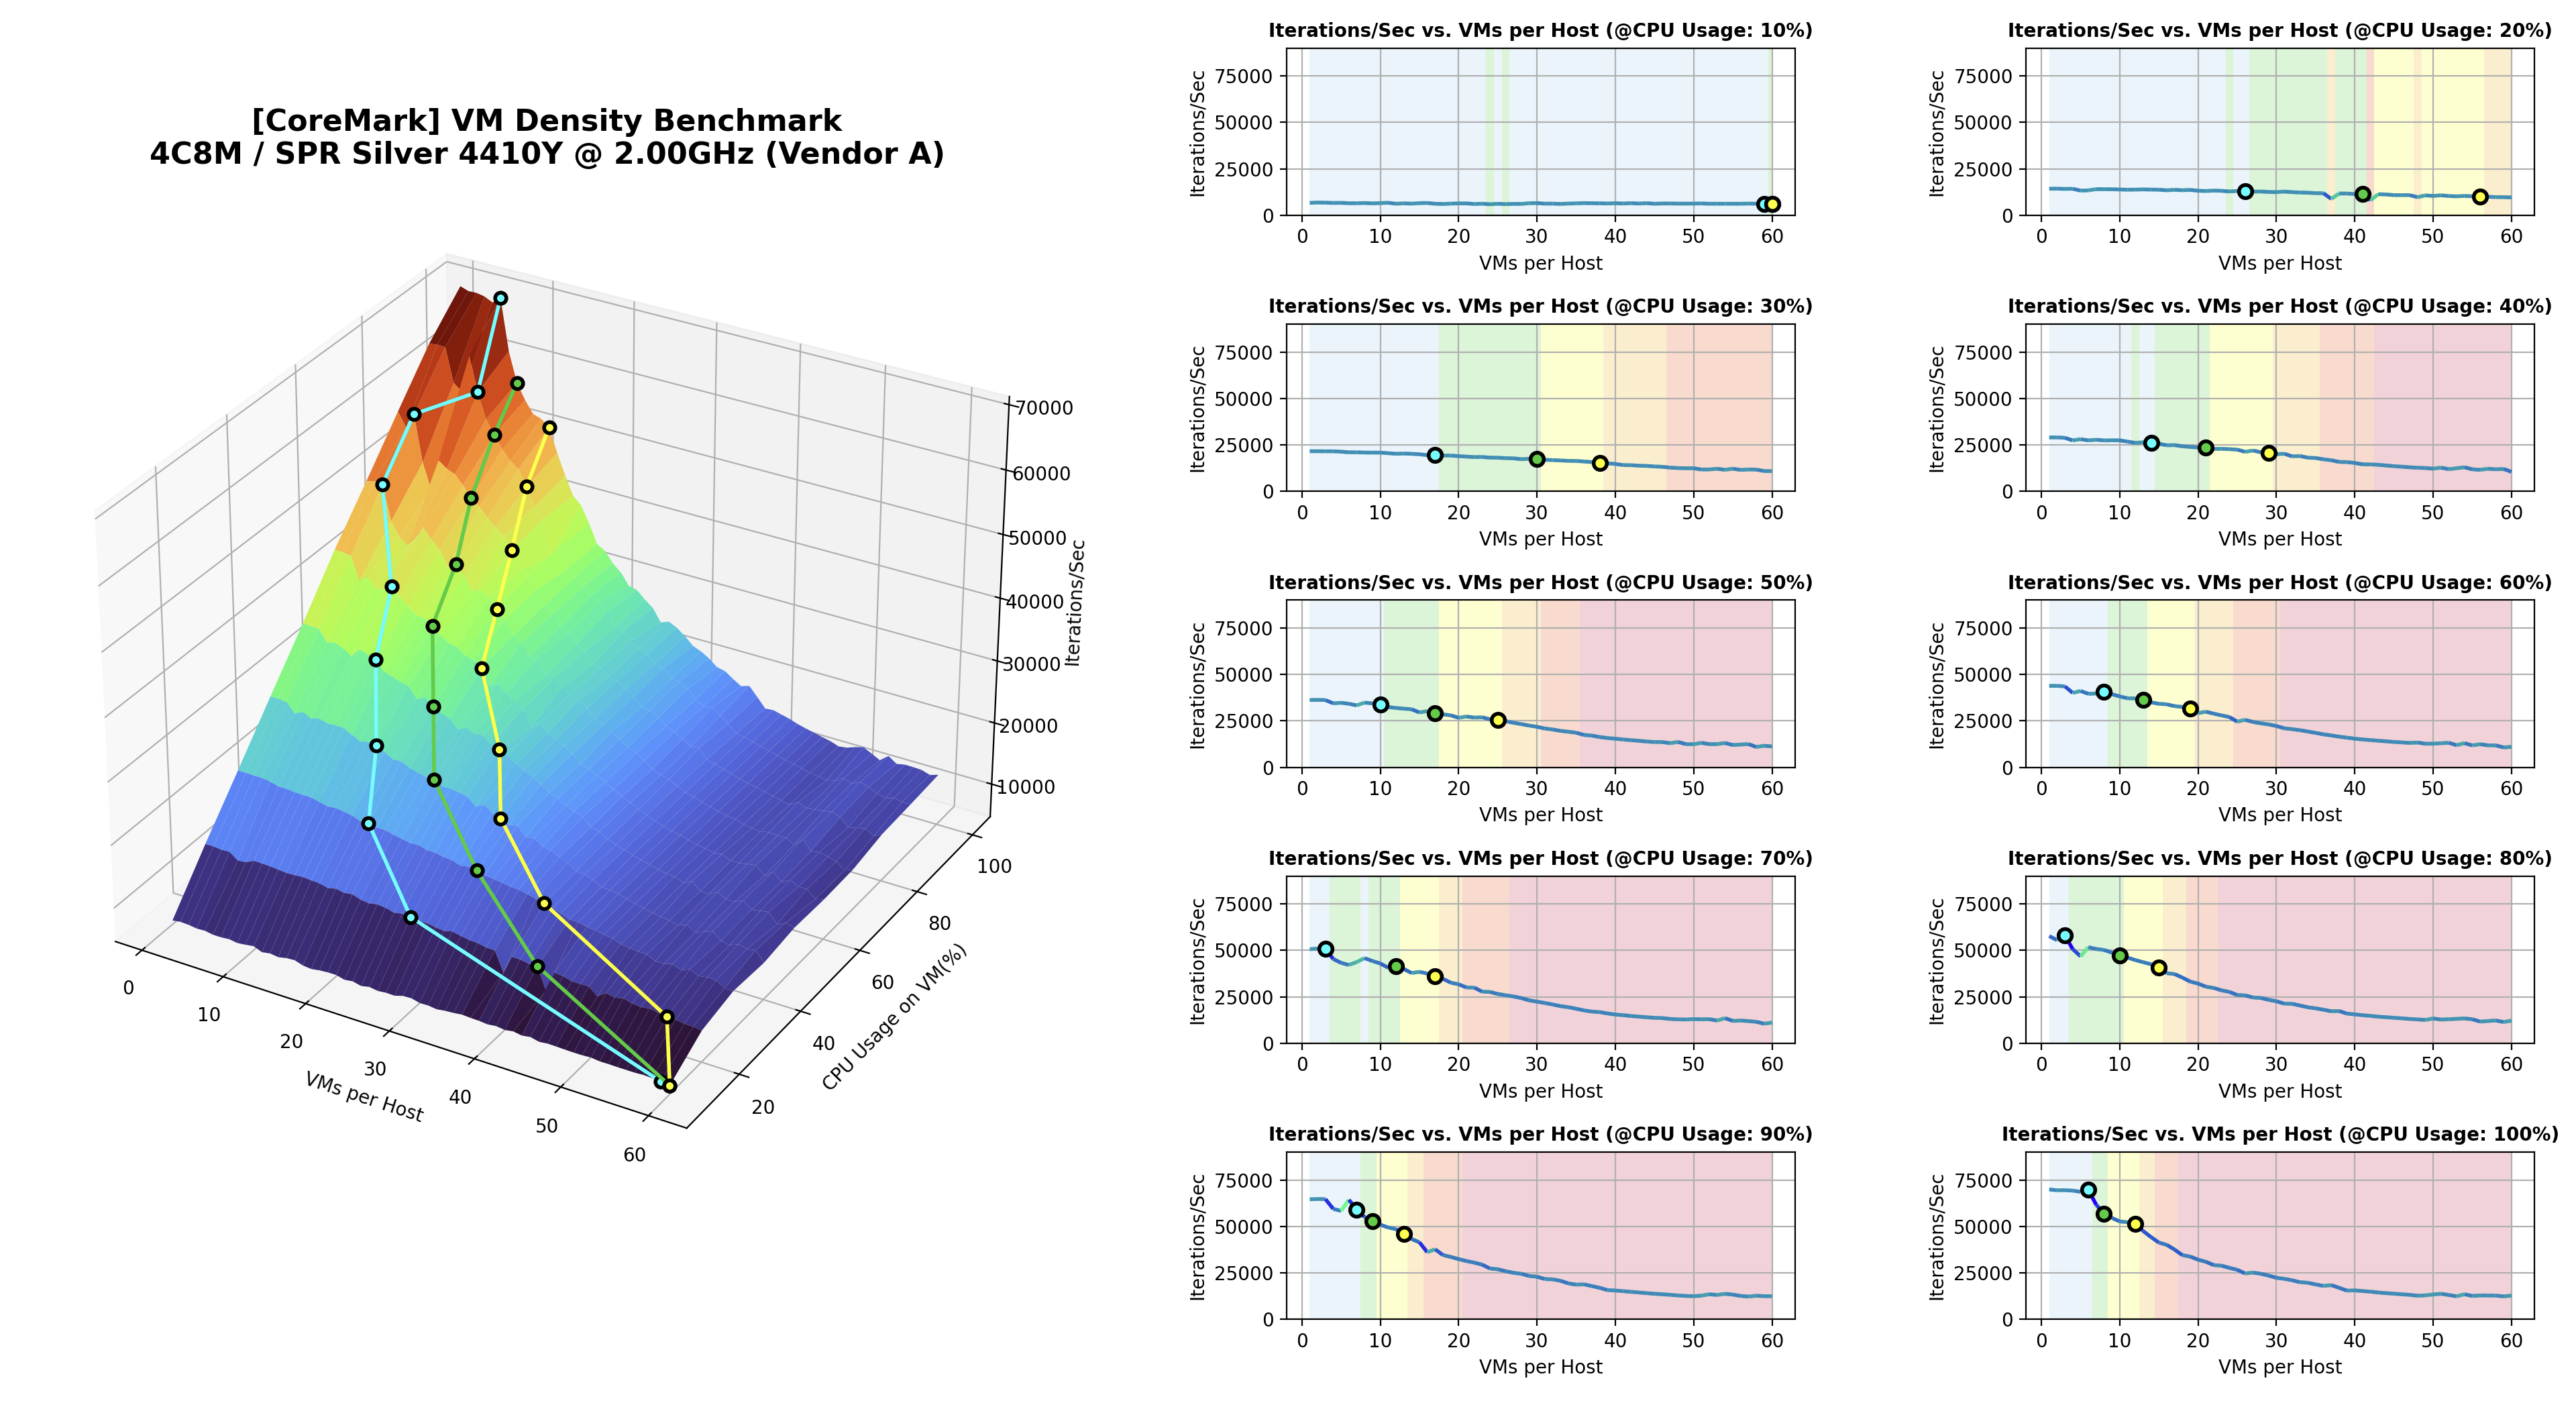 | 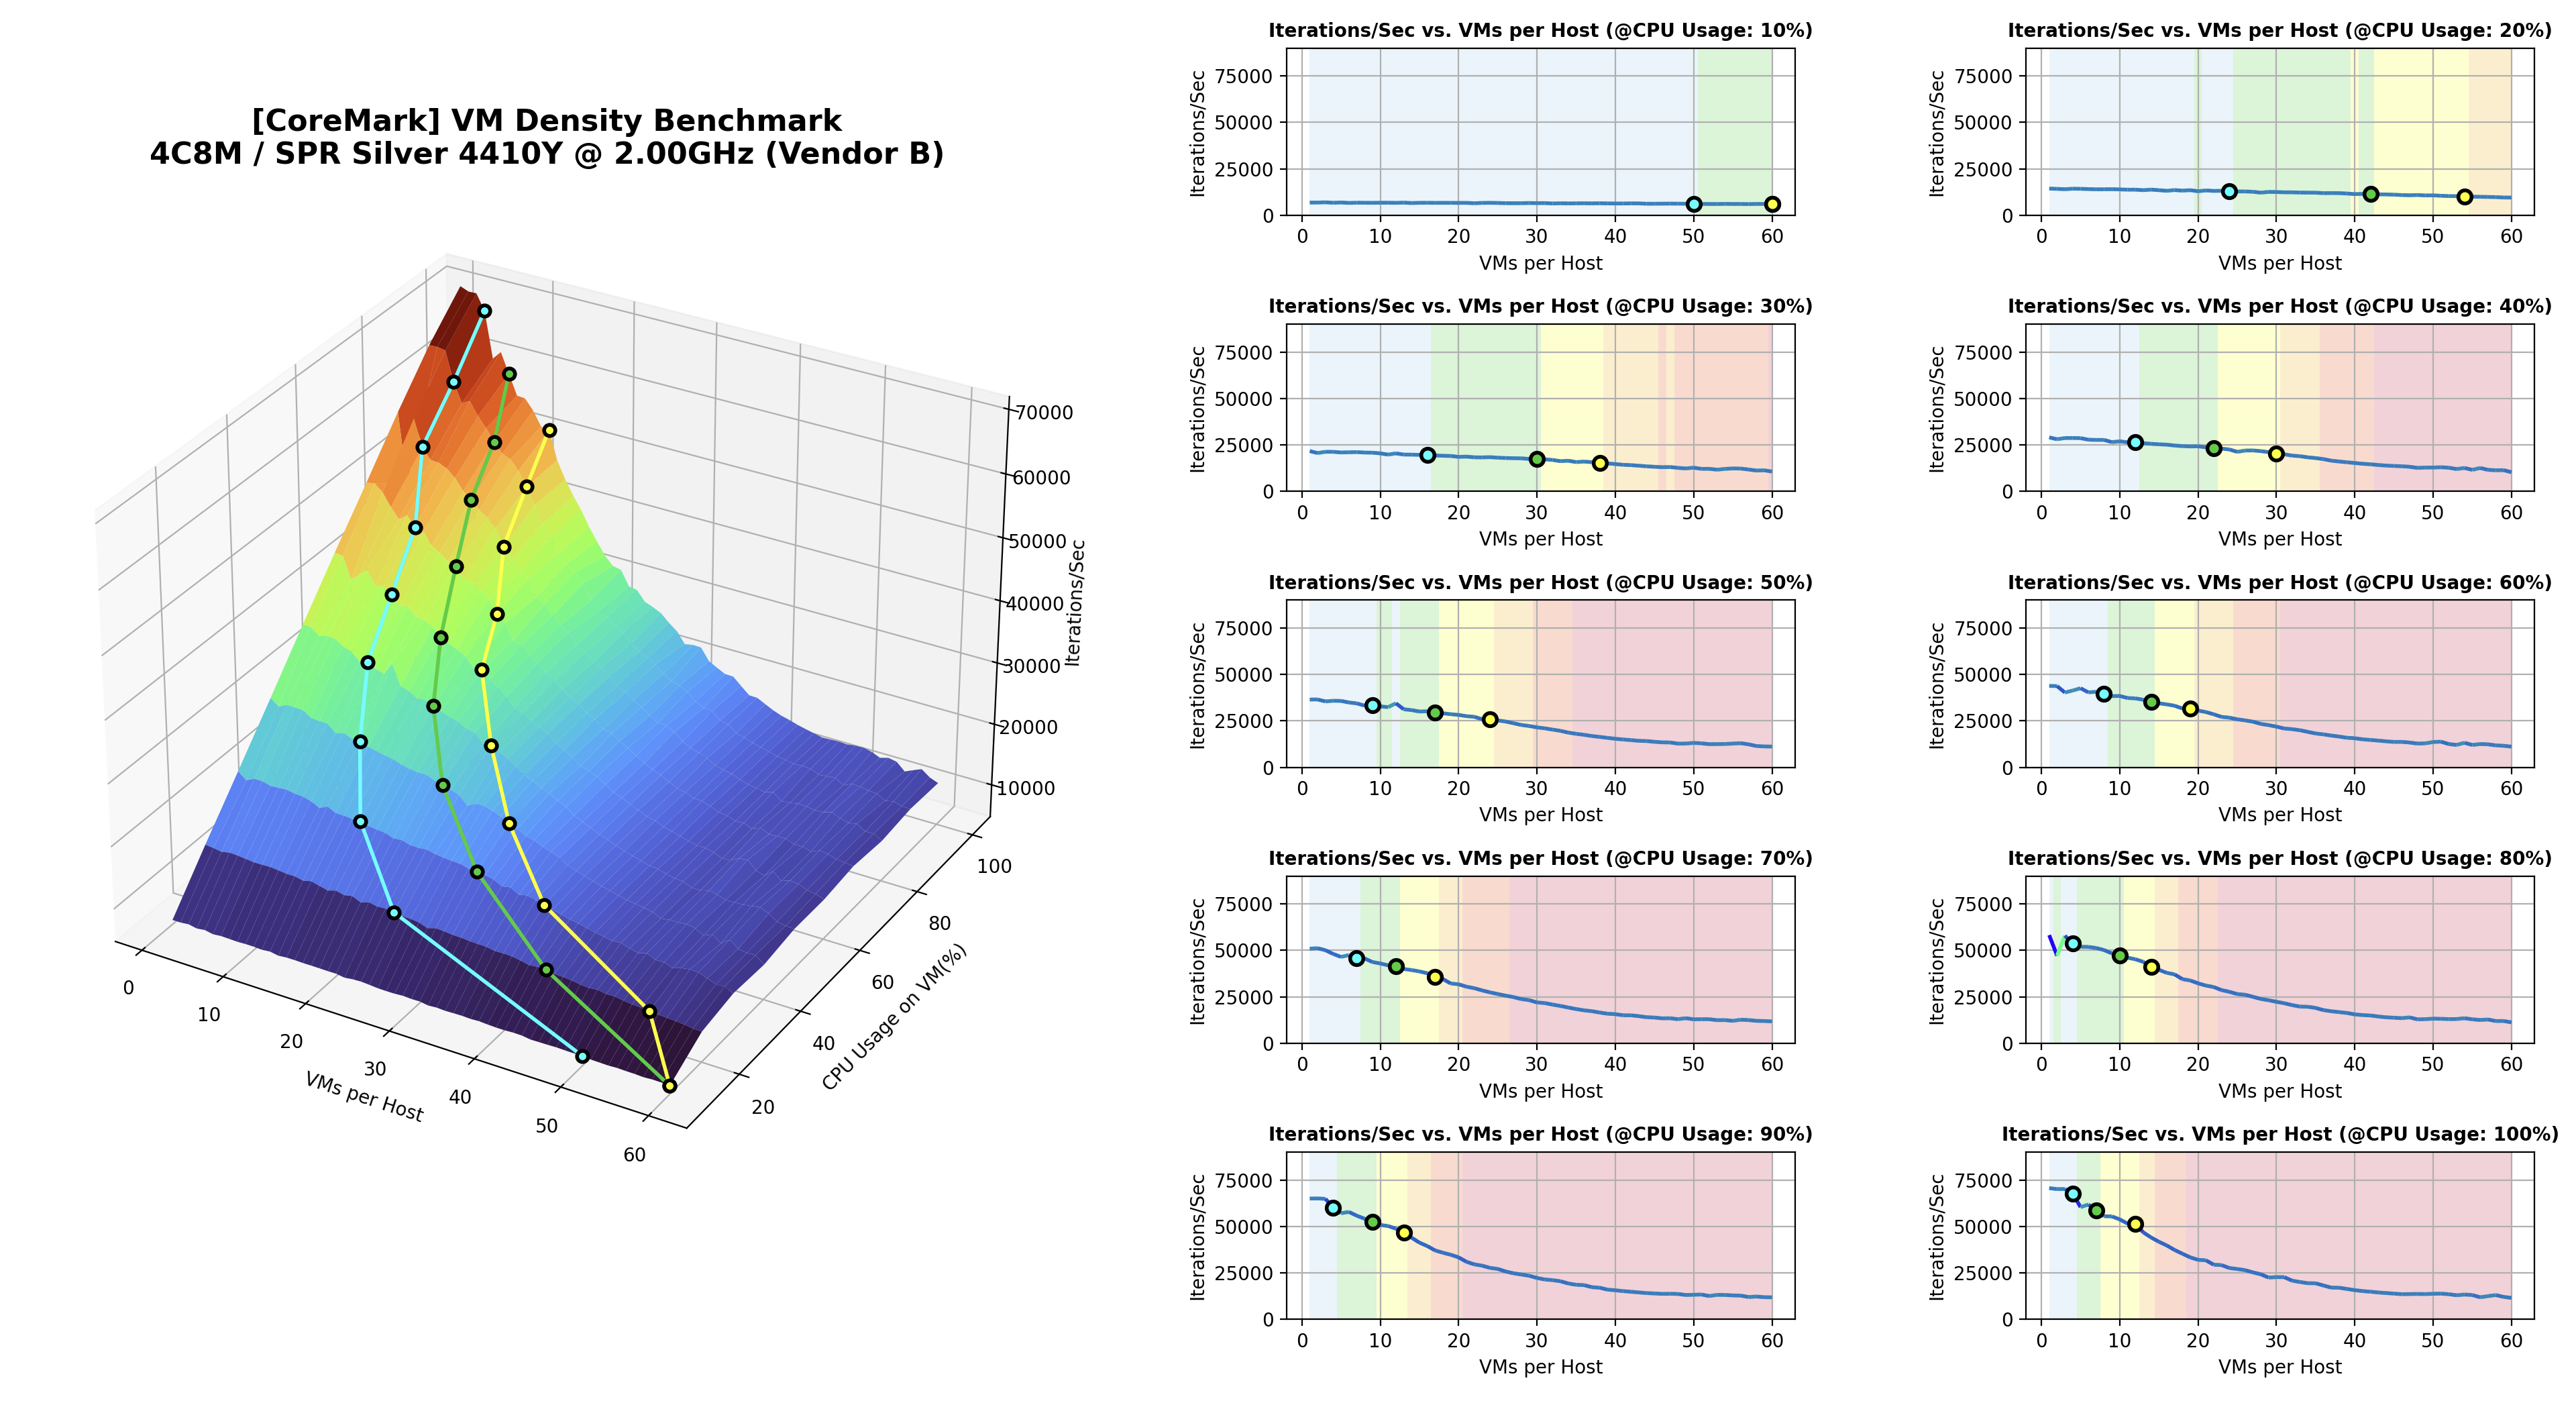 | 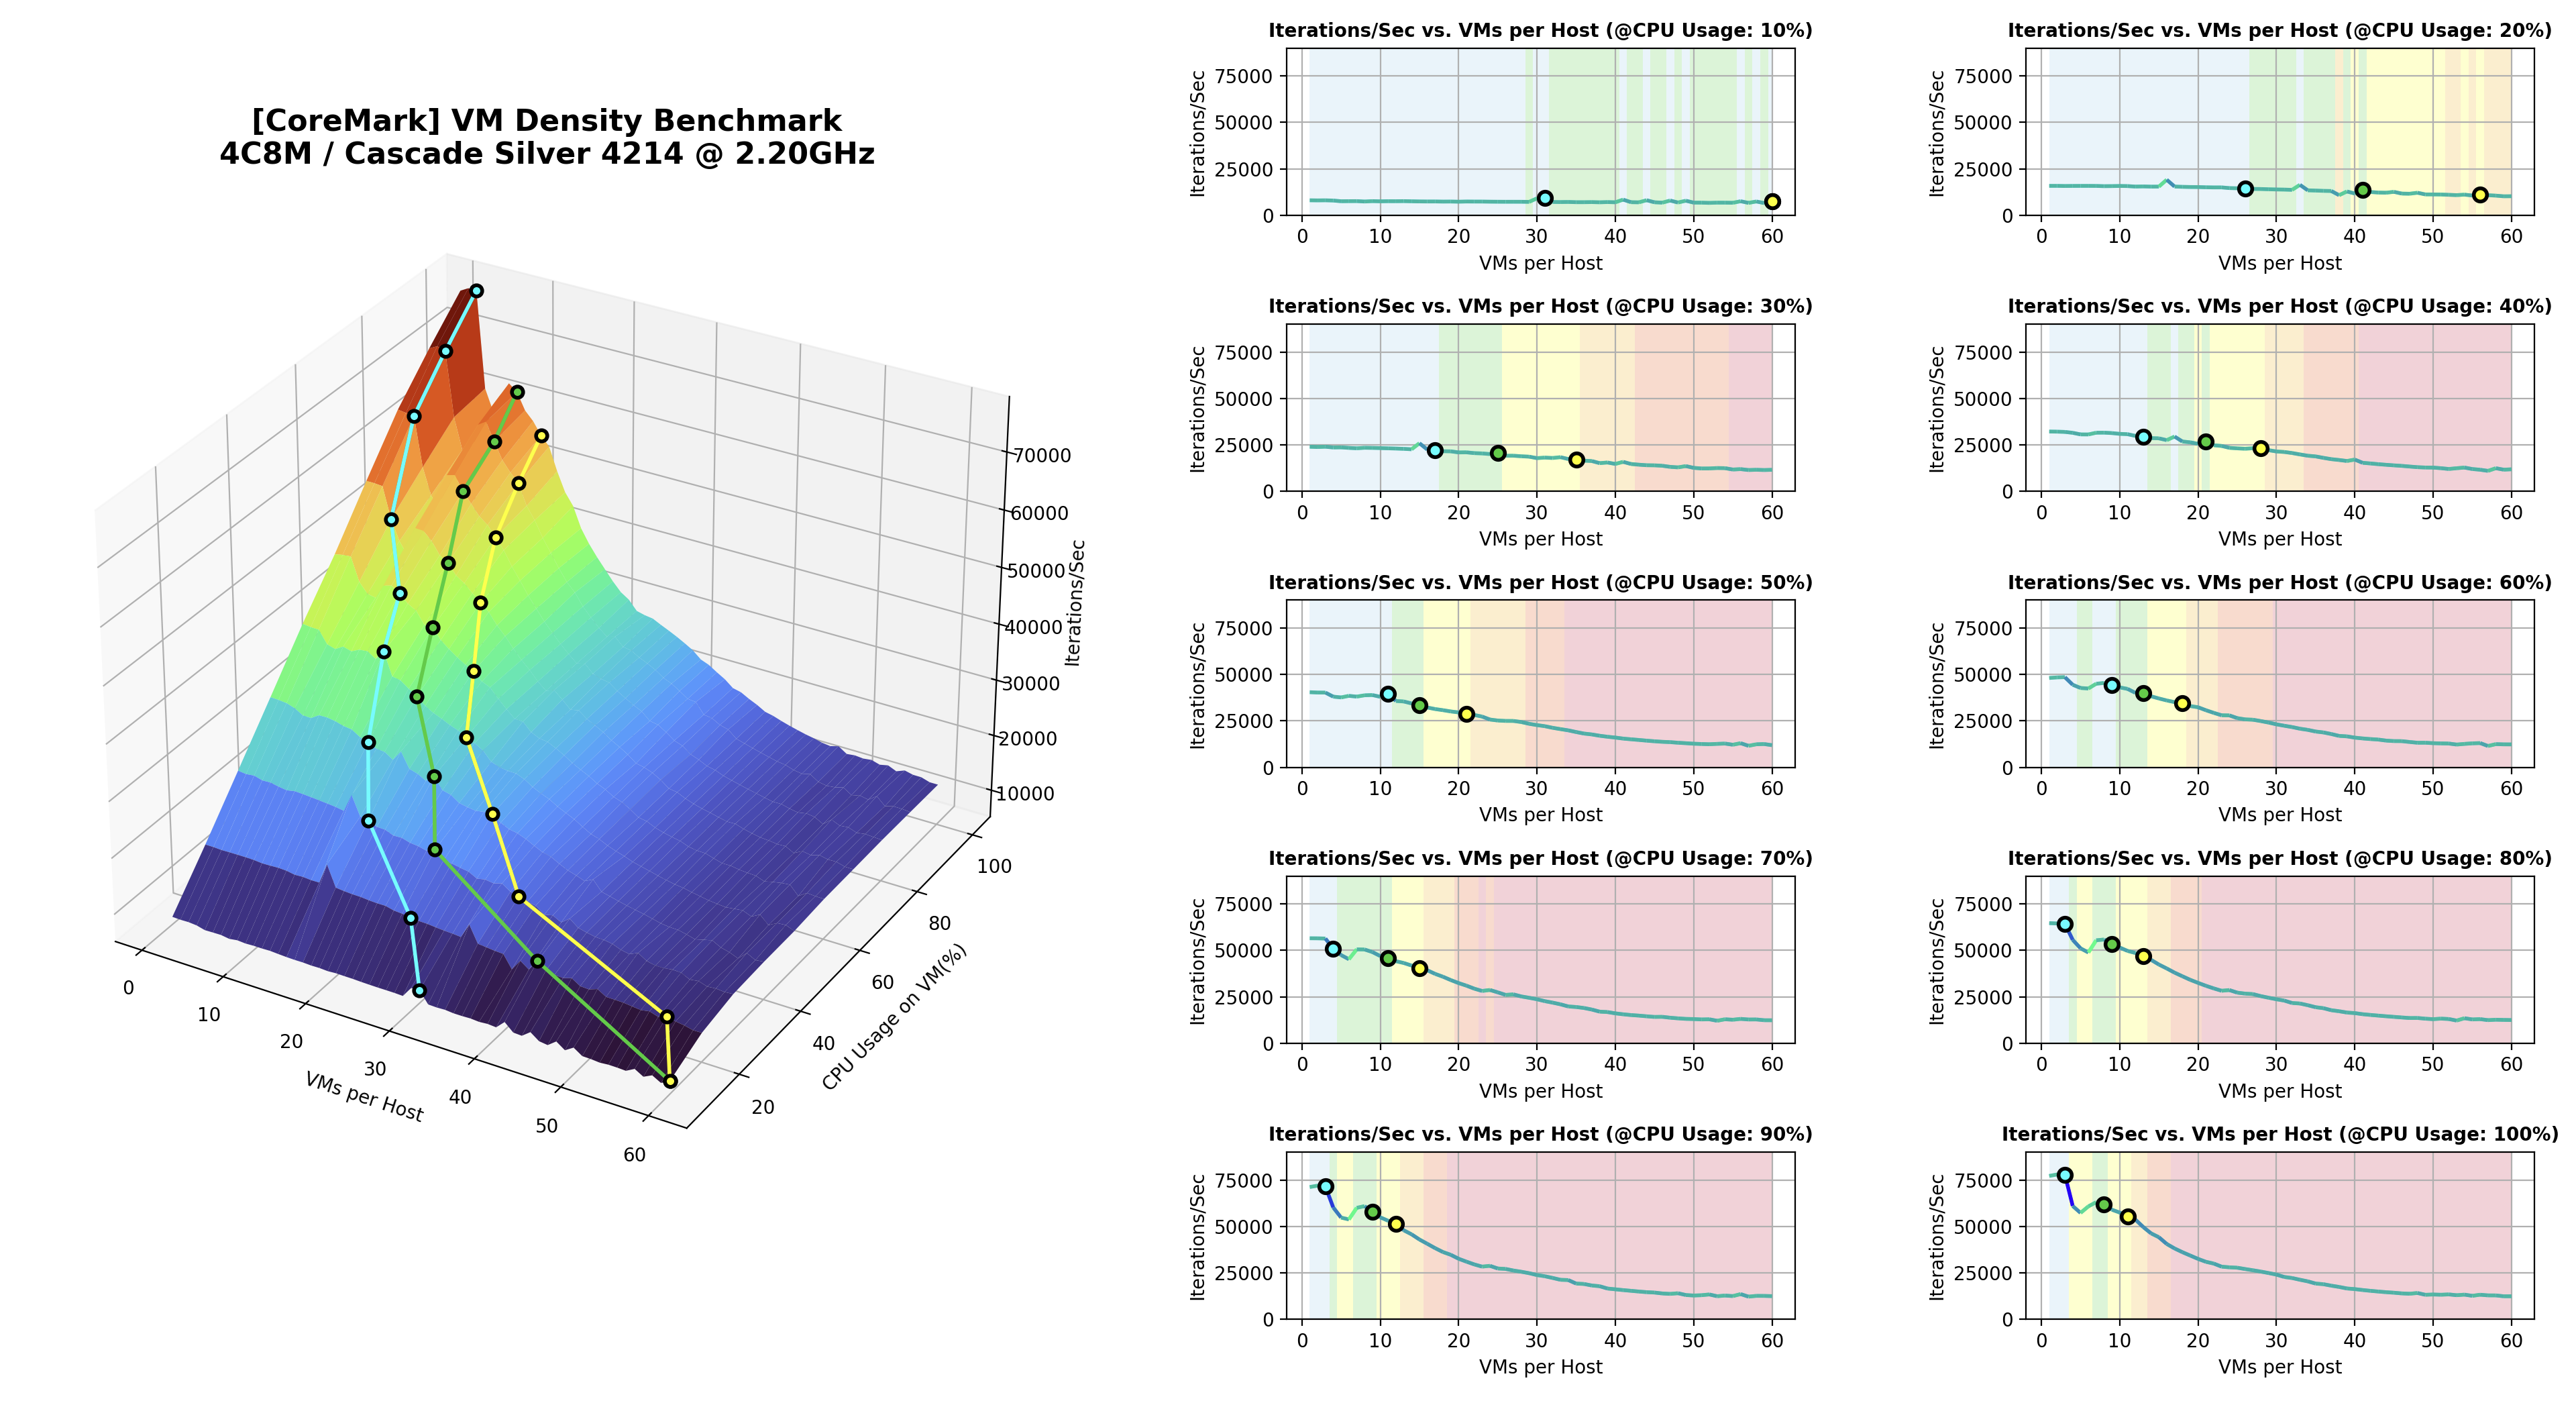 |
| 8 vCPU 16GB MEM | 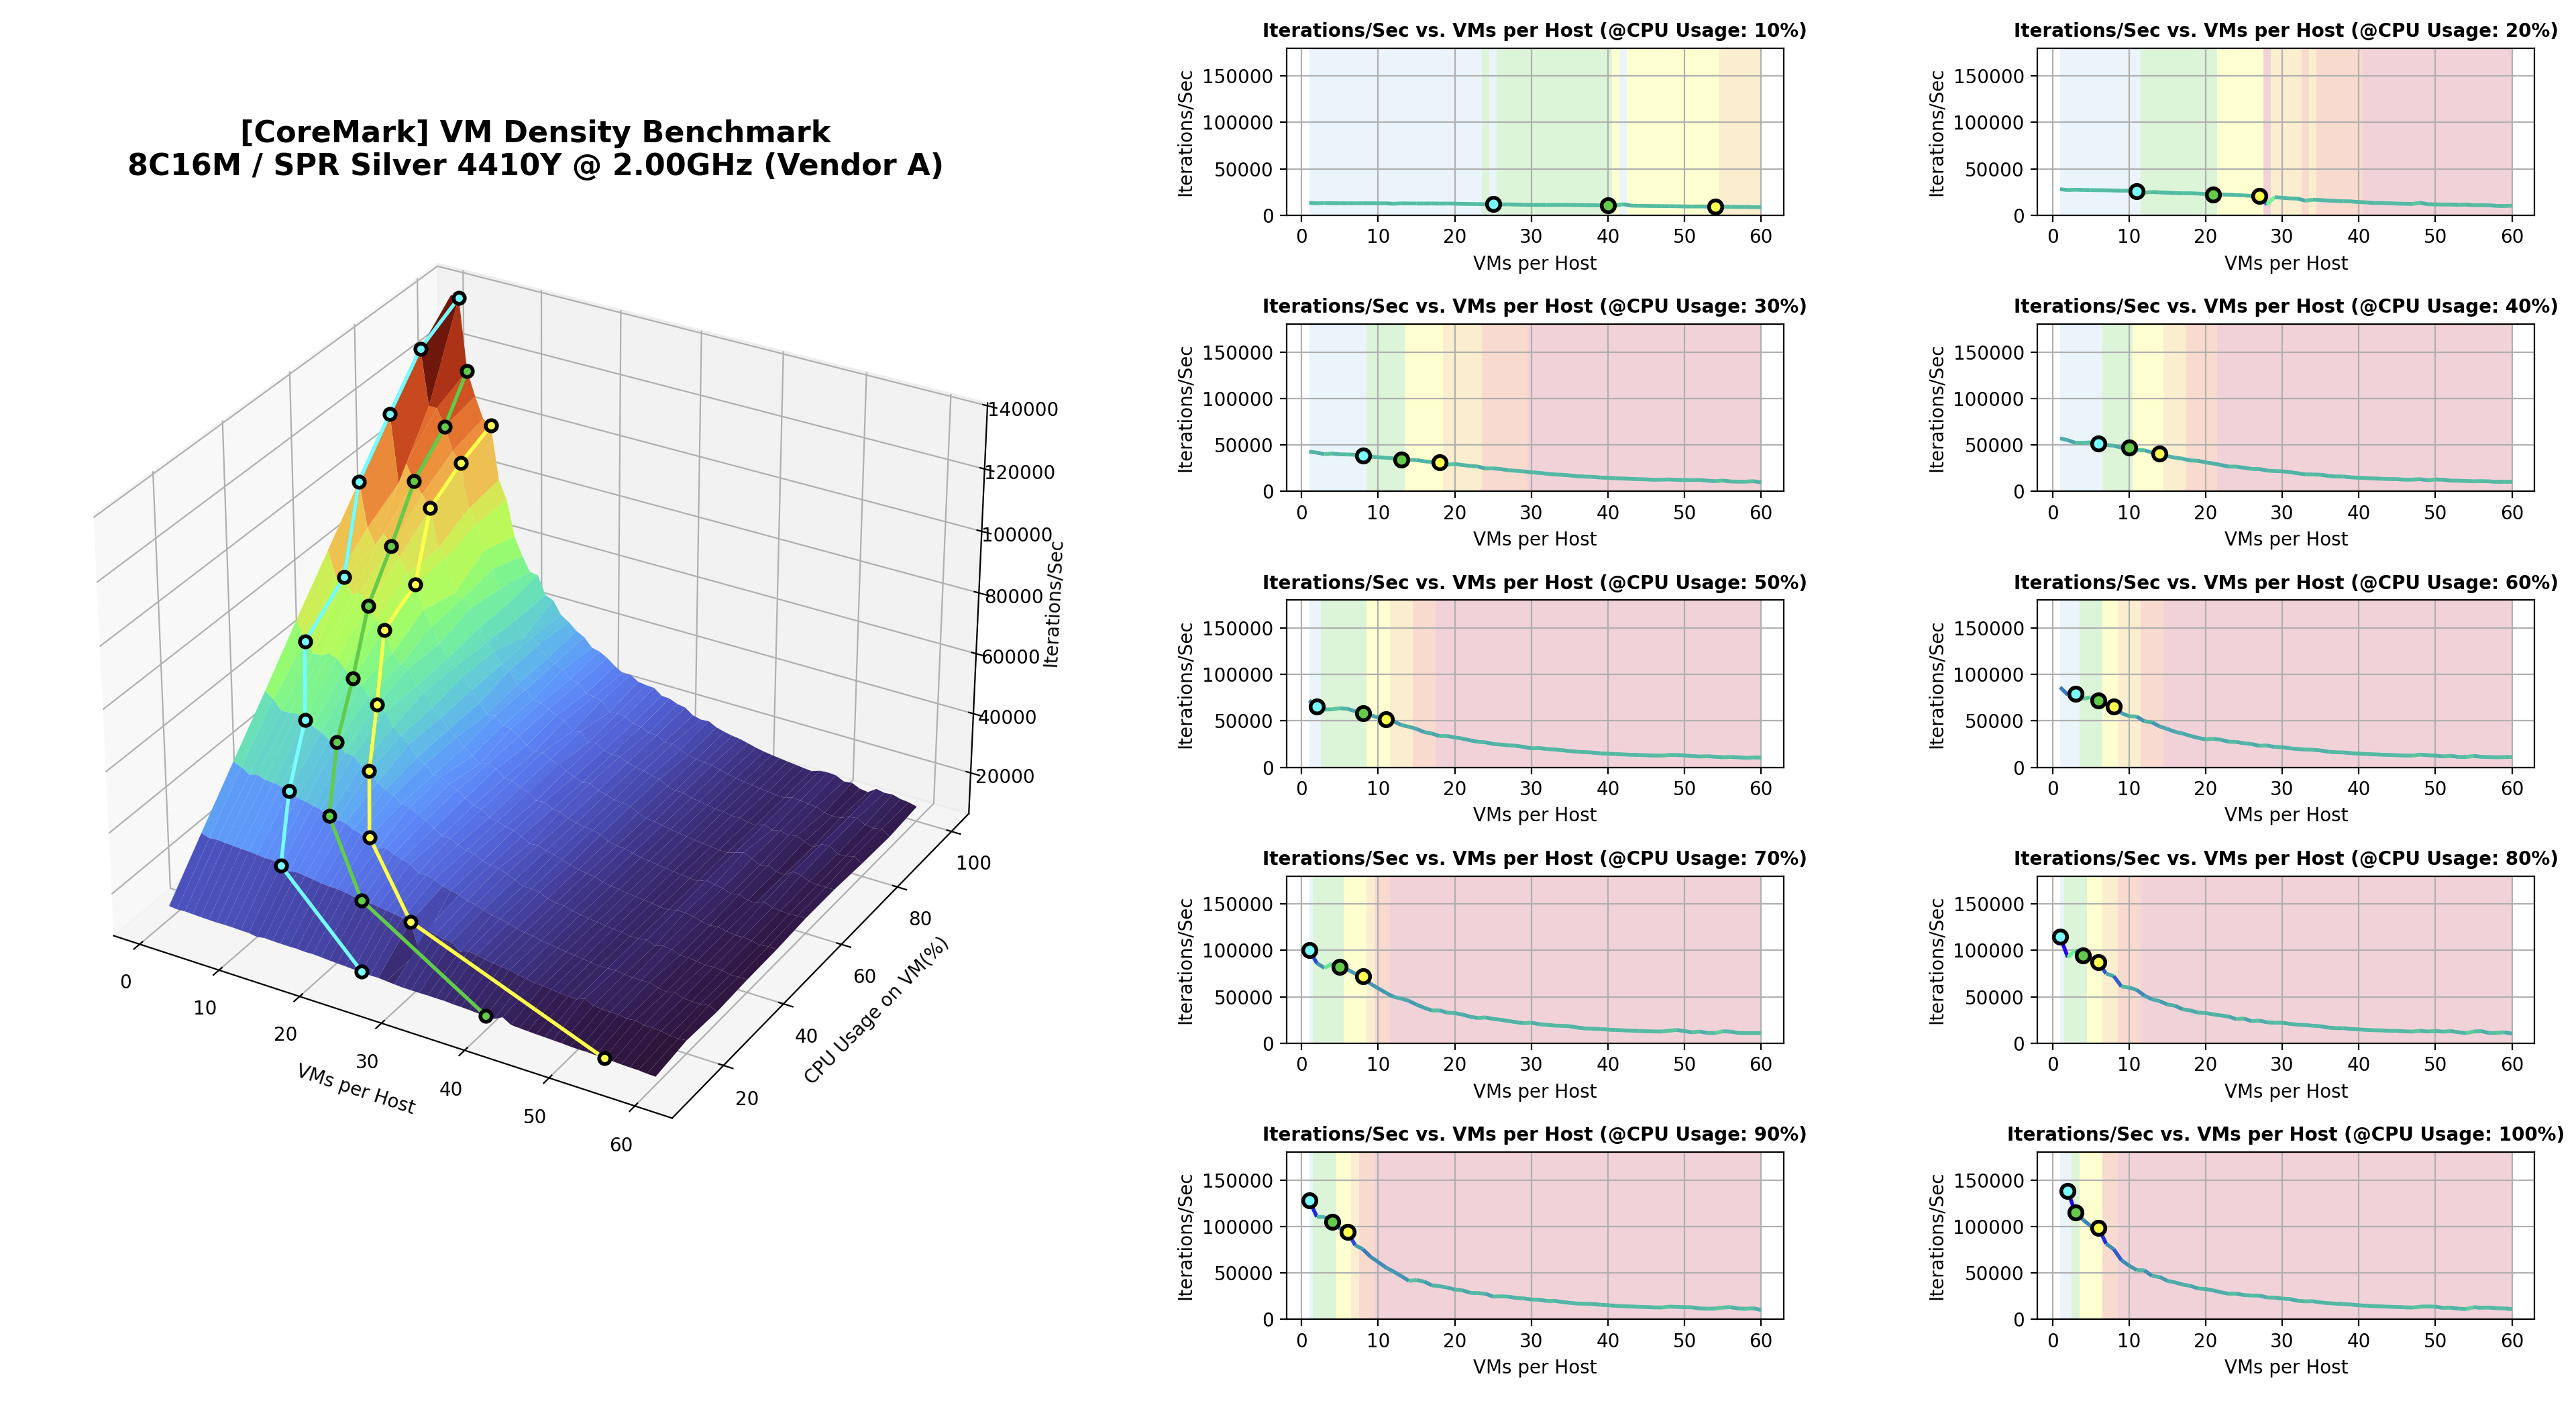 | 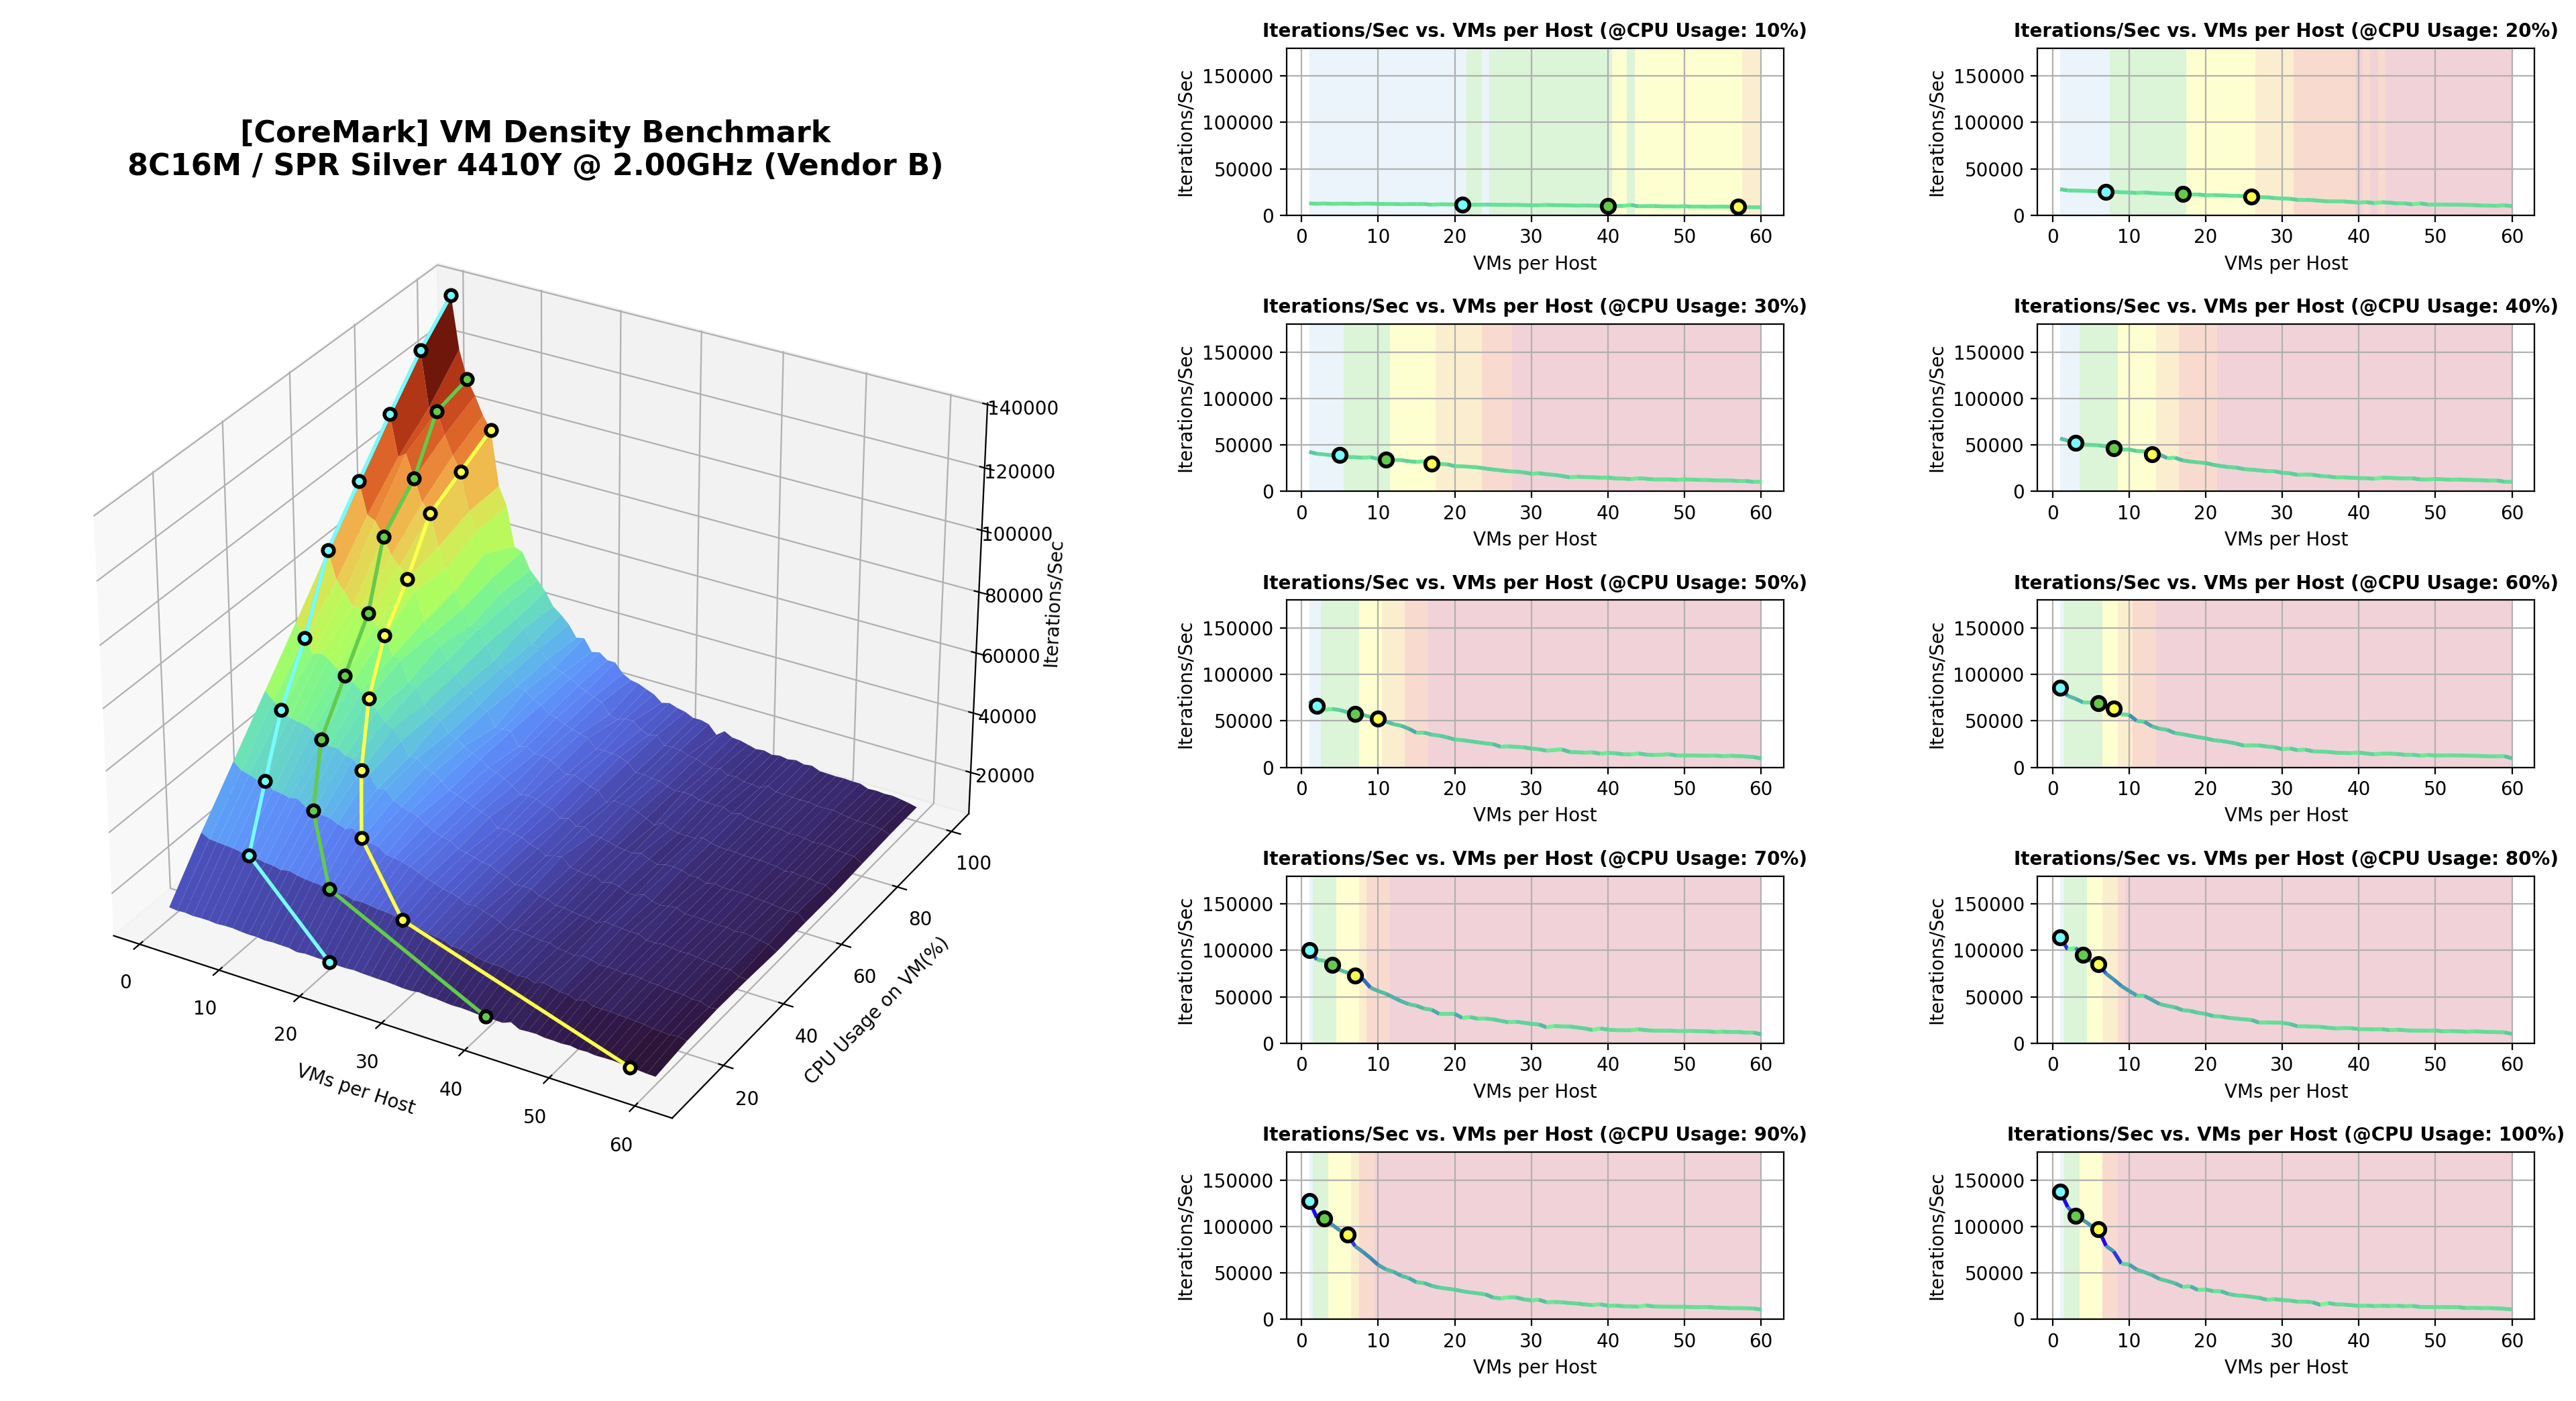 | 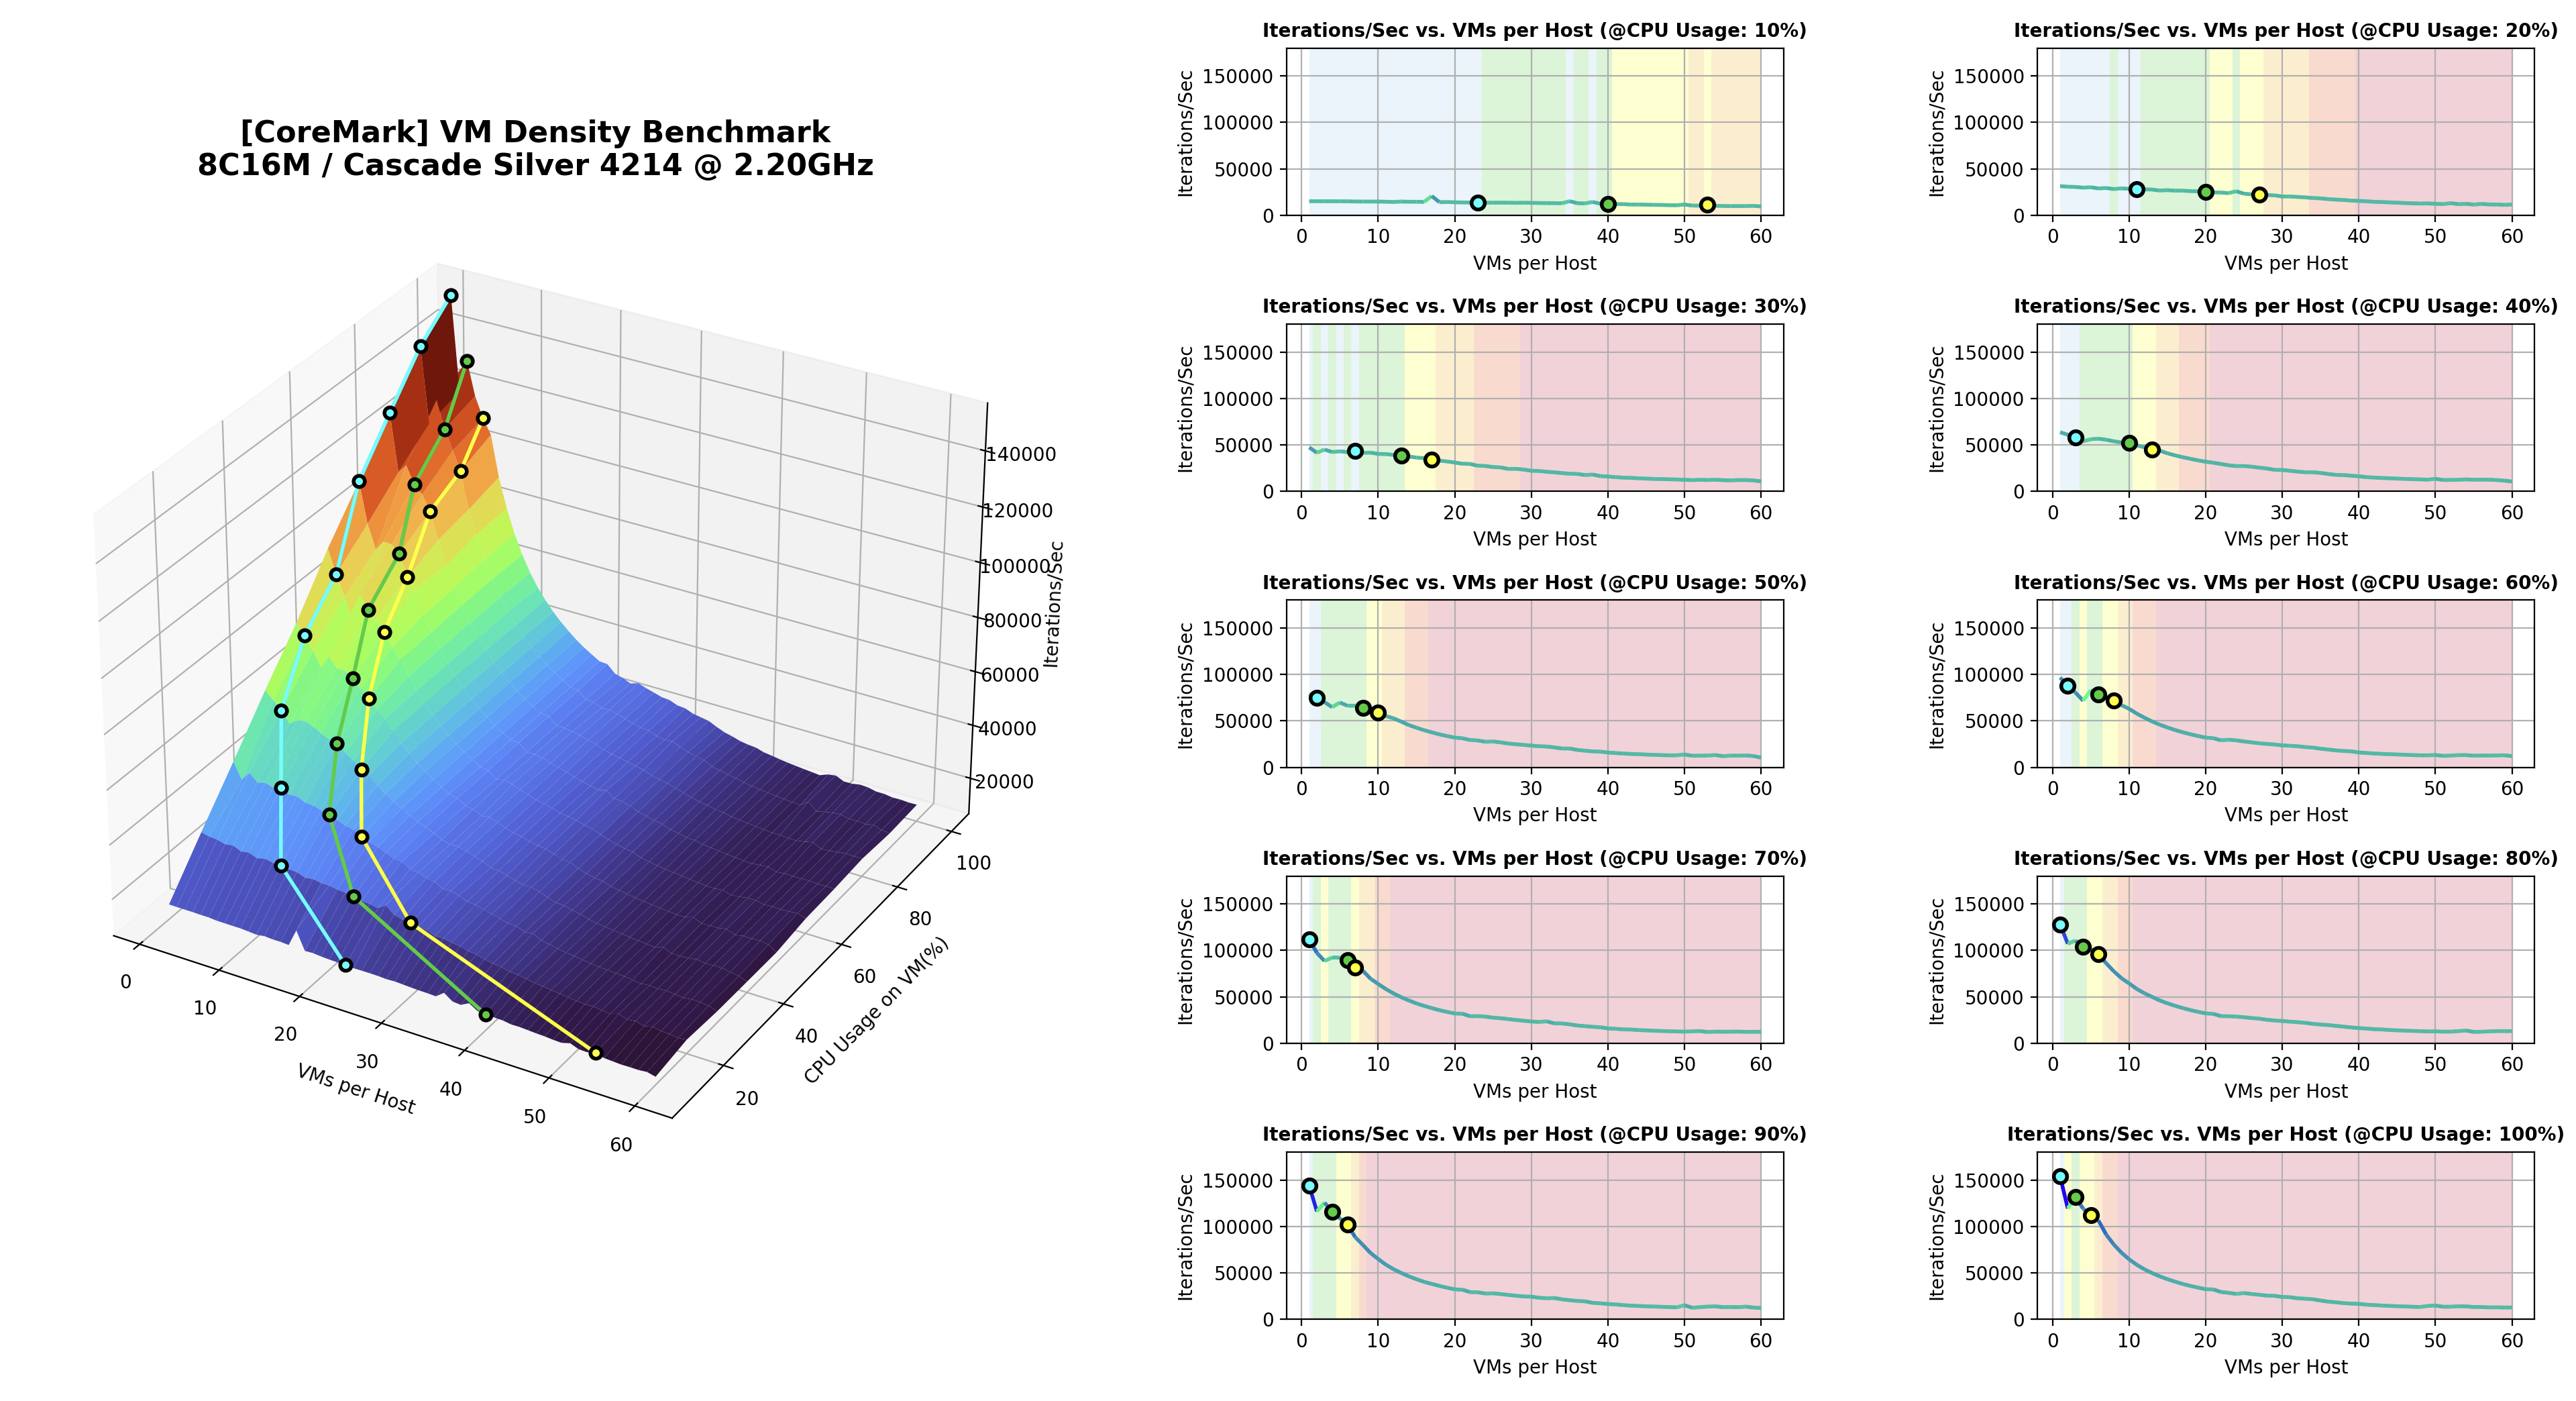 |
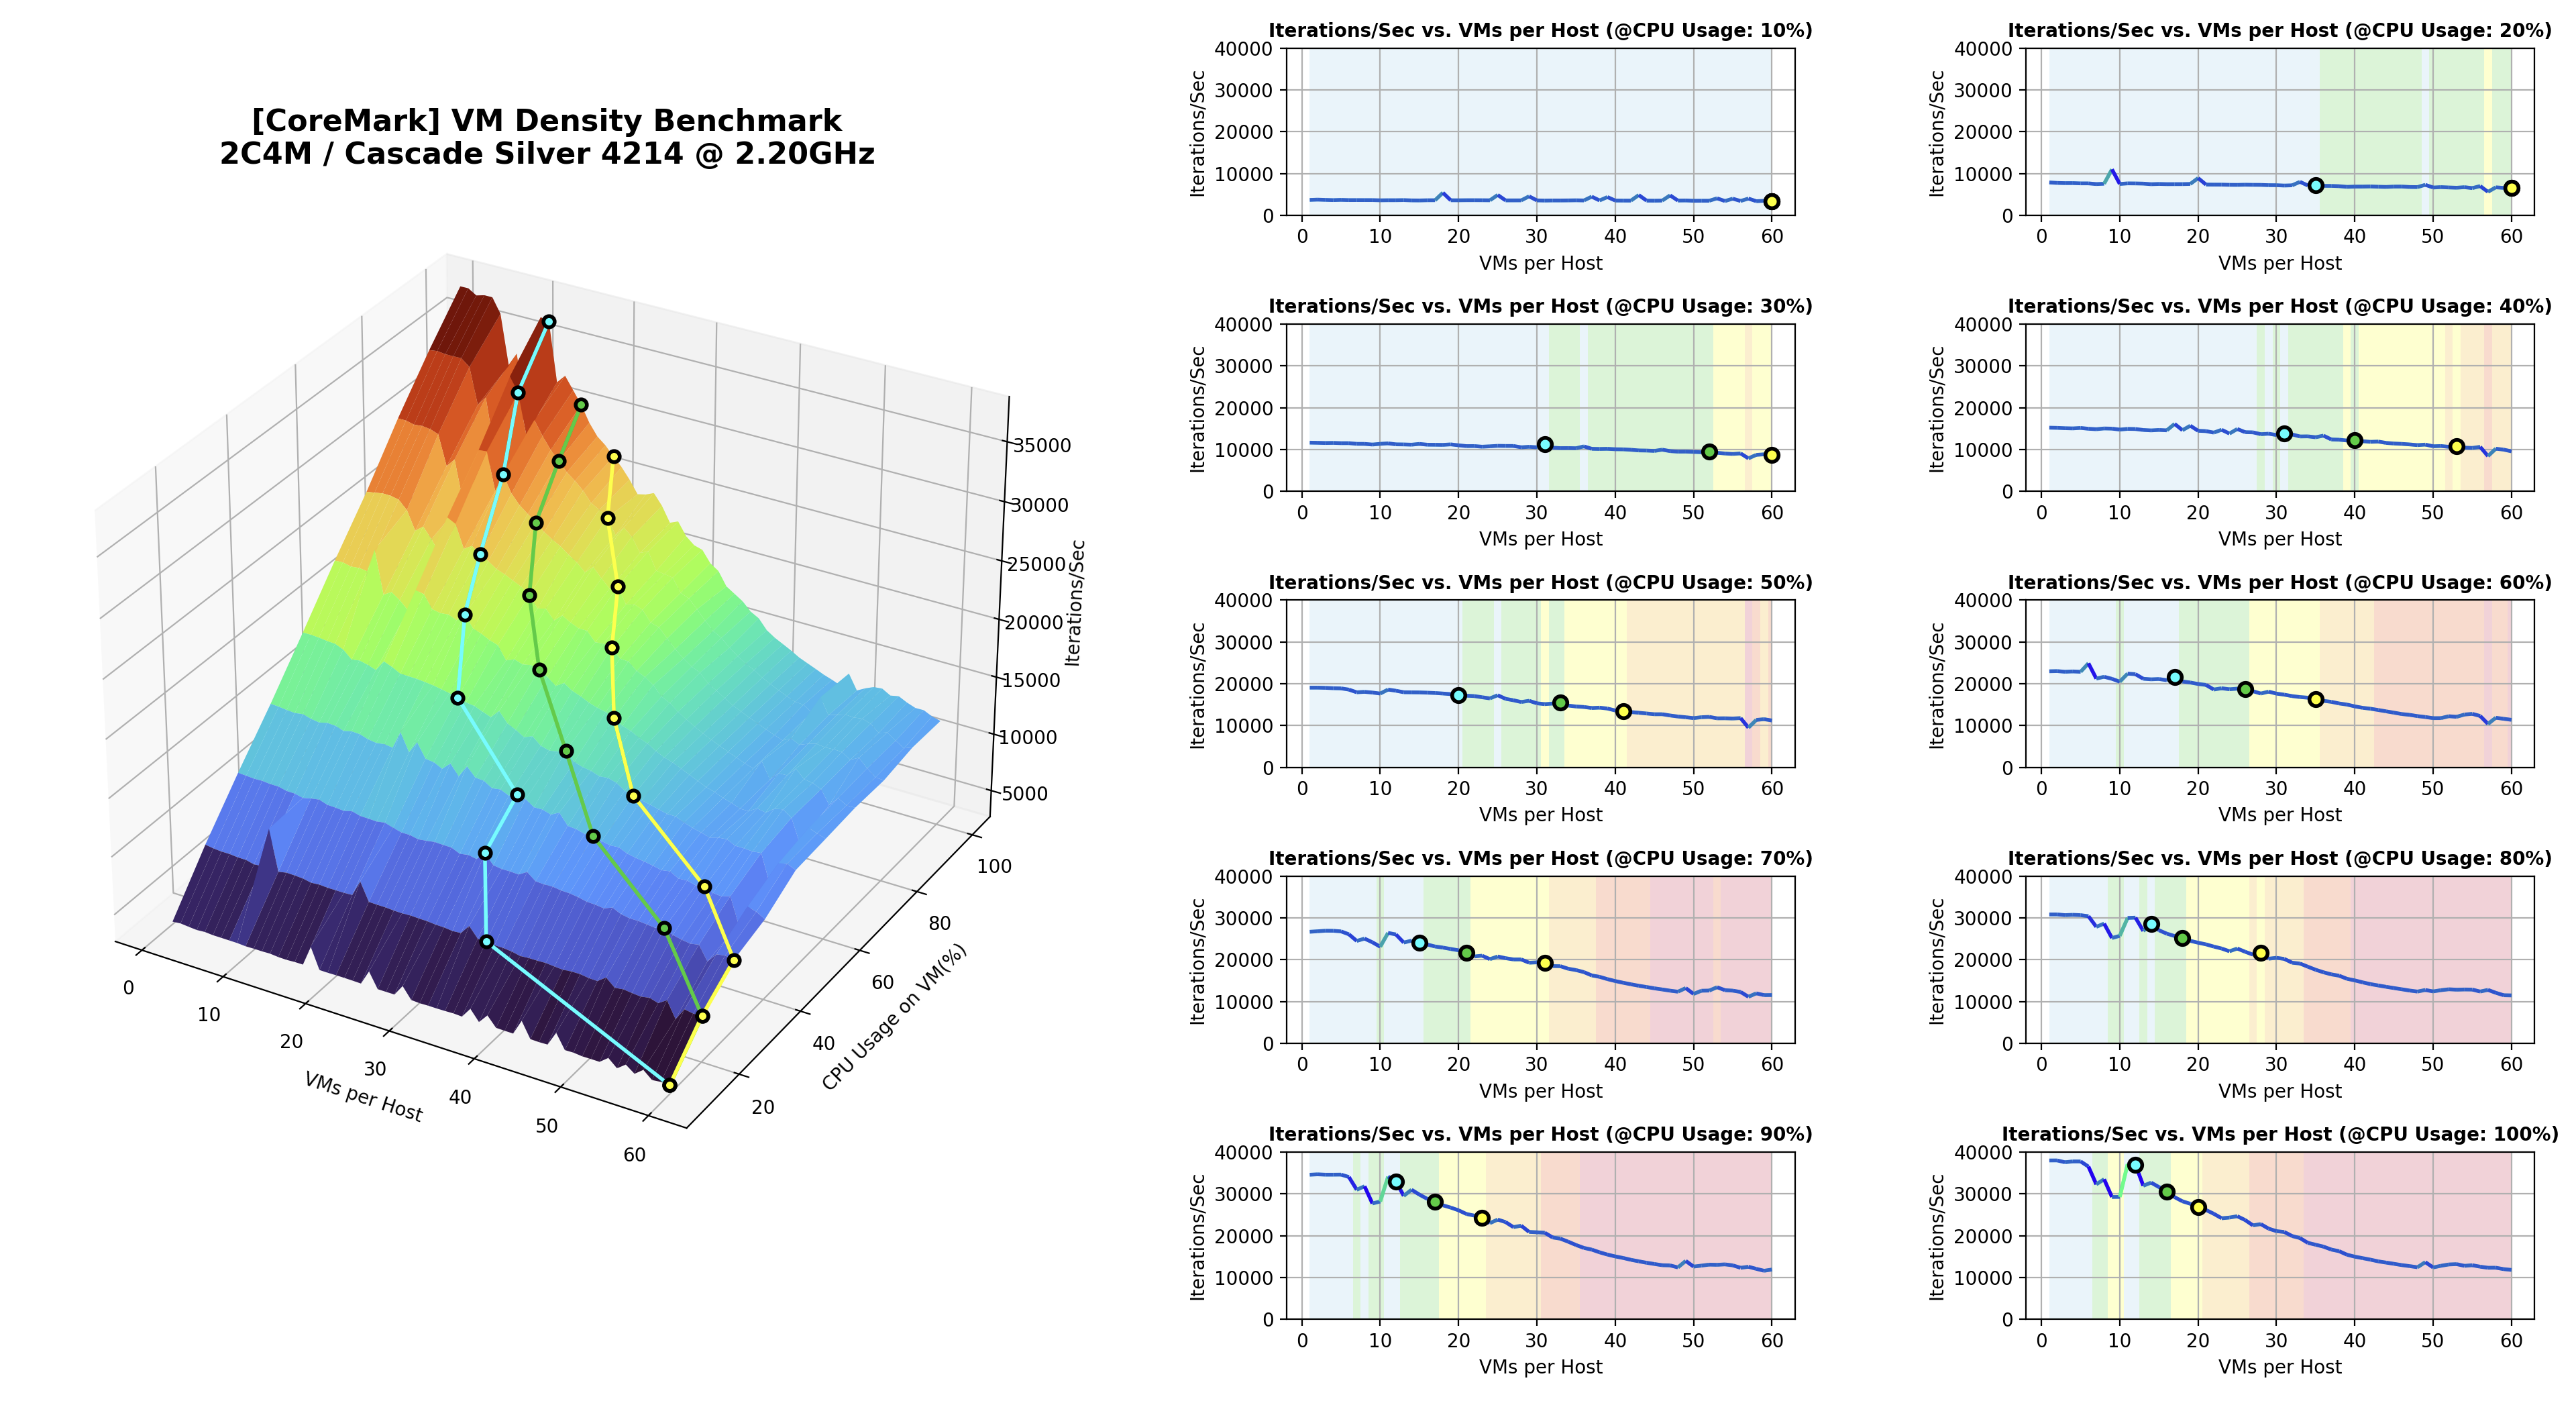
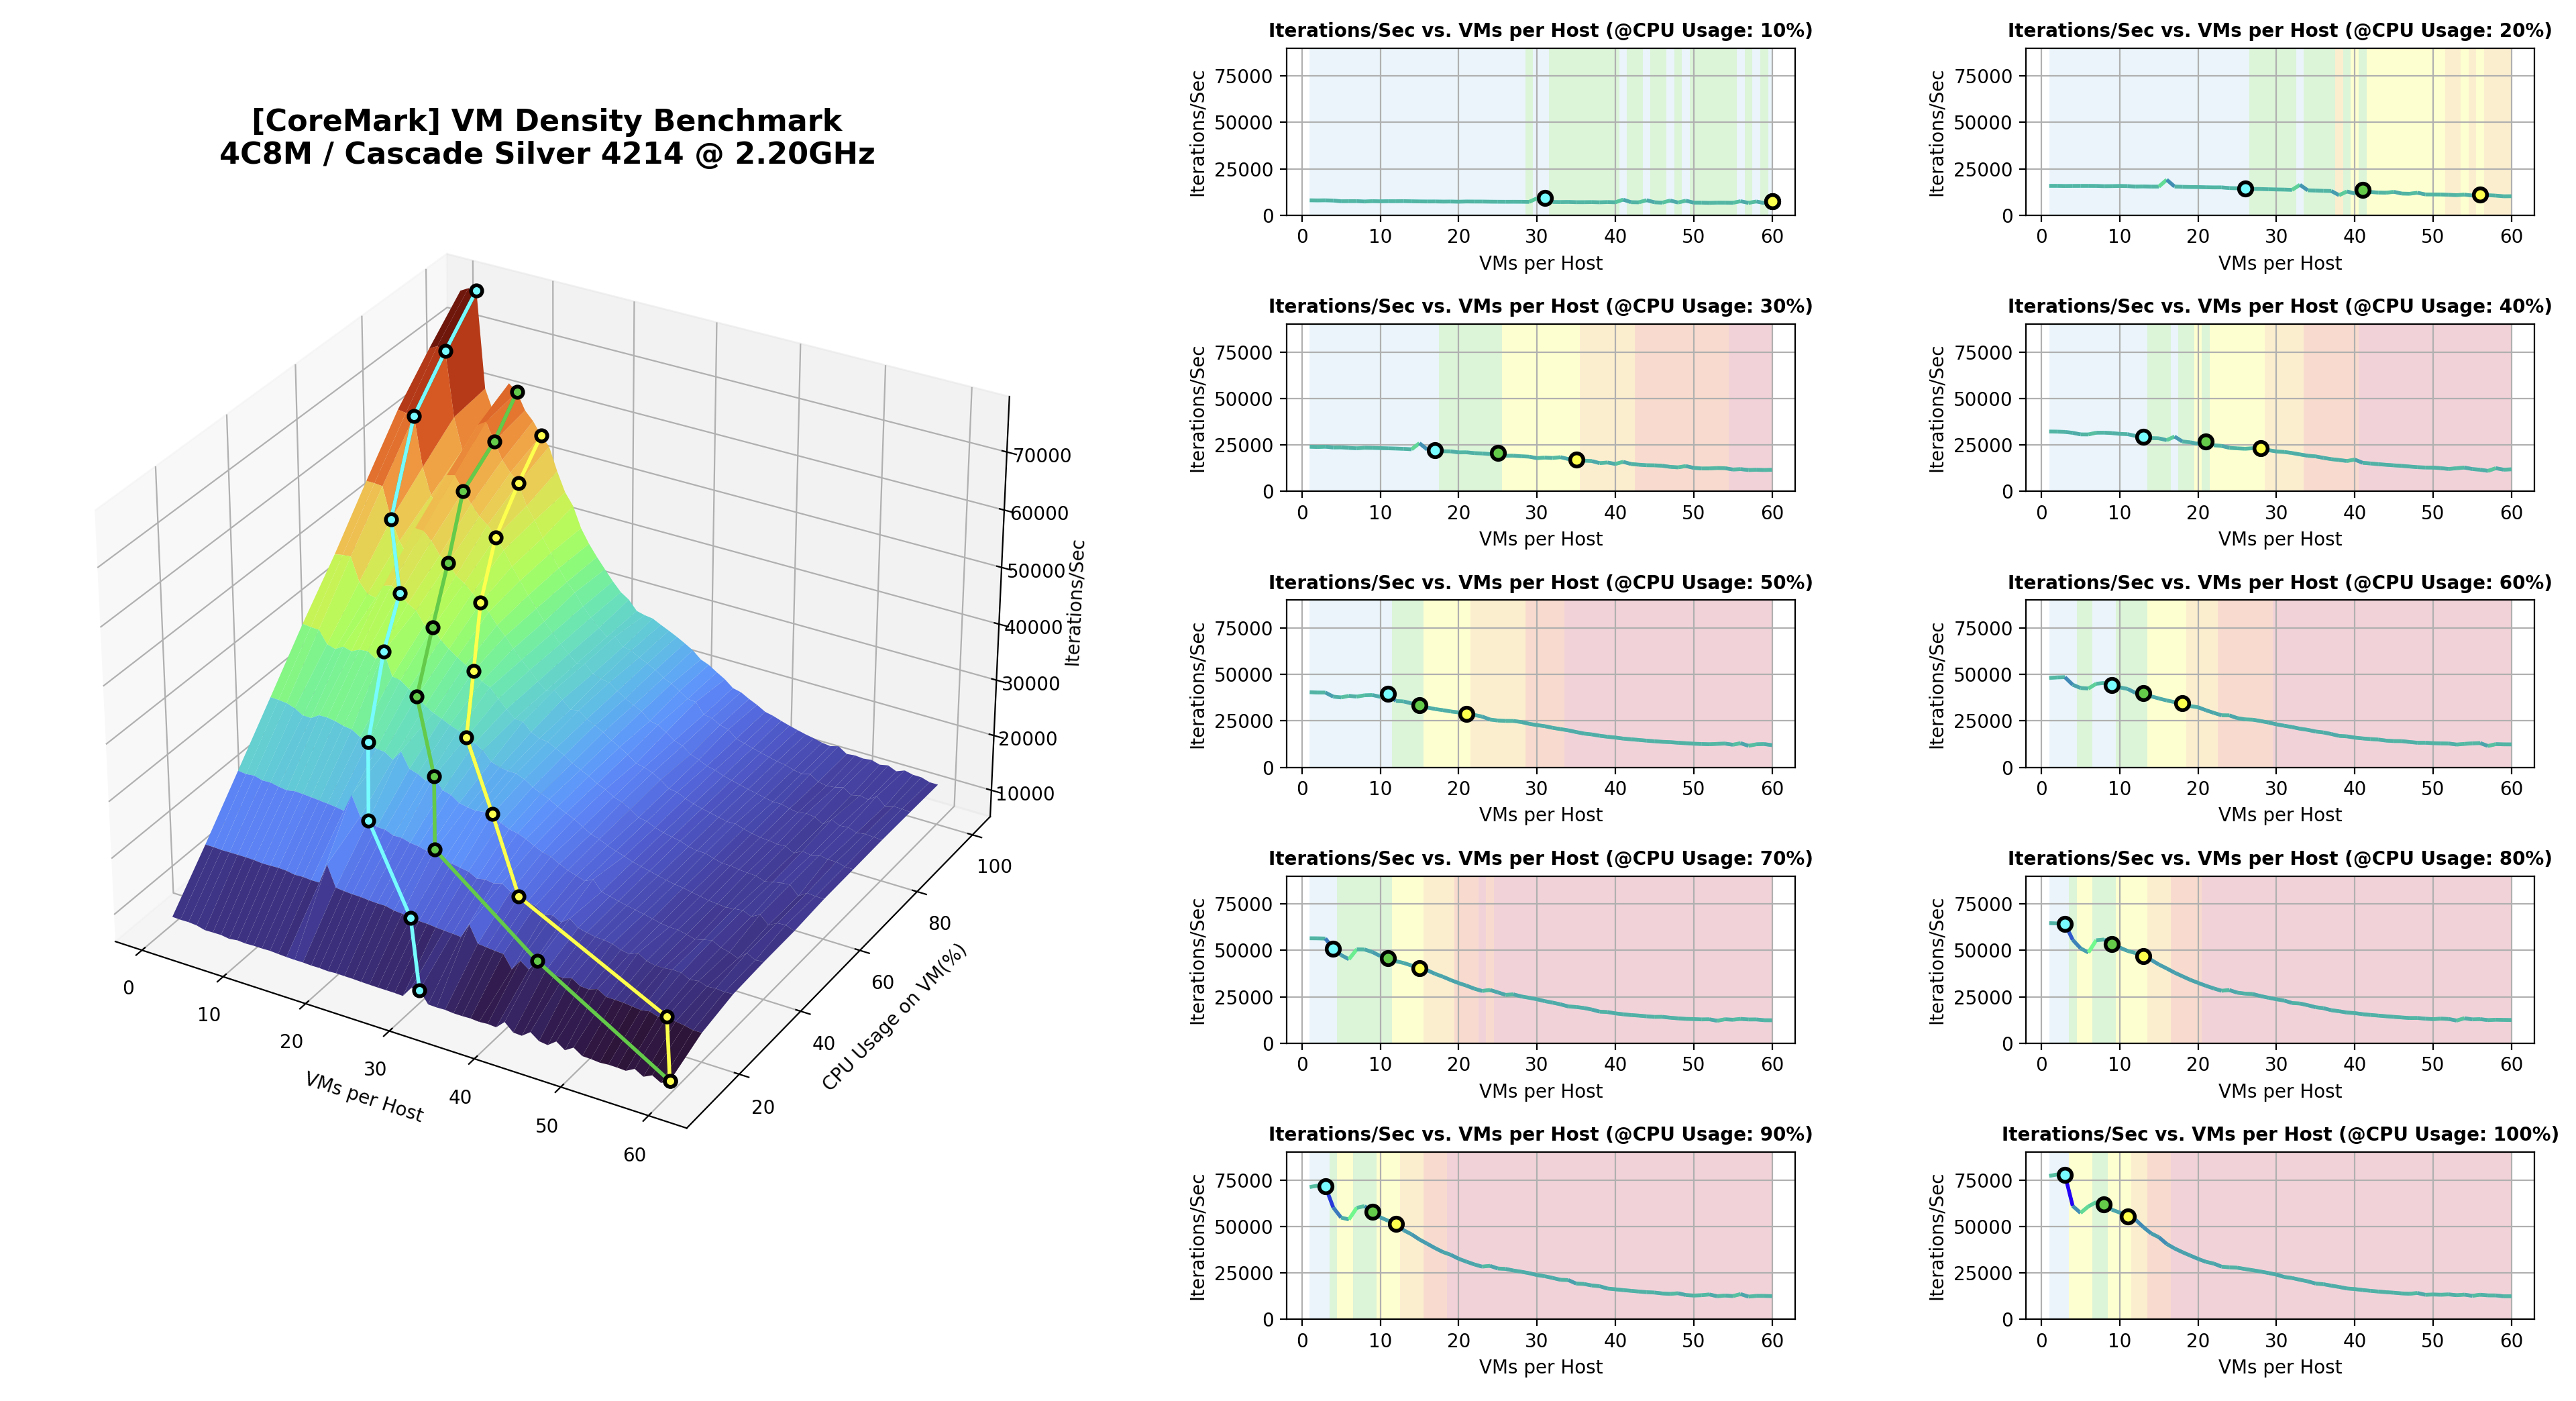
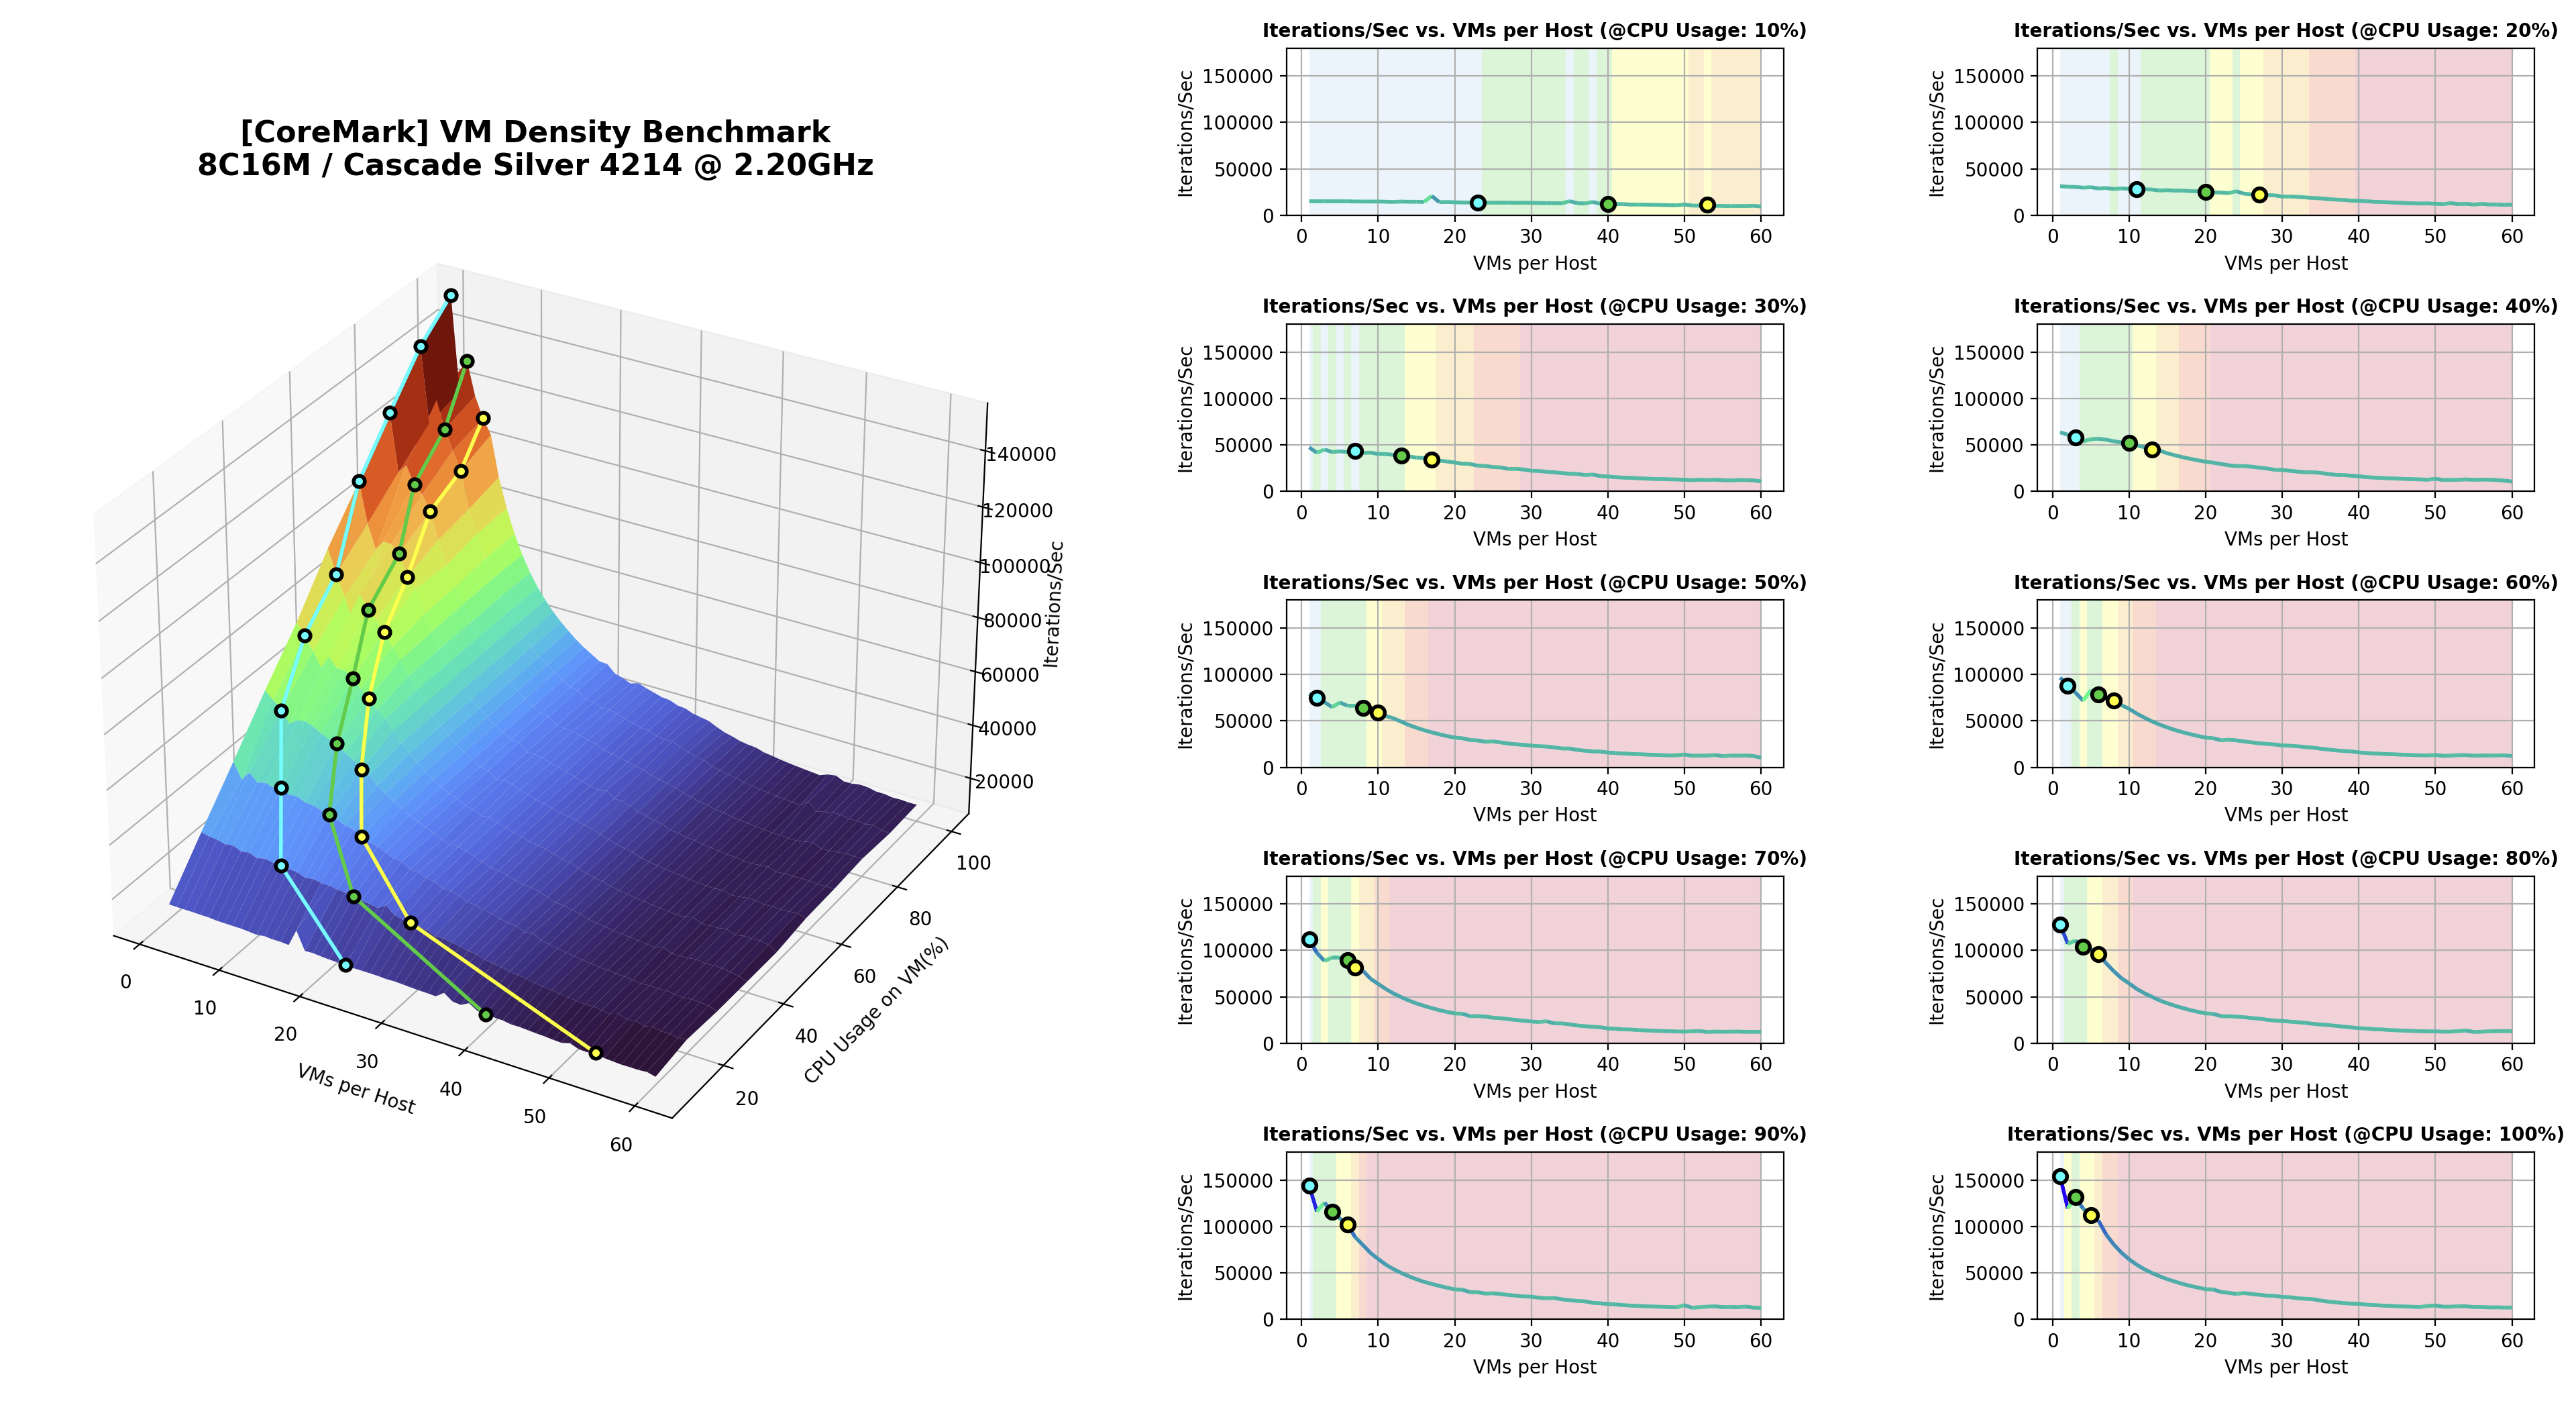
< 全体 PM スペック ・ VM フレーバー別結果 >
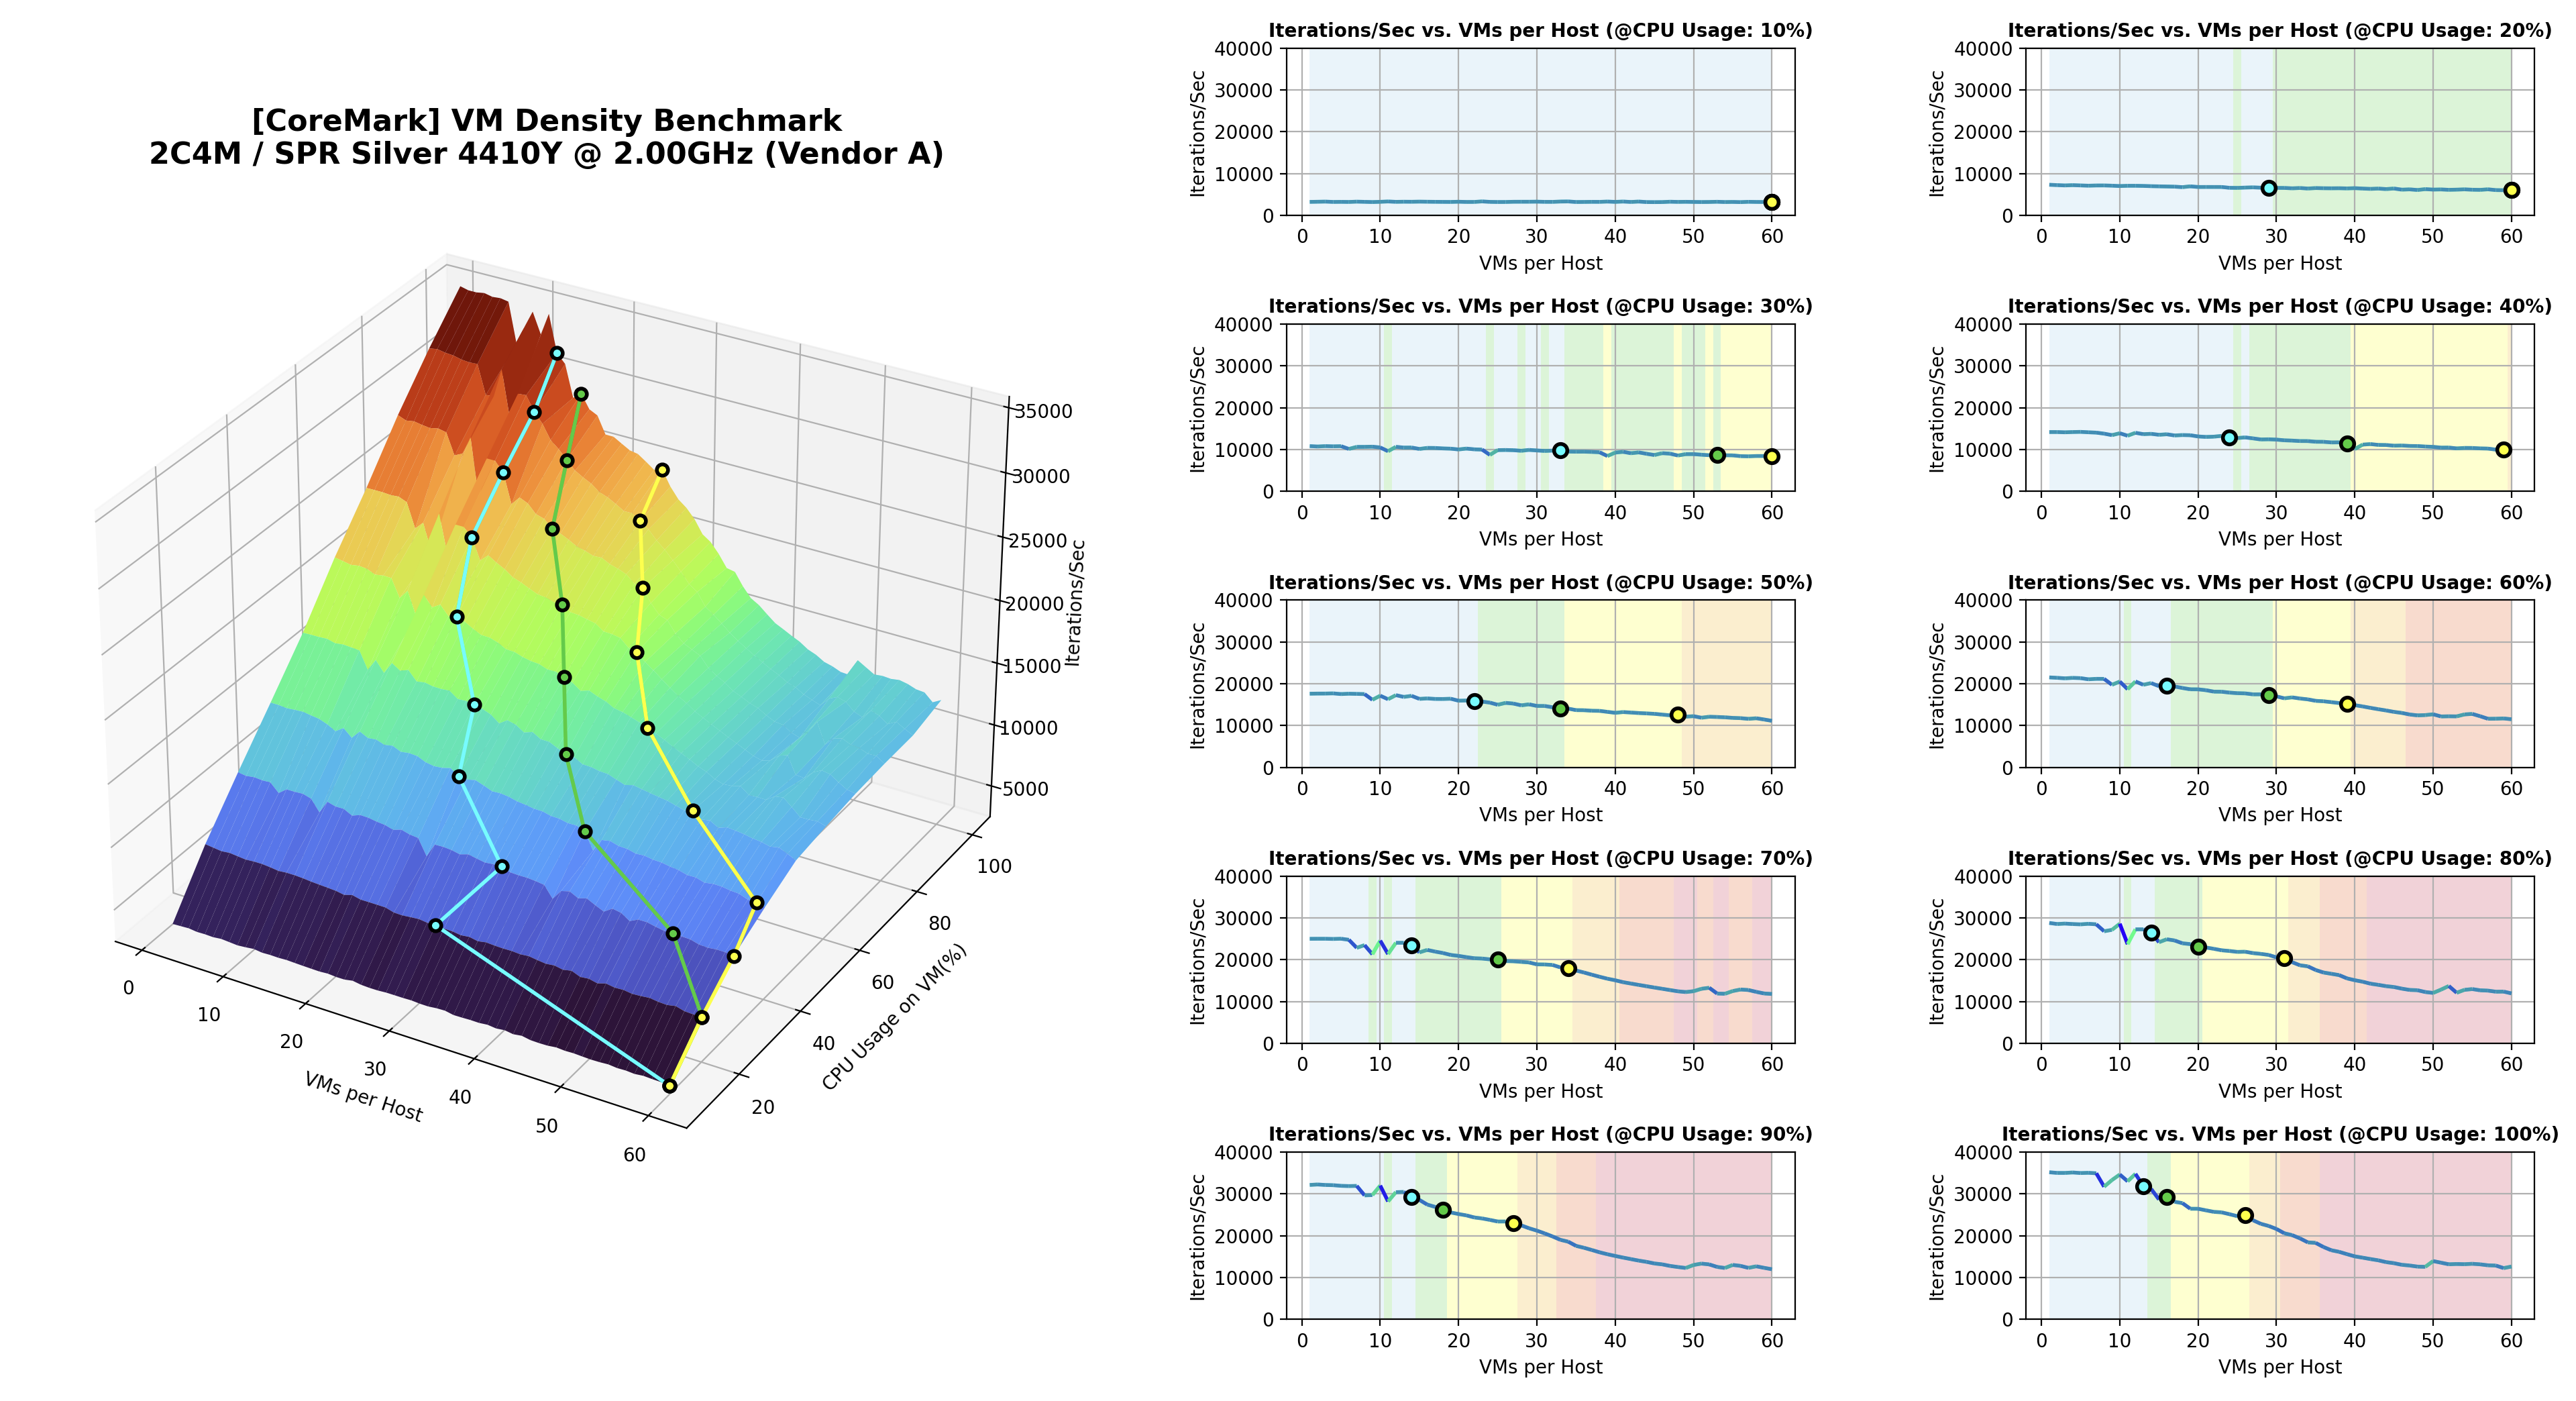
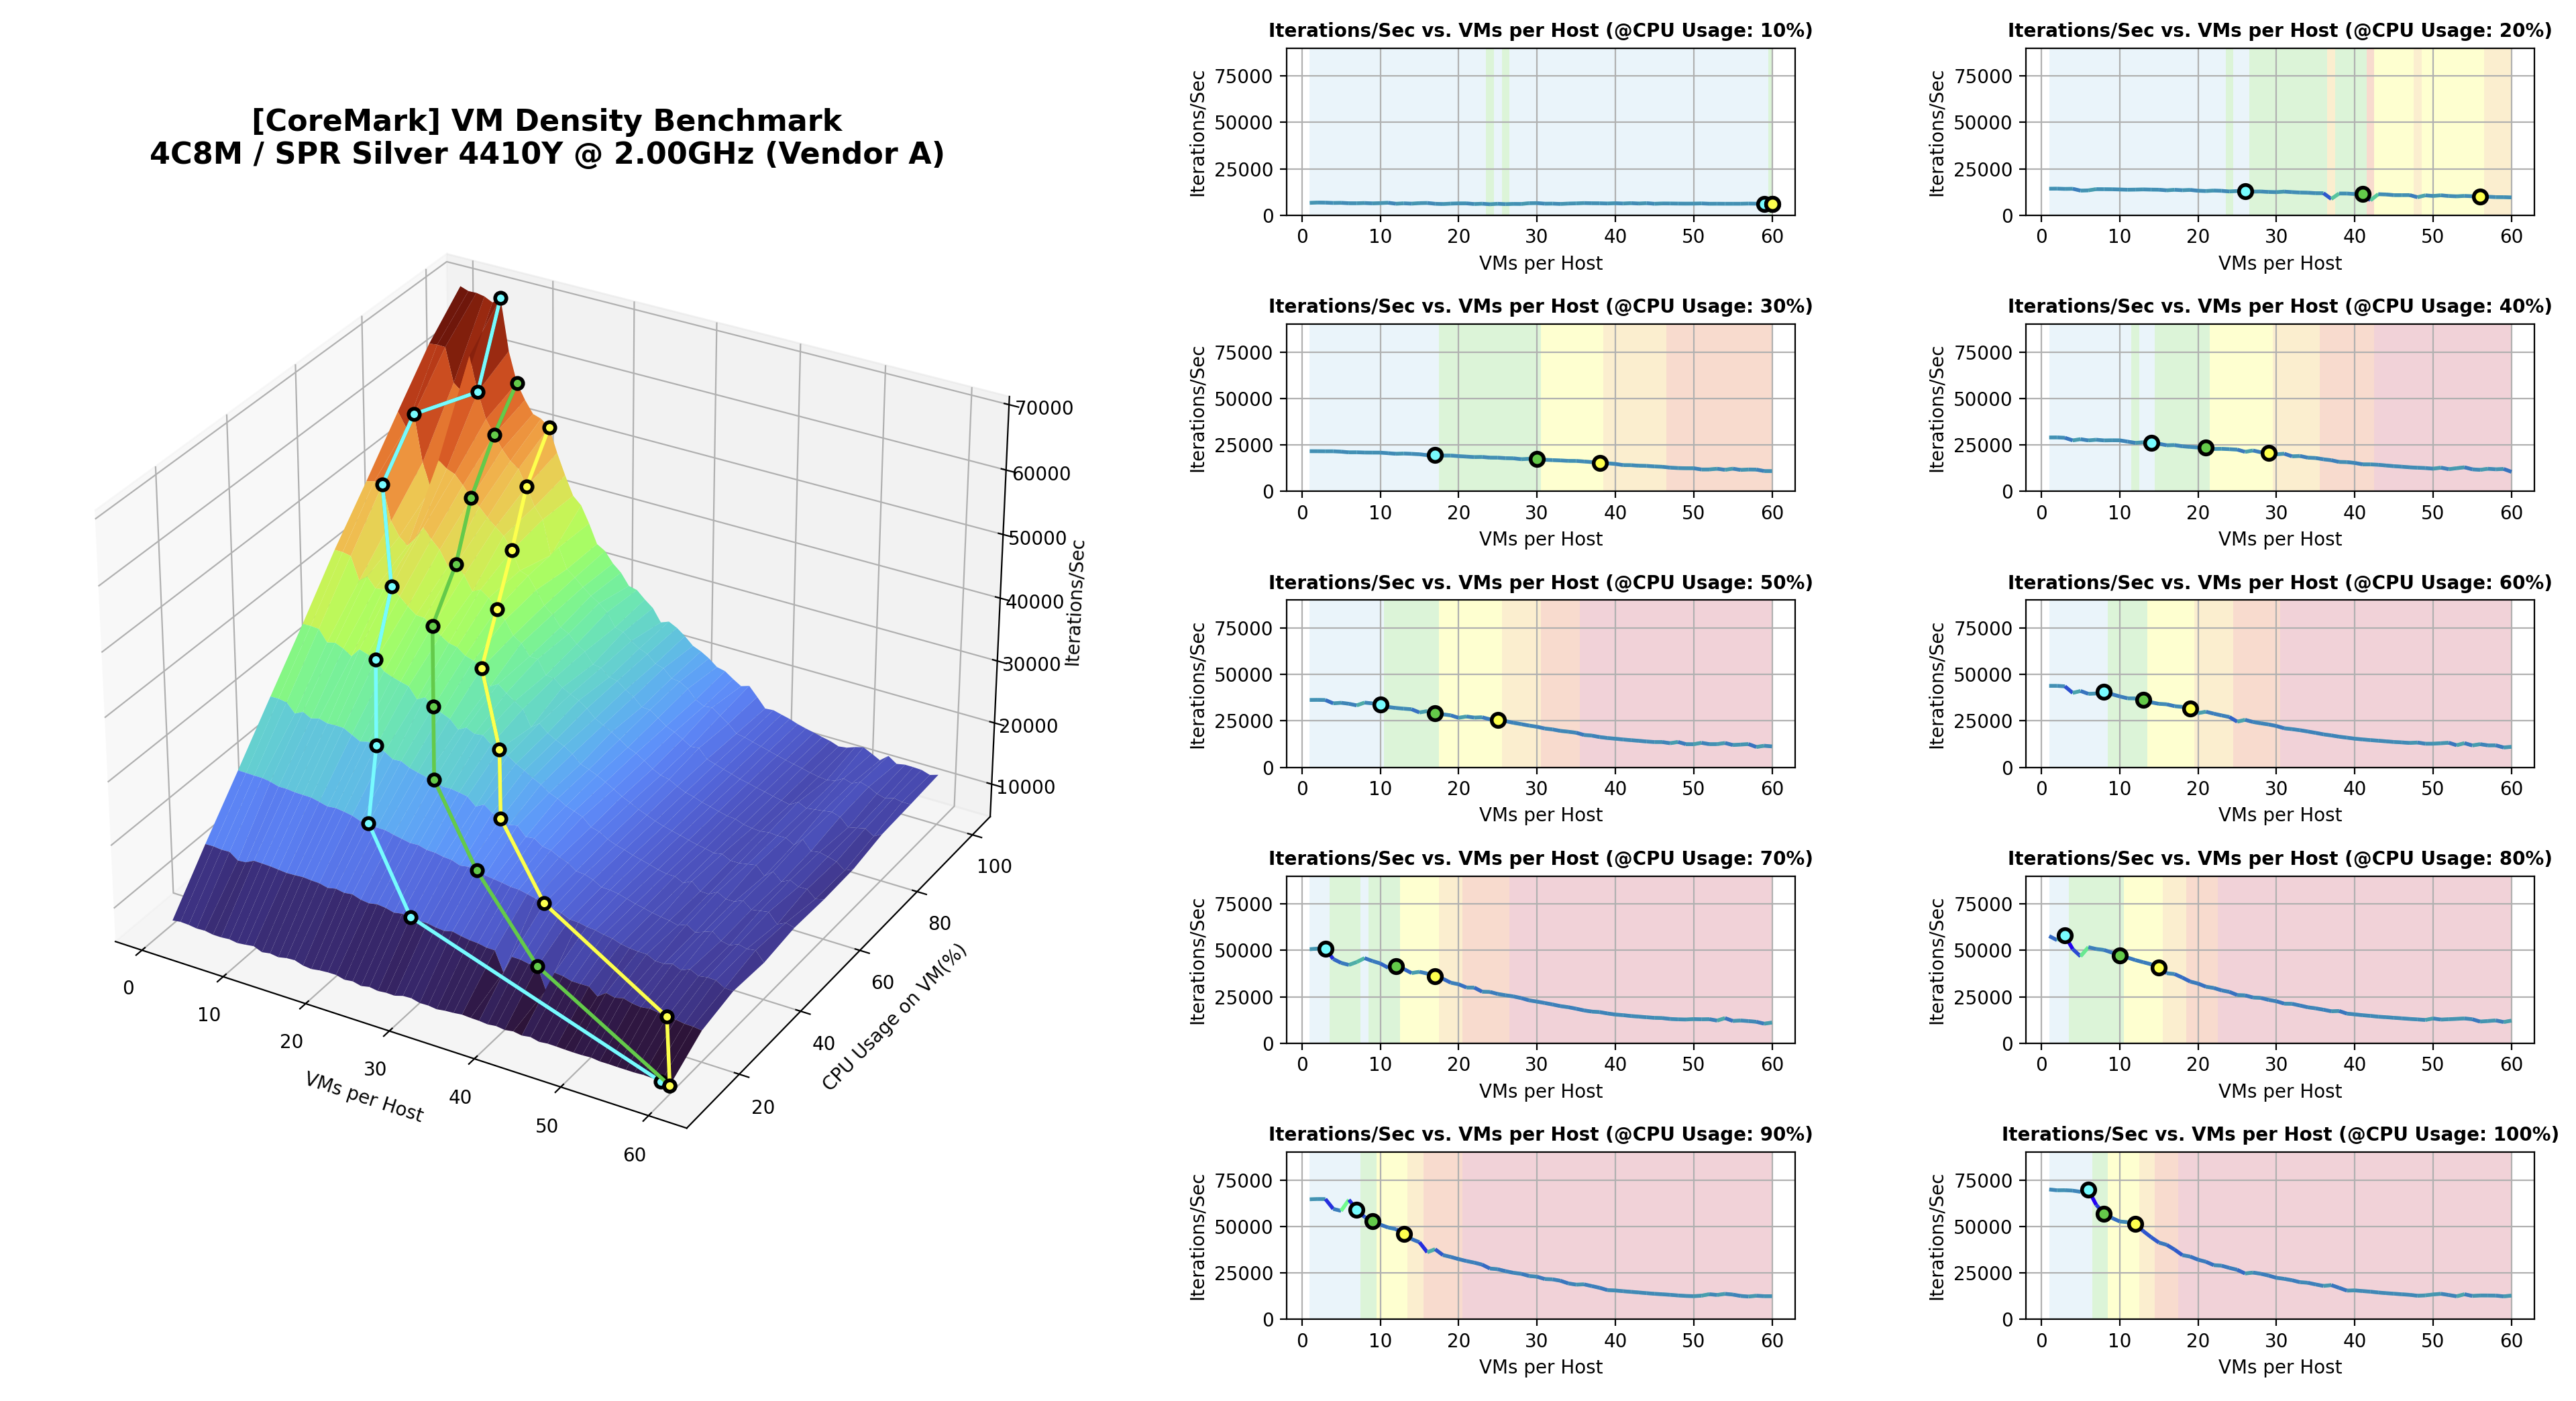
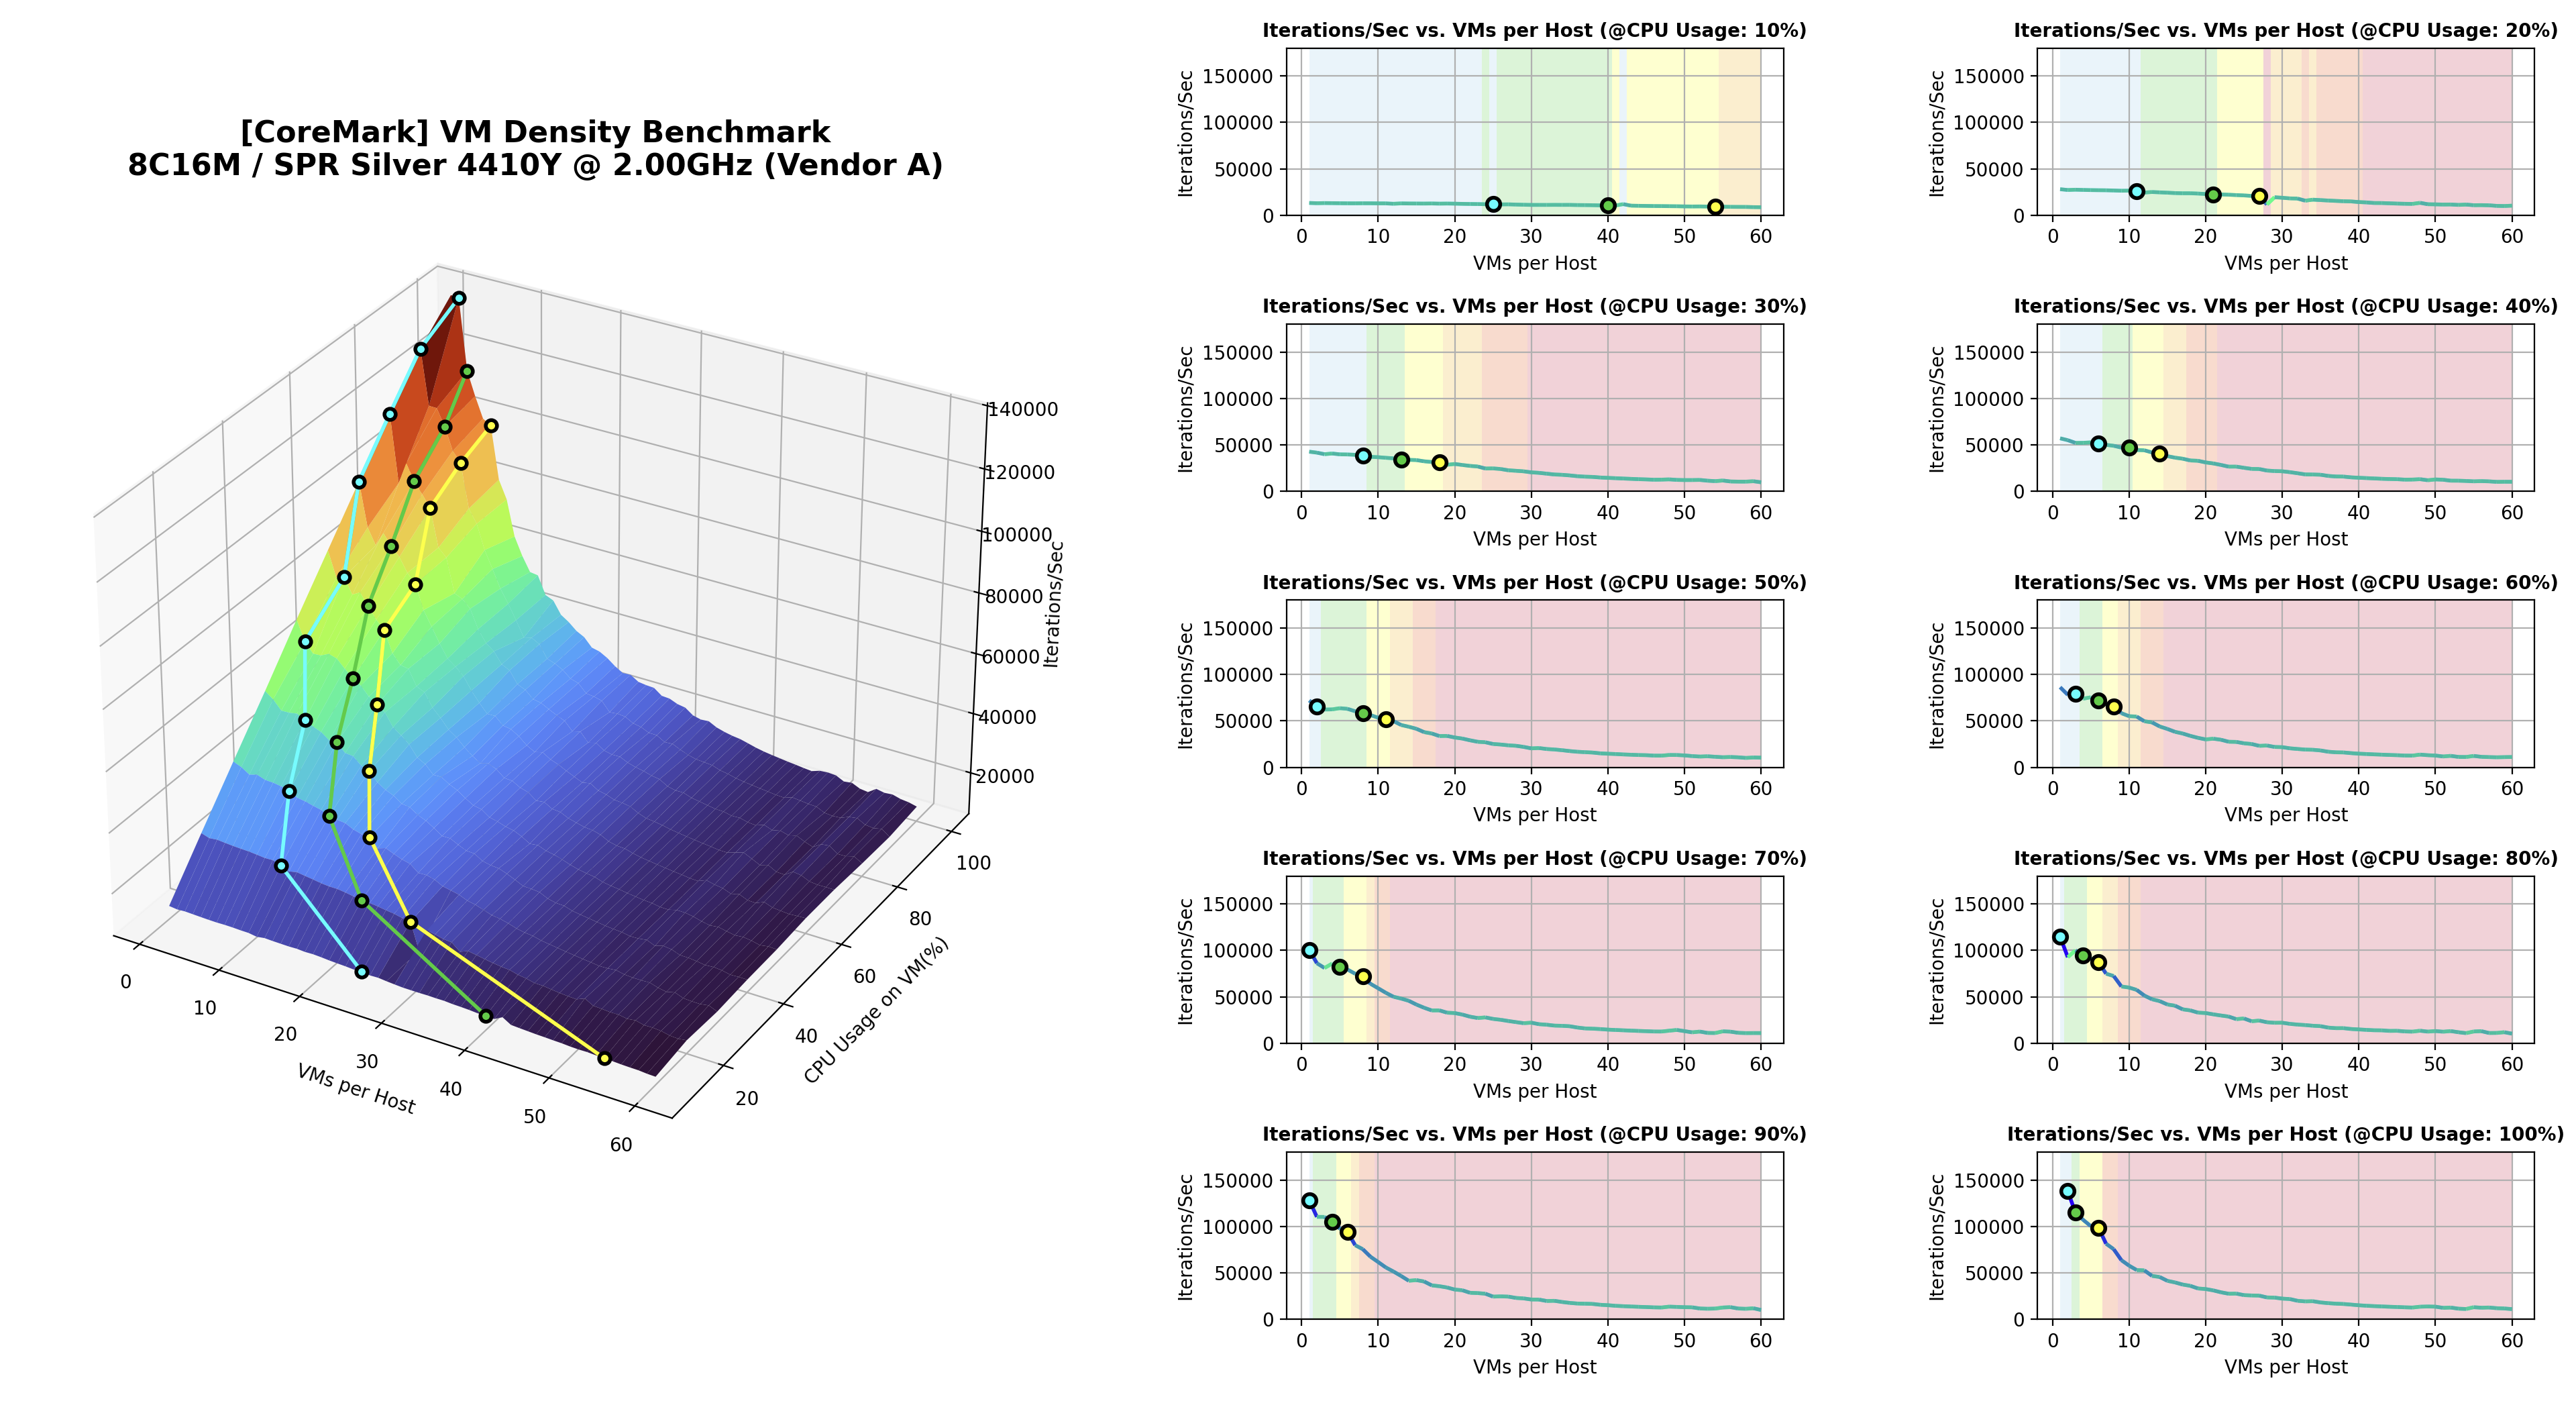
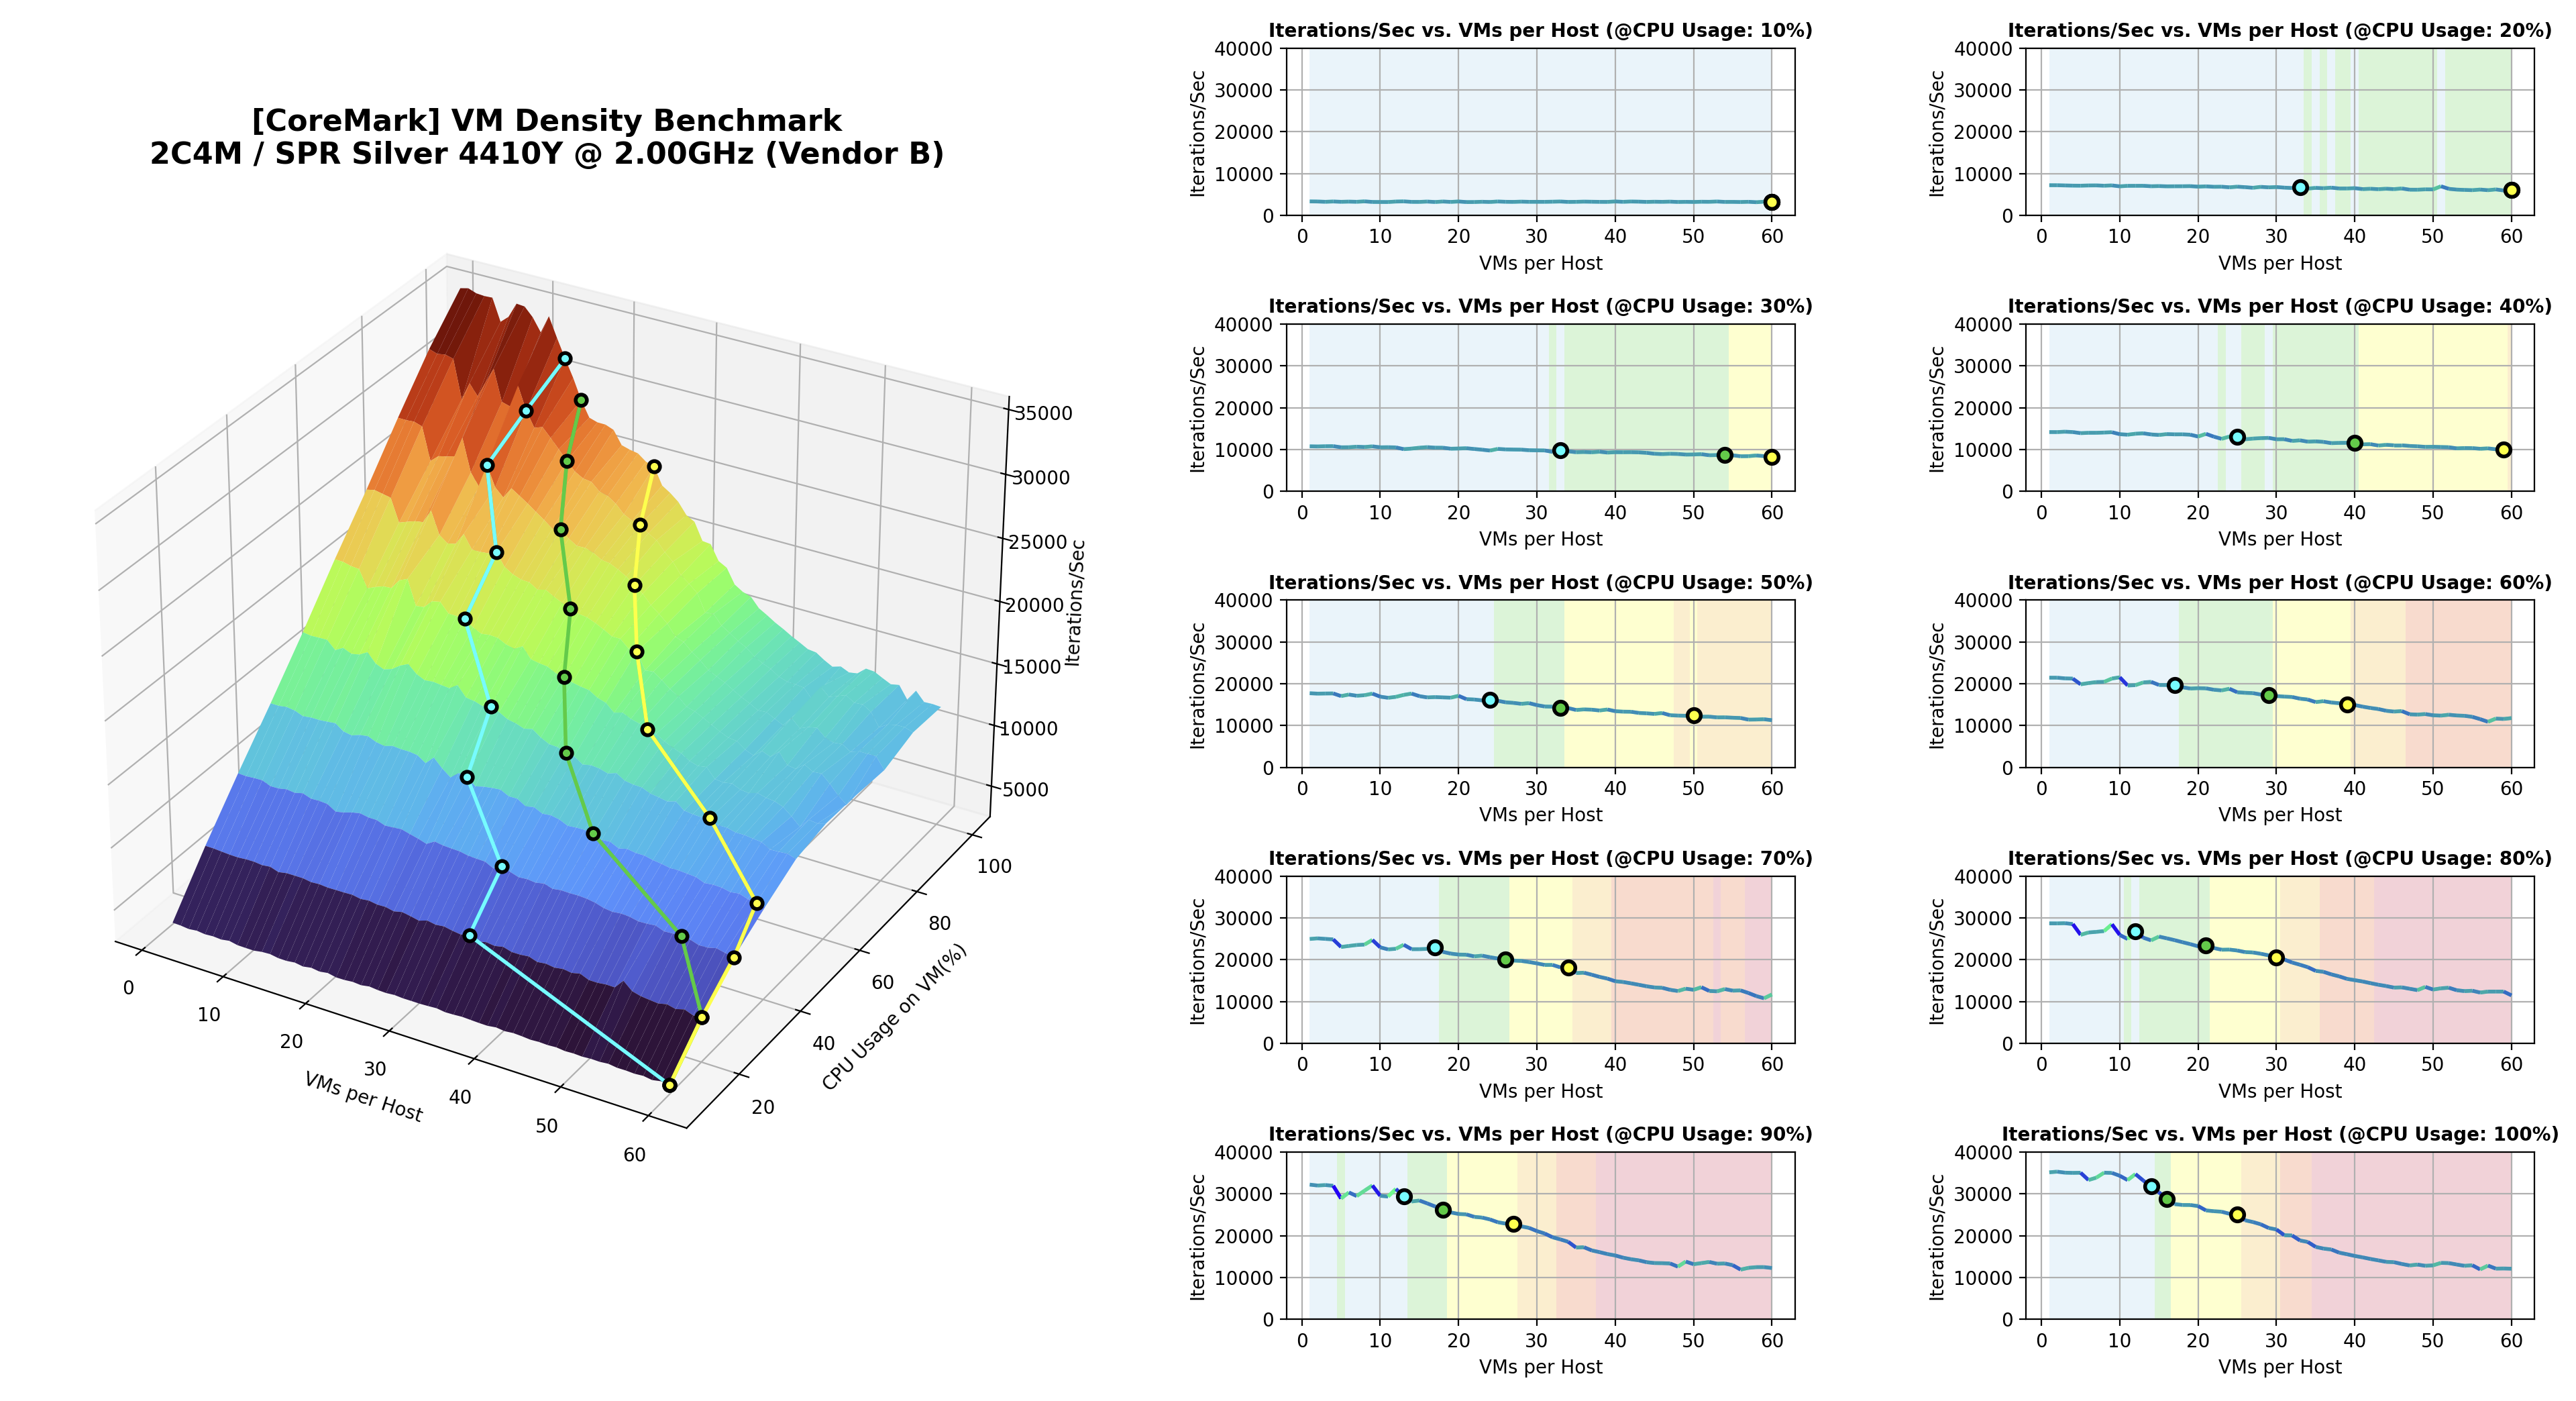
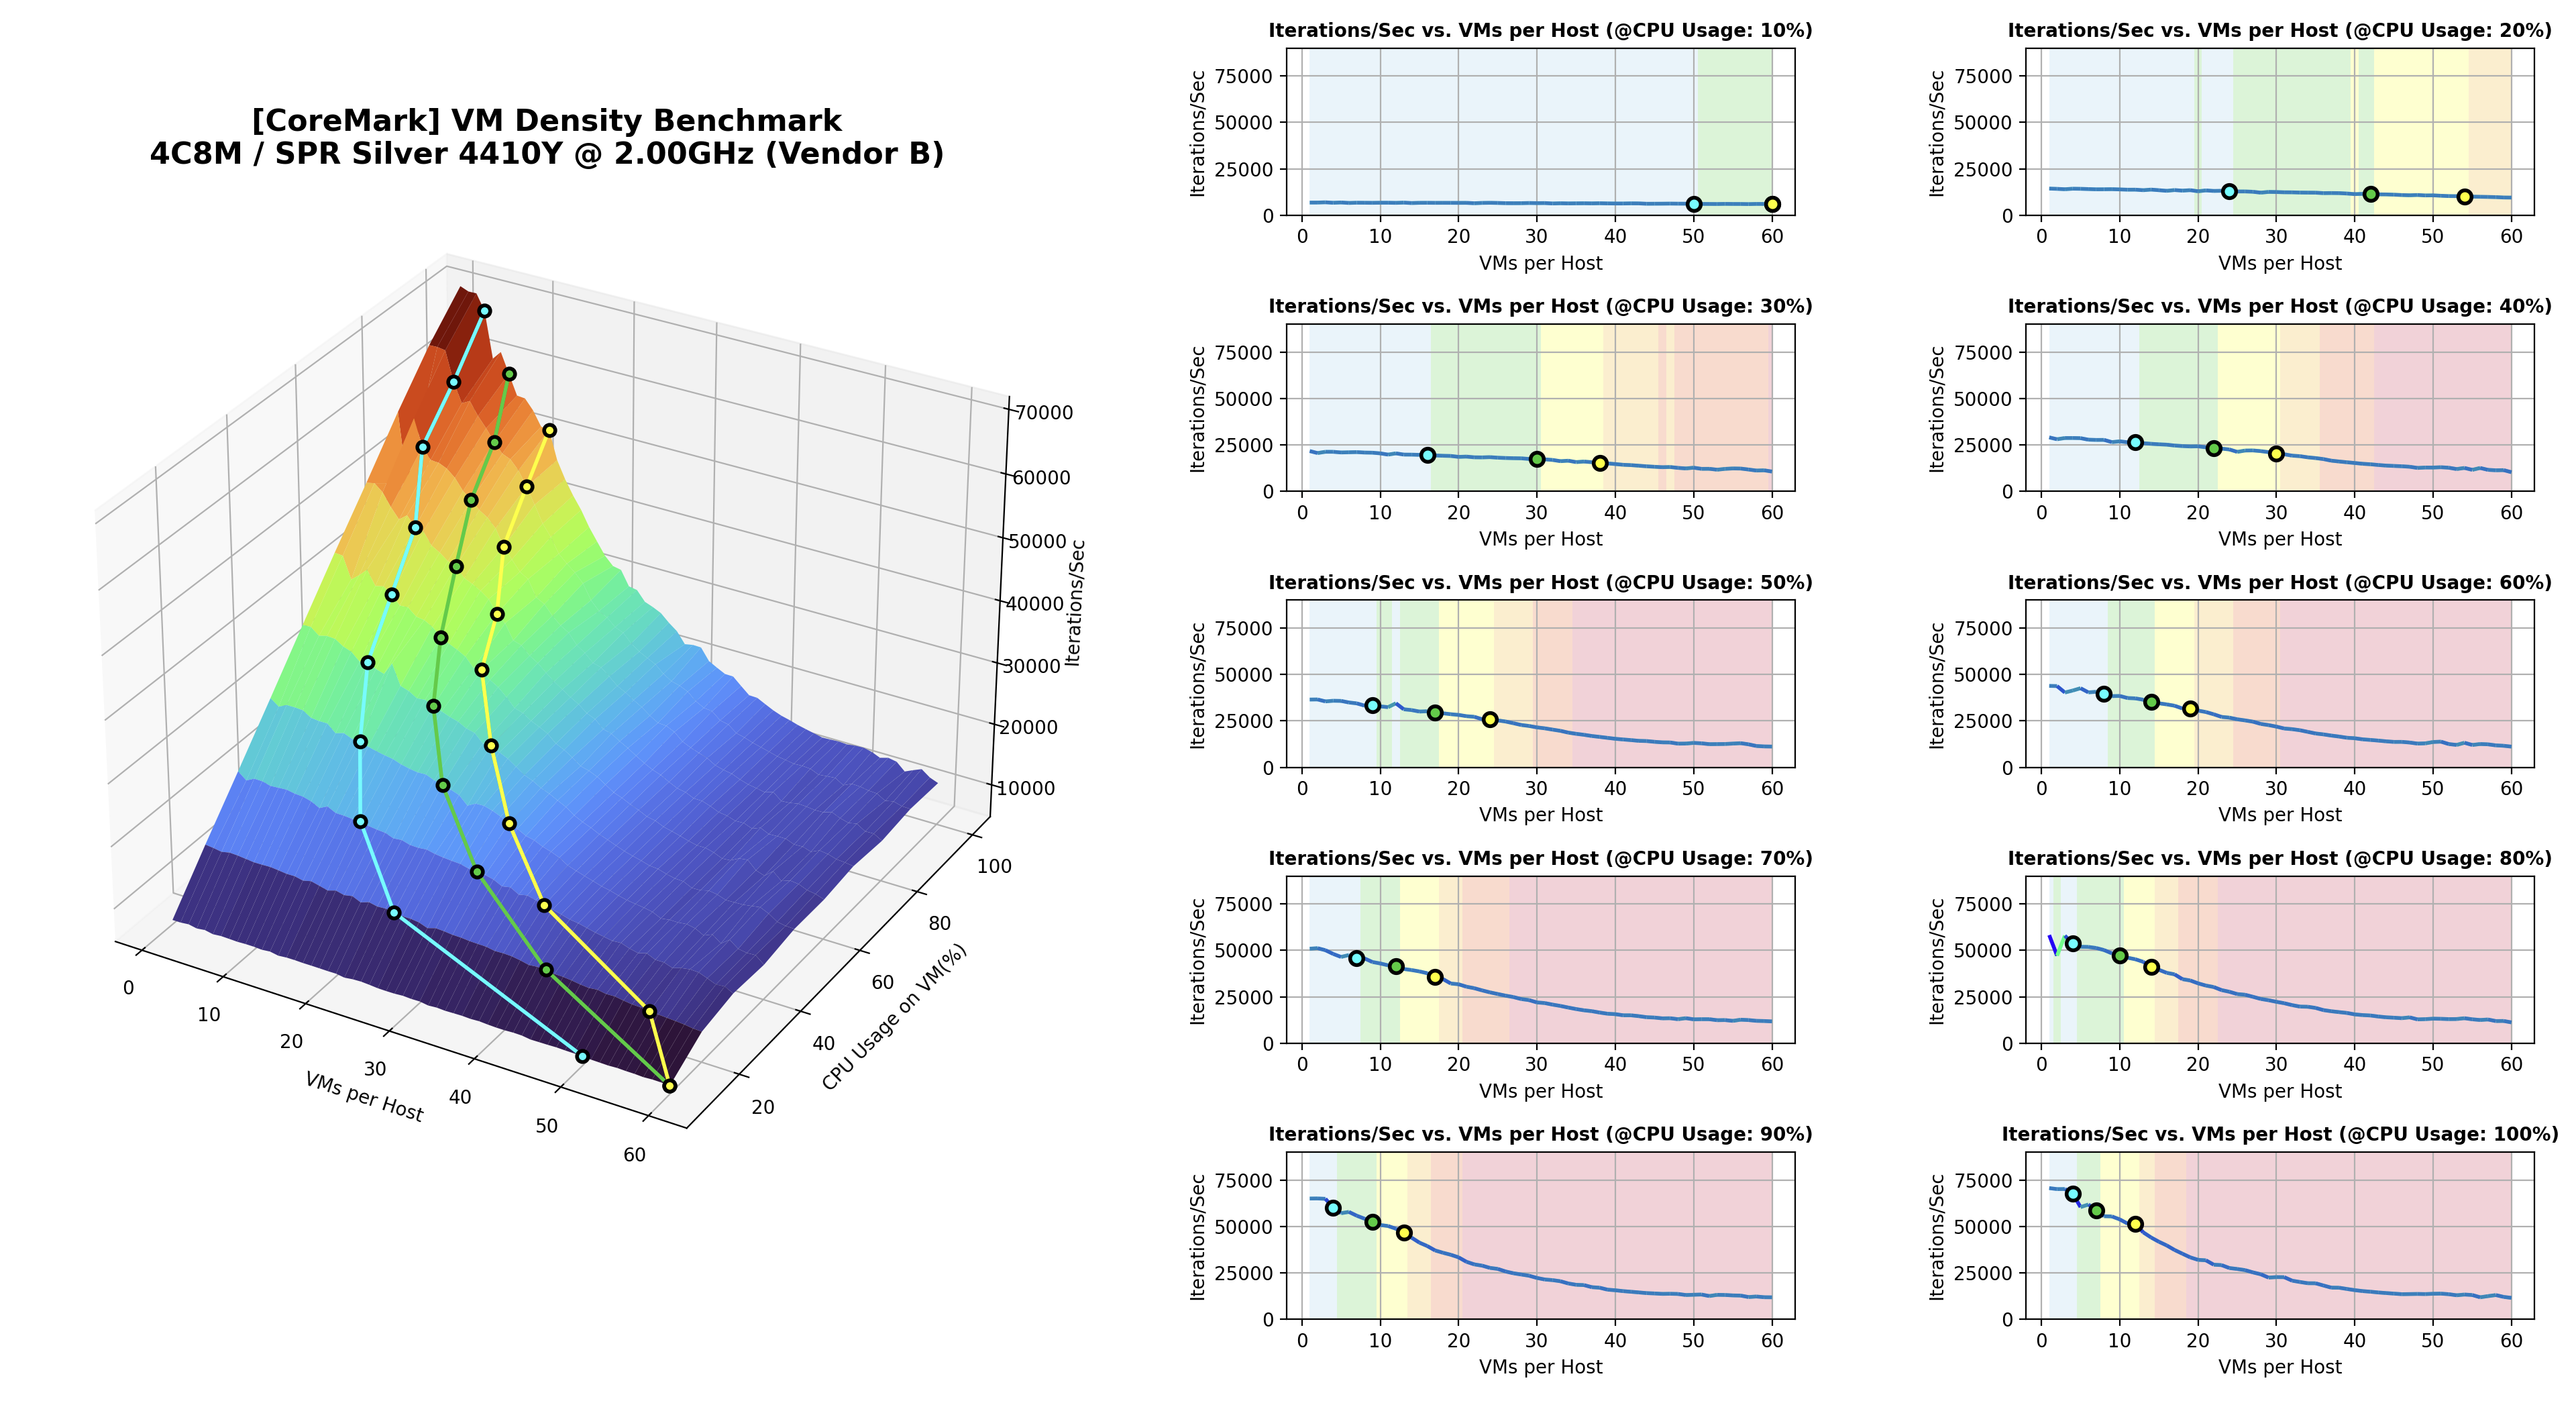
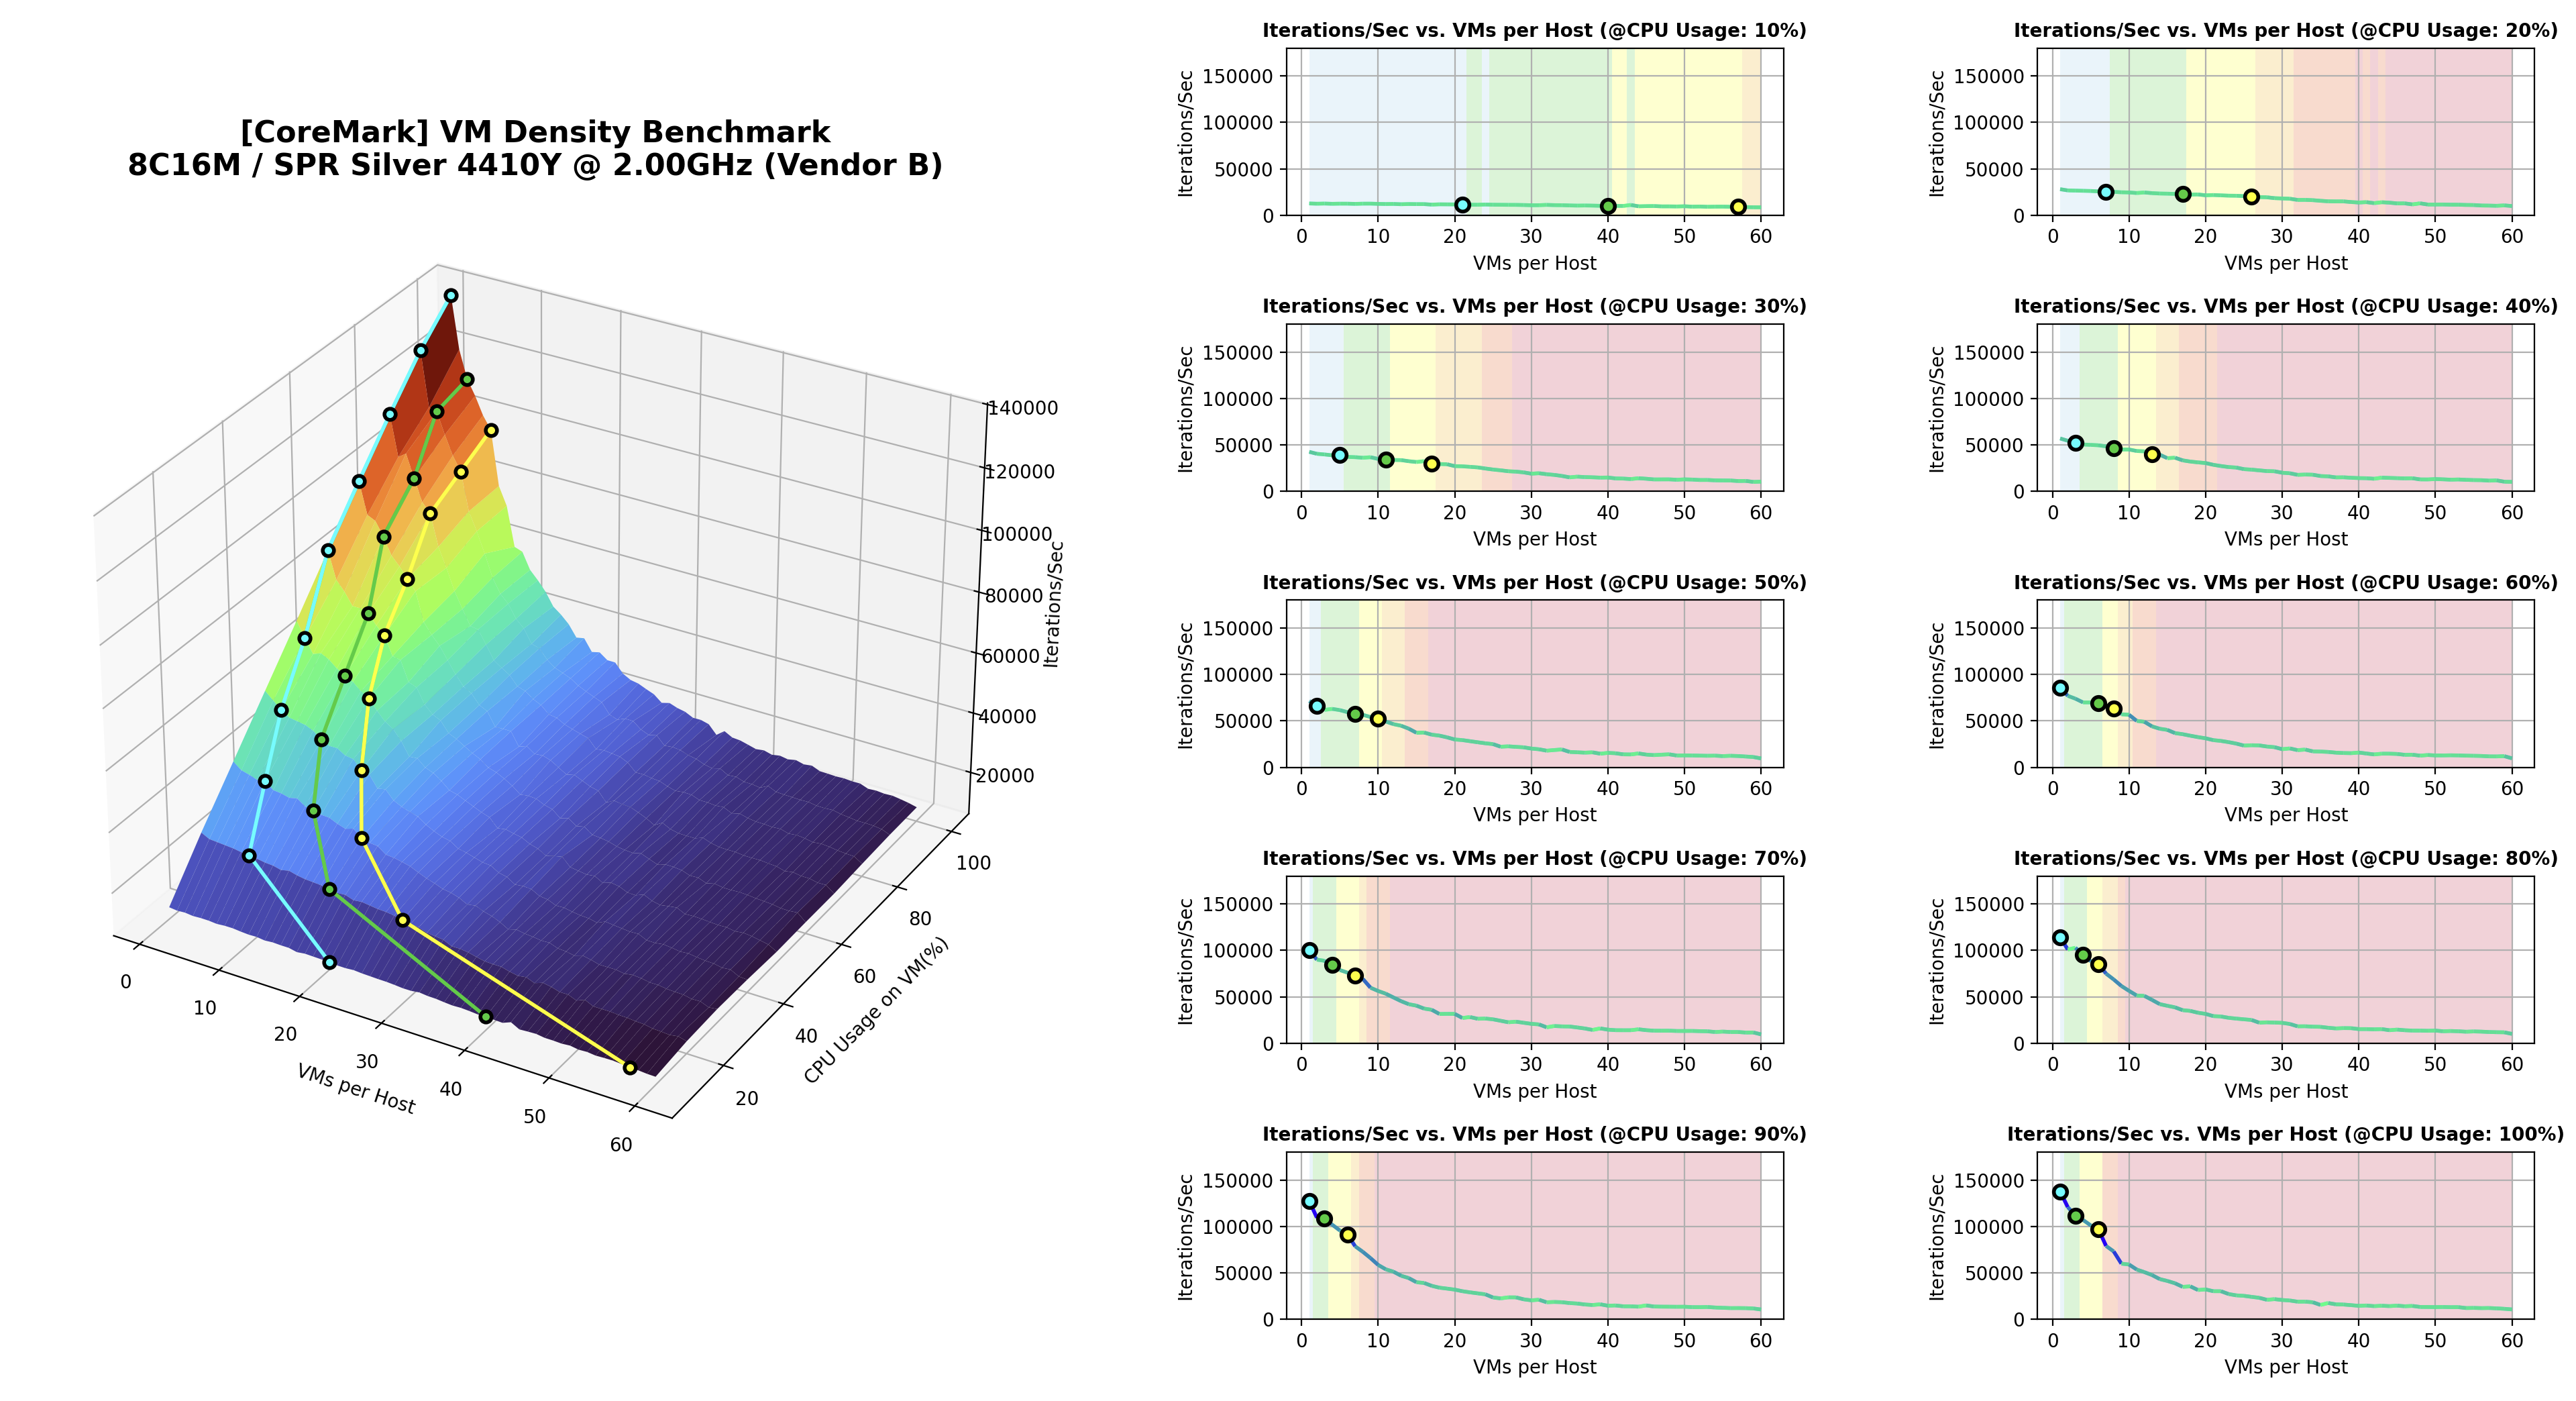
1) 資料紹介
VM 数の増加に伴う VM の CPU パフォーマンスの変化を、PM の CPU スペック ・ VM のフレーバー ・ VM の CPU 使用率別に表しています。これは各条件による全体的な VM の CPU パフォーマンスの低下形態を把握することが目的です。
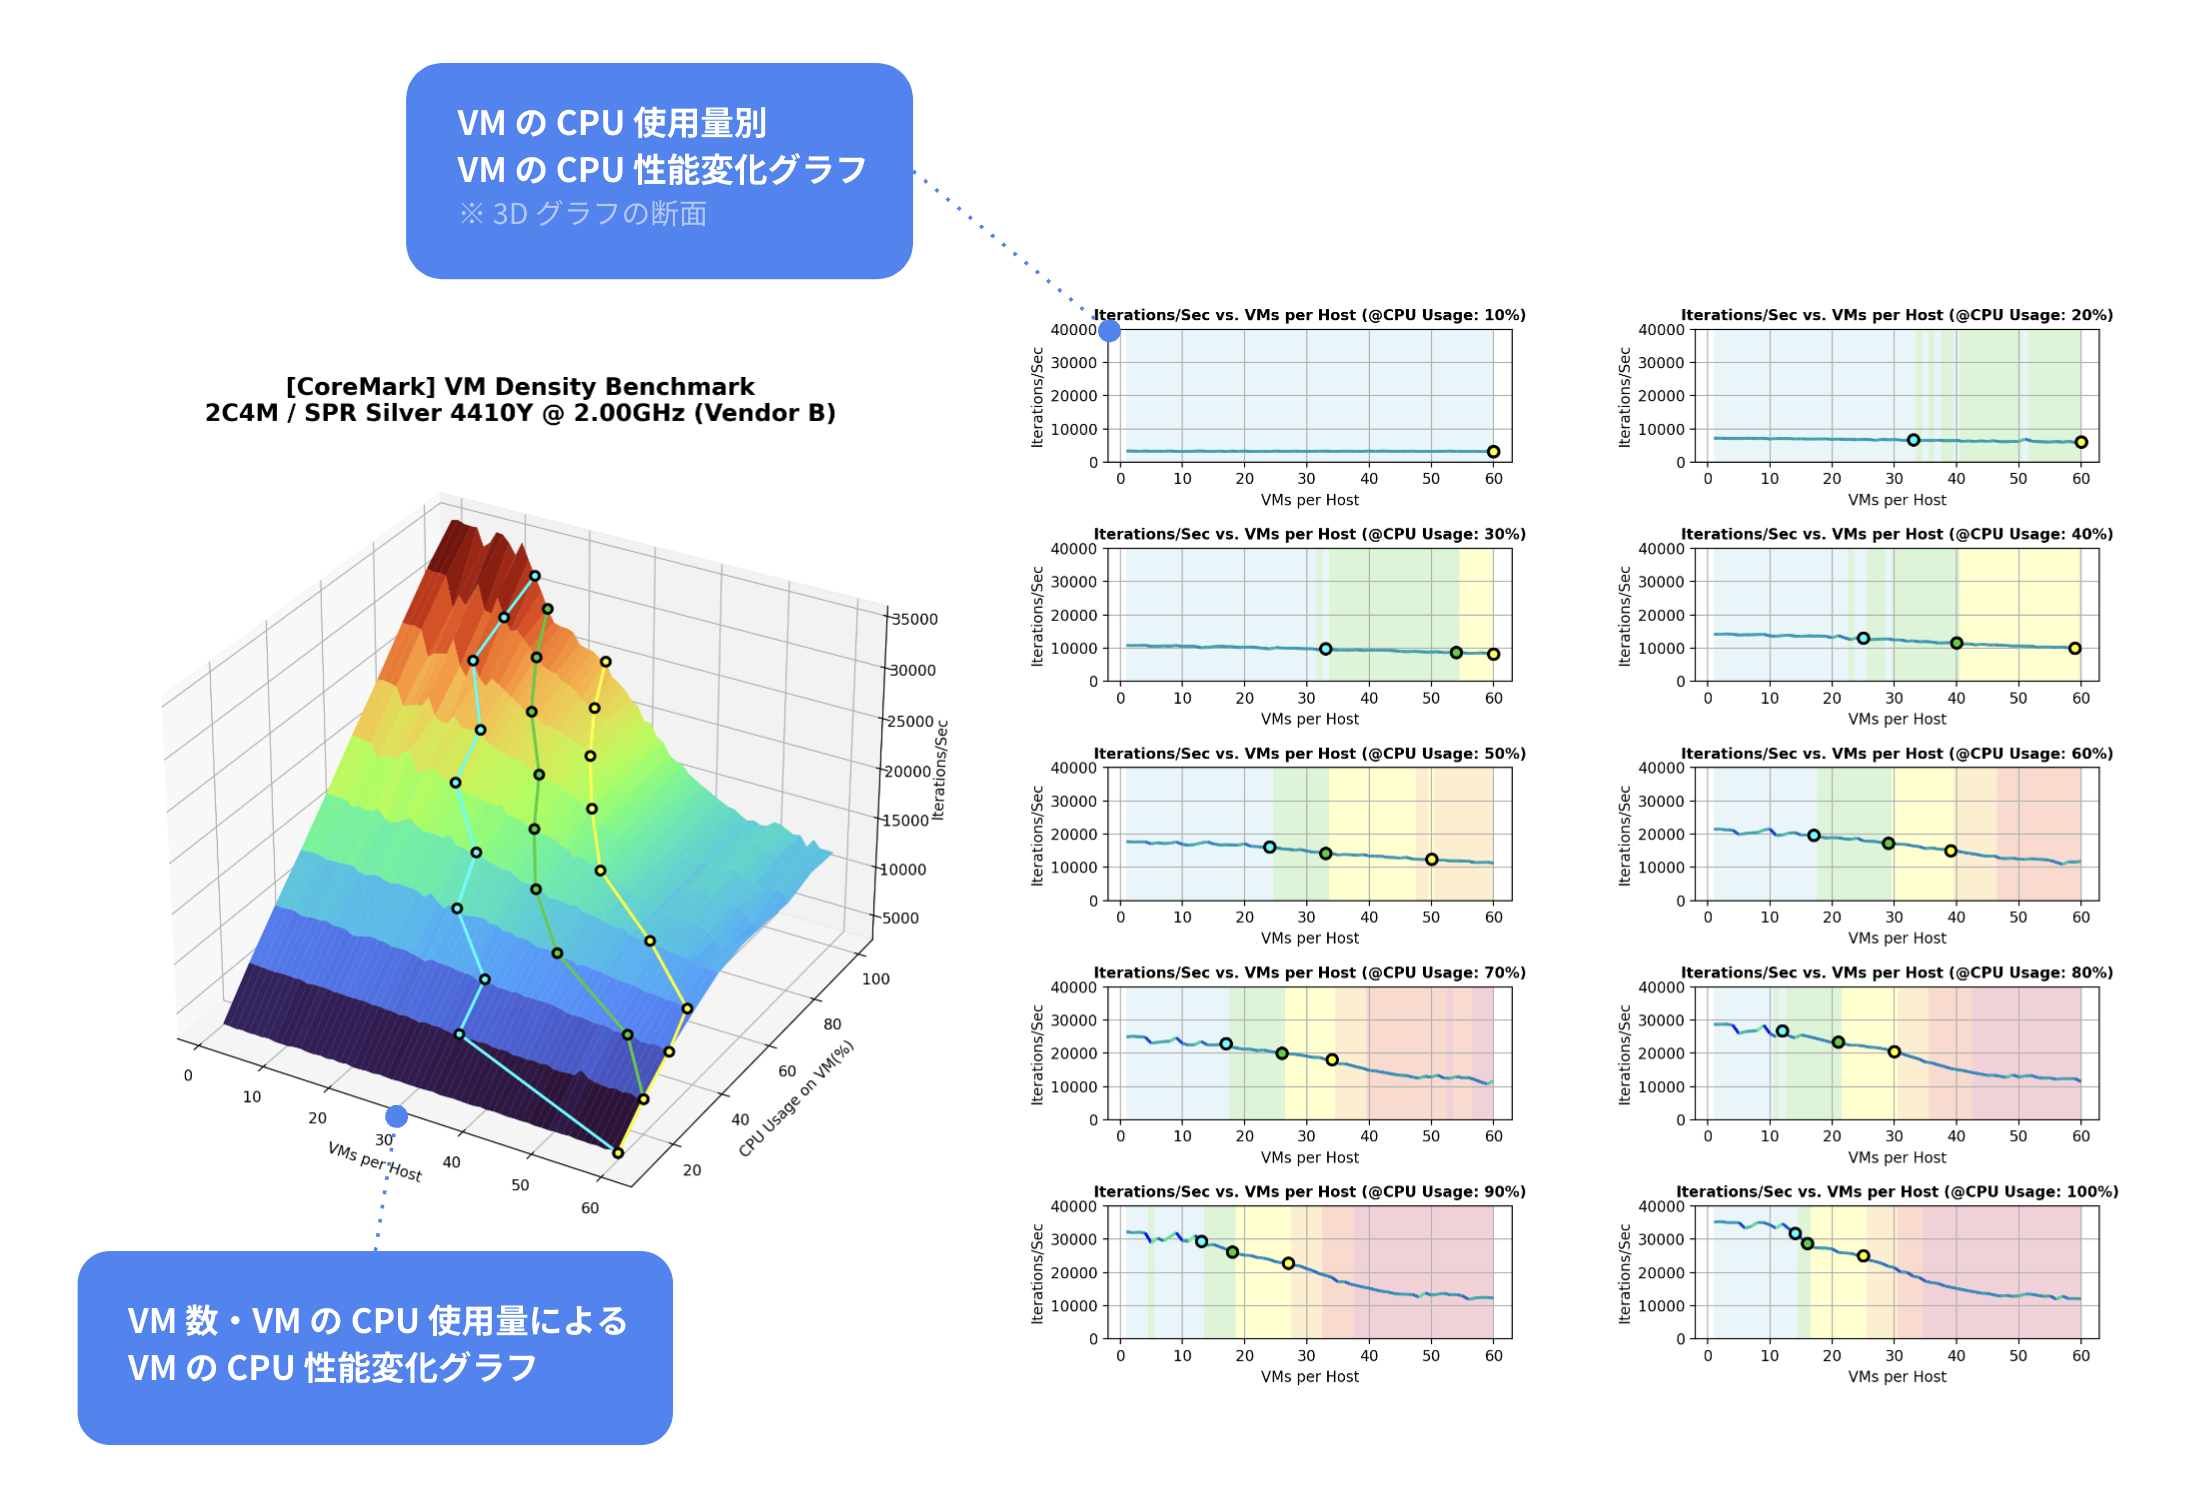
一つの PM の CPUスペック + VM のフレイバーの組み合わせごとに、上の図のように 3D グラフと 2D グラフで構成された結果が得られます。先に述べたように、テストは各条件ごとに複数の VM で同時にベンチマークプログラムを実行する方法で行い、ベンチマークプログラムには CoreMark を使用しました。
Iterations/Sec は、各 VM に対する CoreMark の実行結果の平均値であり、VM の CPU パフォーマンスを意味します。ここで重要なのは、ベンチマークの結果 Iterations/Sec 自体に大きな意味はないということです。
例えば、VM の CPU 使用率が 10% であるときの結果が CPU 使用率が 100% であるときに比べて低いからといって、その VM のパフォーマンスが実際に低下したわけではありません。また、VM が 1 台で VM の CPU 使用率が 100% であるときの結果が最も高いからといって、最適な VM 密度が 1 になるわけでもありません。VM の CPU 使用率に制限をかけてベンチマークプログラムを実行した結果であるため、CPU 使用率 10% であるときの結果が CPU 使用率 100% であるときの結果よりも低くなります。
このように VM の CPU 使用率を制限した理由は、実際の運用環境ですべての VM が常に CPU を 100% 使用するわけではないからです。テストの目的は、実際の運用環境で VM が平均 XX% の CPU を使用している場合、お互いのパフォーマンスに影響を与えずに共存可能な最大 VM 数を見つけ出すことでした。そのため、左端の VM が 1 台であるときの結果、つまり何も妨害がない状況で VM が本来見せるべきパフォーマンスを基準として、そのパフォーマンスを維持した状態で PM に VM をどれほど追加できるかを確認しました。
3D グラフ(全体的な VM の CPU パフォーマンス変化グラフ)
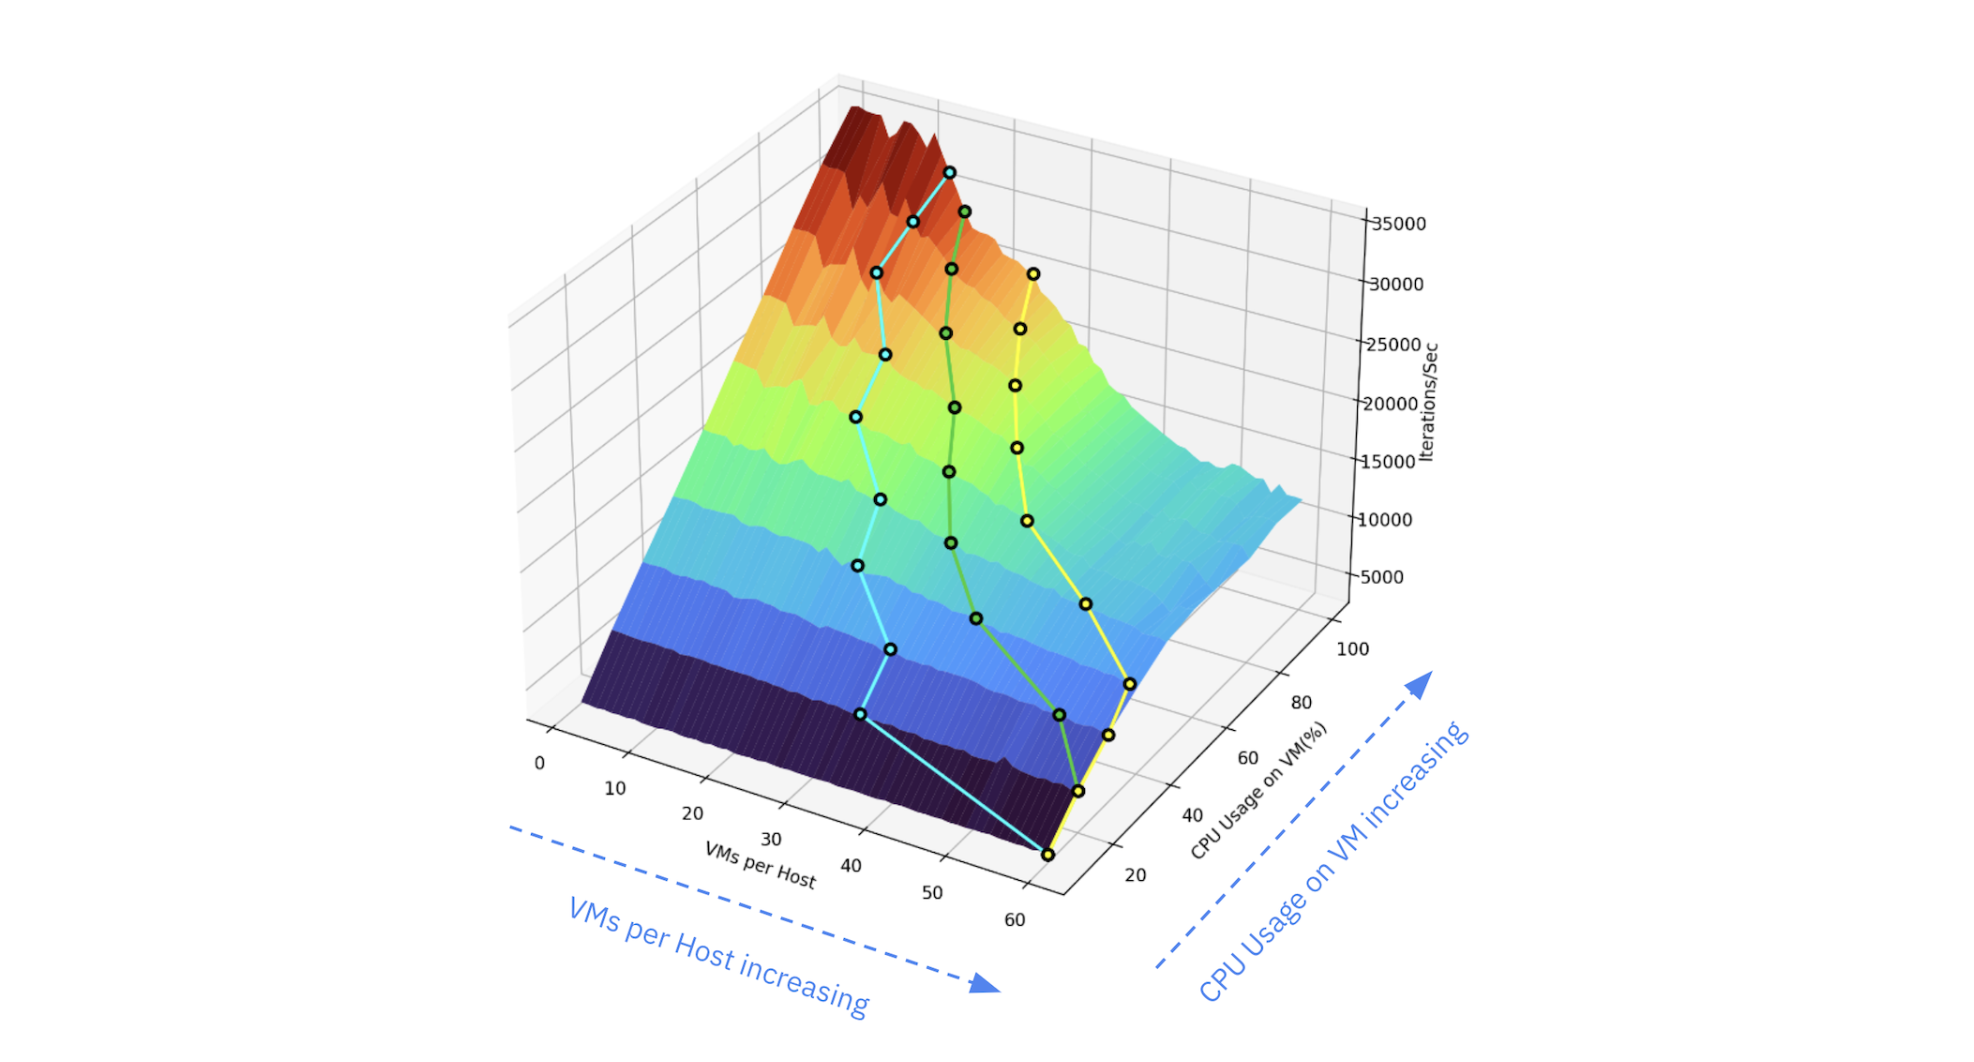
上記は X 軸を VM 数、Y 軸を VM の CPU 使用率、Z 軸をベンチマークの結果を持つ 3D グラフです。VM 数及び VM の CPU 使用率によって VM の CPU パフォーマンスがどのように変化するのか、全体的な傾向を把握することができます。
2D グラフ(VM の CPU 使用率別 VM の CPU パフォーマンス変化グラフ)
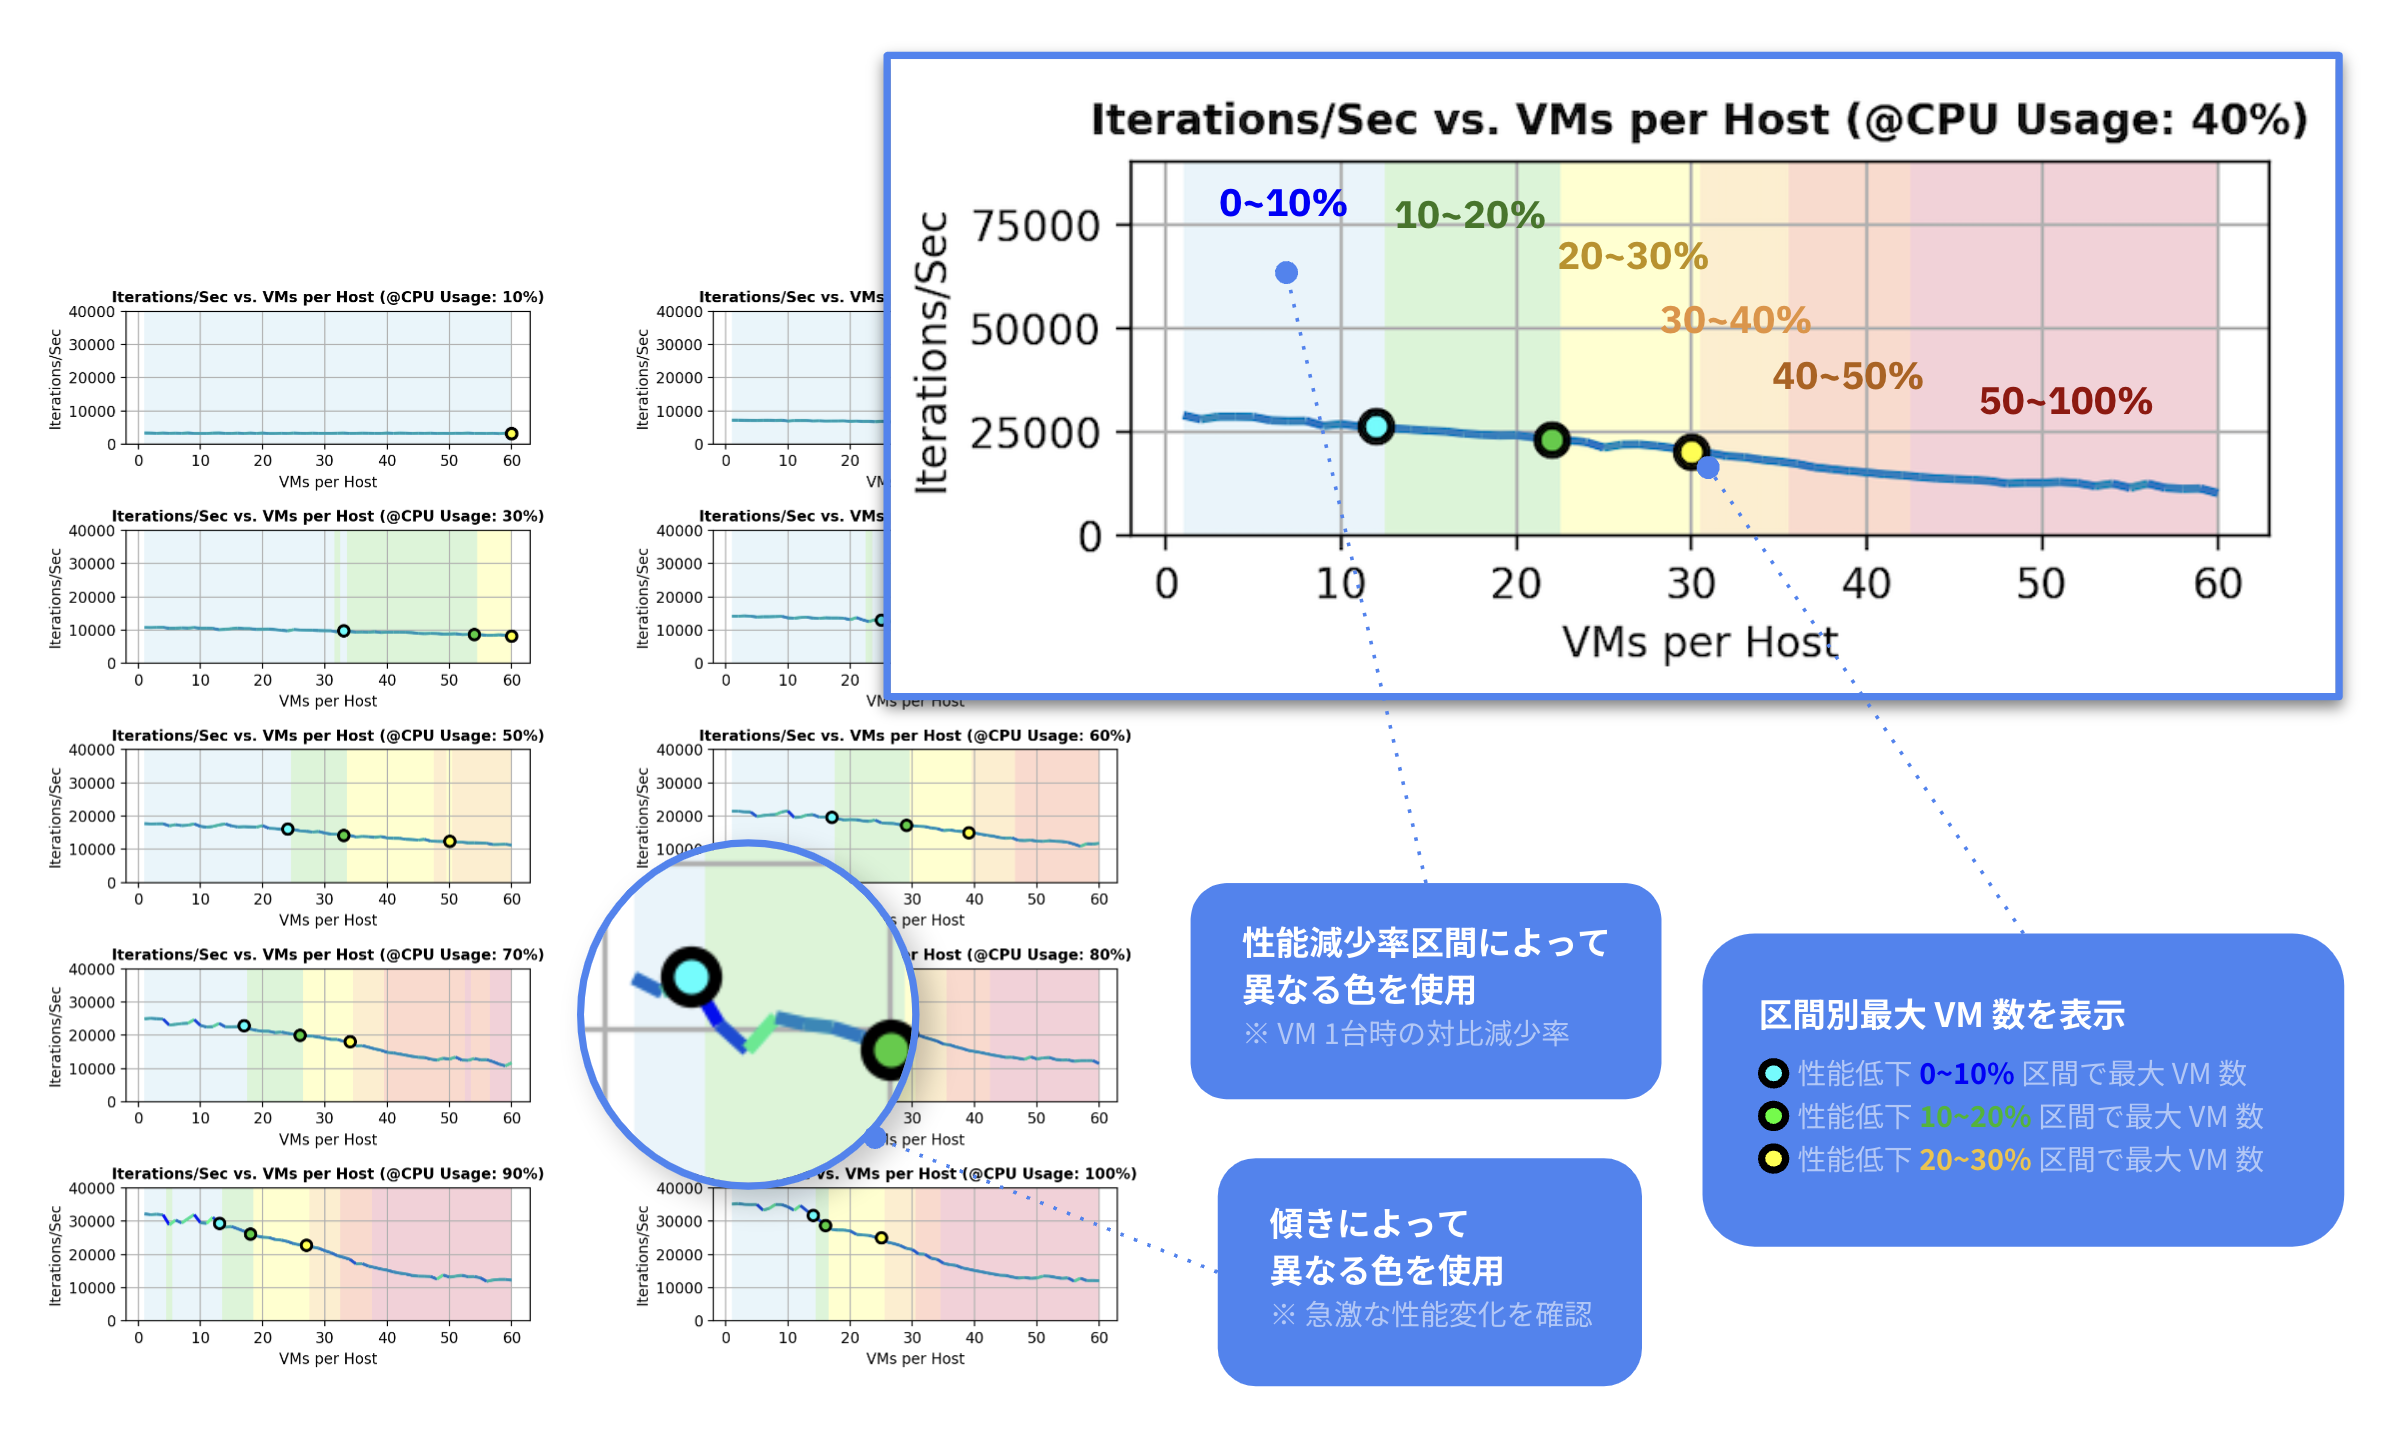
先ほど紹介した 3D グラフを VM の CPU 使用率 10%、20%、30%、…100% をそれぞれ断面で表しました。
それぞれが意味するのは、VM の CPU 使用率ごとの VM 数の増加に伴う VM のパフォーマンスの変化です。つまり、このグラフから「 VM の平均 CPU 使用率が XX% だとすると、何台の VM からパフォーマンスがどの程度低下し始めるか 」を読み取ることができます。
VM の CPU パフォーマンスがどの程度低下したかを把握しやすくするために、VM が 1 台のときのベンチマーク結果を基準に、パフォーマンスの低下率を区間ごとに色分けして表示しました。各区間ごとのパフォーマンスの低下率の範囲は以下の通りです。
-
0 ~ 10%
-
10 ~ 20%
-
20 ~ 30%
-
30 ~ 40%
-
40 ~ 50%
-
50% ~
0 ~ 10%、10 ~ 20%、20 ~ 30% の 3 つの区間については、各区間ごとに最も右側に該当する VM の数に追加でマークを付けています。このマークは、VM の CPU パフォーマンスの低下を 0 ~ 10%、10 ~ 20%、20 ~ 30% まで耐えるとすると、PM 1 台で最大で収容可能な VM 数になります。
またグラフの傾きによって色を変え、VM の CPU パフォーマンスが急激に低下するタイミングをより明確にしています。(濃い青に近いほど急激なパフォーマンス低下を意味します)
2) VM の CPU パフォーマンス変化の分析
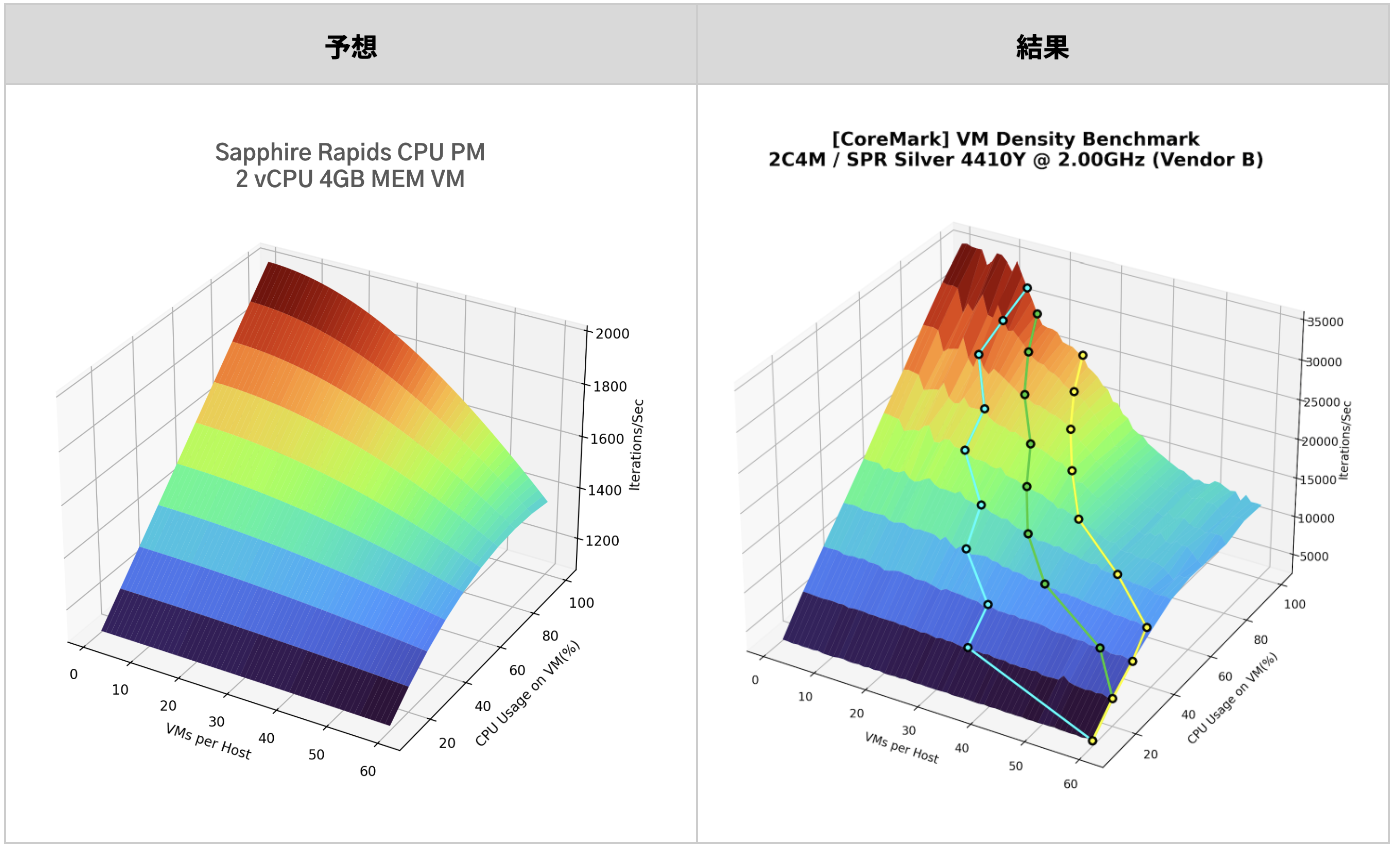
3D グラフにて、テストを進める前に結果を予想して描いたグラフと同様の結果を得ることができました。より多くの VM がより多くの CPU リソースを使用するほど、限られた PM の CPU リソースに対する競争が増加するため、ベンチマーク結果が減少することが確認できます。
特に、PM の CPU リソースを好きなだけ使用できるほど VM 数が少ない場合は、CPU 使用率の制限を高くすると、そのままベンチマーク結果の向上につながりますが、VM 数が多い場合は、CPU 使用率の制限を高くしても、他の VM とのリソース競争により、ベンチマーク結果が増加しないという予想が一致しました。
また、VM の CPU 使用率が少ないときは、PM の CPU リソースに比較的余裕ができるため、VM 数を増やしてもベンチマーク結果が大きく落ちないという予想と一致する結果を示しました。
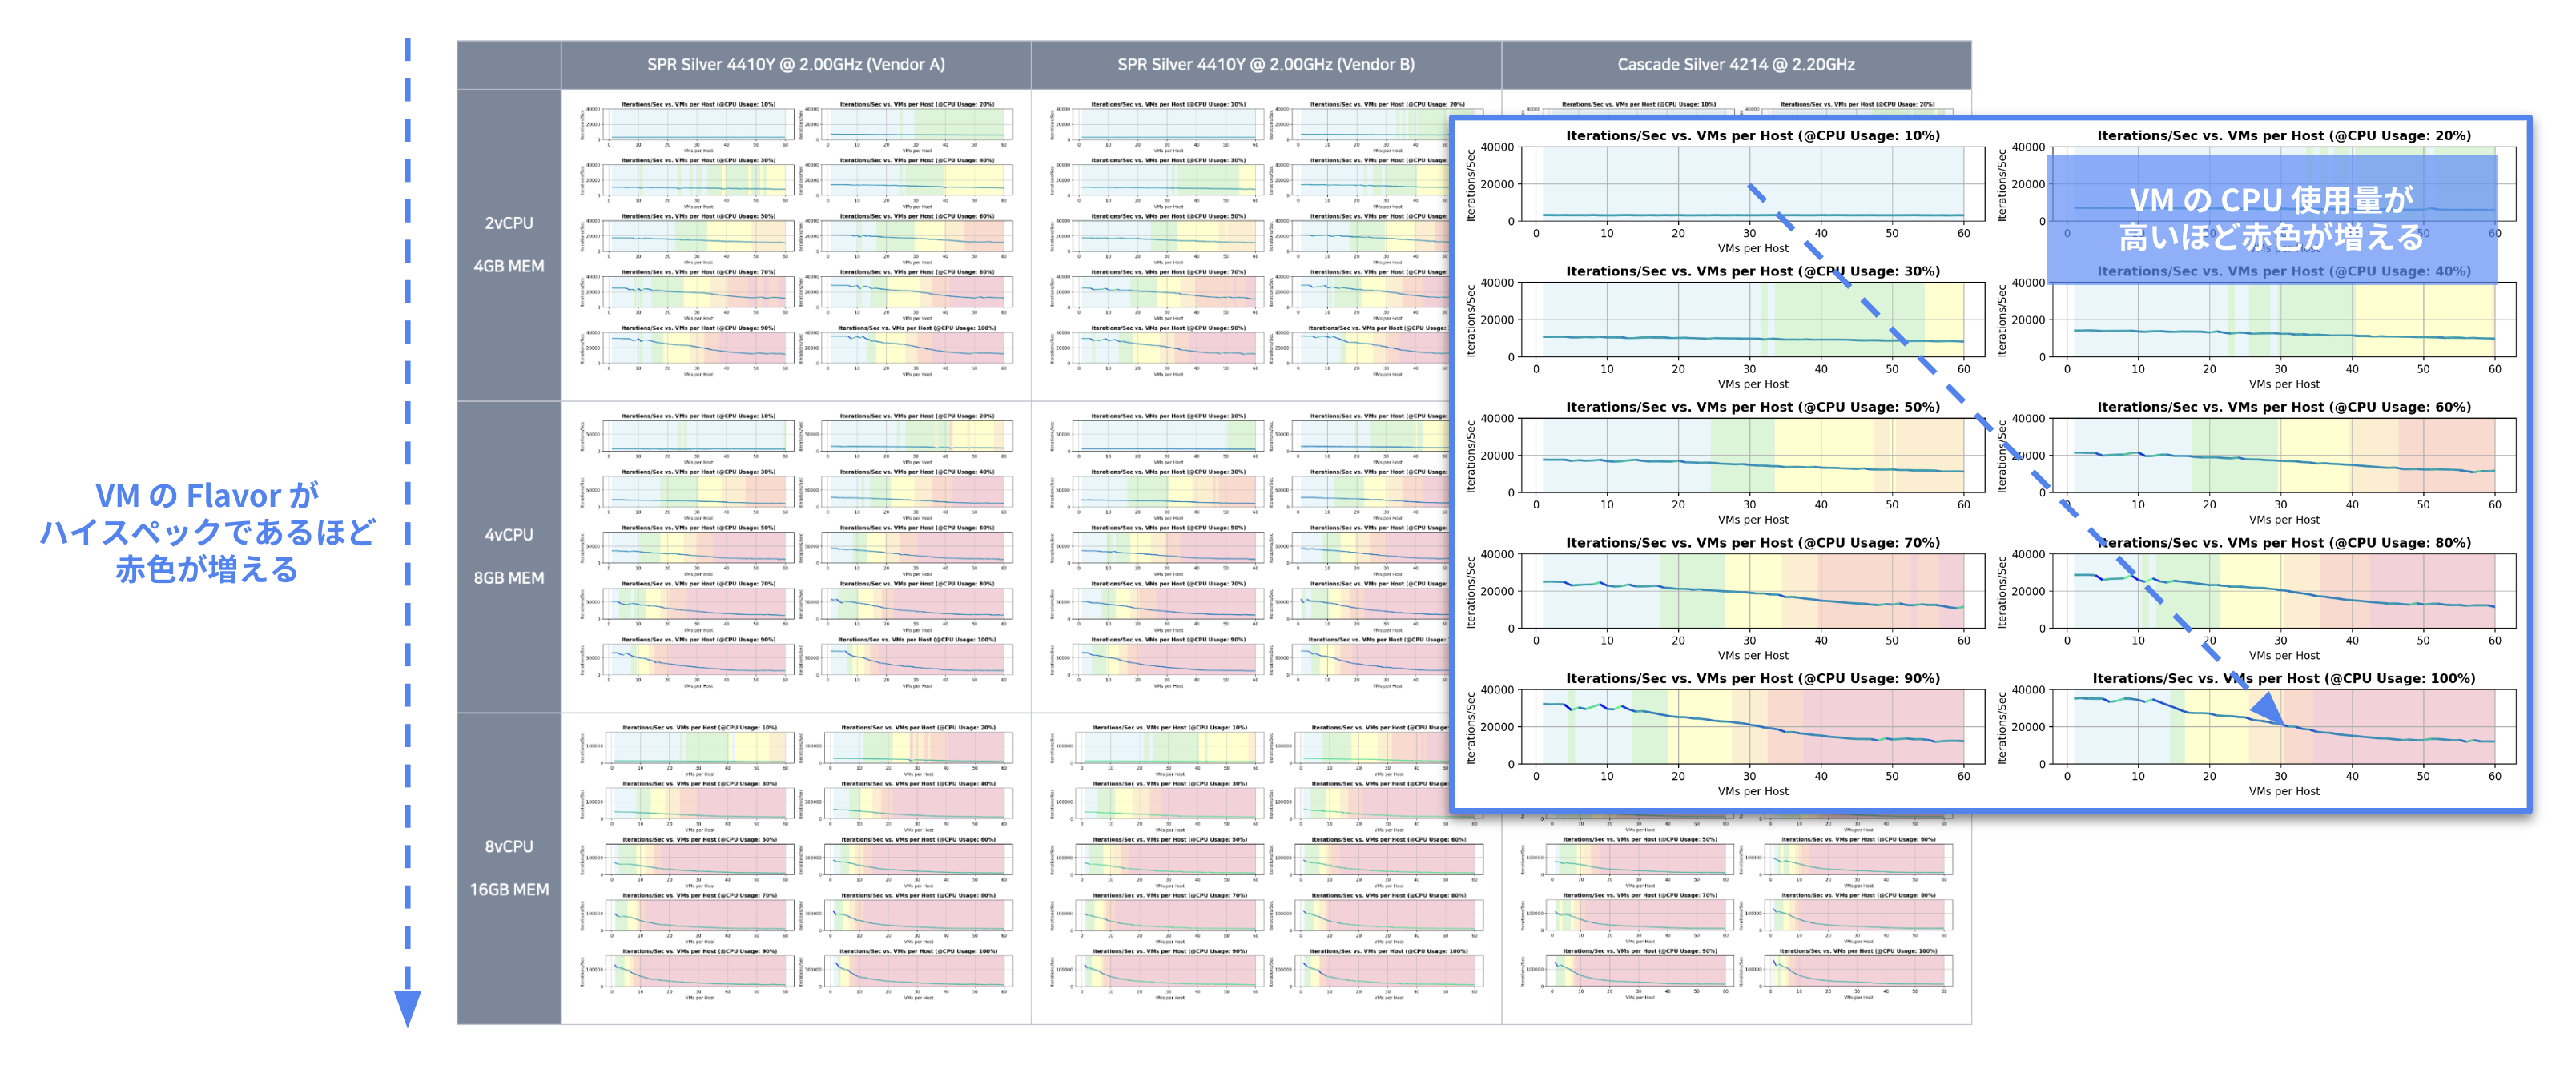
2D グラフも全体的に予想通りの結果が得られました。
全体の結果を VM のフレイバーの観点から見ると、VM のフレイバーが高スペックであるほど(VM の vCPU 数が多いほど)青 ・ 緑 ・ 黄色などのパフォーマンス低下の少ない部分の色が減り、赤色が増えることが確認できます。これは VM のフレイバーが高スペックであるほど、少ない VM 数でも大きなパフォーマンス低下が発生することを意味します。
また、VM の CPU使用率の観点から、各 PM の CPU スペック + VM のフレイバーの組み合わせ別の結果を見ると、VM の CPU 使用率が高くなっても、青 ・ 緑 ・ 黄色など、パフォーマンス低下が少ない部分の色が減り、赤色が増えることが確認できます。これは VM の CPU 使用率が高ければ高いほど、少ない VM 数でも大きなパフォーマンス低下が発生することを意味します。
その結果、VM のフレイバーが低スペックであるほど、そして VM の CPU 使用率が低いほど、VM の数を増やしてもパフォーマンスがある程度守られていることが確認できました。
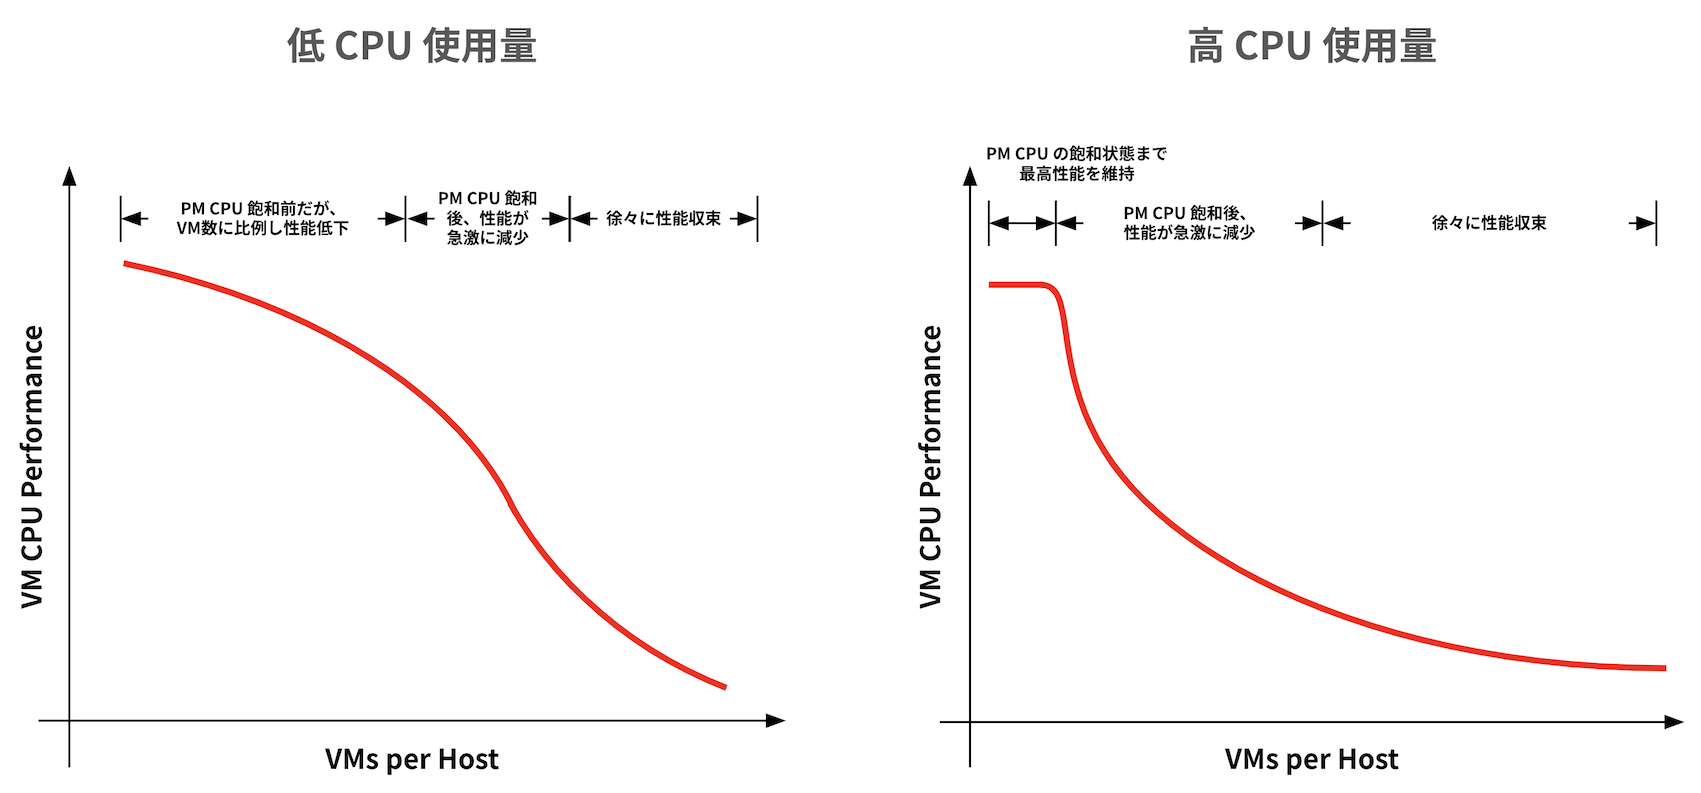
これまでの内容と同じように、全体的な結果は予想と大きな違いはありませんでした。ただ、細かく予想と異なる点があり、VM の CPU 使用率が低い時と高い時、2 つのケースに分けてそれぞれグラフを見る必要があります。
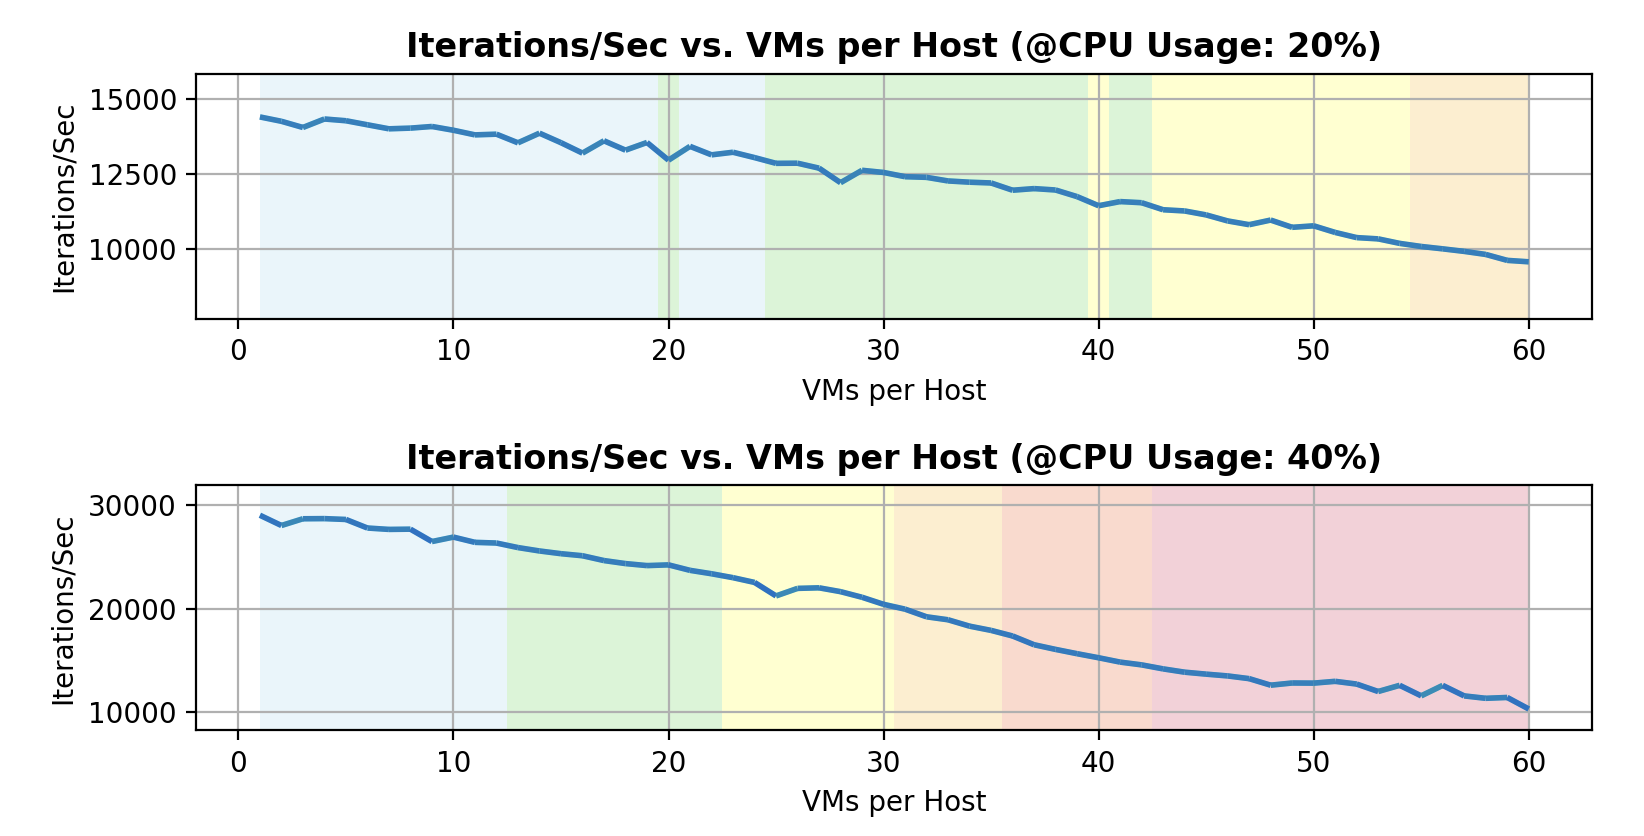
まず、VM の CPU 使用率が低い場合、VM の CPU 使用率が低いほどパフォーマンスが安定的に維持できるという予想とは異なり、VM 数が少ない区間から大幅なパフォーマンス低下が発生しました。
もちろん、VM の CPU 使用率が多い時と比べるとパフォーマンスの低下量は少ないですが、PM の CPU リソースに余裕がある状態でも、他の VM の影響を受けてパフォーマンス低下が発生することが確認できました。
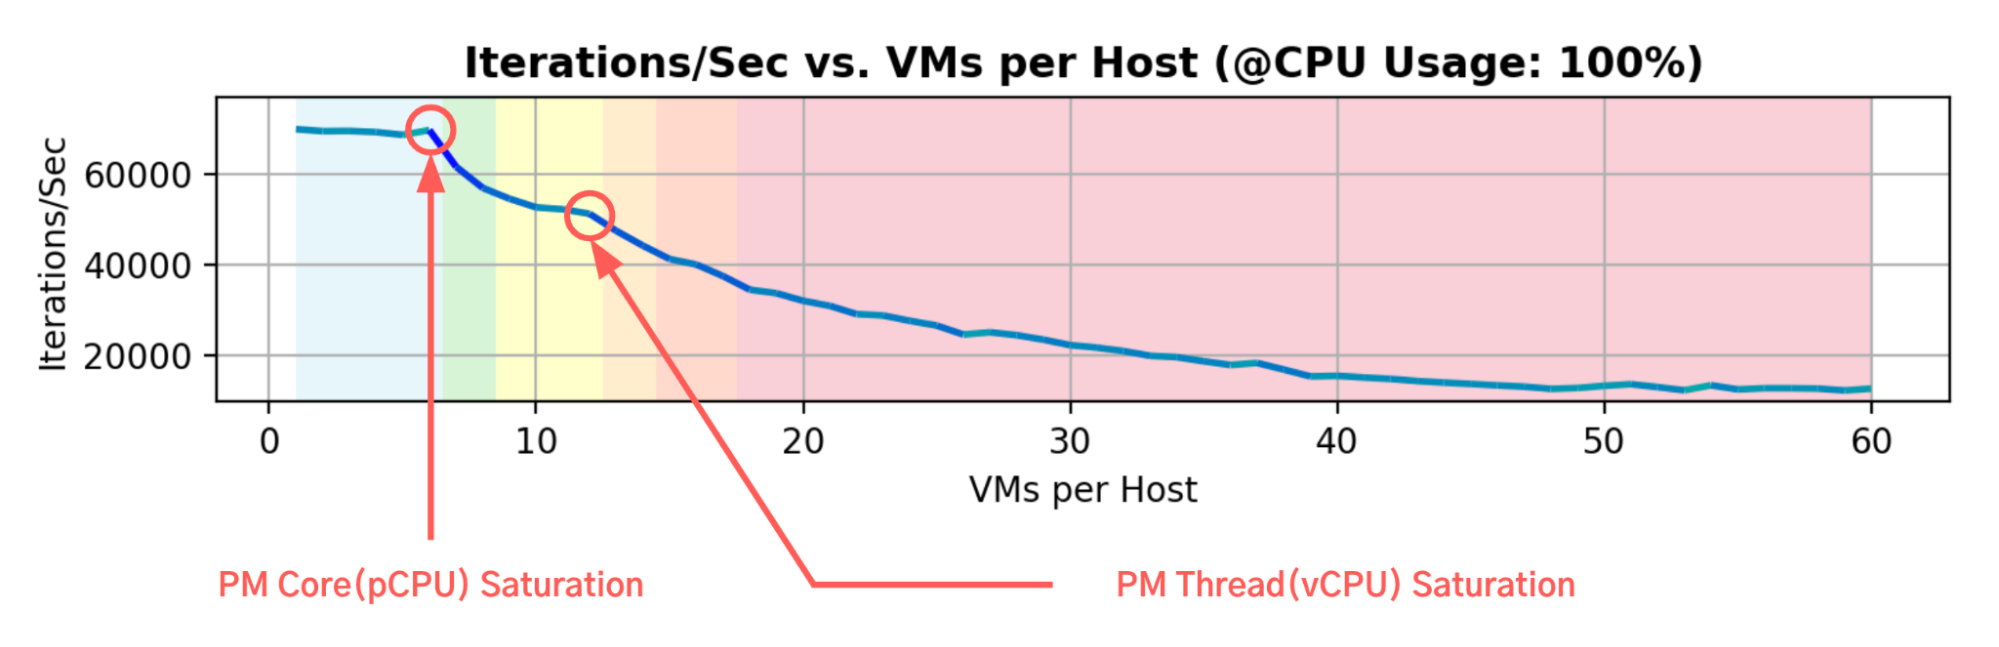
VM の CPU 使用率が高い場合、CPU のパフォーマンス低下し始める時期が予想より早くなりました。
ハイパースレッディングを有効にした状態であれば、PM のスレッド(vCPU)が飽和するまでは、VM 数を増やしてもパフォーマンスがある程度維持されることが期待されました。しかしながら、PM のコア(pCPU)が飽和した後からかなりのパフォーマンス低下が発生しました。
VM の CPU 使用率が低くとも高くとも、VM の数が増えれば増えるほどそれに比例して CPU パフォーマンスが低下するという予想とは異なり、一度パフォーマンスが低下し始めると急激に低下し、ある程度を超えると鈍化していきました。つまり、予想よりも 1 / N (N = VM 数)に近い形でパフォーマンスが変化しました。
4. VM の CPU パフォーマンス低下に影響する要因
1) 資料紹介
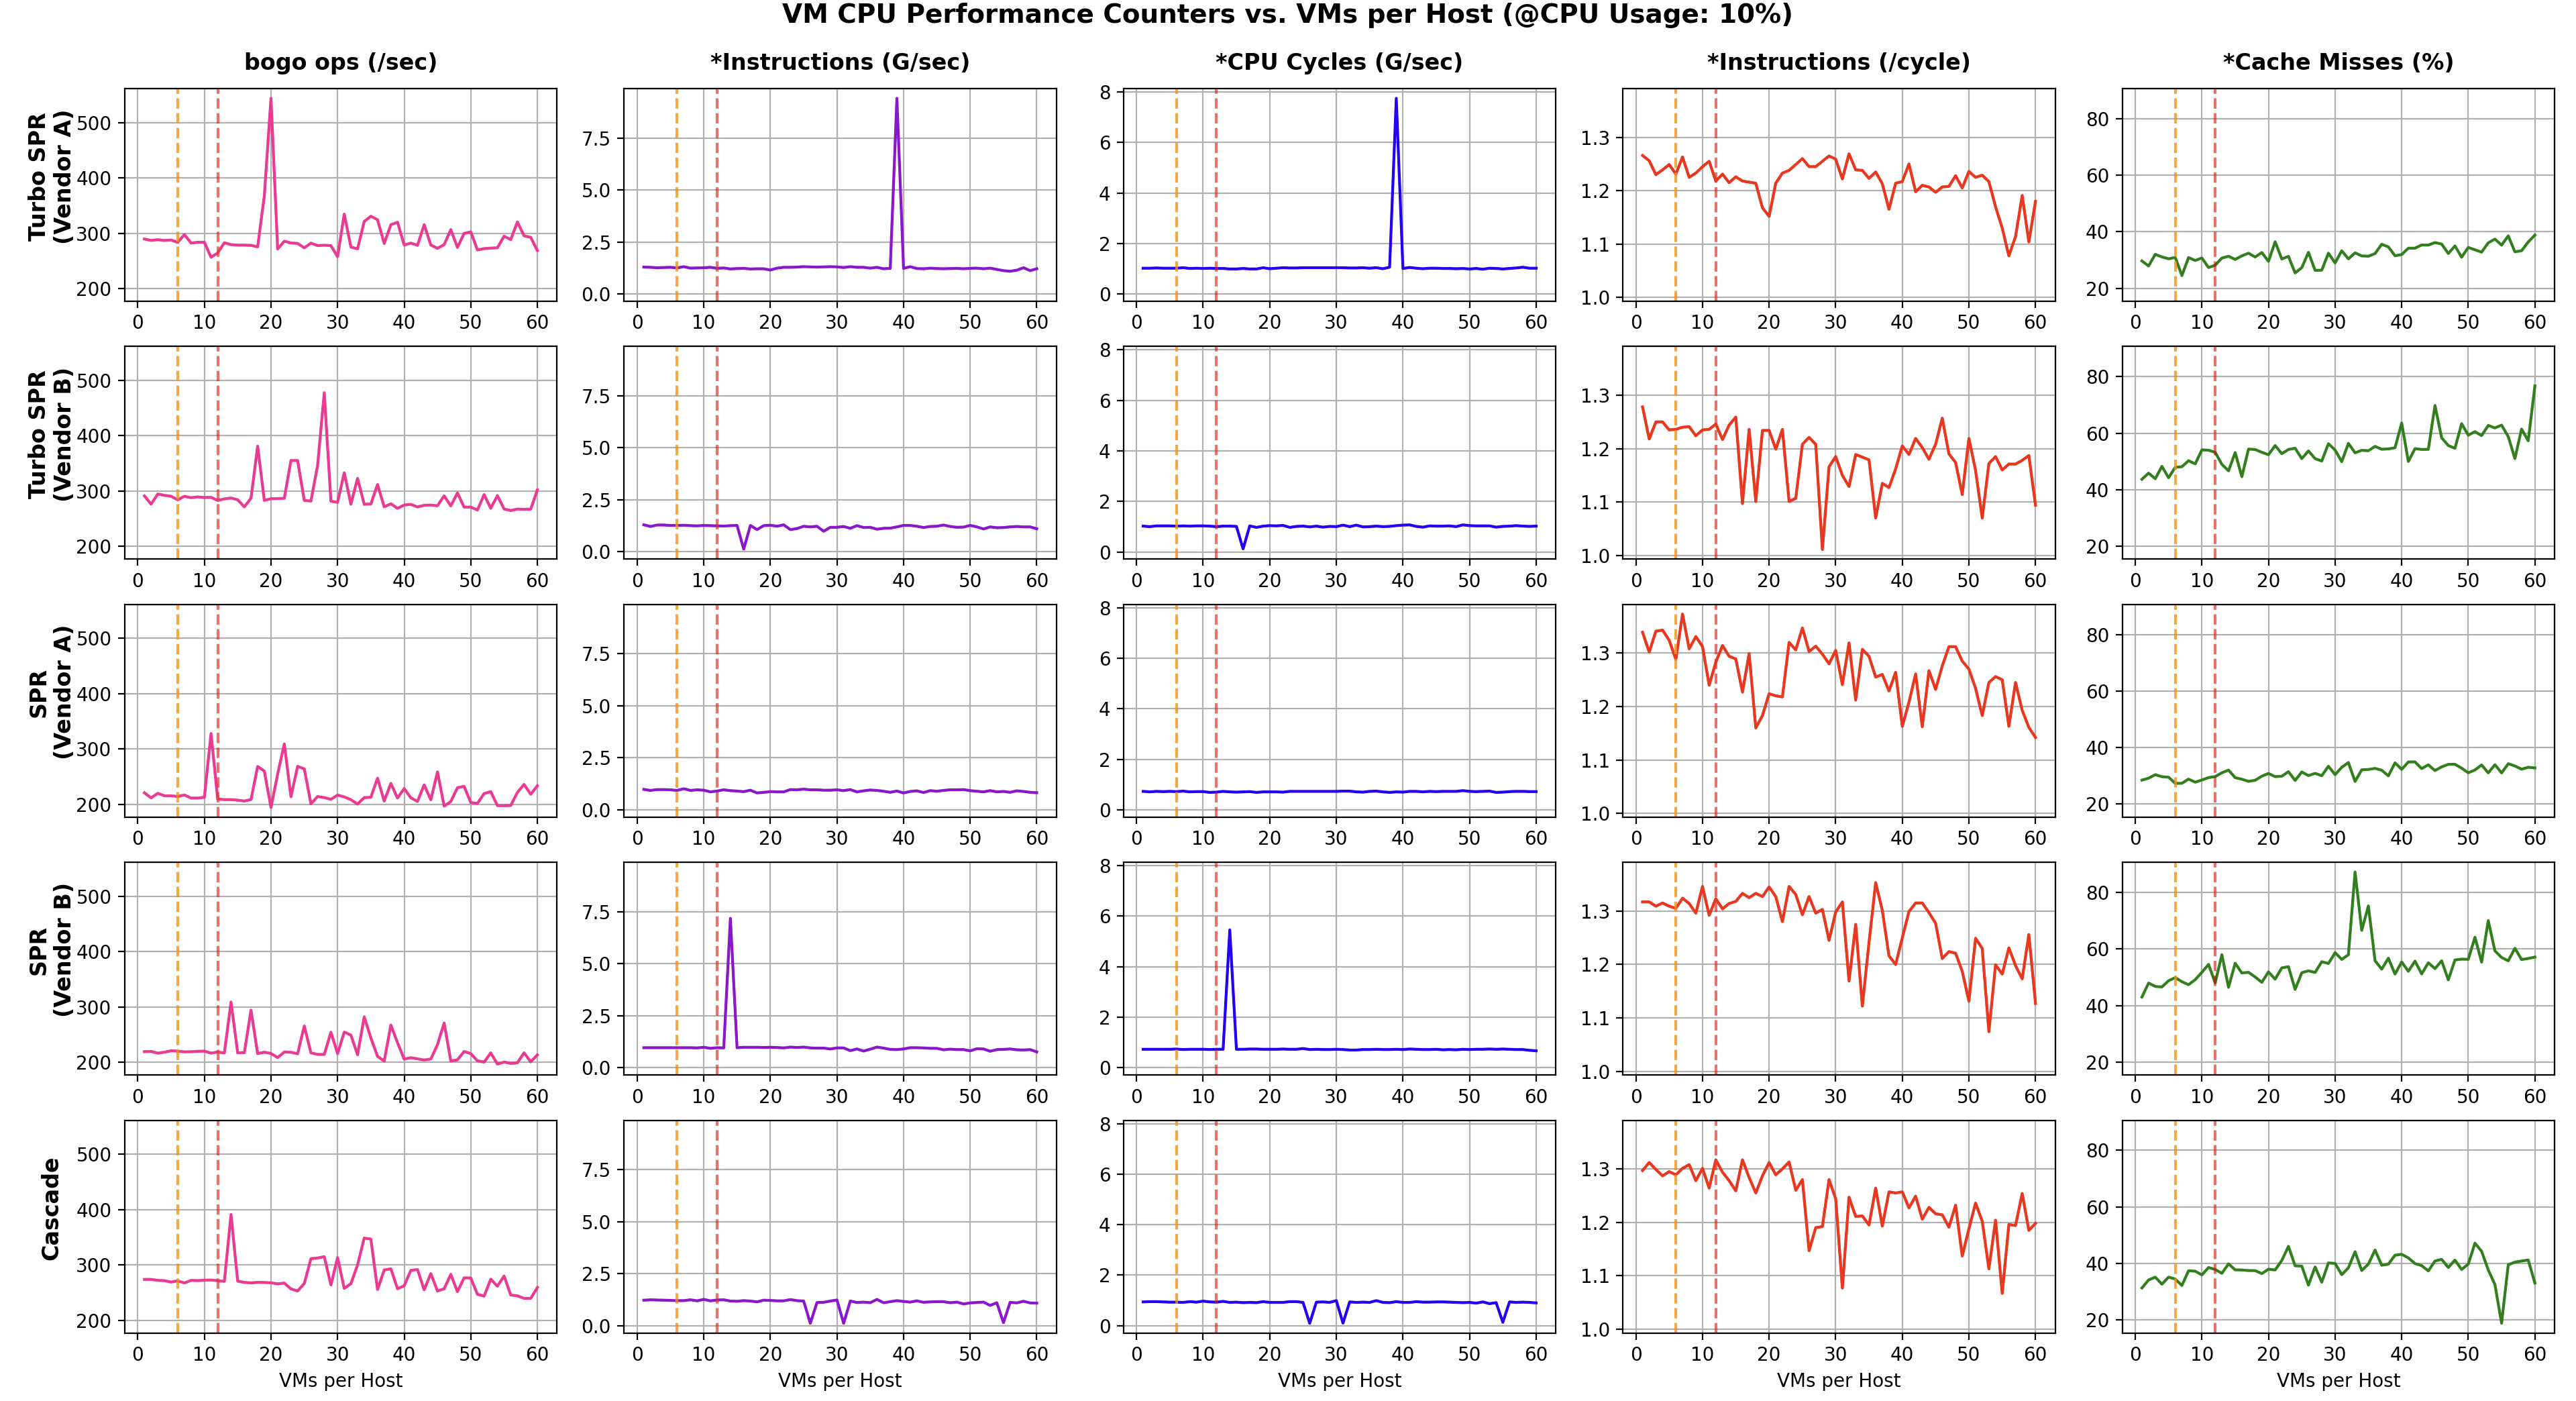
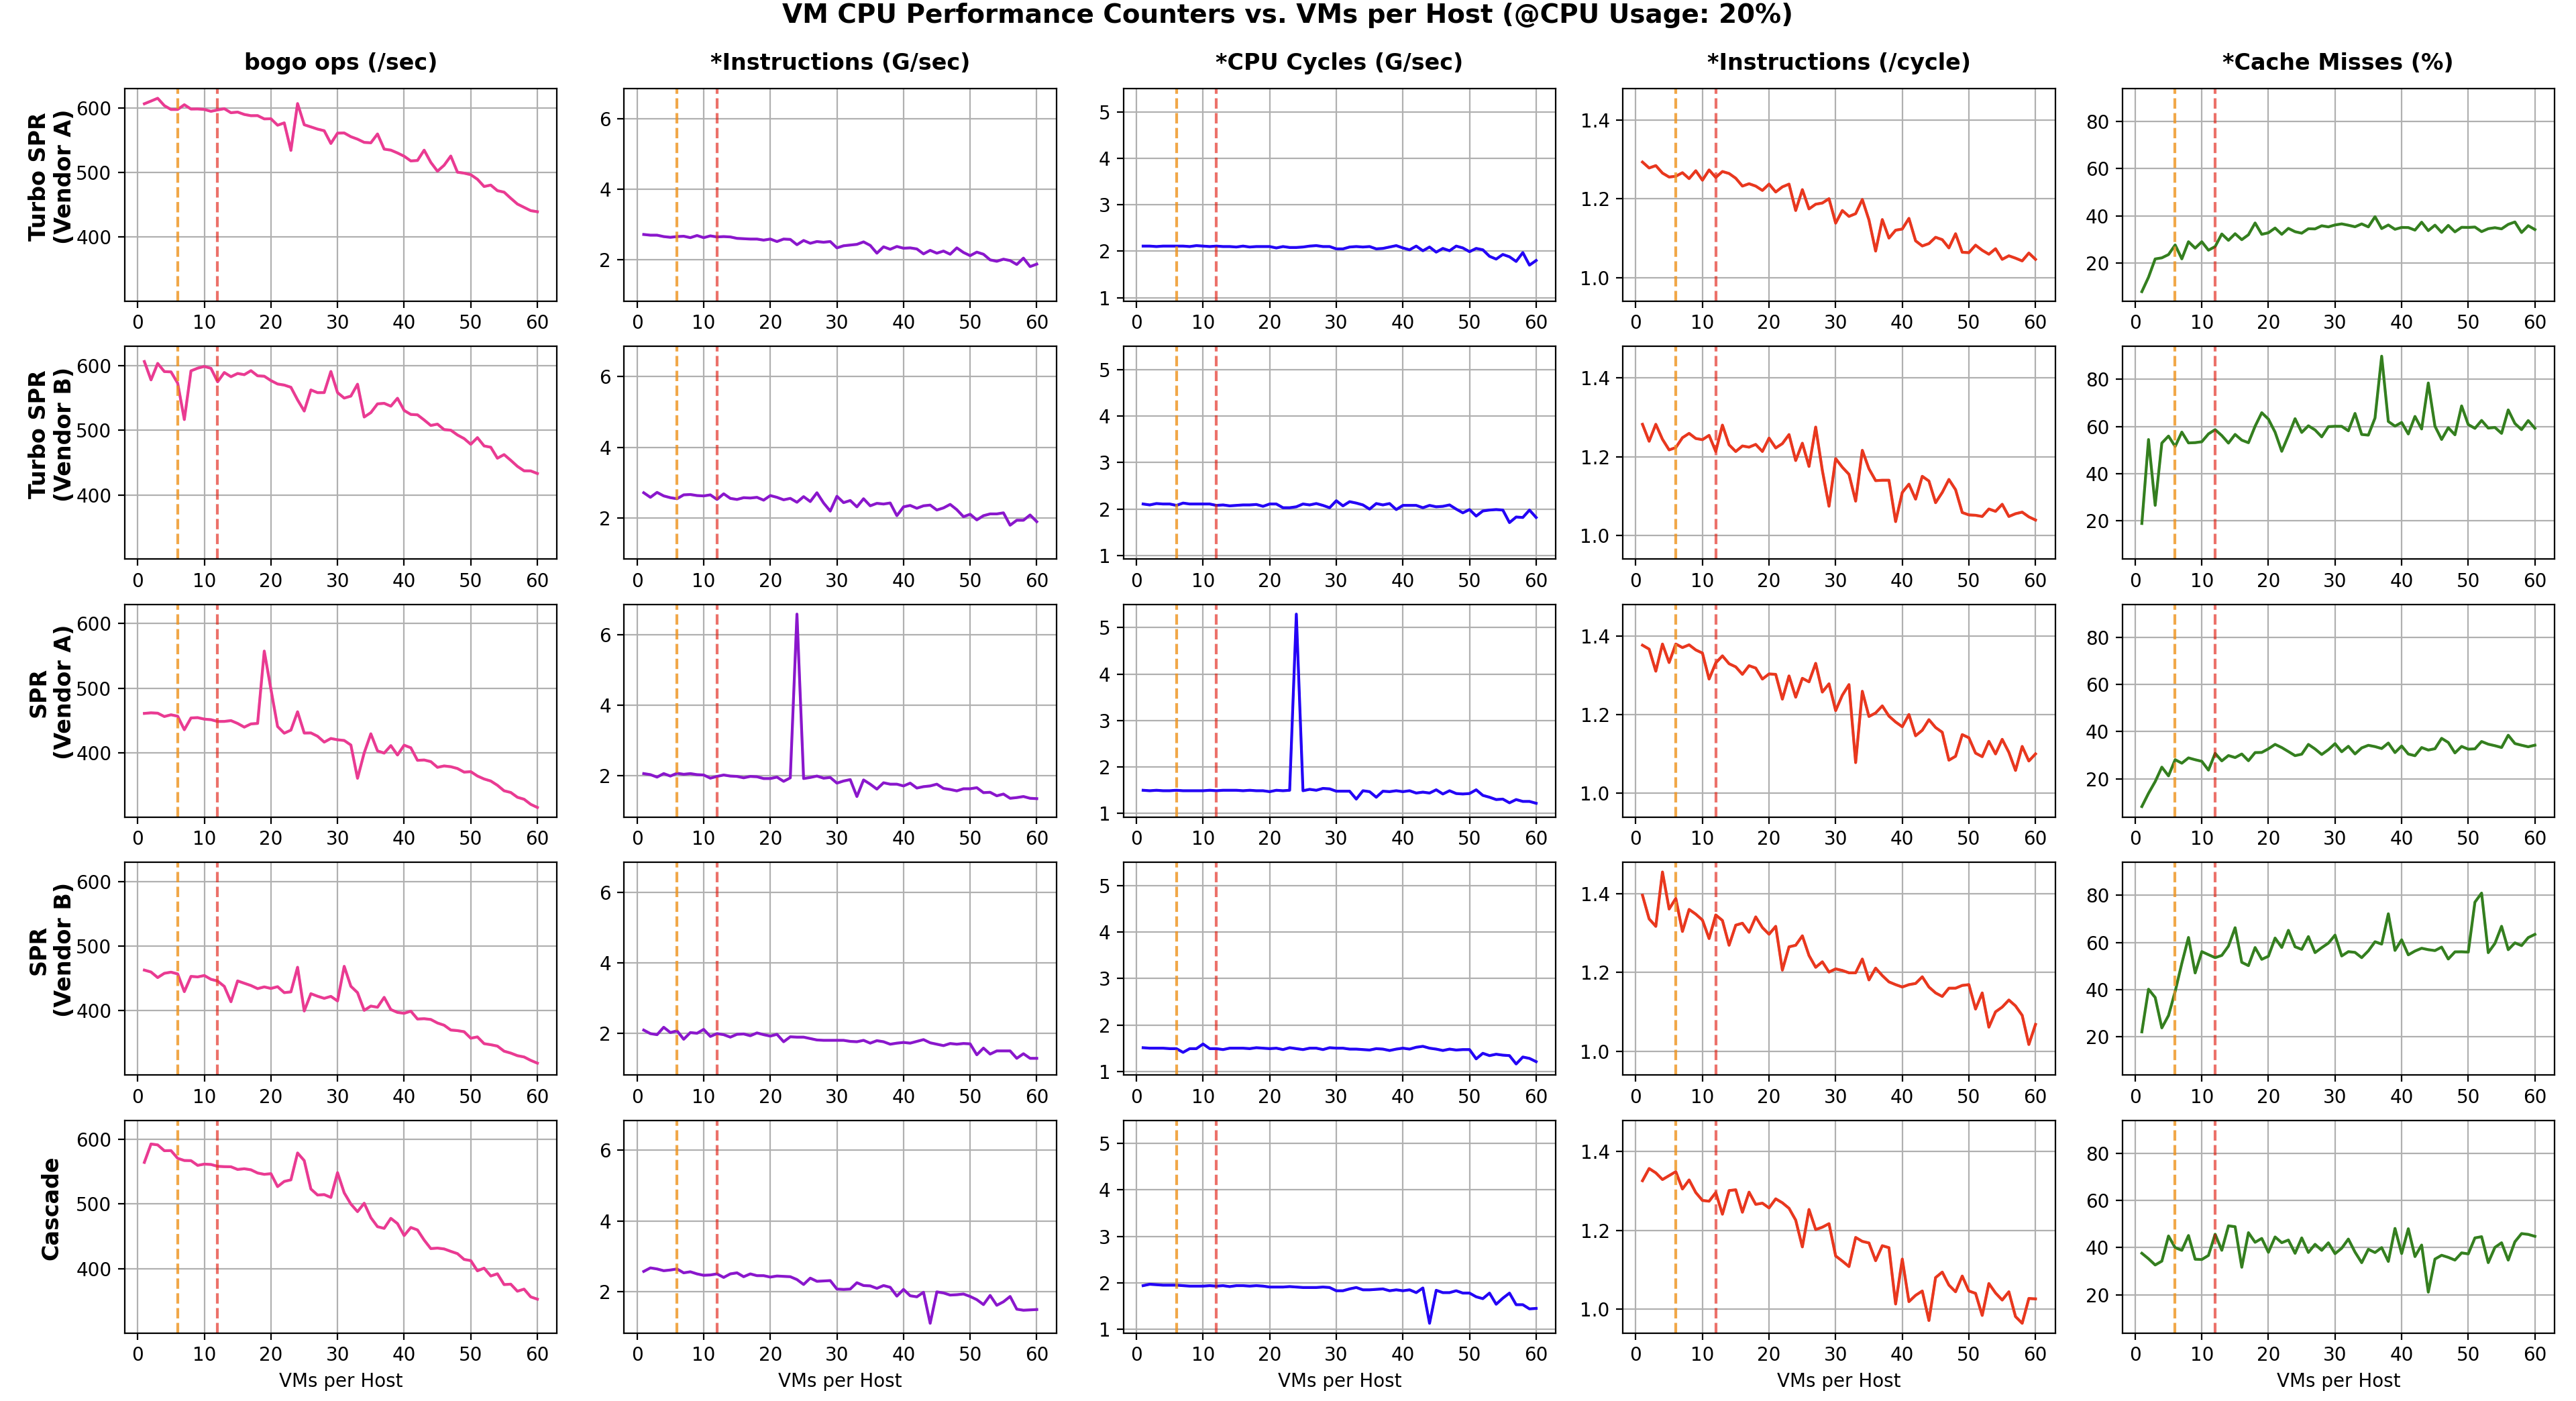
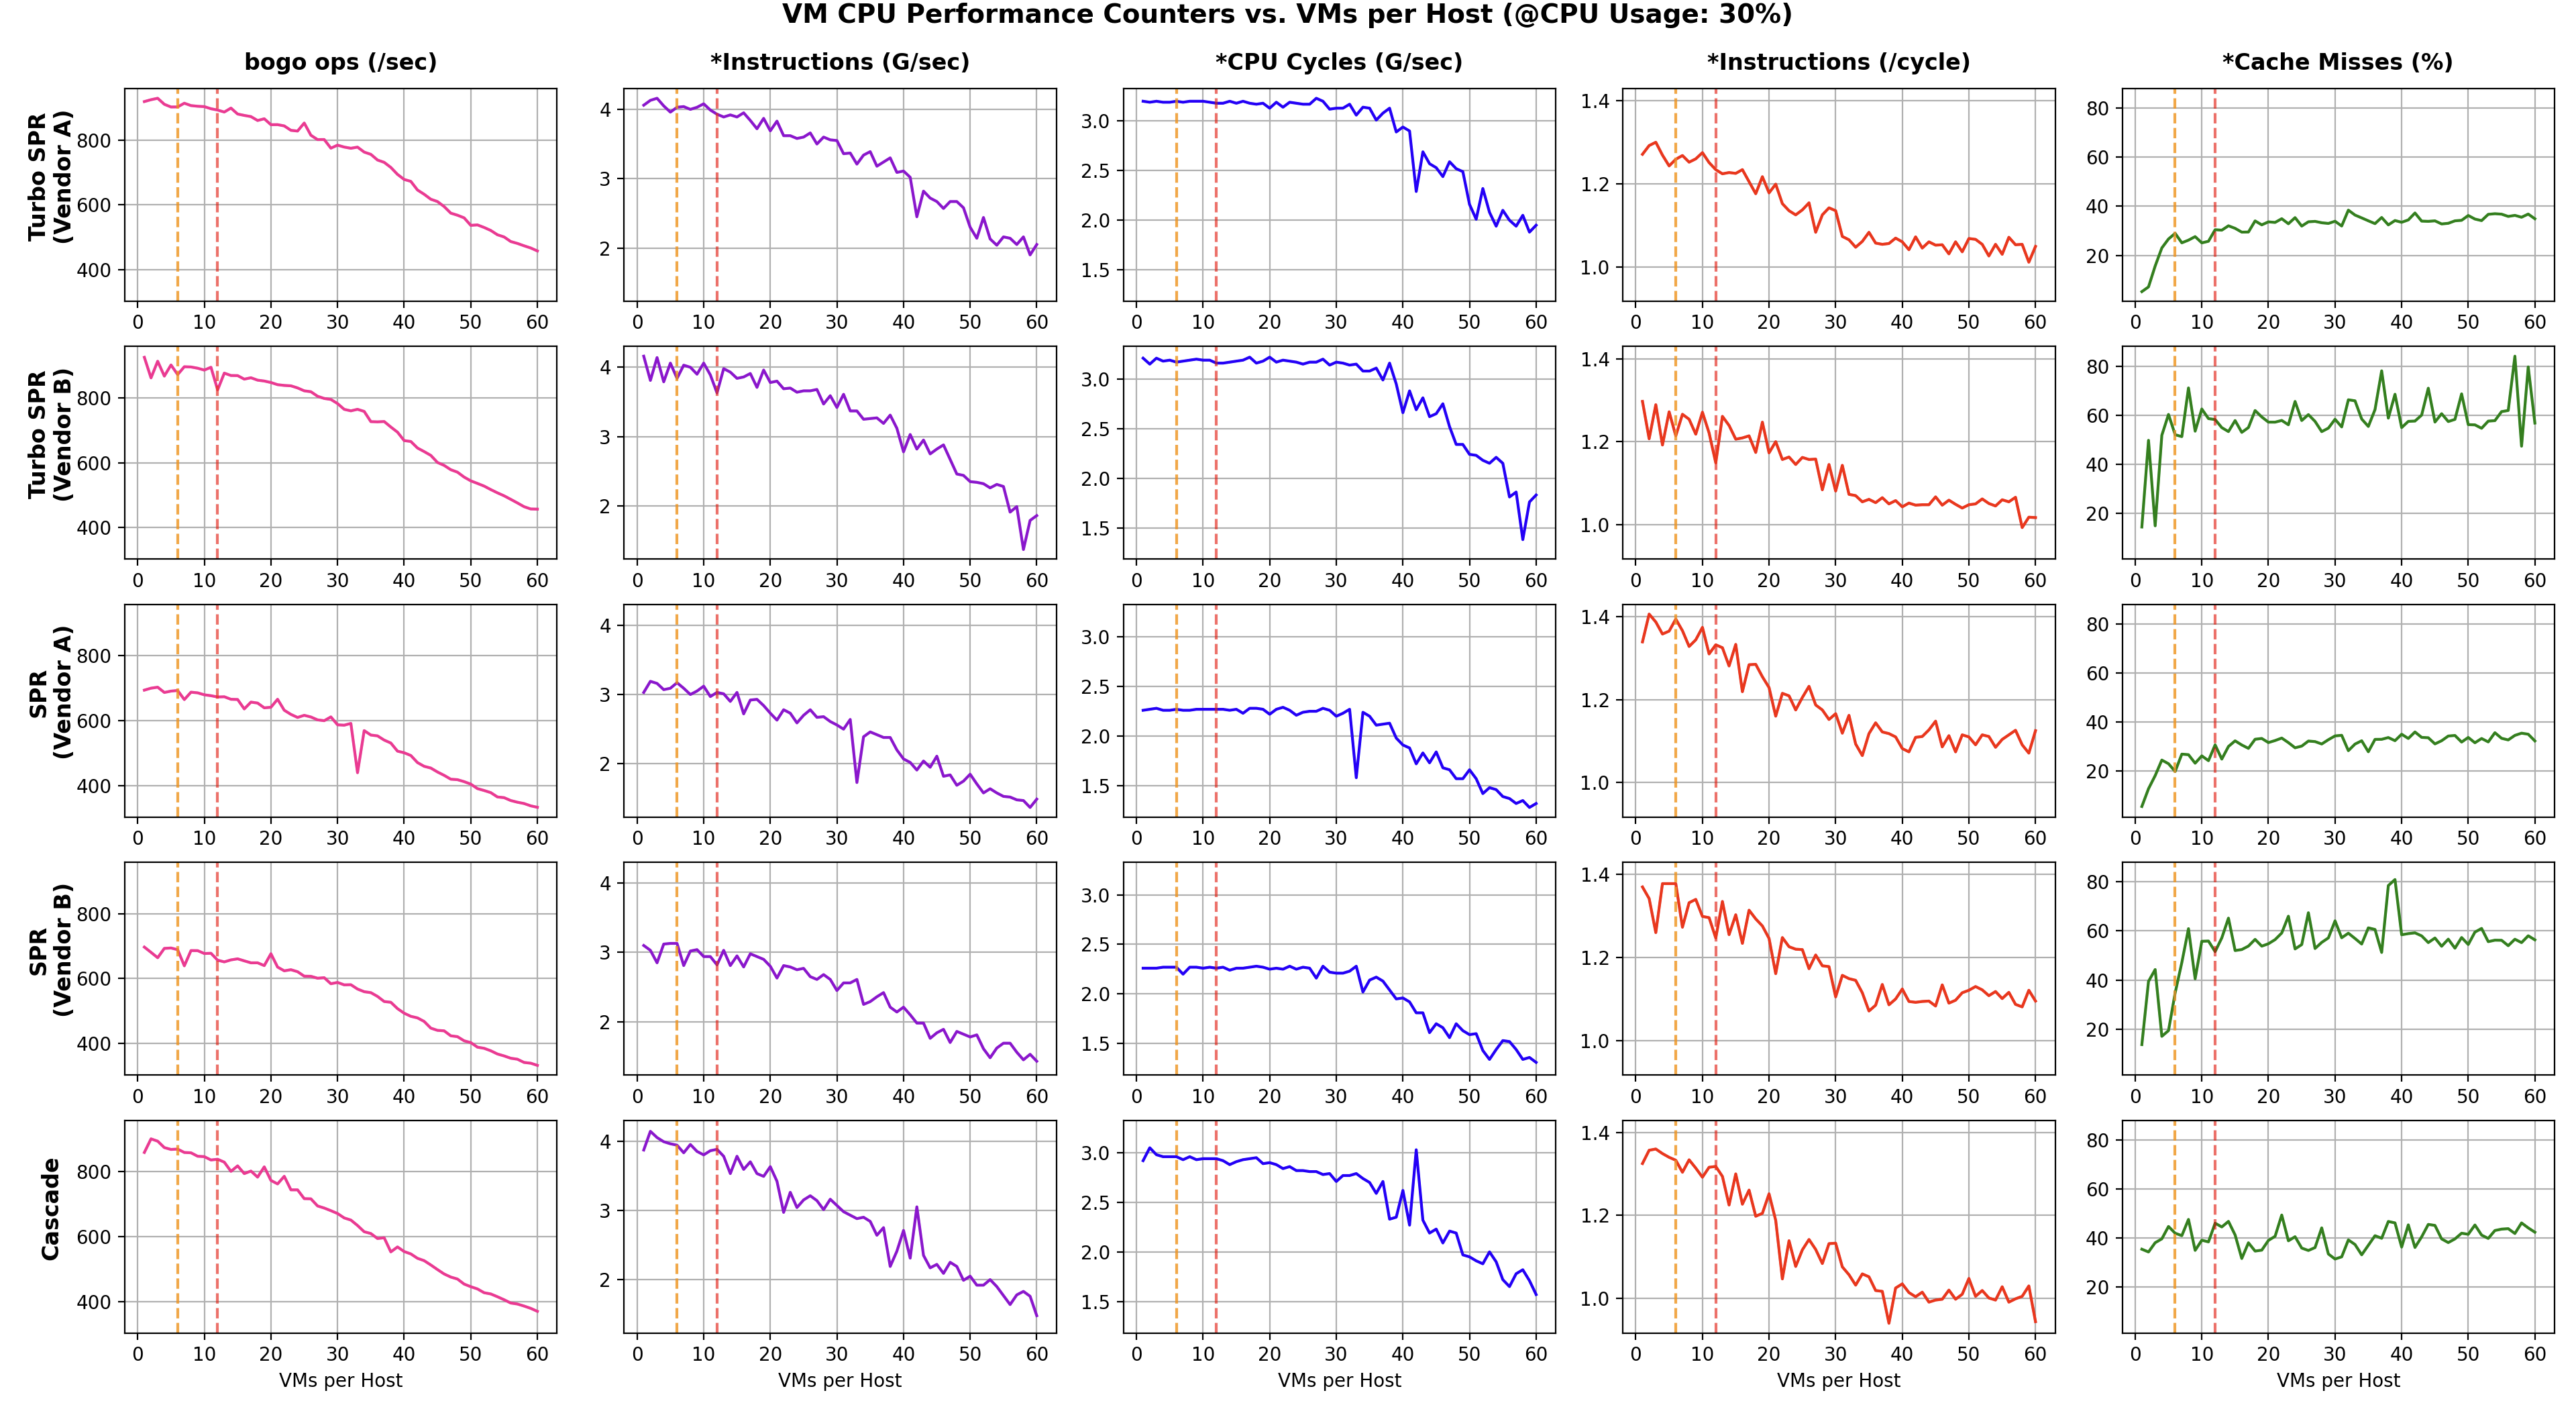
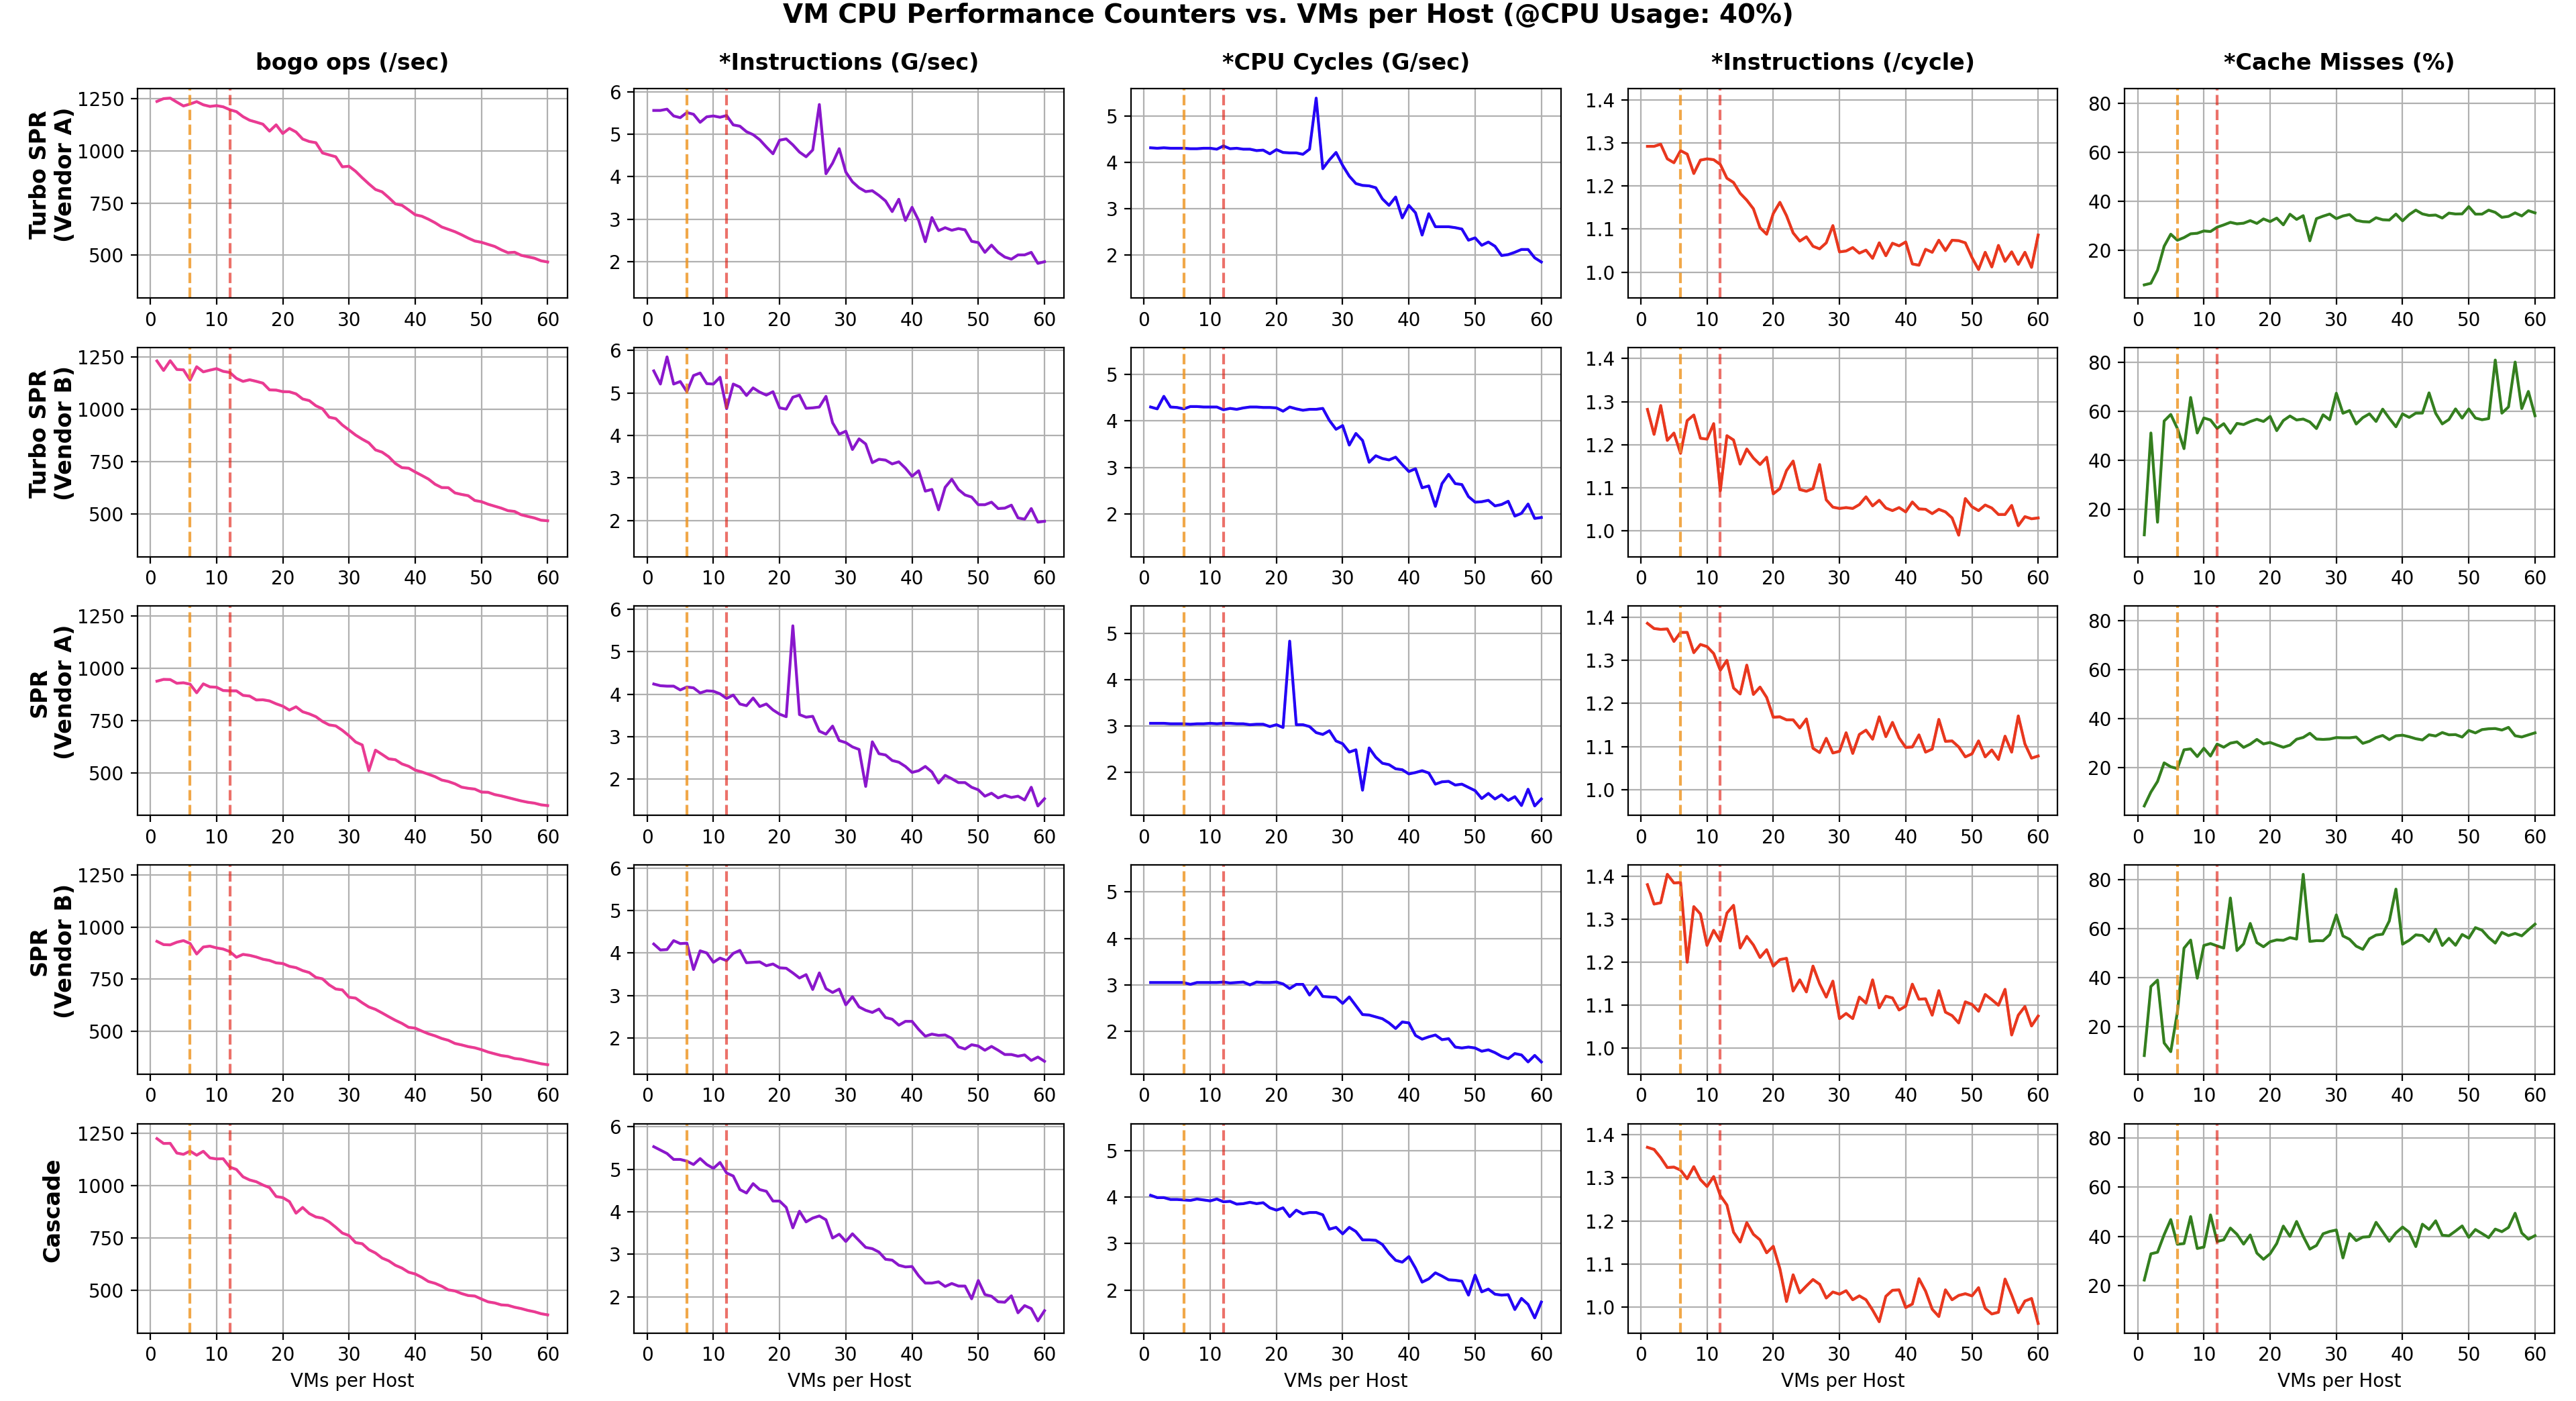
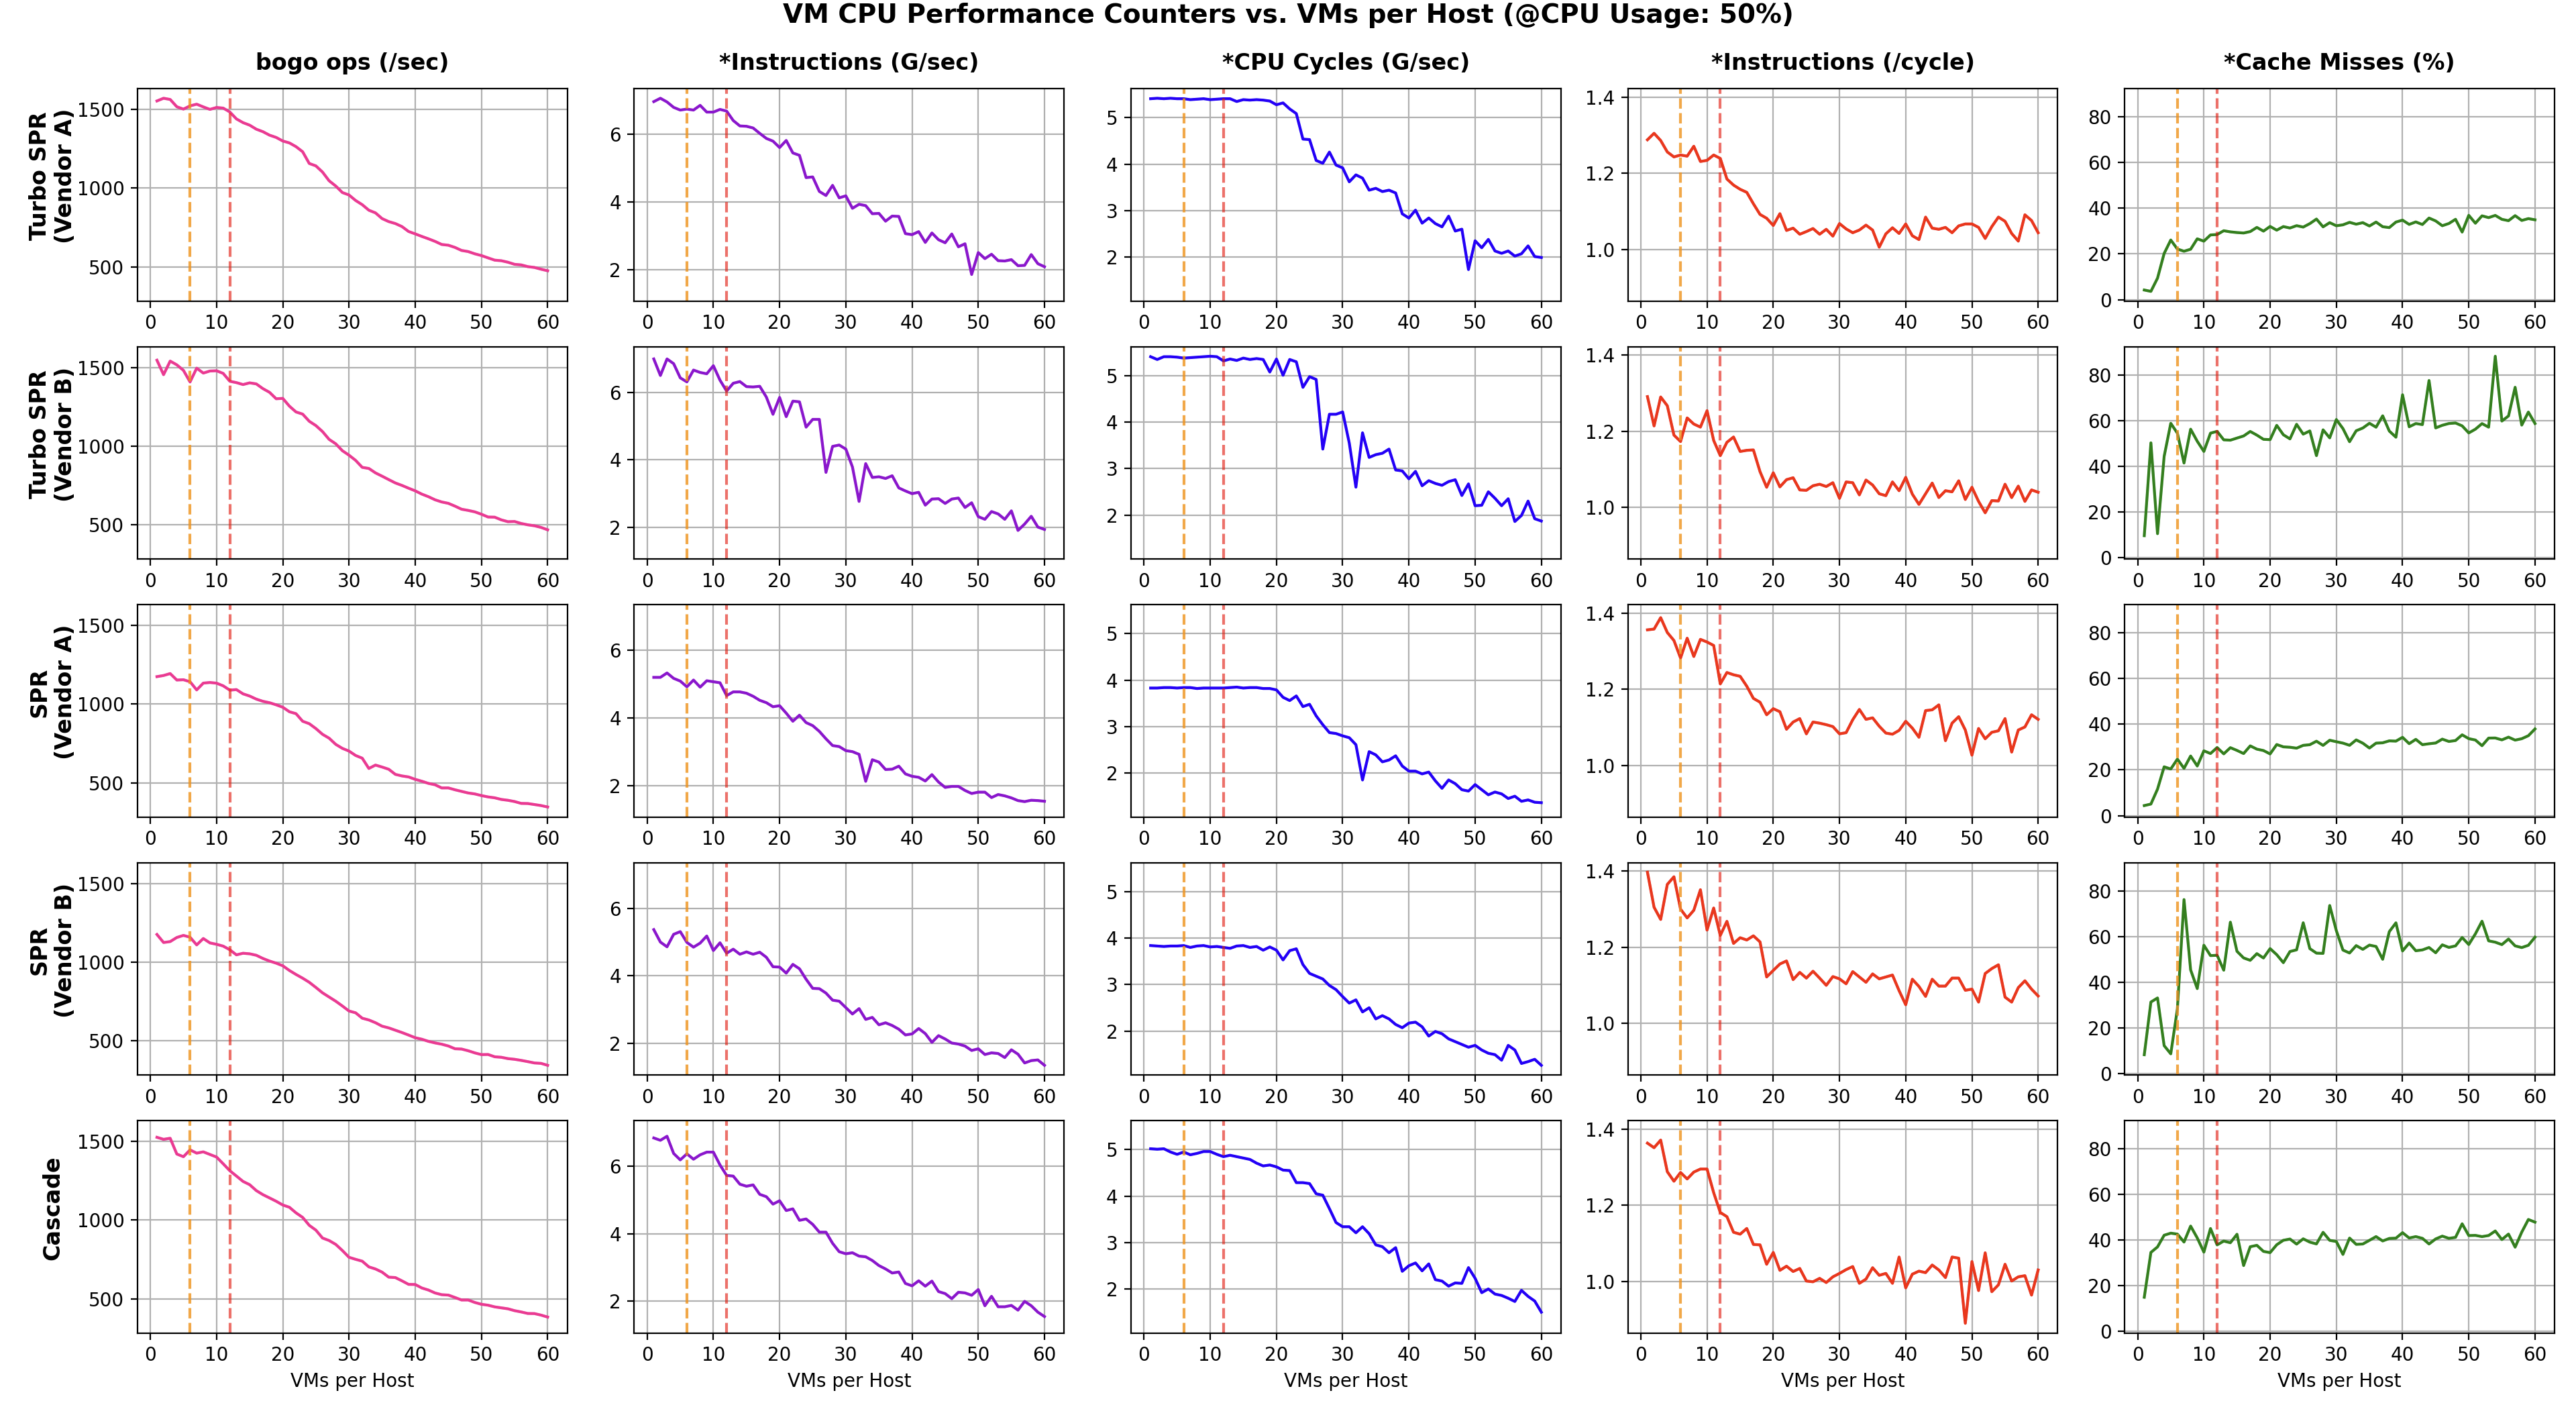
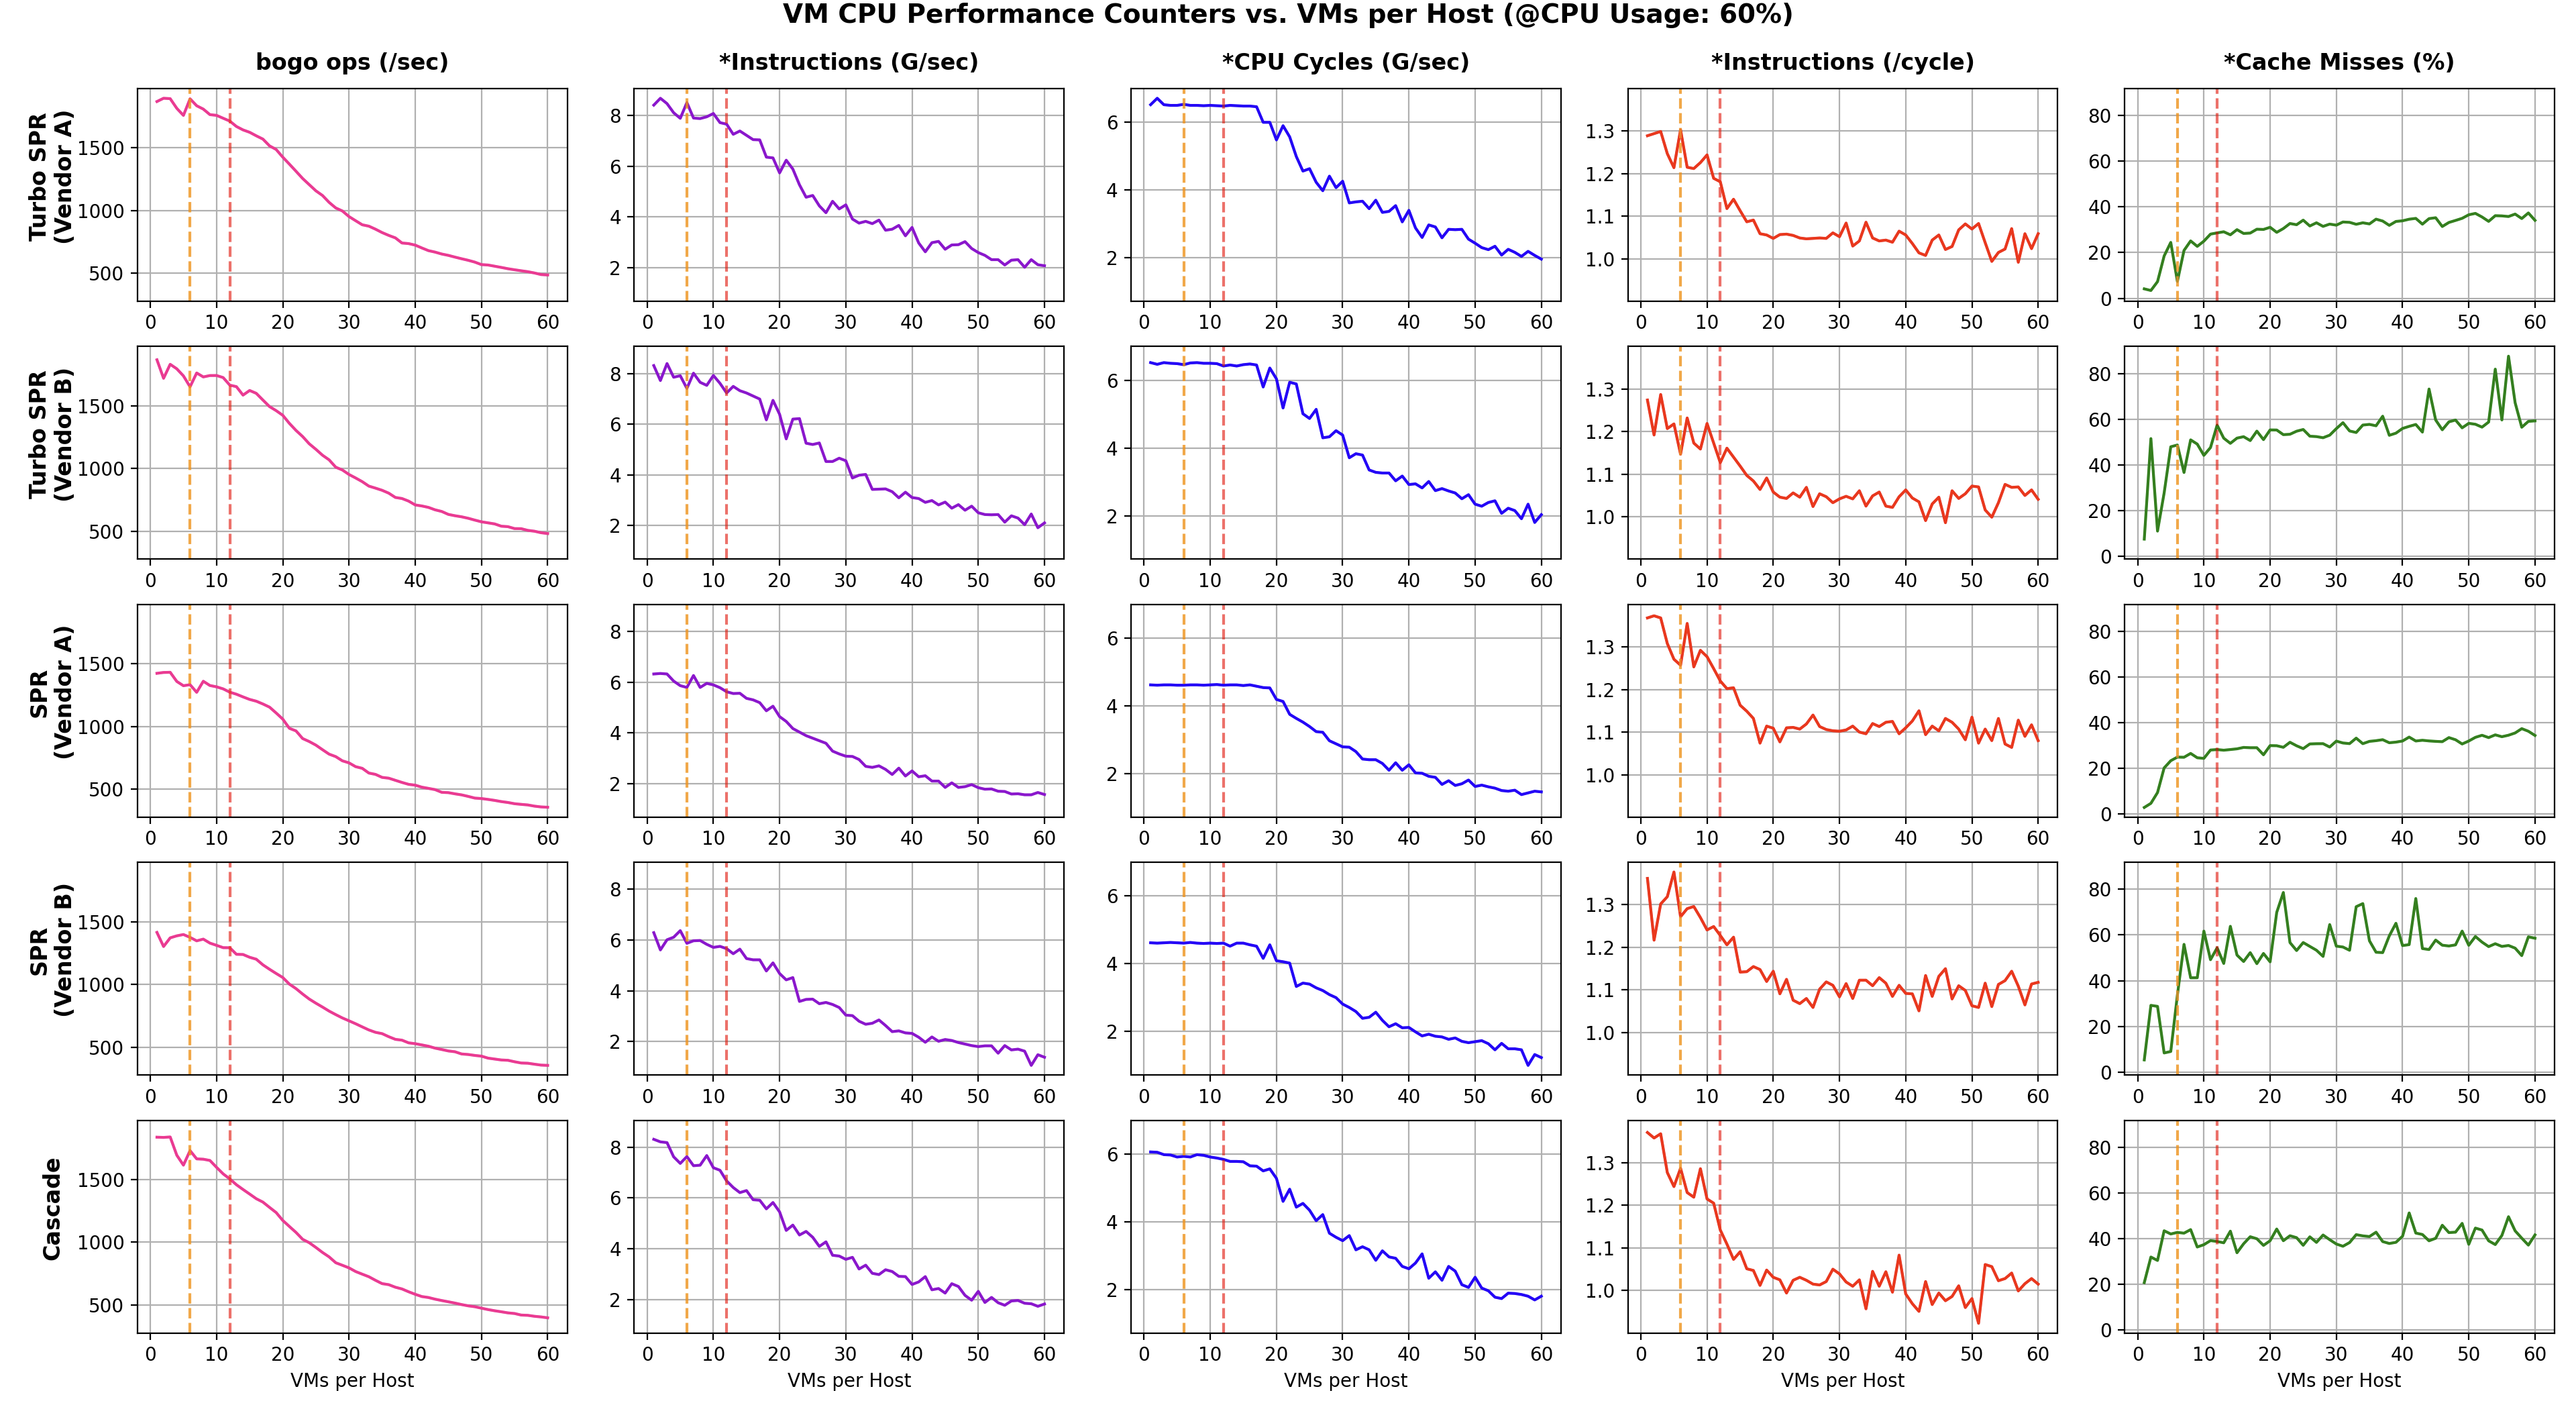
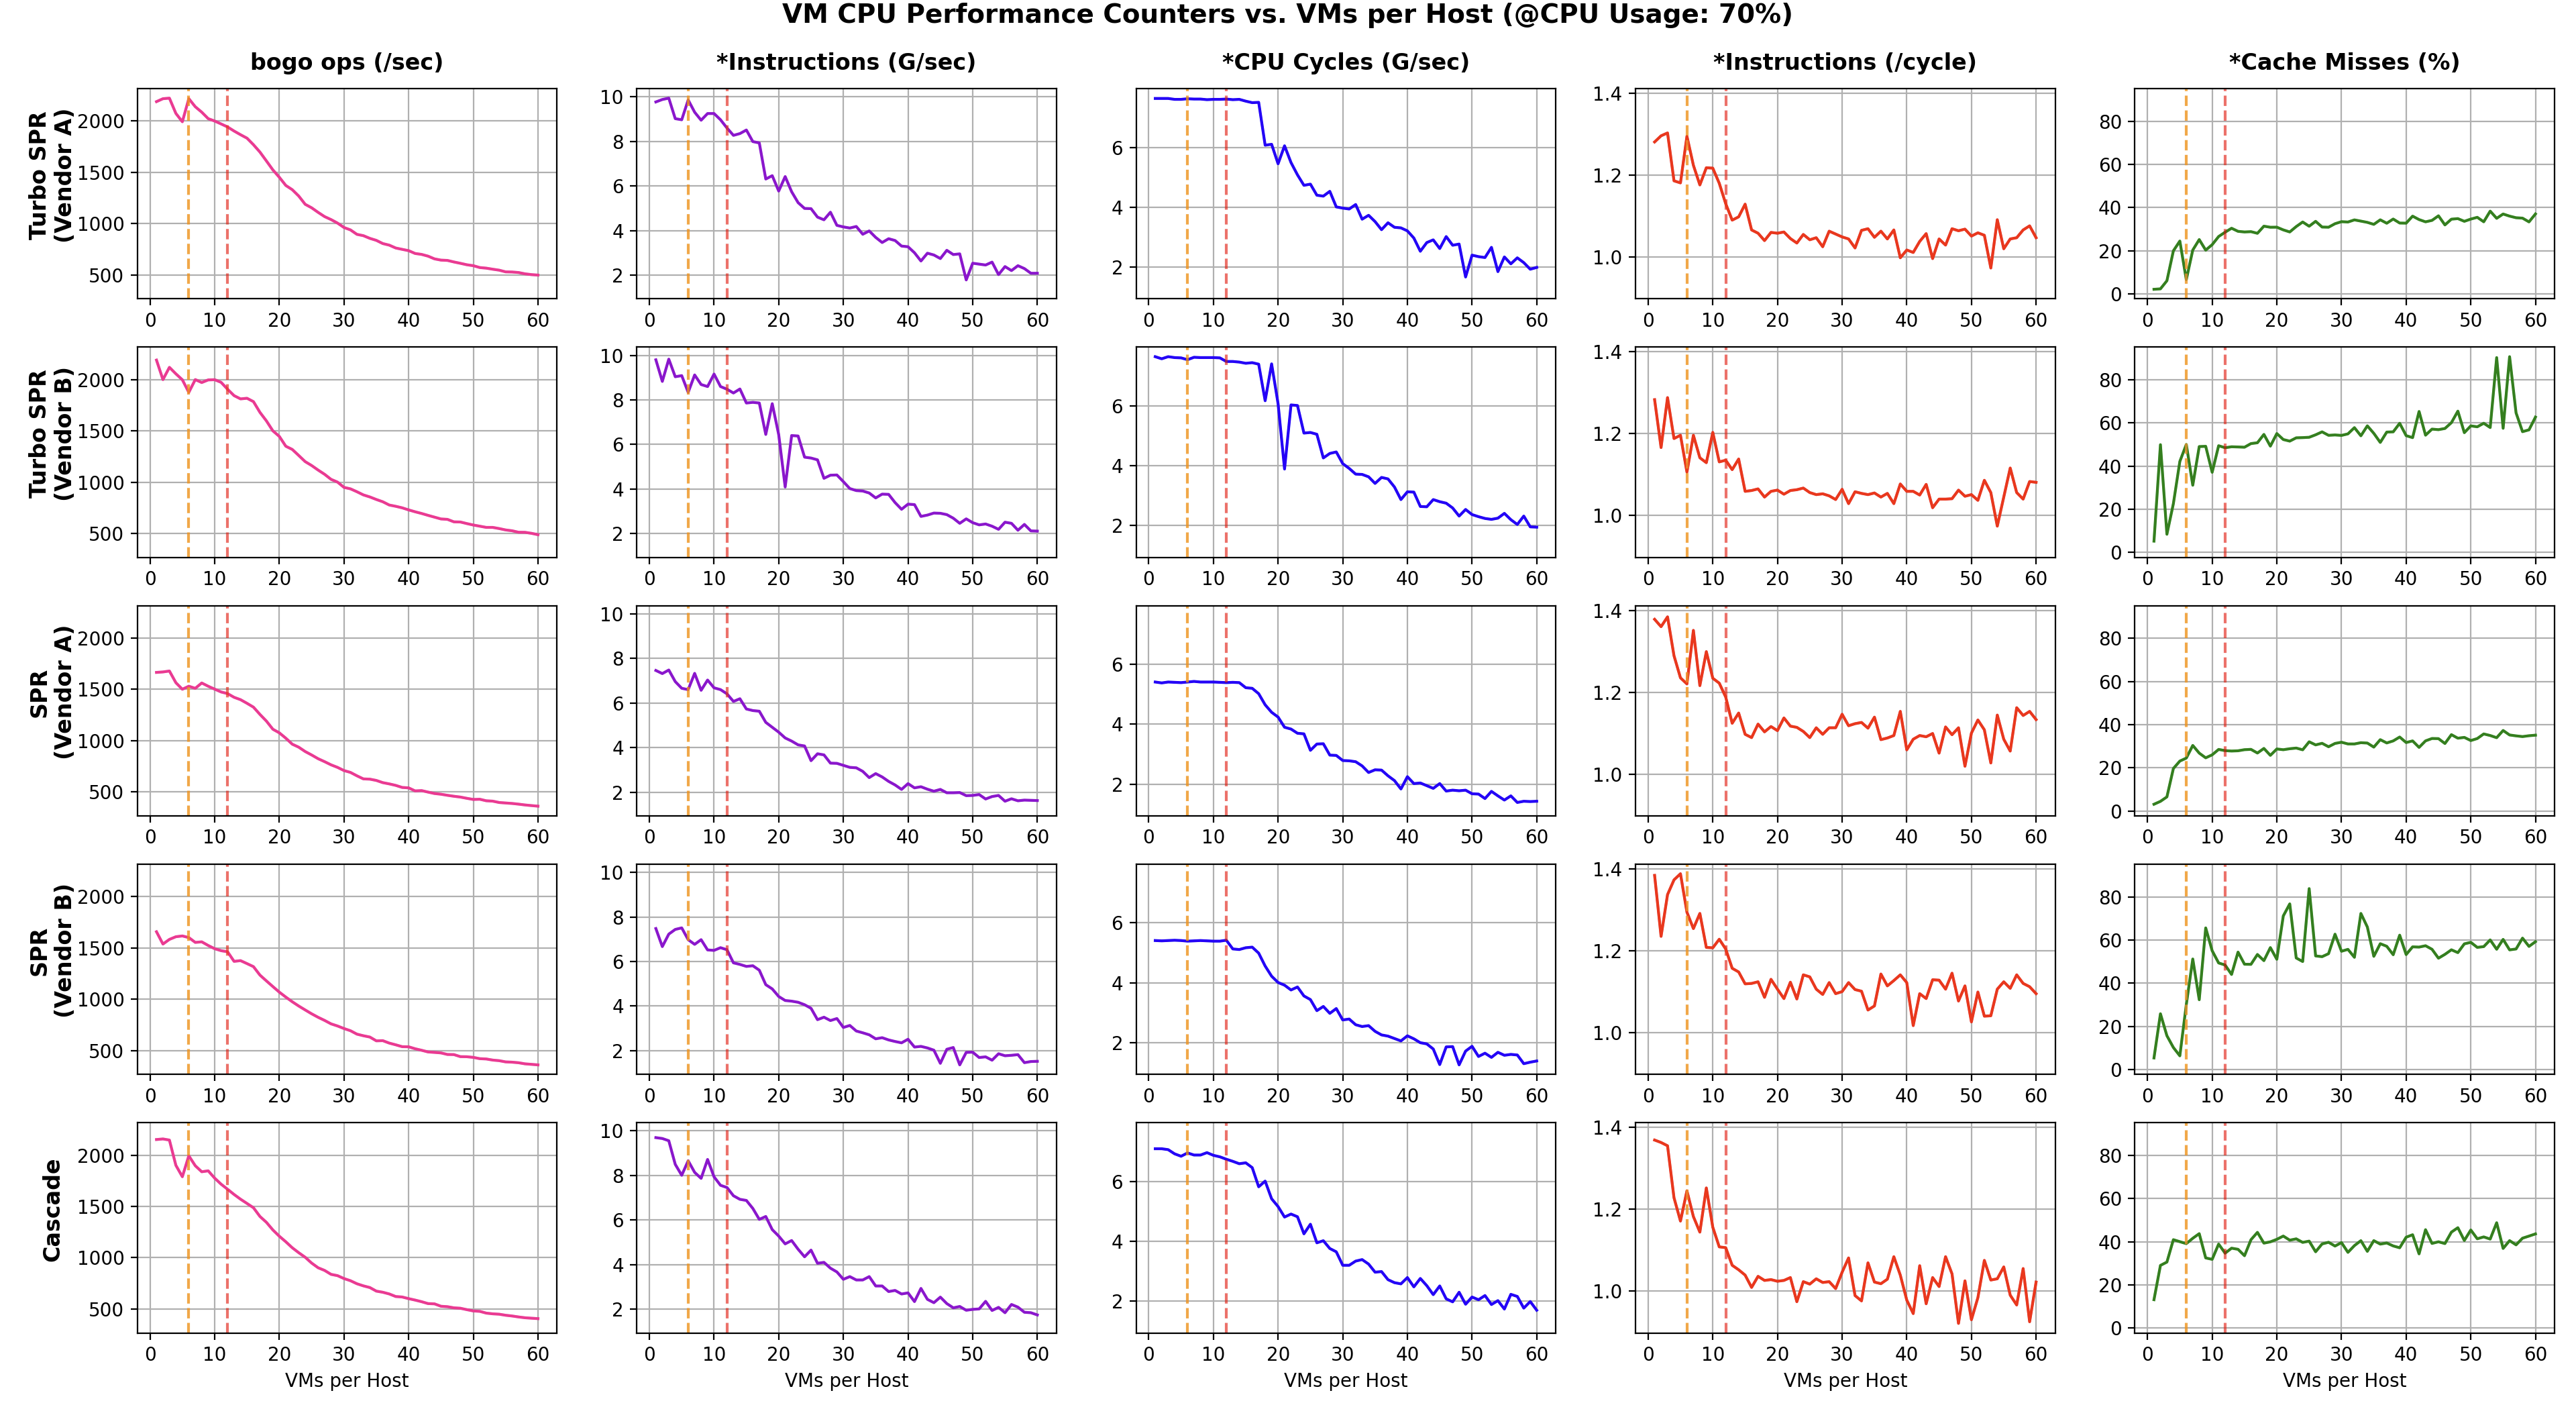
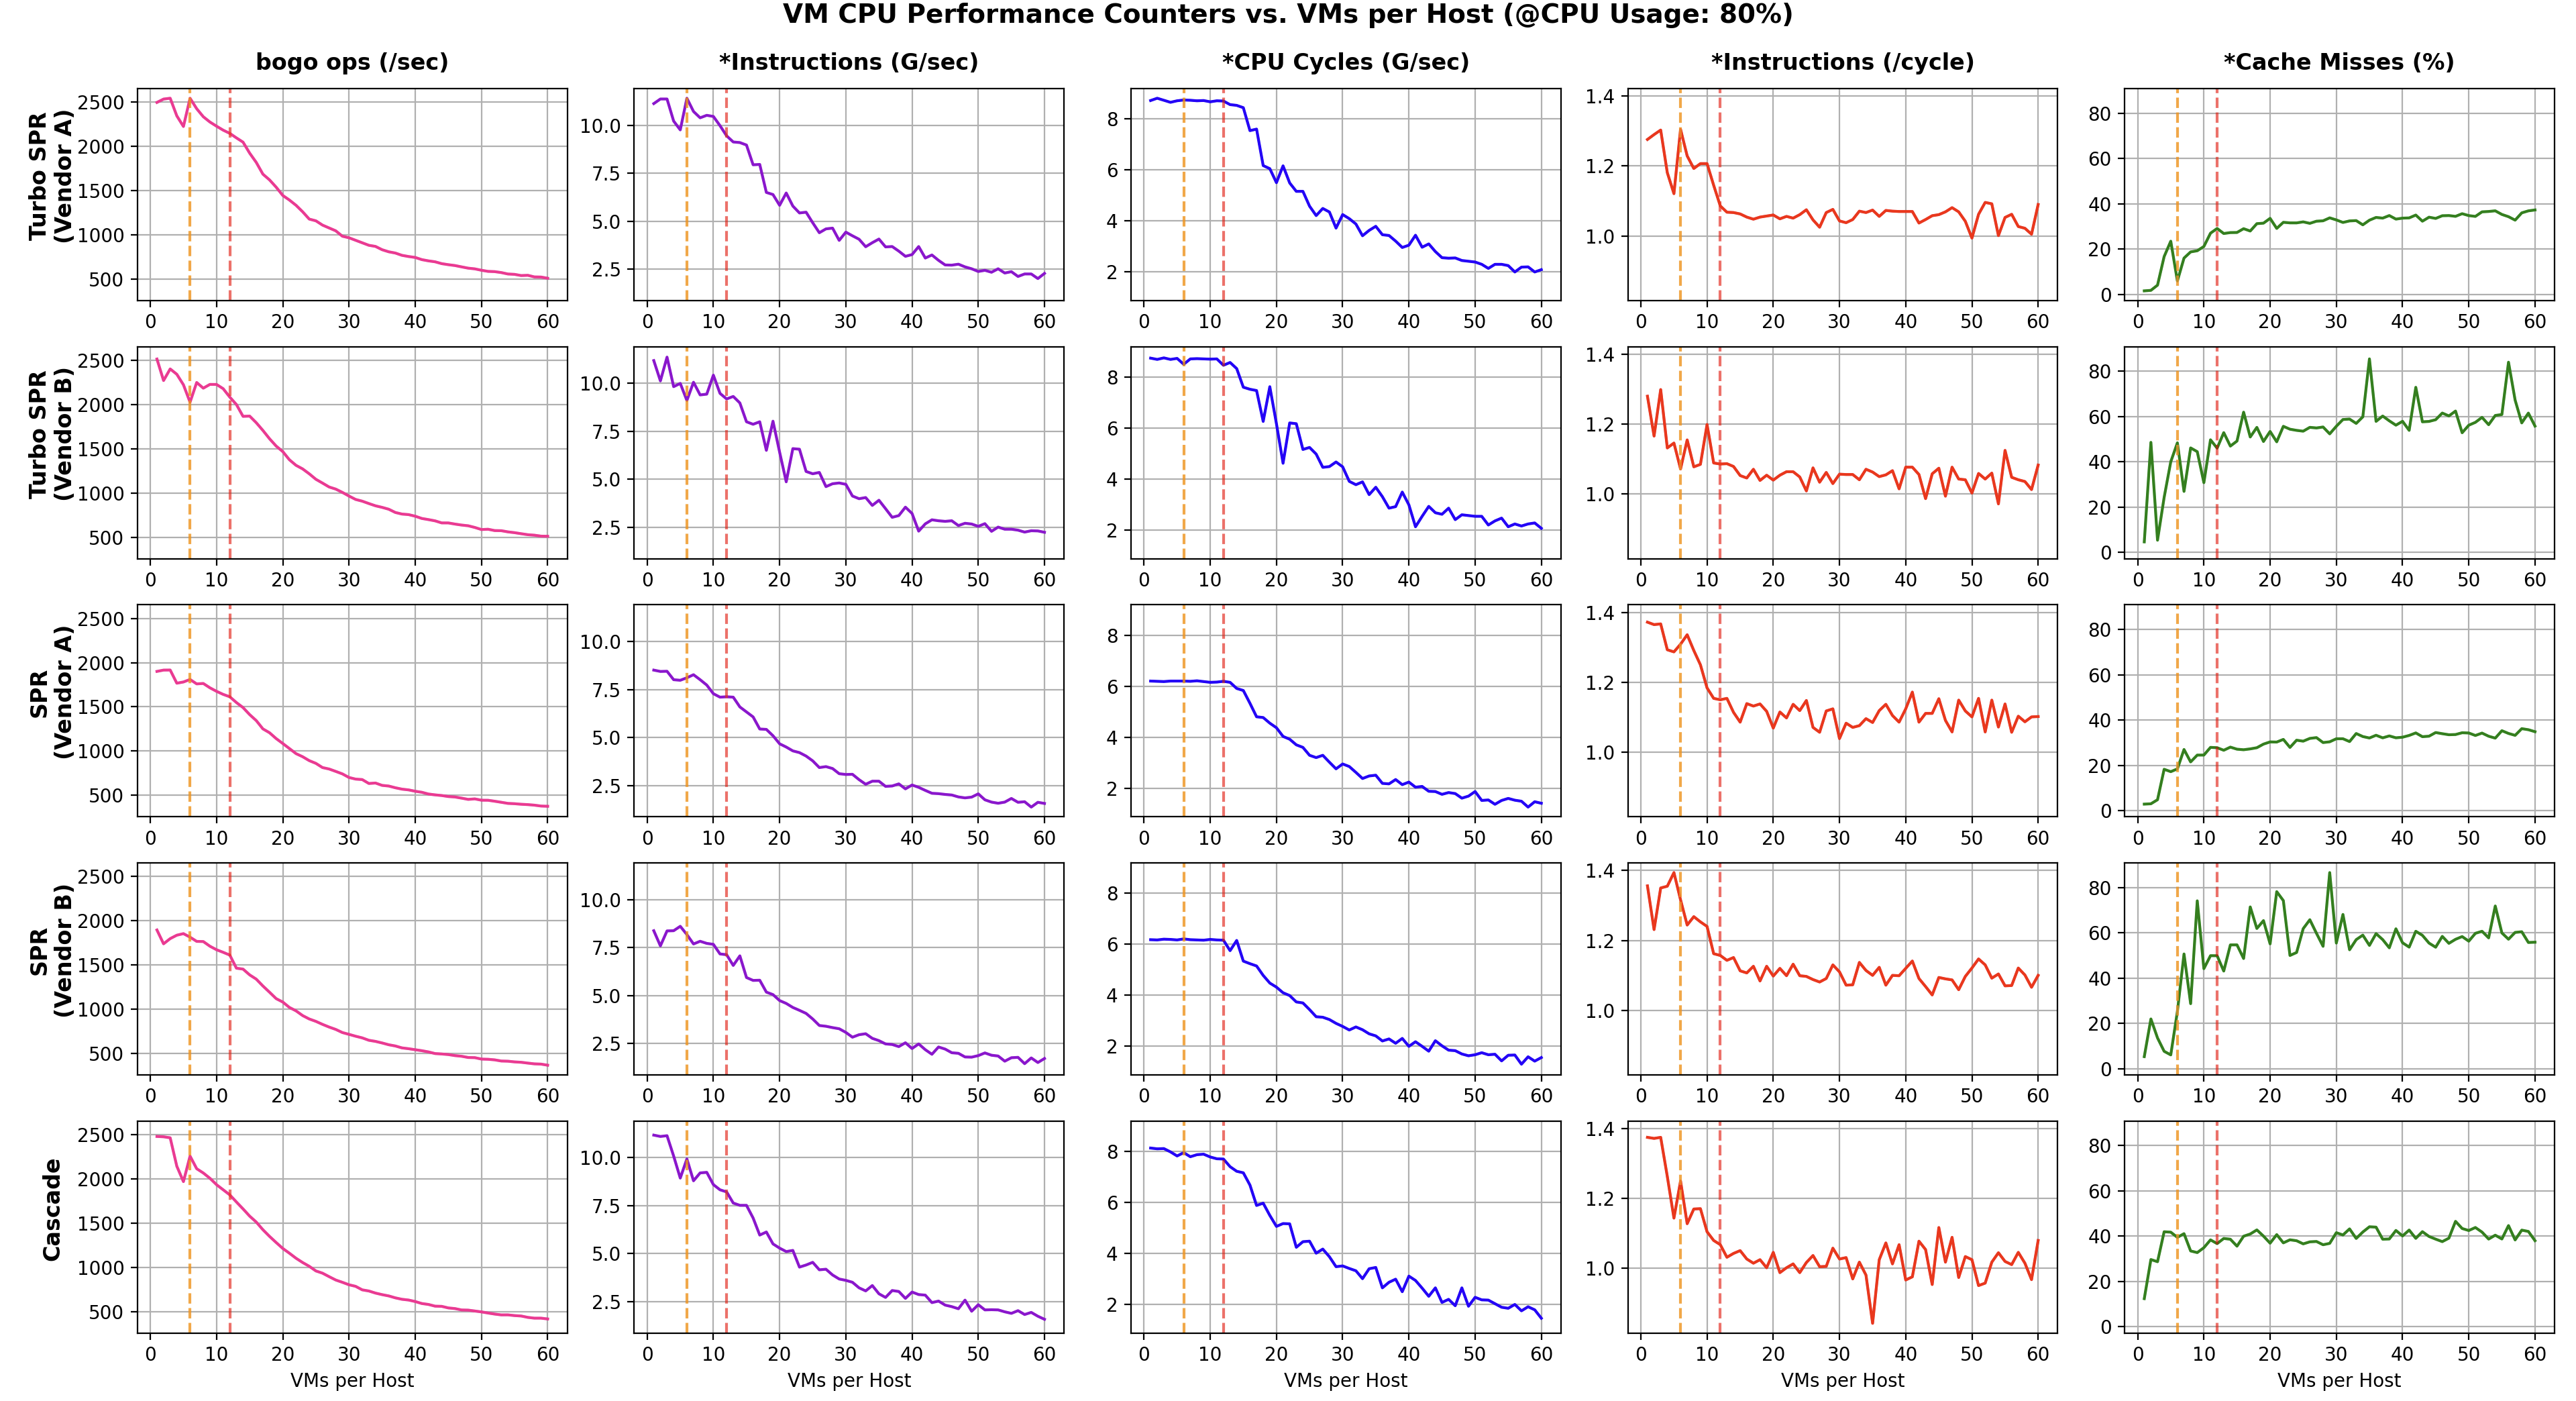
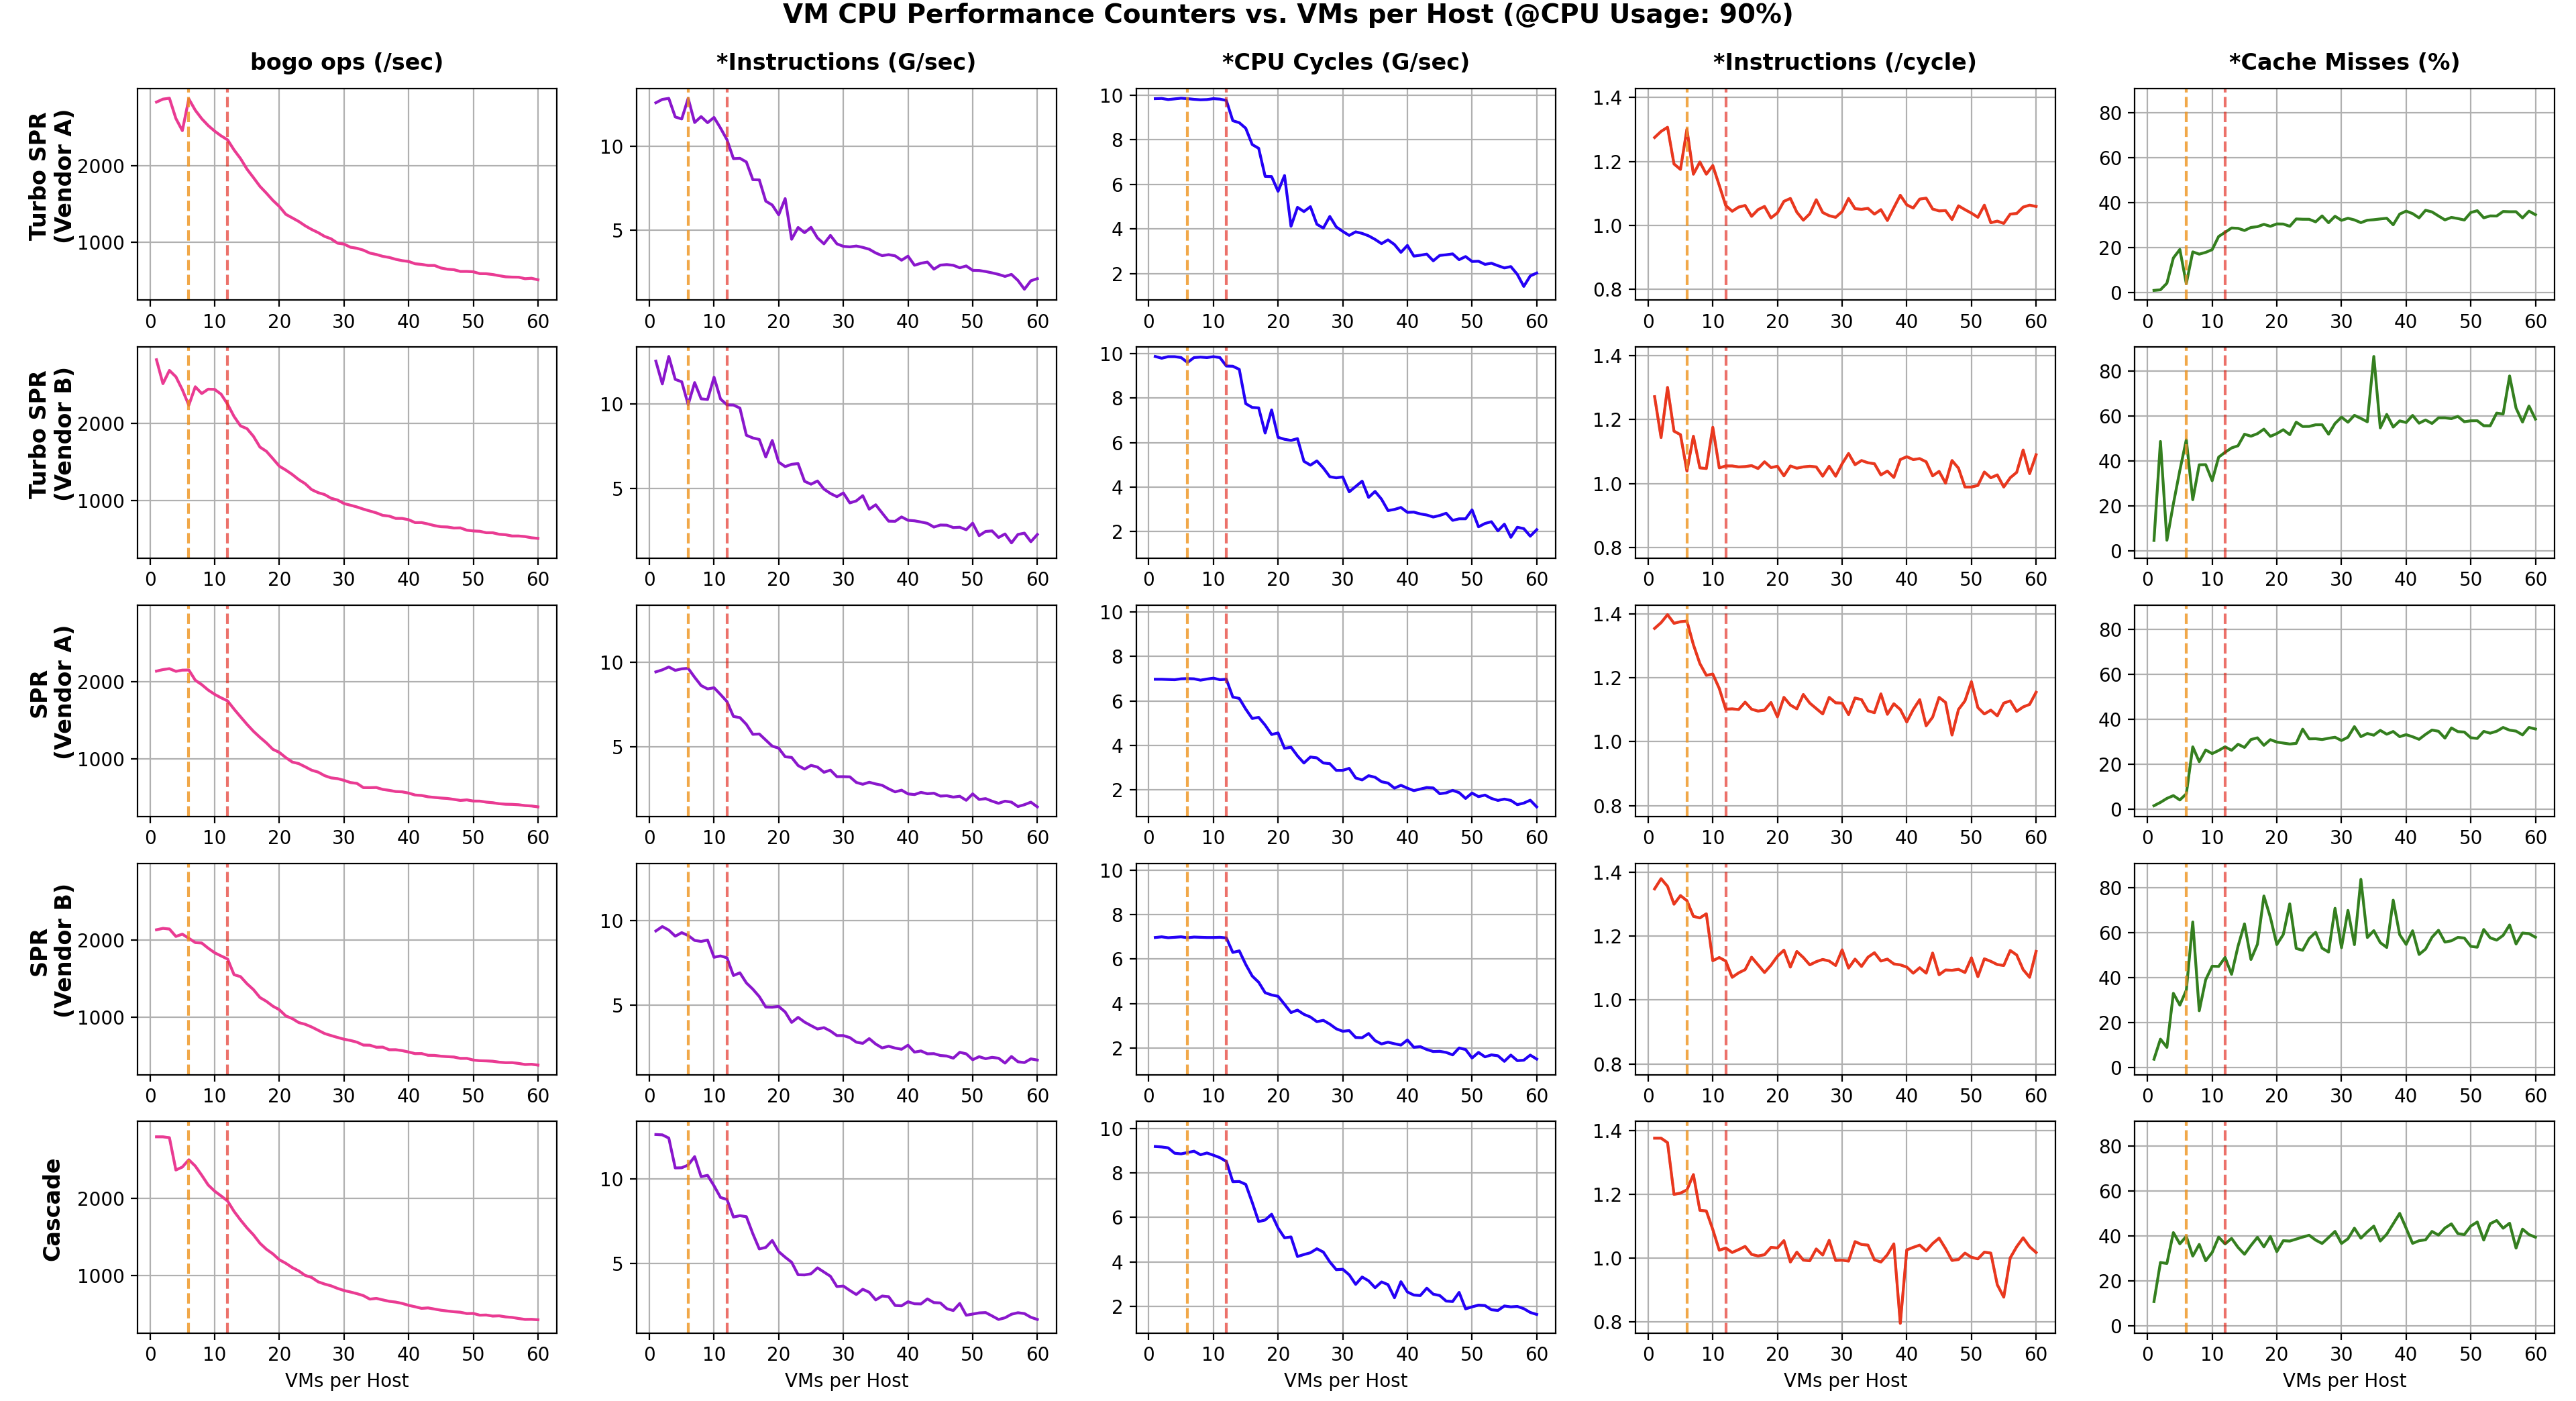
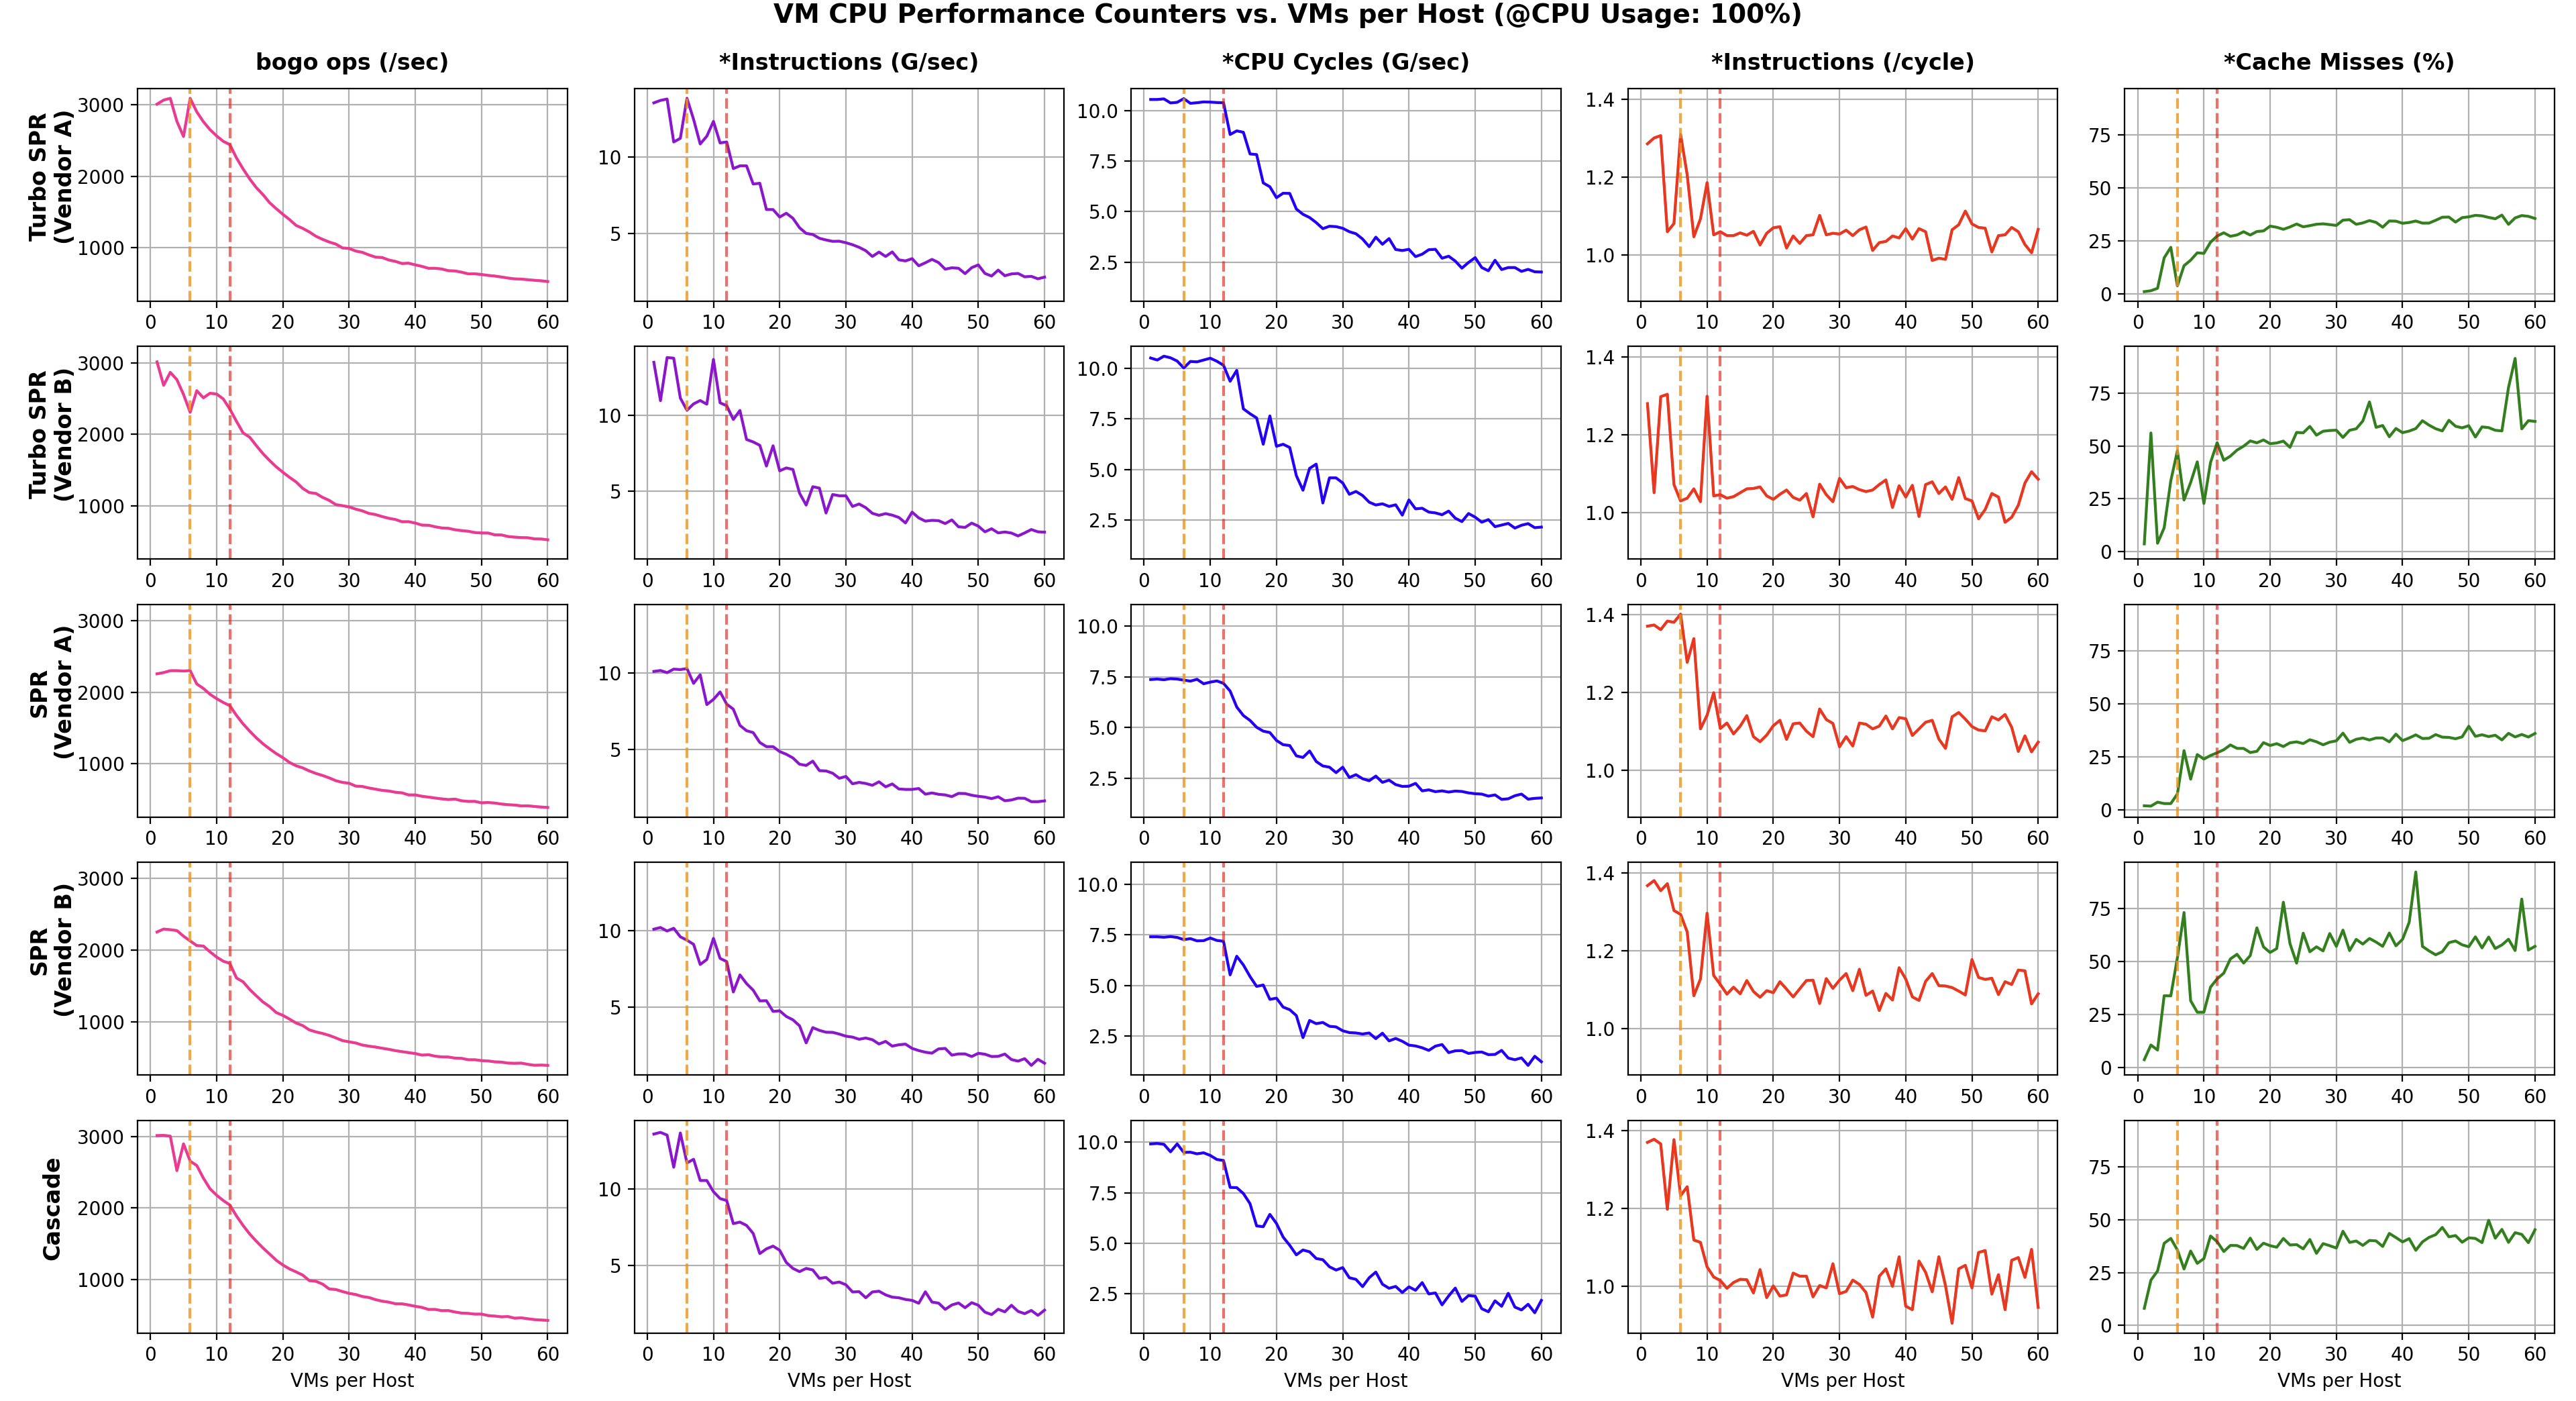
先ほど紹介した「 3. VM 数の増加に伴う VM の CPU パフォーマンスの変化 」をより詳細に分析するための資料です。VM の CPU 使用率が 10%、20%、30%、…100% それぞれに対する VM 数の増加による VM の CPU パフォーマンスカウンター(CPU Performance Counter)の変化を表しています。
VM 数が増えると、内部的にどのような変化が発生し最終的に VM の CPU パフォーマンス低下につながるのか、その原因を把握するために別のテストを実施しました。テスト方法自体は前回と同様ですが、4 vCPU / 8GB MEM フレイバーの VM に対してのみ、stress-ng というベンチマークプログラムを使用して行った点が異なります。また、VM の CPU パフォーマンスカウンター値を取得するために、stress-ng の --perf オプションを使用しました。
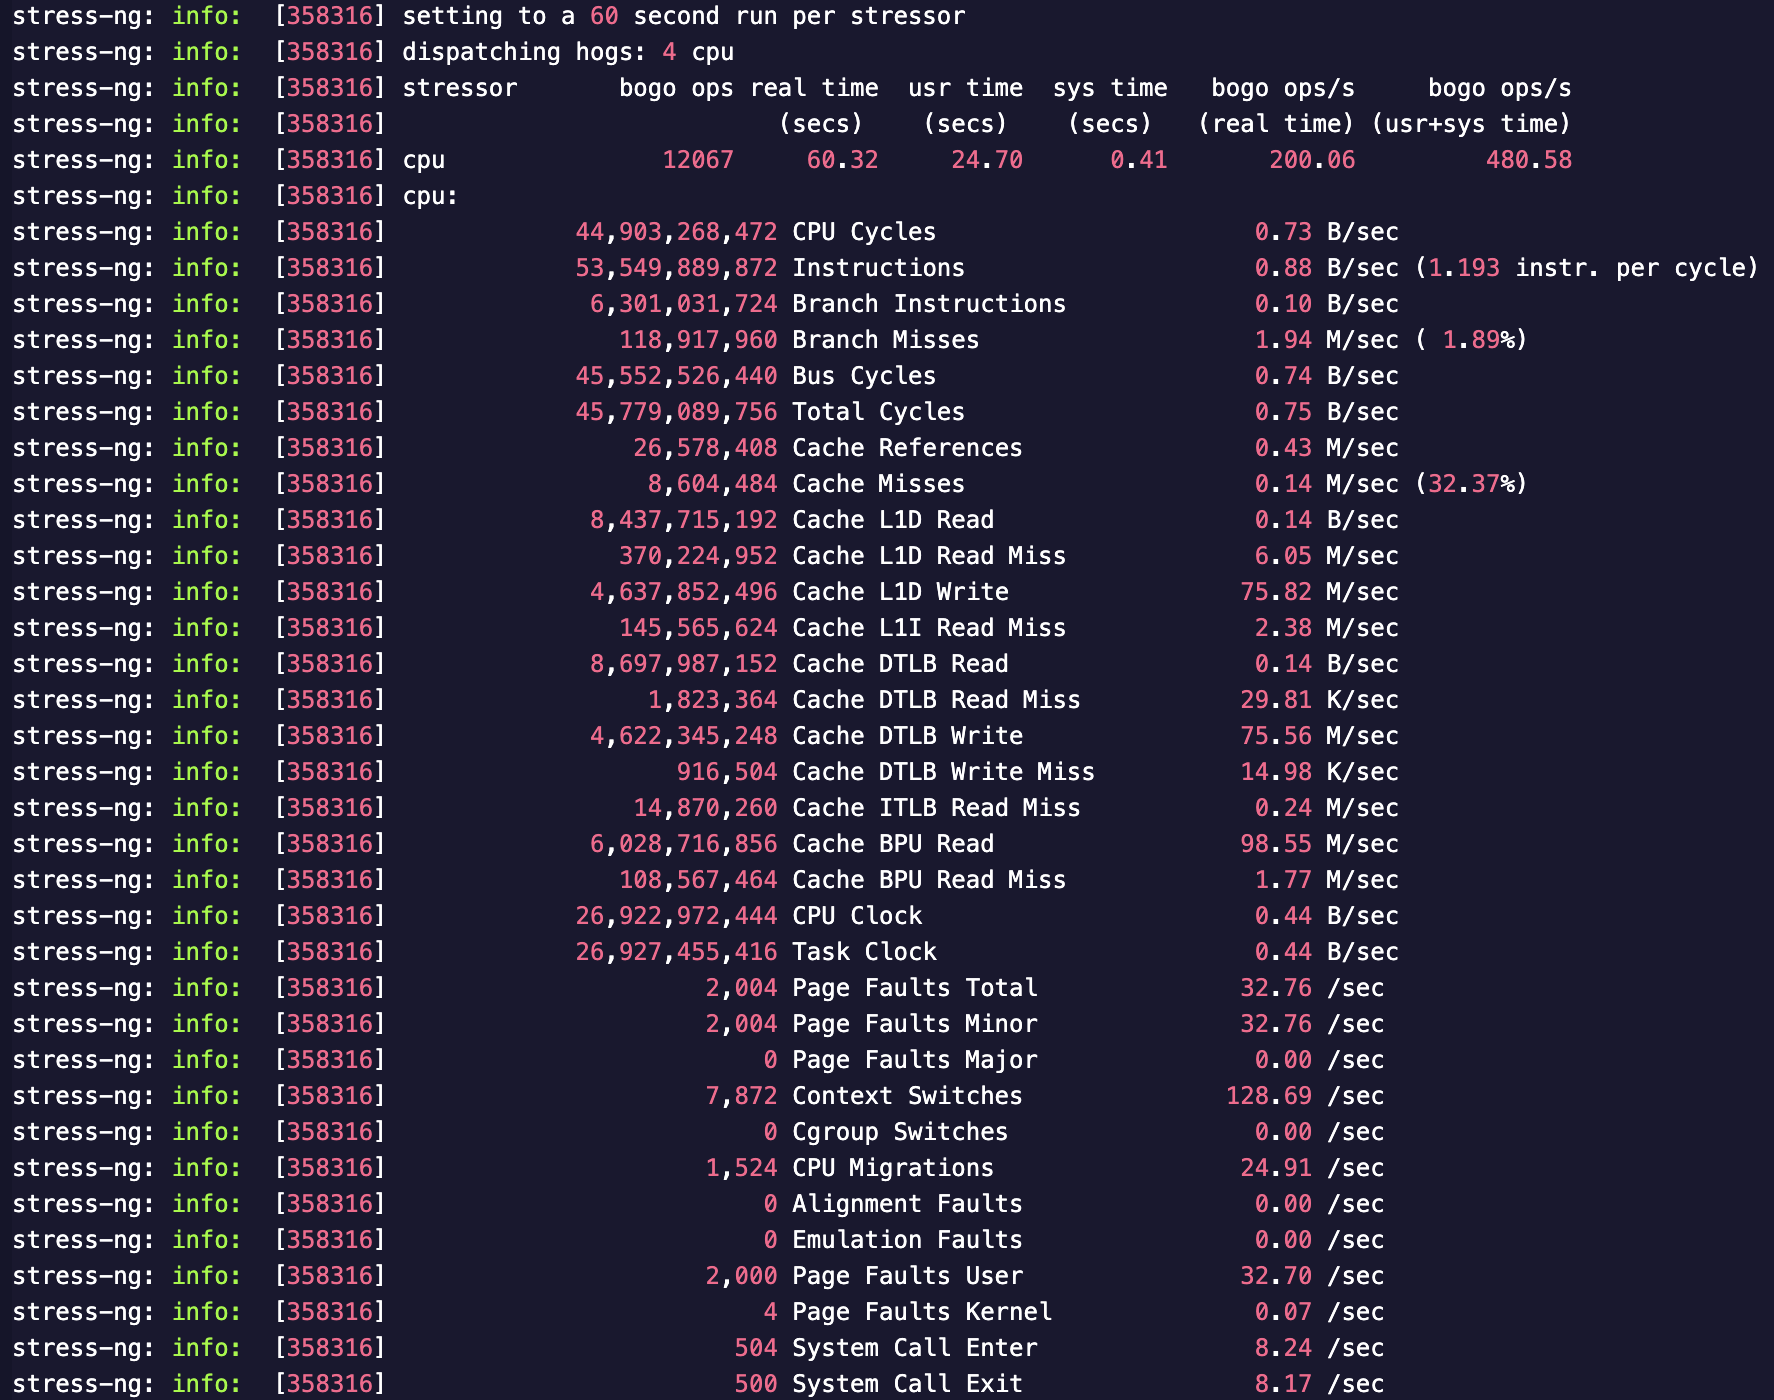
stress-ng の --perf オプションを使うと、上記の図のようにベンチマーク結果と一緒に CPU パフォーマンスカウンターの統計を確認することができます。
各 PM ごとに VM の CPU 使用率を変えながら行ったテスト結果を基に、以下のように最終的なグラフを構成しました。
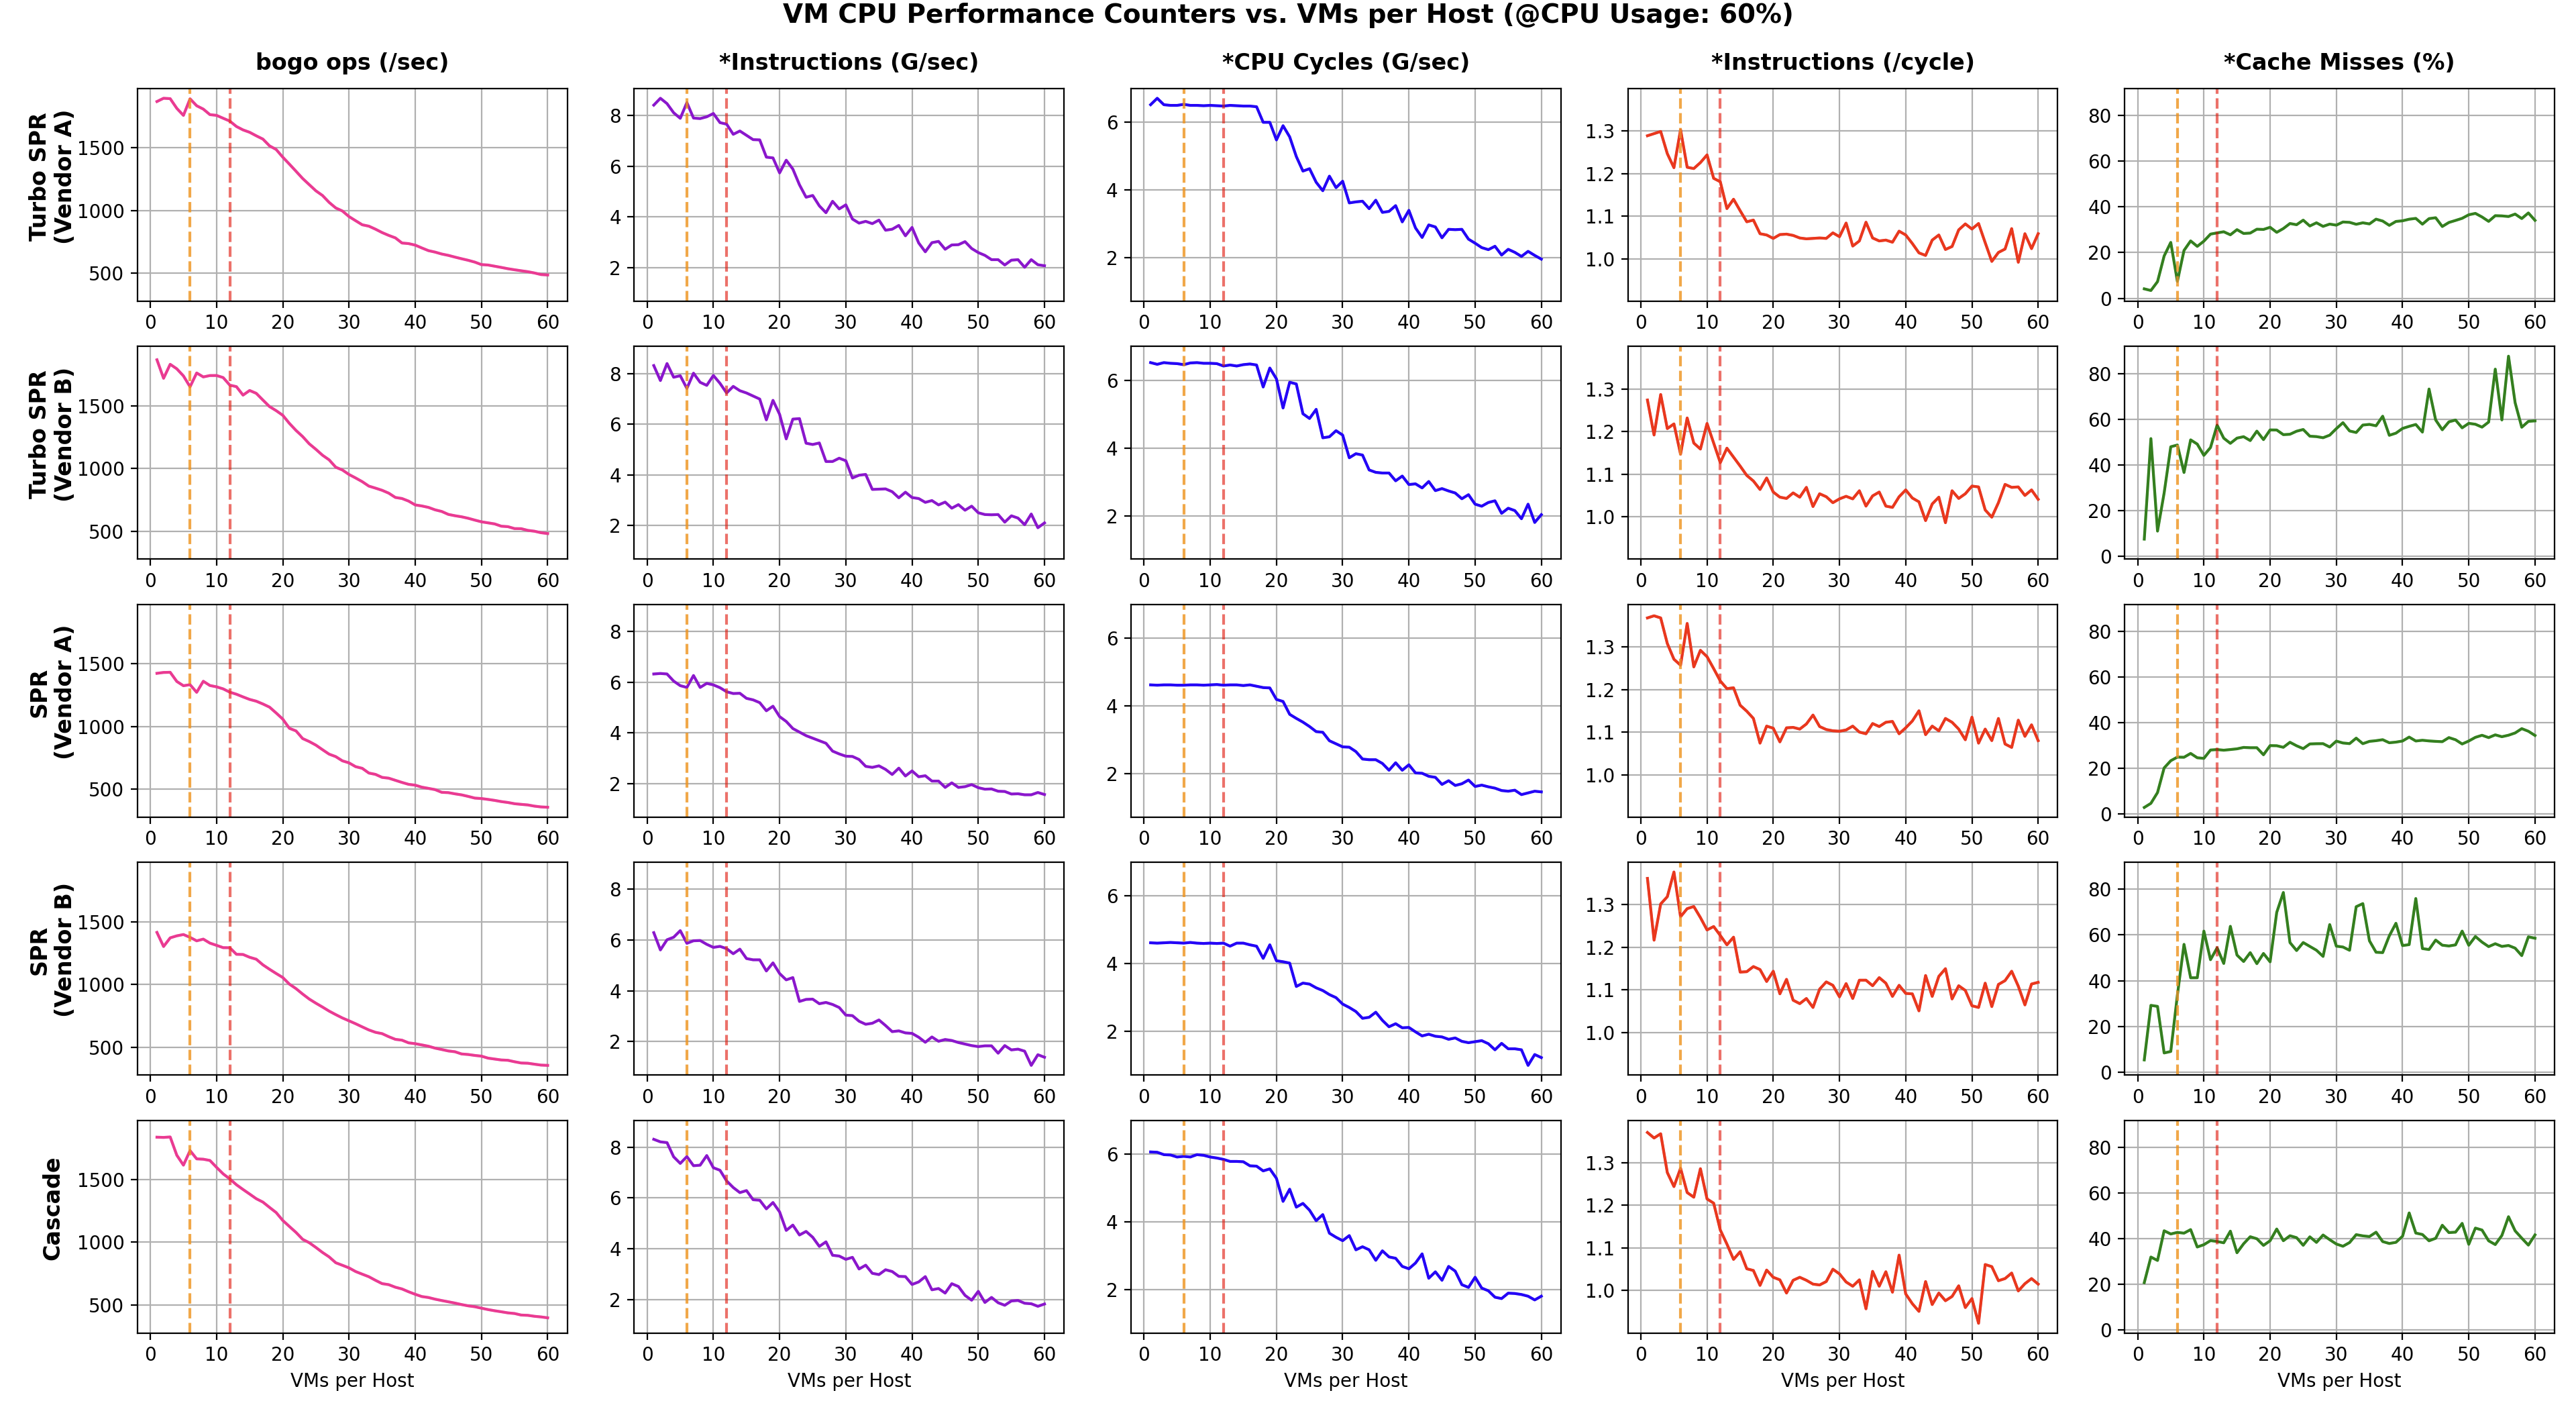
各行は 1 つの PM に対応し、各列はベンチマーク結果と VM の CPU パフォーマンスカウンターの値を示します。
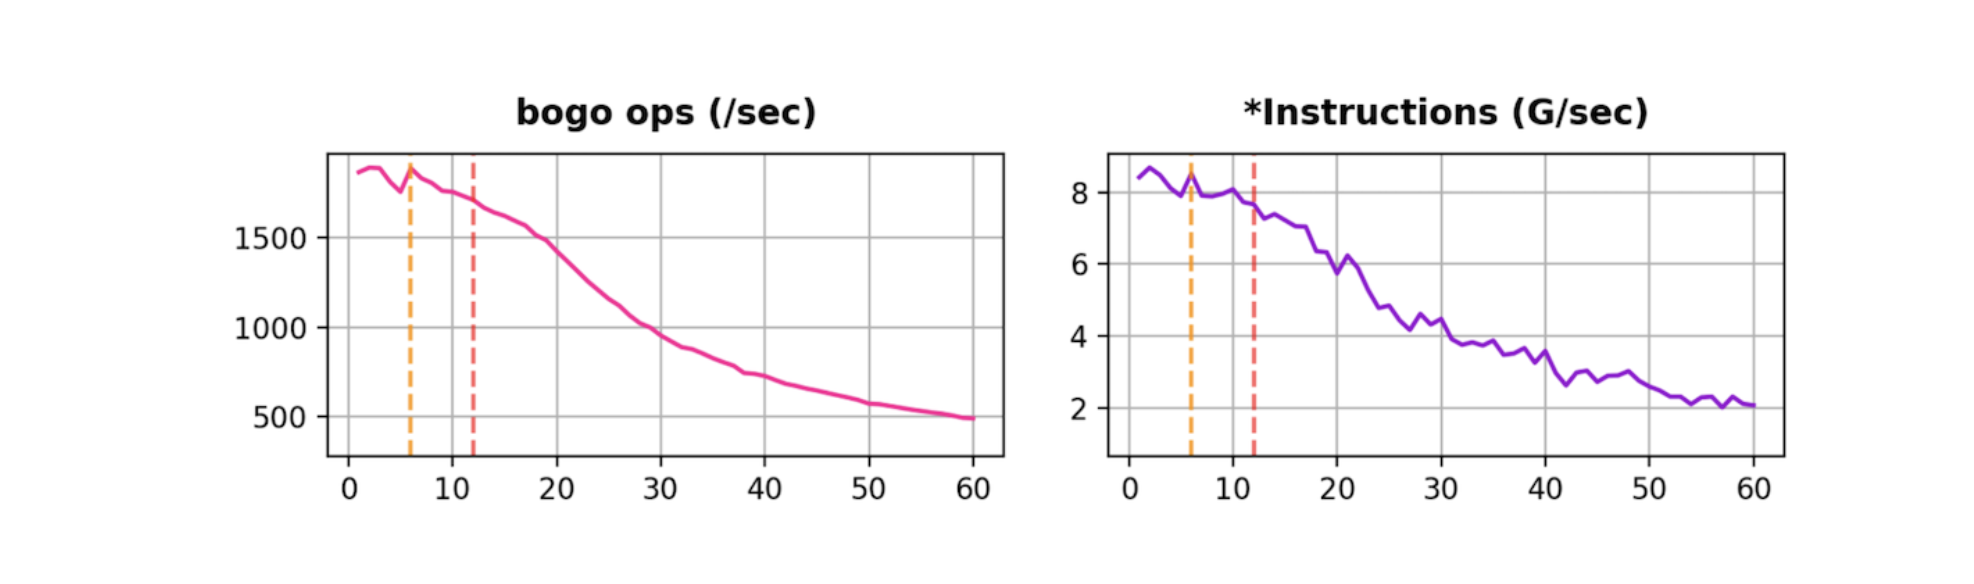
bogo ops(/sec) は、N 個の VM で同時に stress-ng ベンチマーク(cpu-method=all)を実行させた結果の平均です。
その他 * で始まる項目は、実際のベンチマーク実行は N 個の VM で同時に行われましたが、1 つの VM のみから抽出(サンプリング)した VM の CPU パフォーマンスカウンター値です。VM の CPU パフォーマンスカウンター値を収集するためには、仮想 CPU パフォーマンスカウンター(Virtual CPU Performance Counters)の有効化設定が必要ですが、一括作業が困難なため、PM スペックごとに 1 台の VM ごとに設定を行いました。
オレンジ色の点線は、PM のコア(pCPU)数と VM の vCPU 数の合計が等しくなる VM 数(24 ÷ 4 = 6)を、赤色の点線は、PM のスレッド(vCPU)数と VM の vCPU 数の合計が等しくなる VM 数(48 ÷ 4 = 12)を表します。
2) グラフ分析
bogo ops(/sec) ≒ Instructions(G/sec)
-
bogo ops(/sec) グラフと Instructions(G/sec) グラフは似たような形状をしています。
-
ベンチマークの結果である VM の CPU パフォーマンスは、Instructions(G/sec) 値をそのまま追従していることが分かります。
-
Instructions(G/sec) のグラフが bogo ops(/sec) のグラフに比べて不安定なのは、N 個の VM に対して平均値を出した bogo ops(/sec) とは異なり、1 台の VM のみから抽出(サンプリング)した結果によるものです。
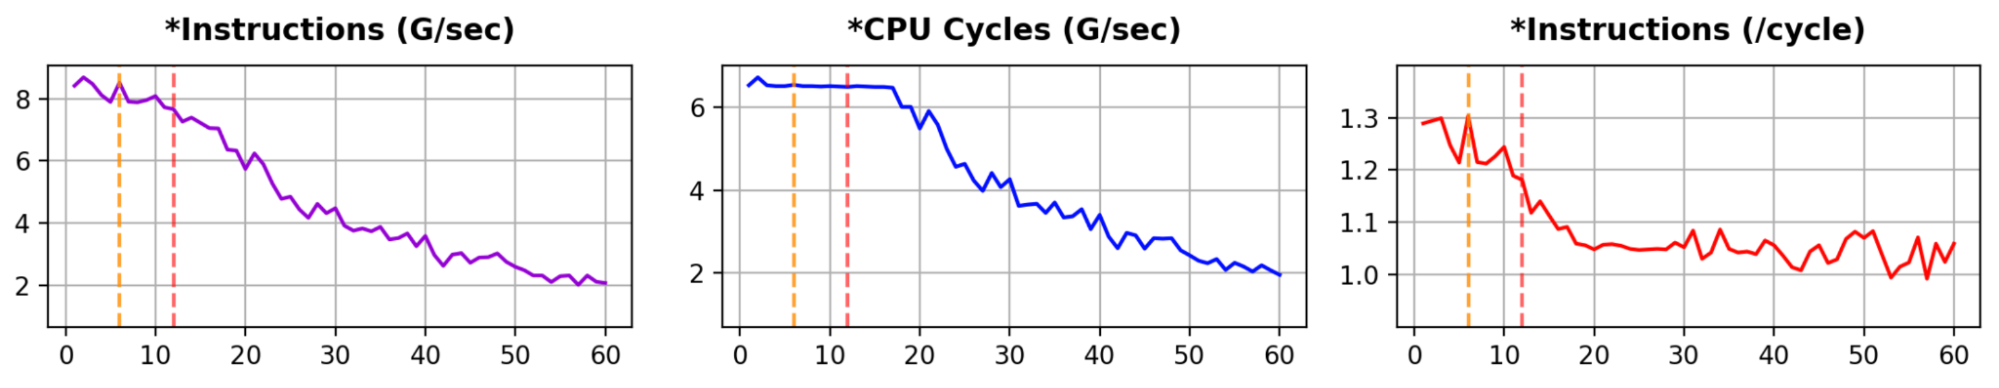
Instructions(G/sec) = CPU Cycles(G/sec) × Instructions(/cycle)
-
Instructions(G/sec) は CPU Cycles(G/sec) と Instructions(/cycle) の積で表すことができます。
-
CPU Cycles(G/sec) がそのままでも Instructions(/cycle) が減少し、逆に Instructions(/cycle) がそのままでも CPU Cycles(G/sec) が減少すると Instructions(G/sec) は減少します。
CPU Cycles(/sec) と Instructions(/cycle) の関係
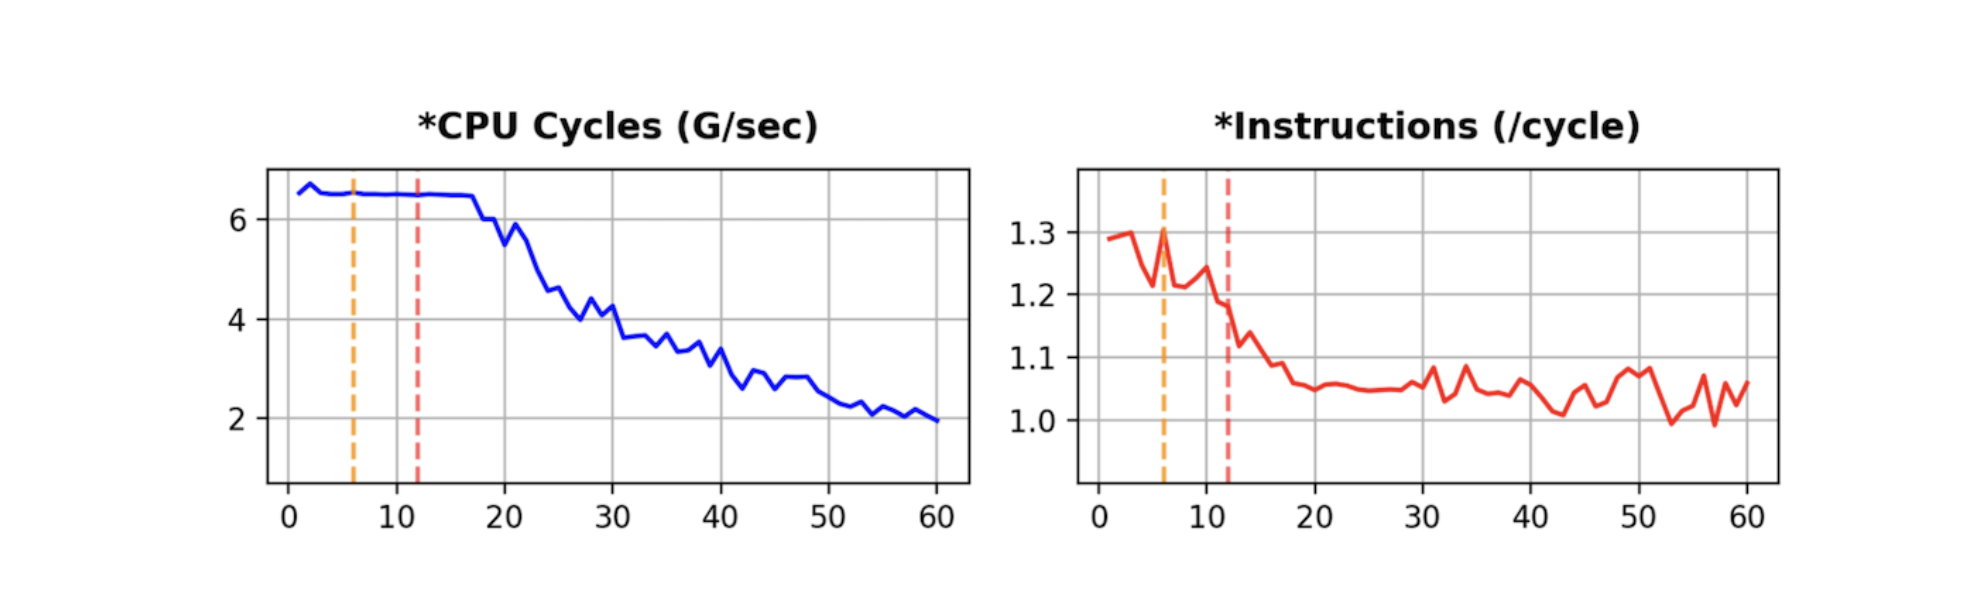
- Instructions(/cycle) と CPU Cycles(/sec) が同時に減少することはなく、Instructions(/cycle) の減少が止まると CPU Cycles(/sec) の減少が始まります。
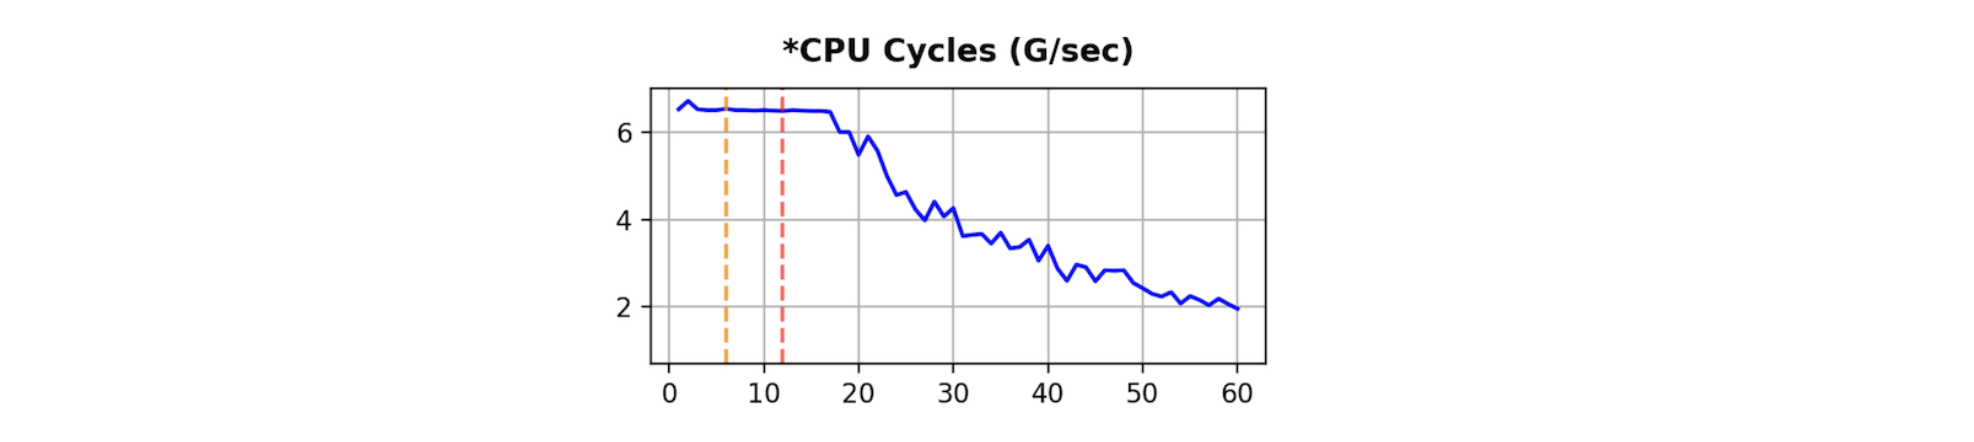
CPU Cycles(G/sec)
-
CPU Cycles(G/sec) は、VM の各 vCPU に対する 1 秒あたりのクロックサイクル数の合計を意味します。(今回は 4 vCPU なので、vCPU あたりのクロックサイクル数は 4 で割って計算できます)
-
CPU Cycles(G/sec) は、少なくとも VM の vCPU 数の合計が PM のスレッド(vCPU)数と同じになるまで(赤色の点線まで)は減少しない傾向があります。
-
VM の CPU 使用率が低いほど、VM の vCPU 数の合計が PM のスレッド(vCPU)数を超えた後も CPU Cycles(G/sec) が維持される傾向があり、これは VM の CPU 使用率が低いほど PM の CPU リソースに余裕ができるためと考えられます。
-
つまり、CPU Cycles(G/sec) が減少し始めるということは、PM の CPU リソースが飽和したことを意味し、その時点以降は CPU Cycles(G/sec) が Instructions(G/sec)(≒bogo ops(/sec))減少の原因と考えられます。
Instructions(/cycle)
-
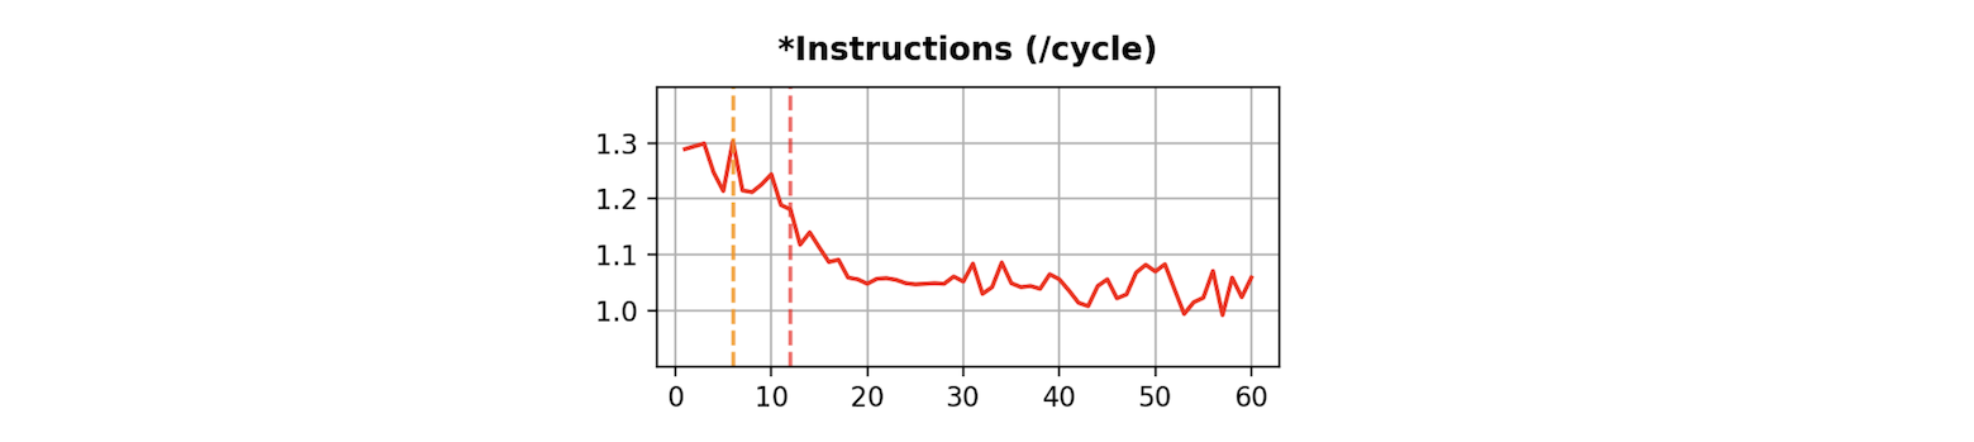
Instructions(/cycle) は、VM の各 vCPU に対して 1 CPU クロックサイクル ごとに実行された Instruction 個数の合計を意味します。
-
Instructions(/cycle) は、初期には VM 数の増加に伴って継続的に減少し、ある時点から収束する様子が確認できます。この時点は CPU Cycles(G/sec) が減少し始める時点と同じで、これは PM の CPU リソースが飽和するまで Instructions(/cycle) が減少することを意味します。
-
実際に VM の CPU 使用率が低いほど、VM の vCPU 数の合計が PM のスレッド(vCPU)数を超えた後(赤色の点線を超えた後)も Instructions(/cycle) がさらに減少する傾向があります。
-
CPU Cycles(G/sec) は PM の CPU リソースが飽和するまで減少しないため、PM の CPU リソースが飽和する前に発生する Instructions(G/sec)(≒ bogo ops(/sec))減少の原因は Instructions(/cycle) と考えられます。
Cache Misses(%)
-
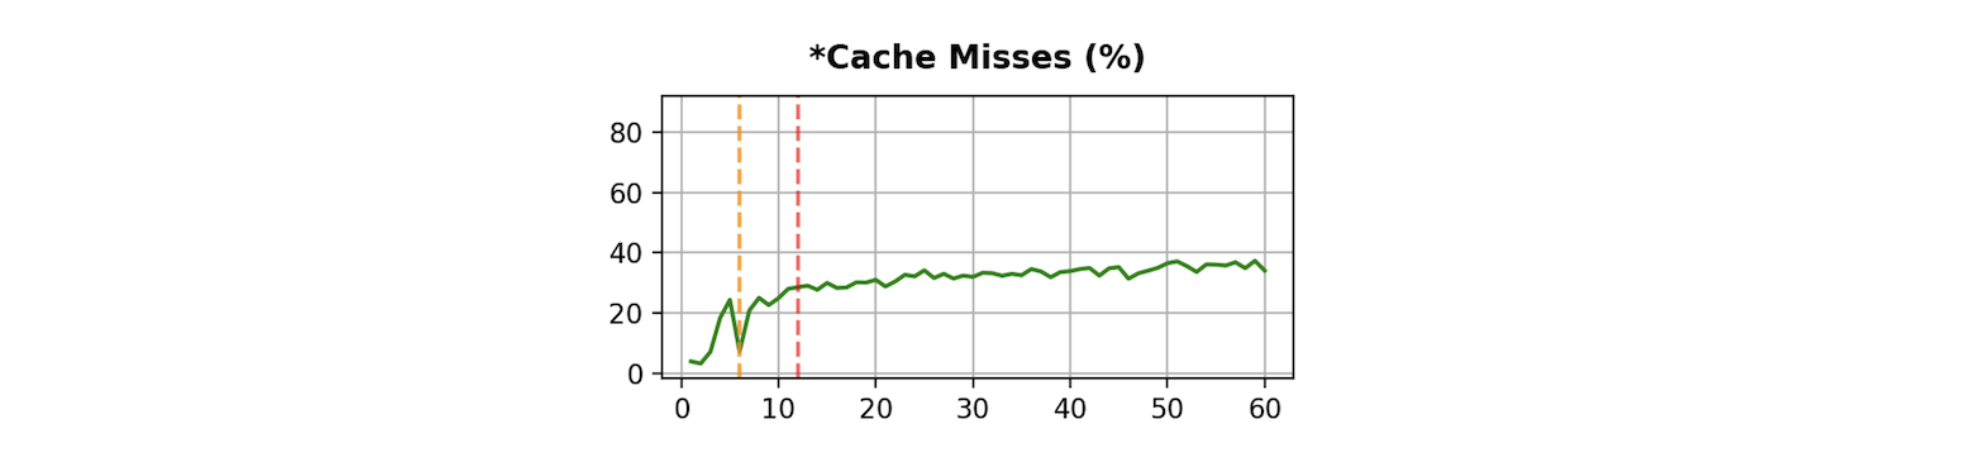
VM の仮想 CPU パフォーマンスカウンターの値のため、実際の PM の CPU キャッシュとどのように関連するのか説明しがたい部分がありますが、VM の全体的なキャッシュミス率(%)を示します。(Cache Misses / Cache References)
-
Cache Misses(%) は、VM の CPU 使用率に関係なく、最初は VM 数の増加に伴って大きく増加し、VM の vCPU 数の合計が PM のスレッド(vCPU)数を超えた後(赤色の点線を超えた後)は増加が止まるか、非常に小さい幅でゆっくり増加する傾向があります。
Instructions(/cycle) とCache Misses(%) の関係
-
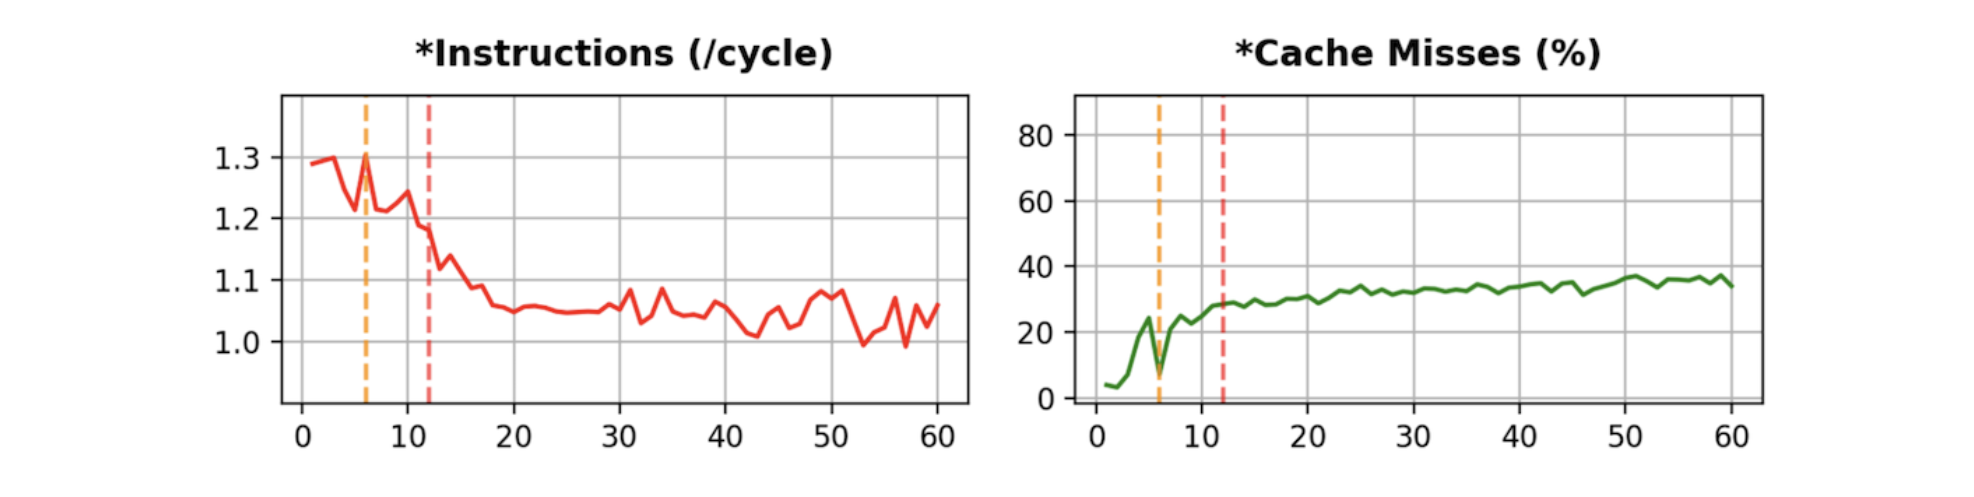
Instructions(/cycle) は Cache Misses(%) と反比例する傾向があります。
-
Cache Misses(%) が増加すると Instructions(/cycle) は減少し、逆に Cache Misses(%) が減少すると Instructions(/cycle) は増加します。
-
Cache Misses(%) 以外にも Instructions(/cycle) に影響する要素が存在するため、グラフの形状が完全に一致するわけではありません。
-
しかし、Cache Misses(%) に顕著な変化がある場合、大体 Instructions(/cycle) にも対応する変化を発見することができ、これにより Cache Misses(%) が Instructions(/cycle) に重要な役割を果たしていることを確認できます。
Branch Misses(%)
-
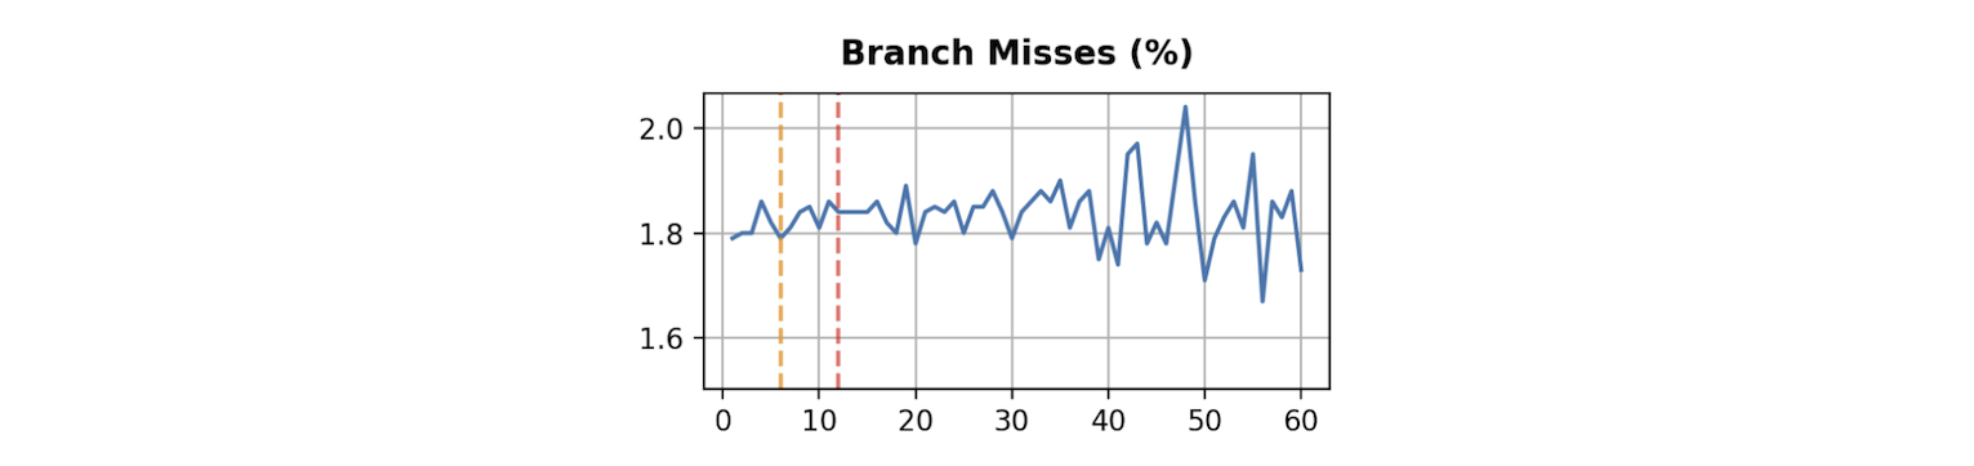
Branch Misses(%) 指標は、PM の CPU スペック、VM の CPU 使用率及び VM 数などの条件に関わらず、1.8% 程度が一定に保たれていました。
-
VM 数の増加による変化が微々たるものであり、PM の CPU スペック間の差がほとんどないため、今回のテストでは大きな意味を持たない指標と判断し、結果グラフから除外しました。
3) VM 数が増えると VM の CPU パフォーマンスが低下する理由
Instructions(/cycle) の減少
-
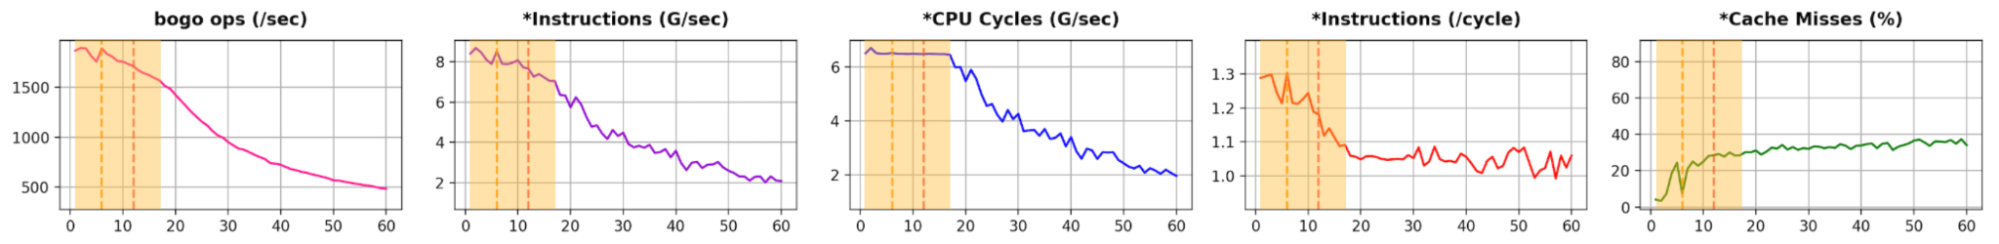
CPU Cycles(/sec) には変動がなく、Instructions(/cycle) が減少する区間です。
-
VM の CPU 使用率が低いほど、Instructions(/cycle) の減少が止まる時点、同じく CPU Cycles(/sec) が減少し始める時点が遅くなります。
-
この区間では、VM 数が増加するにつれて、Instructions(/cycle) の減少により VM の CPU パフォーマンスが低下します。
-
Instructions(/cycle) 減少の原因の一つに、Cache Misses(%) の増加が挙げられます。
-
Cache Misses(%) は、VM の CPU 使用率に関係なく初期には VM 数の増加とともに大きく増加し、 VM の vCPU 数の合計が PM のスレッド(vCPU)数を超えてからはほとんど増加しません。
CPU Cycles(/sec) の減少
-
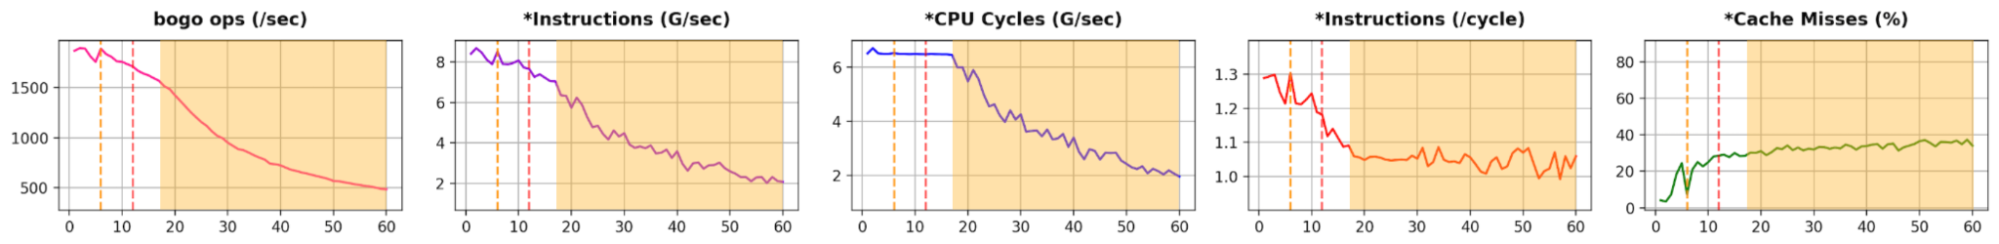
Instructions(/cycle) の減少が止まり、CPU Cycles(/sec) が減少する区間です。
-
VM の CPU 使用率が高いほど、Instructions(/cycle) の減少が止まる時点、同じく CPU Cycles(/sec) が減少し始める時点が早くなります。
-
この区間では、VM 数が増加するにつれて CPU Cycles(/sec) の減少により、VM の CPU パフォーマンスが低下します。
-
Cache Misses(%) の場合、VM の vCPU 数の合計が PM のスレッド(vCPU)数を超えてからはほとんど増加しないため、Instructions(/cycle) 減少の原因は Cache Misses(%) であるとは考えがたいです。
4) Turbo Boost モードの有効化有無によるパフォーマンス差
-
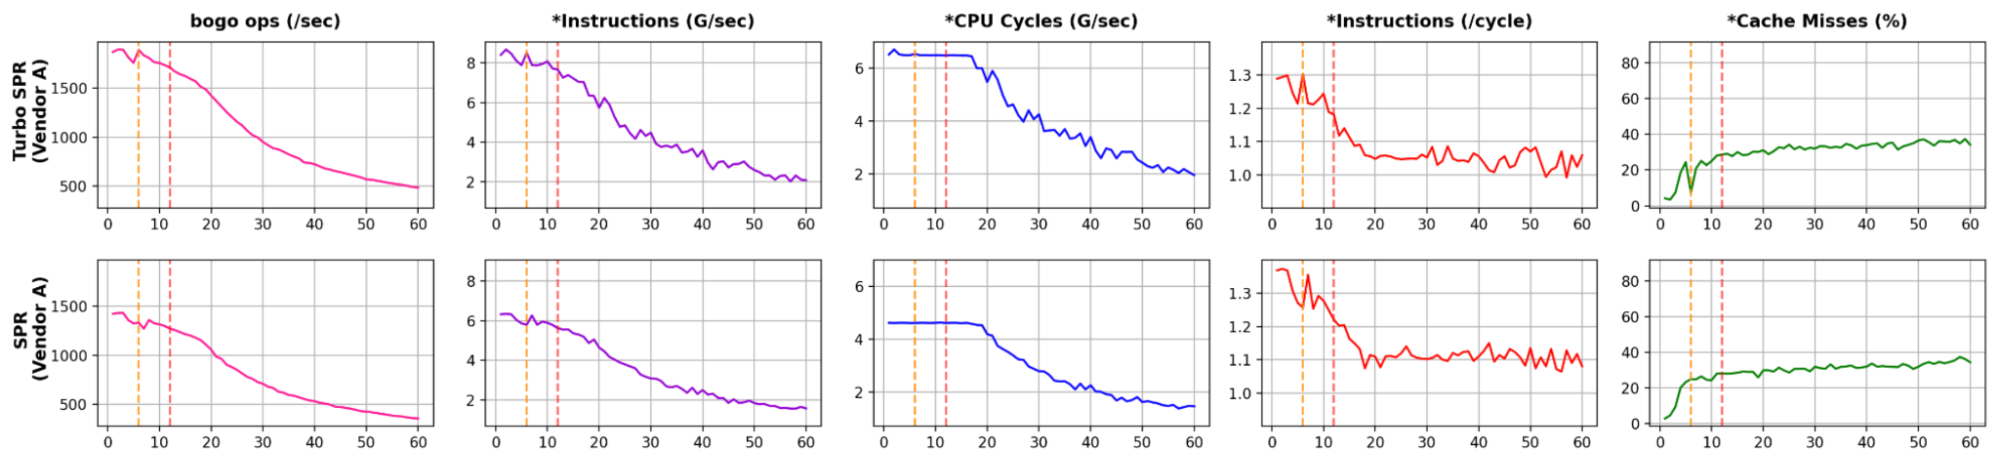
Intel CPU がサポートする機能である Turbo Boost モードを有効にした場合は、そうではない場合に比べて CPU Cycles(/sec) が約 35% 程度増加し、Instructinos(/cycle) は約 8% 程度減少する傾向があります。
-
Instructinos(/cycle) が若干減少しますが、CPU Cycles(/sec) が大幅に増加し、最終的に VM の CPU のパフォーマンスが向上します。
5) PM の CPU スペックの違いによるパフォーマンス低下率の違い
-
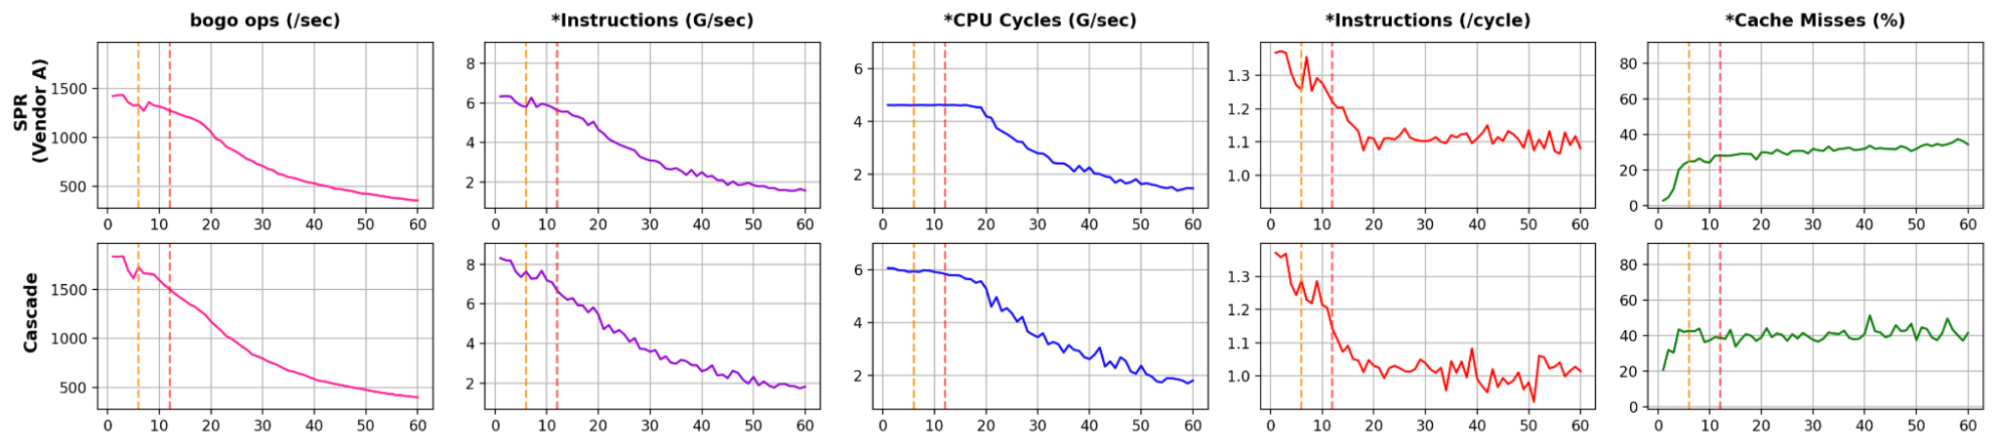
CPU Cycles(/sec) の場合、Cascade Lake が Sapphire Rapids に比べて高い値で始まりますが、 VM 数が十分に増加した後は Cascade Lake と Sapphire Rapids は似たような値になります。
-
Instructions(/cycle) の場合、Cascade Lake と Sapphire Rapids は似たような値で始まりますが、VM数が十分に増加した後は Sapphire Rapids が Cascade Lake に比べて 10% 高い値になります。
-
その結果、Cascade Lake は Sapphire Rapids と比較してパフォーマンスが大幅に低下し、このテストでは Cascade Lake CPU PM の最適な VM 密度の結果に悪影響を及ぼす可能性があります。
-
しかし、PM の CPU スペック別のベンチマーク結果は、ベンチマークプログラムの特性によって変わる可能性があるため、CPU スペックが異なる 2 つの PM を絶対的な数値で比較するのは適切ではありません。
6) ベンダー間の Cache Misses(%) の違い
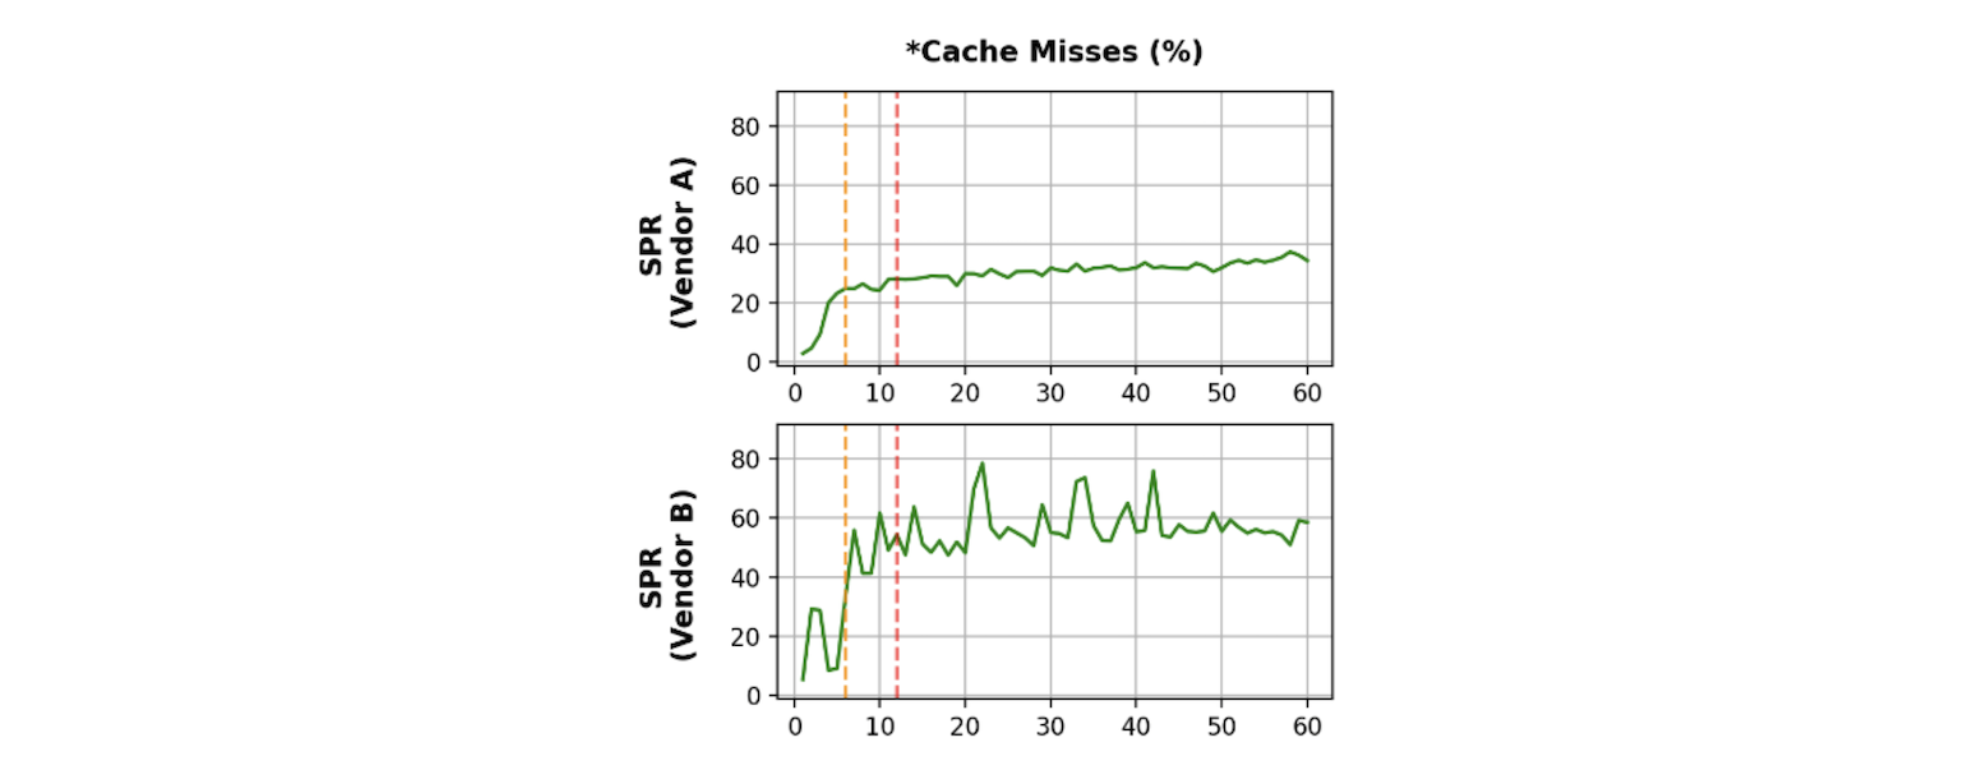
-
ベンダー B 装置と比較し、ベンダー A 装置で安定した Cache Misses(%) の推移を示します。
-
ベンダー B 装置では Cache Misses(%) の変化幅が大きく、最大 60% まで増加します。
-
一方、ベンダー A 装置では Cache Misses(%) の変化幅が小さく、最大 40% まで増加します。
-
これは同じ CPU モデルを使用するPMであっても、ベンダーによって全体的な機器構成の違いによるパフォーマンス差が発生する可能性があることを意味します。
5. 最適な VM 密度
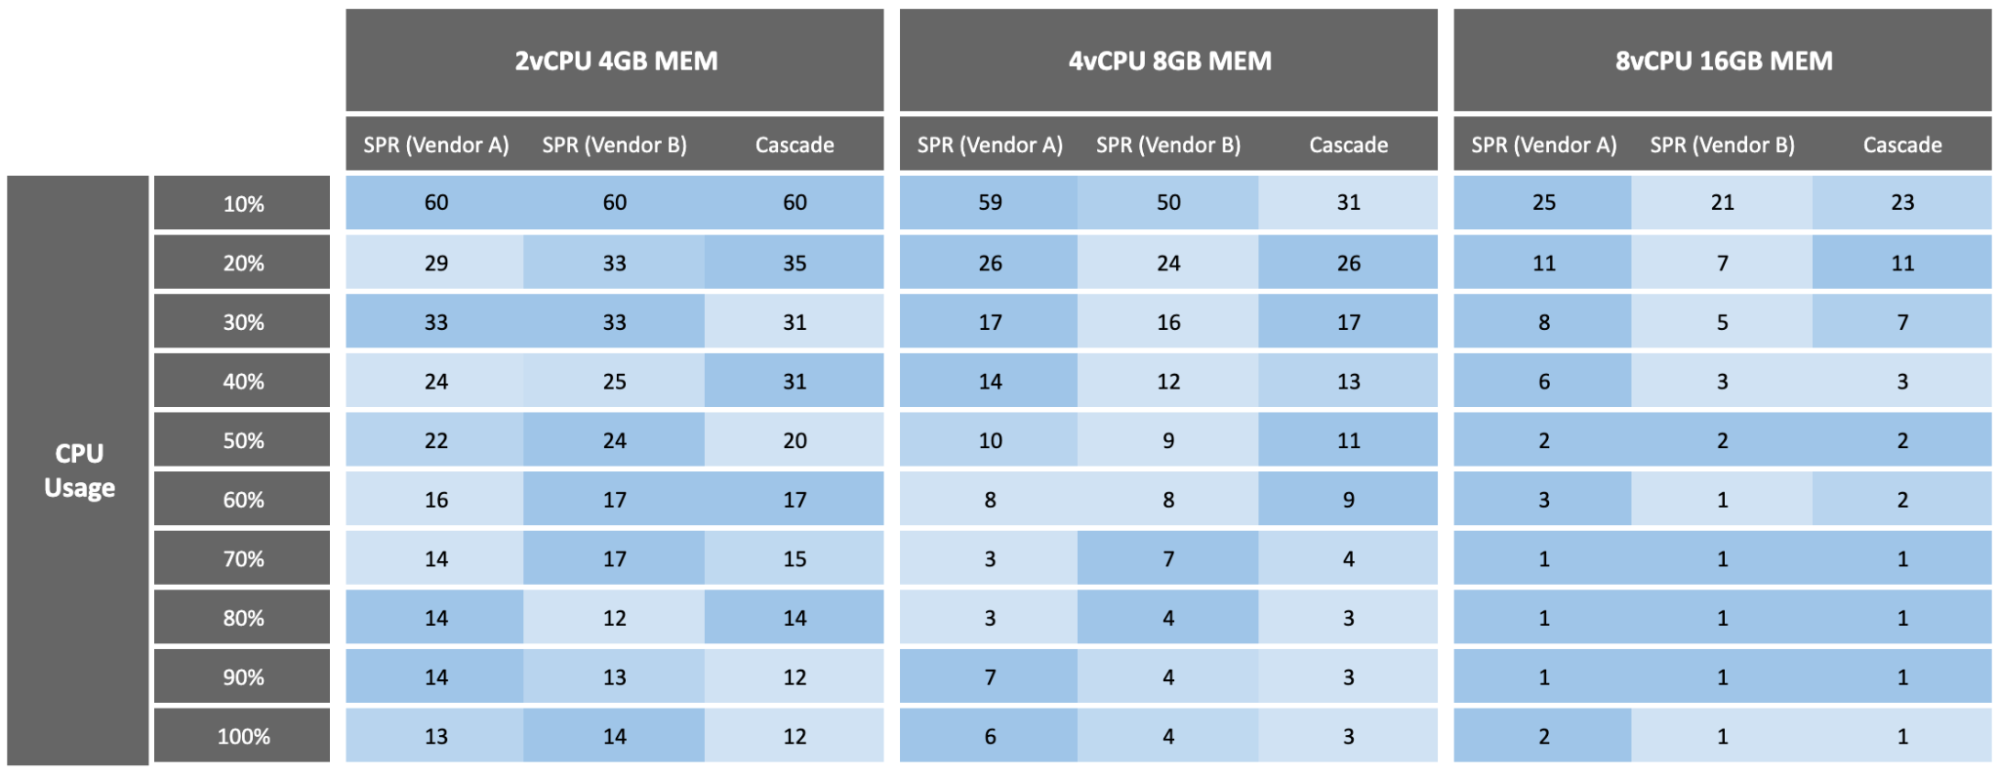
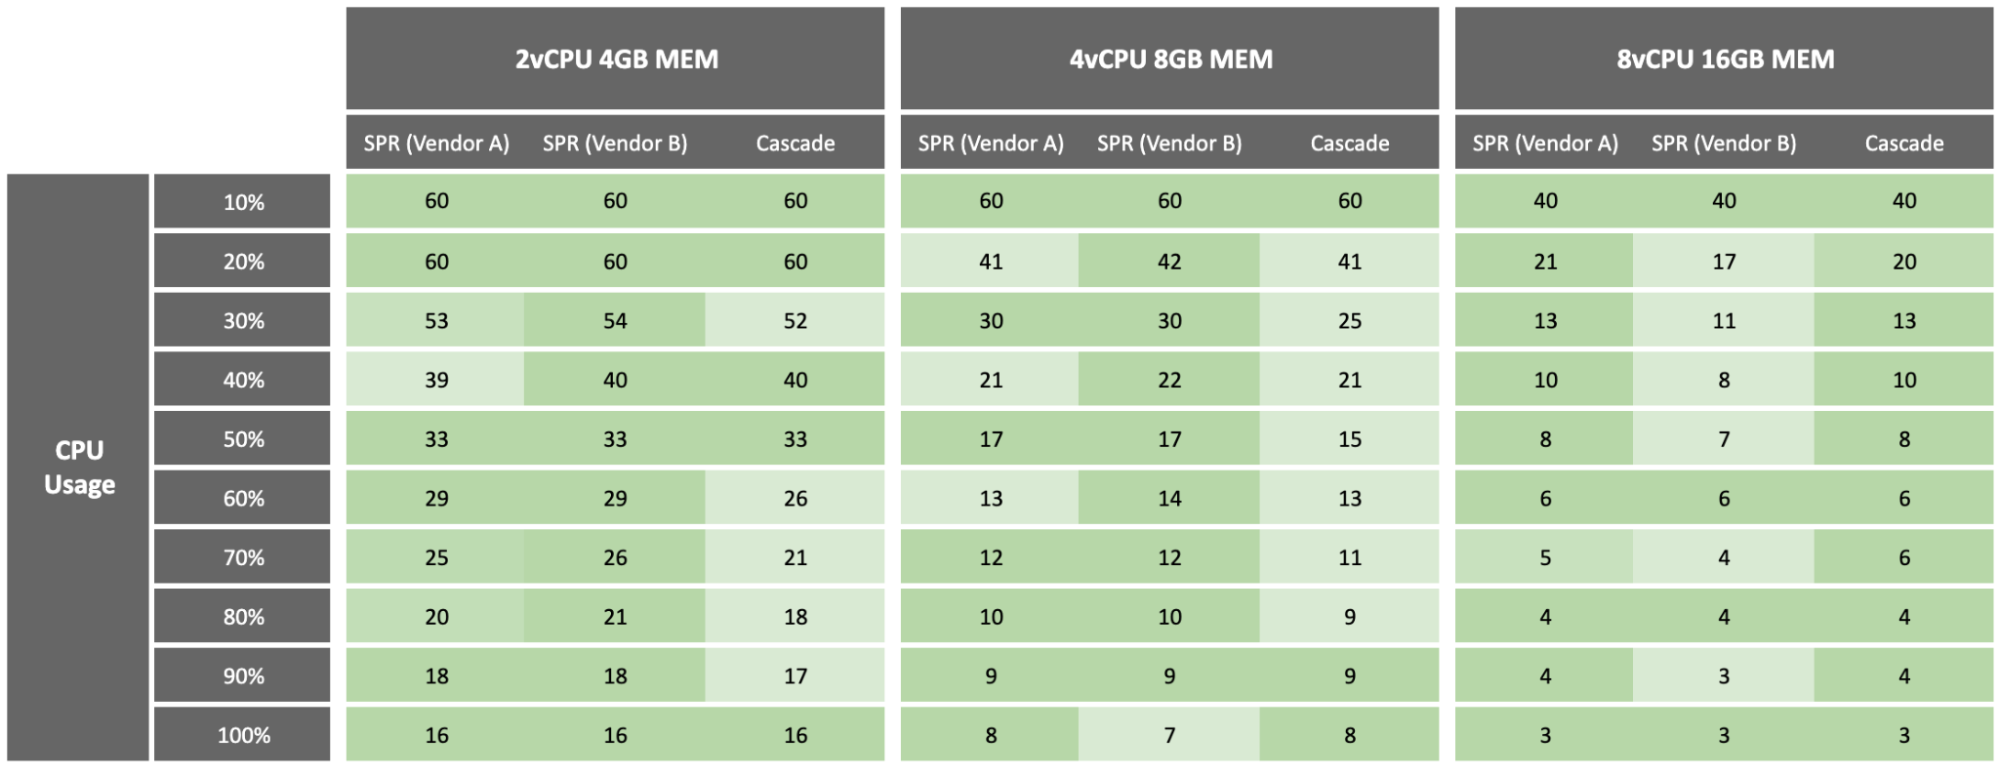
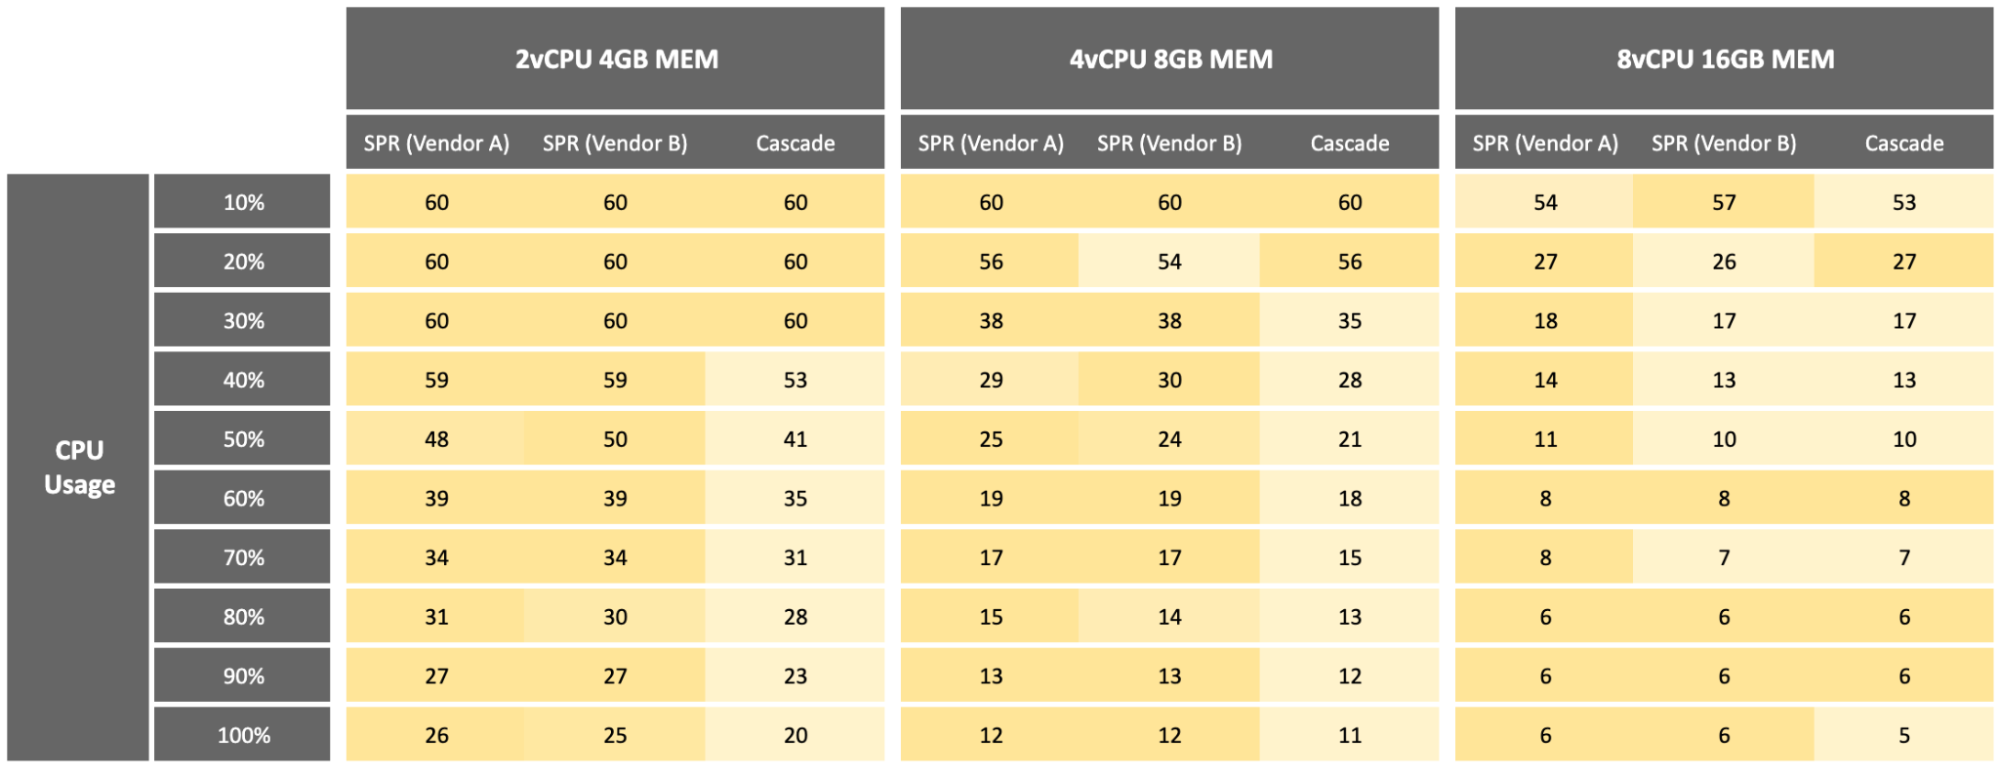
1) 資料紹介
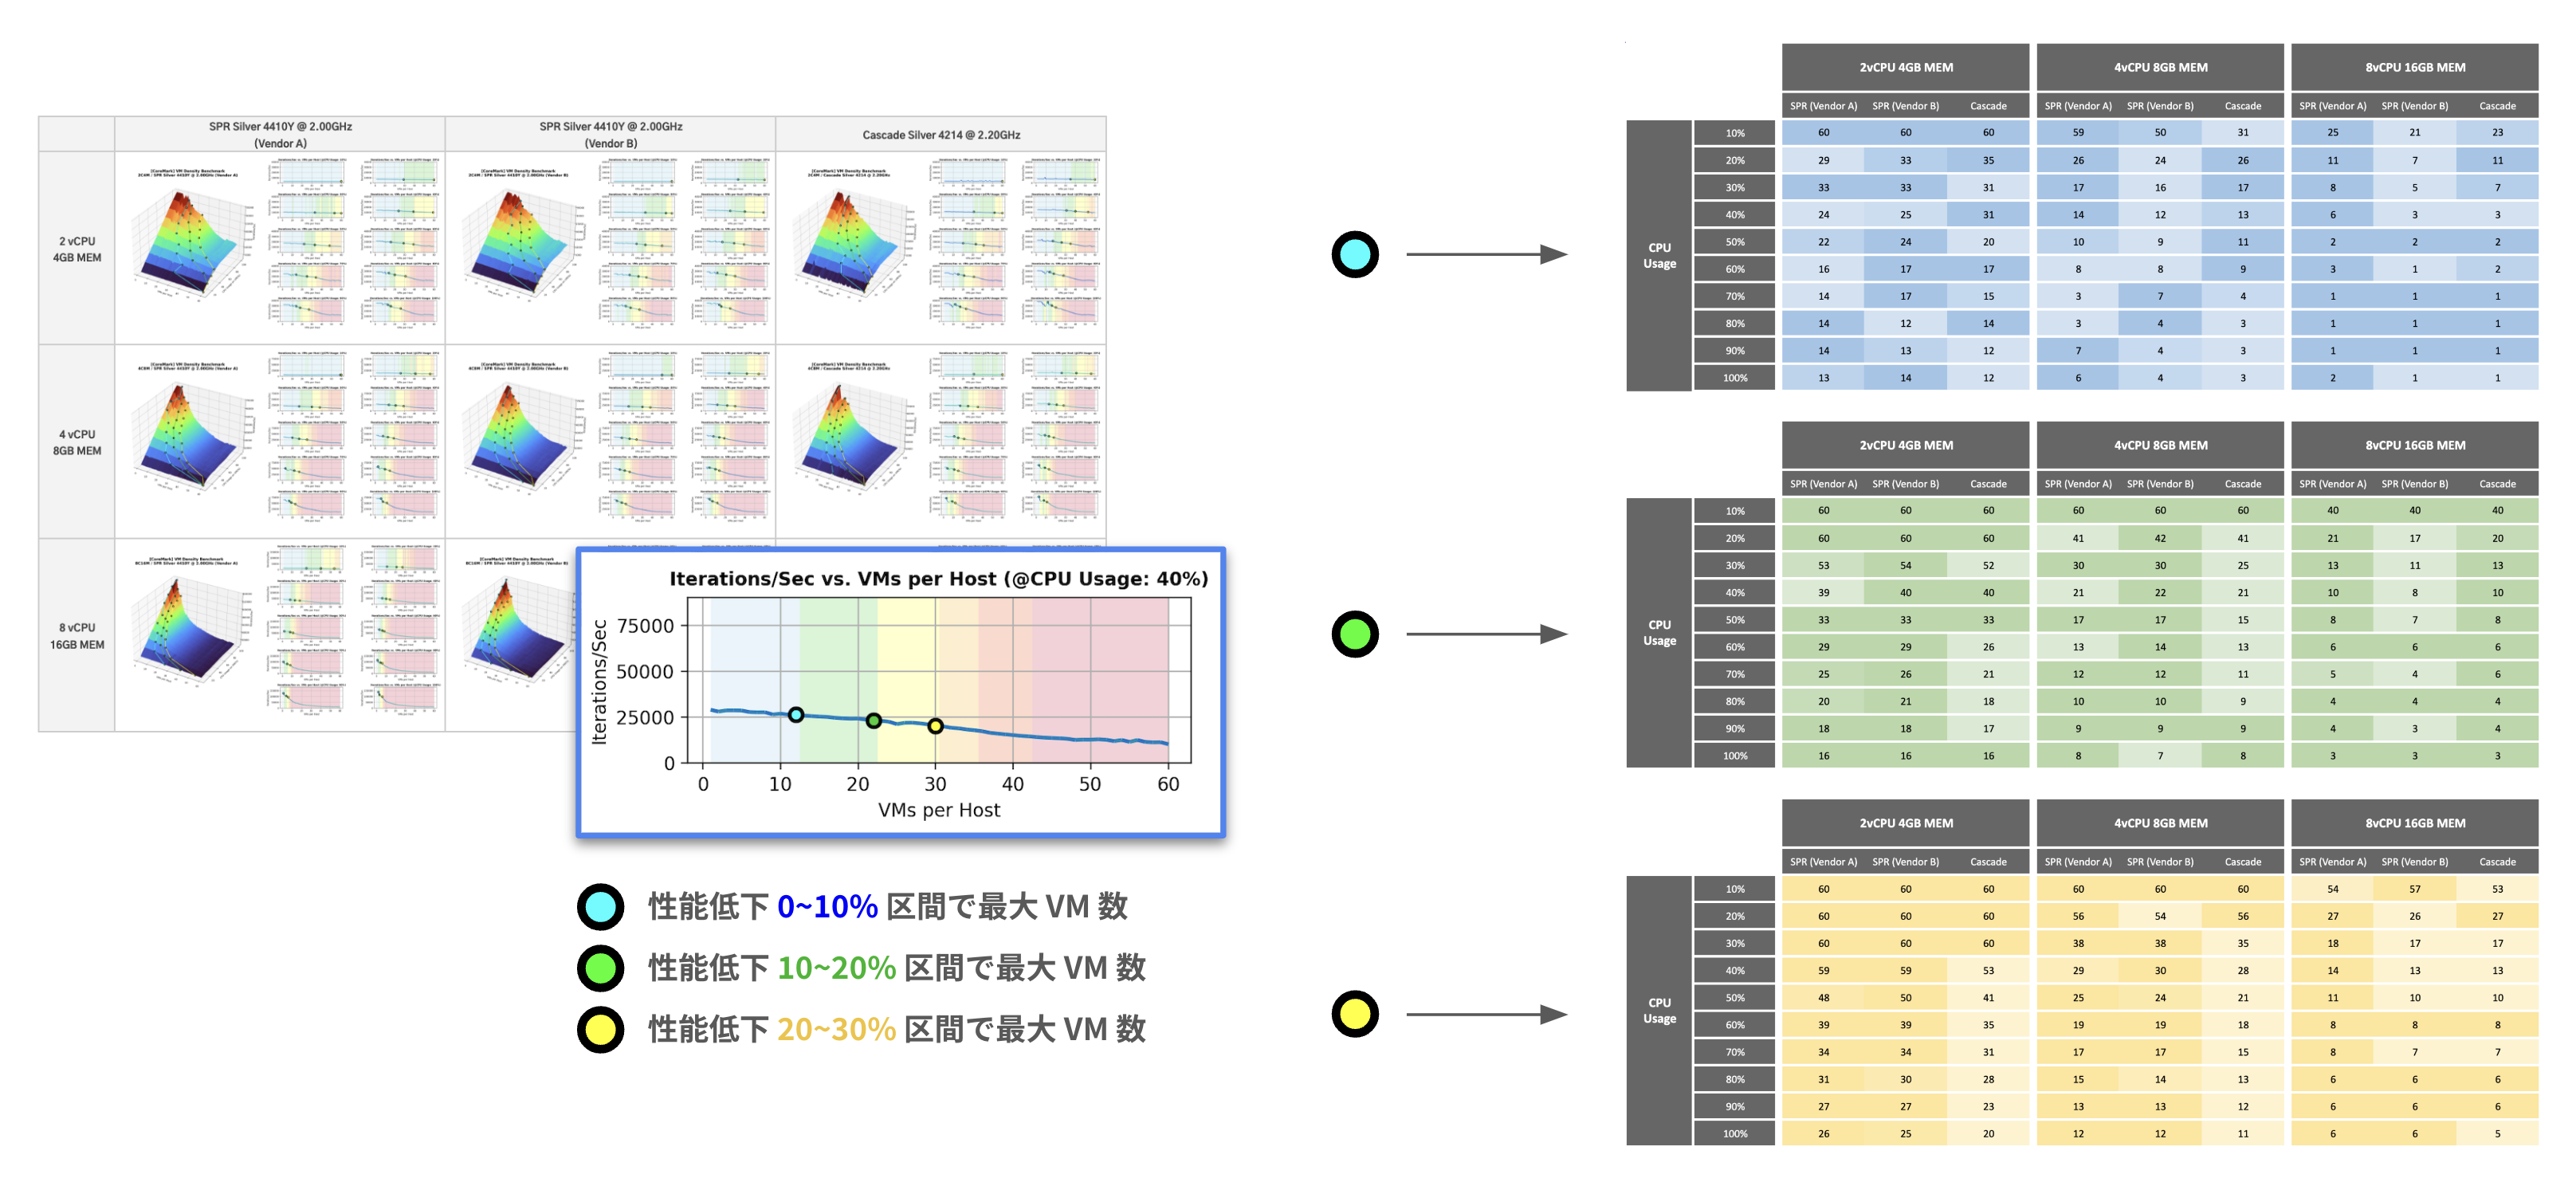
先に紹介した「 3. VM 数の増加に伴う VM の CPU パフォーマンスの変化 」グラフの VM の CPU パフォーマンス低下区間別の最大 VM 数マーカーをそのまま表にした結果です。
VM の CPU パフォーマンス低下率 0 ~ 10%、10 ~ 20%、20 ~ 30% の区間別に、それぞれの PM スペック ・ VM のフレイバー ・ VM の CPU 使用率条件に対する最大許容可能な VM 数、すなわち CPU 観点からの最適な VM 密度を示します。
それぞれの PM スペックごとに最大値 ・ 中央値 ・ 最小値によって色を変えて表しています。(濃いほどより多くの VM を収容できることを意味します)
これに基づいて、ある程度の VM のCPUパフォーマンス低下を考慮できるとすると、PM 1 台あたりに収容できる最大 VM 数を確認することができます。
2) 実際の運用環境を考慮した最適な VM 密度
この結果を基に、実際の運用環境において PM の CPU スペック ・ VM のフレイバー ・ VM の CPU 使用率が明らかな場合、1 台の PM に何台の VM を収容するかを設計することができます。
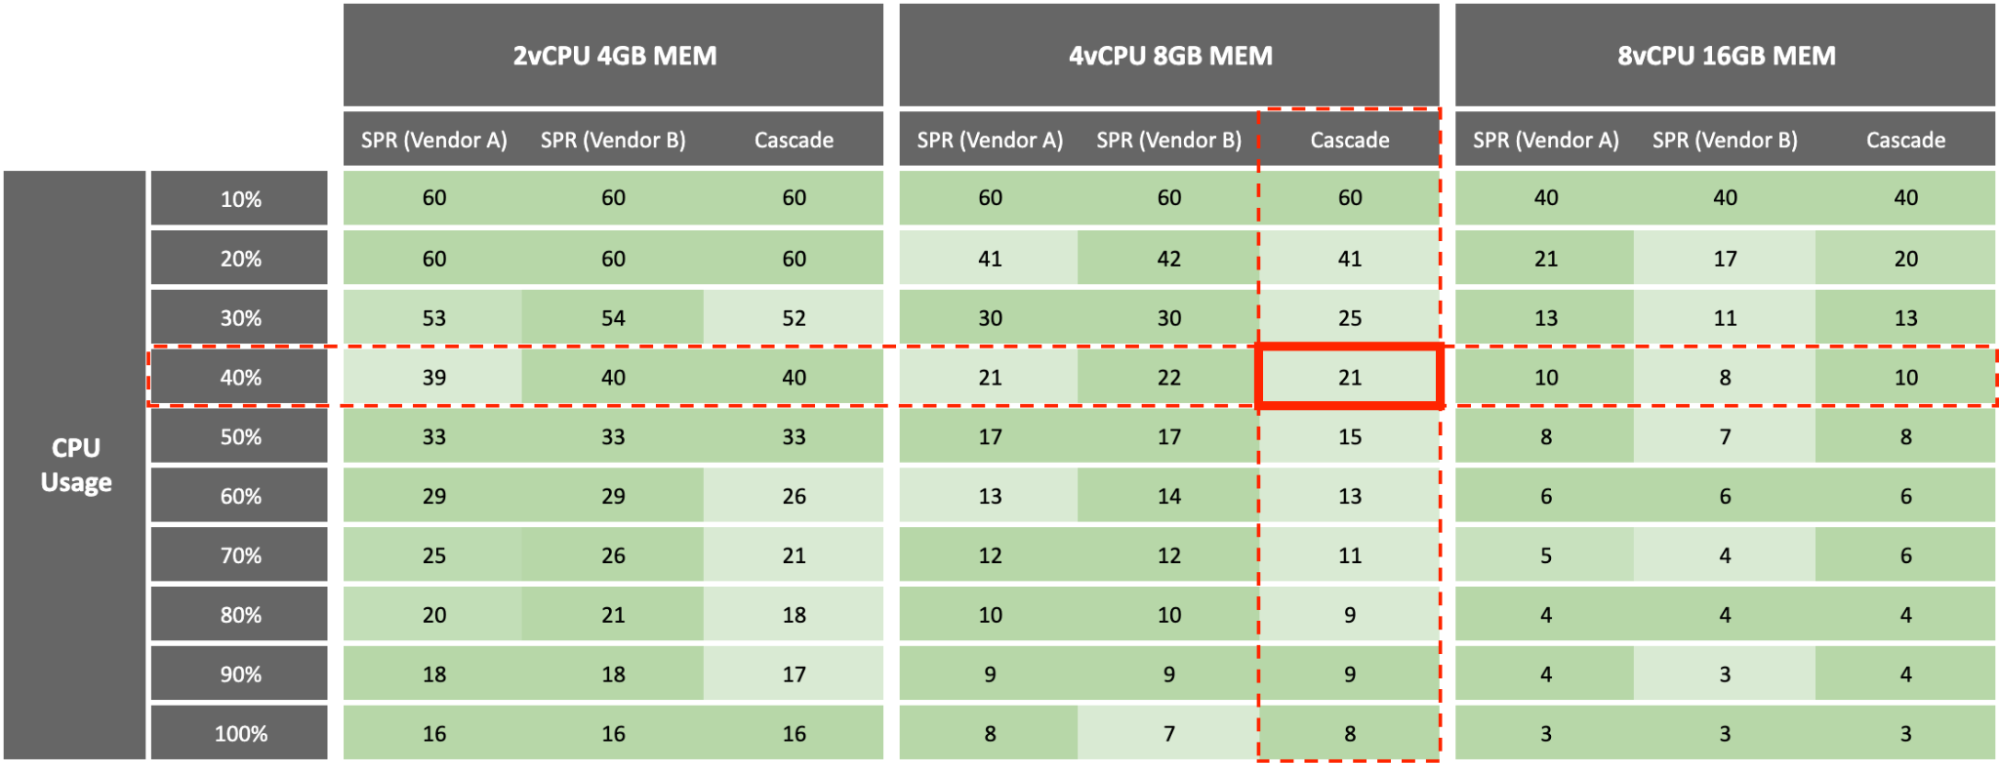
例えば、 Cascade Silver 4214 @ 2.20GHz CPU スペックの PM に 4 vCPU 8GB MEM フレイバーの VM を運用している環境で、VM の平均 CPU 使用率が 40%、VM の CPU パフォーマンス低下を最大 20% まで許容できるとすると、PM 1 台あたり 21 台の VM を運用することについて検討できます。
ただし、CPU の観点だけで行われたテストのため、あくまでも PM のメモリやディスクのスペックに不足がないという前提で導き出された結果であることを考慮する必要があります。
6. おわりに
今回は、効率的な VMWare インフラ運用のための CPU 観点の VM 密度テスト方法とその結果を紹介しました。
実際のところ、最適な VM 密度というのは、CPU 以外にもメモリやディスクなどの様々なシステム構成要素を考慮しなければなりません。なお、運用環境やサービスの要件などの状況による変数も多いため、直接インフラを運用して最適値を探していく必要があります。
また、今回のテストに使用した PM の CPU スペック ・ VM のフレイバー およびベンチマークプログラムは、実際の環境をシミュレーションできる範囲が極めて限られています。さらに、実際の運用環境では、負荷の急増に備えるための余裕リソースの確保など、様々な現実的な要素も考慮する必要があるため、今回のテストで導き出した最適な VM 密度の値自体は大きな意味を持ちません。
しかし、「 PM のリソースは限られているため、VM の数が増えると VM のパフォーマンスは低下する 」という明らかな事実に「 どのように ・ どの程度 ・ なぜ 」についての洞察することだけでも十分な意義があると考えます。さらに、今回紹介した VM 密度テスト方法を CPU だけでなく、メモリやディスクなどにも適用し様々な条件で試行すれば、より現実的な VM 密度を導き出すことができるのではないでしょうか。
最後になりますが、この内容が少しでも今後の効率的な VMWare インフラ運用に貢献することができれば嬉しく思います。
お読み頂き、誠にありがとうございました。
이 글은 < 효율적인 VMWare 인프라 운영을 위한 최적의 VM 집적도 테스트 >를 일본어로 작성한 문서입니다.
다른 번역본 보기:
🇰🇷 한국어: https://tech.kakao.com/posts/634
🇯🇵 日本語: https://tech.kakao.com/posts/637
🇺🇸🇬🇧 English: https://tech.kakao.com/posts/638