Backend
실시간 메시징 시스템 개발 - “성능 테스트 설계와 분석”
tim.aeom카카오
2024년 12월 12일
원문에서 보기 ↗실시간 메시징 시스템 개발 시리즈
-
Part 1. 실시간 메시징 시스템 개발 - “삽질 과정”
- 실시간 메시징 시스템 구축 과정에서 직면한 기술적 과제들과 해결 과정을 공유합니다.
-
👉 Part 2. 실시간 메시징 시스템 개발 - “성능 테스트 설계와 분석”
- 대규모 트래픽 처리를 위한 실시간 메시징 시스템 성능 테스트 방법론과 테스트 설계 및 분석 과정을 소개합니다.
-
Part 3. 실시간 메시징 시스템 개발 - “성능 개선 레슨런”
- 실시간 메시징 시스템의 병목 지점 발견, 개선 방안 도출과 실제 적용 사례까지 전체 과정을 공유합니다.
들어가며
안녕하세요, 인터랙션플랫폼의 팀입니다. 🙇
이전 글에서 실시간 메시징 시스템 개발에 대한 전반적인 내용을 다루었다면, 이번 글은 실시간 메시징 시스템을 구축하면서 성능 테스트와 분석을 어떻게 했는지 공유하려고 합니다.
이전 글에서는 실시간 메시징 시스템 개발 과정에서 맞닥뜨린 기술적 과제에 대해서 알아보았습니다. 이 글에서는 실시간 메시징 시스템의 성능에 영향을 미치는 주요 요인과, 성능을 측정하는 기준, 그리고 이를 기반으로 테스트 시나리오를 설계하고 그 결과를 분석하는 방법에 대해서 설명합니다.
실시간 메시징 성능
성능 측정과 비교
성능 측정은 왜 하는 걸까요?
실시간 메시징 성능에 대해서 이야기하기 전에, 먼저 성능 측정을 왜 하는 건지 고민해 볼 필요가 있습니다. 성능을 측정하는 건 성능을 비교하기 위함이고, 성능을 비교하는 건 보다 더 효율적으로 자원을 사용하기 위함입니다. 좋은 성능의 애플리케이션은 덜 좋은 성능의 애플리케이션보다 같은 자원을 사용해서 더 많은 사용자에게 서비스를 제공할 수 있습니다.
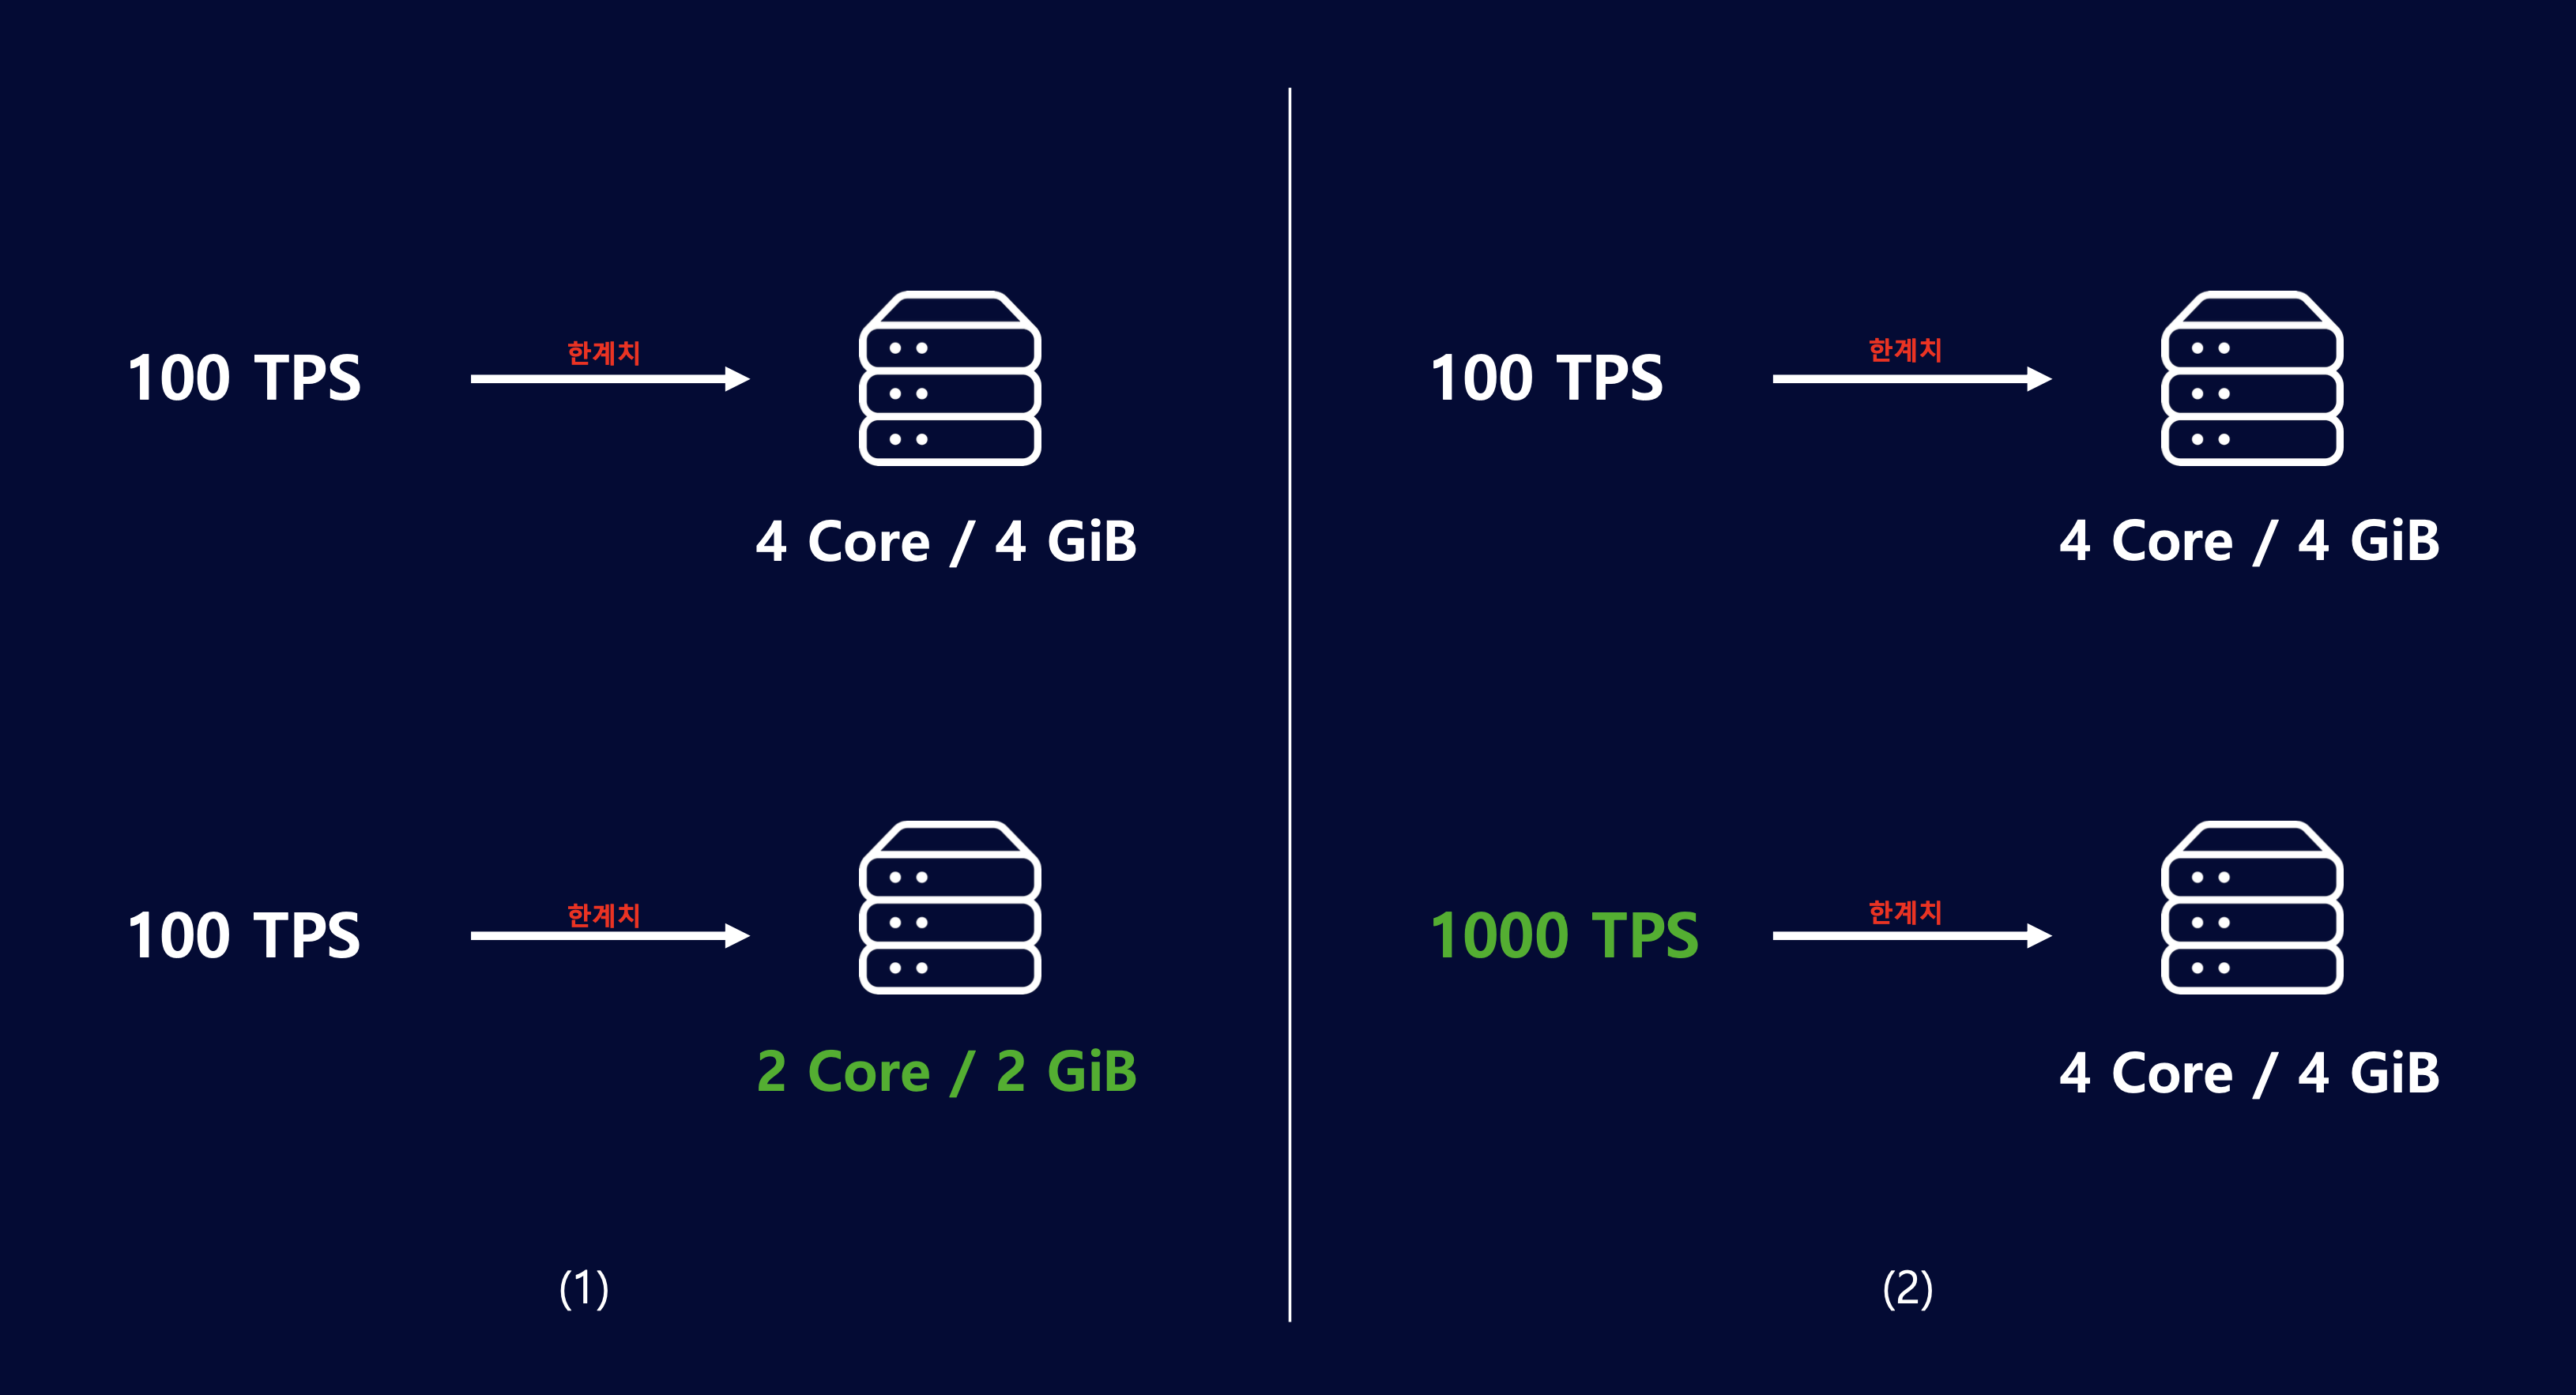
(1) 같은 TPS 를 처리하기 위해 더 적은 리소스를 사용하는 애플리케이션이 더 좋은 성능임을 표현
(2) 같은 리소스에서 더 많은 TPS 를 처리하는 애플리케이션이 더 효율적임을 표현
하지만, 많은 경우 성능 측정과 비교는 이렇게 단순하지 않습니다. 예를 들어 리소스를 적게 사용하지만, 응답 속도가 비교적 느릴 수도 있습니다. 이 경우에도 성능이 좋다고 해석할 수 있을까요?
보다 정확한 결론을 내리기 위해서는 성능 측정을 위한 기준이 있어야 합니다. 테스트하고자 하는 인터페이스를 통일시키고, 테스트 대상을 제외한 나머지 환경은 통일해야 합니다. 테스트 결과에 영향을 주는 요인을 분석하고, 통제해야 합니다.
성능 측정 기준
무엇을 측정하나요?
대부분 API를 제공하는 애플리케이션의 성능을 측정할 때에는 TPS(Transactions Per Second)라는 단위를 사용하여 측정합니다. 말 그대로, 초당 처리할 수 있는 트랜잭션 수를 의미합니다.
일반적인 API 서버의 TPS
단순한 데이터 조회, 변경과 같은 API 서버의 TPS는 요청이 발생하는 시점부터 응답을 내려주기까지를 하나의 트랜잭션으로 간주합니다. 100K TPS는 1초 동안 100K(100,000)개의 트랜잭션을 처리했다는 의미로 해석할 수 있습니다.
또 조금 다르게 (덧붙여서) 해석해 보면 1초라는 짧은 시간 동안 10만명의 사용자가 요청을 보냈을 때 이를 처리할 수 있다는 뜻이기도 합니다.
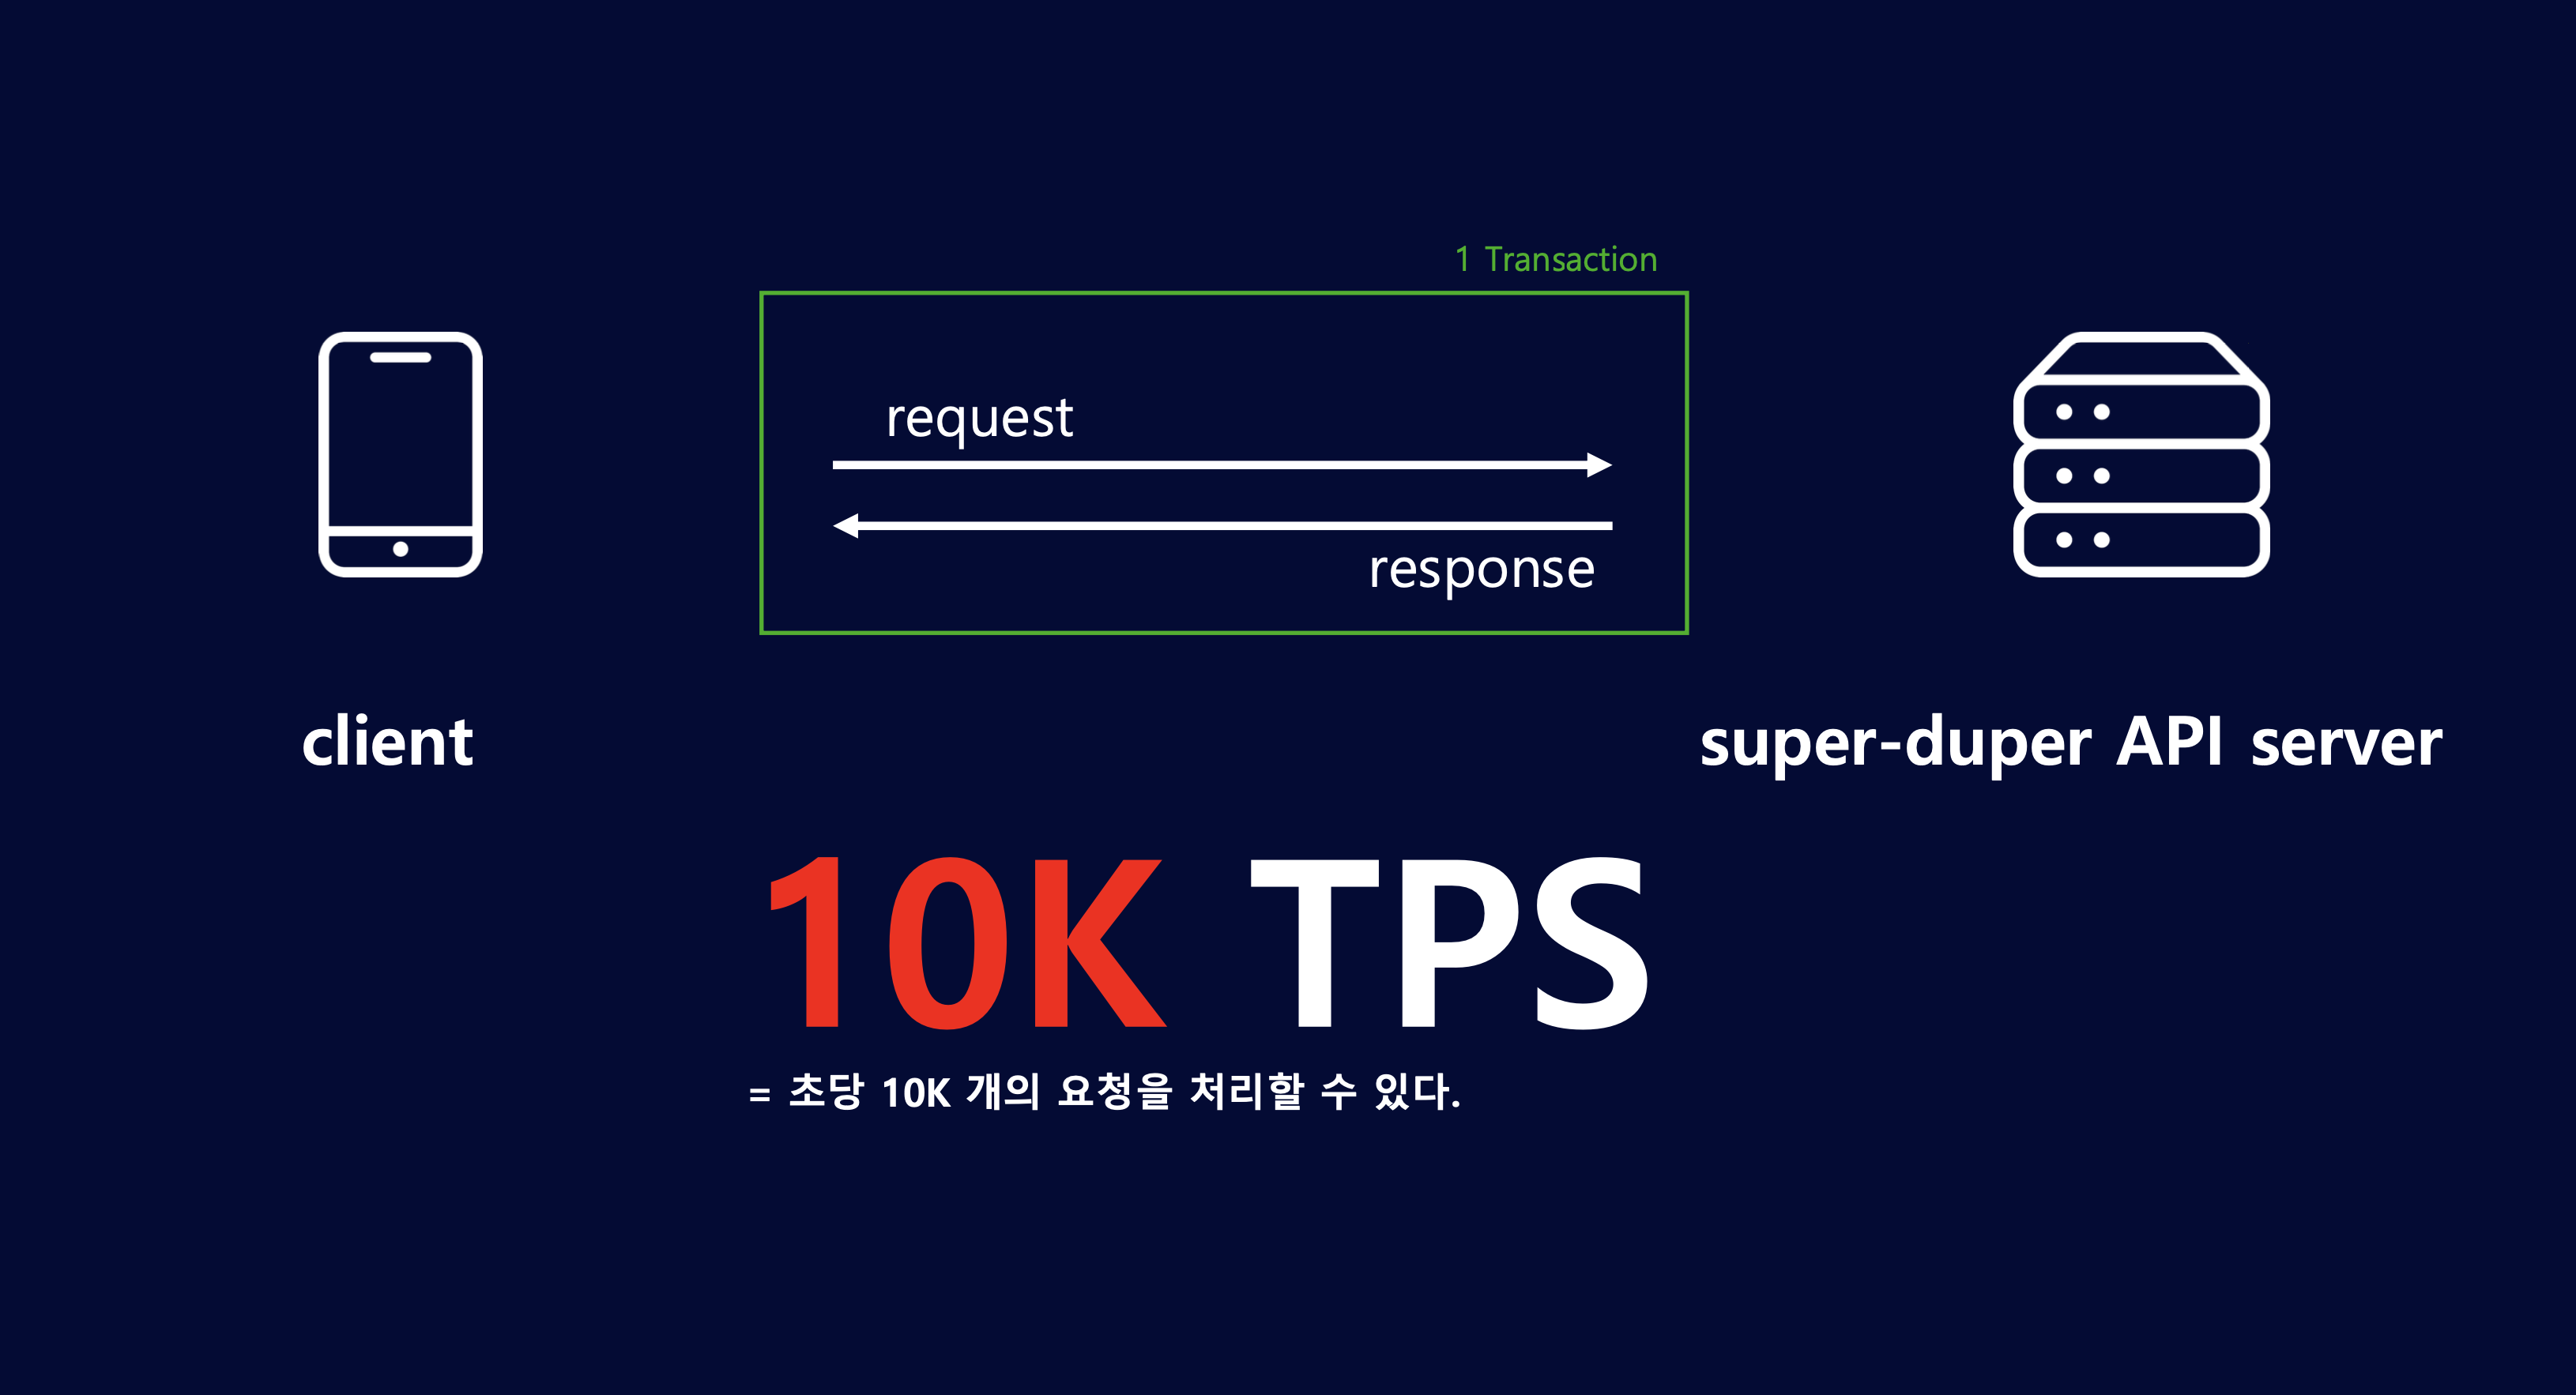
실시간 메시징 서버의 TPS
실시간 메시징 API는 어떻게 트랜잭션을 묶을 수 있을까요?
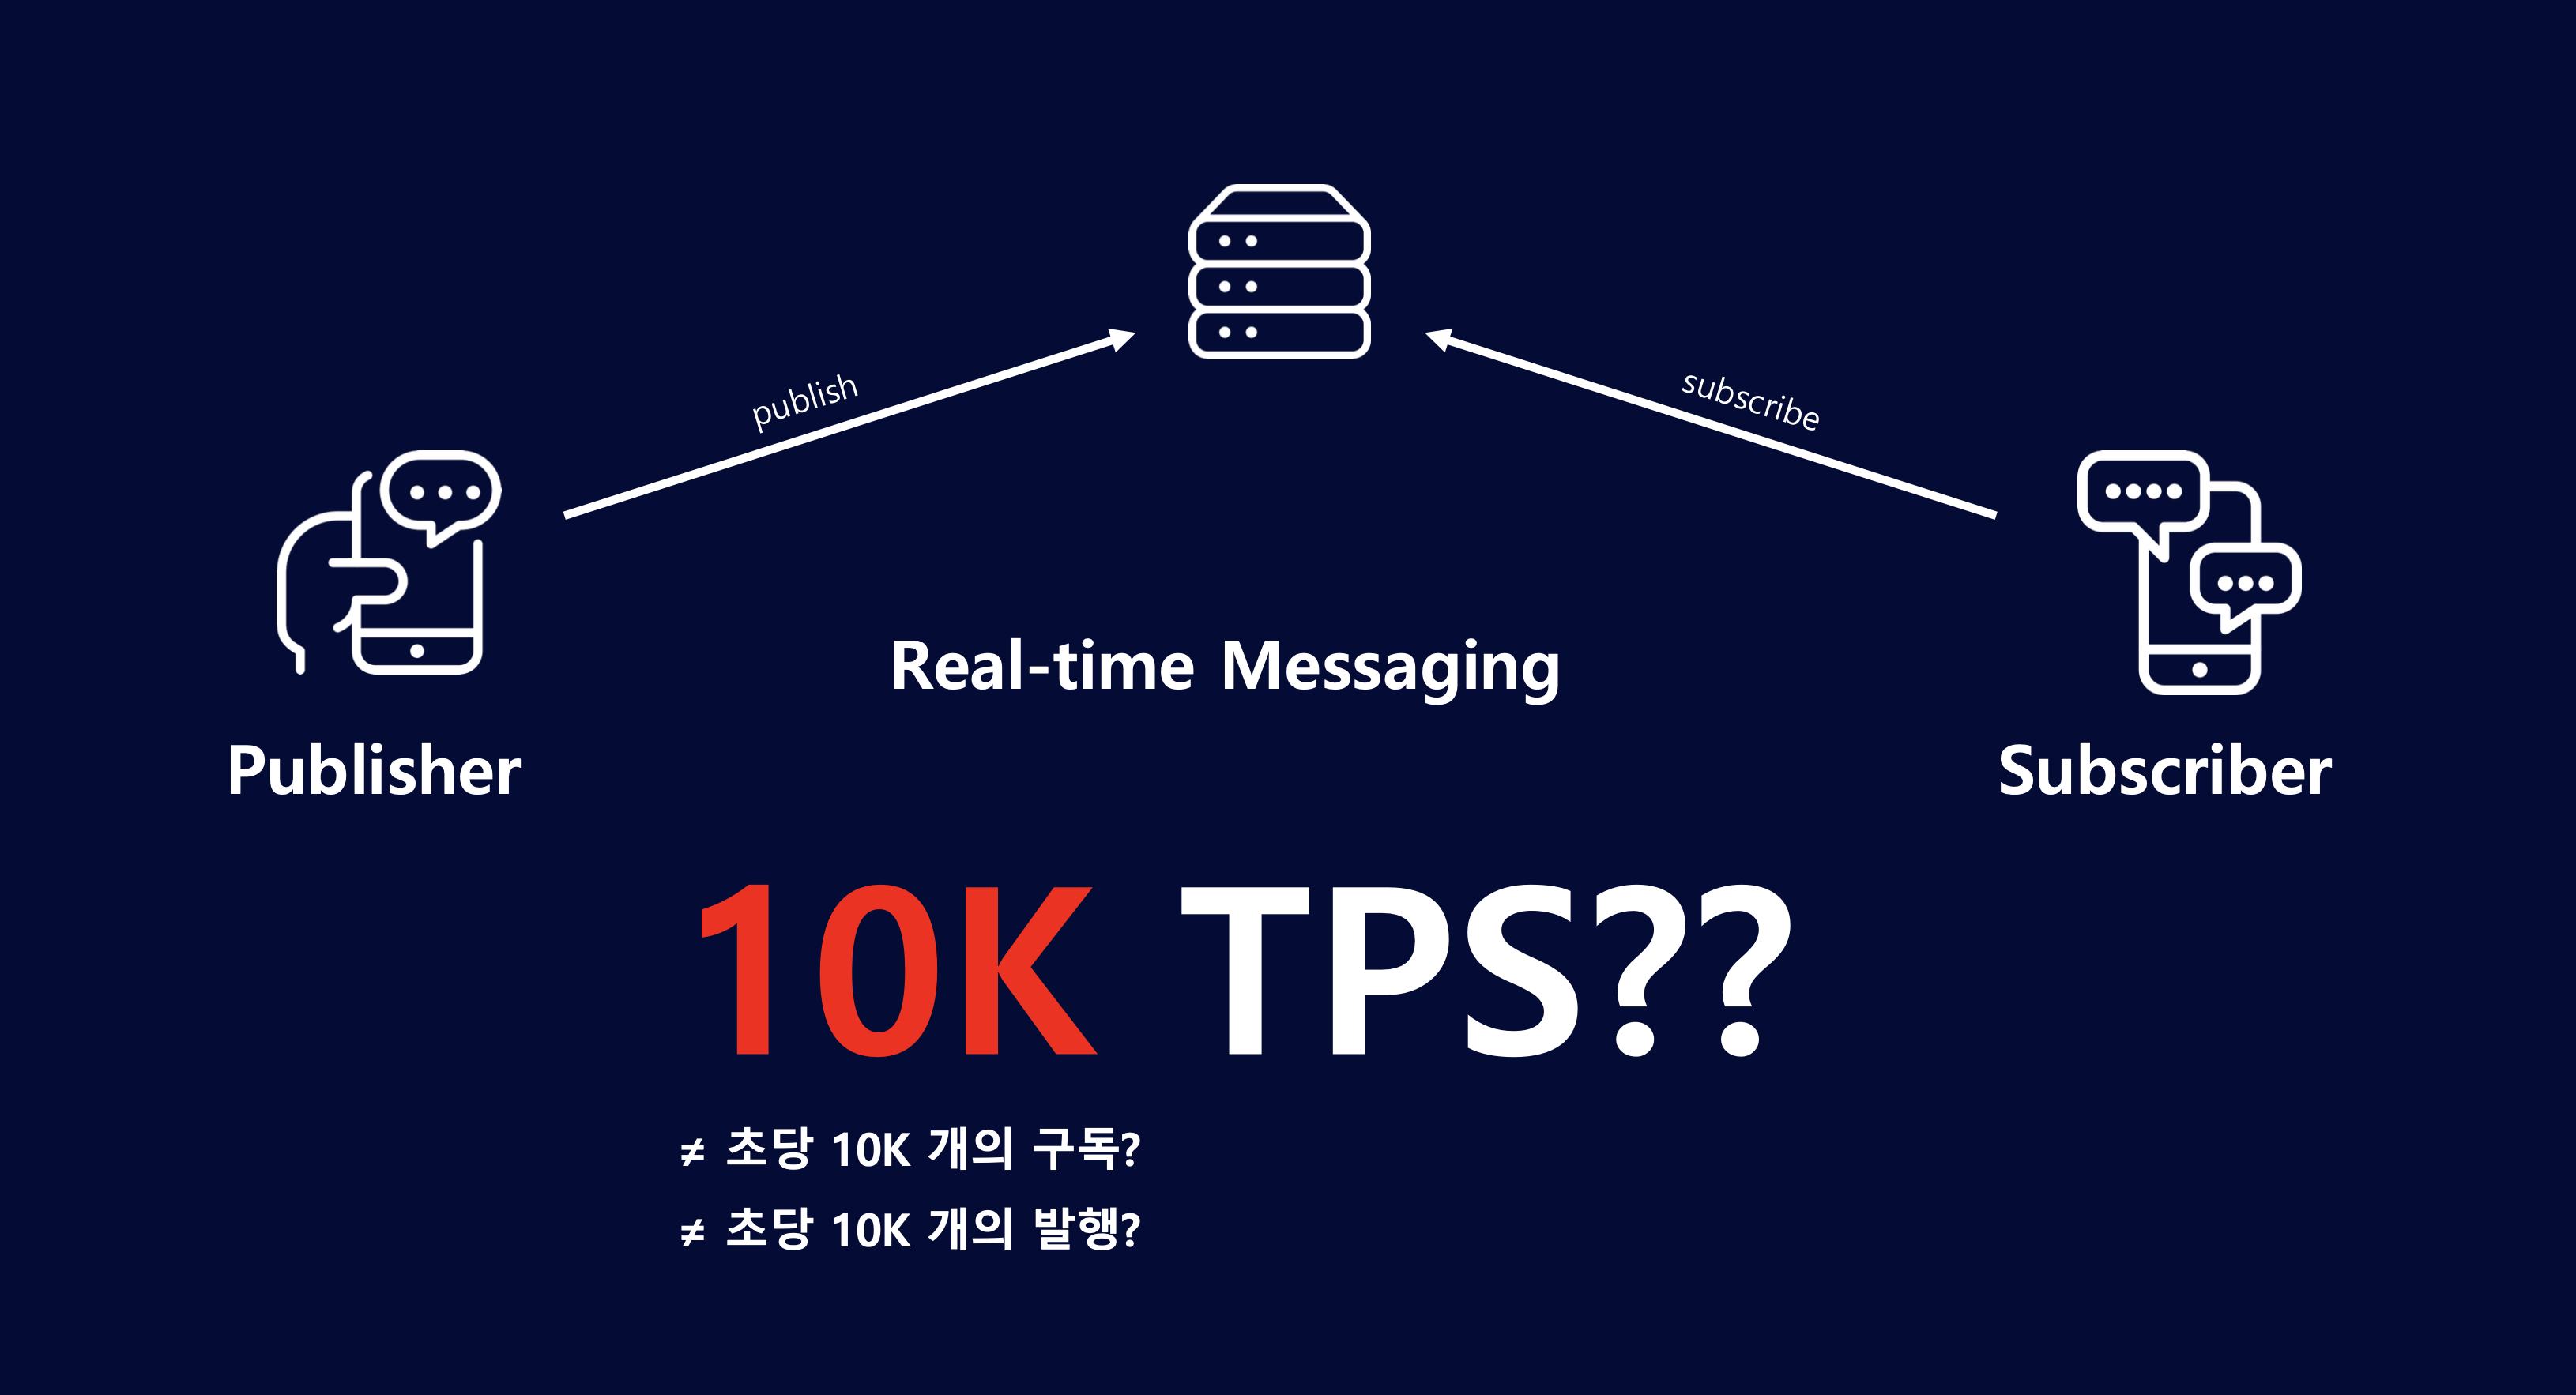
실시간 메시징은 구독(Subscribe) API와 발행(Publish) API를 제공합니다. 카리브에서 실시간 메시징은 채널이라는 매개체를 통해 전달됩니다.
구독 API는 채널로부터 메시지를 전달받을 수 있습니다. 발행 API는 채널에 메시지를 전송할 수 있습니다.
구독 API를 호출하면 Long Live Connection을 생성합니다. 커넥션이 만들어지고 채널에 구독하면 발행된 메시지를 전달받을 수 있습니다. Long Live Connection의 특성상 한 번 맺은 커넥션은 일정 시간 동안 유지됩니다.
구독 API를 호출하는 사용자는 채널에 발행되는 메시지를 가져오기 위해 호출합니다. 발행 API를 호출하는 사용자는 채널을 구독하고 있는 구독자들에게 메시지를 전달하기 위해 호출합니다.
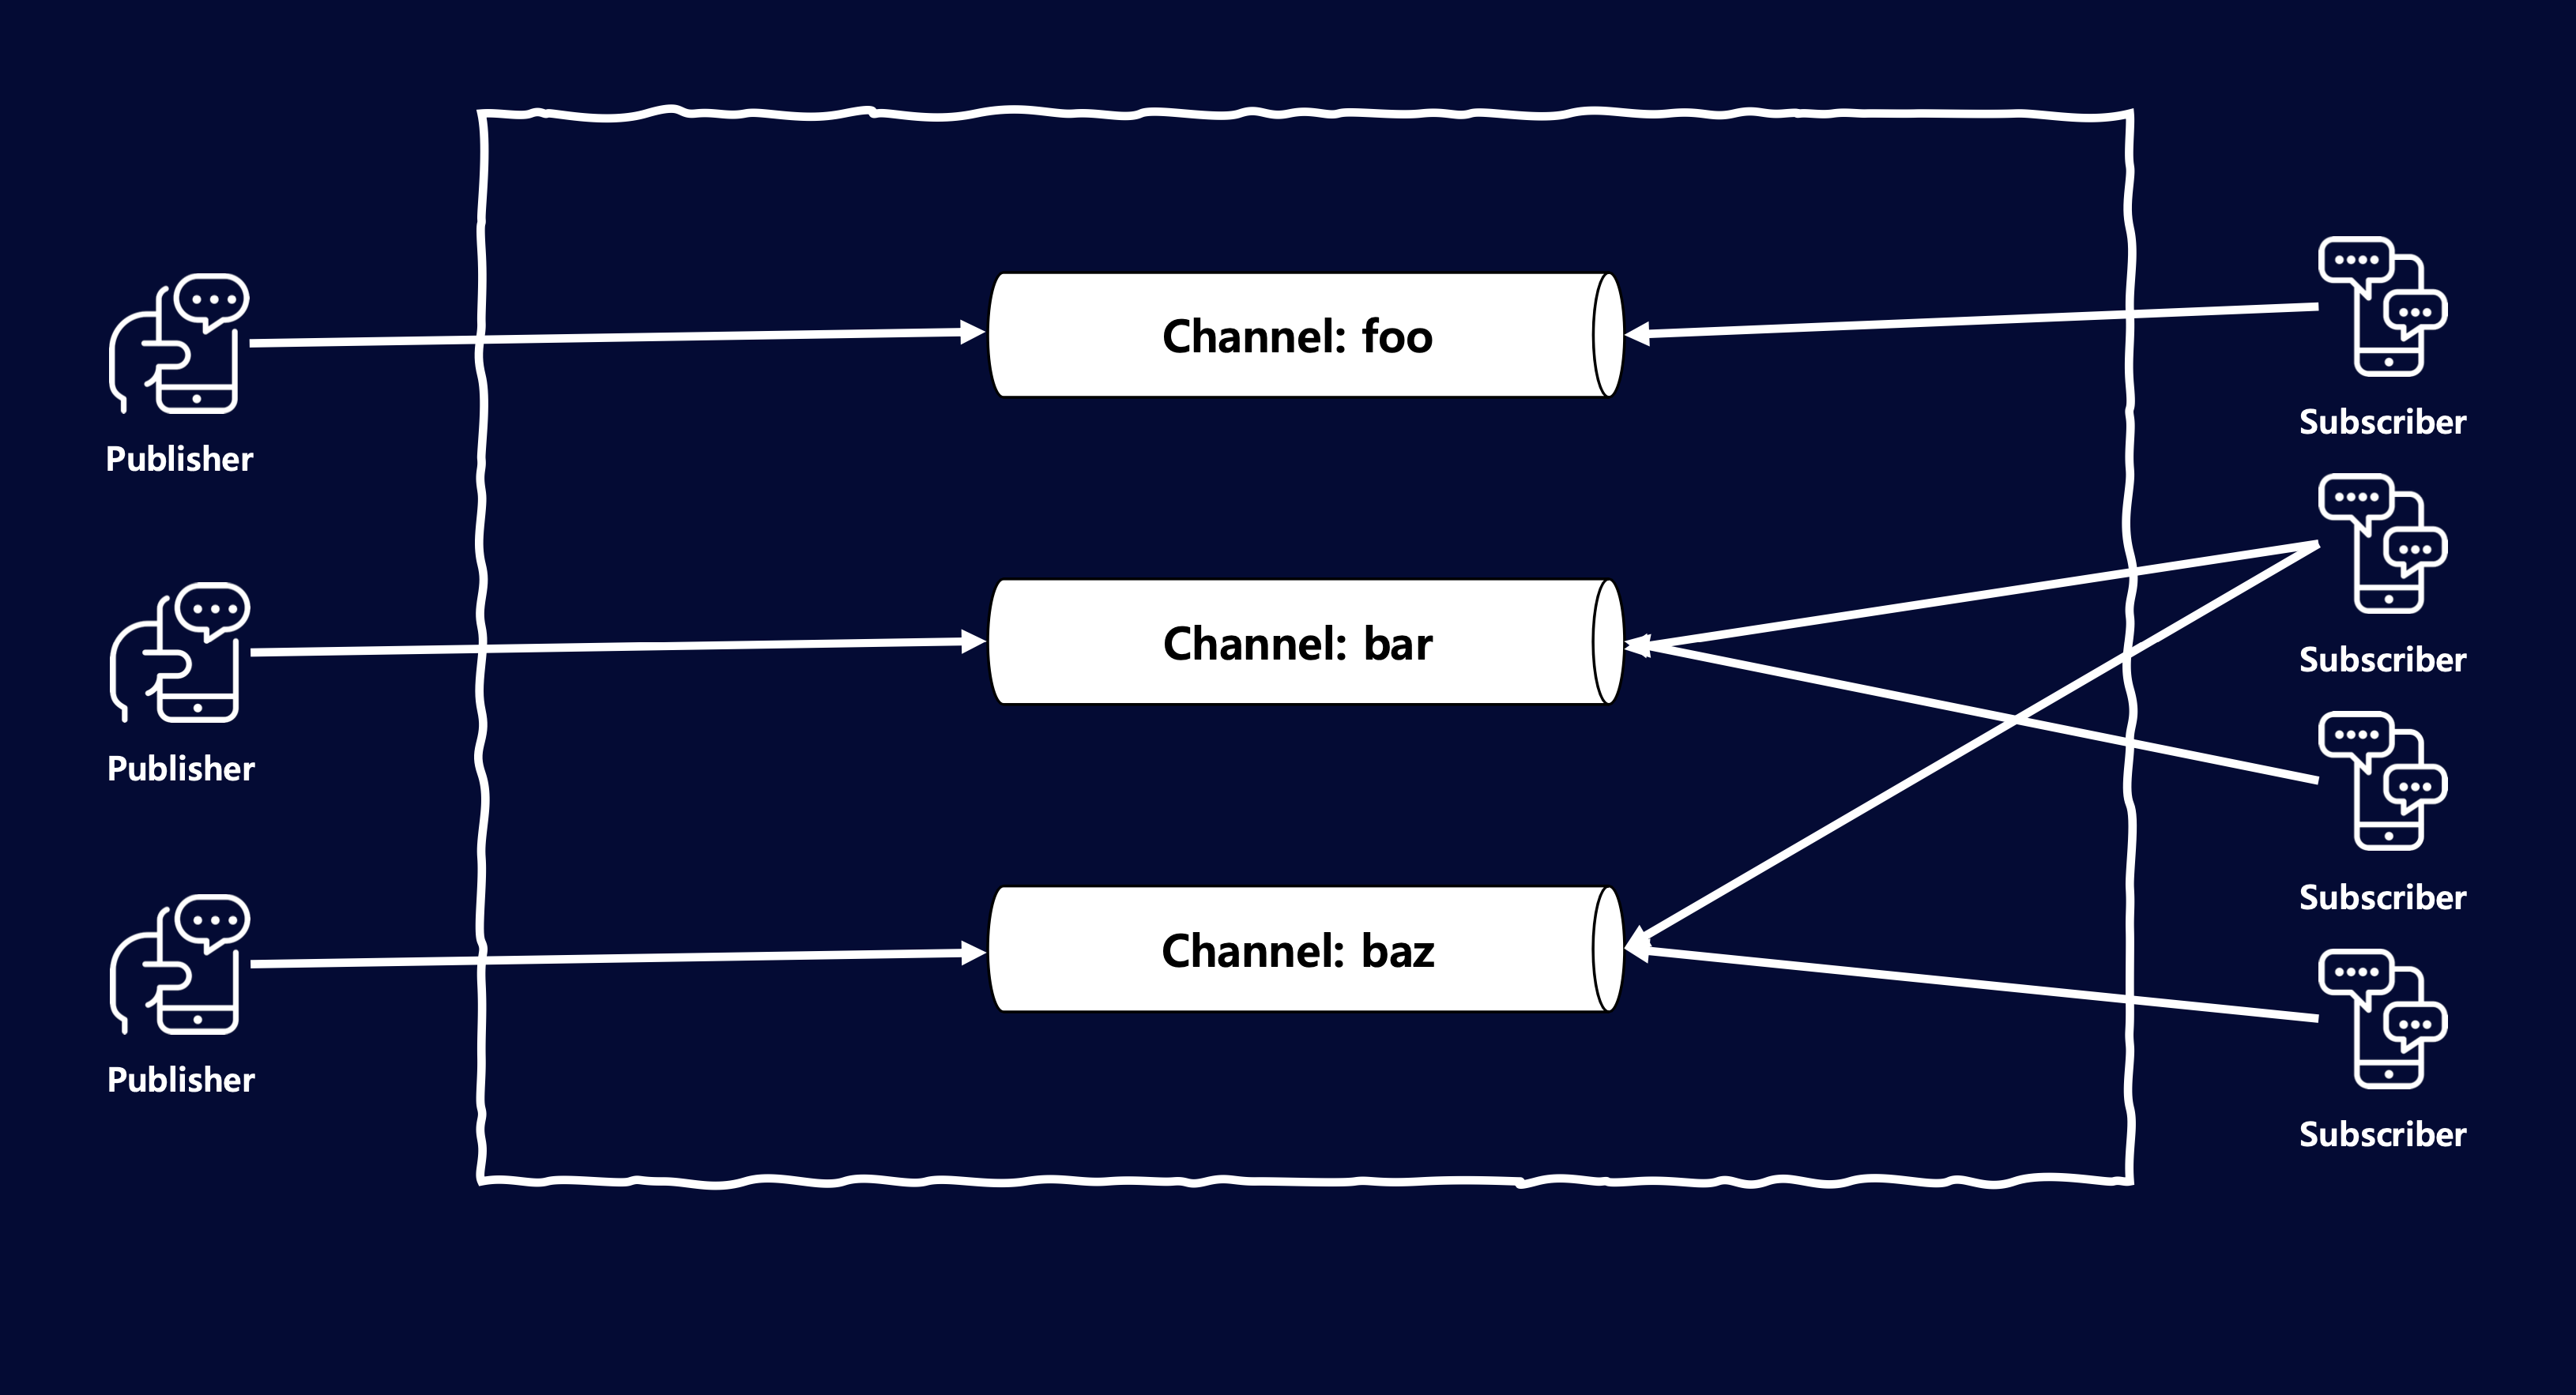
구독 혹은 발행 API에 대한 요청과 응답을 하나의 트랜잭션으로 맺어야 할까요?
정확한 기준을 세우지 않으면 아래와 같은 문제에 직면할 수 있습니다. 구독 API를 하나의 트랜잭션으로 가정하여 성능 테스트를 수행했고, 구독 API에 대해서 초당 100K TPS를 달성했습니다. 그런데 실제 서비스 환경에서는 구독자가 서버 당 1K 수준에서도 서비스 불가 상태가 될 수도 있습니다.
예상했던 한계치(TPS) 보다 훨씬 적은 수준의 부하에서 서비스 장애가 발생하는 것은 예측하기 어렵고 큰 장애로 이어집니다.
실시간 메시징 성능은 구독과 발행 API 가 서로 긴밀하게 연결되어 있습니다. 메시지 구독 혹은 발행 성능을 모두 고려하지 않으면 이와 같은 문제가 충분히 발생할 수 있습니다.이제 서로 어떤 연관이 있는지 고민해 볼 차례입니다.
실시간 메시징 시스템의 성능 영향 요인: 구독자 수, 메시지 발행량, 데이터 구조
실시간 메시징에서 100K TPS를 처리할 수 있다는 문장은 어떻게 해석할 수 있을까요? 10만 개의 구독/발행 API를 처리할 수 있다고 판단할 수 있을까요?
메시지가 얼마나 발행되고 있는지, 구독자는 얼마나 존재하는지, 메시지의 크기 혹은 채널의 수 등 다양한 요인이 영향을 줄 수 있습니다. 실시간 메시징 시스템의 실제 성능은 아래와 같은 요인들의 복합적인 상호작용에 의해 결정됩니다.
- 구독자 수
- 메시지 발행량
- 데이터 구조
구독자 수
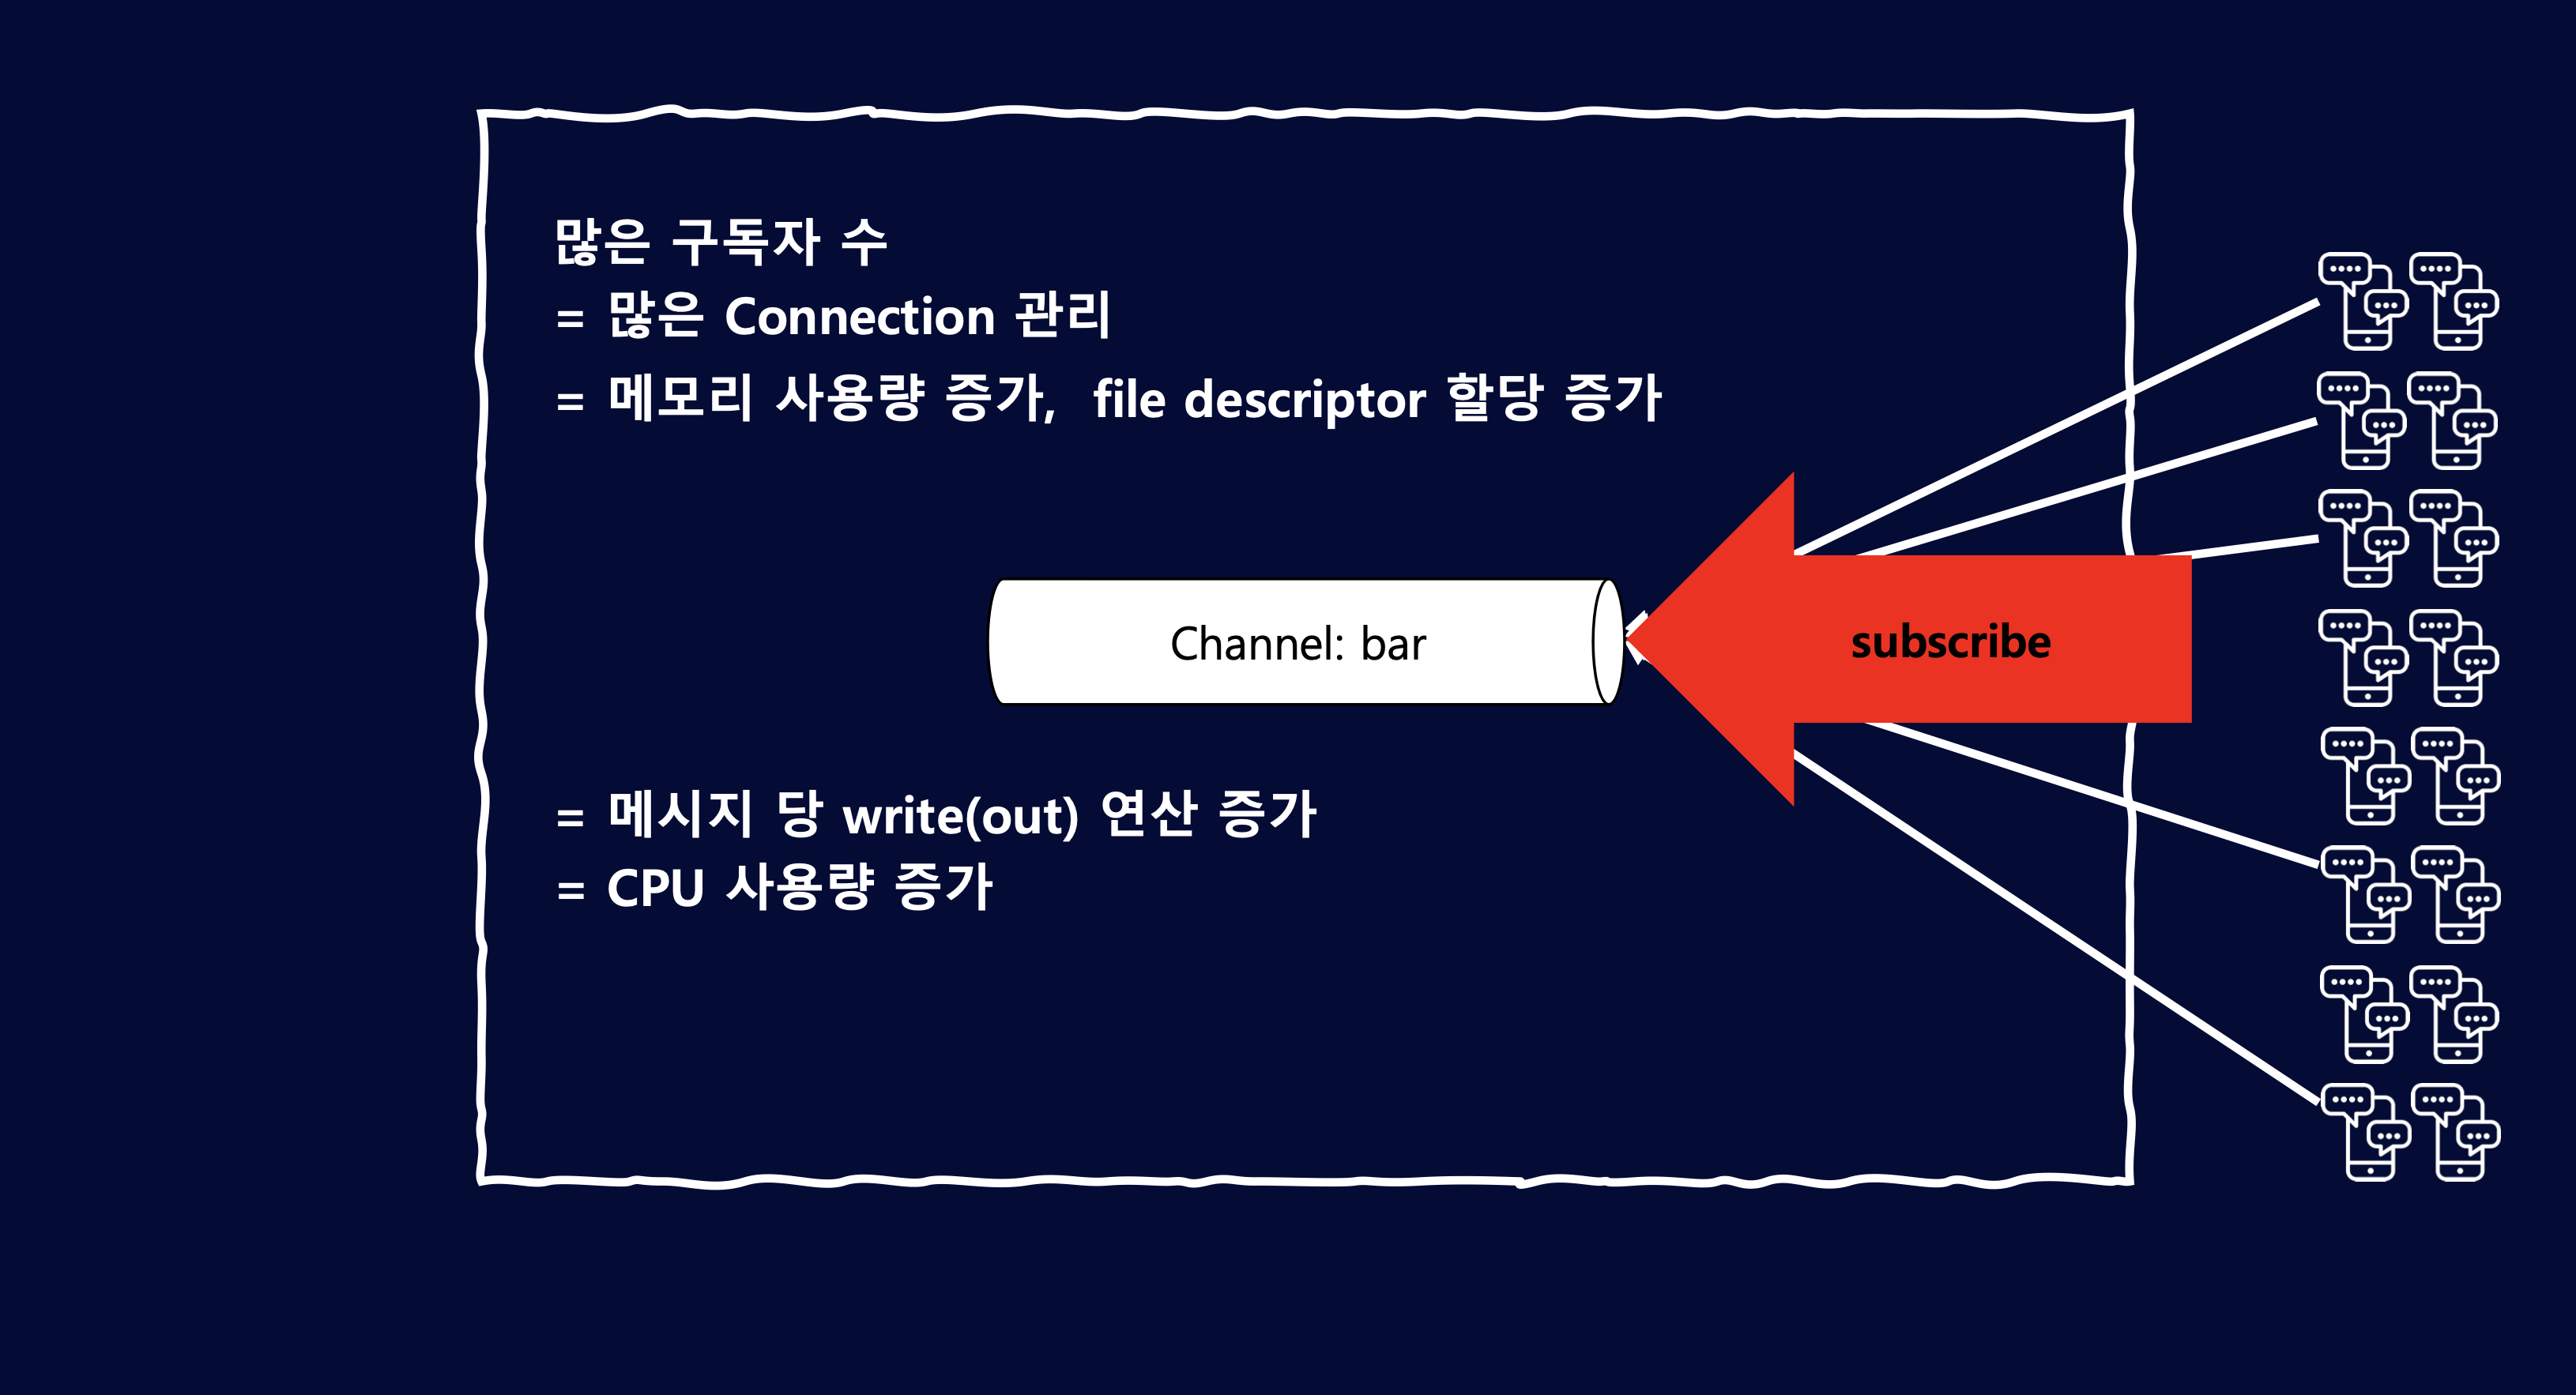
많은 구독자 수는 연결을 유지하기 위해 자원을 점유합니다. 자연스럽게 메모리 할당량이 증가합니다. 구독자들에게 메시지를 전달하기 위한 쓰기 연산이 많아집니다. I/O 연산은 CPU를 많이 점유합니다.
구독자 수가 많아지면 메모리 할당량과 CPU 사용량이 증가합니다.
메시지 발행량
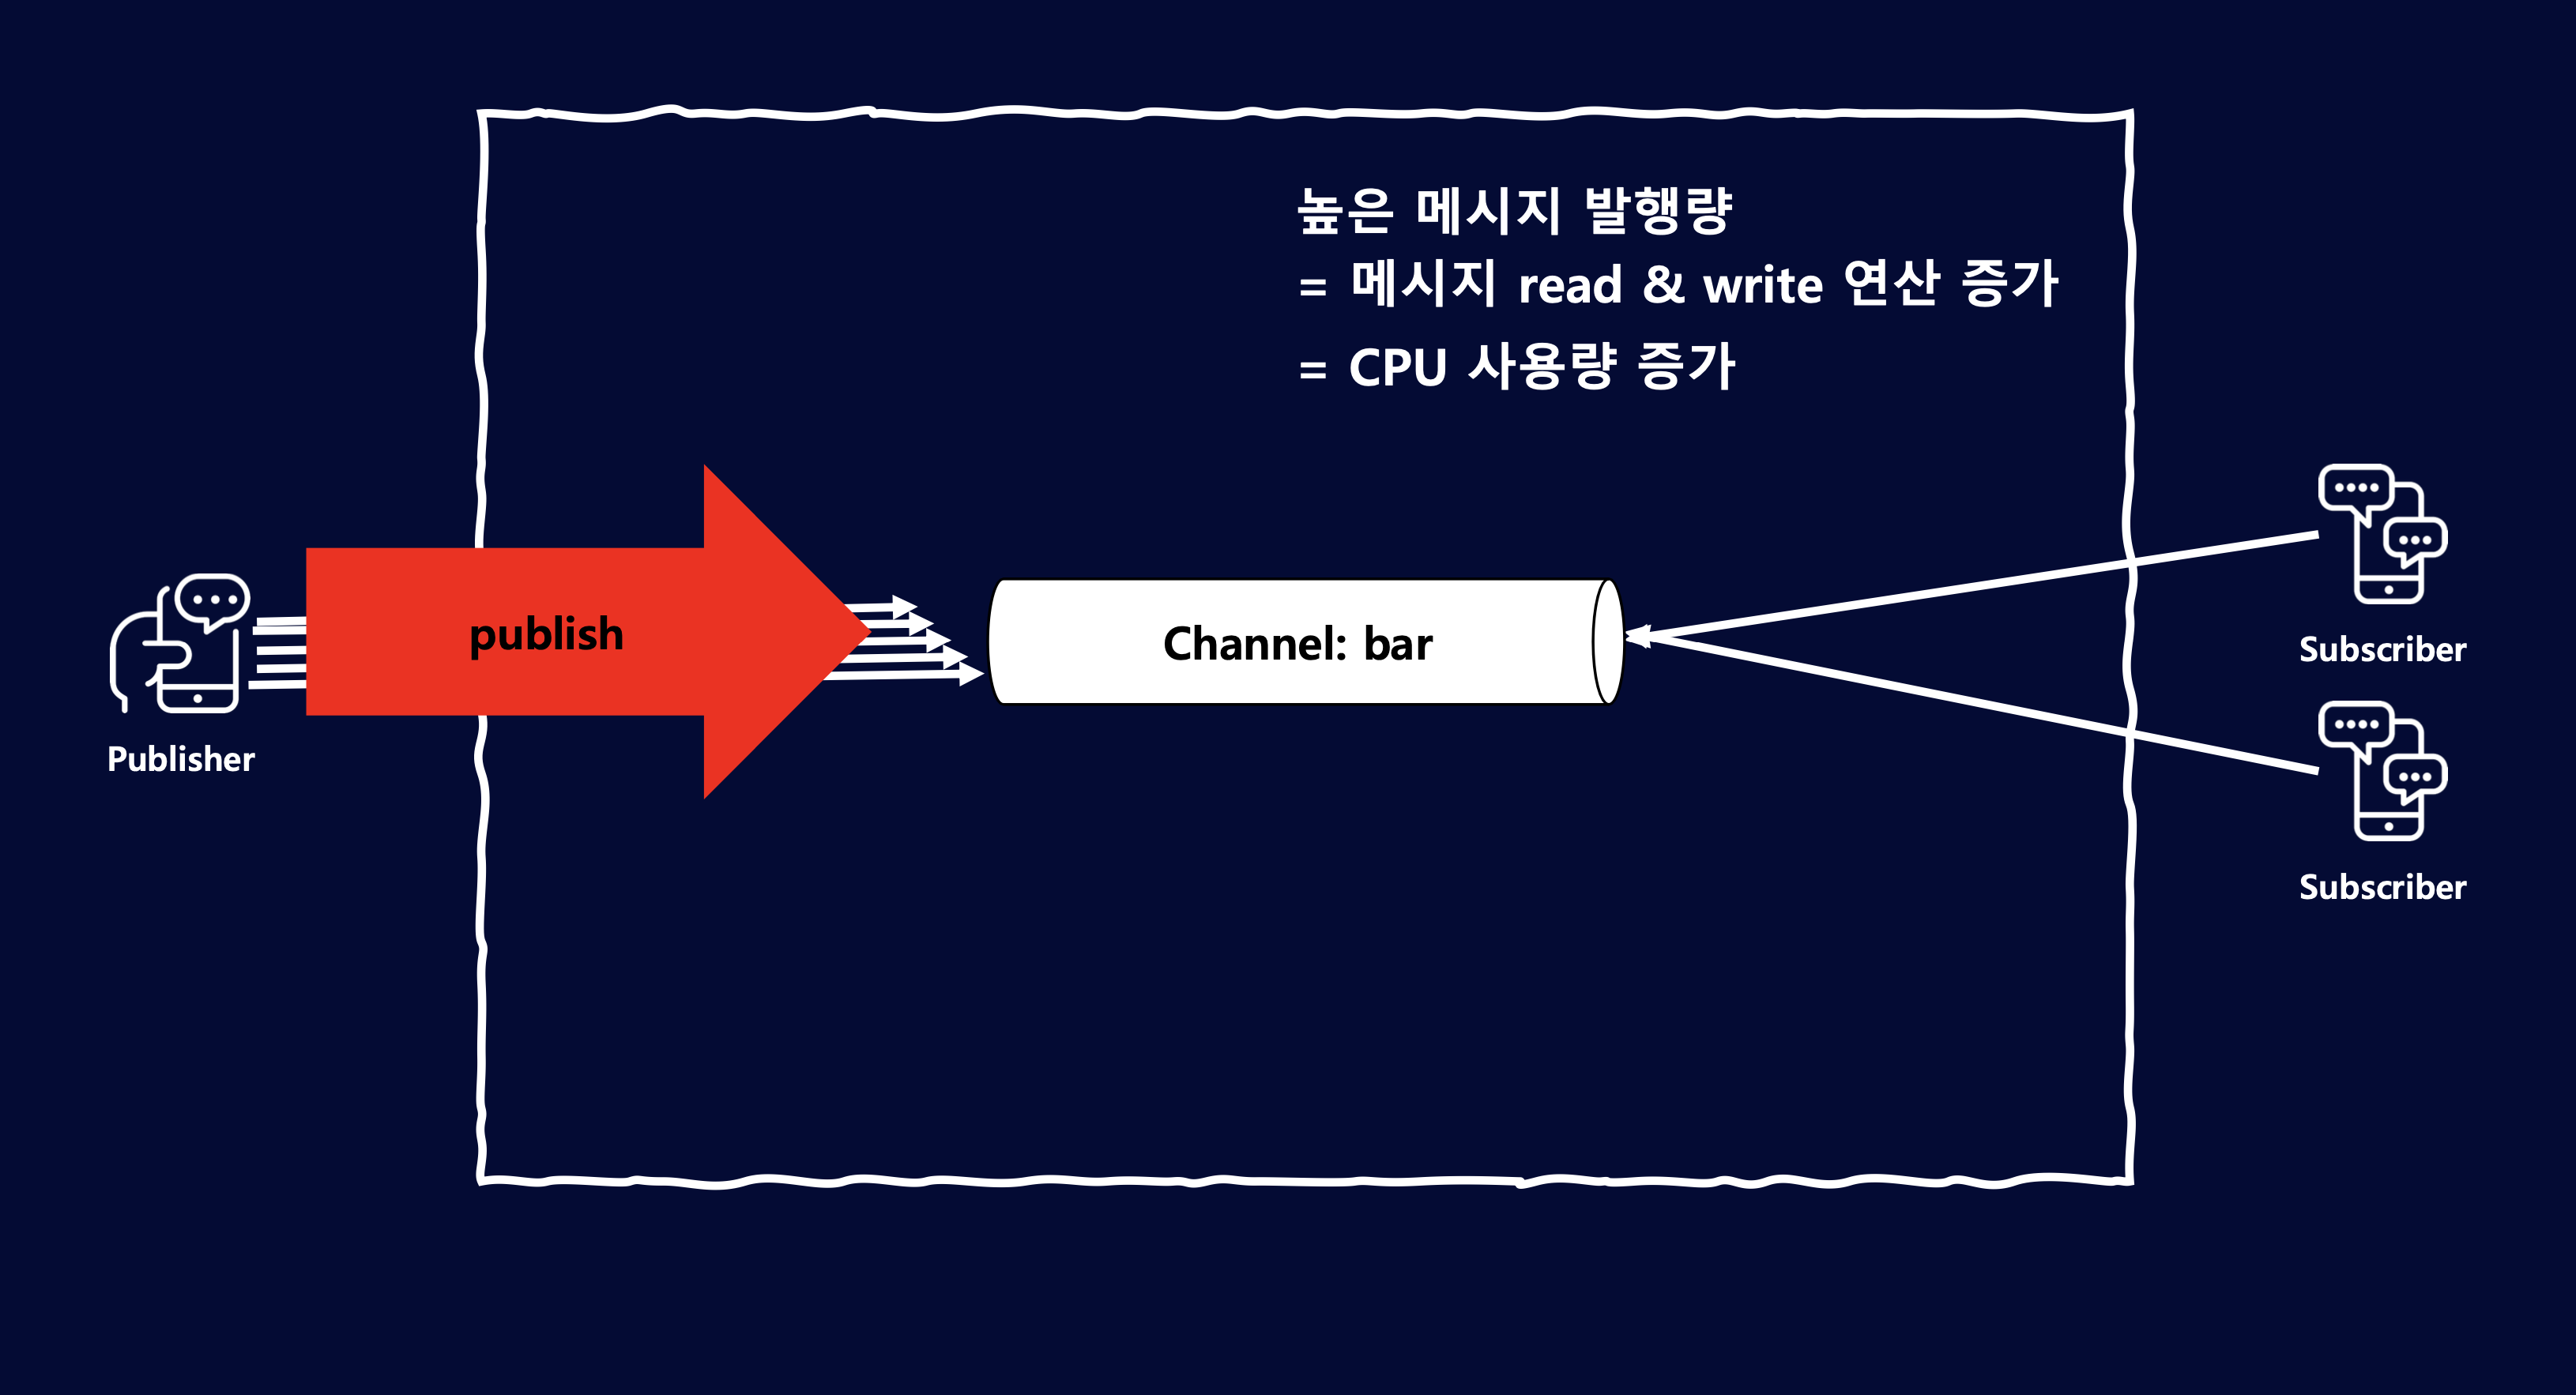
발행하는 메시지가 많아지면 I/O 연산이 많아지고 CPU 사용량이 증가합니다.
데이터 구조
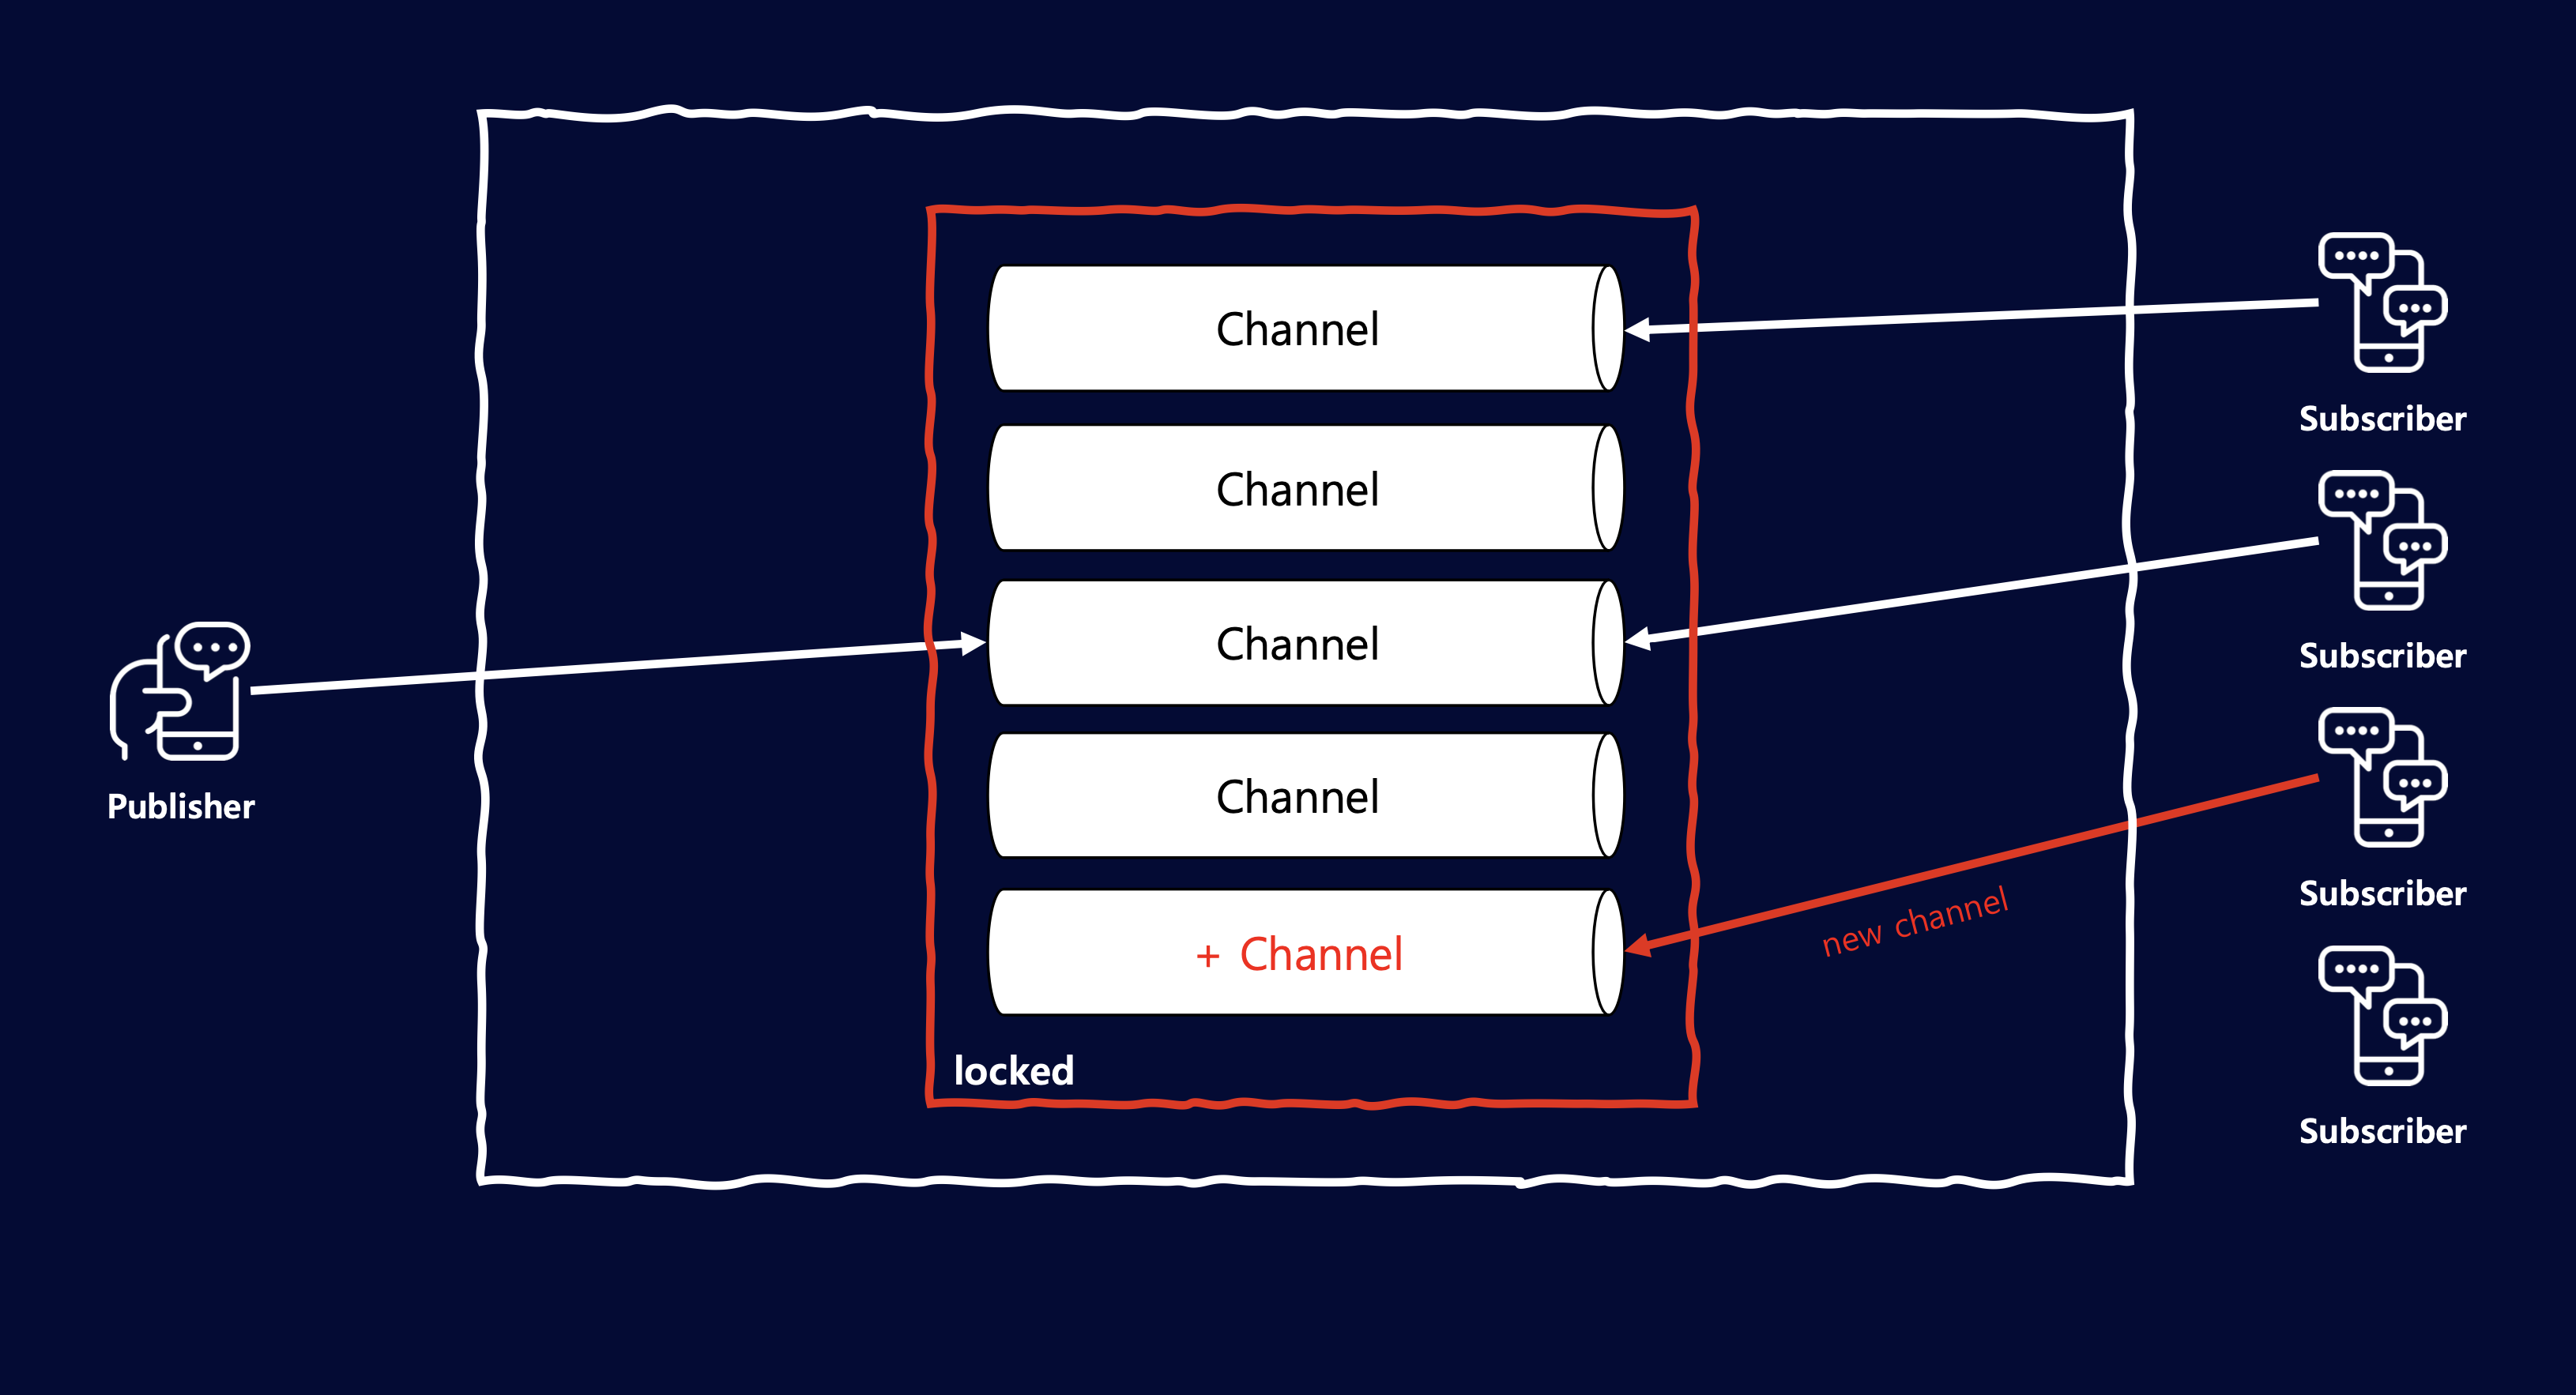
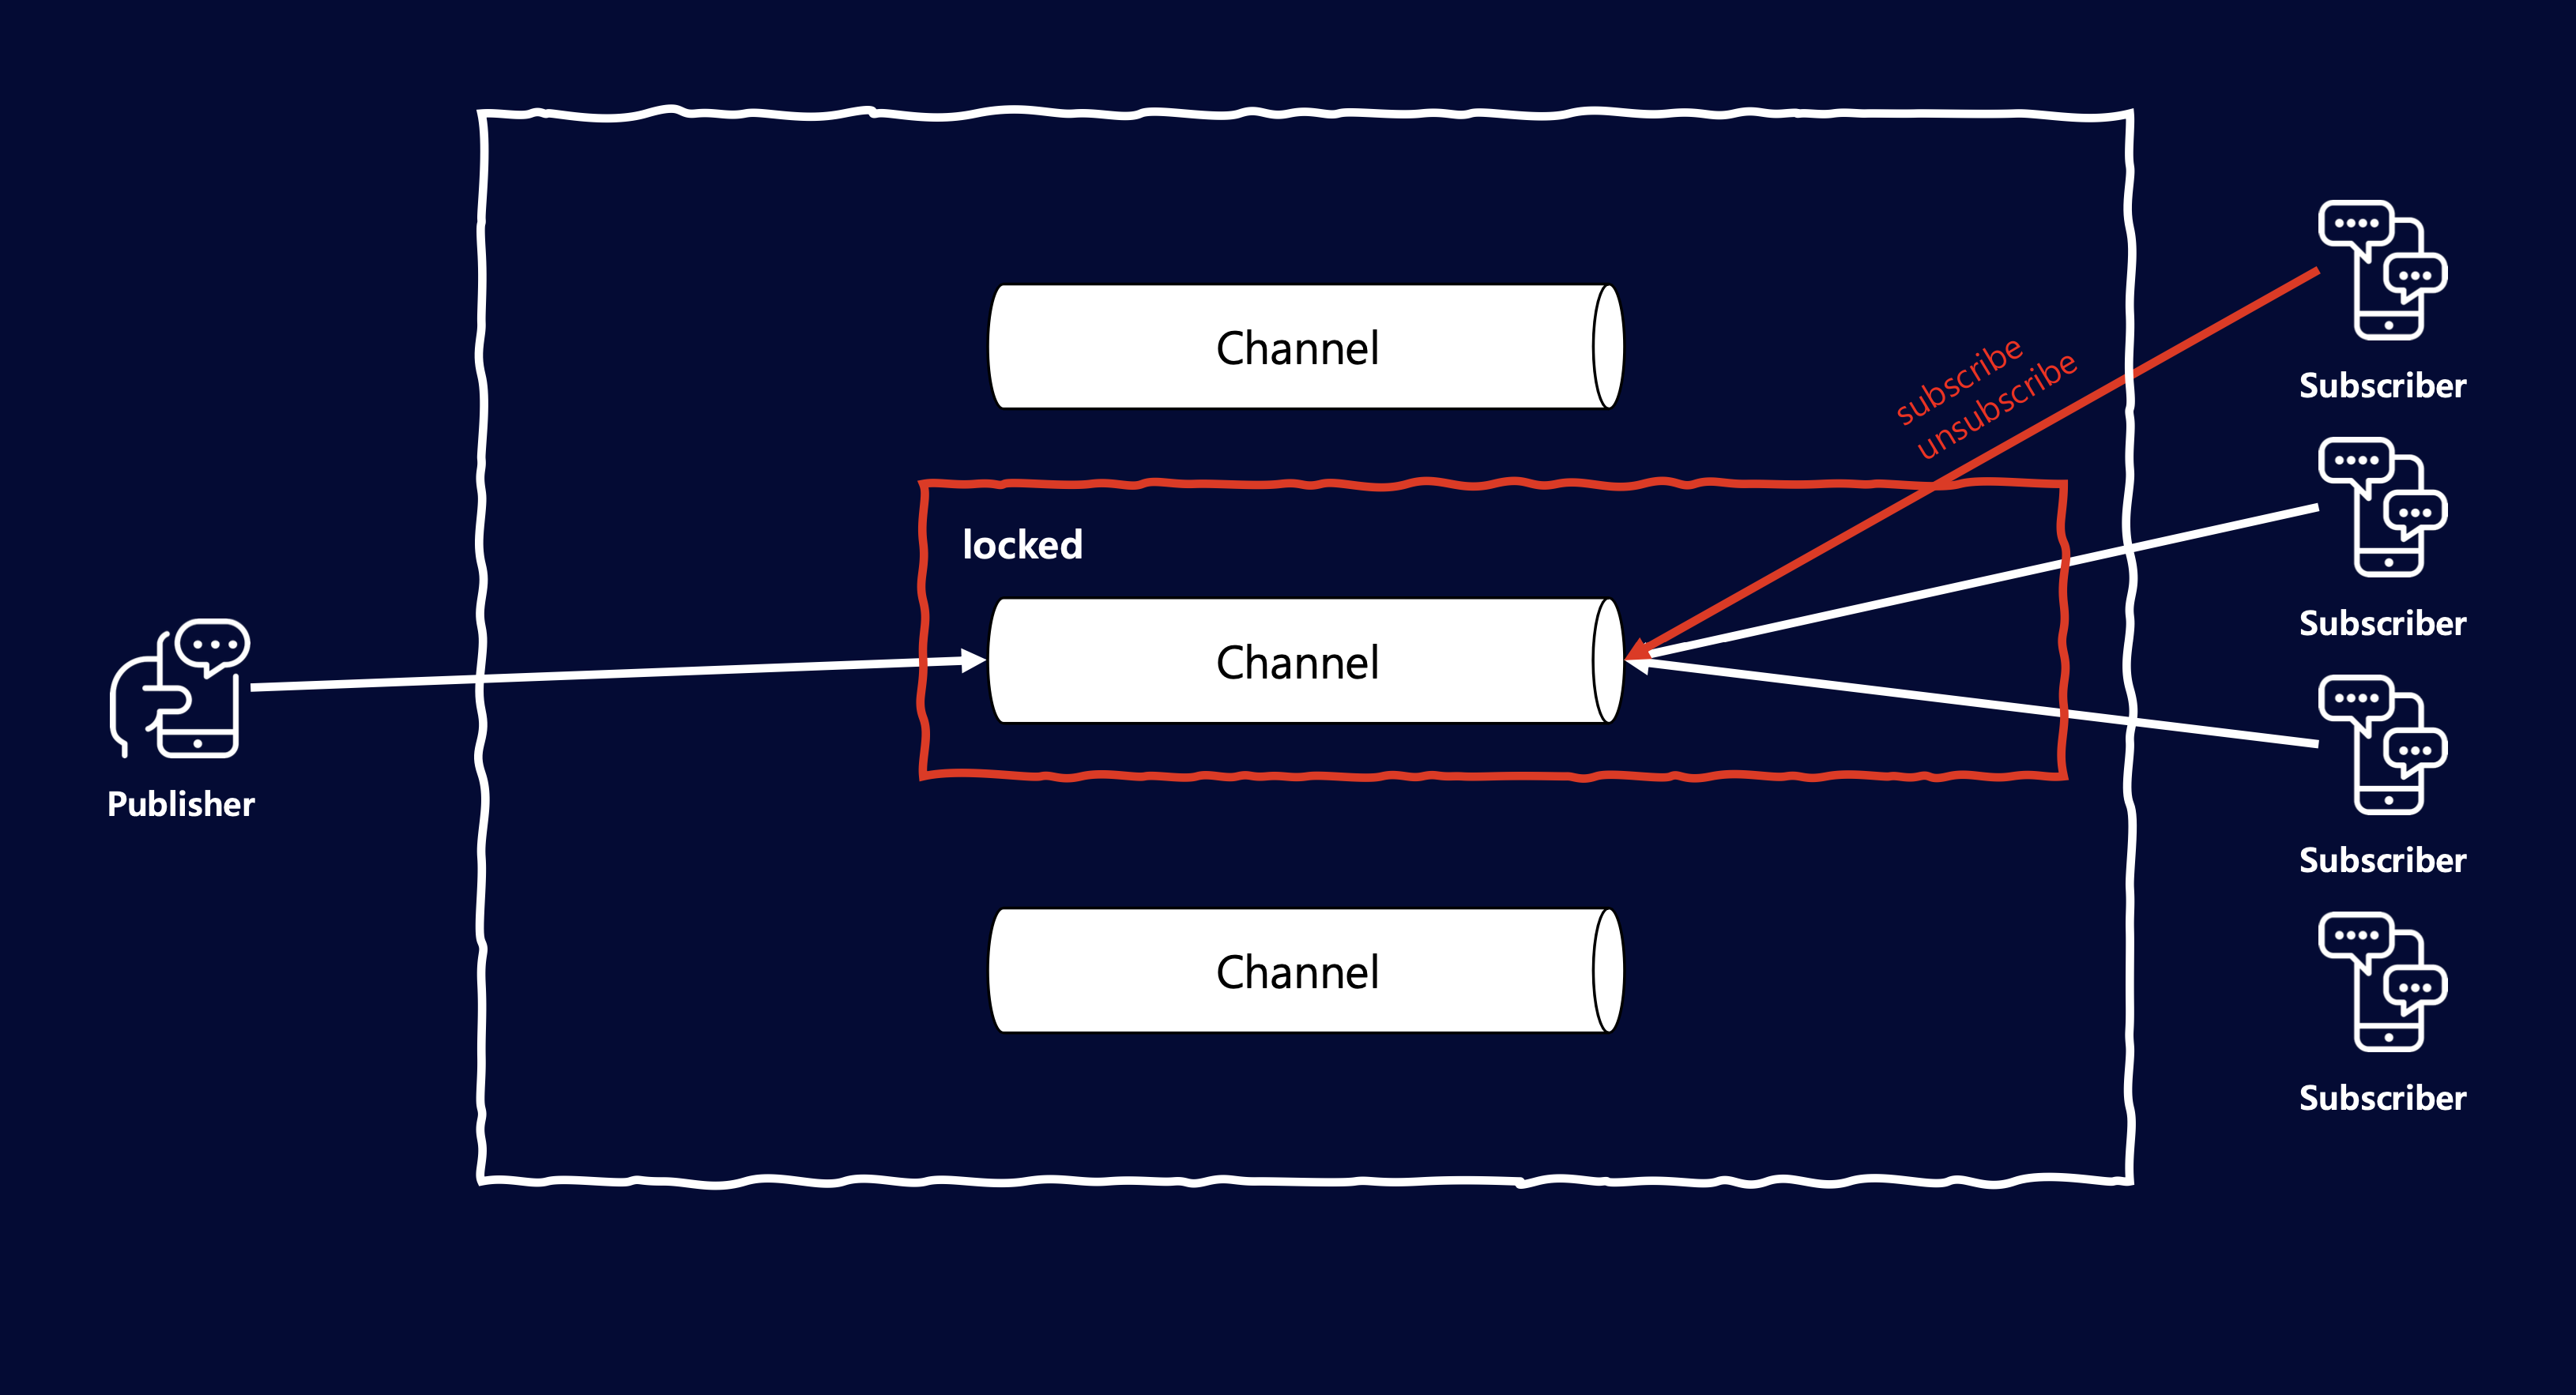
채널 혹은 구독자를 관리하기 위한 데이터 구조도 중요합니다. 실시간으로 채널 혹은 구독자가 추가, 제거되어야 합니다. 동시성을 위해서는 lock과 같은 기술을 사용해야 합니다. 동기화 과정에서도 성능 문제를 고려해야 합니다.
성능 테스트 시나리오 설계
성능 주요 인자
실시간 메시징 성능에 가장 큰 영향을 주는 요인은 구독자 수 와 메시지 발행량 입니다.
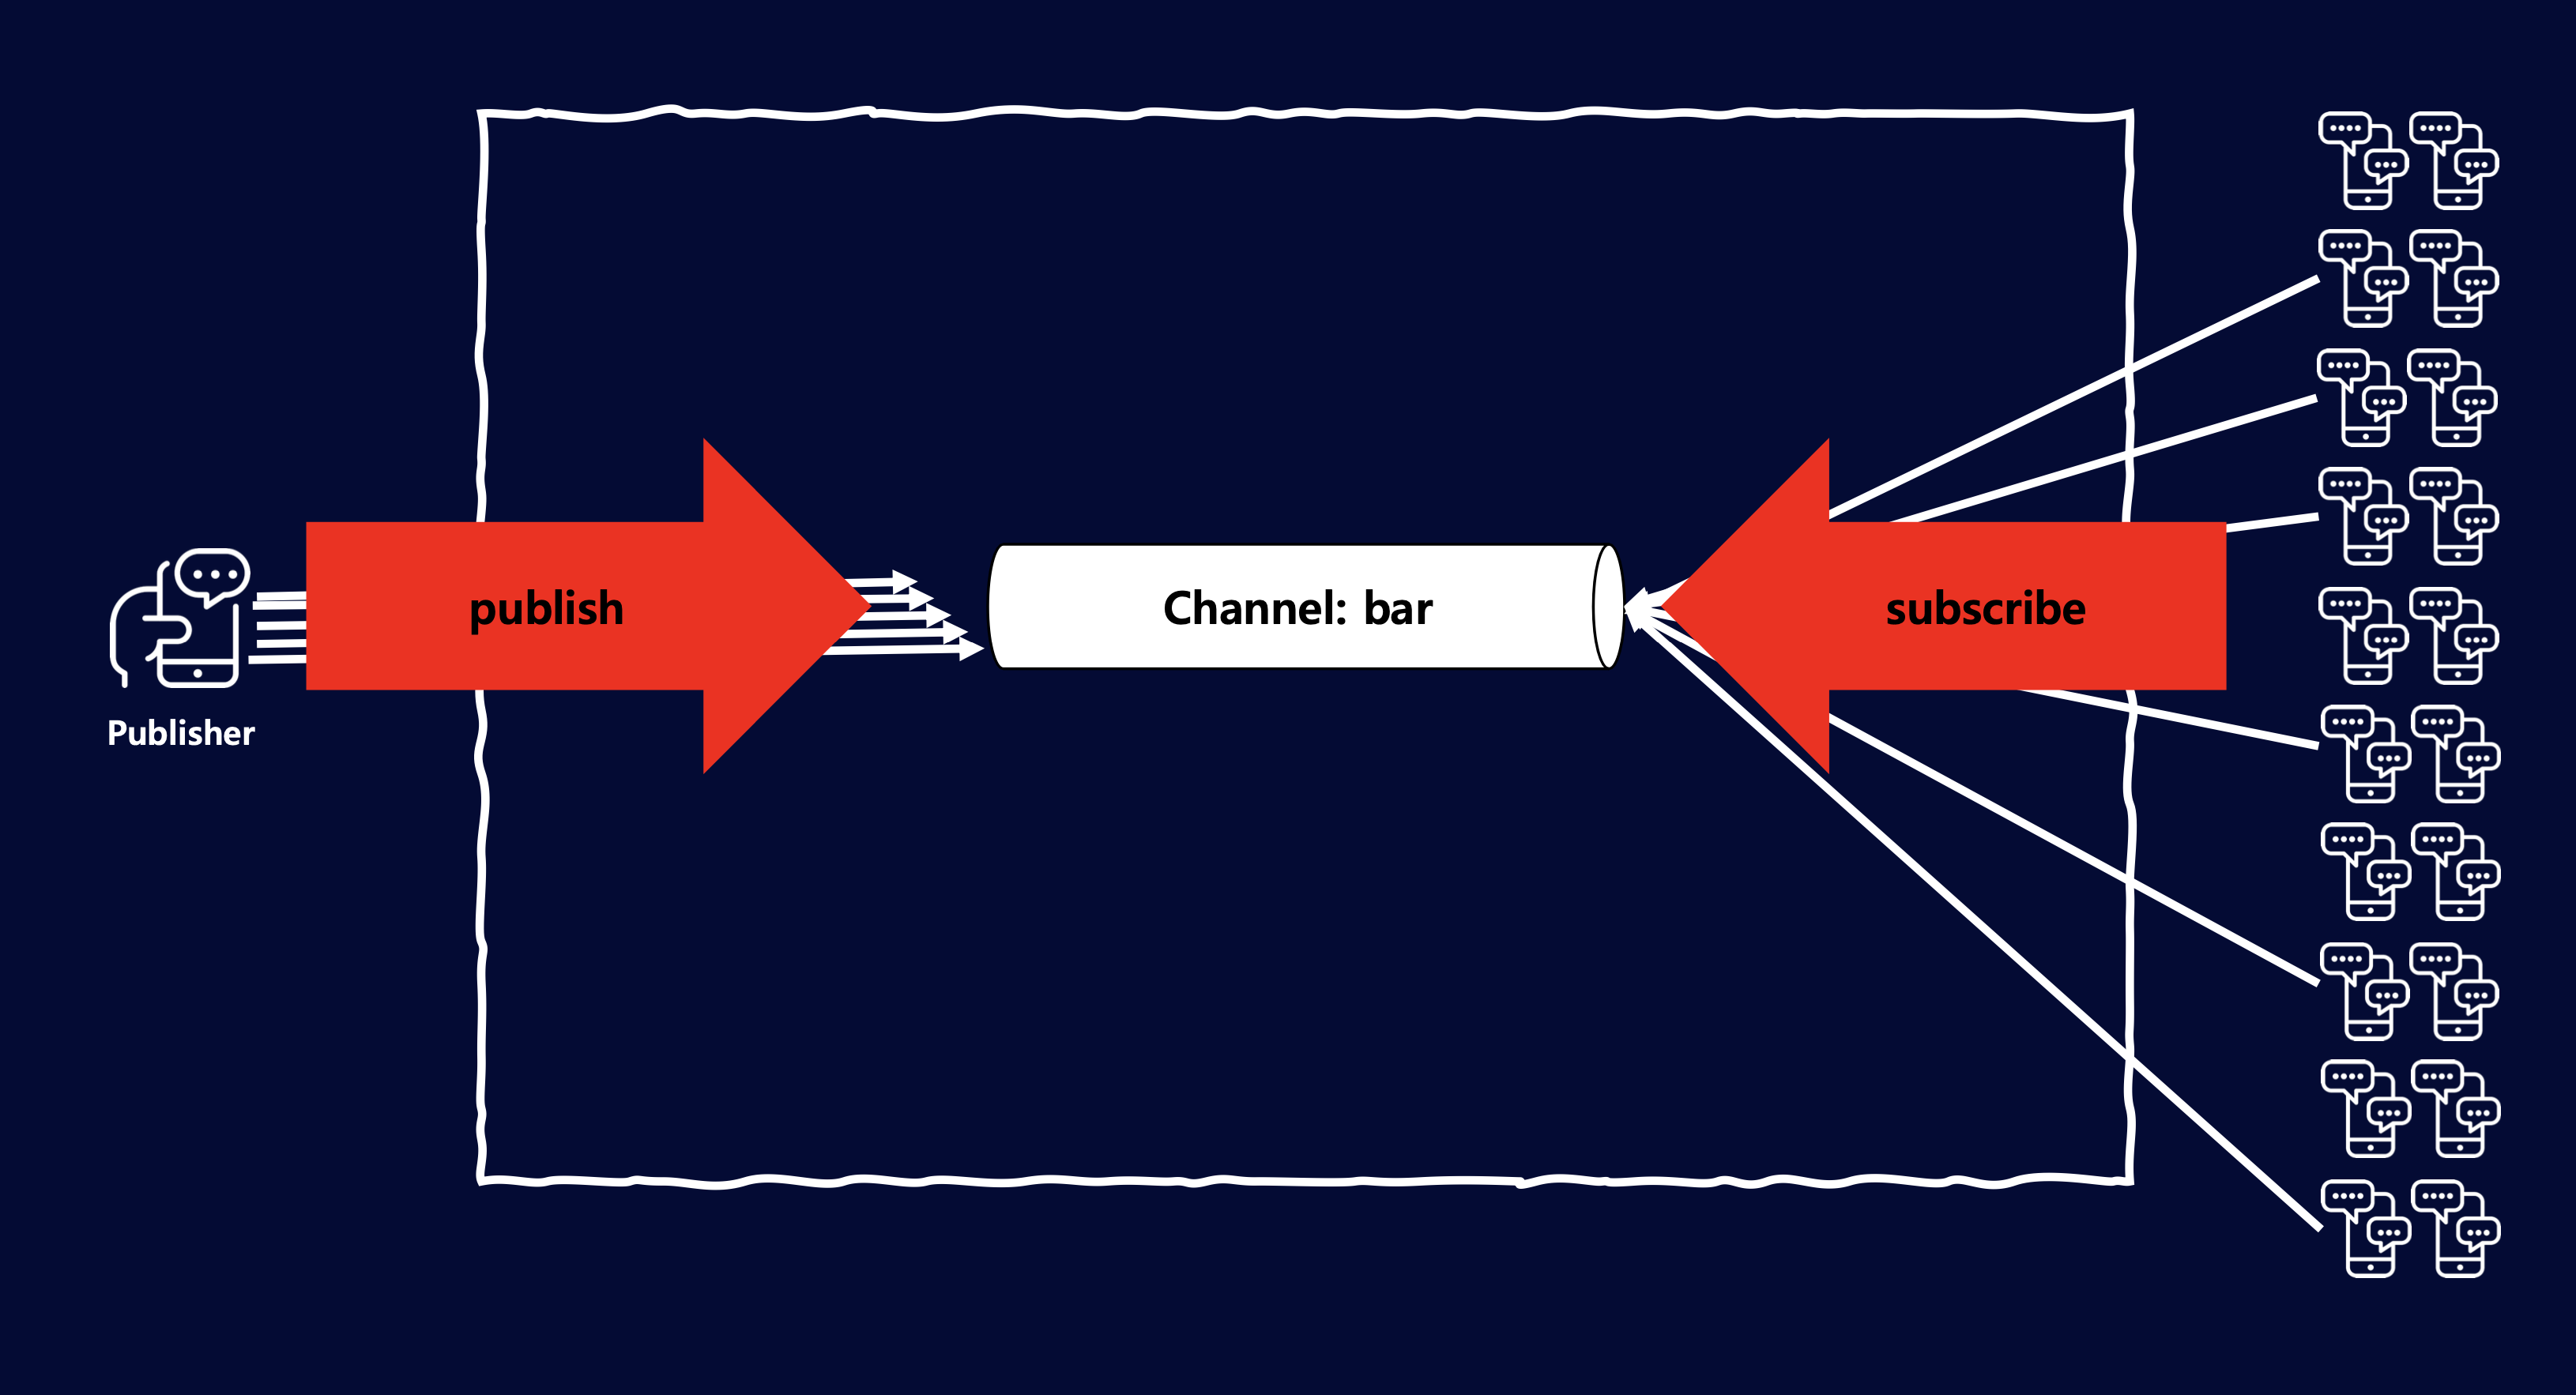
실시간 메시징은 대표적인 fan-out 구조입니다.
(= 한 개의 메시지 발행이 얼마나 많은 구독자들에게 fan-out 되는가?)
메시지가 많이 fan-out 될수록 I/O 연산이 증가하고 부하가 발생합니다.
성능 테스트 시나리오
성능에 큰 영향을 주는 요인을 기준으로 테스트 시나리오를 정리했습니다.
“N 명의 구독자가 1 개의 채널을 구독하고 있을 때, 초당 M 개의 메시지를 처리할 수 있는가?”
시나리오를 기반으로 N과 M을 높여가면서 성능을 측정합니다.
성능에 영향을 주는 요인에는 다양한 것들이 있습니다.
-
장비의 리소스(e.g. CPU, Memory)
-
인프라 요소(런타임, 네트워크 환경)
-
구독(세션) 유지 시간
-
구독 중인 채널 수
-
메시지 크기
-
…
초기에는 성능에 큰 영향을 주는 요인을 찾기 위해
다양하게 변수를 바꾸어가면서 비교하는 과정이 있었습니다.
결과적으로 성능에 가장 큰 영향을 주는 요인은 구독자 수 와 메시지 발행량 이었습니다.
다른 요인들도 충분히 성능에 영향을 줄 수 있었지만 두 요인에 비해 미비하거나 실제 운영 환경에서의 시나리오와 맞지 않는 등의 이유로 값을 고정하고 성능 테스트를 진행했습니다.
성능 테스트
성능 테스트 환경 구축
성능을 측정하기 위해 부하를 발생시키고, 결과를 확인할 수 있는 환경을 구축합니다.
카카오는 사내 인프라 조직에서 제공하는 다양한 개발 도구를 쉽게 사용할 수 있습니다. ✌️
쉽고 빠르게 쿠버네티스 클러스터 환경을 구축할 수 있는 DKOS부터 VM 인스턴스를 만들어서 사용할 수 있는 krane, 도커 이미지 빌드 배포 D2Hub 등, 개인적으로 이런 환경이 없었다면 이렇게 의미 있는 실험, 도전을 해볼 수 없지 않았을까 생각도 듭니다.
덕분에 저희는 비즈니스 로직의 성능을 테스트하는 데에 더 집중할 수 있었습니다.
이어서 성능을 측정하기 위한 서버와 부하를 재현하기 위한 클라이언트를 어떻게 세팅했고, 결과를 해석하기 위한 지표를 어떻게 수집했는지 설명합니다.
클라이언트
부하를 재현하고, 성능 테스트의 인터페이스 역할을 합니다.
위 시나리오 (“N 명의 구독자가 1 개의 채널을 구독하고 있을 때, 초당 M 개의 메시지를 처리할 수 있는가?”) 의 실험 변수 N, M을 입력하면 이에 맞는 부하가 발생해야 합니다.
메시지 발행 클라이언트
초당 M 개의 메시지를 전송하는 역할을 담당합니다. 처음에는 Publish API를 호출하는 방식으로 구현을 고민했었는데, 카리브의 publish API는 Redis에 메시지를 전달하는 것이 전부였기 때문에, 좀 더 메시지를 fan-out 하는 구조의 성능을 측정하기 위해서 전역 브로커 역할을 하는 Redis에 직접 메시지를 전송했습니다.
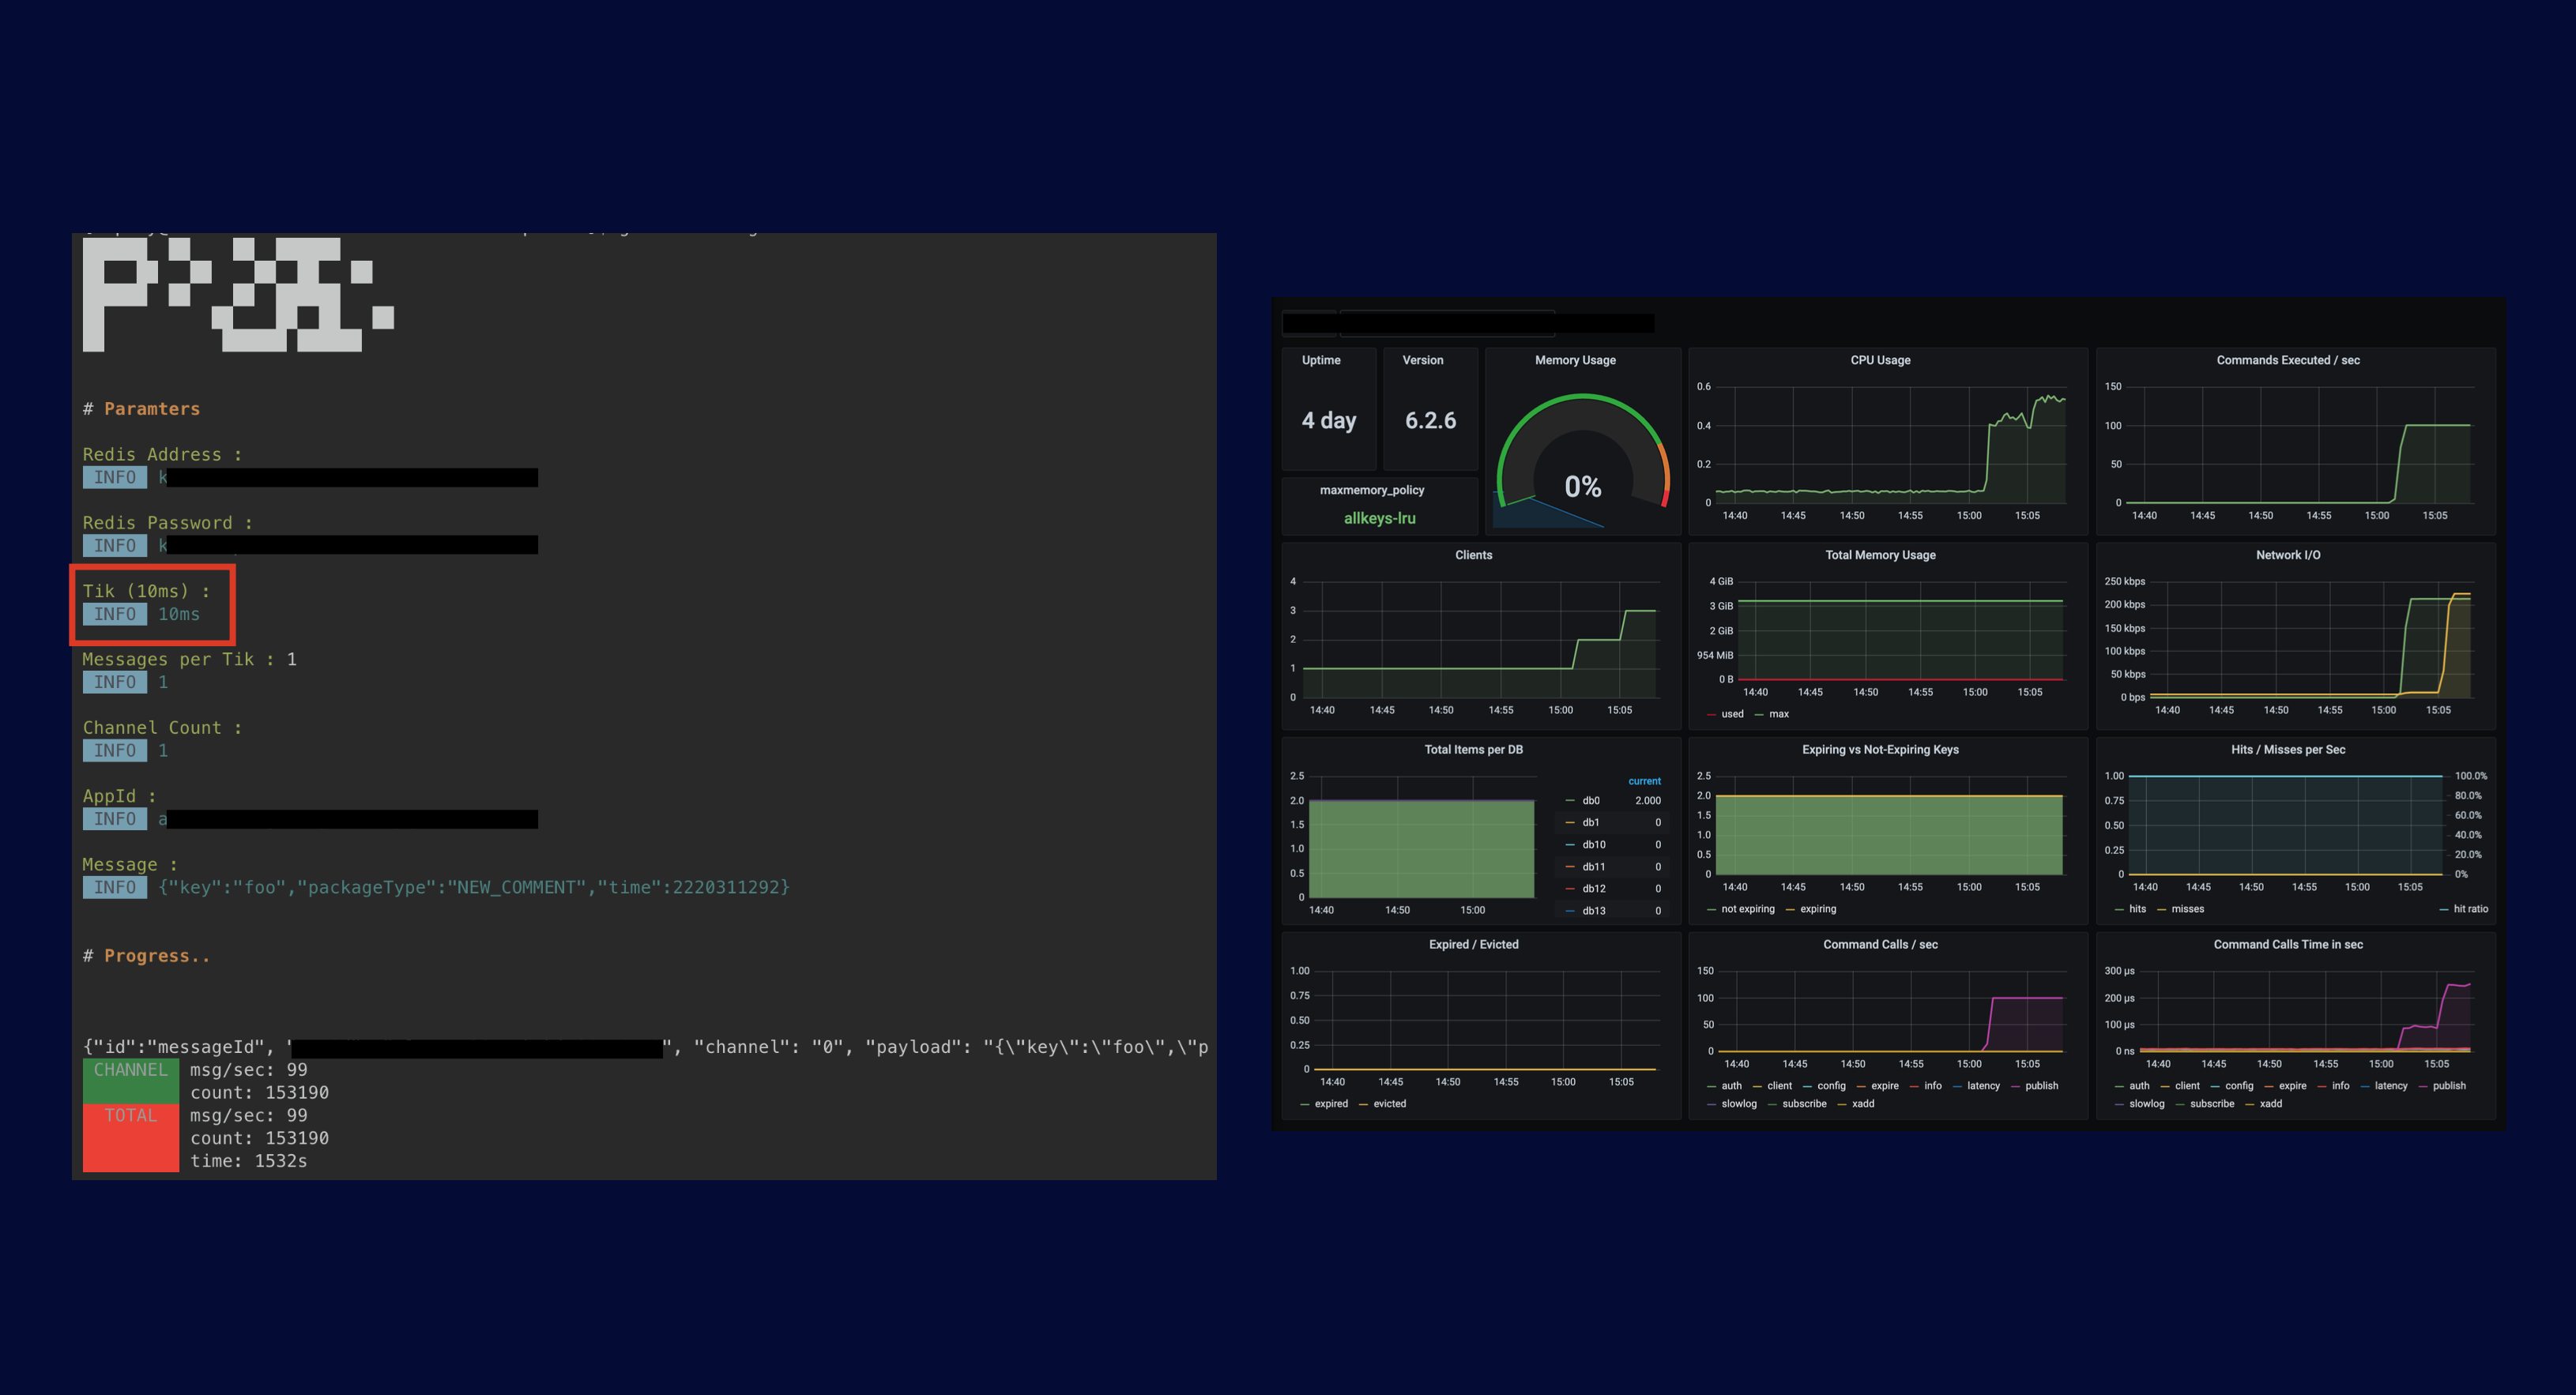
1초당 메시지를 100개 발행하기 위해 10ms 마다 1개씩 메시지를 전송하도록 했습니다. 여기서 중요한 점은 “10ms 마다”입니다. Redis에 메시지를 전송하는 시간은 아주 짧습니다. 만약 1초마다 메시지 100개를 전송하게 되면, 수백 ms 만에 100개가 모두 전송되고 나머지 시간 동안에는 아무 일도 하지 않습니다.
이런 시나리오는 현실적이지 않습니다. 사용자들이 정확한 타이밍에 맞추어 활동하지 않으니까요. 최대한 균등하게 메시지를 분배하기 위해 짧은 주기로 나누어 메시지를 전송합니다.
메시지 구독 클라이언트
구독자 N 명을 재현하기 위해서 여러 개의 가상 유저를 통해 Subscribe API를 호출합니다.
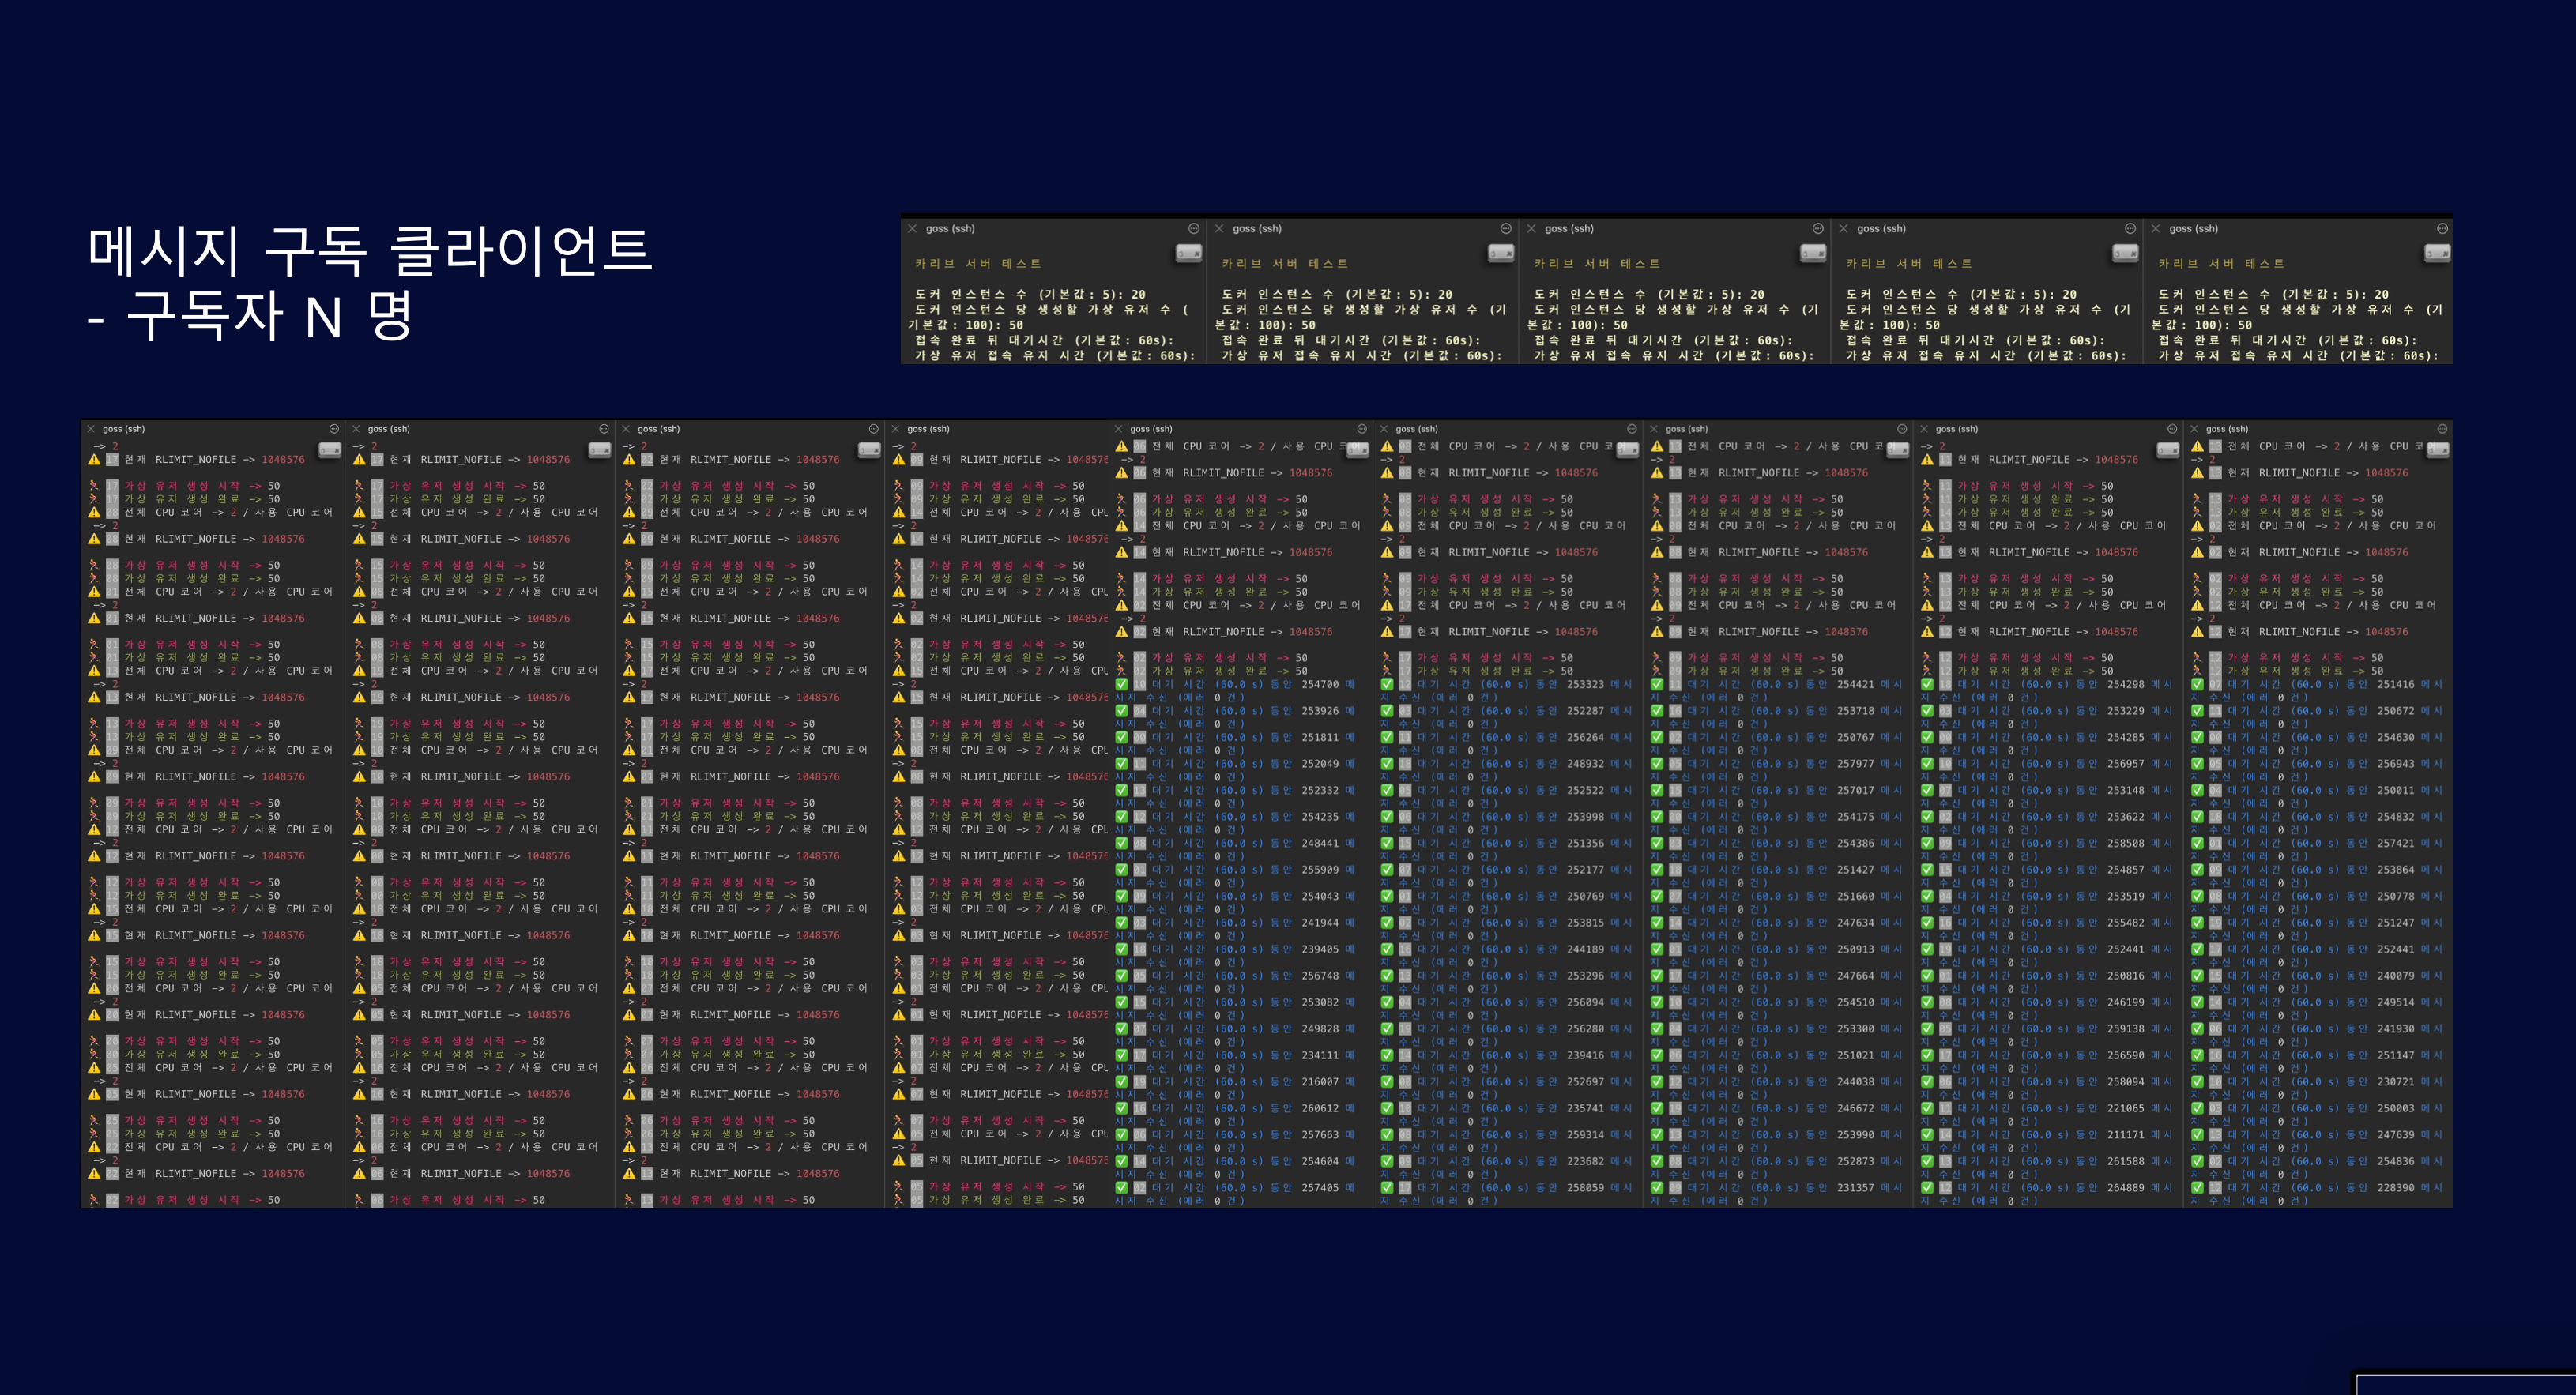
컨테이너 기반의 테스트는 더 쉽게 여러 프로세스에서의 요청을 재현할 수 있습니다.
하나의 애플리케이션(프로세스/스레드)으로 부하를 발생시킬 수도 있지만, 여러 개의 프로세스/스레드를 통해 요청을 보내는 것이 더 현실적입니다.
실제 환경에서는 모두 다 다른 지역, 다른 프로세스, 다른 스레드에서 요청을 보낼 확률이 높으니까요. 무엇보다 고민해야 할 복잡한 케이스도 줄어듭니다. 예를 들면 rate limit, 포트 고갈(file descriptor), 네트워크 이슈 등이 있습니다.
구독 클라이언트는 부하를 재현하고 동시에 메시지를 잘 받았는지에 대한 결과를 확인할 수 있어야 합니다. 초당 100개 메시지 발행되고 있는 상태에서 60초 동안 채널 구독을 했다면, 각 구독자는 6000개의 메시지를 전달받아야 합니다.
이는 실시간 메시징 시스템이 제공하고자 하는 서비스입니다. 예상 메시지의 절반 수준인 3000개만 테스트 시간 내에 전달받았다면, 사용자 측면에서 서비스에 문제가 생겼다고 판단할 수 있습니다. 전달받은 메시지가 없다면? 서비스 중단입니다.
CPU 스로틀이 발생하고, 메모리 누수가 발생하고, 여러 지표를 통해 애플리케이션의 상태를 진단할 수 있지만, 가장 중요한 건 “사용자가 메시지를 잘 전달받았는가?”입니다.
서버
클라이언트를 통해 사용자가 메시지를 잘 전달받았는지 확인하면서 동시에 서버의 상태를 진단하는 것도 중요합니다.
성능 테스트의 최종 목표는 서버의 부하 한계를 측정하고, 각 애플리케이션(컨테이너)의 리소스를 산정하고, 실서비스에 배포하기 위한 레플리카 수를 결정합니다.
테스트 과정에서는 병목이 발생하는 구간을 파악하고 가능한 한 성능을 개선합니다.
서버가 실행되는 컨테이너 리소스는 기대했던 실서비스 환경과 최대한 유사하게 할당했습니다. 성능 테스트가 모두 끝나고, 조금 더 효율적으로 사용하기 위해 약간의 리소스 조정이 있었지만, 실험이 끝나기 전까지는 처음 할당한 값을 그대로 유지했습니다.
지표 수집
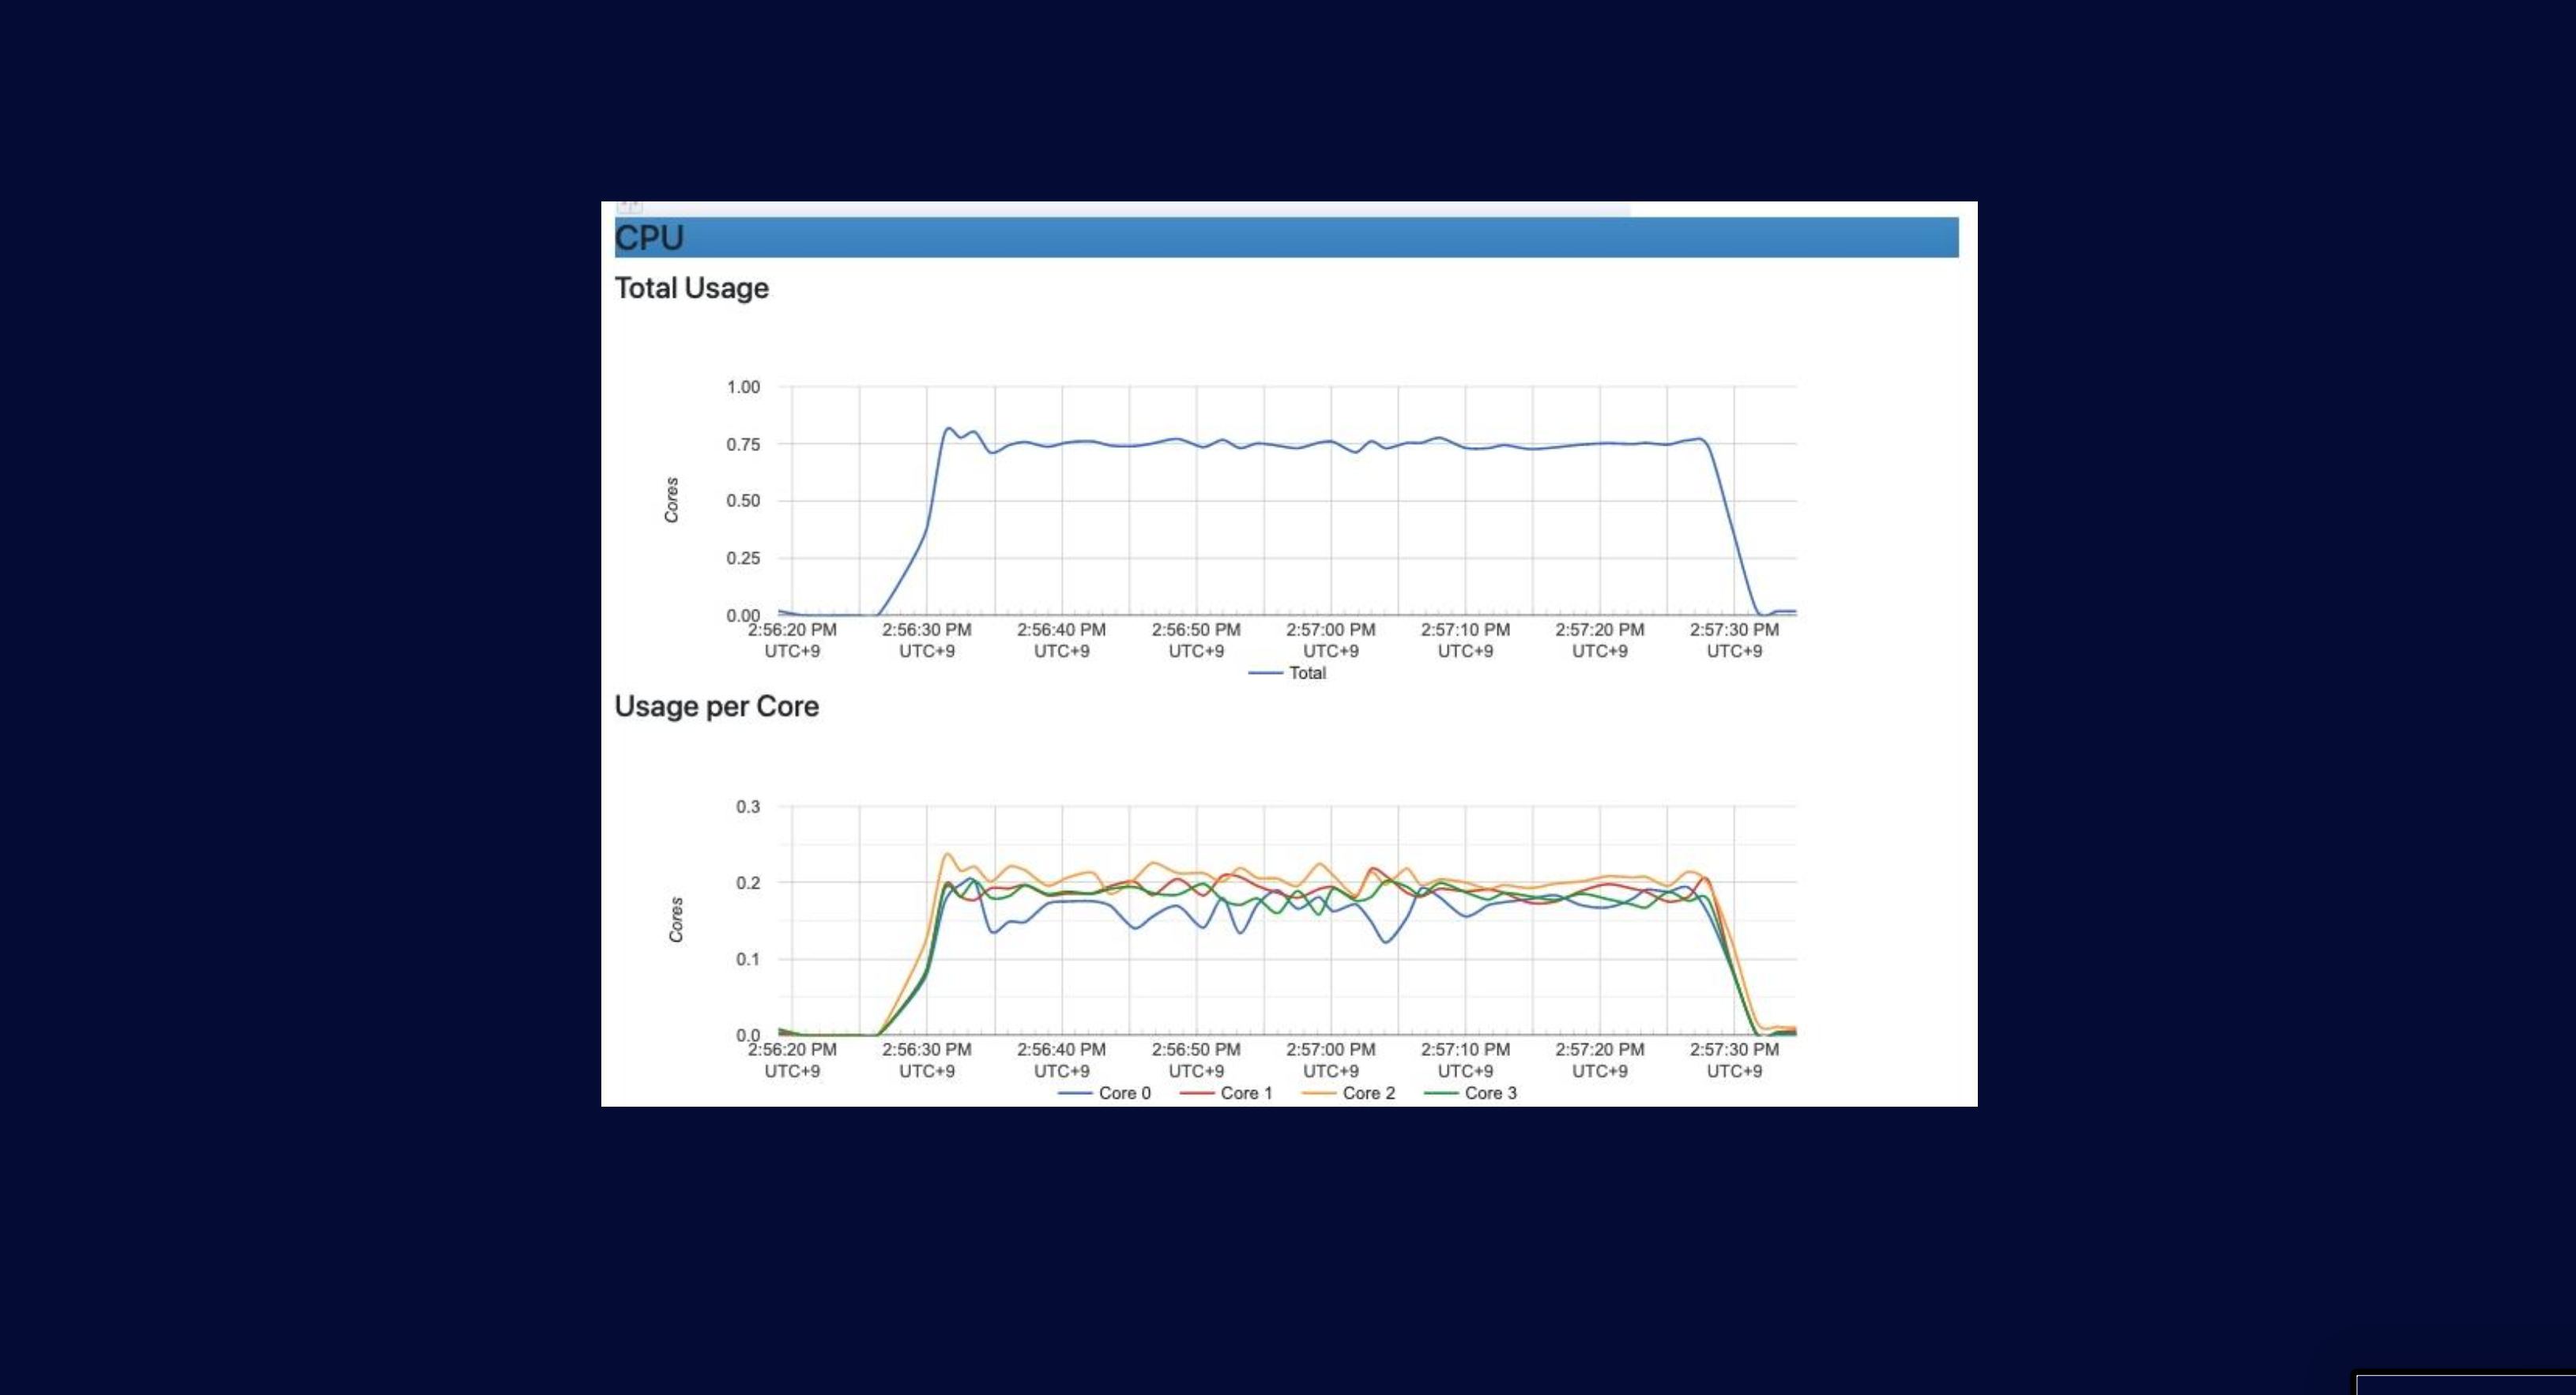
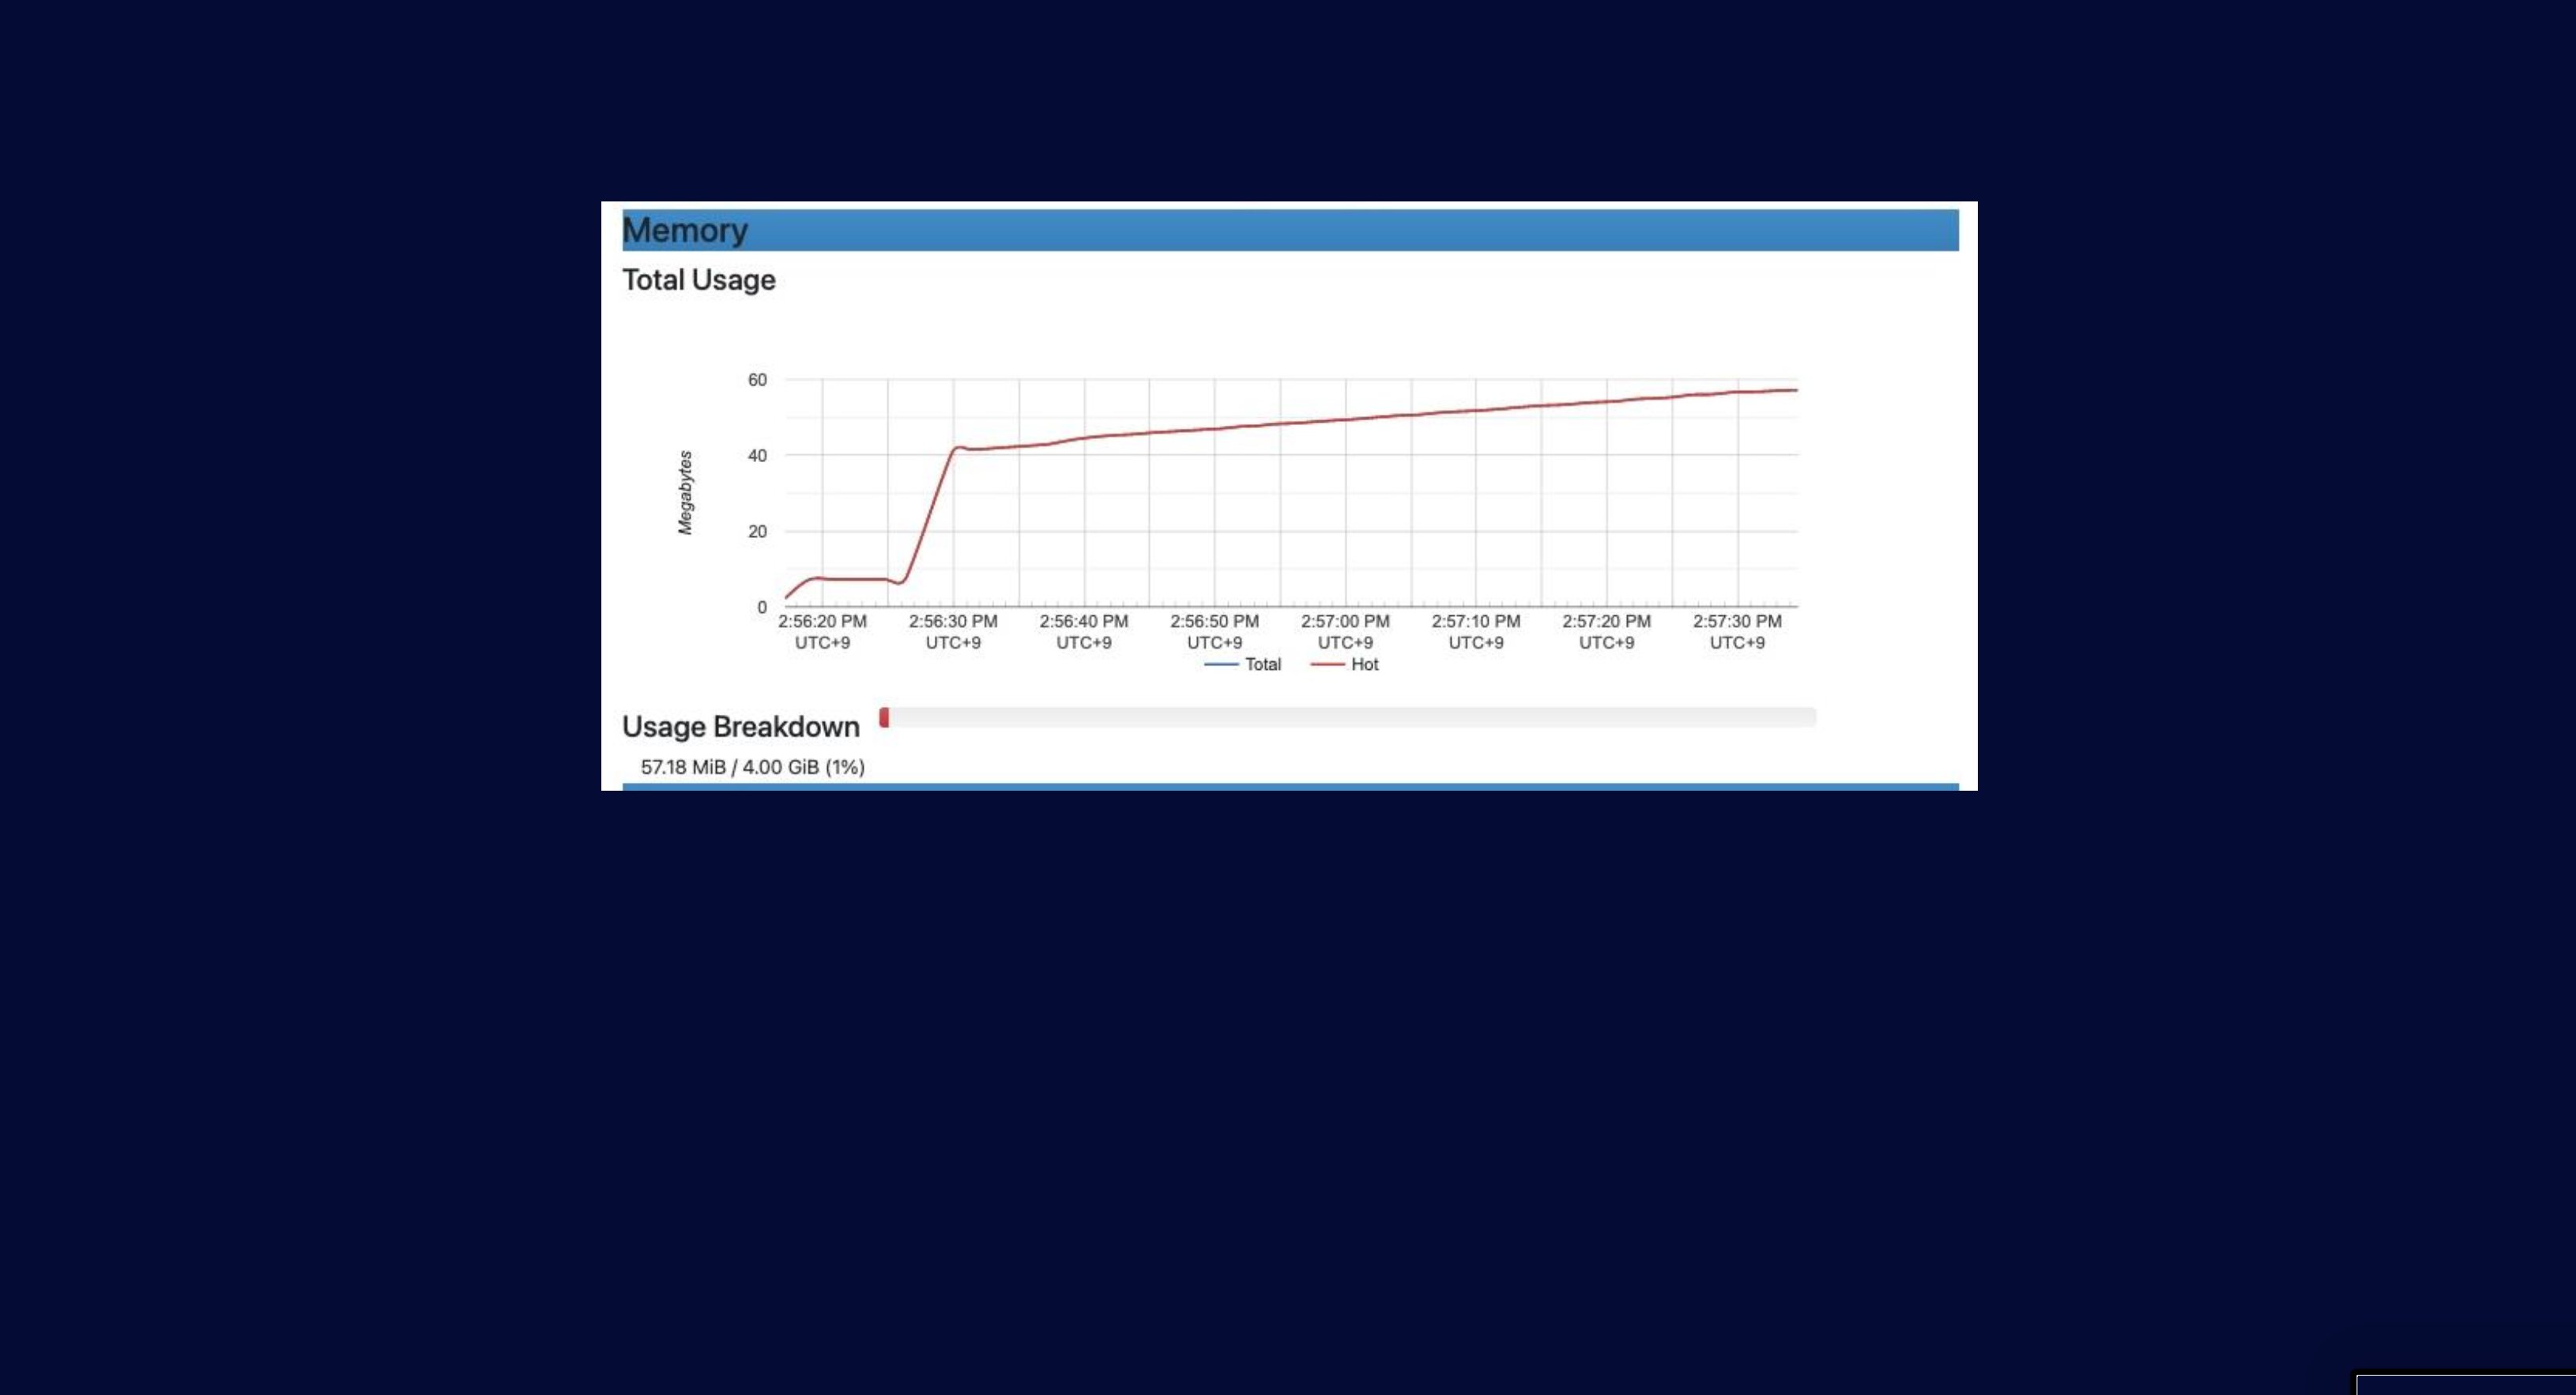
성능 진단을 위해 지표 수집을 해야 합니다. 서버는 가상 머신에서 도커 컨테이너로 실행됩니다. 도커 컨테이너를 띄우면서 리소스를 할당하기 때문에 가상 머신의 리소스에 집중하기보다, 컨테이너 리소스를 추적하는 것이 더 적절합니다.
컨테이너 지표를 보기 위해 cAdvisor라는 오픈소스를 사용했습니다. 같은 도커 데몬에 의해 실행 중인 컨테이너 지표를 쉽게 확인할 수 있습니다.
성능 테스트
“N 명의 구독자가 1 개의 채널을 구독하고 있을 때, 초당 M 개의 메시지를 처리할 수 있는가?”
이제 서버 애플리케이션을 실행시키고 메시지 발행 클라이언트를 통해 초당 M 개의 메시지를 발생시킵니다. 그리고 구독 클라이언트를 실행하여 N 명의 구독자에게 메시지가 잘 전달되는지 확인합니다.
애플리케이션이 정상적으로 서비스를 제공했다면, 구독자는 메시지를 모두 전달받았어야 합니다. 애플리케이션이 한계치에 다다랐다면, CPU 혹은 Memory 지표, 네트워크 지표 등 추이를 통해 확인해 볼 수 있습니다. CPU 가 100% 사용 중이라면, 한계에 다다랐다고 해석할 수 있습니다. 기대하는 수신 메시지 수보다 실제 받은 메시지 수가 적다는 것은 메시지가 유실되었다는 뜻입니다.
성능 테스트 한계
N과 M을 늘리다 보면 CPU 사용량이 증가하고 메시지 유실률이 증가합니다. 이번 실시간 메시징 개발 프로젝트에서 N과 M이 곧 성능 지표였습니다. 더 이상 늘릴 수 없는 한계에 다다르면 예상되는 병목 지점을 찾고, 개선해 보았습니다.
실험 사이클이 점점 빨라지면서 N, M의 최댓값을 빠르게 찾고, 성능을 개선하기 위한 가설을 세우고 실험을 하는 속도가 빨라졌습니다.
팀원들은 각자 의심되는 병목 구간을 예상하고, 개선해 보았는데 성능이 개선될수록 실제 병목 구간을 찾는데에 어려움을 느꼈습니다. 어느 순간부터 이대로는 더 이상 성능 개선이 어렵다고 판단했습니다.
성능 테스트 결과는 “CPU 100% 사용 중”, “서비스가 제대로 동작하지 않음”이라는 해석이 가능하지만, 이 외에 더 자세한 정보를 얻을 수 없었습니다.
만약 테스트 결과가 “정확히 여기에서 리소스를 아주 많이 사용하고 있어"라고 정보를 준다면 어떨까요? 해당 지점에서 리소스를 조금 덜 사용하도록 개선해 볼 수 있지 않을까요? 컴퓨팅 자원을 어디에서 많이 사용하는지 심층적으로 분석해야 할 필요성을 느꼈습니다.
성능 심층 분석
프로파일링
프로파일링은 애플리케이션의 성능 데이터를 수집하고 분석하는 것입니다. 지금까지 성능 테스트를 통해 “N명의 사용자가 구독 중인 채널에 초당 메시지가 M개 처리될 수 있다.”를 확인했다면, 이젠 프로파일링을 통해 “N명의 사용자가 구독 중인 채널에 초당 메시지가 M개 처리중일 때” 어디에서 어떻게 컴퓨팅 자원을 사용하는지 확인합니다.
Made by GO!
실시간 메시징 시스템은 Go 언어로 개발되었습니다. 그리고 Go 플랫폼에서는 프로파일링을 위한 pprof라는 도구를 제공합니다.
pprof를 사용하면 아래와 같은 정보를 쉽고 빠르게 파악할 수 있습니다.
-
어떤 함수에서 CPU 시간을 많이 점유하는지
-
메모리 할당이 얼마나 이루어지는지
-
고루틴 스케줄링이 어떻게 되는지
-
Lock으로 인한 병목이 발생하는지
실시간 메시징 시스템 개발 과정에서는 고루틴 스케줄링과 CPU 점유율에 대한 정보만으로도 많은 인사이트를 얻고, 성능을 개선할 수 있었습니다.
Mini pub/sub으로 보는 프로파일링
아주 간단한 pub/sub 애플리케이션을 예시로 사용 방법을 소개합니다.
샘플 코드
Pub/Sub을 위해 내부적으로 구독자를 관리하기 위한 Broker가 필요합니다. Broker는 자신이 관리하는 구독자 목록에 구독자를 추가하거나, 메시지를 자신이 관리하는 구독자들에게 전파합니다.
type Broker struct {
	*sync.RWMutex
	subscribers []*Subscriber
}

type Subscriber struct {
	ch chan string
}

func (b *Broker) Subscribe(s Subscriber) {
	b.Lock()
	defer b.Unlock()

	# (1)

	b.subscribers = append(b.subscribers, &s)
}

func (b *Broker) Publish(m string) {
	b.RLock()
	defer b.RUnlock()

	# (2)

	for _, subscriber := range b.subscribers {
		subscriber.ch <- m
	}
}
조금 뒤에 (1), (2)에 코드 블록을 삽입하여 일정한 지연 시간을 발생시키려고 합니다.
개인적으로 Go 언어의 장점 중 하나는 강력한 built-in 라이브러리라고 생각합니다. 그중에서도 net 라이브러리를 사용하면 아주 쉽게 HTTP 웹 서버를 구축할 수 있습니다.
func main() {
	broker := &Broker{&sync.RWMutex{}, []*Subscriber{}}

	http.HandleFunc("/subscribe", func(w http.ResponseWriter, req *http.Request) {
		subscriber := Subscriber{ch: make(chan string, 100)}
		defer close(subscriber.ch)

		broker.Subscribe(subscriber)
		for {
			select {
			case m := <-subscriber.ch:
				_, _ = fmt.Fprintf(w, "data: %s\n", m)
				w.(http.Flusher).Flush()
			}
		}
	})

	http.HandleFunc("/publish", func(w http.ResponseWriter, req *http.Request) {
		body, _ := io.ReadAll(req.Body)
		broker.Publish(string(body))
	})

	log.Fatal(http.ListenAndServe(":8090", nil))
}
테스트
메시지 구독을 위해 Subscribe API를 호출합니다.
$ curl 'http://localhost:8090/subscribe'
다른 탭을 띄워서 Publish API를 호출하여 메시지를 전송합니다.
$ curl 'http://localhost:8090/publish' -d 'hello world!'
Subscribe API를 호출한 탭에서 메시지가 잘 출력되는지 확인합니다.
pprof 적용
net/http/pprof 라이브러리를 사용하면 정말 쉽게 프로파일링을 시도해 볼 수 있습니다. net/http를 import 하는 곳에 net/http/pprof 를 함께 import 해주기만하면 됩니다.
import (
	"net/http"
	_ "net/http/pprof"
)
프로파일링을 위한 엔드포인트가 5개 추가되었습니다.
http://localhost:.../debug/pprof/http://localhost:.../debug/pprof/cmdlinehttp://localhost:.../debug/pprof/profilehttp://localhost:.../debug/pprof/symbolhttp://localhost:.../debug/pprof/trace
실행
빌드 후 프로그램을 실행합니다.
실행 환경에 따라 명령어는 조금 다를 수 있습니다.
$ go build -o pubsub
$ ./pubsub
pub/sub 기능이 잘 동작하는지 확인해 봅니다.
먼저 새로운 터미널을 열고 구독 API를 요청하여 대기합니다.
# Terminal 1
$ curl http://localhost:8090/subscribe
다른 새로운 터미널을 열고 발행 API를 요청합니다.
# Terminal 2
$ curl http://localhost:8090/publish -d 'hello?'
다시 구독 API 를 요청한 터미널로 돌아가서 메시지가 잘 도착하는지 확인합니다.
# Terminal 1
$ curl http://localhost:8090/subscribe
hello?
그리고 이제 프로파일링을 위한 http://localhost:8090/debug/pprof 페이지에 접근이 가능합니다.
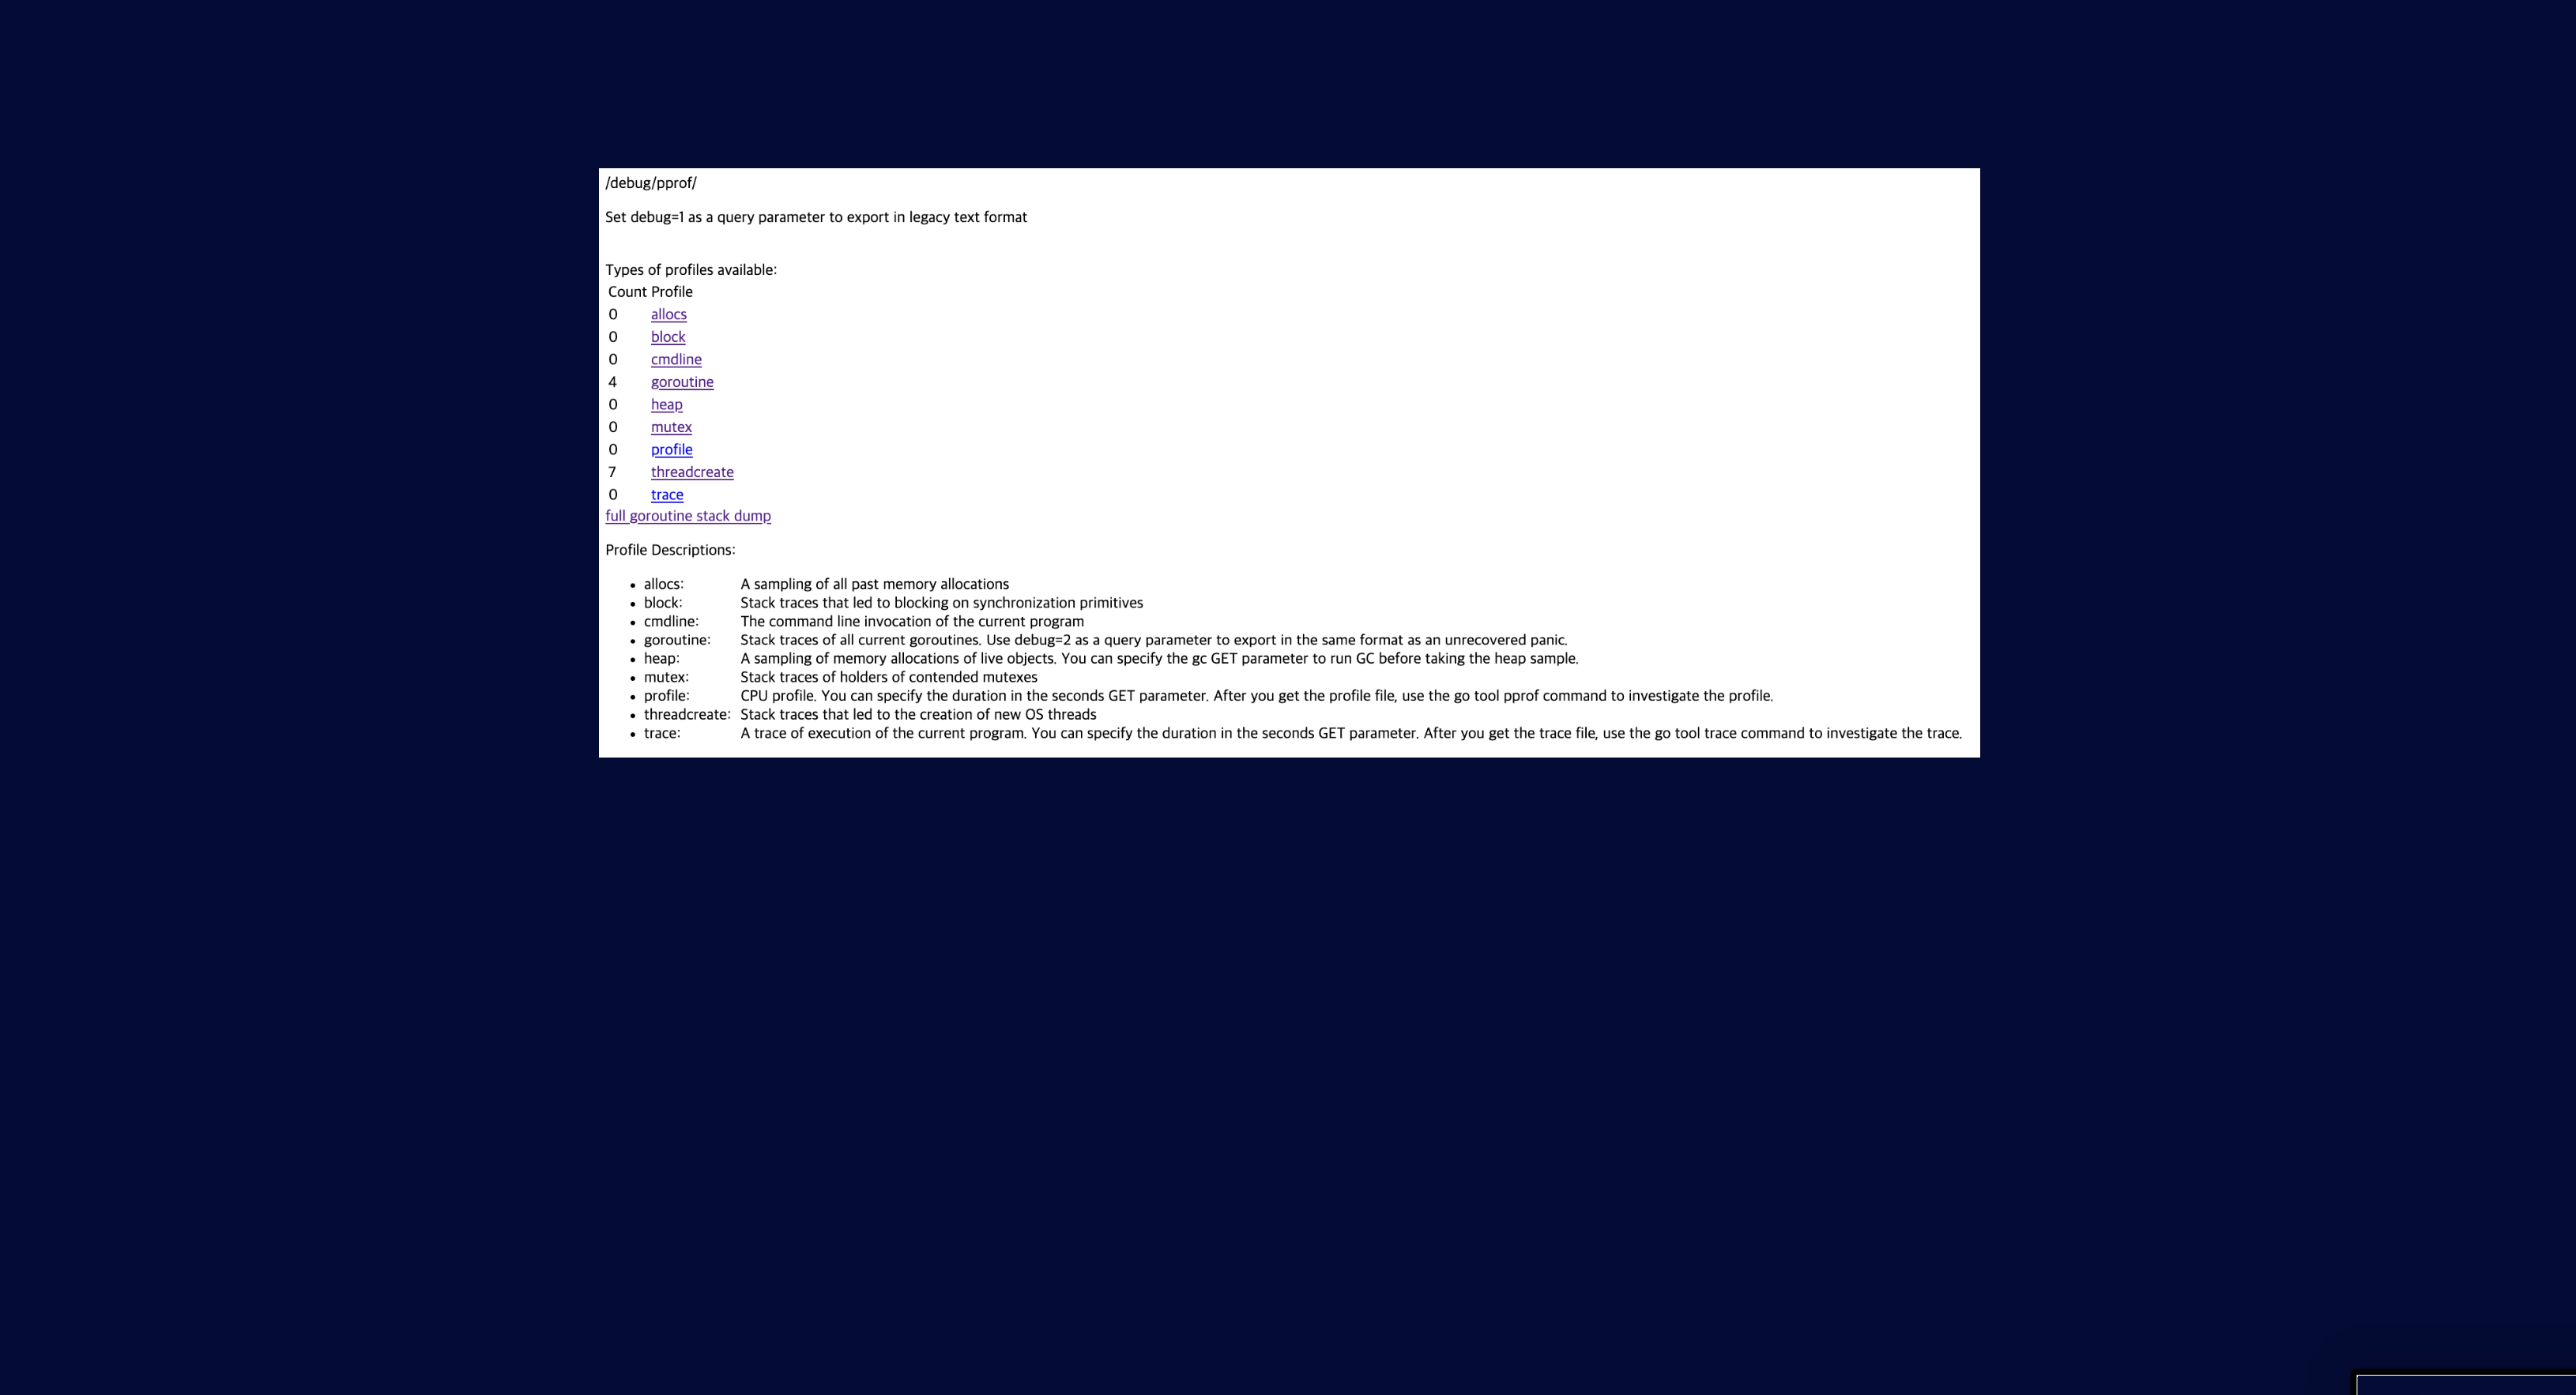
다양한 프로파일을 수집하고 분석해 볼 수 있습니다. 어떤 프로파일을 분석할지에 대한 기준은 Go Diagnositcs를 참고하는 것을 추천드립니다.
CPU 프로파일링
해당 페이지에서는 곧바로 CPU 프로파일링 결과를 확인할 수 없습니다. Go pprof의 CPU 프로파일링은 샘플링 기법으로 수집합니다.
일정기간 동안 일정한 주기로 스냅샷을 저장합니다. 스냅샷은 각 프로세서에서 수행하고 있는 함수 콜스택 정보가 담겨있습니다. 샘플링이 종료되면 저장된 스냅샷을 병합합니다. 때문에 샘플링을 수집할 기간을 파라미터로 제공해야합니다. 아래 예시는 30초 동안 CPU 샘플을 수집합니다.
$ go tool pprof 'http://localhost:8090/debug/pprof/profile?seconds=30'
Fetching profile over HTTP from http://localhost:8090/debug/pprof/profile?seconds=30
Saved profile in /Users/tim/pprof/pprof.___go_build_pprof.samples.cpu.001.pb.gz
File: ___go_build_pprof
Type: cpu
Time: Nov 27, 2024 at 9:00pm (KST)
Duration: 30.07s, Total samples = 30ms (  0.1%)
Entering interactive mode (type "help" for commands, "o" for options)
(pprof)
곧바로 CLI 환경에서 프로파일링을 해볼 수 있습니다. help 명령어를 수행하면 어떤 것들을 할 수 있는지 확인해 볼 수 있습니다.
(pprof) help
  Commands:
    callgrind        Outputs a graph in callgrind format
    comments         Output all profile comments
    disasm           Output assembly listings annotated with samples
    dot              Outputs a graph in DOT format
    eog              Visualize graph through eog
    evince           Visualize graph through evince
    gif              Outputs a graph image in GIF format
    gv               Visualize graph through gv
 ...
top 10 은 CPU를 가장 많이 사용한 함수 10개를 출력합니다.
(pprof) top 10
Showing nodes accounting for 30ms, 100% of 30ms total
Showing top 10 nodes out of 17
      flat  flat%   sum%        cum   cum%
      10ms 33.33% 33.33%       10ms 33.33%  runtime.kevent
      10ms 33.33% 66.67%       10ms 33.33%  runtime.pthread_cond_signal
      10ms 33.33%   100%       10ms 33.33%  runtime.pthread_cond_wait
         0     0%   100%       20ms 66.67%  runtime.findRunnable
         0     0%   100%       10ms 33.33%  runtime.mPark (inline)
         0     0%   100%       30ms   100%  runtime.mcall
         0     0%   100%       10ms 33.33%  runtime.netpoll
         0     0%   100%       10ms 33.33%  runtime.notesleep
         0     0%   100%       10ms 33.33%  runtime.notewakeup
         0     0%   100%       30ms   100%  runtime.park_m
사실 위 샘플을 수집하는 30초 동안 pub/sub API를 몇 번 호출했습니다. 하지만 관련된 함수는 하나도 보이지 않습니다. 이제 위에서 이야기했던 Subscribe, Publish 함수에 임의로 지연 시간이 발생하도록 코드를 수정합니다.
func (b *Broker) Subscribe(s Subscriber) {
	b.Lock()
	defer b.Unlock()

	busy1()

	b.subscribers = append(b.subscribers, &s)
}

func (b *Broker) Publish(m string) {
	b.RLock()
	defer b.RUnlock()

	busy1()

	for _, subscriber := range b.subscribers {
		subscriber.ch <- m
	}
}

func busy1() {
	timeout := time.After(5 * time.Second)
	for {
		select {
		case <-timeout:
			return
		default:
			// I'm so busy...
		}
	}
}
다시 한번 샘플을 수집하고 top 명령어를 수행하면 익숙한 함수가 눈에 들어옵니다.
$ go tool pprof 'http://localhost:8090/debug/pprof/profile?seconds=30'
Fetching profile over HTTP from http://localhost:8090/debug/pprof/profile?seconds=30
Saved profile in /Users/tim/pprof/pprof.___go_build_pprof.samples.cpu.002.pb.gz
File: ___go_build_pprof
Type: cpu
Time: Nov 27, 2024 at 9:06pm (KST)
Duration: 30.08s, Total samples = 17.87s (59.41%)
Entering interactive mode (type "help" for commands, "o" for options)
(pprof) top 10
Showing nodes accounting for 17.77s, 99.44% of 17.87s total
Dropped 22 nodes (cum <= 0.09s)
Showing top 10 nodes out of 21
      flat  flat%   sum%        cum   cum%
     9.61s 53.78% 53.78%      9.61s 53.78%  runtime.empty (inline)
     3.91s 21.88% 75.66%     16.94s 94.80%  runtime.selectnbrecv
     3.42s 19.14% 94.80%     13.03s 72.92%  runtime.chanrecv
     0.73s  4.09% 98.88%      0.73s  4.09%  runtime.pthread_cond_signal
     0.10s  0.56% 99.44%     17.04s 95.36%  main.busy1 (inline)
         0     0% 99.44%     12.77s 71.46%  main.(*Broker).Publish
         0     0% 99.44%      4.27s 23.89%  main.(*Broker).Subscribe
         0     0% 99.44%      4.27s 23.89%  main.main.func1
         0     0% 99.44%     12.77s 71.46%  main.main.func2
         0     0% 99.44%     17.04s 95.36%  net/http.(*ServeMux).ServeHTTP
샘플을 수집하는 동안 Subscribe API를 한 번 호출한 상태에서 3회의 Publish API를 호출했습니다.
눈썰미가 좋으신 분은 아까와 또 다른 점을 몇 가지 파악하셨을 텐데요. 😏
중요한 부분은 Duration: 30.08s, Total samples = 17.87s (59.41%)입니다.
이전 버전에서는 Duration: 30.07s, Total samples = 30ms ( 0.1%)입니다.
30초 동안 샘플링을 했는데, 그중에서 샘플이 차지하는 시간을 의미합니다.
하나의 스냅샷은 프로세서에서 실행 중인 함수 콜 스택 정보를 담고 있습니다.
프로세서가 열심히 함수 콜 스택에 쌓인 명령어를 수행한 시간이 17.87s입니다.
busy1 함수의 cum을 보면 17.04s입니다.
cum 은 함수가 실행되고, 종료되기까지의 시간을 의미합니다.
cum 이 높을수록 콜스택에 포함되어 있는 시간이 많았다는 것을 의미합니다.
반면 flat을 보면 0.10s입니다.
flat 은 순수하게 그 함수에서 사용한 CPU 시간입니다.
flat 이 높을수록 그 함수가 콜스택 최상단에 많이 있었다는 것을 의미합니다.
flat% 는 전체 실행 시간 17.87s 중 차지하는 비율입니다. (0.10 / 17.87 = 0.56%)
busy1 함수는 그 자체로는 오랜 시간 실행되지 않았다는 의미입니다.
그렇다면 flat 이 가장 큰 runtime.empty (inline) 은 어떤 함수길래
전체 실행 중 53.78% 를 차지하고 있는 걸까요?
사실 상단에 있는 empty, selectnbrecv, chanrecv는 모두 go chan과 관련된 함수입니다.
for {
	select {
	case <-timeout:   // empty, selectnbrecv, chanrecv
		return
	default:
		// I'm so busy...
	}
}
이럴 때에는 list 명령어를 사용해 보면 도움이 됩니다.
(pprof)  list  busy
Total:  17.87s
ROUTINE  ========================  main.busy1  in  /Users/tim/GolandProjects/pprof/pubsub.go
	100ms  17.04s  (flat,  cum)  95.36%  of  Total
		.		.  37:func  busy1()  {
		.		.  38:  timeout  :=  time.After(5  *  time.Second)
		.		.  39:  for  {
		.		.  40:  select  {
	100ms  17.04s  41:  case  <-timeout:
		.		.  42:  return
		.		.  43:  default:
		.		.  44:  //  I'm  so  busy...
		.		.  45:  }
		.		.  46:  }
case <- timeout: 을 보면 flat 100ms, cum 17.04s 가 표시됩니다.
해당 코드 자체는 17.04s 중 100ms 정도 CPU를 점유했고
나머지는 case <- timeout: 내부 수행에서 점유했다고 해석할 수 있습니다.
아래 명령어로 실제 CPU 점유율도 직접 확인해 볼 수 있습니다.
(pprof) list runtime.empty
...
(pprof) list runtime.select
...
(pprof) list runtime.chan
...
어때요? 참 쉽죠?
사실 처음부터 저런 용어들과 수치가 의미하는 바를 이해하기는 어렵습니다.
저 또한 이해하기 위해서 많은 문서와 삽질을 해야만 했습니다.
이 글을 읽고 계시는 여러분들은 조금 더 빨리 이해할 수 있기를 바랍니다.
빠른 이해를 위해서는 도식화, 그림만한 것이 없습니다.
go pprof는 graphviz를 사용하여 프로파일링 결과를 그래프로 나타냅니다.
graphviz를 설치하고 아래 명령어를 실행하면 순식간에 그래프를 그려줍니다.
(svg 파일을 만들어서 브라우저로 실행하는데, svg 확장자 기본 응용 프로그램에 따라 직접 실행이 필요할 수 있습니다.)
# main 함수 관련된 것만 나타냅니다.
(pprof) web main
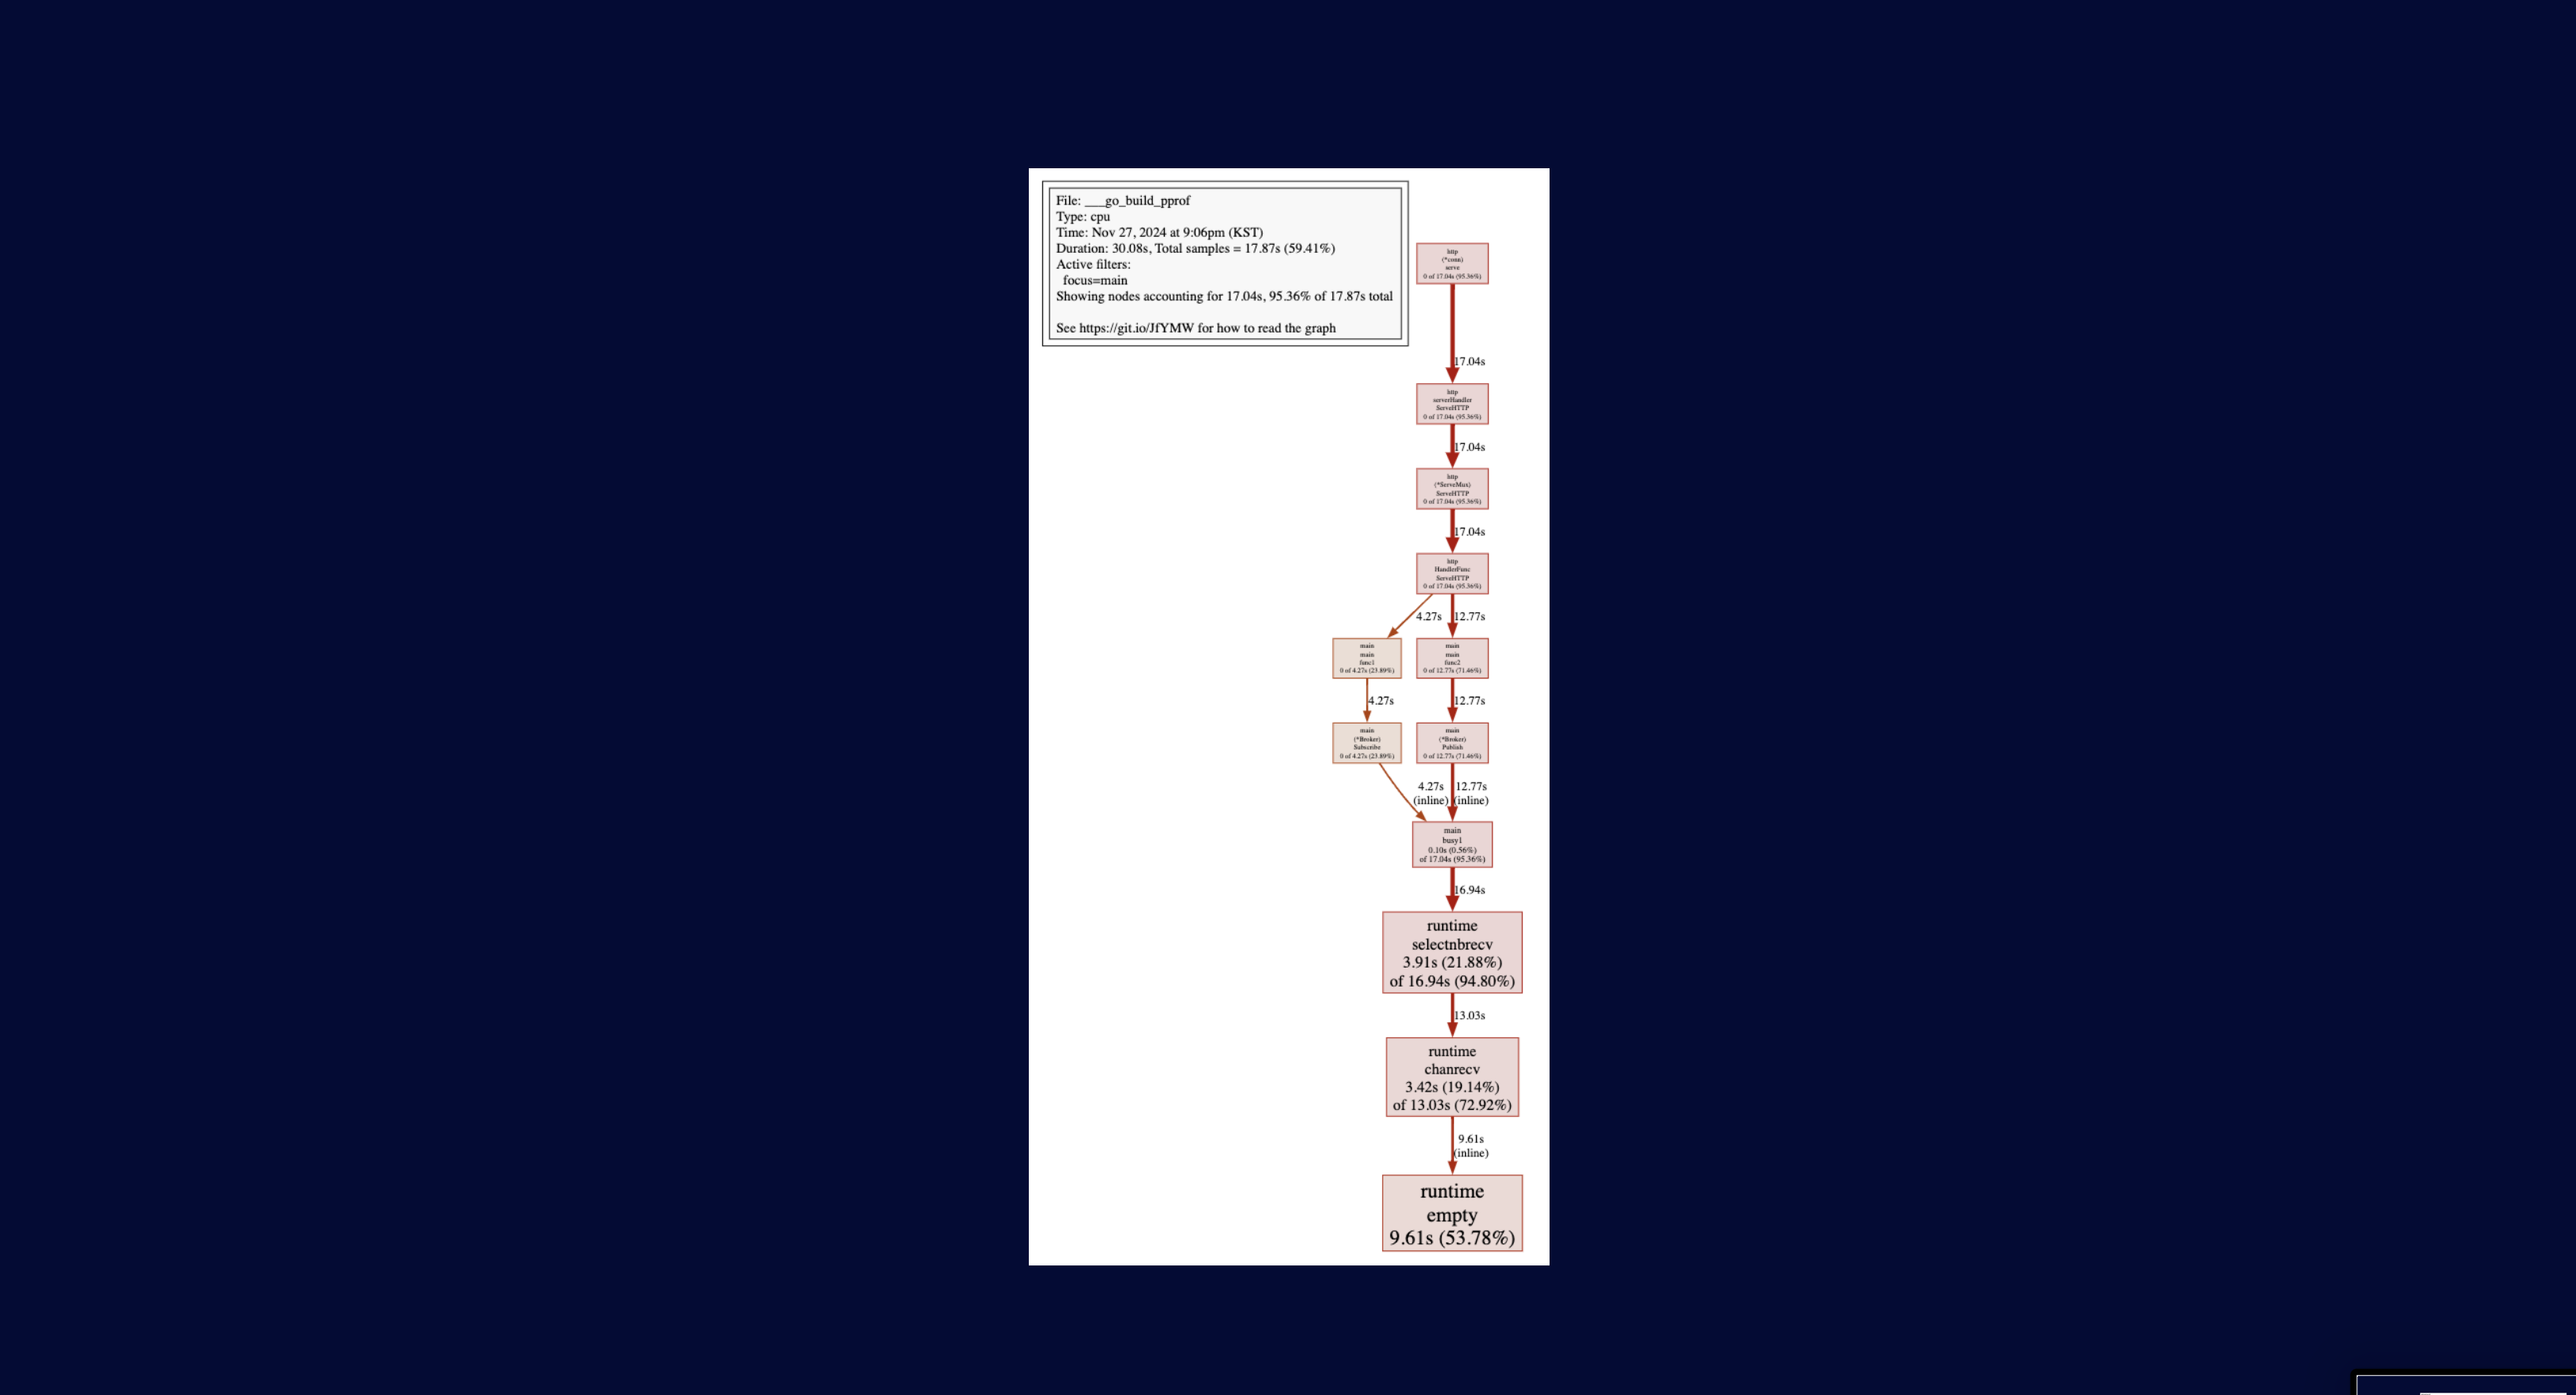
하나의 busy1 함수를 실행시키는 상위 함수가 Subscribe, Publish 두 개로 나누어지는 것이 보이시나요? 이러한 정보는 CLI 환경에서는 잘 보이지 않습니다.
그래프가 보여주는 노드와 엣지의 의미를 더 쉽게 이해하기 위해서
마지막으로 한 번 더 코드를 수정해 보겠습니다
아래는 각각 5초, 3초, 1초 바쁜 busy 함수들입니다.
차이는 busy1, busy2, busy3 은 각각 5,3,1초 바쁘고
busy10 은 busy11 을 호출하고 busy11 은 busy12 를 호출합니다. (체이닝)
func busy1() {
	timeout := time.After(5 * time.Second)
	for {
		select {
		case <-timeout:
			return
		default:
			// I'm so busy...
		}
	}
}

func busy2() {
	timeout := time.After(3 * time.Second)
	for {
		select {
		case <-timeout:
			return
		default:
			// I'm so busy...
		}
	}
}

func busy3() {
	timeout := time.After(1 * time.Second)
	for {
		select {
		case <-timeout:
			return
		default:
			// I'm so busy...
		}
	}
}

func busy10() {
	timeout := time.After(5 * time.Second)
	for {
		select {
		case <-timeout:
			busy11()
			return
		default:
			// I'm so busy...
		}
	}
}

func busy11() {
	timeout := time.After(3 * time.Second)
	for {
		select {
		case <-timeout:
			busy12()
			return
		default:
			// I'm so busy...
		}
	}
}

func busy12() {
	timeout := time.After(1 * time.Second)
	for {
		select {
		case <-timeout:
			return
		default:
			// I'm so busy...
		}
	}
}
그리고 Subscribe에서는 busy1, busy2, busy3을 호출하고
Publish에서는 busy10을 호출합니다.
func (b *Broker) Subscribe(s Subscriber) {
	b.Lock()
	defer b.Unlock()

	busy1()
	busy2()
	busy3()

	b.subscribers = append(b.subscribers, &s)
}

func (b *Broker) Publish(m string) {
	b.RLock()
	defer b.RUnlock()

	busy10()

	for _, subscriber := range b.subscribers {
		subscriber.ch <- m
	}
}
그리고 CPU 샘플링을 수집하면서 Subscribe를 1번 수행하고, 10초 정도 뒤 Publish를 실행해 보겠습니다.
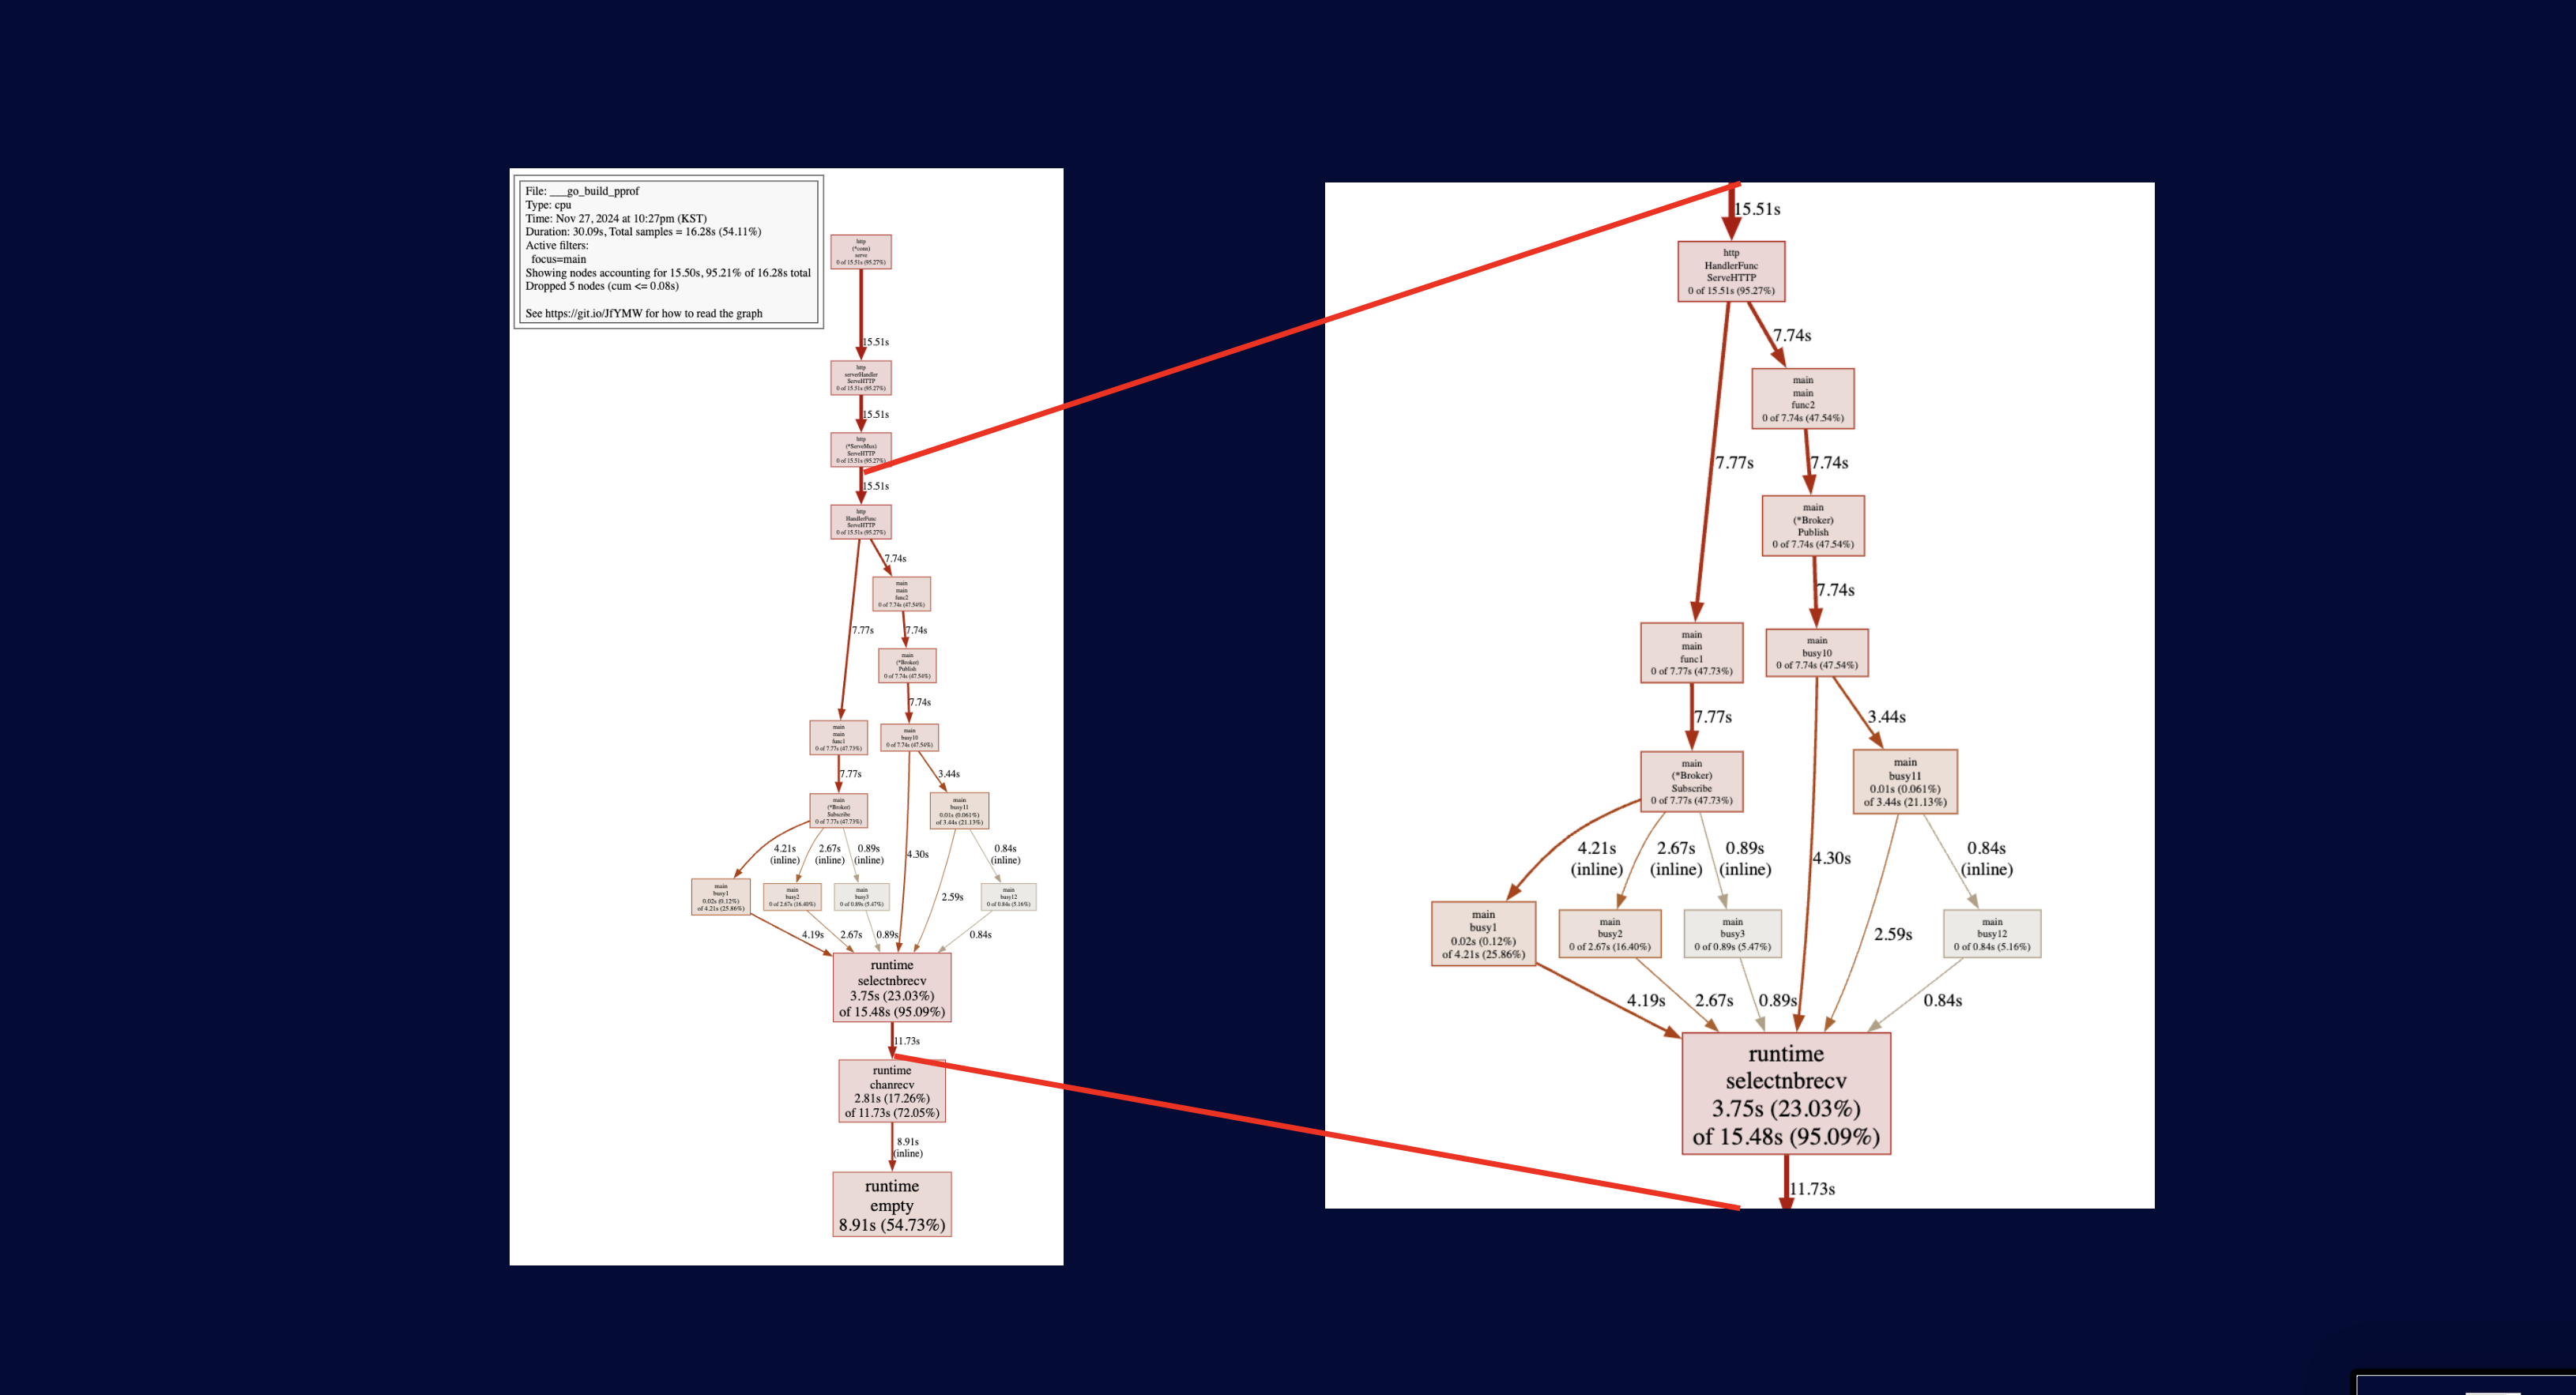
busy 함수를 각각 호출한 Subscribe는 5초, 3초, 1초에 가까운 4.21s, 2.67s, 0.89s를 확인할 수 있습니다. 이는 주기적으로 샘플을 수집하는 샘플링 방식의 특성 때문입니다. (정상)
busy 함수를 체이닝 하듯 호출한 Publish는 8초, 4초, 1초에 가까운 7.74s, 3.44s, 0.84s입니다.
그리고 이 숫자들은 모두 cum 입니다. cum 은 누계(cumulative)의 약자입니다.
위에서 설명한 대로 busy 함수가 시작했을 때부터 끝날 때까지, 즉 하위 함수의 실행 시간을 포함한 시간입니다.
각 노드 안에는 해당 함수가 실행된 시간 flat 정보가 담겨있습니다.
노드와 엣지의 색상, 크기 모두 의미를 담고 있습니다.
(자세한 정보는 pprof 문서 참고)
멀티 프로세서 환경
같은 코드로 샘플링 중에 여러 번 Subscribe, Publish를 호출하다 보면
아래와 같은 결과가 나오기도 합니다.
go tool pprof 'http://localhost:8090/debug/pprof/profile?seconds=30'
Fetching profile over HTTP from http://localhost:8090/debug/pprof/profile?seconds=30
Saved profile in /Users/tim/pprof/pprof.___go_build_pprof.samples.cpu.005.pb.gz
File: ___go_build_pprof
Type: cpu
Time: Nov 27, 2024 at 10:41pm (KST)
Duration: 30.19s, Total samples = 42.14s (139.60%)
Entering interactive mode (type "help" for commands, "o" for options)

(pprof) top 10 main
Active filters:
   focus=main
Showing nodes accounting for 39.67s, 94.14% of 42.14s total
Dropped 7 nodes (cum <= 0.21s)
Showing top 10 nodes out of 17
      flat  flat%   sum%        cum   cum%
    16.78s 39.82% 39.82%     16.78s 39.82%  runtime.empty (inline)
    12.20s 28.95% 68.77%     39.47s 93.66%  runtime.selectnbrecv
    10.49s 24.89% 93.66%     27.27s 64.71%  runtime.chanrecv
     0.15s  0.36% 94.02%      8.73s 20.72%  main.busy1 (inline)
     0.02s 0.047% 94.07%     12.27s 29.12%  main.busy11
     0.01s 0.024% 94.09%     27.36s 64.93%  main.busy10
     0.01s 0.024% 94.11%      3.21s  7.62%  main.busy12 (inline)
     0.01s 0.024% 94.14%      2.69s  6.38%  main.busy2 (inline)
         0     0% 94.14%     27.37s 64.95%  main.(*Broker).Publish
         0     0% 94.14%     12.31s 29.21%  main.(*Broker).Subscribe

(pprof) top 3 main -cum
Active filters:
   focus=main
Showing nodes accounting for 0, 0% of 42.14s total
Dropped 7 nodes (cum <= 0.21s)
Showing top 3 nodes out of 17
      flat  flat%   sum%        cum   cum%
         0     0%     0%     39.68s 94.16%  net/http.(*ServeMux).ServeHTTP
         0     0%     0%     39.68s 94.16%  net/http.(*conn).serve
         0     0%     0%     39.68s 94.16%  net/http.HandlerFunc.ServeHTTP
이상한 점이 보이시나요?
30초 동안 샘플링을 수행했는데
Duration: 30.19s, Total samples = 42.14s (139.60%)
샘플 시간이 30초를 넘기는 현상이 발생합니다.
이건 멀티 프로세서 환경에서 아주 정상적인 환경입니다.
아까 말했듯이 CPU 샘플링은 주기적으로 각 프로세서에서 실행 중인 콜스택 정보 를 담고 있습니다.
애플리케이션 실행을 위해 4개의 프로세서(4 Core)가 할당된 경우
샘플링 시간보다 최대 4배에 가까운 수치가 나올 수 있습니다. (400%)
때문에 결과를 보고 샘플 시간을 보고 판단하기보다
샘플 기간 중 함수 실행 기간이 차지하는 비중
flat%, cum% 등을 참고하는 것이 더 정확한 분석에 도움이 됩니다.
더 나아가서
제가 알려드린 pprof 기능은 아주 일부분에 불과합니다.
지금까지의 예시는 pprof 프로파일링 결과를 곧바로 CLI 환경에서 확인해 보았습니다.
샘플링이 끝나면 특정 경로(PPROF_TMPDIR)에 결과물을 저장합니다.
웹 환경에서 샘플링 결과물을 확인하면 보다 더 쉽고 빠르게 다양한 방법으로 지표를 확인할 수 있습니다.
go tool pprof -http=:8080 /.../pprof/pprof.___go_build_pprof.samples.cpu.001.pb.gz
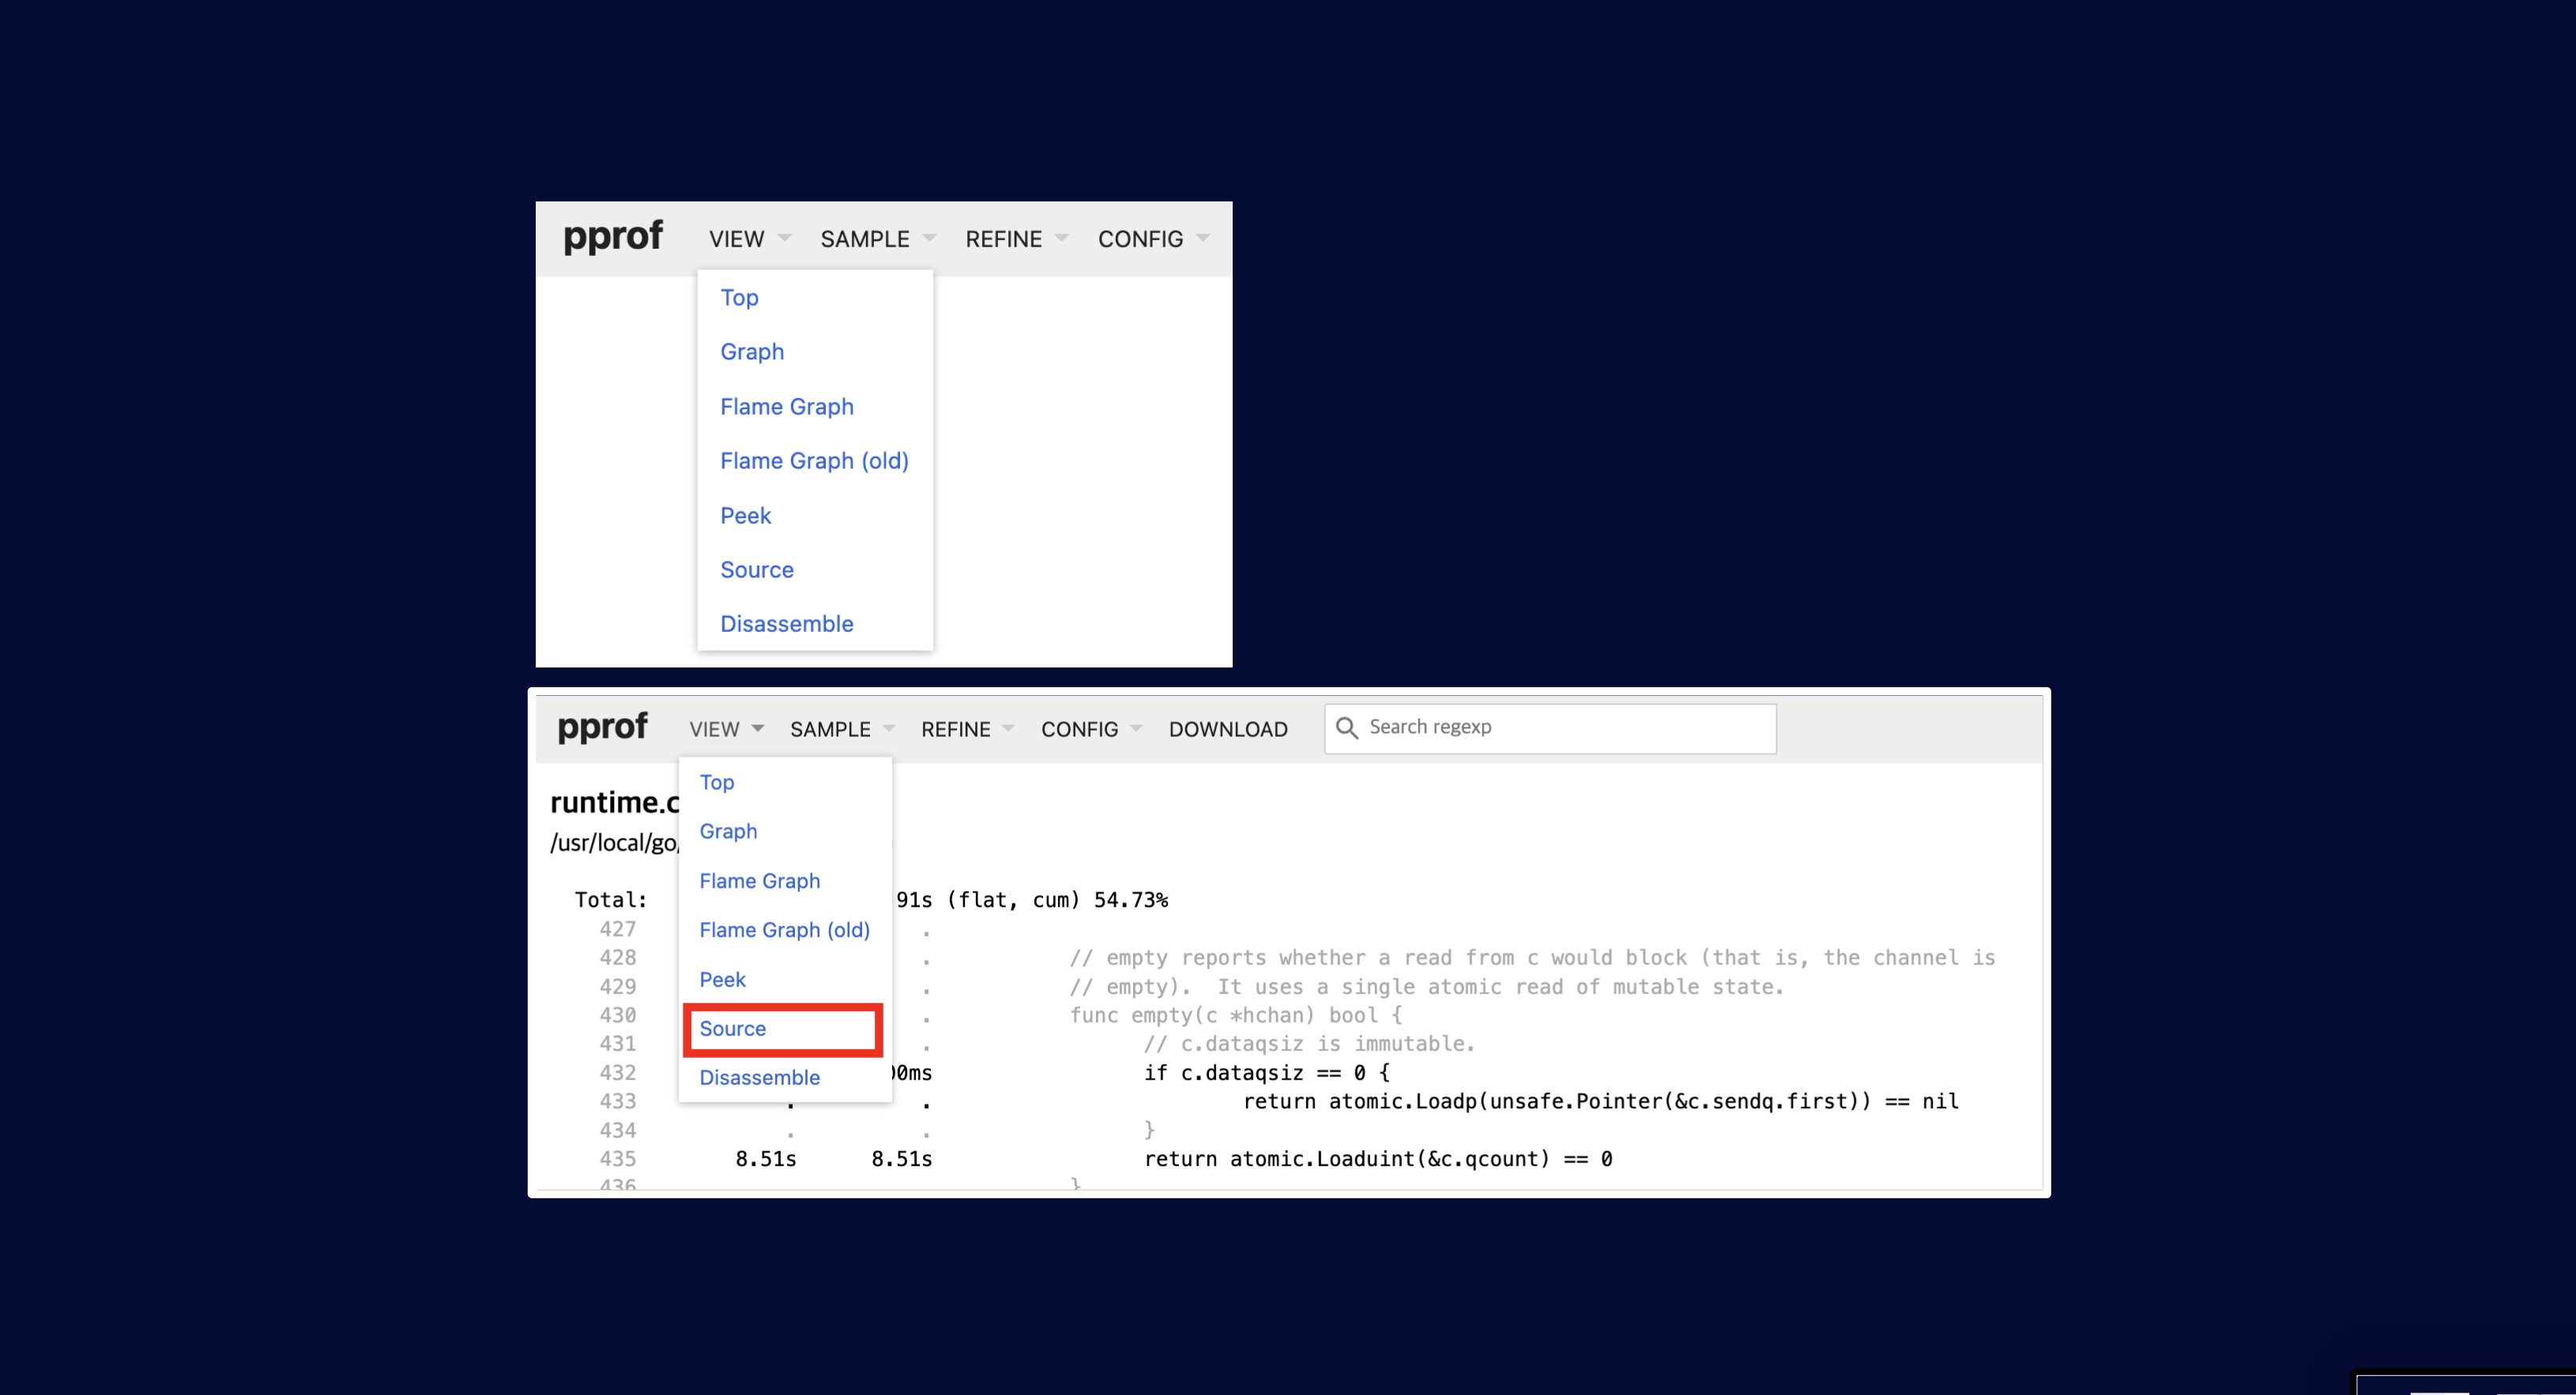
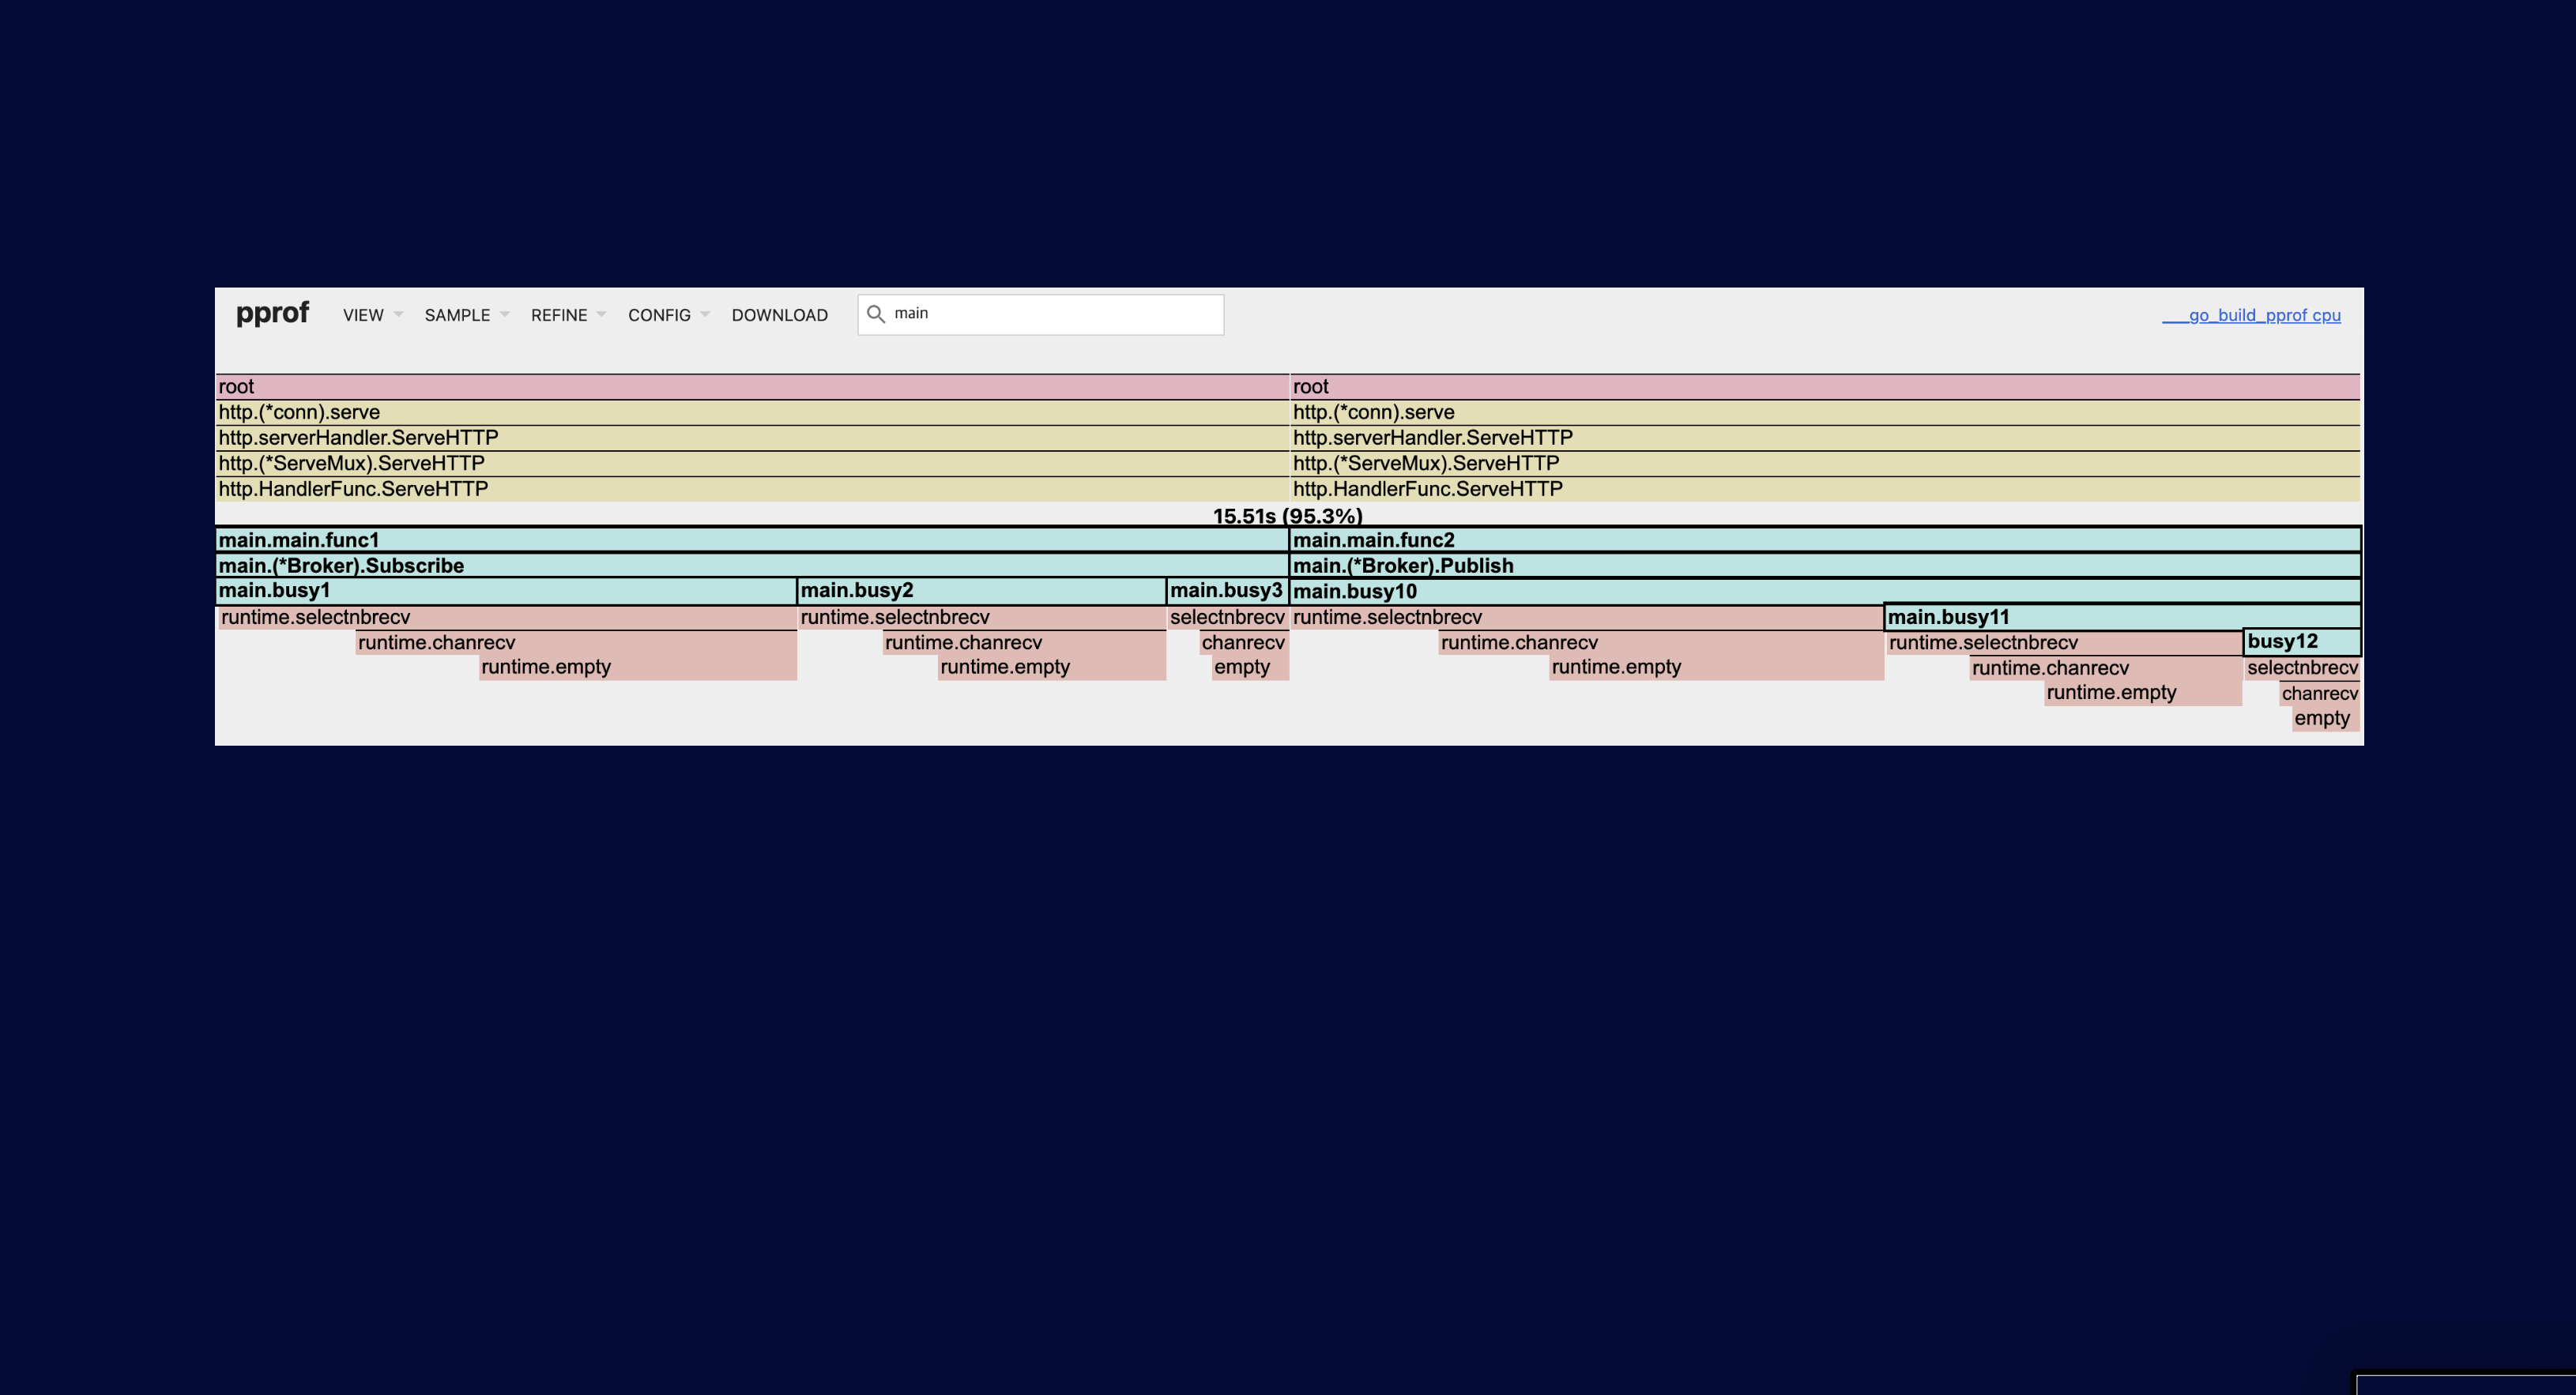
특히 flame graph는 함수의 호출 관계를 더 명확하게 확인할 수 있었던 것 같습니다.
여기서 소개드리지 못한 내용, 저도 아직 모르는 내용이 너무 많습니다.
메모리 할당, 누수 분석, 고루틴 스케줄링과 경합 등 여러 가지 지표를 가지고 다양한 관점에서 분석해 볼 수 있습니다.
이미 카카오 테크 블로그에 Golang GC 튜닝 가이드라는 메모리 프로파일링으로 성능을 튜닝한 경험을 공유한 글이 있습니다. 카리브의 지표 모니터링(프로메테우스)을 위해 글 작성자 분께서 속한 조직에서 제공하는 저장소를 사용하고 있는데, 무척 반가웠습니다.
너무 좋은 내용이 많아서 이 글도 함께 추천드립니다.
조금 더 나아가서
프로파일링 도구를 사용하면 애플리케이션의 상태를 좀 더 디테일하게 진단해 볼 수 있습니다.
IntelliJ, GoLand 같은 IDE에서도 애플리케이션의 프로파일링을 지원하는 것으로 알고 있습니다.
이러한 프로파일링 도구를 사용할 때에 주의해야 할 점은
프로파일링 하는 행위 자체가 성능에 영향을 주기도 한다는 점입니다.
그리고 동시에 여러 지표 수집을 하면 서로 영향을 줄 수 있다는 점입니다.
따라서 실제 운영 환경뿐만 아니라 성능 측정을 할 때에도 해당 기능이 활성화되어 있는지 주의해야합니다.
그리고 수집한 지표 결과가 나타내는 바를 잘 이해하고 해석해야 합니다.
잘못된 분석은 잘못된 해석으로 이어지고,
꽤 먼 길을 돌아가게 되는 원인이 될 수 있습니다.
어떤 문제를 해결할 것인지를 정의하고
어떤 지표를 수집할 것인지 정하는 것이 중요합니다.
카리브 심층 분석 결과
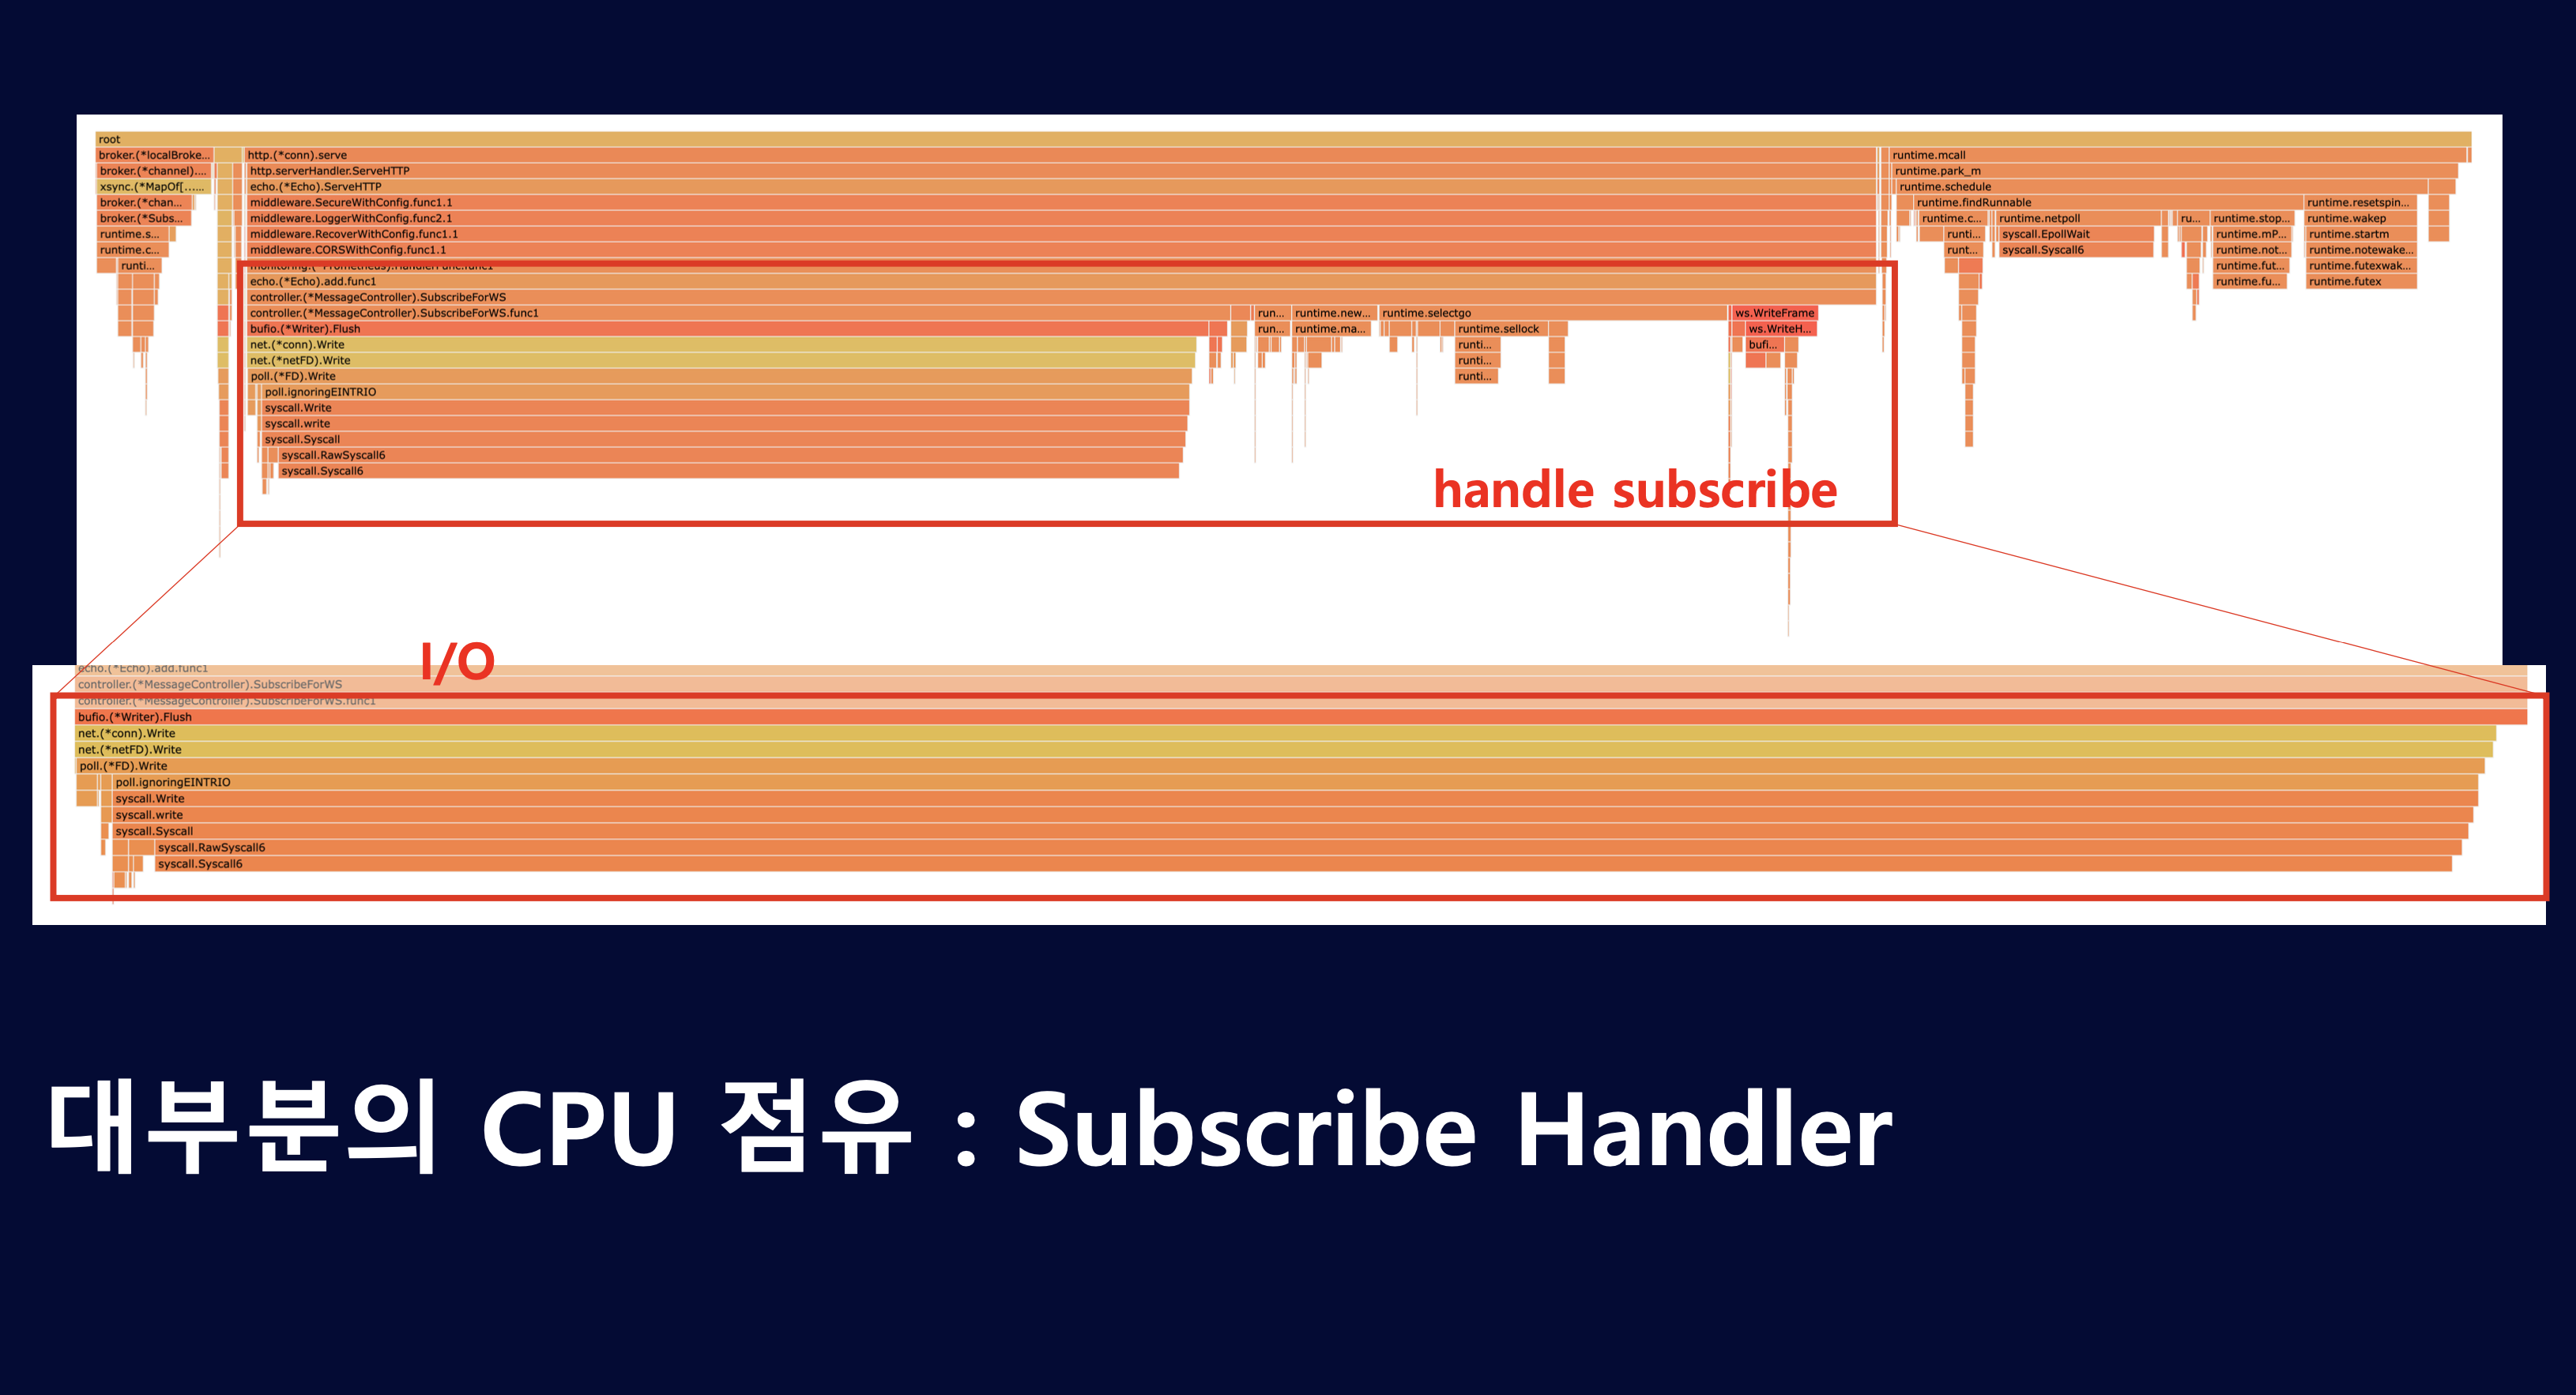
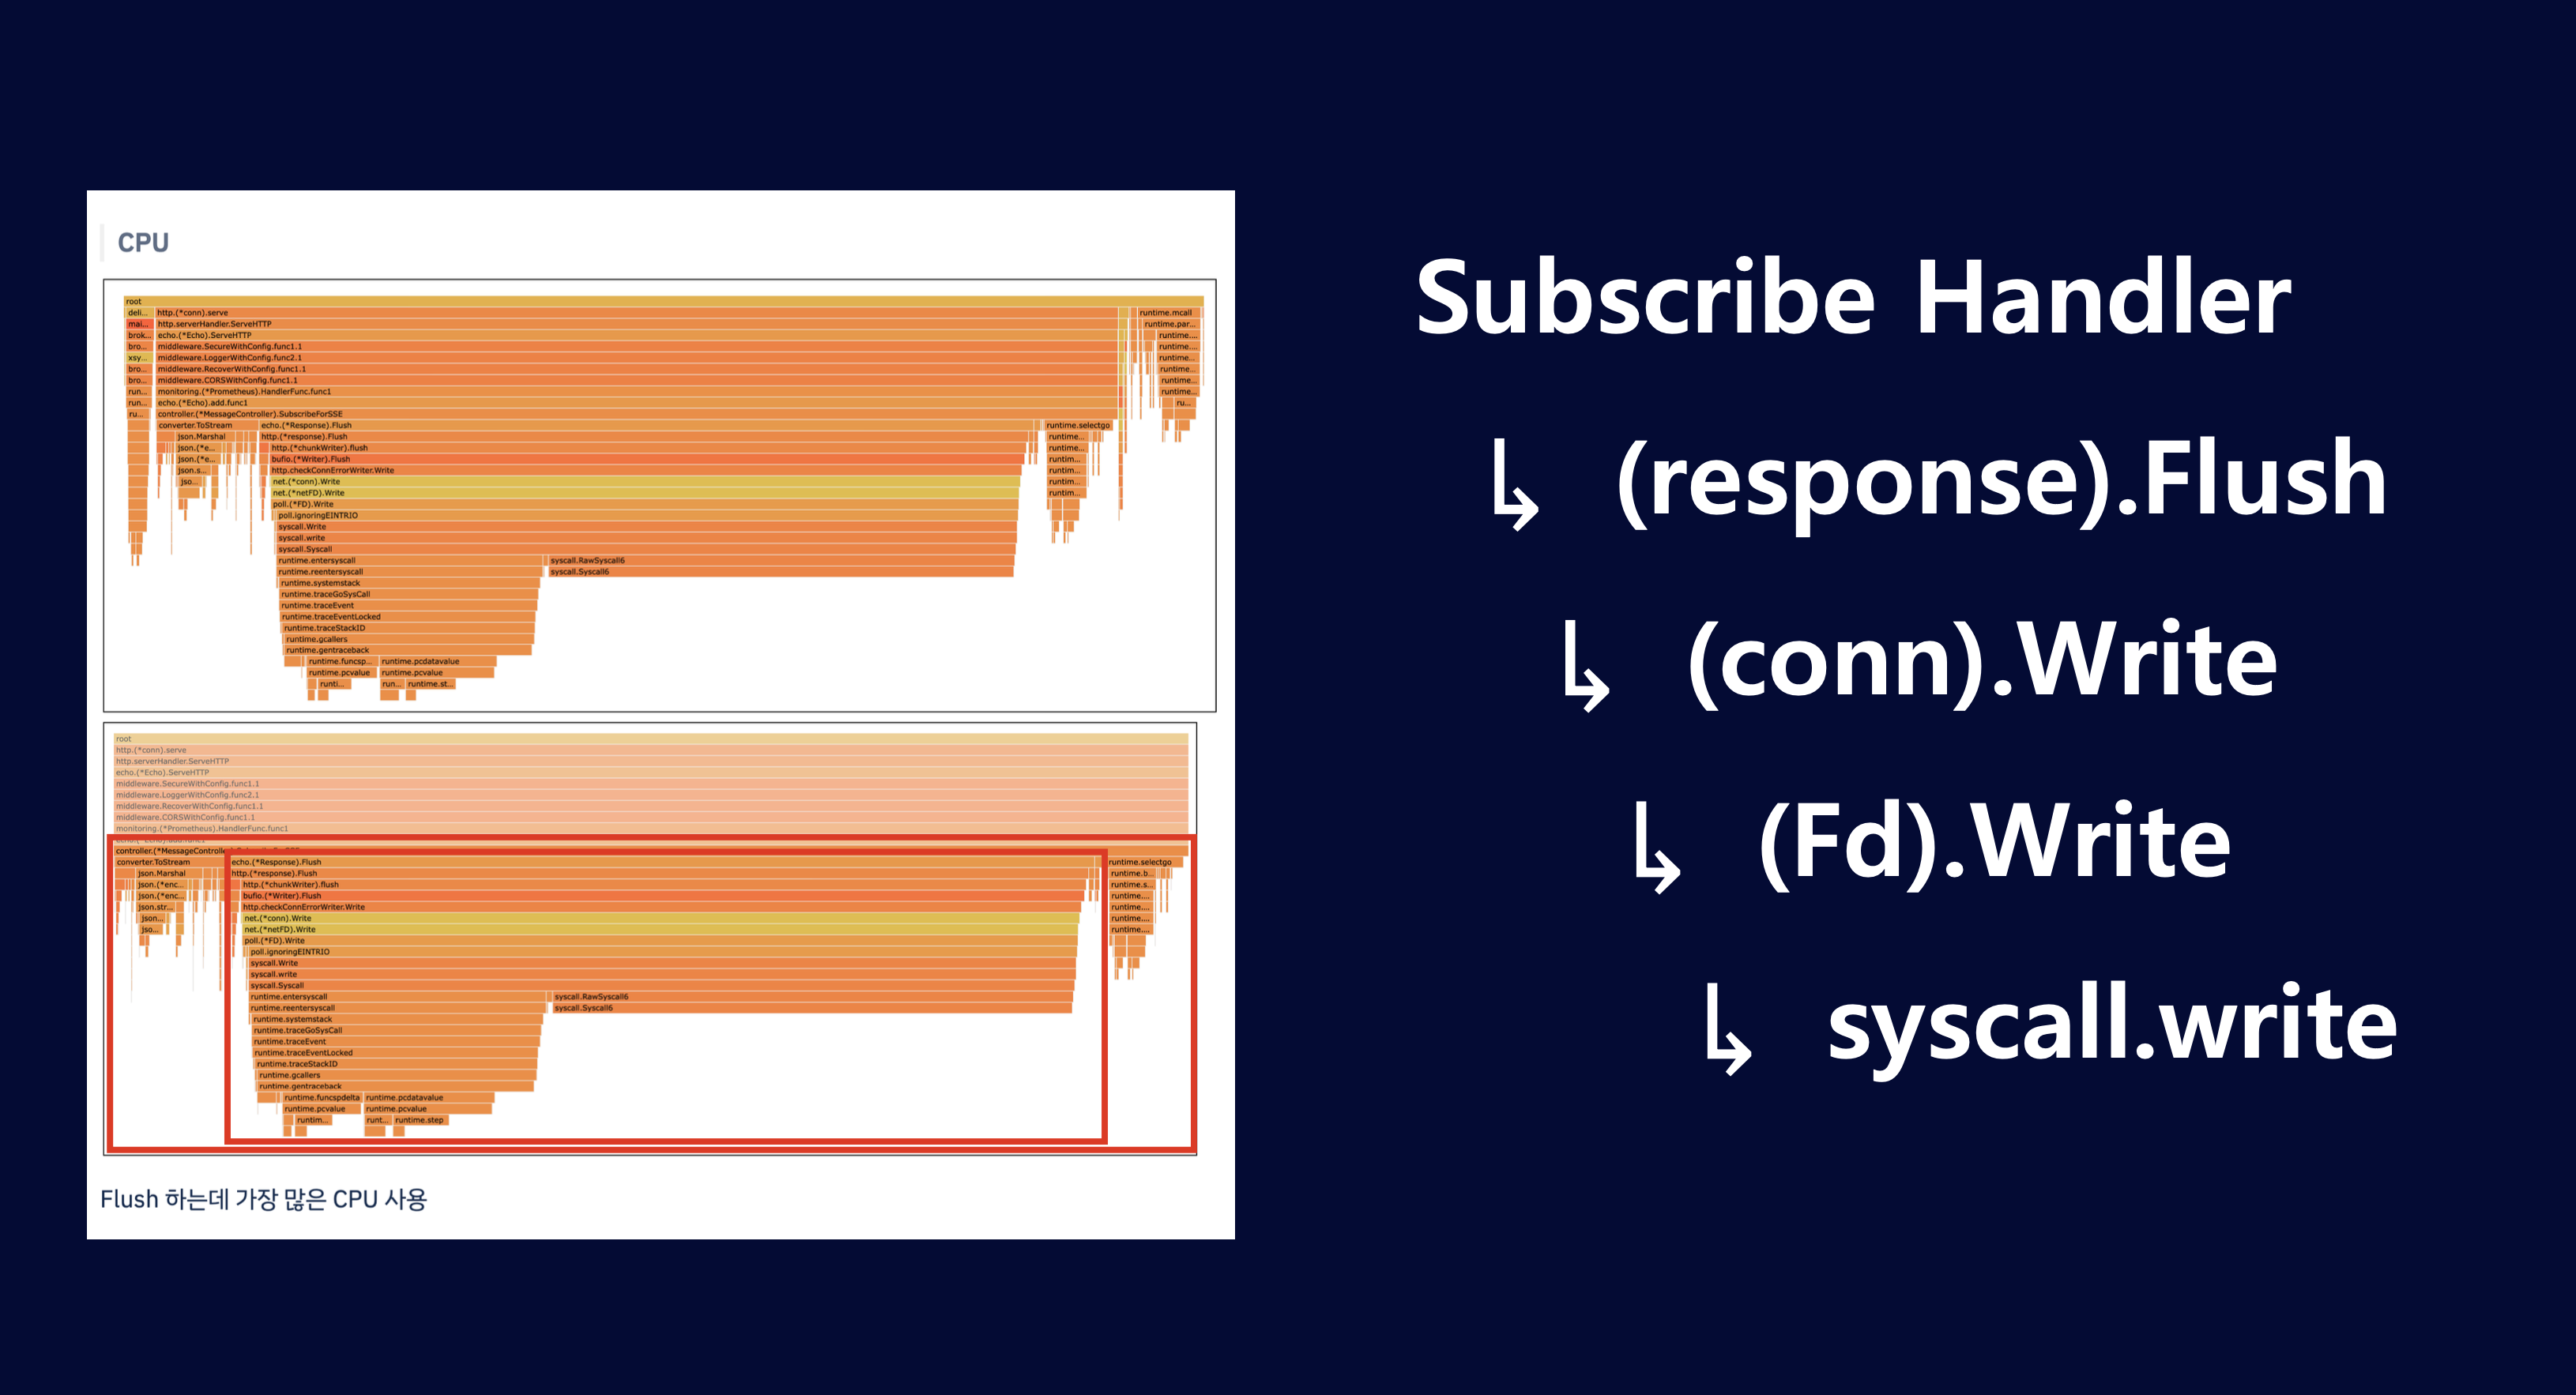
실시간 메시징은 하나의 메시지 Publish 가 발생했을 때 얼마나 많은 Subscribe 구독자들에게 메시지를 fan-out 할 수 있는지에 대한 문제입니다.
심층 분석 결과 이 문제에 대해 다시 한번 상기하게 되었고, 구독자가 많아질수록, 메시지가 여러 사람에게 전달되어야 함으로써 I/O 연산이 증가하고 대부분의 CPU 사용량을 차지하는 것을 확인했습니다.
이를 위해서 다양한 방법으로 I/O 연산을 줄이려는 시도를 해보았고 다음 챕터에서 조지가 소개해드릴 예정입니다.
마치며
본 프로젝트를 진행하면서 정말 많은 것들을 시도해 보고 배울 수 있었습니다.
성능 테스트를 하면서 같은 지표에 대해서도 다양한 관점으로 해석할 수 있다는 점을 확인했으며, 이를 통해 올바른 데이터해석의 중요성을 체감했습니다.
또한, 데이터 기반 의사소통의 장단점에 대해서도 고민해 볼 수 있었습니다. 수치로된 실험 결과는 너무나 강력해서 설득하기에 아주 좋은 도구가 되지만, 반대로 잘못된 해석은 심각한 오해의 원인이 되기도 합니다. 이에 관련한 실험 문화에 대해서도 생각을 많이 해볼 수 있었습니다.
프로젝트가 끝난 지 1년이 지났고, 이제 카리브 기능을 여러 서비스에 적용하기 위해 노력하고 있습니다. “사용자의 입장에서 사용하기에 편한가?”라는 고민이 많이 생긴 요즘 더 편리한 기능과 사용성을 개선하기 위한 과제를 만들어 진행하고 있습니다. 결국 사용자가 없으면, 성능은 빛을 발할 수 없습니다.
성능에 대해서 이렇게 깊이 있는 고민한 경험 자체로도 너무 즐겁고 행복한 시간이었습니다. 특히 함께 열정적으로 토론하고 같은 목표를 가지고 달려온 에이든(aiden.ahn)과 조지(george.5)에게 감사드립니다. 옆에서 든든하게 지켜봐 주신 매튜(matthew.hwang)와 인플(인터랙션플랫폼) 크루분들에게도 감사드립니다.
무엇보다 이 긴 글을 여기까지 읽어주신 여러분의 관심에 감사드립니다.
행복한 개발 하세요.
관련 글 목록
Written by Tim.aeom
Edited by Marron.b