AI/ML
스팸 콘텐츠 대응을 위한 카카오의 대규모 언어 모델(LLM) 도입 사례 / 제6회 Kakao Tech Meet
kakao tech카카오
2024년 7월 5일
원문에서 보기 ↗6월 13일에 진행한 제6회 Kakao Tech Meet의 발표 영상과 발표자 이야기를 공유합니다.
#AI #LLM #SpamDetection #TextClassification #TextGeneration
발표자 zoey(조혜연님) 인터뷰
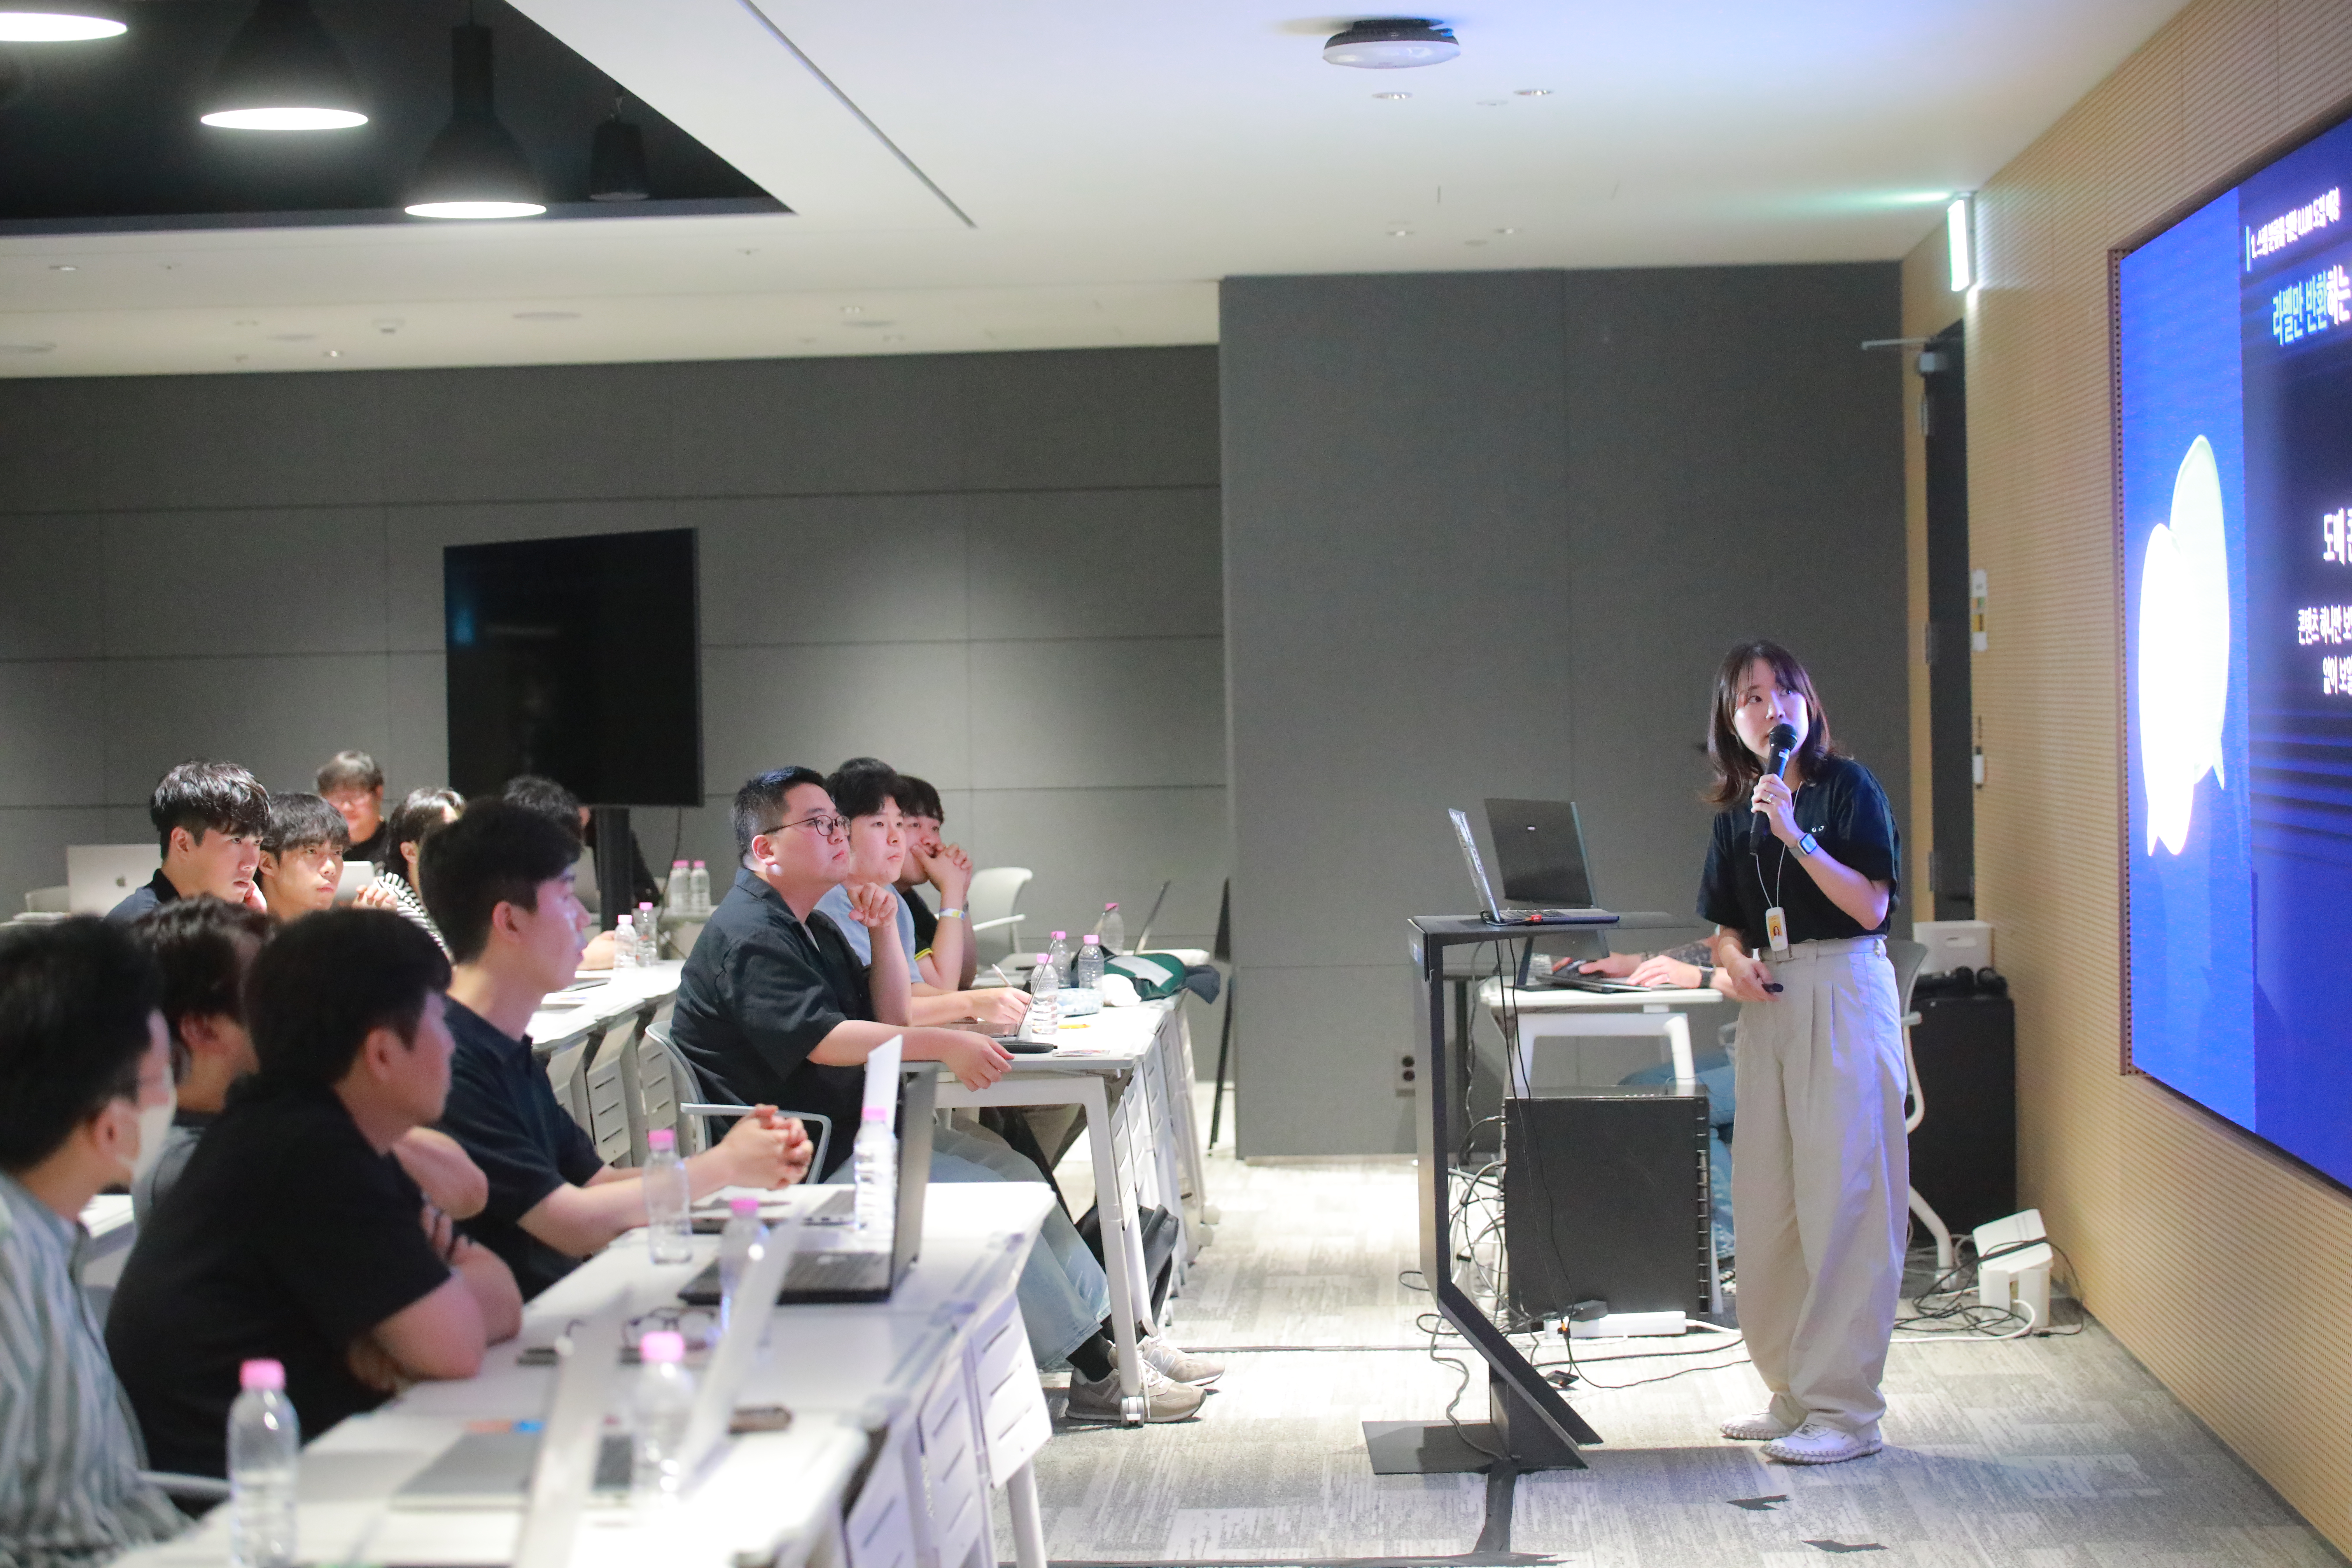
Q. 발표 주제를 선정한 과정에 대해서 이야기해주세요. 주제를 선택한 이유와 고려 요소가 있을까요?
발표 주제는 스팸 콘텐츠 대응을 위한 LLM 도입 사례인대요. 주제를 선정한 과정에 대해 말씀드리면 저는 스팸이라 부르는 유해 콘텐츠를 차단하는 조직에서 일하고 있어요. 스팸 콘텐츠 대응을 하면서, 저희 조직의 스팸 분류 작업이 어떤 고민을 필요로 하는지 공유하고 싶었어요. LLM을 통해 문장 생성뿐만 아니라 분류 문제도 해결할 수 있다는 점과 LLM의 장점을 활용해 분류 결과를 문장으로 재생성함으로써 스팸을 모니터링하는 운영자들에게 실질적인 도움을 제공하고 있습니다. 이런 과정을 통해 LLM의 다양한 활용 가능성과 사람에게 설명가능한 AI에 대해 전달하고자 이 주제를 선택하게 되었습니다.
Q. 발표를 준비하면서 가장 많은 시간을 고민한 부분은 무엇인가요?
참석자들의 LLM에 대한 이해도가 어느 정도인지를 몰라 어떻게 쉽게 설명할지 고민했어요. 또한 스팸 분야 자체가 흔하지 않아 발표 내용을 어떻게 청자들에게 잘 전달할지 고민하며 예시를 많이 사용했습니다. 이런 저의 고민이 청자들에게 잘 전달되었으면 좋겠습니다.
Q. 테크밋을 마무리하신 소감을 들려주세요. 인상적이었던 부분이 있나요?
카카오에서 기술적인 이야기를 주제로 발표하는 것은 처음이었는데, 떨리기도 했지만 재미있었습니다. 집중해서 경청해주시는 참석자들의 모습을 보며 더 열심히 발표 내용을 전달해야겠다고 생각했습니다. 발표한 내용이 잘 전달됐는지 궁금했는데, 패널 토의를 통해 추가적인 내용을 전달할 수 있어서 좋았습니다. 상호작용하는 느낌이 정말 좋았어요.
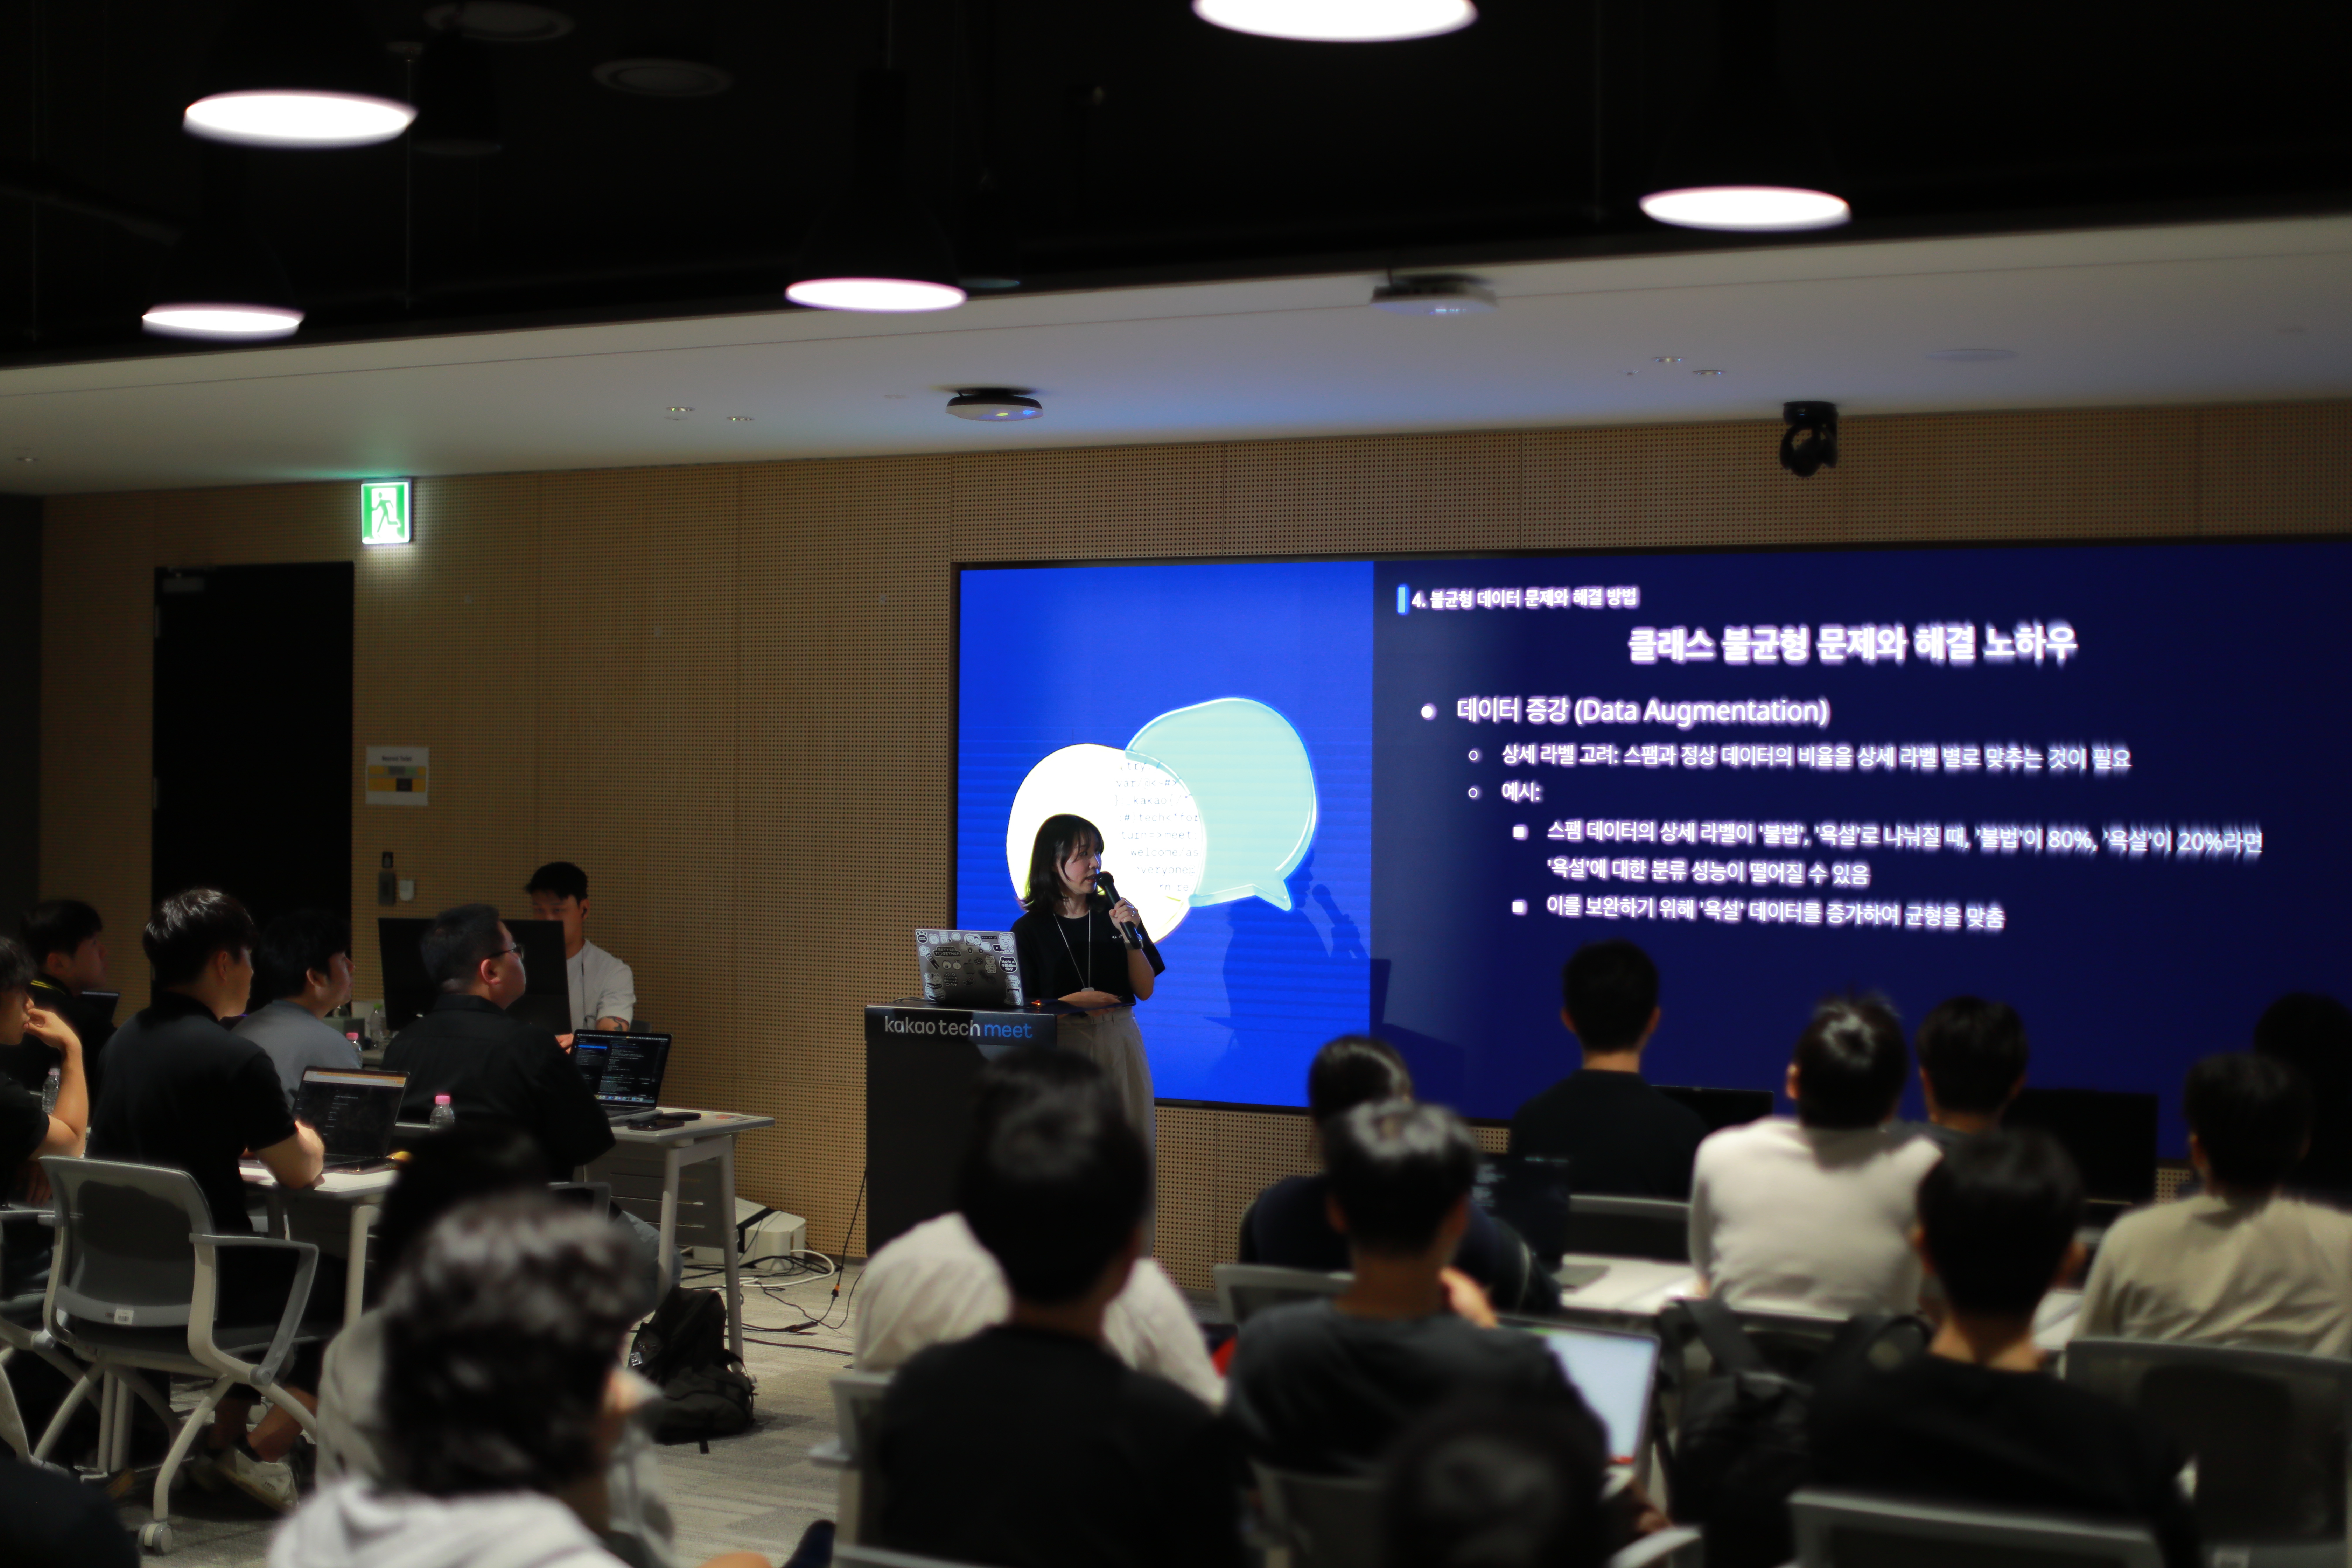
Q. 못다 한 이야기가 있다면?
현장에서 들어온 질문 중 하나가 '데이터의 개수가 얼마나 되어야 하나요?'였는대요. 사내 프로젝트를 외부에 발표하다보니 구체적인 수치를 물어보는 질문에 명쾌한 답변을 드리지 못하기도 했지만 사실, 이 질문에는 정답이 없어요. 왜냐하면 우리가 어떤 목표를 가지고 모델을 만들고자 하는지, 어떤 결과를 기대하는지에 따라 필요한 데이터의 양이 달라지기 때문이죠. 이에 대한 해답은 상황에 따라 다를 수밖에 없습니다.
예를 들어, 만약 특정 상황에 모델을 편향시키고 싶다면 그 상황에 맞는 데이터를 더 많이 수집할 수 있고, 반대로 모델이 다양한 상황을 잘 이해하도록 하고 싶다면 가능한 한 많은 데이터를 활용해 다양한 패턴을 학습시키는 것이 좋습니다.
'이런 상황에서 어떻게 판단해야 하나요?'라는 질문에 대한 답변도 비슷합니다. 모델러는 모델을 학습할 때 어떤 기준을 세워서 데이터를 수집하고 라벨링합니다. 이 과정에서 '이런 상황’이라는 것이 어느 정도 가이드라인으로 정리될거에요. 예를 들어, 'apple’이라는 단어를 분류할 때 해결하려는 도메인이 주식과 관련 되었다면 '회사’로, 음식이라면 '과일’로 라벨링을 해야할거에요.
이처럼 데이터와 모델을 활용해 문제를 해결하는 과정은 매우 주관적이고, 상황에 따라 다양한 접근이 가능합니다. 이럴 때 명확한 규칙이 있으면 좋겠지만, 실제로는 해당 도메인을 깊이 이해하고, 데이터의 특성을 정밀하게 분석하고 이해하는 과정이 훨씬 중요하다고 이야기드리고 싶어요.
발표 영상은 카카오테크 유튜브 채널(재생목록)에서도 시청하실 수 있습니다.