AI/ML
나만의 프로필 이미지 생성 모델 개발기
ted.chl카카오
2024년 11월 14일
원문에서 보기 ↗안녕하세요. 카카오의 AI 모델 개발을 담당하는 카나나 알파(Kanana ⍺) 조직에서 비주얼 생성 모델을 연구하고 있는 Ted입니다. 저희 조직에서는 최근 들어 많은 일상 속에 자리 잡은 이미지 및 비디오 생성 기술 또한 자체적으로 연구를 진행하고 있는데요. 오픈소스 모델 대비 우수한 성능을 보이며, 다양한 부가가치를 창출할 수 있는 모델 개발을 목표로 하고 있습니다.
이 글에서는 카나나 알파에서 개발 중인 이미지 생성 모델 Kollage by Kanana에서 개인화된 프로필 이미지 생성에 특화된 모델 Kollage Profile을 중점적으로 소개해 드리려고 합니다. 콜라주 프로필의 개발 과정부터 성능 비교, 마지막으로 이번 if(kakaoAI)2024 기간 운영한 카나나 포토부스 현장까지 생생히 전해드리겠습니다.
이미지 생성이란?
이미지 생성이 처음부터 짠!하고 나타난 것은 아닙니다. 과거부터 계속해 연구가 되어왔던 분야 중 하나입니다. 적대적 생성 신경망(Generative Adversarial Network)^[1]^이라고 불리는 GAN 모델은 그중에서 가장 대표적인 이미지 생성 연구 분야였습니다. Generator와 Discriminator가 서로 경쟁하며 훌륭한 수준의 이미지를 생성할 수 있어 나름 딥러닝 연구 분야에 한 획을 그었다고 볼 수 있습니다.
하지만, 패러다임의 변화는 언제나 필요했습니다. 고해상도이면서 고품질의 이미지 생성에는 GAN의 한계점이 존재했으며, 물리법칙 중 확산(Diffuse) 법칙에 영감을 받은 디퓨전(Diffusion) 모델^[2]^이 대세를 이루게 됩니다. 깨끗한 물에 물감을 한 방울 떨어뜨리면 색이 퍼지면서 점점 확산되는데, 이러한 과정은 비가역적, 즉 다시 원래 상태로 돌아올 수 없게 됩니다. 마찬가지로, 아래 그림에서 X_0서 X_T로 갈수록 노이즈(Noise)가 확산(q(x_t | x_{t-1}))되는데, 이론적으로 보자면 이 반대의 과정인 X_T에서 X_0로 가는 형태(q(x_{t-1} | x_t))는 비가역적이기에 알 수가 없습니다. 하지만, 인공지능 모델 p_{\theta}(x_{t-1} | x_t)을 활용하게 된다면 단계별로 차근차근 비가역적인 행동을 가역적인 문제를 풀 수 있어, 아래 이미지와 같이 노이지한 이미지로부터 깨끗한 이미지를 생성할 수 있게 됩니다.
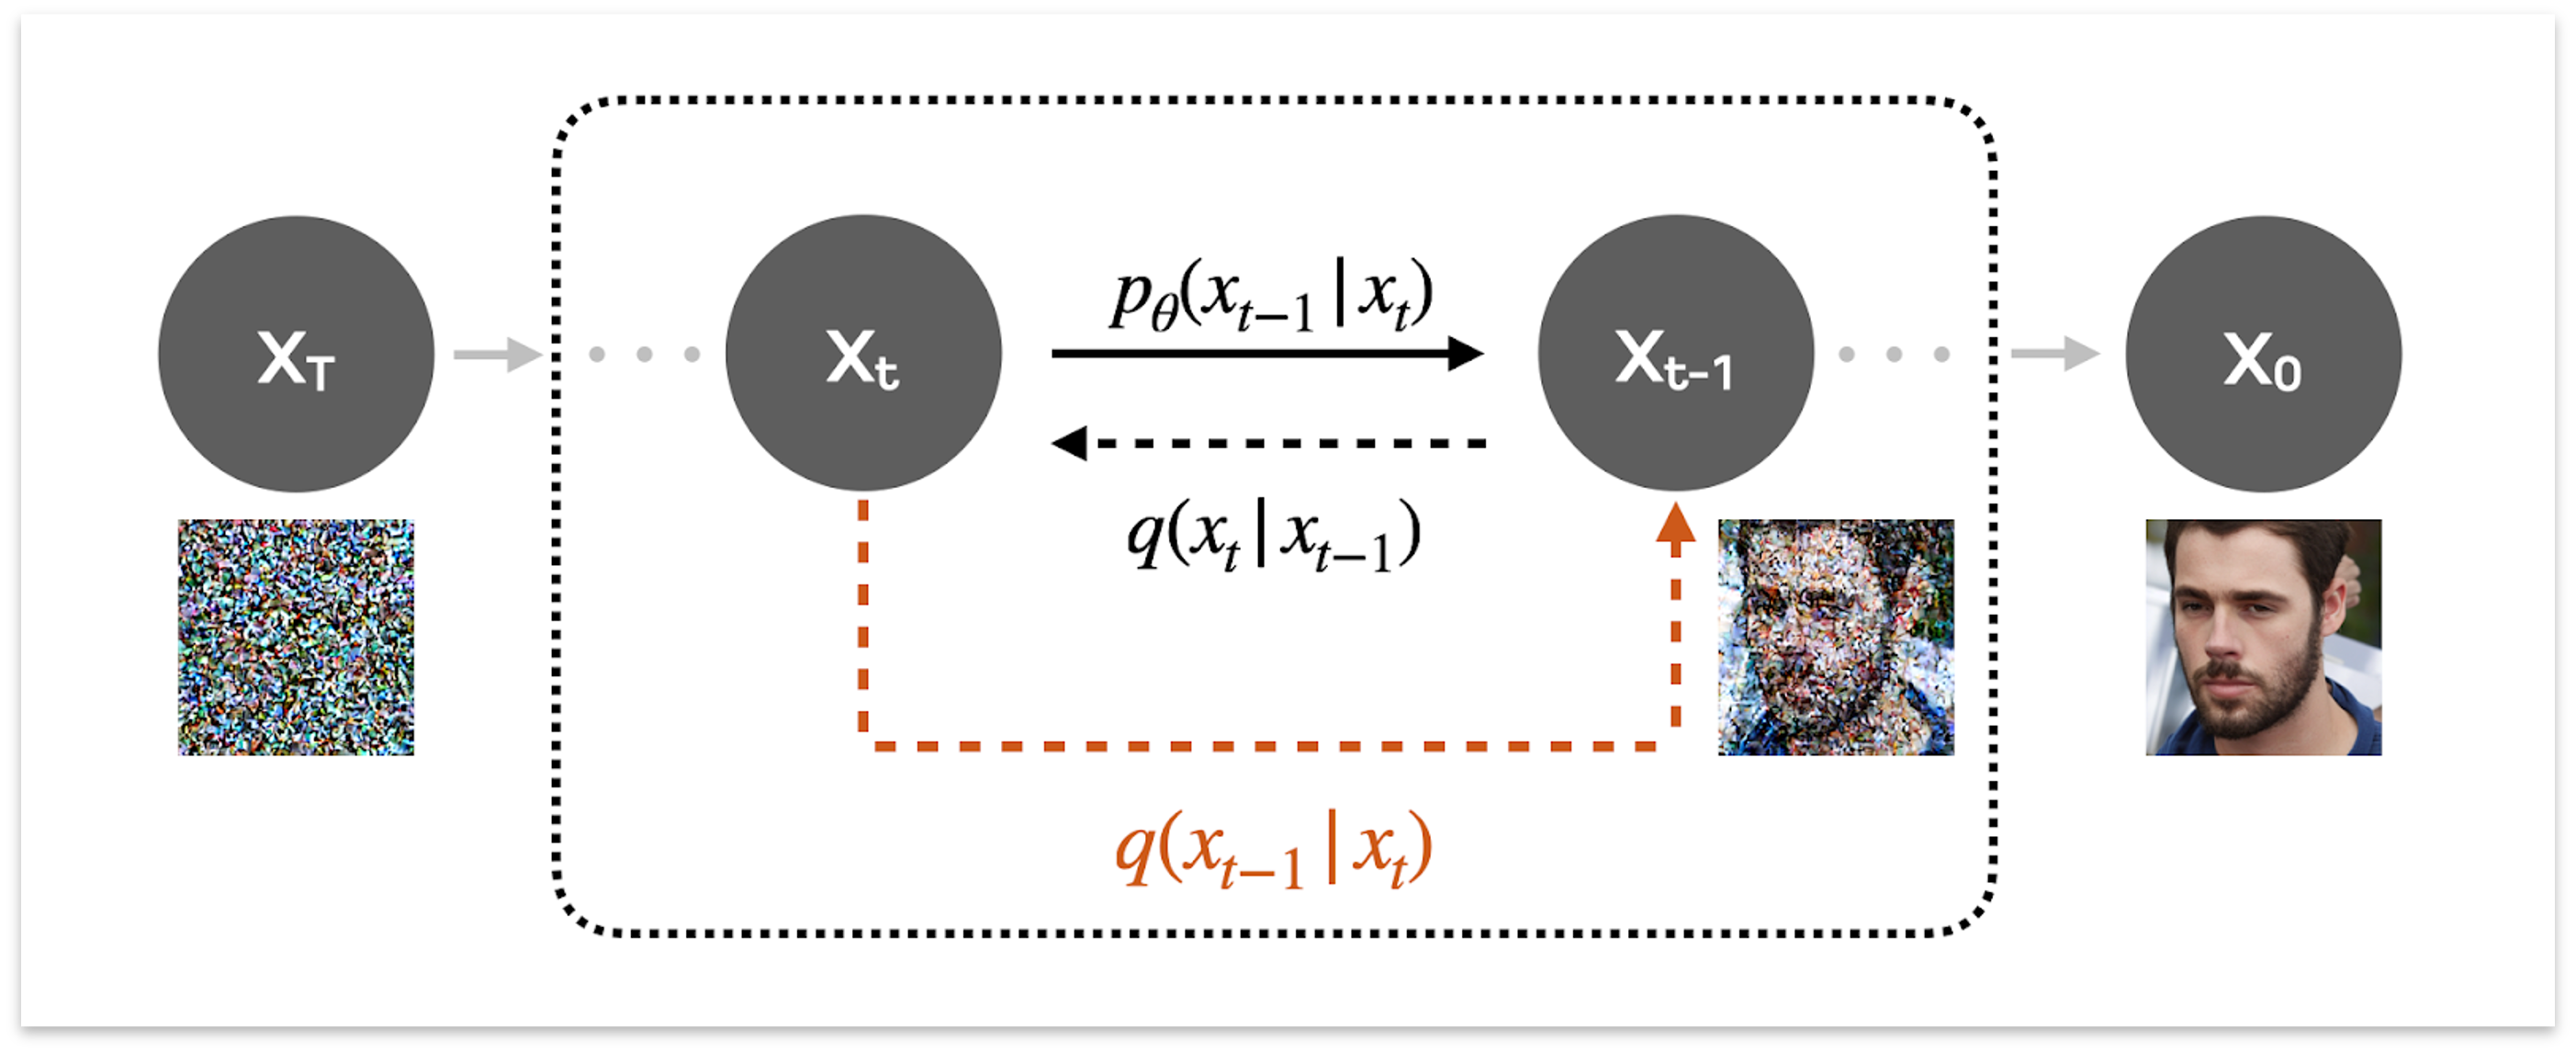
실제 디퓨전 모델 학습에서는 X_0라는 데이터가 충분히 많이 있으며, 다양한 연구 기법에 따라 시간 간격(Timestep, T)의 값을 어떻게 할지, 시간 간격에 따라 노이즈의 값은 얼마나 줄지에 따라 p_{\theta}가 디노이징(De-noise)한 결과물이 실제 이미지와 같아지게끔 손실 함수를 구성해 학습하게 됩니다. 즉, 다양한 시간 간격에서 노이즈가 섞인 이미지를 입력하면 노이즈가 제거되는 이미지를 생성하게끔 모델이 학습하게 되고, 실제 추론(Inference) 단계에서는 노이즈로부터 시작해 반복적으로 노이즈를 제거해 이미지가 생성되는 것입니다.
카카오의 프로필 이미지 생성 연구
콜라주 프로필 모델 또한 디퓨전 모델 방식을 채택하고 있습니다. 디퓨전 모델 방식에서는 이미지를 생성할 때 어떤 이미지를 생성하고 싶은지 모델에게 알려줘야 하는 과정이 필요합니다. 이를 디퓨전 모델에서 ‘조건(Condition)을 입력 또는 주입한다’고 부릅니다.
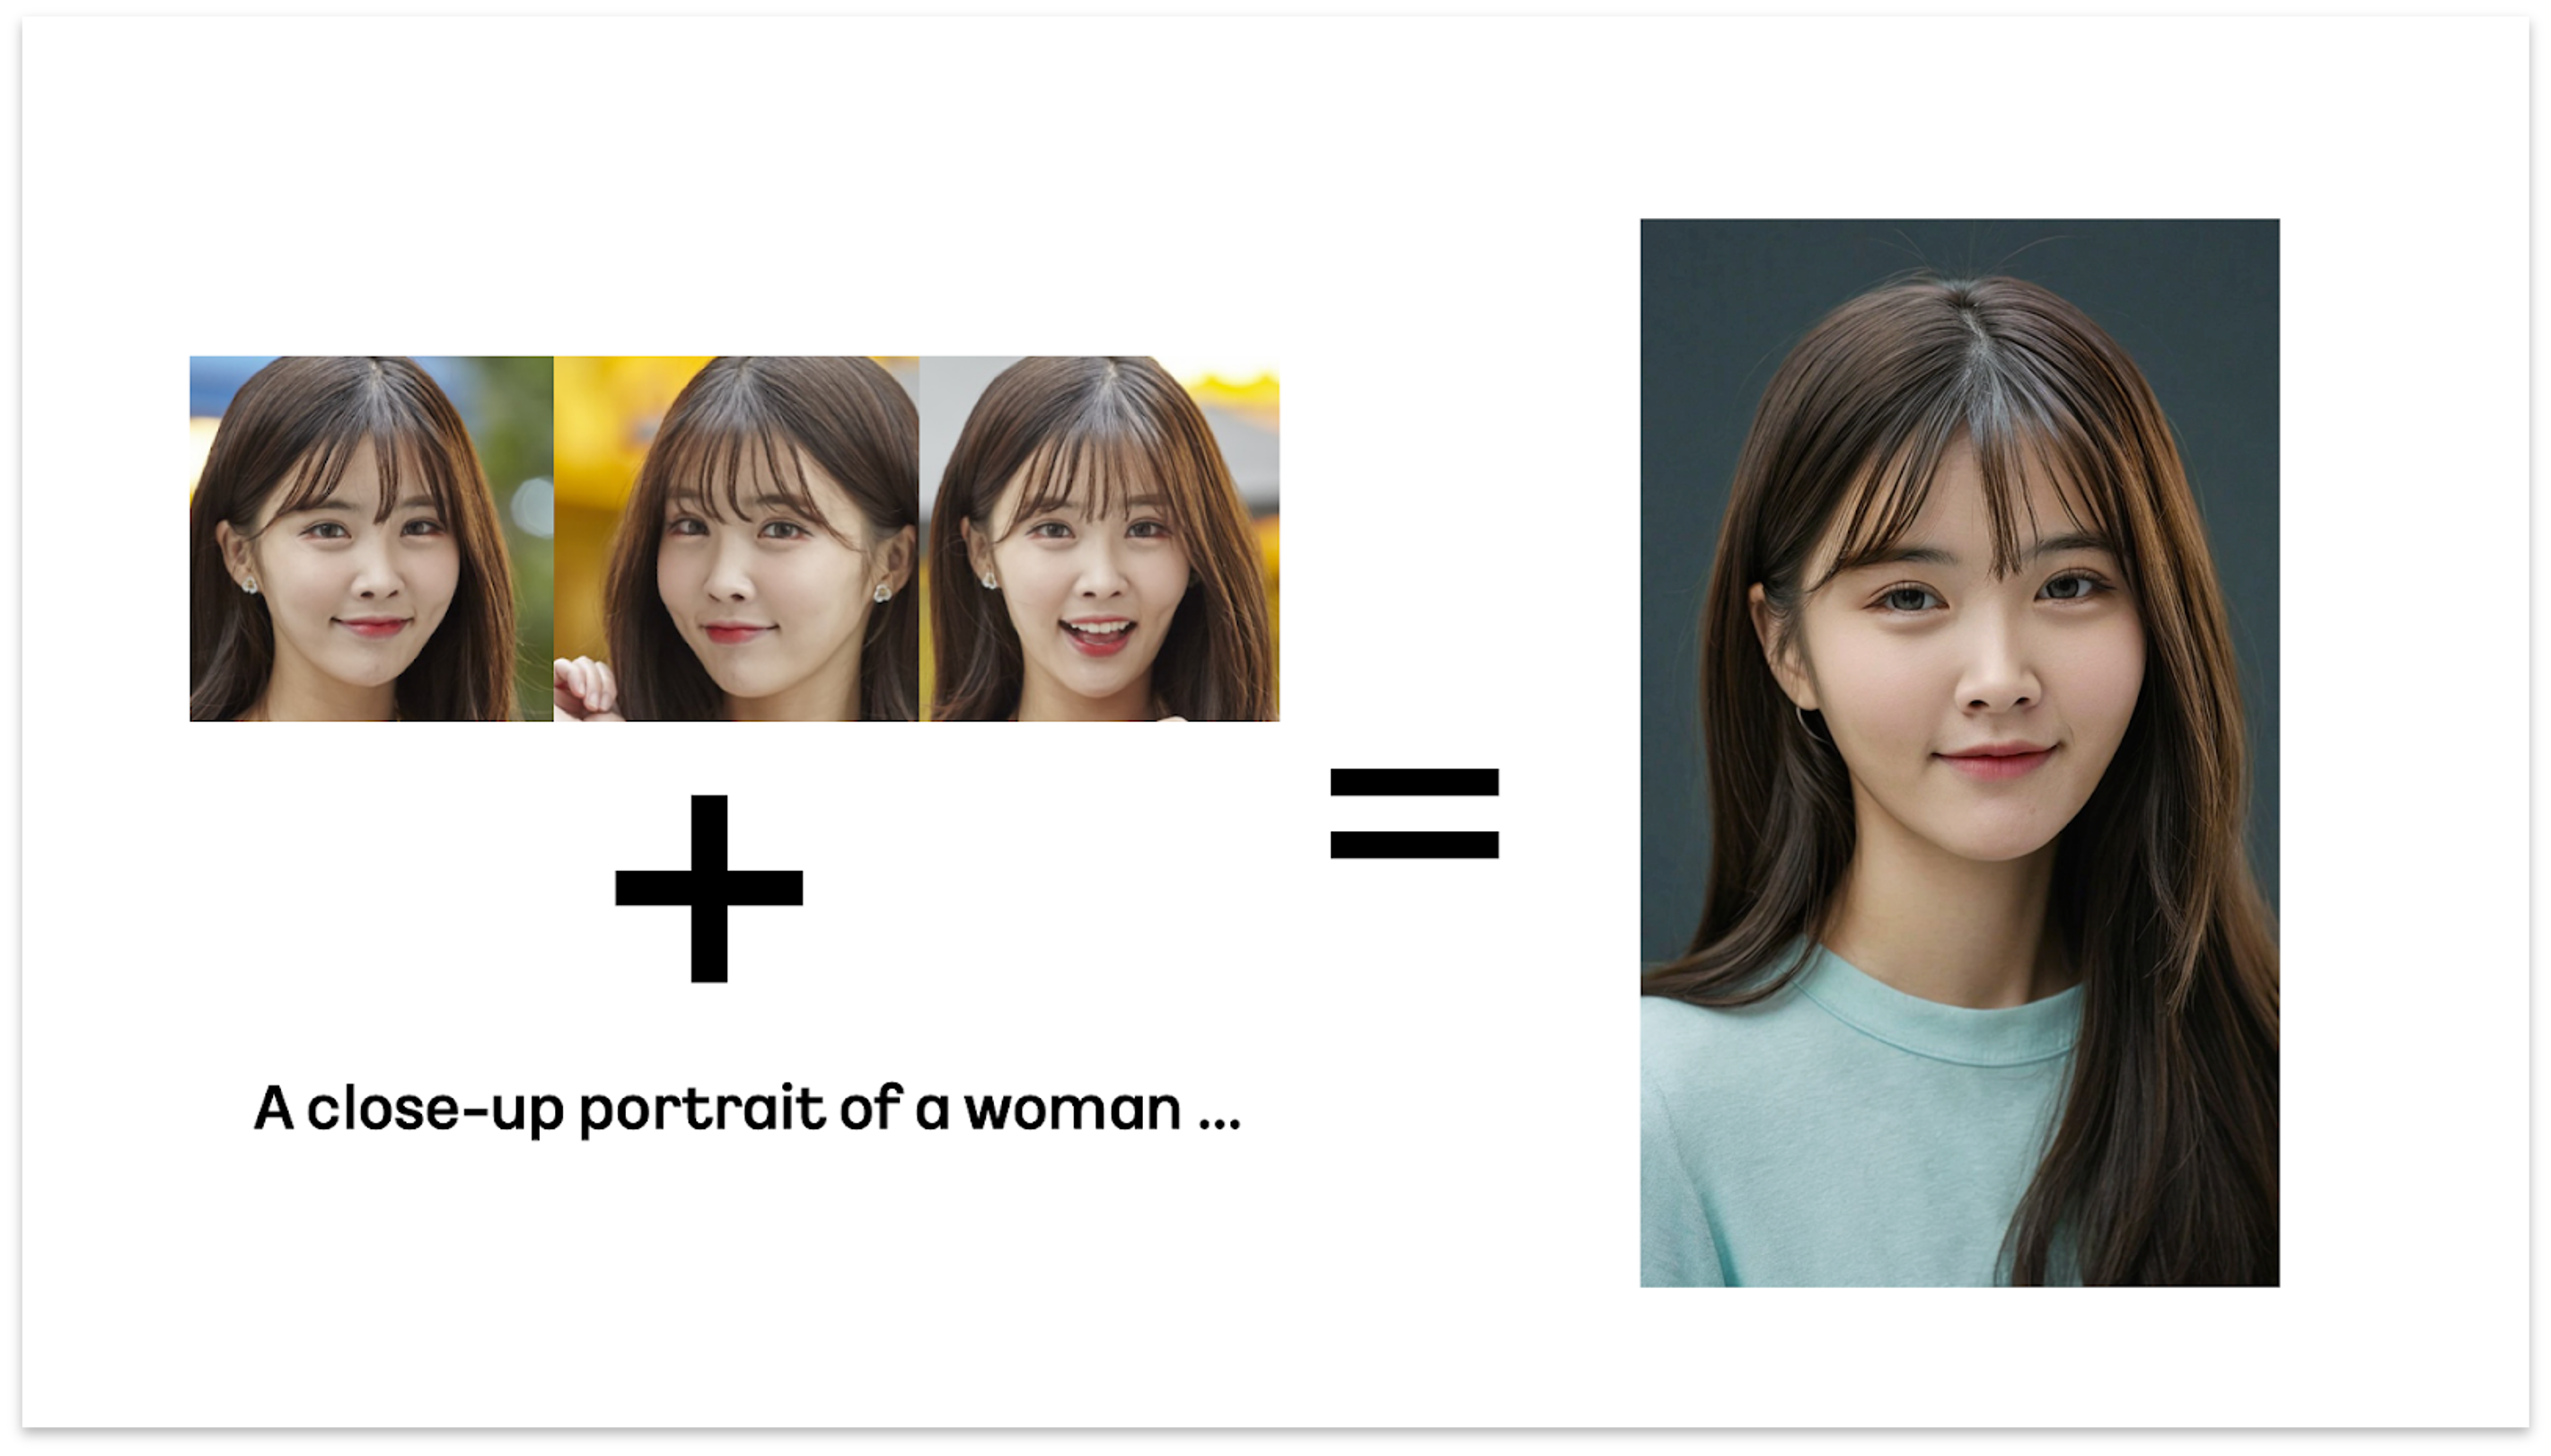
프로필 모델 개발에 있어 가장 중요한 것은 바로 해당 인물과 높은 유사도를 가진 이미지를 생성해야 한다는 점인데요. 이에 따라 프로필 모델에서는 바로 텍스트 와 얼굴 이미지를 조건으로 입력하게 됩니다. 주어진 텍스트에 알맞으면서도 닮은 얼굴의 사람 이미지가 생성되어야 하죠.
데이터셋 구축과 처리
프로필 모델의 학습 데이터는 일반적인 이미지 생성 모델과는 전혀 다른 형태의 데이터 구성과 가공이 필요합니다. 그중에서도 저희는 인물에 초점이 맞춰진 모델이기에, 무조건 인물 사진으로만 구성된 데이터셋이 필요했습니다. 내부에서는 크게 두 종류의 데이터셋을 구분해 학습을 진행하고 있는데, 바로 SISI (Single Identity, Single Image )와 SIMI (Single Identity, Multi Image)입니다.
두 데이터셋 모두 인물이 포함된 이미지-텍스트 페어 데이터셋이며, 각각 한 명의 인물이 한 장의 이미지로만 이루어져 있고(SISI), 한 명의 인물이 여러 장의 이미지로 이뤄져 있는(SIMI) 데이터셋입니다. 이 중에서 가장 중요한 것은 AI 프로필 이미지를 잘 생성하기 위한 프로필 이미지스러운 전처리(Preprocess) 과정입니다.
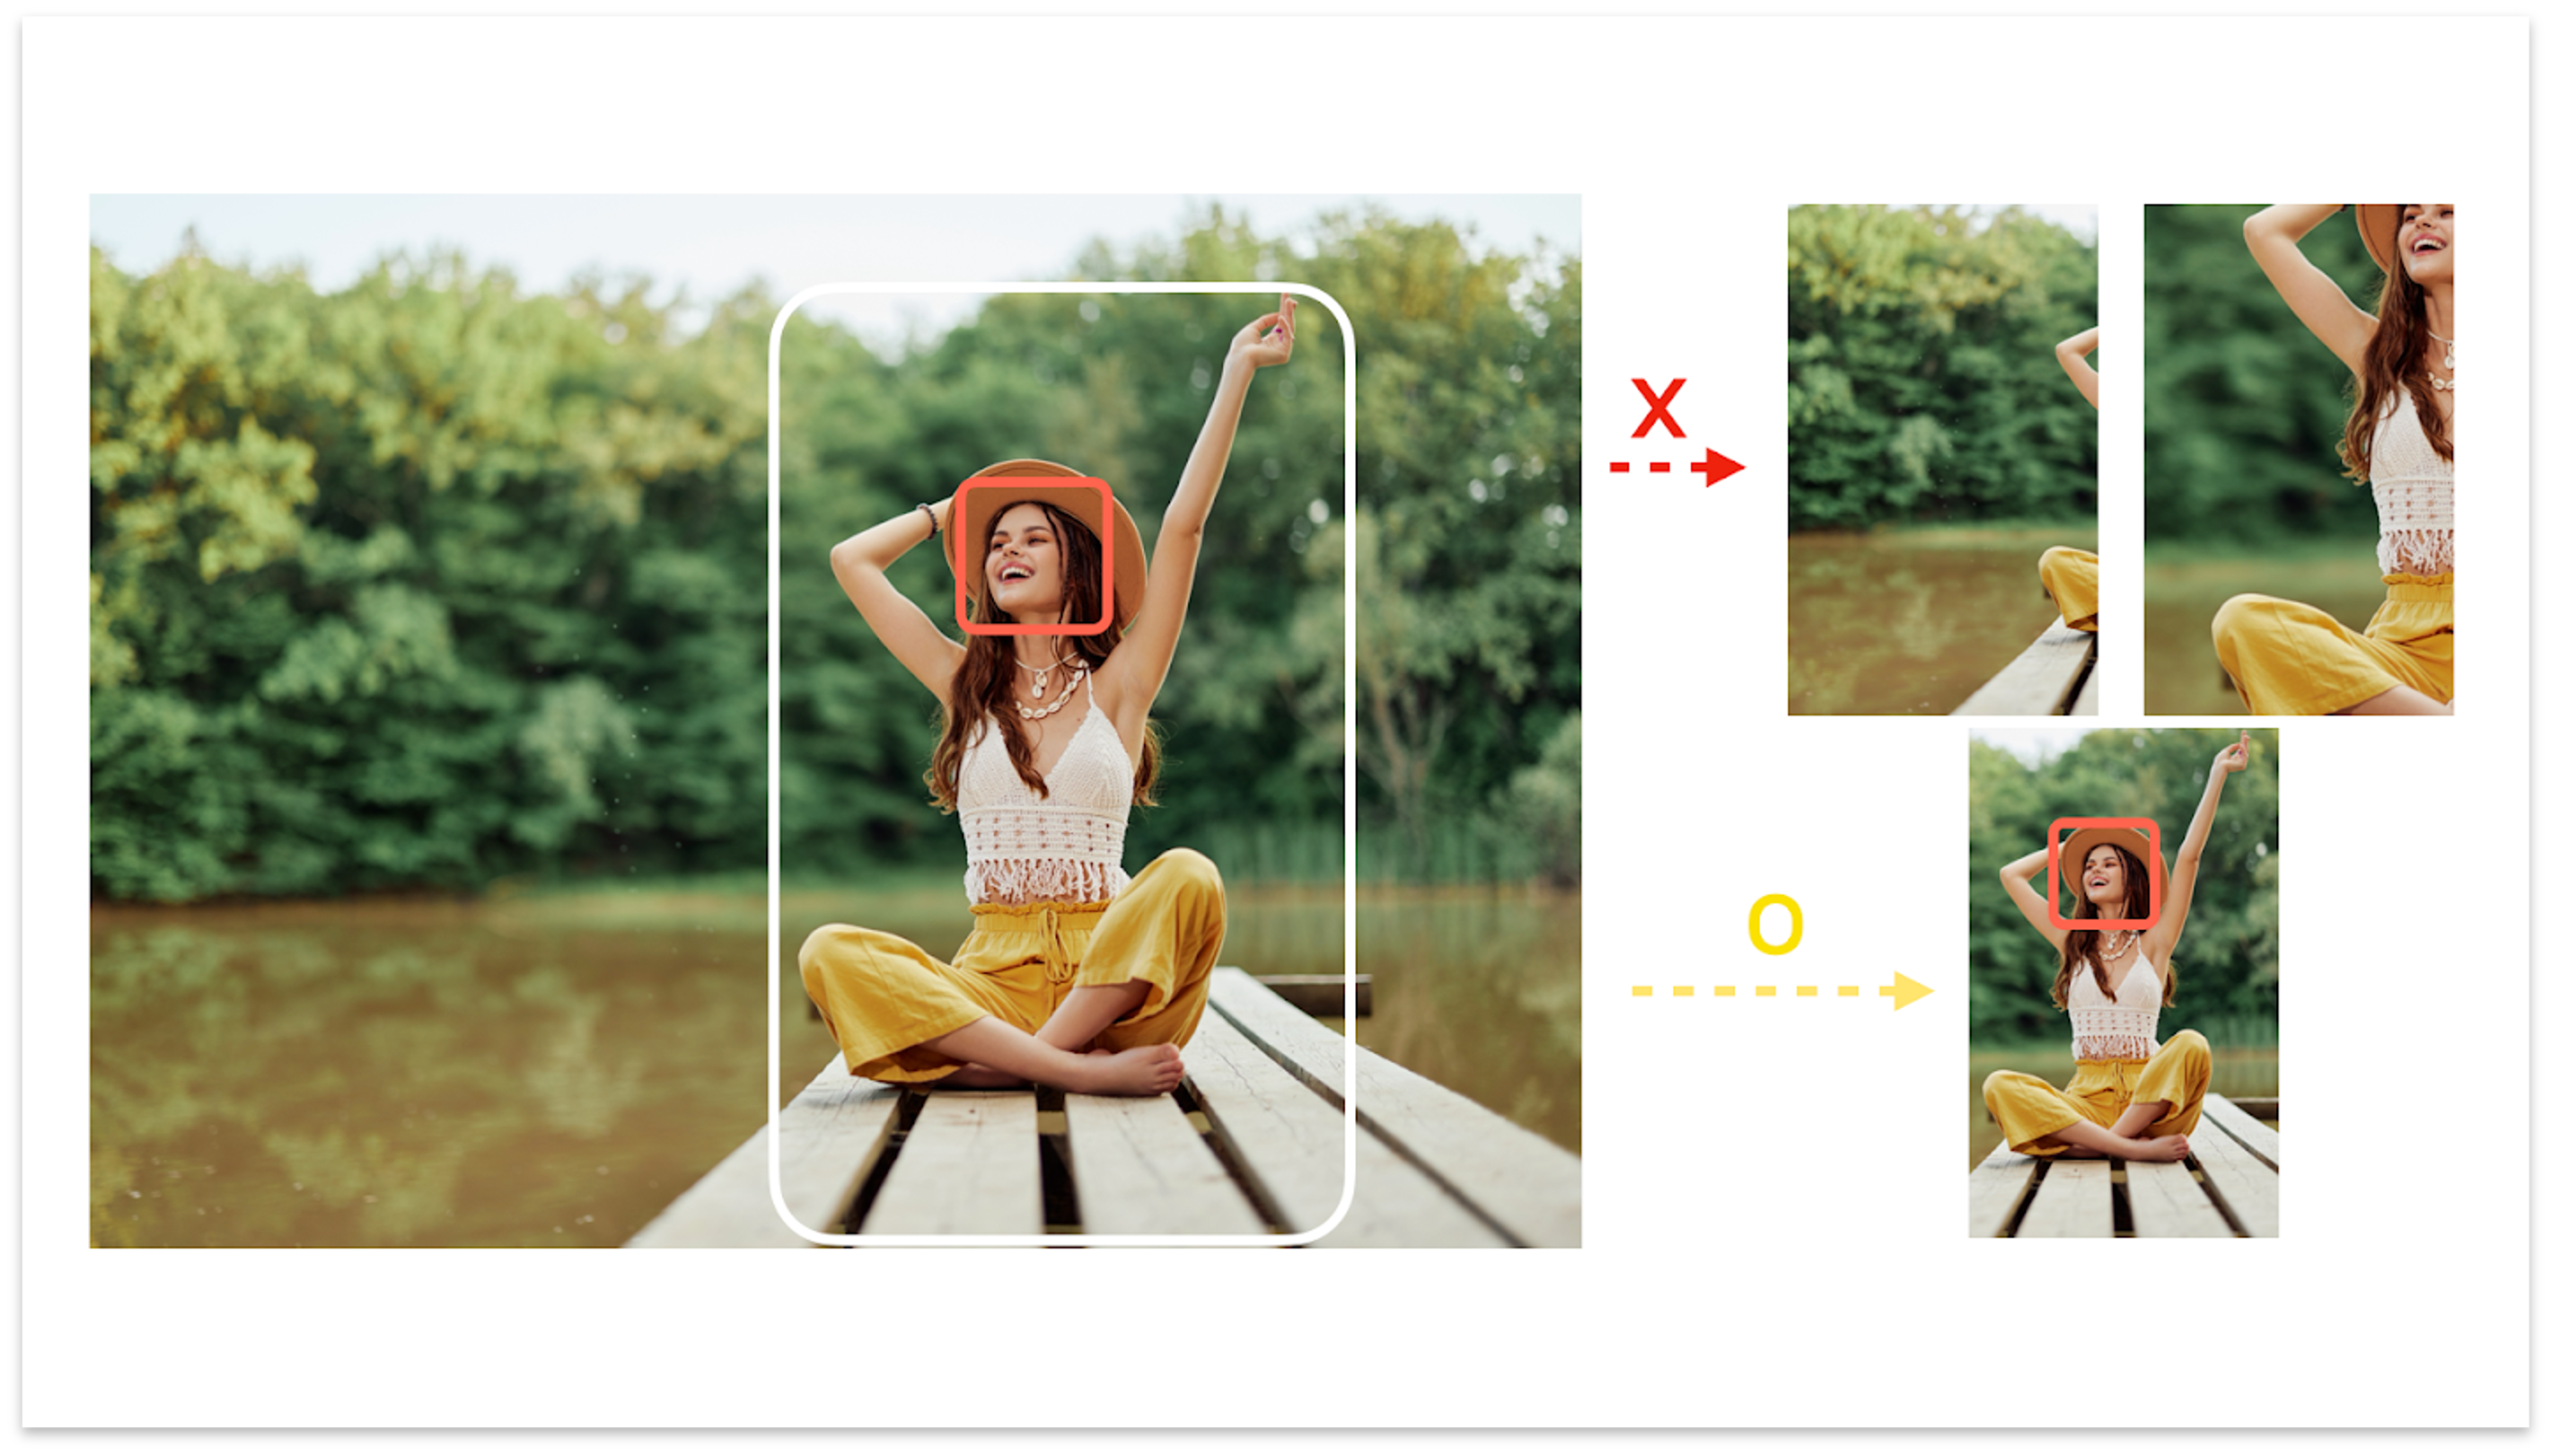
이미지를 잘 생성하기 위해서는 학습 데이터를 어떻게 모델에 주입하느냐가 중요합니다. 예를 들어, 얼굴을 너무 크게 나오도록 이미지를 자르면 모델은 얼굴 생성에만 집중할 것이고, 반대로 얼굴이 너무 작게 나오게 이미지를 자르면 얼굴보다는 주변의 배경 등의 생성에만 집중할 것입니다. 저희는 인물 사진을 볼 때 일반적으로 얼굴의 위치가 사진의 윗부분에 존재하고, 신체도 어느 정도 있는 경우를 가장 만족할 만한 수준으로 고려하고, 아래와 같이 인물 이미지를 전처리했습니다. 이렇게 학습 데이터셋에 어느 정도 제약을 주게 되면, 모델 학습이 비교적 쉬워지면서 원하는 결과물을 잘 생성할 수 있게 됩니다.
전용 백본 모델의 개발
콜라주 프로필 모델은 ‘입력 얼굴과 닮은 자연스러운 인물 생성 ’을 위한 AI 모델을 목표로 하고 있습니다. 인물 생성에 특화된 모델을 기반으로 학습하기 위해 카나나 알파에서는 인물 특화 전용 백본 모델 연구에 많은 노력을 기울이고 있습니다. 다양한 시도 끝에, HG-DPO^[3]^라는 새로운 방법론을 바탕으로 초상화 인물(Human Portrait) 이미지를 잘 생성할 수 있는 백본 모델의 파인 튜닝(Fine-tuning)을 진행했습니다.
HG-DPO는 LLM 분야에서도 잘 알려진 DPO(Direct Preference Optimization)^[4]^에서 발전된 연구로 저희는 Pickscore^[5]^, Aesthetic score^[6]^와 같은 이미지 품질 평가 모델을 바탕으로 자체적인 대규모 데이터셋을 확보 후 파인 튜닝을 진행했습니다. 이러한 독자적인 방법론은 추후 프로필 모델 외에도, 모든 콜라주 모델에 차례대로 적용해 나갈 예정입니다. 이를 이용한다면 인물 생성과 성능에 큰 향상을 줄 수 있을 것이라 기대하고 있습니다. 좀 더 자세한 연구 방법과 결과는 저희 조직 내 훌륭한 세 명의 연구원분들이 출판한 논문을 참고하실 수 있습니다. (논문 바로가기)
학습 및 평가
모델의 학습과 평가의 목표는 모델 구조를 설계하는 것부터 시작해 어떤 손실 함수를 사용할 것이며, 평가 전략과 방법을 잘 세워 성능이 얼마만큼 잘 향상되는지 관찰하는 것입니다.
모델 학습
저희 모델 구조는 크게 2가지 구조로 나눠집니다. 앞서 살펴본 기본적인 이미지 생성 능력을 가지면서 인물 이미지 생성에 특화될 수 있는 백본 모델과 주어진 인물과 닮은 인물이 생성될 수 있도록 만드는 아이디(Identity) 모듈입니다. 저희는 이 아이디 모듈을 Instantbooth^[7]^이라 불리는 연구 방법을 기반으로 재설계했으며, 그중에서도 어색하지 않고 자연스럽게 닮은 인물을 생성할 수 있는 능력을 가지게끔 많은 노력을 하였습니다.
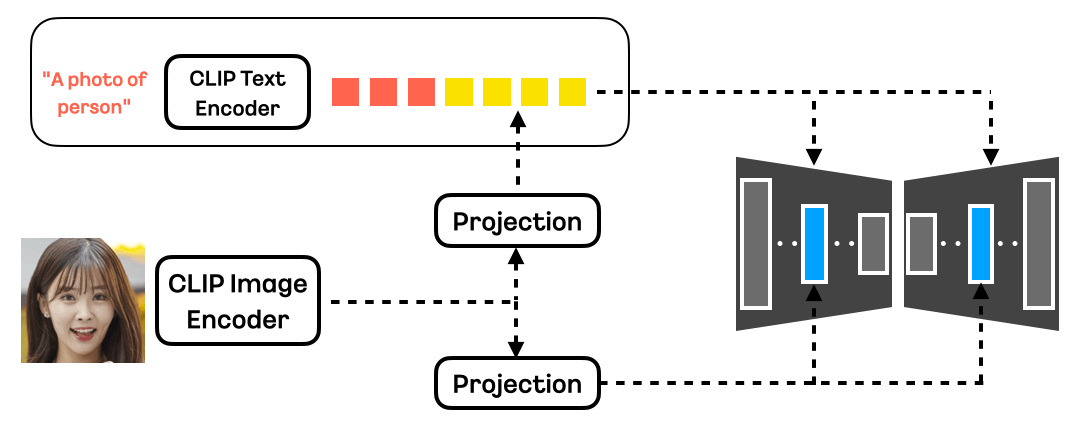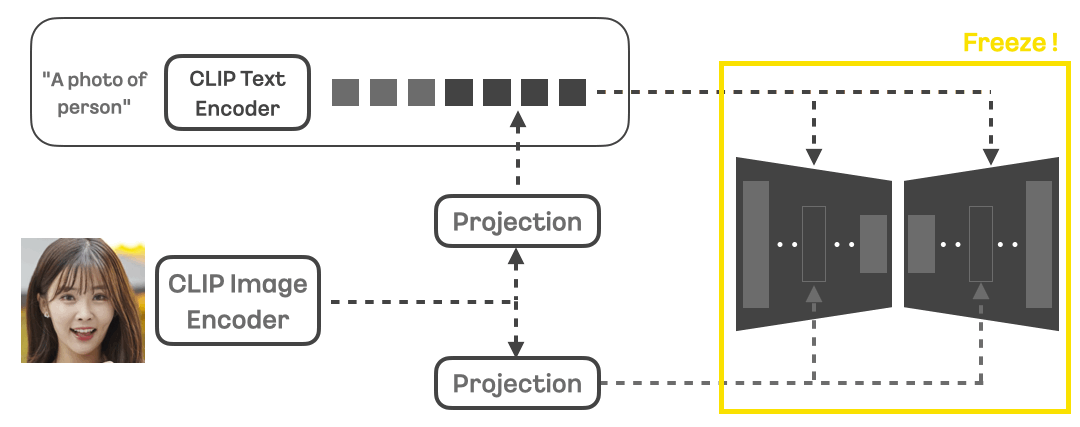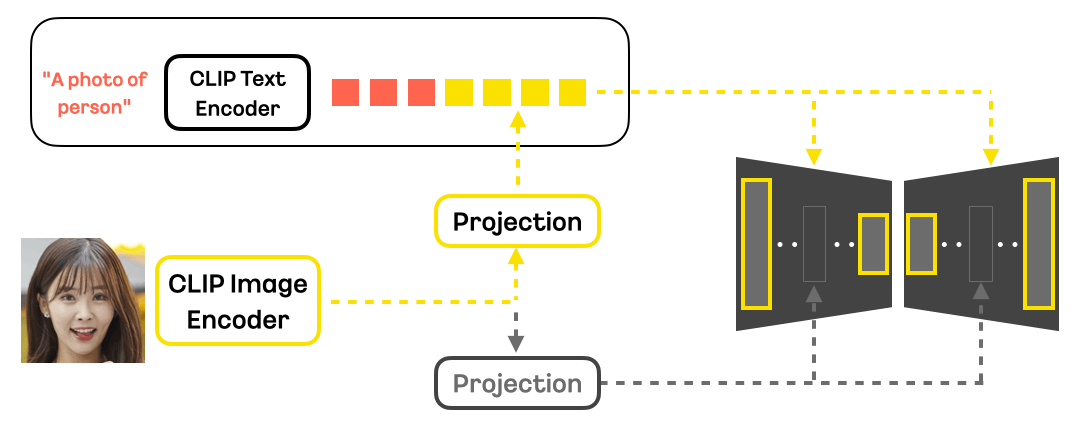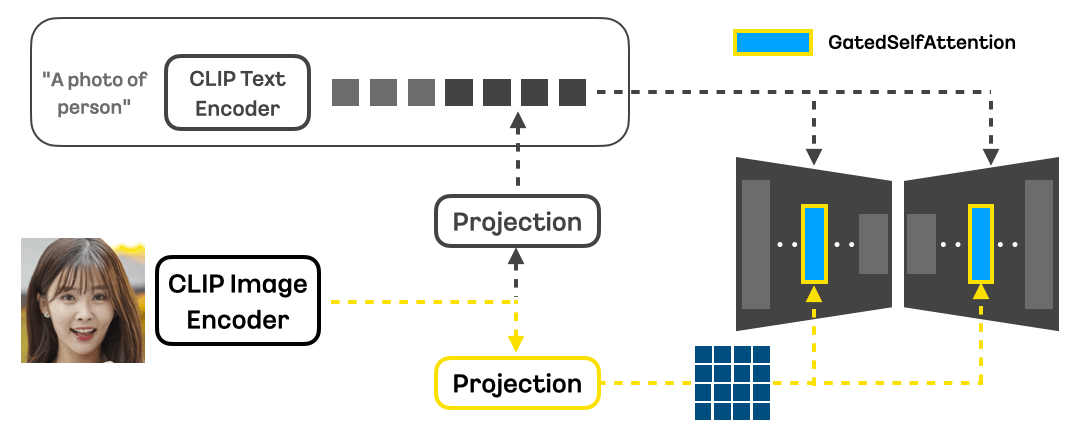
자연스럽게 닮은 정보를 주입하기 위한 방법의 핵심은 얼굴의 전반적인 정보와 자세한 정보를 서로 분리한 채 모델이 배울 수 있게 만들어 보는 것입니다. 먼저, 얼굴 이미지의 정보를 이미지 인코더(CLIP Image Encoder^[8]^)를 이용해 잘 추출한 후 정보의 차원을 맞추고 사상시키기 위한 레이어(Projection)를 거친 후, 텍스트 임베딩(Embedding)과 함께 결합된 글로벌 임베딩을 얻을 수 있습니다. 일반적인 텍스트는 고수준(High-level)의 정보를 가지고 있다고 알려져 있으며, 닮은 정보 또한 비슷한 공간(Space)에서 가질 수 있게 만들어 얼굴의 형태, 위치 등을 구성할 수 있습니다. 두 번째로 비슷한 구성으로 패치 임베딩을 활용해 백본 모델 내부에 새로운 어텐션(Attention) 모듈^[9]^을 구성해 픽셀 수준(Pixel-level)에서의 닮은 정보를 주입할 수 있습니다.
이러한 모델 구조와 전용 백본 모델, 수백만 장의 데이터셋을 하나로 모아, 두 가지의 손실 함수를 이용해 모델을 학습하게 됩니다. 일반적으로 디퓨전 모델에 활용되는 디퓨전 손실 함수와 함께, 얼굴의 닮은 정보를 직접적으로 알려주며 닮은 정도를 개선할 수 있는 Identity 손실 함수^[10]^를 사용해 모델의 성능을 크게 높일 수 있었습니다.
여기서 더 나아가, 최근 딥페이크와 같은 AI 기술 관련 범죄와 악용사례를 고려하여 비가시성 워터마크 및 얼굴 위변조 탐지 기술 활용, 부적절한 단어 및 특정인물 탐지/필터링 적용을 통해 보다 안전한 AI 모델을 만들기 위한 과정도 거치고 있습니다.
모델 결과 비교
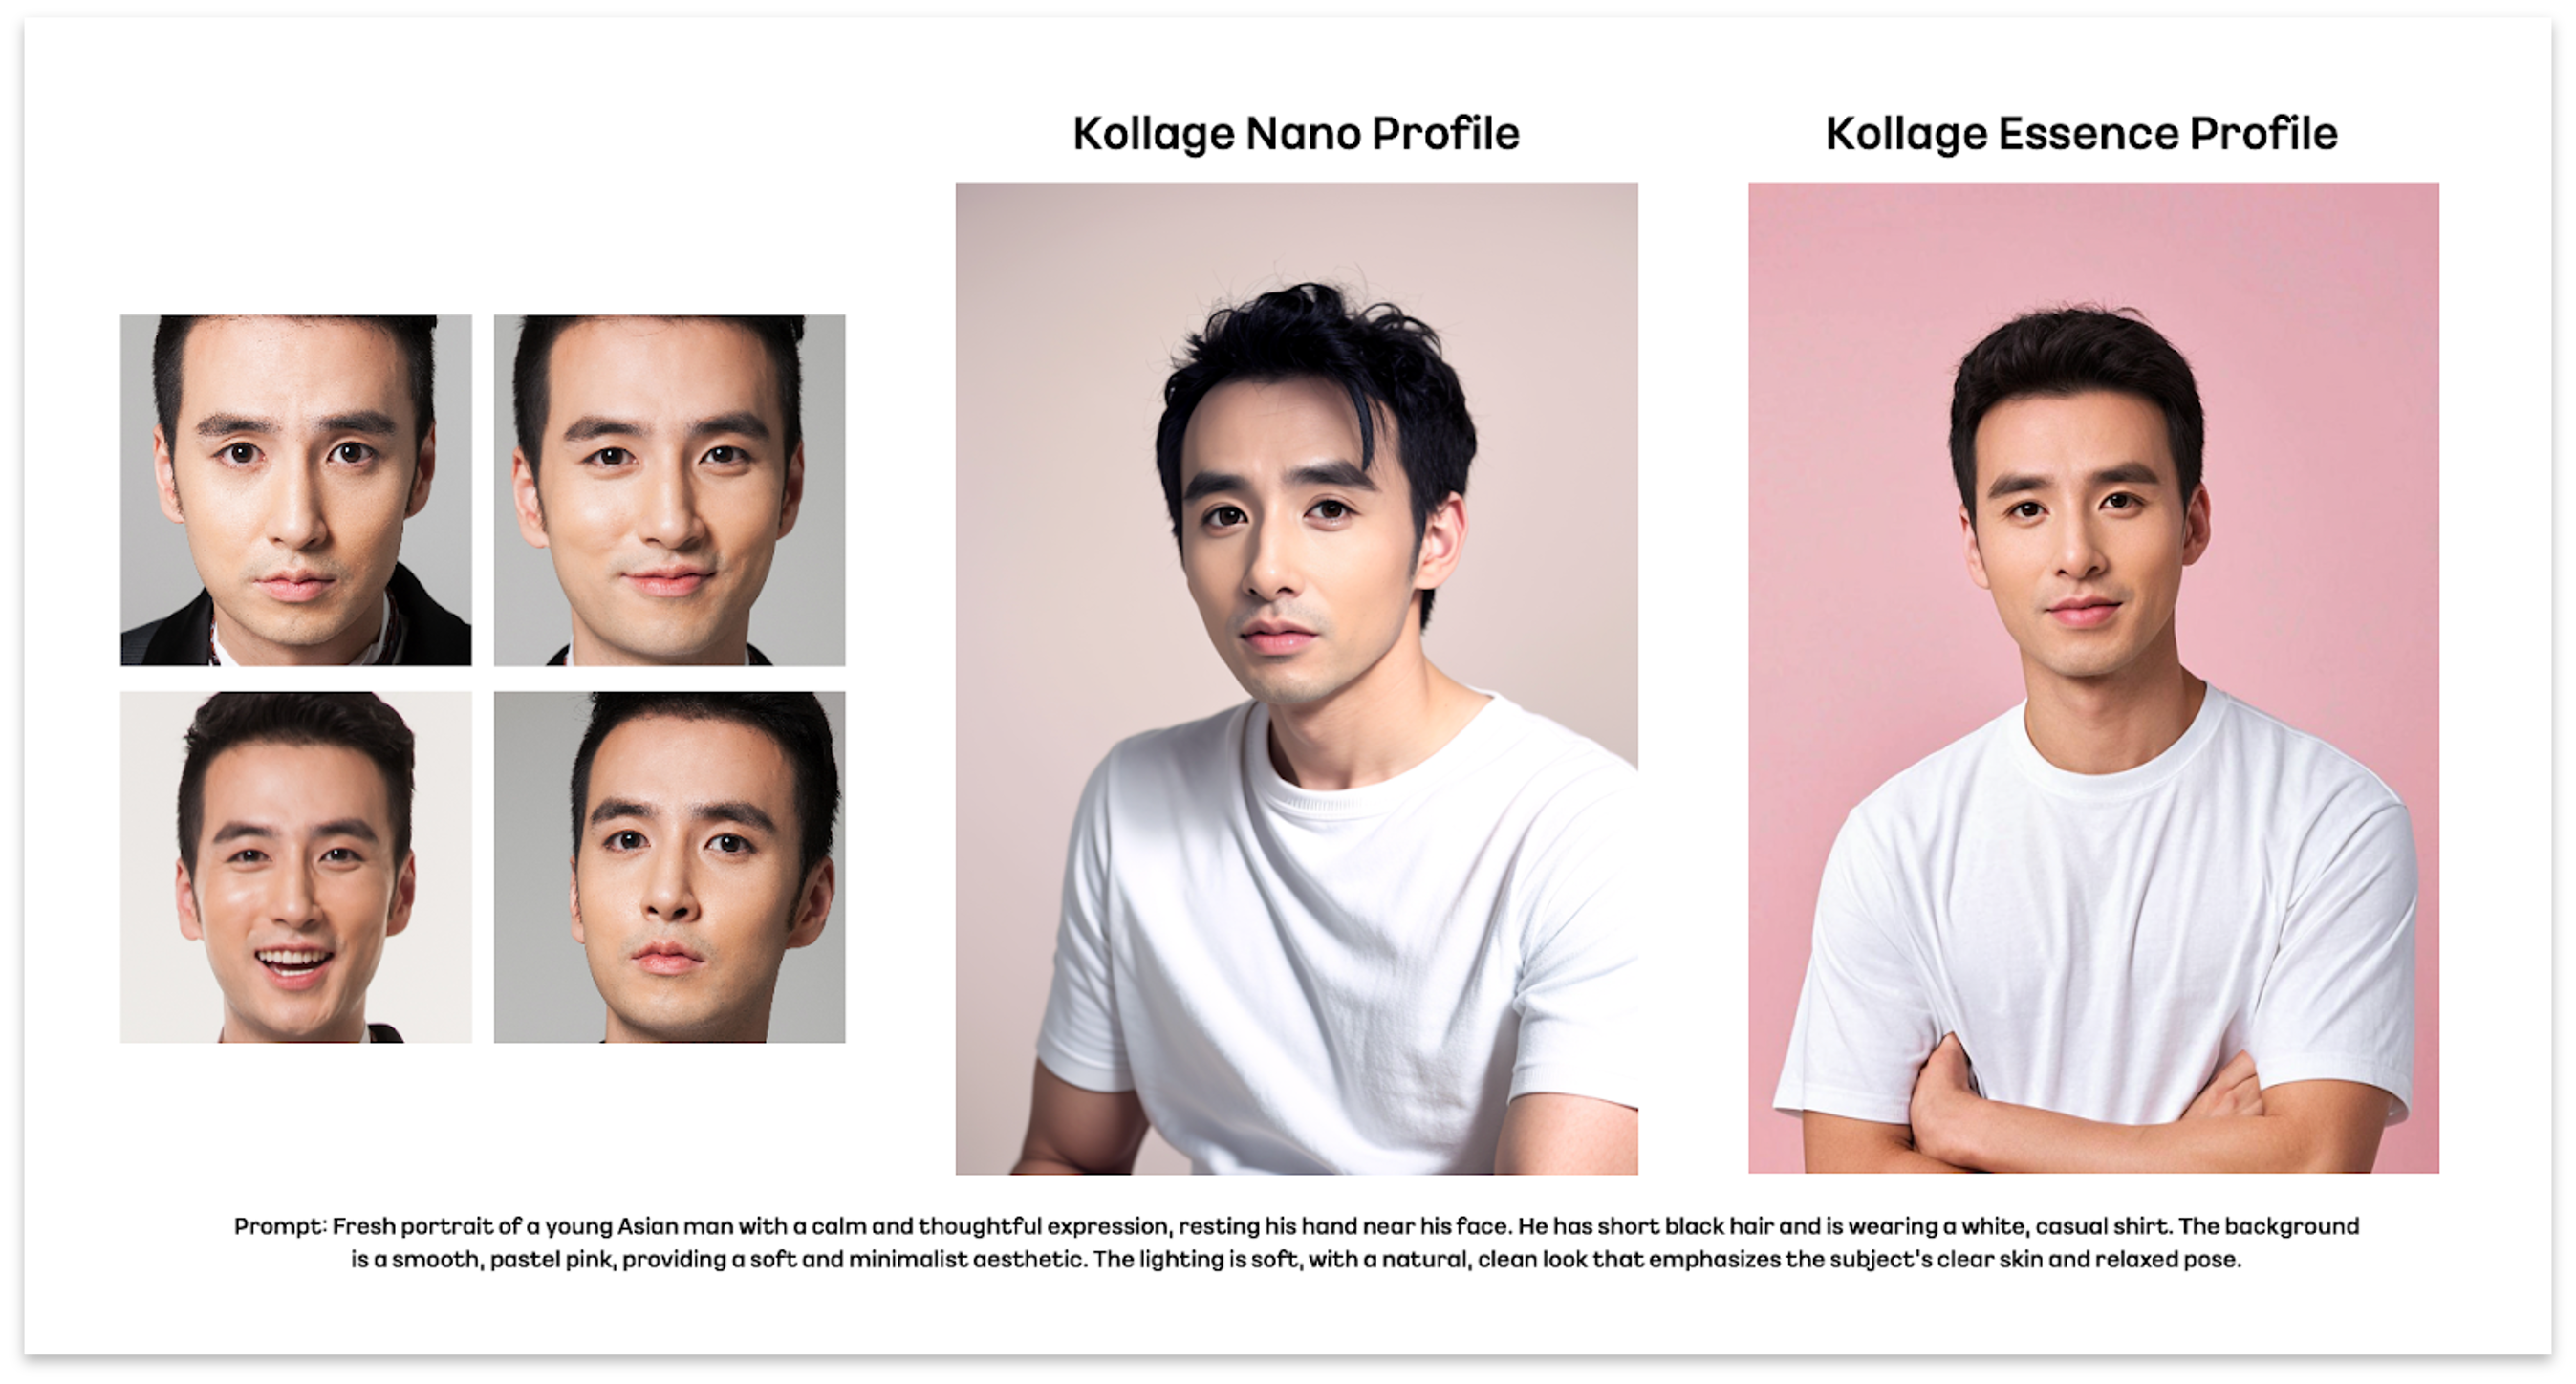
콜라주 프로필 모델은 현재 크기에 따라 나노(Nano)와 에센스(Essence) 두 가지 모델의 개발이 완료되었습니다. 이 두 모델 모두 충분한 성능을 보이고 있으나, 생성 속도와 해상도에 차이가 있기에 각 서비스에 최적화된 형태로 적절히 활용할 계획입니다.
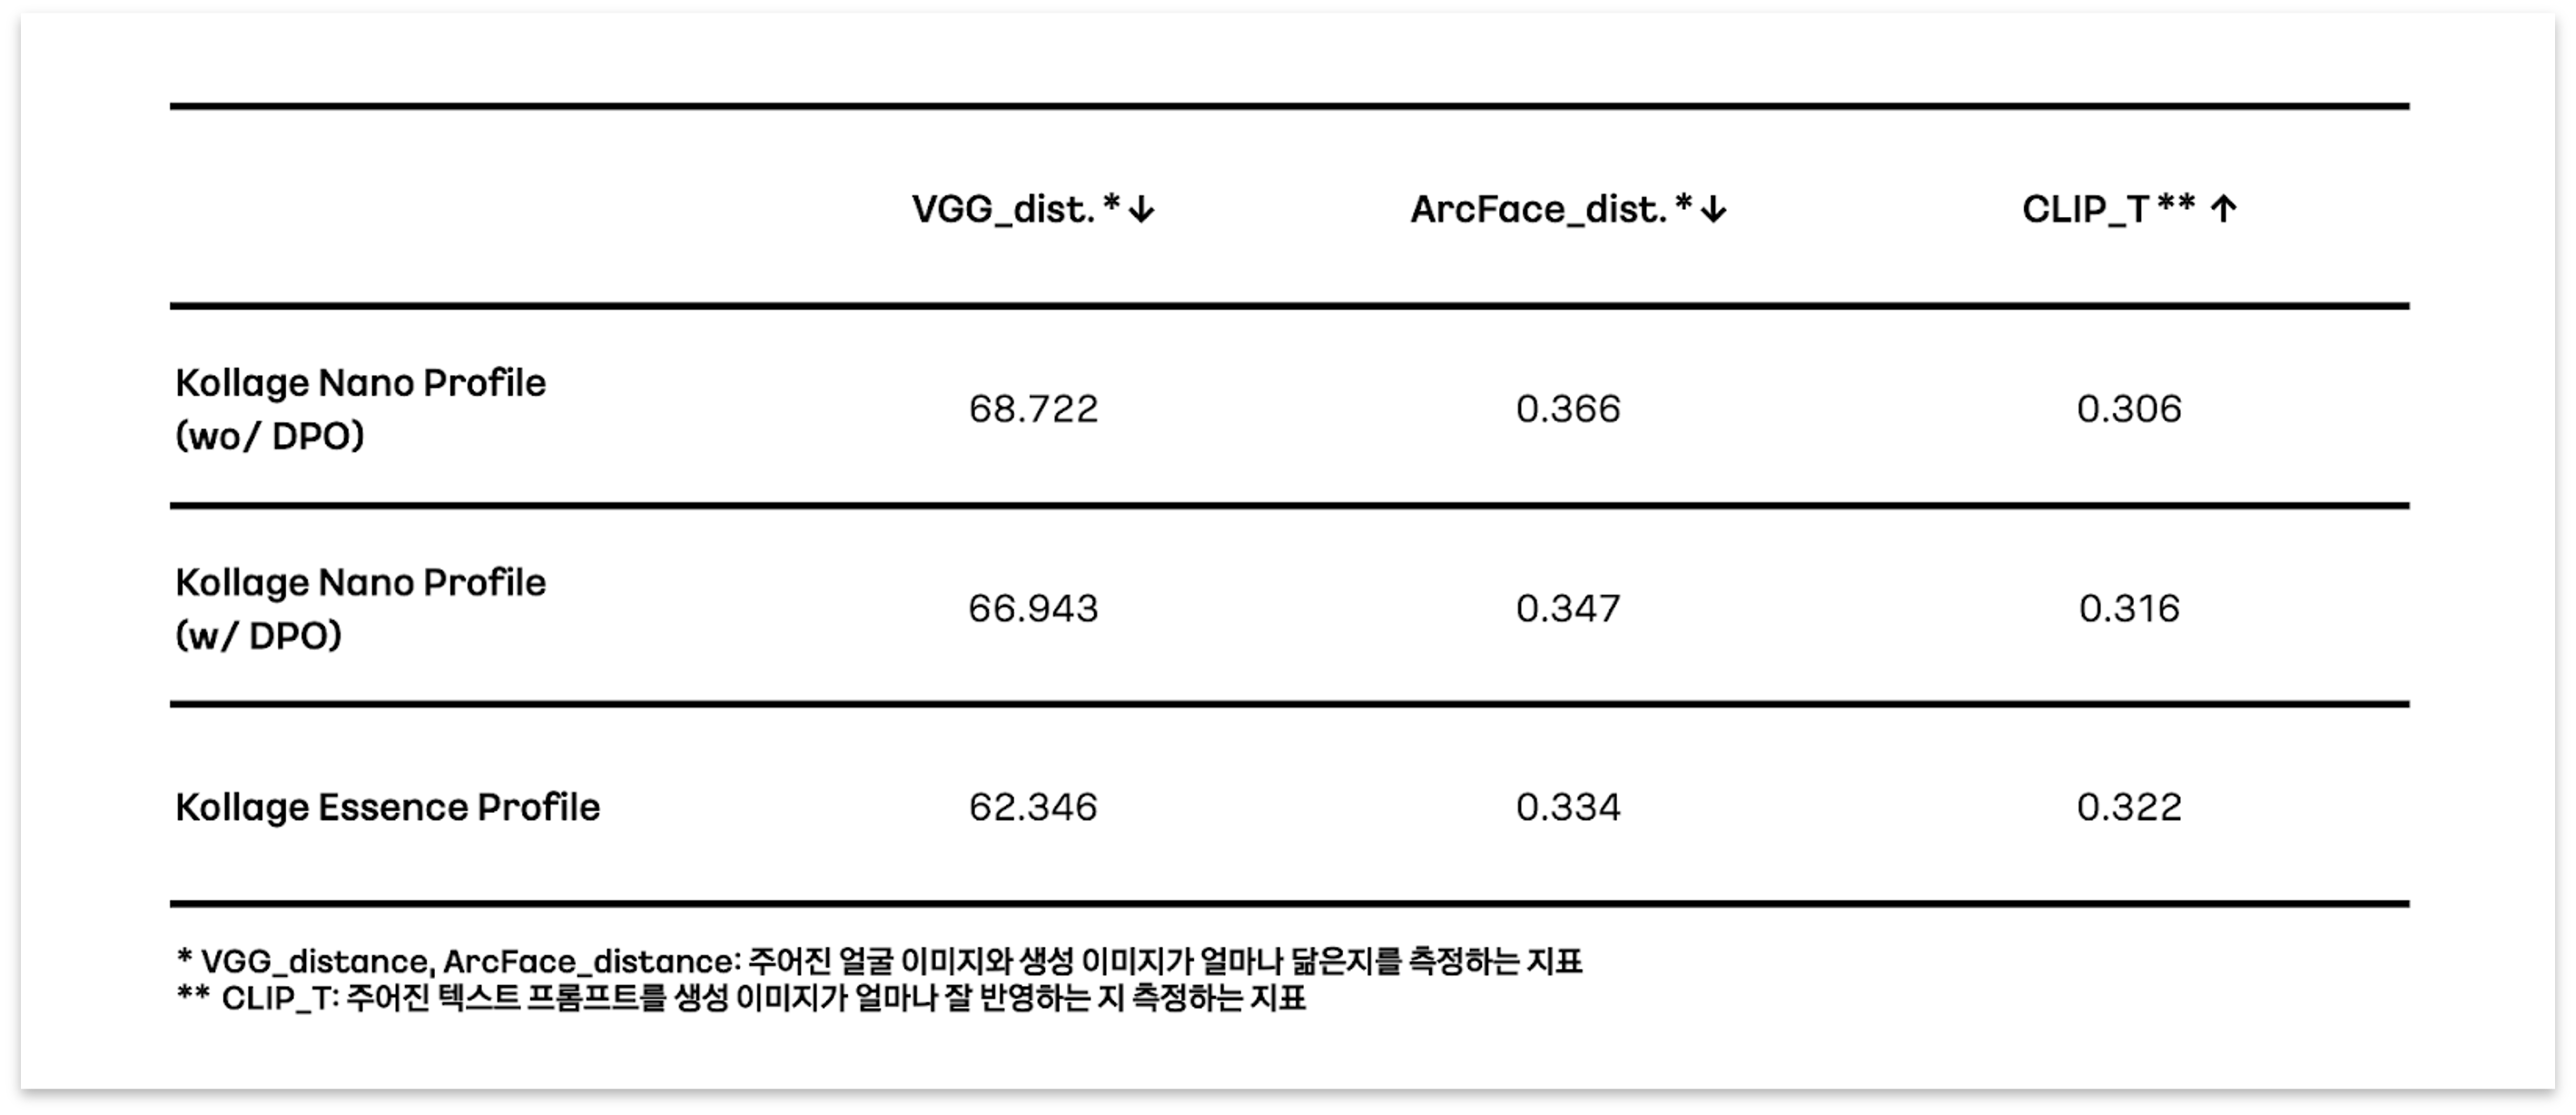
모델 평가에 있어 저희가 가장 중점에 둔 부분은 닮음 및 텍스트 반영 정도입니다. 이 두 평가 지표는 꽤 신뢰성이 컸지만, 이미지의 품질, 결점 등의 경우 정량적 평가가 힘들었기에, 정성적인 평가를 주로 활용했습니다. 현재 콜라주 나노 모델의 경우, HG-DPO 방법론 적용 전과 후의 결과를 모두 비교했으며, 콜라주 에센스의 경우 DPO가 적용되지 않아 추후 적용할 계획입니다. 다만 정량적인 성능 평가는 차례대로 증가했으며, 모델 크기와 DPO 적용에 따라 일관적인 성능 향상을 보였습니다.
실제 이미지를 비교해 보면, 저희 프로필 모델의 성능을 더욱 체감할 수 있을 것입니다. 두 모델 모두 자연스럽게 닮은 실사 이미지를 목표로 하기에 얼굴, 배경, 포즈 모두 실제와 같은 모습이 생성되어 추후 다양한 서비스 적용 시에도 아쉬움이 없게끔 만들고 있습니다.
콜라주 프로필 모델 체험하기: 카나나 포토부스
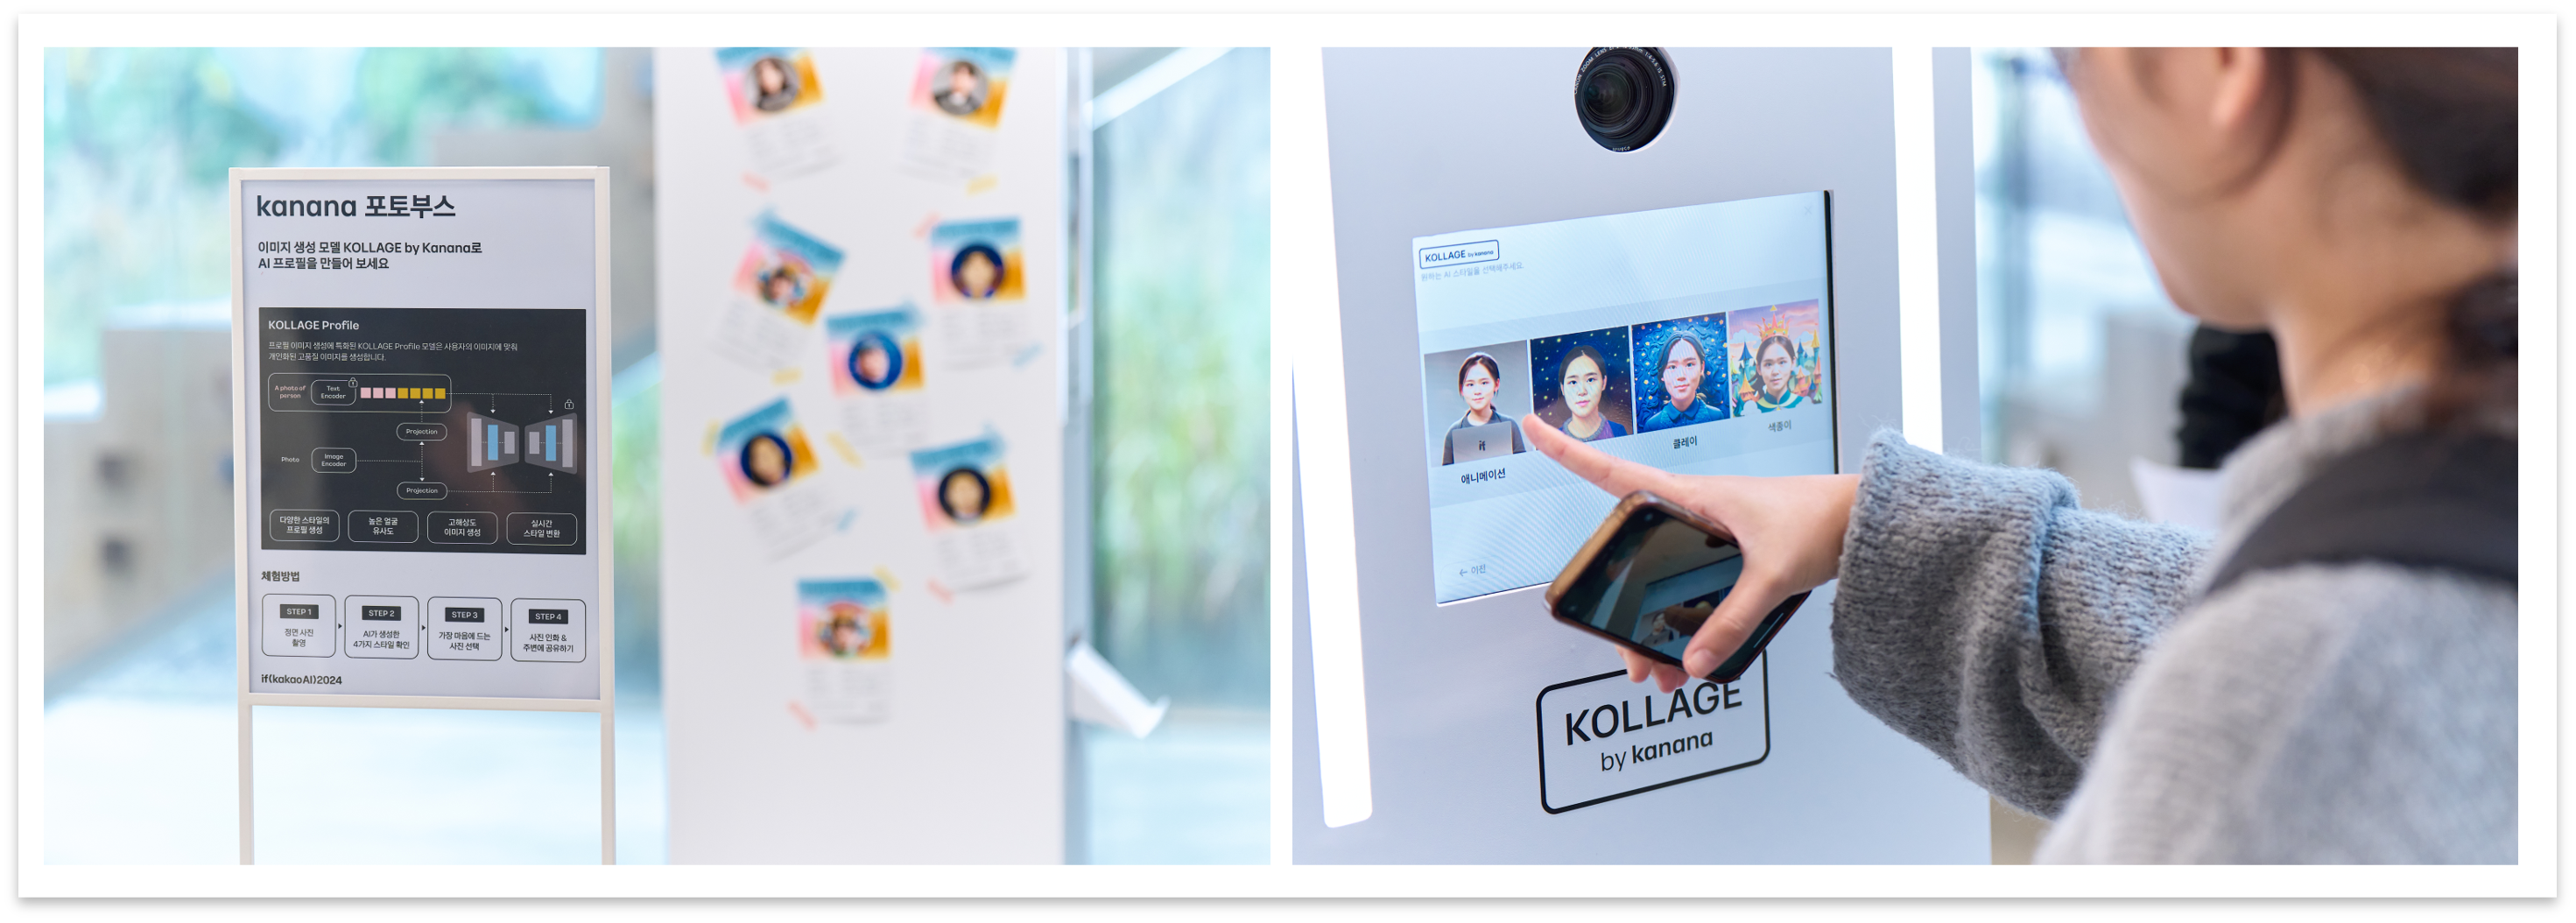
이번 if(kakaoAI)2024가 열린 3일 동안, 행사 현장에서는 콜라주 프로필 모델을 체험해 볼 수 있는 카나나 포토부스가 운영되었습니다. 참가자들이 즉석에서 사진을 촬영하면 약 30초 이내에 총 4가지의 스타일(애니메이션, 크레파스, 클레이 및 색종이)의 AI 프로필 이미지를 생성해 주었는데요.
행사 기간 내내 긴 대기 줄에도 불구하고 많은 분들이 적극적으로 참여해 주시고, 각기 다른 스타일의 프로필 이미지를 확인하며 호응해 주신 분들의 모습도 매우 인상적이었습니다. 현장에서 사용자의 직접적인 피드백을 들으면서 이미지 생성 모델에 대한 관심과 기대감을 더욱 실감할 수 있었습니다.
마치며
이번 if(kakaoAI)의 발표자로서 여러분들에게 저희의 기술과 경험을 알려드릴 수 있어 좋은 경험이었습니다. 개인적으로 주위 크루들의 피드백과 현장의 목소리를 들으면서 앞으로 어떤 연구를 해야 하고 목표가 무엇인지 다시 한번 생각해 보며, 스스로에게 동기부여를 준 계기가 되었습니다. 더욱 흥미로운 연구 경험을 공유하고 참석자분들의 질문을 충분히 소화시켜 드리지 못해 아쉽지만, 추후 기회가 된다면 더욱 알찬 내용과 멋진 기술 이야기를 계속해 공유해 보겠습니다.
앞으로도 카나나 알파 조직에서는 최신 연구 동향과 경험을 바탕으로 글로벌 최고 수준의 Personalized T2I 모델 개발을 목표로 달려갈 것입니다. 이뿐만 아니라, 현재 학습 중인 동영상 생성 모델인 Kinema by Kanana에도 추후 개인화 기술을 적용할 수 있도록 할 계획이니 많은 관심 부탁드립니다. 감사합니다.
Contributions
Kanana ⍺ 조직의 hans.d (김한샘), malfo.y (이현준), tomas.py (Bui Minh Tuan), orca.ai (나상현), arthur.a (김용규), ethan.yyy (김태완), vivigo.gyoza (임성택), ted.chl (이창화), maverick.roger (박민호), joshua.r (노명철)., marcus.e (강민석) benjamin.d (강동오) 가 기여해 주셨습니다.
Acknowledgements
전체 내용에 대한 검수를 맡아주신 Kanana ⍺ 조직의 loophy.cc (조정민)님께 감사의 말을 전합니다.
관련 글 목록
- 카카오의 AI 모델, 카나나 모델 패밀리를 소개합니다
- 밑바닥부터 Kanana-LLM 개발하기: Pre-training
- 밑바닥부터 Kanana-LLM 개발하기: Post-training
- 나만의 프로필 이미지 생성 모델 개발기
- 이미지도 찰떡같이 이해하는 카카오의 멀티모달 언어모델 Kanana-v 알아보기
- 작지만 강한 Kanana Nano 효율적으로 개발하기
참고문헌
[1] Goodfellow, Ian, et al. “Generative adversarial nets”, NIPS, 2014
[2] Ho, Jonathan, Ajay Jain, and Pieter Abbeel. “Denoising diffusion probabilistic models”, NIPS, 2020
[3] Sanghyeon Na et al. “Boost Your Own Human Image Generation Model via Direct Preference Optimization with AI Feedback”, arXiv, 2024
[4] Rafailov, Rafael, et al. “Direct preference optimization: Your language model is secretly a reward model”, NIPS, 2024
[5] Yuval Kirstain et al, “Pick-a-Pic: An Open Dataset of User Preferences for Text-to-Image Generation”, NIPS, 2024
[6] https://github.com/christophschuhmann/improved-aesthetic-predictor
[7] Shi, Jing, et al. “Instantbooth: Personalized text-to-image generation without test-time finetuning.”, CVPR, 2024
[8] Radford, A. et al. “Learning Transferable Visual Models From Natural Language Supervision”, ICML, 2021
[9] Yuheng Li, et al. “GLIGEN: Open-Set Grounded Text-to-Image Generation”, CVPR, 2023
[10] Deng, Jiankang et al. “ArcFace: Additive Angular Margin Loss for Deep Face Recognition”, CVPR, 2019