Engineering
Kanana 언어모델에 추론 기능 붙여보기 (feat. Kanana-1.5)
kevin.nlp, louie.m, terry.uh, sean.ai카카오
2025년 8월 29일
원문에서 보기 ↗안녕하세요, 카카오의 언어모델 ‘Kanana’의 연구 및 개발을 담당하는 Kevin, Louie, Terry, 그리고 Sean 입니다.
2024년 9월 OpenAI의 o1 모델이 출시되고, 2025년 1월에 DeepSeek R1이 공개된 이후, LLM의 추론 능력에 대한 관심이 폭발적으로 늘어났습니다. 학습 단계에서 더 많은 연산 자원을 투자하는 것은 물론, 테스트 시점에도 사고 과정에 충분한 연산을 할당하는 방식의 LLM 추론 기술은 기존 LLM들의 성능을 한 차원 높여주고 있습니다. 이제 LLM은 대부분의 사람보다 코드포스(Codeforces) 순위가 높고, 고등 수학 올림피아드 문제도 인간보다 더 잘 푸는 시대가 되었습니다.
저희도 Kanana의 성능을 혁신적으로 높이기 위해 다양한 내부 연구를 꾸준히 이어왔습니다. 그 결과, 기존에는 풀지 못했던 많은 문제들을 추론 기법을 도입하여 성공적으로 해결할 수 있게 되었습니다. 이번 블로그에서는 이러한 연구 과정에서 저희가 겪었던 시행착오와 인사이트를 여러분과 공유하고자 합니다.
1. Supervised Fine-Tune (SFT)
LLM이 추론 능력을 발휘한다고 판단할 수 있는 대표적인 신호는, 모델의 답변에서 계획(Planning) , 평가(Evaluation) , 반성(Reflection) , 탐구 (Exploration )와 같은 사고 과정이 드러나는 경우입니다. 이러한 개별적인 요소들은 웹 텍스트, 책, 혹은 인간 간의 대화 속에서도 자연스럽게 존재하지만, 특정한 문제 풀이 상황에서 이 모든 과정이 복합적으로 드러나는 경우는 드뭅니다. 기존 학습 단계에서 이러한 추론 패턴이 충분히 내재화되지 않았다면, 이를 보완하기 위해서는 추론 중심의 학습 데이터(Reasoning Demonstration Data)를 기반으로 Supervised Fine-Tune(SFT)를 수행하는 과정이 필요합니다.
SFT는 단순히 모델이 추론 과정을 내재화하는 역할만 하는 것이 아니라, 강화학습(Reinforcement Learning, RL) 단계가 효과적으로 작동하기 위한 초석 을 마련합니다. RL에서는 반드시 긍정적인 학습 신호 (Positive Signal)가 필요합니다. 하지만 RL 초기 모델이 문제를 전혀 풀지 못한다면, 학습 과정에서 어떤 방식으로 문제를 접근해야 하는지 단서조차 얻을 수 없어 성능 향상을 기대하기 어렵습니다.
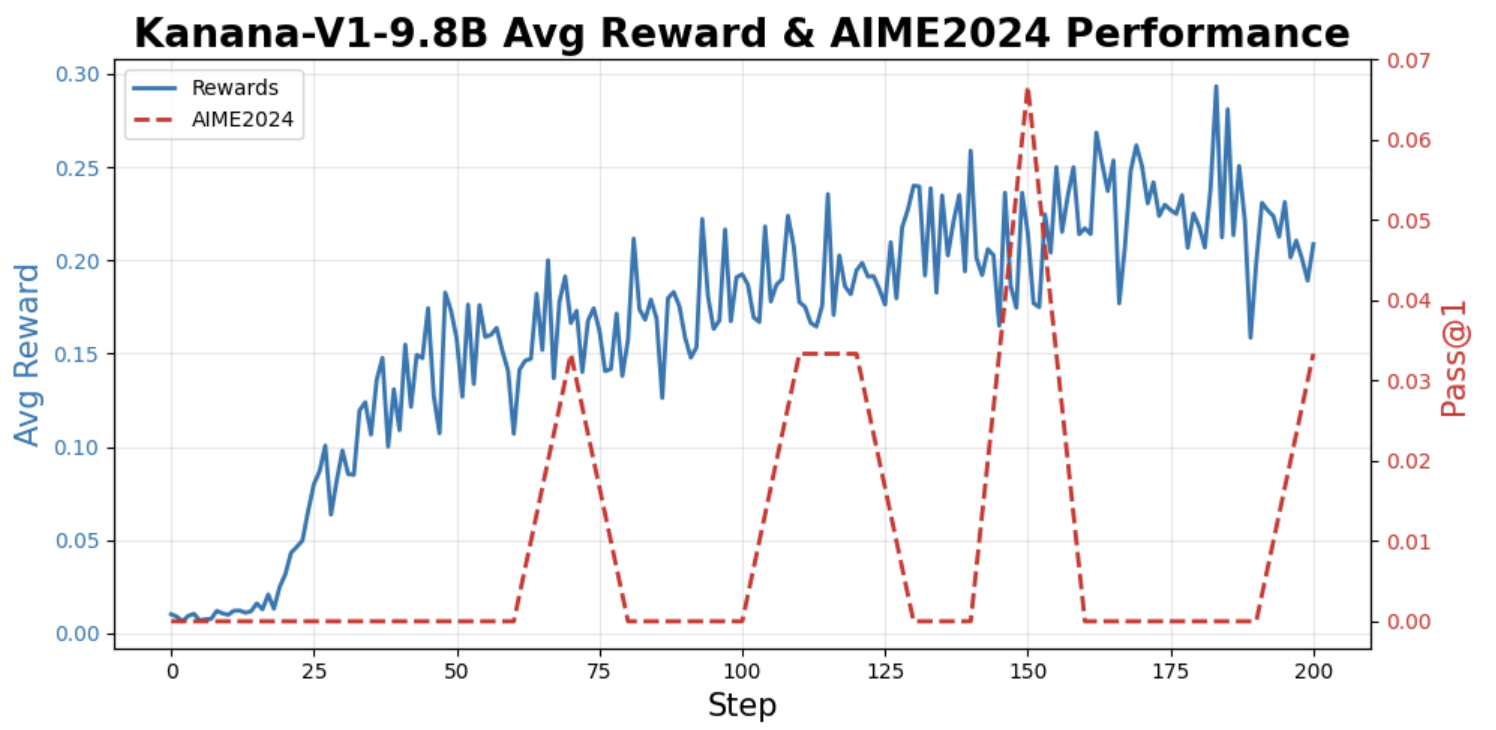
이 점은 저희가 진행한 Zero-RL 실험 을 통해 명확히 확인되었습니다. 여기서 Zero-RL이란, SFT(지도 학습)를 전혀 거치지 않은 Pre-trained 모델을 바로 강화학습에 투입하는 방식을 말합니다. 아래 그래프는 Kanana-9.8B 모델을 PPO 알고리즘으로 Zero-RL 실험을 수행했을 때의 Reward 그리고 AIME 2024 점수 변화를 보여줍니다. Kanana-9.8B 모델의 Reward 점수를 보면 최대 0.3 수준에 그치는 걸 확인할 수 있습니다. 특히 AIME 2024 평가에서 대부분의 타임 스텝에서 0점을 기록 하였습니다. 이는 곧 SFT 없이 RL만으로는 충분한 학습 신호를 얻기 어렵다는 점을 잘 보여줍니다.
최신 공개된 연구들에서도 비슷한 패턴을 확인할 수 있습니다. Magistral 24B 모델은 SFT만으로도 AIME2024에서 pass@1 65.4점을 기록했습니다. 여기서 중요한 점은, 기존의 많은 수학 Reasoning 관련 연구들이 주로 최종 RL 단계의 성능만 리포트하고, SFT 단계에서의 구체적인 성능은 잘 드러내지 않았다는 것입니다. 이로 인해 SFT가 얼마나 중요한지, 그리고 RL 성능이 어디서부터 출발하는지 명확하게 파악하기 어려웠지만, Magistral은 SFT 성능 자체를 명확히 공개했습니다.
그 수치는 이미 기존 RL 기반 모델들이 도달한 성능에 필적하거나 그 이상이었습니다. 이를 통해 저희는 “좋은 성능의 Reasoning LLM을 얻기 위해서는 SFT 단계에서 이미 충분히 높은 성능이 확보되어야 한다”는 사실을 직접적으로 확인할 수 있습니다. 즉, Magistral은 단순히 뛰어난 성능을 보인 모델일 뿐 아니라, SFT의 중요성을 실험적으로 뒷받침한 드문 사례라고 할 수 있습니다. 따라서 SFT는 단순한 전처리 과정이 아니라, 좋은 성능의 Reasoning LLM을 만들기 위해 반드시 거쳐야 하는 핵심 단계라 할 수 있습니다.
1.1 Reasoning Demonstration Data 활용 고도화: Two-staged SFT
앞서 설명했듯이 SFT 단계에서는 추론 과정을 모델이 학습할 수 있도록 Reasoning Demonstration Data가 필요합니다. 이러한 데이터는 일반적으로 아래의 두 가지 방식으로 만들어 집니다.
- CoT Prompting 기반 생성 추론 특화 모델이 없는 상황에서, Instruction-following 능력이 강력한 PLM(Pre-trained Language Model)을 활용해 Chain-of-Thought(CoT) prompting을 적용하는 방식입니다. 이 방법은 DeepSeek-V3처럼 자체적으로 매우 강력한 PLM을 보유한 경우에 효과적입니다.
- 추론 모델 기반 Data Distillation 이미 공개된 강력한 추론 모델을 활용하여 질문–정답 쌍에 대한 체계적인 추론 과정을 생성하고, 이를 Reasoning Demonstration 데이터로 활용하는 방식입니다.
최근 오픈소스 추론 모델들은 단순 CoT prompting 기반 PLM보다 훨씬 뛰어난 성능을 보이고 있습니다. 따라서 저희는 이러한 최신 추론 모델들의 강점을 적극적으로 활용할 수 있는 Data Distillation 방식을 선택했습니다. 이는 단순히 자체 PLM의 Instruction-following 능력에 의존하기보다는, 이미 검증된 오픈소스 Reasoning 모델이 보여주는 안정적이고 높은 품질의 추론 경로를 학습 데이터로 이전할 수 있다는 점에서 훨씬 효율적입니다.
저희는 높은 품질의 추론 경로를 활용하기 위해서, 오픈소스 Reasoning 모델로부터 생성된 SFT 데이터(예: AM-DeepSeek-Distilled-40M, AceReason-1.1-SFT)를 활용하는 것을 기본으로 하고, 모델이 추론을 배우는 데 진짜 도움이 되는 데이터만을 잘 고르는 데에 집중했습니다. 이를 위해 DeepDistill에서 제안하는 Metric인 verify_score 와 CV 를 참고하여, 저희는 데이터의 난이도에 따라 두 단계로 학습하는 Two-staged SFT를 설계했습니다.
verify_score는 모델이 생성한 응답이 얼마나 올바른지를 나타내는 지표로, 수학 문제라면 정답 여부로, 코드 문제라면 실행 성공 여부로 계산됩니다. 즉, 각 응답의 ‘정확도’를 보여줍니다. 하지만 모델은 같은 문제에 대해서도 여러 번 시도할 수 있습니다. 이때 단순히 평균 점수만 본다면 학습 가치를 제대로 파악하기 어렵습니다.
이를 보완한 지표가 바로 CV입니다. 예를 들어 두 문제 모두 평균 점수가 0.5라고 하더라도, 모델이 항상 비슷한 점수를 내는 문제는 이미 안정적이라 추가 학습 효과가 크지 않고, 반대로 어떤 시도에서는 맞고 어떤 시도에서는 틀리는 문제라면 들쭉날쭉하기 때문에 학습을 통해 개선할 여지가 있을 수 있습니다. CV는 여러 번의 시도로부터 계산된 verify_score의 표준편차를 verify_score의 평균으로 나눈 값으로, 예시에 주어진 어떤 시도에서는 맞고 어떤 시도에서 틀리는 문제는 높은 CV가 높은 수치로 기록됩니다.
CV = \frac{\sigma}{\mu} = \frac{\sqrt{\frac{1}{n} \sum_{i=1}^n (\text{verify\_score}_i - \mu)^2}}{\mu}, \quad \mu = \frac{1}{n} \sum_{i=1}^n \text{verify\_score}_i
결국, verify_score는 정확도를, CV는 문제의 난이도와 학습 잠재력을 알려주는 지표입니다. 두 지표를 함께 쓰면, 단순히 쉬운 문제 대신 모델이 불안정하게 답하는 ‘도전적이면서 학습 가치가 높은 문제’를 골라낼 수 있습니다.
Stage I: 적절한 난이도의 데이터를 선별하여 학습
첫 번째 단계에서는 verify_score와 CV를 함께 고려해 Stage I를 위한 데이터를 선별하였습니다.
- 정확도 기준(verify_score)
- 쿼리별로 가장 높은 verify_score가 카테고리별 임계값을 넘지 못하면 해당 문제는 제거했습니다. 예를 들어, 수학, 코드, 과학 문제, Instruction-follow 문제는 0.99 , 대화형 문제는 0.7로 임계값을 설정했습니다.
- 난이도 기준(CV)
- 임계값을 넘은 문제에 대해 CV를 계산했습니다. CV가 높으면 도전적이므로 학습 가치가 크다고 판단하여 정답률 기준을 넘는 응답만 유지시켰습니다. 반대로 CV가 낮으면 안정적으로 답변을 내뱉게 되는 문제이니 학습 효과가 낮다고 판단하여 제거하였습니다.
다만 Other/Multiturn 카테고리는 예외적으로 유지했습니다. Other 카테고리는 수학·코드·과학처럼 정형화된 문제 외에, 일반 상식, 논리적 추론, 일상적 논리 문제 등을 포함합니다. 이러한 데이터들은 CV가 낮더라도 여전히 모델의 일반화 성능과 다양한 태스크에 대한 적응력을 높이는 데 필요하다고 보았기 때문에, 다양성을 확보하기 위해 일정 비율 유지했습니다. 이 과정을 통해 단순히 ‘많은 데이터’가 아니라, 학습에 진짜 도움이 되는 데이터만을 남길 수 있었습니다. 최종적으로는 약 300만 개의 추론 중심 샘플을 확보했습니다.
Stage II: 고난이도 데이터를 선별하여 학습
Stage I 이후 모델의 추론력이 일정 수준까지 올라가면, 더 이상 중간 난이도의 문제로는 학습 효과가 크지 않습니다. 이때 필요한 것은 더 복잡하고 불확실성이 큰 문제들입니다.
Stage II에서는 난이도를 의도적으로 높여, 모델이 풀기는 어렵지만 학습하면 크게 성장할 수 있는 문제 에 집중했습니다. 카테고리는 Stage I과 동일하게 유지하되, verify_score 임계값은 0.99 이상 으로 더 엄격히 적용하고, 그중에서도 CV가 가장 높은 문제들만 선택했습니다. 또한 동일 쿼리에 여러 응답이 있을 경우, 무작위로 하나만 남겨 과적합을 방지했습니다.
이 과정을 통해 모델은 이미 풀 수 있는 쉬운 문제를 반복하는 대신, 새로운 추론 패턴을 배울 수 있는 도전적 문제에 더 많은 시간을 투자할 수 있었습니다.
Two-staged SFT 전략은 요약하자면 아래와 같습니다.
- Stage I
- verify_score와 CV를 활용해 적절한 난이도의 데이터를 선별하여 학습
- Stage II
- CV가 높은 고난이도의 데이터를 선별하여 학습 → 추론 성능 극대화
즉, 이 전략의 핵심은 정확도와 불안정성을 함께 고려해 단계적으로 학습 데이터를 조정하는 것 입니다. 이를 통해 모델은 단순히 정답을 많이 맞히는 것을 넘어, 추론 과정 자체를 더 깊이 학습할 수 있었습니다.
1.2 Learning Rate Ablation: LR의 결정적 역할
마지막으로 저희가 주목한 것은 Learning Rate(LR)의 선택이었습니다. 데이터 난이도 조절만큼이나 학습률 역시 성능을 좌우하는 핵심 변수였습니다. 아래 표는 Stage I과 Stage II 각각에서 서로 다른 Peak Learning Rate로 학습했을 때의 AIME2024 평가셋에서의 성능 비교 결과입니다. LR 스케줄은 Cosine LR 스케줄로 고정했습니다.
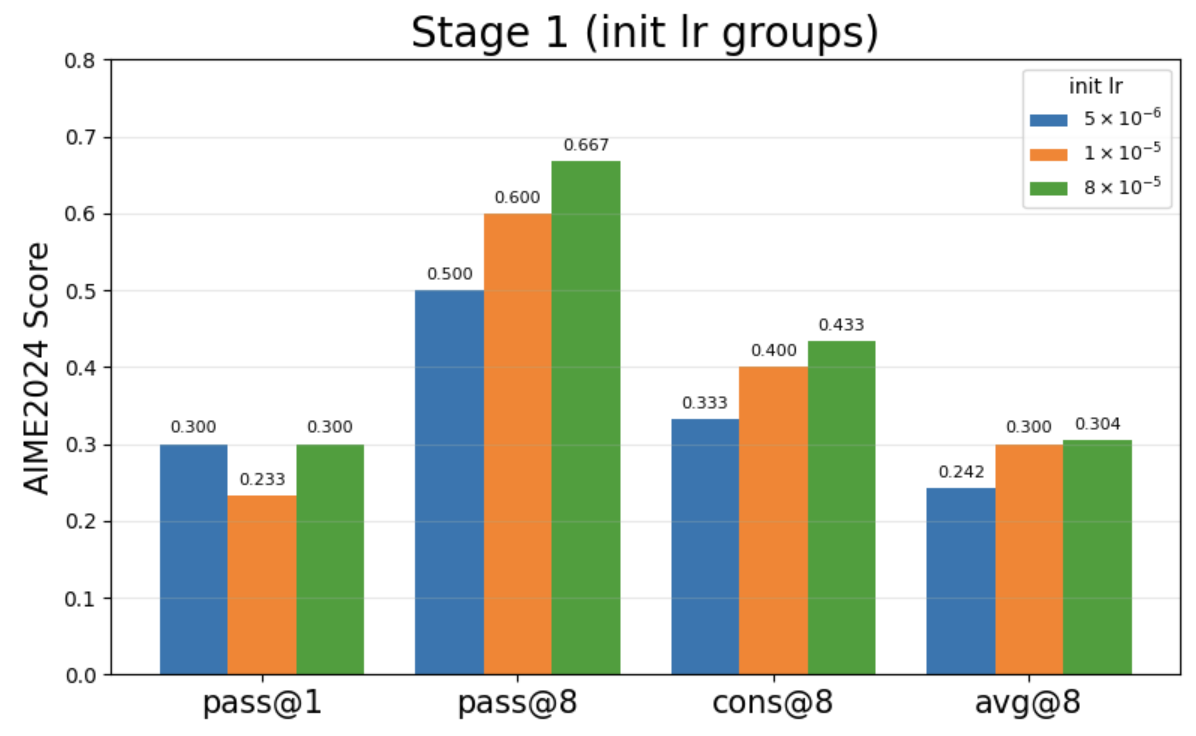
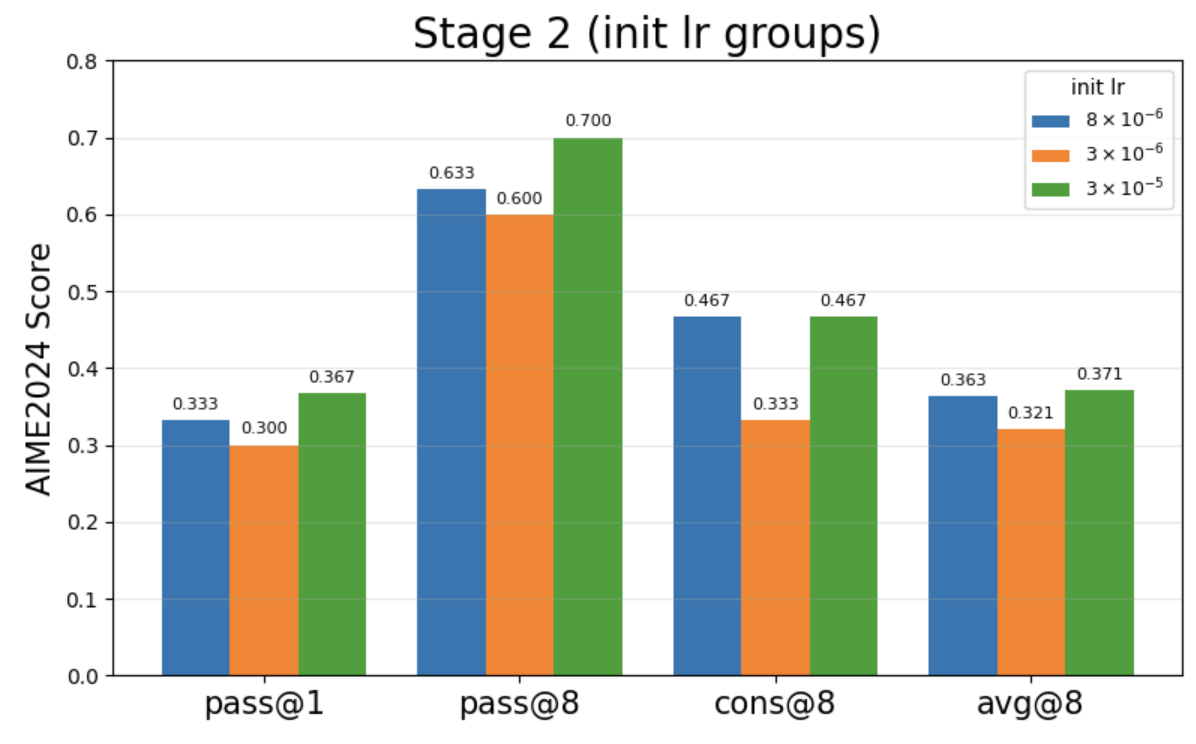
실험 결과, Stage I과 Stage II 모두에서 큰 LR을 사용하는 것이 가장 효과적임을 확인했습니다.
- Stage I에서는
8 \times 10^{-5} \to 8 \times 10^{-6}스케줄이 pass@8 = 0.667, avg@8 = 0.304로 가장 높은 성능을 보였습니다. - Stage II에서는
3 \times 10^{-5} \to 3 \times 10^{-6}스케줄이 pass@1 = 0.367, pass@8 = 0.700, avg@8 = 0.371로 최고 성능을 기록했습니다.
반대로 지나치게 작은 LR을 사용하면 성능이 크게 떨어졌습니다. 이는 곧 LR이 모델이 도달할 수 있는 성능 상한을 결정짓는 핵심 요인임을 보여줍니다.정리하자면, 저희의 SFT 전략은 아래의 두 가지 축으로 요약할 수 있습니다.
- Reasoning Demonstration 활용 방식 고도화
- verify_score와 CV 기준으로 데이터를 선별, 일종의 Curriculum Learning 형식으로 Two-staged SFT를 수행함
- Learning Rate 최적화
- 두 단계 모두에서 충분히 큰 LR을 사용해야 최고의 성능에 도달 가능
2. Reinforcement Learning
2.1 Data
LLM이 올림피아드 수준의 수학 문제를 능숙하게 풀기 위해 강화학습(RL) 단계에서 중요한 점은, 모델이 충분히 어려운 문제에 노출되고, 그 문제들 중 일부는 실제로 풀 수 있어야 한다는 것입니다. 이를 통해 학습 과정에서 충분한 피드백(학습 시그널)을 얻을 수 있습니다. 저희는 이런 목표에 맞춰, 다양한 난이도의 문제로 구성된 DeepMath-103K 데이터셋을 강화학습에 사용하기로 했습니다.
저희는 DeepMath-103K 데이터셋을 그대로 사용하기 보다는 타 오픈소스 모델의 강화학습 데이터셋 전처리 방식을 따르기로 했습니다. 1) SFT 데이터셋에 사용된 프롬프트는 강화학습 단계에서 제외하였고, 2) 충분한 난이도를 가진 문제들만 학습에 사용되도록 했습니다 (Qwen Team, 2025).
Removing Overlap with SFT Data
우선, DeepMath-103K 데이터셋을 대상으로 기존 SFT 학습 데이터와의 중복 여부를 검사했습니다. n-gram 단위(n=13)로 중복 검사를 수행하여 겹치는 문제들을 제거하였습니다. 이 단계를 거친 후 총 93K의 문제가 데이터셋에 남았습니다.이 과정을 통해 강화학습에서 순수하게 새로운 데이터로부터 피드백을 받을 수 있도록 했습니다.
Data Filtering with Difficulty Estimation
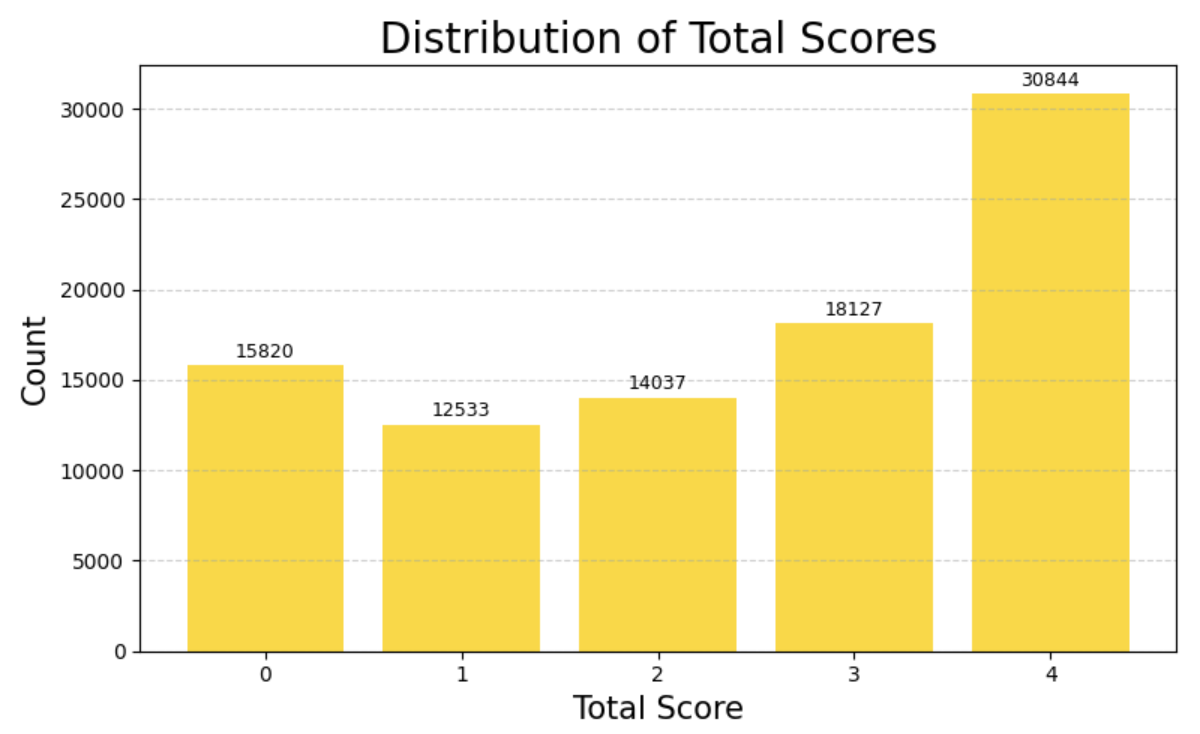
다음 단계에서는 SFT를 수행한 모델을 이용하여 각 문제의 난이도를 평가했습니다. 구체적으로, 각 문제에 대해 4개의 답변을 생성한 뒤 정답의 개수를 세어 난이도 점수를 매겼습니다. 점수는 0(4개 모두 오답)에서 4(4개 모두 정답)까지로, 점수가 높을수록 더 쉬운 문제임을 의미합니다. 분석 결과, 전체 문제 중 약 33.7%가 점수 4(모델이 모두 정답을 맞춘 매우 쉬운 문제)로 나타났고, 약 17%는 점수 0(모두 오답)으로 분류되었습니다.
저희는 모델에게 너무 쉬운 문제는 학습에 도움이 되지 않는다고 판단하여, 난이도 점수가 높은(쉬운) 문제들은 학습 데이터에서 제외했습니다. 최종적으로, 난이도 점수 0~3 범위의 문제들만 남긴 DeepMath-62K (총 62,364개) 데이터셋을 구성하였습니다.
위의 필터링 과정을 거치고 나서도 문제들을 면밀히 살펴보면, 강화학습에 쓰기에는 몇 가지 적합하지 않은 문제들도 발견할 수 있었습니다. 아래에 구체적인 예시와 그 이유를 설명하겠습니다.
Q)
Let
f(x)be a polynomial of degree four having extreme values atx=1andx=2. If
\lim_{x \to 0} \left[1 + \frac{f(x)}{x^2} \right] = 3then find the value of
f(2). Choose from the following options:(1)
-8(2)-4(3)0(4)4
위 예시와 같은 객관식(Multiple Choice Question, MCQ) 문제는 답을 제대로 생각하지 않아도, 우연히 맞출 확률이 높아집니다. 모델이 잘못된 추론 과정을 거쳐도 정답을 맞힐 수 있습니다. 강화학습의 목적은 단순히 답을 맞히는 것이 아니라, 모델이 올바른 추론 과정을 학습하도록 유도하는 것입니다. 이런 이유로 객관식 형태의 문제들은 학습 데이터셋에서 제외하였습니다.
Q) Determine whether the statement "If
a(n) + p(n) \in \Theta(b(n) + p(n)), thena(n) \in \Theta(b(n))" is true or false. Justify your answer using the definition of\Thetanotation:\exists c_1, c_2, n_0 \in \mathbb{R^{\geq 0}}, \forall n \in \mathbb{N}, n > n_0 \Rightarrow c_1 \cdot g(n) \leq f(n) \leq c_2 \cdot g(n). Provide a clear explanation.Q) If
p: \Bbb R \rightarrow \Bbb Ris a real polynomial with a right inverseq, mustqalso be a left inverse ofp? Provide a justification for your answer.
위와 같이 '맞다/아니다(Yes or No)'로 답하는 문제들도 마찬가지로 정답을 맞힐 확률이 높기 때문에, MCQ와 같은 이유로 학습 데이터셋에서 제외했습니다. 실제로 이러한 전략은 Magistral 같은 최신 수학 모델의 학습 과정에서도 활용되고 있습니다.
Q) Determine the rank of the matrix
Bwhere the elements are given byb_{ij} = \frac{1}{\ln(i) + \ln(j)}.
DeepMath 데이터셋은 인공적으로 만들어진(Synthetic) 데이터다 보니, 정보가 부족해(Underspecified) 답이 명확하지 않은 경우도 있습니다. 위 문제의 경우, 행렬의 크기가 명시되어 있지 않아서, 풀이 과정에서 임의로 크기를 가정해야 합니다. 이처럼 추론 과정과는 관련 없는 요소에서 답이 달라질 수 있기 때문에, 이러한 문제도 학습에서 제외했습니다.
2.2 Reinforcement Fine-Tuning
Reasoning 학습과 같은 Reinforcement Fine-Tuning을 수행할 때, 대표적으로는 PPO와 GRPO 알고리즘이 많이 사용되기 때문에, 저희도 이 두 가지 방법론을 염두해두고 비교실험을 진행했습니다. 각각의 방법론을 간략하게 설명하면 아래와 같습니다.
PPO는 Actor-Critic 구조를 따르며, Policy(Actor)가 행동을 선택하고 Value function(Critic)이 해당 상태에서의 기대 Reward를 추정해 Baseline으로 사용합니다. Critic을 통해 Variance를 줄일 수 있지만, LLM 강화학습 맥락에서는 Reward 모델이 보통 마지막 토큰에만 점수를 주기 때문에 각 토큰마다 정확한 Value Function을 학습하는 것이 어렵고, 계산 자원도 많이 소모되는 단점이 있습니다.
- Actor update
\mathcal{L}_{\pi}(\theta) = \mathbb{E}_{x \sim \rho, y \sim \pi_{\theta_{old}} (\cdot \vert x)} \left [ \frac{1}{\vert y \vert} \sum_{t=1}^{\vert y \vert} \min \left ( \frac{\pi_{\theta}(y_t \vert x, y_{
- Critic update
\mathcal{L}_{V}(\phi) = \frac{1}{2} \mathbb{E}_{\tau \sim \pi_{\theta}} \left [ \frac{1}{T} \sum_{t=0}^{T-1} \max \left ( \left\| \hat{V}_{\phi}(s_t) - r_{T-1} \right\|^2 , \left\| \text{clip} \left ( \hat{V}_{\phi}(s_t), \hat{V}_{\phi_k} (s_t) - \epsilon', \hat{V}_{\phi_k} (s_t) + \epsilon' \right ) - r_{T-1} \right\|^2 \right ) \right ]
이와 달리, GRPO (Group Relative Policy Optimization)는 PPO의 Critic 근사 과정을 제거한 알고리즘입니다. Critic으로 Value를 근사하는 대신 같은 질문에 대해 여러 답변을 샘플링하고, 그 평균 Reward를 Baseline으로 사용하는 방식을 취합니다. 이로써 별도의 Value Function 학습이 필요 없기 때문에 메모리와 연산 효율에서 PPO보다 간단하고 실용적입니다.
- Actor update
\mathcal{L}_{\pi}(\theta) = \mathbb{E}_{x \sim \rho, {\{y^i\}}_{i=1}^{G} \sim \pi_{\theta_{\text{old}}} ( \cdot \vert x )} \left [ \frac{1}{G} \sum_{i=1}^{G} \frac{1}{\vert y^i \vert} \sum_{t=1}^{\vert y^i \vert} \min \left ( \frac{\pi_{\theta}(y^i_t \vert x, y^i_{
GRPO 기준에서의 Clipping Hyperparameter Ablation 실험
강화학습에서 널리 쓰이는 PPO(Proximal Policy Optimization)와 GRPO(Group Relative Policy Optimization)는 Gradient Update 시 정책(Policy)이 너무 많이 변하는 것을 방지하기 위해 Clipping 기법을 도입합니다. 하지만 최근 연구에서는 Clipping이 항상 긍정적인 효과를 내는 것은 아니라는 점이 지적되고 있습니다. 예를 들어, Engstrom et al. 2020에서는 PPO에 Clipping을 적용했을 때와 그렇지 않았을 때 성능 차이가 크지 않다고 보고 했으며, LLM 추론 모델 관련 연구(Yu et al. 2025, Minimax 2025)에서도 Clipping이 오히려 낮은 확률 토큰(Low-probability Token) 학습을 방해하여 성능 저하를 유발할 수 있다고 알려져 있습니다.
저희는 이러한 문제 의식을 바탕으로 GRPO 알고리즘에서의 Clipping Hyperparameter Ablation 실험을 진행했습니다. 기존 PPO/GRPO에서 사용되는 \epsilon 파라미터는 정책 업데이트 비율 (Importance Ratio )이 지나치게 커지거나 작아지지 않도록 억제하는 역할을 합니다. 저희는, Yu et al. (2025)에서 제안된 Clip-Higher 전략에 착안하여, 이 \epsilon 파라미터를 하한을 제어하는 \epsilon_{low}와 상한을 제어하는 \epsilon_{high}로 분리해 각각 조정하는 방식으로 실험을 설계했습니다. 추가적으로 학습 효율을 고려하여 Stage-wise Length Extension Strategy를 적용했습니다. 즉, 학습 초반에는 16K Max Response Length로 시작해 빠르게 수렴하도록 한 뒤, 이후 단계에서 32K로 확장하여 더 긴 문맥을 활용할 수 있도록 했습니다.
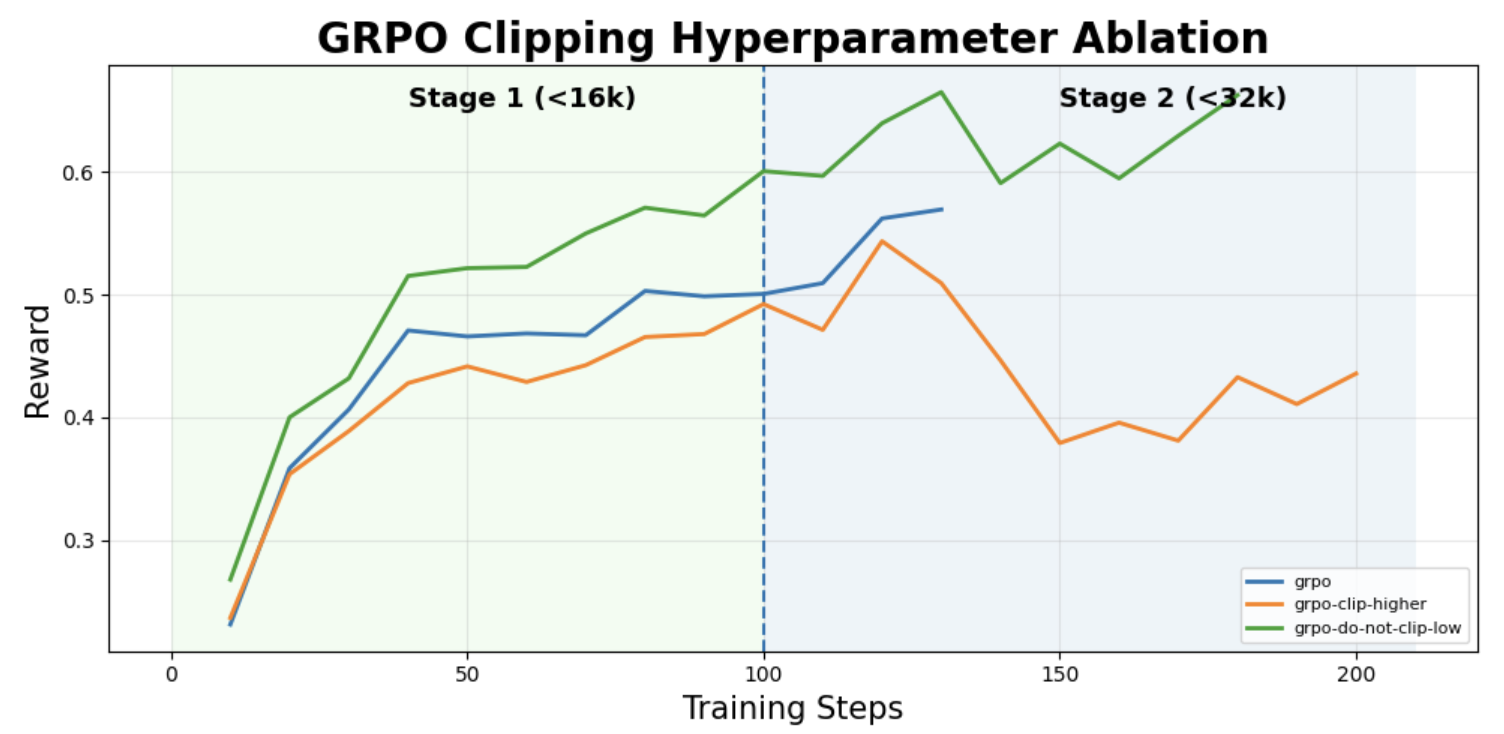
아래의 변수들만 변경하고, 그 이외에는 동일한 조건에서 학습을 통해 확인해 본 결과 아래와 같았습니다.
- GRPO (
\epsilon_{low}= 0.2,\epsilon_{high}= 0.28)- DAPO 논문에서 제안된 설정으로, GRPO-do-not-clip-low 실험보다는 낮은 성능을 보였지만 여전히 일정 수준의 안정적인 Reward 향상을 유지했습니다.
- GRPO-clip-higher: (
\epsilon_{low}= 0.2,\epsilon_{high}= 0.5)- GRPO 실험보다 더 큰 Upper Bound를 설정했지만, Stage 2에서 Reward가 하락했습니다.
- 이는
\epsilon_{high}값을 지나치게 높이면 학습이 불안정해지고 정책 업데이트가 흔들려 성능이 저하될 수 있음을 보여줍니다.
- GRPO-do-not-clip-low (
\epsilon_{low}= 0.99,\epsilon_{high}= 0.5)- Stage 1부터 빠르게 Reward가 상승했고, Stage 2에서도 가장 높은 Reward에 도달했습니다.
- Clipping을 사실상 거의 제거한 설정으로, 모델이 낮은 확률 토큰까지 적극적으로 학습할 수 있었던 것이 좋은 성능의 주요 원인일거라 추측합니다.
이번 실험을 통해 확인한 결론은, GRPO에서는 \epsilon_{low}를 완화하는 것이 성능 향상에 효과적이며, 반대로 \epsilon_{high}를 과도하게 늘리는 것은 성능 저하를 유발할 수 있다는 점입니다.
PPO vs GRPO
최근 다양한 추론 모델 관련 연구에서 GRPO를 사용하고 있습니다 (Liu et al. 2025, Luo et al. 2025, He et al. 2025). 그러나 GRPO와 PPO를 동일한 조건에서 비교한 연구는 올해 초를 기준으로 거의 없었고, 저희는 이 의문을 해결하기 위해 PPO와 GRPO를 비교해 보기로 했습니다.
공정한 비교를 위해 PPO와 GRPO 모두 학습 중 답변 생성 과정에서 배치 사이즈를 동일하게 유지해 주었습니다. 즉, 하나의 Step에 사용되는 문제와 문제당 생성 답변 수를 같게 설정했습니다. 또한 앞선 Clipping Hyperparameter Ablation 결과인 \epsilon_{low}를 완화하는 것을 PPO와 GRPO와 동일하게 적용하였습니다.
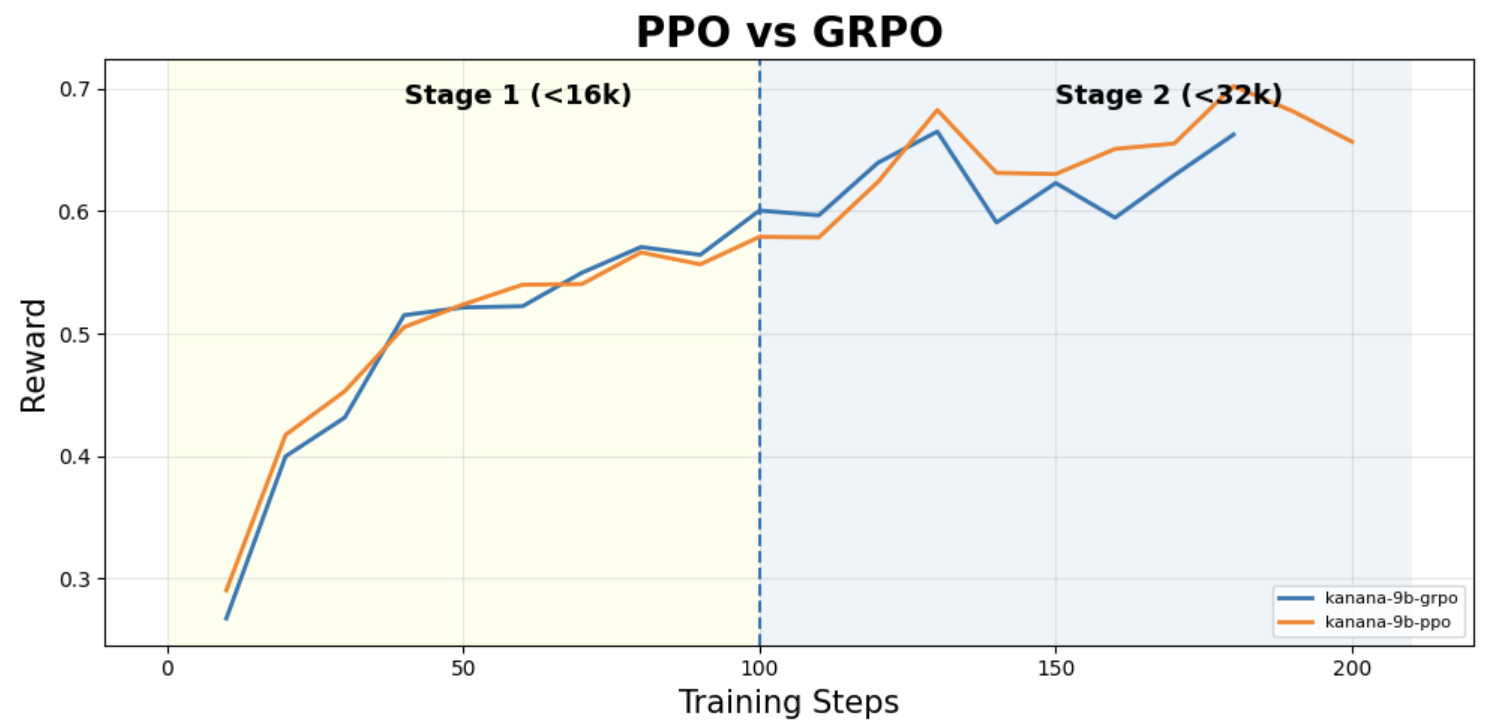
위 그림은 동일한 조건에서 PPO와 GRPO를 학습시킨 결과입니다. Stage 1 (16k Max Response Length 학습 구간 )에서는 PPO와 GRPO 모두 유사한 속도로 Reward가 상승했습니다. 초기 학습에서는 두 알고리즘 간 차이가 거의 없음을 확인할 수 있습니다. Stage 2 (32k Max Response Length 학습 구간)에서는 PPO가 GRPO보다 약간 더 높은 Reward에 도달했습니다. 즉, Value Function을 명시적으로 근사하는 PPO가 후반 학습에서 조금 더 이점을 보였을거라 추측합니다. 학습 Reward 비교 시 두 알고리즘의 성능 차이가 있으며, 이런 경향은 Validation Dataset 평가 시에도 유지되었습니다.
3. 평가
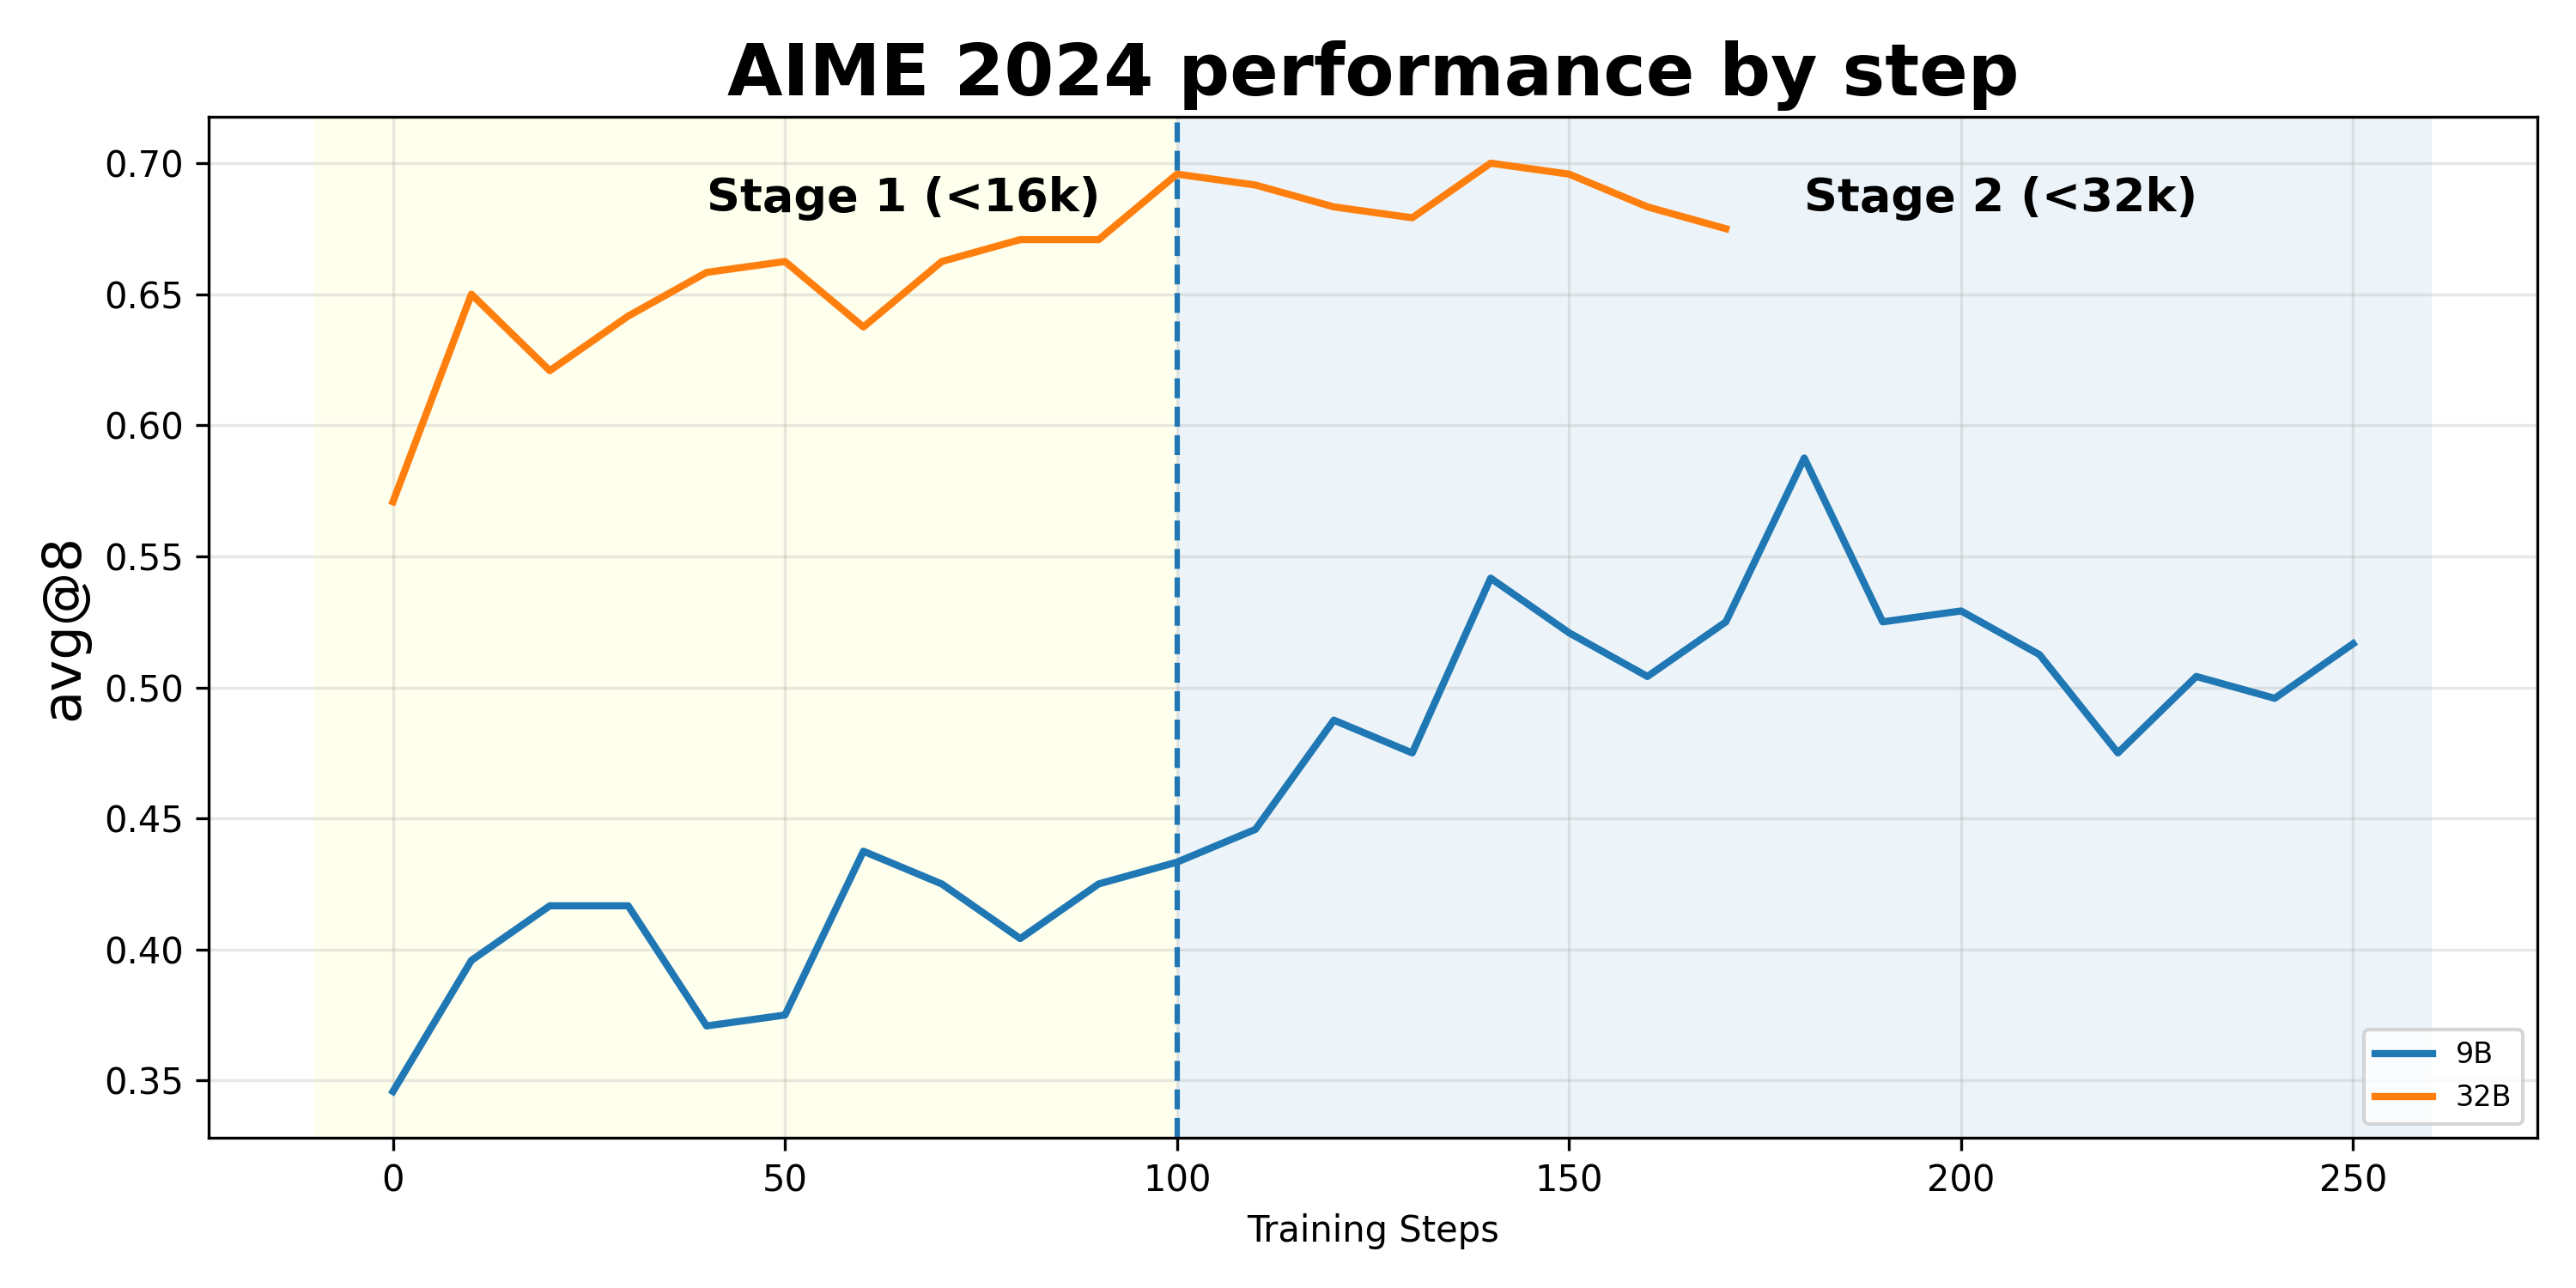
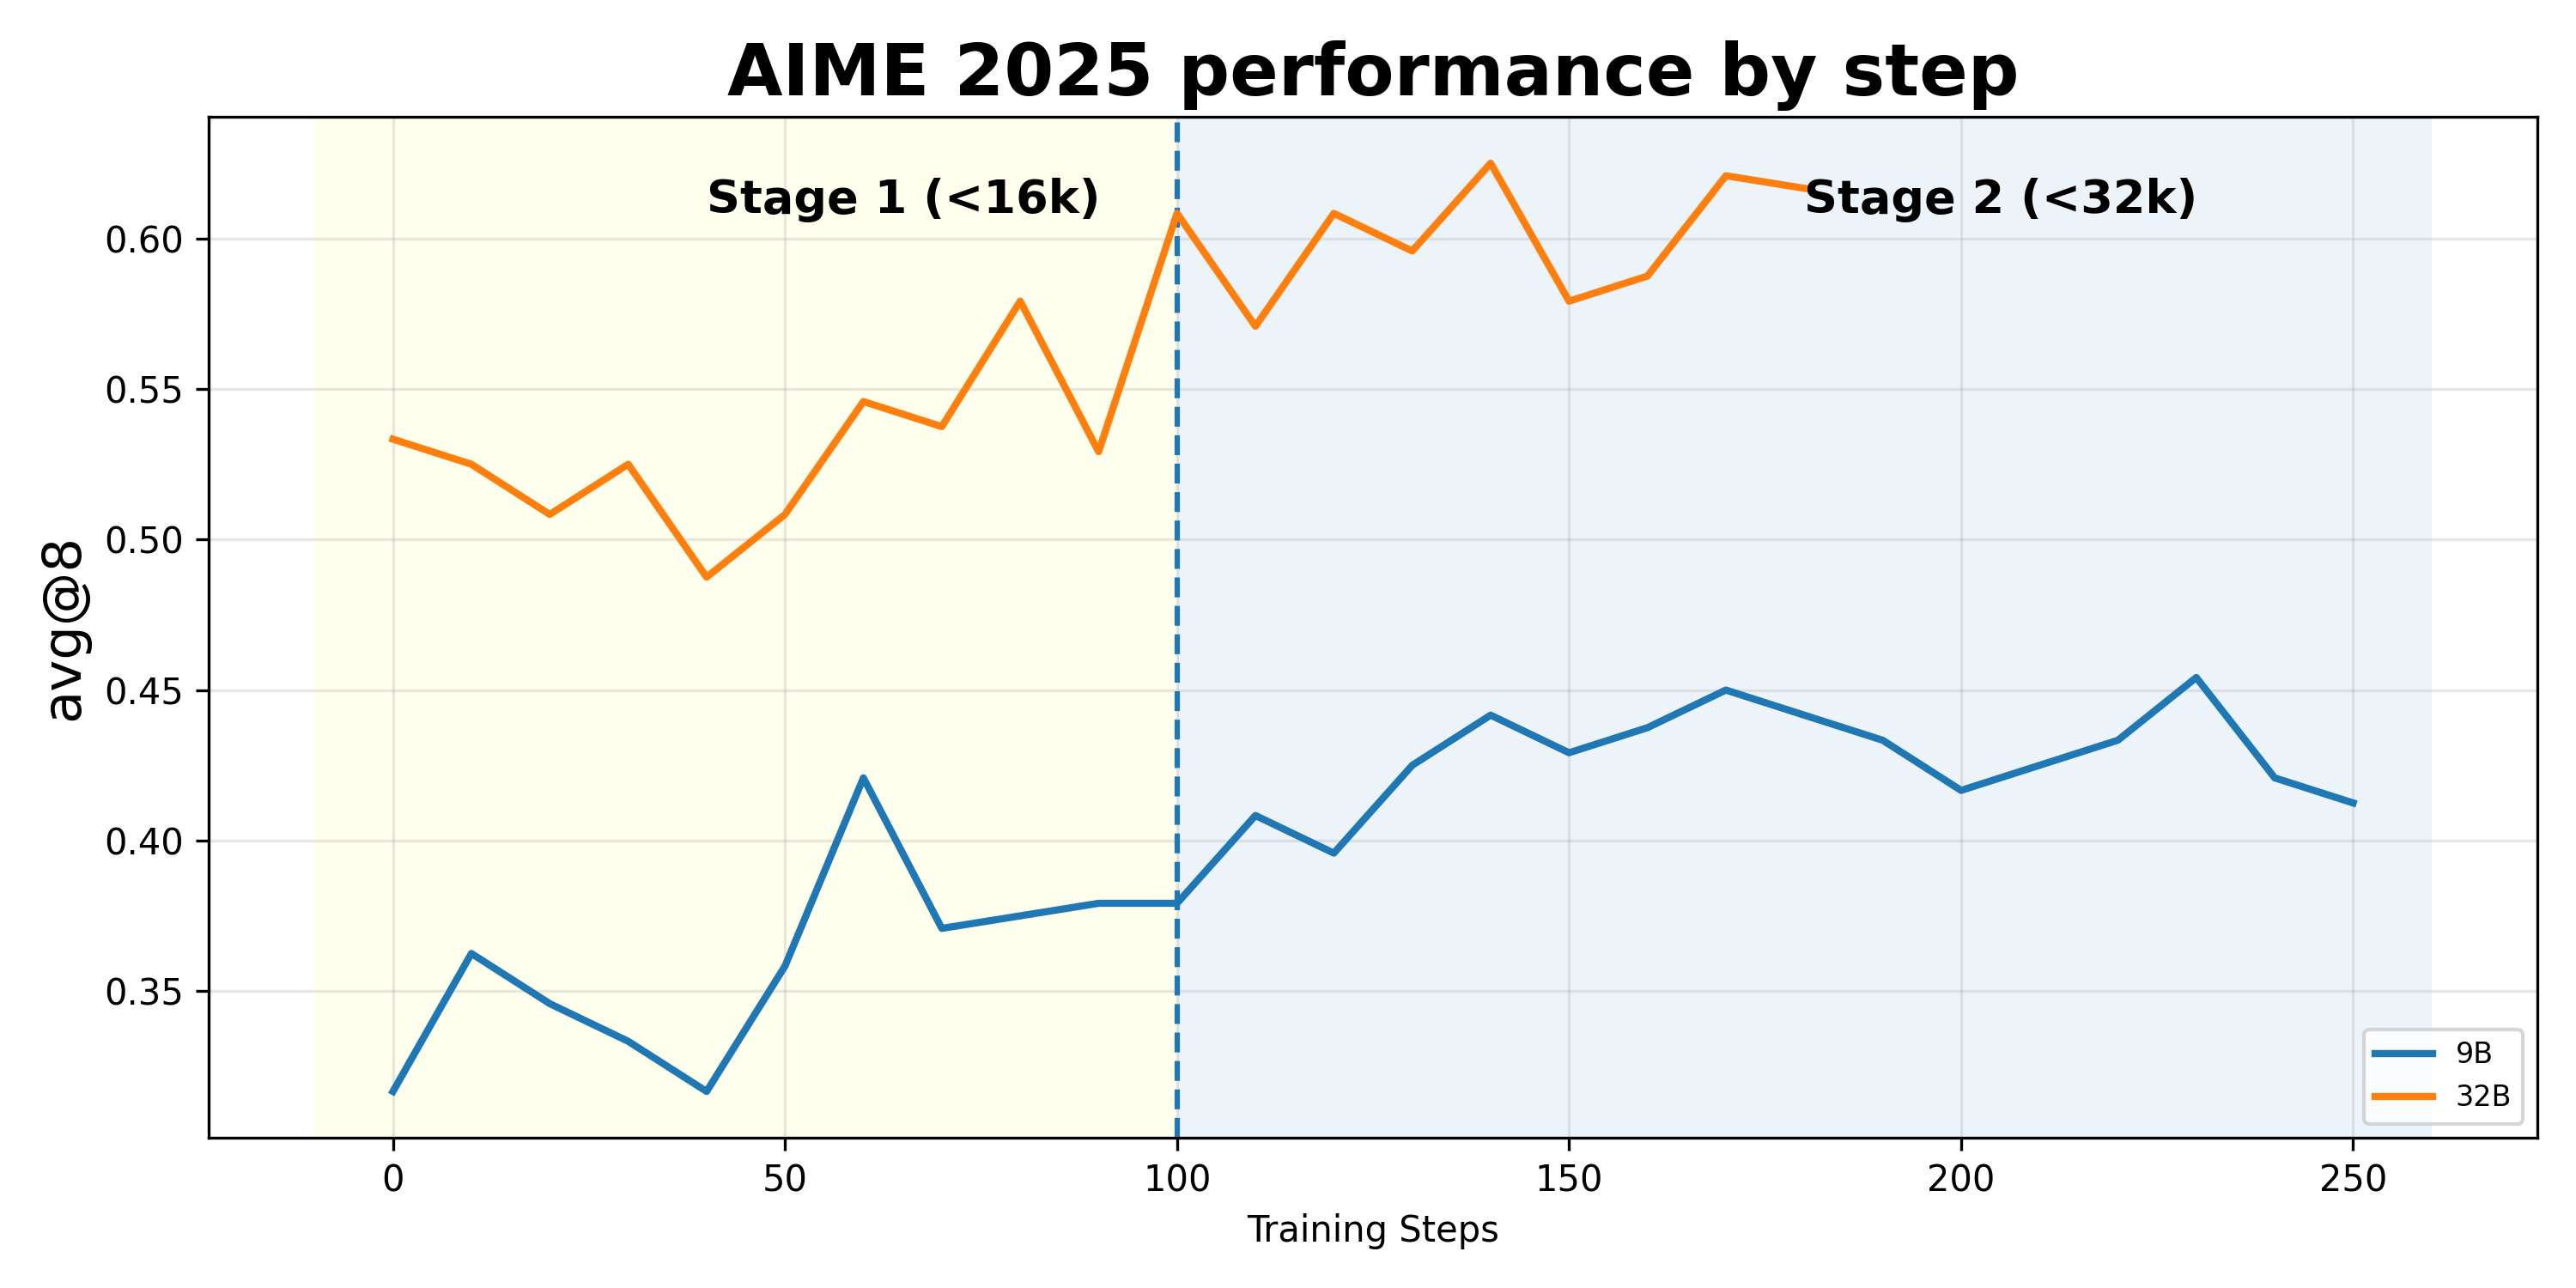
평가로는 추론형 LLM들을 평가하는 데 자주 사용되는 American Invitational Mathematics Examination (AIME)을 사용하였습니다. AIME는 최근 추론형 LLM들을 평가하는 데 사용된 수학 시험입니다. AIME의 특징적인 면으로는 미국의 국제 수학 올림피아드(IMO) 대표 학생들을 선발하는 시험으로, 문제의 난이도는 매우 높아, 우수한 학생들도 쉽게 풀기 어렵습니다. 평가 데이터로서 특징적인 것은, 모든 답이 0에서 999 사이의 숫자로 제한되어 있다는 점입니다.
저희는 Kanana-1.5-Essence-9.8b-base와 Kanana-1.5–flag-32.5b-base에 Two-staged SFT 를 수행하고, PPO에 \epsilon_{low} 값을 크게 설정하는 방식으로 Reinforcement Fine-tuning을 수행한 모델을 AIME 2024, AIME 2025에 평가하였습니다. 학습 단계별로 AIME 2024, AIME 2025의 점수 변화는 아래와 같습니다.
4. One More Thing: Staged RL
지금까지 강화학습 실험을 진행할 때 주로 수학 데이터셋만을 사용해 왔습니다. 이번에는 이와 유사하게, 코드 데이터셋만을 사용하여 강화학습을 진행해 보았습니다. 수학과 코드는 서로 다른 종류의 데이터이지만, 모두 일정 수준 이상의 추론 능력을 요구한다는 공통점이 있습니다. 이러한 이유로, 한 도메인(예: 수학 또는 코드)에서만 학습해도 다른 도메인으로의 능력 전이가 일어날 수 있으리라 기대했습니다. 실제로 AceReason과 Magistral 연구에서도 이와 비슷한 현상이 실험적으로 관찰된 바 있습니다. 실험 결과, 코드 데이터셋만으로 강화학습을 진행했음에도 불구하고, 수학 문제에 대한 모델의 성능이 향상되는 것을 확인할 수 있었습니다.
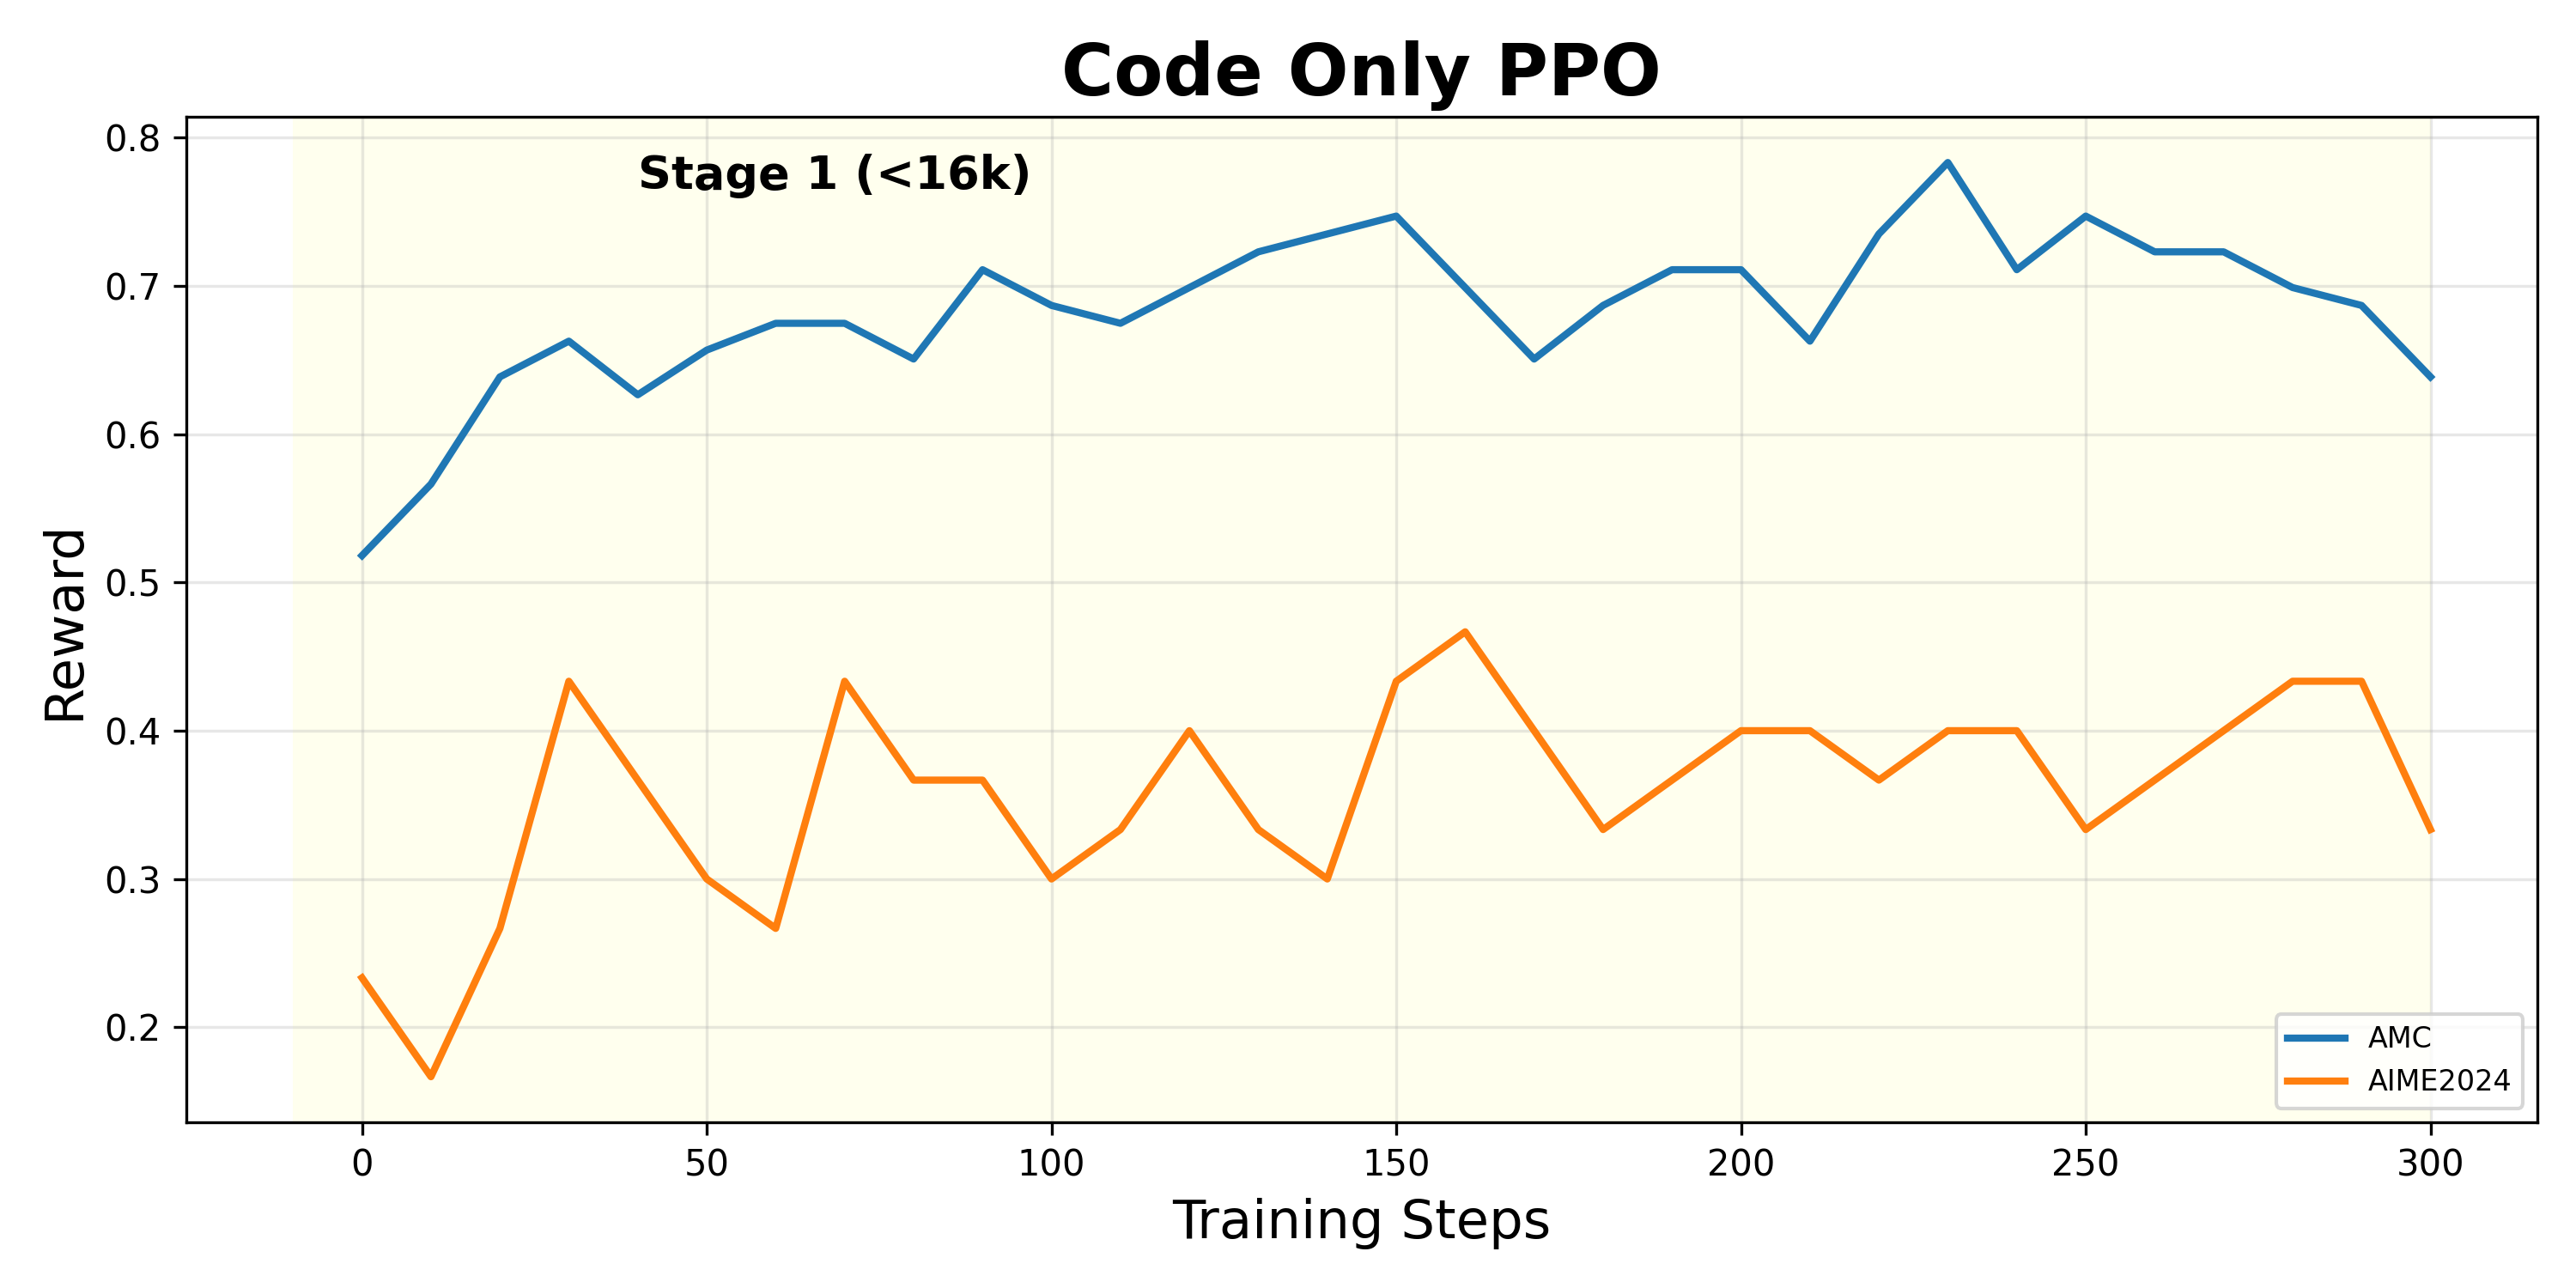
이와 더불어 AceReason-Nemotron 1.1과 DeepSeekMath 두 연구에서 보고된 결과에 참고하여 Staged-RL 실험을 설계하였습니다. AceReason-Nemotron 1.1에서는 수학 → 코드 순서로 학습했을 때 코드 성능이 더 크게 향상되었다고 보고하였으며, DeepSeekMath에서는 코드 → 수학 순서로 프리트레이닝을 수행할 때 MMLU 점수가 가장 크게 개선된 것으로 나타났습니다. DeepSeek 팀은 이 결과에 대해 “모델이 코드를 학습하면서 수학 문제를 푸는 데 필요한 능력도 함께 습득한다”라고 해석했습니다. 이를 근거로 이종 도메인을 적절히 나눠서 학습하면 추론 능력의 일반화가 가능하다고 보고 추가 실험을 진행했습니다.
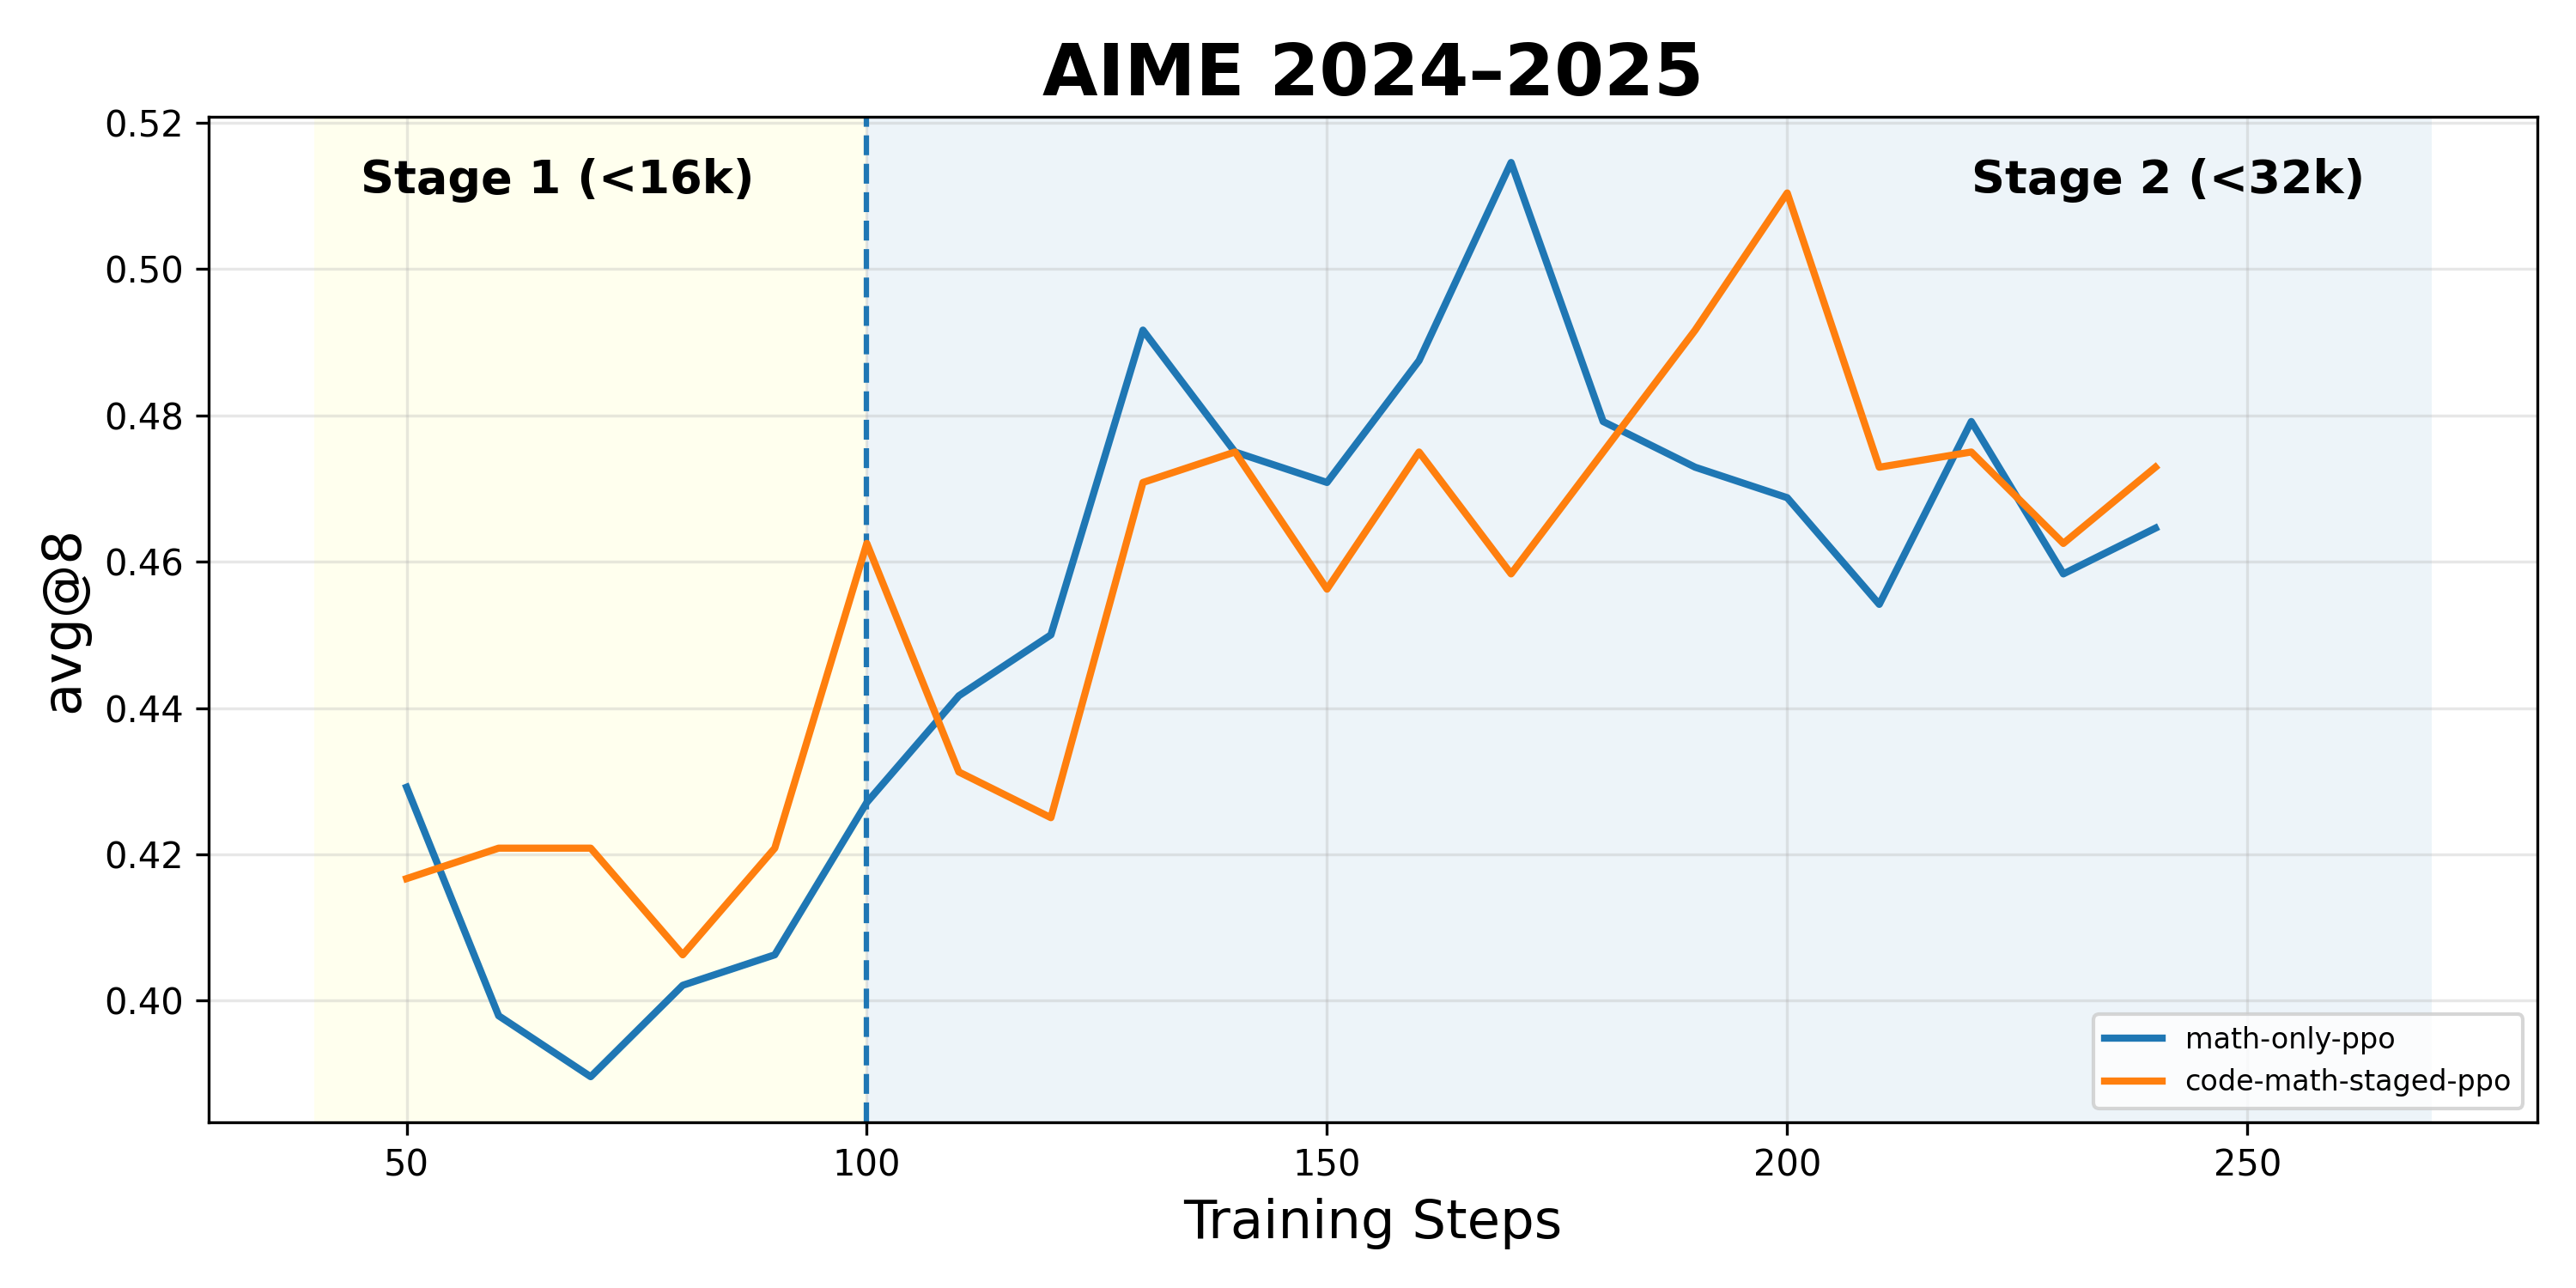
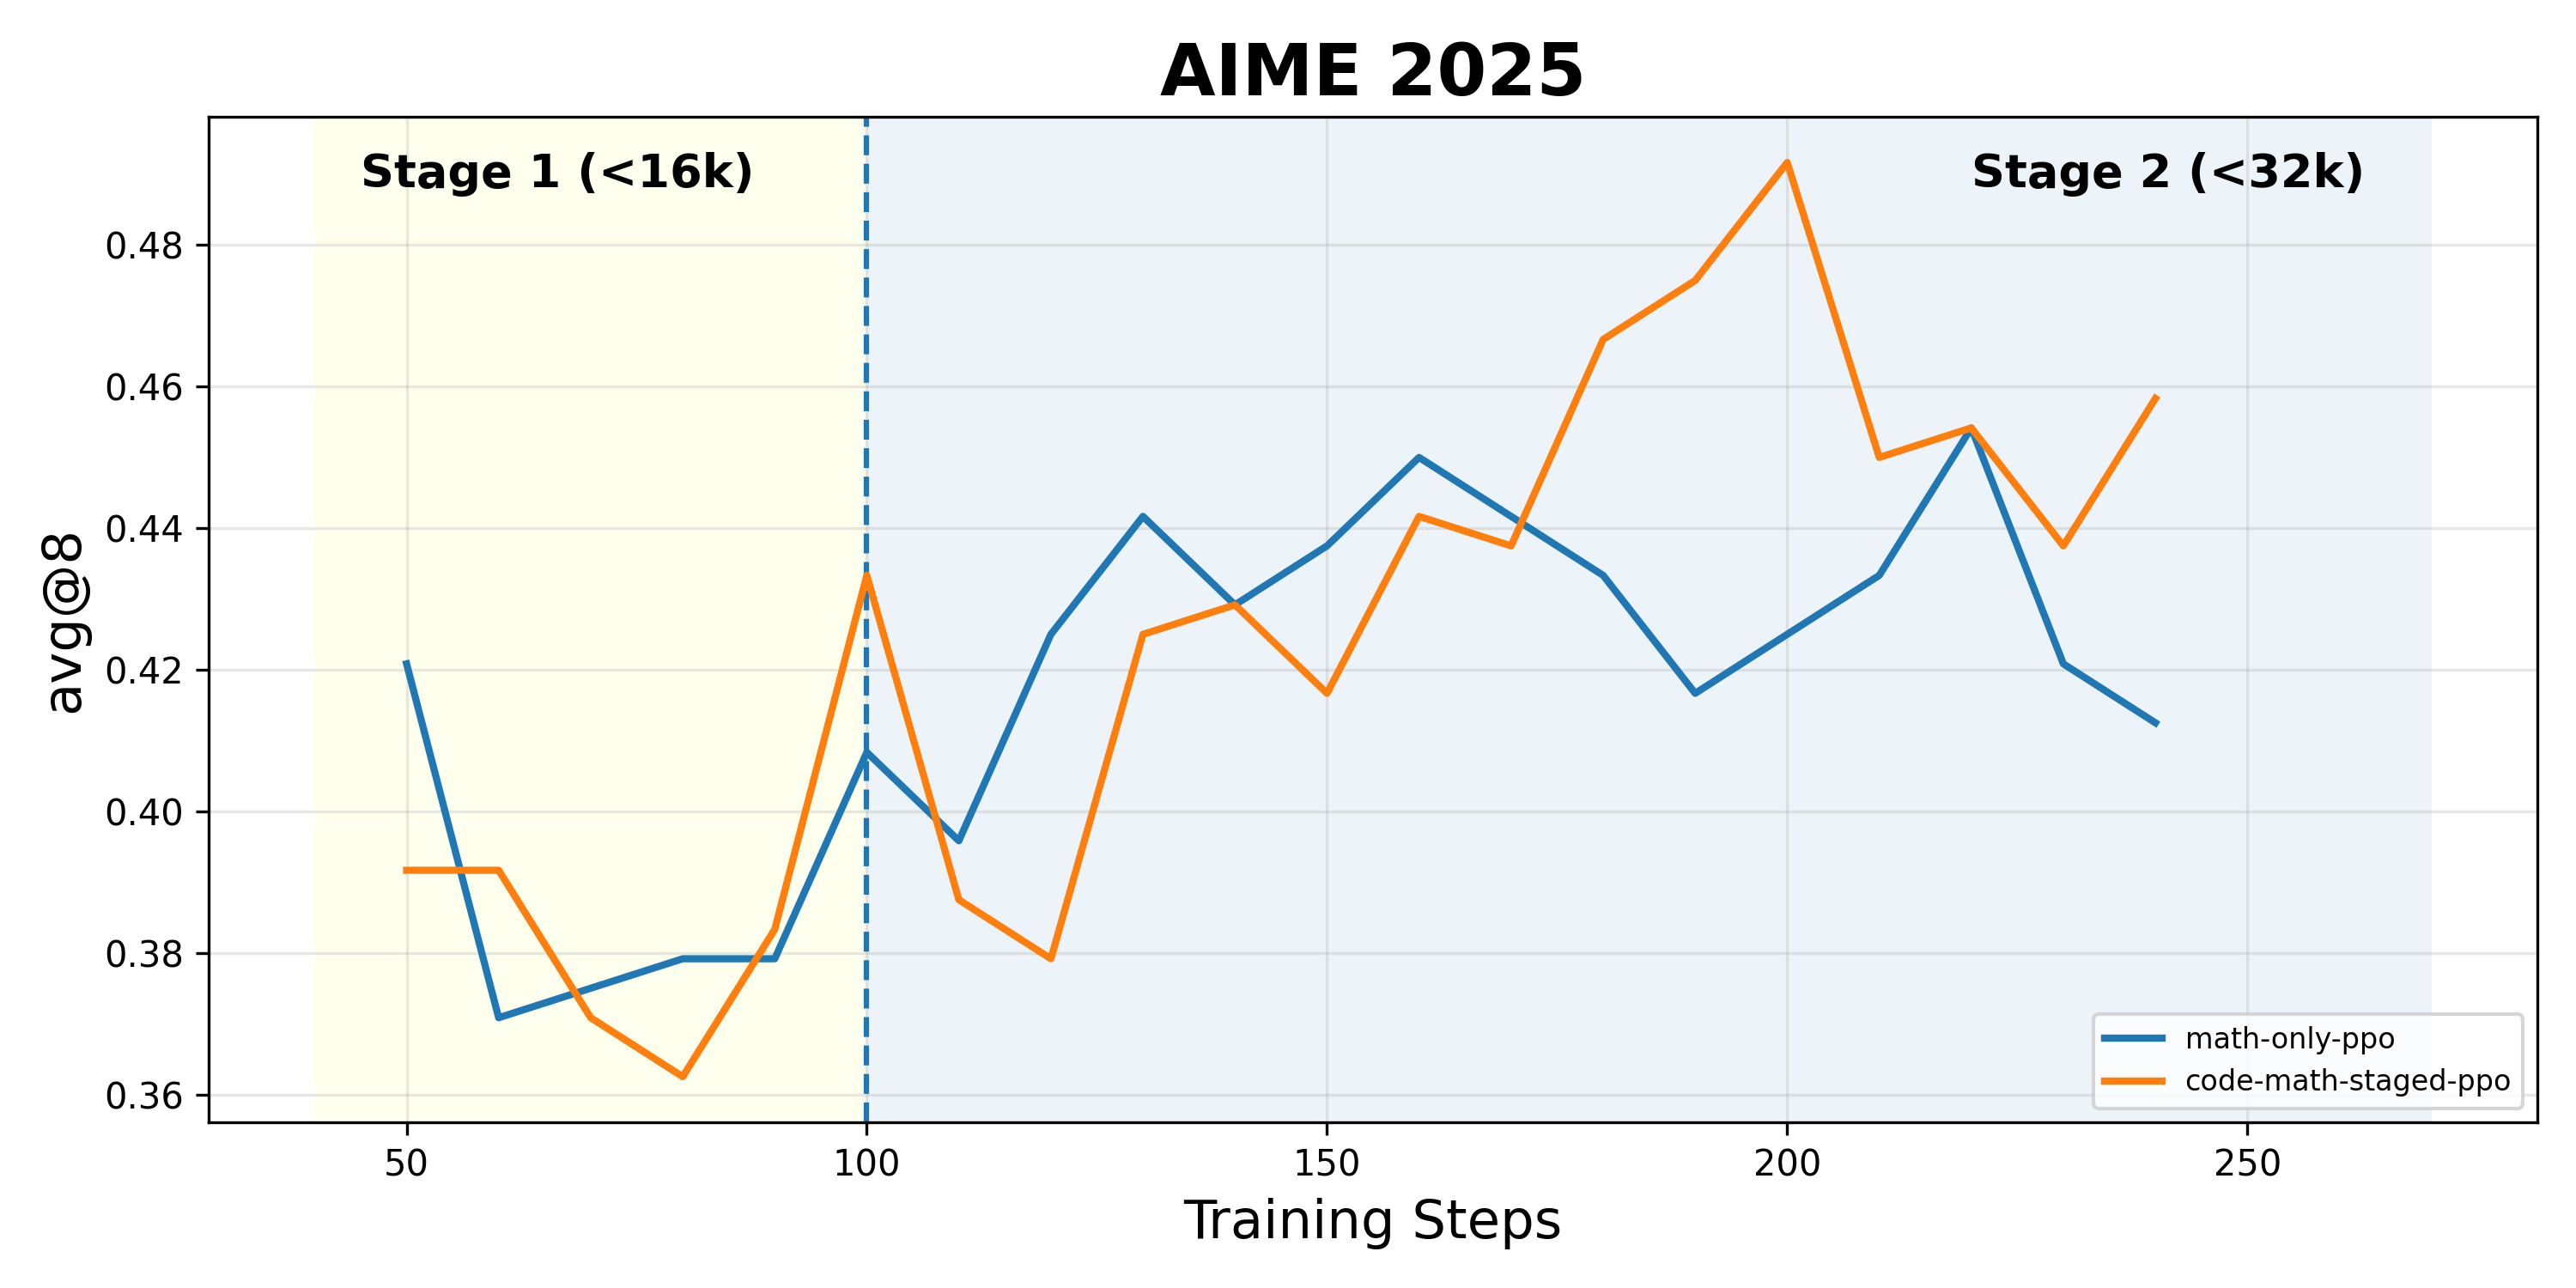
위 그림은 우리 실험 중 Stage 1에서 수학, 코드 데이터셋을 각각 학습하고 Stage 2에선 동일하게 수학 데이터셋만으로 학습한 모델의 체크포인트를 AIME 2025 벤치마크 점수를 스텝별로 평균 낸 결과입니다. 주황색 실선이 Staged RL을 적용한 결과이고, 상대적으로 적은 타겟 도메인 데이터를 활용하고도 AIME 2025에서는 최고점 기준, 코드 → 수학 Staged RL 모델이 수학만 학습한 모델 대비 4점 가량 더 높은 결과를 보였습니다. 이로써 단일 도메인으로 학습하는 것보다 이종 도메인을 적절히 나눠서 학습하는 것이 추론 성능의 일반화에 더 좋다는 결과를 확인했습니다.
마무리하며
Kanana 언어모델에 추론 기능을 붙여 보면서 저희가 발견한 것을 요약하자면 아래와 같습니다.
- 추론 데이터셋을 학습할 때는 상대적으로 높은 LR이 유의미한 성능 차이를 가져온다.
- PPO나 GRPO 학습 시, 기존의 학습 방식과는 다르게, Importance가 작은 Token에 Clipping을 하지 않는 것이 더 좋다.
- GRPO보다는 PPO가 학습 후반부에 더 안정적으로 학습하며, 모델의 최종 성능도 더 좋다.
- 코드 데이터로만 강화학습을 해도 수학 벤치마크에서의 성능이 상승한다.
최근 Grok 4에서는 강화학습에 더 많은 연산을 투입하여 좋은 성능의 모델을 만들었습니다. 앞으로 저희도 더 많은 연산을 강화학습에 투입하여 모델의 성능을 한 차원 끌어올리고자 합니다. 수학, 코드뿐만 아니라 Verify가 가능한 모든 분야의 문제에 대해 강화학습을 적용할 것입니다. 또한, Claude 4, Qwen 3와 같이 Instruct 모델과 추론 모델의 Hybrid 모델 연구를 진행하고 있습니다. 더 나아가 사용자가 Kanana 모델을 사용하면서 더 나은 경험을 할 수 있도록 Inference Time에서 생성되는 토큰 길이를 조정할 수 있도록 하려 합니다.
저희의 이러한 시도가 추론 모델 연구에 의미있는 기여가 되기를 바라며, 앞으로도 Kanana 모델에 많은 관심 부탁드립니다. 감사합니다.
Appendix
평가를 수행할 때, Response를 얻기 위한 Generation은 전부 Nucleus Sampling (top_p=0.95)를 사용했으며 이 때, Temperatue Scaling(temperature=0.6)을 적용하였습니다. Max Response Length는 32K로 평가하였습니다. 사용한 Evaluation Metric은 아래와 같습니다.
- pass@1
- Problem당 1개의 Response를 생성하고, 정답이면 1
- pass@8
- Problem당 8개의 Response들을 생성하고, 그 중 1개라도 정답이면 경우 1
- cons@8
- Problem당 8개의 Response들을 생성하고, Majority Voting의 결과가 정답이면 1
- avg@8
- Problem당 8개의 Response들을 생성하고, 각각의 Response가 정답이면 1을 주고 평균을 냄
"2.2 Reinforcement Fine-Tuning"의 PPO, GRPO 수식의 표기는 아래와 같습니다.
x: 입력 질문 (prompt)y,y^i: 모델이 생성한 출력 (응답 시퀀스)t: 토큰 위치\pi_{\theta}: 현재 Policy Model\pi_{\theta_{\text{old}}}: Behavior Policyr(x,y): Reward Function이 부여한 보상\hat{V}*{\phi}(s_t): Value Function 추정값G: 같은 질문에 대해 샘플링한 응답 개수\epsilon: Actor Clipping Hyperparameter\epsilon’: Critic Clipping Hyperparameter
Acknowledgments
이 글의 방향성 설정과 검수를 함께 해주신 mat.mul(김보섭), 전체 내용의 검수를 맡아주신 loophy.cc(조정민) 님께 감사의 말을 전합니다.
관련 글 목록