DevOps
KEDA
Jensen여기어때
2023년 10월 30일
원문에서 보기 ↗안녕하세요. 여기어때컴퍼니 인프라개발팀에서 EKS(Elastic Kubernetes Service, AWS의 관리형 Kubernetes 서비스)를 담당하고 있는 젠슨입니다.
지난 시간에 Karpenter에 대해서 알아보는 시간을 가졌습니다. 마지막에 대형 이벤트에 준비하기 위해 WorkerNode의 수량을 미리 늘려 놓아야 한다는 내용까지 알아보았습니다. 사실 처음 이러한 요청을 들었을 때 생각이 났던 것은 ‘작은 spec의 pod를 미리 WorkerNode당 1개 씩 배포하면 되지 않을까?’였습니다. 물론 방법은 맞지만 단점이 있었습니다. 이벤트 발생 시간 전, 후에 사람이 직접 pod를 배포하고 삭제해줘야 한다는 것이었습니다.
기존 CA(Cluster Autoscaling) 사용시에는 이러한 대형 이벤트가 있을 경우 AWS의 AutoScalingGroup을 통해서 예약이 가능했습니다. 이러한 기능이 Karpenter를 사용하면서 사라지게 된 것입니다.
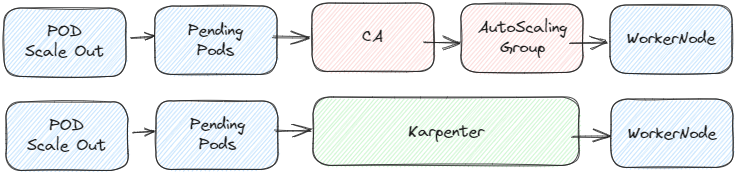
AutoScalingGroup이 사라짐
그러면 Karpenter를 사용하는 우리는 이러한 예약작업을 (사람이 매일) 직접 해야 하는 것일까? 정답은 ‘그렇지 않다.’였습니다. 우리보다 앞서 고민한 사람들이 이미 이러한 일에 대비를 해 놓았습니다. 우리는 잘 사용해 주면 됩니다. 이 솔루션의 이름은 바로 KEDA(Kubernetes-based Event Driven Autoscaling) 입니다. KEDA는 이러한 작은 POD를 스케쥴링 해주는 역할을 담당합니다. 그럼 설치 방법부터 바로 보겠습니다.
Copyright 2023. 여기어때컴퍼니 All Right Reserved. Graphic by 김제린(Riny).
- KEDA 설치
아래의 URL을 통해 KEDA에 대한 설치부터 설정 등의 상세한 정보를 알 수 있습니다.
이제 간단한 설치부터 진행해 보겠습니다.
# REPO add
helm repo add kedacore https://kedacore.github.io/charts

# REPO update
helm repo update

# KEDA install
helm install keda kedacore/keda -n keda --create-namespace

NAME: keda
LAST DEPLOYED: Tue Sep  5 12:40:29 2023
NAMESPACE: keda
STATUS: deployed
REVISION: 1
TEST SUITE: None
NOTES:
:::^.     .::::^:     :::::::::::::::    .:::::::::.                   .^.
7???~   .^7????~.     7??????????????.   :?????????77!^.              .7?7.
7???~  ^7???7~.       ~!!!!!!!!!!!!!!.   :????!!!!7????7~.           .7???7.
7???~^7????~.                            :????:    :~7???7.         :7?????7.
7???7????!.           ::::::::::::.      :????:      .7???!        :7??77???7.
7????????7:           7???????????~      :????:       :????:      :???7?5????7.
7????!~????^          !77777777777^      :????:       :????:     ^???7?#P7????7.
7???~  ^????~                            :????:      :7???!     ^???7J#@J7?????7.
7???~   :7???!.                          :????:   .:~7???!.    ~???7Y&@#7777????7.
7???~    .7???7:      !!!!!!!!!!!!!!!    :????7!!77????7^     ~??775@@@GJJYJ?????7.
7???~     .!????^     7?????????????7.   :?????????7!~:      !????G@@@@@@@@5??????7:
::::.       :::::     :::::::::::::::    .::::::::..        .::::JGGGB@@@&7:::::::::
                                                                      ?@@#~
                                                                      P@B^
                                                                    :&G:
                                                                    !5.
...

# 설치 확인
kubectl get all -n keda
NAME                                                   READY   STATUS    RESTARTS       AGE
pod/keda-admission-webhooks-86d579d9fd-pjdz8           1/1     Running   0              3m16s
pod/keda-operator-7cbf7b677d-bggm4                     1/1     Running   1 (3m6s ago)   3m16s
pod/keda-operator-metrics-apiserver-7c8b69df88-24tkw   1/1     Running   0              3m16s

NAME                                      TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)            AGE
service/keda-admission-webhooks           ClusterIP   10.100.37.155   <none>        443/TCP            3m17s
service/keda-operator                     ClusterIP   10.100.234.55   <none>        9666/TCP           3m17s
service/keda-operator-metrics-apiserver   ClusterIP   10.100.51.40    <none>        443/TCP,8080/TCP   3m17s

NAME                                              READY   UP-TO-DATE   AVAILABLE   AGE
deployment.apps/keda-admission-webhooks           1/1     1            1           3m17s
deployment.apps/keda-operator                     1/1     1            1           3m17s
deployment.apps/keda-operator-metrics-apiserver   1/1     1            1           3m17s

NAME                                                         DESIRED   CURRENT   READY   AGE
replicaset.apps/keda-admission-webhooks-86d579d9fd           1         1         1       3m17s
replicaset.apps/keda-operator-7cbf7b677d                     1         1         1       3m17s
replicaset.apps/keda-operator-metrics-apiserver-7c8b69df88   1         1         1       3m17s
설치가 잘 되었습니다. 실제로 KEDA가 동작할 때의 kind는 ScaleObject입니다. 어떻게 동작하는지 아래에서 보여 드리겠습니다.
- ScaleObject 배포
ScaleObject는 cron으로 일정을 잡고 각 일정마다 ScaleTargetRef의 리소스를 변경시키는 형태로 기존에 HPA를 사용해 보신 분이라면 친숙하게 느껴지실 것 입니다. 왜냐하면 KEDA가 POD의 수량을 직접적으로 조절하는 것이 아니라 그러한 역할을 담당하는 HPA의 보조역할로 개발되었기 때문입니다.
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  namespace: default
  name: keda
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: nginx
  triggers:
    - type: cron
      metadata:
        timezone: Asia/Seoul
        # 분 시 일 월 요일
        start: 00 08 * * *
        end: 00 11 * * *
        desiredReplicas: '10'
# 배포
kubectl apply -f scaleobject.yaml
조금 더 설명하면 HPA를 이용하여 CPU, Memory와 같은 Resource 기반의 AutoScaling이 가능하지만 그 밖에 외부 Metric 지표(Prometheus, AWS, Kafka…등)를 이용한 Autoscaling은 KEDA를 이용하면 된다고 이해하시면 될 것 같습니다. 아래 리스트는 KEDA 공식 사이트에서 제공한다고 나와 있는 외부 Metric 대상들 입니다.
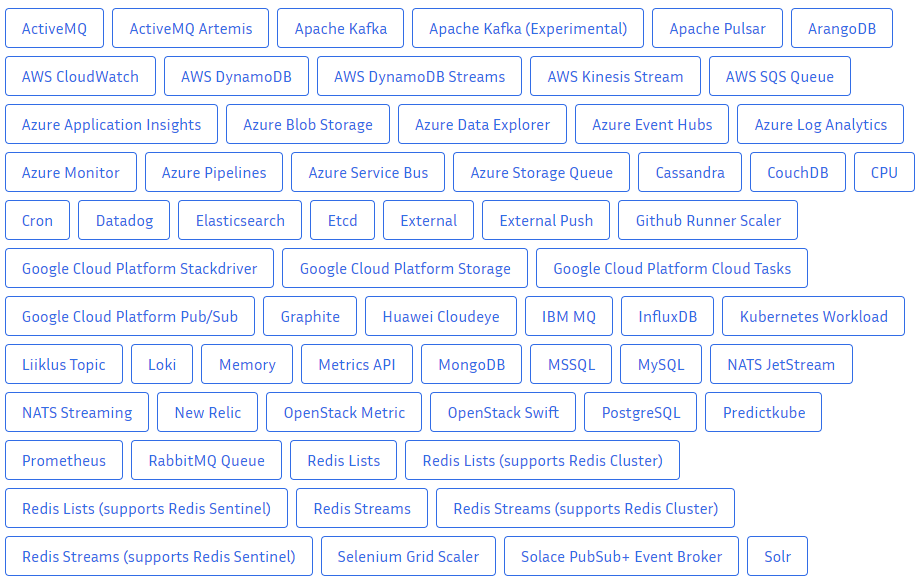
KEDA EVENT Source and Scalers
위의 yaml에서 우리는 cron을 사용했습니다. 우리나라 표준시로 매일 08:00~11:00 사이에는 nginx deployment를 10개 유지하라는 내용입니다. 그러면 현재 상태에서 KEDA가 동작하느냐? 아닙니다. 당연히 KEDA를 통해 배포될 nginx deployment가 있어야 합니다.
- Deployment 배포
Deployment는 아무 Sample이나 사용하셔도 되지만 최대한 리소스를 적게 사용하고 affnity 값을 꼭 넣어줘야 합니다. 아래는 동일한 WorkerNode에 동일한 이름의 POD가 배치될 수 없다는 설정입니다. 쉽게 이야기하면 1개의 WorkerNode에는 1개의 POD만 생성된다. 즉, 위에서 10개의 POD를 스케쥴링해 놓았기 때문에 그 시간에는 10개의 WorkerNode가 생성되어 있다는 것입니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  namespace: default
  name: nginx
  labels:
    app: nginx
spec:
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
        - image: nginx
          imagePullPolicy: Always
          name: nginx
          resources:
            limits:
              cpu: 1m
            requests:
              cpu: 1m
          ports:
            - containerPort: 80
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: app
                    operator: In
                    values:
                      - nginx
              topologyKey: "kubernetes.io/hostname"
# deployment 배포
kubectl apply -f nginx.yaml
이제 거의 끝났습니다. 실제로 원하는 대로 동작하는지만 확인해 보면 됩니다. 아래에 ArgoCD를 통해 배포 후 변화하는 과정에 대해서 보여드리겠습니다.
- KEDA Test
현재 서비스를 위해 제공되고 있는 6개의 WorkerNode가 있습니다. 아직 KEDA 수행 전이고 맨 위에 있는 nginx가 ReplicaSet 0으로 배포 되어 있는 것이 보입니다.
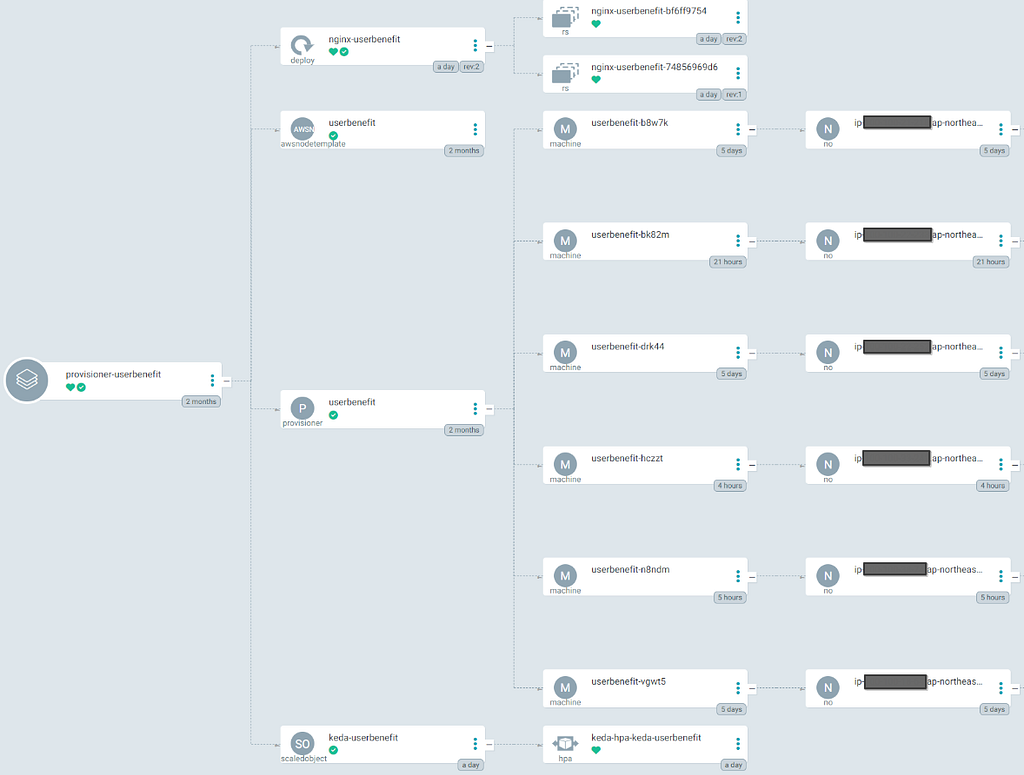
KEDA 동적 전 — WorkerNode
KEDA가 동작하는 시각이 되면 자동으로 nginx가 배포되면서 아래와 같이 10대의 WorkderNode가 생성됩니다.
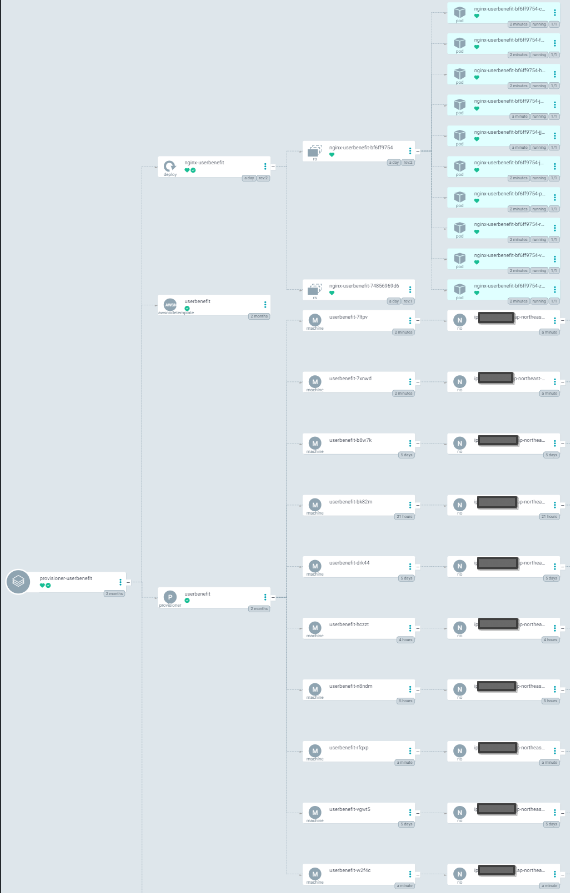
KEDA 동작 후 — WorkerNode
WorkerNode 당 1대의 POD가 들어가도록 설정해 놓았기 때문에 6대의 WorkerNode가 10대로 늘어난 것입니다. nginx가 어떻게 배포 되어 있는지 살펴보면 아래와 같습니다.
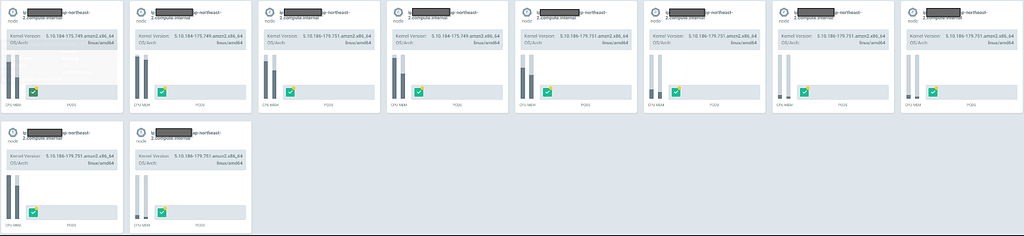
nginx 배포 상태
마지막으로 KEDA를 설정해 놓았던 시간이 종료되면 자동으로 nginx의 ReplicaSet 수량은 0으로 줄어들고 늘어났던 WorkerNode의 수량도 줄어들게 됩니다. 결국 실제로 WorkerNode의 수량을 늘리는 것은 아니지만 POD의 Affinity 설정과 KEDA의 도움으로 이벤트와 같은 대용량 트래픽이 발생할 수 있는 시점에 WorkerNode를 미리 증설해 놓는 작업을 수행할 수 있습니다.
CA를 사용할 때 손쉽게 사용했던 기능을 Karpenter에서 사용할 수 없다는 사실을 알았을 때 2개를 병합하여 사용해야 하나라는 생각까지 했었습니다. 현재는 여러가지 테스트를 통해 CA 없이 Karpenter 만으로도 충분히 운영이 가능하다는 것을 알게 되었고 여기어때컴퍼니에서는 CA를 완전히 제거 후 운영중에 있습니다.
이외에 한 가지 더 말씀드리면 기존 EC2로 서비스를 운영하던 시절과는 다르게 Karpenter와 POD를 통해 서비스를 제공하면 몇 십 대의 POD들이 순간적으로 생성되고 삭제되는 과정들이 반복됩니다. 이러한 과정 속에 낭비되는 WorkerNode들이 발생할 것이고 이를 해결하기 위해 Karpenter 설정 중 ttlSecondsAfterEmpty 와 ttlSecondsUntilExpired , consolidation 등의 옵션에 대해서 고민하시게 될 것입니다. 실제로 여기어때컴퍼니에서도 많은 생각이 있었던 부분입니다. 안정적인 운영을 생각하면 비용이 많이 나가고 비용을 생각하면 안정적인 운영이 이루어지지 않을 수 있습니다. 운영하시는 환경마다 다를 수 있지만 위의 설정에 대한 적절한 값들은 각자 고민해 보셔야 할 것입니다.
지금까지 긴 글 읽어 주셔서 감사합니다. 언제나 그렇듯 이 글 또한 누군가에게는 도움이 되는 글이었으면 좋겠습니다.