Backend
Golang GC 튜닝 가이드
yanoo.kim카카오
2024년 5월 13일
원문에서 보기 ↗Golang으로 프로그램을 개발하다 보면, 어느 순간 GC(Garbage Collector)가 성능의 짐이 됩니다. 알아서 메모리를 관리해 줬던 고마운 GC가, CPU 자원 소모량을 점차 늘려가며 로직에 부담을 주게 되는 것입니다. 이제부터는 인터넷 여기저기를 찾아가며 Garbage Collecting 작업을 효과적으로 수행하기 위한 튜닝을 궁리해야 할 시간입니다.
이 글은 이러한 문제를 해결하기 위한 실질적인 Golang GC 튜닝 방법을 소개하는 글입니다. 독자 여러분께 인터넷 여기저기서 찾고 배운 튜닝 방법들을 정리하여 전달하는 한편, 잘 언급되지 않지만 크게 도움받은 부분들을 전달하는 데 내용을 집중하였습니다.
따라서 검색 가능한 다른 글들에서 이미 자주 언급된 내용과 Golang의 GC가 동작하는 방식은 이 글에서 다루지 않습니다. 물론 이 주제들 또한 Golang GC를 튜닝하기 위해 이해하면 도움이 되는 내용이기 때문에, 필요한 경우 글 말미의 레퍼런스를 참고해 주시면 되겠습니다. [1]
1. 모든 Golang 튜닝의 핵심은 Profile이다
Golang GC 튜닝에 앞서 정말 튜닝이 필요한 상황인지 먼저 확인해야 합니다. 튜닝할 필요도 없는데 괜히 머리를 싸매고 시간을 보내는 것은 낭비일 수 있습니다. 이때, 튜닝이 필요한지 또는 아닌지를 판단할 수 있는 핵심 도구가 바로 Profile입니다. 우리는 Profiling을 통해 프로그램 내 성능에 악영향을 주는 여러 원인들뿐만 아니라, GC가 주는 악영향까지 확인할 수 있습니다.
Golang의 Profiling 방법은 여러 가지가 있습니다. 이 중 Golang의 공식 블로그에서는 아래와 같이 프로그램에서 직접 Profile 결과를 파일로 저장하는 방법과 웹으로 Profiling을 요청받아 응답하는 방법 두 가지를 소개하고 있습니다.
import (
	"os"
	"runtime/pprof"
)
…
	f, err := os.Create(“cpu.profile”)
	if err != nil {
		log.Fatal(err)
	}
	pprof.StartCPUProfile(f)
	defer pprof.StopCPUProfile()
…
<프로그램에서 직접 Profile한 결과를 “cpu.profile”이란 이름으로 저장>
import (
    "http"
    _ "net/http/pprof"
    ...
)

func main() {
    ...

    go func() {
     http.ListenAndServe("0.0.0.0:6060", nil)
    }()

    ...
}
<웹으로 Profiling 요청에 응답받을 수 있도록 웹서버를 구동>
저는 필요할 때 제 단말기에서 바로 Profiling 결과를 확인할 수 있는 웹 방식을 선호합니다(물론 인프라가 갖춰져 있으시다면, Pyroscope 도구를 통한 Continuous Profiling을 추천드립니다).
이제 웹 방식을 통해 구동된 웹서버에 명령어를 사용해 Profiling을 요청을 하면, 필요할 때 언제든지 최신의 성능 측정 결과를 응답받을 수 있습니다.
명령어 예시들은 아래와 같습니다.
go tool pprof -http=0.0.0.0:8080 http://…..:6060/debug/pprof/profile
wget -O cpu.pprof http://…..:6060/debug/pprof/profile
go tool pprof -http=0.0.0.0:8080 cpu.pprof
명령어를 실행하면 프로파일링을 위해 30초 정도의 시간이 소요된 후(소요시간 30초는 변경할 수 있습니다), 웹브라우저 상에서 프로파일링 한 결과를 확인할 수 있습니다. 이때, 본인의 단말에서 프로파일링 명령어를 실행한 경우 웹브라우저가 자동으로 실행되며 결과를 확인할 수 있습니다. 또한, 서버에서 명령어를 실행한 경우 외부 웹브라우저에서 서버의 주소를 통해 프로파일링 결과에 접근할 수 있습니다.
이후 프로파일링 결과 화면에서 상위항목(Top)으로 목록을 정렬하면 CPU를 많이 점유하는 함수들을 순서대로 확인할 수 있습니다.
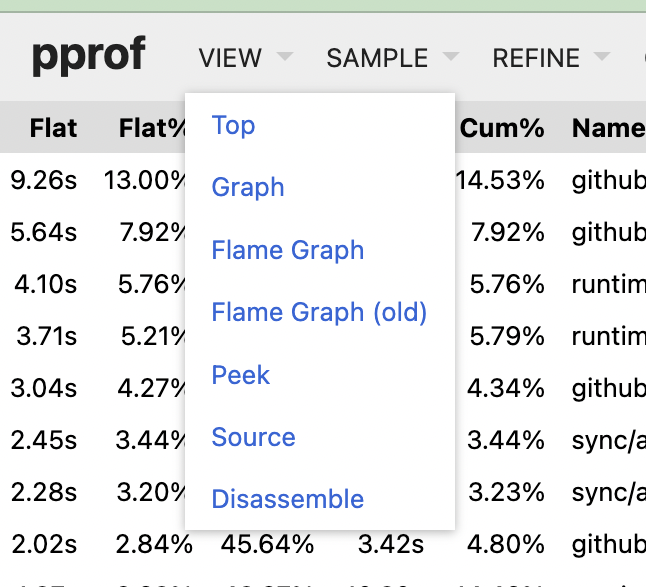
이때 아래와 같이 Golang의 GC가 사용하는 함수인 runtime.findObject 또는 runtime.greyObject 가 목록의 최상위권에 보이는 경우, 마침내 GC 튜닝을 해야 할 시점이 된 것을 알 수 있습니다. [2]
Showing nodes accounting for 362.50s, 69.04% of 525.02s total
Dropped 1758 nodes (cum <= 2.63s)
Showing top 30 nodes out of 238
      flat  flat%   sum%        cum   cum%
       84s 16.00% 16.00%     88.10s 16.78%  runtime.findObject
...
    43.66s  8.32% 33.56%     60.19s 11.46%  runtime.greyobject
 ...
   26.62s  5.07% 43.72%     26.74s  5.09%  runtime.heapBitsForAddr
    16.75s  3.19% 46.91%    186.01s 35.43%  runtime.scanobject
...
        5s  0.95% 60.07%    192.15s 36.60%  runtime.gcDrain
     4.87s  0.93% 61.00%     26.61s  5.07%  runtime.mallocgc
2. GOGC를 끄고, GOMEMLIMIT만으로 문제 해결하기
Golang GC 튜닝의 핵심은 GC가 동작하는 동안 프로그램의 동작이 멈추는 Stop the World (이하 STW) 현상을 개선하는 것입니다. 즉, STW가 덜 발생하도록 GC를 튜닝해야 하며, 발생하더라도 빨리 해소되도록 구현해야 합니다.
이를 해결하는 가장 쉬운 방법은 GOGC를 끄고 GOMEMLIMIT을 사용해 STW가 덜 발생하게 하는 것입니다.
GOGC에 대해 먼저 설명하면, GOGC는 현시점의 Heap 크기와 직전 시점의 Heap 크기에 대한 증가율을 바탕으로 GC를 수행할지를 결정하는 방법입니다. GC가 동작하는 Default 비율 값은 100으로, 기존 대비 Heap이 100% 증가, 즉 2배가 되면 GC를 수행합니다. 이 값을 낮추면 GC가 더 자주 수행되고, 이 값을 높일수록 GC가 덜 수행되게 됩니다.
거대하고 복잡한 Golang 프로그램에서는 GOGC의 수행 기준값이 너무 작거나, 또는 너무 커도 성능상의 문제가 발생하며 그래서 골치가 아픕니다. 이 두 경우에 대해서 자세히 설명드리겠습니다.
1) GOGC 값이 작은 경우
GC가 너무 빈번하게 수행될 수 있습니다. 특히 프로그램이 재시작되어 아직 메모리 소비량이 작은 경우, 약간의 Heap 메모리 할당에도 허겁지겁 GC가 수행됩니다. 예시로 1GB의 Heap 메모리 크기가 2GB가 되어도 100% 증가이지만, 기준 값이 10MB인 경우, 겨우 20MB가 되어도 이 역시 100% 증가이기 때문입니다.
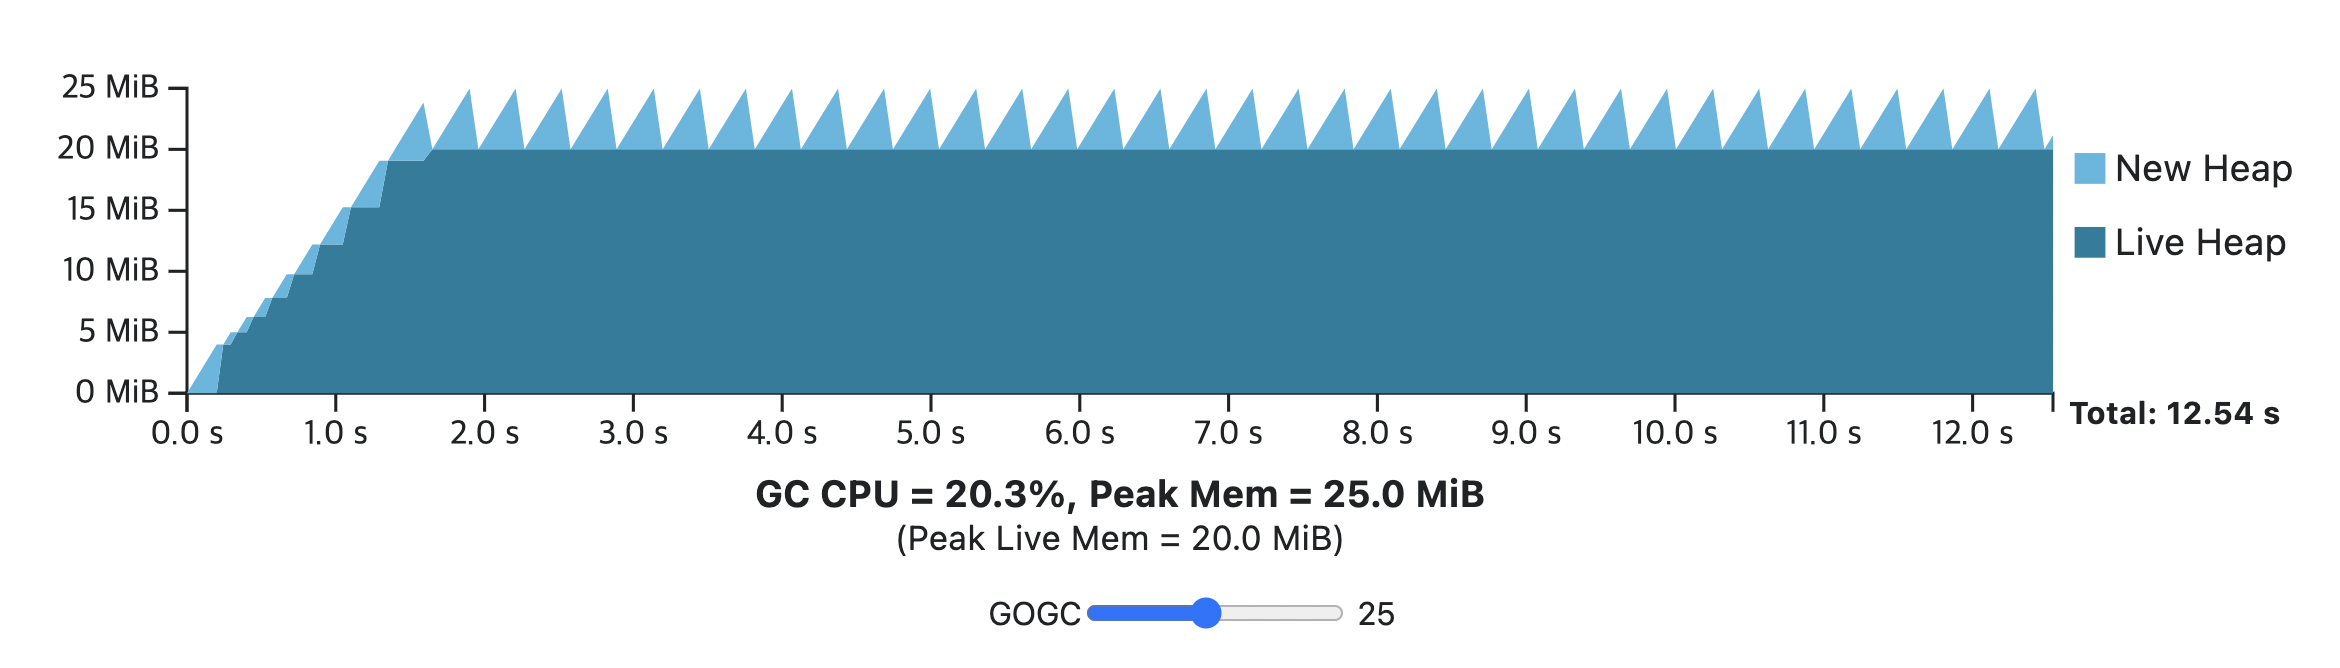
< GOGC값이 작아, GC가 자주 발생하는 현상 [3]>
2) GOGC 값이 큰 경우
OutOfMemory(이하 OOM) 발생 가능성이 커집니다. 기존 Heap 사용량이 40GB이고 GOGC가 50이라면, 1.5배 상승한 60GB가 되어야 GC가 수행되기 때문입니다.
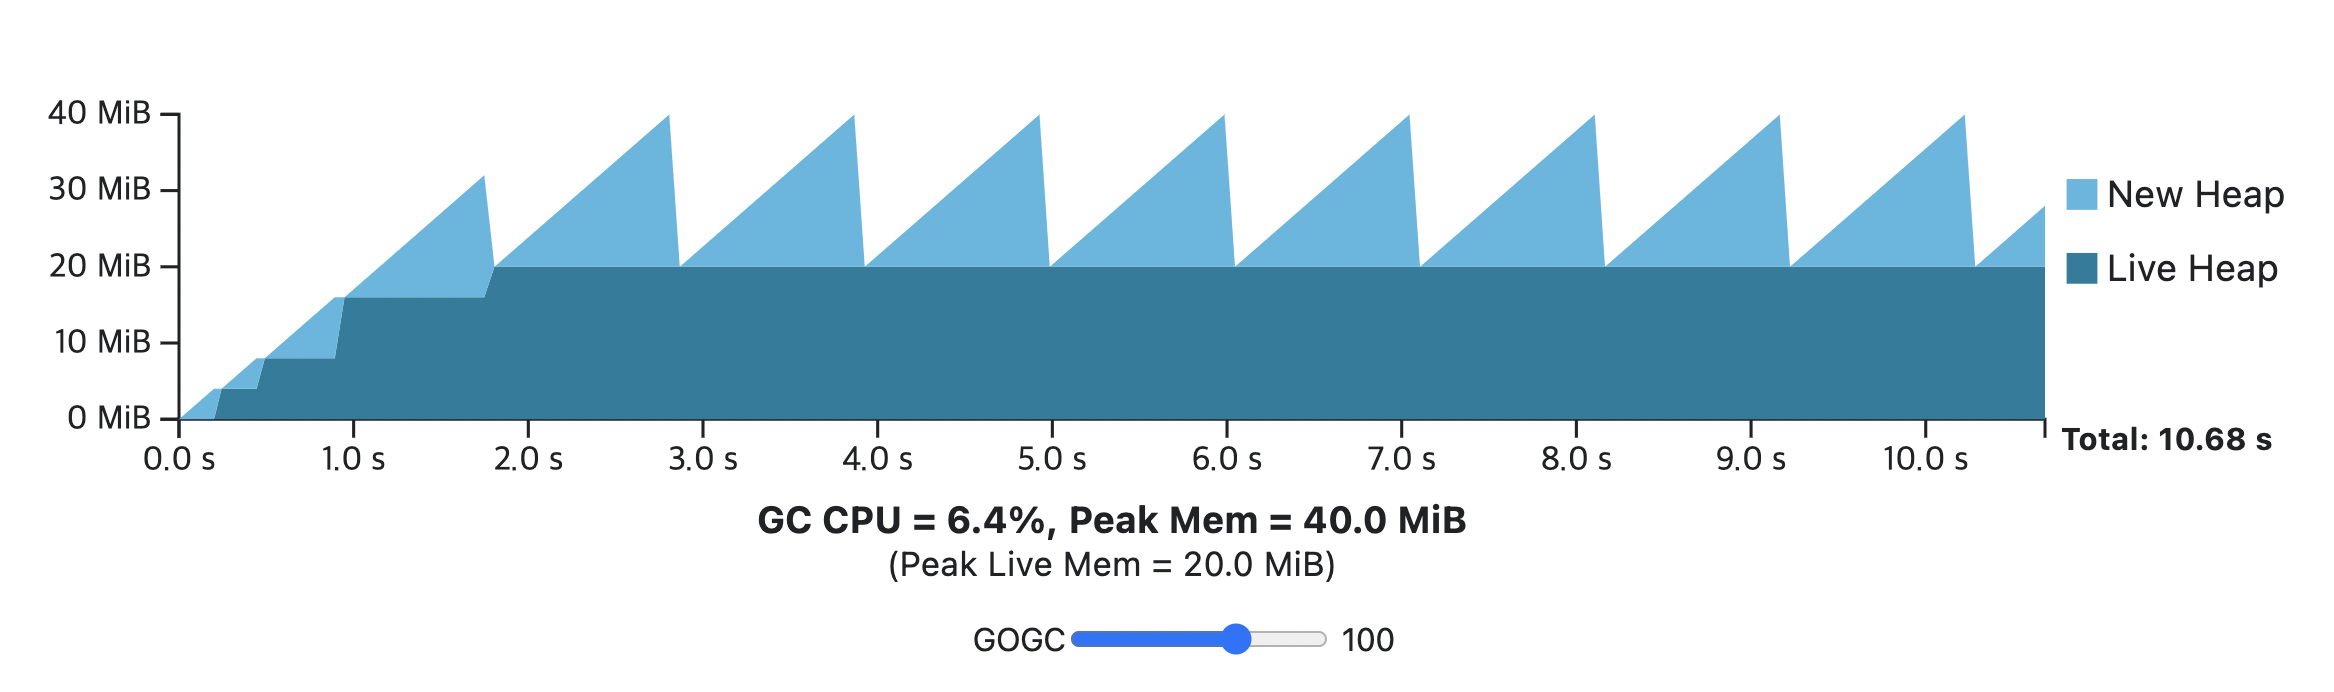
< GOGC값이 커서 최대 메모리 사용량이 너무 큼 [3] >
이를 극복하기 위해 프로그램이 시작되자마자 더미 메모리를 할당하는 ballast[4] 기법도 존재합니다. 하지만 GOMEMLIMIT이라는 멋진 GC 튜닝 해결책이 나왔기에, ballast는 잊으셔도 됩니다.
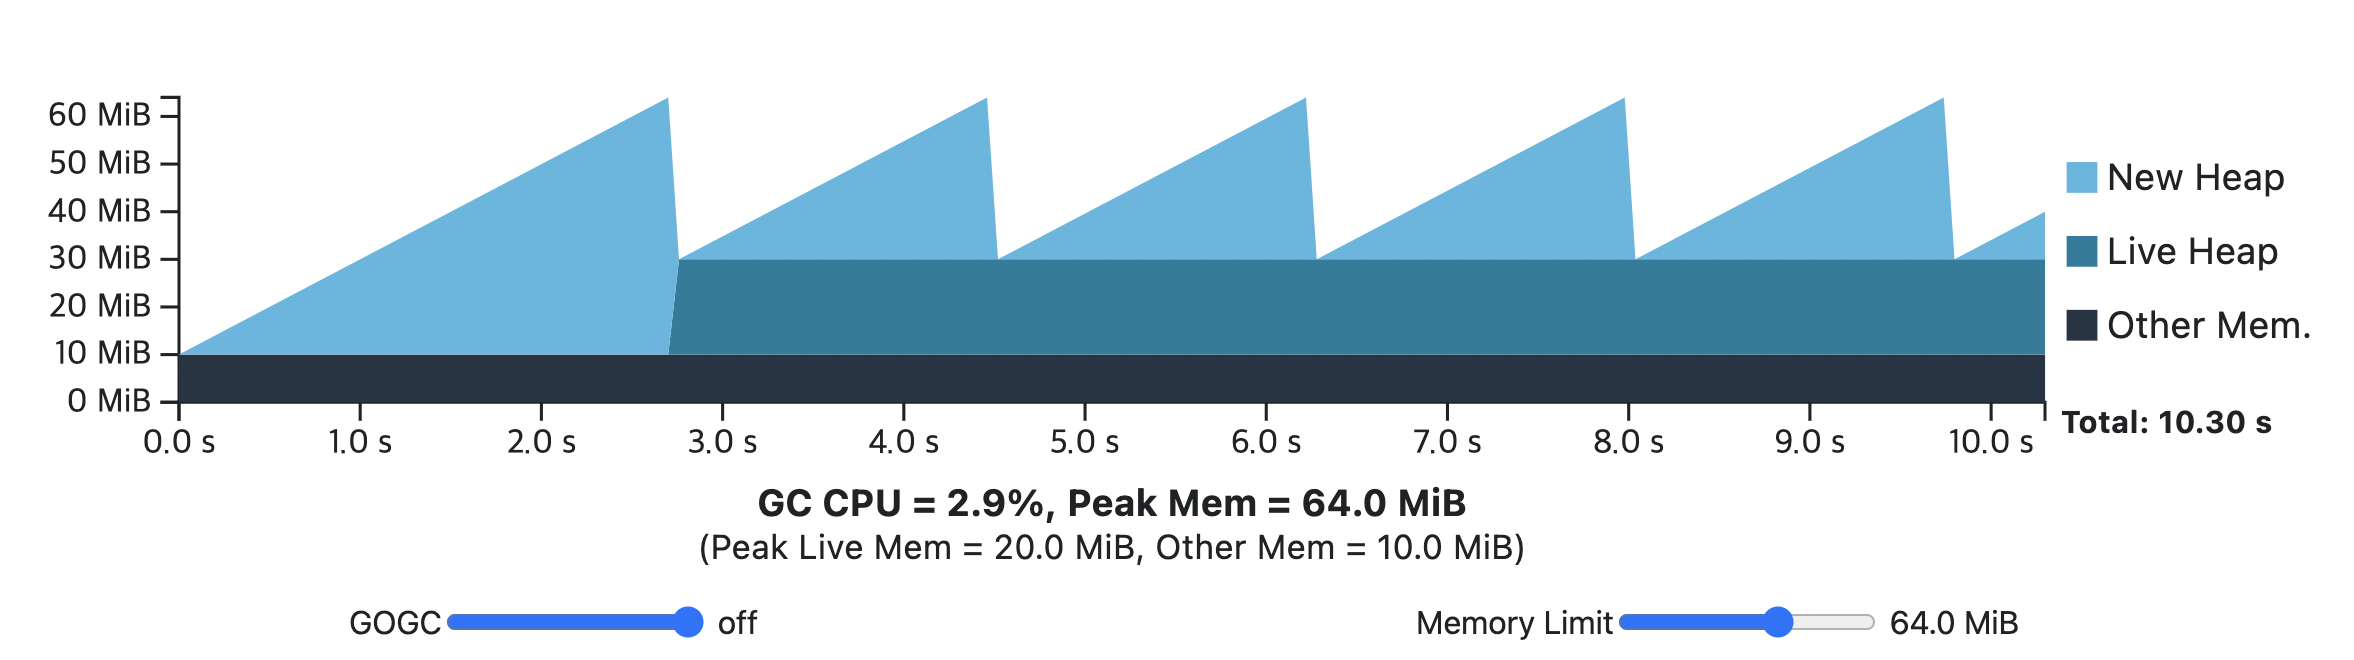
GOMEMLIMIT은 프로그램이 사용할 수 있는 메모리 사용량 한계선을 정하는 설정입니다. 이 방식에서는 설정한 GOMEMLIMIT의 값만큼 메모리 사용량이 올라가는 경우에만 GC가 수행됩니다.
따라서 프로그램이 사용할 수 있는 최대 메모리 한계선을 미리 산정한 후, 그 값보다 작은 값 을 GOMEMLIMIT으로 설정하면 손쉽게 GC를 튜닝할 수 있습니다. 한계선보다 작은 값을 설정하는 이유는 GOMEMLIMIT은 SoftLimit으로 프로그램이 설정된 GOMEMLIMIT 보다 조금 더 많은 메모리를 사용할 수 있기 때문입니다. 이로써 GC가 항상 최대한 늦게 동작할 수 있는 환경이 갖추어지며, GC Cycle이 최대로 길어지게 되어 STW가 최소화됩니다.
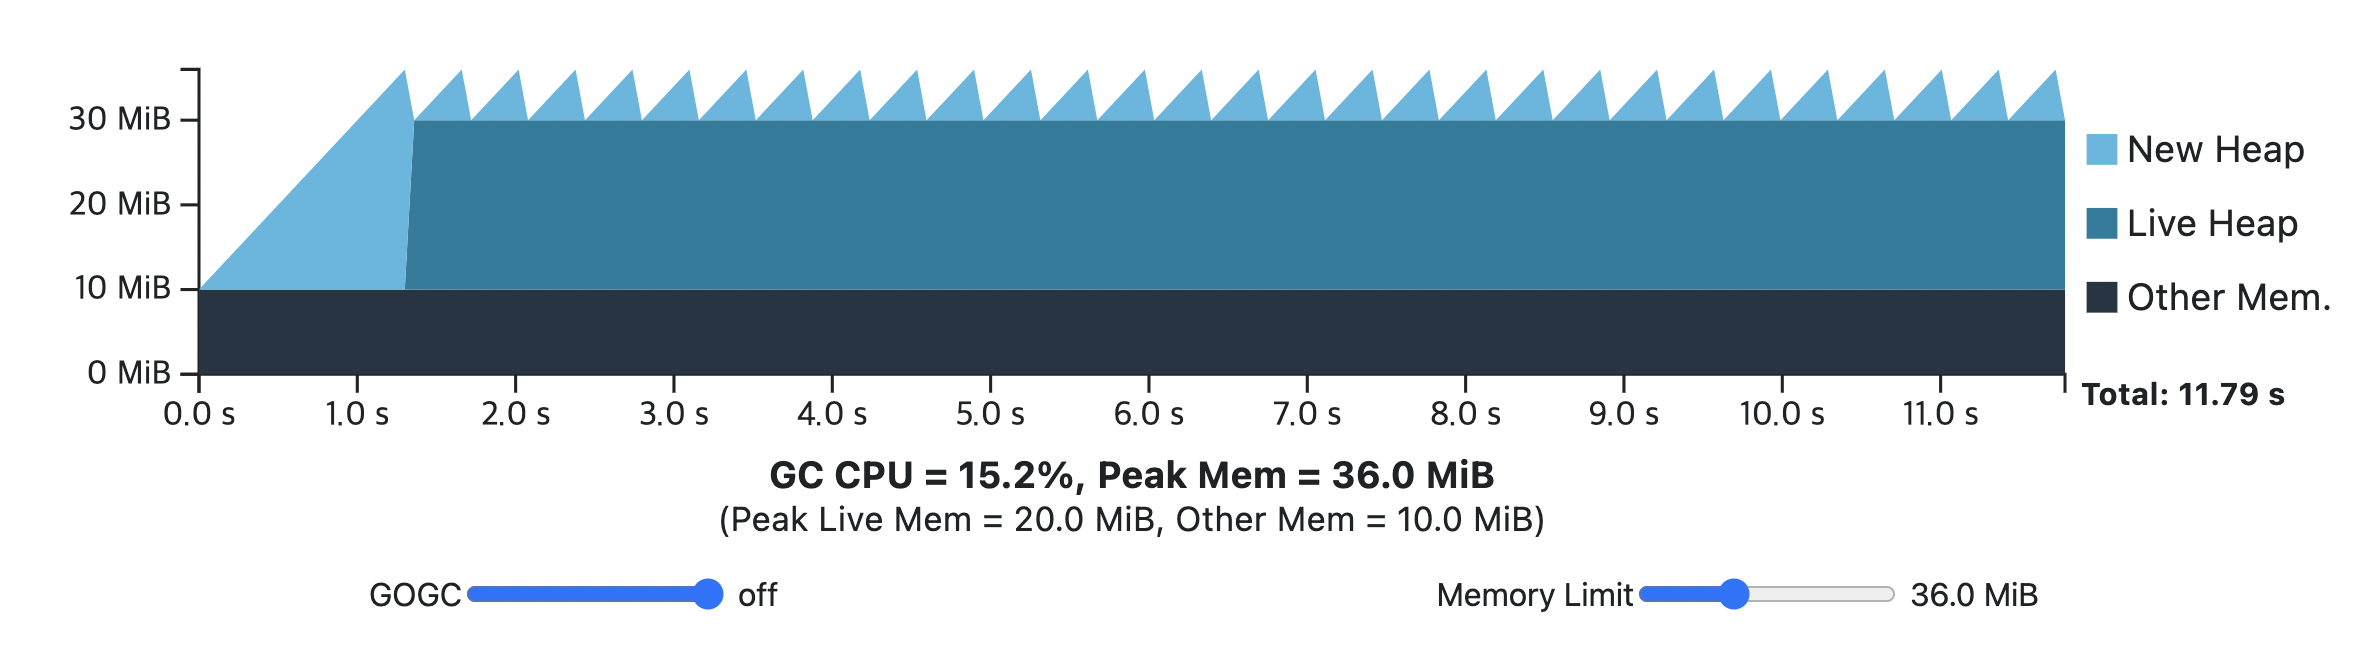
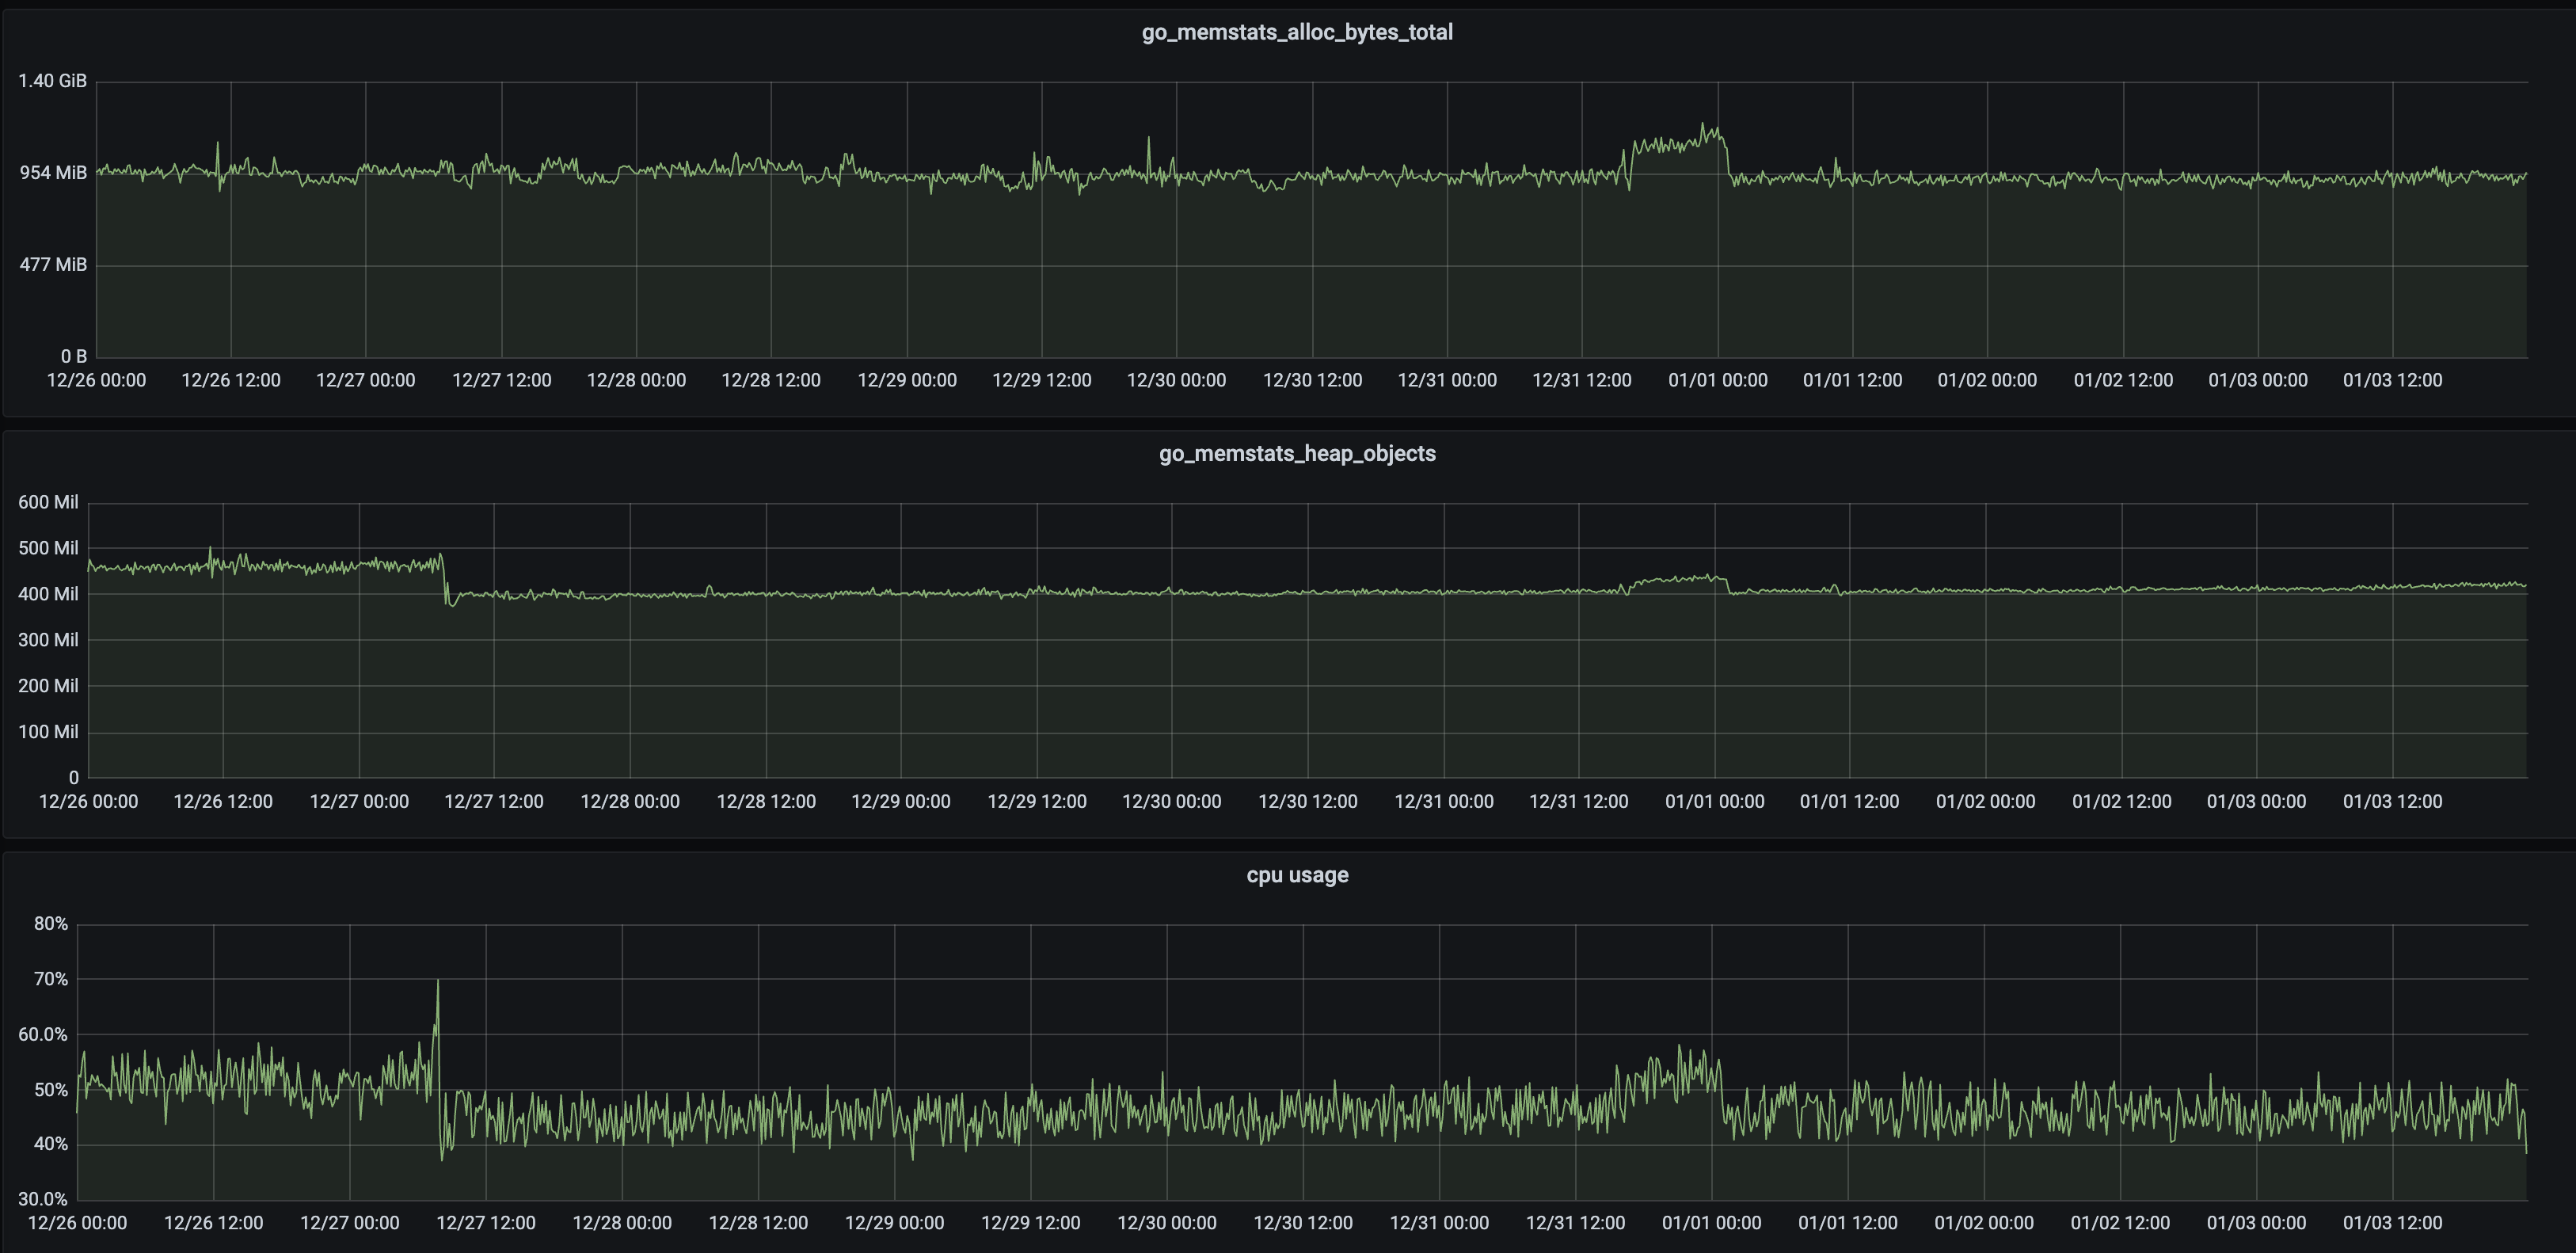
3. Heap Profile의 alloc_space와 alloc_objects가 높은 값을 튜닝하라
앞서 ‘모든 Golang 튜닝의 핵심은 Profile이다’ 문단에서 언급한 Profiling을 Heap 메모리에도 적용할 수 있습니다. Golang의 메모리 영역은 크게 Stack과 Heap으로 구성되어 있고, 이 중 Stack 메모리는 GC가 없어도 함수의 호출과 종료에 따라 자연스럽게 관리됩니다. 반대로 Heap 메모리는 GC의 관리가 필요한 객체들이 있는 메모리 영역으로, 바로 이 Heap 영역이 GC 튜닝의 핵심 이라고 말씀드릴 수 있습니다. [5]
Heap Profile은 Heap 메모리를 차지하고 있는 객체를 아래와 같은 네 가지의 지표를 기준으로 분석합니다.
- inuse_objects: 현재 사용 중인 객체의 수
- inuse_space: 현재 사용 중인 메모리 양
- alloc_objects: 프로그램이 시작된 후 할당된 총 객체 수
- alloc_space: 프로그램이 시작된 후 할당된 총 메모리 양
GC 튜닝의 관점에서, inuse 타입 지표와 alloc 타입 지표 중 무엇이 더 중요할까요? 이 중에서는 alloc 타입이 더 중요한 지표입니다.
예시로 inuse가 1GB인데 alloc이 1GB인 객체는, 처음 한 번 메모리에 할당된 후 계속해서 사용되고 있다는 의미입니다. 즉, GC가 개입할 필요가 없기에 CPU 효율적이죠.
반대로 inuse가 1GB인데 alloc이 1TB인 객체는, Heap 메모리를 객체에 1024번 할당했다는 뜻입니다. 이는 GC도 1024번 일어났다는 뜻이며, 그만큼 CPU를 사용했다는 의미가 되겠습니다.
그렇다면 alloc_space와 alloc_objects 지표들은 어떠할까요? 이 경우 둘 모두 중요합니다. alloc_space가 크다면 , 프로그램 동작 과정에서 사용되는 Heap 메모리가 빠르게 증가한다는 것을 의미합니다. 이에 따라 GC Cycle이 빨라지며, GC가 자주 수행 됩니다. 성능을 개선하려면 이를 튜닝하여 GC Cycle을 다시 늦춰 GC가 수행되는 주기를 길게 바꿔야죠.
아울러 alloc_objects가 크다면 , GC 과정에서 일어나는 Marking 작업 등에서 CPU 자원을 소모하게 됩니다. 즉, 큰 alloc_space 값은 GC의 주기를 짧아지게 할 뿐만 아니라 GC의 수행시간 자체도 오래 걸리게 되는 것입니다. 결과적으로 프로그램의 성능에 영향을 미치는 STW 시간도 늘어나게 됩니다.
4. Flame graph로 튜닝 포인트 찾기
Golang의 Profiling은 어떤 함수가 리소스를 많이 소모했는지를 Flame graph로 표현합니다.
아래와 같이 alloc_objects와 alloc_space 지표를 기준으로 Flame graph를 표시했을 때, 특정 함수의 가로축 길이가 길어 전체에서 차지하는 비중이 긴 경우, 해당 함수가 프로그램 동작 과정에서 GC의 개입이 필요한 객체들을 많이 생성하고 있다는 것을 알 수 있습니다.
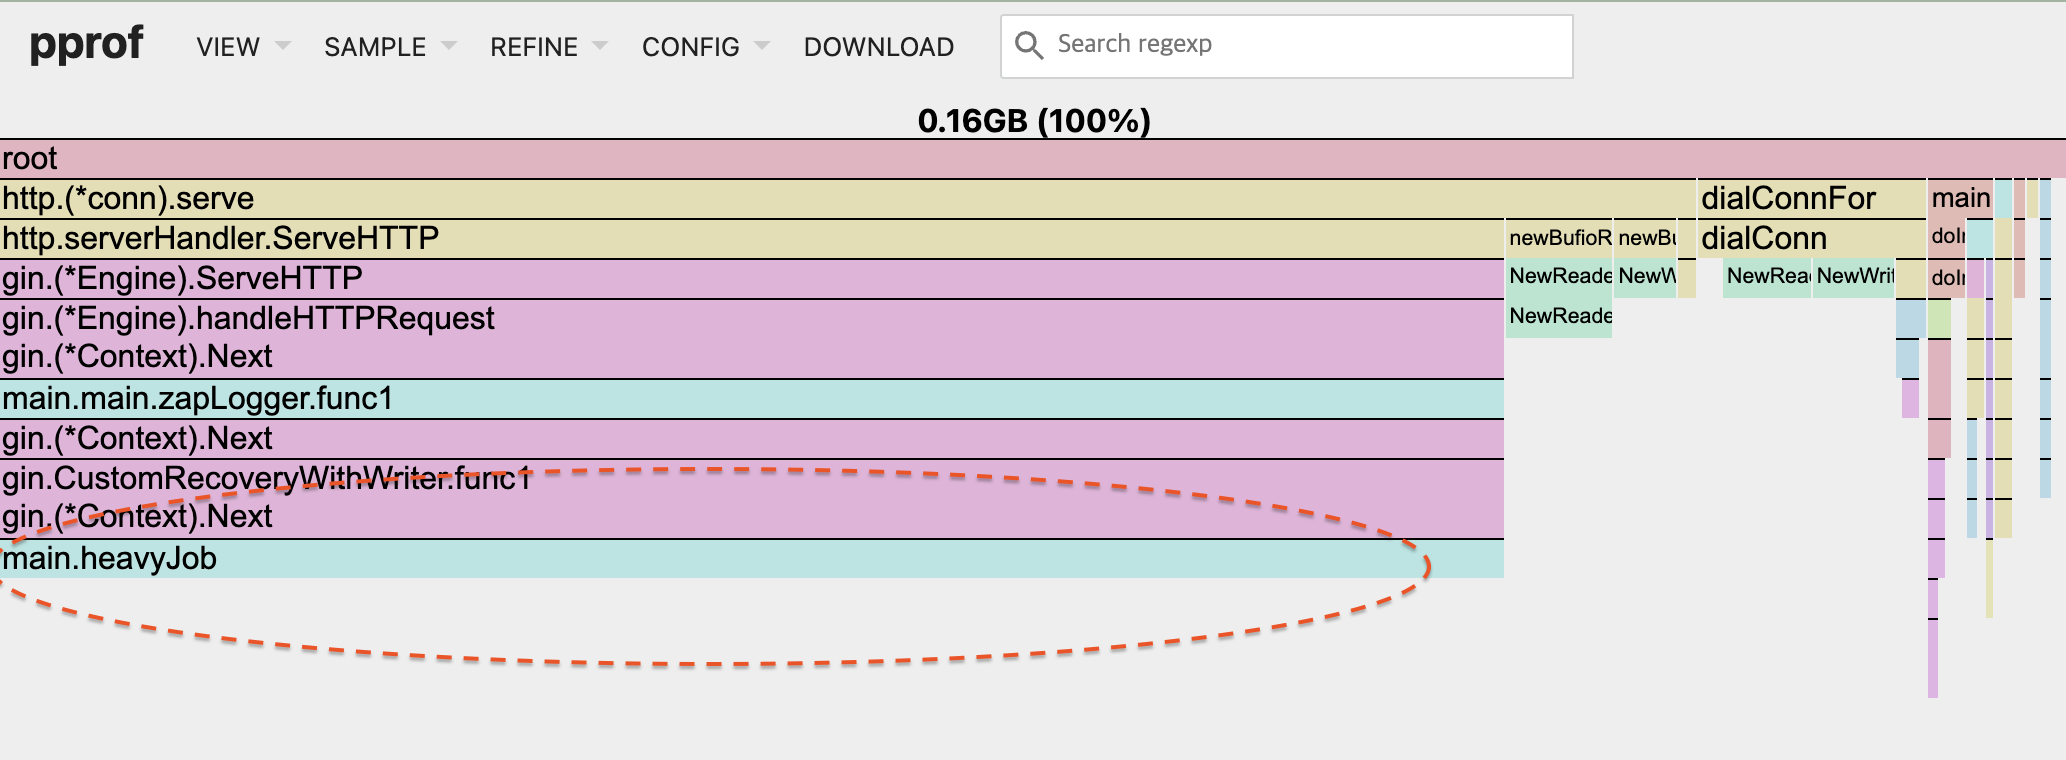
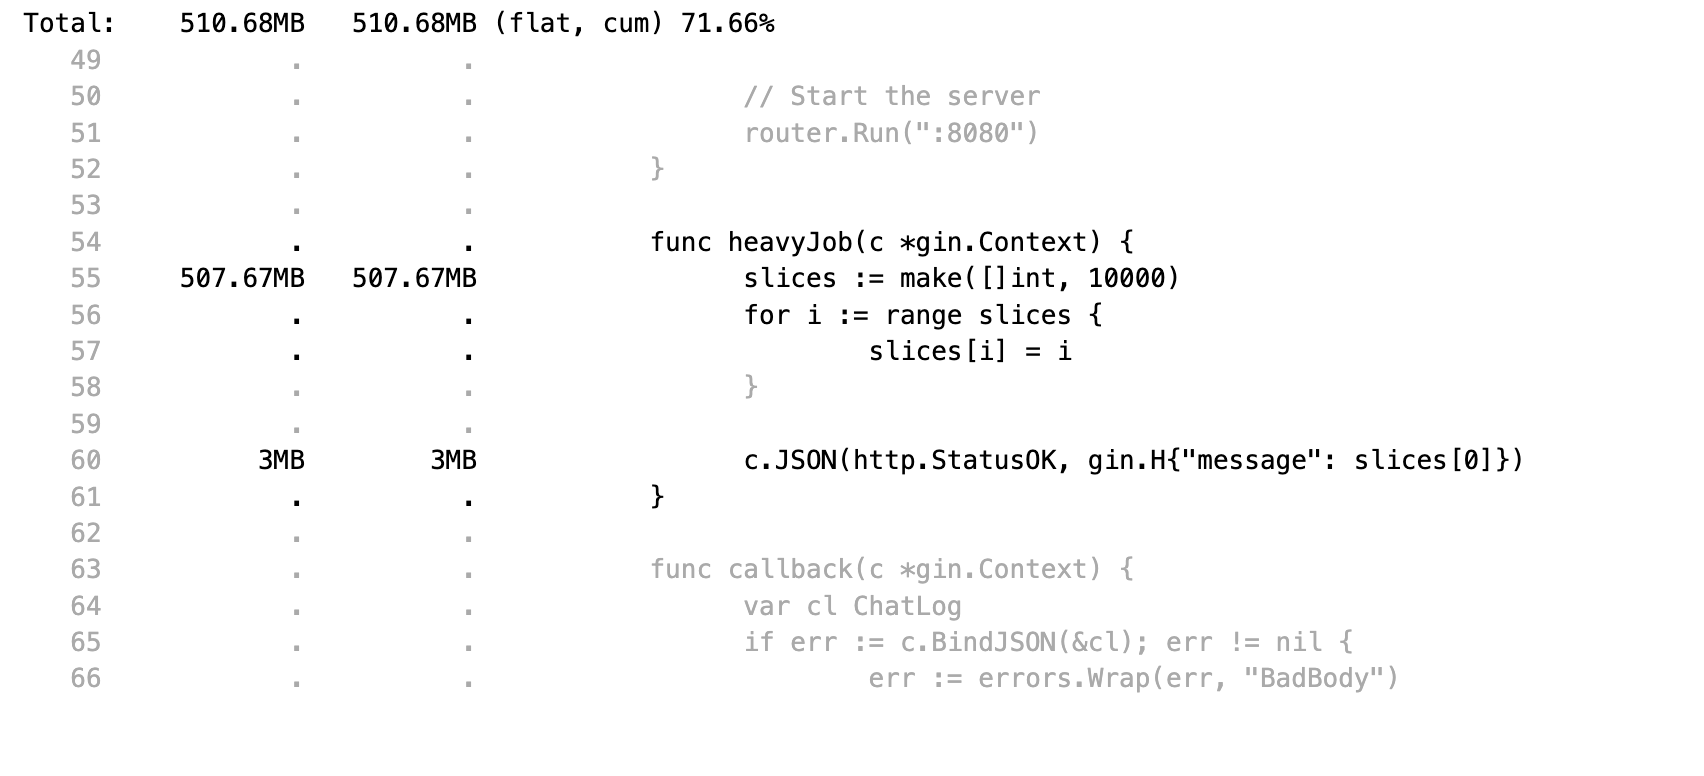
확인이 필요한 함수를 클릭하면 아래와 같이 원본 소스코드를 바로 확인할 수 있고, 함수 내에서 어떤 코드가 객체를 많이 할당하고 있는지도 확인할 수 있습니다.
5. -gcflags=‘-m -m’을 통해, 무엇이 왜 Heap 메모리로 객체가 할당되었는지 확인하기
이제 무엇을 튜닝해야 할지와 소스코드의 위치는 찾았습니다. 하지만 어떻게 튜닝해야 할지는 아직 방법을 모르는 상태입니다. 왜 특정 개체가 GC가 수행되어야 하는 Heap 메모리 영역에 할당되었는지를 알아야, 프로그램 전체적으로 GC가 필요한 객체들을 줄이고 튜닝할 수 있는 것입니다. 그때 사용할 수 있는 Golang의 빌드(Build) 옵션이 바로 gcflags 입니다. [6]
gcflags에 대해 설명하기 위해, 먼저 아래와 같은 소스코드를 예시로 사용하겠습니다.
package main

import (
    "fmt"
)

func main() {
    i := 0
    j := i + 1
    k := j + 1

    fmt.Println(j)
    fmt.Printf("%d\n",k)
}
이 소스코드의 빌드 시 아래와 같이 gcflags 옵션을 사용할 수 있습니다.
% go build -gcflags='-m' main.go
# command-line-arguments
…
./main.go:13:17: j escapes to heap
./main.go:14:15: ... argument does not escape
./main.go:14:23: k escapes to heap
적용한 gcflags 옵션을 통해, j와 k 객체는 Heap 메모리에 할당되었고, i 객체는 Heap에 할당되지 않은 것을 알 수 있습니다. 이 중 Heap 메모리에 할당된 객체는 GC의 관리 대상이 되는데, 이러한 객체들을 줄이는 것이 GC 튜닝의 목표이며, gcflags 옵션으로 그 대상들을 정확히 확인할 수 있습니다(j와 k가 왜 Heap 영역에 할당되었는지는 이어서 다시 설명하겠습니다).
또한, gcflags 옵션에 ‘-m -m’을 인자로 전달하면, 그 원인도 살필 수 있습니다. 변수가 Heap 메모리에 할당되는 데는 다양한 이유가 있으며, 원인을 참고하여 최대한 많은 객체를 Stack 메모리 영역으로 할당해야 합니다.
% go build -gcflags='-m -m' main.go
# command-line-arguments
…
./main.go:14:23: k escapes to heap:
./main.go:14:23:   flow: {storage for ... argument} = &{storage for k}:
./main.go:14:23:     from k (spill) at ./main.go:14:23
./main.go:14:23:     from ... argument (slice-literal-element) at ./main.go:14:15
./main.go:14:23:   flow: fmt.a = &{storage for ... argument}:
./main.go:14:23:     from ... argument (spill) at ./main.go:14:15
./main.go:14:23:     from fmt.format, fmt.a := "%d\n", ... argument (assign-pair) at ./main.go:14:15
./main.go:14:23:   flow: {heap} = *fmt.a:
./main.go:14:23:     from fmt.Fprintf(os.Stdout, fmt.format, fmt.a...) (call parameter) at ./main.go:14:15
./main.go:13:17: j escapes to heap:
./main.go:13:17:   flow: {storage for ... argument} = &{storage for j}:
./main.go:13:17:     from j (spill) at ./main.go:13:17
./main.go:13:17:     from ... argument (slice-literal-element) at ./main.go:13:16
./main.go:13:17:   flow: fmt.a = &{storage for ... argument}:
./main.go:13:17:     from ... argument (spill) at ./main.go:13:16
./main.go:13:17:     from fmt.a := ... argument (assign-pair) at ./main.go:13:16
./main.go:13:17:   flow: {heap} = *fmt.a:
./main.go:13:17:     from fmt.Fprintln(os.Stdout, fmt.a...) (call parameter) at ./main.go:13:16
./main.go:13:16: ... argument does not escape
./main.go:13:17: j escapes to heap
./main.go:14:15: ... argument does not escape
./main.go:14:23: k escapes to heap
6. GC 튜닝은 Benchmark를 중심으로 확인하자
하지만 gcflags 옵션으로 일일이 escapes to heap을 확인하는 것은 눈이 아픈 일입니다. 그리고 코드상에 escapes to heap이 많아도, 실제 발생하는 오브젝트(Object) 할당은 적을 수 있습니다. 한 번 할당한 오브젝트를 계속 재활용할 수도 있고, 실제로는 자주 호출되지 않는 코드일 수도 있기 때문이죠.
가장 확실한 건 실제 서비스에 배포 후 이를 확인하는 것이지만, 그러면 너무 피곤하고 괴로울 수 있습니다. 따라서 Benchmark를 중심으로 집중적으로 튜닝하는 게 좋습니다.
Benchmark를 사용하는 예시 명령은 아래와 같습니다.
% go test -bench=. -benchmem -benchtime=10s -cpuprofile=cpu.prof -memprofile=mem.prof -gcflags='-m'
# golang/gctune [golang/gctune.test]
./gctune_test.go:15:6: can inline BenchmarkNoConstantCapacity
./gctune_test.go:23:6: can inline BenchmarkConstantCapacity
./gctune_test.go:15:34: b does not escape
./gctune_test.go:18:18: make([]int, n) escapes to heap
./gctune_test.go:23:32: b does not escape
./gctune_test.go:26:18: make([]int, n, 1024) does not escape
# golang/gctune.test
_testmain.go:39:6: can inline init.0
_testmain.go:47:24: inlining call to testing.MainStart
_testmain.go:47:42: testdeps.TestDeps{} escapes to heap
_testmain.go:47:24: &testing.M{...} escapes to heap
goos: darwin
goarch: arm64
pkg: golang/gctune
BenchmarkNoConstantCapacity-10    	42037057	       271.2 ns/op	    2048 B/op	       1 allocs/op
BenchmarkConstantCapacity-10      	1000000000	         0.6588 ns/op	       0 B/op	       0 allocs/op
PASS
이때 사용된 옵션들을 설명하면 아래와 같습니다.
- -benchmem 한 번의 bench loop에서 오브젝트 할당이 얼마나 자주, 크게 할당했는지를 보여줍니다. 위 예제는 두 Benchmark의 결과를 보여주는데, 한 Benchmark는 루프를 한번 수행할 때마다 Heap 메모리에 2048 바이트의 객체를 하나 할당했고, 다른 하나는 루프를 수행할 동안 Heap 메모리에 어떠한 객체도 할당하지 않았음을 보여줍니다.
- -cpuprofile, -memprofile Bench가 동작하는 동안의 Profiling 결과를 파일로 저장하는 옵션입니다. 이를 통해 객체 할당이 어디서 일어났는지를 쉽게 확인할 수 있죠.
- -gcflags=’-m’ 위에서 언급한 이 빌드 옵션은 테스트 시에도 사용할 수 있습니다. 이를 통해 어디서 Heap 메모리로 할당이 일어났는지, 왜 일어났는지를 확인할 수 있습니다.
이렇게 Benchmark를 사용해 튜닝을 진행한 후에도 Heap 메모리에 할당된 오브젝트는 줄었는데, 오히려 Bench 상에서의 속도는 떨어지는 결과 가 나올 수도 있습니다. 특히 Pool 같은 기법을 사용하면 객체가 재활용되며 Heap 영역의 할당은 줄지만, Pool에 대한 추가적인 연산들이 수행되며 CPU 자원을 소모하기 때문입니다.
또한, Heap 메모리 할당을 줄여서 얻는 이득은 GC가 발생해야만 그 효과를 확인할 수 있는데, Benchmark는 짧은 시간 동안만 실행되는 경우가 많아 GC 부하가 잘 드러나지 않기 때문입니다.
어느 것이 이득인지는 작성된 프로그램에 따라 다를 수 있기 때문에, 이것은 개발자의 판단이 필요한 부분입니다.
7. Heap 할당을 줄이는 팁들
이제부터 본격적으로 Heap 메모리 할당을 줄일 수 있는 팁들을 하나씩 소개드리겠습니다.
1) 비정형 인자는 Heap에 할당되니 조심해야 합니다.
아래 코드에서 j와 k 객체는 Heap 메모리에 할당되지만, i는 Stack 메모리에 할당되었습니다.
그 이유는 fmt.Println, fmt.Printf 함수 때문입니다. 두 함수는 any 타입의 인자를 사용하기 때문에 무엇이든 전달받을 수 있습니다.[7] 그리고 무엇이든 받기 위해, 각 변수에는 그 type을 설명하는 보조 정보가 필요하게 됩니다. 이때, 보조 정보가 있는 데이터는 반드시 Heap 메모리 영역에 할당되게 됩니다. 즉 any 만이 아니라, interface 및 reflect 등의 타입을 읽고 해석하는 추상화가 필요한 데이터들은 GC 부하를 일으키는 원인으로 작용합니다. [8]
package main

import (
    "fmt"
)

func main() {
    i := 0
    j := i + 1  // j escapes to heap
    k := j + 1 //  escapes to heap

    fmt.Println(j)
    fmt.Printf("%d\n",k)
}
그렇다고 반드시 비정형 인자를 소스코드에 사용하지 말라는 의미는 아닙니다. 비정형 인자 또한 코드의 가독성과 생산성을 높여주는 좋은 장점들이 있습니다. 필요 이상으로 사용을 금하다가 가독성과 생산성을 떨어뜨리면, 배보다 배꼽이 크게 될 수 있습니다. 비정형 인자를 제거하는 방법은 GC 튜닝이 필요할 때, 혹은 프로그램의 성능이 문제다 싶은 상황이 오면 적용하는 것을 권장합니다.
추가로 강조드리고 싶은 점은, 비정형 인자로 사용될 때만 오브젝트가 Heap 메모리에 할당되는 것이 아니라, 비정형 인자로 사용될 가능성 만 있어도 컴파일 시점에 Heap 영역으로 할당되도록 정해진다는 것입니다.
아래 코드를 예시로 들어 설명드리겠습니다.
예시에서 i가 1일 가능성은 없습니다. Golang 컴파일러가 똑똑하게 이를 Deadcode로 판단하면 좋으련만 그렇지 못했습니다. 또한, j와 k가 fmt의 함수들로 인해 any, 즉 비정형인자로 사용될 가능성이 있다고 판단하였고 선언 시점부터 j와 k를 Heap 메모리에 할당하였습니다.
package main

import (
    "fmt"
)

func main() {
    i := 0
    j := i + 1  // j escapes to heap
    k := j + 1 //  escapes to heap

    if i == 1 {
            fmt.Println(j)
            fmt.Printf("%d\n",k)
    }
}
에러가 발생했을 때 예외적인 상황을 파악하기 위해 Logging을 하는 경우가 종종 있습니다. 반전은 이런 코드가 인자로 사용된 변수들을 항상 Heap 메모리 영역으로 할당하게끔 만들 수 있다는 것입니다. 드문 경우에 짧은 시간 동안 동작하는 코드지만 GC 대상이 늘어나는 비극적인 상황이죠. 따라서 Logger를 사용할 때도 비정형 인자를 피하는 것이 중요합니다.
2) type을 정해서 출력하는 Logger를 선택합니다.
비정형 인자를 가장 많이 사용하는 경우가 Logging입니다. Golang에는 여러 Logger들이 존재하는데, 이 중 무엇을 선택하느냐에 따라서 Heap 메모리 할당에 큰 차이를 보입니다.
선택할 수 있는 Logger의 종류에는 아래와 같이 log, slog 및 zap 등이 있습니다.
import “log”

func logtest() {
	int4log := 2 // escapes to heap
	slice4len := make([]int, 10, 1024)
	slice4log := make([]int, 10, 1024) // escapes to heap
	log.Println(slice4log, int4log)    // slice4log & int4log  escapes to heap
	log.Println(len(slice4len))        // len(slice4len) escape to heap
}
import “slog”

import (
	"log/slog"
	"os"
)

func slogtest() {
	int4slog := 3
	slice4len := make([]int, 10, 1024)
	slice4slog := make([]int, 10, 1024) // escapes to heap

	logger := slog.New(slog.NewJSONHandler(os.Stdout, nil))

	logger.Info(                                  // context.backgroundCtx() escapes to heap
		"slogtest",
		slog.Any("slice", slice4slog),            // ~R0 escapes to heap
		slog.Int("int", int4slog),                // ~R0, KindInt64 escapes to heap
		slog.Int("len",len(slice4len)))           // ~R0, KindInt64 escapes to heap
}
import (
	"go.uber.org/zap"
)

func zaptest() {
	int4zaplogger := 4
	slice4len := make([]int, 10, 1024)
	slice4zaplogger := make([]int, 10, 1024) // escapes to heap

	zaplogger, _ := zap.NewProduction()

	zaplogger.Info("zaplogtest",
		zap.Ints("ints", slice4zaplogger), // zap.ints(zap.nums) escapes to heap
		zap.Int("int", int4zaplogger),
		zap.Int("len", len(slice4len)))

	zaplogger.Sync()

}
기본 패키지의 log는 fmt 패키지의 여러 함수들처럼 any의 사용비중이 높고, 이에 따라 당연히 인자들이 모두 Heap으로 할당됩니다. slog는 go1.21에서 추가된 신규 패키지인데요, 보기에는 type을 정하게 되어있어 비정형 인자가 아닐 거 같고, 그래서 Heap 할당이 없을 것처럼 생각됩니다. 하지만, 내부적으로 Value를 추상화하는 관점에서 any를 사용하였고, 이로 인해 Heap 메모리에 할당되어 버립니다. 즉, 애써 타입을 적었지만, fmt 패키지와 다를 바가 없는 것입니다.
하지만 Uber에서 만든 zap logger는 slog와 비슷한 모양을 가졌으면서도, Heap 메모리에 할당이 훨씬 적습니다. 일단 Primitive type들은 확실하게 Stack 메모리에만 할당되며 Heap 영역으로 Esacpe 하지 않습니다. 물론 예외적인 경우도 있지만, 그래도 다른 Logger보다는 훨씬 좋은 성능을 보여줍니다.
3) Pointer 변수는 무조건 Heap에 할당되니 조심해야 합니다.
보통 함수의 인자로 포인터를 즐겨 사용합니다. 값을 복사하는 것보다, 포인터로 넘기는 것이 CPU 효율적이라고 생각하기 때문인데요, Golang에서는 CallByPointer보다 CallByValue가 효율적인 경우가 자주 일어납니다. 왜냐하면 포인터로 선언되는 순간, 해당 오브젝트는 무조건 Heap 영역에 할당되기 때문 입니다. [9]
4) slice를 생성 시 Capacity가 상수인 경우 Stack 메모리에 들어갈 수 있습니다.
slice 또는 map을 생성(Make) 할 때, Capacity를 입력하는 방식은 필수적이면서도 유용한 팁입니다. slice나 map이 커져가면, 새롭게 메모리를 할당하고 해당 영역에 데이터를 다시 적재한 후 기존 객체는 버려버리는 realloc이 발생하는데, 이것을 피할 수 있기 때문입니다.
여기에 추가로, 가능하다면 Capacity(또는 len)을 상수로 입력한다면, 아예 Heap 메모리 할당을 없는 일로 만들 수 있습니다.
이는 Golang이 Data type을 고려해 크기가 64KB 이하인 객체의 경우 Stack 메모리에 선언하는 기능이 있기 때문입니다. [10] 이 방법은 놀랍도록 쉬우면서도 성능 개선에 많은 도움을 줄 수 있습니다.
package main

import (
    "testing"
)

var (
    n = 256
)

const (
    maxSize = 1024
)

func BenchmarkNoConstantCapacity(b *testing.B) {
    total := 0
    for i := 0; i < b.N; i++ {
        s := make([]int, n)
        total += len(s)
    }
}

func BenchmarkConstantCapacity(b *testing.B) {
    total := 0
    for i := 0; i < b.N; i++ {
        s := make([]int, n, maxSize)
        total += len(s)
    }
}
go test -v -bench=. -benchmem -gcflags="-m"

...
./go_test.go:18:18: make([]int, n) escapes to heap
...
./go_test.go:26:18: make([]int, n, maxSize) does not escape
...
goos: darwin
goarch: arm64
pkg: exam
BenchmarkNoConstantCapacity
BenchmarkNoConstantCapacity-10       4909958           233.0 ns/op      2048 B/op          1 allocs/op
BenchmarkConstantCapacity
BenchmarkConstantCapacity-10        1000000000           0.6222 ns/op          0 B/op          0 allocs/op
PASS
ok      exam    2.348s
5) Pool은 Heap 메모리 할당을 줄일 수 있지만, CPU가 많이 소모될 수 있습니다.
이런저런 방법 모두 적용할 수 없어 Tuning이 어렵다면 가장 쉽게 적용할 수 있는 방법이 Pool입니다.
하지만 Pool을 관리하면서 오는 비용 때문에 오히려 CPU 리소스를 낭비할 수 있기 때문에, 무엇이 유리한지는 잘 선택해야 합니다.
Pool을 적용한 예시 코드는 아래와 같습니다.
package main

import (
    "fmt"
    "sync"
    "testing"
)

var (
    n      = 256
    baPool = sync.Pool{
        New: func() any {
            res := make([]int, n)
            return &res
        },
    }
)

const (
    maxSize = 1024
)

func BenchmarkNoCapacity(b *testing.B) {
    total := 0
    for i := 0; i < b.N; i++ {
        s := make([]int, n)
        total += len(s)
    }
}

func BenchmarkPool(b *testing.B) {
    total := 0
    for i := 0; i < b.N; i++ {
        s := baPool.Get().(*[]int)
        total += len(*s)
        baPool.Put(s)
    }
}

func BenchmarkConstantCapacity(b *testing.B) {
    total := 0
    for i := 0; i < b.N; i++ {
        s := make([]int, n, maxSize)
        total += len(s)
    }
}
goos: darwin
goarch: arm64
BenchmarkNoCapacity-10          	13474758	       265.0 ns/op	    2048 B/op	       1 a4llocs/op
BenchmarkPool-10                	416718634	         8.661 ns/op	       0 B/op	       0 allocs/op
BenchmarkConstantCapacity-10    	21055032	       171.7 ns/op	       0 B/op	       0 allocs/op
PASS
ok  	command-line-arguments	12.347s
6) 최신 패키지를 잘 살펴봅니다.
보통 Sort는 꽤 비싼 연산이지만, ‘적은 개수를 정렬하려는 거니 괜찮을 거야’라는 생각에 자주 사용하는 경우도 으레 있습니다. 이때 기본적으로 제공되는 sort.Slice가 많이 사용되는데요, 대신 slices.SortFunc를 사용하는 편이 GC 튜닝에 더 유용합니다. 왜냐하면 sort.Slice는 호출될 때마다 무조건 두 개의 객체를 Heap 메모리에 생성하고 할당하는데 반해, slices.Sort는 생성하는 객체 자체가 없기 때문이죠.
물론 Golang은 계속해서 새로운 버전이 출시되며 발전하고 있기 때문에, 언젠가는 sort.Slice도 최적화되어 Heap 영역 할당이 없도록 바뀔지도 모릅니다. 이러한 측면에서나 Golang에 추가된 새로운 기능, 새로운 GC 및 새로운 패키지를 즐기기 위해서라도 Golang의 신규 버전들을 모니터링하시기를 권장드립니다.
slices.SortFunc와 sort.Slice에 대한 Benchmark는 아래와 같습니다.
package main

 import (
    "math/rand"
    "sort"
    "testing"
    "time"

    "golang.org/x/exp/slices"
)

func BenchmarkSlicesSortFunc(b *testing.B) {
    for i := 0; i < b.N; i++ {
        b.StopTimer()
        data := generateTestData(1000) // Generate a slice of 1000 integers
        b.StartTimer()
        slices.SortFunc(data, func(a, b int) int { return a - b })
    }
}

// Benchmark using sort.Slice
func BenchmarkSortSlice(b *testing.B) {
    for i := 0; i < b.N; i++ {
        b.StopTimer()
        data := generateTestData(1000) // Generate a slice of 1000 integers
        b.StartTimer()
        sort.Slice(data, func(i, j int) bool { return data[i] < data[j] })
    }
}

// Function to generate test data
func generateTestData(n int) []int {
    rand.Seed(time.Now().UnixNano())
    data := make([]int, n)
    for i := range data {
        data[i] = rand.Intn(n) // Random integers between 0 and n-1
    }
    return data
}
goos: darwin
goarch: arm64
pkg: exam
BenchmarkSlicesSortFunc
BenchmarkSlicesSortFunc-10         24333         52203 ns/op           0 B/op          0 allocs/op
BenchmarkSortSlice
BenchmarkSortSlice-10              18000         62061 ns/op          56 B/op          2 allocs/op
PASS
ok      exam    8.010s
정리
지금까지 Golang GC 튜닝 및 튜닝을 위한 여러 테크닉들을 살펴보았습니다. 하지만 튜닝에 있어 가장 중요한 점은 역설적이게도 ‘필요한 만큼만’하고 멈추는 것입니다. 프로그램의 기본은 자료구조와 알고리즘이며 테크닉을 중심으로 세심하게 코드에 공들이는 것보다, 처음부터 좋은 설계로 좋은 구조를 갖도록 하는 것이 훨씬 중요합니다. 과도한 튜닝은 코드의 가독성과 생산성을 떨어뜨리고 코드의 유지보수를 어렵게 만들어, 더 좋은 구조로 바꾸기 어렵게 만드는 장애물이 될 수 있기 때문입니다. 잘 조리된 요리의 풍미를 살리는 마지막 향신료 한 방울처럼, 독자분들이 항상 적절한 정도로 코드를 튜닝하시길 바랍니다.
Reference
- [1]
- [2] https://tip.golang.org/doc/gc-guide#Optimization_guide
- [3] https://tip.golang.org/doc/gc-guide
- [4] https://blog.twitch.tv/en/2019/04/10/go-memory-ballast-how-i-learnt-to-stop-worrying-and-love-the-heap/
- [5] https://go.dev/doc/faq#stack_or_heap
- [6] https://medium.com/invalid-memory/golang-cost-of-using-the-heap-e70363469754
- [7] https://pkg.go.dev/fmt#Print
- [8] https://github.com/golang/go/issues/15528
- [9] https://articles.wesionary.team/use-case-of-pointers-in-go-w-practical-example-heap-stack-pointer-receiver-60b8950473da
- [10]
written by Yanoo.kim
edited by June.6