Engineering
많은 수의 가격데이터 를 효율적으로 검색하기위한 여정: Part-1.시작
박현주Aaron(아론) / 검색플랫폼개발팀여기어때
2022년 5월 12일
원문에서 보기 ↗안녕하세요.
여기어때 검색개발팀 아론입니다.
저희팀은 여기어때의 검색시스템을 담당하고 있으며, 사용자의 여행 Needs에 빠르게 대응하려고 노력하고 있습니다.
여기어때 주요 서비스 중 하나인 숙박 예약은 보통의 커머스와는 다르게 미래의 상품(객실)을 판매하면서, 날짜에 따라 가격이 다를 수 있기에 같은 상품(객실)이지만 다수의 가격 데이터가 존재할 수 있는 서비스입니다.
오늘은 이 가격 데이터를 보다 효율적으로 관리하고 이용하기 위해 검색개발팀에서 노력한 내용을 공유하고자 합니다.
현재 시스템에서 수용이 가능할까?
이전의 여기어때 숙박 예약 가능일은 당일로부터 최대 90일 이후, 연속 숙박은 최대 7박까지로 제한되어 있었습니다. 그러나 ‘한 달 살기’ 등의 트렌드가 생겨나고, 더 일찍 계획을 수립하는 등, 여행에 대한 고객의 행동 패턴 변화에 따라 예약 가능일과 연속 숙박일을 늘려야 했습니다.
또한 판매가 기준으로 가격 정렬과 필터를 제공했었는데, 할인 이벤트가 적용된 가격과 쿠폰 적용 후 가격을 기준으로 고객에게 보여드리는 것이 좋겠다고 생각했습니다.
그런데 예기치 않은 걸림돌을 만나게 되었습니다.
당시 저희의 ES(Elastic Search)문서는 객실 기준으로 구성되어있었고 검색시점에 Script를 이용해 가격을 계산하고 있었습니다. 그런데 이 가격정보가 기본정렬에 포함되어있어 대부분의 검색이 일어날 때 마다 Script가 수행되었기 때문에 판매 가능일과 연속 숙박일이 늘어날 수록 Latency에 대한 부담이 더욱 가중되는 상황이었고, 다양한 할인 정책과 쿠폰 적용 시 Latency가 추가로 발생하여 서비스 영향이 클 것으로 판단하였습니다.
그래서 저희는 색인구조 재설계를 시작했습니다.
서비스기준 색인구조 재설계
색인 재설계 시 가장 중요하게 생각한 점은 두 가지인데, 첫 번째로 Latency를 최소화 하는 것 , 두 번째는 전체 색인 생성시간을 단축하여 최신의 데이터를 빠르게 제공하는 것 이었습니다.
이를 위해 색인시점에 모든 전처리를 완료하여 검색시점에 별도의 Script를 사용하지 않는 것으로 결정하였습니다.
또한, 여기어때 서비스에서는 숙소 기준으로 목록을 보여주기 때문에 객실이 아닌 숙소를 기준으로 ES 문서를 구성하고 하위 객실정보를 nested field로 구성하는 쪽으로 방향을 잡았습니다.
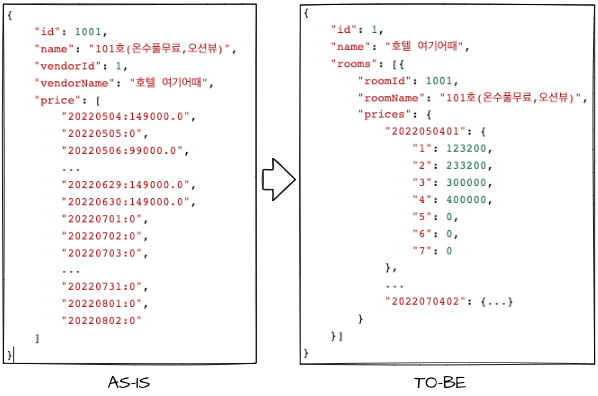
색인 재설계 전/후 문서 예시 비교
전년 피크타임 기준으로 성능테스트 결과, 재설계 이전 대비 QPS(Query per second)가 337% 향상되었음을 확인하였고, 저희가 계획한 서비스 수용이 가능할 것으로 판단하였습니다.
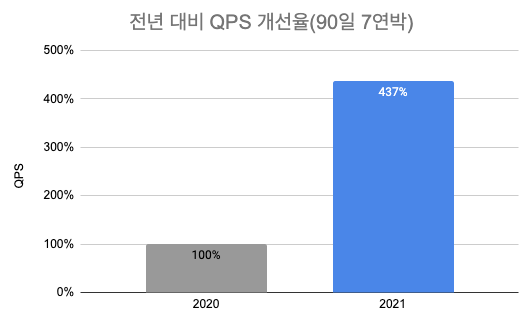
이제 예약 가능일, 연박 숙박일을 늘려보자
신규 구성된 색인에서 예약 가능일과 연속 숙박일을 조정하며 실험을 진행한 결과 예약 가능일과 연속 숙박일 증가에 따라(정확히는 가격데이터 증가량에 따라…) 개별 ES 문서의 크기가 기하학적으로 증가함을 확인하였습니다.
가격데이터 수 = 숙소 수 ✕ 객실 수 ✕ 예약 가능일 ✕ 연속 숙박일
예시로 1개 숙소에 객실 10개, 모든 날짜 예약 가능하며, 30일 연속 숙박을 선택하는 경우 약 11만개의 가격 데이터가 생성되고,
1 ✕ 10 ✕ 365 ✕ 30 = 109,500
서비스 중인 숙소가 10,000개 라고 하면 약 11억개의 가격데이터가 생성됩니다.(물론, 현실적으로는 위와 같이 극단적인 수량은 아닙니다만…)
109,500 ✕ 10,000 = 1,095,000,000
이로 인해 색인 생성시간이 증가하고, 검색 Latency가 높아져 QPS가 떨어지는 현상이 확인되었습니다.
위 실험결과로 저희가 해야 할 일은 색인 생성시간을 단축하고 적정 QPS 유지 하면서 ES 문서 크기 또한 줄여야 하는 것 임을 알 수 있었습니다.
비우기의 시작은 사용하지 않는 것 부터…
문서 크기를 줄이기 위해 데이터 구조를 다시 파악하는 도중 일부 데이터들을 기본값으로 설정하고 저장하는 것을 확인하였습니다. 숙소정보 등록여부에 따라 차이가 있지만 이 데이터의 비율이 대략 20%정도로 확인되어 우선적으로 비워내기로 했습니다.
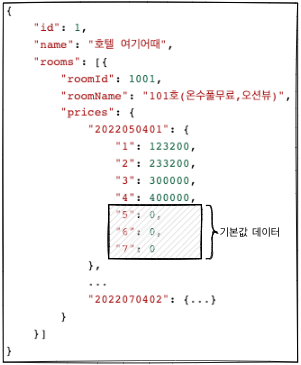
이 중 정렬에서 사용하는 데이터의 Mapping이 생성되지 않은 경우 SearchParseException 오류가 발생하게 되므로 unmapped_type 과 missing_value를 적용하여 데이터가 없어도 오류가 발생하지 않고 정렬이 되도록 하였습니다.
멀티검색(_msearch)은 꼭 필요한 경우에만..
카테고리 서비스의 경우 숙소목록 내 영역별 숙소 중복노출을 위해 멀티검색을 사용하였는데 멀티검색 사용 시 다수의 검색이 동시에 수행되어 데이터 노드의 CPU 사용량이 많아지게 됩니다. CPU 사용량이 많아지면 검색 Latency가 높아지기 때문에 개선이 필요합니다.
다행히 일부 카테고리의 경우 정책변경으로 인해 중복노출이 필요하지 않기 때문에 영역별 노출 순서를 정렬로 풀어서 멀티검색을 사용처를 최소화 하였습니다.
인덱스 노드(색인 생성 용도) 증설
여기어때 검색시스템의 경우 색인 안정성 및 잦은 실시간 색인으로 인한 Segment 파편화 해소를 위해 색인을 매일 재생성하여 관리하고 있습니다.
따라서 색인 생성에 대한 서비스 영향을 최소화 하기 위해 데이터 노드는 색인을 생성하는 Indexing Type, coordinating-node로 데이터를 제공하는 Serving Type으로 구분하여 운영 하고 있습니다.
(저희는 Index Node, Data Node, Search Node로 부릅니다.)
저희는 색인 생성시간 단축을 위해 Index Node를 증설하여 색인 생성이 병렬로 되도록 구성하였습니다.
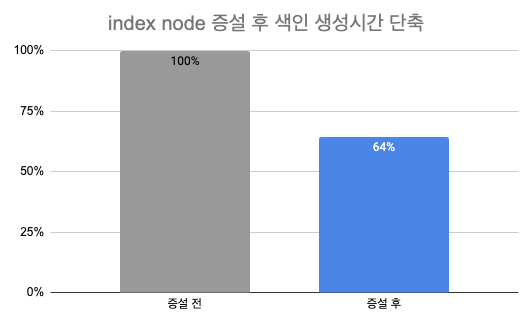
데이터노드(검색 용도) 증설
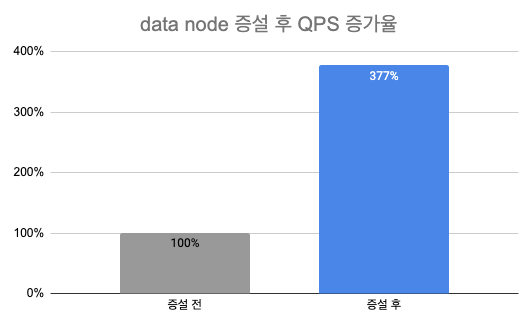
검색 Latency 단축을 위해 기존 대비 Data Node 증설하여 CPU 리소스 사용량 분산처리하였습니다.
결론
하드웨어 및 소프트웨어 개선을 통해 기존 대비 313% 향상된 QPS를 확보할 수 있었습니다.
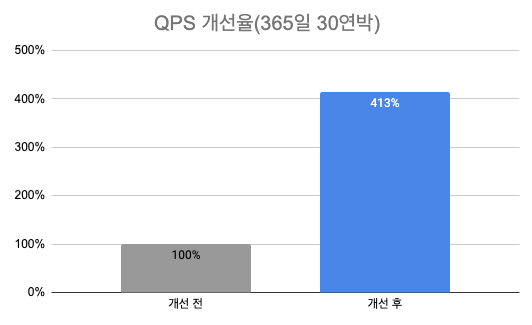
이처럼 일부 성능개선을 통해 예약 가능일(365일)과 연속 숙박일(30연박)을 수용하기 위한 기반을 마련하였지만 서비스가 확장됨에 따라 가격데이터 뿐만 아니라 관련 데이터도 모두 증가 될 것 이며 검색 문서 크기도 지속적으로 증가 될 것으로 예상됩니다.
이에 따라 검색개발팀에서는 숙박 도메인 탐색에 최적화된 색인구조를 찾기 위해 많은 실험과 도전을 하고 그에 따른 다양한 경험을 공유할 예정이니 지켜봐 주시기 바랍니다.
감사합니다.