AI/ML
밑바닥부터 Kanana LLM 개발하기: Pre-training
mat.mul카카오
2024년 11월 14일
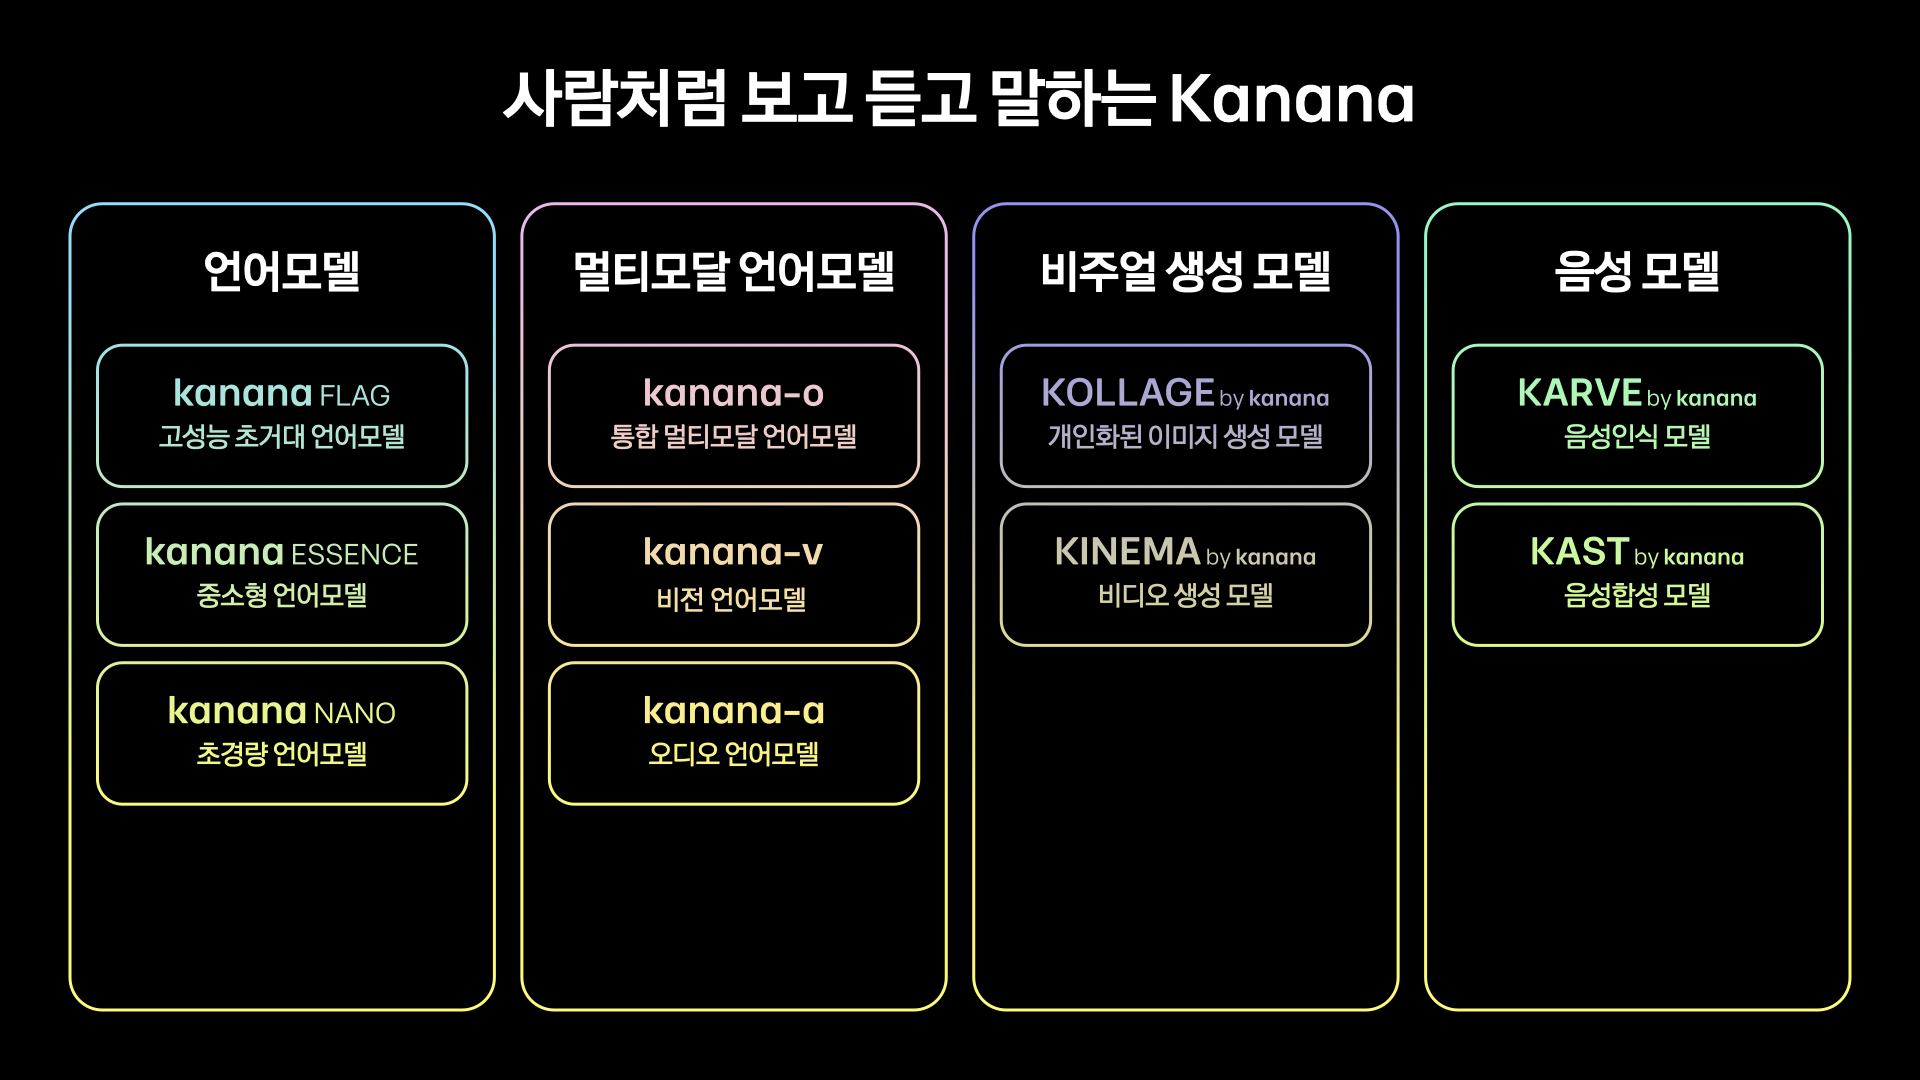
원문에서 보기 ↗안녕하세요. 카카오의 AI 모델 개발을 담당하는 카나나 알파(Kanana ⍺) 조직에서 자체 언어모델을 개발하고 있는 Mat입니다. 저희 조직에서는 카나나 언어모델(Kanana LLM: Kanana Nano, Essence, Flag)의 Pre-training을 담당하고 있습니다.
이 글에서는 효율적인 고성능 언어모델 학습을 위한 데이터와 학습전략 관점에서 카나나 언어모델의 학습 과정과 성능 결과를 소개하고자 합니다. 중점적으로 다룰 Kanana Essence와 Nano 모델은 각각 서비스에 가장 최적화된 중형 사이즈의 모델과 모바일 디바이스에서도 활용 가능한 초경량 모델로, 유사 사이즈의 글로벌 SOTA 모델들과 비교해 동등한 수준의 영어 성능과 압도적인 한국어 성능을 확인하였습니다.
효율적인 Pre-training을 위한 전략: Two staged pre-training
먼저 언어모델(Large Language Model, LLM) 학습 과정은 크게 Pre-training과 Post-training으로 구분됩니다. 상대적으로 Pre-training 과정은 Post-training 대비 아주 큰 Compute budget 이 필요합니다. 예를 들어, 우리가 잘 알고 있는 Meta의 LLM 중 가장 큰 모델인 llama-3.1-405b 모델은 Pre-training 과정에서 15.6T의 Token을 16,000개의 H100 GPU로 54일 동안 학습했습니다. 현실적으로 이렇게 큰 Compute budget을 투자하기는 어렵기에, 저희 조직에서는 효율적인 구조하에 좋은 성능을 내는 LLM을 만드는 데에 집중했습니다. 이에 따라 어떤 크기의 모델을, 어떤 데이터를 이용해서, 어떤 방식으로 학습할지 전략을 구성하였습니다.
사실상 기존 LLM의 학습방식에 따른 Scaling law는 충분한 Compute budget 하에 파라미터의 크기와 학습에 사용하는 데이터를 늘리면 자연스레 성능이 좋아지는 것이기 때문에 저희에게 적절한 방법이 아니었습니다. 저희는 일종의 다른 변수를 통해 Scaling law를 개선할 수 있어야 했습니다. 예를 들어, 학습의 단계를 나누어 서로 다른 Data distribution을 사용하거나, 학습에 사용하는 데이터의 품질에 따라 Scaling law가 개선되어야 했습니다. 결국 여러 방식을 탐색한 끝에 선택한 방식은 Two staged pre-training이었습니다.
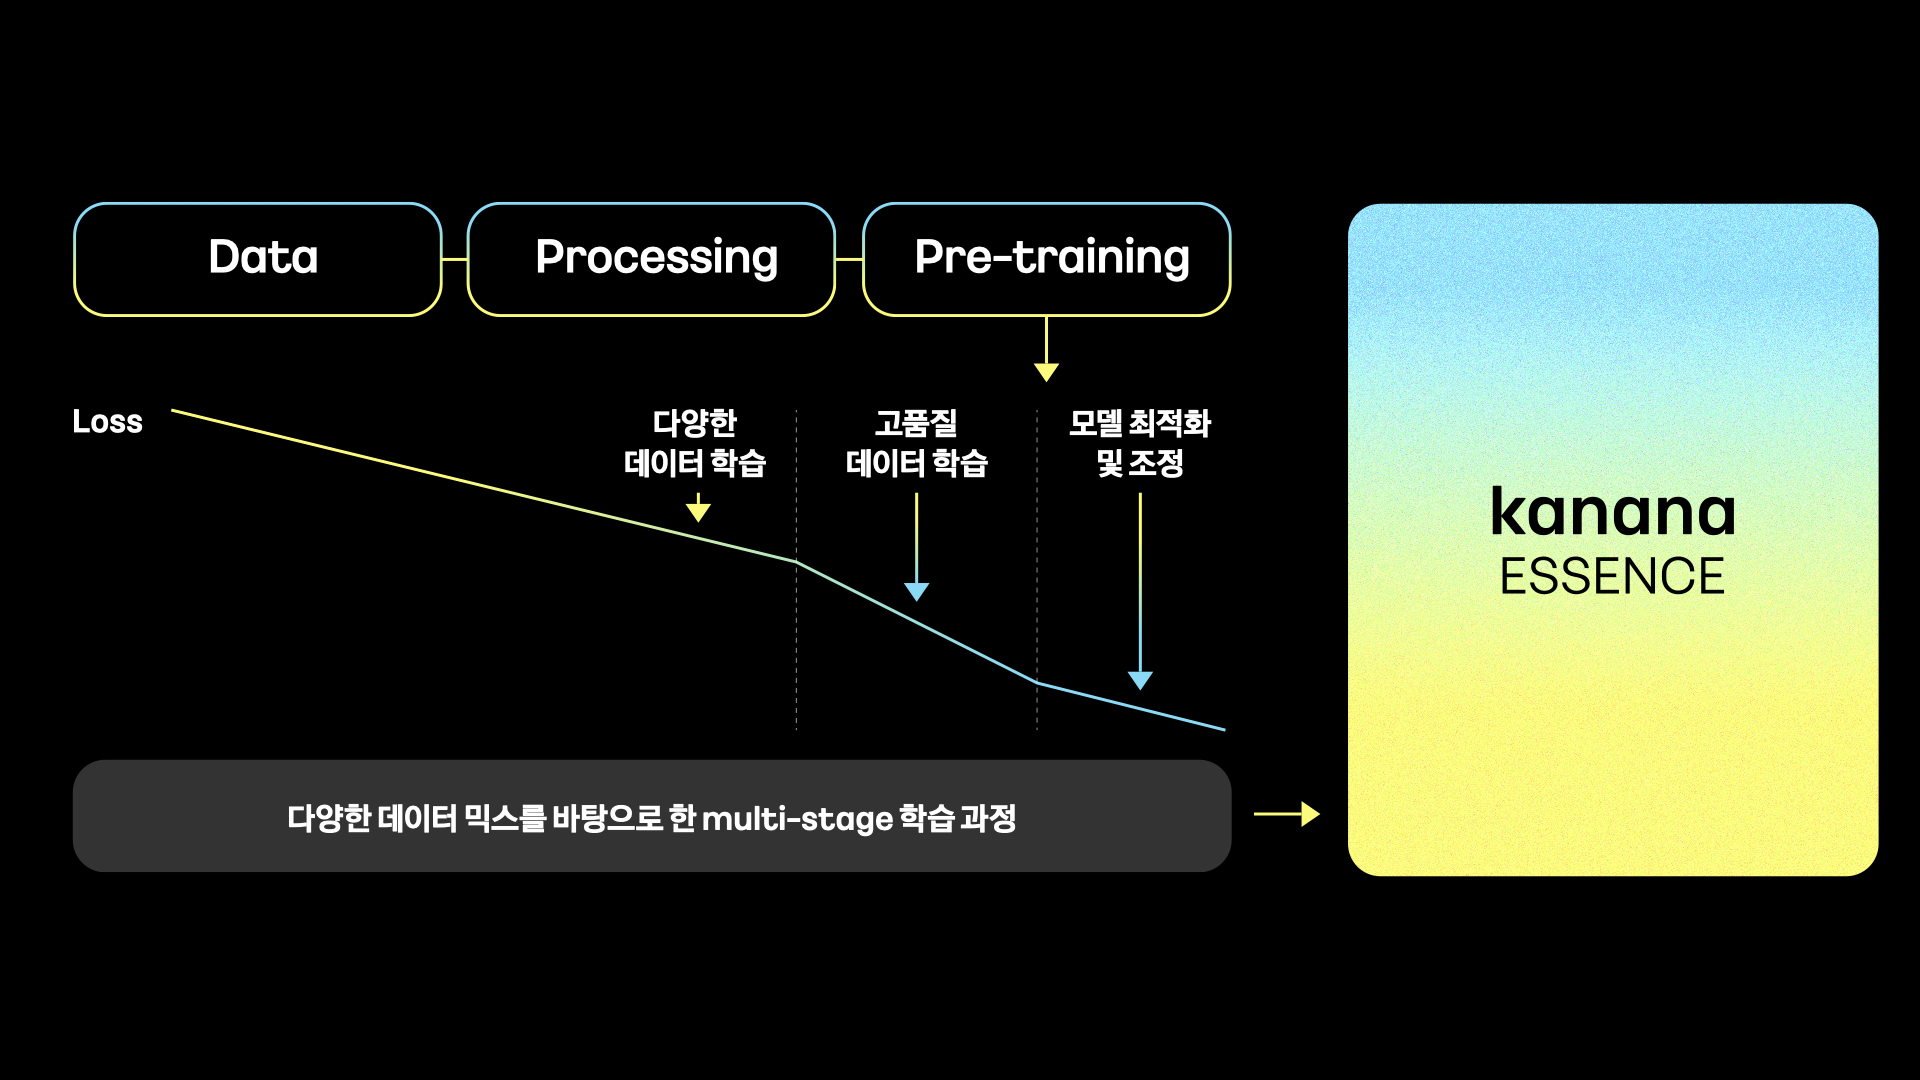
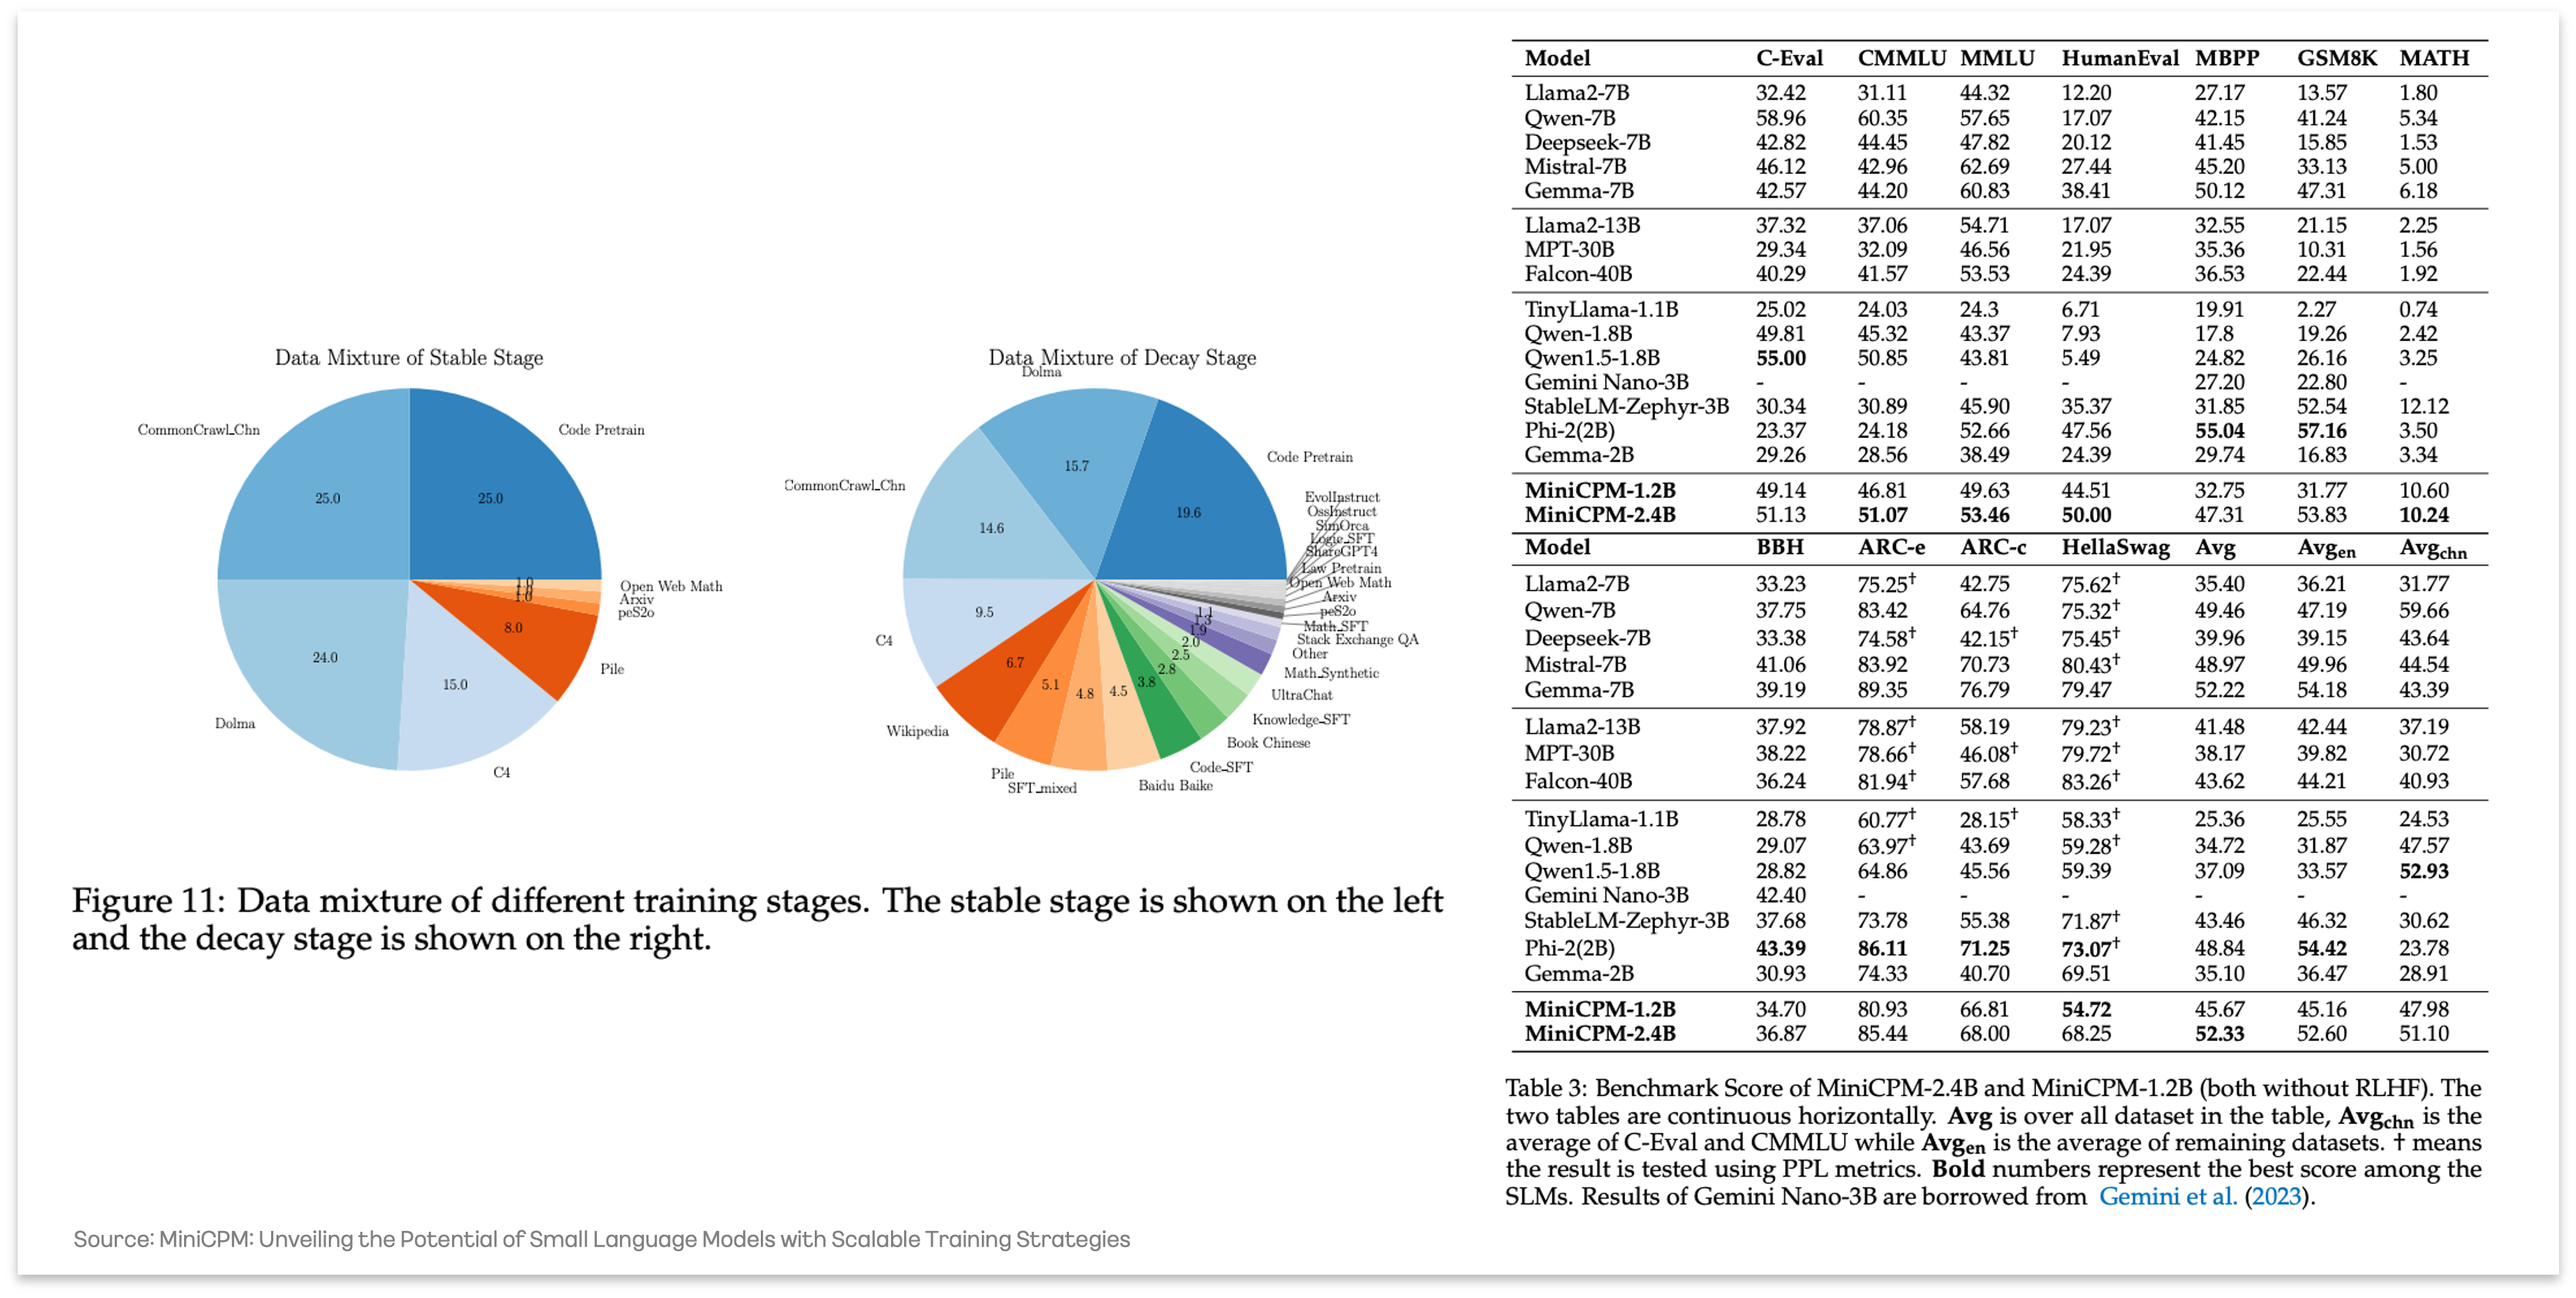
Two staged pre-training은 Pre-training을 두 단계로 나누어서 학습하는 방법으로, Stage 1(Stable stage)와 Stage 2(Decay stage)로 구성됩니다. 각각의 Stage에 서로 다른 Data distribution을 활용해 학습하는 방식입니다. 여기서 “MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies”라는 논문 결과를 모티브로, 세부 학습 전략을 구성하였습니다. 해당 연구에서는 아래와 같은 Stage 별 Data distribution을 가지고, 전체 1.1T의 Token만 학습하고도 훨씬 크고 더 많은 Token을 학습에 사용한 LLM들(예: llama2-7b)과 거의 비교할 만한 성능을 확보한 것을 확인할 수 있습니다.
Two staged pre-training 을 위한 데이터 전략
Two staged pre-training 방식은 각 Stage에 따라 Data distribution을 다르게 학습하기 때문에 해당 Stage에 적합한 데이터 수집과 전처리 과정이 중요합니다. 일반적으로 Stage 1 학습에서는 특정 도메인을 목표로 하지 않고 다양한 도메인을 포괄적으로 다룰 수 있는 데이터(예: CommonCrawl)를 주로 사용하며, 전체 Pre-training 학습 관점에서 더 많은 학습 시간을 할당합니다. 반대로 Stage 2에서는 Stage 1에 비해 더 적은 학습시간을 할당하며, 특정한 도메인을 다루는 데이터(예: arXiv)를 더 많이 사용하거나, 상대적으로 LLM 학습에 도움이 될 만한 고품질의 데이터를 기존 대비 더 많이 사용합니다.
1. 데이터 수집
각 Stage에 적합한 데이터를 구성하기 위해 “해당 말뭉치를 LLM 학습에 사용하는 목적”을 크게 4가지로 정의했습니다. Stage마다 데이터의 목적을 반영한 Data distribution 탐색을 하기 위해서는 목적에 따라 말뭉치를 분류하여 데이터화하는 과정이 필요했습니다. 이 과정에서 LLM 학습에 사용해도 문제가 없는 라이센스(예: apache-2.0, cc-by-4.0)에 해당하는 말뭉치들만 수집하여 데이터화하였습니다.
| 목적 | 학습에 사용 가능(예시) | 학습에 사용 불가능(예시) |
|---|---|---|
| common sense & general knowledge | 모두의 말뭉치 (국립국어원) | 저작권이 있는 신문 기사 |
| stem | 대규모 구매 도서 기반 한국어 말뭉치 데이터 (AI 허브) | KCI 논문들 |
| code | permissive license에 해당하는 코드 뭉치들 | no license이거나 permissive license가 아닌 코드 뭉치들 |
| wikipedia | 한국어 위키피디아 | 나무위키 |
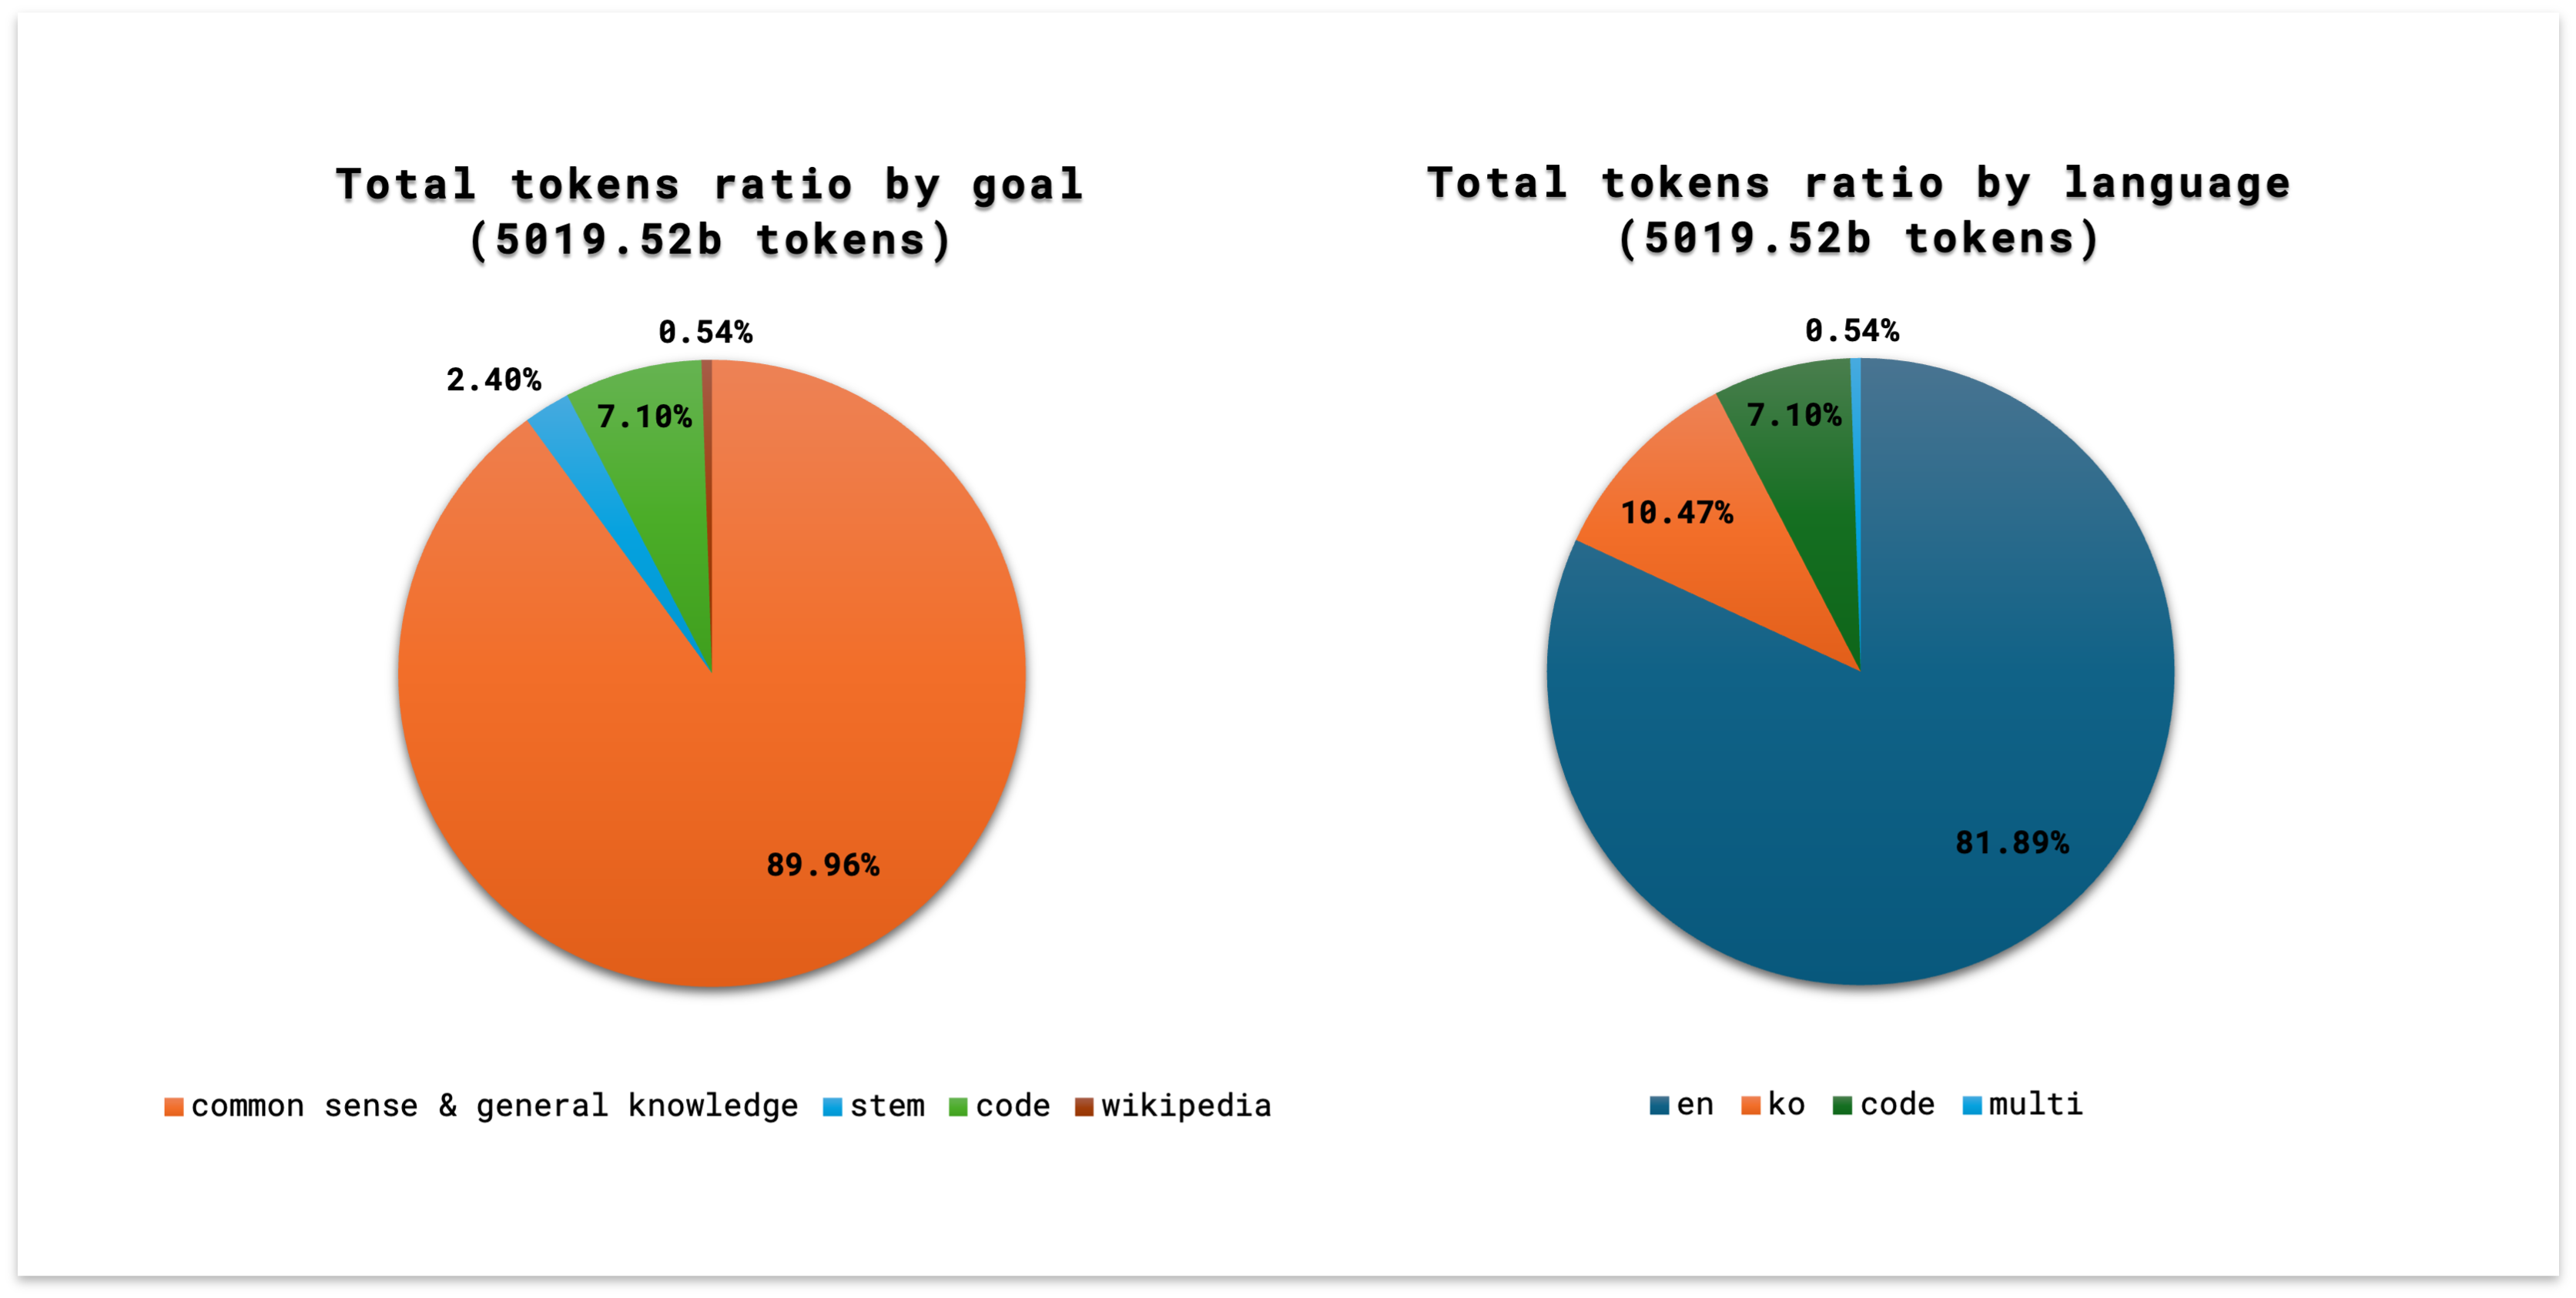
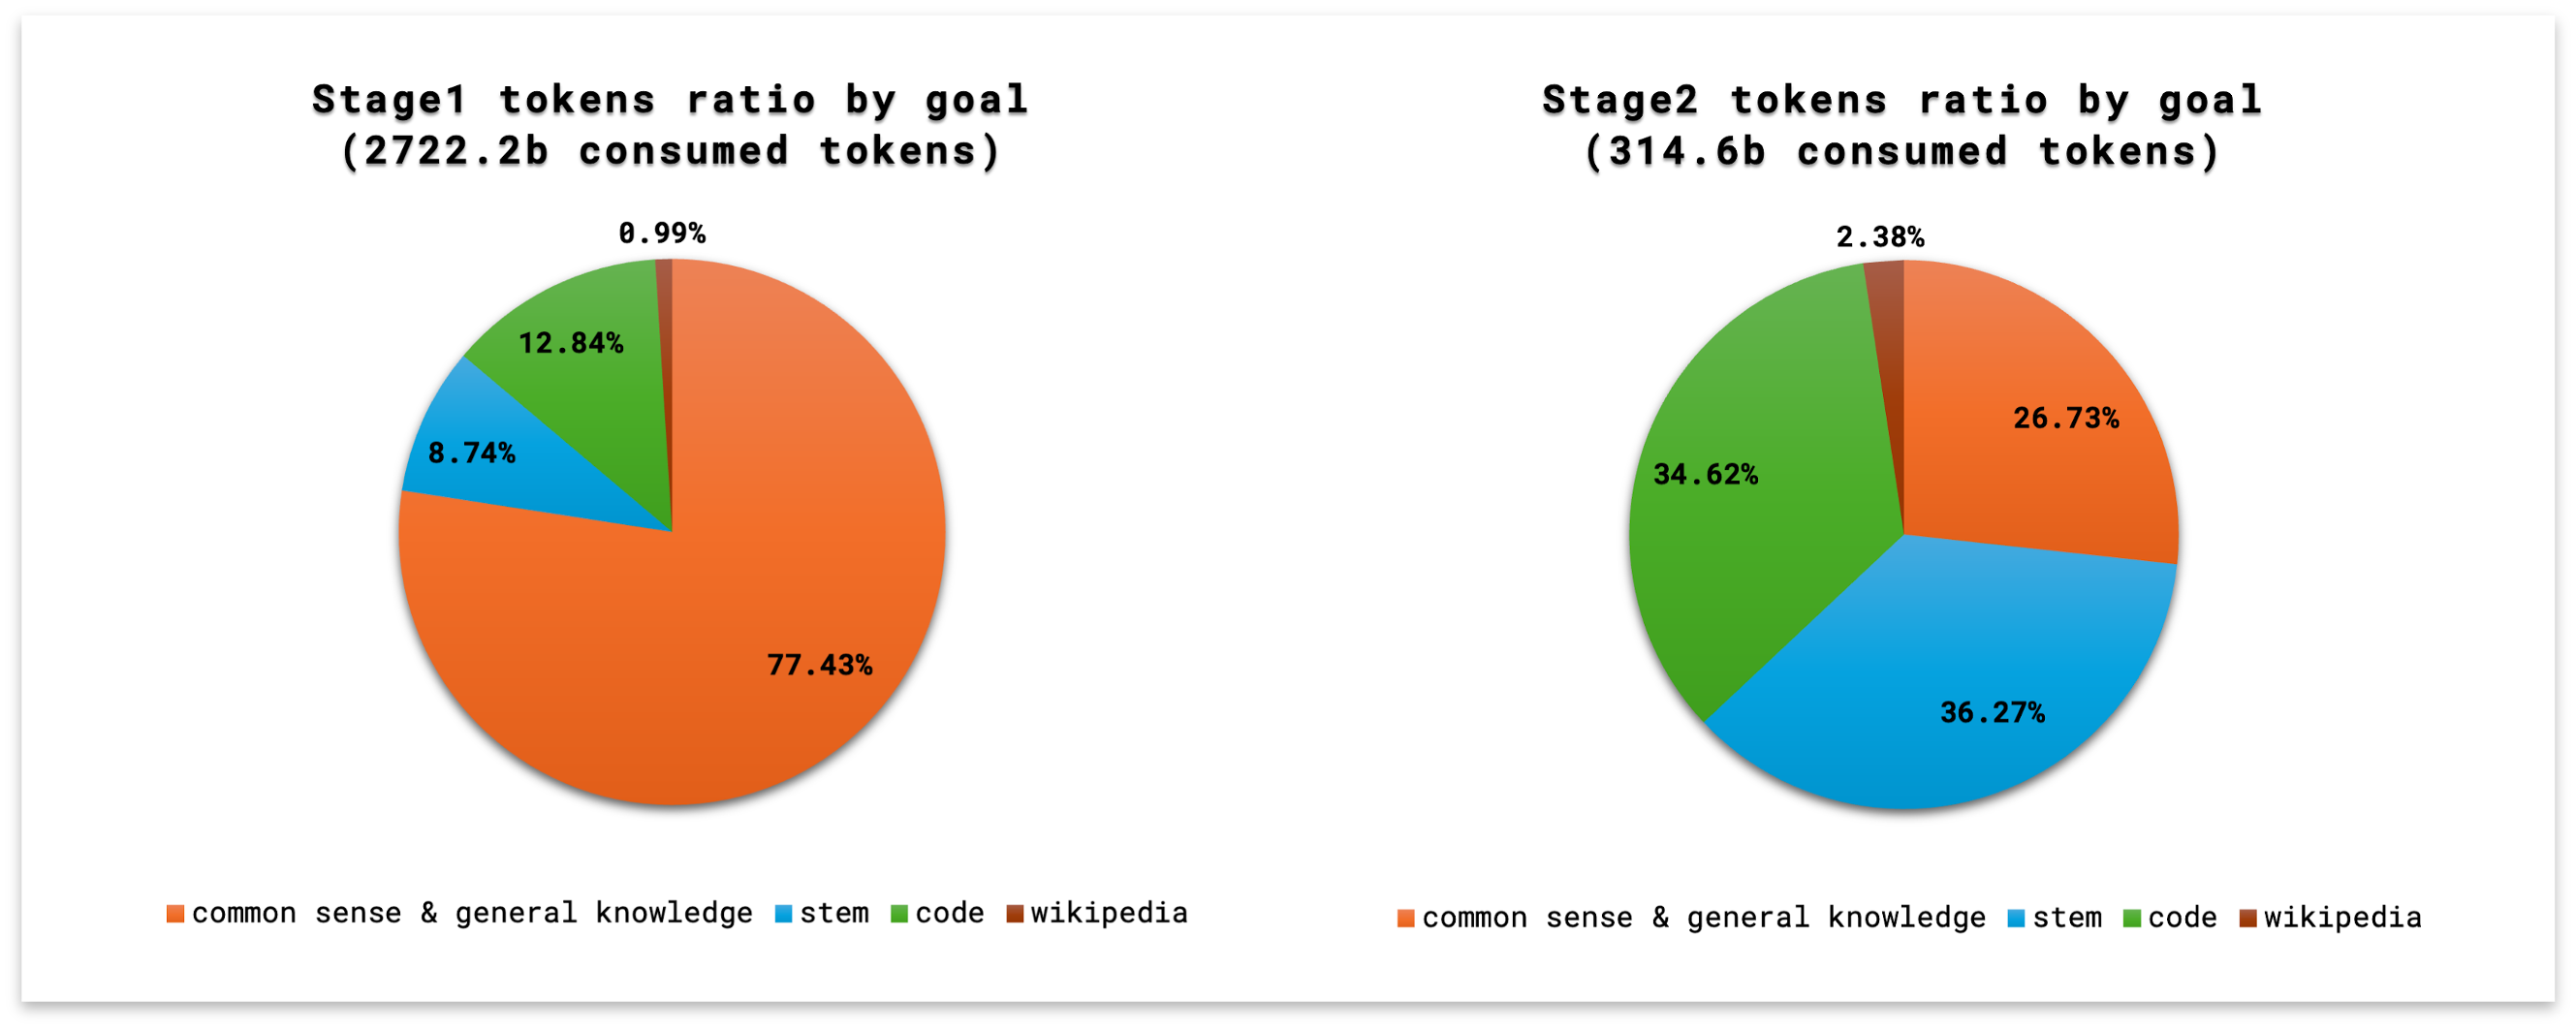
수집한 말뭉치는 전체 5T Token으로, 학습 데이터의 분포는 아래와 같습니다.
2. 데이터 전처리
이렇게 수집한 5T가량의 데이터를 각 Stage의 목적에 따라 각기 다른 전처리 과정을 수행하였습니다.
1) 목적이 Common sense & General knowledge인 경우
Common sense & General knowledge 데이터의 경우 FineWeb, DataComp-LM과 같은 논문에서 사용한 전처리 과정을 적용하였습니다. 이 과정에서 혹여라도 데이터에 존재할 수도 있는 민감한 개인정보를 처리하기 위해 개인정보 익명화 및 제거도 같이 수행하였습니다.
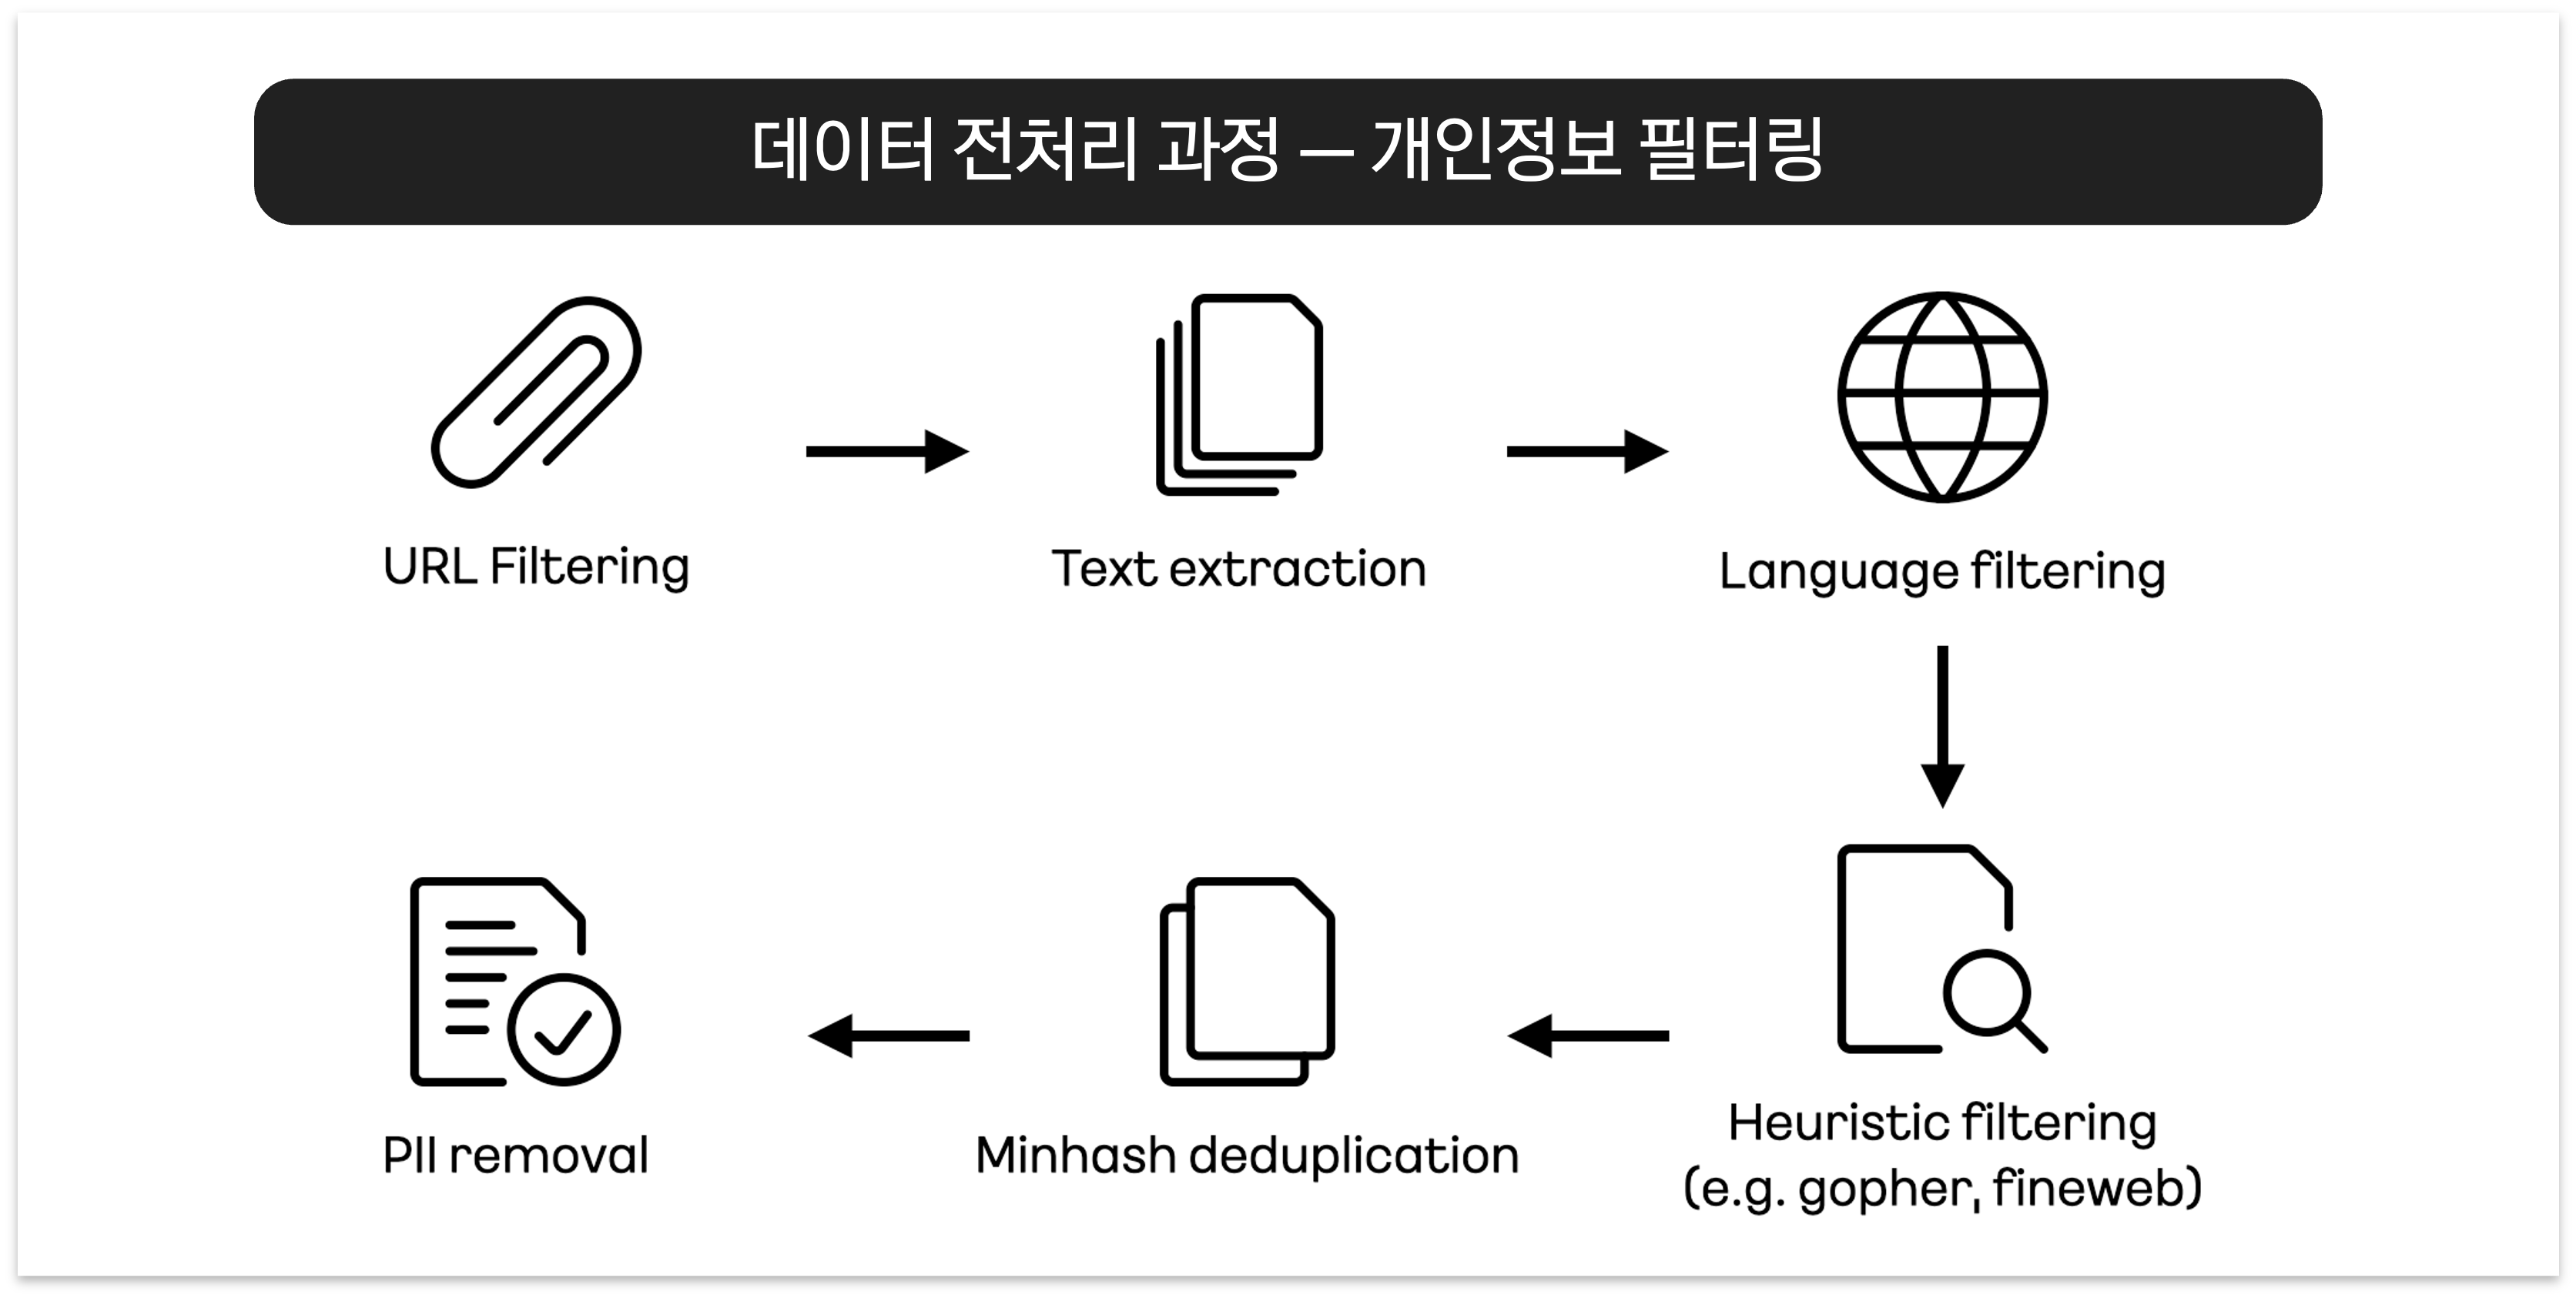
이렇게 기본적인 데이터 전처리를 수행한 뒤, Stage 2에 사용할 고품질 데이터를 선별하기 위해 데이터 Quality를 점수화하는 시도를 거쳤습니다.
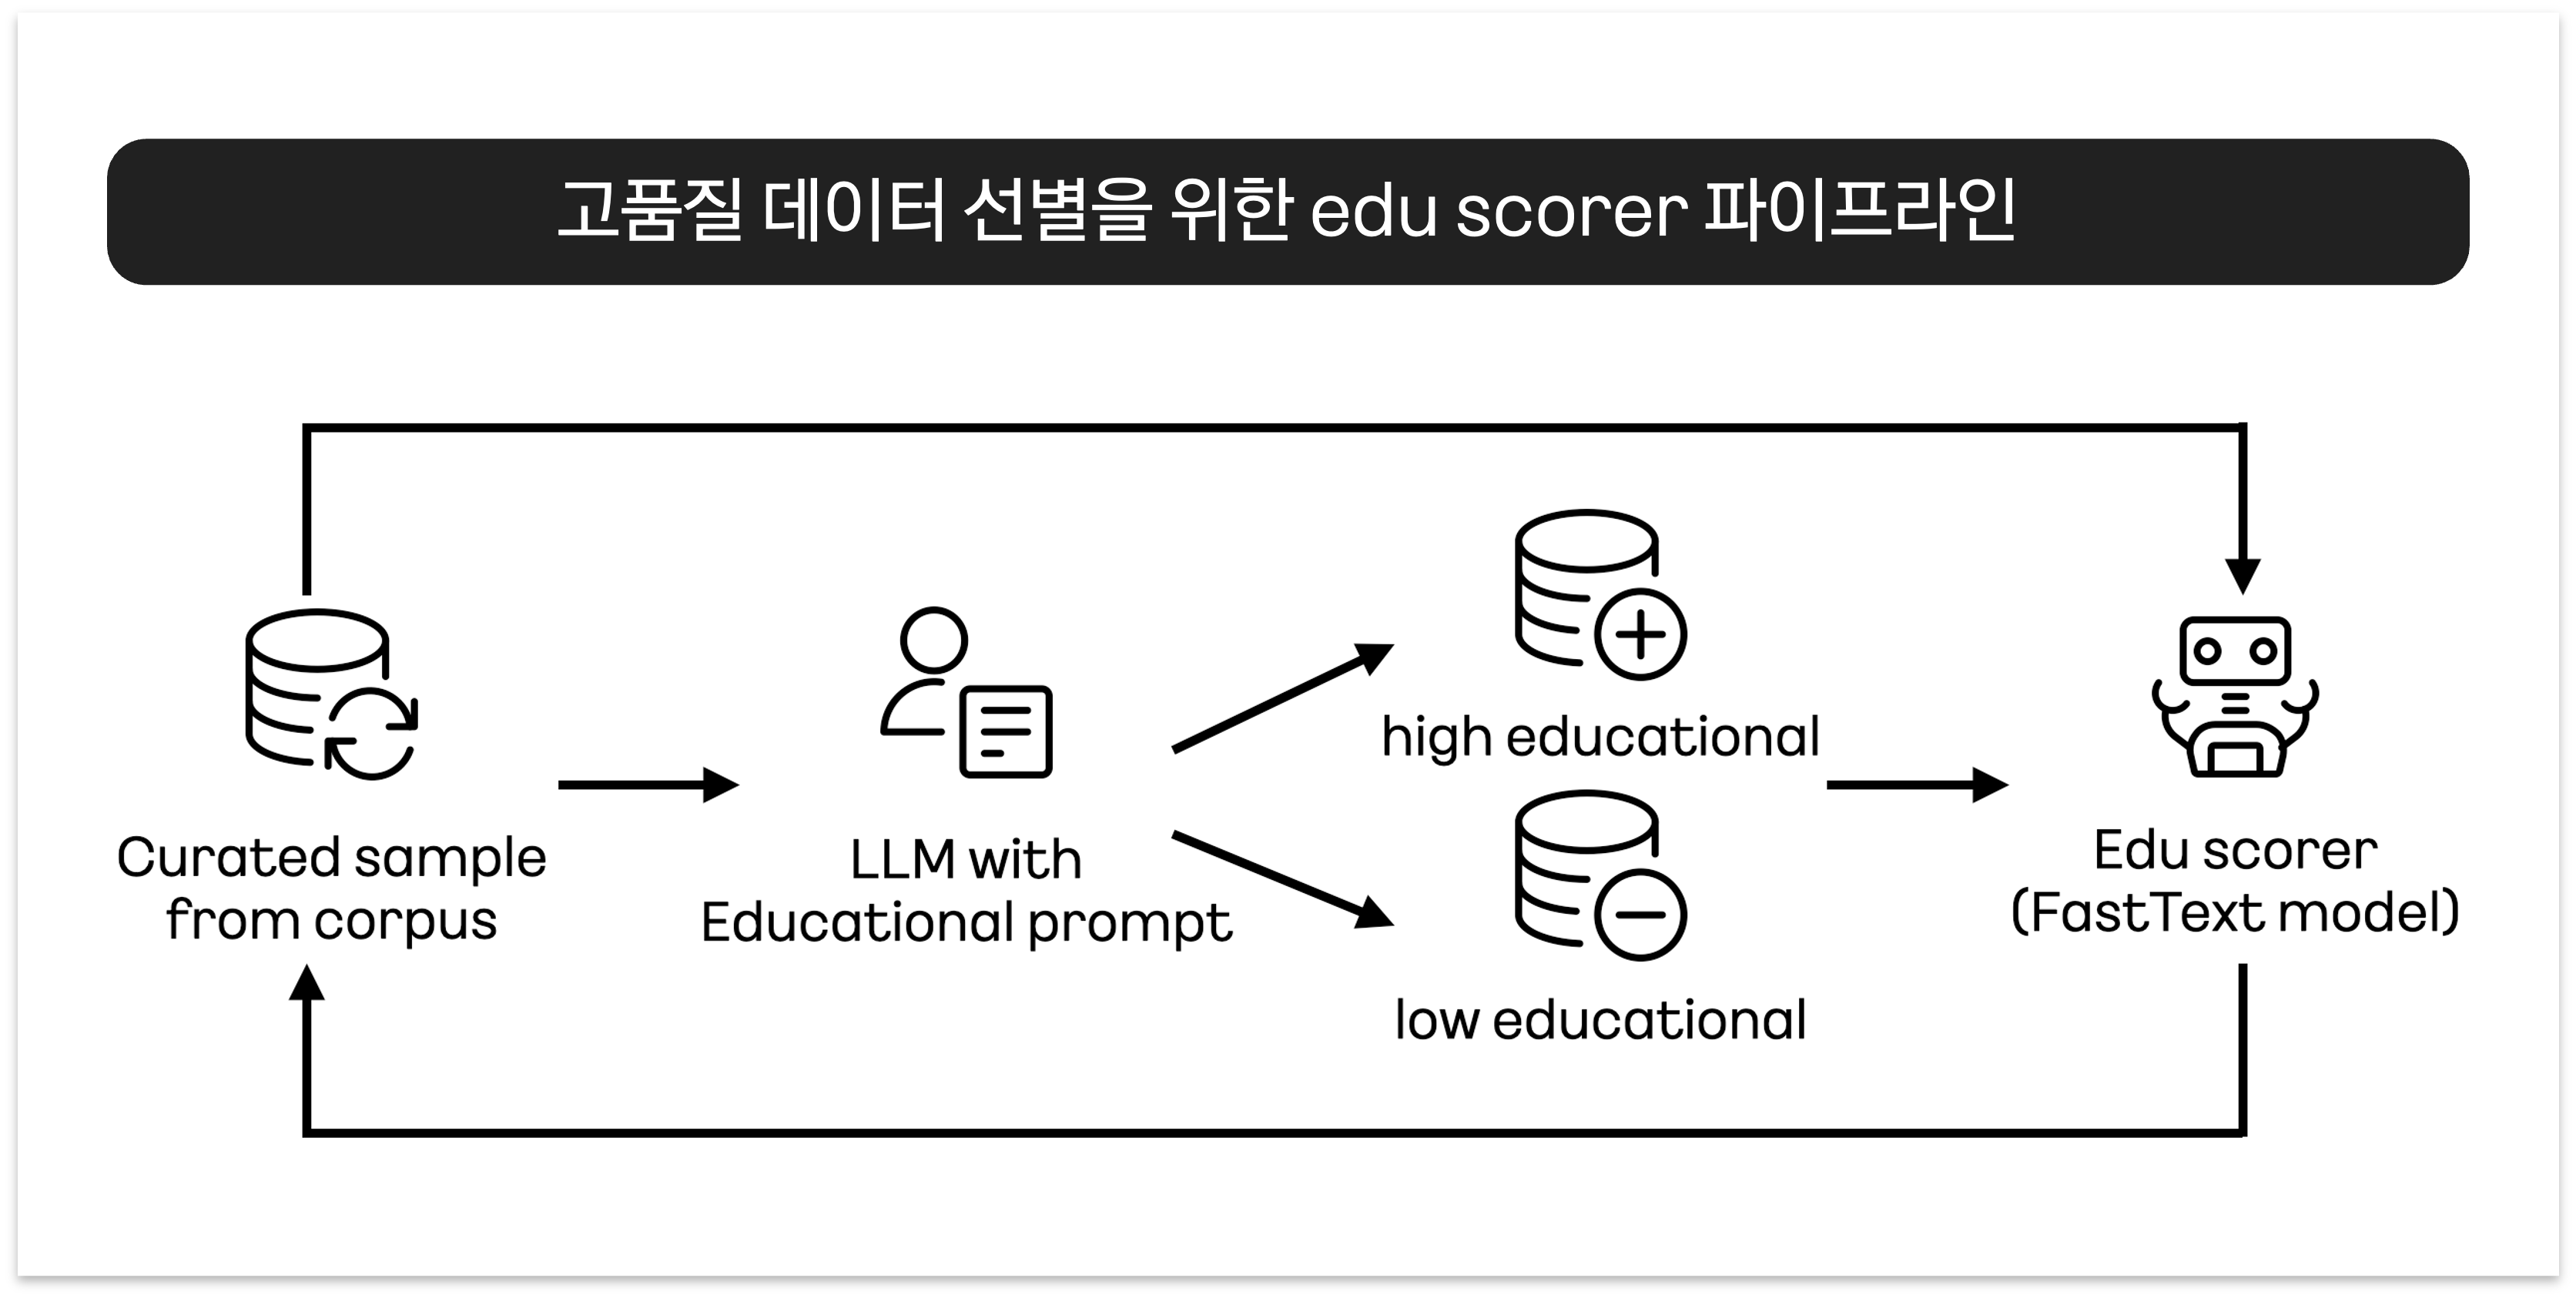
먼저 한국어 데이터에 대해서는 “The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale”에서 제시된 방식과 유사하게 일종의 Quality를 측정하는 Edu scorer를 만들었습니다. 해당 연구에서는 데이터가 얼마나 교육적인지를 데이터의 Quality로 간주하고, Quality의 점수가 높은 것을 활용하는 것이 LLM 학습에 매우 유용함을 보였습니다.
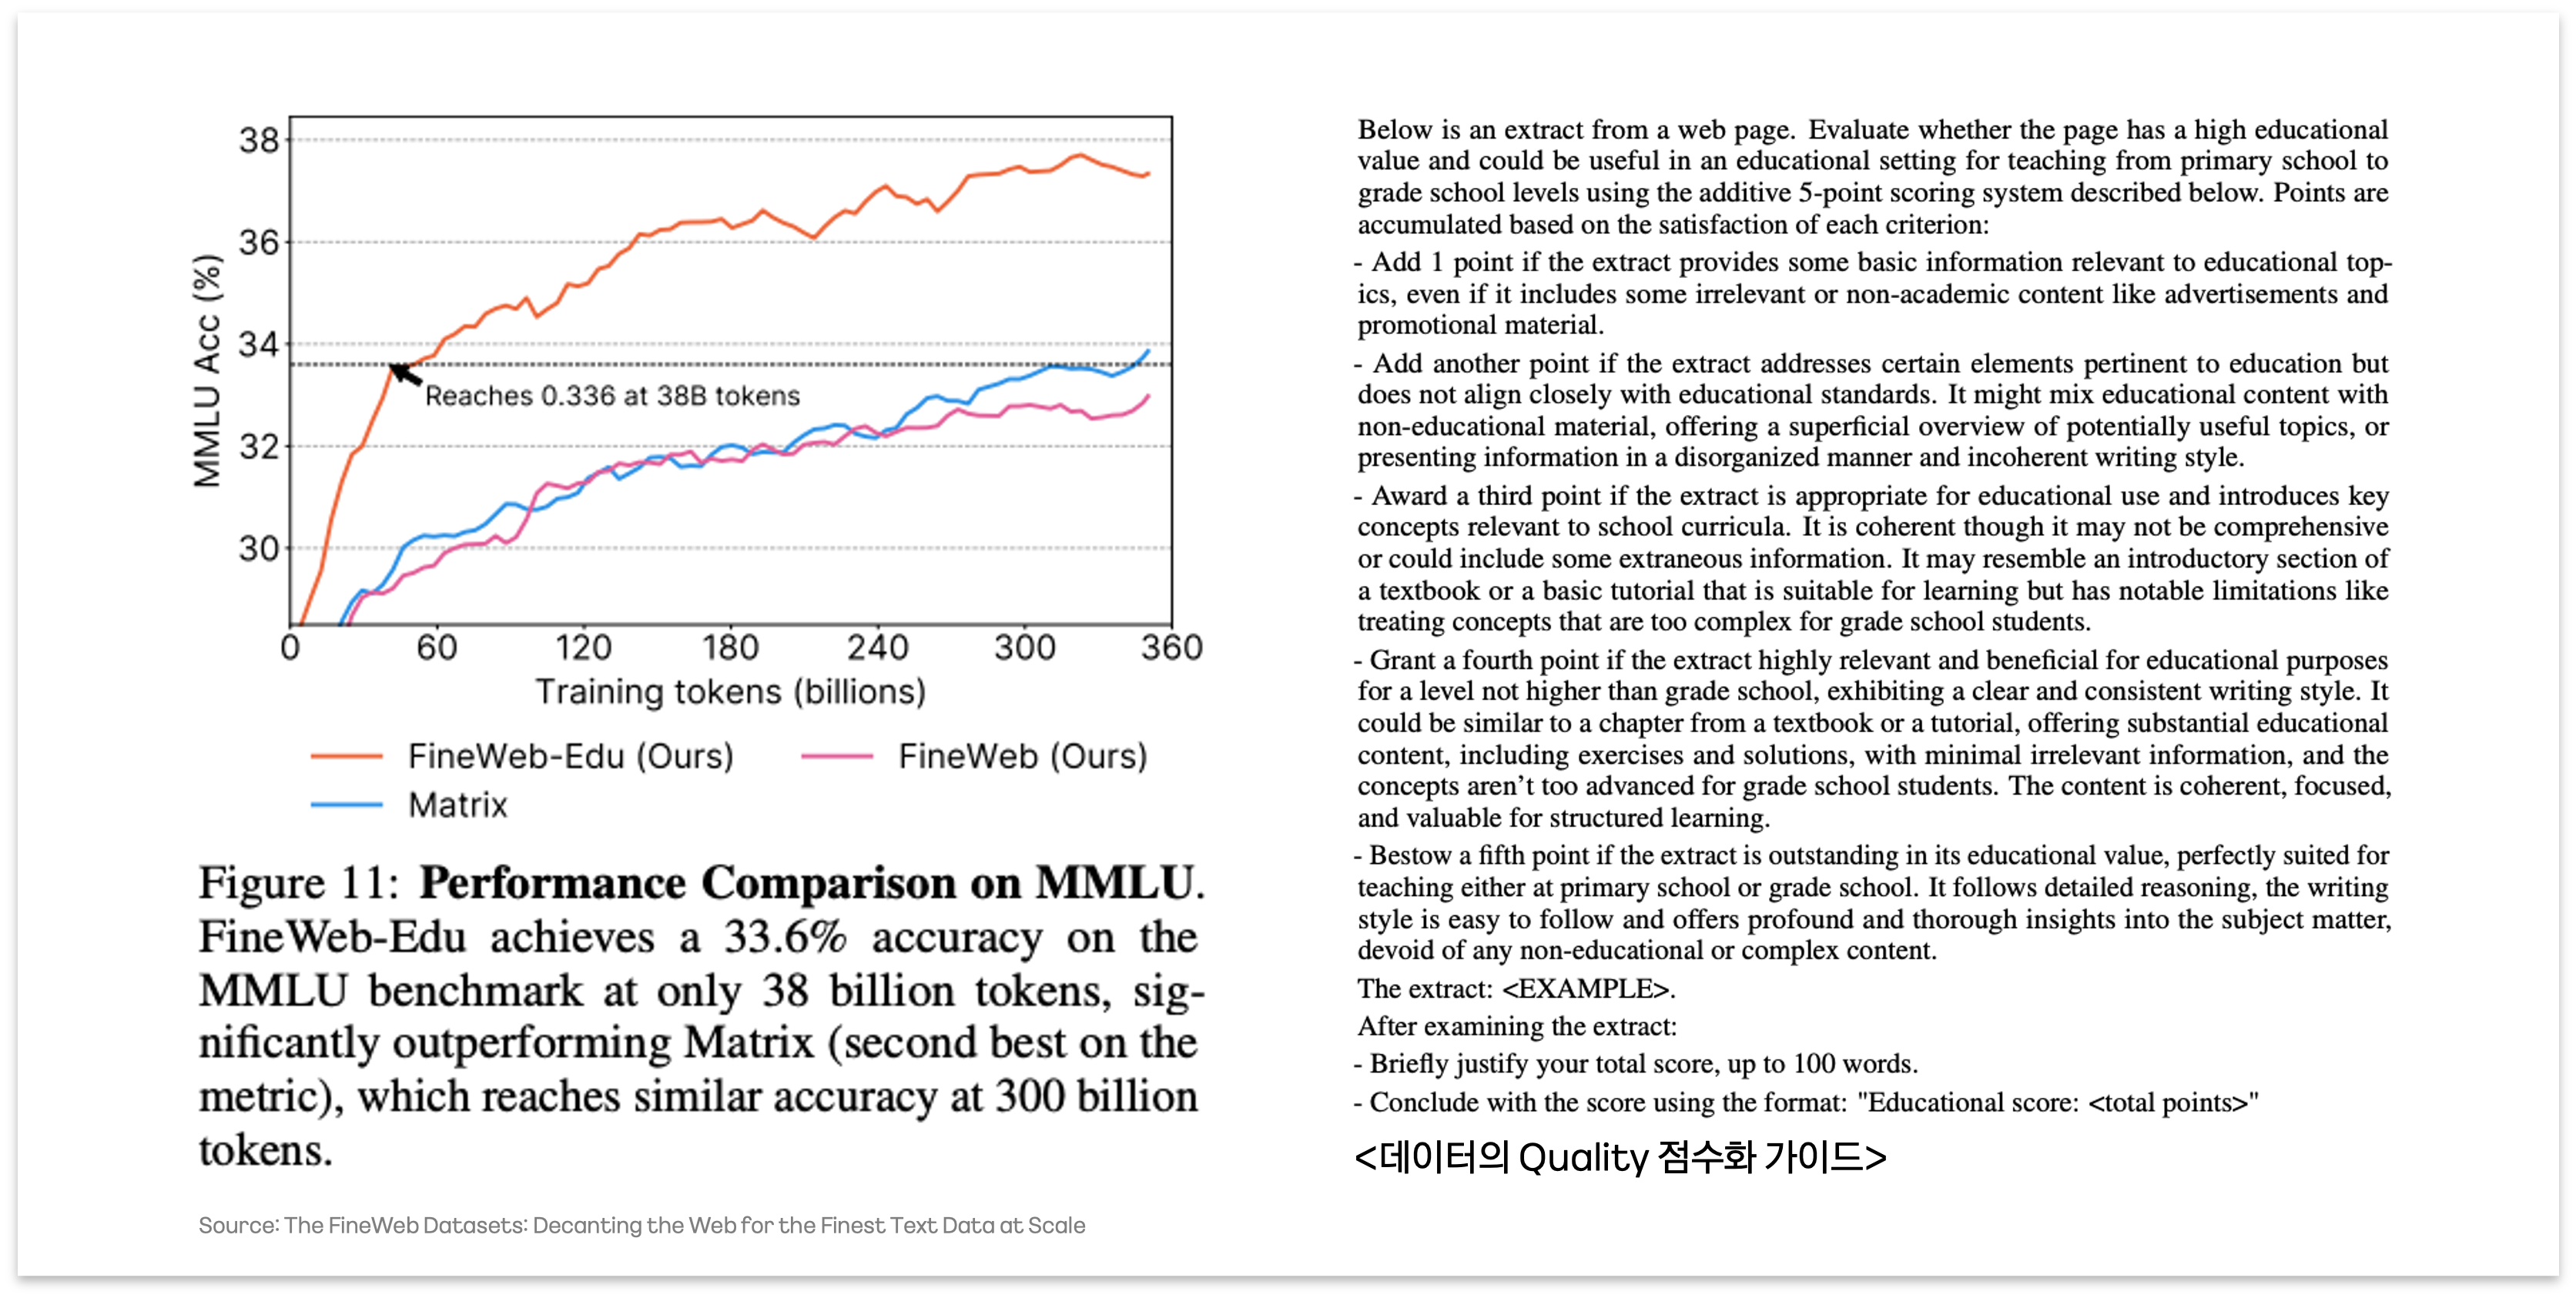
이때, Edu scorer를 만드는 파이프라인은 아래와 같습니다. 데이터셋에서 샘플을 적당히 가져오고, 이를 llama-3.1-70b와 같은 LLM에 아래와 같은 프롬프트와 함께 데이터를 전달하여 Quality 점수를 측정합니다. 측정한 Quality 점수를 기반으로 High educational, Low educational로 샘플을 분류하고, 이를 작은 적당한 모델로 학습합니다. 저희가 참고한 연구에서는 Embedding 모델을 기반으로 Regression head를 붙여서 학습했지만, 저희는 GPU를 사용하지 않고, CPU만으로 대량의 추론을 통해 데이터의 Quality 점수를 측정하기 위해 FastText를 이용하여 Edu scorer를 학습하였습니다.
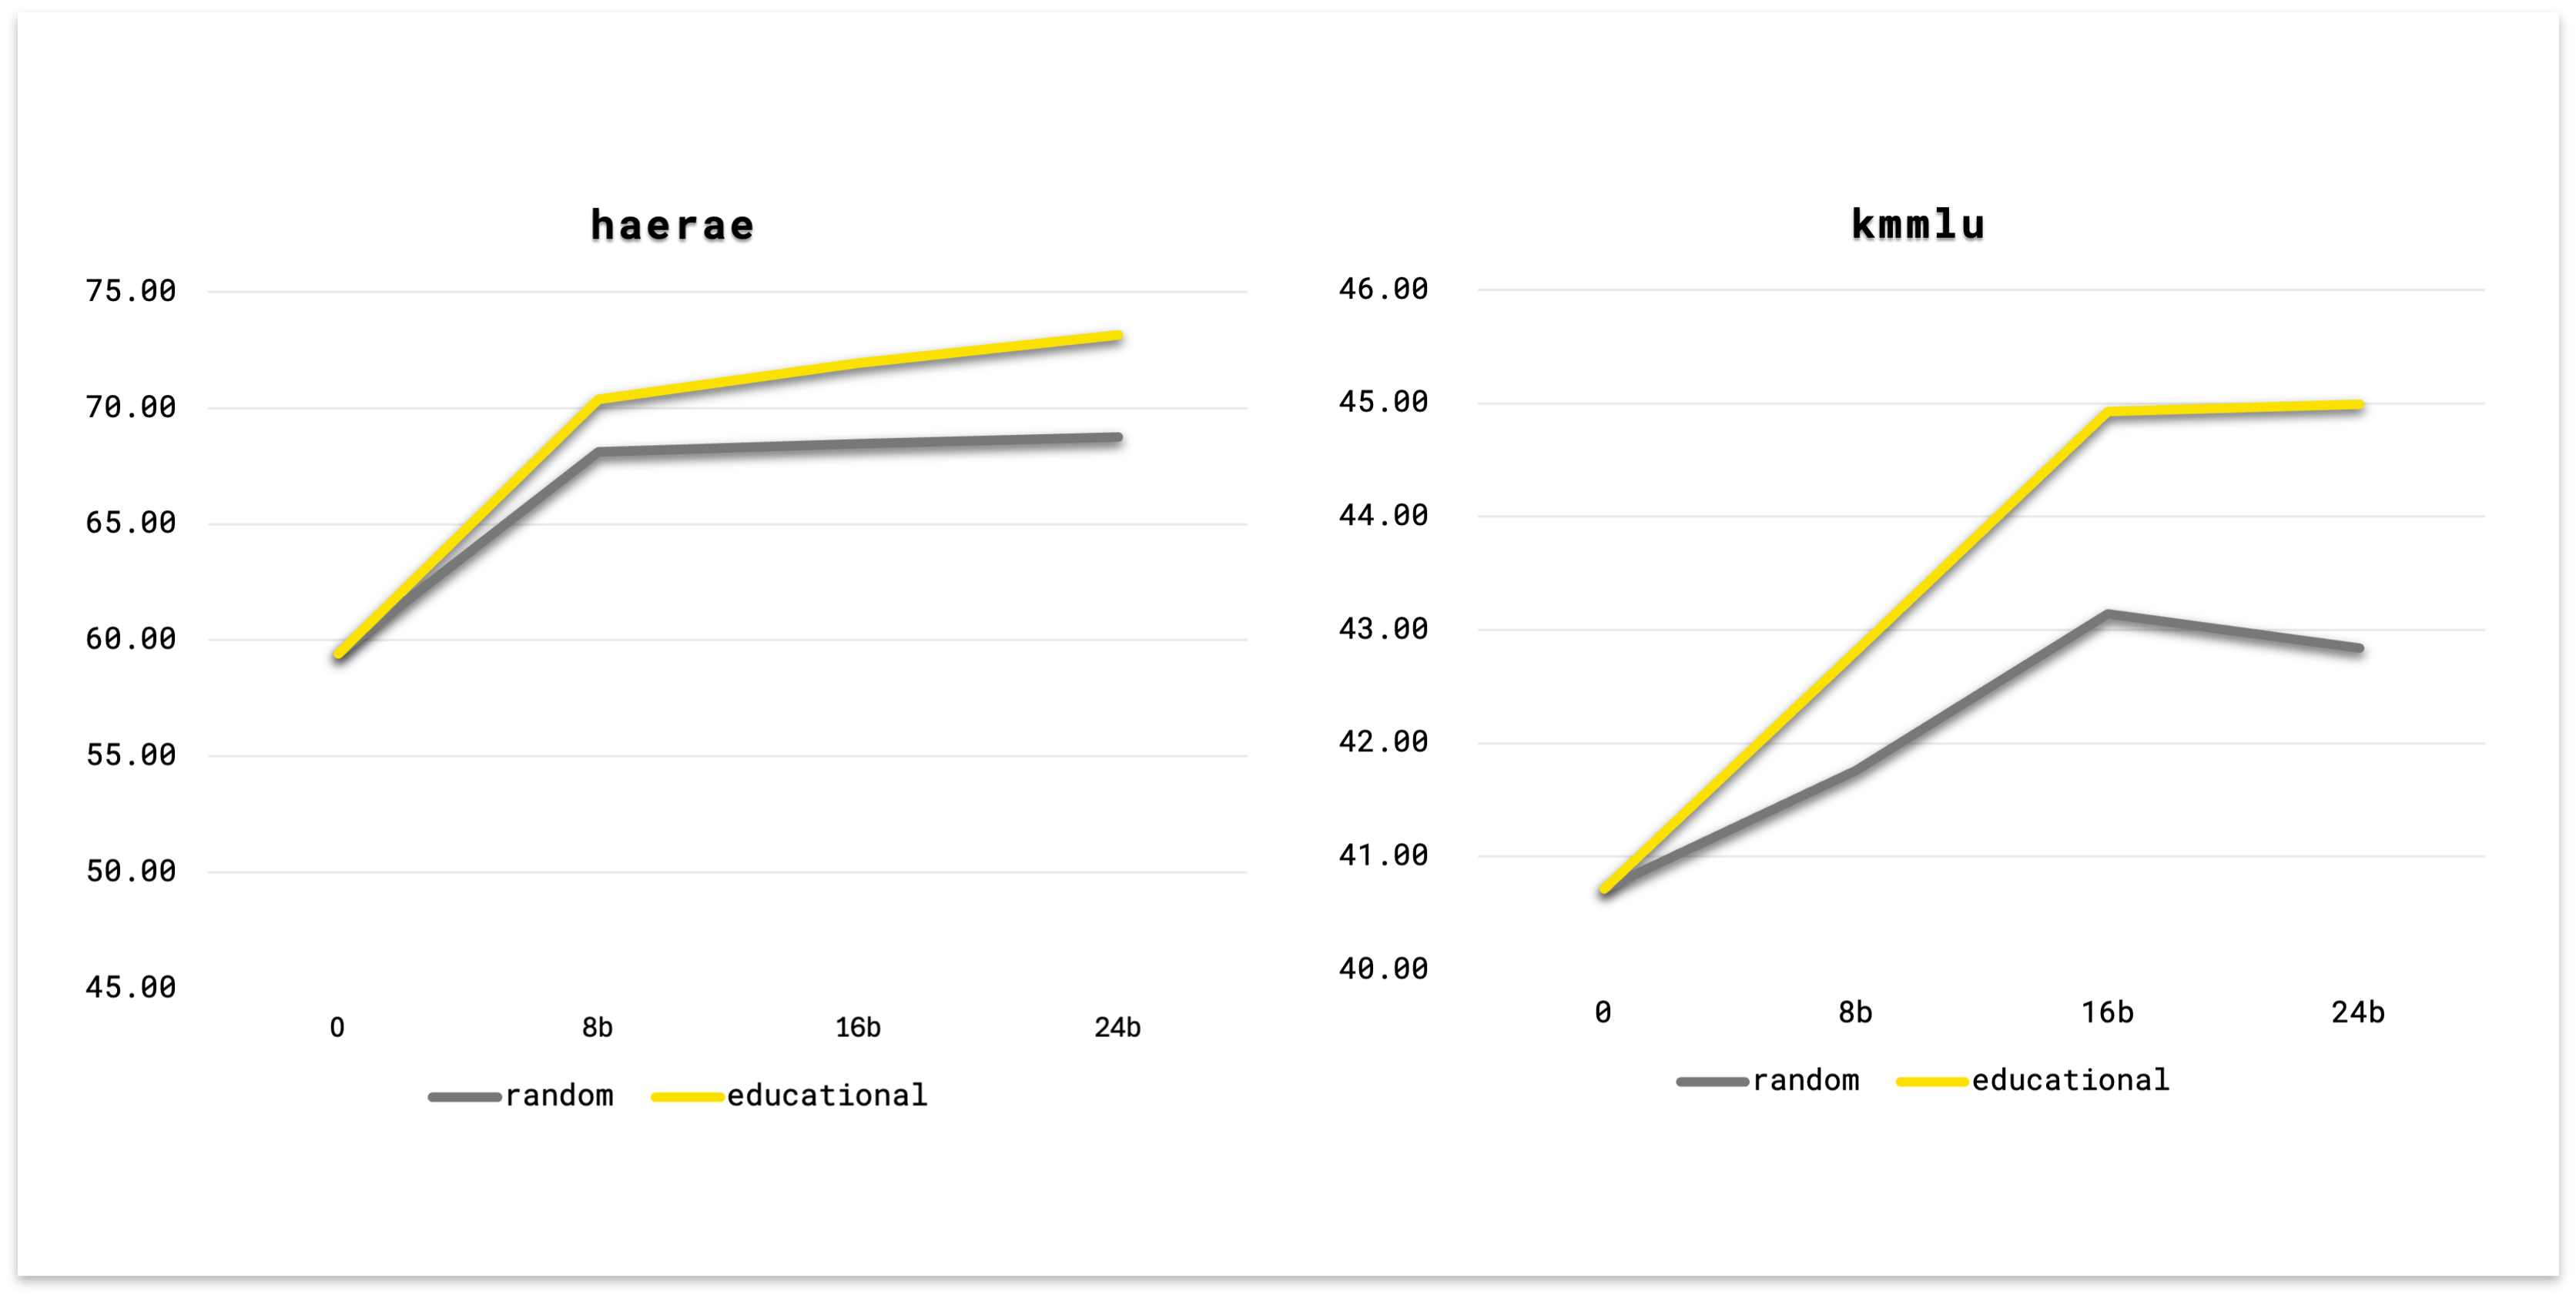
Edu scorer를 이용해서 선별한 High educational 데이터셋과 임의로 뽑은 데이터셋으로 각각 llama-3-8b 모델을 같은 양의 Token을 학습하여 비교해 본 결과, Edu scorer로 선별한 데이터셋이 LLM 학습에 있어서는 상대적으로 Quality가 좋아서, Stage 2 용 데이터셋을 충분히 구성할 수 있음을 확인할 수 있었습니다.
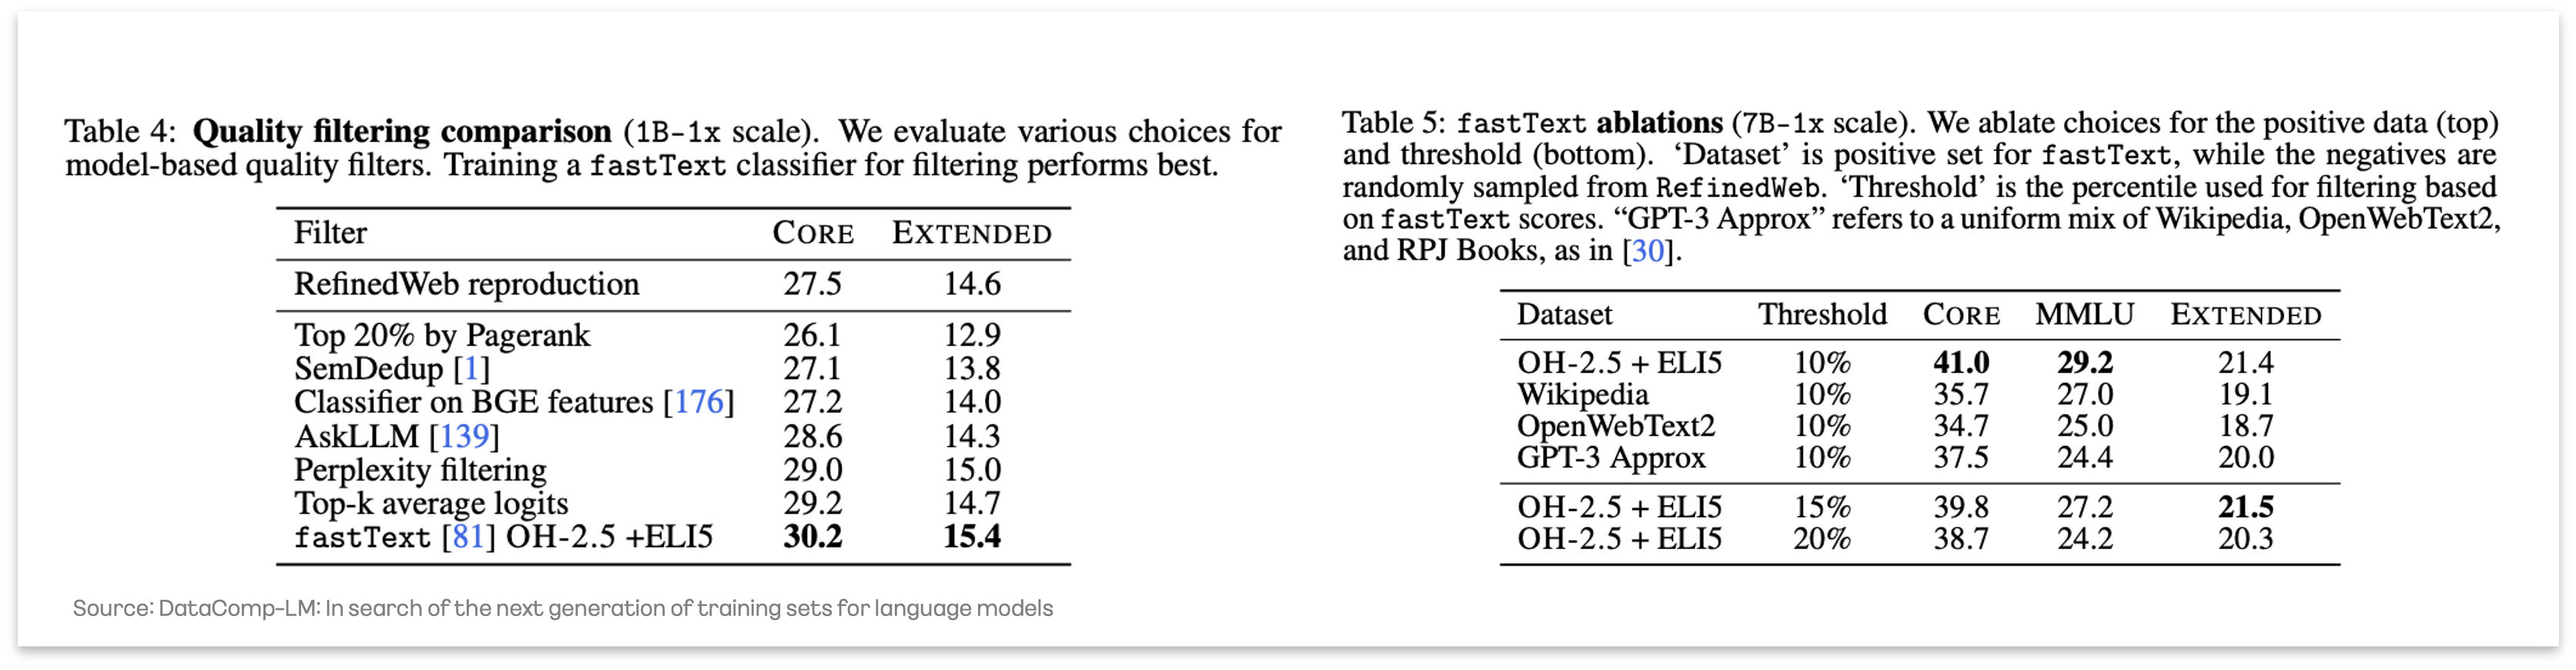
영어 데이터의 경우, “DataComp-LM: In search of the next generation of training sets for language models” 연구에서 활용한 FastText 기반의 Quality 관련 모델을 사용하여, Stage 2를 위한 High quality 데이터를 선별하였습니다.
2) 목적이 Code인 경우
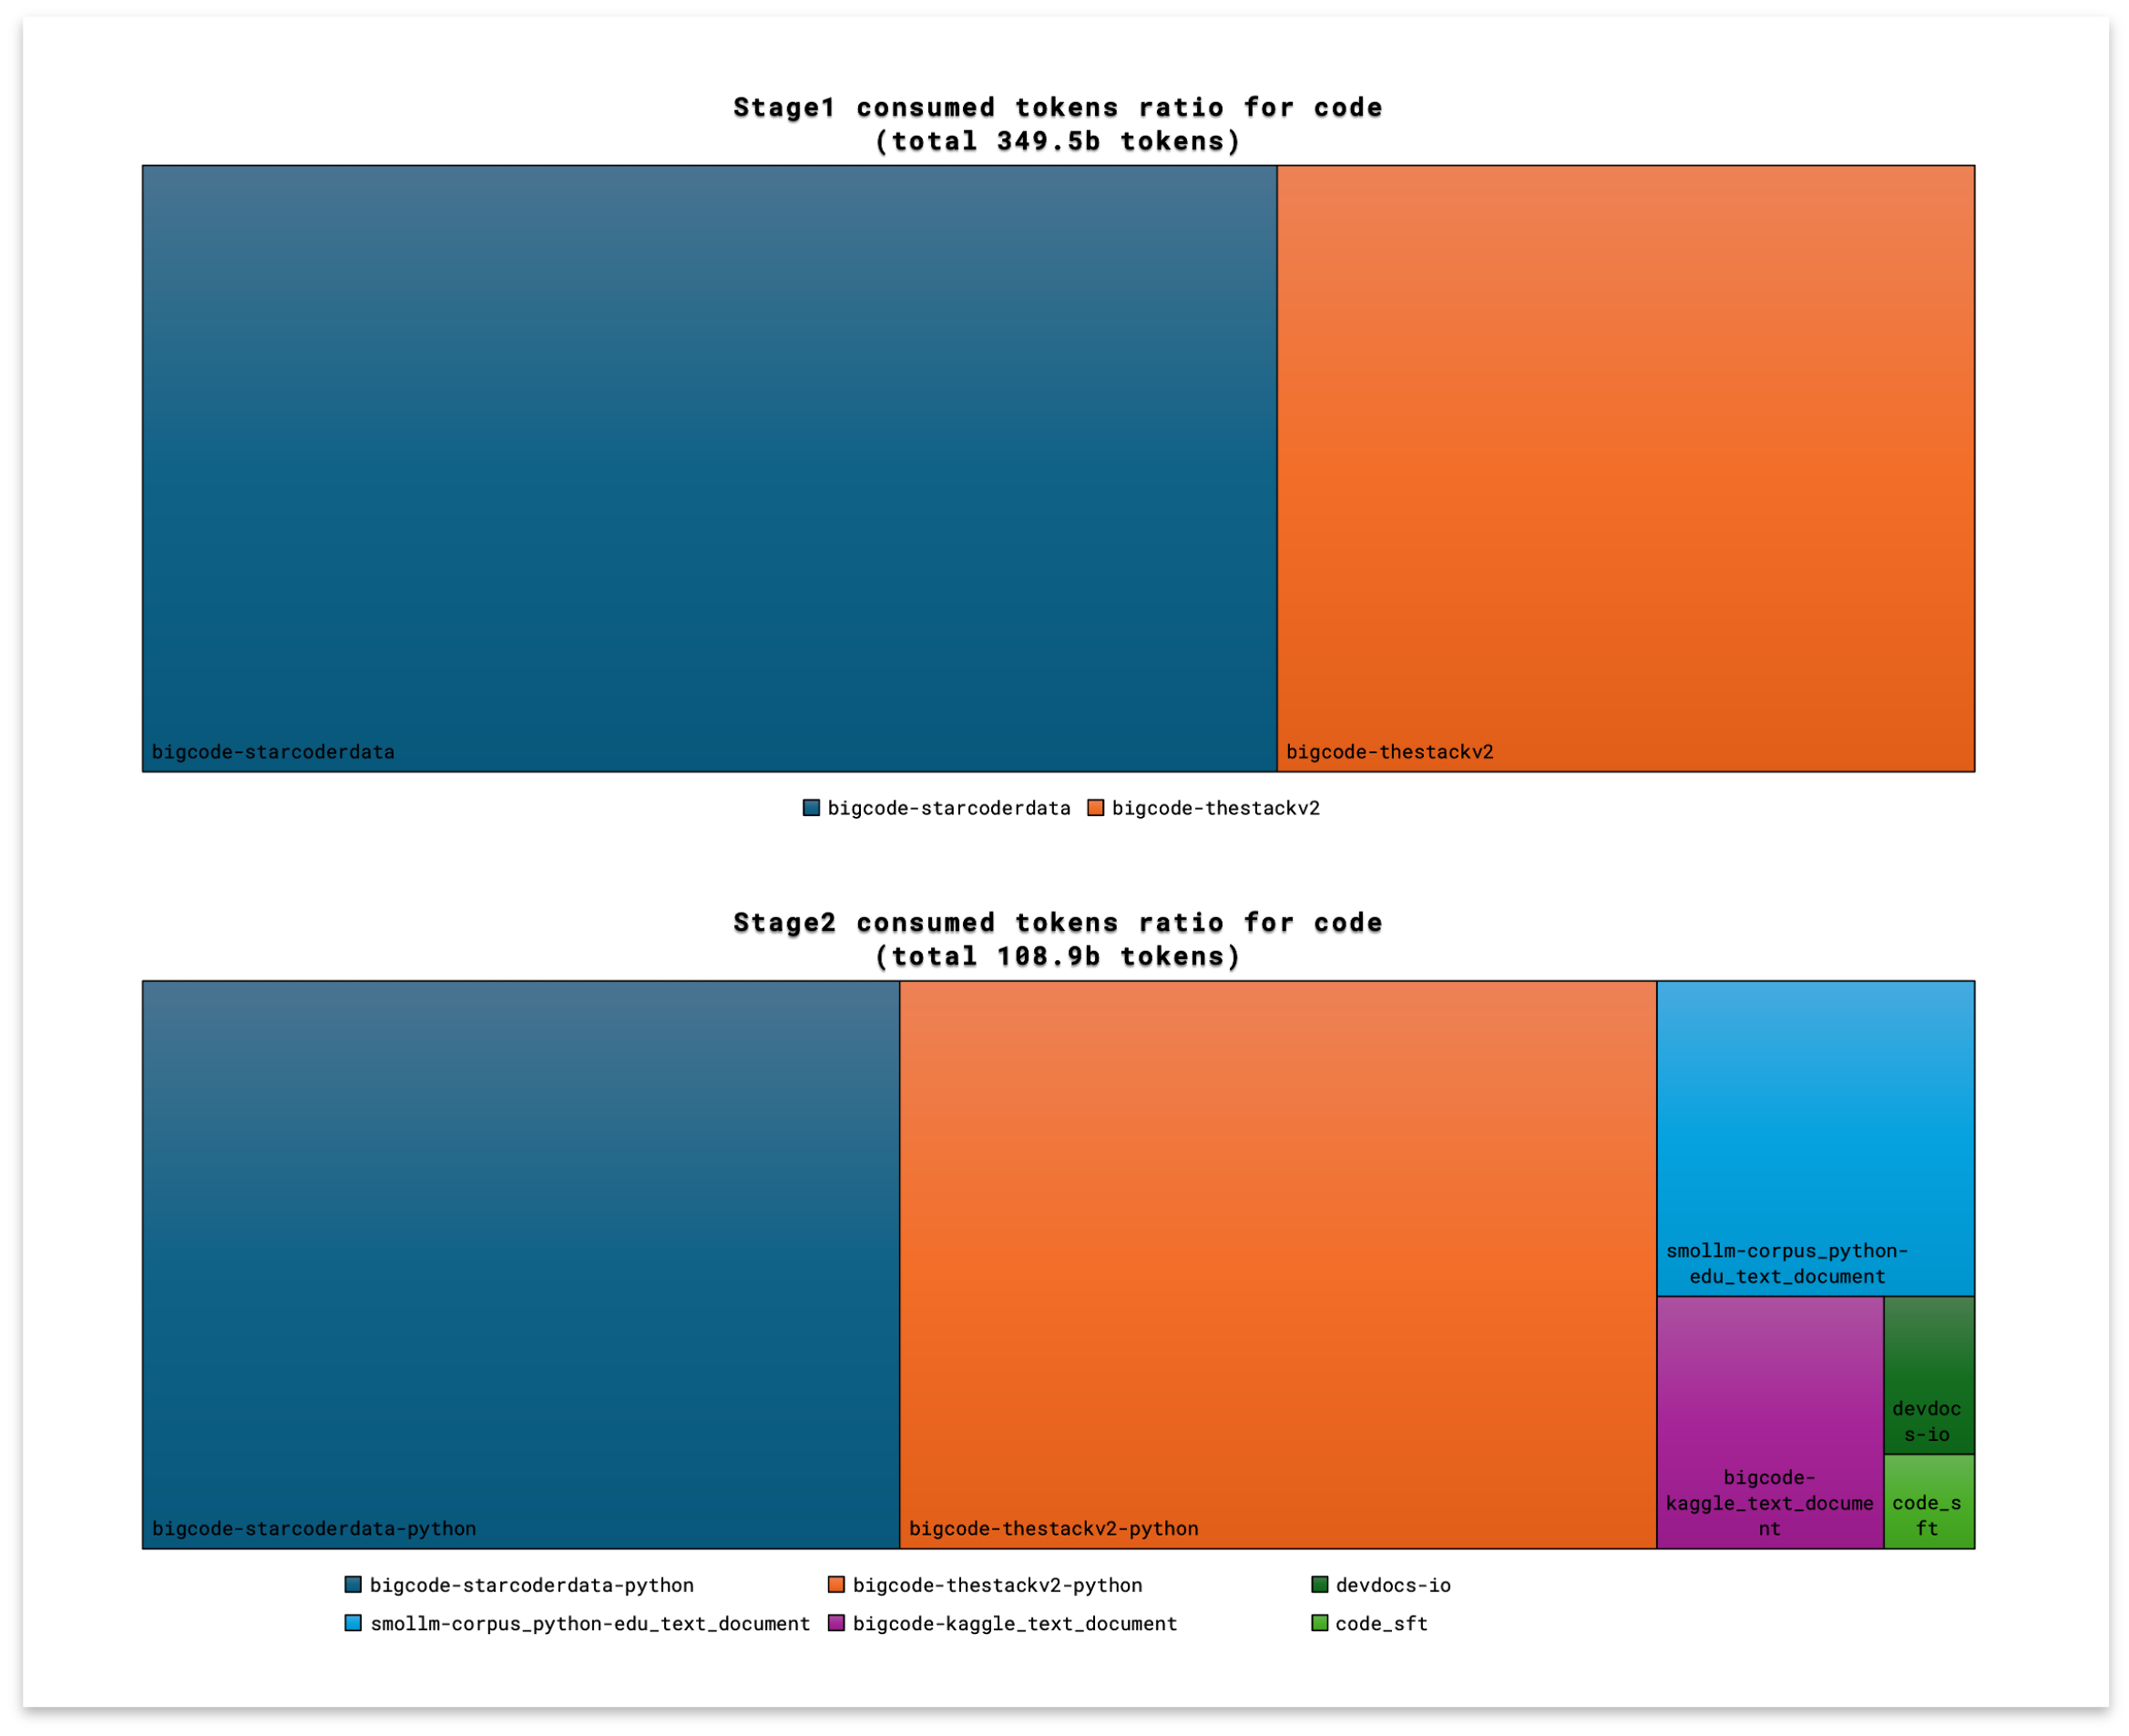
Code 데이터는 먼저 Stage 1 데이터셋을 구성할 때는 오픈소스 코드 말뭉치인 starcoderdata, TheStackV2에서 Permissive license에 해당하는 데이터만 선별하여 구성하였습니다. 특히 TheStackV2는 여러 버전이 존재하는데, 저희는 코드 전용 모델을 만드는 것이 아니므로 최소한의 프로그래밍 언어에 관련된 데이터만 가지고 있는 train-smol-ids 버전에서 Permissive license인 데이터를 선별하였습니다. 이 과정에서 TheStackV2의 Token의 양이 434B에서 133B로 줄었습니다.
Stage 2의 데이터셋을 구성할 때는 Stage 1을 구성한 데이터셋에서 Python과 관련된 코드 데이터만 사용하였고, 거기에 덧붙여 자연어와 코드가 적절히 섞여 있는 데이터, Instruction following을 위한 Supervised Fine-tuning(SFT) 데이터셋을 추가하였습니다. 특히 SFT 데이터셋의 경우 LLM의 성능 평가를 위한 벤치마크의 평가 데이터를 포함하거나 유사한 데이터가 존재할 가능성이 있기에, 데이터셋의 목적과 일치되는 벤치마크에 Decontamination 작업을 수행해야 합니다. 따라서 저희는 Humaneval, MBPP 벤치마크에 Decontamination을 수행하였습니다.
| Target benchmarks | Keep rates | Final tokens |
|---|---|---|
| Humaneval, MBPP | 97.73% | 0.89B |
이렇게 구성한 Stage 별 데이터셋의 분포는 아래의 이미지와 같습니다.
3) 목적이 Stem인 경우
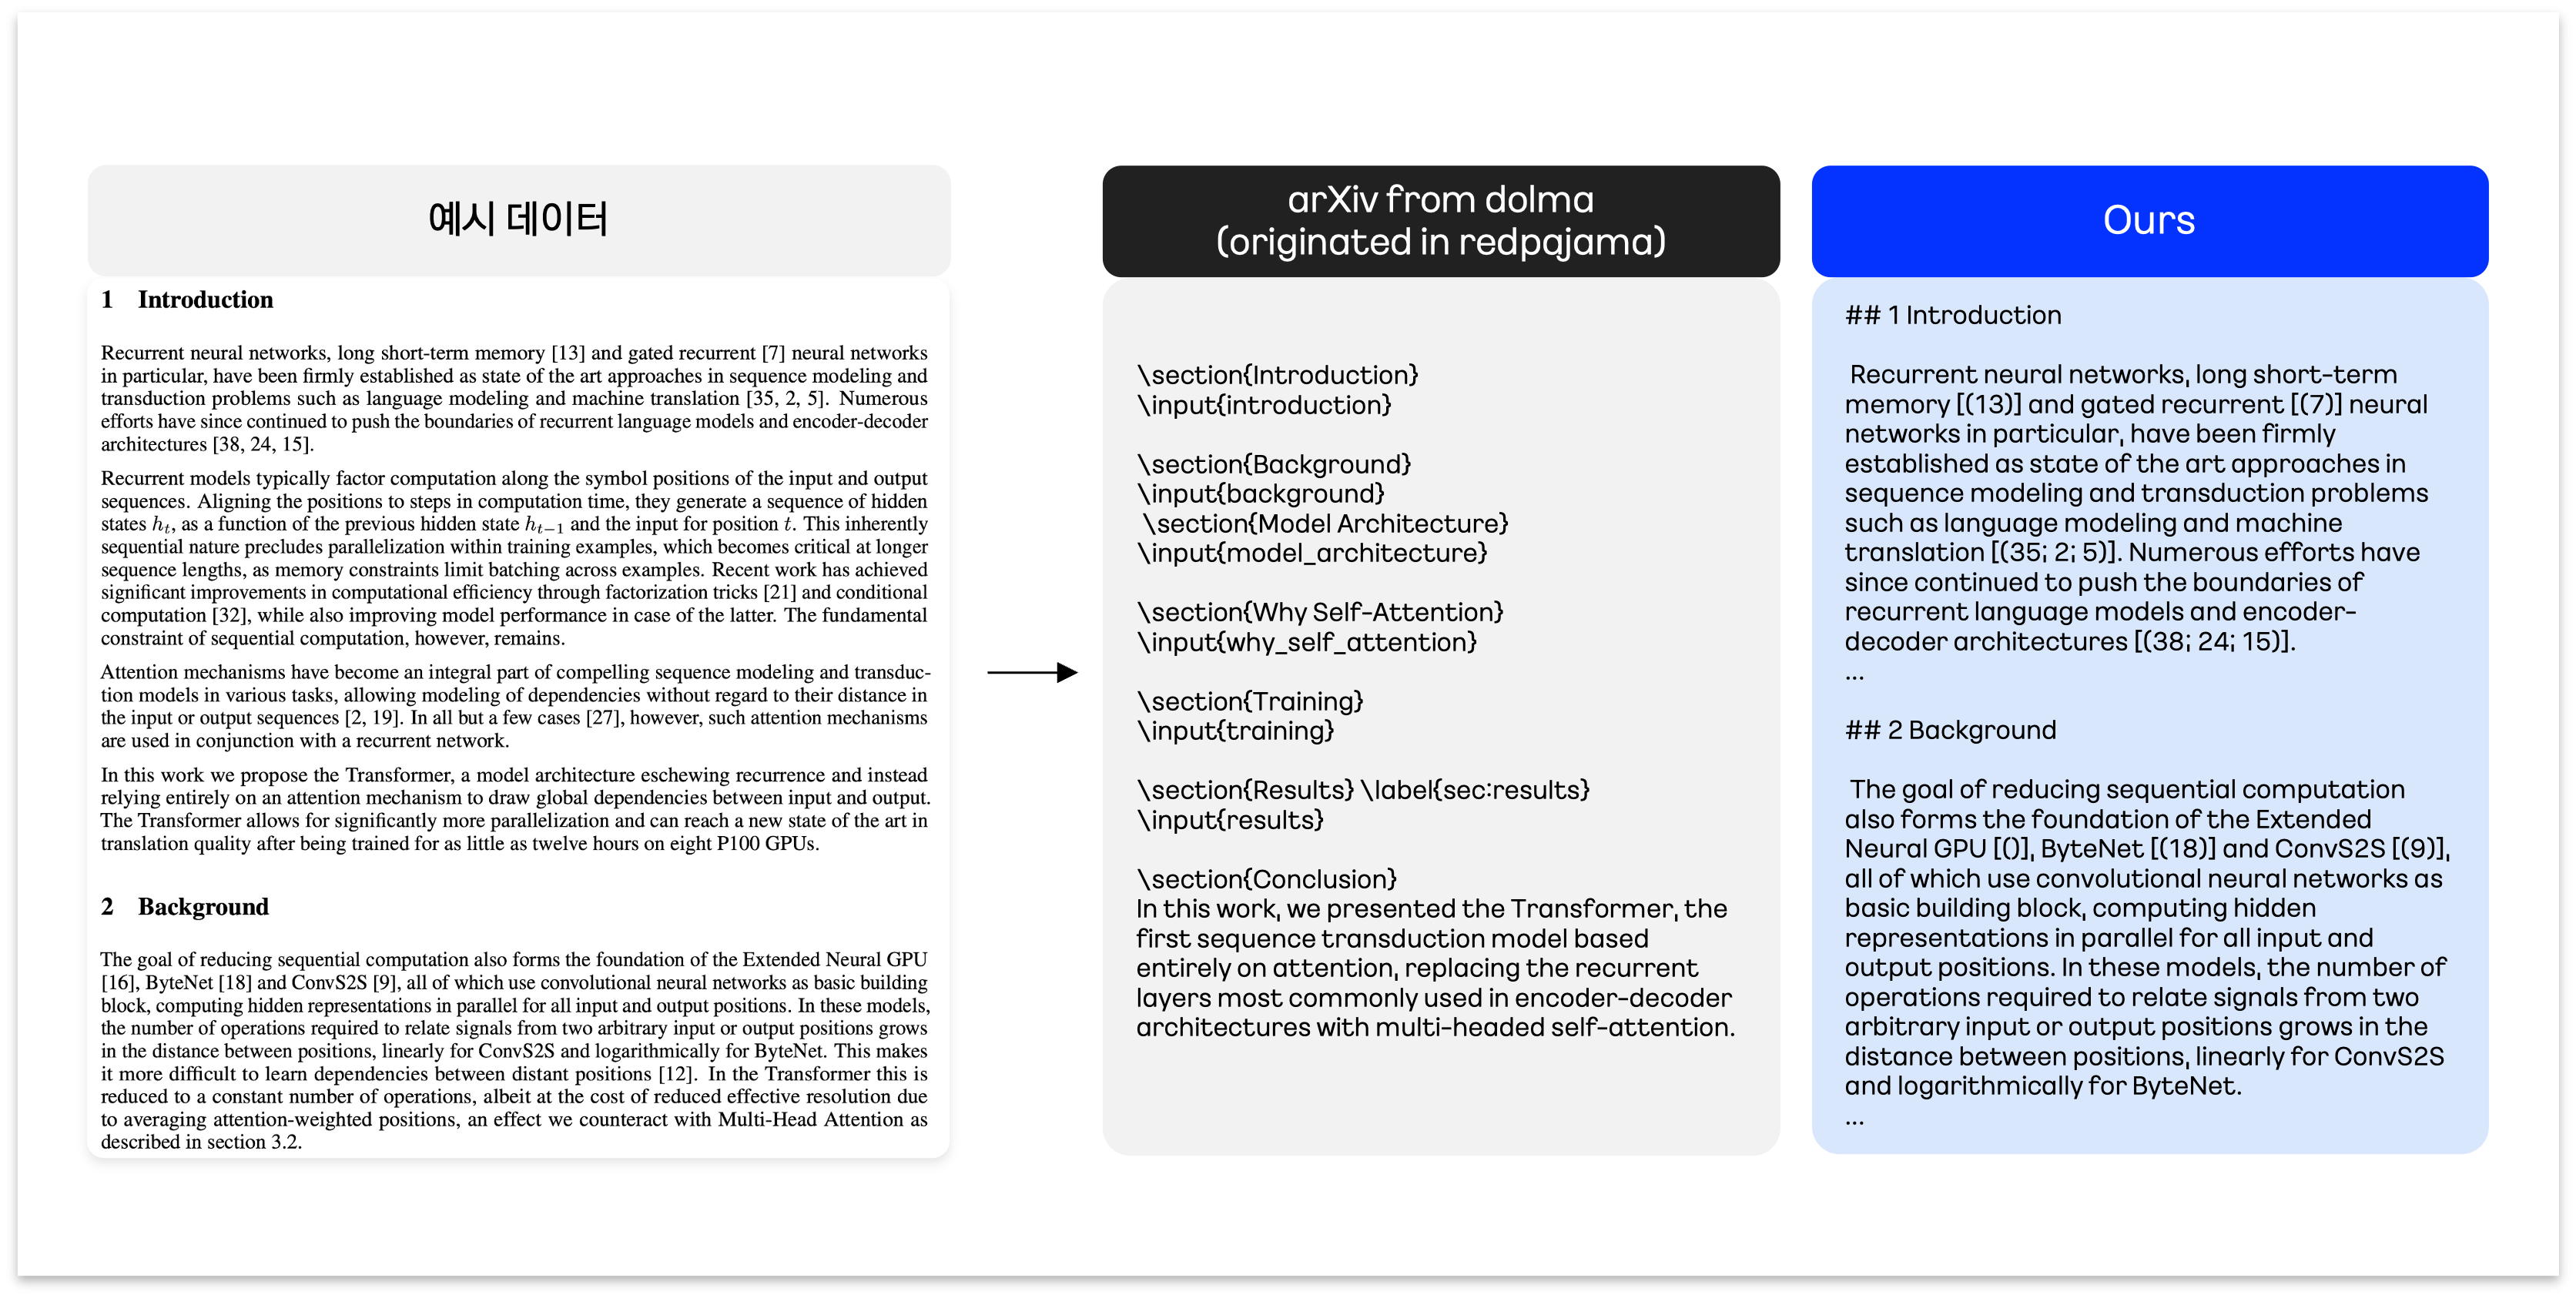
Stem 데이터의 경우 처음부터 Permissive license에 해당하는 말뭉치만 수집했기 때문에, Code인 경우와 같은 전처리가 더 필요하지는 않았습니다. 다만 Stage 1을 구성하면서 공개된 arXiv 데이터를 확인해 봤을 때, Latex 구조에 따른 처리가 잘되지 않음을 확인하였고, 이에 따라 공개된 것을 사용하지 않고, arXiv를 직접 전처리하여 데이터를 만들었습니다. 아래의 이미지는 “Attention is all you need” 연구가 공개된 arXiv 데이터셋에서 어떻게 표현되었는지에 대한 예시로, Latex의 명령어만 있을 뿐 실제 내용이 빠져있음을 확인할 수 있습니다. 반대로 저희가 직접 전처리한 arXiv 데이터에서는 내용이 잘 보존된 것을 확인할 수 있습니다.
추가로 Stage 2를 위한 데이터셋을 구성하면서 목적이 Code인 데이터셋을 구성하는 과정과 유사하게 Stem 중 Math에 관련된 SFT 데이터셋을 수집하고, 관련 벤치마크인 GSM8K, MATH에 Decontamination을 수행하였습니다.
| Target benchmarks | Keep rates | Final tokens |
|---|---|---|
| GSM8K, MATH | 76.28% | 1.56B |
4) 목적이 Wikipedia인 경우
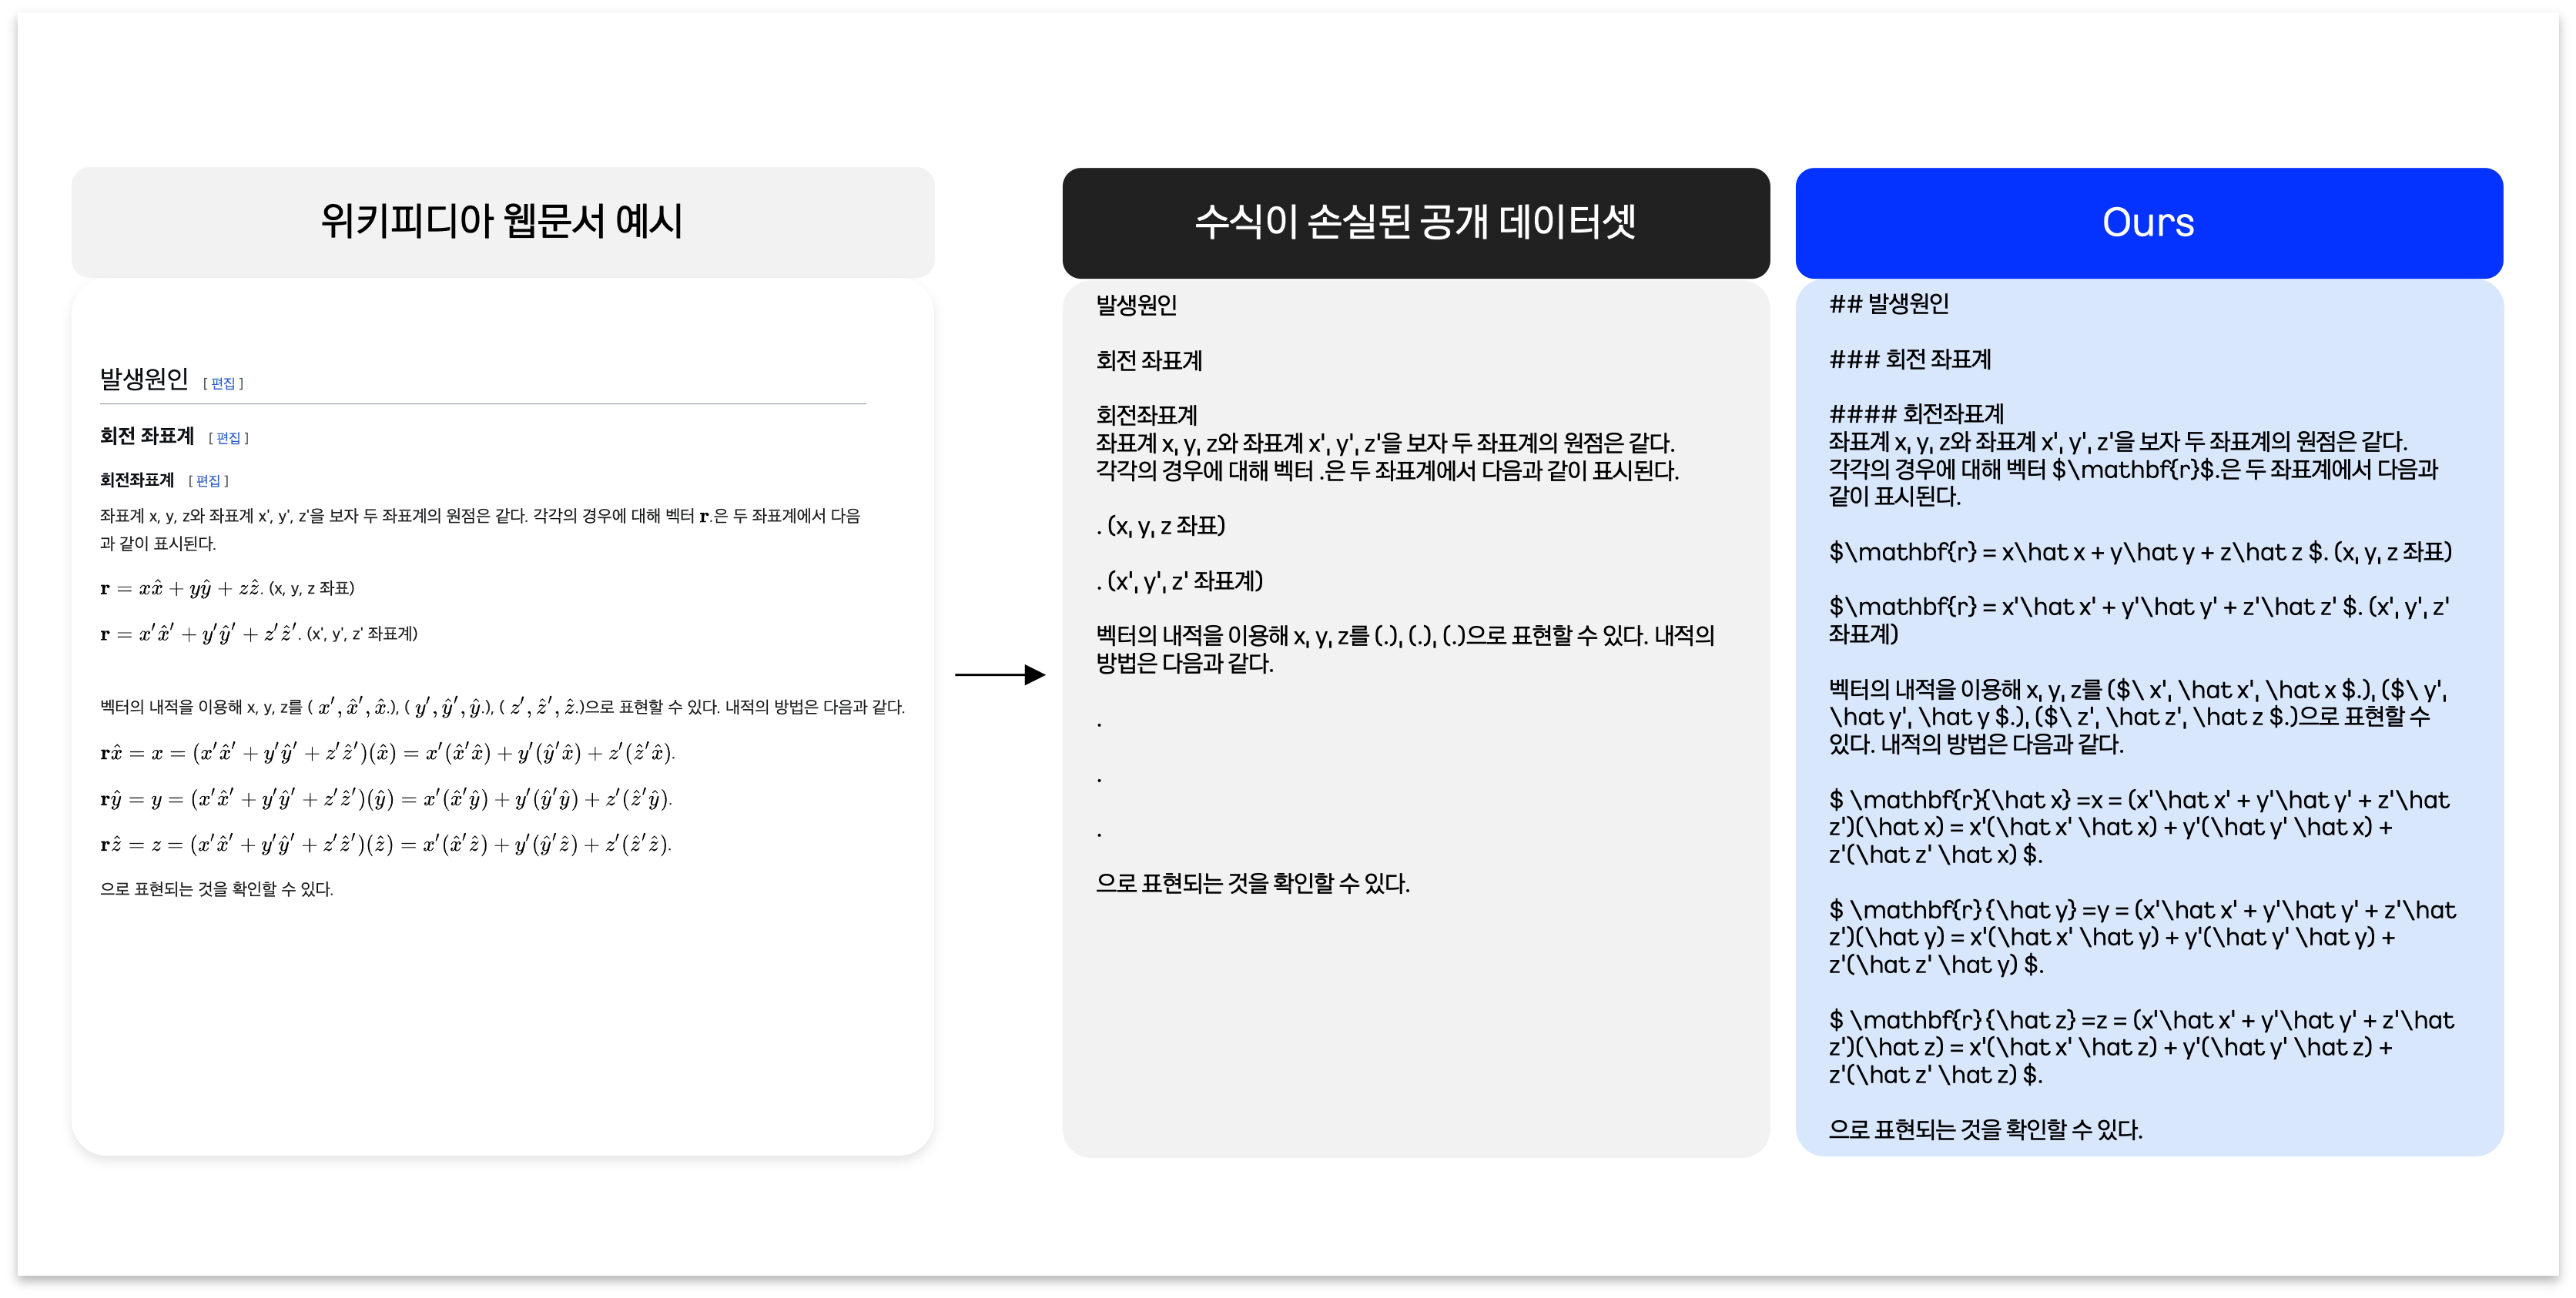
목적이 Wikipedia인 경우에는 Stage 1은 한국어, 영어를 포함한 29개 언어에 대한 Wikipedia를 사용하고, Stage 2의 경우에는 한국어, 영어를 중심으로 구성하였습니다. 다만 공개된 Wikipedia 데이터를 확인해 봤을 때 수식이 손실되는 문제가 있다고 판단하였고, 한국어 및 영어 데이터만 직접 수식을 살려서 데이터를 다시 수집하였습니다.
아래 이미지는 웹상의 한국어 Wikipedia에 실제로 존재하는 “코리올리 효과”에 대한 문서로, 실제 웹 페이지에는 수식이 존재하나, 공개된 한국어 Wikipedia 데이터에는 수식이 대부분 사라진 것을 확인할 수 있습니다. 이 부분에 대한 데이터 전처리를 직접 하여 다시 수집한 Wikipedia 데이터의 경우 수식이 잘 보존된 것을 확인할 수 있습니다.
Two staged pre-training 학습 전략
데이터 수집과 전처리 과정을 거친 후, 저희는 Compute budget을 고려하여 Two staged pre-training의 전체 학습 Token budget을 3T Token으로 하고, Stage 1과 Stage 2에서 각각 2.7T, 0.3T Token을 사용해서 Kanana Essence를 먼저 Pre-training 하는 것으로 결정하였습니다.
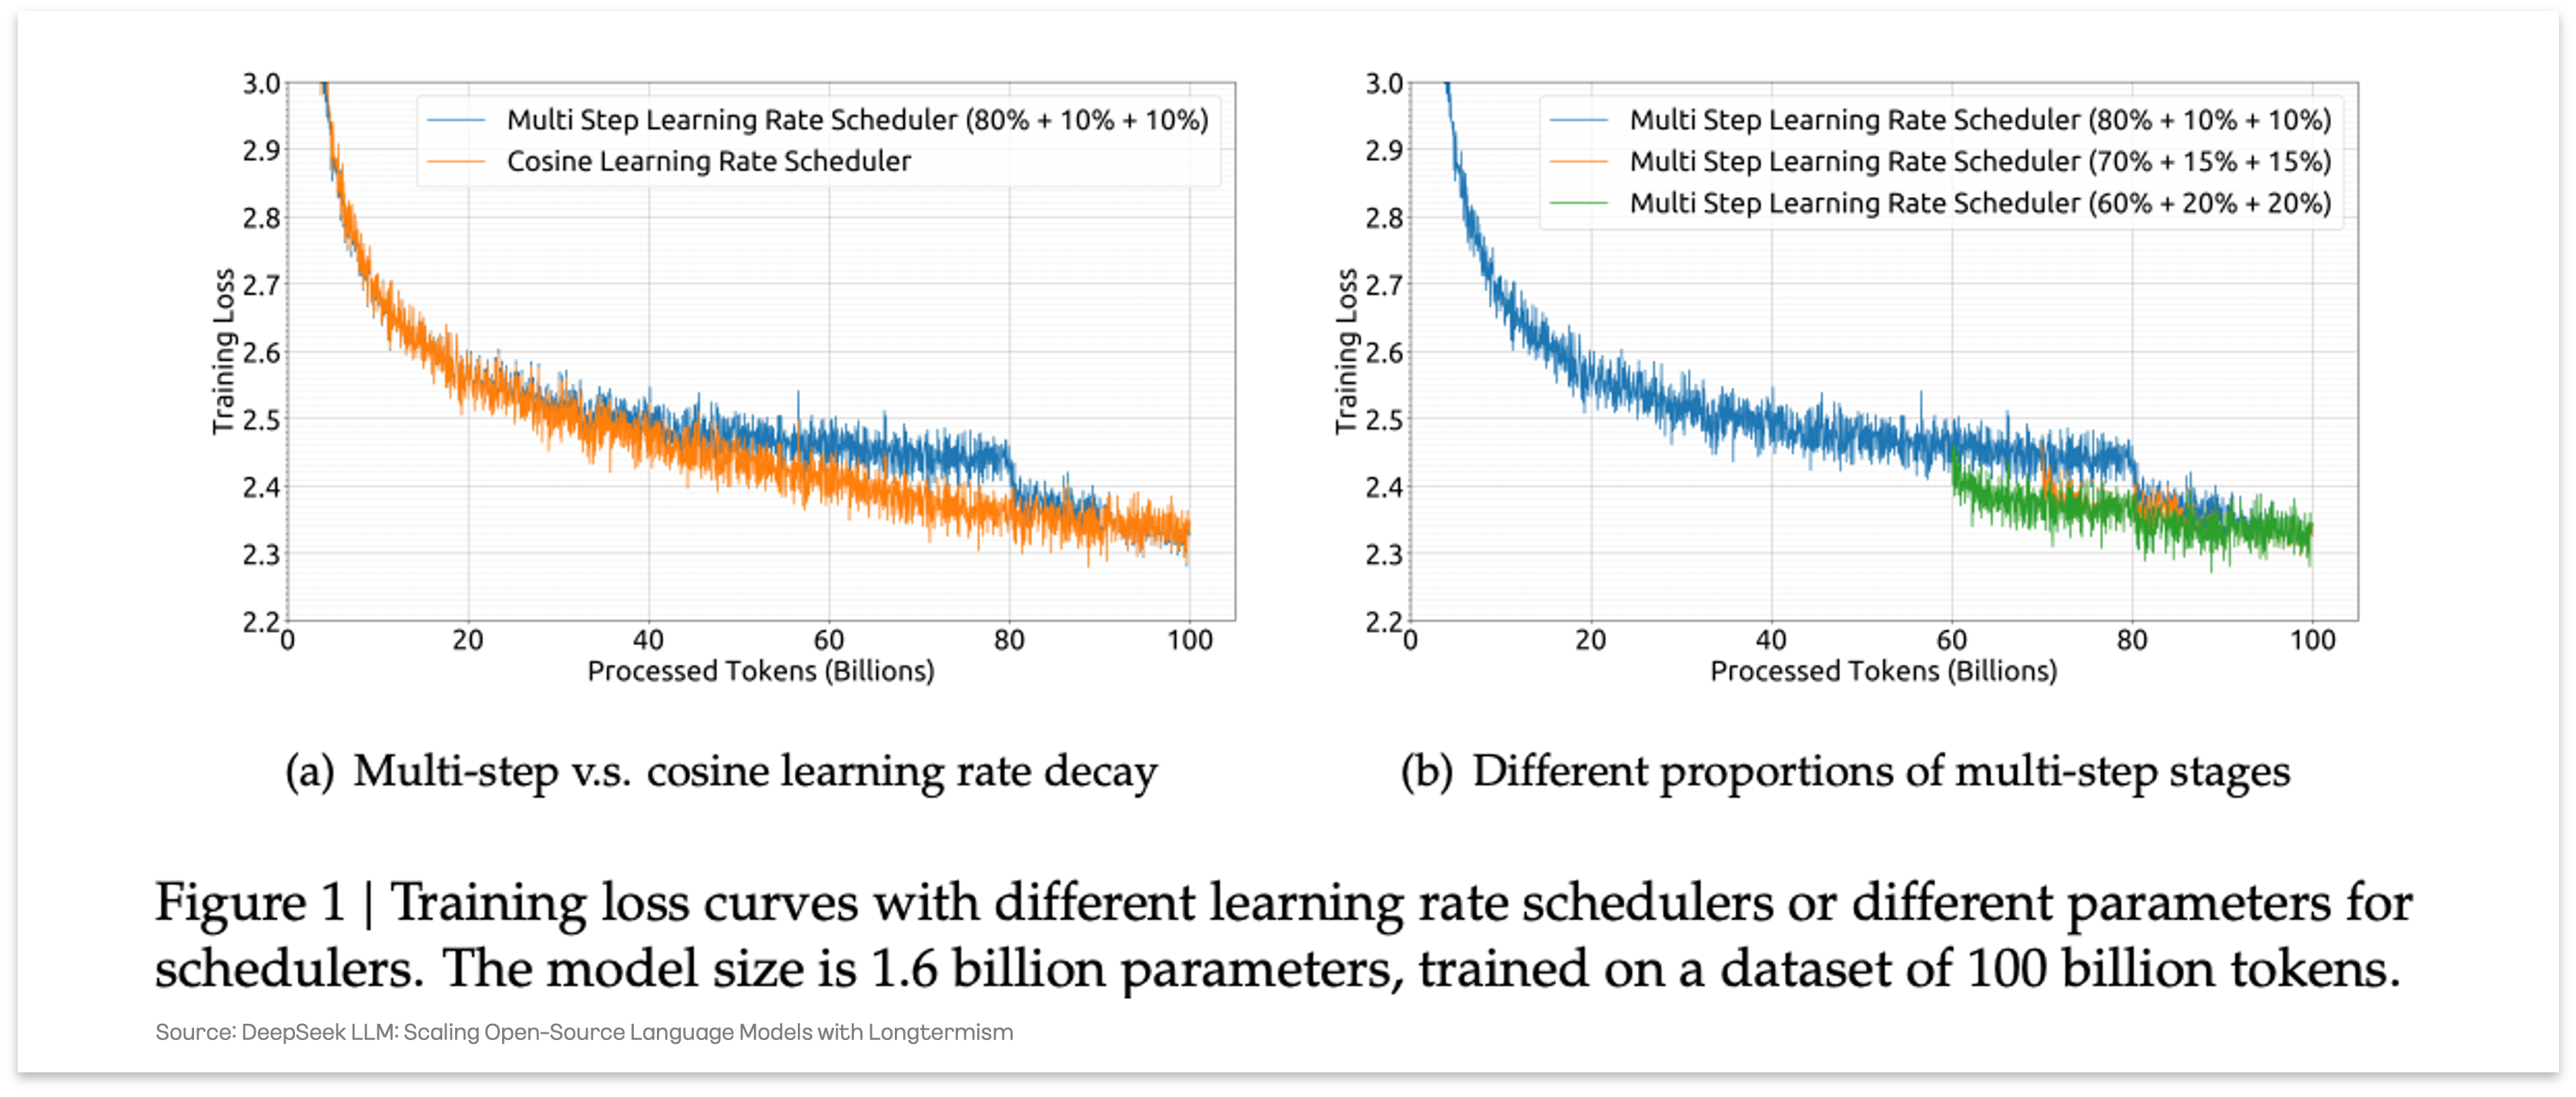
Kanana Essence의 구조는 사실상 업계에서 표준인 llama와 유사한 구조(예: Grouped query attention, RoPE 등)로 선정하였으며, 8K Context length를 가지도록 학습하는 것을 계획했습니다. 학습 방식은 “DeepSeek LLM: Scaling Open-Source Language Models with Longtermism” 연구에서 제시한 방법론들을 활용하였습니다. 해당 연구에서 제시한 Hyperparameter에 대한 Scaling law를 활용하여, Learning rate와 Batch size 등을 결정하였습니다. 특히 Learning rate scheduler의 경우, 기존에 많은 연구들에서 활용하는 Cosine learning rate scheduler 아닌 Multi-step learning rate scheduler를 사용하였습니다. 그 이유는 연구에서 제시된 바와 같이 Cosine learning rate scheduler를 사용할 때보다, 더 낮은 Train loss를 달성할 수 있기 때문입니다.
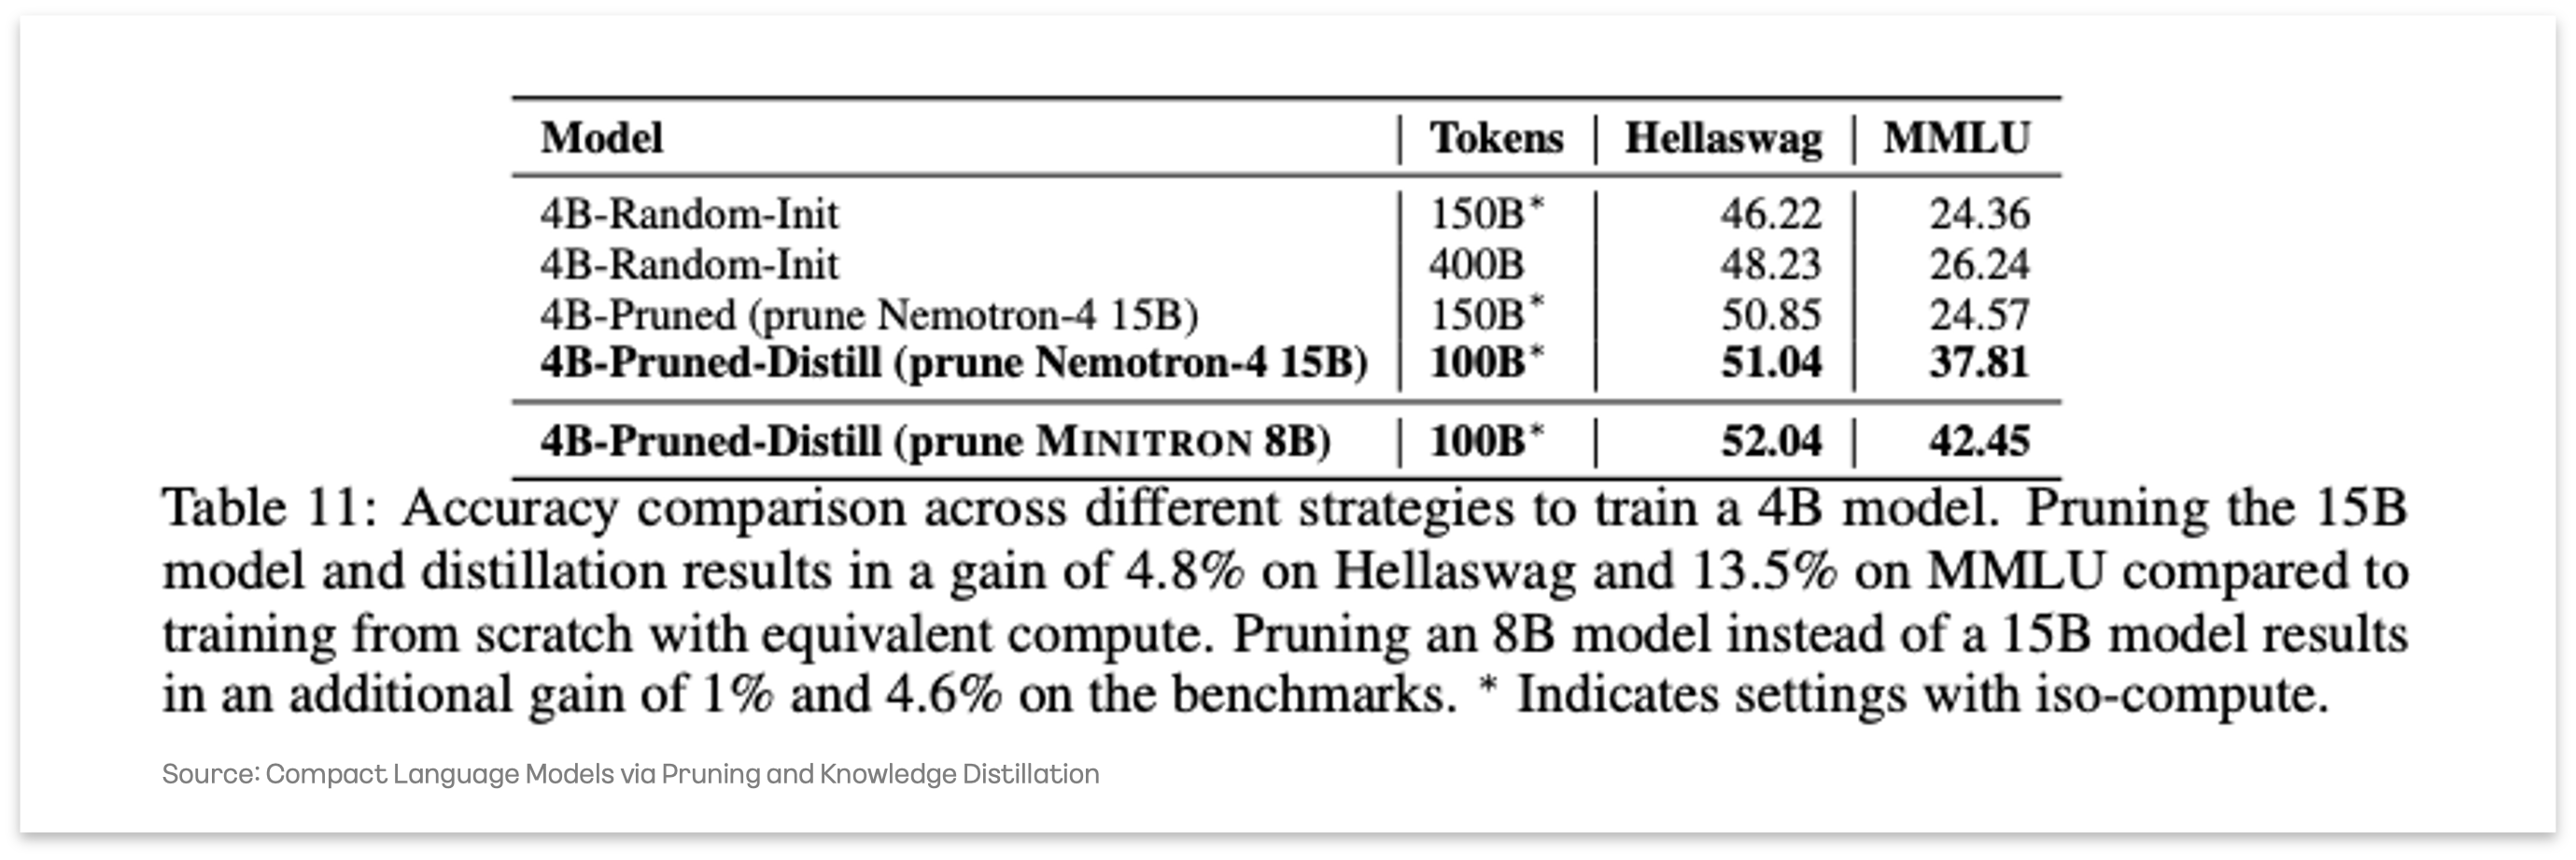
Kanana Nano는 비용 효율적으로 학습하기 위해 “Compact Language Models via Pruning and Knowledge Distillation” 연구에서 제시한 Pruning & distillation 기법으로 학습하는 전략을 채택하였습니다. 해당 연구에서 제시한 결과를 보면 4B 크기의 LLM을 처음부터 From scratch로 만드는 것보다, 이미 학습된 15B 크기의 LLM으로부터 Pruning & distillation 기법을 적용하여 학습하는 것이, 훨씬 적은 Token을 학습에 사용하고도, 더 좋은 성능을 달성하는 것을 확인할 수 있습니다.
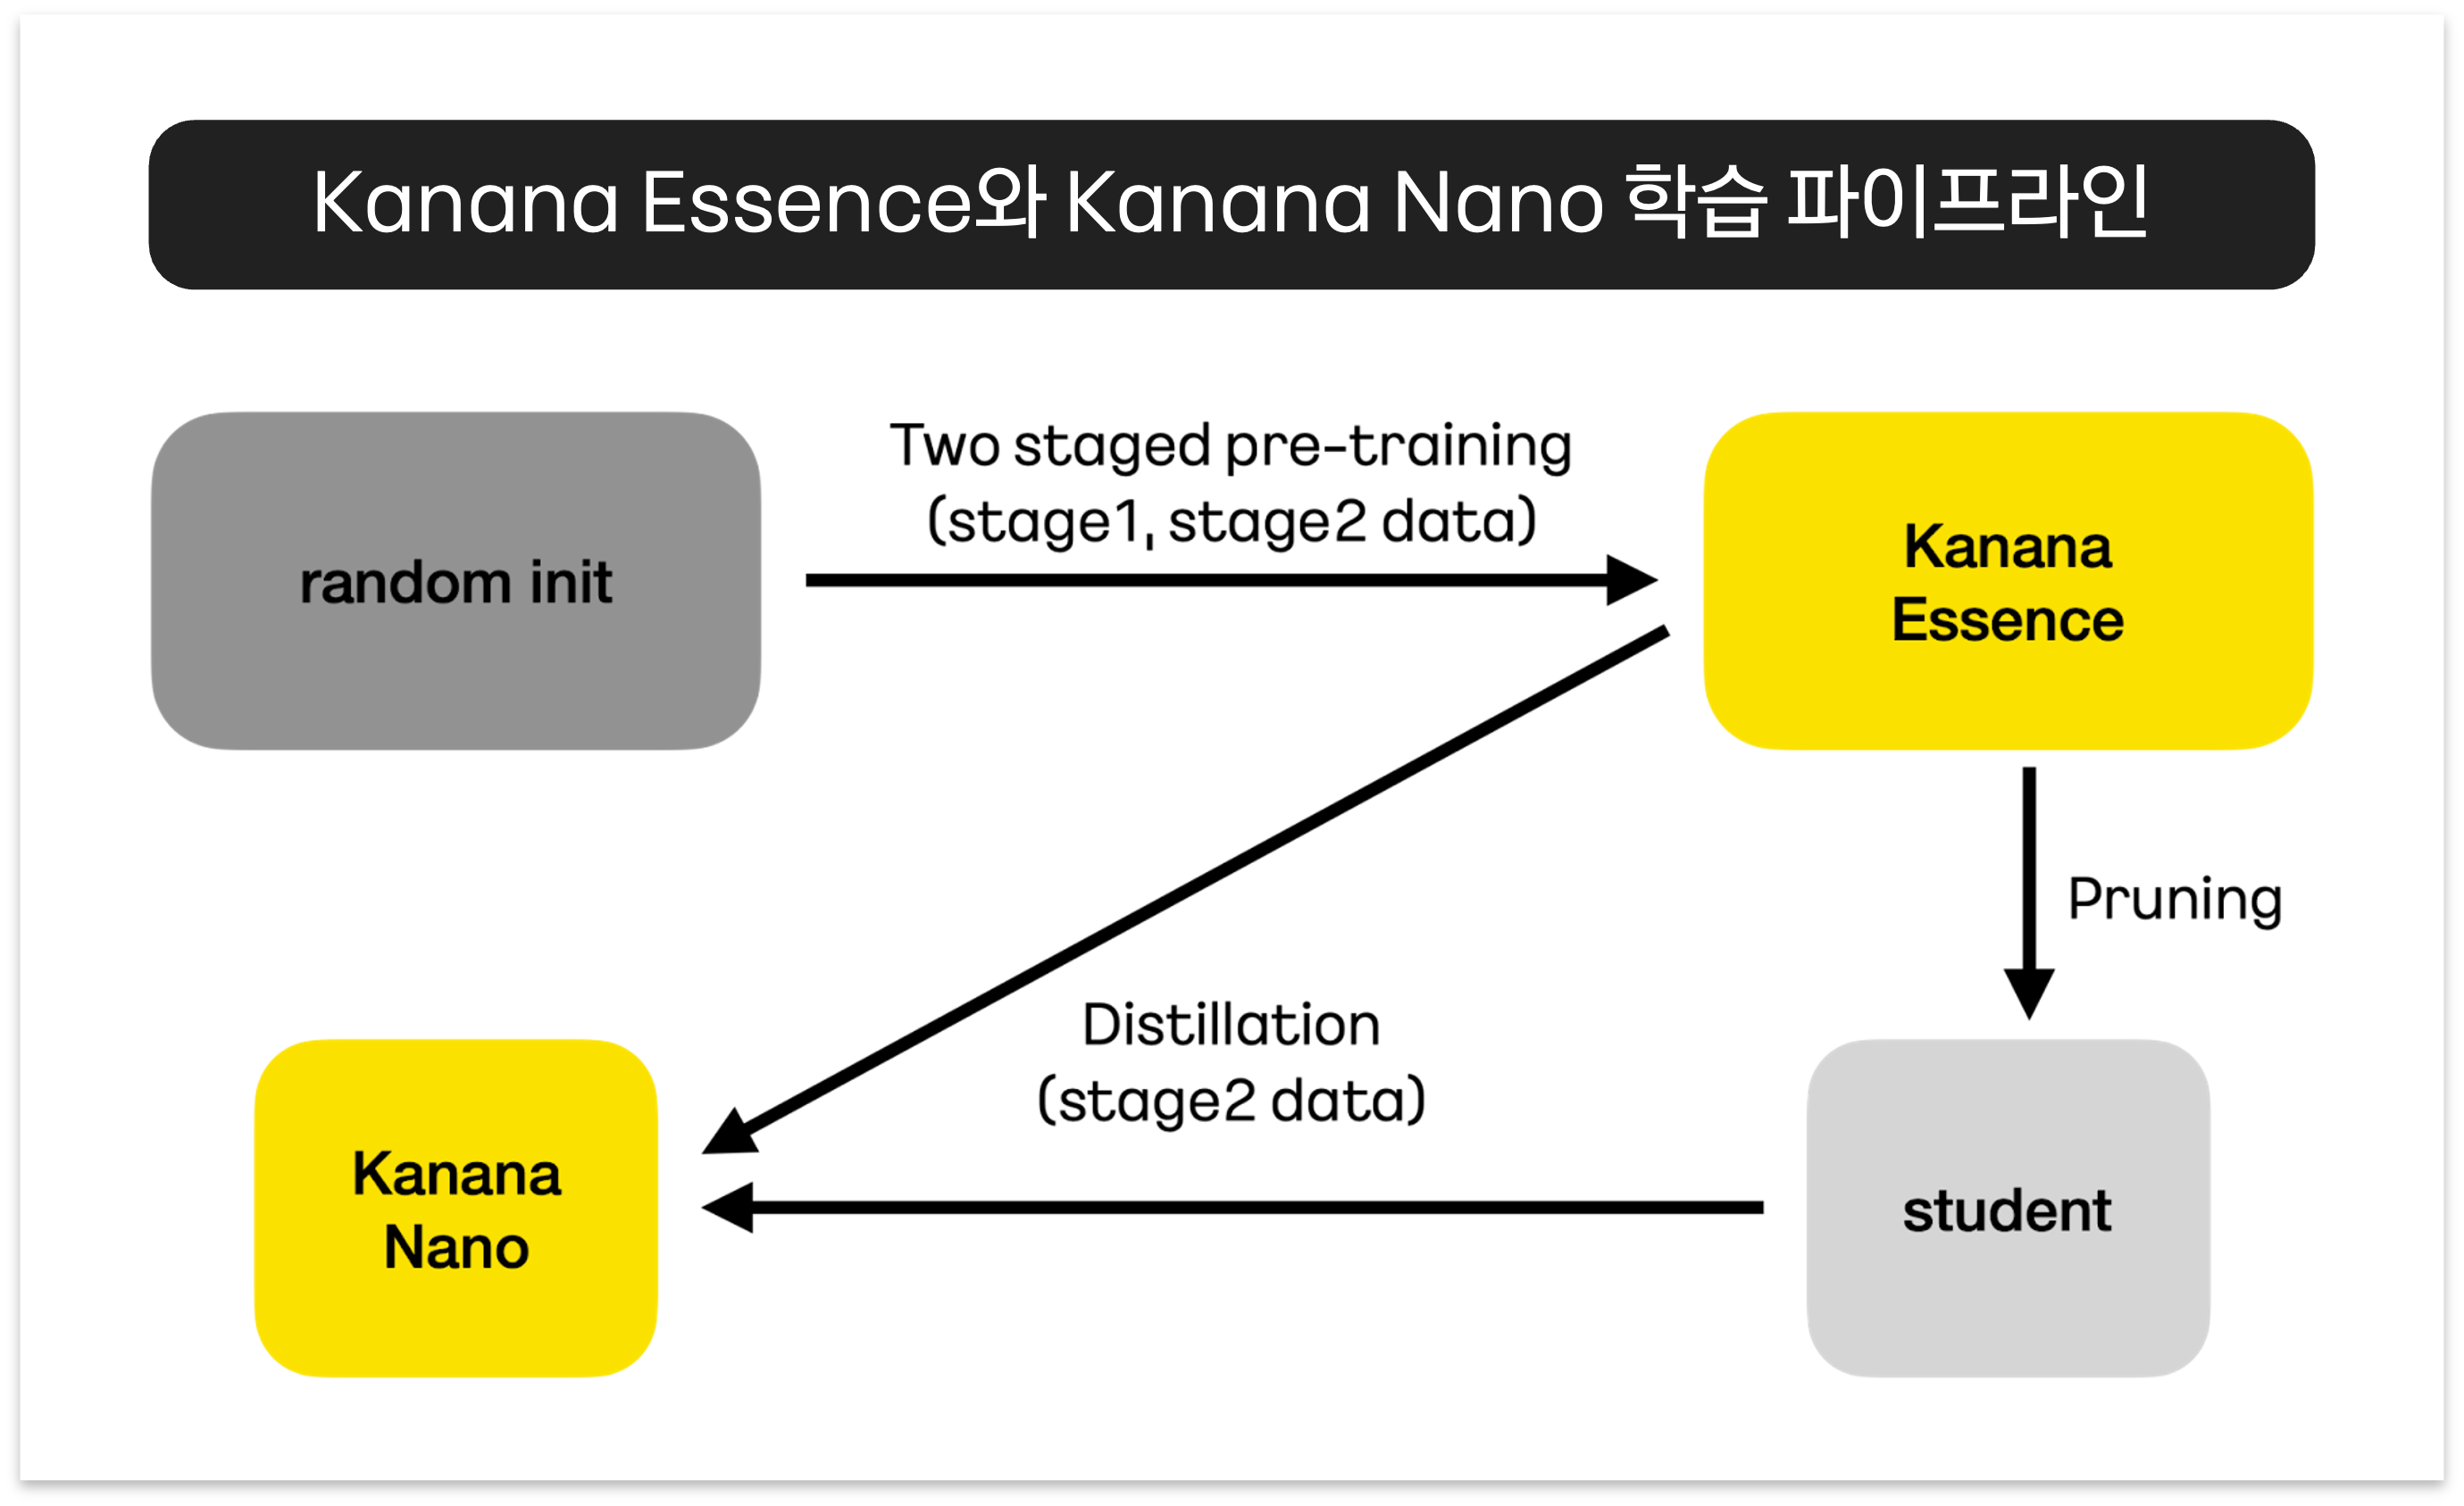
결론적으로 Kanana Essence를 먼저 학습하고, 이후 Pruning & distillation 기법으로 Kanana Nano를 학습하는 것으로 두 모델을 확보하는 전략을 채택하였습니다. 두 모델을 확보하는 파이프라인은 아래와 같습니다.
1. Kanana Essence 학습
Kanana Essence는 서비스에 가장 최적화된 중형 사이즈의 모델입니다. 이와 같은 전략에서 가장 중요한 것은 먼저 학습하는 Kanana Essence의 성능을 최대화하는 것이었습니다. 이를 위해 각각 Stage 별로 목표를 두고, 각 목표에 맞게 학습의 효율을 끌어올릴 수 있는 데이터셋의 목적에 따른 Data distribution 탐색이 필요했습니다.
Stage 1 Data distribution 탐색 및 학습
Stage 1의 목표로서 학습의 성능을 최대화해야 하는 벤치마크로, 한국어의 경우는 kmmlu와 haerae를 영어인 경우 mmlu로 선택하였습니다. 한국어의 경우 특별히 haerae가 추가된 이유는 과거 연구에서 kmmlu가 한국의 Cultural knowledge를 요구하는 정도가 생각보다 그 비율이 적고, 반대로 haerae가 더 높다고 생각되는 결과들이 보고된 바 있기 때문입니다. “HAE-RAE Bench: Evaluation of Korean Knowledge in Language Models” 연구에서 한국어 말뭉치로만 학습된 Polyglot-ko 모델이 LLAMA-2와 같은 LLM 대비 훨씬 높은 성능을 기록한 바 있습니다. 반면에 “KMMLU: Measuring Massive Multitask Language Understanding in Korean” 연구에서는 kmmlu 벤치마크가 한국에 관한 Cultural knowledge를 요구하는 Task가 20% 정도라고 보고되었습니다.
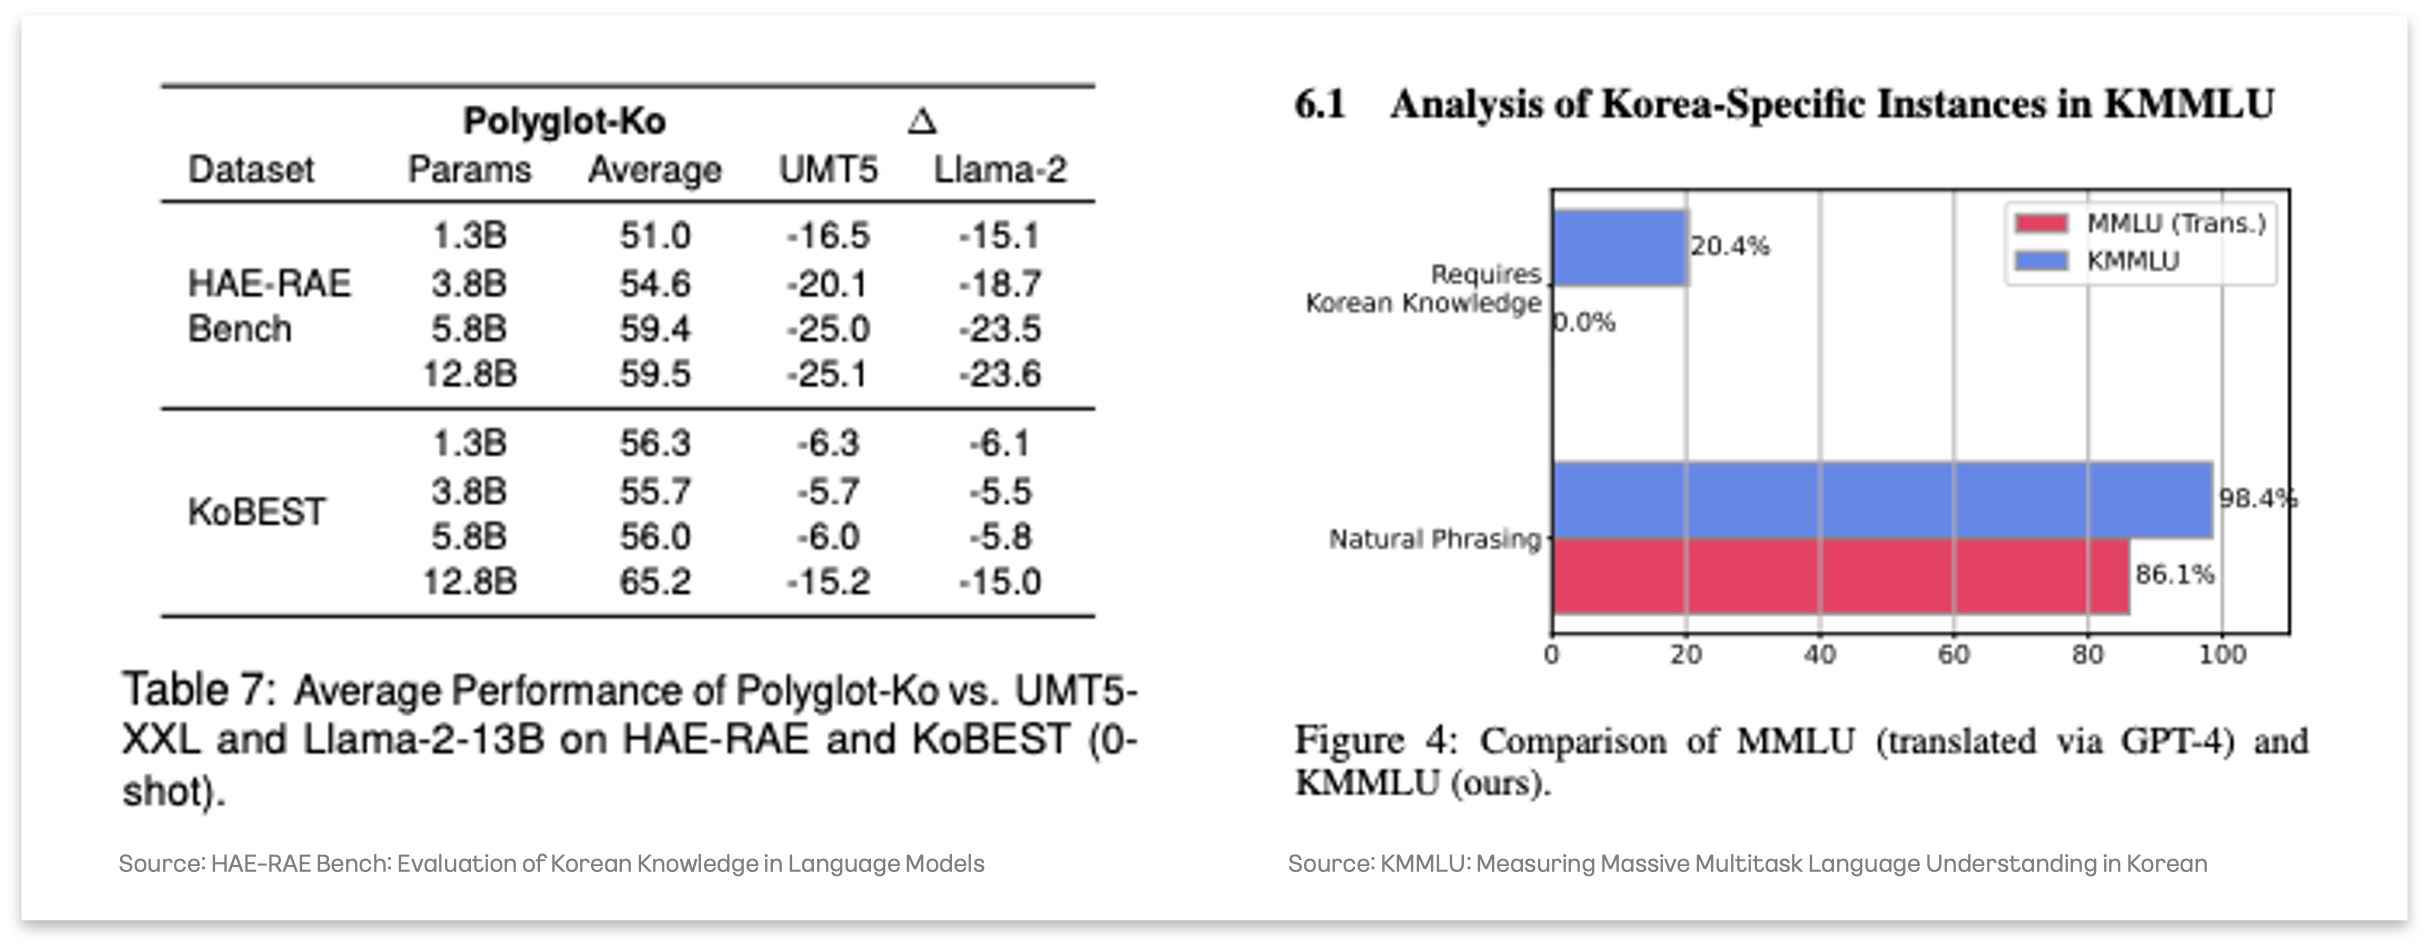
따라서 한국에 관한 Cultural knowledge를 좀 더 적절히 고려하기 위해 kmmlu, haerae, mmlu 세 가지 벤치마크 점수의 평균을 최대화하는 Data distribution을 찾고자 하였고, 250B를 학습하여 Data distribution을 검증하는 Ablation을 진행하였습니다. Ablation 목록은 표와 같습니다.
| 구분 | 내용 |
|---|---|
| Ablation 0 (Baseline) | 목적별 수집된 Token 양에 기반한 Distribution을 사용함. |
| Ablation 1 | 목적이 Common sense & general knowledge인 한국어 Token들을 절반만 사용함. |
| Ablation 2 | 목적이 Common sense & general knowledge인 한국어 Token들을 Multi-epoch (2 Epochs)로 사용함. |
| Ablation 3 | 목적이 Stem인 영어 Token들을 Multi-epoch (2 Epochs)로 사용함. |
각각의 Alation에 대해서 학습한 결과 Ablation 1과 Ablation 3이 Baseline인 Ablation 0 대비 모든 벤치마크에서 성능이 비슷하거나 더 좋은 것을 확인하였습니다.
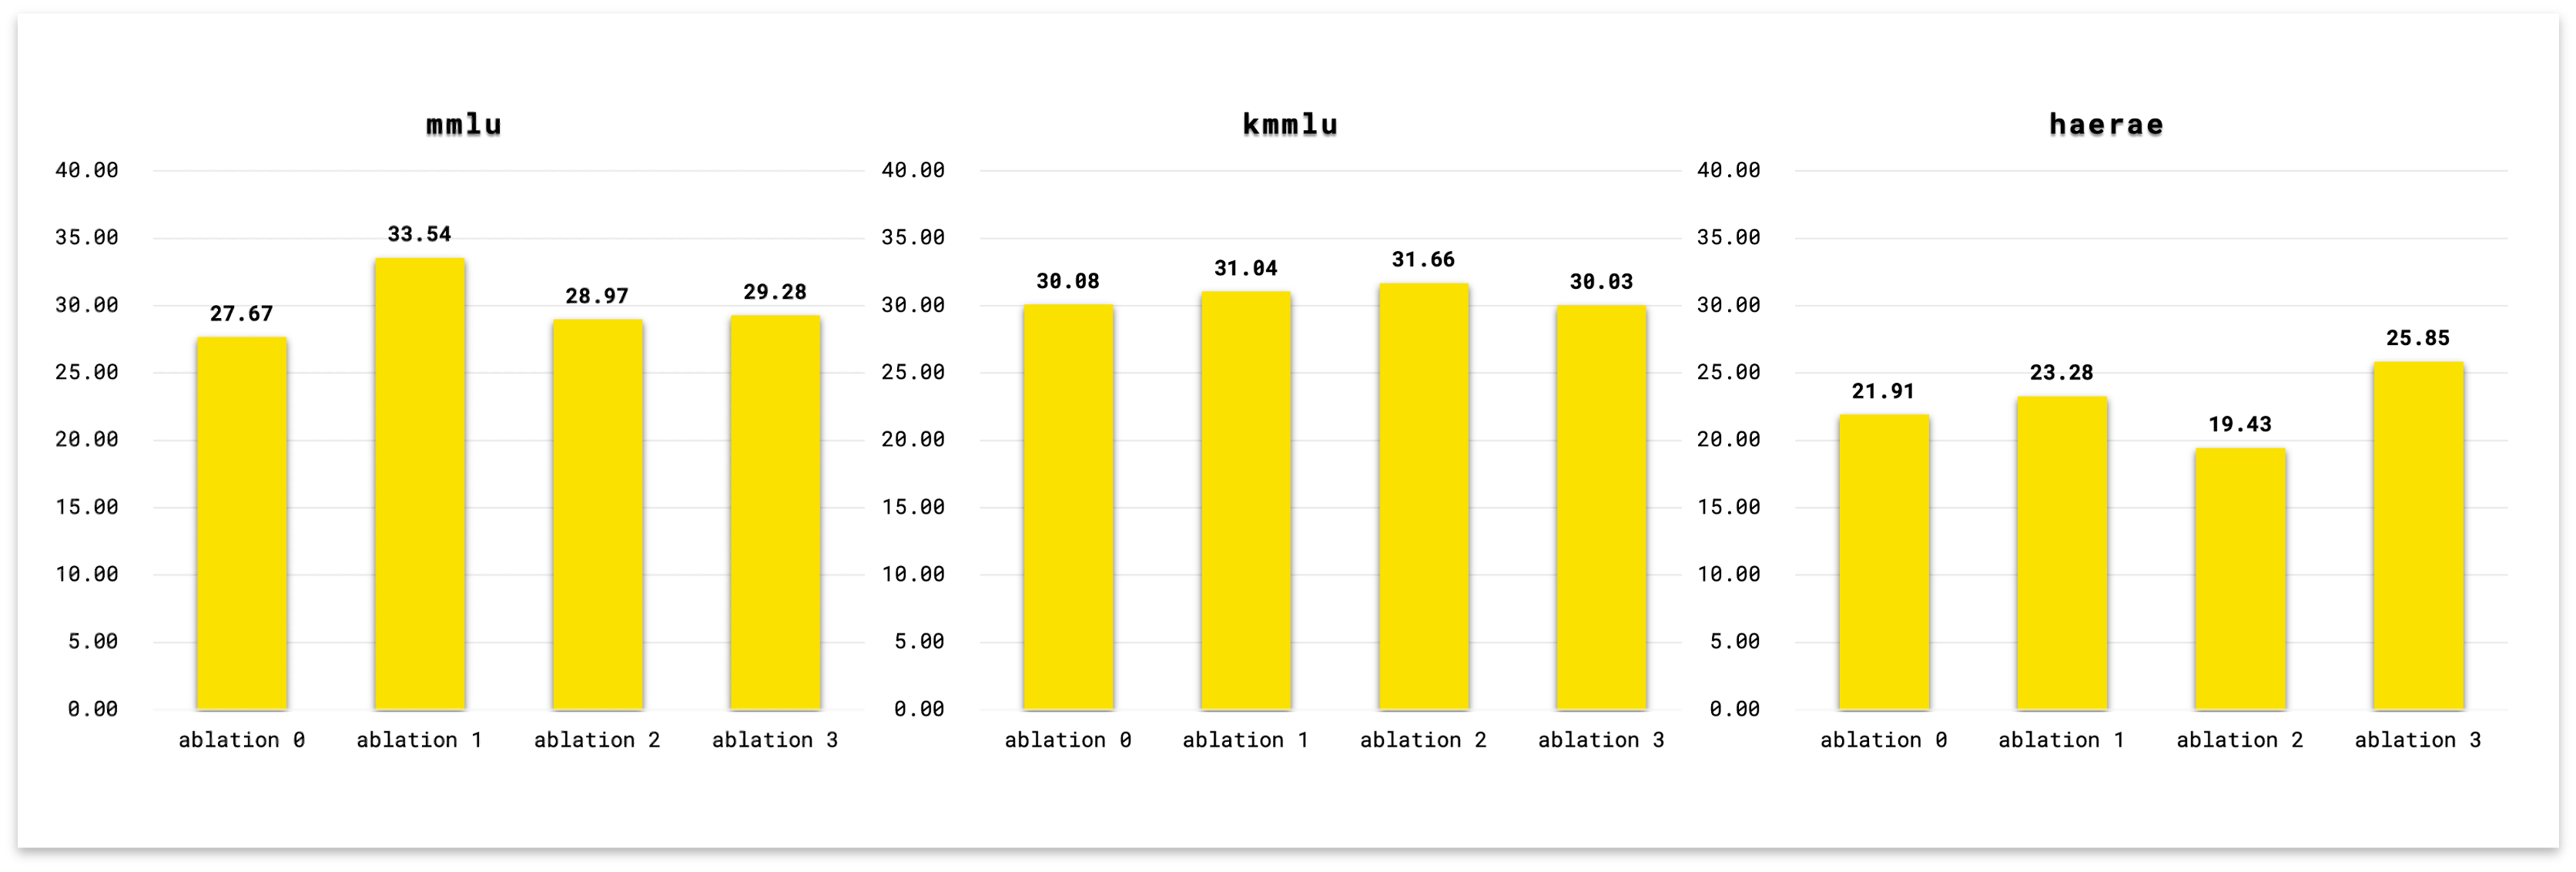
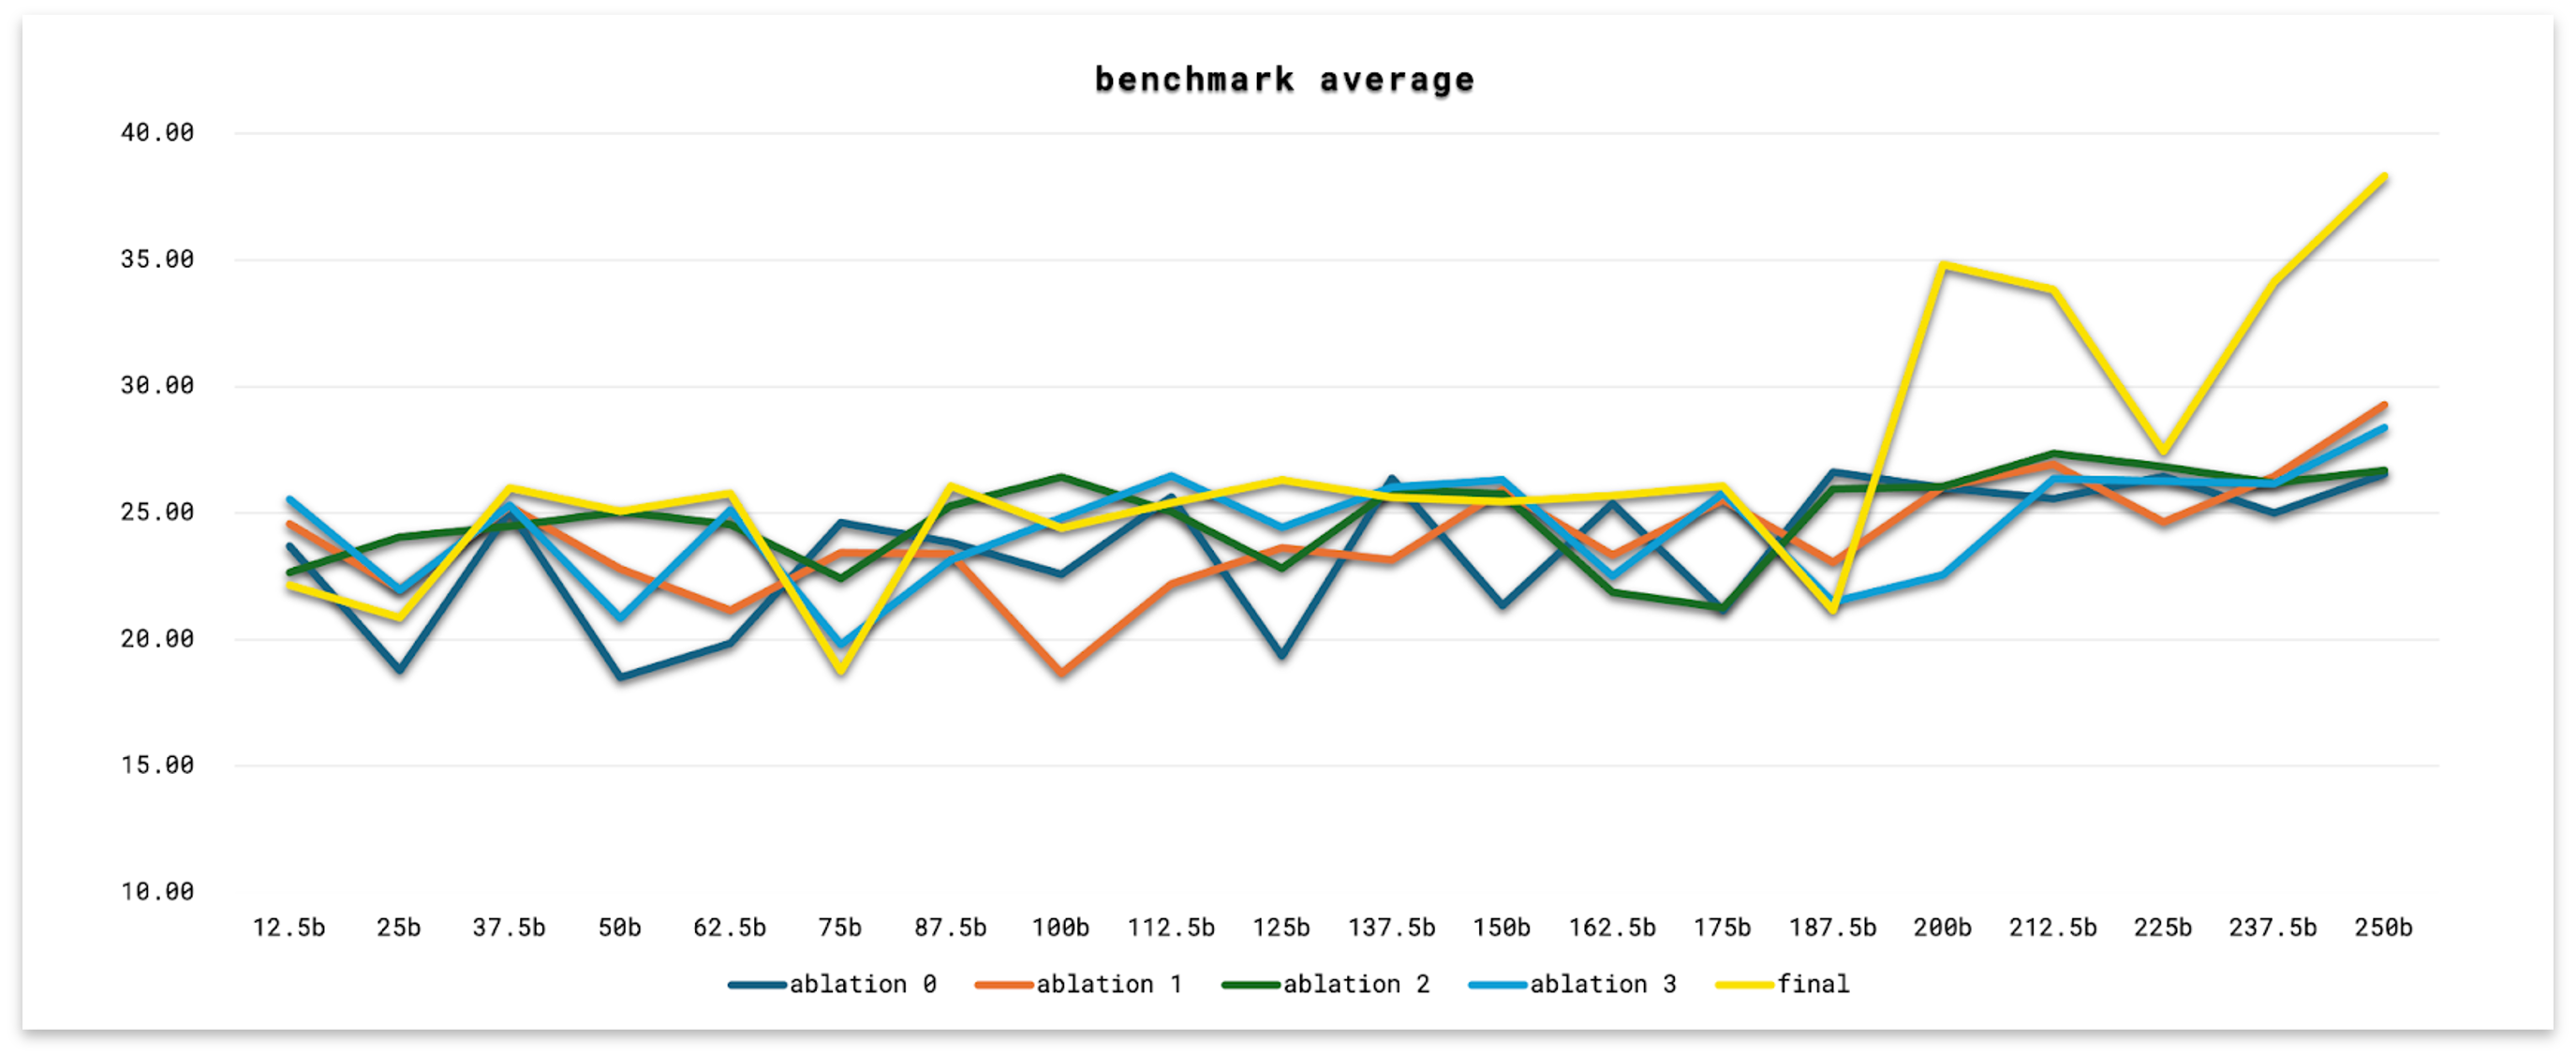
Ablation 1과 3을 비교해 보면 Ablation 1은 mmlu와 kmmlu 측면에서 좋은 양상을 보이고, 반대로 Ablation 3은 haerae에서 좋은 성능을 보입니다. 이 결과를 바탕으로 Ablation 1과 3을 모두 선택하였습니다. 여기에 덧붙여 영어 말뭉치를 측정해 둔 Quality 점수를 기반으로 점수가 낮은 것을 제외하고 250B Token을 학습시켜 본 결과, 유의미한 차이를 확인할 수 있었습니다.
Ablation을 통해 결정한 Data distribution으로 2.7T Token 학습을 진행한 결과, 비슷한 크기의 llama-3.1-8b 모델 대비 한국어 관련 벤치마크에서는 높은 점수를 기록하지만, 수학과 코드 관련 벤치마크에서는 상대적으로 낮은 것을 확인할 수 있었습니다.
| mmlu (acc, 5-shots) | kmmlu (em, 5-shots) | haerae (acc-norm, 5-shots) | gsm8k (em_strict, 5-shots) | humaneval (pass@1, 0-shots) | MBPP (pass@1, 3-shots) | |
|---|---|---|---|---|---|---|
| Stage 1 | 63.49 | 45.62 | 78.37 | 35.48 | 23.78 | 35.20 |
| llama-3.1-8b | 65.18 | 41.46 | 61.78 | 50.87 | 35.37 | 48.60 |
Stage 2 Data distribution 탐색 및 학습
Stage 1 학습의 결과에서 수학과 코드 관련 성능을 개선하기 위해, 여러 가지 Ablation을 진행했습니다. 특히 수학과 코드 관련 성능을 개선하는 것뿐만 아니라, Stage 1에서 목표로 했던 벤치마크들인 mmlu, kmmlu, haerae 등도 최소 성능을 유지해야 했기 때문에, gsm8k, humaneval, MBPP 벤치마크 등을 추가해서, 6개의 벤치마크의 점수 평균을 올리는 최적의 Data distribution을 찾고자 하였습니다.
또한 Stage 1과 달리 Stage 2에서는 상대적으로 적은 0.3T Token의 학습만 하므로, Compute budget을 나누어 여러 Ablation 들을 병렬적으로 학습하는 것이 가능하였습니다. 결론적으로 17가지의 Ablation을 통해서 llama-3.1-8b보다 벤치마크 점수 평균이 훨씬 높은 경우를 찾을 수 있었습니다.
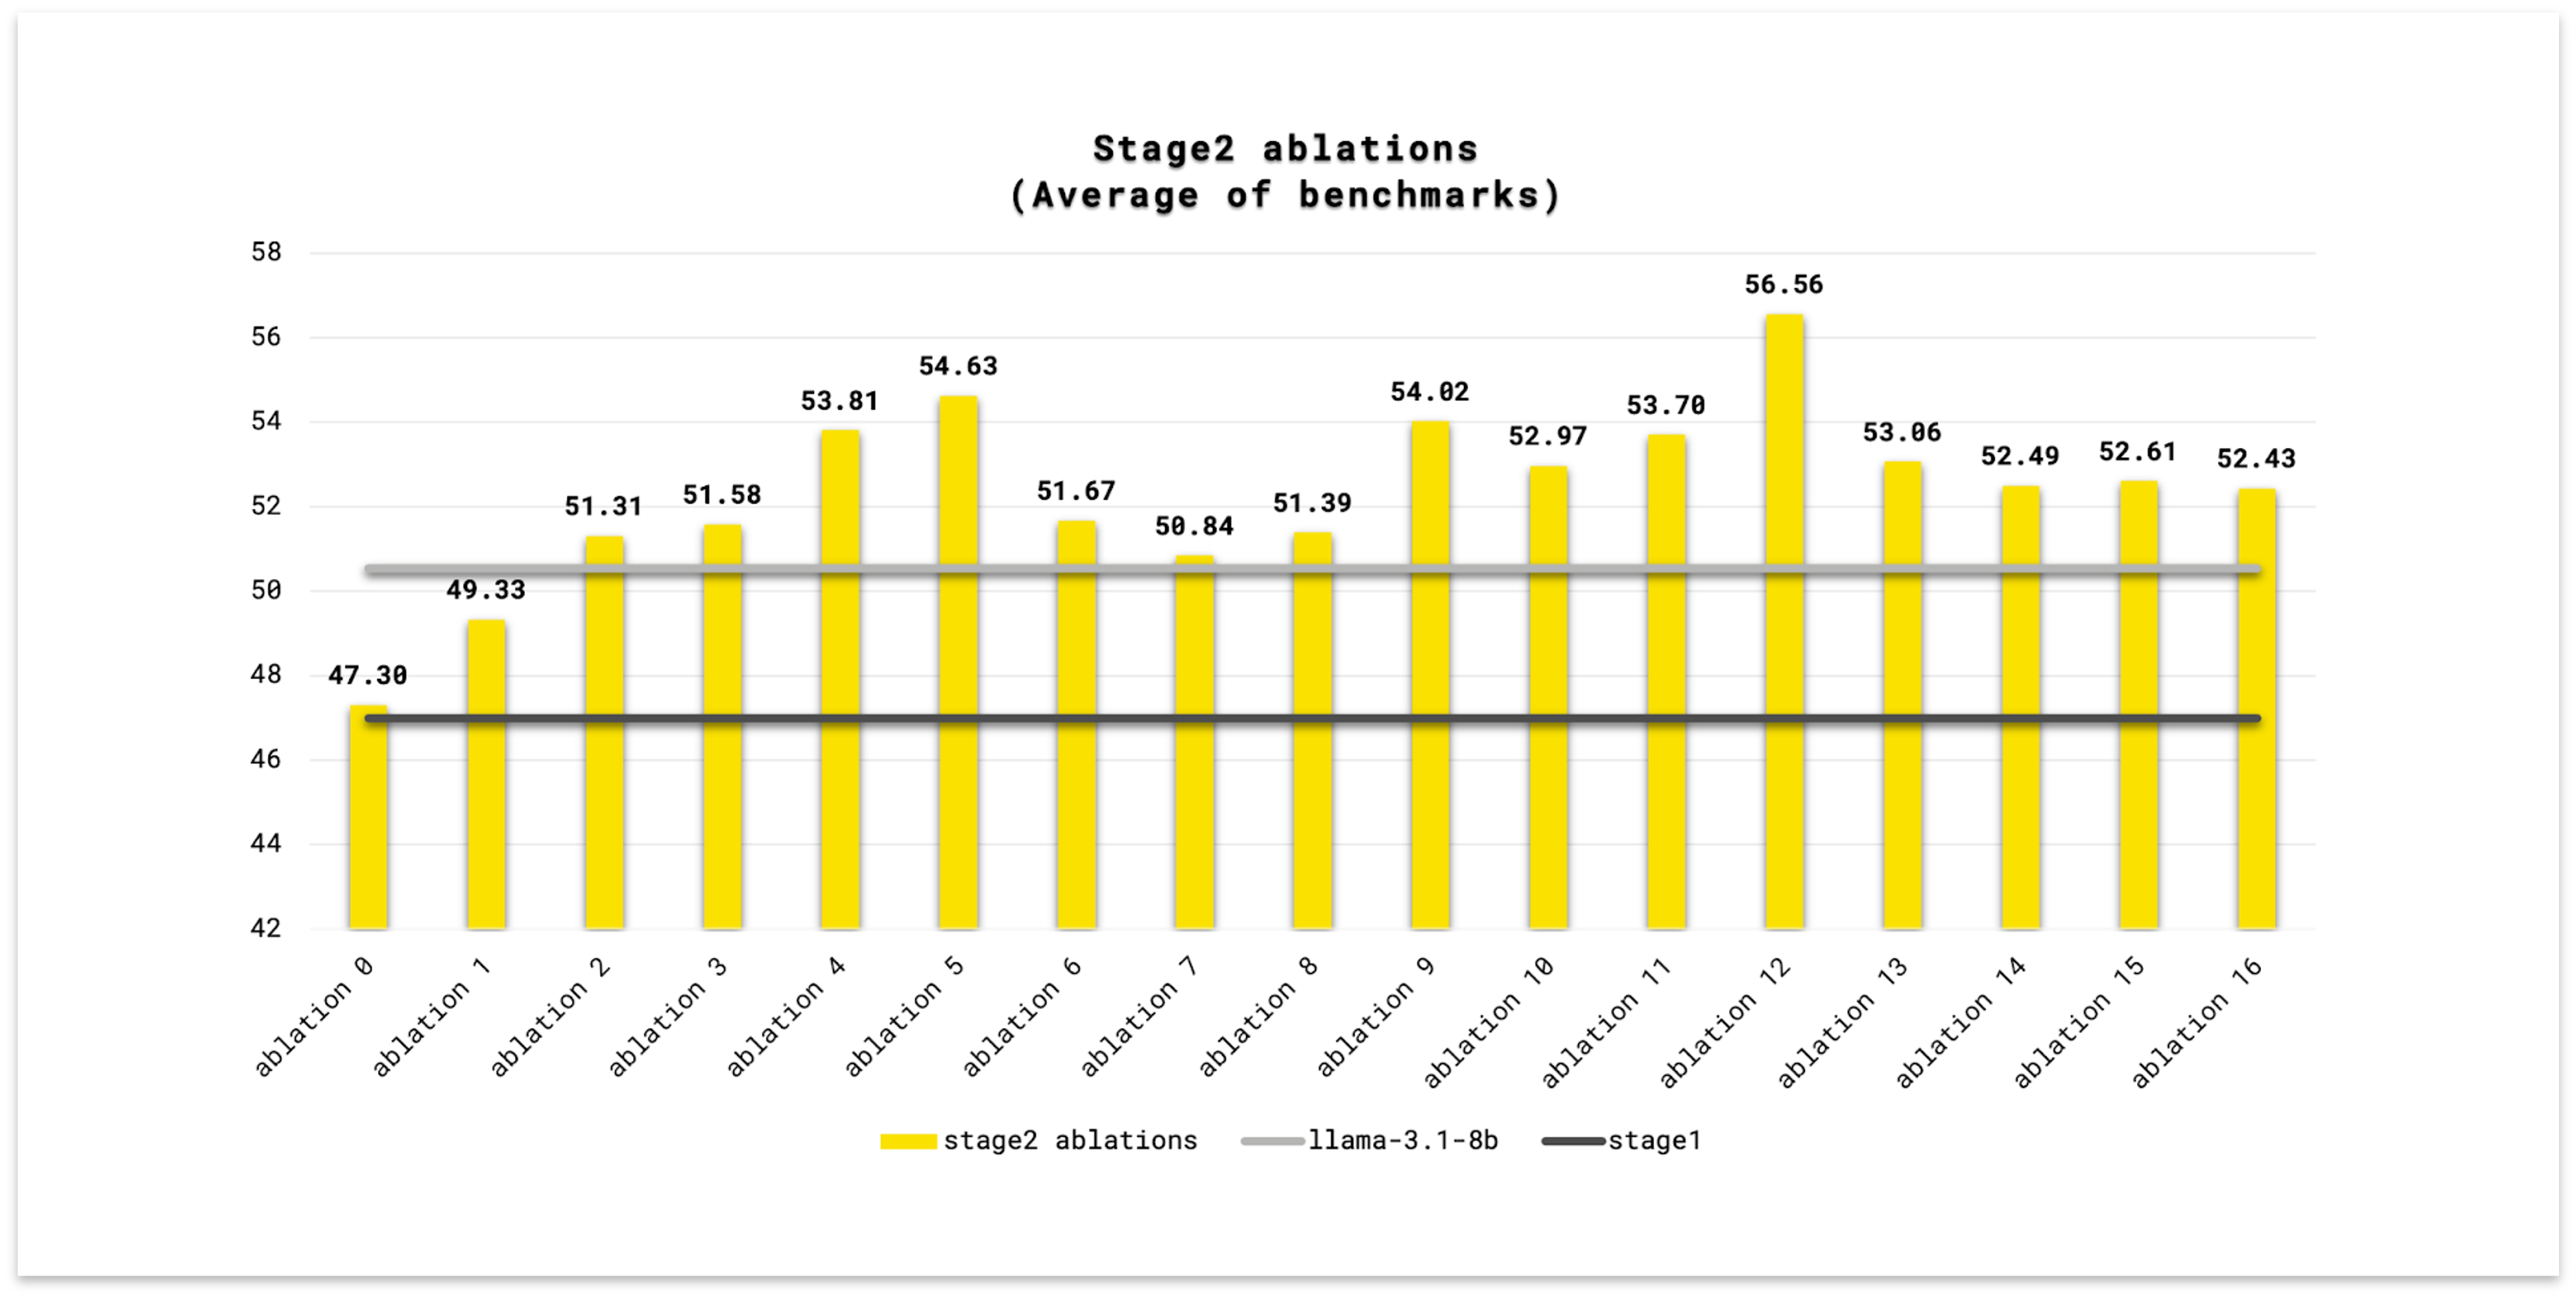
총 17가지의 Ablation을 수행했지만, 유의미한 발견을 할 수 있었던 Ablation 들은 아래의 표와 같습니다.
| 구분 | 내용 |
|---|---|
| Ablation 0 (Baseline) | Stage 1의 데이터와 Data distribution을 유지한 채로 학습 |
| Ablation 1 | Stage 1의 Data distribution을 유지, 데이터의 Quality를 개선 |
| Ablation 2 | Ablation 1을 기준으로 Data distribution을 Uniform 하게 변경 |
| Ablation 3 | Ablation 2를 기준으로 목적이 Stem과 Code인 것의 비중을 올림 |
| Ablation 11 | Ablation 3보다 좀 더 큰 Learning rate를 사용 |
| Ablation 12 | Ablation 11에서 SFT 데이터를 추가로 사용 |
유의했던 Ablation의 점수들을 시각화해서 보면 아래와 같습니다.
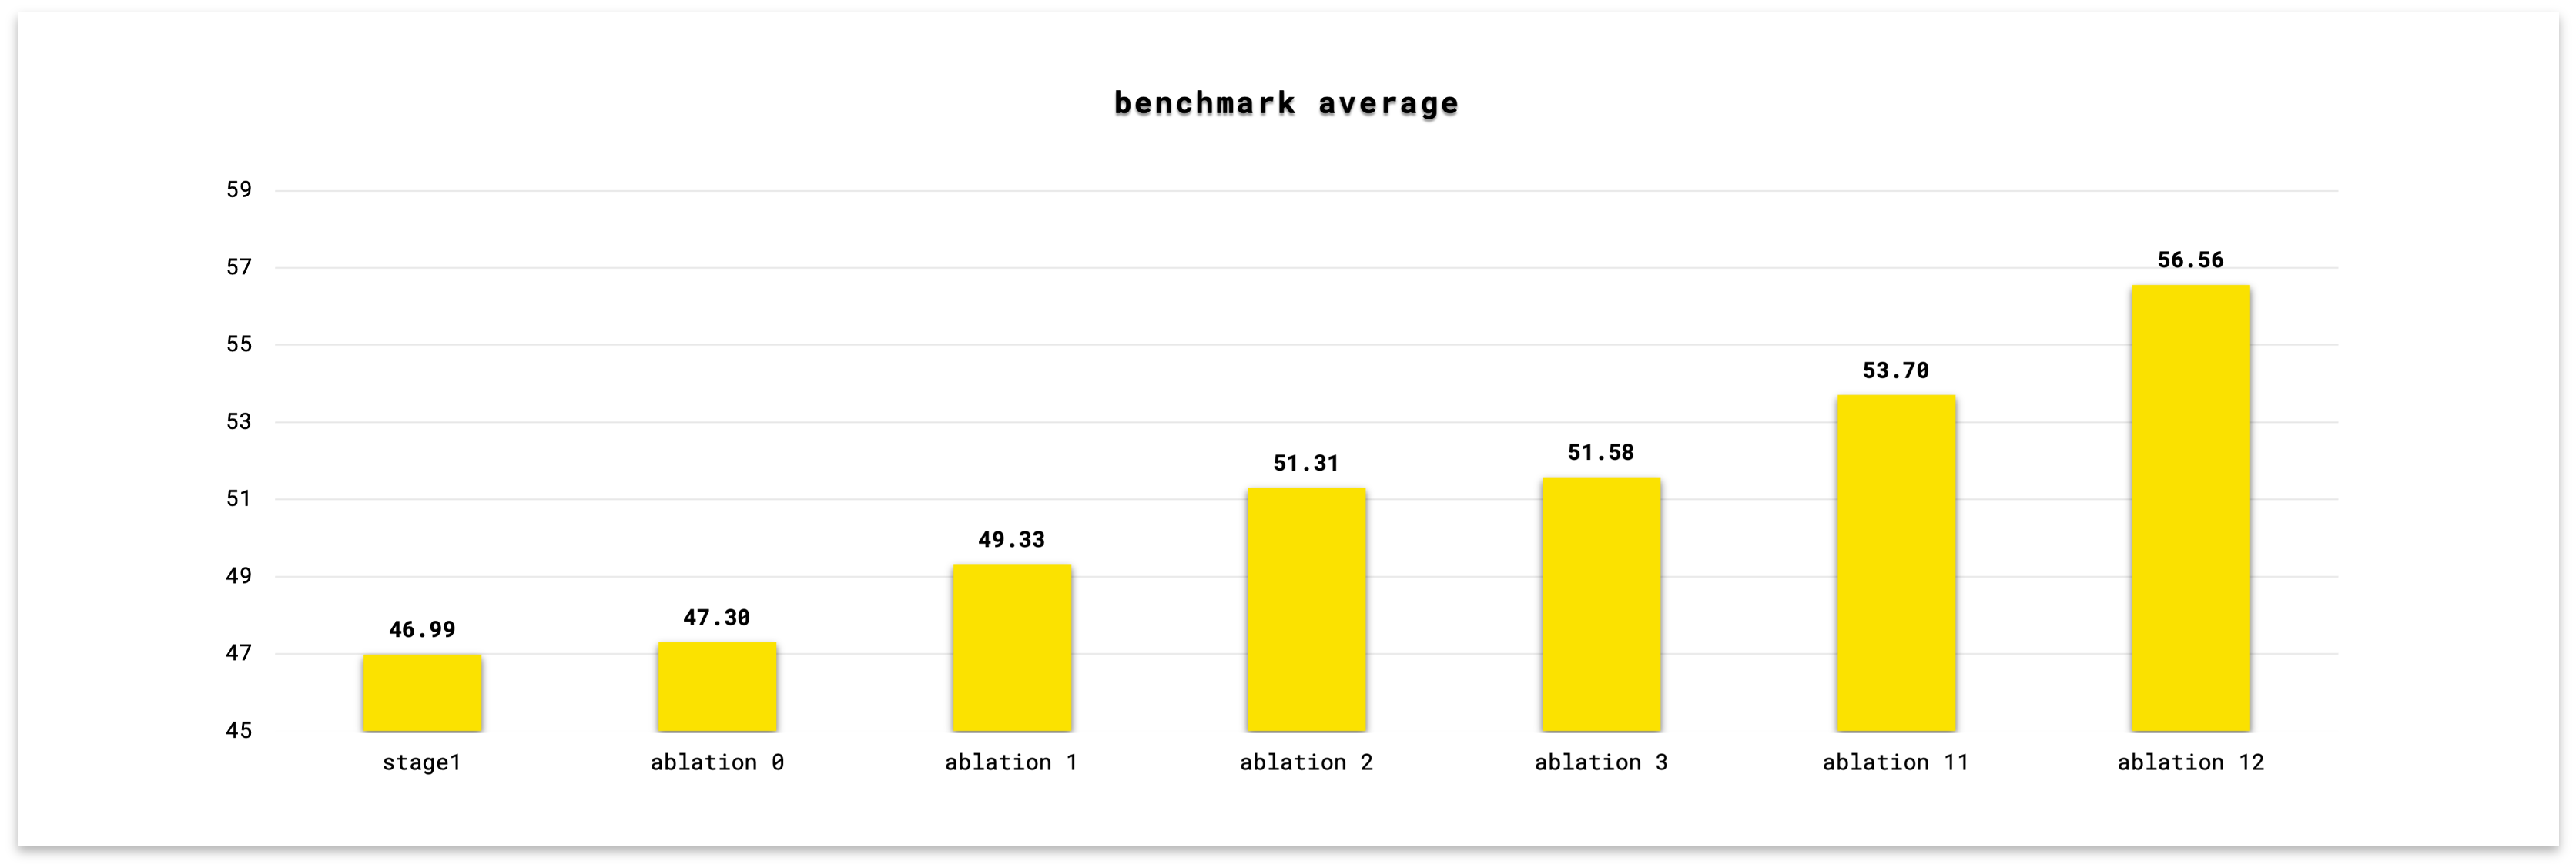
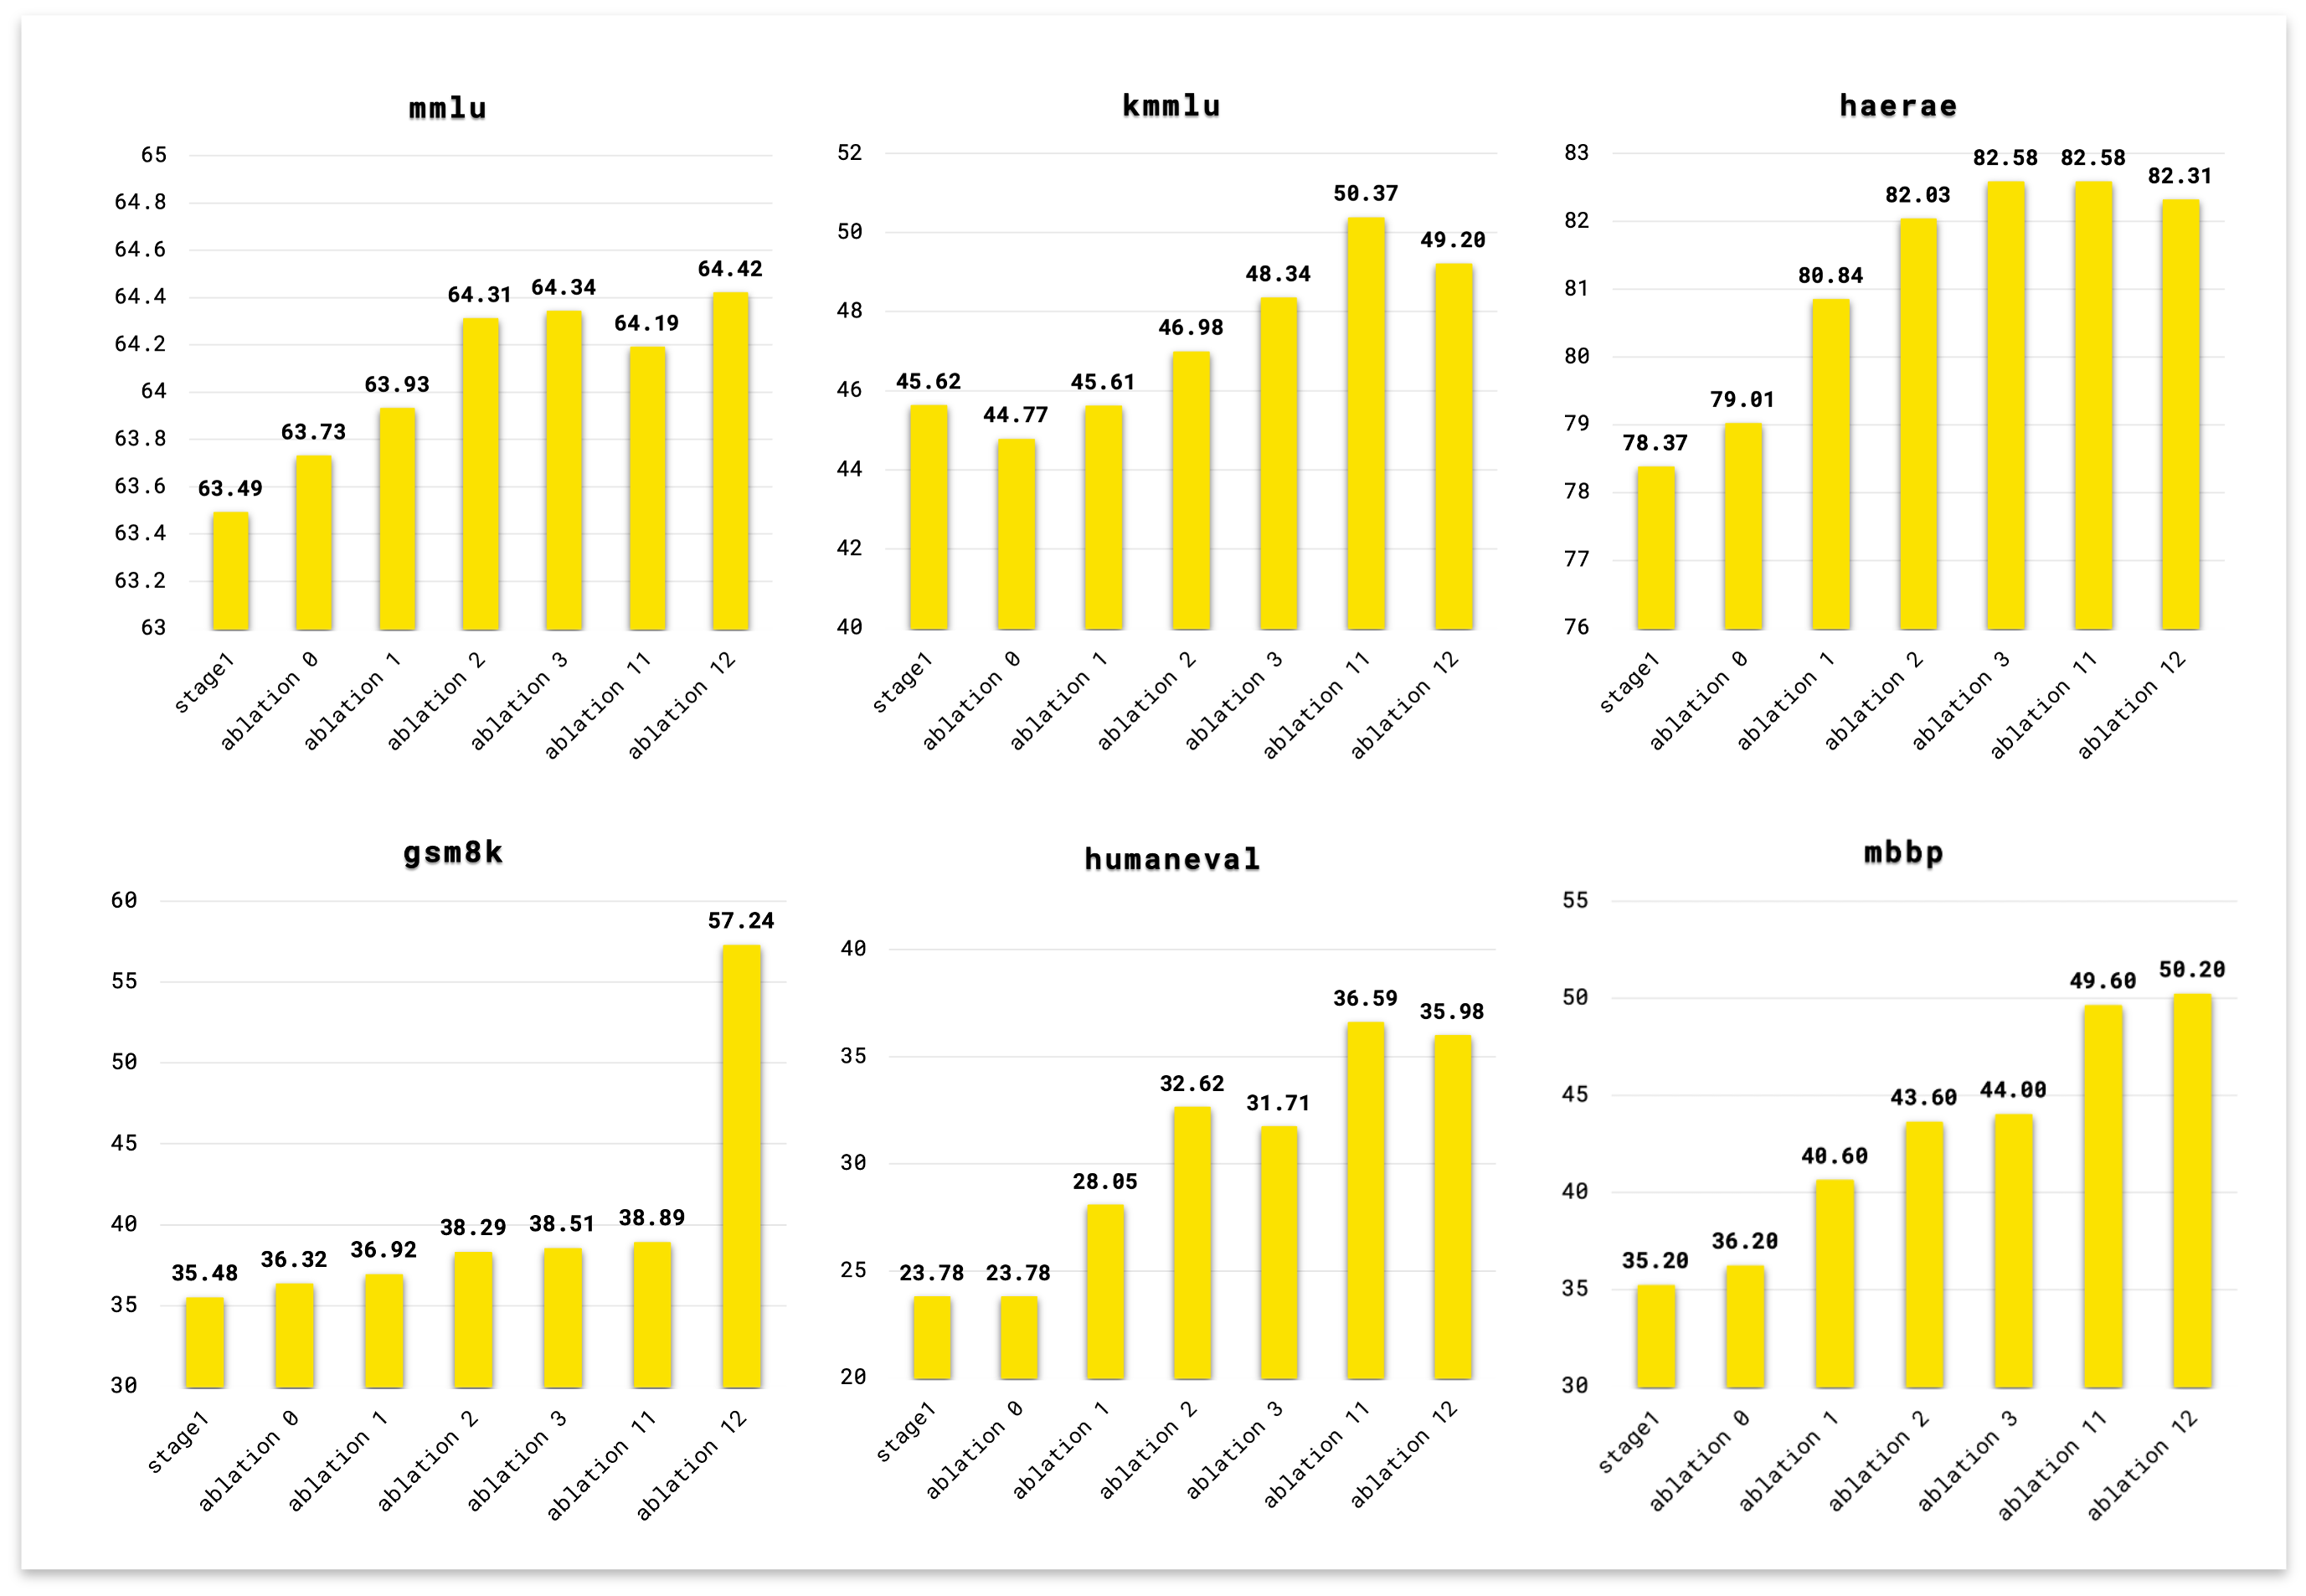
Baseline인 Ablation 0과 비교해서 Ablation 1의 경우, 목적별 Data distribution을 고정하고 각 Data의 Quality를 올렸을 때, 벤치마크의 점수 평균이 47.30에서 49.33으로 개선되는 것을 확인하였습니다. 대부분의 벤치마크에서 조금씩 개선이 있었지만, 특히 코드 관련 벤치마크인 humaneval과 MBPP의 성능이 크게 증가함을 관찰할 수 있었고, 이는 Stage 2의 코드 데이터 구성을 Stage 1과 다르게 Python 언어 위주로 구성한 것에 기인합니다.
Ablation 2, 3에서는 Ablation 1을 기준으로 Data distribution에서 목적이 Stem, Code인 데이터가 큰 비중을 차지하게 하여, Stem과 Code 데이터를 실제 많이 학습하게 하였습니다. 이 과정에서 벤치마크의 점수 평균이 Ablation 1의 점수였던 49.33에서 Ablation 2에서는 51.31, Ablation 3에서는 51.58로 개선됨을 확인할 수 있었고, 수학 관련 벤치마크인 gsm8k에서는 성능 향상이 미미하였지만, 그 외에 모든 벤치마크에서 성능이 크게 증가하였습니다.
Ablation 11에서는 Ablation 2, 3으로 실험하는 과정에서 적절한 Data distribution을 찾았다고 판단하여, Learning rate를 크게 사용하여 학습하였습니다. 이 과정에서 벤치마크의 점수 평균이 Ablation 3의 점수인 51.58에서 53.70으로 크게 증가하였고, 특히 kmmlu의 점수는 50점을 넘기도 했습니다.
Ablation 12에서는 Ablation 11 기준으로 목적이 Code, Stem에 해당하는 SFT 데이터셋을 추가하여 학습하였고, 수학 관련 벤치마크인 gsm8k의 성능이 크게 증가하여 Ablation 11의 점수인 53.70에서 56.56으로 크게 증가하였습니다.
마지막으로 성능을 최대한으로 끌어내기 위해 비교실험을 통해 Stage 2로 선정한 Ablation 12의 데이터와 Data distribution을 기준으로, 6B Token을 Learning rate annealing을 적용하여 학습하고, 이 과정에서 얻은 Checkpoint를 Average 하였습니다. 이 과정으로 Ablation 11의 점수인 56.56에서 57.52로 소폭 성능이 향상했습니다.
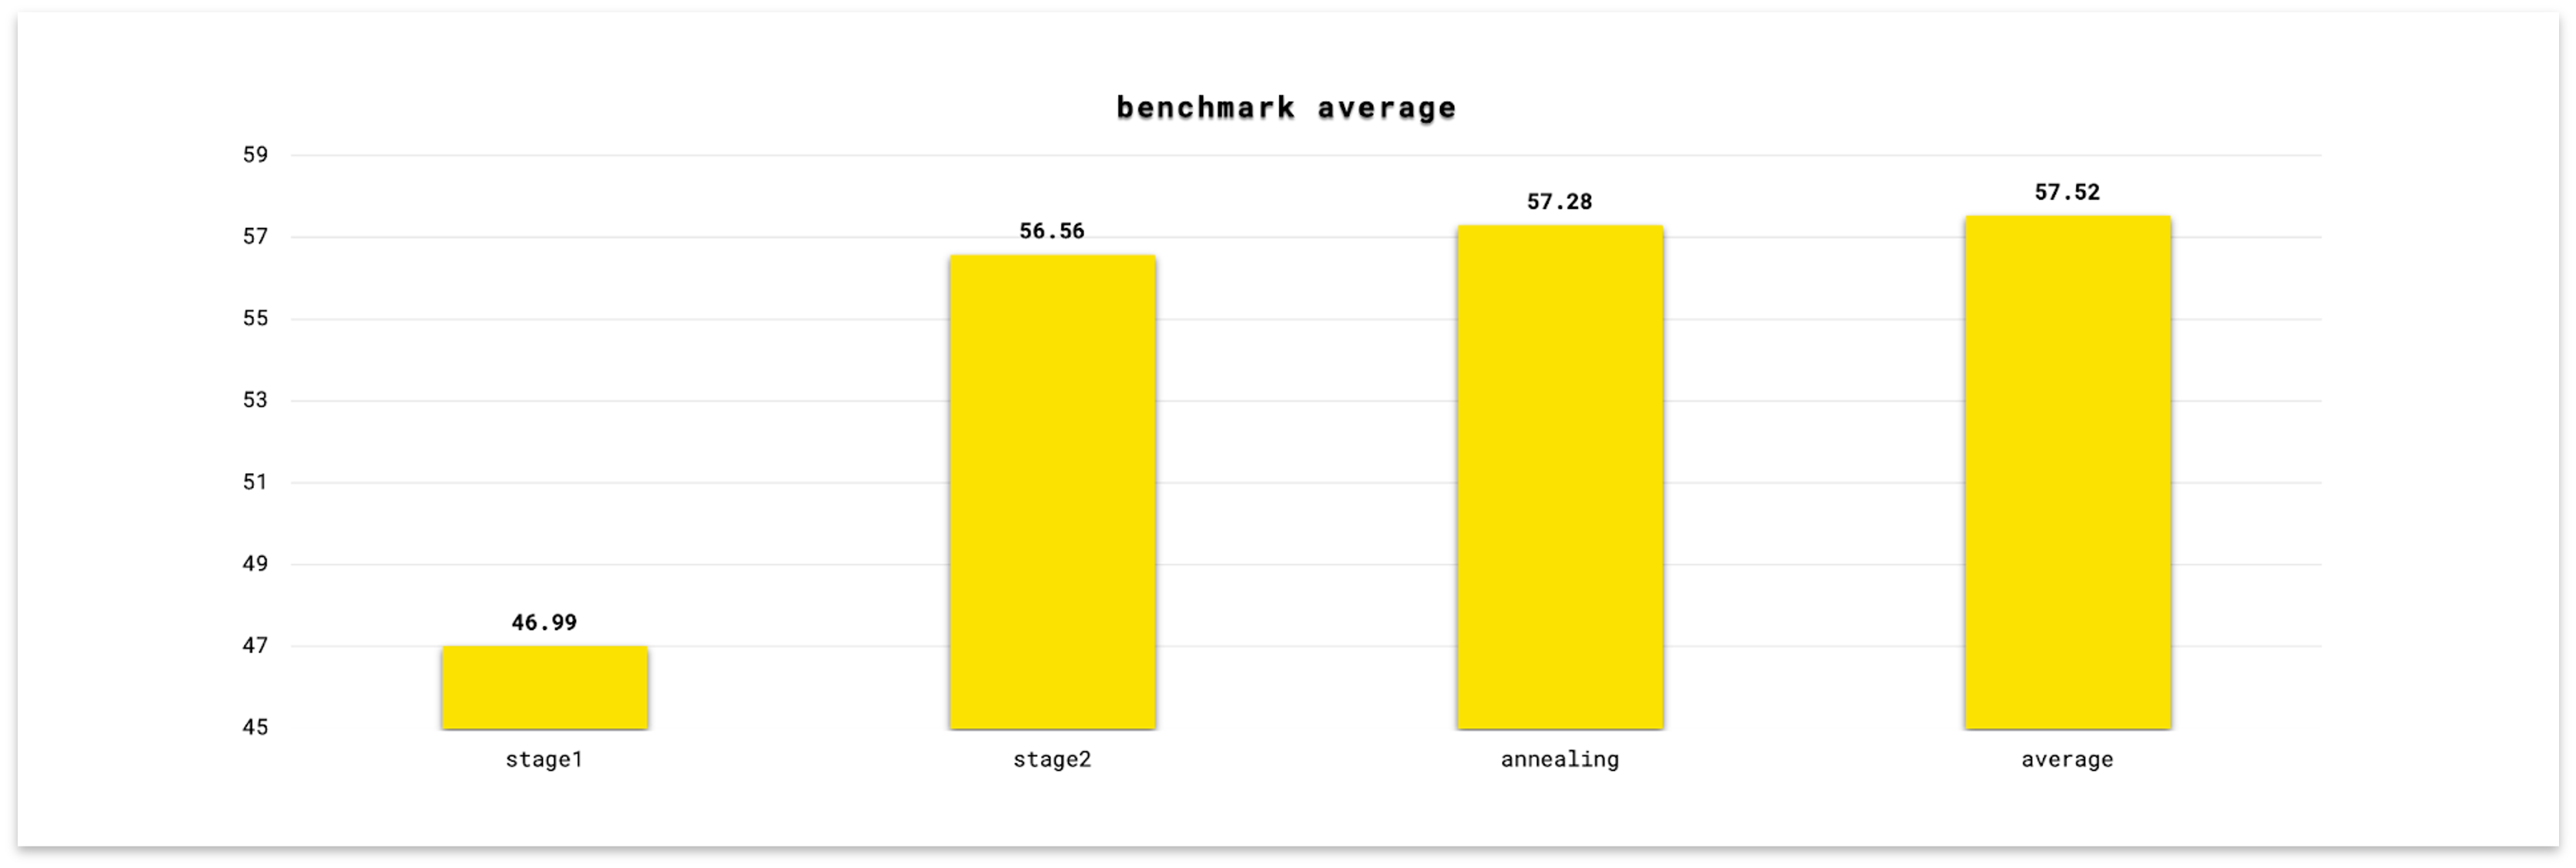
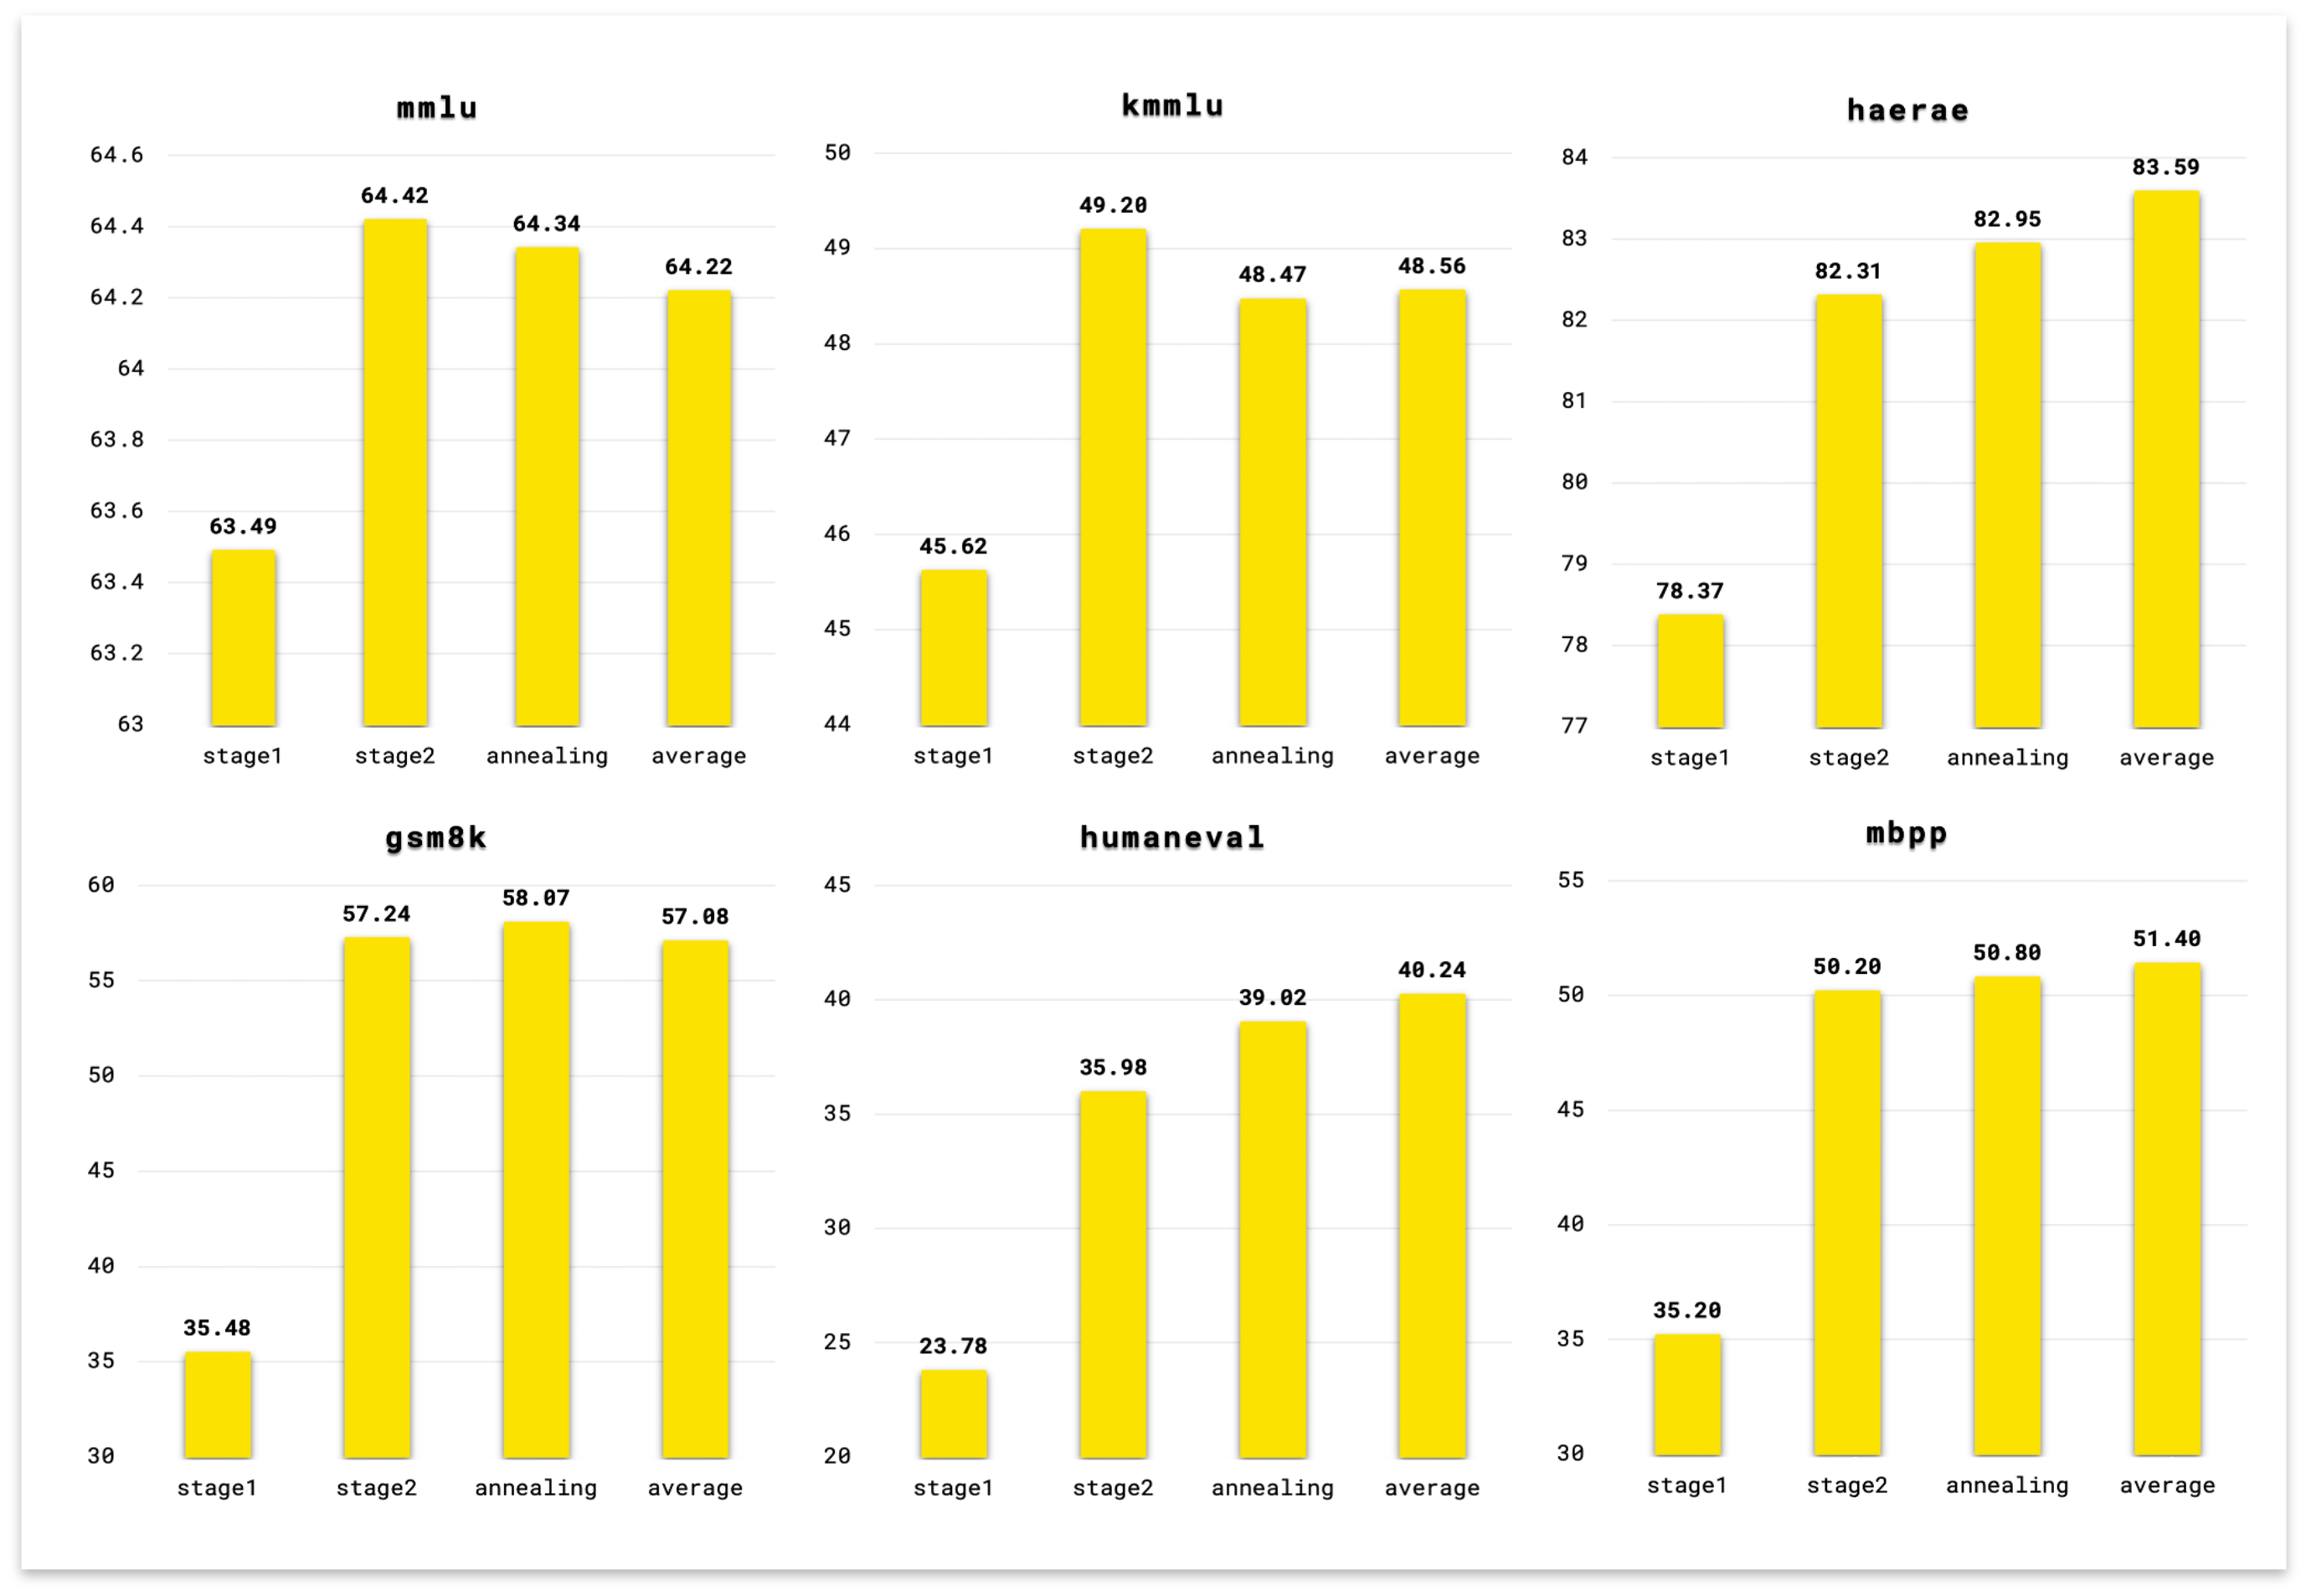
결론적으로 Two staged pre-training과 Ablation을 통해서, llama-3.1-8b가 학습한 Token 대비 훨씬 적은 3T가량의 Token만으로 더 좋은 성능을 Pre-training 단계에서 달성하였습니다.
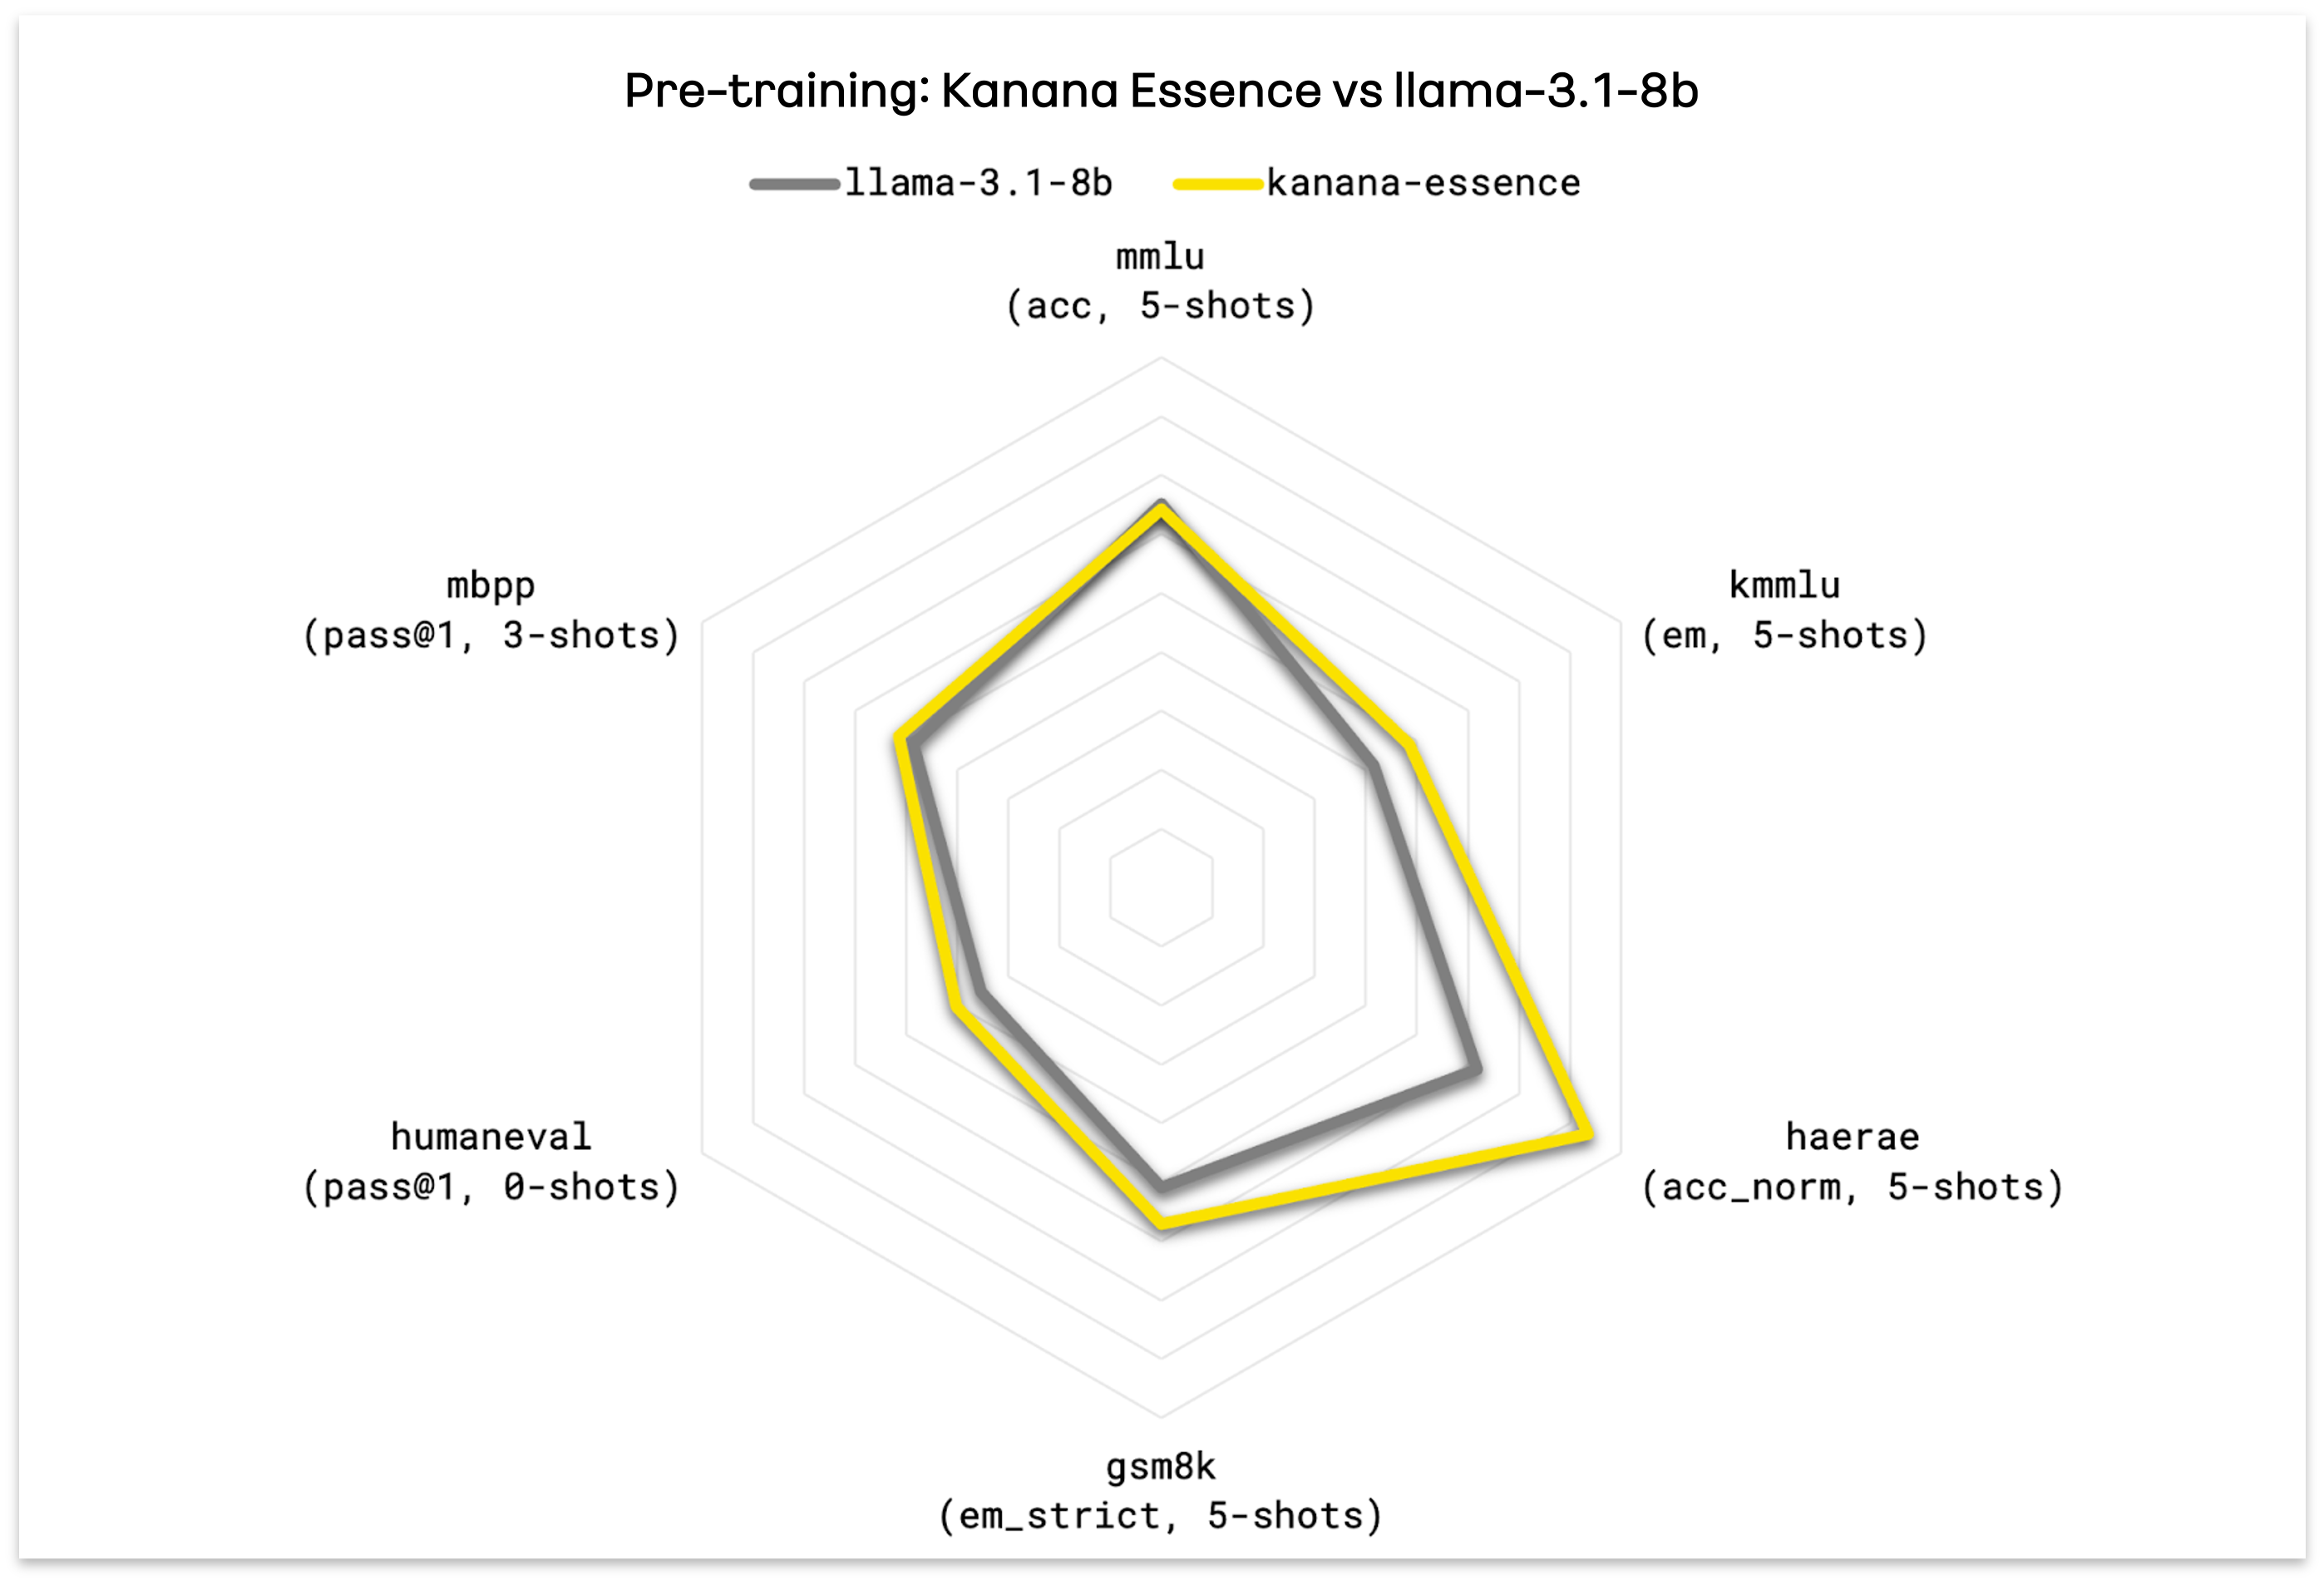
llama-3.1-8b뿐만 아니라 비슷한 크기의 오픈소스 LLM인 gemma-2-9b, qwen2-7b 등과 비교해도 한국어 관련 벤치마크인 kmmlu와 haerae에서는 Kanana Essence가 다른 모델 대비 좋음을 알 수 있습니다.
| mmlu (acc, 5-shots) | kmmlu (em, 5-shots) | haerae (acc_norm, 5-shots) | gsm8k (em_strict, 5-shots) | humaneval (pass@1, 0-shots) | MBPP (pass@1, 3-shots) | average | |
|---|---|---|---|---|---|---|---|
| Kanan Essence | 64.22 | 48.56 | 83.59 | 57.08 | 40.24 | 51.40 | 57.52 |
| llama-3.1-8b | 65.18 | 41.46 | 61.78 | 50.87 | 35.37 | 48.60 | 50.54 |
| gemma-2-9b | 70.34 | 48.52 | 66.18 | 68.16 | 37.20 | 53.60 | 57.33 |
| qwen2-7b | 70.41 | 49.26 | 61.50 | 77.71 | 49.39 | 53.60 | 60.31 |
| mistral-7b-v0.3 | 62.21 | 37.40 | 49.40 | 36.32 | 25.61 | 37.40 | 41.39 |
2. Kanana Nano 학습
Kanana Nano 모델은 모바일 디바이스에서도 활용 가능한 초경량 모델입니다. Pruning & distillation 방식으로 Kanana Nano를 학습하기에 앞서 Baseline으로서 비교 대상이 필요하였고, 이를 위해서 Kanana Essence에서 사용한 레시피를 활용하여 From scratch로 학습을 먼저 수행했습니다. Kanana Nano로 염두에 둔 Arhitecture는 역시 llama와 유사한 구조로 Kanana Essence와 비교해 보면 아래의 표와 같습니다.
| Kanana Essence | Kanana Nano | |
|---|---|---|
| Tie embedding | False | False |
| Context length | 8k | 8k |
| Hidden layers | 32 | 32 |
| Attention heads | 32 | 16 |
| Key value heads | 8 | 8 |
학습된 모델을 비슷한 크기의 llama-3.2-3b와 비교했을 때, 아래의 표와 같이 상회하는 성능을 보여 학습에 사용한 레시피가 적절하게 최적화되어 있음을 다시 한번 확인할 수 있었습니다.
| mmlu (acc, 5-shots) | kmmlu (em, 5-shots) | haerae (acc_norm, 5-shots) | gsm8k (em_strict, 5-shots) | humaneval (pass@1, 0-shots) | MBPP (pass@1, 3-shots) | average | |
|---|---|---|---|---|---|---|---|
| from scratch | 56.00 | 40.36 | 75.8 | 43.97 | 32.32 | 44.40 | 48.81 |
| llama-3.2-3b | 56.40 | 35.99 | 47.67 | 25.61 | 35.37 | 39.00 | 38.67 |
Pruning & distillation
“Compact Language Models via Pruning and Knowledge Distillation” 연구에서는 Pruning & distillation을 제안하면서 이 기법을 사용할 때 참고할 수 있는 Best practice를 아래의 이미지와 같이 제시하고 있습니다.
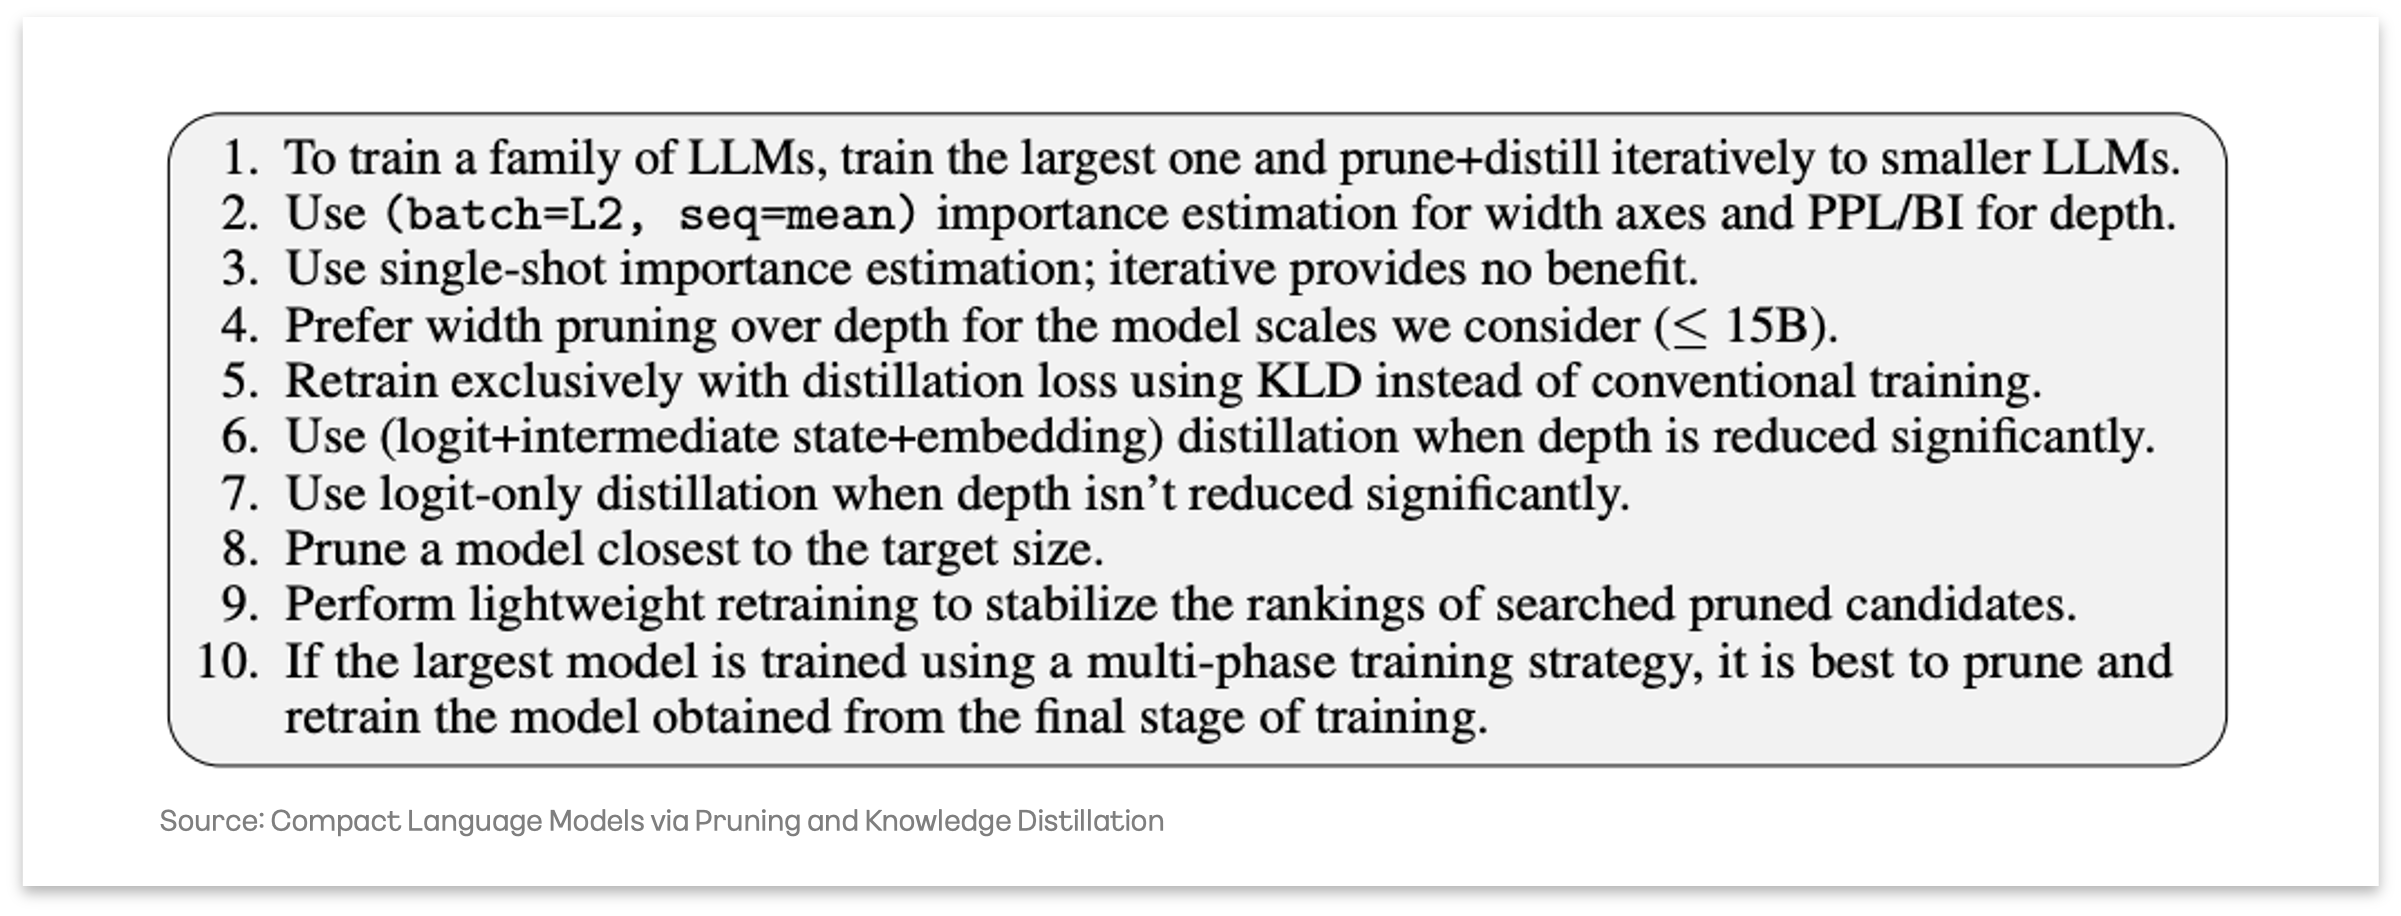
저희는 실제로 이 기법을 활용하는 데 있어 Best practice에 따라 Pruning & distillation을 수행하였습니다. Width pruning을 사용하고, Teacher의 Logit만으로 Distillation 학습을 수행했으며, Two staged pre-training 중 Stage 2에 활용한 데이터만 사용하였습니다. 특히 유의미했던 것은 1번과 8번 항목으로 Kanana Essence에서 바로 Kanana Nano로 Pruning & distillation을 시도했을 때, Kanana Essence에 Pruning을 적용하여 Kanana Nano를 초기화할 경우 학습에 실패했습니다.
결론적으로 Best practice의 1번과 8번 항목을 참고하여 Kanana Nano보다는 크지만, Kanana Essence보다는 작은 크기의 중간 모델을 Kanana Essence로부터 Pruning & distillation을 적용해서 학습했습니다. 해당 모델로부터 Pruning을 하고, Kanana Essence로부터 Distillation 학습을 수행해서 Kanana Nano 학습에 성공하였습니다. 이 과정을 통해서 학습한 Kanana Nano의 성능은 아래와 같습니다.
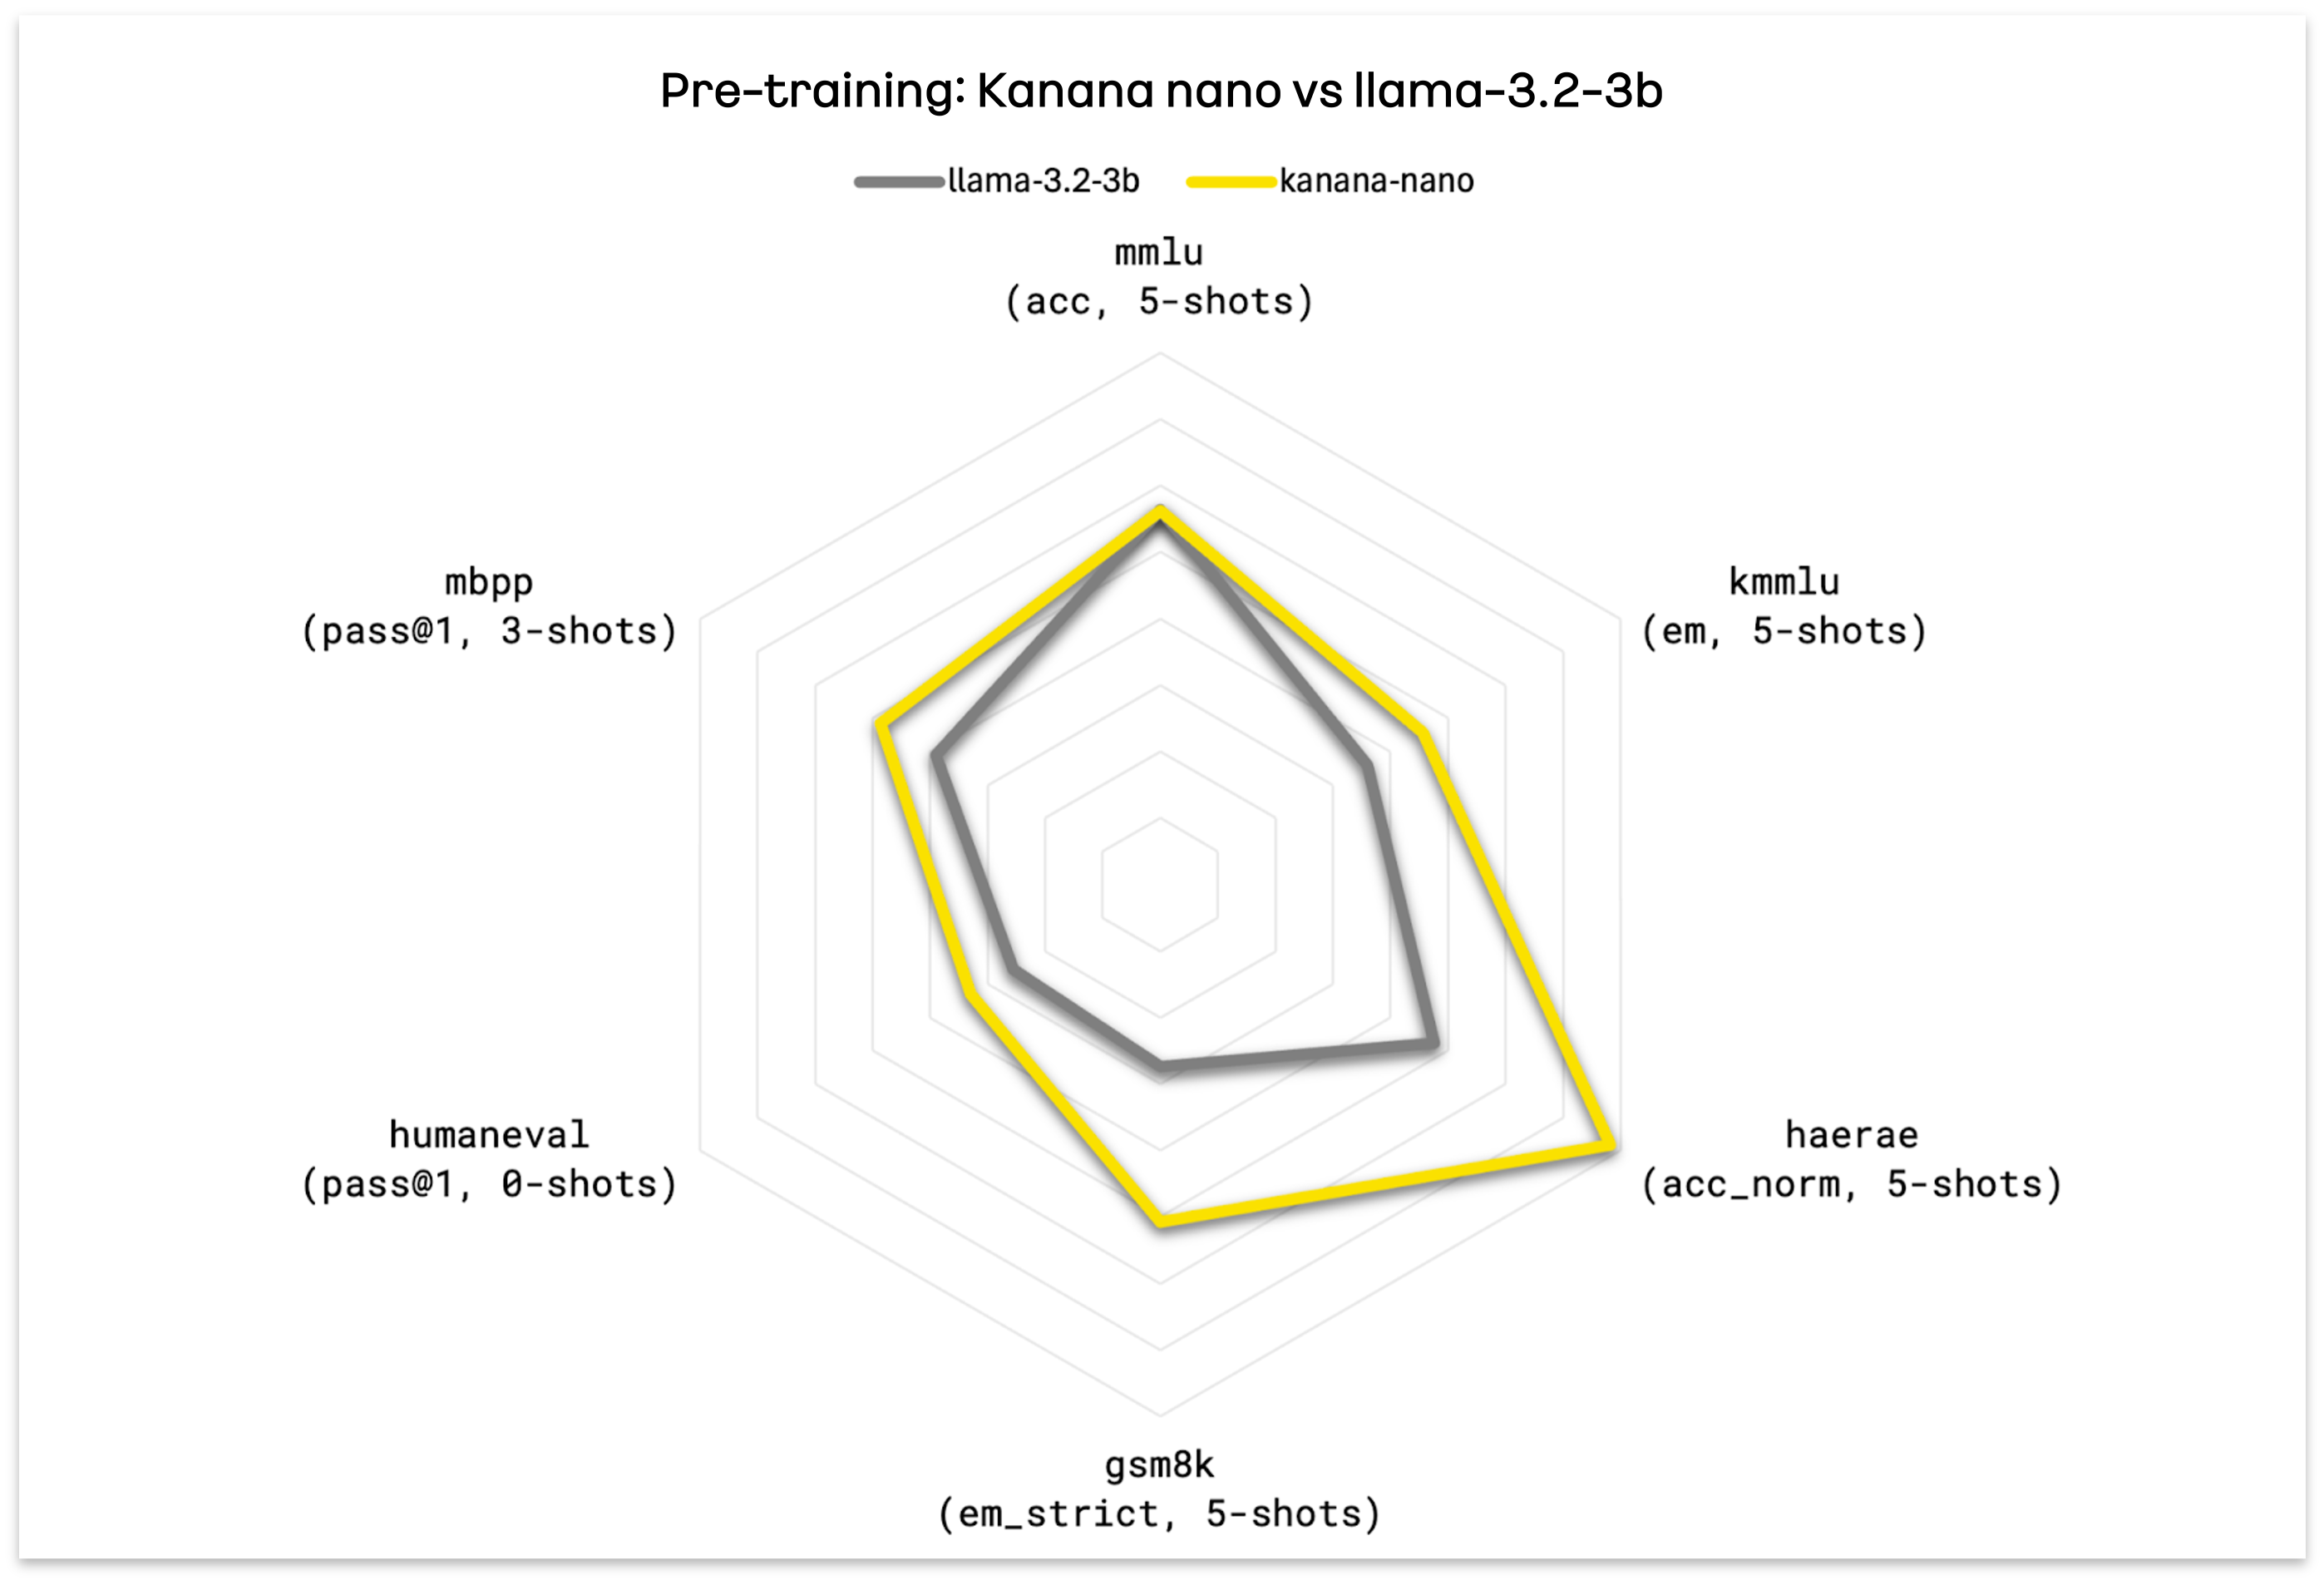
| mmlu (acc, 5-shots) | kmmlu (em, 5-shots) | haerae (acc_norm, 5-shots) | gsm8k (em_strict, 5-shots) | humaneval (pass@1, 0-shots) | MBPP (pass@1, 3-shots) | average | |
|---|---|---|---|---|---|---|---|
| Kanana Nano (Pruning & distillation) | 56.27 | 45.62 | 78.19 | 50.80 | 32.93 | 48.60 | 52.07 |
| From scratch | 56.00 | 40.36 | 75.80 | 43.97 | 32.32 | 44.40 | 48.81 |
| llama-3.2-3b | 56.40 | 35.99 | 47.67 | 25.61 | 35.37 | 39.00 | 38.67 |
Pruning & distillation으로 학습하여 From scratch로 학습 대비, 1/10의 데이터만 사용하고 훨씬 좋은 성능을 확보할 수 있었습니다. 특히 한국어 관련 벤치마크인 kmmlu와 haerae, 수학과 코드 관련 벤치마크인 gsm8k, MBPP 등에서 From scratch 대비 유의미하게 성능이 높았습니다.
비슷한 크기의 오픈소스 모델들과 비교해 봐도 그 성능이 유의미하게 좋음을 아래의 표를 통해서 확인할 수 있습니다.
| mmlu (acc, 5-shots) | kmmlu (em, 5-shots) | haerae (acc_norm, 5-shots) | gsm8k (em_strict, 5-shots) | humaneval (pass@1, 0-shots) | MBPP (pass@1, 3-shots) | average | |
|---|---|---|---|---|---|---|---|
| Kanana Nano | 56.27 | 45.62 | 78.19 | 50.80 | 32.93 | 48.60 | 52.07 |
| llama-3.2-3b | 56.40 | 35.99 | 47.67 | 27.37 | 25.61 | 39.00 | 38.67 |
| gemma-2-2b | 52.89 | 31.32 | 45.55 | 24.72 | 20.12 | 28.20 | 33.80 |
| qwen2-1.5b | 56.10 | 36.90 | 42.25 | 58.91 | 34.15 | 37.60 | 44.32 |
| minitron-4b-base | 58.57 | 34.71 | 47.11 | 25.25 | 25.00 | 34.80 | 37.57 |
Further Work
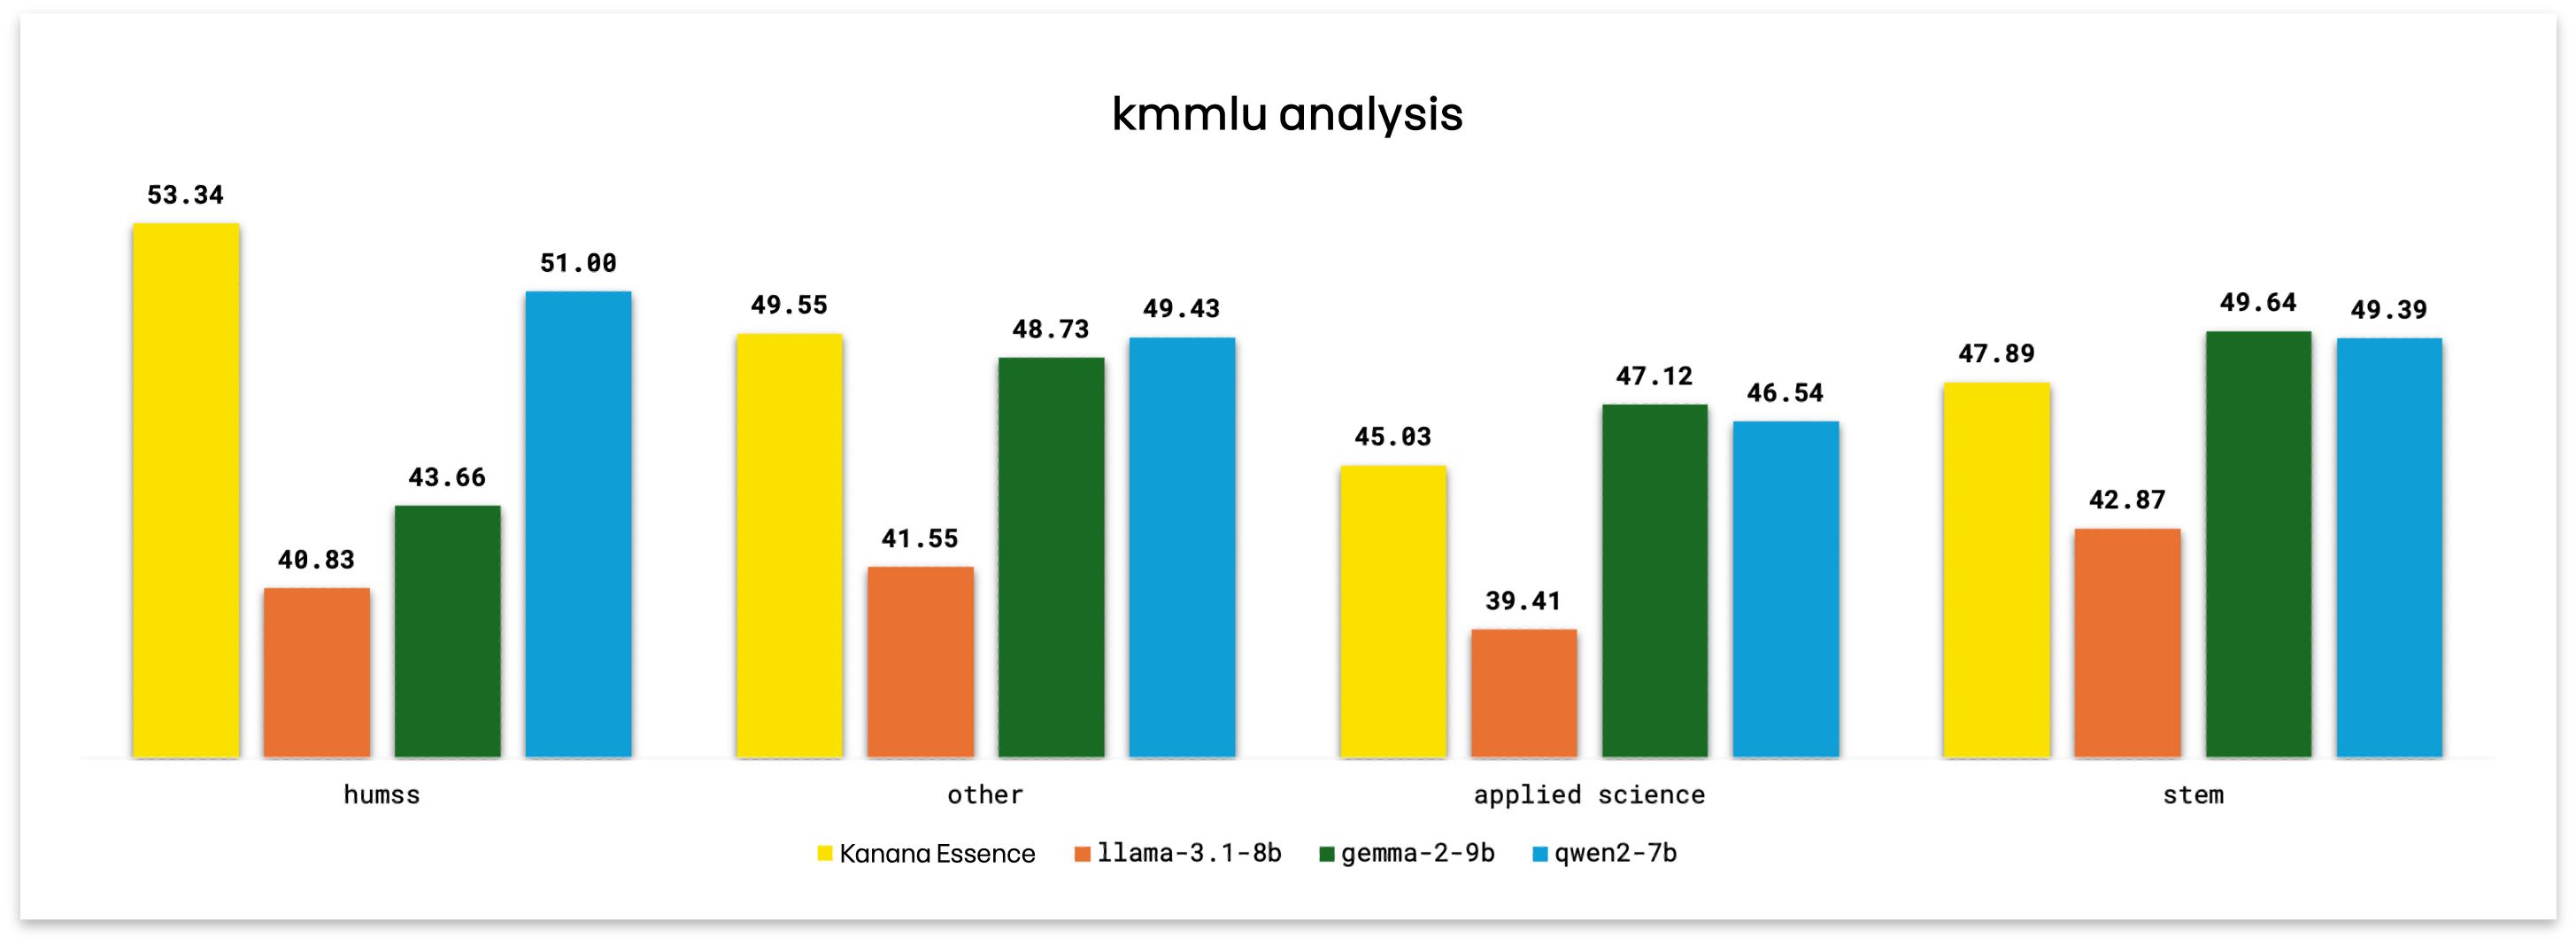
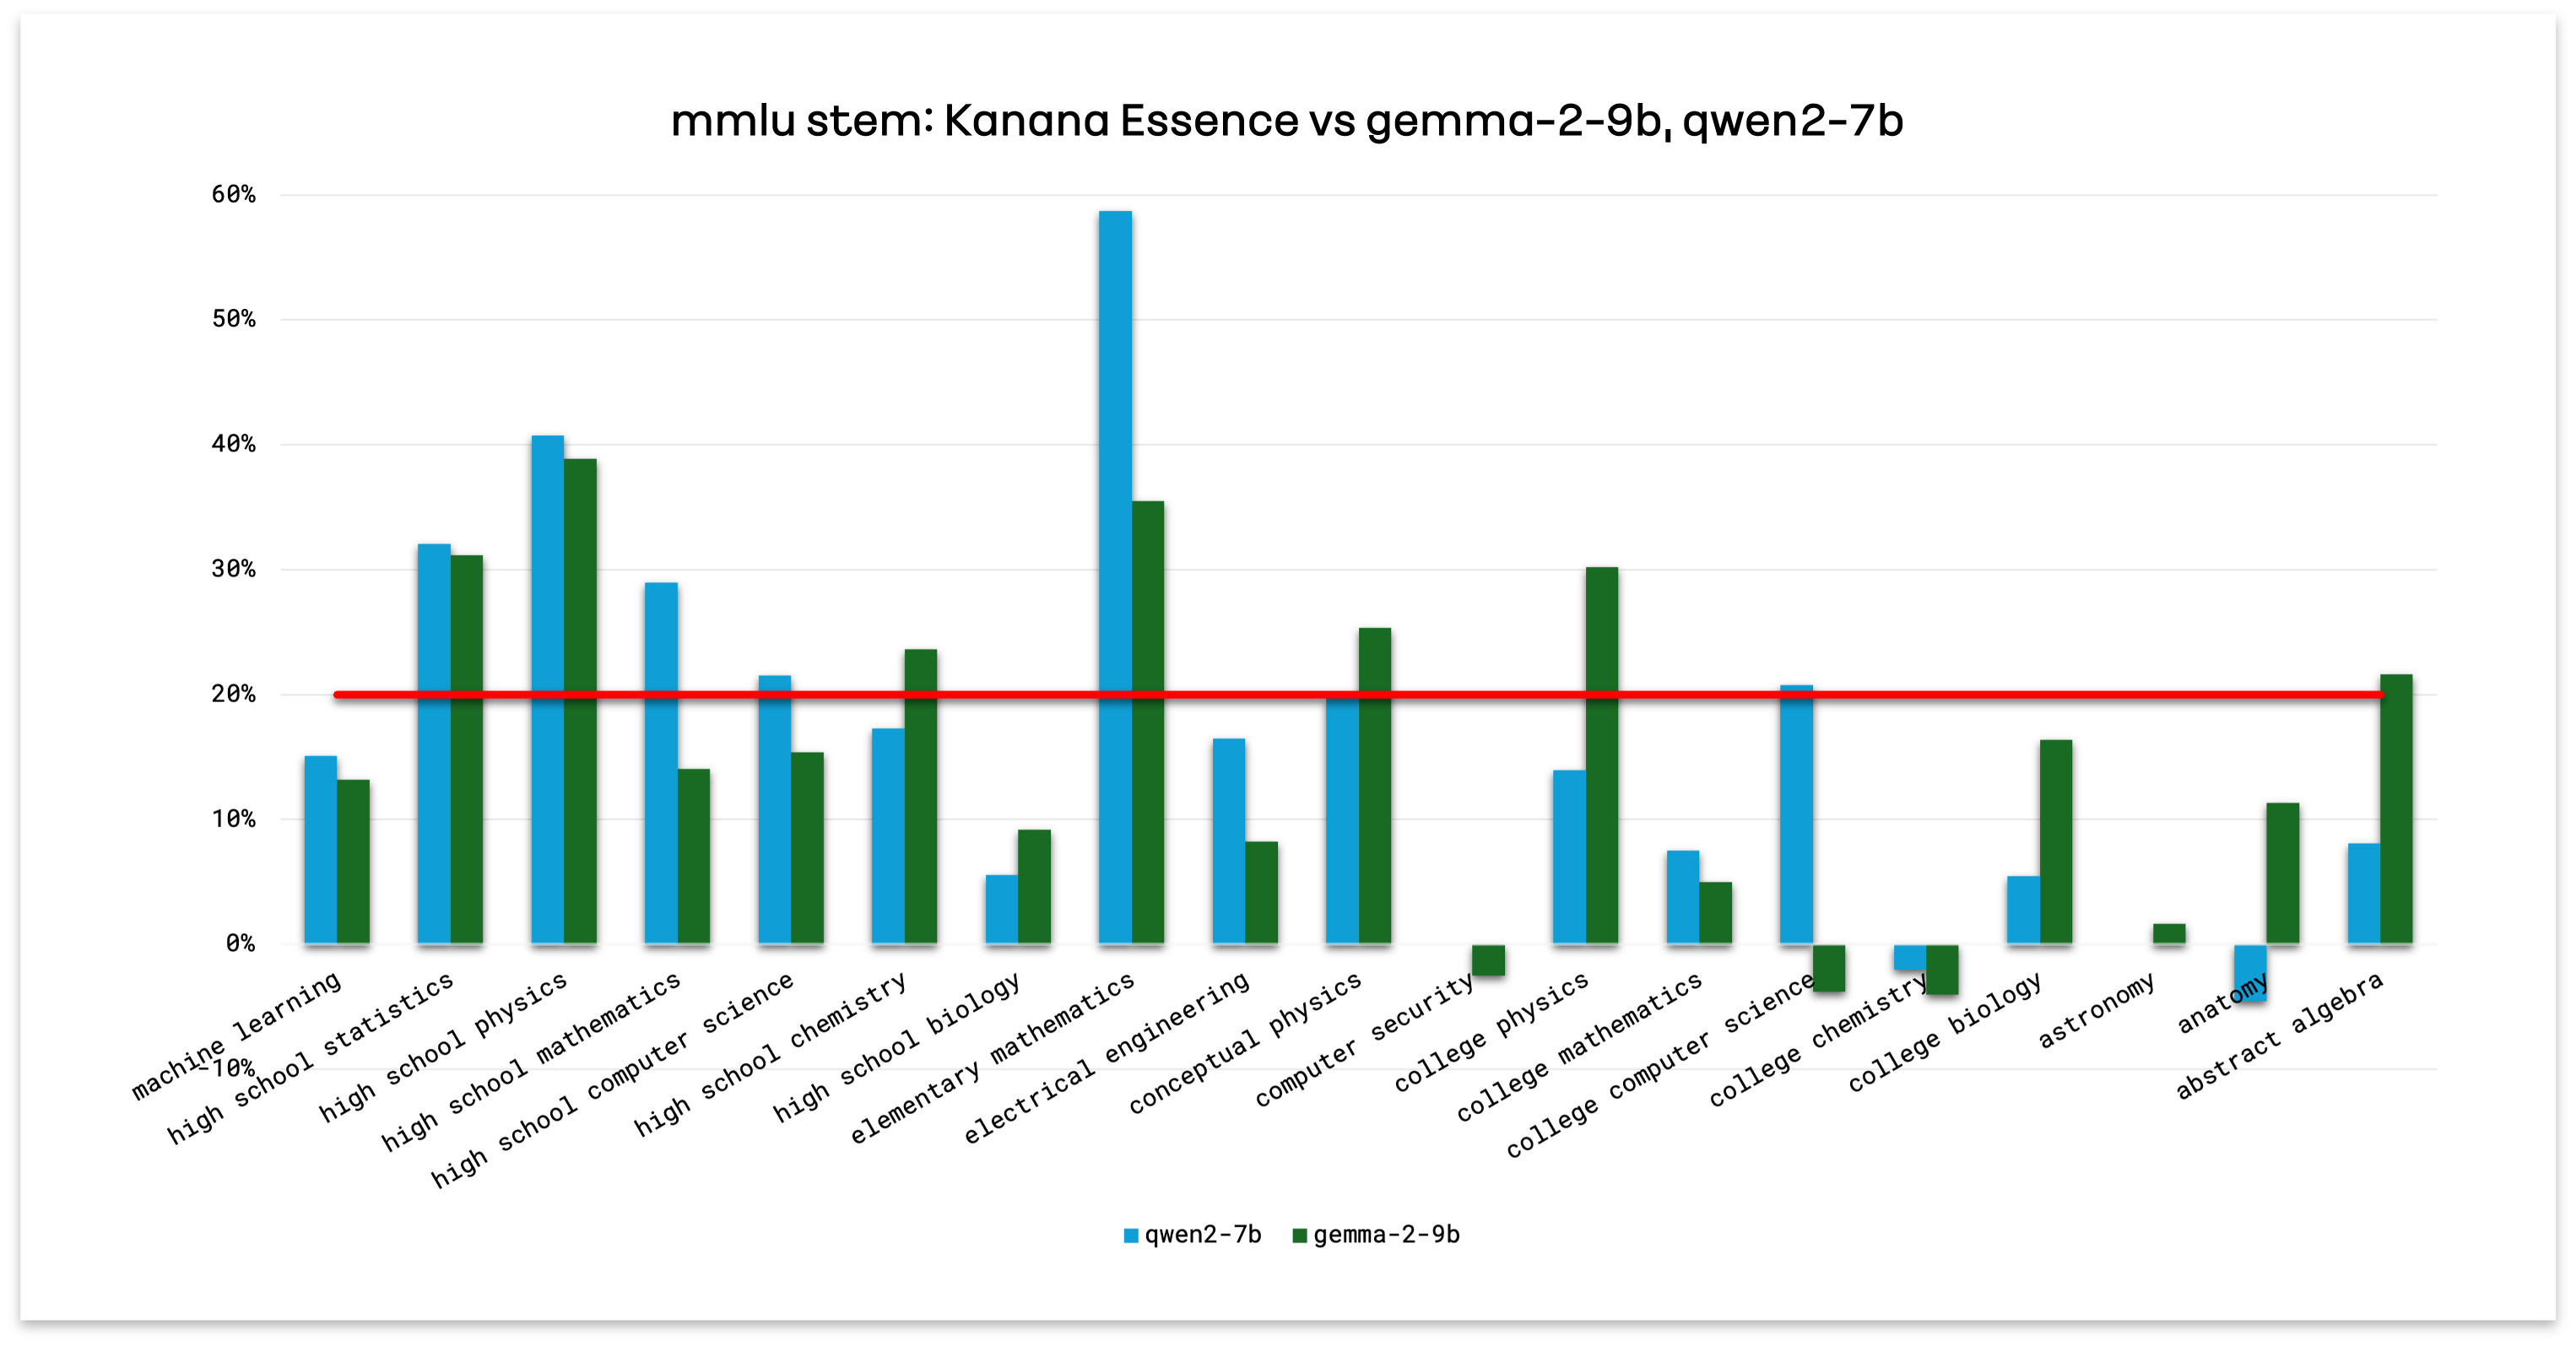
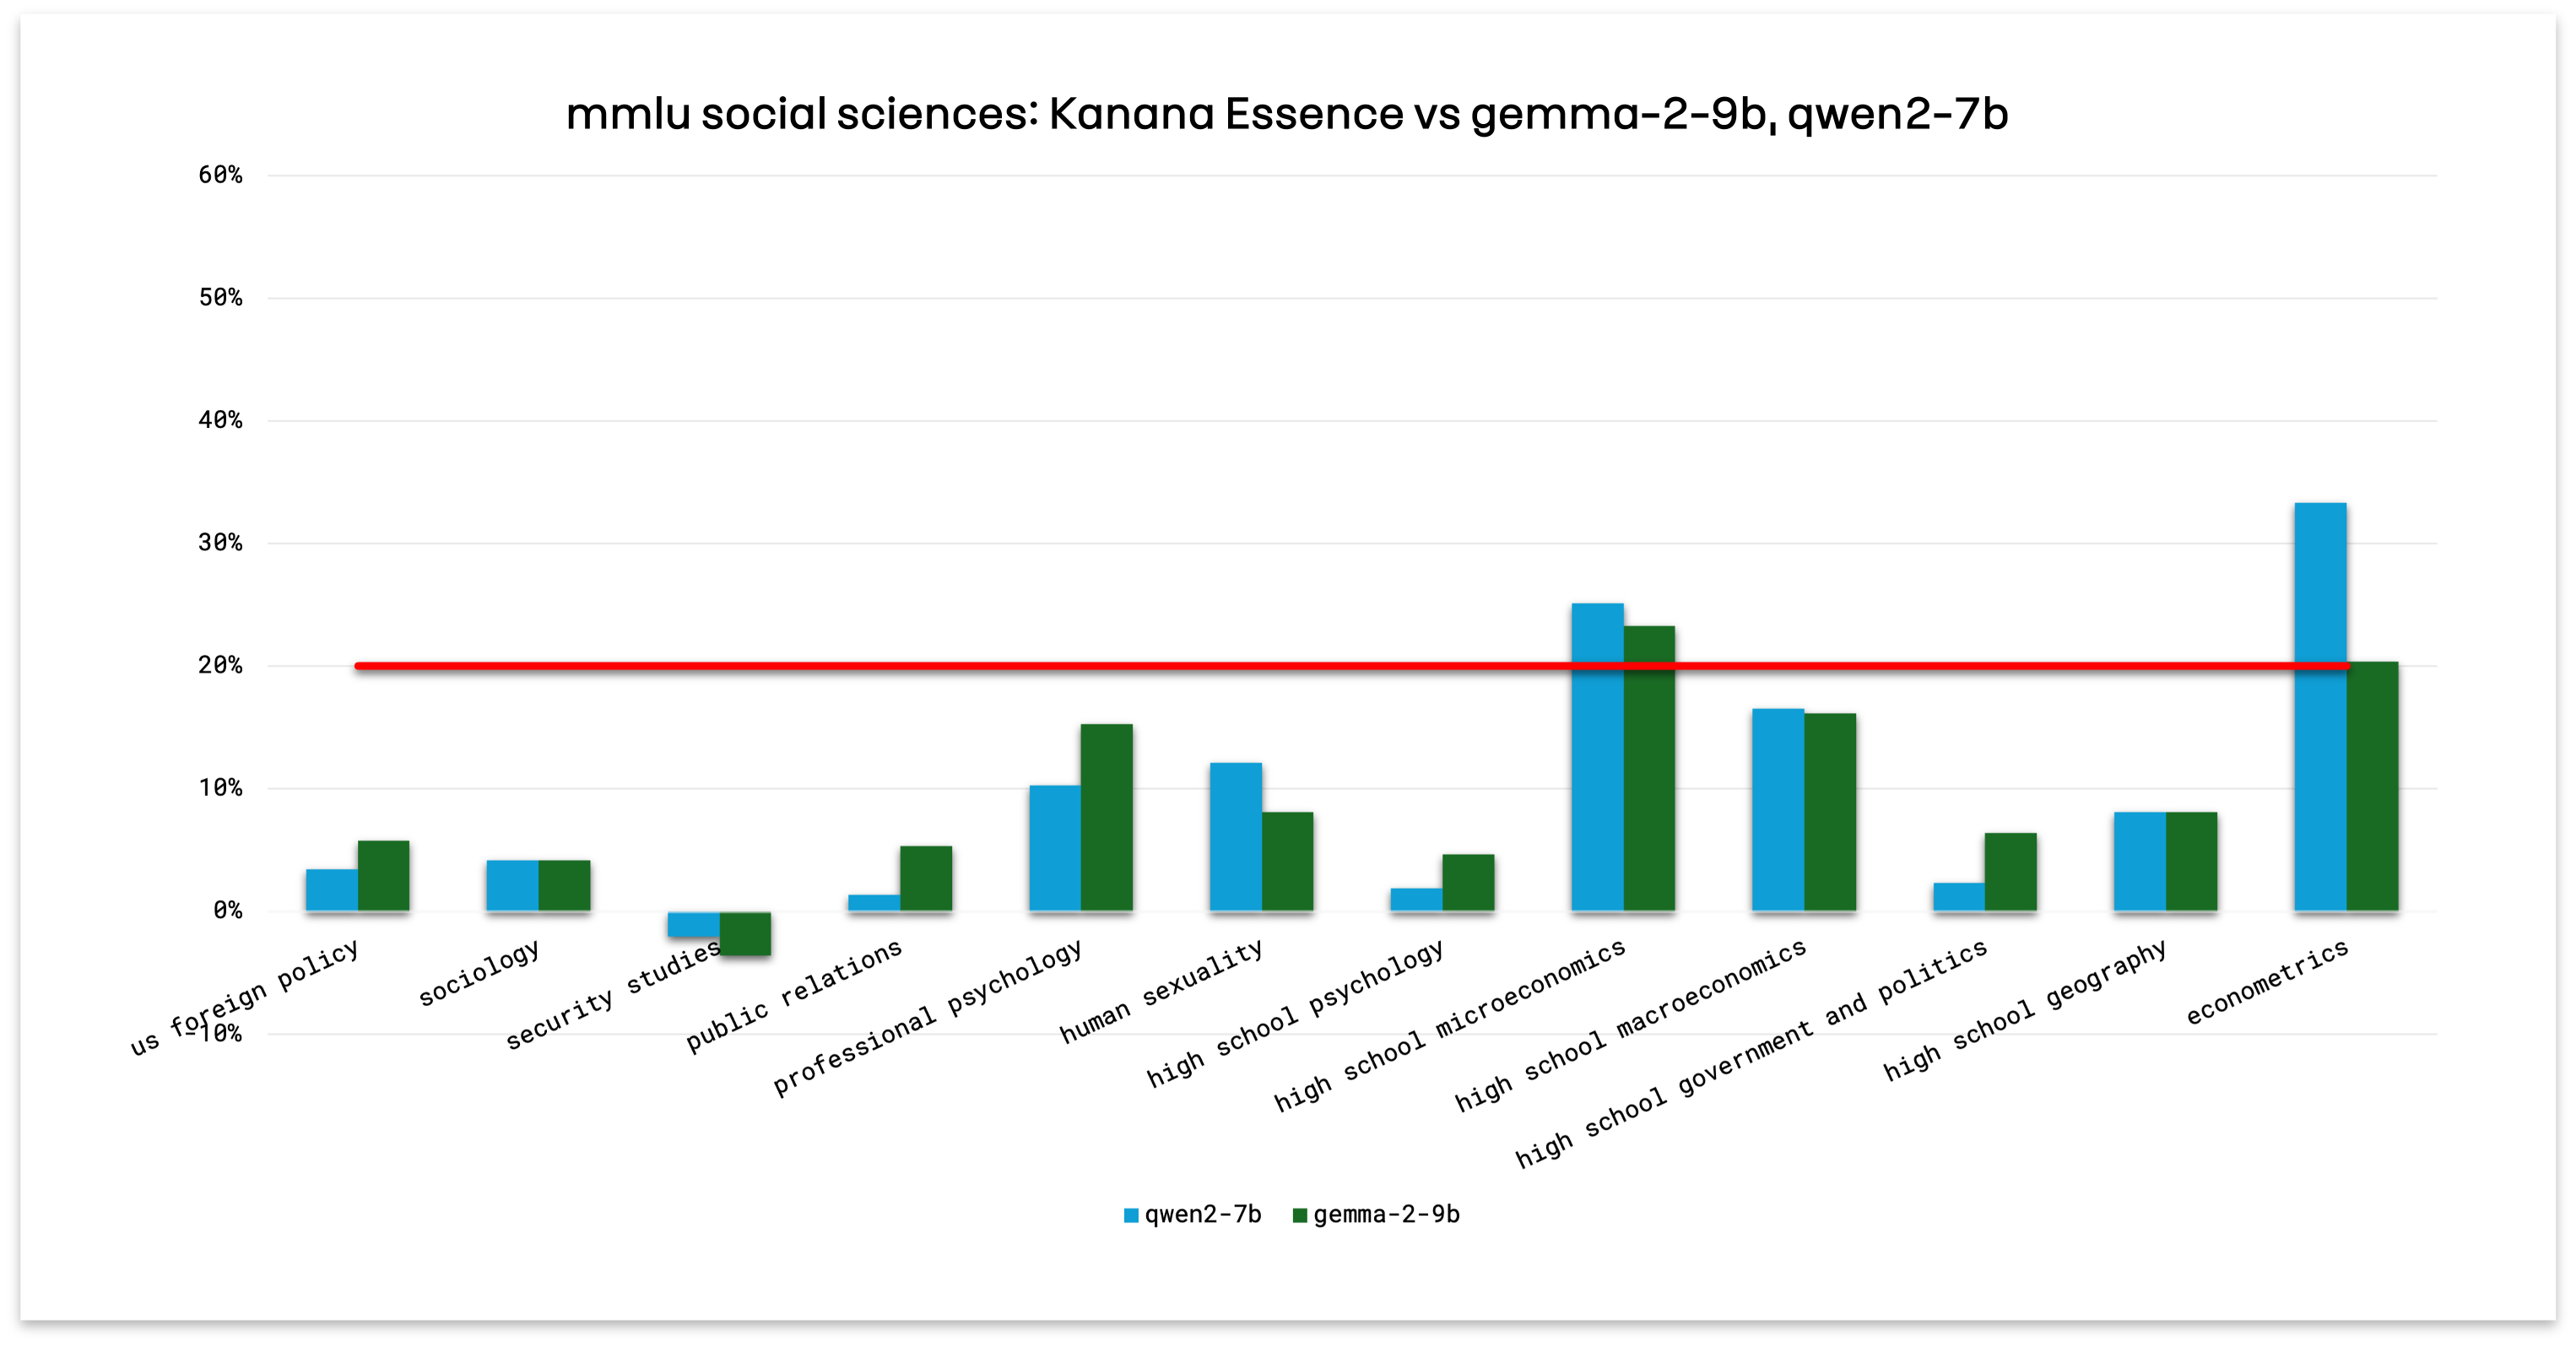
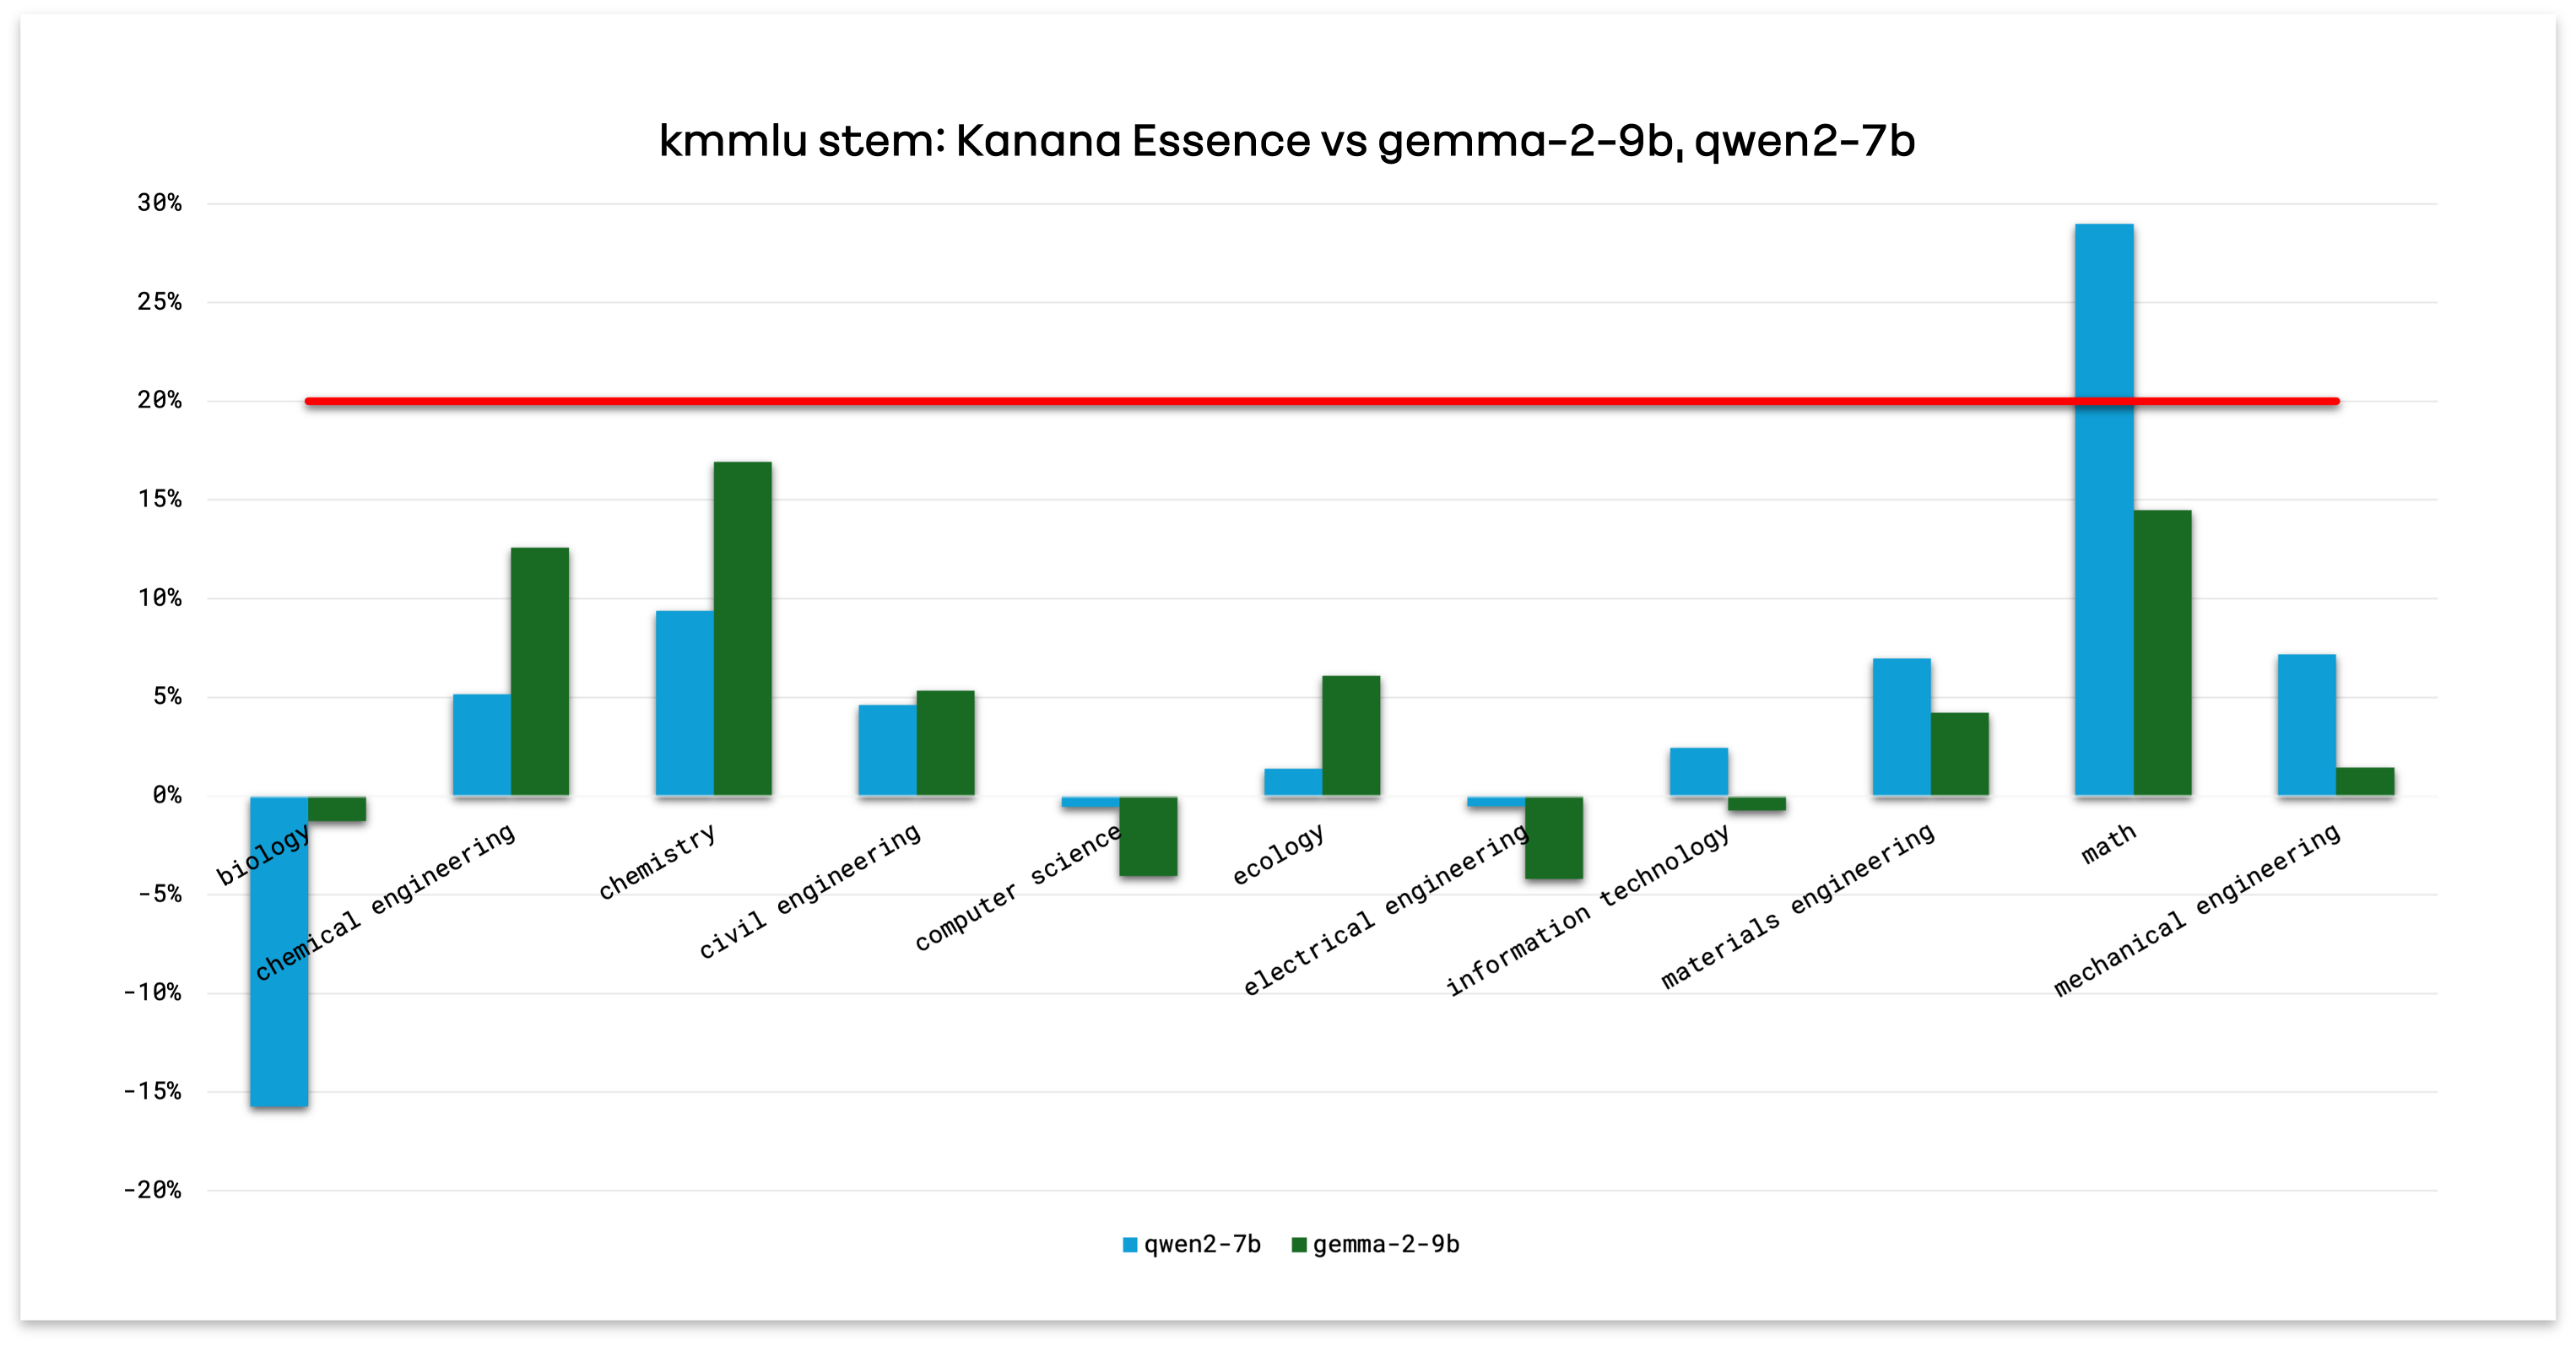
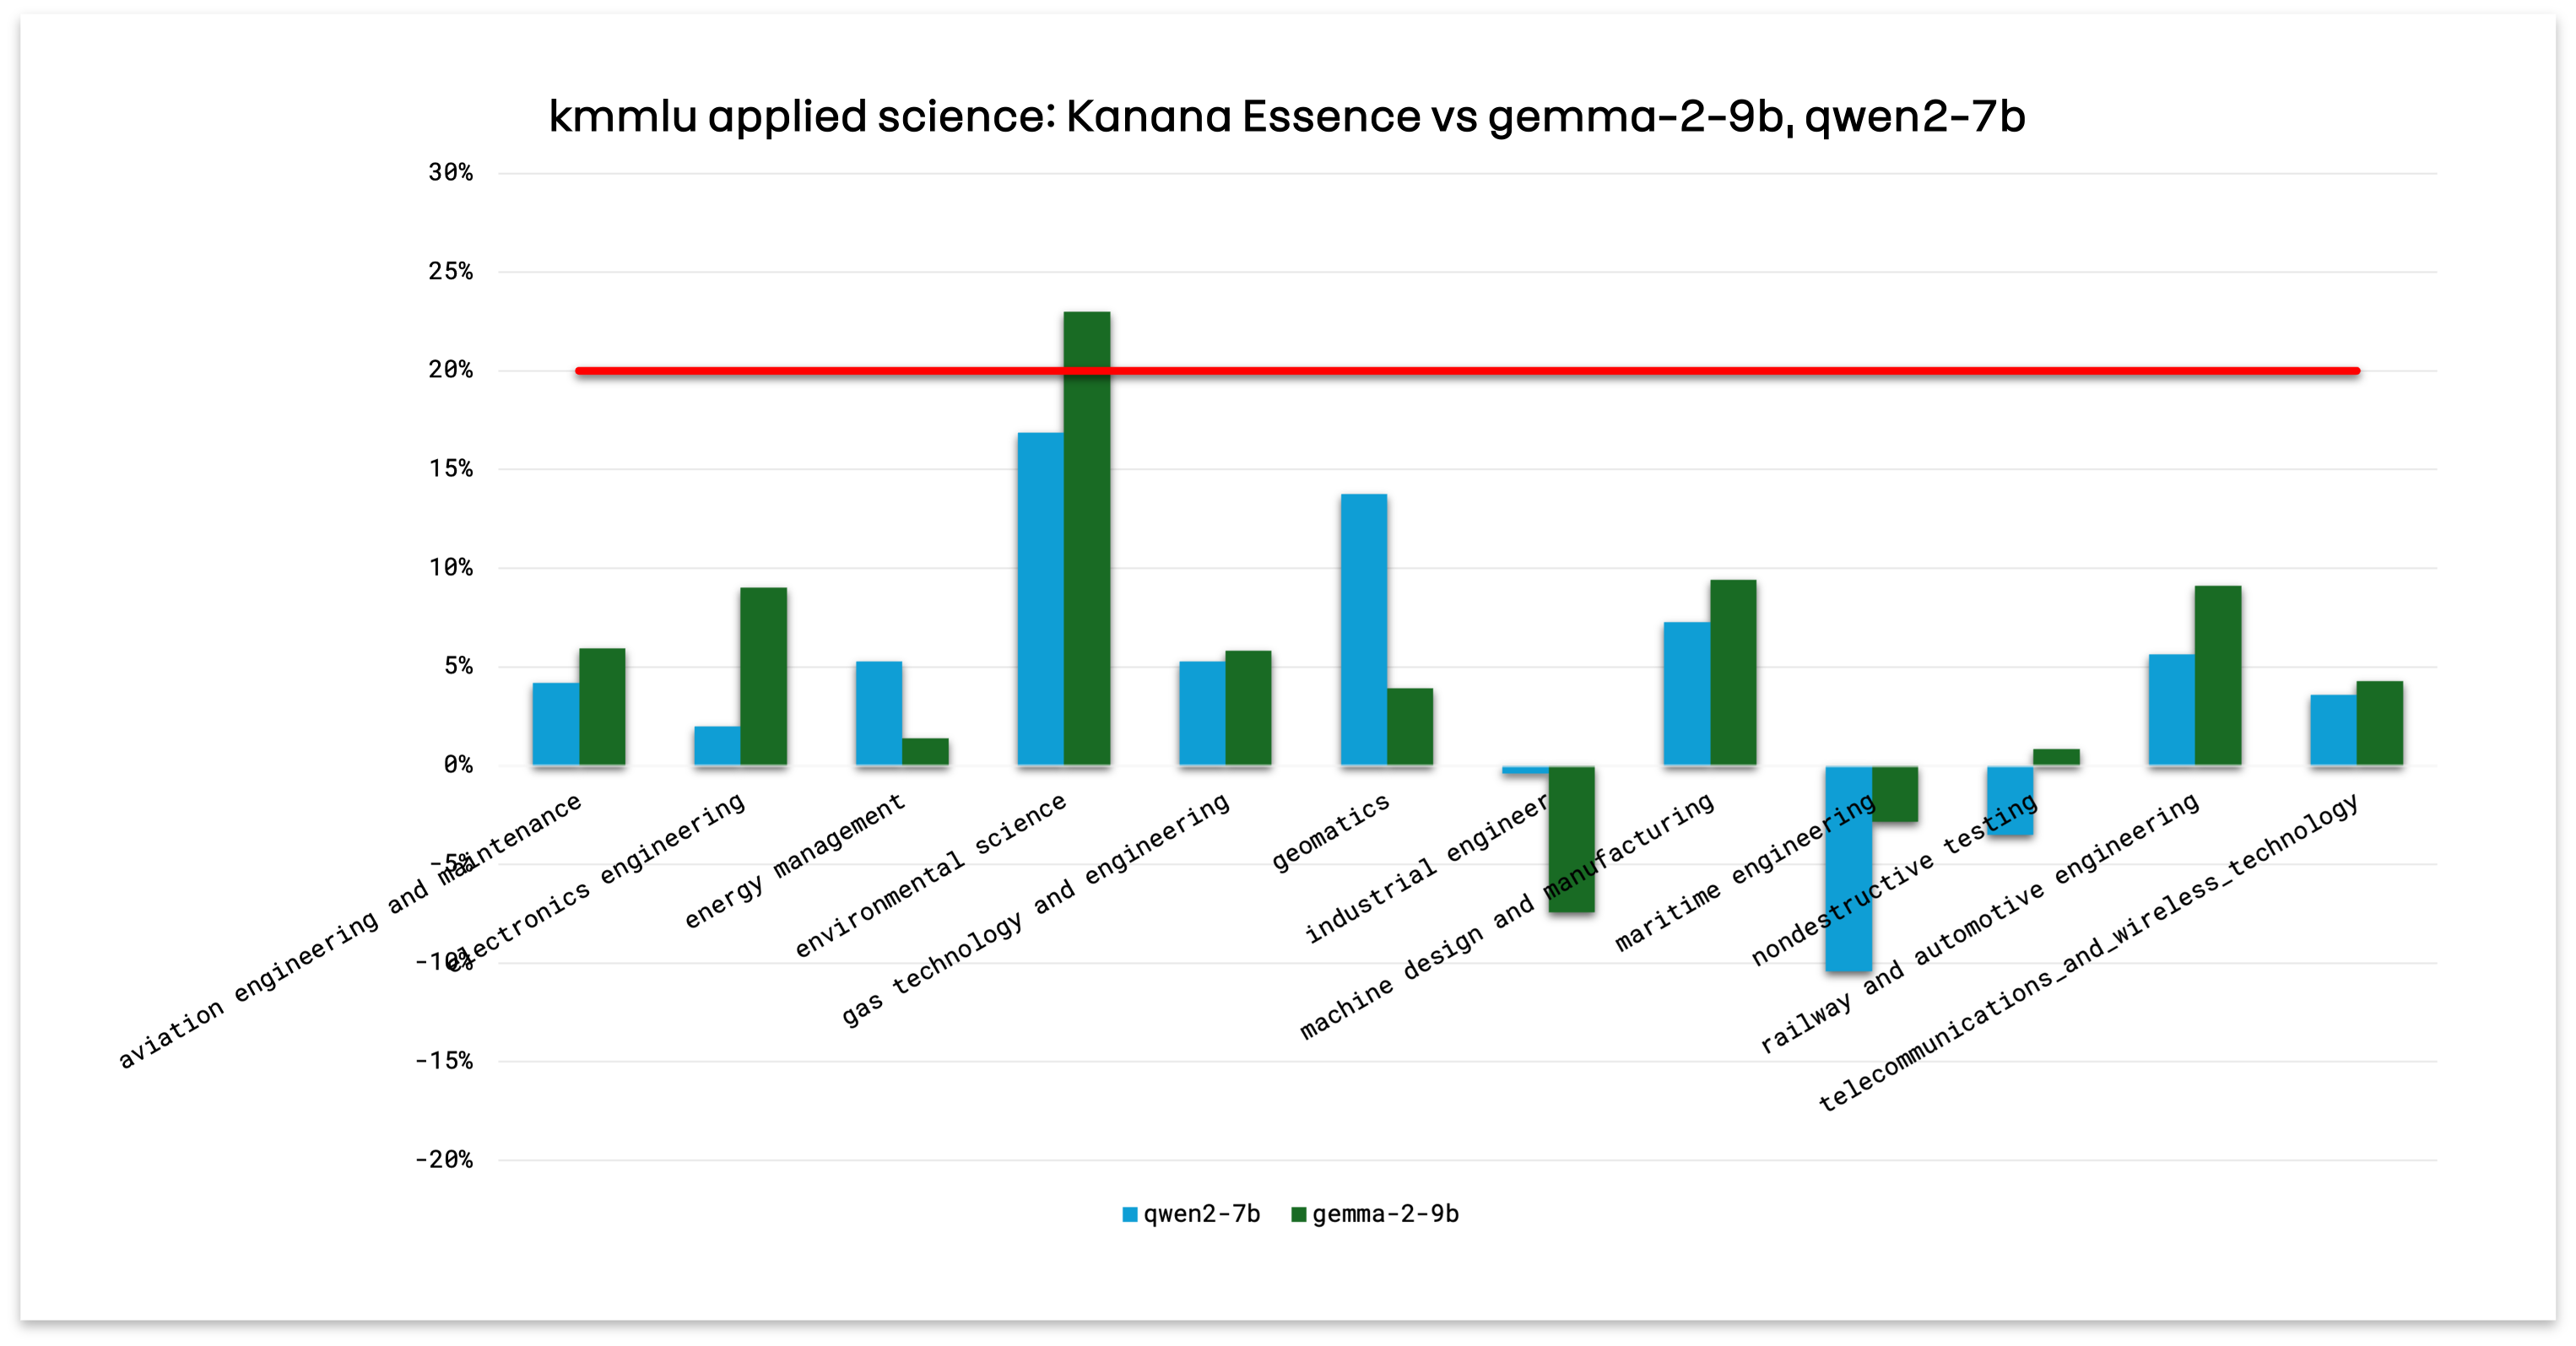
향후 Kanana Essence, Nano의 성능을 개선하기 위해 자체 학습한 LLM의 부족한 점을 파악해야 했습니다. 이를 위해 오픈소스 모델 중 llama-3.1-8b를 제외하고, 비슷한 크기의 다른 모델인 gemma-2-9b, qwen2-7b 모델과 영어 및 한국어 관련 벤치마크 중 mmlu, kmmlu 벤치마크의 영역별 성능을 비교했습니다. mmlu에서는 Kanana Essence가 Stem과 Social sciences 영역에서 두 모델 대비 상대적으로 낮은 점수를 기록하는 것을 확인하였고, kmmlu에서는 Stem과 Applied science 영역에서 상대적으로 낮은 점수를 보이는 것을 확인하였습니다.
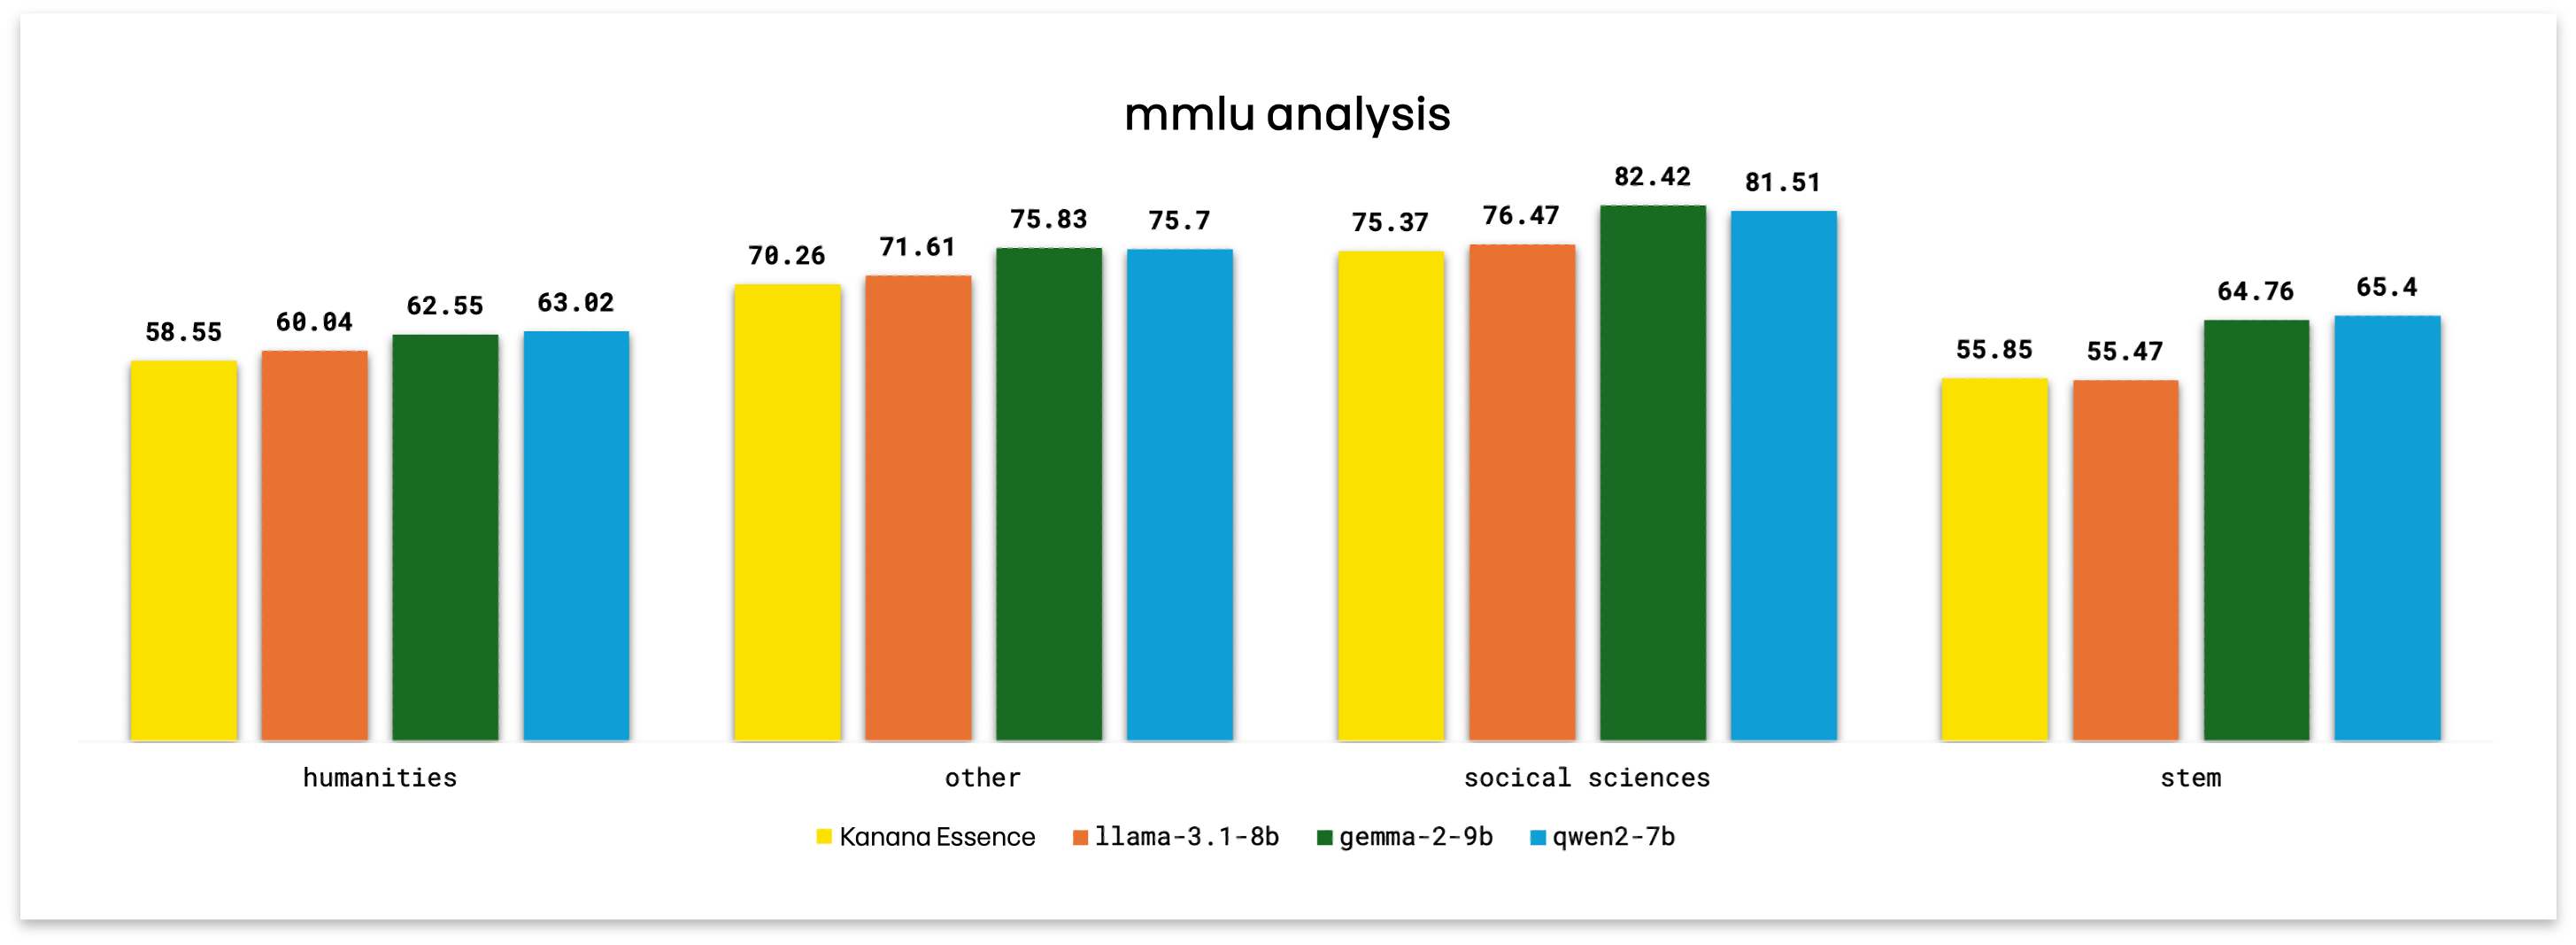
mmlu에서 Stem과 Social sciences 영역에 속하는 세부 Task들의 성능을 비교했을 때, gemma-2-9b, qwen-2-7b가 수치계산이 필요한 Task에서 Kanana Essence 대비 잘하는 Task가 많음을 확인할 수 있었습니다. 구체적으로 Stem 영역에서는 High school statistics, High school physics, Elementary mathematics 등이 Kanana Essence 대비 두 모델이 20% 이상 성능이 좋고, Social sciences 영역에서는 High school microeconomics, Econometrics 등의 Task에서 20% 이상 성능이 좋았습니다. 이는 Kanana Essence의 학습 데이터를 구성하는 과정에서 지식을 요구하는 영역과 관련된 말뭉치가 부족하지만, 그중에서도 특히 수치계산 관련 말뭉치들이 부족했음을 시사합니다.
kmmlu에서도 Stem과 Applied sciences에 속한 Task의 성능들을 두 모델과 비교해 본 결과, mmlu의 분석 결과와 유사하게 수치계산이 필요한 영역이 상대적으로 부족함을 확인하였습니다.
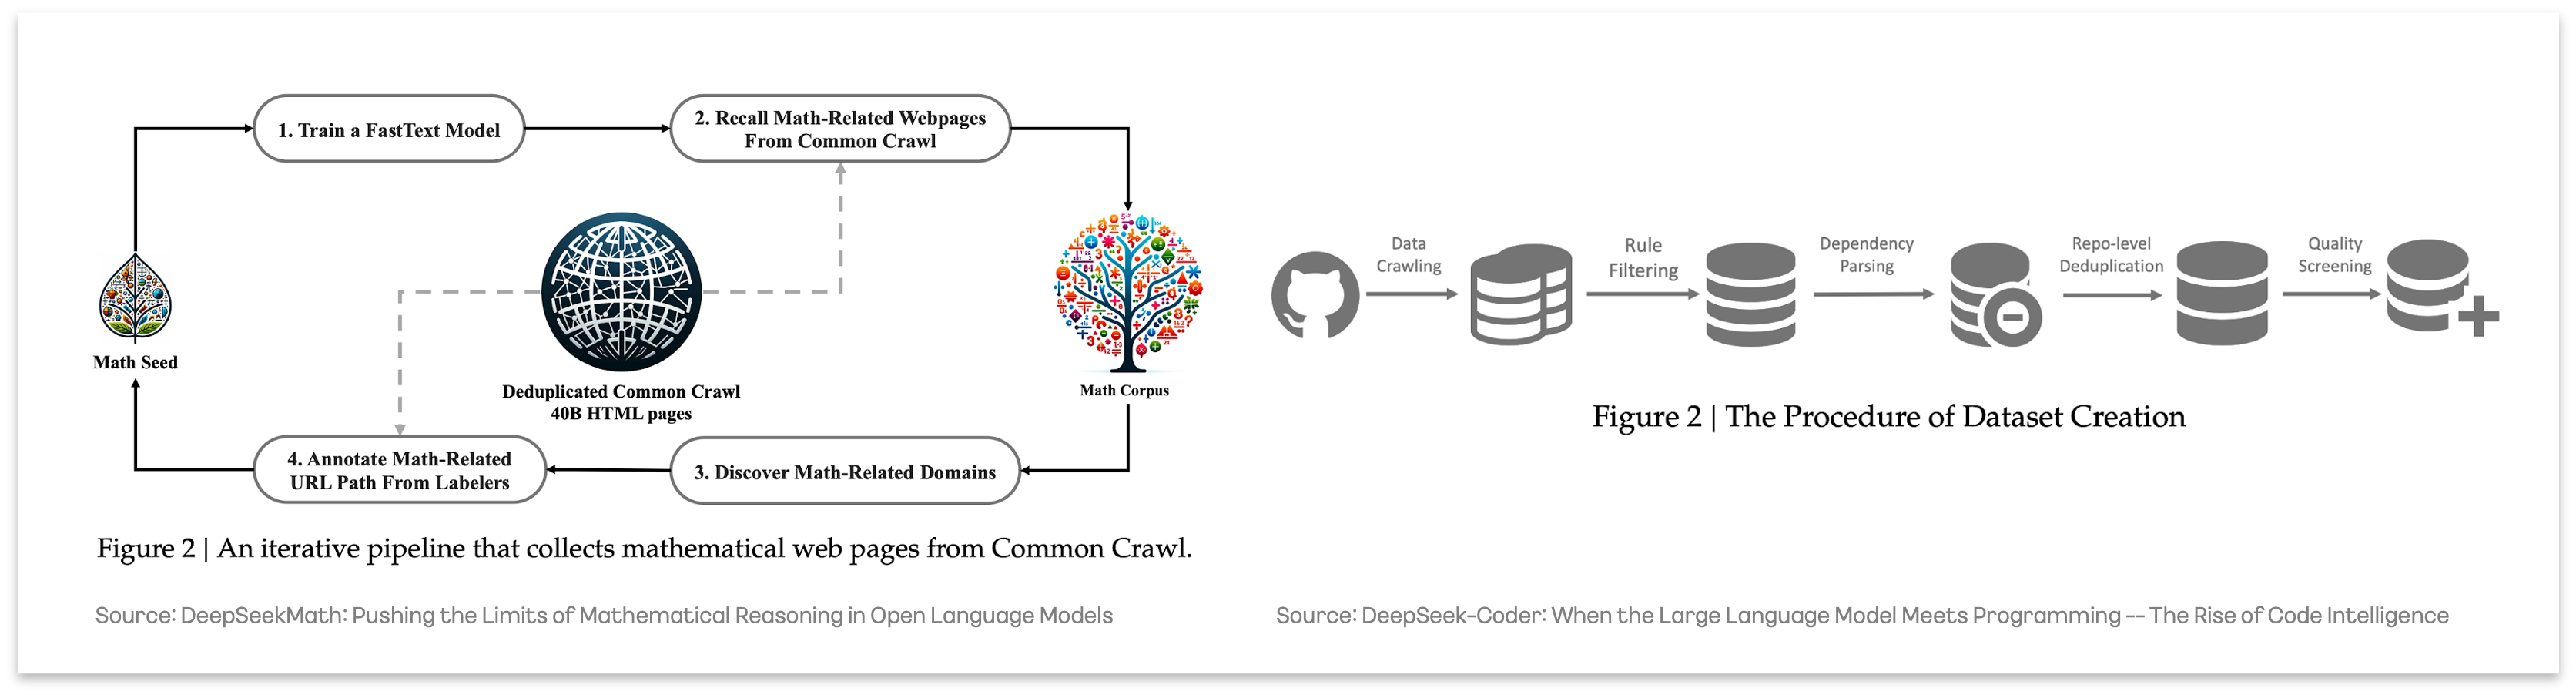
두 모델과의 비교 분석을 통해서 지식과 관련된 말뭉치뿐만 아니라 수치계산이 필요한 도메인에 관련된 말뭉치 보강에 대한 필요성을 느끼고, 현재 관련 데이터를 “DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models” 연구와 유사하게 CommonCrawl에서 직접 수집하고 처리하는 방식으로 데이터를 보강하고 있습니다. 더불어 Code 관련 말뭉치의 경우도 Quality가 좋은 말뭉치의 부족함을 느끼고, “DeepSeek-Coder: When the Large Language Model Meets Programming - The Rise of Code Intelligence” 연구와 같은 방식(예: Dependency parsing)을 차용하여 개선하고 있습니다.
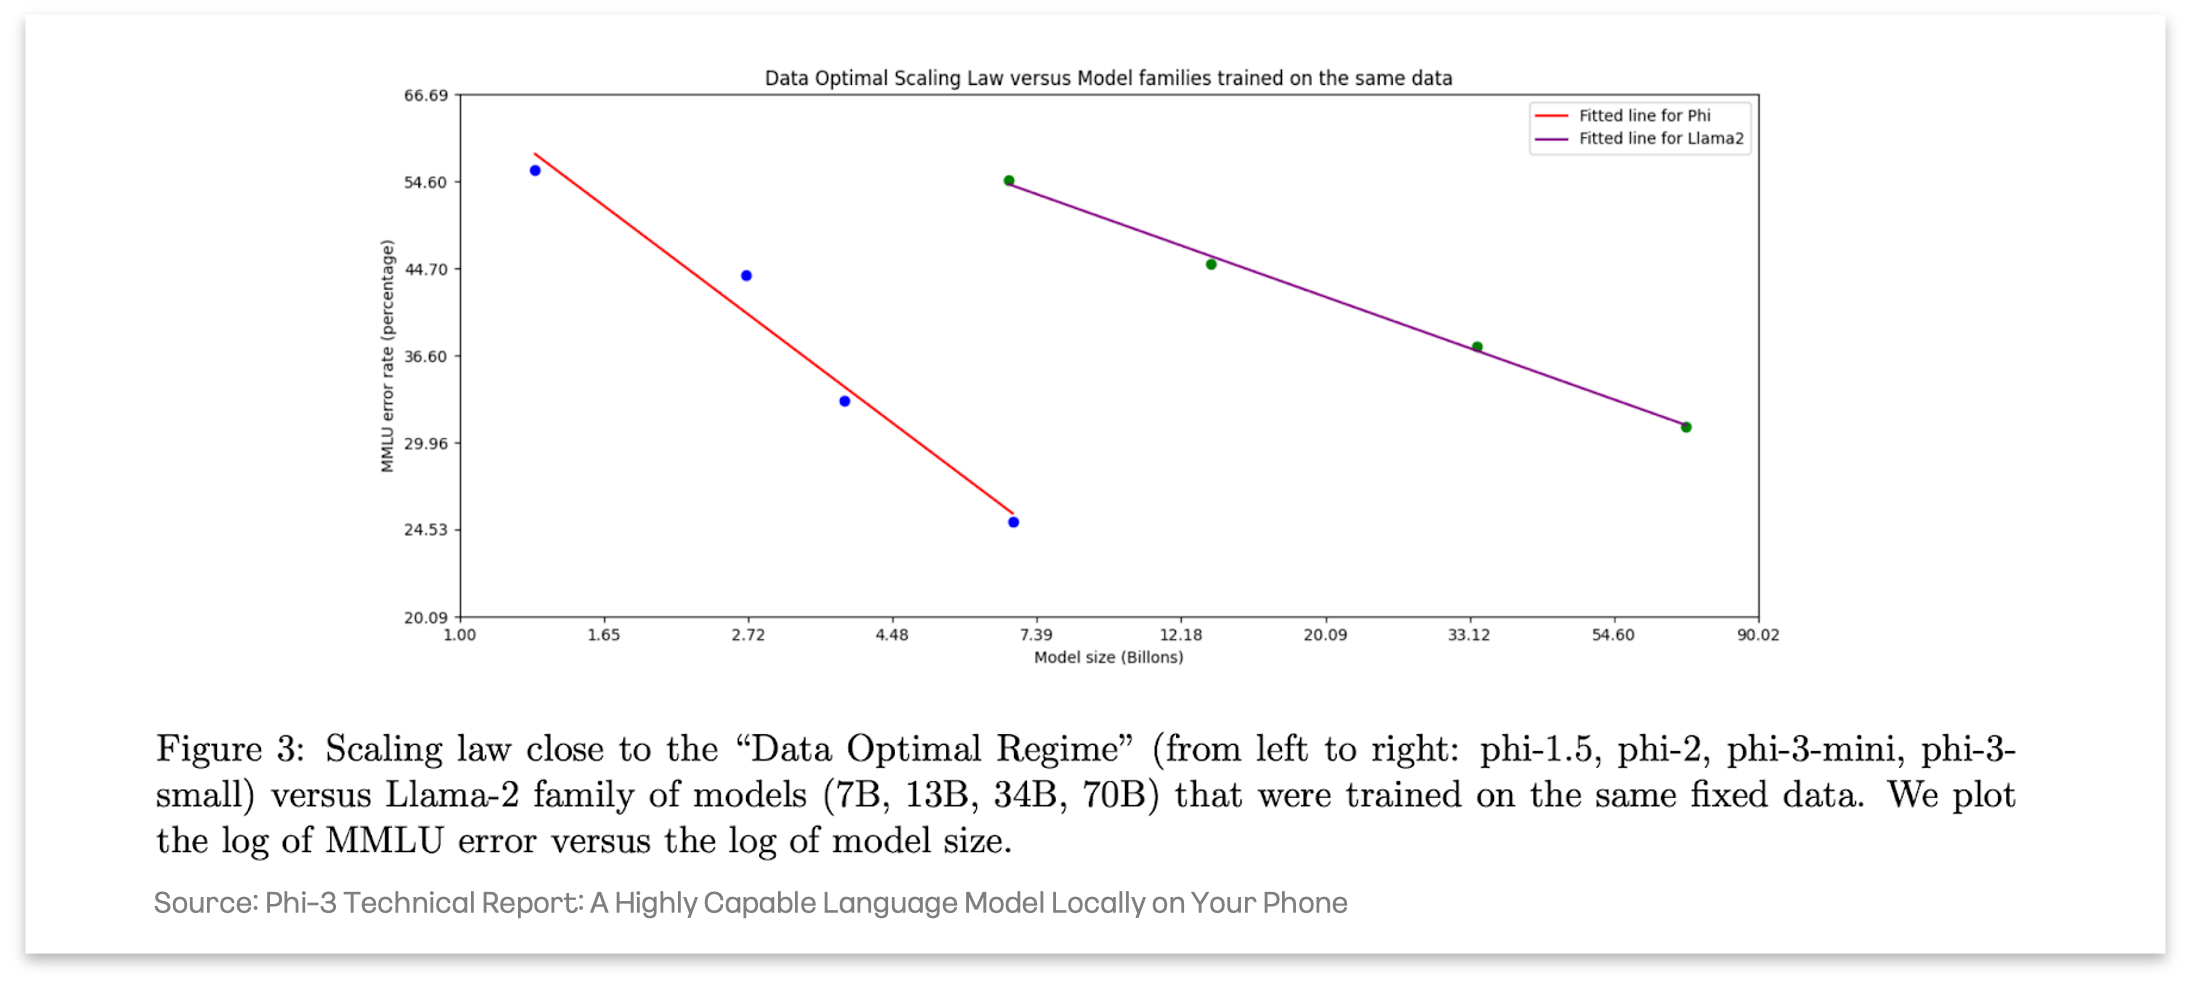
마지막으로 “Textbooks Are All You Need”, “Textbooks Are All You Need II: phi-1.5 technical report” 등의 연구와 같이, 특정 도메인(예: 우리의 경우 Stem, Code)에 대해 High quality의 Synthetic dataset을 생성해 데이터를 개선하여 학습하는 것을 목표로 하고 있습니다. 두 연구를 기초로 확장된 연구인 “Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone” 연구에서 High quality의 Synthetic dataset으로 Web에서 직접 모은 Dataset의 품질을 개선한 결과, Scaling law를 개선하여 효율적으로 학습할 수 있음을 보여주었습니다.
결론적으로 모델의 구조를 개선하거나 크기를 키우는 데에 선행하여, Kanana Essence, Nano를 학습하는 데 사용한 데이터에서 상대적으로 부족한 영역의 데이터를 개선하는 여러 가지 방식으로 진행하고 있습니다. 또한, 이 학습 노하우를 바탕으로 Kanana LLM 중 가장 큰 모델인 Kanana Flag도 학습을 진행하고 있습니다. 앞으로도 카카오는 개선된 Scaling law로 더 좋은 LLM을 학습해 나갈 것입니다.
지금까지 카카오의 자체 언어모델, Kanana LLM의 Pre-training 과정과 성능을 소개했습니다. 이어지는 글에서는 이 베이스 모델을 바탕으로 어떻게 사용자의 명령을 잘 이해하고 따를 수 있게 만드는지 LLM의 Post-training 과정과 성능 결과를 공유할 예정입니다.
Contributions
Kanana ⍺ 조직의 juliet.bak (박윤주), lambda.xprime (이호진), lana.ny (김나연), mat.mul (김보섭), ryan.u (류민호), wavy.jung (정두해)이 기여해 주셨습니다.
Acknowledgements
arXiv 데이터셋 개선에 기여해 주신 Kanana ⍺ 조직의 sonny.7 (손동희)님과 전체 내용에 대한 검수를 맡아주신 loophy.cc (조정민)님께 감사의 말을 전합니다.