Engineering
Kanana-2 개발기 (2): 개선된 post-training recipe를 중심으로
juliet.bak, kevin.nlp카카오
2026년 1월 15일
원문에서 보기 ↗안녕하세요. 카카오의 AI 모델 개발을 담당하는 카나나 LLM 조직에서 Post-training을 연구하고 있는 Juliet, Kevin입니다.
지난 12월 19일 카카오가 자체 개발한 차세대 언어모델 Kanana-2-30b-a3b를 오픈소스로 공개한 데에 이어, 한 달여 만에 성능과 활용성을 대폭 강화한 Kanana-2 모델 4종(Base, Mid-training, Instruct, Thinking) 모델을 공개합니다.
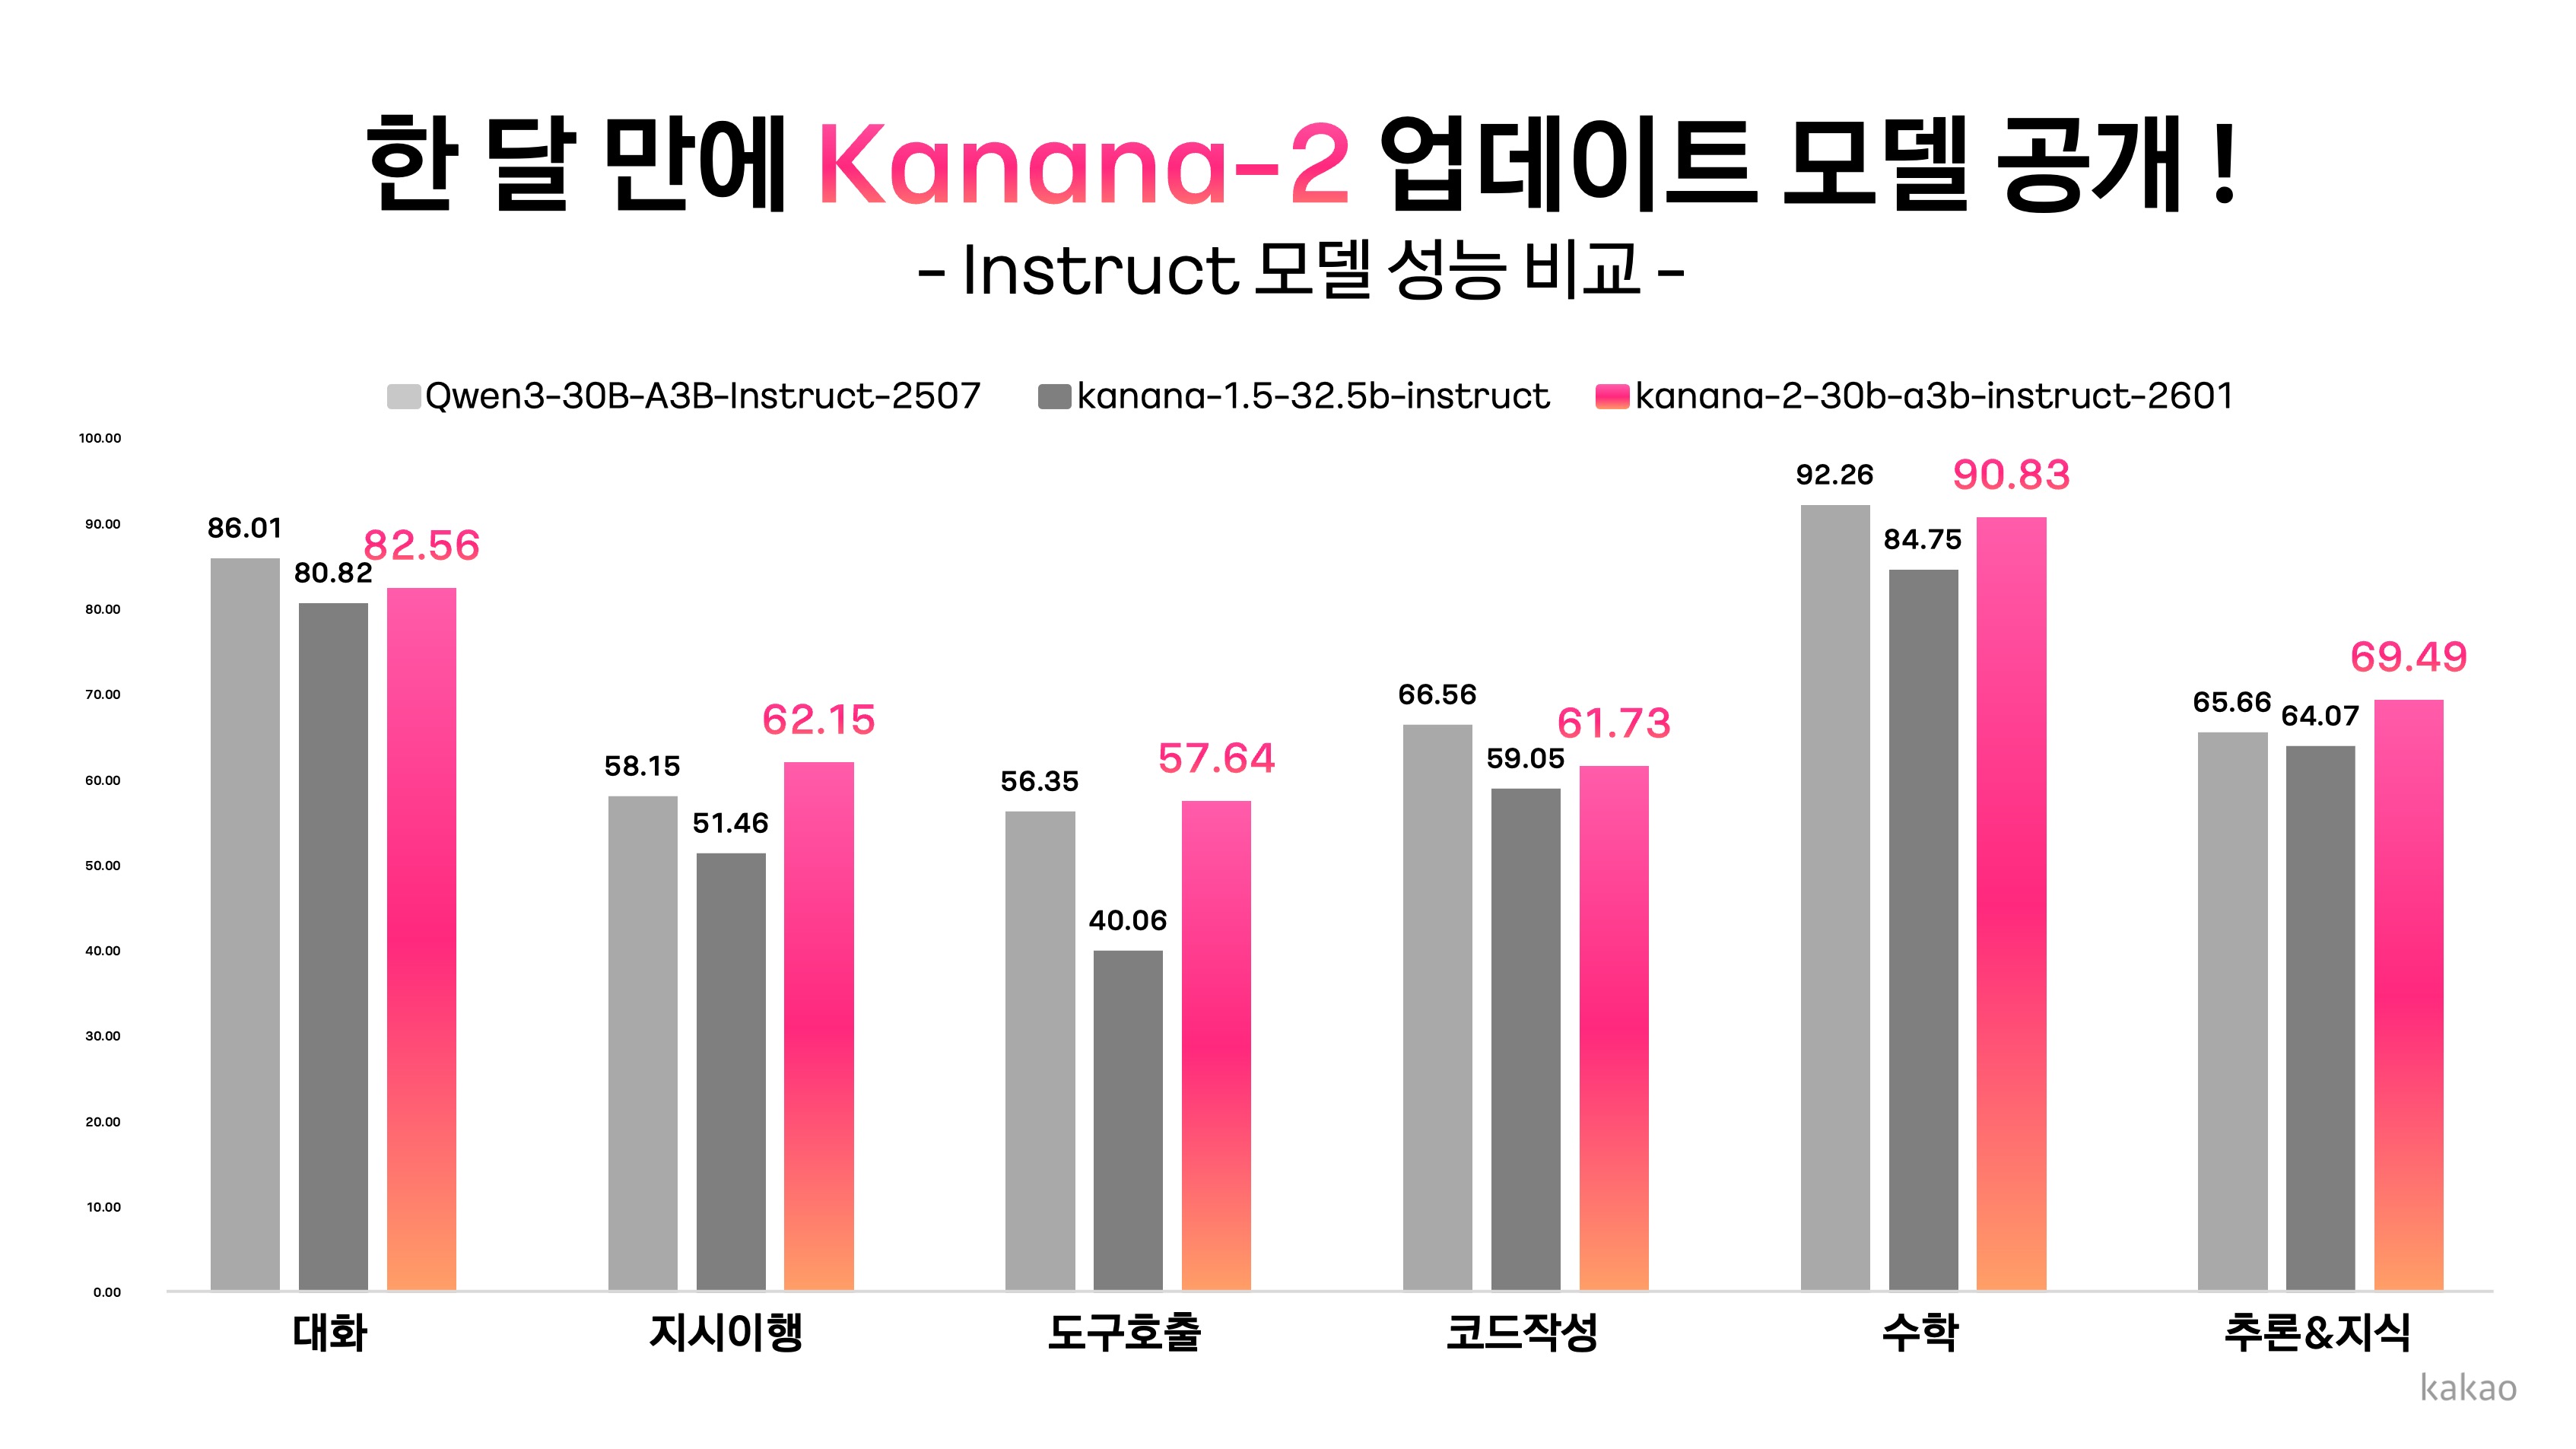
Kanana-2-30b-a3b-instruct-2601 성능 비교
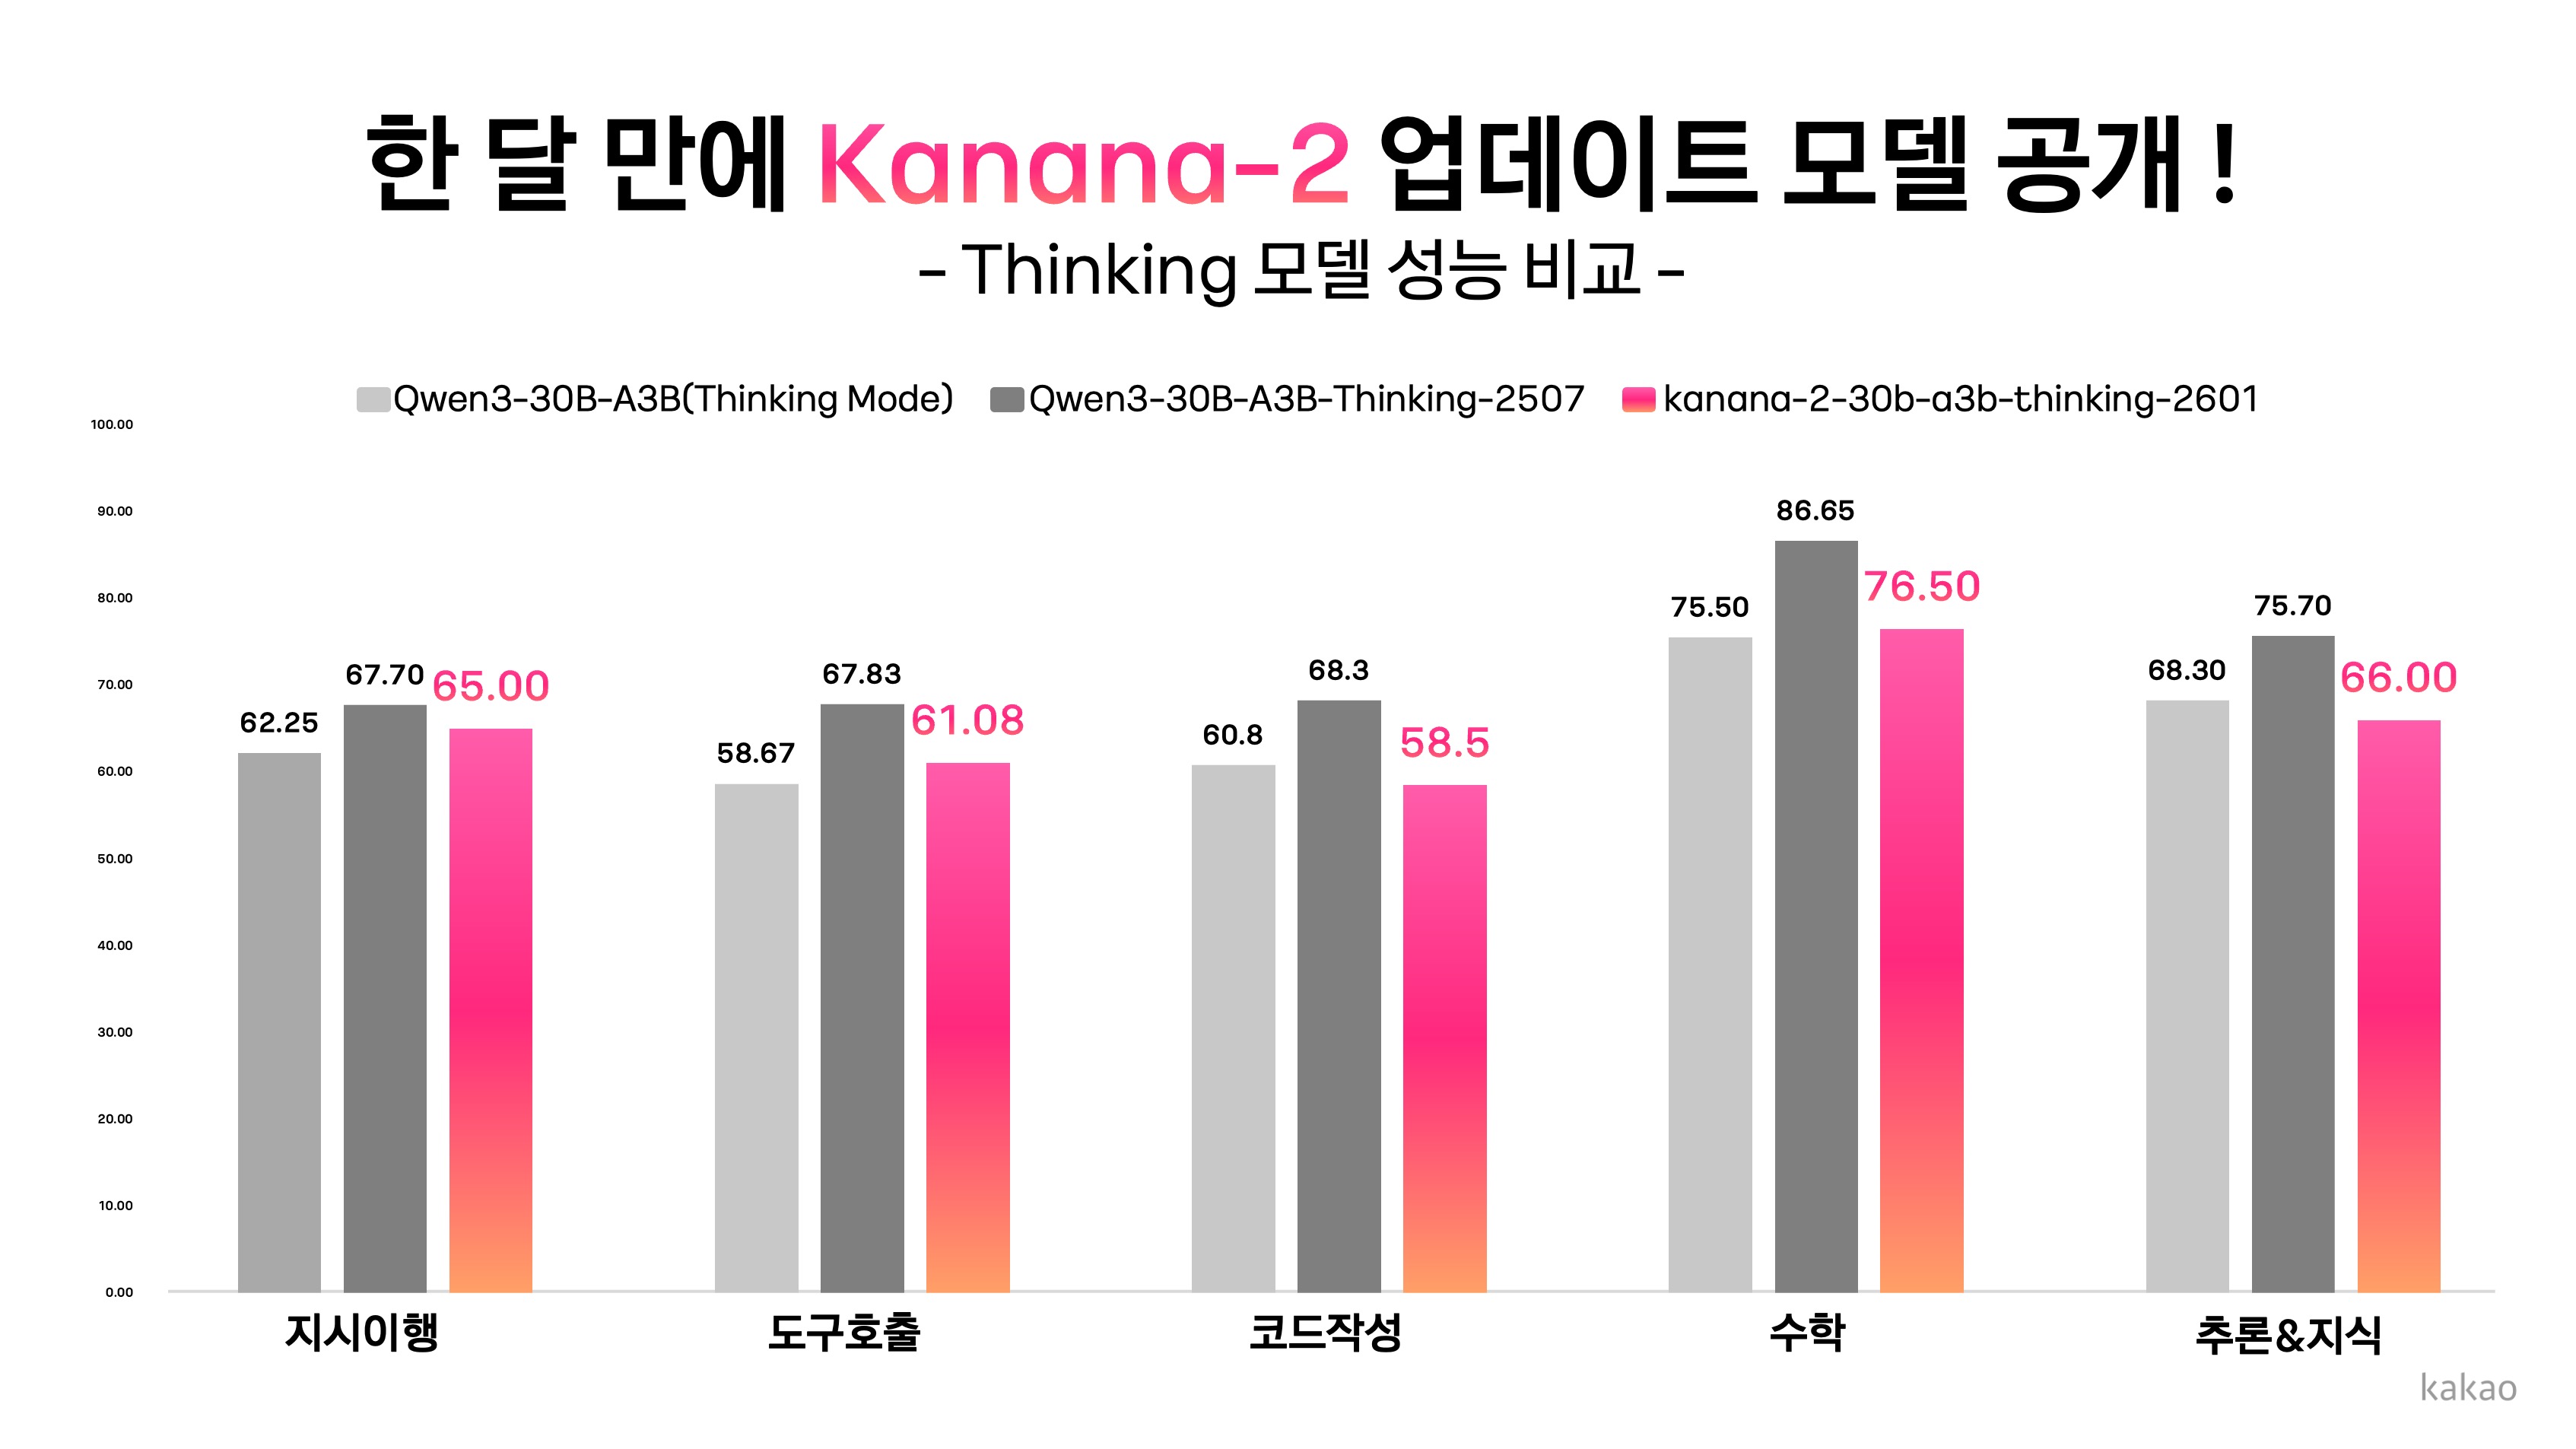
Kanana-2-30b-a3b-thinking-2601 성능 비교
Kanana-1과 Kanana-1.5 공개를 거쳐 축적해온 연구 성과를 바탕으로, 이번 Kanana-2에서는 성능과 추론 능력을 한 단계 끌어올리는 동시에, 단순한 대화형 AI를 넘어 Agentic AI 구현에 최적화된 방향 으로 모델을 고도화했습니다. 특히 저희는 실제 에이전트 환경에서 중요한 도구 호출(Tool Calling)과 지시 이행(Instruction Following) 능력을 핵심 목표로 두고 Post-training 레시피를 설계 했습니다. 이번 글에서는 앞선 Pre-training을 다룬 Kanana-2 개발기 1편에 이어, Kanana-2 Instruct와 Thinking 모델을 만들기 위해 어떤 훈련 레시피를 선택했는지, 그리고 어떤 시행착오들이 있었는지, 이러한 과정들이 모델의 성능 측면에서 어떤 변화를 만들었는지 공유드리고자 합니다.
1. Mid-training
Why Mid-training?
최근 다양한 연구[1, 2, 3, 4]에서 더 높은 Reasoning 성능을 얻기 위해 Pre-training과 Post-training 사이에 Mid-training이라는 별도의 훈련 스테이지를 두고 있습니다.
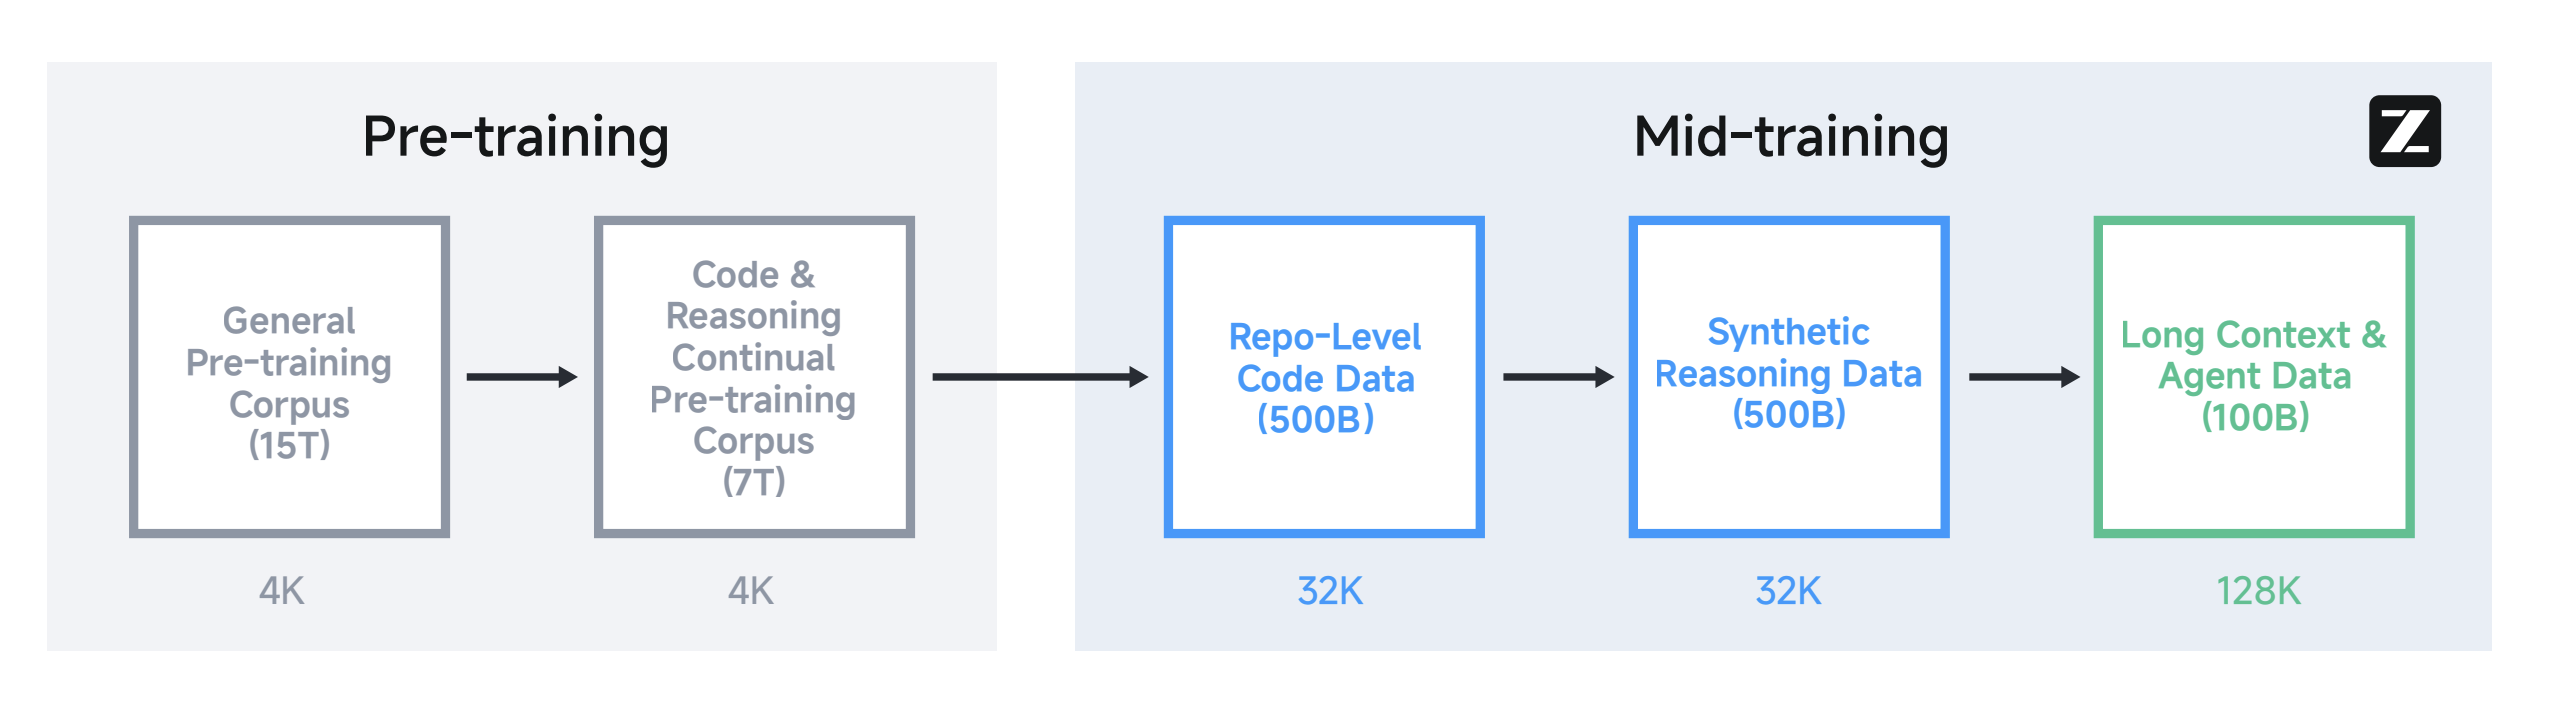
(그림 1) GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models [1]
Mid-training은 Pre-training을 마친 LLM이 본격적인 Post-training에 들어가기 전에 수행하는 추가적인 훈련 단계입니다. 이 단계는 모델이 특정 능력을 효과적으로 습득하고 잠재력을 최대한 발휘할 수 있도록 기반을 다지는 역할을 합니다.
일반적으로 Pre-training 단계에서는 방대한 양의 텍스트 데이터를 학습하여 언어의 구조, 통계적 패턴, 기본적인 지식을 습득합니다. 그러나 이 단계만으로는 복잡한 추론(Reasoning), 특정 도메인 지식의 깊은 이해, 혹은 에이전트 역할을 수행하는 데 필요한 도구 호출(Tool Calling)과 같은 특화된 능력을 갖추기 어렵습니다.
Mid-training은 이러한 갭을 메우기 위해 설계되었으며, 주로 다음과 같은 목적으로 사용됩니다.
- 추론 및 논리적 사고 능력 강화: 수학, 코드, 복잡한 지침 이행 등 논리적 사고를 요구하는 데이터셋을 집중적으로 학습시켜 모델의 추론 능력을 한 단계 끌어올립니다.
- 특정 역할 수행을 위한 기초 다지기: Agentic AI처럼 특정 역할을 수행하도록 모델을 고도화할 때, 그 역할을 잘 수행하는 데 필수적인 핵심 개념이나 패턴을 미리 학습시킵니다.
- 데이터 효율성 증대: Mid-training을 통해 기초 능력을 확보하면, 이후의 비용이 비싼 RL(Reinforcement Learning) 단계에서 더 적은 데이터로도 높은 성능 향상을 기대할 수 있습니다.
요약하자면, Mid-training은 '범용적인 언어 이해력’을 '특정 목표 지향적인 고성능 능력’으로 전환시키기 위한 가교 역할을 하는 중간 훈련 단계라고 이해할 수 있습니다.
Mid-training Dataset
Mid-training의 효과는 결국 어떤 데이터를 어떤 형태로 얼마나 잘 구성하느냐에 의해 크게 좌우됩니다. 최근 LLM 커뮤니티에서는 여러 도메인에서 성능을 끌어올리는 고품질 추론 데이터셋들 [5, 6]이 활발히 공개되고 있고, 이러한 데이터셋들과 함께 “왜 Mid-training이 필요한가”에 대한 실증적 근거도 함께 쌓이고 있습니다.
저희는 이러한 최신 연구 동향을 반영하여, 복잡한 문제 해결 과정을 담고 있는 수학, 코드, 툴, 일반 대화 등 다양한 도메인을 포괄하는 데이터를 엄선했습니다. 특히, 단순히 문제와 정답만을 포함하는 것이 아니라, ‘추론의 과정(Chain-of-Thought)’이 명확하게 담긴 데이터를 확보하는 데 주력했습니다.
이러한 과정을 통해, 최신 고성능 모델들로부터 추출한 데이터를 포함하여 총 200B 토큰 규모에 달하는 방대하고 품질 높은 추론 데이터셋을 구축하였습니다.
Pre-training Dataset Replaying
저희는 Mid-training 데이터셋을 설계하는 과정에서 한 가지 중요한 질문에 직면했습니다.
"추론 능력 강화를 위한 데이터 주입이 왜 특정 언어/벤치마크에서는 오히려 성능 저하를 일으킬까?"
Kanana-2 Pre-trained 모델에 대해 공개된 고품질 영어 추론 데이터셋을 활용하여 Reasoning 중심의 SFT(Supervised Fine-Tuning) 및 RL을 선행 실험했을 때, 이러한 현상을 명확히 관찰할 수 있었습니다. 예를 들어 AIME와 같은 고난도 수학 벤치마크에서는 예상대로 큰 폭의 성능 향상을 보였으나, 동시에 KoMT-bench와 같은 한국어 벤치마크에서는 성능이 크게 하락하는 것을 관찰하였습니다.
| 실험 모델 | MT-bench | KoMT-bench | GSM8k | MATH | AIME24 | AIME25 |
|---|---|---|---|---|---|---|
| (1) PLM + Instruct SFT | 8.15 | 7.86 | 85.29 | 70.42 | 9.21 | 11.71 |
| (2) PLM + Reasoning SFT/RL | 6.57 | 2.95 | 87.26 | 71.02 | 53.21 | 44.61 |
| (3) PLM + Reasoning SFT/RL + Instruct SFT | 7.68 | 6.52 | 87.41 | 73.22 | 28.31 | 27.08 |
| Δ (3) - (1) Difference | -0.47 ▼ | -1.34▼ | +2.12 ▲ | +2.80 ▲ | +19.10 ▲ | +15.37 ▲ |
(표 1) Reasoning 훈련 유무에 따른 벤치마크 성능 비교
이는 데이터 자체의 품질 문제라기보다는, 훈련 분포가 특정 언어 및 스타일에 편향될 때 발생하는 능력 편향을 시사합니다. 즉, 모델이 영어 추론 데이터를 집중적으로 학습하며 Reasoning 능력은 강화되지만, 그 과정에서 한국어 대화/지시문 스타일에 필수적인 언어적 표현 능력과 정렬이 상대적으로 약화될 수 있다는 것입니다.
이러한 치명적 망각(Catastrophic Forgetting) 현상을 방지하고 균형 잡힌 모델로 만들기 위해, 저희는 Mid-training 단계에 기존 Pre-training 데이터의 분포를 일정 비율로 리플레이 하는 전략을 사용했습니다. Pre-training 데이터를 추론 데이터와 함께 섞어 학습시키면, 모델이 새로 주입되는 Reasoning 능력을 효과적으로 유지하면서도, 언어적 기반과 스타일 정렬이 무너지는 것을 최소화할 수 있었습니다.
저희는 다양한 실험을 통해 최종적으로 약 200B의 고품질 영어 추론 데이터셋과 50B의 한국어를 포함하는 Pre-trained replay 데이터를 포함하는 250B의 Mid-training 데이터셋을 구성하여 Kanana-2 Mid-trained 모델을 훈련했습니다.
이러한 데이터 구성이 Reasoning 능력의 극대화와 기존 언어 능력 및 정렬의 유지라는 두 마리 토끼를 잡기 위한 최적의 균형점 역할을 했고, 이후의 Post-training 단계에서 안정적인 성능 향상의 기반이 되었습니다.
Result
Mid-training을 마친 모델은 베이스 모델 대비 수학 및 코딩 영역에서 유의미한 성능 향상을 보였으며, MMLU 및 KMLLU와 같은 일반적인 언어 능력 지표에서도 망각 없이 기존 성능을 유지했습니다.
| 모델 | MMLU (5-shot) | KMMLU (5-shot) | HAERAE (5-shot) | KoSimpleQA (5-shot) | HumanEval (0-shot) | MBPP (3-shot) | GSM8K (8-shot) | MATH (4-shot) |
|---|---|---|---|---|---|---|---|---|
| Qwen3-30B-A3B | 81.14 | 62.25 | 72.04 | 26.33 | 53.32 | 72.58 | 88.10 | 62.58 |
| Kanana-1.5-32.5B | 76.76 | 61.56 | 90.65 | 45.70 | 75.59 | 65.96 | 85.14 | 47.68 |
| Kanana-2- 30B-A3B (Base) | 74.83 | 61.98 | 88.91 | 49.55 | 66.48 | 60.21 | 76.57 | 48.86 |
| Kanana-2- 30B-A3B (Mid-Training) | 75.44 | 62.15 | 88.73 | 49.40 | 75.29 | 62.39 | 82.71 | 54.40 |
(표 2) Base 모델과의 Pre-training 벤치마크 성능 비교
Mid-training을 통해 내재화된 추론 역량은 SFT 단계 이후에 그 진가를 더욱 발휘합니다. 동일한 Instruct SFT를 적용했을 때, Mid-training을 거친 모델은 그렇지 않은 모델 대비 일반 대화를 포함한 모든 영역에서 유의미한 성능 향상을 기록했습니다.
| 실험 모델 | MT-bench | KoMT-bench | IFEval | MATH | HumanEval+ | MBPP+ |
|---|---|---|---|---|---|---|
| (1) Base + General SFT | 8.14 | 7.81 | 75.60 | 74.30 | 76.22 | 71.16 |
| (2) Base + Mid-training + General SFT | 8.39 | 8.02 | 79.11 | 81.26 | 78.66 | 73.02 |
| Δ Mid training | +0.25 ▲ | +0.21 ▲ | +3.51 ▲ | +6.96 ▲ | +2.44 ▲ | +1.86 ▲ |
(표 3) Mid-training 여부에 따른 instruct sft 이후 성능 비교
Mid-training의 효과는 동일한 Thinking SFT를 적용했을 때에도 뚜렷하게 나타나는 것을 확인하였습니다. 그림 2와 같이, Mid-training된 모델은 Base 모델 대비 훈련 초기 구간부터 압도적인 수렴 속도를 보여줍니다. 또한, Thinking Augmented Pre-training [7]에서 분석한 것과 마찬가지로 훈련이 지속되어도 일관된 성능 우위를 보입니다.
(그림 2) 시작 모델에 따른 Thinking SFT 훈련 추이
2. Instruct model
Overview
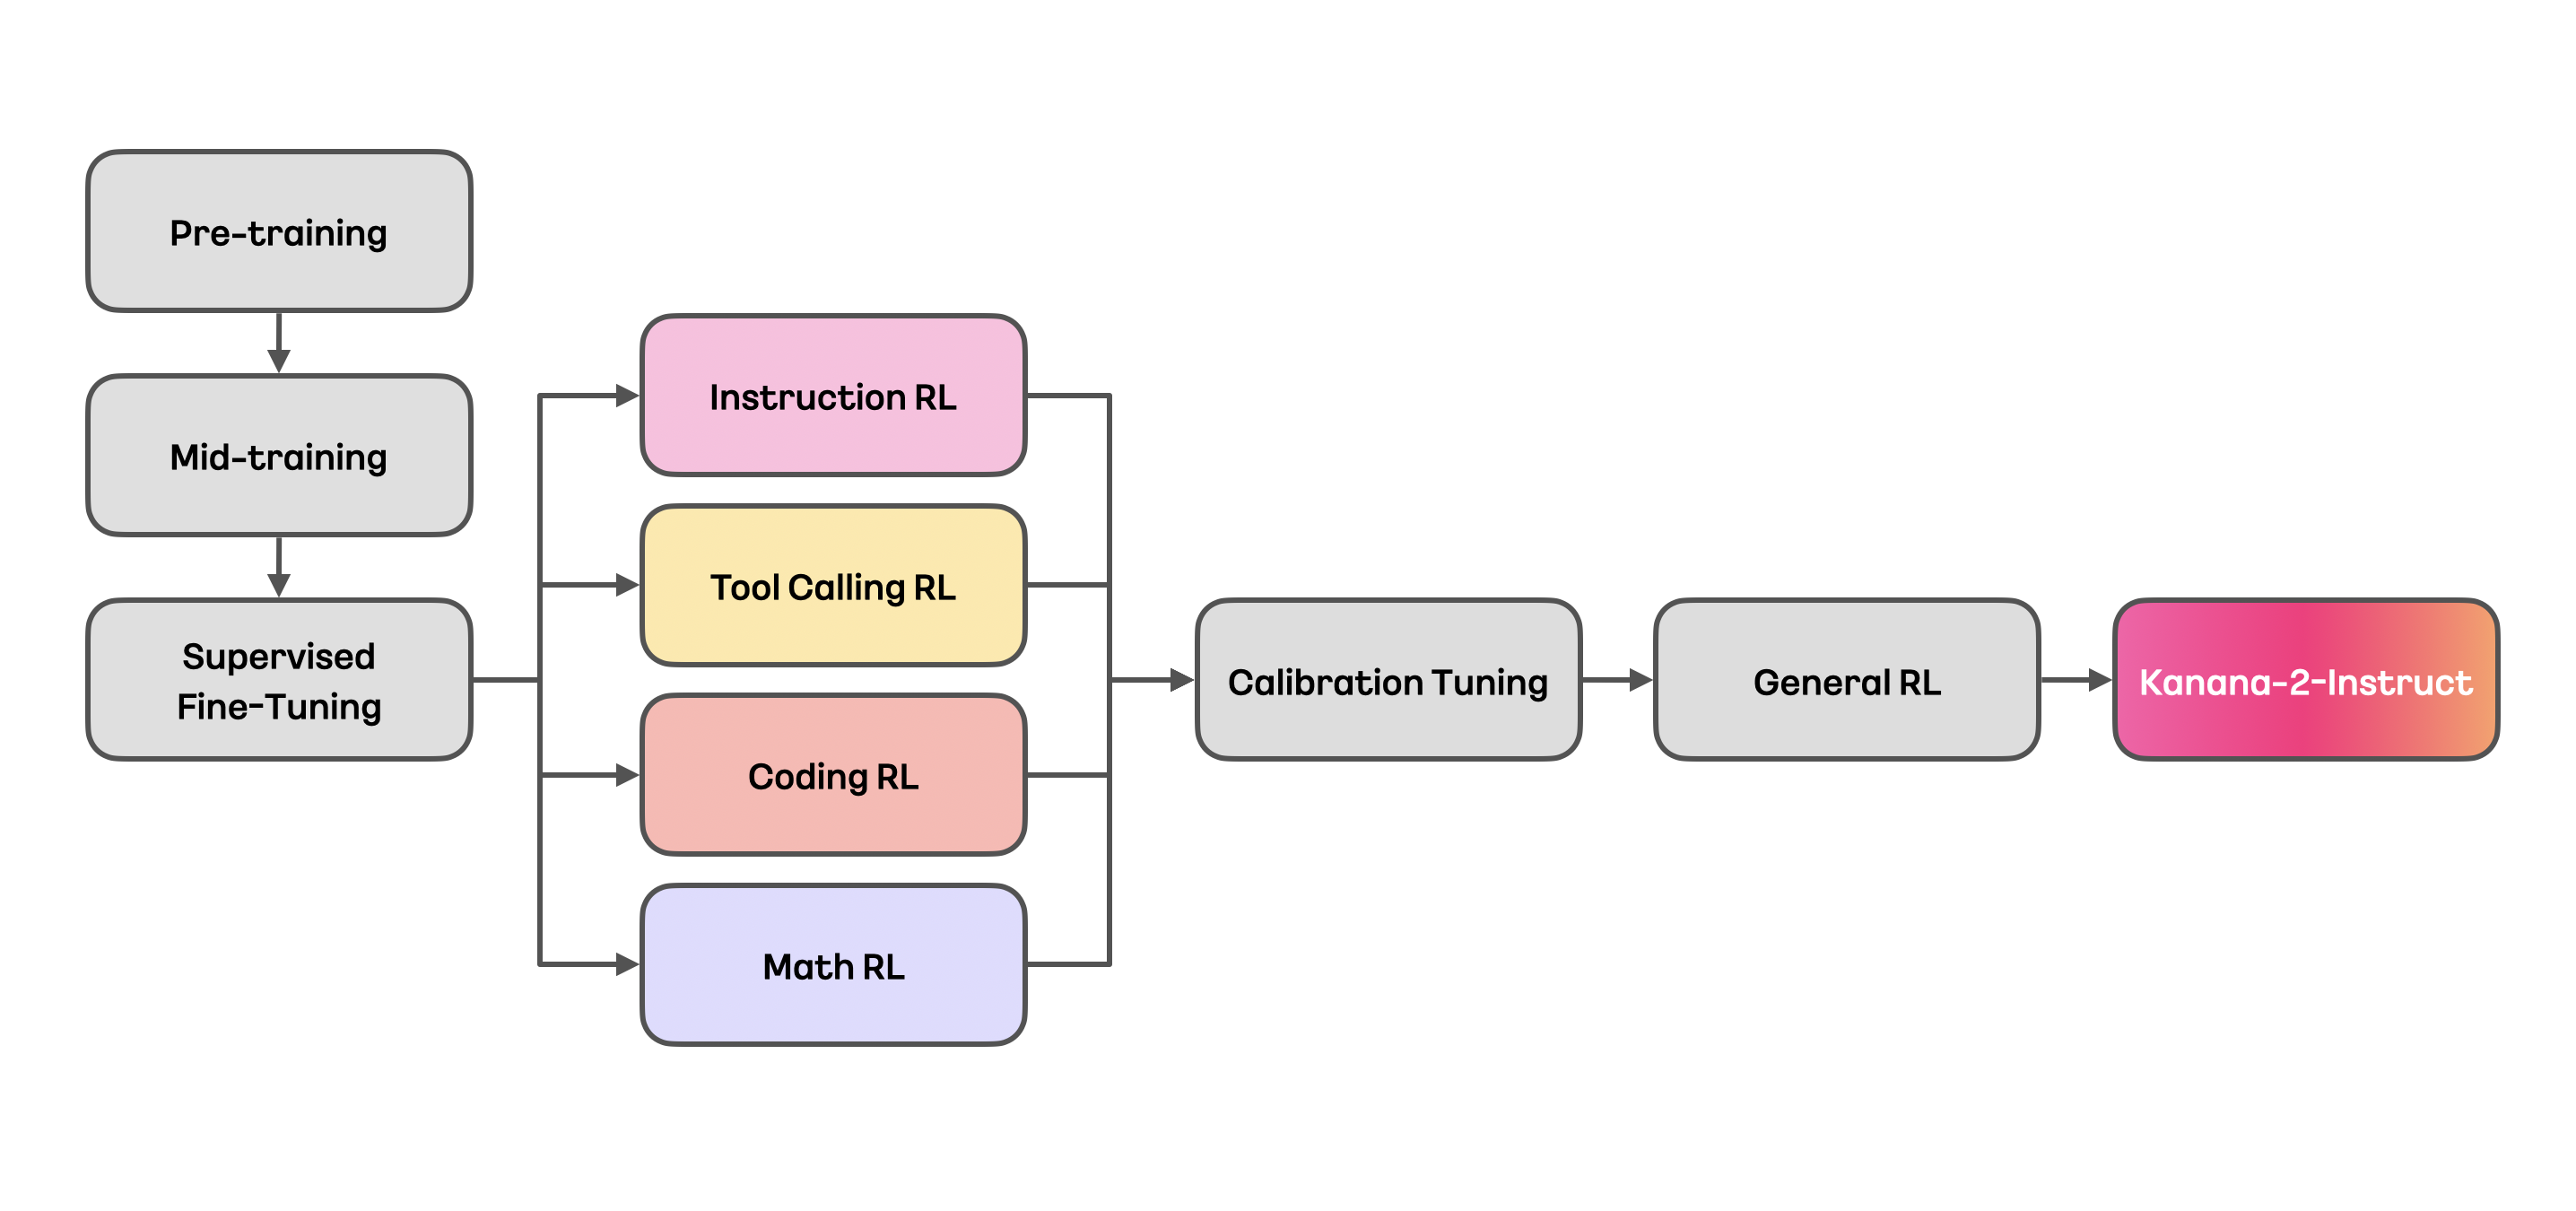
(그림 3) Kanana-2-Instruct 모델 훈련 파이프라인
Kanana-2 Instruct 모델은 Mid-training을 통해 확보된 모델의 기반 위에 고품질 데이터를 활용한 Supervised Fine-Tuning (SFT)과 Reinforcement Learning (RL)을 통해 완성되었습니다. 특히 저희는 Instruct 모델을 만들면서 다음 두가지 방향에 집중하였습니다.
- Agentic AI 환경에서 필수적인 Instruction Following 및 Tool Calling 능력 극대화
- 효율적인 훈련을 위해 Parallel RL 및 Calibration Tuning과 같은 훈련 파이프라인 도입
이어지는 섹션에서는 저희가 각각의 도메인에 대해 어떤 새로운 레시피를 적용했는지, 그리고 Parallel RL과 Calibration Tuning으로 이어지는 새로운 훈련 파이프라인에 대해 소개드리도록 하겠습니다.
Supervised Fine-Tuning
SFT 단계에서는 Kanana-1.5 레시피를 기본으로 유지하되, 최근 활발히 공개되고 있는 Nemotron-Post-Training-Dataset-V2 [8]를 비롯한 오픈소스 SFT 데이터셋을 추가로 활용하는 실험을 진행하였습니다. 우선 Nemotron을 포함한 다양한 공개 SFT 데이터셋을 수집한 뒤, 각 데이터 인스턴스를 Chat, Math, Code, Tool Calling 등의 카테고리로 분류하였습니다.
이후 카테고리별로 두 가지 설정을 비교 평가하였습니다. 첫째는 기존 Kanana-1.5 SFT 데이터셋의 동일 카테고리를 신규 데이터로 완전히 대체하는 방식(Replacement)이며, 둘째는 기존 레시피에 신규 데이터를 추가로 합치는 방식(Addition)입니다.
실험 결과, Chat과 Math 도메인에서는 Addition이 가장 우수한 성능을 보였습니다. 반면 Code 도메인에서는 기존 Kanana-1.5 레시피가 더 우수했으며, Tool Calling 도메인에서는 기존 데이터를 신규 데이터로 완전히 대체하는 Replacement가 가장 좋은 성능을 보였습니다. 이러한 결과를 반영하여 Kanana-2-Instruct의 최종 SFT 데이터 구성을 확정하였습니다.
Instruction following RL
실세계의 Instruction Following은 단일 프롬프트에서 규칙 기반으로 검증 가능한 형식을 맞추는 수준을 넘어섭니다. 대화가 여러 턴에 걸쳐 진행되면서 지시가 누적되거나 수정되기도 하고, 중간에 새로운 제약이 추가되거나, 때로는 모호한 요구를 사용자와 협업적으로 해석해 풀어가야 하는 상황도 빈번합니다. 예를 들어 Multi-IF[9]는 이러한 멀티턴 기반 Instruction Following 능력을 요구하며, Multi-Challenge[10]는 아래 그림과 같이 단순한 규칙 기반 검증만으로는 평가하기 어려운 복합적인 Instruction Following 역량을 요구합니다.
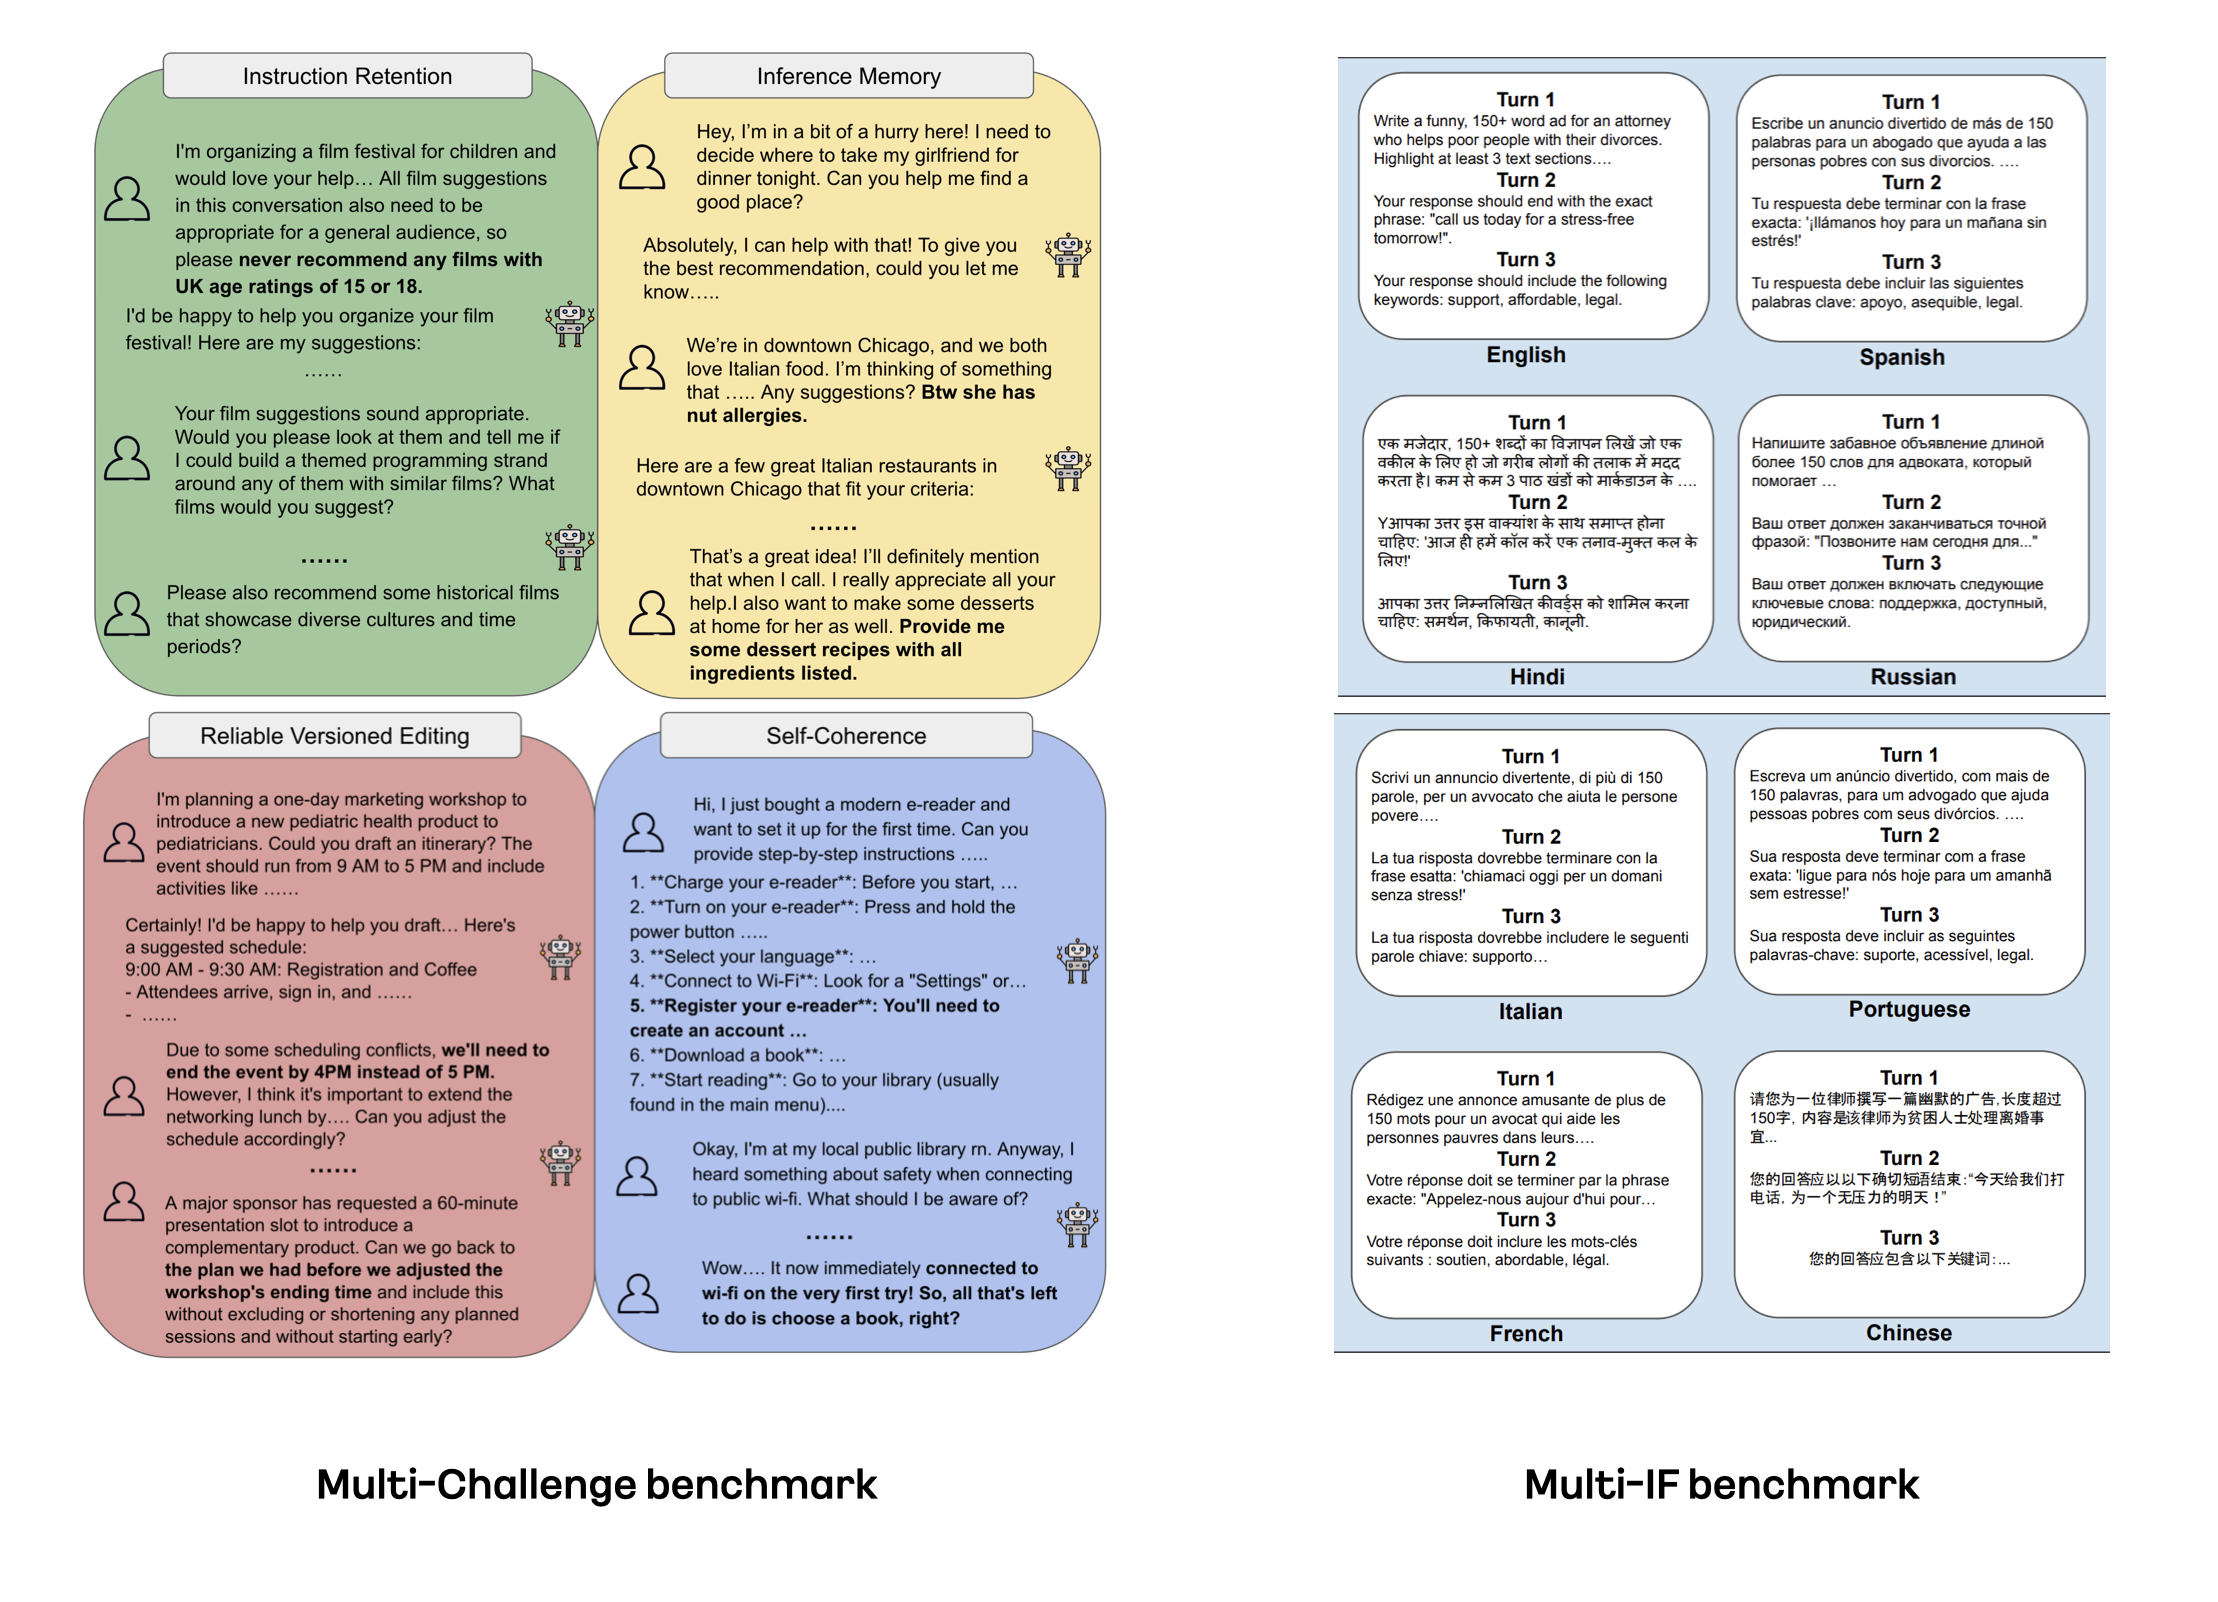
(그림 4) Instruction Following 벤치마크
저희는 이러한 복잡한 Instruction Following 문제를 해결하고자 다음과 같은 과정을 통해 Instruction Following 데이터셋을 직접 제작하였고 이를 훈련에 활용하였습니다.
<표기법>
-
문제 타입 집합: T = {t₁, t₂, …}
- 모델이 해결해야 할 문제 유형 (예: 장기 기억, 형식 맞추기, 일관성 유지 등)과 그에 대한 설명을 모은 집합
-
사용자 페르소나 집합: P = {p₁, p₂, …}
- 사용자의 성격, 직업, 발화 스타일 등을 정의하는 페르소나 텍스트 집합
-
n번째 턴 발화: (uₙ, or aₙ)
- 사용자 발화는 uₙ, 모델 답변은 aₙ
-
대화 히스토리: Dₙ = [u₁, a₁, …, uₙ₋₁, aₙ₋₁]
- n번째 사용자 턴 직전까지의 누적된 대화
-
각 대화 에피소드마다 문제 타입 tₙ와 페르소나 pₙ를 집합 T × P에서 무작위로 샘플링합니다.
-
샘플링된 (tₙ, pₙ)를 Blueprint 에이전트에 입력하여 대화 설계도 B를 생성합니다.
- B는 각 턴별 가이드라인 (gₙ)과 모든 응답이 따라야 할 루브릭 (rₘ)을 포함합니다.
- gₙ: n번째 턴에서 사용자와 모델이 각각 어떤 발화를 해야하는지에 대한 가이드
- rₘ: 모델의 답변을 평가하는 기준, 즉 통과 조건으로 총 m개를 생성
- BlueprintAgent(tₙ, pₙ) → B = ([g₁, g₂, …, gₙ], [r₁, r₂, …, rₘ])
-
현재까지의 대화 히스토리 Dₙ과 설계도 B를 User 에이전트에게 입력하여, 다음 사용자 턴 uₙ을 생성합니다. UserAgent(Dₙ, B) → uₙ
-
모델 답변 생성: Assistant 에이전트에게는 설계도 B를 주지 않고, Dₙ과 uₙ만 입력하여 답변 aₙ을 얻습니다. 이때 모델은 자신이 데이터셋 생성 중이라는 정보를 전혀 입력 받지 않습니다. AssistantAgent(Dₙ, uₙ) → aₙ
-
평가: 생성된 답변 aₙ을 루브릭 r을 사용하여 평가합니다 rₘ(Dₙ, uₙ, aₙ) → passₘ
-
다음 턴 진행:
- 모든 루브릭을 통과하여 all(passₘ) = true 일 경우, 대화 히스토리를 갱신하고 다음 턴으로 진행합니다. Dₙ ⊕ [uₙ, aₙ] → Dₙ₊₁
- 통과하지 못한 루브릭이 존재하여 all(passₘ) = false 일 경우, 해당 에피소드(대화) 생성을 즉시 종료합니다.
이렇게 만든 데이터셋은 Instruction Following RL 훈련에 사용되었습니다. 멀티턴 데이터셋을 다음과 같이 턴별로 분해하였고 Assistant 답변 aₙ을 제거한 채로 모델에 입력합니다.
- 하나의 데이터 샘플:
- Sₙ = [u₁, a₁, …, uₙ, aₙ]
- 턴별로 샘플을 분해:
- S₁ = [u₁, a₁]
- S₂ = [u₁, a₁, u₂, a₂]
- …
- 턴별로 분해된 샘플에서 마지막 Assistant 턴을 제거
- S₁ = [u₁]
- S₂ = [u₁, a₁, u₂]
- …
각 루브릭의 충족 여부 판단에는 Qwen3-30B-A3B 모델을 Generative Reward Model로 사용하여 평가하도록 구성하였습니다.
이와 같이 생성한 데이터와 함께 새로운 Instruction Following 레시피를 적용한 결과, 다양한 Instruction Following 태스크에서 기존 레시피 대비 성능을 유의미하게 상회하는 개선을 확인할 수 있었습니다.
Tool Calling RL
Tool Calling 능력은 Agentic AI 구현에서 핵심 요소입니다. Kanana-1.5는 단일 턴 질의에 대한 단일 도구 호출은 가능했으나, 멀티턴 환경이나 멀티스텝 추론이 필요한 시나리오에서는 성능이 크게 저하되는 한계가 있었습니다. 연속된 대화 맥락을 유지한 채 도구를 적절히 선택·호출하고, 결과를 바탕으로 다음 행동을 계획하는 복합적인 추론 역량이 부족했기 때문입니다.
Kanana-2에서는 이 문제를 해결하기 위해 Toucan[11] 등 공개된 고품질 오픈소스 멀티턴 Tool Calling 데이터셋을 활용하였습니다. Instruction Following RL과 동일한 방식으로 멀티턴 데이터를 턴 단위로 분해하여 RL 훈련에 활용하였고, 이를 통해 모델은 단순한 질의-응답을 넘어, 누적된 대화 맥락 속에서 적절한 도구를 호출하고 그 결과를 바탕으로 다음 행동을 계획하는 능력을 효과적으로 학습할 수 있었습니다.
또한 Tool Calling의 정확도를 높이기 위해, NVIDIA의 Tool-N1[12]에서 영감을 받아 Exact Match 기반의 엄격한 보상 함수를 설계하였습니다.
- 성공적인 도구 호출 (Task Completion):
- 복잡한 멀티스텝 태스크에서 모든 도구 호출 단계가 정확히 수행된 경우에만 1.0의 리워드를 부여하였습니다.
- 단 하나의 호출이라도 실패하거나 잘못되면 0점을 부여하는 방식으로, Partial Reward를 제공하지 않았습니다. 이를 통해 모델이 불완전한 풀이가 아닌, 완전한 도구 사용을 학습하도록 유도하였습니다.
- 불필요한 도구 호출 방지 (Irrelevant Tool Call):
- 도구 호출이 필요하지 않은 일반 대화 상황에서는, 도구를 호출하지 않고 자연어로 응답했을 때에만 1.0의 리워드를 부여하였습니다.
- 반대로 도구가 필요 없는 상황에서 도구 호출을 시도할 경우 0점을 부여하여, 도구 오남용을 강하게 억제하였습니다.
이러한 데이터 구성과 보상 설계를 통해 Kanana-2는 단순히 도구를 호출할 수 있는 수준을 넘어, 멀티턴 상황에서도 정확한 도구 호출을 수행하고, 도구 호출이 불필요한 상황을 올바르게 판단하는 능력을 갖추게 되었습니다.
Parallel RL Pipeline
추가로 이번 Kanana-2 개발에서는 Parallel RL(병렬 강화 학습)이라는 새로운 훈련 파이프라인을 도입하였습니다. 이를 통해 기존 레시피의 한계였던 태스크 간 수렴 시점 불균형과, 레시피 변경 시 반복되는 전면 재훈련으로 인한 비효율을 해소하고자 했습니다.
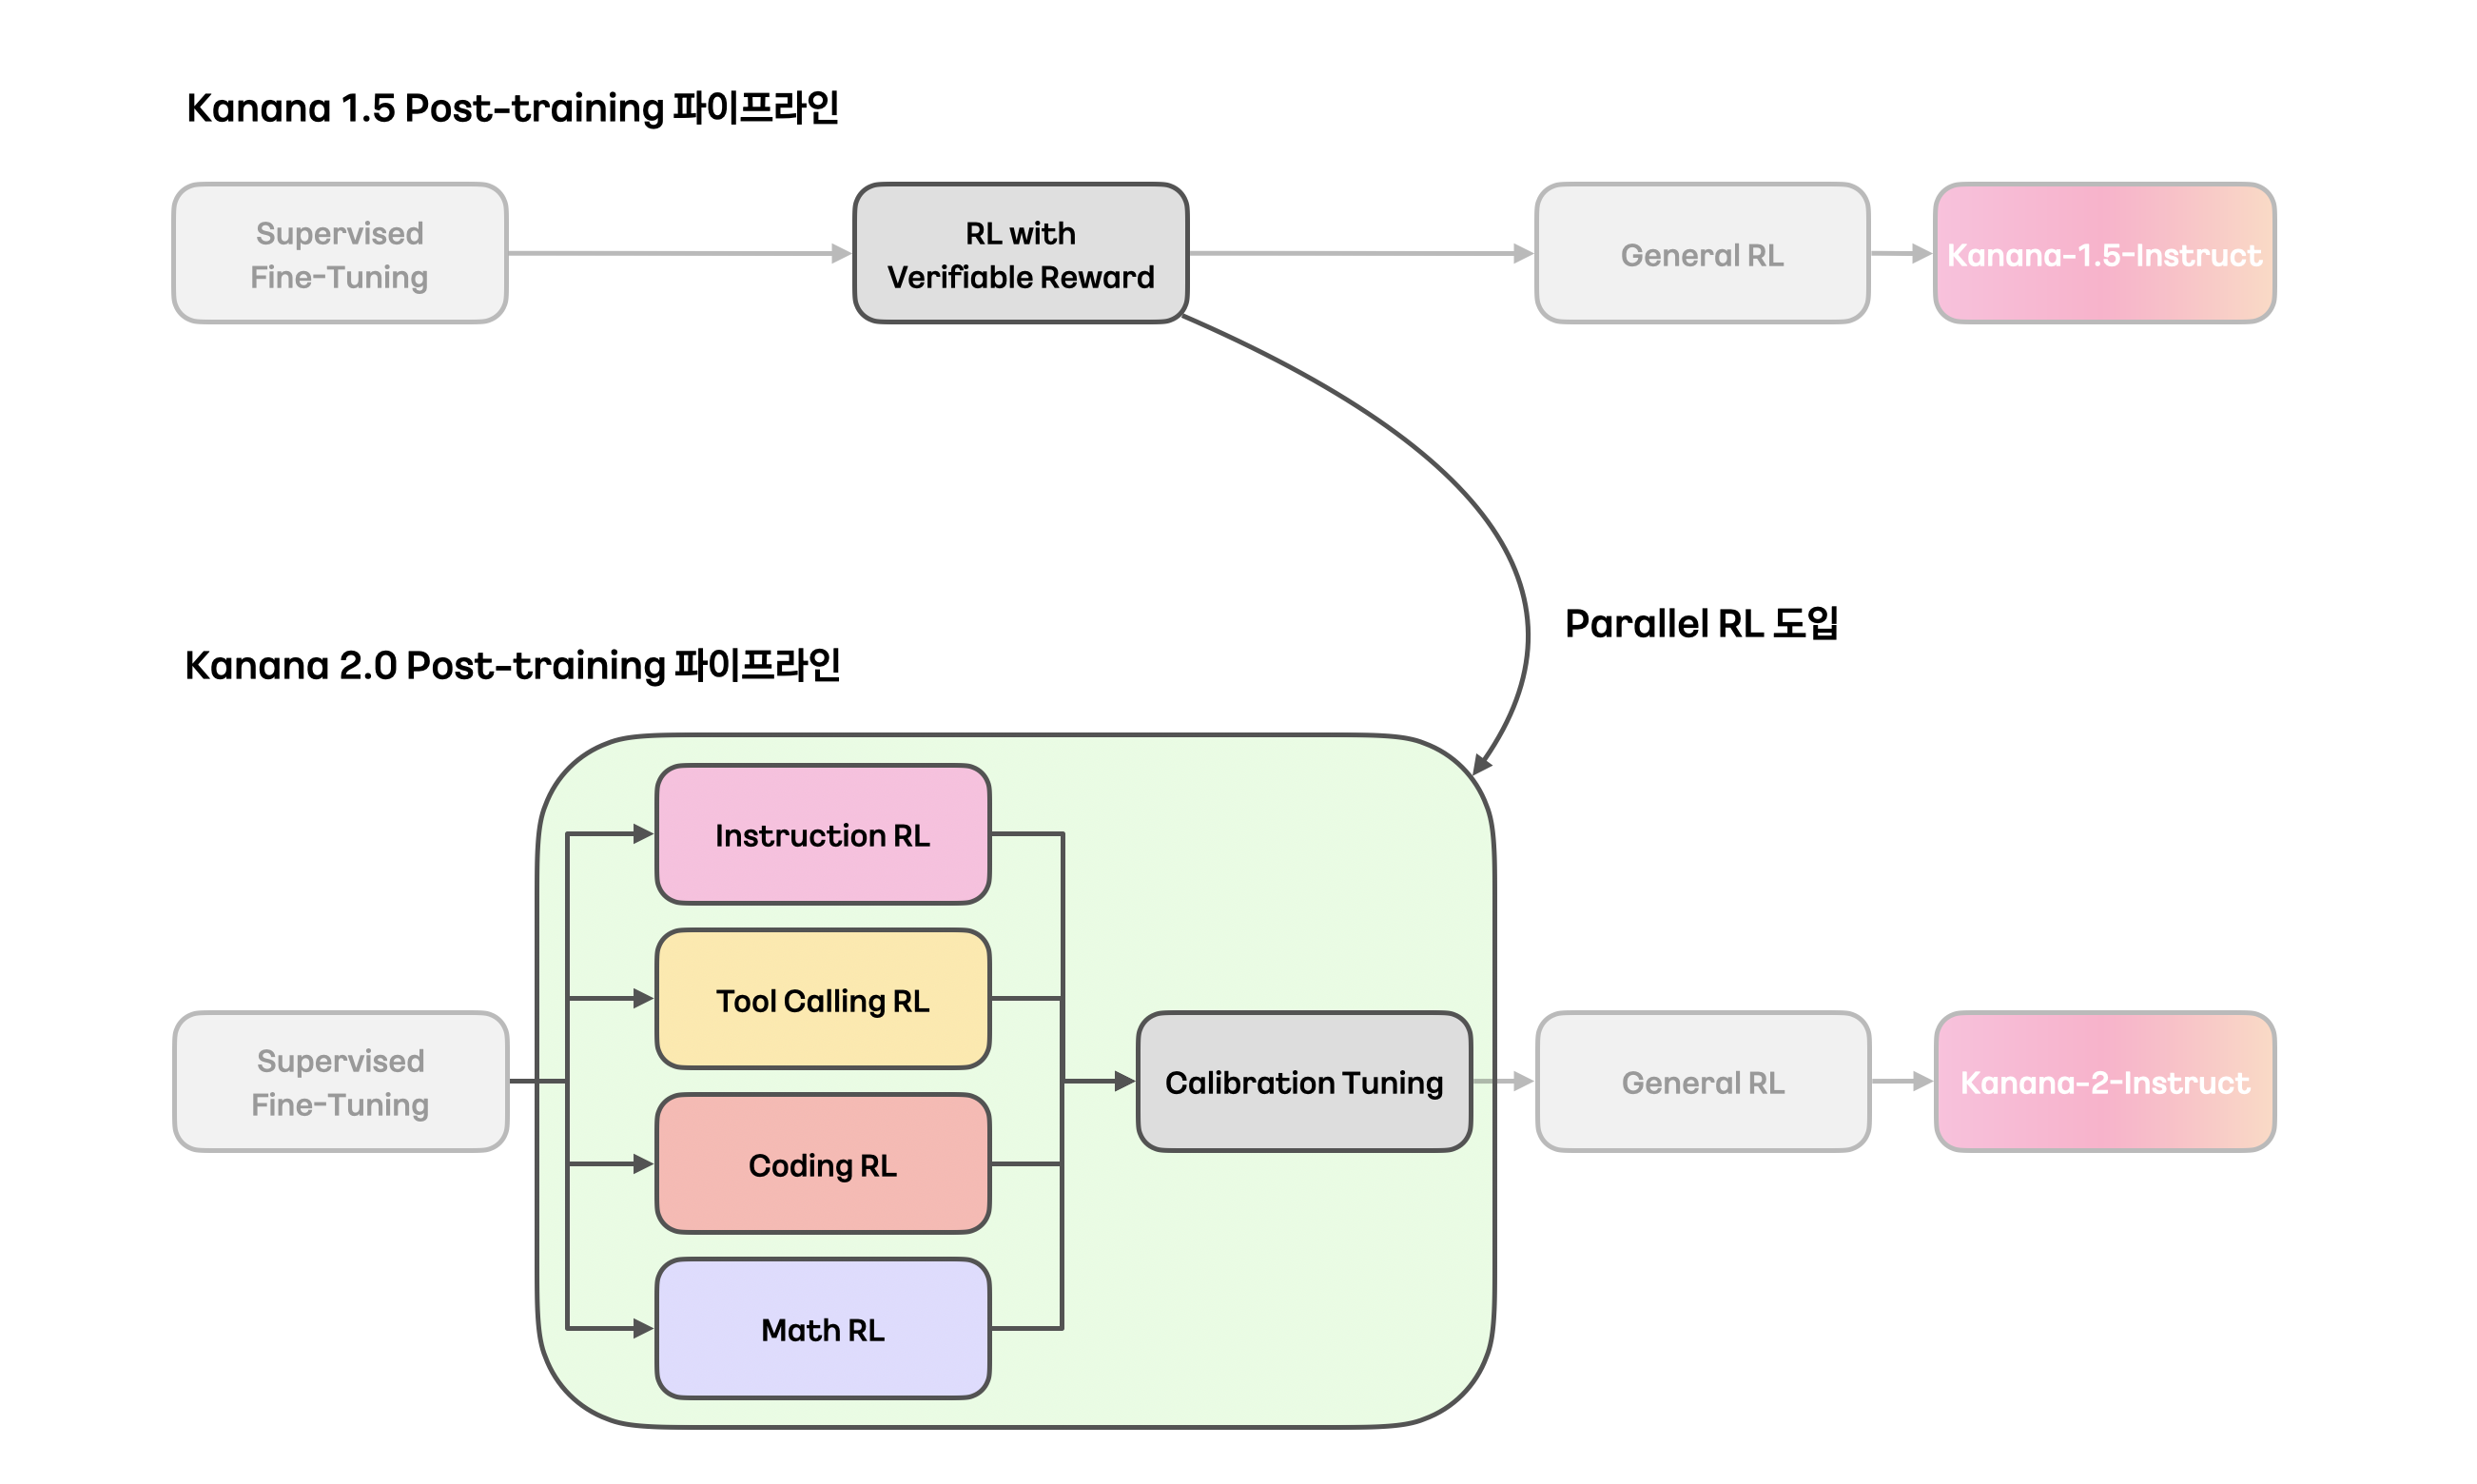
(그림 5) Parallel RL 도입으로 인한 Post-training 파이프라인 변경
지난 Kanana-1.5-Moe 블로그 포스트[13]에서 다양한 RL 도메인 간 수렴 시점 불균형 문제를 언급드린 바 있습니다. 당시에는 Generative RM을 사용하는 General RL 태스크와 규칙 기반 Reward Function을 사용하는 태스크로 RL 훈련을 2분할 하였습니다. 그러나 이후 분석 결과, 규칙 기반 Reward Function을 사용하는 태스크들(Math, Coding, Tool Calling, Instruction Following) 또한 각각 서로 다른 수렴 특성을 가지므로, 각 태스크가 최적 지점까지 도달하기 위해서는 태스크별로 독립적인 훈련이 필요하다는 결론에 이르렀습니다.
또한 기존 방식에서는 특정 태스크(예: Instruction Following)의 훈련 레시피를 변경할 때마다, 그 변화가 다른 태스크(Math, Coding 등)에 미치는 영향을 확인하기 위해 전체 태스크 데이터를 포함한 RL 훈련을 매번 새로 수행해야 했습니다. 특히 Kanana-1.5에서 이미 검증된 레시피를 그대로 적용하기로 한 Math나 Coding 태스크까지 반복 재훈련하는 것은 자원과 시간 측면에서 큰 낭비였습니다.
이러한 문제에 대응하여 저희는 다음과 같은 장점을 갖는 Parallel RL 파이프라인을 고안했습니다.
- 태스크 간 수렴 시점 불균형 해소: Instruction Following, Tool Calling, Math, Coding 등 각 태스크를 독립 파이프라인으로 분리하여 강화 학습을 수행하였습니다. 이를 통해 다른 태스크의 수렴 타이밍에 영향을 받지 않고, 태스크별로 최적의 훈련 스텝과 하이퍼파라미터를 적용하여 성능을 최대한 끌어올릴 수 있었습니다. 결과적으로 태스크 간 수렴 시점 차이에서 비롯되는 구조적인 문제가 해소되었습니다.
- 훈련 효율성 극대화 및 빠른 실험 반복: Instruction Following이나 Tool Calling처럼 레시피 탐색이 중요한 태스크는 해당 태스크의 RL만 변경하여 빠르게 재실험할 수 있습니다. 반면 Math, Coding처럼 레시피가 이미 안정화된 태스크는 재훈련 없이 유지하고, 최종 단계에서 Merging 및 Calibration을 통해 통합합니다. 이 구조는 레시피 변경 실험의 반복 속도를 크게 개선하여 전체 개발 효율을 높였습니다.
Parallel RL을 통해 태스크별로 최적화된 모델들은, 다음 섹션에서 설명드릴 Merging & Calibration 단계를 거쳐 하나의 강력한 Kanana-2 Instruct 모델로 완성됩니다.
Merging & Calibration
Parallel RL을 통해 Instruction Following, Tool Calling, Math, Coding 등 태스크별로 최적화된 모델을 확보한 뒤, 최종적으로 하나의 Kanana-2 Instruct 모델로 통합하였습니다. 저희는 이 통합 단계에서 Linear Merging 방식을 채택하였습니다.
각 도메인에서 최고 성능을 보인 개별 모델들을 Linear Merging한 결과, 통합 모델은 모든 도메인에서 전반적으로 준수한 성능을 보였습니다. 다만 각 도메인별 개별 모델이 달성했던 최고 성능과 비교하면, 일부 지표에서 성능 하락이 관찰되었습니다. 이는 여러 전문화된 능력을 하나의 파라미터 공간으로 합치는 과정에서 발생하는 간섭 현상으로 해석할 수 있습니다.
이러한 성능 저하를 보완하고 도메인별 최고 성능을 최대한 복원하기 위해, 저희는 Calibration Tuning이라는 추가 학습 단계를 도입하였습니다. Merging 직후의 모델에 대해 매우 짧은 추가 SFT를 수행하여, 병합 과정에서 흐트러진 능력 분포를 재정렬하는 것을 목표하였습니다.
- 데이터셋 구성:
- 각 태스크별 최고 성능 모델을 사용하여 응답을 생성하였습니다.
- 이때 RL 훈련에서 사용한 것과 동일한 프롬프트 포맷 및 데이터 구조를 그대로 적용하여, 모델이 가장 익숙한 형태의 이상적인 응답을 재생성하도록 설계하였습니다.
- SFT 훈련 진행:
- 위와 같이 구축한 응답 데이터셋을 활용하여 Merged 모델에 짧은 스텝의 SFT를 수행하였습니다.
- Calibration SFT는 모델의 전반적인 능력 분포를 크게 변화시키지 않으면서도, 각 도메인에서 기대하는 최고 수준의 성능을 빠르게 복원하도록 유도하는 역할을 했습니다.
Calibration Tuning 이후, Merged 모델은 Instruction Following, Tool Calling 등 서비스 핵심 영역을 포함한 전 도메인에서 개별 모델이 달성했던 최고 성능을 성공적으로 복원할 수 있었습니다. 아래 표를 통해 Calibration Tuning의 효과를 확인 할 수 있습니다.
Instruction Following 벤치마크
| 모델 | IFEval (strict prompt) | IFBench (strict prompt) | Multi-IF (English) | Multi-Challenge |
|---|---|---|---|---|
| Instruction Following Only | 87.62 | 53.06 | 73.52 | 22.34 |
| After Linear Merging | 82.07 | 32.99 | 73.59 | 24.54 |
| After Calibration Tuning | 87.25 | 48.30 | 77.88 | 35.16 |
(표 4) Instruction Following 벤치마크에서의 성능 비교
Tool Calling 벤치마크
| 모델 | BFCL-v3 live-simple | BFCL-v3 live-multiple | BFCL-v3 live-parallel | BFCL-v3 live-irrelavance | BFCL-v3 multi-turn-base | BFCL-v3 multi-turn-miss-func | BFCL-v3 multi-turn-miss-param |
|---|---|---|---|---|---|---|---|
| Tool Calling Only | 82.56 | 79.39 | 81.25 | 75.51 | 46.00 | 31.50 | 30.00 |
| After Linear Merging | 79.84 | 79.68 | 75.00 | 69.16 | 42.50 | 25.50 | 31.00 |
| After Calibration Tuning | 77.91 | 78.73 | 75.00 | 80.39 | 52.00 | 29.50 | 33.50 |
(표 5) Tool Calling 벤치마크에서의 성능 비교
Coding 벤치마크
| 모델 | Humaneval+ | MBPP+ | LiveCodeBench-V5 |
|---|---|---|---|
| Coding Only | 79.27 | 74.34 | 32.05 |
| After Linear Merging | 78.66 | 74.07 | 26.27 |
| After Calibration Tuning | 81.10 | 73.02 | 31.08 |
(표 6) Coding 벤치마크에서의 성능 비교
Math 벤치마크
| 모델 | GSM8K | Math |
|---|---|---|
| Math Only | 93.03 | 88.32 |
| After Linear Merging | 92.49 | 82.72 |
| After Calibration Tuning | 93.10 | 88.56 |
(표 7) Math 벤치마크에서의 성능 비교
Result
Kanana-2 Instruct 모델은 Mid-training, Parallel RL, Calibration Tuning으로 구성된 새로운 훈련 파이프라인을 적용하였습니다. 또한 복잡한 멀티턴 Instruction Following과 정교한 Tool Calling 등 Agentic AI 환경에서 핵심이 되는 영역에 대해 새로운 레시피를 개발하고 반영함으로써, 해당 환경에 최적화된 강력한 성능을 확보할 수 있었습니다.
다음은 Qwen3-30B-A3B-Instruct-2507, Kanana-1.5-32.5B-Instruct, Kanana-2-30B-A3B-Instruct의 성능을 비교한 결과입니다.
Instruction Following 벤치마크
| 모델 | IFEval (strict prompt) | IFBench (strict prompt) | Multi-IF (English) | Multi-Challenge |
|---|---|---|---|---|
| Qwen3-30B-A3B-Instruct-2507 | 84.10 | 30.27 | 77.93 | 41.76 |
| Kanana-1.5-32.5B-Instruct | 79.48 | 38.78 | 68.51 | 19.05 |
| Kanana-2-30B-A3B-Instruct-2601 | 87.25 | 48.30 | 77.88 | 35.16 |
(표 8) Instruction Following 벤치마크에서의 성능 비교
Tool Calling 벤치마크
| 모델 | BFCL-v3 live-simple | BFCL-v3 live-multiple | BFCL-v3 live-parallel | BFCL-v3 live-irrelavance | BFCL-v3 multi-turn-base | BFCL-v3 multi-turn-miss-func | BFCL-v3 multi-turn-miss-param |
|---|---|---|---|---|---|---|---|
| Qwen3-30B-A3B-Instruct-2507 | 81.40 | 76.83 | 62.50 | 74.26 | 51.00 | 28.00 | 23.50 |
| Kanana-1.5-32.5B-Instruct | 74.81 | 69.04 | 75.00 | 46.37 | 13.00 | 13.50 | 9.00 |
| Kanana-2-30B-A3B-Instruct-2601 | 77.91 | 78.73 | 75.00 | 80.39 | 52.00 | 29.50 | 33.50 |
(표 9) Tool Calling 벤치마크에서의 성능 비교
그 외 벤치마크
| 모델 | MT-bench | KoMT -bench | Human eval+ | MBPP+ | LiveCode Bench-V5 | GSM8K | Math | GPQA diamond | MMLU | KMMLU | HAERAE |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-30B-A3B-Instruct-2507 | 8.71 | 8.49 | 86.59 | 75.13 | 37.95 | 93.56 | 90.96 | 54.55 | 87.13 | 67.56 | 53.41 |
| Kanana-1.5-32.5B-Instruct | 8.23 | 7.94 | 79.88 | 71.96 | 25.30 | 91.58 | 77.92 | 42.42 | 82.75 | 65.75 | 65.34 |
| Kanana-2-30B-A3B-Instruct-2601 | 8.29 | 8.21 | 81.10 | 73.02 | 31.08 | 93.10 | 88.56 | 52.53 | 81.61 | 68.26 | 75.57 |
(표 10) 그외 벤치마크에서의 성능 비교
3. Thinking model
Overview
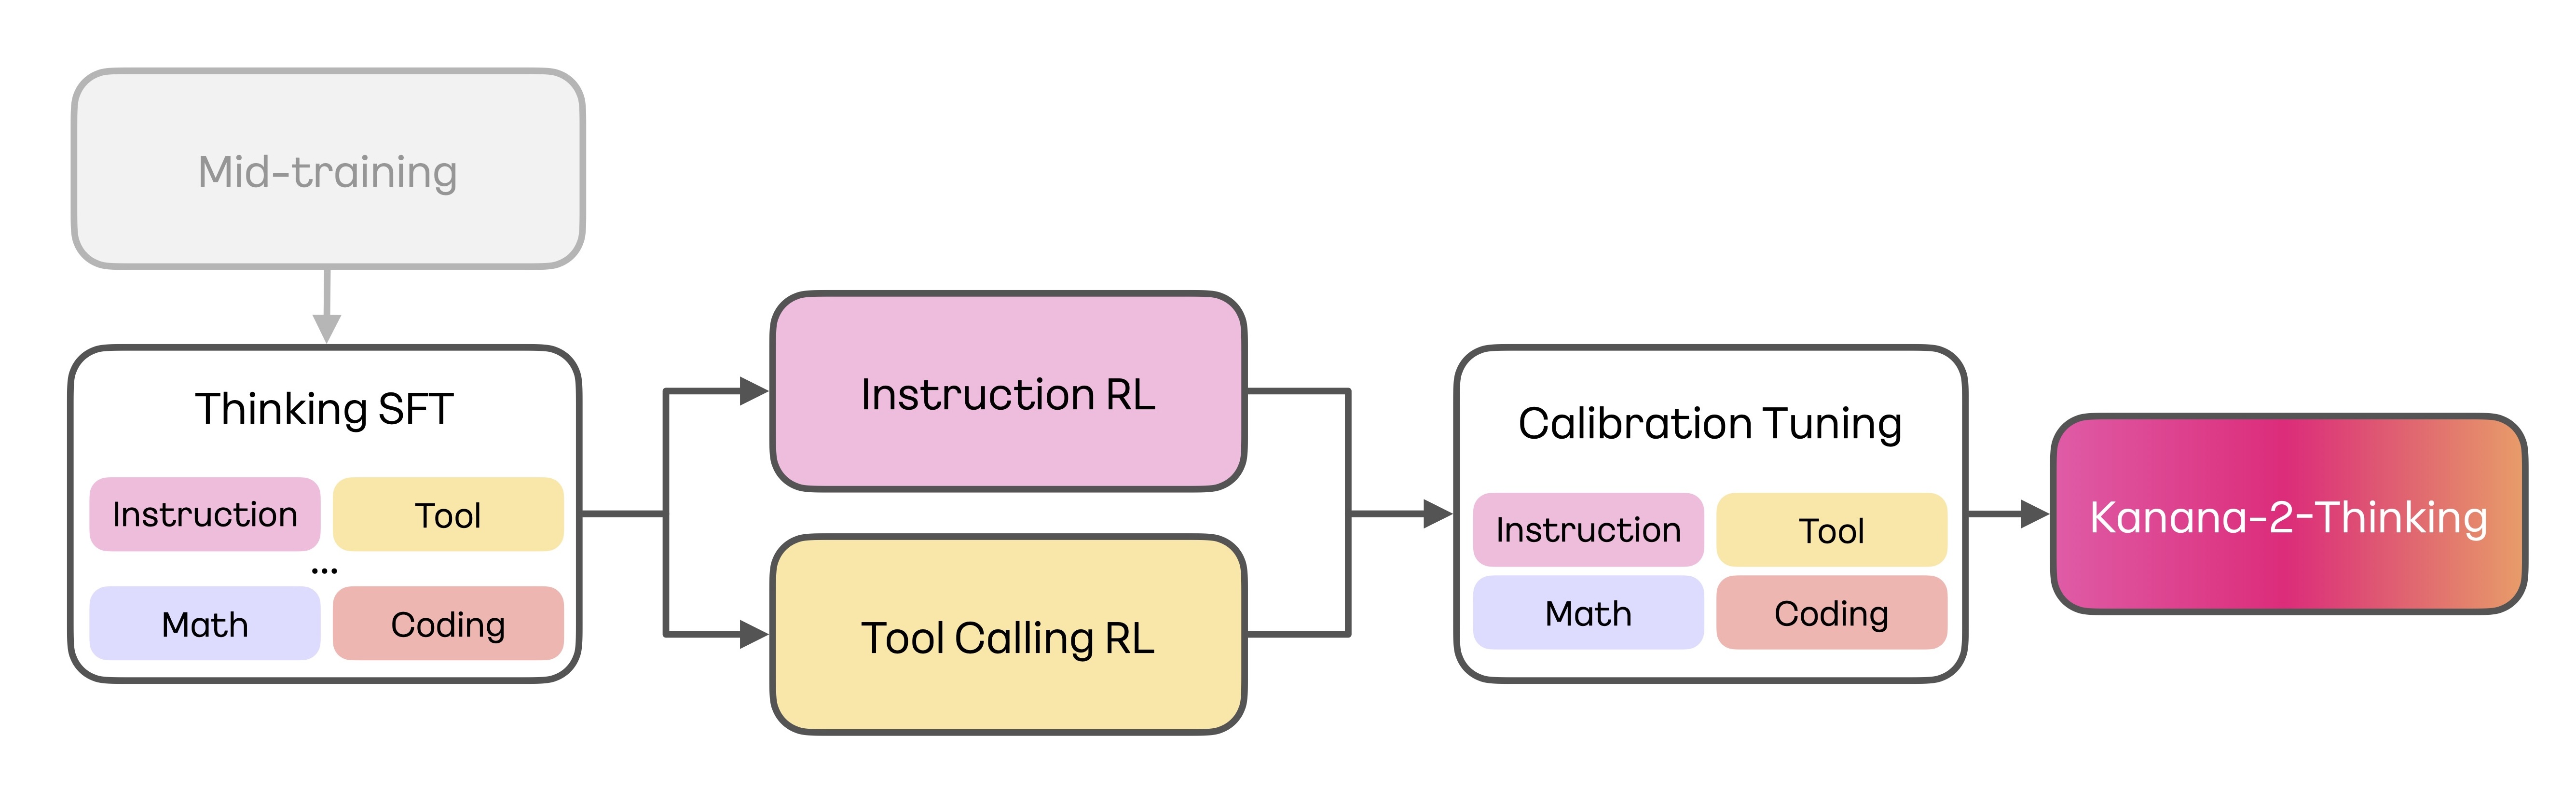
(그림 6) Kanana-2-Thinking 모델 훈련 파이프라인
Instruct 모델이 사용자의 지시를 정확하고 신속하게 이행하는 데에 초점을 맞춘다면, Thinking 모델은 심층 추론 과정을 통해 복잡한 문제를 해결하는 데 특화된 모델입니다. Kanana-2 Thinking 모델은 Mid-training으로 다져진 강력한 추론 잠재력 위에, 엄선된 고품질 Thinking SFT와 Parallel RL 전략을 결합하여 완성되었습니다.
특히 저희는 Thinking 모델을 개발하며 다음 세 가지 방향에 집중하였습니다.
- 영어권의 방대한 지식과 논리에 기반하여 복잡한 코드·수학 문제 해결
- 고난이도의 한국어 질문에 대해서도 자연스러운 한국어로 답변 생성
- Instruction following 및 Tool Calling 능력 극대화
이어지는 섹션에서는 위 핵심 역량들을 빠짐없이 두루 갖추기 위한 SFT, Parallel RL과 Calibration Tuning 파이프라인에 대해 상세히 소개하겠습니다.
Supervised Fine-Tuning
Mid-training 단계가 추론 잠재력을 배양하는 과정이었다면, Thinking SFT 단계는 이 잠재력을 실제 문제 해결 능력으로 발현시키는 단계입니다. 저희는 이 단계에서 데이터의 양을 늘리기보다는, 고품질의 사고 과정을 가진 응답만을 엄선하여 학습 밀도를 높이는 데에 집중하였습니다.
저희는 수학, 코드, 도구, 일반 대화, 지시문 이행(Instruction Following) 등 다양한 도메인 데이터의 구성을 탐색하였습니다. 이를 통해 깊이 있는 사고력과 범용적인 능력의 균형을 맞출 수 있었고, 데이터 샘플 수의 상세 비중은 그림 7과 같습니다.
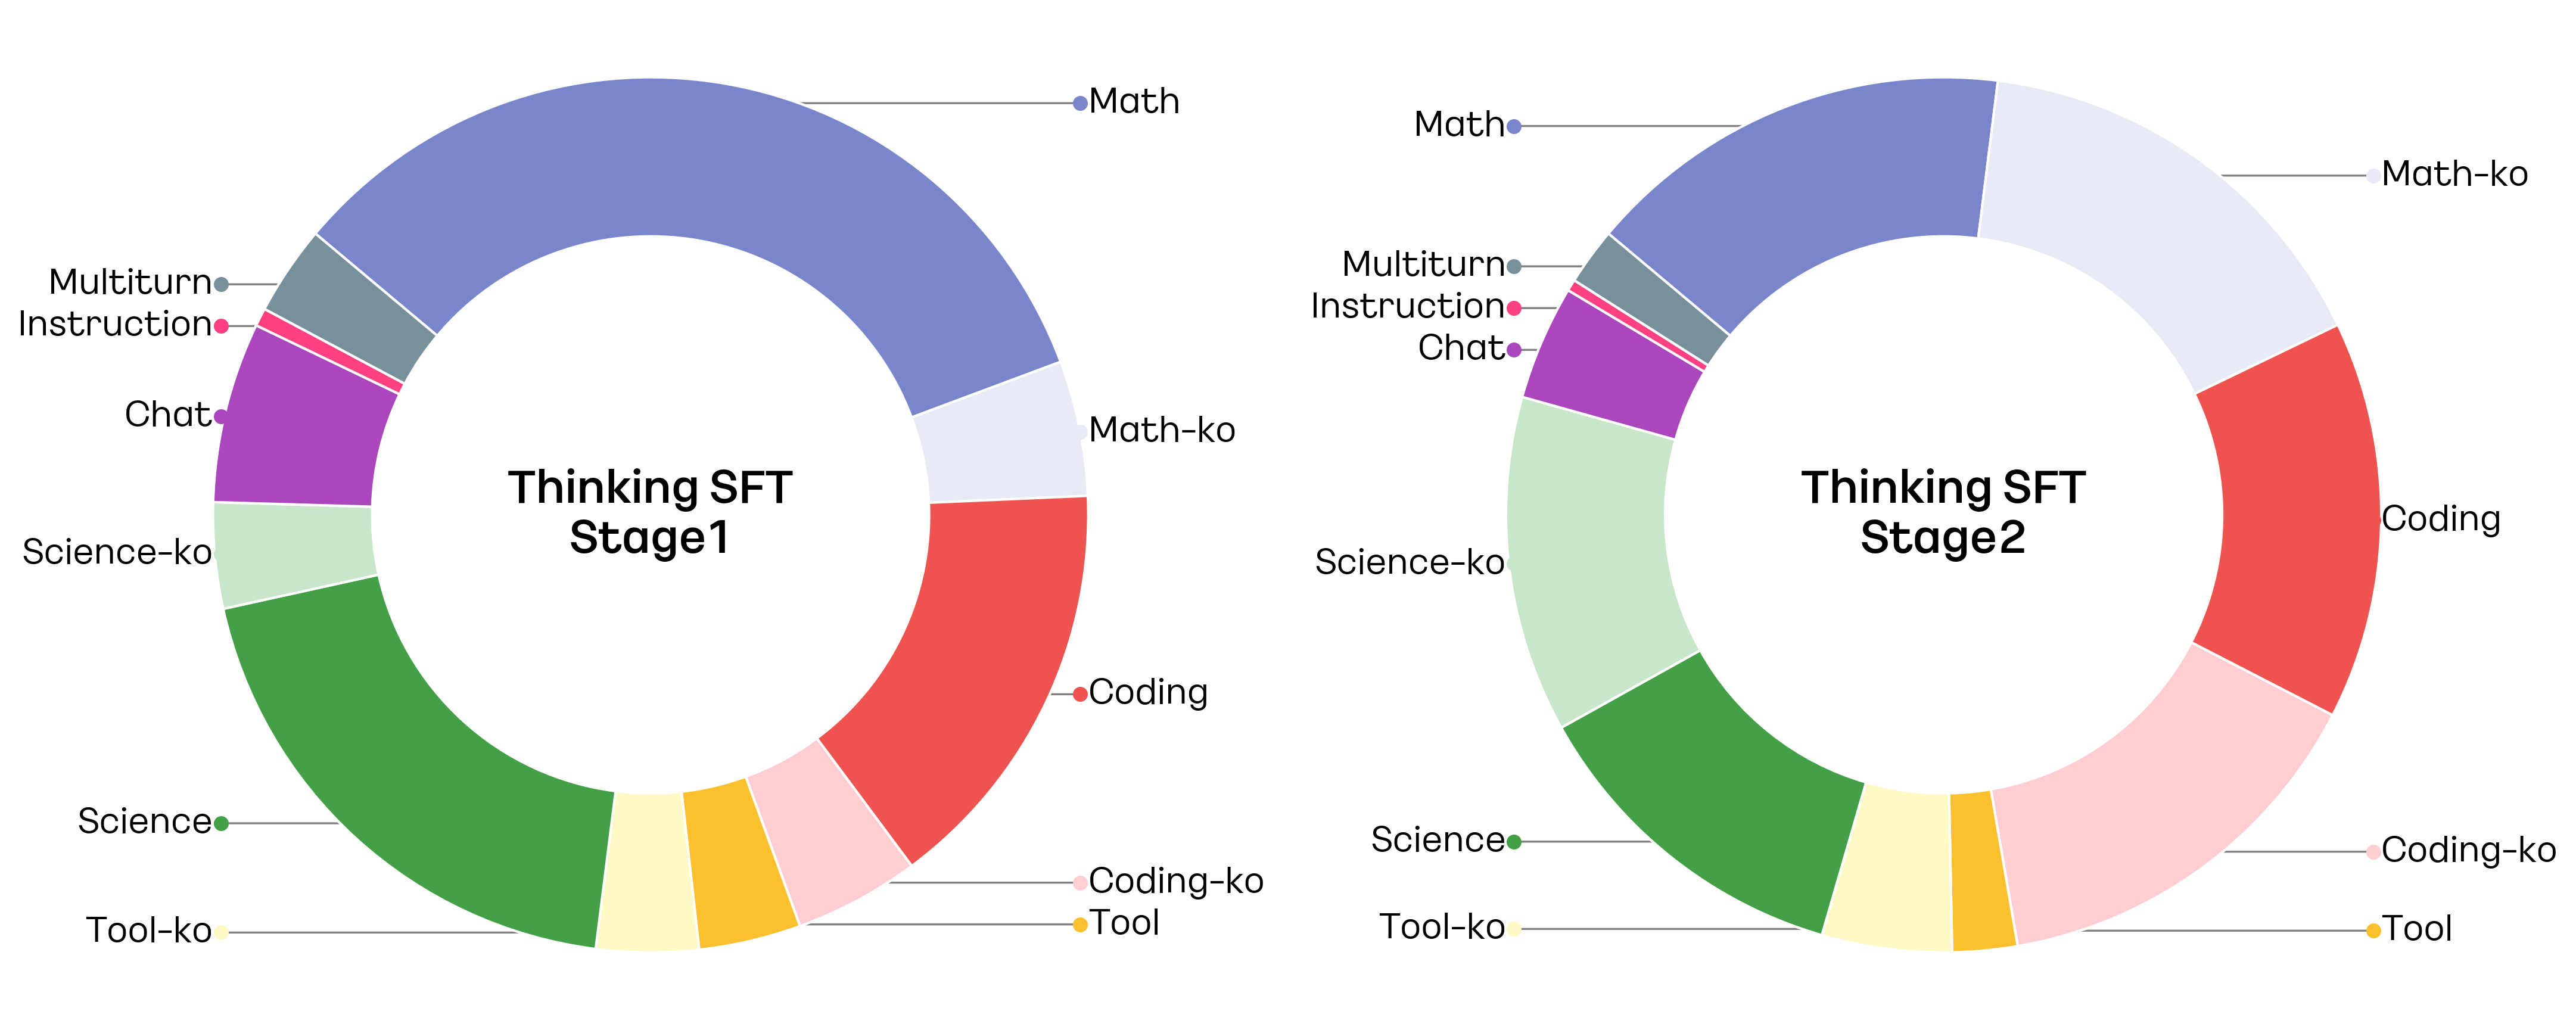
(그림 7) Kanana-2 Thinking SFT 학습 데이터 구성
Thinking 모델 개발 과정의 또다른 핵심 과제는 “영어 수준의 고품질 답변을 한국어로 어떻게 가능하게 할 것인가?” 였습니다. 초기 실험에서는 영어 추론 데이터 일부를 LLM을 통해 한국어로 번역하여 학습시켜 보았습니다. 이때 샘플들을 단순히 전체 번역할 경우, 내용이 지나치게 간소화되거나 논리적 연결이 헐거워지는 한계가 있었습니다. 이를 완화하기 위해 청크 단위로 나누어서 번역을 수행하였으나, 한국어만으로 고난이도의 문제들을 해결하기는 부족함을 확인하였습니다.
이에 저희는 한국어 질문 → 영어 사고 과정 → 한국어 답변으로 이어지는 데이터 구조를 채택했습니다. 이 전략을 통해, 모델은 가장 방대한 지식을 가진 영어로 복잡한 논리를 전개하고, 최종 답변은 사용자의 언어인 한국어로 출력합니다.
Parallel RL Pipeline
Thinking SFT를 마친 모델은 심층 추론 능력은 뛰어났으나, 학습 데이터에 부족했던 사용자의 현실적인 지시를 이행(Instruction Following, IF)하거나 멀티턴 대화에서 도구를 호출(Tool Calling)하는 능력은 보완이 필요했습니다.
초기에는 이를 해결하고자 Sequential RL (SFT → IF RL → Tool RL) 방식을 시도하였습니다. 일반적으로 RL은 SFT에 비해 기존에 학습된 내용을 잘 보존하는 특성이 있어, Tool RL 후에도 IF 성능은 양호하게 유지되었습니다. 그러나 IF와 Tool 성능을 극대화하기 위해 학습을 지속하면, 수학 풀이 등 문제 해결 능력은 점차 저하되는 경향을 보였습니다.
이에 저희는 Instruct 섹션에서 제안한 Parallel RL 전략을 Thinking 모델에도 도입하였습니다. SFT 모델 위에 각 도메인을 개별적으로 최적화함으로써, 지시 이행과 도구 호출 성능을 극대화하면서도 기존의 문제 해결 성능 또한 안정적으로 유지하였습니다.
두 도메인의 RL 학습에는 공통적으로 GRPO 알고리즘을 적용하였습니다. 이때 탐색의 다양성을 확보하고자 DAPO [14]에서 제안한 clip_higher를 도입하였으며, Rollout 횟수는 4번으로 설정했습니다. 추가로, 보상 함수에서 모델이 템플릿에 지정된 사고 과정 포맷을 준수하는지를 엄격하게 검사하였습니다.
Instruction Following RL은 룰 기반으로 명확히 검증 가능한 단일 및 다중 지시문을 대상으로 수행하였습니다. 특히 다중 지시문의 경우, 전체 중 충족된 비율에 따라 최대 1.0점까지 부여하는 Partial Reward 방식을 채택했습니다. 이는 지시 이행 관련 Thinking SFT 데이터가 부족해 초기 성능이 낮은 상황에서, 사고 과정이 긴 추론 모델의 특성상 Strict Reward 방식의 더딘 수렴 속도가 연산 비용 부담으로 이어졌기 때문입니다. 아울러 사고 과정을 충분히 전개할 수 있도록 최대 길이는 입력 2K, 출력 16K로 설정하였으며, 결과적으로 IFBench 및 IFEval 점수가 대폭 향상되는 성과를 거두었습니다.
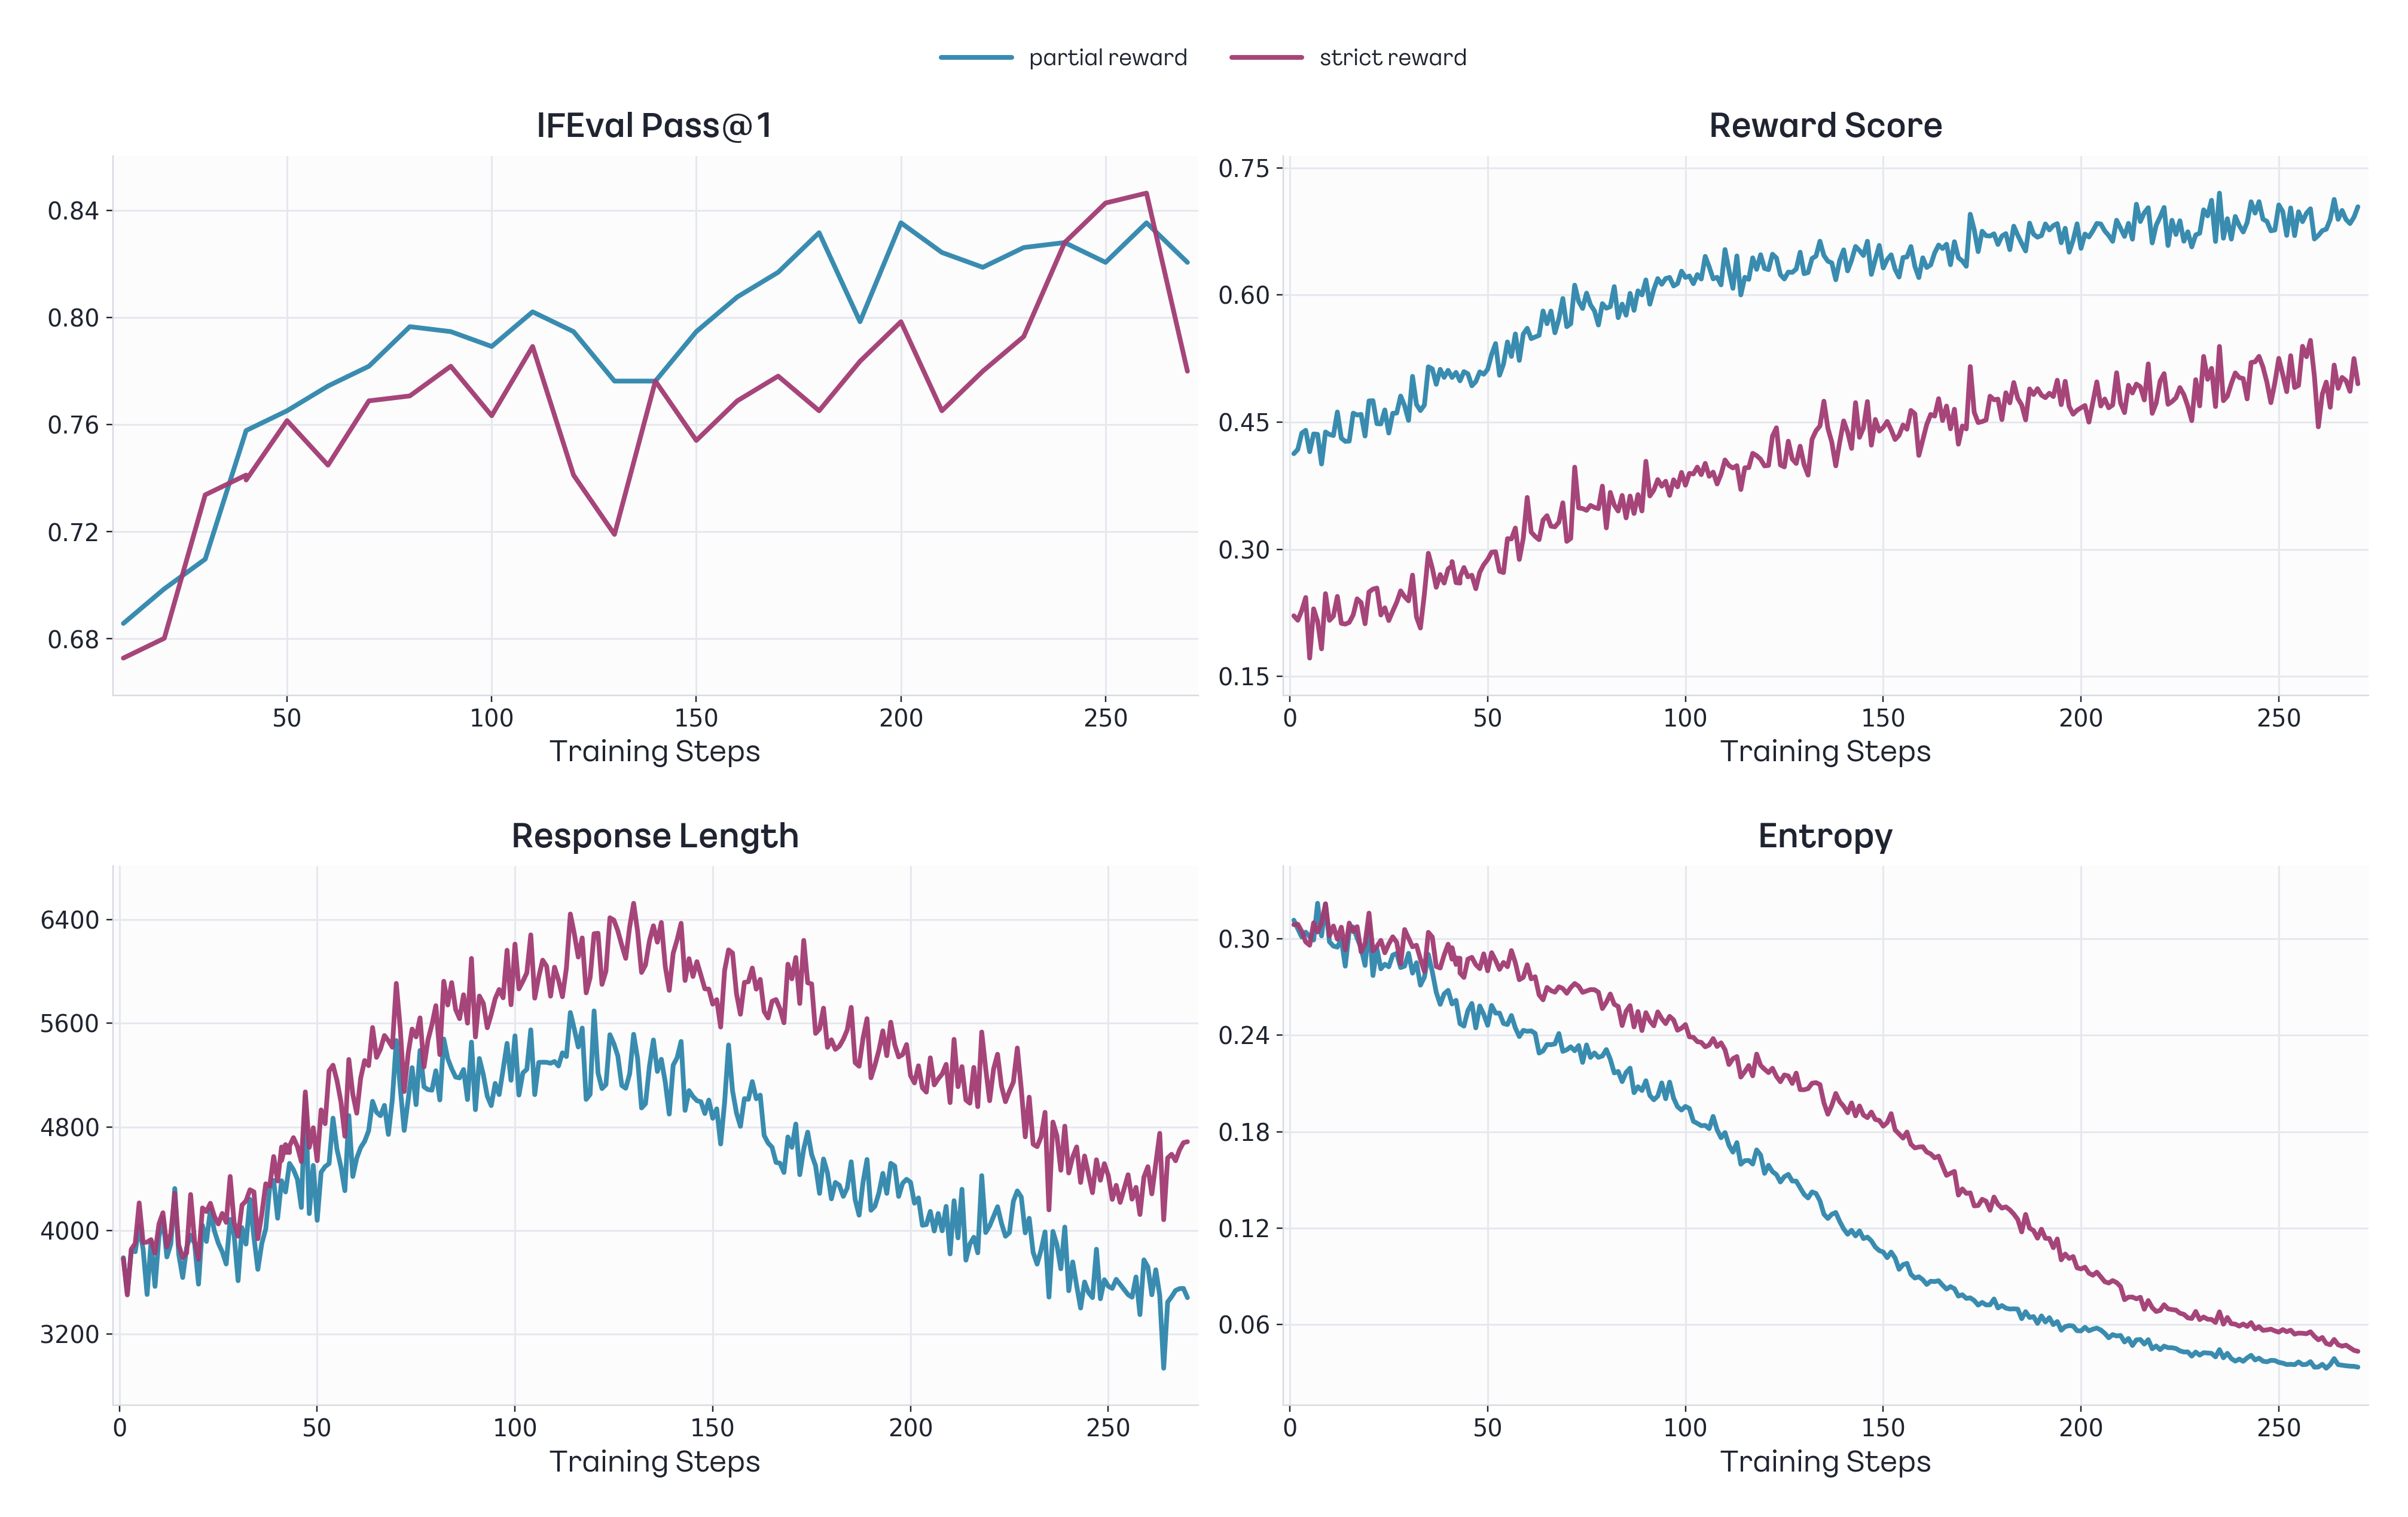
(그림 8) Instruction Following RL 훈련 추이 (Partial vs Strict)
Tool Calling RL에서는 도구 호출이 필요한 (Relevance) 데이터와, 적절한 도구가 없어 호출을 수행하지 않아야 하는 (Irrelevance) 데이터의 비중을 면밀히 조절하였습니다. 멀티턴 프롬프트 및 보상 함수는 Instruct 섹션과 동일한 설계를 적용하였습니다. 이때 긴 대화 문맥과 도구 명세를 처리하기 위해 최대 입력은 12K, 출력은 4K로 설정하였습니다. Tool RL 수행 결과, 멀티턴 도구 호출 성능이 유의미하게 상승하였습니다. 또한, 표 12와 같이 Kanana-2 Thinking 모델은 필수 파라미터가 누락된 경우 (miss-param) 혹은 적절한 도구가 제공되지 않은 (miss-func) 상황에 대한 대응 지표도 우수합니다.
Merging & Calibration
Parallel RL에서 확보한 모델들을 최종적으로 하나의 Kanana-2 Thinking 모델로 통합하기 위해, 앞선 Instruct 섹션에서 제안한 방식과 유사하게 Linear Merging 후 Calibration Tuning을 수행하였습니다.
이 단계에서는 도메인별 병합 가중치를 조정하여 모델들을 통합한 후, 짧은 스텝의 Calibration SFT를 진행하였습니다. 이때, RL 훈련에서와 동일한 프롬프트를 사용하여 각 도메인별 최고 성능 모델이 생성한 응답을 수집하였습니다. 이 중 정답 검증을 통과한 경우만을 Rejection Sampling하여 모델이 다시 빠르게 학습하기 용이한 데이터를 구축하였습니다. 아울러, 수학 및 코딩 도메인의 성능 저하를 방지하기 위해, 기존 Thinking SFT 데이터도 일정 비율 혼합하여 구성을 최적화하였습니다. 그 결과 표 11과 같이, 통합된 모델은 모든 도메인에서 기존에 달성했던 최고 성능을 성공적으로 복원할 수 있었습니다.
| 실험 모델 | BFCL-v3 multi-turn ^1^ | BFCL-v3 live | IFBench | IFEval | AIME25 |
|---|---|---|---|---|---|
| IF RL | 33.50 | 73.97 | 48.98 | 83.99 | 65.67 |
| Tool RL | 46.33 | 75.86 | 25.03 | 66.58 | 73.67 |
| Linear Merged | 39.33 | 74.16 | 47.21 | 82.74 | 67.00 |
| Calibration Tuned | 46.56 | 75.62 | 47.82 | 82.18 | 74.00 |
(표 11) Linear Merging 및 Calibration Tuning 전후의 성능 비교
Result
Kanana-2 Thinking 모델은 Mid-training, SFT, Parallel RL, Merge 및 Calibration에 이르는 정교한 학습 과정을 거쳤습니다. 그 결과, 복잡한 문제 해결은 물론 한국어 답변 능력과 Instruction Following과 Tool Calling 등 서비스 핵심 역량까지 갖출 수 있었습니다.
다음은 Qwen3-30B-A3B (thinking), Qwen3-30B-A3B-Thinking-2507과
Kanana-2-30B-A3B-Thinking의 성능을 비교한 결과입니다.
| 모델 | IFBench | IFEval | BFCL-v3 multi-turn-base | BFCL-v3 multi-turn-miss-func | BFCL-v3 multi-turn-miss-param | BFCL v3 live | MMLU-Pro | GPQA diamond | AIME25 |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-30B-A3B (Thinking) | 42.3 | 82.2 | 43.2 | 40.2 | 27.7 | 80.3 | 75.3 | 61.3 | 72.7 |
| Qwen3-30B-A3B-Thinking-2507 | 47.6 | 87.8 | 64.8 | 57.7 | 35.8 | 82.9 | 80.8 | 70.6 | 82.3 |
| Kanana-2-30B-A3B-Thinking-2601 | 47.8 | 82.2 | 52.5 | 46.7 | 40.5 | 75.6 | 74.2 | 57.8 | 74.0 |
(표 12) Kanana-2 Thinking 최종 성능
| 모델 | AIME24 | 한국어 AIME24 ^2^ | LiveCode Bench-V5 | 한국어 LiveCode Bench-V5 ^3^ |
|---|---|---|---|---|
| Qwen3-30B-A3B (Thinking) | 78.3 | 72.3 | 60.8 | 61.5* |
| Qwen3-30B-A3B-Thinking-2507 | 91.0 | 80.3 | 68.3 | 66.3* |
| Kanana-2-30B-A3B-Thinking-2601 | 79.0 | 75.0 | 58.5 | 51.2 |
(표 13) Kanana-2 Thinking 최종 성능 (한/영 비교)
*: 대부분의 응답이 영어로 생성되었습니다.
4. Conclusion
Kanana-2 Instruct와 Thinking 모델을 개발하면서 Agentic AI의 핵심 역량인 Instruction Following 및 Tool Calling 성능을 극대화 하였습니다. 특히 Mid-training, Supervised Fine-Tuning 이후에 Parallel RL과 Calibration Tuning 파이프라인을 새롭게 도입하여, 각 도메인별 최고 성능의 모델을 하나로 온전히 통합하는 데에 성공하였습니다.
향후에는 Parallel RL의 적용 범위를 고차원 텍스트 추론, STEM 전반, 그리고 복잡한 Agentic Workflow 영역까지 대폭 확장할 계획입니다. 아울러, 이번에 심도 있게 다루지는 못했던 수학 및 코딩 도메인의 추론 성능을 한 차원 더 끌어올릴 것입니다. 특히, 고난이도의 문제를 해결하는 과정에서 사고 과정이 장황해지며 RL 학습 비용이 급증하는 문제를 완화하기 위해, 비동기 알고리즘 도입 등 최적화 영역을 적극 탐색하고 있습니다.
5. References
[1] GLM-4.5 Team, GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models, arXiv preprint arXiv:2508.06471 (2025)
[2] Wang, et al. OctoThinker: Mid-training Incentivizes Reinforcement Learning Scaling, arXiv preprint arXiv:2506.20512 (2025)
[3] Zhang, et al. On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models, arXiv preprint arXiv:2512.07783 (2025)
[4] Meituan LongCat Team, Introduing LongCat-Flash-Thinking: A Technical Report, arXiv preprint arXiv:2509.18883 (2025)
[5] Liu, et al, AceReason-Nemotron 1.1: Advancing Math and Code Reasoning through SFT and RL Synergy, arXiv preprint arXiv:2506.13284 (2025)
[6] a-m-team, AM-DeepSeek-R1-0528-Distilled, https://huggingface.co/datasets/a-m-team/AM-DeepSeek-R1-0528-Distilled
[7] Wang, et al. Thinking augmented Pre-training, arXiv preprint arXiv:2509.20186 (2025)
[8] Nathawani, et al. Nemotron-Post-Training-Dataset-v2, https://huggingface.co/datasets/nvidia/Nemotron-Post-Training-Dataset-v2
[9] Yun, et al. Multi-IF: Benchmarking LLMs on Multi-Turn and Multilingual Instructions Following, arXiv preprint arXiv:2410.15553 (2024)
[10] Ved, et al. MultiChallenge: A Realistic Multi-Turn Conversation Evaluation Benchmark Challenging to Frontier LLMs, arXiv preprint arXiv:2501.17399 (2025)
[11] Zhangchen, et al. TOUCAN: Synthesizing 1.5M Tool-Agentic Data from Real-World MCP Environments, arXiv preprint arXiv:2510.01179 (2025)
[12] Shaokun, et al. Nemotron-Research-Tool-N1: Exploring Tool-Using Language Models with Reinforced Reasoning, arXiv preprint arXiv:2505.00024 (2025)
[13] Kim, et al. 국내 최초 MoE 모델 ‘Kanana-MoE’ 개발기, https://tech.kakao.com/posts/716
[14] Yu, et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale, arXiv preprint arXiv:2503.14476 (2025)
[15] Son, et al. Linguistic Generalizability of Test-Time Scaling in Mathematical Reasoning, arXiv preprint arXiv:2502.17407 (2025)
Contributions
Language Model Training
- chloe.py, juliet.bak, kevin.nlp, kong.2024, louie.m, noah.nl, ryan.u, terry.uh
Acknowledgements
글의 검수를 맡아주신 Language Model Training 팀의 mat.mul, Multimodal model 조직의 loophy.cc께 감사드립니다
Appendix
커뮤니티에서 한국어 LLM 모델을 평가할 때 사용하는 몇 가지 테스트를 Kanana-2-30b-a3b-instruct-2601 과 Kanana-2-30b-a3b-thinking-2601로 수행한 결과입니다. “괭”의 구성 성분을 설명하는 테스트의 경우만 일부 어려워하는 것을 볼 수 있습니다.
kanana-2-30b-a3b-instruct-2601
| 질문 | “괭” 이란 글자의 구성 성분을 설명해 줘. 단계별로 생각해서 대답해 줘. |
|---|---|
| 답변 | 네, "괭"이라는 글자의 구성 성분을 단계별로 설명해 드리겠습니다. 1. 기본 글자 확인 "괭"은 한글의 한 글자이며, 현대 한글에서는 '한글로 된 음절’로 취급합니다. 2. 초성, 중성, 종성 분해 한글 음절은 초성(첫소리), 중성(가운데소리), 종성(끝소리)로 구성됩니다. - 초성 : ㄱ - 중성 : ㅙ - 종성 : ㅇ 3. 중성 'ㅙ’의 내부 구조 'ㅙ’는 이중 모음으로, 'ㅗ’와 'ㅐ’가 결합된 형태입니다. - ‘ㅗ’ (원순 모음) - ‘ㅐ’ (평순 모음) 4. 정리 - 초성: ㄱ - 중성: ㅙ (ㅗ + ㅐ) - 종성: ㅇ 따라서 "괭"은 ‘ㄱ’(초성) + ‘ㅙ’(중성, ㅗ+ㅐ) + ‘ㅇ’(종성)으로 구성되어 있습니다. 이 음절은 'ㄱ’이 첫소리, 'ㅙ’가 가운뎃소리, 'ㅇ’이 끝소리로 결합되어 "괭"이라는 소리가 납니다. |
| 질문 | strawberry에서 r의 개수를 알려줘. 단계별로 생각해서 대답해 줘. |
|---|---|
| 답변 | 네, 단계별로 생각해보겠습니다. 1. 단어 확인 : strawberry라는 단어를 먼저 확인합니다. → strawberry 2. 알파벳 분해 : 이 단어를 알파벳 단위로 분해합니다. → s, t, r, a, w, b, e, r, r, y 3. ‘r’ 찾기 : 분해한 알파벳 중에서 'r’인 것만 골라냅니다. → r, r, r 4. 개수 세기 : 'r’이 몇 개인지 셉니다. → 3개 따라서, strawberry에서 'r’의 개수는 3개입니다. ✅ |
| 질문 | starbrerry에서 r의 개수를 알려줘. 단계별로 생각해서 대답해 줘. |
|---|---|
| 답변 | 좋아요, 단계별로 생각해 보겠습니다. 1. 문제 이해 "starbrerry"에서 문자 'r’이 몇 개 있는지 세라는 요청입니다. 2. 문자열 확인 주어진 단어는 "starbrerry"입니다. 3. 문자 단위로 분해 s, t, a, r, b, r, e, r, r, y 4. 'r’만 추출 r, r, r, r 5. 개수 세기 총 4개입니다. 6. 최종 답변 "starbrerry"에서 'r’의 개수는 4개입니다. ✅ 답변: 4 |
kanana-2-30b-a3b-thinking-2601
| 질문 | “괭” 이란 글자의 구성 성분을 설명해 줘. |
|---|---|
| 답변 | Okay, the user is asking about the components of the Korean character “괭”. Let me start by recalling what I know about Hangul structure. Each Korean character is made up of jamo, which are the individual letters. “괭” is a combination of several jamo. First, I need to break down “괭” into its constituent parts. Let me think: the character starts with a 초성 (initial consonant), then a 모음 (vowel), followed by another consonant, and maybe a 받침 (final consonant). Wait, “괭” is a bit complex. Let me check each part. The first part is “ㄱ”, which is the initial consonant. Then the vowel “ㅘ”. After that, there’s “ㅇ” as the final consonant. So putting it together: ㄱ + ㅘ + ㅇ. But wait, sometimes the final consonant might be part of the syllable. Let me confirm the structure. Alternatively, maybe it’s ㄱ + ㅘ + ㅇ. So the components are the initial consonant “g/k”, the vowel “wa”, and the final consonant “ng”. But I should make sure that “괭” is indeed structured that way. Let me visualize the character. The top part is “ㄱ”, then the middle is “ㅘ”, and the bottom is “ㅇ”. Yes, that seems right. So the components are 초성: ㄱ, 중성: ㅘ, and 종성: ㅇ. But I should explain each part clearly. Also, note that “ㅘ” is a combination of ㅗ and ㅏ. So maybe mention that as well. The user might be interested in the breakdown of each jamo. Let me structure the answer step by step, starting with the initial consonant, then the vowel, then the final consonant. Also, mention that “ㅘ” is a diphthong made from ㅗ and ㅏ. That should cover the components thoroughly. </think> "괭"이라는 글자는 한글의 자모(문자) 조합으로 이루어져 있으며, 다음과 같은 구성 요소로 분해할 수 있습니다: 1. 초성(첫 번째 자모) : ㄱ - "ㄱ"은 "기역"이라고 불리는 자음으로, “g” 또는 “k” 소리를 나타냅니다. 2. 중성(두 번째 자모) : ㅘ - "ㅘ"는 ㅗ 와 ㅏ 가 결합된 이중 모음(이중 자음)으로, “wa” 소리를 나타냅니다. - 즉, "ㅘ"는 "오"와 "아"가 합쳐진 형태입니다. 3. 종성(세 번째 자모) : ㅇ - "ㅇ"은 "이응"이라고 불리는 자음으로, 받침이 없을 때는 소리가 나지 않지만, 여기서는 종성으로 사용되어 “ng” 소리를 나타냅니다. ### 전체 구조: ㄱ + ㅘ + ㅇ → "괭"은 “gwaeng” (예: "광"의 발음과 유사)과 같은 소리로 읽힙니다. ### 추가 설명: - "ㅘ"는 이중 모음으로, "오"와 "아"가 결합된 형태입니다. - "ㅇ"이 종성으로 사용될 때는 일반적으로 “ng” 소리로 발음되지만, 일부 경우에는 묵음으로도 쓰일 수 있습니다. - "괭"은 "광"이나 "강"과 같은 단어와 비슷한 발음을 가지며, 주로 이름이나 특정 단어에서 사용됩니다. 이러한 구조는 한글의 음절 구조(초성-중성-종성)를 잘 보여줍니다. |
| 질문 | strawberry에서 r의 개수를 알려줘. |
|---|---|
| 답변 | Okay, the user is asking for the number of 'r’s in the word “strawberry”. Let me start by writing down the word to visualize it better. S-T-R-A-W-B-E-R-R-Y. Now, I need to count each ‘r’ in the word. Let’s go letter by letter. First letter: S – no ‘r’ here. Second: T – nope. Third: R – that’s one ‘r’. Fourth: A – not an ‘r’. Fifth: W – no. Sixth: B – still no. Seventh: E – nope. Eighth: R – that’s the second ‘r’. Ninth: R – third ‘r’. Tenth: Y – not an ‘r’. Wait, so after the E, there are two R’s in a row? Let me check again. The word is strawberry. Breaking it down: S-T-R-A-W-B-E-R-R-Y. Yes, after the E, it’s R-R-Y. So that’s two 'r’s in a row. So total 'r’s would be the one at position 3, then two more at positions 8 and 9. That’s three 'r’s total. But wait, maybe I should double-check. Sometimes people might miscount when letters are repeated. Let me write it out: 1. S 2. T 3. R (1) 4. A 5. W 6. B 7. E 8. R (2) 9. R (3) 10. Y Yes, that’s three 'r’s. So the answer should be 3. But I should make sure there’s no trick here. The user might be testing if I notice the double R’s. Alternatively, maybe they’re thinking of the pronunciation, but the question is about the written letters. So yes, three 'r’s in “strawberry”. </think> "strawberry"라는 단어에는 3개의 'r ’이 있습니다. 단어별로 살펴보면: S-T-R-A-W-B-E-R-R-Y - 첫 번째 ‘r’: 3번째 글자 - 두 번째 ‘r’: 8번째 글자 - 세 번째 ‘r’: 9번째 글자 따라서 총 3개의 'r’이 포함되어 있습니다. 🍓 |
| 질문 | starbrerry에서 r의 개수를 알려줘. |
|---|---|
| 답변 | We are given the string “starbrerry” and asked to count the number of ‘r’ in it. Let’s break down the string: s t a r b r e r r y We can see that the letter ‘r’ appears at positions 3, 5, 6, and 7 (if we count from 0, but we don’t need the positions, just the count). Alternatively, we can simply count the occurrences of the character ‘r’ in the string. Steps: 1. Define the string: “starbrerry” 2. Count the number of times the character ‘r’ appears. Let’s do it: The string: “starbrerry” Breaking it down: s -> not r t -> not r a -> not r r -> count 1 b -> not r r -> count 2 e -> not r r -> count 3 r -> count 4 y -> not r So, there are 4 'r’s. Therefore, the answer is 4. </think> 문자열 "starbrerry"에는 'r’이 네 번 나타납니다. |
관련 글 목록
- Kanana-2 개발기 (1): Pre-training에서의 의사결정들을 중심으로
- 더 똑똑하고 효율적인 Kanana-2 오픈소스 공개
- “생각하고 답변하는” 카카오의 하이브리드 멀티모달 언어모델, Kanana-v-4b-hybrid 개발기
- 더욱 똑똑하게 답하며, 더욱 풍부한 감정표현을 향한 Kanana-o의 진화 과정
- 한국어와 이미지를 한 번에, 카카오의 멀티모달 임베딩 모델 개발기
- Agentic AI를 향한 카나나 모델의 진화
- Kanana 언어모델에 추론 기능 붙여보기 (feat. Kanana-1.5)
- 국내 최초 MoE 모델 ‘Kanana-MoE’ 개발기
- Kanana LLM 1.5 개발기
- 더 똑똑해진 카카오의 언어모델 ‘Kanana 1.5’ 상업적 활용 가능한 오픈소스 공개
- 카카오의 언어모델, Kanana 테크니컬 리포트 공개
- 카카오의 AI 모델, 카나나 모델 패밀리를 소개합니다